16 Занятие 16: Оптимизация запросов / Подходы к настройке
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_16_optim_tuning.html Archive: QPT-handouts-16.zip Страниц PDF: 35
Page 1: Оптимизация запросов / Подходы к настройке
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Что настраивать?
- Настройка сервера
- Настройка приложения
- Запросы
Page 3: Что настраивать?
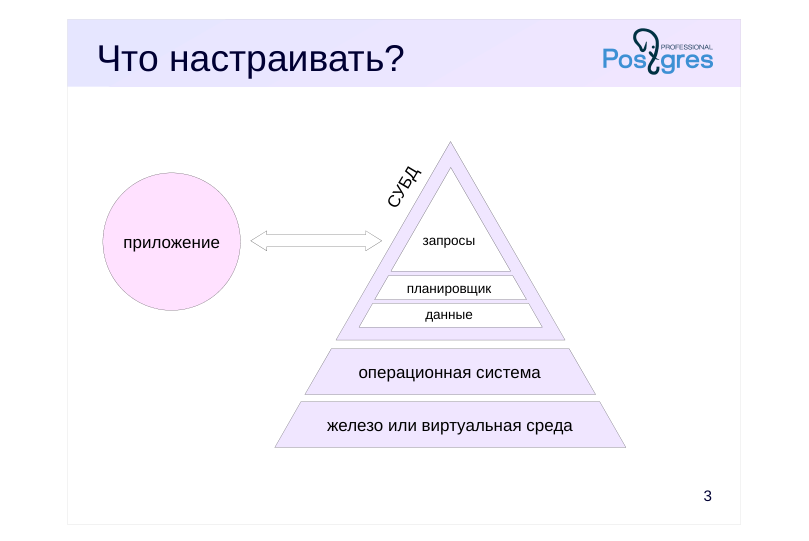 {#source-figure-003 caption=“Source slide page 3: Что настраивать?”}
- запросы
- приложение
Комментарии преподавателя
Производительность работы информационной системы обеспечивается на разных уровнях.
Мы совсем не рассматриваем два важных уровня: оборудование (которое может быть виртуализировано, и тогда к картине добавляется еще один слой) и операционную систему. В частности, работа СУБД с данными происходит через файловую систему, а эффективность и надежность операций ввода-вывода зависит от дисковой подсистемы. Поэтому прежде всего нужно обеспечить необходимые ресурсы и настроить ОС для их максимального использования.
Сервер баз данных настраивается так, чтобы служебные задачи не занимали больше ресурсов, чем необходимо, и чтобы большинство запросов работали приемлемо. На этом уровне мы можем не только настраивать конфигурационные параметры (из которых рассмотрим лишь малую часть), но и управлять расположением данных. Наша задача состоит в том, чтобы обеспечить разумное распределение ресурсов и адекватную работу планировщика.
Далее дело доходит до настройки отдельных запросов. В теме «Профилирование» мы говорили, что разработчик обычно думает над оптимизацией запросов, которые в данный момент пишет, а администратор — над оптимизацией запросов, оказывающих наибольшее влияние на сервер в целом. В этой теме мы рассмотрим некоторые приемы оптимизации запросов.
Но запросы, составляющие рабочую нагрузку, инициируются приложением. Поэтому и настройка приложения не менее важна, чем настройка СУБД.
Page 4: Настройка сервера
Использование ресурсов
- Физическое расположение данных
- Статистика и настройки оптимизатора
Page 5: Ресурсы: CPU и ввод-вывод
Фоновые рабочие процессы
- max_parallel_workers_per_gather = 2
- max_parallel_workers = 8
- max_worker_processes = 8
- Ввод-вывод
- effective_io_concurrency = 1
- maintenance_io_concurrency = 10
Комментарии преподавателя
Начнем с настроек, которые определяют, какими ресурсами может распоряжаться СУБД.
PostgreSQL может использовать несколько ядер процессоров при параллельной обработке. Для этого запускаются дополнительные фоновые рабочие процессы. Подробно параллельное выполнение запросов было рассмотрено в теме «Параллельный доступ», а использование фоновых процессов для прикладной разработки — в теме «Фоновые процессы» курса DEV2.
Из настроек, связанных с использованием ввода-вывода, отметим параметр effective_io_concurrency. Он сообщает системе количество независимых дисков в дисковом массиве. Фактически этот параметр влияет только на количество страниц, которые будут предварительно считываться в кеш при сканировании по битовой карте.
Похожий параметр, действующий для некоторых служебных задач, называется maintenance_io_concurrency.
Page 6: Ресурсы: память
Память
- ↑
- work_mem
- = 4MB
- hash_mem_multiplier
- = 2
- maintenance_work_mem = 64MB
- ↑
- shared_buffers
- = 128MB
- effective_cache_size
- = 4GB
Комментарии преподавателя
Ряд настроек влияет на выделение и использование памяти.
Параметр work_mem определяет размер доступной памяти для отдельных операций (рассматривался в соответствующих темах).
Также он влияет и на выбор плана. Например, при небольших значениях предпочтение отдается сортировке, которая лучше работает при недостатке памяти, чем хеширование. Поэтому для узлов, использующих хеширование, размер рабочей памяти можно увеличить с помощью параметра-мультипликатора hash_mem_multiplier.
Параметр maintenance_work_mem влияет на скорость построения индексов и на работу служебных процессов.
Параметр shared_buffers определяет размер буферного кеша экземпляра. Настройка этого параметра рассматривается в курсе DBA2, но точно можно сказать, что значение по умолчанию крайне мало.
Параметр effective_cache_size подсказывает PostgreSQL общий объем кешируемых данных (как в буферном кеше, так и в кеше ОС). Чем больше его значение, тем более предпочтительным будет индексный доступ. Этот параметр не влияет на реальное выделение памяти.
Page 7: Физическое расположение
Табличные пространства
- разнесение данных по разным физическим устройствам
- ALTER TABLESPACE SET …
- Секционирование
- разделение таблицы на отдельно управляемые части
- для упрощения администрирования и ускорения доступа
- Шардирование
- размещение секций на разных серверах для масштабирования
- нагрузки на чтение и запись
- секционирование и расширение postgres-fdw
- или сторонние решения
Комментарии преподавателя
Физическая организация данных может сильно влиять на производительность.
С помощью табличных пространств можно управлять размещением объектов по физическим устройствам ввода-вывода. Например, активно используемые данные хранить на SSD-дисках, а архивные — на более медленных HDD.
Часть параметров сервера, которые зависят от характеристик носителя, (например, random_page_cost) можно устанавливать на уровне табличных пространств.
Секционирование позволяет организовать работу с данными очень большого объема. Основная выгода для производительности состоит в замене полного сканирования всей таблицы сканированием отдельной секции. Заметим, что секции тоже можно размещать по различным табличным пространствам.
Еще один вариант — размещение секций на разных серверах (шардирование) с возможностью выполнения распределенных запросов. Стандартный PostgreSQL содержит только базовые механизмы, необходимые для организации шардирования: секционирование и расширение postgres-fdw. Более эффективно и полноценно шардинг реализуется с помощью внешних решений. Обзорно этот вопрос рассматривается в последней теме курса DBA3.
https://postgrespro.ru/docs/postgresql/16/ddl-partitioning
https://postgrespro.ru/docs/postgresql/16/postgres-fdw
Page 8: Оптимизатор: статистика
Актуальность
- настройка автоочистки и автоанализа
- autovacuum_max_workers, autovacuum_analyze_scale_factor, …
- Точность
- default_statistics_target = 100
- индекс по выражению, расширенная статистика
Комментарии преподавателя
Планировщик опирается в своих оценках на статистику, поэтому статистика должна собираться достаточно часто. Достигается это настройкой процесса автоочистки и автоанализа. Детали настройки подробно рассматриваются в курсе DBA2.
Кроме того, статистика должна быть достаточно точной. Абсолютной точности достичь не получится (и не нужно), но погрешности не должны приводить к построению некорректных планов. Признаком неактуальной, неточной статистики будет серьезное несоответствие ожидаемого и реального числа строк в листовых узлах плана.
Для увеличения точности может потребоваться изменить значение default_statistics_target (глобально или для отдельных столбцов таблиц). Иногда будет полезным индекс по выражению, обладающий собственной статистикой. В отдельных случаях можно использовать расширенную статистику.
Page 9: Оптимизатор: стоимость
Ввод-вывод
- seq_page_cost
- = 1.0
- random_page_cost = 4.0
- ↓ для SSD
- Время процессора
- cpu_tuple_cost, cpu_index_tuple_cost, cpu_operator_cost
- стоимость пользовательских функций
Комментарии преподавателя
Имеется большое число настроек для стоимости элементарных операций, из которых, как мы уже видели, в итоге складывается стоимость плана запроса. Такие настройки имеет смысл изменять, если запросы, несмотря на точную оценку кардинальности, выполняются не самым эффективным образом.
Параметры seq_page_cost и random_page_cost связаны со вводом-выводом и определяют относительную стоимость чтения одной страницы при последовательном и при произвольном доступе.
Значение seq_page_cost равно единице и его не стоит изменять. Высокое значение параметра random_page_cost отражает реалии HDD-дисков. Для SSD-дисков (а также в случаях, когда все данные с большой вероятностью будут закешированы), значение этого параметра необходимо значительно уменьшать, например, до 1.1.
Параметры времени процессора определяют веса для учета стоимости обработки прочитанных данных. Обычно эти параметры не меняют, поскольку трудно спрогнозировать эффект изменений.
Но, как мы видели в теме «Функции», иногда полезно задать стоимость пользовательской функции в единицах cpu_operator_cost.
https://postgrespro.ru/docs/postgresql/16/runtime-config-query#RUNTIME-C ONFIG-QUERY-CONSTANTS
Page 10: Настройки стоимости
Пример запроса с корректной оценкой кардинальности:
Планировщик выбрал последовательное сканирование, и сделал это на основе полной информации. Так ли удачно это решение? Проверим, скомандовав планировщику не использовать последовательное сканирование, если есть другие способы:
Аналогичные enable-параметры есть и для прочих способов соединения, методов доступа и многих других операций. Эти параметры довольно грубо вмешиваются в работу планировщика, но весьма полезны для отладки и экспериментов.
Результат, скорее всего, окажется в пользу индексного сканирования, поскольку все данные закешированы и произвольный доступ выполняется быстро. Такая же ситуация возможна при использовании быстрых SSD-дисков. Делать выводы на основании одного запроса неправильно, но систематическая ошибка должна послужить поводом к изменению глобальных настроек. В таком случае стоит либо уменьшить значение random_page_cost, чтобы планировщик не завышал стоимость индексного доступа, либо увеличить effective_cache_size, чтобы сделать индексное сканирование более привлекательным.
Page 11: Настройка приложения
Клиенты и соединения
- Схема данных
Page 12: Клиенты и соединения
Много сеансов
- пул соединений
- Курсоры
- если нужна часть выборки
- cursor_tuple_fraction
- Много коротких запросов
- подготовленные операторы
- перенос логики в SQL
Комментарии преподавателя
Если приложение открывает слишком много соединений или устанавливает их слишком часто и на короткое время, может потребоваться установить между приложением и СУБД пул соединений. Однако пул накладывает на приложение определенные ограничения. Подробно этот вопрос рассмотрен в курсе DEV2.
Курсоры следует использовать, только если нужно получить небольшую часть выборки и ее размер зависит от действий пользователя. В этом случае параметр cursor_tuple_fraction подскажет планировщику, что нужно оптимизировать получение первых строк выборки.
Если приложение выполняет слишком большое количество мелких запросов (каждый из которых сам по себе выполняется эффективно), общая эффективность будет очень невысока. Это часто происходит при использовании средств объектно-реляционного отображения (ORM). В теме «Профилирование» мы рассматривали похожий пример с функцией, которая вызывалась в цикле.
В таких случаях со стороны СУБД практически нет средств для оптимизации (кроме подготовленных операторов, если запросы повторяются). Действенный метод — избавление от процедурного кода в приложении и перенос его на сервер БД в виде небольшого числа крупных SQL-команд. Это дает планировщику возможность применить более эффективные способы доступа и соединений и избавляет от многочисленных пересылок данных от клиента к серверу и обратно. К сожалению, если приложение уже написано, переделать его бывает очень затратно.
Page 13: Схема данных
Нормализация — устранение избыточности в данных
- упрощает запросы и проверку согласованности
- Денормализация — привнесение избыточности
- может повысить производительность, но требует синхронизации
- индексы
- предрассчитанные поля (генерируемые столбцы или триггеры)
- материализованные представления
- кеширование результатов в приложении
Комментарии преподавателя
На логическом уровне база данных должна быть нормализованной: неформально, в данных не должно быть избыточности. Если это не так, мы имеем дело с ошибкой проектирования: будет сложно проверять согласованность данных, возможны различные аномалии при изменении данных и т. п.
Однако на уровне хранения некоторое дублирование может дать существенный выигрыш в производительности — ценой того, что избыточные данные необходимо синхронизировать с основными.
Самый частый способ денормализации — индексы (хотя о них обычно не думают в таком контексте). Индексы обновляются автоматически.
Можно дублировать некоторые данные (или результаты расчета на основе этих данных) в столбцах таблиц. Можно использовать генерируемые столбцы или синхронизировать данные с помощью триггеров. Так или иначе, за денормализацию отвечает база данных.
Другой пример — материализованные представления. Их также надо обновлять, например, по расписанию или другим способом. Подробно это рассматривалось в теме «Материализация».
Дублировать данные можно и на уровне приложения, кешируя результаты выполнения запросов. Это популярный способ, но часто к нему прибегают из-за неправильной работы приложения с базой данных (например, в случае использования ORM). На приложение ложится задача по своевременному обновлению кеша, обеспечению разграничения доступа к данным кеша и т. п.
Page 14: Схема данных
Типы данных
- выбор подходящих типов
- составные типы (массивы, JSON) вместо отдельных таблиц
- Ограничения целостности
- помимо обеспечения целостности данных, могут учитываться
- планировщиком для устранения ненужных соединений, улучшения
- оценок селективности и других оптимизаций
- первичный ключ и уникальность — уникальный индекс
- внешний ключ
- отсутствие неопределенных значений
- проверка CHECK (constraint_exclusion)
Комментарии преподавателя
Важен правильный выбор типов данных из всего многообразия, предлагаемого PostgreSQL. Например, представление интервалов дат не двумя отдельными столбцами, а с помощью диапазонных типов (daterange, tstzrange) позволяет использовать индексы GiST и SP-GiST для таких операций, как пересечение интервалов.
В ряде случаев эффект дает использование составных типов (таких как массивы или JSON) вместо классического подхода с созданием отдельной таблицы. Это позволяет сэкономить на соединении и не требует хранения большого количества служебной информации в заголовках версий строк. Но такое решение следует принимать с большой осторожностью, поскольку оно имеет свои минусы.
Ограничения целостности важны сами по себе, но в некоторых случаях планировщик может учитывать их и для оптимизации.
● Ограничения первичного ключа и уникальности поддерживаются уникальными индексами. Это позволяет строить более точную статистику и эффективнее выполнять соединения.
● Наличие внешнего ключа и ограничений NOT NULL позволяет в ряде случаев устранять лишние соединения (что особенно важно при использовании представлений), а также улучшает оценку селективности в случае, если соединение происходит по нескольким столбцам.
● Ограничение CHECK с использованием параметра constraint_exclusion позволяет не сканировать таблицы (или секции), если в них гарантированно нет требуемых данных.
Page 15: Схема данных
Ссылочное ограничение целостности особенно важно при составном ключе. Пример точной оценки строк, которое будет получено в результате соединения:
Однако если удалить внешний ключ, оценка становится неадекватной. Это еще одно проявление проблемы коррелированных предикатов:
Page 16: Запросы
Пути оптимизации
- Короткие запросы
- Длинные запросы
Page 17: Пути оптимизации
Цель оптимизации — получить адекватный план
- Исправление неэффективностей
- каким-то образом найти и исправить узкое место
- бывает сложно определить, в чем проблема
- часто приводит к борьбе с планировщиком
- Правильный расчет кардинальности
- добиться правильного расчета кардинальности в каждом узле
- и положиться на планировщик
- если план все еще неадекватный, настраивать глобальные параметры
Комментарии преподавателя
Цель оптимизации запроса — получить адекватный план выполнения. Есть разные пути, которыми можно идти к этой цели.
Можно посмотреть в план запроса, понять причину неэффективного выполнения и сделать что-то, исправляющее ситуацию. К сожалению, проблема не всегда бывает очевидной, а исправление часто сводится к борьбе с оптимизатором.
Если идти таким путем, то хочется иметь возможность целиком или частично отключить планировщик и самому создать план выполнения. Такая возможность называется подсказками (хинтами) и в явном виде отсутствует в PostgreSQL.
Другой подход состоит в том, чтобы добиться корректного расчета кардинальности в каждом узле плана. Для этого, конечно, нужна аккуратная статистика, но этого часто бывает недостаточно.
Если идти таким путем, то мы не боремся с планировщиком, а помогаем ему принять верное решение. К сожалению, это часто оказывается слишком сложной задачей.
Если при правильно оцененной кардинальности планировщик все равно строит неэффективный план, это повод заняться настройкой глобальных конфигурационных параметров.
Обычно имеет смысл применять оба способа, смотря по ситуации и сообразуясь со здравым смыслом.
Page 18: Короткие запросы
Читают небольшую часть данных, выдают мало строк
- Характерны для OLTP
Note Важно получать ответ быстро
- Характерные особенности плана
- условия с высокой селективностью
- индексы
- соединения методом вложенного цикла
Комментарии преподавателя
Запросы можно (довольно условно) разделить на две группы, имеющие свои особенности и требующие разных подходов к оптимизации: «короткие» и «длинные».
К первой относятся запросы, характерные для OLTP-систем. Такие запросы читают немного данных и выдают одну или несколько строк. Они могут обращаться и к большим таблицам, но в этом случае имеют условия с высокой селективностью, позволяющие читать лишь малую часть данных.
Обычно короткие запросы обслуживают пользовательский интерфейс, и поэтому важно, чтобы они выполнялись как можно быстрее. Приоритет отдается времени отклика.
Это обеспечивается тем, что необходимые запросам данные читаются либо из очень небольших таблиц (одна-две страницы), либо по индексу. Соединения, как правило, выполняются методом вложенного цикла, который не требует подготовительных действий (в отличие от хеш-соединения) и не вызывает проблем при небольшом количестве соединяемых строк.
Page 19: Короткие запросы
Сразу отключим параллельное выполнение. Для коротких запросов оно бесполезно, а параллельные планы сложнее читать.
Рассмотрим запрос, который выводит посадочные талоны, выданные на рейсы, отправляющиеся в течение часового интервала:
Этот запрос можно отнести к разряду коротких: из двух больших таблиц требуется гораздо меньше процента данных. Однако в плане мы видим, что таблицы читаются полностью. Кроме того, наблюдается большая разница между прогнозируемой и фактической кардинальностью. Начнем оптимизацию с самого вложенного узла, Seq Scan по таблице рейсов flights. Из-за чего планировщик ошибается в оценке кардинальности? Дело в функции date_trunc: для нее нет вспомогательной функции планировщика, поэтому берется фиксированная оценка селективности 0,5%. В темах «Базовая статистика» и «Расширенная статистика» мы исправляли подобные ситуации с помощью индекса по выражению и расширенной статистики. Но в данном случае достаточно переписать условие так, чтобы слева от оператора находилось поле таблицы:
Теперь оценка больше похожа на правду, а запрос заодно стал использовать индекс. Хорошо ли это? В целом хорошо, но индекс создан по столбцам flight_no и scheduled_departure, а условие есть только на второй столбец. В теме «Методы доступа» мы выяснили, что в этом случае индекс будет сканироваться полностью, что нельзя считать эффективным способом доступа к данным. Создадим новый индекс:
Page 20: Page 20
Проверим наш запрос:
В принципе, мы достигли желаемого: планировщик использует индексный доступ, данные соединяются методом вложенного цикла. Проверим еще количество страниц, которые потребовалось прочитать:
Page 21: Page 21
Возможным улучшением будет исключение доступа к таблице flights за счет сканирования только индекса. Удалим созданный ранее индекс и сделаем другой с дополнительным столбцом, который нужен для соединения:
Мы выиграли еще около 20% чтений. Это может быть важно для запросов, которые выполняются часто, но вряд ли это наш случай. Скорее всего, включение в индекс всех полей таблицы boarding_passes будет избыточным — накладные расходы перевесят выигрыш в производительности. Остановимся на достигнутом.
Page 22: Длинные запросы
Читают большие таблицы целиком
- Характерны для OLAP
Note Важно не читать одни и те же данные повторно
- Характерные особенности плана
- условия с низкой селективностью
- полное сканирование
- соединение хешированием
- агрегация
- параллельное выполнение
Комментарии преподавателя
Длинные запросы встречаются в OLAP-системах. Они характеризуются тем, что для получения результата должны прочитать большое количество данных. При этом не важно, сколько строк возвращает запрос: в результате агрегации может остаться и одна.
Такие запросы могут читать большие таблицы целиком, а условия обычно низкоселективны. Поэтому вместо индексного доступа более эффективным становится последовательное сканирование, а вместо соединения вложенным циклом — хеш-соединение. Тем более, что для длинного запроса важно выдать весь результат за разумное время, а не первые строки как можно раньше.
Очень важно следить, чтобы одни и те же данные не читались в запросе несколько раз. Это может происходить по самым разным причинам (из-за коррелированных подзапросов, из-за использования функций и т. п.), которые приводят к появлению вложенных циклов, явных или неявных.
Разумеется, в плане длинного запроса могут встречаться и индексный доступ (при наличии высокоселективных условий), и соединение вложенным циклом (при соединении небольшого количества строк).
Благодаря тому, что длинные запросы обрабатывают много данных и обычно агрегируют их (пользователям редко бывают нужны миллионы строк), они могут выигрывать от параллельного выполнения.
Page 23: Длинные запросы
Задача: посчитать количество пассажиров, летевших рейсами, и вылет, и прибытие которых состоялись с опозданием от одной минуты до четырех часов. Вот запрос, решающий задачу, но время его выполнения нас не устраивает:
Короткий это запрос или длинный? Узнаем селективность условий:
Условия отбирают примерно 80% строк, все таблицы в запросе большие. Очевидно, это длинный запрос. Проверим его план:
Page 24: Page 24
Здесь мы видим индексный доступ и соединения вложенным циклом — операции, совсем не подходящие для длинного запроса. Почему так получилось? Проблема в ошибке оценки селективности условий. Планировщик считает, что из таблицы flights будет выбрано всего пять строк. Попробуем быстро проверить гипотезу, что переход на другой способ соединения поможет делу. Попросим планировщик не использовать вложенный цикл, если это возможно:
Page 25: Page 25
Обращения к таблицам автоматически сменились на последовательное чтение. Запрос ускорился, ему потребовалось прочитать примерно 130 тысяч блоков. Мы не смотрели план выполнения первой версии с параметром buffers, но она — проверьте! — читает в 200 с лишним раз больше данных.
Нам осталось более аккуратно объяснить планировщику, какой план стоит использовать. Самый мягкий способ — предоставить более точную статистику. В данном случае подойдет статистика по выражению, которую мы рассматривали в теме «Расширенная статистика»:
Проверим план:
Page 26: Page 26
Оценки исправились, теперь во всех узлах они довольно точно соответствуют реальным цифрам. Однако планировщик выбрал не тот план, что мы видели: он перестал использовать соединение вложенным циклом, но оставил индексный доступ и применил соединение слиянием. Если бы мы выполнили запрос, то увидели бы, что время еще сократилось, хотя и было прочитано более двух миллионов страниц. Считать ли такой результат хорошим? Если мы уверены, что размера кеша хватит, чтобы в нем находились данные наших крупных таблиц — неплохо, ведь запрос ускоряется. Но мы уже говорили о том, что время — ненадежный показатель, поскольку в реальной системе за кеш будут конкурировать данные многих таблиц, и реальное обращение к страницам может оказаться медленнее ожидаемого. Это может послужить поводом вернуться к настройкам сервера БД с помощью параметров random_page_cost и effective_cache_size. Однако зададимся вопросом: не читаем ли мы лишние данные? Знание предметной области позволяет нам прийти к выводу, что таблица ticket_flights вовсе не нужна в запросе. Таблицу flights можно соединить непосредственно с boarding_passes — внешние ключи проверяют корректность данных, но не требуются для соединения. Добавление ticket_flights никак не ограничивает данные (не может быть ситуации, при которой посадочный талон есть, а перелет отсутствует). Вообще, переформулирование запроса — самый разнообразный и вариативный способ влияния на производительность. Некоторые эквивалентные преобразования планировщик умеет выполнять сам, но мы можем: переписать условия так, чтобы они могли (или наоборот, не могли) использовать индекс; заменить коррелированные подзапросы (которые, по сути, являются вложенным циклом) соединениями; устранить лишние сканирования (как в этом примере, или, скажем, за счет применения оконных функций); использовать недоступные планировщику трансформации, такие, как преобразование условий OR в UNION; и т. п. Итак, упрощаем запрос:
Page 27: Page 27
Потребовалось прочитать всего 61 тысячу страниц. Проверим, сколько всего страниц в таблицах:
Теперь мы уверены, что не читаем лишних данных. Можно ли еще что-то улучшить? План запроса говорит о том, что выполнялось двухпроходное соединение хешированием. Можно увеличить значение параметра work_mem, чтобы хеш-соединению было достаточно одного прохода без временных файлов.
Page 28: Page 28
В начале темы мы отключали параллельные планы. Однако для длинных запросов параллельные планы могут иметь смысл. Конечно, при условии наличия свободных ядер, как рассматривалось в теме «Параллельный доступ». Посмотрим:
Мы видим, что планировщик использует параллельный план, но в виртуальной машине с одним ядром он, конечно, не дает никаких преимуществ.
Page 29: Подсказки оптимизатору
Отсутствуют в явном виде
- хотя средства влияния имеются: конфигурационные параметры,
- материализация CTE и другие
- Сторонние расширения
- pg_hint_plan
Комментарии преподавателя
Еще один (традиционный для других СУБД) способ влияния — подсказки оптимизатору — отсутствует в PostgreSQL. Это принципиальное решение сообщества: https://wiki.postgresql.org/wiki/OptimizerHintsDiscussion.
На самом деле часть подсказок все-таки неявно существует в виде конфигурационных параметров и других средств.
Кроме того, есть специальные расширения, например https://postgrespro.ru/docs/enterprise/16/pg-hint-plan (автор — Киотаро Хоригучи). Но нельзя забывать, что использование подсказок, сильно ограничивающих свободу планировщика, может навредить в будущем, когда распределение данных изменится.
Page 30: Итоги
Настройка выполняется на разных уровнях системы
- Доступен широкий спектр методов влияния на план выполнения запросов
- Разные типы запросов требуют разных подходов
- Ничто не заменит голову и здравый смысл
Page 31: Практика
- Оптимизируйте запрос, выводящий контактную информацию пассажиров, купивших билеты бизнес-класса, рейсы которых были задержаны более чем на 5 часов: SELECT t.* FROM tickets t JOIN ticket_flights tf ON tf.ticket_no = t.ticket_no JOIN flights f ON f.flight_id = tf.flight_id WHERE tf.fare_conditions = ‘Business’ AND f.actual_departure > f.scheduled_departure + interval ‘5 hour’; 2. Оптимизируйте запрос, вычисляющий среднюю стоимость билетов на перелеты, выполняемые различными типами самолетов. Начните с варианта, предложенного в комментарии.
Page 32: 1. Оптимизация короткого запроса
Отключим параллельное выполнение.
Здесь мы имеем дело с запросом, характерным для OLTP — небольшое число строк, для получения которых надо выбрать только небольшую часть данных. Поэтому общее направление оптимизации — переход от полного сканирования и соединения хешированием к индексам и вложенным циклам. Заметим, что рейс, задержанный более чем на 5 часов, всего один, а планировщик сканирует всю таблицу. Можно построить индекс по выражению на разности двух столбцов и немного переписать условие:
Page 33: Page 33
Теперь займемся таблицей ticket_flights, которая тоже сканируется полностью, хотя из нее читается незначительная часть строк. Помог бы индекс по классам обслуживания fare_conditions, но лучше создать индекс по столбцу flight_id, что позволит эффективно выполнять соединение вложенным циклом с flights:
Время выполнения уменьшилось до миллисекунд.
2. Оптимизация длинного запроса
Очевидно, мы имеем дело с длинным запросом: в нем присутствует большая таблица перелетов ticket_flights, при этом ни на одну таблицу не накладывается никаких условий. Выполним запрос и посмотрим на план его выполнения:
Page 34: Page 34
В плане запроса видим, что оценки кардинальности вполне адекватны во всех узлах, большие таблицы сканируются последовательно и применяется хеш-соединение. Однако при этом запрос читает в несколько раз больше страниц, чем необходимо:
Причина в коррелированном подзапросе, который выполняется для каждой из девяти моделей самолетов, образуя неявный вложенный цикл. Раскроем подзапрос, добавив группировку. Может показаться заманчивым избавиться от таблицы самолетов aircrafts, ведь код самолета можно получить непосредственно из таблицы рейсов flights. Однако в этом случае из результатов пропадет модель, не совершившая ни одного рейса. Поэтому необходимо левое соединение. Кроме того, сразу вспомним, что в демонстрации мы увеличивали work_mem, чтобы избежать двухпроходного соединения.
Page 35: Page 35
Лишние чтения пропали, запрос ускорился.