14 Занятие 14: Оптимизация запросов / Материализация
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_14_optim_materialization.html Archive: QPT-handouts-16.zip Страниц PDF: 24
Page 1: Оптимизация запросов / Материализация
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Материализация в запросах
- Временные таблицы
- Управление порядком соединений
- Материализованные представления
Page 3: Узел Materialize
 {#source-figure-003 caption=“Source slide page 3: Узел Materialize”}
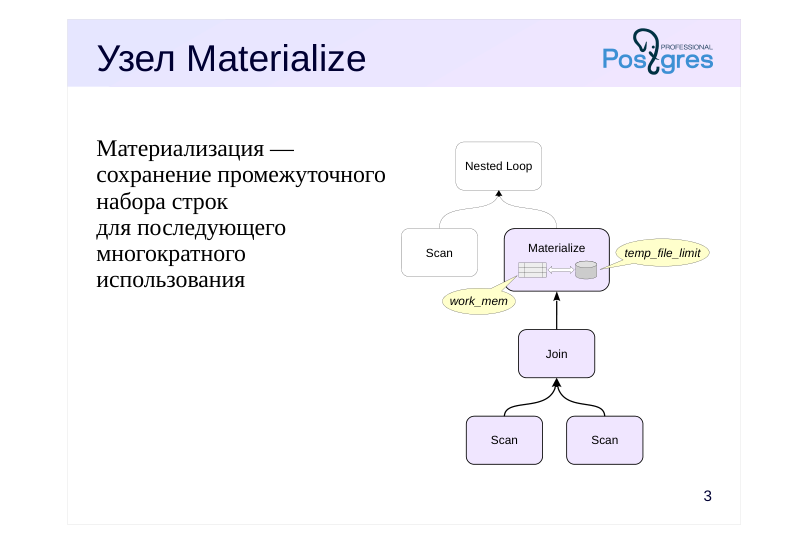
Материализация — сохранение промежуточного набора строк для последующего многократного использования
Комментарии преподавателя
Материализацией называется сохранение промежуточного набора строк с целью повторного использования, как правило, многократного. Сохранять набор можно на разных уровнях: для конкретного запроса, на уровне сеанса или на уровне базы данных.
Обычно узлы запроса передают друг другу данные по принципу конвейера: когда алгоритму, выполняющемуся в узле плана, требуется очередная строка набора, узел обращается к одному из дочерних узлов за следующей порцией. Однако в некоторых случаях исполнителю запроса имеет смысл (а иногда и необходимо) сразу получить все строки, сохранить их и иметь возможность обращаться к сохраненному результату повторно. Такое сохранение выполняет узел Materialize.
Строки сохраняются в оперативной памяти, пока их объем укладывается в ограничение work_mem. При превышении этого ограничения все строки сбрасываются во временный файл и при необходимости читаются оттуда. Объем всех временных файлов одного сеанса ограничен значением параметра temp_file_limit.
Например, на слайде верхний узел Nested Loop выполняет соединение вложенным циклом, но к внутреннему набору данных нет эффективного доступа: он вычисляется с помощью другого соединения. Чтобы не повторять многократно вложенное соединение, его результат можно материализовать.
Page 4: Узел Materialize
 {#source-figure-004 caption=“Source slide page 4: Узел Materialize”}
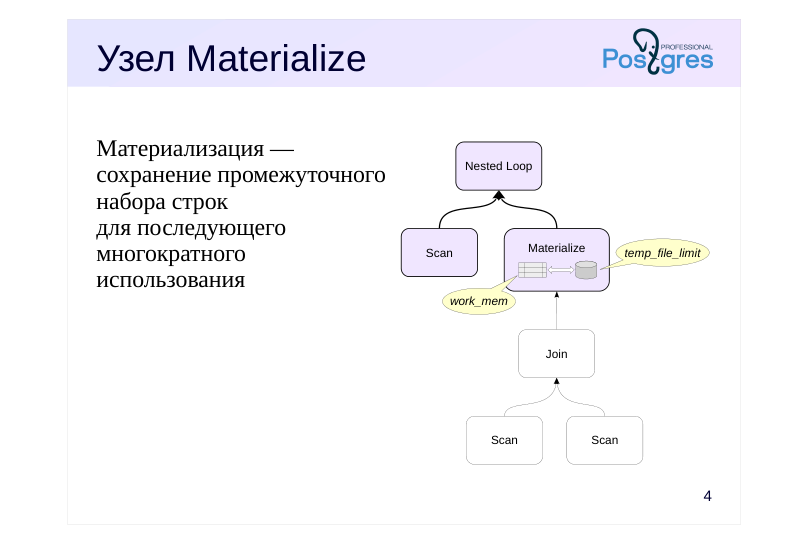
Материализация — сохранение промежуточного набора строк для последующего многократного использования
Комментарии преподавателя
После того как результат вложенного соединения материализован, узел Nested Loop будет обращаться к уже готовому набору строк.
Page 5: Узел Materialize
Если операция требует существенных ресурсов, а к ее результату обращаются многократно, планировщик может выбрать план с узлом Materialize, в котором полученные строки накапливаются для повторного использования:
Здесь для предиката внутреннего набора строк нет подходящего индекса, поэтому план с материализацией оказывается выгодным. В некоторых случаях планировщик использует материализацию внутреннего набора данных и при соединении слиянием, чтобы иметь возможность перечитать часть строк при повторяющихся значениях во внешнем наборе:
Page 6: Материализация CTE
 {#source-figure-006 caption=“Source slide page 6: Материализация CTE”}
Комментарии преподавателя
Общие табличные выражения (common table expression, CTE), они же подзапросы WITH, — прекрасный способ структурировать запрос и сделать его более понятным. В отличие от обычных подзапросов, использование CTE не приводит к большой вложенности.
По возможности планировщик раскрывает (не материализует) подзапросы CTE. Это позволяет ему выбирать оптимальный порядок соединений. По умолчанию подзапрос материализуется в следующих ситуациях:
● Основной запрос обращается к подзапросу несколько раз — чтобы не повторять вычисления.
В этом случае материализацию можно отменить, указав предложение AS NOT MATERIALIZED.
● Подзапрос имеет побочные эффекты (изменяет данные) — чтобы изменение произошло ровно один раз. (К побочным эффектам относится также обращение к изменчивым функциям, см. тему «Функции».)
В этом случае материализацию отменить невозможно.
Материализацию всегда можно принудительно включить, указав предложение AS MATERIALIZED.
https://postgrespro.ru/docs/postgresql/16/queries-with#QUERIES-WITH-CT E-MATERIALIZATION
Page 7: Материализация CTE
Оптимизатор старается не материализовать подзапросы в WITH без надобности:
Но явное указание заставляет оптимизатор планировать подзапрос отдельно от основного запроса:
Если подзапрос используется в запросе несколько раз, планировщик выбирает материализацию, чтобы не выполнять одни и те же действия многократно:
Page 8: Page 8
Обычно это оправдано, особенно если в подзапросе происходят затратные вычисления. Но в некоторых случаях (как в этом примере) план без материализации может оказаться эффективнее, и тогда ее можно отменить. Сравните значение buffers с предыдущим вариантом:
Однако если подзапрос изменяет данные, материализация будет выполнена в любом случае: изменение обязано произойти только один раз.
Page 9: Рекурсивные запросы
 {#source-figure-009 caption=“Source slide page 9: Рекурсивные запросы”}
Комментарии преподавателя
Рекурсивные запросы строятся на базе общих табличных выражений.
Узел Recursive Union использует рабочую и промежуточную таблицы: рабочая таблица хранит строки, получаемые на текущей итерации, а промежуточная — накапливает результат. Содержимое рабочей таблицы считывается в рекурсивной части запроса узлом Worktable Scan.
Каждая из этих двух таблиц материализуется по тем же правилам: пока содержимое таблицы помещается в work_mem, она хранится в памяти, а затем все строки сбрасываются на диск.
После выполнения рекурсивного запроса накопленное содержимое промежуточной таблицы передается узлу CTE Scan, а рабочая таблица отбрасывается.
https://postgrespro.ru/docs/postgresql/16/queries-with#QUERIES-WITH-RE CURSIVE
Page 10: Рекурсивные запросы
Убедимся в том, что рекурсивный запрос материализует промежуточные данные. Для этого намеренно напишем его так, чтобы рабочая и промежуточная таблицы не поместились в память:
Обратите внимание на строки temp read/written в узлах WorkTable Scan и Recursive Union, специфичных для рекурсивных запросов.
Page 11: Оконные функции
 {#source-figure-011 caption=“Source slide page 11: Оконные функции”}
Комментарии преподавателя
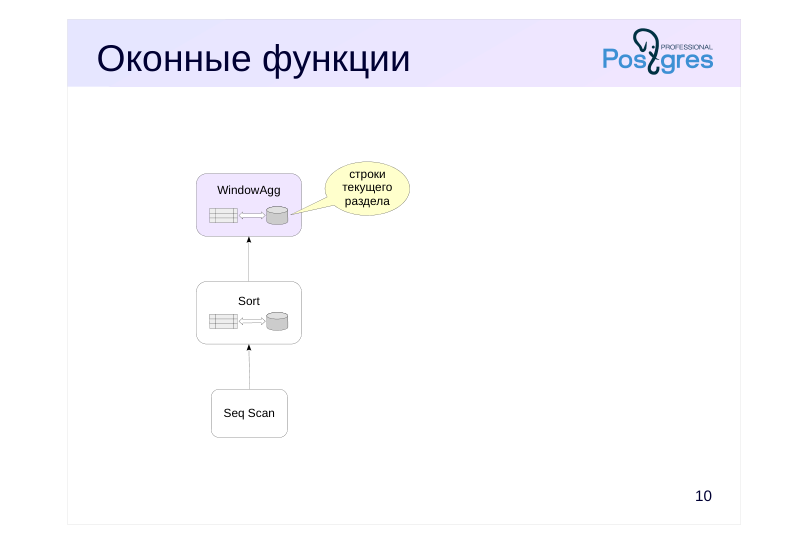
При вычислении оконных функций в узле WindowAgg (см. тему «Сортировка») тоже применяется материализация: строки текущего раздела (PARTITION BY) могут неоднократно попадать в рамку, и поэтому материализуются.
В этом случае материализованными строками пользуется только сам узел WindowAgg: родительскому узлу передается результат вычислений, а не эти промежуточные данные.
https://postgrespro.ru/docs/postgresql/16/tutorial-window
Page 12: Временные таблицы
Таблица, доступная в пределах одного сеанса
- регистрируется в системном каталоге
- не журналируется
- создаются файлы на диске
- кеширование в локальной памяти сеанса (temp_buffers)
- Очистка и анализ
- только вручную
Комментарии преподавателя
Для получения промежуточных данных может использоваться сложный алгоритм, например, написанный на процедурном языке. В таком случае данные не получится посчитать в CTE, но их можно поместить во временную таблицу и использовать в нескольких запросах.
Временные таблицы удобнее для промежуточных данных, чем обычные, поскольку они существуют только в пределах сеанса или транзакции (в зависимости от указанного при создании режима) и автоматически удаляются вместе с данными и зависимыми объектами (представлениями и индексами). К тому же временные таблицы не журналируются и кешируются в локальной памяти процесса, обслуживающего сеанс — это делает работу с ними более быстрой.
Локальная память процесса недоступна процессам автоочистки, поэтому очистку и анализ следует проводить вручную. Память для кеша выделяется по необходимости и ограничена для сеанса параметром temp_buffers (после первого обращения к временной таблице изменить ограничение уже нельзя).
https://postgrespro.ru/docs/postgresql/16/sql-createtable
Однако для временных таблиц создаются записи в системном каталоге и файлы на диске. Поэтому при массовой работе с временными таблицами — например, в системе 1С — будет разрастаться системный каталог и увеличится нагрузка на файловую систему. Поэтому для 1С используют специальные патчи, нивелирующие эти нежелательные эффекты.
Page 13: Временные таблицы
Создадим временную таблицу:
Временная таблица создается во временной схеме pg_temp. По умолчанию таблица существует до конца сеанса; можно указать, чтобы при завершении транзакции удалялись строки (ON COMMIT DELETE ROWS) или сама таблица (ON COMMIT DROP). Зачастую есть смысл проанализировать только что заполненную временную таблицу, прежде чем использовать ее в запросах. Сравните оценки кардинальности при выборе из обычной таблицы и из временной:
В последнем случае оптимизатор, не имея статистики, предполагает, что таблица занимает 10 страниц, на которых умещается 520 строк, и стоимость получается завышенной:
Если проанализировать таблицу, оценка станет точной:
Page 14: Порядок соединений
Количество вариантов соединений растет экспоненциально с ростом количества таблиц в запросе
- Соединение JOIN
- полный перебор при числе соединений не более join_collapse_limit = 8
- дальше — группами по join_collapse_limit таблиц
- Соединение через запятую
- полный перебор при числе соединений не более geqo_threshold = 12
- дальше — генетический алгоритм
- Материализация — подсказка планировщику
Комментарии преподавателя
С ростом количества таблиц в запросе число вариантов соединений и, как следствие, затраты на выбор плана растут экспоненциально.
Если число соединений (записанных в виде JOIN) превышает значение join_collapse_limit (по умолчанию 8), планировщик рассматривает возможные соединения в группах по join_collapse_limit таблиц, а затем соединяет эти группы между собой.
(Для подзапросов в предложении FROM есть похожий параметр — from_collapse_limit.)
Если таблицы соединены запятой (без ключевого слова JOIN), планировщик рассматривает все варианты соединений, но переключается на генетический алгоритм оптимизации, когда количество соединений превышает geqo_threshold (12 по умолчанию).
Все это может приводить к неоптимальным планам. Подробности можно прочитать в статье Павла Толмачева: https://habr.com/ru/company/postgrespro/blog/662021/
Вручную управляя материализацией — либо с помощью CTE, либо разбивая запрос на части и задействуя временные таблицы, — разработчик может разделить таблицы на группы, каждую из которых оптимизатор будет планировать отдельно. Обычно CTE — более простой и эффективный способ, но второй вариант позволяет проанализировать временную таблицу и сообщить таким образом планировщику больше информации о данных.
https://postgrespro.ru/docs/postgresql/16/explicit-joins
Page 15: Управление порядком соединений
Значение по умолчанию параметра join_collapse_limit выбрано так, чтобы планирование соединения такого количества таблиц не требовало чрезмерных ресурсов:
Выполним запрос, в котором используется явное соединение таблиц с помощью ключевого слова JOIN:
В выбранном плане сначала соединяются таблицы рейсов (flights) и перелетов (ticket_flights), а затем результат соединяется с билетами (tickets). Установив параметр join_collapse_limit в единицу, можно зафиксировать порядок соединений:
Теперь таблицы соединяются друг с другом в том порядке, в котором они перечислены в запросе, несмотря на то, что итоговая стоимость запроса выше. Однако такой способ перекладывает на автора запроса слишком много ответственности. Планировщик сможет выбирать только то, какой из наборов строк поставить в соединении внешним, а какой — внутренним.
С похожим параметром from_collapse_limit предлагается познакомиться в практике.
Page 16: Page 16
Page 17: Мат. представления
Материализация результата запроса
- только для чтения
- возможно создание индексов
- Обновление данных
- ручная синхронизация
- инкрементальное обновление — расширение pg_ivm
- Очистка и анализ
- вручную и автоматически
Комментарии преподавателя
Материализованное представление — это именованный результат запроса, сохраненный на уровне базы данных. К материализованному представлению можно обращаться как к обычной таблице, доступной только для чтения.
По материализованному представлению можно построить индексы (но нельзя добавить ограничение целостности — ограничения должны проверяться в базовых таблицах). Для материализованного представления собирается такая же статистика, как и для обычных таблиц.
В отличие от обычных представлений, строки материализованного представления не изменяются при изменении базовых таблиц. Синхронизация выполняется вручную.
https://postgrespro.ru/docs/postgresql/16/sql-creatematerializedview
Полная синхронизация материализованного представления может быть слишком затратной. Штатное инкрементальное обновление (отдельных строк по мере изменения базовых таблиц) не доступно, но такую возможность дает расширение pg_ivm (автор — Юго Нагата, https://github.com/sraoss/pg\_ivm).
Page 18: Материализованные представления
Создадим материализованное представление:
Схема pg_temp при поиске проверяется первой, теперь придется обращаться к материализованному представлению по полному имени. Это неудобно, лучше удалить временную таблицу:
Материализованные представления можно индексировать:
При анализе и автоанализе для материализованных представлений собирается та же статистика, что и для таблиц. При изменении содержимого базовых таблиц строки материализованного представления не изменяются:
Синхронизацию нужно проводить явно. Команда REFRESH полностью блокирует материализованное представление на время перестроения, что может быть нежелательным. В данном случае этого можно избежать, указав CONCURRENTLY, поскольку на материализованном представлении создан уникальный индекс:
Page 19: Page 19
Page 20: Итоги
Оптимизатор может материализовать строки, полученные узлами плана, для повторного использования
- Можно управлять материализацией с помощью CTE, временных таблиц и материализованных представлений
- Материализация позволяет управлять порядком соединений
Page 21: Практика
- В начале демонстрации приводились примеры двух запросов с узлом Materialize. Выдайте планировщику указание не использовать этот узел и проверьте, в каком случае он сможет обойтись без материализации, а в каком — нет. 2. Проверьте план выполнения запроса при значениях параметра from_collapse_limit 8 (по умолчанию) и 1:
Комментарии преподавателя
Воспользуйтесь параметром enable_material: https://postgrespro.ru/docs/postgresql/16/runtime-config-query#GUC-ENAB LE-MATERIAL
Прочитайте про параметр в документации: https://postgrespro.ru/docs/postgresql/16/explicit-joins
Page 22: 1. Отключение узла Materialize
Проверим план первого запроса из демонстрации:
Попросим планировщик не использовать материализацию:
Планировщик обошелся без материализации, но стоимость плана увеличилась. Проверим второй запрос:
Page 23: Page 23
В данном случае планировщик не может не использовать материализацию, поскольку для соединения слиянием требуется не только перемещаться по набору данных вперед, но и возвращаться назад.
2. Параметр from\_collapse\_limit
Сначала посмотрим, как работает запрос со значением from_collapse_limit по умолчанию:
В подзапросе соединяются две таблицы, но оптимизатор раскрывает подзапрос и выбирает порядок соединения для всех трех таблиц. Первыми здесь соединяются таблицы перелетов (ticket_flights) и рейсов (flights). Теперь уменьшим значение from_collapse_limit до единицы и посмотрим на новый план того же запроса:
Page 24: Page 24
План запроса поменялся — сначала соединяются две таблицы из подзапроса, который теперь не раскрывается. Если во FROM вместо списка таблиц использовать конструкцию JOIN, оптимизатор сначала преобразует каждую такую конструкцию в список таблиц (при этом обрабатывая таблицы группами не более чем по join_collapse_limit), а потом уже раскрывает подзапросы (на глубину не более чем from_collapse_limit). Поэтому имеет смысл устанавливать обоим параметрам равные значения.