11 Занятие 11: Статистика / Базовая статистика
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_11_stats_basic.html Archive: QPT-handouts-16.zip Страниц PDF: 27
Page 1: Статистика / Базовая статистика
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Базовая статистика
- Наиболее частые значения и гистограммы
- Статистика элементов составных значений
- Использование статистики для оценки кардинальности и селективности
- Частные и общие планы выполнения
- Частичный индекс и индекс по выражению
Page 3: Базовая статистика
Размер таблицы
- строки (pg_class.reltuples) и страницы (pg_class.relpages)
- Собирается
- операциями DDL
- очисткой
- анализом
- Настройка
- default_statistics_target = 100
Комментарии преподавателя
Базовая статистика собирается на уровне всей таблицы и на уровне отдельных столбцов.
К статистике таблицы относится информация о размере объекта (reltuples и relpages в таблице pg_class). Поскольку такая статистика крайне важна, она обновляется некоторыми DDL-операциями (CREATE INDEX, CREATE TABLE AS SELECT) и уточняется при очистке и анализе.
Кроме того, планировщик масштабирует количество строк в соответствии с отклонением реального размера файла данных от значения relpages.
При анализе просматривается случайная выборка строк. Установлено, что размер выборки, обеспечивающий хорошую точность оценок, практически не зависит от размера таблицы. В качестве размера выборки используется ориентир статистики, заданный параметром default_statistics_target, умноженный на 300.
При этом следует понимать, что статистика не должна быть абсолютно точной, чтобы планировщик мог выбрать приемлемый план; часто достаточно попадания в порядок.
https://postgrespro.ru/docs/postgresql/16/row-estimation-examples
Page 4: Базовая статистика
 {#source-figure-004 caption=“Source slide page 4: Базовая статистика”}
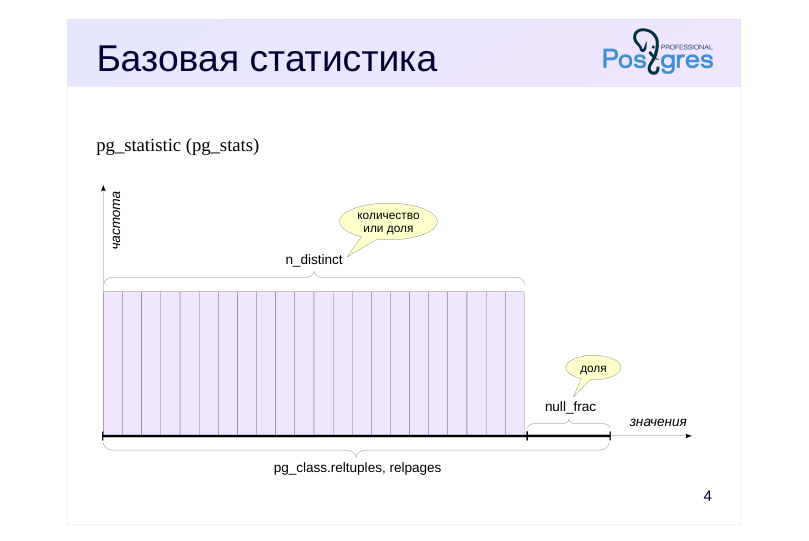
pg_statistic (pg_stats)
Комментарии преподавателя
Вся остальная статистика собирается отдельно для каждого столбца при анализе таблицы. Обычно этим занимается автоанализ (его настройка рассматривается в курсе DBA2).
Статистика на уровне столбцов хранится в таблице pg_statistic. Но смотреть проще в представление pg_stats, которое показывает информацию в более удобном виде.
Поле null_frac содержит долю строк с неопределенными значениями в столбце (от 0 до 1).
Поле n_distinct хранит число уникальных значений в столбце. Если значение n_distinct отрицательно, то модуль этого числа показывает долю уникальных значений. Например, −1 означает, что все значения уникальны (типичный случай для первичного ключа).
https://postgrespro.ru/docs/postgresql/16/planner-stats#PLANNER-STATS-S INGLE-COLUMN
Page 5: Число строк
Начнем с оценки кардинальности в простом случае запроса без предикатов.
Точное значение:
Оптимизатор получает значение из pg_class:
Значение параметра, управляющего ориентиром статистики, по умолчанию равно 100:
Поскольку при анализе таблицы учитывается 300 × default_statistics_target строк, то оценки для относительно крупных таблиц могут не быть абсолютно точными.
Доля неопределенных значений
Часть рейсов еще не отправились, поэтому время вылета для них не определено:
Точное значение:
Оценка оптимизатора получена как общее число строк, умноженное на долю NULL-значений:
Page 6: Число уникальных значений
Проверим количество моделей самолетов в таблице рейсов:
Это соответствует действительности:
А в таблице самих самолетов?
Здесь значение -1 говорит о том, что каждое значение является уникальным. Это неудивительно, ведь aircraft_code является первичным ключом в этой таблице.
Кардинальность соединения
Селективность соединения — доля строк от декартова произведения двух таблиц, которая остается после применения условия соединения. Поэтому для расчета кардинальности соединения оптимизатор оценивает кардинальность декартова произведения и умножает его на селективность условия соединения (и на селективность условий фильтров, если они есть). Рассмотрим пример:
Точное значение кардинальности:
Page 7: Page 7
Базовая формула для расчета селективности соединения (в предположении равномерного распределения) — минимальное из значений 1/nd1 и 1/nd2, где nd1 — число уникальных значений ключа соединения в первом наборе строк; nd2 — число уникальных значений ключа соединения во втором наборе строк. В данном случае получаем ровно то, что требуется:
Page 8: Наиболее частые значения
 {#source-figure-008 caption=“Source slide page 8: Наиболее частые значения”}
Комментарии преподавателя
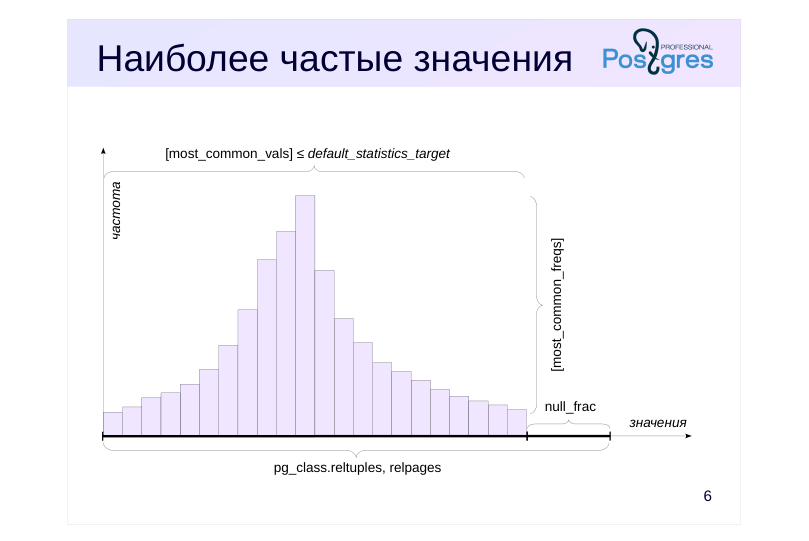
Если бы данные всегда были распределены равномерно, то есть все значения встречались бы с одинаковой частотой, этой информации было бы почти достаточно (нужен еще минимум и максимум).
Но в реальности неравномерные распределения встречаются очень часто. Поэтому собирается еще и следующая информация:
● массив наиболее частых значений — поле most_common_vals;
● массив частот этих значений — поле most_common_freqs.
Частота из этих массивов непосредственно служит оценкой селективности для поиска конкретного значения.
Все это прекрасно работает, пока число различных значений не очень велико. Максимальный размер каждого из массивов ограничен параметром default_statistics_target. Это значение можно переопределять на уровне отдельного столбца; в таком случае размер анализируемой выборки будет определяться по максимальному значению для таблицы.
Тонкий момент представляют «большие» значения. Чтобы не увеличивать размер pg_statistic и не нагружать планировщик бесполезной работой, значения, превышающие 1 Кбайт, исключаются из статистики и анализа. В самом деле, если в поле хранятся такие большие значения, скорее всего, они уникальны и не имеют шансов попасть в most_common_vals.
Page 9: Наиболее частые значения
Для эксперимента ограничим размер списка наиболее частых значений (который по умолчанию определяется параметром default_statistics_target) на уровне столбца:
Если значение попало в список наиболее частых, селективность можно узнать непосредственно из статистики. Пример (Шереметьево):
Точное значение:
Вот как выглядит список наиболее частых значений и частота их встречаемости:
Кардинальность вычисляется как число строк, умноженное на частоту значения:
Список наиболее частых значений может использоваться и для оценки селективности неравенств. Для этого в most_common_vals надо найти все значения, удовлетворяющие неравенству, и просуммировать частоты соответствующих элементов из most_common_freqs. Если же указанного значения нет в списке наиболее частых, то селективность вычисляется исходя из предположения, что все данные (кроме наиболее частых) распределены равномерно. Например, в списке частых значений нет Владивостока.
Page 10: Page 10
Точное значение:
Для получения оценки вычислим сумму частот наиболее частых значений:
На менее частые значения приходятся оставшиеся строки. Поскольку мы исходим из предположения о равномерности распределения менее частых значений, селективность будет равна 1/nd, где nd — число уникальных значений:
Учитывая, что из этих значений 10 входят в список наиболее частых, а неопределенных значений нет, получаем следующую оценку:
Page 11: Гистограмма
 {#source-figure-011 caption=“Source slide page 11: Гистограмма”}
Комментарии преподавателя
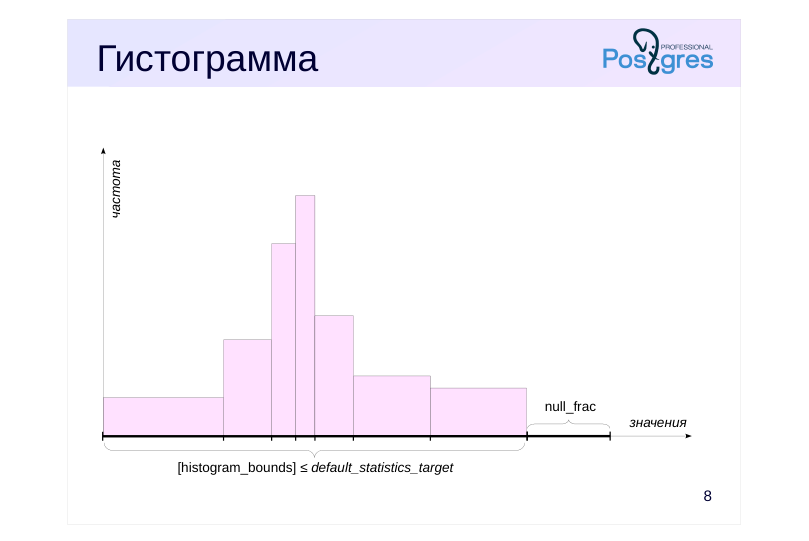
Если число различных значений слишком велико, чтобы записать их в массив, на помощь приходит гистограмма. Гистограмма состоит из нескольких корзин, в которые помещаются значения. Количество корзин ограничено тем же параметром default_statistics_target.
Ширина корзин выбирается так, чтобы в каждую попало примерно одинаковое число значений (на рисунке это выражается в одинаковой площади прямоугольников).
При таком построении достаточно хранить только массив крайних значений каждой корзины — поле histogram_bounds. Частота одной корзины равна 1/(число корзин).
Оценить селективность условия поле < значение можно как N/(общее число корзин), где N — число корзин, лежащих слева от значения. Оценку можно улучшить, добавив часть корзины, в которую попадает само значение.
Если же надо оценить селективность условия поле = значение, то гистограмма в этом не может помочь, и приходится довольствоваться предположением о равномерном распределении и брать в качестве оценки 1/n_distinct.
Page 12: Комбинация методов
 {#source-figure-012 caption=“Source slide page 12: Комбинация методов”}
Комментарии преподавателя
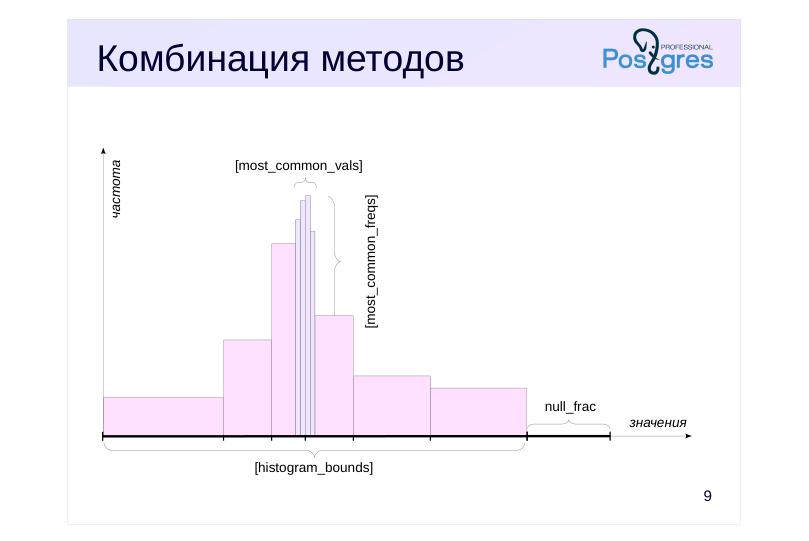
Но обычно два подхода объединяются: строится список наиболее частых значений, а все остальные значения покрываются гистограммой.
При этом гистограмма строится так, что в ней не учитываются значения, попавшие в список. Это позволяет улучшить оценки.
Page 13: Гистограмма
При условиях «больше» и «меньше» для оценки будет использоваться список наиболее частых значений, или гистограмма, или оба способа вместе. Гистограмма строится так, чтобы не включать наиболее частые значения и NULL:
Число корзин гистограммы определяется параметром default_statistics_target, а границы выбираются так, чтобы в каждой корзине находилось примерно одинаковое количество значений. Рассмотрим пример:
Точное значение:
Как получена оценка? Учтем частоту наиболее частых значений, попадающих в указанный интервал:
Указанный интервал занимает ровно 2 корзины гистограммы из 10, а неопределенных значений в данном столбце нет, получаем следующую оценку:
В общем случае учитываются и не полностью занятые корзины (с помощью линейной аппроксимации).
Кардинальность соединения
В случае неравномерного распределения данных в ключах соединения базовая формула расчета селективности соединения (минимальное из значений 1/nd1 и 1/nd2) дает неправильный результат. Например, рейсы совершают разные модели самолетов с разной вместимостью, и для соединения рейсов с местами мы получили бы:
Page 14: Page 14
При этом точное значение в два раза меньше:
Однако планировщик умеет учитывать списки наиболее частых значений и гистограммы, и получает практически точную оценку:
К сожалению, ситуация ухудшается, когда соединяются несколько таблиц. Например, добавим в предыдущий запрос таблицу самолетов — это никак не повлияет на общее количество строк в выборке:
Однако теперь планировщик ошибается:
Дело в том, что, соединив первые две таблицы, планировщик не имеет детальной статистики о результирующем наборе строк. Во многих случаях именно это является основной причиной плохих оценок.
Page 15: Дополнительные поля
Упорядоченность (использовать ли битовую карту?)
- pg_stats.correlation
- (1 — по возрастанию, 0 — хаотично, –1 — по убыванию)
- Видимость (использовать ли сканирование только индекса?)
- pg_class.relallvisible
- Средний размер значения в байтах (оценка памяти)
- pg_stats.avg_width
Комментарии преподавателя
Сервер хранит еще несколько показателей статистики.
В поле pg_stats.correlation записывается показатель физической упорядоченности значений столбца. Если значения хранятся строго по возрастанию, показатель будет близок к единице; если по убыванию — к минус единице. Чем более хаотично расположены данные на диске, тем ближе значение показателя к нулю. Именно это поле использует оптимизатор, когда выбирает между сканированием битовой карты и обычным индексным сканированием.
Поле pg_class.relallvisible хранит количество страниц таблицы, которые содержат только актуальные версии строк (эта информация обновляется вместе с картой видимости). Если количество недостаточно велико, планировщик может отказаться от сканирования только индекса в пользу сканирования по битовой карте.
В поле pg_stats.avg_width сохраняется средний размер значений в данном столбце в байтах для расчета необходимого для операции объема памяти.
https://postgrespro.ru/docs/postgresql/16/view-pg-stats
Page 16: Элементы составных полей
Наиболее частые элементы
- pg_stats.most_common_elems
- pg_stats.most_common_elem_freqs
- Гистограмма количества элементов
- pg_stats.elem_count_histogram
Комментарии преподавателя
Для таких составных типов, как массивы или tsvector, в pg_stats хранится распределение не только самих значений, но и их элементов:
● most_common_elems и most_common_elem_freqs содержат наиболее частые элементы и их частоты;
● elem_count_histogram содержит гистограмму количества элементов в значении (например, в случае массива — гистограмму длин массивов).
Это позволяет более точно планировать запросы с участием полей не в первой нормальной форме. В частности, эта информация важна для классов операторов индексного метода GIN, поскольку позволяет отделить частые значения (то есть встречающиеся во многих документах, условие с низкой селективностью) от редких (условие с высокой селективностью).
Page 17: Элементы составных полей
Для примера рассмотрим таблицу pg_constraint — в ней хранятся ограничения целостности, определенные для таблиц. И в ней есть поле conkey с массивом номеров столбцов, образующих ограничение:
Для этого поля можно получить наиболее частые значения и их частоты. Чтобы было удобнее просматривать статистику, соберем ее с уменьшенным значением ориентира:
В данном случае значения в столбце — это массивы элементов. Такая статистика не позволит оценить кардинальность, например, для условия вхождения элемента в массив. Однако планировщик не ошибается в оценке:
Для таких условий используется статистика по отдельным элементам:
Page 18: Page 18
Для частот и гистограмм в конце массива содержится дополнительная информация (минимум, максимум, среднее), поэтому количество значений превышает установленный ориентир. Планировщик получает оценку, используя частоту элемента 2:
Page 19: Частные и общие планы
Частные планы
- может быть полезен при неравномерном распределении,
- но запрос планируется заново при каждом вызове
- Seq Scan on tasks
- Index Scan on tasks
- Index Cond: status = ’todo'
- Filter: status = ‘done’
- строится
- с учетом значений
- параметров
- Общий план
- оптимален для равномерного распределения
- кешируется в сеансе для подготовленных операторов
- Index Scan on tasks
- Index Cond: id = $1
- строится
- без учета значений
- параметров
Комментарии преподавателя
При простом протоколе запросов (вспомните тему «Планирование и выполнение») каждый запрос планируется заново с учетом значений параметров.
Расширенный протокол позволяет подготавливать операторы, причем операторы могут иметь параметры. Подготовка всегда включает разбор и переписывание запроса, и дерево разбора сохраняется в локальной памяти обслуживающего процесса.
При выполнении подготовленного оператора есть варианты. Запрос может, как обычно, планироваться каждый раз заново с учетом значений параметров. Такие планы называются частными (custom).
Это имеет смысл при неравномерном распределении, ведь для разных значений оптимальные планы могут отличаться. Например, для высокоселективных условий может лучше работать индексный доступ, а если значение встречается часто — последовательный.
Но запрос можно спланировать и без учета параметров. Это позволяет сохранить не только дерево разбора, но и сам план, и не тратить время на повторное планирование. Такой план называется общим (generic).
Общий план отлично работает в случае равномерного распределения, когда селективность условия не зависит от конкретного значения. Но в случае неравномерного распределения общий план может хорошо работать для одних значений и плохо — для других.
Разберемся, как планировщик решает, какой вариант использовать.
Page 20: Частные и общие планы
Подготовим запрос и создадим индекс:
Поиск отмененных рейсов будет использовать индекс, поскольку статистика говорит о том, что таких рейсов мало:
А поиск прибывших рейсов — нет, поскольку их много:
Такие планы называются частными, поскольку они построены с учетом конкретных значений параметров. Однако планировщик строит и общий план без учета конкретных значений параметров. Если в какой-то момент оказывается, что стоимость общего плана не превышает среднюю стоимость уже построенных ранее частных планов, планировщик начинает пользоваться общим планом, больше не выполняя планирование. Но первые пять раз используются частные планы, чтобы накопить статистику. Выполним оператор еще три раза:
Количество выполнений общего и частных планов можно посмотреть в представлении pg_prepared_statements:
Page 21: Page 21
В следующий раз планировщик переключится на общий план. Вместо конкретного значения в плане будет указан номер параметра:
Имея текст запроса с параметрами, представленными номерами (например, из журнала сообщений сервера), можно посмотреть общий план такого запроса следующим образом:
Переход на общий план может быть нежелателен в случае неравномерного распределения значений. Параметр plan_cache_mode позволяет отключить использование частных планов (или наоборот, с самого начала использовать общий план):
Частичный индекс
Поиск уже прибывших рейсов будет выполняться последовательным сканированием таблицы flights, поэтому индексные записи с ключом Arrived никогда не используются. При этом они занимают место и требуют ресурсов для синхронизации с изменениями строк таблицы. Проверим размер полного индекса по полю status:
Page 22: Page 22
Можно поместить в индекс только ссылки на строки, удовлетворяющие условиям с высокой селективностью. Заменим полный индекс на частичный:
Размер частичного индекса существенно меньше, чем полного:
Когда это выгодно (для редких значений) будет использоваться частичный индекс:
…а для частых значений — последовательное сканирование:
Таким образом можно сэкономить дисковое пространство и снизить затраты на сопровождение полного индекса.
Индекс по выражению
Если в условиях используются не столбцы, а, например, обращения к функциям, планировщик не учитывает множество значений. Например, рейсов, совершенных в январе, будет примерно 1/12 от общего количества:
Однако планировщик не понимает смысла функции extract и использует фиксированную селективность 0,5%:
Page 23: Page 23
Ситуацию можно исправить, построив индекс по выражению, так как для таких выражений собирается собственная статистика.
Теперь оценка исправилась:
Статистика для индексов по выражению хранится вместе с базовой статистикой по столбцам таблиц:
Индекс можно построить только по детерминированному выражению, то есть для одинаковых значений параметров (столбцов) оно всегда должно выдавать одинаковый результат. Подробнее об этом рассказано в теме «Функции».
Page 24: Итоги
Характеристики данных собираются в виде статистики
- Статистика нужна для оценки кардинальности
- Кардинальность используется для оценки стоимости
- Стоимость позволяет выбрать оптимальный план
- Основа успеха — адекватная статистика и корректная кардинальность
Page 25: Практика
- Создайте индекс на таблице билетов (tickets) по имени пассажира (passenger_name). 2. Какая статистика имеется для этой таблицы? 3. Объясните оценку кардинальности и выбор плана выполнения следующих запросов: а) выборка всех билетов, б) выборка билетов на имя ALEKSANDR IVANOV, в) выборка билетов на имя ANNA VASILEVA, г) выборка билета с идентификатором 0005432000284.
Page 26: 1. Индекс
2. Наличие статистики
Некоторые основные значения:
Ни один столбец не содержит неопределенных значений. Уникальных номеров бронирования примерно в два раза меньше, чем строк в таблице (то есть на каждое бронирование в среднем приходится два билета). Имеется около 10000 разных имен. Все остальные столбцы содержат уникальные значения. Размеры массивов наиболее частых значений и гистограмм соответствуют значению параметра default_statistics_target (100). Для имен пассажиров есть наиболее частые значения. Для других столбцов они не имеют смысла, так как максимальное количество билетов (5) встречается в 194 бронированиях, а остальные столбцы уникальны. Гистограммы есть для всех столбцов, они нужны для оценки предикатов с условиями неравенства. Строки таблицы физически упорядочены по номеру билета. Данные в других столбцах расположены более или менее хаотично.
3. Планы запросов
Кардинальность равна числу строк в таблице; выбрано полное сканирование.
Page 27: Page 27
Селективность оценена по списку наиболее частых значений; выбрано сканирование по битовой карте.
Селективность оценена исходя из равномерного распределения; выбрано сканирование по битовой карте.
Кардинальность равна 1, так как значения этого столбца уникальны; выбрано индексное сканирование.