10 Занятие 10: Способы соединения / Соединение слиянием
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_10_join_mergejoin.html Archive: QPT-handouts-16.zip Страниц PDF: 25
Page 1: Способы соединения / Соединение слиянием
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Алгоритм соединения слиянием
- Вычислительная сложность
- Соединение слиянием в параллельных планах
Page 3: Соединение слиянием
 {#source-figure-003 caption=“Source slide page 3: Соединение слиянием”}
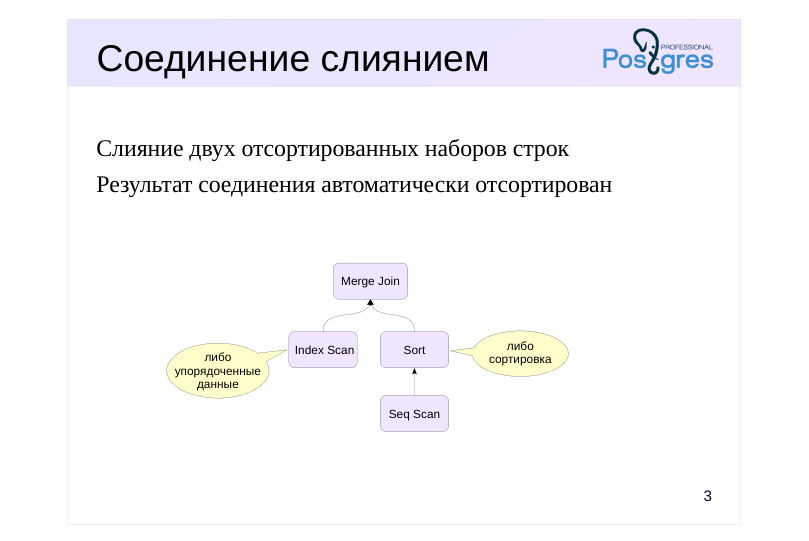
Слияние двух отсортированных наборов строк
- Результат соединения автоматически отсортирован
Комментарии преподавателя
Третий, и последний, способ соединения — соединение слиянием.
Идея этого способа состоит в том, что два предварительно отсортированных набора данных нетрудно объединить в один общий — и точно так же отсортированный — набор. Похожим образом работает узел Gather Merge.
Подготовительным этапом для соединения слиянием служит сортировка обоих наборов строк. Сортировка — дорогая операция, она имеет сложность O(N log N).
Но иногда этого этапа удается избежать, если можно сразу получить отсортированные по нужным столбцам наборы строк, например, за счет индексного доступа к таблице.
Page 4: Слияние
 {#source-figure-004 caption=“Source slide page 4: Слияние”}
Комментарии преподавателя
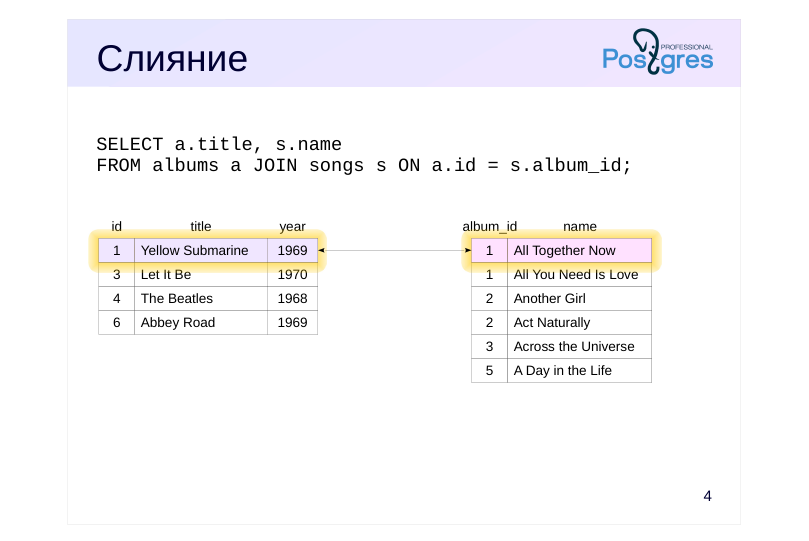
Само слияние устроено просто. Сначала берем первые строки обоих наборов и сравниваем их между собой. В данном случае мы сразу нашли соответствие и можем вернуть первую строку результата: («Yellow Submarine», «All Together Now»).
Общий алгоритм таков: читаем следующую строку того набора, для которого значение поля, по которому происходит соединение, меньше (один набор «догоняет» другой). Если же значения одинаковы, как в нашем примере, то читаем следующую строку второго (внутреннего) набора.
Page 5: Слияние
 {#source-figure-005 caption=“Source slide page 5: Слияние”}
Комментарии преподавателя
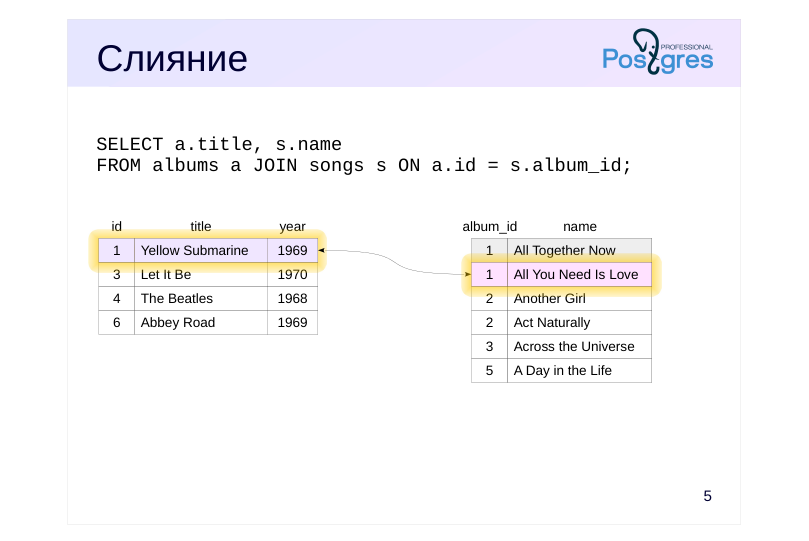
Вновь соответствие: («Yellow Submarine», «All You Need Is Love»).
Снова читаем следующую строку второго набора.
Page 6: Слияние
 {#source-figure-006 caption=“Source slide page 6: Слияние”}
Комментарии преподавателя
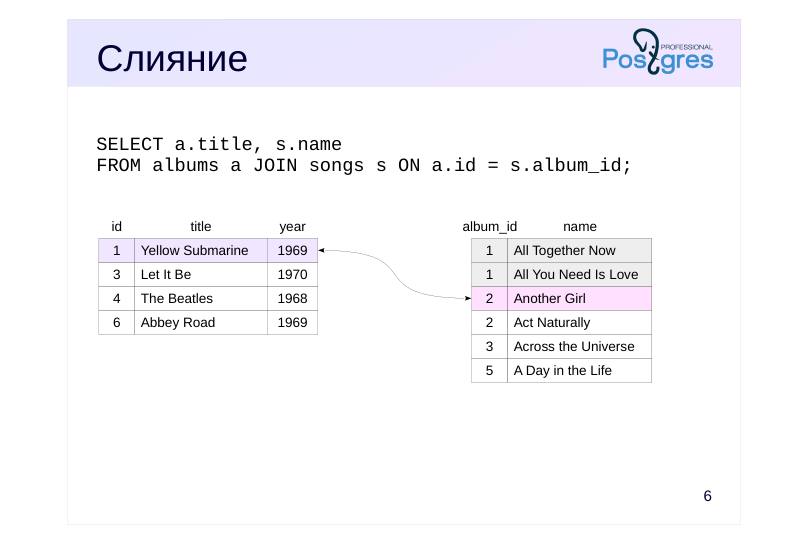
В данном случае соответствия нет.
Поскольку 1 < 2, читаем следующую строку первого набора.
Page 7: Слияние
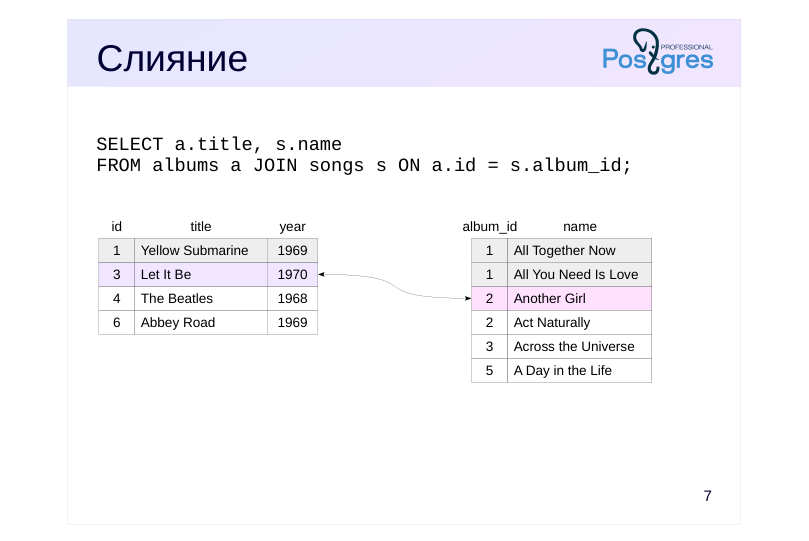 {#source-figure-007 caption=“Source slide page 7: Слияние”}
Комментарии преподавателя
Соответствия нет.
3 > 2, поэтому читаем следующую строку второго набора.
Page 8: Слияние
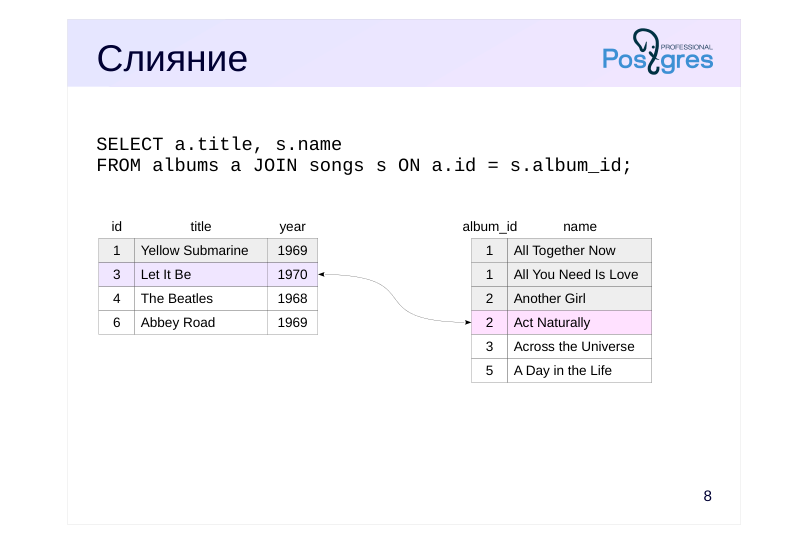 {#source-figure-008 caption=“Source slide page 8: Слияние”}
Комментарии преподавателя
Снова нет соответствия, снова 3 > 2, снова читаем строку второго набора.
Page 9: Слияние
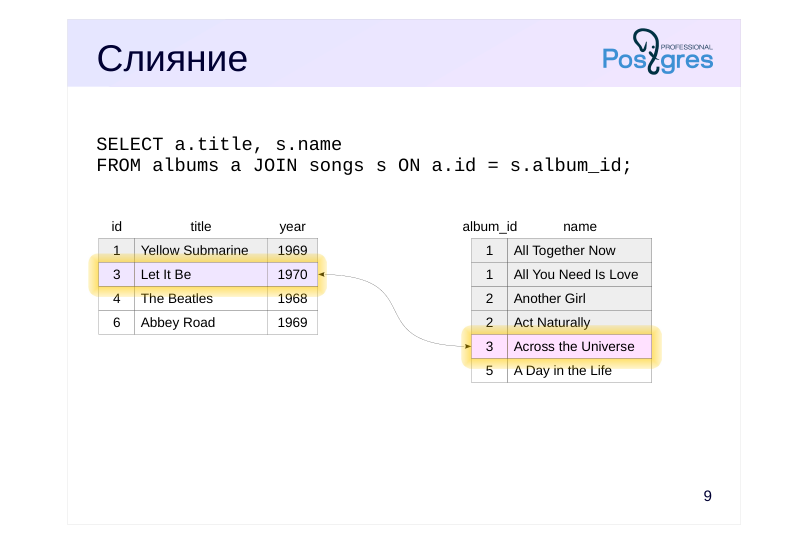 {#source-figure-009 caption=“Source slide page 9: Слияние”}
Комментарии преподавателя
Есть соответствие: («Let It Be», «Across the Universe»).
3 = 3, читаем следующую строку второго набора.
Page 10: Слияние
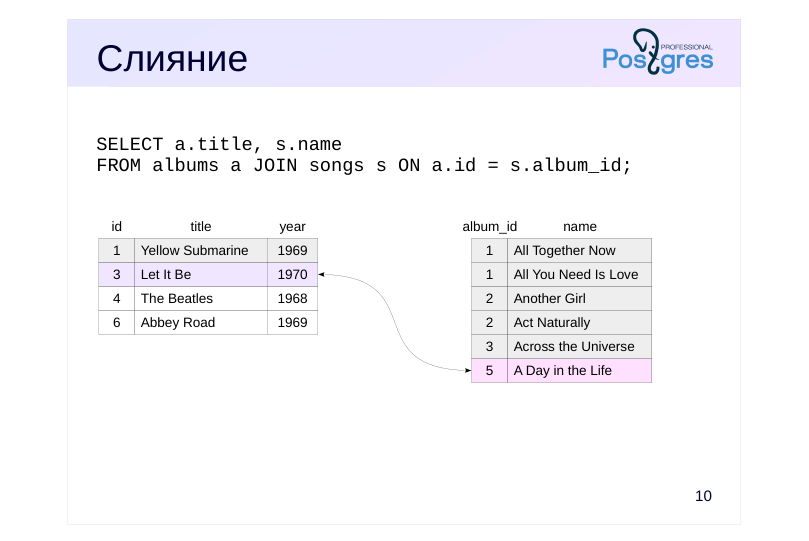 {#source-figure-010 caption=“Source slide page 10: Слияние”}
Соответствия нет. 3 < 5, читаем строку первого набора.
Page 11: Слияние
 {#source-figure-011 caption=“Source slide page 11: Слияние”}
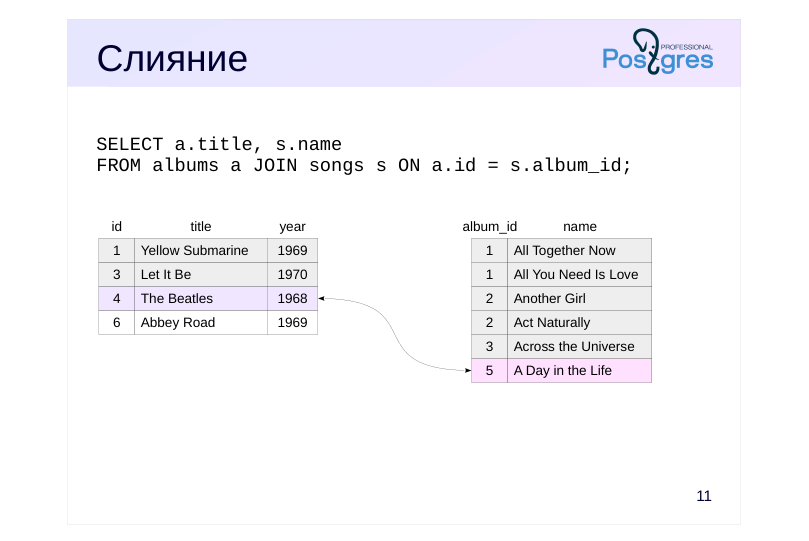
Соответствия нет. 4 < 5, читаем строку первого набора.
Page 12: Слияние
 {#source-figure-012 caption=“Source slide page 12: Слияние”}
Комментарии преподавателя
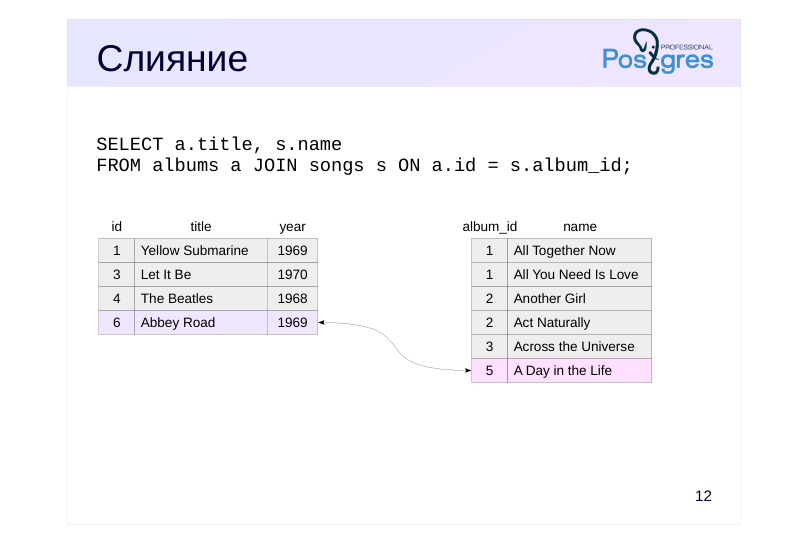
И последний шаг: снова нет соответствия.
На этом соединение слиянием окончено.
На самом деле алгоритм сложнее — если в первом (внешнем) наборе строк встречается несколько одинаковых значений, нужно иметь возможность перечитать строки второго (внутреннего) набора с тем же ключом соединения.
Псевдокод алгоритма можно посмотреть в файле src/backend/executor/nodeMergejoin.c.
Важно, что алгоритм слияния возвращает результат соединения в отсортированном виде. В частности, полученный набор строк можно использовать для следующего соединения слиянием без дополнительной сортировки.
Page 13: Соединение слиянием
Если результат необходим в отсортированном виде, оптимизатор может предпочесть соединение слиянием. Особенно, если данные от дочерних узлов можно получить уже отсортированными — как в этом примере:
Вот еще один пример с двумя соединениями слиянием, в котором один узел Merge Join получает отсортированный набор от другого узла Merge Join:
Здесь соединяются перелеты (ticket_flights) и посадочные талоны (boarding_passes), и с этим, уже отсортированным по номерам билетов, набором строк соединяются билеты (tickets). Для Merge Join также существуют модификации Left, Right, Semi, Anti и Full. В настоящее время соединение слиянием поддерживает только эквисоединения, соединения по операциям «больше» или «меньше» не реализованы. Таким образом, модификация Full существует только для соединений хешированием и слиянием, и оба варианта работают только с условием равенства. Если пренебречь производительностью, полное соединение можно получить, объединив результаты левого соединения и антисоединения — таким вариантом придется воспользоваться, если потребуется полное соединение по иному условию.
Page 14: Вычислительная сложность
~ N+M, где
- N и M — число строк в первом и втором наборах данных,
- если не требуется сортировка
- ~ N log N+M log M,
- если сортировка нужна
- Возможные начальные затраты на сортировку
- Эффективно для большого числа строк
Комментарии преподавателя
В случае, когда не требуется сортировать данные, общая сложность соединения слиянием пропорциональна сумме числа строк в обоих наборах данных. Но, в отличие от соединения хешированием, здесь не требуются накладные расходы на построение хеш-таблицы.
Поэтому соединение слиянием может успешно применяться как в OLTP-, так и в OLAP-запросах.
Однако если сортировка требуется, то стоимость становится пропорциональной произведению количества строк на логарифм этого количества, и на больших объемах такой способ скорее всего проиграет соединению хешированием.
Page 15: Вычислительная сложность
Посмотрим на стоимость соединения слиянием:
Начальная стоимость включает: сумму начальных стоимостей дочерних узлов (включает стоимость сортировки, если она необходима); стоимость получения первой пары строк, соответствующих друг другу. Полная стоимость добавляет к начальной: сумму стоимостей получения обоих наборов данных; стоимость сравнения строк. Общий вывод: стоимость соединения слиянием пропорциональна N + M (где N и M — число соединяемых строк), если не требуется отдельная сортировка. Сортировка набора из K строк добавляет к оценке как минимум K × log(K). В отличие от соединения хешированием, слияние без сортировки хорошо подходит для случая, когда надо быстро получить первые строки.
Обратите внимание и на то, как уменьшилась общая стоимость.
Page 16: В параллельных планах
 {#source-figure-016 caption=“Source slide page 16: В параллельных планах”}
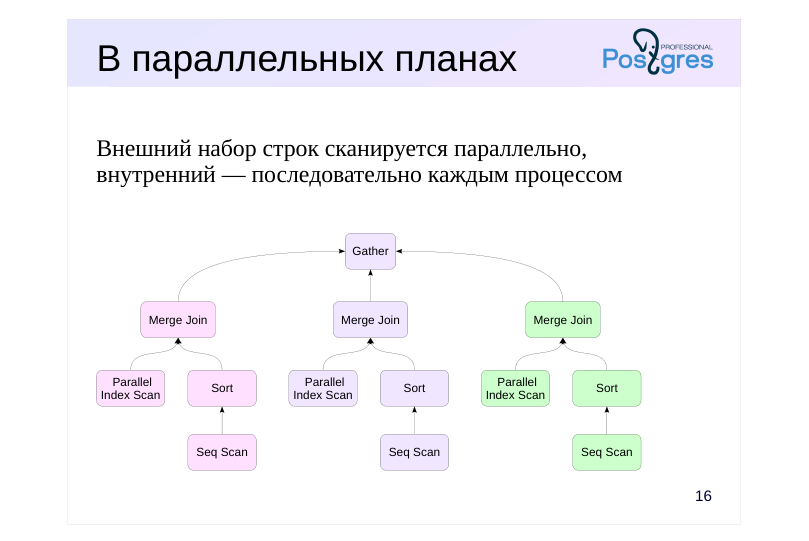
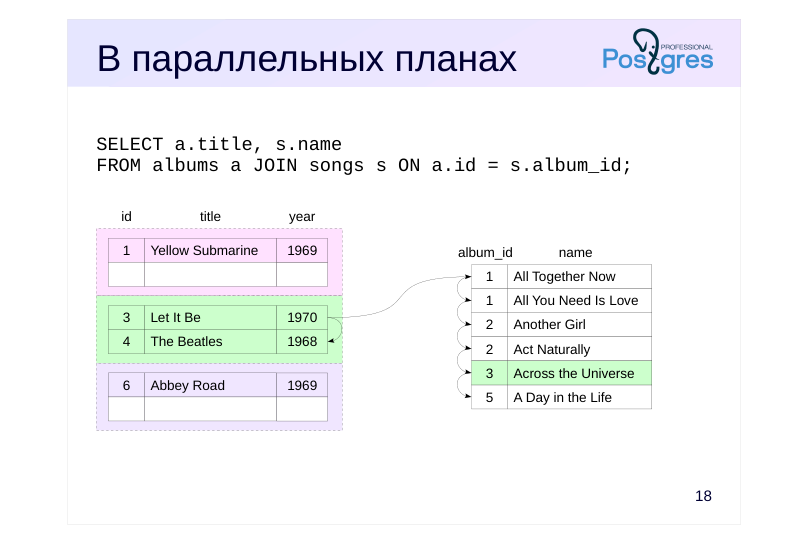
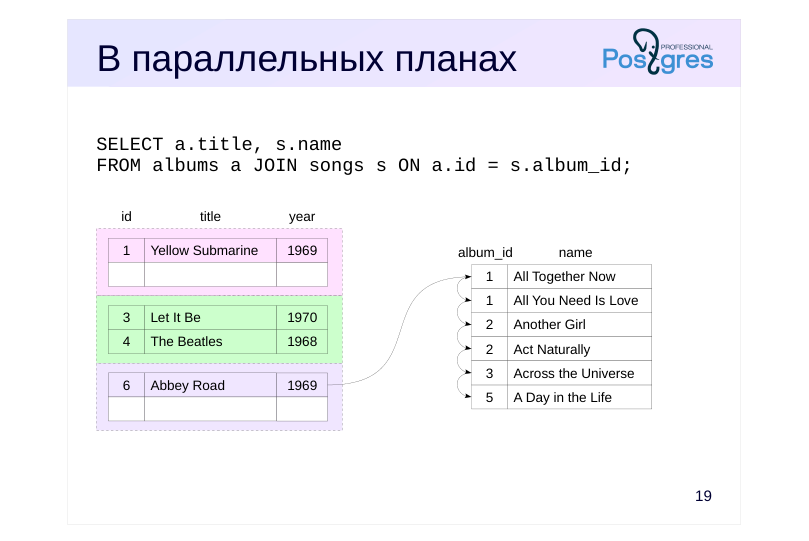
Внешний набор строк сканируется параллельно, внутренний — последовательно каждым процессом
Комментарии преподавателя
Соединение слиянием может использоваться в параллельных планах.
Так же, как и при соединении вложенным циклом, сканирование одного набора строк выполняется рабочими процессами параллельно, но другой набор строк каждый рабочий процесс читает полностью самостоятельно. Поэтому при соединении больших объемов строк в параллельных планах гораздо чаще используется соединение хешированием, имеющее эффективный параллельный алгоритм.
Page 17: В параллельных планах
 {#source-figure-017 caption=“Source slide page 17: В параллельных планах”}
Комментарии преподавателя
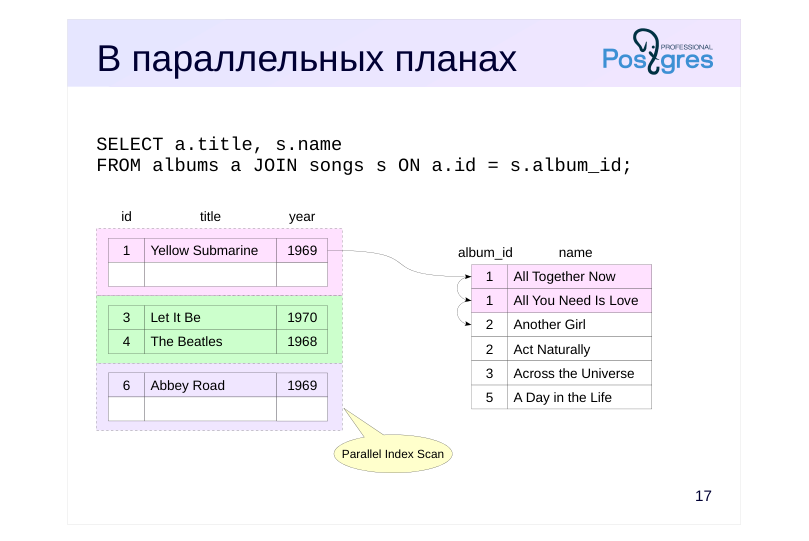
Внутренний набор данных будет просканирован каждым из рабочих процессов от начала и до того момента, как станет понятно, что больше нет соответствий.
На этом слайде показаны строки, перебираемые первым процессом.
Page 18: В параллельных планах
 {#source-figure-018 caption=“Source slide page 18: В параллельных планах”}
Комментарии преподавателя
Второй процесс просканирует весь набор и найдет одно соответствие.
Page 19: В параллельных планах
 {#source-figure-019 caption=“Source slide page 19: В параллельных планах”}
Комментарии преподавателя
А третий процесс не обнаружит ни одного соответствия.
Конечно, все три процесса сканируют внутренний набор одновременно, а не по очереди.
Page 20: В параллельных планах
Нам потребуется индекс:
Вот пример параллельного плана, в котором используется соединение слиянием:
Здесь индекс на таблице бронирований bookings_pkey сканируется параллельно, а результат группировки из подзапроса t — каждым процессом полностью.
Page 21: Итоги
Соединение слиянием может потребовать подготовки
- надо отсортировать наборы строк
- или получить их заранее отсортированными
- Эффективно для больших выборок
- хорошо, если наборы уже отсортированы
- хорошо, если нужен отсортированный результат
- Не зависит от порядка соединения
- Поддерживает только эквисоединения
- другие не реализованы, но принципиальных ограничений нет
Комментарии преподавателя
Чтобы начать соединение слиянием, оба набора строк должны быть отсортированы. Хорошо, если удается получить данные уже в нужном порядке; если нет — требуется выполнить сортировку.
Само слияние выполняется очень эффективно даже для больших наборов строк. В качестве приятного бонуса результирующая выборка тоже упорядочена, поэтому такой способ соединения привлекателен, если вышестоящим узлам плана также требуется сортировка (например, запрос с фразой ORDER BY или еще одна сортировка слиянием).
Итак, в распоряжении планировщика есть три способа соединения: вложенный цикл, хеширование и слияние (не считая различных модификаций). Для каждого способа есть ситуации, в которых он оказывается более эффективным, чем остальные. Это позволяет планировщику выбрать именно тот способ, который — как предполагается — лучше подойдет в каждом конкретном случае. А точность предположений напрямую зависит от имеющейся статистики.
Page 22: Практика
- Проверьте план выполнения запроса, показывающего все места в салонах в порядке кодов самолетов: SELECT * FROM aircrafts a JOIN seats s ON a.aircraft_code = s.aircraft_code ORDER BY a.aircraft_code; Но оформите его в виде курсора. Уменьшите значение параметра cursor_tuple_fraction в десять раз. Как при этом изменился план выполнения? 2. Самолет можно заменить другим, если его вместимость отличается не более, чем на 20%. Получите таблицу замен между моделями Боинг и Аэробус, выполнив полное соединение. Как выполняется запрос?
- Запрос, который нужно выполнить:
Page 23: 1. Параметр cursor_tuple_fraction
План выполнения курсора:
Текущее значение cursor_tuple_fraction:
Уменьшим его:
Теперь планировщик выбирает другой план: его начальная стоимость ниже (хотя общая стоимость, наоборот, выше).
2. Полное соединение
Попробуем выполнить запрос.
Получаем ошибку: полное соединение реализовано только для условия равенства, поскольку только вложенный цикл
Page 24: Page 24
поддерживает соединение по произвольному условию, но зато не поддерживает полное соединение. Обойти ограничение можно, объединив результаты левого внешнего соединения и антисоединения:
План запроса показывает, что соединения выполняются методом вложенного цикла: