09 Занятие 09: Способы соединения / Соединение хешированием
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_09_join_hashjoin.html Archive: QPT-handouts-16.zip Страниц PDF: 36
Page 1: Способы соединения / Соединение хешированием
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Последовательное соединение хешированием: одно-и двухпроходное
- Вычислительная сложность
- Параллельное соединение хешированием: одно-и двухпроходное
Page 3: Хеш-соединение
 {#source-figure-003 caption=“Source slide page 3: Хеш-соединение”}
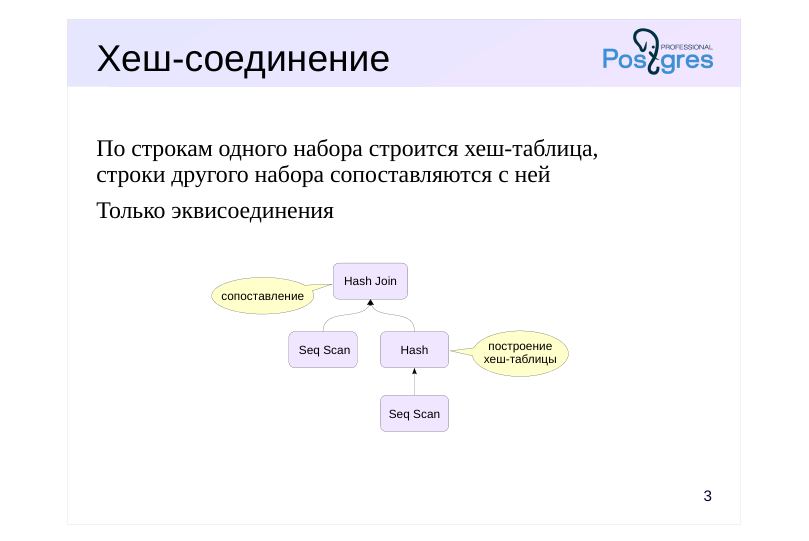
По строкам одного набора строится хеш-таблица, строки другого набора сопоставляются с ней
- Только эквисоединения
Комментарии преподавателя
Основную идею хеширования мы рассмотрели в темах «Типы индексов» и «Группировка».
Для соединения хеширование применяется следующим образом. Сначала по одному из наборов в узле Hash строится хеш-таблица. Затем в узле Hash Join строки другого набора сопоставляются с построенной таблицей.
Как и хеш-индекс, хеш-соединение может работать только с условием равенства: хеш-функция не сохраняет порядок значений.
Рассмотрим на примере, как происходит соединение.
Page 4: Однопроходное соединение
Применяется, когда для хеш-таблицы достаточно оперативной памяти
Page 5: Построение хеш-таблицы
 {#source-figure-005 caption=“Source slide page 5: Построение хеш-таблицы”}
Комментарии преподавателя
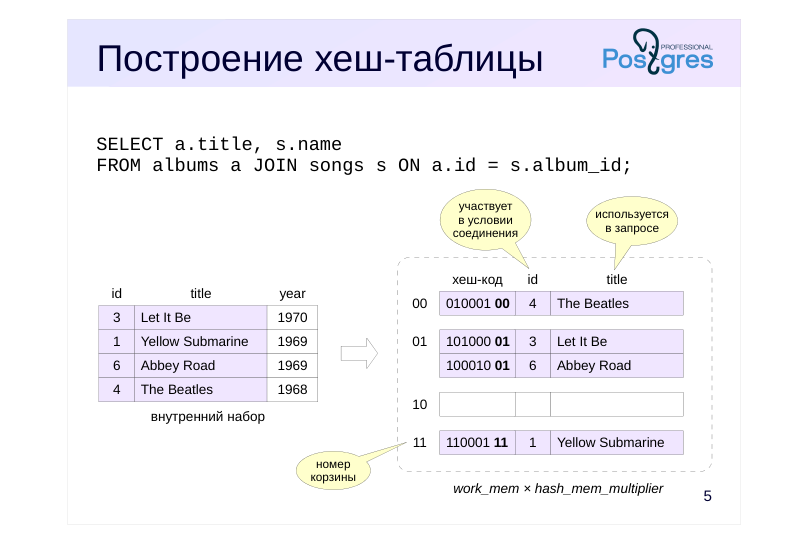
Первым этапом в памяти строится хеш-таблица.
Строки первого (внутреннего) набора читаются последовательно, и для каждой из них вычисляется хеш-функция от значений полей, входящих в условие соединения (в нашем примере это числовые идентификаторы id).
В корзину хеш-таблицы помещаются вычисленный хеш-код и все поля, которые входят в условие соединения или используются в запросе.
Размер хеш-таблицы в памяти ограничен значением work_mem × × hash_mem_multiplier. Наилучшая эффективность достигается, если вся хеш-таблица помещается в этот объем памяти целиком. Поэтому планировщик обычно выбирает в качестве внутреннего меньший из двух наборов строк. Также стоит не использовать в запросе лишние поля, в том числе «звездочку», чтобы не перегружать хеш-таблицу ненужной информацией.
Page 6: Сопоставление
 {#source-figure-006 caption=“Source slide page 6: Сопоставление”}
Комментарии преподавателя
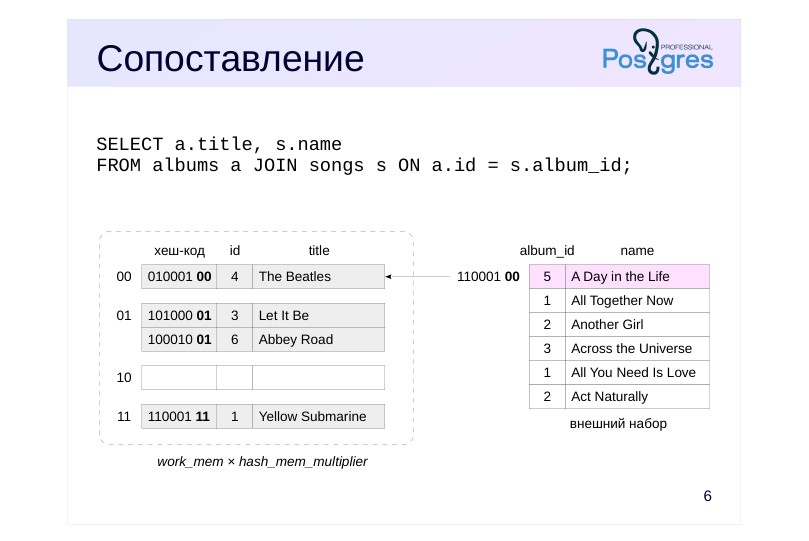
На втором этапе мы последовательно читаем второй набор строк. По мере чтения мы вычисляем хеш-функцию от значений полей, участвующих в условии соединения. Если в соответствующей корзине хеш-таблицы обнаруживается строка
с таким же хеш-кодом,
и со значениями полей, подходящими под условие соединения,
то мы нашли пару.
Проверки одного только хеш-кода недостаточно. Во-первых, не все условия соединения, перечисленные в запросе, могут быть учтены при выполнении соединения хешированием (поддерживаются только эквисоединения). Во-вторых, возможны коллизии, при которых разные значения получат одинаковые хеш-коды (вероятность этого мала, но тем не менее она есть).
В нашем примере для первой строки соответствия нет.
Page 7: Сопоставление
 {#source-figure-007 caption=“Source slide page 7: Сопоставление”}
Комментарии преподавателя
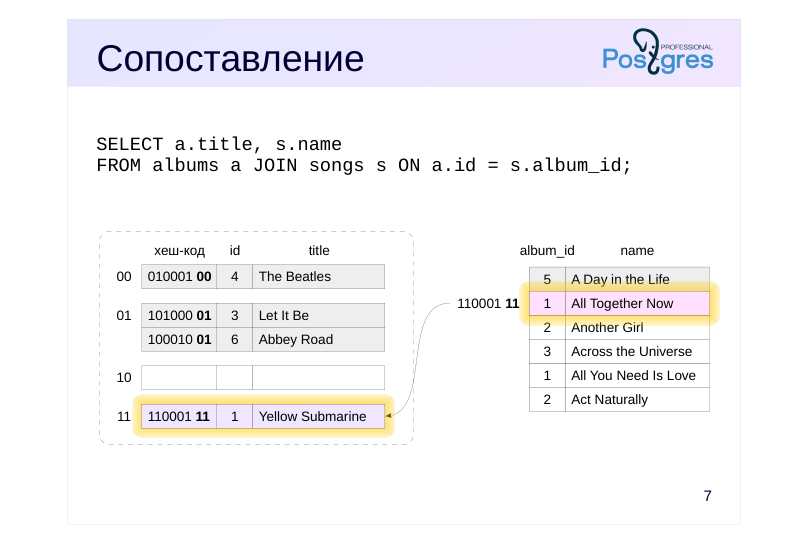
Вторая строка второго набора дает соответствие, которое уже можно вернуть вышестоящему узлу плана: («Yellow Submarine», «All Together Now»).
Page 8: Сопоставление
 {#source-figure-008 caption=“Source slide page 8: Сопоставление”}
Комментарии преподавателя
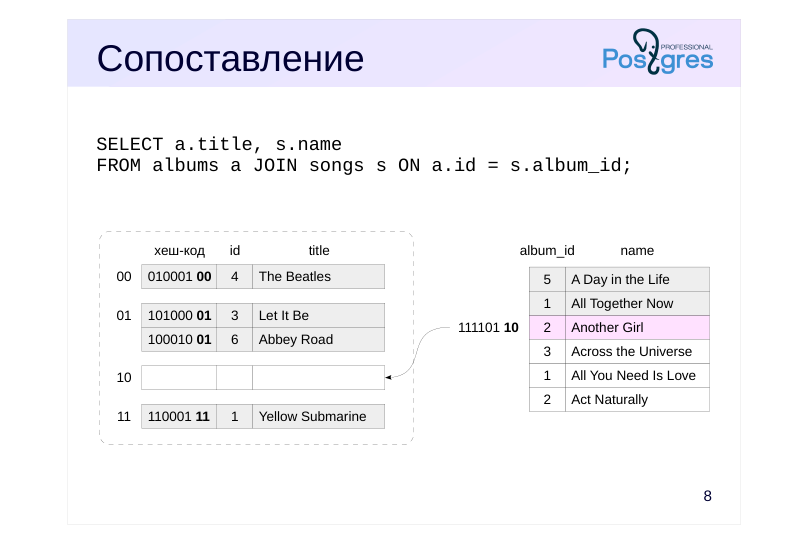
Для третьей строки соответствия нет (соответствующая корзина хеш-таблицы пуста).
Page 9: Сопоставление
 {#source-figure-009 caption=“Source slide page 9: Сопоставление”}
Комментарии преподавателя
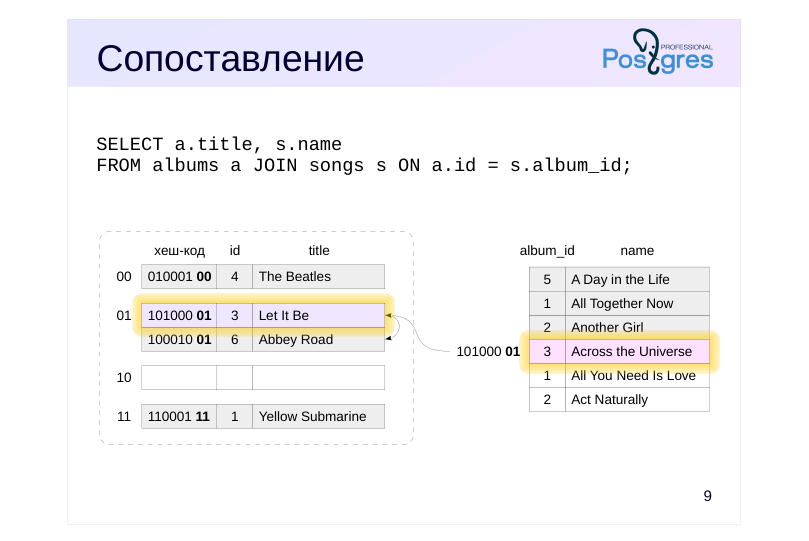
Для четвертой получаем соответствие («Let It Be», «Across the Universe»).
Заметим, что в корзине хеш-таблицы оказалось две строки первого набора, и их придется просмотреть обе.
Page 10: Сопоставление
 {#source-figure-010 caption=“Source slide page 10: Сопоставление”}
Комментарии преподавателя
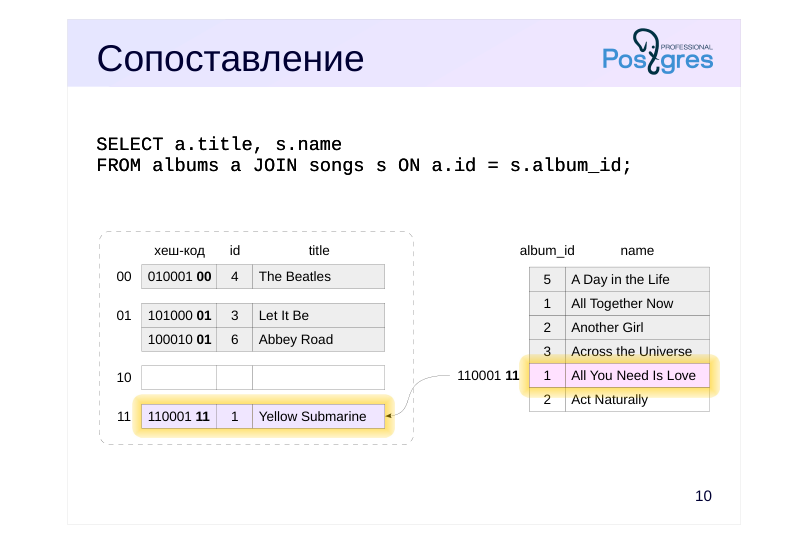
Для пятой строки получаем соответствие («Yellow Submarine», «All You Need Is Love»).
Page 11: Сопоставление
 {#source-figure-011 caption=“Source slide page 11: Сопоставление”}
Комментарии преподавателя
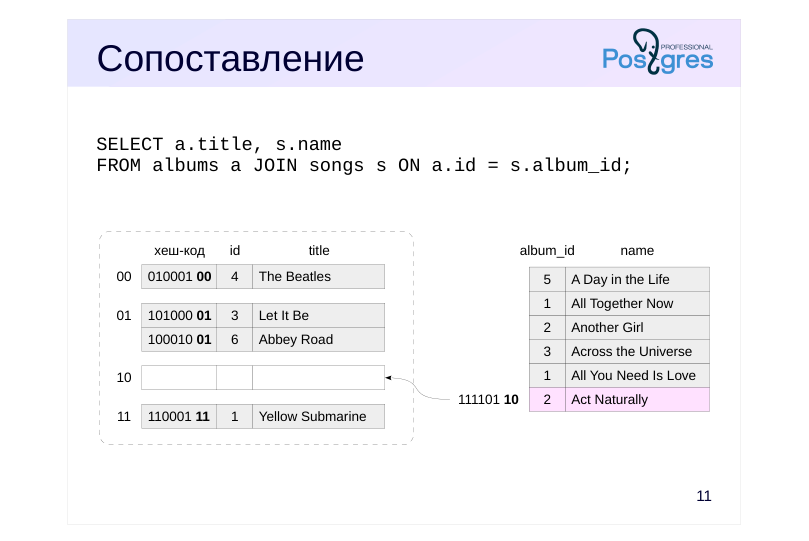
Для шестой строки соответствия нет. На этом работа соединения завершена.
Исходный код алгоритма можно найти в файле src/backend/executor/nodeHashjoin.c
Page 12: Однопроходное соединение хешированием
При низкой селективности оптимизатор предпочитает соединение хешированием:
Узел Hash Join начинает работу с того, что обращается к дочернему узлу Hash. Тот получает от своего дочернего узла (здесь — Seq Scan) весь набор строк и строит хеш-таблицу. Затем Hash Join обращается ко второму дочернему узлу и соединяет строки, постепенно возвращая полученные результаты. Проверим, как выполняется этот запрос:
Хеш-таблица поместилась в память (Batches: 1). Параметр Buckets показывает число корзин в хеш-таблице, а Memory Usage — объем использованной оперативной памяти. Обратите внимание, что хеш-таблица строилась по меньшему набору строк. Модификации Hash Join включают уже рассмотренные ранее Left, Semi и Anti, а также Right для правого и Full для полного соединений:
Page 13: Page 13
Обратите внимание, что независимо от того, в каком порядке перечислены таблицы в соединении, хеш-таблица строится по меньшему набору.
Page 14: Двухпроходное соединение
Применяется, когда хеш-таблица не помещается в оперативную память: наборы данных разбиваются на пакеты и последовательно соединяются
Page 15: Построение хеш-таблицы
 {#source-figure-015 caption=“Source slide page 15: Построение хеш-таблицы”}
Комментарии преподавателя
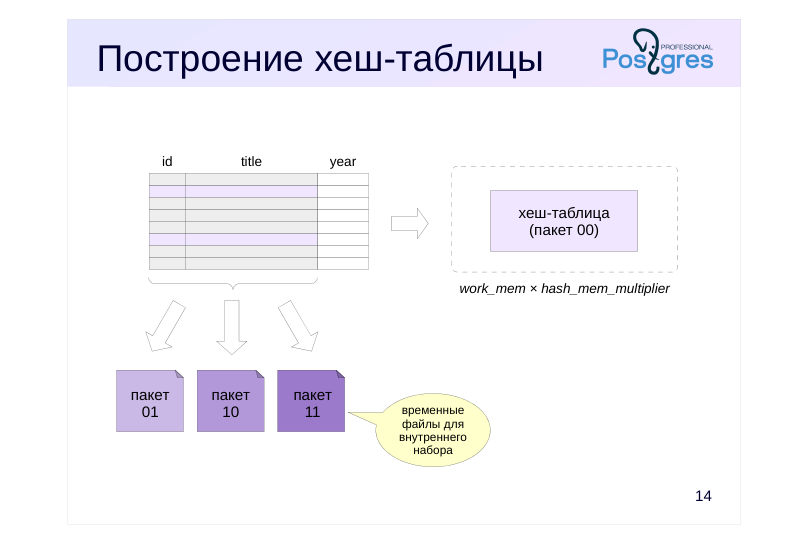
Если хеш-таблица не помещается в объем памяти, ограниченный work_mem × hash_mem_multiplier, первый (внутренний) набор строк разбивается на отдельные пакеты. Для распределения по пакетам используется некоторое количество битов хеш-кода, поэтому число пакетов всегда является степенью числа 2. В идеале в каждый пакет попадает примерно одинаковое количество строк, но, если значения в строках повторяются, возможен перекос.
При планировании запроса заранее вычисляется минимально необходимое число пакетов так, чтобы хеш-таблица для каждого пакета помещалась в памяти. Это число не уменьшается, даже если оптимизатор ошибся с оценками, но при необходимости может динамически увеличиваться.
Хеш-таблица для первого пакета остается в памяти, а строки, принадлежащие другим пакетам, сбрасываются на диск во временные файлы — каждый пакет в свой файл.
На рисунке показано четыре пакета.
Page 16: name album_id Сопоставление – пакет 1
 {#source-figure-016 caption=“Source slide page 16: name album_id Сопоставление – пакет 1”}
Комментарии преподавателя
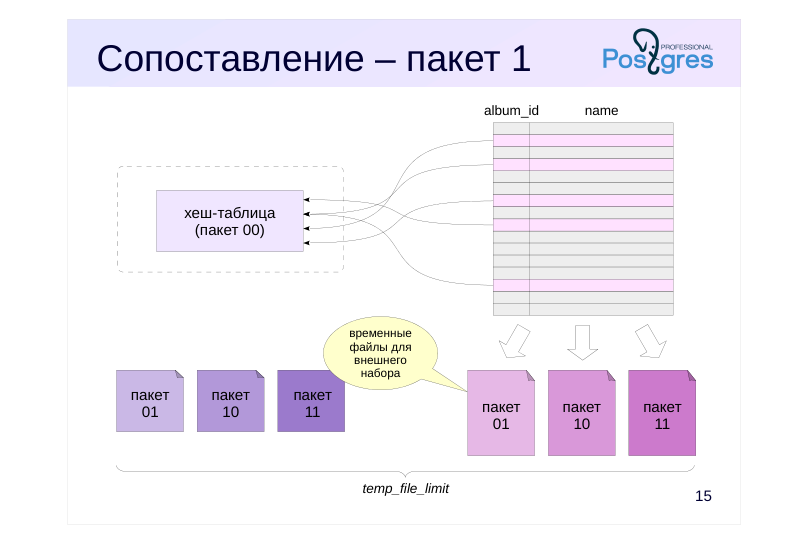
Далее читается второй (внешний) набор строк. Если строка принадлежит первому пакету, она сопоставляется с хеш-таблицей, которая как раз содержит первый пакет. С другими пакетами строку сопоставлять не надо — в них не может найтись соответствие, поскольку хеш-коды заведомо будут отличаться.
Если строка принадлежит другому пакету, она сбрасывается на диск — опять же, каждый пакет в свой временный файл.
Таким образом, при N пакетах используются 2(N–1) файлов.
Следует учитывать, что использование временных файлов на диске ограничивается параметром temp_file_limit, который определяет общий предел дисковой памяти для сеанса. (Буферы временных таблиц в это ограничение не входят.)
Page 17: Сопоставление – пакет 2
 {#source-figure-017 caption=“Source slide page 17: Сопоставление – пакет 2”}
Комментарии преподавателя
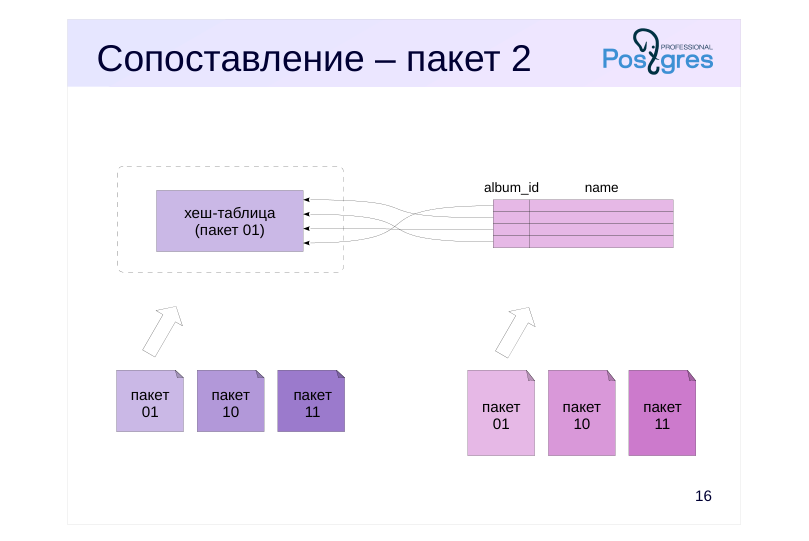
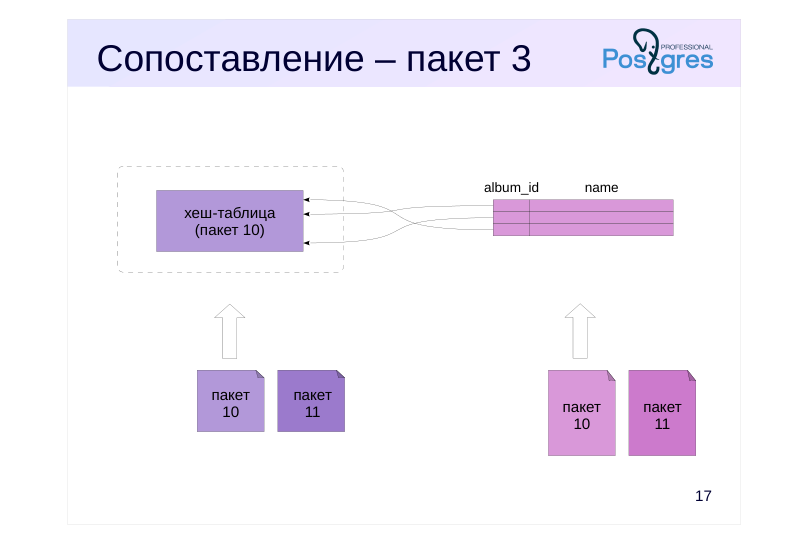
Далее по очереди обрабатываются все пакеты, начиная со второго. Из временного файла в хеш-таблицу считываются строки внутреннего набора, затем из другого временного файла считываются строки внешнего набора и сопоставляются с хеш-таблицей.
Процедура повторяется для всех оставшихся N–1 пакетов. На рисунке показано соединение для второго пакета (01).
Page 18: Сопоставление – пакет 3
 {#source-figure-018 caption=“Source slide page 18: Сопоставление – пакет 3”}
Комментарии преподавателя
На рисунке показано соединение для третьего пакета (10).
Page 19: Сопоставление – пакет 4
 {#source-figure-019 caption=“Source slide page 19: Сопоставление – пакет 4”}
Комментарии преподавателя
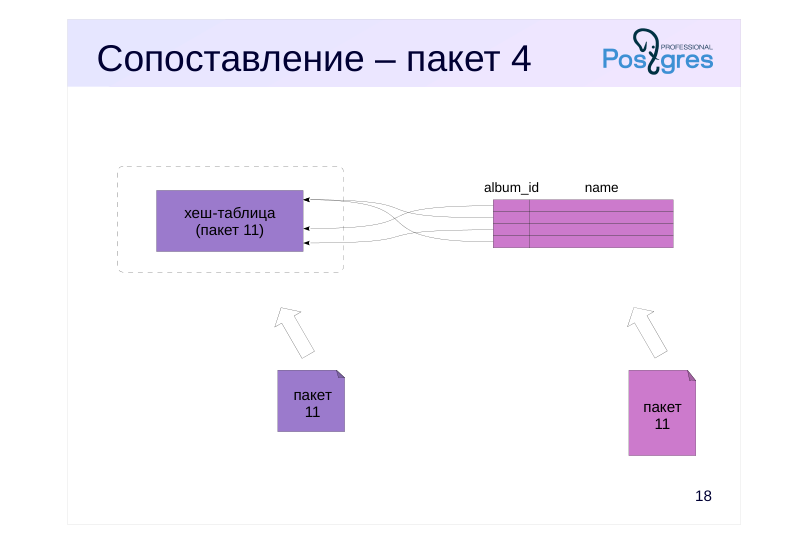
После обработки последнего пакета соединение завершено и временные файлы освобождены.
Таким образом, при нехватке оперативной памяти алгоритм соединения становится двухпроходным: каждый пакет (кроме первого) требуется записать на диск и затем прочитать повторно. Разумеется, это сказывается на эффективности соединения. Поэтому важно, чтобы:
● в хеш-таблицу попадали только действительно нужные поля (обязанность автора запроса),
● хеш-таблица строилась по меньшему набору строк (обязанность планировщика).
Page 20: Двухпроходное соединение хешированием
Возьмем теперь большие таблицы и выведем статистику ввода-вывода:
Теперь хеш-таблица не поместилась в память и используется двухпроходное соединение. Потребовалось 32 пакета (Batches). Видно, что узел Hash записывает пакеты во временные файлы (temp written), а узел Hash Join и записывает, и читает (temp read и written). Сравним с таким же запросом, который выводит только одно поле:
Расход памяти уменьшился, так как в хеш-таблице теперь только одно поле (вместо трех), и количество пакетов уменьшилось вдвое.
Page 21: Вычислительная сложность
~ N+M, где
- N и M — число строк в первом и втором наборах данных
- Начальные затраты на построение хеш-таблицы
- Эффективно для большого числа строк
Комментарии преподавателя
Общая сложность соединения хешированием пропорциональна сумме числа строк в одном и другом наборах данных. Поэтому метод соединения хешированием гораздо эффективнее вложенного цикла при большом числе строк.
Однако, чтобы начать соединение, требуется построить хеш-таблицу: из-за этого при небольшом числе строк вложенный цикл более эффективен.
Соединение хешированием (в сочетании с полным сканированием таблиц) характерно для OLAP-запросов, в которых надо обработать большое число строк, причем общая пропускная способность важнее времени отклика.
Page 22: Стоимость хеш-соединения
Начальная стоимость узла Hash Join складывается из стоимостей: получения всего первого набора данных (здесь — билеты); построения хеш-таблицы — пока таблица не готова, соединение не может начаться. Можно обратить внимание на то, что в узле Hash стоимость построения хеш-таблицы не отражена. Полная стоимость добавляет к начальной следующие стоимости: получения всего второго набора данных (здесь — перелеты); проверки по хеш-таблице; обращения к диску в случае, когда предполагается использование более одного пакета. Главный вывод: стоимость хеш-соединения пропорциональна N + M, где N и M — число строк в соединяемых наборах данных. При больших N и M это значительно выгоднее, чем произведение в случае соединения вложенным циклом.
Page 23: Параллельный алгоритм
 {#source-figure-023 caption=“Source slide page 23: Параллельный алгоритм”}
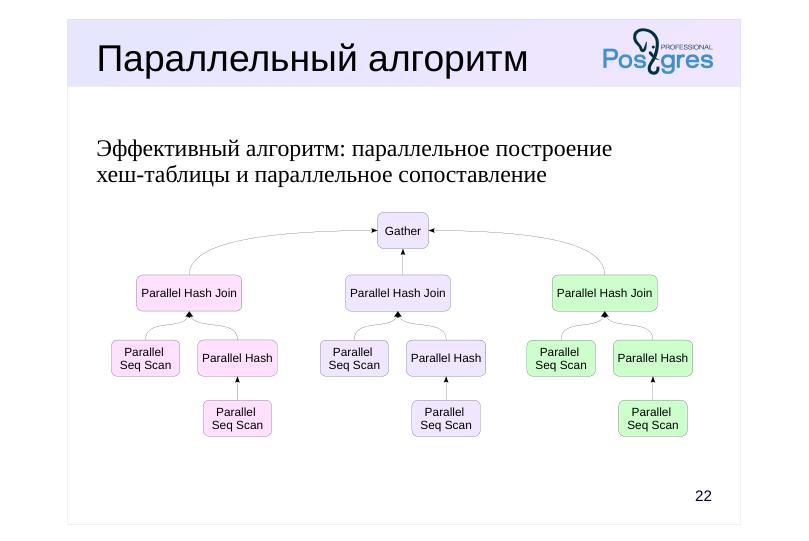
Эффективный алгоритм: параллельное построение хеш-таблицы и параллельное сопоставление
Комментарии преподавателя
В отличие от других способов соединения, хеш-соединение не только может участвовать в параллельных планах, но и имеет отдельный эффективный алгоритм работы. Этот алгоритм позволяет параллельно выполнять оба этапа соединения: и построение хеш-таблицы по первому (внутреннему) набору строк, и сопоставление с ней строк второго (внешнего) набора.
Возможность параллельного хеш-соединения управляется параметром enable_parallel_hash; по умолчанию параметр включен.
Как и у последовательного алгоритма, у параллельного есть два варианта: однопроходный при достаточном количестве оперативной памяти и двухпроходный.
Начнем с однопроходного варианта.
Page 24: Параллельно, один проход
Процессы используют общую хеш-таблицу
Page 25: Построение хеш-таблицы
 {#source-figure-025 caption=“Source slide page 25: Построение хеш-таблицы”}
Комментарии преподавателя
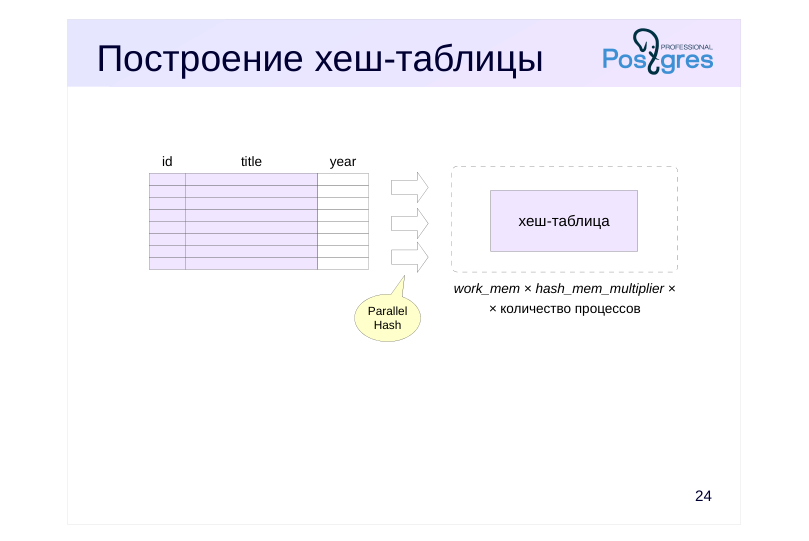
Однопроходный алгоритм используется, если хеш-таблица помещается в суммарный объем памяти, выделенный всем участвующим в соединении процессам, то есть размер хеш-таблицы ограничен значением work_mem × hash_mem_multiplier × количество процессов.
Процессы параллельно читают первый набор строк (например, используя узел Parallel Seq Scan) и строят общую хеш-таблицу в разделяемой памяти, где каждый из них имеет к ней доступ.
Page 26: name album_id Сопоставление
 {#source-figure-026 caption=“Source slide page 26: name album_id Сопоставление”}
Комментарии преподавателя
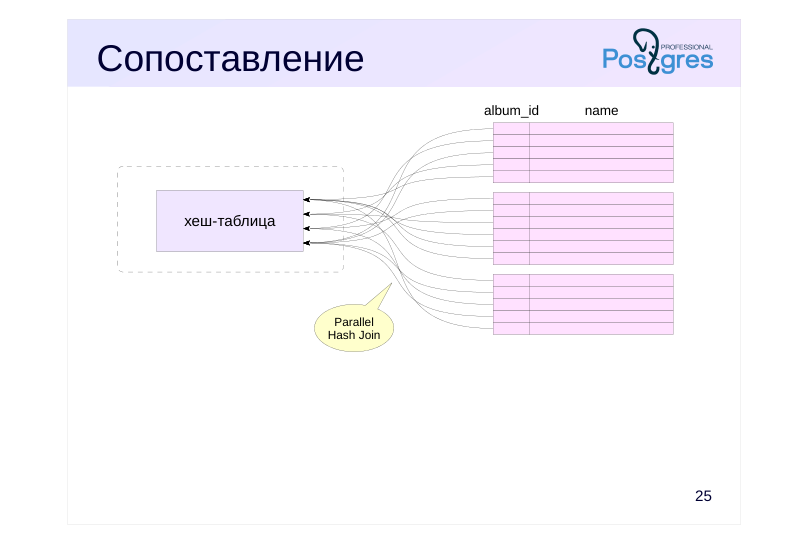
После того, как хеш-таблица полностью построена, рабочие процессы приступают к параллельному чтению второго набора и сопоставляют прочитанные ими строки с общей хеш-таблицей. Таким образом, каждый из процессов проверяет по хеш-таблице только часть данных.
Page 27: Однопроходное параллельное хеш-соединение
Увеличим объем памяти, выделяемый процессу для построения хеш-таблицы:
Выполним запрос с агрегацией:
Обратите внимание на использование памяти (Memory Usage): объем превышает ограничение, установленное для одного рабочего процесса (64MB = work_mem × hash_mem_multiplier), но в общую память трех процессов хеш-таблица помещается. Поэтому выполняется однопроходное соединение (Batches: 1).
Page 28: Параллельно, два прохода
Наборы строк разбиваются на пакеты, которые затем параллельно обрабатываются рабочими процессами
Page 29: Разбиение на пакеты
 {#source-figure-029 caption=“Source slide page 29: Разбиение на пакеты”}
Комментарии преподавателя
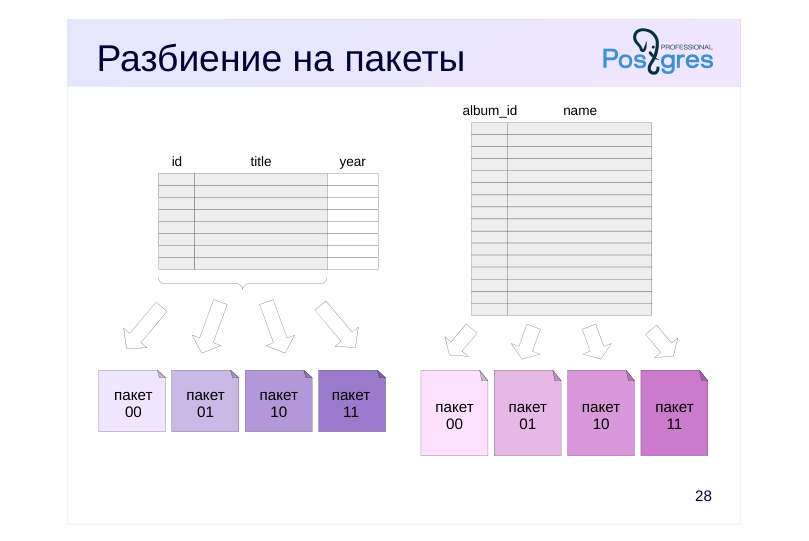
Хеш-таблица может не поместиться в объем памяти, ограниченный work_mem × hash_mem_multiplier × количество процессов, причем это может выясниться и на этапе выполнения соединения. В этом случае используется двухпроходный алгоритм, который существенно отличается и от двухпроходного последовательного, и от однопроходного параллельного.
Сначала рабочие процессы параллельно читают первый набор данных, разбивают его на пакеты и записывают пакеты во временные файлы. Первый пакет тоже попадает в файл; хеш-таблица в памяти не строится.
Обратите внимание, что каждый процесс записывает строки во все временные файлы; запись синхронизируется.
Затем рабочие процессы параллельно читают второй набор данных и также разбивают его на пакеты и записывают во временные файлы.
Таким образом, при N пакетах на диск записываются 2N файлов.
Page 30: Сопоставление
 {#source-figure-030 caption=“Source slide page 30: Сопоставление”}
Комментарии преподавателя
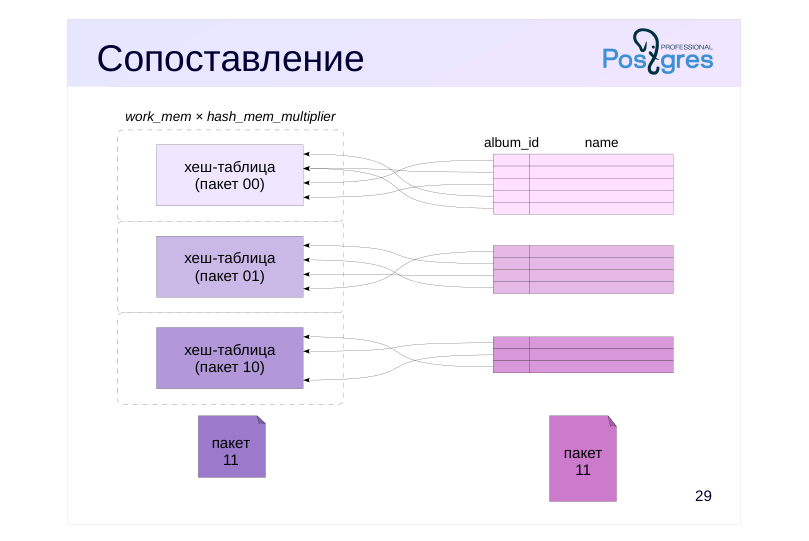
Затем каждый рабочий процесс выбирает себе по одному пакету.
Процесс загружает первый набор выбранного пакета в хеш-таблицу в памяти. В этом алгоритме у каждого процесса своя хеш-таблица размером work_mem × hash_mem_multiplier, но располагаются они в общей памяти, то есть доступ к каждой таблице есть у всех рабочих процессов.
После заполнения хеш-таблицы процесс читает второй набор выбранного пакета и сопоставляет строки.
Когда процесс завершает обработку одного пакета, он выбирает следующий, еще не обработанный.
Page 31: Сопоставление
 {#source-figure-031 caption=“Source slide page 31: Сопоставление”}
Комментарии преподавателя
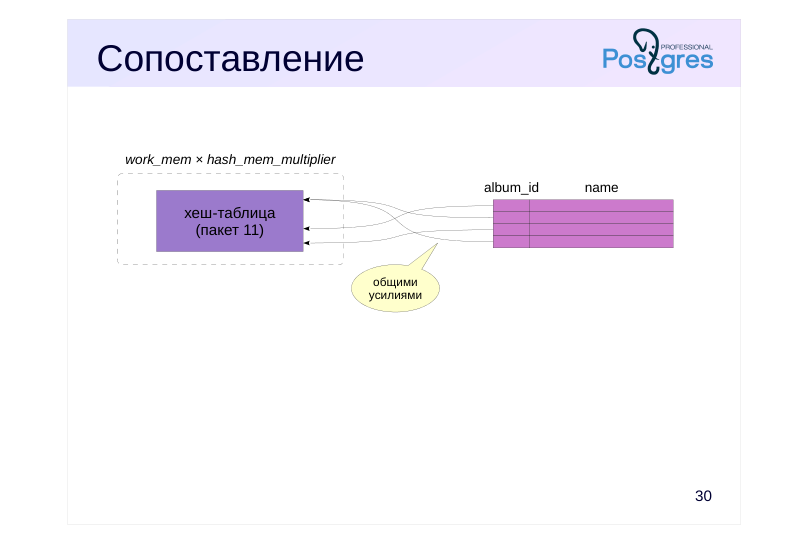
Когда необработанные пакеты заканчиваются, освободившийся процесс подключается к обработке одного из еще не завершенных пакетов, пользуясь тем, что все хеш-таблицы находятся в разделяемой памяти.
Несколько хеш-таблиц работают лучше, чем одна большая: в этом случае проще организовать совместную работу и меньше ресурсов тратится на синхронизацию.
Page 32: Двухпроходное параллельное хеш-соединение
Теперь уменьшим объем памяти:
Выполним тот же запрос с агрегацией:
Соединение стало двухпроходным с четырьмя пакетами.
Page 33: Итоги
Соединение хешированием требует подготовки
- надо построить хеш-таблицу
- Эффективно для больших выборок
- в том числе есть возможность параллельного соединения
- Зависит от порядка соединения
- внутренний набор должен быть меньше внешнего,
- чтобы минимизировать хеш-таблицу
- Поддерживает только эквисоединения
- для хеш-кодов операторы «больше» и «меньше» не имеют смысла
Комментарии преподавателя
В отличие от соединения вложенным циклом, хеш-соединение требует подготовки: построения хеш-таблицы. Пока таблица не построена, ни одна результирующая строка не может быть получена.
Зато соединение хешированием эффективно работает на больших объемах данных. Оба набора строк читаются последовательно и только один раз (два раза в случае нехватки оперативной памяти).
Ограничением соединения хеширования является поддержка только эквисоединений. Дело в том, что хеш-значения можно сравнивать только на равенство, операции «больше» и «меньше» просто не имеют смысла.
Page 34: Практика
- Напишите запрос, показывающий занятые места в салоне для всех рейсов. Какой способ соединения выбрал планировщик? Проверьте, хватило ли оперативной памяти для размещения хеш-таблиц. 2. Измените запрос, чтобы он выводил только общее количество занятых мест. Как изменился план запроса? Почему планировщик не использовал аналогичный план для предыдущего запроса? 3. Напишите запрос, показывающий имена пассажиров и номера рейсов, которыми они следуют. Разберитесь по плану запроса, в какой последовательности выполняются операции.
Комментарии преподавателя
Для этого достаточно соединить рейсы (flights) с посадочными талонами (boarding_passes).
Такой запрос должен соединять три таблицы: билеты (tickets), перелеты (ticket_flights) и рейсы (flights).
Page 35: 1. Список занятых мест
Использовано соединение хешированием.
Хеш-таблица не поместилась целиком в память, потребовалось два пакета.
2. Количество занятых мест
Здесь планировщик использовал параллельный план. В предыдущем запросе это не было оправдано из-за высокой стоимости пересылки данных между процессами, а в данном случае передается только одно число.
Page 36: Page 36
Обратите внимание на поле loops в узлах выше и ниже Gather — оно соответствует реальному числу процессов, работавших над запросом.
3. Пассажиры и номера рейсов
Сначала выполняется соединение билетов (tickets) с перелетами (ticket_flights), причем хеш-таблица строится по таблице билетов. Затем рейсы (flights) соединяются с результатом первого соединения; хеш-таблица строится по таблице рейсов.