08 Занятие 08: Способы соединения / Соединение вложенным циклом
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_08_join_nestloop.html Archive: QPT-handouts-16.zip Страниц PDF: 27
Page 1: Способы соединения / Соединение вложенным циклом
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Общие соображения о соединениях
- Соединение вложенным циклом
- Модификации: левые, полу-и анти-соединения
- Мемоизация
- Вычислительная сложность
- Вложенный цикл в параллельных планах
Page 3: Соединения
Способы соединения — не соединения SQL
- inner/left/right/full/cross join, in, exists — логические операции
- способы соединения — механизм реализации
- Соединяются не таблицы, а наборы строк
- могут быть получены от любого узла дерева плана
- Наборы строк соединяются попарно
- порядок соединений важен с точки зрения производительности
- обычно важен и порядок внутри пары
Комментарии преподавателя
Мало получать данные с помощью рассмотренных методов доступа, надо еще и уметь соединять их. Для этого PostgreSQL предоставляет несколько способов.
Способы соединения представляют собой алгоритмы для соединения двух наборов строк. С их помощью реализуются и другие конструкции языка SQL, например, EXISTS. Не стоит путать одно с другим: SQL-соединения — это логические операции над двумя множествами; способы соединения PostgreSQL — это возможные реализации таких соединений, учитывающие производительность.
Часто можно услышать, что соединяются таблицы. Это удобное упрощение, но на самом деле в общем случае соединяются наборы строк. Эти наборы действительно могут быть получены непосредственно из таблицы (с помощью одного из методов доступа), но с тем же успехом могут, например, являться результатом соединения других наборов строк.
Наконец, наборы строк всегда соединяются попарно. Порядок, в котором соединяются таблицы, в большинстве случаев не влияет на результат запроса (например, a join b join c или b join c join a), но очень сильно влияет на производительность. Как мы увидим дальше, важен и порядок, в котором соединяются два набора строк (a join b или b join a).
Page 4: Nested Loop
 {#source-figure-004 caption=“Source slide page 4: Nested Loop”}
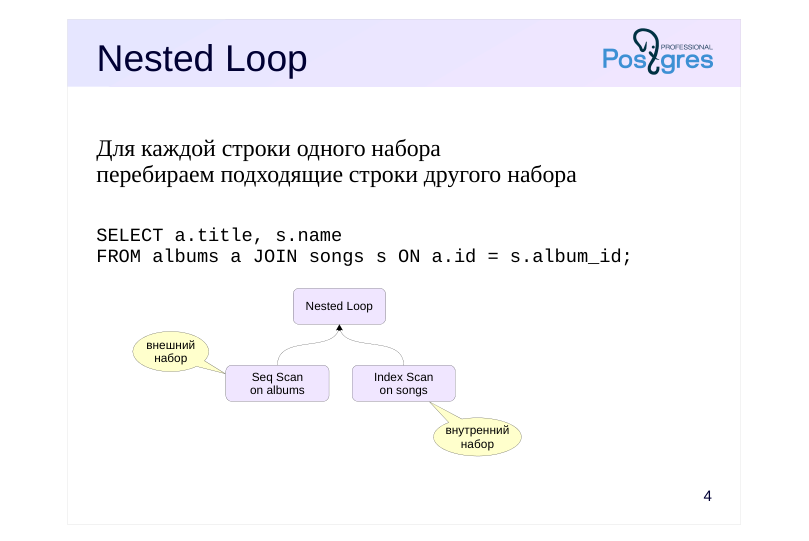
Для каждой строки одного набора перебираем подходящие строки другого набора
Комментарии преподавателя
Начнем с соединения вложенными циклами (nested loop), как с самого простого. Его алгоритм таков: для каждой строки одного из наборов перебираем и возвращаем соответствующие ему строки второго набора. По сути, это два вложенных цикла, отсюда и название способа.
Заметим, что ко второму (внутреннему) набору мы будем обращаться столько раз, сколько строк в первом (внешнем) наборе. Если нет эффективного метода доступа для поиска соответствующих строк во втором наборе (то есть, попросту говоря, индекса на таблице), придется неоднократно перебирать большое количество строк, не относящихся к делу. Очевидно, это будет не лучший выбор, хотя для небольших наборов алгоритм и в этом случае может оказаться достаточно эффективным.
В плане запроса мы будем видеть узел Nested Loop с двумя дочерними узлами (которые могут представлять не только методы доступа, но и другие операции, например, соединения или агрегации).
Page 5: Nested Loop
 {#source-figure-005 caption=“Source slide page 5: Nested Loop”}
Комментарии преподавателя
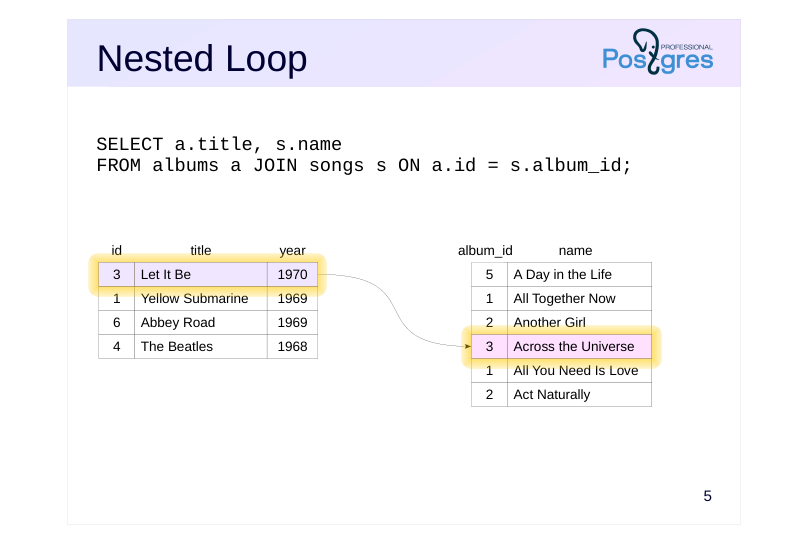
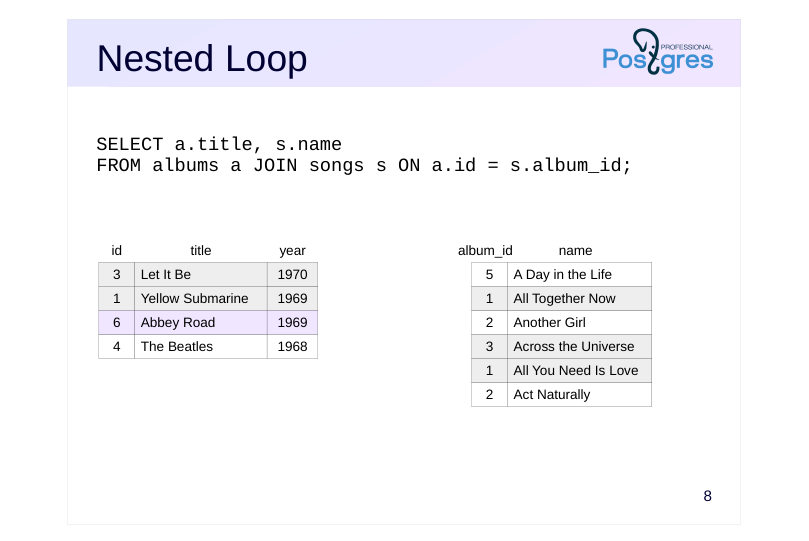
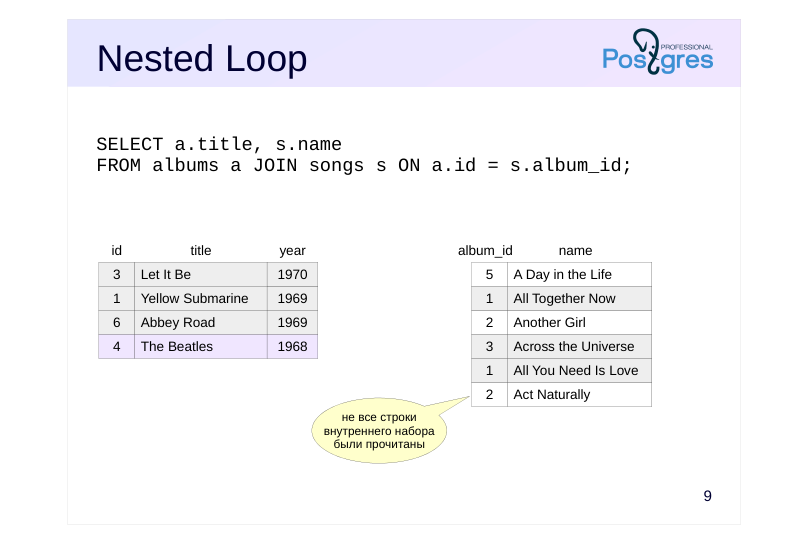
Рисунки иллюстрируют этот способ соединения. На них: • строки, к которым ранее уже был доступ, показаны серым; • строки, доступ к которым выполняется на текущем шаге, выделены цветом; • оранжевым контуром выделены строки, составляющие пару, подходящую по условию соединения (в данном примере — по равенству числовых идентификаторов).
Сначала мы читаем первую строку первого набора и находим ее пару во втором наборе. Соответствие нашлось, и у нас уже есть первая строка результата, которую можно вернуть вышестоящему узлу плана: («Let It Be», «Across the Universe»).
Page 6: Nested Loop
 {#source-figure-006 caption=“Source slide page 6: Nested Loop”}
Комментарии преподавателя
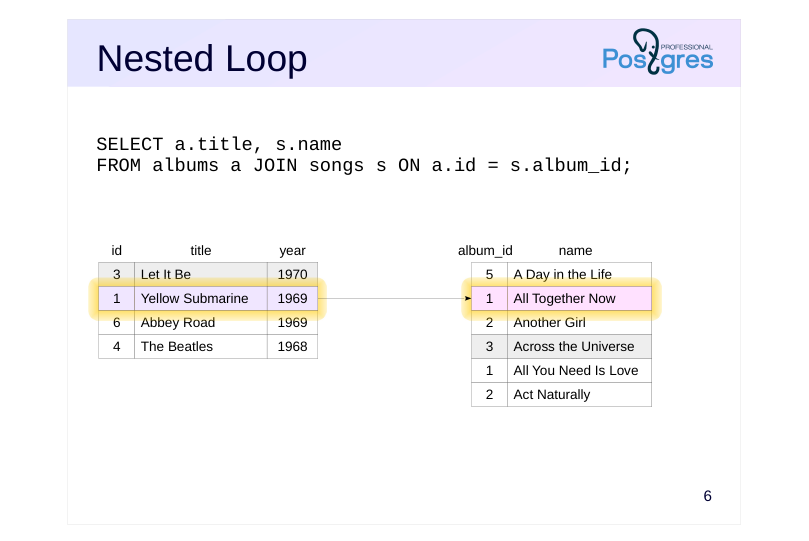
Читаем вторую строку первого набора.
Для нее тоже перебираем пары из второго набора. Сначала возвращаем («Yellow Submarine», «All Together Now»)…
Page 7: Nested Loop
 {#source-figure-007 caption=“Source slide page 7: Nested Loop”}
Комментарии преподавателя
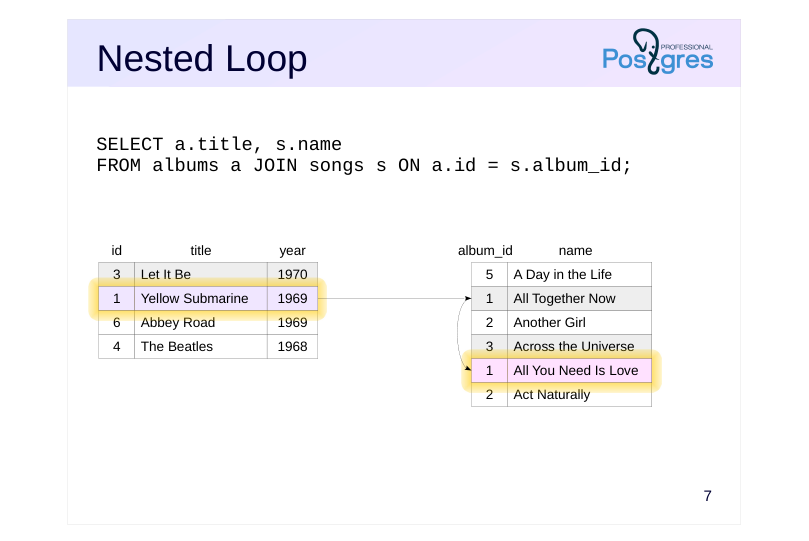
…затем вторую пару («Yellow Submarine», «All You Need Is Love»).
Page 8: Nested Loop
 {#source-figure-008 caption=“Source slide page 8: Nested Loop”}
Комментарии преподавателя
Переходим к третьей строке первого набора. Для нее соответствий нет.
Page 9: Nested Loop
 {#source-figure-009 caption=“Source slide page 9: Nested Loop”}
Комментарии преподавателя
Для четвертой строки тоже нет соответствий. На этом работа соединения заканчивается.
Часть строк второго набора мы вообще не рассматривали — на рисунке они остались белыми.
(С исходным кодом алгоритма можно ознакомиться в файле src/backend/executor/nodeNestloop.c.)
Page 10: Соединение вложенным циклом
Так выглядит план для соединения вложенным циклом, которое оптимизатор обычно предпочитает для небольших выборок (смотрим перелеты, включенные в два билета):
Планировщик использует параметризованное соединение. Для каждой строки внешнего набора (узел Index Scan по таблице билетов) выбираются строки из внутреннего набора (узел Index Scan по таблице перелетов), отвечающие условию соединения. На каждой итерации внешнего цикла условие индексного доступа для внутреннего набора имеет вид ticket_no = константа. Процесс повторяется до тех пор, пока внешний набор не исчерпает все строки. Команда EXPLAIN ANALYZE позволяет узнать, сколько раз на самом деле выполнялся вложенный цикл (loops), сколько в среднем было выбрано строк (rows) и сколько потрачено времени (time) за один раз. Видно, что планировщик немного ошибся — в итоге получилось 8 строк вместо 6:
Вот еще один пример соединения вложенным циклом. Здесь мы выводим самолеты, способные обслуживать перелеты заданной протяженности:
Это непараметризованное соединение: для каждой строки внешнего набора придется читать весь внутренний набор (про узел Materialize мы будем говорить позже; в данном случае это просто значения из VALUES) и для полученных пар строк проверять условие Join Filter. По сути, это декартово произведение двух наборов строк с фильтрацией. Обратите внимание, что соединение вложенным циклом позволяет соединять строки по любому условию, не обязательно по равенству значений.
Page 11: Модификации
Существует несколько модификаций алгоритма. Для левого соединения:
Эта модификация возвращает строки, даже если для левого (a) набора строк не нашлось соответствия в правом (s) наборе. Антисоединение возвращает те строки одного набора, для которых не нашлось соответствия в другом наборе. Такая модификация может использоваться для обработки предиката NOT EXISTS:
Та же операция антисоединения используется и для аналогичного запроса, записанного иначе:
Для предиката EXISTS может использоваться полусоединение, которое возвращает строки одного набора, для которых нашлось хотя бы одно соответствие в другом наборе:
Page 12: Page 12
Обратите внимание: хотя в плане для таблицы s указано rows=149, на самом деле достаточно получить всего одну строку, чтобы понять значение предиката EXISTS. PostgreSQL так и делает (actual rows=1):
Модификаций алгоритма вложенного цикла для правого (RIGHT) и полного (FULL) соединений не существует. Это связано с тем, что полный проход по второму набору строк может не выполняться.
Page 13: Мемоизация
 {#source-figure-013 caption=“Source slide page 13: Мемоизация”}
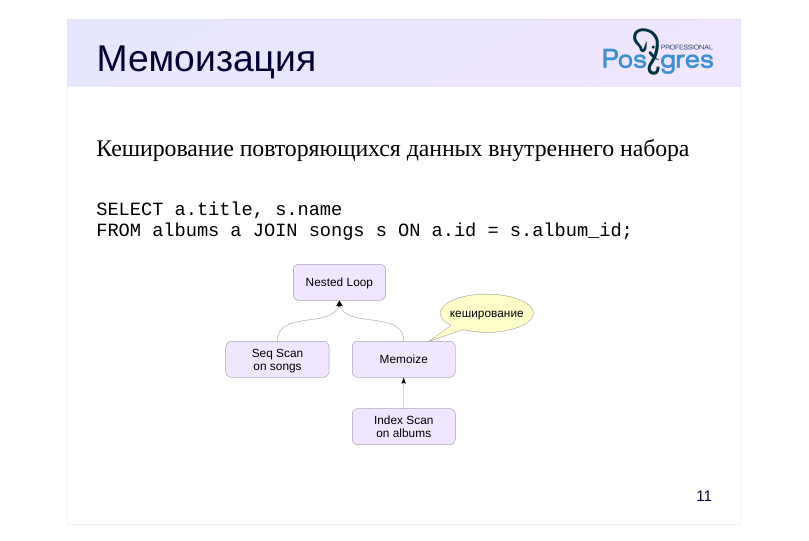
Кеширование повторяющихся данных внутреннего набора
Комментарии преподавателя
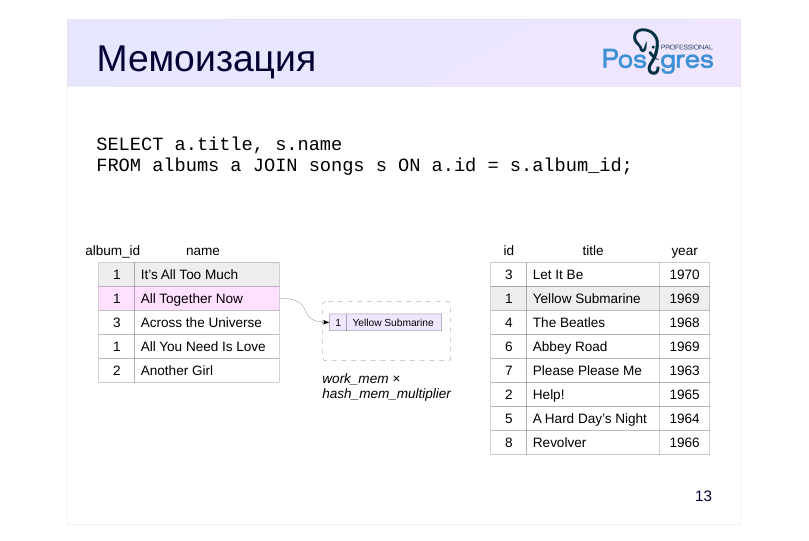
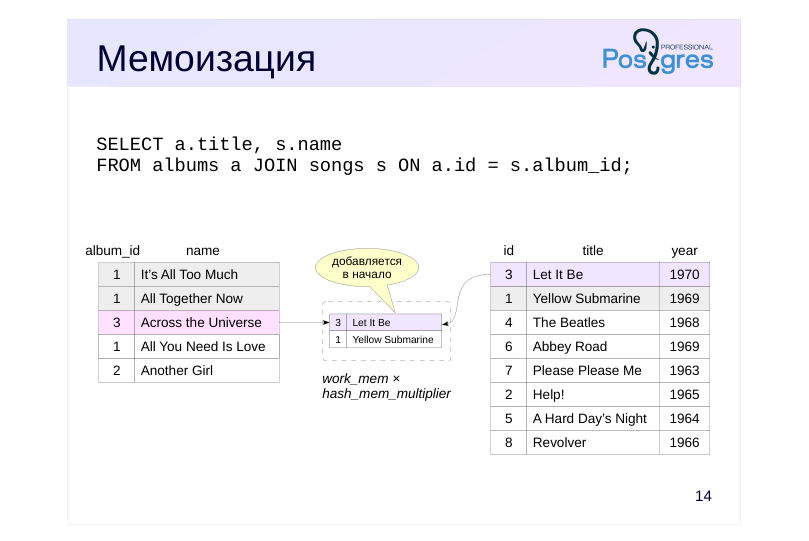
Если внутренний набор сканируется много раз с повторяющимися значениями параметров, иногда имеет смысл закешировать результат, чтобы не читать много раз одни и те же данные. Эта операция называется мемоизацией. Она выполняется в узле Memoize, который встраивается между Nested Loop и узлом, поставляющим данные.
(Если планировщик ошибается в своих расчетах, мемоизацию можно отключить, установив параметр enable_memoize в значение off.)
Для кеширования используется хеш-таблица. Ключом хеширования служит параметр или несколько параметров, с которыми выполняется обращение к внутреннему набору.
Page 14: Мемоизация
 {#source-figure-014 caption=“Source slide page 14: Мемоизация”}
album_id
Комментарии преподавателя
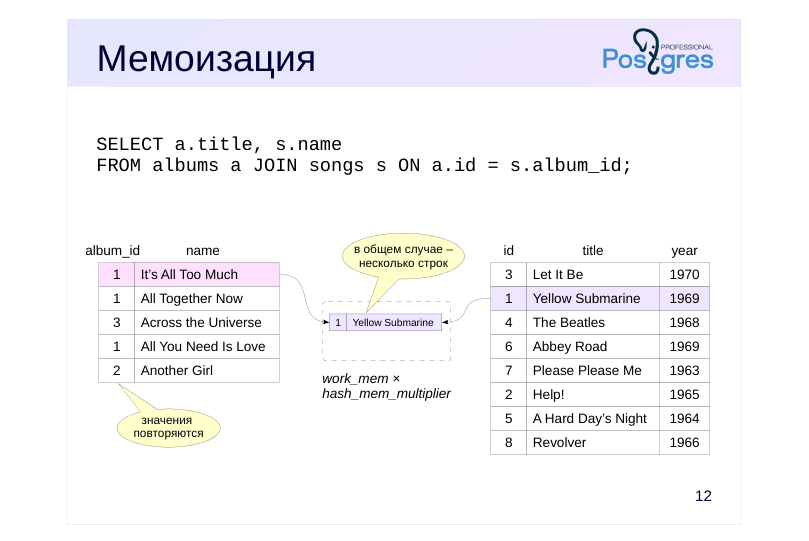
Рассмотрим пример. В отличие от предыдущего, здесь песен меньше, чем альбомов; к тому же, почти все они относятся к одному и тому же альбому.
Если необходимой строки нет в хеш-таблице, узел Memoize читает ее из внутреннего набора, сохраняет в кеше и возвращает родительскому узлу Nested Loop.
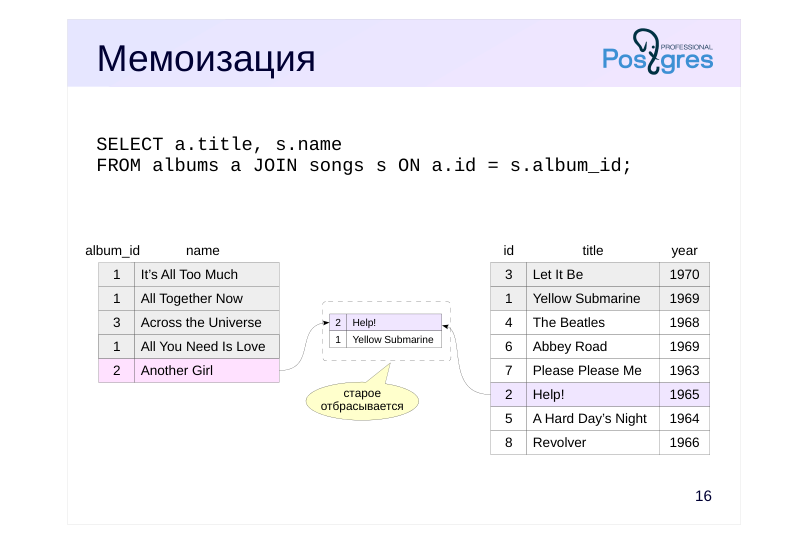
В общем случае значению параметра могут соответствовать несколько строк из внутреннего набора — будут закешированы все эти строки. Если все они не помещаются в память (которая ограничена размером work_mem × hash_mem_multiplier), значение параметра игнорируется, поскольку кешировать только часть строк нет смысла. В плане запроса количество таких ситуаций будет показано как overflow.
Page 15: Мемоизация
 {#source-figure-015 caption=“Source slide page 15: Мемоизация”}
album_id
Комментарии преподавателя
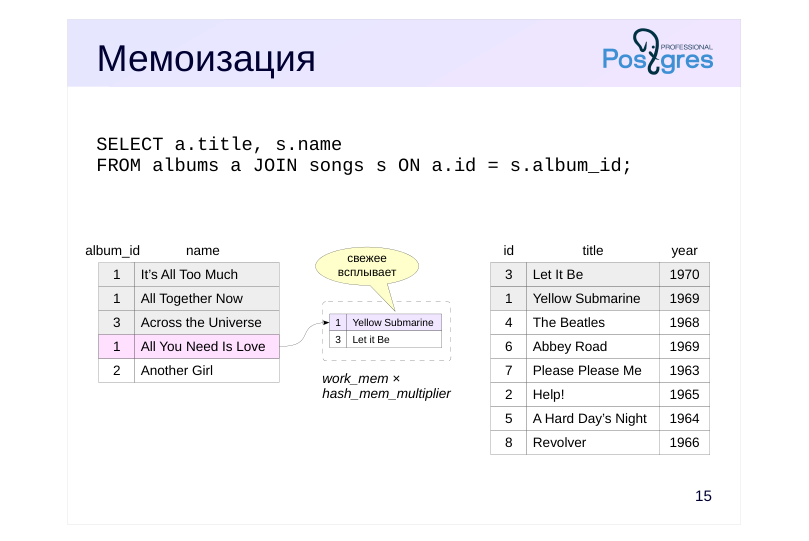
Если необходимая строка уже есть в кеше, узел Memoize сразу возвращает ее узлу Nested Loop. Обращения к внутреннему набору не происходит.
Page 16: Мемоизация
 {#source-figure-016 caption=“Source slide page 16: Мемоизация”}
album_id
Комментарии преподавателя
Пока в кеше хватает места, новые значения продолжают кешироваться. При этом новое значение добавляется в начало кеша.
Page 17: Мемоизация
 {#source-figure-017 caption=“Source slide page 17: Мемоизация”}
album_id
Комментарии преподавателя
Уже закешированное значение «всплывает наверх», когда к нему обращаются, а остальные, соответственно, опускаются вниз.
Page 18: Мемоизация
 {#source-figure-018 caption=“Source slide page 18: Мемоизация”}
album_id
Комментарии преподавателя
Если память заканчивается, из кеша удаляются «нижние» строки, к которым дольше всего не было обращений. Таким образом реализуется алгоритм вытеснения LRU.
Page 19: Мемоизация
Посмотрим план запроса, в котором соединяются таблицы перелетов и модели самолетов. Пример подобран таким образом, что из внутреннего набора (таблица aircrafts_data) будет получена только одна строка по ключу f.aircraft_code (Cache Key), она и будет закеширована в узле Memoize:
Обратите внимание: в первый раз за нужной строкой приходится сходить в таблицу (Misses: 1); все повторные обращения обслуживаются кешем (Hits: 112), для этого хватило одного килобайта памяти; вытеснений из кеша не было (Evictions: 0); строки, выбранные из внутреннего набора, всегда умещались в выделенную память (Overflows: 0).
Page 20: Вычислительная сложность
~ N × M, где
- N — число строк во внешнем наборе данных,
- M — среднее число строк внутреннего набора,
- приходящееся на одну итерацию
- Соединение эффективно только для небольшого числа строк
Комментарии преподавателя
Если принять за N число строк во внешнем наборе данных, а за M — среднее число строк внутреннего набора, приходящееся на одну итерацию, то общая сложность соединения будет пропорциональна произведению N × M.
Для непараметризованного соединения M будет в точности равно числу строк внутреннего набора; для параметризованного — M может быть значительно меньше.
Метод соединения вложенным циклом эффективен только для небольшого числа строк. В частности, такой метод (в сочетании с индексным доступом) характерен для OLTP-запросов, в которых надо очень быстро вернуть мало строк.
Page 21: Стоимость соединения вложенным циклом
Посмотрим на стоимость следующего плана выполнения:
Первый результат выдается сразу, без предварительных действий, поэтому начальная стоимость узла Nested Loop равна сумме начальных стоимостей дочерних узлов Index Scan. Полная стоимость узла Nested Loop складывается из: стоимости получения данных от внешнего набора (полная стоимость узла Index Scan по билетам); стоимости получения данных от внутреннего набора (полная стоимость узла Index Scan по перелетам), умноженной на расчетное число строк внешнего набора (2); стоимости процессорной обработки строк. В общем случае формула более сложная, но основной вывод: стоимость пропорциональна N × M, где N — число строк во внешнем наборе данных, а M — среднее число строк внутреннего набора, читаемое за одну итерацию. В худшем случае стоимость получается квадратичной.
Page 22: В параллельных планах
 {#source-figure-022 caption=“Source slide page 22: В параллельных планах”}
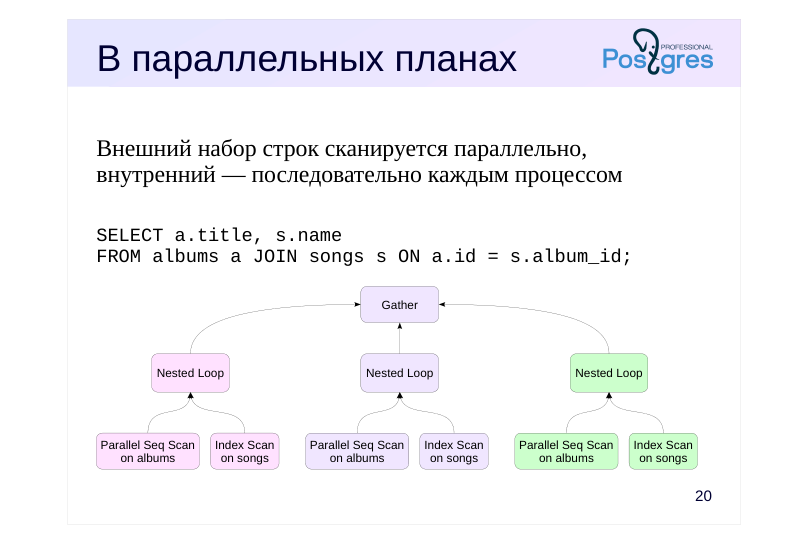
Внешний набор строк сканируется параллельно, внутренний — последовательно каждым процессом
Комментарии преподавателя
Соединение вложенным циклом может использоваться в параллельных планах.
Внешний набор строк сканируется несколькими рабочими процессами параллельно. Получив строку из внешнего набора, процесс затем перебирает соответствующие ему строки внутреннего набора последовательно.
Page 23: В параллельных планах
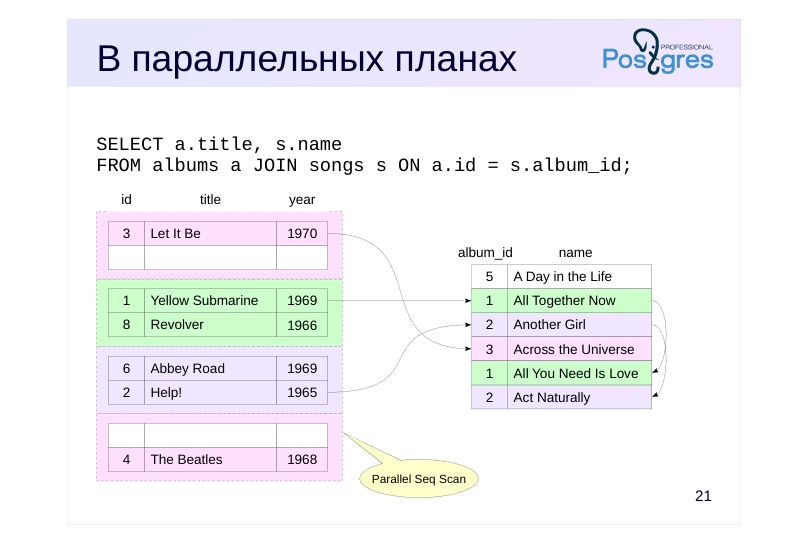 {#source-figure-023 caption=“Source slide page 23: В параллельных планах”}
Комментарии преподавателя
Чтобы получить очередную страницу из внешнего набора, процессы синхронизируются. К внутреннему набору данных каждый процесс обращается независимо от остальных.
Page 24: Вложенный цикл в параллельных планах
Найдем всех пассажиров, купивших билеты на определенный рейс:
На верхнем уровне используется соединение вложенным циклом. Внешний набор данных состоит из одной строки, полученной из таблицы рейсов (flights) по уникальному индексу. Для получения внутреннего набора используется параллельный план. Каждый из процессов читает свою часть таблицы перелетов (ticket_flights) и соединяет ее с билетами (tickets) с помощью другого вложенного цикла.
Page 25: Итоги
Вложенный цикл не требует подготовительных действий
- может отдавать результат соединения без задержек
- Эффективен для небольших выборок
- внешний набор строк не очень велик
- к внутреннему есть эффективный доступ (обычно по индексу)
- Зависит от порядка соединения
- обычно лучше, если внешний набор меньше внутреннего
- Поддерживает соединение по любому условию
- как эквисоединения, так и любые другие
Комментарии преподавателя
Сильной стороной способа соединения вложенными циклами является его простота: не требуется никаких подготовительных действий, мы можем начать возвращать результат практически моментально.
Обратная сторона состоит в том, что этот способ крайне неэффективен для больших объемов данных. Ситуация та же, что и с индексами: чем больше выборка, тем больше накладных расходов.
Таким образом, соединение вложенными циклами имеет смысл применять, если:
● один из наборов строк небольшой;
● к другому набору есть эффективный доступ по условию соединения;
● общее количество строк результата невелико.
Это обычная ситуация для OLTP-запросов (например, запросов от пользовательского интерфейса, где веб-страница или экранная форма должны открыться быстро и не выводят большой объем информации).
Еще одна особенность, которую стоит отметить: соединение вложенными циклами может работать для любого условия соединения. Подходит как эквисоединение (по условию равенства, как в примере), так и любое другое.
Page 26: Практика
- Создайте индекс на таблице рейсов (flights) по аэропортам отправления (departure_airport). Найдите все рейсы из Ульяновска и проверьте план выполнения запроса. 2. Постройте таблицу расстояний между всеми аэропортами (так, чтобы каждая пара встречалась только один раз). Какой способ соединения используется в таком запросе?
Комментарии преподавателя
- Используйте оператор <@> из расширения earthdistance.
Page 27: 1. Рейсы из Ульяновска
Индекс на таблице рейсов:
План запроса:
Планировщик использовал соединение вложенным циклом. Заметим, что в данном случае соединение необходимо, так как в Ульяновске два аэропорта:
2. Таблица расстояний между аэропортами
Чтобы отсечь повторяющиеся пары, можно соединить таблицы по условию «больше»:
Вложенный цикл — единственный способ соединения для такого условия.