07 Занятие 07: Сортировка и группировка / Группировка
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_07_sort_group.html Archive: QPT-handouts-16.zip Страниц PDF: 23
Page 1: Сортировка и группировка / Группировка
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Применение группировки
- Группировка хешированием
- Группировка сортировкой
- Комбинированная группировка
- Группировка в параллельных планах
- Оконные функции
Page 3: Применение группировки
Явное указание
- GROUP BY
- Исключение дубликатов
- DISTINCT
- UNION, INTERSECT, EXCEPT
Комментарии преподавателя
В SQL-запросе набор строк можно сгруппировать с помощью предложения GROUP BY, в сочетании с которым обычно используются агрегатные функции, обрабатывающие все строки группы. Похожую возможность для оконных функций дает предложение PARTITION BY.
Группировка может выполняться и неявно при устранении дубликатов в запросе со словом DISTINCT или с командами обработки двух наборов строк (UNION, INTERSECT, EXCEPT без слова ALL), которые удаляют дубликаты.
Сервер выбирает один из доступных способов группировки, учитывая имеющиеся ресурсы, возможность получить отсортированные данные для ключа группировки и другие факторы.
Page 4: Применение группировки
Выполним запрос, явно группирующий строки таблицы seats по классам обслуживания:
Теперь получим все различные классы обслуживания:
В третьем (исключительно учебном) примере дважды получим все строки таблицы seats и объединим их с помощью команды UNION:
Результаты всех трех запросов одинаковы, и во всех планах есть узел HashAggregate.
Page 5: Группировка хешированием
 {#source-figure-005 caption=“Source slide page 5: Группировка хешированием”}
Комментарии преподавателя
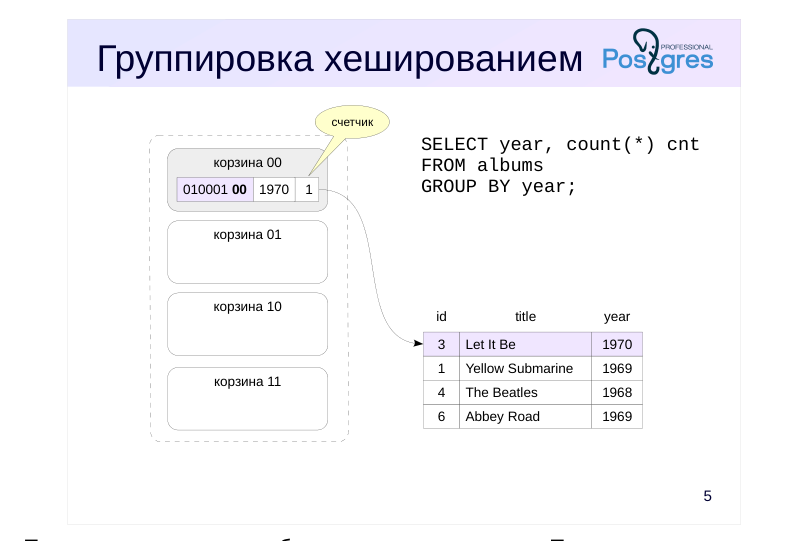
Про идею хеширования было рассказано в теме «Типы индексов». При группировке значений может использоваться похожий принцип.
В примере на слайде показано, как вычисляется значение агрегатной функции count при группировке по полю year. Сервер получает и по очереди обрабатывает строки таблицы.
Предварительно рассчитывается количество корзин — степень числа 2, и определяется число разрядов хеш-кода, содержащих номер корзины. В примере на слайде это два последних разряда.
Для строки вычисляется хеш-функция от значения year. По хеш-коду определяется номер корзины и в хеш-таблицу добавляется запись с хеш-кодом, если его еще нет в таблице.
Поскольку в нашем примере вычисляется значение агрегатной функции count, в каждой записи хеш-таблицы дополнительно хранится счетчик, который увеличивается при обработке очередной строки.
В нашем примере первая строка порождает новую запись в корзине 00.
Page 6: Группировка хешированием
 {#source-figure-006 caption=“Source slide page 6: Группировка хешированием”}
Комментарии преподавателя
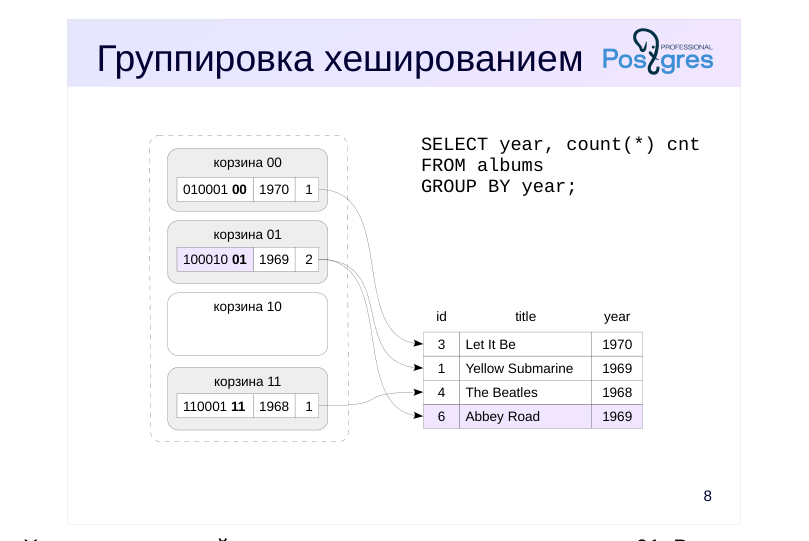
Вторая строка попадает в корзину 01 и порождает в ней новую запись.
Page 7: Группировка хешированием
 {#source-figure-007 caption=“Source slide page 7: Группировка хешированием”}
Комментарии преподавателя
Третья строка порождает новую запись в корзине 11.
Page 8: Группировка хешированием
 {#source-figure-008 caption=“Source slide page 8: Группировка хешированием”}
Комментарии преподавателя
Хеш-код последней строки попадает в корзину с номером 01. В корзине уже есть запись с таким значением ключа, поэтому сервер увеличивает значение ее счетчика на единицу. На этом обработка таблицы завершается: в хеш-таблице собрались все уникальные значения. Алгоритм возвращает сами значения и их количество.
Такой же алгоритм (с незначительными модификациями) используется и для получения уникальных записей без вычисления агрегатной функции, и при вычислении других агрегатных функций.
Page 9: Группировка хешированием
Узел, который отвечает за агрегацию методом хеширования, обозначается в плане выполнения как HashAggregate:
Обратите внимание на начальную стоимость: результаты начинают выдаваться только после построения хеш-таблицы по всем строкам. Выполнив запрос, можно увидеть объем памяти, выделенной под хеш-таблицу:
Page 10: Хеш-группировка и пакеты
 {#source-figure-010 caption=“Source slide page 10: Хеш-группировка и пакеты”}
Комментарии преподавателя
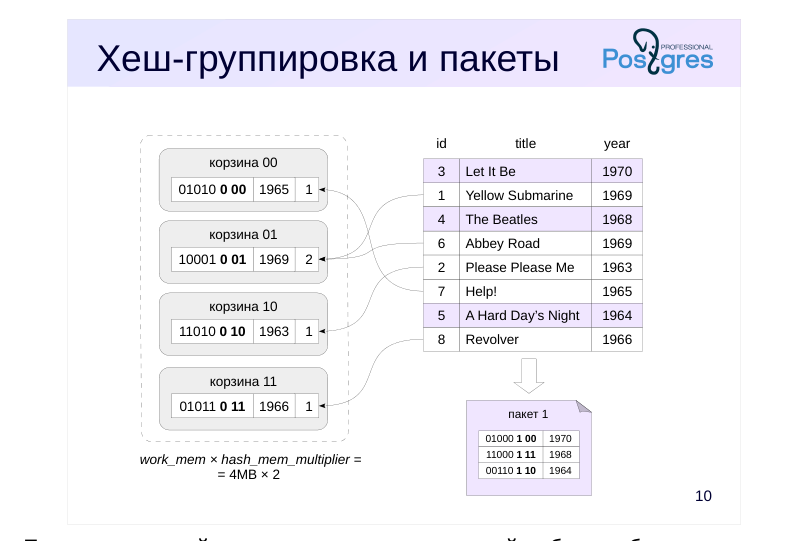
Если выделенной памяти не хватает, исходный набор разбивается на части (пакеты), так чтобы хеш-таблица для каждого пакета умещалась в оперативной памяти. Расчетное количество пакетов — степень числа 2; в хеш-коде выделяется нужное количество битов, которые определяют принадлежность записи пакету (на слайде два пакета, поэтому достаточно одного бита). Хеш-таблица для пакета 0 располагается в оперативной памяти, строки остальных пакетов помещаются во временные файлы — каждый пакет в свой файл.
Использование временных файлов значительно снижает производительность, и при хешировании этот эффект проявляется сильнее, чем для других алгоритмов. Поэтому при группировке хешированием выделяется work_mem × hash_mem_multiplier оперативной памяти — по умолчанию вдвое больше, чем обычно.
Page 11: Хеш-группировка и пакеты
 {#source-figure-011 caption=“Source slide page 11: Хеш-группировка и пакеты”}
Комментарии преподавателя
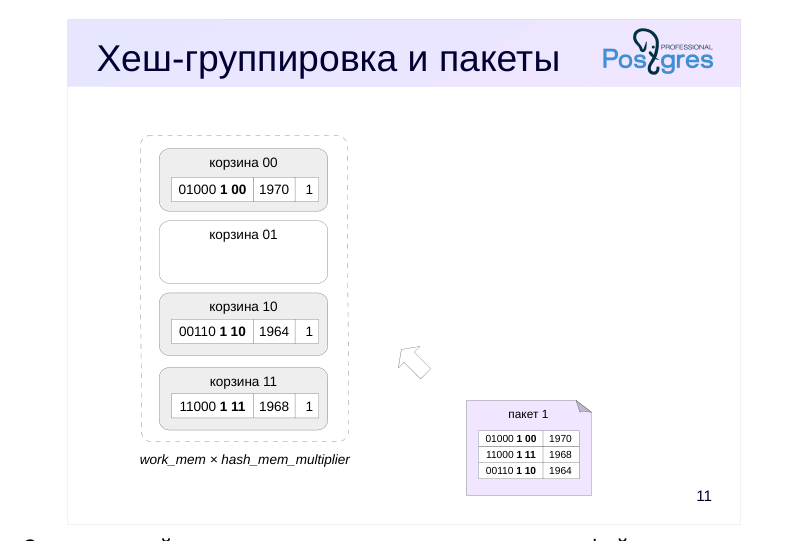
Затем каждый из пакетов, записанных во временные файлы, читается в память и формирует новую хеш-таблицу.
После обработки всех исходных строк, а также каждого из дополнительных пакетов сервер может возвращать частичные результаты (строки для каждой группы всегда находятся в одном пакете).
Page 12: Хеш-группировка и пакеты
Рассмотрим план другого запроса, с группировкой по большой таблице:
В плане появилось предложение Planned Partitions — оптимизатор предполагает, что хеш-таблица не поместится в выделенную память и придется разбивать ее на пакеты. Выполним запрос:
При выполнении размер одного из пакетов оказался слишком велик, поэтому он был дополнительно разбит на два более мелких пакета. Общее количество пакетов (Batches) увеличилось по сравнению с расчетным.
Page 13: Группировка сортировкой
 {#source-figure-013 caption=“Source slide page 13: Группировка сортировкой”}
Комментарии преподавателя
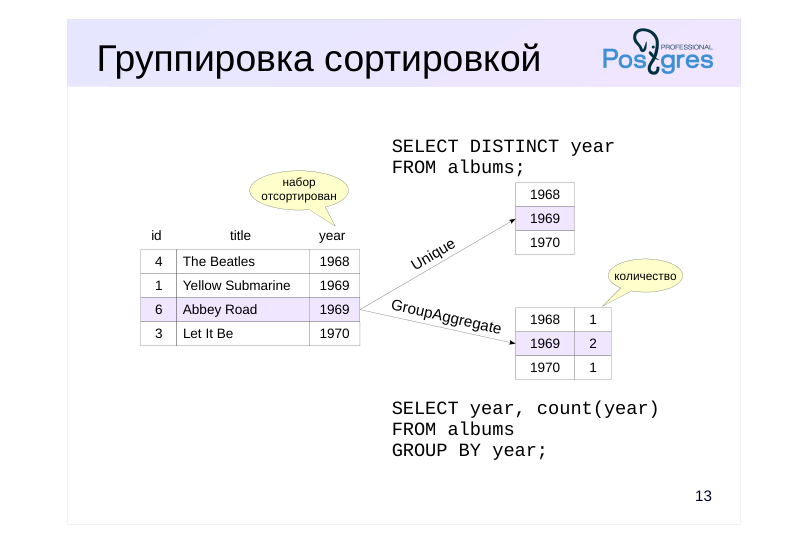
Исключение дубликатов и группировка могут выполняться не только путем хеширования, но и с помощью сортировки. В этом случае требуется набор данных, предварительно отсортированный по полям группировки.
Узел Unique устраняет дубликаты, добавляя к результату очередное значение, если оно не совпадает с предыдущим.
Узел GroupAggregate возвращает агрегированные данные. В примере на слайде узел строит список различных значений поля year, подсчитывая, сколько раз встретилось каждое из них в наборе данных.
Как было рассмотрено в предыдущей теме, упорядоченный набор строк может быть получен с помощью индексного доступа или в результате сортировки в узле Sort. В первом случае узлы Unique и GroupAggregate обычно более выгодны, чем HashAggregate, поскольку выполняются быстро и не требуют много памяти. Однако во втором случае построение хеш-таблицы, как правило, эффективнее сортировки.
В отличие от HashAggregate, оба узла: Unique и GroupAggregate – возвращают упорядоченные данные.
Page 14: Группировка сортировкой
Пример плана с узлом GroupAggregate, в котором происходит группировка отсортированного набора:
В этом запросе сортировку набора данных обеспечивает индексный доступ. Запрос с DISTINCT использует для устранения дубликатов узел Unique:
Поскольку узел возвращает результаты, упорядоченные так же, как требует предложение ORDER BY, дополнительная сортировка не требуется.
Комбинированная группировка
При группировке по нескольким наборам полей (которая возникает при использовании конструкций GROUPING SETS, CUBE или ROLLUP в предложении GROUP BY) может оказаться выгодным совместно использовать группировку хешированием и группировку сортировкой. В плане запроса такая комбинированная группировка отображается в виде узла MixedAggregate. В качестве примера рассмотрим запрос к таблице перелетов, в котором подсчитывается и объединяется количество строк для трех различных вариантов группировки:
Узел MixedAggregate получает набор данных, отсортированный по столбцу fare_conditions. На первом этапе в процессе чтения набора выполняется группировка по столбцу fare_conditions (Group Key). По мере чтения строки переупорядочиваются по столбцу ticket_no и одновременно с этим записываются в хеш-таблицу с ключом amount. На втором этапе сканируется набор строк, отсортированный на предыдущем этапе по столбцу ticket_no, и значения группируются по этому же столбцу (Sort Key и вложенный Group Key). Наконец, сканируется хеш-таблица, подготовленная на первом этапе, и значения группируются по столбцу amount (Hash
Page 15: Page 15
Key).
Page 16: В параллельных планах
 {#source-figure-016 caption=“Source slide page 16: В параллельных планах”}
Комментарии преподавателя
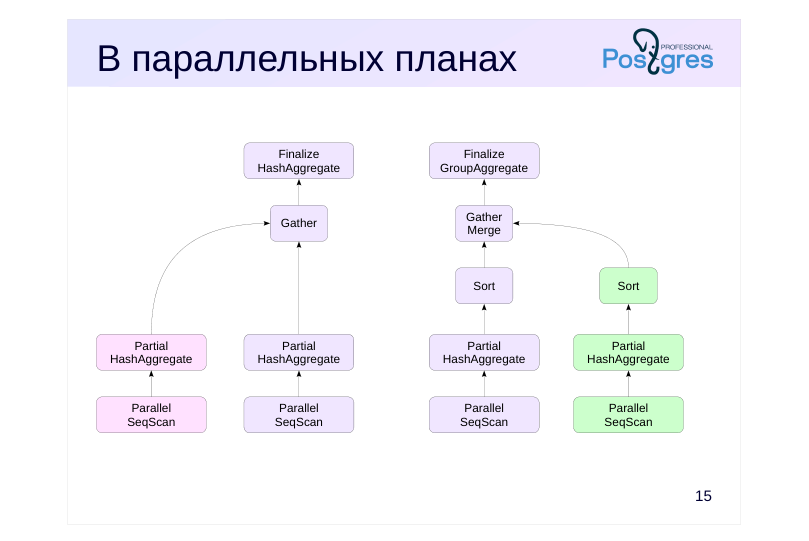
Агрегация не имеет специальной параллельной реализации, но может выполняться в параллельных планах. В этом случае каждый рабочий процесс агрегирует свою часть данных и передает результат узлу Gather, который собирает данные в единый набор. Следующий узел выполняет агрегацию объединенного набора и вычисляет значение агрегатной функции.
Пример такого плана показан на слайде слева. Обычно такой вариант выигрывает, если количество групп достаточно велико.
Если же групп немного, может оказаться выгодным отсортировать сгруппированные строки в каждом процессе. А дальше воспользоваться тем, что наборы упорядочены, и на последнем этапе выполнить более быструю группировку сортировкой.
Пример такого плана показан на слайде справа.
Page 17: В параллельных планах
Сгруппируем строки таблицы перелетов по рейсам (их, очевидно, много):
Здесь каждый процесс в узле Partial HashAggregate вычисляет агрегатную функцию по своим данным с помощью собственной хеш-таблицы. Ведущий процесс после сбора данных в узле Gather получает итоговое значение агрегата, объединяя группы в узле Finalize HashAggregate тоже с помощью хеширования. Теперь сгруппируем строки таблицы перелетов по стоимости. Количество групп будет небольшим:
Как будет выполняться такой запрос?
Поскольку групп немного, оказывается выгодным отсортировать результаты в каждом процессе (Sort), собрать их в ведущем процессе в один отсортированный набор (Gather Merge), а затем, объединяя группы, вычислить агрегатную
Page 18: Page 18
функцию (Finalize GroupAggregate).
Page 19: Оконные функции
 {#source-figure-019 caption=“Source slide page 19: Оконные функции”}
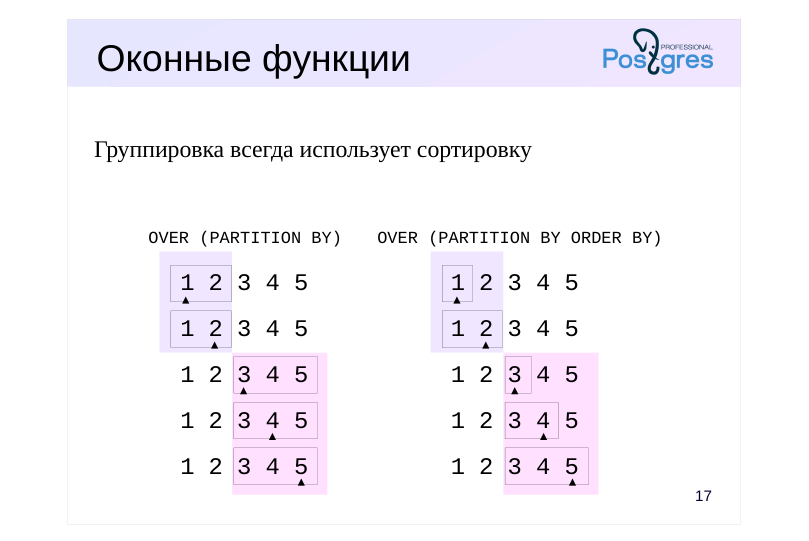
Группировка всегда использует сортировку
Комментарии преподавателя
Группировка используется и в оконных функциях.
Если определение окна включает конструкцию PARTITION BY, оконная функция вычисляется на основе групп строк (аналогично группировке GROUP BY).
Для каждой группы строк границы рамки меняются в своих пределах. Если при этом нет других указаний, для всех строк одной группы будет получено одинаковое значение функции.
Как и в примере из темы «Сортировка», указание ORDER BY упорядочивает строки в каждой группе; в этом случае предполагается, что рамка охватывает строки от первой до текущей.
В отличие от обычной группировки GROUP BY, группировка в определении окна всегда реализуется с помощью сортировки: план строится так, чтобы на вход узлу WindowAgg пришел набор строк, отсортированный сначала по ключам группировки PARTITION BY, а затем — по ключам сортировки ORDER BY. Хеширование не применяется даже в отсутствие конструкции ORDER BY.
Page 20: Итоги
Группировка происходит не только при агрегации, но и при устранении дубликатов
- Выполняется с помощью хеширования или сортировки
Page 21: Практика
- Как выполняется запрос, вычисляющий количество мест каждой категории в таблице seats? Попробуйте со значениями параметров по умолчанию, а затем запретите группировку хешированием. 2. Изучите запрос с оконной функцией и предложением PARTITION BY: SELECT status, count(*) OVER (PARTITION BY status) FROM flights WHERE flight_no = ‘PG0007’ AND departure_airport = ‘VKO’ AND flight_id BETWEEN 24104 AND 24115;
- Добавьте вызов функции row_number с тем же окном
- и сравните результаты и планы выполнения.
Комментарии преподавателя
- Запрос: SELECT fare_conditions, count(*) FROM seats GROUP BY fare_conditions;
Для запрета группировки хешированием установите параметр enable_hashagg в off.
Page 22: 1. Разные способы группировки
Сначала выполним запрос со значениями параметров по умолчанию:
Для группировки используется узел HashAggregate. Запретим группировку хешированием:
Повторно выполним запрос и сравним планы выполнения:
Теперь остается только вариант с узлом GroupAggregate, а для него приходится сортировать данные в узле Sort. Вернем значение по умолчанию:
2. Оконные функции и PARTITION BY
Приведенный запрос возвращает количество элементов в каждой группе:
В плане выполнения видно, что группировка обеспечивается тем же узлом WindowAgg, который мы видели при использовании конструкции ORDER BY в определении окна:
Page 23: Page 23
Добавим номер текущей строки в ее группе с помощью функции row_number():
Добавление новой функции с совпадающим окном не порождает новые узлы в плане: