06 Занятие 06: Сортировка и группировка / Сортировка
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_06_sort_sort.html Archive: QPT-handouts-16.zip Страниц PDF: 22
Page 1: Сортировка и группировка / Сортировка
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Получение отсортированных данных
- Сортировка в памяти
- Внешняя сортировка
- Инкрементальная сортировка
- Сортировка в параллельных планах
- Сортировка при построении индекса
- Оконные функции с сортировкой
Page 3: Получение данных
Индексный доступ (В-дерево)
- возвращает отсортированный набор строк
- Последовательный доступ (Seq Scan)
- возвращает неупорядоченный набор строк
- необходима дополнительная операция сортировки
Комментарии преподавателя
Как уже было сказано ранее, индексный доступ (при использовании B-дерева) позволяет сразу же получить набор строк, отсортированный по ключам индексирования.
Но что делать, если сортировка требуется по полям, для которых нет индекса? В этом случае серверу приходится сначала получить данные из таблицы с помощью последовательного сканирования, а затем выполнить дополнительную операцию сортировки.
Page 4: Получение отсортированных данных
Индексный доступ автоматически возвращает строки, отсортированные по проиндексированному столбцу:
Но если попросить сервер отсортировать данные по столбцу без индекса, потребуется два отдельных шага: получение данных и сортировка.
Дальше мы будем разбираться, как устроена сортировка в узле Sort.
Page 5: Сортировка в памяти
Быстрая сортировка (quick sort)
- Частичная пирамидальная сортировка (top-N heapsort)
- когда нужна только часть значений
Комментарии преподавателя
В идеальном случае набор строк, подлежащий сортировке, целиком помещается в память, ограниченную параметром work_mem. В этом случае все строки просто сортируются алгоритмом быстрой сортировки (quick sort) и результат возвращается родительскому узлу.
Если нужно получить лишь несколько первых строк отсортированного набора (при использовании предложения LIMIT), сортировать весь набор не обязательно. В этом случае сервер может применить частичную пирамидальную сортировку (top-N heapsort), которая также выполняется в оперативной памяти.
Page 6: Сортировка в памяти
В распоряжении планировщика имеется несколько методов сортировки. В следующем примере используется быстрая сортировка (Sort Method: quicksort). В той же строке указан объем использованной памяти:
Чтобы начать выдавать данные, узлу Sort нужно полностью отсортировать набор строк. Поэтому начальная стоимость узла включает в себя полную стоимость чтения таблицы. В общем случае сложность быстрой сортировки равна O(M logM), где M — число строк в исходном наборе. Если набор строк ограничен, планировщик может переключиться на частичную сортировку (грубо говоря, вместо полной сортировки здесь 100 раз находится минимальное значение):
Обратите внимание, что стоимость запроса снизилась и для сортировки потребовалось меньше памяти. В общем случае сложность алгоритма top-N heapsort ниже, чем для быстрой сортировки — она равна O(M logN).
Page 7: Внешняя сортировка
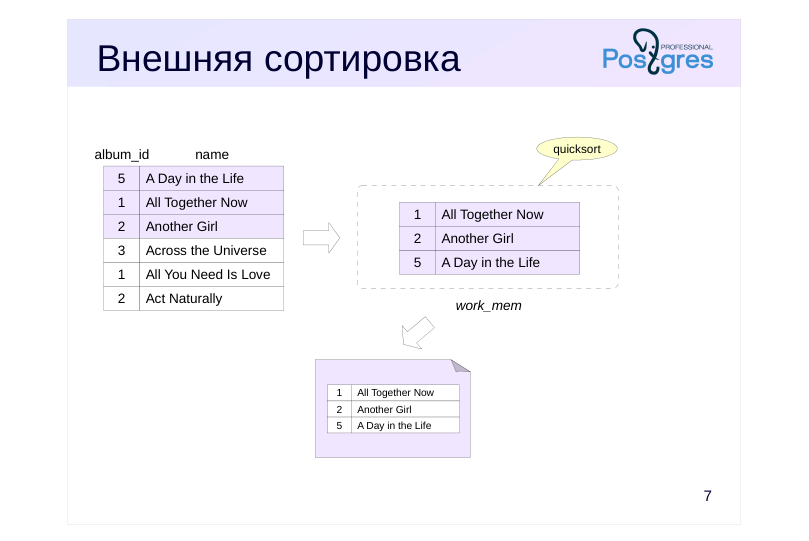 {#source-figure-007 caption=“Source slide page 7: Внешняя сортировка”}
Комментарии преподавателя
Если набор строк велик, он не поместится в память целиком. В таком случае используется алгоритм внешней сортировки.
Набор строк читается в память, пока есть возможность, затем сортируется и записывается во временный файл.
Page 8: Внешняя сортировка
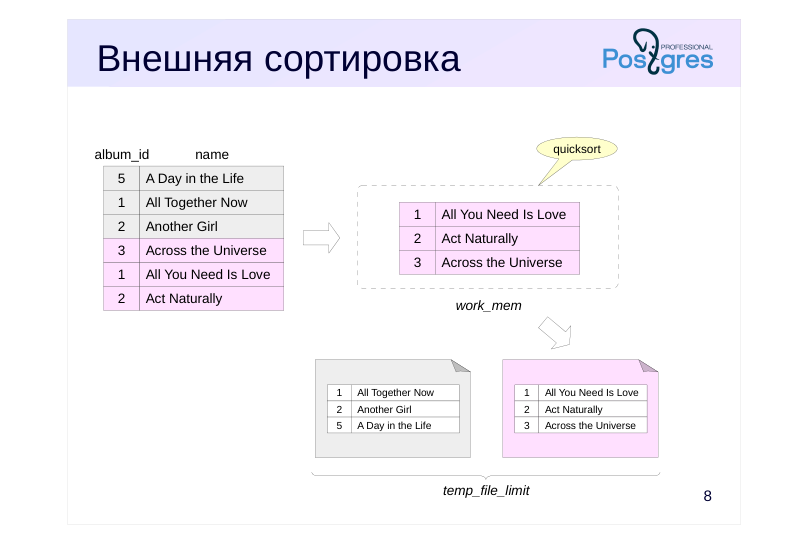 {#source-figure-008 caption=“Source slide page 8: Внешняя сортировка”}
Комментарии преподавателя
Эта процедура повторяется столько раз, сколько необходимо, чтобы записать все данные в файлы, каждый из которых по отдельности отсортирован.
Напомним, что общий размер временных файлов сеанса (не включая временные таблицы) ограничен значением параметра temp_file_limit.
Page 9: Внешняя сортировка
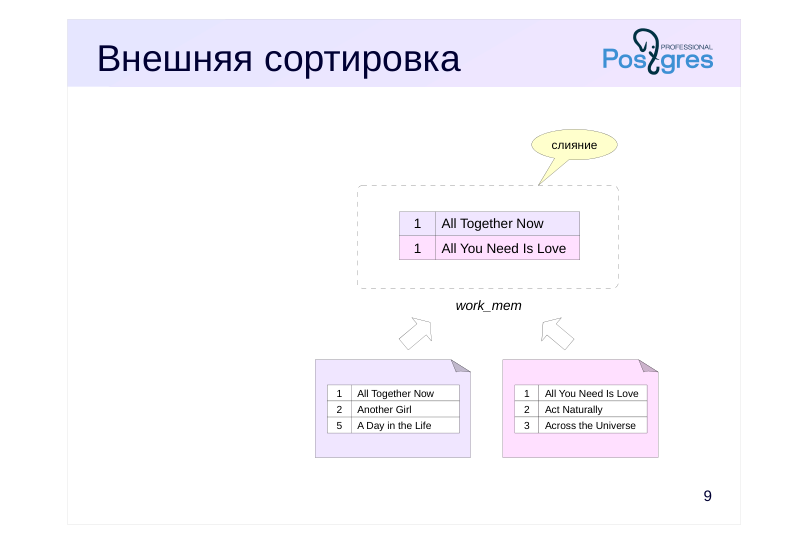 {#source-figure-009 caption=“Source slide page 9: Внешняя сортировка”}
Комментарии преподавателя
Далее несколько файлов (два или более) соединяются с сохранением порядка строк.
Для соединения не требуется много места в памяти, достаточно разместить по одной строке из каждого файла (как в примере на слайде). Среди этих строк выбирается минимальная (максимальная) и возвращается как часть результата, а на ее место читается новая строка из того же файла. На практике строки читаются не по одной, а пакетами, чтобы ускорить ввод-вывод.
Если оперативной памяти недостаточно, чтобы соединить сразу все файлы, сначала соединяется часть файлов и результат записывается в новый временный файл, затем происходит соединение этих новых файлов и так далее.
Мы не обсуждаем здесь все детали реализации сортировки, с ними можно ознакомиться в файле src/backend/utils/sort/tuplesort.c.
История развития способов сортировки в PostgreSQL хорошо описана в презентации Грегори Старка «Sorting Through The Ages»: https://wiki.postgresql.org/images/5/59/Sorting\_through\_the\_ages.pdf, синхронный перевод доклада на русский язык доступен на сайте https://pgconf.ru/talk/1587768.
Page 10: Внешняя сортировка
Пример плана с внешней сортировкой (Sort Method: external merge):
Обратите внимание на то, что узел Sort записывает и читает временные данные (temp read и written). Увеличим значение work_mem:
Теперь все строки поместились в память, и планировщик выбрал более дешевую быструю сортировку.
Page 11: Incremental Sort
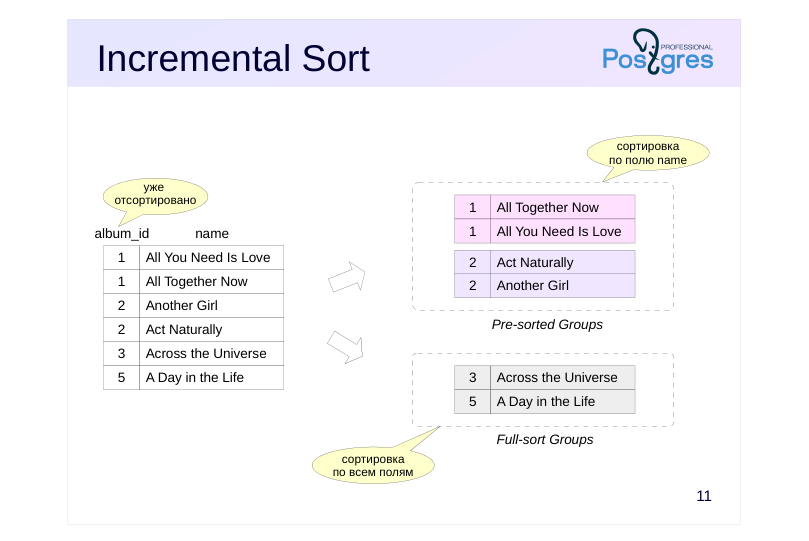 {#source-figure-011 caption=“Source slide page 11: Incremental Sort”}
Комментарии преподавателя
Если набор данных требуется отсортировать по ключам K1 … Km … Kn и при этом известно, что набор уже отсортирован по первым m ключам, можно не пересортировывать все данные заново. Достаточно разбить набор данных на группы, имеющие одинаковые значения начальных ключей K1 … Km (значения таких групп следуют друг за другом), и затем отсортировать отдельно каждую из групп по оставшимся ключам Km+1 … Kn. Такой способ называется инкрементальной сортировкой.
Алгоритм обрабатывает относительно крупные группы строк отдельно, а небольшие объединяет и сортирует полностью. Поскольку сортируемые наборы данных уменьшаются, уменьшается и требование к доступному объему памяти. Но увеличение количества наборов приводит к росту накладных расходов.
- Наборы могут обрабатываться как в оперативной памяти, так и на диске
- если не хватает объема work_mem.
Инкрементальная сортировка позволяет выдавать результаты уже после обработки первой группы, не дожидаясь сортировки всего набора.
Отключить использование инкрементальной сортировки можно с помощью параметра enable_incremental_sort.
Page 12: Инкрементальная сортировка
Инкрементальная сортировка может использовать как сортировку в памяти, так и внешнюю сортировку. Для иллюстрации создадим индекс на таблице bookings:
Посмотрим на пример инкрементальной сортировки:
Здесь данные, полученные из таблицы bookings по только что созданному индексу bookings_total_amount_idx, уже отсортированы по столбцу total_amount (Presorted Key), поэтому остается доупорядочить строки по столбцу book_date. Строка Pre-sorted Groups относится к крупным группам, которые досортировывались по столбцу book_date, а строка Full-sort Groups — к небольшим группам, которые были объединены и отсортированы полностью. В примере все группы поместились в выделенную память и применялась быстрая сортировка. Уменьшим work_mem и повторим запрос:
Теперь, при нехватке памяти, для некоторых крупных групп пришлось применить внешнюю сортировку с использованием временных файлов (Pre-sorted Groups … external merge).
Page 13: В параллельных планах
 {#source-figure-013 caption=“Source slide page 13: В параллельных планах”}
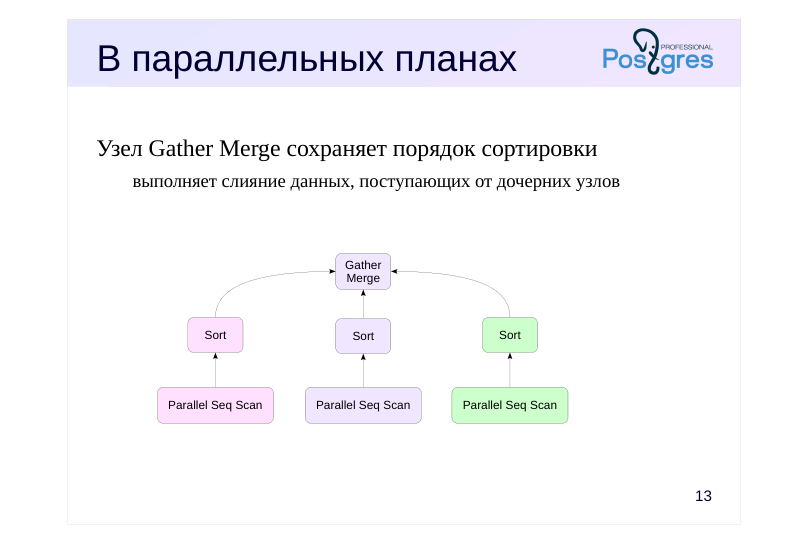
Узел Gather Merge сохраняет порядок сортировки
- выполняет слияние данных, поступающих от дочерних узлов
Комментарии преподавателя
Сортировка может участвовать в параллельных планах. Каждый рабочий процесс сортирует свою часть данных и передает результат вышестоящему узлу, который собирает данные в единый набор.
Но узел Gather для этого не годится, поскольку он выдает результат в том порядке, в котором строки поступают от рабочих процессов.
Поэтому в таких планах используется узел Gather Merge, сохраняющий порядок сортировки поступающих строк. Для этого он реализует алгоритм слияния, объединяя несколько отсортированных наборов в один.
Page 14: В параллельных планах
Запрос, сортирующий большую таблицу по неиндексированному полю, может выполняться параллельно:
Здесь каждый процесс читает и сортирует свою часть таблицы, а затем отсортированные наборы сливаются при передаче их ведущему процессу с сохранением порядка.
Page 15: Построение B-дерева
Используется сортировка
- сначала все строки сортируются
- затем строки собираются в листовые индексные страницы
- ссылки на них собираются в страницы следующего уровня
- и так далее, пока не дойдем до корня
- Может выполняться параллельно
- max_parallel_maintenance_workers
- Ограничение
- maintenance_work_mem, так как операция не частая
Комментарии преподавателя
При построении индекса (речь идет про B-дерево) сервер мог бы добавлять записи в пустой индекс по одной, обрабатывая последовательно строки таблицы. Но такой способ крайне неэффективен.
Поэтому при создании и перестроении индекса используется сортировка: все строки таблицы сортируются, и формируются записи, которые раскладываются по листовым индексным страницам. Затем достраиваются верхние уровни дерева, состоящие из ссылок на элементы страниц нижележащего уровня, до тех пор, пока на очередном уровне не получится одна страница — она и будет корнем дерева.
Сортировка устроена точно так же, как рассматривалось выше. Однако размер памяти ограничен не work_mem, а maintenance_work_mem, поскольку операция создания индекса не слишком частая и имеет смысл выделить для нее больше памяти.
Построение индекса может выполняться параллельно. Количество рабочих процессов выбирается так же, как и при выполнении параллельных запросов (в зависимости от размера таблицы), но ограничено значением параметра max_parallel_maintenance_workers.
Page 16: Оконные функции
 {#source-figure-016 caption=“Source slide page 16: Оконные функции”}
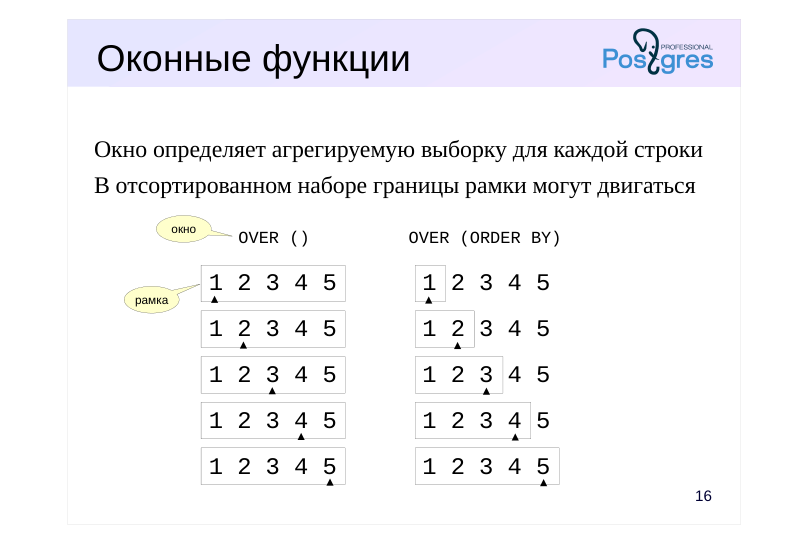
Окно определяет агрегируемую выборку для каждой строки
- В отсортированном наборе границы рамки могут двигаться
- OVER ()
- OVER (ORDER BY)
- окно
Комментарии преподавателя
Использование сортировки в оконных функциях имеет особенности.
В отличие от обычных агрегатных функций, оконные функции вычисляются для каждой строки набора, не уменьшая его размер. После имени функции в предложении OVER указывается окно, определяющее набор строк, которую должна обработать оконная функция в каждой строке набора. Такая выборка называется рамкой.
Если окно указано как OVER(), то рамка одинакова для каждой строки и состоит из всех строк набора.
Page 17: Оконные функции
Посмотрим план запроса, вычисляющего сумму бронирований нарастающим итогом:
Оконная функция вычисляется в узле WindowAgg, который получает отсортированные данные от дочернего узла Sort. Добавление к запросу других оконных функций, использующих тот же порядок строк (не обязательно с совпадающим окном), а также предложения ORDER BY не приводит к появлению лишних сортировок:
Здесь два узла WindowAgg (каждый для своего окна), но общий узел Sort. Стоимость запроса увеличилась, но лишь немного. Конечно, оконные функции, требующие разного порядка строк, вынуждают сервер пересортировывать данные:
В этом примере нижний узел WindowAgg (соответствующий функции count) получает упорядоченный набор строк по индексу, а для верхнего узла WindowAgg (соответствующего функции sum) строки переупорядочивает узел Sort. Сортировка в оконных функциях может использовать любые методы, рассмотренные выше. Например, быструю сортировку:
Page 18: Page 18
Или внешнюю:
Page 19: Итоги
Сортировка используется при выполнении запросов и для построения B-деревьев
- Существуют разные способы реализации сортировки
- в памяти
- внешняя (создаются временные файлы)
- инкрементальная
- Наличие индексов может позволить избежать сортировки
Page 20: Практика
- Какой план будет выбран для следующего запроса: SELECT * FROM flights ORDER BY scheduled_departure; Изменится ли план выполнения, если увеличить значение work_mem до 32 Мбайт?
- Создайте индекс по столбцам passenger_name и passenger_id таблицы билетов (tickets). Потребовался ли временный файл для выполнения этой операции?
Комментарии преподавателя
- Включите журналирование использования временных файлов, установив значение параметра log_temp_files в ноль.
Page 21: 1. Выполнение запроса с сортировкой
Выполним запрос со значениями параметров по умолчанию:
Сервер выбрал внешнюю сортировку (Sort Method: external merge). Обратите внимание на количество страниц и тип ввода-вывода (Buffers): значения temp read и written говорят о том, что сервер использовал временные файлы. Выполните запрос повторно несколько раз — видно, что серверу всегда не хватает оперативной памяти. Увеличим значение параметра work_mem до 32 Мбайт:
Увеличив work_mem, мы позволяем серверу использовать больше оперативной памяти для сортировки. Повторно выполним запрос и сравним планы выполнения:
Теперь сервер использует сортировку в памяти (Sort Method: quicksort), в строке Buffers исчезли поля temp read и written.
2. Построение индекса
Включим журналирование временных файлов:
Текущее значение maintenance_work_mem:
Page 22: Page 22
Создаем индекс:
Временный файл понадобился: