05 Занятие 05: Доступ к данным / Типы индексов
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_05_am_indexes.html Archive: QPT-handouts-16.zip Страниц PDF: 26
Page 1: Доступ к данным / Типы индексов
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Хеш-индекс
- GiST
- Класс операторов
- SP-GiST
- GIN
- BRIN
Page 3: Идея хеширования
 {#source-figure-003 caption=“Source slide page 3: Идея хеширования”}
Комментарии преподавателя
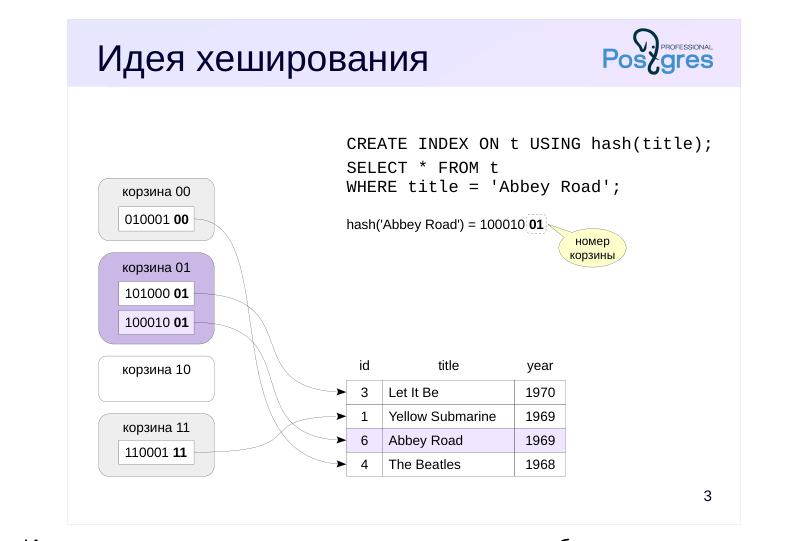
Идея хеширования состоит в том, что значения любого типа данных равномерно распределяются по ограниченному количеству корзин хеш-таблицы с помощью функции хеширования. Если хеш-таблица имеет достаточный размер, чтобы в одну корзину в среднем попадало одно значение (хеш-код), поиск значения в хеш-таблице выполняется за константное время. Для этого:
вычисляется хеш-функция от заданного значения;
по нескольким битам полученного хеш-кода определяется номер корзины;
корзина просматривается в поисках хеш-кода.
Если данные распределены неравномерно, в одну корзину могут попасть много значений. В этом случае эффективность поиска будет страдать.
По сути, хеш-индекс представляет собой хеш-таблицу, которая хранится на диске.
https://postgrespro.ru/docs/postgresql/16/hash-intro
Page 4: Хеш-индекс
Хранит только хеш-коды, но не исходные значения
- размер не зависит от ключа индексирования
- невозможно сканирование только индекса
- Индекс увеличивается динамически
- скачкообразный рост
- Поиск только по условию равенства
Комментарии преподавателя
Хеш-индекс хранит только значения хеш-функции и ссылки на версии строк; само индексируемое значение не сохраняется. Поэтому размер хеш-индекса не зависит от размера ключа индексирования, но теряется возможность сканирования только индекса — значение можно прочитать только из таблицы.
Размер хеш-индекса увеличивается динамически при добавлении новых значений. При увеличении количество корзин удваивается, поэтому рост размера происходит скачкообразно.
В отличие от B-дерева, хеш-индексы имеют много ограничений, в частности:
● единственная поддерживаемая операция — поиск по условию равенства, поскольку хеш-функция не сохраняет порядок следования значений;
● не поддерживается ограничение уникальности;
● нельзя создать многоколоночный индекс и добавить к индексу дополнительные include-столбцы.
Поэтому хеш-индексы не получили широкого распространения. Однако за счет меньшего размера и фиксированного времени поиска хеш-индекс может в ряде случаев работать быстрее, чем индекс на основе B-дерева.
Page 5: Хеш-индекс
Посмотрим на план запроса, получающего определенное место в салонах всех самолетов:
Поскольку подходящего индекса нет, используется последовательное сканирование. Создадим хеш-индекс по полю seat_no и повторим запрос:
Теперь планировщик использует хеш-индекс и строит битовую карту. Поменяем условие равенства на «больше»:
С неравенствами хеш-индекс использоваться не может.
Page 6: Пример индекса GiST
 {#source-figure-006 caption=“Source slide page 6: Пример индекса GiST”}
Комментарии преподавателя
GiST расшифровывается как generalized search tree — обобщенное дерево поиска.
Идею работы GiST-индексов рассмотрим на примере точек на плоскости.
Плоскость разбивается на несколько прямоугольников, которые в сумме покрывают все индексируемые точки. Эти прямоугольники составляют верхний уровень дерева.
Как видно на рисунке, прямоугольники могут пересекаться (хотя это и уменьшает эффективность поиска).
Page 7: Пример индекса GiST
 {#source-figure-007 caption=“Source slide page 7: Пример индекса GiST”}
Комментарии преподавателя
На следующем уровне дерева каждый из больших прямоугольников распадается на прямоугольники меньшего размера.
Page 8: Пример индекса GiST
 {#source-figure-008 caption=“Source slide page 8: Пример индекса GiST”}
Комментарии преподавателя
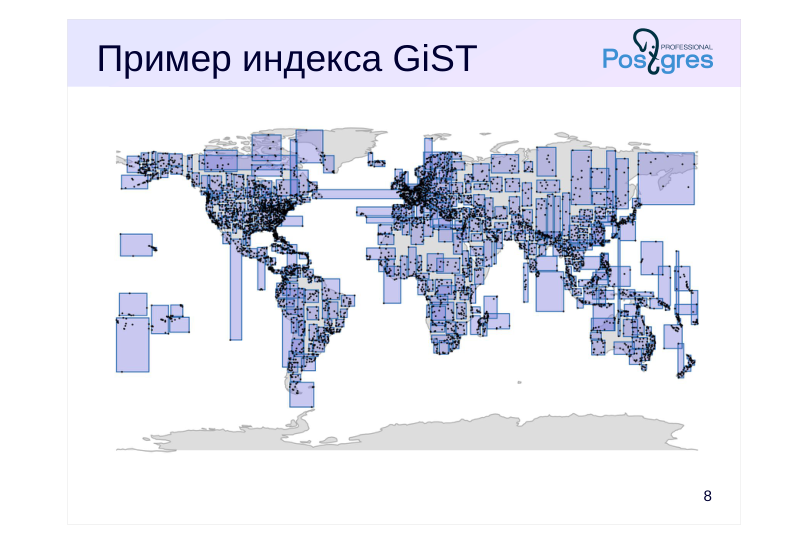
На последнем уровне дерева каждый ограничивающий прямоугольник будет содержать столько точек, сколько помещается на одну индексную страницу.
Общее условие разбиения таково: прямоугольник родительской вершины охватывает все прямоугольники соответствующего поддерева. Это позволяет, например, быстро находить точки, лежащие внутри определенной области:
находим прямоугольники, пересекающиеся с заданной областью, на верхнем уровне индекса;
спускаемся в выбранные поддеревья и повторяем поиск в них.
Такой алгоритм индексирования называется R-деревом.
Page 9: Индекс GiST
Сбалансированное дерево поиска
- рассчитано на произвольные типы данных
- не требуется упорядоченность
- Типичные поддерживаемые операции
- вхождение в область
- нахождение слева, справа, сверху, снизу от области
- Поиск ближайших соседей
- первые k значений, ближайших к заданному
Комментарии преподавателя
B-дерево представляет собой сбалансированное дерево, значения в котором упорядочены в соответствии с операциями «больше» и «меньше». Индекс GiST также образует сбалансированное дерево, но значения в нем распределяются по другому принципу, например, на основе взаимного расположения точек на плоскости.
Поэтому GiST можно применять к тем типам данных, для которых не имеют смысла операции «больше» и «меньше», и ускорять другие, более важные для этих типов, операции. Например, для геометрических фигур на плоскости индекс GiST может ускорять поиск вхождения значения в определенную область или поиск значений, находящихся в определенной стороне от заданной области.
Другая важная особенность GiST-индекса — поддержка поиска ближайших соседей. Индекс позволяет быстро получить несколько значений, ближайших к заданному.
https://postgrespro.ru/docs/postgresql/16/gist-intro
Page 10: Индекс GiST
Для демонстрации работы GiST-индекса обратимся к таблице airports_data (на этой таблице построено представление airports). В таблице есть поле coordinates типа point, по нему и будем строить GiST-индекс. Но сначала выполним следующий запрос — найдем все аэропорты, находящиеся недалеко от Москвы:
Без индекса просматривается вся таблица. Создадим GiST-индекс:
Таблица airports_data невелика, поэтому планировщик все равно будет использовать последовательное сканирование. Временно отключим этот метод доступа:
Повторим запрос:
Теперь планировщик получает нужные строки, обращаясь к индексу airports_gist_idx. Удалим созданный индекс:
Page 11: Класс операторов
 {#source-figure-011 caption=“Source slide page 11: Класс операторов”}
Посредник между индексным методом и типом данных
- Может включать значительную часть логики индексирования
Комментарии преподавателя
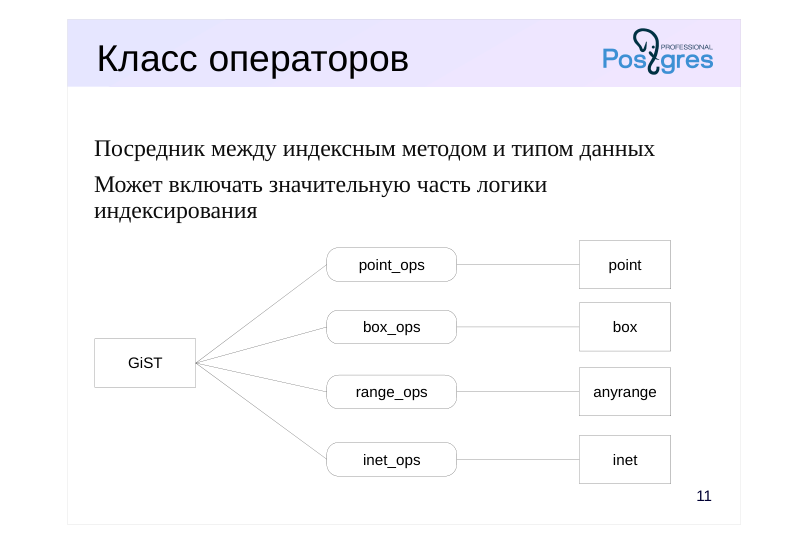
Чтобы индексные методы доступа могли работать с разными типами данных (которые в PostgreSQL могут подключаться на лету), между индексами и типами данных есть посредник — класс операторов, в который входят необходимые операторы и вспомогательные функции.
Такие индексы, как B-деревья и хеш-индексы, тоже используют классы операторов, но они довольно простые: содержат такие операторы, как «равно», «больше» и «меньше».
Классы операторов для GiST-индексов включают в себя значительную часть логики индексирования и определяют правила, по которым значения добавляются в индекс и затем ищутся в нем. Поэтому для разных типов данных GiST может ускорять разные операции.
Например, с помощью GiST можно индексировать значения диапазонных типов (таких, как int4range или tstzrange). Такой индекс позволяет находить диапазоны, включенные в заданный диапазон, пересекающиеся с заданным диапазоном, примыкающие к заданному диапазону и т. п.
GiST можно считать каркасом, на основе которого строятся произвольные схемы индексации (не только R-дерево), реализуя нужным образом класс операторов. Это гораздо проще, чем создать с нуля новый тип индекса, что весьма трудоемко и требует очень высокой квалификация разработчика.
https://postgrespro.ru/docs/postgresql/16/indexes-opclass
Page 12: Пример индекса SP-GiST
 {#source-figure-012 caption=“Source slide page 12: Пример индекса SP-GiST”}
Комментарии преподавателя
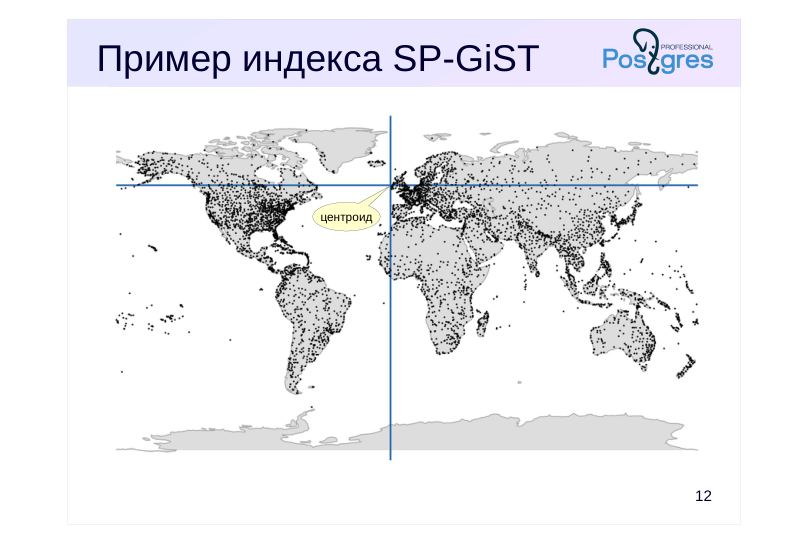
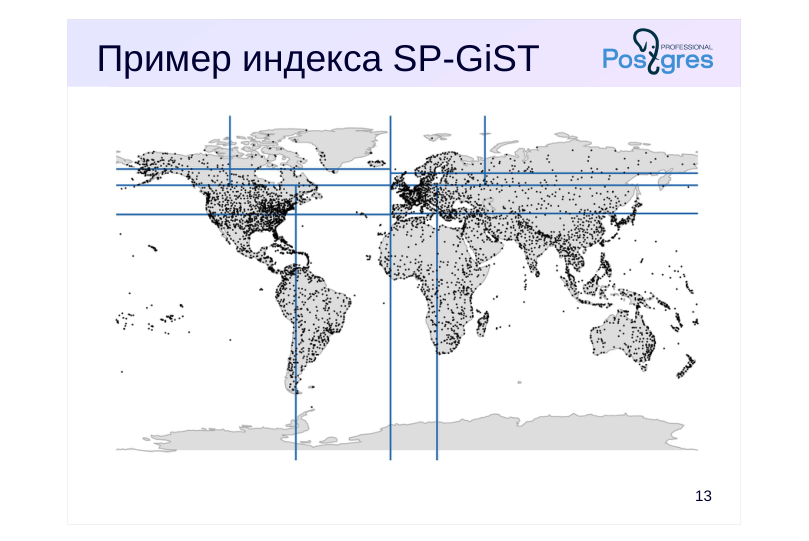
SP-GiST расшифровывается как space partitioning GiST. Это тоже обобщенное дерево поиска, но оно строится путем разбиения пространства поиска на непересекающиеся области.
Рассмотрим пример индекса SP-GiST для точек на плоскости.
Один из вариантов — дерево квадрантов. Корневой узел разбивает плоскость на четыре части (квадранта) по отношению к выбранной точке-центроиду.
Page 13: Пример индекса SP-GiST
 {#source-figure-013 caption=“Source slide page 13: Пример индекса SP-GiST”}
Комментарии преподавателя
Далее каждый из четырех квадрантов делится на собственные квадранты.
Page 14: Пример индекса SP-GiST
 {#source-figure-014 caption=“Source slide page 14: Пример индекса SP-GiST”}
Комментарии преподавателя
Разбиение продолжится, пока все точки в квадранте не станут помещаться на одну индексную страницу.
Page 15: Индекс SP-GiST
Несбалансированное дерево поиска
- слабо ветвящееся дерево с большой глубиной
- рассчитано на произвольные типы данных
- Операции аналогичны GiST
- вхождение в область
- нахождение слева, справа, сверху, снизу от области
- поиск ближайших соседей
Комментарии преподавателя
SP-GiST, как и GiST, является каркасом, на основе которого, реализуя классы операторов, можно строить произвольные схемы индексации. Например, дерево квадрантов для точек реализуется классом операторов point_ops. Другой способ деления плоскости — на две, а не на четыре части. Такой способ называется k-мерным деревом и реализуется другим классом операторов — kd_point_ops.
Разбиение плоскости на непересекающиеся области порождает несбалансированные деревья, которые обычно слабо ветвятся и имеют большую глубину.
Как правило, индексы SP-GiST предоставляют поддержку тех же типов данных и операторов, что и GiST. Но из-за другой структуры индекса они могут оказаться как более, так и менее эффективными, чем GiST.
https://postgrespro.ru/docs/postgresql/16/spgist
Page 16: Индекс SP-GiST
Создадим индекс SP-GiST по полю coordinates в таблице airports_data. Для точек есть два класса операторов. По умолчанию используется point_ops (дерево квадрантов), а мы для примера укажем kd_point_ops (k-мерное дерево):
Попробуем найти все аэропорты, расположенные выше (севернее) Надыма:
Теперь таблица сканируется по битовой карте, построенной на основе SP-GiST-индекса airports_spgist_idx.
Page 17: Идея GIN-индекса
 {#source-figure-017 caption=“Source slide page 17: Идея GIN-индекса”}
Комментарии преподавателя
GIN — generalized inverted index, обобщенный инвертированный индекс.
Идею этого индексного метода проще всего понять на примере предметного указателя в обычной книге. На страницах книги встречаются термины, а в предметном указателе перечислены в алфавитном порядке все термины с указанием номеров страниц, на которых они присутствуют.
Индекс GIN в первую очередь используется для индексации документов с целью ускорения полнотекстового поиска. По сути, это обычное B-дерево, но в него помещены не сами документы, а составляющие их слова. GIN-индекс оптимизирован с учетом того, что каждое слово может встречаться во многих документах. Если «список страниц» очень велик, он может храниться не в самой индексной странице, а в отдельном B-дереве.
https://postgrespro.ru/docs/postgresql/16/gin
Page 18: Индекс GIN
Инвертированный список
- для типов данных, значения которых (документы) состоят из элементов
- индексируются элементы, а не документы
- Типичная поддерживаемая операция
- проверка соответствия документа поисковому запросу
- проверка вхождения элемента в массив
- поиск документов JSON по ключам или значениям
Комментарии преподавателя
GIN работает с типами данных, значения которых состоят из элементов, а не являются атомарными. При этом индексируются не сами значения, а их элементы.
Как и GiST и SP-GiST, метод GIN является каркасом, который можно настроить не только на работу с текстом (состоящим из слов), но и с другими типами данных: с массивами (состоящими из элементов), с документами JSON (состоящими из ключей и значений). Для этого создается класс операторов, реализующий разбиение документа на элементы и проверку соответствия документа поисковому запросу.
Page 19: Индекс GIN
В столбце days_of_week представления routes хранится массив номеров дней недели, по которым выполняется рейс:
Для представления нельзя построить индекс, поэтому сохраним его строки в отдельной таблице:
Теперь создадим GIN-индекс:
С помощью GIN-индекса можно, например, отобрать рейсы, отправляющиеся только по средам и субботам:
Созданный GIN-индекс содержит всего семь элементов: целые числа от 1 до 7, представляющие дни недели. Для каждого из них в индексе хранятся ссылки на рейсы, выполняющиеся в этот день.
Page 20: Пример индекса BRIN
 {#source-figure-020 caption=“Source slide page 20: Пример индекса BRIN”}
Комментарии преподавателя
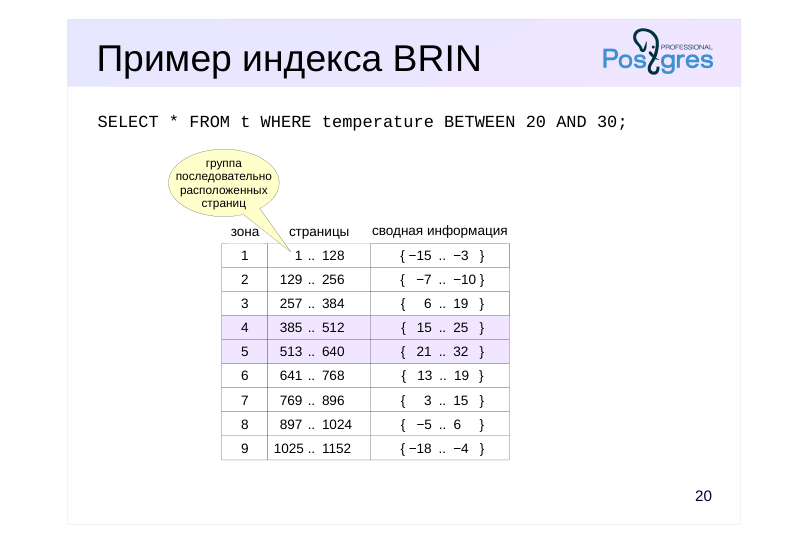
BRIN — block range index, «индекс зон блоков». Таблица разбивается на зоны определенной (настраиваемой) длины, каждая из которых охватывает набор последовательно расположенных страниц. Например, на слайде показан индекс с зоной размером 128 страниц. По каждой зоне собирается сводная информация, например, минимум и максимум значений индексируемого столбца.
При выполнении запроса можно пропустить все зоны, значения в которых гарантированно не попадают под условие. В примере на слайде только две зоны могут содержать значения температуры, удовлетворяющие условию.
Индекс BRIN не хранит идентификаторы версий строк, как все другие индексы, поэтому в выбранных зонах необходимо просмотреть все версии строк. В некотором смысле BRIN можно рассматривать как ускоритель последовательного сканирования.
https://postgrespro.ru/docs/postgresql/16/brin
Page 21: Индекс BRIN
Список зон со сводной информацией
- зона охватывает группу последовательно расположенных страниц
- сводная информация: минимум, максимум и т. п.
- требуется корреляция с физическим расположением строк
- Не хранит ссылки на версии строк
- только сканирование по битовой карте
- Предназначен для очень больших таблиц
- небольшой размер
- настраиваемое соотношение размера и точности
Комментарии преподавателя
Используя классы операторов, можно выбирать сводную информацию, хранимую в индексе для каждой зоны. Это может быть как просто минимум и максимум, так и несколько диапазонов значений, а для геометрических типов данных можно хранить охватывающий прямоугольник (как в GiST).
В любом случае для эффективной работы BRIN необходима корреляция между значениями столбца и физическим расположением строк, чтобы в одну зону попадали значения со сходной сводной информацией. Обновления данных нарушают корреляцию и могут сказаться на эффективности индекса.
Поскольку BRIN не хранит ссылки на версии строк, он возвращает перечень страниц зоны в виде неточной битовой карты. Обычное индексное сканирование (и сканирование только индекса) невозможны.
Зато BRIN-индекс имеет очень небольшой размер, который, к тому же, может настраиваться за счет указания размера зоны. Чем больше зона, тем меньше индекс, но меньше и точность. Благодаря этому BRIN идеально подходит для очень больших таблиц, характерных для хранилищ данных.
Page 22: Индекс BRIN
Для примера построим индекс BRIN по самой большой таблице:
Индексы BRIN дают ощутимый эффект только для очень больших таблиц. Тем не менее, планировщик использует построенный индекс, поскольку по сводной информации (минимум и максимум) можно отсечь зоны, не содержащие требуемых значений:
Поскольку BRIN не хранит ссылки на версии строк, единственный возможный способ доступа — сканирование по неточной (lossy) битовой карте.
Page 23: Итоги
Помимо B-дерева, существуют и другие, более специфичные типы индексов
- Хеш-индекс для поиска по равенству
- GiST и SP-GiST для несортируемых типов данных
- GIN для документов
- BRIN для очень больших таблиц
Page 24: Практика
- Сравните размеры и время построения хеш-индекса по полям разного размера (book_ref и contact_data) таблицы билетов tickets. Повторите то же для индекса на основе B-дерева. 2. Воспользуйтесь GIN-индексом и расширением pg_trgm для поиска пассажиров, номер телефона которых содержит последовательность цифр 1234. Можно ли ускорить такой запрос с помощью B-дерева?
Комментарии преподавателя
Для оценки размера индекса можно использовать функцию pg_total_relation_size(‘имя-индекса’).
Создайте GIN-индекс по выражению contact_data-»‘phone’, используя класс операторов gin_trgm_ops из расширения pg_trgm.
Страница документации: https://postgrespro.ru/docs/postgresql/16/pgtrgm
Page 25: 1. Сравнение размера и времени создания индексов
Посмотрим структуру таблицы tickets:
Поле book_ref имеет фиксированный размер, а поле contact_data имеет тип jsonb. Включим подсчет времени выполнения запросов:
Создадим hash-индексы…
…и индексы B-tree:
Время создания хеш-индексов примерно одинаково, а время создания btree-индексов зависит от размера индексируемого поля.
Теперь проверим размеры полученных индексов:
Размер hash-индексов тоже примерно одинаковый. А размер индексов B-tree (как и время их построения) зависит от размера индексируемого поля, поскольку такие индексы хранят индексируемые значения.
Page 26: 2. Расширение pg_trgm
Выполним запрос:
Обратите внимание на количество прочитанных страниц (Buffers) — их почти пятьдесят тысяч. Добавим расширение pg_trgm:
Создадим GIN-индекс с классом операторов gin_trgm_ops:
Такой класс операторов ускоряет поиск по шаблону, который начинается на знак процента, и даже по регулярным выражениям. Индекс на основе B-дерева этого не позволяет. Повторим запрос:
Количество прочитанных страниц сократилось более чем на порядок, время выполнения существенно уменьшилось.