22 Занятие 22: Отказоустойчивые решения / Кластер BiHA
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_22_biha.html Archive: PGPRO-handouts-16.zip Страниц PDF: 35
Page 1: Отказоустойчивые решения / Кластер BiHA
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Кластер BiHA
- Архитектура и принцип работы
- Конфигурация
- Создание кластера
- Режимы репликации
- Отработка отказов
- Выборы
- Режим 2+1
Page 3: Кластер BiHA
Кластер физической репликации
- синхронная и асинхронная репликация
- масштабируемость по операциям чтения
- Встроенная высокая доступность
- автоматическое обнаружение и отработка отказа узла
- кворум на базе алгоритма консенсуса Raft
- не требует внешнего управления кластером
- Работает на Linux-платформах
Комментарии преподавателя
Расширение BiHA (Built-in High Availability) позволяет организовать отказоустойчивый кластер физической репликации, включающий в себя выделенный узел-лидер и несколько узлов-последователей. Лидер передает потоки репликации на узлы-последователи, доступные только для чтения. Репликация может быть синхронной или асинхронной. Балансировка запросов на чтение между несколькими узлами позволяет увеличить пропускную способность системы.
Клиентские соединения могут направляться на определенные узлы внешним балансировщиком или пулером. В версии Postgres Pro Enterprise 17 для этого используют расширение Proxima.
https://postgrespro.ru/docs/enterprise/17/proxima#PROXIMA
BiHA обеспечивает отказоустойчивость за счет автоматического выявления отказа узла и изменения конфигурации кластера, означающей автоматическое переключение ролей узлов и восстановление данных на вернувшихся в строй узлах. При отказе лидера новый выбирается на основе кворума с использованием алгоритма консенсуса Raft. Ручное изменение конфигурации узлов также возможно без остановки обслуживания.
BiHA не использует внешнее программное обеспечения для управления кластером. https://postgrespro.ru/docs/enterprise/16/biha
В настоящее время BiHA не работает в среде MS Windows.
Page 4: Архитектура
 {#source-figure-004 caption=“Source slide page 4: Архитектура”}
Комментарии преподавателя
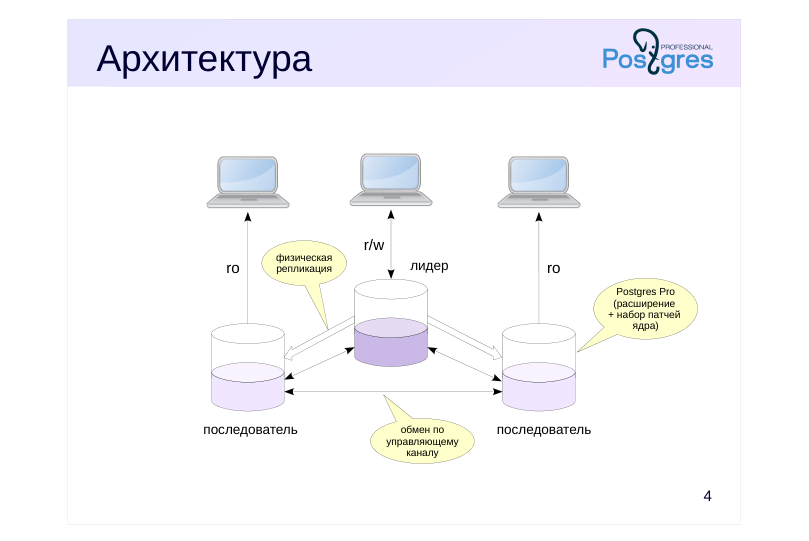
Расширение BiHA включает в себя доработанное ядро СУБД, SQL-интерфейс управления и сам код расширения.
На каждом из узлов запускаются служебные процессы BiHA worker, координирующие работу кластера. Эти процессы обмениваются служебной информацией, используя BiHA Control Protocol (BCP). Сами данные с узла-лидера передаются на последователи с помощью штатного механизма физической репликации (поток WAL-записей).
Для инициализации кластера и управления им используется утилита bihactl. Она может создавать узел-лидер, добавлять узлы-последователи, преобразовывать уже существующий экземпляр в узел-лидер или узел-последователь в кластере, а также проверять статус узлов кластера.
https://postgrespro.ru/docs/enterprise/16/biha-architecture#BIHA-ARCHITE CTURE
Page 5: Параметры конфигурации
 {#source-figure-005 caption=“Source slide page 5: Параметры конфигурации”}
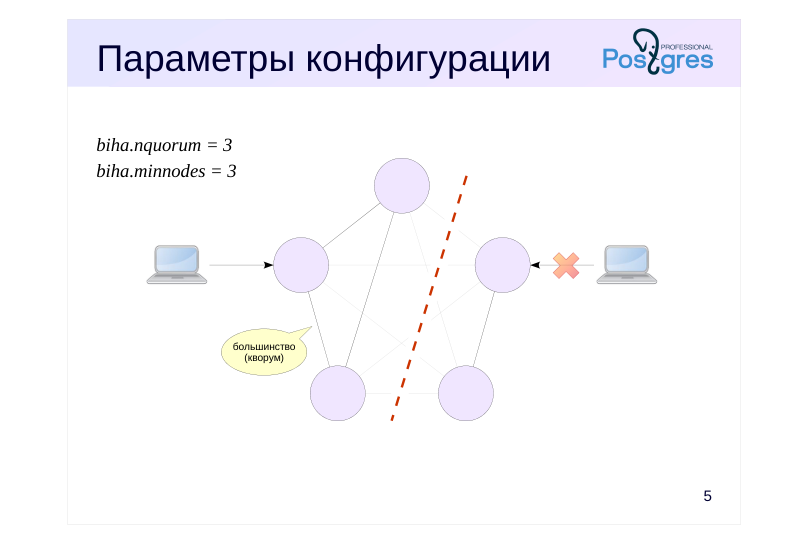
biha.nquorum = 3 biha.minnodes = 3
Комментарии преподавателя
При создании узлов кластера с помощью утилиты bihactl, кроме очевидных параметров (адрес, порт, каталог данных) нужно указать параметры, относящиеся ко всему кластеру. Самые важные из них:
● biha.nquorum — минимальное число узлов, при котором проводятся выборы лидера;
● biha.minnodes — минимальное число узлов, при котором лидер изменяет данные.
Если biha.nquorum или более связанных узлов остались без лидера, они проводят выборы нового лидера. Поведение текущего лидера от этого параметра не зависит.
Если лидер находится в группе из не менее чем biha.minnodes узлов, он обрабатывает запросы на чтение и запись, а при меньшем числе узлов — только на чтение.
По умолчанию для biha.minnodes берется значение biha.nquorum. Чтобы избежать ситуации split-brain, оба параметра рекомендуется задать как (общее число узлов + 1) / 2, округленное в большую сторону. Тогда при разделении сети лидер, оказавшись в меньшинстве, перестанет принимать запросы на запись, а большинство узлов выберет нового лидера. Однако при четном числе узлов имеет смысл задать biha.minnodes как ровно половину от общего числа узлов, чтобы разделение на две равные части не повлияло на работу лидера.
https://postgrespro.ru/docs/enterprise/16/biha-architecture#BIHA-CLUSTER-VARIANTS
Page 6: Инициализация кластера
 {#source-figure-006 caption=“Source slide page 6: Инициализация кластера”}
Комментарии преподавателя
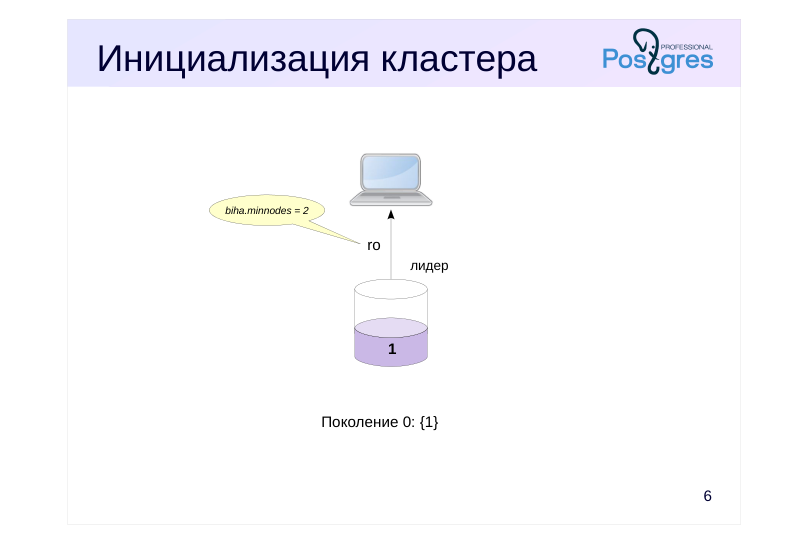
Кластер BiHA можно получить из существующей системы, использующей физическую репликацию, но мы создадим новый трехузловой кластер с нуля.
Первый узел будущего кластера необходимо инициализировать командой bihactl init. Будет создан экземпляр со служебной базой данных biha_db и схемой biha, для него будут установлены необходимые конфигурационные параметры, а также создан слот репликации.
Поскольку мы рассчитываем на три узла, параметр biha.nquorum установим равным двум (параметр biha.minnodes получит то же значение).
https://postgrespro.ru/docs/enterprise/16/biha-architecture#BIHA-POSTGRE S-CONFIGURATION
Созданный узел станет лидером, но перейдет в режим только чтения, поскольку находится в одиночестве.
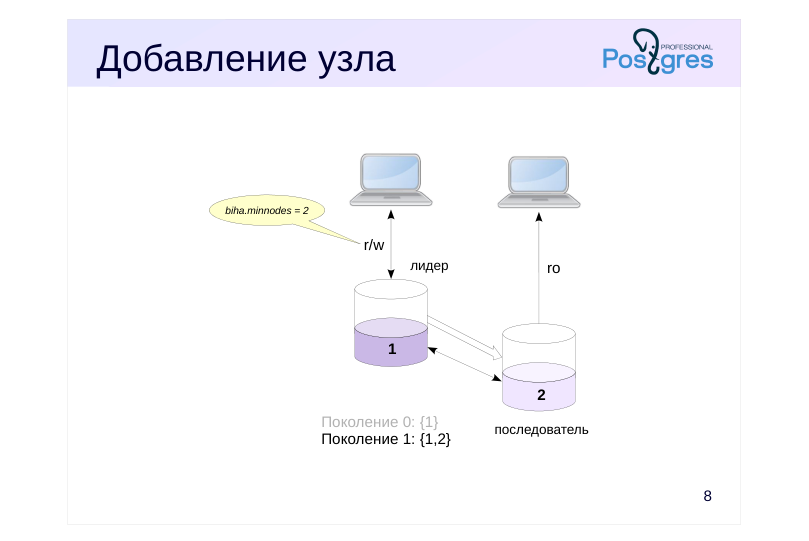
Далее мы будем встречаться с понятием номера поколения кластера (term). Текущее состояние соответствует нулевому поколению, в него входит единственный узел. Номер поколения автоматически увеличивается при изменении состояния кластера, например, при удалении или добавлении узла, при смене лидера.
Page 7: Подготовка BiHA-кластера
В этой демонстрации основной экземпляр PostgresPro Enterprise не используется, остановим его.
Все узлы будут локальными экземплярами. Подготовим каталог для данных узла-лидера:
Подключаться к узлам по протоколу репликации будет пользователь biha_replication_user; его пароли на всех узлах кластера BiHA должны быть одинаковыми. В нашем случае удобно включить в файл паролей одну общую строку:
С помощью команды init утилиты bihactl инициализируем кластер и создадим в нем узел-лидер. Будет запущена утилита initdb, а также сформирована конфигурация:
С помощью параметров утилиты заданы: –biha-node-id — уникальный идентификатор узла кластера; –host, –port и –pgdata — узел, порт и путь к каталогу данных создаваемого экземпляра; –biha-port — порт для обмена служебной информацией между узлами; –nquorum — значение параметра biha.nquorum для всех узлов. Команда init возвращает «магическую» строку, которая содержит данные для подключения последователей к лидеру. Строку удобно использовать в скриптах подготовки узлов-последователей, чтобы не вводить данные вручную, поэтому мы записали ее в файл /var/lib/postgresql/magic_str:
Фактически, в этой строке зашифрован набор параметров:
Запустим узел.
Конфигурационные параметры при инициализации были записаны в дополнительные файлы, подключаемые к файлам postgresql.conf и pg_hba.conf с помощью директив include. Параметры настройки узла размещаются в подключенном файле postgresql.biha.conf:
Page 8: Page 8
Параметры кластера должны быть согласованы на всех узлах, поэтому для их изменения используются специальные функции, которые следует запускать только на лидере. Настройки аутентификации находятся в подключенном файле pg_hba.biha.conf:
Ряд параметров, критически важных для работы расширения, хранится в отдельном файле pg_biha/biha.conf, и их нельзя изменить с помощью команды ALTER SYSTEM:
Кроме этого, в параметре shared_preload_libraries основного файла конфигурации указывается загружаемая библиотека расширения:
Состояние узла сохраняется в файле biha.state:
Page 9: Page 9
А состояние всего кластера можно увидеть с помощью команды bihactl status:
Состояние LEADER_RO означает, что узел находится в режиме только для чтения. При значении biha.minnodes=1 кластер состоял бы из единственного узла со статусом RW. Ту же информацию можно получить, обратившись к представлению biha.status_v.
Page 10: Добавление узла
 {#source-figure-010 caption=“Source slide page 10: Добавление узла”}
Комментарии преподавателя
Новый узел добавляется в кластер командой bihactl add, выполняемой на подключаемом узле; при этом в кластере будет сформировано новое поколение. Когда число узлов станет равным значению параметра biha.minnodes, кластер станет полностью работоспособным: его лидер сможет работать на запись.
Перед созданием кластера необходимо обеспечить сетевую связность и настроить на всех узлах синхронизацию времени.
Как говорилось, мы планируем развернуть трехузловой кластер — именно такая конфигурация обычно и эксплуатируется. Но что, если в нашем распоряжении только два узла? Какие значения параметров можно выбрать?
При biha.nquorum = 2 и biha.minnodes = 2 потеря любого узла приведет к недоступности кластера на запись.
Если установить biha.nquorum = 1 и biha.minnodes = 1, при разделении сети между двумя работоспособными узлами последователь станет лидером — возникнет ситуация split-brain с двумя работающими лидерами. Это самая плохая ситуация.
Если же установить biha.nquorum = 2 и biha.minnodes = 1, то отказ последователя не нарушит работу лидера, и при разделении сети split-brain не возникнет. Но при отказе лидера последователь не станет новым лидером.
Page 11: Два узла
Добавим в кластер узел-последователь. Используем магическую строку, полученную при инициализации кластера. Будет создана физическая резервная копия узла-лидера (по умолчанию с помощью pg_basebackup):
Запускаем новый узел и ждем, пока он подключится к лидеру.
Теперь кластер состоит из двух узлов. Первый из них является лидером и может теперь принимать запросы на изменение данных (LEADER_RW), а второй является последователем (FOLLOWER). Посмотрим на процессы экземпляров. Среди них есть BiHA worker, координирующие работу кластера, и обычные для физической репликации процессы.
Page 12: Три узла
 {#source-figure-012 caption=“Source slide page 12: Три узла”}
Комментарии преподавателя
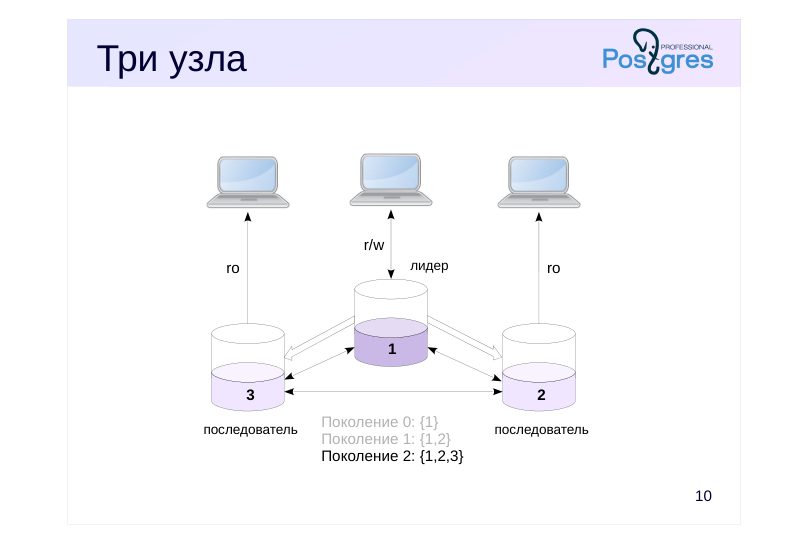
Добавляя дополнительные узлы в кластер, мы избавляемся от недостатка двухузловой конфигурации: в ней невозможно продолжить запись после потери сетевой связности без риска split-brain. Трех узлов уже достаточно для того, чтобы кластер оставался полностью работоспособным после одного любого сбоя.
В такой конфигурации один из узлов является лидером, остальные — последователями. При отказе лидера новый будет автоматически избран на основе кворума. Лидер также может быть назначен вручную.
Page 13: Три узла в кластере
Добавим в кластер еще один узел-последователь:
Запустим третий узел и проверим статус кластера:
Появился еще один последователь, номер поколения увеличился. Состояние подключения узлов в кластере можно получить из представления nodes_v:
Проверим репликацию. Создадим базу на лидере, а в ней — таблицу:
Подождем завершения репликации и подключимся к созданной базе данных на втором узле:
Данные появились на втором узле:
И на третьем:
Page 14: Page 14
Page 15: Режимы репликации
 {#source-figure-015 caption=“Source slide page 15: Режимы репликации”}
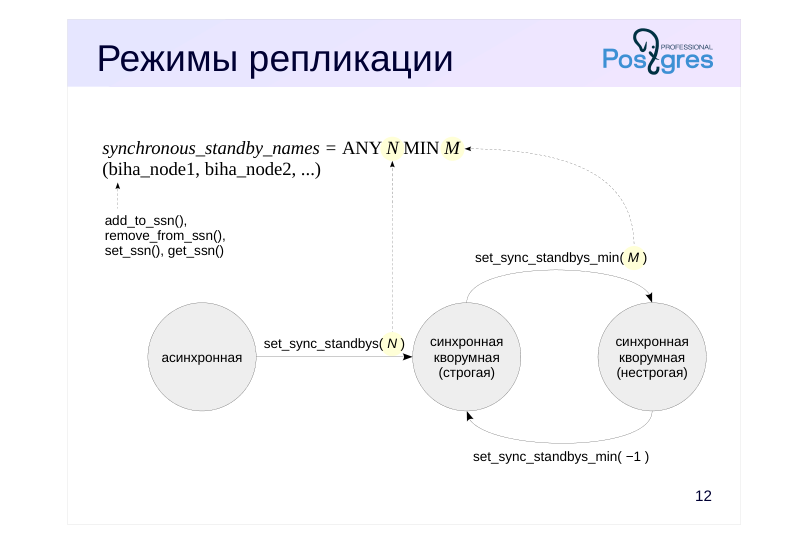
synchronous_standby_names = ANY N MIN M (biha_node1, biha_node2, …)
Комментарии преподавателя
По умолчанию кластер BiHA использует асинхронную репликацию, но можно использовать и синхронную кворумную — задав ее при инициализации кластера или перейдя на нее в существующем кластере.
Синхронизацией управляет параметр synchronous_standby_names: при фиксации транзакции лидер будет ожидать подтверждения от любых N (ANY N) узлов из списка синхронных. Синхронный режим включается функцией biha.set_sync_standbys, которая и устанавливает число N.
Если временно доступно менее N синхронных узлов, фиксация транзакций будет приостановлена. Чтобы продолжить работу в случае временной недоступности синхронных узлов, можно включить нестрогую кворумную синхронную репликацию. Тогда лидер будет продолжать подтверждать транзакции, пока к нему подключено как минимум M синхронных узлов (MIN M). Значение устанавливается функцией biha.set_sync_standbys_min, а значение −1 возвращает кластер к строгой синхронной репликации.
После включения синхронной репликации перейти на асинхронную уже нельзя, но можно изменить список синхронных узлов функциями biha.set_ssn, biha.remove_from_ssn и biha.add_to_ssn. Узлы, не входящие в список, будут работать асинхронно.
https://postgrespro.ru/docs/enterprise/16/biha-administration#BIHA-ENABLI NG-SYNC-REPLICATION
https://postgrespro.ru/docs/enterprise/16/runtime-config-replication#GUC-SY NCHRONOUS-STANDBY-NAMES
Page 16: Синхронная репликация
Включим в кластере синхронную кворумную репликацию с подтверждением от двух узлов:
Для просмотра текущего значения параметра synchronous_standby_names используем функцию biha.get_ssn:
Page 17: Отказ последователя
 {#source-figure-017 caption=“Source slide page 17: Отказ последователя”}
Комментарии преподавателя
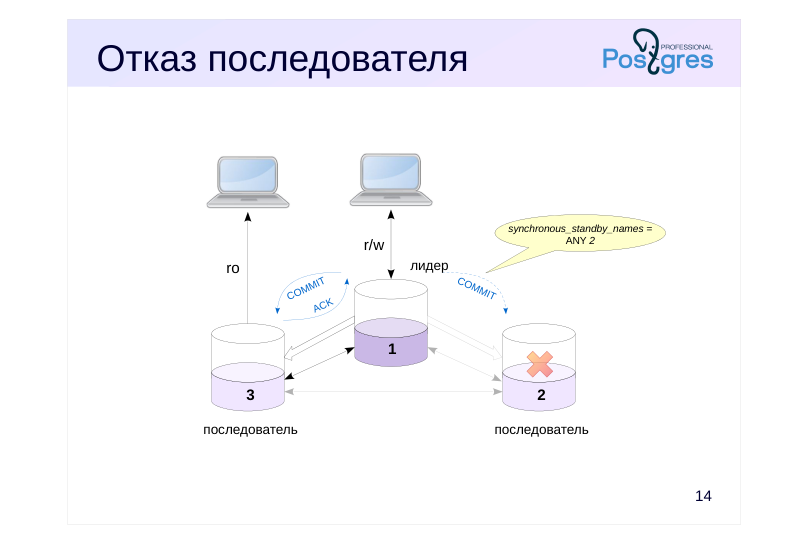
Если последователь был настроен как асинхронный, то отказ одного узла никак не отразится на лидере, кластер продолжит свою работу.
Если же используется синхронная репликация, то при настройке synchronous_standby_names = ANY 2 отказ узла приведет к невозможности завершения транзакции: лидер должен дождаться подтверждения от двух узлов-последователей, а работает только один.
Чтобы продолжить работу в такой ситуации, можно включить нестрогую синхронную репликацию ANY 2 MIN 1.
Page 18: Отказ синхронного последователя
Нарушим кворум синхронизации, остановив второй узел:
Кластер пока считает узел работающим. Подождем, пока будет обнаружен отказ…
После обнаружения отказа кластер продолжает работать, лидер принимает запросы на запись, но не может зафиксировать транзакцию:
Смягчим ограничение, включив нестрогую кворумную синхронную репликацию:
Теперь транзакция завершена:
В параметре synchronous_standby_names появилось указание MIN со значением 1:
Page 19: Отказ последователей
 {#source-figure-019 caption=“Source slide page 19: Отказ последователей”}
Комментарии преподавателя
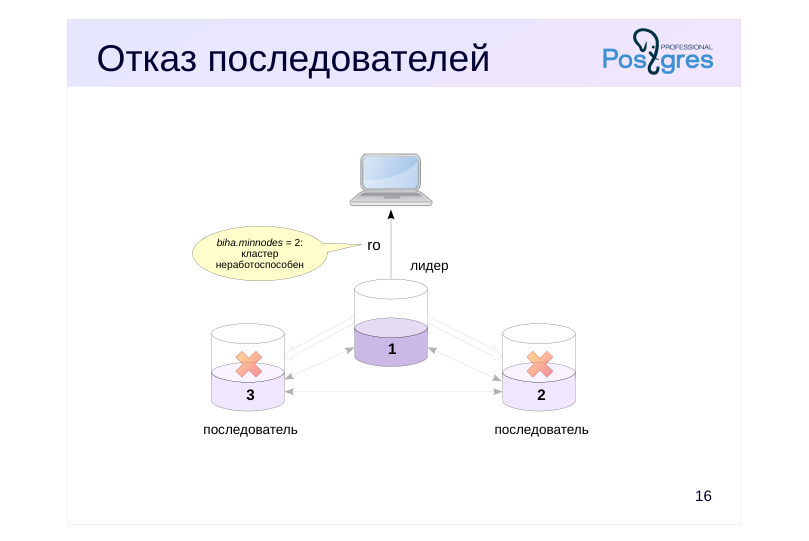
При отказе второго последователя оставшийся в строю лидер перестанет выполнять запросы, изменяющие данные (запросы на чтение будут продолжать работать).
Page 20: Отказ последователей
Сейчас один из последователей остановлен, но кластер в рабочем состоянии:
Остановим оставшегося последователя:
И немного подождем, чтобы кластер отработал отказ узла…
В строю остался лидер, но доступен он лишь для чтения:
Снова запустим второй узел и дождемся его возвращения в строй.
Статус лидера сменился на LEADER_RW, кластер обрабатывает запросы на изменение данных:
Page 21: Отказ лидера
 {#source-figure-021 caption=“Source slide page 21: Отказ лидера”}
Комментарии преподавателя
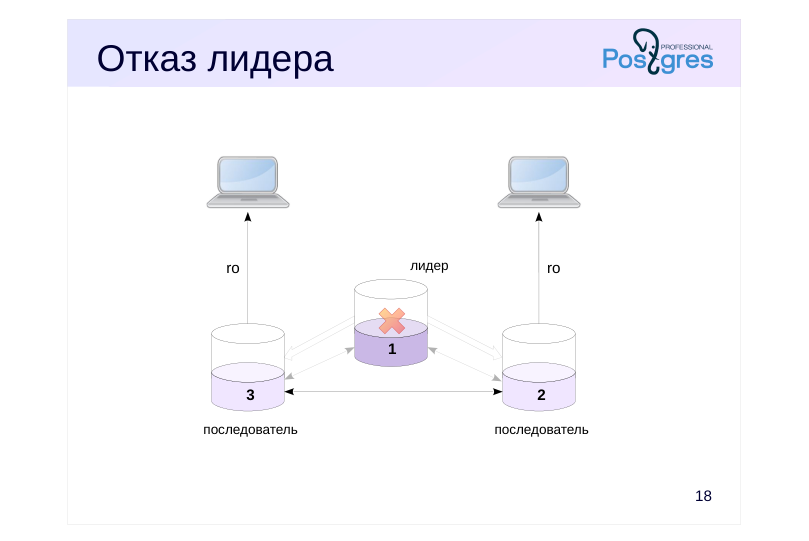
При отказе лидера выполняется автоматическое повышение статуса одного из последователей по результатам выборов.
Применяемый в выборах алгоритм консенсуса RAFT гарантирует однозначное определение нового лидера. Выборы проводятся в группах узлов, составляющих кворум; чтобы предотвратить ситуацию split-brain, значение параметра biha.nquorum должно превышать половину узлов.
В процессе выборов узлы выдвигают себя в качестве кандидатов на роль лидера и запрашивают голоса других узлов. Фактор победы в голосовании — наличие на узле наиболее актуальных данных, то есть новым лидером кластера становится последователь с наибольшим числом записей в WAL. В синхронном кластере можно задать для узлов приоритет, определяющий порядок выдвижения на роль лидера: для этого в параметре biha.node_priority узла указывается тайм-аут, по истечении которого узел предложит себя в качестве кандидата.
При необходимости можно вообще запретить узлу становиться лидером или участвовать в голосовании — для этого существуют параметры biha.can_be_leader и biha.can_vote.
https://postgrespro.ru/docs/enterprise/16/biha-architecture#BIHA-ELECTION S
Page 22: Новый лидер
 {#source-figure-022 caption=“Source slide page 22: Новый лидер”}
Комментарии преподавателя
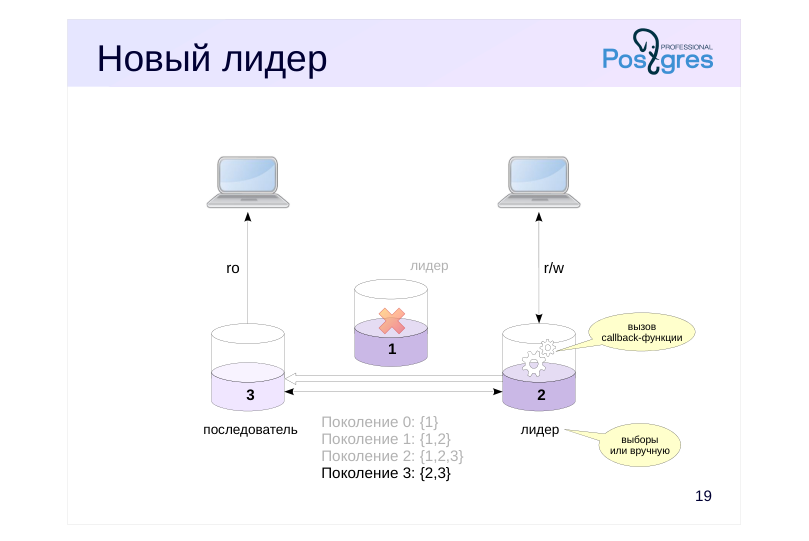
Помимо автоматического переключения узлов, BiHA поддерживает ручное переключение. Вручную назначить нового лидера можно с помощью функции biha.set_leader; ее рекомендуется вызывать на том узле, который планируется сделать лидером.
https://postgrespro.ru/docs/enterprise/16/biha-administration#BIHA-SWITCH OVER
При изменении состояния кластера есть возможность вызывать на узлах заранее зарегистрированные пользовательские функции — обработчики событий. Это функции для обратного вызова (callback-функции), которые могут выполнить дополнительные действия, например, отправить оповещение администратору, уведомить об изменениях внешнее ПО, управляющее подключением клиентов (различные прокси и балансировщики), или обеспечить ограждение (fencing) старого лидера.
https://postgrespro.ru/docs/enterprise/16/biha-administration#BIHA-CALLBA CKS
Page 23: Возвращение узла
 {#source-figure-023 caption=“Source slide page 23: Возвращение узла”}
Комментарии преподавателя
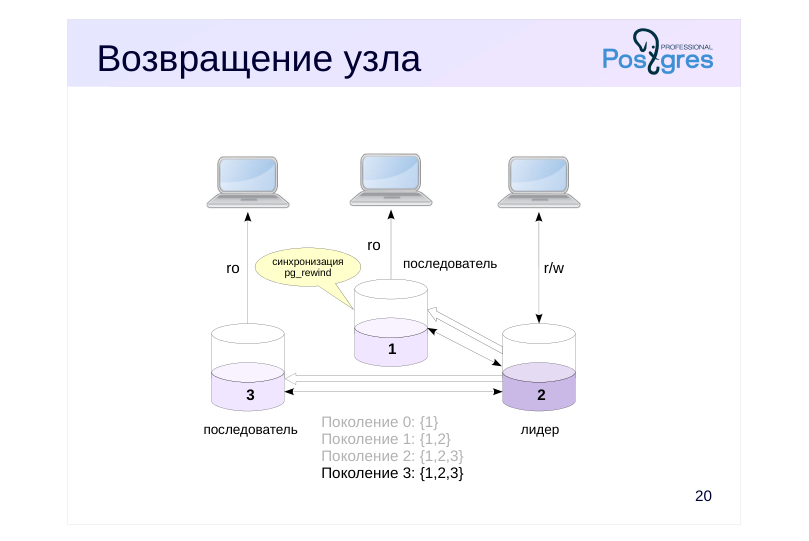
После переключения ролей узлов BiHA выполняет синхронизацию данных кластера в изменившейся конфигурации. Чаще всего на последователях требуется применение записей WAL, полученных с нового лидера. Однако в случае, когда в состав кластера возвращается старый лидер, может потребоваться обратное действие — его «откат» до состояния нового, который выполняется утилитой pg_rewind.
Автоматическое выполнение отката определяется параметром biha.autorewind и по умолчанию выключено. Так сделано потому, что существует риск потери пользовательских транзакций в журнале предзаписи на синхронизируемом узле. Кроме этого, при неудачной автоматической синхронизации узел может перейти в состояние ошибки, и для возвращения его в строй потребуется вмешательство администратора.
https://postgrespro.ru/docs/enterprise/16/biha-administration#BIHA-AUTOM ATIC-CLUSTER-SYNCHRONIZATION-AFTER-FAILOVER
Page 24: Отказ лидера
Сейчас в кластере два узла:
Теперь остановим лидера.
После небольшого ожидания посмотрим на втором узле, в каком состоянии находится кластер…
Последний работающий узел кластера остался в состоянии FOLLOWER. Он он может стать лидером, поскольку для кворума нужны два узла. Принудительно назначим лидера:
Новый лидер принадлежит уже новому поколению. При этом запросы на изменение данных он выполнять не может:
Снова включим первый узел.
Первый узел обнаружил новое поколение и нового лидера в нем, поэтому подключился к кластеру последователем.
Page 25: Page 25
Таким образом, узлы поменялись ролями.
Вернем в строй и третий узел, запретив ему становиться лидером:
В кластере снова три узла. Лидером по-прежнему выступает второй узел, все узлы находятся в одном новом поколении:
Если теперь остановить второй узел (лидера), то оставшиеся узлы автоматически выберут нового лидера из своего числа:
Немного подождем…
Лидером снова стал первый узел; третий мы запретили выбирать.
Page 26: Режим 2+1
 {#source-figure-026 caption=“Source slide page 26: Режим 2+1”}
Комментарии преподавателя
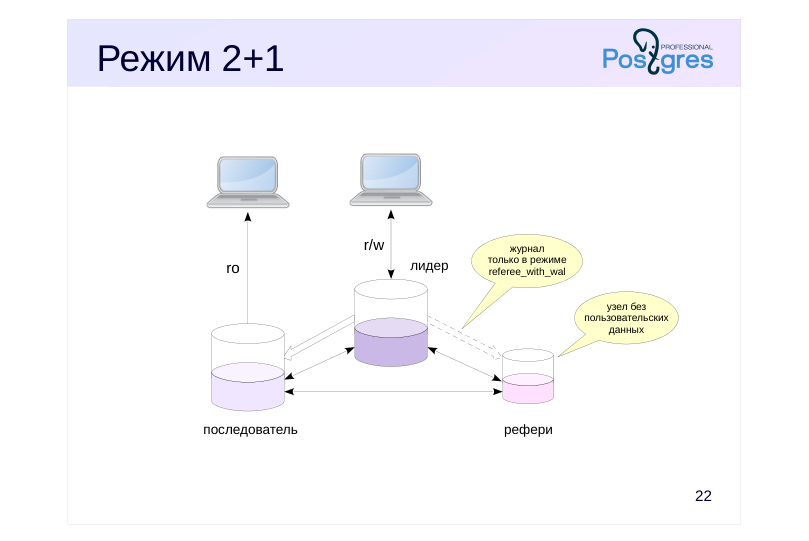
В кластере можно создать узел-рефери, который будет участвовать в выборах узла-лидера и поможет избежать проблемы split-brain, которая возможна, если лидер и единственный последователь перестают видеть друг друга. При инициализации узла-рефери на нем создаются лишь служебная база biha_db и системные таблицы; пользовательские данные на узел не копируются. Поэтому для рефери требуется меньше дискового пространства, ресурсов процессора и памяти.
Режим работы узла-рефери определяется параметром –mode команды bihactl add. Поддерживаются два режима:
● referee. Узел только принимает участие в выборах лидера, в синхронной репликации не участвует.
● referee_with_wal. Узел принимает участие в выборах лидера и участвует в репликации данных — получает все журналы с лидера. Если в момент начала выборов больше всего записей будет на узле-рефери, то узлы-последователи будут пытаться получать с него недостающие журнальные файлы.
В обоих режимах узел-рефери отправляет и получает сообщения о контроле состояния по каналу управления и поддерживает функции мониторинга кластера.
Рефери — это конечное состояние узла: он не может стать ни лидером, ни последователем.
https://postgrespro.ru/docs/enterprise/16/biha-architecture#BIHA-REFEREE
Page 27: Режим 2+1. Узел-рефери
Взамен остановленного нами второго узла создадим узел-рефери. Но сначала удалим второй узел из кластера. Сделать это можно с помощью функции biha.remove_node, вызывать которую нужно на лидере:
В кластере осталось два узла:
При добавлении узла-рефери (параметр –mode=referee) утилита pg_basebackup создаст частичную резервную копию лидера кластера. Данные нового экземпляра будут размещены в каталоге данных остановленного узла, поэтому этот каталог следует заранее очистить:
Стартуем вновь созданный экземпляр:
На новый экземпляр была скопирована только база biha_db и системные таблицы. Пользовательские данные других баз (даже postgres) не переносятся, чтобы уменьшить потребление ресурсов. Если все-таки необходимо, чтобы база postgres попала на узел-рефери (она может понадобится некоторым утилитам или системам мониторинга), нужно в команде выше дополнительно указать параметр –referee-with-postgres-db.
Остановим лидера.
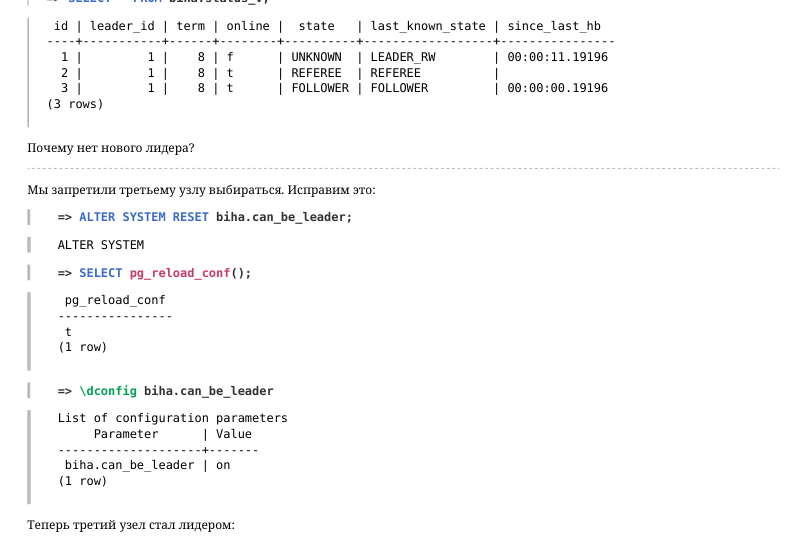
Оставшиеся узлы должны автоматически выбрать нового. Узел-рефери участвует в голосовании, но сам стать лидером
Page 28: Page 28
 {#source-figure-028 caption=“Source slide page 28: Page 28”}
никогда не сможет.
Почему нет нового лидера? Мы запретили третьему узлу выбираться. Исправим это:
Теперь третий узел стал лидером:
Page 29: Итоги
Postgres Pro BiHA — кластерное решение для высокой доступности на основе физической репликации
- Не требует установки дополнительного ПО
- Автоматически переключает и восстанавливает узлы при сбоях
- Допускает гибкую настройку для достижения баланса производительности, надежности и стоимости системы
Page 30: Практика
- Настройте синхронную физическую репликацию между двумя серверами. 2. Преобразуйте ведущий узел в лидера синхронного трехузлового BiHA-кластера. Проверьте его статус. 3. Преобразуйте ведомый узел (реплику) в узел-последователь и проверьте статус кластера. 4. Добавьте в кластер еще один узел-последователь, работающий как асинхронная реплика. Проверьте статус кластера и работу репликации. Остановите этот узел и убедитесь в том, что это не мешает фиксации транзакций.
Комментарии преподавателя
Создайте два дополнительных экземпляра Postgres Pro Enterprise: для ведущего выполните инициализацию с помощью initdb, а ведомый создайте из копии ведущего, созданной pg_basebackup.
Используйте команду bihactl init c параметрами –convert и –sync-standbys=1.
Для добавления последователя используйте команду bihactl add c параметрами –convert-standby и –use-leader.
Для добавления последователя используйте команду bihactl add c параметрами –convert-standby и –use-leader, а затем переведите его в асинхронный режим функцией biha.remove_from_ssn.
Page 31: 1. Синхронная репликация
Подготовим экземпляр Postgres Pro, который станет ведущим. Создаем каталог PGDATA:
Инициализируем экземпляр:
Дополним конфигурацию узла 1:
Запускаем:
Разворачиваем реплику. Сделаем копию ведущего узла, разместив ее в каталоге /var/lib/pgpro/ent-16-biha-2
Page 32: Page 32
Дополним конфигурацию узла 2:
Запускаем:
Проверим статус репликации:
Настроим синхронную репликацию. Для этого установим на ведущем сервере значение параметра synchronous_standby_names:
Репликация стала синхронной:
2. Преобразование ведущего в узел-лидер BiHA
Остановим ведущий сервер.
Как и в демонстрации, зададим пароль для роли biha_replication_user, записав его в файл:
Команда bihactl init с параметром –convert преобразует узел в лидера BiHA-кластера. Мы хотим продолжить работу в синхронном режиме, поэтому в параметре –sync-standbys зададим число синхронных узлов-последователей для подключения к лидеру:
Page 33: Page 33
Запускаем лидера, проверяем статус кластера:
По умолчанию значение biha.minnodes устанавливается равным biha.nquorum (у нас это 2), поэтому новый лидер не может пока выполнять изменение данных.
3. Преобразование ведомого сервера в последователя BiHA
Остановим ведомый сервер.
Нужно, чтобы пароль роли biha_replication_user в файле паролей совпадал с паролем этой роли на лидере. В нашем случае это так, и команда bihactl init с параметром –convert-standby преобразует узел в последователя BiHA-кластера:
Запускаем последователя, с лидера проверяем статус кластера:
4. Асинхронный последователь
Page 34: Page 34
Добавим второго последователя:
Новый узел подключится как синхронный. Переведем его в асинхронный режим репликации:
Проверим статус кластера:
Проверим работу репликации:
Репликация работает в разных режимах:
Теперь отключим третий узел:
Page 35: Page 35
Поскольку узел использовал асинхронную репликацию, вывод его из строя не мешает фиксации транзакций:
Уборка
Остановим и удалим экземпляры кластера BiHA.