13 Занятие 13: Производительность / Отчеты по нагрузке pgpro_pwr
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_13_pwr.html Archive: PGPRO-handouts-16.zip Страниц PDF: 23
Page 1: Производительность / Отчеты по нагрузке pgpro_pwr
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Обзор pgpro_pwr
- Архитектура pgpro_pwr
- Установка pgpro_pwr
- Выборки
- Политика хранения
- Выборочные линии
- Размеры отношений
- Отчеты
Page 3: Обзор pgpro_pwr
Расширение для выявления ресурсоемких операций в БД
- поиск запросов, потребляющих много ресурсов
- определение характера и интенсивности нагрузки
- анализ исторической информации о нагрузке
- сравнение профилей нагрузки
- помощь в расследовании инцидентов
Комментарии преподавателя
Расширение pgpro_pwr предназначено для выявления наиболее ресурсоемких операций в базе данных. PWR произносится как «пауэр» (power) — это сокращение от Postgres Pro Workload Reporting.
Расширение основано на pg_profile — расширении с открытым исходным кодом для PostgreSQL:
https://github.com/zubkov-andrei/pg\_profile
Предназначение:
● поиск запросов, потребляющих больше всего ресурсов СУБД;
● получение информации о типе и интенсивности нагрузки;
● исследование нагрузки на «горячие» объекты;
● сохранение и анализ нагрузки в историческом разрезе;
● сравнение профилей нагрузки, имевших место в разное время;
● облегчение расследования инцидентов;
● проведение анализа нагрузочного тестирования.
Основная идея расширения — сохранение снимков собранных данных для последующего анализа.
Документация:
https://postgrespro.ru/docs/enterprise/16/pgpro-pwr
Page 4: Архитектура pgpro_pwr
 {#source-figure-004 caption=“Source slide page 4: Архитектура pgpro_pwr”}
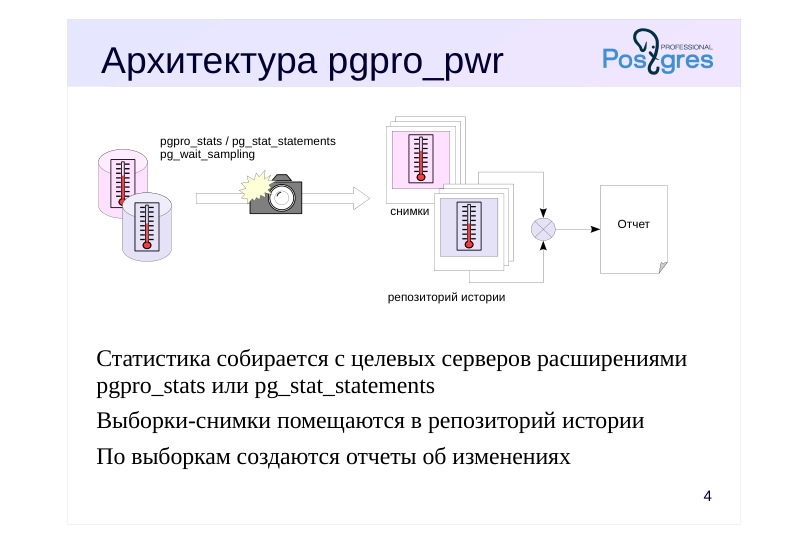
Статистика собирается с целевых серверов расширениями pgpro\_stats или pg\_stat\_statements
- Выборки-снимки помещаются в репозиторий истории
- По выборкам создаются отчеты об изменениях
Комментарии преподавателя
Исходные данные собираются с целевых серверов с помощью представлений сборщика статистики и расширения pgpro_stats или pg_stat_statements. Рекомендуется использовать расширение pgpro_stats, так как оно выдает планы операторов, информацию о событиях ожидания и нагрузке по отдельным базам данных, ролям, клиентам и приложениям. Сводная статистика ожиданий поступает от расширения pg_wait_sampling. Если нет возможности использовать pgpro_stats, можно использовать pg_stat_kcache как источник информации об использовании ресурсов процессора и о нагрузке на файловую систему (rusage).
Работа модуля pgpro_pwr заключается в обработке накапливаемых статистических выборок. Выборка содержит статистику о наиболее активных объектах и запросах, собранную с момента получения предыдущей выборки. По выборкам строят отчеты.
Расширение pgpro_pwr состоит из следующих частей:
● репозиторий истории — хранилище собранных данных;
● механизм управления выборками — предоставляет функции для получения выборок и поддержки репозитория в актуальном состоянии посредством удаления устаревших данных;
● механизм отчетов — представляет функции построения отчетов по данным из репозитория;
● административные функции для создания серверов, линий выборок и для управления ими.
Page 5: Установка pgpro_pwr
Пакет pgpro\_pwr устанавливается средствами ОС
- Упрощенная установка
- pgpro_pwr непосредственно на целевом сервере,
- отслеживание нагрузки от имени суперпользователя
- Развернутая установка
- нагрузка отслеживается на одном или нескольких удаленных серверах
- от имени специально зарегистрированного пользователя
Комментарии преподавателя
Предполагается, что уже установлено расширение pgpro_stats или pg_stat_statements и настроен сборщик статистики Postgres Pro.
Само расширение pgpro_pwr собрано в отдельный установочный пакет и по умолчанию не устанавливается.
Упрощенная установка предназначена для случаев, когда pgpro_pwr устанавливается непосредственно на целевой сервер и будет отслеживать его нагрузку от имени суперпользователя. Она сводится к созданию отдельной схемы для объектов расширения и установке расширения. Так как pgpro_pwr зависит от расширения dblink, то либо в команду CREATE EXTENSION добавляют ключевое слово CASCADE, либо устанавливают dblink заранее.
Развернутая установка должна выполняться, когда планируется использовать pgpro_pwr для отслеживания нагрузки на одном или нескольких серверах с соблюдением принципа наименьших привилегий.
Описание вариантов установки в документации: https://postgrespro.ru/docs/enterprise/16/pgpro-pwr#PGPRO-PWR-INSTALL ATION
Page 6: Установка расширения pgpro_pwr
Создадим тестовую базу данных на основе demo:
Для удобства настроим путь поиска:
Пакет расширения pgpro_pwr уже установлен в виртуальной машине. Добавим загрузку библиотек вспомогательных расширений и зададим параметры сбора статистики.
Перезагрузим сервер.
Создадим схему для объектов расширения и добавим расширение в базу данных.
Page 7: Выборки
 {#source-figure-007 caption=“Source slide page 7: Выборки”}
Данные собираются с зарегистрированных серверов
- Выборка содержит данные с момента предыдущей выборки
Комментарии преподавателя
Расширение pgpro_pwr собирает данные с зарегистрированных серверов. По умолчанию создается активное определение сервера с именем local, соответствующее текущему кластеру.
Данные с активных серверов собираются функцией take_sample; неактивный сервер можно указывать явно. Если имеется несколько серверов, можно получить выборки с их подмножества функцией take_sample_subset.
Выборка содержит информацию об изменениях в измеряемых параметрах СУБД, происшедших с момента предыдущей выборки. Аккумулируемые регулярные выборки позволяют строить отчеты о нагрузке базы данных за предыдущее время. Обычно достаточно получать одну-две выборки в час.
При формировании выборки предыдущая статистика сбрасывается функцией pgpro_stats_statements_reset или pg_stat_statements_reset в зависимости от того, какое расширение поставляет данные.
https://postgrespro.ru/docs/enterprise/16/pgpro-pwr#PGPRO-PWR-MANAGI NG-SERVERS
https://postgrespro.ru/docs/enterprise/16/pgpro-pwr#PGPRO-PWR-SAMPL ES
Page 8: Политика хранения
 {#source-figure-008 caption=“Source slide page 8: Политика хранения”}
Настройка
- pgpro_pwr.max_sample_age = 7
- срок хранения в днях, глобально
- set_server_max_sample_age()
- для конкретного сервера
Комментарии преподавателя
Для выборок можно определять политики хранения. Политика задает временнóй интервал, в течении которого выборки сохраняются (окно удержания). Политику можно установить:
● глобально с помощью параметра конфигурации pgpro_pwr.max_sample_age;
● для конкретного сервера с помощью вызова функции set_server_max_sample_age.
Page 9: Выборочные линии
 {#source-figure-009 caption=“Source slide page 9: Выборочные линии”}
Именованная последовательность выборок
- можно использовать для построения отчета
- можно задать срок хранения (имеет приоритет над политикой)
Комментарии преподавателя
Для построения отчета по нагрузке требуется две выборки; они задают период, за который были собраны данные для отчета.
Другой способ задания периода для отчета состоит в создании выборочной линии. Линия имеет имя и определяется либо начальной и конечной выборками, либо диапазоном времени.
Выборочные линии позволяют также переопределить политику хранения отдельных выборок. Для каждой выборочной линии можно задать время хранения в днях. Если время хранения не задано, то относящиеся к выборочной линии выборки вообще не будут удаляться.
Для управления выборочными линиями предназначены функции:
● create_baseline — создает выборочную линию;
● drop_baseline — удаляет выборочную линию;
● keep_baseline — задает срок хранения;
● show_baselines — выдает информацию об имеющихся выборочных линиях.
https://postgrespro.ru/docs/enterprise/16/pgpro-pwr#PGPRO-PWR-BASELI NES
Page 10: Получение выборки и создание выборочной линии
 {#source-figure-010 caption=“Source slide page 10: Получение выборки и создание выборочной линии”}
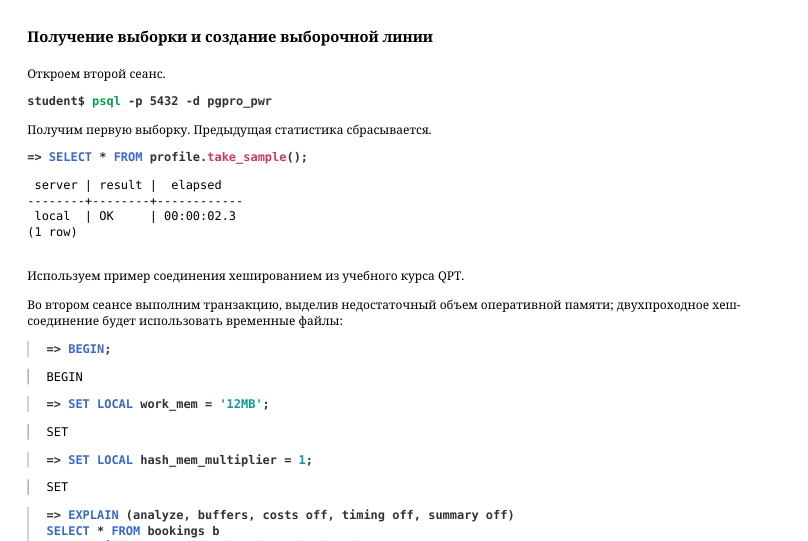
Откроем второй сеанс.
Получим первую выборку. Предыдущая статистика сбрасывается.
Используем пример соединения хешированием из учебного курса QPT. Во втором сеансе выполним транзакцию, выделив недостаточный объем оперативной памяти; двухпроходное хеш-соединение будет использовать временные файлы:
Получим вторую выборку — в нее попадут данные о нагрузке после первой выборки:
Теперь во втором сеансе выполним транзакцию, выделив достаточно рабочей памяти для хеш-соединения:
Page 11: Page 11
А сейчас получим третью выборку — в нее попадут данные о нагрузке после второй выборки:
Список выборок:
Сформируем из имеющихся выборок две выборочные линии.
Список выборочных линий:
Page 12: Page 12
Page 13: Размеры отношений
 {#source-figure-013 caption=“Source slide page 13: Размеры отношений”}
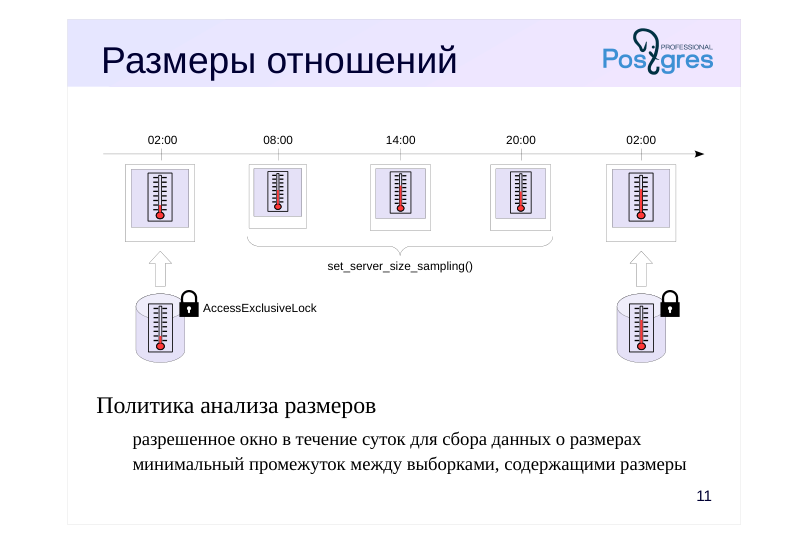
Политика анализа размеров
- разрешенное окно в течение суток для сбора данных о размерах
- минимальный промежуток между выборками, содержащими размеры
Комментарии преподавателя
Сбор сведений о размерах всех отношений в базе данных занимает продолжительное время, при этом на каждое анализируемое отношение устанавливается исключительная блокировка AccessExclusiveLock.
Однако чаще всего достаточно собирать информацию о размерах один раз в сутки. Для этого можно определить политику анализа размеров для серверов, которая устанавливает:
● окно в течение суток, когда разрешается сбор сведений о размерах отношений;
● минимальный промежуток между двумя выборками со сведениями о размерах.
Политику можно задать с помощью функции set_server_size_sampling.
Просмотреть политики для серверов можно, вызвав функцию show_servers_size_sampling.
https://postgrespro.ru/docs/enterprise/16/pgpro-pwr#PGPRO-PWR-RELATI ON-SIZES-COLLECTION
Page 14: Отчеты
Отчеты pgpro\_pwr формируются в формате HTML
- get_report() — обычные отчеты, предоставляющие статистику
- по нагрузке для заданного интервала
- get_diffreport() — разностные отчеты со статистикой
- по одинаковым объектам в двух сравниваемых интервалах
- Выбранный элемент отчета автоматически выделяется в других разделах отчета
- Настройка
- pgpro_pwr.max = 7
- число первых по некоторому критерию
- объектов, выбираемых для каждой
- таблицы отчета
Комментарии преподавателя
Функции построения отчетов позволяют определить интервалы разными способами, принимая идентификаторы выборок, выборочные линии или диапазоны времени. В последнем случае выбирается минимальный интервал, охватывающий указанный диапазон.
Почти любой элемент в отчете можно выделить одним щелчком мыши. Выбранный элемент сразу будет выделен во всех разделах отчета, что облегчит его поиск.
Разделы отчета подробно описаны в документации: https://postgrespro.ru/docs/enterprise/16/pgpro-pwr#PGPRO-PWR-REPOR T-GENERATION
Page 15: Отчеты
Получим отчет. Для построения обычного отчета достаточно указать две выборки или одну выборочную линию. В плане запроса, выполненного в условиях недостатка рабочей памяти, видно, что используются временные файлы для двухпроходного хеш-соединения. Раздел отчета “Top SQL by temp usage” должен содержать сведения об этом запросе.
Открываем /tmp/report_1_2.html…
Получим разностный отчет. Используем две выборочные линии. В разностном отчете должно быть заметно, что во втором запросе рабочей памяти хватило для выполнения однопроходного хеш-соединения и временные файлы не использовались. В отчете просмотрите разделы: Top SQL by temp usage; Load distribution among heavily loaded databases; Load distribution.
Открываем /tmp/report_diff.html…
Page 16: Итоги
Расширение pgpro\_pwr предназначено для выявления ресурсоемких операций в БД
- Статистика собирается расширениями pgpro_stats или pg_stat_statements
- Поддерживается политика хранения выборок
- Можно получать обычные и разностные отчеты в HTML
Page 17: Практика
- Подготовьте СУБД для работы с расширением pgpro_pwr. 2. Создайте базу данных и установите расширение pgpro_pwr. 3. Проведите нагрузочное тестирование с помощью pgbench, получив две выборки — до и после тестирования. 4. Создайте новое табличное пространство и сделайте выборку. 5. Снова проведите тестирование с помощью pgbench так, чтобы индексы были в новом табличном пространстве, после чего сделайте еще одну выборку. 6. Получите разностный отчет для первого и второго тестов.
Комментарии преподавателя
Подключите разделяемые библиотеки pg_wait_sampling и pgpro_stats.
В базе данных создайте схему для объектов расширения pgpro_pwr.
Выполните обычную инициализацию таблиц pgbench и обычный тест нагрузки, например, на 60 секунд.
Предварительно создайте каталог для табличного пространства, например, в домашнем каталоге пользователя postgres.
Заново проведите инициализацию таблиц pgbench, указав для табличного пространства ключ –index-tablespace. Сделайте новую выборку.
Получите разностный отчет с двумя промежутками.
Page 18: 1. Подготовка СУБД для работы с расширением pgpro_pwr
Подключим разделяемые библиотеки. Расширение pgpro_pwr получает сводную статистику ожиданий от расширения pg_wait_sampling:
Параметр track_io_timing нужен для анализа времени, затраченного операторами на чтение или запись блоков:
Параметр track_functions позволяет отслеживать вызовы пользовательских функций:
Перезагрузим сервер.
2. Создание базы данных и установка расширения pgpro\_pwr
Создадим базу данных.
Создадим схему для хранения объектов расширения и установим расширение.
Page 19: 3. Нагрузочное тестирование
Сделаем выборку:
Инициализируем нагрузочные таблицы pgbench:
Запустим pgbench на 30 секунд:
Получим вторую выборку, в которую попадут данные о нагрузке при инициализации и нагрузочном тесте:
4. Создание нового табличного пространства
Создадим табличное пространство.
Сделаем выборку:
5. Нагрузочное тестирование при размещении индексов в отдельном табличном пространстве
Page 20: Page 20
Инициализируем нагрузочные таблицы pgbench:
Запустим pgbench на 30 секунд:
Получим еще одну выборку:
Получим список выборок:
5. Получение разностного отчета
Получим разностный отчет.
Открываем /tmp/report_diff.html…
Уборка
Удалим созданную базу данных, табличное пространство и файл отчета.
Page 21: Page 21
Сбросим настройки параметров конфигурации.
Page 22: Практика PPEM
- В основном экземпляре создайте базу данных demo_pwr из шаблона demo. Подготовьте новую базу к работе с pgpro_pwr. 2. Сделайте снимок статистики новой базы с учетом размеров отношений. 3. Удалите схему bookings из базы данных demo_pwr. 4. Снова сделайте снимок статистики, подобный снимку из п. 2. 5. Постройте отчет по снимкам, построенным в пунктах 2 и 4, и найдите в нем данные, отражающие изменения, сделанные в п. 3.
Комментарии преподавателя
- В созданной базе установите необходимые расширения (нужные библиотеки уже были загружены в основном практическом задании) и создайте сервер профилировщика.
Page 23: 1. Создание базы и подготовка к работе с pgpro_pwr
На вкладке «Базы данных» нажмите «Создать базу данных» и заполните форму, указав базу demo в качестве шаблона. Выбрав новую базу, из вкладки «Расширения» создайте в ней расширение pgpro_pwr, включая установку зависимых расширений. Используя вкладку «Профилировщик» / «Серверы», создайте сервер профилировщика для новой базы — в строке подключения укажите dbname=demo_pwr.
2. Снимок статистики
Выберите вкладку «Снимки статистики» и нажмите «Сделать снимок» с выключенным параметром skip_sizes.
3. Изменения в данных
На вкладке «Базы данных» выберите demo_pwr, а в ней схему bookings. В столбце «Действия» для указанной схемы нажмите на пиктограмму «Удалить». Подтвердите удаление схемы, включив параметр каскадного удаления.
4. Повторный снимок статистики
Сделайте еще один снимок статистики, как в п. 2
5. Построение и просмотр отчета
На вкладке «Профилировщик» / «Построение отчетов» создайте стандартный отчет по снимкам, созданным в пунктах 2 и 4. В полученном отчете, в разделе «Server statistics» / «Database statistics», крайний правый столбец будет отражать изменение объема данных.