07 Занятие 07: Производительность / Транзакции и сеансы
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_07_transactions.html Archive: PGPRO-handouts-16.zip Страниц PDF: 36
Page 1: Производительность / Транзакции и сеансы
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- 64-битные номера транзакций
- Автономные транзакции
- Данные в памяти
- Встроенный пул соединений
Page 3: 64-битные транзакции
Формат данных
- Заморозка
Page 4: 32-битные номера
 {#source-figure-004 caption=“Source slide page 4: 32-битные номера”}
PostgreSQL, Postgres Pro Standard
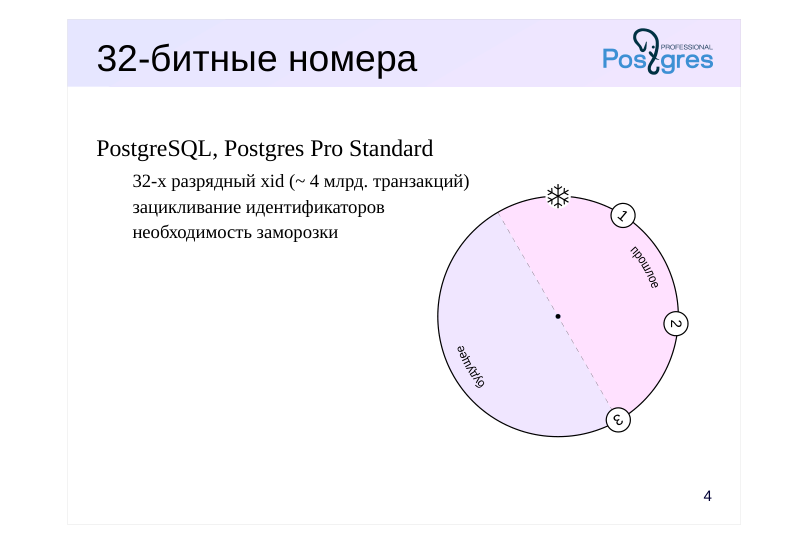
- 32-х разрядный xid (~ 4 млрд. транзакций)
- зацикливание идентификаторов
- необходимость заморозки
Комментарии преподавателя
32-битные идентификаторы транзакций допускают примерно четыре миллиарда уникальных значений. В современных реалиях при большой нагрузке идентификаторы могут закончиться через несколько дней и работа СУБД станет невозможна. Поэтому применяют заморозку: версии строк с достаточно большими xmin помечаются как очень старые и, следовательно, видимые во всех снимках данных. После заморозки версий с определенным номером во всех таблицах кластера номер можно использовать повторно (т. н. transaction wraparound).
Заморозка выполняется как одна из задач процесса очистки и активно использует подсистему ввода-вывода. При большой нагрузке требуется постоянно мониторить сервер и принимать оперативные меры, если заморозка не успевает освобождать номера транзакций.
Page 5: 64-битные номера
 {#source-figure-005 caption=“Source slide page 5: 64-битные номера”}
Postgres Pro Enterprise
- 64-х разрядный счетчик транзакций
- не подвержены зацикливанию
Комментарии преподавателя
Использование 64-битного счетчика позволило бы иметь практически бесконечное число идентификаторов транзакций, отказаться от их повторного использования и связанных с этим действий по администрированию.
Но простое увеличение разрядности идентификаторов привело бы к увеличению размера заголовков версий строк и, как следствие, к повышенному расходу дискового пространства и ресурсов ввода-вывода при обработке данных.
Поэтому в Postgres Pro Enterprise реализован компромиссный вариант 64-х битных идентификаторов: в специальной области в конце страницы хранится 64-битное базовое значение xid, а в полях xmin и xmax заголовка версии строки — 32-битное смещение. 64-битный номер транзакции xmin или xmax вычисляется сложением базового значения и значения, хранящегося в заголовке версии строки.
Такой же формат применяется для идентификаторов мультитранзакций: базовое значение хранится в специальной области страницы, а смещение — в поле xmax заголовка версии строки.
https://habr.com/ru/company/postgrespro/blog/707968/
Page 6: Заморозка
Синхронная
- если смещения не хватает и необходимо увеличить базовое значение
- При очистке
- уменьшает pg_xact и pg_multixact
- vacuum_freeze_min_age = 50 млн
- vacuum_freeze_table_age = 150 млн
- autovacuum_freeze_max_age = 10 млрд
- vacuum_failsafe_age = 1.6 млрд
- vacuum_multixact_freeze_min_age = 5 млн
- vacuum_multixact_freeze_table_age = 150 млн
- autovacuum_multixact_freeze_max_age = 20 млрд
- vacuum_multixact_failsafe_age = 1.6 млрд
Комментарии преподавателя
Поскольку смещения в заголовке версии строки 32-битные, диапазон значений xid в пределах страницы — от базового до базового плюс 232−1. Если в какую-либо версию строки на странице нужно записать больший номер, сервер увеличивает базовое значение xid. Если при этом версии строк с небольшими номерами xid препятствуют такому увеличению, сервер замораживает эти версии «на лету».
Поскольку 64-битные номера транзакций не используются повторно, своевременная заморозка не критична для работы многоверсионности: параметр autovacuum_freeze_max_age имеет значение по умолчанию 10 млрд вместо 200 млн в обычном PostgreSQL, и значение autovacuum_multixact_freeze_max_age также увеличено. Однако заморозка все же выполняется как часть процедуры очистки, чтобы уменьшать размер CLOG (подкаталога pg_xact) и статусов мультитранзакций (pg_multixact).
Ограничением этого решения является то, что очень долгие транзакции (возраст которой превышает 232), удерживающие снимок, будут мешать замораживать версии строк. Поэтому, хотя необходимость в регулярной заморозке отпадает, долгих транзакций по-прежнему стоит избегать.
В PostgresPro Enterprise 17 появилась фоновая заморозка: дополнительный процесс выполняет очистку и заморозку недавно измененных страниц. Ее рекомендуется включать, если автоочистка не справляется со своими задачами.
https://postgrespro.ru/docs/enterprise/16/routine-vacuuming#VACUUM-FOR -WRAPAROUND
Page 7: Структура страниц
Чтобы заглянуть в страницы, воспользуемся расширением pageinspect.
В тестовой таблице будет две страницы по две версии строки в каждой.
В конце каждой страницы данных находится так называемая специальная область, в которой в том числе хранится базовое значение xid:
В заголовках версий строк хранится 32-битное смещение (хотя значения xmin и xmax для удобства выводятся уже приведенными к 64-битному виду):
Текущее значение счетчика транзакций:
Пусть теперь сервер выполнит 2^32 транзакций. Выполнение такого количества транзакций работающим сервером заняло бы очень много времени, поэтому остановим его и воспользуемся утилитой pg_resetwal, чтобы поменять текущее значение счетчика.
Для гарантированного запуска сервера после изменения счетчика создадим пустой файл статусов транзакций:
Page 8: Page 8
Внимание! Категорически запрещается применять утилиту pg_resetwal в производственной среде за исключением использования ее по прямому указанию технической поддержки. Утилита изменяет внутренние структуры данных, что может привести к потере или искажению информации. Теперь изменим одну строку таблицы.
При этом сервер запишет номер текущей транзакции в поле xmax старой версии строки и в поле xmin новой версии, которая будет размещена в нулевой странице. Поскольку номер текущей транзакции отличается от значений xmin в существующих версиях более чем на 2^32, сервер увеличит базовый xid и выполнит локальную заморозку в нулевой странице. Для этого он выставит в заголовках версий соответствующий флаг, а в поле xmin запишет зарезервированное значение 2, означающее «номер заморожен». В первой странице заморозка не делается, поэтому базовый номер xid изменился только в нулевой странице.
Page 9: Автономные транзакции
Устройство автономных транзакций
- Видимость данных в автономных транзакциях
- Автономные транзакции в SQL
- Автономные транзакции в PL/pgSQL и PL/Python
- Ограничения автономных транзакций
Page 10: Автономные транзакции
Автономная транзакция — это независимая транзакция, которая запускается внутри родительской и должна быть завершена (зафиксирована или отменена) до завершения родительской.
Автономная транзакция может включать в себя другие автономные транзакции (транзакция верхнего уровня не может быть автономной). Когда вложенная автономная транзакция запускается, ее родительская транзакция приостанавливается и помещается в стек автономных транзакций. Когда автономная транзакция фиксируется или отменяется, родительская транзакция извлекается из стека и продолжает работу. Таким образом, на каждом уровне вложенности активной является только одна транзакция. Поэтому внутри автономной транзакции команды COMMIT или ROLLBACK будут завершать эту автономную транзакцию, а не родительскую. В отличие от вложенной транзакции, которая возникает в обычном PostgreSQL при выполнении команды SAVEPOINT (и, возможно, ROLLBACK TO), результат автономной транзакции не зависит от исхода родительской. В процедурных языках автономные транзакции тоже завершаются до завершения родительских, но происходит это неявно. Например, в PL/pgSQL добавлена конструкция для блока, операторы которого должны выполняться в автономной транзакции:
По сути, такая запись — просто сокращение для
Ошибка в блоке с автономной транзакцией приводит к ее откату, после чего ошибка обрабатывается в секции EXCEPTION или передается в вызывающий блок. В PL/Python добавлен метод, позволяющий выполнить SQL в автономной транзакции:
Page 11: Видимость
Снимки родительской и автономных транзакций независимы
- Read Committed видит изменения
- Repeatable Read, Serializable не видят изменений
- Возможны взаимоблокировки
Комментарии преподавателя
Родительская и дочерняя автономная транзакция используют собственные снимки данных, время жизни которых зависит от уровня изоляции. Поэтому родительская транзакция с уровнем изоляции Read Committed будет видеть все изменения дочерних автономных транзакций, а родительская с уровнем изоляции Repeatable Read или Serializable не увидит никаких изменений.
Автономная транзакция может вызвать взаимоблокировку, если она попытается получить блокировку ресурса, уже заблокированного родительской транзакцией.
Page 12: Ограничения
max\_autonomous\_transactions = 100
- Вложенность до 128 уровней
- Не поддерживается блокировка FOR UPDATE
- Нельзя обращаться к временным схемам
- Нельзя изменить уровень изоляции в PL/pgSQL и PL/Python
- Не поддерживаются в расширениях
- in_memory
- online_analyze
- Нельзя создавать слоты логической репликации
Комментарии преподавателя
Одновременно можно запустить не более max_autonomous_transactions автономных транзакций во всех сеансах (по умолчанию 100).
Глубина вложенности автономных транзакций — не более 128.
FOR UPDATE не поддерживается, поэтому, например, нельзя заблокировать строку в родительской транзакции, а в дочерней автономной пропустить ее с помощью SKIP LOCKED.
В автономной транзакции нельзя обращаться к объектам временных схем, в частности, ко временным таблицам.
В блоке PL/pgSQL и методе PL/Python нельзя задать уровень изоляции автономной транзакции, отличающийся от текущего.
Автономные транзакции не работают с расширениями in_memory и online_analyze.
Также нельзя создавать слоты логической репликации из автономной транзакции.
https://postgrespro.ru/docs/enterprise/16/atx
Page 13: Использование автономных транзакций
Обычно автономные транзакции используются для аудита, когда нужно сохранить информацию о событии, произошедшем в родительской транзакции, независимо от ее исхода. Опустошим таблицу:
Мы хотим записывать в таблицу test_audit информацию обо всех изменениях таблицы test, в том числе и о тех, которые не были зафиксированы.
Для этого понадобятся триггер и триггерная функция, тело которой выполняется в автономной транзакции.
Теперь информация об изменениях будет сохраняться в таблице test_audit, даже если транзакция впоследствии обрывается.
Откатим транзакцию:
В таблице ничего не осталось:
Page 14: Page 14
Однако попытки изменить данные записаны в таблицу аудита.
Page 15: Данные в памяти
pg\_variables
- in_memory
Page 16: Расширение pg_variables
Функции для работы с переменными различных типов
- скалярные
- массивы
- коллекции записей и произвольных типов
- Поддержка транзакционности
- Хранение в памяти сеанса
- работает на реплике
- несовместимо с пулами соединений
Комментарии преподавателя
Расширение pg_variables позволяет работать в памяти сеанса со скалярными переменными, массивами и коллекциями. Переменные объединяются в так называемые пакеты, выполняющие роль пространств имен.
Коллекции представляют собой множества пар ключ—значение. В качестве таких пар могут выступать обычные составные значения (записи), в которых первый атрибут считается ключом. Это позволяет использовать коллекции в качестве быстрой альтернативы временным таблицам, которая к тому же работает и на физических репликах.
Поддерживаются как транзакционные, так и нетранзакционные переменные. Изменения нетранзакционных переменных: создание, изменение, удаление – необратимы. Изменения транзакционных переменных можно отменить, откатив транзакцию полностью или до точки сохранения. Но в любом случае переменная существует только до конца сеанса и другим сеансам не видна.
Утилита ora2pgpro, рассмотренная в теме «Миграция», использует pg_variables для экспорта ассоциативных массивов Oracle в коллекции.
Расширение несовместимо с пулом соединений, включая встроенный пул Postgres Pro.
https://postgrespro.ru/docs/enterprise/16/pg-variables
Page 17: Расширение pg_variables
Установим расширение в базе данных:
Расширение оперирует термином «пакет», под которым понимается пространство имен переменных. Команды ниже автоматически создадут пакет vars (первый параметр), поместят в него две переменные int_n и int_t (второй параметр) целочисленного типа (тип определяется по фактическому типу третьего параметра) и зададут им значения. Первая переменная нетранзакционная (по умолчанию):
Вторая — транзакционная:
С помощью функций можно получить информацию о переменных и прочитать их значения:
Обратите внимание, что функции необходимо передавать третий параметр, чтобы сообщить тип скалярной переменной. Проверим транзакционность переменных, откатив транзакцию:
Читаем значения переменных:
Page 18: Page 18
Обратите внимание, что необходимо указывать флаг is_transactional при каждом изменении значения транзакционной переменной. В противном случае произойдет ошибка:
Работа с массивами организована аналогично. Рассмотрим работу с коллекциями записей. Запрос ниже вставляет в коллекцию tbl_1 пакета tbls несколько записей. Если пакет или коллекция не существуют (как в нашем случае), они будут созданы автоматически:
Первое поле каждой записи выступает в качестве первичного ключа. Если при вставке обнаружится запись с таким же ключом, будет выдана ошибка:
Мы можем изменять или удалять записи, обращаясь к ним по ключу:
Что получилось в результате? Прочитаем все данные из коллекции:
Данные в коллекциях хранятся в порядке возрастания, по записям удобно перемещаться с помощью итераторов:
Можно двигаться и в обратную сторону с помощью функций pgv_last и pgv_prior.
Page 19: Page 19
Количество элементов в коллекции вернет функция pgv_count:
Получить список созданных пакетов и объем памяти, используемый переменными можно так:
Удалить переменную и весь пакет целиком можно при помощи функции pgv_remove:
Функция pgv_free удаляет все пакеты и переменные:
Page 20: Расширение in_memory
Обертка сторонних данных для оперативных таблиц
- таблицы организованы по индексу
- данные располагаются в листовых страницах B-дерева
- Поддержка транзакционности
- Хранение в общей памяти сервера
- работает на реплике
- несовместимо со встроенным пулом соединений и подготовленными
- транзакциями
Комментарии преподавателя
С помощью расширения in_memory можно создавать небольшие оперативные таблицы, то есть таблицы в общей памяти сервера. Работа с таблицей происходит с помощью обертки сторонних данных.
Оперативные таблицы организованы по индексу — строки таблиц хранятся в страницах листьев индекса B-tree, что обеспечивает быстрый доступ к данным по первичному ключу (вторичные индексы не поддерживаются).
Для экономии памяти используются небольшие страницы размером 1 Кбайт. Поскольку индекс B-tree должен содержать на странице минимум три записи, максимальная длина строки ограничена 304 байтами (TOAST не поддерживается). Когда строки удаляются из оперативной таблицы, соответствующие страницы данных не освобождаются; для освобождения ресурсов требуется опустошение или удаление таблицы.
Оперативные таблицы полностью поддерживают транзакции, включая точки сохранения. Однако уровень изоляции Serializable не поддерживается, вместо него используется Repeatable Read.
Оперативные таблицы существуют только в памяти: они не сохраняются на диск и не журналируются, но их можно использовать на физических репликах.
Расширение нельзя использовать с подготовленными (двухфазными) транзакциями и при работе со встроенным пулом соединений.
https://postgrespro.ru/docs/enterprise/16/in-memory
Page 21: Расширение in_memory
Для работы расширения необходимо загрузить библиотеку и перезапустить СУБД:
Теперь установим расширение в базу:
Доступ к оперативным таблицам организуется с помощью обертки сторонних данных, для этого создан сторонний сервер in_memory:
Далее следует создать стороннюю таблицу на этом сервере — это и будет оперативная таблица:
По умолчанию в таблице будет создан уникальный индекс B-tree по первому столбцу, с сортировкой по возрастанию. При необходимости можно указать другую структуру индекса в параметре indices предложения OPTIONS (несмотря на множественное число названия параметра, индекс может быть только один):
Для столбцов можно указать правило сортировки, но всегда используется класс операторов по умолчанию. Оперативные таблицы созданы:
С таблицами можно выполнять все основные операции DML. Внесем данные и прочитаем несколько строк:
Page 22: Page 22
В отличие от коллекций расширения pg_variables, оперативные таблицы хранятся в общей памяти сервера и доступны другим сеансам:
Объем памяти, выделяемый для оперативных таблиц, задается параметром in_memory.shared_pool_size. Количество использованных и свободных страниц можно получить с помощью функции:
При удалении строк из оперативных таблиц командой DELETE страницы данных не освобождаются:
Чтобы освободить страницы, можно опустошить (TRUNCATE) или удалить таблицу. Также содержимое таблицы пропадает при перезапуске сервера:
Page 23: Пул соединений
Проблема и решения
- Встроенный пул
- Подключение
- Ограничения пула
Page 24: Проблема и решения
Один сеанс — один обслуживающий процесс
- повышенный расход ресурсов
- увеличение конкуренции
- прогрев локальных кешей
- Пул соединений в сервере приложений или драйвере
- J2EE, JDBC, ODBC, node-postgres, Psycopg2
- Пул соединений как сторонний продукт
- PgBouncer, Odyssey
- Встроенный пул Postgres Pro Enterprise сохраняет контекст сеанса
Комментарии преподавателя
Простейшая архитектура, при которой для каждого клиентского соединения запускается отдельный обслуживающий процесс, имеет ряд недостатков, которые при большом количестве клиентов становятся критичными. Увеличивается конкуренция при обращении к ресурсам, растут накладные расходы на запуск процессов (в частности, на наполнение кешей) и освобождение ресурсов при их завершении. Кроме того, размер многих структур в общей памяти сервера пропорционален числу клиентских соединений.
По этим причинам в нагруженные многопользовательские системы добавляют пул соединений, позволяющий нескольким клиентам использовать одно соединение с сервером. Как правило, для этого либо применяют отдельное решение, такое как PgBouncer или Odyssey, либо задействуют возможности сервера приложений или драйвера PostgreSQL.
При таком подходе администратору приходится обслуживать дополнительную компоненту архитектуры, а разработчику — учитывать особенности работы приложения с пулом соединений.
Встроенный пул соединений Postgres Pro Enterprise позволяет воспользоваться преимуществами пула, сохранив при этом большинство возможностей, связанных с контекстом сеанса.
В 17-й версии Postgres Pro Enterprise на смену встроенному пулу придет proxima — расширение, объединяющее функциональность прокси-сервера и пула соединений.
Page 25: Встроенный пул
 {#source-figure-025 caption=“Source slide page 25: Встроенный пул”}
Комментарии преподавателя
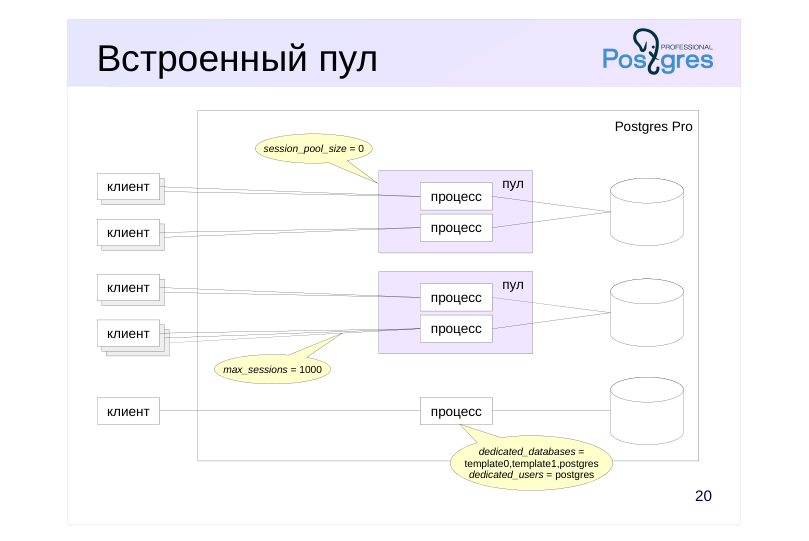
Для каждой базы данных создается отдельный пул, количество пулов не ограничено. Если количество процессов в пуле меньше значения session_pool_size, для нового сеанса запускается новый процесс, а если предел достигнут, сеанс привязывается к одному из существующих процессов.
Процесс, к которому привязано несколько сеансов, поочередно обслуживает их транзакции, сохраняя при этом контекст каждого сеанса. Поэтому значение session_pool_size следует задавать достаточно большим, чтобы клиент не ждал слишком долго, пока завершится транзакция другого соединения.
Одновременно процесс обслуживает не больше max_sessions сеансов. Если число соединений с одной базой достигнет max_sessions × × session_pool_size, следующая попытка подключения вернет ошибку.
Если клиент соединяется с базой данных, входящей в список dedicated_databases, или подключается под ролью, входящей в dedicated_users, для него будет создан выделенный процесс, не входящий в пулы. По умолчанию это сеансы пользователя postgres и подключения к базам template0, template1 и postgres. Количество выделенных процессов не ограничено.
https://postgrespro.ru/docs/enterprise/16/how-connection-pooler-works
Page 26: Подключение
 {#source-figure-026 caption=“Source slide page 26: Подключение”}
Комментарии преподавателя
Подключение нового клиента устроено следующим образом.
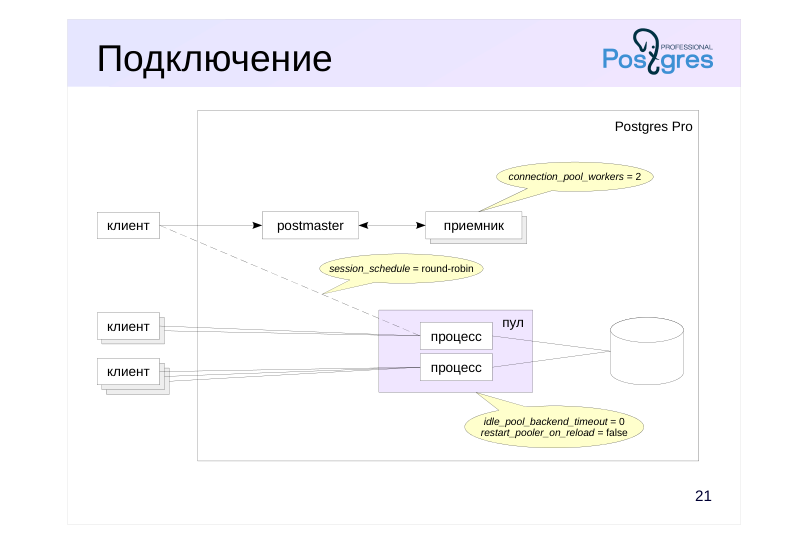
Процесс postmaster слушает входящие соединения. Подключаясь, клиент передает стартовый пакет данных, в котором указаны параметры соединения — имя базы данных, имя роли. Postmaster передает этот пакет одному из процессов-приемников для анализа. Количество процессов-приемников определяется значением параметра connection_pool_workers и должно быть достаточным, чтобы анализ входящих соединений не стал узким местом.
Получив от приемника информацию о базе данных и роли, postmaster направляет соединение в подходящий пул. Применяется одна из трех стратегий, которые можно указать в параметре session_schedule: round-robin назначает процессы по очереди, random — случайным образом, load-balancing выбирает процесс с наименьшим числом сеансов.
Когда все соединения, использующие какой-то процесс, завершаются, процесс продолжает работать. Автоматическое завершение неиспользуемого процесса по истечении определенного времени настраивается параметром idle_pool_backend_timeout.
Для перезагрузки рабочих процессов можно установить параметр restart_pooler_on_reload = true и перечитать конфигурацию.
https://postgrespro.ru/docs/enterprise/16/connection-pooler-configuration
Page 27: Ограничения пула
Не поддерживаются SSL-соединения
- Долгие транзакции задерживают работу других соединений
- Не поддерживаются рекомендательные блокировки уровня сеанса
- Нельзя перехватывать ошибку «connection to client lost»
- Не работают модули, полагающиеся на состояние сеанса
- Нельзя изменять параметры в других сеансах
- Остановка сервера в режиме smart работает как fast
- Параметр idle_session_timeout игнорируется
Комментарии преподавателя
Нужно учитывать следующие ограничения при использовании пула.
● SSL-соединения в текущей реализации не поддерживаются.
● Долгая транзакция будет задерживать работу транзакций в других соединениях, использующих тот же процесс.
● Ошибка «connection to client lost» обрабатывается пулом, чтобы завершать зависшие соединения по тайм-ауту, перехватывать ее не нужно.
● Не работают модули, использующие состояние на уровне сеанса, такие как plantuner, а также расширения multimaster, in_memory, online_analyze, pg_variables.
● Нельзя изменять параметры других сеансов.
● Не поддерживается передача сообщений между процессами (команды LISTEN, NOTIFY и т. п.).
● Остановка сервера в режиме smart работает как fast.
● Решения 1С не поддерживаются, они используют собственный пул соединений.
● Тайм-аут idle_session_timeout не работает.
https://postgrespro.ru/docs/enterprise/16/connection-pooler-limitations
Page 28: Встроенный пул соединений
Выделим в пуле по два процесса для каждой базы данных:
Если начать транзакцию в основном сеансе, ей будет выделен один из процессов:
Сеанс может хранить свое состояние в пользовательских параметрах:
Транзакции, начавшейся в другом сеансе, будет выделен другой процесс:
По умолчанию процессы выделяются по очереди (стратегия round-robin), поэтому третьему сеансу будет назначен процесс 806894. Но этот процесс занят выполнением транзакции первого сеанса, поэтому третий сеанс будет ждать:
Когда транзакция первого сеанса заканчивается…
…третий сеанс может воспользоваться освободившимся процессом 806894:
Page 29: Page 29
 {#source-figure-029 caption=“Source slide page 29: Page 29”}
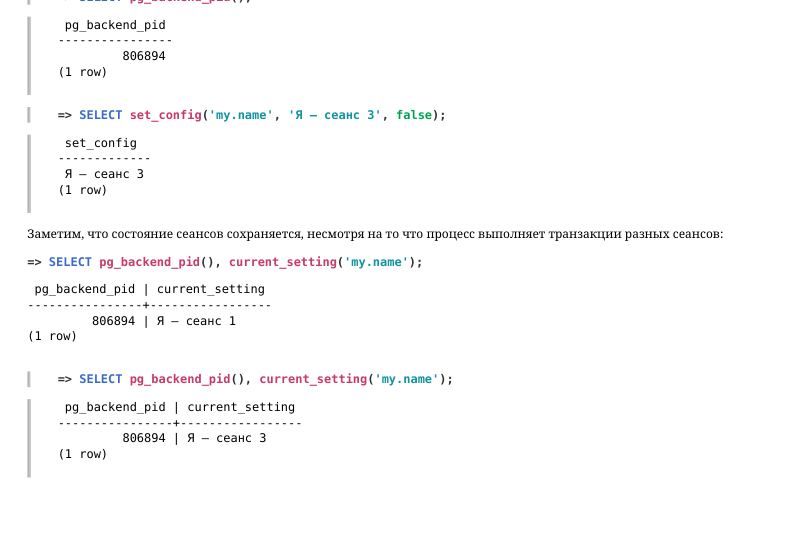
Заметим, что состояние сеансов сохраняется, несмотря на то что процесс выполняет транзакции разных сеансов:
Page 30: Итоги
64-битные идентификаторы транзакций упрощают обслуживание данных при высокой нагрузке
- Автономные транзакции дают возможность удобно и эффективно реализовать аудит
- Расширения pg_variables и in_memory могут служить альтернативой временным таблицам
- Встроенный пул позволяет ограничить число соединений, не жертвуя контекстом сеанса
Page 31: Практика
- Воспроизведите взаимоблокировку основной транзакции и вложенной в нее автономной. 2. Реализуйте аудит изменений данных в таблице двумя способами: используя расширение dblink и автономные транзакции. Сравните производительность. 3. Убедитесь, что при использовании встроенного пула соединений сохраняется содержимое временных таблиц уровня сеанса.
Page 32: 1. Взаимоблокировка в автономной транзакции
Создадим базу данных:
Начинаем транзакцию и блокируем строку:
Пытаемся блокировать ту же строку в автономной транзакции и получаем ошибку:
Основную транзакцию можно зафиксировать:
2. Аудит: dblink и автономные транзакции
Тестовая таблица:
Таблица для аудита:
Первый вариант триггерной функции использует расширение dblink:
Page 33: Page 33
Триггер:
Замеряем время.
Опустошим обе таблицы и заменим триггерную функцию на вариант, использующий автономную транзакцию.
Еще раз замеряем время.
Автономные транзакции работают быстрее, поскольку нет накладных расходов на установку соединения.
3. Временные таблицы и пул соединений
Включим пул соединений, выделив один процесс для каждой базы данных. Транзакции сеансов будут использовать его по очереди:
В каждом из двух сеансов создадим временную таблицу.
Page 34: Page 34
 {#source-figure-034 caption=“Source slide page 34: Page 34”}
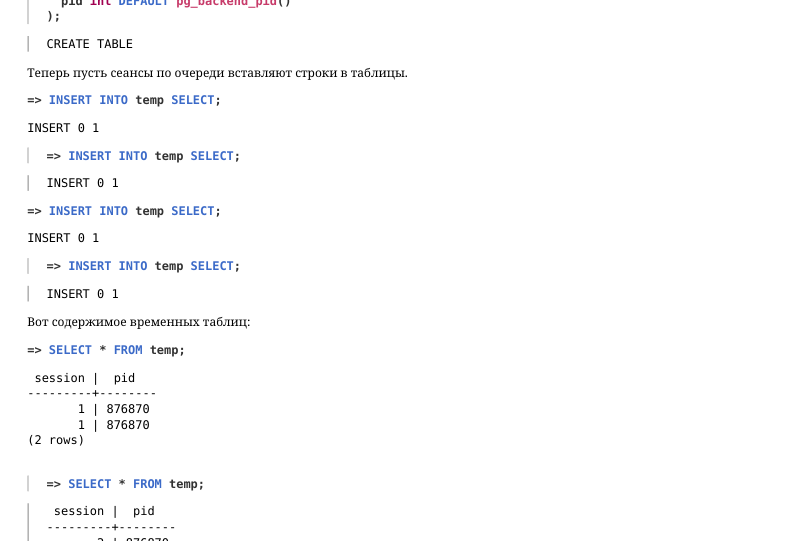
Теперь пусть сеансы по очереди вставляют строки в таблицы.
Вот содержимое временных таблиц:
Встроенный пул соединений Postgres Pro Enterprise сохраняет временные таблицы уровня сеанса. При использовании сторонних менеджеров пула сохранение контекста сеанса не гарантируется.
Уборка
Удалим созданную базу данных и выключим пул соединений.
Page 35: Практика PPEM
- Создайте базу данных newbase и в ней схему dblink. 2. Установите расширение dblink в одноименную схему базы newbase. 3. Используя расширение dblink и консоль psql, выведите список моделей самолетов из базы данных demo.
Комментарии преподавателя
- Получить данные по моделям самолетов можно с помощью запроса SELECT * FROM dblink.dblink( ‘dbname=demo’, ‘SELECT model FROM aircrafts’ ) AS (m text);
Page 36: 1. Создание базы данных и схемы
В навигационной панели выберите «Базы данных» и на главной странице нажмите «Создать базу данных». В открывшемся окне заполните необходимые поля и нажмите «Сохранить» — новая база появится в списке. Выбрав новую базу, нажмите «Создать схему», заполните поля на форме и выберите «Создать».
2. Установка расширения dblink
Выберите новую базу в списке на главной странице и на вкладке «Расширения» навигационной панели нажмите «Установить расширение». В открывшейся форме выберите из списка баз newbase, в списке доступных расширений найдите dblink и выберите для установки созданную в п. 1 одноименную схему. Нажмите кнопку «Установить».
3. Работа с psql-консолью. Доступ к удаленной базе с помощью dblink
В списке «Базы данных» главной страницы найдите newbase, и в столбце «Действия» нажмите на пиктограмму «{/}» (открыть PSQL-консоль) — откроется окно утилиты с приглашением, указывающим на подключение к выбранной базе. Для получения требуемой информации наберите и выполните запрос:
Чтобы скопировать текст запроса из буфера обмена, используйте клавиши Ctrl+V, затем в контекстном меню выберите Paste или нажмите клавишу P.