06 Занятие 06: Данные / CFS — сжатая файловая система
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_06_cfs.html Archive: PGPRO-handouts-16.zip Страниц PDF: 24
Page 1: Данные / CFS — сжатая файловая система
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Возможность и польза сжатия
- Реализация сжатия в Postgres Pro Enterprise
- Использование CFS
- Объем данных и степень сжатия
- Фрагментация и сбор мусора
Page 3: Возможности и польза
Данные БД обычно хорошо сжимаются
- текстовые данные
- дублирование
- Преимущества сжатия
- уменьшение объема хранения
- экономия ресурсов ввода-вывода
- последовательное чтение и запись
- Сжатие при записи грязного буфера
- в буферном кеше нужны несжатые данные
Комментарии преподавателя
В базах данных обычно хранятся большие объемы текста и повторяющейся информации. Поэтому для большинства баз сжатие может быть довольно эффективным и позволяет сократить объем хранимых данных в несколько раз. PostgreSQL сжимает данные в TOAST-таблицах, но небольшие текстовые поля, умещающиеся в странице, не сжимаются. Сжатие может быть полезно не только для таблиц, но и для индексов по текстовым ключам или для индексов с большим количеством повторяющихся значений.
Помимо очевидного плюса — экономии места, сжатие может также увеличить быстродействие системы по двум причинам. Во-первых, сокращается объем дискового ввода-вывода. Во-вторых, появляется возможность последовательно записывать сжатые измененные данные в смежные области диска, увеличивая скорость обращения к ним за счет последовательного доступа.
Работать со сжатыми данными в общей памяти сервера (в буферном кеше) непроизводительно, поэтому логично выполнять сжатие страницы при сохранении грязного буфера и разжимать ее при чтении в буферный кеш.
Page 4: Реализация сжатия
 {#source-figure-004 caption=“Source slide page 4: Реализация сжатия”}
Комментарии преподавателя
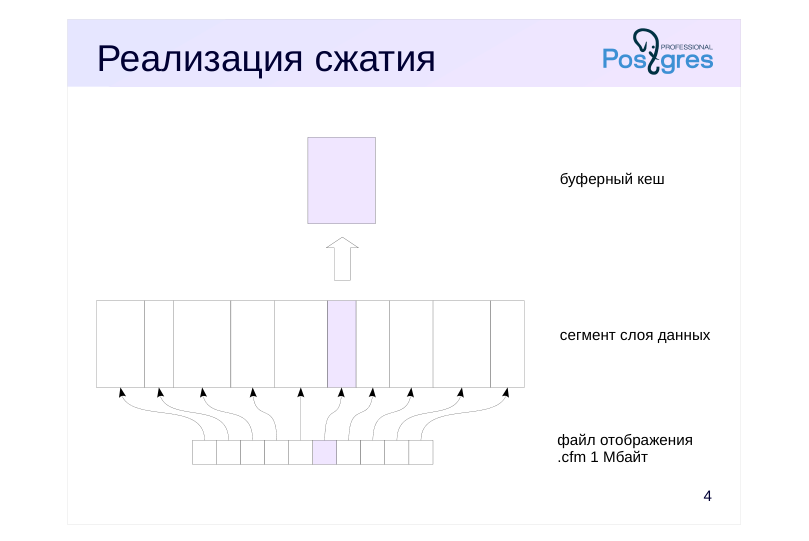
Буферный кеш для эффективности использует страницы фиксированного размера (обычно 8 Кбайт), а сжатые страницы имеют разный размер, который к тому же меняется при изменении данных. Это вынуждает перемещать страницы внутри сегмента, и поэтому вводится дополнительный уровень адресации (отображение страниц), который представляет собой набор указателей на текущее местоположение всех страниц.
Сжатые данные также хранятся в файлах-сегментах, но для каждого из них имеется своя карта отображения страниц. Карта имеет размер 1 Мбайт (32 байта на заголовок + по 8 байт на каждый из 131072 указателей) и поэтому обычно находится в кеше ОС.
https://postgrespro.ru/docs/enterprise/16/cfs-implementation
Page 5: Реализация сжатия
 {#source-figure-005 caption=“Source slide page 5: Реализация сжатия”}
Комментарии преподавателя
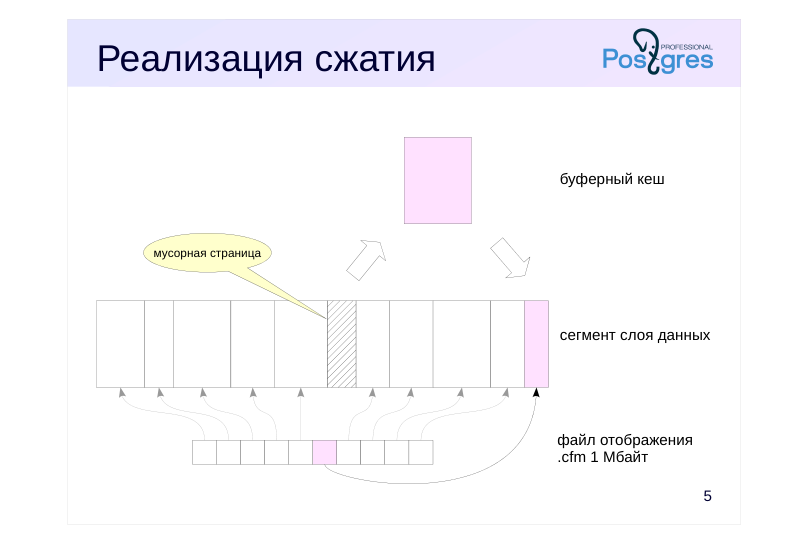
При записи (в частности, при выполнении контрольной точки) страница, находящаяся в грязном буфере, сжимается в соответствии с настройками сжатия и добавляется в конец сегмента, а в указатель в файле отображения заносится новая позиция страницы. После этого область файла данных, в которой раньше находилась страница, становится ненужной. Такие области с мусорными страницами будут накапливаться, что приведет к увеличению фрагментации хранимых данных.
Механизм сбора мусора будет рассмотрен позже в этой теме.
Page 6: Использование CFS
- Системные отношения не сжимаются
- Проверка контрольной суммы — при чтении в буфер
- pg_checksums и pg_basebackup не проверяют
Комментарии преподавателя
Сжатие можно включить только на уровне табличного пространства и только в момент его создания, при этом нужно задать алгоритм сжатия. Изменить факт и алгоритм сжатия в дальнейшем нельзя.
Поддерживаются библиотеки zstd, pglz, zlib, lz4. По умолчанию используется алгоритм zstd.
Системные отношения никогда не сжимаются — для соответствующих сегментов не создаются файлы отображения и механизм сжатия не используется.
Проверка контрольных сумм сжатых страниц возможна, только когда они находятся в развернутом виде в буферном кеше. Поэтому утилиты pg_checksums и pg_basebackup контрольные суммы страниц не проверяют.
https://postgrespro.ru/docs/enterprise/16/cfs-usage
Page 7: Настройка табличного пространства
Убедимся, что сжатие поддерживается:
Создадим табличное пространство со сжатием.
Page 8: Объем данных
Стандартные функции
- pg_relation_size
- pg_table_size
- pg_indexes_size
- pg_total_relation_size
- работают корректно
- pg_database_size
- файлы отображения
- pg_tablespace_size
- файлы отображения + pg_compression
Комментарии преподавателя
Стандартные функции pg_*_size, возвращающие занимаемый на диске объем, корректно работают со сжатыми табличными пространствами.
В объеме базы данных учитываются файлы отображения, а в объеме табличного пространства — файлы отображения и служебный файл pg_compression.
https://postgrespro.ru/docs/enterprise/16/functions-admin#FUNCTIONS-CO MPRESSION-CONTROL
Page 9: Степень сжатия
Параметры
- cfs_level = 1
- 0 — без сжатия, 1 — самое быстрое
- cfs_compress_temp_relations = off
- Функции
- cfs_estimate
- прогноз степени сжатия
- (среднее по первым 10% страниц)
- cfs_compression_ratio
- фактическое сжатие по всем сегментам
Комментарии преподавателя
Уровень сжатия настраивается параметром cfs_level. Значение 0 отключает сжатие, значение 1 (по умолчанию) соответствует максимальной скорости. Значения от 2 до 100 позволяют указать конкретный уровень сжатия; максимальное значение зависит от используемого алгоритма.
Временные таблицы по умолчанию не сжимаются. Параметр cfs_compress_temp_relations позволяет включить их сжатие, что может быть полезно при большом объеме временных данных.
Функция cfs_estimate оценивает степень сжатия для всех доступных алгоритмов с учетом текущего значения cfs_level. Анализируются первые 10% (но не более 100) страниц таблицы.
Функция cfs_compression_ratio возвращает фактическую степень сжатия таблицы. Степень сжатия — это отношение объема несжатых данных к объему сжатых. В данном случае объем страниц в буферном кеше делится на объем сжатых страниц, сохраненных в файле.
https://postgrespro.ru/docs/enterprise/16/runtime-config-cfs
https://postgrespro.ru/docs/enterprise/16/functions-admin#FUNCTIONS-CO MPRESSION-CONTROL
Page 10: Сжатая таблица
В новой базе данных таблицы и индексы будут по умолчанию располагаться в сжатом табличном пространстве.
Создадим таблицу с минимальным fillfactor и расположим ее сначала вне сжатого пространства. Мы не хотим, чтобы автоочистка изменяла данные в страницах во время демонстрации, поэтому отключим ее:
Вставим в таблицу 100000 одинаковых строк:
Сколько места в оперативной памяти занимает основной слой таблицы?
А сколько на диске?
Ровно столько же, ведь сжатие пока не используется. Проверим, какой выигрыш может дать сжатие. Но сначала выполним контрольную точку, чтобы сбросить грязные страницы из буферного кеша на диск. Это может повлиять на результат.
Прогнозируемая по части страниц степень сжатия:
Page 11: Page 11
Видим, что наилучшая степень сжатия ожидается при использовании zstd. Этот алгоритм сжатия как раз используется (по умолчанию) в табличном пространстве cts. Перенесем таблицу в сжатое табличное пространство и снова поинтересуемся ее размером.
Фактическая степень сжатия немного отличается от прогнозируемой:
Таблица сжалась в десятки раз. Системный каталог тоже находится в пространстве по умолчанию (cts), но системные таблицы никогда не сжимаются.
Page 12: Фрагментация
 {#source-figure-012 caption=“Source slide page 12: Фрагментация”}
- мусорные страницы
- процент мусора > cfs_gc_threshold
Комментарии преподавателя
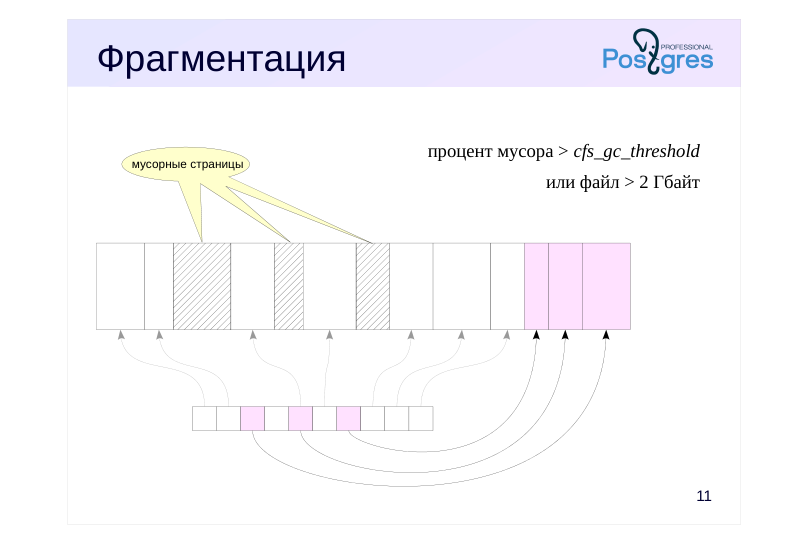
Чтобы бороться с фрагментацией, в Postgres Pro Enterprise реализован механизм сбора мусора.
Файл данных подлежит обработке, если суммарный размер мусорных страниц превышает cfs_gc_threshold процентов от размера файла или размер файла больше 2 Гбайт. Одновременно с файлом данных обрабатывается соответствующий файл отображения.
Page 13: Сбор мусора
 {#source-figure-013 caption=“Source slide page 13: Сбор мусора”}
Комментарии преподавателя
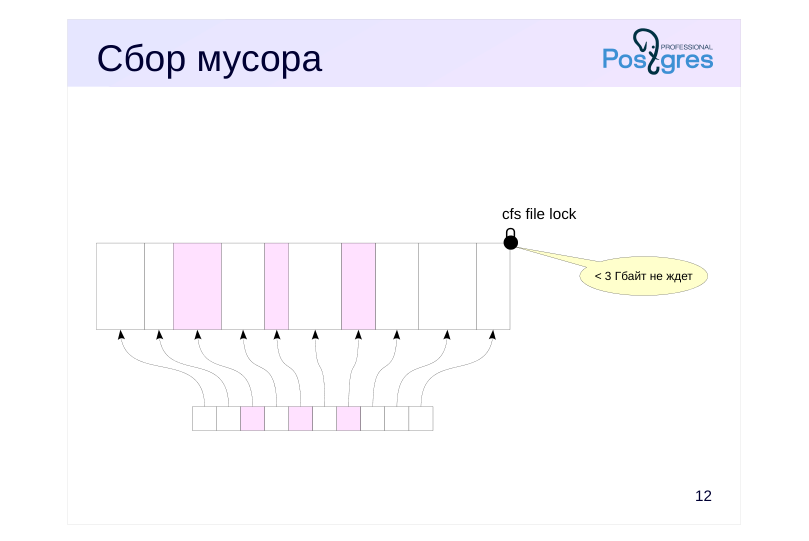
На время обработки файл данных полностью блокируется — ставится легкая блокировка cfs file lock в исключительном режиме, которая запрещает обслуживающим процессам обращаться к файлу. Если не удается получить блокировку немедленно, а размер файла менее 3 Гбайт, процедура сбора мусора его пропустит, а если файл имеет больший размер — будет ждать получения блокировки.
Затем нужные страницы копируются в новый файл данных и строится новый файл отображения. По окончании обработки старые файлы удаляются, а новые переименовываются; это происходит атомарно.
Обслуживающие процессы устанавливают на файл ту же блокировку, но в разделяемом режиме, чтобы процесс сбора мусора дождался окончания работы с файлом, прежде чем начинать работу.
Page 14: Сбор мусора
Настройки
- cfs_gc = on
- cfs_gc_workers = 1
- cfs_gc_threshold = 30
- cfs_gc_delay = 0
- cfs_gc_period = 5000ms
- Запуск
- cfs_start_gc( число-процессов ), 0 — синхронно
- cfs_gc_relation( отношение )
Комментарии преподавателя
Сбор мусора выполняется одним или несколькими процессами в ручном или фоновом режиме.
По умолчанию фоновый сбор мусора включен (cfs_gc = on) и использует один рабочий процесс (cfs_gc_workers = 1).
Если выключить фоновый сбор (cfs_gc = off) и задать параметр cfs_gc_workers = 0, можно вызовом функции cfs_start_gc(0) запустить сбор мусора синхронно, а вызовом cfs_start_gc(N) — асинхронно N процессами. Функция cfs_gc_relation собирает мусор в файлах определенного отношения, возвращая число обработанных файлов.
Параметр cfs_gc_threshold задает минимальный процент мусора, при котором файл размером до 2 Гбайт подлежит обработке (файлы больше 2 Гбайт обрабатываются всегда). Эти условия действуют независимо от способа запуска.
После обработки каждого файла процесс приостанавливается на cfs_gc_delay миллисекунд. По окончании обработки всех файлов процесс бездействует cfs_gc_period миллисекунд.
При ручном запуске можно задать все упомянутые параметры на уровне сеанса, чтобы, например, обработать файлы с меньшим уровнем фрагментации или сделать обработку более интенсивной.
Page 15: Сбор мусора
Функции для мониторинга
- cfs_fragmentation (отношение)
- cfs_gc_activity_scanned_files
- cfs_gc_activity_processed_files
- cfs_gc_activity_processed_pages
- cfs_gc_activity_processed_bytes
- Запись в журнал
- cfs_gc_respond_time = 3600ms
- cfs_log_verbose = off
Комментарии преподавателя
Для мониторинга процессов сбора мусора имеется несколько функций. Статистика накапливается с момента запуска сервера.
Параметр cfs_gc_respond_time задает интервал, в течение которого CFS ждет снятия блокировки с файла при сборке мусора, прежде чем в журнал сообщений будет записано предупреждение.
CFS может выводить в журнал информацию о процессе сбора мусора; уровнем детализации сообщений при этом управляет параметр cfs_log_verbose. При его значении on (по умолчанию) устанавливается уровень LOG, а при значении off — уровень INFO.
Важно, чтобы сбор мусора выполнялся регулярно, иначе файлы отношений будут неограниченно расти, что приведет к падению производительности, а в дальнейшем к недостатку свободного места на диске. Поэтому рекомендуется не отключать фоновый сбор и при необходимости настроить его частоту и производительность.
https://postgrespro.ru/docs/enterprise/16/functions-admin#FUNCTIONS-CO MPRESSION-CONTROL
https://postgrespro.ru/docs/enterprise/16/runtime-config-cfs#RUNTIME-CON FIG-CFS
Page 16: Сбор мусора
Сейчас таблица не фрагментирована:
Посмотрим, что будет, если отключить сбор мусора.
Изменим все строки таблицы.
Объем хранения вырос вдвое, фрагментация превысила умолчательный порог 30%. При дальнейшем изменении таблицы рост продолжится. Новые версии строк попадут в новые страницы, которые запишутся в конец файла.
Теперь просто прочитаем данные — все строки таблицы — и снова увидим, что размер таблицы увеличился:
Page 17: Page 17
Почему так происходит? Из курса DBA2 нам известно, что при первом обращении к измененным строкам в них устанавливаются биты-подсказки. А это означает, что такие измененные страницы тоже будут записаны в конец файла, увеличивая его размер. Выполним очистку таблицы. Работа очистки приведет к изменениям в страницах данных, что также увеличит размер файла таблицы и количество мусорных страниц:
Конечно же, в реальной системе мусор необходимо собирать. Попробуем собрать мусор в таблице вручную, задав минимальный порог на уровне сеанса, чтобы были обработаны все сегменты:
Неиспользуемые страницы удалены, размер файла уменьшился:
Обновим таблицу и выполним контрольную точку, чтобы сжатые страницы записались в файл.
Объем опять вырос (примерно вдвое), фрагментация около 50%. Теперь вернем автоматический сбор мусора и сбросим порог, который мы задавали на уровне сеанса.
Page 18: Page 18
Сбор мусора выполнится автоматически (немного подождем).
Page 19: Итоги
Сжатие настраивается для табличных пространств
- Можно выбирать алгоритм и управлять уровнем сжатия
- Встроенный механизм сбора мусора сокращает объем хранимых данных
Page 20: Практика
- Создайте сжатое табличное пространство, использующее алгоритм zstd с максимальным уровнем сжатия 19. 2. Поместите копию одной из таблиц демобазы в сжатое табличное пространство. Насколько уменьшился ее размер? 3. Удалите созданную в п. 2 базу и сжатое пространство.
Комментарии преподавателя
- Чтобы контролировать изменения данных в страницах, отключите автоматическую очистку для таблицы.
Page 21: 1. Сжатое табличное пространство
2. База данных
Загружаем определение таблицы и ее строки в новую базу:
Page 22: Page 22
3. Удаление табличного пространства
Уборка
Сбросим настройку параметра конфигурации.
Page 23: Практика PPEM
- В экземпляре ent-16 создайте сжатое табличное пространство, использующее алгоритм lz4, и разместите его в каталоге /var/lib/postgresql/lz4_cfs. 2. Создайте в сжатом табличном пространстве базу данных demo_cfs из шаблона demo.
- Сравните размеры баз данных demo и demo_cfs. 4. Удалите базу данных и сжатое пространство.
Page 24: 1. Создание табличного пространства
На главной странице откройте список экземпляров, щелкнув по блоку «Экземпляры», и выберите ent-16. В навигационной панели выберите вкладку «Табличные пространства» и нажмите «Создать пространство». В открывшемся окне введите название, требуемый каталог размещения и способ сжатия, а затем нажмите «Сохранить».
2. Создание базы данных из шаблона
В навигационной панели, на вкладке «Базы данных», нажмите «Создать базу данных». В диалоговом окне введите название, выберите требуемый шаблон и табличное пространство и нажмите «Сохранить».
3. Сравнение размеров данных таблиц
Дождитесь обновления информации по созданной базе в списке баз данных — в нем должны появиться сведения о количестве таблиц и индексов и их размерах, а также о размере базы. Сравните размер исходной базы шаблона и новой базы.
4. Удаление табличного пространства
В выпадающем меню в колонке «Действия» для новой базы выберите пункт «Удалить» и подтвердите его. В навигационной панели выберите вкладку «Табличные пространства» и в строке сжатого пространства нажмите на пиктограмму удаления. Дополнительно подтвердите удаление в появившемся диалоговом окне.