19 Занятие 19: Репликация / Обзор логической репликации
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_19_replica_overview_logical.html Archive: DEV2-handouts-16.zip Страниц PDF: 26
Page 1: Репликация / Обзор логической репликации
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Логическая репликация
- Публикации и подписчики
- Уровни журнала
- Обнаружение и разрешение конфликтов
- Особенности работы триггеров
- Задачи, решаемые с помощью логической репликации
- Ограничения
Page 3: Логическая репликация
Механизм
- публикующий сервер читает собственные журнальные записи,
- декодирует их в изменения строк данных и отправляет подписчикам
- сервер-подписчик применяет изменения к своим таблицам
- Особенности
- публикация-подписка: поток данных возможен в обе стороны
- требуется совместимость на уровне протокола
- возможна выборочная репликация отдельных таблиц
Комментарии преподавателя
При физической репликации только один сервер (мастер) выполняет изменения и генерирует журнальные записи. Остальные серверы (реплики) только читают журнальные записи мастера и применяют их.
При логической репликации все серверы работают в обычном режиме, могут изменять данные и генерировать собственные журнальные записи. Любой сервер может публиковать свои изменения, а другие — подписываться на них. При этом один и тот же сервер может как публиковать изменения, так и подписываться на другие. Это позволяет организовать произвольные потоки данных между серверами.
Публикующий сервер читает собственные журнальные записи, но не пересылает их подписчикам в исходном виде (как при физической репликации), а предварительно декодирует их в «логический», независимый от платформы и версии PostgreSQL вид. Поэтому для логической репликации обычно не нужна двоичная совместимость, реплика должна лишь понимать протокол репликации. Также можно получать и применять изменения не всех объектов, а только отдельных таблиц.
https://postgrespro.ru/docs/postgresql/16/logical-replication
Page 4: Логическая репликация
 {#source-figure-004 caption=“Source slide page 4: Логическая репликация”}
Комментарии преподавателя
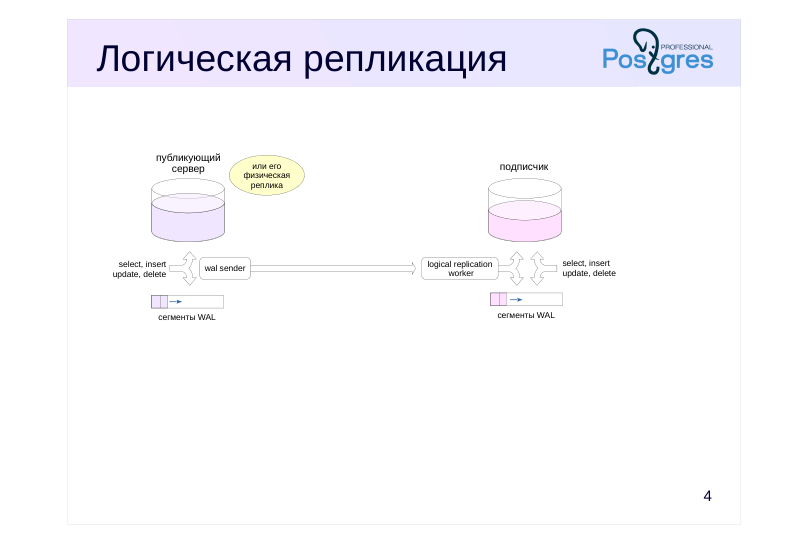
На публикующем сервере процесс wal_sender формирует журнальные записи, отражающие изменения в публикуемых данных, а фоновый процесс logical replication worker на сервере-подписчике получает информацию от публикующего сервера и применяет ее.
Подписчик может получать изменения не только напрямую с публикующего сервера, но и с его физической реплики. В этом случае отправку изменений подписчику выполняет процесс wal_sender физической реплики. Такая схема работы полезна для уменьшения нагрузки на публикующий сервер.
https://postgrespro.ru/docs/postgresql/16/logical-replication-publication
https://postgrespro.ru/docs/postgresql/16/logical-replication-subscription
Page 5: Публикации и подписки
Публикация
- включает одну или несколько таблиц базы данных
- можно указать столбцы и фильтр для строк
- обрабатывает команды INSERT, UPDATE, DELETE, TRUNCATE
- выдает изменения построчно после фиксации транзакции
- использует слот логической репликации
- Подписка
- получает и применяет изменения
- возможна начальная синхронизация
- без разбора, переписывания и планирования — сразу выполнение
- возможны конфликты с локальными данными
Комментарии преподавателя
Логическая репликация использует модель «публикация-подписка».
На одном сервере создается публикация, которая может включать ряд таблиц одной базы данных. Начиная с версии 15 можно опубликовать только часть данных таблицы: указать набор столбцов и задать условие фильтрации для строк. Другие серверы могут подписываться на эту публикацию: получать и применять изменения.
Реплицируются только измененные строки таблиц (а не команды SQL). Команды DDL не передаются; таблицы-приемники на подписчике надо создавать вручную. Но есть возможность автоматической начальной синхронизации содержимого таблиц при создании подписки.
После фиксации транзакции информация о строках, которые она изменила, извлекается из записей WAL на сервере публикации — эта процедура называется логическим декодированием. Сформированные сообщения пересылаются подписке по протоколу репликации в формате, независимом от платформы и версии сервера.
Применение изменений происходит без выполнения команд SQL и связанных с этим накладных расходов на разбор и планирование. С другой стороны, результат выполнения одной команды SQL может превратиться в множество однострочных изменений.
https://postgrespro.ru/docs/postgresql/16/logical-replication
Page 6: Уровни журнала
Параметр wal\_level
- minimal < replica < logical
- восстановление восстановление восстановление после сбоя после сбоя после сбоя восстановление восстановление из резервной копии, из резервной копии, репликация репликация логическая репликация
Комментарии преподавателя
Чтобы публикующий сервер смог сформировать сообщения об изменениях на уровне табличных строк, в журнал необходимо помещать дополнительную информацию, в частности идентификаторы затрагиваемых при репликации строк и сообщения о фактах изменения определений таблиц и типов данных. Это позволяет подписчику в любой момент знать структуру объектов, участвующих в репликации.
Такой расширенный уровень журнала называется logical. Поскольку по умолчанию используется уровень replica, для логической репликации потребуется изменить значение параметра wal_level на публикующем сервере.
https://postgrespro.ru/docs/postgresql/16/protocol-logical-replication#PROT OCOL-LOGICAL-MESSAGES-FLOW
Page 7: Логическая репликация
Пусть на первом сервере имеется таблица:
Склонируем кластер с помощью резервной копии, как мы делали в теме «Обзор физической репликации», но команде pg_basebackup не будем передавать ключ -R, поскольку нам потребуется независимый сервер, а не реплика.
Если второй сервер работает, остановим его
Перемещаем резервную копию в каталог данных второго сервера, поменяв владельца файлов:
Запускаем второй сервер:
Получили два независимых сервера, на каждом из них есть пустая таблица test. Добавим в таблицу на первом сервере пару строк:
Теперь мы хотим настроить между серверами логическую репликацию. Для этого понадобится дополнительная информация в журнале первого сервера:
На первом сервере создаем публикацию:
На втором сервере подписываемся на эту публикацию:
Page 8: Page 8
При создании подписки на сервере публикации автоматически создался слот репликации — объект, который помнит, какие изменения получил подписчик, и в случае разрыва соединения позволяет возобновить передачу с нужного места.
Проверяем репликацию:
Состояние подписки можно посмотреть в представлении:
К процессам сервера-подписчика добавился logical replication worker (его номер указан в pg_stat_subscription.pid):
Page 9: Конфликты
Режимы идентификации для изменения и удаления
- столбцы первичного ключа (по умолчанию)
- столбцы указанного уникального индекса с ограничением NOT NULL
- все столбцы
- без идентификации (по умолчанию для системного каталога)
- Конфликты — нарушение ограничений целостности
- репликация приостанавливается до устранения конфликта вручную
Комментарии преподавателя
Вставка новых строк происходит достаточно просто. Интереснее обстоит дело при изменениях и удалениях — в этом случае надо как-то идентифицировать старую версию строки. По умолчанию для этого используются столбцы первичного ключа, но при определении таблицы можно указать и другие способы (replica identity): использовать уникальный индекс или использовать все столбцы. Можно вообще отказаться от поддержки репликации для некоторых таблиц (по умолчанию не реплицируются таблицы системного каталога).
Поскольку таблицы на сервере публикации и сервере подписки могут изменяться независимо друг от друга, при вставке новых версий строк возможны конфликты — нарушения ограничений целостности. В этом случае процесс применения записей приостанавливается до тех пор, пока конфликт не будет разрешен вручную.
https://postgrespro.ru/docs/postgresql/16/sql-altertable
https://postgrespro.ru/docs/postgresql/16/logical-replication-conflicts
https://postgrespro.ru/docs/postgresql/16/sql-altersubscription
Page 10: Конфликты
Локальные изменения на подписчике не запрещаются, вставим строку в таблицу на втором сервере.
Если теперь строку с таким же значением первичного ключа вставить на первом сервере, при ее применении на стороне подписки произойдет конфликт.
Подписка не может применить изменение, репликация остановилась.
Чтобы разрешить конфликт, удалим строку на втором сервере и немного подождем…
Репликация возобновилась.
Page 11: Триггеры на подписчике
При обычной работе
- в обслуживающих процессах (session_replication_role = origin или local)
- ENABLE TRIGGER
- ENABLE ALWAYS TRIGGER
- При применении реплицированных изменений
- в процессе logical replication worker (session_replication_role = replica)
- ENABLE REPLICA TRIGGER
- ENABLE ALWAYS TRIGGER
- только на уровне строк (за исключением начальной синхронизации)
Комментарии преподавателя
Срабатывание триггеров на сервере-подписчике имеет некоторые особенности.
При применении изменений, полученных из публикации, обычные триггеры работать не будут. Это удобно, если на обоих серверах созданы одинаковые таблицы с одинаковым набором триггеров: в таком случае триггер уже отработал на публикующем сервере и его не надо выполнять на подписчике.
Если нужно, чтобы триггер все-таки срабатывал, его необходимо определить как репликационный (ALTER TABLE … ENABLE REPLICA TRIGGER) или универсальный (ENABLE ALWAYS TRIGGER).
Изменения реплицируются построчно, поэтому работают только триггеры таблиц на уровне строк (FOR EACH ROW), но не на уровне оператора (FOR EACH STATEMENT). Исключение составляет начальная синхронизация — при ней срабатывают триггеры и на уровне строк, и на уровне оператора.
При обычной работе срабатывают «обычные» триггеры (просто созданные командой CREATE TRIGGER, или явно разрешенные командой ALTER TABLE … ENABLE TRIGGER) и универсальные триггеры (ENABLE ALWAYS TRIGGER).
Сервер отличает обычный процесс от процесса, применяющего реплицированные изменения, с помощью параметра сеанса session_replication_role. По умолчанию параметр имеет значение origin, а процесс logical replication worker задает ему значение replica.
https://postgrespro.ru/docs/postgresql/16/sql-altertable
Page 12: Триггеры на подписчике
 {#source-figure-012 caption=“Source slide page 12: Триггеры на подписчике”}
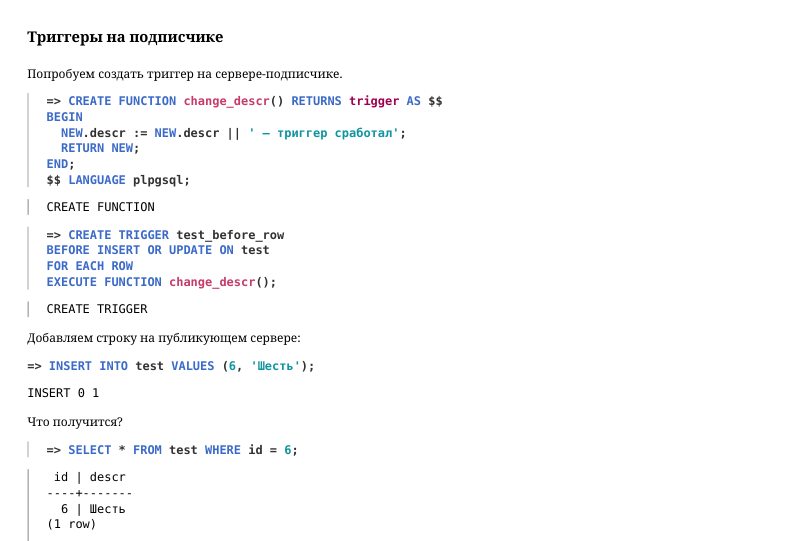
Попробуем создать триггер на сервере-подписчике.
Добавляем строку на публикующем сервере:
Что получится?
Обычный триггер не срабатывает при применении изменений из публикации, зато он будет срабатывать при локальных изменениях на подписчике:
Допустим, нам нужно, чтобы триггер срабатывал только для изменений, происходящих при репликации. Для этого явно включим его как репликационный:
Проверим:
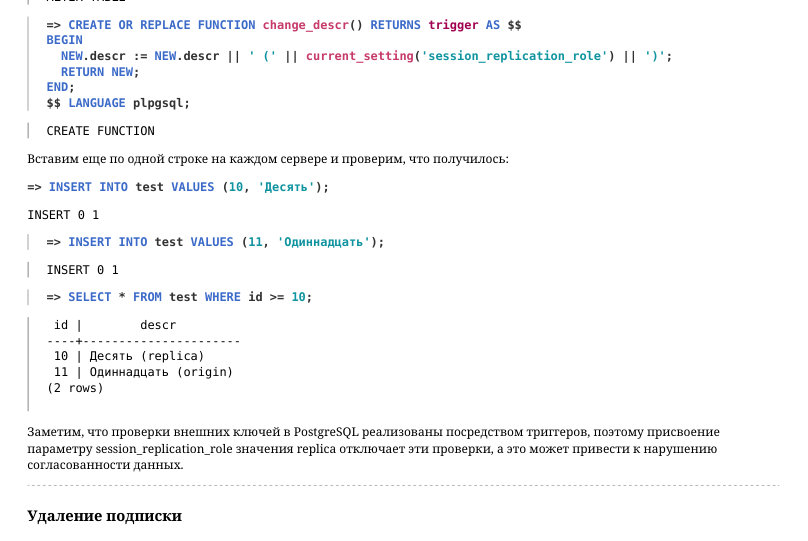
Теперь триггер работает только при применении реплицированных изменений. Если необходимо добиться срабатывания триггера и при репликации, и при локальных изменениях, нужно определить его как ALWAYS TRIGGER. А чтобы различить эти изменения, используем параметр session_replication_role:
Page 13: Page 13
 {#source-figure-013 caption=“Source slide page 13: Page 13”}
Вставим еще по одной строке на каждом сервере и проверим, что получилось:
Заметим, что проверки внешних ключей в PostgreSQL реализованы посредством триггеров, поэтому присвоение параметру session_replication_role значения replica отключает эти проверки, а это может привести к нарушению согласованности данных.
Удаление подписки
Если репликация больше не нужна, надо аккуратно удалить подписку — иначе на публикующем сервере останется открытым репликационный слот.
Page 14: Задачи: консолидация
 {#source-figure-014 caption=“Source slide page 14: Задачи: консолидация”}
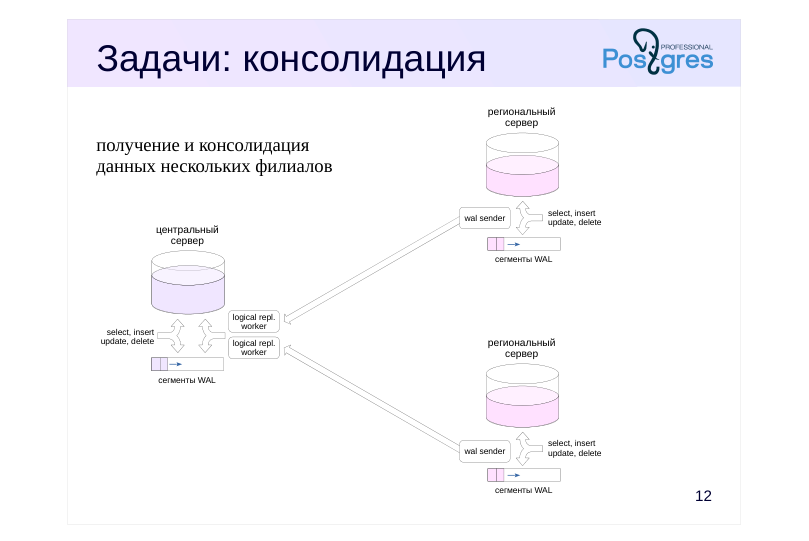
получение и консолидация данных нескольких филиалов
Комментарии преподавателя
Рассмотрим несколько задач, которые можно решить с помощью логической репликации.
Пусть имеются несколько региональных филиалов, каждый из которых работает на собственном сервере PostgreSQL. Задача состоит в консолидации части данных на центральном сервере.
Для решения задачи на региональных серверах создаются публикации необходимых данных. Центральный сервер подписывается на эти публикации. Полученные данные можно обрабатывать с помощью триггеров на стороне центрального сервера (например, приводя данные к единому виду).
С точки зрения бизнес-логики есть множество особенностей, требующих внимания. В каких-то случаях может быть проще периодически передавать данные в пакетном режиме.
На иллюстрации: на центральном сервере работают два процесса приема журналов, по одному на каждую подписку.
Page 15: Задачи: справочники
 {#source-figure-015 caption=“Source slide page 15: Задачи: справочники”}
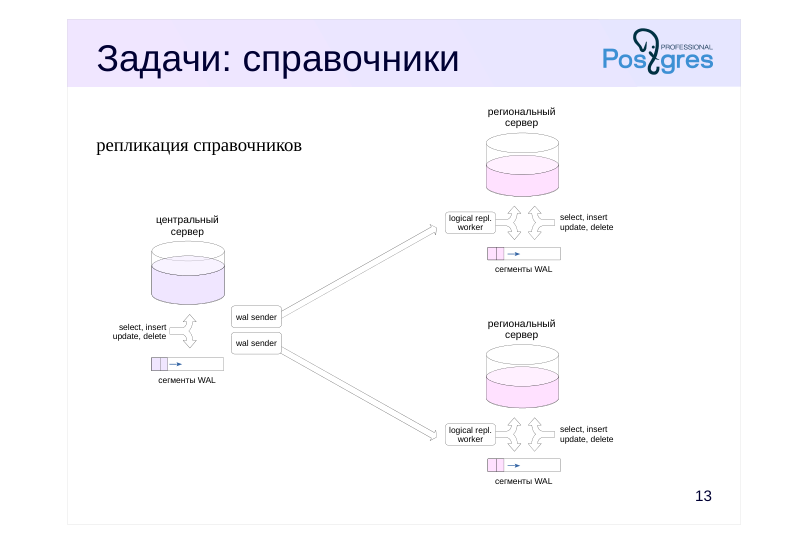
репликация справочников
Комментарии преподавателя
Другая задача: на центральном сервере поддерживаются справочники, актуальные версии которых должны быть доступны на региональных серверах.
В этом случае схему надо развернуть наоборот: центральный сервер публикует изменения, а региональные серверы подписываются на эти обновления.
Page 16: Задачи: мастер-мастер
 {#source-figure-016 caption=“Source slide page 16: Задачи: мастер-мастер”}
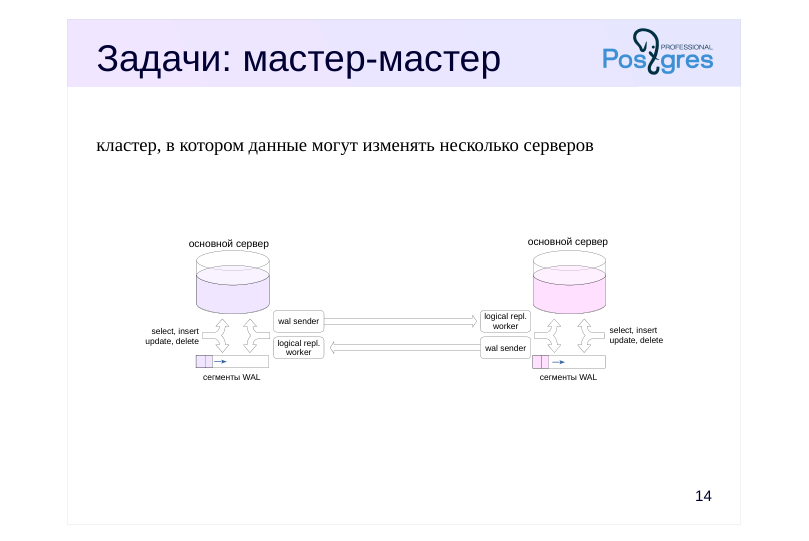
кластер, в котором данные могут изменять несколько серверов
Комментарии преподавателя
Задача: обеспечить надежное хранение данных на нескольких серверах с возможностью записи на любом сервере (что полезно, например, для геораспределенной системы).
Для решения можно использовать двунаправленную репликацию, передавая изменения в одних и тех же таблицах от одного сервера к другому и обратно.
Двунаправленная репликация появилась в PostgreSQL 16. Система умеет различать источники репликации (origin), и при создании подписки можно указать, чтобы с публикующего сервера не отправлялись изменения, помеченные определенным источником.
Конечно, прикладная система должна быть построена таким образом, чтобы избегать конфликтов при изменении данных в одних и тех же таблицах. Например, использовать глобальные уникальные идентификаторы или гарантировать, что разные серверы работают с разными диапазонами ключей.
Надо учитывать, что система мастер-мастер, построенная на логической репликации, не обеспечивает сама по себе выполнение глобальных распределенных транзакций и, следовательно, о согласованности данных между серверами придется позаботиться отдельно.
Page 17: Ограничения
Не реплицируются
- команды DDL
- значения последовательностей
- большие объекты (lo)
- изменения материализованных представлений, внешних таблиц
- Могут вызвать проблемы
- массовые изменения данных
- Не поддерживается
- автоматическое разрешение конфликтов
Комментарии преподавателя
Логическая репликация имеет ряд ограничений.
Не реплицируются команды DDL — все изменения схемы данных надо переносить вручную.
Реплицироваться могут только обычные базовые таблицы и секционированные таблицы. То есть нельзя реплицировать отношения другого рода, такие как представления, материализованные представления и внешние таблицы.
Не реплицируются значения последовательностей. Это означает, что если сервер-подписчик добавляет строки в таблицу с суррогатным уникальным ключом, для которой настроена репликация, возможны конфликты. Конфликтов можно избежать, выделяя двум серверам разные диапазоны значений последовательностей, или используя вместо них универсальные уникальные идентификаторы (UUID).
Изменения реплицируются построчно, поэтому выполнение на публикаторе команды SQL, затрагивающей много строк, приведет к повышенной нагрузке на подписчик.
И, как уже говорилось, нет возможности автоматического разрешения конфликтов.
Эти ограничения уменьшают применимость логической репликации.
https://postgrespro.ru/docs/postgresql/16/logical-replication-restrictions
Page 18: Итоги
Логическая репликация передает изменения строк отдельных таблиц
- разнонаправленная
- совместимость на уровне протокола
- Модель «публикация — подписка»
- Следует учитывать имеющиеся ограничения
Page 19: Практика
Мы открываем второй магазин. Он работает независимо от основного (свои пользователи, склад, закупки и продажи), но имеет тот же ассортимент. 1. Разверните второй сервер из резервной копии, как показано в демонстрации. Очистите таблицу операций. 2. Организуйте репликацию справочников книг и авторов из основного магазина во второй. Предполагается, что эти таблицы могут меняться только на основном сервере.
- Убедитесь, что изменения названий книг и т. п. передаются
- на второй сервер, но изменения наличного количества
- происходят на двух серверах независимо.
Page 20: 1. Развертывание второго магазина
Для развертывания сервера выполняем те же команды, что и в демонстрации:
Очистим таблицу операций, поскольку второй магазин ведет свою деятельность независимо от основного:
При выполнении команды TRUNCATE не сработает триггер update_onhand_qty_trigger, поэтому очистим наличное количество вручную:
2. Репликация справочников книг и авторов
Все три связанные таблицы должны входить в публикацию. Иначе на второй сервер реплицируются данные с нарушением внешних ключей:
Как только мы настроим репликацию справочников, на второй сервер в том числе будут передаваться и изменения наличного количества (books.onhand_qty). Очевидно, что это неудачное решение: такие изменения не нужны второму серверу, наличное количество вычисляется на нем независимо от основного сервера. Следовало бы поместить наличное количество в отдельную таблицу, изменив соответствующим образом триггер update_onhand_qty_trigger и интерфейсную функцию get_catalog. Другой способ — отменять нежелательные обновления с помощью триггера. Он не требует изменения остального кода системы, но не устраняет бесполезную пересылку данных по сети.
Page 21: Page 21
Созданный триггер будет срабатывать только при репликации и не будет мешать обновлять наличное количество при нормальной работе:
Создаем подписку. Поскольку текущее состояние справочников уже попало на второй сервер из резервной копии, отключаем начальную синхронизацию данных:
Page 22: Практика+
- На двух серверах ведутся однотипные таблицы бухгалтерских транзакций. Требуется консолидировать все записи в ту же таблицу на одном из серверов (например, для целей построения общей отчетности). Предложите способ различить «свои» и «чужие» записи и предотвратить конфликты при логической репликации. Реализуйте предложенную схему. 2. Настройте логическую репликацию в обратном направлении. Проверьте работу двунаправленной репликации.
Комментарии преподавателя
- Исходите из следующего вида таблицы транзакций:
- Чтобы публикация не отправляла реплицированные изменения, задайте подписке параметр origin = none.
Page 23: 1. Консолидация
На первом (публикующем) сервере установим необходимый уровень журнала:
Создадим таблицу транзакций:
Чтобы отличать строки разных серверов, понадобится дополнительный столбец. Например:
Чтобы не допустить конфликта значений первичного ключа, выделим каждому из серверов свое множество значений: первому серверу — нечетные, второму — четные. Имя последовательности, которая используется для генерации уникальных номеров, можно узнать с помощью функции:
Недостатком такой схемы является то, что при появлении третьего сервера ее придется перестраивать. Другой возможный вариант — использовать для первичного ключа универсальные уникальные идентификаторы, представленные типом данных uuid. Для этого можно использовать встроенную функцию get_random_uuid или средства из расширений pgcrypto и uuid-ossp:
Однако тип uuid занимает 16 байт (bigint — только 8) и генерация нового значения происходит относительно долго. Еще один вариант — создать составной первичный ключ:
В этом случае конфликтов гарантированно не будет, но индекс получится больше. Мы используем первый вариант: последовательности, генерирующие разные значения.
Page 24: Page 24
Теперь развернем второй сервер из резервной копии, как показано в демонстрации.
Заполним таблицу транзакций тестовыми данными — разными на разных серверах.
На втором сервере не забудем заменить настройки последовательности:
Настроим репликацию с первого сервера на второй.
После небольшой паузы убедимся, что данные первого сервера успешно реплицированы:
Page 25: 2. Двунаправленная репликация
Настройка уровня журнала уже скопирована на второй сервер:
Теперь очистим таблицы и сбросим последовательности
Чтобы публикация не отправляла подписке реплицированные изменения, нужно задать для подписки параметр origin:
Теперь настроим репликацию со второго сервера на первый.
Проверим:
Page 26: Page 26
Удалим треть строк на каждом сервере:
Репликация работает. Удалим подписки, чтобы не оставлять активные слоты репликации.