18 Занятие 18: Репликация / Обзор физической репликации
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_18_replica_overview_physical.html Archive: DEV2-handouts-16.zip Страниц PDF: 26
Page 1: Репликация / Обзор физической репликации
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Задачи и виды репликации
- Физическая репликация
- Уровни журнала
- Варианты использования реплики
- Переключение на реплику
Page 3: Задачи и виды репликации
Синхронизация данных на разных серверах
- Основные задачи
- отказоустойчивость, высокая доступность
- масштабируемость
- Физическая репликация
- синхронизация на уровне страниц и версий строк
- Логическая репликация
- синхронизация на уровне строк таблиц
Комментарии преподавателя
Одиночный сервер, управляющий базами данных, может не удовлетворять предъявляемым требованиям.
Один сервер — возможная точка отказа. Два (или больше) серверов позволяют сохранить доступность системы в случае сбоя (отказоустойчивость) или — более широко — в любом случае, например, при проведении плановых работ (высокая доступность).
Один сервер может не справляться с нагрузкой. Наращивать ресурсы сервера может оказаться невыгодно или вообще невозможно. Но можно распределить нагрузку на несколько серверов (масштабирование).
Информационные системы могут использовать общие данные.
Таким образом, речь идет о том, чтобы иметь несколько серверов, работающих с одними и теми же данными. Под репликацией понимается процесс синхронизации этих данных.
В зависимости от уровня, на котором происходит синхронизация, различают физическую и логическую репликацию: при физической репликации синхронизируются изменения, произошедшие в страницах данных и статусах транзакций, а при логической — изменения строк таблиц.
Page 4: Физическая репликация
Механизм
- один сервер транслирует журнальные записи на другой сервер,
- и тот проигрывает полученные записи
- Особенности
- мастер-реплика: поток данных только в одну сторону
- требуется двоичная совместимость серверов
- возможна репликация только всего кластера
Комментарии преподавателя
Механизм физической репликации состоит в том, что один сервер передает журнальные записи на другой сервер, а тот их проигрывает — как при восстановлении после сбоя.
При физической репликации серверы имеют назначенные роли: мастер и реплика. Мастер передает на реплику свои журнальные записи в виде файлов или потока записей; реплика применяет эти записи к своим файлам данных. Применение происходит чисто механически, без «понимания смысла» изменений, поэтому важна двоичная совместимость между серверами (одинаковые платформы и основные версии PostgreSQL). Поскольку журнал общий для всего кластера, то и реплицировать можно только весь кластер целиком.
Page 5: Физическая репликация
 {#source-figure-005 caption=“Source slide page 5: Физическая репликация”}
Комментарии преподавателя
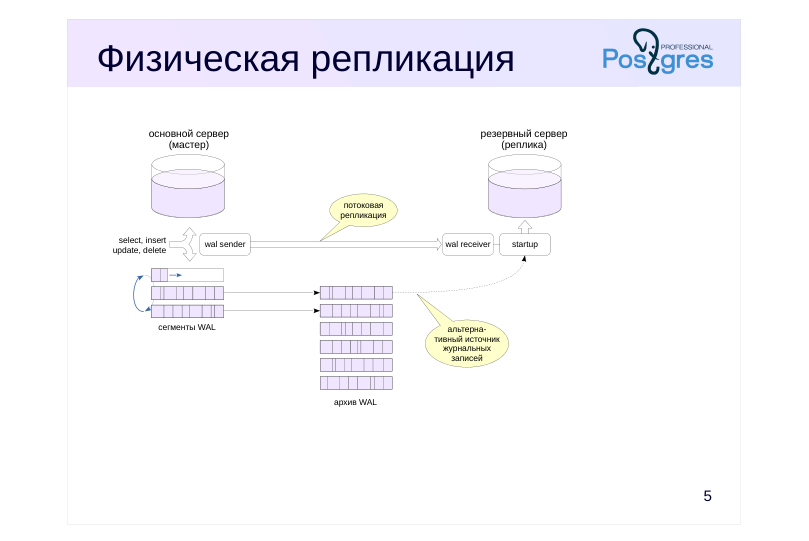
Чтобы организовать репликацию между двумя серверами, мы создаем реплику из физической резервной копии основного сервера. При обычном восстановлении из такой резервной копии получается новый независимый сервер. А если включить репликацию, ведомый сервер начинает работать в режиме постоянного восстановления: он все время применяет новые журнальные записи, приходящие с основного сервера (этим занимается процесс startup). Таким образом, реплика постоянно поддерживается в почти актуальном состоянии.
Есть два способа доставки журналов от мастера к реплике. Основной, который используется на практике — потоковая репликация.
В этом случае реплика (процесс walreceiver) подключается к мастеру (процесс walsender) по протоколу репликации и получает поток записей WAL. За счет этого при потоковой репликации отставание реплики сведено к минимуму или даже к нулю при синхронном режиме.
Если в системе настроено непрерывное архивирование, то возможна файловая репликация. В этом случае реплика будет заметно отставать, поскольку файловый архив пополняется только при переключении сегмента WAL.
На практике файловую репликацию используют как дополнение к потоковой. Если реплика не может получить очередную журнальную запись по протоколу репликации, она будет пробовать прочитать соответствующий файл из архива сегментов WAL.
https://postgrespro.ru/docs/postgresql/16/high-availability
Page 6: Уровни журнала
Параметр wal\_level
- minimal < replica
- восстановление восстановление после сбоя после сбоя восстановление из резервной копии, репликация
Комментарии преподавателя
Поскольку на реплику попадает только та информация, которая содержится в журнале, в журнал должны записываться все необходимые для синхронизации данные.
Состав информации, попадающей в журнал, регулируется параметром wal_level.
До версии PostgreSQL 10 уровнем по умолчанию был minimal, гарантирующий только восстановление после сбоя. На таком уровне репликация работать не может, поскольку для обеспечения надежности в этом случае часть изменений сразу записывается на энерго-независимый носитель и не попадает в журнал.
В версиях 10+ уровень по умолчанию — replica. На этом уровне в журнал записываются все изменения данных, что позволяет восстанавливать систему из горячих резервных копий, сделанных утилитой pg_basebackup, а также использовать физическую репликацию.
Поскольку резервное копирование и репликация — востребованные задачи, уровень по умолчанию и был изменен в пользу replica.
Page 7: Настройка физической репликации
Посмотрим, как организовать потоковую репликацию между двумя серверами. Мы ограничимся самым простым вариантом; детально репликация рассматривается в курсе для администраторов DBA3. Минимальный набор параметров, которые нужно проверить:
Начиная с версии PostgreSQL 10, параметры по умолчанию уже имеют подходящие значения. Разрешение на подключение по протоколу репликации в pg_hba.conf:
Разрешение тоже имеется. Развернем реплику из физической резервной копии, для этого используем утилиту pg_basebackup. Целевой каталог копии должен быть пустым или отсутствовать:
Ключ –checkpoint=fast просит утилиту выполнить контрольную точку как можно быстрее (без пауз), а ключ -R — добавить настройки для реплики:
Утилита создала заготовку конфигурационного файла…
… и сигнальный файл, который даст реплике указание перейти в режим постоянного восстановления:
Кластер, в котором мы собираемся развернуть реплику, уже предварительно инициализирован. Если сервер работает, его необходимо остановить:
Копия была размещена в домашнем каталоге пользователя student, а теперь переносим ее в каталог данных кластера и делаем владельцем файлов пользователя postgres:
Можно запускать сервер:
Page 8: Page 8
Посмотрим на процессы реплики.
Процесс walreceiver принимает поток журнальных записей, а процесс startup применяет изменения. Сравним с процессами мастера.
Процесс walsender отправляет реплике журнальные записи. Состояние репликации можно смотреть в специальном представлении на мастере:
значения *_lsn — показывают, какие журнальные записи отправлены на реплику, получены ею, записаны на диск и применены; sync_state — синхронная или асинхронная репликация (об этом подробнее позже).
Page 9: Использование реплики
Допускаются
- запросы на чтение данных (SELECT, COPY TO, курсоры)
- установка параметров сервера (SET, RESET)
- управление транзакциями (BEGIN, COMMIT, ROLLBACK…)
- создание резервной копии (pg_basebackup)
- Не допускаются
- любые изменения (INSERT, UPDATE, DELETE, TRUNCATE, nextval…)
- блокировки, предполагающие изменение (SELECT FOR UPDATE…)
- команды DDL (CREATE, DROP…), в т. ч. создание временных таблиц
- команды сопровождения (VACUUM, ANALYZE, REINDEX…)
- управление доступом (GRANT, REVOKE…)
- не срабатывают триггеры и рекомендательные блокировки
Комментарии преподавателя
По умолчанию реплика работает в режиме горячего резерва, в этом случае разрешены клиентские подключения, но только для чтения данных. Также будет работать установка параметров сервера и команды управления транзакциями — например, можно начать (читающую) транзакцию с нужным уровнем изоляции.
Кроме того, реплику можно использовать и для изготовления резервных копий (конечно, принимая во внимание возможное отставание от мастера).
В режиме горячего резерва на реплике не допускаются никакие изменения данных (включая последовательности), многие виды блокировок, команды DDL, а также такие команды, как vacuum, analyze, reindex и команды управления доступом — словом, все, что так или иначе изменяет данные.
При необходимости реплику можно запустить в режиме теплого резерва, задав параметр hot_standby = off, тогда подключения будут вообще невозможны.
https://postgrespro.ru/docs/postgresql/16/hot-standby
Page 10: Использование реплики
Выполним несколько команд на основном сервере:
Проверим реплику:
Вставим строку в таблицу на основном сервере:
Итак, репликация работает и запросы на реплике выполняются. При этом изменения на реплике не допускаются:
Page 11: Использование реплики
 {#source-figure-011 caption=“Source slide page 11: Использование реплики”}
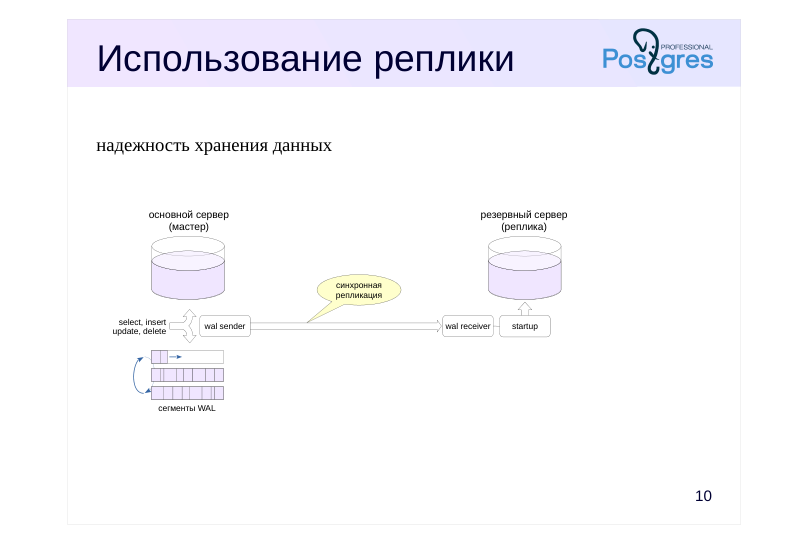
надежность хранения данных
Комментарии преподавателя
Механизм репликации позволяет построить систему так, чтобы она отвечала предъявляемым к ней требованиям. Рассмотрим несколько типичных задач и средства их решения.
Одна из возможных задач — обеспечить надежность хранения данных.
Напомним, что фиксация транзакций может работать в синхронном и асинхронном режимах. В первом случае фиксация не завершается до тех пор, пока данные не будут надежно записаны на энерго-независимый носитель. Во втором — есть риск потерять часть зафиксированных данных, но фиксация не ждет записи на диск, и система работает быстрее.
Аналогичная картина и с репликацией. При синхронном режиме (synchronous_commit = on) и наличии реплики фиксация ждет не только записи WAL на диск, но и подтверждения приема журнальных записей от синхронной реплики. Это еще больше увеличивает надежность (данные не пропадут, даже если основной сервер выйдет из строя), но и еще больше замедляет систему.
Существуют и промежуточные варианты настройки, которые не дают полной гарантии надежности, но все-таки снижают вероятность потери данных.
Page 12: Использование реплики
 {#source-figure-012 caption=“Source slide page 12: Использование реплики”}
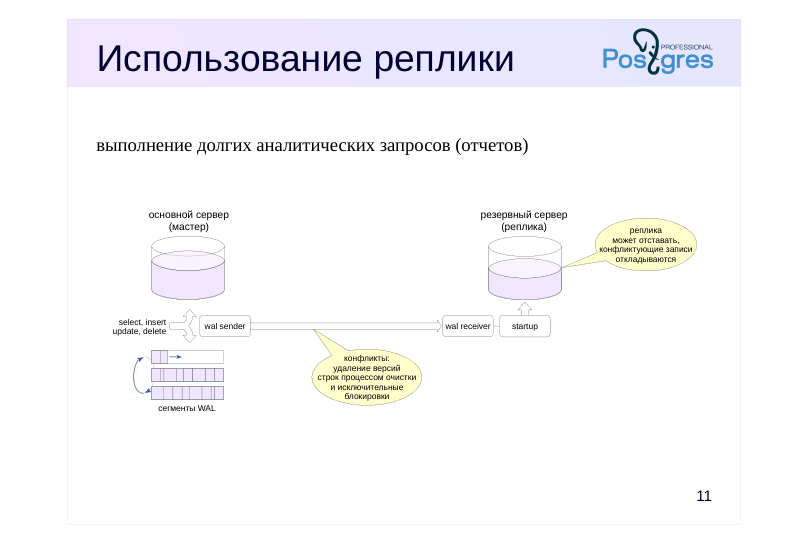
выполнение долгих аналитических запросов (отчетов)
Комментарии преподавателя
Как уже говорилось, долгие запросы удерживают горизонт очистки, из-за чего не удается удалять ненужные версии строк. Если какие-то таблицы в это время активно изменяются, они могут сильно вырасти в размере. Поэтому для выполнения долгих аналитических запросов можно использовать реплику.
Тонкий момент состоит в том, что с основного сервера могут приходить журнальные записи, конфликтующие с выполняющимся запросом. Есть два источника таких записей.
Очистка удаляет версии строк, уже не нужные основному серверу, но еще нужные для выполнения запроса на реплике.
Исключительные блокировки, происходящие на основном сервере, несовместимые с запросом на реплике.
Поэтому «отчетную» реплику настраивают так, чтобы она принимала WAL-записи, но откладывала их применение, если они конфликтуют с запросами. Это приводит к тому, что данные на реплике могут «отставать» от основного сервера, но, как правило, для долгих аналитических запросов это не существенно.
Page 13: Несколько реплик
 {#source-figure-013 caption=“Source slide page 13: Несколько реплик”}
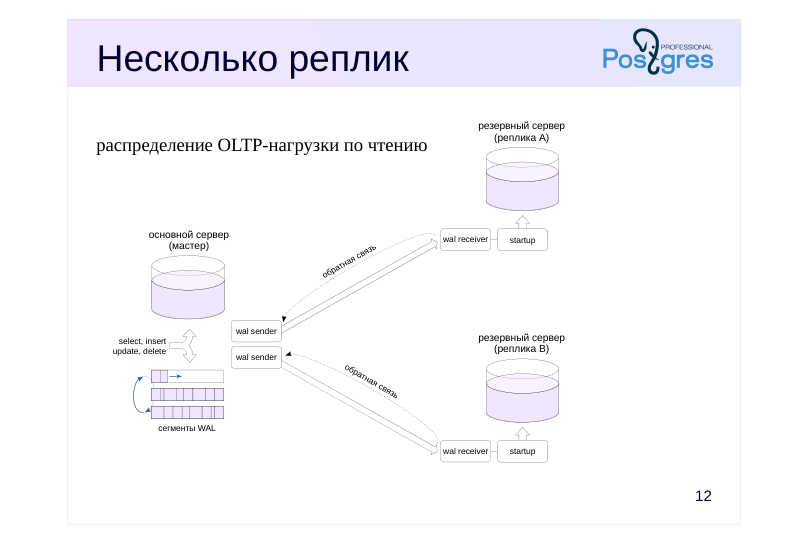
распределение OLTP-нагрузки по чтению
Комментарии преподавателя
К основному серверу можно подключить несколько реплик, например, для распределения OLTP-нагрузки по чтению.
OLTP-запросы не должны быть долгими. Это позволяет использовать обратную связь между репликой и основным сервером по протоколу репликации. В этом случае основной сервер знает, какой горизонт транзакций нужен запросам на реплике, и очистка не будет удалять соответствующие версии строк. Иными словами, обратная связь дает такой же эффект, как если бы все запросы выполнялись непосредственно на основном сервере.
Однако репликация обеспечивает только базовый механизм. Для автоматического распределения нагрузки необходимы внешние средства (балансировщики). Следует также иметь в виду, что между основным сервером и репликами не гарантируется согласованность данных, даже в случае синхронной репликации. Если приложение читает данные только с одного из серверов, оно, разумеется, будет получать согласованные данные. Но это не выполняется, если приложение читает данные с нескольких серверов. С реплики можно прочитать как устаревшие данные, так и данные, которых еще не видно на основном сервере. Подробнее эти вопросы обсуждаются в курсе DBA3 «Резервное копирование и репликация».
Page 14: Каскадная репликация
 {#source-figure-014 caption=“Source slide page 14: Каскадная репликация”}
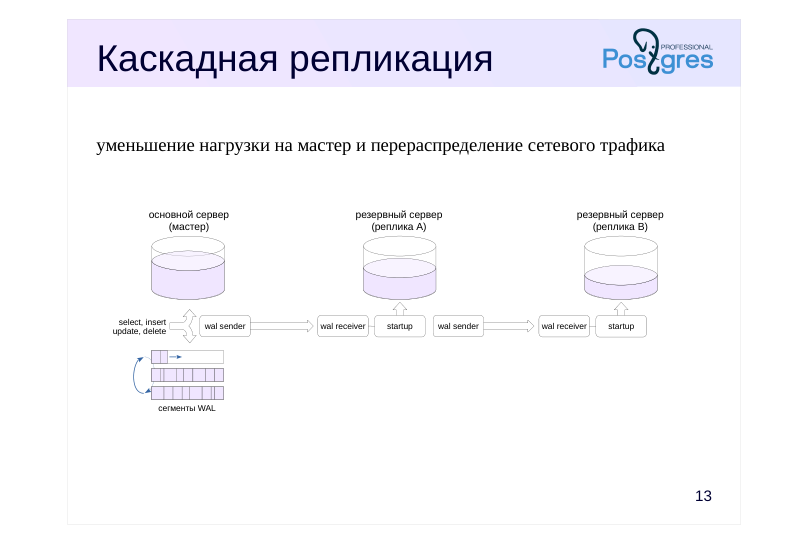
уменьшение нагрузки на мастер и перераспределение сетевого трафика
Комментарии преподавателя
Несколько реплик, подключенных к одному основному серверу, будут создавать на него определенную нагрузку. Кроме того, надо учитывать нагрузку на сеть при пересылке нескольких копий потока журнальных записей.
Для снижения нагрузки реплики можно соединять каскадом; при этом серверы передают журнальные записи друг другу по цепочке. Чем дальше от мастера, тем большее запаздывание может накопиться в изменяемых данных.
Заметим, что каскадная синхронная репликация не поддерживается: основной сервер может быть синхронизирован только с непосред-ственно подключенной к нему репликой. А вот обратная связь поступает к основному серверу от всех реплик.
Page 15: Отложенная репликация
 {#source-figure-015 caption=“Source slide page 15: Отложенная репликация”}
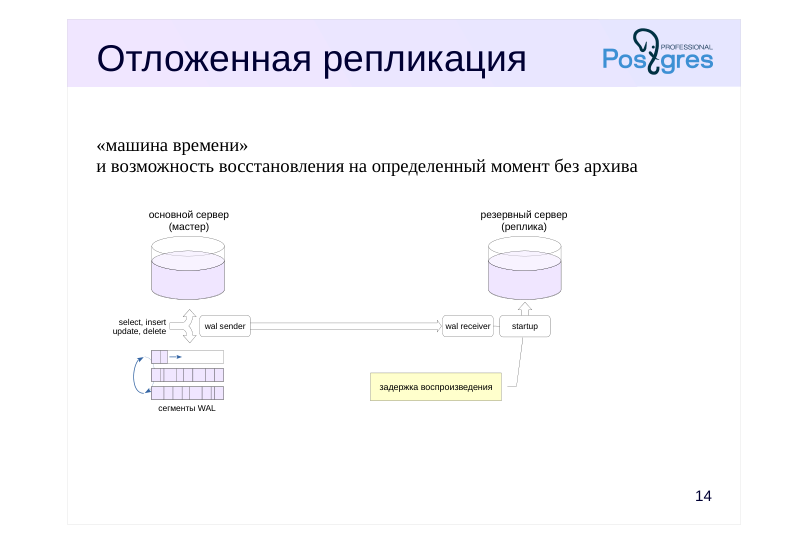
«машина времени» и возможность восстановления на определенный момент без архива
Комментарии преподавателя
Полезной может оказаться возможность просматривать данные на некоторый момент в прошлом и, при необходимости, восстановить сервер на этот момент. Это позволяет, в частности, справиться с ошибкой пользователя, совершившего неправильные действия, требующие отмены.
Обычный механизм восстановления из архива на момент времени (point-in-time recovery) в принципе позволяет решить эту задачу, но требует большой подготовительной работы и занимает много времени. А способа построить снимок данных по состоянию на произвольный момент в прошлом в PostgreSQL нет.
Задача решается созданием реплики, которая применяет записи WAL не сразу, а через установленный интервал времени.
В этом курсе мы не обсуждаем необходимые настройки для каждого из показанных вариантов. Для подробной информации обратитесь к курсу DBA3 «Резервное копирование и репликация».
Page 16: Переключение на реплику
Плановое переключение
- останов основного сервера для технических работ без прерывания
- обслуживания
- ручной режим
- Аварийное переключение
- переход на реплику из-за сбоя основного сервера
- ручной режим,
- но в принципе можно автоматизировать с помощью
- дополнительного кластерного ПО
Комментарии преподавателя
Имеющуюся реплику можно использовать и для того, чтобы переключить на нее приложение с основного сервера.
Причины перехода на резервный сервер бывают разные. Это может быть необходимость технических работ на основном сервере — тогда переход выполняется в удобное время в штатном режиме. Возможен и сбой основного сервера, в таком случае переходить на резервный сервер нужно как можно быстрее, чтобы не прерывать обслуживание пользователей.
Даже в случае сбоя переход осуществляется вручную, если не используется специальное кластерное программное обеспечение, которое следит за состоянием серверов и может инициировать переход автоматически.
Page 17: Переключение на реплику
 {#source-figure-017 caption=“Source slide page 17: Переключение на реплику”}
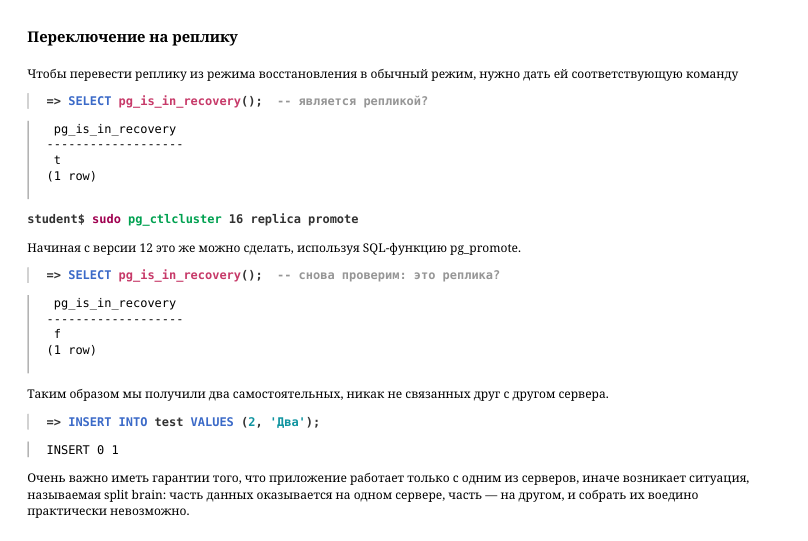
Чтобы перевести реплику из режима восстановления в обычный режим, нужно дать ей соответствующую команду
Начиная с версии 12 это же можно сделать, используя SQL-функцию pg_promote.
Таким образом мы получили два самостоятельных, никак не связанных друг с другом сервера.
Очень важно иметь гарантии того, что приложение работает только с одним из серверов, иначе возникает ситуация, называемая split brain: часть данных оказывается на одном сервере, часть — на другом, и собрать их воедино практически невозможно.
Page 18: Итоги
Механизм физической репликации основан на передаче журнальных записей на реплику и их применении
- трансляция потока записей или файлов WAL
- Физическая репликация создает точную копию всего кластера
- однонаправленная, требует двоичной совместимости
- базовый механизм для решения целого ряда задач
Page 19: Практика
- Разверните реплику так, как показано в демонстрации.
- Проверьте, как работает приложение, если переключить его на использование реплики. 2. Добавьте к механизму фоновых заданий возможность выполнять задания на реплике с помощью расширения dblink. Убедитесь, что долгое задание не приведет к появлению такой же долгой транзакции на основном сервере.
Комментарии преподавателя
- Переключатель сервера находится в верхней части информационной панели приложения.
Обратите внимание на то, какие операции по-прежнему работают, а какие — вызывают ошибку.
- Приложение позволяет при отправке задания на выполнение указать удаленный сервер, и записывает имя узла и порт в таблицу tasks.
Добавьте в процедуру process_tasks проверку: если указаны узел и порт, вызывайте функцию run не локально, а с помощью расширения dblink на указанном сервере. (Расширение рассматривалось в теме «Фоновые процессы»)
Чтобы долгое задание не приводило к появлению такой же долгой транзакции на основном сервере, используйте dblink в асинхронном режиме, и периодически опрашивайте готовность запроса в отдельных, коротких, транзакциях.
Page 20: 1. Развертывание реплики
Выполняем те же команды, что и в демонстрации.
При переключении приложения на реплику: Поиск книг и другие операции, не требующие изменения данных, работают; Вход, покупка книг и другие операции, изменяющие данные, выдают ошибку.
2. Фоновые задания в удаленном режиме
Добавим в процедуру запуска задания обработку узла и порта. Если они указаны, будем выполнять функцию run на указанном сервере с помощью расширения dblink. За основу берем вариант процедуры, написанной в практике к теме «Асинхронная обработка».
Page 21: Page 21
Обратите внимание на следующее:
Page 22: Page 22
Для краткости не обрабатывается статус вызова функции dblink_send_query, что, конечно же, необходимо делать. В цикле ожидания результатов удаленного запуска выполняется фиксация. В противном случае получалась бы долгая транзакция, удерживающая горизонт базы данных. Дублируется код для обработки исключительных ситуаций. Это связано с тем, что процедура не может выполнять фиксацию внутри блока с секцией EXCEPTION. Команда COMMIT перенесена из конца цикла forever в начало. Это сделано для удобства прерывания обработки в случае ошибки (см. обработчик dblink_connect). Работающий в системе фоновый процесс, выполняющий процедуру process_tasks, будет продолжать выполнять старую версию процедуры. Его необходимо прервать и перезапустить:
Page 23: Практика+
- Настройте физическую потоковую репликацию между двумя серверами в синхронном режиме. Проверьте работу репликации. Убедитесь, что при остановленной реплике фиксация не завершается. 2. По умолчанию применение конфликтующих записей на реплике откладывается максимум на 30 секунд. Отключите откладывание применения и убедитесь, что долгий запрос, выполняющийся на реплике, будет прерван, если необходимые ему версии строк удаляются и очищаются на мастере. Включите обратную связь и убедитесь, что теперь запрос не прерывается из-за того, что на мастере откладывается очистка.
Комментарии преподавателя
- Для этого на мастере установите с помощью ALTER SYSTEM следующие параметры:
● synchronous_commit = on
● synchronous_standby_names = ‘“16/replica”’
- За откладывание применения конфликтующих записей на реплике отвечает параметр max_standby_streaming_delay. Установите его в 0. Обратная связь включается параметром hot_standby_feedback = on. Оба параметра устанавливаются через ALTER SYSTEM с последующим перечитыванием настроек.
Чтобы запрос выполнялся долго на небольшом объеме данных, можно добавить в него вызов функции pg_sleep.
Page 24: 1. Синхронная репликация
Разворачиваем реплику, как было показано в демонстрации:
Запускаем реплику.
Настроим синхронную репликацию на мастере. По умолчанию cинхронный режим включен, но записи о фиксации транзакций синхронизируются только с локальной файловой системой:
А синхронизация с репликой не настроена:
Реплик может быть несколько, и мастер должен знать, с какой из них синхронизироваться. Реплика представляется именем, заданным в ее параметре cluster_name:
Репликация стала синхронной.
Page 25: Page 25
Теперь остановим реплику…
…и попробуем выполнить какую-либо транзакцию:
Управление возвратится только когда реплика будет снова запущена и репликация восстановится:
2. Конфликтующие записи
Отключаем откладывание применения конфликтующих записей:
Добавляем строки в таблицу:
Выполняем на реплике долгий запрос…
…а в это время на мастере удаляем строки из таблицы и выполняем очистку:
Очистка стерла все версии строк (10 removed). В итоге запрос на реплике завершается ошибкой:
Повторим эксперимент со включенной обратной связью.
Page 26: Page 26
Теперь очистка не удаляет версии строк, поскольку знает о запросе, выполняющемся на реплике (10 are dead but not yet removable ) и запрос отрабатывает:
Итак: В первом случае (max_standby_streaming_delay) откладывается воспроизведение журнальных записей на реплике. Во втором случае (hot_standby_feedback) откладывается очистка на мастере. Отключим синхронную репликацию.