17 Занятие 17: Расширяемость / Обзор полнотекстового поиска
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_17_ext_fts_overview.html Archive: DEV2-handouts-16.zip Страниц PDF: 32
Page 1: Расширяемость / Обзор полнотекстового поиска
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Зачем нужен полнотекстовый поиск?
- Документы и запросы
- Анализаторы
- Словари и шаблоны
- Конфигурации
- Индексная поддержка
Page 3: Зачем текстовый поиск?
Средства SQL — LIKE, регулярные выражения
- нет морфологического поиска
- нет возможности ранжирования результатов
- нет индексной поддержки
- Внешние поисковые системы
- сложно синхронизировать с базой данных
- отсутствие транзакционности
- нет доступа к метаданным
- сложности с разграничением доступа
Комментарии преподавателя
В инструментарии SQL уже есть средства поиска по тексту. Это и совсем простые команды LIKE и ILIKE, и упрощенные регулярные выражения SIMILAR TO, и полноценные регулярные выражения (оператор ~). Зачем нужен отдельный механизм?
Имеющиеся средства не позволяют искать с учетом разных словоформ, не позволяют отранжировать результаты по релевантности, имеют ограниченную индексную поддержку (для простого случая префиксного поиска, либо с помощью триграмм, как было показано в практике темы «Классы операторов»).
Для поиска можно использовать внешние поисковые системы. Но и они имеют ряд ограничений, которые невозможно преодолеть из-за того, что такие системы оторваны от базы данных. Их сложно синхронизировать с актуальным содержимым БД; они не транзакционны; они видят только те документы, которые им показывают, и не видят остальной информации в базе; сложно реализовать разграничение прав доступа к информации.
Полнотекстовый поиск позволяет преодолеть ограничения обычных средств SQL и сохранить все их преимущества.
https://postgrespro.ru/docs/postgresql/16/textsearch
Page 4: Документы и запросы
Документ
- произвольный текст, который можно разобрать на слова (лексемы)
- docx, pdf и т. п. надо предварительно преобразовать в текст
- внутреннее компактное представление tsvector
- Запрос
- одна или несколько лексем, соединенных логическими связками:
- &
- и
- |
- или
- !
- не
- <->
- предшествует (фразовый поиск)
- ( )
- для изменения приоритета
- внутреннее представление tsquery
Комментарии преподавателя
Документ, по которому нужен поиск, должен быть предварительно переведен в специальное представление — тип данных tsvector.
Исходный документ может быть произвольным текстом, который можно разобрать на отдельные слова (точнее, лексемы — разницу подробнее рассмотрим дальше). По двоичным документам тоже можно искать, если предварительно перевести их в текстовый вид (с помощью сторонних библиотек).
Поисковый запрос также должен быть представлен значением специального типа — tsquery. Запрос может состоять либо из одной лексемы, либо из нескольких лексем, связанных логическими операторами «и», «или», «не». Также поддерживается оператор предшествования, который обеспечивает фразовый поиск: можно найти документ, содержащий заданные слова не в любом месте, а стоящие рядом (или на определенном расстоянии друг от друга).
https://postgrespro.ru/docs/postgresql/16/datatype-textsearch
Page 5: Соответствие
Соответствие документа запросу
- оператор @@
- Релевантность
- веса лексем (A, B, C, D в порядке убывания важности)
- ts_rank — по частоте найденных лексем
- ts_rank_cd — также учитывает близость лексем
- оператор расстояния <=> (расширение rum)
Комментарии преподавателя
Чтобы проверить, соответствует ли документ (точнее, его представление в виде tsvector) запросу (точнее, его представлению tsquery), надо использовать оператор @@.
Результаты запроса можно ранжировать по «релевантности», чтобы понять, какие из найденных документов больше соответствуют запросу, а какие — меньше.
Релевантность учитывает вес лексем, который может быть задан буквенной меткой от A до D. По умолчанию (если метки нету) лексеме присваивается наименьшая важность (D). Выделение весами позволяет считать более важными, например, слова из заголовка или краткой аннотации по сравнению со словами в основном тексте документа.
В PostgreSQL есть две встроенные функции: ts_rank (учитывает, насколько часто лексемы из запроса встречаются в документе) и ts_rank_cd (дополнительно учитывает близость найденных лексем). Обе функции позволяют отмасштабировать свой результат с учетом размера документа.
https://postgrespro.ru/docs/postgresql/16/functions-textsearch
Расширение rum (https://github.com/postgrespro/rum) вводит еще одну возможность: оператор расстояния <=>, представляющий собой комбинацию функций ts_rank и ts_rank_cd.
Заметим, что в PostgreSQL не реализована возможность поиска документов, «похожих» на другой документ (основанная, например, на методе TF-IDF).
Page 6: Язык запросов
Будем знакомиться с полнотекстовым поиском на примере базы сообщений из рассылки pgsql-hackers за 1997-2017 года. Эта база уже загружена из резервной копии командой
База представлена одной таблицей:
Мы преимущественно будем смотреть на темы писем, потому что они достаточно короткие. Общее количество записей:
Чтобы воспользоваться полнотекстовым поиском, документ надо привести к типу tsvector, а запрос — к типу tsquery. Простой пример, в котором поисковый запрос состоит из одного слова:
Стоит обратить внимание, что найдены документы, содержащие разные формы слова magical, независимо от регистра букв. Позже мы узнаем, как это происходит. Язык запросов позволяет использовать логические связки. Документы, содержащие magic и value:
Page 7: Page 7
Документы, содержащие magic и value, но не time:
Документы, содержащие magic и либо value, либо constant:
Также доступен фразовый поиск, учитывающий порядок и близость позиций лексем. Например, для фразы «time value»:
Или та же фраза «time value», но между словами должно быть еще одно любое слово:
Имеется также функция, позволяющая получить поисковый запрос, не указывая логические связки, примерно как в веб-поиске. Например, такой запрос:
эквивалентен следующему:
Page 8: Page 8
Как вывести результат, если поиск идет по большому документу? Запрос выдаст нам весь текст письма:
Но можно воспользоваться функцией для форматирования результата, чтобы показать то место в документе, где обнаружено соответствие:
Page 9: Page 9
Page 10: Анализатор
документ → анализатор → фрагмент+тип, фрагмент+тип, …
- Выделяет в тексте документа фрагменты и назначает фрагментам типы
- Штатный анализатор default
- 23 типа фрагментов (слова, числа, адреса, теги XML и т. п.)
- Другие анализаторы
- расширения
- набор функций на языке C
Комментарии преподавателя
Рассмотрим, как происходит превращение исходного документа в tsvector, а запроса в tsquery.
Вначале документ пропускается через анализатор (parser), который выделяет в нем фрагменты (tokens). Более того, каждому фрагменту анализатор сопоставляет тип, который используется для дальнейшей обработки. Например, стандартный анализатор (единственный встроенный в PostgreSQL) выделяет 23 типа фрагментов: слова, числа, адреса url и email, XML-теги и другие. За счет этого он довольно универсален.
Чтобы использовать другой анализатор, его нужно написать на языке C, скомпилировать и подключить. Существуют расширения, которые устанавливают уже готовые анализаторы. Например, https://github.com/postgrespro/pg\_tsparser — анализатор, построенный на базе стандартного, но он не считает подчеркивание и минус символами-разделителями слов (что полезно для индексации программного кода).
https://postgrespro.ru/docs/postgresql/16/textsearch-parsers
Page 11: Анализатор
Единственный установленный анализатор называется default:
Посмотрим, как он разбивает текст на фрагменты — с помощью служебной функции:
На этом этапе слова остаются без изменений. Обратите внимание, что из одного слова может получиться несколько «пересекающихся» фрагментов. Типы фрагментов, выделяемые анализатором, можно посмотреть так:
Page 12: Page 12
Page 13: Словари
фрагмент → словарь → лексема, лексема, …
- Словарь превращает фрагмент в лексему
- убрать стоп-слова
- привести буквы к одному регистру
- привести словоформы к общему виду
- привести синонимы к одному варианту
- и т. п.
- Штатные словари
- simple — нижний регистр и стоп-слова
- стемминг для 28 языков
Комментарии преподавателя
Полученный от анализатора фрагмент пропускается через словарь и превращается в лексему (lexeme) или в несколько лексем.
Смысл такого преобразования в том, чтобы «нормализовать» слова, привести их к такому виду, чтобы их было легко найти. Например:
● из текста можно убрать стоп-слова (которые встречаются почти в каждом документе, так что искать их бессмысленно);
● можно привести слова к одному регистру;
● можно отрезать от слов изменяющиеся части (окончания), чтобы находить любые словоформы (стемминг);
● можно свести все синонимы к одному.
В PostgreSQL изначально установлен словарь simple, а также словари стемминга для 28 языков, которые отрезают от слов изменяемые части. Такие словари работают быстро, но не всегда точно, потому что опираются не на словарь, а на алгоритмы.
https://postgrespro.ru/docs/postgresql/16/textsearch-dictionaries
Page 14: Шаблоны словарей
Словарь — параметризованный шаблон
- набор функций на языке C
- Штатные шаблоны
- простой словарь
- стеммер snowball
- словарь ispell
- синонимы: приведение синонимов к одному виду
- тезаурус: приведение фраз к одному виду
Комментарии преподавателя
Чтобы добавить новый словарь, нужно воспользоваться шаблоном (template), параметризовав его. Шаблон — это, по сути, набор функций на C, реализующих словарь.
В PostgreSQL входят несколько шаблонов:
● простой словарь simple (выполняет преобразование в нижний регистр и проверяет результат по списку стоп-слов);
● словарь snowball (использует специфический стеммер для заданного языка, есть возможность задать свой список стоп-слов);
● словарь ispell (поддерживает морфологические словари, в том числе MySpell и Hunspell, используемые, например, в OpenOffice);
● словарь синонимов, позволяющий определять синонимы для слов;
● «тезаурус», позволяющий заменять синонимами целые фразы.
Page 15: Словари
Посмотрим, как работает стемминг. Функция вернет нам заменяющую слово «The» лексему, обратившись к указанному в первом параметре словарю:
Это стоп-слово, оно исчезает. Другой пример:
Слово приведено к нижнему регистру и отброшено окончание «s» — таким образом, мы найдем документ, если будем искать «bell» или «bells». А превратится ли слово «went» в «go»?
Нет — стемминг не справится с формами слова, для этого нужен полноценный морфологический словарь. Представим, что в нашем документе встречаются слова с диакритическими знаками. Обычный стемминг сохранит букву с умляутом, но с точки зрения поиска это может быть нежелательным:
Воспользуемся расширением unaccent, чтобы избавиться от умляута.
Page 16: Конфигурация
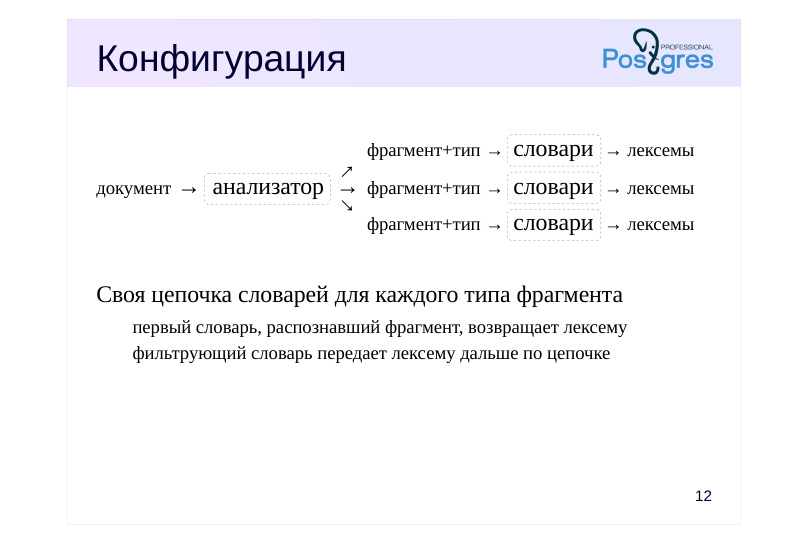 {#source-figure-016 caption=“Source slide page 16: Конфигурация”}
фрагмент+тип → словари → лексемы
- документ → анализатор → фрагмент+тип → словари → лексемы
- фрагмент+тип → словари → лексемы
- Своя цепочка словарей для каждого типа фрагмента
- первый словарь, распознавший фрагмент, возвращает лексему
- фильтрующий словарь передает лексему дальше по цепочке
Комментарии преподавателя
Итак, документ пропускается через анализатор, который выделяет в нем фрагменты. Какие именно словари будут использоваться для преобразования фрагмента в лексемы, определяется его типом. Таким образом можно по-разному обрабатывать слова, числа и т. п.
Анализатор и цепочки словарей для каждого типа фрагмента настраиваются и называются конфигурацией текстового поиска.
Каждый словарь в цепочке решает, что именно делать с фрагментом:
● Фрагмент можно отфильтровать как стоп-слово. На этом обработка фрагмента, очевидно, прекращается.
● Фрагмент можно заменить на лексему и прекратить обработку. Например, словарь simple переводит любое слово в нижний регистр и умеет фильтровать стоп-слова.
● Фрагмент можно заменить на лексему, но передать ее дальше, чтобы другие словари также смогли обработать ее (такой словарь называется фильтрующим).
● Наконец, словарь может не опознать фрагмент и передать его дальше без изменений. Так, например, поступает словарь синонимов: если синоним не найден, фрагмент передается дальше по цепочке.
https://postgrespro.ru/docs/postgresql/16/textsearch-configuration
Page 17: Настройка конфигурации
Для каждого типа фрагментов настраивается цепочка словарей — такая настройка называется конфигурацией. Доступные конфигурации:
Одна из них выбирается в качестве конфигурации по умолчанию и используется, если явно не указать другую:
Посмотрим на эту конфигурацию подробнее:
Page 18: Page 18
Например, для слов (word) используется стемминг английского языка (english_stem). Встроим в конфигурацию словарь, который при обработке английских слов устраняет диакритические знаки. Для этого зададим цепочку словарей для лексем типа «слово» (word):
Unaccent — фильтрующий словарь, поэтому к полученной лексеме далее будет применен стемминг. Проверим:
Итак, во что же превращается исходный текст при преобразовании в tsvector?
Конечный результат — список лексем и их позиций в документе.
Page 19: Page 19
Аналогичное преобразование проходит и поисковый запрос:
Page 20: Индексная поддержка
GiST
- неточное представление с обязательной перепроверкой по таблице
- эффективность уменьшается при увеличении количества слов
- поддержка INCLUDE
- быстрое обновление (зависит от числа документов)
- GIN
- точное и компактное представление
- эффективность не теряется при увеличении количества слов
- медленное обновление (зависит от числа слов в документах)
- RUM (расширение на основе GIN)
- дополнительная информация в индексе (позиции лексем и др.)
- выдача результатов сразу в порядке релевантности
Комментарии преподавателя
От полнотекстового поиска требуется не только функциональность, но и скорость работы. Для ускорения поиска используются индексы нескольких типов.
Индекс GiST хорош быстрым обновлением (что важно, если документы активно изменяются) и поддерживает функциональность INCLUDE (поможет стать покрывающим для запроса). Однако он не обеспечивает высокой скорости поиска и его эффективность понижается с ростом числа слов.
Индекс GIN — основной выбор для полнотекстового поиска. Он обеспечивает быстрый поиск (производительность не деградирует с увеличением числа слов), хотя и медленно обновляется при изменении документов.
Проблемы этих двух традиционных индексов в том, что они учитывают только лексемы, но отбрасывают их позиции в документе и другую вспомогательную информацию, в том числе веса. Поэтому они хороши для поиска, но в принципе не могут ускорить ранжирование. По той же причине не ускоряется фразовый поиск.
Индекс RUM (доступный как расширение: https://github.com/postgrespro/rum) нацелен на устранение этого недостатка: он позволяет выдавать результаты сразу в порядке релевантности и ускоряет поиск фраз.
https://postgrespro.ru/docs/postgresql/16/textsearch-indexes
Page 21: Производительность текстового поиска
Вернемся к примеру с архивом почтовых рассылок. Как мы видели, поиск может выполняться довольно долго, даже если искать по темам писем:
Что можно сделать? Во-первых, необходимо избавиться от преобразования документов в tsvector каждый раз, когда требуется что-то найти. Добавим в таблицу столбец типа tsvector и заполним его. Учтем сразу и тему письма, и текст. У вектора поиска есть ограничение на размер слова, поэтому слишком длинные последовательности символов игнорируются. Благодаря конструкции GENERATED ALWAYS, значения в столбце будут автоматически вычисляться для новых и измененных строк. Единственное ограничение: выражение должно иметь категорию изменчивости IMMUTABLE. Другой традиционный способ — обновлять значение с помощью триггера. Создание отдельного столбца для tsvector — наиболее эффективное решение. Единственный минус состоит в том, что требуется дополнительное место для хранения tsvector. Вместо создания столбца можно было бы сразу построить индекс по соответствующему выражению. В этом случае места нужно меньше, но эффективность поиска может страдать из-за необходимости повторных вычислений tsvector по документу.
Теперь в запросе можно использовать уже готовое поле, но, конечно, будет по-прежнему просматриваться вся таблица:
Поэтому следующий шаг к ускорению поиска — индексная поддержка. Мы создадим индекс типа GIN. Это обычный выбор для полнотекстового поиска: индекс имеет сравнительно небольшой размер и обеспечивает более высокую точность поиска, чем GiST.
Page 22: Page 22
Как видно, поиск теперь использует индекс и выполняется гораздо быстрее. Вряд ли нам нужны все несколько тысяч результатов. Допустим, мы хотим получить десять наиболее релевантных.
Сначала находятся все результаты, ранжируются, сортируются, и только потом отбираются 10 лучших. Конечно, это неэффективно. Такие запросы можно ускорить с помощью RUM-индекса.
Индекс типа RUM устроен так же, как GIN, но дополнительно хранит информацию о позициях лексем. Это позволяет вычислять релевантность (степень соответствия документа поисковому запросу) непосредственно при обходе индекса.
Вот как выглядит запрос, использующий упорядочивающий оператор <=>:
Page 23: Page 23
Page 24: Итоги
Интегрированный полнотекстовый поиск обеспечивает
- актуальность результатов
- транзакционность
- учет языковых особенностей
- фразовый поиск
- ранжирование результатов
- индексную поддержку
- Поиск охватывает любую информацию, приводимую к текстовому виду
- Возможна тонкая настройка под конкретные нужды
Page 25: Практика
- Сейчас поиск в книжном магазине работает только по названиям книг. Замените его на полнотекстовый поиск по названиям книг, полным именам авторов и аннотациям. Проверьте сделанные изменения в приложении. Убедитесь, что поиск не зависит от формы слов в запросе.
Комментарии преподавателя
- Добавьте в таблицу books столбец типа tsvector, генерируемый по необходимым значениям. Учтите, что значение tsvector должно зависеть от данных из нескольких таблиц.
Посмотрите код функции public.get_catalog и подумайте, что нужно сделать, чтобы заменить существующее условие поиска на полнотекстовое.
Для проверки найдите книги по запросам «проблема» и «проблемы».
Page 26: 1. Полнотекстовый поиск в приложении
Добавим столбец типа tsvector:
Для поиска нам требуются данные нескольких таблиц, поэтому конструкция GENERATED ALWAYS не годится и придется воспользоваться триггером. Начнем с функции, создающей необходимое значение tsvector:
Мы используем конфигурацию поиска для русского языка, чтобы поиск работал без учета окончаний. Теперь напишем триггерную функцию и триггер для таблицы books:
Но измениться может и имя автора, и состав авторов книги, поэтому также требуются триггеры на таблицы authors и authorships. Причем следует использовать триггеры AFTER, чтобы функция build_tsv брала из этих таблиц уже измененные данные. В случае авторов надо найти все затронутые изменением книги и обновить у них tsv:
Page 27: Page 27
Здесь мы предполагаем, что первичный ключ никогда не обновляется. Обратите внимание, что для таблицы books мы явно указали поля, на которые срабатывает триггер fill_tsv, так что триггер не будет срабатывать лишний раз. И для авторства:
Теперь обновим новый столбец у всех книг. Эту операцию, конечно, можно и нужно выполнять пакетно, как рассматривалось ранее, если количество строк велико.
Наконец, заменим функцию search_cond, которая формирует условие поиска:
Page 28: Практика+
- Восстановите базу данных с архивом рассылок из резервной копии. Добавьте в таблицу mail_messages столбец search_vector и заполните его так же, как в демонстрации. 2. Сколько документов содержат одновременно фразы «vacuum full» и «index page»? Сравните скорость поиска без индекса и с индексами разных типов (GiST, GIN, RUM), а также размер индексов. 3. Сколько документов содержит слово «vacuuming» именно в такой форме?
Комментарии преподавателя
Создавайте индексы по одному и удаляйте их сразу после эксперимента перед созданием следующего, чтобы в запросе гарантированно использовался нужный индекс.
Проще всего ответить на этот вопрос с помощью регулярных выражений. Но, поскольку тема посвящена полнотекстовому поиску, измените конфигурацию поиска, установив для лексем типа «asciiword» (к которым относятся слова из латинских букв) словарь «simple».
После этого необходимо пересоздать столбец search_vector, так как он будет содержать значение, не соответствующие новой конфигурации.
Page 29: 1. Подготовка
2. Поиск двух фраз
Запрос без индексов:
Page 30: Page 30
Запрос с индексом GiST:
Запрос с индексом GIN:
Запрос с индексом RUM:
Page 31: Page 31
Следует учитывать, что скорость выполнения запросов зависит от многих причин (от состояния буферного кеша, от нагрузки на сервер и т. д.), поэтому запросы лучше выполнить по нескольку раз и усреднить результаты.
3. Поиск точной формы слова
Изменяем конфигурацию поиска.
Теперь преобразование сохраняет форму слова:
Пересоздаем столбец.