14 Занятие 14: Расширяемость / Создание расширений
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_14_ext_extensions.html Archive: DEV2-handouts-16.zip Страниц PDF: 22
Page 1: Расширяемость / Создание расширений
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Расширения в PostgreSQL
- Создание расширений
- Версии расширений и обновление
- Особенности работы утилиты pg_dump
Page 3: Расширяемость PostgreSQL
Возможности
- функции и языки программирования
- типы данных, операторы, методы доступа
- обертки сторонних данных (FDW)
- Механизмы
- изменяемый системный каталог
- API для подключения внешних обработчиков
- загрузка и выполнение пользовательского кода
Комментарии преподавателя
Расширяемость — важнейшая черта PostgreSQL — это возможность подключать «на лету» новый функционал без изменения кода сервера.
Таким образом можно добавлять языки программирования и разрабатывать на них функции, определять новые типы данных и операторы для работы с ними, создавать новые методы доступа для типов данных, разрабатывать обертки сторонних данных для подключения к внешним источникам.
Для того чтобы это было возможным, системный каталог PostgreSQL хранит большое количество информации об объектах БД. Эта информация не зашита жестко в код сервера. Пользователи могут изменять содержимое таблиц системного каталога, тем самым добавляя новые объекты и связанный с ними функционал.
Кроме того, в исходном коде PostgreSQL встроено большое количество хуков и различных API для подключения пользовательских функций. Это дает возможность разрабатывать такие расширения как pg_stat_statements, auto_explain, pldebugger и многие, многие другие.
Завершает картину возможность загружать в серверные процессы пользовательский код. Например, можно написать разделяемую библиотеку и подключать ее по ходу работы.
https://postgrespro.ru/docs/postgresql/16/extend-how
В качестве предостережения следует отметить, что выполнение процессами сервера неправильно написанного пользовательского кода может привести к катастрофическим последствиям. Следует доверять только проверенному коду из надежных источников.
Page 4: Расширения
Группа взаимосвязанных объектов БД
- установка всех объектов одной командой
- невозможность удалить отдельный объект
- сохранение связи при выгрузке с помощью pg_dump
- инструменты для перехода на новую версию
- Источники
- в составе дистрибутива (contrib)
- внешние расширения
- возможность создания собственных расширений
Комментарии преподавателя
Бывают ситуации, когда несколько объектов базы данных логически связаны между собой. Например, несколько типов данных, функции и операторы для работы с ними, классы операторов. Такую связь можно сделать явной с помощью механизма расширений.
Это облегчает управление объектами:
● все объекты устанавливаются одной командой;
● невозможно удалить отдельный объект — расширение можно удалить только полностью;
● связь между объектами сохраняется и при создании резервной копии с помощью утилиты pg_dump;
● есть инструменты для управления версиями расширений.
В состав PostgreSQL входит значительное количество полезных расширений, частью из которых мы уже пользовались.
https://postgrespro.ru/docs/postgresql/16/contrib
https://postgrespro.ru/docs/postgresql/16/contrib-prog
Другой источник — PostgreSQL Extension Network (PGXN) — сеть расширений по аналогии с CPAN для Perl: https://pgxn.org/
Расширения могут распространяться и другими способами, в том числе через пакетные репозитории дистрибутивов ОС.
В этой теме мы рассмотрим, как создавать собственные расширения.
Page 5: Создание расширения
 {#source-figure-005 caption=“Source slide page 5: Создание расширения”}
Комментарии преподавателя
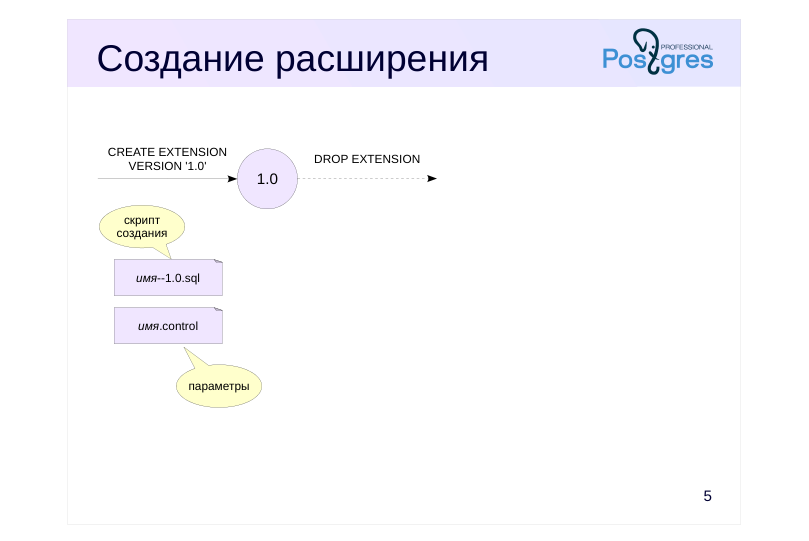
Расширение устанавливается в базу данных командой CREATE EXTENSION. При этом должны существовать два файла:
● управляющий файл «имя.control» с параметрами расширения;
● скрипт создания объектов расширения «имя–версия.sql».
Версия традиционно имеет вид «1.0», «1.1» и т. д., но это не обязательно: ее имя может состоять из любых символов (но не должно содержать «–» и начинаться или заканчиваться на «-»).
Обычно версию не указывают в команде CREATE EXTENSION, поскольку текущая актуальная версия записана в управляющем файле (параметр default_version) и используется по умолчанию.
Другие параметры расширения указывают зависимости от других расширений (requires), возможность перемещения объектов расширения между схемами (relocatable), возможность установки только суперпользователем (superuser) и др.
https://postgrespro.ru/docs/postgresql/16/extend-extensions
https://postgrespro.ru/docs/postgresql/16/sql-createextension
Расширение удаляется командой DROP EXTENSION. Скрипт для удаления объектов писать не нужно.
https://postgrespro.ru/docs/postgresql/16/sql-dropextension
Page 6: Создание расширения
 {#source-figure-006 caption=“Source slide page 6: Создание расширения”}
Создадим простое расширение — конвертер единиц измерения, и назовем его uom (units of measure). Начнем с каталога, в котором будем создавать необходимые файлы:
Сначала создадим управляющий файл с настройками (мы можем сделать это в любом текстовом редакторе). default_version определяет версию по умолчанию, без этого параметра версию придется указывать явно; relocatable говорит о том, что расширение можно перемещать из схемы в схему (мы поговорим об этом чуть позже); encoding требуется, если используются символы, отличные от ASCII; comment определяет комментарий к расширению.
Это не все возможные параметры; полный список можно узнать из документации. Теперь займемся файлом с командами, создающими объекты расширения. Первая строка файла предотвращает случайный запуск скрипта вручную. Все команды будут выполнены в одной транзакции — неявном блоке BEGIN … END. Поэтому команды управления транзакциями (и служебные команды, такие, как VACUUM) здесь не допускаются. Путь поиска (параметр search_path) будет установлен на единственную схему — ту, в которой создаются объекты расширения.
Чтобы PostgreSQL нашел созданные нами файлы, они должны оказаться в каталоге SHAREDIR/extension. Значение SHAREDIR можно узнать так:
Например, посмотрим на файлы расширения pg_background:
Конечно, файлы расширения можно скопировать вручную, но стандартный способ — воспользоваться утилитой make. Ей понадобится Makefile, который должен выглядеть, как показано ниже.
Page 7: Page 7
Переменная EXTENSION задает имя расширения; Переменная DATA определяет список файлов, которые надо скопировать в SHAREDIR (кроме управляющего); Последние строки не меняются. Они подключают специальный Makefile для расширений, который содержит всю необходимую логику сборки и установки. Важно, чтобы утилита pg_config была доступна — иначе неизвестны пути, по которым установлен PostgreSQL.
Теперь выполним make install в каталоге расширения:
Создадим базу данных и подключимся к ней:
Проверим, доступно ли наше расширение?
Попробуем создать в новой базе расширение uom:
Мы не указали версию, поэтому было взято значение из управляющего файла (1.0).
Все работает. Само расширение не относится к какой-либо схеме, но объекты расширения — относятся. В какой схеме они созданы?
Page 8: Page 8
Объекты установлены в схему, в которой они были бы созданы по умолчанию; в данном случае — public. При создании расширения мы можем указать эту схему явно:
Поскольку мы указали в управляющем файле, что расширение переносимо (relocatable), его можно переместить в другую схему:
Теперь все объекты находятся в схеме uom:
Можно ли прочитать данные из таблицы без указания схемы, где она расположена?
Нет, потому что теперь таблица не находится в пути поиска. А будет ли работать функция, если при ее вызове мы явно укажем схему? Напомним, что в определении тела функции обращение к таблице не включало название схемы.
Да, потому что код функции был оформлен в современном стиле стандарта SQL, а значит еще на этапе создания был выполнен его разбор и теперь обращение к таблице производится по ее идентификатору, а не по символическому имени. Позаботимся о путях поиска; данные из таблицы читаются:
Отметим, что некоторые расширения не допускают перемещения, но это бывает нечасто.
Page 9: Обновление расширения
 {#source-figure-009 caption=“Source slide page 9: Обновление расширения”}
Комментарии преподавателя
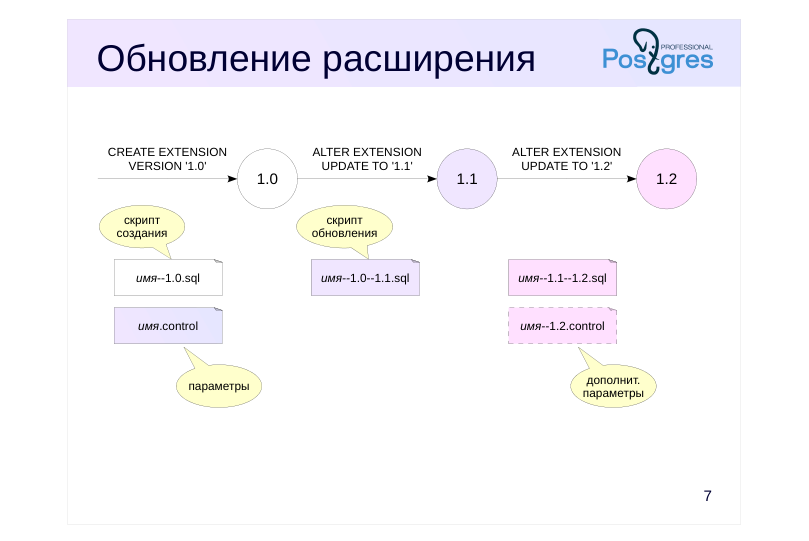
Обновление версии расширения выполняется командой ALTER EXTENSION UPDATE. При этом должен существовать скрипт обновления «имя–старая-версия–новая-версия.sql», содержащий необходимые для обновления команды.
Также необходимо изменить управляющий файл «имя.control», обновив актуальную версию и, возможно, другие параметры.
При необходимости может существовать и отдельный управляющий файл, привязанный к версии. Например, если в версии 1.2 появилась зависимость от другого расширения, то эту зависимость неправильно указывать в основном управляющем файле. Параметры, указанные в дополнительном управляющем файле, более приоритетны, чем параметры основного управляющего файла.
В примере, приведенном на слайде, имеются скрипты обновления 1.0→1.1 и 1.1→1.2. Можно создать и скрипт 1.0→1.2, но, как правило, это не требуется: механизм расширений сам берет на себя выбор пути с учетом доступных переходов между версиями. Например, если установлена версия 1.0, то ее можно обновить сразу до 1.2: сначала автоматически применится скрипт 1.0→1.1, а затем 1.1→1.2.
Как и при создании, при обновлении номер версии обычно не указывают — в этом случае обновление происходит до последней актуальной версии, записанной в основном управляющем файле.
https://postgrespro.ru/docs/postgresql/16/sql-alterextension
Page 10: Версии расширения и обновление
При некотором размышлении мы можем сообразить, что не любые единицы допускают преобразование. Например, метры нельзя пересчитать в килограммы. Создадим версию 1.1 нашего расширения, которая это учитывает. В управляющем файле исправим версию на 1.1:
И создадим файл с командами для обновления:
Добавим в Makefile новый файл в список DATA:
Выполним make install, чтобы разместить файлы расширения:
Какие версии расширения нам доступны?
Page 11: Page 11
Какие пути обновления доступны?
Очевидно, путь один. Заметьте, что если бы мы создали файл «uom–1.1–1.0.sql», можно было бы «понизить версию». Для механизма расширений имена версий ничего не значат. Выполним обновление:
Теперь нам доступен новый функционал:
Утилита pg\_dump
Что попадает в резервную копию базы данных, созданную с помощью утилиты pg_dump?
Page 12: Page 12
Вначале идут установки различных параметров сервера; Объекты расширения не попадают в резервную копию, вместо этого выполняется команда CREATE EXTENSION — это позволяет сохранить зависимости между объектами. В процессе работы с расширением пользователь может захотеть расширить справочник единиц измерения:
Что теперь попадает в резервную копию?
Сделанные пользователем изменения будут потеряны. Но этого можно избежать, если мы сможем разделить предустановленные значения и пользовательские. Подготовим версию 1.2 расширения.
В управляющем файле исправим версию на 1.2:
Создадим файл с командами для обновления. Вызов функции pg_extension_config_dump определяет, какие строки таблицы требуют выгрузки.
Page 13: Page 13
Добавим в Makefile новый файл в список DATA:
Выполним make install, чтобы разместить файлы расширения:
И выполним обновление:
Повторим эксперимент:
Что теперь попадает в резервную копию?
На этот раз все правильно: после создания расширения в таблицу добавляются строки, созданные пользователем.
Page 14: Page 14
Page 15: Итоги
Расширения — упаковка взаимосвязанных объектов БД, предназначенных для решения какой-либо задачи
- Расширения упрощают использование функционала
- Имеются средства для разработки собственных расширений
Page 16: Практика
- Создайте расширение bookfmt, содержащее все необходимое для работы с типом данных для формата изданий. Установите расширение, чтобы объединить имеющиеся в базе данных разрозненные объекты. 2. Воспользуйтесь стандартным расширением isn для того чтобы проверить корректность кодов ISBN у имеющихся в магазине книг.
Комментарии преподавателя
- Объекты базы данных, относящиеся к книжному формату — тип данных book_format, приведение типов, функции, операторы и класс операторов — мы создавали в темах «Пользовательские типы данных» и «Классы операторов».
Если создать расширение так, как это показывалось в демонстрации, то для его установки придется удалить из базы существующие объекты. Что, конечно, нежелательно для работающей системы.
Поэтому сначала создайте и установите пустое расширение, а затем напишите скрипт для его обновления, добавляющий к расширению уже имеющиеся в базе данных объекты с помощью команды ALTER EXTENSION ADD ….
- В достаточно старых книгах используется 10-значный код ISBN. С 2007 года для совместимости со штрихкодами используют 13-значный код ISBN (первые три цифры всегда равны 978).
Код имеет формат: 978 страна изд-во издание контрольная_цифра.
Между группами цифр обычно ставятся дефисы, но это незначащий символ. Контрольная цифра вычисляется по специальным правилам.
В расширении isn имеются функции isbn(text) для 10-значного кода и isbn13(text) для 13-значного. Если контрольная цифра неверна, функции вызывают ошибку.
Page 17: 1. Расширения для книжного формата
Сначала создадим «пустое» расширение без объектов.
Установим расширение.
Теперь напишем скрипт для обновления, в котором добавим в расширение уже существующие в базе объекты.
Page 18: Page 18
Выполним обновление:
Теперь все объекты объединены в расширение, которые мы при необходимости сможем развивать. А для того чтобы расширением могли воспользоваться другие, надо подготовить файл «bookfmt–1.0.sql» с командами, создающими все необходимые объекты.
2. Проверка кодов ISBN
Установим расширение:
Проблемные данные часто встречаются в реальных системах. В данном случае они могут быть вызваны не только ошибками при вводе, но и неправильно указанным кодом в самой книге. Расширение isn имеет возможность работы в нестрогом режиме, допуская ошибки (но предупреждая о них).
Page 19: Практика+
- Создайте расширение с функцией для подготовки текста к публикации. Функция должна применить к текстовому параметру последовательность правил, выполняющих замену по регулярному выражению, и вернуть результат. Правила должны храниться в таблице и применяться в порядке их вставки. К предопределенным правилам пользователь может добавлять собственные. Работа функции не должна зависеть от настройки пути поиска, но должна позволять выбрать схему при установке. 2. Установите расширение в схему typo, добавьте в таблицу пользовательское правило. Корректно ли выгружает копию базы данных утилита pg_dump? Проверьте возможность добавить правило после восстановления из резервной копии.
Комментарии преподавателя
- В качестве предопределенных правил используйте, например:
(^|\s)\"(\S) → \1«\2
(\S)\"(\s|$) → \1»\2
(^|\s)-(\s|$) → \1—\2
Эти правила заменяют (не всегда корректно) обычные символы на кавычки-елочки и тире:
- Буквы “р” нет, - сказал я. → — Буквы «р» нет, — сказал я.
Чтобы обеспечить независимость от пути поиска, расширение придется сделать непереносимым. Укажите соответствующий параметр в управляющем файла, а в теле функции используйте макрос @extschema@ для указания схемы, в которой находится таблица правил. Этот макрос будет заменен на выбранную схему при установке.
- Чтобы утилита pg_dump правильно выгружала пользовательские правила, используйте функцию pg_extension_config_dump и для самой таблицы, и для последовательности, созданной для первичного ключа.
При вызове pg_dump можно указать ключи –clean и –create, чтобы копия включала в себя команды для удаления и создания базы данных.
Page 20: 1. Расширение для подготовки текста
В управляющем файле указываем relocatable = false:
Создаем файл с командами.
Makefile и установка расширения в систему:
Page 21: 2. Проверка
Создаем базу данных и схему, и устанавливаем расширение:
При установке макрос был автоматически заменен на имя выбранной схемы:
Проверим:
Добавим правило:
Page 22: Page 22
Выгружаем копию базы данных и восстанавливаемся из нее (при восстановлении база данных будет удалена и создана заново):
Обратите внимание, что последней командой было установлено корректное значение последовательности. Если бы функция pg_extension_config_dump была вызвана только для таблицы, этого бы не произошло.
Проверяем: