13 Занятие 13: Расширяемость / Асинхронная обработка
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_13_ext_async.html Archive: DEV2-handouts-16.zip Страниц PDF: 29
Page 1: Расширяемость / Асинхронная обработка
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Зачем нужна асинхронная обработка данных
- Доступные решения
- Реализация очереди средствами PostgreSQL
Page 3: Асинхронная обработка
Разнесение во времени возникновения события и его обработки
- Соображения производительности
- клиенту не требуется ждать ответа
- возможность управлять ресурсами для обработки
- Реализация
- очередь сообщений
- более сложный вариант: модель публикация — подписка
Комментарии преподавателя
Идея асинхронной обработки событий состоит в том, что возникновение события и его обработка разносятся во времени.
Например, пользователь хочет получить детализацию расходов на мобильную связь. Детализация формируется несколько минут. Можно показать пользователю «песочные часы» и заставить его ждать (синхронная обработка), а можно выслать детализацию по электронной почте, когда она будет готова (асинхронная обработка).
Другой пример: интеграция двух систем. Первая система обращается ко второй, передавая пакет сообщений. Обработка одного сообщения занимает несколько секунд, но в пакете может оказаться тысяча сообщений. Можно заставить первую систему ожидать получения результата (синхронная обработка), а можно ответить «работаем», обработать сообщения асинхронно и уже затем сообщить результат.
Асинхронная обработка сложнее синхронной, но часто оказывается очень удобной. Она позволяет работать эффективнее (клиенту не надо простаивать, дожидаясь ответа) и управлять ресурсами (обрабатывать события с удобной скоростью и в удобное время, а не немедленно).
(Асинхронная обработка широко применяется и в ядре PostgreSQL. Вспомните режим асинхронной фиксации; процесс контрольной точки; процесс автоочистки.)
Обычная реализация состоит в наличии очереди событий (сообщений): одни процессы создают события, другие — обрабатывают. Возможны более сложные модели, в которых есть возможность публиковать события и подписываться на события нужного типа.
Page 4: Внешние системы
RabbitMQ, ActiveMQ, ZeroMQ и т. п.
- Плюсы
- эти системы работают
- следование стандартам (AMQP, JMP, STOMP, MQTT…)
- гибкость, масштабирование, производительность
- Возможные минусы
- отдельная система (включающая отдельную СУБД)
- со своими особенностями настройки, администрирования, мониторинга
- все сложности построения распределенных систем
- (отсутствие глобальных транзакций)
Комментарии преподавателя
Одним из вариантов реализации очередей событий являются внешние системы. Названия многих из них традиционно заканчиваются на MQ — Message Queuing.
Как правило, это большие серьезные системы, обеспечивающие гибкость, масштабируемость, высокую производительность и прочие полезные свойства. К тому же они реализуют один или несколько стандартных протоколов работы с сообщениями, что позволяет интегрировать их с другими системами, понимающими те же протоколы.
Но надо понимать, что любая большая система потребует серьезных затрат на ее изучение и внедрение. Потребуется разобраться с особенностями настройки, администрирования, мониторинга. Заметим, что в состав систем работы с очередями входит и отдельная СУБД для надежного хранения очередей.
Кроме того, использование внешней системы приводит ко всем сложностям построения распределенных систем. При отсутствии глобальных транзакций, объединяющих разные системы, возможны случаи потери сообщений в результате сбоев.
Page 5: Очередь внутри базы: PgQ
Плюсы
- система давно на рынке и широко используется
- Возможные минусы
- мало гибкости, например, исключительно пакетная обработка
- плохо документирована
- внешняя программа-демон
Комментарии преподавателя
Более простым решением может служить реализация очереди в самой СУБД. Особенно это имеет смысл, если события возникают и обрабатываются на сервере баз данных.
Наиболее известна система PgQ, разработанная в свое время компанией Skype (https://github.com/pgq). Эта система достаточно широко используется и про нее известно, что она работает. Если требуется готовое решение, то ей можно и воспользоваться. Поддерживаются версии PostgreSQL 10+.
Из минусов этого решения отметим:
● Недостаточную гибкость. Например, возможна только пакетная обработка событий. Пока обработчик не пометит пакет, как полностью обработанный, все события пакета могут быть доставлены повторно в случае сбоя.
● Отсутствие качественной документации (есть описание API: https://pgq.github.io/extension/pgq/).
● Необходимость во внешней (относительно СУБД) программе, обеспечивающей работу очереди.
Page 6: Очередь внутри базы: pgmq
Плюсы
- система активно развивается
- легковесная реализация
- все компоненты внутри базы
- Возможные минусы
- недостаточная гибкость в управлении на низком уровне
- слабо документирована
- только исходные коды, необходимость сборки
Комментарии преподавателя
Решение заявлено компанией Tembo как легковесная реализация очередей. Расширение pgmq написано на Rust и использует инфраструктуру сборки расширений pgrx.
Очереди и метаинформация представлены таблицами в базе данных, а элементы очереди («сообщения») — записями в таблицах. Сообщения можно помещать в очередь (в том числе по несколько сразу), читать из очереди, удалять и архивировать. Для выполнения этих основных действий (и еще ряда дополнительных) в расширении предусмотрен набор функций. Детали реализации очереди скрыты от пользователя, что упрощает работу.
Из минусов pgmq отметим следующие:
● Недостаточная гибкость в управлении на низком уровне. Связано с тем, что расширение pgmq базируется на фреймворке pgrx, в который встроено, в том числе, управление соединениями с сервером СУБД. Повлиять на него средствами уже собранного pgmq нельзя.
● Документация недостаточно подробна.
● В репозитории отсутствуют готовые пакеты, а сборка расширения может оказаться нетривиальной и ресурсоемкой.
https://github.com/tembo-io/pgmq
Page 7: Очередь средствами расширения pgmq
Создадим базу данных и подключимся к ней:
Расширение pgmq уже собрано и доступно для установки. Выполним команду создания расширения в нашей базе. Все его объекты будут размещены в схеме pgmq:
Создадим очередь под названием pgmq_queue:
Информация об очередях хранится в таблице meta; посмотреть очереди можно с помощью табличной функции:
Также были созданы таблицы для сообщений очереди: основная q_pgmq_queue и архивная a_pgmq_queue:
Поместим в очередь несколько сообщений (полезная информация представляется значением типа jsonb)…
…и заглянем в основную таблицу очереди:
Page 8: Page 8
 {#source-figure-008 caption=“Source slide page 8: Page 8”}
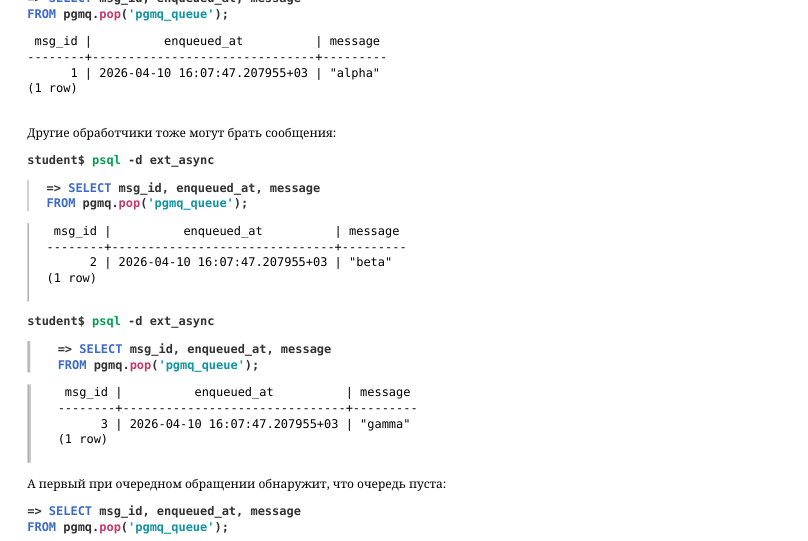
Простой способ забрать сообщение из очереди — вызвать функцию pop:
Другие обработчики тоже могут брать сообщения:
А первый при очередном обращении обнаружит, что очередь пуста:
И напоследок удалим саму очередь. При этом ее основная и архивная таблицы исчезнут, как и информация в таблице meta:
Page 9: Очередь своими руками
Возможные плюсы
- не требуются внешние зависимости
- простые требования — простая реализация
- Минусы
- требуется отладка и тестирование
- при усложнении требований готовая система может обойтись дешевле
Комментарии преподавателя
Для решения простой задачи, требующей асинхронной обработки, использование сторонних систем может оказаться невыгодным. Возможно, проще написать собственную реализацию, чем приспосабливаться к особенностям сторонней системы.
Конечно, нужно понимать, что:
● реализация должна быть сделана аккуратно, иначе она может привести к проблемам эксплуатации;
● если к системе очередей предъявляются серьезные требования (или есть шанс, что такие требования появятся в будущем), то развитие, тестирование и поддержка собственного решения, наоборот, может оказаться невыгодной.
Далее мы посмотрим, как реализовать очередь сообщений в PostgreSQL своими руками, и какие подводные камни есть на этом пути.
Page 10: Реализация очереди сообщений
Наша задача: реализовать простую очередь сообщений с возможностью конкурентного получения сообщений из нескольких процессов. Полезную информацию снова представим типом JSON — так очередь будет достаточно универсальна. В каждый конкретный момент времени в таблице сообщений не будет много строк, но за все время работы их может оказаться существенное количество. Поэтому идентификатор надо сразу сделать 64-разрядным:
Вставка сообщений в очередь проста:
Теперь займемся функцией получения и блокирования очередного сообщения. Нам требуется блокировать полученную строку, чтобы одно сообщение не могло быть выбрано два раза (двумя одновременно работающими обработчиками). Это можно сделать с помощью фразы FOR UPDATE:
Но в таком случае аналогичный запрос в другом процессе будет заблокирован до завершения первой транзакции.
Вторая транзакция заблокирована.
Page 11: Page 11
Для того чтобы не останавливаться на заблокированных строках, служит фраза SKIP LOCKED команды SELECT.
Итак, функция для получения и блокирования очередного сообщения может выглядеть следующим образом:
В практических заданиях к темам «Очистка» и «Фоновые задания» мы рассматривали типичное решение для получения пакета строк таблицы, например, с целью обновления или удаления. Запрос выглядел так:
Как видите, в обоих случаях используется тот же самый подход: выбирается и блокируется часть строк (одна или несколько), при этом уже заблокированные строки пропускаются. Теперь напишем функцию завершения работы с сообщением. Мы будем просто удалять его из очереди.
Page 12: Page 12
Теперь мы готовы написать цикл обработки сообщений. Оформим его в виде процедуры.
В этом варианте цикл заканчивается, когда в очереди не остается необработанных сообщений. Вместо этого можно не прекращать цикл, но продолжать ожидать новые события, засыпая, например, на одну секунду. Пробуем.
Теперь в два потока.
Обработка 10 сообщений двумя потоками заняла около 5 секунд, но горизонт транзакций держался на одном уровне все время обработки очереди! Это будет мешать выполнению очистки и создавать проблемы для всей базы данных.
Page 13: Вспоминаем про горизонт
Что получилось: одна большая транзакция
- take_message();
- обработка
- complete_message();
- take_message();
- обработка
- complete_message();
- take_message();
- обработка
- complete_message();
- COMMIT;
Комментарии преподавателя
Показанное решение имеет существенный недостаток: вся обработка выполняется в одной длинной транзакции. Вспоминая темы «Многоверсионность» и «Очистка» модуля «Архитектура», можно с уверенностью сказать, что обработка очереди будет мешать нормальной работе очистки.
Page 14: Вспоминаем про горизонт
Что надо: каждое событие в отдельной транзакции
- take_message();
- обработка
- complete_message();
- take_message();
- обработка
- complete_message();
- take_message();
- обработка
- complete_message();
- COMMIT;
- COMMIT;
- COMMIT;
Комментарии преподавателя
Чтобы таких проблем не возникало, надо раздробить длинную транзакцию на несколько более коротких. В нашем случае — обрабатывать каждое событие в собственной транзакции.
Page 15: Вспоминаем про горизонт
 {#source-figure-015 caption=“Source slide page 15: Вспоминаем про горизонт”}
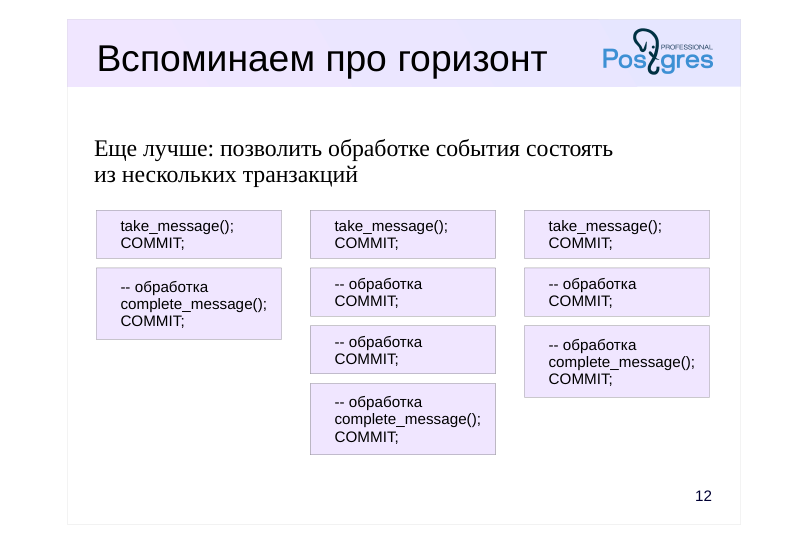
Еще лучше: позволить обработке события состоять из нескольких транзакций
Комментарии преподавателя
Более того, обработка одного события тоже может (в принципе) разбиваться на несколько транзакций.
В таком случае мы сначала фиксируем изменение статуса события в очереди («в работе»), затем выполняем обработку, а в конце фиксируем факт завершения работы с событием (например, удаляем его из таблицы).
Page 16: Учитываем горизонт транзакций
Это легко сделать, поскольку процедура позволяет управлять транзакциями.
Проверим:
Теперь горизонт транзакций продвигается вперед и не мешает очистке. Однако момент срабатывания автоматической очистки определяется на основе данных статистики, которая обновляется лишь по окончании работы всего оператора CALL.
Таким образом, чтобы таблица с очередью вовремя очищалась, можно: модифицировать процедуру process_queue таким образом, чтобы обеспечить ее гарантированное периодическое завершение и положиться на автоочистку; периодически запускать обычную (неавтоматическую) очистку. Один из способов реализации — использование фоновых процессов, которые рассмотрены в соответствующей теме этого курса.
Page 17: Чего не хватает
 {#source-figure-017 caption=“Source slide page 17: Чего не хватает”}
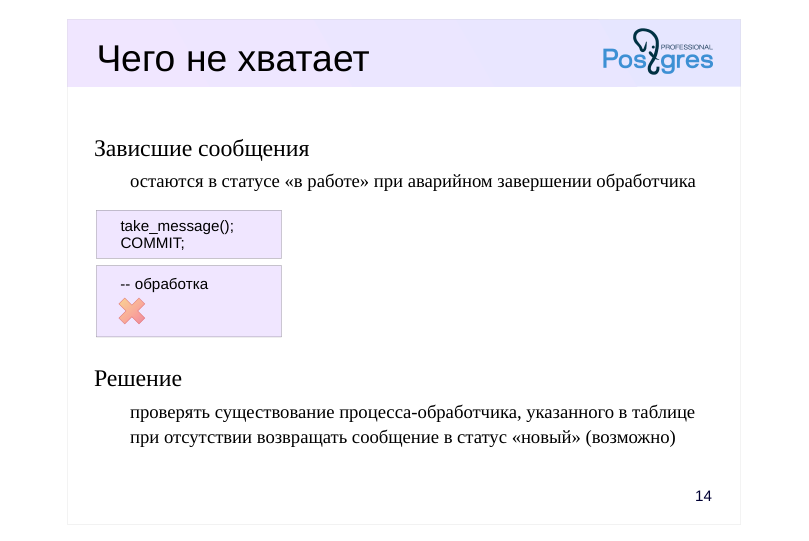
Зависшие сообщения
- остаются в статусе «в работе» при аварийном завершении обработчика
- Решение
- проверять существование процесса-обработчика, указанного в таблице
- при отсутствии возвращать сообщение в статус «новый» (возможно)
Комментарии преподавателя
Чего не хватает в нашей реализации?
Во-первых, обработчик может завершиться аварийно. Если мы фиксируем изменение статуса обработки, то событие «повиснет» в статусе «в работе» и не будет больше обрабатываться.
В нашей реализации мы уже сделали шаг в нужную сторону: в таблице сохраняется номер обслуживающего процесса (pid), который взял событие в работу. Можно написать простую проверку: если pid имеется в таблице, но процесса с таким номером нет в системе — значит, произошел сбой.
Что делать в таком случае? Если обработка события выполнялась в одной транзакции, то она была прервана и, следовательно, можно безопасно вернуть событие в статус «новое» — оно будет обработано повторно.
Если же обработка делится на несколько транзакций, надо быть уверенным в том, что обработку можно запускать повторно.
Page 18: Чего не хватает
Корректная обработка исключительных ситуаций
- Сохранение результатов обработки
- Решение
- не удалять обработанные сообщения, а помечать отдельным статусом
- потребуется правильный индекс
- потребуется периодическое удаление исторических данных
- обращаем внимание на очистку
Комментарии преподавателя
Во-вторых, наша реализация никак не обрабатывает исключительные ситуации. Это, конечно, несложно добавить. При возникновении исключения хотелось бы иметь информацию о том, что случилось.
Да и если событие обработано без ошибок, может быть полезным сохранять какую-то информацию об обработке. Это, конечно, зависит от конкретной задачи.
Наша реализация удаляет обработанные события из очереди, но вместо этого можно оставлять их, помечая специальным статусом («завершено», «ошибка» и т. п.). Тогда всю информацию об обработке можно иметь непосредственно в таблице с событиями. В таком случае потребуется эффективный доступ к еще не обработанным сообщениям: частичный индекс с условием pid IS NULL. (Другим решением может быть перенос обработанных событий в отдельную таблицу.)
За удобство потребуется платить реализацией периодического удаления «хвоста» очереди — исторических данных. Если период достаточно большой, то, возможно, удаление надо выполнять пакетами — чтобы не допускать лишнего разрастания таблицы и не мешать очистке.
И, поскольку таблица очередей изменяется довольно активно, надо обеспечить ее своевременную очистку, о чем говорилось в демонстрации.
Page 19: Итоги
Асинхронная обработка полезна во многих случаях
- Внешние системы имеет смысл использовать, если
- вписываются в общую архитектуру информационной системы
- к реализации предъявляются серьезные требования
- Очередь сообщений в базе данных — простое решение для простых задач
- важна правильная реализация:
- эффективное получение очередного события (SKIP LOCKED),
- избегание долгих транзакций,
- своевременная очистка таблицы очереди
- чем больше требований, тем сложнее будет реализация
Page 20: Практика
- В приложении предусмотрен механизм фоновых заданий, но серверная часть обработки очереди отсутствует.
- Напишите недостающие функции: - take_task — получает очередное задание из очереди; - complete_task — завершает обработку задания; - process_tasks — основной цикл обработки заданий. 2. Запустите процедуру обработки очереди заданий в фоновом режиме. Проверьте, что фоновые задания, поставленные в очередь в приложении, выполняются, а результаты их работы доступны для просмотра.
Комментарии преподавателя
- Фоновые задания позволяют запустить специально зарегистрированную функцию из пользовательского интерфейса и затем просматривать состояние и результат выполнения.
В качестве результата функция может возвращать множество строк, то есть в простейшем виде тело функции может состоять из одного SQL-запроса. На вход функция должна принимать один параметр типа jsonb. Пример задания: public.greeting_program.
Напишите подпрограммы take_task, complete_task и process_tasks по аналогии с показанными в демонстрации примерами. Учтите:
● take_task должна возвращать задачу в статусе «scheduled» и заполнить подходящие поля таблицы tasks:
started = текущее время, status = «running», pid = номер процесса.
● complete_task должна не удалять задание, а заполнить поля tasks:
finished = текущее время, при нормальном завершении: status = «finished», result = результат, в случае ошибки: status = «error», result = сообщение об ошибке.
● process_tasks не должна завершаться; организуйте бесконечный цикл с задержкой в 1 сек между задачами. Убедитесь, что в режиме ожидания не возникает долгой транзакции. Для удобства установите параметр application_name в значение «process_tasks».
Для фактического выполнения задания процедура должна вызвать функцию empapi.run(task tasks). В случае успешного выполнения функция вернет результат, оформленный в виде текстовой строки. В случае ошибки будет сгенерировано исключение.
Page 21: 1. Реализация обработки очереди заданий
Функция получения задания из очереди аналогична показанной в демонстрации, но должна учитывать поля таблицы:
(Игнорируйте столбцы host и port — они пригодятся в теме «Обзор физической репликации».)
Поскольку мы не будем удалять задания из очереди, создадим частичный индекс для эффективного доступа к следующему необработанному заданию:
Функция завершения работы с заданием дополнительно принимает статус завершения и текстовый результат:
Процедура обработки очереди:
Page 22: Page 22
Обратите внимание, что первая команда COMMIT предшествует команде CONTINUE. В противном случае при отсутствии заданий возникала бы долгая транзакция. Несколько слов о том, зачем нужна функция run. В принципе, выполнить задание и получить результат можно было бы таким образом:
К сожалению, PL/pgSQL не позволяет гибко работать со значениями составного типа: у значения неизвестного наперед типа (record) нельзя перебрать все имеющиеся в нем поля. Поэтому для вывода приходится полагаться на стандартное преобразование строки в текст. Это будет некрасиво выглядеть в случае нескольких полей:
Для аккуратного оформления результата можно воспользоваться другим процедурным языком. Мы используем функцию, написанную на PL/Python. Функция run не вызывается напрямую приложением, но в теме «Обзор физической репликации» мы будем вызывать ее на другом сервере, поэтому она находится в схеме empapi, а не public. Подробнее о том, в каких случаях могут пригодиться другие языки, будет рассказано в теме «Языки программирования».
2. Запуск обработки очереди в фоновом режиме
В очереди стоит тестовое задание:
Page 23: Page 23
Запускаем обработку (в один поток) и, если все сделано правильно, оно будет выполнено.
Между вызовами нужна небольшая задержка, чтобы функция pg_background_detach не освободила общую память до того, как фоновый процесс обратится к ней — такова особенность текущей реализации. Поэтому мы не вызываем обе функции в одном операторе. Подождем немного…
Задание успешно выполнено. Обратите внимание, что результат выполнения содержит и названия столбцов из оригинального запроса. Фоновые процессы, обрабатывающие очередь, легко найти благодаря тому, что процедура устанавливает параметр application_name:
Page 24: Практика+
- Напишите тест, проверяющий, что обработка очереди, показанная в демонстрации, работает корректно при выполнении в несколько потоков. Убедитесь, что тест не проходит, если убрать предложение FOR UPDATE SKIP LOCKED. 2. Добавьте в реализацию проверку «зависших» сообщений. Если такая ситуация будет обнаружена, зависшее сообщение должно быть снова принято в работу.
Комментарии преподавателя
- Вставьте в таблицу сообщений большое количество строк и проверьте, что:
а) было обработано каждое сообщение;
б) каждое сообщение было обработано ровно один раз.
Уберите из реализации секундную задержку (имитацию работы), чтобы тест выполнялся быстрее и с достаточным уровнем конкурентности между процессами.
Page 25: 1. Тестирование реализации очереди
Повторим реализацию очереди, показанную в демонстрации. Таблица:
Функция получения и блокирования очередного сообщения:
Функция завершения работы с сообщением:
В процедуру обработки очереди внесем изменение: вместо секундной задержки будем записывать информацию об обрабатываемом сообщении в отдельную таблицу:
Page 26: Page 26
Создаем большое количество сообщений:
Запускаем обработку в два потока, засекая время:
Проанализируем результаты. При корректной работе мы должны обнаружить в журнальной таблице ровно 1000 уникальных идентификаторов, что будет означать, что обработаны все события, и ни одно не обработано дважды.
Все корректно. Проверим теперь реализацию без предложения FOR UPDATE SKIP LOCKED.
Запускаем обработку:
Page 27: Page 27
Как видим, часть сообщений была обработана дважды. Например:
Это произошло из-за того, что сообщение, обрабатываемое одним процессом, никак не блокируется и доступно для другого процесса. Восстановим корректную функцию:
2. Обработка зависших сообщений
Мы можем перехватить ошибку, возникающую при обработке события, но тем не менее всегда есть шанс того, что сама процедура-обработчик завершится аварийно. Сымитируем такую ситуацию:
Запускаем обработку…
Page 28: Page 28
…а в это время в другом сеансе:
Обработчик «упал». Причем, благодаря команде LOCK TABLE, — сразу после того, как зафиксировал номер процесса в таблице очереди. В очереди остались необработанные сообщения и среди них — одно зависшее:
Самый простой способ исправить ситуацию — изменить функцию выбора сообщения:
Если события обрабатываются быстро и важна высокая пропускная способность, то проверку лучше выполнять отдельно и только время от времени, чтобы избежать постоянного обращения к pg_stat_activity. Снова запустим обработчик, и все сообщения, включая зависшее, будут обработаны.