12 Занятие 12: Расширяемость / Фоновые процессы
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_12_ext_bgworkers.html Archive: DEV2-handouts-16.zip Страниц PDF: 22
Page 1: Расширяемость / Фоновые процессы
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Механизм фоновых процессов
- Применение в ядре PostgreSQL
- Возможности для прикладных задач
- Расширение dblink
- Расширение pg_background
Page 3: Фоновые процессы
Фиксированный набор служебных процессов
- postmaster
- walwriter
- checkpointer
- autovacuum
- и другие
- Динамически порождаемые фоновые процессы
- контролируются процессом postmaster
- имеют доступ к разделяемой памяти
- могут устанавливать внутреннее соединение с базами данных
- реализуются на языке C
Комментарии преподавателя
PostgreSQL состоит из набора взаимодействующих процессов. За основными процессами закреплены собственные имена и они имеют особый смысл для сервера. Например, при остановке экземпляра нужно записать в журнал сообщение о завершении контрольной точки, поэтому процесс walwriter надо останавливать после checkpointer, и т. п. Обычно (хотя и не всегда) такие процессы работают постоянно от старта сервера до его останова.
Но вместе с тем часто возникает необходимость временно запустить процесс, который выполнит необходимую работу и завершится. Такую возможность предоставляет механизм фоновых процессов (background workers): https://postgrespro.ru/docs/postgresql/16/bgworker
Как и все остальные, фоновые процессы порождаются и контролируются процессом postmaster. Фоновые процессы имеют все возможности, такие как доступ к разделяемой памяти сервера и соединение с базами данных по внутреннему протоколу SPI (рассматривается в теме «Языки программирования»).
Фоновые процессы должны быть написаны на языке C, пример можно найти в исходном коде (src/test/modules/worker_spi).
Заметим, что процесс автоочистки (autovacuum launcher) тоже динамически порождает рабочие процессы (autovacuum worker), но исторически делает это по-своему, не используя общий механизм фоновых процессов.
Page 4: Использование
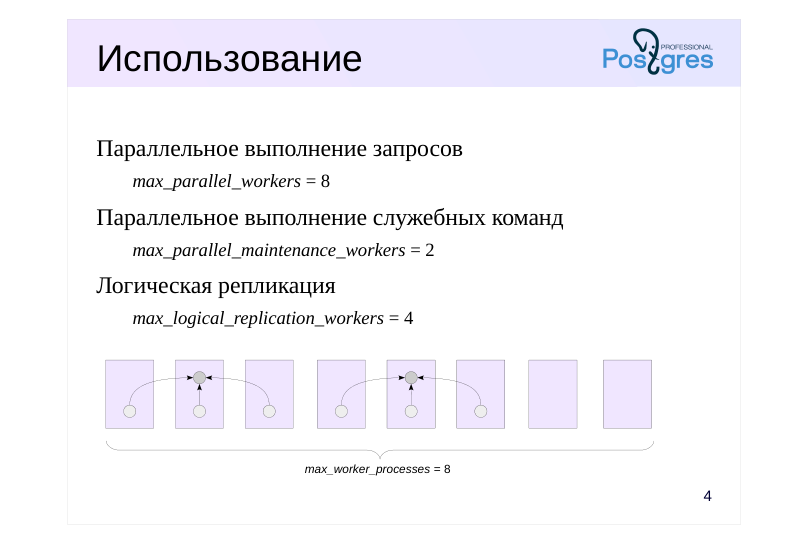 {#source-figure-004 caption=“Source slide page 4: Использование”}
Параллельное выполнение запросов
- max_parallel_workers = 8
- Параллельное выполнение служебных команд
- max_parallel_maintenance_workers = 2
- Логическая репликация
- max_logical_replication_workers = 4
Комментарии преподавателя
Фоновые процессы используются в PostgreSQL для различных целей.
Параллельное выполнение запросов.
Параллельное выполнение служебных команд (CREATE INDEX и REINDEX (в т. ч. CONCURRENTLY) для B-деревьев, VACUUM).
В этих случаях имеется ведущий процесс, инициирующий запуск рабочих процессов и получающий от них информацию.
- Логическая репликация (для процессов на стороне сервера-подписчика).
Общее количество фоновых процессов в системе ограничено значением параметра max_worker_processes, и отдельными параметрами ограничено количество процессов для каждой из трех категорий. Если в пуле недостаточно фоновых процессов, то обработка будет выполняться последовательно, а не параллельно (а логическая репликация и вовсе не будет работать).
Page 5: Использование фоновых процессов
Вот простой наглядный пример использования фоновых процессов для распараллеливания запросов. Если требуется посчитать количество строк в большой таблице, ведущий процесс запускает несколько рабочих процессов (в данном случае 2):
Запланированное количество и число реально запущенных процессов могут отличаться, если на момент запуска запроса пул фоновых процессов будет исчерпан. В конце частичные результаты собираются и агрегируются лидирующим процессом чтобы получить итоговое значение.
Page 6: Прикладные задачи
Некоторые идеи
- планировщик заданий внутри СУБД
- асинхронная обработка событий
- распараллеливание сложной обработки данных
- автономные транзакции
- и другое
- Но пользовательские задачи неудобно писать на языке C
Комментарии преподавателя
Кроме штатного использования, фоновые процессы можно приспособить и для решения пользовательских задач.
Например, можно организовать планировщик заданий внутри СУБД. В отличие от, например, cron, такой планировщик не будет зависеть от используемой операционной системы. (Планировщик внутри СУБД реализован в Postgres Pro Enterprise и рассматривается в курсе PGPRO).
Можно выполнять асинхронную обработку событий (что будет подробно рассмотрено в одноименной теме).
Можно распараллеливать сложную длинную обработку больших объемов данных.
Можно реализовать автономные транзакции, хотя и весьма дорогим способом. (В Postgres Pro Enterprise имеются автономные транзакции, они рассматриваются в курсе PGPRO).
И так далее.
Однако писать прикладные задачи на языке С крайне неудобно и требует неоправданно высокой квалификации.
Page 7: Расширение dblink
Назначение
- выполнение произвольных SQL-команд на удаленном сервере
- в качестве удаленного сервера может выступать и локальный
- Плюсы
- стандартное расширение
- Минусы
- фоновые процессы не используются,
- устанавливается новое соединение
Комментарии преподавателя
Одно из возможных решений — использовать расширение dblink, которое предназначено для выполнения SQL-запросов на удаленном сервере PostgreSQL (в качестве удаленного может выступать и локальный сервер).
Это проверенное временем стандартное расширение. Однако оно не использует механизм фоновых процессов — устанавливается полноценное новое соединение с сервером, что существенно дороже.
https://postgrespro.ru/docs/postgresql/16/dblink
Page 8: Расширение dblink
Это стандартное расширение. Установим его:
Ниже — самый простой способ выполнить одиночный запрос на удаленном сервере. Первый параметр функции — строка соединения, второй — команда, которую надо выполнить. Функция возвращает множество строк типа record, поэтому структуру составного типа необходимо указывать явно при ее вызове.
Команду, не возвращающую строки, можно выполнить с помощью другой функции:
Обе функции открывают соединение, выполняют команду и тут же закрывают соединение. Но есть возможность явно управлять соединением. Откроем его, указав имя:
Можно открыть и несколько соединений. Текущие открытые соединения показывает функция:
Теперь можно выполнять команды, используя открытое соединение. В том числе можно вручную управлять транзакциями:
Page 9: Page 9
Важная возможность — асинхронные вызовы. Следующая функция отправит запрос на сервер и тут же вернет управление:
1 — успешно; 0 — ошибка. Далее мы можем проверить, выполняется ли еще запрос:
Результат получаем так (если запрос еще не выполнился, функция сама дождется результатов):
Не забываем закрыть соединение:
Page 10: Page 10
Page 11: Расширение pg_background
Назначение
- возможность выполнить команду SQL в фоновом процессе
- команда может вызвать подпрограмму на любом серверном языке
- Плюсы
- используются фоновые процессы Минусы
- стороннее расширение
Комментарии преподавателя
Есть и другое решение, которое позволяет прикладным разработчикам воспользоваться фоновыми процессами — стороннее расширение pg_background:
https://github.com/vibhorkum/pg\_background
Фактически это небольшая обертка над низкоуровневым API фоновых процессов, позволяющая запускать в фоновом режиме произвольные команды SQL. Разумеется, таким образом можно вызывать хранимые функции и процедуры, написанные на любых серверных языках программирования (например, PL/pgSQL).
Page 12: Расширение pg_background
Расширение уже собрано и доступно для установки в виртуальной машине курса:
Расширение предоставляет всего три функции. Функция pg_background_launch запускает фоновый процесс, выполняющий одну SQL-команду. Например, выполним в фоне простой запрос. Для удобства он будет работать 10 секунд:
Пока запрос выполняется, мы можем увидеть процесс в pg_stat_activity:
Обратите внимание на ожидание. Функция pg_background_result выводит результат выполнения фоновой команды (при необходимости дожидаясь ее окончания). Функция возвращает значения типа record, поэтому для вывода необходимо конкретизировать названия и типы полей составного типа.
Функция pg_background_detach отключает текущий процесс от ожидания результатов фонового процесса. Из-за особенности текущей реализации между вызовами pg_background_launch и pg_background_detach должна быть небольшая задержка. Передача результатов выполняется через очередь сообщений в разделяемой памяти сервера. Поэтому при переполнении очереди фоновый процесс будет ждать, пока мы не прочитаем накопившиеся сообщения, даже если они нас не интересуют. Запустим процесс, возвращающий много информации:
Page 13: Page 13
Обратите внимание на ожидание. Отключимся от процесса:
Больше фоновый процесс ничего не ждет (и, возможно, уже отработал). Заметим, что в случае dblink сложностей с переполнением буфера не возникает, потому что используется не межпроцессное взаимодействие, а устанавливается обычное соединение по клиент-серверному протоколу. Интересно, что изначально в состав расширения pg_background планировалось включить четвертую функция pg_background_run(pid, query), которая должна была передавать новое задание уже запущенному процессу, избегая затрат на создание очередного фонового процесса. Однако пока что это не реализовано.
Page 14: Итоги
Сервер предоставляет механизм фоновых процессов
- Фоновые процессы используются для внутренних целей, но могут быть использованы и для прикладных задач
- Расширение pg_background позволяет реализовывать фоновые процессы на процедурных языках
Page 15: Практика
- Реализуйте расчет рейтинга книг на основе данных о голосах пользователей «за» и «против». Чтобы не допускать разрастание таблицы, выполняйте обновление пакетами по N строк. Между частичными обновлениями запускайте очистку. Оформите обновление в виде хранимой процедуры, принимающей N как параметр. 2. Выполните процедуру обновления в фоновом режиме.
Комментарии преподавателя
- Рейтинг книги оценивается числом от 0 до 1.
«Наивная» формула для определения рейтинга может быть такой:
votes_up / (votes_up + votes_down), если votes_up + votes_down > 0;
0, иначе.
Недостаток этой формулы показывает пример: книга, набравшая 100 голосов «за» и 1 голос «против», получит меньший рейтинг, чем книга, набравшая всего один голос «за».
Можно подумать над более справедливой формулой, а можно воспользоваться уже готовой функцией public.rating.
Пакетное обновление рассматривалось в практике к теме «Очистка». Здесь применим тот же подход. Однако подумайте над тем, как пересчитывать рейтинг только тех книг, для которых это необходимо.
Команда VACUUM не может быть вызвана внутри транзакции, но ее можно выполнить как отдельную SQL-команду в фоновом процессе.
Page 16: 1. Процедура расчета рейтинга
Для вычисления рейтинга мы будем пользоваться готовой функцией public.rating. Эта функция вычисляет рейтинг с учетом баланса между долей положительных оценок и неопределенностью малого числа наблюдений (нижняя граница доверительного интервала Вильсона для параметра Бернулли). Один из возможных способов не пересчитывать рейтинг без надобности состоит в том, чтобы добавить к таблице книг столбец логического типа, указывающий на необходимость пересчета. Процедура расчета рейтинга будет сбрасывать этот флаг, а любое изменение количества голосов — устанавливать. Мы реализуем другой способ. Добавим к таблице столбец с датой последнего пересчета рейтинга. Процедура пересчета будет выполняться только для тех книг, «возраст» рейтинга которых больше определенного порога. Это позволит при необходимости (например, если изменится формула) пересчитать рейтинг всех книг, не обновляя предварительно все строки таблицы.
Обратите внимание: добавление столбца затрагивает только системный каталог и не приводит к перезаписи всех строк таблицы. Для обработки строк пакетами нужно определиться: с размером пакета; с тем, как из всех строк выбирать для обработки только нужное количество. Важный момент: обработка пакета может — в принципе — завершиться ошибкой. Важно, чтобы это не повлияло на возможность продолжить обработку и довести ее до конца. Для выбора пакета строк мы используем подход, показанный ранее в практике к теме «Очистка». Будем выбирать и блокировать первые подходящие N строк, игнорируя уже заблокированные:
Здесь мы выбираем строки, для которых рейтинг не рассчитан или рассчитан «давно». Когда прекращать обновление? Если анализировать количество обновленных строк и сравнивать с размером пакета, то можно пропустить строки, которые были заблокированы каким-нибудь другим процессом. Поэтому лучше явно проверять наличие строк, требующих обработки. И еще один момент: поскольку команду VACUUM нельзя использовать в функциях и процедурах, мы будем запускать ее в фоновом процессе. Теперь мы готовы к тому, чтобы написать процедуру обновления. Для удобства передадим в качестве параметра не только размер пакета, но и порог возраста.
Page 17: Page 17
Проверим:
2. Расчета рейтинга в фоновом режиме
Page 18: Page 18
Просто вызовем процедуру в фоновом процессе. Таким образом, из одного фонового процесса можно вызывать другой (конечно, необходимо, чтобы не было превышено предельное количество фоновых процессов, установленное в системе).
Page 19: Практика+
- Фоновый процесс не будет запущен, если запуск приведет к превышению числа допустимых процессов. Напишите функцию-обертку для pg_background_launch, которая пытается запустить процесс N раз с интервалом в одну секунду. 2. Сравните накладные расходы на порождение процесса расширений dblink и pg_background, многократно выполняя простой запрос.
Комментарии преподавателя
- Предварительно исследуйте, как функция pg_background_launch сигнализирует об ошибке. Для этого удобно уменьшить значение параметра max_worker_processes, но учтите, что один фоновый процесс в системе уже запущен (logical replication launcher) — не уменьшайте значение до 1.
Обработка ошибок рассматривается в курсе DEV1.
- Разумеется, накладные расходы dblink будут существенно зависеть от способа аутентификации (в нашем случае — проверка пароля scram-sha-256).
Page 20: 1. Превышение числа фоновых процессов
Уменьшим значение параметра-ограничителя до 2, учитывая, что один фоновый процесс (logical replication launcher) запускается системой автоматически. Изменение требует рестарта сервера.
Запустим один длительный фоновый процесс:
Теперь попробуем запустить еще один, перехватывая исключение:
Ошибка с кодом 53000 относится к группе insufficient_resources. Функция может выглядеть следующим образом:
Page 21: Page 21
Проверим:
Восстановим значение параметра по умолчанию:
2. Сравнение dblink и pg\_background
Просто запрос (выполняем с помощью динамического SQL, чтобы исключить кеширование плана запроса):
Page 22: Page 22
Расширение pg_background:
Расширение dblink: