11 Занятие 11: Расширяемость / Слабоструктурированные данные
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_11_ext_semistruct.html Archive: DEV2-handouts-16.zip Страниц PDF: 29
Page 1: Расширяемость / Слабоструктурированные данные
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Что такое слабоструктурированные данные
- Применение в реляционных базах данных
- Необходимые операции
- Тип данных для XML: xml
- Типы данных для JSON: json и jsonb
- Индексирование документов JSON
Page 3: Что это такое
Наиболее известные примеры: XML и JSON
- Схема данных определяется самим документом
- документ содержит разметку для выделения элементов
- и определения иерархии
- Данные не соответствуют реляционной модели
- конкретный документ можно представить в виде таблиц
- документы общего вида тоже можно, но практически — неудобно
Комментарии преподавателя
Слабоструктурированные (semi-structured) данные — это данные, представленные не в реляционном (табличном) виде. Обычно это текстовый документ, но в отличие от текста на естественном языке, документ содержит разметку, определяющую структурные единицы.
Широко известными примерами форматов (языков разметки) являются XML и JSON, в последнее время также популярен YAML.
Структура, или схема, документа определяется его собственной разметкой. (Это не исключает возможности определить структуру отдельно — например, для XML есть языки DTD, XMLSchema.)
Разметка, как правило, позволяет определить вложенные элементы, образующие иерархию.
Конечно, любую конкретную иерархию можно представить и в табличном виде. Можно уложить в таблицы и произвольную иерархию без жесткой схемы, но результат будет лишен типизации данных, возможности создания ограничений целостности, с ним будет крайне неудобно работать в терминах запросов SQL. Поэтому с некоторыми видами данных действительно удобнее и логичнее работать именно в таком, слабоструктурированном, виде.
Page 4: Применение
Интерфейсный формат
- между приложением и внешней системой
- между клиентской и серверной частями приложения
- Внутри базы данных как атомарное значение
- только хранение и извлечение
- не нарушает 1NF, достаточно обычных средств SQL
- Внутри базы данных как неатомарное значение
- операции с отдельными частями документа
- SQL не достаточно; требуется специальный язык запросов
- и набор дополнительных операций
- гибкость, когда данные плохо укладываются в реляционную модель
Комментарии преподавателя
Документы XML или JSON могут применяться как удобный интерфейсный формат между разными компонентами, независимый от конкретной платформы или языка программирования. Например, для взаимодействия с внешними системами, или для обмена данными между клиентской и серверной частями системы. В последнем случае интерфейсный формат позволяет клиенту послать сложный запрос, а серверу выполнить его эффективным образом (в отличие от традиционного подхода, принятого в ORM, когда сервер базы данных нагружается большим количеством мелких запросов, не оставляя возможностей для оптимизации).
Если слабоструктурированные данные хранятся внутри самой базы данных, то все зависит от того, как эти данные используются. Если внутри SQL запросов не делается попыток работать с отдельными частями документов, то такие значения можно считать атомарными с точки зрения СУБД. Тут достаточно обычных средств SQL.
Конечно, более интересен случай, когда серверу необходимо выделять часть документа, фильтровать вывод на основе содержания документов и т. п. Для этого SQL уже не хватает и нужен специализированный язык доступа к слабоструктурированным данным. Если СУБД предоставляет такую возможность, это позволяет комбинировать строгий реляционный подход для данных, имеющих четкую структуру, и подход в духе NoSQL для данных, которые сложно представить в табличном виде.
Page 5: Операции
Преобразование документа к реляционному виду
- сохранение транспортного документа в базу данных
- использование средств SQL для обработки
- Преобразование реляционных данных к виду документа
- выгрузка данных в транспортный формат
- Выделение части документа
- специализированный язык запросов
- Индексирование документов
- поддержка операций специализированного языка запросов
Комментарии преподавателя
Чтобы работать со слабоструктурированными документами в реляционной базе данных, понадобятся возможности для преобразования данных из одного вида в другой, поскольку в одних ситуациях удобнее использовать реляционные средства, в других — документоориентированные. Особенно это важно, если такой язык, как XML или JSON, используется в качестве транспортного формата.
Кроме этого, нужны средства для выделения части документа — каких-то отдельных значений, или какого-то подмножества элементов. Такие средства обычно представлены в виде специализированного языка запросов, который учитывает иерархическую структуру документов. Такие языки запросов можно использовать не только для выделения части документа, но и, например, для выбора тех документов, в которых присутствует заданный фрагмент.
Если слабоструктурированные документы используются в реляционной СУБД, встает задача индексирования таких данных. Для этого, как правило, не годятся обычные B-деревья, поскольку требуется поддерживать не операции сравнения документов, а операции, связанные со специализированным языком запросов.
Page 6: Формат XML
eXtensible Markup Language
- универсальный язык разметки, первый стандарт 1998 года
- форматы на основе XML: XHTML, FB2, RSS и Atom, SVG, SOAP…
- Структура
- вложенные элементы
- отделяются тегами, могут иметь атрибуты, содержат текст
- Инструментарий
- описание схемы (DTD, XML Schema), языки запросов XPath и XQuery,
- язык преобразования XSLT
- PostgreSQL: XPath 1.0
Комментарии преподавателя
XML (eXtensible Markup Language) появился в контексте веба и разрабатывается консорциумом W3C. XML является текстовым документом, содержащим специальную разметку. XML определяет синтаксическую структуру разметки, которая с помощью тегов выделяет элементы (возможно, вложенные друг в друга), которые могут также иметь атрибуты. (Язык XML довольно сложен, в нем имеются также инструкции обработки, комментарии и другие сущности, но мы не будем на этом останавливаться.)
XML позволяет определить расширения XML, определяя конкретный набор элементов и их атрибутов, и наделяя их определенной семантикой. К известным расширениям относятся XHTML (более строгий HTML, совместимый с XML), FB2 (формат электронных книг), RSS и Atom (форматы для новостных лент), SVG (векторная графика), SOAP (формат сообщений веб-сервисов) и другие.
За время существования формата XML сформировался богатый инструментарий для работы с ним, включающий языки описания схемы документов (такие, как DTD, XMLSchema), языки запросов (базовый XPath и более богатый XQuery на его основе), языки преобразования документов XML (XSLT и XSL-FO на его основе).
В реляционных базах работу с XML регламентирует стандарт SQL/XML. PostgreSQL поддерживает только XPath 1.0. Преобразования XSLT доступны в расширениях (xml2 или в сторонних). Индексирование не реализовано (хотя все возможности для этого есть).
https://postgrespro.ru/docs/postgresql/16/datatype-xml
https://postgrespro.ru/docs/postgresql/16/functions-xml
Page 7: Тип данных для XML
xml
- хранение в виде обычного текста + синтаксическая проверка
- сохраняется исходное форматирование
- может хранить XML-документ или фрагмент документа
Комментарии преподавателя
Тип xml хранит документ в виде текстовой строки. Но по сравнению с типом text он проверяет введенные значения на допустимость по правилам XML.
Допускается хранение корректно оформленных документов, а также их фрагментов, в которых может быть несколько элементов верхнего уровня или текстовых узлов.
Для типа xml не определены никакие операторы сравнения, поэтому столбец этого типа нельзя проиндексировать с помощью B-tree. Однако можно, например, использовать индекс по выражению, в котором вызывается XPath и результат приводится к строке символов.
Существуют и другие ограничения реализации этого типа в PostgreSQL.
https://postgrespro.ru/docs/postgresql/16/xml-limits-conformance
Page 8: XML: тип xml
Будем работать с документом, описывающим компоненты компьютера.
Теги выделяются угловыми скобками. Для каждого открывающего тега (
В PostgreSQL имеется тип xml, значение которого хранится в виде символьной строки, а при приведении к типу происходит проверка структуры. В зависимости от значения параметра xmloption проверка ожидает: document — документ (с одним корнем), content — фрагмент документа (любой набор элементов).
При приведении к типу xml форматирование сохраняется:
А попытка привести некорректный фрагмент даст ошибку:
Page 9: XML: выражения XPath
Посмотрим, какие средства есть для получения части XML-документа. Для этого используются выражения языка запросов XPath 1.0. Мы не будем детально рассматривать все возможности XPath, но посмотрим некоторые примеры. XML состоит из иерархии элементов, поэтому язык описывает перемещения по дереву. Часть документа, соответствующая пути от корня:
В пути можно указывать не только непосредственные потомки:
По дереву элементов можно «двигаться» не только вниз к листьям, но и вверх к корню:
Вместо конкретного имени элемента можно указать, что подходит любой:
Здесь мы получили в массиве две части XML-документа. Можно посчитать количество:
Можно извлечь не весь элемент, а только его текст:
Атрибуты записываются с помощью «собаки». Найдем значения атрибутов size_gb:
Page 10: Page 10
Условия фильтрации записываются в квадратных скобках. Найдем все элементы, объем памяти которых начинается от 1000 гигабайт:
Сравнение работает, потому что XPath поддерживает числовые типы. Кроме этого, поддерживаются строки и логический тип. Выражения XPath применяются не только в функции xpath, но и в других. Например, можно проверить, содержит ли XML-документ указанный фрагмент:
XML: преобразование в реляционный вид и обратно
Для того чтобы преобразовать XML-документ к реляционному (табличному) виду, используется функция xmltable. Пусть у нас имеется таблица для дисковых накопителей:
Сначала выделим нужную часть документа:
Теперь можно написать вызов функции xmltable. В нем мы указываем выражение XPath, сам документ, а также описываем, как получать значения для столбцов таблицы с помощью дополнительных XPath-выражений:
Page 11: Page 11
Обратите внимание: выражения XPath для столбцов отсчитываются не от корня документа, а от текущего контекста (элемента, найденного основным выражением XPath); в выражениях можно использовать некоторые арифметические операции. Результат такого запроса можно непосредственно вставить в таблицу:
Для создания документов XML имеется довольно много функций, с помощью которых можно собрать документ «по кусочкам». Но есть также функции, позволяющие выгрузить в XML целую таблицу, или результат запроса, или даже всю базу данных в фиксированном формате.
Page 12: Формат JSON
JavaScript Object Notation
- простой язык разметки, стандарт 1999 года
- появился в JavaScript, но распространен повсеместно
- Структура
- объекты (пары «ключ: значение»), массивы значений
- значения текстовые, числовые, даты, логические
- Инструментарий
- PostgreSQL: язык запросов JSONPath,
- неполная пока поддержка стандарта SQL/JSON,
- индексирование
Комментарии преподавателя
Формат JSON — подмножество языка JavaScript, описывающее:
● простые значения (текстовые, числовые, даты и логические);
● объекты, состоящие из пар «ключ — значение»;
● массивы значений.
В двух последних случаях значения могут быть как простыми, так и объектами или массивами, то есть документ имеет иерархическую структуру.
Несмотря на то, что JSON — «родной» формат для JavaScript, он получил огромное распространение благодаря своей простоте и удобству, и повсеместно используется в современном интернете.
Изначально PostgreSQL предоставлял собственные операции для работы с JSON; при необходимости более серьезного инструментария можно было воспользоваться расширением jsQuery. В настоящее время в PostgreSQL реализована часть стандарта SQL/JSON:2016, включая язык запросов JSONPath.
Имеется и индексирование документов JSON. Это позволяет комбинировать реляционные возможности PostgreSQL с возможностями, предоставляемыми NoSQL-базами.
https://postgrespro.ru/docs/postgresql/16/datatype-json
https://postgrespro.ru/docs/postgresql/16/functions-json
https://github.com/postgrespro/jsquery
Page 13: Типы данных для JSON
Json
- хранение в виде обычного текста + синтаксическая проверка
- сохраняется исходное форматирование
- необходимость повторного разбора при каждом запросе
- Jsonb
- внутренний формат, исключающий повторный разбор
- поддержка SQL/JSON (язык запросов JSONPath)
- поддержка индексирования
Комментарии преподавателя
Имеются два типа данных для представления документов JSON: json и jsonb.
Первый появился раньше и, по сути, просто хранит документ в виде текстовой строки (при этом, конечно, проверяется, что строка является корректным документом JSON). Но при любом обращении к части документа JSON его приходится заново разбирать. Это вызывает большие накладные расходы. Кроме того, для формата json не реализован язык JSONPath и не работает индексирование. Поэтому json применяется редко.
Обычно используется тип jsonb (b — binary). Этот формат сохраняет однажды разобранную иерархию элементов, что позволяет эффективно работать с документом. Следует учитывать, что исходный вид документа при этом не сохраняется: нарушается порядок следования элементов, пропадают отступы и дублирующиеся ключи.
https://postgrespro.ru/docs/postgresql/16/datatype-json#DATATYPE-JSONP ATH
Page 14: JSON: типы данных json и jsonb
Документ, описывающий компоненты компьютера, может выглядеть в JSON так:
Тип json хранит документ как обычный текст:
В jsonb документ разбирается и записывается во внутреннем формате, сохраняющем структуру разбора. Из-за этого при выводе документ составляется заново в эквивалентном, но ином виде:
Чтобы вывести документ в человекочитаемом виде, можно использовать специальную функцию:
Page 15: Page 15
Дальше мы будем работать с типом jsonb, который предоставляет больше возможностей.
JSON: выражения JSONPath и другие средства
Для получения части JSON-документа стандарт SQL:2016 определил язык запросов JSONPath. Вот некоторые примеры. Так же, как и XPath, JSONPath позволяет спускаться по дереву элементов. Часть документа, соответствующая пути от корня:
Элементы массива указываются в квадратных скобках:
Можно получить и все элементы сразу:
Page 16: Page 16
Условия фильтрации записываются в скобках после вопросительного знака. Символ @ обозначает текущий путь. Найдем диски, объем памяти которых начинается от 1000 гигабайт:
Условия являются частью пути, который можно продолжить дальше. Выберем только модель:
В пути может быть и несколько условий:
Кроме средств JSONPath, можно применять и «традиционную» стрелочную нотацию. Переходим к ключу motherboard, затем к ключу ram, затем берем первый (нулевой) элемент массива:
Двойная стрелка возвращает не jsonb, а текстовое представление (необходимые фильтрации придется выполнять уже на уровне SQL):
Page 17: Page 17
Начиная с версии PostgreSQL 14 для работы c jsonb можно использовать индексную нотацию:
JSON: преобразование в реляционный вид и обратно
Стандарт определяет функцию jsontable, но ее реализация ожидается только в PostgreSQL 17. Разумеется, можно выйти из положения и теми средствами, которые существуют. Сначала выделим все диски:
На основе этого запроса несложно сделать вставку в таблицу:
Для обратного преобразования удобно воспользоваться функцией row_to_json:
Соединить строки в общий JSON-массив можно, например, так:
Здесь отдельные строки преобразуются в объекты JSON автоматически.
Page 18: Метод доступа GIN
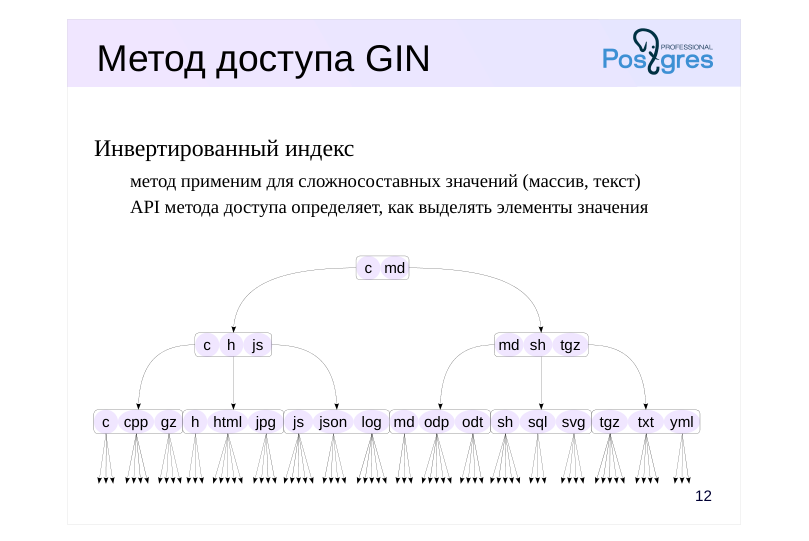 {#source-figure-018 caption=“Source slide page 18: Метод доступа GIN”}
Инвертированный индекс
- метод применим для сложносоставных значений (массив, текст)
- API метода доступа определяет, как выделять элементы значения
Комментарии преподавателя
Идея метода доступа GIN (Generalized Inverted Index) основана на том, что для сложносоставных значений имеет смысл использовать в качестве ключей элементы значений, а не значения целиком.
Представьте предметный указатель в конце книги. Страницы книги — сложносоставные значения (текст), а указатель позволяет ответить на вопрос «на каких страницах встречается такой-то термин?».
Для хранения элементов в GIN используется обычное B-дерево, поэтому элементы должны принадлежать к сортируемому типу данных. Основные отличия от B-дерева состоят в следующем:
● Когда нужно проиндексировать новое значение, это значение разбивается на элементы и индексируются сразу все элементы. Поэтому в индекс добавляется не один элемент, а сразу несколько (обычно много).
● Каждый элемент индекса ссылается на множество табличных строк.
● Хотя элементы и организованы в B-дерево, классы операторов GIN не поддерживают операции сравнения «больше», «меньше».
Таким образом, GIN оптимизирован для других условий использования, нежели B-дерево. (Но имеется расширение btree_gin, реализующее классы операторов GIN для обычных типов данных.)
https://postgrespro.ru/docs/postgresql/16/gin
https://postgrespro.ru/docs/postgresql/16/datatype-json#JSON-INDEXING
Page 19: Метод доступа GIN для индексирования JSON
Пусть теперь таблица с дисками будет содержать JSON-документы.
Заполним ее разными моделями, от 10 до 1000 Гбайт:
Вот что получилось:
Сколько всего моделей имеют емкость 10 Гбайт и сколько времени займет поиск?
Оператор @? проверяет, есть ли в документе JSON заданный путь.
Как выполняется этот запрос?
Конечно, используется полное сканирование таблицы — у нас нет подходящего индекса.
Page 20: Page 20
Документы JSONB можно индексировать с помощью метода GIN. Для этого есть два доступных класса операторов:
Класс по умолчанию, jsonb_ops, более универсален, но менее эффективен. Этот класс операторов помещает в индекс все ключи и значения. Из-за этого поиск получается неточным: значение 10 может быть найдено не только в контексте емкости (ключ capacity), но и как число пластин (ключ plates). Зато такой индекс поддерживает и другие операции с JSONB. Попробуем.
Доступ, тем не менее, ускоряется.
Другой класс операторов, jsonb_path_ops, помещает в индекс значения вместе с путем, который к ним ведет. За счет этого поиск становится более точным, хотя поддерживаются не все операции. Проверим и этот способ:
Так гораздо лучше. Еще один вариант — построить индекс на основе B-дерева по выражению. Вот так:
Page 21: Page 21
Но такой способ, конечно, менее универсален — под каждый запрос потребуется создавать отдельный индекс. Сравним размер индексов (для сравнения выводится и размер таблицы):
Page 22: Итоги
PostgreSQL поддерживает слабоструктурированные типы
- Частичная поддержка XML
- формат теряет популярность
- Полноценная поддержка JSON
- направление активно развивается
- Индексирование на основе метода доступа GIN
Page 23: Практика
- Часть сведений о книгах (ISBN, аннотация и другие) выводятся приложением только на отдельной странице. Сейчас эти данные хранятся в таблице books, но не передаются приложению. Измените функцию, реализующую API приложения, так, чтобы сведения передавались в виде одного объекта JSON. Проверьте реализацию в приложении. 2. Многочисленные столбцы, хранящие дополнительные сведения о книгах, никак не используются в серверной части приложения. Замените их на один столбец, в котором сведения будут храниться в формате JSON. Сделайте это прозрачно для приложения.
Комментарии преподавателя
Сведения должны передаваться в объекте JSON следующего формата: { “ISBN”: isbn, “Аннотация”: abstract, “Издательство”: publisher, “Год выпуска”: year, “Гарнитура”: typeface, “Издание”: edition, “Серия”: series }
Действуйте в предположении, что во время замены столбцов приложение работает и должно корректно выполнять запросы пользователей. Не забудьте, что вместе с заменой столбцов на один общий необходимо исправить и интерфейсную функцию приложения.
Кроме того, считайте, что одновременно с работой приложения могут изменяться как данные о существующих книгах, так и добавляться новые книги.
Page 24: 1. Дополнительные сведения о книгах
Приложение рассчитывает получить дополнительные сведения о книгах в столбце additional таблицы, возвращаемой вызовом webapi.get_catalog, которая, в свою очередь, обращается за данными к public.get_catalog. Последняя получает дополнительные атрибуты через отдельную функцию, которая сейчас возвращает пустой документ:
Изменим функцию следующим образом:
2. Замена нескольких столбцов на один формата JSON
Добавим к таблице books необходимый столбец:
Если данные о книгах могут изменяться в процессе наших действий, мы можем создать триггер, который будет переносить изменения в новый столбец:
Теперь перенесем в новый столбец исторические данные:
Начиная с этого момента старые столбцы менять нельзя. Если бы у нас была процедура загрузки новых поступлений, ее
Page 25: Page 25
следовало бы переделать на заполнение нового столбца. Переключим приложение на использование нового столбца:
Теперь можно удалить временный триггер:
И можно удалить ненужные теперь столбцы таблицы:
Удаление столбцов происходит быстро, поскольку данные фактически не удаляются, а только становятся невидимыми. Поэтому размер таблицы не уменьшится до тех пор, пока строки не будут физически перезаписаны, например, при обновлениях.
Page 26: Практика+
- В базе данных имеются таблицы пользователей и их заказов, связанные отношением «один ко многим». Напишите функцию, которая по идентификатору пользователя возвращает документ JSON, содержащий все сведения о пользователе вместе с массивом его заказов. 2. В пользовательском интерфейсе необходимо выводить названия городов, хранящиеся в базе данных, на выбранном языке. Один из способов — хранить все переводы названий в объекте JSON в виде пар «код языка — название». Реализуйте такой способ. Для удобства создайте представление, показывающее название городов на языке, заданном в конфигурационном параметре сервера.
Комментарии преподавателя
- Таблицы могут быть следующими: CREATE TABLE users( id integer PRIMARY KEY GENERATED ALWAYS AS IDENTITY, name text);
Результат должен иметь вид: { “user_id”: …, “name”: …, “orders”: [ { “order_id”: …, “amount”: … }, … ] }
Для того чтобы сформировать объект JSON из нескольких полей, воспользуйтесь функцией jsonb_build_object.
- Название пользовательского конфигурационного параметра должно содержать точку в своем имени, например, «translation.lang».
Получить текущее значение параметра можно функцией current_setting.
Page 27: 1. Формирование JSON
Создадим таблицы и тестовые данные:
Функция использует jsonb_build_object для создания объекта и jsonb_agg для создания массива:
Проверим:
Page 28: Page 28
2. Хранение переводов
Таблица с городами:
Представление может быть устроено следующим образом:
Проверим результат с разными значениями параметра:
Page 29: Page 29
Таким образом приложение может установить язык один раз в начале сеанса, и затем запросы не будут зависеть от выбора пользователя.