10 Занятие 10: Расширяемость / Классы операторов
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_10_ext_opclasses.html Archive: DEV2-handouts-16.zip Страниц PDF: 27
Page 1: Расширяемость / Классы операторов
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Методы доступа (типы индексов)
- Классы и семейства операторов
- Метод доступа btree и создание класса операторов для него
- Идея метода доступа gist и примеры его использования
Page 3: Методы доступа
Определяют способ получения данных
- Табличные методы доступа — организация данных и чтение всей таблицы
- Индексные методы доступа (типы индексов) — быстрый доступ к небольшой части данных
- алгоритмы, связанные с поисковой структурой данных
- эффективная одновременная работа
- страничная организация данных
- журналирование операций
Комментарии преподавателя
Методы доступа определяют способ получения данных. Их можно разделить на табличные и индексные методы.
Табличный метод определяет организацию данных в таблице и работает, когда надо прочитать все данные (Seq Scan). В PostgreSQL существует единственный табличный метод heap, и других готовых методов (таких, например, как колоночное хранилище) еще нет, но они должны появиться в будущем.
https://postgrespro.ru/docs/postgresql/16/tableam
Индексный метод доступа работает, когда надо быстро получить часть данных (обычно небольшую) с помощью индекса.
Индексный метод можно рассматривать как каркас, который реализует основные алгоритмы для работы с индексной структурой данных, а также берет на себя заботу о низкоуровневых деталях, таких как:
● эффективная конкурентная работа с индексной структурой (в том числе стратегия блокирования);
● страничная организация данных индекса;
● журналирование операций над индексом в WAL.
https://postgrespro.ru/docs/postgresql/16/indexam
Page 4: Методы доступа
В версии 16 имеется единственный встроенный табличный метод доступа:
Зато много различных индексных методов доступа:
С btree знакомы все — это «обычный» метод доступа на основе B-дерева, который используется по умолчанию и покрывает большинство потребностей. Остальные методы доступа также очень полезны, но в специальных ситуациях. Некоторые из них мы рассмотрим позже. Для получения информации мы делали запросы к таблицам системного каталога, однако в арсенале psql есть удобная команда, позволяющая получить информацию о методах доступа, классах и семействах операторов, ей дальше мы и будем пользоваться:
Page 5: Классы операторов
 {#source-figure-005 caption=“Source slide page 5: Классы операторов”}
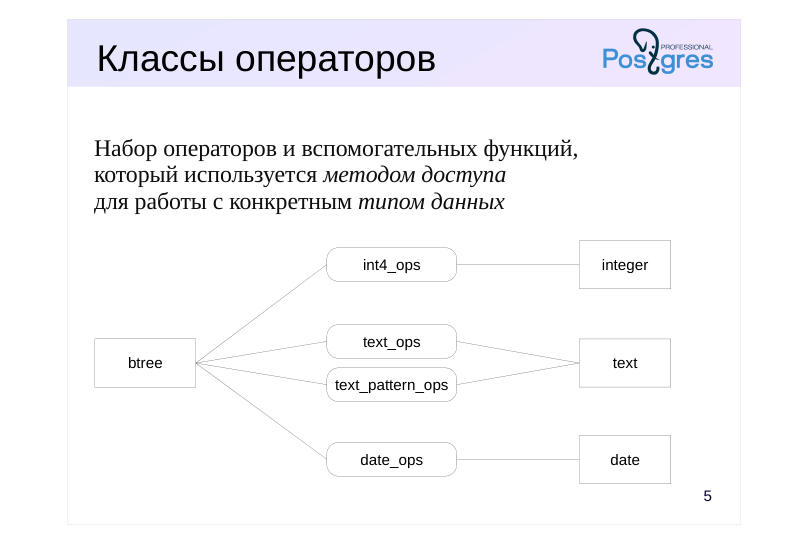
Набор операторов и вспомогательных функций, который используется методом доступа для работы с конкретным типом данных
Комментарии преподавателя
Дальше мы будем говорить не о табличном, а об индексном доступе.
Итак, с одной стороны есть индексный метод доступа (например, btree), а с другой — конкретные типы данных (такие, как integer, text и т. п.).
Чтобы связать метод доступа с типами данных, используются классы операторов. Класс операторов состоит из набора операторов (и, при необходимости, вспомогательных функций), который реализует API индексного метода доступа.
Важно, что часть логики индексирования находится в методе доступа, а часть — в классе операторов. Поэтому недостаточно понять только устройство метода доступа; надо учитывать и то, какой используется класс операторов.
Для B-деревьев это не так очевидно, поскольку на долю класса операторов приходится совсем немного. Но в других методах доступа разные классы операторов могут радикально менять логику.
Заметим также, что для одного и того же метода доступа и одного и того же типа данных может быть определено несколько классов операторов. В этом случае пользователь может выбирать то поведение, которое требуется.
https://postgrespro.ru/docs/postgresql/16/indexes-opclass
Page 6: Классы операторов
Посмотрим, какие классы операторов определены для B-дерева и для разных типов данных. Для целых чисел:
Для удобства такие «похожие по смыслу» классы операторов объединяются в семейства операторов:
Семейства операторов позволяют планировщику работать с выражениями разных (но «похожих») типов, даже если они не приведены к одному общему. Вот классы операторов для типа text (если для одного типа есть несколько классов операторов, то один будет помечен для использования по умолчанию):
Классы операторов pattern_ops отличаются от обычных тем, что сравнивают строки посимвольно, игнорируя правила сортировки (collation). А так можно посмотреть, какие операторы включены в конкретный класс операторов:
Метод доступа — это тип индекса, а собственно индекс — это конкретная структура, созданная на основе метода доступа, в которой для каждого столбца используется свой класс операторов. Пусть имеется какая-нибудь таблица:
Page 7: Page 7
Привычная команда создания индекса выглядит так:
Но это просто сокращение для:
Page 8: Метод доступа btree
 {#source-figure-008 caption=“Source slide page 8: Метод доступа btree”}
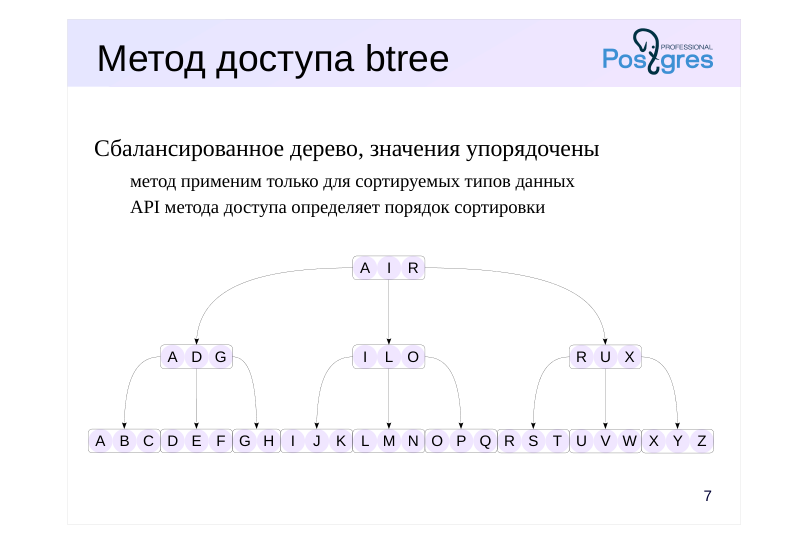
Сбалансированное дерево, значения упорядочены
- метод применим только для сортируемых типов данных
- API метода доступа определяет порядок сортировки
Комментарии преподавателя
Рассмотрим теперь несколько конкретных методов доступа, и начнем с B-деревьев.
Эта структура данных представляет собой дерево (сбалансированное по высоте), которое содержит упорядоченные данные. В каждом узле хранится информация о том, какие диапазоны значений расположены в дочерних узлах.
Это позволяет находить искомое значение, спускаясь от вершины дерева к листьям, каждый раз однозначно выбирая подходящий диапазон. Например, для поиска буквы «H» (на рисунке) мы начинаем с корня. Поскольку «A» <= «H» < «I», мы спускаемся в первый дочерний узел, и так далее.
Итак, этот метод доступа применим только для сортируемых данных (к которым относятся большинство «обычных» типов данных). От класса операторов требуется только определить, как именно упорядочиваются значения конкретного типа.
https://postgrespro.ru/docs/postgresql/16/btree
https://postgrespro.ru/docs/postgresql/16/xindex
Page 9: Класс операторов для B-дерева
Класс операторов для B-дерева определяет, как именно будут сортироваться значения в индексе. Для этого он включает пять операторов сравнения, как мы уже видели на примере bool_ops. Определим перечислимый тип для единиц измерения информации:
И объявим составной тип данных для представления объема информации:
Используем новый тип в таблице, которую заполним случайными значениями.
По умолчанию значения составного типа сортируются в лексикографическом порядке, но этот порядок не совпадает с естественным порядком:
Чтобы исправить сортировку, создадим класс операторов. Начнем с функции, которая пересчитает объем в байты.
Помимо операторов сравнения нам понадобится еще одна вспомогательная функция — тоже для сравнения. Она должна возвращать: −1, если первый аргумент меньше второго; 0, если аргументы равны; 1, если первый аргумент больше второго.
Page 10: Page 10
С помощью этой функции мы определим пять операторов сравнения (и функции для них). Начнем с «меньше»:
И аналогично остальные четыре.
Готово. Мы уже можем правильно сравнивать объемы:
Page 11: Page 11
Чтобы значения были правильно упорядочены при выборке, нам осталось создать класс операторов. За каждым оператором закреплен собственный номер (в случае btree: 1 — «меньше» и т. д.), поэтому имена операторов могут быть любыми.
Теперь значения отсортированы правильно. Наш класс операторов будет использоваться по умолчанию при создании индекса:
Любой индекс в PostgreSQL может использоваться только для выражений вида:
Причем оператор должен входить в соответствующий класс операторов. Будет ли использоваться созданный индекс в таком запросе?
Да, поскольку: поле test.cap проиндексировано с помощью метода доступа btree и класса операторов capacity_ops; оператор < входит в класс операторов capacity_ops. Поэтому и при доступе с помощью индекса значения будут возвращаться в правильном порядке:
Page 12: Page 12
Page 13: Метод доступа GiST
 {#source-figure-013 caption=“Source slide page 13: Метод доступа GiST”}
Комментарии преподавателя
Однако не все типы данных сортируемы. Например, не имеют естественной упорядоченности геометрические фигуры (точки, прямоугольники и т. п.), диапазоны, массивы и т. п. Конечно, для таких типов данных можно определить операции сравнения, но практической пользы от них будет немного. Важнее уметь использовать индексы, например, для поиска точек, входящих в заданную область или в массив, т. е. для операторов, отличных от «больше», «меньше» и т. п.
B-дерево здесь не годится, но идею индексирования с помощью сбалансированного дерева можно обобщить. При поиске по дереву в каждом узле принимается решение, в каком поддереве (в общем случае — в нескольких поддеревьях) продолжить поиск. Для этого каждому поддереву ставится в соответствие условие (предикат), которому удовлетворяют все находящиеся в нем данные.
Класс операторов для GiST (generalized search tree — обобщенное дерево поиска) определяет, как выглядит предикат, и еще многие детали, необходимые для эффективной работы.
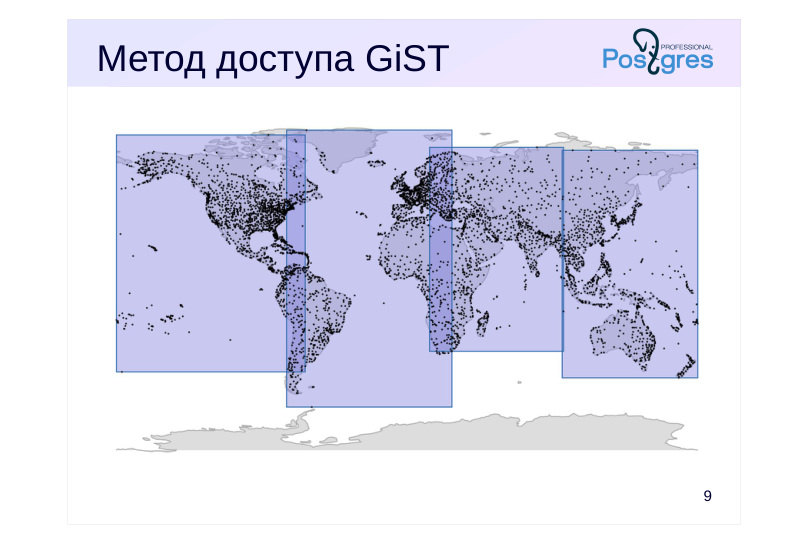
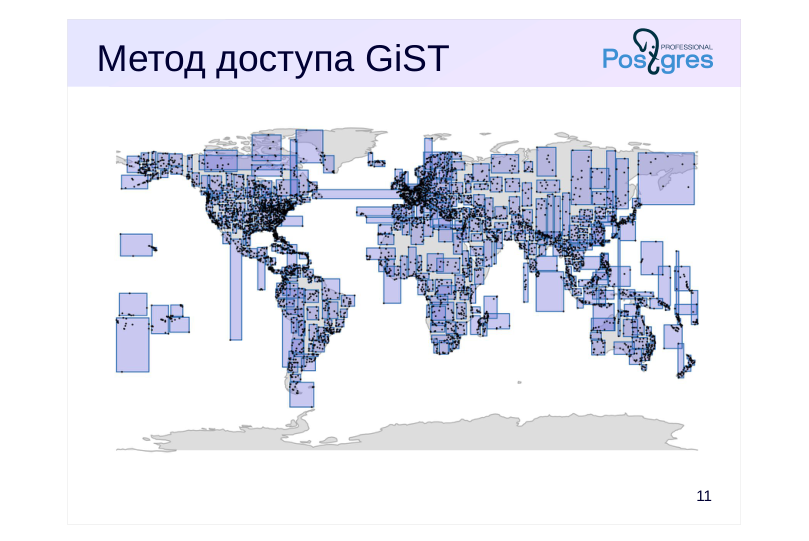
Идею работы GiST-индексов рассмотрим на примере точек на плоскости.
Плоскость разбивается на несколько прямоугольников, которые в сумме покрывают все индексируемые точки. Эти прямоугольники составляют верхний уровень дерева.
Как видно на рисунке, прямоугольники могут пересекаться (хотя это и уменьшает эффективность поиска).
https://postgrespro.ru/docs/postgresql/16/gist
Page 14: Метод доступа GiST
 {#source-figure-014 caption=“Source slide page 14: Метод доступа GiST”}
Комментарии преподавателя
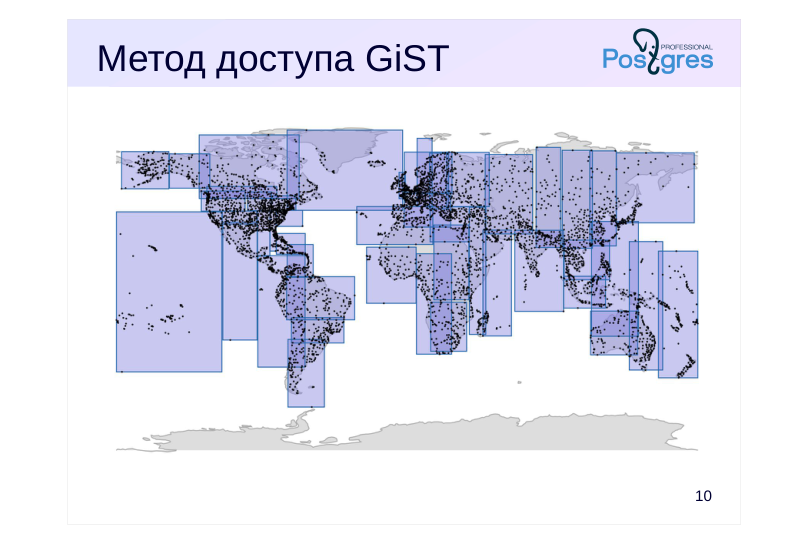
На следующем уровне дерева каждый из больших прямоугольников распадается на прямоугольники меньшего размера.
Page 15: Метод доступа GiST
 {#source-figure-015 caption=“Source slide page 15: Метод доступа GiST”}
Комментарии преподавателя
На последнем уровне дерева каждый ограничивающий прямоугольник будет содержать столько точек, сколько помещается на одну индексную страницу.
Общее условие разбиения таково: прямоугольник родительской вершины охватывает все прямоугольники соответствующего поддерева. Это позволяет, например, быстро находить точки, лежащие внутри определенной области:
находим прямоугольники, пересекающиеся с заданной областью, на верхнем уровне индекса;
спускаемся в выбранные поддеревья и повторяем поиск в них.
Такой алгоритм индексирования называется R-деревом.
Page 16: Метод доступа GiST
Какие именно операторы поддерживает GiST-индекс, существенно зависит от класса операторов. Информацию можно получить как из документации, так и из системного каталога. Возьмем, например, тип данных point (точки). Доступный класс операторов:
Операторы в этом классе:
В частности, оператор <@ проверяет, принадлежит ли точка одной из геометрических фигур. Создадим таблицу со случайными точками:
Сколько точек расположено в круге радиуса 0.1?
Как выполняется такой запрос?
Полным перебором всей таблицы. Создание GiST-индекса позволит ускорить эту операцию. Класс операторов можно не указывать, он один.
Page 17: Page 17
Еще один интересный оператор <-> вычисляет расстояние от одной точки до другой. Его можно использовать, чтобы найти точки, ближайшие к данной (так называемый поиск ближайших соседей, k-NN search):
Эта операция (весьма непростая, если реализовывать ее в приложении) также ускоряется индексом:
GiST-индекс можно построить и для столбца диапазонного типа:
Здесь мы видим другой набор операторов. Одно из применений GiST-индекса — поддержка ограничений целостности типа EXCLUDE (ограничения исключения). Возьмем классический пример бронирования аудиторий:
Page 18: Page 18
Ограничение целостности можно сформулировать так: нельзя, чтобы в разных строках таблицы были два пересекающихся (оператор &&) диапазона. Такое ограничение можно задать декларативно на уровне базы данных:
Проверим:
Частая ситуация — наличие дополнительного условия в таком ограничении целостности. Добавим номер аудитории:
Но мы не сможем добавить этот столбец в ограничение целостности, поскольку класс операторов для метода gist и типа integer не определен.
В этом случае поможет расширение btree_gist, которое добавляет классы операторов для типов данных, которые обычно индексируются с помощью B-деревьев:
Теперь разные аудитории можно бронировать на одно время:
Но одну и ту же — нельзя:
Page 19: Итоги
PostgreSQL предоставляет разнообразную индексную поддержку любых типов данных, включая пользовательские
- Методы доступа — каркас индексирования, реализующий основной алгоритм и низкоуровневые детали
- btree, hash, gist, sp-gist, gin, brin…
- Классы операторов связывают метод с типами данных
Комментарии преподавателя
В этой теме рассматриваются лишь самые основные понятия, связанные с индексной поддержкой.
Заинтересованным в подробностях рекомендуем внимательно ознакомиться с разделами документации, ссылки на которые приведены в комментариях к слайдам, а также с главами 4 и 5 книги https://postgrespro.ru/education/books/internals
Page 20: Практика
- Добавьте в таблицу retail_prices ограничение целостности, не позволяющее создать пересекающиеся диапазоны действия цен для одной книги. Проверьте план выполнения запроса для поиска актуальной цены (get_retail_price). Использует ли он индекс, созданный для поддержки ограничения целостности? 2. Сортировка книг в приложении по формату издания работает неверно, поскольку значения типа для формата издания упорядочиваются лексикографически. Сделайте так, чтобы значения упорядочивались по площади книжной страницы и проверьте, что сортировка в приложении исправилась.
Комментарии преподавателя
- Пример похожего ограничения целостности приводился в демонстрации.
Если индекс не будет использоваться запросом из функции get_retail_price, дело может быть в том, что в таблице retail_prices слишком мало строк и полное сканирование оказывается выгоднее. Чтобы проверить применимость индекса, вы можете либо добавить больше строк в таблицу, либо временно запретить использование полного сканирования: SET enable_seqscan = off;
- Создайте класс операторов для метода доступа btree и типа данных book_format, как было показано в демонстрации.
Page 21: 1. Ограничение целостности для retail_prices
Добавим ограничение целостности в таблицу:
Такое ограничение гарантирует, что данные не будет повреждены, даже если в коде функции set_retail_price будет допущена ошибка. В функции get_retail_price используется запрос следующего вида:
Как видно из плана, таблица по-прежнему перебирается полностью. Но планировщик будет использовать созданный индекс, как только это окажется выгодным:
Page 22: 2. Упорядочивание для форматов издания
Создадим класс операторов, как было показано в демонстрации.
Page 23: Page 23
Все готово. Проверим:
Page 24: Практика+
- В таблице хранятся даты событий. Какой индекс позволит ускорить запросы вида «найти определенное количество событий, наиболее близких по времени к указанной дате»? Проверьте. 2. Расширение pg_trgm добавляет функции и операторы для работы с триграммами, а также индексную поддержку. В частности, GiST-индекс ускоряет поиск по условиям вида столбец LIKE ‘%что-то%’
- Проверьте работу индекса. Найдите в системном каталоге
- все доступные операторы для класса gist_trgm_ops.
- Что в случае триграмм может служить общим предикатом,
- которому удовлетворяют все данные поддерева?
Комментарии преподавателя
- Триграммы — это последовательности из трех символов, на которые разбивается строка. Например, из «что-то» получаются следующие триграммы: « ч», « чт», «что», «то-», «о-т», «-то», «то », «о ».
Триграммы позволяют определять «похожесть» строк: если и в одной, и в другой много одинаковых триграмм, то и сами строки похожи.
Поиск по LIKE, где в начале шаблона находятся обычные символы (‘что-то%’) ускоряется и простым индексом на основе B-дерева. Но такой индекс бесполезен, если шаблон начинается с %.
https://postgrespro.ru/docs/postgresql/16/pgtrgm
Для проверки можно воспользоваться таблицей с данными почтовой рассылки pgsql-hackers. Чтобы восстановить эту таблицу в базу данных ext_opclasses, выполните команду:
В качестве запроса можно использовать следующий:
Page 25: 1. Индекс для событий
Создадим таблицу и заполним ее случайными данными:
Поиск наиболее близких дат — задача поиска ближайших соседей. Метод доступа btree не поддерживает (пока) поиск ближайших соседей, поэтому придется воспользоваться методом gist (и расширением btree_gist, добавляющим, в том числе, класс операторов для дат).
Ускорить необходимые нам запросы поможет GiST-индекс:
Вот как может выглядеть запрос:
Его план выполнения использует созданный индекс:
2. Расширение pg\_trgm
Page 26: Page 26
Установим расширение:
Посмотрим, как с его помощью ускоряется поиск по условию LIKE, на примере таблицы с архивом почтовой рассылки.
Создадим индекс:
Page 27: Page 27
Операторы для класса операторов gist_trgm_ops:
Операторы ~~ и ~~* эквивалентны LIKE и ILIKE; Операторы ~ и ~* проверяют соответствие регулярному выражению (с учетом и без учета регистра). Значение остальных операторов описано на странице документации расширения pg_trgm. Класс операторов для триграмм использует так называемое сигнатурное дерево. Триграммы заменяются на сигнатуры, то есть двоичные числа, в которых все биты нулевые, и лишь один определенный бит установлен в единицу. И вся строка заменяется на сигнатуру, которая вычисляется как побитовое ИЛИ сигнатур составляющих ее триграмм. Таким образом, вместо строки в индексе сохраняется одно число. Общим предикатом в сигнатурном дереве является побитовое ИЛИ всех сигнатур, которые находятся ниже в поддереве. Замена индексируемых элементов битовой сигнатурой позволяет индексировать с помощью GiST вообще все, что угодно (например, изображения). Но, к сожалению, это не слишком эффективный метод. Во-первых, число бит в сигнатуре ограничено, и поэтому некоторые разные элементы будут иметь одинаковую сигнатуру. Во-вторых, чем выше узел стоит в дереве, тем больше в его сигнатуре будет единиц. Это означает, что при поиске придется спускаться в лишние поддеревья и необходимо все время перепроверять полученные результаты. В теме «Слабоструктурированные данные» будет показан другой, более эффективный (но менее универсальный) метод доступа — GIN.