08 Занятие 08: Расширяемость / Типы для больших значений
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_08_ext_lob.html Archive: DEV2-handouts-16.zip Страниц PDF: 23
Page 1: Расширяемость / Типы для больших значений
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Хранение в файловой системе
- Технология TOAST
- Тип bytea
- Большие объекты
Page 3: Варианты хранения
Файловая система
- в базе данных только ссылки на файлы
- Встроенные типы
- PostgreSQL
- стандарт SQL
- двоичные данные
- bytea
- blob
- символьные данные
- text
- clob
- Подсистема «больших объектов»
Комментарии преподавателя
Для хранения и обработки больших объемов данных в стандарте SQL предусмотрены типы:
● clob (character large object) — для символьных данных;
● blob (binary large object) — для двоичных данных.
В PostgreSQL типы clob и blob отсутствуют. Вместо них для символьных данных можно использовать тип text, а для двоичных — bytea (byte array).
Работа с данными типа text не зависит от размера значения, поэтому в дальнейшем будем говорить только о двоичных данных. Например, об изображениях, видео, аудио и пр. Как правило такие данные хранят содержимое файлов соответствующих форматов.
В качестве альтернативы типу bytea, можно использовать «отчасти устаревшую» (цитата из документации) подсистему работы с большими объектами.
Но прежде чем размещать данные файлов внутри базы, следует рассмотреть возможность хранения их «в обычном виде» в файловой системе.
Page 4: Файловая система
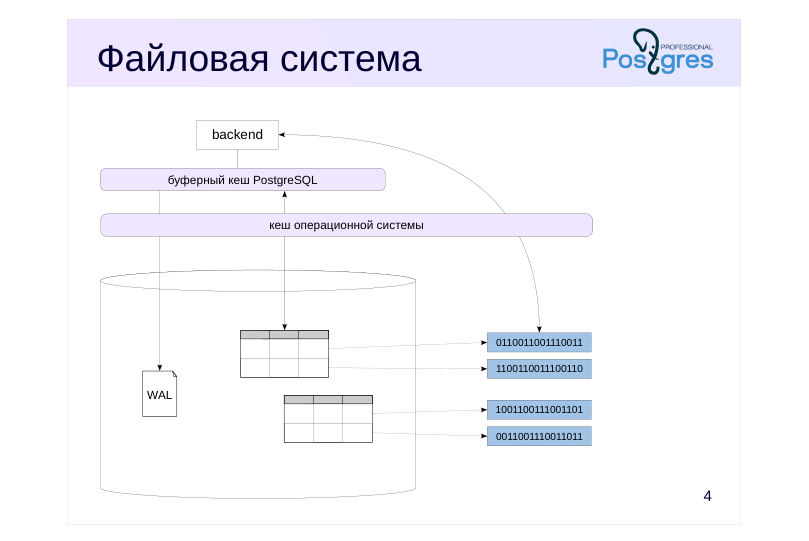 {#source-figure-004 caption=“Source slide page 4: Файловая система”}
Комментарии преподавателя
Если говорить о двоичных данных большого объема, то один из вариантов — отказаться от размещения их в СУБД. В этом случае файлы с двоичными данными располагаются непосредственно в файловой системе, а внутри базы данных поддерживаются только ссылки на них.
Page 5: Файловая система
Преимущества
- скорость чтения и записи файлов
- не увеличивается размер базы данных
- Недостатки
- не используются возможности СУБД: транзакции, управление доступом
- отсутствуют гарантии согласованности, долговечности данных
- усложняется архитектура системы,
- например, в части резервного копирования и восстановления
Комментарии преподавателя
Такой подход может быть оправдан в первую очередь производительностью. Скорость чтения и записи файлов увеличивается за счет избежания затрат, характерных для СУБД:
● двойная запись на диск (в WAL и файлы данных);
● двойное кеширование в оперативной памяти (файловый кеш и буферный кеш СУБД);
● накладные расходы на хранение в базе данных и обработку (нарезка на фрагменты для хранения и склейка их при чтении);
● возможное распухание таблиц и индексов приводит к дополнительному чтению устаревших фрагментов значения.
Кроме того, удается сократить расходы на обслуживание. Не требуется очистка и переиндексация таблиц с большими данными. Копирование файлов, в том числе инкрементальное, можно выполнять средствами ОС. А резервные копии только базы данных будут создаваться быстрее, меньшего размера и потребуют меньше времени на восстановление.
С другой стороны, становится невозможным использовать преимущества СУБД:
● транзакционная обработка: атомарность и согласованность записи, конкурентный доступ, восстановление после сбоя;
● управление доступом пользователей на чтение и запись данных.
Архитектура системы может потребовать пересмотра и доработки процедур резервного копирования и восстановления, использования реплик, обнаружения неиспользуемых файлов и пр.
Page 6: TOAST
Хранение «длинных» атрибутов в отдельной таблице
- применяется для типов переменной длины: text, bytea, xml, json и др.
- «длинные» атрибуты нарезаются на фрагменты меньше страницы
- возможно сжатие (методы pglz и lz4)
- размер значения до 1 Гбайта
- TOAST-таблица
- читается только при обращении к «длинному» атрибуту
- возможна частичная декомпрессия значения при чтении
- собственная версионность
- работает прозрачно для приложения
Комментарии преподавателя
Любая версия строки в PostgreSQL должна целиком помещаться на одну страницу. Для «длинных» версий строк применяется технология TOAST — The Oversized Attributes Storage Technique. Точнее, TOAST применяется к отдельным атрибутам, имеющим тип переменной длины, например, text и bytea, а также xml и json, которые будут рассмотрены позже в этом курсе. В любом случае размер одного значения (возможно сжатого) не должен превышать 1 Гбайта.
Для каждой основной таблицы при необходимости создается отдельная TOAST-таблица (и к ней специальный индекс). Версии строк в TOAST-таблице тоже должны помещаться на одну страницу, поэтому «длинные» значения хранятся порезанными на части, обычно около 2 Кбайт. Из этих частей PostgreSQL прозрачно для приложения «склеивает» необходимое значение.
TOAST-таблица используется только при обращении к «длинному» значению. Если эти данные упакованы, то начальные фрагменты сжатого атрибута считываются порциями и сразу распаковываются, позволяя избежать извлечения «длинного» значения целиком. Но если требуется изменить несколько байт значения, то оно будет считано и записано полностью.
Для TOAST-таблицы поддерживается своя версионность: если обновление данных не затрагивает «длинное» значение, новая версия строки будет ссылаться на то же самое значение в TOAST-таблице — это экономит место.
Page 7: Стратегии хранения
- основная
- сжатие
- данных
- TOAST-
- таблица
- таблица
- Extended да да да
- External да ― да
- в самую
- последнюю
- Main да в последнюю
- очередь
- очередь
- Plain да ― ―
Комментарии преподавателя
Столбцы таблиц используют одну из четырех стратегий хранения значений, устанавливаемую в зависимости от типа данных:
● EXTENDED. Допускается сжатие и перенос в таблицу TOAST. Для типов, поддерживающих перенос в TOAST, обычно используется эта стратегия.
● EXTERNAL. Допускается только перенос в таблицу TOAST, но не сжатие. Если загружаемые данные уже сжаты, имеет смысл выбрать стратегию EXTERNAL для экономии затрат на малоэффективное повторное сжатие.
● MAIN. Поля с этой стратегией сжимаются только в том случае, если обработки полей EXTENDED и EXTERNAL оказалось недостаточно, чтобы уместить версию строки на странице. Перенос в таблицу TOAST тоже возможен, но только как крайняя мера.
● PLAIN. Хранение только в основной таблице. Используется для типов, значения которых имеют небольшой размер.
При создании пользовательского типа данных можно задать стратегию, применяемую по умолчанию.
На уровне столбца таблицы можно переопределить стратегию, а также указать метод сжатия.
https://postgrespro.ru/docs/postgresql/16/storage-toast
Page 8: Тип bytea
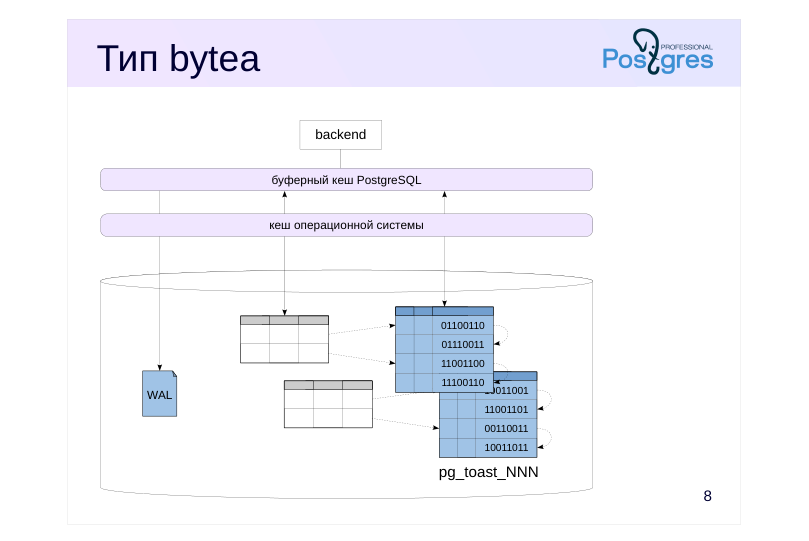 {#source-figure-008 caption=“Source slide page 8: Тип bytea”}
Комментарии преподавателя
Хранить двоичные объекты в базе данных можно двумя способами.
Первый способ заключается в создании столбцов с типом bytea в таблицах.
Тип bytea использует технологию хранения TOAST. Поэтому значения большого размера размещаются не в самой таблице, а нарезаются на фрагменты и хранятся в TOAST-таблице, связанной с основной.
Page 9: Тип bytea
Преимущества
- транзакционность, управление доступом
- согласованность и долговечность больших данных
- интерфейс SQL
- Недостатки
- увеличение размера базы данных
- меньшая скорость, чем при работе с файлами
- размер значения до 1 Гбайта
- значения считываются и записываются целиком
Комментарии преподавателя
Главное преимущество хранения больших значений в базе данных — это использование возможностей СУБД. Транзакционный механизм гарантирует согласованность данных и защиту от сбоев. А разграничивать доступ пользователей к значениям можно при помощи средств СУБД.
Для работы с типом bytea используется язык SQL, что делает эти действия удобными.
Двоичные типы данных, функции и операторы для работы с ними:
https://postgrespro.ru/docs/postgresql/16/datatype-binary
https://postgrespro.ru/docs/postgresql/16/functions-binarystring
Как мы уже говорили ранее, хранение внутри базы данных увеличивает размер базы и расходы на ее сопровождение, а также уменьшает скорость чтения и записи данных из-за необходимости нарезать значение на фрагменты и склеивать их, помещая в дополнительный кеш.
К недостаткам использования типа bytea можно отнести и ограничение TOAST на размер одного значения в 1 Гбайт.
Также отметим, что при работе c TOAST изменение даже небольшой части значения приводит к считыванию в буферный кеш всех занятых значением страниц и к перезаписи всего значения. С чтением части значения дело обстоит лучше: возможно извлечение только необходимого фрагмента.
Page 10: Тип bytea и TOAST
По умолчанию двоичные данные выводятся в шестнадцатеричном формате.
Значения начинаются с ‘\x’, далее каждый байт представлен двумя шестнадцатеричными цифрами:
Добавим нулевой символ к строке:
Шестнадцатеричный формат появился в версии 9.0. До этого был доступен только формат «спецпоследовательностей».
В этом формате ASCII-символы отображаются как есть, а остальные представлены спецпоследовательностями:
Параметр bytea_output определяет только формат вывода двоичных данных. Входные данные принимаются в любом из этих двух форматов.
Теперь создадим таблицу со столбцом типа bytea.
Таблица TOAST создается автоматически для хранения больших значений data и filename (значения типа text также могут быть большими). Найдем имя служебной таблицы:
Page 11: Page 11
Служебные таблицы TOAST всегда располагаются в специальной схеме pg_toast — чтобы не пересекаться с обычными объектами базы данных. Получить список TOAST-таблиц можно командой psql:
Посмотрим на структуру TOAST-таблицы:
chunk_id — идентификатор значения, chunk_seq — порядковый номер фрагмента значения, chunk_data — данные фрагмента. Можно обратить внимание, что вывод команды \d для TOAST-таблиц содержит название основной таблицы. Доступ к значениям в TOAST всегда осуществляется по индексу. Это самый быстрый способ получить все фрагменты одного значения для склейки, но доступ ко всем значениям будет заведомо неэффективен. Кроме того, чтение большого объема данных из TOAST-таблиц может приводить к вытеснению полезных данных из буферного кеша. Механизм буферного кольца, предотвращающий массовое вытеснение, для TOAST-таблиц не используется, так как задействуется только при полном последовательном сканировании таблицы, но не при индексном доступе. Добавим в demo_bytea строку. В качестве данных возьмем логическую резервную копию базы данных приложения.
Заметим время вставки.
Для считывания файла воспользуемся встроенной функцией pg_read_binary_file.
Использование TOAST прозрачно для приложения. Нам не нужно обращаться к служебной таблице в запросах. Вот первые 16 байт загруженного файла в двоичном виде:
Page 12: Page 12
Общий размер загруженного значения соответствует размеру файла:
Однако размер таблицы demo_bytea составляет всего одну страницу, данных загруженного файла в ней нет:
Значение столбца data попало в TOAST-таблицу. Можно убедиться, что в служебной таблице появилось одно значение:
Сколько места требуется для хранения TOAST-таблицы, если сравнивать с размером файла: меньше, больше или ровно столько же?
Почему потребовалось меньше места?
Стратегия хранения extended предполагает сжатие данных при помещении в TOAST. А текстовые данные хорошо сжимаются. Начиная с PostgreSQL 14 появилась возможность выбора метода сжатия: pglz (используется по умолчанию) и lz4. Изменим метод сжатия для столбца data и повторим наш опыт, предварительно опустошив таблицу.
Page 13: Page 13
Вставка данных выполнилась заметно быстрее, но места для сжатых данных потребуется больше — lz4 сжимает данные не так эффективно:
Сжатие вообще можно запретить, выбрав стратегию external:
Это изменение будет действовать только для новых строк, поэтому снова опустошим таблицу и загрузим файл заново.
Сколько теперь потребуется места для хранения TOAST-таблицы, если сравнивать с размером исходного файла: меньше, больше или ровно столько же?
Теперь для хранения используется немного больше места. Почему?
На размер повлияли накладные расходы на хранение фрагментов в отдельных строках с дополнительными столбцами и служебной информацией.
Page 14: Большие объекты
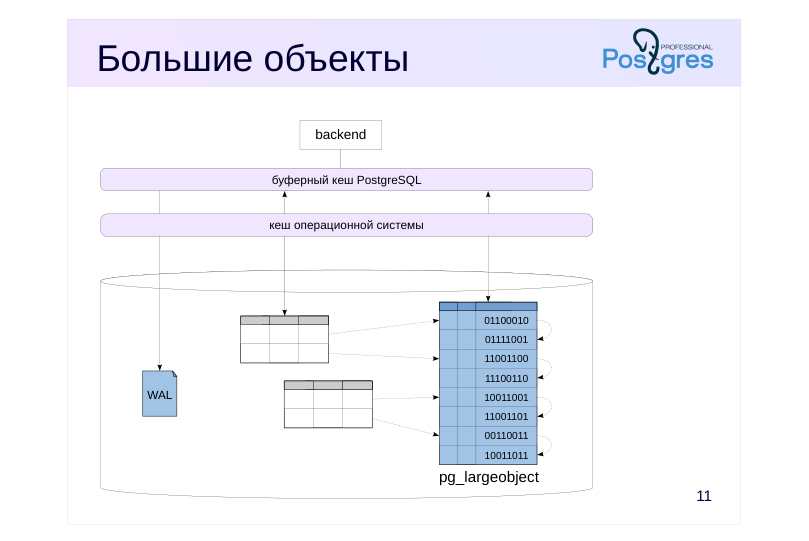 {#source-figure-014 caption=“Source slide page 14: Большие объекты”}
Комментарии преподавателя
Другой вариант хранения двоичных данных большого размера внутри базы данных — использование подсистемы «больших объектов», появившейся задолго до TOAST.
Все большие объекты сохраняются в отдельной таблице системного каталога pg_largeobject. Для ссылок на большие объекты в столбцах других таблиц предоставляются идентификаторы типа oid. Доступ к этим объектам осуществляется при помощи специального интерфейса, похожего на интерфейс работы с файлами.
https://postgrespro.ru/docs/postgresql/16/largeobjects
Page 15: Большие объекты
Преимущества
- транзакционность, управление доступом
- согласованность и долговечность больших данных
- размер значения до 4 Тбайт
- потоковое чтение и запись фрагментов значения
- Недостатки
- увеличение размера базы данных
- меньшая скорость, чем при работе с файлами
- специальный интерфейс
- риск появления осиротевших объектов
- не поддерживается логической репликацией
- ограничение на количество больших объектов (2
Комментарии преподавателя
Большие объекты наследуют те же преимущества и недостатки, что и тип bytea, относительно хранения в файловой системе.
По сравнению с типом bytea у больших объектов есть преимущества. Во-первых, размер одного объекта может достигать 4 Тбайт. А во-вторых, интерфейс для работы с большими объектами позволяет работать с произвольным фрагментом значения, а не со всем значением целиком, как обычно происходит с TOAST.
С другой стороны, использование специального интерфейса делает работу с большими объектами не такой удобной, как с чистым SQL. К тому же драйвер PostgreSQL должен поддерживать этот интерфейс.
Идентификатор большого объекта хранится в 4-байтовом типе oid, что ограничивает количество объектов в системе числом 4294967296. Таблицы TOAST тоже используют oid, но ограничение на количество значений действует в пределах таблицы, а не на всю систему.
Кроме того, хранение всех больших объектов в отдельной таблице увеличивает риск появления осиротевших объектов, на которые не осталось ссылок в обычных таблицах. Для поиска и удаления осиротевших объектов можно использовать утилиту vacuumlo, а для предотвращения их появления — расширение lo.
https://postgrespro.ru/docs/postgresql/16/lo
https://postgrespro.ru/docs/postgresql/16/vacuumlo
Логическая репликация не поддерживает изменения в таблицах системного каталога, в том числе в pg_largeobject, то есть большие объекты не реплицируются.
Page 16: Использование large objects
Большие объекты хранятся в таблице системного каталога pg_largeobject, структура которой похожа на структуру TOAST-таблицы.
Создадим таблицу для хранения ссылок на большие объекты.
Для работы с большими объектами будем использовать интерфейсные функции SQL.
Функция lo_import загружает файл с сервера в pg_largeobject и возвращает указатель на него (OID). Функция lo_get считывает указанную часть значения:
Что будет, если удалить строку из таблицы demo_largeobject?
Строка удалится, а большой объект станет «потерянным»:
Дополнительная утилита vacuumlo, поставляемая с сервером, позволяет найти большие объекты, на которые не осталось ссылок, и удалить их:
Page 17: Page 17
Для предотвращения потери ссылок также можно воспользоваться расширением lo.
Расширение создает тип данных lo (обертка над oid) и функцию lo_manage для использования в триггерных функциях.
Загрузим большой объект и поместим ссылку на него в таблицу.
Убедимся, что все на месте, и удалим.
Табличный триггер удалил связанный большой объект.
Page 18: Итоги
Для работы с двоичными данными предоставлены
- тип bytea, использующий технологию TOAST
- подсистема «больших объектов»
- Использование файловой системы позволяет добиться высокой скорости за счет отказа от возможностей СУБД
Page 19: Практика
- Добавьте в таблицу books поле cover с типом bytea. Загрузите в поле cover обложки книг из файлов формата jpeg. Файлы находятся в каталоге /home/student/covers. 2. Создайте функцию webapi.get_image, возвращающую обложку книги по переданному идентификатору. 3. Сравните время, за которое выполняется запрос ко всем столбцам таблицы books (SELECT *) и к столбцам без cover.
Комментарии преподавателя
Для чтения файлов можно использовать функцию pg_read_binary_file.
Функция get_image уже создана в базе данных, но ничего не возвращает. Заголовок функции:
Page 20: 1. Перекладывание сканов обложек в базу данных
Сканы обложек находятся в каталоге covers:
Названия файлов хранятся в таблице books в столбце cover_filename. Расширим таблицу столбцом для хранения картинок:
Используемую по умолчанию компрессию данных стоит отключить: дополнительно сжать файлы JPEG не удастся, а ресурсы на упаковку/распаковку можно сэкономить. Установить нужную стратегию хранения можно только отдельной командой после добавления столбца:
Переложим файлы в этот столбец:
2. Функция, возвращающая скан обложки
3. Время выполнения SELECT \*
Сравните время самостоятельно; здесь мы не приводим результат выполнения запросов из-за большого размера. Вывод должен быть очевиден: в промышленном коде следует обращаться только к тем столбцам, которые действительно необходимы.
Page 21: Практика+
- Создайте таблицу с полем типа bytea. Загрузите в таблицу любой файл, этот же файл загрузите как большой объект. Выполните контрольную точку, чтобы в кеше не осталось грязных буферов. 2. Добавьте один произвольный байт к значению в столбце типа bytea таблицы. Сколько грязных буферов, относящихся к TOAST-таблице, появилось в буферном кеше? 3. Добавьте один произвольный байт к значению большого объекта. Сколько грязных буферов, относящихся к таблице pg_largeobject, появилось в буферном кеше?
Комментарии преподавателя
2 и 3. Чтобы получить количество грязных буферов для таблицы, установите расширение pg_buffercache и воспользуйтесь запросом:
- Можно воспользоваться функцией lo_put, записывающей данные по заданному смещению.
Page 22: 1. Подготовка
Расширение для просмотра буферного кеша:
Создадим таблицу со столбцом типа bytea:
Загрузим файл с одной из обложек книг в таблицу:
Этот же файл загрузим как большой объект и запомним его oid:
Для чистоты эксперимента очистим таблицы и сбросим все грязные буферы на диск:
2. Изменение bytea
Добавим к значению нулевой байт:
Сколько всего страниц в основном слое TOAST-таблицы?
А сколько грязных буферов хранит страницы основного слоя?
Page 23: Page 23
То есть после изменения одного байта все страницы TOAST-таблицы стали грязными.
3. Изменение большого объекта
Добавим в конец объекта нулевой байт:
Посчитаем грязные буферы таблицы pg_largeobject:
Грязным стал всего один буфер.