04 Занятие 04: Архитектура / Журналирование
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_04_arch_wal.html Archive: DEV2-handouts-16.zip Страниц PDF: 27
Page 1: Архитектура / Журналирование
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Буферный кеш
- Журнал предзаписи
Page 3: Буферный кеш
Устройство и использование
- Фоновая запись
- Локальный кеш для временных таблиц
Page 4: Буферный кеш
 {#source-figure-004 caption=“Source slide page 4: Буферный кеш”}
Комментарии преподавателя
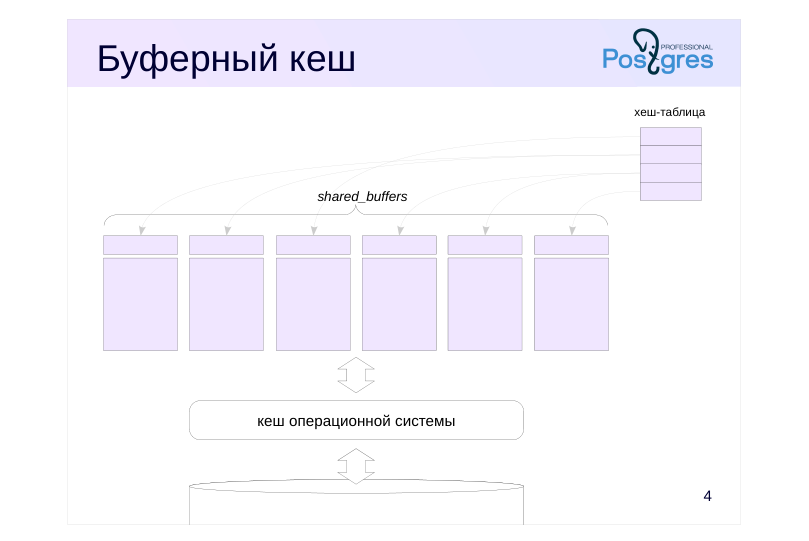
Задача буферного кеша — сглаживать разницу в производительности двух типов памяти: оперативной (быстрая, но мало) и дисковой (медленная, но много). Чтобы работать с данными — читать или изменять их, — процессы читают страницы в буферный кеш и, пока страница находится в кеше, мы экономим на обращениях к диску.
Буферный кеш располагается в общей памяти сервера и представляет собой массив буферов (его размер задается конфигурационным параметром shared_buffers). Каждый буфер состоит из места под одну страницу данных и заголовка. Заголовок содержит расположение страницы на диске (файл и номер страницы) и другую информацию.
Чтобы нужную страницу можно было быстро найти в кеше, используется хеш-таблица. Ключом хеширования в ней служит файл и номер страницы внутри файла. Чтобы найти страницу, надо проверить все буферы, указанные в соответствующей корзине хеш-таблицы: либо страница найдется, либо мы убедимся в том, что ее нет в кеше.
В последнем случае страницу придется прочитать в буферный кеш с диска. Однако напомним, что PostgreSQL читает и записывает данные не в обход кеша операционной системы, а через него. Это, очевидно, приводит к дублированию данных и двойному кешированию, но такова текущая реализация. Поэтому «промах» мимо буферного кеша не обязательно означает, что данные будут физически читаться с диска.
Page 5: Буферный кеш
Создадим таблицу.
В состав PostgreSQL входит расширение, которое позволяет посмотреть, что происходит в буферном кеше.
Размер кеша определяется конфигурационным параметром:
Расширение показывает каждый буфер как отдельную строку одноименного представления:
Page 6: Страница в кеше
 {#source-figure-006 caption=“Source slide page 6: Страница в кеше”}
Комментарии преподавателя
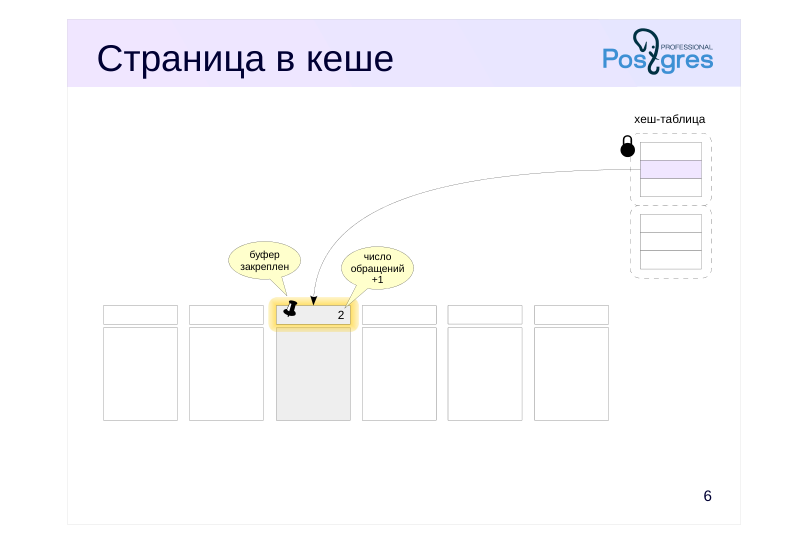
Рассмотрим случай, когда необходимая страница находится в кеше.
Буферный кеш и хеш-таблица находятся в общей памяти, и доступ к ним есть у всех процессов сервера. Поэтому одновременный, конкурентный доступ к этим структурам необходимо упорядочивать.
Вычислив хеш-код, процесс блокирует необходимый фрагмент хеш-таблицы в разделяемом режиме (только для чтения) с помощью так называемой «легкой блокировки», и уже затем находит буфер, содержащий нужную страницу.
Сервер управляет блокировками данных в разделяемой памяти полностью автоматически. Разработчики PostgreSQL прилагают много усилий к тому, чтобы эти блокировки работали эффективно. Например, чтобы не блокировать всю хеш-таблицу сразу, она разделена на несколько (128) фрагментов, каждый из которых может работать независимо от других. Тем не менее надо понимать, что, хотя доступ к кешу быстрее, чем к диску, он все же не бесплатен.
Дальше процесс «закрепляет» буфер, увеличивая счетчик pin count в заголовке страницы. Пока буфер закреплен (значение pin count больше нуля), считается, что буфер используется и его содержимое не должно «радикально» измениться. Например, в странице может появиться новая версия строки — обычно это не помешает другим процессам благодаря многоверсионности и правилам видимости. Но в закрепленный буфер не может быть прочитана другая страница.
Процесс также увеличивает счетчик обращений к странице (usage count). Счетчик используется для того, чтобы понимать, какие страницы используются часто, а какие нет.
Page 7: Изменение в странице
 {#source-figure-007 caption=“Source slide page 7: Изменение в странице”}
Комментарии преподавателя
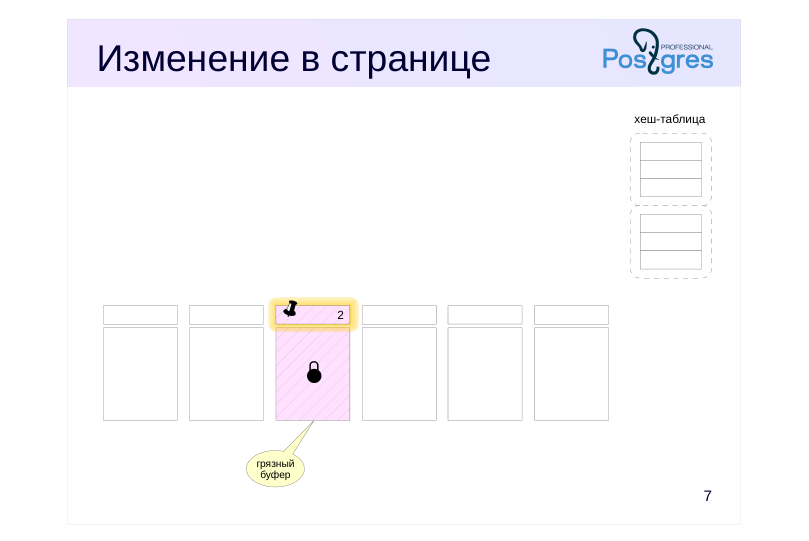
Если процессу необходимо изменить содержимое страницы в буфере, он должен получить монопольную блокировку для этой страницы (чтобы не менять данные в тот момент, когда их читают другие процессы).
Измененная страница, еще не записанная на диск, называется «грязной». В заголовке буфера делается отметка об этом. (На рисунках грязные буферы выделены цветом и штриховкой.)
Page 8: Чтение с вытеснением
 {#source-figure-008 caption=“Source slide page 8: Чтение с вытеснением”}
Комментарии преподавателя
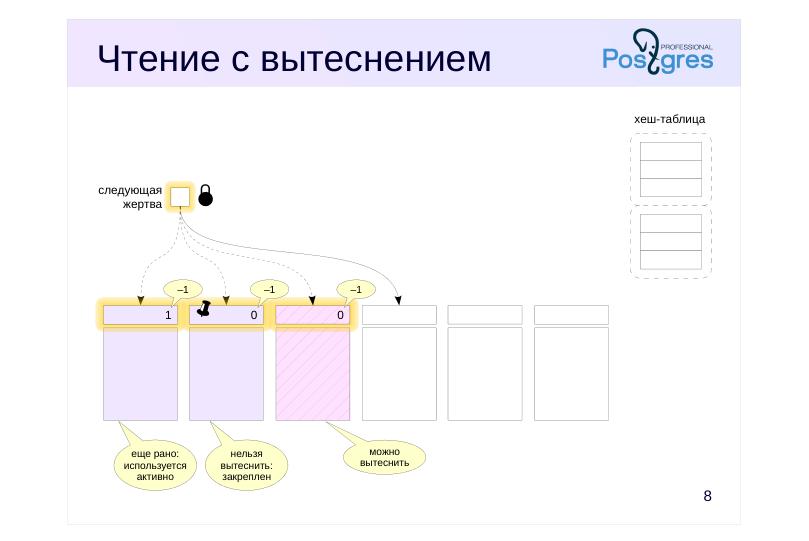
Если нужной страницы не нашлось в кеше, ее необходимо прочитать с диска, а для этого надо освободить какой-то из буферов, вытеснив находящуюся там другую страницу. Идея состоит в том, чтобы вытеснять страницы, к которым обращались редко, с тем, чтобы активно используемые данные как можно дольше находились в кеше.
Механизм вытеснения использует указатель на следующую «жертву». Этот указатель пробегает по кругу все буферы, уменьшая на единицу их счетчики обращений (usage count). Выбирается первый же буфер, который одновременно:
● имеет значение счетчика обращений, равное 0;
● не закреплен.
По-английски этот алгоритм называется clock-sweep.
Чем больше значение счетчика у буфера (то есть чем чаще он используется), тем больше у него шансов задержаться в кеше. Чтобы избежать «наматывания кругов» при вытеснении, максимальное значение счетчика обращений ограничено числом 5.
В нашем примере процесс обращается к первому буферу по указателю. Счетчик обращений этого буфера еще не равен 0, так что он уменьшается на единицу и указатель сдвигается к следующему буферу.
Следующий буфер закреплен (то есть используется каким-то процессом), и поэтому страница не может быть вытеснена из него. Значение его счетчика также уменьшается на единицу.
Наконец, мы приходим к незакрепленному буферу с нулевым счетчиком обращений. Страница из этого буфера и будет вытеснена.
Page 9: Чтение с вытеснением
 {#source-figure-009 caption=“Source slide page 9: Чтение с вытеснением”}
Комментарии преподавателя
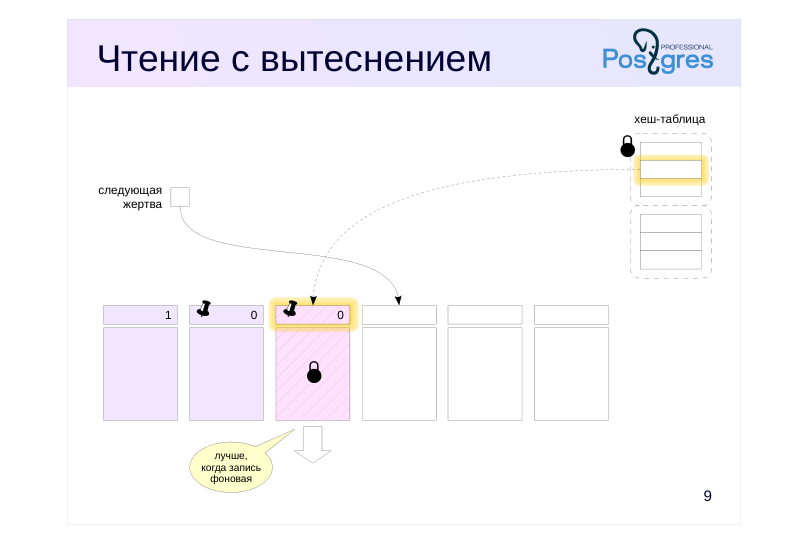
Однако в нашем примере найденный буфер оказался грязным — он содержит измененные данные. Поэтому сначала страницу требуется сохранить на диск. Для этого буфер закрепляется и устанавливается блокировка содержимого страницы, после чего страница записывается на диск.
Значительно эффективнее, когда запись происходит асинхронно и процесс обнаруживает вытесняемую страницу чистой. Чтобы это было возможным, существует процесс фоновой записи (background writer).
Процесс фоновой записи использует тот же самый алгоритм поиска буферов для вытеснения, что и обслуживающие процессы, только указатель у него свой. Он может опережать указатель на «жертву», но никогда не отстает от него.
Записываются буферы, которые одновременно:
● содержат измененные (грязные) страницы;
● не закреплены (pin count = 0);
● имеют нулевое число обращений (usage count = 0).
Таким образом фоновый процесс записи находит те буферы, которые с большой вероятностью вскоре потребуется вытеснить.
Теперь страница может быть выброшена, а из хеш-таблицы необходимо удалить ссылку на эту страницу. Для этого потребуется монопольно заблокировать нужный фрагмент хеш-таблицы.
Page 10: Чтение с вытеснением
 {#source-figure-010 caption=“Source slide page 10: Чтение с вытеснением”}
Комментарии преподавателя
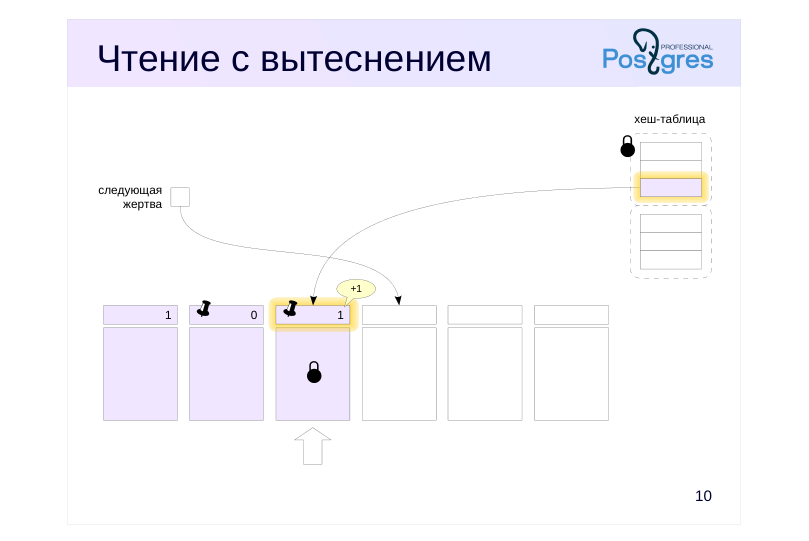
После того, как страница из грязного буфера записана на диск, в освободившийся буфер читается новая страница, а в хеш-таблицу добавляется ссылка на нее.
Счетчик обращений увеличивается на единицу. Ссылка на следующую «жертву» уже указывает на следующий буфер, а у только что загруженного есть время нарастить свой счетчик обращений, пока указатель не обойдет по кругу весь буферный кеш и не вернется вновь.
Page 11: Использование буферного кеша
Перезапустим сервер, чтобы очистить буферный кеш.
С помощью расширения можно убедиться, что в кеше нет буферов, относящихся к нашей таблице:
Теперь выполним запрос, который прочитает все страницы таблицы. Команда EXPLAIN ANALYZE с параметром BUFFERS покажет, какое количество обращений к буферам потребовалось для выполнения.
В данном случае запрос прочитал 18 страниц, ни одной из которых не оказалось в кеше (read). А почему эти страницы были изменены (dirtied)? Как рассматривалось в теме «Многоверсионность», при первом чтении новых версий строк в заголовках этих версий проставляется статус транзакции (зафиксирована или оборвана). Это вызывает изменение страницы. Что теперь мы обнаружим в кеше?
Как раз 18 буферов заполнены данными таблицы. А как изменится выполнение того же самого запроса?
Теперь все данные были взяты из кеша (hit) и время выполнения запроса уменьшилось. Именно с наличием кеша и связан тот факт, что при повторном выполнении запросы обычно работают быстрее.
Page 12: Page 12
Page 13: Временные таблицы
Данные временных таблиц
- видны только одному сеансу — нет смысла использовать общий кеш
- существуют в пределах сеанса — не жалко потерять при сбое
- Используется локальный буферный кеш
- не требуются блокировки
- память выделяется по необходимости в пределах temp_buffers
- обычный алгоритм вытеснения
Комментарии преподавателя
Исключением из общего правила являются временные таблицы. Поскольку временные данные видны только одному процессу, им нечего делать в общем буферном кеше. Более того, временные данные существуют только в рамках одного сеанса, так что их не нужно защищать от сбоя.
Для временных данных используется облегченный локальный кеш.
Поскольку локальный кеш доступен только одному процессу, для него не требуются блокировки. Память выделяется по мере необходимости (в пределах, заданных параметром temp_buffers), ведь временные таблицы используются далеко не во всех сеансах. В локальном кеше используется обычный алгоритм вытеснения.
Page 14: Журнал предзаписи
Устройство журнала
- Контрольная точка
- Восстановление после сбоя
- Синхронный и асинхронный режимы
Page 15: Журнал предзаписи
Необходимость
- данные меняются в оперативной памяти (в частности, в буферном кеше)
- и попадают на диск асинхронно
- при сбое остается только информация, записанная на диск
- Механизм
- действия над данными записываются в журнал:
- изменение страниц в буферном кеше, фиксация и отмена транзакций
- журнальная запись попадает на диск раньше измененных данных
- после сбоя операции, записанные в журнал, но не попавшие на диск,
- можно выполнить повторно
Комментарии преподавателя
Основная причина существования журнала — необходимость восстановления согласованности данных в случае сбоя, при котором теряется содержимое оперативной памяти, в частности, буферного кеша. Тем самым обеспечивается выполнение свойства долговечности (буква «D» из набора свойств транзакций ACID).
Одновременно с изменением данных создается запись в журнале, содержащая достаточную информацию для повторения этой операции. Журнальная запись в обязательном порядке попадает на диск (или другое энергонезависимое устройство) до того, как туда попадет измененная страница — отсюда и название: «журнал предзаписи», «write-ahead log».
Журналировать нужно все операции, при выполнении которых возможна ситуация, что при сбое результат операции не дойдет до диска. В частности, в журнал записываются изменение страниц в буферном кеше и факт фиксации и отмены транзакций.
В журнал не записываются операции с нежурналируемыми (и временными) таблицами.
В случае сбоя можно прочитать журнал и при необходимости повторить те операции, которые уже были выполнены, но результат которых не успел попасть на диск.
https://postgrespro.ru/docs/postgresql/16/wal-intro
Page 16: Устройство журнала
 {#source-figure-016 caption=“Source slide page 16: Устройство журнала”}
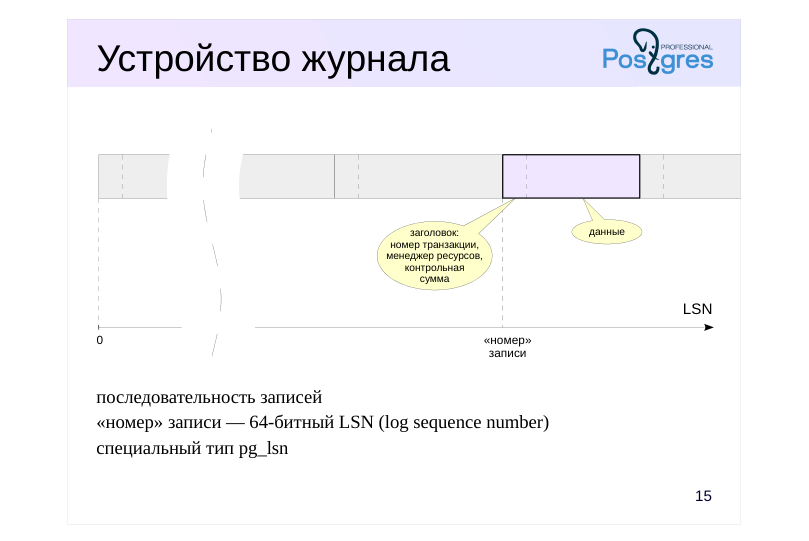
последовательность записей «номер» записи — 64-битный LSN (log sequence number) специальный тип pg_lsn
Комментарии преподавателя
Логически журнал можно представить себе как последовательность записей различной длины. Каждая запись содержит данные о некоторой операции, предваренные заголовком. В заголовке, в числе прочего, указаны:
● Номер транзакции, к которой относится запись.
● Менеджер ресурсов — компонент системы, ответственный за данную запись, который понимает, как интерпретировать данные. Есть отдельные менеджеры для таблиц, для каждого типа индекса, для статуса транзакций и т. п.
● Контрольная сумма (CRC).
Для того чтобы сослаться на определенную запись, используется тип данных pg_lsn (LSN = log sequence number) — 64-битное число, представляющее собой байтовое смещение записи относительно начала журнала.
На диске журнал хранится в виде файлов фиксированного размера (обычно 16 Мбайт). Когда заканчивается место в текущем файле, система переключается на следующий.
В оперативной памяти работа с журналом ведется в специальных буферах, которые организованы наподобие буферного кеша.
Page 17: Устройство журнала
Начнем транзакцию.
Текущая позиция в журнале:
LSN выводится как два 32-битных числа в шестнадцатеричной системе через косую черту. Выполним какое-нибудь действие, например, изменим строку в таблице:
Изменится ли позиция в журнале?
Позиция увеличилась. Завершим теперь транзакцию.
Позиция в журнале снова изменилась:
Размер журнальных записей (в байтах), соответствующих нашей транзакции, можно узнать простым вычитанием одной позиции из другой:
Безусловно, в журнал попадает информация обо всех действиях во всем кластере, но в данном случае мы считаем, что в нашей системе больше ничего не происходит.
Page 18: Контрольная точка
 {#source-figure-018 caption=“Source slide page 18: Контрольная точка”}
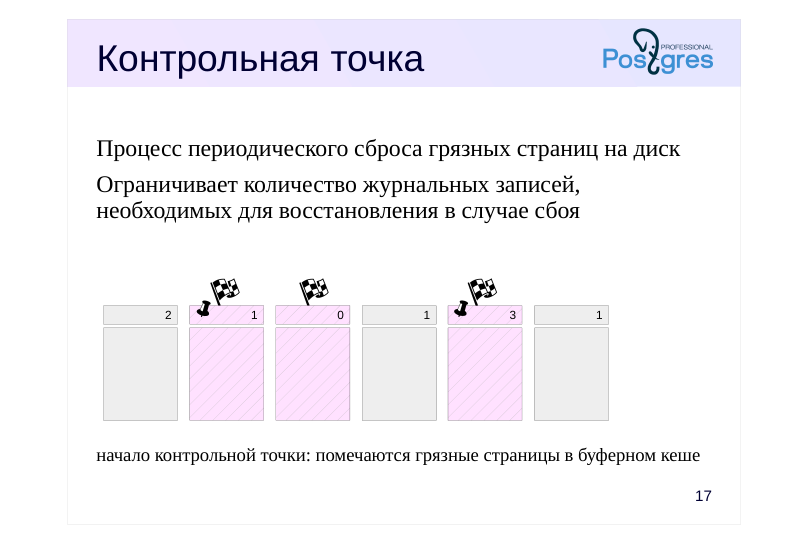
Процесс периодического сброса грязных страниц на диск
- Ограничивает количество журнальных записей, необходимых для восстановления в случае сбоя
- начало контрольной точки: помечаются грязные страницы в буферном кеше
Комментарии преподавателя
Если не предпринять специальных мер, то активно использующаяся страница, попав в буферный кеш, может никогда не вытесняться. Это означает, что при восстановлении после сбоя придется просматривать все журнальные записи, созданные с момента запуска сервера.
На практике это, конечно, недопустимо. Во-первых, файлы занимают много места — их все придется хранить на сервере. Во-вторых, время восстановления будет запредельно большим.
Поэтому существует специальный фоновый процесс контрольной точки (checkpointer), который периодически сбрасывает все грязные страницы на диск (но не вытесняет их из кеша). После того, как контрольная точка завершена, журналы вплоть до начала контрольной точки больше не нужны для восстановления.
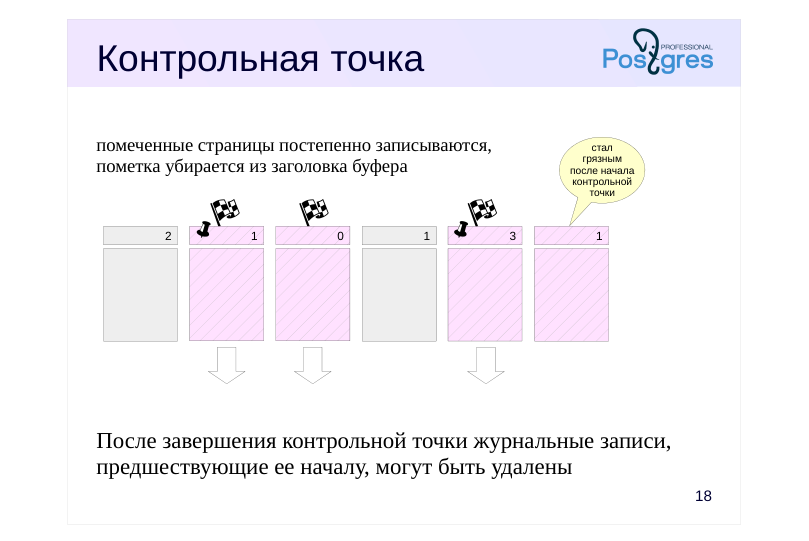
Грязных страниц может оказаться много, и сбрасывать их одно-моментно на диск — плохая идея. Поэтому в начале выполнения контрольной точки в заголовках грязных буферов ставится специальный флаг, который говорит о том, что в ходе выполнения текущей контрольной точки данная страница должна быть сброшена.
Page 19: Контрольная точка
 {#source-figure-019 caption=“Source slide page 19: Контрольная точка”}
помеченные страницы постепенно записываются, пометка убирается из заголовка буфера
- После завершения контрольной точки журнальные записи, предшествующие ее началу, могут быть удалены
Комментарии преподавателя
Затем процесс контрольной точки постепенно проходит по всем буферам и сбрасывает помеченные страницы на диск. Еще раз отметим, что страницы не вытесняются из кеша, а только записываются. Поэтому контрольная точка не обращает внимания на число обращений к буферу и признак закрепленности.
Конечно, в процессе работы процесса контрольной точки страницы продолжают изменяться в буферном кеше. Но новые грязные буферы уже не рассматриваются процессом контрольной точки, так как на момент начала работы они не были грязными и не отмечены флагом.
В конце работы процесс создает журнальную запись об окончании контрольной точки и сохраняет LSN ее начала, чтобы при необходимости можно было быстро найти последнюю завершенную контрольную точку.
После этого сервер имеет право удалить все журнальные записи, предшествующие началу только что завершенной контрольной точки.
Page 20: Контрольная точка
Сейчас в буферном кеше находится несколько грязных буферов:
Контрольная точка выполняется сервером периодически, но ее можно вызвать и вручную.
Поскольку по умолчанию буферный кеш имеет небольшой размер, контрольная точка выполняется очень быстро. Но в реальных системах, использующих большой буферный кеш, это может занимать существенное время. Сколько грязных буферов останется в буферном кеше?
Ни одного. Хотя, если бы в нашей системе была какая-то активность, грязные буферы — появившиеся уже после начала контрольной точки — могли бы остаться.
Page 21: Восстановление
 {#source-figure-021 caption=“Source slide page 21: Восстановление”}
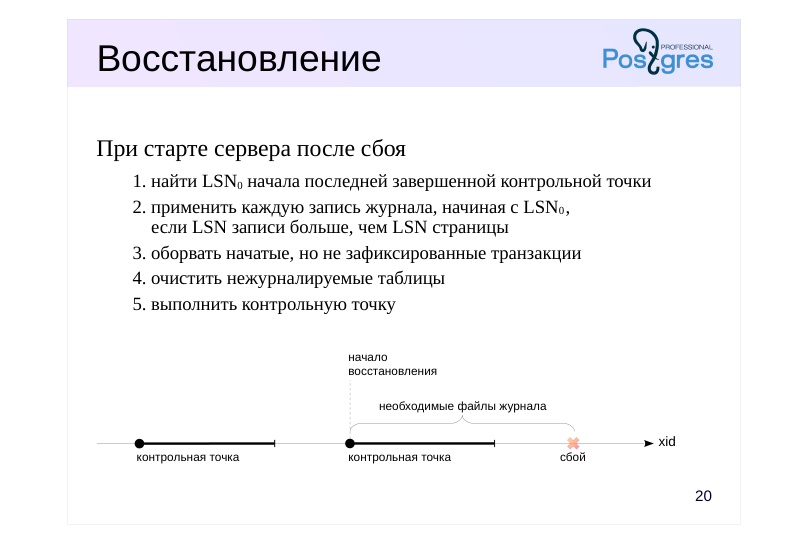
При старте сервера после сбоя
- найти LSN0 начала последней завершенной контрольной точки
- применить каждую запись журнала, начиная с LSN0 ,
- если LSN записи больше, чем LSN страницы
- оборвать начатые, но не зафиксированные транзакции
- очистить нежурналируемые таблицы
- выполнить контрольную точку
Комментарии преподавателя
Если в работе сервера произошел сбой, то при последующем запуске процесс startup обнаруживает это и выполняет автоматическое восстановление.
Сначала процесс startup определяет LSN0 начала последней завершенной контрольной точки. Далее процесс читает журнальные записи, начиная с найденной позиции, последовательно применяя записи к страницам, если в этом есть необходимость.
Чтобы понять, нужно ли применять журнальную запись к странице, надо сравнить LSN последнего изменения страницы (который при любых изменениях записывается в ее заголовок) с LSN журнальной записи. Если LSN страницы оказывается меньше, то операцию необходимо повторить.
Таким образом восстанавливается согласованность данных во всех страницах. Все транзакции, которые были начаты, но не зафиксированы, трактуются как оборванные.
В конце процесса все нежурналируемые таблицы очищаются, поскольку их содержимое корректно восстановить невозможно.
На этом процесс startup завершает работу, а процесс checkpointer выполняет контрольную точку, чтобы зафиксировать восстановленное состояние.
Page 22: Режимы журналирования
Синхронный
- сброс журнальных записей на диск при каждой фиксации
- гарантируется долговечность
- увеличивается время отклика
- Асинхронный
- сброс журнальных записей происходит периодически
- гарантируется согласованность, но не долговечность
- недавно зафиксированные изменения могут пропасть
- Настройка
- synchronous_commit = on / off
- можно
- изменять на уровне
- транзакции
Комментарии преподавателя
Запись журнала происходит в одном из двух режимов.
В синхронном режиме при фиксации транзакции продолжение работы невозможно до тех пор, пока все журнальные записи, относящиеся к этой транзакции, не окажутся на диске (энергонезависимом носителе).
При синхронной записи гарантируется долговечность — если транзакция зафиксирована, то все ее журнальные записи уже на диске и не будут потеряны. Обратная сторона состоит в том, что синхронная запись увеличивает время отклика (команда COMMIT не возвращает управление до окончания синхронизации) и поэтому снижает производительность системы.
В асинхронном режиме журнал записывается частями в фоновом режиме.
Асинхронная запись эффективнее синхронной. Во-первых, фиксация изменений не должна ничего ждать. Во-вторых, при каждой записи на диск обрабатываются все накопившиеся журнальные записи и, таким образом, уменьшается число избыточных обращений к диску.
Однако надежность уменьшается: зафиксированные данные могут пропасть в случае сбоя, если между фиксацией и сбоем прошло не очень много времени.
Параметр synchronous_commit, управляющий режимом записи журнала, можно устанавливать не только глобально, но и в рамках отдельных транзакций. Это позволяет увеличивать производительность, жертвуя надежностью только части транзакций.
https://postgrespro.ru/docs/postgresql/16/wal-async-commit
Page 23: Итоги
Буферный кеш ускоряет доступ к часто используемым данным (но не решает всех проблем производительности)
- Использование буферов в оперативной памяти приводит к необходимости журналирования
- Процесс контрольной точки ограничивает размер хранимых журнальных файлов и сокращает время восстановления
- Журнал не только позволяет восстановить согласованность после сбоев, но может использоваться и для других задач
Page 24: Практика
- Воспользуйтесь расширением pg_prewarm, чтобы автоматически восстанавливать содержимое буферного кеша после перезагрузки сервера. Проверьте и затем отключите расширение. 2. Создайте таблицу и вставьте в нее столько строк, чтобы ее объем составлял примерно половину от объема буферного кеша. Перезагрузите сервер, чтобы очистить кеш. Выполните запрос на чтение всех строк таблицы и после этого проверьте, сколько буферов в кеше содержат страницы этой таблицы. Объясните результат. 3. Сравните производительность системы при синхронном и асинхронном режимах фиксации, используя утилиту эталонного тестирования pgbench.
Комментарии преподавателя
- Для этого потребуется добавить расширение pg_prewarm в загружаемые библиотеки:
и затем перезагрузить сервер.
https://postgrespro.ru/docs/postgresql/16/pgprewarm
Для анализа используйте расширение pg_buffercache, показанное в демонстрации.
Инициализируйте тестовые таблицы, вызвав pgbench с ключом -i.
Затем выполняйте эталонный тест в одном и другом режимах на протяжении некоторого времени.
https://postgrespro.ru/docs/postgresql/16/pgbench
Page 25: 1. Прогрев кеша с помощью pg_prewarm
Расширение необходимо добавить в загружаемые библиотеки и перезапустить сервер:
Создадим таблицу с данными:
Проверим наличие страниц в буферном кеше:
Перезапустим сервер.
Проверим буферный кеш:
Все страницы были автоматически загружены в буферный кеш при старте сервера. Отключим расширение.
2. Массовое вытеснение
Размер буферного кеша:
Page 26: Page 26
В созданной таблице 10 тысяч строк занимают:
Добавим еще строк так, чтобы увеличить размер таблицы примерно до половины буферного кеша:
Перезагрузим сервер.
Выполним запрос, читающий все табличные страницы:
В буферном кеше данные таблицы занимают всего:
Это работает механизм, защищающий буферный кеш от массового вытеснения «одноразовыми» данными, которые вряд ли понадобятся снова. Он действует при полном сканировании больших таблиц, очистке и т. п. Такие операции используют только небольшую часть кеша (так называемое буферное кольцо).
3. Зависимость производительности от режима фиксации
Инициализируем тестовые таблицы:
Синхронная фиксация включена:
Page 27: Page 27
Запускаем эталонный тест TPC-B на 30 секунд:
Показатель — количество транзакций в секунду (tps). Выключаем синхронную фиксацию:
Повторяем тест:
Число транзакций в секунду заметно выше. Ускорение, конечно, зависит от типа нагрузки и характеристик оборудования. Восстановим значение параметра по умолчанию: