16 Занятие 16: PL/pgSQL / Обработка ошибок
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_16_plpgsql_exceptions.html Archive: DEV1-handouts-16.zip Страниц PDF: 27
Page 1: PL/pgSQL / Обработка ошибок
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Обработка ошибок в блоке PL/pgSQL
- Имена и коды ошибок
- Как происходит поиск обработчика
- Накладные расходы на обработку ошибок
Page 3: Обработка ошибок в блоке
Обработка выполняется, если есть секция EXCEPTION
- Выполняется откат к точке сохранения в начале блока
- точка сохранения устанавливается неявно, если в блоке есть
- секция EXCEPTION
- Если имеется обработчик, соответствующий ошибке
- выполняются команды обработчика
- блок завершается успешно
- Если нет подходящего обработчика
- блок завершается ошибкой
Комментарии преподавателя
Если внутри блока кода происходит ошибка времени выполнения, то обычно программа (блок, функция или процедура) аварийно прерывается, а текущая транзакция переходит в состояние сбоя: ее нельзя зафиксировать и можно только откатить.
Но ошибку можно перехватить и обработать. Для этого в блоке можно указать дополнительную секцию EXCEPTION, внутри которой перечислить условия, соответствующие ошибке, и операторы для обработки каждой такой ситуации.
EXCEPTION в целом соответствует конструкции try-catch в некоторых языках программирования (за исключением особенностей, связанных с обработкой транзакций, конечно).
В начале каждого блока с секцией EXCEPTION неявно устанавливается точка сохранения. Перед обработкой ошибки происходит откат к этой точке, в результате отменяются сделанные в блоке изменения, а также снимаются установленные в блоке блокировки.
Из-за наличия точки сохранения в блоках процедур с EXCEPTION запрещено использовать команды COMMIT и ROLLBACK. Зато, хотя команды SAVEPOINT и ROLLBACK TO SAVEPOINT не работают в PL/pgSQL, точку сохранения и откат к ней все-таки можно использовать и в процедурах, и в функциях — неявно.
https://postgrespro.ru/docs/postgresql/16/plpgsql-control-structures#PLPGS QL-ERROR-TRAPPING
Page 4: Обработка ошибок в блоке
Рассмотрим простой пример.
Когда нет ошибок, все операторы блока выполняются обычным образом:
Теперь добавим в таблицу «лишнюю» строку, чтобы спровоцировать ошибку.
Если в блоке нет секции EXCEPTION, выполнение операторов в блоке прерывается и весь блок считается завершившимся с ошибкой:
Чтобы перехватить ошибку, в блоке нужна секция EXCEPTION, определяющая обработчик или несколько обработчиков. Эта конструкция работает аналогично CASE: условия просматриваются сверху вниз, выбирается первая подходящая ветвь и выполняются ее операторы. Что будет выведено?
Выполняется обработчик, соответствующий ошибке too_many_rows. Обратите внимание: после обработки в таблице остается 2 строки, так как перед выполнением обработчика произошел откат к неявной точке сохранения, которая устанавливается в начале блока.
Page 5: Page 5
Также заметьте, что локальная переменная функции сохранила то значение, которое было на момент возникновения ошибки. Тонкий момент: если ошибка произойдет в секции DECLARE или в самом обработчике внутри EXCEPTION, то в этом блоке ее перехватить не получится.
Page 6: Имена и коды ошибок
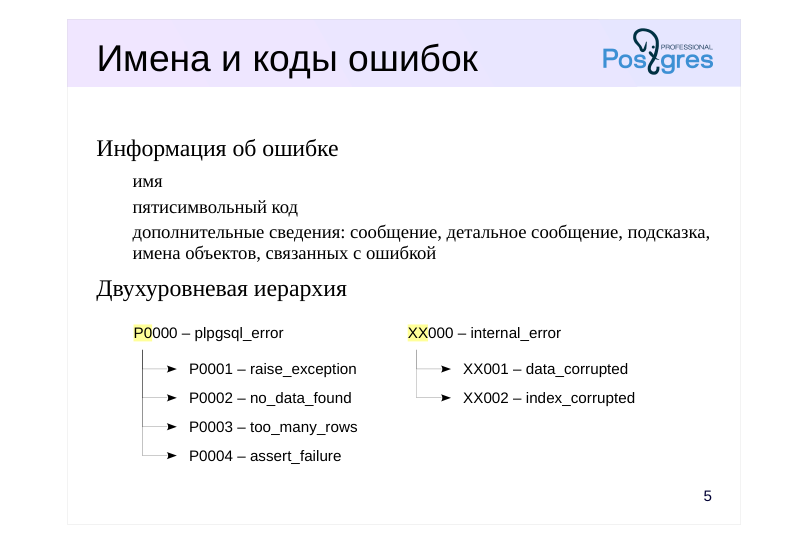 {#source-figure-006 caption=“Source slide page 6: Имена и коды ошибок”}
Информация об ошибке
- имя
- пятисимвольный код
- дополнительные сведения: сообщение, детальное сообщение, подсказка,
- имена объектов, связанных с ошибкой
- Двухуровневая иерархия
Комментарии преподавателя
Каждой возможной ошибке соответствует имя и код (строка из пяти символов). В условии WHEN можно указывать как имя, так и код.
Ошибки организованы в своеобразную двухуровневую иерархию. Категория ошибки имеет код, заканчивающийся на три нуля, и соответствует любой ошибке с теми же первыми двумя символами.
Например, код 23000 соответствует категории, которая включает все ошибки, связанные с нарушением ограничений целостности (такие, как 23502 — нарушение ограничения NOT NULL или 23505 — нарушение уникальности).
Таким образом, кроме обычных ошибок можно использовать имя или код категории. Можно также использовать специальное имя OTHERS для того, чтобы перехватить любую ошибку (кроме самых фатальных).
Кроме имени и кода любая ошибка может иметь дополнительные сведения, облегчающие ее диагностику: сообщение, детальное сообщение, подсказку.
Все ошибки описаны в приложении A документации:
https://postgrespro.ru/docs/postgresql/16/errcodes-appendix
Ошибки можно не только перехватывать, но и программно вызывать.
https://postgrespro.ru/docs/postgresql/16/plpgsql-errors-and-messages
Page 7: Имена и коды ошибок
Имена ошибок мы уже видели, а для указания кода служит конструкция SQLSTATE. В обработчике можно получить код ошибки и сообщение с помощью предопределенных переменных SQLSTATE и SQLERRM (вне блока EXCEPTION эти переменные не определены).
Какой обработчик будет использован?
Выбирается первый подходящий обработчик, в данном случае — plpgsql_error (напомним, что это не отдельная ошибка, а категория). До последнего обработчика дело никогда не дойдет. Ошибку можно принудительно вызвать по ее коду или имени. Здесь мы используем специальное имя others, соответствующее любой ошибке, которую можно перехватить (за исключением прерванного клиентом выполнения и нарушения отладочной проверки assert — их можно перехватить отдельно, но обычно это не имеет смысла).
При необходимости можно задействовать и пользовательские коды ошибок, отсутствующие в справочнике, а также указать некоторую дополнительную информацию (в примере — только часть из возможного):
Page 8: Page 8
В обработчике эту информацию нельзя получить из переменных; если нужно проанализировать такие данные в коде, есть специальная конструкция:
Page 9: Поиск обработчика
Необработанная ошибка «поднимается» на уровень выше
- в объемлющий блок PL/pgSQL, если он есть
- в вызывающую подпрограмму, если она есть
- Поиск обработчика определяется стеком вызовов
- то есть не определен статически, а зависит от выполнения программы
- Никем не обработанная ошибка отправляется клиенту
- транзакция переходит в состояние сбоя, клиент должен ее откатить
- информация об ошибке записывается в журнал сообщений сервера
Комментарии преподавателя
Если ни одно из условий, перечисленных в секции EXCEPTION, не сработает, то ошибка «поднимается» на уровень выше.
Если ошибка возникла в блоке, вложенном в другой блок, то сервер будет пытаться найти обработчик в объемлющем блоке. Если и там не найдется подходящего обработчика, весь объемлющий блок будет считаться ошибочным и ошибка поднимется еще выше, и так далее.
Если мы перебрали все объемлющие блоки и не обнаружили подходящего обработчика возникшей ошибки, ошибка «поднимается» на уровень той подпрограммы, которая вызвала наш блок. То есть, чтобы разобраться, в каком порядке будут просматриваться обработчики ошибки, надо проанализировать стек вызовов.
Если ни один из возможных обработчиков ошибки не сработает:
● сообщение об ошибке обычно попадает в журнал сообщений сервера (это зависит от настроек сервера, см. тему «PL/pgSQL. Отладка»);
● об ошибке сообщается клиенту, который инициировал вызов кода в базе данных. Клиент ставится перед фактом: транзакция переходит в состояние сбоя, и ее можно только откатить.
Как именно клиент будет обрабатывать ошибку, зависит от него самого. Например, psql выведет сообщение об ошибке и всю доступную диагностическую информацию. Клиент, ориентированный на конечного пользователя, может вывести знаменитое «обратитесь к системному администратору» и т. д.
Page 10: Поиск обработчика
Рассмотрим несколько примеров поиска обработчика в случае вложенных блоков. Что будет выведено?
Ошибка обрабатывается в том блоке, в котором она возникла. Внешний блок выполняется так, как будто никакой ошибки не было. А так?
Обработчик во внутреннем блоке не подходит; блок завершается с ошибкой, которая обрабатывается уже во внешнем блоке. Не забывайте, что в блоке с секцией EXCEPTION происходит откат к точке сохранения, неявно установленной в начале блока. В данном случае будут отменены все изменения, сделанные в обоих блоках. А так?
Page 11: Page 11
Так не срабатывает ни один обработчик, и вся транзакция обрывается. Обычно не нужно стремиться обработать все возможные ошибки в серверном коде. Нет ничего плохого в том, чтобы передать возникшую ошибку клиенту. В целом, обрабатывать ошибку имеет смысл на том уровне, на котором можно сделать что-то осмысленное в возникшей ситуации. Поэтому обрабатывать ошибку внутри базы данных стоит, когда можно что-то сделать именно на серверной стороне (например, повторить операцию при ошибке сериализации). Про журналирование сообщений об ошибках мы еще будем говорить в теме «PL/pgSQL. Отладка». Теперь рассмотрим пример с процедурами.
Что произойдет при вызове?
То, что мы видим в сообщении об ошибке — это стек вызовов: сверху вниз = изнутри наружу. Заметьте, что в этом сообщении, как и во многих других, вместо слова procedure используется function. В обработчике ошибки тоже можно получить доступ к стеку, правда, в виде одной строки:
Проверим:
Page 12: Page 12
Поскольку блок с секцией EXCEPTION устанавливает неявную точку сохранения, то и в этом блоке, и во всех блоках выше по стеку вызовов, процедуры лишаются возможности использовать команды COMMIT и ROLLBACK.
Page 13: Накладные расходы
Любой блок с секцией EXCEPTION выполняется медленнее
- из-за установки неявной точки сохранения
- Дополнительные расходы при возникновении ошибки
- из-за отката к точке сохранения
- Обработку ошибок можно и нужно использовать, но не стоит употреблять без необходимости
- PL/pgSQL и так интерпретируется и использует SQL для вычисления
- выражений
- для многих задач эта скорость более чем удовлетворительна
- проблемы с производительностью обычно связаны с запросами,
- а не с кодом PL/pgSQL
Комментарии преподавателя
Одно только указание секции EXCEPTION уже влечет за собой накладные расходы из-за того, что в начале блока будет неявно устанавливаться точка сохранения. А если ошибка действительно возникает, то накладные расходы еще более увеличиваются из-за того, что выполняется откат транзакции к точке сохранения.
Поэтому если есть простой способ обойтись без обработки исключений, лучше от нее отказаться. Не стоит строить логику работы программы на «жонглировании» исключениями.
Однако если обработка ошибок действительно нужна, не стоит сомневаться — обрабатывать ошибки можно и нужно несмотря на накладные расходы.
Во-первых, язык PL/pgSQL довольно медленный сам по себе из-за интерпретации и обращений к SQL для вычисления выражений.
Во-вторых, очень часто эта скорость вполне удовлетворительна. Да, можно и быстрее, если написать на C, но зачем?
И в-третьих, основные проблемы с производительностью, как правило, связаны со скоростью выполнения запросов из-за неправильно построенных планов, а вовсе не со скоростью работы процедурного кода (см. курс QPT «Оптимизация запросов»).
Так что если есть альтернативное решение, которое и проще, и быстрее — конечно лучше воспользоваться им.
Page 14: Накладные расходы
Чтобы оценить накладные расходы, рассмотрим простой пример. Пусть имеется таблица с текстовым полем, в которое пользователи заносят произвольные данные (обычно это признак неудачного дизайна, но иногда приходится). Нам нужно выделить числа в отдельный столбец числового типа.
Решим задачу с помощью обработки ошибок, возникающих при преобразовании текстовых данных к числу:
Проверим:
В другом варианте функции вместо обработки ошибки будем проверять формат с помощью регулярного выражения (слегка упрощенного):
Проверим этот вариант:
Page 15: Page 15
Получается заметно быстрее. В этом примере исключение срабатывало всего в 1% случаев. Чем чаще — тем больше будет дополнительных накладных расходов на откат к точке сохранения.
Встречаются (и довольно часто) случаи, когда можно обойтись без обработки ошибок, если выбрать другие подходящие средства. Задача: вернуть строку из справочника или NULL, если строки нет.
Функция с обработкой ошибки:
Проверим, что функция работает правильно:
Page 16: Page 16
Можно ли проще? Да, надо просто убрать STRICT или использовать подзапрос:
В таком варианте хорошо видно, что PL/pgSQL тут вообще не нужен — достаточно SQL. Проверим:
Задача: обновить строку таблицы с определенным идентификатором, а если такой строки нет — вставить ее. Первый подход. Что здесь плохо?
Плохо практически все, начиная с того, что такая функция будет работать некорректно на уровне изоляции Read Committed при наличии нескольких параллельно выполняющихся сеансов. Причина в том, что после выполнения SELECT и перед следующей операцией данные в базе могут измениться. Это легко продемонстрировать, если добавить задержку между командами. Для разнообразия возьмем немного другой (но тоже неправильный) вариант:
Page 17: Page 17
Теперь выполним функцию в двух сеансах почти одновременно:
Правильное решение можно построить с помощью обработки ошибки:
Проверим.
Да, теперь все правильно. Но можно решить задачу проще с помощью варианта команды INSERT, который пробует выполнить вставку, а при возникновении конфликта — обновление. И снова достаточно простого SQL.
Page 18: Page 18
Задача: гарантировать, что данные обрабатываются одновременно только одним процессом (на уровне изоляции Read Committed). Используя ту же таблицу, представим, что периодически категория требует специальной однопоточной обработки. Можно написать функцию следующим образом:
Проверим, что все правильно:
Но и эту задачу можно решить без обработки ошибок, используя рекомендательные блокировки:
Проверим:
Приведем и пример, когда без обработки ошибок не обойтись. Задача: организовать обработку пакета документов; ошибка при обработке одного документа не должна приводить к общему сбою.
Page 19: Page 19
Процедура, обрабатывающая один документ, иногда приводит к ошибке:
Теперь напишем процедуру, обрабатывающую все документы. Она вызывает в цикле обработку одного документа и при необходимости обрабатывает ошибку. Обратите внимание, что фиксация транзакции выполняется вне блока с секцией EXCEPTION.
Такую же обработку можно организовать и при помощи функции, но тогда все документы будут обрабатываться в одной общей транзакции, что может приводить к проблемам, если обработка выполняется долго. Этот вопрос детально изучается в курсе DEV2. Проверим результат:
Page 20: Page 20
Как видим, часть документов не обработалась, но это не помешало обработке остальных. Информация об ошибках удобно сохраняется в самой таблице:
И еще раз обратим внимание, что при возникновении ошибки происходит откат к точке сохранения в начале блока: благодаря этому версии документов в статусе ERROR остались равными 1.
Page 21: Итоги
Поиск обработчика ошибки происходит «изнутри наружу» в порядке вложенности блоков и вызова подпрограмм
- В начале блока с EXCEPTION устанавливается неявная точка сохранения, при ошибке происходит откат к этой точке
- Неперехваченная ошибка приводит к обрыву транзакции, сообщения отправляются клиенту и в журнал сервера
- Обработка ошибок связана с накладными расходами
Page 22: Практика
- Если при добавлении новой книги указать одного и того же автора несколько раз, произойдет ошибка. Измените функцию add_book: перехватите ошибку нарушения уникальности и вместо нее вызовите ошибку с понятным текстовым сообщением.
- Проверьте изменения в приложении.
Комментарии преподавателя
- Чтобы определить название ошибки, которую необходимо перехватить, перехватите все ошибки (WHEN OTHERS) и выведите необходимую информацию (вызвав новую ошибку с соответствующим текстом).
После этого не забудьте заменить WHEN OTHERS на конкретную ошибку — пусть остальные типы ошибок обрабатываются на более высоком уровне, раз в этом месте кода нет возможности сделать что-то конструктивное.
(В реальной жизни не стоило бы обрабатывать и нарушение уникальности — лучше было бы изменить приложение так, чтобы оно не позволяло указывать двух одинаковых авторов.)
Page 23: 1. Обработка повторяющихся авторов при добавлении книги
Page 24: Практика+
- Ряд языков имеет конструкцию try … catch … finally …, в которой try соответствует BEGIN, catch — EXCEPTION, а операторы из блока finally срабатывают всегда, независимо от того, возникло ли исключение и было ли оно обработано блоком catch. Предложите способ добиться подобного эффекта в PL/pgSQL. 2. Сравните стеки вызовов, получаемые конструкциями GET STACKED DIAGNOSTICS с элементом pg_exception_context и GET [CURRENT] DIAGNOSTICS с элементом pg_context. 3. Напишите функцию getstack, возвращающую текущий стек вызовов в виде массива строк. Сама функция getstack не должна фигурировать в стеке.
Комментарии преподавателя
Самый простой способ — просто повторить операторы finally в нескольких местах. Однако попробуйте построить такую конструкцию, чтобы эти операторы можно было написать ровно один раз.
Для начала обратитесь к документации:
https://postgrespro.ru/docs/postgresql/16/plpgsql-statements#PLPGSQL-ST ATEMENTS-DIAGNOSTICS
https://postgrespro.ru/docs/postgresql/16/plpgsql-control-structures#PLPGS QL-EXCEPTION-DIAGNOSTICS
Page 25: 1. Try-catch-finally
Сложность состоит в том, что операторы finally должны выполняться всегда, даже в случае возникновения ошибки в операторах catch (блок EXCEPTION). Решение может использовать два вложенных блока и фиктивное исключение, которое вызывается при нормальном завершении внутреннего блока. Это дает возможность поместить операторы finally в одно место — обработчик ошибок внешнего блока.
Page 26: Page 26
Но в предложенном решении всегда происходит откат всех изменений, выполненных в блоке, поэтому оно не годится для команд, изменяющих состояние базы данных. Также не стоит забывать о накладных расходах на обработку исключений: это задание — не более, чем просто упражнение.
2. GET DIAGNOSTICS
GET STACKED DIAGNOSTICS дает стек вызовов, приведший к ошибке. GET [CURRENT] DIAGNOSTICS дает текущий стек вызовов.
3. Стек вызовов как массив
Собственно функция:
Чтобы проверить ее работу, создадим несколько функций, которые вызывают друг друга: