07 Занятие 07: Учебное приложение / Книжный магазин
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_07_bstore_schema.html Archive: DEV1-handouts-16.zip Страниц PDF: 28
Page 1: Учебное приложение / Книжный магазин
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Обзор приложения «Книжный магазин»
- Проектирование схемы данных, нормализация
- Итоговая схема данных приложения
- Организация интерфейса между клиентом и сервером
Page 3: Приложение
 {#source-figure-003 caption=“Source slide page 3: Приложение”}
Комментарии преподавателя
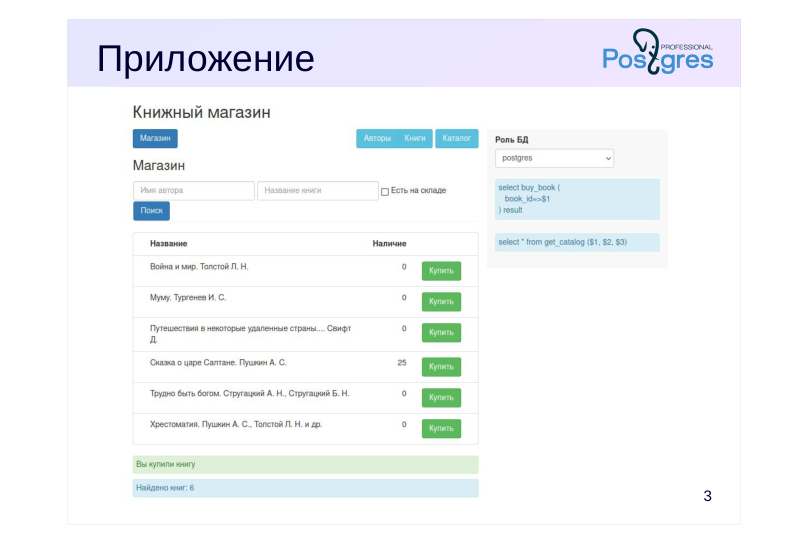
Приложение состоит из нескольких частей, представленных вкладками.
«Магазин» — это интерфейс веб-пользователя, в котором он может покупать книги.
Остальные вкладки соответствуют внутреннему интерфейсу, доступному только сотрудникам («админка» сайта).
«Каталог» — интерфейс кладовщика, в котором он может заказывать закупку книг на склад магазина и просматривать операции поступлений и покупок.
«Книги» и «Авторы» — интерфейс библиотекаря, в котором он может регистрировать авторов и их книги.
В учебных целях вся функциональность представлена на одной общей веб-странице. Если какая-то часть функциональности недоступна из-за того, что на сервере нет подходящего объекта (таблицы, функции и т. п.), приложение сообщит об этом. Также приложение выводит текст запросов, которые оно посылает на сервер.
В ходе курса мы начнем с пустой базы данных и постепенно реализуем в ней все необходимые компоненты.
P. S. Исходный код приложения не является темой курса, но может быть получен в репозитории https://pubgit.postgrespro.ru/pub/dev1app.git
Page 4: Демонстрация приложения
В этой демонстрации мы показываем приложение «Книжный магазин» в том виде, в котором оно будет после завершения всех практических заданий. Приложение откроется в отдельной вкладке браузера виртуальной машины курса: Открываем http://localhost…
Page 5: Книги
ER-модель для высокоуровневого проектирования
- сущности — понятия предметной области
- связи — отношения между сущностями
- атрибуты — свойства сущностей и связей
- сущность
Книга
- атрибуты
- название
- авторы
- количество
- операции
Комментарии преподавателя
После того, как мы посмотрели на внешний вид приложения и поняли его функциональность, нам нужно разобраться со схемой данных. Мы не будем хоть сколько-нибудь глубоко вникать в вопросы проектирования баз данных — это отдельная дисциплина, не входящая в данный курс. Но совсем обойти вниманием эту тему тоже нельзя.
Часто для высокоуровневого проектирования баз данных используется модель «сущность — связи», или ER-модель (Entity — Relationship). Она оперирует сущностями (понятиями предметной области), связями между ними и атрибутами (свойствами сущностей и связей). Модель позволяет рассуждать на логическом уровне, не опускаясь до деталей представления данных на физическом (в виде таблиц).
Первым подходом к проектированию может служить диаграмма, представленная на слайде: можно представить одну большую сущность «Книга», а все остальное сделать ее атрибутами.
Page 6: Схема данных
 {#source-figure-006 caption=“Source slide page 6: Схема данных”}
- Данные дублируются
- сложно поддерживать согласованность
- сложно обновлять
- сложно писать запросы
Комментарии преподавателя
Очевидно, что это неправильный подход. На диаграмме это может быть не так заметно, но давайте попробуем отобразить диаграмму на таблицы БД. Это можно сделать разными способами, например так, как показано на слайде: сущность становится таблицей, ее атрибуты — столбцами этой таблицы.
Здесь хорошо видно, что часть данных дублируется (эти фрагменты выделены на рисунке). Дублирование приводит к сложностям с обеспечением согласованности — а это едва ли не главная задача СУБД.
Например, каждая из двух строк, относящихся к книге 3, должна содержать общее количество (7 штук). Что нужно сделать, чтобы отразить покупку книги? С одной стороны, надо добавить строки для отражения операции покупки (а сколько строк добавлять, еще две?). С другой, во всех строках надо уменьшить количество с 7 до 6. А что делать, если в результате какой-нибудь ошибки значение количества в одной из этих строк будет отличаться от значения в другой строке? Как сформулировать ограничение целостности, которое запрещает такую ситуацию?
Также усложняются и многие запросы. Как найти общее число книг? Как найти всех уникальных авторов?
Итак, такая схема плохо работает для реляционных баз данных.
Page 7: Схема данных (вариант)
- Данные без схемы
- поддержка согласованности на стороне приложения
- сложно писать запросы
- низкая производительность (множественные соединения)
Комментарии преподавателя
Другой вариант отображения сущности в таблицу — так называемая схема EAV: сущность — атрибут — значение. Она позволяет уложить вообще все, что угодно, в одну-единственную таблицу. Формально мы получаем реляционную базу данных, а фактически здесь отсутствует схема и СУБД не может гарантировать согласованность данных. Поддержка согласованности данных целиком ложится на приложение, что, безусловно, рано или поздно приведет к ее нарушению.
В такой схеме сложно писать запросы (хотя и довольно просто их генерировать), и в результате работа со сколько-нибудь большим объемом данных становится проблемой из-за постоянных многократных соединений таблицы самой с собой.
Однако следует отметить, что такой подход имеет и плюсы. Например, очевидно, что такую «схему» данных легко наращивать: при добавлении новой сущности или атрибута мы просто добавляем в нашу таблицу новые строки.
И все-таки так делать не стоит.
Page 8: Схема данных (вариант)
- Данные без схемы
- поддержка согласованности на стороне приложения
- сложно писать запросы (специальный язык)
- индексная поддержка есть
Комментарии преподавателя
Еще одна вариация на ту же тему — представление данных в виде JSON, в духе NoSQL. По сути, тут применимы все замечания, сделанные ранее.
Кроме того, запросы к такой структуре придется писать не на SQL, а используя какой-то специализированный язык (раньше скорее всего выбор пал бы на jsQuery, а в PostgreSQL 16 удобно пользоваться возможностями SQL/JSON Path Language, определенными в стандарте SQL:2016).
https://github.com/postgrespro/jsquery
https://postgrespro.ru/docs/postgresql/16/functions-json#FUNCTIONS-SQLJ SON-PATH
Хотя у PostgreSQL есть индексная поддержка JSON, производительность все равно под вопросом.
Такую схему удобно применять, когда от базы данных требуется только получение JSON по идентификатору, но не требуется серьезная работа с данными внутри JSON. Это не наш случай.
(Разумеется, это не категоричное утверждение. См. последнее задание в практике.)
Page 9: Книги и операции
 {#source-figure-009 caption=“Source slide page 9: Книги и операции”}
Нормализация — уменьшение избыточности данных
- разбиение крупных сущностей на более мелкие
Книга
Операция
Комментарии преподавателя
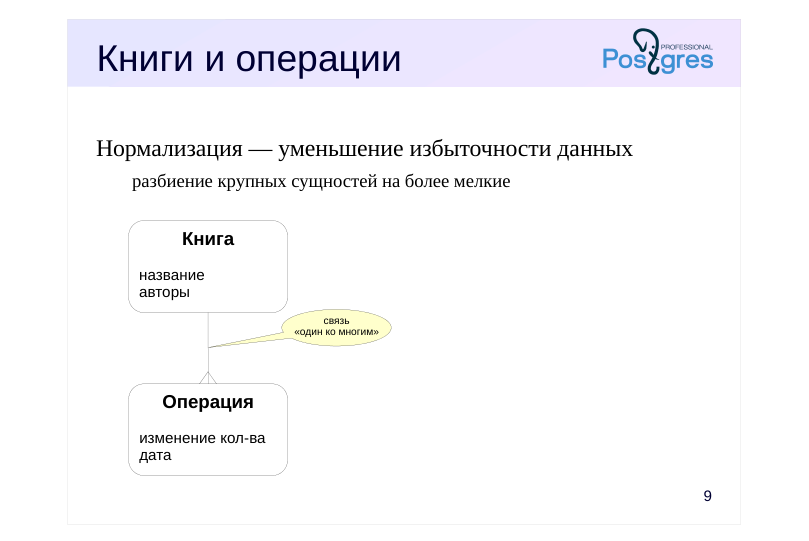
Итак, нам требуется устранить избыточность данных, чтобы привести их в вид, удобный для обработки в реляционной СУБД. Этот процесс называется нормализацией.
Возможно, вы знакомы с понятиями нормальных форм (первая, вторая, третья, Бойса-Кодда и т. д.). Мы не будем говорить о них; на неформальном уровне достаточно понимать, что весь этот математический аппарат преследует одну-единственную цель: устранение избыточности.
Средство для уменьшения избыточности — разбиение большой сущности на несколько меньших. Как именно это сделать, подскажет здравый смысл (который все равно нельзя заменить одним только знанием нормальных форм).
В нашем случае все достаточно просто. Давайте начнем с отделения книг от операций. Эти две сущности связаны отношением «один ко многим»: каждая книга может иметь несколько операций, но каждая операция относится только к одной книге.
Page 10: Схема данных
Комментарии преподавателя
На уровне структуры базы данных это может быть представлено двумя таблицами: книги (books) и операции (operations).
Операция состоит в изменении количества книг (положительном при заказе; отрицательном при покупке). Заметьте, что теперь у книги нет атрибута «количество». Вместо этого достаточно просуммировать изменения количества по всем операциям, относящимся к данной книге. Дополнительный атрибут «количество» у книги снова привел бы к избыточности данных.
Не исключено, что такое решение вас насторожило. Удобно ли вместо простого обращения к полю подсчитывать сумму? Но мы можем создать представление, которое для каждой книги будет показывать количество. Это не приведет к появлению избыточности, поскольку представление — это всего лишь запрос.
Второй момент — производительность. Если подсчет суммы приведет к ухудшению производительности, мы можем выполнить обратный процесс — денормализацию: добавить в таблицу книг поле «количество» и обеспечить его согласованность с таблицей операций. Надо ли этим заниматься — вопрос, ответ на который выходит за рамки этого курса (он рассматривается в курсе QPT «Оптимизация запросов»). Но из общих соображений понятно, что для нашего «игрушечного» магазина это не требуется. Однако мы еще вернемся к вопросу денормализации в теме «Триггеры».
Итак, как видно на слайде, выделение операций в отдельную сущность решило часть проблем дублирования, но не все.
Page 11: Книги, авторы и операции
 {#source-figure-011 caption=“Source slide page 11: Книги, авторы и операции”}
Книга
Операция
Комментарии преподавателя
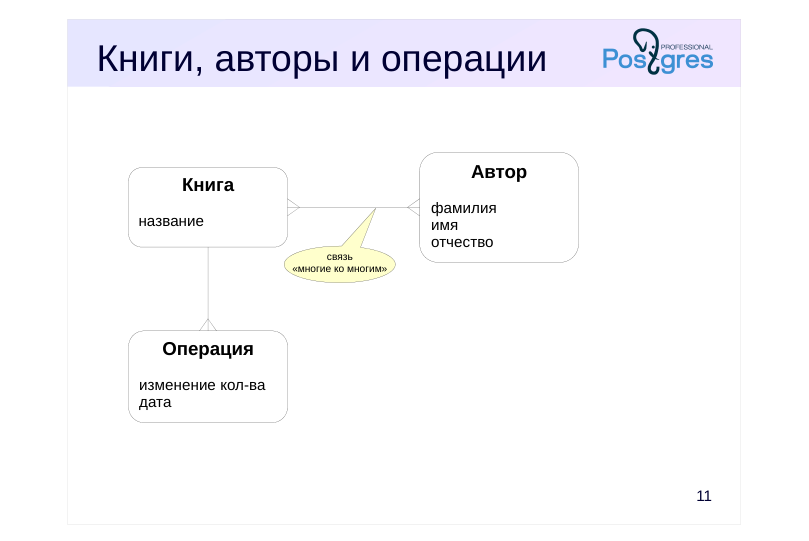
Поэтому надо сделать еще один шаг: отделить авторов от книг и связать их соотношением «многие ко многим»: и каждая книга может быть написана несколькими авторами, и каждый автор может написать несколько книг. На уровне таблиц такая связь реализуется с помощью дополнительной промежуточной таблицы.
Атрибутами автора можно сделать фамилию, имя и отчество. Это имеет смысл, поскольку нам может потребоваться работать отдельно с каждым из этих атрибутов, например, выводить фамилию и инициалы.
Page 12: Схема данных приложения
Итак, схема данных приложения состоит из четырех таблиц:
Книги
Здесь мы используем типы данных: integer — целое число; text — символьный, текстовая строка произвольной длины. А также используем ограничение целостности: PRIMARY KEY — первичный ключ. Конструкция GENERATED AS IDENTITY служит для автоматической генерации уникальных значений (в версиях до 10 для этого использовался псевдотип serial).
- Строки столбцов, объявленных как GENERATED AS IDENTITY, получают значения из специальных объектов базы данных — последовательностей. Имя использованной последовательности можно узнать так:
Последовательности можно при необходимости создавать вручную, а также обращаться к ним непосредственно:
Последовательность — самый эффективный способ генерации уникальных номеров. Но следует иметь в виду, что последовательность не гарантирует: отсутствия пропусков в нумерации (так как изменение происходит не транзакционно); монотонного возрастания номеров (если используется кеширование значений в сеансах).
Page 13: Page 13
Вот какие данные находятся в таблице книг:
Обратите внимание, что названия могут быть длинными. Мы используем расширенный формат вывода psql, а появившийся в PostgreSQL 16 параметр xheader_width поможет обрезать строку заголовка “широкого” столбца:
Сравните вывод:
Авторы
Page 14: Page 14
Здесь дополнительно используется ограничение целостности: NOT NULL — обязательность, то есть недопустимость неопределенных значений.
Обратите внимание, что отчество может отсутствовать (или быть заданным пустой строкой). Ограничение PRIMARY KEY в выводе команды \d упоминалось вместе со словами «индекс» и «btree». Btree (B-дерево) — основной тип индекса, используемый в базах данных для ускорения поиска и для поддержки ограничений целостности (первичного ключа и уникальности). Представим себе, что в магазине продаются книги миллиона авторов-однофамильцев:
Сколько времени занимает поиск одного автора в такой таблице?
Если попросить оптимизатор показать план запроса, мы увидим в нем Seq Scan — последовательное сканирование всей таблицы в поисках нужного значения (Filter):
А если искать по полю, которое проиндексировано?
Page 15: Page 15
Время уменьшилось на несколько порядков. А в плане запроса появился индекс:
Можно создать индекс и по фамилии (и проанализировать таблицу, чтобы собрать актуальную статистику):
Однако индекс не является универсальным средством увеличения производительности. Обычно индекс очень полезен, если из таблицы требуется выбрать небольшую долю всех имеющихся строк. Если нужно прочитать много данных, индекс будет только мешать, и оптимизатор это понимает:
Кроме того, надо учитывать накладные расходы на обновление индексов при изменении таблицы и занимаемое ими место на диске. Отменим все наши изменения (включая создание индекса):
Авторства
С помощью этой таблицы реализуется связь «многие ко многим».
Page 16: Page 16
Здесь к уже использованным ограничениям добавляется ограничение ссылочной целостности: FOREIGN KEY — внешний ключ. Фактически таблица содержит два внешних ключа: один ссылается на таблицу книг, другой — на таблицу авторов. Столбец seq_num определяет последовательность, в которой должны перечисляться авторы одной книги, если их несколько. Также обратите внимание на то, что первичный ключ — составной.
Операции
В этой таблице используется еще один тип данных: date — дата (без указания времени). Для столбца date_created указано значение по умолчанию (DEFAULT) — текущая дата.
Кроме тех типов данных, которые используются в таблицах приложения, мы постоянно будем встречаться с логическим типом (boolean). Например, такой тип имеют логические выражения в условии WHERE.
Note Важно помнить, что, в отличие от традиционных языков программирования, SQL использует трехзначную логику: кроме значений true и false, логическое значение может принимать неопределенное значение NULL (которое можно понимать как «значение неизвестно»).
Page 17: Page 17
В примерах встречаются и некоторые другие типы данных, информацию о работе с ними можно найти в материалах курса («Основные типы данных и функции», datatypes.pdf). Кроме того, в курсе мы подробно рассмотрим более сложные типы: составной — записи, аналогичные строкам таблиц (в теме «SQL. Составные типы»); массивы (в теме «PL/pgSQL. Массивы»).
Page 18: Организация интерфейса
Таблицы и триггеры
- чтение данных напрямую из таблицы (представления);
- запись данных напрямую в таблицу (представление),
- плюс триггеры для изменения связанных таблиц
- приложение должно быть в курсе модели данных,
- максимальная гибкость
- сложно поддерживать согласованность
- Функции
- чтение данных из табличных функций;
- запись данных через вызов функций
- приложение отделено от модели данных и ограничено API
- большой объем работы по изготовлению функций-оберток,
- потенциальные проблемы с производительностью
Комментарии преподавателя
Есть несколько способов организации интерфейса между клиентской и серверной частями приложения.
Один вариант — разрешить приложению напрямую обращаться к таблицам в базе данных и изменять их. При этом от приложения требуется детальное «знание» модели данных. Отчасти это требование можно ослабить за счет использования представлений (view).
Кроме того, от приложения требуется и определенная дисциплина — иначе очень сложно поддержать согласованность данных, защищаясь на уровне БД от любых возможных некорректных действий приложения. Но в этом случае достигается максимальная гибкость.
Другой вариант — запретить приложению доступ к таблицам и разрешить только вызовы функций. Чтение данных можно организовать с помощью табличных функций (которые возвращают набор строк). Изменение данных можно выполнять, вызывая другие функции и передавая им необходимые данные. В этом случае внутри функций можно реализовать все необходимые проверки согласованности — база данных будет защищена, но приложение сможет пользоваться только предоставленным и ограниченным набором возможностей. Такой вариант требует написания большого количества функций-оберток и может привести к потере производительности.
Вполне возможны и промежуточные варианты. Например, разрешить чтение данных непосредственно из таблиц, а изменение выполнять только через вызов функций.
Page 19: Интерфейс покупателя
 {#source-figure-019 caption=“Source slide page 19: Интерфейс покупателя”}
Комментарии преподавателя
В нашем приложении мы попробуем разные варианты организации интерфейса (хотя в реальной жизни обычно лучше систематически придерживаться какого-то одного подхода).
Магазин будет использовать интерфейсные функции:
● для поиска книг — get_catalog (тема «SQL. Составные типы»);
● для покупки книг — buy_book («PL/pgSQL. Выполнение запросов»).
Page 20: Интерфейс сотрудника
 {#source-figure-020 caption=“Source slide page 20: Интерфейс сотрудника”}
Комментарии преподавателя
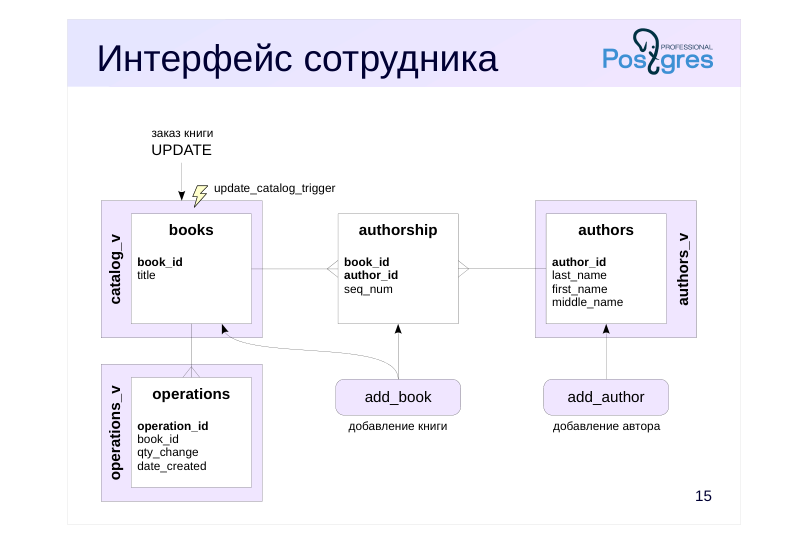
«Админка» для получения данных будет использовать представления (которые мы создадим в практике к этой теме):
● список книг — catalog_v;
● список авторов — authors_v;
● список операций — operations_v.
Добавление автора будет выполнять функция add_author (создадим ее в теме «PL/pgSQL. Выполнение запросов»), добавление книги — функция add_book («PL/pgSQL. Массивы»).
Для заказа книг сделаем представление catalog_v обновляемым («PL/pgSQL. Триггеры»).
Page 21: Представления
Представление — запрос, у которого есть имя. Например, можно создать представление, которое показывает только авторов без отчества:
Теперь имя представления можно использовать в запросах практически так же, как и таблицу:
В простом случае с представлением будут работать и другие операции, например:
С помощью триггеров можно сделать так, чтобы и в сложных случаях для представлений работали вставка, обновление и удаление строк. Мы рассмотрим это в теме «PL/pgSQL. Триггеры». При планировании запроса представление «разворачивается» до базовых таблиц:
Приложение использует три представления. Сначала они будут очень простыми, но в следующих темах мы перенесем в них часть логики приложения. Представление для авторов — конкатенация фамилии, имени и отчества (если оно есть):
Представление для каталога книг — пока просто название книги:
Page 22: Page 22
Представление для операций — дополнительно определяет тип операции (поступление или покупка):
Page 23: Итоги
Проектирование баз данных — отдельная тема
- теория важна, но не заменяет здравый смысл
- Отсутствие избыточности в данных делает работу удобнее и упрощает поддержку согласованности
- Для клиент-серверного интерфейса можно использовать таблицы, представления, функции, триггеры
Page 24: Практика
- В базе данных bookstore создайте схему bookstore. Настройте путь поиска к этой схеме на уровне подключения к БД. 2. В схеме bookstore создайте таблицы books, authors, authorship и operations с необходимыми ограничениями целостности так, чтобы они соответствовали показанным в демонстрации. 3. Вставьте в таблицы данные о нескольких книгах. Проверьте себя с помощью запросов. 4. В схеме bookstore создайте представления authors_v, catalog_v и operations_v так, чтобы они соответствовали показанным в демонстрации. Проверьте, что приложение стало показывать данные на вкладках «Книги», «Авторы» и «Каталог».
Комментарии преподавателя
Вспомните материал темы «Организация данных. Логическая структура».
Ориентируйтесь на показанный в демонстрации вывод команд \d утилиты psql.
Вы можете использовать те же данные, что были показаны в демонстрации, или придумать свои собственные.
Попробуйте написать запросы к базовым таблицам, возвращающие тот же результат, что и показанные в демонстрации запросы к представлениям. Затем оформите запросы в виде представлений.
После выполнения практики обязательно сверьте свои запросы с решением, приведенным к этой теме. При необходимости внесите коррективы.
Page 25: 1. Схема и путь поиска
2. Таблицы
Авторы:
Книги:
Авторство:
Операции:
3. Данные
Авторы:
Книги:
Авторство:
Page 26: Page 26
Операции:
4. Представления
Представление для авторов:
Представление для каталога:
Представление для операций:
Page 27: Практика+
- Какие дополнительные атрибуты могут появиться у выделенных сущностей при развитии приложения? 2. Допустим, требуется хранить информацию об издательстве. Дополните ER-диаграмму и отобразите ее в таблицы. 3. Некоторые книги могут входить в серии (например, «Библиотека приключений»). Как изменится схема данных? 4. Пусть наш магазин стал торговать компьютерными комплектующими (материнскими платами, процессорами, памятью, жесткими дисками, мониторами и т. п.). Какие сущности и какие атрибуты вы бы выделили? Учтите, что на рынке постоянно появляются новые типы оборудования со своими характеристиками.
Комментарии преподавателя
- Разные издательства вполне могут иметь серии, названные одинаково.
Page 28: 1. Дополнительные атрибуты
Несколько примеров: Авторы: роль (автор, редактор, переводчик и т. п.); Книги: аннотация; Операции: текущий статус (оплачено, передано в службу доставки и т. п.).
2. Издательства
Надо добавить сущность «Издательство» с атрибутом «Название» (как минимум). Книги связаны с издательствами отношением «многие ко многим»: книга может публиковаться в разных издательствах. Поэтому на физическом уровне потребуется промежуточная таблица «Публикации» с атрибутом «Год издания». (Разумеется, это упрощенная модель; при желании ее можно уточнять еще очень долго.)
3. Серии
Добавим сущность «Серия». К серии относится не сама книга, а ее конкретная публикация, так что имеет смысл вывести «Публикацию» на уровень ER-модели и связать ее с серий отношением «один ко многим» (каждая публикация принадлежит к одной серии, каждая серия может включать несколько публикаций). Также серия связана отношением «один ко многим» с издательством (у издательства может быть несколько серий, а каждая серия принадлежит конкретному издательству). Остается вопрос о внесерийных изданиях. Его можно решить либо введением фиктивной серии «Без серии», либо возможностью не указывать для публикации внешний ключ серии.
4. Компьютерные комплектующие
Рассматривая каждый конкретный тип комплектующих, можно без труда выделить необходимые атрибуты. Какие-то атрибуты будут общими (скажем, фирма-производитель и название модели), а какие-то будут иметь смысл только для данного конкретного типа. Например: Процессор: частота; Монитор: диагональ, разрешение; Жесткий диск: типоразмер, емкость. Проблема в том, что рынок комплектующих очень динамичен. Некоторое время назад жесткие диски определялись частотой вращения и емкостью, а сейчас важен тип (твердотельный, вращающийся, гибридный). Для мониторов во времена ЭЛТ была важна частота обновления, а сейчас важен тип матрицы. Дисководы уже никому не нужны, зато появились флеш-накопители. И так далее. Таким образом, либо придется постоянно изменять схему данных (а, значит, и постоянно изменять приложение, которое работает с этими данными!), либо искать более универсальную модель за счета отказа от жесткой структуры и контроля согласованности. Некоторые универсальные модели (например, хранение части данных в JSON) мы затрагивали в презентации.