07 Занятие 07: Репликация / Сценарии использования
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba3_07_replica_usecases.html Archive: DBA3-handouts-16.zip Страниц PDF: 33
Page 1: Репликация / Сценарии использования
Авторские права
© Postgres Professional, 2017–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Использование физической репликации
- Использование логической репликации
Page 3: Физическая репликация
Горячий резерв для высокой доступности
- Балансировка OLTP-нагрузки
- Реплика для отчетов
- Несколько реплик и каскадная репликация
- Отложенная репликация
Page 4: Горячий резерв для HA
 {#source-figure-004 caption=“Source slide page 4: Горячий резерв для HA”}
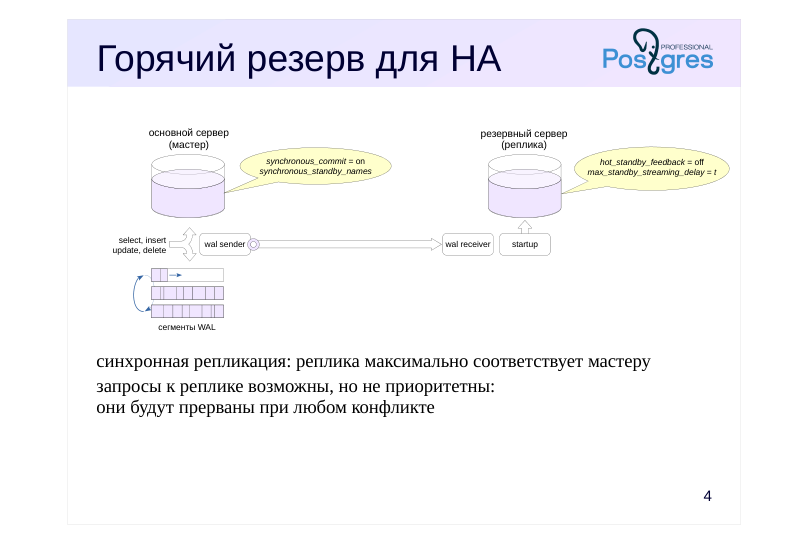
синхронная репликация: реплика максимально соответствует мастеру запросы к реплике возможны, но не приоритетны: они будут прерваны при любом конфликте
Комментарии преподавателя
Реплика может создаваться для решения разных задач, и настройка зависит от ее предназначения.
Один из возможных вариантов — обеспечение горячего резерва для целей высокой доступности. Это означает, что при сбое основного сервера требуется как можно быстрее перейти на реплику, не потеряв при этом данные.
Надежность обеспечивает синхронная репликация в режиме synchronous_commit = on (значение write не гарантирует надежность; значение apply может привести к неоправданным задержкам).
Для синхронной репликации значение параметра synchronous_standby_names должно содержать список резервных серверов (реплик).
Чтобы реплика как можно меньше отставала от основного сервера, нужно применять журнальные записи сразу же. Для этого выставляем задержку max_standby_streaming_delay в небольшое значение.
Чтобы запросы к реплике не могли негативно повлиять на основной сервер, выключаем обратную связь (hot_standby_feedback = off).
С такими настройками запросы к реплике возможны, но в случае конфликтов они будут прерваны. Если запросы к реплике не предполагаются, она может работать в режиме «теплого резерва» (hot_standby = off).
Заметим, что репликация — базовый механизм для обеспечения высокой доступности, но далеко не все, что нужно. Более подробнее это обсуждается в модуле «Кластерные технологии».
Page 5: Балансировка OLTP
 {#source-figure-005 caption=“Source slide page 5: Балансировка OLTP”}
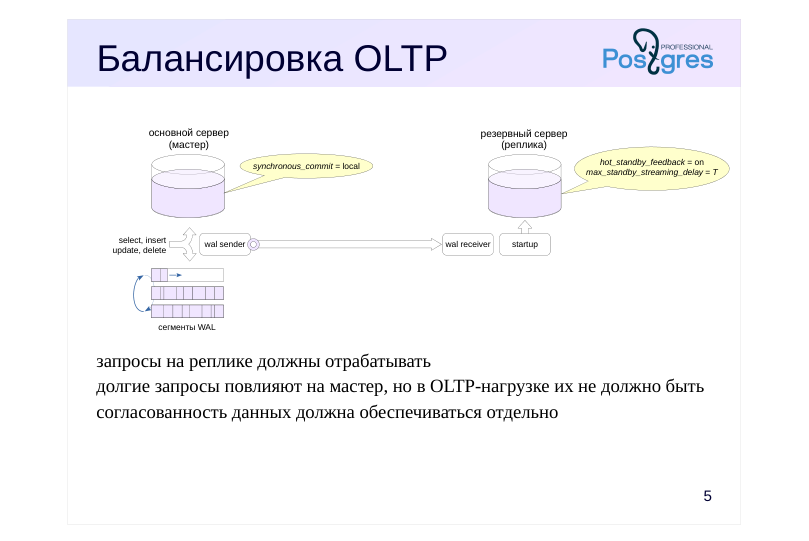
запросы на реплике должны отрабатывать долгие запросы повлияют на мастер, но в OLTP-нагрузке их не должно быть согласованность данных должна обеспечиваться отдельно
Комментарии преподавателя
Другой вариант — реплика используется для балансировки OLTP-нагрузки на чтение.
OLTP-нагрузка характеризуется небольшими по длительности запросами. Это позволяет достаточно тесно связать реплику с основным сервером, чтобы запросы гарантированно не прерывались из-за конфликтов, и в то же время не беспокоиться о негативном влиянии на основной сервер.
Включаем обратную связь (hot_standby_feedback = on) и выставляем достаточно большую задержку применения конфликтных записей (max_standby_streaming_delay).
Синхронная репликация в такой конфигурации, скорее всего, не требуется. Она все равно не обеспечивает согласованность данных: фиксация изменения на основном сервере не гарантирует, что запрос к реплике немедленно его увидит.
Для обеспечения согласованности нужно, чтобы изменения появлялись на обоих серверах одновременно. Режим synchronous_commit = apply позволяет дождаться применения журнальной записи на реплике (ценой сильного падения производительности основного сервера), но тогда можно увидеть данные на реплике раньше, чем на мастере. Надежное и прозрачное для приложений решение можно получить, используя специальные протоколы распределенных транзакций (см. модуль «Кластерные технологии»).
Page 6: Реплика для отчетов
 {#source-figure-006 caption=“Source slide page 6: Реплика для отчетов”}
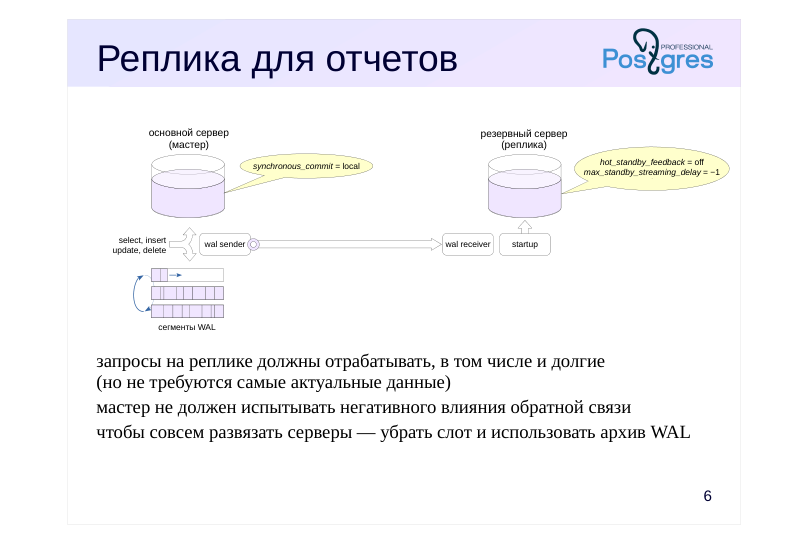
запросы на реплике должны отрабатывать, в том числе и долгие (но не требуются самые актуальные данные) мастер не должен испытывать негативного влияния обратной связи чтобы совсем развязать серверы — убрать слот и использовать архив WAL
Комментарии преподавателя
Еще один возможный вариант — разделение по серверам нагрузки разного типа. Основной сервер может брать на себя OLTP-нагрузку, а длительные читающие запросы (отчеты) можно вынести на реплику.
Кроме распределения нагрузки между серверами, такое решение позволит избежать проблемы с тем, что длительные запросы на основном сервере могут задерживать выполнение очистки и приводить к раздуванию (bloat).
Из этих соображений «отчетная» реплика должна быть максимально отделена от основного сервера. Должна быть отключена обратная связь (hot_standby_feedback = off), а время откладывания конфликтующих журнальных записей нужно сильно увеличить, вплоть до бесконечности (max_standby_streaming_delay = −1).
Поскольку для длительных отчетов не требуются сиюминутные данные, можно, при наличии архива, отказаться от слота репликации (не забыв выставить параметр max_standby_archive_delay аналогично max_standby_streaming_delay). Тогда, если мастер успеет удалить необходимый реплике файл, реплика возьмет его из архива.
Такую реплику можно также использовать для выполнения резервного копирования.
Разумеется, на практике возможны и другие сочетания параметров. Главное — четко понимать, какую задачу требуется решить, и какое влияние оказывают те или иные параметры.
Page 7: Несколько реплик
 {#source-figure-007 caption=“Source slide page 7: Несколько реплик”}
Комментарии преподавателя
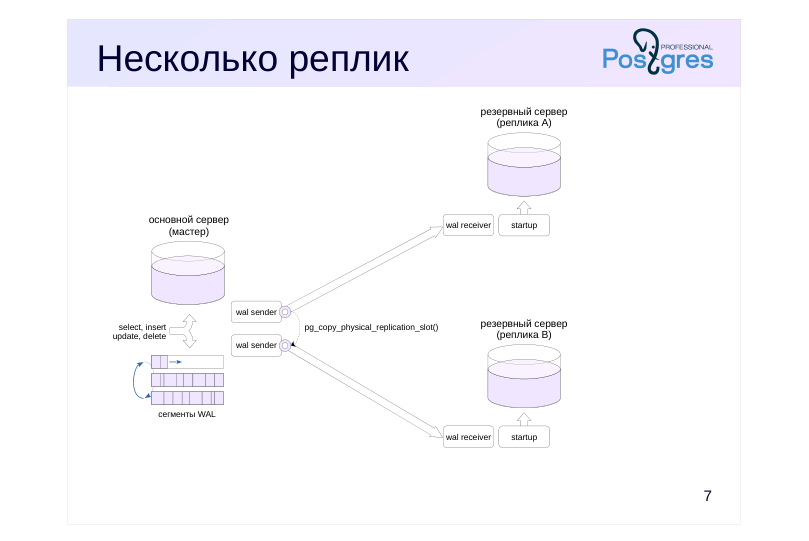
К основному серверу можно подключить несколько реплик. Никаких специальных настроек для этого не требуется, но надо учитывать, что каждой реплике будет соответствовать отдельный процесс wal sender и отдельный слот репликации. При развертывании можно растиражировать одну базовую копию и клонировать слот репликации функцией pg_copy_physical_replication_slot.
https://postgrespro.ru/docs/postgresql/16/functions-admin#FUNCTIONS-RE PLICATION
Обычно такая схема требуется для распределения нагрузки, но собственно распределение должно решаться внешними средствами (см. модуль «Кластерные технологии»).
Page 8: Мастер и две физические реплики
Настроим конфигурацию с двумя репликами. Создадим автономную резервную копию первого сервера, одновременно создав слот.
Поскольку третий сервер при старте начнет применять записи WAL с той же позиции, что и второй, можно дублировать слот:
Выложим автономную копию в каталоги PG_DATA второго и третьего серверов:
В конфигурации третьего сервера укажем слот gamma:
Запускаем обе реплики:
Слоты инициализировались:
Проверяем.
Page 9: Page 9
 {#source-figure-009 caption=“Source slide page 9: Page 9”}
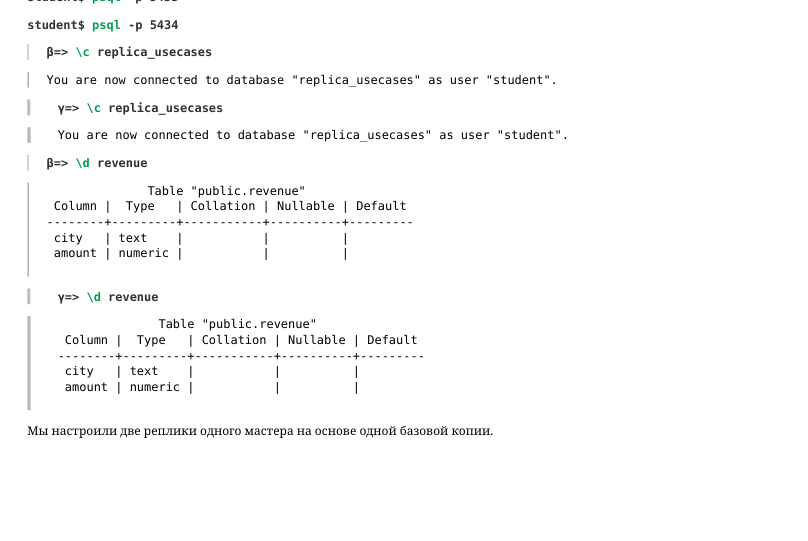
Мы настроили две реплики одного мастера на основе одной базовой копии.
Page 10: Каскадная репликация
 {#source-figure-010 caption=“Source slide page 10: Каскадная репликация”}
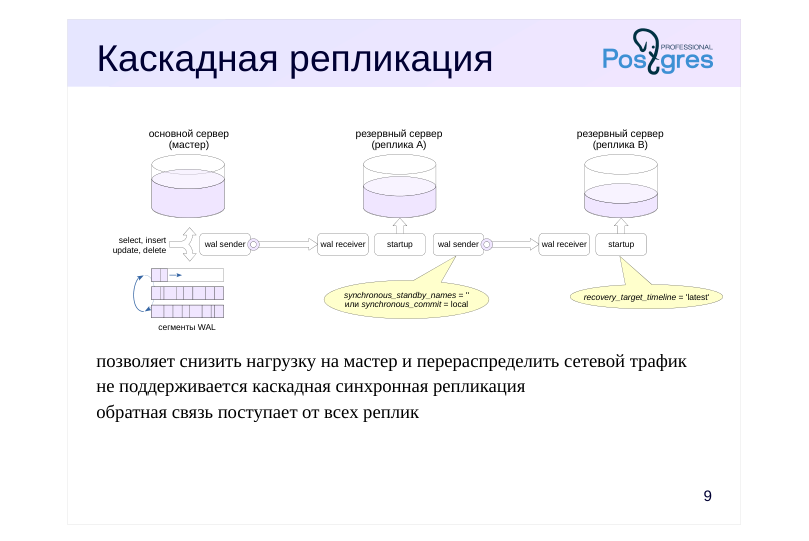
позволяет снизить нагрузку на мастер и перераспределить сетевой трафик не поддерживается каскадная синхронная репликация обратная связь поступает от всех реплик
Комментарии преподавателя
Несколько реплик, подключенных к одному основному серверу, будут создавать на него определенную нагрузку. Кроме того, надо учитывать нагрузку на сеть для пересылки нескольких копий потока журнальных записей.
Для снижения нагрузки реплики можно соединять каскадом; при этом серверы передают журнальные записи друг другу по цепочке. Чем дальше от мастера, тем большее запаздывание может накопиться. Схема мониторинга усложняется: процесс надо контролировать на нескольких серверах.
Если совершится переход на реплику (ближайшую к основному серверу), то на ней увеличится номер линии времени. Значение recovery_target_timeline = ’latest’ направит восстановление по этой новой линии (это значение по умолчанию).
Заметим, что каскадная синхронная репликация не поддерживается: основной сервер может быть синхронизирован только с непосредственно подключенной к нему репликой. Поэтому на первой в каскаде реплике нужно установить synchronous_standby_names = ’’ или synchronous_commit = ’local'.
А вот обратная связь поступает основному серверу от всех реплик.
Page 11: Отложенная репликация
 {#source-figure-011 caption=“Source slide page 11: Отложенная репликация”}
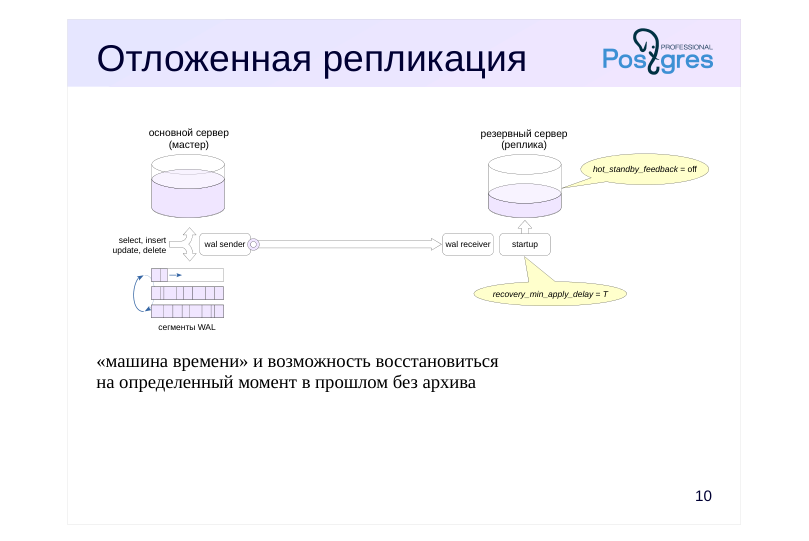
«машина времени» и возможность восстановиться на определенный момент в прошлом без архива
Комментарии преподавателя
Задача: иметь возможность просмотреть данные на некоторый момент в прошлом и, при необходимости, восстановить сервер на этот момент.
Восстановление из архива на момент времени (point-in-time recovery) решает эту задачу, но занимает много времени и требует подготовки.
Другое решение — создать реплику, которая применяет журнальные записи с заданной задержкой (recovery_min_apply_delay). При этом требуется синхронизация часов между серверами.
Откладывается применение не всех записей, а только записей о фиксации изменений. Записи до фиксации могут быть применены «раньше времени», но это не представляет проблемы благодаря многоверсионности. Обратную связь следует отключать, чтобы не вызвать разрастание таблиц на мастере.
Типичный сценарий: на основном сервере происходит какая-либо проблема (допустим, удалены критичные данные). На реплике данные еще есть, поскольку соответствующие записи еще не применены. Дальнейшее проигрывание записей приостанавливается с помощью функции pg_wal_replay_pause, пока идет исследование проблемы. Функцией pg_get_wal_replay_pause_state можно проверить состояние приостановки.
Если принято решение продолжать, функцией pg_wal_replay_resume завершают паузу в проигрывании записей WAL и восстановление продолжается. Если решено вернуться на момент времени до удаления, нужно указать целевую точку восстановления одним из параметров recovery_target_* и перезапустить реплику.
Page 12: Логическая репликация
Консолидация и общие справочники
- Обновление основной версии сервера
- Мастер-мастер
- Логическое декодирование на физической реплике
Page 13: Консолидация
 {#source-figure-013 caption=“Source slide page 13: Консолидация”}
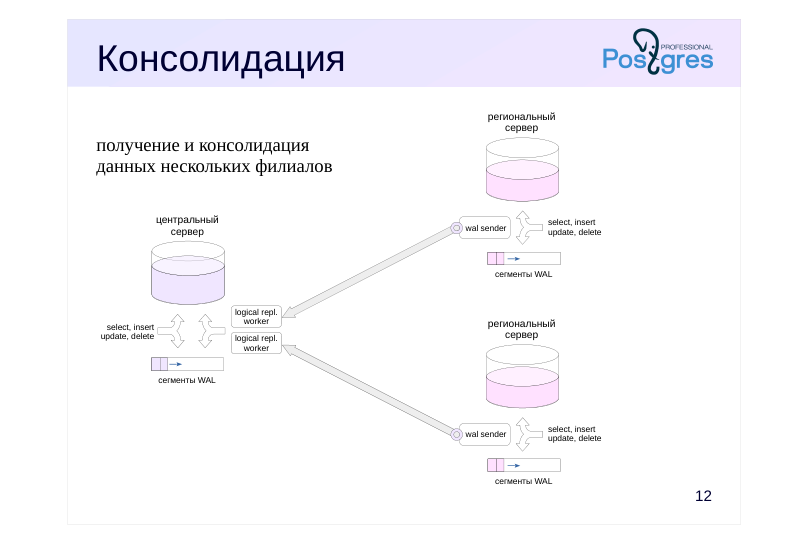
получение и консолидация данных нескольких филиалов
Комментарии преподавателя
Пусть имеются несколько региональных филиалов, каждый из которых работает на собственном сервере PostgreSQL. Задача состоит в консолидации части данных на центральном сервере.
Для решения на региональных серверах создаются публикации необходимых данных. Центральный сервер подписывается на эти публикации. Полученные данные можно обрабатывать (например, приводить к единому виду) с помощью триггеров на стороне центрального сервера.
Поскольку репликация основана на передаче данных через слот, между серверами необходимо более или менее постоянное соединение, так как во время разрыва соединения региональные серверы будут вынуждены сохранять файлы журнала.
Есть множество особенностей такого процесса и с точки зрения бизнес-логики, требующих всестороннего изучения. В ряде случаев может оказаться проще передавать данные пакетами раз в определенный интервал времени.
Page 14: Общие справочники
 {#source-figure-014 caption=“Source slide page 14: Общие справочники”}
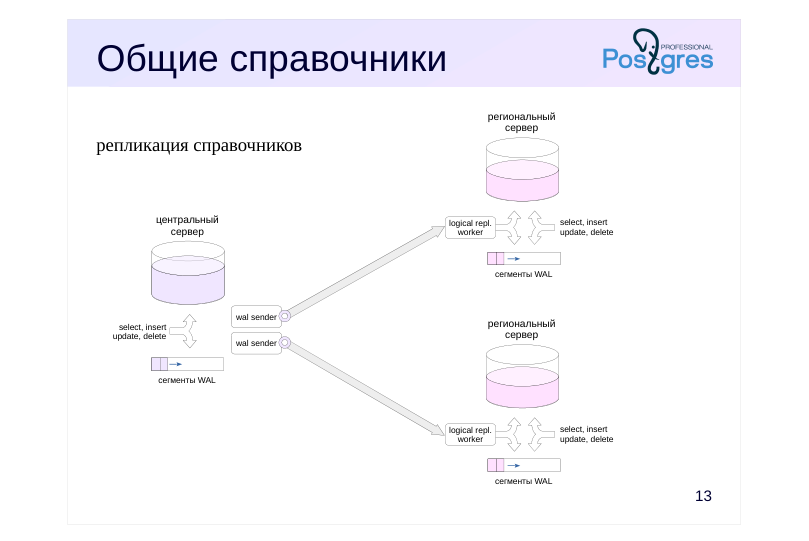
репликация справочников
Комментарии преподавателя
Другая задача: на центральном сервере поддерживаются справочники, актуальные версии которых должны быть доступны на региональных серверах.
В этом случае схему надо развернуть наоборот: центральный сервер публикует изменения, а региональные серверы подписываются на эти обновления.
Page 15: Консолидация с помощью логической репликации
 {#source-figure-015 caption=“Source slide page 15: Консолидация с помощью логической репликации”}
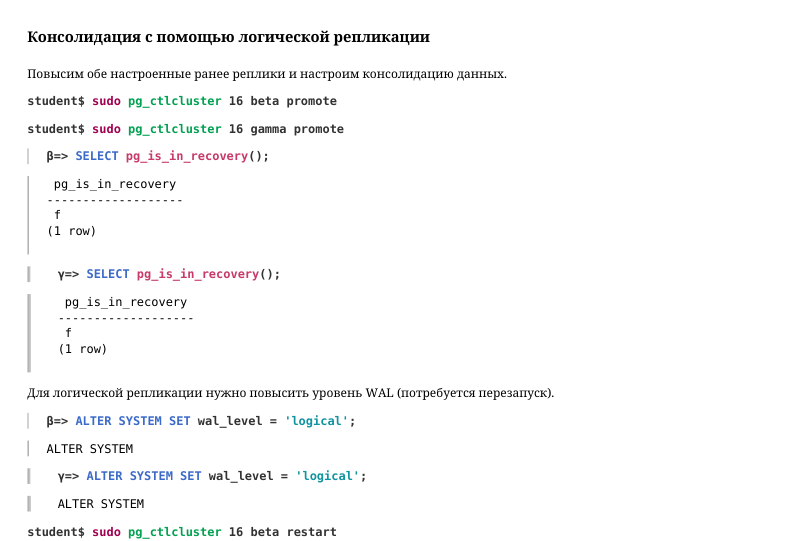
Повысим обе настроенные ранее реплики и настроим консолидацию данных.
Для логической репликации нужно повысить уровень WAL (потребуется перезапуск).
Удалим на сервере alpha слоты репликации:
Публикуем таблицу на втором и третьем серверах:
Первый сервер подписывается на обе публикации:
Page 16: Page 16
В филиалах кипит работа:
А центральный офис видит работу всей компании (подождем несколько секунд, чтобы сработала репликация):
Page 17: Обновление серверов
 {#source-figure-017 caption=“Source slide page 17: Обновление серверов”}
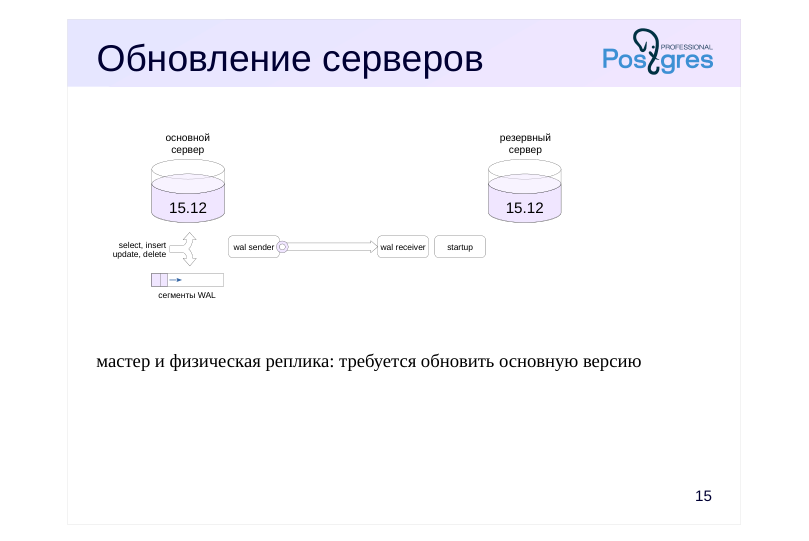
мастер и физическая реплика: требуется обновить основную версию
Комментарии преподавателя
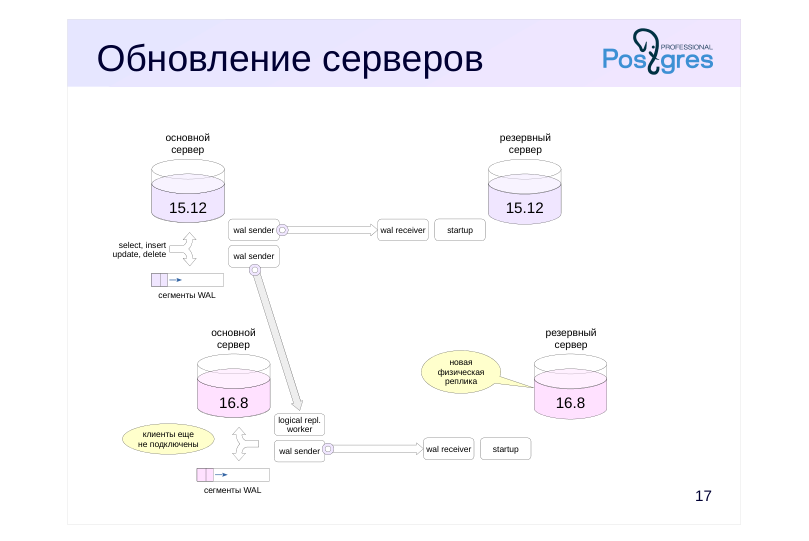
Логическая репликация может использоваться для обновления основной версии сервера без прерывания обслуживания (или с минимальным прерыванием).
Допустим, имеется основной сервер и физическая потоковая реплика.
Page 18: Обновление серверов
 {#source-figure-018 caption=“Source slide page 18: Обновление серверов”}
Комментарии преподавателя
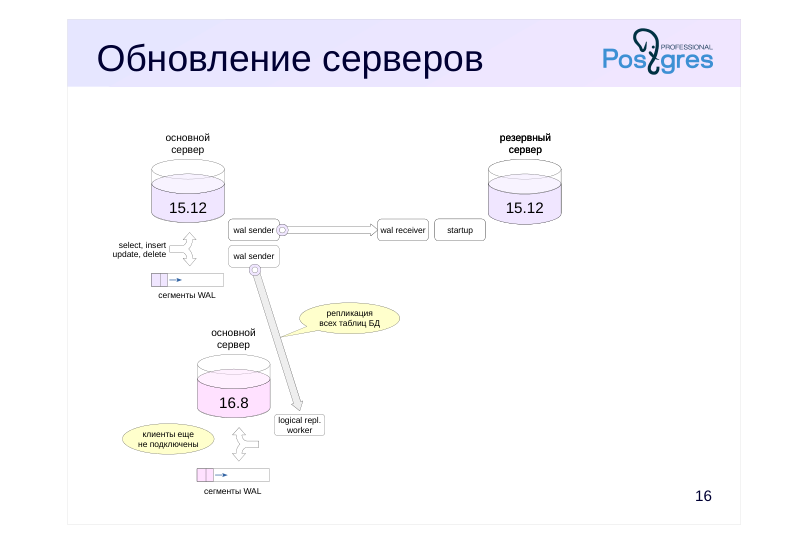
Создаем новый сервер с требуемой версией PostgreSQL и переносим на него структуру всех таблиц выбранной базы данных.
На основном сервере предыдущей версии публикуем изменения всех таблиц базы данных. Поскольку изменения схемы данных не реплицируются, на время обновления такие изменения должны быть запрещены.
Page 19: Обновление серверов
 {#source-figure-019 caption=“Source slide page 19: Обновление серверов”}
Комментарии преподавателя
Создаем физическую реплику, аналогичную реплике сервера предыдущей версии.
В итоге получаем параллельную структуру серверов с новой версией PostgreSQL. Эта структура аналогична имеющейся для старой версии.
Page 20: Обновление серверов
 {#source-figure-020 caption=“Source slide page 20: Обновление серверов”}
Комментарии преподавателя
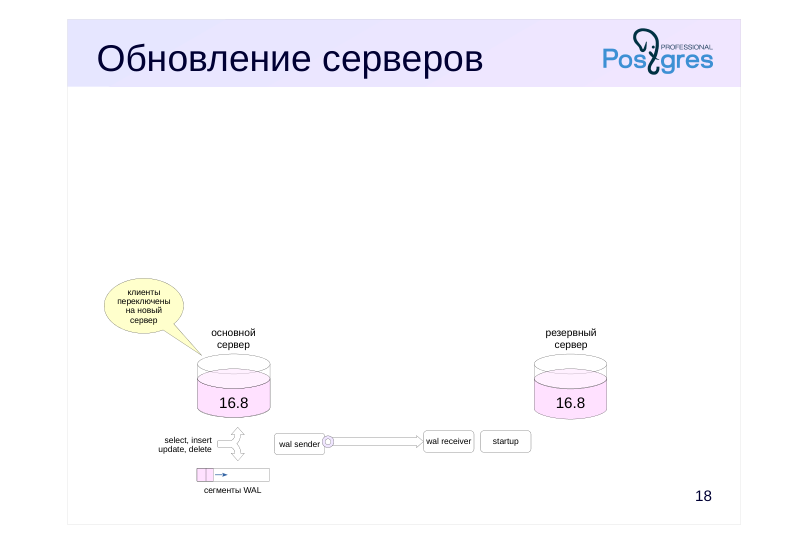
После этого переключаем клиентов на новые серверы, а старые останавливаем. Прерывание обслуживания будет определяться тем, насколько плавно можно выполнить это переключение.
Надо иметь в виду, что такой процесс нельзя считать универсальным: он накладывает достаточно много ограничений и существенно более сложен, чем использование утилиты pg_upgrade, которая позволяет выполнить обновление за небольшое время.
Page 21: Мастер-мастер
 {#source-figure-021 caption=“Source slide page 21: Мастер-мастер”}
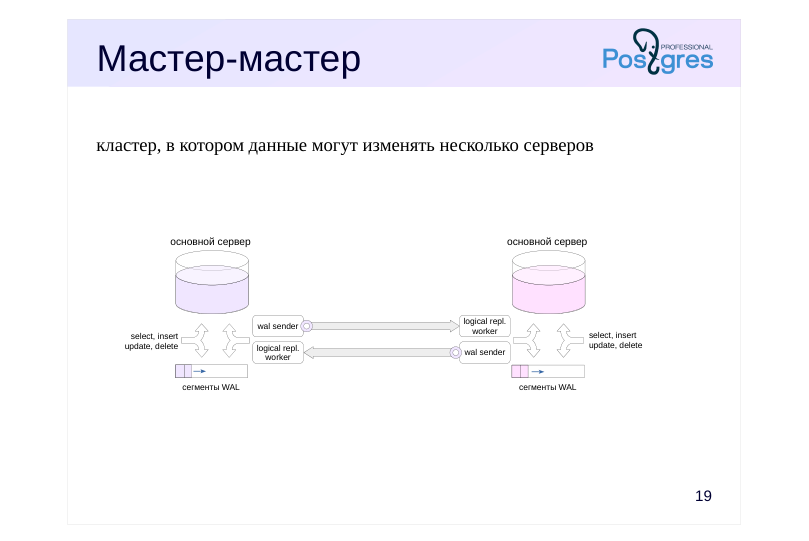
кластер, в котором данные могут изменять несколько серверов
Комментарии преподавателя
Задача: обеспечить надежное хранение данных на нескольких серверах с возможностью записи на любом сервере (что полезно, например, для геораспределенной системы).
Для решения можно использовать двунаправленную репликацию, передавая изменения в одних и тех же таблицах от одного сервера к другому и обратно (устанавливая ограничение на источник репликации, как было рассмотрено в теме «Логическая репликация»).
Конечно, прикладная система должна быть построена таким образом, чтобы избегать конфликтов при изменении данных в одних и тех же таблицах. Например, использовать глобальные уникальные идентификаторы или гарантировать, что разные серверы работают с разными диапазонами ключей. Также можно использовать фильтрацию строк таблиц, появившуюся в PostgreSQL 15.
Надо учитывать, что система мастер-мастер, построенная на логической репликации, не обеспечивает сама по себе выполнение глобальных распределенных транзакций. При использовании синхронной репликации можно гарантировать надежность, но не согласованность данных между серверами. Кроме того, никаких средств для автоматизации обработки сбоев, подключения или удаления узлов из кластера и т. п. в PostgreSQL не предусмотрено — эти задачи должны решаться внешним средствами.
Page 22: Декодирование на реплике
 {#source-figure-022 caption=“Source slide page 22: Декодирование на реплике”}
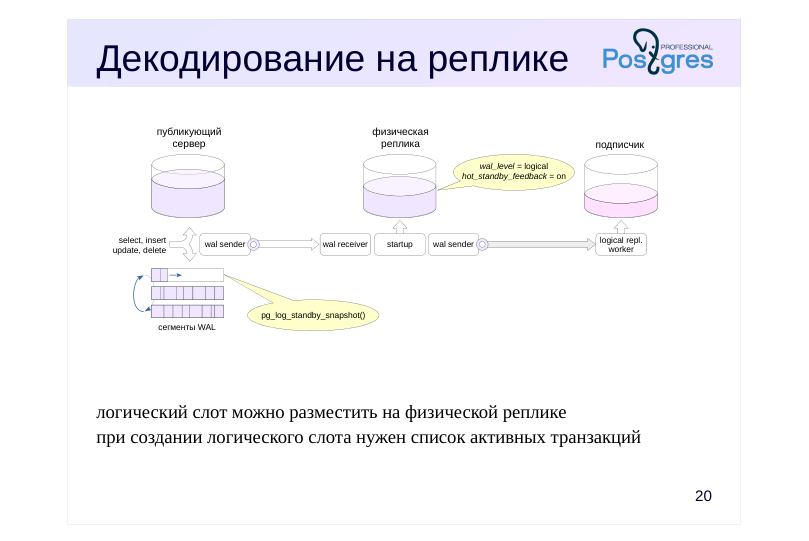
логический слот можно разместить на физической реплике при создании логического слота нужен список активных транзакций
Комментарии преподавателя
Начиная с PostgreSQL 16, слот логической публикации может размещаться на физической реплике, что позволяет снять часть нагрузки с мастера.
На реплике следует включить обратную связь параметром hot_standby_feedback, чтобы основной сервер не удалил нужные реплике версии строк раньше времени.
При создании слота логической репликации нужна информация о номерах активных транзакций. Эту информацию передают процессы bgwriter и checkpointer мастера в виде записи WAL, и если на мастере нет активности, создание слота задержится. Чтобы избежать ожидания, можно вызвать на мастере функцию pg_log_standby_snapshot.
https://postgrespro.ru/docs/postgresql/16/logicaldecoding-explanation
https://postgrespro.ru/docs/postgresql/16/functions-admin
Page 23: Итоги
Физическая репликация — базовый механизм для решения целого ряда задач
- обеспечение высокой доступности
- балансировка однотипной нагрузки
- разделение разных видов нагрузки
- и др.
- Логическая репликация расширяет возможности
Page 24: Практика
- Настройте физическую потоковую репликацию между серверами alpha и beta. 2. Настройте каскадную репликацию на сервер gamma с задержкой применения записей WAL в десять секунд. 3. Проверьте работу репликации, убедитесь в том, что на сервере gamma данные появляются с установленной задержкой. 4. Остановите alpha и перейдите на сервер beta. 5. Проверьте, что сервер gamma продолжает работать в режиме реплики.
Комментарии преподавателя
После завершения практических заданий удалите созданную базу данных и слот репликации, а также сбросьте настройки параметров конфигурации.
Page 25: 1. Настройка репликации между серверами alpha и beta
Сначала создадим базу данных.
Создаем слот и автономную резервную копию.
Файлы postgresql.auto.conf и standby.signal подготовлены утилитой pg_basebackup.
Запускаем реплику:
2. Настройка репликации между серверами beta и gamma
Создадим автономную резервную копию с сервера beta, чтобы показать возможность выполнения резервного копирования с реплики. Слот создается утилитой.
Файл postgresql.auto.conf подготовлен утилитой pg_basebackup, добавляем задержку воспроизведения:
Вот что получилось:
Page 26: Page 26
Запускаем сервер gamma.
3. Проверка работы
На alpha создадим таблицу и проверим, что она появилась сначала на beta, а через 10 секунд — и на gamma.
Проверяем gamma:
Таблицы пока нет. Подождем 10 секунд…
Таблица появилась.
4. Переход на сервер beta
Текущая линия времени на gamma:
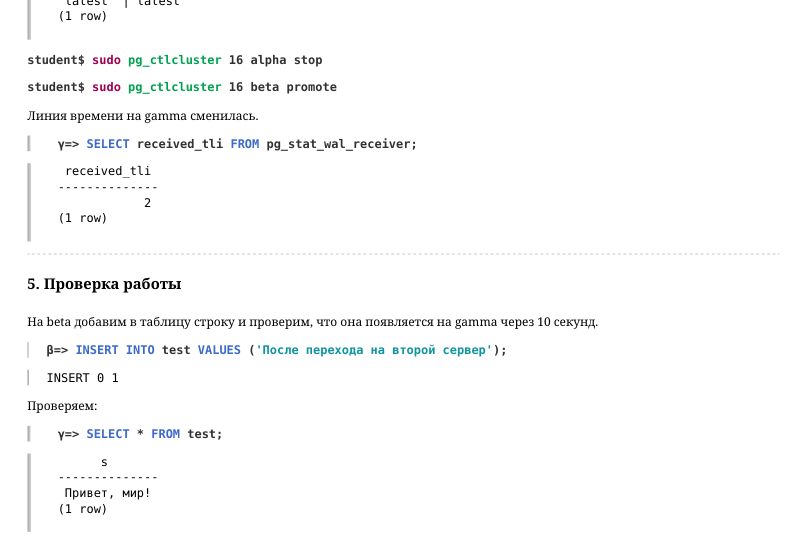
При повышении beta номер линии увеличится на единицу, процедура восстановления на gamma пойдет по новой линии благодаря значению по умолчанию:
Page 27: Page 27
 {#source-figure-027 caption=“Source slide page 27: Page 27”}
Линия времени на gamma сменилась.
5. Проверка работы
На beta добавим в таблицу строку и проверим, что она появляется на gamma через 10 секунд.
Проверяем:
Второй строки пока нет. Ждем 10 секунд…
Строка появилась.
Уборка
Удалим созданные базы данных и слоты репликации, сбросим настройки параметров конфигурации.
Page 28: Page 28
Page 29: Практика+
- Настройте физическую репликацию между серверами alpha и beta с обратной связью. При этом учтите необходимый уровень WAL для последующей настройки логической репликации. 2. Настройте логическую репликацию таблицы с сервера alpha на сервер gamma, поместив слот на beta — физическую реплику. Чтобы ускорить создание слота логической репликации на beta, воспользуйтесь функцией pg_log_standby_snapshot.
Комментарии преподавателя
- Перенесите структуру публикуемой таблицы на сервер gamma любым способом, например, используя pg_dump. Данные не переносите.
Публикация должна быть создана на alpha, подписка — на gamma, а в строке соединения подписки нужно указать сервер beta.
Верните конфигурацию системы к исходной: удалите созданную базу данных, слот репликации и сбросьте настройки параметров конфигурации.
Page 30: 1. Физическая репликация alpha → beta
Сразу включим обратную связь и установим уровень журнала, нужный для логической репликации:
Создадим базу данных и таблицу.
Создаем автономную резервную копию.
Проверим работу физической репликации.
2. Логическая репликация beta → gamma
Скопируем базу данных и структуру таблицы на сервер gamma с beta, используя pg_dump.
Page 31: Page 31
Мы скопировали лишь структуру таблицы, не данные. Создадим публикацию.
Подпишемся на публикуемые репликой (сервером beta) изменения в таблице test.
Подписка ждет создания слота на сервере beta. Чтобы сократить ожидание, попросим alpha добавить в WAL запись с номерами активных транзакций:
Page 32: Page 32
 {#source-figure-032 caption=“Source slide page 32: Page 32”}
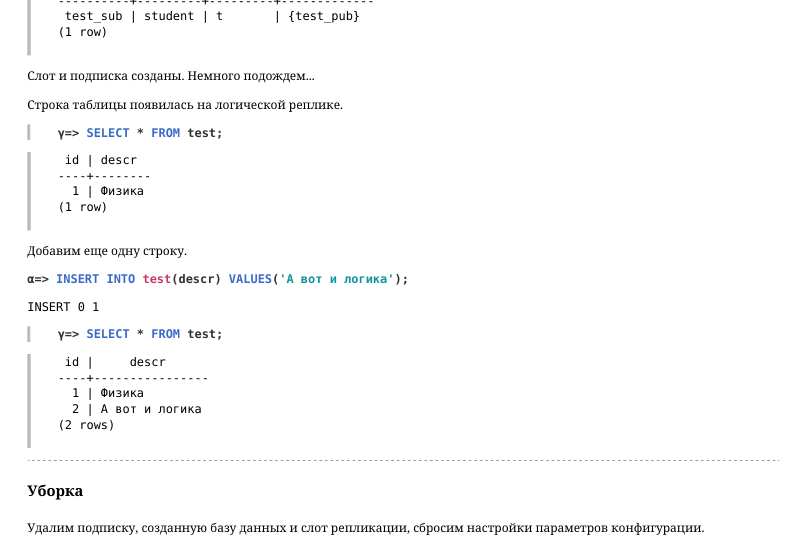
Слот и подписка созданы. Немного подождем… Строка таблицы появилась на логической реплике.
Добавим еще одну строку.
Уборка
Удалим подписку, созданную базу данных и слот репликации, сбросим настройки параметров конфигурации.