06 Занятие 06: Репликация / Логическая репликация
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba3_06_replica_logical.html Archive: DBA3-handouts-16.zip Страниц PDF: 43
Page 1: Репликация / Логическая репликация
Авторские права
© Postgres Professional, 2017–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Сравнение логической и физической репликации
- Публикации и подписки
- Начальная синхронизация
- Идентификация и фильтрация строк
- Логическое декодирование
- Большие транзакции
- Конфликты
- Источники репликации
Page 3: Сравнение
Физическая
- мастер-реплика: поток данных только в одну сторону
- передача потока журнальных записей или файлов журнала
- требуется двоичная совместимость серверов
- реплицируется только весь кластер
- Логическая
- публикация-подписки: у сервера нет выделенной роли
- передача изменений табличных строк
- требуется совместимость на уровне протокола
- возможна выборочная репликация отдельных таблиц
Комментарии преподавателя
При физической репликации серверы имеют назначенные роли: мастер и реплика. Мастер передает журнальные записи на реплику, которая применяет эти записи к своим файлам данных. Применение происходит чисто механически, без «понимания смысла» изменений, поэтому важна двоичная совместимость между серверами (одинаковые платформы и основные версии PostgreSQL). Поскольку журнал общий для всего кластера, то и реплицировать можно только кластер целиком.
При логической репликации на одном сервере создается публикация, другие серверы могут на нее подписаться. У сервера нет выделенной роли: один и тот же сервер может как публиковать изменения, так и подписываться на другие (или даже свои) публикации.
По умолчанию информация об изменениях строк в таблицах передается подписке в текстовом, независимом от платформы виде, в котором двоичная совместимость не требуется.
https://postgrespro.ru/docs/postgresql/16/logical-replication
Page 4: Схема репликации
 {#source-figure-004 caption=“Source slide page 4: Схема репликации”}
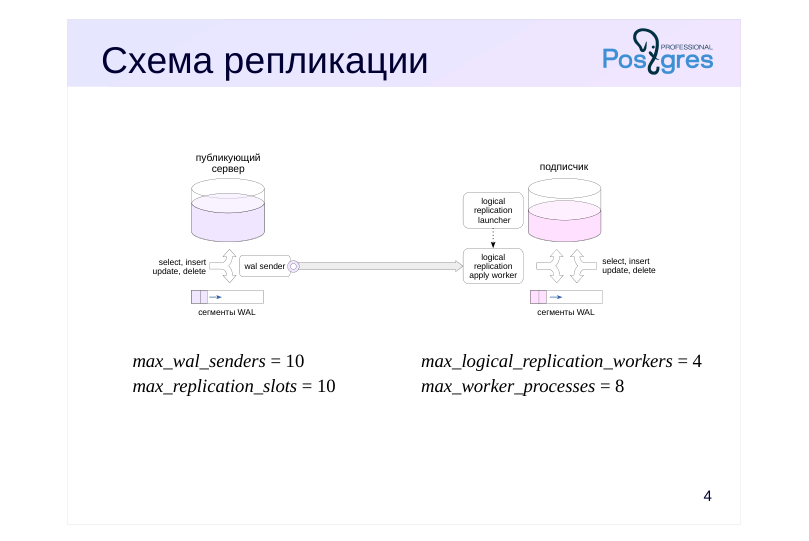
- max_wal_senders = 10
- max_logical_replication_workers = 4
- max_replication_slots = 10
- max_worker_processes = 8
Комментарии преподавателя
Логическая репликация использует модель «публикация–подписка».
При старте экземпляра запускается фоновый процесс logical replication launcher, периодически проверяющий таблицу pg_subscription системного каталога на предмет появления новой подписки. Как только подписка появляется, для нее запускается фоновый процесс logical replication apply worker. Он соединяется с сервером публикации, на котором, как при любом подключении по протоколу репликации, запускается процесс wal sender. Этот процесс читает журнал предзаписи, отбирает нужные и преобразует их в платформонезависимые сообщения протокола. При этом обязательно используется слот логической репликации.
На стороне подписки рабочий процесс принимает сообщения и применяет изменения. В это же время сервер-подписчик может принимать обычные запросы на чтение и запись.
Обратите внимание, что на публикующем сервере может быть запущено много процессов wal sender — по одному на каждую подписку. Значения параметров max_wal_senders и max_replication_slots должны быть не меньше этого количества.
На сервере подписки необходимо установить параметры max_logical_replication_workers (для процессов, принимающих изменения по подписке) и в целом max_worker_processes (как минимум на единицу больше, учитывая logical replication launcher, но этот пул используется и для других нужд).
https://postgrespro.ru/docs/postgresql/16/logical-replication-architecture
Page 5: Публикация
Объект базы данных
- выдает изменения данных построчно в порядке фиксации транзакций
- только базовые и секционированные таблицы
- wal_level = logical
- Публикуются операции
- insert, update, delete, truncate
- Права
- создать публикацию — привилегия CREATE на базу данных
- добавить таблицу — владелец или суперпользователь
- добавить все таблицы схемы или базы данных — суперпользователь
Комментарии преподавателя
На одном сервере создается публикация, выделяющая изменения в одной или нескольких таблицах (базовых или секционированных) одной базы данных. Чтобы создать публикацию, нужна привилегия CREATE на базу данных. Для репликации из нескольких баз данных потребуется создать несколько публикаций.
Включить в публикацию одну или несколько таблиц может их владелец или суперпользователь. Все таблицы схемы или базы данных может опубликовать только суперпользователь.
Для работы логической репликации в журнале публикующего сервера необходима дополнительная информация (параметр wal_level = logical).
Публикация включает в себя изменения строк, происходящие в таблицах в результате выполнения команд DML. Команда MERGE, выполненная на публикующем сервере, применяется как INSERT, UPDATE или DELETE.
По умолчанию изменения передаются не сразу, а только при фиксации транзакции.
https://postgrespro.ru/docs/postgresql/16/logical-replication-publication
https://postgrespro.ru/docs/postgresql/16/sql-createpublication
Page 6: Подписка
Объект базы данных
- получает сообщения от одной или нескольких публикаций
- возможна подписка в двоичном формате
- применяет изменения построчно
- таблицы и столбцы сопоставляются по полным именам
- Права
- создание подписки — роль pg_create_subscription и суперпользователи
Комментарии преподавателя
Определив в базе данных подписку на публикации, можно получать и применять изменения. По сути, подписка — это подключение к публикующему серверу, созданное для репликации данных.
Создавать подписки могут члены роли pg_create_subscription и суперпользователи.
Применение изменений всегда происходит построчно. Хотя каждое изменение не требует разбора и планирования запроса, массовые изменения из-за этого могут выполняться медленно.
Таблицы идентифицируются по полным именам (включая схему), столбцы также идентифицируются по именам. Это позволяет подписке использовать отличающуюся схему данных (например, иметь в таблице дополнительные столбцы).
При создании подписки можно указать параметр binary, устанавливающий передачу данных в двоичном формате. Двоичный формат может ускорить обработку если определены функции двоичного получения и отправки для требуемых типов данных. Однако при использовании двоичного формата важна совместимость машинного представления данных на разных платформах.
https://postgrespro.ru/docs/postgresql/16/logical-replication-subscription
Page 7: Публикации и подписки
 {#source-figure-007 caption=“Source slide page 7: Публикации и подписки”}
Комментарии преподавателя
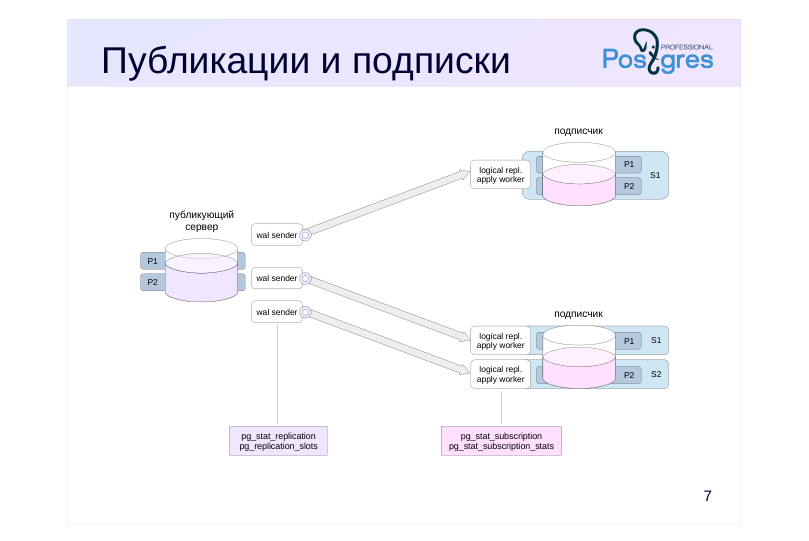
На публикующем сервере можно распределять объекты по публикациям любым образом. Можно включить все таблицы в одну публикацию, можно разделить их между несколькими публикациями — это не влияет на производительность.
Однако каждая подписка создает отдельное подключение к публикующему серверу, нагружая его лишней работой. На публикующем сервере в таком случае будет запущено несколько процессов wal sender, каждый из которых будет самостоятельно читать WAL и выполнять логическое декодирование (рассматривается ниже) в своей локальной памяти. Поэтому если необходимо подписаться на несколько публикаций, это лучше сделать в одной общей подписке.
Напомним, что публикации и подписки — объекты базы данных, поэтому для каждой базы потребуется отдельное соединение.
Мониторинг логической репликации на публикующем сервере идентичен мониторингу физической репликации. Здесь важнейшие инструменты — представления pg_stat_replication и pg_replication_slots.
Информация о состоянии подписок находится в pg_subscription.
https://postgrespro.ru/docs/postgresql/16/catalog-pg-subscription#CATALO G-PG-SUBSCRIPTION
Данные о применении изменений в представлении pg_stat_subscription.
https://postgrespro.ru/docs/postgresql/16/monitoring-stats#MONITORING-P G-STAT-SUBSCRIPTION
Данные об ошибках в процессе репликации в pg_stat_subscription_stats.
https://postgrespro.ru/docs/postgresql/16/monitoring-stats#MONITORING-P G-STAT-SUBSCRIPTION-STATS
Page 8: Логическая репликация
Мы собираемся настроить логическую репликацию таблицы test с сервера alpha на сервер beta. Для начала создадим базу данных.
Для работы логической репликации понадобится изменить уровень журнала.
Второй кластер изначально будет копией первого, поэтому выполним резервное копирование в каталог PGDATA второго сервера.
Теперь на первом сервере создадим таблицу и заполним ее данными.
На втором сервере таблицы test нет. Поскольку команды DDL не реплицируются, таблицу необходимо создать вручную. Структура ее может отличаться, но таблица должна содержать все публикуемые столбцы.
На первом сервере создаем публикацию.
Заметьте, что публикация создана, хотя в ней нет ни одной таблицы. Обычно публикацию создают, указав: список таблиц, причем в этом случае можно указать публикуемые столбцы; все таблицы в заданных схемах (требует прав суперпользователя);
Page 9: Page 9
все таблицы базы данных (требует прав суперпользователя). Добавим в публикацию таблицу.
На втором сервере подписываемся на публикацию.
Проверим созданную подписку.
Значения столбцов id, descr и cluster_name были получены из публикации. Начиная с PostgreSQL 15, можно публиковать не все, а только некоторые столбцы:
Проверим:
Обратите внимание на столбец cluster_name — теперь он получил значение по умолчанию (beta) на подписчике.
Page 10: Page 10
Состояние подписки можно посмотреть в представлении:
received_lsn — позиция в журнале, до которой получены изменения; latest_end_lsn — позиция в журнале, подтвержденная процессу wal sender. К процессам сервера добавился logical replication worker (его номер указан в pg_stat_subscription.pid):
Page 11: Ограничения
Не реплицируются
- последовательности материализованные представления временные и нежурналируемые таблицы внешние таблицы большие объекты DDL Требование к TRUNCATE
- таблицы, связанные внешними ключами, должны быть в одной
- подписке
Комментарии преподавателя
Реплицируются только изменения содержимого базовых и секционированных таблиц, вызванные командами DML.
Не реплицируются содержимое остальных объектов, объединяемых термином «отношение»: последовательностей, материализованных представлений, временных и нежурналируемых таблиц, внешних таблиц. Не реплицируются большие объекты.
Команды DDL также не реплицируются, поэтому нужно предварительно создать таблицы на стороне подписки.
Команда TRUNCATE реплицируется успешно только в случае, если все таблицы подписчика, внешние ключи которых ссылаются на опустошаемые таблицы, включены в подписку.
https://postgrespro.ru/docs/postgresql/16/logical-replication-restrictions
Page 12: Начальная синхронизация
 {#source-figure-012 caption=“Source slide page 12: Начальная синхронизация”}
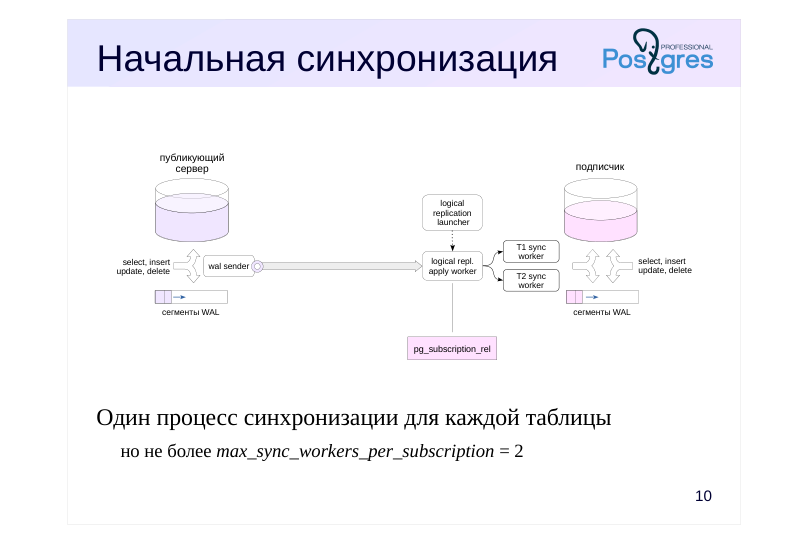
Один процесс синхронизации для каждой таблицы
- но не более max_sync_workers_per_subscription = 2
Комментарии преподавателя
По умолчанию (если не задано значение параметра copy_data = false) при создании подписки выполняется начальная синхронизация содержимого таблиц. Она происходит бесшовно благодаря использованию механизма экспорта снимка данных.
Начальную синхронизацию желательно завершить как можно скорее, чтобы не удерживать открытым снимком горизонт очистки дольше необходимого. Поэтому синхронизация распараллеливается: процесс apply worker просматривает список реплицируемых таблиц и запускает дополнительные рабочие процессы, которые и выполняют синхронизацию. Синхронизация одной таблицы всегда выполняется одним процессом.
Максимальное количество параллельных процессов синхронизации ограничено параметром max_sync_workers_per_subscription (по умолчанию — два процесса).
Состояние репликации для каждой таблицы в подписке показывает представление pg_subscription_rel.
https://postgrespro.ru/docs/postgresql/16/catalog-pg-subscription-rel#CATAL OG-PG-SUBSCRIPTION-REL
Если для подписки указать параметр binary, то в двоичном формате будет выполняться не только репликация, но и начальная синхронизация.
Page 13: Начальная синхронизация
По умолчанию подписчик сначала получает содержимое таблиц, и только после этого запускается процесс репликации. Это выполняется бесшовно с гарантией того, что никакие изменения не будут потеряны. Создадим три таблицы с большим количеством строк и публикацию:
На подписчике создадим пустые таблицы той же структуры:
Подпишемся на публикацию и сразу же заглянем в системную таблицу, показывающую состояние репликации каждой таблицы, и в список процессов.
Здесь мы видим, что таблица test реплицируется (r), а три новые таблицы пока еще синхронизируются (i).
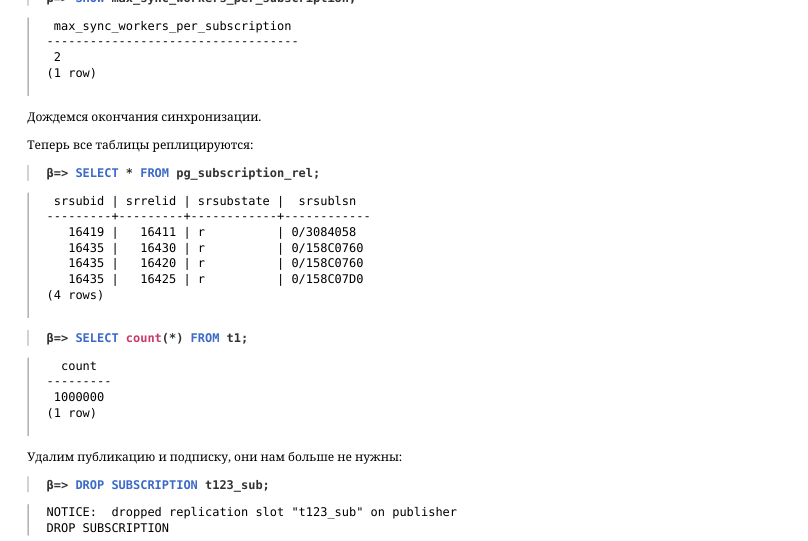
Добавился процесс apply worker для новой подписки и два процесса синхронизации. Таблиц три, но количество
Page 14: Page 14
 {#source-figure-014 caption=“Source slide page 14: Page 14”}
одновременно работающих процессов ограничено параметром:
Дождемся окончания синхронизации. Теперь все таблицы реплицируются:
Удалим публикацию и подписку, они нам больше не нужны:
Page 15: Идентификация строк
Для операций изменения и удаления необходимо выбрать подходящую строку
- Логический идентификатор строк
- DEFAULT
- столбцы первичного ключа (по умолчанию)
- FULL
- все столбцы
- NOTHING
- без идентификации
- (по умолчанию для системного каталога)
Комментарии преподавателя
Вставка новых строк на стороне подписки происходит однозначно. Сложнее при изменениях и удалениях — в этих случаях надо определить, к какой строке на подписчике применять операцию. Поэтому для каждой таблицы определяется логический идентификатор строк. По умолчанию строки идентифицируются столбцами первичного ключа, но идентификатор можно изменить командой ALTER TABLE … REPLICA IDENTITY.
Строки можно идентифицировать по другому уникальному индексу, в котором все столбцы имеют ограничение NOT NULL.
Еще один вариант — идентификация по всем столбцам. Начиная с версии 16, для поиска строк в этом случае может использоваться полный индекс на основе B-дерева, первое поле которого должно быть столбцом из публикации. Версии 17+ могут использовать и хеш-индексы. Если подходящего индекса нет, выполняется полное сканирование, что крайне неэффективно для больших таблиц.
Можно вообще отказаться от поддержки репликации для некоторых таблиц (по умолчанию так настроены таблицы системного каталога).
При изменении или удалении в WAL уровня replica не попадают значения столбцов удаляемой версии строки — это одна из причин, по которой на публикующем сервере необходим уровень журнала logical. На этом уровне в журнал дополнительно записываются старые значения столбцов, входящих в логический идентификатор. По этой причине при идентификации по всем столбцам объем журнала может существенно увеличиться по сравнению с уровнем replica.
https://postgrespro.ru/docs/postgresql/16/sql-altertable#SQL-ALTERTABLE-REPLICA-IDENTITY
Page 16: Фильтрация строк
Фильтр в публикации
- Возможна фильтрация
- insert
- по любым публикуемым столбцам
- delete
- по столбцам логического идентификатора
- update
- по столбцам логического идентификатора;
- в результате может получиться insert или delete
- truncate
- фильтр игнорируется
- Только простые выражения
Комментарии преподавателя
По умолчанию публикующий сервер отправляет все строки опубликованных таблиц.
В PostgreSQL 15 появилась возможность указать выражение фильтра; строки, для которых выражение имеет значение false или NULL, опубликованы не будут.
Фильтрация не распространяется на операцию truncate. Для операций insert в выражение фильтра можно включать любые публикуемые столбцы, а для update и delete — только столбцы, входящие в логический идентификатор строк.
Для операции update выражение фильтра вычисляется и для старой, и для новой версий строки. Если для обеих версий выражение фильтра дает false или NULL, строка не реплицируется. Если старая строка не соответствует фильтру, а новая — соответствует, то выполняется вставка новой строки. Если, наоборот, старая версия соответствует, а новая — нет, строка удаляется. Если обе соответствуют условию фильтра, выполняется обновление.
Фильтровать можно лишь с помощью простых выражений: запрещены пользовательские функции, операторы, типы и правила сортировки; нельзя ссылаться на системные столбцы; нельзя обращаться ко встроенным функциям с категориями изменчивости volatile и stable.
https://postgrespro.ru/docs/postgresql/16/logical-replication-row-filter.html
Page 17: Идентификация и фильтрация
По умолчанию логический идентификатор строк определяется столбцами первичного ключа:
d — по умолчанию (первичный ключ, если есть); i — индекс; f — все столбцы; n — никакие. Допустим, нужно реплицировать только те строки, у которых в поле cluster_name находится значение alpha. Столбец cluster_name участвует в выражении фильтра, поэтому его нужно опубликовать (сейчас он не опубликован). Публикуем все столбцы, не указывая их список.
Проверим, как работает репликация изменений.
Строка со значением gamma не реплицировалась. Попробуем изменить строку.
Для update и delete в выражении фильтра допускаются только столбцы, входящие в логический идентификатор строк, а для insert — любые столбцы.
Page 18: Page 18
Изменим условие фильтрации.
Теперь мы можем изменить строку:
Строка изменилась и на подписчике. Новое условие фильтрации работает:
Строка с id = 0 не была опубликована и поэтому не реплицировалась.
Page 19: Логическое декодирование
 {#source-figure-019 caption=“Source slide page 19: Логическое декодирование”}
Комментарии преподавателя
При потоковой физической репликации процесс wal sender читает записи WAL и передает их реплике в неизменном виде.
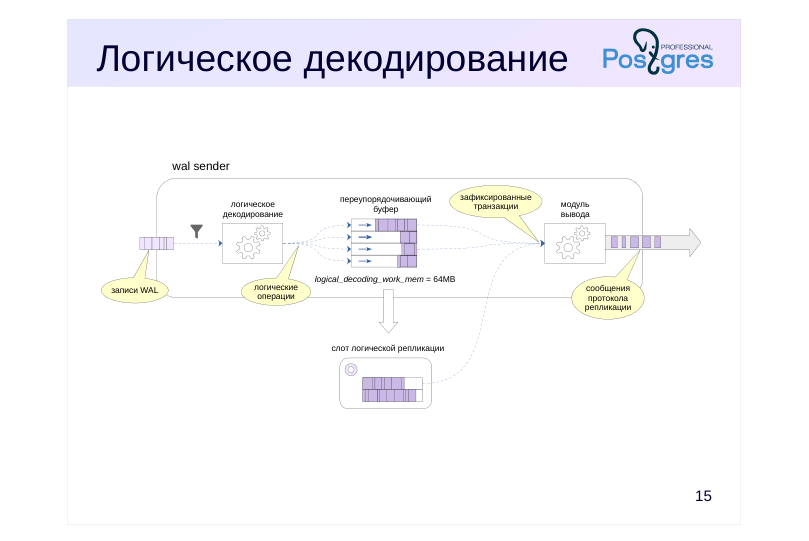
При логической репликации записи преобразуются. Модуль логического декодирования отбирает из них те, которые соответствуют публикуемым операциям и таблицам, учитывая столбцы и условия фильтров. Отобранные записи преобразуется в информацию о логических операциях, направляются в переупорядочивающий буфер и сохраняются в нем в соответствии с номерами транзакций.
В журнал на уровне logical дополнительно записывается информация, необходимая для логического декодирования, в частности:
● для update — новые значения всех столбцов, а не только измененных;
● для update и delete — старые значения столбцов, входящих в логический идентификатор;
● для commit — OID базы данных.
Переупорядочивающий буфер находится в локальной памяти процесса wal sender. Если объем данных в нем приблизится к значению параметра logical_decoding_work_mem, самая большая транзакция сбрасывается в слот репликации (файл в PGDATA/pg_replslots/имя).
При фиксации транзакции все ее операции направляются в модуль вывода, который преобразует их в сообщения протокола репликации.
https://postgrespro.ru/docs/postgresql/16/logicaldecoding
https://postgrespro.ru/docs/postgresql/16/runtime-config-resource#GUC-LO GICAL-DECODING-WORK-MEM
Page 20: Слот и логическое декодирование
Очистим содержимое таблицы и посмотрим, как работает логическое декодирование.
Создадим вручную слот логической репликации. Для передачи изменений подписчику используется модуль вывода pgoutput, а для наблюдения удобнее модуль вывода test_decoding:
Теперь на сервере alpha два слота:
В отдельном сеансе начнем транзакцию и вставим строку в таблицу:
Модуль вывода может запросить у слота изменения:
Транзакция не завершена, модуль вывода пока ничего не получил. Сделаем еще несколько изменений и завершим транзакцию.
Page 21: Page 21
 {#source-figure-021 caption=“Source slide page 21: Page 21”}
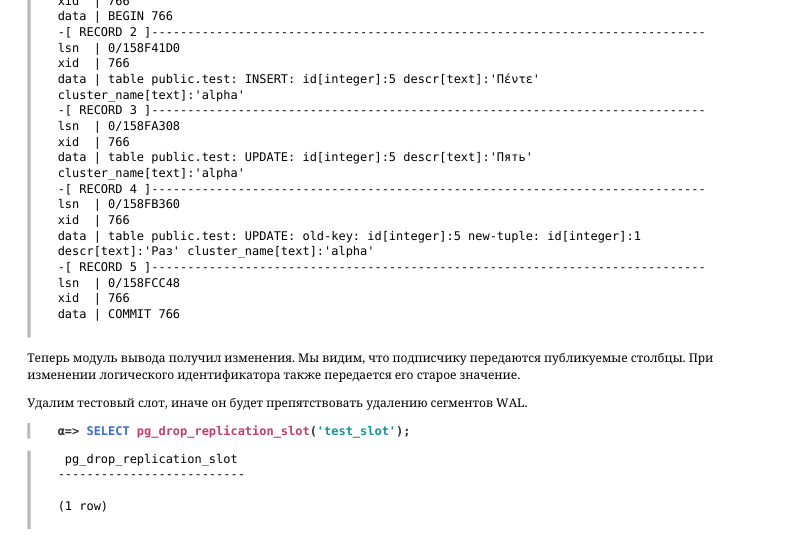
Теперь модуль вывода получил изменения. Мы видим, что подписчику передаются публикуемые столбцы. При изменении логического идентификатора также передается его старое значение. Удалим тестовый слот, иначе он будет препятствовать удалению сегментов WAL.
Page 22: Большие транзакции
 {#source-figure-022 caption=“Source slide page 22: Большие транзакции”}
Комментарии преподавателя
По умолчанию (параметр подписки streaming = off) изменения накапливаются в переупорядочивающем буфере и отправляются подписчику после фиксации транзакции.
Если транзакция изменяет много данных, могут возникать проблемы:
● расход памяти wal sender на переупорядочивающий буфер;
● запись файлов при превышении памяти, выделенной под переупорядочивающий буфер (logical_decoding_work_mem);
● отставание реплики. Если задать streaming = on, публикующий сервер будет передавать изменяемые данные подписчику во время работы транзакции. Когда общий объем изменений превышает значение параметра logical_decoding_work_mem, накопленные изменения самой большой по объему транзакции не сбрасываются в файл, а сразу передаются в модуль вывода. При этом подписчик сохраняет такие изменения в своих временных файлах и применяет при фиксации транзакции.
Начиная с PostgreSQL 16, если задано streaming = parallel и есть доступные рабочие процессы, изменения на подписчике не сохраняются, а сразу же применяются дополнительными процессами. Число таких процессов для одной подписки ограничено параметром max_parallel_apply_workers_per_subscription.
https://postgrespro.ru/docs/postgresql/16/sql-createsubscription#SQL-CREA TESUBSCRIPTION-WITH-STREAMING
https://postgrespro.ru/docs/postgresql/16/runtime-config-replication#GUC-M AX-PARALLEL-APPLY-WORKERS-PER-SUBSCRIPTION
Page 23: Конфликты
Приводят к ошибке
- нарушение ограничений целостности,
- недостаточные права на целевую таблицу или политика защиты строк
- репликация выдает ошибку,
- подписка с параметром disable_on_error отключается
- можно вручную исправить данные на стороне подписки
- или пропустить конфликтующую транзакцию
- Игнорируются
- обновляемая или удаляемая строка отсутствует на подписчике
- репликация продолжается, но согласованность может быть нарушена
Комментарии преподавателя
Поскольку таблицы на публикующем сервере и на подписчике могут изменяться независимо друг от друга, при выполнении операции, поступившей от подписки, возможен конфликт с существующими данными.
Часто конфликтом называют ситуацию, когда операция не может быть выполнена, обычно из-за нарушения ограничения целостности, или отсутствия прав у владельца подписки на целевую таблицу, или ограничений на уровне строк (RLS, row level security).
В этом случае применение операции завершается ошибкой. Подписчик периодически повторяет попытки, но до разрешения конфликта они будут неудачными. Конфликты можно разрешать только вручную, автоматическое разрешение пока не реализовано. Есть два варианта: исправить данные на подписчике или пропустить конфликтующую транзакцию. Во втором случае нужно отключить репликацию, вызвать функцию pg_replication_origin_advance или выполнить команду ALTER SUBSCRIPTION … SKIP …, и снова включить репликацию. Можно также заранее настроить автоматическое отключение репликации, указав параметр подписки disable_on_error.
Если строка, которую необходимо изменить или удалить, отсутствует на подписчике, операция не будет выполнена. В этом случае ошибка не возникает, но такие игнорируемые конфликты говорят о том, что согласованность данных между публикующим сервером и подписчиком нарушена.
https://postgrespro.ru/docs/postgresql/16/logical-replication-conflicts
Page 24: Конфликты
 {#source-figure-024 caption=“Source slide page 24: Конфликты”}
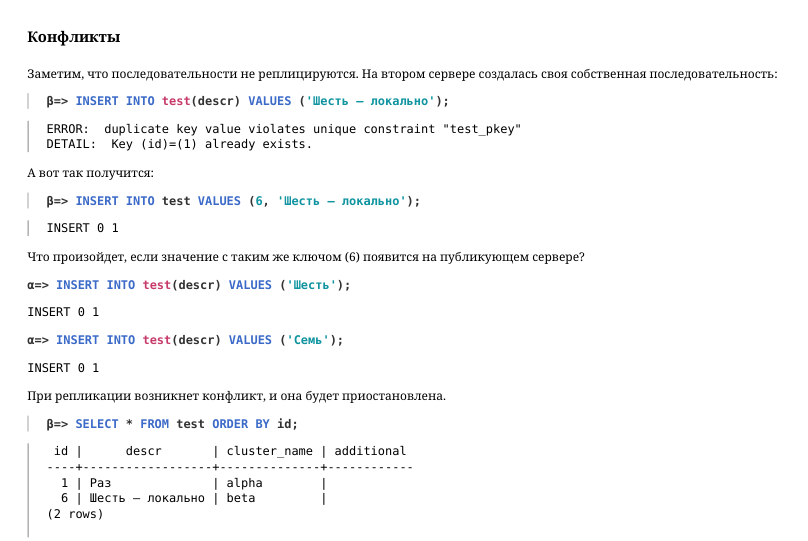
Заметим, что последовательности не реплицируются. На втором сервере создалась своя собственная последовательность:
А вот так получится:
Что произойдет, если значение с таким же ключом (6) появится на публикующем сервере?
При репликации возникнет конфликт, и она будет приостановлена.
Фактически, процесс logical replication apply worker будет периодически перезапускаться, проверяя, не устранен ли конфликт. Поэтому информация в pg_stat_subscription пропадает:
В журнал сообщений будут попадать записи о нарушении ограничений целостности:
А в таблице pg_stat_subscription_stats при каждой очередной попытке выполнить операцию будет расти счетчик ошибок:
(В PostgreSQL 18 в эту таблицу добавлены отдельные счетчики для каждого типа конфликта.) Чтобы разрешить конфликт, удалим конфликтующую строку из таблицы и немного подождем:
Page 25: Page 25
Проверим:
Данные появились, репликация восстановлена.
Пропуск конфликтующей транзакции
Можно разрешить конфликт по-другому: пропустить транзакцию, приводящую к конфликту. Конфликтующая транзакция:
Перед пропуском транзакции подписка должна быть отключена:
Вместо отключения вручную можно было установить параметр подписки disable_on_error. Подписка остановлена:
Посмотрим в журнал сообщений:
Сообщение в журнале содержит LSN записи о фиксации конфликтующей транзакции. Транзакцию можно пропустить командой:
Вместо предыдущей команды суперпользователь мог бы использовать функцию pg_replication_origin_advance. Включим репликацию.
Page 26: Page 26
Репликация работает, но так как мы пропустили транзакцию, данные рассогласованы:
Опустошим таблицу:
Триггеры на подписчике
На подписчике могут выполняться триггеры; по умолчанию триггер будет срабатывать при локальных изменениях, но не при репликации. Это удобно, если на обоих серверах созданы одинаковые таблицы с одинаковым набором триггеров: в таком случае триггер уже отработал на публикующем сервере, его не надо выполнять на подписчике. Попробуем.
Триггер не сработал. Можно изменить таблицу, чтобы триггер срабатывал только при репликации:
Page 27: Page 27
 {#source-figure-027 caption=“Source slide page 27: Page 27”}
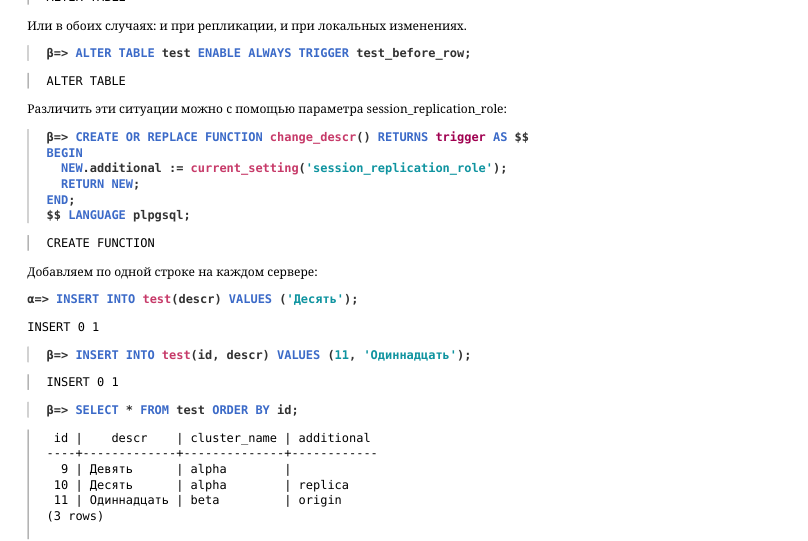
Или в обоих случаях: и при репликации, и при локальных изменениях.
Различить эти ситуации можно с помощью параметра session_replication_role:
Добавляем по одной строке на каждом сервере:
Триггер сработал в обоих случаях.
Page 28: Источник репликации
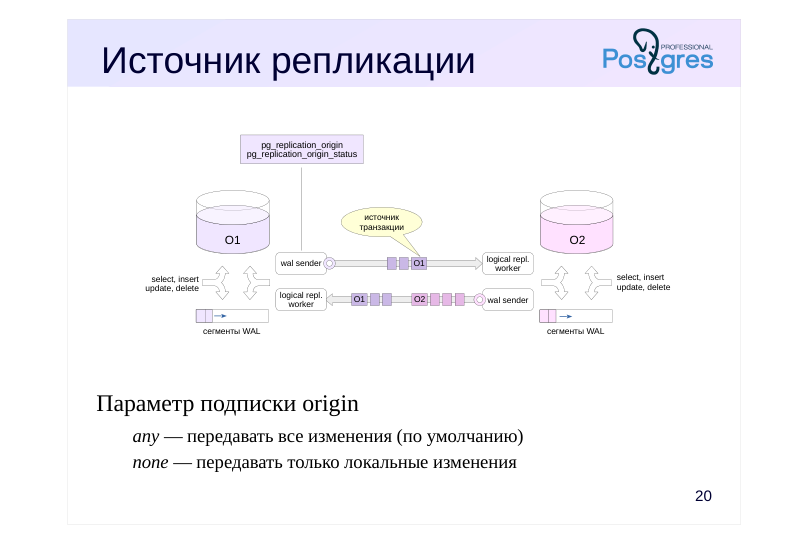 {#source-figure-028 caption=“Source slide page 28: Источник репликации”}
Параметр подписки origin
- any — передавать все изменения (по умолчанию)
- none — передавать только локальные изменения
Комментарии преподавателя
Если определить на одном сервере и публикацию, и подписку, и передавать все изменения, то реплицированные изменения будут реплицироваться и возникнет «снежный ком».
Начиная с PostgreSQL 16, публикующий сервер в начале транзакции, которая была получена с другого узла, передает по протоколу сообщение об источнике этой транзакции. Это также важно при каскадной репликации.
https://postgrespro.ru/docs/postgresql/16/protocol-logical-replication#PROT OCOL-LOGICAL-MESSAGES-FLOW
По умолчанию подписка имеет параметр origin = any и публикация передает ей все транзакции: и локальные, и полученные с другого узла.
В топологиях, где могут появиться циклы, например, при двунаправленной репликации, следует устанавливать origin = none. Тогда публикация будет передавать только локальные изменения.
https://postgrespro.ru/docs/postgresql/16/sql-createsubscription#SQL-CREA TESUBSCRIPTION-WITH-ORIGIN
Информацию об источниках можно увидеть в pg_replication_origin.
https://postgrespro.ru/docs/postgresql/16/catalog-pg-replication-origin#CATA LOG-PG-REPLICATION-ORIGIN
Текущая позиция воспроизведения для конкретного источника репликации выводится в представлении pg_replication_origin_status.
https://postgrespro.ru/docs/postgresql/16/view-pg-replication-origin-status#V IEW-PG-REPLICATION-ORIGIN-STATUS
Page 29: Источник репликации
Удалим строки таблицы:
Опубликуем несколько столбцов таблицы test на сервере beta.
Теперь публикации есть на обоих серверах. Если сейчас на alpha создать подписку, она будет принимать от beta все изменения, в том числе и те, которые были отправлены публикацией сервера alpha. Применить такие изменения alpha не сможет из-за нарушения ограничения целостности, репликация остановится. Чтобы beta получала только изменения, сделанные локально на alpha, зададим параметр подписки origin:
Для тех изменений, которые произошли в результате репликации, источник будет непуст, и публикация не отправит их подписке. Пусть и alpha станет подписчиком beta. Начальную синхронизацию отключим, поскольку таблица пуста. Также используем параметр подписки origin, чтобы получать только изменения, сделанные на beta:
Подписки теперь есть на обоих серверах.
Вставим строку на сервере alpha.
Проверяем на beta.
Вставляем строку на сервере beta.
Проверяем на alpha.
Page 30: Page 30
Проверим изменение данных.
Если репликация больше не нужна, надо удалить подписки — иначе на публикующем сервере останутся открытыми репликационные слоты.
Page 31: Итоги
Логическая репликация использует модель «публикация—подписка»
- Передаются изменения табличных строк
- Строки сопоставляются по логическим идентификаторам
- Несовпадение данных на серверах может приводить к конфликтам
- Передача информации об источнике позволяет отслеживать ход каскадной репликации и исключить зацикливание
Page 32: Практика
- Создайте две базы данных на одном сервере.
- В первой базе данных создайте таблицу с первичным ключом и добавьте в нее несколько строк. Настройте логическую репликацию таблицы из первой базы во вторую, проверьте работу репликации и удалите подписку. 2. Настройте логическую репликацию таблицы с сервера alpha на сервер beta. Выполните транзакцию, изменяющую значительный объем данных; перед ее фиксацией убедитесь, что данные помещены на диск. Повторите то же самое, но в потоковом режиме. Сохранялись ли данные на диске?
Комментарии преподавателя
- Воспользуйтесь утилитой pg_dump с ключом –schema-only.
Если попробовать выполнить это обычным образом, команда создания подписки «повиснет» из-за того, что она должна дождаться завершения активных транзакций на публикующем сервере, то есть и самой себя в том числе. В таком случае необходимо заранее создать слот логической репликации, как описано в документации: https://postgrespro.ru/docs/postgresql/16/sql-createsubscription
- Чтобы публикация не попала в логическую копию, используйте ключ –no-publications.
Проверьте значение параметра logical_decoding_work_mem, определяющего максимальный размер переупорядочивающего буфера. При превышении этого значения данные будут вытесняться на диск.
Page 33: 1. Логическая репликация на одном сервере
Сначала установим уровень журнала logical.
Базы данных:
Таблица в первой базе:
Воспользоваться логической резервной копией для переноса схемы особенно удобно, когда таблиц много.
Переносить данные с помощью pg_dump не имеет смысла, поскольку в процессе переноса таблицы могут измениться.
Публикация:
Page 34: Page 34
Поскольку репликация будет настроена на одном и том же сервере, вначале вручную создаем слот логической репликации.
И затем создаем подписку:
Проверим работу репликации:
Удалим подписку и слот.
2. Логическая репликация с сервера alpha на сервер beta
Запустим сервер beta и скопируем команды DDL для таблицы test. Команды создания публикации на подписчике не нужны.
Page 35: Page 35
Создадим подписку на сервере beta, слот на alpha создается автоматически.
Репликация работает. Опустошим таблицу test на сервере публикации (alpha):
Подписчик получил изменение. Начнем транзакцию, в которой вставим в таблицу значительное число строк.
Параметр logical_decoding_work_mem определяет максимальный размер переупорядочивающего буфера.
При превышении этого ограничения данные помещаются на диск в каталог PGDATA/pg_replslot/имя-слота. Сколько места на диске занимает каталог?
Page 36: Page 36
По умолчанию, пока транзакция не зафиксирована, никакие данные подписке не передаются.
Зафиксируем транзакцию…
…и немного подождем: Подписчик получил все строки:
А сохраненные на диске данные удалены:
Заглянем в представление pg_stat_replication_slots:
spill_txns — количество вытесненных на диск транзакций; spill_count — сколько раз данные вытеснялись на диск из-за превышения logical_decoding_work_mem; spill_bytes — сколько байт было вытеснено на диск. Повторим эксперимент в потоковом режиме. Сбросим статистику и снова опустошим таблицу.
Теперь зададим для подписки потоковый режим:
И снова запустим большую транзакцию.
Page 37: Page 37
Теперь данных в каталоге слота гораздо меньше, часть их уже отправлена подписчику:
Зафиксируем транзакцию…
…и немного подождем:
Заглянем в представление pg_stat_replication_slots:
На этот раз при исчерпании выделенной оперативной памяти данные на диск не вытеснялись, а отправлялись подписчику.
Уборка
Удалим подписку, слот и базы данных, сбросим параметры конфигурации.
Page 38: Page 38
Page 39: Практика+
- Создайте и опубликуйте на сервере alpha таблицу со столбцом типа bytea. Вставьте в таблицу несколько миллионов строк. Сравните время начальной синхронизации для подписки в обычном и двоичном режимах, используя для этого сервер beta. 2. Включите для подписки параллельную синхронизацию. Добавляя в таблицу строки, изучите процессы, обслуживающие подписку.
Комментарии преподавателя
- Оценить время начальной синхронизации можно с помощью мониторинга таблицы pg_subscription_rel. Его можно организовать на стороне клиента с помощью метакоманды \watch или на стороне сервера с помощью функции, написанной, например, на PL/pgSQL.
https://postgrespro.ru/docs/postgresql/16/catalog-pg-subscription-rel#CATAL OG-PG-SUBSCRIPTION-REL
https://postgrespro.ru/docs/postgresql/16/plpgsql
- Задайте подходящее значение параметра подписки streaming. Для мониторинга процессов подписки используйте представление pg_stat_subscription.
Page 40: 1. Начальная синхронизация данных при логической репликации
Создадим базу данных.
Изменим уровень журнала WAL и перезапустим сервер.
Создадим таблицу с большим количеством строк.
Запустим сервер beta и скопируем на него базу со структурой таблиц, но без данных.
Создадим публикацию на сервере alpha.
Page 41: Page 41
 {#source-figure-041 caption=“Source slide page 41: Page 41”}
Подписка на beta исходно будет неактивна.
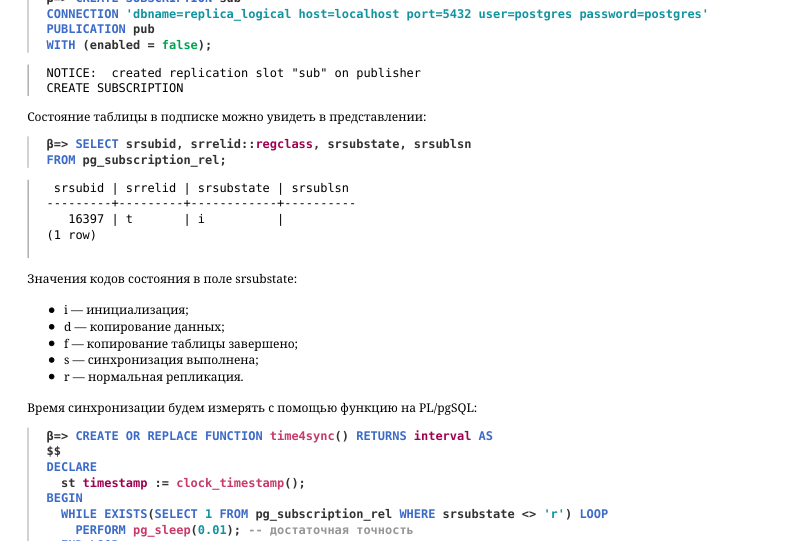
Состояние таблицы в подписке можно увидеть в представлении:
Значения кодов состояния в поле srsubstate: i — инициализация; d — копирование данных; f — копирование таблицы завершено; s — синхронизация выполнена; r — нормальная репликация. Время синхронизации будем измерять с помощью функцию на PL/pgSQL:
Активируем подписку и измерим время начальной синхронизации.
Теперь настроим синхронизацию в двоичном режиме. Удалим подписку, опустошим таблицу и создадим новую подписку, указав параметр binary.
Включаем подписку и измеряем время синхронизации.
Page 42: Page 42
Видим, что начальная синхронизация заметно ускорилась. Параметр binary действует и на последующую синхронизацию. Однако двоичный режим возможен не для всех типов данных; нужно также учитывать переносимость между разными архитектурами и основными версиями PostgreSQL. Двоичный режим реализован в версии 14, а в версиях до 16 начальная синхронизация всегда выполняется в текстовом режиме.
2. Параллельное применение изменений
Зададим для подписки параллельный режим.
Процессы, обслуживающие подписку:
Опустошим таблицу, вставим в нее большое число строк и повторим запрос к представлениям системного каталога:
Появился дополнительный процесс, который применяет изменения, не дожидаясь окончания транзакции на сервере публикации.
Вставка строк окончена. Подождем еще немного…
Теперь подписчик получил все строки.
Уборка
Page 43: Page 43
Удалим подписку.
Удалим базы данных.
Сбросим изменения в конфигурации.
Перезагрузим сервер alpha.
Остановим сервер beta.