05 Занятие 05: Репликация / Переключение на реплику
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba3_05_replica_switchover.html Archive: DBA3-handouts-16.zip Страниц PDF: 34
Page 1: Репликация / Переключение на реплику
Авторские права
© Postgres Professional, 2017–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Переключение на реплику
- Возвращение в строй бывшего мастера
- Особенности, связанные с файловым архивом
Page 3: Переключение на реплику
Причины
- плановое переключение (switchover):
- останов основного сервера для проведения технических работ
- аварийное переключение (failover):
- переход на реплику из-за сбоя основного сервера
- Процедура
- убедиться, что мастер остановлен
- $ pg_ctl promote или
- pg_promote()
- автоматическое переключение: отсутствует
- (для автоматизации требуется стороннее кластерное ПО)
Комментарии преподавателя
Причиной перехода на резервный сервер может быть необходимость проведения технических работ на основном сервере — тогда переход выполняется в удобное время в штатном режиме (switchover). А в случае сбоя переходить на резервный сервер нужно как можно быстрее, чтобы сократить время простоя системы (failover).
Чтобы переключить реплику в режим самостоятельного сервера, ей посылают команду, вызывая либо pg_ctl promote из операционной системы, либо функцию pg_promote из SQL. Переключение с помощью триггерного файла (параметр promote_trigger_file) начиная с 16-й версии не поддерживается.
Перед этим важно убедиться, что мастер остановлен. Если он продолжает работу и к нему еще подключены клиенты, данные на разных серверах могут «разойтись», и свести их потом воедино — нетривиальная и неавтоматизируемая задача. Скорее всего, часть данных придется просто потерять.
Для перехода на резервный сервер необходимо переключить на него клиентов. Автоматизация такого переключения требует стороннего кластерного программного обеспечения (это обсуждается в модуле «Кластерные технологии»), так как в PostgreSQL собственных средств для этого нет.
https://postgrespro.ru/docs/postgresql/16/warm-standby-failover
Page 4: Повышение реплики
Применяет журнальные записи
- уже полученные wal receiver, но еще не примененные startup
- Завершает процессы
- wal receiver
- startup
- Запускает процессы
- wal writer
- autovacuum launcher
- archiver (зависит от настройки)
- Переходит на новую линию времени
Комментарии преподавателя
Получив сигнал, реплика повышается: завершает восстановление и переходит в режим обычного сервера.
Для этого процесс startup применяет журнальные записи, которые уже были получены процессом wal receiver, но еще не применены. На этом wal receiver и startup завершают свою работу — на основном сервере они не нужны.
А вот процессы wal writer и autovacuum launcher, наоборот, запускаются. Может запускаться и процесс archiver.
Выйдя из режима восстановления, сервер переходит на новую линию времени.
С точностью до некоторых деталей, все происходит так же, как при окончании восстановления из резервной копии.
Page 5: Настройка потоковой репликации
В этой демонстрации мы будем выполнять контрольные точки вручную, а интервал расписания увеличим.
Подключим расширение pg_walinspect. Оно потребуется для исследования записей о контрольных точках в WAL. Нужны права суперпользователя.
Мы будем использовать автономную резервную копию несколько раз, поэтому создаем ее в формате tar.
Выкладываем копию в каталог PGDATA сервера beta:
Нам потребуется файл standby.signal.
Настроим подключение к мастеру.
Создадим на сервере alpha слот репликации и запустим реплику beta.
Проверим реплику:
Page 6: Page 6
Останов мастера и контрольная точка
Добавим в таблицу еще одну строку и корректно остановим мастер. При этом выполнится контрольная точка.
Информация о контрольной точке записалась в управляющий файл:
Получила ли реплика эту запись о контрольной точке? Исследуем WAL на реплике, начиная с LSN записи о контрольной точке.
В поле record_length показана длина записи в байтах. Последняя позиция, полученная репликой, больше LSN записи о контрольной точке:
Разница немного превышает длину записи (114) из-за выравнивания записей WAL: на 64-разрядной платформе LSN записей кратны восьми байтам.
Повышение реплики
Сейчас сервер beta является репликой (находится в режиме восстановления):
Повышаем реплику. Можно использовать функцию pg_promote(), которая выполняет то же действие.
Есть еще один вариант выполнить повышение: удалить файл standby.signal и перезапустить резервный сервер. Это не вполне «честный» способ, поскольку в этом случае реплика не поймет, что восстановление завершено, и не перейдет на
Page 7: Page 7
новую линию времени. Теперь бывшая реплика beta стала полноценным экземпляром.
Page 8: Возвращение в строй
 {#source-figure-008 caption=“Source slide page 8: Возвращение в строй”}
Комментарии преподавателя
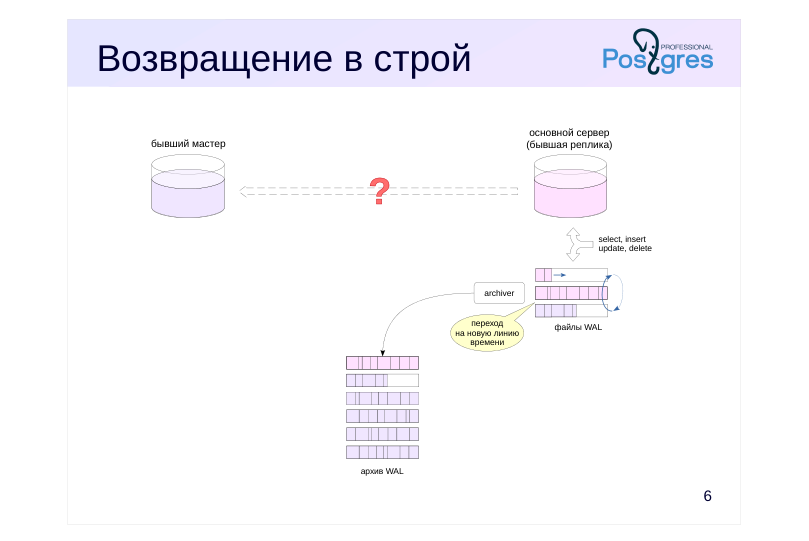
После повышения бывшая реплика выступает в качестве самостоятельного сервера. Она обслуживает запросы клиентов и формирует архив журнальных записей — уже с новой линией времени.
Если переключение не было вызвано выходом сервера из строя, то нужен способ быстро вернуть старый мастер в строй — теперь уже в качестве реплики (failback).
Page 9: Простое подключение
 {#source-figure-009 caption=“Source slide page 9: Простое подключение”}
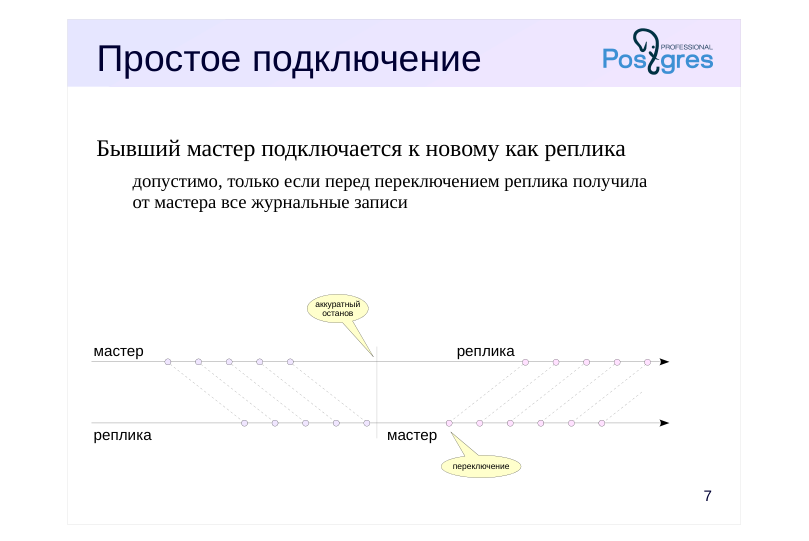
Бывший мастер подключается к новому как реплика
- допустимо, только если перед переключением реплика получила
- от мастера все журнальные записи
Комментарии преподавателя
В случае аккуратной остановки мастера (в режиме fast или smart) все журнальные записи мастера скорее всего дойдут до реплики, хотя это и не гарантируется. Процесс останова организован таким образом, что сначала отключаются все обслуживающие процессы, затем выполняется контрольная точка, и только в самую последнюю очередь останавливается процесс wal sender, чтобы реплика получила запись WAL о контрольной точке.
Позицию в журнале мастера можно проверить с помощью утилиты pg_controldata (запись latest checkpoint location), а позицию на реплике покажет функция pg_last_wal_receive_lsn. Эта функция возвращает текущую позицию в WAL, поэтому ее значение должно опережать latest checkpoint location на длину записи о контрольной точке.
Если все журнальные записи действительно были получены, то бывший мастер можно непосредственно подключить к новому, изменив соответствующим образом конфигурационные параметры.
В случае останова мастера без выполнения контрольной точки (сбой или режим immediate), такое подключение на нагруженном сервере, скорее всего, будет невозможно. При этом сервер не сможет стартовать, а в журнале сообщений будет фиксироваться ошибка.
Page 10: Возвращение в строй: прямое подключение
Введем сервер alpha в строй, но теперь уже в качестве реплики. Для этого создадим файл standby.signal:
Настроим подключение к мастеру.
Запустим alpha и убедимся, что этот сервер стал репликой.
На сервере beta мы можем изменять данные:
А реплика alpha их принимает.
Page 11: Резервная копия
 {#source-figure-011 caption=“Source slide page 11: Резервная копия”}
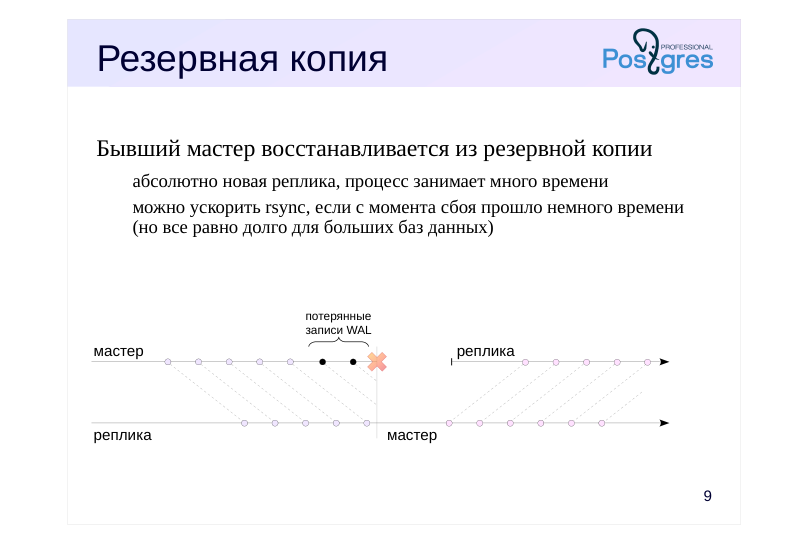
Бывший мастер восстанавливается из резервной копии
- абсолютно новая реплика, процесс занимает много времени
- можно ускорить rsync, если с момента сбоя прошло немного времени
- (но все равно долго для больших баз данных)
Комментарии преподавателя
Если мастер был остановлен аварийно, велика вероятность того, что часть журнальных записей не успела дойти до реплики. В этом случае просто так подключать мастер нельзя.
Простой и надежный вариант — создать абсолютно новую реплику путем изготовления и развертывания базовой резервной копии. Однако для больших баз данных этот процесс может занимать много времени.
Вариант такого подхода — не использовать утилиту pg_basebackup, а сделать копию с помощью API резервирования с использованием утилиты rsync. Если выполнять копирование сразу после перехода на реплику, то большая часть файлов не успеет поменяться и процесс может пройти существенно быстрее. Но это, конечно, усложняет процедуру.
Page 12: Утилита pg_rewind
 {#source-figure-012 caption=“Source slide page 12: Утилита pg_rewind”}
Подготовка к восстановлению
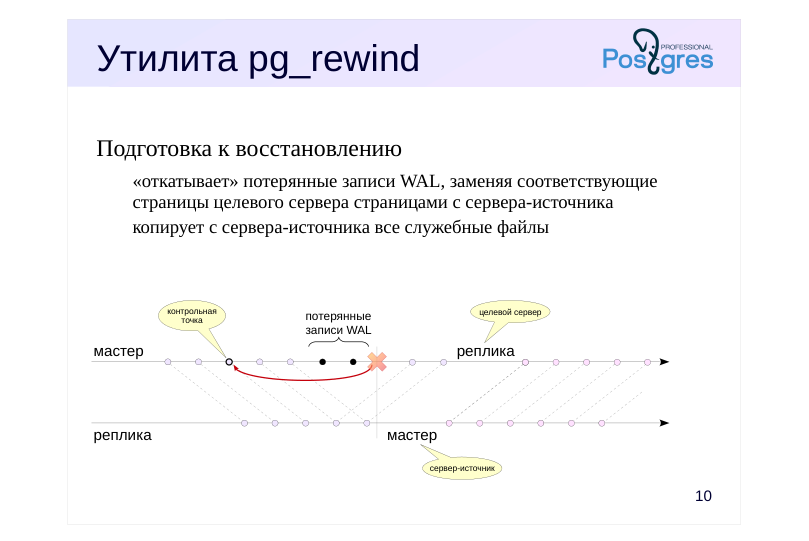
- «откатывает» потерянные записи WAL, заменяя соответствующие
- страницы целевого сервера страницами с сервера-источника
- копирует с сервера-источника все служебные файлы
Комментарии преподавателя
Еще более быстрый вариант состоит в использовании штатной утилиты pg_rewind.
Утилита определяет место расхождения между двумя серверами, определяет ближайшую к нему общую контрольную точку, и, просматривая журнал, определяет все страницы, измененные с момента этой контрольной точки.
Найденные страницы (которых должно быть немного) заменяются страницами с сервера-источника (нового мастера). Кроме того, утилита копирует с сервера-источника все служебные файлы.
Дальше применяются все необходимые записи WAL с нового мастера. Фактически, это выполняет уже не утилита, а обычный процесс восстановления после запуска сервера. Чтобы восстановление началось с нужного момента, утилита создает управляющий файл backup_label.
https://postgrespro.ru/docs/postgresql/16/app-pgrewind
Page 13: Особенности pg_rewind
Целевой сервер (бывший мастер)
- все необходимые журнальные файлы должны сохраниться в pg_wal
- или в архиве
- должны быть включены контрольные суммы или wal_log_hints = on
- должен быть включен параметр full_page_writes = on
- Сервер-источник (текущий мастер)
- клиент-серверное подключение:
- -source-server = строка подключения
- корректно остановленный сервер:
- -source-pgdata = каталог
Комментарии преподавателя
Для сервера-источника, если он запущен, ключом –source-server задается строка клиент-серверного подключения libpq (утилита не использует протокол репликации). Роль для подключения должна иметь право выполнения функций pg_ls_dir, pg_stat_file, pg_read_binary_file.
Если же сервер-источник остановлен корректно, можно указать его каталог данных ключом –source-pgdata.
Утилита имеет ряд особенностей:
● Все сегменты WAL, содержащие записи от последней общей контрольной точки до текущего момента, должны находиться в каталоге pg_wal целевого сервера или быть доступны для получения из архива. Во втором случае надо задать параметр restore_command и ключ –restore-target-wal.
● Из-за ошибок при записи возможно рассогласование данных внутри страницы (проблема неатомарной записи, обсуждается в теме «Базовая резервная копия»). Чтобы решить проблему, на целевом сервере первое изменение страницы после контрольной точки должно вызывать запись в WAL полного ее образа. Для этого должен быть установлен full_page_writes = on. Этот режим не учитывает «незначительные» изменения страниц (hint bits), поэтому дополнительно требуется, чтобы в кластере либо были включены контрольные суммы страниц, либо был установлен параметр wal_log_hints = on.
● Если целевой сервер был остановлен нештатно, без контрольной точки, утилита запустит его в однопользовательском режиме и тут же остановит корректно.
Page 14: Возвращение в строй: утилита pg_rewind
Воспроизведем теперь аварийную ситуацию появления двух пишущих серверов — разделение сети (мы подробно обсуждаем этот и другие виды сбоев в теме «Обзор кластерных технологий» этого курса). Выведем сервер alpha из режима реплики, не останавливая основной сервер beta.
Теперь и на alpha, и на beta можно изменять данные:
В реальности такой ситуации необходимо всячески избегать, поскольку теперь непонятно, какому серверу верить. Придется либо полностью потерять изменения на одном из серверов, либо придумывать, как объединить данные. Наш выбор — потерять изменения, сделанные на сервере beta. Откатим на beta изменения, которые противоречат изменениям, сделанным на alpha. Для этого мы используем утилиту pg_rewind, поэтому убедимся, что на целевом сервере (beta) заданы необходимые значения параметров:
Остановим целевой сервер некорректно.
В ключах утилиты pg_rewind надо указать каталог PGDATA целевого сервера и способ обращения к серверу-источнику (alpha): либо строку подключения (если сервер работает), либо местоположение его каталога PGDATA (если он выключен). В нашем случае сервер alpha запущен. Поскольку целевой сервер beta не был остановлен корректно, утилита запустит его в однопользовательском режиме и остановит с выполнением контрольной точки. Для запуска нужно указать расположение файла конфигурации. Ключ -R обеспечит запуск целевого сервера как реплики после завершения работы утилиты: восстановив согласованность, он останется в режиме восстановления.
Page 15: Page 15
В результате pg_rewind «откатила» страницы данных к последней контрольной точке перед моментом, когда изменения серверов разошлись. Утилита также создала файл backup_label с информацией о позиции WAL, с которой нужно начинать восстановление. Заглянем в него:
Используя параметр -R, мы попросили утилиту создать сигнальный файл standby.signal и задать в конфигурационном файле строку соединения.
На сервере alpha заранее создан слот репликации, задействуем его.
Теперь beta запустится в режиме реплики.
Слот репликации инициализировался и используется:
Данные, измененные на новом мастере (alpha), получены репликой (beta):
Page 16: Page 16
Добавим еще одну строку:
Итак, мы ввели бывший мастер (beta) в строй в качестве реплики.
Page 17: Переключение и архив
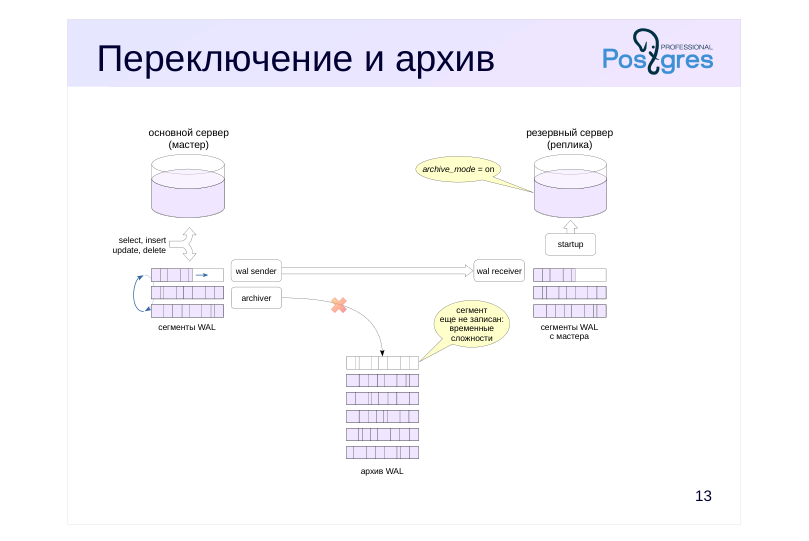 {#source-figure-017 caption=“Source slide page 17: Переключение и архив”}
Комментарии преподавателя
Архив журнала предзаписи, пополняемый с помощью механизма непрерывного архивирования, имеет неприятную особенность в контексте потоковой репликации и переключения на реплику: при отказе мастера некоторые сегменты могут не попасть в архив. Например, если возникли проблемы с местом на диске, archive_command будет возвращать ошибку.
Page 18: Переключение и архив
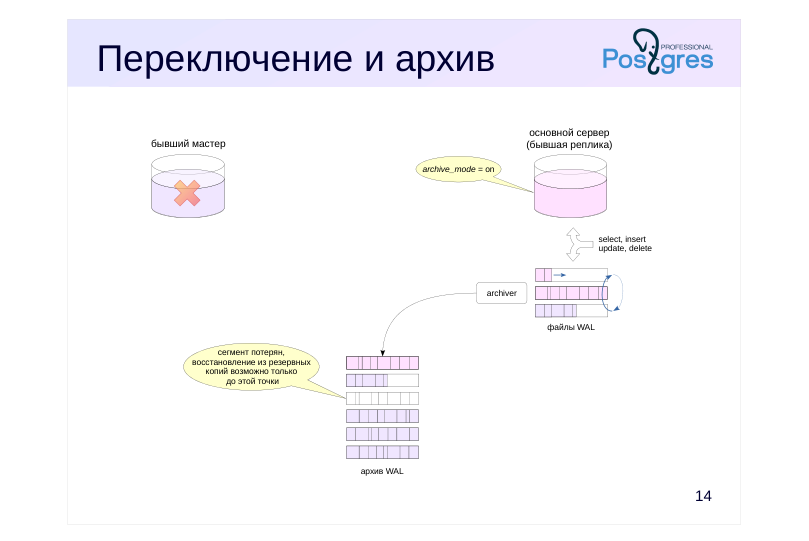 {#source-figure-018 caption=“Source slide page 18: Переключение и архив”}
Комментарии преподавателя
Но реплика не в курсе настроек архивирования на мастере. Когда бывшая реплика займет место мастера, она не запишет недостающие сегменты в архив (хотя они у нее есть), потому что рассчитывает на то, что архив работал без сбоев. В результате архив будет неполным.
А это означает, что из имеющихся резервных копий можно восстановить систему только до образовавшейся «дыры». Если такая ситуация возникла (а это еще нужно заметить), требуется в срочном порядке выполнить резервное копирование.
Потоковый архив лишен этого недостатка, поскольку утилита pg_receivewal отслеживает содержимое каталога и запрашивает у сервера недостающие журнальные записи. Но, как отмечалось в модуле «Резервное копирование», использование этой утилиты сопряжено с поддержанием дополнительной инфраструктуры.
Page 19: Проблемы с файловым архивом
Восстановим серверы alpha и beta из резервной копии и настроим на обоих файловую архивацию в общий архив.
Архив сегментов WAL.
Одинаковые настройки архивации на серверах alpha и beta.
На реплике (beta) создадим файл standby.signal и настроим подключение к мастеру.
Запускаем мастер (alpha) и создаем слот репликации.
Теперь стартуем реплику.
Текущий сегмент журнала:
Принудительно переключим сегмент WAL. Чтобы переключение произошло, нужно гарантировать, что текущий и следующий сегменты содержат какие-либо записи.
Page 20: Page 20
Теперь журнальные записи пишутся в следующий сегмент, а предыдущий попал в архив:
Представим, что возникли трудности с архивацией. Причиной может быть, например, заполнение диска или проблемы с сетевым соединением, а мы смоделируем их, возвращая статус 1 из команды архивации.
Опять переключим сегмент WAL.
Сегмент не архивируется.
Процесс archiver будет продолжать попытки, но безуспешно.
Сервер beta в режиме реплики не выполнял архивацию, а после повышения не будет архивировать пропущенный сегмент. Остановим alpha, повышаем beta.
Еще раз принудительно переключим сегмент, теперь уже на beta.
Page 21: Page 21
Что с архивом?
Сегмент 000000010000000000000004 отсутствует, архив теперь непригоден для восстановления и репликации.
Page 22: Переключение и архив
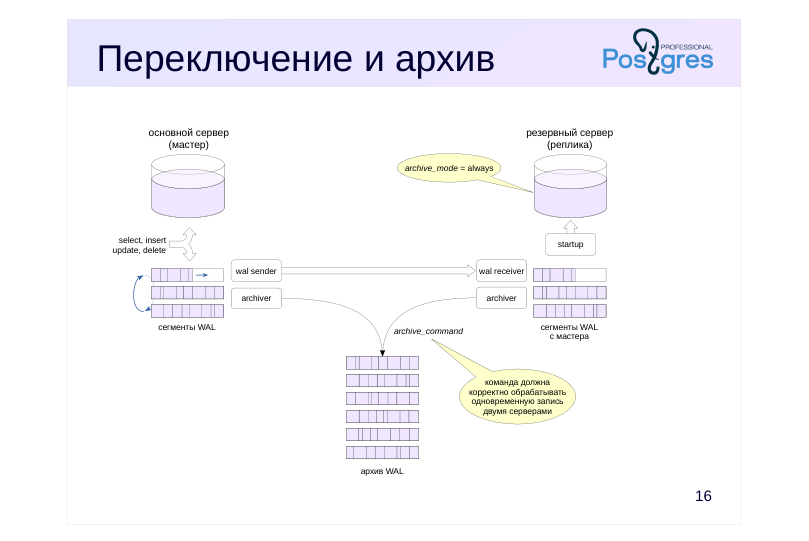 {#source-figure-022 caption=“Source slide page 22: Переключение и архив”}
Комментарии преподавателя
При установке archive_mode = always на реплике запускается процесс archiver, который записывает сегменты в архив наравне с мастером. Таким образом, один и тот же файл будет записан два раза с двух серверов. Это накладывает на команду archive_command серьезные требования:
● она не должна перезаписывать существующий файл, но должна сообщать об успехе, если файл с тем же содержимым уже есть в архиве;
● она должна корректно обрабатывать одновременный вызов с двух серверов.
При такой настройке сегмент не пропадет, поскольку реплика будет продолжать попытки записи даже после останова мастера.
(Разумеется, можно настроить archive_command и так, чтобы мастер и реплика сохраняли сегменты журнала в разные архивы, но вряд ли это практично.)
Page 23: Архивация с реплики
Чтобы при переключении на реплику архив не пострадал, на реплике нужно использовать значение archive_mode = always. При этом команда архивации должна корректно обрабатывать одновременную запись сегмента мастером и репликой. Еще раз восстановим alpha и beta из резервной копии и настроим на обоих файловую архивацию в общий архив.
Архив сегментов WAL.
Настройка архивации на мастере (alpha). Мы заменили логическую связку в команде архивации, чтобы при наличии файла она сразу возвращала 0.
Настройка архивации на реплике (beta). Используем режим always и ту же команду архивации.
На реплике нужен еще standby.signal.
Запускаем мастер и создаем слот репликации.
Теперь стартуем реплику.
Page 24: Page 24
Повторим опыт. Переключаем сегмент:
Проверяем состояние архивации:
Заполненный сегмент попал в архив. На сервере alpha возникли проблемы с архивацией, команда возвращает 1:
Alpha продолжает генерировать сегменты WAL.
Но основной сервер их не архивирует:
Однако архивация с реплики срабатывает и сегмент оказывается в архиве:
Выполняем переключение на реплику.
Beta стала основным сервером и генерирует файлы WAL.
Page 25: Page 25
Еще раз заглянем в архив:
В архиве появились файлы реплики, пропусков в нем нет, проблема решена.
Page 26: Итоги
Переключение используется как в штатных, так и в нештатных ситуациях
- После переключения бывший мастер надо вернуть в строй
- Обе процедуры должны быть заранее отработаны
- Файловый архив журнала предзаписи требует внимания
Page 27: Практика
- Выполните необходимую настройку потоковой репликации с сервера alpha на beta с использованием слота, без непрерывного архивирования. 2. Сымитируйте сбой сервера alpha и переключитесь на сервер beta. 3. Верните в строй сервер alpha в качестве реплики, выполнив резервную копию с нового мастера beta и настроив необходимые параметры.
- Убедитесь, что репликация работает и использует слот. 4. Переключитесь на сервер alpha, чтобы бывший мастер снова стал основным сервером.
Комментарии преподавателя
- Для имитации сбоя можно остановить сервер в режиме immediate:
pg_ctlcluster 16 имя_кластера stop -m immediate –skip-systemctl-redirect
или завершить основной процесс postgres:
kill -QUIT номер_процесса
Номер процесса можно найти в первой строке файла PGDATA/postmaster.pid.
После завершения практических заданий удалите слот и созданную базу данных, сбросьте измененные параметры.
Page 28: 1. Настройка репликации без архива
Настраиваем репликацию. Остановим сервер beta и очистим его каталог данных.
Формируем автономную резервную копию в каталоге данных сервера beta, предварительно создав слот replica.
Запускаем сервер в режиме реплики.
Проверим настройки. Выполним несколько команд на мастере:
Проверим реплику:
2. Сбой основного сервера и переход на реплику
Имитируем аварийную остановку мастера.
Повышаем реплику.
Page 29: 3. Возвращение в строй бывшего мастера
Создаем автономную резервную копию сервера beta в каталоге данных сервера alpha. Перед этим удалим конфигурационный файл, иначе pg_basebackup его скопирует и допишет параметры.
Очистим каталог данных на сервере alpha.
Запускаем утилиту резервного копирования, попросив ее создать слот и настройки репликации.
Параметры конфигурации и сигнальный файл подготовлены утилитой:
Слот репликации инициализировался и используется:
Проверим репликацию:
4. Переключение на новую реплику
Повышаем реплику.
Page 30: Page 30
В итоге прежний мастер снова стал основным сервером.
Уборка
Удалим слот и базу данных, сбросим измененные параметры.
Page 31: Практика+
- Настройте сервер alpha, чтобы после контрольной точки сохранялись два дополнительных сегмента WAL, и запустите физическую репликацию с alpha на сервер beta без слота репликации. 2. Аварийно остановите сервер alpha и выполните повышение beta. Запустите alpha и измените данные на нем. Убедитесь, что данные на alpha и beta не совпадают. 3. Остановите сервер alpha и запустите его в качестве реплики сервера beta, используя утилиту pg_rewind.
Комментарии преподавателя
- Настройте репликацию с простейшими настройками и без слота репликации. Для гарантии сохранения двух дополнительных сегментов WAL задайте подходящее значение wal_keep_size.
После завершения практических заданий удалите слот и созданную базу данных, сбросьте измененные параметры.
Page 32: 1. Репликация
Мы не используем слоты репликации, поэтому потребуем сохранять два дополнительных сегмента WAL.
Остановим сервер beta и сделаем его репликой для сервера alpha.
Создадим базу данных и таблицу в ней.
Изменения реплицированы на сервер beta.
Проверим статус репликации.
На реплике можно посмотреть статистику приемника WAL:
Page 33: 2. Разрыв репликации
На мастер-сервере отключено питание.
Повышаем beta.
Изменяем данные на новом мастере.
На сервере alpha питание восстановлено.
Данные на серверах разошлись.
Остановим сервер alpha (бывший мастер).
3. Ввод в строй бывшего мастера
Мы хотим запустить сервер alpha как реплику. Для этого нужно вернуть его к состоянию, совместимому с beta. Используем штатную утилиту.
На сервере beta выполняются пишущие транзакции.
Данные, измененные на сервере beta, получены сервером alpha:
Page 34: Page 34
 {#source-figure-034 caption=“Source slide page 34: Page 34”}
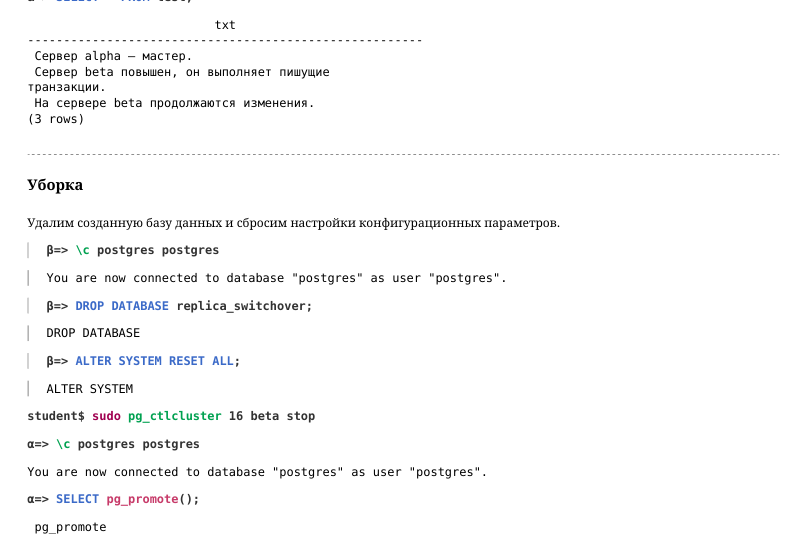
Уборка
Удалим созданную базу данных и сбросим настройки конфигурационных параметров.