04 Занятие 04: Репликация / Физическая репликация
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba3_04_replica_physical.html Archive: DBA3-handouts-16.zip Страниц PDF: 39
Page 1: Репликация / Физическая репликация
Авторские права
© Postgres Professional, 2017–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Задачи репликации
- Схема работы физической репликации
- Способы доставки журнальных записей
- Особенности и ограничения использования реплики
- Синхронная и асинхронная репликация
- Мониторинг репликации
- Возможные проблемы и способы их решения
Page 3: Задачи репликации
Репликация
- процесс синхронизации нескольких копий кластера баз данных
- на разных серверах
- Базовый механизм для решения ряда задач
- отказоустойчивость
- при возникновении сбоя система
- должна сохранить работоспособность
- масштабируемость
- распределение нагрузки между серверами
Комментарии преподавателя
Одиночный сервер, управляющий базами данных, может не удовлетворять требованиям, предъявляемым к системе. Есть две основных задачи, для решения которых требуется наличие нескольких серверов.
Во-первых, отказоустойчивость: один физический сервер — это возможная точка отказа. Если сервер выходит из строя, система становится недоступной.
Во-вторых, производительность. Один сервер может не справляться с нагрузкой. Зачастую желательна возможность не вертикального, а горизонтального масштабирования — распределения нагрузки на несколько серверов. Дело может быть как в стоимости аппаратуры, так и в необходимости различных настроек для разных типов нагрузки (например, для OLTP и отчетности).
В случае PostgreSQL распределенные системы строятся по принципу «shared nothing»: несколько серверов работают независимо друг от друга и не имеют ни общей оперативной памяти, ни общих дисков. Следовательно, если серверы должны работать с одними и теми же данными, то эти данные требуется синхронизировать между ними. Механизм синхронизации и называется репликацией.
Page 4: Мастер→реплика
Записи WAL передаются на реплику и применяются
- поток данных только в одну сторону
- реплицируется кластер целиком, выборочная репликация невозможна
- Реплика — точная копия мастера
- одна и та же основная версия сервера
- полностью совместимые архитектуры и платформы
- Реплика доступна только для чтения
Комментарии преподавателя
При физической репликации серверы имеют назначенные роли: один является ведущим («мастер»), а остальные — ведомыми («реплики»).
Мастер передает на реплику журнальные записи, а реплика применяет эти записи к своим файлам данных. Применение происходит чисто механически, без «понимания смысла» изменений, и выполняется быстрее, чем работало бы повторное выполнение операторов SQL. Но критична двоичная совместимость между серверами — они должны работать на одной и той же программно-аппаратной платформе и на них должны быть запущены одинаковые основные версии PostgreSQL.
https://postgrespro.ru/docs/postgresql/16/hot-standby#HOT-STANDBY-ADM IN
Журнал — общий для всего кластера, поэтому реплицировать можно только кластер целиком, а не отдельные базы данных или таблицы. Возможность «отфильтровать» журнальные записи отсутствует.
Реплика не генерирует журнальные записи, а лишь применяет записи мастера. Поэтому реплика может быть доступна только для чтения — никакие операции, изменяющие данные, на реплике не допустимы.
Page 5: Потоковая репликация
 {#source-figure-005 caption=“Source slide page 5: Потоковая репликация”}
Комментарии преподавателя
При наличие файла recovery.signal сервер восстанавливается из резервной копии: проигрывает журнальные записи, восстанавливает согласованность и завершает восстановление. Запуск реплики выполняется точно так же, но восстановление не завершается: реплика продолжает читать и воспроизводить журнальные записи мастера. Сигналом к этому служит файл standby.signal.
В теме «Базовая резервная копия» мы рассматривали два способа доставки журнальных записей от сервера к клиенту: потоковая и файловая. Они же применяются и для доставки журнальных записей реплике. На практике в основном используется потоковая репликация.
В этом случае процесс wal receiver реплики подключается к мастеру по протоколу репликации, используя строку подключения из параметра primary_conninfo, и читает поток записей WAL. За счет этого при потоковой репликации отставание реплики от мастера минимально (и при необходимости может быть сведено к нулю). Полученные записи пишутся на диск в виде сегментов WAL так же, как это происходит на мастере. Далее процесс startup — тот же самый, что обеспечивает восстановление после сбоев — применяет записи к файлам данных, только теперь он работает постоянно.
Мастер запускает процесс wal sender, обслуживающий соединение с репликой. Потоковая репликация может, если нужно, использовать слот репликации. Имя слота передается в параметре primary_slot_name.
Page 6: Настройка потоковой репликации
Поскольку в нашей конфигурации не будет архива журнала предзаписи, важно на всех этапах использовать слот репликации — иначе при определенной задержке мастер может успеть удалить необходимые сегменты и придется заново сформировать резервную копию и повторить действия по настройке. Создаем слот:
Посмотрим на созданный слот:
Вначале слот не инициализирован (restart_lsn и wal_status пустые). Сформируем автономную резервную копию в каталоге данных сервера beta, используя созданный слот. При запуске с ключом -R утилита добавит в копию файлы, необходимые для запуска будущей реплики.
Снова проверим слот:
Page 7: Page 7
После выполнения резервной копии слот инициализировался, и мастер теперь хранит все файлы журнала с начала копирования (restart_lsn, wal_status). Сравните со строкой в backup_label:
Файл postgresql.auto.conf был подготовлен утилитой pg_basebackup, поскольку мы указали ключ -R. Этот файл содержит информацию для подключения к мастеру и имя слота репликации:
По умолчанию реплика будет «горячей», то есть сможет выполнять запросы во время восстановления. Если такая возможность не нужна, реплику можно сделать «теплой» (hot_standby = off). Утилита также создала сигнальный файл standby.signal, наличие которого указывает серверу войти в режим постоянного восстановления.
Журнальные записи, необходимые для восстановления согласованности, реплика возьмет из автономной базовой копии. Далее она войдет в режим непрерывного восстановления и будет получать и проигрывать поток записей.
Page 8: Репликация с архивом
 {#source-figure-008 caption=“Source slide page 8: Репликация с архивом”}
Комментарии преподавателя
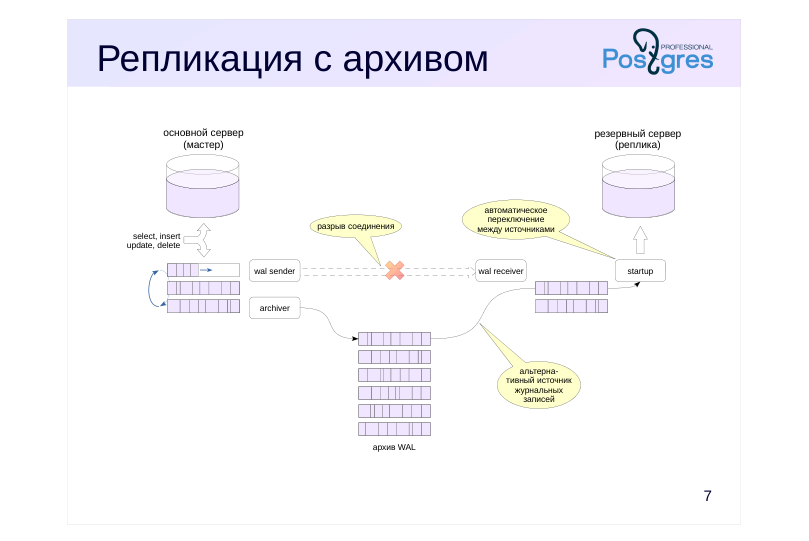
Другой способ доставки журнальных записей состоит в том, чтобы предоставить реплике доступ к архиву журналов — точно так же, как при обычном восстановлении из архива (этот механизм рассмотрен в модуле «Резервное копирование»).
Если реплика по каким-то причинам не сможет получить очередную журнальную запись по протоколу репликации (например, из-за обрыва связи), она попробует прочитать ее из архива с помощью команды, заданной в параметре restore_command. При восстановлении связи реплика снова автоматически переключится на использование потоковой репликации.
В принципе, репликация может работать и с одним только архивом, без потоковой репликации. Но в этом случае:
● реплика вынужденно отстает от мастера на время заполнения сегмента;
● мастер ничего не знает о существовании реплики, что в некоторых случаях может привести к проблемам.
Page 9: Процессы
Мастер Реплика
- wal sender
- wal receiver
- startup
- archiver
- archiver
- (archive_mode = always)
- checkpointer
- checkpointer
- (контрольные точки)
- (точки перезапуска)
- background writer
- background writer
- wal writer
- autovacuum
Комментарии преподавателя
На мастере и на реплике выполняется разный набор процессов. Кроме уже рассмотренных wal sender (на мастере) и wal receiver и startup (на реплике), работают также другие процессы.
Общие процессы:
● background writer — записывает грязные страницы из буферного кеша на диск (на реплике, для того, чтобы применить журнальную запись, страницы точно так же читаются в буферный кеш и затем записываются в фоновом режиме или при вытеснении).
● checkpointer — выполняет точки перезапуска (restart point, см. тему «Архив журналов предзаписи»). Если в процессе восстановления случится сбой, реплика сможет продолжить с последней точки перезапуска, а не с самого начала.
Процессы только на мастере:
● wal writer — реплика не создает журналы упреждающей записи, а только получает их с мастера.
● autovacuum launcher/worker — реплика не выполняет очистку, ее выполнение на мастере передается реплике через журнал.
Есть также процесс, наличие которого зависит от настройки:
● archiver — при значении archive_mode = on выполняется только на мастере, а при archive_mode = always также и на реплике (подробнее рассматривается в теме «Переключение на реплику»).
Page 10: Процессы реплики
Сравним процессы на мастере:
И на реплике:
Page 11: Очистка архива
 {#source-figure-011 caption=“Source slide page 11: Очистка архива”}
Комментарии преподавателя
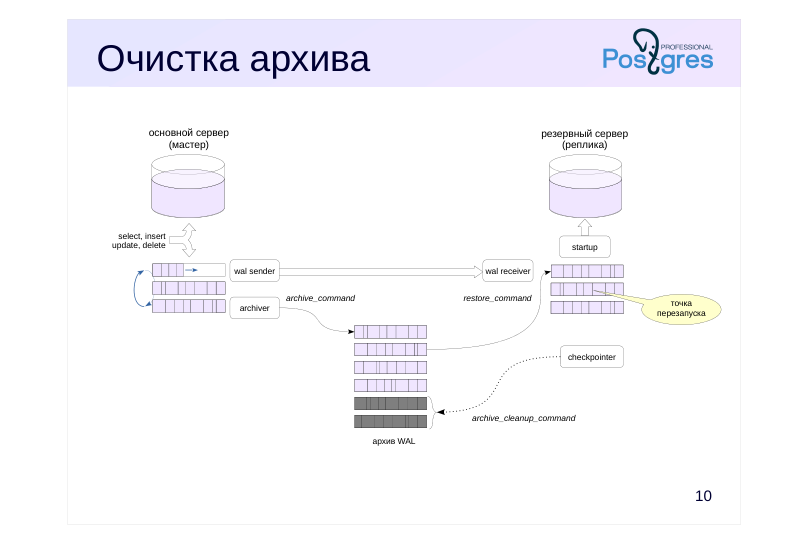
В точках перезапуска процесс checkpointer будут удалять ненужные сегменты журнала в локальном каталоге pg_wal.
Если архив используется только для синхронизации одной реплики, можно и его очищать автоматически. Для этого в параметре archive_cleanup_command задается команда, которая будет выполняться по окончании каждой точки перезапуска. В команде удобно вызывать утилиту pg_archivecleanup (вместо %r сервер подставит имя сегмента, содержащего точку):
archive_cleanup_command = ‘pg_archivecleanup /path/to/archive %r’
https://postgrespro.ru/docs/postgresql/16/runtime-config-wal#RUNTIME-CO NFIG-WAL-ARCHIVE-RECOVERY
https://postgrespro.ru/docs/postgresql/16/pgarchivecleanup
Page 12: Использование реплики
Допускаются
- запросы на чтение данных (select, copy to, курсоры)
- установка параметров сервера (set, reset)
- управление транзакциями (begin, commit, rollback…)
- создание резервной копии (pg_basebackup)
- Не допускаются
- любые изменения (insert, update, delete, truncate, nextval…)
- блокировки, предполагающие изменение (select for update…)
- команды DDL (create, drop…), в том числе создание временных таблиц
- команды сопровождения (vacuum, analyze, reindex…)
- управление доступом (grant, revoke…)
Комментарии преподавателя
Как мы уже говорили, на реплике не допускается любое изменение данных. Более точно, не допускаются:
● изменения таблиц, материализованных представлений, последовательностей;
● блокировки (так как для этого требуется изменение страниц данных);
● команды DDL, включая создание временных таблиц;
● такие команды, как VACUUM и ANALYZE;
● команды управления доступом.
При этом реплика может выполнять запросы на чтение данных, если установлен параметр hot_standby = on. Также будет работать установка параметров сервера и команды управления транзакциями — например, можно начать (читающую) транзакцию с нужным уровнем изоляции.
Кроме того, реплику можно использовать и для изготовления резервных копий.
Page 13: Использование реплики
Выполним несколько команд на мастере:
Проверим реплику:
При этом изменения на реплике не допускаются:
Вообще реплику от мастера можно отличить с помощью функции:
Page 14: Ограничения
Изоляция и многоверсионность
- большое число точек сохранения задерживает выполнение запросов
- не поддерживается уровень изоляции Serializable
- Триггеры и блокировки
- триггеры и рекомендательные блокировки не работают
- Резервное копирование с реплики
- параметр full_page_writes должен быть заранее включен на мастере
- задержки из-за ожидания контрольной точки и переключения сегментов
- Порядок изменений
- каталоги табличных пространств нужно сначала создавать на реплике
- значения параметров max_… нужно сначала увеличивать на реплике
Комментарии преподавателя
У репликации есть ряд ограничений и особенностей.
Если на мастере выполняется транзакция с числом вложенных транзакций больше 64 (то есть активно используются точки сохранения), создание снимка на реплике будет приостановлено — это означает невозможность некоторое время выполнять запросы.
Не поддерживается уровень изоляции Serializable на реплике.
Триггеры не будут срабатывать на реплике (они выполнились на мастере и реплицируется уже результат их работы). Не будут работать и рекомендательные (advisory) блокировки.
При выполнении резервного копирования с реплики нет технической возможности полноценно управлять мастером, в частности, вызывать контрольные точки и включать параметр full_page_writes. Поэтому параметр нужно включить на мастере заранее, а контрольную точку приходится ждать (что может существенно задержать процесс).
Создание табличных пространств реплицируется, но если у пользователя ОС, под которым работает СУБД, недостаточно прав для создания каталога, произойдет ошибка. Лучше всего сначала создать каталоги на мастере и на всех репликах, а уже затем выполнять команду CREATE TABLESPACE.
Если на мастере увеличить параметр, задающий ограничение какого-либо ресурса, репликация может приостановиться. Это относится к параметрам max_connections, max_prepared_transactions, max_locks_per_transaction, max_wal_senders и max_worker_processes.
Page 15: Мониторинг
 {#source-figure-015 caption=“Source slide page 15: Мониторинг”}
Комментарии преподавателя
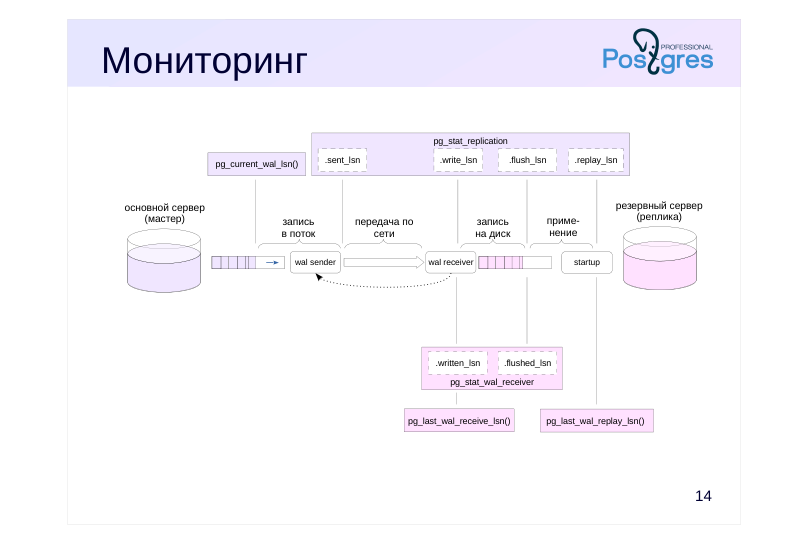
В ходе репликации возможны проблемы, о которых должен предупредить заранее настроенный мониторинг. Основной информацией являются позиции в журнале предзаписи. Можно выделить пять важных точек:
- появление журнальной записи на мастере; 2) передача записи процессом wal sender; 3) получение записи процессом wal receiver; 4) синхронизация записи с диском (flush); 5) применение полученной записи процессом startup.
Все эти точки обычно отслеживаются на мастере. Первую точку дает функция pg_current_wal_lsn, остальные — представление pg_stat_replication. Реплика передает мастеру статус репликации при каждой записи на диск, но как минимум раз в интервал времени, указанный в wal_receiver_status_interval (по умолчанию — 10 секунд).
Если используется слот репликации, то информацию о нем можно получить из представления pg_replication_slots.
Часть информации о ходе репликации можно получить и на реплике в представлении pg_stat_wal_receiver и с помощью функций pg_last_wal_receive_lsn и pg_last_wal_replay_lsn.
Состояние репликации показывают функции pg_is_in_recovery и pg_get_wal_replay_pause_state. Параметр log_replication_commands включает вывод в журнал сообщений информации о выполняющихся командах протокола репликации.
Page 16: Мониторинг репликации
Сейчас реплика находится в режиме восстановления и применяет журнальные записи:
Текущее значение max_connections на мастере:
Если количество пользователей выросло, мы захотим увеличить это ограничение:
А что с репликой?
Репликация остановилась. В журнале видим причину:
Последуем рекомендации: увеличим значение параметра на реплике.
Проверим реплику:
Page 17: Page 17
Репликация возобновилась. Чтобы избежать остановки репликации, ограничения нужно сначала увеличивать на реплике. Состояние репликации можно смотреть в специальном представлении на мастере. Чтобы пользователь получил доступ к этой информации, он должен входить в групповую роль pg_read_all_stats или быть суперпользователем.
Роль pg_monitor входит в роль pg_read_all_stats и наследует ее привилегии.
Обратите внимание на поля *_lsn (и *_lag) — они показывают отставание реплики на разных этапах. Сейчас все позиции совпадают, отставание нулевое. Теперь вставим в таблицу большое количество строк, чтобы увидеть репликацию в процессе работы.
Page 18: Page 18
Видно, что возникла небольшая задержка. Проверим реплику:
Все строки успешно доставлены. И еще раз проверим состояние репликации:
Все позиции выровнялись.
Page 19: Режимы репликации
Асинхронный
- synchronous_commit
- = off
- local
- Синхронный
- фиксация с ожиданием подтверждения от синхронной реплики
- обеспечивает надежность, но не согласованность
- synchronous_commit
- = remote_write
- on
- remote_apply
- synchronous_standby_names = список реплик
- FIRST N (список реплик)
- ANY N (список реплик)
Комментарии преподавателя
Как известно, фиксация транзакций может выполняться в двух режимах. В более быстром асинхронном режиме есть шанс потерять уже зафиксированные изменения в случае сбоя. В синхронном режиме команда COMMIT не завершается, пока запись не дойдет до диска. При наличии нескольких серверов можно еще повысить надежность, если дожидаться от реплики подтверждения того, что она получила запись о фиксации. В этом случае данные не пропадут даже при выходе носителя из строя.
Синхронная репликация включается тем же параметром synchronous_commit, что и синхронная фиксация. Разные значения этого параметра позволяют управлять уровнем надежности. При значении remote_write мастер ожидает подтверждения о получении записи (остается шанс потерять изменения, если на реплике случится сбой и она не успеет записать данные на диск).
При значении on мастер ожидает подтверждения о попадании журнальной записи на диск реплики (это надежный режим; однако приложение, обратившись к реплике, может не увидеть изменений).
Наконец, значение remote_apply заставляет мастер дождаться применения записи на реплике. Каждый следующий режим вызывает все большие задержки.
Мастер может синхронизироваться как с одной, так и с несколькими репликами. Можно указать список реплик в порядке приоритета или организовать синхронизацию на основе кворума, при которой мастер дожидается подтверждения от любых N реплик из числа доступных.
Page 20: Потеря нужного сегмента
Мастер может удалить файл журнала, нужный реплике
- если реплика не успеет его получить
- (например, будет остановлена на некоторое время)
- Решение 1. Слот репликации
- вводит зависимость мастера от реплики, требует мониторинга
- max_slot_wal_keep_size = −1
- Решение 2. Архив журнала предзаписи
- позволяет обойтись без слота
Комментарии преподавателя
При репликации возможен ряд сложностей, которые можно решать разными способами.
Сервер PostgreSQL периодически удаляет файлы журнала, которые не требуются для восстановления. При этом мастер может удалить файл, который содержит данные, еще не переданные реплике.
Это не проблема, если используется архив журналов предзаписи, поскольку реплика, получив отказ по протоколу репликации, прочитает необходимые ей данные из архива, а затем, «догнав» мастер, снова переключится на получение данных из потока.
Но если архива нет, реплика не сможет продолжать восстановление и ее придется пересоздавать из новой резервной копии. Чтобы этого избежать, можно использовать слот репликации. Однако надо понимать, что создание слота ставит мастер в зависимость от реплики: если реплика не будет получать журнальные записи, они будут накапливаться на мастере, что может привести к заполнению файловой системы. Чтобы не допустить этого, стоит установить предел накапливаемого объема параметром max_slot_wal_keep_size. При превышении этого ограничения слот перестанет функционировать и удерживать журнальные файлы от удаления.
В любом случае слот — еще одна точка, которую необходимо включать в мониторинг.
Page 21: Влияние слота репликации
Остановим реплику.
Ограничим размер WAL двумя сегментами.
Слот неактивен, но помнит номер последней записи, полученной репликой:
Вставим еще строки в таблицу.
Номер LSN в слоте не изменился:
Выполним контрольную точку, которая должна очистить журнал, поскольку его размер превышает допустимый.
Каков теперь размер журнала?
Контрольная точка не удалила сегменты — их удерживает слот, несмотря на превышение ограничения. Если оставить слот без присмотра, дисковое пространство может быть исчерпано. Скорее всего, бесперебойная работа основного сервера важнее, чем синхронизация реплики. Чтобы предотвратить разрастание журнала, можно ограничить объем, удерживаемый слотом:
Теперь журнал очищается контрольной точкой:
Page 22: Page 22
Но слот уже не обеспечивает наличие записей WAL (wal_status=lost):
А реплика не может синхронизироваться:
Для синхронизации реплики в таких случаях можно воспользоваться архивом, задав параметр restore_command. Если это невозможно, придется заново настроить репликацию, повторив формирование базовой копии.
Page 23: Конфликты: проблема
Записи WAL, несовместимые с запросами на реплике
- очистка удаляет версии строк, нужные запросам на реплике
- исключительные блокировки объектов
- закрепление буферов
- Мониторинг
- pg_stat_database_conflicts
Комментарии преподавателя
Вторая проблема возникает, если реплика используется для выполнения запросов. Мастер может выполнить действие, несовместимое с запросом на реплике:
● очистка может удалить версию строки, которая используется запросом, или потребовать блокировку, несовместимую с запросом;
● может прийти запись об исключительной блокировке объекта (например, при удалении таблицы);
● иногда конфликт возникает из-за закрепления буфера.
Возникновение таких конфликтов можно отслеживать с помощью представления pg_stat_database_conflicts.
Page 24: Конфликты: решения
Решение 0: избегать конфликтов
- не выполнять команды, вызывающие блокировки
- отменить усечение файла в конце очистки: параметр хранения
- vacuum_truncate = off
- Решение 1: откладывать применение конфликтующих записей
- max_standby_streaming_delay
- max_standby_archive_delay
- кроме взаимоблокировок, DROP TABLESPACE, DROP DATABASE
Комментарии преподавателя
Один из путей борьбы с конфликтами — избегать действий на мастере, приводящих к исключительным блокировкам. Например, можно не выполнять команды DROP TABLE, TRUNCATE, LOCK, DROP INDEX, DROP TRIGGER и т. п. или выполнять их в то время, когда на реплике заведомо нет выполняющихся запросов.
Некоторых неявных блокировок можно избежать, отключая соответствующую функциональность на мастере. Например, если в результате очистки освободились страницы в конце файла, при уменьшении его размера устанавливается исключительная блокировка таблицы. Но можно отменить усечение файла, задав параметр хранения таблицы vacuum_truncate = off. Однако отменять или надолго откладывать очистку нельзя, поэтому избежать конфликта в случае очистки нужных запросу версий строк таким образом не получится.
Другой способ — откладывать применение полученных несовместимых журнальных записей на реплике. Этот способ работает и при потоковой репликации, и при использовании архива; он откладывает записи, относящиеся и к очистке, и к исключительным блокировкам. В параметрах устанавливается максимальная задержка применения (от времени получения записи). Если к этому моменту конфликтующий запрос не успеет завершиться, он будет прерван.
Однако конфликты, вызванные редкими причинами (удаление базы данных или табличного пространства, взаимоблокировки) не откладываются и разрешаются немедленной отменой запроса.
Page 25: Конфликты: решения
Решение 2: обратная связь по протоколу репликации
- снимок на реплике предотвращает удаление версий строк
- так же, как и локальный
- hot_standby_feedback = on
- только для конфликта очистки с запросом на реплике
- Мониторинг
- pg_stat_replication.backend_xmin
- pg_replication_slots.xmin
Комментарии преподавателя
Еще один путь решения — откладывать несовместимые действия на мастере. Для этого включается обратная связь.
Этот способ работает только для очистки (исключительную блокировку отложить не получится) и только в случае потоковой репликации (если реплика переключается на получение записей из архива, она фактически перестает существовать для мастера).
Каждый снимок данных определяет так называемый горизонт — это значение счетчика транзакций, по которому проходит граница между ненужными и нужными версиями строк. Минимальный горизонт по всем снимкам реплики определяет возможность очистки. Подробности обсуждаются в теме «Снимки данных» курса DBA2.
Благодаря обратной связи мастер понимает, какие версии строк нужны реплике. В таком случае (с точки зрения очистки) запрос на реплике ничем не отличается от запроса на самом мастере.
Обратная связь позволяет отслеживать горизонт очистки на стороне мастера. Если слот репликации не используется, горизонт виден в поле pg_stat_replication.backend_xmin, а при использовании слота — в pg_replication_slots.xmin. Нужно учитывать, что при включенной обратной связи слот, даже неактивный, будет задерживать очистку, что может привести к увеличению размеров файлов данных. Этот эффект будет исследован в практике.
Page 26: Итоги
Механизм репликации основан на передаче журнальных записей на реплику и их применении
- основной режим: потоковая репликация
- может быть поддержана архивом журнальных записей
- Реплика — точная копия мастера
- не генерирует собственные записи WAL, доступна только для чтения
- Сложный механизм, требующий настройки и мониторинга
- настройка существенно зависит от решаемых задач
Page 27: Практика
- Настройте потоковую репликацию между двумя серверами в синхронном режиме, со слотом, без обратной связи. 2. Проверьте работу репликации. Убедитесь, что при остановленной реплике фиксация не завершается. 3. Воспроизведите ситуацию, при которой запрос на реплике прерывается из-за очистки версий строк на мастере. 4. Запретите откладывать применение конфликтующих изменений; проверьте, что запрос отменяется сразу. 5. Включите обратную связь и убедитесь, что очистка на мастере не прерывает выполнение запроса. 6. Остановите реплику и убедитесь, что слот препятствует очистке. Удалите слот, чтобы очистка возобновилась.
Комментарии преподавателя
- Для синхронного режима установите на мастере параметры:
● synchronous_commit = on
● synchronous_standby_names = ‘“16/beta”’
- Для этого на реплике можно начать транзакцию с уровнем изоляции Repeatable Read и периодически выполнять запросы к таблице, а на мастере изменить эту таблицу и выполнить очистку.
Учтите, что параметр max_standby_streaming_delay по умолчанию имеет значение 30 секунд.
Установите параметр max_standby_streaming_delay в ноль.
Установите на реплике параметр hot_standby_feedback = on. Максимальный интервал оповещений устанавливается в параметре wal_receiver_status_interval (по умолчанию 10 секунд).
После выполнения практических заданий удалите созданную базу данных и сбросьте настройки параметров конфигурации.
Не забудьте отменить синхронную фиксацию, иначе при остановленной реплике не удастся зафиксировать транзакцию. Не устанавливайте synchronous_commit = off. Вместо этого установите synchronous_commit = ’local’ или сбросьте значение параметра synchronous_standby_names.
Page 28: 1. Физическая потоковая репликация в синхронном режиме
Создаем и запускаем реплику точно так же, как в демонстрации.
Резервная копия:
Для того чтобы основной сервер мог идентифицировать реплику, в основной конфигурации уже установлен параметр cluster_name:
Другой вариант — добавить атрибут application_name в строку соединения:
Теперь включаем на мастере режим синхронной репликации.
Если все реплики синхронные, можно задать значение, соответствующее любому имени:
Однако мастер не может отличить реплику от, например, утилиты pg_receivewal. При такой настройке он будет делать попытки синхронизироваться с любым клиентом, подключившимся по протоколу репликации, и это может привести к бесконечному ожиданию при фиксации транзакций. Поэтому лучше перечислять имена явно.
2. Проверка физической репликации
Page 29: Page 29
sync_state: sync говорит о том, что репликация работает в синхронном режиме; application_name: 16/beta — имя, под которым мастер знает реплику. Остановим реплику.
Фиксация ждет появления синхронной реплики…
После старта реплики фиксация завершается.
3. Отмена запроса из-за очистки на мастере
Мы хотим, чтобы в журнал сервера выводилось сообщение, если из-за конфликта с выполняющимся запросом применение журнальной записи на реплике откладывается более чем на deadlock_timeout.
Для этого установим параметр log_recovery_conflict_waits.
Также уменьшим максимальное время, на которое может быть приостановлена потоковой репликация, прежде чем запрос на реплике будет отменен.
Начинаем транзакцию с уровнем изоляции Repeatable Read: первый оператор создаст снимок данных, который будут
Page 30: Page 30
использовать все операторы транзакции.
На мастере изменяем единственную строку и выполняем очистку. При этом первая версия строки будет удалена.
Через 5 секунд запрос на реплике еще сработает — реплика задерживает применение конфликтующей журнальной записи:
А в журнале отчета сервера уже есть сообщение об ожидании разрешения конфликта:
Еще через 5 секунд такой же запрос уже будет аварийно прерван, поскольку версия строки, входящая в снимок, больше не существует.
4. Запрет откладывания применения конфликтующей записи
Выставим нулевое время задержки применения конфликтующих изменений.
Снова начинаем транзакцию…
Page 31: Page 31
На мастере изменяем строку и выполняем очистку…
Запрос на реплике прерывается тут же:
5. Обратная связь
Установим обратную связь и, чтобы не ждать долго, небольшой интервал оповещений.
Снова начинаем транзакцию…
На мастере изменяем строку и выполняем очистку…
Благодаря обратной связи, очистка не может удалить старую версию строки (tuples: 0 removed, 2 remain, 1 are dead but not
Page 32: Page 32
yet removable).
После завершения транзакции на реплике мастер может выполнить очистку (tuples: 1 removed, 1 remain, 0 are dead but not yet removable). Журнальные записи реплицируются, но ничего не сломают.
6. Влияние слота на очистку при остановленной реплике
Теперь отменим синхронизацию и остановим реплику:
Еще раз изменим строку таблицы:
Слот неактивен, но помнит минимальный xmin снимков реплики:
Это значение xmin меньше, чем минимальный xmin локальных снимков:
Поэтому слот будет задерживать очистку (tuples: 0 removed, 2 remain, 1 are dead but not yet removable).
Page 33: Page 33
Удалим слот.
Теперь очистка сработает (tuples: 1 removed).
Уборка
Удалим созданную базу данных и сбросим настройки параметров конфигурации.
Page 34: Практика+
- Настройте потоковую физическую репликацию вместе с архивацией сегментов WAL, использовав для потока репликации сетевой интерфейс виртуальной машины. 2. Проверьте работу потоковой репликации через этот сетевой интерфейс. 3. Сымитируйте отказ сети, выключив сетевой интерфейс виртуальной машины. 4. Убедитесь, что потоковая репликация остановилась, при этом реплика получает изменения благодаря архивации сегментов WAL, но с задержками. 5. Заново запустите сетевой интерфейс виртуальной машины, проверив затем, что потоковая репликация автоматически восстановилась.
Комментарии преподавателя
- Проверить состояние сетевых интерфейсов можно командой: ip a
Проверить доступность сетевого адреса можно командой: ping -c1 <IP адрес>
Внесите изменения в файл pg_hba.conf для разрешения подключений к серверу alpha через любые сетевые интерфейсы, а также измените конфигурацию этого сервера так, чтобы он прослушивал все сетевые интерфейсы.
Процесс wal_receiver завершается, если сетевое соединение отсутствует в течение времени wal_receiver_timeout. Задайте небольшое значение этого параметра.
Отказ сети смоделируйте, выключив сетевой интерфейс: sudo ip l set enp0s3 down
Убедитесь, что после переключения сегмента WAL реплика получает изменения, сделанные до переключения.
Включить сетевой интерфейс можно командой: sudo ip l set enp0s3 up
После выполнения практических заданий удалите созданную базу данных и сбросьте настройки параметров конфигурации.
Page 35: 1. Физическая потоковая репликация + архив WAL
Имя основного сетевого интерфейса виртуальной машины enp0s3:
Проверим доступность основного сетевого интерфейса виртуальной машины.
Разрешим подключения к серверу alpha с адресов IPv4, принадлежащих сетям интерфейсов сервера.
Включим прослушивание всех интерфейсов сервером и настроим архивирование WAL.
Каталог для архива WAL.
Резервная копия:
Подготовим настройки для реплики. Параметр wal_receiver_timeout задает время, по истечении которого реплика прерывает неактивное соединение. Это позволит ей быстрее обнаружить разрыв сетевого соединения.
Page 36: 2. Проверка репликации
Реплика получает записи WAL через поток…
…и сообщает мастеру о принятых записях без задержек:
Таблица реплицирована:
Page 37: 3. Отказ сети
Выключаем сетевой интерфейс — авария сети.
Сеть недоступна.
Процесс wal receiver остановлен:
На мастере добавляем строку…
…но реплика ее не получает:
Потоковая репликация остановилась:
4. Архивация
Однако архивация на мастере продолжает работать. Переключим сегмент WAL:
Сегмент попал в архив:
Теперь реплика сможет применить записи нового сегмента и мы увидим строку таблицы, вставленную до переключения.
Page 38: 5. Восстановление сети
Вставим еще одну строку в таблицу на мастере.
На реплику она не попадает.
Теперь восстановим сетевой интерфейс — авария ликвидирована.
Опять работает потоковая репликация:
На мастере добавляем еще строку.
Реплика получила все строки.
Page 39: Уборка
 {#source-figure-039 caption=“Source slide page 39: Уборка”}
Удалим созданную базу данных, сбросим значения параметров конфигурации.