03 Занятие 03: Резервное копирование / Архив журналов предзаписи
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba3_03_backup_archive.html Archive: DBA3-handouts-16.zip Страниц PDF: 31
Page 1: Резервное копирование / Архив журналов предзаписи
Авторские права
© Postgres Professional, 2017–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Файловый архив — непрерывная архивация
- Потоковый архив — утилита pg_receivewal
- Восстановление с использованием архива
- Очистка архива
Page 3: Непрерывная архивация
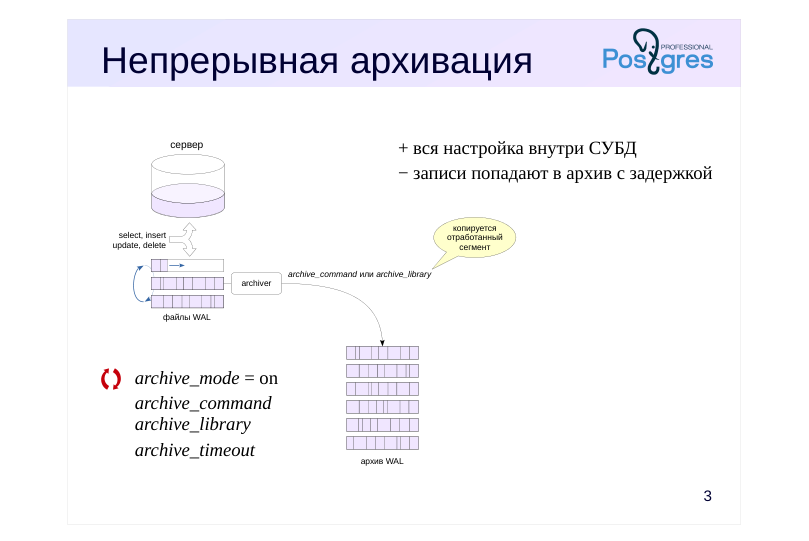 {#source-figure-003 caption=“Source slide page 3: Непрерывная архивация”}
- archive_mode = on
- archive_command
- archive_library
- archive_timeout
Комментарии преподавателя
Базовая резервная копия, рассмотренная в предыдущей теме, содержит все журнальные записи, необходимые для согласования страниц файлов данных. Такая копия называется автономной и позволяет восстановить состояние сервера на момент окончания резервирования.
Если же к автономной копии добавлять новые файлы журнала предзаписи, генерируемые сервером, можно будет восстановить кластер на произвольный момент времени. На практике заполненные журнальные сегменты копируются не в саму копию, а в отдельный архив. Этим занимается процесс archiver при значении параметра archive_mode = on.
В PostgreSQL есть два способа копирования сегмента WAL в архив:
Командой ОС. При переключении на очередной сегмент WAL процесс выполняет команду, которую он получает из параметра archive_command.
С помощью функций модуля архивирования (начиная с версии 15). Имя модуля задается параметром archive_library. https://postgrespro.ru/docs/postgresql/16/archive-modules
На слабо загруженных серверах параметром archive_timeout задают максимальное время, которое может пройти до переключения на новый сегмент WAL. Переключение можно выполнить и вручную, используя функцию pg_switch_wal.
https://postgrespro.ru/docs/postgresql/16/continuous-archiving
Page 4: archive_command
Команда ОС, архивирующая заполненный сегмент WAL
- копирует файл %p в архив под именем %f,
- сам архив может быть организован любым образом
- должна завершаться со статусом 0 только при успехе
- не должна перезаписывать уже существующие файлы
- должна гарантировать запись в энергонезависимую память
- удобно реализовать нужную логику в собственном скрипте
- Мониторинг
- текущий статус — представление pg_stat_archiver
- удобно включить коллектор сообщений (logging_collector = on)
- и получать диагностику в журнале сообщений сервера
Комментарии преподавателя
Команда архивирования должна скопировать указанный файл в некий архив. Архив может быть организован любым образом. Например, это может быть файловая система на отдельном сервере.
Команда обязана завершаться с нулевым статусом только при успехе; в этом случае скопированный сегмент может быть удален контрольной точкой. При ненулевом статусе не скопированный сегмент и следующие за ним не удаляются, а сервер периодически повторяет команду архивирования, пока не получит 0.
Команда не должна перезаписывать уже существующие файлы, так как это скорее всего означает какую-то ошибку, и перезапись файла может погубить архив.
Для гарантии надежности команда должна обеспечить попадание файла в энергонезависимую память: иначе при сбое архива можно потерять сегмент, если сервер PostgreSQL успеет его удалить.
Текущий статус архивации показывает представление pg_stat_archiver. Удобно включить сбор сообщений с помощью процесса logging_collector, так как в этом случае сообщения об ошибках при выполнения archive_command будут попадать в журнал сервера.
Если подразумевается сложная логика, то ее удобно записать в скрипт и использовать имя скрипта в качестве команды копирования.
https://postgrespro.ru/docs/postgresql/16/runtime-config-wal#GUC-ARCHIV E-COMMAND
Page 5: Настройка непрерывной архивации
Архив будем хранить в каталоге /var/lib/postgresql/archive. Он должен быть доступен пользователю-владельцу PostgreSQL.
В реальной практике архив может размещаться на отдельном сервере или дисковой системе с доступом по сети. Включим режим архивирования и установим команду копирования заполненных сегментов журнала.
В archive_command мы сначала проверяем наличие файла с указанным именем в архиве, и копируем его только в случае отсутствия.
В archive_command можно указать произвольную команду, лишь бы она завершалась со статусом 0 только в случае успеха. Например, можно организовать сжатие архивируемых сегментов:
В идеале команда архивирования должна выполнять sync, чтобы файл гарантированно попал в энергонезависимую память. Иначе при сбое он может пропасть из архива, а сервер может успеть стереть его из каталога pg_wal. Обычно удобно поместить всю необходимую логику архивирования в отдельный скрипт и вызывать его:
Изменение archive_mode требует рестарта сервера.
Появился процесс archiver:
Проверим работу архивации. Создадим базу и таблицу.
Вот какой сегмент WAL используется сейчас:
Page 6: Page 6
Чтобы заполнить файл, пришлось бы выполнить большое количество операций. В тестовых целях проще принудительно переключить сегмент:
Сегмент сменился:
А предыдущий должен был попасть в архив. Проверим:
Текущий статус архивации показывает представление pg_stat_archiver:
Таким образом, файловая архивация настроена и работает.
Page 7: pg_receivewal
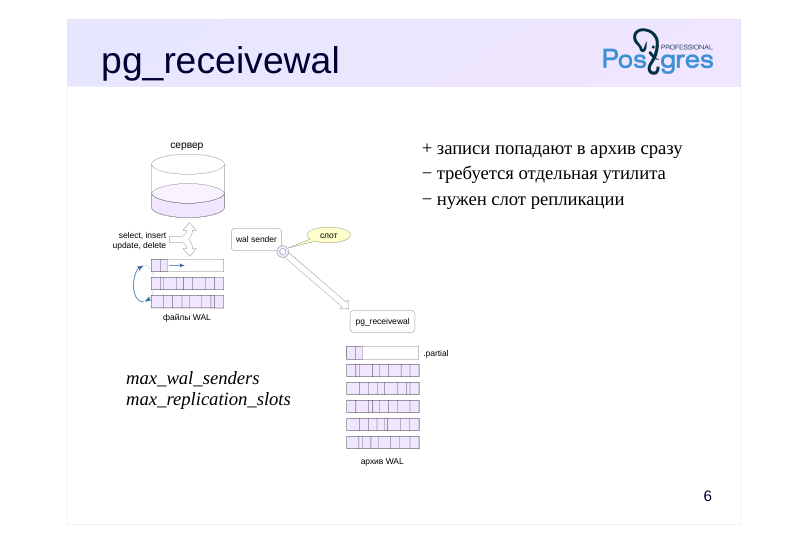 {#source-figure-007 caption=“Source slide page 7: pg_receivewal”}
- max_wal_senders
- max_replication_slots
Комментарии преподавателя
Можно организовать пополнение архива иным способом, с помощью протокола репликации. Для этого используется утилита pg_receivewal.
Обычно утилита запускается на отдельном сервере, хранящем архив. Она формирует файлы аналогично тому, как это делает сам сервер, и записывает их в указанный каталог. Не до конца заполненные сегменты имеют суффикс .partial. По умолчанию синхронизация кеша с файловой системой происходит только при закрытии сегмента WAL, но можно сделать запись синхронной, задав параметр –synchronous.
Утилита может сжимать сегменты WAL. Для этого в параметре –compress нужно указать алгоритм (gzip или lz4) и уровень сжатия.
При первом запуске (когда архив пуст) архивирование начнется с начала текущего сегмента. Обычно же архивирование начинается с начала сегмента, следующего за последним заполненным сегментом в архиве. При использовании слота репликации это гарантирует отсутствие пропусков в архиве, даже если утилита отключалась на некоторое время.
По умолчанию утилита получает записи бесконечно, но можно завершить ее работу при получении записи с заданным LSN, если указать –endpos=lsn.
Учтите, что утилита не запускается автоматически как сервис и не демонизируется.
https://postgrespro.ru/docs/postgresql/16/app-pgreceivewal
Page 8: Потоковый архив
Чтобы настроить пополнение архива по протоколу потоковой репликации, остановим сначала файловую архивацию.
Текущее состояние архива.
Сначала попросим утилиту pg_receivewal создать слот, чтобы гарантировать получение всех записей журнала.
Затем запустим ее фоном в режиме архивации. Увидев, что в архиве уже есть файлы, утилита запросит у сервера следующий сегмент, чтобы в архиве не было пропусков.
Добавим в таблицу много строк и удалим их.
В архиве появились новые файлы.
Последний файл, скорее всего, имеет суффикс .partial — в него идет запись. Теперь мы настроили потоковую архивацию.
Page 9: Базовая копия
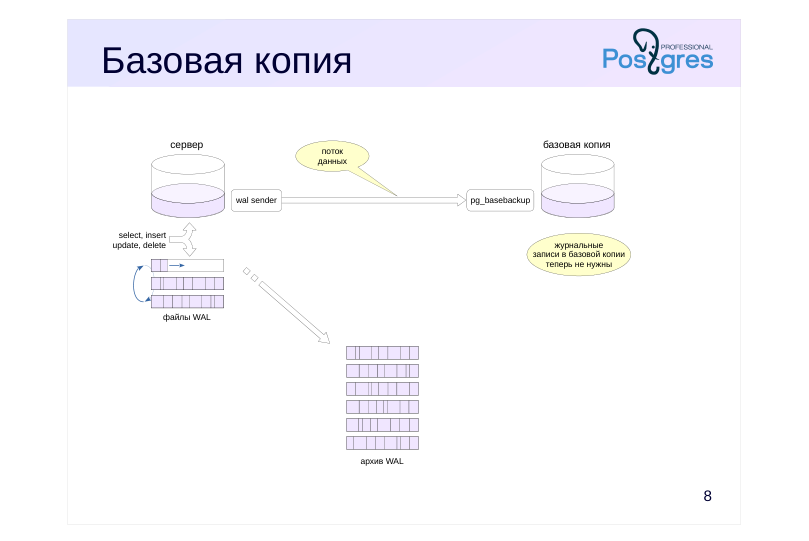 {#source-figure-009 caption=“Source slide page 9: Базовая копия”}
Комментарии преподавателя
Если мы располагаем настроенным архивом журнала предзаписи, то в базовой резервной копии файлы журнала перестают быть обязательными — ведь их при восстановлении можно получить из архива. Поэтому pg_basebackup можно запускать с ключом –wal-method=none.
(Но и никакого вреда от журнальных файлов внутри базовой копии, кроме занимаемого объема, тоже нет. Более того, они позволят восстановить систему в ситуации, если архив окажется недоступен.)
Page 10: Базовая резервная копия
Поскольку архив пополняется автоматически, попросим pg_basebackup не добавлять файлы журнала к резервной копии:
В каталоге pg_wal резервной копии сегментов WAL нет:
Зато в архиве прибавилось файлов:
Page 11: Восстановление
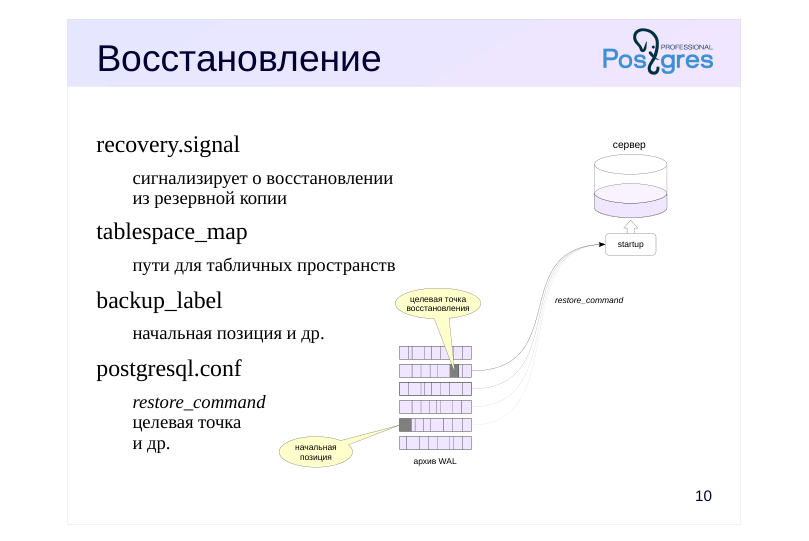 {#source-figure-011 caption=“Source slide page 11: Восстановление”}
recovery.signal
- сигнализирует о восстановлении из резервной копии tablespace_map
- пути для табличных пространств
- backup_label
- начальная позиция и др.
- postgresql.conf
- restore_command
- целевая точка
- и др.
Комментарии преподавателя
Процессом восстановления управляют три файла и параметры.
Файл recovery.signal создается вручную. Его наличие дает указание серверу перейти в режим восстановления. Содержимое файла игнорируется. Если recovery.signal отсутствует, то PostgreSQL считает, что он выполняет автоматическое восстановление после сбоя. Если же файл есть, сервер понимает, что происходит управляемое пользователем восстановление из резервной копии и обращает внимание на два других файла, которые генерируются при создании базовой резервной копии:
● Файл tablespace_map содержит пути для табличных пространств. Если символические ссылки в pg_tblspc отсутствуют (это верно для формата tar), то они будут созданы при старте сервера на основании информации в tablespace_map.
С этим файлом мы уже встречались в теме «Базовая резервная копия».
● Файл метки backup_label содержит название, время создания копии и — самое важное — название сегмента WAL и позицию в нем, с которой надо начинать восстановление.
При восстановлении процесс startup читает файлы из архива с помощью команды из параметра restore_command и применяет журнальные записи от начальной позиции, указанной в файле метки, до целевой точки восстановления.
Page 12: Настройка восстановления
Настройку восстановления начнем с создания сигнального файла.
При создании базовой резервной копии был создан файл метки backup_label.
Главная информация в этом файле — начальная точка для восстановления (START WAL LOCATION). Теоретически восстановление можно начать и с более ранней (но не более поздней) позиции, но это потребует больше времени. Поскольку в нашем кластере нет дополнительных табличных пространств, файл tablespace_map не нужен. Осталось задать в конфигурационном файле restore_command и другие параметры.
Page 13: restore_command
Команда ОС, восстанавливающая сегмент WAL
- выполняет действие, «обратное» archive_command
- копирует файл %f из архива на сервер по пути %p
- должна завершаться со статусом 0 только при успехе
- (может вызываться для несуществующих файлов)
- Мониторинг
- log_startup_progress_interval = 10s
- журналирование статуса процесса startup
Комментарии преподавателя
Параметр restore_command определяет команду, «обратную» команде архивирования archive_command. Она должна скопировать файл из архива в каталог pg_wal и завершаться со статусом 0 только при успехе. Это очень важно, так как в процессе восстановления сервер может выполнять команду восстановления для файлов, которых не окажется в архиве — это не ошибка, но команда должна завершиться с ненулевым статусом.
Начиная с 14-й версии PostgreSQL изменение параметра restore_command не требует рестарта сервера.
https://postgrespro.ru/docs/postgresql/16/runtime-config-wal#RUNTIME-CO NFIG-WAL-ARCHIVE-RECOVERY
С 15-й версии за состоянием процесса восстановления можно следить в журнале сообщений сервера при включенном параметре log_startup_progress_interval. При значении по умолчанию информация сбрасывается в журнал раз в 10 секунд.
В более ранних версиях информация о текущем состоянии восстановления отображалась только в имени unix-процесса startup.
Page 14: Точка перезапуска
Аналог контрольной точки при восстановлении
- сброс грязных буферов
- запись в управляющий файл
- удаление ненужных сегментов WAL
- Выполняется при применении записи о контрольной точке
- если после точки перезапуска прошло не менее checkpoint_timeout
- или объем WAL приближается к max_wal_size
- Мониторинг
- log_checkpoints
- pg_stat_bgwriter
Комментарии преподавателя
Когда при восстановлении процесс startup применяет журнальные записи, данные в общей памяти сервера изменяются так же, как при обычной работе: появляются грязные буферы. Если произойдет сбой, после него нужно будет повторять восстановление, и на этот случай необходимо хранить журнальные записи. Чтобы ограничить объем хранимых записей и не начинать восстановление с самого начала, сервер периодически выполняет точки перезапуска (restart points), сбрасывая, как при контрольной точке, грязные буферы структур общей памяти: буферного кеша, кеша clog и других. При успешном завершении точки перезапуска сервер делает запись в управляющем файле и удаляет сегменты WAL, которые целиком предшествуют ее началу.
Точка перезапуска выполняется, когда процесс startup встречает в WAL запись о контрольной точке, если после последней точки перезапуска прошло не менее checkpoint_timeout времени или если объем журнала приближается к значению max_wal_size. Иными словами, точка перезапуска инициируется журнальной записью о контрольной точке, но если ни одно из условий не выполняется, запись пропускается.
Если включен параметр log_checkpoints, в журнал сообщений будет попадать информация обо всех точках перезапуска, а представление pg_stat_bgwriter показывает накопленную статистику.
https://postgrespro.ru/docs/postgresql/16/wal-configuration
Page 15: Цель восстановления
 {#source-figure-015 caption=“Source slide page 15: Цель восстановления”}
Восстановление до определенной точки (PITR)
- recovery_target = ‘immediate’
- только восстановить согласованность
- recovery_target_name = ‘имя’
- до именованной точки, созданной
- pg_create_restore_point(‘имя’)
- recovery_target_time = ‘время’
- до указанного времени
- recovery_target_xid = ‘xid’
- до указанной транзакции
- recovery_target_lsn = ’lsn'
- до указанного LSN
- recovery_target_inclusive = on|off
- включать ли указанную точку
- recovery_target_action = pause
pause
- promote
- принимает подключения
- shutdown
- останавливается
Комментарии преподавателя
Если цель восстановления не задана, кластер будет восстановлен максимально близко к моменту сбоя. Однако процесс восстановления можно остановить и в любой другой момент, указав целевую точку:
● Параметр recovery_target = ‘immediate’ остановит восстановление, как только будет достигнута согласованность. Фактически, это эквивалентно восстановлению из базовой копии без архива.
● Параметр recovery_target_name позволяет указать именованную целевую точку восстановления, созданную заранее с помощью функции pg_create_restore_point.
● Параметр recovery_target_time позволяет указать произвольное время (timestamp), recovery_target_xid — произвольную транзакцию, recovery_target_lsn — номер LSN. С помощью параметра recovery_target_inclusive можно включить или исключить саму точку.
Параметр recovery_target_action позволяет выбрать состояние, в котором окажется сервер по достижении целевой точки:
● При значении pause восстановление приостанавливается. Администратор может выполнить запросы и решить, корректно ли была выбрана цель, после чего либо завершить восстановление (функция pg_wal_replay_resume), либо задать новую цель, перезапустить сервер и продолжить применение записей WAL.
● Если задано значение promote, сервер сразу сможет принимать запросы на подключения.
● Значение shutdown приведет к остановке сервера. При этом файл recovery.signal не удаляется.
Page 16: Окончание восстановления
 {#source-figure-016 caption=“Source slide page 16: Окончание восстановления”}
recovery.signal удаляется
- backup_label backup_label.old
- выполняется recovery_end_command
- проблемы диагностируются по журналу сообщений
Комментарии преподавателя
После того как восстановление закончено, процесс startup завершается, postmaster запускает остальные служебные процессы, необходимые для работы экземпляра, и сервер начинает работать в обычном режиме. Файл recovery.signal удаляется, backup_label переименовывается в backup_label.old.
В параметре recovery_end_command можно задать команду, которая выполнится по окончании восстановления; это могут быть действия с файловой системой, очистка архива, отправка уведомления и др.
Возможна ситуация, когда запущенный сервер не стартует. В этом случае в операционной системе будут отсутствовать процессы экземпляра (и не будет файла postmaster.pid), а recovery.signal не будет удален. Причину ошибки можно узнать из журнала сообщений сервера (например, в параметрах была допущена ошибка). После исправления причины ошибки сервер следует запустить еще раз.
Важный момент: если на сервере-источнике было настроено непрерывное архивирование, то на резервном сервере его надо либо отключить, либо перенаправить в другой архив.
Page 17: Восстановление из базовой резервной копии
Зададим настройки восстановления на сервере beta. В простейшем случае достаточно указать команду восстановления, которая будет копировать указанный сегмент WAL обратно из архива по указанному пути:
Если не указана целевая точка восстановления (один из параметров recovery_target*), то к базовой резервной копии будут применены записи WAL из всех файлов в архиве. Выкладываем резервную копию в каталог данных сервера beta и запускаем его.
После успешного восстановления файл recovery.signal удаляется, а файл метки переименовывается в backup_label.old:
Поскольку были применены все записи WAL, сервер beta сразу начинает принимать подключения. Проверим, что восстановлено в таблице:
Накопительная статистика сервера содержит информацию о точках перезапуска:
Page 18: Линии времени
 {#source-figure-018 caption=“Source slide page 18: Линии времени”}
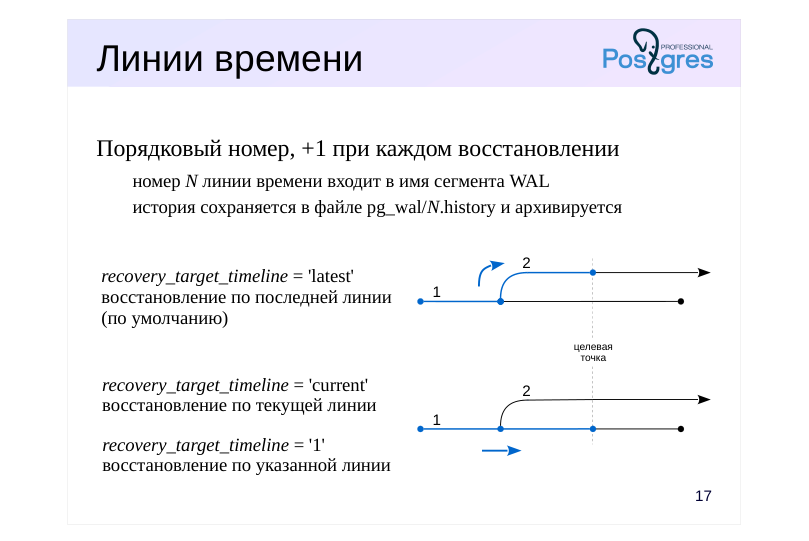
Порядковый номер, +1 при каждом восстановлении
- номер N линии времени входит в имя сегмента WAL
- история сохраняется в файле pg_wal/N.history и архивируется
- recovery_target_timeline = ’latest’ восстановление по последней линии (по умолчанию)
- recovery_target_timeline = ‘current’ восстановление по текущей линии
- recovery_target_timeline = ‘1’ восстановление по указанной линии
Комментарии преподавателя
После восстановления на момент в прошлом сервер начинает генерировать новые записи WAL, номера которых будут повторять номера записей «из прошлой жизни». Чтобы не потерять записи и, вместе с ними, возможность восстановления на другой момент, PostgreSQL вводит понятие линии времени. После каждого восстановления с использованием recovery.signal номер линии времени увеличивается, и этот номер является частью номера сегментов WAL.
Линии времени образуют древовидную структуру, на рисунках приведен пример. Первая линия имеет номер 1. Произошло восстановление на момент времени в прошлом, и началась линия 2.
Если выполнить восстановление с указанием параметра recovery_target_timeline = ’latest’ (по умолчанию), то, дойдя то точки ветвления, применение записей WAL продолжится по второй (более поздней) линии.
Если же указать параметр recovery_target_timeline = ‘1’, то восстановление продолжится по первой (указанной) линии, а если указать recovery_target_timeline = ‘current’, то по текущей (в нашем случае тоже по линии 1).
Информацию о точках ветвления PostgreSQL берет из файлов истории pg_wal/N.history. Поэтому их никогда не следует удалять из архива.
Page 19: Линии времени
Что стало с линией времени после восстановления?
Номер увеличился на единицу. В каталоге pg_wal появился файл истории, соответствующий этой ветви:
В нем есть информация о «точках ветвления», через которые мы пришли в данную линию времени:
Эти файлы PostgreSQL использует, когда мы указываем линию времени в параметре recovery_target_timeline. Поэтому файлы истории подлежат архивации вместе с сегментами WAL, и удалять из архива их не надо.
Page 20: Очистка архива
 {#source-figure-020 caption=“Source slide page 20: Очистка архива”}
Комментарии преподавателя
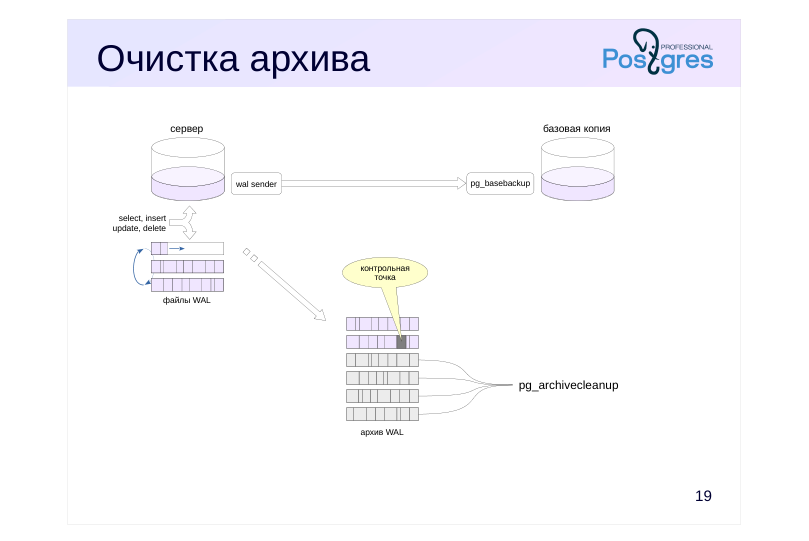
Архив со временем разрастается, поэтому требуется периодическая очистка от ненужных файлов.
Для очистки можно воспользоваться утилитой pg_archivecleanup. Утилите нужно указать имя сегмента WAL, и она удалит все ему предшествующие.
https://postgrespro.ru/docs/postgresql/16/pgarchivecleanup
Вопрос в том, как определить позицию в архиве, начиная с которой сегменты уже не нужны.
Если архив используется только для восстановления из одной базовой резервной копии, можно выполнять очистку сразу после ее обновления.
Но если архив должен поддерживать восстановление из нескольких базовых резервных копий, то для автоматизации очистки либо придется написать собственный скрипт, либо — что лучше — воспользоваться одной из сторонних программ резервного копирования, таких как pg_probackup, которые позволяют гибко настроить политику хранения резервных копий.
Page 21: Очистка архива
Сейчас архив первого сервера содержит ненужные файлы, они попали туда до формирования базовой копии:
Утилите pg_archivecleanup нужно передать путь к архиву и имя последнего сохраняемого сегмента WAL (его можно найти в файле backup_label).
Посмотрим, какие файлы остались в архиве:
Архив очищен. Утилиту можно вызывать сразу после формирования базовой резервной копии, поместив обе команды в скрипт.
Page 22: Итоги
Физическое резервирование — базовые резервные копии и архив журнала предзаписи
- Хорошо подходит
- для текущего периодического резервирования
- для восстановления после сбоя с минимальной потерей данных
- для восстановления на произвольный момент времени
- для резервирования данных большого объема
- Плохо подходит
- для длительного хранения
- Не подходит
- для миграции на другую платформу
Page 23: Практика
- На сервере alpha создайте базу данных и таблицу с данными. 2. Настройте непрерывное архивирование. 3. Сделайте копию кластера без файлов журнала. 4. Вставьте еще несколько строк в таблицу и убедитесь, что текущий сегмент WAL попал в архив. 5. Восстановите сервер beta из резервной копии, указав в параметрах одну только команду восстановления. 6. Снова восстановите сервер beta из той же резервной копии, на этот раз указав целевую точку восстановления immediate.
Комментарии преподавателя
После выполнения практических заданий удалите базы данных и сбросьте изменения параметров конфигурации.
Page 24: 1. База данных и таблица
2. Настройка непрерывной архивации
3. Базовая резервная копия
Поскольку нам потребуется восстанавливаться из одной копии два раза, сделаем ее в формате tar со сжатием.
4. Добавление строк в таблицу
Переключаем сегмент:
Проверяем статус архивации:
5. Восстановление из базовой резервной копии
Page 25: Page 25
Для простоты отключим непрерывное архивирование на резервном сервере и укажем только команду восстановления:
Создаем recovery.signal.
Запускаем сервер.
Восстановились все строки. Поскольку по умолчанию применяются все имеющиеся журнальные записи, сервер сразу перешел в обычный режим и готов принимать запросы на изменение данных:
6. Восстановление из базовой резервной копии — immediate
Создаем recovery.signal, в конфигурационный файл записываем команду восстановления и целевую точку:
Запускаем сервер.
Восстановилась только первая строка. На этот раз были применены только журнальные записи, необходимые для согласования данных. Сервер уже принимает запросы на чтение, при необходимости восстановление можно продолжить:
Page 26: Page 26
 {#source-figure-026 caption=“Source slide page 26: Page 26”}
Функция pg_get_wal_replay_pause_state() возвращает: not paused — приостановка не запрашивалась; pause requested — запрошена приостановка; paused — восстановление приостановлено. Поскольку нам не нужно применять последующие записи, завершаем восстановление, переводя сервер в обычный режим (нужны права суперпользователя):
Чтобы не выходить из режима восстановления вручную, можно было заранее задать значение recovery_target_action = ‘promote’.
Уборка
Удалим резервную копию и базы данных, сбросим настройки параметров конфигурации.
Page 27: Практика+
- На сервере alpha создайте таблицу, в которую будут периодически записываться данные. Создайте физическую резервную копию и настройте непрерывную архивацию WAL. 2. Вставьте в подготовленную таблицу трижды по 100 строк (данные за январь, февраль и март), отмечая время сразу после вставки. Между вставками удалите некоторые строки: сымитируйте ситуацию, в которой пользователь случайно удаляет часть данных в неизвестный момент, но проблему замечают не сразу. 3. Восстановите удаленные данные, не останавливая при этом сервер alpha.
Комментарии преподавателя
- Используйте сервер beta как вспомогательный.
Page 28: 1. Таблица и резервирование с архивом WAL
Подготовим таблицу:
После формирования структуры данных создадим физическую копию:
Архив сегментов WAL:
Добавим файл параметров архивирования в каталог дополнительной конфигурации.
Перезапускаем сервер.
2. Вставка данных в таблицу
Наше условное приложение добавляет в таблицу 100 строк в конце каждого месяца. Вставка строк за январь:
Запомним момент времени после завершения вставки:
Пользователь по ошибке удаляет часть данных:
Вставим данные за февраль:
Page 29: Page 29
Снова запомним момент времени после окончания транзакции:
Пользователь зачем-то еще раз выполняет ту же команду:
Но ошибку пока не заметили. Выполняем еще одну вставку:
Опять запомним момент времени:
Теперь ошибка обнаружена:
3. Восстановление с помощью архива
Задача: восстановить данные, не останавливая сервер alpha. Пропали данные за январь и февраль, поэтому план действий таков: на сервере beta восстанавливаем, используя архив WAL, данные на конец загрузки январских строк; выгружаем логическую копию данных за январь; заново восстанавливаем данные, но теперь на конец загрузки февральских строк; выгружаем логическую копию данных за февраль (январские данные в этот момент могут быть повреждены); загружаем восстановленные данные в таблицу приложения на сервере alpha. Остановим сервер beta и поместим физическую копию в его каталог данных.
Необходимо создать файл recovery.signal:
Мы хотим восстановить состояние сервера на определенный момент времени, то есть выполнить point-in-time recovery (PITR). Зададим команду восстановления и укажем целевую точку восстановления на запомненный момент сразу после загрузки данных за январь:
Перед началом восстановления принудительно переключим сегмент на alpha, чтобы все записи WAL попали в архив.
Page 30: Page 30
Архивация происходит при начале записи в следующий сегмент.
Запускаем сервер beta.
Проверим, что данные за январь восстановлены:
Сервер beta находится в состоянии восстановления:
Однако это не помешает выгрузить логическую копию данных.
Переходим к февралю. Указываем новое время:
Чтобы продолжить восстановление, перезапустим сервер beta.
Проверяем восстановленные данные:
Мы видим, что февральские строки на месте, а январские уже повреждены. Выгружаем февраль:
Теперь восстановим выгруженные данные за два месяца на сервере alpha.
Page 31: Page 31
Все получилось:
Начиная с версии PostgreSQL 17 можно было бы не удалять строки, а воспользоваться командой COPY с параметром ON ERROR ignore, чтобы пропустить уже существующие в таблице.
Уборка
Удалим базы данных и настройки параметров конфигурации.
Удалим ненужные файлы.