01 Занятие 01: Резервное копирование / Логическое резервирование
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba3_01_backup_logical.html Archive: DBA3-handouts-16.zip Страниц PDF: 33
Page 1: Резервное копирование / Логическое резервирование
Авторские права
© Postgres Professional, 2017–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Понятие логической резервной копии
- Копирование и восстановление отдельных таблиц
- Копирование и восстановление баз данных
- Копирование и восстановление кластера
Page 3: Логическая копия
Команды SQL для создания объектов и наполнения данными
- можно сделать копию отдельного объекта или отдельной базы
- можно восстановиться на другой версии или архитектуре
- (не требуется двоичная совместимость)
- − невысокая скорость работы
- − восстановление только на момент создания резервной копии
Комментарии преподавателя
Логическая копия содержит набор команд SQL, выполнив которые можно восстановить кластер, базу данных или выбранные таблицы. В процессе восстановления из логической копии создаются необходимые объекты и наполняются данными.
Команды можно выполнить на другой версии СУБД или даже на другой платформе и архитектуре, так как не требуется двоичная совместимость.
В частности, логическую резервную копию можно использовать для долговременного хранения: ее можно будет восстановить и после обновления сервера на новую версию.
Однако для большой базы команды могут выполняться очень долго. Восстановить систему из логической копии можно ровно на момент начала резервного копирования.
https://postgrespro.ru/docs/postgresql/16/backup-dump
Page 4: SQL-команда COPY
 {#source-figure-004 caption=“Source slide page 4: SQL-команда COPY”}
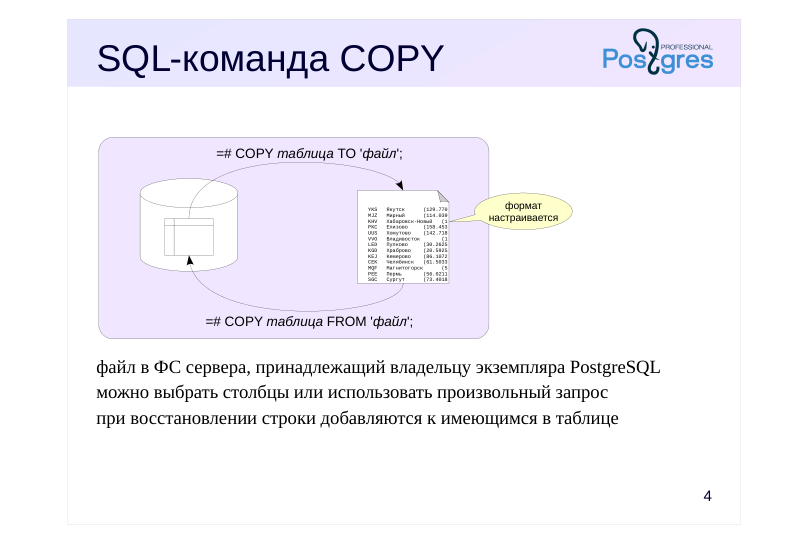
- файл в ФС сервера, принадлежащий владельцу экземпляра PostgreSQL можно выбрать столбцы или использовать произвольный запрос при восстановлении строки добавляются к имеющимся в таблице
Комментарии преподавателя
Команда COPY TO записывает содержимое таблицы или результат запроса в файл или поток вывода. Строки представлений или секционированных таблиц можно скопировать с помощью запроса.
Для использования COPY TO требуется роль pg_write_server_file.
Команда COPY FROM добавляет в таблицу строки из файла или стандартного потока ввода. Она работает существенно быстрее, чем аналогичные команды INSERT. Следить за процессом копирования можно в представлении pg_stat_progress_copy.
Для COPY FROM требуется роль pg_read_server_files (а для чтения потока ввода — pg_execute_server_program).
Тонкость: при выполнении команды COPY FROM не применяются правила (rules), хотя ограничения целостности и триггеры выполняются. Если столбец таблицы при вставке должен получать значения, генерируемые последовательностью, но COPY заполняет этот столбец явно, последовательность не будет изменять свое состояние (счетчик).
Оба варианта команды COPY позволяют выбрать столбцы таблицы, а также указать такие параметры, как:
● FORMAT — формат данных (текстовый, CSV или двоичный);
● DELIMITER — разделитель полей;
● NULL — текстовое представление NULL;
● ENCODING — кодировку;
● HEADER — заголовок, описывающий столбцы. https://postgrespro.ru/docs/postgresql/16/sql-copy
Page 5: Команда psql \copy
 {#source-figure-005 caption=“Source slide page 5: Команда psql \copy”}
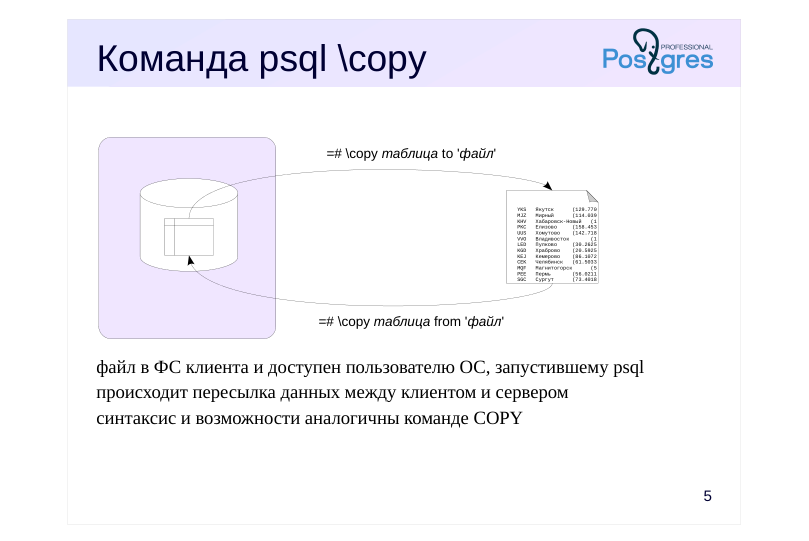
- файл в ФС клиента и доступен пользователю ОС, запустившему psql происходит пересылка данных между клиентом и сервером синтаксис и возможности аналогичны команде COPY
Комментарии преподавателя
В psql существует метакоманда \copy — вариант команды COPY с аналогичным синтаксисом, — выполняющаяся на стороне клиента.
Файл должен быть доступен пользователю операционной системы, запустившему psql. Обращение к файлу происходит на клиенте, а на сервер передается только содержимое.
https://postgrespro.ru/docs/postgresql/16/app-psql#APP-PSQL-META-COM MANDS-COPY
Page 6: Команда COPY
Создадим базу данных и таблицу.
Выведем содержимое таблицы в терминал:
Видно, как различаются в выводе пустые строки и неопределенные значения. Формат вывода настраивается достаточно гибко. Можно изменить разделитель, представление неопределенных значений и т. п. Например:
Обратите внимание, что символ-разделитель внутри строки был экранирован (символ для экранирования тоже настраивается). Вместо таблицы можно указать произвольный запрос.
Таким образом можно сохранить результат запроса, данные представления и т. п. Команда поддерживает вывод в формате CSV, который поддерживается множеством программ.
Аналогично работает и ввод данных из файла или с терминала.
Но при вводе с терминала требуется маркер конца файла — обратная косая черта с точкой; в обычном файле он не нужен. Чтобы данные загрузились, при вводе надо указать те же параметры, что были указаны при выводе.
Page 7: Page 7
При загрузке также можно указать условие:
Вот что загрузилось в таблицу (для наглядности настроим в psql вывод неопределенных значений):
Загрузим все строки:
Page 8: Копия базы данных
 {#source-figure-008 caption=“Source slide page 8: Копия базы данных”}
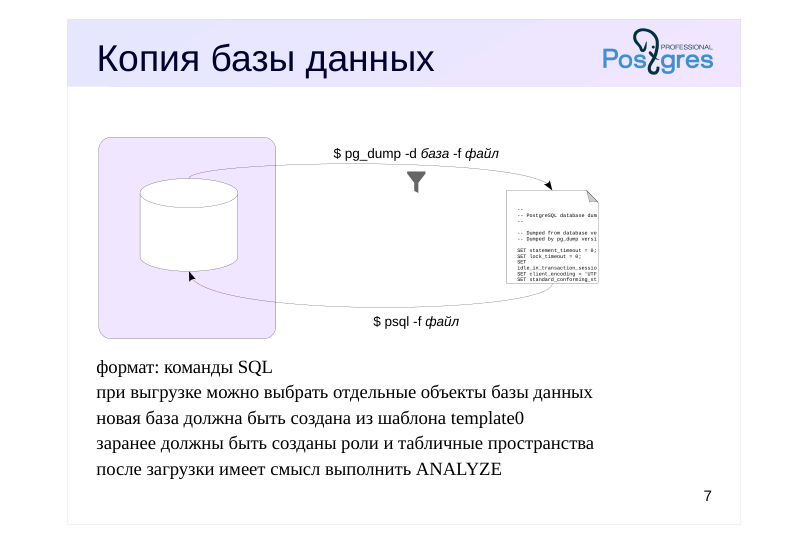
- формат: команды SQL при выгрузке можно выбрать отдельные объекты базы данных новая база должна быть создана из шаблона template0 заранее должны быть созданы роли и табличные пространства после загрузки имеет смысл выполнить ANALYZE
Комментарии преподавателя
Для создания полноценной резервной копии базы данных используется утилита pg_dump.
Если не указать имя файла (-f, –file), то утилита выведет результат в стандартный поток вывода.
Результатом является скрипт, предназначенный для psql, который содержит команды для создания объектов и наполнения их данными.
Дополнительными ключами утилиты можно ограничить набор объектов: выбрать указанные таблицы или все объекты в указанных схемах, выгрузить только определения объектов или только данные и т. п.
Следует иметь в виду, что базу данных для восстановления надо создавать из шаблона template0, так как все изменения, сделанные в template1, попадут в резервную копию.
Кроме того, заранее должны быть созданы необходимые роли и табличные пространства. Поскольку эти объекты не относятся к конкретной БД, они не будут выгружены в резервную копию.
После восстановления базы данных имеет смысл выполнить команду ANALYZE — она соберет статистику, необходимую оптимизатору для планирования запросов.
https://postgrespro.ru/docs/postgresql/16/app-pgdump
Page 9: Утилита pg_dump
При запуске без дополнительных параметров утилита pg_dump выдает команды SQL, создающие все объекты в текущей базе данных. Чтобы получить команды, позволяющие восстановить копию на системе с другим набором ролей, могут пригодиться ключи: -O, –no-owner — не генерировать команды для установки владельца объектов; -x, –no-acl — не генерировать команды для установки привилегий.
Page 10: Page 10
Видно, что pg_dump создал таблицу t и заполнил ее с помощью уже рассмотренной нами команды COPY. Ключ –column-inserts позволяет использовать команды INSERT, но загрузка будет работать существенно дольше. Логическая резервная копия в формате plain может содержать злонамеренно вставленные метакоманды, например \gexec. Чтобы избежать проблем при выполнении скрипта в psql, pg_dump добавляет в его начало метакоманду \restrict с последующим ключом. Эта команда включает ограниченный режим, в котором psql игнорирует все метакоманды, кроме команды \unrestrict с таким же ключом, отменяющей ограниченный режим. Эти ключи полезны для выгрузки и загрузки данных частями: -s, –schema-only — выгрузить только определения объектов без данных; -a, –data-only — выгрузить только данные, без создания объектов. Удобны, если восстанавливать копию на системе, в которой уже есть данные (и наоборот, на чистой системе): -c, –clean — генерировать команды DROP для создаваемых объектов; -C, –create — генерировать команды создания БД и подключения к ней. Важный момент: в выгрузку попадают и изменения, сделанные в шаблонной БД template1. Поэтому восстанавливать резервную копию лучше на базе данных, созданной из template0. При использовании ключа –create это учитывается автоматически:
Существуют ключи для выбора объектов, которые должны попасть в резервную копию: -n, –schema — шаблон для имен схем; -t, –table — шаблон для имен таблиц. И наоборот, включить в копию все, кроме указанного: -N, –exclude-schema — шаблон для имен схем; -T, –exclude-table — шаблон для имен таблиц. Например, восстановим таблицу t в другой базе данных на другом сервере.
Page 11: Page 11
Page 12: Формат custom
 {#source-figure-012 caption=“Source slide page 12: Формат custom”}
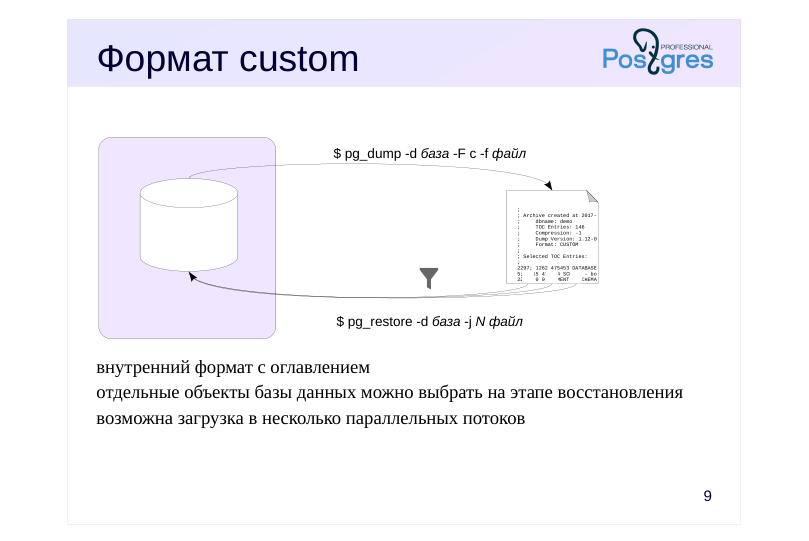
- внутренний формат с оглавлением отдельные объекты базы данных можно выбрать на этапе восстановления возможна загрузка в несколько параллельных потоков
Комментарии преподавателя
Утилита pg_dump поддерживает несколько форматов резервной копии. По умолчанию это plain — простые команды для psql.
Формат custom (-F c, –format=custom) создает резервную копию в специальном формате, содержащем не только объекты, но и оглавление. Наличие оглавления позволяет выбирать объекты для восстановления не при создании копии, а непосредственно при восстановлении. Файл формата custom по умолчанию сжат.
Для восстановления потребуется другая утилита — pg_restore. Она читает файл и преобразует его в команды psql. Если не указать явно имя базы данных (в ключе -d), то команды будут выведены в стандартный поток вывода. Если же база данных указана — утилита соединится с этой БД и выполнит команды без участия psql.
Чтобы восстановить только часть объектов, можно воспользоваться одним из двух подходов. Во-первых, можно ограничить объекты аналогично тому, как они ограничиваются в pg_dump. Вообще, pg_restore использует многие параметры утилиты pg_dump.
Во-вторых, можно получить из оглавления список объектов, содержащихся в резервной копии (ключ –list). Затем этот список можно отредактировать вручную, удалив ненужное и передать измененный список на вход pg_restore (ключ –use-list).
Загрузку можно выполнить параллельно, указав количество потоков ключом -j — это еще одно преимущество формата custom.
https://postgrespro.ru/docs/postgresql/16/app-pgdump
Page 13: Утилита pg_dump — формат custom
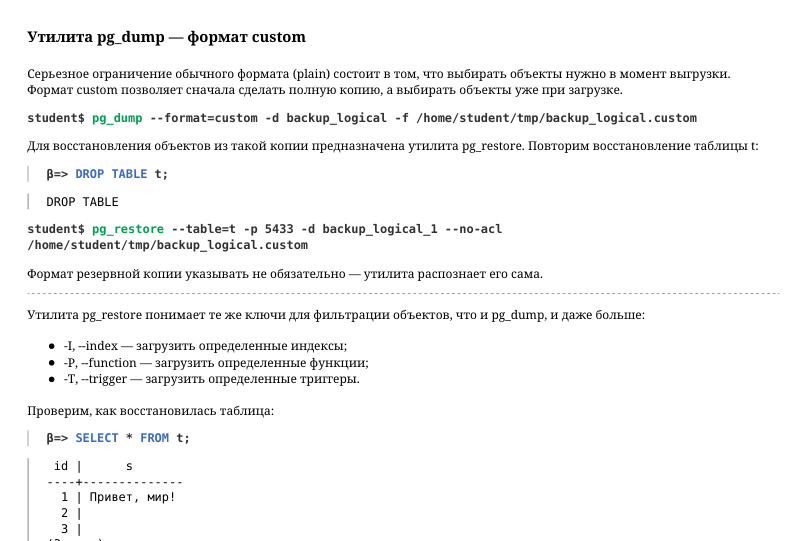 {#source-figure-013 caption=“Source slide page 13: Утилита pg_dump — формат custom”}
Серьезное ограничение обычного формата (plain) состоит в том, что выбирать объекты нужно в момент выгрузки. Формат custom позволяет сначала сделать полную копию, а выбирать объекты уже при загрузке.
Для восстановления объектов из такой копии предназначена утилита pg_restore. Повторим восстановление таблицы t:
Формат резервной копии указывать не обязательно — утилита распознает его сама. Утилита pg_restore понимает те же ключи для фильтрации объектов, что и pg_dump, и даже больше: -I, –index — загрузить определенные индексы; -P, –function — загрузить определенные функции; -T, –trigger — загрузить определенные триггеры. Проверим, как восстановилась таблица:
Еще один пример: восстановим целиком исходную базу данных backup_logical на другом сервере.
Здесь мы указали БД postgres, но могли указать любую — утилита сама создаст нужную БД и тут же переключится в нее. Проверим:
Page 14: Формат directory
 {#source-figure-014 caption=“Source slide page 14: Формат directory”}
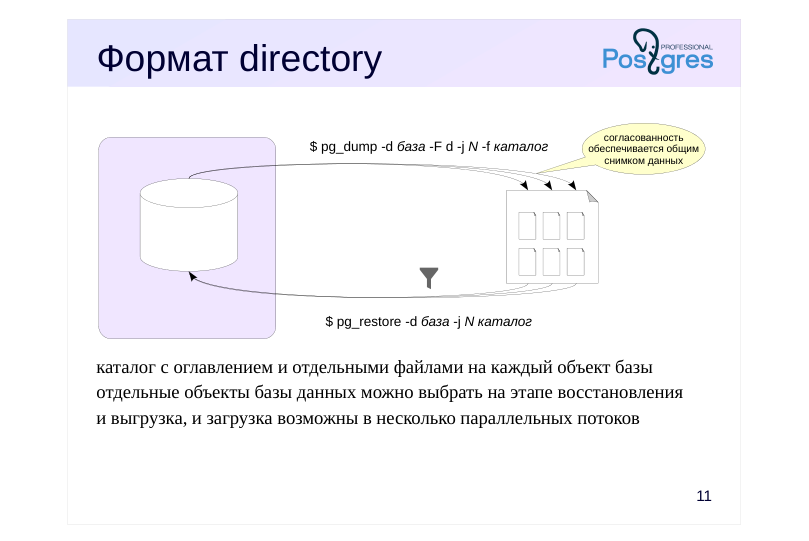
каталог с оглавлением и отдельными файлами на каждый объект базы отдельные объекты базы данных можно выбрать на этапе восстановления и выгрузка, и загрузка возможны в несколько параллельных потоков
Комментарии преподавателя
Еще один формат резервной копии — directory. В таком случае будет создан не один файл, а каталог, содержащий объекты и оглавление. По умолчанию файлы внутри каталога будут сжаты.
Преимущество перед форматом custom состоит в том, что такая резервная копия может создаваться параллельно в несколько потоков (количество указывается в ключе -j, –jobs).
Разумеется, несмотря на параллельное выполнение, копия будет содержать согласованные данные. Это обеспечивается общим снимком данных для всех параллельно работающих процессов.
https://postgrespro.ru/docs/postgresql/16/functions-admin#FUNCTIONS-SN APSHOT-SYNCHRONIZATION
Восстановление, как и для формата custom, возможно в несколько потоков.
В остальном возможности по работе с форматом directory не отличаются от ранее рассмотренных: поддерживаются те же ключи и подходы.
Page 15: Утилита pg_dump — формат directory
Формат directory интересен тем, что позволяет выгружать данные в несколько параллельных потоков.
При этом гарантируется согласованность данных: все параллельные потоки будут использовать один и тот же снимок данных. Заглянем внутрь каталога:
В нем находится файл оглавления и по одному файлу на каждый выгружаемый объект (у нас он всего один):
Для восстановления из резервной копии предварительно отключимся от базы данных backup_logical:
В команду восстановления добавляем ключ –clean, который генерирует команду удаления существующей БД:
Page 16: Сравнение форматов
plain custom directory tar
- утилита для восстановления psql pg_restore
- сжатие gzip, lz4 или zstd
- выборочное восстановление да да да
- параллельное резервирование да
- параллельное восстановление да да
Комментарии преподавателя
В приведенной таблице разные форматы сравниваются с точки зрения предоставляемых ими возможностей.
Имеется и четвертый формат — tar. Он не рассматривался, так как не привносит ничего нового и не дает преимуществ перед другими форматами. Фактически он соответствует созданию tar-файла из каталога в формате directory, но не поддерживает сжатие и параллелизм.
Page 17: Копия кластера БД
 {#source-figure-017 caption=“Source slide page 17: Копия кластера БД”}
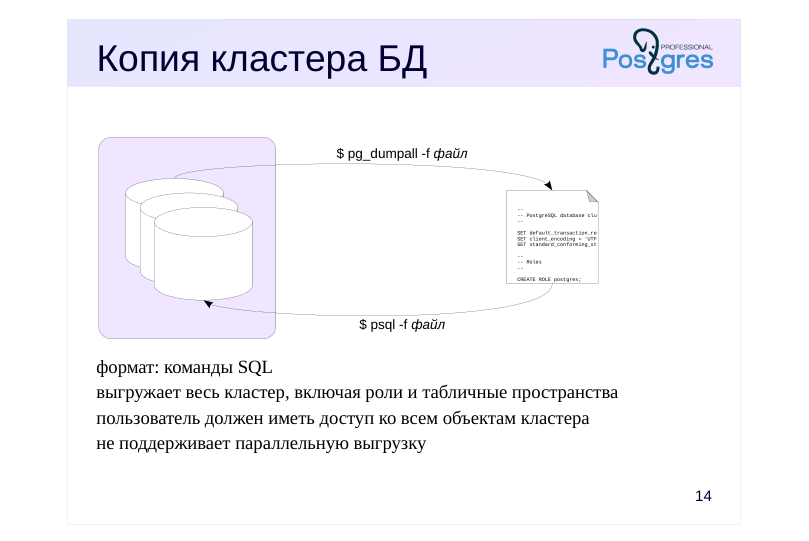
- формат: команды SQL выгружает весь кластер, включая роли и табличные пространства пользователь должен иметь доступ ко всем объектам кластера не поддерживает параллельную выгрузку
Комментарии преподавателя
Чтобы создать резервную копию всего кластера, включая роли и табличные пространства, можно воспользоваться утилитой pg_dumpall.
Поскольку pg_dumpall требуется доступ ко всем объектам всех БД, имеет смысл запускать ее от имени суперпользователя. Утилита по очереди подключается к каждой БД кластера и выгружает информацию с помощью pg_dump. Кроме того, она сохраняет и данные, относящиеся к кластеру в целом.
Чтобы начать работу, утилите требуется подключиться хотя бы к какой-то базе данных. По умолчанию выбирается postgres или template1, но можно указать и другую.
Результатом работы pg_dumpall является скрипт для psql. Другие форматы не поддерживаются. Это означает, что pg_dumpall не поддерживает параллельную выгрузку данных, что может оказаться проблемой при больших объемах данных. В таком случае можно воспользоваться ключом –globals-only, чтобы выгрузить только роли и табличные пространства, а сами базы данных выгрузить отдельно с помощью pg_dump в параллельном режиме.
https://postgrespro.ru/docs/postgresql/16/app-pg-dumpall
Page 18: Утилита pg_dumpall
Утилита pg_dump годится для выгрузки одной базы данных, но никогда не выгружает общие объекты кластера БД, такие, как роли и табличные пространства. Чтобы сделать полную копию кластера, нужна утилита pg_dumpall. Утилиты pg_dumpall, pg_dump и pg_restore не требуют каких-то отдельных привилегий, но у выполняющей их роли должны быть привилегии на чтение (создание) всех затронутых объектов. Утилитой pg_dump может, например, пользоваться владелец базы данных. Но поскольку для копирования кластера надо иметь доступ ко всем БД, мы выполняем pg_dumpall под суперпользовательской ролью.
В копию кластера попадают: команды, которые выгружает pg_dump для каждой базы; команды для общих объектов кластера (ролей и табличных пространств). Команды для общих объектов можно получить отдельно:
Page 19: Page 19
Восстановление выполняется с помощью psql — никакой другой формат не поддерживается.
Page 20: Page 20
Page 21: Page 21
Page 22: Page 22
В процессе восстановления могут возникать ошибки из-за невозможности удалить некоторые объекты или создать уже существующие, в данном случае это нормально и не мешает процессу.
Влияние политик защиты строк
Если на таблицах определены политики защиты строк (подробно рассматриваются в теме «Доступ на уровне строк» курса DBS), то есть опасность выгрузить неполные данные и даже не узнать об этом. Чтобы этого не произошло, перед выполнением команды COPY можно установить параметр row_security в значение off — в этом случае применение политики приведет к явной ошибке. Простой пример. Настроим политику так, чтобы не были видны пустые строки, и включим ее для владельца таблицы:
Теперь COPY выгрузит только две строки:
Page 23: Page 23
Но если установить параметр в off, получим ошибку:
Утилиты pg_dump и pg_dumpall автоматически устанавливают row_security = off, так что дополнительные действия не нужны:
Утилита попыталась выгрузить строки таблицы командой COPY и завершилась ошибкой — она сообщает, что выгрузить все строки таблицы t не удается. Если все-таки решим выгрузить только доступные строки, можно использовать –enable-row-security:
Чтобы обойти политики защиты строк и выгрузить все данные, пользователь должен иметь атрибут BYPASSRLS:
Теперь запросы от роли student будут игнорировать политики защиты строк:
Page 24: Page 24
Page 25: Итоги
Логическое резервирование позволяет сделать копию всего кластера, базы данных или отдельных объектов
- Хорошо подходит
- для данных небольшого объема
- для длительного хранения, за время которого меняется версия сервера
- для миграции на другую платформу
- Плохо подходит
- для восстановления после сбоя с минимальной потерей данных
Page 26: Практика
- Создайте пару баз данных с таблицами и представлениями, получите с помощью pg_dumpall копию только глобальных объектов кластера, а затем сделайте копии баз данных с помощью утилиты pg_dump в параллельном режиме. Восстановите кластер на другом сервере, используя созданные резервные копии. 2. Создайте таблицу с двумя столбцами, один из которых является первичным ключом и заполняется последовательностью. Воспроизведите ситуацию, когда при загрузке с помощью COPY последовательность не генерирует новые значения, вызывая нарушение уникальности при последующей вставке строк.
Комментарии преподавателя
- Объявите столбец как GENERATED ALWAYS AS IDENTITY.
После выполнения практических заданий удалите созданные базы данных и файлы логических копий.
Page 27: 1. Логическое копирование
Создадим базы данных, пару таблиц и представлений.
Сделаем копию глобальных объектов.
Логические копии баз данных в параллельном режиме:
Теперь восстановим кластер. Сначала восстанавливаем глобальные объекты:
Page 28: Page 28
Затем — две базы данных в параллельном режиме:
Проверим:
Удалим созданные базы данных.
2. COPY для таблицы с последовательностью
Таблица с двумя столбцами:
Page 29: Page 29
Созданы таблица и последовательность:
Загружаем строки, не указывая значения для первого столбца.
Содержимое таблицы соответствует ожиданиям:
Счетчик последовательности корректен:
Можно добавить очередную строку:
Вставляя строки с помощью команды INSERT, мы не можем указывать значение столбца, объявленного как GENERATED ALWAYS. Оно должно генерироваться последовательностью:
Однако COPY дает такую возможность:
На первый взгляд все нормально…
Page 30: Page 30
Но это не так:
Нарушение первичного ключа произошло из-за того, что COPY не обращается к последовательности:
Исправим ситуацию, изменив состояние последовательности.
Теперь добавление удастся:
Уборка
Удалим базу данных.
Page 31: Практика+
- Создайте таблицу с несколькими строками. Подберите такие параметры \copy, чтобы при записи копии в файл перепутались корректные данные и неопределенные значения (NULL) из-за неудачного выбора кода. 2. Используя \copy, создайте текстовый файл, в котором отсутствие значения обозначается как N/A. Загрузите строки из этого файла в таблицу, в которой отсутствие значения представляет NULL. 3. Создайте таблицу с данными размером несколько мегабайт и получите размеры логических копий в пользовательском формате с разными способами сжатия. Также измерьте время, затраченное при копировании с каждым методом сжатия.
Комментарии преподавателя
Если ошибочно использовать код для NULL, который будет совпадать с каким-либо нормальным содержимым столбцов таблицы, получившаяся копия не позволит корректно восстановить данные.
Сгенерировать данные можно, например, запросом SELECT (random()::numeric*(g.i))^(g.i) AS n FROM generate_series(1,2_500) AS g(i);
Измерить время можно командой /usr/bin/time -f %e pg_dump … .
После выполнения практических заданий удалите созданные базы данных и временные файлы.
Page 32: 1. Ломаем COPY
Создадим базу данных.
Например, можно установить отображение неопределенных значений, совпадающее с какими-либо данными:
Установим для неопределенных значений код N:
Вывод двух разных значений теперь неотличим друг от друга. Корректно восстановить из такой копии данные невозможно.
Осторожнее с изменением формата по умолчанию!
2. Загрузка данных с пропусками
Создадим файл, в котором отсутствие данных будет отмечено как N/A.
Создадим таблицу для загрузки данных.
Загрузим данные в таблицу из файла. Значение N/A должно загружаться как NULL.
3. Сжатие в pg\_dump
Создадим таблицу достаточно большого размера.
Page 33: Page 33
Измерим время выгрузки данных без сжатия (а также прогреем кеш).
Сколько потребуется времени на выгрузку со сжатием gzip (используется по умолчанию)?
Теперь испытаем lz4.
А теперь — zstd.
Сравним размеры полученных копий:
Выводы: gzip сжимает лучше всех, однако работает в несколько раз дольше; lz4 — самый быстрый, но дает весьма небольшой эффект; zstd — хороший компромисс: степень сжатия лишь немного уступает gzip, а скорость сравнима с lz4.
Уборка
Удалим созданные базы данных и временные файлы.