16 Занятие 16: Задачи администрирования / Локализация
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_16_admin_localization.html Archive: DBA2-handouts-16.zip Страниц PDF: 32
Page 1: Задачи администрирования / Локализация
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Назначение локализации
- Локали и категории
- Провайдеры локалей
- Настройка сервера
- Работа с датами, числами, денежными единицами
- Настройка клиента
- Сообщения сервера и клиентских утилит
- Правила сортировки
Page 3: Назначение
Поддержка кодировок
- выбор кодировки символов для различных языков
- перекодировка символов между клиентом и сервером
- Функционал, зависящий от локализации
- сортировка и сравнение символов
- функции upper, lower, initcap
- поиск по шаблону
- функции to_char с датами, числами, денежными единицами
- язык сообщений сервера и утилит
Комментарии преподавателя
Возможности локализации в PostgreSQL позволяют хранить текст в различных кодировках. Для русского языка поддерживаются все основные кодировки символов, включая UTF8, WIN1251, KOI8R, ISO_8859_5.
Клиентское приложение может работать в кодировке, отличной от кодировки сервера, в таком случае выполняется преобразование символов между клиентом и сервером.
Кроме поддержки различных кодировок локализация влияет на работу следующего функционала сервера:
● сортировка символов, например в предложениях ORDER BY или в операциях сравнения (>, <);
● преобразование букв в верхний и нижний регистр в функциях upper, lower, initcap;
● поиск по шаблону в регулярных выражениях, операторах LIKE, SIMILAR TO, включая поиск без учета регистра символов;
● форматирование дат, чисел и денежных единиц в функциях to_char;
● выбор языка сообщений сервера и утилит.
https://postgrespro.ru/docs/postgresql/16/locale
Page 4: Локали и категории
Локали
- определяют язык, территорию и кодировку символов,
- например ru_RU.UTF8
- установлены в операционной системе
- Категории локали и соответствующие им параметры
- LC_COLLATE
- правила сортировки символов
- LC_CTYPE
- классификация символов
- LC_MESSAGES
- lc_messages
- язык сообщений
- LC_MONETARY
- lc_monetary
- формат денежных единиц
- LC_NUMERIC
- lc_numeric
- формат чисел
- LC_TIME
- lc_time
- формат даты и времени
Комментарии преподавателя
PostgreSQL использует возможности локализации, предоставляемые операционной системой. Поэтому в ОС следует предварительно настроить локали, которые потребуются для работы СУБД.
Обычно локали в ОС задаются в формате «язык_регион.кодировка». Например, ru_RU.UTF8 определяет локаль с русским языком (ru), на котором говорят в России (RU), и кодировкой UTF8. В Windows используются развернутые имена: Russian_Russia.1251.
Язык и территория определяют такие национальные особенности, как порядок символов, формат даты, разделитель десятичных разрядов и т. п.
Иногда бывает нужно комбинировать поведение разных локалей. Например, вместе с форматами даты и времени, принятыми в России, использовать английские сообщения сервера. PostgreSQL поддерживает раздельную установку категорий локали через одноименные параметры конфигурации.
Для категорий локали LC_COLLATE и LC_CTYPE соответствующие неизменяемые параметры сервера удалены начиная с версии PostgreSQL 16; теперь за информацией о локали базы данных следует обращаться к таблице системного каталога pg_database.
Page 5: Провайдеры локалей
Стандартная библиотека libc
- соответствие POSIX
- Внешняя библиотека ICU
- переносимое решение
- широкие дополнительные возможности
Комментарии преподавателя
PostgreSQL реализует поддержку различных провайдеров локалей. Провайдеры — это библиотеки, предоставляющие данные локалей и реализующие сортировку. Стандартный провайдер libc использует системную библиотеку C и предоставляет ее локали. Эти локали используются большинством утилит операционной системы.
Также поддерживается провайдер ICU, использующий одноименную внешнюю библиотеку. Имена локалей в ICU строятся по правилам языковых меток IETF BCP 47. Такие метки имеют вид «язык-регион» или просто «язык» (например ru-RU). При использовании локалей ICU PostgreSQL проверяет имена и приводит их к каноническому виду в соответствии с правилами. Параметр icu_validation_level позволяет настроить уровень сообщений при проверках локалей.
https://postgrespro.ru/docs/postgresql/16/locale#ICU-LANGUAGE-TAG
https://www.rfc-editor.org/rfc/bcp/bcp47.txt
Информация о выбранном провайдере и локали базы сохраняется в столбцах pg_datlocprovider и daticulocale таблицы pg_database. По ряду причин настройки libc нужны во всех базах данных (даже использующих провайдер ICU), поэтому в столбцах datcollate и datctype всегда будет информация о локали libc.
Команды и утилиты для установки параметров локали позволяют явно выбрать и провайдера. По умолчанию используется провайдер libc.
https://postgrespro.ru/docs/postgresql/16/locale#LOCALE-PROVIDERS
Page 6: Настройка сервера
 {#source-figure-006 caption=“Source slide page 6: Настройка сервера”}
Комментарии преподавателя
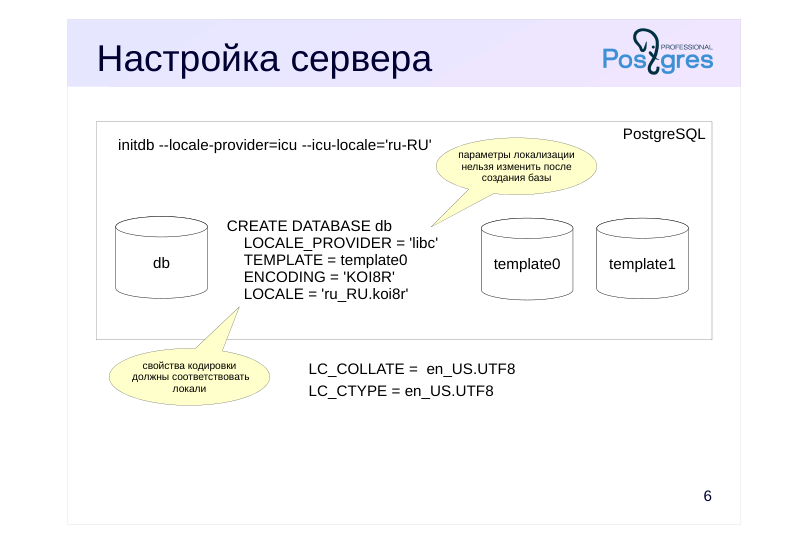
При инициализации кластера провайдер и локаль шаблонных баз задаются с помощью ключей утилиты initdb. По умолчанию используется провайдер libc и локаль из окружения ОС.
При создании базы данных она наследует настройки локализации шаблона. Если требуется создать базу с другими параметрами локализации, нужно использовать шаблон template0, в котором гарантированно нет никаких данных, зависящих от локали. При этом можно сменить провайдера, кодировку символов, а также категории локали LC_CTYPE и LC_COLLATE. Значения для категорий обычно совпадают, поэтому их удобно задавать одним параметром (ключом): для libc — LOCALE, а для ICU — ICU_LOCALE.
При этом кодировка базы данных должна быть совместима с параметрами локали LC_CTYPE и LC_COLLATE этой базы данных. Локали C и POSIX совместимы с любым набором символов, а для остальных локалей провайдера libc есть только один набор символов, который будет работать правильно. (Исключение: в среде Windows кодировка UTF-8 может использоваться с любой локалью.) Локали провайдера ICU можно использовать с большинством кодировок.
Page 7: Локали и категории
В операционной системе сервера уже установлены локали с поддержкой русского языка:
Параметры локализации сеанса ОС определяются переменными окружения:
Помимо переменных, соответствующих категориям локали, здесь также присутствуют переменные, имеющие особое значение: LC_ALL — если установлена, то используется для всех категорий локали, даже если они заданы; LANG — используется для тех категорий локали, для которых значение не задано; LANGUAGE — если установлена, то используется вместо LC_MESSAGES (об этом далее). При установке PostgreSQL из пакета в виртуальной машине курса для инициализации кластера main были использованы параметры сеанса ОС и провайдер libc. Чтобы задать другие значения, можно использовать ключи –locale-provider, –locale (эквивалентен LANG), а также ключи для категорий, например так:
Четыре параметра PostgreSQL соответствуют одноименным категориям локали. Видно, что их меньше чем в ОС:
Значения этих параметров записываются в конфигурационный файл. При этом параметры lc_monetary, lc_numeric и lc_time может изменить любой пользователь (context=user), а lc_messages — только суперпользователь. Для категорий локали LC_COLLATE и LC_CTYPE соответствующих серверных параметров нет. Каждый обслуживающий процесс при запуске сбрасывает значение LC_ALL и устанавливает переменные окружения ОС для категорий локали в соответствии с конфигурационными параметрами lc_*. При изменении параметра по ходу сеанса обслуживающий процесс устанавливает это же значение для соответствующей переменной окружения. Стандартные базы postgres, template0 и template1 используют значения LC_COLLATE, LC_CTYPE a также провайдера локали, установленные при инициализации кластера. Новые базы данных по умолчанию копируют параметры используемого шаблона:
Page 8: Page 8
Даты и LC\_TIME
Параметр конфигурации, отвечающий за соответствующую категорию локали:
Для использования названий месяцев и дней недели на русском языке в форматной маске функции to_char используется префикс TM:
То же самое для американского английского:
Вернем параметр к исходному значению:
Функции to_date/to_char позволяют в явном виде указать формат даты и времени при вводе/выводе значений. На неявное преобразование даты в текст и наоборот влияет параметр datestyle. Вот несколько примеров:
Page 9: Page 9
Числа и LC\_NUMERIC
Параметр конфигурации, отвечающий за соответствующую категорию локали:
Разделители групп разрядов (G), а также целой и дробной части (D), принятые в России:
То же для США:
Денежные единицы и LC\_MONETARY
Параметр конфигурации, отвечающий за соответствующую категорию локали:
Денежный тип данных money добавляет к сумме код валюты:
Page 10: Page 10
Но нужно учитывать, что в таблице с таким типом можно хранить только одну валюту, и та будет меняться вместе с LC_MONETARY:
Page 11: Настройка клиента
 {#source-figure-011 caption=“Source slide page 11: Настройка клиента”}
Комментарии преподавателя
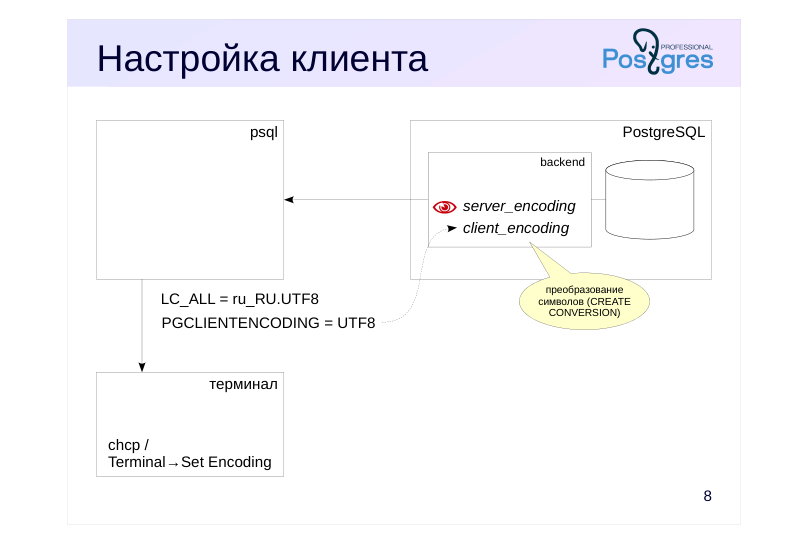
Для настройки локализации клиентского приложения нужно сделать следующее.
● Проверить, что настройки сервера корректны. Как минимум, что используется правильная кодировка БД (неизменяемый параметр server_encoding покажет кодировку, заданную при создании БД).
● Проверить, что в клиентской ОС установлены нужные локали, и настроить категории локали (переменные среды LC_*) в сеансе ОС.
● Настроить кодировку, с которой работает приложение, и проверить настройки устройства вывода. Например, psql в Windows обычно использует кодировку Win-1251, поэтому в терминале (cmd.exe) необходимо выполнить команду chcp 1251 и установить шрифт true type (например, Lucida Console).
● После подключения к БД проверить параметр client_encoding. Этот параметр отвечает за перекодировку символов между клиентом и сервером. При необходимости установить в значение кодировки приложения. Значение client_encoding можно задать и в переменной среды PGCLIENTENCODING.
Обслуживающий процесс автоматически перекодирует символы между кодировкой БД (server_encoding) и кодировкой клиента (client_encoding). Для большинства пар кодировок в PostgreSQL преднастроены необходимые процедуры преобразования символов: они находятся в таблице системного каталога pg_conversion. Можно определить дополнительную процедуру перекодировки (CREATE CONVERSION), однако на практике это вряд ли потребуется.
Page 12: Работа клиента и сервера в разных кодировках
Создадим базу данных с кодировкой KOI8R, а клиент по-прежнему будет использовать UTF8. В качестве провайдера локалей укажем ICU. Чтобы база данных успешно создалась, нужно использовать шаблон template0: это пустая БД, индексы в которой гарантированно не пострадают в результате изменения кодировки:
В нашем случае (при создании базы с провайдером ICU) нам понадобилось указать параметры LC_CTYPE и LC_COLLATE для соответствия устанавливаемой кодировке.
Подключимся к admin_localization_koi8r и убедимся, что работает перекодировка символов.
Кодировки клиента и сервера:
Значение параметра client_encoding устанавливает клиент, в данном случае psql. В интерактивном режиме значение устанавливается по кодировке клиента (переменной LC_CTYPE в ОС). Но при запуске из скрипта, как сейчас в демонстрации, параметр устанавливается в значение кодировки базы данных. Явно зададим такое же значение, как и у клиентской локали:
Теперь символы будут правильно конвертироваться из UTF8 в KOI8R и обратно:
Page 13: Page 13
Список доступных перекодировок для koi8:
Page 14: Сообщения сервера
 {#source-figure-014 caption=“Source slide page 14: Сообщения сервера”}
Комментарии преподавателя
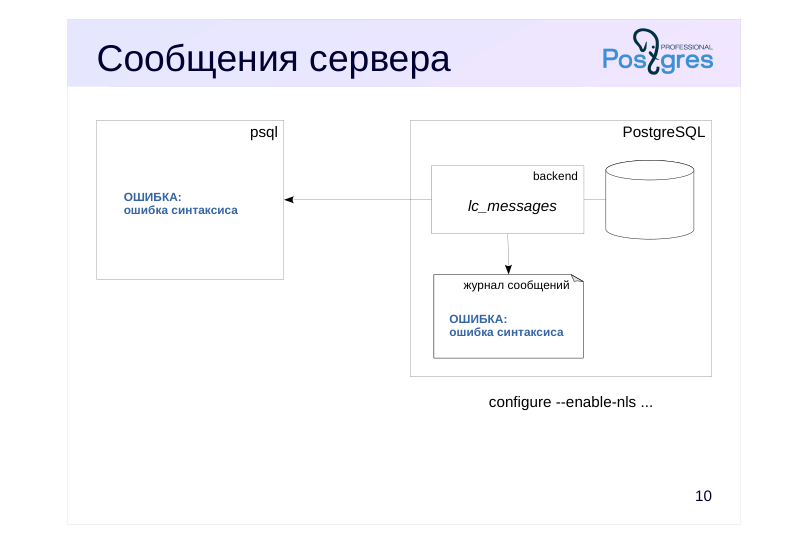
Сообщения сервера (и утилит) PostgreSQL переведены на несколько языков, в том числе и на русский.
Для того чтобы сообщения сервера выводились на русском языке, нужно, чтобы сервер PostgreSQL был собран с поддержкой национальных языков (configure –enable-nls). Большинство пакетов собирается с таким параметром.
Параметр конфигурации lc_messages управляет языком сообщений сервера.
Сообщения сервера не только отправляются клиенту, но и записываются в журнал сервера. При выборе языка, отличного от английского, следует убедиться, что инструменты работы с журналом сервера понимают этот язык. Например pgBadger может работать только с английскими сообщениями.
Подробнее о переводе сообщений сервера для переводчиков и разработчиков: https://postgrespro.ru/docs/postgresql/16/nls
Page 15: Сообщения утилит
 {#source-figure-015 caption=“Source slide page 15: Сообщения утилит”}
Комментарии преподавателя
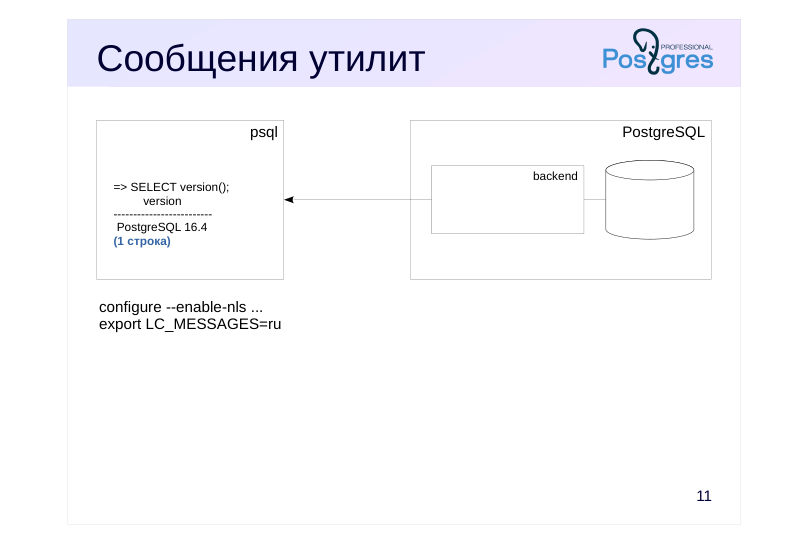
Утилиты PostgreSQL (psql, pg_dump и пр.) также поддерживают национальные языки.
Для того, чтобы сообщения утилит выводились на языке, отличном от английского, нужно, чтобы клиент PostgreSQL был собран с поддержкой NLS (обычно это так). Язык вывода устанавливается на клиенте переменной среды LC_MESSAGES (параметр сервера lc_messages влияет только на сообщения самого сервера, но не клиента).
Большинство ОС (включая Windows) используют следующий порядок просмотра переменных среды для языка сообщений: LANGUAGE, LC_ALL, LC_MESSAGES, LANG.
Page 16: Сообщения сервера и клиента
Сообщения сервера можно выводить на разных языках. Предварительно нужно убедиться, что PostgreSQL собран с поддержкой национальных языков:
Список доступных языков и файлы сообщений здесь:
Для записи в журнал будем использовать ошибочную команду:
В журнал сервера записывается такое же сообщение об ошибке и сама ошибочная команда.
Page 17: Page 17
Для вывода сообщений на русском языке надо изменить параметр lc_messages.
Теперь сообщение выводится клиенту и в журнал на русском языке. Посмотрим на сообщения, которые выводит клиент psql. Они остались на английском языке:
Язык сообщений клиента, собранного с поддержкой национальных языков, определяется переменными ОС LC_MESSAGES и LANGUAGE, причем LANGUAGE имеет приоритет:
Для полной русификации установим русский язык и для сообщений psql.
Теперь все сообщения выводятся на русском языке.
Page 18: Правила сортировки
Объекты базы данных
- разные правила сортировки в одной БД
- начальное наполнение при создании БД
- Использование правил
- кластер
- база данных
- столбец таблицы
- выражение
- Стандартные правила сортировки
- default, C, POSIX
- unicode, ucs_basic
Комментарии преподавателя
Чтобы в одной базе данных можно было по-разному сортировать и сравнивать текстовые данные, в PostgreSQL существуют специальные объекты — правила сортировки (collation).
Правила сортировки позволяют использовать порядок сортировки, отличный от установленного по умолчанию для базы данных. Их можно использовать для столбцов таблиц, в определении доменов и просто в выражениях, где сортируются или сравниваются символьные строки. При создании нового правила сортировки указываются провайдер и классификация символов.
Начальный список правил сортировки формируется при инициализации кластера: для всех имеющихся в ОС локалей загружаются их правила сортировки. В дальнейшем при добавлении локалей в ОС можно дозагрузить правила.
Стандартные правила сортировки C и POSIX работают одинаково и создаются для всех кодировок сервера. Для этих правил буквами считаются латинские символы от A до Z, а остальные сортируются в соответствии со своими кодами в данной кодировке. Правило default использует значения LC_COLLATE, LC_CTYPE и провайдера, заданных при создании базы данных. Также доступны правила сортировки unicode и ucs_basic, определенные в стандарте SQL.
Все имеющиеся правила сортировки можно увидеть в таблице системного каталога pg_collation.
https://postgrespro.ru/docs/postgresql/16/collation
Page 19: Провайдер libc
Порядок символов
- зависит от реализации в операционной системе
- отслеживается версия библиотеки
- Используется по умолчанию
- для кластера и базы данных
Комментарии преподавателя
Правила сортировки провайдера libc в PostgreSQL работают точно так же, как и в операционной системе. Однако библиотека libc может быть реализована по-разному в разных операционных системах. Как следствие, сортировка для одних и тех же локалей может отличаться в зависимости от ОС сервера базы данных. Если приложение должно поддерживать работу (включая логическую репликацию) СУБД на разных ОС, следует убедиться, что сортировка везде работает корректно.
Более серьезной потенциальной проблемой является установка новой версии библиотеки libc в ОС. Такое может произойти, например, при переходе на новый сервер с новой версией ОС. Изменение в новой версии libc используемых в базе данных правил сортировки может привести к некорректной работе индексов и другим проблемам.
Page 20: Провайдер ICU
Порядок символов
- зависит от версии библиотеки, но не от операционной системы
- отслеживается версия библиотеки
- Дополнительные возможности
- управление порядком сортировки групп символов
- дополнительные (особые) правила сортировки
Комментарии преподавателя
Для использования провайдера ICU в определении правил сортировки необходимо, чтобы PostgreSQL был собран с поддержкой этой библиотеки. Библиотека ICU и реализованные в ней правила сортировки работают одинаково на всех операционных системах.
Библиотека ICU допускает видоизменение правил сортировки без смены языка и территории. Можно указать разный порядок сортировки для отдельных групп символов. Например, символы какой группы должны идти раньше: кириллица, латиница или цифры; буквы в верхнем регистре или в нижнем. Для настройки этих правил можно включить в языковую метку соответствующие параметры.
Дополнительные правила сортировки задаются особым синтаксисом, их примеры приведены в демонстрации.
https://postgrespro.ru/docs/postgresql/16/collation#ICU-CUSTOM-COLLATI ONS
Page 21: Правила сортировки
При инициализации кластера в системном каталоге каждой базы данных создаются специальные объекты — правила сортировки. Они создаются на основе информации об установленных в ОС локалях. Начальное наполнение базы правилами сортировки:
Правила сортировки для русского языка, полученные из ОС:
Обратите внимание, что отображаются только правила сортировки, применимые к кодировке текущей базы данных, поэтому для разных баз одного экземпляра PostgreSQL результат команды может отличаться. Правила сортировки для провайдера ICU создаются только в том случае, если сервер собран с параметром –with-icu. Для таких правил сортировки формируются имена, включающие метку языка и указание суффикса «-x-icu» для отличия от локалей libc.
Page 22: Правила сортировки ICU
Сортировка для правила ru-x-icu отличается от используемой по умолчанию сортировки для правила ru_RU. Кириллица идет раньше латиницы:
Ключевое слово COLLATE после выражения (в ORDER BY) явно задает правило сортировки. По умолчанию используется правило с именем default, соответствующее параметрам локали базы данных. Возможности библиотеки ICU позволяют по-разному настраивать сортировку отдельных групп символов путем определения новых правил с параметрами, заданными в виде части языковой метки. Создадим новое правило сортировки, где латинские символы идут раньше символов кириллицы:
Еще одно, где в дополнение к предыдущему буквы идут раньше цифр:
Проверяем сортировку:
Если вышеуказанных параметров правил сортировки недостаточно, порядок элементов можно изменить с помощью особых правил сортировки:
И еще один пример. Обратите внимание на синтаксис правила:
Page 23: Page 23
Page 24: Детерминизм
Детерминированные правила сортировки
- равенство строк при побайтовом совпадении
- Недетерминированные правила сортировки
- строки, состоящие из разных байтов, могут быть равными
- дополнительная гибкость
- производительность ниже
- не поддерживают LIKE и другие операции
Комментарии преподавателя
Правило сортировки в зависимости от типа используемого сравнения может быть детерминированным или недетерминированным.
Детерминированные сравнения считают равными строки, состоящие из одних и тех же байтов. При недетерминированном сравнении даже не совпадающие побайтово строки могут считаться равными. Например, в Unicode буква «ё» может быть представлена одним символом Cyrillic Small Letter Io (U+0451), а может быть составлена из буквы «е» (U+0435) и диакритического знака «диерезис» (U+0308).
Все стандартные правила — детерминированные. Пользовательские правила по умолчанию тоже будут детерминированными.
Недетерминированные правила дают дополнительную гибкость: можно, например, задать ограничение уникальности без учета регистра или диакритических символов. Но производительность детерминированных правил обычно выше. К тому же недетерминированные правила не поддерживают некоторые операции, такие как поиск по шаблону.
Page 25: Недетерминированные правила сортировки
Определим недетерминированное правило для регистронезависимой сортировки:
Теперь строки в разных регистрах могут быть равными:
Но поиск по шаблону для недетерминированного правила невозможен:
Page 26: Отслеживание изменений
Изменение библиотеки-провайдера приводит к проблемам
- неправильная сортировка значений в индексах
- сравнения строк в ограничениях целостности
- сравнения строк в запросах
- и т. д.
- Номер версии библиотеки хранится в системном каталоге
- При изменении установленной версии — предупреждение
- libc не гарантирует стабильность и платформонезависимость версии
Комментарии преподавателя
Если при изменении библиотеки-провайдера сравнение начинает работать иначе, это может повлиять на используемые в базе данных правила сортировки и вызвать проблемы:
● неправильную работу запросов из-за нарушения сортировки значений в индексах;
● некорректные данные из-за изменившегося поведения при сравнении строк в ограничениях целостности CHECK и триггерах;
● некорректные результаты из-за изменившегося поведения сравнения строк в запросах, процедурном коде и политиках защиты строк.
Поэтому при использовании правил сортировки PostgreSQL будет предупреждать о возможных проблемах, связанных с изменением библиотек.
При создании правила текущий номер версии библиотеки сохраняется в системном каталоге, в таблицах pg_collation и pg_database. При каждом использовании правила сохраненный номер версии сверяется с текущим номером, и при их несоответствии запросы будут выдавать предупреждения.
Если обнаружено расхождение, следует пересоздать индексы, использующие измененные правила сортировки, а также проверить все места, где используются эти правила.
Нужно помнить, что, в отличие от ICU, провайдер libc не гарантирует одинаковую работу сортировки даже при совпадении версий библиотеки.
Page 27: Изменения в библиотеках-провайдерах
При создании правила сортировки в системном каталоге сохраняется версия библиотеки, переданная операционной системой. Если в ОС изменится версия библиотеки, каждый раз при использовании правила будет выдаваться предупреждение о том, что версии не совпадают. Проверить соответствие версий можно запросом:
Изменение правила сортировки может привести к некорректной работе индексов. Если подобное произошло, рекомендуется пересоздать индексы с новой версией правила сортировки. После этого можно обновить версию в системном каталоге командой ALTER COLLATION … REFRESH VERSION и предупреждения перестанут выдаваться. Запрос для получения списка объектов, которые зависят от требующих обновления правил сортировки:
Такая же проверка выполняется и для правил сортировки на уровне баз данных. Функция pg_database_collation_actual_version показывает актуальную версию правила сортировки в операционной системе:
Если версия правила, заданного для базы данных, не совпадает с версией библиотеки в ОС, при подключении к базе данных выдается предупреждение. В этом случае рекомендуется перестроить индексы, использующие правило default. После этого можно обновить номер версии, хранящийся в pg_database, командой ALTER DATABASE … REFRESH COLLATION VERSION.
Page 28: Page 28
Page 29: Итоги
Перед инициализацией кластера нужные для СУБД локали должны быть установлены в ОС
- Клиент и сервер могут работать в различных кодировках с автоматическим преобразованием символов
- Сообщения сервера и утилит переведены на множество языков, включая русский
- Правила сортировки используют внешние библиотеки, изменения в которых могут привести к повреждению данных и некорректным результатам
Page 30: Практика
- Перенос данных между базами в разных кодировках.
- Создайте базу данных с кодировкой KOI8R. Создайте
- таблицу и добавьте в нее строки, содержащие символы
- кириллицы. Сделайте копию базы данных утилитой
- pg_dump. Восстановите таблицу из копии в базу
- с кодировкой UTF8.
- Получите номер сегодняшнего дня недели. Меняется ли номер дня недели в зависимости от настроек локализации?
Комментарии преподавателя
- Для создания БД в кодировке KOI8R:
● убедитесь, что в ОС установлена нужная локаль;
● в команде CREATE DATABASE используйте шаблон template0 и параметры ENCODING и LOCALE.
- Для получения номера дня недели используйте функцию to_char.
Допустимые форматные маски даты:
https://postgrespro.ru/docs/postgresql/16/functions-formatting#FUNCTIONS-FORMATTING-DATETIME-TABLE
Page 31: 1. Кодировки базы данных
Проверим, что в ОС есть локали с кодировкой koi8:
Создаем базы данных с кодировками KOI8R и UTF8:
Подключаемся к базе с кодировкой KOI8R:
Убедимся, что клиент и сервер используют разные кодировки:
Создаем таблицу, содержащую строки с кириллицей:
Page 32: Page 32
Получаем логическую копию:
Содержимое копии выгружается в кодировке базы данных (KOI8R), а в начале файла есть команда установки параметра client_encoding в то же значение KOI8R. Восстанавливаем таблицу в базе данных admin_localization_utf8:
Благодаря установке client_encoding при восстановлении символы автоматически перекодируются. Проверим, что кириллица корректно перенесена:
2. Номер сегодняшнего дня недели
Текущие настройки локализации даты и времени:
Для получения номера дня недели есть две форматные маски: ID — неделя начинается с понедельника; D — неделя начинается с воскресенья.
Номер дня недели не зависит от настроек локализации, в частности, от параметра lc_time: