12 Занятие 12: Блокировки / Блокировки объектов
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_12_locks_objects.html Archive: DBA2-handouts-16.zip Страниц PDF: 34
Page 1: Блокировки / Блокировки объектов
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Общая информация о блокировках
- Блокировки отношений и других объектов
- Предикатные блокировки
Page 3: Общая информация
Задача и механизм использования блокировок
- Блокируемые ресурсы
- Факторы, влияющие на эффективность
- Время жизни блокировок
Page 4: Блокировки
Задача: упорядочение конкурентного доступа к разделяемым ресурсам
- Механизм
- перед обращением к ресурсу процесс захватывает блокировку,
- после обращения — освобождает
- блокировки приводят к очередям и ожиданиям
- Альтернативы
- многоверсионность — несколько версий данных
- оптимистические блокировки — процессы не блокируются,
- но при неудачном стечении обстоятельств возникает ошибка
Комментарии преподавателя
Блокировки используются, чтобы упорядочить конкурентный доступ к разделяемым ресурсам.
Под конкурентным доступом понимается одновременный доступ нескольких процессов. Сами процессы могут выполняться как параллельно (если позволяет аппаратура), так и последовательно в режиме разделения времени.
Блокировки не нужны, если нет конкуренции (одновременно к данным обращается только один процесс) или если нет разделяемого ресурса (например, общий буферный кеш нуждается в блокировках, а локальный — нет).
Перед тем как обратиться к ресурсу, защищенному блокировкой, процесс должен захватить эту блокировку. Когда процесс больше не нуждается в ресурсе, он освобождает блокировку, чтобы ресурсом могли воспользоваться другие процессы.
Захват блокировки возможен не всегда: ресурс может оказаться уже занятым кем-то другим. Тогда процесс либо встает в очередь ожидания, либо повторяет попытку захвата блокировки через определенное время. Так или иначе это приводит к тому, что процесс вынужден простаивать в ожидании освобождения блокировки.
Иногда удается применить другие, неблокирующие, стратегии. Например, в одноименном модуле мы обсуждали механизм многоверсионности. Еще один пример — оптимистические блокировки, которые не блокируют процесс, но в случае неудачи приводят к ошибке.
Page 5: Ресурсы
Ресурс
- все, что можно идентифицировать
- Примеры ресурсов
- реальные хранимые объекты: страницы, таблицы, строки и т. п.
- структуры данных в общей памяти (хеш-таблицы, буферы…)
- абстрактные ресурсы (число)
Комментарии преподавателя
Ресурсом, защищаемым блокировкой, в принципе может быть все, что угодно, лишь бы ресурс можно было однозначно идентифицировать.
Например, ресурсом может быть объект, с которым работает СУБД, такой как страница данных (идентифицируется именем файла и позицией внутри файла), таблица (oid в системном каталоге), версия строки (страница и позиция внутри страницы).
Ресурсом может быть структура в памяти, такая как хеш-таблица, буфер и т. п. (идентифицируется заранее присвоенным номером).
Иногда даже бывает удобно использовать абстрактные ресурсы, не имеющие никакого физического смысла (идентифицируются числом).
Page 6: Факторы эффективности
Гранулярность блокировки
- степень детализации, уровень в иерархии ресурсов
- например: таблица → страница → строки, хеш-таблица → корзины
- выше гранулярность — больше возможностей для параллелизма
- Режимы блокировок
- совместимость режимов определяется матрицей
- больше совместимых режимов — больше возможностей для
- параллелизма
Комментарии преподавателя
На эффективность блокировок оказывает влияние много факторов, из которых мы выделим всего несколько.
Гранулярность (степень детализации) важна, если ресурсы образуют иерархию. Например, таблица состоит из страниц, которые содержат табличные строки. Все эти объекты могут выступать в качестве ресурсов. Если процесс заинтересован всего в нескольких строках, а блокировка устанавливается на уровне таблицы, другие процессы не смогут работать с остальными строками.
Поэтому чем выше гранулярность – тем больше возможностей для распараллеливания, но это приводит к увеличению числа блокировок, информацию о которых надо где-то хранить.
Блокировки могут захватываться в разных режимах. Имена режимов могут быть абсолютно произвольными, важна лишь матрица их совместимости друг с другом.
Режим, несовместимый ни с каким режимом, принято называть исключительным (exclusive). Если режимы совместимы, блокировка может захватываться несколькими процессами одновременно; такие режимы называют разделяемыми (shared).
В целом, чем больше можно найти режимов, совместимых друг с другом, тем больше возможностей для параллелизма.
Page 7: Время жизни
Долговременные блокировки
- обычно захватываются до конца транзакции
- и относятся к хранимым данным
- большое число режимов
- развитая «тяжеловесная» инфраструктура, мониторинг
- Краткосрочные блокировки
- обычно захватываются на доли секунды
- и относятся к структурам в оперативной памяти
- минимум режимов
- «легковесная» инфраструктура, мониторинг может отсутствовать
Комментарии преподавателя
По времени использования блокировки можно разделить на длительные и короткие.
Долговременные блокировки захватываются на потенциально большое время (обычно до конца транзакции) и чаще всего относятся к таким ресурсам, как таблицы (отношения) и строки. Как правило, PostgreSQL управляет такими блокировками автоматически, но пользователь, тем не менее, имеет определенный контроль над этим процессом.
Для длительных блокировок характерно большое число режимов, чтобы допускать как можно больше одновременных действий над данными.
Обычно для долговременных блокировок предусмотрены развитая инфраструктура (например, поддержка очередей и обнаружение взаимоблокировок) и средства мониторинга.
Краткосрочные блокировки захватываются на небольшое время (от нескольких тактов процессора до долей секунд) и обычно относятся к структурам данных в общей памяти. Такими блокировками PostgreSQL управляет полностью автоматически — об их существовании надо просто знать.
Для коротких блокировок характерны ограниченный набор простых режимов (часто всего лишь исключительный и разделяемый) и простая инфраструктура. Средства мониторинга могут отсутствовать.
Page 8: Виды блокировок
 {#source-figure-008 caption=“Source slide page 8: Виды блокировок”}
Комментарии преподавателя
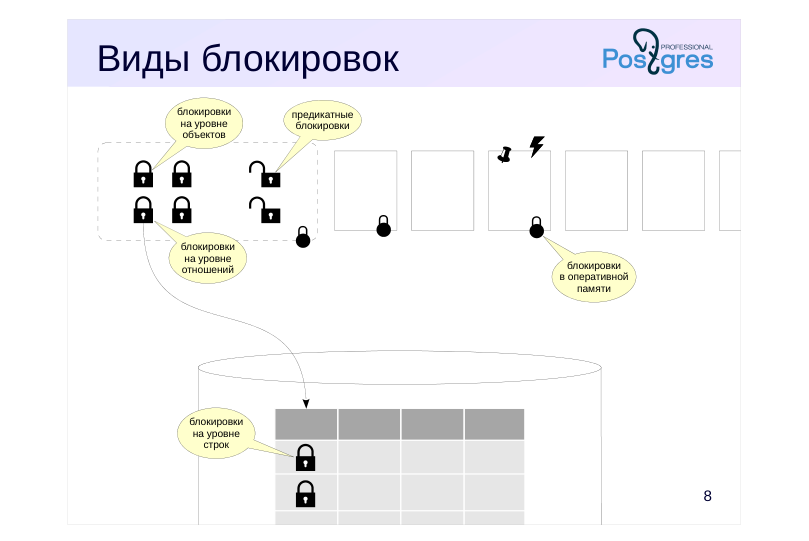
В PostgreSQL используются разные виды блокировок.
Блокировки на уровне объектов относятся к долговременным, «тяжеловесным». В качестве ресурсов здесь выступают отношения и другие объекты (например, схемы).
Еще один класс блокировок (оптимистических) — предикатные.
Информация обо всех этих блокировках хранится однотипным образом в оперативной памяти. Перечисленные виды блокировок подробно рассматриваются дальше в данной теме.
Среди долговременных блокировок особо выделяются блокировки на уровне строк. Их реализация отличается от остальных видов долговременных блокировок из-за потенциально огромного их количества (представьте обновление миллиона строк). Эти блокировки будут рассмотрены в теме «Блокировки строк».
К краткосрочным блокировкам относятся различные блокировки структур оперативной памяти. Они рассматриваются в теме «Блокировки в оперативной памяти».
Page 9: Блокировки объектов
 {#source-figure-009 caption=“Source slide page 9: Блокировки объектов”}
Page 10: Устройство
Информация в общей памяти сервера
- представление pg_locks:
- locktype — тип блокируемого ресурса,
- mode — режим блокировки
- Ограниченное количество
- max_locks_per_transaction × max_connections
- Инфраструктура
- очередь ожидания: ждущие процессы не потребляют ресурсы
- обнаружение взаимоблокировок
Комментарии преподавателя
Начнем рассмотрение блокировок с блокировок уровня объектов, таких как таблицы, индексы, страницы, номера транзакций и др. Такие блокировки защищают объекты от одновременного изменения или использования в то время, когда объект изменяется, а также для ряда других нужд.
Информация о блокировках объектов располагается в общей памяти сервера. Их количество ограничено произведением значений двух параметров: max_locks_per_transaction и max_connections (по умолчанию 64 × 100). Этот пул блокировок — общий для всех транзакций, то есть одна транзакция вполне может захватить больше блокировок, чем max_locks_per_transaction; важно лишь, чтобы общее число блокировок в системе не превысило установленный предел.
Все блокировки можно увидеть в представлении pg_locks.
Если ресурс уже заблокирован, и транзакция пытается захватить блокировку в несовместимом режиме, то она становится в очередь и ожидает освобождения блокировки. Ожидающие транзакции не потребляют ресурсы процессора, они «засыпают» и пробуждаются только при освобождении ресурса. Ряд команд SQL позволяют указать ключевое слово NOWAIT: в этом случае попытка захватить занятый ресурс приводит не к ожиданию, а к ошибке.
Возможна ситуация взаимоблокировки (тупика), при которой две или более транзакций ждут друг друга. PostgreSQL автоматически определяет такие ситуации и аварийно прерывает бесконечное ожидание.
Page 11: Блокировки отношений
Тип ресурса: Relation
- Режимы
- Access Share
- SELECT
- Row Share
- SELECT FOR UPDATE/SHARE
- Row Exclusive
- UPDATE, DELETE, INSERT, MERGE
- Share Update Exclusive
- VACUUM, ANALYZE, ALTER TABLE,
- СREATE INDEX CONCURRENTLY
- Share
- CREATE INDEX
- Share Row Exclusive
- CREATE TRIGGER, ALTER TABLE
- Exclusive
- REFRESH MATERIALIZED VIEW
- CONCURRENTLY
- Access Exclusive
- DROP, TRUNCATE, REINDEX, VACUUM FULL,
- LOCK TABLE, ALTER TABLE,
- REFRESH MATERIALIZED VIEW
- допускают
- параллельное
- изменение
- данных
- в таблице
Комментарии преподавателя
Важный частный случай блокировок — блокировки отношений (таблиц, индексов, последовательностей и т. п.). Такие блокировки имеют тип relation в представлении pg_locks.
Для них определено целых 8 различных режимов, которые показаны на слайде вместе с примерами команд SQL, использующих эти режимы. Матрица совместимости, которая показывает, какие блокировки можно захватывать совместно, приведена в документации.
Такое количество режимов существует для того, чтобы позволить выполнять одновременно как можно большее количество команд, относящихся к одной таблице (индексу и т. п.).
Самый слабый режим — Access Share, он захватывается командой SELECT и совместим с любым режимом, кроме самого сильного — Access Exclusive. Это означает, что запрос не мешает ни другим запросам, ни изменению данных в таблице, ни чему-либо другому, но не дает, например, удалить таблицу в то время, когда из нее читаются данные.
Другой пример: режим Share (как и другие более сильные режимы) не совместим с изменением данных в таблице. Например, команда CREATE INDEX заблокирует команды INSERT, UPDATE и DELETE (и наоборот). Поэтому существует команда CREATE INDEX CONCURRENTLY, использующая режим Share Update Exclusive, который совместим с такими изменениями (за счет этого команда выполняется дольше).
https://postgrespro.ru/docs/postgresql/16/explicit-locking#LOCKING-TABLE S
Page 12: Очередь ожидания
 {#source-figure-012 caption=“Source slide page 12: Очередь ожидания”}
Комментарии преподавателя
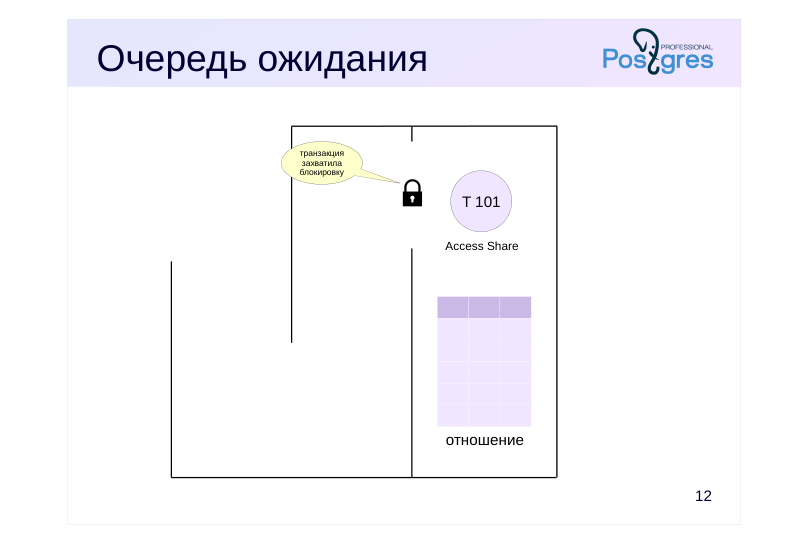
Чтобы лучше представить, к чему приводит появление несовместимой блокировки, можно посмотреть на приведенный пример.
Вначале на таблице выполняется команда SELECT, которая запрашивает и получает блокировку уровня Access Share.
Page 13: Очередь ожидания
 {#source-figure-013 caption=“Source slide page 13: Очередь ожидания”}
Комментарии преподавателя
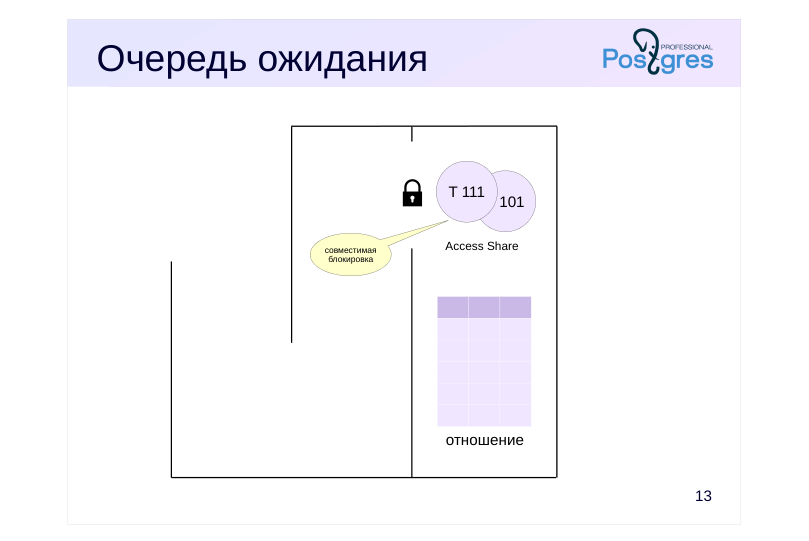
Затем еще одна команда SELECT запрашивает блокировку уровня Access Share и получает ее, так как запрошенная блокировка совместима с существующей.
Page 14: Очередь ожидания
 {#source-figure-014 caption=“Source slide page 14: Очередь ожидания”}
Комментарии преподавателя
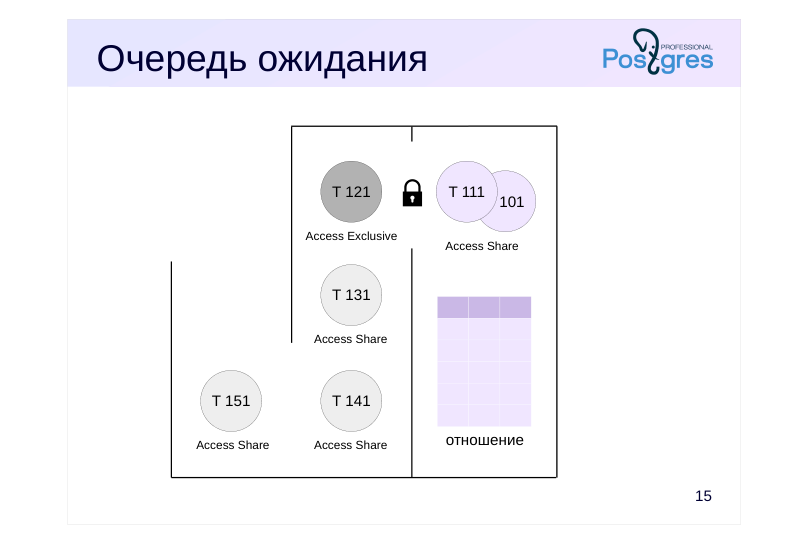
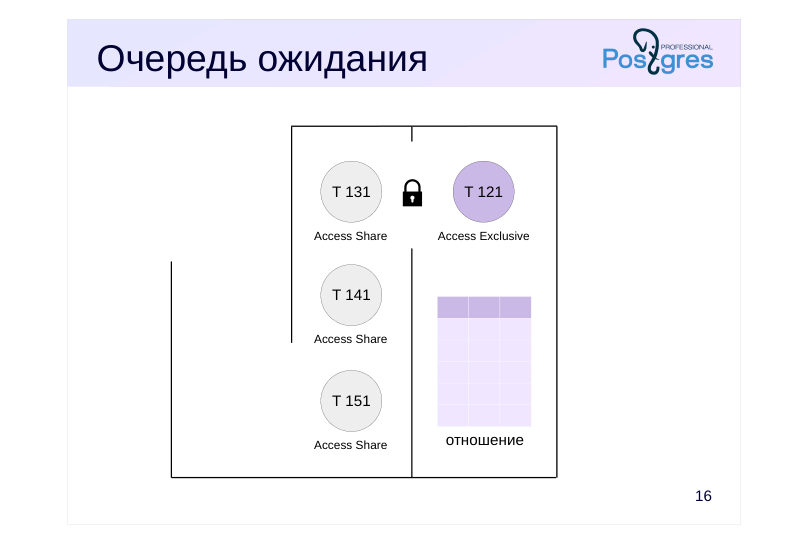
Затем администратор выполняет команду VACUUM FULL, которой требуется блокировка уровня Access Exclusive, несовместимая с существующими Access Share. Транзакция встает в очередь.
Page 15: Очередь ожидания
 {#source-figure-015 caption=“Source slide page 15: Очередь ожидания”}
Комментарии преподавателя
Затем в системе появляются еще несколько команд SELECT. И, хотя какие-то из них теоретически могли бы «проскочить вперед», пока VACUUM FULL ждет своей очереди, все они честно занимают место за VACUUM FULL.
Page 16: Очередь ожидания
 {#source-figure-016 caption=“Source slide page 16: Очередь ожидания”}
Комментарии преподавателя
После того, как две первые транзакции с командами SELECT завершаются и освобождают блокировки, VACUUM FULL начинает выполняться.
Теперь только когда VACUUM FULL завершит свою работу и снимет (исключительную) блокировку, все накопившиеся в очереди команды SELECT смогут захватить блокировки уровня Access Share и начать выполняться.
Таким образом, не вовремя выполненная команда может парализовать работу системы на время, значительно превышающее время выполнения самой команды.
Обратите внимание: исключительная блокировка может потребоваться также обычной очистке (и автоочистке), чтобы в конце своей работы выполнить усечение таблицы, то есть «откусить» пустой хвост файла данных и вернуть место операционной системе. Очистка не должна допускать ситуаций долгого ожидания, поэтому в случае проблем этап усечения можно отключить параметром хранения vacuum_truncate или вызывая очистку с указанием VACUUM (truncate off).
Page 17: Другие ресурсы
Типы
- Extend — добавление страниц к файлу отношения
- Object — не-отношение: база данных, схема и т. п.
- Page — страница (используется некоторыми типами индексов)
- Tuple — версия строки
- Advisory — рекомендательная блокировка
- Transactionid — транзакция
- Virtualxid — виртуальная транзакция
- Режимы
- исключительный
- разделяемый
Комментарии преподавателя
Кроме отношений есть еще несколько типов блокируемых ресурсов. Их блокировки захватываются либо только в исключительном режиме, либо в исключительном и разделяемом. К ним относятся:
● Extend при добавлении страниц к файлу какого-либо отношения;
● Object для блокирования объекта, который не является отношением (примеры таких объектов: база данных, схема, подписка и т. п.);
● Page для блокирования страницы (редкая блокировка, используется некоторыми типами индексов);
● Tuple используется в некоторых случаях для установки приоритета среди нескольких транзакций, ожидающих блокировку одной строки (подробнее см. тему «Блокировка строк» этого модуля);
● Advisory для рекомендательных блокировок (о них чуть позже).
Особый интерес представляют блокировки типа Transactionid и Virtualxid. Каждая транзакция удерживает исключительную блокировку своих номеров: и виртуального, и настоящего, если он есть. Это дает простой способ дождаться окончания какой-либо транзакции: надо запросить блокировку ее номера. Подробнее это рассматривается в теме «Блокировки строк».
Page 18: Средства мониторинга
Вывод сообщений в журнал сервера
- параметр log_lock_waits:
- выводит сообщение об ожидании дольше deadlock_timeout
- Текущие блокировки
- представление pg_locks
- функция pg_blocking_pids
Комментарии преподавателя
Возникающие в системе блокировки необходимы для обеспечения целостности и изоляции, однако могут приводить к нежелательным ожиданиям. Такие ожидания можно отслеживать, чтобы разобраться в их причине и по возможности устранить (например, изменив алгоритм работы приложения).
Один способ мониторинга состоит в том, чтобы включить параметр log_lock_waits. В этом случае в журнал сообщений сервера будет попадать информация, если транзакция ждала дольше, чем deadlock_timeout (несмотря на то, что используется параметр для взаимоблокировок, здесь речь идет об обычных ожиданиях).
Второй способ состоит в том, чтобы в момент возникновения долгой блокировки (или на периодической основе) выполнять запрос к представлению pg_locks, смотреть на блокируемые и блокирующие транзакции (функция pg_blocking_pids) и расшифровывать их при помощи pg_stat_activity.
Page 19: Блокировки отношений и других объектов
Создадим таблицу «банковских» счетов. В ней будем хранить номер счета и сумму.
Во втором сеансе начнем транзакцию. Нам понадобится номер обслуживающего процесса.
Какие блокировки удерживает только что начавшаяся транзакция?
Только блокировку собственного виртуального номера. Теперь обновим строку таблицы. Как изменится ситуация?
Добавилась блокировка отношения в режиме RowExclusiveLock (что соответствует команде UPDATE) и исключительная блокировка собственного номера (который появился, как только транзакция начала изменять данные). Теперь попробуем в еще одном сеансе создать индекс по таблице.
Page 20: Page 20
Команда не выполняется — ждет освобождения блокировки. Какой?
Видим, что транзакция пыталась получить блокировку таблицы в режиме ShareLock, но не смогла (granted = f). Столбец waitstart в этом случае показывает время, когда обслуживающий процесс начал ожидать блокировку. Мы можем найти номер блокирующего процесса (в общем виде — несколько номеров)…
…и посмотреть информацию о сеансах, к которым они относятся:
После завершения транзакции блокировки снимаются и индекс создается.
Page 21: Advisory Locks
Устанавливаются приложением
- Продолжительность
- до конца сеанса
- до конца транзакции
- Режимы
- исключительный
- разделяемый
Комментарии преподавателя
Рекомендательные блокировки можно использовать, если нужна логика блокирования, которую неудобно реализовывать с помощью других, «обычных» блокировок. Рекомендательные блокировки устанавливаются только приложением; PostgreSQL никогда не делает этого автоматически.
Имена функций, связанных с рекомендательными блокировками, начинаются с pg_advisory и могут содержать уточняющие ключевые слова.
Рекомендательная блокировка может быть установлена до конца сеанса (функция pg_advisory_lock) или до конца транзакции (pg_advisory_xact_lock).
Блокировки уровня сеанса, в отличие от блокировок уровня транзакции, не освобождаются автоматически по окончании транзакции, их нужно явно освобождать функцией pg_advisory_unlock. Таким образом, сеансовые рекомендательные блокировки нарушают обычную логику транзакций — блокировка, полученная в транзакции, даже если произойдет откат этой транзакции, будет сохраняться в сеансе; аналогично, освобождение блокировки остается в силе, даже если транзакция, в которой оно было выполнено, позже прерывается.
По умолчанию рекомендательные блокировки захватываются в исключительном режиме. Для использования разделяемого режима к имени функции добавляется слово shared, например, pg_advisory_lock_shared и pg_advisory_unlock_shared.
https://postgrespro.ru/docs/postgresql/16/explicit-locking#ADVISORY-LOCK S
Page 22: Рекомендательные блокировки
 {#source-figure-022 caption=“Source slide page 22: Рекомендательные блокировки”}
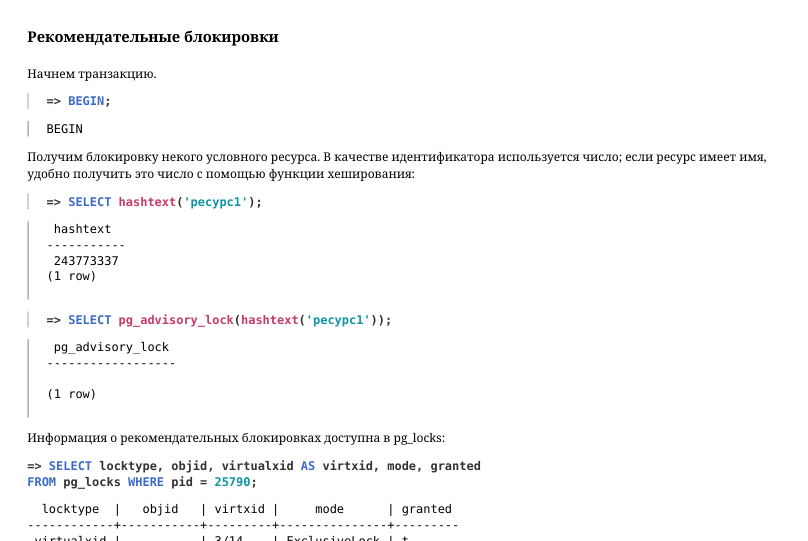
Начнем транзакцию.
Получим блокировку некого условного ресурса. В качестве идентификатора используется число; если ресурс имеет имя, удобно получить это число с помощью функции хеширования:
Информация о рекомендательных блокировках доступна в pg_locks:
Если другой сеанс попробует захватить ту же блокировку, он будет ждать ее освобождения:
В приведенном примере блокировка действует до конца сеанса, а не транзакции, как обычно.
Захвативший блокировку сеанс может получить ее повторно, даже если есть очередь ожидания.
Блокировку можно явно освободить:
Но в нашем примере блокировка была получена сеансом дважды, поэтому придется освободить ее еще раз:
Page 23: Page 23
Существуют другие варианты функций для получения рекомендательных блокировок до конца транзакции, для получения разделяемых блокировок и т. п. Вот их полный список:
Page 24: Предикатные блокировки
 {#source-figure-024 caption=“Source slide page 24: Предикатные блокировки”}
Page 25: Предикатные блокировки
Задача: реализация уровня изоляции Serializable
- используются в дополнение к обычной изоляции на снимках данных
- оптимистические блокировки, название сложилось исторически
- Информация в общей памяти сервера
- представление pg_locks
- Ограниченное количество
- max_pred_locks_per_transaction × max_connections
Комментарии преподавателя
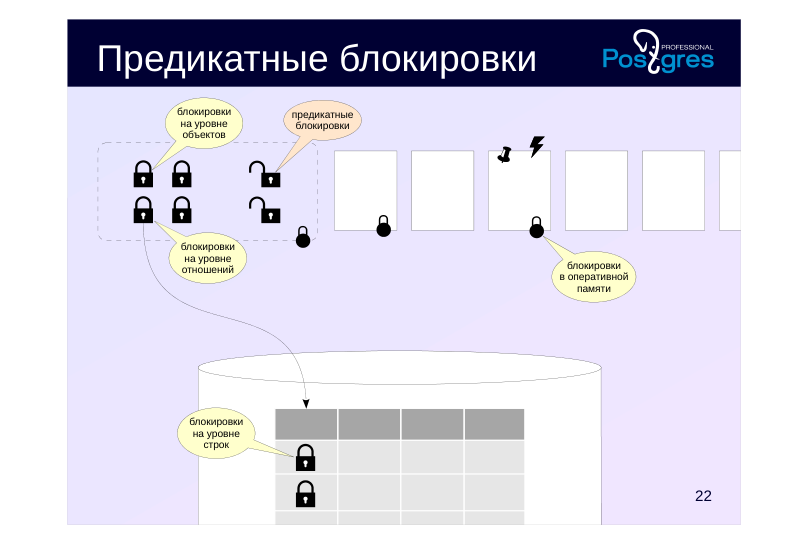
Термин предикатная блокировка появился давно, еще при первых попытках реализовать полную изоляцию (Serializable) на основе блокировок в ранних СУБД. Идея состояла в том, что блокировать надо не только определенные строки, но и предикаты. Например, при выполнении запроса с условием a > 10 надо заблокировать диапазон a > 10, чтобы избежать появления фантомных строк и других аномалий.
В PostgreSQL уровень Serializable реализован поверх существующего механизма снимков данных, но термин остался. Фактически такие «блокировки» ничего не блокируют, а используются для отслеживания зависимостей транзакций по данным.
Как и для обычных блокировок, информация о предикатных блокировках отображается в представлении pg_locks, все они устанавливаются в одном специальном режиме SIRead (Serializable Isolation Read).
Число предикатных блокировок ограничено произведением параметров max_pred_locks_per_transaction и max_connections (= 64 × 100).
Именно с использованием предикатных блокировок связано ограничение, что для достижения полной изоляции все транзакции должны работать на уровне Serializable. Отслеживание зависимостей будет работать только для транзакций, которые устанавливают предикатные блокировки.
https://postgrespro.ru/docs/postgresql/16/transaction-iso#XACT-SERIALIZA BLE
https://wiki.postgresql.org/wiki/SSI
https://github.com/postgres/postgres/blob/REL\_16\_STABLE/src/backend/sto rage/lmgr/README-SSI
Page 26: Предикатные блокировки
Типы ресурсов
- Relation — отношение
- max_pred_locks_per_relation
- Page — страница
- max_pred_locks_per_page
- Tuple — версия строки
- повышение
- Режим
- уровня
- SIRead
Комментарии преподавателя
Предикатные блокировки захватываются на трех уровнях.
При полном сканировании таблицы блокировка устанавливается на уровне всей таблицы.
При индексном сканировании устанавливаются блокировки тех страниц индекса, которые соответствуют условию доступа (предикату). Кроме того, устанавливаются блокировки на уровне отдельных табличных версий строк (это не то же самое, что блокировки строк, которые рассматриваются в одноименной теме).
При увеличении количества предикатных блокировок происходит автоматическое повышение уровня (эскалация): вместо нескольких мелких блокировок захватывается одна более высокого уровня.
Если число блокировок версий строк одной страницы превышает значение параметра max_pred_locks_per_page (2 по умолчанию), вместо них захватывается одна блокировка уровня страницы.
Если число блокировок страниц или версий одной таблицы (индекса) превышает значение параметра max_pred_locks_per_relation, вместо них захватывается одна блокировка на все отношение. По умолчанию параметр равен −2; для отрицательных чисел значение вычисляется как max_pred_locks_per_transaction / abs(max_pred_locks_per_relation).
Повышение уровня блокировок может приводить к ложным ошибкам сериализации, из-за чего снижается пропускная способность системы.
Page 27: Предикатные блокировки
Начнем транзакцию с уровнем Serializable и прочитаем одну строку таблицы последовательным сканированием.
Посмотрим на блокировки:
Появилась предикатная блокировка всей таблицы accounts (несмотря на то что читается одна строка).
Теперь прочитаем одну строку таблицы, используя индекс:
Блокировки:
При индексном сканировании устанавливаются мелкогранулярные предикатные блокировки: блокировки прочитанных страниц индекса; блокировки прочитанных версий строк.
Page 28: Page 28
Page 29: Итоги
Блокировки отношений и других объектов БД используются для организации конкурентного доступа к общим ресурсам
- поддерживаются очереди и обнаружение взаимоблокировок
- рекомендательные блокировки для ресурсов, не связанных
- с хранимыми объектами
- Предикатные блокировки используются для реализации уровня изоляции Serializable
- ничего не блокируют, отслеживают зависимости транзакций по данным
Page 30: Практика
- Какие блокировки на уровне изоляции Read Committed удерживает транзакция, прочитавшая одну строку таблицы по первичному ключу? Проверьте на практике.
- Воспроизведите автоматическое повышение уровня предикатных блокировок при чтении строк таблицы по индексу. Покажите, что при этом возможна ложная ошибка сериализации.
- Настройте сервер так, чтобы в журнал сообщений сбрасывалась информация о долгих (более 100 миллисекунд) ожиданиях блокировок. Воспроизведите ситуацию, при которой в журнале появятся такие сообщения.
Комментарии преподавателя
- В каждой из двух транзакций прочитайте две строки таблицы, используя индекс, и измените одну из прочитанных строк. Такие транзакции сериализуются. Задайте max_pred_locks_per_relation = 2 и повторите опыт.
Page 31: 0. Подготовка
 {#source-figure-031 caption=“Source slide page 31: 0. Подготовка”}
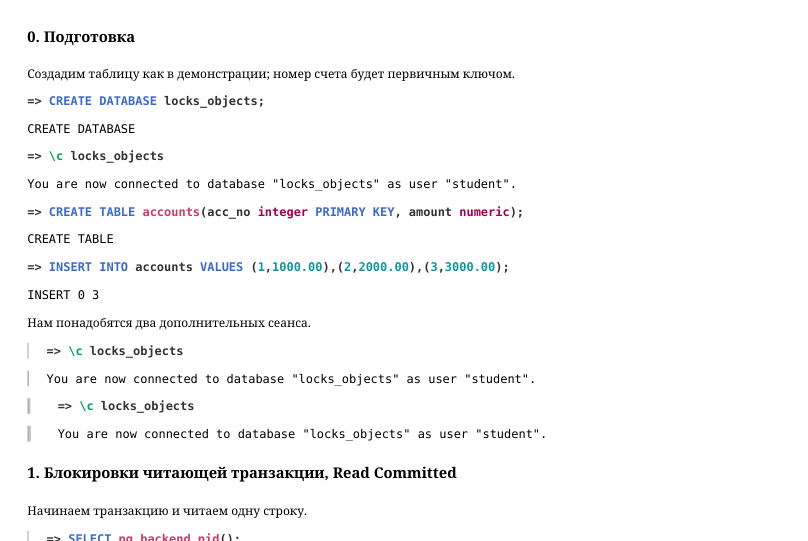
Создадим таблицу как в демонстрации; номер счета будет первичным ключом.
Нам понадобятся два дополнительных сеанса.
1. Блокировки читающей транзакции, Read Committed
Начинаем транзакцию и читаем одну строку.
Блокировки:
Здесь мы видим: Блокировку таблицы accounts в режиме AccessShareLock; Блокировку индекса accounts_pkey, созданного для первичного ключа, в том же режиме; Исключительную блокировку собственного номера виртуальной транзакции. Если смотреть блокировки в самой транзакции, к ним добавится блокировка на представление pg_locks:
Page 32: Page 32
 {#source-figure-032 caption=“Source slide page 32: Page 32”}
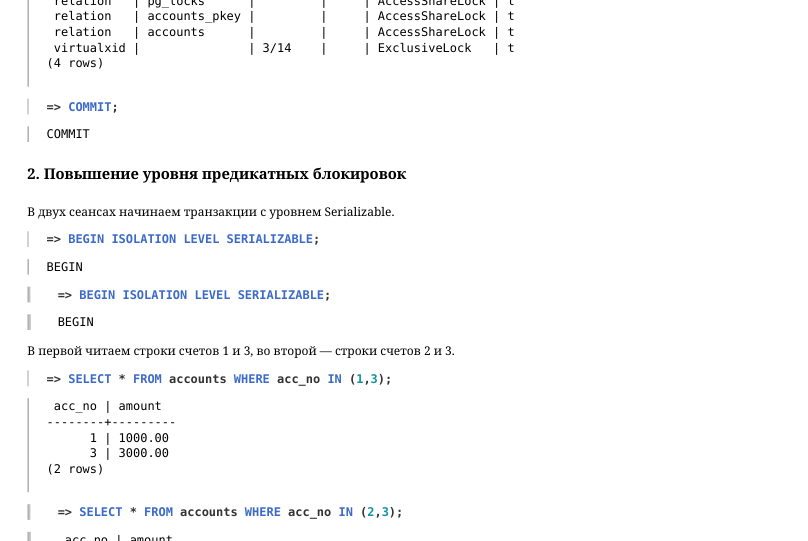
2. Повышение уровня предикатных блокировок
В двух сеансах начинаем транзакции с уровнем Serializable.
В первой читаем строки счетов 1 и 3, во второй — строки счетов 2 и 3.
Блокируются страница индекса и отдельные версии строк:
Изменим в первом сеансе остаток первого счета, во втором — второго.
Транзакции сериализуются:
Теперь настроим повышение уровня так, чтобы при блокировке двух версий строк блокировалась вся таблица.
Page 33: Page 33
 {#source-figure-033 caption=“Source slide page 33: Page 33”}
Повторяем опыт.
Теперь каждая транзакция блокирует всю таблицу:
Изменяем остатки…
…и фиксируем транзакции.
Из-за повышения уровня блокировок сериализация невозможна.
3. Вывод в журнал информации о блокировках
Требуется изменить параметры:
Page 34: Page 34
Воспроизведем блокировку.
В первом сеансе выполним задержку и после этого завершим транзакцию.
Вот что попало в журнал: