10 Занятие 10: Журналирование / Контрольная точка
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_10_wal_checkpoint.html Archive: DBA2-handouts-16.zip Страниц PDF: 25
Page 1: Журналирование / Контрольная точка
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Процесс контрольной точки
- Процесс фоновой записи
- Мониторинг
Page 3: Контрольная точка
Необходимость контрольной точки
- Процесс выполнения контрольной точки
- Алгоритм восстановления после сбоя
- Настройка
Page 4: Необходимость
Размер хранимых журнальных записей
- с какого сегмента начинать применять журнальные записи
- при восстановлении?
- активно использующаяся страница может не вытесняться из кеша
- Время восстановления
- сколько времени займет восстановление после сбоя?
Комментарии преподавателя
Если не предпринять специальных мер, то активно использующаяся страница, попав в буферный кеш, может никогда не вытесняться. Это означает, что при восстановлении после сбоя нам придется просматривать все журнальные записи, созданные с момента запуска сервера.
На практике это, конечно, недопустимо. Во-первых, файлы занимают много места — их все придется хранить на сервере. Во-вторых, время восстановления будет запредельно большим — придется просмотреть множество журнальных записей.
Поэтому существует процедура контрольной точки, которая выполняет сброс всех грязных страниц на диск, но не вытесняет их из кеша. Специальный фоновый процесс checkpointer периодически выполняет контрольную точку. После того как контрольная точка завершена, журнальные записи, предшествующие ее началу, больше не нужны для восстановления.
Page 5: Процедура КТ
 {#source-figure-005 caption=“Source slide page 5: Процедура КТ”}
записываются грязные буферы CLOG
Комментарии преподавателя
Рассмотрим подробнее, что происходит при выполнении контрольной точки.
Во-первых, помимо буферного кеша, в оперативной памяти располагаются и другие структуры, содержимое которых нужно сохранять на диске.
В частности, контрольная точка сбрасывает на диск буферы статуса транзакций (CLOG). Поскольку количество таких буферов невелико (их 128 штук), они записываются сразу же.
Page 6: Процедура КТ
 {#source-figure-006 caption=“Source slide page 6: Процедура КТ”}
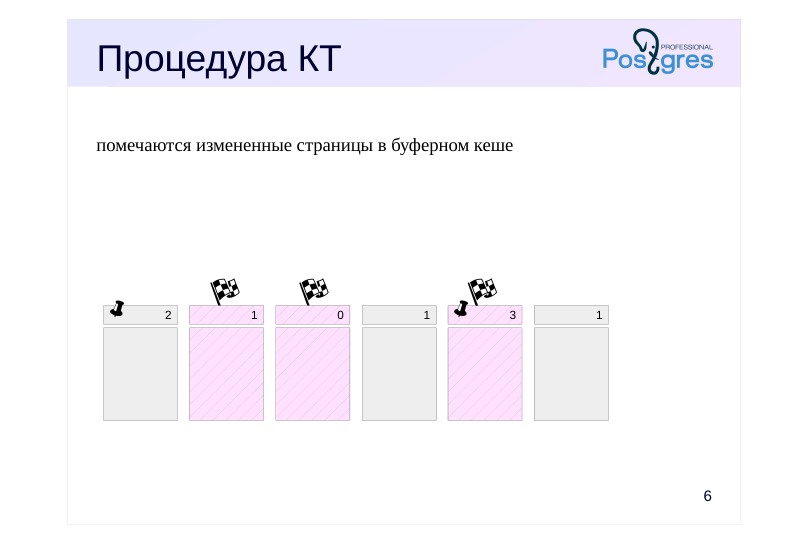
помечаются измененные страницы в буферном кеше
Комментарии преподавателя
Во-вторых, основная работа контрольной точки — сбросить на диск все страницы из буферного кеша, которые были грязными на момент начала контрольной точки.
Поскольку размер буферного кеша может быть очень велик, сбрасывать сразу все страницы плохо — это приостановит нормальную работу сервера и создаст большую нагрузку на дисковую подсистему. Поэтому контрольная точка растягивается во времени и фактически превращается в отрезок.
Сначала все измененные на текущий момент страницы помечаются в заголовке буфера специальным флагом…
Page 7: Процедура КТ
 {#source-figure-007 caption=“Source slide page 7: Процедура КТ”}
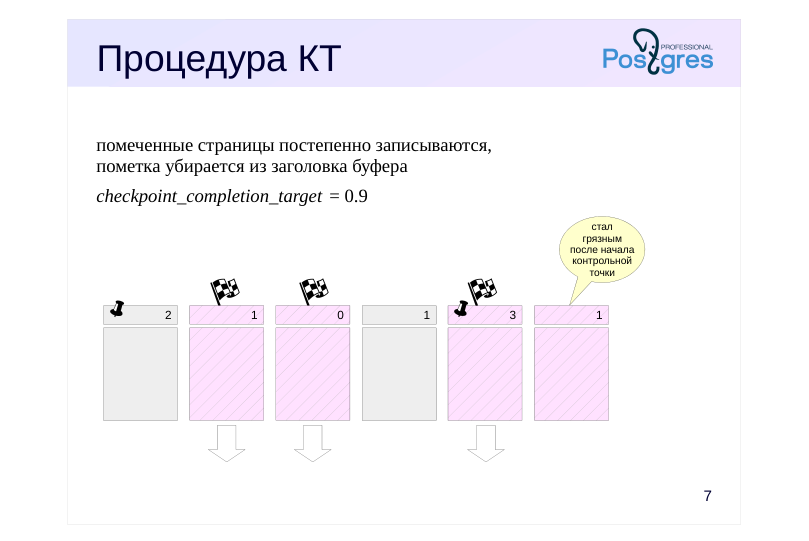
помеченные страницы постепенно записываются, пометка убирается из заголовка буфера
- checkpoint_completion_target = 0.9
Комментарии преподавателя
…а затем процедура контрольной точки постепенно проходит по всем буферам и сбрасывает помеченные страницы на диск. Еще раз отметим, что страницы не вытесняются из кеша, а только записываются. Поэтому контрольная точка не обращает внимания на число обращений к буферу и признак закрепленности.
Помеченные буферы могут также быть записаны и обслуживающими процессами — смотря кто доберется до буфера первым. В любом случае при записи снимается установленный ранее флаг, так что буфер будет записан только один раз.
В процессе работы контрольной точки страницы продолжают изменяться в буферном кеше. Но новые грязные буферы уже не рассматриваются процедурой контрольной точки, так как на момент начала работы они не были грязными.
Активность записи грязных буферов определяется значением параметра checkpoint_completion_target. Он показывает, какую часть времени между двумя соседними контрольными точками следует использовать для записи страниц. Со значением 0.9, заданным по умолчанию, можно ожидать, что PostgreSQL завершит процедуру контрольной точки незадолго до следующей запланированной. Значения выше умолчательного 0.9 использовать не рекомендуется, поскольку фактически процедура может занять несколько больше времени, чем указано в параметре.
Page 8: Процедура КТ
 {#source-figure-008 caption=“Source slide page 8: Процедура КТ”}
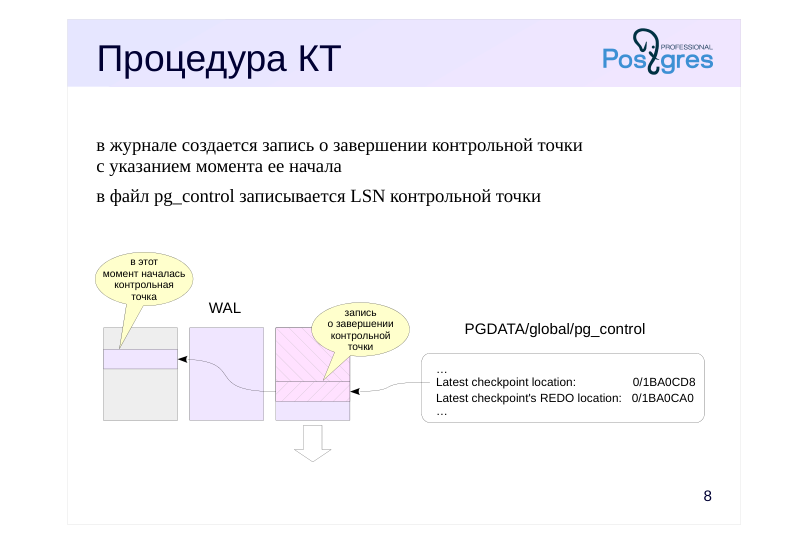
в журнале создается запись о завершении контрольной точки с указанием момента ее начала
- в файл pg_control записывается LSN контрольной точки
Комментарии преподавателя
В конце работы процедура создает журнальную запись об окончании контрольной точки. В этой записи содержится LSN момента начала работы контрольной точки. Поскольку контрольная точка ничего не записывает в журнал в начале своей работы, по этому LSN может находиться любая журнальная запись.
Кроме того, в специальный файл PGDATA/global/pg_control записывается указание на созданную журнальную запись. Таким образом можно быстро выяснить последнюю пройденную контрольную точку.
Page 9: Контрольная точка
Заглянем в управляющий файл /var/lib/postgresql/16/main/global/pg_control. Это можно сделать с помощью утилиты pg_controldata.
Видим много справочной информации, из которой особый интерес представляют данные о последней контрольной точке и статус кластера: «in production». Выполним вручную контрольную точку и посмотрим, как это отражается в журнале и в управляющем файле.
Page 10: Page 10
В журнал попадает запись о том, что контрольная точка пройдена (CHECKPOINT_ONLINE):
В описании записи указан LSN начала контрольной точки (redo). Сравним с данными управляющего файла:
Информация об LSN, очевидно, совпадает.
Page 11: Восстановление
 {#source-figure-011 caption=“Source slide page 11: Восстановление”}
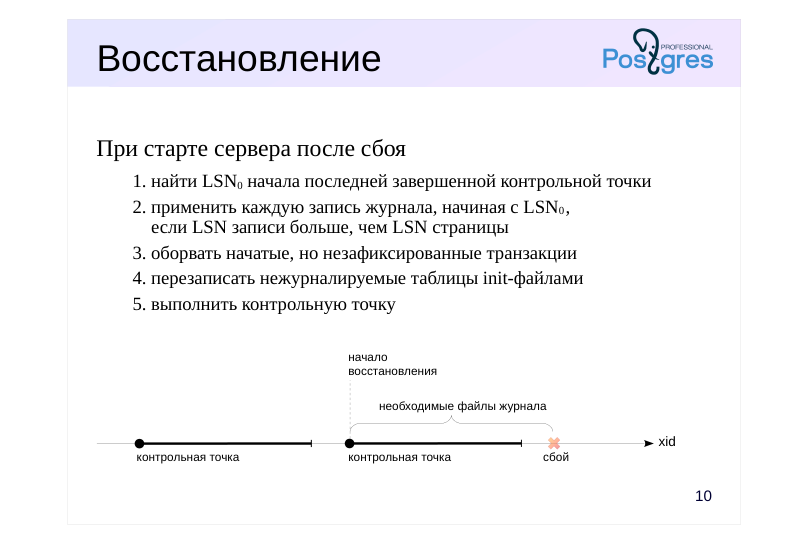
При старте сервера после сбоя
- найти LSN0 начала последней завершенной контрольной точки
- применить каждую запись журнала, начиная с LSN0 ,
- если LSN записи больше, чем LSN страницы
- оборвать начатые, но незафиксированные транзакции
- перезаписать нежурналируемые таблицы init-файлами
- выполнить контрольную точку
Комментарии преподавателя
Если в работе сервера произошел сбой, то при последующем запуске процесс startup обнаруживает это (в файле pg_control статус отличен от «shut down») и выполняет автоматическое восстановление.
Сначала процесс читает из того же файла LSN записи о последней завершенной контрольной точке. Из этой записи процесс узнает позицию LSN0 начала этой контрольной точки.
(Для полноты картины заметим: если присутствует файл backup_label, запись о контрольной точке читается из него — это нужно для восстановления из резервных копий. Подробнее см. курс DBA3.)
Далее процесс startup читает журнал вперед от найденной позиции, последовательно применяя записи к страницам, если в этом есть необходимость (что можно проверить, сравнив LSN страницы на диске с LSN журнальной записи). Изменение страниц происходит в буферном кеше, как при обычной работе.
Записи, относящиеся к страницам CLOG, восстанавливают статус транзакций. Транзакции, не зафиксированные к концу восстановления, считаются оборванными; их изменения не видны в снимках данных.
Аналогично записи применяются и к файлам: например, если запись говорит, что файл должен быть создан, а его нет — файл создается.
В конце процесса все нежурналируемые таблицы перезаписываются с помощью образов в init-файлах. На этом процесс startup завершает восстановление и выполняет контрольную точку, чтобы зафиксировать восстановленное состояние.
Page 12: Восстановление
Теперь сымитируем сбой, принудительно выключив сервер.
Сейчас на диске находятся журнальные записи, но табличные страницы не были сброшены на диск. Проверим состояние кластера:
Состояние не изменилось. При запуске PostgreSQL поймет, что произошел сбой и требуется восстановление.
Как видим, таблица и данные восстановлены. Теперь остановим экземпляр корректно. При такой остановке PostgreSQL выполняет контрольную точку, чтобы сбросить на диск все данные.
Проверим состояние кластера:
Теперь состояние — «shut down», что соответствует корректной остановке.
Page 13: Частота контрольных точек
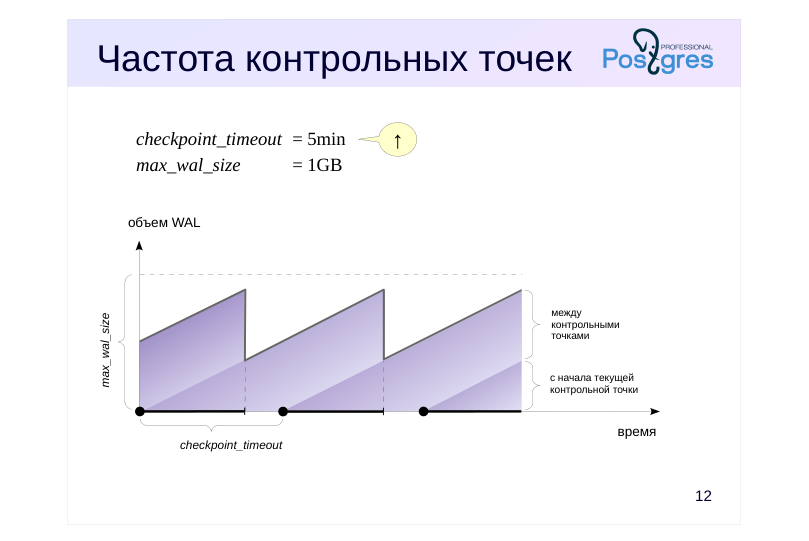 {#source-figure-013 caption=“Source slide page 13: Частота контрольных точек”}
↑
- checkpoint_timeout = 5min
- max_wal_size
- = 1GB
Комментарии преподавателя
Обычно контрольная точка настраивается из следующих соображений.
Сначала надо определиться, какая частота срабатываний нас устраивает (исходя из допустимого времени восстановления и объема журнальных файлов за это время при стандартной нагрузке). Чем реже можно позволить себе контрольные точки, тем лучше — это сокращает накладные расходы.
Устраивающая частота записывается в параметр checkpoint_timeout (значение по умолчанию — 5 минут — слишком мало, часто время увеличивают до получаса).
Однако возможна ситуация, когда нагрузка станет выше расчетной и за указанное время будет сгенерирован слишком большой объем журнальных записей. Чтобы этого не случилось, в параметре max_wal_size указывают общий допустимый объем журнальных записей.
Для восстановления после сбоя сервер должен хранить файлы с момента начала последней завершенной контрольной точки до начала текущей (объем между контрольными точками) плюс файлы, накопившиеся во время работы текущей контрольной точки. Поэтому общий объем можно оценить как
(1 + checkpoint_completion_target) * объем-между-контр-точками.
Таким образом большая часть контрольных точек происходит по расписанию, раз в checkpoint_timeout единиц времени. Но при повышенной нагрузке контрольная точка вызывается чаще, чтобы постараться уложиться в объем max_wal_size.
Page 14: Объем файлов журнала
Сервер хранит журнальные файлы
- необходимые для восстановления (обычно < max_wal_size)
- еще не прочитанные через слоты репликации
- еще не записанные в архив, если настроена непрерывная архивация
- не превышающие по объему wal_keep_size
- не превышающие по объему min_wal_size (при переиспользовании)
- Настройки
- max_wal_size
- = 1GB
- wal_keep_size
- = 0
- wal_recycle
- = on
- min_wal_size
- = 80MB
Комментарии преподавателя
Надо понимать, что объем, указанный в параметре max_wal_size, может быть превышен. Это не жесткое ограничение, а ориентир для процесса checkpointer, влияющий на активность записи грязных буферов.
Кроме того, сервер не имеет права стереть журнальные файлы, еще не переданные через слоты репликации, и файлы, еще не записанные в архив при непрерывном архивировании. Это может привести к перерасходу места, так что если этот функционал используется, необходим постоянный мониторинг.
Можно на случай отставания реплики параметром wal_keep_size установить минимальный объем файлов журнала, остающихся после контрольной точки. Это не гарантирует, что журнальная запись сохранится до момента, когда она понадобится реплике, но все же позволяет работать без слота репликации.
По умолчанию некоторое количество журнальных файлов будет не удаляться, а переименовываться и использоваться заново. Параметр min_wal_size задает минимальный неудаляемый объем. Это позволяет сэкономить на постоянном создании и удалении файлов. Однако для файловых систем с copy-on-write быстрее создать новый файл, поэтому для них рекомендуется отключить переиспользование, установив wal_recycle=off.
https://postgrespro.ru/docs/postgresql/16/wal-configuration
https://postgrespro.ru/docs/postgresql/16/runtime-config-wal#RUNTIME-CO NFIG-WAL-CHECKPOINTS
Page 15: Объем журнала
Снова запустим экземпляр.
Установим минимальное значение min_wal_size и отключим переиспользование, чтобы после контрольной точки оставалось не больше двух сегментов.
Добавим строки в таблицу.
Список файлов журнала:
Выполним вручную контрольную точку и опять посмотрим на журнал:
После контрольной точки в журнале осталось не более двух сегментов, в том числе тот, который был текущим в момент ее начала. А если в кластере после начала контрольной точки происходили какие-либо изменения, в журнале могли появиться и другие сегменты.
Page 16: Фоновая запись
Процесс фоновой записи
- Настройка
Page 17: Процесс фоновой записи
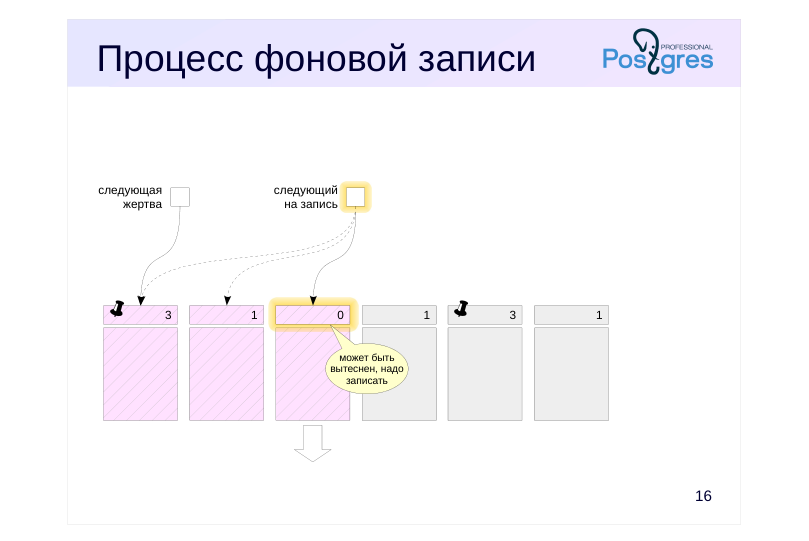 {#source-figure-017 caption=“Source slide page 17: Процесс фоновой записи”}
Комментарии преподавателя
Когда обслуживающий процесс собирается вытеснить страницу из буфера, он может обнаружить, что буфер грязный, и ему придется записывать эту страницу на диск. Чтобы снизить вероятность таких ситуаций, в дополнение к процессу контрольной точки (checkpointer) существует также процесс фоновой записи (background writer, bgwriter или просто writer).
Процесс фоновой записи использует тот же самый алгоритм поиска буферов, что и обслуживающие процессы, только использует свой указатель. Он может опережать указатель на «жертву», но никогда не отстает от него.
Записываются буферы, которые одновременно:
● содержат измененные данные (грязные),
● не закреплены (pin count = 0),
● имеют нулевое число обращений (usage count = 0).
Таким образом, фоновый процесс записи, «забегая вперед», находит те буферы, которые с большой вероятностью вскоре потребуется вытеснить. За счет этого обслуживающий процесс скорее всего обнаружит, что выбранный им буфер не является грязным.
Page 18: Процесс фоновой записи
Алгоритм
- уснуть на bgwriter_delay
- если в среднем за цикл запрашивается N буферов, то записать
- N * bgwriter_lru_multiplier
- ≤ bgwriter_lru_maxpages
- грязных буферов
- Настройки
- bgwriter_delay
- = 200ms
- bgwriter_lru_maxpages
- = 100
- bgwriter_lru_multiplier
- = 2.0
- bgwriter_flush_after
- = 512kB
Комментарии преподавателя
Процесс фоновой записи работает циклами максимум по bgwriter_lru_maxpages страниц, засыпая между циклами на время bgwriter_delay.
(Таким образом, если установить параметр bgwriter_lru_maxpages в ноль, процесс фактически не будет работать.)
Точное число буферов для записи определяется по среднему количеству буферов, которые запрашивались обслуживающими процессами с прошлого цикла (используется скользящее среднее, чтобы сгладить неравномерность между циклами, но при этом не зависеть от давней истории). Вычисленное количество буферов умножается на коэффициент bgwriter_lru_multiplier.
Если процесс совсем не обнаружил грязных буферов (то есть в системе ничего не происходит), он «впадает в спячку», из которой его выводит обращение серверного процесса за буфером. После этого процесс просыпается и опять работает обычным образом.
При необходимости записи большого количества данных сервер даёт указание ОС произвести промежуточный сброс данных в хранилище (fsync) по достижении объема, задаваемого параметром bgwriter_flush_after. Это уменьшает задержки фиксации транзакций и выполнение синхронизации в конце контрольной точки.
Процесс фоновой записи имеет смысл настраивать после того, как настроена контрольная точка. Совместно с контрольной точкой эти процессы должны успевать записывать грязные буферы до того, как они потребуются обслуживающим процессам.
Page 19: Мониторинг
Контрольные точки
- checkpoint_warning = 30s
- log_checkpoints = on
- статусы процессов startup, checkpointer
- Запись грязных буферов процессами
- представления pg_stat_bgwriter, pg_stat_io
Комментарии преподавателя
Параметр checkpoint_warning позволяет выводить в журнал предупреждение, если интервал между контрольными точками меньше, чем значение параметра. Если это происходит регулярно, следует подумать об увеличении max_wal_size или уменьшении интервала между контрольными точками checkpoint_timeout.
Включенный по умолчанию параметр log_checkpoints выводит в журнал подробную информацию о каждой выполненной контрольной точке.
Когда сервер находится в режиме восстановления, можно следить за статусом процессов startup и checkpointer средствами операционной системы, например с помощью утилиты ps.
Статистику работы процессов, записывающих грязные буферы (контрольной точки, фоновой записи и обслуживающих процессов), показывает представление pg_stat_bgwriter, а начиная с версии 16 — представление pg_stat_io.
В 17-ой версии PostgreSQL появится новое представление pg_stat_checkpointer, в которое из pg_stat_bgwriter будет перенесена информация о статистике процесса контрольной точки.
Page 20: Мониторинг
Параметр checkpoint_warning выводит предупреждение, если контрольные точки, вызванные переполнением размера журнальных файлов, выполняются слишком часто. Его значение по умолчанию:
Его следует привести в соответствие со значением checkpoint_timeout. Параметр log_checkpoints позволяет получать в журнале сообщений сервера информацию о выполняемых контрольных точках. По умолчанию (начиная с PostgreSQL 15) параметр включен:
Запишем что-нибудь в таблицу и выполним контрольную точку.
Вот какую информацию можно узнать из журнала сообщений:
Статистика работы процессов контрольной точки и фоновой записи отражается в одном общем представлении (раньше обе задачи решались одним процессом; затем их функции разделили, но представление осталось).
checkpoints_timed — контрольные точки по расписанию (checkpoint_timeout); checkpoints_req — контрольные точки по требованию (max_wal_size) и выполненные вручную; buffers_checkpoint — страницы, сброшенные при контрольных точках; buffers_clean — страницы, сброшенные процессом фоновой записи; buffers_backend — страницы, сброшенные обслуживающими процессами; maxwritten_clean — количество остановок по достижению bgwriter_lru_maxpages. В хорошо настроенной системе значение buffers_backend должно быть существенно меньше, чем сумма buffers_checkpoint и buffers_clean. Большое значение checkpoints_req (по сравнению с checkpoints_timed) говорит о том, что контрольные точки происходят чаще, чем предполагалось.
Page 21: Page 21
Однако информация об объеме ввода-вывода, выдаваемая представлением pg_stat_bgwriter, не вполне корректна: в столбце buffers_backend отражены результаты работы не только клиентских процессов, но и некоторых других (например, автоочистки). В этот же столбец добавляются операции расширения файлов отношений, хотя это не запись из буферного кеша на диск. Использованное нами ранее представление pg_stat_io предоставляет статистику в более информативном виде:
writes — количество операций записи; fsyncs — количество вызовов fsync; extends — количество операций расширения отношений.
Page 22: Итоги
Процесс контрольной точки ограничивает размер хранимых журнальных файлов и сокращает время восстановления
- Контрольная точка и фоновая запись сбрасывают на диск грязные буферы
- Обслуживающие процессы могут сбрасывать грязные буферы, но не должны этим заниматься
Page 23: Практика
- Настройте выполнение контрольной точки раз в 30 секунд. Установите параметры min_wal_size и max_wal_size в 32 МБ.
- Несколько минут c помощью утилиты pgbench подавайте нагрузку 100 транзакций/сек.
- Измерьте, какой объем журнальных файлов был сгенерирован за это время.
- Проверьте данные статистики и оцените, какой объем приходится в среднем на одну контрольную точку. Все ли контрольные точки выполнялись по расписанию? Как можно объяснить полученный результат?
- Сбросьте настройки к значениям по умолчанию.
Page 24: 1. Настройка контрольной точки
2. Нагрузка
Инициализируем таблицы.
Сбросим статистику.
Запускаем pgbench, предварительно запомнив позицию в журнале.
Page 25: 3. Объем журнальных файлов
4. Статистика
Число контрольных точек по расписанию и по требованию:
Средний объем на контрольную точку:
Несмотря на то что в среднем объем журнальных записей за контрольную точку не превосходит установленного предела, часть контрольных точек выполнялась не по расписанию. Это говорит о неравномерности потока журнальных записей (вызванной выполнением автоочистки и другими причинами). Поэтому в реальной системе замеры лучше выполнять на достаточно больших интервалах времени.