08 Занятие 08: Журналирование / Буферный кеш
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_08_wal_buffercache.html Archive: DBA2-handouts-16.zip Страниц PDF: 29
Page 1: Журналирование / Буферный кеш
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Устройство и использование буферного кеша
- Механизм вытеснения страниц
- Массовое вытеснение и буферные кольца
- Настройка размера кеша
- Локальный кеш для временных таблиц
- Прогрев кеша
Page 3: Буферный кеш
 {#source-figure-003 caption=“Source slide page 3: Буферный кеш”}
Комментарии преподавателя
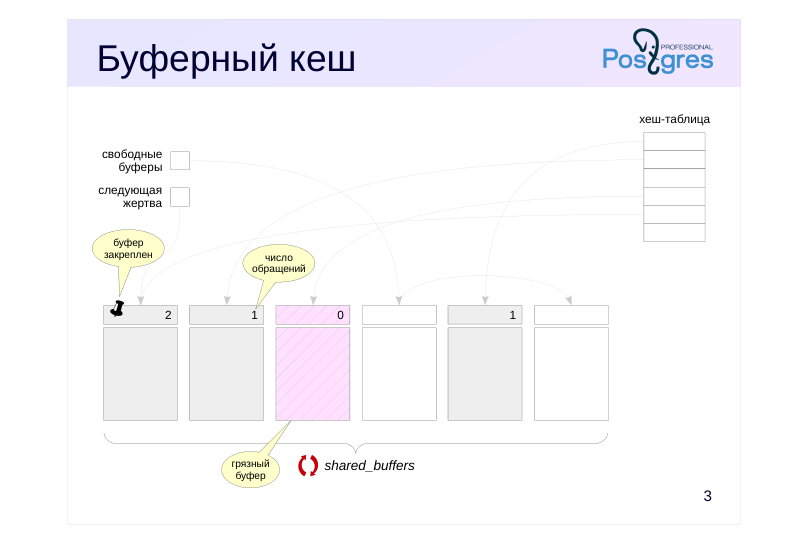
Задача буферного кеша — сглаживать разницу в производительности двух типов памяти: оперативной (быстрая, но мало) и дисковой (медленная, но много). Чтобы работать с данными — читать или изменять, — процессы читают страницы в буферный кеш. Пока страница находится в кеше, мы экономим на обращениях к диску.
Буферный кеш располагается в общей памяти сервера и представляет собой массив буферов. Каждый буфер состоит из места под одну страницу данных и заголовка. Заголовок содержит, в числе прочего:
● расположение страницы на диске (файл и номер страницы в нем);
● число обращений к буферу (счетчик usage count, увеличивается каждый раз, когда процесс читает или изменяет буфер);
● признак того, что данные на странице изменились и рано или поздно должны быть записаны на диск (такой буфер называют грязным);
● признак закрепления (счетчик pin count количества процессов, работающих в данный момент с содержимым буфера).
Размер буферного кеша задается параметром shared_buffers. Его изменение требует перезапуска сервера.
Изначально кеш содержит пустые буферы, и все они связаны в список свободных буферов. Смысл указателя на «следующую жертву» станет ясен чуть позже.
Чтобы быстро находить нужную страницу в кеше, используется хеш-таблица.
Page 4: Страница в кеше
 {#source-figure-004 caption=“Source slide page 4: Страница в кеше”}
Комментарии преподавателя
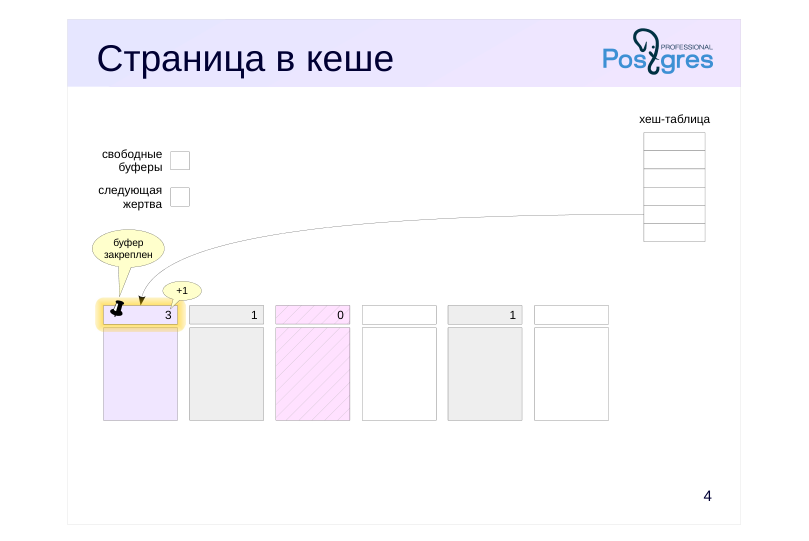
Когда процессу требуется прочитать страницу, он сначала пытается найти ее в буферном кеше с помощью хеш-таблицы.
Ключом хеширования служит файл и номер страницы внутри файла; получив номер буфера, процесс быстро проверяет, действительно ли он содержит нужную страницу. Как и в любой хеш-таблице, здесь возможны коллизии; в таком случае процессу придется проверить несколько страниц.
Если нужная страница найдена в кеше, процесс должен «закрепить» буфер (увеличить счетчик pin count) и увеличить число обращений (счетчик usage count). Буфер могут закреплять несколько процессов одновременно, поэтому используется именно счетчик, а не логический признак.
Пока буфер закреплен (значение pin count больше нуля), считается, что буфер используется и его содержимое не должно «радикально» измениться. Например, в странице может появиться новая версия строки — это никому не мешает благодаря многоверсионности и правилам видимости. Но в закрепленный буфер не может быть прочитана другая страница.
Page 5: Страница в кеше
Создадим таблицу с одной строкой:
Информацию о содержимом буферного кеша и его использовании можно получить с помощью расширения pg_buffercache, включающего в себя одноименное представление и дополнительные функции:
Создадим для удобства представление, расшифровывающее некоторые столбцы. Условие на базу данных необходимо, так как в буферном кеше содержатся данные всего кластера. Расшифровать мы можем только информацию из той БД, к которой подключены. Глобальные объекты считаются принадлежащими БД с нулевым OID.
В буферном кеше уже находятся страницы таблицы; они появились при выполнении вставки:
Команда EXPLAIN с указанием analyze и buffers показывает использование буферного кеша при выполнении запроса:
Page 6: Page 6
Строка «Buffers: shared hit=1» говорит о том, что страница была найдена в кеше. После выполнения запроса счетчик использования увеличился на единицу:
Page 7: Чтение в свободный буфер
 {#source-figure-007 caption=“Source slide page 7: Чтение в свободный буфер”}
Комментарии преподавателя
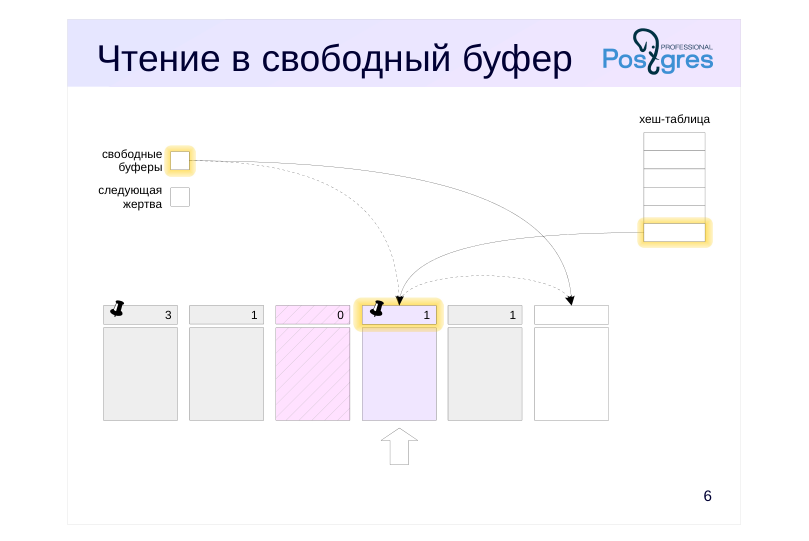
Может получиться так, что необходимая страница не будет найдена в кеше. В этом случае ее необходимо считать с диска в какой-либо буфер.
В первую очередь поиск подходящего буфера будет проходить по списку свободных буферов, если он не пуст.
Найденный по указателю буфер закрепляется, в него читается необходимая страница, число обращений устанавливается в единицу.
Указатель на свободный буфер передвигается на следующий по списку буфер, если он есть.
Кроме того, ссылку на загруженную страницу необходимо прописать в хеш-таблицу, чтобы в дальнейшем ее можно было найти.
Page 8: Чтение в свободный буфер
 {#source-figure-008 caption=“Source slide page 8: Чтение в свободный буфер”}
Комментарии преподавателя
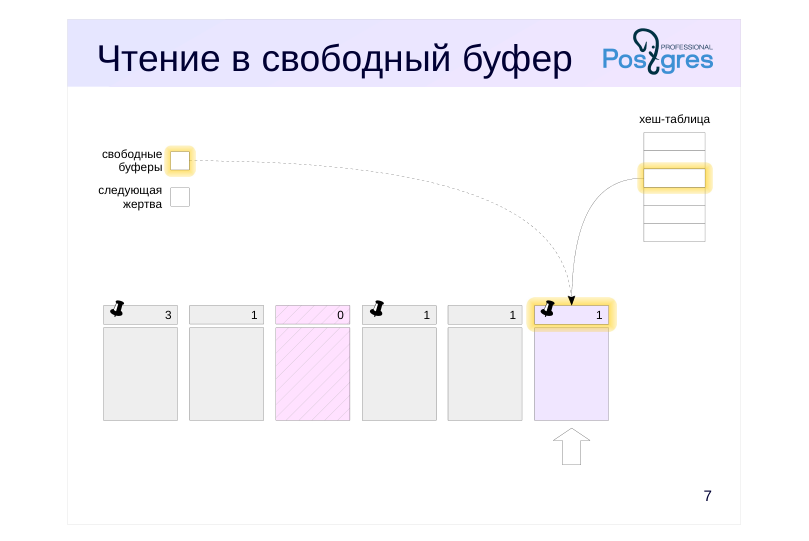
В конце концов будет заполнен и последний свободный буфер.
Теперь ссылка на свободный буфер пуста — в дальнейшем, чтобы прочитать новую страницу в любой занятый буфер, придется из этого буфера вытеснить страницу, которая там находится.
Буферы возвращаются в список свободных при удалении или опустошении таблицы или при отсечении части хвостовых страниц при очистке — то есть в случаях, когда страница в буфере не заменяется другой, а просто исчезает.
Page 9: Чтение в свободный буфер
Перезагрузим сервер, чтобы сбросить буферный кеш.
В кеше есть свободные буферы:
Выполним запрос к таблице:
Строка «Buffers: shared read=1» показывает, что страницу пришлось прочитать с диска. Вот она:
Количество свободных буферов уменьшилось:
В кеш попала не только прочитанная страница, но и страницы таблиц системного каталога, которые потребовались планировщику.
Page 10: Чтение с вытеснением
 {#source-figure-010 caption=“Source slide page 10: Чтение с вытеснением”}
Комментарии преподавателя
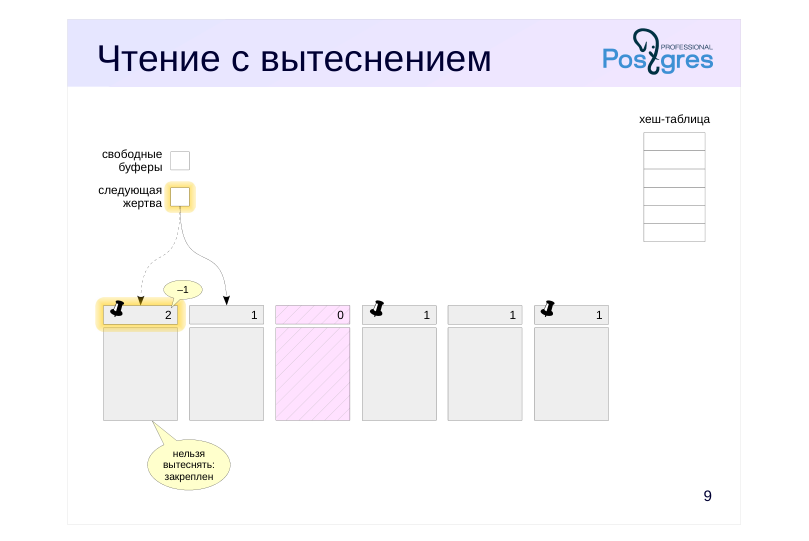
Механизм вытеснения использует указатель на следующую «жертву».
Алгоритм состоит в том, чтобы перебирать по кругу все буферы, уменьшая их счетчики обращений (usage count). Выбирается первый же буфер, у которого значение счетчика равно нулю и который в принципе может быть занят новой страницей. По-английски этот алгоритм называется clock-sweep: аналогия с часовой стрелкой, которая пробегает циферблат по кругу.
Чем больше значение счетчика у буфера (то есть чем чаще он используется), тем больше у него шансов задержаться в кеше. Максимальное значение счетчика обращений ограничено числом 5, чтобы избежать «наматывания кругов» при больших значениях.
В нашем примере процесс сначала обращается к буферу по указателю. Буфер закреплен (то есть используется каким-то процессом), и поэтому страница не может быть вытеснена из него. Тем не менее мы уменьшаем значение счетчика обращений на единицу и переходим к следующему буферу.
Page 11: Чтение с вытеснением
 {#source-figure-011 caption=“Source slide page 11: Чтение с вытеснением”}
Комментарии преподавателя
Следующий буфер не закреплен, однако его счетчик обращений больше нуля.
Мы уменьшаем счетчик на единицу и даем странице шанс остаться в кеше.
Page 12: Чтение с вытеснением
 {#source-figure-012 caption=“Source slide page 12: Чтение с вытеснением”}
Комментарии преподавателя
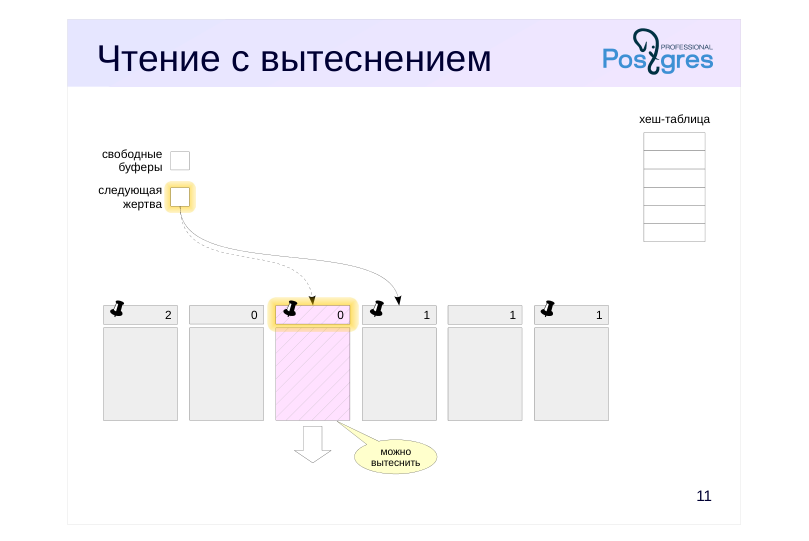
Наконец, мы доходим до незакрепленного буфера с нулевым счетчиком обращений. Страница из этого буфера и будет вытеснена.
Однако в нашем примере найденный буфер оказался грязным — он содержит измененные данные. Поэтому сначала страницу требуется сохранить на диск. Для этого буфер закрепляется (чтобы показать остальным процессам, что он используется), после чего страница записывается на диск.
Это не очень хорошая ситуация: процессу, который собирался прочитать страницу, придется ждать, пока «чужие» данные будут записаны. Этот эффект сглаживается процессами контрольной точки и фоновой записи, которые рассмотрены в теме «Контрольная точка».
Page 13: Чтение с вытеснением
 {#source-figure-013 caption=“Source slide page 13: Чтение с вытеснением”}
Комментарии преподавателя
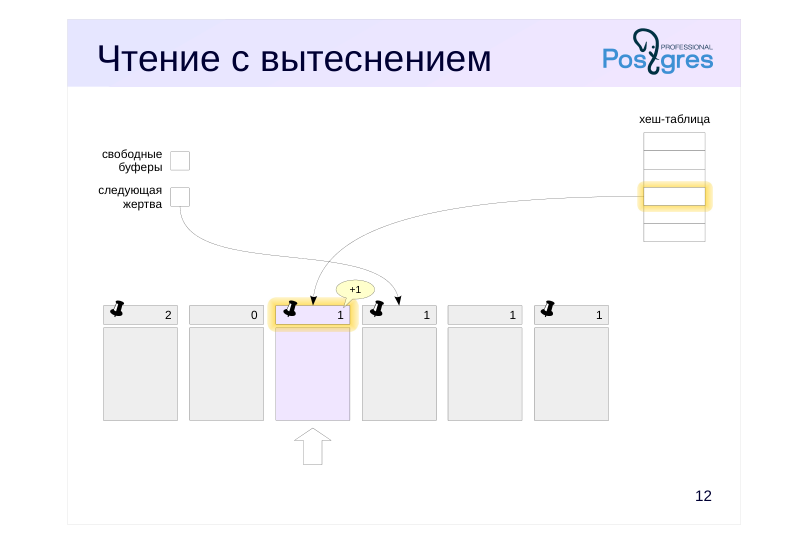
После того как страница из грязного буфера записана на диск, в освободившийся буфер ранее рассмотренным образом читается новая страница.
Ссылка на следующую «жертву» уже указывает на следующий буфер, а у только что загруженного есть время нарастить счетчик обращений, пока указатель не обойдет по кругу весь буферный кеш и не вернется вновь.
Page 14: Настройка размера кеша
Настройка
- ↑
- shared_buffers = 128MB
- Буферный кеш должен содержать «активные» данные
- при меньшем размере постоянно вытесняются полезные страницы
- при большем размере бессмысленно растут накладные расходы
- начальное приближение — 1/4 ОЗУ
- Нужно учитывать двойное кеширование
- если страницы нет в кеше СУБД, она может оказаться в кеше ОС
- алгоритм вытеснения ОС не учитывает специфики базы данных
Комментарии преподавателя
Размер кеша устанавливается параметром shared_buffers. Значение по умолчанию — 128 МБ — сильно занижено.
Как выбрать подходящее значение? Даже самая большая база имеет ограниченный набор данных, с которыми ведется активная работа. В идеале этот набор (плюс некоторое место для «одноразовых» данных) должен помещаться в буферный кеш.
При меньшем размере кеша активно используемые страницы будут постоянно вытеснять друг друга, создавая избыточный ввод-вывод. Признаком такой ситуации может служить то, что все страницы в кеше имеют большое число обращений (usage count).
Однако при большом размере кеша будут расти накладные расходы на его поддержание.
В качестве первого приближения можно взять 1/4 оперативной памяти, но надо понимать, что оптимальное значение зависит не от размера ОЗУ, а от конкретных данных и нагрузки.
Не следует забывать и о том, что PostgreSQL работает с диском через операционную систему и, таким образом, происходит двойное кеширование: страницы попадают как в буферный кеш, так и в кеш ОС. Таким образом, «непопадание» в буферный кеш не всегда приводит к необходимости реального ввода-вывода. Но стратегия вытеснения ОС не учитывает специфики баз данных.
https://postgrespro.ru/docs/postgresql/16/runtime-config-resource#RUNTIM E-CONFIG-RESOURCE-MEMORY
Page 15: Настройка размера кеша
Используя расширение pg_buffercache, можно наблюдать за состоянием кеша под разными углами. Кроме информации о том, как представлена в кеше та или иная страница, можно, например, посмотреть распределение буферов по их «популярности».
Функция pg_buffercache_usage_counts возвращает количество общих буферов для всех возможных значений счетчика использования. Как и представление pg_buffercache, функция не использует блокировки менеджера буферов, поэтому при параллельной работе в базе данных возможна незначительная погрешность результатов функции. Посмотрим, какая доля каких таблиц закеширована (и насколько активно используются эти данные):
А сводную информацию о буферном кеше нам покажет другая функция из расширения:
Подобные запросы могут подсказать, насколько активно используется буферный кеш и дать пищу для размышлений о том, стоит ли увеличивать или уменьшать его размер. Надо учитывать, что такие запросы надо повторять несколько раз: цифры будут меняться в определенных пределах, а набор результатов, полученный для всех буферов, в целом может оказаться несогласованным. Информацию, подобную той, что возвращают функции pg_buffercache_summary() и pg_buffercache_usage_counts(), можно получить и с помощью представления pg_buffercache, однако использование функций менее затратно, что удобно для использования в системах мониторинга.
Page 16: Page 16
Page 17: Массовое вытеснение
 {#source-figure-017 caption=“Source slide page 17: Массовое вытеснение”}
Комментарии преподавателя
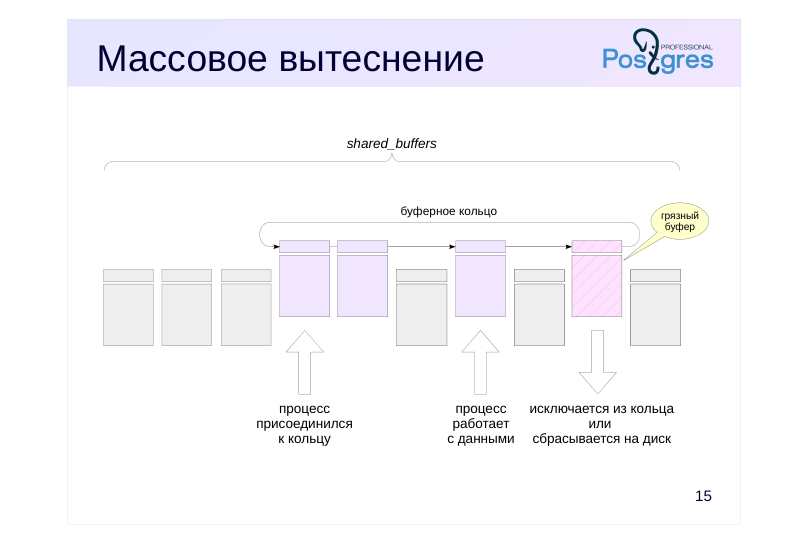
При операциях, выполняющих массовое чтение или запись данных, есть опасность вытеснения полезных страниц из буферного кеша «одноразовыми» данными. Чтобы этого не происходило, для таких операций используются буферные кольца — выделенные небольшие части буферного кеша. Вытеснение действует в этом случае только в пределах кольца, и остальные данные в кеше не страдают.
Если в процессе работы в кольце появляются грязные буферы, то они будут отключены от кольца или записаны на диск.
Page 18: Буферное кольцо
Последовательное чтение
- 32 страницы
- грязный буфер исключается из кольца
- Очистка
- vacuum_buffer_usage_limit = 32
- грязный буфер вытесняется на диск
- Массовая запись
- ≤2048 страниц
- грязный буфер вытесняется на диск
Комментарии преподавателя
При последовательном чтении (sequential scan) таблиц используется кольцо размером 32 страницы. Если при работе с этими данными появляются грязные буферы (в результате простановки битов-подсказок или при выполнении UPDATE), они отключаются от кольца, возвращаются в основной кеш и вытесняются затем уже на общих основаниях. А вместо отключенного буфера в кольцо из кеша подключается другой буфер. Такая стратегия рассчитана на то, что данные в основном читаются, а не изменяются.
Если в процессе чтения таблицы другой процесс начнет последовательное сканирование, он подключается к уже имеющемуся буферному кольцу, а потом дочитывает страницы, которые были вытеснены из кольца.
Для работы очистки используется кольцо, размер которого задается параметром vacuum_buffer_usage_limit. По умолчанию его значение невелико (32 страницы), так как замедление очистки обычно не столь критично, как замедление пользовательских процессов (исключение — защитный режим: в нем очистка может использовать весь кеш).
Для массовых операций записи, таких как COPY или CREATE TABLE AS SELECT, кольцо имеет достаточно большой размер (обычно 2048 страниц, но не больше одной восьмой всего буферного кеша).
Page 19: Массовое вытеснение
Для полного чтения таблиц, размер которых превышает четверть буферного кеша, используется буферное кольцо. Размер кеша (в страницах):
Добавим строк в таблицу:
Перезагрузим сервер, чтобы сбросить буферный кеш.
И сбросим общую статистику ввода-вывода:
Прочитаем данные из таблицы:
Были прочитаны все страницы с данными, но сколько буферов кеша ими занято?
При сканировании большой таблицы размер кольца — 32 буфера. В 16-й версии PostgreSQL появилось представление pg_stat_io, которое показывает статистику ввода/вывода с точки зрения СУБД (кеширование на уровне ОС в нем не учитывается).
Page 20: Page 20
Строка с контекстом normal показывает операции чтения-записи в общей части буферного кеша, а bulkread — в буферных кольцах. reads — количество чтений из файлов, hits — сколько раз страница нашлась в кеше, reuses — число повторных использований буферов в буферном кольце. Разность между reads и reuses в строке bulkread равна размеру кольца (32). А теперь сбросим статистику и изменим все строки таблицы. При этом буферы со страницами будут отсоединяться от буферного кольца и оставаться в кеше:
Сейчас в кеше находятся все или почти все страницы таблицы, количество которых удвоилось из-за появления новых версий строк:
Еще раз заглянем в статистику.
Таблица еще раз полностью сканируется через буферное кольцо. При этом 32 страницы остались в кольце от предыдущего сканирования, а остальные пришлось прочитать заново. Измененные страницы одна за другой передаются в общий кеш, обращения к ним учитываются в строке normal. При этом обновление каждой из 30 тысяч строк таблицы требует нескольких обращений к страницам, поэтому значение в поле hits довольно велико.
Page 21: Локальный кеш
Временные таблицы
- видны только одному сеансу — нет смысла использовать общий кеш
- существуют в пределах сеанса — не жалко потерять при сбое
- Особенности
- не требуются блокировки
- память выделяется по необходимости в пределах temp_buffers
- обычный алгоритм вытеснения
- механизм буферных колец не используется
Комментарии преподавателя
Исключением из общего правила являются временные таблицы. Поскольку временные данные видны только одному процессу, им нечего делать в общем буферном кеше. Более того, временные данные существуют только в рамках одного сеанса, так что их не нужно защищать от сбоя.
Для временных данных используется облегченный локальный кеш.
Поскольку локальный кеш доступен только одному процессу, для него не требуются блокировки. Память выделяется по мере необходимости (в пределах, заданных параметром temp_buffers), ведь временные таблицы используются далеко не во всех сеансах. В локальном кеше используется обычный алгоритм вытеснения.
Временные таблицы на физическом уровне хранятся схожим с обычными таблицами образом. Параметр temp_tablespaces задает табличные пространства, в которых будут создаваться временные объекты (временные таблицы и индексы временных таблиц), когда в команде CREATE табличное пространство не указывается явно.
Значение параметра temp_tablespaces может содержать список имен табличных пространств. Когда этот список содержит больше одного имени, PostgreSQL выбирает из него случайный элемент при создании каждого временного объекта; однако при создании последующих объектов внутри транзакции табличные пространства перебираются последовательно. Если же в списке оказывается пустая строка (значение по умолчанию), PostgreSQL будет использовать табличное пространство по умолчанию для текущей базы данных.
Page 22: Временные таблицы
Создадим временную таблицу с одной строкой:
В плане выполнения запроса обращение к локальному кешу выглядит как «Buffers: local»:
Видим, что вставка строки привела к расширению таблицы (extends).
Page 23: Прогрев кеша
Расширение pg\_prewarm
- ручной прогрев кеша операционной системы
- ручной прогрев буферного кеша
- автоматический прогрев буферного кеша при перезапуске сервера
Комментарии преподавателя
После перезапуска сервера буферный кеш пуст и должно пройти некоторое время, чтобы он «прогрелся», то есть набрал актуальные активно использующиеся данные. Иногда может оказаться полезным сразу прочитать в кеш данные определенных таблиц.
Расширение pg_prewarm позволяет в ручном режиме прочитать некоторые таблицы либо в кеш операционной системы, либо и в буферный кеш СУБД тоже.
Расширение также позволяет в автоматическом режиме восстановить содержимое буферного кеша после перезапуска сервера. Для этого необходимо подключить библиотеку расширения, добавив ее в параметр shared_preload_libraries.
https://postgrespro.ru/docs/postgresql/16/pgprewarm
Page 24: Прогрев кеша
Рассмотрим самый простой сценарий использования расширения для прогрева кеша.
В очередной раз перезапустим сервер, чтобы в кеше не было данных таблицы test:
Вызов функции pg_prewarm без дополнительных параметров полностью считывает основной слой указанной таблицы в буферный кеш:
Page 25: Итоги
Вся работа с данными происходит через буферный кеш
- Редко используемые страницы вытесняются, часто используемые — остаются
- Буферный кеш сокращает объем ввода-вывода, но приводит к необходимости журналирования
Page 26: Практика
- Создайте таблицу и вставьте в нее некоторое количество строк. Определите, сколько занимает таблица а) страниц на диске, б) буферов в кеше.
- Узнайте количество грязных буферов в кеше на текущий момент. Выполните контрольную точку командой CHECKPOINT. Сколько грязных буферов осталось теперь?
- Подключите библиотеку расширения pg_prewarm и проверьте, что после перезапуска сервера содержимое буферного кеша восстанавливается.
Комментарии преподавателя
Чтобы проверить содержимое буферного кеша, используйте расширение pg_buffercache: https://postgrespro.ru/docs/postgresql/16/pgbuffercache.html
Page 27: 1. Таблица в кеше
Создадим таблицу:
Выполним VACUUM — это обеспечит нам наличие всех слоев:
Сколько страниц на диске занимает таблица?
Из них основной слой:
Карта свободного пространства:
И карта видимости:
Сколько буферов в кеше занимает таблица?
Page 28: Page 28
2. Грязные буферы в кеше
Выполним контрольную точку:
Грязных буферов не осталось. Подробнее о контрольной точке рассказывается в отдельной теме.
3. Автоматический прогрев кеша
Подключим библиотеку pg_prewarm и перезапустим сервер.
Теперь отдельный фоновый процесс будет сбрасывать на диск список страниц, находящихся в буферном кеше, раз в pg_prewarm.autoprewarm_interval единиц времени.
Прочитаем таблицу t в буферный кеш:
Page 29: Page 29
Можно либо подождать, либо сбросить список страниц вручную:
В файл записываются идентификаторы базы данных, табличного пространства и файла, номер слоя и номер страницы:
Снова перезапустим сервер.
После запуска фоновый процесс прочитает в буферный кеш все страницы, указанные в файле.
Вернемся к настройкам по умолчанию.