04 Занятие 04: Многоверсионность / HOT-обновления и самоочистка
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_04_mvcc_hot.html Archive: DBA2-handouts-16.zip Страниц PDF: 26
Page 1: Многоверсионность / HOT-обновления и самоочистка
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Почему очистки не хватает
- HOT-обновления
- Самоочистка в таблице
- Самоочистка в индексе
Page 3: Почему очистки не хватает
Мертвые версии строк
- приводят к разрастанию файлов
- Синхронизация индексов
- при любом изменении строки таблицы нужно менять все индексы
- Расщепление индексных страниц
- снижает производительность
- увеличивает размер
Комментарии преподавателя
При работе механизма многоверсионности образуются ненужные версии строк, что приводит к разрастанию таблиц и индексов и, как следствие, снижает производительность запросов.
Если у таблицы есть индексы, при изменении таблицы приходится их синхронизировать. Это приводит к изменению большого числа страниц и также снижает производительность.
Проблема усугубляется особенностью реализации B-дерева в PostgreSQL: если на индексной странице недостаточно места для вставки новой записи, страница делится («расщепляется») на две и все данные перераспределяются между ними. Частые расщепления снижают производительность при вставке и изменении строк.
Более того, при удалении (или очистке) записей две индексные страницы не «склеиваются обратно» в одну. Из-за этого размер индекса может не уменьшиться даже при удалении существенной части данных.
Регулярная очистка решает проблему разрастания таблиц и индексов, однако требует значительных ресурсов. Поэтому даже при обычном, не связанном с очисткой, обращении к странице желательно удалять ненужные версии строк или индексные записи. А чтобы предотвратить избыточные обновления индексов при изменении таблицы, PostgreSQL объединяет версии строк в HOT-цепочки. Мы рассмотрим их на следующих слайдах.
Page 4: Обычное обновление
 {#source-figure-004 caption=“Source slide page 4: Обычное обновление”}
Комментарии преподавателя
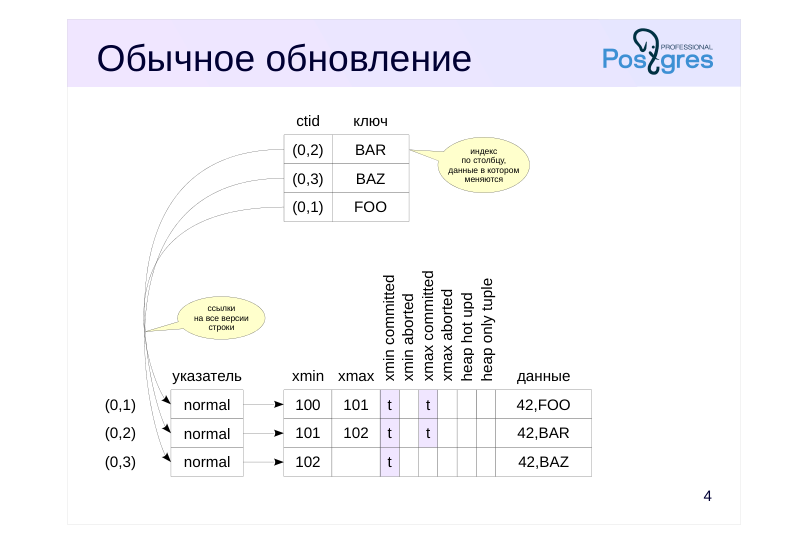
Напомним, что при обычном обновлении в индексе создаются ссылки на все версии строки, присутствующие в табличных страницах.
(Исключение составляет индекс BRIN, который не содержит ссылок на отдельные табличные строки; подробности устройства индексов различных типов рассматриваются в курсе QPT «Оптимизация запросов»).
Чем это плохо?
При любом изменении строки придется изменять все индексы, созданные для таблицы (даже если измененные поля не входят в индекс). Естественно, чем больше индексов создано на таблице, тем с большими сложностями приходится сталкиваться.
Page 5: HOT-обновление
 {#source-figure-005 caption=“Source slide page 5: HOT-обновление”}
Комментарии преподавателя
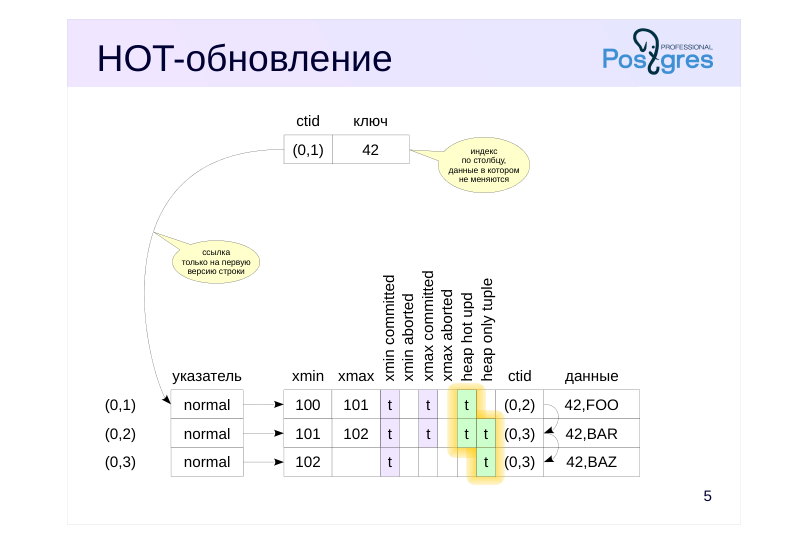
Если индекс создан по полю, значение которого не изменилось в результате обновления строки, можно не создавать в B-дереве дополнительную ссылку для того же значения ключа. Именно так работает оптимизация, называемая HOT-обновлением — Heap-Only Tuple Update.
При таком обновлении в индексной странице находится лишь одна ссылка – на первую версию строки табличной страницы, а внутри табличной страницы организуется цепочка версий:
● строки, которые изменены и входят в цепочку, маркируются битом Heap Hot Updated;
● строки цепочки, на которые нет ссылок из индекса, маркируются битом Heap Only Tuple (то есть — «только табличная версия строки»);
● версии строк связаны в список с помощью поля ctid, входящего в заголовок версий.
Если при сканировании индекса PostgreSQL попадает в табличную страницу и обнаруживает версию, помеченную как Heap Hot Updated, он понимает, что надо пройти дальше по цепочке обновлений. (Разумеется, для всех полученных таким образом версий строк проверяется видимость, прежде чем они будут возвращены клиенту.)
https://git.postgresql.org/gitweb/?p=postgresql.git;f=src/backend/access/hea p/README.HOT;hb=HEAD
Page 6: HOT-обновление
Значения индексированных столбцов не должны изменяться
- иначе придется добавить в индекс ссылку на новую версию строки,
- и версию нельзя будет пометить как «heap only»
- Цепочка обновлений — только в пределах одной страницы
- не требуется обращение к другим страницам,
- обход цепочки не ухудшает производительность
- если в табличной странице не хватает места для новой версии,
- цепочка обрывается (как если бы оптимизация не работала)
- место в странице можно зарезервировать, уменьшив параметр
- хранения таблицы fillfactor (100 % → 10 %)
Комментарии преподавателя
Подчеркнем, что HOT-обновления работают только в случае, если не изменяется ни один ключ в индексах. Иначе в каком-либо индексе появилась бы ссылка непосредственно на новую версию строки, что противоречит идее этой оптимизации. Только упомянутый выше индекс BRIN не препятствует HOT-обновлению (в нем нет ссылок на табличные строки).
В том числе HOT-обновления применяются и к таблицам, на которых нет вообще ни одного индекса: при обновлении любых полей такой таблицы будет строиться цепочка версий.
Оптимизация действует только в пределах одной страницы, поэтому дополнительный обход цепочки не требует обращения к другим страницам и не ухудшает производительность.
Однако если на странице не хватит свободного места, чтобы разместить новую версию строки, цепочка прервется. На версию строки, размещенную на другой странице, придется сделать и ссылку из индекса.
Поэтому при частых обновлениях неиндексированных полей может иметь смысл уменьшить параметр хранения fillfactor. Этот параметр определяет пороговый процент занятого на странице места, после которого вставка новых строк в эту страницу будет запрещена. Значение по умолчанию – 100%, можно уменьшать до 10%. Оставшееся место резервируется для обновлений: в этом случае новая версия строки может занять свободное место на той же странице. (С другой стороны, чем выше fillfactor, тем компактнее располагаются записи и, соответственно, размер таблицы получается меньше.)
Page 7: HOT-обновление
Создадим таблицу. Для простоты не будем создавать индекс: любое обновление будет HOT-обновлением. Каждая строка таблицы состоит из 2000 символов; если использовать только латинские буквы, то версия строки будет занимать 2000 байт плюс заголовок. Параметр fillfactor установим в 75%, чтобы на страницу помещалось только три версии и одна была доступна для обновления.
Для изучения содержимого страницы используем расширение pageinspect.
Для удобства создадим уже знакомое представление в немного более компактном виде и дополненное двумя полями:
Вставим строку и обновим ее, чтобы создать новую версию:
Поскольку обновленный столбец не входит ни в какой индекс (в нашем случае ни одного индекса просто нет), в табличной странице появляется цепочка версий:
Page 8: Page 8
флаг hhu (Heap Hot Updated) показывает, что надо идти по цепочке ctid, флаг hot (Heap Only Tuple) показывает, что на данную версию строки нет ссылок из индексов. При дальнейших изменениях цепочка будет расти (в пределах страницы):
Page 9: Самоочистка в таблице
Выполняется при любом обращении к странице
- если ранее выполненное обновление не нашло места
- для новой версии строки на этой же странице
- если страница заполнена более чем на fillfactor или более чем на 90%
- Действует в пределах одной табличной страницы
- не освобождает указатели, на которые могут ссылаться индексы
- не обновляет карту свободного пространства
- не обновляет карту видимости
Комментарии преподавателя
При обращении к странице — как при обновлении, так и при чтении — может происходить быстрая самоочистка, если PostgreSQL сочтет, что место на странице заканчивается. Должно выполниться одно из условий:
Ранее выполненное на этой странице обновление не обнаружило достаточного места, чтобы разместить здесь же новую версию строки и установило в заголовке страницы соответствующий признак, по которому при следующем обращении к ней срабатывает очистка.
Страница заполнена более чем на fillfactor или более чем на 90% — очистка сработает сразу.
Самоочистка убирает версии строк, не видимые ни в одном снимке (находящиеся за горизонтом базы данных), но работает строго в пределах одной табличной страницы. Указатели на версии строк не освобождаются, так как на них могут быть ссылки из индексов, а это уже другая страница — она не очищается.
Карта свободного пространства не обновляется из экономии ресурсов, а также из соображения, что освобожденное место лучше приберечь для обновлений, а не для вставок. Также не обновляется и карта видимости.
Тот факт, что страница может очищаться при чтении, означает, что запрос SELECT может вызвать изменение страниц. Это еще один такой случай, в дополнение к рассмотренному в теме «Страницы и версии строк» изменению битов-подсказок.
Page 10: До HOT-самоочистки
 {#source-figure-010 caption=“Source slide page 10: До HOT-самоочистки”}
Комментарии преподавателя
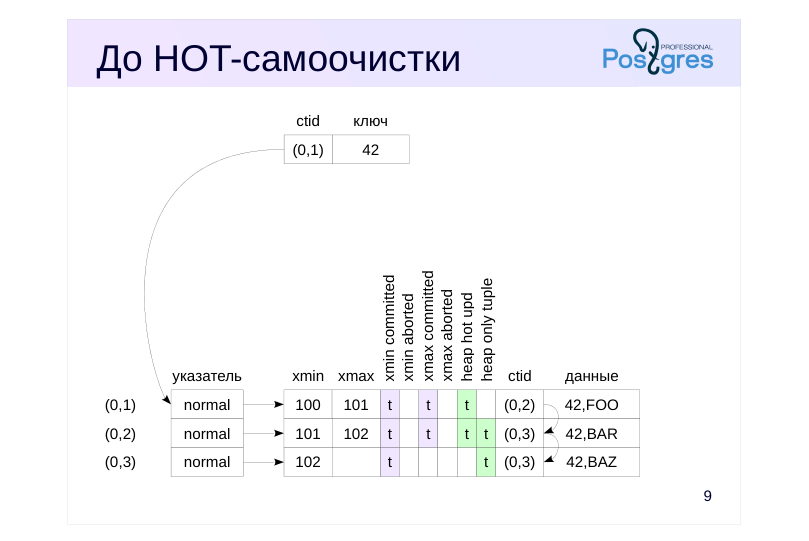
Частный, но важный случай самоочистки представляет собой очистка при HOT-обновлениях.
На рисунке приведена ситуация до очистки. В таблице три версии одной и той же строки. На первую из них (0,1) ссылается индекс, остальные две (0,2) и (0,3) помечены как «только табличные».
Версии строк (0,1) и (0,2) неактуальны, не видны ни в одном снимке и могут быть удалены.
Page 11: После HOT-самоочистки
 {#source-figure-011 caption=“Source slide page 11: После HOT-самоочистки”}
Комментарии преподавателя
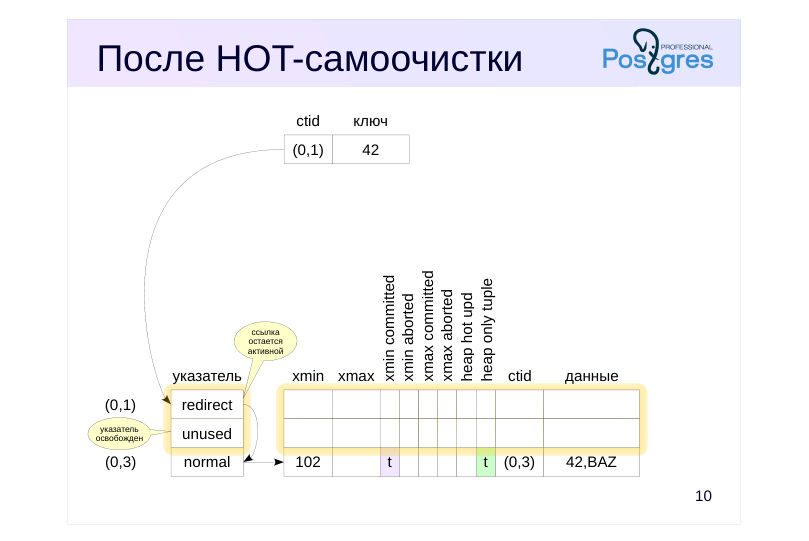
Самоочистка удаляет неактуальные версии строк.
При HOT-обновлениях в индексе может быть только одна ссылка на версию строки, представляющую собой «голову» HOT-цепочки, которая поддерживается внутри одной табличной страницы. При любых изменениях версий строки указатель должен оставаться на своем месте и ссылаться на голову цепочки.
Поэтому применяется двойная адресация: для указателя, на который ссылается индекс — в данном случае (0,1), — используется статус «redirect», перенаправляющий на указатель нужной версии строки.
Указатель на вторую версию (0,2) больше не нужен. Он получает статус «unused» и будет использован при вставке какой-нибудь новой версии строки.
Все оставшиеся версии строк сдвигаются вместе так, чтобы свободное место на странице было представлено одним фрагментом. Соответствующим образом изменяются и значения указателей. Благодаря этому не возникает проблем с фрагментацией свободного места в странице.
Page 12: HOT-самоочистка
Проверим, как работает самоочистка при HOT-обновлениях. Обновим строку еще раз:
В странице сейчас четыре версии строки:
На самом деле мы только что превысили порог fillfactor. 75% от размера страницы составляет 6144 байтов, а разница между значениями pagesize и upper равна 8192-64=8128:
Проверим, что порог действительно превышен. Обновим строку еще раз:
Какие изменения произойдут со страницей?
Все неактуальные версии строк (0,1), (0,2) и (0,3) были очищены; после этого новая версия строки была добавлена на освободившееся место. Указатели на очищенные строки освобождены (имеют статус unused). При этом указатель на первую версию остался на месте, но получил статус redirect. Проследите ссылки от этой головной версии до конца HOT-цепочки. Выполним обновление еще несколько раз:
Page 13: Page 13
Следующее обновление снова вызывает самоочистку:
А теперь построим индекс по столбцу s и создадим вспомогательное представление, чтобы заглянуть в него:
При создании индекса перестройки данных в табличных страницах не происходит, HOT-цепочки сохраняются:
А из индекса ссылка ведет к указателю начала цепочки:
Page 14: До самоочистки
 {#source-figure-014 caption=“Source slide page 14: До самоочистки”}
Комментарии преподавателя
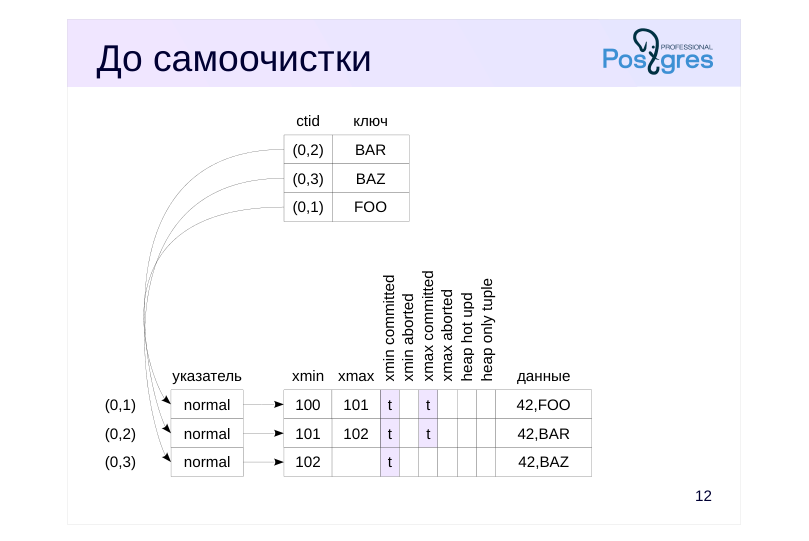
Разумеется, самоочистка работает и для версий, появившихся в результате обычного (не HOT) обновления.
На рисунке приведена ситуация до очистки. В табличной странице три версии одной строки. Две из них неактуальны, не видны ни в одном снимке и могут быть удалены.
В индексе есть три ссылки на каждую из версий строки.
Page 15: После самоочистки
 {#source-figure-015 caption=“Source slide page 15: После самоочистки”}
Комментарии преподавателя
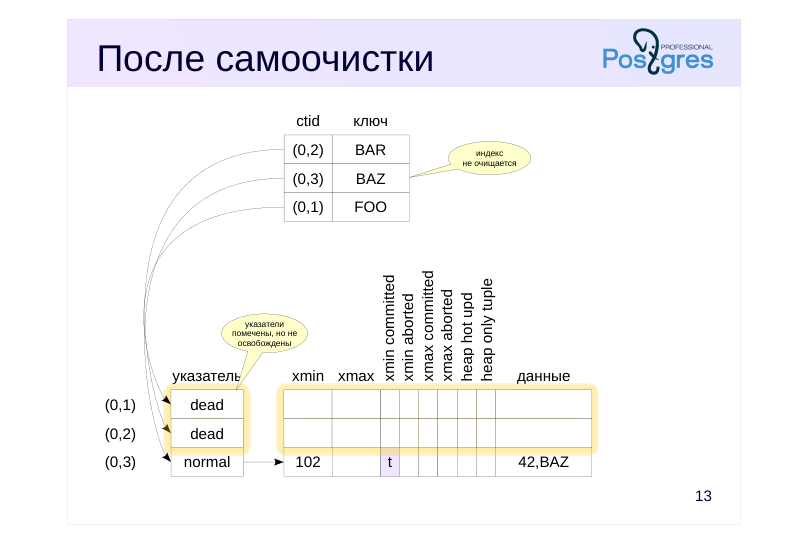
Если выполнено условие для срабатывания самоочистки, две неактуальные версии строки (0,1) и (0,2) могут быть ею удалены. Тогда указатели на удаленные версии получают статус «dead», а освободившееся место может быть использовано для вставки новых версий.
В отличие от ситуации с HOT-обновлениями, здесь нельзя освободить указатели на удаленные версии строк, поскольку на них существуют ссылки из индексной страницы. При индексном доступе PostgreSQL может получить (0,1) или (0,2) в качестве идентификатора версии строки, а затем попробовать пройти по этому идентификатору в табличную страницу, но благодаря статусу указателя обнаружит, что эта версия уже не существует.
Принципиально то, что самоочистка работает только в пределах одной табличной страницы и не очищает страницы индекса.
Page 16: Самоочистка в индексе
Ненужные индексные записи
- помечаются при выполнении запросов
- будут удалены, если в странице не хватает места
- Восходящее удаление индексных записей
- если места все равно не хватает, проверяются версии строк
Комментарии преподавателя
Если таблица имеет несколько индексов и обновляемый столбец входит хотя бы в один из них, HOT-обновление будет невозможно. При этом значения столбцов, входящих в другой индекс, могут не измениться, однако в такой индекс все равно придется добавить ссылку на новую версию строки (индекс изменяется физически, но не логически). Чтобы избежать частой очистки или перестройки индекса, можно заранее распознавать ненужные индексные записи и удалять их при недостатке места в индексной странице. В PostgreSQL есть два механизма, позволяющие это делать.
Если при выполнении запроса выясняется, что индексная запись ссылается на версию строки, которая не существует или находится за горизонтом, такая запись помечается как мертвая. Если не удается разместить в странице очередную индексную запись, в первую очередь удаляются такие помеченные записи.
Если избежать расщепления таким образом не удается, включается механизм «восходящего удаления кортежей» (bottom-up delete), добавленный в PostgreSQL 14. Для индексных записей с одинаковым значением ключа проверяются соответствующие версии строк. Если оказывается, что версия отсутствует или находится за горизонтом, индексная запись будет удалена. Проверка требует обращения к таблице, но это оказывается выгоднее, чем лишнее расщепление индексной страницы.
Page 17: Самоочистка индекса
Уменьшим длину строки таблицы, опустошим ее, вставим семь строк и обновим их:
Заглянем в постраничную статистику индекса с помощью функции из расширения pageinspect:
В индексе сейчас всего одна листовая страница (она же корневая), в которой осталось около 900 байт свободного места. В ней находятся 14 индексных записей:
А вот строки, на которые они указывают:
Page 18: Page 18
Семь записей ссылаются на актуальные версии табличных строк, остальные семь — на мертвые, но получить эту информацию из индекса невозможно. Поэтому при следующем обновлении страница индекса расщепится. Но если какой-то запрос обратится к таблице через индекс, ему придется пройти по ссылкам и узнать статусы табличных строк:
Такой запрос помечает ненужные индексные записи как dead…
… и если после этого выполнить обновление,..
… то оно не приводит к расщеплению страницы, поскольку удается освободить место для новых записей:
Page 19: Восходящее удаление
Теперь добавим к таблице второй текстовый столбец и индекс по нему:
Опять опустошим таблицу и вставим строки в таблицу:
Теперь, поскольку оба столбца проиндексированы, при обновлении HOT-цепочки строиться не будут. Если изменять только первый столбец, индекс по нему будет расти:
Однако ключи второго индекса логически не изменяются, поэтому при недостатке места срабатывает механизм восходящего удаления и страница второго индекса расщепляться не будет:
Page 20: Page 20
Page 21: Итоги
Если изменяемый столбец не входит ни в один индекс и на странице есть место — применяется HOT-обновление
- При недостатке места в странице таблицы или индекса автоматически выполняется самоочистка
Page 22: Практика
- Воспроизведите ситуацию самоочистки без участия HOT-обновлений. Проверяйте содержимое табличной и индексной страниц с помощью расширения pageinspect.
- Воспроизведите ситуацию HOT-обновления на таблице с индексом по некоторым полям.
- Воспроизведите ситуацию HOT-обновления, при которой самоочистка не освобождает достаточно места на странице и новая версия создается на другой странице. Сколько записей будет в индексе в этом случае?
Комментарии преподавателя
- Запрос для индексной страницы появлялся в демонстрации к теме «Страницы и версии строк» этого модуля:
Page 23: 1. Самоочистка
Создадим таблицу с двумя полями. Параметр fillfactor установим в 75%, как в демонстрации.
Создадим индекс по столбцу s:
Как обычно, используем расширение pageinspect.
Добавим строку и будем обновлять столбец s:
При этом в индексе для каждой из версий была сформирована запись:
Page 24: Page 24
Наличие индекса на обновляемом столбце привело к тому, что HOT-обновление не использовалось:
Как и в демонстрации, еще одно обновление строки приводит к самоочистке:
Все неактуальные версии строк (0,1), (0,2) и (0,3) очищены; после этого на освободившееся место добавлена новая версия строки (0,5). Самоочистка не затрагивает индекс:
По этой причине указатели на очищенные строки в таблице не освобождены, а имеют статус dead.
2. HOT-обновление при наличии индекса
Удалим индекс по столбцу s и добавим другой, по столбцу id:
Опустошим таблицу и повторим команды, приводящие к самоочистке:
Page 25: Page 25
В индексной странице только одна ссылка на таблицу:
В табличной странице — версии строки, объединенные в список:
Индекс на столбце не мешает HOT-обновлению, если этот столбец не обновляется.
3. Разрыв HOT-цепочки
В новом сеансе начнем транзакцию и построим снимок:
Теперь выполняем обновление в первом сеансе:
Page 26: Page 26
Следующее обновление уже не сможет освободить место на странице:
Видим ссылку (1,1), ведущую на страницу 1. Представление pg_stat_all_tables покажет количество измененных строк (в том числе с применением HOT), а также количество измененных строк с переходом на новую табличную страницу. Если это значение при работе с таблицей будет достаточно большим, то следует задуматься об уменьшении значения fillfactor.
Теперь в индексе две записи, каждая указывает на начало своей HOT-цепочки: