12 Занятие 12: Задачи администрирования / Мониторинг
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba1_12_admin_monitoring.html Archive: DBA1-handouts-16.zip Страниц PDF: 30
Page 1: Задачи администрирования / Мониторинг
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Средства операционной системы
- Накопительная статистика сервера
- Журнал сообщений сервера
- Внешние системы мониторинга
Page 3: Средства ОС
Процессы
- ps, pgrep…
- параметр update_process_title для обновления статуса процессов
- параметр cluster_name для установки имени кластера
- Использование ресурсов
- iostat, vmstat, sar, top…
- Дисковое пространство
- df, du, quota…
Комментарии преподавателя
PostgreSQL работает под управлением операционной системы и в известной степени зависит от ее настроек.
Используя инструменты операционной системы, можно посмотреть информацию о процессах PostgreSQL. При включенном (по умолчанию) параметре сервера update_process_title в имени процесса отображается его текущее состояние. Параметр cluster_name задает имя экземпляра, по которому его можно отличать в списке процессов.
Использование системных ресурсов (процессора, ОЗУ, дисков) в Unix проверяют с помощью iostat, vmstat, sar, top и других инструментов.
Необходимо следить и за размером дискового пространства. Место, занимаемое базой данных, можно смотреть как из самой БД (см. модуль «Организация данных»), так из ОС (команда du). Размер доступного дискового пространства надо смотреть в ОС (команда df).
Дисковые квоты Unix ограничивают использование диска пользователями ОС. Так как процессы PostgreSQL принадлежат единственному пользователю postgres (по умолчанию), дисковая квота для него должна быть достаточной. PostgreSQL не позволяет квотировать использование ролями дискового пространства.
В целом набор инструментов и подходы могут сильно различаться в зависимости от используемой ОС и файловой системы, поэтому подробно здесь не рассматриваются.
https://postgrespro.ru/docs/postgresql/16/monitoring-ps
https://postgrespro.ru/docs/postgresql/16/diskusage
Page 4: Накопительная статистика
Процесс сбора статистики
- Текущие активности системы
- Отслеживание выполнения команд
- Дополнительные расширения
Комментарии преподавателя
Существует два основных источника информации о происходящем в системе. Первый из них — статистическая информация, которая собирается PostgreSQL и хранится в кластере.
Page 5: Сбор статистики
Настройки накопительной статистики
- параметр
- действие
- track_activities
- включает мониторинг текущих команд
- track_counts
- сбор статистики по обращениям к таблицам
- и индексам
- track_functions
- отслеживание использования пользовательских
- функций
- выключен по умолчанию
- track_io_timing
- мониторинг времени чтения и записи блоков
- выключен по умолчанию
- track_wal_io_timing
- мониторинг времени записи WAL
- выключен по умолчанию
Комментарии преподавателя
Система накопительной статистики в PostgreSQL собирает и позволяет получать информацию о работе сервера. Накопительная статистика отслеживает обращения к таблицам и индексам как на уровне блоков на диске, так и на уровне отдельных строк. Кроме того, для каждой таблицы собираются сведения о количестве строк и действиях по очистке и анализу.
Можно также учитывать количество вызовов пользовательских функций и время, затраченное на их выполнение.
Количеством собираемой информации управляют несколько параметров сервера, так как чем больше информации собирается, тем больше и накладные расходы.
https://postgrespro.ru/docs/postgresql/16/monitoring-stats
Page 6: Архитектура
 {#source-figure-006 caption=“Source slide page 6: Архитектура”}
Комментарии преподавателя
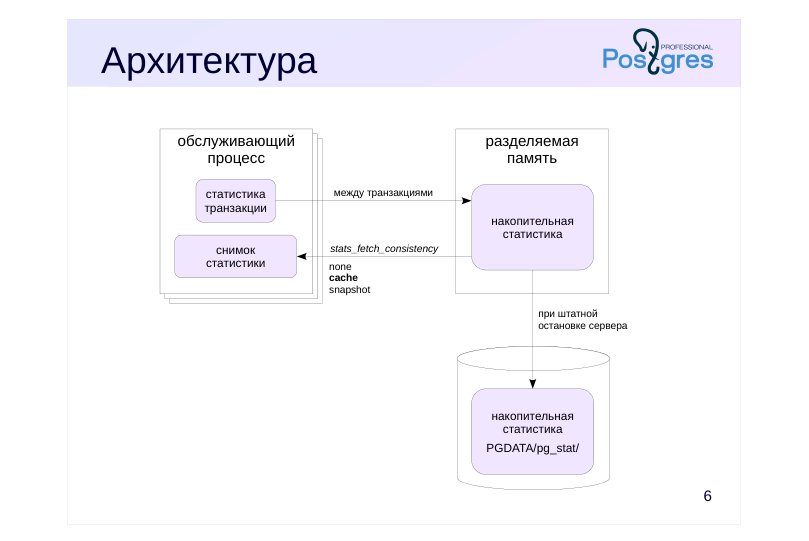
Обслуживающие процессы собирают статистику в рамках транзакций. Затем эта статистика самим процессом записывается в разделяемую память, но не чаще, чем раз в одну секунду (задано при компиляции).
Накопительная статистика запоминается в PGDATA/pg_stat/ при штатной остановке сервера и считывается при его запуске. При аварийной остановке все счетчики сбрасываются.
Обслуживающий процесс может кешировать данные статистики при обращении к ней. Уровнем кеширования управляет параметр stats_fetch_consistency:
● none — без кеширования, статистика только в разделяемой памяти;
● cache — кешируется статистика по одному объекту;
● snapshot — кешируется вся статистика текущей базы данных.
По умолчанию используется значение cache — это компромисс между согласованностью и эффективностью.
Закешированная статистика не перечитывается и сбрасывается в конце транзакции или при вызове pg_stat_clear_snapshot().
Из-за задержек и кеширования обслуживающий процесс использует не самую свежую статистику, но обычно это и не требуется.
Page 7: Накопительная статистика
Вначале включим сбор статистики ввода-вывода:
Смотреть на активности сервера имеет смысл, когда какие-то активности на самом деле есть. Чтобы сымитировать нагрузку, воспользуемся pgbench — штатной утилитой для запуска эталонных тестов. Сначала утилита создает набор таблиц и заполняет их данными.
Сбросим накопленную ранее статистику по базе данных:
А также статистику экземпляра по вводу-выводу:
Запускаем тест TPC-B на несколько секунд:
Page 8: Page 8
Теперь мы можем посмотреть статистику обращений к таблицам в терминах строк:
И в терминах страниц:
Существуют аналогичные представления для индексов:
Page 9: Page 9
Эти представления, в частности, могут помочь определить неиспользуемые индексы. Такие индексы не только бессмысленно занимают место на диске, но и тратят ресурсы на обновление при каждом изменении данных в таблице. Есть также представления для пользовательских и системных объектов (all, user, sys), для статистики текущей транзакции (pg_stat_xact*) и другие. Можно посмотреть общую статистику по базе данных:
Здесь есть много полезной информации о количестве произошедших взаимоблокировок, зафиксированных и отмененных транзакций, использовании временных файлов, ошибках подсчета контрольных сумм. Здесь же хранится статистика общего количества сеансов и количества прерванных по разным причинам сеансов. Столбец numbackends показывает текущее количество обслуживающих процессов, подключенных к базе данных. Статистика ввода-вывода на уровне сервера доступна в представлении pg_stat_io. Например, выполним контрольную точку и посмотрим количество операций чтения и записи страниц по типам процессов:
Page 10: Page 10
Page 11: Текущие активности
Настройка
- статистика
- параметр
- текущие активности
- track_activities
- и ожидания обслуживающих
- включен по умолчанию
- и фоновых процессов
Комментарии преподавателя
Текущие активности всех обслуживающих и фоновых процессов отображаются в представлении pg_stat_activity. Подробнее на нем мы остановимся в демонстрации.
Работа этого представления зависит от параметра track_activities, включенного по умолчанию.
Page 12: Текущие активности
 {#source-figure-012 caption=“Source slide page 12: Текущие активности”}
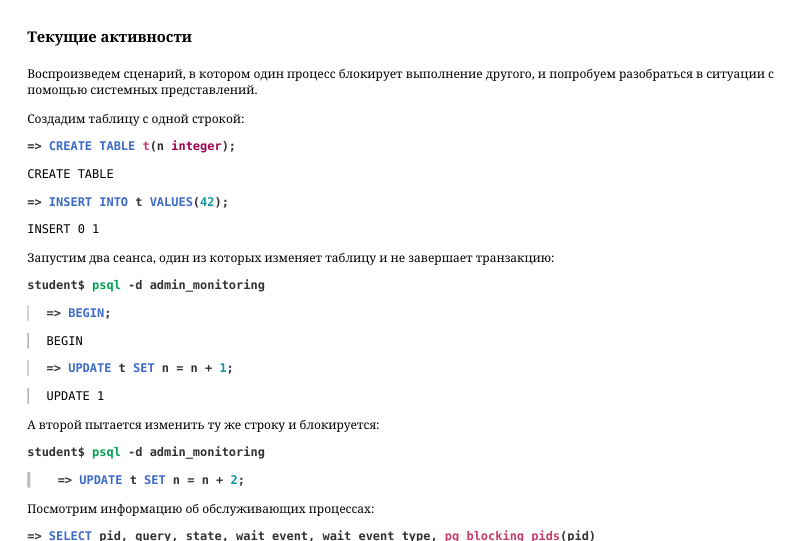
Воспроизведем сценарий, в котором один процесс блокирует выполнение другого, и попробуем разобраться в ситуации с помощью системных представлений. Создадим таблицу с одной строкой:
Запустим два сеанса, один из которых изменяет таблицу и не завершает транзакцию:
А второй пытается изменить ту же строку и блокируется:
Посмотрим информацию об обслуживающих процессах:
Состояние «idle in transaction» означает, что сеанс начал транзакцию, но в настоящее время ничего не делает, а транзакция осталась незавершенной. Это может стать проблемой, если ситуация возникает систематически (например, из-за некорректной реализации приложения или из-за ошибок в драйвере), поскольку открытая транзакция удерживает снимок данных и таким образом препятствует очистке. В арсенале администратора имеется параметр idle_in_transaction_session_timeout, позволяющий принудительно завершать сеансы, в которых транзакция простаивает больше указанного времени. Также имеется параметр idle_session_timeout — принудительно завершает сеансы, простаивающие больше указанного времени вне транзакции.
Page 13: Page 13
А мы покажем, как завершить блокирующий сеанс вручную. Сначала узнаем номер заблокированного процесса при помощи функции pg_blocking_pids:
Блокирующий процесс можно вычислить и без функции pg_blocking_pids, используя запросы к таблице блокировок. Запрос покажет две строки: одна транзакция получила блокировку (granted), а другая ее ожидает.
В общем случае нужно аккуратно учитывать тип блокировки. Выполнение запроса можно прервать функцией pg_cancel_backend. В нашем случае транзакция простаивает, так что просто прерываем сеанс, вызвав pg_terminate_backend:
Функция unnest нужна, поскольку pg_blocking_pids возвращает массив идентификаторов процессов, блокирующих искомый обслуживающий процесс. В нашем примере блокирующий процесс один, но в общем случае их может быть несколько. Подробнее о блокировках рассказывается в курсе DBA2. Проверим состояние обслуживающих процессов.
Осталось только два, причем заблокированный успешно завершил транзакцию. Представление pg_stat_activity показывает информацию не только про обслуживающие процессы, но и про служебные фоновые процессы экземпляра:
Page 14: Page 14
Сравним с тем, что показывает операционная система:
Page 15: Выполнение команд
Представления для отслеживания выполнения
- команда
- представление
- ANALYZE
- pg_stat_progress_analyze
- CREATE INDEX, REINDEX
- pg_stat_progress_create_index
- VACUUM
- pg_stat_progress_vacuum
- включая процессы автоочистки
- CLUSTER, VACUUM FULL
- pg_stat_progress_cluster
- Создание базовой резервной копии
- pg_stat_progress_basebackup
- COPY
- pg_stat_progress_copy
Комментарии преподавателя
Следить за ходом выполнения некоторых потенциально долгих команд можно, выполняя запросы к соответствующим представлениям.
Структуры представлений описаны в документации:
https://postgrespro.ru/docs/postgresql/16/progress-reporting
Создание резервных копий рассматривается в модуле «Резервное копирование».
Page 16: Дополнительная статистика
Расширения в поставке
- pg_stat_statements
- статистика по запросам
- pgstattuple
- статистика по версиям строк
- pg_buffercache
- состояние буферного кеша
- Другие расширения
- pg_wait_sampling
- статистика ожиданий
- pg_stat_kcache
- статистика по процессору и вводу-выводу
- pg_qualstats
- статистика по предикатам
- …
Комментарии преподавателя
Существуют расширения, позволяющие собирать дополнительную статистику, как входящие в поставку, так и внешние.
Например, расширение pg_stat_statements сохраняет информацию о запросах, выполняемых СУБД; pg_buffercache позволяет заглянуть в содержимое буферного кеша и т. п.
Многие важные расширения рассматриваются в курсах DBA2 и DEV2.
Page 17: Журнал сообщений
Настройка журнальных записей
- Ротация файлов журнала
- Анализ журнала
Комментарии преподавателя
Второй важный источник информации о происходящем на сервере — журнал сообщений.
Page 18: Журнал сообщений
Приемник сообщений (log\_destination = список)
- stderr
- поток ошибок
- csvlog
- формат CSV (только с коллектором)
- jsonlog
- формат JSON (только с коллектором)
- syslog
- демон syslog
- eventlog
- журнал событий Windows
- Коллектор сообщений (logging_collector = on)
- позволяет собирать дополнительную информацию
- никогда не теряет сообщения (в отличие от syslog)
- записывает stderr, csvlog и jsonlog в файл log_directory/log_filename
Комментарии преподавателя
Журнал сообщений сервера можно направлять в разные приемники и выводить в разных форматах. Основной параметр, который определяет приемник и формат — log_destination (можно указать один или несколько приемников через запятую).
Значение stderr (установленное по умолчанию) выводит сообщения в стандартный поток ошибок в текстовом виде. Значение syslog направляет сообщения демону syslog в Unix-системах, а eventlog — в журнал событий Windows.
Обычно дополнительно включают специальный процесс — коллектор сообщений. Он позволяет записать больше информации, поскольку собирает ее со всех процессов, составляющих PostgreSQL. Он спроектирован так, что никогда не теряет сообщения; как следствие, при большой нагрузке он может стать узким местом.
Коллектор сообщений включается параметром logging_collector. При значении stderr информация записывается в каталог, определяемый параметром log_directory, в файл, определяемый параметром log_filename.
Включенный коллектор сообщений позволяет также указать приемник csvlog; в этом случае информация будет сбрасываться в формате CSV в файл log_filename с расширением csv. При использовании приемника jsonlog содержимое файла отчета будет записываться в формате JSON, а имя файла будет иметь расширение json.
Page 19: Информация в журнале
Настройки
- информация
- параметр
- сообщения определенного уровня
- log_min_messages
- время выполнения длинных команд
- log_min_duration_statement
- время выполнения команд
- log_duration
- имя приложения
- application_name
- контрольные точки
- log_checkpoints
- подключения и отключения
- log_(dis)connections
- длинные ожидания
- log_lock_waits
- текст выполняемых команд
- log_statement
- использование временных файлов
- log_temp_files
- …
Комментарии преподавателя
В журнал сообщений сервера можно выводить множество полезной информации. По умолчанию почти весь вывод отключен, чтобы не превратить запись журнала в узкое место для подсистемы ввода-вывода. Администратор должен решить, какая информация важна, обеспечить необходимое место на диске для ее хранения и оценить влияние записи журнала на общую производительность системы.
Page 20: Ротация файлов журнала
С помощью коллектора сообщений
- настройка
- параметр
- маска имени файла
- log_filename
- время ротации, мин
- log_rotation_age
- размер файла для ротации, КБ
- log_rotation_size
- перезаписывать ли файлы
- log_truncate_on_rotation = on
- комбинируя маску файла и время ротации, получаем разные схемы:
- ‘postgresql-%H.log’, ‘1h’
- 24 файла в сутки
- ‘postgresql-%a.log’, ‘1d’
- 7 файлов в неделю
- Внешние средства
- системная утилита logrotate
Комментарии преподавателя
Если записывать журнал в один файл, рано или поздно он вырастет до огромных размеров, что крайне неудобно для администрирования и анализа. Поэтому обычно используется та или иная схема ротации журналов.
https://postgrespro.ru/docs/postgresql/16/logfile-maintenance
Коллектор сообщений имеет встроенные средства ротации, которые настраиваются несколькими параметрами, основные из которых приведены на слайде.
Параметр log_filename позволяет задавать не просто имя, а маску имени файла с помощью спецсимволов даты и времени.
Параметр log_rotation_age задает время переключения на следующий файл в минутах (а log_rotation_size — размер файла, при котором надо переключаться на следующий).
Включение log_truncate_on_rotation перезаписывает уже существующие файлы.
Таким образом, комбинируя маску и время переключения, можно получать разные схемы ротации.
https://postgrespro.ru/docs/postgresql/16/runtime-config-logging#RUNTIME-CONFIG-LOGGING-WHERE
В качестве альтернативы можно воспользоваться внешними программами ротации, например пакетный дистрибутив для Ubuntu использует системную утилиту logrotate (ее настройки находятся в файле /etc/logrotate.d/postgresql-common).
Page 21: Анализ журнала
Средства операционной системы
- grep, awk…
- Специальные средства анализа
- pgBadger — требует определенных настроек журнала
Комментарии преподавателя
Анализировать журналы можно по-разному.
Можно искать определенную информацию средствами ОС или специально разработанными скриптами.
Стандартом де-факто для анализа является программа PgBadger https://github.com/darold/pgbadger, но надо иметь в виду, что она накладывает определенные ограничения на содержимое журнала. В частности, допускаются сообщения только на английском языке.
Page 22: Анализ журнала
Посмотрим самый простой случай. Например, нас интересуют сообщения FATAL:
Сообщение «terminating connection» вызвано тем, что мы завершали блокирующий процесс. Обычное применение журнала — анализ наиболее продолжительных запросов. Включим вывод всех команд и времени их выполнения:
Теперь выполним какую-нибудь команду:
И посмотрим журнал:
Page 23: Внешний мониторинг
Универсальные системы мониторинга
- Zabbix, Munin, Cacti…
- в облаке: Okmeter, NewRelic, Datadog…
- Системы мониторинга PostgreSQL
- pg_profile, pgpro_pwr
- PGObserver
- PostgreSQL Workload Analyzer (PoWA)
- Open PostgreSQL Monitoring (OPM)
- …
Комментарии преподавателя
На практике требуется полноценная система мониторинга, которая собирает различные метрики как с PostgreSQL, так и с операционной системы, хранит историю этих метрик, отображает их в виде понятных графиков, имеет средства оповещения при выходе определенных метрик за установленные границы и т. д.
Собственно PostgreSQL не располагает такой системой; он только предоставляет средства для получения информации о себе (которые мы рассмотрели). Поэтому для полноценного мониторинга нужно выбрать внешнюю систему. Таких систем существует довольно много. Есть универсальные системы, имеющие плагины или агенты для PostgreSQL. К ним относятся Zabbix, Munin, Cacti, облачные сервисы Okmeter, NewRelic, Datadog и другие.
Есть и системы, ориентированные специально на PostgreSQL, такие, как PGObserver, PoWA, OPM и т. д. Расширение pg_profile позволяет строить снимки статических данных и сравнивать их, выявляя ресурсоемкие операции и их динамику. Расширенная коммерческая версия этого расширения — pgpro_pwr.
https://postgrespro.ru/docs/enterprise/16/pgpro-pwr
Неполный, но представительный список систем мониторинга можно посмотреть на странице https://wiki.postgresql.org/wiki/Monitoring
Для более глубокого погружения в эту тему можно прочитать книгу Алексея Лесовского «Мониторинг PostgreSQL»: https://edu.postgrespro.ru/monitoring.pdf
Page 24: Итоги
Мониторинг заключается в контроле работы сервера как со стороны операционной системы, так и со стороны самого сервера
- PostgreSQL предоставляет накопительную статистику и журнал сообщений сервера
- Для полноценного мониторинга требуется внешняя система
Page 25: Практика
- В новой базе данных создайте таблицу, выполните вставку нескольких строк, а затем удалите все строки.
- Посмотрите статистику обращений к таблице и сопоставьте
- цифры (n_tup_ins, n_tup_del, n_live_tup, n_dead_tup)
- с вашей активностью.
- Выполните очистку (vacuum), снова проверьте статистику и сравните с предыдущими цифрами. 2. Создайте ситуацию взаимоблокировки двух транзакций.
- Посмотрите, какая информация записывается при этом
- в журнал сообщений сервера.
Комментарии преподавателя
- Взаимоблокировка (deadlock) — ситуация, в которой две (или больше) транзакций ожидают друг друга. В отличие от обычной блокировки при взаимоблокировке у транзакций нет возможности выйти из этого «тупика» и СУБД вынуждена принимать меры — одна из транзакций будет принудительно прервана, чтобы остальные могли продолжить выполнение.
Проще всего воспроизвести взаимоблокировку на таблице с двумя строками. Первая транзакция меняет (и, соответственно, блокирует) первую строку, а вторая — вторую. Затем первая транзакция пытается изменить вторую строку и «повисает» на блокировке. А потом вторая транзакция пытается изменить первую строку — и тоже ждет освобождения блокировки.
Page 26: Статистика обращений к таблице
Создаем базу данных и таблицу:
Проверяем статистику обращений.
Мы вставили 1000 строк (n_tup_ins = 1000), удалили 1000 строк (n_tup_del = 1000). После этого не осталось активных версий строк (n_live_tup = 0), все 1000 строк не актуальны на текущий момент (n_dead_tup = 1000). Выполним очистку.
Page 27: Page 27
Неактуальные версии строк убраны при очистке (n_dead_tup = 0), очистка обрабатывала таблицу один раз (vacuum_count = 1).
2. Взаимоблокировка
Одна транзакция блокирует первую строку таблицы…
Затем другая транзакция блокирует вторую строку…
Теперь первая транзакция пытается изменить вторую строку и ждет ее освобождения…
А вторая транзакция пытается изменить первую строку…
…и происходит взаимоблокировка. Сервер обрывает одну из транзакций:
Page 28: Page 28
Другая транзакция разблокируется:
Проверим информацию в журнале сообщений:
Page 29: Практика+
- Установите расширение pg_stat_statements.
- Выполните несколько произвольных запросов.
- Посмотрите, какую информацию показывает представление
- pg_stat_statements.
Комментарии преподавателя
- Для установки расширения потребуется перед выполнением команды CREATE EXTENSION изменить значение параметра shared_preload_libraries с последующей перезагрузкой сервера.
https://postgrespro.ru/docs/postgresql/16/pgstatstatements
Page 30: 1. Расширение pg_stat_statements
Расширение собирает статистику планирования и выполнения всех запросов. Для работы расширения требуется загрузить одноименный модуль. Для этого имя модуля нужно прописать в параметре shared_preload_libraries и перезагрузить сервер. Изменять этот параметр лучше в файле postgresql.conf, но для целей демонстрации установим параметр с помощью команды ALTER SYSTEM.
Теперь выполним несколько запросов.
Посмотрим на статистику запроса, который выполнялся чаще всего.
Разделяемая библиотека больше не требуется, восстановим исходное значение параметра: