11 Занятие 11: Организация данных / Низкий уровень
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba1_11_data_lowlevel.html Archive: DBA1-handouts-16.zip Страниц PDF: 20
Page 1: Организация данных / Низкий уровень
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Файлы данных
- Слои: данные, карты видимости и свободного пространства
- Длинные версии строк и TOAST
Page 3: Слои объекта
 {#source-figure-003 caption=“Source slide page 3: Слои объекта”}
Комментарии преподавателя
Обычно каждому объекту БД, хранящему данные (таблице, индексу, последовательности, материализованному представлению), соответствует несколько слоев (forks). Каждый слой содержит определенный вид данных.
Вначале слой содержит один-единственный файл. Имя файла состоит из числового идентификатора, к которому может быть добавлено окончание, соответствующее имени слоя.
Файл постепенно растет и, когда его размер доходит до 1 Гбайта, создается следующий файл этого же слоя. Такие файлы иногда называют сегментами. Порядковый номер сегмента добавляется в конец имени файла. Общий размер любого слоя показывает функция pg_relation_size.
Ограничение размера файла в 1 Гбайт возникло исторически для поддержки различных файловых систем, некоторые из которых не умеют работать с файлами большого размера. Установить другой размер можно только при сборке сервера из исходных кодов (–with-segsize).
Таким образом, одному объекту БД на диске может соответствовать несколько файлов. Для небольшой таблицы их будет 3, для индекса — два. Все файлы объектов, принадлежащих одному табличному пространству и одной БД, будут помещены в один каталог. Это необходимо учитывать, потому что файловые системы могут не очень хорошо работать с большим количеством файлов в каталоге.
Page 4: Слои
Основной слой
- собственно данные (версии строк)
- существует для всех объектов
- Слой инициализации (init)
- «пустышка» для основного слоя
- используется при сбое; только для нежурналируемых таблиц
- Карта видимости (vm)
- существует только для таблиц
- Карта свободного пространства (fsm)
- существует и для таблиц, и для индексов
Комментарии преподавателя
Посмотрим теперь на типы слоев.
Основной слой — это собственно данные: версии строк таблиц или индексные записи. Имена файлов основного слоя совпадают с идентификатором. Основной слой существует для любых объектов.
Имена файлов слоя инициализации оканчиваются на «_init». Этот слой существует только для нежурналируемых таблиц (созданных с указанием UNLOGGED) и их индексов. Такие объекты ничем не отличаются от обычных, но действия с ними не записываются в журнал упреждающей записи. За счет этого работа с ними происходит быстрее, но в случае сбоя их содержимое невозможно восстановить. При восстановлении PostgreSQL просто удаляет все слои таких объектов и записывает слой инициализации на место основного слоя. В результате получается пустая таблица.
https://postgrespro.ru/docs/postgresql/16/storage-init
Слой vm (visibility map) — битовая карта видимости. Имена файлов этого слоя оканчиваются на «_vm». Слой существует только для таблиц; для индексов не поддерживается отдельная версионность.
Слой fsm (free space map) — карта свободного пространства. Имена файлов этого слоя оканчиваются на «_fsm». Этот слой существует и для таблиц, и для индексов.
Про две эти карты рассказывалось в модуле «Архитектура».
https://postgrespro.ru/docs/postgresql/16/storage-fsm
https://postgrespro.ru/docs/postgresql/16/storage-vm
Page 5: Расположение файлов
Создадим таблицу и посмотрим на файлы, принадлежащие ей.
Чтобы сформировались дополнительные слои, выполним очистку:
Путь до основного файла относительно PGDATA можно получить функцией:
Поскольку таблица находится в табличном пространстве pg_default, путь начинается с base. Затем идет имя каталога для базы данных:
Затем — собственно имя файла. Его можно узнать следующим образом:
Тем и удобна функция pg_relation_filepath, что выдает готовый путь без необходимости выполнять несколько запросов к системному каталогу. Посмотрим на файлы. Доступ к каталогу PGDATA имеет только пользователь ОС postgres, поэтому команда ls выдается от его имени:
Мы видим три слоя: основной слой, карту свободного пространства (fsm) и карту видимости (vm). Аналогично можно посмотреть и на файлы индекса:
Page 6: Page 6
И на файлы последовательности, созданной для первичного ключа:
Для индекса карта свободного пространства строится при наличии пустых страниц, а для последовательности существует только основной слой. Временные таблицы хранятся так же, как и постоянные.
К имени файла добавляется префикс, соответствующий номеру схемы для временных объектов.
Существует полезное приложение oid2name, входящее в стандартную поставку, с помощью которого можно легко связать объекты БД и файлы. Можно посмотреть все базы данных:
Page 7: Page 7
Можно посмотреть все объекты в базе:
Или все табличные пространства в базе:
Можно по имени таблицы узнать имя файла:
Или наоборот, по номеру файла узнать таблицу:
Размер слоев
Размер файлов, входящих в слой, можно, конечно, посмотреть в файловой системе, но существует специальная функция для получения размера каждого слоя в отдельности:
Page 8: TOAST
Версия строки должна помещаться на одну страницу
- можно сжать часть полей
- можно вынести часть полей в отдельную toast-таблицу
- можно сжать и вынести одновременно
- Toast-таблица
- находится в схеме pg_toast (pg_toast_temp_N)
- поддержана собственным индексом
- содержит фрагменты «длинных» значений размером меньше страницы
- читается только при обращении к «длинному» полю
- имеет собственную версионность
- используется прозрачно для приложения
Комментарии преподавателя
Любая версия строки в PostgreSQL должна целиком помещаться на одну страницу. Для «длинных» версий строк применяется технология TOAST — The Oversized Attributes Storage Technique. Она подразумевает несколько стратегий работы с «длинными» полями. Значение поля может быть сжато так, чтобы версия строки поместилась на страницу. Значение может быть убрано из версии и перемещено в отдельную служебную таблицу. Могут применяться и оба подхода: какие-то значения будут сжаты, какие-то — перемещены, какие-то — сжаты и перемещены одновременно.
Для каждой основной таблицы при необходимости создается отдельная toast-таблица (и к ней специальный индекс). Такие таблицы и индексы располагаются в отдельной схеме pg_toast и поэтому обычно не видны (для временных таблиц используется схема pg_toast_temp_N аналогично обычной pg_temp_N).
Версии строк в toast-таблице тоже должны помещаться на одну страницу, поэтому длинные значения хранятся порезанными на фрагменты. Из этих фрагментов PostgreSQL прозрачно для приложения «склеивает» необходимое значение.
Toast-таблица используется только при обращении к длинному значению. Кроме того, для toast-таблицы поддерживается своя версионность: если обновление данных не затрагивает «длинное» значение, новая версия строки будет ссылаться на то же самое значение в toast-таблице — это экономит место.
https://postgrespro.ru/docs/postgresql/16/storage-toast
Page 9: TOAST
В таблице t есть столбец типа numeric. Этот тип может работать с очень большими числами. Например, с такими:
При этом, если вставить такое значение в таблицу, размер файлов не изменится:
Поскольку версия строки не может поместиться на одну страницу, значение атрибута n хранится в отдельной TOAST-таблице. TOAST-таблица и индекс к ней создаются автоматически для каждой таблицы, в которой есть потенциально «длинный» тип данных, и используются по необходимости. Имя и идентификатор такой таблицы можно найти следующим образом:
Вот и файлы TOAST-таблицы:
Существуют несколько стратегий работы с длинными значениями. Название стратегии показывается в поле Storage:
plain — TOAST не применяется (тип имеет фиксированную длину);
Page 10: Page 10
extended — применяется как сжатие, так и отдельное хранение; external — сжатие не используется, только отдельное хранение; main — такие поля обрабатываются в последнюю очередь и выносятся в TOAST-таблицу, только если сжатия недостаточно. Стратегия назначается для каждого столбца при создании таблицы. Ее можно указать явно, а значение по умолчанию зависит от типа данных. При необходимости стратегию можно впоследствии изменить. Например, если известно, что в столбце хранятся уже сжатые данные, разумно поставить стратегию external. Просто для примера:
Эта операция не меняет существующие данные в таблице, но определяет стратегию работы с новыми версиями строк.
Page 11: Размер таблицы
 {#source-figure-011 caption=“Source slide page 11: Размер таблицы”}
Комментарии преподавателя
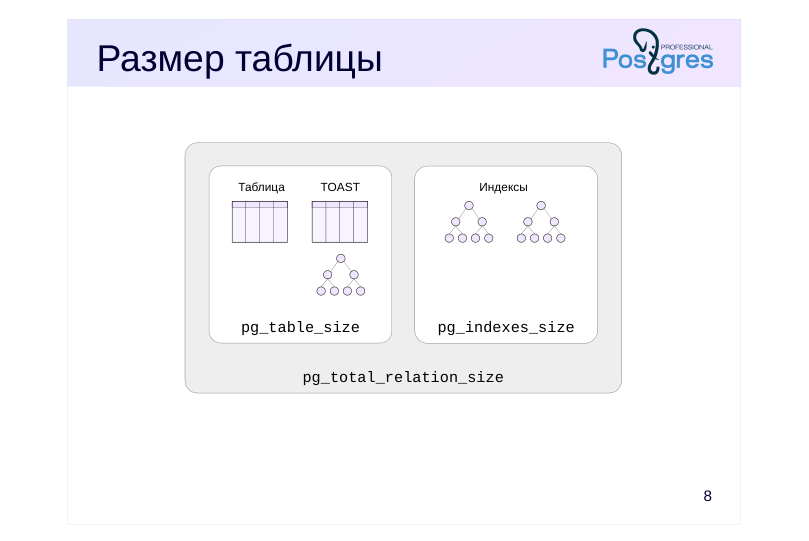
Как уже говорилось, размер отдельного слоя можно получить функцией pg_relation_size. Чтобы не суммировать размеры отдельных слоев, есть несколько функций, показывающих размеры таблицы:
● pg_table_size показывает размер таблицы и ее toast-части (toast-таблицы и обслуживающего ее индекса), но без обычных индексов. Эту же функцию можно использовать для вычисления размера отдельного индекса: и таблицы, и индексы являются отношениями, и, несмотря на название, функция принимает любое отношение.
● pg_indexes_size суммирует размеры всех индексов таблицы, кроме индекса toast-таблицы.
● pg_total_relation_size показывает полный размер таблицы, вместе со всеми ее индексами.
Page 12: Размер таблицы
Размер таблицы, включая TOAST-таблицу и обслуживающий ее индекс:
Общий размер всех индексов таблицы:
Для получения размера отдельного индекса можно воспользоваться функцией pg_table_size. TOAST-части у индексов нет, поэтому функция покажет только размер всех слоев индекса (main, fsm). Сейчас у таблицы есть только индекс по первичному ключу, поэтому размер этого индекса совпадает со значением pg_indexes_size:
Общий размер таблицы, включающий TOAST и все индексы:
Page 13: Итоги
Объект представлен несколькими слоями
- Слой состоит из одного или нескольких файлов-сегментов
- Для «длинных» версий строк используется TOAST
Page 14: Практика
- Создайте нежурналируемую таблицу в пользовательском табличном пространстве и убедитесь, что для таблицы существует слой init.
- Удалите созданное табличное пространство. 2. Создайте таблицу со столбцом типа text. Какая стратегия хранения применяется для этого столбца?
- Измените стратегию на external и вставьте в таблицу
- короткую и длинную строки.
- Проверьте, попали ли строки в toast-таблицу, выполнив
- прямой запрос к ней. Объясните, почему.
Page 15: 1. Нежурналируемая таблица
Посмотрим на файлы таблицы. Обратите внимание, что следующая команда ls выполняется от имени пользователя postgres. Чтобы повторить такую команду, удобно сначала открыть еще одно окно терминала и переключиться в нем на другого пользователя командой:
И затем в этом же окне выполнить:
Удалим созданное табличное пространство:
2. Таблица с текстовым столбцом
По умолчанию для типа text используется стратегия extended.
Page 16: Page 16
Изменим стратегию на external:
Проверим TOAST-таблицу:
TOAST-таблица «спрятана», так как находится в схеме, которой нет в пути поиска. И это правильно, поскольку TOAST работает прозрачно для пользователя. Но заглянуть в таблицу все-таки можно:
Видно, что в TOAST-таблицу попала только длинная строка (два фрагмента, общий размер совпадает с длиной строки). Короткая строка не вынесена в TOAST просто потому, что в этом нет необходимости — версия строки и без этого помещается в страницу.
Page 17: Практика+
- Создайте базу данных.
- Сравните размер базы данных, возвращаемый функцией
- pg_database_size, с общим размеров всех таблиц в этой базе.
- Объясните полученный результат. 2. В TOAST поддерживаются два метода сжатия: pglz и lz4. Проверьте средствами SQL, был ли PostgreSQL скомпилирован с поддержкой этих методов. 3. Создайте текстовый файл размером больше 10 Мбайт. Загрузите его содержимое в таблицу с текстовым полем, сначала без сжатия, а затем используя каждый из алгоритмов. Сравните итоговый размер таблицы и время загрузки данных для трех вариантов.
Комментарии преподавателя
Список таблиц базы данных можно получить из таблицы pg_class системного каталога.
С помощью представления pg_config можно узнать, какие параметры были установлены скрипту configure при сборке ПО сервера. Строка, содержащая список параметров, велика; выделить необходимые параметры можно функцией string_to_table().
Чтобы получить текст для эксперимента, можно взять достаточно большой двоичный файл (например, исполняемый файл postgres) и преобразовать его в текст. Для преобразования можно использовать алгоритм Base32 (ключ -w0 отменяет переносы строк):
Page 18: 1. Сравнение размеров базы данных и таблиц в ней
Даже пустая база данных содержит таблицы, относящиеся к системного каталогу. Полный список отношений можно получить из таблицы pg_class. Из выборки надо исключить: таблицы, общие для всего кластера (они не относятся к текущей базе данных); индексы и TOAST-таблицы (они будут автоматически учтены при подсчете размера).
Размер базы данных оказывается несколько больше:
Дело в том, что функция pg_database_size возвращает размер каталога файловой системы, а в этом каталоге находятся несколько служебных файлов.
Обратите внимание, что следующая команда ls выполняется от имени пользователя postgres. Чтобы повторить такую команду, удобно сначала открыть еще одно окно терминала и переключиться в нем на другого пользователя командой:
И затем в этом же окне выполнить:
pg_filenode.map — отображение oid некоторых таблиц в имена файлов; pg_internal.init — кеш системного каталога; PG_VERSION — версия PostgreSQL. Из-за того, что одни функции работают на уровне объектов базы данных, а другие — на уровне файловой системы, бывает сложно точно сопоставить возвращаемые размеры. Это относится и к функции pg_tablespace_size.
2. Поддержка методов сжатия TOAST
Представление pg_config показывает параметры, которые были переданы скрипту configure при сборке PostgreSQL.
Page 19: Page 19
Какой метод сжатия TOAST используется по умолчанию?
Какие методы можно применять?
3. Сравнение методов сжатия
Сравним методы сжатия на примере текстовых данных. Чтобы получить текст большого объема, возьмем исполняемый файл postgres и преобразуем его в текст с помощью алгоритма Base 32, который применяется в электронной почте.
Получившийся текстовый файл имеет достаточный размер.
Создадим таблицу для загрузки текстовых данных. Для столбца txt установим стратегию хранения external, которая допускает отдельное хранение, но не сжатие.
Загрузим данные из текстового файла.
Проверим размер таблицы, включая TOAST.
Опустошим таблицу и зададим сжатие с помощью pglz.
Page 20: Page 20
Теперь используется стратегия EXTENDED, которая допускает как сжатие, так и отдельное хранение. Снова загрузим данные.
Размер таблицы значительно уменьшился, но при этом заметно выросло время загрузки. Снова опустошим таблицу и зададим теперь сжатие с помощью lz4.
Еще раз загрузим данные и сравним.
Алгоритм lz4 слегка уступает pglz по степени сжатия, однако работает значительно быстрее. Удалим текстовый файл.