08 Занятие 08: Организация данных / Базы данных и схемы
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba1_08_data_databases.html Archive: DBA1-handouts-16.zip Страниц PDF: 24
Page 1: Организация данных / Базы данных и схемы
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Базы данных и шаблоны
- Схемы и путь поиска
- Специальные схемы, временные объекты
- Управление базами, схемами и объектами в них
Page 3: Кластер баз данных
 {#source-figure-003 caption=“Source slide page 3: Кластер баз данных”}
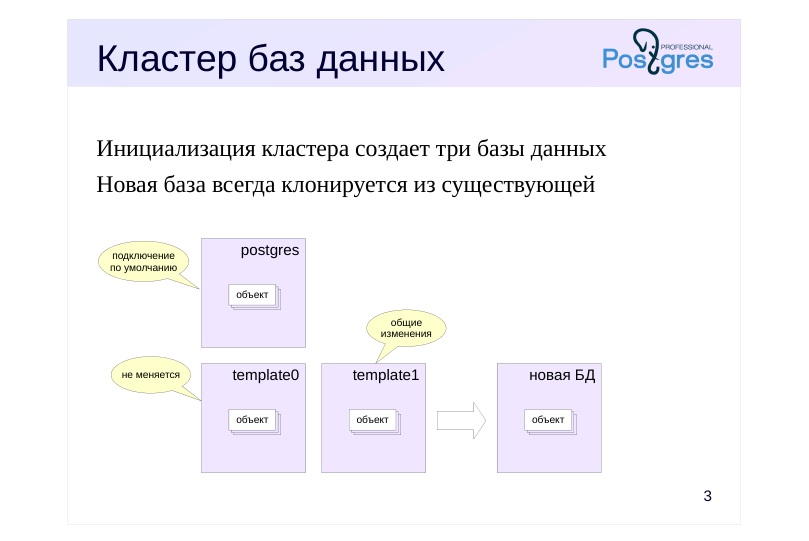
Инициализация кластера создает три базы данных
- Новая база всегда клонируется из существующей
Комментарии преподавателя
Экземпляр PostgreSQL управляет несколькими базами данных — кластером. При инициализации кластера с помощью специальной процедуры создаются три одинаковые базы данных. https://postgrespro.ru/docs/postgresql/16/bki
Все остальные БД, создаваемые пользователем, клонируются из какой-либо существующей.
Шаблон template1 используется по умолчанию для создания новых БД. В него можно добавить объекты и расширения, которые будут копироваться в каждую новую базу данных.
Шаблон template0 не должен изменяться. Он нужен как минимум в двух ситуациях. Во-первых, для восстановления БД из резервной копии, выполненной pg_dump (так как в эту копию попадут не только объекты данной БД, но и объекты, установленные в template1). Во-вторых, при создании новой БД с кодировкой, отличной от указанной при инициализации кластера.
База данных postgres используется при подключении по умолчанию пользователем postgres. Она не является обязательной, но некоторые утилиты предполагают ее наличие, поэтому ее не рекомендуется удалять, даже если она не нужна.
https://postgrespro.ru/docs/postgresql/16/manage-ag-templatedbs
Page 4: Базы данных
Список имеющихся баз показывает команда \l[ist]:
В списке присутствует четвертая база данных student, которая не создается при инициализации кластера. Она была создана для целей курса, чтобы при запуске psql не указывать базу данных: ведь по умолчанию используется база данных с таким же именем, как и пользователь ОС. Список баз данных можно посмотреть и в самой базе данных:
datistemplate — является ли база данных шаблоном; datallowconn — разрешены ли соединения с базой данных; datconnlimit — максимальное количество соединений (-1 = без ограничений).
Создание базы из шаблона
Подключимся к шаблонной базе template1:
Проверим, доступна ли функция digest, вычисляющая хеш-код текстовой строки:
Такой функции нет. На самом деле digest определена в пакете pgcrypto. Установим его:
Теперь нам доступны функции, входящие в расширение pgcrypto. Например, можно вычислить MD5-дайджест:
Page 5: Page 5
Чтобы шаблон можно было использовать для создания базы, к нему не должно быть активных подключений, поэтому отключимся от базы template1.
Для создания новой базы данных служит команда CREATE DATABASE:
Базу данных можно создать и из операционной системы утилитой createdb.
Поскольку по умолчанию для создания используется шаблон template1, в новой базе также будут доступны функции пакета pgcrypto:
Управление базами данных
Созданную базу данных можно переименовать (к ней не должно быть подключений):
Можно изменить и другие параметры, например, ограничить количество подключений:
Page 6: Размер базы данных
Размер базы данных можно узнать с помощью функции:
Чтобы не считать разряды, можно вывести размер в читаемом виде:
В этой базе данных еще нет пользовательских объектов (кроме расширения pgcrypto); фактически, это размер «пустой» базы.
Page 7: Схемы
Пространство имен для объектов внутри базы данных
- каждый объект принадлежит какой-либо схеме
- Задачи
- разделение объектов на логические группы
- предотвращение конфликта имен между приложениями
- Схема и пользователь — разные сущности
Комментарии преподавателя
Схемы представляют собой пространства имен для объектов БД. Они позволяют разделить объекты на логические группы для управления ими, предотвратить конфликты имен при работе нескольких пользователей или при установке приложений.
Каждый объект, существующий в базе данных, принадлежит какой-либо схеме.
В PostgreSQL схема и пользователь — разные сущности (хотя настройки по умолчанию позволяют пользователям удобно работать с одноименными схемами).
https://postgrespro.ru/docs/postgresql/16/ddl-schemas
Page 8: Базы и схемы кластера
 {#source-figure-008 caption=“Source slide page 8: Базы и схемы кластера”}
Комментарии преподавателя
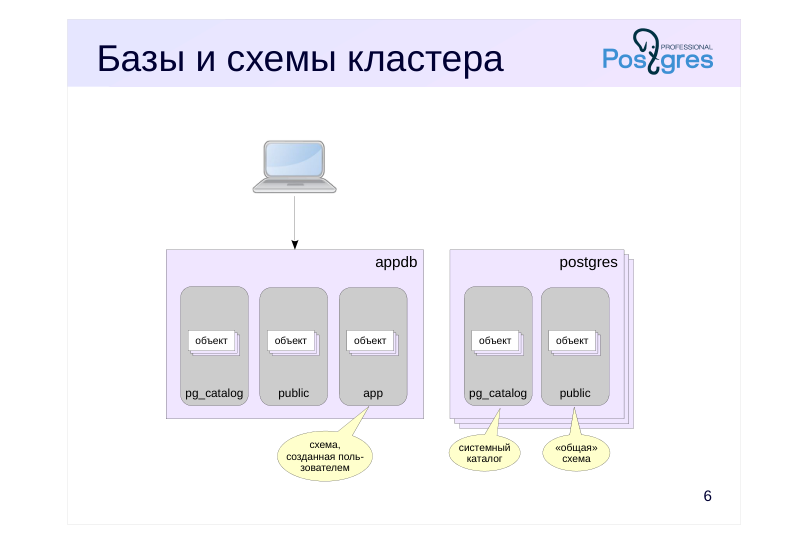
Кластер состоит из баз данных; база содержит различные схемы, по которым, в свою очередь, распределены объекты.
Есть некоторое количество стандартных схем, которые существуют в любой базе данных. Кроме того, пользователь может создавать свои собственные схемы.
Клиент подключается одновременно только к одной базе данных, но в этой базе может работать с объектами в любых схемах.
Page 9: Схемы
Список схем можно узнать командой psql (dn = describe namespace):
Создадим новую схему:
Теперь создадим таблицу — по умолчанию она будет создана в схеме public:
Список таблиц можно получить командой \dt:
Объект можно перемещать между схемами. Поскольку речь идет о логической организации, перемещение происходит только в системном каталоге; сами данные физически остаются на месте.
Теперь к таблице t можно обращаться с явным указанием схемы:
Но если опустить имя схемы, таблица не будет найдена:
Как же работать с объектами, располагающимися в разных схемах?
Page 10: Page 10
Page 11: Путь поиска
Определение схемы объекта
- квалифицированное имя (схема.имя) явно определяет схему
- имя без квалификатора проверяется в схемах, указанных в пути поиска
- Путь поиска
- определяется параметром search_path
- исключаются несуществующие схемы и схемы, к которым нет доступа;
- подставляются неявно подразумеваемые схемы
- реальное значение показывает функция current_schemas
- первая явно указанная в пути схема используется для создания объектов
Комментарии преподавателя
При указании объекта надо определить, о какой схеме идет речь, поскольку в разных схемах могут храниться одноименные объекты.
Если имя объекта квалифицировано именем схемы, то все просто — используется явно указанная схема (как на рисунке на предыдущем слайде). Если имя использовано без квалификатора, PostgreSQL пытается найти имя в одной из схем, перечисленных в пути поиска, который определяется конфигурационным параметром search_path.
Реальный путь поиска может отличаться от значения параметра search_path. Из указанного пути исключаются несуществующие схемы, а также схемы, к которым у пользователя нет доступа (этому вопросу посвящен обзор разграничения доступа). Кроме того, в начало пути поиска неявно добавляются некоторые специальные схемы.
Реальный путь поиска, включая неявные схемы, возвращает вызов функции current_schemas(true). Схемы перебираются в указанном в пути поиска порядке, слева направо. Если в схеме нет объекта с нужным именем, поиск продолжается в следующей схеме.
При создании нового объекта с именем без квалификатора он попадает в первую явно указанную в пути схему.
Можно провести аналогию между путем поиска search_path и путем PATH в операционных системах.
https://postgrespro.ru/docs/postgresql/16/ddl-schemas#DDL-SCHEMAS-PA TH
https://postgrespro.ru/docs/postgresql/16/runtime-config-client#GUC-SEAR CH-PATH
Page 12: Специальные схемы
Схема public
- по умолчанию входит в путь поиска
- если ничего не менять и есть доступ к этой схеме,
- все объекты будут в ней
- Схема, совпадающая по имени с пользователем
- по умолчанию входит в путь поиска, но не существует
- если создать, объекты пользователя будут в этой схеме
- Схема pg_catalog
- схема для объектов системного каталога
- если pg_catalog нет в пути, она неявно подразумевается первой
Комментарии преподавателя
Существует несколько специальных схем, обычно присутствующих в каждой базе данных.
Схема public используется по умолчанию для хранения объектов, если у пользователя есть доступ к ней. Начиная с PostgreSQL 15, начальные права доступа к схеме public ограничены.
Схема pg_catalog хранит объекты системного каталога. Системный каталог — это метаинформация об объектах, принадлежащих кластеру, которая хранится в самом кластере в виде таблиц. Альтернативное представление системного каталога (определенное в стандарте SQL) дает схема information_schema.
В схеме pg_catalog находятся объекты системного каталога (в частности, таблицы pg_*).
Если не указать в пути поиска pg_catalog, эта схема будет проверяться раньше других, чтобы системные объекты были видны.
Page 13: Путь поиска
Разберемся, почему новая таблица создается в схеме public. Для этого надо посмотреть на путь поиска:
Конструкция “$user” обозначает схему с тем же именем, что и имя текущего пользователя (в нашем случае — student). Поскольку такой схемы нет, она игнорируется, и таблица создается в схеме public. Чтобы не думать над тем, какие схемы существуют, каких нет, и какие не указаны явно, можно воспользоваться следующей функцией:
Если функция вызывается с аргументом true, в результат включаются системные схемы, например, pg_catalog. Установим путь поиска, например, так:
Теперь таблица t будет найдена:
Здесь мы установили конфигурационный параметр на уровне сеанса (при повторном подключении значение пропадет). Устанавливать такое значение на уровне всего кластера тоже не правильно — возможно, этот путь нужен не всегда и не всем. Но параметр можно установить и на уровне отдельной базы данных:
Теперь он будет устанавливаться для всех новых подключений к базе appdb. Проверим:
Еще одна функция — current_schema — возвращает первое имя схемы, не являющейся системной. Это имя той обычной схемы, в которой будут создаваться новые объекты.
Page 14: Page 14
Page 15: Специальные схемы
Временные таблицы
- существуют на время сеанса или транзакции
- не журналируются (невозможно восстановление после сбоя)
- не попадают в общий буферный кеш
- Схема pg_temp_N
- автоматически создается для временных таблиц
- pg_temp — ссылка на конкретную временную схему данного сеанса
- если pg_temp нет в пути, она неявно подразумевается самой первой
- по окончании сеанса все объекты временной схемы удаляются,
- а сама схема остается и повторно используется для других сеансов
Комментарии преподавателя
PostgreSQL умеет работать с временными таблицами. Такие таблицы предназначены для хранения данных, которые должны быть доступны только текущему сеансу (и только на время его жизни, или даже на время текущей транзакции).
При восстановлении после сбоя прежних сеансов не существует, так что временные таблицы не восстанавливаются. Поэтому такие таблицы не журналируются. Кроме того, страницы временных таблиц не попадают в общий буферный кеш — работа с ними ведется во внутренней памяти обслуживающего процесса. Благодаря этому, работа с временной таблицей происходит несколько более эффективно, чем с обычной.
Доступ к временным таблицам организован с помощью схем. Для сеанса создается временная схема с именем pg_temp_N (pg_temp_1, pg_temp_2 и т. п.). Обращаться к ней нужно по имени pg_temp (без номера) — для каждого сеанса это имя ссылается на конкретную временную схему.
Если pg_temp нет в пути, то эта схема просматривается перед всеми остальными. При желании можно указать схему pg_temp (как и pg_catalog) явно на нужном месте.
После окончания сеанса все объекты временной схемы удаляются, а сама схема остается для повторного использования.
Есть и другие специальные схемы; они носят более технический характер.
Page 16: Временные таблицы и pg_temp
Создадим временную таблицу:
Таблица создана в специальной схеме. Каждому сеансу выделяется отдельная «временная» схема, так что он может видеть только свои собственные временные таблицы. Но куда пропала из списка обычная таблица t? Ответ дает развернутый путь поиска: в него теперь подставлена временная схема, и объект в ней «перекрывает» одноименный объект схемы app.
Тем не менее, к каждой из таблиц можно обращаться с явным указанием схемы. Для временной таблицы надо использовать псевдосхему pg_temp — она автоматически отображается в нужную схему pg_temp_N:
В принципе, во временной схеме можно создавать не только таблицы.
Временные таблицы и данные в них могут иметь различные сроки жизни (в зависимости от указания ON COMMIT DELETE, PRESERVE или DROP). В любом случае при переподключении все объекты во временной схеме уничтожаются:
Page 17: Удаление объектов
Схему нельзя удалить, если в ней находятся какие-либо объекты:
Но можно удалить схему вместе со всеми ее объектами:
Если база данных больше не нужна, ее также можно удалить.
Page 18: Итоги
Логически
- кластер содержит базы данных,
- базы данных — схемы,
- схемы — конкретные объекты (таблицы, индексы и т. п.)
- Базы данных создаются клонированием существующих
- Схема указывается явно или определяется по пути поиска
- Некоторые схемы имеют специальное назначение
Page 19: Практика
- Создайте новую базу данных и подключитесь к ней. 2. Проверьте размер созданной базы данных. 3. Создайте две схемы: app и названную так же, как пользователь.
- Создайте несколько таблиц в обеих схемах и наполните их какими-нибудь данными. 4. Проверьте, на сколько увеличился размер базы данных. 5. Установите путь поиска так, чтобы при подключении к БД таблицы из обеих схем были доступны по неквалифицированному имени; приоритет должна иметь «пользовательская» схема.
Page 20: 1. База данных
2. Размер БД
Запомним значение в переменной psql:
3. Схемы и таблицы
В какой схеме будут созданы таблицы без явного указания?
Таблицы для схемы student:
Таблицы для схемы app:
Page 21: 4. Изменение размера БД
Размер изменился на:
5. Путь поиска
С текущими настройками пути поиска видны таблицы только схемы student:
Изменим путь поиска:
Теперь видны таблицы из обеих схем, но приоритет остается за student:
Page 22: Page 22
Page 23: Практика+
- Создайте базу данных. Сделайте так, чтобы в каждом новом сеансе, подключенном к этой базе данных, устанавливалось значение параметра temp_buffers, в четыре раза превышающее значение по умолчанию.
Комментарии преподавателя
- Используйте команду ALTER DATABASE … SET
https://postgrespro.ru/docs/postgresql/16/sql-alterdatabase
Подробнее о параметре temp_buffers:
https://postgrespro.ru/docs/postgresql/16/runtime-config-resource#GUC-TE MP-BUFFERS
Page 24: 1. Установка temp_buffers
Параметр temp_buffers определяет объем памяти, выделяемый в каждом сеансе под локальный кеш для временных таблиц. Если данные временных таблиц не помещаются в temp_buffers, страницы вытесняются, как это происходит в обычном буферном кеше. Недостаточное значение может привести к деградации производительности при активном использовании временных таблиц. Значение по умолчанию для temp_buffers составляет 8 Мбайт:
Установим для всех новых сеансов базы данных значение 32 Мбайта:
Настройки, сделанные командой ALTER DATABASE, сохраняются в таблице pg_db_role_setting. Их можно посмотреть в psql следующей командой:
Конечно, параметр temp_buffers не обязательно настраивать на уровне базы данных. Например, его можно настроить в postgresql.conf для всего кластера.