Оптимизация запросов
Оптимизация запросов
Курс сохраняет официальный порядок тем. Русские материалы извлечены из PDF в читаемый нативный Markdown для дальнейшей редакторской работы.
Состояние материалов: 官方 PDF 已提取为原生 Markdown
Базовый язык: Базовый язык: English. Текущий английский архив используется как базовый; русская версия сохранена для сверки глав.
О курсе
Планирование и выполнение запросов, методы доступа, соединения, статистика и практическая оптимизация запросов.
Состояние материалов
| Язык | Текущий архив | Версия | Темы | Страница курса |
|---|---|---|---|---|
| English | QPT-handouts-16-en-20251018.zip | 16-20251018 | 17 | HTTP 200 |
| Русский | QPT-handouts-16.zip | 16 | 17 | HTTP 200 |
Содержание
Дополнительные материалы
demodb.pdfqpt_new_features.pdfqpt_student_guide.pdf
Редакторский статус
Русский комплект доступен в виде нативного Markdown. Если английский комплект не найден, английский маршрут оставлен для будущего источника.
00 Занятие 00: PostgreSQL 16 / Оптимизация запросов
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_00_introduction.html Archive: QPT-handouts-16.zip Страниц PDF: 9
Page 1: PostgreSQL 16 / Оптимизация запросов
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Администраторам
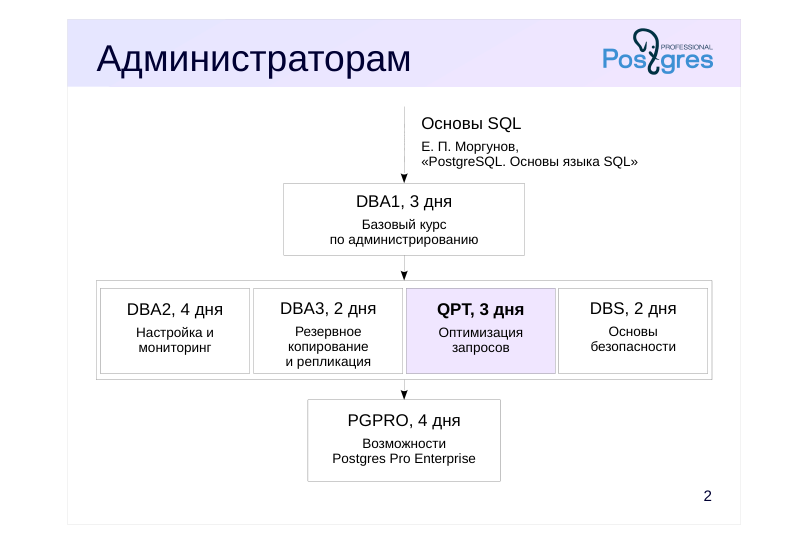 {#source-figure-002 caption=“Source slide page 2: Администраторам”}
- DBA2, 4 дня
Комментарии преподавателя
Для прохождения всех курсов необходимо знание основ языка SQL. Курса по SQL в нашей линейке нет, но имеется множество книг и образовательных ресурсов для освоения SQL. Мы рекомендуем книгу Евгения Моргунова «PostgreSQL. Основы языка SQL»:
https://postgrespro.ru/education/books/sqlprimer
Для администраторов мы предлагаем следующие курсы.
Курс DBA1 – базовый, он дает сведения об архитектуре PostgreSQL, об установке, настройке и управлении сервером. Приводятся обзоры разграничения доступа, резервного копирования и репликации.
В курсе DBA2 обсуждается настройка конфигурационных параметров исходя из понимания внутренней организации сервера; говорится о мониторинге сервера с использованием обратной связи для итеративной настройки параметров.
Курс DBA3 посвящен рассмотрению резервного копирования, а также настройкам физической и логической репликации и сценариям ее использования. Также дается общее представление о способах и сложностях построения высокодоступных, масштабируемых кластеров.
Курс DBS рассказывает про настройку подключений клиентов к СУБД и про управление доступом внутри самой СУБД.
В курсе QPT разбираются планирование и выполнение запросов, настройка параметров экземпляра, связанных с производительностью, и изучается поиск проблемных запросов и их оптимизация.
В курсе PGPRO рассматриваются дополнительные возможности, которые предоставляет СУБД Postgres Pro Enterprise.
Page 3: Разработчикам
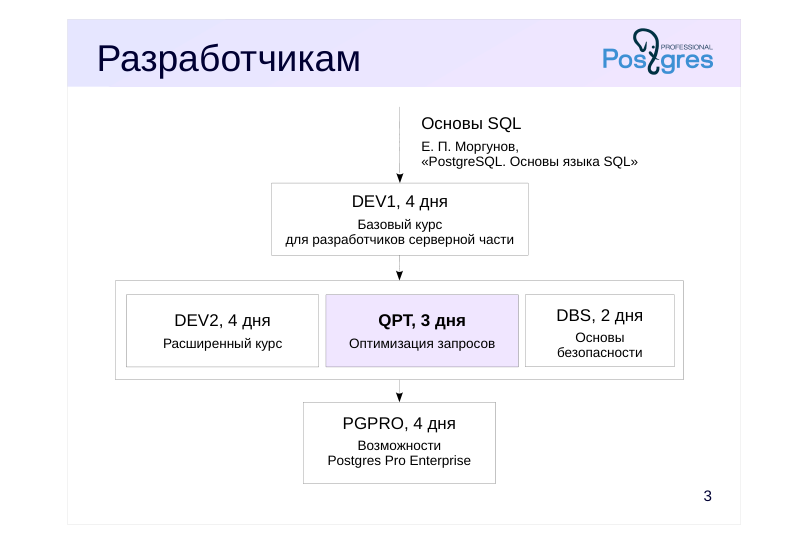 {#source-figure-003 caption=“Source slide page 3: Разработчикам”}
- DEV2, 4 дня
Комментарии преподавателя
Для разработчиков серверной части приложений мы предлагаем следующие курсы.
Базовым курсом для разработчиков является курс DEV1, в котором даются общие сведения об архитектуре PostgreSQL и использовании основных объектов базы данных; изучается программирование на стороне сервера на языках SQL и PL/pgSQL с использованием основных типов данных (включая составной тип и массивы), а также рассматривается взаимодействие с клиентской частью.
В курсе DEV2 рассматриваются особенности внутреннего устройства сервера, влияющие на разработку прикладного кода, и всесторонне изучается расширяемость: возможность дополнить серверные механизмы собственным кодом, что позволяет использовать PostgreSQL для решения самых разнообразных задач.
Курсы DBS, QPT и PGPRO являются общими для разработчиков и администраторов.
Разработчикам могут быть интересны и курсы по администрированию, если есть необходимость детальнее изучить внутреннее устройство PostgreSQL, а также в случае, когда на проекте нет выделенной роли администратора.
https://postgrespro.ru/education/courses
Page 4: О курсе QPT
Продолжительность: 3 дня
- Предварительные знания
- знакомство с ОС Unix
- уверенное владение SQL (знакомство с PL/pgSQL не обязательно,
- но полезно)
- PostgreSQL в объеме курса DBA1 или DEV1
- Какие навыки будут получены
- детальное понимание механизмов планирования и выполнения запросов
- настройка параметров экземпляра, связанных с производительностью
- поиск проблемных запросов и их оптимизация
Page 5: Используемые материалы
Подготовленная виртуальная машина
- ОС Xubuntu 24.04
- PostgreSQL 16 с документацией на русском языке
- демонстрационная база данных «Авиаперевозки»
- DBeaver
- Учебные материалы
- руководство слушателя
- презентации, демонстрации, практические задания и их решение
- (в форматах html и pdf)
- схема демонстрационной базы данных
Комментарии преподавателя
Если вы проходите курс самостоятельно, обязательно начните со знакомства с Руководством слушателя. В числе прочего в нем написано, где скачать и как использовать виртуальную машину курса и прочие материалы. Все материалы курса доступны по адресу:
https://postgrespro.ru/education/courses/QPT
Выполнение практических заданий очень важно для получения навыков работы с PostgreSQL. Обязательно старайтесь сначала самостоятельно выполнить задания, а затем просмотрите предлагаемые нами решения, даже если задание не вызвало вопросов. В решениях могут содержаться дополнительные сведения, которые не упоминаются в презентациях и демонстрациях.
Учебные материалы (презентации, демонстрации, практические задания и их решения) доступны в двух форматах. Формат html удобен для онлайн-работы, он позволяет копировать фрагменты текста и кода. Документ в формате pdf разбит на страницы и удобен для печати.
Дополнительные справочные материалы помогут быстро найти нужную информацию.
В виртуальной машине установлен DBeaver. В курсе мы используем только psql, но при желании можно воспользоваться и графической средой.
Page 6: Организационные вопросы
День: ~8 академических часов + обед (1час)
- Каждая тема, как правило, состоит из
- презентации и демонстраций: ~30–60 мин
- практических заданий: ~20–30 мин, включая перерыв
Page 7: День 1
Демонстрационная база данных
- Авиаперевозки
- Выполнение запросов
- Планирование и выполнение
- Доступ к данным
- Методы доступа
- Параллельный доступ
Page 8: День 2
Методы доступа (продолжение)
- Типы индексов
- Сортировка и группировка
- Сортировка
- Группировка
- Способы соединения
- Соединение вложенным циклом
- Соединение хешированием
- Соединение слиянием
Page 9: День 3
Статистика
- Базовая статистика
- Расширенная статистика
- Оптимизация запросов
- Профилирование
- Материализация
- Функции
- Подходы к настройке
01 Занятие 01: Демонстрационная база данных / Авиаперевозки
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_01_demodb_bookings.html Archive: QPT-handouts-16.zip Страниц PDF: 27
Page 1: Демонстрационная база данных / Авиаперевозки
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Цели и задачи
- Предметная область и общая схема демобазы
- Подробное описание объектов
Page 3: Авиаперевозки
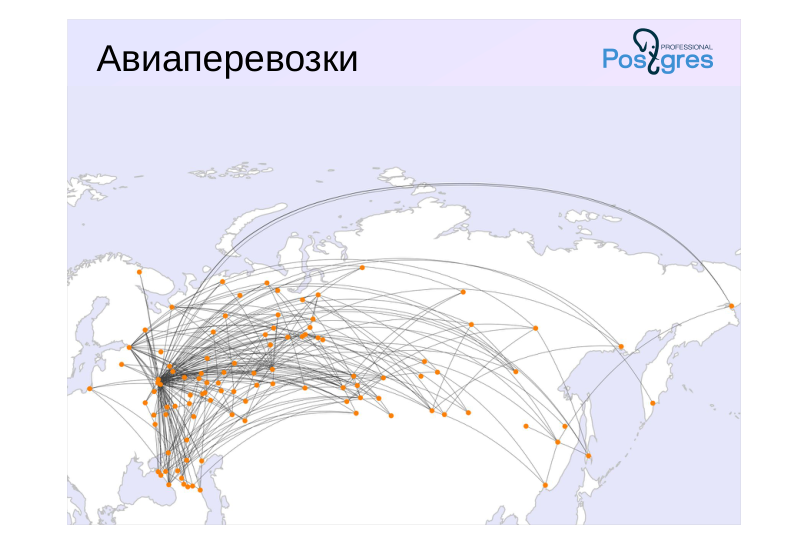 {#source-figure-003 caption=“Source slide page 3: Авиаперевозки”}
Комментарии преподавателя
Демонстрационная база данных создавалась для таких задач, как:
● самостоятельное изучение языка запросов SQL;
● подготовка книг, пособий и учебных курсов по языку SQL;
● демонстрация возможностей PostgreSQL в статьях и заметках.
При разработке демонстрационной базы данных мы преследовали несколько целей:
● схема данных должна быть достаточно простой, чтобы быть понятной без особых пояснений;
● в то же время схема данных должна быть достаточно сложной, чтобы позволять строить осмысленные запросы;
● база данных должна быть наполнена данными, напоминающими реальные, с которыми будет интересно работать.
Демонстрационная база данных распространяется под лицензией PostgreSQL.
База данных доступна в трех вариантах, отличающихся размером. Например, в курсе по оптимизации запросов используется база большого объема, содержащая данные по полетам за один год.
В данной теме рассматривается версия демобазы от 15.08.2017.
https://postgrespro.ru/education/demodb
Page 4: Общая схема
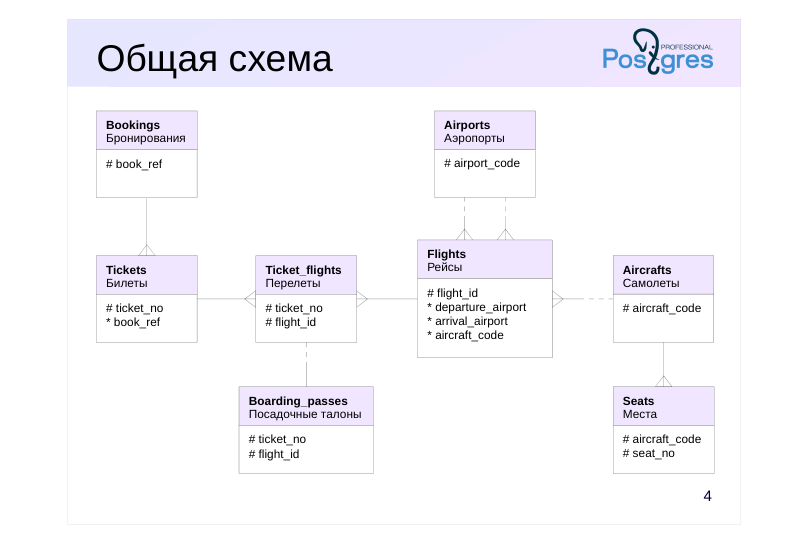 {#source-figure-004 caption=“Source slide page 4: Общая схема”}
Комментарии преподавателя
Основной сущностью является бронирование (bookings).
В одно бронирование можно включить несколько пассажиров, каждому из которых выписывается отдельный билет (tickets).
Билет включает один или несколько перелетов (ticket_flights). Несколько перелетов могут включаться в билет в случаях, когда нет прямого рейса, соединяющего пункты отправления и назначения (полет с пересадками), либо когда билет взят «туда и обратно».
Каждый рейс (flights) следует из одного аэропорта (airports) в другой. Рейсы с одним номером имеют одинаковые пункты вылета и назначения, но будут отличаться датой отправления.
При регистрации на рейс пассажиру выдается посадочный талон (boarding_passes), в котором указано место в самолете. Пассажир может зарегистрироваться только на тот рейс, который есть у него в билете. Комбинация рейса и места в самолете уникальна.
Количество мест (seats) в самолете и их распределение по классам обслуживания зависит от модели самолета (aircrafts), выполняющего рейс. Предполагается, что каждая модель самолета имеет только одну компоновку салона.
На приведенной схеме отмечены только столбцы, соответствующие первичным и внешним ключам. Далее мы рассмотрим основные объекты демонстрационной базы данных подробнее.
Page 5: Бронирования
Bookings
- пассажир заранее (за месяц) бронирует билет себе и, возможно,
- нескольким другим пассажирам
- book_ref
- номер бронирования (комбинация букв и цифр)
- book_date
- дата бронирования
- total_amount
- общая стоимость включенных в бронирование билетов
Комментарии преподавателя
Пассажир заранее (book_date, максимум за месяц до рейса) бронирует билет себе и, возможно, нескольким другим пассажирам. Бронирование идентифицируется номером (book_ref, шестизначная комбинация букв и цифр).
Поле total_amount хранит общую стоимость включенных в бронирование перелетов всех пассажиров.
Page 6: Бронирование
Начнем с бронирования и выберем какое-нибудь одно:
Мы видим дату бронирования и общую сумму. Если сравнивать дату с текущей, то бронирование сделано довольно давно:
Но для демобазы «текущим» моментом является другая дата:
Так что «на самом деле» билеты забронированы 20 дней назад:
Page 7: Билеты
Tickets
- билет выдается на одного пассажира и может включать несколько
- перелетов
- ни идентификатор пассажира, ни имя не являются постоянными;
- нельзя однозначно найти все билеты одного и того же пассажира
- ticket_no
- номер билета
- book_ref
- номер бронирования
- passenger_id
- идентификатор пассажира (номер документа)
- passenger_name
- имя пассажира
- contact_data
- контактные данные пассажира
Комментарии преподавателя
Билет имеет уникальный номер (ticket_no), состоящий из 13 цифр.
Билет содержит идентификатор пассажира (passenger_id) — номер документа, удостоверяющего личность, — его фамилию и имя (passenger_name) и контактную информацию (contact_data).
Ни идентификатор пассажира, ни имя не являются постоянными (можно поменять паспорт, можно сменить фамилию), поэтому однозначно найти все билеты одного и того же пассажира невозможно.
Page 8: Билеты
Посмотрим, какие билеты включены в выбранное бронирование:
Летят два человека; на каждого оформляется собственный билет с информацией о пассажире.
Page 9: Перелеты
Ticket\_flights
- перелет соединяет билеты с рейсами
- ticket_no
- номер билета
- flight_id
- идентификатор рейса
- fare_conditions
- класс обслуживания
- amount
- стоимость перелета
Комментарии преподавателя
Перелет соединяет билет с рейсом и идентифицируется их номерами.
Для каждого перелета указываются его стоимость (amount) и класс обслуживания (fare_conditions).
Page 10: Перелеты
По какому маршруту летят пассажиры? Добавим в запрос перелеты.
Здесь мы смотрим только на один билет — все маршруты в одном бронировании всегда совпадают. Видим, что в билете 6 перелетов; из них один бизнес-классом, другие — экономом.
Page 11: Рейсы
Flights
- рейс выполняется по расписанию из одного аэропорта в другой
- естественный ключ — номер рейса и дата отправления,
- но используется суррогатный ключ
- flight_id
- идентификатор рейса
- flight_no
- номер рейса
- scheduled_departure/arrival
- вылет и прилет по расписанию
- actual_departure/arrival
- фактический вылет и прилет
- departure/arrival_airport
- аэропорты отправления и прибытия
- status
- статус рейса
- aircraft_code
- код самолета
Комментарии преподавателя
Рейс соединяет аэропорты вылета и прибытия. Если нет прямого рейса, в билет включаются несколько рейсов.
Page 12: Рейсы
Теперь разберемся, какие рейсы скрываются за выбранными перелетами.
Видим три рейса «туда» и три «обратно». «Туда» все рейсы уже совершены (Arrived), а в настоящее время пассажир летит «обратно» (Departed). Следующий рейс будет по расписанию (On Time), а на последний еще не открыта регистрация (Scheduled). Посмотрим внимательнее на все столбцы одного из рейсов.
Реальное время может отличаться от времени по расписанию (обычно не сильно). Номер flight_no одинаков для всех рейсов, следующих по одному маршруту по расписанию:
Page 13: Аэропорты
Airports
- город не выделен в отдельную таблицу
- реализация: многоязычное представление над airports_data
- airport_code
- код аэропорта
- airport_name
- название аэропорта
- city
- город
- coordinates
- координаты аэропорта (долгота и широта)
- timezone
- часовой пояс
Комментарии преподавателя
Аэропорт идентифицируется трехбуквенным кодом (airport_code) и имеет свое имя (airport_name).
Для города не предусмотрено отдельной сущности, но введено поле с названием города (city), позволяющее найти аэропорты одного города. Это представление также включает координаты аэропорта (coordinates) и часовой пояс (timezone).
Значения полей airport_name и city определяются в зависимости от выбранного в конфигурационном параметре bookings.lang языка.
Page 14: Аэропорты
В качестве ключа для аэропортов используется общепринятый трехбуквенный код. Посмотрим полную информацию об одном аэропорте:
Помимо названия и города, хранятся координаты аэропорта и часовой пояс. Теперь мы можем расшифровать сведения о рейсах:
Чтобы не выписывать каждый раз подобный запрос, существует представление flights_v:
Здесь видим и местное время в часовых поясах городов отправления и прибытия, длительность полета, названия аэропортов.
Page 15: Page 15
Поскольку в демобазе маршруты не меняются со временем, из таблицы рейсов можно выделить информацию, которая не зависит от конкретной даты вылета. Такая информация собрана в представлении routes:
Видно, что рейсы выполняются ежедневно (массив days_of_week).
Page 16: Самолеты
Aircrafts
- модели самолетов, выполняющие рейсы
- реализация: многоязычное представление над aircrafts_data
- aircraft_code
- код самолета
- model
- модель самолета
- range
- максимальная дальность полета, км
Комментарии преподавателя
Каждая модель воздушного судна идентифицируется своим трехзначным кодом (aircraft_code). Указывается также название модели (model) и максимальная дальность полета в километрах (range).
Значение поля model определяется в зависимости от выбранного в конфигурационном параметре bookings.lang языка.
Page 17: Самолеты
Модели самолетов, обслуживающих рейсы, также используют стандартные трехсимвольные коды в качестве первичных ключей.
Page 18: Места
Seats
- места определяют схему салона
- все самолеты одной модели имеют одну и ту же компоновку салона
- aircraft_code
- код самолета
- seat_no
- номер места
- fare_conditions
- класс обслуживания
Комментарии преподавателя
Места определяют схему салона каждой модели. Каждое место определяется своим номером (seat_no) и имеет закрепленный за ним класс обслуживания (fare_conditions) — Economy, Comfort или Business.
Page 19: Места
В демобазе все самолеты одной модели имеют одинаковую конфигурацию салона. Посмотрим на первый ряд:
Это бизнес-класс. А вот общее число мест различных классов обслуживания:
Page 20: Посадочные талоны
Boarding\_passes
- посадочный талон выдается при регистрации на рейс
- ticket_no
- номер билета
- flight_id
- идентификатор рейса
- boarding_no
- номер посадочного талона (в порядке регистрации)
- seat_no
- номер места
Комментарии преподавателя
При регистрации на рейс, которая возможна за сутки до плановой даты отправления, пассажиру выдается посадочный талон. Он идентифицируется так же, как и перелет — номером билета и номером рейса.
Посадочным талонам присваиваются последовательные номера (boarding_no) в порядке регистрации пассажиров на рейс (этот номер будет уникальным только в пределах данного рейса). В посадочном талоне указывается номер места (seat_no).
Page 21: Посадочные талоны
На каких местах сидел наш пассажир? Для этого надо заглянуть в посадочный талон, который выдается при регистрации на рейс:
На два оставшихся рейса пассажир еще не зарегистрировался.
Page 22: Многоязычность
Конфигурационный параметр
- bookings.lang
- Таблицы для хранения многоязычных названий
- airports_data
- aircrafts_data
Комментарии преподавателя
Язык, на котором выводятся названия городов, аэропортов и моделей самолетов, переключается с помощью конфигурационного параметра bookings.lang. В состав демобазы входят названия на русском (ru) и английском (en) языках.
Можно самостоятельно расширить языковую поддержку, добавив в строки таблиц airports_data и aircrafts_data названия на произвольном языке.
Page 23: Многоязычность
В демобазе заложена возможность перевода названий аэропортов, городов и самолетов на другие языки. Как мы видели, по умолчанию все названия выводятся по-русски:
Чтобы сменить язык, достаточно установить конфигурационный параметр:
Реализация использует представление над базовой таблицей, которая содержит переводы в формате JSON:
Page 24: Итоги
Схема демобазы достаточно проста, но позволяет писать сложные и интересные запросы
- Данные в демобазе похожи на настоящие
- Демобазу можно использовать для изучения языка SQL, демонстрации возможностей PostgreSQL и т. п.
Page 25: Практика
Напишите несколько запросов к демонстрационной базе данных. 1. Сколько человек бывает включено в одно бронирование? 2. До каких городов нельзя добраться из Москвы без пересадок? 3. Какая модель самолета выполняет больше всего рейсов, а какая — меньше всего? 4. А какая модель перевезла больше всего пассажиров?
- В результате будет два столбца:
- Количество человек в бронировании
- Число бронирований
Page 26: 1. Сколько человек в одном бронировании?
Посчитаем количество человек в каждом бронировании, а затем число бронирований для каждого количества.
2. До каких городов нельзя добраться из Москвы без пересадок?
Найдем города, куда можно добраться, и выведем все остальные.
Интересно, что из Москвы в Москву без пересадок добраться не получится.
3. Какие модели выполняют больше всего и меньше всего рейсов?
Page 27: Page 27
Больше всех трудится маленькая Сессна, а одна модель авиапарка вообще не используется на рейсах.
4. Какая модель перевезла больше всего пассажиров?
Число пассажиров на рейсе можно посчитать по посадочным талонам.
02 Занятие 02: Выполнение запросов / Планирование и выполнение
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_02_query_query.html Archive: QPT-handouts-16.zip Страниц PDF: 32
Page 1: Выполнение запросов / Планирование и выполнение
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Общие подходы к оптимизации
- Простой протокол и этапы обработки запросов
- Расширенный протокол
- Подробнее о планировании
Page 3: Подходы к оптимизации
Настройка параметров
- подстройка под имеющуюся нагрузку
- глобальное влияние на всю систему
- мониторинг
- Оптимизация запросов
- уменьшение нагрузки
- локальное воздействие (запрос или несколько запросов)
- профилирование
Комментарии преподавателя
Этот курс посвящен оптимизации запросов. Вообще «оптимизация» — очень широкое понятие; задумываться об оптимизации необходимо еще на этапе проектирования системы и выбора архитектуры. Мы будем говорить только о тех работах, которые выполняются при эксплуатации уже существующего приложения.
Можно выделить два основных подхода. Первый состоит в том, чтобы отслеживать состояние системы и добиваться того, чтобы она справлялась с имеющейся нагрузкой. Для этого можно настраивать параметры СУБД (основные из которых рассматриваются в курсе DBA2 и отчасти в этом курсе), а также настраивать операционную систему. Если настройки не помогают, при таком подходе остается только модернизировать аппаратуру (что тоже помогает не всегда).
Другой подход, который в основном мы и будем рассматривать далее, состоит в том, чтобы не приспосабливаться под нагрузку, а уменьшать ее. «Полезная» нагрузка формируется запросами. Если удается найти узкое место, то можно попробовать тем или иным способом повлиять на выполнение запроса и получить тот же результат, потратив меньше ресурсов. Такой способ действует более локально (на отдельный запрос или ряд запросов), но уменьшение нагрузки благоприятно сказывается и на работе всей системы.
Мы начнем с того, что в деталях разберем механизмы выполнения запросов, а уже после этого поговорим о том, как распознать неэффективную работу, и о конкретных способах воздействия.
Page 4: Этапы обработки запроса
Разбор
- Переписывание (трансформация)
- Планирование (оптимизация)
- Выполнение
Комментарии преподавателя
Сначала рассмотрим, как выполняется запрос в простом случае – например, если в psql написать команду SELECT.
Page 5: Разбор
- системный
- каталог
- дерево
- запроса
- разбор
- (parse)
- текст запроса
Комментарии преподавателя
Обработка обычного запроса выполняется в несколько этапов.
Во-первых, запрос разбирается (parse).
Сначала производится синтаксический разбор: текст запроса представляется в виде дерева — так с ним удобнее работать.
Затем выполняется семантический анализ (parse analysis), в ходе которого определяется, на какие объекты БД ссылается запрос и есть ли у пользователя доступ к ним (для этого анализатор заглядывает в системный каталог).
Page 6: Синтаксический разбор
 {#source-figure-006 caption=“Source slide page 6: Синтаксический разбор”}
Комментарии преподавателя
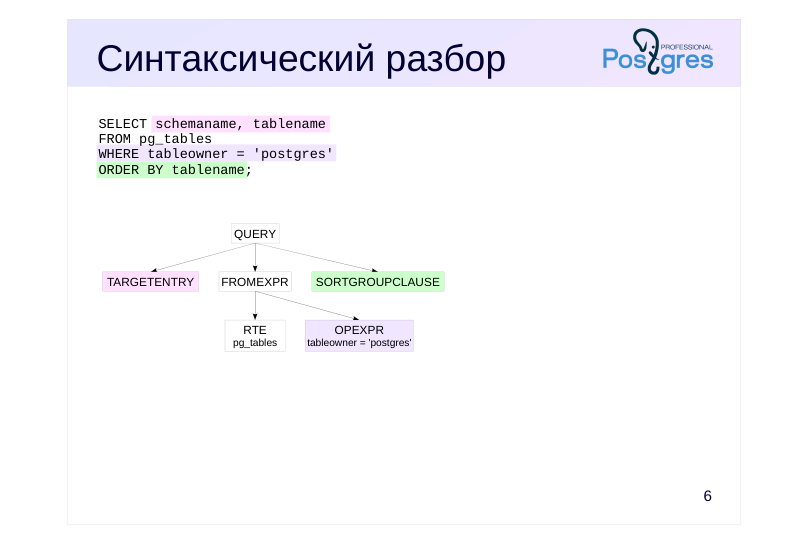
Рассмотрим простой пример: запрос, приведенный на слайде.
На этапе синтаксического разбора в памяти обслуживающего процесса будет построено дерево, упрощенно показанное на рисунке ниже запроса. Цветом показано примерное соответствие частей текста запроса и узлов дерева.
(RTE — неочевидное сокращение от Range Table Entry. Этим именем внутри PostgreSQL называются таблицы, подзапросы, результаты соединений — иными словами, наборы строк, с которыми может оперировать SQL.)
Если любопытно, то реальное дерево можно увидеть, установив параметр debug_print_parse и заглянув в журнал сообщений сервера. Практического смысла в этом нет (если, конечно, вы не разработчик ядра PostgreSQL).
Page 7: Семантический разбор
 {#source-figure-007 caption=“Source slide page 7: Семантический разбор”}
Комментарии преподавателя
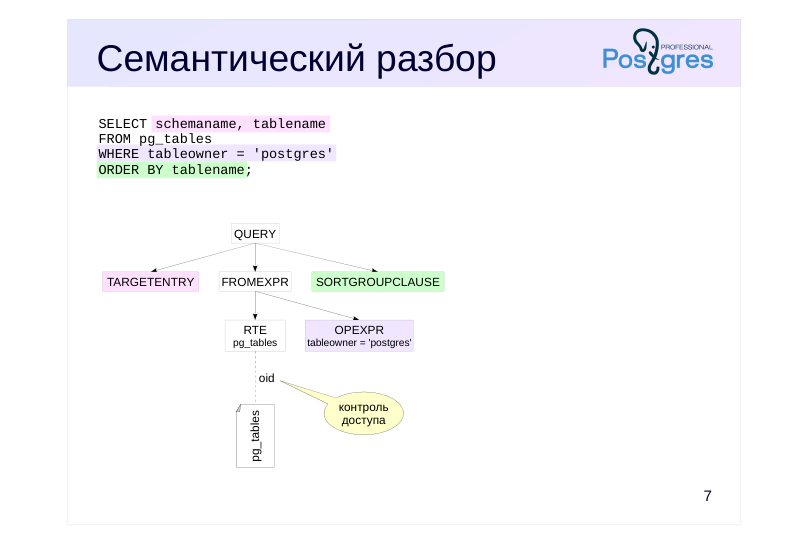
На этапе семантического разбора анализатор сверяется с системным каталогом и связывает имя «pg_tables» с представлением, имеющим определенный идентификатор (oid) в системном каталоге. Также будут проверены права доступа к этому представлению.
Page 8: Переписывание
 {#source-figure-008 caption=“Source slide page 8: Переписывание”}
Комментарии преподавателя
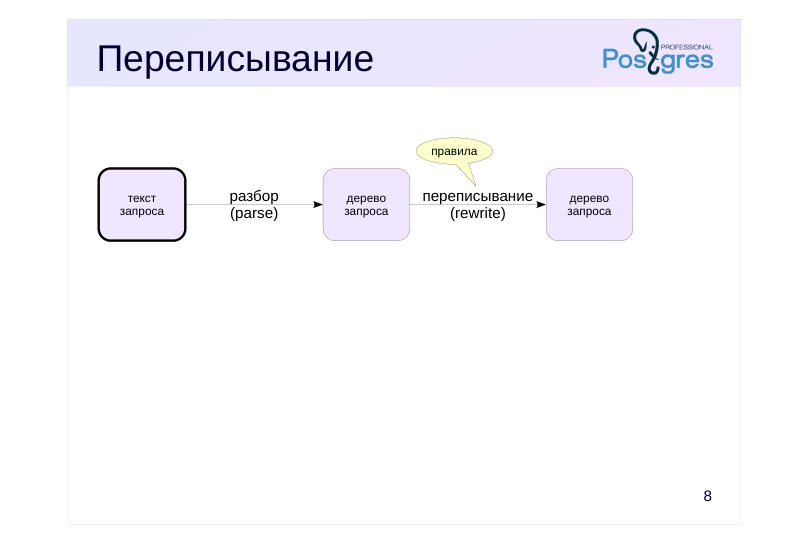
Во-вторых, запрос переписывается, или трансформируется (rewrite) с учетом правил.
Важный частный случай переписывания — подстановка текста запроса вместо имени представления. Заметим, что текст представления опять необходимо разобрать, поэтому мы несколько упрощаем, говоря, что первые два этапа происходят друг за другом.
Page 9: Переписывание
 {#source-figure-009 caption=“Source slide page 9: Переписывание”}
Комментарии преподавателя
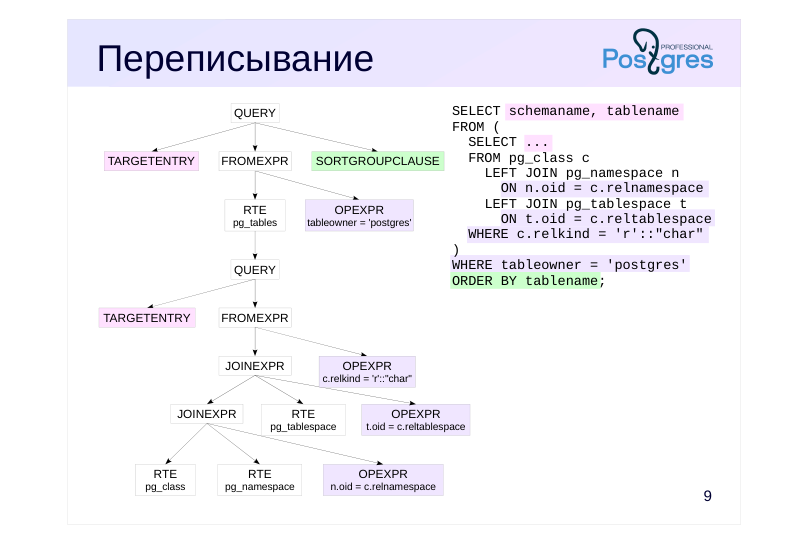
На слайде приведен запрос с подставленным текстом представления (это условность: реально в таком виде запрос не существует — вся работа по переписыванию происходит только с деревом запроса).
Родительский узел поддерева, соответствующего подзапросу, — тот узел, который ссылается на это представление. На рисунке в этом поддереве хорошо видна древовидная структура запроса.
Дерево после переписывания можно увидеть в журнале сообщений сервера, установив параметр debug_print_rewritten.
Page 10: Планирование
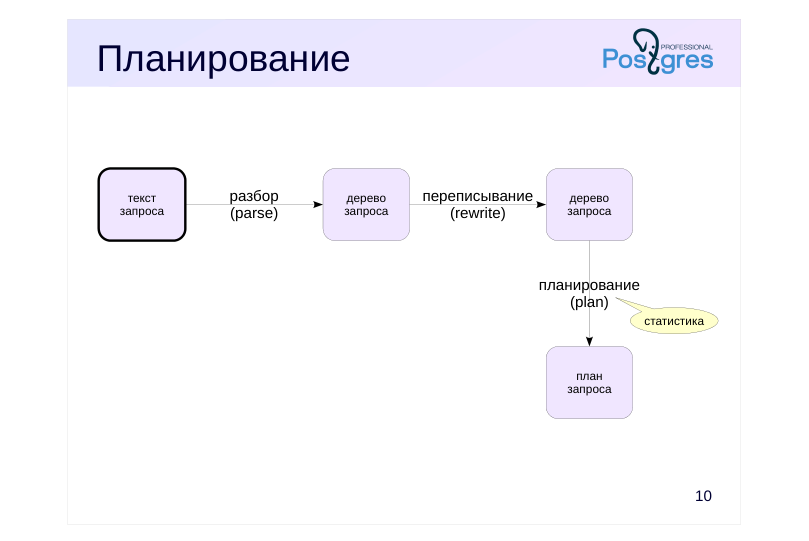 {#source-figure-010 caption=“Source slide page 10: Планирование”}
Комментарии преподавателя
В-третьих, запрос планируется (plan).
SQL — декларативный язык, и один запрос можно выполнить разными способами. Планировщик (он же оптимизатор) перебирает различные способы выполнения и оценивает их. Оценка дается на основе некоторой математической модели исходя из информации об обрабатываемых данных (статистики).
Тот способ выполнения, для которого прогнозируется минимальная стоимость, представляется в виде дерева плана.
Page 11: Планирование
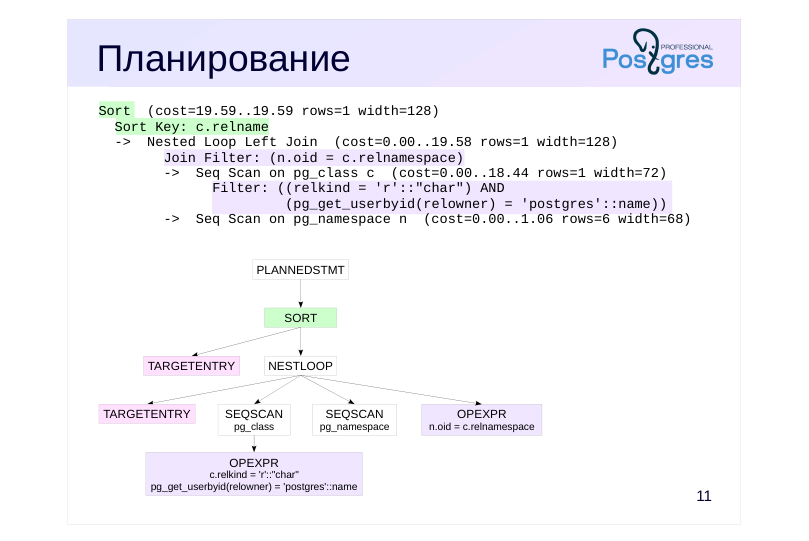 {#source-figure-011 caption=“Source slide page 11: Планирование”}
Комментарии преподавателя
На слайде приведен пример дерева плана, которое представляет способ выполнения запроса.
Здесь операции Seq Scan – это чтение соответствующих таблиц, а Nested Loop – способ соединения двух таблиц. В виде текста на слайде приведен план выполнения в том виде, как его показывает команда EXPLAIN. Подробно о методах доступа к данным, о способах соединения и об EXPLAIN мы будем говорить в следующих темах.
Пока имеет смысл обратить внимание на два момента:
● из трех таблиц осталось только две: планировщик сообразил, что одна из таблиц не нужна для получения результата и ее можно безболезненно удалить из дерева плана;
● каждый узел дерева снабжен информацией о предполагаемом числе строк (rows) и о стоимости (cost).
Для интересующихся — увидеть «настоящее» дерево плана можно, установив параметр debug_print_plan.
Page 12: Выполнение
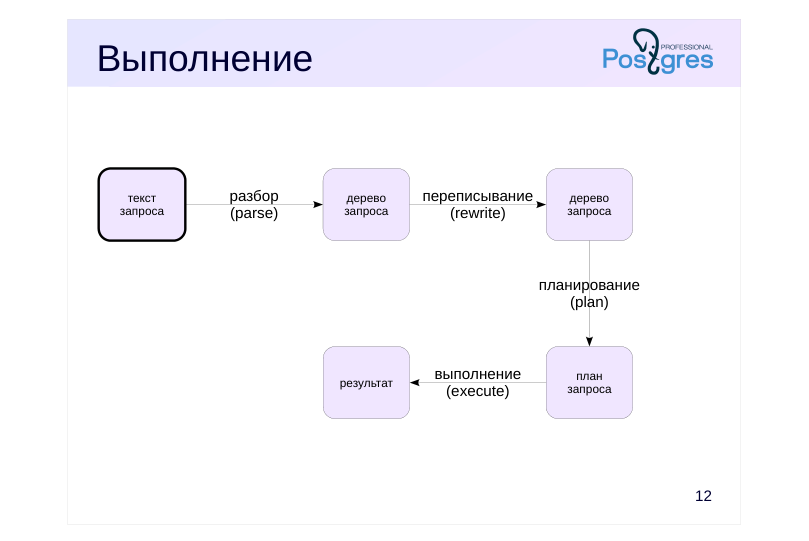 {#source-figure-012 caption=“Source slide page 12: Выполнение”}
Комментарии преподавателя
В-четвертых, запрос выполняется (execute) в соответствии с выбранным планом, и результат возвращается клиенту.
Задав параметрам log_parser_stats, log_planner_stats и log_executor_stats значение on, можно вывести в журнал подробную статистику каждого этапа. Но на практике это обычно не требуется.
https://postgrespro.ru/docs/postgresql/16/query-path
Page 13: Простой протокол
Простой протокол запросов применяется, когда на сервер отправляется оператор и, если это SELECT или команда с фразой RETURNING, мы ожидаем получение всех строк результата. Например:
Обычный удобный способ получить план запроса — команда EXPLAIN (пока отключаем вывод стоимости):
Если задан параметр buffers, в поле Planning Buffers будет показано число страниц буферного кеша, которое было прочитано при построении плана. Если добавить параметр analyze, сервер выполнит запрос и отобразит его план с детальной информацией о выполнении. Будьте аккуратны с запросами, изменяющими данные!
В поле Buffers отображается тип кеша (shared — буферный кеш в общей памяти) и количество страниц: hit — найденных в кеше; read — не найденных в кеше и запрошенных у операционной системы; written — записанных в файлы; dirtied — ставших грязными (т.е. впервые измененных в кеше). Теперь создадим временную таблицу и вставим в нее строки таблицы airports:
Временная таблица кешируется в локальной памяти сеанса (Buffers … local). Предупреждение: вывод времени выполнения каждого шага, как в этом примере, может существенно замедлять выполнение запроса на некоторых платформах. Если такая информация не нужна, лучше указывать timing off.
Page 14: Page 14
Page 15: Выполнение
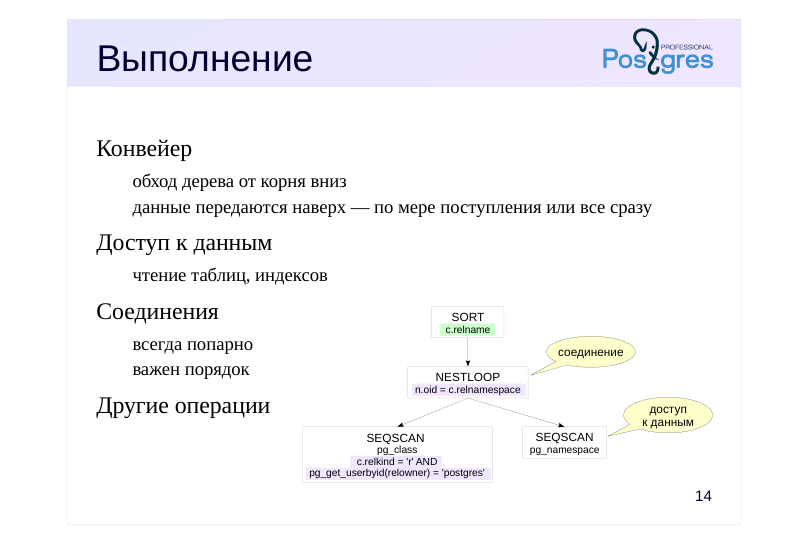 {#source-figure-015 caption=“Source slide page 15: Выполнение”}
Конвейер
- обход дерева от корня вниз
- данные передаются наверх — по мере поступления или все сразу
- Доступ к данным
- чтение таблиц, индексов
- Соединения
- всегда попарно
- важен порядок
- Другие операции
Комментарии преподавателя
На этапе выполнения дерево плана (на слайде оно перерисовано так, чтобы показать только самое основное) работает как конвейер.
Выполнение начинается с корня дерева. Корневой узел (в нашем случае это операция сортировки SORT) обращается за данными к дочернему узлу; получив данные, он выполняет свою работу (сортировку) и отдает данные наверх (то есть клиенту).
Некоторые узлы (как NESTLOOP на рисунке) соединяют данные, полученные из разных источников. Здесь узел обращается по очереди к двум дочерним узлам (соединение всегда осуществляется попарно) и, получив от них строки, соединяет их и возвращает наверх (то есть узлу сортировки).
Два нижних узла представляют обращение к таблице за данными. Они читают строки из соответствующих таблиц и отдают наверх (то есть узлу соединения).
Некоторые узлы могут вернуть результат, только получив от дочерних узлов все данные. К таким узлам относится сортировка — нельзя отсортировать неполную выборку. Другие узлы могут возвращать данные по мере поступления. Например, доступ к данным с помощью чтения таблицы может отдавать наверх данные по мере чтения (это позволяет быстро получить первую часть результата — например, для страничного отображения на веб-странице).
Чтобы разобраться с планами выполнения, нужно понять, какие существуют методы доступа к данным, какие есть способы соединения этих данных, и посмотреть некоторые другие операции.
Page 16: JIT-компиляция
Компиляция части запросов в исходный код
- вычисление выражений в предложении WHERE
- вычисления целевого списка выражений (SELECT)
- агрегаты и проекции
- Преобразование версий строк
- перенос версий строк с диска в развернутое представление в памяти
Комментарии преподавателя
Динамическая компиляция JIT (just-in-time, «точно в нужное время») используется для компиляции кода или его фрагментов в момент выполнения программы. Эта технология позволяет ускорить выполнение интерпретируемого кода и используется во многих системах.
В PostgreSQL с помощью JIT-компиляции можно скомпилировать часть кода, который выполняется при работе запросов SQL. Для этого PostgreSQL должен быть собран с поддержкой LLVM.
JIT-компиляция лучше подходит для длительных, нагружающих процессор аналитических запросов. Для коротких OLTP-запросов накладные расходы на JIT-компиляцию могут превышать время выполнения самих запросов.
Влиять на JIT-компиляцию можно с помощью конфигурационных параметров. Есть несколько оптимизаций, связанных с JIT; они включаются, только если стоимость запроса превышает указанное в соответствующих параметрах граничное значение.
https://postgrespro.ru/docs/postgresql/16/jit-reason
Page 17: JIT-компиляция
По умолчанию JIT-компиляция включена, но для демобазы она выключена:
Выполним запрос, рассчитывающий значение числа π. В запросе активно используются вычисления, которые JIT может оптимизировать:
Команда EXPLAIN ANALYZE покажет подробную информацию о том, какие оптимизации JIT сработали:
Выключим JIT-компиляцию и повторим запрос:
Page 18: Page 18
Время выполнения запроса, скорее всего, немного увеличивается. В рамках курса мы не будем подробно рассматривать оптимизации JIT. Чтобы сообщения о JIT-компиляции не загромождали планы запросов, на уровне демобазы JIT отключен.
Page 19: Расширенный протокол
Уточнение схемы обработки запроса
- Подготовленные операторы
- Курсоры
Комментарии преподавателя
PostgreSQL также предусматривает расширенный протокол запросов. На практике это означает возможность использования подготовленных операторов и курсоров.
Page 20: Простой протокол
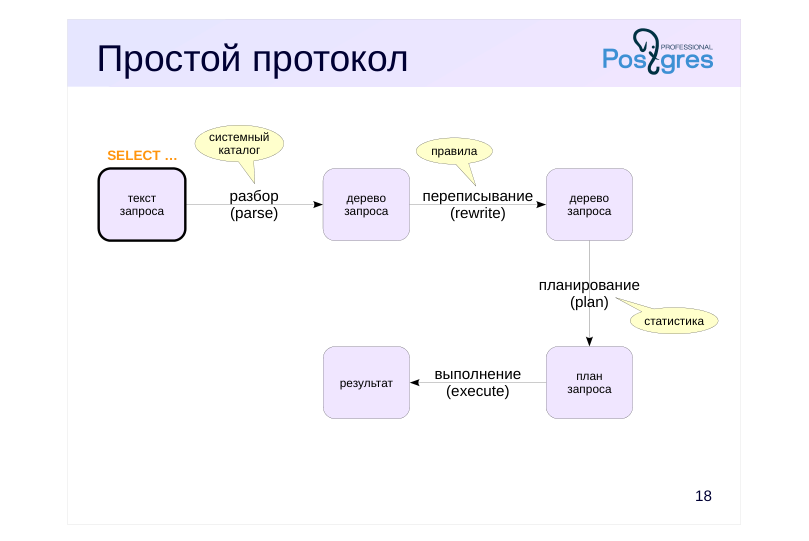 {#source-figure-020 caption=“Source slide page 20: Простой протокол”}
Комментарии преподавателя
На слайде повторно приведена полная схема обработки запросов по простому протоколу, которую мы уже рассмотрели.
Page 21: Расширенный протокол
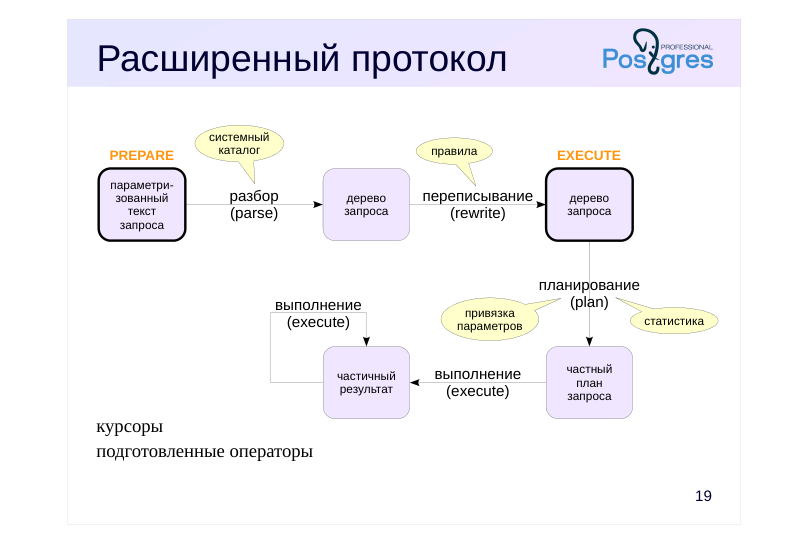 {#source-figure-021 caption=“Source slide page 21: Расширенный протокол”}
курсоры подготовленные операторы
Комментарии преподавателя
Расширенный протокол позволяет более детально управлять обработкой запроса.
Во-первых, запрос может быть подготовлен. Для этого клиент передает запрос серверу (возможно, в параметризованном виде), а сервер выполняет разбор и переписывание и сохраняет подготовленное дерево запроса в локальную память обслуживающего процесса.
Чтобы выполнить подготовленный запрос, клиент называет его имя и указывает конкретные значения параметров. Сервер строит частный план запроса, учитывая значения переданных параметров, и выполняет его.
Подготовка позволяет избежать повторного разбора и переписывания одного и того же запроса, если он выполняется в одном сеансе неоднократно.
Во-вторых, можно использовать курсоры. Механизм курсоров позволяет получать результат выполнения запроса не весь сразу, а построчно. Информация об открытом курсоре также хранится в локальной памяти обслуживающего процесса.
https://postgrespro.ru/docs/postgresql/16/protocol-flow#PROTOCOL-FLOW-EXT-QUERY
Page 22: Расширенный протокол
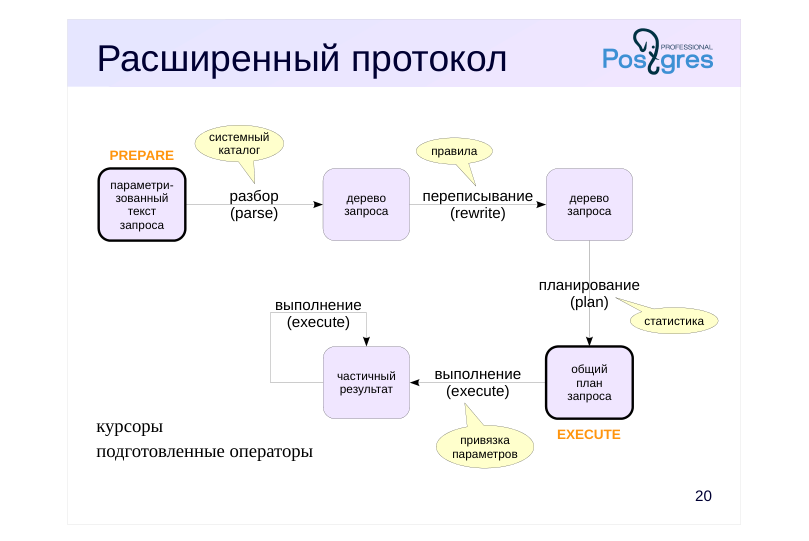 {#source-figure-022 caption=“Source slide page 22: Расширенный протокол”}
привязка параметров курсоры подготовленные операторы
Комментарии преподавателя
Если запрос не имеет параметров, серверу нет смысла перепланировать запрос при каждом выполнении. В этом случае он сразу запоминает общий (generic) план выполнения. Это позволяет еще больше экономить ресурсы.
Если же запрос имеет параметры, то сервер может перейти на общий план, если сочтет, что в среднем он получается не хуже частных планов. Подробнее о том, в каких случаях происходит переключение, говорится в теме «Базовая статистика».
Есть и еще один повод использовать подготовленные операторы: гарантировать защиту от внедрения SQL-кода, если входные данные для запроса получены из ненадежного источника (например, из поля ввода на веб-форме).
Page 23: Подготовленные операторы
Создадим подготовленный оператор для запроса с параметром:
Теперь мы можем вызывать оператор по имени:
Все подготовленные операторы можно увидеть в представлении:
name — имя подготовленного оператора, statement — создавшая его команда, prepare_time — момент создания, parameter_types — типы параметров (массив), result_types — типы столбцов результата (массив), from_sql — оператор создан командой SQL PREPARE (а не вызовом функции драйвера), generic_plans — сколько раз использовался общий план, custom_plans — сколько раз строились и использовались частные планы. Если подготовленный оператор больше не нужен, его можно удалить командой DEALLOCATE, но в любом случае оператор пропадет при завершении сеанса.
Команды PREPARE, EXECUTE, DEALLOCATE — команды SQL. Клиенты на других языках программирования будут использовать операции, определенные в соответствующем драйвере. Но любой драйвер использует один и тот же протокол для взаимодействия с сервером. Если в psql выполнить запрос с параметрами, он будет использовать расширенный протокол запросов. В этом случае нужно предварительно задать значения параметров:
Подготовленный оператор будет создан неявно.
Page 24: Page 24
После выполнения запроса подготовленный оператор удаляется:
Значения параметров после выполнения сбрасываются, поэтому задавать их нужно перед каждым запросом:
Такой подход можно использовать, если нужно отладить выполнение запроса с расширенным протоколом.
Курсоры
Курсоры дают возможность построчной обработки результата. Они часто используются в приложениях и имеют особенности, связанные с оптимизацией. На SQL использование курсоров можно продемонстрировать следующим образом. Объявляем курсор (при этом он сразу же открывается) и выбираем первую строку:
Читаем вторую строку результата и закрываем открытый курсор (курсор закроется и автоматически по окончании транзакции):
Page 25: Подробнее о планировании
Процесс планирования
- Оценка кардинальности
- Оценка стоимости
- Выбор наилучшего плана
Комментарии преподавателя
Планирование запроса — очень важный и достаточно сложный этап, поэтому остановимся на нем подробнее.
Page 26: Процесс планирования
Статистика
- данные о размере таблиц и распределении данных
- Оценка кардинальности
- селективность условий — доля выбираемых строк,
- кардинальность — итоговое число строк
- для расчета требуется статистика
- Оценка стоимости
- в первую очередь зависит от типа узла и числа обрабатываемых строк
- Перебор планов оптимизатором
- выбирается план с наименьшей стоимостью
Комментарии преподавателя
Оптимизатор перебирает всевозможные планы выполнения, оценивает их и выбирает план с наименьшей стоимостью.
При расчете стоимости узла плана оптимизатор учитывает тип этого узла (понятно, что стоимость чтения данных напрямую из таблицы будет отличаться от стоимости чтения с помощью индекса) и объем обрабатываемых узлом данных. Остальные факторы считаются менее существенными.
Для оценки объема данных важны два понятия:
● кардинальность — общее число строк;
● селективность — доля строк, отбираемых условиями (предикатами).
Для оценки селективности и кардинальности надо, в свою очередь, иметь сведения о данных: размер таблиц, распределение значений в столбцах и др.
Таким образом, в итоге все сводится к статистике — информации, собираемой и обновляемой процессом автоанализа или командой ANALYZE.
Если кардинальность оценена правильно, то и стоимость обычно рассчитывается довольно точно. Основные ошибки оптимизатора связаны именно с неправильной оценкой кардинальности. Это может происходить из-за неадекватной статистики, невозможности ее использования или несовершенства моделей, лежащих в основе оптимизатора. Об этом мы будем говорить подробнее.
Page 27: Оценка кардинальности
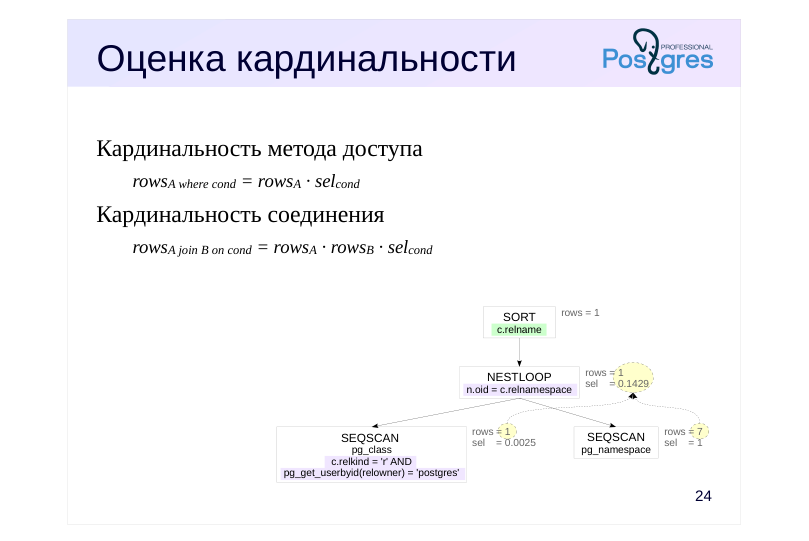 {#source-figure-027 caption=“Source slide page 27: Оценка кардинальности”}
Кардинальность метода доступа
- rowsA where cond = rowsA · selcond Кардинальность соединения
- rowsA join B on cond = rowsA · rowsB · selcond
Комментарии преподавателя
Оценку кардинальности удобно рассматривать как рекурсивный процесс. Чтобы оценить кардинальность узла, надо сначала оценить кардинальности дочерних узлов, а затем — зная тип узла — вычислить на их основе кардинальность самого узла.
Таким образом, сначала можно рассчитать кардинальности листовых узлов, в которых находятся методы доступа к данным. Для этого нам нужно знать размер таблицы и селективность условий, наложенных на нее. Как конкретно это делается, мы рассмотрим позже.
Пока отметим, что достаточно уметь оценивать селективность простых условий, а селективность условий, составленных с помощью логических операций, рассчитываются по простым формулам:
selx and y = selx · sely ; selx or y = 1 – (1 – selx) (1 – sely)
Следует учитывать, что эти формулы предполагают независимость предикатов. В случае коррелированных предикатов такая оценка будет неточной (ее можно улучшить с помощью расширенной статистики).
Затем можно рассчитать кардинальности соединений. Кардинальности соединяемых наборов данных нам уже известны, осталось оценить селективность условий соединения. Пока будем просто считать, что это как-то возможно.
Аналогично можно поступить и с другими узлами, например, с сортировками или агрегациями.
Важно отметить, что ошибка расчета кардинальности, возникшая в нижних узлах, будет распространяться выше, приводя в итоге к неверной оценке и выбору неудачного плана.
Page 28: Оценка стоимости
 {#source-figure-028 caption=“Source slide page 28: Оценка стоимости”}
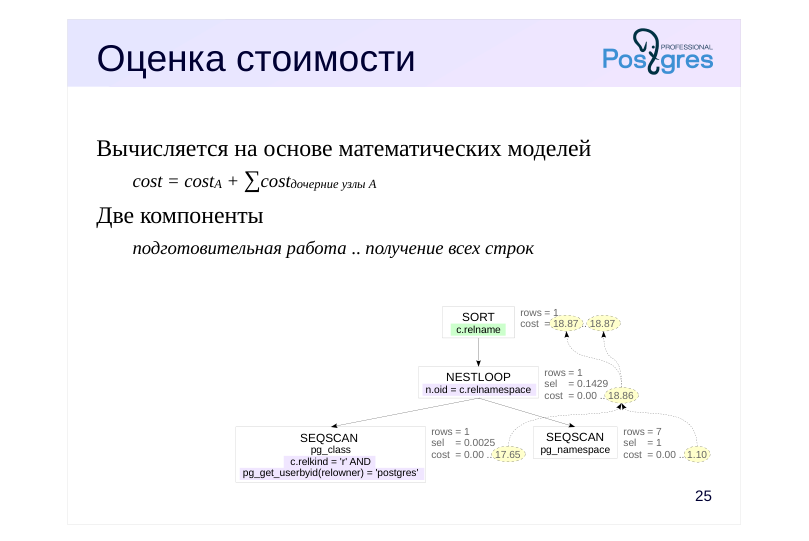
Вычисляется на основе математических моделей
- cost = costA + ∑costдочерние узлы A Две компоненты
- подготовительная работа .. получение всех строк
Комментарии преподавателя
Теперь рассмотрим общий процесс оценки стоимости. Он также рекурсивен по своей природе. Чтобы рассчитать стоимость поддерева, сначала надо вычислить стоимости дочерних узлов и сложить их, а затем добавить стоимость самого узла.
Стоимость работы узла определяется на основе математической модели, заложенной в планировщик, с учетом оценки числа обрабатываемых строк (которая уже рассчитана).
Стоимость состоит из двух компонент, оцениваемых отдельно. Первая — стоимость подготовительной работы (начальная стоимость), вторая — стоимость получения всех строк выборки (полная стоимость).
Некоторые операции не требуют никакой подготовки; у таких узлов начальная стоимость будет равна нулю.
Другие операции, наоборот, требуют выполнения предварительных действий. Например, сортировка в приведенном примере должна сначала получить от дочернего узла все данные, чтобы начать работу. У таких узлов начальная стоимость будет отлична от нуля — эту стоимость придется «заплатить» независимо от того, сколько строк результата потребуется.
Важно понимать, что стоимость отражает оценку планировщика и может не коррелировать с реальным временем выполнения. Можно считать, что стоимость выражена в неких «условных единицах», которые сами по себе ни о чем не говорят. Стоимость нужна лишь для того, чтобы планировщик мог сравнивать разные планы одного и того же запроса.
Page 29: Выбор лучшего плана
Перебор планов
- порядок соединений, способы соединений, методы доступа
- по возможности полный перебор,
- при большом числе вариантов — сокращение пространства поиска
- Простые запросы и подготовленные операторы
- оптимизируется получение всех строк
- минимальная полная стоимость
- Курсоры
- оптимизируется получение части первых строк
- минимальная стоимость cursor_tuple_fraction строк
Комментарии преподавателя
Оптимизатор старается перебрать все возможные планы выполнения запроса, чтобы выбрать из них лучший.
Для сокращения перебора используется алгоритм динамического программирования, но при большом количестве вариантов (в первую очередь из-за числа соединяемых таблиц) точное решение задачи оптимизации за разумное время становится невозможным. В таком случае планировщик сокращает количество перебираемых планов, либо рассматривая не все варианты попарных соединений, либо переключаясь на генетический алгоритм оптимизации (GEQO — Genetic Query Optimization). Это может привести к тому, что оптимизатор выберет не лучший план не из-за ошибок в оценке, а просто потому, что лучший план не рассматривался.
https://postgrespro.ru/docs/postgresql/16/geqo
Что же считается «лучшим планом»?
Для обычных запросов лучший план минимизирует ресурсы, необходимые для получения всех строк, то есть имеет минимальную полную стоимость.
Однако при использовании курсоров может быть важно как можно быстрее получить первые строки. Поэтому существует параметр cursor_tuple_fraction (значение по умолчанию 0.1), задающий долю строк, которую надо получить как можно быстрее. Чем меньше значение этого параметра, тем больше на выбор плана влияет начальная стоимость, а не полная.
Page 30: Итоги
Обработка запроса состоит из нескольких шагов: разбор и переписывание, планирование, выполнение
- Имеются два протокола выполнения запросов
- простой — непосредственное выполнение и получение результата
- расширенный — подготовленные операторы и курсоры
- Время выполнения зависит от качества планирования
- План строится оптимизатором на основе стоимости
Page 31: Практика
- Влияние подготовки на выполнение долгого оператора. Вычислите среднюю стоимость одного перелета; посчитайте среднее время выполнения этого запроса. Подготовьте оператор для этого запроса; снова посчитайте среднее время выполнения. Во сколько раз ускорилось выполнение?
- Влияние подготовки на выполнение коротких операторов. Многократно запросите данные о бронировании с номером 0824C5; посчитайте среднее время выполнения. Подготовьте оператор для этого запроса; снова посчитайте среднее время выполнения. Во сколько раз ускорилось выполнение в этом случае?
Комментарии преподавателя
Время выполнения одного и того же запроса может отличаться, причем довольно сильно (особенно время первого выполнения). Чтобы сгладить разницу, время надо усреднить, выполнив запрос несколько раз. Для этого удобно использовать язык PL/pgSQL, учитывая, что:
● динамический запрос, выполняемый командой PL/pgSQL EXECUTE (не путать с командой SQL EXECUTE!), каждый раз проходит все этапы;
● запрос SQL, встроенный в PL/pgSQL-код, выполняется с помощью подготовленных операторов.
Пример синтаксиса команды для обычного оператора:
Для подготовленного оператора (здесь SELECT заменяется на PERFORM, поскольку нас не интересует результат как таковой):
Page 32: 1. Долгий запрос
Обычный оператор:
Подготовленный оператор:
Время изменилось незначительно — большую часть занимает выполнение запроса.
2. Быстрый запрос
Обычный оператор:
Подготовленный оператор:
Время сократилось существенно — разбор и планирование занимают большую часть общего времени.
03 Занятие 03: Доступ к данным / Методы доступа
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_03_am_am.html Archive: QPT-handouts-16.zip Страниц PDF: 38
Page 1: Доступ к данным / Методы доступа
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Последовательное сканирование (Seq Scan)
- Сканирование индекса (Index Scan)
- Сканирование по битовой карте (Bitmap Scan)
- Сканирование только индекса (Index-Only Scan)
- Сравнение эффективности методов доступа
Page 3: Seq Scan
 {#source-figure-003 caption=“Source slide page 3: Seq Scan”}
Последовательное чтение всех страниц
- страницы читаются в кеш
- проверяется видимость версий строк
- данные возвращаются в произвольном порядке
- время сканирования зависит от физического размера файла
Комментарии преподавателя
В распоряжении оптимизатора имеется несколько способов доступа к данным. Самый простой из них — последовательное сканирование таблицы. Файл (или файлы) основного слоя таблицы читается постранично от начала до конца. Напомним, что чтение происходит через буферный кеш (для временных таблиц – через локальный кеш сеанса).
Последовательное чтение файла позволяет использовать тот факт, что операционная система обычно читает данные порциями большими, чем размер страницы — с большой вероятностью несколько следующих страниц уже окажутся в кеше ОС.
Последовательное сканирование эффективно работает, когда надо прочитать всю таблицу или значительную ее часть (если селективность условия низка).
При последовательном сканировании на каждой странице рассматриваются все версии строк — в том числе и неактуальные (мертвые) версии, которые еще не удалены процедурой очистки (процессом автоочистки). Если в файлах таблицы остается много мертвых, но не вычищенных версий строк, это будет приводить к замедлению скорости работы последовательного сканирования. В частности поэтому своевременное выполнение очистки может существенно ускорить выполнение некоторых запросов.
Подробнее про версии строк, снимки данных и очистку ненужных версий строк рассказано в курсе DBA2.
https://postgrespro.ru/docs/postgresql/16/mvcc
https://postgrespro.ru/docs/postgresql/16/sql-vacuum
Page 4: Последовательное сканирование
В плане выполнения запроса последовательное сканирование представлено узлом Seq Scan:
В скобках приведены важные значения: cost — оценка стоимости; rows — оценка числа строк, возвращаемых операцией; width — оценка среднего размера одной строки в байтах. Стоимость указывается в некоторых условных единицах и состоит из двух компонент. Первое число показывает начальную стоимость вычисления узла. Для последовательного сканирования это ноль — чтобы начать возвращать данные, никакой подготовки не требуется. Второе число показывает полную стоимость получения всех данных. Как считается полная стоимость? Оптимизатор PostgreSQL учитывает ввод-вывод и ресурсы процессора. Составляющая ввода-вывода рассчитывается как произведение числа страниц в таблице и условной стоимости чтения одной страницы:
Составляющая ресурсов процессора складывается из стоимости обработки каждой строки:
Последовательное сканирование и мертвые версии строк
Создадим копию таблицы flights, отключив для нее автоочистку, чтобы мертвые версии строк не удалялись автоматически:
И проверим размер полученной таблицы:
Удалим все строки из этой таблицы:
Page 5: Page 5
Мертвые версии строк останутся в файле таблицы до ближайшей очистки, поэтому размер таблицы останется прежним:
Получим план запроса с параметрами analyze и buffers — обратите внимание на количество страниц в Buffers и стоимость:
Прочитано более двух тысяч страниц. Очистим таблицу вручную и снова проверим размер таблицы:
Мертвые версии строк удалены, размер таблицы уменьшился. Снова получим план запроса:
Таблица пуста — не прочитано ни одной версии строки, стоимость плана минимальна. Время, затраченное на обработку неактуальных версий строк, может быть существенным для таблиц большего размера.
Page 6: Массовое вытеснение
 {#source-figure-006 caption=“Source slide page 6: Массовое вытеснение”}
Комментарии преподавателя
При последовательном сканировании через буферный кеш проходит большое количество страниц с «одноразовыми» данными, которые могут вытеснять полезные страницы из буферов. Чтобы этого не происходило, используются так называемые буферные кольца. Для последовательного чтения большой таблицы (размер которой превышает четверть буферного кеша) из всего кеша используются только 32 страницы, в пределах которых действует вытеснение. При этом остальные данные в буфере не страдают.
Если в процессе чтения меняются биты-подсказки или сами данные, появляется грязный буфер. Такой буфер отцепляется от кольца и будет вытеснен на общих основаниях, а в кольцо добавляется новый буфер. Такая стратегия рассчитана на то, что в основном данные читаются, а не меняются.
Если в процессе чтения таблицы другому процессу потребуется та же таблица, он не начинает читать ее с начала, а подключается к имеющемуся буферному кольцу. После окончания сканирования процесс дочитывает «пропущенное» начало таблицы.
При работе с временными таблицами через локальный кеш механизм буферных колец не используется.
Page 7: Массовое вытеснение
Сбросим текущие значения статистики ввода-вывода:
Прочитаем все строки из таблицы, размер которой больше четверти shared_buffers:
Прочитано 49415 страниц. Накопленную статистику показывает представление pg_stat_io:
Всего было прочитано (reads) 49415 страниц, из них (reuses) 49383 страниц были загружены в кеш с вытеснением. Таким образом, для сканирования использовалось буферное кольцо размером 49415 − 49383 = 32 страницы. Снова сбросим статистику и повторно обратимся к той же таблице:
Page 8: Page 8
Теперь видим, что 32 страницы уже находились в кеше после прошлого чтения (hits), так что серверу пришлось прочитать оставшиеся 49383 страниц (reads), и при этом из кеша вытеснилось 49351 страниц (reuses). Снова размер кольца составляет 49383 − 49351 = 32 буферов, но в них уже находились другие страницы, а не те, что использовались в первый раз.
Page 9: B-дерево
Индекс
- вспомогательная структура во внешней памяти
- сопоставляет ключи и идентификаторы строк таблицы
- Устройство: дерево поиска
- сбалансированное
- сильно ветвистое
- только сортируемые типы данных (операции «больше», «меньше»)
- результаты поиска автоматически отсортированы
- Использование
- ускорение доступа
- поддержка ограничений целостности
Комментарии преподавателя
В этой теме мы будем рассматривать только один из доступных в PostgreSQL типов индексов: B-дерево (B-tree). Это наиболее часто применяющийся на практике тип индекса. Некоторые другие типы индексов рассмотрены далее в этом курсе в теме «Типы индексов».
Как и все индексы в PostgreSQL, B-дерево является вторичной структурой — индекс не содержит в себе никакой информации, которую нельзя было бы получить из самой таблицы, однако занимает дополнительное место на диске. Индекс можно удалить и пересоздать. Индексы нужны для ускорения операций, затрагивающих небольшую часть таблицы: выборки малого количества строк, а также поддержки ограничений целостности (первичных и уникальных ключей).
Индексы сопоставляют значения проиндексированных полей (ключи поиска) и идентификаторы строк таблицы. Для этого в индексе B-tree строится упорядоченное дерево ключей, в котором можно быстро найти нужный ключ, а вместе с ним — и ссылки на версии строк. Но проиндексировать можно только данные, допускающие сортировку (должны быть определены операции «больше», «меньше»). Например, числа, строки и даты могут быть проиндексированы, а точки на плоскости — нет (для них существуют другие типы индексов). При индексации текстовых строк нужно учитывать особенности правил сортировки (подробнее см. курс DBA2, тема «Локализация»).
Особенностями B-дерева является его сбалансированность (постоянная глубина) и сильная ветвистость. Хотя размер дерева зависит от проиндексированных столбцов, на практике деревья обычно имеют глубину не больше 4–5.
Page 10: B-дерево
 {#source-figure-010 caption=“Source slide page 10: B-дерево”}
Комментарии преподавателя
В верхней части слайда приведен пример B-дерева. Его страницы состоят из индексных записей, каждая из которых содержит:
● ключ – значения столбцов, по которым построен индекс (такие столбцы называются ключевыми);
● ссылку на другую страницу индекса или ссылки на версии строк.
Внутри страницы ключи всегда упорядочены.
Листовые страницы ссылаются непосредственно на табличные версии строк, содержащие ключи индексирования. Эти страницы связаны двунаправленным списком, чтобы было удобно перебирать ключи в порядке возрастания или убывания.
Внутренние страницы ссылаются на нижележащие страницы индекса, а значения ключей определяют диапазон значений, которые можно обнаружить, спустившись по ссылке.
Верхняя страница дерева, на которую нет ссылок, называется корнем.
Индексная страница может быть заполнена частично. Свободное место используется для вставки в индекс новых записей. Если же на странице не хватает места — она разделяется на две новых страницы. Разделившиеся страницы никогда не объединяются, и это в некоторых случаях может приводить к разрастанию индекса.
По умолчанию считается, что неопределенные значения «больше» обычных, и они хранятся в дереве справа. Этот порядок можно изменить при создании индекса с помощью предложений NULLS LAST и NULLS FIRST.
Page 11: Index Scan: одно значение
 {#source-figure-011 caption=“Source slide page 11: Index Scan: одно значение”}
Комментарии преподавателя
Рассмотрим, как происходит поиск одного значения с помощью индекса. Например, нам нужно найти в таблице строку, в которой значение проиндексированного столбца равно четырем.
Начинаем с корня дерева. Индексные записи в корневой странице определяют диапазоны значений ключей в нижележащих страницах: «от 1 до 9» и «9 и больше». Нам подходит диапазон «от 1 до 9», что соответствует строке с ключом 1. Заметим, что ключи хранятся упорядоченно, следовательно, поиск внутри страницы выполняется очень эффективно.
Ссылка из найденной записи приводит нас к странице второго уровня. В ней мы находим диапазон «от 3 до 6» (ключ 3) и переходим к странице третьего уровня.
Эта страница является листовой. В ней мы находим ключ, равный 4, и переходим на страницу таблицы.
Заметьте, что ключи могут повторяться, причем даже в уникальном индексе: из-за работы механизма многоверсионности могут возникать разные версии одной и той же строки. Для экономии места ключи хранятся в индексной странице в одном экземпляре.
Прежде чем вернуть найденные версии строк, необходимо проверить их видимость.
На иллюстрациях цветом выделены записи и страницы, которые потребовалось прочитать.
Page 12: Сканирование индекса
Рассмотрим таблицу бронирований:
Столбец book_ref является первичным ключом и для него автоматически был создан индекс bookings_pkey. Проверим план запроса с поиском одного значения:
Выбран метод доступа Index Scan, указано имя использованного индекса. Здесь обращение и к индексу, и к таблице представлено одним узлом плана. Строкой ниже указано условие доступа. Начальная стоимость индексного доступа — оценка ресурсов для спуска к листовому узлу. Она зависит от высоты дерева. При оценке считается, что необходимые страницы окажутся в кеше, и оцениваются только ресурсы процессора: цифра получается небольшой. Полная стоимость добавляет оценку чтения необходимых листовых страниц индекса и табличных страниц. В данном случае, поскольку индекс уникальный, модель рассчитывает на то, что будет прочитана одна индексная страница и одна табличная. Стоимость каждого из чтений оценивается параметром random_page_cost:
Его значение обычно больше, чем seq_page_cost, поскольку произвольный доступ стоит дороже (хотя для SSD-дисков этот параметр следует существенно уменьшить). Итого получаем 8, и еще немного добавляет оценка процессорного времени на обработку строк. В строке Index Cond плана указываются только те условия, по которым происходит обращение к индексу или которые могут быть проверены на уровне индекса. Дополнительные условия, которые можно проверить только по таблице, отображаются в отдельной строке Filter:
Page 13: Index Scan: диапазон
 {#source-figure-013 caption=“Source slide page 13: Index Scan: диапазон”}
Комментарии преподавателя
B-дерево позволяет эффективно искать не только отдельные значения, но и диапазоны значений (по условиям «меньше», «больше», «меньше или равно», «больше или равно», а также «between»).
Вот как это происходит. Сначала мы ищем крайний ключ условия. Например, для условия «от 4 до 9» мы можем выбрать значение 4 или 9, а для условия «меньше 9» надо взять 9. Затем спускаемся до листовой страницы индекса так, как мы рассматривали в предыдущем примере, и получаем первое значение из таблицы.
Дальше остается двигаться по листовым страницам индекса вправо (или влево, в зависимости от условия), перебирая записи этих страниц до тех пор, пока мы не встретим ключ, выпадающий из диапазона.
На слайде показан пример поиска значений по условию «x BETWEEN 4 AND 9» или, что тоже самое, «x >= 4 AND x <= 9». Спустившись к значению 4, мы затем перебираем ключи 5, 6, и так далее до 9. Встретив ключ 10, прекращаем поиск.
Нам помогают два свойства: упорядоченность ключей на всех страницах и связанность листовых страниц двунаправленным списком. Результат поиска автоматически получается отсортированным.
Обратите внимание, что к одной и той же табличной странице нам пришлось обращаться несколько раз. Мы прочитали первую страницу таблицы (значение 4), затем последнюю (тоже 4), затем опять первую (5), затем опять последнюю (6) и так далее.
Page 14: Поиск по диапазону
Мы получаем данные из индекса, спускаясь от корня дерева к левому листовому узлу и проходя по списку листовых страниц. Поэтому индексное сканирование всегда возвращает данные в том порядке, в котором они хранятся в дереве индекса и который был указан при его создании:
Тот же самый индекс может использоваться и для получения строк в обратном порядке:
В этом случае мы спускаемся от корня дерева к правому листовому узлу и проходим по списку листовых страниц в обратную сторону. Обратите внимание на количество страниц (Buffers), которое потребовалось прочитать. Сравним поиск по диапазону с повторяющимся поиском отдельных значений. Получим тот же результат с помощью конструкции IN, и посмотрим, сколько страниц потребовалось прочитать в этом случае:
Количество страниц увеличилось, поскольку в этом случае приходится спускаться от корня к каждому значению. В версии 17 этот запрос выполняется так же эффективно, как и поиск по диапазону.
Page 15: Bitmap Index Scan
 {#source-figure-015 caption=“Source slide page 15: Bitmap Index Scan”}
Комментарии преподавателя
Многократный просмотр одних и тех же табличных страниц крайне неэффективен. Даже в лучшем случае, если нужная страница находится в буферном кеше, ее нужно найти и заблокировать (см. курс DBA2: тема «Буферный кеш» модуля «Журналирование»), а в худшем приходится иметь дело со случайными чтениями с диска.
Чтобы не тратить ресурсы на повторный просмотр табличных страниц, применяется еще один способ доступа — сканирование по битовой карте. Он похож на обычный индексный доступ, но происходит в два этапа.
Сначала сканируется индекс (Bitmap Index Scan) и в локальной памяти процесса строится битовая карта. Битовая карта состоит из фрагментов. Фрагменты соответствуют табличным страницам, а каждый бит фрагмента соответствует версии строки в этой странице. При построении битовой карты в ней отмечаются те версии строк, которые удовлетворяют условию и должны быть прочитаны.
За счет разделения битовой карты на фрагменты карта, в которой отмечено немного версий, будет занимать мало места.
Page 16: Bitmap Heap Scan
 {#source-figure-016 caption=“Source slide page 16: Bitmap Heap Scan”}
Комментарии преподавателя
Когда индекс просканирован и битовая карта готова, начинается сканирование таблицы (Bitmap Heap Scan). При этом:
● используется собственный механизм предвыборки, при котором асинхронно читаются effective_io_concurrency страниц (по умолчанию значение равно единице);
● на одной странице может проверяться несколько версий строк, но каждая страница просматривается ровно один раз.
Page 17: Сканирование по битовой карте
Будем рассматривать таблицу бронирований bookings. Создадим на ней два дополнительных индекса:
Посмотрим, какой метод доступа будет выбран для поиска диапазона.
Чтобы упорядочить сканирование большого числа страниц, планировщик выбрал сканирование по битовой карте. Этот метод состоит из двух узлов: Bitmap Index Scan читает индекс и строит битовую карту; Bitmap Heap Scan читает табличные страницы, используя построенную карту. Обратите внимание на стоимости: карта должна быть построена полностью, прежде чем ее можно будет использовать.
Объединение битовых карт
Кроме того, что битовая карта позволяет избежать повторных чтений табличных страниц, с ее помощью можно объединять несколько условий:
Здесь сначала были построены две битовые карты — по одной на каждое условие, а затем объединены побитовой операцией «или». Таким же образом могут быть использованы и разные индексы:
Page 18: Page 18
Page 19: Неточные фрагменты
Битовая карта без потери точности
- пока размер карты не превышает work_mem,
- информация хранится с точностью до версии строки
- Битовая карта с потерей точности
- если память закончилась, происходит огрубление
- части уже построенной карты до отдельных страниц
- требуется примерно 1 МБ памяти на 64 ГБ данных;
- ограничение work_mem может быть превышено
Комментарии преподавателя
Битовая карта хранится в локальной памяти обслуживающего процесса, и под ее хранение выделяется work_mem байт. Временные файлы никогда не используются.
Если карта перестает помещаться в work_mem, часть ее фрагментов «огрубляется» — каждый бит начинает соответствовать целой странице, а не отдельной версии строки (lossy bitmap). Стоимость обработки таких фрагментов увеличивается. Освободившееся место используется для того, чтобы продолжить строить карту.
В принципе, при сильно ограниченном work_mem и большой выборке битовая карта может не поместиться в памяти, даже если в ней совсем не останется информации на уровне версий строк. В таком случае ограничение work_mem нарушается — под карту будет дополнительно выделено столько памяти, сколько необходимо.
Page 20: Неточные фрагменты
 {#source-figure-020 caption=“Source slide page 20: Неточные фрагменты”}
Комментарии преподавателя
На рисунке показана битовая карта, состоящая из двух фрагментов. Первый фрагмент — точный, каждый его бит соответствует одной версии строки. Второй фрагмент — неточный, в нем каждый бит соответствует целой странице.
Неточные фрагменты требуют перепроверки условий для всех версий строк в табличной странице, а это сказывается на производительности. Если две битовые карты объединяются, причем фрагмент хотя бы одной из карт неточен, то и результирующий фрагмент тоже вынужденно будет неточным. Поэтому размер work_mem играет большую роль для эффективности сканирования по битовой карте.
Page 21: Неточные фрагменты
Узел Bitmap Heap Scan показывает условие перепроверки (Recheck Cond). Сама же перепроверка выполняется не всегда, а только при потере точности, когда битовая карта не помещается в память. Повторим запрос, изменив условие: будем искать бронирования с суммой до 5 тысяч ₽, сделанные за последний месяц.
Строка «Heap Blocks: exact» говорит о том, что все фрагменты битовой карты построены с точностью до строк — перепроверка не выполняется. Уменьшим размер выделяемой памяти.
Page 22: Page 22
Здесь появились lossy-фрагменты битовой карты — с точностью до страниц. Также указано, сколько строк не прошло перепроверку условия (Rows Removed by Index Recheck). Восстановим значение параметра.
Page 23: Index Scan / Bitmap Scan
 {#source-figure-023 caption=“Source slide page 23: Index Scan / Bitmap Scan”}
Комментарии преподавателя
Если данные в таблице физически упорядочены, обычное индексное сканирование не будет читать табличную страницу повторно. В таком (нечастом на практике) случае метод сканирования по битовой карте теряет смысл, проигрывая обычному индексному сканированию.
Разумеется, планировщик это тоже учитывает (как именно — рассматривается в теме «Базовая статистика»).
Page 24: Кластеризация
Если строки таблицы упорядочены так же, как и индекс, битовая карта становится излишней. Продемонстрируем это с помощью команды CLUSTER. Сейчас строки таблицы физически упорядочены по номеру бронирования:
Переупорядочим строки в соответствии с индексом по столбцу total_amount. Пока идет процесс, обратите внимание: Команда CLUSTER устанавливает исключительную блокировку, поскольку полностью перестраивает таблицу (как VACUUM FULL); Строки упорядочиваются, но не поддерживаются в упорядоченном виде — в процессе работы кластеризация будет ухудшаться.
Убедимся, что строки упорядочены по стоимости:
До кластеризации использовалось сканирование по битовой карте, но теперь проще и выгодней сделать обычное индексное сканирование.
Page 25: Index-Only Scan
 {#source-figure-025 caption=“Source slide page 25: Index-Only Scan”}
Комментарии преподавателя
Если в запросе требуются только проиндексированные данные, они уже есть в самом индексе и к таблице обращаться не надо. Такой индекс называется покрывающим для запроса.
Это хорошая оптимизация, исключающая обращения к табличным страницам. Но, к сожалению, индексные страницы не содержат информацию о видимости строк — чтобы проверить, надо ли показывать найденную в индексе строку, мы вынуждены заглянуть и в табличную страницу, что сводит оптимизацию на нет.
Поэтому критическую роль в эффективности сканирования только индекса играет карта видимости. Если табличная страница содержит гарантированно видимые данные и это отражено в карте видимости, к такой табличной странице обращаться не надо. Но страницы, не отмеченные в карте видимости, посетить все-таки придется.
Это одна из причин, по которым стоит выполнять очистку достаточно часто — именно этот процесс обновляет карту видимости.
Планировщик не знает точно, сколько табличных страниц потребуют проверки, но учитывает оценку этого числа. При плохом прогнозе планировщик может отказаться от использования сканирования только индекса.
При обработке каждой индексной записи в листовом узле сначала проверяется наличие табличной страницы в карте видимости, а при ее отсутствии читается сама табличная страница.
https://postgrespro.ru/docs/postgresql/16/indexes-index-only-scans
Page 26: Сканирование только индекса
Если вся необходимая информация содержится в самом индексе, то нет необходимости обращаться к таблице — за исключением проверки видимости:
Посмотрим план этого запроса с помощью EXPLAIN ANALYZE:
Строка Heap Fetches показывает, сколько версий строк было проверено с помощью таблицы. В данном случае карта видимости содержит актуальную информацию, обращаться к таблице не потребовалось. Обновим первую строку таблицы:
Сколько версий строк придется проверить теперь?
Проверять пришлось все версии, попавшие на измененную страницу.
Page 27: Многоколоночный индекс
 {#source-figure-027 caption=“Source slide page 27: Многоколоночный индекс”}
Комментарии преподавателя
Индекс можно создать по нескольким столбцам. В этом случае имеет значение порядок следования столбцов и порядок сортировки.
На рисунке приведен пример многоколоночного индекса, построенного по двум столбцам (оба — по возрастанию значений). Такой индекс ускоряет поиск, если в запросе есть условие на один или несколько первых ключей, поскольку в индексных записях ключи отсортированы сначала по первому столбцу, затем по второму и так далее.
В примере, показанном на слайде, поиск происходит по первому и второму столбцам; индекс подошел бы и для условия только на первый столбец.
Page 28: Многоколоночный индекс
 {#source-figure-028 caption=“Source slide page 28: Многоколоночный индекс”}
Комментарии преподавателя
Однако если запрос содержит условие только на второй столбец, индекс оказывается бесполезным. На слайде видно, что листовые записи, в которых второй столбец равен «A», могут оказаться в любом месте индекса — у нас нет способа спуститься к ним от корня дерева.
Иногда в таких случаях планировщик все-таки прибегает к только индексному сканированию, но при этом просматривается весь индекс целиком.
Аналогично, индекс не может выдавать записи в порядке, отличном от указанного при создании индекса. Например, показанный на слайде индекс не может выдавать записи, отсортированные по первому столбцу в порядке возрастания, а по второму — в порядке убывания.
Page 29: Многоколоночные индексы
На таблице перелетов ticket_flights создан индекс по столбцам ticket_no, flight_id. Запрос по обоим столбцам использует индекс:
Запрос только по номеру билета — тоже:
Но для запроса по номеру рейса такой индекс не годится:
Page 30: Include-индексы
Индекс с дополнительными неключевыми столбцами
- Неключевые столбцы
- не используются при поиске по индексу
- не учитываются ограничением уникальности
- значения хранятся в индексной записи
- и возвращаются без обращения к таблице
Комментарии преподавателя
Покрывающий индекс, как правило, увеличивает эффективность выборки. Чтобы сделать индекс покрывающим, в него может понадобиться добавить столбцы, но это не всегда возможно:
● добавление столбца в уникальный индекс нарушит гарантию уникальности исходных столбцов;
● тип данных добавляемого столбца может не поддерживаться индексом.
В таких случаях можно добавить к индексу неключевые столбцы, указав их в предложении INCLUDE.
https://postgrespro.ru/docs/postgresql/16/sql-createindex
Значения таких столбцов не формируют дерево индекса, а просто хранятся как дополнительные сведения в индексных записях листовых страниц. Поиск по неключевым столбцам не работает, но их значения могут быть получены без обращения к таблице.
В настоящее время include-индексы поддерживаются только для индексов на основе B-деревьев, GiST и SP-GiST-индексов.
Include-индексы создаются, чтобы индекс стал покрывающим, но не стоит путать эти два термина. Индекс вполне может быть покрывающим для некоторого запроса, но не использовать предложение INCLUDE. А include-индекс может не быть покрывающим для каких-то запросов.
Page 31: Include-индексы
Индекс tickets_pkey не является покрывающим для приведенного запроса, поскольку требуется вернуть не только столбец ticket_no, который есть в индексе, но и book_ref, которого в индексе нет:
Buffers показывает количество прочитанных страниц (hit+read). Создадим include-индекс, добавив в него неключевой столбец book_ref, так как он требуется запросу:
Повторим запрос:
Теперь оптимизатор выбирает метод Index Only Scan и использует только что созданный индекс. Количество прочитанных страниц сократилось. Поскольку карта видимости актуальна, обращаться к таблице не пришлось (Heap Fetches: 0). В include-индекс можно включать столбцы с типами данных, которые не поддерживаются B-деревом (например, геометрические типы и xml).
Page 32: Сравнение эффективности
 {#source-figure-032 caption=“Source slide page 32: Сравнение эффективности”}
Комментарии преподавателя
Индексное сканирование лучше всего работает при очень высокой селективности, когда по индексу выбирается одно или несколько значений.
При средней селективности обычно лучше всего показывает себя сканирование по битовой карте. Хотя этот способ требует предварительного построения битовой карты, он выигрывает у индексного сканирования, поскольку обходится без повторных чтений одних и тех же страниц (если только данные в таблице не расположены физически в нужном порядке, что бывает нечасто). В худшем случае производительность индексного доступа пропорциональна числу выбираемых строк, а сканирования по битовой карте — числу страниц.
При низкой селективности лучше всего работает последовательное сканирование: если надо выбрать все или почти все табличные строки, обращение к индексным страницам только увеличивает накладные расходы. Этот эффект усиливается в случае вращающихся дисков, где скорость произвольного чтения существенно ниже скорости чтения последовательно расположенных страниц.
Значение селективности, при котором становится выгодно переключиться на другой метод доступа, сильно зависит от конкретной таблицы и конкретного индекса. Планировщик учитывает множество параметров, чтобы выбрать наиболее подходящий способ.
Еще одно замечание: при индексном доступе результат возвращается отсортированным, что в ряде случаев увеличивает привлекательность такого доступа даже при низкой селективности.
Page 33: Сравнение эффективности
 {#source-figure-033 caption=“Source slide page 33: Сравнение эффективности”}
Комментарии преподавателя
Эффективность сканирования только индекса сильно зависит от актуальности карты видимости и от того, сколько страниц действительно содержат только актуальные версии строк.
В лучшем случае этот метод доступа может быть эффективнее последовательного сканирования даже при низкой селективности (если индекс меньше, чем таблица, и особенно на SSD-дисках).
В худшем случае, когда требуется проверять видимость каждой строки, метод вырождается в обычное индексное сканирование.
Поэтому планировщику приходится учитывать состояние карты видимости: при неблагоприятном прогнозе исключительно индексное сканирование не применяется из-за опасности получить замедление вместо ускорения.
Page 34: Итоги
Оптимизатор располагает несколькими методами доступа
- последовательное сканирование
- сканирование индекса
- сканирование только индекса
- сканирование по битовой карте
- Модель стоимости учитывает множество параметров
Page 35: Практика
- Убедитесь, что при повторном выполнении запрос, выбирающий все строки из таблицы flights, читает данные из кеша СУБД. 2. В демонстрации был создан include-индекс для таблицы билетов tickets. Замените им индекс, поддерживающий первичный ключ. 3. Создайте индекс по столбцу amount таблицы перелетов ticket_flights. Найдите перелеты стоимостью более 120000 руб. (примерно 1% строк). Какой метод доступа был выбран? 4. Повторите п. 3 для стоимости менее 42000 руб. (около 90% строк).
Комментарии преподавателя
Используйте команду EXPLAIN с параметрами analyze и buffers.
Попробуйте также запретить выбранный метод доступа (параметр enable_seqscan) и сравнить скорости выполнения.
Page 36: 1. Запрос всех строк таблицы flights
Все страницы прочитаны с диска в общую память (Buffers: shared read=2624). Возможно, часть страниц была получена из кеша операционной системы, но PostgreSQL об этом ничего не знает. Повторим запрос:
Так как мы только что обращались к таблице, в буферном кеше сохранились ее страницы. Поэтому сервер читает данные из буферного кеша общей памяти (Buffers: shared hit=2624).
2. Include-индекс для первичного ключа
Чтобы изменения выполнились атомарно, сделаем их в транзакции.
В демонстрации был создан такой include-индекс:
Теперь индекс tickets_pkey является избыточным и может быть заменен на новый. Для этого удалим старое ограничение целостности (при этом удалится и старый индекс) и добавим новое ограничение, указав имя уже созданного нового индекса. При этом надо учесть наличие внешнего ключа на таблице ticket_flights, которое тоже придется создать заново:
Page 37: Page 37
Вернемся к исходному состоянию:
3. Выборка 1% строк
Выбрано сканирование по битовой карте, она уместилась в оперативную память без потери точности. Для небольшой выборки сканирование по битовой карте эффективнее, чем последовательное.
4. Выборка 90% строк
Запретим последовательное сканирование.
Page 38: Page 38
Точная битовая карта не умещается в оперативную память, во многих страницах пришлось проверять все версии строк. Для большой выборки полное сканирование выгоднее. Чтобы уменьшить влияние случайных факторов, запросы всегда следует повторять несколько раз, усредняя результаты.
04 Занятие 04: Доступ к данным / Параллельный доступ
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_04_am_parallels.html Archive: QPT-handouts-16.zip Страниц PDF: 28
Page 1: Доступ к данным / Параллельный доступ
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Параллельные планы
- Размер пула процессов
- Параллельное последовательное сканирование
- Параллельный индексный доступ
Page 3: Параллельные планы
 {#source-figure-003 caption=“Source slide page 3: Параллельные планы”}
Ведущий процесс
- выполняет последовательную часть плана
- запускает рабочие процессы и получает от них данные
- Рабочие процессы
- одновременно работают над параллельной частью плана
Комментарии преподавателя
PostgreSQL поддерживает параллельное выполнение запросов. Идея состоит в том, что ведущий процесс, выполняющий запрос, порождает (с помощью postmaster, конечно) несколько рабочих процессов, которые одновременно выполняют одну и ту же «параллельную» часть плана. Результаты этого выполнения передаются ведущему процессу, который собирает их в узле Gather.
Если рабочие процессы не успевают загрузить ведущего данными, ведущий процесс тоже подключается к выполнению того же самого параллельного плана.
Разумеется, запуск процессов и пересылка данных требуют определенных ресурсов, поэтому далеко не каждый запрос выполняется параллельно.
Кроме того, даже при параллельном выполнении не все шаги плана запроса могут быть распараллелены. Часть операций может выполняться ведущим процессом в одиночку, последовательно.
https://postgrespro.ru/docs/postgresql/16/parallel-query
Заметим, что в PostgreSQL нет другого теоретически возможного режима распараллеливания, при котором несколько процессов составляют конвейер для обработки данных (грубо говоря, отдельные узлы плана выполняются отдельными процессами). Разработчики PostgreSQL сочли такой режим неэффективным.
Page 4: Размер пула процессов
 {#source-figure-004 caption=“Source slide page 4: Размер пула процессов”}
Комментарии преподавателя
Параллельным выполнением управляет довольно много параметров.
Сначала рассмотрим те, что ограничивают число рабочих процессов.
Вообще механизм рабочих процессов используется не только для параллельного выполнения запросов. Например, рабочие процессы задействованы в логической репликации, ими могут пользоваться расширения. Рабочие процессы можно использовать в прикладном коде (подробнее об этом — в теме «Фоновые процессы» курса DEV2). Общее число одновременно выполняющихся рабочих процессов ограничено параметром max_worker_processes (по умолчанию 8).
Число одновременно выполняющихся рабочих процессов, занимающихся параллельными планами, ограничено параметром max_parallel_workers (по умолчанию тоже 8).
Число одновременно выполняющихся рабочих процессов, обслуживающих один ведущий процесс, ограничено параметром max_parallel_workers_per_gather (по умолчанию 2).
Значения этих параметров следует изменить в зависимости от возможностей аппаратуры, объема данных и загруженности системы. Например, даже если в базе данных есть большие таблицы и запросы могли бы выиграть от распараллеливания, но при этом в системе нет свободных ядер, то параллельное выполнение не будет иметь смысла.
Page 5: Parallel Seq Scan
Параллельное последовательное сканирование
- агрегация
- параллельная агрегация
- Число рабочих процессов
- Ограничения
Page 6: Parallel Seq Scan
 {#source-figure-006 caption=“Source slide page 6: Parallel Seq Scan”}
страницы читаются последовательно, но разными процессами
Комментарии преподавателя
Примером узла, выполняющегося в параллельном режиме является Parallel Seq Scan — «параллельное последовательное сканирование».
Название звучит противоречиво, но, тем не менее, отражает суть операции. Страницы таблицы читаются последовательно, в том же самом порядке, в котором они читались бы при обычном последовательном сканировании. Однако запросы на чтение выдаются несколькими параллельно работающими процессами. Процессы синхронизируются между собой, чтобы их запросы шли в правильном порядке.
Преимущество такого сканирования проявляется в том, что параллельные процессы одновременно обрабатывают свои страницы. Чтобы эффект оправдал дополнительные накладные расходы на пересылку данных от процесса к процессу, обработка должна быть достаточно ресурсоемкой. Хорошим примером является агрегация данных, поскольку для нее необходимы ресурсы процессора, а пересылать требуется только одно итоговое число. В таком случае параллельное выполнение запроса может занять существенно меньше времени, чем последовательное.
Page 7: Агрегация
Рассмотрим запрос с агрегатной функцией на небольшой таблице. Такой запрос выполняется последовательно:
План состоит из двух узлов. Верхний узел Aggregate, в котором происходит вычисление count, получает данные от дочернего узла Seq Scan. Обратите внимание на узел Aggregate: его начальная стоимость практически равна полной. Это означает, что узел не может выдать результат (состоящий из одной строки), пока не обработает все данные — что вполне логично. Разница между оценкой для Aggregate и верхней оценкой для Seq Scan — стоимость работы собственно узла Aggregate. Она рассчитывается исходя из того, что надо будет посчитать каждую строку, выданную узлом Seq Scan; одна элементарная операция оценивается значением параметра cpu_operator_cost:
Параллельное последовательное сканирование
Теперь рассмотрим такой же пример, но с большой таблицей. Здесь в плане запроса увидим параллельное последовательное сканирование:
Все, что находится ниже узла Gather — параллельная часть плана. Она выполняется в каждом из рабочих процессов (которых запланировано два) и, возможно, в ведущем процессе. Узел Gather и все узлы выше выполняются только в ведущем процессе. Это последовательная часть плана. Начнем разбираться снизу вверх. Узел Parallel Seq Scan представляет сканирование таблицы в параллельном режиме. В поле rows показана оценка числа строк, которые обработает один рабочий процесс. Всего их запланировано 2, и еще часть работы выполнит ведущий, поэтому общее число строк делится на 2.4 (доля ведущего процесса уменьшается с ростом числа рабочих процессов).
Page 8: Page 8
По умолчанию ведущий процесс участвует в выполнении параллельной части плана:
Если ведущий процесс становится узким местом, его можно разгрузить:
В этом случае общее число строк делится на число запланированных рабочих процессов (2):
Вернем значение по умолчанию для параметра parallel_leader_participation:
Для оценки узла Parallel Seq Scan компонента ввода-вывода берется полностью (таблицу все равно придется прочитать страница за страницей), а ресурсы процессора делятся между процессами (на 2.4 в данном случае).
Выведем план еще раз:
Page 9: Page 9
Следующий узел — Partial Aggregate — выполняет агрегацию данных, полученных рабочим процессом, то есть в данном случае подсчитывает количество строк. Оценка выполняется уже известным образом (и добавляется к оценке сканирования таблицы):
Следующий узел — Gather — выполняется ведущим процессом. Он отвечает за запуск рабочих процессов и получение от них данных. Запуск процессов и пересылка каждой строки данных оцениваются следующими значениями:
В данном случае пересылается всего одна строка и основная стоимость приходится на запуск. И снова посмотрим на план запроса:
Последний узел — Finalize Aggregate — агрегирует полученные частичные агрегаты. Поскольку для этого надо сложить всего три числа, оценка минимальна.
Page 10: Число рабочих процессов
Равно нулю (параллельный план не строится)
- если размер таблицы < min_parallel_table_scan_size = 8MB
- Фиксировано
- если для таблицы указан параметр хранения parallel_workers
- Вычисляется по формуле
- 1 + ⌊ log 3 (размер таблицы / min_parallel_table_scan_size) ⌋
- Всегда не больше max_parallel_workers_per_gather
Комментарии преподавателя
Сколько рабочих процессов будет использоваться?
Планировщик вообще не будет рассматривать параллельное сканирование, если физический размер таблицы меньше значения параметра min_parallel_table_scan_size.
Обычно число процессов вычисляется по формуле, приведенной на слайде. Она означает, что при увеличении таблицы в три раза будет добавляться очередной процесс. Например, для стандартного значения min_parallel_table_scan_size = 8MB:
таблица процессы таблица процессы
8MB 1 216MB 4
24MB 2 648MB 5
72MB 3 1.9GB 6
Число процессов можно и явно указать в параметре хранения parallel_workers таблицы.
При этом число процессов в любом случае не будет превышать значения параметра max_parallel_workers_per_gather. Если при выполнении запроса доступное число процессов окажется меньше запланированного, будут использоваться только доступные (вплоть до последовательного выполнения, если пул полностью исчерпан).
Page 11: Число рабочих процессов при последовательном сканировании
Планировщик не рассматривает параллельные планы для таблиц размером меньше, чем:
Если запросить информацию из таблицы немного большего размера (flights, 19 Мбайт), будет запланирован один дополнительный процесс:
При запросе данных из большой таблицы (bookings, 105 Мбайт) расчетное количество — три процесса.
Однако запланировано два процесса, так как параметр max_parallel_workers_per_gather ограничивает число процессов параллельного участка плана и сейчас действует значение по умолчанию (2).
Ослабив ограничение, получим план с тремя процессами:
Page 12: Page 12
Для конкретной таблицы параметром хранения parallel_workers можно задать рекомендованное количество процессов:
Если установить параметр хранения в ноль, планировщик всегда будет выбирать последовательное сканирование данной таблицы. Но в любом случае количество запланированных процессов не будет превышать max_parallel_workers_per_gather, независимо от параметра хранения. Восстановим начальные значения параметров:
Page 13: Не распараллеливаются
Запросы на запись
- а также запросы с блокировкой строк
- Курсоры
- в том числе запросы в цикле FOR в PL/pgSQL
- Запросы с функциями PARALLEL UNSAFE
- Запросы в функциях, вызванных из распараллеленного запроса
Комментарии преподавателя
Не каждый запрос может выполняться в параллельном режиме.
Не распараллеливаются запросы, изменяющие или блокирующие данные (UPDATE, DELETE, SELECT FOR UPDATE и т. п.).
Не распараллеливаются запросы, выполнение которых может быть приостановлено — это относится к запросам в курсорах, в том числе в циклах FOR PL/pgSQL.
Не распараллеливаются запросы, содержащие функции, помеченные как PARALLEL UNSAFE (пометки параллельности рассматриваются в теме «Функции»).
Не распараллеливаются запросы, содержащиеся в функциях, которые вызываются из распараллеленного запроса (чтобы не допустить рекурсивного разрастания).
Часть из этих ограничений может быть снята в следующих версиях PostgreSQL.
https://postgrespro.ru/docs/postgresql/16/when-can-parallel-query-be-used
Page 14: Только последовательно
Чтение результатов общих табличных выражений (CTE)
- Чтение результатов нераскрываемых подзапросов
- Обращения к временным таблицам
- Вызовы функций PARALLEL RESTRICTED
- Функции, использующие вложенные транзакции
Комментарии преподавателя
В целом, чем большую часть плана удается выполнить параллельно, тем больший возможен эффект. Однако есть ряд операций, которые не препятствуют распараллеливанию плана, но сами могут выполняться только последовательно в ведущем процессе.
К ним относятся:
● чтение результатов общих табличных выражений (подзапросов в предложении WITH);
● чтение результатов других нераскрываемых подзапросов (которые представляются в плане узлами, например, SubPlan);
● обращения ко временным таблицам (так как они доступны только ведущему процессу);
● вызовы функций, помеченных как PARALLEL RESTRICTED.
Если в запросе вызывается функция, использующая вложенные транзакции (например, функция на PL/pgSQL с обработкой исключений), запрос завершится с ошибкой. Такие функции должны быть помечены как PARALLEL RESTRICTED. Подробнее пометки параллельности рассматриваются в теме «Функции».
https://postgrespro.ru/docs/postgresql/16/parallel-safety
Page 15: Только последовательные операции
Некоторые операции всегда выполняются последовательно, например, обращения к временным таблицам. Для примера создадим временную таблицу tmp_bookings — копию таблицы bookings:
- Используя операцию объединения множеств UNION ALL (без удаления дубликатов), объединим результаты двух запросов — к основной и временной таблицам:
Данные из таблицы bookings читаются параллельно (по умолчанию используется два процесса), а из временной таблицы tmp_bookings — последовательно. Если операция не выполняется параллельно, это не обязательно означает, что она в принципе не распараллеливается: возможно, планировщик счел, что в данном случае последовательное выполнение эффективнее. Параметр debug_parallel_query позволяет проверить, может ли операция выполняться в параллельном режиме. Без агрегации обращение к таблице bookings выполняется последовательно:
Но со включенным параметром мы видим, что в принципе параллельный план возможен:
Параметр служит только для отладки. С ним параллельное выполнение планируется, даже если оно не выгодно, и всегда использует единственный процесс.
Page 16: Parallel Index Scan
Параллельное сканирование индекса
- Параллельное сканирование только индекса
- Параллельное сканирование по битовой карте
- Число рабочих процессов
Page 17: Parallel Index Scan
 {#source-figure-017 caption=“Source slide page 17: Parallel Index Scan”}
Комментарии преподавателя
Индексный доступ тоже может выполняться в параллельном режиме. Это происходит в два этапа. Сначала ведущий процесс спускается от корня дерева к листовой странице.
Page 18: Parallel Index Scan
 {#source-figure-018 caption=“Source slide page 18: Parallel Index Scan”}
Комментарии преподавателя
Затем рабочие процессы выполняют параллельное чтение листовых страниц индекса, двигаясь по списку.
Процесс, прочитавший индексную страницу, выполняет и чтение необходимых табличных страниц. При этом может получиться так, что одну и ту же табличную страницу прочитают несколько процессов (этот пример показан на слайде: последняя табличная страница содержат строки, ссылки на которые ведут от нескольких индексных страниц, прочитанных разными процессами). Конечно, сама страница будет находиться в буферном кеше в одном экземпляре.
Page 19: Параллельное сканирование индекса
В качестве примера параллельного сканирования индекса найдем общую стоимость всех бронирований с кодами, меньшими 400000 (они составляют примерно одну четверть от общего числа):
Аналогичный план мы уже видели при параллельном последовательном сканировании, но в данном случае данные читаются с помощью индекса узлом Parallel Index Scan. Полная стоимость складывается из стоимостей доступа к индексу и к таблице. Оценка стоимости индексного доступа не делится между процессами, так как индекс читается процессами последовательно, страница за страницей:
Значением параметра cpu_operator_cost оценивается операция сравнения значений («меньше»). Стоимость доступа к 1/4 табличных страниц (поделенных между процессами) оценивается аналогично последовательному сканированию, поскольку строки физически упорядочены по book_ref:
Page 20: Parallel Index Only Scan
 {#source-figure-020 caption=“Source slide page 20: Parallel Index Only Scan”}
Комментарии преподавателя
Сканирование только индекса тоже может выполняться параллельно. Это происходит точно так же, как и при обычном индексном сканировании: ведущий процесс спускается от корня к листовой странице, а затем рабочие процессы параллельно сканируют листовые страницы индекса, обращаясь при необходимости к соответствующим страницам таблицы для проверки видимости.
Page 21: Параллельное сканирование только индекса
Рассмотрим похожий пример, в котором сканирование только индекса выполняется параллельно:
Стоимость доступа к таблице здесь учитывает только обработку строк, без ввода-вывода:
Вклад индексного доступа остается прежним.
Page 22: Parallel Bitmap Heap Scan
 {#source-figure-022 caption=“Source slide page 22: Parallel Bitmap Heap Scan”}
Комментарии преподавателя
Сканирование по битовой карте может выполняться параллельно.
Первый этап — сканирование индекса и построение битовой карты — всегда выполняется последовательно ведущим процессом.
А второй этап — сканирование таблицы — выполняется рабочими процессами параллельно. Это происходит аналогично параллельному последовательному сканированию.
Page 23: Параллельное сканирование по битовой карте
Для построения битовой карты нам понадобится новый индекс для таблицы bookings:
Сколько бронирований сделано за последний месяц на сумму до 20 тысяч ₽?
Ведущий процесс строит битовую карту в узле Bitmap Index Scan. Сканирование таблицы по построенной битовой карте выполняется параллельно в узле Parallel Bitmap Heap Scan.
Page 24: Число рабочих процессов
Равно нулю (параллельный план не строится)
если размер выборки < min\_parallel\_index\_scan\_size = 512kB
- Фиксировано
если для таблицы указан параметр хранения parallel\_workers
- Вычисляется по формуле
1 + ⌊ log 3 (размер выборки / min\_parallel\_index\_scan\_size) ⌋
- Но не больше, чем max_parallel_workers_per_gather
Комментарии преподавателя
Число рабочих процессов выбирается примерно так же, как и в случае последовательного сканирования. Объем данных, который предполагается прочитать из индекса (определяемый числом индексных страниц), сравнивается со значением параметра min_parallel_index_scan_size (по умолчанию 512kB).
Если в случае последовательного сканирования таблицы объем данных определялся размером всей таблицы, то при индексном доступе планировщик должен спрогнозировать, сколько индексных страниц будет прочитано. Как именно это происходит, рассматривается позже в теме «Базовая статистика».
Если размер выборки меньше, параллельный план не рассматривается оптимизатором. Например, никогда не будет выполняться параллельно доступ к одному значению — в этом случае просто нечего распараллеливать.
Если размер выборки достаточно велик, число рабочих процессов определяется по формуле, если только оно не указано явно в параметре хранения parallel_workers таблицы (не индекса!).
Число процессов в любом случае не будет превышать значения параметра max_parallel_workers_per_gather.
Page 25: Итоги
Параллельные операции используют ресурсы процессора в нескольких рабочих процессах
- PostgreSQL выделяет рабочие процессы из общего пула
- Все методы доступа могут работать в параллельном режиме
Page 26: Практика
Выполните запрос, вычисляющий общее количество бронирований, с различными настройками планировщика и сравните планы выполнения: 1. С настройками по умолчанию. 2. Запретив последовательное сканирование. 3. Дополнительно запретив сканирование только индекса. 4. Разрешив все методы доступа, но отключив параллельность.
Комментарии преподавателя
Речь идет о запросе EXPLAIN (costs off) SELECT count(book_ref) FROM bookings;
Установите параметр enable_seqscan в off.
Установите параметр enable_indexonlyscan в off.
Восстановите значения параметров по умолчанию и установите параметр max_parallel_workers_per_gather в 0.
Page 27: 1. План запроса с настройками по умолчанию
Параллельное последовательное сканирование оказывается наиболее выгодным.
2. Запрет последовательного сканирования
Отключим Seq Scan и повторим запрос:
Индексный доступ медленнее табличного, но в данном случае достаточно просканировать только индекс.
3. Запрет сканирования только индекса
Отключим и Index Only Scan:
Остальные параллельные способы получения данных оказываются невыгодными, лучше вообще не использовать параллельность.
4. Запрет параллельности
Сбросим все параметры и запретим параллельные планы:
Page 28: Page 28
Планировщик выбрал последовательное сканирование как самый выгодный способ получить все строки. Меняя значения конфигурационных параметров, можно исследовать поведение оптимизатора: например, понять, какие альтернативные планы он рассматривал.
05 Занятие 05: Доступ к данным / Типы индексов
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_05_am_indexes.html Archive: QPT-handouts-16.zip Страниц PDF: 26
Page 1: Доступ к данным / Типы индексов
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Хеш-индекс
- GiST
- Класс операторов
- SP-GiST
- GIN
- BRIN
Page 3: Идея хеширования
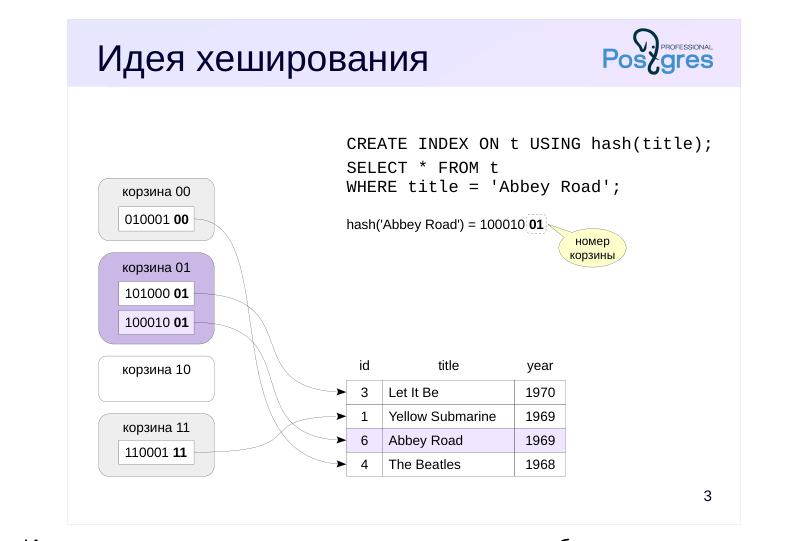 {#source-figure-003 caption=“Source slide page 3: Идея хеширования”}
Комментарии преподавателя
Идея хеширования состоит в том, что значения любого типа данных равномерно распределяются по ограниченному количеству корзин хеш-таблицы с помощью функции хеширования. Если хеш-таблица имеет достаточный размер, чтобы в одну корзину в среднем попадало одно значение (хеш-код), поиск значения в хеш-таблице выполняется за константное время. Для этого:
вычисляется хеш-функция от заданного значения;
по нескольким битам полученного хеш-кода определяется номер корзины;
корзина просматривается в поисках хеш-кода.
Если данные распределены неравномерно, в одну корзину могут попасть много значений. В этом случае эффективность поиска будет страдать.
По сути, хеш-индекс представляет собой хеш-таблицу, которая хранится на диске.
https://postgrespro.ru/docs/postgresql/16/hash-intro
Page 4: Хеш-индекс
Хранит только хеш-коды, но не исходные значения
- размер не зависит от ключа индексирования
- невозможно сканирование только индекса
- Индекс увеличивается динамически
- скачкообразный рост
- Поиск только по условию равенства
Комментарии преподавателя
Хеш-индекс хранит только значения хеш-функции и ссылки на версии строк; само индексируемое значение не сохраняется. Поэтому размер хеш-индекса не зависит от размера ключа индексирования, но теряется возможность сканирования только индекса — значение можно прочитать только из таблицы.
Размер хеш-индекса увеличивается динамически при добавлении новых значений. При увеличении количество корзин удваивается, поэтому рост размера происходит скачкообразно.
В отличие от B-дерева, хеш-индексы имеют много ограничений, в частности:
● единственная поддерживаемая операция — поиск по условию равенства, поскольку хеш-функция не сохраняет порядок следования значений;
● не поддерживается ограничение уникальности;
● нельзя создать многоколоночный индекс и добавить к индексу дополнительные include-столбцы.
Поэтому хеш-индексы не получили широкого распространения. Однако за счет меньшего размера и фиксированного времени поиска хеш-индекс может в ряде случаев работать быстрее, чем индекс на основе B-дерева.
Page 5: Хеш-индекс
Посмотрим на план запроса, получающего определенное место в салонах всех самолетов:
Поскольку подходящего индекса нет, используется последовательное сканирование. Создадим хеш-индекс по полю seat_no и повторим запрос:
Теперь планировщик использует хеш-индекс и строит битовую карту. Поменяем условие равенства на «больше»:
С неравенствами хеш-индекс использоваться не может.
Page 6: Пример индекса GiST
 {#source-figure-006 caption=“Source slide page 6: Пример индекса GiST”}
Комментарии преподавателя
GiST расшифровывается как generalized search tree — обобщенное дерево поиска.
Идею работы GiST-индексов рассмотрим на примере точек на плоскости.
Плоскость разбивается на несколько прямоугольников, которые в сумме покрывают все индексируемые точки. Эти прямоугольники составляют верхний уровень дерева.
Как видно на рисунке, прямоугольники могут пересекаться (хотя это и уменьшает эффективность поиска).
Page 7: Пример индекса GiST
 {#source-figure-007 caption=“Source slide page 7: Пример индекса GiST”}
Комментарии преподавателя
На следующем уровне дерева каждый из больших прямоугольников распадается на прямоугольники меньшего размера.
Page 8: Пример индекса GiST
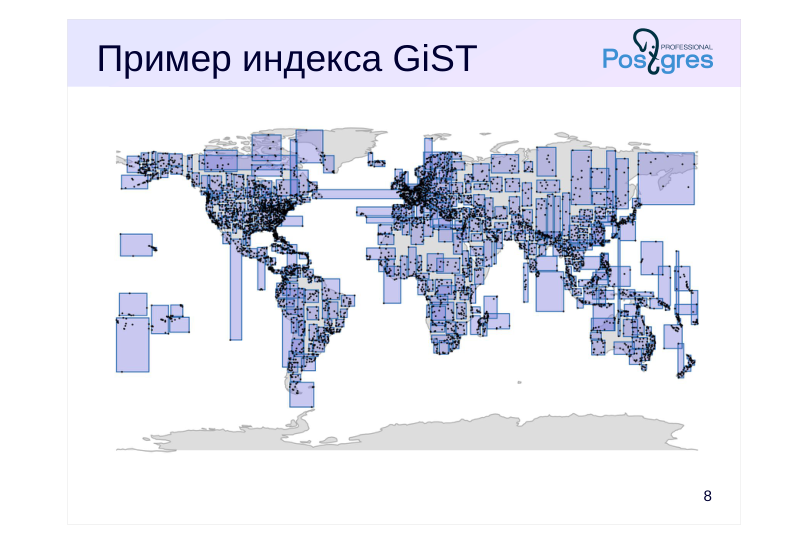 {#source-figure-008 caption=“Source slide page 8: Пример индекса GiST”}
Комментарии преподавателя
На последнем уровне дерева каждый ограничивающий прямоугольник будет содержать столько точек, сколько помещается на одну индексную страницу.
Общее условие разбиения таково: прямоугольник родительской вершины охватывает все прямоугольники соответствующего поддерева. Это позволяет, например, быстро находить точки, лежащие внутри определенной области:
находим прямоугольники, пересекающиеся с заданной областью, на верхнем уровне индекса;
спускаемся в выбранные поддеревья и повторяем поиск в них.
Такой алгоритм индексирования называется R-деревом.
Page 9: Индекс GiST
Сбалансированное дерево поиска
- рассчитано на произвольные типы данных
- не требуется упорядоченность
- Типичные поддерживаемые операции
- вхождение в область
- нахождение слева, справа, сверху, снизу от области
- Поиск ближайших соседей
- первые k значений, ближайших к заданному
Комментарии преподавателя
B-дерево представляет собой сбалансированное дерево, значения в котором упорядочены в соответствии с операциями «больше» и «меньше». Индекс GiST также образует сбалансированное дерево, но значения в нем распределяются по другому принципу, например, на основе взаимного расположения точек на плоскости.
Поэтому GiST можно применять к тем типам данных, для которых не имеют смысла операции «больше» и «меньше», и ускорять другие, более важные для этих типов, операции. Например, для геометрических фигур на плоскости индекс GiST может ускорять поиск вхождения значения в определенную область или поиск значений, находящихся в определенной стороне от заданной области.
Другая важная особенность GiST-индекса — поддержка поиска ближайших соседей. Индекс позволяет быстро получить несколько значений, ближайших к заданному.
https://postgrespro.ru/docs/postgresql/16/gist-intro
Page 10: Индекс GiST
Для демонстрации работы GiST-индекса обратимся к таблице airports_data (на этой таблице построено представление airports). В таблице есть поле coordinates типа point, по нему и будем строить GiST-индекс. Но сначала выполним следующий запрос — найдем все аэропорты, находящиеся недалеко от Москвы:
Без индекса просматривается вся таблица. Создадим GiST-индекс:
Таблица airports_data невелика, поэтому планировщик все равно будет использовать последовательное сканирование. Временно отключим этот метод доступа:
Повторим запрос:
Теперь планировщик получает нужные строки, обращаясь к индексу airports_gist_idx. Удалим созданный индекс:
Page 11: Класс операторов
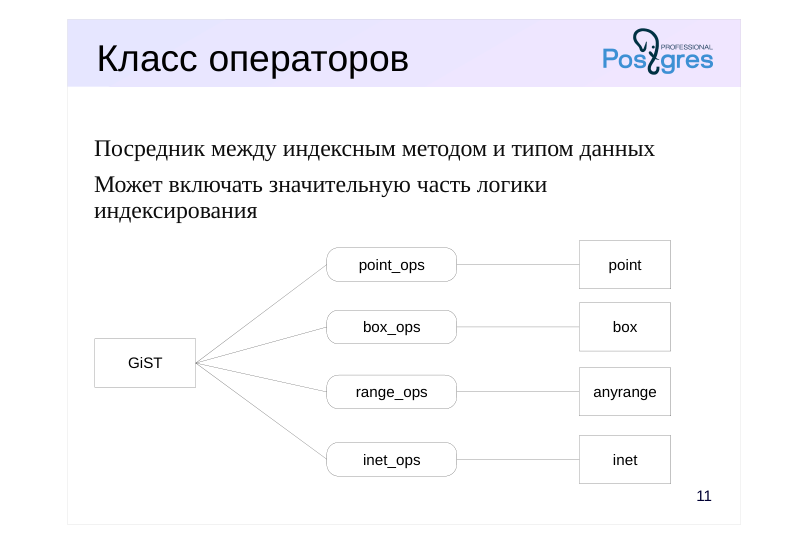 {#source-figure-011 caption=“Source slide page 11: Класс операторов”}
Посредник между индексным методом и типом данных
- Может включать значительную часть логики индексирования
Комментарии преподавателя
Чтобы индексные методы доступа могли работать с разными типами данных (которые в PostgreSQL могут подключаться на лету), между индексами и типами данных есть посредник — класс операторов, в который входят необходимые операторы и вспомогательные функции.
Такие индексы, как B-деревья и хеш-индексы, тоже используют классы операторов, но они довольно простые: содержат такие операторы, как «равно», «больше» и «меньше».
Классы операторов для GiST-индексов включают в себя значительную часть логики индексирования и определяют правила, по которым значения добавляются в индекс и затем ищутся в нем. Поэтому для разных типов данных GiST может ускорять разные операции.
Например, с помощью GiST можно индексировать значения диапазонных типов (таких, как int4range или tstzrange). Такой индекс позволяет находить диапазоны, включенные в заданный диапазон, пересекающиеся с заданным диапазоном, примыкающие к заданному диапазону и т. п.
GiST можно считать каркасом, на основе которого строятся произвольные схемы индексации (не только R-дерево), реализуя нужным образом класс операторов. Это гораздо проще, чем создать с нуля новый тип индекса, что весьма трудоемко и требует очень высокой квалификация разработчика.
https://postgrespro.ru/docs/postgresql/16/indexes-opclass
Page 12: Пример индекса SP-GiST
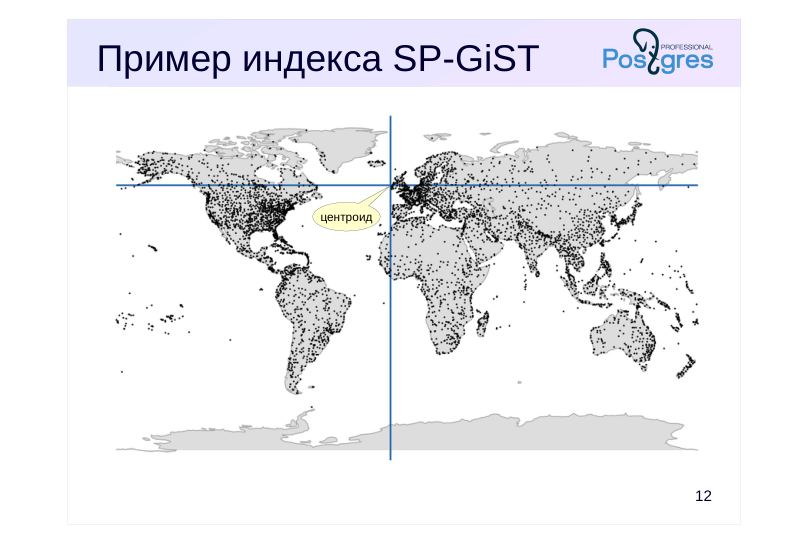 {#source-figure-012 caption=“Source slide page 12: Пример индекса SP-GiST”}
Комментарии преподавателя
SP-GiST расшифровывается как space partitioning GiST. Это тоже обобщенное дерево поиска, но оно строится путем разбиения пространства поиска на непересекающиеся области.
Рассмотрим пример индекса SP-GiST для точек на плоскости.
Один из вариантов — дерево квадрантов. Корневой узел разбивает плоскость на четыре части (квадранта) по отношению к выбранной точке-центроиду.
Page 13: Пример индекса SP-GiST
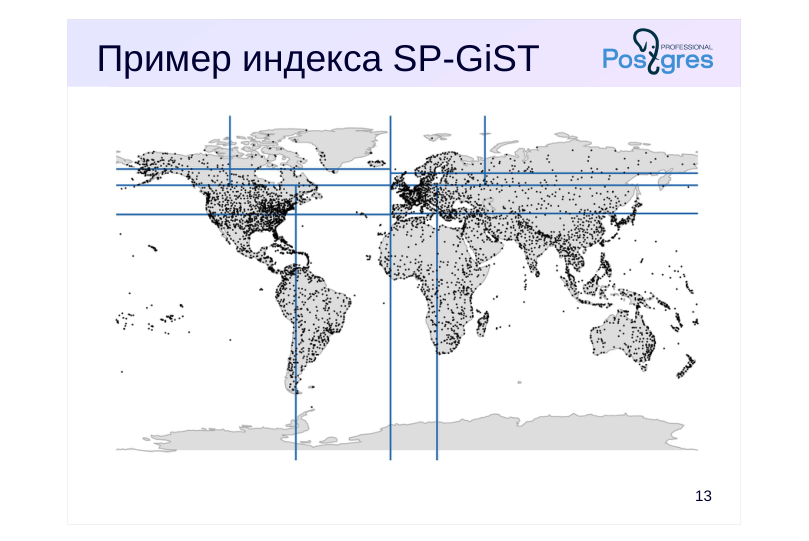 {#source-figure-013 caption=“Source slide page 13: Пример индекса SP-GiST”}
Комментарии преподавателя
Далее каждый из четырех квадрантов делится на собственные квадранты.
Page 14: Пример индекса SP-GiST
 {#source-figure-014 caption=“Source slide page 14: Пример индекса SP-GiST”}
Комментарии преподавателя
Разбиение продолжится, пока все точки в квадранте не станут помещаться на одну индексную страницу.
Page 15: Индекс SP-GiST
Несбалансированное дерево поиска
- слабо ветвящееся дерево с большой глубиной
- рассчитано на произвольные типы данных
- Операции аналогичны GiST
- вхождение в область
- нахождение слева, справа, сверху, снизу от области
- поиск ближайших соседей
Комментарии преподавателя
SP-GiST, как и GiST, является каркасом, на основе которого, реализуя классы операторов, можно строить произвольные схемы индексации. Например, дерево квадрантов для точек реализуется классом операторов point_ops. Другой способ деления плоскости — на две, а не на четыре части. Такой способ называется k-мерным деревом и реализуется другим классом операторов — kd_point_ops.
Разбиение плоскости на непересекающиеся области порождает несбалансированные деревья, которые обычно слабо ветвятся и имеют большую глубину.
Как правило, индексы SP-GiST предоставляют поддержку тех же типов данных и операторов, что и GiST. Но из-за другой структуры индекса они могут оказаться как более, так и менее эффективными, чем GiST.
https://postgrespro.ru/docs/postgresql/16/spgist
Page 16: Индекс SP-GiST
Создадим индекс SP-GiST по полю coordinates в таблице airports_data. Для точек есть два класса операторов. По умолчанию используется point_ops (дерево квадрантов), а мы для примера укажем kd_point_ops (k-мерное дерево):
Попробуем найти все аэропорты, расположенные выше (севернее) Надыма:
Теперь таблица сканируется по битовой карте, построенной на основе SP-GiST-индекса airports_spgist_idx.
Page 17: Идея GIN-индекса
 {#source-figure-017 caption=“Source slide page 17: Идея GIN-индекса”}
Комментарии преподавателя
GIN — generalized inverted index, обобщенный инвертированный индекс.
Идею этого индексного метода проще всего понять на примере предметного указателя в обычной книге. На страницах книги встречаются термины, а в предметном указателе перечислены в алфавитном порядке все термины с указанием номеров страниц, на которых они присутствуют.
Индекс GIN в первую очередь используется для индексации документов с целью ускорения полнотекстового поиска. По сути, это обычное B-дерево, но в него помещены не сами документы, а составляющие их слова. GIN-индекс оптимизирован с учетом того, что каждое слово может встречаться во многих документах. Если «список страниц» очень велик, он может храниться не в самой индексной странице, а в отдельном B-дереве.
https://postgrespro.ru/docs/postgresql/16/gin
Page 18: Индекс GIN
Инвертированный список
- для типов данных, значения которых (документы) состоят из элементов
- индексируются элементы, а не документы
- Типичная поддерживаемая операция
- проверка соответствия документа поисковому запросу
- проверка вхождения элемента в массив
- поиск документов JSON по ключам или значениям
Комментарии преподавателя
GIN работает с типами данных, значения которых состоят из элементов, а не являются атомарными. При этом индексируются не сами значения, а их элементы.
Как и GiST и SP-GiST, метод GIN является каркасом, который можно настроить не только на работу с текстом (состоящим из слов), но и с другими типами данных: с массивами (состоящими из элементов), с документами JSON (состоящими из ключей и значений). Для этого создается класс операторов, реализующий разбиение документа на элементы и проверку соответствия документа поисковому запросу.
Page 19: Индекс GIN
В столбце days_of_week представления routes хранится массив номеров дней недели, по которым выполняется рейс:
Для представления нельзя построить индекс, поэтому сохраним его строки в отдельной таблице:
Теперь создадим GIN-индекс:
С помощью GIN-индекса можно, например, отобрать рейсы, отправляющиеся только по средам и субботам:
Созданный GIN-индекс содержит всего семь элементов: целые числа от 1 до 7, представляющие дни недели. Для каждого из них в индексе хранятся ссылки на рейсы, выполняющиеся в этот день.
Page 20: Пример индекса BRIN
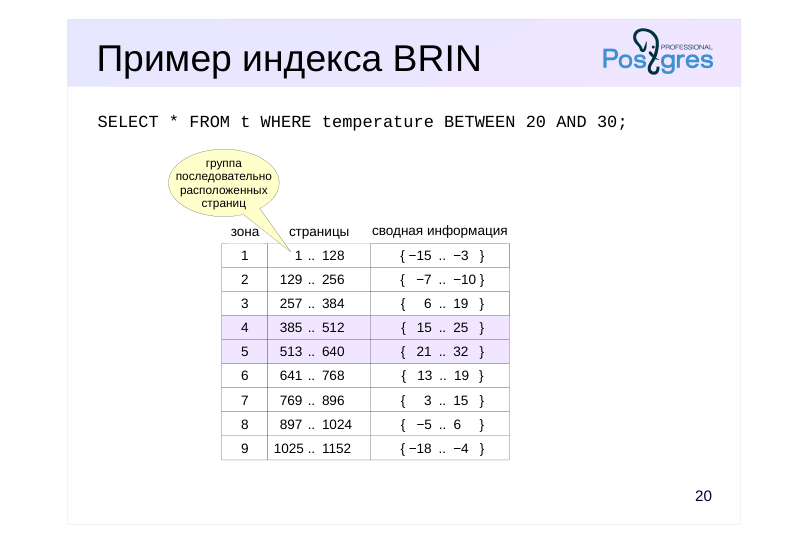 {#source-figure-020 caption=“Source slide page 20: Пример индекса BRIN”}
Комментарии преподавателя
BRIN — block range index, «индекс зон блоков». Таблица разбивается на зоны определенной (настраиваемой) длины, каждая из которых охватывает набор последовательно расположенных страниц. Например, на слайде показан индекс с зоной размером 128 страниц. По каждой зоне собирается сводная информация, например, минимум и максимум значений индексируемого столбца.
При выполнении запроса можно пропустить все зоны, значения в которых гарантированно не попадают под условие. В примере на слайде только две зоны могут содержать значения температуры, удовлетворяющие условию.
Индекс BRIN не хранит идентификаторы версий строк, как все другие индексы, поэтому в выбранных зонах необходимо просмотреть все версии строк. В некотором смысле BRIN можно рассматривать как ускоритель последовательного сканирования.
https://postgrespro.ru/docs/postgresql/16/brin
Page 21: Индекс BRIN
Список зон со сводной информацией
- зона охватывает группу последовательно расположенных страниц
- сводная информация: минимум, максимум и т. п.
- требуется корреляция с физическим расположением строк
- Не хранит ссылки на версии строк
- только сканирование по битовой карте
- Предназначен для очень больших таблиц
- небольшой размер
- настраиваемое соотношение размера и точности
Комментарии преподавателя
Используя классы операторов, можно выбирать сводную информацию, хранимую в индексе для каждой зоны. Это может быть как просто минимум и максимум, так и несколько диапазонов значений, а для геометрических типов данных можно хранить охватывающий прямоугольник (как в GiST).
В любом случае для эффективной работы BRIN необходима корреляция между значениями столбца и физическим расположением строк, чтобы в одну зону попадали значения со сходной сводной информацией. Обновления данных нарушают корреляцию и могут сказаться на эффективности индекса.
Поскольку BRIN не хранит ссылки на версии строк, он возвращает перечень страниц зоны в виде неточной битовой карты. Обычное индексное сканирование (и сканирование только индекса) невозможны.
Зато BRIN-индекс имеет очень небольшой размер, который, к тому же, может настраиваться за счет указания размера зоны. Чем больше зона, тем меньше индекс, но меньше и точность. Благодаря этому BRIN идеально подходит для очень больших таблиц, характерных для хранилищ данных.
Page 22: Индекс BRIN
Для примера построим индекс BRIN по самой большой таблице:
Индексы BRIN дают ощутимый эффект только для очень больших таблиц. Тем не менее, планировщик использует построенный индекс, поскольку по сводной информации (минимум и максимум) можно отсечь зоны, не содержащие требуемых значений:
Поскольку BRIN не хранит ссылки на версии строк, единственный возможный способ доступа — сканирование по неточной (lossy) битовой карте.
Page 23: Итоги
Помимо B-дерева, существуют и другие, более специфичные типы индексов
- Хеш-индекс для поиска по равенству
- GiST и SP-GiST для несортируемых типов данных
- GIN для документов
- BRIN для очень больших таблиц
Page 24: Практика
- Сравните размеры и время построения хеш-индекса по полям разного размера (book_ref и contact_data) таблицы билетов tickets. Повторите то же для индекса на основе B-дерева. 2. Воспользуйтесь GIN-индексом и расширением pg_trgm для поиска пассажиров, номер телефона которых содержит последовательность цифр 1234. Можно ли ускорить такой запрос с помощью B-дерева?
Комментарии преподавателя
Для оценки размера индекса можно использовать функцию pg_total_relation_size(‘имя-индекса’).
Создайте GIN-индекс по выражению contact_data-»‘phone’, используя класс операторов gin_trgm_ops из расширения pg_trgm.
Страница документации: https://postgrespro.ru/docs/postgresql/16/pgtrgm
Page 25: 1. Сравнение размера и времени создания индексов
Посмотрим структуру таблицы tickets:
Поле book_ref имеет фиксированный размер, а поле contact_data имеет тип jsonb. Включим подсчет времени выполнения запросов:
Создадим hash-индексы…
…и индексы B-tree:
Время создания хеш-индексов примерно одинаково, а время создания btree-индексов зависит от размера индексируемого поля.
Теперь проверим размеры полученных индексов:
Размер hash-индексов тоже примерно одинаковый. А размер индексов B-tree (как и время их построения) зависит от размера индексируемого поля, поскольку такие индексы хранят индексируемые значения.
Page 26: 2. Расширение pg_trgm
Выполним запрос:
Обратите внимание на количество прочитанных страниц (Buffers) — их почти пятьдесят тысяч. Добавим расширение pg_trgm:
Создадим GIN-индекс с классом операторов gin_trgm_ops:
Такой класс операторов ускоряет поиск по шаблону, который начинается на знак процента, и даже по регулярным выражениям. Индекс на основе B-дерева этого не позволяет. Повторим запрос:
Количество прочитанных страниц сократилось более чем на порядок, время выполнения существенно уменьшилось.
06 Занятие 06: Сортировка и группировка / Сортировка
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_06_sort_sort.html Archive: QPT-handouts-16.zip Страниц PDF: 22
Page 1: Сортировка и группировка / Сортировка
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Получение отсортированных данных
- Сортировка в памяти
- Внешняя сортировка
- Инкрементальная сортировка
- Сортировка в параллельных планах
- Сортировка при построении индекса
- Оконные функции с сортировкой
Page 3: Получение данных
Индексный доступ (В-дерево)
- возвращает отсортированный набор строк
- Последовательный доступ (Seq Scan)
- возвращает неупорядоченный набор строк
- необходима дополнительная операция сортировки
Комментарии преподавателя
Как уже было сказано ранее, индексный доступ (при использовании B-дерева) позволяет сразу же получить набор строк, отсортированный по ключам индексирования.
Но что делать, если сортировка требуется по полям, для которых нет индекса? В этом случае серверу приходится сначала получить данные из таблицы с помощью последовательного сканирования, а затем выполнить дополнительную операцию сортировки.
Page 4: Получение отсортированных данных
Индексный доступ автоматически возвращает строки, отсортированные по проиндексированному столбцу:
Но если попросить сервер отсортировать данные по столбцу без индекса, потребуется два отдельных шага: получение данных и сортировка.
Дальше мы будем разбираться, как устроена сортировка в узле Sort.
Page 5: Сортировка в памяти
Быстрая сортировка (quick sort)
- Частичная пирамидальная сортировка (top-N heapsort)
- когда нужна только часть значений
Комментарии преподавателя
В идеальном случае набор строк, подлежащий сортировке, целиком помещается в память, ограниченную параметром work_mem. В этом случае все строки просто сортируются алгоритмом быстрой сортировки (quick sort) и результат возвращается родительскому узлу.
Если нужно получить лишь несколько первых строк отсортированного набора (при использовании предложения LIMIT), сортировать весь набор не обязательно. В этом случае сервер может применить частичную пирамидальную сортировку (top-N heapsort), которая также выполняется в оперативной памяти.
Page 6: Сортировка в памяти
В распоряжении планировщика имеется несколько методов сортировки. В следующем примере используется быстрая сортировка (Sort Method: quicksort). В той же строке указан объем использованной памяти:
Чтобы начать выдавать данные, узлу Sort нужно полностью отсортировать набор строк. Поэтому начальная стоимость узла включает в себя полную стоимость чтения таблицы. В общем случае сложность быстрой сортировки равна O(M logM), где M — число строк в исходном наборе. Если набор строк ограничен, планировщик может переключиться на частичную сортировку (грубо говоря, вместо полной сортировки здесь 100 раз находится минимальное значение):
Обратите внимание, что стоимость запроса снизилась и для сортировки потребовалось меньше памяти. В общем случае сложность алгоритма top-N heapsort ниже, чем для быстрой сортировки — она равна O(M logN).
Page 7: Внешняя сортировка
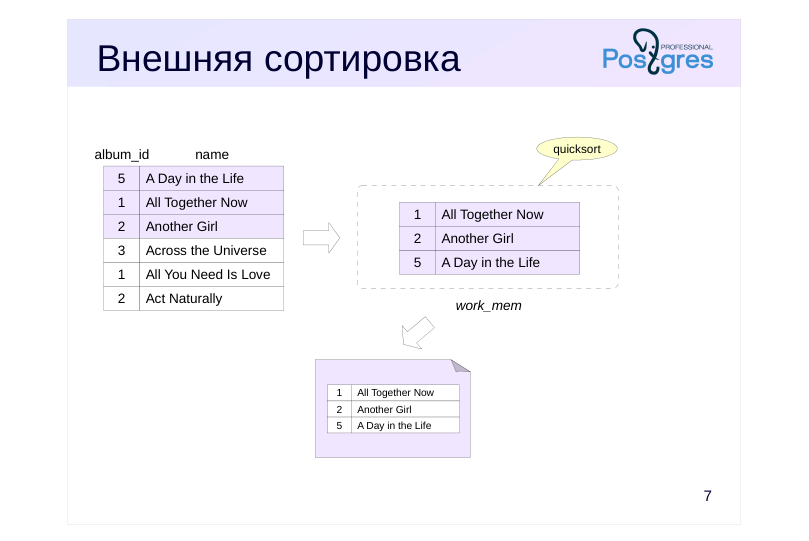 {#source-figure-007 caption=“Source slide page 7: Внешняя сортировка”}
Комментарии преподавателя
Если набор строк велик, он не поместится в память целиком. В таком случае используется алгоритм внешней сортировки.
Набор строк читается в память, пока есть возможность, затем сортируется и записывается во временный файл.
Page 8: Внешняя сортировка
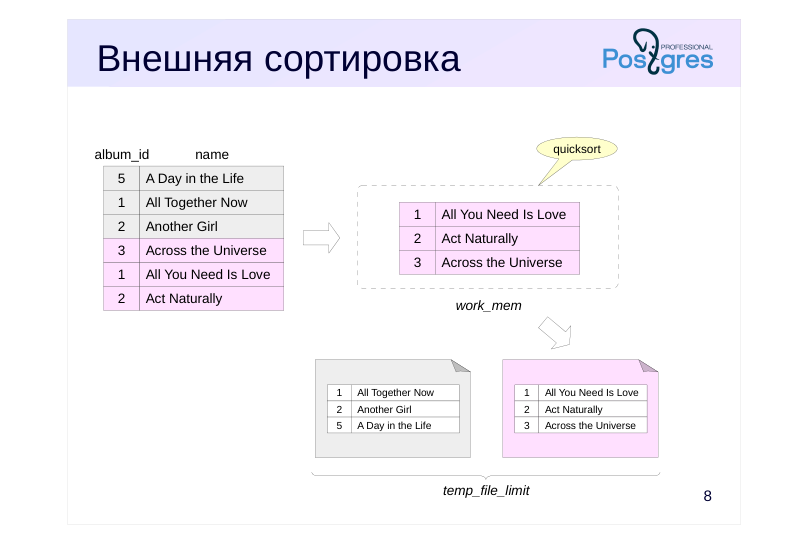 {#source-figure-008 caption=“Source slide page 8: Внешняя сортировка”}
Комментарии преподавателя
Эта процедура повторяется столько раз, сколько необходимо, чтобы записать все данные в файлы, каждый из которых по отдельности отсортирован.
Напомним, что общий размер временных файлов сеанса (не включая временные таблицы) ограничен значением параметра temp_file_limit.
Page 9: Внешняя сортировка
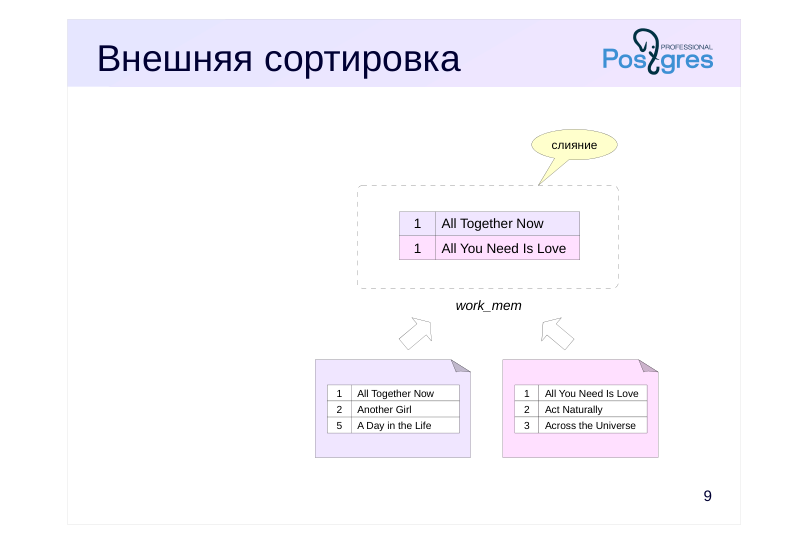 {#source-figure-009 caption=“Source slide page 9: Внешняя сортировка”}
Комментарии преподавателя
Далее несколько файлов (два или более) соединяются с сохранением порядка строк.
Для соединения не требуется много места в памяти, достаточно разместить по одной строке из каждого файла (как в примере на слайде). Среди этих строк выбирается минимальная (максимальная) и возвращается как часть результата, а на ее место читается новая строка из того же файла. На практике строки читаются не по одной, а пакетами, чтобы ускорить ввод-вывод.
Если оперативной памяти недостаточно, чтобы соединить сразу все файлы, сначала соединяется часть файлов и результат записывается в новый временный файл, затем происходит соединение этих новых файлов и так далее.
Мы не обсуждаем здесь все детали реализации сортировки, с ними можно ознакомиться в файле src/backend/utils/sort/tuplesort.c.
История развития способов сортировки в PostgreSQL хорошо описана в презентации Грегори Старка «Sorting Through The Ages»: https://wiki.postgresql.org/images/5/59/Sorting\_through\_the\_ages.pdf, синхронный перевод доклада на русский язык доступен на сайте https://pgconf.ru/talk/1587768.
Page 10: Внешняя сортировка
Пример плана с внешней сортировкой (Sort Method: external merge):
Обратите внимание на то, что узел Sort записывает и читает временные данные (temp read и written). Увеличим значение work_mem:
Теперь все строки поместились в память, и планировщик выбрал более дешевую быструю сортировку.
Page 11: Incremental Sort
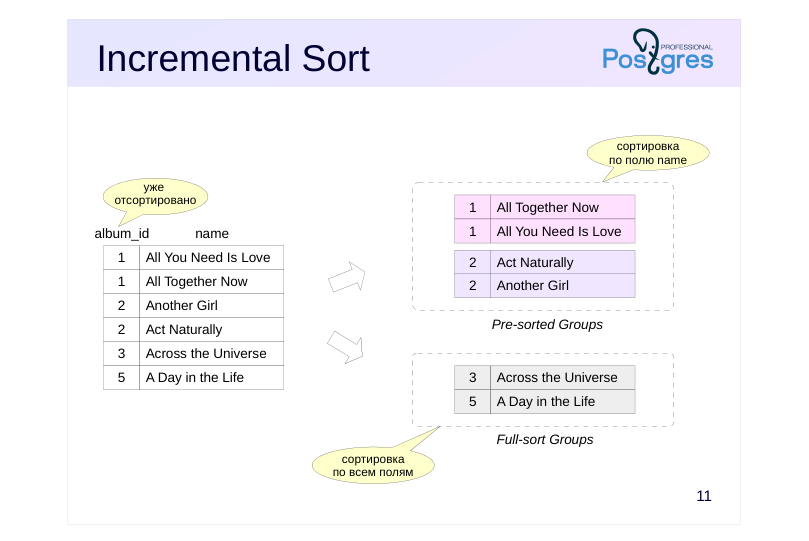 {#source-figure-011 caption=“Source slide page 11: Incremental Sort”}
Комментарии преподавателя
Если набор данных требуется отсортировать по ключам K1 … Km … Kn и при этом известно, что набор уже отсортирован по первым m ключам, можно не пересортировывать все данные заново. Достаточно разбить набор данных на группы, имеющие одинаковые значения начальных ключей K1 … Km (значения таких групп следуют друг за другом), и затем отсортировать отдельно каждую из групп по оставшимся ключам Km+1 … Kn. Такой способ называется инкрементальной сортировкой.
Алгоритм обрабатывает относительно крупные группы строк отдельно, а небольшие объединяет и сортирует полностью. Поскольку сортируемые наборы данных уменьшаются, уменьшается и требование к доступному объему памяти. Но увеличение количества наборов приводит к росту накладных расходов.
- Наборы могут обрабатываться как в оперативной памяти, так и на диске
- если не хватает объема work_mem.
Инкрементальная сортировка позволяет выдавать результаты уже после обработки первой группы, не дожидаясь сортировки всего набора.
Отключить использование инкрементальной сортировки можно с помощью параметра enable_incremental_sort.
Page 12: Инкрементальная сортировка
Инкрементальная сортировка может использовать как сортировку в памяти, так и внешнюю сортировку. Для иллюстрации создадим индекс на таблице bookings:
Посмотрим на пример инкрементальной сортировки:
Здесь данные, полученные из таблицы bookings по только что созданному индексу bookings_total_amount_idx, уже отсортированы по столбцу total_amount (Presorted Key), поэтому остается доупорядочить строки по столбцу book_date. Строка Pre-sorted Groups относится к крупным группам, которые досортировывались по столбцу book_date, а строка Full-sort Groups — к небольшим группам, которые были объединены и отсортированы полностью. В примере все группы поместились в выделенную память и применялась быстрая сортировка. Уменьшим work_mem и повторим запрос:
Теперь, при нехватке памяти, для некоторых крупных групп пришлось применить внешнюю сортировку с использованием временных файлов (Pre-sorted Groups … external merge).
Page 13: В параллельных планах
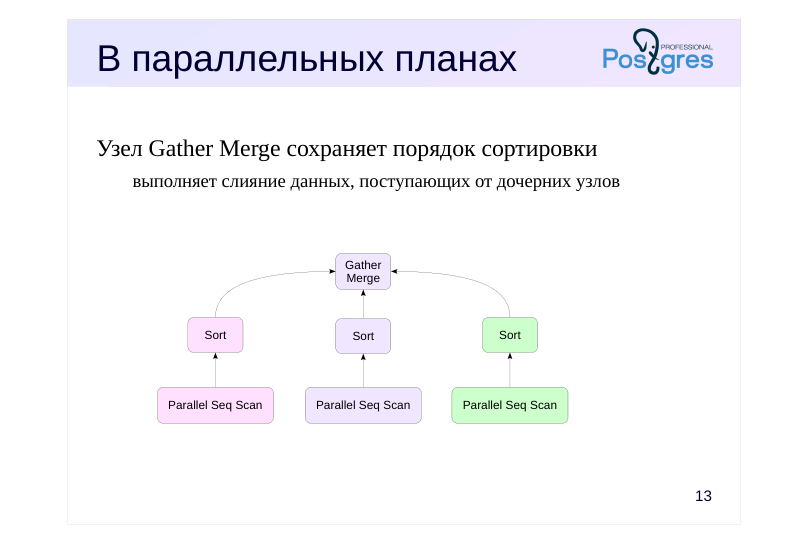 {#source-figure-013 caption=“Source slide page 13: В параллельных планах”}
Узел Gather Merge сохраняет порядок сортировки
- выполняет слияние данных, поступающих от дочерних узлов
Комментарии преподавателя
Сортировка может участвовать в параллельных планах. Каждый рабочий процесс сортирует свою часть данных и передает результат вышестоящему узлу, который собирает данные в единый набор.
Но узел Gather для этого не годится, поскольку он выдает результат в том порядке, в котором строки поступают от рабочих процессов.
Поэтому в таких планах используется узел Gather Merge, сохраняющий порядок сортировки поступающих строк. Для этого он реализует алгоритм слияния, объединяя несколько отсортированных наборов в один.
Page 14: В параллельных планах
Запрос, сортирующий большую таблицу по неиндексированному полю, может выполняться параллельно:
Здесь каждый процесс читает и сортирует свою часть таблицы, а затем отсортированные наборы сливаются при передаче их ведущему процессу с сохранением порядка.
Page 15: Построение B-дерева
Используется сортировка
- сначала все строки сортируются
- затем строки собираются в листовые индексные страницы
- ссылки на них собираются в страницы следующего уровня
- и так далее, пока не дойдем до корня
- Может выполняться параллельно
- max_parallel_maintenance_workers
- Ограничение
- maintenance_work_mem, так как операция не частая
Комментарии преподавателя
При построении индекса (речь идет про B-дерево) сервер мог бы добавлять записи в пустой индекс по одной, обрабатывая последовательно строки таблицы. Но такой способ крайне неэффективен.
Поэтому при создании и перестроении индекса используется сортировка: все строки таблицы сортируются, и формируются записи, которые раскладываются по листовым индексным страницам. Затем достраиваются верхние уровни дерева, состоящие из ссылок на элементы страниц нижележащего уровня, до тех пор, пока на очередном уровне не получится одна страница — она и будет корнем дерева.
Сортировка устроена точно так же, как рассматривалось выше. Однако размер памяти ограничен не work_mem, а maintenance_work_mem, поскольку операция создания индекса не слишком частая и имеет смысл выделить для нее больше памяти.
Построение индекса может выполняться параллельно. Количество рабочих процессов выбирается так же, как и при выполнении параллельных запросов (в зависимости от размера таблицы), но ограничено значением параметра max_parallel_maintenance_workers.
Page 16: Оконные функции
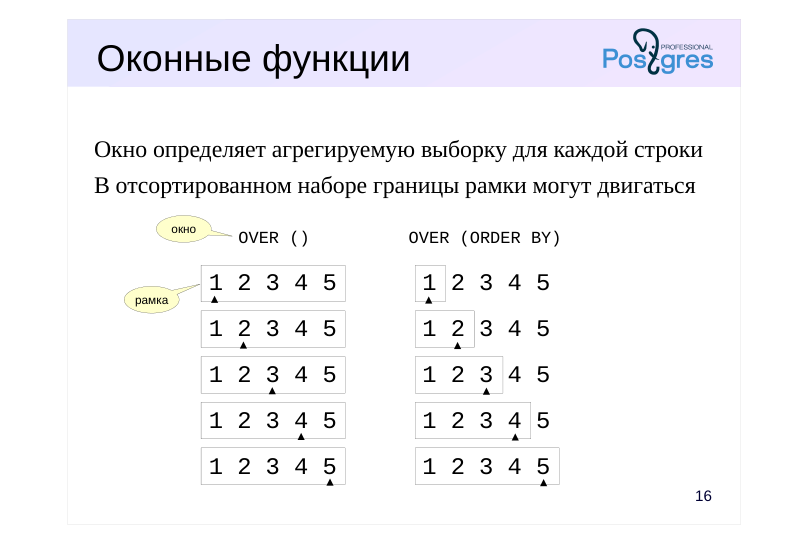 {#source-figure-016 caption=“Source slide page 16: Оконные функции”}
Окно определяет агрегируемую выборку для каждой строки
- В отсортированном наборе границы рамки могут двигаться
- OVER ()
- OVER (ORDER BY)
- окно
Комментарии преподавателя
Использование сортировки в оконных функциях имеет особенности.
В отличие от обычных агрегатных функций, оконные функции вычисляются для каждой строки набора, не уменьшая его размер. После имени функции в предложении OVER указывается окно, определяющее набор строк, которую должна обработать оконная функция в каждой строке набора. Такая выборка называется рамкой.
Если окно указано как OVER(), то рамка одинакова для каждой строки и состоит из всех строк набора.
Page 17: Оконные функции
Посмотрим план запроса, вычисляющего сумму бронирований нарастающим итогом:
Оконная функция вычисляется в узле WindowAgg, который получает отсортированные данные от дочернего узла Sort. Добавление к запросу других оконных функций, использующих тот же порядок строк (не обязательно с совпадающим окном), а также предложения ORDER BY не приводит к появлению лишних сортировок:
Здесь два узла WindowAgg (каждый для своего окна), но общий узел Sort. Стоимость запроса увеличилась, но лишь немного. Конечно, оконные функции, требующие разного порядка строк, вынуждают сервер пересортировывать данные:
В этом примере нижний узел WindowAgg (соответствующий функции count) получает упорядоченный набор строк по индексу, а для верхнего узла WindowAgg (соответствующего функции sum) строки переупорядочивает узел Sort. Сортировка в оконных функциях может использовать любые методы, рассмотренные выше. Например, быструю сортировку:
Page 18: Page 18
Или внешнюю:
Page 19: Итоги
Сортировка используется при выполнении запросов и для построения B-деревьев
- Существуют разные способы реализации сортировки
- в памяти
- внешняя (создаются временные файлы)
- инкрементальная
- Наличие индексов может позволить избежать сортировки
Page 20: Практика
- Какой план будет выбран для следующего запроса: SELECT * FROM flights ORDER BY scheduled_departure; Изменится ли план выполнения, если увеличить значение work_mem до 32 Мбайт?
- Создайте индекс по столбцам passenger_name и passenger_id таблицы билетов (tickets). Потребовался ли временный файл для выполнения этой операции?
Комментарии преподавателя
- Включите журналирование использования временных файлов, установив значение параметра log_temp_files в ноль.
Page 21: 1. Выполнение запроса с сортировкой
Выполним запрос со значениями параметров по умолчанию:
Сервер выбрал внешнюю сортировку (Sort Method: external merge). Обратите внимание на количество страниц и тип ввода-вывода (Buffers): значения temp read и written говорят о том, что сервер использовал временные файлы. Выполните запрос повторно несколько раз — видно, что серверу всегда не хватает оперативной памяти. Увеличим значение параметра work_mem до 32 Мбайт:
Увеличив work_mem, мы позволяем серверу использовать больше оперативной памяти для сортировки. Повторно выполним запрос и сравним планы выполнения:
Теперь сервер использует сортировку в памяти (Sort Method: quicksort), в строке Buffers исчезли поля temp read и written.
2. Построение индекса
Включим журналирование временных файлов:
Текущее значение maintenance_work_mem:
Page 22: Page 22
Создаем индекс:
Временный файл понадобился:
07 Занятие 07: Сортировка и группировка / Группировка
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_07_sort_group.html Archive: QPT-handouts-16.zip Страниц PDF: 23
Page 1: Сортировка и группировка / Группировка
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Применение группировки
- Группировка хешированием
- Группировка сортировкой
- Комбинированная группировка
- Группировка в параллельных планах
- Оконные функции
Page 3: Применение группировки
Явное указание
- GROUP BY
- Исключение дубликатов
- DISTINCT
- UNION, INTERSECT, EXCEPT
Комментарии преподавателя
В SQL-запросе набор строк можно сгруппировать с помощью предложения GROUP BY, в сочетании с которым обычно используются агрегатные функции, обрабатывающие все строки группы. Похожую возможность для оконных функций дает предложение PARTITION BY.
Группировка может выполняться и неявно при устранении дубликатов в запросе со словом DISTINCT или с командами обработки двух наборов строк (UNION, INTERSECT, EXCEPT без слова ALL), которые удаляют дубликаты.
Сервер выбирает один из доступных способов группировки, учитывая имеющиеся ресурсы, возможность получить отсортированные данные для ключа группировки и другие факторы.
Page 4: Применение группировки
Выполним запрос, явно группирующий строки таблицы seats по классам обслуживания:
Теперь получим все различные классы обслуживания:
В третьем (исключительно учебном) примере дважды получим все строки таблицы seats и объединим их с помощью команды UNION:
Результаты всех трех запросов одинаковы, и во всех планах есть узел HashAggregate.
Page 5: Группировка хешированием
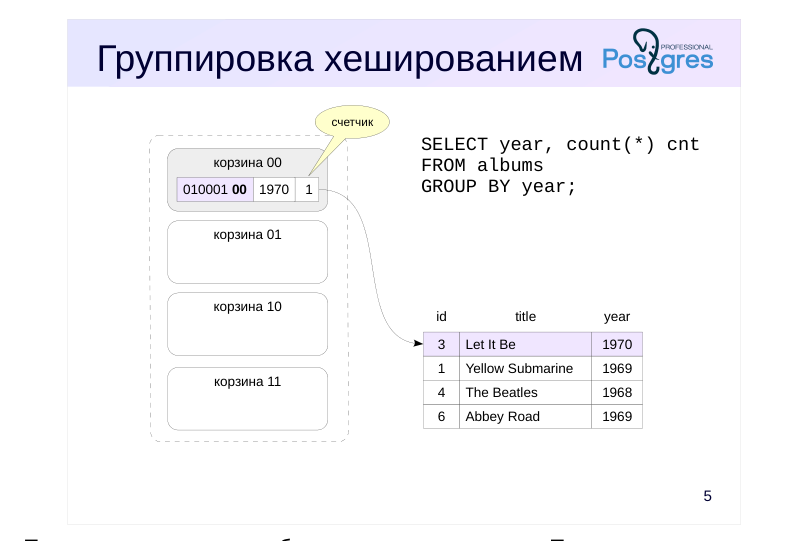 {#source-figure-005 caption=“Source slide page 5: Группировка хешированием”}
Комментарии преподавателя
Про идею хеширования было рассказано в теме «Типы индексов». При группировке значений может использоваться похожий принцип.
В примере на слайде показано, как вычисляется значение агрегатной функции count при группировке по полю year. Сервер получает и по очереди обрабатывает строки таблицы.
Предварительно рассчитывается количество корзин — степень числа 2, и определяется число разрядов хеш-кода, содержащих номер корзины. В примере на слайде это два последних разряда.
Для строки вычисляется хеш-функция от значения year. По хеш-коду определяется номер корзины и в хеш-таблицу добавляется запись с хеш-кодом, если его еще нет в таблице.
Поскольку в нашем примере вычисляется значение агрегатной функции count, в каждой записи хеш-таблицы дополнительно хранится счетчик, который увеличивается при обработке очередной строки.
В нашем примере первая строка порождает новую запись в корзине 00.
Page 6: Группировка хешированием
 {#source-figure-006 caption=“Source slide page 6: Группировка хешированием”}
Комментарии преподавателя
Вторая строка попадает в корзину 01 и порождает в ней новую запись.
Page 7: Группировка хешированием
 {#source-figure-007 caption=“Source slide page 7: Группировка хешированием”}
Комментарии преподавателя
Третья строка порождает новую запись в корзине 11.
Page 8: Группировка хешированием
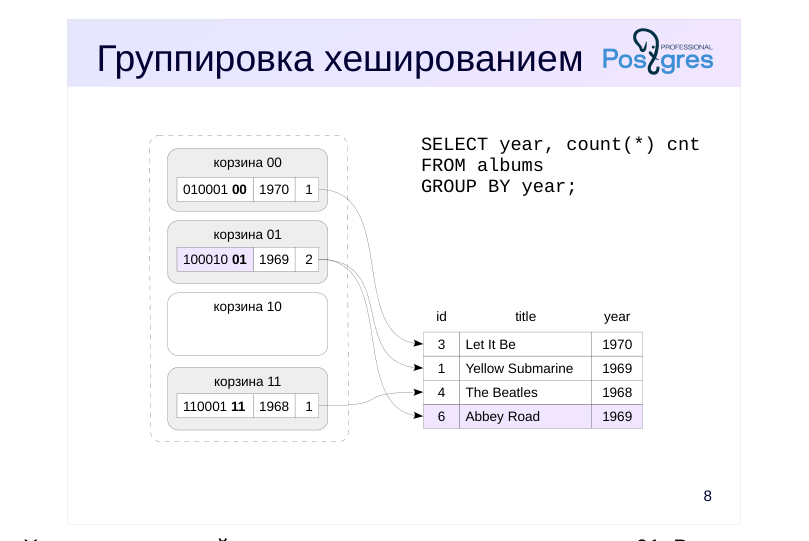 {#source-figure-008 caption=“Source slide page 8: Группировка хешированием”}
Комментарии преподавателя
Хеш-код последней строки попадает в корзину с номером 01. В корзине уже есть запись с таким значением ключа, поэтому сервер увеличивает значение ее счетчика на единицу. На этом обработка таблицы завершается: в хеш-таблице собрались все уникальные значения. Алгоритм возвращает сами значения и их количество.
Такой же алгоритм (с незначительными модификациями) используется и для получения уникальных записей без вычисления агрегатной функции, и при вычислении других агрегатных функций.
Page 9: Группировка хешированием
Узел, который отвечает за агрегацию методом хеширования, обозначается в плане выполнения как HashAggregate:
Обратите внимание на начальную стоимость: результаты начинают выдаваться только после построения хеш-таблицы по всем строкам. Выполнив запрос, можно увидеть объем памяти, выделенной под хеш-таблицу:
Page 10: Хеш-группировка и пакеты
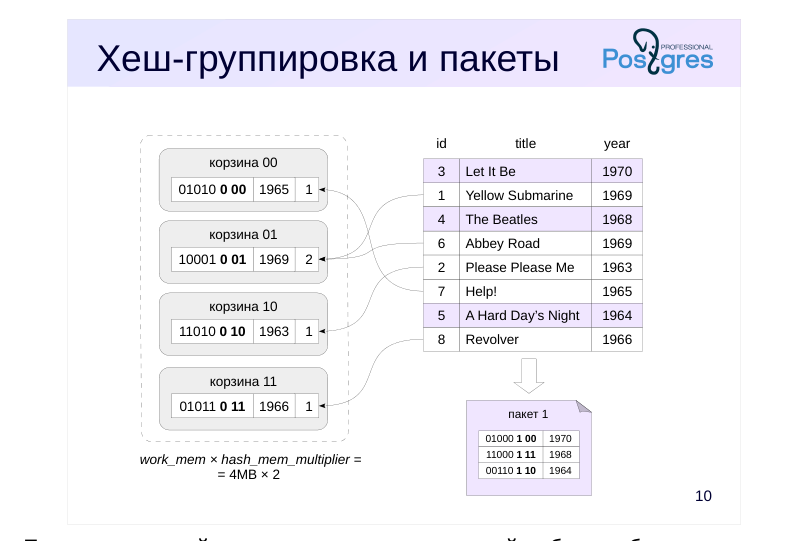 {#source-figure-010 caption=“Source slide page 10: Хеш-группировка и пакеты”}
Комментарии преподавателя
Если выделенной памяти не хватает, исходный набор разбивается на части (пакеты), так чтобы хеш-таблица для каждого пакета умещалась в оперативной памяти. Расчетное количество пакетов — степень числа 2; в хеш-коде выделяется нужное количество битов, которые определяют принадлежность записи пакету (на слайде два пакета, поэтому достаточно одного бита). Хеш-таблица для пакета 0 располагается в оперативной памяти, строки остальных пакетов помещаются во временные файлы — каждый пакет в свой файл.
Использование временных файлов значительно снижает производительность, и при хешировании этот эффект проявляется сильнее, чем для других алгоритмов. Поэтому при группировке хешированием выделяется work_mem × hash_mem_multiplier оперативной памяти — по умолчанию вдвое больше, чем обычно.
Page 11: Хеш-группировка и пакеты
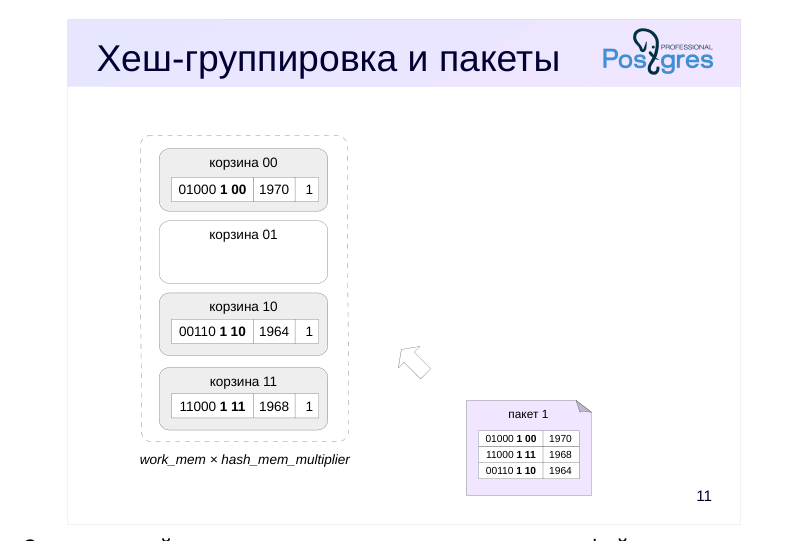 {#source-figure-011 caption=“Source slide page 11: Хеш-группировка и пакеты”}
Комментарии преподавателя
Затем каждый из пакетов, записанных во временные файлы, читается в память и формирует новую хеш-таблицу.
После обработки всех исходных строк, а также каждого из дополнительных пакетов сервер может возвращать частичные результаты (строки для каждой группы всегда находятся в одном пакете).
Page 12: Хеш-группировка и пакеты
Рассмотрим план другого запроса, с группировкой по большой таблице:
В плане появилось предложение Planned Partitions — оптимизатор предполагает, что хеш-таблица не поместится в выделенную память и придется разбивать ее на пакеты. Выполним запрос:
При выполнении размер одного из пакетов оказался слишком велик, поэтому он был дополнительно разбит на два более мелких пакета. Общее количество пакетов (Batches) увеличилось по сравнению с расчетным.
Page 13: Группировка сортировкой
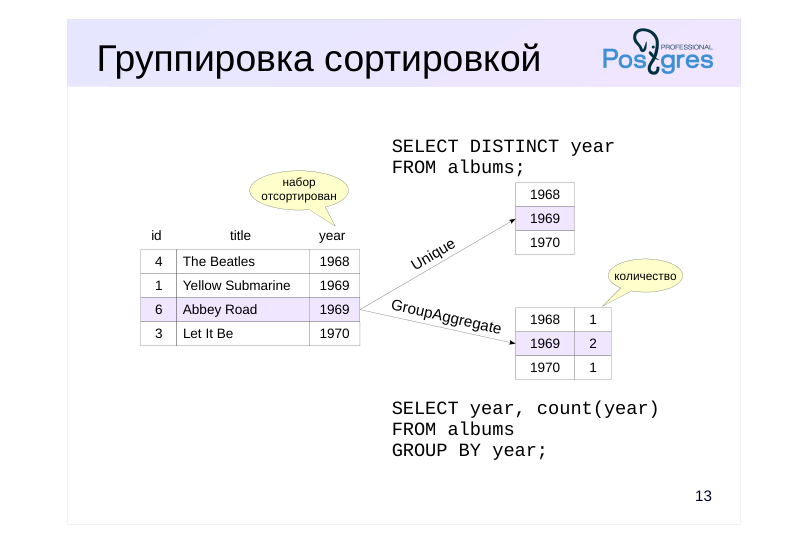 {#source-figure-013 caption=“Source slide page 13: Группировка сортировкой”}
Комментарии преподавателя
Исключение дубликатов и группировка могут выполняться не только путем хеширования, но и с помощью сортировки. В этом случае требуется набор данных, предварительно отсортированный по полям группировки.
Узел Unique устраняет дубликаты, добавляя к результату очередное значение, если оно не совпадает с предыдущим.
Узел GroupAggregate возвращает агрегированные данные. В примере на слайде узел строит список различных значений поля year, подсчитывая, сколько раз встретилось каждое из них в наборе данных.
Как было рассмотрено в предыдущей теме, упорядоченный набор строк может быть получен с помощью индексного доступа или в результате сортировки в узле Sort. В первом случае узлы Unique и GroupAggregate обычно более выгодны, чем HashAggregate, поскольку выполняются быстро и не требуют много памяти. Однако во втором случае построение хеш-таблицы, как правило, эффективнее сортировки.
В отличие от HashAggregate, оба узла: Unique и GroupAggregate – возвращают упорядоченные данные.
Page 14: Группировка сортировкой
Пример плана с узлом GroupAggregate, в котором происходит группировка отсортированного набора:
В этом запросе сортировку набора данных обеспечивает индексный доступ. Запрос с DISTINCT использует для устранения дубликатов узел Unique:
Поскольку узел возвращает результаты, упорядоченные так же, как требует предложение ORDER BY, дополнительная сортировка не требуется.
Комбинированная группировка
При группировке по нескольким наборам полей (которая возникает при использовании конструкций GROUPING SETS, CUBE или ROLLUP в предложении GROUP BY) может оказаться выгодным совместно использовать группировку хешированием и группировку сортировкой. В плане запроса такая комбинированная группировка отображается в виде узла MixedAggregate. В качестве примера рассмотрим запрос к таблице перелетов, в котором подсчитывается и объединяется количество строк для трех различных вариантов группировки:
Узел MixedAggregate получает набор данных, отсортированный по столбцу fare_conditions. На первом этапе в процессе чтения набора выполняется группировка по столбцу fare_conditions (Group Key). По мере чтения строки переупорядочиваются по столбцу ticket_no и одновременно с этим записываются в хеш-таблицу с ключом amount. На втором этапе сканируется набор строк, отсортированный на предыдущем этапе по столбцу ticket_no, и значения группируются по этому же столбцу (Sort Key и вложенный Group Key). Наконец, сканируется хеш-таблица, подготовленная на первом этапе, и значения группируются по столбцу amount (Hash
Page 15: Page 15
Key).
Page 16: В параллельных планах
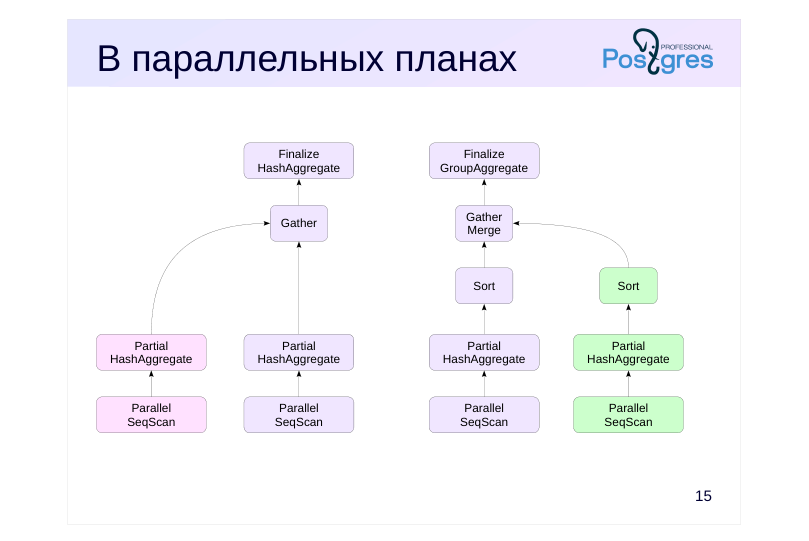 {#source-figure-016 caption=“Source slide page 16: В параллельных планах”}
Комментарии преподавателя
Агрегация не имеет специальной параллельной реализации, но может выполняться в параллельных планах. В этом случае каждый рабочий процесс агрегирует свою часть данных и передает результат узлу Gather, который собирает данные в единый набор. Следующий узел выполняет агрегацию объединенного набора и вычисляет значение агрегатной функции.
Пример такого плана показан на слайде слева. Обычно такой вариант выигрывает, если количество групп достаточно велико.
Если же групп немного, может оказаться выгодным отсортировать сгруппированные строки в каждом процессе. А дальше воспользоваться тем, что наборы упорядочены, и на последнем этапе выполнить более быструю группировку сортировкой.
Пример такого плана показан на слайде справа.
Page 17: В параллельных планах
Сгруппируем строки таблицы перелетов по рейсам (их, очевидно, много):
Здесь каждый процесс в узле Partial HashAggregate вычисляет агрегатную функцию по своим данным с помощью собственной хеш-таблицы. Ведущий процесс после сбора данных в узле Gather получает итоговое значение агрегата, объединяя группы в узле Finalize HashAggregate тоже с помощью хеширования. Теперь сгруппируем строки таблицы перелетов по стоимости. Количество групп будет небольшим:
Как будет выполняться такой запрос?
Поскольку групп немного, оказывается выгодным отсортировать результаты в каждом процессе (Sort), собрать их в ведущем процессе в один отсортированный набор (Gather Merge), а затем, объединяя группы, вычислить агрегатную
Page 18: Page 18
функцию (Finalize GroupAggregate).
Page 19: Оконные функции
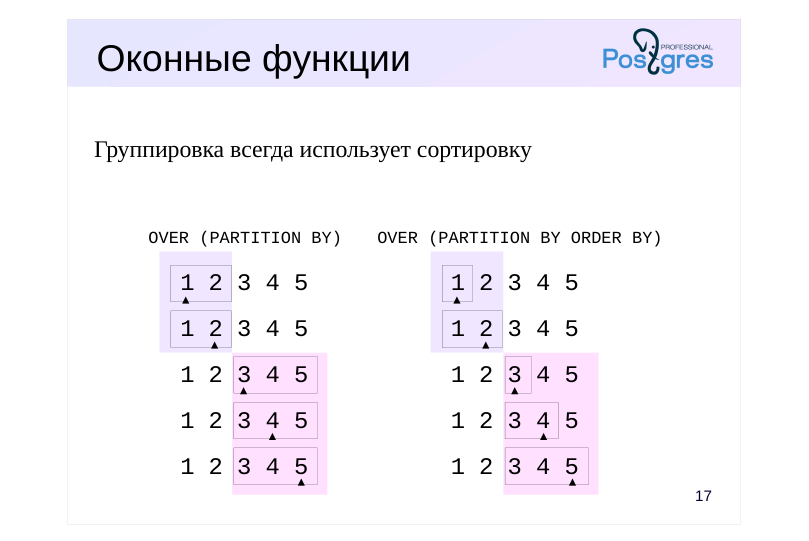 {#source-figure-019 caption=“Source slide page 19: Оконные функции”}
Группировка всегда использует сортировку
Комментарии преподавателя
Группировка используется и в оконных функциях.
Если определение окна включает конструкцию PARTITION BY, оконная функция вычисляется на основе групп строк (аналогично группировке GROUP BY).
Для каждой группы строк границы рамки меняются в своих пределах. Если при этом нет других указаний, для всех строк одной группы будет получено одинаковое значение функции.
Как и в примере из темы «Сортировка», указание ORDER BY упорядочивает строки в каждой группе; в этом случае предполагается, что рамка охватывает строки от первой до текущей.
В отличие от обычной группировки GROUP BY, группировка в определении окна всегда реализуется с помощью сортировки: план строится так, чтобы на вход узлу WindowAgg пришел набор строк, отсортированный сначала по ключам группировки PARTITION BY, а затем — по ключам сортировки ORDER BY. Хеширование не применяется даже в отсутствие конструкции ORDER BY.
Page 20: Итоги
Группировка происходит не только при агрегации, но и при устранении дубликатов
- Выполняется с помощью хеширования или сортировки
Page 21: Практика
- Как выполняется запрос, вычисляющий количество мест каждой категории в таблице seats? Попробуйте со значениями параметров по умолчанию, а затем запретите группировку хешированием. 2. Изучите запрос с оконной функцией и предложением PARTITION BY: SELECT status, count(*) OVER (PARTITION BY status) FROM flights WHERE flight_no = ‘PG0007’ AND departure_airport = ‘VKO’ AND flight_id BETWEEN 24104 AND 24115;
- Добавьте вызов функции row_number с тем же окном
- и сравните результаты и планы выполнения.
Комментарии преподавателя
- Запрос: SELECT fare_conditions, count(*) FROM seats GROUP BY fare_conditions;
Для запрета группировки хешированием установите параметр enable_hashagg в off.
Page 22: 1. Разные способы группировки
Сначала выполним запрос со значениями параметров по умолчанию:
Для группировки используется узел HashAggregate. Запретим группировку хешированием:
Повторно выполним запрос и сравним планы выполнения:
Теперь остается только вариант с узлом GroupAggregate, а для него приходится сортировать данные в узле Sort. Вернем значение по умолчанию:
2. Оконные функции и PARTITION BY
Приведенный запрос возвращает количество элементов в каждой группе:
В плане выполнения видно, что группировка обеспечивается тем же узлом WindowAgg, который мы видели при использовании конструкции ORDER BY в определении окна:
Page 23: Page 23
Добавим номер текущей строки в ее группе с помощью функции row_number():
Добавление новой функции с совпадающим окном не порождает новые узлы в плане:
08 Занятие 08: Способы соединения / Соединение вложенным циклом
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_08_join_nestloop.html Archive: QPT-handouts-16.zip Страниц PDF: 27
Page 1: Способы соединения / Соединение вложенным циклом
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Общие соображения о соединениях
- Соединение вложенным циклом
- Модификации: левые, полу-и анти-соединения
- Мемоизация
- Вычислительная сложность
- Вложенный цикл в параллельных планах
Page 3: Соединения
Способы соединения — не соединения SQL
- inner/left/right/full/cross join, in, exists — логические операции
- способы соединения — механизм реализации
- Соединяются не таблицы, а наборы строк
- могут быть получены от любого узла дерева плана
- Наборы строк соединяются попарно
- порядок соединений важен с точки зрения производительности
- обычно важен и порядок внутри пары
Комментарии преподавателя
Мало получать данные с помощью рассмотренных методов доступа, надо еще и уметь соединять их. Для этого PostgreSQL предоставляет несколько способов.
Способы соединения представляют собой алгоритмы для соединения двух наборов строк. С их помощью реализуются и другие конструкции языка SQL, например, EXISTS. Не стоит путать одно с другим: SQL-соединения — это логические операции над двумя множествами; способы соединения PostgreSQL — это возможные реализации таких соединений, учитывающие производительность.
Часто можно услышать, что соединяются таблицы. Это удобное упрощение, но на самом деле в общем случае соединяются наборы строк. Эти наборы действительно могут быть получены непосредственно из таблицы (с помощью одного из методов доступа), но с тем же успехом могут, например, являться результатом соединения других наборов строк.
Наконец, наборы строк всегда соединяются попарно. Порядок, в котором соединяются таблицы, в большинстве случаев не влияет на результат запроса (например, a join b join c или b join c join a), но очень сильно влияет на производительность. Как мы увидим дальше, важен и порядок, в котором соединяются два набора строк (a join b или b join a).
Page 4: Nested Loop
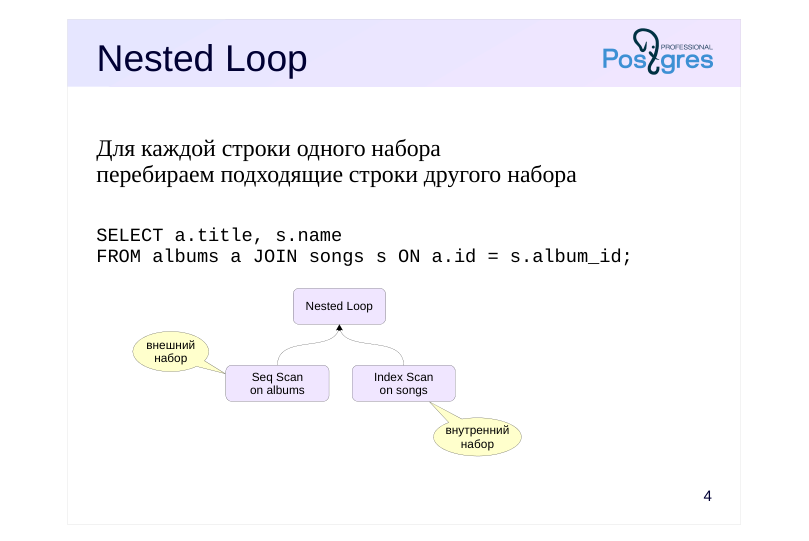 {#source-figure-004 caption=“Source slide page 4: Nested Loop”}
Для каждой строки одного набора перебираем подходящие строки другого набора
Комментарии преподавателя
Начнем с соединения вложенными циклами (nested loop), как с самого простого. Его алгоритм таков: для каждой строки одного из наборов перебираем и возвращаем соответствующие ему строки второго набора. По сути, это два вложенных цикла, отсюда и название способа.
Заметим, что ко второму (внутреннему) набору мы будем обращаться столько раз, сколько строк в первом (внешнем) наборе. Если нет эффективного метода доступа для поиска соответствующих строк во втором наборе (то есть, попросту говоря, индекса на таблице), придется неоднократно перебирать большое количество строк, не относящихся к делу. Очевидно, это будет не лучший выбор, хотя для небольших наборов алгоритм и в этом случае может оказаться достаточно эффективным.
В плане запроса мы будем видеть узел Nested Loop с двумя дочерними узлами (которые могут представлять не только методы доступа, но и другие операции, например, соединения или агрегации).
Page 5: Nested Loop
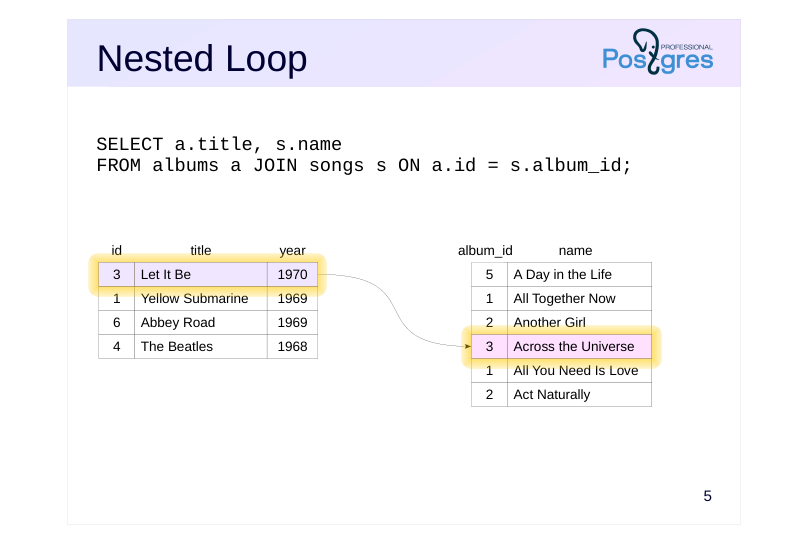 {#source-figure-005 caption=“Source slide page 5: Nested Loop”}
Комментарии преподавателя
Рисунки иллюстрируют этот способ соединения. На них: • строки, к которым ранее уже был доступ, показаны серым; • строки, доступ к которым выполняется на текущем шаге, выделены цветом; • оранжевым контуром выделены строки, составляющие пару, подходящую по условию соединения (в данном примере — по равенству числовых идентификаторов).
Сначала мы читаем первую строку первого набора и находим ее пару во втором наборе. Соответствие нашлось, и у нас уже есть первая строка результата, которую можно вернуть вышестоящему узлу плана: («Let It Be», «Across the Universe»).
Page 6: Nested Loop
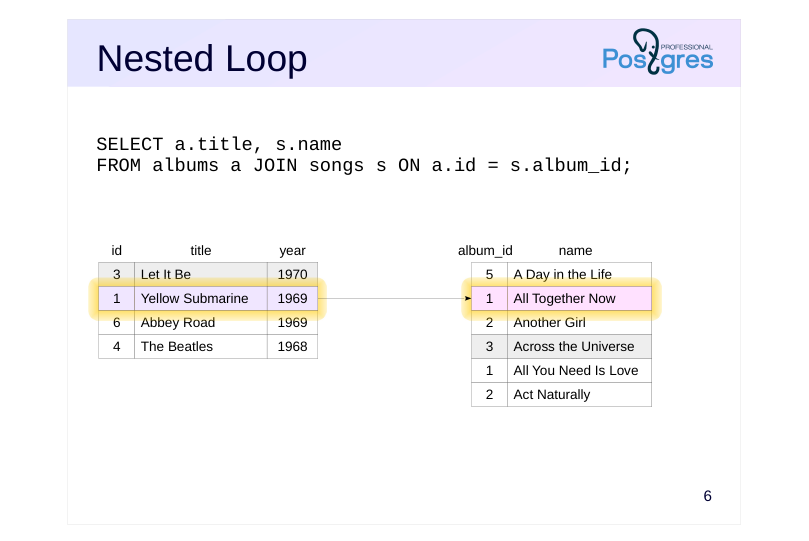 {#source-figure-006 caption=“Source slide page 6: Nested Loop”}
Комментарии преподавателя
Читаем вторую строку первого набора.
Для нее тоже перебираем пары из второго набора. Сначала возвращаем («Yellow Submarine», «All Together Now»)…
Page 7: Nested Loop
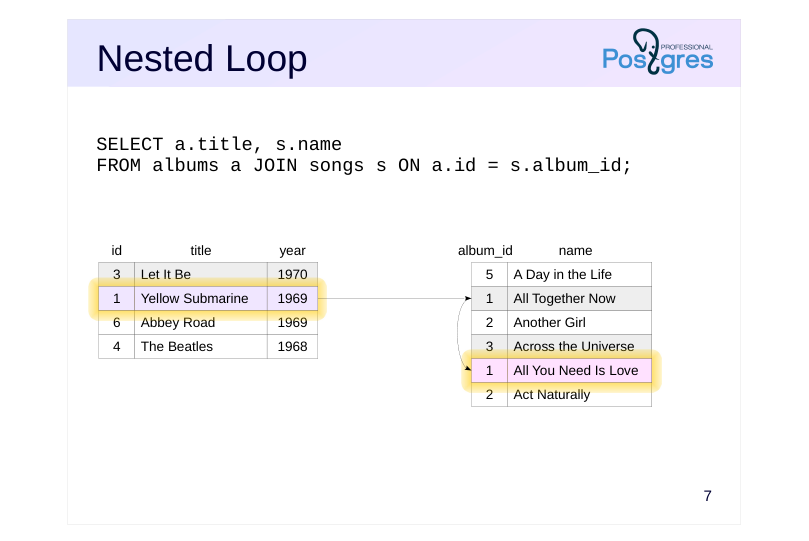 {#source-figure-007 caption=“Source slide page 7: Nested Loop”}
Комментарии преподавателя
…затем вторую пару («Yellow Submarine», «All You Need Is Love»).
Page 8: Nested Loop
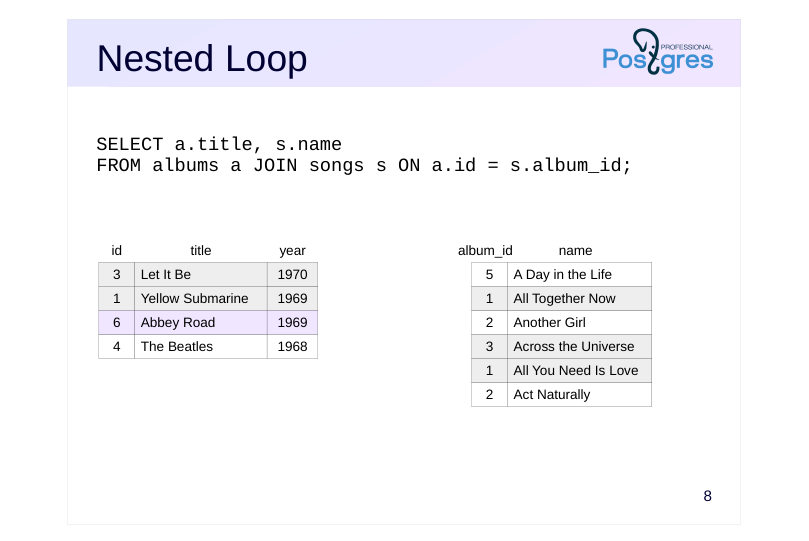 {#source-figure-008 caption=“Source slide page 8: Nested Loop”}
Комментарии преподавателя
Переходим к третьей строке первого набора. Для нее соответствий нет.
Page 9: Nested Loop
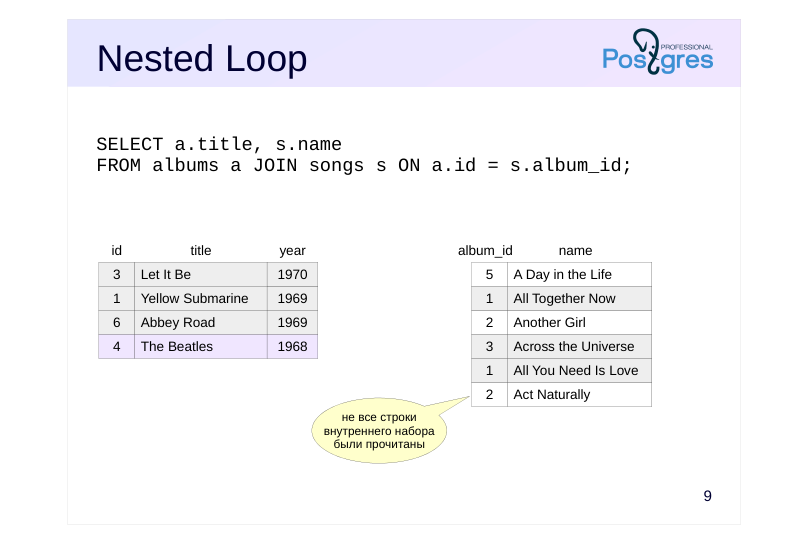 {#source-figure-009 caption=“Source slide page 9: Nested Loop”}
Комментарии преподавателя
Для четвертой строки тоже нет соответствий. На этом работа соединения заканчивается.
Часть строк второго набора мы вообще не рассматривали — на рисунке они остались белыми.
(С исходным кодом алгоритма можно ознакомиться в файле src/backend/executor/nodeNestloop.c.)
Page 10: Соединение вложенным циклом
Так выглядит план для соединения вложенным циклом, которое оптимизатор обычно предпочитает для небольших выборок (смотрим перелеты, включенные в два билета):
Планировщик использует параметризованное соединение. Для каждой строки внешнего набора (узел Index Scan по таблице билетов) выбираются строки из внутреннего набора (узел Index Scan по таблице перелетов), отвечающие условию соединения. На каждой итерации внешнего цикла условие индексного доступа для внутреннего набора имеет вид ticket_no = константа. Процесс повторяется до тех пор, пока внешний набор не исчерпает все строки. Команда EXPLAIN ANALYZE позволяет узнать, сколько раз на самом деле выполнялся вложенный цикл (loops), сколько в среднем было выбрано строк (rows) и сколько потрачено времени (time) за один раз. Видно, что планировщик немного ошибся — в итоге получилось 8 строк вместо 6:
Вот еще один пример соединения вложенным циклом. Здесь мы выводим самолеты, способные обслуживать перелеты заданной протяженности:
Это непараметризованное соединение: для каждой строки внешнего набора придется читать весь внутренний набор (про узел Materialize мы будем говорить позже; в данном случае это просто значения из VALUES) и для полученных пар строк проверять условие Join Filter. По сути, это декартово произведение двух наборов строк с фильтрацией. Обратите внимание, что соединение вложенным циклом позволяет соединять строки по любому условию, не обязательно по равенству значений.
Page 11: Модификации
Существует несколько модификаций алгоритма. Для левого соединения:
Эта модификация возвращает строки, даже если для левого (a) набора строк не нашлось соответствия в правом (s) наборе. Антисоединение возвращает те строки одного набора, для которых не нашлось соответствия в другом наборе. Такая модификация может использоваться для обработки предиката NOT EXISTS:
Та же операция антисоединения используется и для аналогичного запроса, записанного иначе:
Для предиката EXISTS может использоваться полусоединение, которое возвращает строки одного набора, для которых нашлось хотя бы одно соответствие в другом наборе:
Page 12: Page 12
Обратите внимание: хотя в плане для таблицы s указано rows=149, на самом деле достаточно получить всего одну строку, чтобы понять значение предиката EXISTS. PostgreSQL так и делает (actual rows=1):
Модификаций алгоритма вложенного цикла для правого (RIGHT) и полного (FULL) соединений не существует. Это связано с тем, что полный проход по второму набору строк может не выполняться.
Page 13: Мемоизация
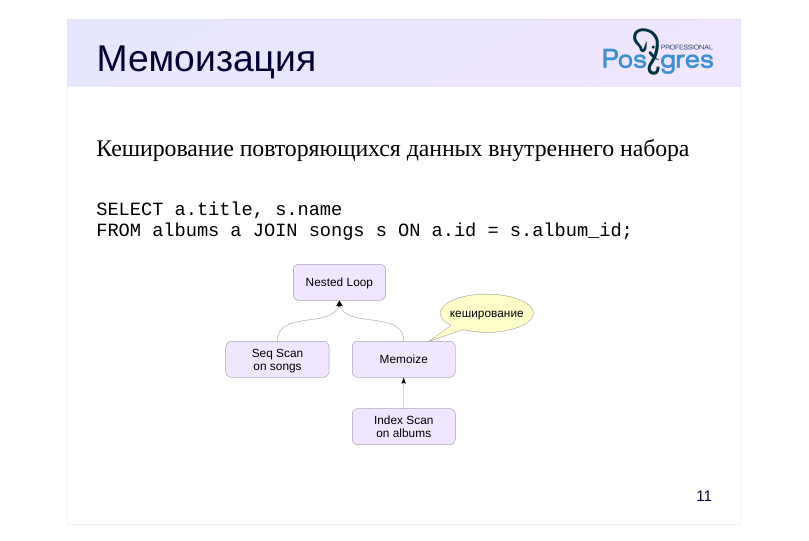 {#source-figure-013 caption=“Source slide page 13: Мемоизация”}
Кеширование повторяющихся данных внутреннего набора
Комментарии преподавателя
Если внутренний набор сканируется много раз с повторяющимися значениями параметров, иногда имеет смысл закешировать результат, чтобы не читать много раз одни и те же данные. Эта операция называется мемоизацией. Она выполняется в узле Memoize, который встраивается между Nested Loop и узлом, поставляющим данные.
(Если планировщик ошибается в своих расчетах, мемоизацию можно отключить, установив параметр enable_memoize в значение off.)
Для кеширования используется хеш-таблица. Ключом хеширования служит параметр или несколько параметров, с которыми выполняется обращение к внутреннему набору.
Page 14: Мемоизация
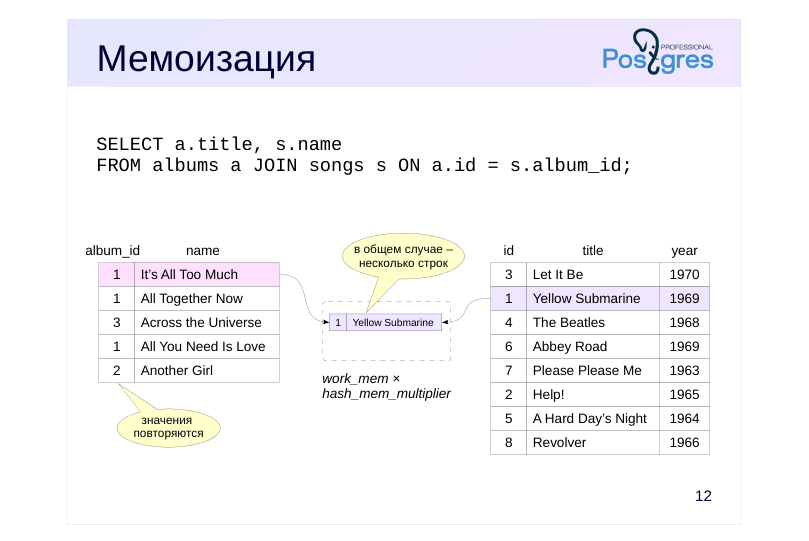 {#source-figure-014 caption=“Source slide page 14: Мемоизация”}
album_id
Комментарии преподавателя
Рассмотрим пример. В отличие от предыдущего, здесь песен меньше, чем альбомов; к тому же, почти все они относятся к одному и тому же альбому.
Если необходимой строки нет в хеш-таблице, узел Memoize читает ее из внутреннего набора, сохраняет в кеше и возвращает родительскому узлу Nested Loop.
В общем случае значению параметра могут соответствовать несколько строк из внутреннего набора — будут закешированы все эти строки. Если все они не помещаются в память (которая ограничена размером work_mem × hash_mem_multiplier), значение параметра игнорируется, поскольку кешировать только часть строк нет смысла. В плане запроса количество таких ситуаций будет показано как overflow.
Page 15: Мемоизация
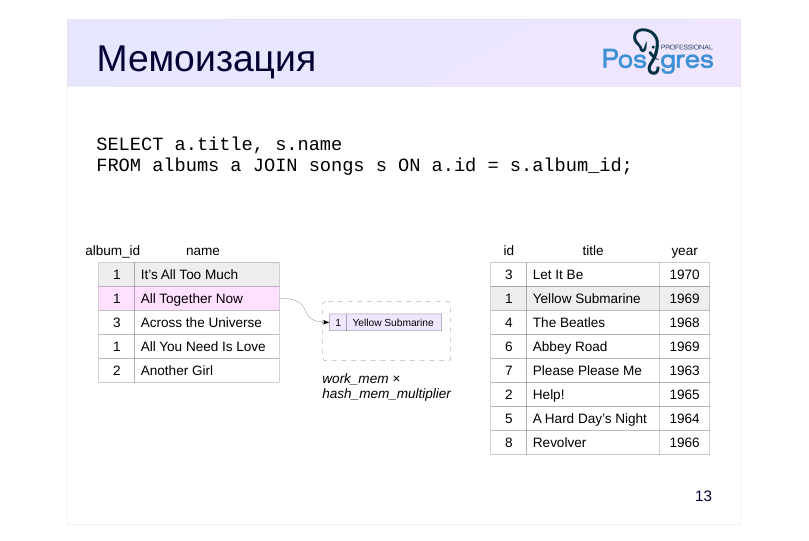 {#source-figure-015 caption=“Source slide page 15: Мемоизация”}
album_id
Комментарии преподавателя
Если необходимая строка уже есть в кеше, узел Memoize сразу возвращает ее узлу Nested Loop. Обращения к внутреннему набору не происходит.
Page 16: Мемоизация
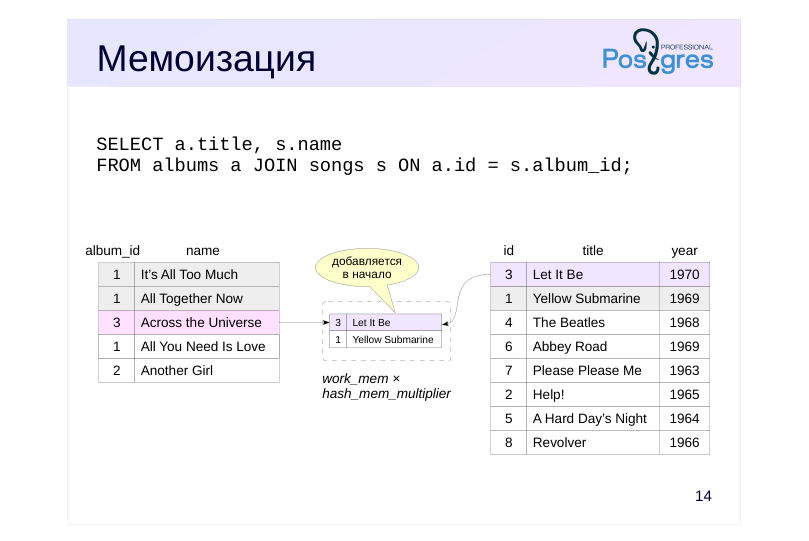 {#source-figure-016 caption=“Source slide page 16: Мемоизация”}
album_id
Комментарии преподавателя
Пока в кеше хватает места, новые значения продолжают кешироваться. При этом новое значение добавляется в начало кеша.
Page 17: Мемоизация
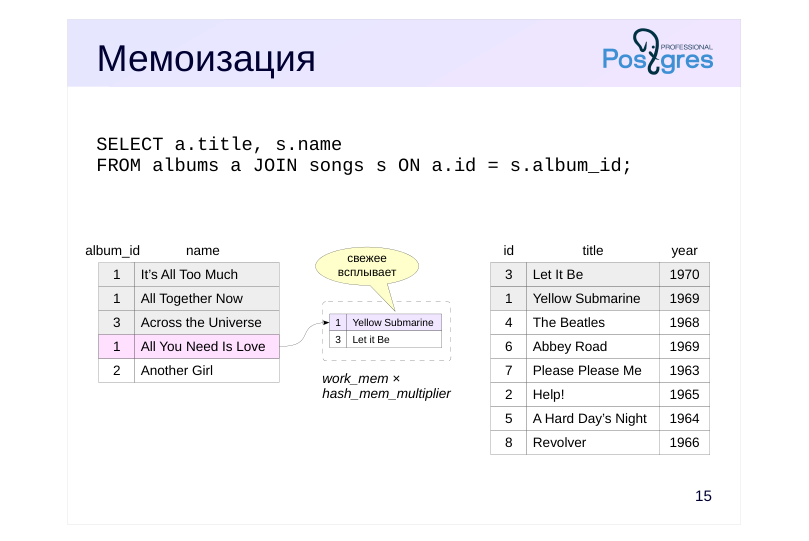 {#source-figure-017 caption=“Source slide page 17: Мемоизация”}
album_id
Комментарии преподавателя
Уже закешированное значение «всплывает наверх», когда к нему обращаются, а остальные, соответственно, опускаются вниз.
Page 18: Мемоизация
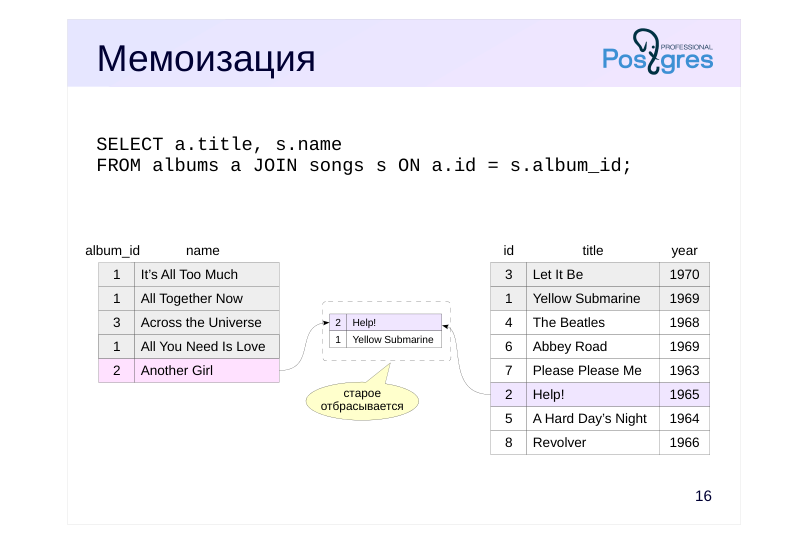 {#source-figure-018 caption=“Source slide page 18: Мемоизация”}
album_id
Комментарии преподавателя
Если память заканчивается, из кеша удаляются «нижние» строки, к которым дольше всего не было обращений. Таким образом реализуется алгоритм вытеснения LRU.
Page 19: Мемоизация
Посмотрим план запроса, в котором соединяются таблицы перелетов и модели самолетов. Пример подобран таким образом, что из внутреннего набора (таблица aircrafts_data) будет получена только одна строка по ключу f.aircraft_code (Cache Key), она и будет закеширована в узле Memoize:
Обратите внимание: в первый раз за нужной строкой приходится сходить в таблицу (Misses: 1); все повторные обращения обслуживаются кешем (Hits: 112), для этого хватило одного килобайта памяти; вытеснений из кеша не было (Evictions: 0); строки, выбранные из внутреннего набора, всегда умещались в выделенную память (Overflows: 0).
Page 20: Вычислительная сложность
~ N × M, где
- N — число строк во внешнем наборе данных,
- M — среднее число строк внутреннего набора,
- приходящееся на одну итерацию
- Соединение эффективно только для небольшого числа строк
Комментарии преподавателя
Если принять за N число строк во внешнем наборе данных, а за M — среднее число строк внутреннего набора, приходящееся на одну итерацию, то общая сложность соединения будет пропорциональна произведению N × M.
Для непараметризованного соединения M будет в точности равно числу строк внутреннего набора; для параметризованного — M может быть значительно меньше.
Метод соединения вложенным циклом эффективен только для небольшого числа строк. В частности, такой метод (в сочетании с индексным доступом) характерен для OLTP-запросов, в которых надо очень быстро вернуть мало строк.
Page 21: Стоимость соединения вложенным циклом
Посмотрим на стоимость следующего плана выполнения:
Первый результат выдается сразу, без предварительных действий, поэтому начальная стоимость узла Nested Loop равна сумме начальных стоимостей дочерних узлов Index Scan. Полная стоимость узла Nested Loop складывается из: стоимости получения данных от внешнего набора (полная стоимость узла Index Scan по билетам); стоимости получения данных от внутреннего набора (полная стоимость узла Index Scan по перелетам), умноженной на расчетное число строк внешнего набора (2); стоимости процессорной обработки строк. В общем случае формула более сложная, но основной вывод: стоимость пропорциональна N × M, где N — число строк во внешнем наборе данных, а M — среднее число строк внутреннего набора, читаемое за одну итерацию. В худшем случае стоимость получается квадратичной.
Page 22: В параллельных планах
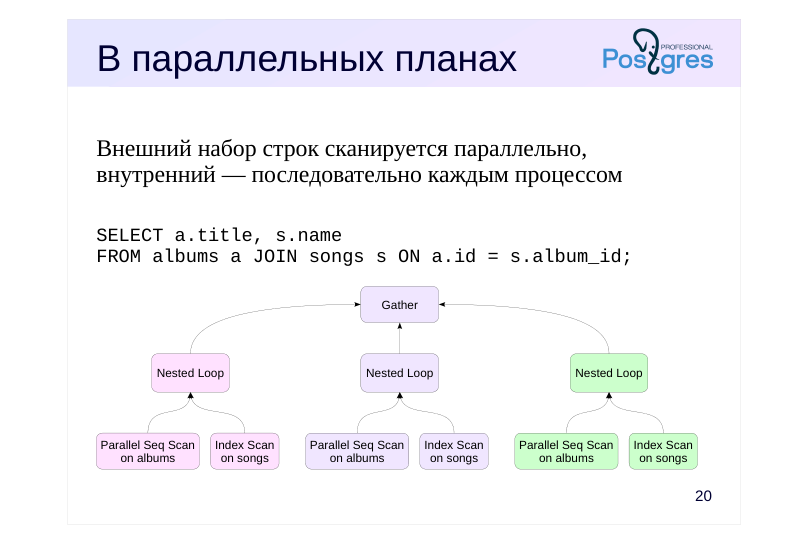 {#source-figure-022 caption=“Source slide page 22: В параллельных планах”}
Внешний набор строк сканируется параллельно, внутренний — последовательно каждым процессом
Комментарии преподавателя
Соединение вложенным циклом может использоваться в параллельных планах.
Внешний набор строк сканируется несколькими рабочими процессами параллельно. Получив строку из внешнего набора, процесс затем перебирает соответствующие ему строки внутреннего набора последовательно.
Page 23: В параллельных планах
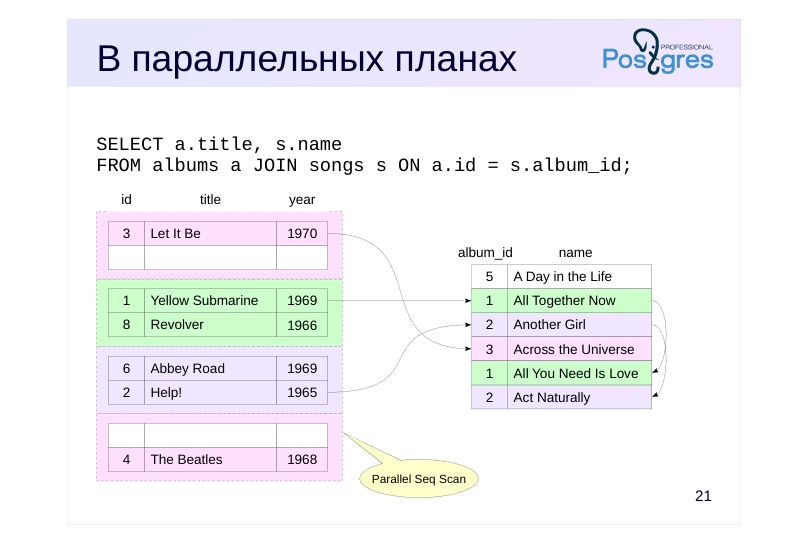 {#source-figure-023 caption=“Source slide page 23: В параллельных планах”}
Комментарии преподавателя
Чтобы получить очередную страницу из внешнего набора, процессы синхронизируются. К внутреннему набору данных каждый процесс обращается независимо от остальных.
Page 24: Вложенный цикл в параллельных планах
Найдем всех пассажиров, купивших билеты на определенный рейс:
На верхнем уровне используется соединение вложенным циклом. Внешний набор данных состоит из одной строки, полученной из таблицы рейсов (flights) по уникальному индексу. Для получения внутреннего набора используется параллельный план. Каждый из процессов читает свою часть таблицы перелетов (ticket_flights) и соединяет ее с билетами (tickets) с помощью другого вложенного цикла.
Page 25: Итоги
Вложенный цикл не требует подготовительных действий
- может отдавать результат соединения без задержек
- Эффективен для небольших выборок
- внешний набор строк не очень велик
- к внутреннему есть эффективный доступ (обычно по индексу)
- Зависит от порядка соединения
- обычно лучше, если внешний набор меньше внутреннего
- Поддерживает соединение по любому условию
- как эквисоединения, так и любые другие
Комментарии преподавателя
Сильной стороной способа соединения вложенными циклами является его простота: не требуется никаких подготовительных действий, мы можем начать возвращать результат практически моментально.
Обратная сторона состоит в том, что этот способ крайне неэффективен для больших объемов данных. Ситуация та же, что и с индексами: чем больше выборка, тем больше накладных расходов.
Таким образом, соединение вложенными циклами имеет смысл применять, если:
● один из наборов строк небольшой;
● к другому набору есть эффективный доступ по условию соединения;
● общее количество строк результата невелико.
Это обычная ситуация для OLTP-запросов (например, запросов от пользовательского интерфейса, где веб-страница или экранная форма должны открыться быстро и не выводят большой объем информации).
Еще одна особенность, которую стоит отметить: соединение вложенными циклами может работать для любого условия соединения. Подходит как эквисоединение (по условию равенства, как в примере), так и любое другое.
Page 26: Практика
- Создайте индекс на таблице рейсов (flights) по аэропортам отправления (departure_airport). Найдите все рейсы из Ульяновска и проверьте план выполнения запроса. 2. Постройте таблицу расстояний между всеми аэропортами (так, чтобы каждая пара встречалась только один раз). Какой способ соединения используется в таком запросе?
Комментарии преподавателя
- Используйте оператор <@> из расширения earthdistance.
Page 27: 1. Рейсы из Ульяновска
Индекс на таблице рейсов:
План запроса:
Планировщик использовал соединение вложенным циклом. Заметим, что в данном случае соединение необходимо, так как в Ульяновске два аэропорта:
2. Таблица расстояний между аэропортами
Чтобы отсечь повторяющиеся пары, можно соединить таблицы по условию «больше»:
Вложенный цикл — единственный способ соединения для такого условия.
09 Занятие 09: Способы соединения / Соединение хешированием
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_09_join_hashjoin.html Archive: QPT-handouts-16.zip Страниц PDF: 36
Page 1: Способы соединения / Соединение хешированием
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Последовательное соединение хешированием: одно-и двухпроходное
- Вычислительная сложность
- Параллельное соединение хешированием: одно-и двухпроходное
Page 3: Хеш-соединение
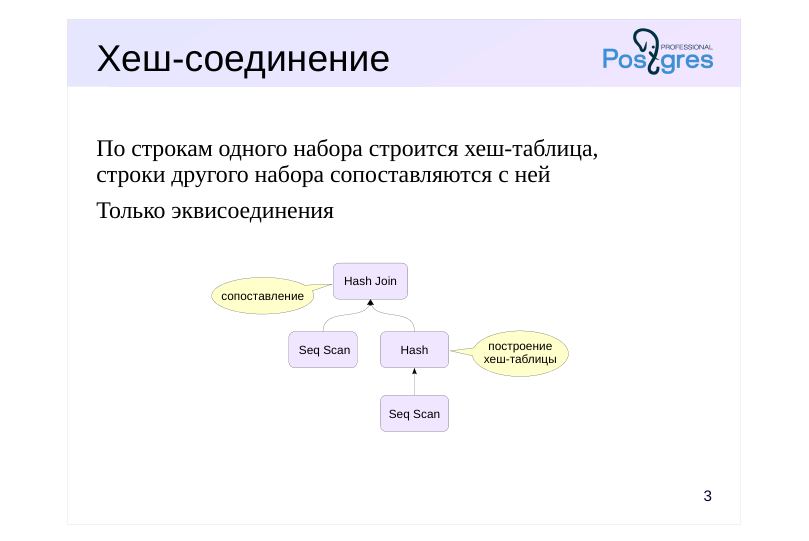 {#source-figure-003 caption=“Source slide page 3: Хеш-соединение”}
По строкам одного набора строится хеш-таблица, строки другого набора сопоставляются с ней
- Только эквисоединения
Комментарии преподавателя
Основную идею хеширования мы рассмотрели в темах «Типы индексов» и «Группировка».
Для соединения хеширование применяется следующим образом. Сначала по одному из наборов в узле Hash строится хеш-таблица. Затем в узле Hash Join строки другого набора сопоставляются с построенной таблицей.
Как и хеш-индекс, хеш-соединение может работать только с условием равенства: хеш-функция не сохраняет порядок значений.
Рассмотрим на примере, как происходит соединение.
Page 4: Однопроходное соединение
Применяется, когда для хеш-таблицы достаточно оперативной памяти
Page 5: Построение хеш-таблицы
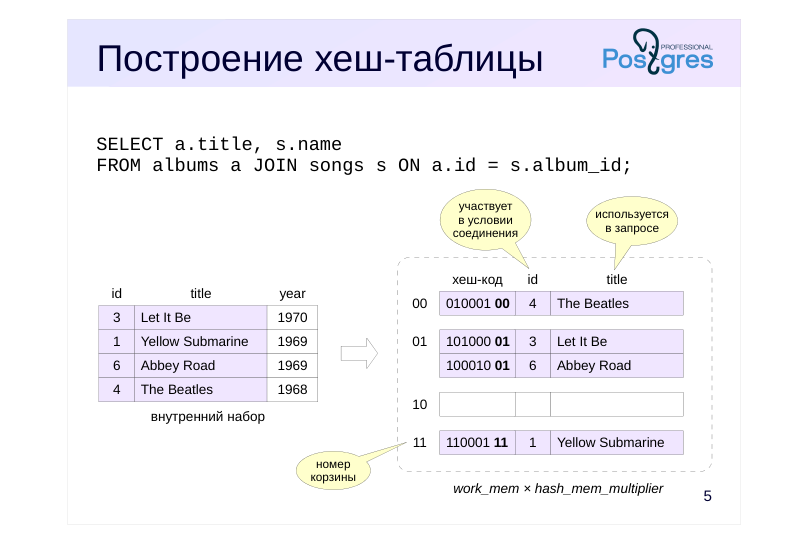 {#source-figure-005 caption=“Source slide page 5: Построение хеш-таблицы”}
Комментарии преподавателя
Первым этапом в памяти строится хеш-таблица.
Строки первого (внутреннего) набора читаются последовательно, и для каждой из них вычисляется хеш-функция от значений полей, входящих в условие соединения (в нашем примере это числовые идентификаторы id).
В корзину хеш-таблицы помещаются вычисленный хеш-код и все поля, которые входят в условие соединения или используются в запросе.
Размер хеш-таблицы в памяти ограничен значением work_mem × × hash_mem_multiplier. Наилучшая эффективность достигается, если вся хеш-таблица помещается в этот объем памяти целиком. Поэтому планировщик обычно выбирает в качестве внутреннего меньший из двух наборов строк. Также стоит не использовать в запросе лишние поля, в том числе «звездочку», чтобы не перегружать хеш-таблицу ненужной информацией.
Page 6: Сопоставление
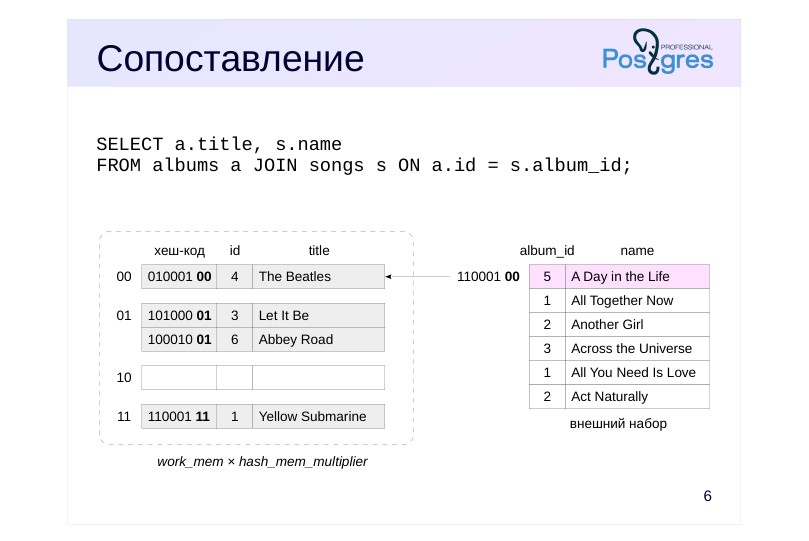 {#source-figure-006 caption=“Source slide page 6: Сопоставление”}
Комментарии преподавателя
На втором этапе мы последовательно читаем второй набор строк. По мере чтения мы вычисляем хеш-функцию от значений полей, участвующих в условии соединения. Если в соответствующей корзине хеш-таблицы обнаруживается строка
с таким же хеш-кодом,
и со значениями полей, подходящими под условие соединения,
то мы нашли пару.
Проверки одного только хеш-кода недостаточно. Во-первых, не все условия соединения, перечисленные в запросе, могут быть учтены при выполнении соединения хешированием (поддерживаются только эквисоединения). Во-вторых, возможны коллизии, при которых разные значения получат одинаковые хеш-коды (вероятность этого мала, но тем не менее она есть).
В нашем примере для первой строки соответствия нет.
Page 7: Сопоставление
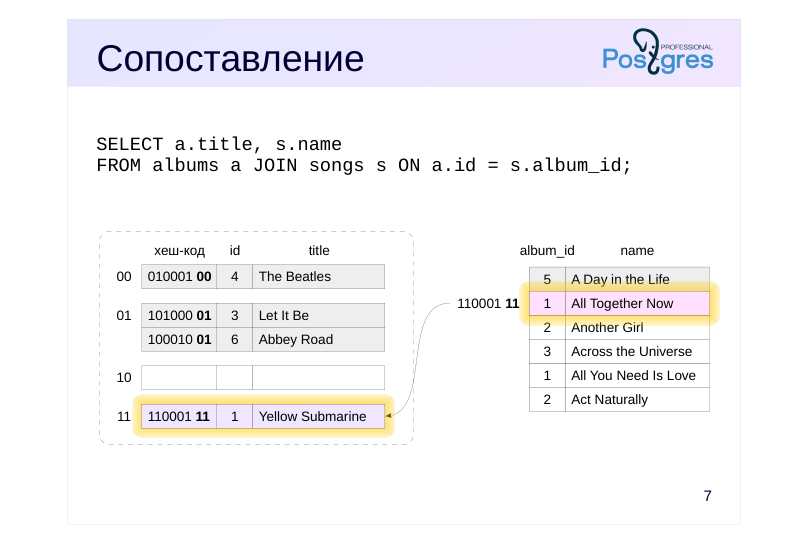 {#source-figure-007 caption=“Source slide page 7: Сопоставление”}
Комментарии преподавателя
Вторая строка второго набора дает соответствие, которое уже можно вернуть вышестоящему узлу плана: («Yellow Submarine», «All Together Now»).
Page 8: Сопоставление
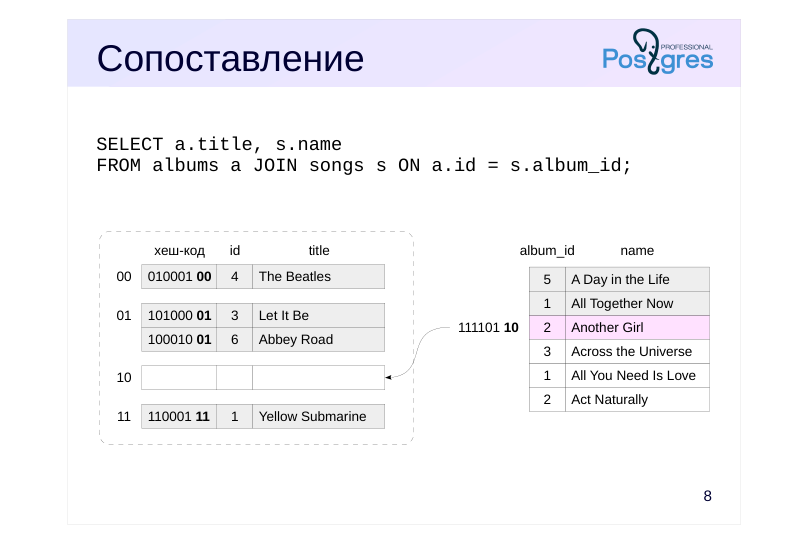 {#source-figure-008 caption=“Source slide page 8: Сопоставление”}
Комментарии преподавателя
Для третьей строки соответствия нет (соответствующая корзина хеш-таблицы пуста).
Page 9: Сопоставление
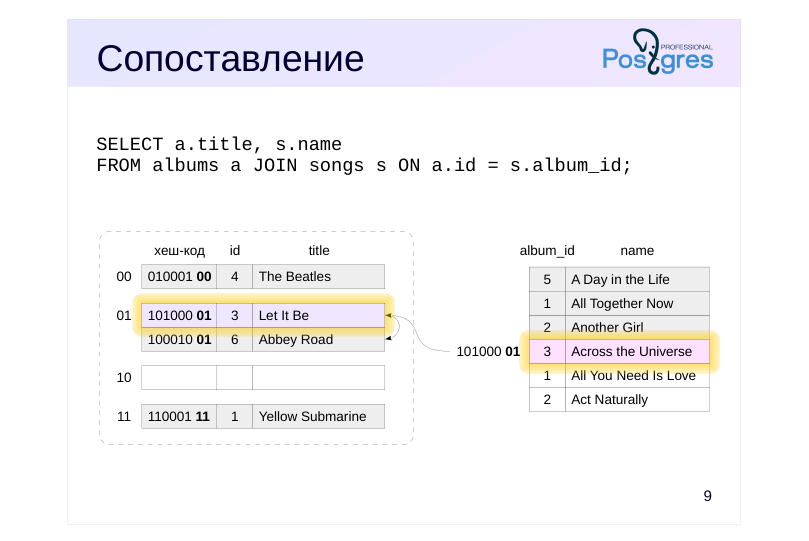 {#source-figure-009 caption=“Source slide page 9: Сопоставление”}
Комментарии преподавателя
Для четвертой получаем соответствие («Let It Be», «Across the Universe»).
Заметим, что в корзине хеш-таблицы оказалось две строки первого набора, и их придется просмотреть обе.
Page 10: Сопоставление
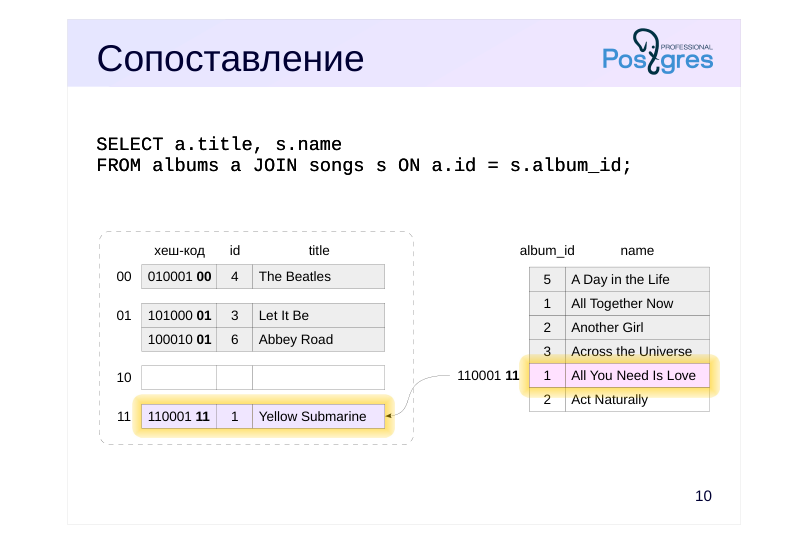 {#source-figure-010 caption=“Source slide page 10: Сопоставление”}
Комментарии преподавателя
Для пятой строки получаем соответствие («Yellow Submarine», «All You Need Is Love»).
Page 11: Сопоставление
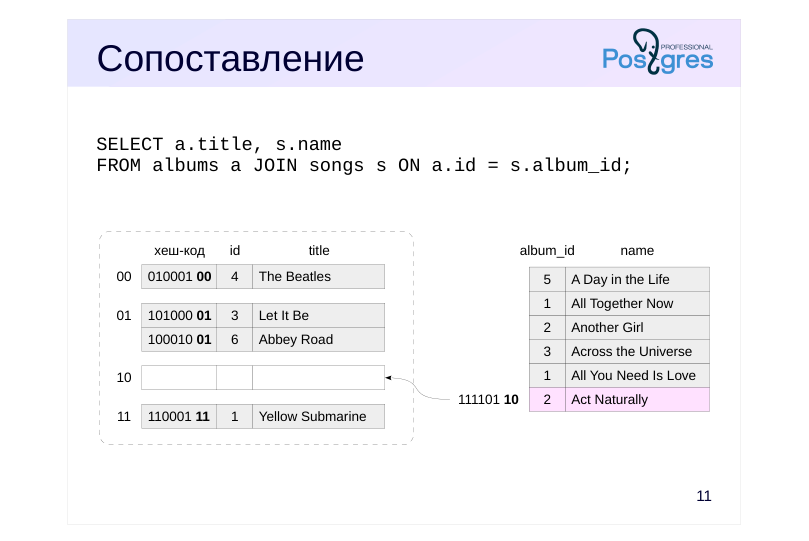 {#source-figure-011 caption=“Source slide page 11: Сопоставление”}
Комментарии преподавателя
Для шестой строки соответствия нет. На этом работа соединения завершена.
Исходный код алгоритма можно найти в файле src/backend/executor/nodeHashjoin.c
Page 12: Однопроходное соединение хешированием
При низкой селективности оптимизатор предпочитает соединение хешированием:
Узел Hash Join начинает работу с того, что обращается к дочернему узлу Hash. Тот получает от своего дочернего узла (здесь — Seq Scan) весь набор строк и строит хеш-таблицу. Затем Hash Join обращается ко второму дочернему узлу и соединяет строки, постепенно возвращая полученные результаты. Проверим, как выполняется этот запрос:
Хеш-таблица поместилась в память (Batches: 1). Параметр Buckets показывает число корзин в хеш-таблице, а Memory Usage — объем использованной оперативной памяти. Обратите внимание, что хеш-таблица строилась по меньшему набору строк. Модификации Hash Join включают уже рассмотренные ранее Left, Semi и Anti, а также Right для правого и Full для полного соединений:
Page 13: Page 13
Обратите внимание, что независимо от того, в каком порядке перечислены таблицы в соединении, хеш-таблица строится по меньшему набору.
Page 14: Двухпроходное соединение
Применяется, когда хеш-таблица не помещается в оперативную память: наборы данных разбиваются на пакеты и последовательно соединяются
Page 15: Построение хеш-таблицы
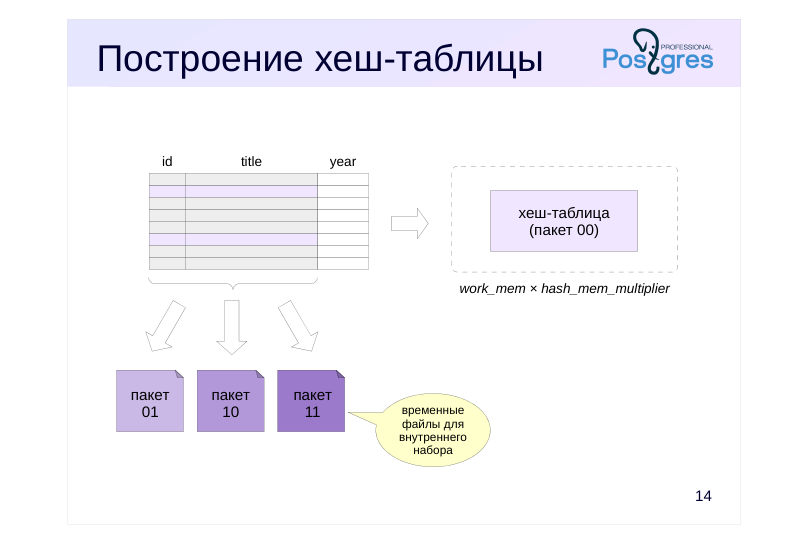 {#source-figure-015 caption=“Source slide page 15: Построение хеш-таблицы”}
Комментарии преподавателя
Если хеш-таблица не помещается в объем памяти, ограниченный work_mem × hash_mem_multiplier, первый (внутренний) набор строк разбивается на отдельные пакеты. Для распределения по пакетам используется некоторое количество битов хеш-кода, поэтому число пакетов всегда является степенью числа 2. В идеале в каждый пакет попадает примерно одинаковое количество строк, но, если значения в строках повторяются, возможен перекос.
При планировании запроса заранее вычисляется минимально необходимое число пакетов так, чтобы хеш-таблица для каждого пакета помещалась в памяти. Это число не уменьшается, даже если оптимизатор ошибся с оценками, но при необходимости может динамически увеличиваться.
Хеш-таблица для первого пакета остается в памяти, а строки, принадлежащие другим пакетам, сбрасываются на диск во временные файлы — каждый пакет в свой файл.
На рисунке показано четыре пакета.
Page 16: name album_id Сопоставление – пакет 1
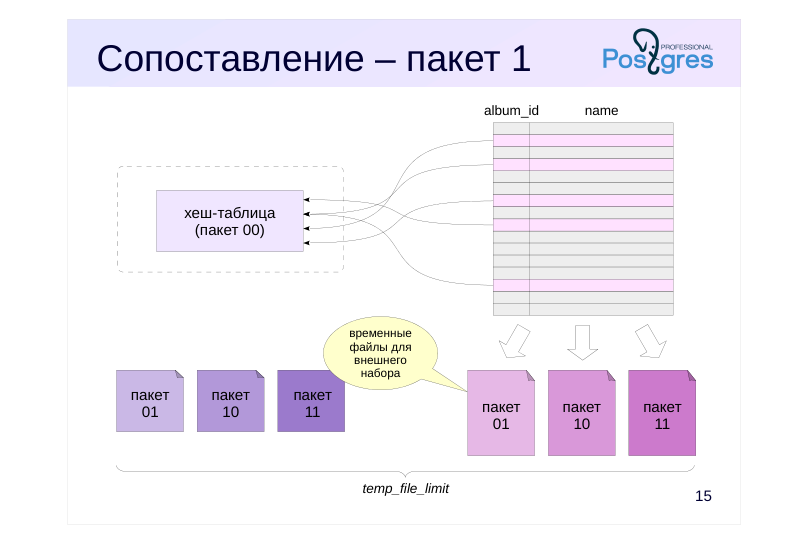 {#source-figure-016 caption=“Source slide page 16: name album_id Сопоставление – пакет 1”}
Комментарии преподавателя
Далее читается второй (внешний) набор строк. Если строка принадлежит первому пакету, она сопоставляется с хеш-таблицей, которая как раз содержит первый пакет. С другими пакетами строку сопоставлять не надо — в них не может найтись соответствие, поскольку хеш-коды заведомо будут отличаться.
Если строка принадлежит другому пакету, она сбрасывается на диск — опять же, каждый пакет в свой временный файл.
Таким образом, при N пакетах используются 2(N–1) файлов.
Следует учитывать, что использование временных файлов на диске ограничивается параметром temp_file_limit, который определяет общий предел дисковой памяти для сеанса. (Буферы временных таблиц в это ограничение не входят.)
Page 17: Сопоставление – пакет 2
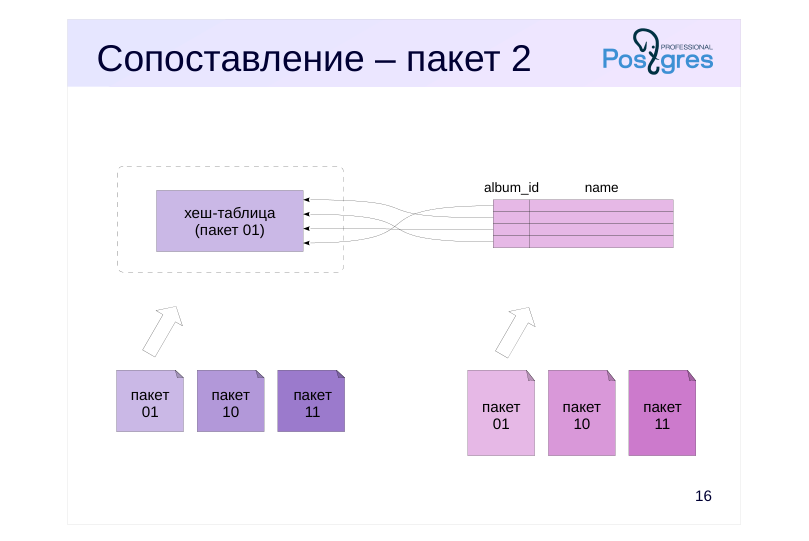 {#source-figure-017 caption=“Source slide page 17: Сопоставление – пакет 2”}
Комментарии преподавателя
Далее по очереди обрабатываются все пакеты, начиная со второго. Из временного файла в хеш-таблицу считываются строки внутреннего набора, затем из другого временного файла считываются строки внешнего набора и сопоставляются с хеш-таблицей.
Процедура повторяется для всех оставшихся N–1 пакетов. На рисунке показано соединение для второго пакета (01).
Page 18: Сопоставление – пакет 3
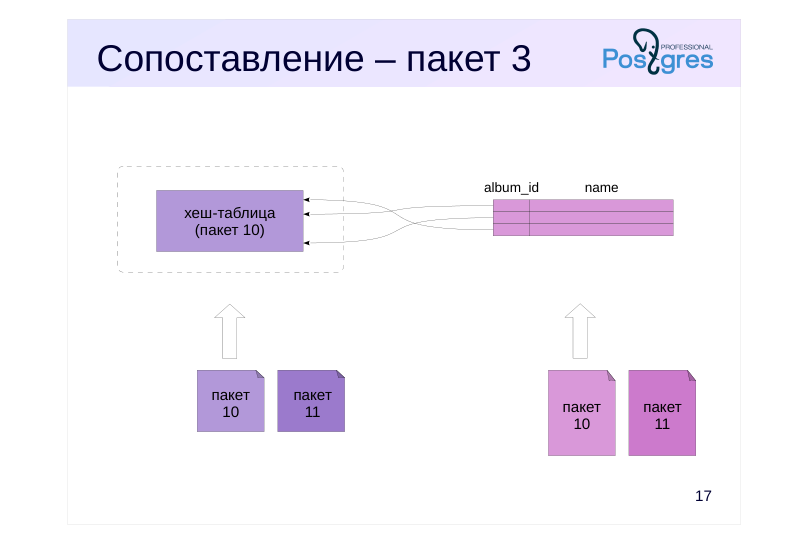 {#source-figure-018 caption=“Source slide page 18: Сопоставление – пакет 3”}
Комментарии преподавателя
На рисунке показано соединение для третьего пакета (10).
Page 19: Сопоставление – пакет 4
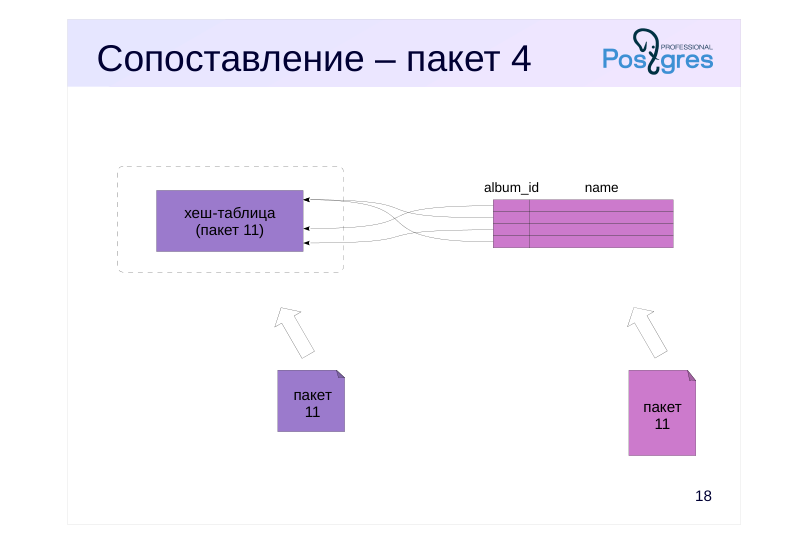 {#source-figure-019 caption=“Source slide page 19: Сопоставление – пакет 4”}
Комментарии преподавателя
После обработки последнего пакета соединение завершено и временные файлы освобождены.
Таким образом, при нехватке оперативной памяти алгоритм соединения становится двухпроходным: каждый пакет (кроме первого) требуется записать на диск и затем прочитать повторно. Разумеется, это сказывается на эффективности соединения. Поэтому важно, чтобы:
● в хеш-таблицу попадали только действительно нужные поля (обязанность автора запроса),
● хеш-таблица строилась по меньшему набору строк (обязанность планировщика).
Page 20: Двухпроходное соединение хешированием
Возьмем теперь большие таблицы и выведем статистику ввода-вывода:
Теперь хеш-таблица не поместилась в память и используется двухпроходное соединение. Потребовалось 32 пакета (Batches). Видно, что узел Hash записывает пакеты во временные файлы (temp written), а узел Hash Join и записывает, и читает (temp read и written). Сравним с таким же запросом, который выводит только одно поле:
Расход памяти уменьшился, так как в хеш-таблице теперь только одно поле (вместо трех), и количество пакетов уменьшилось вдвое.
Page 21: Вычислительная сложность
~ N+M, где
- N и M — число строк в первом и втором наборах данных
- Начальные затраты на построение хеш-таблицы
- Эффективно для большого числа строк
Комментарии преподавателя
Общая сложность соединения хешированием пропорциональна сумме числа строк в одном и другом наборах данных. Поэтому метод соединения хешированием гораздо эффективнее вложенного цикла при большом числе строк.
Однако, чтобы начать соединение, требуется построить хеш-таблицу: из-за этого при небольшом числе строк вложенный цикл более эффективен.
Соединение хешированием (в сочетании с полным сканированием таблиц) характерно для OLAP-запросов, в которых надо обработать большое число строк, причем общая пропускная способность важнее времени отклика.
Page 22: Стоимость хеш-соединения
Начальная стоимость узла Hash Join складывается из стоимостей: получения всего первого набора данных (здесь — билеты); построения хеш-таблицы — пока таблица не готова, соединение не может начаться. Можно обратить внимание на то, что в узле Hash стоимость построения хеш-таблицы не отражена. Полная стоимость добавляет к начальной следующие стоимости: получения всего второго набора данных (здесь — перелеты); проверки по хеш-таблице; обращения к диску в случае, когда предполагается использование более одного пакета. Главный вывод: стоимость хеш-соединения пропорциональна N + M, где N и M — число строк в соединяемых наборах данных. При больших N и M это значительно выгоднее, чем произведение в случае соединения вложенным циклом.
Page 23: Параллельный алгоритм
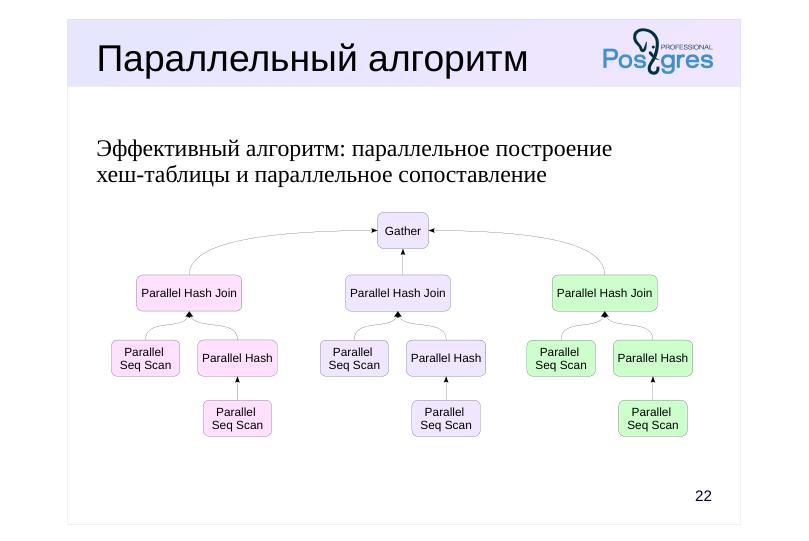 {#source-figure-023 caption=“Source slide page 23: Параллельный алгоритм”}
Эффективный алгоритм: параллельное построение хеш-таблицы и параллельное сопоставление
Комментарии преподавателя
В отличие от других способов соединения, хеш-соединение не только может участвовать в параллельных планах, но и имеет отдельный эффективный алгоритм работы. Этот алгоритм позволяет параллельно выполнять оба этапа соединения: и построение хеш-таблицы по первому (внутреннему) набору строк, и сопоставление с ней строк второго (внешнего) набора.
Возможность параллельного хеш-соединения управляется параметром enable_parallel_hash; по умолчанию параметр включен.
Как и у последовательного алгоритма, у параллельного есть два варианта: однопроходный при достаточном количестве оперативной памяти и двухпроходный.
Начнем с однопроходного варианта.
Page 24: Параллельно, один проход
Процессы используют общую хеш-таблицу
Page 25: Построение хеш-таблицы
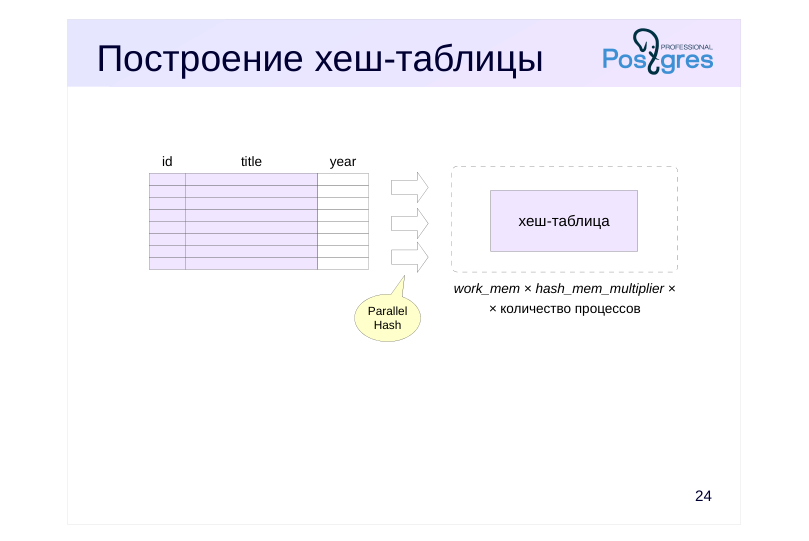 {#source-figure-025 caption=“Source slide page 25: Построение хеш-таблицы”}
Комментарии преподавателя
Однопроходный алгоритм используется, если хеш-таблица помещается в суммарный объем памяти, выделенный всем участвующим в соединении процессам, то есть размер хеш-таблицы ограничен значением work_mem × hash_mem_multiplier × количество процессов.
Процессы параллельно читают первый набор строк (например, используя узел Parallel Seq Scan) и строят общую хеш-таблицу в разделяемой памяти, где каждый из них имеет к ней доступ.
Page 26: name album_id Сопоставление
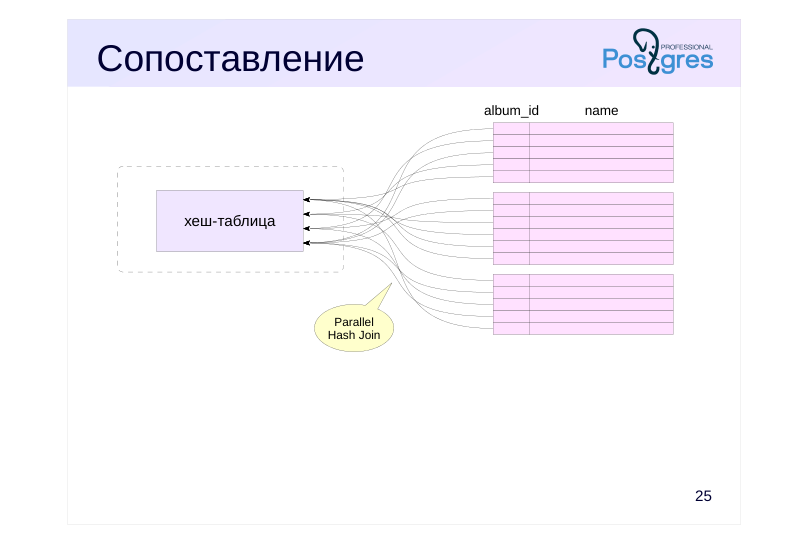 {#source-figure-026 caption=“Source slide page 26: name album_id Сопоставление”}
Комментарии преподавателя
После того, как хеш-таблица полностью построена, рабочие процессы приступают к параллельному чтению второго набора и сопоставляют прочитанные ими строки с общей хеш-таблицей. Таким образом, каждый из процессов проверяет по хеш-таблице только часть данных.
Page 27: Однопроходное параллельное хеш-соединение
Увеличим объем памяти, выделяемый процессу для построения хеш-таблицы:
Выполним запрос с агрегацией:
Обратите внимание на использование памяти (Memory Usage): объем превышает ограничение, установленное для одного рабочего процесса (64MB = work_mem × hash_mem_multiplier), но в общую память трех процессов хеш-таблица помещается. Поэтому выполняется однопроходное соединение (Batches: 1).
Page 28: Параллельно, два прохода
Наборы строк разбиваются на пакеты, которые затем параллельно обрабатываются рабочими процессами
Page 29: Разбиение на пакеты
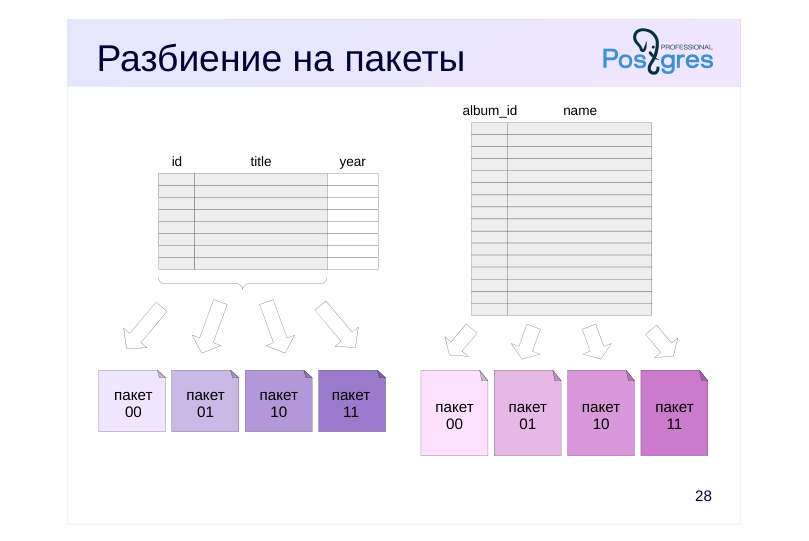 {#source-figure-029 caption=“Source slide page 29: Разбиение на пакеты”}
Комментарии преподавателя
Хеш-таблица может не поместиться в объем памяти, ограниченный work_mem × hash_mem_multiplier × количество процессов, причем это может выясниться и на этапе выполнения соединения. В этом случае используется двухпроходный алгоритм, который существенно отличается и от двухпроходного последовательного, и от однопроходного параллельного.
Сначала рабочие процессы параллельно читают первый набор данных, разбивают его на пакеты и записывают пакеты во временные файлы. Первый пакет тоже попадает в файл; хеш-таблица в памяти не строится.
Обратите внимание, что каждый процесс записывает строки во все временные файлы; запись синхронизируется.
Затем рабочие процессы параллельно читают второй набор данных и также разбивают его на пакеты и записывают во временные файлы.
Таким образом, при N пакетах на диск записываются 2N файлов.
Page 30: Сопоставление
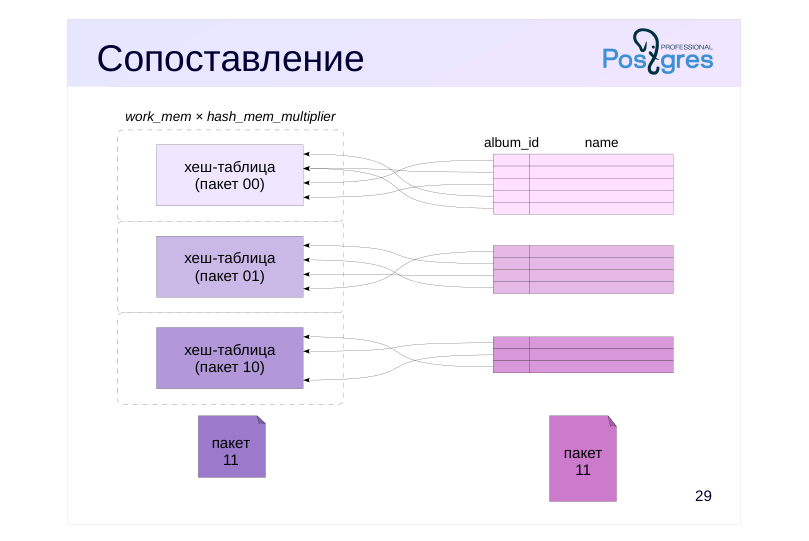 {#source-figure-030 caption=“Source slide page 30: Сопоставление”}
Комментарии преподавателя
Затем каждый рабочий процесс выбирает себе по одному пакету.
Процесс загружает первый набор выбранного пакета в хеш-таблицу в памяти. В этом алгоритме у каждого процесса своя хеш-таблица размером work_mem × hash_mem_multiplier, но располагаются они в общей памяти, то есть доступ к каждой таблице есть у всех рабочих процессов.
После заполнения хеш-таблицы процесс читает второй набор выбранного пакета и сопоставляет строки.
Когда процесс завершает обработку одного пакета, он выбирает следующий, еще не обработанный.
Page 31: Сопоставление
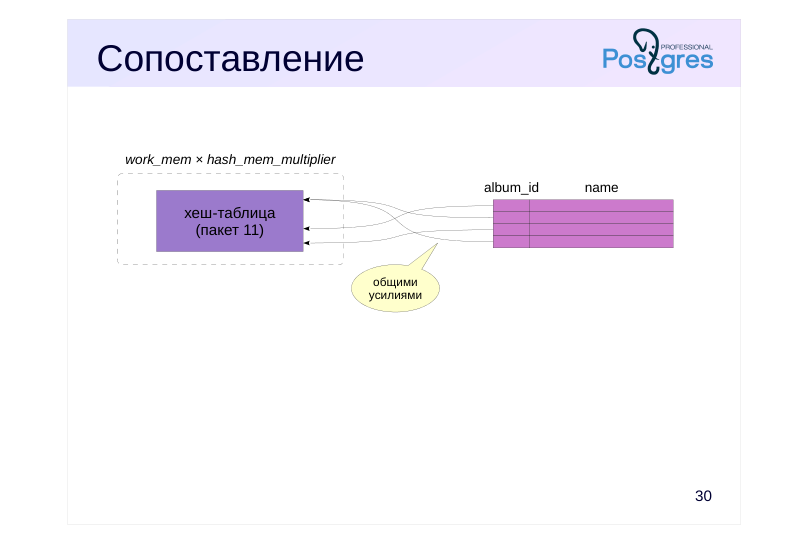 {#source-figure-031 caption=“Source slide page 31: Сопоставление”}
Комментарии преподавателя
Когда необработанные пакеты заканчиваются, освободившийся процесс подключается к обработке одного из еще не завершенных пакетов, пользуясь тем, что все хеш-таблицы находятся в разделяемой памяти.
Несколько хеш-таблиц работают лучше, чем одна большая: в этом случае проще организовать совместную работу и меньше ресурсов тратится на синхронизацию.
Page 32: Двухпроходное параллельное хеш-соединение
Теперь уменьшим объем памяти:
Выполним тот же запрос с агрегацией:
Соединение стало двухпроходным с четырьмя пакетами.
Page 33: Итоги
Соединение хешированием требует подготовки
- надо построить хеш-таблицу
- Эффективно для больших выборок
- в том числе есть возможность параллельного соединения
- Зависит от порядка соединения
- внутренний набор должен быть меньше внешнего,
- чтобы минимизировать хеш-таблицу
- Поддерживает только эквисоединения
- для хеш-кодов операторы «больше» и «меньше» не имеют смысла
Комментарии преподавателя
В отличие от соединения вложенным циклом, хеш-соединение требует подготовки: построения хеш-таблицы. Пока таблица не построена, ни одна результирующая строка не может быть получена.
Зато соединение хешированием эффективно работает на больших объемах данных. Оба набора строк читаются последовательно и только один раз (два раза в случае нехватки оперативной памяти).
Ограничением соединения хеширования является поддержка только эквисоединений. Дело в том, что хеш-значения можно сравнивать только на равенство, операции «больше» и «меньше» просто не имеют смысла.
Page 34: Практика
- Напишите запрос, показывающий занятые места в салоне для всех рейсов. Какой способ соединения выбрал планировщик? Проверьте, хватило ли оперативной памяти для размещения хеш-таблиц. 2. Измените запрос, чтобы он выводил только общее количество занятых мест. Как изменился план запроса? Почему планировщик не использовал аналогичный план для предыдущего запроса? 3. Напишите запрос, показывающий имена пассажиров и номера рейсов, которыми они следуют. Разберитесь по плану запроса, в какой последовательности выполняются операции.
Комментарии преподавателя
Для этого достаточно соединить рейсы (flights) с посадочными талонами (boarding_passes).
Такой запрос должен соединять три таблицы: билеты (tickets), перелеты (ticket_flights) и рейсы (flights).
Page 35: 1. Список занятых мест
Использовано соединение хешированием.
Хеш-таблица не поместилась целиком в память, потребовалось два пакета.
2. Количество занятых мест
Здесь планировщик использовал параллельный план. В предыдущем запросе это не было оправдано из-за высокой стоимости пересылки данных между процессами, а в данном случае передается только одно число.
Page 36: Page 36
Обратите внимание на поле loops в узлах выше и ниже Gather — оно соответствует реальному числу процессов, работавших над запросом.
3. Пассажиры и номера рейсов
Сначала выполняется соединение билетов (tickets) с перелетами (ticket_flights), причем хеш-таблица строится по таблице билетов. Затем рейсы (flights) соединяются с результатом первого соединения; хеш-таблица строится по таблице рейсов.
10 Занятие 10: Способы соединения / Соединение слиянием
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_10_join_mergejoin.html Archive: QPT-handouts-16.zip Страниц PDF: 25
Page 1: Способы соединения / Соединение слиянием
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Алгоритм соединения слиянием
- Вычислительная сложность
- Соединение слиянием в параллельных планах
Page 3: Соединение слиянием
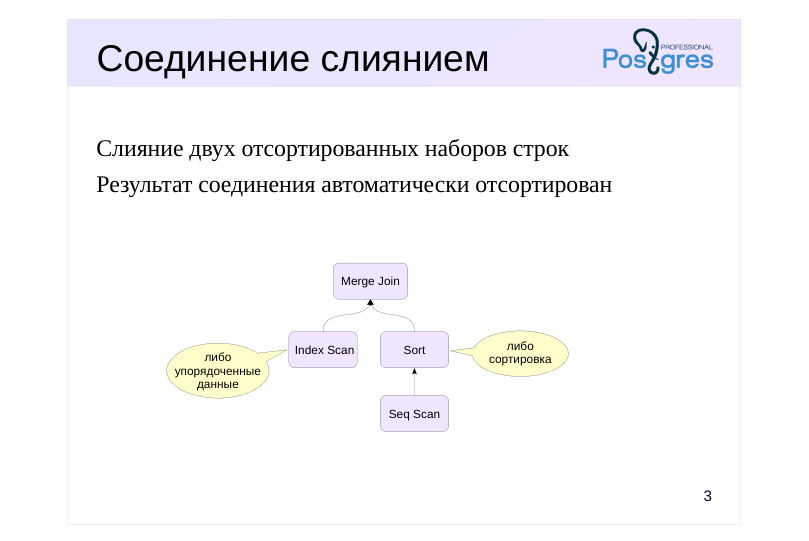 {#source-figure-003 caption=“Source slide page 3: Соединение слиянием”}
Слияние двух отсортированных наборов строк
- Результат соединения автоматически отсортирован
Комментарии преподавателя
Третий, и последний, способ соединения — соединение слиянием.
Идея этого способа состоит в том, что два предварительно отсортированных набора данных нетрудно объединить в один общий — и точно так же отсортированный — набор. Похожим образом работает узел Gather Merge.
Подготовительным этапом для соединения слиянием служит сортировка обоих наборов строк. Сортировка — дорогая операция, она имеет сложность O(N log N).
Но иногда этого этапа удается избежать, если можно сразу получить отсортированные по нужным столбцам наборы строк, например, за счет индексного доступа к таблице.
Page 4: Слияние
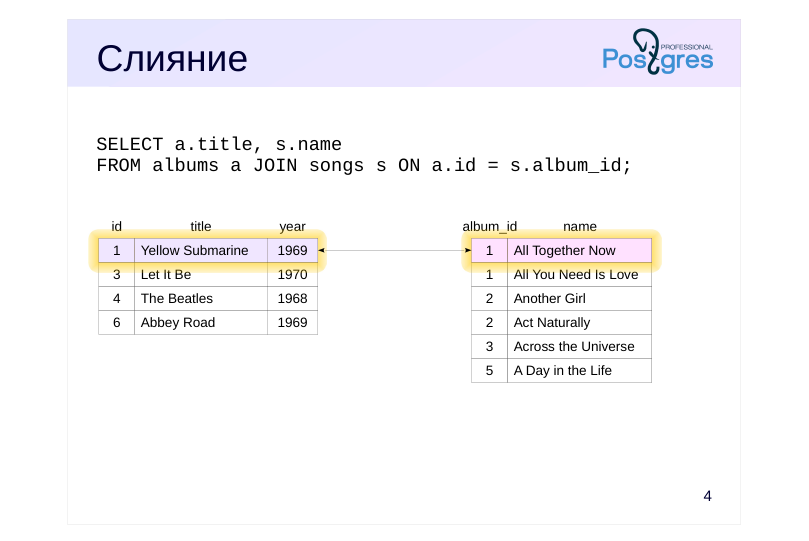 {#source-figure-004 caption=“Source slide page 4: Слияние”}
Комментарии преподавателя
Само слияние устроено просто. Сначала берем первые строки обоих наборов и сравниваем их между собой. В данном случае мы сразу нашли соответствие и можем вернуть первую строку результата: («Yellow Submarine», «All Together Now»).
Общий алгоритм таков: читаем следующую строку того набора, для которого значение поля, по которому происходит соединение, меньше (один набор «догоняет» другой). Если же значения одинаковы, как в нашем примере, то читаем следующую строку второго (внутреннего) набора.
Page 5: Слияние
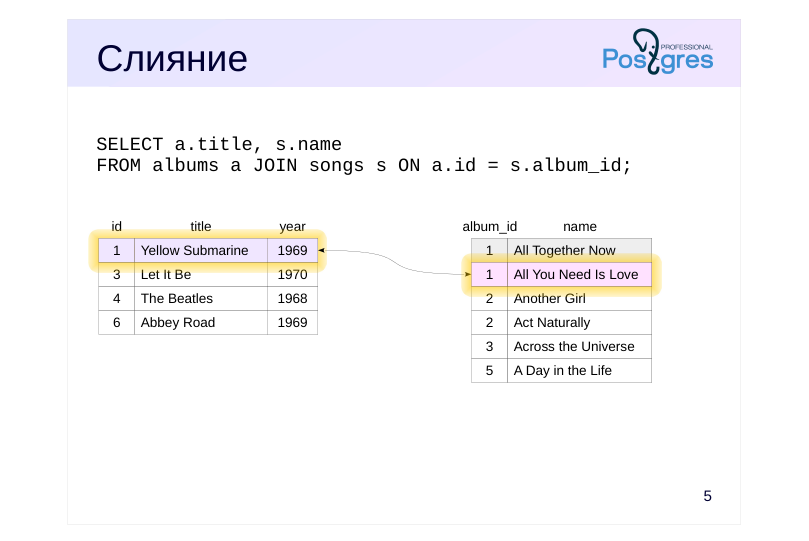 {#source-figure-005 caption=“Source slide page 5: Слияние”}
Комментарии преподавателя
Вновь соответствие: («Yellow Submarine», «All You Need Is Love»).
Снова читаем следующую строку второго набора.
Page 6: Слияние
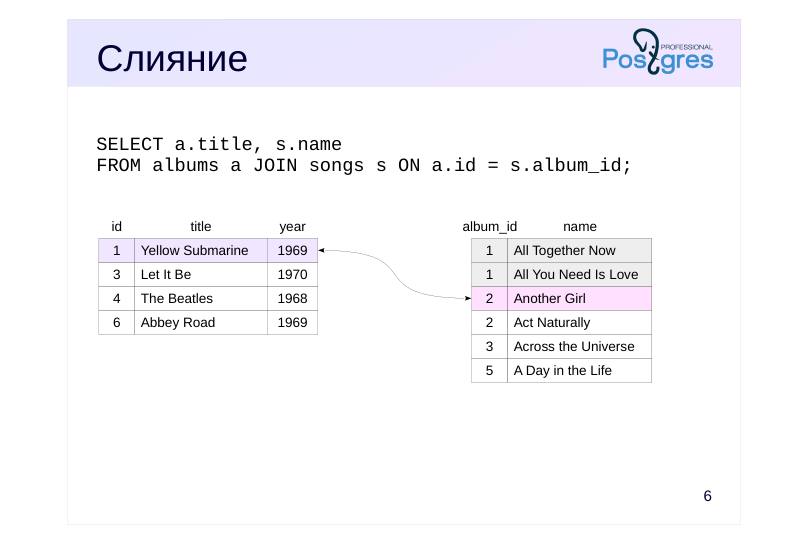 {#source-figure-006 caption=“Source slide page 6: Слияние”}
Комментарии преподавателя
В данном случае соответствия нет.
Поскольку 1 < 2, читаем следующую строку первого набора.
Page 7: Слияние
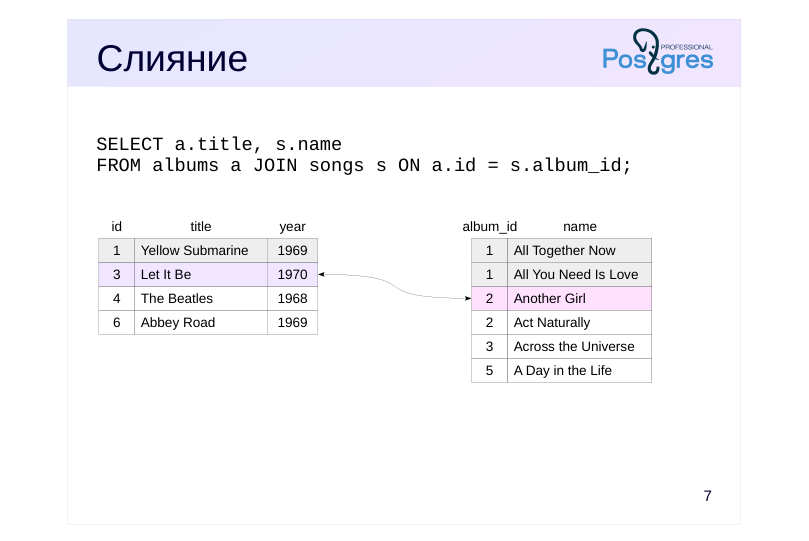 {#source-figure-007 caption=“Source slide page 7: Слияние”}
Комментарии преподавателя
Соответствия нет.
3 > 2, поэтому читаем следующую строку второго набора.
Page 8: Слияние
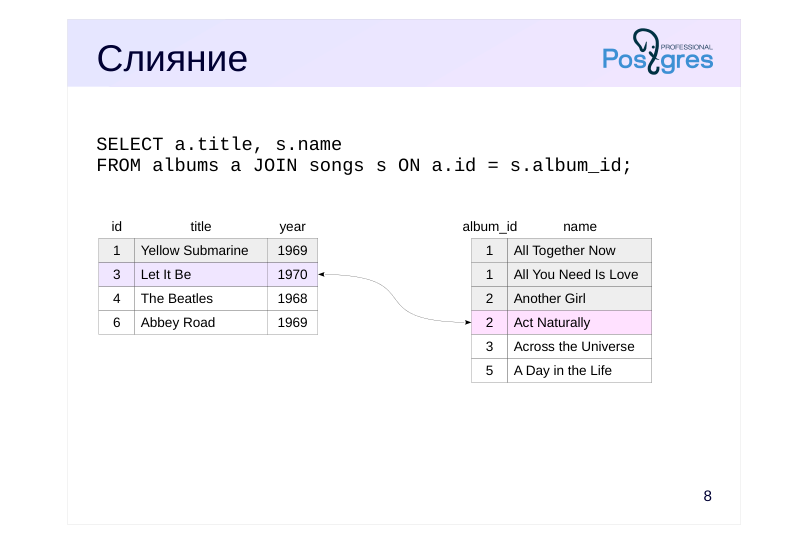 {#source-figure-008 caption=“Source slide page 8: Слияние”}
Комментарии преподавателя
Снова нет соответствия, снова 3 > 2, снова читаем строку второго набора.
Page 9: Слияние
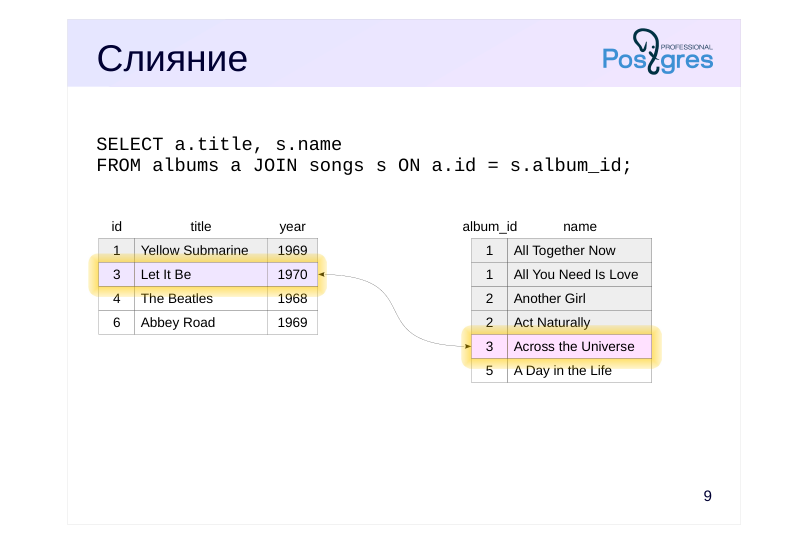 {#source-figure-009 caption=“Source slide page 9: Слияние”}
Комментарии преподавателя
Есть соответствие: («Let It Be», «Across the Universe»).
3 = 3, читаем следующую строку второго набора.
Page 10: Слияние
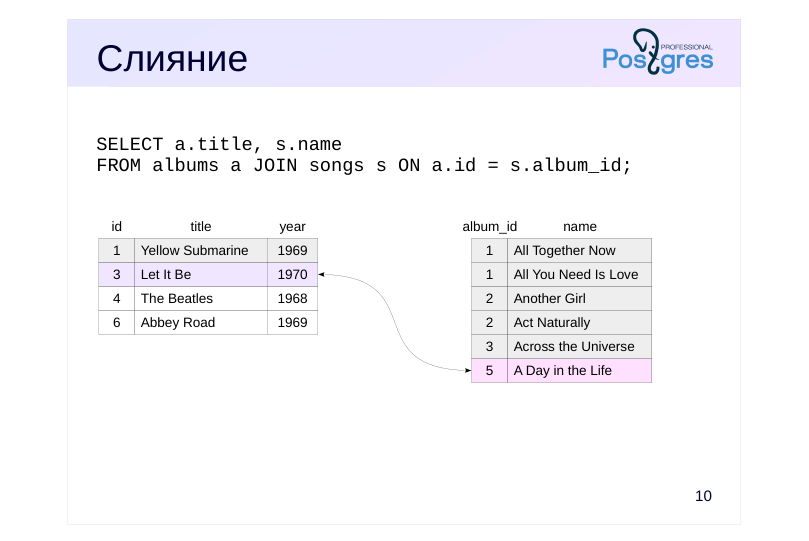 {#source-figure-010 caption=“Source slide page 10: Слияние”}
Соответствия нет. 3 < 5, читаем строку первого набора.
Page 11: Слияние
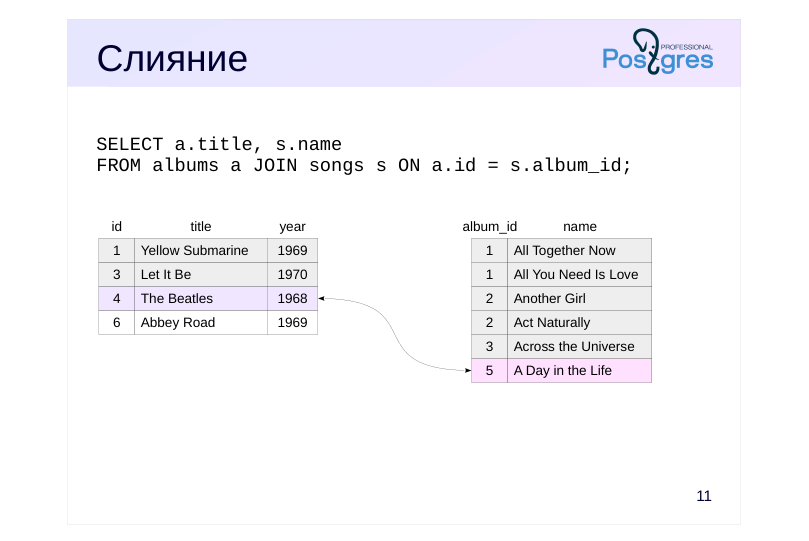 {#source-figure-011 caption=“Source slide page 11: Слияние”}
Соответствия нет. 4 < 5, читаем строку первого набора.
Page 12: Слияние
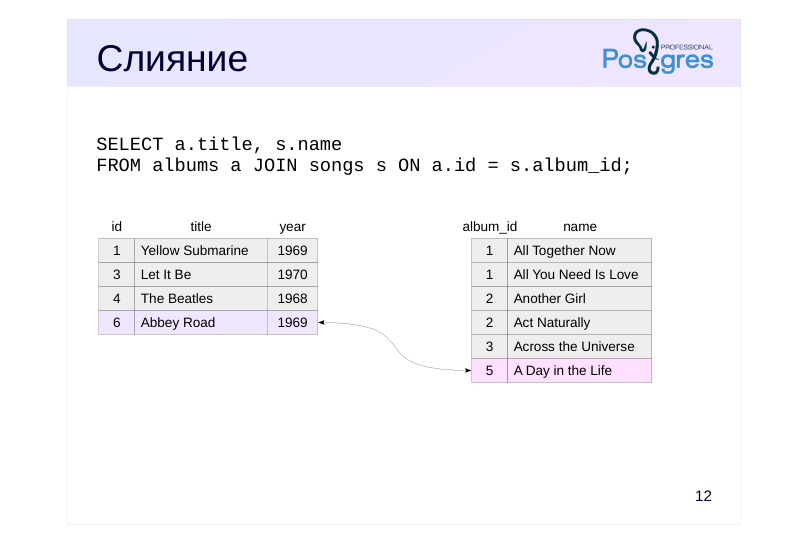 {#source-figure-012 caption=“Source slide page 12: Слияние”}
Комментарии преподавателя
И последний шаг: снова нет соответствия.
На этом соединение слиянием окончено.
На самом деле алгоритм сложнее — если в первом (внешнем) наборе строк встречается несколько одинаковых значений, нужно иметь возможность перечитать строки второго (внутреннего) набора с тем же ключом соединения.
Псевдокод алгоритма можно посмотреть в файле src/backend/executor/nodeMergejoin.c.
Важно, что алгоритм слияния возвращает результат соединения в отсортированном виде. В частности, полученный набор строк можно использовать для следующего соединения слиянием без дополнительной сортировки.
Page 13: Соединение слиянием
Если результат необходим в отсортированном виде, оптимизатор может предпочесть соединение слиянием. Особенно, если данные от дочерних узлов можно получить уже отсортированными — как в этом примере:
Вот еще один пример с двумя соединениями слиянием, в котором один узел Merge Join получает отсортированный набор от другого узла Merge Join:
Здесь соединяются перелеты (ticket_flights) и посадочные талоны (boarding_passes), и с этим, уже отсортированным по номерам билетов, набором строк соединяются билеты (tickets). Для Merge Join также существуют модификации Left, Right, Semi, Anti и Full. В настоящее время соединение слиянием поддерживает только эквисоединения, соединения по операциям «больше» или «меньше» не реализованы. Таким образом, модификация Full существует только для соединений хешированием и слиянием, и оба варианта работают только с условием равенства. Если пренебречь производительностью, полное соединение можно получить, объединив результаты левого соединения и антисоединения — таким вариантом придется воспользоваться, если потребуется полное соединение по иному условию.
Page 14: Вычислительная сложность
~ N+M, где
- N и M — число строк в первом и втором наборах данных,
- если не требуется сортировка
- ~ N log N+M log M,
- если сортировка нужна
- Возможные начальные затраты на сортировку
- Эффективно для большого числа строк
Комментарии преподавателя
В случае, когда не требуется сортировать данные, общая сложность соединения слиянием пропорциональна сумме числа строк в обоих наборах данных. Но, в отличие от соединения хешированием, здесь не требуются накладные расходы на построение хеш-таблицы.
Поэтому соединение слиянием может успешно применяться как в OLTP-, так и в OLAP-запросах.
Однако если сортировка требуется, то стоимость становится пропорциональной произведению количества строк на логарифм этого количества, и на больших объемах такой способ скорее всего проиграет соединению хешированием.
Page 15: Вычислительная сложность
Посмотрим на стоимость соединения слиянием:
Начальная стоимость включает: сумму начальных стоимостей дочерних узлов (включает стоимость сортировки, если она необходима); стоимость получения первой пары строк, соответствующих друг другу. Полная стоимость добавляет к начальной: сумму стоимостей получения обоих наборов данных; стоимость сравнения строк. Общий вывод: стоимость соединения слиянием пропорциональна N + M (где N и M — число соединяемых строк), если не требуется отдельная сортировка. Сортировка набора из K строк добавляет к оценке как минимум K × log(K). В отличие от соединения хешированием, слияние без сортировки хорошо подходит для случая, когда надо быстро получить первые строки.
Обратите внимание и на то, как уменьшилась общая стоимость.
Page 16: В параллельных планах
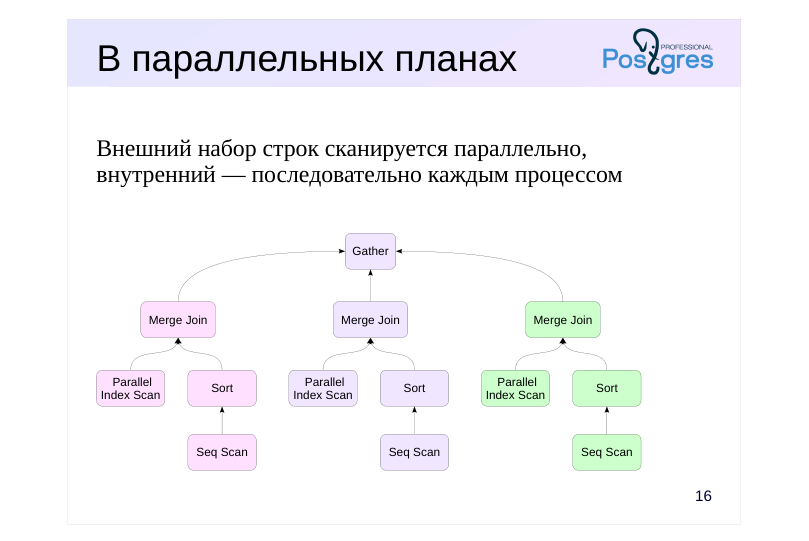 {#source-figure-016 caption=“Source slide page 16: В параллельных планах”}
Внешний набор строк сканируется параллельно, внутренний — последовательно каждым процессом
Комментарии преподавателя
Соединение слиянием может использоваться в параллельных планах.
Так же, как и при соединении вложенным циклом, сканирование одного набора строк выполняется рабочими процессами параллельно, но другой набор строк каждый рабочий процесс читает полностью самостоятельно. Поэтому при соединении больших объемов строк в параллельных планах гораздо чаще используется соединение хешированием, имеющее эффективный параллельный алгоритм.
Page 17: В параллельных планах
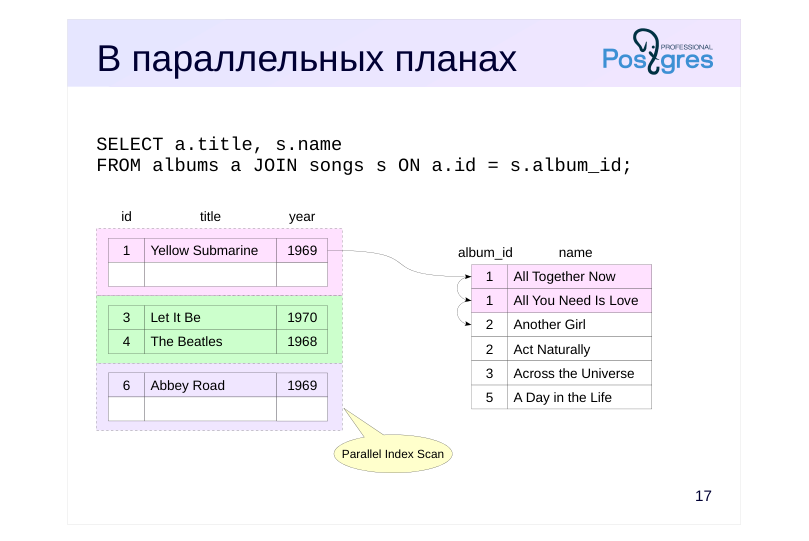 {#source-figure-017 caption=“Source slide page 17: В параллельных планах”}
Комментарии преподавателя
Внутренний набор данных будет просканирован каждым из рабочих процессов от начала и до того момента, как станет понятно, что больше нет соответствий.
На этом слайде показаны строки, перебираемые первым процессом.
Page 18: В параллельных планах
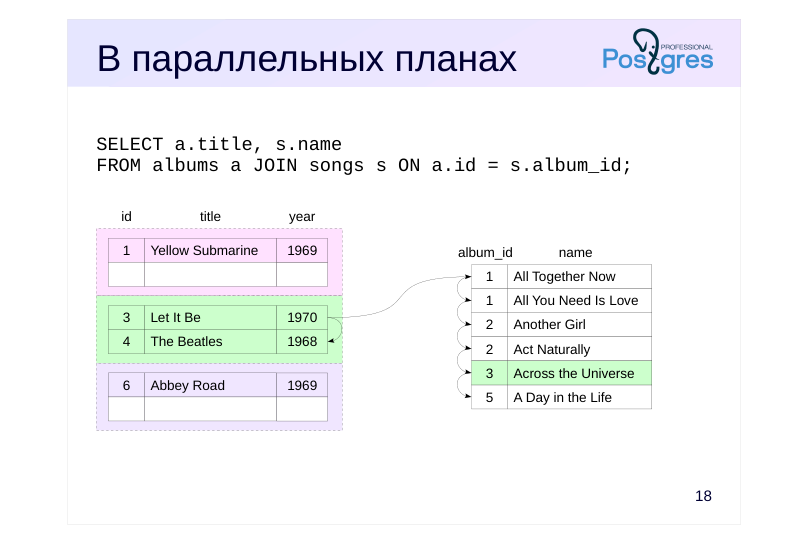 {#source-figure-018 caption=“Source slide page 18: В параллельных планах”}
Комментарии преподавателя
Второй процесс просканирует весь набор и найдет одно соответствие.
Page 19: В параллельных планах
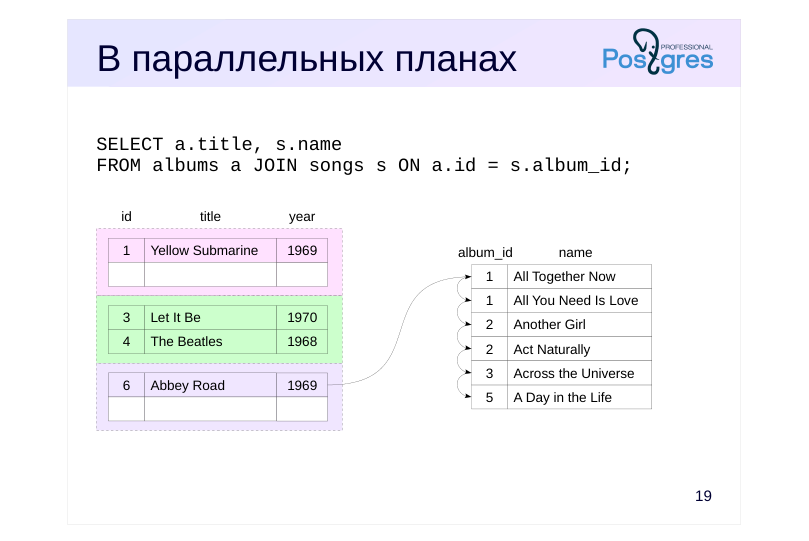 {#source-figure-019 caption=“Source slide page 19: В параллельных планах”}
Комментарии преподавателя
А третий процесс не обнаружит ни одного соответствия.
Конечно, все три процесса сканируют внутренний набор одновременно, а не по очереди.
Page 20: В параллельных планах
Нам потребуется индекс:
Вот пример параллельного плана, в котором используется соединение слиянием:
Здесь индекс на таблице бронирований bookings_pkey сканируется параллельно, а результат группировки из подзапроса t — каждым процессом полностью.
Page 21: Итоги
Соединение слиянием может потребовать подготовки
- надо отсортировать наборы строк
- или получить их заранее отсортированными
- Эффективно для больших выборок
- хорошо, если наборы уже отсортированы
- хорошо, если нужен отсортированный результат
- Не зависит от порядка соединения
- Поддерживает только эквисоединения
- другие не реализованы, но принципиальных ограничений нет
Комментарии преподавателя
Чтобы начать соединение слиянием, оба набора строк должны быть отсортированы. Хорошо, если удается получить данные уже в нужном порядке; если нет — требуется выполнить сортировку.
Само слияние выполняется очень эффективно даже для больших наборов строк. В качестве приятного бонуса результирующая выборка тоже упорядочена, поэтому такой способ соединения привлекателен, если вышестоящим узлам плана также требуется сортировка (например, запрос с фразой ORDER BY или еще одна сортировка слиянием).
Итак, в распоряжении планировщика есть три способа соединения: вложенный цикл, хеширование и слияние (не считая различных модификаций). Для каждого способа есть ситуации, в которых он оказывается более эффективным, чем остальные. Это позволяет планировщику выбрать именно тот способ, который — как предполагается — лучше подойдет в каждом конкретном случае. А точность предположений напрямую зависит от имеющейся статистики.
Page 22: Практика
- Проверьте план выполнения запроса, показывающего все места в салонах в порядке кодов самолетов: SELECT * FROM aircrafts a JOIN seats s ON a.aircraft_code = s.aircraft_code ORDER BY a.aircraft_code; Но оформите его в виде курсора. Уменьшите значение параметра cursor_tuple_fraction в десять раз. Как при этом изменился план выполнения? 2. Самолет можно заменить другим, если его вместимость отличается не более, чем на 20%. Получите таблицу замен между моделями Боинг и Аэробус, выполнив полное соединение. Как выполняется запрос?
- Запрос, который нужно выполнить:
Page 23: 1. Параметр cursor_tuple_fraction
План выполнения курсора:
Текущее значение cursor_tuple_fraction:
Уменьшим его:
Теперь планировщик выбирает другой план: его начальная стоимость ниже (хотя общая стоимость, наоборот, выше).
2. Полное соединение
Попробуем выполнить запрос.
Получаем ошибку: полное соединение реализовано только для условия равенства, поскольку только вложенный цикл
Page 24: Page 24
поддерживает соединение по произвольному условию, но зато не поддерживает полное соединение. Обойти ограничение можно, объединив результаты левого внешнего соединения и антисоединения:
План запроса показывает, что соединения выполняются методом вложенного цикла:
Page 25: Page 25
11 Занятие 11: Статистика / Базовая статистика
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_11_stats_basic.html Archive: QPT-handouts-16.zip Страниц PDF: 27
Page 1: Статистика / Базовая статистика
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Базовая статистика
- Наиболее частые значения и гистограммы
- Статистика элементов составных значений
- Использование статистики для оценки кардинальности и селективности
- Частные и общие планы выполнения
- Частичный индекс и индекс по выражению
Page 3: Базовая статистика
Размер таблицы
- строки (pg_class.reltuples) и страницы (pg_class.relpages)
- Собирается
- операциями DDL
- очисткой
- анализом
- Настройка
- default_statistics_target = 100
Комментарии преподавателя
Базовая статистика собирается на уровне всей таблицы и на уровне отдельных столбцов.
К статистике таблицы относится информация о размере объекта (reltuples и relpages в таблице pg_class). Поскольку такая статистика крайне важна, она обновляется некоторыми DDL-операциями (CREATE INDEX, CREATE TABLE AS SELECT) и уточняется при очистке и анализе.
Кроме того, планировщик масштабирует количество строк в соответствии с отклонением реального размера файла данных от значения relpages.
При анализе просматривается случайная выборка строк. Установлено, что размер выборки, обеспечивающий хорошую точность оценок, практически не зависит от размера таблицы. В качестве размера выборки используется ориентир статистики, заданный параметром default_statistics_target, умноженный на 300.
При этом следует понимать, что статистика не должна быть абсолютно точной, чтобы планировщик мог выбрать приемлемый план; часто достаточно попадания в порядок.
https://postgrespro.ru/docs/postgresql/16/row-estimation-examples
Page 4: Базовая статистика
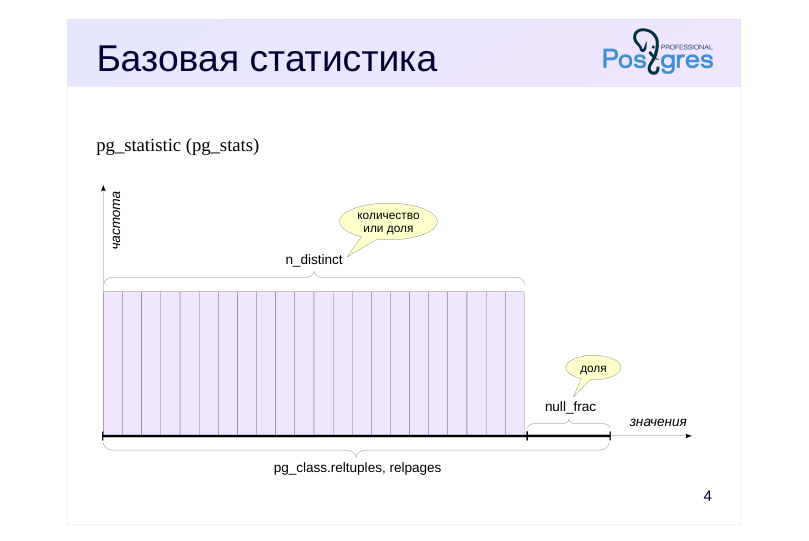 {#source-figure-004 caption=“Source slide page 4: Базовая статистика”}
pg_statistic (pg_stats)
Комментарии преподавателя
Вся остальная статистика собирается отдельно для каждого столбца при анализе таблицы. Обычно этим занимается автоанализ (его настройка рассматривается в курсе DBA2).
Статистика на уровне столбцов хранится в таблице pg_statistic. Но смотреть проще в представление pg_stats, которое показывает информацию в более удобном виде.
Поле null_frac содержит долю строк с неопределенными значениями в столбце (от 0 до 1).
Поле n_distinct хранит число уникальных значений в столбце. Если значение n_distinct отрицательно, то модуль этого числа показывает долю уникальных значений. Например, −1 означает, что все значения уникальны (типичный случай для первичного ключа).
https://postgrespro.ru/docs/postgresql/16/planner-stats#PLANNER-STATS-S INGLE-COLUMN
Page 5: Число строк
Начнем с оценки кардинальности в простом случае запроса без предикатов.
Точное значение:
Оптимизатор получает значение из pg_class:
Значение параметра, управляющего ориентиром статистики, по умолчанию равно 100:
Поскольку при анализе таблицы учитывается 300 × default_statistics_target строк, то оценки для относительно крупных таблиц могут не быть абсолютно точными.
Доля неопределенных значений
Часть рейсов еще не отправились, поэтому время вылета для них не определено:
Точное значение:
Оценка оптимизатора получена как общее число строк, умноженное на долю NULL-значений:
Page 6: Число уникальных значений
Проверим количество моделей самолетов в таблице рейсов:
Это соответствует действительности:
А в таблице самих самолетов?
Здесь значение -1 говорит о том, что каждое значение является уникальным. Это неудивительно, ведь aircraft_code является первичным ключом в этой таблице.
Кардинальность соединения
Селективность соединения — доля строк от декартова произведения двух таблиц, которая остается после применения условия соединения. Поэтому для расчета кардинальности соединения оптимизатор оценивает кардинальность декартова произведения и умножает его на селективность условия соединения (и на селективность условий фильтров, если они есть). Рассмотрим пример:
Точное значение кардинальности:
Page 7: Page 7
Базовая формула для расчета селективности соединения (в предположении равномерного распределения) — минимальное из значений 1/nd1 и 1/nd2, где nd1 — число уникальных значений ключа соединения в первом наборе строк; nd2 — число уникальных значений ключа соединения во втором наборе строк. В данном случае получаем ровно то, что требуется:
Page 8: Наиболее частые значения
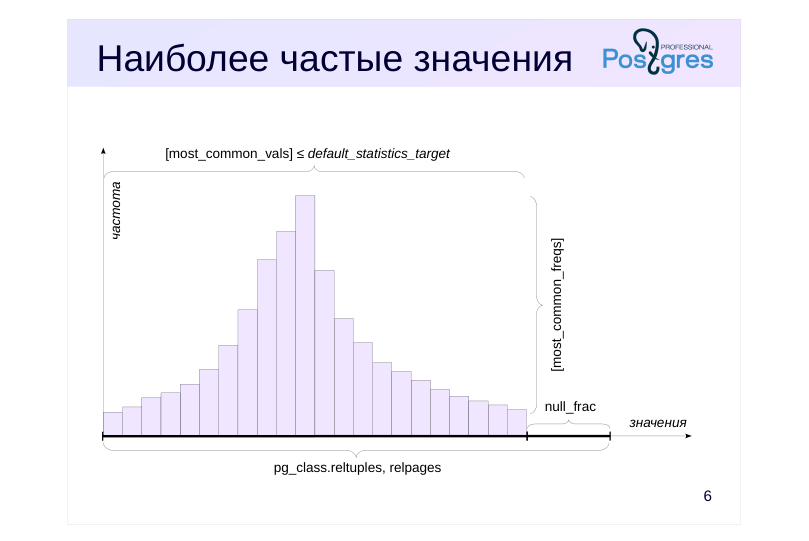 {#source-figure-008 caption=“Source slide page 8: Наиболее частые значения”}
Комментарии преподавателя
Если бы данные всегда были распределены равномерно, то есть все значения встречались бы с одинаковой частотой, этой информации было бы почти достаточно (нужен еще минимум и максимум).
Но в реальности неравномерные распределения встречаются очень часто. Поэтому собирается еще и следующая информация:
● массив наиболее частых значений — поле most_common_vals;
● массив частот этих значений — поле most_common_freqs.
Частота из этих массивов непосредственно служит оценкой селективности для поиска конкретного значения.
Все это прекрасно работает, пока число различных значений не очень велико. Максимальный размер каждого из массивов ограничен параметром default_statistics_target. Это значение можно переопределять на уровне отдельного столбца; в таком случае размер анализируемой выборки будет определяться по максимальному значению для таблицы.
Тонкий момент представляют «большие» значения. Чтобы не увеличивать размер pg_statistic и не нагружать планировщик бесполезной работой, значения, превышающие 1 Кбайт, исключаются из статистики и анализа. В самом деле, если в поле хранятся такие большие значения, скорее всего, они уникальны и не имеют шансов попасть в most_common_vals.
Page 9: Наиболее частые значения
Для эксперимента ограничим размер списка наиболее частых значений (который по умолчанию определяется параметром default_statistics_target) на уровне столбца:
Если значение попало в список наиболее частых, селективность можно узнать непосредственно из статистики. Пример (Шереметьево):
Точное значение:
Вот как выглядит список наиболее частых значений и частота их встречаемости:
Кардинальность вычисляется как число строк, умноженное на частоту значения:
Список наиболее частых значений может использоваться и для оценки селективности неравенств. Для этого в most_common_vals надо найти все значения, удовлетворяющие неравенству, и просуммировать частоты соответствующих элементов из most_common_freqs. Если же указанного значения нет в списке наиболее частых, то селективность вычисляется исходя из предположения, что все данные (кроме наиболее частых) распределены равномерно. Например, в списке частых значений нет Владивостока.
Page 10: Page 10
Точное значение:
Для получения оценки вычислим сумму частот наиболее частых значений:
На менее частые значения приходятся оставшиеся строки. Поскольку мы исходим из предположения о равномерности распределения менее частых значений, селективность будет равна 1/nd, где nd — число уникальных значений:
Учитывая, что из этих значений 10 входят в список наиболее частых, а неопределенных значений нет, получаем следующую оценку:
Page 11: Гистограмма
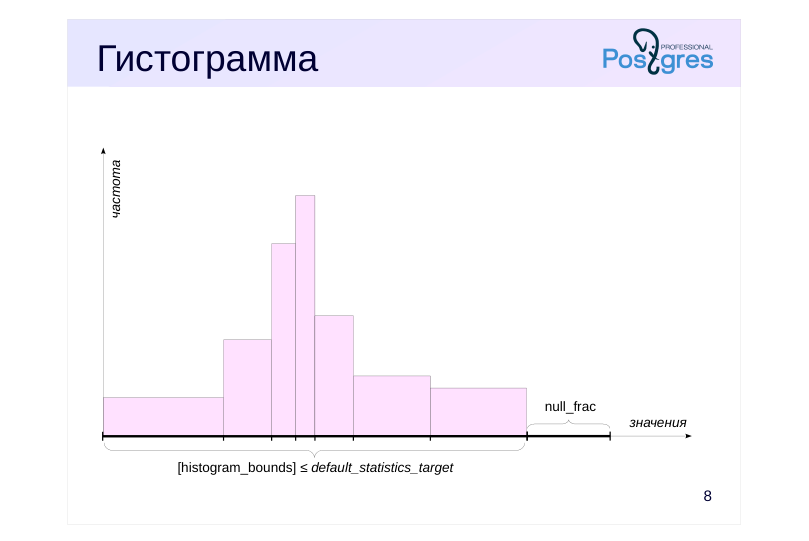 {#source-figure-011 caption=“Source slide page 11: Гистограмма”}
Комментарии преподавателя
Если число различных значений слишком велико, чтобы записать их в массив, на помощь приходит гистограмма. Гистограмма состоит из нескольких корзин, в которые помещаются значения. Количество корзин ограничено тем же параметром default_statistics_target.
Ширина корзин выбирается так, чтобы в каждую попало примерно одинаковое число значений (на рисунке это выражается в одинаковой площади прямоугольников).
При таком построении достаточно хранить только массив крайних значений каждой корзины — поле histogram_bounds. Частота одной корзины равна 1/(число корзин).
Оценить селективность условия поле < значение можно как N/(общее число корзин), где N — число корзин, лежащих слева от значения. Оценку можно улучшить, добавив часть корзины, в которую попадает само значение.
Если же надо оценить селективность условия поле = значение, то гистограмма в этом не может помочь, и приходится довольствоваться предположением о равномерном распределении и брать в качестве оценки 1/n_distinct.
Page 12: Комбинация методов
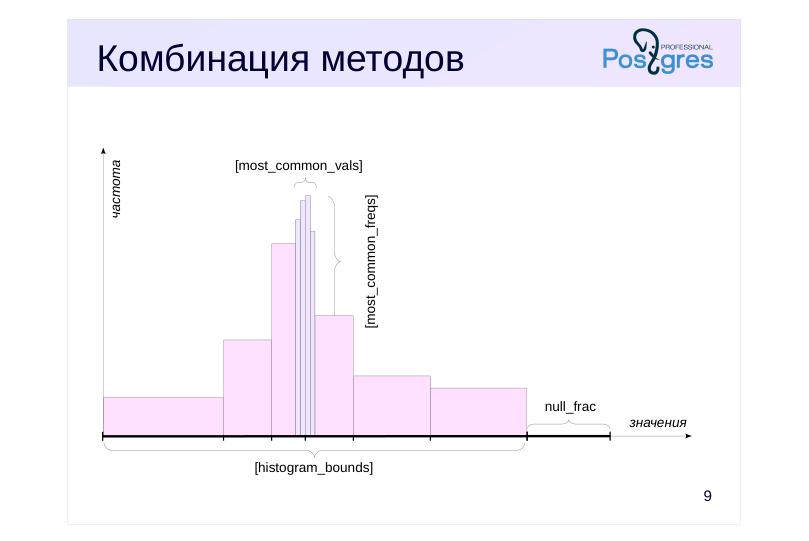 {#source-figure-012 caption=“Source slide page 12: Комбинация методов”}
Комментарии преподавателя
Но обычно два подхода объединяются: строится список наиболее частых значений, а все остальные значения покрываются гистограммой.
При этом гистограмма строится так, что в ней не учитываются значения, попавшие в список. Это позволяет улучшить оценки.
Page 13: Гистограмма
При условиях «больше» и «меньше» для оценки будет использоваться список наиболее частых значений, или гистограмма, или оба способа вместе. Гистограмма строится так, чтобы не включать наиболее частые значения и NULL:
Число корзин гистограммы определяется параметром default_statistics_target, а границы выбираются так, чтобы в каждой корзине находилось примерно одинаковое количество значений. Рассмотрим пример:
Точное значение:
Как получена оценка? Учтем частоту наиболее частых значений, попадающих в указанный интервал:
Указанный интервал занимает ровно 2 корзины гистограммы из 10, а неопределенных значений в данном столбце нет, получаем следующую оценку:
В общем случае учитываются и не полностью занятые корзины (с помощью линейной аппроксимации).
Кардинальность соединения
В случае неравномерного распределения данных в ключах соединения базовая формула расчета селективности соединения (минимальное из значений 1/nd1 и 1/nd2) дает неправильный результат. Например, рейсы совершают разные модели самолетов с разной вместимостью, и для соединения рейсов с местами мы получили бы:
Page 14: Page 14
При этом точное значение в два раза меньше:
Однако планировщик умеет учитывать списки наиболее частых значений и гистограммы, и получает практически точную оценку:
К сожалению, ситуация ухудшается, когда соединяются несколько таблиц. Например, добавим в предыдущий запрос таблицу самолетов — это никак не повлияет на общее количество строк в выборке:
Однако теперь планировщик ошибается:
Дело в том, что, соединив первые две таблицы, планировщик не имеет детальной статистики о результирующем наборе строк. Во многих случаях именно это является основной причиной плохих оценок.
Page 15: Дополнительные поля
Упорядоченность (использовать ли битовую карту?)
- pg_stats.correlation
- (1 — по возрастанию, 0 — хаотично, –1 — по убыванию)
- Видимость (использовать ли сканирование только индекса?)
- pg_class.relallvisible
- Средний размер значения в байтах (оценка памяти)
- pg_stats.avg_width
Комментарии преподавателя
Сервер хранит еще несколько показателей статистики.
В поле pg_stats.correlation записывается показатель физической упорядоченности значений столбца. Если значения хранятся строго по возрастанию, показатель будет близок к единице; если по убыванию — к минус единице. Чем более хаотично расположены данные на диске, тем ближе значение показателя к нулю. Именно это поле использует оптимизатор, когда выбирает между сканированием битовой карты и обычным индексным сканированием.
Поле pg_class.relallvisible хранит количество страниц таблицы, которые содержат только актуальные версии строк (эта информация обновляется вместе с картой видимости). Если количество недостаточно велико, планировщик может отказаться от сканирования только индекса в пользу сканирования по битовой карте.
В поле pg_stats.avg_width сохраняется средний размер значений в данном столбце в байтах для расчета необходимого для операции объема памяти.
https://postgrespro.ru/docs/postgresql/16/view-pg-stats
Page 16: Элементы составных полей
Наиболее частые элементы
- pg_stats.most_common_elems
- pg_stats.most_common_elem_freqs
- Гистограмма количества элементов
- pg_stats.elem_count_histogram
Комментарии преподавателя
Для таких составных типов, как массивы или tsvector, в pg_stats хранится распределение не только самих значений, но и их элементов:
● most_common_elems и most_common_elem_freqs содержат наиболее частые элементы и их частоты;
● elem_count_histogram содержит гистограмму количества элементов в значении (например, в случае массива — гистограмму длин массивов).
Это позволяет более точно планировать запросы с участием полей не в первой нормальной форме. В частности, эта информация важна для классов операторов индексного метода GIN, поскольку позволяет отделить частые значения (то есть встречающиеся во многих документах, условие с низкой селективностью) от редких (условие с высокой селективностью).
Page 17: Элементы составных полей
Для примера рассмотрим таблицу pg_constraint — в ней хранятся ограничения целостности, определенные для таблиц. И в ней есть поле conkey с массивом номеров столбцов, образующих ограничение:
Для этого поля можно получить наиболее частые значения и их частоты. Чтобы было удобнее просматривать статистику, соберем ее с уменьшенным значением ориентира:
В данном случае значения в столбце — это массивы элементов. Такая статистика не позволит оценить кардинальность, например, для условия вхождения элемента в массив. Однако планировщик не ошибается в оценке:
Для таких условий используется статистика по отдельным элементам:
Page 18: Page 18
Для частот и гистограмм в конце массива содержится дополнительная информация (минимум, максимум, среднее), поэтому количество значений превышает установленный ориентир. Планировщик получает оценку, используя частоту элемента 2:
Page 19: Частные и общие планы
Частные планы
- может быть полезен при неравномерном распределении,
- но запрос планируется заново при каждом вызове
- Seq Scan on tasks
- Index Scan on tasks
- Index Cond: status = ’todo'
- Filter: status = ‘done’
- строится
- с учетом значений
- параметров
- Общий план
- оптимален для равномерного распределения
- кешируется в сеансе для подготовленных операторов
- Index Scan on tasks
- Index Cond: id = $1
- строится
- без учета значений
- параметров
Комментарии преподавателя
При простом протоколе запросов (вспомните тему «Планирование и выполнение») каждый запрос планируется заново с учетом значений параметров.
Расширенный протокол позволяет подготавливать операторы, причем операторы могут иметь параметры. Подготовка всегда включает разбор и переписывание запроса, и дерево разбора сохраняется в локальной памяти обслуживающего процесса.
При выполнении подготовленного оператора есть варианты. Запрос может, как обычно, планироваться каждый раз заново с учетом значений параметров. Такие планы называются частными (custom).
Это имеет смысл при неравномерном распределении, ведь для разных значений оптимальные планы могут отличаться. Например, для высокоселективных условий может лучше работать индексный доступ, а если значение встречается часто — последовательный.
Но запрос можно спланировать и без учета параметров. Это позволяет сохранить не только дерево разбора, но и сам план, и не тратить время на повторное планирование. Такой план называется общим (generic).
Общий план отлично работает в случае равномерного распределения, когда селективность условия не зависит от конкретного значения. Но в случае неравномерного распределения общий план может хорошо работать для одних значений и плохо — для других.
Разберемся, как планировщик решает, какой вариант использовать.
Page 20: Частные и общие планы
Подготовим запрос и создадим индекс:
Поиск отмененных рейсов будет использовать индекс, поскольку статистика говорит о том, что таких рейсов мало:
А поиск прибывших рейсов — нет, поскольку их много:
Такие планы называются частными, поскольку они построены с учетом конкретных значений параметров. Однако планировщик строит и общий план без учета конкретных значений параметров. Если в какой-то момент оказывается, что стоимость общего плана не превышает среднюю стоимость уже построенных ранее частных планов, планировщик начинает пользоваться общим планом, больше не выполняя планирование. Но первые пять раз используются частные планы, чтобы накопить статистику. Выполним оператор еще три раза:
Количество выполнений общего и частных планов можно посмотреть в представлении pg_prepared_statements:
Page 21: Page 21
В следующий раз планировщик переключится на общий план. Вместо конкретного значения в плане будет указан номер параметра:
Имея текст запроса с параметрами, представленными номерами (например, из журнала сообщений сервера), можно посмотреть общий план такого запроса следующим образом:
Переход на общий план может быть нежелателен в случае неравномерного распределения значений. Параметр plan_cache_mode позволяет отключить использование частных планов (или наоборот, с самого начала использовать общий план):
Частичный индекс
Поиск уже прибывших рейсов будет выполняться последовательным сканированием таблицы flights, поэтому индексные записи с ключом Arrived никогда не используются. При этом они занимают место и требуют ресурсов для синхронизации с изменениями строк таблицы. Проверим размер полного индекса по полю status:
Page 22: Page 22
Можно поместить в индекс только ссылки на строки, удовлетворяющие условиям с высокой селективностью. Заменим полный индекс на частичный:
Размер частичного индекса существенно меньше, чем полного:
Когда это выгодно (для редких значений) будет использоваться частичный индекс:
…а для частых значений — последовательное сканирование:
Таким образом можно сэкономить дисковое пространство и снизить затраты на сопровождение полного индекса.
Индекс по выражению
Если в условиях используются не столбцы, а, например, обращения к функциям, планировщик не учитывает множество значений. Например, рейсов, совершенных в январе, будет примерно 1/12 от общего количества:
Однако планировщик не понимает смысла функции extract и использует фиксированную селективность 0,5%:
Page 23: Page 23
Ситуацию можно исправить, построив индекс по выражению, так как для таких выражений собирается собственная статистика.
Теперь оценка исправилась:
Статистика для индексов по выражению хранится вместе с базовой статистикой по столбцам таблиц:
Индекс можно построить только по детерминированному выражению, то есть для одинаковых значений параметров (столбцов) оно всегда должно выдавать одинаковый результат. Подробнее об этом рассказано в теме «Функции».
Page 24: Итоги
Характеристики данных собираются в виде статистики
- Статистика нужна для оценки кардинальности
- Кардинальность используется для оценки стоимости
- Стоимость позволяет выбрать оптимальный план
- Основа успеха — адекватная статистика и корректная кардинальность
Page 25: Практика
- Создайте индекс на таблице билетов (tickets) по имени пассажира (passenger_name). 2. Какая статистика имеется для этой таблицы? 3. Объясните оценку кардинальности и выбор плана выполнения следующих запросов: а) выборка всех билетов, б) выборка билетов на имя ALEKSANDR IVANOV, в) выборка билетов на имя ANNA VASILEVA, г) выборка билета с идентификатором 0005432000284.
Page 26: 1. Индекс
2. Наличие статистики
Некоторые основные значения:
Ни один столбец не содержит неопределенных значений. Уникальных номеров бронирования примерно в два раза меньше, чем строк в таблице (то есть на каждое бронирование в среднем приходится два билета). Имеется около 10000 разных имен. Все остальные столбцы содержат уникальные значения. Размеры массивов наиболее частых значений и гистограмм соответствуют значению параметра default_statistics_target (100). Для имен пассажиров есть наиболее частые значения. Для других столбцов они не имеют смысла, так как максимальное количество билетов (5) встречается в 194 бронированиях, а остальные столбцы уникальны. Гистограммы есть для всех столбцов, они нужны для оценки предикатов с условиями неравенства. Строки таблицы физически упорядочены по номеру билета. Данные в других столбцах расположены более или менее хаотично.
3. Планы запросов
Кардинальность равна числу строк в таблице; выбрано полное сканирование.
Page 27: Page 27
Селективность оценена по списку наиболее частых значений; выбрано сканирование по битовой карте.
Селективность оценена исходя из равномерного распределения; выбрано сканирование по битовой карте.
Кардинальность равна 1, так как значения этого столбца уникальны; выбрано индексное сканирование.
12 Занятие 12: Статистика / Расширенная статистика
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_12_stats_extended.html Archive: QPT-handouts-16.zip Страниц PDF: 19
Page 1: Статистика / Расширенная статистика
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Функциональная зависимость
- Наиболее частые комбинации значений
- Число уникальных комбинаций значений
- Статистика по выражениям
Page 3: Расширенная статистика
Включает
- многовариантную статистику (по нескольким столбцам)
- статистику по выражениям
- Объект базы данных, создается вручную
- хранится в pg_statistic_ext и pg_statistic_ext_data
- представления pg_stats_ext и pg_stats_ext_exprs
- После создания статистика собирается автоматически
Комментарии преподавателя
Базовой статистики, которая собирается автоматически, может не хватать для точных оценок кардинальности и селективности.
PostgreSQL позволяет администратору вручную определить, какая дополнительная — расширенная — статистика требуется. Можно собрать статистику, охватывающую не один столбец, а сразу несколько (многовариантная статистика), или статистику по произвольному выражению.
Заметьте, что базовая статистика собирается для таблиц и их столбцов, но не для индексов (за исключением индексов по выражениям). Поэтому и индекс, построенный по нескольким столбцам, не приводит сам по себе к появлению многовариантной статистики.
Расширенная статистика создается командой CREATE STATISTICS. После того, как объект создан, соответствующая статистика будет собираться автоматически в фоновом режиме или командой ANALYZE.
https://postgrespro.ru/docs/postgresql/16/planner-stats#PLANNER-STATS-E XTENDED
Собранная информация хранится в таблицах pg_statistic_ext и pg_statistic_ext_data; доступная пользователю статистика отображается в представлениях pg_stats_ext и pg_stats_ext_exprs.
Page 4: Зависимые столбцы
 {#source-figure-004 caption=“Source slide page 4: Зависимые столбцы”}
Функциональная зависимость (dependencies)
- значение одного столбца определяет значение другого столбца
- статистика улучшает оценку селективности условий
Комментарии преподавателя
Существует несколько видов многовариантной статистики (то есть статистики по нескольким столбцам таблицы), которые можно указать при создании объекта расширенной статистики.
Функциональная зависимость между столбцами показывает, насколько данные в одном столбце определяются значением другого столбца.
В примере на слайде почтовый индекс однозначно определяет город, поэтому селективность условия city = ‘Самара’ and index = ‘443000’ определяется селективностью предиката index = ‘443000’. Такие предикаты, селективность которых нельзя рассчитывать отдельно друг от друга, называются коррелированными.
https://postgrespro.ru/docs/postgresql/16/planner-stats#PLANNER-STATS-E XTENDED-FUNCTIONAL-DEPS
Page 5: Функциональные зависимости
Рассмотрим запрос с двумя условиями:
Оценка оказывается сильно заниженной:
Причина в том, что планировщик полагается на независимость предикатов и считает итоговую селективность как произведение селективностей предикатов. Это хорошо видно в приведенном плане: оценка в узле Bitmap Index Scan (условие на flight_no) верная, а после фильтрации в узле Bitmap Heap Scan (условие на departure_airport) — заниженная. Однако мы понимаем, что номер рейса однозначно определяет аэропорт отправления: фактически, второе условие избыточно (конечно, считая, что аэропорт указан правильно). Это можно объяснить планировщику с помощью статистики по функциональной зависимости:
Собранная статистика хранится в следующем виде:
Сначала идут порядковые номера атрибутов, а после двоеточия — коэффициент зависимости.
Page 6: Page 6
Теперь оценка улучшилась. Команда \d показывает объекты расширенной статистики для конкретной таблицы:
В разделе Statistics objects показаны имена, столбцы и нестандартные целевые значения объектов статистики.
Page 7: Частые комбинации
 {#source-figure-007 caption=“Source slide page 7: Частые комбинации”}
Наиболее частые комбинации значений (mcv)
- как pg_stats.most_common_vals/freqs, но для нескольких столбцов
- статистика улучшает оценку селективности условий
Комментарии преподавателя
Список наиболее частых комбинаций значений позволяет сохранить несколько комбинаций значений и их частоту.
На слайде показаны возможные пары город — река. Очевидно, что предикаты со столбцами city и river коррелированы, но, в отличие от предыдущего примера, ни один из этих столбцов не определяет другой (между городами и реками отношение «многие ко многим»). В этом случае статистика по функциональным зависимостям не поможет улучшить оценки.
https://postgrespro.ru/docs/postgresql/16/planner-stats#PLANNER-STATS-E XTENDED-MCV-LISTS
Page 8: Частые комбинации
Столбцы могут быть коррелированы, но не всегда между ними есть прямая функциональная зависимость. Выполним такой запрос:
Планировщик ошибается в несколько раз. Учет функциональной зависимости недостаточно исправит ситуацию:
В этом случае можно добавить расширенную статистику по частым комбинациям значений нескольких столбцов:
Теперь оценка улучшилась. Количество собираемых наиболее частых значений определяется параметром default_statistics_target. Его можно задать
Page 9: Page 9
для конкретной статистики:
Оценка кардинальности еще немного улучшилась. Однако это не привело к дальнейшему улучшению плана, поэтому увеличение ориентира статистики в данном случае вряд ли оправдано. Статистику по наиболее частым комбинациям можно посмотреть так:
Page 10: Уникальные комбинации
 {#source-figure-010 caption=“Source slide page 10: Уникальные комбинации”}
Число уникальных комбинаций значений (ndistinct)
- как pg_stats.ndistinct, но для нескольких столбцов
- статистика улучшает оценку кардинальности для группировки
Комментарии преподавателя
Число уникальных комбинаций значений позволяет улучшить оценку кардинальности при группировке по нескольким столбцам.
В примере на слайде число возможных комбинаций всех полей, очевидно, нельзя определить, просто перемножив количество уникальных значений для каждого столбца по отдельности.
https://postgrespro.ru/docs/postgresql/16/planner-stats#PLANNER-STATS-E XTENDED-N-DISTINCT-COUNTS
Page 11: Уникальные комбинации
Другая ситуация, в которой планировщик ошибается с оценкой, связана с группировкой. Количество пар аэропортов, связанных прямыми рейсами, ограничено:
Но планировщик не знает об этом:
Расширенная статистика позволяет исправить и эту оценку (если не указать вид статистики, в создаваемый объект будут включены все поддерживаемые виды):
Статистику по уникальным комбинациям можно увидеть так:
Посмотреть список всех объектов расширенной статистики можно командой \dX:
Page 12: Page 12
Отображается наличие статистики по типам (Ndistinct, Dependencies, MCV), а значения нужно смотреть в таблице pg_statistic_ext_data.
Page 13: Статистика по выражению
 {#source-figure-013 caption=“Source slide page 13: Статистика по выражению”}
Расширенная статистика по выражению
- как если бы в таблице был определен генерируемый столбец
- статистика улучшает оценку селективности условий с выражениями
Комментарии преподавателя
Расширенная статистика по выражению позволяет собрать всю базовую статистику, которая была бы собрана, если бы в таблице был определен столбец, вычисляемый по этому выражению.
Если в предикате слева или справа от оператора стоит не имя столбца, а выражение, планировщик использует фиксированную оценку селективности. С помощью статистики по выражению это можно исправить.
Заметим, что выражения также можно использовать вместо имен столбцов в многовариантной статистике любого типа.
Page 14: Статистика по выражению
Как мы видели в теме «Базовая статистика», если в условии используются выражение, планировщик, не имея информации о селективности, использует константу и часто ошибается:
В теме «Базовая статистика» мы исправляли ситуацию, построив индекс по выражению, но это возможно не во всех случаях. К тому же индексы требуют ресурсов для хранения и постоянной синхронизации. Можно поступить иначе — добавить расширенную статистику по выражению:
Оценка стала корректной. Расширенная статистика по выражениям хранится отдельно. Вот несколько столбцов:
Page 15: Итоги
Расширенная статистика помогает в сложных случаях
- Создается вручную, поддерживается автоматически
- Может увеличить затраты на анализ и планирование
Page 16: Практика
- Используя команды из демонстрации, создайте статистики типа dependencies, mcv и ndistinct для таблицы flights. Измерьте время выполнения команды ANALYZE. Удалите расширенные статистики, снова измерьте время выполнения команды ANALYZE и сравните с предыдущим результатом. 2. Напишите запрос, выбирающий все перелеты в бизнес-классе стоимостью более 100 тыс. рублей. Поможет ли расширенная статистика улучшить оценку кардинальности результата? Если да, то какой тип статистики лучше использовать?
Комментарии преподавателя
- Выполняйте измерение времени несколько раз и усредняйте результаты, чтобы сгладить неравномерности.
Page 17: 1. Затраты на анализ
Создадим расширенные статистики аналогично тому, как это было сделано в демонстрации. Статистика по функциональной зависимости:
Списки наиболее частых комбинаций значений:
Статистика по уникальным комбинациям значений:
Измерим время анализа.
В первый раз анализ может занимать существенно больше времени, чем обычно.
Удалим созданные расширенные статистики:
Повторно измеряем время:
Page 18: 2. Применение расширенной статистики
Было создано всего три расширенные статистики, но время анализа до и после удаления заметно различается. С увеличением количества собираемых расширенных статистик будет расти и время на анализ, что может привести к увеличению нагрузки на сервер. Поэтому использовать расширенную статистику нужно осмысленно и только в тех случаях, когда это необходимо. Перелеты в бизнес-классе стоимостью свыше 100 тысяч ₽:
Оптимизатор ошибается на порядок. Причина в том, что стоимость билета и класс обслуживания коррелируют между собой, поэтому расширенная статистика должна помочь исправить оценку. Поскольку между столбцами нет прямой функциональной зависимости, добавим статистику по наиболее частым значениям:
Оценка немного улучшилась, но все еще сильно отличается от точного значения. Можно заметить, что доля строк, удовлетворяющих условию, немногим более 1%:
Поскольку по умолчанию хранится 100 наиболее частых пар, среди них с большой вероятностью встретится не более 1–2 удовлетворяющих условию, и из-за этого оценка оптимизатора не будет адекватной. Попробуем повысить точность, увеличив объем статистики:
Page 19: Page 19
Оценка стала практически точной.
13 Занятие 13: Оптимизация запросов / Профилирование
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_13_optim_profiling.html Archive: QPT-handouts-16.zip Страниц PDF: 20
Page 1: Оптимизация запросов / Профилирование
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Профилирование как инструмент для поиска узких мест
- Выбор подзадачи для профилирования
- Средства построения профиля
Page 3: Инструмент
Профилирование
- выделение подзадач
- продолжительность
- количество выполнений
- Что оптимизировать?
- чем больше доля подзадачи в общем времени выполнения,
- тем больше потенциальный выигрыш
- необходимо учитывать затраты на оптимизацию
- полезно взглянуть на задачу шире
Комментарии преподавателя
В предыдущих темах мы разобрались с тем, как работают запросы, из каких «кирпичиков» строится план выполнения и что влияет на выбор того или иного плана. Это самое сложное и важное. Поняв механизмы, с помощью логики и здравого смысла можно разобраться в любой возникшей ситуации и понять, эффективно ли выполняется запрос и что можно сделать, чтобы улучшить показатели.
Но как найти тот запрос, который имеет смысл оптимизировать?
В принципе, решение любой задачи оптимизации (не только в контексте СУБД) начинается с профилирования, хоть этот термин и не всегда употребляется явно. Мы должны разбить задачу, вызывающую нарекания, на подзадачи и измерить, какую часть общего времени они занимают. Также полезна информация о числе выполнений каждой из подзадач.
Чем больше доля подзадачи в общем времени, тем больше выигрыш от оптимизации именно этой подзадачи. На практике приходится учитывать и ожидаемые затраты на оптимизацию: получить потенциальный выигрыш может оказаться нелегко.
Бывает так, что подзадача выполняется быстро, но часто (это, например, характерно для запросов, генерируемых ORM-ами). Может оказаться невозможным ускорить выполнение отдельных запросов, но стоит задаться вопросом: должна ли подзадача выполняться так часто? Такой вопрос может привести к необходимости изменения архитектуры, что всегда непросто, но в итоге дать существенный выигрыш.
Page 4: Что профилировать
Всю активность системы
- полезно администратору для поиска ресурсоемких задач
- мониторинг, расширение pg_profile
- Отдельную задачу, вызывающую нарекания
- полезно для решения конкретной проблемы
- чем точнее, тем лучше: широкий охват размывает картину
Комментарии преподавателя
Профиль общей активности может многое сказать администратору, который занят не решением конкретной проблемы, а поиском наиболее ресурсоемких задач, оптимизация которых, вероятно, снизит нагрузку на систему.
Такой профиль должна показывать система мониторинга.
Можно также воспользоваться расширением pg_profile. Оно основано на статистических представлениях PostgreSQL, информация из которых сохраняется в хранилище снимков активности. Изучая и сравнивая между собой снимки, можно выявлять проблемы и причины их возникновения. Автор расширения — Андрей Зубков (https://github.com/zubkov-andrei/pg\_profile).
Детальное обсуждение того, как именно строить систему мониторинга, какие инструменты для этого использовать и какие метрики собирать выходит за рамки курса, но порекомендуем книгу Алексея Лесовского «Мониторинг PostgreSQL»:
https://postgrespro.ru/education/books/monitoring
Для решения конкретной проблемы необходимо строить профиль так, чтобы измерения затрагивали только действия, необходимые для воспроизведения именно этой проблемы. Если, например, пользователь жалуется на то, что «окно открывается целую минуту», бессмысленно смотреть на всю активность в базе данных за эту минуту: в эти цифры попадут действия, не имеющие никакого отношения к открытию окна.
Page 5: Что измерять
Время выполнения
- имеет смысл для пользователя
- крайне нестабильный показатель
- Страничный ввод-вывод
- стабилен по отношению ко внешним факторам
- мало что говорит пользователям
Комментарии преподавателя
В каких единицах измерять ресурсы? Самая осмысленная для конечного пользователя характеристика — это время отклика: сколько прошло времени «от нажатия на кнопку» до «получения результата».
Однако с технической точки зрения смотреть на время не всегда удобно. Оно сильно зависит от массы внешних факторов: от наполненности кеша, от текущей загруженности сервера. Если поиском проблемы занимаются не на основном, а на тестовом сервере с иными характеристиками, то добавляется и разница в аппаратном обеспечении, в настройках, в профиле нагрузки.
В этом смысле может оказаться удобнее смотреть на ввод-вывод, то есть на число прочитанных и записанных страниц. Этот показатель более стабилен. Он не зависит от характеристик «железа» и от нагрузки, то есть будет совпадать на разных серверах с одинаковыми данными и равными значениями параметров конфигурации.
Поэтому очень важно анализировать проблемы на полном наборе данных. Для этого, например, можно использовать Database Lab Engine — средство быстрого создания тонких клонов, разработанное Postgres.ai: https://github.com/postgres-ai/database-lab-engine.
Ввод-вывод, как правило, адекватно отражает объем работы, необходимый для выполнения запроса, поскольку основное время уходит на чтение и обработку страниц с данными. Хотя такой показатель не имеет смысла для конечного пользователя.
Page 6: Профиль приложения
Подзадачи
- клиентская часть
- сервер приложений
- сервер баз данных
- ← проблема часто, но не всегда, именно здесь
- сеть
- Как профилировать
- технически трудно, нужны разнообразные средства мониторинга
- подтвердить предположение обычно несложно
Комментарии преподавателя
Для пользователя имеет смысл время отклика. Это означает, что в профиль, вообще говоря, должна входить не только СУБД, но и клиентская часть, и сервер приложений, и передача данных по сети.
Часто проблемы с производительностью кроются именно в СУБД, поскольку один неадекватно построенный план запроса может увеличивать время на порядки. Но это не всегда так. Проблема может оказаться в том, что у клиента медленное соединение с сервером, что клиентская часть долго отрисовывает полученные данные и т. п.
К сожалению, получить такой полный профиль достаточно трудно. Для этого все компоненты информационной системы должны быть снабжены подсистемами мониторинга и трассировки, учитывающими особенности именно этой системы. Но обычно несложно измерить общее время отклика (хотя бы и секундомером) и сравнить с общим временем работы СУБД; убедиться в отсутствии существенных сетевых задержек и т. п. Если же этого не проделать, то вполне может оказаться, что мы будем искать ключи там, где светлее, а не там, где их потеряли. Собственно, весь смысл профилирования и состоит в том, чтобы выяснить, что именно нуждается в оптимизации.
Далее мы будем считать установленным, что проблема именно в СУБД.
Page 7: Профиль PL/pgSQL
Расширение PL Profiler
- стороннее расширение
- предназначено только для функций на PL/pgSQL
- профилирование отдельного скрипта или сеанса
- отчет о работе в html, включая flame graph
- Расширение plpgsql_check
- стороннее расширение
- проверяет PL/pgSQL и встроенный SQL
- позволяет находить ошибки компиляции
- поиск зависимых объектов в функциях
- возможность автоматического профилирования функций
Комментарии преподавателя
При выполнении пользователем некоторого действия, выполняется обычно не один, а несколько запросов. Как определить тот запрос, который имеет смысл оптимизировать? Для этого нужен профиль, детализированный до запросов.
Однако серверная часть приложения, выполняющаяся в СУБД, может состоять не только из SQL-запросов, но и содержать процедурный код. Если код написан на языке PL/pgSQL, то для его профилирования можно воспользоваться сторонним расширением PL Profiler (основной автор — Ян Вик: https://github.com/bigsql/plprofiler).
Расширение позволяет профилировать как отдельно выполняемые скрипты, так и снимать профиль работающего сеанса. Результат работы формируется как html-файл, содержащий необходимую информацию. В том числе он включает изображение вызовов в виде «языков пламени» (flame graph).
Еще можно порекомендовать расширение plpgsql_check (основной автор — Павел Стехуле: https://github.com/okbob/plpgsql\_check). Это расширение проверяет достоверность идентификаторов SQL, используемых в коде PL/pgSQL, пытается выявить проблемы с производительностью, имеет встроенный профилировщик кода.
Поскольку курс посвящен оптимизации запросов SQL, мы не будем рассматривать эти расширения, но упоминаем их для полноты картины.
Page 8: Профиль запросов
Журнал сообщений сервера
- включается конфигурационными параметрами:
- log_min_duration_statement = 0
- время и текст всех запросов
- log_line_prefix
- идентифицирующая информация
- сложно включить для отдельного сеанса
- большой объем; при увеличении порога времени теряем информацию
- не отслеживаются вложенные запросы
- (можно использовать расширение auto_explain)
- анализ внешними средствами, такими, как pgBadger
Комментарии преподавателя
Для получения профиля по выполняемым SQL-запросам есть два основных средства, встроенных в PostgreSQL: журнал сообщений сервера и статистика.
В журнале сообщений с помощью конфигурационных параметров можно включить вывод информации о запросах и времени их выполнения. Обычно для этого используется параметр log_min_duration_statement, хотя есть и другие.
Как локализовать в журнале именно те запросы, которые относятся к действиям пользователя? Имело бы смысл включать и выключать параметр для конкретного сеанса, но штатных средств для этого не предусмотрено. Можно фильтровать общий поток сообщений, выделяя только нужные; для этого удобно в параметр log_line_prefix вывести дополнительную идентифицирующую информацию. Использование пула соединений еще больше усложняет ситуацию.
Для анализа вложенных запросов (когда в запросе вызывается функция, содержащая другие запросы) потребуется модуль auto_explain (https://postgrespro.ru/docs/postgresql/16/auto-explain).
Следующая проблема — анализ журнала. Для этого приходится применять внешние средства, из которых стандартом де-факто является расширение pgBadger (https://github.com/darold/pgbadger).
Разумеется, можно выводить в журнал и собственные сообщения, если они могут помочь делу.
Page 9: Профиль запросов
Расширение pg\_stat\_statements
- подробная информация о запросах в представлении
- (в том числе о вложенных)
- ограниченный размер хранилища
- запросы считаются одинаковыми «с точностью до констант»,
- даже если имеют разные планы выполнения
- идентификация только по имени пользователя и базе данных
- унифицированный идентификатор запроса (compute_query_id = auto)
Комментарии преподавателя
Второй способ — статистика, а именно расширение pg_stat_statements ( https://postgrespro.ru/docs/postgresql/16/pgstatstatements).
Расширение собирает достаточно подробную информацию о выполняемых запросах (в том числе в терминах ввода-вывода страниц) и отображает ее в представлении pg_stat_statements.
Поскольку число различных запросов может быть очень большим, размер хранилища ограничен конфигурационным параметром; в нем остаются наиболее часто используемые запросы.
При этом «одинаковыми» считаются запросы, имеющие одинаковое (с точностью до констант) дерево разбора. Надо иметь в виду, что такие запросы могли иметь разные планы выполнения и выполняться разное время.
К сожалению, есть сложности и с идентификацией: запросы можно отнести к конкретному пользователю и базе данных, но не к сеансу.
При установке конфигурационного параметра compute_query_id в значение auto или on ядро СУБД будет вычислять единый идентификатор запроса. Его можно выводить в журнал сообщений, настроив параметр log_line_prefix, а также использовать для соединения информации из ядра (колонка pg_stat_activity.query_id), pg_stat_statements и других расширений.
https://postgrespro.ru/docs/postgresql/16/runtime-config-statistics#GUC-CO MPUTE-QUERY-ID
Page 10: Расширение pg_stat_statements
Подключим расширение pg_stat_statements, с помощью которого будем строить профиль:
Подключение библиотеки требует перезагрузки.
Настроим расширение так, чтобы собиралась информация о всех запросах, в том числе вложенных:
Создадим представление, чтобы смотреть на собранную статистику выполнения операторов:
Здесь мы для простоты показываем только часть полей и выводим только общее число страниц кеша.
Профиль выполнения
Рассмотрим задачу. Требуется построить отчет, выводящий сводную таблицу количества перевезенных пассажиров: строками отчета должны быть модели самолетов, а столбцами — категории обслуживания. Сначала создадим функцию, возвращающую число пассажиров для заданной модели и категории обслуживания:
Для отчета создадим функцию, возвращающую набор строк:
Page 11: Page 11
Теперь исследуем работу предложенной реализации. Сбросим статистику:
Дата последнего сброса статистики видна в представлении pg_stat_statements_info:
Выполним функцию report():
Посмотрим, какую статистику мы получили:
Page 12: Page 12
Первым идет основной запрос, который детализируется ниже. Toplevel — признак выполнения запроса на верхнем уровне. Вторым идет запрос из функции qty — он вызывался 27 раз. Третий — запрос, по которому работает цикл. Обратите внимание, что идентификатор запроса в pg_stat_statements совпадает с системным благодаря настройке compute_query_id:
Page 13: Профиль одного запроса
EXPLAIN ANALYZE
- подзадачи — узлы плана
- продолжительность — actual time
- или страничный ввод-вывод — buffers
- количество выполнений — loops
- Особенности
- помимо наиболее ресурсоемких узлов, кандидаты на оптимизацию —
- узлы с большой ошибкой прогноза кардинальности
- любое вмешательство может привести к полной перестройке плана
- иногда приходится довольствоваться простым EXPLAIN
Комментарии преподавателя
Так или иначе, среди выполненных запросов мы находим тот, который будем оптимизировать. Как работать с самим запросом? Тут тоже поможет профиль, который выдает команда EXPLAIN ANALYZE.
Подзадачами такого профиля являются узлы плана (план — не плоский список, а дерево). Продолжительность выполнения узла и число его повторений покажут time и loops из блока значений actual. С помощью параметра buffers можно получить объем ввода-вывода (и время, потраченное на операции ввода-вывода, если включен параметр track_io_timing).
План выполнения содержит также крайне важную информацию об ожидании оптимизатора относительно кардинальности каждого шага. Как правило, если нет серьезной ошибки в прогнозе кардинальности, то и план будет построен адекватный (если нет, то надо менять глобальные настройки). Поэтому стоит обращать внимание не только на наиболее ресурсоемкие узлы, но и на узлы с большим (на порядок или выше) расхождением между rows и actual rows. Смотреть надо на наиболее вложенный проблемный узел, поскольку ошибка будет распространяться от него выше по дереву.
Бывают ситуации, когда запрос выполняется так долго, что выполнить EXPLAIN ANALYZE не представляется возможным. В таком случае придется довольствоваться простым EXPLAIN и пытаться разобраться в причине неэффективности без полной информации.
Работать с большими планами в текстовом виде не всегда удобно. Для лучшей наглядности можно пользоваться сторонними инструментами, из которых отметим https://explain.tensor.ru/about.
Page 14: Профиль одного запроса
Попробуем теперь вывести тот же отчет одним запросом и посмотрим на его выполнение командой EXPLAIN с параметрами analyze и buffers, чтобы в плане отображалось количество фактически прочитанных и записанных страниц файлов данных и временных файлов:
Page 15: Page 15
Обратите внимание, как уменьшилось время выполнения запроса и насколько меньше страниц пришлось прочитать благодаря устранению избыточных чтений (верхняя строчка Buffers). Можно посчитать общее количество страниц во всех задействованных таблицах:
Это число может служить грубой оценкой сверху для запроса, которому требуются все строки: обработка существенно большего числа страниц может говорить о том, что данные перебираются по нескольку раз. Видно, что в данном случае план близок к оптимальному. Его тоже можно улучшить, но уже не так радикально (очевидный момент — недостаток оперативной памяти для хеш-соединений).
Page 16: Итоги
Для поиска задач, нуждающихся в оптимизации, используется профилирование
- Средства профилирования зависят от задачи:
- журнал сообщений сервера и pg_stat_statements
- EXPLAIN ANALYZE
Page 17: Практика
- Выполните первую версию отчета, показанного в демонстрации, включив вывод текста и времени выполнения запросов в журнал сообщений. 2. Посмотрите, какая информация попала в журнал сообщений. 3. Повторите предыдущие пункты, включив расширение auto_explain с выводом вложенных запросов.
Page 18: 1. Отчет
Включаем вывод операторов и времени их выполнения в журнал:
2. Сообщения в журнале
Вложенные SQL-операторы не выводятся.
3. Расширение auto\_explain
Page 19: Page 19
Выведем несколько последних строк журнала сообщений:
Page 20: Page 20
В журнал попадают вложенные запросы и планы выполнения — собственно, это и есть основная функция расширения. Помимо этого, с указанными настройками в журнал попадают параметры запроса (строка Query Parameters) и идентификатор запроса (строка Query Identifier).
14 Занятие 14: Оптимизация запросов / Материализация
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_14_optim_materialization.html Archive: QPT-handouts-16.zip Страниц PDF: 24
Page 1: Оптимизация запросов / Материализация
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Материализация в запросах
- Временные таблицы
- Управление порядком соединений
- Материализованные представления
Page 3: Узел Materialize
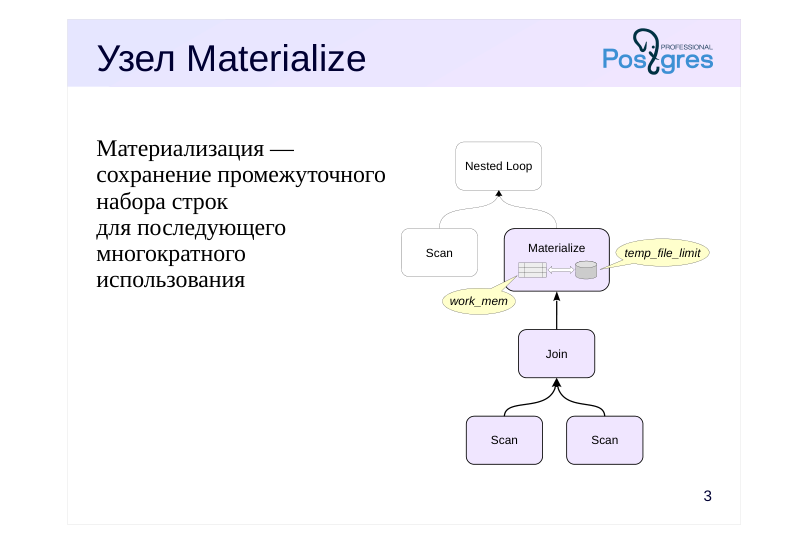 {#source-figure-003 caption=“Source slide page 3: Узел Materialize”}
Материализация — сохранение промежуточного набора строк для последующего многократного использования
Комментарии преподавателя
Материализацией называется сохранение промежуточного набора строк с целью повторного использования, как правило, многократного. Сохранять набор можно на разных уровнях: для конкретного запроса, на уровне сеанса или на уровне базы данных.
Обычно узлы запроса передают друг другу данные по принципу конвейера: когда алгоритму, выполняющемуся в узле плана, требуется очередная строка набора, узел обращается к одному из дочерних узлов за следующей порцией. Однако в некоторых случаях исполнителю запроса имеет смысл (а иногда и необходимо) сразу получить все строки, сохранить их и иметь возможность обращаться к сохраненному результату повторно. Такое сохранение выполняет узел Materialize.
Строки сохраняются в оперативной памяти, пока их объем укладывается в ограничение work_mem. При превышении этого ограничения все строки сбрасываются во временный файл и при необходимости читаются оттуда. Объем всех временных файлов одного сеанса ограничен значением параметра temp_file_limit.
Например, на слайде верхний узел Nested Loop выполняет соединение вложенным циклом, но к внутреннему набору данных нет эффективного доступа: он вычисляется с помощью другого соединения. Чтобы не повторять многократно вложенное соединение, его результат можно материализовать.
Page 4: Узел Materialize
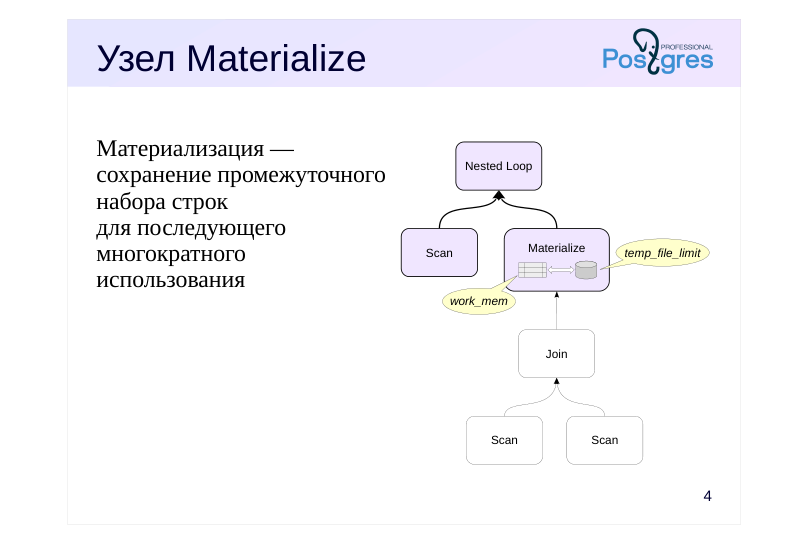 {#source-figure-004 caption=“Source slide page 4: Узел Materialize”}
Материализация — сохранение промежуточного набора строк для последующего многократного использования
Комментарии преподавателя
После того как результат вложенного соединения материализован, узел Nested Loop будет обращаться к уже готовому набору строк.
Page 5: Узел Materialize
Если операция требует существенных ресурсов, а к ее результату обращаются многократно, планировщик может выбрать план с узлом Materialize, в котором полученные строки накапливаются для повторного использования:
Здесь для предиката внутреннего набора строк нет подходящего индекса, поэтому план с материализацией оказывается выгодным. В некоторых случаях планировщик использует материализацию внутреннего набора данных и при соединении слиянием, чтобы иметь возможность перечитать часть строк при повторяющихся значениях во внешнем наборе:
Page 6: Материализация CTE
 {#source-figure-006 caption=“Source slide page 6: Материализация CTE”}
Комментарии преподавателя
Общие табличные выражения (common table expression, CTE), они же подзапросы WITH, — прекрасный способ структурировать запрос и сделать его более понятным. В отличие от обычных подзапросов, использование CTE не приводит к большой вложенности.
По возможности планировщик раскрывает (не материализует) подзапросы CTE. Это позволяет ему выбирать оптимальный порядок соединений. По умолчанию подзапрос материализуется в следующих ситуациях:
● Основной запрос обращается к подзапросу несколько раз — чтобы не повторять вычисления.
В этом случае материализацию можно отменить, указав предложение AS NOT MATERIALIZED.
● Подзапрос имеет побочные эффекты (изменяет данные) — чтобы изменение произошло ровно один раз. (К побочным эффектам относится также обращение к изменчивым функциям, см. тему «Функции».)
В этом случае материализацию отменить невозможно.
Материализацию всегда можно принудительно включить, указав предложение AS MATERIALIZED.
https://postgrespro.ru/docs/postgresql/16/queries-with#QUERIES-WITH-CT E-MATERIALIZATION
Page 7: Материализация CTE
Оптимизатор старается не материализовать подзапросы в WITH без надобности:
Но явное указание заставляет оптимизатор планировать подзапрос отдельно от основного запроса:
Если подзапрос используется в запросе несколько раз, планировщик выбирает материализацию, чтобы не выполнять одни и те же действия многократно:
Page 8: Page 8
Обычно это оправдано, особенно если в подзапросе происходят затратные вычисления. Но в некоторых случаях (как в этом примере) план без материализации может оказаться эффективнее, и тогда ее можно отменить. Сравните значение buffers с предыдущим вариантом:
Однако если подзапрос изменяет данные, материализация будет выполнена в любом случае: изменение обязано произойти только один раз.
Page 9: Рекурсивные запросы
 {#source-figure-009 caption=“Source slide page 9: Рекурсивные запросы”}
Комментарии преподавателя
Рекурсивные запросы строятся на базе общих табличных выражений.
Узел Recursive Union использует рабочую и промежуточную таблицы: рабочая таблица хранит строки, получаемые на текущей итерации, а промежуточная — накапливает результат. Содержимое рабочей таблицы считывается в рекурсивной части запроса узлом Worktable Scan.
Каждая из этих двух таблиц материализуется по тем же правилам: пока содержимое таблицы помещается в work_mem, она хранится в памяти, а затем все строки сбрасываются на диск.
После выполнения рекурсивного запроса накопленное содержимое промежуточной таблицы передается узлу CTE Scan, а рабочая таблица отбрасывается.
https://postgrespro.ru/docs/postgresql/16/queries-with#QUERIES-WITH-RE CURSIVE
Page 10: Рекурсивные запросы
Убедимся в том, что рекурсивный запрос материализует промежуточные данные. Для этого намеренно напишем его так, чтобы рабочая и промежуточная таблицы не поместились в память:
Обратите внимание на строки temp read/written в узлах WorkTable Scan и Recursive Union, специфичных для рекурсивных запросов.
Page 11: Оконные функции
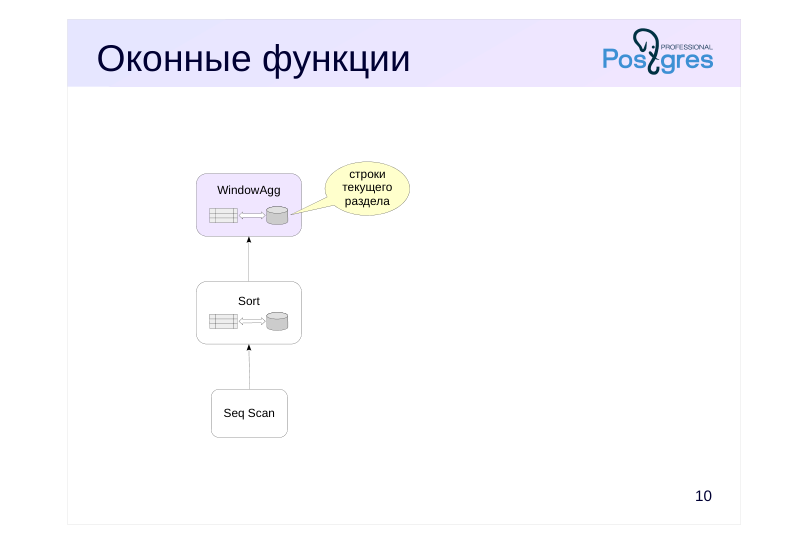 {#source-figure-011 caption=“Source slide page 11: Оконные функции”}
Комментарии преподавателя
При вычислении оконных функций в узле WindowAgg (см. тему «Сортировка») тоже применяется материализация: строки текущего раздела (PARTITION BY) могут неоднократно попадать в рамку, и поэтому материализуются.
В этом случае материализованными строками пользуется только сам узел WindowAgg: родительскому узлу передается результат вычислений, а не эти промежуточные данные.
https://postgrespro.ru/docs/postgresql/16/tutorial-window
Page 12: Временные таблицы
Таблица, доступная в пределах одного сеанса
- регистрируется в системном каталоге
- не журналируется
- создаются файлы на диске
- кеширование в локальной памяти сеанса (temp_buffers)
- Очистка и анализ
- только вручную
Комментарии преподавателя
Для получения промежуточных данных может использоваться сложный алгоритм, например, написанный на процедурном языке. В таком случае данные не получится посчитать в CTE, но их можно поместить во временную таблицу и использовать в нескольких запросах.
Временные таблицы удобнее для промежуточных данных, чем обычные, поскольку они существуют только в пределах сеанса или транзакции (в зависимости от указанного при создании режима) и автоматически удаляются вместе с данными и зависимыми объектами (представлениями и индексами). К тому же временные таблицы не журналируются и кешируются в локальной памяти процесса, обслуживающего сеанс — это делает работу с ними более быстрой.
Локальная память процесса недоступна процессам автоочистки, поэтому очистку и анализ следует проводить вручную. Память для кеша выделяется по необходимости и ограничена для сеанса параметром temp_buffers (после первого обращения к временной таблице изменить ограничение уже нельзя).
https://postgrespro.ru/docs/postgresql/16/sql-createtable
Однако для временных таблиц создаются записи в системном каталоге и файлы на диске. Поэтому при массовой работе с временными таблицами — например, в системе 1С — будет разрастаться системный каталог и увеличится нагрузка на файловую систему. Поэтому для 1С используют специальные патчи, нивелирующие эти нежелательные эффекты.
Page 13: Временные таблицы
Создадим временную таблицу:
Временная таблица создается во временной схеме pg_temp. По умолчанию таблица существует до конца сеанса; можно указать, чтобы при завершении транзакции удалялись строки (ON COMMIT DELETE ROWS) или сама таблица (ON COMMIT DROP). Зачастую есть смысл проанализировать только что заполненную временную таблицу, прежде чем использовать ее в запросах. Сравните оценки кардинальности при выборе из обычной таблицы и из временной:
В последнем случае оптимизатор, не имея статистики, предполагает, что таблица занимает 10 страниц, на которых умещается 520 строк, и стоимость получается завышенной:
Если проанализировать таблицу, оценка станет точной:
Page 14: Порядок соединений
Количество вариантов соединений растет экспоненциально с ростом количества таблиц в запросе
- Соединение JOIN
- полный перебор при числе соединений не более join_collapse_limit = 8
- дальше — группами по join_collapse_limit таблиц
- Соединение через запятую
- полный перебор при числе соединений не более geqo_threshold = 12
- дальше — генетический алгоритм
- Материализация — подсказка планировщику
Комментарии преподавателя
С ростом количества таблиц в запросе число вариантов соединений и, как следствие, затраты на выбор плана растут экспоненциально.
Если число соединений (записанных в виде JOIN) превышает значение join_collapse_limit (по умолчанию 8), планировщик рассматривает возможные соединения в группах по join_collapse_limit таблиц, а затем соединяет эти группы между собой.
(Для подзапросов в предложении FROM есть похожий параметр — from_collapse_limit.)
Если таблицы соединены запятой (без ключевого слова JOIN), планировщик рассматривает все варианты соединений, но переключается на генетический алгоритм оптимизации, когда количество соединений превышает geqo_threshold (12 по умолчанию).
Все это может приводить к неоптимальным планам. Подробности можно прочитать в статье Павла Толмачева: https://habr.com/ru/company/postgrespro/blog/662021/
Вручную управляя материализацией — либо с помощью CTE, либо разбивая запрос на части и задействуя временные таблицы, — разработчик может разделить таблицы на группы, каждую из которых оптимизатор будет планировать отдельно. Обычно CTE — более простой и эффективный способ, но второй вариант позволяет проанализировать временную таблицу и сообщить таким образом планировщику больше информации о данных.
https://postgrespro.ru/docs/postgresql/16/explicit-joins
Page 15: Управление порядком соединений
Значение по умолчанию параметра join_collapse_limit выбрано так, чтобы планирование соединения такого количества таблиц не требовало чрезмерных ресурсов:
Выполним запрос, в котором используется явное соединение таблиц с помощью ключевого слова JOIN:
В выбранном плане сначала соединяются таблицы рейсов (flights) и перелетов (ticket_flights), а затем результат соединяется с билетами (tickets). Установив параметр join_collapse_limit в единицу, можно зафиксировать порядок соединений:
Теперь таблицы соединяются друг с другом в том порядке, в котором они перечислены в запросе, несмотря на то, что итоговая стоимость запроса выше. Однако такой способ перекладывает на автора запроса слишком много ответственности. Планировщик сможет выбирать только то, какой из наборов строк поставить в соединении внешним, а какой — внутренним.
С похожим параметром from_collapse_limit предлагается познакомиться в практике.
Page 16: Page 16
Page 17: Мат. представления
Материализация результата запроса
- только для чтения
- возможно создание индексов
- Обновление данных
- ручная синхронизация
- инкрементальное обновление — расширение pg_ivm
- Очистка и анализ
- вручную и автоматически
Комментарии преподавателя
Материализованное представление — это именованный результат запроса, сохраненный на уровне базы данных. К материализованному представлению можно обращаться как к обычной таблице, доступной только для чтения.
По материализованному представлению можно построить индексы (но нельзя добавить ограничение целостности — ограничения должны проверяться в базовых таблицах). Для материализованного представления собирается такая же статистика, как и для обычных таблиц.
В отличие от обычных представлений, строки материализованного представления не изменяются при изменении базовых таблиц. Синхронизация выполняется вручную.
https://postgrespro.ru/docs/postgresql/16/sql-creatematerializedview
Полная синхронизация материализованного представления может быть слишком затратной. Штатное инкрементальное обновление (отдельных строк по мере изменения базовых таблиц) не доступно, но такую возможность дает расширение pg_ivm (автор — Юго Нагата, https://github.com/sraoss/pg\_ivm).
Page 18: Материализованные представления
Создадим материализованное представление:
Схема pg_temp при поиске проверяется первой, теперь придется обращаться к материализованному представлению по полному имени. Это неудобно, лучше удалить временную таблицу:
Материализованные представления можно индексировать:
При анализе и автоанализе для материализованных представлений собирается та же статистика, что и для таблиц. При изменении содержимого базовых таблиц строки материализованного представления не изменяются:
Синхронизацию нужно проводить явно. Команда REFRESH полностью блокирует материализованное представление на время перестроения, что может быть нежелательным. В данном случае этого можно избежать, указав CONCURRENTLY, поскольку на материализованном представлении создан уникальный индекс:
Page 19: Page 19
Page 20: Итоги
Оптимизатор может материализовать строки, полученные узлами плана, для повторного использования
- Можно управлять материализацией с помощью CTE, временных таблиц и материализованных представлений
- Материализация позволяет управлять порядком соединений
Page 21: Практика
- В начале демонстрации приводились примеры двух запросов с узлом Materialize. Выдайте планировщику указание не использовать этот узел и проверьте, в каком случае он сможет обойтись без материализации, а в каком — нет. 2. Проверьте план выполнения запроса при значениях параметра from_collapse_limit 8 (по умолчанию) и 1:
Комментарии преподавателя
Воспользуйтесь параметром enable_material: https://postgrespro.ru/docs/postgresql/16/runtime-config-query#GUC-ENAB LE-MATERIAL
Прочитайте про параметр в документации: https://postgrespro.ru/docs/postgresql/16/explicit-joins
Page 22: 1. Отключение узла Materialize
Проверим план первого запроса из демонстрации:
Попросим планировщик не использовать материализацию:
Планировщик обошелся без материализации, но стоимость плана увеличилась. Проверим второй запрос:
Page 23: Page 23
В данном случае планировщик не может не использовать материализацию, поскольку для соединения слиянием требуется не только перемещаться по набору данных вперед, но и возвращаться назад.
2. Параметр from\_collapse\_limit
Сначала посмотрим, как работает запрос со значением from_collapse_limit по умолчанию:
В подзапросе соединяются две таблицы, но оптимизатор раскрывает подзапрос и выбирает порядок соединения для всех трех таблиц. Первыми здесь соединяются таблицы перелетов (ticket_flights) и рейсов (flights). Теперь уменьшим значение from_collapse_limit до единицы и посмотрим на новый план того же запроса:
Page 24: Page 24
План запроса поменялся — сначала соединяются две таблицы из подзапроса, который теперь не раскрывается. Если во FROM вместо списка таблиц использовать конструкцию JOIN, оптимизатор сначала преобразует каждую такую конструкцию в список таблиц (при этом обрабатывая таблицы группами не более чем по join_collapse_limit), а потом уже раскрывает подзапросы (на глубину не более чем from_collapse_limit). Поэтому имеет смысл устанавливать обоим параметрам равные значения.
15 Занятие 15: Оптимизация запросов / Функции
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_15_optim_functions.html Archive: QPT-handouts-16.zip Страниц PDF: 26
Page 1: Оптимизация запросов / Функции
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Категории изменчивости
- Подстановка кода функции в текст запроса
- Вызов табличных функций
- Настройки COST и ROWS
- Вспомогательные функции планировщика
- Конфигурационные параметры
Page 3: Категории изменчивости
Volatile
- возвращаемое значение может произвольно меняться
- при одинаковых значениях входных параметров
- используется по умолчанию
- Stable
- значение не меняется в пределах одного оператора SQL
- функция не может менять состояние базы данных
- Immutable
- значение не меняется, функция детерминирована
- функция не может менять состояние базы данных
Комментарии преподавателя
Каждой функции сопоставлена категория изменчивости, которая определяет свойства возвращаемого значения при одинаковых значениях входных параметров.
Категория Volatile говорит о том, что возвращаемое значение может произвольно меняться. Такие функции будут выполняться каждый раз при каждом вызове. Если при создании функции категория не указана, назначается именно эта категория.
Категория Stable используется для функций, возвращаемое значение которых не меняется в пределах одного SQL-оператора. В частности, такие функции не могут менять состояние БД. Такая функция может быть выполнена один раз во время выполнения запроса, а затем будет использоваться вычисленное значение.
Категория Immutable еще более строгая: возвращаемое значение не меняется никогда. Такую функцию можно выполнить на этапе планирования запроса, а не во время выполнения.
Можно — не означает, что всегда происходит именно так, но планировщик вправе выполнить такие оптимизации.
https://postgrespro.ru/docs/postgresql/16/xfunc-volatility
Page 4: Категории изменчивости и оптимизация
Благодаря дополнительной информации о поведении функции, которую дает указание категории изменчивости, оптимизатор может сэкономить на вызовах функции. Для экспериментов создадим функцию, возвращающую случайное число:
Проверим план выполнения следующего запроса:
В плане мы видим обращение к табличной функции generate_series в узле Function Scan. Ее результат фильтруется, для каждой строки в фильтре честно вызывается скалярная функция random. В этом можно убедиться и воочию:
Page 5: Page 5
Здесь случайным образом получаем от 0 до 10 строк. Функция с категорией изменчивости Stable будет вызвана всего один раз — поскольку мы фактически указали, что ее значение не может измениться в пределах оператора:
Узел Result формирует строку выборки, а выражение One-Time Filter вычисляется один раз, так что результатом запроса будет либо 0, либо 10 строк.
Наконец, категория Immutable позволяет вычислить значение функции еще на этапе планирования, поэтому во время выполнения вычисление условия фильтра уже не требуется:
Page 6: Page 6
Для Immutable получаем случайный план! Ответственность «за дачу заведомо ложных показаний» лежит на разработчике.
Page 7: Подстановка кода функций
Скалярные функции на SQL
- один оператор SELECT без предложения FROM,
- возвращает одно значение
- вызываемые функции не должны быть изменчивее вызывающей
- и др.
- Табличные функции на SQL
- один оператор SELECT
- категория Immutable или Stable
- функция не STRICT
- и др.
Комментарии преподавателя
Оптимизатор PostgreSQL умеет подставлять (inline) тело функции в SQL-запрос. Это работает как со скалярными, так и с табличными функциями.
В обоих случаях есть много ограничений: функция должна быть написана на языке SQL, использовать единственный оператор SELECT и т. д. Скалярная функция, к тому же, не должна обращаться к таблицам базы данных и вызывать функции, имеющие менее строгую категорию, а табличная — быть стабильной или постоянной.
Важным преимуществом подстановки тела функции в запрос является то, что функция становится прозрачной для планировщика. Например, дополнительные условия в теле основного запроса могут быть применены к запросу из тела функции, что позволит как можно раньше отфильтровать лишние строки.
https://wiki.postgresql.org/wiki/Inlining\_of\_SQL\_functions
Page 8: Подстановка кода функций в SQL-запрос
Тело очень простых скалярных функций на языке SQL может быть подставлено прямо в основной SQL-оператор на этапе разбора запроса. В этом случае время на вызов функции не тратится. Пример мы уже видели: наша функция rnd(). Проверим, какой будет план запроса в случае, когда категория изменчивости функции rnd (Stable) не соответствует категории изменчивости функции random (Volatile):
В фильтре упоминается функция rnd(). Поменяем категорию изменчивости функции на Volatile:
Теперь в фильтре упоминается функция random(), но не rnd(). Она будет вызываться напрямую, минуя «обертку» в виде функции rnd(). Возможностей для подстановки табличных функций гораздо больше. Например, в таких функциях допускаются обращения к таблицам.
При подстановке табличные функции работают наподобие представлений с параметрами. Планировщик оптимизирует весь запрос, функция прозрачна для него:
Page 9: Page 9
Page 10: Вызов табличных функций
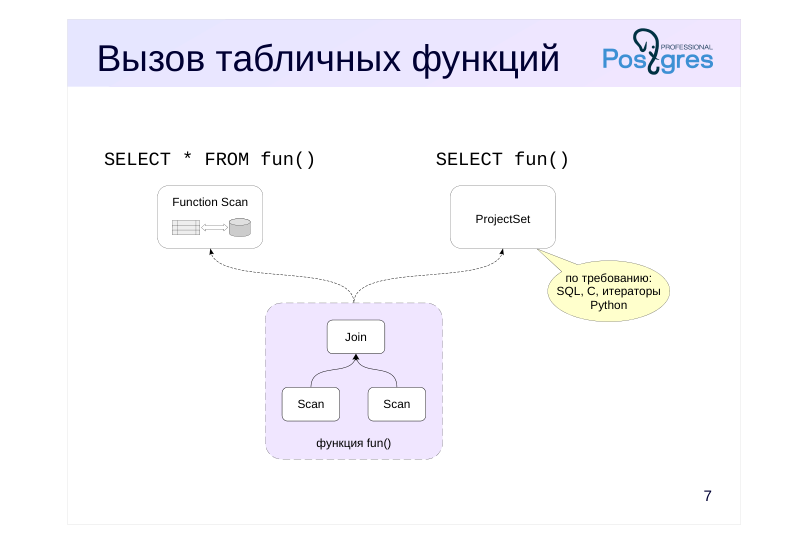 {#source-figure-010 caption=“Source slide page 10: Вызов табличных функций”}
Комментарии преподавателя
Когда табличная функция вызывается в предложении FROM, за ее вычисление отвечает узел Function Scan. При этом сначала все строки, возвращаемые функцией, материализуются, и только затем передаются родительскому узлу плана. Таково текущее ограничение реализации.
Если же функция вызывается в предложении SELECT, в плане она выполняется в узле ProjectSet. В этом случае функция может воспользоваться интерфейсом возвращения строк «по требованию» (value-per-call), без материализации.
Так работают функции на языке SQL, большинство встроенных функций (написанных на С) и функции на PL/Python, возвращающие итератор. Функции на других языках программирования тоже могут использовать этот интерфейс, если такая возможность в них реализована.
Page 11: Табличные функции
Вызовем функцию generate_series в предложении FROM с ограничением на количество строк (LIMIT):
В плане запроса видим узел Function Scan — сначала были получены все строки из функции, и только потом наложено ограничение LIMIT. А теперь повторим запрос, только вызовем функцию из предложения SELECT:
Теперь в плане появился узел ProjectSet, который формирует десять строк выборки — в данном случае оптимизатору удалось получать строки по требованию. Время выполнения запроса сократилось на порядки. Узел Result здесь представляет опущенное в запросе предложение FROM — он передает родительскому узлу ровно одну строку. Однако не все функции могут возвращать строки по одной. Например, обращение к любой функции на языке PL/pgSQL возвращает все строки результата:
Вызовем функцию из предложения SELECT:
В плане — узел ProjectSet, но теперь серверу приходится получить результат функции полностью, а затем наложить ограничение LIMIT. Время выполнения это хорошо показывает. В предложении SELECT может быть несколько вызовов табличных функций, а сами функции могут вкладываться друг в друга:
Page 12: Page 12
Нижний узел ProjectSet формирует выборку из результатов выполнения двух табличных функций: generate_series(1,3) и unnest. В этой выборке оказываются три строки. Верхний узел ProjectSet формирует итоговую выборку, вычисляя внешний вызов generate_series. Без учета материализации такой запрос эквивалентен следующему запросу, в котором функции вызываются в предложении FROM:
Page 13: Настройки COST и ROWS
CREATE FUNCTION fun( )
- Function Scan ( rows=1000 cost=100 )
- оценки
- по умолчанию
- CREATE FUNCTION fun( ) ROWS 12 COST 123
- Function Scan ( rows=12 cost=123 )
- ROWS
- COST
Комментарии преподавателя
Обычно (если не удалось подставить тело функции в запрос) оптимизатор не имеет возможности анализировать код функции и воспринимает ее как «черный ящик».
Однако можно дать оптимизатору приблизительную информацию о стоимости вызова функции и числе возвращаемых строк.
Параметр COST задает стоимость пользовательской функции в единицах cpu_operator_cost. По умолчанию функции на C получают оценку 1, а на других языках — 100.
Параметр ROWS указывает примерное число возвращаемых строк.
COST и ROWS можно указывать как при создании функции, так и для уже существующих функций.
https://postgrespro.ru/docs/enterprise/16/sql-createfunction
Page 14: Настройки COST и ROWS
Напишем табличную функцию на языке PL/pgSQL, выводящую дни недели:
План запроса:
Стоимость выполнения функции считается постоянной, для пользовательских функций по умолчанию она равна стоимости 100 операторов:
Но это значение можно изменить:
В плане изменилась начальная стоимость. Сервер оценивает кардинальность результата этой функции как 1000, хотя фактическое значение равно семи. С помощью указания ROWS можно подсказать серверу ориентировочное количество строк, которое вернет функция:
Повторим запрос:
Page 15: Page 15
Теперь сервер считает, что функция вернет 10 строк, поэтому уменьшилась полная стоимость узла:
Измененные значения можно увидеть в системном каталоге:
Или с помощью метакоманды psql:
Page 16: Вспомогательные функции
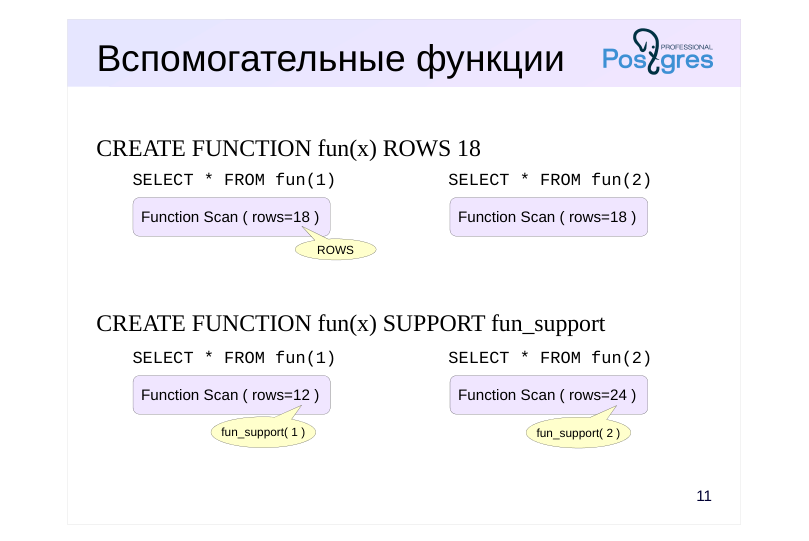 {#source-figure-016 caption=“Source slide page 16: Вспомогательные функции”}
CREATE FUNCTION fun(x) ROWS 18
- CREATE FUNCTION fun(x) SUPPORT fun_support
Комментарии преподавателя
Параметры COST и ROWS позволяют задать стоимость и количество строк, возвращаемых функцией, как постоянные величины. Но константы не всегда дают желаемый результат.
В PostgreSQL есть возможность для функции написать вспомогательную функцию, которая предоставляет планировщику информацию, зависящую от значений аргументов основной (целевой) функции.
Вспомогательная функция может по значениям аргументов целевой функции выдавать:
● оценку ее стоимости;
● оценку числа возвращаемых строк;
● выражение, эквивалентное вызову функции.
Дополнительно для функций, возвращающих boolean:
● оценку селективности;
● эквивалентный предикат с индексируемым оператором.
Вспомогательная функция должна быть написана на языке С.
https://postgrespro.ru/docs/postgresql/16/xfunc-optimization
Page 17: Вспомогательные функции планировщика
Посмотрим план запроса с вызовом функции generate_series:
В отличии от функции days_of_week, оптимизатор сразу правильно оценивает количество возвращаемых строк. Более того, оценка зависит от параметров функции:
Благодаря вспомогательной функции (она может быть написана только на языке С) планировщик получает дополнительную информацию, которую использует для вычисления селективности условий, кардинальности функции или ее стоимости. Посмотреть, имеется ли вспомогательная функция, можно в таблице pg_proc:
Как видно, вспомогательные функции существуют не для всех перегруженных вариантов функции generate_series. Посмотрим на план запроса, генерирующего ряд дат:
Без вспомогательной функции и указания ROWS оптимизатор не имеет информации о числе строк в результате и поэтому использует значение по умолчанию (1000). С каждой версией в PostgreSQL появляются новые вспомогательные функции.
Page 18: Пометки параллельности
CREATE FUNCTION fun( ) PARALLEL …
- небезопасные для распараллеливания
- (по умолчанию)
UNSAFE
- ограниченно распараллеливаемые
- RESTRICTED
- безопасные для распараллеливания
- SAFE
Комментарии преподавателя
В теме «Параллельная обработка» было рассказано про то, что не каждый запрос может выполняться в параллельном режиме. Поскольку оптимизатор не может проанализировать тело функции, он рассчитывает на пометки параллельности, определяя по ним возможность параллельной обработки.
При создании функции (или позже) можно указать одну из трех пометок:
● UNSAFE — запрещаются параллельные планы, если в запросе есть вызов функции;
● RESTRICTED — разрешаются параллельные планы, но запрещено вызывать функцию в параллельной части плана;
● SAFE — безопасна для параллельной обработки.
По умолчанию используется пометка UNSAFE.
Пометки параллельности указываются также для пользовательских агрегатных функций.
https://postgrespro.ru/docs/postgresql/16/parallel-safety#PARALLEL-LABELI NG
Page 19: Пометки параллельности
Пометки параллельности можно увидеть в столбце proparallel таблицы pg_proc (r=restricted, s=safe, u=unsafe):
Все основные стандартные функции безопасны. Пометки также показывает метакоманда \df+ утилиты psql (поле Parallel):
Проверим, как пометка параллельности влияет на план выполнения запроса. Напишем функцию, вычисляющую стоимость билета. Она помечена как безопасная для параллельного выполнения:
Запрос проверяет, что общая стоимость бронирований совпадает с общей стоимостью билетов:
Page 20: Page 20
План запроса состоит из двух частей: в узле InitPlan 1 выполняется подзапрос с агрегацией по tickets, а подзапрос в узле InitPlan 2 выполняет агрегацию по bookings. Сейчас оба подзапроса выполняются параллельно. Поменяем пометку параллельности на UNSAFE:
Теперь оба подзапроса выполняются последовательно — пометка запрещает параллельные планы. А теперь пометим функцию как ограниченно распараллеливаемую (RESTRICTED):
Подзапрос с функцией выполняется последовательно ведущим процессом, для второго подзапроса выбран параллельный план.
Конфигурационные параметры
В ряде случаев может оказаться удобным оформить запросы в виде хранимых подпрограмм (например, с целью предоставить к ним доступ приложению). В этом случае дополнительным преимуществом может быть возможность
Page 21: Page 21
установки параметров для конкретных подпрограмм. Рассмотрим в качестве примера запрос:
Допустим, мы хотим использовать параллельные планы, но именно этот запрос собираемся выполнять последовательно. Тогда мы можем установить параметр на уровне функции:
О том, как проверить план запроса, выполняющегося внутри функции, мы говорили в теме «Профилирование». Воспользуемся расширением auto_explain:
Выполним запрос:
Выведем последние строки журнала сообщений:
Page 22: Итоги
Функция — черный ящик для планировщика, если ее тело не подставляется в запрос
- Вызов табличных функций обычно материализуется
- Планировщику можно дать дополнительную информацию
- категорию изменчивости функции
- кардинальность и стоимость
- пометку параллельности
- Вспомогательные функции помогают оптимизировать вызовы встроенных функций
Page 23: Практика
- Отключите материализацию общего табличного выражения, в котором вызывается функция random. Объясните результат. 2. Напишите функцию-обертку на SQL для запроса SELECT * FROM generate_series (1, 10_000_000). Рассмотрите три варианта: сам исходный запрос и вызовы функции в предложениях FROM и SELECT. Сравните планы выполнения запросов и использование временных файлов. Что меняется при установке категории изменчивости Stable? 3. Какую категорию изменчивости имеет функция days_of_week из демонстрации? Какова ее изменчивость на самом деле?
- Определение функции:
Page 24: 1. Материализация изменчивых функций в CTE
Общее табличное выражение с изменчивой функцией всегда материализуется:
В этом случае указание NOT MATERIALIZED не действует:
2. Функция-обертка
По умолчанию функция имеет категорию изменчивости Volatile. Базовый запрос:
Поскольку функция вызывается в предложении FROM, происходит материализация. Памяти work_mem не хватает, все строки сбрасываются на диск (temp written) и затем считываются (temp read). Вызов функции в предложении SELECT:
Page 25: Page 25
В узле ProjectSet нет материализации, поэтому цифры temp written/read остались без изменений. Однако время выполнения сильно увеличилось: оно тратится на передачу десяти миллионов строк от узла к узлу по одной строке. Вызов функции в предложении FROM:
Здесь к узлу Function Scan внутри функции добавляется еще один в основном запросе, поэтому количество использованных временных страниц удваивается. Сменим категорию изменчивости функции:
При вызове функции из предложения SELECT ничего не меняется:
Вызовем функцию из предложения FROM:
Теперь тело функции подставляется в основной запрос.
3. Дни недели
Функция была создана следующей командой:
Категория изменчивости не указана, поэтому подразумевается Volatile. Может показаться, что это постоянная функция (Immutable), поскольку у нее нет параметров и список дней недели не меняется.
Page 26: Page 26
Однако названия дней недели зависят от настройки локализации. Текущее значение:
Изменим настройку:
Теперь функция возвращает названия дней недели на английском языке, поэтому правильным будет задать категорию Stable:
16 Занятие 16: Оптимизация запросов / Подходы к настройке
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: qpt_16_optim_tuning.html Archive: QPT-handouts-16.zip Страниц PDF: 35
Page 1: Оптимизация запросов / Подходы к настройке
Авторские права
© Postgres Professional, 2019–2024 Авторы: Егор Рогов, Павел Лузанов, Павел Толмачев, Илья Баштанов Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Что настраивать?
- Настройка сервера
- Настройка приложения
- Запросы
Page 3: Что настраивать?
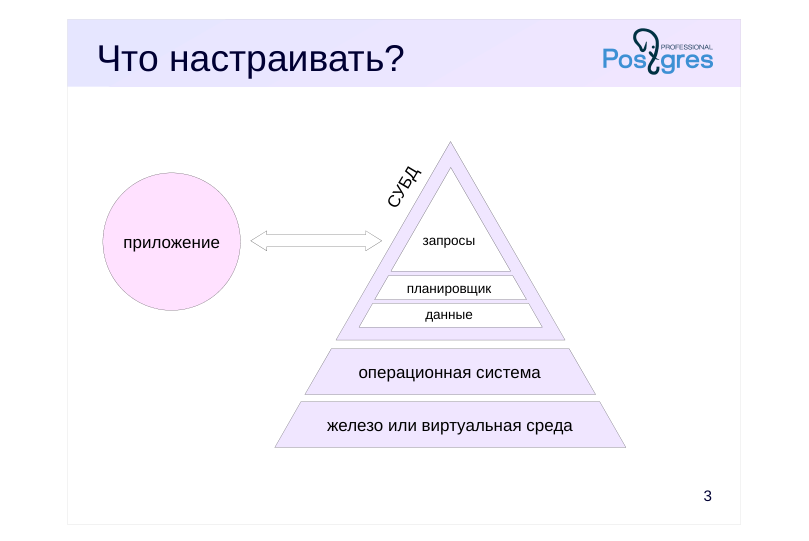 {#source-figure-003 caption=“Source slide page 3: Что настраивать?”}
- запросы
- приложение
Комментарии преподавателя
Производительность работы информационной системы обеспечивается на разных уровнях.
Мы совсем не рассматриваем два важных уровня: оборудование (которое может быть виртуализировано, и тогда к картине добавляется еще один слой) и операционную систему. В частности, работа СУБД с данными происходит через файловую систему, а эффективность и надежность операций ввода-вывода зависит от дисковой подсистемы. Поэтому прежде всего нужно обеспечить необходимые ресурсы и настроить ОС для их максимального использования.
Сервер баз данных настраивается так, чтобы служебные задачи не занимали больше ресурсов, чем необходимо, и чтобы большинство запросов работали приемлемо. На этом уровне мы можем не только настраивать конфигурационные параметры (из которых рассмотрим лишь малую часть), но и управлять расположением данных. Наша задача состоит в том, чтобы обеспечить разумное распределение ресурсов и адекватную работу планировщика.
Далее дело доходит до настройки отдельных запросов. В теме «Профилирование» мы говорили, что разработчик обычно думает над оптимизацией запросов, которые в данный момент пишет, а администратор — над оптимизацией запросов, оказывающих наибольшее влияние на сервер в целом. В этой теме мы рассмотрим некоторые приемы оптимизации запросов.
Но запросы, составляющие рабочую нагрузку, инициируются приложением. Поэтому и настройка приложения не менее важна, чем настройка СУБД.
Page 4: Настройка сервера
Использование ресурсов
- Физическое расположение данных
- Статистика и настройки оптимизатора
Page 5: Ресурсы: CPU и ввод-вывод
Фоновые рабочие процессы
- max_parallel_workers_per_gather = 2
- max_parallel_workers = 8
- max_worker_processes = 8
- Ввод-вывод
- effective_io_concurrency = 1
- maintenance_io_concurrency = 10
Комментарии преподавателя
Начнем с настроек, которые определяют, какими ресурсами может распоряжаться СУБД.
PostgreSQL может использовать несколько ядер процессоров при параллельной обработке. Для этого запускаются дополнительные фоновые рабочие процессы. Подробно параллельное выполнение запросов было рассмотрено в теме «Параллельный доступ», а использование фоновых процессов для прикладной разработки — в теме «Фоновые процессы» курса DEV2.
Из настроек, связанных с использованием ввода-вывода, отметим параметр effective_io_concurrency. Он сообщает системе количество независимых дисков в дисковом массиве. Фактически этот параметр влияет только на количество страниц, которые будут предварительно считываться в кеш при сканировании по битовой карте.
Похожий параметр, действующий для некоторых служебных задач, называется maintenance_io_concurrency.
Page 6: Ресурсы: память
Память
- ↑
- work_mem
- = 4MB
- hash_mem_multiplier
- = 2
- maintenance_work_mem = 64MB
- ↑
- shared_buffers
- = 128MB
- effective_cache_size
- = 4GB
Комментарии преподавателя
Ряд настроек влияет на выделение и использование памяти.
Параметр work_mem определяет размер доступной памяти для отдельных операций (рассматривался в соответствующих темах).
Также он влияет и на выбор плана. Например, при небольших значениях предпочтение отдается сортировке, которая лучше работает при недостатке памяти, чем хеширование. Поэтому для узлов, использующих хеширование, размер рабочей памяти можно увеличить с помощью параметра-мультипликатора hash_mem_multiplier.
Параметр maintenance_work_mem влияет на скорость построения индексов и на работу служебных процессов.
Параметр shared_buffers определяет размер буферного кеша экземпляра. Настройка этого параметра рассматривается в курсе DBA2, но точно можно сказать, что значение по умолчанию крайне мало.
Параметр effective_cache_size подсказывает PostgreSQL общий объем кешируемых данных (как в буферном кеше, так и в кеше ОС). Чем больше его значение, тем более предпочтительным будет индексный доступ. Этот параметр не влияет на реальное выделение памяти.
Page 7: Физическое расположение
Табличные пространства
- разнесение данных по разным физическим устройствам
- ALTER TABLESPACE SET …
- Секционирование
- разделение таблицы на отдельно управляемые части
- для упрощения администрирования и ускорения доступа
- Шардирование
- размещение секций на разных серверах для масштабирования
- нагрузки на чтение и запись
- секционирование и расширение postgres-fdw
- или сторонние решения
Комментарии преподавателя
Физическая организация данных может сильно влиять на производительность.
С помощью табличных пространств можно управлять размещением объектов по физическим устройствам ввода-вывода. Например, активно используемые данные хранить на SSD-дисках, а архивные — на более медленных HDD.
Часть параметров сервера, которые зависят от характеристик носителя, (например, random_page_cost) можно устанавливать на уровне табличных пространств.
Секционирование позволяет организовать работу с данными очень большого объема. Основная выгода для производительности состоит в замене полного сканирования всей таблицы сканированием отдельной секции. Заметим, что секции тоже можно размещать по различным табличным пространствам.
Еще один вариант — размещение секций на разных серверах (шардирование) с возможностью выполнения распределенных запросов. Стандартный PostgreSQL содержит только базовые механизмы, необходимые для организации шардирования: секционирование и расширение postgres-fdw. Более эффективно и полноценно шардинг реализуется с помощью внешних решений. Обзорно этот вопрос рассматривается в последней теме курса DBA3.
https://postgrespro.ru/docs/postgresql/16/ddl-partitioning
https://postgrespro.ru/docs/postgresql/16/postgres-fdw
Page 8: Оптимизатор: статистика
Актуальность
- настройка автоочистки и автоанализа
- autovacuum_max_workers, autovacuum_analyze_scale_factor, …
- Точность
- default_statistics_target = 100
- индекс по выражению, расширенная статистика
Комментарии преподавателя
Планировщик опирается в своих оценках на статистику, поэтому статистика должна собираться достаточно часто. Достигается это настройкой процесса автоочистки и автоанализа. Детали настройки подробно рассматриваются в курсе DBA2.
Кроме того, статистика должна быть достаточно точной. Абсолютной точности достичь не получится (и не нужно), но погрешности не должны приводить к построению некорректных планов. Признаком неактуальной, неточной статистики будет серьезное несоответствие ожидаемого и реального числа строк в листовых узлах плана.
Для увеличения точности может потребоваться изменить значение default_statistics_target (глобально или для отдельных столбцов таблиц). Иногда будет полезным индекс по выражению, обладающий собственной статистикой. В отдельных случаях можно использовать расширенную статистику.
Page 9: Оптимизатор: стоимость
Ввод-вывод
- seq_page_cost
- = 1.0
- random_page_cost = 4.0
- ↓ для SSD
- Время процессора
- cpu_tuple_cost, cpu_index_tuple_cost, cpu_operator_cost
- стоимость пользовательских функций
Комментарии преподавателя
Имеется большое число настроек для стоимости элементарных операций, из которых, как мы уже видели, в итоге складывается стоимость плана запроса. Такие настройки имеет смысл изменять, если запросы, несмотря на точную оценку кардинальности, выполняются не самым эффективным образом.
Параметры seq_page_cost и random_page_cost связаны со вводом-выводом и определяют относительную стоимость чтения одной страницы при последовательном и при произвольном доступе.
Значение seq_page_cost равно единице и его не стоит изменять. Высокое значение параметра random_page_cost отражает реалии HDD-дисков. Для SSD-дисков (а также в случаях, когда все данные с большой вероятностью будут закешированы), значение этого параметра необходимо значительно уменьшать, например, до 1.1.
Параметры времени процессора определяют веса для учета стоимости обработки прочитанных данных. Обычно эти параметры не меняют, поскольку трудно спрогнозировать эффект изменений.
Но, как мы видели в теме «Функции», иногда полезно задать стоимость пользовательской функции в единицах cpu_operator_cost.
https://postgrespro.ru/docs/postgresql/16/runtime-config-query#RUNTIME-C ONFIG-QUERY-CONSTANTS
Page 10: Настройки стоимости
Пример запроса с корректной оценкой кардинальности:
Планировщик выбрал последовательное сканирование, и сделал это на основе полной информации. Так ли удачно это решение? Проверим, скомандовав планировщику не использовать последовательное сканирование, если есть другие способы:
Аналогичные enable-параметры есть и для прочих способов соединения, методов доступа и многих других операций. Эти параметры довольно грубо вмешиваются в работу планировщика, но весьма полезны для отладки и экспериментов.
Результат, скорее всего, окажется в пользу индексного сканирования, поскольку все данные закешированы и произвольный доступ выполняется быстро. Такая же ситуация возможна при использовании быстрых SSD-дисков. Делать выводы на основании одного запроса неправильно, но систематическая ошибка должна послужить поводом к изменению глобальных настроек. В таком случае стоит либо уменьшить значение random_page_cost, чтобы планировщик не завышал стоимость индексного доступа, либо увеличить effective_cache_size, чтобы сделать индексное сканирование более привлекательным.
Page 11: Настройка приложения
Клиенты и соединения
- Схема данных
Page 12: Клиенты и соединения
Много сеансов
- пул соединений
- Курсоры
- если нужна часть выборки
- cursor_tuple_fraction
- Много коротких запросов
- подготовленные операторы
- перенос логики в SQL
Комментарии преподавателя
Если приложение открывает слишком много соединений или устанавливает их слишком часто и на короткое время, может потребоваться установить между приложением и СУБД пул соединений. Однако пул накладывает на приложение определенные ограничения. Подробно этот вопрос рассмотрен в курсе DEV2.
Курсоры следует использовать, только если нужно получить небольшую часть выборки и ее размер зависит от действий пользователя. В этом случае параметр cursor_tuple_fraction подскажет планировщику, что нужно оптимизировать получение первых строк выборки.
Если приложение выполняет слишком большое количество мелких запросов (каждый из которых сам по себе выполняется эффективно), общая эффективность будет очень невысока. Это часто происходит при использовании средств объектно-реляционного отображения (ORM). В теме «Профилирование» мы рассматривали похожий пример с функцией, которая вызывалась в цикле.
В таких случаях со стороны СУБД практически нет средств для оптимизации (кроме подготовленных операторов, если запросы повторяются). Действенный метод — избавление от процедурного кода в приложении и перенос его на сервер БД в виде небольшого числа крупных SQL-команд. Это дает планировщику возможность применить более эффективные способы доступа и соединений и избавляет от многочисленных пересылок данных от клиента к серверу и обратно. К сожалению, если приложение уже написано, переделать его бывает очень затратно.
Page 13: Схема данных
Нормализация — устранение избыточности в данных
- упрощает запросы и проверку согласованности
- Денормализация — привнесение избыточности
- может повысить производительность, но требует синхронизации
- индексы
- предрассчитанные поля (генерируемые столбцы или триггеры)
- материализованные представления
- кеширование результатов в приложении
Комментарии преподавателя
На логическом уровне база данных должна быть нормализованной: неформально, в данных не должно быть избыточности. Если это не так, мы имеем дело с ошибкой проектирования: будет сложно проверять согласованность данных, возможны различные аномалии при изменении данных и т. п.
Однако на уровне хранения некоторое дублирование может дать существенный выигрыш в производительности — ценой того, что избыточные данные необходимо синхронизировать с основными.
Самый частый способ денормализации — индексы (хотя о них обычно не думают в таком контексте). Индексы обновляются автоматически.
Можно дублировать некоторые данные (или результаты расчета на основе этих данных) в столбцах таблиц. Можно использовать генерируемые столбцы или синхронизировать данные с помощью триггеров. Так или иначе, за денормализацию отвечает база данных.
Другой пример — материализованные представления. Их также надо обновлять, например, по расписанию или другим способом. Подробно это рассматривалось в теме «Материализация».
Дублировать данные можно и на уровне приложения, кешируя результаты выполнения запросов. Это популярный способ, но часто к нему прибегают из-за неправильной работы приложения с базой данных (например, в случае использования ORM). На приложение ложится задача по своевременному обновлению кеша, обеспечению разграничения доступа к данным кеша и т. п.
Page 14: Схема данных
Типы данных
- выбор подходящих типов
- составные типы (массивы, JSON) вместо отдельных таблиц
- Ограничения целостности
- помимо обеспечения целостности данных, могут учитываться
- планировщиком для устранения ненужных соединений, улучшения
- оценок селективности и других оптимизаций
- первичный ключ и уникальность — уникальный индекс
- внешний ключ
- отсутствие неопределенных значений
- проверка CHECK (constraint_exclusion)
Комментарии преподавателя
Важен правильный выбор типов данных из всего многообразия, предлагаемого PostgreSQL. Например, представление интервалов дат не двумя отдельными столбцами, а с помощью диапазонных типов (daterange, tstzrange) позволяет использовать индексы GiST и SP-GiST для таких операций, как пересечение интервалов.
В ряде случаев эффект дает использование составных типов (таких как массивы или JSON) вместо классического подхода с созданием отдельной таблицы. Это позволяет сэкономить на соединении и не требует хранения большого количества служебной информации в заголовках версий строк. Но такое решение следует принимать с большой осторожностью, поскольку оно имеет свои минусы.
Ограничения целостности важны сами по себе, но в некоторых случаях планировщик может учитывать их и для оптимизации.
● Ограничения первичного ключа и уникальности поддерживаются уникальными индексами. Это позволяет строить более точную статистику и эффективнее выполнять соединения.
● Наличие внешнего ключа и ограничений NOT NULL позволяет в ряде случаев устранять лишние соединения (что особенно важно при использовании представлений), а также улучшает оценку селективности в случае, если соединение происходит по нескольким столбцам.
● Ограничение CHECK с использованием параметра constraint_exclusion позволяет не сканировать таблицы (или секции), если в них гарантированно нет требуемых данных.
Page 15: Схема данных
Ссылочное ограничение целостности особенно важно при составном ключе. Пример точной оценки строк, которое будет получено в результате соединения:
Однако если удалить внешний ключ, оценка становится неадекватной. Это еще одно проявление проблемы коррелированных предикатов:
Page 16: Запросы
Пути оптимизации
- Короткие запросы
- Длинные запросы
Page 17: Пути оптимизации
Цель оптимизации — получить адекватный план
- Исправление неэффективностей
- каким-то образом найти и исправить узкое место
- бывает сложно определить, в чем проблема
- часто приводит к борьбе с планировщиком
- Правильный расчет кардинальности
- добиться правильного расчета кардинальности в каждом узле
- и положиться на планировщик
- если план все еще неадекватный, настраивать глобальные параметры
Комментарии преподавателя
Цель оптимизации запроса — получить адекватный план выполнения. Есть разные пути, которыми можно идти к этой цели.
Можно посмотреть в план запроса, понять причину неэффективного выполнения и сделать что-то, исправляющее ситуацию. К сожалению, проблема не всегда бывает очевидной, а исправление часто сводится к борьбе с оптимизатором.
Если идти таким путем, то хочется иметь возможность целиком или частично отключить планировщик и самому создать план выполнения. Такая возможность называется подсказками (хинтами) и в явном виде отсутствует в PostgreSQL.
Другой подход состоит в том, чтобы добиться корректного расчета кардинальности в каждом узле плана. Для этого, конечно, нужна аккуратная статистика, но этого часто бывает недостаточно.
Если идти таким путем, то мы не боремся с планировщиком, а помогаем ему принять верное решение. К сожалению, это часто оказывается слишком сложной задачей.
Если при правильно оцененной кардинальности планировщик все равно строит неэффективный план, это повод заняться настройкой глобальных конфигурационных параметров.
Обычно имеет смысл применять оба способа, смотря по ситуации и сообразуясь со здравым смыслом.
Page 18: Короткие запросы
Читают небольшую часть данных, выдают мало строк
- Характерны для OLTP
Note Важно получать ответ быстро
- Характерные особенности плана
- условия с высокой селективностью
- индексы
- соединения методом вложенного цикла
Комментарии преподавателя
Запросы можно (довольно условно) разделить на две группы, имеющие свои особенности и требующие разных подходов к оптимизации: «короткие» и «длинные».
К первой относятся запросы, характерные для OLTP-систем. Такие запросы читают немного данных и выдают одну или несколько строк. Они могут обращаться и к большим таблицам, но в этом случае имеют условия с высокой селективностью, позволяющие читать лишь малую часть данных.
Обычно короткие запросы обслуживают пользовательский интерфейс, и поэтому важно, чтобы они выполнялись как можно быстрее. Приоритет отдается времени отклика.
Это обеспечивается тем, что необходимые запросам данные читаются либо из очень небольших таблиц (одна-две страницы), либо по индексу. Соединения, как правило, выполняются методом вложенного цикла, который не требует подготовительных действий (в отличие от хеш-соединения) и не вызывает проблем при небольшом количестве соединяемых строк.
Page 19: Короткие запросы
Сразу отключим параллельное выполнение. Для коротких запросов оно бесполезно, а параллельные планы сложнее читать.
Рассмотрим запрос, который выводит посадочные талоны, выданные на рейсы, отправляющиеся в течение часового интервала:
Этот запрос можно отнести к разряду коротких: из двух больших таблиц требуется гораздо меньше процента данных. Однако в плане мы видим, что таблицы читаются полностью. Кроме того, наблюдается большая разница между прогнозируемой и фактической кардинальностью. Начнем оптимизацию с самого вложенного узла, Seq Scan по таблице рейсов flights. Из-за чего планировщик ошибается в оценке кардинальности? Дело в функции date_trunc: для нее нет вспомогательной функции планировщика, поэтому берется фиксированная оценка селективности 0,5%. В темах «Базовая статистика» и «Расширенная статистика» мы исправляли подобные ситуации с помощью индекса по выражению и расширенной статистики. Но в данном случае достаточно переписать условие так, чтобы слева от оператора находилось поле таблицы:
Теперь оценка больше похожа на правду, а запрос заодно стал использовать индекс. Хорошо ли это? В целом хорошо, но индекс создан по столбцам flight_no и scheduled_departure, а условие есть только на второй столбец. В теме «Методы доступа» мы выяснили, что в этом случае индекс будет сканироваться полностью, что нельзя считать эффективным способом доступа к данным. Создадим новый индекс:
Page 20: Page 20
Проверим наш запрос:
В принципе, мы достигли желаемого: планировщик использует индексный доступ, данные соединяются методом вложенного цикла. Проверим еще количество страниц, которые потребовалось прочитать:
Page 21: Page 21
Возможным улучшением будет исключение доступа к таблице flights за счет сканирования только индекса. Удалим созданный ранее индекс и сделаем другой с дополнительным столбцом, который нужен для соединения:
Мы выиграли еще около 20% чтений. Это может быть важно для запросов, которые выполняются часто, но вряд ли это наш случай. Скорее всего, включение в индекс всех полей таблицы boarding_passes будет избыточным — накладные расходы перевесят выигрыш в производительности. Остановимся на достигнутом.
Page 22: Длинные запросы
Читают большие таблицы целиком
- Характерны для OLAP
Note Важно не читать одни и те же данные повторно
- Характерные особенности плана
- условия с низкой селективностью
- полное сканирование
- соединение хешированием
- агрегация
- параллельное выполнение
Комментарии преподавателя
Длинные запросы встречаются в OLAP-системах. Они характеризуются тем, что для получения результата должны прочитать большое количество данных. При этом не важно, сколько строк возвращает запрос: в результате агрегации может остаться и одна.
Такие запросы могут читать большие таблицы целиком, а условия обычно низкоселективны. Поэтому вместо индексного доступа более эффективным становится последовательное сканирование, а вместо соединения вложенным циклом — хеш-соединение. Тем более, что для длинного запроса важно выдать весь результат за разумное время, а не первые строки как можно раньше.
Очень важно следить, чтобы одни и те же данные не читались в запросе несколько раз. Это может происходить по самым разным причинам (из-за коррелированных подзапросов, из-за использования функций и т. п.), которые приводят к появлению вложенных циклов, явных или неявных.
Разумеется, в плане длинного запроса могут встречаться и индексный доступ (при наличии высокоселективных условий), и соединение вложенным циклом (при соединении небольшого количества строк).
Благодаря тому, что длинные запросы обрабатывают много данных и обычно агрегируют их (пользователям редко бывают нужны миллионы строк), они могут выигрывать от параллельного выполнения.
Page 23: Длинные запросы
Задача: посчитать количество пассажиров, летевших рейсами, и вылет, и прибытие которых состоялись с опозданием от одной минуты до четырех часов. Вот запрос, решающий задачу, но время его выполнения нас не устраивает:
Короткий это запрос или длинный? Узнаем селективность условий:
Условия отбирают примерно 80% строк, все таблицы в запросе большие. Очевидно, это длинный запрос. Проверим его план:
Page 24: Page 24
Здесь мы видим индексный доступ и соединения вложенным циклом — операции, совсем не подходящие для длинного запроса. Почему так получилось? Проблема в ошибке оценки селективности условий. Планировщик считает, что из таблицы flights будет выбрано всего пять строк. Попробуем быстро проверить гипотезу, что переход на другой способ соединения поможет делу. Попросим планировщик не использовать вложенный цикл, если это возможно:
Page 25: Page 25
Обращения к таблицам автоматически сменились на последовательное чтение. Запрос ускорился, ему потребовалось прочитать примерно 130 тысяч блоков. Мы не смотрели план выполнения первой версии с параметром buffers, но она — проверьте! — читает в 200 с лишним раз больше данных.
Нам осталось более аккуратно объяснить планировщику, какой план стоит использовать. Самый мягкий способ — предоставить более точную статистику. В данном случае подойдет статистика по выражению, которую мы рассматривали в теме «Расширенная статистика»:
Проверим план:
Page 26: Page 26
Оценки исправились, теперь во всех узлах они довольно точно соответствуют реальным цифрам. Однако планировщик выбрал не тот план, что мы видели: он перестал использовать соединение вложенным циклом, но оставил индексный доступ и применил соединение слиянием. Если бы мы выполнили запрос, то увидели бы, что время еще сократилось, хотя и было прочитано более двух миллионов страниц. Считать ли такой результат хорошим? Если мы уверены, что размера кеша хватит, чтобы в нем находились данные наших крупных таблиц — неплохо, ведь запрос ускоряется. Но мы уже говорили о том, что время — ненадежный показатель, поскольку в реальной системе за кеш будут конкурировать данные многих таблиц, и реальное обращение к страницам может оказаться медленнее ожидаемого. Это может послужить поводом вернуться к настройкам сервера БД с помощью параметров random_page_cost и effective_cache_size. Однако зададимся вопросом: не читаем ли мы лишние данные? Знание предметной области позволяет нам прийти к выводу, что таблица ticket_flights вовсе не нужна в запросе. Таблицу flights можно соединить непосредственно с boarding_passes — внешние ключи проверяют корректность данных, но не требуются для соединения. Добавление ticket_flights никак не ограничивает данные (не может быть ситуации, при которой посадочный талон есть, а перелет отсутствует). Вообще, переформулирование запроса — самый разнообразный и вариативный способ влияния на производительность. Некоторые эквивалентные преобразования планировщик умеет выполнять сам, но мы можем: переписать условия так, чтобы они могли (или наоборот, не могли) использовать индекс; заменить коррелированные подзапросы (которые, по сути, являются вложенным циклом) соединениями; устранить лишние сканирования (как в этом примере, или, скажем, за счет применения оконных функций); использовать недоступные планировщику трансформации, такие, как преобразование условий OR в UNION; и т. п. Итак, упрощаем запрос:
Page 27: Page 27
Потребовалось прочитать всего 61 тысячу страниц. Проверим, сколько всего страниц в таблицах:
Теперь мы уверены, что не читаем лишних данных. Можно ли еще что-то улучшить? План запроса говорит о том, что выполнялось двухпроходное соединение хешированием. Можно увеличить значение параметра work_mem, чтобы хеш-соединению было достаточно одного прохода без временных файлов.
Page 28: Page 28
В начале темы мы отключали параллельные планы. Однако для длинных запросов параллельные планы могут иметь смысл. Конечно, при условии наличия свободных ядер, как рассматривалось в теме «Параллельный доступ». Посмотрим:
Мы видим, что планировщик использует параллельный план, но в виртуальной машине с одним ядром он, конечно, не дает никаких преимуществ.
Page 29: Подсказки оптимизатору
Отсутствуют в явном виде
- хотя средства влияния имеются: конфигурационные параметры,
- материализация CTE и другие
- Сторонние расширения
- pg_hint_plan
Комментарии преподавателя
Еще один (традиционный для других СУБД) способ влияния — подсказки оптимизатору — отсутствует в PostgreSQL. Это принципиальное решение сообщества: https://wiki.postgresql.org/wiki/OptimizerHintsDiscussion.
На самом деле часть подсказок все-таки неявно существует в виде конфигурационных параметров и других средств.
Кроме того, есть специальные расширения, например https://postgrespro.ru/docs/enterprise/16/pg-hint-plan (автор — Киотаро Хоригучи). Но нельзя забывать, что использование подсказок, сильно ограничивающих свободу планировщика, может навредить в будущем, когда распределение данных изменится.
Page 30: Итоги
Настройка выполняется на разных уровнях системы
- Доступен широкий спектр методов влияния на план выполнения запросов
- Разные типы запросов требуют разных подходов
- Ничто не заменит голову и здравый смысл
Page 31: Практика
- Оптимизируйте запрос, выводящий контактную информацию пассажиров, купивших билеты бизнес-класса, рейсы которых были задержаны более чем на 5 часов: SELECT t.* FROM tickets t JOIN ticket_flights tf ON tf.ticket_no = t.ticket_no JOIN flights f ON f.flight_id = tf.flight_id WHERE tf.fare_conditions = ‘Business’ AND f.actual_departure > f.scheduled_departure + interval ‘5 hour’; 2. Оптимизируйте запрос, вычисляющий среднюю стоимость билетов на перелеты, выполняемые различными типами самолетов. Начните с варианта, предложенного в комментарии.
Page 32: 1. Оптимизация короткого запроса
Отключим параллельное выполнение.
Здесь мы имеем дело с запросом, характерным для OLTP — небольшое число строк, для получения которых надо выбрать только небольшую часть данных. Поэтому общее направление оптимизации — переход от полного сканирования и соединения хешированием к индексам и вложенным циклам. Заметим, что рейс, задержанный более чем на 5 часов, всего один, а планировщик сканирует всю таблицу. Можно построить индекс по выражению на разности двух столбцов и немного переписать условие:
Page 33: Page 33
Теперь займемся таблицей ticket_flights, которая тоже сканируется полностью, хотя из нее читается незначительная часть строк. Помог бы индекс по классам обслуживания fare_conditions, но лучше создать индекс по столбцу flight_id, что позволит эффективно выполнять соединение вложенным циклом с flights:
Время выполнения уменьшилось до миллисекунд.
2. Оптимизация длинного запроса
Очевидно, мы имеем дело с длинным запросом: в нем присутствует большая таблица перелетов ticket_flights, при этом ни на одну таблицу не накладывается никаких условий. Выполним запрос и посмотрим на план его выполнения:
Page 34: Page 34
В плане запроса видим, что оценки кардинальности вполне адекватны во всех узлах, большие таблицы сканируются последовательно и применяется хеш-соединение. Однако при этом запрос читает в несколько раз больше страниц, чем необходимо:
Причина в коррелированном подзапросе, который выполняется для каждой из девяти моделей самолетов, образуя неявный вложенный цикл. Раскроем подзапрос, добавив группировку. Может показаться заманчивым избавиться от таблицы самолетов aircrafts, ведь код самолета можно получить непосредственно из таблицы рейсов flights. Однако в этом случае из результатов пропадет модель, не совершившая ни одного рейса. Поэтому необходимо левое соединение. Кроме того, сразу вспомним, что в демонстрации мы увеличивали work_mem, чтобы избежать двухпроходного соединения.
Page 35: Page 35
Лишние чтения пропали, запрос ускорился.