Возможности Postgres Pro Enterprise
Возможности Postgres Pro Enterprise
Курс сохраняет официальный порядок тем. Русские материалы извлечены из PDF в читаемый нативный Markdown для дальнейшей редакторской работы.
Состояние материалов: 官方 PDF 已提取为原生 Markdown
Базовый язык: Базовый язык: Русский. В проверенных открытых каталогах не найден текущий английский архив. Для курса Postgres Pro Enterprise базовой является русская версия.
О курсе
Возможности Postgres Pro Enterprise для производительности, безопасности, резервного копирования и высокой доступности.
Состояние материалов
| Язык | Текущий архив | Версия | Темы | Страница курса |
|---|---|---|---|---|
| English | Открытый архив не найден | - | - | HTTP 404 |
| Русский | PGPRO-handouts-16.zip | 16 | 23 | HTTP 200 |
Содержание
Дополнительные материалы
pgpro_new_features.pdfpgpro_student_guide.pdf
Редакторский статус
Русский комплект доступен в виде нативного Markdown. Если английский комплект не найден, английский маршрут оставлен для будущего источника.
00 Занятие 00: Postgres Pro Enterprise 16 / Возможности Postgres Pro Enterprise
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_00_introduction.html Archive: PGPRO-handouts-16.zip Страниц PDF: 12
Page 1: Postgres Pro Enterprise 16 / Возможности Postgres Pro Enterprise
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Администраторам
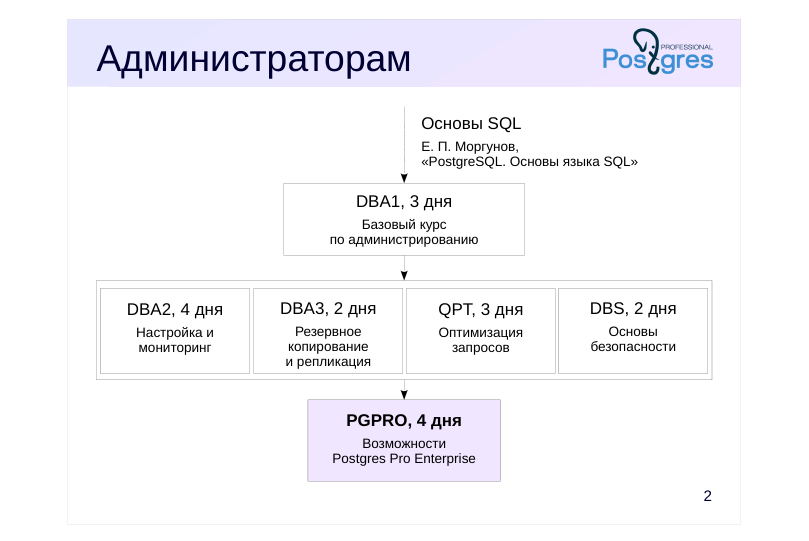 {#source-figure-002 caption=“Source slide page 2: Администраторам”}
- DBA2, 4 дня
Комментарии преподавателя
Для прохождения всех курсов необходимо знание основ языка SQL. Курса по SQL в нашей линейке нет, но имеется множество книг и образовательных ресурсов для освоения SQL. Мы рекомендуем книгу Евгения Моргунова «PostgreSQL. Основы языка SQL»:
https://postgrespro.ru/education/books/sqlprimer
Для администраторов мы предлагаем следующие курсы.
Курс DBA1 – базовый, он дает сведения об архитектуре PostgreSQL, об установке, настройке и управлении сервером. Приводятся обзоры разграничения доступа, резервного копирования и репликации.
В курсе DBA2 обсуждается настройка конфигурационных параметров исходя из понимания внутренней организации сервера; говорится о мониторинге сервера с использованием обратной связи для итеративной настройки параметров.
Курс DBA3 посвящен рассмотрению резервного копирования, а также настройкам физической и логической репликации и сценариям ее использования. Также дается общее представление о способах и сложностях построения высокодоступных, масштабируемых кластеров.
Курс DBS рассказывает про настройку подключений клиентов к СУБД и про управление доступом внутри самой СУБД.
В курсе QPT разбираются планирование и выполнение запросов, настройка параметров экземпляра, связанных с производительностью, и изучается поиск проблемных запросов и их оптимизация.
Page 3: Разработчикам
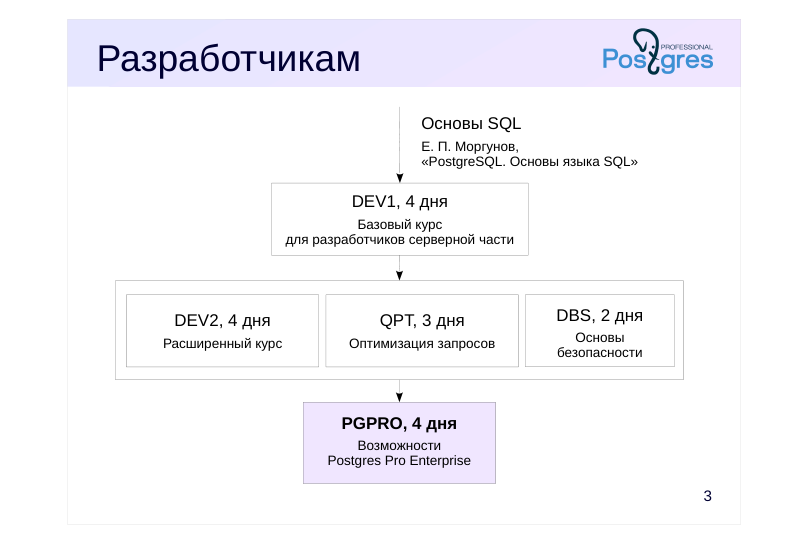 {#source-figure-003 caption=“Source slide page 3: Разработчикам”}
- DEV2, 4 дня
Комментарии преподавателя
Для разработчиков серверной части приложений мы предлагаем следующие курсы.
Базовым курсом для разработчиков является курс DEV1, в котором даются общие сведения об архитектуре PostgreSQL и использовании основных объектов базы данных; изучается программирование на стороне сервера на языках SQL и PL/pgSQL с использованием основных типов данных (включая составной тип и массивы), а также рассматривается взаимодействие с клиентской частью.
В курсе DEV2 рассматриваются особенности внутреннего устройства сервера, влияющие на разработку прикладного кода, и всесторонне изучается расширяемость: возможность дополнить серверные механизмы собственным кодом, что позволяет использовать PostgreSQL для решения самых разнообразных задач.
Курсы DBS, QPT и PGPRO являются общими для разработчиков и администраторов.
Разработчикам могут быть интересны и курсы по администрированию, если есть необходимость детальнее изучить внутреннее устройство PostgreSQL, а также в случае, когда на проекте нет выделенной роли администратора.
https://postgrespro.ru/education/courses
Page 4: О курсе
Продолжительность: 4 дня
- Предварительные знания
- знакомство с ОС Unix
- уверенное владение SQL (знакомство с PL/pgSQL не обязательно,
- но полезно)
- PostgreSQL в объеме курсов DBA1, DBA2, DBA3, DBS и QPT,
- либо DEV1, DEV2, DBS и QPT
- Какие навыки будут получены
- использование дополнительных возможностей Postgres Pro Enterprise
Комментарии преподавателя
В данном курсе PGPRO рассматриваются дополнительные возможности, которые предоставляет СУБД Postgres Pro Enterprise.
Page 5: Используемые материалы
Подготовленная виртуальная машина
- ОС Xubuntu 24.04
- Postgres Pro Enterprise 16 с документацией на русском языке
- дополнительные экземпляры PostgreSQL 16 и Postgres Pro Enterprise 16
- Учебные материалы
- презентации, демонстрации, практические задания и их решение
- (в форматах html и pdf)
Page 6: Виртуальная машина
В виртуальной машине курса установлен Postgres Pro Enterprise 16 с дополнительными расширениями, и в каталоге /var/lib/pgpro/ent-16 инициализирован кластер, использующий порт 5432. Для файлов кластера разрешен групповой доступ, а пользователь ОС student включен в группу postgres, это позволяет ему обращаться к каталогу данных для копирования и восстановления:
Экземпляр запускается автоматически при старте ОС. Подключимся к нему:
В конфигурационный файл добавлен параметр include_dir, чтобы можно было менять параметры с помощью дополнительных файлов:
В конфигурационный файл аутентификации с той же целью добавлена директива include_dir:
В кластере созданы роли: student — для удобства подключения; backup — для тем модуля «Резервное копирование»:
Page 7: Page 7
В кластер добавлены базы данных: student — для удобства подключения; demo — демонстрационная база, используется во многих темах курса (подробнее см. в курсе QPT); templateprobackup — шаблон, в котором роли backup выданы привилегии на выполнение функций, нужные для работы утилиты pg_probackup:
Для тем «PPEM» и «Миграция» установлен PostgreSQL 16 и инициализированы кластеры ppem и prod:
Page 8: Организационные вопросы
День: ~8 академических часов + обед (1час)
- Каждая тема, как правило, состоит из
- презентации и демонстрации: ~25–60 мин
- практических заданий: ~30 мин, включая перерыв
Page 9: День 1
Установка и сопровождение
- Редакции и возможности
- Postgres Pro Enterprise Manager
- Установка, настройка, обновление
- Миграция
- Планировщик заданий
Page 10: День 2
Данные
- CFS — сжатая файловая система
- Производительность
- Транзакции и сеансы
- Оптимизация запросов
- Адаптивная оптимизация
- Перепланирование
- Сохранение планов запросов
Page 11: День 3
Производительность (продолжение)
- Анализ производительности
- Отчеты по нагрузке pgpro_pwr
- Безопасность
- Профили пользователей
- Аудит
- Защищенная схема
- Анонимизация данных
Page 12: День 4
Резервное копирование
- Основы pg_probackup
- Использование pg_probackup
- Другие возможности pg_probackup
- Отказоустойчивые решения
- Кластер multimaster
- Кластер BiHA
01 Занятие 01: Установка и сопровождение / Редакции и возможности
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_01_features.html Archive: PGPRO-handouts-16.zip Страниц PDF: 34
Page 1: Установка и сопровождение / Редакции и возможности
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Продукты Postgres Professional и редакции Postgres Pro
- Возможности Postgres Pro Enterprise
Page 3: Продукты и редакции
Редакции Postgres Pro
- Лицензионная политика
- Другие продукты Postgres Professional
Page 4: Редакции Postgres Pro
Standard
- Certified
- Enterprise
- Enterprise Certified
Комментарии преподавателя
Postgres Pro поставляется в различных редакциях.
Standard — доработанная версия базового PostgreSQL с рядом дополнительных расширений. Подходит для клиентов, которых устраивают базовые возможности, но которым необходимо решение, зарегистрированное в Реестре российского программного обеспечения, а также техподдержка:
https://postgrespro.ru/products/postgrespro/standard
Enterprise — существенно доработанная версия PostgreSQL c функциональностью, предназначенной для высоконагруженных систем в больших компаниях:
https://postgrespro.ru/products/postgrespro/enterprise
Обе редакции имеют сертифицированные ФСТЭК версии, которые могут применяться на объектах критической информационной инфраструктуры, в государственных информационных системах, а также в системах хранения и обработки персональных данных и конфиденциальной информации:
https://postgrespro.ru/products/postgrespro/certified
https://postgrespro.ru/products/postgrespro/enterprisecertified
Начиная с версии 15, ОС Windows не поддерживается Postgres Pro, но компания собирает дистрибутив обычного PostgreSQL под Windows.
https://postgrespro.ru/windows
В этом курсе, если не указано иное, мы рассматриваем возможности Postgres Pro Enterprise.
Page 5: Лицензионная политика
Лицензирование по количеству ядер
- в стоимость лицензии входит годовая техническая поддержка
- бесплатные академические лицензии для образовательных организаций
- Для 1С возможно лицензирование по количеству серверов и пользователей
Комментарии преподавателя
Postgres Pro лицензируется по количеству ядер. В стоимость лицензии входит один год технической поддержки.
Все редакции Postgres Pro поддерживают работу с 1С: в состав входят все необходимые расширения (fasttrun, fulleq, mchar, online_analyze), а ядро включает оптимизации производительности (например, временные таблицы не требуют ввода-вывода, пока помещаются в отведенной оперативной памяти).
При использовании Postgres Pro для работы с 1С можно выбрать другую модель лицензирования — по количеству серверов и пользователей.
https://postgrespro.ru/licensing
Образовательным организациям бесплатно предоставляются академические лицензии на Postgres Pro Standard и Postgres Pro Enterprise. Такие лицензии позволяют использовать СУБД не только для обучения, научных исследований и студенческих конкурсов, но и для административных задач. Они не ограничены по времени, но не включают техническую поддержку.
https://postgrespro.ru/education/university
Дополнительно в компании можно заказать услуги технической поддержки, миграции, аудита информационных систем:
https://postgrespro.ru/services
Подробную информацию по стоимости, срокам лицензии и по вопросам предоставления услуг можно получить, написав на sales@postgrespro.ru
Page 6: Другие продукты
Postgres Pro Enterprise Manager
- Тема 2. Postgres Pro
- Enterprise Manager
- интегрированная панель управления
- централизованный интерфейс мониторинга и администрирования
- Postgres Pro Backup Enterprise
- Темы 18–20
- утилита резервного копирования и восстановления pg_probackup
- Postgres Pro Shardman
- распределенная отказоустойчивая СУБД с ACID-гарантиями
- горизонтальное масштабирование по чтению и записи
Комментарии преподавателя
Кроме СУБД Postgres Pro, компания Postgres Professional предлагает ряд других продуктов.
Postgres Pro Enterprise Manager — интегрированная административная панель управления для Postgres Pro Enterprise. Предоставляет централизованный интерфейс мониторинга и управления СУБД.
https://postgrespro.ru/products/PPEM
Postgres Pro Backup Enterprise — утилита pg_probackup для управления резервным копированием и восстановлением кластеров баз данных PostgreSQL. Утилита работает с обычным PostgreSQL и со всеми редакциями Postgres Pro, но в сочетании с Postgres Pro Enterprise поддерживает CFS и размещение резервных копий в S3-хранилище.
Утилита входит в состав Postgres Pro Enterprise и рассматривается в этом курсе.
https://postgrespro.ru/products/pg\_probackup
Postgres Pro Shardman — распределенная объектно-реляционная СУБД на основе PostgreSQL c дополнительными изменениями и расширениями. Shardman совместим с Postgres Pro Enterprise и использует многие ее возможности (в том числе 64-битные номера транзакций, сбор статистики, аудит, CFS, обеспечение высокой доступности другие).
https://postgrespro.ru/products/shardman
Page 7: Установка и миграция
Автоматическая настройка параметров при инициализации кластера
- Тема 3.
- Установка, настройка,
- обновление
- запуск pgpro_tune по умолчанию
- Упрощение миграции с Oracle
- Тема 4. Миграция
- реализация пакетов
- oracle_fdw — обертка сторонних данных
- orafce — популярные функции системных пакетов Oracle
- ora2pgpro — автоматизация миграции
Комментарии преподавателя
При инициализации кластера Postgres Pro Enterprise по умолчанию выполняется его дополнительная настройка, зависящая от конфигурации оборудования. Для этого запускается утилита pgpro_tune, которая собирает информацию о системе и дописывает в файл конфигурации необходимые параметры.
https://postgrespro.ru/docs/enterprise/16/app-pgpro-tune
Для облегчения миграции с Oracle в Postgres Pro Enterprise реализован функционал пакетов Oracle и добавлены расширения:
● oracle_fdw — обертка сторонних данных для Oracle;
● orafce — распространенные функции из пакетов Oracle;
● ora2pgpro — утилита конвертации кода и переноса объектов из Oracle.
https://postgrespro.ru/docs/enterprise/16/pgpro-migration-tools
Page 8: Планировщик заданий
pgpro\_scheduler — встроенный планировщик заданий
- разовые и планируемые задания
- позволяет обойтись без средств операционной системы
- Тема 5. Планировщик
- заданий
Комментарии преподавателя
Расширение pgpro_scheduler — интегрированный в Postgres Pro Enterprise планировщик заданий. С его помощью можно задавать сложные расписания, динамически вычислять время следующего запуска для повторяющихся заданий, выполнять SQL-команды задания в одной или в нескольких последовательных транзакциях, назначать задания для немедленного или отложенного однократного выполнения одновременно с обычными планируемыми заданиями.
https://postgrespro.ru/docs/enterprise/16/pgpro-scheduler
Page 9: Данные
Сжатая файловая система
- Расширения и утилиты для данных
- Диагностика и исправление повреждений данных
- Работа с данными в памяти
Page 10: Сжатая файловая система
CFS — Compressed File System
- включается для отдельных табличных пространств
- позволяет сжать данные в несколько раз
- сокращает объем дискового ввода-вывода
- измененные страницы записываются последовательно
- Тема 6. CFS — сжатая
- файловая система
Комментарии преподавателя
Использование сжатой файловой системы (Compressed File System, CFS) позволяет сократить объем дискового ввода-вывода за счет хранения сжатых блоков данных и улучшить кучность хранения за счет последовательной записи сжатых блоков в конец файла на диске.
Механизм CFS включается на уровне отдельных табличных пространств.
Как правило, сжатие позволяет уменьшить объем хранимых данных в несколько раз.
https://postgrespro.ru/docs/enterprise/16/cfs
Page 11: Хранение данных
TOAST для системного каталога
- для столбцов со списками управления доступом
- pg_transfer
- быстрое перемещение таблиц между серверами
- pg_repack
- устранение раздувания таблиц и индексов
Комментарии преподавателя
Таблицы системного каталога, содержащие потенциально длинные списки управления доступом (Access Control List), такие как pg_class и pg_attribute, могут использовать TOAST.
С помощью расширения pg_transfer можно специальным образом подготовить таблицу, содержащую много данных, и затем быстро переместить ее на другой экземпляр Postgres Pro простым копированием файлов данных. Расширение выполняет необходимые для этого корректировки системного каталога.
https://postgrespro.ru/docs/enterprise/16/pgtransfer
В Postgres Pro Enterprise включена сторонняя утилита pg_repack, которая позволяет избавиться от раздувания таблиц и индексов без установки исключительной блокировки на все время работы, как того требует команда VACUUM FULL.
https://postgrespro.ru/docs/enterprise/16/app-pgrepack
Page 12: Повреждения данных
amcheck
- контроль целостности
- добавлена проверка уникальности индексов
- pg_filedump
- низкоуровневый просмотр файлов данных
- Просмотр всех версий строк
- функция pg_snapshot_any для отключения правил видимости
Комментарии преподавателя
Postgres Pro Enterprise включает дополнительные средства для контроля целостности, отладки и исследования поврежденных данных.
Штатное расширение amcheck, позволяющее проверять целостность данных, доработано для проверки ограничений уникальности в B-деревьях.
https://postgrespro.ru/docs/enterprise/16/amcheck
Утилита pg_filedump выводит содержимое файлов таблиц и индексов, а также управляющего файла в отформатированном виде. Это может быть полезно для исправления поврежденных данных.
https://postgrespro.ru/docs/enterprise/16/pg-filedump
Функция pg_snapshot_any выводит все версии строк таблицы, отключая правила видимости.
https://postgrespro.ru/docs/enterprise/16/functions-admin#FUNCTIONS-DE BUGGING-TABLE
Page 13: Данные в памяти
pg\_variables
- переменные в памяти сеанса
- in_memory
- небольшие таблицы в общей памяти
- Тема 7.
- Транзакции
- и сеансы
Комментарии преподавателя
Расширение pg_variables позволяет работать с переменными различных типов (скалярными, массивами и коллекциями) в памяти сеанса.
https://postgrespro.ru/docs/enterprise/16/pg-variables
С помощью расширения in_memory можно размещать небольшие таблицы в общей памяти сервера. Работа с таблицей происходит с помощью обертки сторонних данных.
https://postgrespro.ru/docs/enterprise/16/in-memory
Оба расширения можно рассматривать как альтернативу временным таблицам.
Page 14: Производительность
Управление транзакциями и сеансами
- Выполнение и оптимизация запросов
- Анализ нагрузки и мониторинг
Page 15: Транзакции и сеансы
64-разрядный счетчик транзакций
- Автономные транзакции
- Встроенный пул соединений
- сохраняет контекст сеанса
- Тема 7.
- Транзакции
- и сеансы
Комментарии преподавателя
32-битные идентификаторы транзакций в PostgreSQL создают проблемы с обслуживанием переполнения счетчика транзакций. в нагруженных системах. В Postgres Pro Enterprise используются 64-битные идентификаторы, упрощающие администрирование.
Автономные транзакции позволяют зафиксировать или откатить часть операторов независимо от статуса основной транзакции.
В обычном режиме работы сервера каждое подключение обслуживается отдельным процессом, что уменьшает эффективность совместной работы. В Postgres Pro Enterprise реализован встроенный пул соединений, сохраняющий окружения сеансов.
Page 16: Сеансы и подключения
pgbouncer — сторонний пул соединений
- Параметры libpq для подключения к разным серверам
- hostorder, failover_timeout
- Отключение сеансов и переподключение
- reusepass
- Функции для изменения параметров других сеансов
- pg_backend_set_config, pg_backend_load_library
Комментарии преподавателя
Помимо встроенного пула соединений, в Postgres Pro включен сторонний пул соединений pgbouncer. Работа с pgbouncer с точки зрения разработчика приложений рассматривается в курсе DEV2.
Доработанный протокол libpq позволяет распределять сеансы по нескольким серверам:
● hostorder — порядок подключения к серверам (sequential/random);
● failover_timeout — максимальное время для циклического переподключения к узлам, указанным в строке соединения.
https://postgrespro.ru/docs/enterprise/16/libpq-connect
Дополнительный конфигурационный параметр reusepass — разрешается ли использовать запрошенный пароль при повторном установлении подключения (запрет автоматического переподключения).
Добавлены функции pg_backend_set_config и pg_backend_load_library, позволяющие менять параметры других сеансов и загружать в них библиотеки.
https://postgrespro.ru/docs/enterprise/16/functions-admin#FUNCTIONS-AD MIN-SET
Page 17: Приоритизация ресурсов
pgpro\_rp — расширение для приоритизации ресурсов
- использование процессора
- объем читаемых данных
- объем записываемых данных
- Сеансам можно назначать план приоритизации ресурсов
- с помощью триггера входа во время создания сеанса
- с помощью вызова функции
- Планы приоритизации могут меняться в зависимости от времени суток, дней недели и других факторов
Комментарии преподавателя
В высоконагруженных системах возникает потребность неравномерного распределения ограниченных ресурсов между сеансами. В обычной версии PostgreSQL такого механизма нет.
В Postgres Pro Enterprise добавлено расширение pgpro_rp, с помощью которого можно назначить сеансам приоритеты в отношении трех видов ресурсов:
● использование процессора;
● объем чтения (страницы локального и общего кешей);
● объем записи (страницы локального и общего кешей).
С помощью расширения можно создать план приоритизации ресурсов и назначить его роли либо во время входа в сеанс, либо с помощью специальной функции.
Планы могут быть как постоянными, так и зависеть от времени суток, дней недели и других подобных факторов.
https://postgrespro.ru/docs/enterprise/16/pgpro-rp
Расширение pgpro_rp в своей работе использует механизм приоритизации ресурсов, добавленный в ядро Postgres Pro Enterprise
https://postgrespro.ru/docs/enterprise/16/kernel-resources#RESOURCE-PRI ORITIZATION
Page 18: Оптимизация запросов
dump\_stat — перенос статистики планировщика
- pg_query_state — состояние выполняющегося запроса
- pg_hint_plan — указания оптимизатору
- plantuner — запрет определенных индексов
- Тема 8.
- Оптимизация
- запросов
Комментарии преподавателя
Расширение dump_stat позволяет после восстановления из логической копии обойтись без выполнения команды ANALYZE для всего кластера, что для больших БД может значительно сократить время простоя.
https://postgrespro.ru/docs/enterprise/16/dump-stat
Расширение pg_query_state позволяет узнать текущее состояние выполнения запросов.
https://postgrespro.ru/docs/enterprise/16/pg-query-state
Расширение pg_hint_plan позволяет управлять планом выполнения запроса с помощью специальных указаний.
https://postgrespro.ru/docs/enterprise/16/pg-hint-plan
Расширение plantuner позволяет скрывать определенные индексы от планировщика, не удаляя их.
https://postgrespro.ru/docs/enterprise/16/plantuner
Page 19: Оптимизация запросов
AQO — адаптивная оптимизация запросов
- накопление статистики выполнений и коррекция прогноза кардинальности Перепланирование запросов в реальном времени
- прерывание выполнения запроса и запуск повторного планирования
- pgpro_multiplan — сохранение планов запросов
- использование планов без повторной оптимизации идентичных запросов
- Тема 9. Адаптивная
- Тема 11. Сохранение
- оптимизация
- планов запросов
- Тема 10.
- Перепланирование
Комментарии преподавателя
Расширение AQO (Adaptive Query Optimization) используется для адаптивной оптимизации запросов за счет коррекции прогноза кардинальности с учетом накопленной статистики выполнения запросов.
https://postgrespro.ru/docs/enterprise/16/aqo
Перепланирование запросов в реальном времени позволяет прервать запрос, который выполняется слишком долго или требует слишком много ресурсов, и выполнить его повторно с новым планом, который учитывает полученную информацию.
https://postgrespro.ru/docs/enterprise/16/realtime-query-replanning
Расширение pgpro_multiplan позволяет сохранять планы запросов и использовать их для идентичных запросов без повторного планирования.
https://postgrespro.ru/docs/enterprise/16/pgpro-multiplan
Page 20: Планировщик запросов
Удаление замкнутых соединений из планов
- enable_self_join_removal
- Оптимизированы планы с пустыми узлами Materialize
- Уточнение стоимости последовательного сканирования
- seq_scan_startup_cost_first_row = off
- Уточнение селективности соединений по нескольким условиям при наличии расширенной статистики
- enable_compound_index_stats = on
- Уменьшено потребление памяти планировщиком в запросах с большими массивами
Комментарии преподавателя
Имеется возможность удаления замкнутых соединений из планов запросов, что может увеличить скорость выполнения (параметр enable_self_join_removal). Полезно для систем с автоматически генерируемыми запросами.
https://postgrespro.ru/docs/enterprise/16/runtime-config-query#GUC-ENABL E-SELF-JOIN-REMOVAL
Улучшена производительность в случаях, когда в плане возникает много пустых узлов Materialize, которые ничего не возвращают.
Параметр seq_scan_startup_cost_first_row увеличивает начальную стоимость последовательного сканирования. В обычном PostgreSQL эта величина всегда равную нулю, за счет чего планировщик может иногда предпочесть последовательное сканирование доступу по индексу для получения одной строки по первичному ключу.
https://postgrespro.ru/docs/enterprise/16/runtime-config-query#GUC-SEQ-S CAN-STARTUP-COST-FIRST-ROW
При включенном параметре enable_compound_index_stats оптимизатор использует составные индексы для уточнения оценки селективности соединения по нескольким атрибутам, не составляющим внешний ключ (в PostgreSQL в этом случае перемножаются селективности по отдельным колонкам).
Добавлена оптимизация, которая уменьшает потребление памяти планировщиком на запросах, содержащих большие массивы (например, IN для проверки вхождения значения в массив).
Page 21: Выполнение запросов
Управление объемом кеша для подготовленных операторов
- plan_cache_lru_memsize, plan_cache_lru_size
- Режим автоподготовки операторов
- autoprepare_threshold, autoprepare_limit, autoprepare_memory_limit
- Поиск ближайших соседей для B-tree
- Ускорено сканирование только индекса для больших таблиц
- vops — векторные операции для OLAP-запросов
Комментарии преподавателя
Параметрами plan_cache_lru_memsize и plan_cache_lru_size можно ограничить объем памяти, занимаемый подготовленными операторами. Это может помочь, если приложение создает слишком много подготовленных операторов.
https://postgrespro.ru/docs/enterprise/16/runtime-config-resource#GUC-PLA N-CACHE-LRU-MEMSIZE
Добавлен режим автоподготовки операторов (отключен по умолчанию), в котором часто используемые операторы неявно подготавливаются. Может давать преимущество в тех случаях, когда явные команды PREPARE не работают, например, когда применяется pgbouncer.
https://postgrespro.ru/docs/enterprise/16/autoprepare
- В индексах B-tree реализована поддержка алгоритма k-NN – поиска
- ближайших соседей – при сортировке по расстоянию. В обычном
- PostgreSQL для этого приходится пользоваться расширением btree_gist
- так сортировка работает гораздо медленнее.
https://postgrespro.ru/docs/enterprise/16/k-nn-search
Увеличен размер кеша карты видимости, что позволяет сканированию только индекса быстрее работать с таблицами больше 256 Мбайт.
Экспериментальное расширение vops (vectorized operations) позволяет ускорять запросы OLAP с фильтрацией и агрегированием благодаря колоночному хранению внутри страниц («паркет») и использованию векторных операций.
https://postgrespro.ru/docs/enterprise/16/vops
Page 22: Блокировки
Оптимизация механизма проверки взаимоблокировок
- Очередь для разделяемых легких блокировок
- lwlock_shared_limit = 0
- Разделение таблицы блокировок на секции
- log2_num_lock_partitions = 4
- Уменьшена конкуренция при расширении файлов B-tree
Комментарии преподавателя
Одновременная проверка ситуации взаимоблокировки многими процессами (что может произойти на нагруженных системах с большим количеством ядер) вызывает замедление работы сервера вплоть до полной остановки. В Postgres Pro проверка ограничена одним процессом в один момент времени.
Для улучшения работы с легкими блокировками имеется параметр lwlock_shared_limit. Он задает количество разделяемых блокировок, по достижении которого запускается «справедливый» режим ожидания — последующие блокировки добавляются в очередь. В этом случае устраняется возможность бесконечного откладывания исключительных блокировок, что важно при большой конкуренции за ресурс.
https://postgrespro.ru/docs/enterprise/16/runtime-config-locks#GUC-LWLOC K-SHARED-LIMIT
Для повышения параллелизма таблица блокировок разделяется на несколько секций. Количество секций всегда является степенью двойки, поэтому задается показатель степени. В PostgreSQL он всегда равен 4, то есть таблица делится на 16 секций. В Postgres Pro Enterprise показатель можно задать параметром log2_num_lock_partitions, если при большой конкуренции значения по умолчанию не хватает.
https://postgrespro.ru/docs/enterprise/16/runtime-config-locks#GUC-LOG2-NUM-LOCK-PARTITIONS
Уменьшена конкуренция при расширении файлов B-tree: к файлу добавляется сразу несколько страниц, как при расширении таблицы.
Page 23: Буферный кеш
Более эффективная работа с горячими страницами индексов
- Оптимизация для NUMA-архитектур
- Уменьшена конкуренция за хеш-таблицу
- 1024 отдельно блокируемых секций
Комментарии преподавателя
Улучшен менеджер буферного кеша:
● устранено узкое место, возникающее при обращении к горячим страницам индексов при высокой конкуренции;
● изменена внутренняя реализация хеш-таблицы буферного кеша для более эффективной работы, в том числе на NUMA-архитектурах;
● сама хеш-таблица буферного кеша разделена на 1024 секции (в PostgreSQL — 128) для снижения конкуренции на многоядерных системах.
Page 24: Поиск в тексте и в json
Метод доступа RUM
- фразовый поиск и ранжирование
- pg_tsparser — альтернативный анализатор
- Hunspell — словари для ряда языков
- shared_ispell — размещение словарей в общей памяти JsQuery — язык запросов к данным jsonb
- поиск во вложенных объектах и массивах
- операторы сравнения с индексной поддержкой
Комментарии преподавателя
Для улучшения полнотекстового поиска добавлен метод доступа RUM, который похож на GIN, но поддерживает фразовый поиск и выдачу ранжированных результатов.
https://postgrespro.ru/docs/enterprise/16/rum
Расширение pg_tsparser изменяет стандартную стратегию разбора текста для слов, включающих подчеркивания, цифры и буквы, а также для слов, разделенных знаком минуса. Оно удобно, в частности, для поиска в коде.
https://postgrespro.ru/docs/enterprise/16/pg-tsparser
Расширение Hunspell предоставляет возможность использовать популярные словари Hunspell для разных языков.
https://postgrespro.ru/docs/enterprise/16/hunspell-dict
В отличии от стандартной реализации словарей ispell, расширение shared_ispell позволяет разместить словарь в общей памяти.
https://postgrespro.ru/docs/enterprise/16/shared-ispell
Расширение JsQuery предоставляет язык запросов для поиска в значениях типа jsonb. С добавлением в PostgreSQL поддержки стандарта SQL/JSON потеряло актуальность, но сохраняется для совместимости.
https://postgrespro.ru/docs/enterprise/16/jsquery
Page 25: Анализ нагрузки
pgpro\_stats — статистика выполнения
- Тема 12. Анализ
- производительности
- развитие pg_stat_statements
- pgpro_pwr — выявление ресурсоемких операций: выборки и отчеты
- Тема 13. Отчеты по
- нагрузке pgpro_pwr
- развитие pg_profile
Комментарии преподавателя
Расширение pgpro_stats позволяет собрать статистику планирования и выполнения SQL-операторов. Основано на pg_stat_statements.
https://postgrespro.ru/docs/enterprise/16/pgpro-stats
Pgpro_pwr накапливает статистические выборки (полученные на основе других расширений и результатов работы сборщика статистики), анализирует их и строит отчеты о нагрузке.
https://postgrespro.ru/docs/enterprise/16/pgpro-pwr
Page 26: Анализ нагрузки
pg\_wait\_sampling — семплирование событий ожидания
- auto_explain — добавлено время планирования
- pg_waldump — добавлен вывод времени
- Определение объема сгенерированных WAL-записей
- pgBadger — поддержка формата журнала Postgres Pro
- Mamonsu — агент мониторинга для Zabbix
- pgbench — учет ошибок сериализации и взаимоблокировок
Комментарии преподавателя
Расширение pg_wait_sampling семплирует события ожидания. Расширение подробно рассматривается в курсе DBA2.
https://postgrespro.ru/docs/enterprise/16/pg-wait-sampling
В auto_explain добавлено отображение длительности планирования.
https://postgrespro.ru/docs/enterprise/16/auto-explain
В pg_waldump добавлен вывод времени для различных типов журнальных записей.
https://postgrespro.ru/docs/enterprise/16/pgwaldump
Представление pgpro_stat_wal_activity отображает объем сгенерированных каждым процессом записей WAL.
https://postgrespro.ru/docs/enterprise/16/monitoring-stats#MONITORING-P GPRO-STAT-WAL-ACTIVITY-VIEW
Добавлено стороннее расширение pgBadger, адаптированное для корректной работы с Postgres Pro.
Добавлен Mamonsu — агент мониторинга Postgres Pro для Zabbix:
https://postgrespro.ru/docs/enterprise/16/mamonsu
В pgbench скорректирован учет ошибок сериализации и взаимоблокировок.
https://postgrespro.ru/docs/enterprise/16/pgbench
Page 27: Безопасность
Профили, аудит, данные
- Сертификация ФСТЭК
Page 28: Профили, аудит, данные
passwordcheck — запрет простых паролей
- Тема 14. Профили
- Профили пользователя
- пользователей
- парольные политики и ограничения
- pg_proaudit — аудит действий пользователей
- Тема 15. Аудит
- Защищенная схема — ограничение прав администраторов
- Тема 16.
- Защищенная схема
- Анонимизация данных — изменение представления исходного набора данных
- Тема 17.
- Анонимизация
- данных
Комментарии преподавателя
Расширение passwordcheck запрещает использование простых паролей.
https://postgrespro.ru/docs/enterprise/16/passwordcheck
Профили пользователей ограничивают использование системы, в частности, реализуют парольные политики.
https://postgrespro.ru/docs/enterprise/16/sql-createprofile
Расширение pg_proaudit позволяет проводить аудит действий пользователей.
https://postgrespro.ru/docs/enterprise/16/pg-proaudit
Рекомендуемые организационно-технические мероприятия по разграничению прав между привилегированными пользователями СУБД позволят повысить безопасность работы с Postgres Pro.
https://postgrespro.ru/docs/enterprise/16/sod-separation-of-duties
Разграничение прав доступа в ряде случаев не сможет обеспечить полную безопасность данных. В таких ситуациях можно использовать анонимизацию — сохранение конфиденциальности путем изменения представления исходного набора данных.
https://postgrespro.ru/docs/enterprise/16/pgpro-anonymizer
Page 29: Сертификация ФСТЭК
Очистка удаленных данных
- на диске и в оперативной памяти
- Контроль целостности файлов
Комментарии преподавателя
Работа с персональными данными и конфиденциальной информацией требует использования сертифицированной редакции Postgres Pro Enterprise Certified. Для этой редакции сделано несколько изменений, которые отсутствуют и в несертифицированной Postgres Pro Enterprise.
Чтобы не допустить возможности восстановления удаленных данных, освобождаемые области памяти автоматически заполняются нулевыми байтами — как на диске, так и в оперативной памяти.
https://postgrespro.ru/docs/enterprise/16/memory-purge-cert
Утилита pg_integrity_check проверяет контрольные суммы отслеживаемых файлов — исполняемых, конфигурационных, таблиц системного каталога — и блокирует доступ пользователей к базе данных в случае обнаружения несанкционированных изменений.
https://postgrespro.ru/docs/enterprise/16/integrity-checks
Page 30: Резервное копирование
pg\_probackup — система резервного копирования и восстановления
- централизованный каталог копий
- политики хранения
- инкрементальное копирование
- многопоточность
- ptrack
- механизм для получения измененных страниц данных
- Темы 18, 19 и 20.
- Резервное копирование
Комментарии преподавателя
pg_probackup — система резервного копирования и восстановления кластеров баз данных PostgreSQL и Postgres Pro.
Утилита поддерживает каталог резервных копий, позволяя настраивать политики хранения.
Реализованы различные виды инкрементального копирования, многопоточность и другие возможности.
Механизм PTRACK позволяет в определенных случаях значительно ускорить инкрементальное копирование, сообщая утилите номера блоков данных, измененных после предыдущего копирования.
https://postgrespro.ru/docs/enterprise/16/app-pgprobackup
Page 31: Отказоустойчивые решения
Доработки физической репликации
- Синхронный кластер multimaster
- Отказоустойчивый кластер BiHA
Page 32: Репликация
Нестрогая синхронная репликация
- ограничение отставания реплики
- synchronous_standby_gap = 0
- Автоматическое исправление поврежденных страниц
- страницы запрашиваются с резервного сервера
- page_repair = off
- Восстановление поврежденных записей WAL
- walsender может прочитать запись из буфера в оперативной памяти
- wal_sender_check_crc = off
Комментарии преподавателя
Нестрогая синхронная репликация позволяет временно перевести синхронную реплику в асинхронный режим при значительном отставании.
https://postgrespro.ru/docs/enterprise/16/runtime-config-replication#GUC-SY NCHRONOUS-STANDBY-GAP
При чтении страницы с неверной контрольной суммой основной сервер может запросить эту страницу с резервного сервера и автоматически восстановить ее.
https://postgrespro.ru/docs/enterprise/16/warm-standby#REPAIR-PAGE-FR OM-STANDBY
Процесс walsender может восстановить поврежденную запись WAL из буферов оперативной памяти.
https://postgrespro.ru/docs/enterprise/16/wal-restoration
Page 33: Отказоустойчивость
multimaster — синхронный кластер без разделения ресурсов
- все узлы ведущие
- распределенные транзакции
- отказоустойчивость и высокая доступность
- масштабирование читающей нагрузки
- Тема 21.
- Кластер multimaster
- Отказоустойчивый кластер BiHA
- Тема 22.
- Кластер BiHA
- кластер с физической репликацией
- отказоустойчивость и высокая доступность
- масштабирование читающей нагрузки
Комментарии преподавателя
Расширение multimaster позволяет настроить синхронный кластер, в котором любой узел может принимать запросы как на чтение, так и на запись.
Встроенный менеджер глобальных транзакций позволяет работать с кластером как с монолитной базой, гарантируя обычные свойства ACID. Протокол фиксации на основе кворума обеспечивает отказоустойчивость и высокую доступность кластера.
https://postgrespro.ru/docs/enterprise/16/multimaster
Расширение BiHA позволяет организовать отказоустойчивый кластер, где изменения данных обрабатывает узел-лидер, а затем с помощью механизма физической репликации эти изменения распространяются на узлы-последователи. Последователи доступны только для чтения.
https://postgrespro.ru/docs/enterprise/16/biha
Оба расширения обеспечивают отказоустойчивость за счет автоматического выявления отказа узлов и изменения конфигурации кластера, что означает автоматическое переключение узлов и синхронизацию данных на вернувшихся в строй узлах.
Также оба расширения обеспечивают масштабируемость читающих транзакций.
Page 34: Итоги
Postgres Pro Enterprise содержит разнообразные дополнительные возможности
- изменения в коде ядра PostgreSQL
- дополнительные расширения
- улучшения сторонних расширений
- Основные возможности детально рассматриваются в курсе
02 Занятие 02: Установка и сопровождение / Postgres Pro Enterprise Manager
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_02_ppem.html Archive: PGPRO-handouts-16.zip Страниц PDF: 17
Page 1: Установка и сопровождение / Postgres Pro Enterprise Manager
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Назначение и особенности
- Возможности
- Архитектура
- Установка и настройка
- Ролевая модель доступа
- Интерфейс веб-приложения
Page 3: Назначение и особенности
Единая консоль мониторинга и управления
- Централизованный доступ к разным экземплярам и базам
- Работа из окна браузера
- Навигация по иерархии объектов
- Ролевая модель управления доступом
- Поддержка различных редакций PostgreSQL и Postgres Pro
Комментарии преподавателя
Postgres Pro Enterprise Manager (PPEM) — комплексное решение для администрирования инфраструктуры баз данных. PPEM предоставляет удобный интерфейс для управления и мониторинга СУБД PostgreSQL и различных редакций СУБД Postgres Pro.
https://postgrespro.ru/docs/ppem/2/index
PPEM может эксплуатироваться на операционных системах семейства Linux. Информация по совместимости с другим ПО, а также аппаратные и программные требования приведены в документации.
https://postgrespro.ru/docs/ppem/2/ppem-supported-platforms-and-operatin g-systems#PPEM-SUPPORTED-PLATFORMS-AND-OPERATING-SYSTEM S
https://postgrespro.ru/docs/ppem/2/ppem-compatibility
https://postgrespro.ru/docs/ppem/2/ppem-hardware-and-software-requireme nts#PPEM-HARDWARE-AND-SOFTWARE-REQUIREMENTS
Page 4: Возможности
Автообнаружение, настройка и управление экземплярами
- Управление объектами баз данных
- Мониторинг активности, производительности и профилирование
- Регламентные операции по обслуживанию
- Резервное копирование и восстановление
- Прямой доступ к SQL-консоли экземпляров
Комментарии преподавателя
PPEM позволяет выполнять полный цикл задач развертывания, эксплуатации и обслуживания баз данных:
● обнаруживает экземпляры СУБД и добавляет их в веб-приложение, позволяет развернуть новые экземпляры — как одиночные, так и кластерные конфигурации;
● содержит средства просмотра и настройки параметров конфигурации без прямого редактирования файлов конфигурации;
● позволяет работать с объектами экземпляров СУБД;
● получает и отображает данные о внутренней активности СУБД от подсистемы статистики, позволяет отменять запросы и завершать процессы;
● интегрируется с pgpro-otel-collector, по предоставляемым им метрикам строятся графики для анализа работы СУБД;
● интегрирован с pg_profile и pgpro_pwr, предоставляет удобный интерфейс для работы со снимками и отчетами;
● может выполнять служебные операции (очистка, анализ, переиндексация и др.) вручную и автоматически по расписанию;
● позволяет осуществлять резервное копирование как вручную, так и по расписанию, а также создавать экземпляры из резервных копий;
● обеспечивает доступ к SQL-консоли экземпляра.
https://postgrespro.ru/docs/ppem/2/ppem-features#PPEM-FEATURES
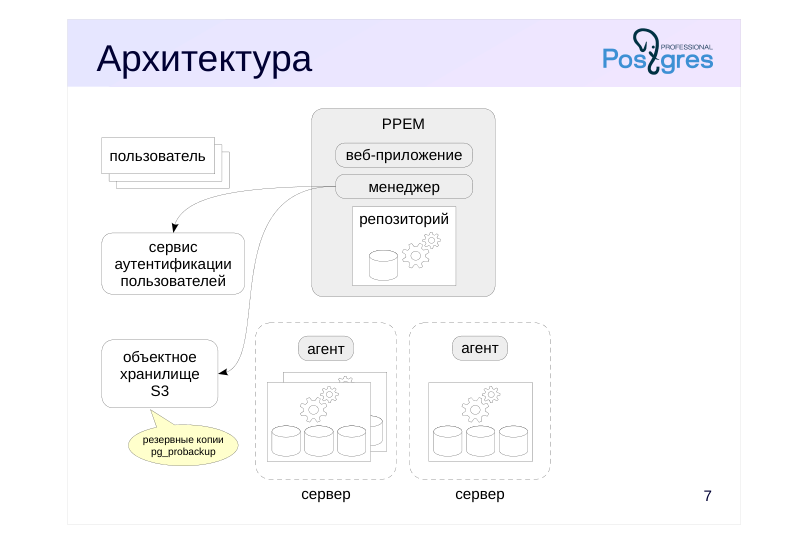
Page 5: Архитектура
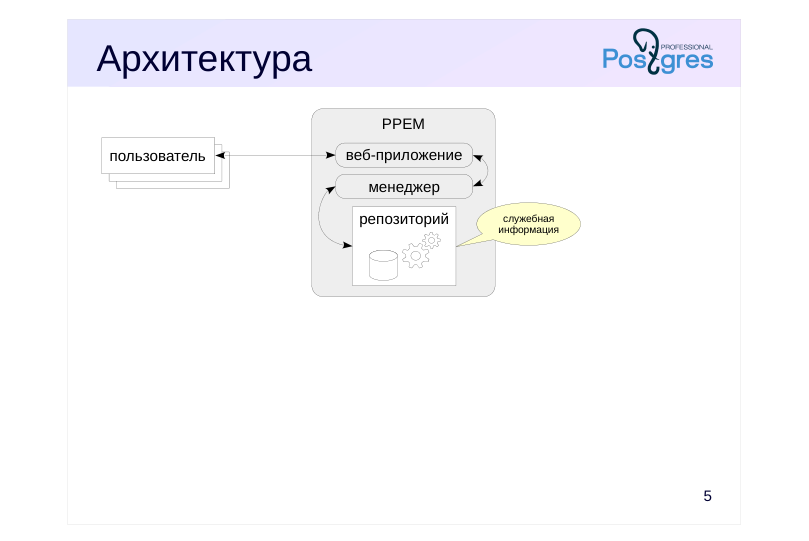 {#source-figure-005 caption=“Source slide page 5: Архитектура”}
Комментарии преподавателя
Веб-приложение — набор компонентов, которые обеспечивают пользовательский интерфейс, доступный через браузер. Пользователь выполняет различные действия в браузере, а веб-приложение преобразует эти действия в запросы и отправляет их менеджеру.
https://postgrespro.ru/docs/ppem/2/ppem-description-of-components#PPEM -WEB-APPLICATION
Менеджер — служба, которая работает в фоновом режиме. Менеджер принимает запросы на обслуживание инфраструктуры СУБД от веб-приложения и преобразует их в операции согласно заложенной логике. Менеджер имеет собственный планировщик для выполнения регулярных служебных заданий. Веб-приложение устанавливается на сервере вместе с менеджером PPEM.
https://postgrespro.ru/docs/ppem/2/ppem-description-of-components#PPEM -MANAGER
Репозиторий — это база данных в отдельном экземпляре СУБД, в которой менеджер хранит свою служебную информацию. Во время запуска менеджер устанавливает соединение с репозиторием и при выполнении операций читает и записывает в него данные. Доступность репозитория крайне важна, без него менеджер работать не может.
https://postgrespro.ru/docs/ppem/2/ppem-description-of-components#PPEM -REPOSITORY
Page 6: Архитектура
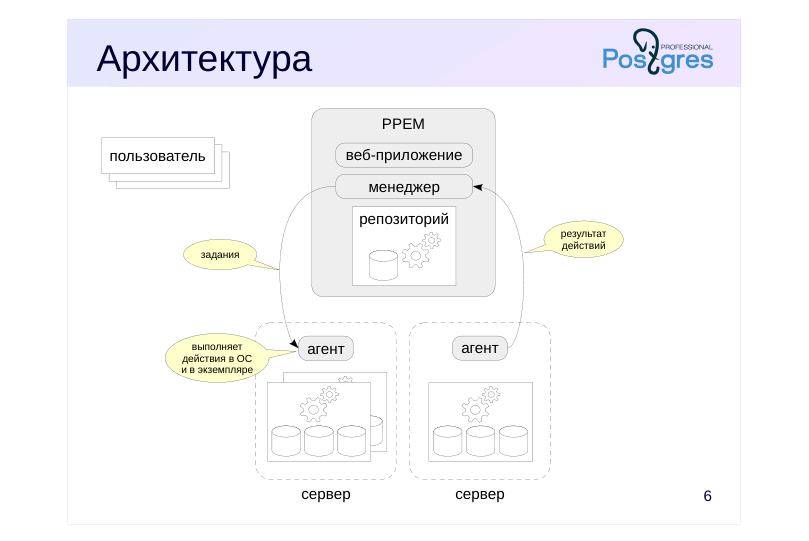 {#source-figure-006 caption=“Source slide page 6: Архитектура”}
Комментарии преподавателя
Агенты — это службы, которые выполняются на управляемых серверах. Агенты принимают задания от менеджера и выполняют действия как в операционной системе, так и в самом управляемом экземпляре СУБД. Действиями могут быть запуск команд, создание каталогов и файлов, выполнение запросов и т. п.
При синхронном выполнении агенты сразу отправляют менеджеру результаты действий для регистрации в репозитории и последующей обработки. При асинхронном выполнении менеджер периодически опрашивает статус задания. Как и менеджер, агенты имеют собственный планировщик служебных заданий, который регулярно выполняет фоновые задачи.
Выполнив операцию, менеджер сообщает веб-приложению ее результат, а приложение отображает его в браузере.
https://postgrespro.ru/docs/ppem/2/ppem-description-of-components#PPEM -AGENT
Объект управления PPEM — это экземпляр СУБД (PostgreSQL или Postgres Pro в редакциях Standard или Enterprise). На одном сервере достаточно одного агента, который может обслуживать несколько экземпляров СУБД. С точки зрения экземпляра агент является обычным клиентом, который подключается к СУБД под заранее определенной ролью.
https://postgrespro.ru/docs/ppem/2/ppem-description-of-components#PPEM -DBMS-INSTANCE
Page 7: Архитектура
 {#source-figure-007 caption=“Source slide page 7: Архитектура”}
Комментарии преподавателя
Для расширения функций и возможностей PPEM может использовать внешние сервисы:
● LDAP — служба каталогов для внешней аутентификации пользователей.
В базовом сценарии использования PPEM аутентифицирует своих пользователей самостоятельно, нужные для этого данные хранятся в репозитории. Но при необходимости можно настроить взаимодействие с внешним каталогом пользователей и групп — поддерживается работа с сервисами OpenLDAP и Microsoft Active Directory. При использовании внешней службы учетные данные сначала проверяются в ней, а затем, если они не были обнаружены, выполняется проверка в репозитории.
● S3-совместимое объектное хранилище для резервных копий.
Для создания резервных копий экземпляров и восстановления из них PPEM использует утилиту pg_probackup. Копии при этом могут сохраняться не только в локальный каталог, но и в S3-совместимое хранилище объектов. Работа с pg_probackup подробно рассматривается далее в модуле «Резервное копирование».
Page 8: Архитектура
 {#source-figure-008 caption=“Source slide page 8: Архитектура”}
Комментарии преподавателя
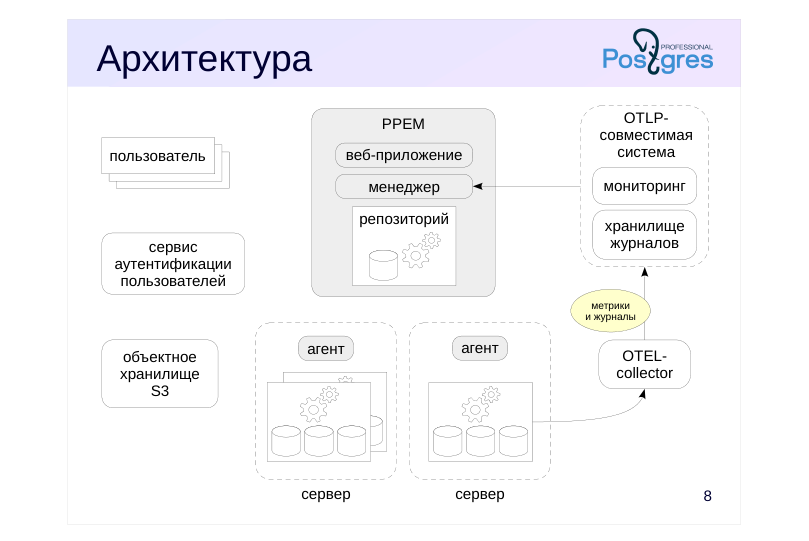
Другими внешними сервисами, с которыми может взаимодействовать PPEM, являются системы хранения метрик и журналов, поддерживающие спецификацию OTLP:
● Система хранения метрик с поддержкой работы по push-и/или по pull-модели. Поддерживается работа с Victoriametrics и Prometheus.
● Система хранения журналов. Поддерживается работа с Elasticsearch.
https://opentelemetry.io/docs/specs/otlp
Запись в эти хранилища выполняет служба pgpro-otel-collector. Задача коллектора — извлекать статистические данные об экземпляре из различных источников (системные представления, таблицы, журналы) и передавать их в системы хранения и мониторинга.
Наряду с внешними системами, коллектор может использовать и внутреннее хранилище: в этом случае собираемые данные сохраняются в базе данных репозитория PPEM. Но такой подход не рекомендуется для использования в производственной среде.
https://postgrespro.ru/docs/otelcol/current
Page 9: Установка и настройка
Менеджер
- установка пакета
- репозиторий
- настройка
- Агенты
- установка
- настройка
- Особенности
- безопасность и разделение доступа
- работа с системами высокой доступности
Комментарии преподавателя
После установки менеджера PPEM из пакета необходимо подготовить экземпляр СУБД PPEM для хранения служебных данных. В этом экземпляре нужно создать базу данных репозитория и роль, от имени которой менеджер будет подключаться к базе. Также необходимо внести соответствующие настройки в файл конфигурации менеджера.
https://postgrespro.ru/docs/ppem/2/ppem-quick-start-installation#PPEM-QUI CK-START-INSTALLING-THE-MANAGER
Агент, будучи установленным из пакета, тоже нуждается в настройке. В служебном экземпляре СУБД нужно создать роль для подключения агента к базе репозитория. Также нужно задать в конфигурационном файле агента его уникальное имя, API-ключ и URL для подключения к менеджеру и учетные данные для доступа к базе репозитория.
https://postgrespro.ru/docs/ppem/2/ppem-quick-start-installation#PPEM-QUI CK-START-INSTALLING-THE-AGENT
В средах с усиленными мерами безопасности службы менеджера и агента могут быть настроены для запуска от имени отдельных, непривилегированных пользователей ОС:
https://postgrespro.ru/docs/ppem/2/ppem-installation-in-secure-environment s
Page 10: Настройки менеджера и агентов PPEM
Для размещения репозитория PPEM в виртуальной машине курса создан экземпляр PostgreSQL:
Запустим экземпляр с репозиторием и сервисы PPEM.
В этом экземпляре есть одноименные база данных репозитория и роль:
Настройки менеджера заданы следующим образом (уберем комментарии и пустые строки):
А агента — вот таким:
Page 11: Page 11
В качестве роли, под которой агент подключается к экземплярам, мы для простоты выбрали роль суперпользователя postgres. Однако в реальной эксплуатации следует завести для этой цели отдельную роль, которую необходимо наделить полномочиями в соответствии с кругом выполняемых агентом задач.
Page 12: Ролевая модель доступа
Субъекты
- пользователи и агенты
- Объекты
- ресурсы PPEM: сервер, агент, экземпляр, пользователь…
- Роли
- набор прав на один класс объектов
- системные роли
- объектно-привязанные роли
Комментарии преподавателя
Управление доступом в PPEM реализовано на основе ролевой модели. Субъектами являются пользователи и агенты, объектами — ресурсы самого PPEM и их представления в репозитории. Ресурсы относятся к разным классам, таким как экземпляры или задания.
Аутентификация субъектов может выполняться:
● Встроенными средствами PPEM. Данные о субъектах хранятся в репозитории и управляются администратором PPEM.
● Через внешний каталог LDAP. Данные о субъектах хранятся во внешнем каталоге, а менеджер настроен на работу с ним.
Уровень доступа субъектов к различным ресурсам определяется правами. Права не назначаются пользователям и группам напрямую, а приобретаются через роли.
Роль содержит набор прав на объекты одного класса. Обычно эти права относятся ко всем объектам класса, но можно указать и конкретный объект, тогда права и роли становятся объектно-привязанными.
Существует набор предопределенных («системных») ролей, удаление и изменение которых из веб-приложения невозможно, но можно создавать дополнительные пользовательские роли с нужными правами.
https://postgrespro.ru/docs/ppem/2/ppem-role-based-access-control-rbac-m odel
Отметим, что пользователи и роли PPEM никак не связаны с ролями обслуживаемых экземпляров СУБД.
Page 13: Веб-приложение
 {#source-figure-013 caption=“Source slide page 13: Веб-приложение”}
Комментарии преподавателя
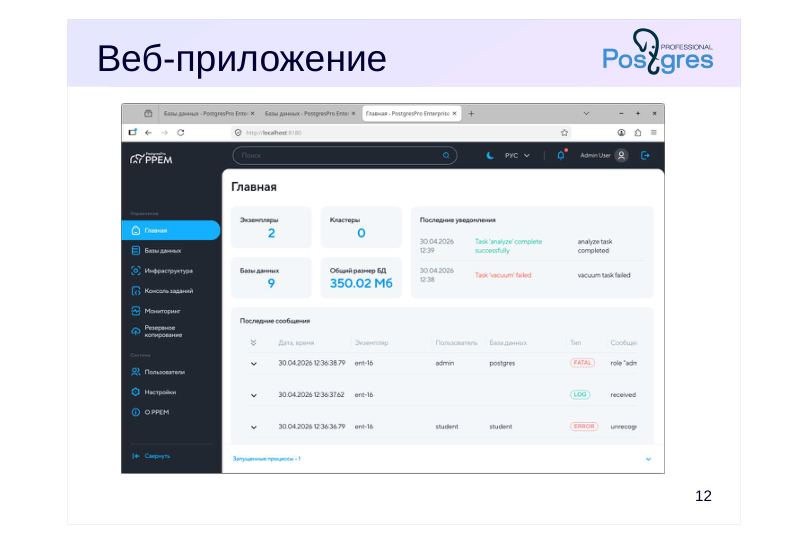
Чтобы начать работать с приложением, нужно в адресной строке браузера ввести сетевой адрес или имя сервера и номер порта, на котором сервер прослушивает входящие подключения. Эти параметры задаются при настройке сервера и указаны в файле конфигурации менеджера; в виртуальной машине курса адрес — localhost:8180.
Далее, на странице авторизации, необходимо ввести логин и пароль пользователя. После этого откроется главная страница приложения, на которой представлена сводная информация о приложении и обслуживаемых ей объектах.
Элементами интерфейса также являются навигационная панель, с помощью которой можно быстро переходить с одной страницы приложения на другую (некоторые страницы приложения содержат вложенные страницы) и панель инструментов со строкой поиска компонентов, а также переключатели тем оформления и языка приложения.
Страницы приложения, преимущественно предназначенные для работы с инфраструктурой, и страницы, предназначенные для работы непосредственно с базами данных, сгруппированы на панели навигации в отдельные разделы «Инфраструктура» и «Базы данных».
В панели инструментов также есть пиктограмма в виде колокольчика, нажав на которую можно просмотреть уведомления самого PPEM.
https://postgrespro.ru/docs/ppem/2/ppem-web-application-interface#PPEM-WEB-APPLICATION-INTERFACE
Page 14: Интерфейс веб-приложения PPEM
Подключимся к серверу и выполним заведомо ошибочные действия, информация о которых попадет в журнал сообщений.
Посмотрим на интерфейс веб-приложения. Его главная страница содержит информацию о количестве обслуживаемых экземпляров, кластеров, базах данных и их размере. Тут же представлены ленты журнала сообщений экземпляров и уведомлений самого PPEM. Обратите внимание на наличие навигационной панели слева и панели инструментов наверху окна. В панели «Последние сообщения» можем найти записи журнала с информацией о наших ошибках — они были прочитаны из журнала сообщений экземпляра:
Открываем http://localhost:8180…
Page 15: Итоги
PPEM — комплексное решение для администрирования инфраструктуры баз данных
- Удобный интерфейс для управления, обслуживания и мониторинга СУБД PostgreSQL и различных редакций Postgres Pro
- Многокомпонентная архитектура с централизованным репозиторием и агентами на управляемых серверах
- Собственная система управления доступом на основе ролевой модели
Page 16: Практика
- Войдите в PPEM как admin и создайте пользователей access-adm и ent-16-adm, которые будут управлять в PPEM ролями пользователей и экземпляром ent-16. Пользователю access-adm выдайте право Access administrator role. 2. Создайте пользовательскую роль Notifications administrator c правами работы с уведомлениями. 3. Войдите в PPEM как access-adm. Назначьте пользователю ent-16-adm роль Notifications administrator и роль Instance administrator role для экземпляра ent-16. 4. Войдите в PPEM как ent-16-adm и выполните проверку целостности каталога данных экземпляра ent-16, а затем перезапустите экземпляр. Убедитесь, что эти команды отработали успешно.
Комментарии преподавателя
Значок на рабочем столе «PPEM start» запускает необходимые службы и открывает приложение в окне браузера. Для первого входа в PPEM используйте логин admin, пароль admin.
Для проверки откройте «Список заданий» во вкладке «Консоль заданий» навигационной панели.
Page 17: 1. Пользователи PPEM
В навигационной панели выберите вкладку «Пользователи» и нажмите кнопку «Добавить пользователя». В открывшемся окне заполните необходимые поля; для пользователя access-adm в список «Личные роли» дополнительно к «Guest role» добавьте «Access administrator role». Нажмите кнопку «Добавить».
2. Пользовательская роль
Откройте вкладку «Пользователи» в навигационной панели, а затем вкладку «Роли». Нажмите «Добавить роль» и в открывшемся окне введите системное название новой роли (правила его формирования указаны под полем ввода) и имя роли. Пользуясь строкой поиска привилегий, найдите те, что относятся к работе с уведомлениями (notification), и отметьте их. Нажмите «Далее», а затем «Добавить».
3. Выдача прав пользователю. Личные роли
Выйдите из сеанса admin, нажав кнопку с соответствующей пиктограммой в панели инструментов. В новом окне приглашения введите логин access-adm и пароль, затем нажмите «Войти». Поскольку вход с этим логином осуществляется впервые, потребуется сменить пароль. В таблице со списком пользователей выберите ent-16-adm и нажмите на пиктограмму редактирования в столбце «Действия». В открывшемся окне в список «Личные роли» добавьте «Instance administrator role» (с указанием ent-16 в поле «Объект») и «Notifications administrator», после чего нажмите «Сохранить».
4. Управление экземпляром
Выйдите из сеанса access-adm. В окне приглашения введите логин ent-16-adm и пароль, затем нажмите «Войти» и смените пароль согласно требованию. Перейдите на главную страницу: наверху навигационной панели нажмите «Главная» или щелкните по значку с эмблемой PPEM (со слоном) в левом верхнем углу. Откройте список экземпляров, щелкнув по блоку «Экземпляры», и затем нажмите на пиктограмму «Проверить целостность каталога» напротив ent-16. Дождитесь появления уведомления в панели инструментов на пиктограмме с изображением колокольчика (красная точка) и, нажав на нее, убедитесь, что проверка завершена. Перезапустите экземпляр ent-16, нажав на соответствующую пиктограмму. Перейдите на главную страницу, выберите в навигационной панели вкладку «Консоль заданий» и убедитесь, что перезапуск выполнен.
03 Занятие 03: Установка и сопровождение / Установка, настройка, обновление
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_03_install.html Archive: PGPRO-handouts-16.zip Страниц PDF: 23
Page 1: Установка и сопровождение / Установка, настройка, обновление
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Установка и начальная настройка
- Обновление сервера
Page 3: Установка и настройка
Архитектуры и ОС
- Пакеты Postgres Pro
- Настройка Postgres Pro
- Информация о сервере
- Нумерация версий
Page 4: Архитектуры и ОС
64-разрядные архитектуры
- AMD/Intel 64 (x86_64)
- ARM64 (aarch64)
- Эльбрус 2000 (e2kv3, e2kv4)
- Power PC, Power ISA (ppc64le)
- OC на базе Linux
- Red Hat Enterprise Linux, CentOS, Rocky Linux, Oracle Linux,
- Rosa/РОСА, РЕД ОС, AlterOS, AlmaLinux
- Debian, Ubuntu, Astra Linux
- Альт
- SUSE Linux Enterprise Server
Комментарии преподавателя
Postgres Pro может работать на серверных операционных системах на базе Linux. Поддерживаются только 64-разрядные архитектуры.
Список поддерживаемых систем можно посмотреть в документации:
https://postgrespro.ru/docs/enterprise/16/binary-installation-on-linux#SUPPO RTED-LINUX-OS
Платформа Windows поддерживалась в версиях до 14 включительно.
Page 5: Пакеты Postgres Pro
Пакет верхнего уровня
- postgrespro-ent-16
- все доступные компоненты сервера
- автоматическая настройка
- Детальный выбор пакетов
- postgrespro-ent-16-* и другие
- только необходимые компоненты
- ручная настройка
- Сторонние пакеты
- дополнительные расширения и утилиты
Комментарии преподавателя
Программное обеспечение Postgres Pro Enterprise поставляется в двоичных пакетах.
Пакет верхнего уровня postgrespro-ent-16 позволяет быстро установить и настроить Postgres Pro Enterprise для серверных и клиентских систем (будут установлены все доступные компоненты без возможности выбора). Такой способ установки не рекомендуется при обновлении или миграции системы.
Для более детальной установки и настройки рекомендуется отобрать отдельные пакеты. Можно установить только серверную часть, клиентские утилиты, документацию и т. п. В этом случае действия по настройке, такие как инициализация кластера, придется выполнять самостоятельно.
Пакеты называются одинаково для всех операционных систем (кроме незначительных отличий в суффиксе названия пакетов для разработчиков postgrespro-ent-16-dev* и пакетов с отладочной информацией postgrespro-ent-16-dbg*).
Существуют также сторонние пакеты и библиотеки, собранные специально для Postgres Pro Enterprise. В них реализованы необходимые функции, содержатся дополнительные утилиты и расширения: в libzstd — функции сжатия данных, oracle-fdw-ent-16 — обертка сторонних данных для Oracle, pgpro-pgbadger — анализатор журналов сообщений и др.
Полный перечень пакетов и библиотек есть в документации:
https://postgrespro.ru/docs/enterprise/16/binary-installation-on-linux#CHOO SING-PGPRO-PACKAGES
Page 6: Настройка Postgres Pro
pg-wrapper — управление ссылками
- путь поиска PATH и страницы man
- pg-setup — управление кластером
- инициализация кластера
- проверка доступных портов
- изменение конфигурации сервера
- включение и отключение автоматического запуска службы
- запуск, остановка или перезапуск службы
- настройка кластера
- Проверка контрольных сумм
- включена по умолчанию
Комментарии преподавателя
В данном курсе рассматривается настройка и работа Postgres Pro Enterprise в среде Linux.
Для добавления ссылок в путь поиска PATH и для подключения man-страниц используется скрипт pg-wrapper.
https://postgrespro.ru/docs/enterprise/16/pg-wrapper
Для инициализации кластера Postgres Pro Enterprise рекомендуется скрипт pg-setup. Он может находить доступные для установки сервера порты, инициализировать и настраивать экземпляры Postgres Pro Enterprise. Запускать pg-setup нужно от имени пользователя root, а действия с СУБД скрипт выполняет под ролью postgres.
https://postgrespro.ru/docs/enterprise/16/pg-setup
Скрипт также позволяет запустить сервер, остановить его и настроить автоматический запуск.
https://postgrespro.ru/docs/enterprise/16/binary-installation-on-linux#STARTI NG-SERVER-AUTOMATICALLY
По умолчанию в кластере:
● включаются подсчет и проверка контрольных сумм;
● запускается утилита pgpro_tune, которая добавляет в конфигурацию экземпляра настройки, оптимизирующие работу на конкретном оборудовании;
● поддерживается библиотека ICU, в которой реализована платформонезависимая сортировка.
https://postgrespro.ru/docs/enterprise/16/collation#COLLATION-MANAGING
Page 7: Информация о сервере
pgpro\_controldata
- вывод информации о кластере и/или сервере
- чтение младших мажорных версий и редакций
- сравнение параметров сервера, влияющих на совместимость
- SQL-функции
- проверка информации о системе после установки
- версия и редакция Postgres Pro
- идентификатор состояния исходного кода
- pg_config
- версия и редакция Postgres Pro Enterprise
Комментарии преподавателя
С помощью утилиты pgpro_controldata можно вывести управляющую информацию о кластере PostgreSQL или Postgres Pro Enterprise и параметры совместимости кластера. Без указания параметров утилита pgpro_controldata работает аналогично утилите pg_controldata. Устанавливается отдельным пакетом.
https://postgrespro.ru/docs/enterprise/16/app-pgprocontroldata
Если Postgres Pro Enterprise уже установлен, с помощью SQL-функций можно узнать версию кластера, название редакции и идентификатор состояния исходного кода (хеш коммита), из которого был собран пакет — эти сведения пригодятся для обращения в техподдержку.
https://postgrespro.ru/docs/enterprise/16/functions-info#FUNCTIONS-INFO-SESSION-TABLE
Аналогичная информация выводится и с помощью утилиты pg_config.
https://postgrespro.ru/docs/enterprise/16/app-pgconfig
Page 8: Проверка системы после установки
В виртуальной машине курса установлен пакет postgrespro-ent-16-server, исполняемые файлы находятся в каталоге /opt/pgpro/ent-16/bin/:
Для инициализации кластера была использована утилита pg-setup. Ключ –no-tune отключает применение дополнительных настроек:
Этой же утилитой pg-setup была настроена служба с автозапуском, так что экземпляром можно управлять в стиле ОС:
Статус можно узнать и с помощью традиционной утилиты pg_ctl:
Для запуска, остановки и перезапуска экземпляра сервера рекомендуется использовать те средства, которые уже используются в вашей компании. Информацию об установленной системе (номер версии и название редакции) можно узнать разными способами, например, с помощью утилиты pg_config или SQL-функций:
Page 9: Page 9
Можно вывести значения конфигурационных параметров SQL-командой SHOW, как это делается в обычном PostgreSQL:
Файл postgresql.conf находится в каталоге данных:
В виртуальной машине в основной конфигурационный файл Postgres Pro Enterprise добавлена директива include_dir для включения дополнительных файлов:
Page 10: Нумерация версий
 {#source-figure-010 caption=“Source slide page 10: Нумерация версий”}
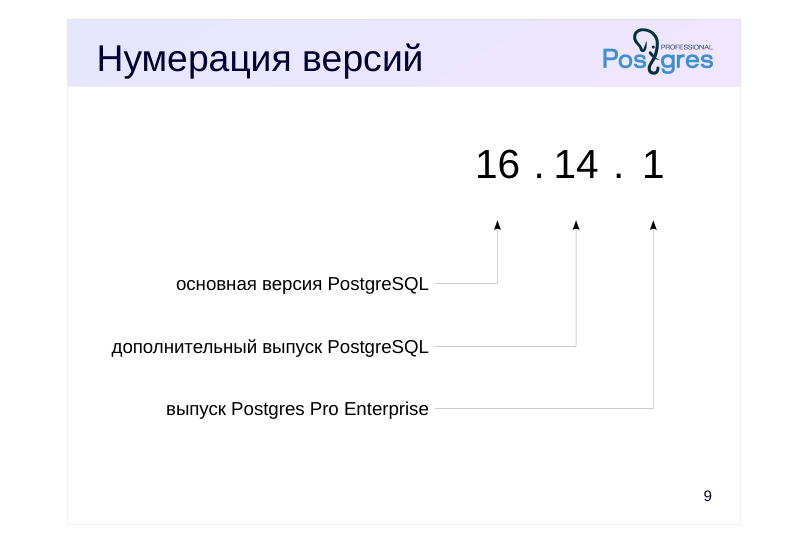
16 14 1 . .
- основная версия PostgreSQL
- дополнительный выпуск PostgreSQL
- выпуск Postgres Pro Enterprise
Комментарии преподавателя
Номер версии Postgres Pro Enterprise состоит из трех частей: номера основной версии (major release), номера дополнительного выпуска (minor release) PostgreSQL и номера выпуска Postgres Pro Enterprise.
Новая основная версия привносит изменение функционала: какие-то возможности добавляются и изменяются, реже — удаляются.
Дополнительные выпуски служат для переноса изменений, сделанных в соответствующем выпуске PostgreSQL, а также для исправления ошибок, проблем безопасности и производительности, найденных в предыдущих выпусках.
Выпуски Postgres Pro Enterprise служат исключительно для исправления ошибок, проблем безопасности и производительности, найденных в предыдущих выпусках Postgres Pro Enterprise.
При обновлении нужно учитывать, что в новом выпуске может быть прекращена поддержка определенных версий операционных систем.
https://postgrespro.ru/docs/enterprise/16/upgrading
Page 11: Обновление сервера
Обновление Postgres Pro Enterprise
- Переход с PostgreSQL и редакций Postgres Pro
Page 12: Обновление Enterprise
Обновление в пределах основной версии
- доп. выпуск PostgreSQL или выпуск Postgres Pro Enterprise
- установить исполняемые файлы и перезапустить сервер
- Обновление основной версии
- pg_dump + pg_restore
- pg_upgrade
Комментарии преподавателя
В целом процедура обновления сервера Postgres Pro Enterprise аналогична процедуре обновления PostgreSQL. Внимательно прочитайте замечания ко всем выпускам между текущим и целевым.
В любом случае сначала устанавливаются пакеты новой версии или выпуска.
При обновлении на дополнительный выпуск или выпуск Postgres Pro Enterprise после этого достаточно перезапустить сервер.
При обновлении основной версии для переноса данных есть два пути:
● сделать логическую резервную копию утилитами pg_dumpall или pg_dump и восстановить данные с помощью pg_restore / psql;
● воспользоваться утилитой pg_upgrade.
Если статистику планировщика запросов не переносили из старой версии, после переноса данных нужно выполнить анализ.
После любого обновления следует проверить и при необходимости обновить версии расширений в базах данных.
Page 13: Варианты перехода
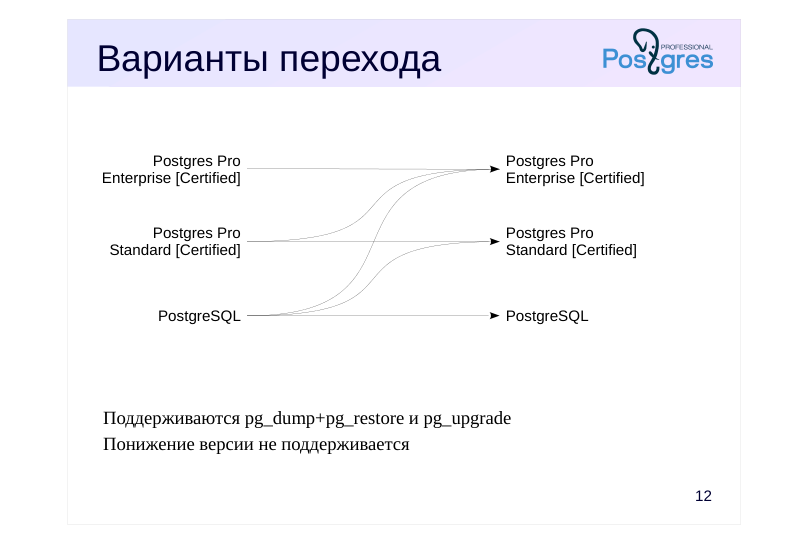 {#source-figure-013 caption=“Source slide page 13: Варианты перехода”}
Поддерживаются pg_dump+pg_restore и pg_upgrade Понижение версии не поддерживается
Комментарии преподавателя
В иерархии PostgreSQL < Postgres Pro Standard < Postgres Pro Enterprise возможен перенос данных с младшей на более старшую редакцию СУБД. При этом поддерживается как перенос с помощью логического резервирования и восстановления (pg_dump + pg_restore), так и перенос с помощью утилиты pg_upgrade. Возможные пути переноса и ограничения показаны на рисунке.
При этом возможен переход только на ту же или бóльшую основную версию СУБД, понижение версии (downgrade) не поддерживается.
Формат табличных страниц Postgres Pro Enterprise отличается от формата PostgreSQL и Postgres Pro Standard (подробности в теме «Транзакции и сеансы»). Однако непосредственно при обновлении pg_upgrade конвертация всех страниц не выполняется — это слишком затратная процедура. Такое преобразование выполняется позже постепенно — страницы конвертируются при первом обращении к ним после обновления системы.
Page 14: Перенос данных из PostgreSQL
При миграции из PostgreSQL можно использовать средства логического резервного копирования или утилиту pg_upgrade. В виртуальной машине установлен PostgreSQL 16 и инициализирован кластер prod. Запустим экземпляр.
В отдельной базе данных создадим таблицу:
Остановим экземпляр PostgreSQL.
Будем переносить данные с помощью pg_upgrade. Нам понадобится пустой кластер Postgres Pro Enterprise.
Для начала запустим утилиту в режиме проверки. Ключами -b и -B нужно указать пути к исполняемым файлам нового и старого кластера, а ключами -d и -D — пути к postgresql.conf.
Page 15: Page 15
Все в порядке, можно переносить данные.
Page 16: Page 16
Добавим директиву include_dir в основной конфигурационный файл и создадим каталог для дополнительных файлов:
Задаем порт в отдельном конфигурационном файле и запускаем сервер Postgres Pro Enterprise.
Данные перенесены в Postgres Pro Enterprise.
Page 17: Итоги
Postgres Pro Enterprise можно установить «по умолчанию» или выборочно
- PostgreSQL и Postgres Pro Standard можно обновить до Postgres Pro Enterprise Postgres Pro Enterprise имеет собственные административные утилиты и функции
Page 18: Практика
- Какой размер имеет сейчас буферный кеш сервера Postgres Pro Enterprise? Увеличьте его на 10 % с помощью команды ALTER SYSTEM. 2. Настройте журнал сообщений так, чтобы в него попадала информация обо всех выполняемых запросах. Запустите стандартный тест pgbench на 90 секунд. Найдите в журнале сообщений информацию о выполненных запросах. Проанализируйте журнал с помощью утилиты pgbadger. 3. Отключите запись информации, настроенную в п.2.
Комментарии преподавателя
Создайте .conf-файл с произвольным именем в подкаталоге conf.d каталога PGDATA кластера и поместите в него необходимые настройки конфигурационных параметров. Содержимое этого файла будет учтено в конфигурации благодаря директиве include_dir, находящейся в конце конфигурационного файла postgresql.conf.
Удалите конфигурационный файл, созданный в п.2
Page 19: 1. Размер кеша
Текущее значение параметра:
Задаем на 10% больше:
Перезапуск и проверка:
2. Тест pgbench и анализ журнала сообщений
Инициализируем pgbench в отдельной базе данных
Включаем вывод в журнал:
Проверяем значение параметра:
Запускаем тест на 90 секунд.
Page 20: Page 20
Файлы журнала сообщений находятся в /var/lib/pgpro/ent-16/log:
Несколько последних записей журнала:
pgBadger уже установлен в виртуальной машине:
Утилите нужно передать: имя html-файла для отчета; формат журнала сообщений; файл журнала или список файлов. Запускаем:
Утилита сгенерировала отчет в файле out.html:
Заглянем в отчет:
Page 21: 3. Восстановление конфигурации
Открываем /tmp/out.html…
Удалим созданный файл и перечитаем конфигурацию:
Уборка
Удалим созданный отчет.
Page 22: Практика PPEM
- Войдите в веб-приложение PPEM как admin и найдите все параметры основного экземпляра, значения которых отличаются от значений по умолчанию. 2. Выясните текущее значение параметра shared_buffers. В каком конфигурационном файле находится строка, устанавливающая это значение? Увеличьте значение в два раза и примените это изменение. 3. Создайте новый экземпляр PostgresPro Enterprise с каталогом данных в /var/lib/pgpro/ent-16-opt. Запустите экземпляр и убедитесь, что он работает.
Page 23: 1. Параметры со значениями, отличными от значений по умолчанию
На главной странице в блоке «Экземпляры» выберите ent-16. В навигационной панели выберите вкладку «Параметры» и установите соответствующий переключатель на главном экране.
2. Значение параметра shared\_buffers
В «Параметрах» найдите shared_buffers. Под названием параметра будет информация, указывающую на строку и файл, где установлено это значение. В поле ввода укажите новое значение параметра и нажмите «Сохранить». Для применения нового значения потребуется перезапуск экземпляра; его нужно дополнительно подтвердить.
3. Создание и запуск нового экземпляра
В блоке «Экземпляры» нажмите «Добавить экземпляр», а затем в открывшемся окне выберите «Создать новый экземпляр» и нажмите «Далее». В новом окне заполните необходимые поля и нажмите «Выполнить». Убедитесь, что инициализация нового экземпляра завершена — в списке он должен иметь статус «Остановлен» — и затем нажмите «Запустить» и дождитесь изменения статуса. Чтобы проверить, что создание и запуск успешны, можно воспользоваться списком заданий. Для этого нажмите на пиктограмму колокольчика в панели инструментов.
04 Занятие 04: Установка и сопровождение / Миграция
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_04_migration.html Archive: PGPRO-handouts-16.zip Страниц PDF: 22
Page 1: Установка и сопровождение / Миграция
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Варианты и сложности миграции
- Миграция данных
- Миграция объектов бизнес-логики
- Реализация системных пакетов из Oracle
- Пакеты в Postgres Pro Enterprise
- Утилита ora2pgpro
Page 3: Варианты и сложности
Миграция на Postgres Pro Enterprise с других СУБД
- Oracle
- MS SQL Server
- MySQL
- PostgreSQL
- Задачи и сложности
- перенос схемы и данных: различия в типах, время переноса больших
- объемов
- перенос кода: хранимый код может сильно зависеть от СУБД
- перенос нестандартного функционала
Комментарии преподавателя
Миграция, то есть переход с одной системы баз данных на другую, — сложная задача с огромным количеством трудностей и нюансов, перечислить которые здесь не представляется возможным. Упомянем главные:
● несоответствие типов переносимых данных в исходной и целевой СУБД;
● время переноса серьезных объемов данных может оказаться достаточно большим;
● трудоемкость переноса хранимого кода, в том числе из-за различий языков и их диалектов;
● сложность переноса функционала, зависящего от СУБД (например такого, как автономные транзакции и пакеты из СУБД Oracle).
Применительно к предмету курса, одним из популярных вариантов является миграция из Oracle в Postgres Pro Enterprise. Рассмотрению этой задачи посвящена почти вся эта тема.
https://postgrespro.ru/docs/enterprise/16/pgpro-migration-tools
Page 4: Миграция объектов
Объекты SQL
- таблицы, индексы, представления, последовательности
- схемы
- Подпрограммы
- процедуры, функции, триггеры
- Другие объекты и нестандартный функционал
- пакеты
- автономные транзакции
Комментарии преподавателя
Миграция стандартных объектов SQL, таких как таблицы, индексы, представления и последовательности, относительно проста и поддается автоматизации.
Сложной может оказаться миграция хранимого кода — функций, процедур, триггеров — из-за разнообразия логики, а также различий в используемых языках и модулях.
Миграция других объектов — тоже сложная задача, поскольку реализация многих из них в Postgres Pro Enterprise может отличаться от других СУБД или вовсе не иметь аналогов. Например, пакеты, которые появились в версии 15, не являются прямыми аналогами пакетов Oracle — их синтаксис и возможности различаются.
Есть большое количество сторонних решений, автоматизирующих процесс миграции; они экономят усилия и снижают количество ошибок. Но в целом задача очень многообразна и сложна, поэтому автоматизировать ее полностью не представляется возможным.
Page 5: Миграция данных
SQL
- выгрузка + psql
- Обертки сторонних данных
- универсальные для СУБД: ODBC, JDBC
- для реляционных СУБД: Oracle (oracle_fdw), MS SQL (tds_fdw), MySQL,
- DB2, SQLite
- для NoSQL-СУБД: MongoDB, Redis, Cassandra
- файловые: file_fdw, CSV, JSON
Комментарии преподавателя
При миграции данных из других СУБД можно использовать SQL как промежуточный формат. Конечно, это самый универсальный подход, но на практике при значительных объемах данных он неприменим. К тому же из-за разницы в диалектах SQL может потребоваться дополнительное преобразование данных и команд.
Для удобства работы со скриптами, часто применяемыми при такой миграции, утилита psql в Postgres Pro Enterprise может передавать им при вызове именованные и позиционные параметры.
https://postgrespro.ru/docs/enterprise/16/app-psql#APP-PSQL-META-COM MAND-INCLUDE
Дополнительные удобства и более высокую производительность можно получить, используя механизм оберток сторонних данных (foreign data wrappers), встроенный в PostgreSQL и позволяющий обращаться к внешним данным как к локальным таблицам. Штатная обертка file_fdw позволяет читать данные из файлов различных форматов. В составе дистрибутива Postgres Pro Enterprise присутствует пакет oracle-fdw-ent-16 с расширением oracle_fdw, устанавливающий одноименную обертку, и пакет tds-fdw-ent-16 для подключения к Microsoft SQL Server. Помимо этого, существует множество сторонних оберток для различных СУБД и форматов файлов.
https://wiki.postgresql.org/wiki/Foreign\_data\_wrappers
Page 6: Параметры при вызове скрипта в утилите psql
Начиная с 15-й версии Postgres Pro Enterprise поддерживается передача именованных и позиционных параметров при вызове скрипта в утилите psql. Если передается «имя=значение», создается переменная с указанным именем. Если указано только значение, оно присваивается позиционной переменной с именем PSQL_ARG1, PSQL_ARG2 и т. д. Именованные и позиционные параметры можно использовать одновременно. Для демонстрации создадим файл example.sql:
Перед выполнением запроса скрипт выводит значения трех переменных, переданных через параметры. Подразумевается, что первые два параметра будут именованными, а последний — позиционным. Запустим скрипт из psql:
Page 7: Системные пакеты Oracle
Расширение orafce
- функции, представления
- пакеты dbms_output, dbms_sql, dbms_pipe, dbms_alert, dbms_utility,
- dbms_assert, utl_file
- и др.
- Реализация других системных пакетов Oracle
- dbms_lob, dbms_application_info
- utl_mail, utl_smtp, utl_http
Комментарии преподавателя
В дистрибутив Postgres Pro Enterprise включен пакет orafce-ent-16, устанавливающий расширение orafce. Оно добавляет в базу данных Postgres Pro Enterprise объекты, аналогичные объектам СУБД Oracle, что сильно упрощает перенос процедурной логики.
https://github.com/orafce/orafce
Несколько расширений, эмулирующих другие системные пакеты Oracle, поставляются в отдельном пакете pgpro-orautl-ent-16:
● utl_mail — управление электронными письмами;
● utl_smtp — отправка электронных писем из PL/pgSQL;
● utl_http — выполнение HTTP-вызовов из SQL и PL/pgSQL.
https://postgrespro.ru/docs/enterprise/16/utl-mail
https://postgrespro.ru/docs/enterprise/16/utl-smtp
https://postgrespro.ru/docs/enterprise/16/utl-http
Еще два расширения добавлены в состав Postgres Pro Enterprise как стандартные и включены в основной пакет:
● dbms_lob — работа с большими объектами: BLOB, CLOB, BFILE и временными LOB;
● pgpro_application_info — реализация пакета dbms_application_info.
https://postgrespro.ru/docs/enterprise/16/dbms-lob
https://postgrespro.ru/docs/enterprise/16/pgpro-application-info
Page 8: Системные пакеты Oracle
Для примера рассмотрим работу с расширением pgpro_application_info, возможности которого можно использовать для анализа производительности и отладки приложений. Расширение содержит ряд подпрограмм, позволяющих приложениям сообщать о своем состоянии и ходе выполнения. Доступ к этой информации осуществляется через представления. Начнем с установки расширения:
Необходима перезагрузка экземпляра:
Добавим расширение в базу данных.
В транзакции первого сеанса будем вызывать процедуры из расширения pgpro_application_info: set_client_info — задает информацию о клиенте, например его название и/или описание; set_module — передает имя выполняемого в данный момент модуля (либо подпрограммы) и действие в нем; set_action — передает название выполняющегося действия в текущем модуле. Во втором сеансе будем проверять состояние первого, используя представление v_session того же расширения:
Первый сеанс:
Второй сеанс:
Обратите внимание, что расширение работает нетранзакционно — в ряде случаев это может оказаться удобным.
Page 9: Page 9
Откатим транзакцию в первом сеансе:
Page 10: Пакеты
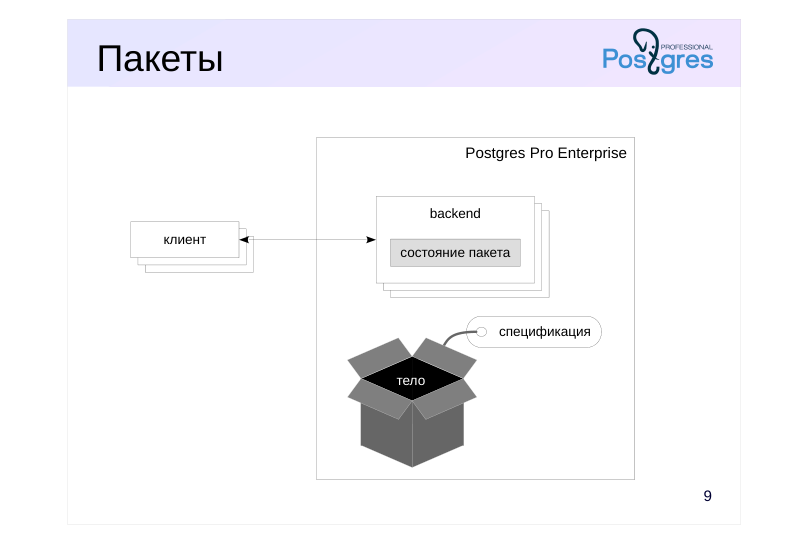 {#source-figure-010 caption=“Source slide page 10: Пакеты”}
Комментарии преподавателя
Пакеты в Oracle позволяют сгруппировать логически связанные объекты (подпрограммы, переменные, типы данных, курсоры и т. п.). Пакет состоит из спецификации (объявления публичных элементов, доступных извне пакета) и тела (реализации подпрограмм, объявленных в спецификации, и внутренних элементов, доступных только внутри пакета). Спецификация определяет интерфейс пакета, а тело рассматривается как черный ящик — изменение реализации не влияет на пользователей пакета.
Спецификация и тело пакета — объекты базы данных Oracle.
Пакетные переменные и курсоры образуют состояние, свое для каждого сеанса, в котором используется пакет.
В теле пакета может находиться секция инициализации пакета — код, который выполняется один раз при первом обращении к пакету. С ее помощью можно задать начальное состояние, например, установить значения пакетных переменных.
В PostgreSQL аналогичной цели — группировке логически связанных объектов — служат схемы. Однако схема не имеет переменных и состояния, что очень сильно усложняет миграцию. Поэтому в Postgres Pro Enterprise реализован основной функционал пакетов. Он не повторяет пакеты Oracle синтаксически, а построен на основе схем.
https://postgrespro.ru/docs/enterprise/16/packages-overview
Page 11: Пакеты
Схема с функцией инициализации
- Состояние
- объявленные в __init__ переменные
- Аналог спецификации
- заголовки публичных подпрограмм
- типы данных
- #export-переменные из __init__ (по умолчанию все)
- Аналог тела
- публичные подпрограммы
- внутренние #private-подпрограммы
Комментарии преподавателя
Пакет в PostgresPro Enterprise — это схема, организованная специальным образом. Сначала в схеме создается функция с именем __init__ – функция инициализации.
Все переменные, объявленные в этой функции, становятся частью состояния пакета. По умолчанию все переменные будут публичными, то есть доступны снаружи пакета из подпрограмм, помеченных модификатором #import. Но можно сделать публичными только часть переменных, упомянув их в модификаторе #export, тогда все остальные будут доступны только из подпрограмм пакета. Обращаться к переменным пакета извне нужно по квалифицированному имени: имя-пакета.имя-переменной.
Затем создаются пакетные подпрограммы – их помечают модификатором #package. По умолчанию такие подпрограммы будут публичными. Если же подпрограмма служит только для внутренних нужд пакета, ее следует пометить модификатором #private.
При обращении к любой пакетной подпрограмме вызывается функция инициализации, которая формирует состояние пакета. Сбросить его можно вызовом функции инициализации или plpgsql_reset_packages (это аналог DBMS_SESSION.RESET_PACKAGES в Oracle).
В пакетах нет явного разделения на спецификацию и тело. По сути, спецификацию образуют заголовки публичных подпрограмм, публичные переменные и типы данных, входящие в схему. Аналогом тела будут все подпрограммы пакета: публичные и внутренние.
Пакет удобно создавать специальной командой CREATE PACKAGE.
https://postgrespro.ru/docs/enterprise/16/plpgsql-package
Page 12: Пакеты
Создадим пакет, предоставляющий локальный для сеанса счетчик:
При первом обращении к пакету выполняется функция инициализации:
В другом сеансе отсчет начинается заново:
А в первом сеансе счетчик продолжает увеличиваться:
Пакеты в Postgres Pro Enterprise реализованы как схемы. Поэтому в списке схем можно увидеть и схему demo:
Page 13: Page 13
Список схем-пакетов можно получить запросом, выводящим схемы, в которых есть функция __init__:
Удалим пакет:
Page 14: Утилита ora2pgpro
Автоматизация миграции из Oracle
- Конвертация кода PL/SQL
- пакеты, функции и процедуры, триггеры
- автономные транзакции
- VARRAY, ассоциативные массивы
- Перенос схемы данных и объектов
- параллельная выгрузка и загрузка данных
- секционированные таблицы (по спискам и по диапазонам, подсекции)
- BLOB, пользовательские типы данных
- поддержка DBLINK, SYNONYM, DIRECTORY
- полнотекстовый поиск
- Oracle Spatial (пространственные данные)
Комментарии преподавателя
Утилита ora2pgpro предназначена для автоматизации конвертации кода и переноса объектов из СУБД Oracle в Postgres Pro Enterprise.
Утилита ora2pgpro создана на основе ora2pg:
https://ora2pg.darold.net/documentation.html
Однако ora2pgpro существенно расширяет возможности ora2pg по переносу кода и типов данных, отсутствующих в PostgreSQL, но реализованных в Postgres Pro Enterprise. Помимо этого, в ora2pgpro устранены ошибки, найденные за время эксплуатации ora2pg.
Некоторые из поддерживаемых возможностей перечислены на слайде. Полный список и все настройки описаны в документации:
https://postgrespro.ru/docs/ora2pgpro/26/index
Для работы утилиты требуется Oracle Instant Client Package.
Утилита ora2pgpro не поддерживается на платформе ARM64 (MacBook с процессором Apple Silicon) и в виртуальной машине курса для этой платформы отсутствует.
Page 15: Утилита ora2pgpro
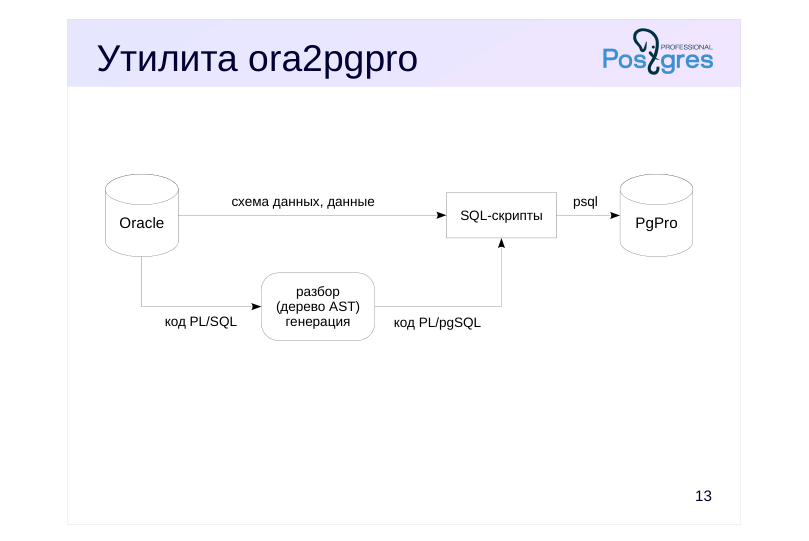 {#source-figure-015 caption=“Source slide page 15: Утилита ora2pgpro”}
Комментарии преподавателя
Утилита ora2pgpro подключается к БД Oracle, извлекает из нее структуру базы, данные и хранимый код (все вместе или по частям), и генерирует SQL-скрипты, которые потом можно загрузить в Postgres Pro Enterprise с помощью psql. В простых случаях, не требующих ручных правок, можно сформировать объекты напрямую в базе Postgres Pro Enterprise.
Утилита управляется директивами, которые позволяют переименовывать таблицы и столбцы в схеме данных, заменять типы данных (например, CHAR(1) на boolean, если он используется для логических значений) и т. д.
Для работы с хранимым кодом (пакетами, процедурами и функциями, триггерами) в утилиту добавлен транслятор, который разбирает код PL/SQL, строит дерево разбора и генерирует по нему код PL/pgSQL, используя все возможности, предоставляемые Postgres Pro Enterprise для совместимости с Oracle.
Page 16: ora2pgpro
Утилита ora2pgpro уже установлена в виртуальной машине курса:
Утилита может работать без подключения к БД Oracle, если необходимые данные заранее выгружены в файлы. Создадим каталог, в котором будут находиться исходные данные для конвертации:
Поместим в него два скрипта, описывающие простой пакет Oracle:
Спецификация и тело пакета располагаются в подкаталоге sources каталога, который мы укажем утилите. В этот же каталог утилита выведет результаты своей работы.
Утилите также потребуется конфигурационный файл, в котором указываются параметры-директивы, управляющие ее работой и описывающие подключение к базам Oracle и Postgres Pro. Мы собираемся запустить утилиту в локальном режиме, поэтому не будем указывать параметры подключения к базе данных Oracle и файл будет коротким:
При запуске указываем тип экспорта PACKAGE (пакеты) и пути к каталогу миграции и к конфигурационному файлу:
Сценарий — результат преобразования схемы — будет записан в файл:
Page 17: Page 17
Выполним этот файл с помощью psql:
В базе данных появилась новая схема-пакет с необходимыми функциями:
Page 18: Итоги
Миграция с других СУБД — сложная задача
- Postgres Pro Enterprise облегчает миграцию с Oracle
- функционал пакетов
- утилита ora2pgpro для автоматизации переноса данных и кода
- аналоги системных пакетов Oracle
- параметры при вызове скрипта в утилите psql
Page 19: Практика
- Создайте базу данных и добавьте в нее расширение orafce. 2. Какие схемы появились после загрузки расширения? 3. Изучите возможности функции dbms_random.string.
Комментарии преподавателя
Пакет orafce-ent-16 уже установлен в виртуальной машине.
С документацией по orafce можно ознакомиться в репозитории
https://github.com/orafce/orafce
Page 20: 1. Добавление расширения orafce
Создадим базу данных pgpro_migration и подключимся к ней:
Расширение orafce распространяется в отдельном пакете orafce-ent-16, который уже установлен в виртуальной машине курса. Поэтому для установки расширения в базу данных достаточно выполнить команду CREATE EXTENSION:
2. Проверка доступных функций
Расширение orafce представляет реализации многих функций, которые существуют в СУБД Oracle, но отсутствуют (или реализованы по-другому) в Postgres Pro. Функции каждого из пакетов располагаются в отдельных схемах:
3. Функция dbms\_random.string
Пакет dbms_random предназначен для генерации случайных чисел и строк. Посмотрим, какие функции в него входят:
Page 21: Page 21
Функция string возвращает случайные строки. Ее первый параметр однобуквенный, он отвечает за вид возвращаемого значения: U/u — строка в верхнем регистре; L/l — строка в нижнем регистре; A/a — строка в смешанном регистре; X/x — строка из буквенно-цифровых символов в верхнем регистре; P/p — строка из любых печатных символов в смешанном регистре. Второй параметр управляет длиной строки:
Уборка
Удалим созданную базу данных.
Page 22: Page 22
05 Занятие 05: Установка и сопровождение / Планировщик заданий
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_05_scheduler.html Archive: PGPRO-handouts-16.zip Страниц PDF: 24
Page 1: Установка и сопровождение / Планировщик заданий
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Назначение
- Архитектура
- Периодические задания
- Управление и наблюдение
- Разовые задания
Page 3: Назначение
Расширение pgpro\_scheduler
- планировщик периодических и разовых заданий мониторинг разграничение прав Задание — команды SQL
- в отдельных транзакциях или все в одной
Комментарии преподавателя
Планировщик заданий требуется для периодического запуска заданий по расписанию, а также для запуска разовых отложенных заданий. В Postgres Pro планировщик реализован в виде расширения pgpro_scheduler.
С его помощью можно планировать регулярные задачи администрирования без доступа к файловой системе сервера и без использования внешнего программного обеспечения.
Задание планировщика состоит из команд SQL, которые могут быть выполнены как в одной транзакции, так и в разных.
Планировщик позволяет наблюдать за ходом выполнения заданий. Он обеспечивает разделение полномочий: каждое задание принадлежит определенному пользователю и выполняется от его имени.
https://postgrespro.ru/docs/enterprise/16/pgpro-scheduler
Page 4: Архитектура
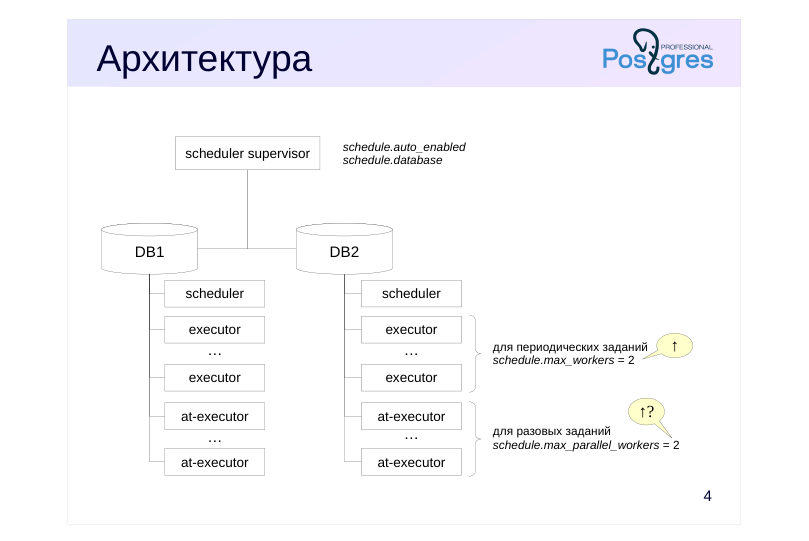 {#source-figure-004 caption=“Source slide page 4: Архитектура”}
- …
- ↑
Комментарии преподавателя
Планировщик задач использует механизм фоновых рабочих процессов.
Основной процесс-диспетчер планировщика (один на весь кластер баз данных) запускается функцией schedule.enable, а для автоматического его запуска при старте сервера нужно установить параметр schedule.auto_enabled = true.
Диспетчерский процесс проверяет настройки и для каждой из указанных в параметре schedule.database баз данных запускает отдельный процесс-менеджер (для показанной на слайде конфигурации нужно задать значение ‘DB1,DB2’). Также сразу запускаются обработчики разовых заданий планировщика, их количество ограничено значением schedule.max_parallel_workers.
Максимальное количество обработчиков для планируемых заданий в каждой базе ограничено параметром schedule.max_workers.
Оба ограничения можно задавать на уровне базы данных командой ALTER DATABASE. Обработчики периодических и разовых заданий работают независимо.
При этом общее количество рабочих процессов сервера ограничено параметром max_worker_processes, его значение должно учитывать потребности и других задач, использующих фоновые процессы.
Если нет свободных процессов для выполнения, задание будет ожидать освобождения обработчика. По умолчанию время ожидания не ограничено, поэтому, планируя задание, разумно указывать ограничение времени, при превышении которого pgpro_scheduler отменит выполнение.
Page 5: Установка расширения pgpro_scheduler
Создадим базу данных:
Для работы расширения необходимо подключить библиотеку:
Общее ограничение на количество фоновых рабочих процессов в системе, значения по умолчанию достаточно для работы с одной базой:
Подключение библиотеки требует перезапуска СУБД.
Установим расширение pgpro_scheduler в базе данных, в которой оно будет использоваться.
Объекты расширения находятся в схеме schedule. Например, представления для мониторинга разовых заданий:
Настройка
Укажем имена баз данных, для которых будут запускаться задания:
Применим изменение конфигурации.
Установим ограничения на уровне базы данных. Максимальное число рабочих процессов для периодических заданий:
Page 6: Page 6
Ограничение на число рабочих процессов, выполняющих разовые задания:
Включим планировщик заданий:
Состояние процессов планировщика заданий:
Информация об этих процессах доступна и в pg_stat_activity:
Page 7: Периодические задания
Команды SQL
- выполняются в одной или в нескольких транзакциях
- Расписание
- в формате cron
- массив дат
- объект JSON
- выражение SQL — время следующего запуска
- диапазон времени
- Дополнительные атрибуты
- пользователь, длительность, время ожидания, обработчик ошибок
Комментарии преподавателя
Функция schedule.create_job позволяет запланировать периодическое задание. Параметры планирования задаются в виде одного объекта jsonb.
Атрибут commands задает одну или несколько команд для выполнения. Если задать команды в виде символьной строки, они выполнятся в одной транзакции. Если же задан массив строк, то каждому элементу массива будет соответствовать отдельная транзакция.
Расписание для задания задается атрибутами:
● cron — в формате crontab;
● dates — значение или массив значений типа timestamptz;
● rule — объектом jsonb.
Атрибутами start_date и end_date можно ограничить время, в которое задание может выполняться; вне диапазона работающее задание будет остановлено, а новое не запустится.
Время следующего запуска задания будет определяться динамически, если в атрибуте next_time_statement задать SQL-выражение. Оно вычисляется после каждого выполнения задания.
Также можно запланировать выполнение задания с правами другого пользователя (атрибут run_as), ограничить длительность выполнения и ожидания, подключить обработчик ошибок в виде SQL-команды.
https://postgrespro.ru/docs/enterprise/16/pgpro-scheduler#PGPRO-SCHED ULER-USAGE
Page 8: Управление и мониторинг
Управление
- изменение атрибутов
- активация
- деактивация
- удаление
- Мониторинг
- свойства задания
- список заданий (всех, выполняющихся, выполненных)
- список запланированных выполнений
- очистка журнала
Комментарии преподавателя
Расширение pgpro_scheduler использует функции в схеме schedule для управления периодическими заданиями и их мониторинга:
● set_job_attribute() — изменение одного атрибута задания;
● set_job_attributes() — изменение нескольких атрибутов задания;
● deactivate_job — деактивировать задание;
● activate_job — активировать задание;
● drop_job — удалить задание;
● get_job — информация о задании;
● get_owned_cron — задания пользователя;
● get_cron — список заданий, выполняемых пользователем;
● get_active_jobs — список выполняющихся заданий;
● get_log — список всех завершенных заданий;
● get_user_log — список завершенных заданий пользователя;
● clean_log — удалить все записи о завершенных заданиях.
Имеется функция timetable, которая возвращает таблицу с описанием всех запланированных выполнений заданий (многократно повторяемых и разовых), попадающих в заданный диапазон времени.
Page 9: Периодические задания
Создадим таблицу:
А теперь создадим периодическое задание, используя формат crontab. Формат использует пять полей для идентификации времени: минуты часа (0-59); часы (0-23); дни месяца (1-31); месяц (1-12 или трехбуквенное сокращение); дни недели (0 — воскресенье … 6 — суббота, или трехбуквенные сокращения). Если в поле после звездочки через косую черту указано число — это шаг выполнения. Например, */10 * * * * означает «раз в десять минут». Расширенный формат cron использует шесть полей с секундами. Например, */30 * * * * * означает «раз в тридцать секунд». Запланируем задание на выполнение раз в минуту:
Получим информацию о запланированном задании:
Функция get_job информирует о задании, возвращая значение типа cron_rec. Проверим поле rule, описывающее расписание, преобразовав расписание из представления JSONB в текстовые строки и урезав их по ширине:
Page 10: Page 10
Через минуту сработает первое задание. Подождем… Проверим, что было добавлено в таблицу t:
Функция timetable информирует о выполненных и запланированных заданиях. Получим список заданий за 5 минут:
Отчет о выполненных заданиях планировщика:
Управление периодическими заданиями
До сих пор задание выполнялось в ноль секунд каждой минуты:
Пусть задание выполняется чаще — раз в десять секунд. Используем расширенный формат cron из шести полей, где первое поле — секунды:
Проверим в rule: задание должно быть запланировано для исполнения с периодичностью раз в десять секунд.
Подождем немного… Проверим, что было добавлено в таблицу t:
Page 11: Page 11
Временно приостановим задание. Новые записи не будут попадать в таблицу.
Проверим состояние задания — оно должно быть не активно:
Подождем немного… Снова запустим задание и проверим состояние:
Подождем еще немного… Проверим записи в таблице t:
Выполненные задания отображаются в журнале:
Снова приостановим задание и очистим таблицу.
Page 12: Команды в отдельных транзакциях
В атрибуте commands значения могут задаваться в виде текста или массива. Если отдельные команды SQL заданы текстовой строкой через точку с запятой, то все команды задания будут выполнены в одной транзакции. Если команды SQL заданы JSON-массивом, то каждая из них будет выполнена в отдельной транзакции. Создадим задание для заполнения таблицы t раз в десять секунд. Каждая SQL-команда выполняется в отдельной транзакции. Значения now() для каждой транзакции — свои, как и идентификаторы транзакции.
Снова немного подождем…
Проверим, что было добавлено в таблицу:
Команды были выполнены одним обслуживающим процессом, но в отдельных транзакциях.
Команды в одной транзакции
Даже если команды заданы массивом, можно задать атрибуту use_same_transaction значение true, и все команды будут выполнены в одной транзакции. Удалим все записи в таблице.
В одной транзакции значения времени, которые возвращает функция now(), будут одинаковыми.
Page 13: Page 13
Подождем чуть-чуть… Удалим задание и проверим, что было добавлено в таблицу.
Все три оператора задания выполнились в одной транзакции. Снова очистим таблицу и запустим первое задание.
Page 14: Разовые задания
- работает независимо
- от периодических
- Выполнить задание
- немедленно
- в определенный момент
- после завершения других заданий
- Назначить повторное выполнение
- Отменить еще не выполняющееся задание
Комментарии преподавателя
Функция submit_job создает разовое задание. По умолчанию задание будет выполнено немедленно. Можно задать время запуска параметром run_after. Также можно в параметре depends_on передать массив идентификаторов других заданий — в этом случае данное задание будет выполнено сразу после их завершения.
Функция resubmit, вызванная в SQL-запросе задания, позволяет задать время следующего запуска этого задания.
Функция cancel_job отменяет задание. Если задание уже выполняется, оно не будет прервано, но повторно назначить его будет нельзя.
Получить список выполненных и запланированных заданий (как периодических, так и разовых) позволяет функция timetable.
Периодические и разовые задания выполняются в разных процессах, поэтому они могут работать параллельно.
Page 15: Разовые задания
Запланируем разовое задание, удаляющее через десять секунд таблицу t:
Таблица t пока на месте:
Подождем немного…
Таблица уже удалена. В таблице заданий выводится информация и о разовых заданиях:
Свойство onrollback периодического задания задает действия при сбое команды задания — будем восстанавливать таблицу, предполагая ее отсутствие:
Проверим состояние задания:
Page 16: Page 16
Подождем еще немного… Теперь таблица восстановлена и пока пуста:
Подождем еще… Теперь таблица уже не пуста:
Посмотрим список завершенных заданий:
Удалим запланированное задание:
Page 17: Page 17
Page 18: Итоги
Расширение pgpro\_scheduler позволяет планировать задания
- Задания выполняются либо периодически по расписанию, либо один раз в запланированное время
- Задания принадлежат пользователям и выполняются от их имени
- Каждое задание выполняется в отдельном процессе
- Имеются средства управления заданиями и их мониторинга
Page 19: Практика
1. Подготовьте систему к работе с расширениями pgpro\_scheduler и pg\_stat\_statements. 2. Установите расширения pgpro\_scheduler и pg\_stat\_statements в базу данных и настройте их.
- Запланируйте задание, собирающее статистику по наиболее часто выполняемым запросам каждые 20 секунд, а также разовое задание, копирующее набранную статистику в файл.
Комментарии преподавателя
Для установки расширений потребуется изменить значение параметра shared_preload_libraries и перезагрузить сервер.
Подключив расширения с помощью CREATE EXTENSION, настройте число рабочих процессов по аналогии с демонстрацией и запустите планировщик.
Для сбора статистики используйте расширение pg_stat_statements и таблицу с такой же структурой, как у представления pg_stat_statements, но с дополнительным полем, в которое будет записываться момент сбора статистики. Ограничьте время работы периодического задания одной минутой с помощью атрибута end_date в аргументе функции schedule.create_job.
Page 20: 1. Подготовка СУБД для работы с расширениями pgpro_scheduler и pg_stat_statements
Создадим базу данных pgpro_scheduler:
Подключим разделяемые библиотеки:
Общее ограничение на количество параллельных процессов:
Перезапустим СУБД.
2. Подключение расширений. Запуск планировщика
Установим расширения:
База данных для нагрузочного тестирования:
Применим изменения конфигурации:
Включим планировщик заданий:
Состояние процессов планировщика заданий:
Page 21: 3. Планирование задач
Создадим таблицу для сохранения выборок статистики:
Запланируем копирование статистики в таблицу stat_tab раз в 20 секунд, причем периодическое задание должно работать одну минуту:
Через минуту содержимое таблицы нужно скопировать в файл с помощью разового задания.
Подождем минуту… Проверим выполненные задания:
В таблице собраны сведения о наиболее частых запросах:
Page 22: Уборка
Разовое задание скопировало таблицу в файл:
Удалим созданную базу данных и файл, сбросим настройки параметров конфигурации.
Page 23: Практика PPEM
Эти задания используют планировщик PPEM, а не расширение pgpro_scheduler.
- Запланируйте выполнение очистки базы demo через одну-две минуты.
- Создайте задание для переиндексации таблиц в табличном пространстве pg_default базы demo и запланируйте его выполнение на регулярной основе каждый будний день в 20:00. 3. Убедитесь, что задание из п. 1 выполнено.
- Деактивируйте задание из п. 2.
Комментарии преподавателя
1, 2. Создавайте задания из панели «Базы данных».
3, 4. Используйте вкладку «Консоль заданий» в навигационной панели PPEM.
Page 24: 1. Однократное задание очистки базы данных
В навигационной панели выберите «Базы данных» и найдите базу demo экземпляра ent-16. В колонке «Действия» (крайняя справа) нажмите на пиктограмму «Очистить-Vacuum», и в открывшемся окне, в блоке «Планирование задачи», выберите «Отложенное по времени». Дайте новому заданию имя и назначьте время выполнения, после чего нажмите «Применить». В навигационной панели, во вкладке «Консоль заданий», выберите вложенную вкладку «Расписание» и убедитесь в наличии нового задания.
2. Переиндексация таблиц по расписанию
В навигационной панели откройте вкладку «Базы данных» и найдите базу demo. В колонке «Действия», в выпадающем меню (пиктограмма с тремя точками), выберите «Перестроить индексы-Reindex». В открывшемся окне выберите нужное табличное пространство, запланируйте задание по требуемому расписанию и нажмите «Применить».
3. Контроль списка заданий
Откройте «Консоль заданий» в навигационной панели, а затем вкладку «Задания». Проверьте, что созданное в п. 1 задание помечено статусом «Completed».
4. Деактивация задания
Во вкладке «Консоль заданий», в списке «Расписание» найдите задание, созданное в п. 2 и в колонке «Действия» нажмите пиктограмму «Деактивировать».
06 Занятие 06: Данные / CFS — сжатая файловая система
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_06_cfs.html Archive: PGPRO-handouts-16.zip Страниц PDF: 24
Page 1: Данные / CFS — сжатая файловая система
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Возможность и польза сжатия
- Реализация сжатия в Postgres Pro Enterprise
- Использование CFS
- Объем данных и степень сжатия
- Фрагментация и сбор мусора
Page 3: Возможности и польза
Данные БД обычно хорошо сжимаются
- текстовые данные
- дублирование
- Преимущества сжатия
- уменьшение объема хранения
- экономия ресурсов ввода-вывода
- последовательное чтение и запись
- Сжатие при записи грязного буфера
- в буферном кеше нужны несжатые данные
Комментарии преподавателя
В базах данных обычно хранятся большие объемы текста и повторяющейся информации. Поэтому для большинства баз сжатие может быть довольно эффективным и позволяет сократить объем хранимых данных в несколько раз. PostgreSQL сжимает данные в TOAST-таблицах, но небольшие текстовые поля, умещающиеся в странице, не сжимаются. Сжатие может быть полезно не только для таблиц, но и для индексов по текстовым ключам или для индексов с большим количеством повторяющихся значений.
Помимо очевидного плюса — экономии места, сжатие может также увеличить быстродействие системы по двум причинам. Во-первых, сокращается объем дискового ввода-вывода. Во-вторых, появляется возможность последовательно записывать сжатые измененные данные в смежные области диска, увеличивая скорость обращения к ним за счет последовательного доступа.
Работать со сжатыми данными в общей памяти сервера (в буферном кеше) непроизводительно, поэтому логично выполнять сжатие страницы при сохранении грязного буфера и разжимать ее при чтении в буферный кеш.
Page 4: Реализация сжатия
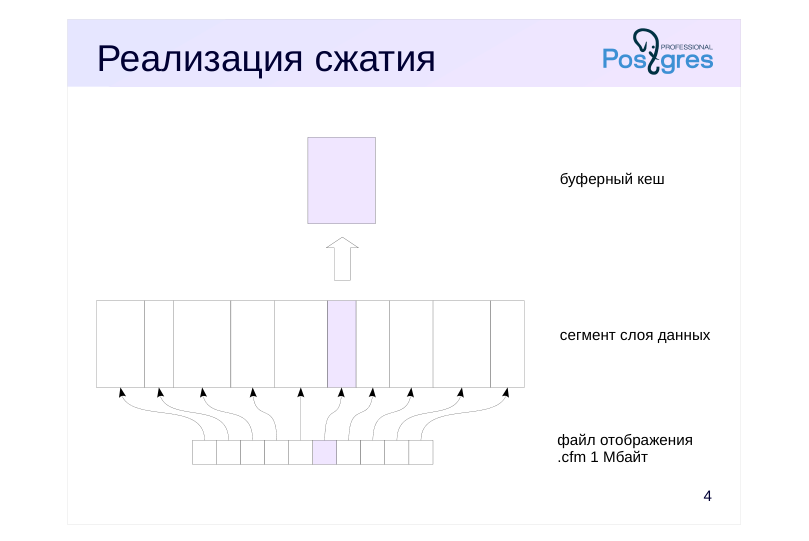 {#source-figure-004 caption=“Source slide page 4: Реализация сжатия”}
Комментарии преподавателя
Буферный кеш для эффективности использует страницы фиксированного размера (обычно 8 Кбайт), а сжатые страницы имеют разный размер, который к тому же меняется при изменении данных. Это вынуждает перемещать страницы внутри сегмента, и поэтому вводится дополнительный уровень адресации (отображение страниц), который представляет собой набор указателей на текущее местоположение всех страниц.
Сжатые данные также хранятся в файлах-сегментах, но для каждого из них имеется своя карта отображения страниц. Карта имеет размер 1 Мбайт (32 байта на заголовок + по 8 байт на каждый из 131072 указателей) и поэтому обычно находится в кеше ОС.
https://postgrespro.ru/docs/enterprise/16/cfs-implementation
Page 5: Реализация сжатия
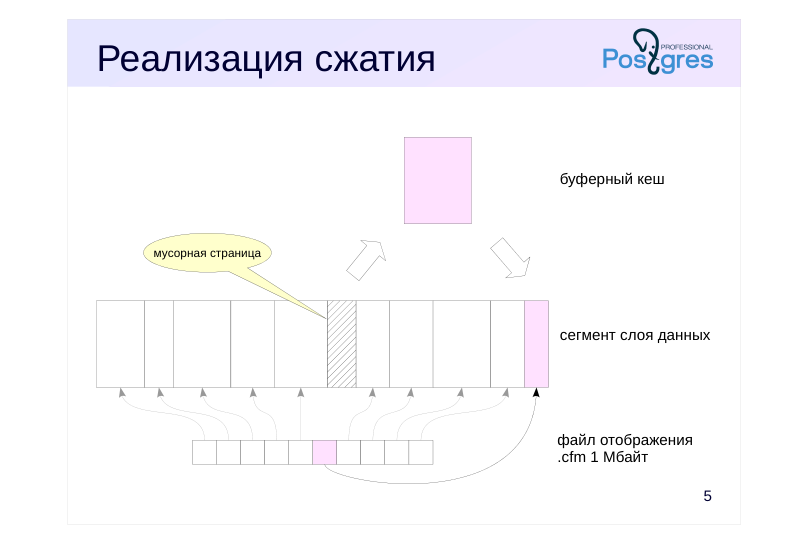 {#source-figure-005 caption=“Source slide page 5: Реализация сжатия”}
Комментарии преподавателя
При записи (в частности, при выполнении контрольной точки) страница, находящаяся в грязном буфере, сжимается в соответствии с настройками сжатия и добавляется в конец сегмента, а в указатель в файле отображения заносится новая позиция страницы. После этого область файла данных, в которой раньше находилась страница, становится ненужной. Такие области с мусорными страницами будут накапливаться, что приведет к увеличению фрагментации хранимых данных.
Механизм сбора мусора будет рассмотрен позже в этой теме.
Page 6: Использование CFS
- Системные отношения не сжимаются
- Проверка контрольной суммы — при чтении в буфер
- pg_checksums и pg_basebackup не проверяют
Комментарии преподавателя
Сжатие можно включить только на уровне табличного пространства и только в момент его создания, при этом нужно задать алгоритм сжатия. Изменить факт и алгоритм сжатия в дальнейшем нельзя.
Поддерживаются библиотеки zstd, pglz, zlib, lz4. По умолчанию используется алгоритм zstd.
Системные отношения никогда не сжимаются — для соответствующих сегментов не создаются файлы отображения и механизм сжатия не используется.
Проверка контрольных сумм сжатых страниц возможна, только когда они находятся в развернутом виде в буферном кеше. Поэтому утилиты pg_checksums и pg_basebackup контрольные суммы страниц не проверяют.
https://postgrespro.ru/docs/enterprise/16/cfs-usage
Page 7: Настройка табличного пространства
Убедимся, что сжатие поддерживается:
Создадим табличное пространство со сжатием.
Page 8: Объем данных
Стандартные функции
- pg_relation_size
- pg_table_size
- pg_indexes_size
- pg_total_relation_size
- работают корректно
- pg_database_size
- файлы отображения
- pg_tablespace_size
- файлы отображения + pg_compression
Комментарии преподавателя
Стандартные функции pg_*_size, возвращающие занимаемый на диске объем, корректно работают со сжатыми табличными пространствами.
В объеме базы данных учитываются файлы отображения, а в объеме табличного пространства — файлы отображения и служебный файл pg_compression.
https://postgrespro.ru/docs/enterprise/16/functions-admin#FUNCTIONS-CO MPRESSION-CONTROL
Page 9: Степень сжатия
Параметры
- cfs_level = 1
- 0 — без сжатия, 1 — самое быстрое
- cfs_compress_temp_relations = off
- Функции
- cfs_estimate
- прогноз степени сжатия
- (среднее по первым 10% страниц)
- cfs_compression_ratio
- фактическое сжатие по всем сегментам
Комментарии преподавателя
Уровень сжатия настраивается параметром cfs_level. Значение 0 отключает сжатие, значение 1 (по умолчанию) соответствует максимальной скорости. Значения от 2 до 100 позволяют указать конкретный уровень сжатия; максимальное значение зависит от используемого алгоритма.
Временные таблицы по умолчанию не сжимаются. Параметр cfs_compress_temp_relations позволяет включить их сжатие, что может быть полезно при большом объеме временных данных.
Функция cfs_estimate оценивает степень сжатия для всех доступных алгоритмов с учетом текущего значения cfs_level. Анализируются первые 10% (но не более 100) страниц таблицы.
Функция cfs_compression_ratio возвращает фактическую степень сжатия таблицы. Степень сжатия — это отношение объема несжатых данных к объему сжатых. В данном случае объем страниц в буферном кеше делится на объем сжатых страниц, сохраненных в файле.
https://postgrespro.ru/docs/enterprise/16/runtime-config-cfs
https://postgrespro.ru/docs/enterprise/16/functions-admin#FUNCTIONS-CO MPRESSION-CONTROL
Page 10: Сжатая таблица
В новой базе данных таблицы и индексы будут по умолчанию располагаться в сжатом табличном пространстве.
Создадим таблицу с минимальным fillfactor и расположим ее сначала вне сжатого пространства. Мы не хотим, чтобы автоочистка изменяла данные в страницах во время демонстрации, поэтому отключим ее:
Вставим в таблицу 100000 одинаковых строк:
Сколько места в оперативной памяти занимает основной слой таблицы?
А сколько на диске?
Ровно столько же, ведь сжатие пока не используется. Проверим, какой выигрыш может дать сжатие. Но сначала выполним контрольную точку, чтобы сбросить грязные страницы из буферного кеша на диск. Это может повлиять на результат.
Прогнозируемая по части страниц степень сжатия:
Page 11: Page 11
Видим, что наилучшая степень сжатия ожидается при использовании zstd. Этот алгоритм сжатия как раз используется (по умолчанию) в табличном пространстве cts. Перенесем таблицу в сжатое табличное пространство и снова поинтересуемся ее размером.
Фактическая степень сжатия немного отличается от прогнозируемой:
Таблица сжалась в десятки раз. Системный каталог тоже находится в пространстве по умолчанию (cts), но системные таблицы никогда не сжимаются.
Page 12: Фрагментация
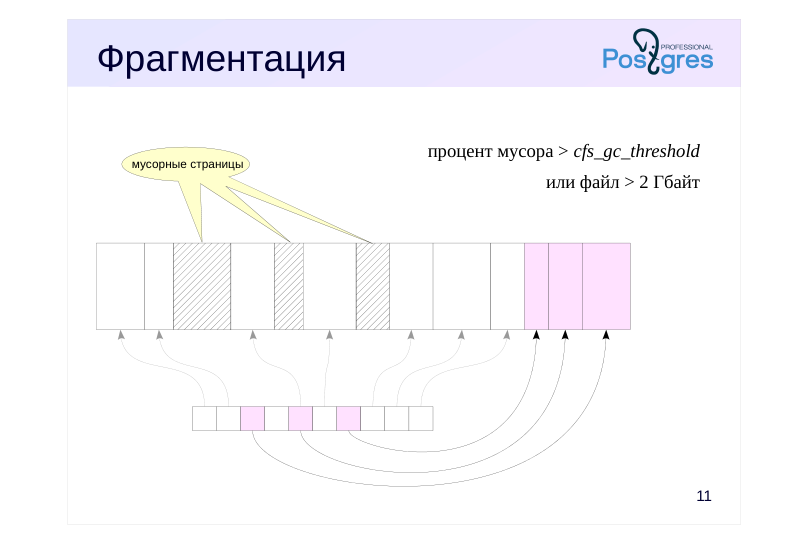 {#source-figure-012 caption=“Source slide page 12: Фрагментация”}
- мусорные страницы
- процент мусора > cfs_gc_threshold
Комментарии преподавателя
Чтобы бороться с фрагментацией, в Postgres Pro Enterprise реализован механизм сбора мусора.
Файл данных подлежит обработке, если суммарный размер мусорных страниц превышает cfs_gc_threshold процентов от размера файла или размер файла больше 2 Гбайт. Одновременно с файлом данных обрабатывается соответствующий файл отображения.
Page 13: Сбор мусора
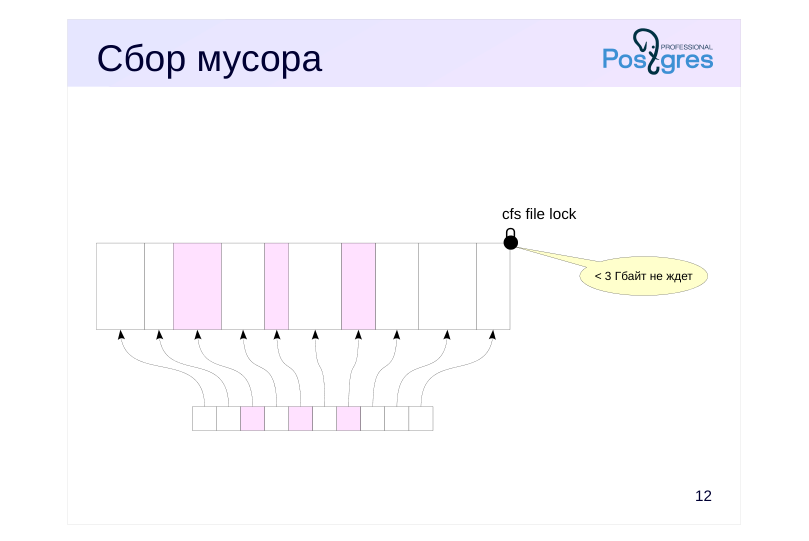 {#source-figure-013 caption=“Source slide page 13: Сбор мусора”}
Комментарии преподавателя
На время обработки файл данных полностью блокируется — ставится легкая блокировка cfs file lock в исключительном режиме, которая запрещает обслуживающим процессам обращаться к файлу. Если не удается получить блокировку немедленно, а размер файла менее 3 Гбайт, процедура сбора мусора его пропустит, а если файл имеет больший размер — будет ждать получения блокировки.
Затем нужные страницы копируются в новый файл данных и строится новый файл отображения. По окончании обработки старые файлы удаляются, а новые переименовываются; это происходит атомарно.
Обслуживающие процессы устанавливают на файл ту же блокировку, но в разделяемом режиме, чтобы процесс сбора мусора дождался окончания работы с файлом, прежде чем начинать работу.
Page 14: Сбор мусора
Настройки
- cfs_gc = on
- cfs_gc_workers = 1
- cfs_gc_threshold = 30
- cfs_gc_delay = 0
- cfs_gc_period = 5000ms
- Запуск
- cfs_start_gc( число-процессов ), 0 — синхронно
- cfs_gc_relation( отношение )
Комментарии преподавателя
Сбор мусора выполняется одним или несколькими процессами в ручном или фоновом режиме.
По умолчанию фоновый сбор мусора включен (cfs_gc = on) и использует один рабочий процесс (cfs_gc_workers = 1).
Если выключить фоновый сбор (cfs_gc = off) и задать параметр cfs_gc_workers = 0, можно вызовом функции cfs_start_gc(0) запустить сбор мусора синхронно, а вызовом cfs_start_gc(N) — асинхронно N процессами. Функция cfs_gc_relation собирает мусор в файлах определенного отношения, возвращая число обработанных файлов.
Параметр cfs_gc_threshold задает минимальный процент мусора, при котором файл размером до 2 Гбайт подлежит обработке (файлы больше 2 Гбайт обрабатываются всегда). Эти условия действуют независимо от способа запуска.
После обработки каждого файла процесс приостанавливается на cfs_gc_delay миллисекунд. По окончании обработки всех файлов процесс бездействует cfs_gc_period миллисекунд.
При ручном запуске можно задать все упомянутые параметры на уровне сеанса, чтобы, например, обработать файлы с меньшим уровнем фрагментации или сделать обработку более интенсивной.
Page 15: Сбор мусора
Функции для мониторинга
- cfs_fragmentation (отношение)
- cfs_gc_activity_scanned_files
- cfs_gc_activity_processed_files
- cfs_gc_activity_processed_pages
- cfs_gc_activity_processed_bytes
- Запись в журнал
- cfs_gc_respond_time = 3600ms
- cfs_log_verbose = off
Комментарии преподавателя
Для мониторинга процессов сбора мусора имеется несколько функций. Статистика накапливается с момента запуска сервера.
Параметр cfs_gc_respond_time задает интервал, в течение которого CFS ждет снятия блокировки с файла при сборке мусора, прежде чем в журнал сообщений будет записано предупреждение.
CFS может выводить в журнал информацию о процессе сбора мусора; уровнем детализации сообщений при этом управляет параметр cfs_log_verbose. При его значении on (по умолчанию) устанавливается уровень LOG, а при значении off — уровень INFO.
Важно, чтобы сбор мусора выполнялся регулярно, иначе файлы отношений будут неограниченно расти, что приведет к падению производительности, а в дальнейшем к недостатку свободного места на диске. Поэтому рекомендуется не отключать фоновый сбор и при необходимости настроить его частоту и производительность.
https://postgrespro.ru/docs/enterprise/16/functions-admin#FUNCTIONS-CO MPRESSION-CONTROL
https://postgrespro.ru/docs/enterprise/16/runtime-config-cfs#RUNTIME-CON FIG-CFS
Page 16: Сбор мусора
Сейчас таблица не фрагментирована:
Посмотрим, что будет, если отключить сбор мусора.
Изменим все строки таблицы.
Объем хранения вырос вдвое, фрагментация превысила умолчательный порог 30%. При дальнейшем изменении таблицы рост продолжится. Новые версии строк попадут в новые страницы, которые запишутся в конец файла.
Теперь просто прочитаем данные — все строки таблицы — и снова увидим, что размер таблицы увеличился:
Page 17: Page 17
Почему так происходит? Из курса DBA2 нам известно, что при первом обращении к измененным строкам в них устанавливаются биты-подсказки. А это означает, что такие измененные страницы тоже будут записаны в конец файла, увеличивая его размер. Выполним очистку таблицы. Работа очистки приведет к изменениям в страницах данных, что также увеличит размер файла таблицы и количество мусорных страниц:
Конечно же, в реальной системе мусор необходимо собирать. Попробуем собрать мусор в таблице вручную, задав минимальный порог на уровне сеанса, чтобы были обработаны все сегменты:
Неиспользуемые страницы удалены, размер файла уменьшился:
Обновим таблицу и выполним контрольную точку, чтобы сжатые страницы записались в файл.
Объем опять вырос (примерно вдвое), фрагментация около 50%. Теперь вернем автоматический сбор мусора и сбросим порог, который мы задавали на уровне сеанса.
Page 18: Page 18
Сбор мусора выполнится автоматически (немного подождем).
Page 19: Итоги
Сжатие настраивается для табличных пространств
- Можно выбирать алгоритм и управлять уровнем сжатия
- Встроенный механизм сбора мусора сокращает объем хранимых данных
Page 20: Практика
- Создайте сжатое табличное пространство, использующее алгоритм zstd с максимальным уровнем сжатия 19. 2. Поместите копию одной из таблиц демобазы в сжатое табличное пространство. Насколько уменьшился ее размер? 3. Удалите созданную в п. 2 базу и сжатое пространство.
Комментарии преподавателя
- Чтобы контролировать изменения данных в страницах, отключите автоматическую очистку для таблицы.
Page 21: 1. Сжатое табличное пространство
2. База данных
Загружаем определение таблицы и ее строки в новую базу:
Page 22: Page 22
3. Удаление табличного пространства
Уборка
Сбросим настройку параметра конфигурации.
Page 23: Практика PPEM
- В экземпляре ent-16 создайте сжатое табличное пространство, использующее алгоритм lz4, и разместите его в каталоге /var/lib/postgresql/lz4_cfs. 2. Создайте в сжатом табличном пространстве базу данных demo_cfs из шаблона demo.
- Сравните размеры баз данных demo и demo_cfs. 4. Удалите базу данных и сжатое пространство.
Page 24: 1. Создание табличного пространства
На главной странице откройте список экземпляров, щелкнув по блоку «Экземпляры», и выберите ent-16. В навигационной панели выберите вкладку «Табличные пространства» и нажмите «Создать пространство». В открывшемся окне введите название, требуемый каталог размещения и способ сжатия, а затем нажмите «Сохранить».
2. Создание базы данных из шаблона
В навигационной панели, на вкладке «Базы данных», нажмите «Создать базу данных». В диалоговом окне введите название, выберите требуемый шаблон и табличное пространство и нажмите «Сохранить».
3. Сравнение размеров данных таблиц
Дождитесь обновления информации по созданной базе в списке баз данных — в нем должны появиться сведения о количестве таблиц и индексов и их размерах, а также о размере базы. Сравните размер исходной базы шаблона и новой базы.
4. Удаление табличного пространства
В выпадающем меню в колонке «Действия» для новой базы выберите пункт «Удалить» и подтвердите его. В навигационной панели выберите вкладку «Табличные пространства» и в строке сжатого пространства нажмите на пиктограмму удаления. Дополнительно подтвердите удаление в появившемся диалоговом окне.
07 Занятие 07: Производительность / Транзакции и сеансы
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_07_transactions.html Archive: PGPRO-handouts-16.zip Страниц PDF: 36
Page 1: Производительность / Транзакции и сеансы
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- 64-битные номера транзакций
- Автономные транзакции
- Данные в памяти
- Встроенный пул соединений
Page 3: 64-битные транзакции
Формат данных
- Заморозка
Page 4: 32-битные номера
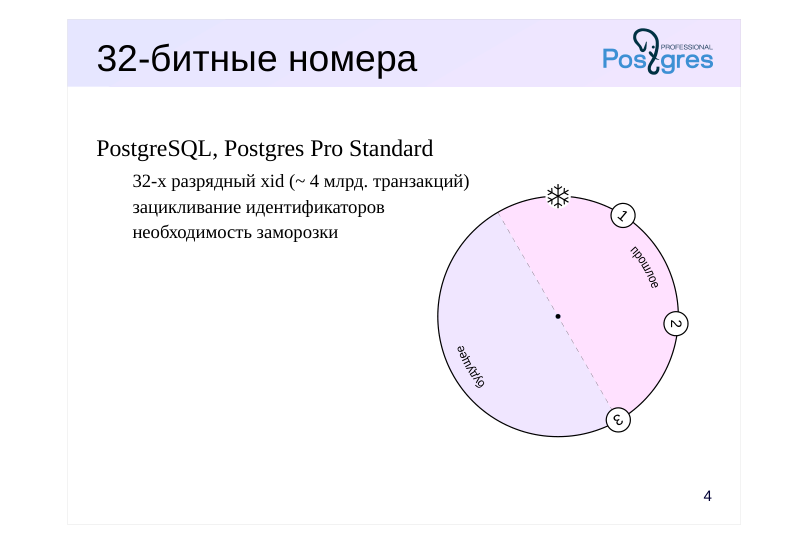 {#source-figure-004 caption=“Source slide page 4: 32-битные номера”}
PostgreSQL, Postgres Pro Standard
- 32-х разрядный xid (~ 4 млрд. транзакций)
- зацикливание идентификаторов
- необходимость заморозки
Комментарии преподавателя
32-битные идентификаторы транзакций допускают примерно четыре миллиарда уникальных значений. В современных реалиях при большой нагрузке идентификаторы могут закончиться через несколько дней и работа СУБД станет невозможна. Поэтому применяют заморозку: версии строк с достаточно большими xmin помечаются как очень старые и, следовательно, видимые во всех снимках данных. После заморозки версий с определенным номером во всех таблицах кластера номер можно использовать повторно (т. н. transaction wraparound).
Заморозка выполняется как одна из задач процесса очистки и активно использует подсистему ввода-вывода. При большой нагрузке требуется постоянно мониторить сервер и принимать оперативные меры, если заморозка не успевает освобождать номера транзакций.
Page 5: 64-битные номера
 {#source-figure-005 caption=“Source slide page 5: 64-битные номера”}
Postgres Pro Enterprise
- 64-х разрядный счетчик транзакций
- не подвержены зацикливанию
Комментарии преподавателя
Использование 64-битного счетчика позволило бы иметь практически бесконечное число идентификаторов транзакций, отказаться от их повторного использования и связанных с этим действий по администрированию.
Но простое увеличение разрядности идентификаторов привело бы к увеличению размера заголовков версий строк и, как следствие, к повышенному расходу дискового пространства и ресурсов ввода-вывода при обработке данных.
Поэтому в Postgres Pro Enterprise реализован компромиссный вариант 64-х битных идентификаторов: в специальной области в конце страницы хранится 64-битное базовое значение xid, а в полях xmin и xmax заголовка версии строки — 32-битное смещение. 64-битный номер транзакции xmin или xmax вычисляется сложением базового значения и значения, хранящегося в заголовке версии строки.
Такой же формат применяется для идентификаторов мультитранзакций: базовое значение хранится в специальной области страницы, а смещение — в поле xmax заголовка версии строки.
https://habr.com/ru/company/postgrespro/blog/707968/
Page 6: Заморозка
Синхронная
- если смещения не хватает и необходимо увеличить базовое значение
- При очистке
- уменьшает pg_xact и pg_multixact
- vacuum_freeze_min_age = 50 млн
- vacuum_freeze_table_age = 150 млн
- autovacuum_freeze_max_age = 10 млрд
- vacuum_failsafe_age = 1.6 млрд
- vacuum_multixact_freeze_min_age = 5 млн
- vacuum_multixact_freeze_table_age = 150 млн
- autovacuum_multixact_freeze_max_age = 20 млрд
- vacuum_multixact_failsafe_age = 1.6 млрд
Комментарии преподавателя
Поскольку смещения в заголовке версии строки 32-битные, диапазон значений xid в пределах страницы — от базового до базового плюс 232−1. Если в какую-либо версию строки на странице нужно записать больший номер, сервер увеличивает базовое значение xid. Если при этом версии строк с небольшими номерами xid препятствуют такому увеличению, сервер замораживает эти версии «на лету».
Поскольку 64-битные номера транзакций не используются повторно, своевременная заморозка не критична для работы многоверсионности: параметр autovacuum_freeze_max_age имеет значение по умолчанию 10 млрд вместо 200 млн в обычном PostgreSQL, и значение autovacuum_multixact_freeze_max_age также увеличено. Однако заморозка все же выполняется как часть процедуры очистки, чтобы уменьшать размер CLOG (подкаталога pg_xact) и статусов мультитранзакций (pg_multixact).
Ограничением этого решения является то, что очень долгие транзакции (возраст которой превышает 232), удерживающие снимок, будут мешать замораживать версии строк. Поэтому, хотя необходимость в регулярной заморозке отпадает, долгих транзакций по-прежнему стоит избегать.
В PostgresPro Enterprise 17 появилась фоновая заморозка: дополнительный процесс выполняет очистку и заморозку недавно измененных страниц. Ее рекомендуется включать, если автоочистка не справляется со своими задачами.
https://postgrespro.ru/docs/enterprise/16/routine-vacuuming#VACUUM-FOR -WRAPAROUND
Page 7: Структура страниц
Чтобы заглянуть в страницы, воспользуемся расширением pageinspect.
В тестовой таблице будет две страницы по две версии строки в каждой.
В конце каждой страницы данных находится так называемая специальная область, в которой в том числе хранится базовое значение xid:
В заголовках версий строк хранится 32-битное смещение (хотя значения xmin и xmax для удобства выводятся уже приведенными к 64-битному виду):
Текущее значение счетчика транзакций:
Пусть теперь сервер выполнит 2^32 транзакций. Выполнение такого количества транзакций работающим сервером заняло бы очень много времени, поэтому остановим его и воспользуемся утилитой pg_resetwal, чтобы поменять текущее значение счетчика.
Для гарантированного запуска сервера после изменения счетчика создадим пустой файл статусов транзакций:
Page 8: Page 8
Внимание! Категорически запрещается применять утилиту pg_resetwal в производственной среде за исключением использования ее по прямому указанию технической поддержки. Утилита изменяет внутренние структуры данных, что может привести к потере или искажению информации. Теперь изменим одну строку таблицы.
При этом сервер запишет номер текущей транзакции в поле xmax старой версии строки и в поле xmin новой версии, которая будет размещена в нулевой странице. Поскольку номер текущей транзакции отличается от значений xmin в существующих версиях более чем на 2^32, сервер увеличит базовый xid и выполнит локальную заморозку в нулевой странице. Для этого он выставит в заголовках версий соответствующий флаг, а в поле xmin запишет зарезервированное значение 2, означающее «номер заморожен». В первой странице заморозка не делается, поэтому базовый номер xid изменился только в нулевой странице.
Page 9: Автономные транзакции
Устройство автономных транзакций
- Видимость данных в автономных транзакциях
- Автономные транзакции в SQL
- Автономные транзакции в PL/pgSQL и PL/Python
- Ограничения автономных транзакций
Page 10: Автономные транзакции
Автономная транзакция — это независимая транзакция, которая запускается внутри родительской и должна быть завершена (зафиксирована или отменена) до завершения родительской.
Автономная транзакция может включать в себя другие автономные транзакции (транзакция верхнего уровня не может быть автономной). Когда вложенная автономная транзакция запускается, ее родительская транзакция приостанавливается и помещается в стек автономных транзакций. Когда автономная транзакция фиксируется или отменяется, родительская транзакция извлекается из стека и продолжает работу. Таким образом, на каждом уровне вложенности активной является только одна транзакция. Поэтому внутри автономной транзакции команды COMMIT или ROLLBACK будут завершать эту автономную транзакцию, а не родительскую. В отличие от вложенной транзакции, которая возникает в обычном PostgreSQL при выполнении команды SAVEPOINT (и, возможно, ROLLBACK TO), результат автономной транзакции не зависит от исхода родительской. В процедурных языках автономные транзакции тоже завершаются до завершения родительских, но происходит это неявно. Например, в PL/pgSQL добавлена конструкция для блока, операторы которого должны выполняться в автономной транзакции:
По сути, такая запись — просто сокращение для
Ошибка в блоке с автономной транзакцией приводит к ее откату, после чего ошибка обрабатывается в секции EXCEPTION или передается в вызывающий блок. В PL/Python добавлен метод, позволяющий выполнить SQL в автономной транзакции:
Page 11: Видимость
Снимки родительской и автономных транзакций независимы
- Read Committed видит изменения
- Repeatable Read, Serializable не видят изменений
- Возможны взаимоблокировки
Комментарии преподавателя
Родительская и дочерняя автономная транзакция используют собственные снимки данных, время жизни которых зависит от уровня изоляции. Поэтому родительская транзакция с уровнем изоляции Read Committed будет видеть все изменения дочерних автономных транзакций, а родительская с уровнем изоляции Repeatable Read или Serializable не увидит никаких изменений.
Автономная транзакция может вызвать взаимоблокировку, если она попытается получить блокировку ресурса, уже заблокированного родительской транзакцией.
Page 12: Ограничения
max\_autonomous\_transactions = 100
- Вложенность до 128 уровней
- Не поддерживается блокировка FOR UPDATE
- Нельзя обращаться к временным схемам
- Нельзя изменить уровень изоляции в PL/pgSQL и PL/Python
- Не поддерживаются в расширениях
- in_memory
- online_analyze
- Нельзя создавать слоты логической репликации
Комментарии преподавателя
Одновременно можно запустить не более max_autonomous_transactions автономных транзакций во всех сеансах (по умолчанию 100).
Глубина вложенности автономных транзакций — не более 128.
FOR UPDATE не поддерживается, поэтому, например, нельзя заблокировать строку в родительской транзакции, а в дочерней автономной пропустить ее с помощью SKIP LOCKED.
В автономной транзакции нельзя обращаться к объектам временных схем, в частности, ко временным таблицам.
В блоке PL/pgSQL и методе PL/Python нельзя задать уровень изоляции автономной транзакции, отличающийся от текущего.
Автономные транзакции не работают с расширениями in_memory и online_analyze.
Также нельзя создавать слоты логической репликации из автономной транзакции.
https://postgrespro.ru/docs/enterprise/16/atx
Page 13: Использование автономных транзакций
Обычно автономные транзакции используются для аудита, когда нужно сохранить информацию о событии, произошедшем в родительской транзакции, независимо от ее исхода. Опустошим таблицу:
Мы хотим записывать в таблицу test_audit информацию обо всех изменениях таблицы test, в том числе и о тех, которые не были зафиксированы.
Для этого понадобятся триггер и триггерная функция, тело которой выполняется в автономной транзакции.
Теперь информация об изменениях будет сохраняться в таблице test_audit, даже если транзакция впоследствии обрывается.
Откатим транзакцию:
В таблице ничего не осталось:
Page 14: Page 14
Однако попытки изменить данные записаны в таблицу аудита.
Page 15: Данные в памяти
pg\_variables
- in_memory
Page 16: Расширение pg_variables
Функции для работы с переменными различных типов
- скалярные
- массивы
- коллекции записей и произвольных типов
- Поддержка транзакционности
- Хранение в памяти сеанса
- работает на реплике
- несовместимо с пулами соединений
Комментарии преподавателя
Расширение pg_variables позволяет работать в памяти сеанса со скалярными переменными, массивами и коллекциями. Переменные объединяются в так называемые пакеты, выполняющие роль пространств имен.
Коллекции представляют собой множества пар ключ—значение. В качестве таких пар могут выступать обычные составные значения (записи), в которых первый атрибут считается ключом. Это позволяет использовать коллекции в качестве быстрой альтернативы временным таблицам, которая к тому же работает и на физических репликах.
Поддерживаются как транзакционные, так и нетранзакционные переменные. Изменения нетранзакционных переменных: создание, изменение, удаление – необратимы. Изменения транзакционных переменных можно отменить, откатив транзакцию полностью или до точки сохранения. Но в любом случае переменная существует только до конца сеанса и другим сеансам не видна.
Утилита ora2pgpro, рассмотренная в теме «Миграция», использует pg_variables для экспорта ассоциативных массивов Oracle в коллекции.
Расширение несовместимо с пулом соединений, включая встроенный пул Postgres Pro.
https://postgrespro.ru/docs/enterprise/16/pg-variables
Page 17: Расширение pg_variables
Установим расширение в базе данных:
Расширение оперирует термином «пакет», под которым понимается пространство имен переменных. Команды ниже автоматически создадут пакет vars (первый параметр), поместят в него две переменные int_n и int_t (второй параметр) целочисленного типа (тип определяется по фактическому типу третьего параметра) и зададут им значения. Первая переменная нетранзакционная (по умолчанию):
Вторая — транзакционная:
С помощью функций можно получить информацию о переменных и прочитать их значения:
Обратите внимание, что функции необходимо передавать третий параметр, чтобы сообщить тип скалярной переменной. Проверим транзакционность переменных, откатив транзакцию:
Читаем значения переменных:
Page 18: Page 18
Обратите внимание, что необходимо указывать флаг is_transactional при каждом изменении значения транзакционной переменной. В противном случае произойдет ошибка:
Работа с массивами организована аналогично. Рассмотрим работу с коллекциями записей. Запрос ниже вставляет в коллекцию tbl_1 пакета tbls несколько записей. Если пакет или коллекция не существуют (как в нашем случае), они будут созданы автоматически:
Первое поле каждой записи выступает в качестве первичного ключа. Если при вставке обнаружится запись с таким же ключом, будет выдана ошибка:
Мы можем изменять или удалять записи, обращаясь к ним по ключу:
Что получилось в результате? Прочитаем все данные из коллекции:
Данные в коллекциях хранятся в порядке возрастания, по записям удобно перемещаться с помощью итераторов:
Можно двигаться и в обратную сторону с помощью функций pgv_last и pgv_prior.
Page 19: Page 19
Количество элементов в коллекции вернет функция pgv_count:
Получить список созданных пакетов и объем памяти, используемый переменными можно так:
Удалить переменную и весь пакет целиком можно при помощи функции pgv_remove:
Функция pgv_free удаляет все пакеты и переменные:
Page 20: Расширение in_memory
Обертка сторонних данных для оперативных таблиц
- таблицы организованы по индексу
- данные располагаются в листовых страницах B-дерева
- Поддержка транзакционности
- Хранение в общей памяти сервера
- работает на реплике
- несовместимо со встроенным пулом соединений и подготовленными
- транзакциями
Комментарии преподавателя
С помощью расширения in_memory можно создавать небольшие оперативные таблицы, то есть таблицы в общей памяти сервера. Работа с таблицей происходит с помощью обертки сторонних данных.
Оперативные таблицы организованы по индексу — строки таблиц хранятся в страницах листьев индекса B-tree, что обеспечивает быстрый доступ к данным по первичному ключу (вторичные индексы не поддерживаются).
Для экономии памяти используются небольшие страницы размером 1 Кбайт. Поскольку индекс B-tree должен содержать на странице минимум три записи, максимальная длина строки ограничена 304 байтами (TOAST не поддерживается). Когда строки удаляются из оперативной таблицы, соответствующие страницы данных не освобождаются; для освобождения ресурсов требуется опустошение или удаление таблицы.
Оперативные таблицы полностью поддерживают транзакции, включая точки сохранения. Однако уровень изоляции Serializable не поддерживается, вместо него используется Repeatable Read.
Оперативные таблицы существуют только в памяти: они не сохраняются на диск и не журналируются, но их можно использовать на физических репликах.
Расширение нельзя использовать с подготовленными (двухфазными) транзакциями и при работе со встроенным пулом соединений.
https://postgrespro.ru/docs/enterprise/16/in-memory
Page 21: Расширение in_memory
Для работы расширения необходимо загрузить библиотеку и перезапустить СУБД:
Теперь установим расширение в базу:
Доступ к оперативным таблицам организуется с помощью обертки сторонних данных, для этого создан сторонний сервер in_memory:
Далее следует создать стороннюю таблицу на этом сервере — это и будет оперативная таблица:
По умолчанию в таблице будет создан уникальный индекс B-tree по первому столбцу, с сортировкой по возрастанию. При необходимости можно указать другую структуру индекса в параметре indices предложения OPTIONS (несмотря на множественное число названия параметра, индекс может быть только один):
Для столбцов можно указать правило сортировки, но всегда используется класс операторов по умолчанию. Оперативные таблицы созданы:
С таблицами можно выполнять все основные операции DML. Внесем данные и прочитаем несколько строк:
Page 22: Page 22
В отличие от коллекций расширения pg_variables, оперативные таблицы хранятся в общей памяти сервера и доступны другим сеансам:
Объем памяти, выделяемый для оперативных таблиц, задается параметром in_memory.shared_pool_size. Количество использованных и свободных страниц можно получить с помощью функции:
При удалении строк из оперативных таблиц командой DELETE страницы данных не освобождаются:
Чтобы освободить страницы, можно опустошить (TRUNCATE) или удалить таблицу. Также содержимое таблицы пропадает при перезапуске сервера:
Page 23: Пул соединений
Проблема и решения
- Встроенный пул
- Подключение
- Ограничения пула
Page 24: Проблема и решения
Один сеанс — один обслуживающий процесс
- повышенный расход ресурсов
- увеличение конкуренции
- прогрев локальных кешей
- Пул соединений в сервере приложений или драйвере
- J2EE, JDBC, ODBC, node-postgres, Psycopg2
- Пул соединений как сторонний продукт
- PgBouncer, Odyssey
- Встроенный пул Postgres Pro Enterprise сохраняет контекст сеанса
Комментарии преподавателя
Простейшая архитектура, при которой для каждого клиентского соединения запускается отдельный обслуживающий процесс, имеет ряд недостатков, которые при большом количестве клиентов становятся критичными. Увеличивается конкуренция при обращении к ресурсам, растут накладные расходы на запуск процессов (в частности, на наполнение кешей) и освобождение ресурсов при их завершении. Кроме того, размер многих структур в общей памяти сервера пропорционален числу клиентских соединений.
По этим причинам в нагруженные многопользовательские системы добавляют пул соединений, позволяющий нескольким клиентам использовать одно соединение с сервером. Как правило, для этого либо применяют отдельное решение, такое как PgBouncer или Odyssey, либо задействуют возможности сервера приложений или драйвера PostgreSQL.
При таком подходе администратору приходится обслуживать дополнительную компоненту архитектуры, а разработчику — учитывать особенности работы приложения с пулом соединений.
Встроенный пул соединений Postgres Pro Enterprise позволяет воспользоваться преимуществами пула, сохранив при этом большинство возможностей, связанных с контекстом сеанса.
В 17-й версии Postgres Pro Enterprise на смену встроенному пулу придет proxima — расширение, объединяющее функциональность прокси-сервера и пула соединений.
Page 25: Встроенный пул
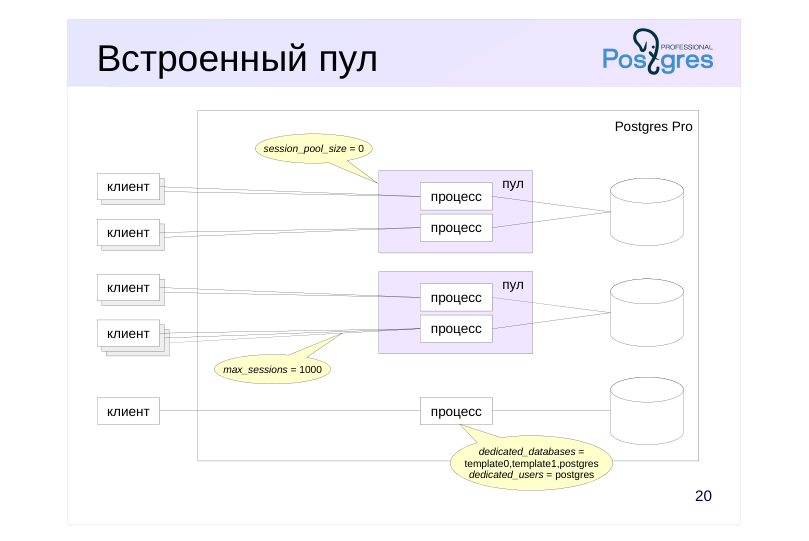 {#source-figure-025 caption=“Source slide page 25: Встроенный пул”}
Комментарии преподавателя
Для каждой базы данных создается отдельный пул, количество пулов не ограничено. Если количество процессов в пуле меньше значения session_pool_size, для нового сеанса запускается новый процесс, а если предел достигнут, сеанс привязывается к одному из существующих процессов.
Процесс, к которому привязано несколько сеансов, поочередно обслуживает их транзакции, сохраняя при этом контекст каждого сеанса. Поэтому значение session_pool_size следует задавать достаточно большим, чтобы клиент не ждал слишком долго, пока завершится транзакция другого соединения.
Одновременно процесс обслуживает не больше max_sessions сеансов. Если число соединений с одной базой достигнет max_sessions × × session_pool_size, следующая попытка подключения вернет ошибку.
Если клиент соединяется с базой данных, входящей в список dedicated_databases, или подключается под ролью, входящей в dedicated_users, для него будет создан выделенный процесс, не входящий в пулы. По умолчанию это сеансы пользователя postgres и подключения к базам template0, template1 и postgres. Количество выделенных процессов не ограничено.
https://postgrespro.ru/docs/enterprise/16/how-connection-pooler-works
Page 26: Подключение
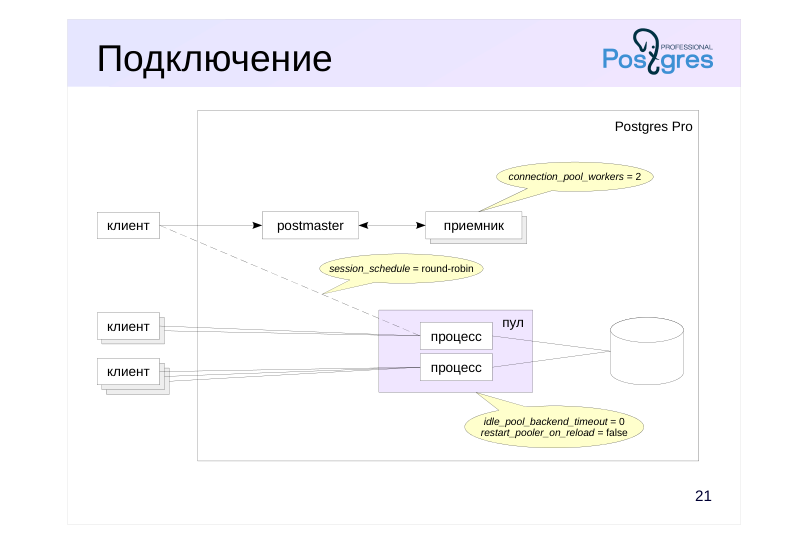 {#source-figure-026 caption=“Source slide page 26: Подключение”}
Комментарии преподавателя
Подключение нового клиента устроено следующим образом.
Процесс postmaster слушает входящие соединения. Подключаясь, клиент передает стартовый пакет данных, в котором указаны параметры соединения — имя базы данных, имя роли. Postmaster передает этот пакет одному из процессов-приемников для анализа. Количество процессов-приемников определяется значением параметра connection_pool_workers и должно быть достаточным, чтобы анализ входящих соединений не стал узким местом.
Получив от приемника информацию о базе данных и роли, postmaster направляет соединение в подходящий пул. Применяется одна из трех стратегий, которые можно указать в параметре session_schedule: round-robin назначает процессы по очереди, random — случайным образом, load-balancing выбирает процесс с наименьшим числом сеансов.
Когда все соединения, использующие какой-то процесс, завершаются, процесс продолжает работать. Автоматическое завершение неиспользуемого процесса по истечении определенного времени настраивается параметром idle_pool_backend_timeout.
Для перезагрузки рабочих процессов можно установить параметр restart_pooler_on_reload = true и перечитать конфигурацию.
https://postgrespro.ru/docs/enterprise/16/connection-pooler-configuration
Page 27: Ограничения пула
Не поддерживаются SSL-соединения
- Долгие транзакции задерживают работу других соединений
- Не поддерживаются рекомендательные блокировки уровня сеанса
- Нельзя перехватывать ошибку «connection to client lost»
- Не работают модули, полагающиеся на состояние сеанса
- Нельзя изменять параметры в других сеансах
- Остановка сервера в режиме smart работает как fast
- Параметр idle_session_timeout игнорируется
Комментарии преподавателя
Нужно учитывать следующие ограничения при использовании пула.
● SSL-соединения в текущей реализации не поддерживаются.
● Долгая транзакция будет задерживать работу транзакций в других соединениях, использующих тот же процесс.
● Ошибка «connection to client lost» обрабатывается пулом, чтобы завершать зависшие соединения по тайм-ауту, перехватывать ее не нужно.
● Не работают модули, использующие состояние на уровне сеанса, такие как plantuner, а также расширения multimaster, in_memory, online_analyze, pg_variables.
● Нельзя изменять параметры других сеансов.
● Не поддерживается передача сообщений между процессами (команды LISTEN, NOTIFY и т. п.).
● Остановка сервера в режиме smart работает как fast.
● Решения 1С не поддерживаются, они используют собственный пул соединений.
● Тайм-аут idle_session_timeout не работает.
https://postgrespro.ru/docs/enterprise/16/connection-pooler-limitations
Page 28: Встроенный пул соединений
Выделим в пуле по два процесса для каждой базы данных:
Если начать транзакцию в основном сеансе, ей будет выделен один из процессов:
Сеанс может хранить свое состояние в пользовательских параметрах:
Транзакции, начавшейся в другом сеансе, будет выделен другой процесс:
По умолчанию процессы выделяются по очереди (стратегия round-robin), поэтому третьему сеансу будет назначен процесс 806894. Но этот процесс занят выполнением транзакции первого сеанса, поэтому третий сеанс будет ждать:
Когда транзакция первого сеанса заканчивается…
…третий сеанс может воспользоваться освободившимся процессом 806894:
Page 29: Page 29
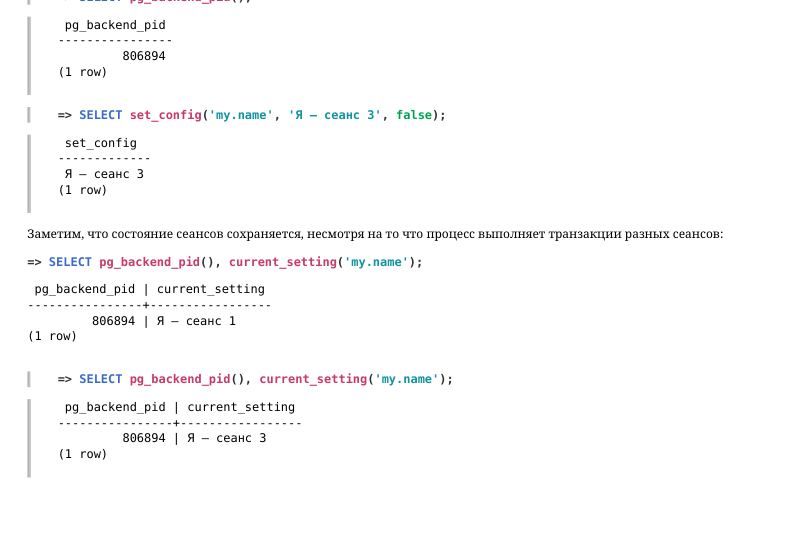 {#source-figure-029 caption=“Source slide page 29: Page 29”}
Заметим, что состояние сеансов сохраняется, несмотря на то что процесс выполняет транзакции разных сеансов:
Page 30: Итоги
64-битные идентификаторы транзакций упрощают обслуживание данных при высокой нагрузке
- Автономные транзакции дают возможность удобно и эффективно реализовать аудит
- Расширения pg_variables и in_memory могут служить альтернативой временным таблицам
- Встроенный пул позволяет ограничить число соединений, не жертвуя контекстом сеанса
Page 31: Практика
- Воспроизведите взаимоблокировку основной транзакции и вложенной в нее автономной. 2. Реализуйте аудит изменений данных в таблице двумя способами: используя расширение dblink и автономные транзакции. Сравните производительность. 3. Убедитесь, что при использовании встроенного пула соединений сохраняется содержимое временных таблиц уровня сеанса.
Page 32: 1. Взаимоблокировка в автономной транзакции
Создадим базу данных:
Начинаем транзакцию и блокируем строку:
Пытаемся блокировать ту же строку в автономной транзакции и получаем ошибку:
Основную транзакцию можно зафиксировать:
2. Аудит: dblink и автономные транзакции
Тестовая таблица:
Таблица для аудита:
Первый вариант триггерной функции использует расширение dblink:
Page 33: Page 33
Триггер:
Замеряем время.
Опустошим обе таблицы и заменим триггерную функцию на вариант, использующий автономную транзакцию.
Еще раз замеряем время.
Автономные транзакции работают быстрее, поскольку нет накладных расходов на установку соединения.
3. Временные таблицы и пул соединений
Включим пул соединений, выделив один процесс для каждой базы данных. Транзакции сеансов будут использовать его по очереди:
В каждом из двух сеансов создадим временную таблицу.
Page 34: Page 34
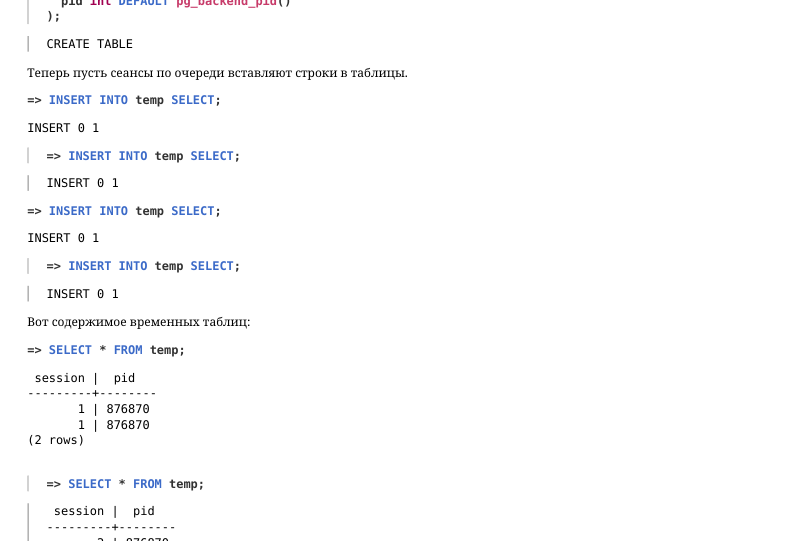 {#source-figure-034 caption=“Source slide page 34: Page 34”}
Теперь пусть сеансы по очереди вставляют строки в таблицы.
Вот содержимое временных таблиц:
Встроенный пул соединений Postgres Pro Enterprise сохраняет временные таблицы уровня сеанса. При использовании сторонних менеджеров пула сохранение контекста сеанса не гарантируется.
Уборка
Удалим созданную базу данных и выключим пул соединений.
Page 35: Практика PPEM
- Создайте базу данных newbase и в ней схему dblink. 2. Установите расширение dblink в одноименную схему базы newbase. 3. Используя расширение dblink и консоль psql, выведите список моделей самолетов из базы данных demo.
Комментарии преподавателя
- Получить данные по моделям самолетов можно с помощью запроса SELECT * FROM dblink.dblink( ‘dbname=demo’, ‘SELECT model FROM aircrafts’ ) AS (m text);
Page 36: 1. Создание базы данных и схемы
В навигационной панели выберите «Базы данных» и на главной странице нажмите «Создать базу данных». В открывшемся окне заполните необходимые поля и нажмите «Сохранить» — новая база появится в списке. Выбрав новую базу, нажмите «Создать схему», заполните поля на форме и выберите «Создать».
2. Установка расширения dblink
Выберите новую базу в списке на главной странице и на вкладке «Расширения» навигационной панели нажмите «Установить расширение». В открывшейся форме выберите из списка баз newbase, в списке доступных расширений найдите dblink и выберите для установки созданную в п. 1 одноименную схему. Нажмите кнопку «Установить».
3. Работа с psql-консолью. Доступ к удаленной базе с помощью dblink
В списке «Базы данных» главной страницы найдите newbase, и в столбце «Действия» нажмите на пиктограмму «{/}» (открыть PSQL-консоль) — откроется окно утилиты с приглашением, указывающим на подключение к выбранной базе. Для получения требуемой информации наберите и выполните запрос:
Чтобы скопировать текст запроса из буфера обмена, используйте клавиши Ctrl+V, затем в контекстном меню выберите Paste или нажмите клавишу P.
08 Занятие 08: Производительность / Оптимизация запросов
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_08_qoptim.html Archive: PGPRO-handouts-16.zip Страниц PDF: 26
Page 1: Производительность / Оптимизация запросов
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Перенос статистики
- Мониторинг выполнения
- Указания оптимизатору
Page 3: Перенос статистики
Расширение dump\_stat
Page 4: Расширение dump_stat
Сохраняет статистику планировщика
- SQL-скрипт с командами INSERT
- Восстанавливает сохраненную статистику
- можно восстановить на другом сервере (той же основной версии)
- не требуется выполнение ANALYZE
Комментарии преподавателя
Модуль dump_stat позволяет выгрузить и восстановить содержимое таблицы pg_statistic.
С помощью этого модуля собранную статистику планировщика можно перенести на другой сервер. При этом не придется выполнять команды ANALYZE, что сократит время простоя для больших баз данных. Еще один сценарий использования — перенос статистики с производственного сервера на тестовый стенд с меньшим набором данных, чтобы сохранить планы выполнения запросов.
Функция dump_statistic модуля выдает SQL-команды INSERT, которые можно записать в скрипт, а затем применить к совместимой базе данных.
Для успешного восстановления статистики расширение должно быть установлено и на исходном, и на целевом сервере, так как в сгенерированных командах используются вызовы функций расширения.
При обновлении версии СУБД структура таблицы pg_statistic может поменяться, поэтому скрипт может оказаться несовместимым.
Подробная информация о модуле:
https://postgrespro.ru/docs/enterprise/16/dump-stat
Page 5: Расширение dump_stat
Создадим таблицу по образцу bookings.flights и соберем статистику.
Подключим расширение dump_stat:
Перегруженная функция dump_statistic позволяет выгрузить статистику по всей базе данных, по таблицам и индексам заданной схемы или по конкретной таблице. Выгрузим статистику по таблице public.flights:
Теперь удалим таблицу и создадим ее заново, но с выключенной автоочисткой, чтобы исключить автоматический сбор статистики.
Статистики пока нет:
Загрузим сохраненную ранее статистику:
Page 6: Page 6
Статистика успешно загрузилась. Расширение больше не требуется, удалим его.
Page 7: Мониторинг выполнения
Расширение pg\_query\_state
Page 8: Расширение pg_query_state
Информация о выполняющемся запросе
- текущее состояние выполнения
- актуальная статистика
- Формат вывода как у EXPLAIN ANALYZE
Комментарии преподавателя
Модуль pg_query_state выводит текущее состояние выполнения запроса в работающем обслуживающем процессе. В отличие от команды EXPLAIN ANALYZE, предоставляющей данные об уже выполненном запросе, модуль pg_query_state информирует о ходе выполнения запроса, который работает в настоящий момент. Формат вывода практически идентичен выводу обычной команды EXPLAIN ANALYZE.
Модуль позволяет исследовать любой обслуживающий процесс и определять его фактическое состояние. Это полезно, когда выполняется длительный запрос и необходимо оценить оставшееся время.
Модуль показывает состояние как основного запроса, так и запросов, вызванных из функций. Для распараллеленных запросов модуль позволяет наблюдать за операциями, которые выполняет как ведущий, так и рабочие процессы.
Подробная информация о модуле:
https://postgrespro.ru/docs/enterprise/16/pg-query-state
Page 9: Расширение pg_query_state
Подключим расширение и соответствующую разделяемую библиотеку.
Необходима перезагрузка экземпляра.
Откроем еще один сеанс:
Номер обслуживающего процесса второго сеанса:
Запустим во втором сеансе запрос. Запрос написан таким образом, что перебирает в цикле все перелеты из таблицы ticket_flights, для каждого из них выбирает номер бронирования из таблицы tickets, и по номеру находит дату бронирования в таблице booking. Это очень неэффективный способ получения результата, но большое время выполнения запроса позволит отследить в первом сеансе ход его выполнения. Мы выведем оценку стоимости и кардинальности (аналогичную той, что выдает команда EXPLAIN) и актуальную информацию о выполнении узлов плана.
Небольшая пауза…
Page 10: Page 10
Сравните для узла Seq Scan прогноз числа строк (rows) с актуальной информацией (Current loop: rows). Таким образом можно обоснованно предположить, какая часть работы уже проделана. Узлы Index Scan вложенных планов выполняются во вложенных циклах. Для них выводятся среднее значение по прошедшим циклам (actual, по аналогии с выводом команды EXPLAIN ANALYZE) и информация о текущем, еще не завершенном цикле (Current loop). Как и команда EXPLAIN ANALYZE, расширение позволяет выводить информацию о времени выполнения узлов и о количестве использованных буферов, а также отслеживать параллельные запросы и запросы, выполняющиеся в вызываемых функциях. Удалим расширение и перезапустим экземпляр.
Page 11: Указания оптимизатору
Расширение pg\_hint\_plan
- Расширение plantuner
Page 12: Расширение pg_hint_plan
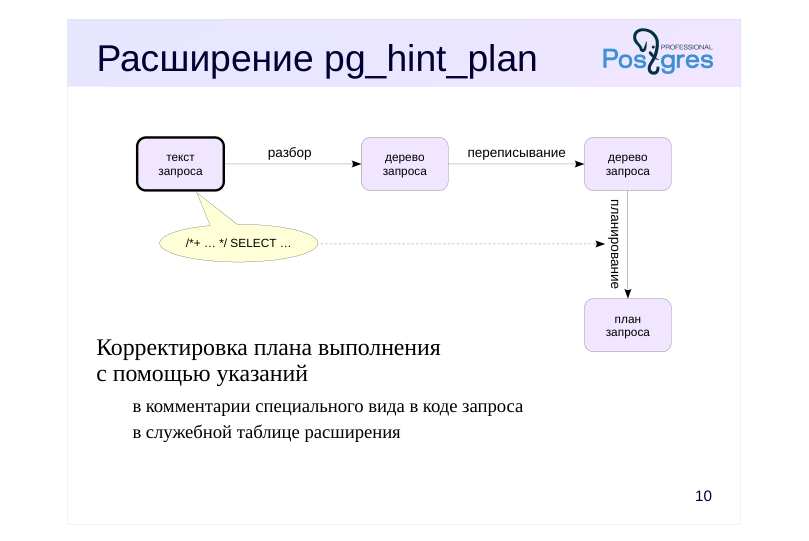 {#source-figure-012 caption=“Source slide page 12: Расширение pg_hint_plan”}
Корректировка плана выполнения с помощью указаний
- в комментарии специального вида в коде запроса
- в служебной таблице расширения
Комментарии преподавателя
Модуль pg_hint_plan разработан японской компанией NTT и включен в состав Postgres Pro Enterprise. Репозиторий проекта:
https://github.com/ossc-db/pg\_hint\_plan
Расширение предназначено для принудительной корректировки планов выполнения с помощью указаний (hints), помещаемых непосредственно в код SQL в виде комментариев специального вида /*+ … */. В случаях, когда принудительно выбранный план выполнить нельзя, планировщик игнорирует указания.
Обработчик pg_hint_plan считывает указания только из первого блочного комментария и немедленно прекращает разбор, обнаруживая недопустимый символ. Допустимыми символами являются буквы, цифры, пробелы, подчеркивания, запятые и скобки. Комментарий с указаниями не может содержать в себе другой блочный комментарий. Указания можно размещать в нескольких строках для улучшения читаемости.
Ошибки в записи или неправильные имена указаний считаются ошибками синтаксиса и выводятся в журнал сообщений сервера. Указания с неправильными обращениями к объектам игнорируются, а в журнале помечаются как неиспользованные. При дублировании или противоречиях в указаниях будет применяться последнее указание, а в журнал выведется сообщение о дублировании.
Подробности в документации:
https://postgrespro.ru/docs/enterprise/16/pg-hint-plan
Page 13: Типы указаний
Метод доступа
- Способ соединения
- Порядок соединений
- Корректировка числа строк соединения
- Параллельная обработка таблицы
- Установка параметра на время планирования
Комментарии преподавателя
Фразы указаний состоят из имени указания и последующих параметров, заключенных в скобки и разделенных пробелами.
Модуль поддерживает шесть типов указаний:
https://postgrespro.ru/docs/enterprise/16/pg-hint-plan#PG-HINT-PLAN-HINT -LIST
Методы доступа, способы соединения и другие вопросы, относящиеся к планам выполнения запросов, подробно рассматриваются в курсе QPT «Оптимизация запросов».
Page 14: Расширение pg_hint_plan
Расширение pg_hint_plan входит в Postgres Pro Enterprise в виде отдельного пакета, который устанавливается средствами ОС из репозитория. В виртуальной машине курса этот пакет уже установлен. Так как функционал расширения реализован в разделяемой библиотеке, она должна быть предварительно загружена в сеансе с помощью команды LOAD или указана в конфигурационном параметре shared_preload_libraries.
Для данного запроса используется параллельный план с двумя рабочими процессами:
Для управления параллелизмом применяется указание Parallel. С параметром hard оно принудительно задает количество процессов. В этом примере мы отключаем параллельное выполнение, указывая ноль:
Принудительно установим три рабочих процесса:
Параметр soft лишь меняет значение параметра max_parallel_workers_per_gather, а в остальном планировщику остается свобода выбора. В данном случае планировщик ограничился двумя процессами из-за относительного небольшого размера таблицы:
Указание Leading позволяет влиять на порядок соединений. Если указаны двойные скобки, то задается не только порядок, но и направление (внешняя таблица и внутренняя
Page 15: Page 15
таблица) соединений:
Попробуем другой порядок:
Часто достаточно указать лишь несколько начальных таблиц, оставив планировщику свободу выбора для остальных соединений. В этом примере планировщик начнет с соединения таблиц f и tf, и поскольку пара помещена в одинарные скобки, сможет сам выбрать направление соединения:
Page 16: Таблица указаний
Таблица hint\_plan.hints
- шаблон для выбора запросов
- имя приложения для выбора сеанса
- код указания
- Указания в таблице приоритетнее, чем указания в коде
- pg_hint_plan.enable_hint_table = on
Комментарии преподавателя
Часто бывает затруднительно изменить код SQL в приложении для явной вставки указаний. В таких случаях указания можно внести в специальную таблицу hint_plan.hints, разрешив ее использование с помощью параметра pg_hint_plan.enable_hint_table.
Идентификатор указания в этой таблице (поле id) заполняется автоматически.
Столбец norm_query_string устанавливает шаблон для выбора запросов, к которым будет применяться указание. Константы в шаблоне должны быть заменены символом знака вопроса. Пробельные символы значимы.
Столбец application_name определяет, к каким сеансам будет применяться указание. Если указана пустая строка, будут выбираться все сеансы.
Столбец hint задает указания (без обрамляющей разметки комментариев).
Указания, заданные в таблице, имеют бо́льший приоритет, чем указания в комментариях.
Page 17: Таблица указаний
Вместо редактирования текстов запросов воспользуемся таблицей hint_plan.hints. Она создается при добавлении расширения в базу данных.
Возьмем запрос с индексным доступом:
Поместим в таблицу указаний требование использовать последовательное сканирование. Константы, фигурирующие в целевом запросе, в столбце norm_query_string таблицы указаний должны заменяться знаками «?». В остальном текст запроса должен посимвольно совпадать, включая переводы строк:
Разрешим использование таблицы указаний:
Теперь план запроса содержит последовательное сканирование:
Отключим расширение.
Page 18: Расширение plantuner
Исключает индексы из рассмотрения оптимизатором
- plantuner.disable_index
- plantuner.enable_index
- Обнуляет статистику для только что созданных таблиц
- plantuner.fix_empty_table
Комментарии преподавателя
Расширение plantuner позволяет исключить из рассмотрения оптимизатора определенные индексы (pg_hint_plan не дает такой возможности). Оптимизатор не будет рассматривать планы, которые используют индексы, указанные в параметре plantuner.disable_index. Однако если имя индекса указать в параметре plantuner.enable_index, он все же будет доступен оптимизатору – таким образом можно разрешить или даже заставить оптимизатор использовать определенный индекс для конкретного запроса, задав параметр на уровне сеанса или функции.
Если таблица создана недавно, ее страницы находятся только в буферном кеше. В таком случае оптимизатор, оценивая число страниц и строк в таблице, иногда ошибается в бóльшую сторону. Указание plantuner.fix_empty_table = on обнуляет эти оценки.
https://postgrespro.ru/docs/enterprise/16/plantuner
Page 19: Расширение plantuner
Создадим для таблицы ticket_flights индексы по стоимости билета и по классу обслуживания:
Следующий запрос будет использовать индекс по стоимости для любого класса обслуживания:
Расширение plantuner позволяет исключить из рассмотрения индекс по стоимости, сохранив при этом возможность выбора метода доступа:
Если в запросе есть предикат с высокой селективностью, буден выбран другой индекс:
Page 20: Page 20
А если селективность низкая, планировщик выбирает полное сканирование:
Следует понимать, что указания оптимизатору, как правило, дают эффект лишь в частных случаях: при определенных значениях констант и определенном состоянии данных в таблицах.
Page 21: Итоги
Модуль dump\_stat позволяет выгружать и загружать статистику без необходимости выполнять ANALYZE
- Расширение pg_query_state помогает отслеживать ход выполнения долгих запросов
- Модули pg_hint_plan и plantuner позволяют управлять планами запросов
Page 22: Практика
- В базе данных demo выполните запрос с соединением таблиц tickets и ticket_flights по равенству значений столбцов ticket_no. Проверьте, что соединение выполняется с помощью слияния (merge join).
- Используя расширение pg_hint_plan, заставьте планировщик выбрать соединение хешированием (hash join).
- С помощью этого же расширения добейтесь, чтобы для доступа к таблице ticket_flights использовалось сканирование по битовой карте.
- Подключите расширение plantuner и запретите использовать индекс tickets_pkey при выполнении запроса из п. 3.
Комментарии преподавателя
- Используйте следующий запрос:
Запретите использовать индекс с помощью команды:
Page 23: 1. Запрос с соединением слиянием
Получим план запроса с соединением таблиц tickets и ticket_flights.
Соединение выполнено слиянием (merge join).
2. Указание выполнить соединение хешированием
Загрузим динамическую библиотеку pg_hint_plan:
Используем указание HashJoin:
3. Указание использовать сканирование по битовой карте
Используем указание BitmapScan:
Page 24: Page 24
4. Запрет использования индекса
Загрузим динамическую библиотеку plantuner:
Запретим использовать индекс tickets_pkey:
Получим план:
Page 25: Практика PPEM
- Подготовьте базу данных demo основного экземпляра для работы с расширением pg_query_state.
- Откройте psql-консоль и запустите в ней длительно выполняющийся запрос из демонстрации.
- Используя вкладку «Активность» экземпляра, исследуйте ход выполнения запроса из п. 2.
Комментарии преподавателя
- Запрос для исследования выполнения:
- Удобно, не закрывая psql-консоль, открыть вкладку «Активность» и установить в ней фильтр по базе данных.
Page 26: 1. Установка расширения pg_query_state
Выберите основной экземпляр ent-16 и на вкладке «Расширения» навигационной панели нажмите «Установить расширение». Заполните поля открывшейся формы и нажмите кнопку «Установить». На вкладке «Параметры» добавьте в параметр shared_preload_libraries библиотеку pg_query_state. Сохраните и примените параметр (потребуется перезапуск экземпляра).
2. Длительно выполняющийся запрос
В списке «Базы данных» найдите demo и в столбце «Действия» нажмите на пиктограмму «{/}» (открыть PSQL-консоль). В открывшемся окне наберите и запустите на выполнение запрос:
3. Отображение хода выполнения запроса
Не закрывая окно psql, откройте вкладку «Активность» и для процесса, выполняющего запрос, в столбце «Действия» нажмите на пиктограмму «План активного запроса». Откроется окно, в котором для отслеживания хода выполнения будет кнопка «Обновить статистику выполнения».
09 Занятие 09: Производительность / Адаптивная оптимизация
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_09_aqo.html Archive: PGPRO-handouts-16.zip Страниц PDF: 29
Page 1: Производительность / Адаптивная оптимизация
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Предназначение AQO
- Принцип работы AQO
- Обучение без классификации
- Классификация запросов
- Песочница
Page 3: Предназначение AQO
Исправление неверных оценок кардинальности, когда штатные средства не помогают
- отклонение кардинальности от вычисленной планировщиком
- AQO улучшает оценки в запросах с простыми условиями
- атрибут оператор-сравнения константа
- Основная сфера применения — сложные аналитические запросы
Комментарии преподавателя
Модуль адаптивной оптимизации запросов AQO (Adaptive Query Optimization) можно применить в тех случаях, когда стандартные инструменты улучшения оценок селективности и кардинальности (подробно описанные в курсе QPT) не срабатывают.
Модуль AQO работает с простыми условиями вида «атрибут = константа», «атрибут > константа» и подобными.
AQO улучшает оценку количества строк, умножая оценку планировщика на коэффициент коррекции AQO. Это может способствовать выбору лучшего плана и, следовательно, ускорению выполнения запросов.
Основная сфера применения AQO — сложные аналитические запросы с повторяющейся структурой, для которых EXPLAIN ANALYZE выдает неверную оценку кардинальности.
Page 4: Пример запроса с неверной оценкой
Начнем с установки расширения:
Необходима перезагрузка экземпляра.
Добавим расширение AQO в базу данных:
В качестве примера мы будем использовать запрос с ошибкой вычисления кардинальности, вызванной коррелированными предикатами.
Точное количество строк отличается от оценки:
Причина неверной оценки в том, что рейс PG0007 всегда вылетает из Внуково, но планировщику об этом неизвестно. В курсе QPT показано, как использовать расширенную статистику по функциональным зависимостям, чтобы исправить неверную оценку кардинальности. В этой теме мы улучшим оценку с помощью расширения AQO.
Page 5: Принцип работы AQO
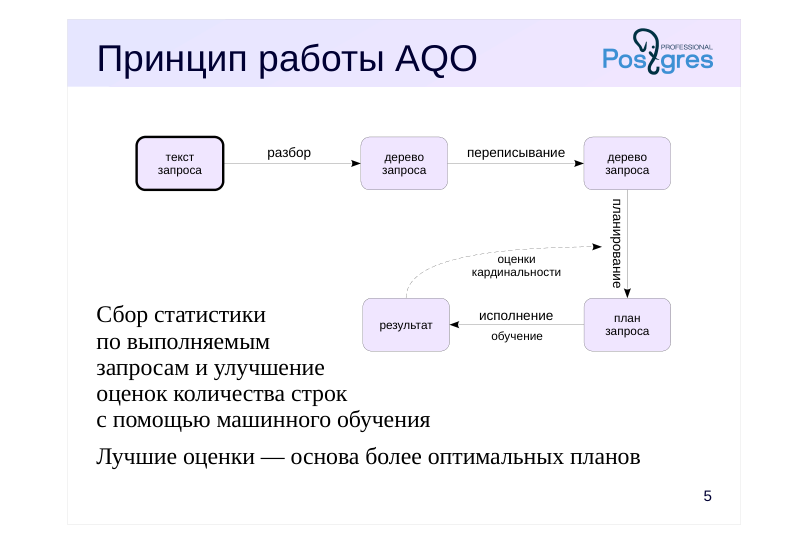 {#source-figure-005 caption=“Source slide page 5: Принцип работы AQO”}
Сбор статистики по выполняемым запросам и улучшение оценок количества строк с помощью машинного обучения
- Лучшие оценки — основа более оптимальных планов
Комментарии преподавателя
Модуль AQO собирает статистику по выполненным запросам для обучения модели, с помощью которой AQO предоставляет уточненные оценки. Именно это концептуально отличает AQO от обычного планировщика, на работу которого никак не влияют ранее выполненные запросы.
Для оценки кардинальности используется метод машинного обучения на базе алгоритма поиска ближайших соседей k-NN вместо обычной статистики планировщика.
Page 6: Принцип работы AQO
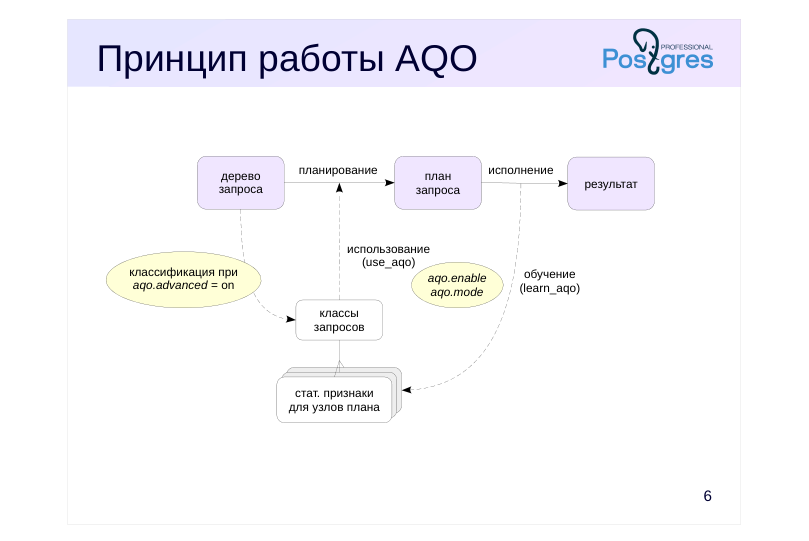 {#source-figure-006 caption=“Source slide page 6: Принцип работы AQO”}
Комментарии преподавателя
Расширение AQO включается параметром aqo.enable.
При исполнении плана запроса AQO получает статистическую информацию (признаки, features) о реальной кардинальности каждого узла плана — происходит обучение модели. Полученные данные сохраняются в файлах и при запуске AQO загружаются в разделяемую память.
Когда статистическая информация накоплена, модель может использоваться для уточнения оценки планировщика.
По умолчанию все запросы считаются принадлежащими одному классу. Поэтому статистика, собранная для узлов плана, будет применяться и к другим планам с теми же узлами.
Если установить параметру aqo.advanced значение on, выполняется классификация: в один класс попадают запросы, отличающиеся только константами. В таком случае статистика будет собираться и применяться для каждого класса отдельно.
Как именно обучается и используется модель, определяется режимом работы (параметр aqo.mode).
https://postgrespro.ru/docs/enterprise/16/aqo
Page 7: Без классификации
Режим learn
- статистика применяется и собирается
- начальное обучение
- Режим frozen
- статистика применяется, но новая не собирается
- стабилизация
Комментарии преподавателя
Если классификация не применяется (aqo.advanced = off), все запросы относятся к одному общему классу. В этом случае имеют смысл два режима работы: learn и frozen.
В использующемся по умолчанию режиме learn модель обучается на всех выполняемых запросах и используются для уточнения оценок всех планов.
Этот режим используется для начального обучения AQO: после включения расширения надо выполнять проблемные запросы, варьируя константы, до тех пор, пока не будет достигнуто необходимое качество их планирования. Обучать модель на всех запросах не требуется: обычно большая их часть планируется правильно и без AQO, а в некоторых случаях применение AQO может и ухудшить производительность.
Затем расширение переводится в режим frozen, в котором собранная статистика продолжает использоваться, но новые данные не собираются.
Этот режим позволяет стабилизировать планы и снизить влияние AQO на время планирования запросов. Конечно, при дальнейшем изменении данных точность планирования может ухудшиться; в таком случае можно на время вернуться в режим обучения, чтобы обновить статистику.
Page 8: Без классификации: режим learn
С помощью параметра aqo.enable включим aqo на уровне кластера и перечитаем конфигурацию:
По умолчанию устанавливается режим learn:
Выполним показанный ранее запрос:
Для AQO этот запрос является новым (AQO not used), поэтому для планирования использовались обычные оценки. Но AQO уже получил данные для обучения модели. Найдем статистику AQO по идентификатору запроса (query hash):
Выполним запрос еще раз. Теперь используется уточненная оценка (AQO: error=0%):
Page 9: Page 9
Количество выполнений с AQO увеличилось:
Спрогнозировать правильную кардинальность для других констант модель пока не может:
Но, получив новые данные, модель выдает исправленную оценку:
Page 10: Page 10
Обратите внимание, что расширение ориентируется на дерево разбора, и поэтому не чувствительно к таким изменениям, как регистр текста, переносы строк, псевдонимы таблиц и т. п. Более того: поскольку статистика не делится по классам запросов, накопленная информация об узлах будет применяться к любым планам, которые содержат известные узлы (сравните подписи к узлам Nested Loop и Bitmap Heap Scan).
Без классификации: режим frozen
После проведения обучения мы можем заморозить модель, чтобы она перестала обучаться, но продолжала выдавать оценки.
Для известных констант сохраняется уточненная оценка:
Page 11: Page 11
Для новых значений модель выдает прогноз на основе тех данных, на которых она была обучена:
Page 12: Классификация запросов
Режимы learn и frozen
- Режим controlled
- статистика применяется (use_aqo),
- но обновляется (learn_aqo) только для известных запросов
- стабилизация без «заморозки»
- Режим intelligent
- автоматическое управление обучением и применением (auto_tune)
- сначала только сбор статистики;
- применение при реальном улучшении, иначе — отказ от использования
- Тонкая настройка
- ручное управление свойствами use_aqo, learn_aqo, auto_tune
Комментарии преподавателя
При включенной классификации (aqo.advanced = on) статистика собирается отдельно для каждого класса запросов; класс составляют запросы, у которых деревья разбора отличаются только константами. В этом случае к уже рассмотренным режимам работы learn и frozen добавляются еще два: controlled и intelligent (без классификации они не отличаются от обычного learn).
В режиме controlled модель применяется для уже известных классов запросов: она продолжает обучаться на них (свойство learn_aqo) и используется для уточнения оценок (use_aqo). Но для новых классов запросов статистика не собирается. Этот режим можно использовать вместо frozen, чтобы тратить ресурсы только на нужные запросы, но при этом не «замораживать» статистику, а продолжать обновлять ее.
В режиме intelligent расширение самостоятельно управляет обучением и использованием (свойство auto_tune). Новые запросы сначала выполняются шесть раз без AQO, а затем обученная модель начинает использоваться (включается свойство use_aqo). Далее модель может выключаться или включаться в зависимости от того, уменьшает ли ее использование время планирования и выполнения запроса. Если после 50 итераций улучшения не происходит, AQO перестает собирать статистику по данному классу запросов и пытаться ее применить (выключает свойства use_aqo и learn_aqo).
Этот режим работы следует применять с осторожностью, поскольку принимаемые решения могут оказаться недостаточно точными.
Свойствами use_aqo, learn_aqo и auto_tune можно управлять вручную отдельно для каждого класса запросов.
Page 13: С классификацией: режим controlled
Включим теперь классификацию запросов, удалим все данные машинного обучения и повторим эксперименты.
Сначала обучим модель на запросах одного класса (класс составляют запросы с одинаковым деревом разбора без учета констант).
Если раньше информация об известных узлах применялась ко всем запросам, то теперь для каждого класса собирается собственная статистика. Поэтому в следующем запросе все узлы имеют подпись AQO not used — именно для такого класса узел Bitmap Heap Scan еще не встречался:
Page 14: Page 14
Теперь переведем расширение в режим controlled:
В этом режиме работы запросы из неизвестных классов не обрабатываются (Using aqo: false):
Но для уже известных классов запросов модель продолжает обучаться. Оценка для новой пары «аэропорт — номер рейса» не точна:
Page 15: Page 15
Но в следующий раз модель исправляется, получив новые данные:
При включенной классификации можно вручную управлять отдельными свойствами классов, устанавливая, должна ли модель обучаться и должна ли она использоваться для уточнения оценок:
Например, можно временно отключить использование модели, но продолжить обучение (NULL сохраняет существующее значение):
Page 16: Page 16
Сбросив свойство learn_aqo, можно «заморозить» отдельный класс запросов:
Теперь оценка учитывает данные, полученные в прошлый раз, но дальнейшее обучение остановлено:
В режиме intelligent можно управлять и свойством auto_tune.
С классификацией: режим intelligent
Отключим параллельное выполнение для упрощения планов запросов:
Сбросим еще раз статистику AQO и установим режим intelligent:
Page 17: Page 17
Включим параметр, позволяющий собирать статистику при отключенном использовании AQO:
Несколько раз выполним запрос с большой ошибкой оценки кардинальности. В режиме intelligent сначала происходит обучение, но оценки при планировании не уточняются.
На седьмой раз AQO начинает использовать модель и исправляет оценку кардинальности. Обратите внимание, что при этом поменялся и алгоритм соединения — вложенному циклу планировщик предпочел хеширование:
Page 18: Page 18
Теперь, когда модель используется, автоматика режима intelligent будет смотреть на среднее время планирования и выполнения запроса с AQO и без AQO, включая или выключая использование модели. Выполним запрос еще несколько раз и проверим статистику:
Page 19: Page 19
Если AQO не даст выигрыша по времени выполнения в течение 50 выполнений, оптимизация для данного класса запроса совсем отключится.
Page 20: Песочница
Отдельная база знаний
- в общей памяти сервера
- изолирована от основной базы
- общая для всех сеансов, где включена (aqo.sandbox = on)
- Позволяет
- экспериментировать с AQO, не влияя на основную активность
- работать на физической реплике
Комментарии преподавателя
В AQO есть возможность организовать дополнительную базу знаний, не связанную с основной — песочницу.
На сервере существует единственная песочница, которая располагается в его общей памяти. Во всех сеансах, в которых задано значение aqo.sandbox = on, расширение AQO будет работает не с основной базой знаний, а с общей песочницей.
Это дает возможность экспериментировать с настройками, не влияя на выполняющиеся запросы пользователей, а затем переносить статистику в основную базу знаний.
Также песочница позволяет обучать AQO на запросах, выполняющихся на физической реплике. По умолчанию (если aqo.wal_rw = true) изменения основной базы знаний записываются в WAL и передаются на реплику. Поэтому запросы на реплике могут использовать статистику AQO основного сервера. Однако обучение на реплике невозможно, поскольку на ней нельзя изменять данные. Песочница позволяет обойти это ограничение.
Page 21: Песочница
Переключим AQO на песочницу в текущем сеансе:
Сбросим статистику песочницы, не затрагивая основную базу знаний:
Выполняем запрос, пока оценка кардинальности не станет удовлетворительной:
Теперь мы можем скопировать статистику из песочницы в таблицу:
Переключаемся на основную базу знаний и импортируем статистику, полученную из песочницы:
Page 22: Page 22
Запрос сразу же использует AQO:
Page 23: Итоги
Адаптивная оптимизация запросов AQO — инструмент для улучшения планов методом машинного обучения
- Автоматическое исправление оценок кардинальности, которого сложно достичь традиционными методами
- Несколько режимов работы и возможность тонкой настройки на уровне отдельных классов запросов
Page 24: Практика
- В базе данных demo создайте индекс для таблицы flights по столбцу scheduled_departure и для ticket_flights по столбцу fare_conditions.
- Отключите параллельное выполнение, увеличьте размер рабочей памяти до 256 Мбайт и выполните запрос для получения количества пассажиров, летавших бизнес-классом с 01.08.2016 и прибывших с опозданием не более часа.
- Оптимизируйте запрос с помощью AQO.
Комментарии преподавателя
- Используйте следующий запрос:
- Сбросьте статистику AQO и исследуйте план запроса в режиме обучения (learn).
Page 25: 1. Индексы
Чтобы у планировщика PostgreSQL было больше вариантов соединения таблиц, создадим два индекса.
2. Запрос с обычным планированием
Отключим параллельную обработку и увеличим work_mem, чтобы вся работа происходила в оперативной памяти.
Получим количество пассажиров, которые летели бизнес-классом начиная с 01.08.2016 и прибыли с опозданием не более часа.
Page 26: Page 26
Имеется несоответствие по количествам планируемых и реально полученных строк.
3. AQO
Чтобы заработал AQO, нужно загрузить библиотеку:
Установим расширение:
Режим по умолчанию — learn:
Сбросим предыдущую статистику AQO:
Page 27: Page 27
Включим AQO:
Выполним запрос и исследуем его план:
AQO не оптимизирует запрос, если встречает его впервые. Повторим запрос:
Page 28: Page 28
Теперь количества планируемых и реально полученных строк стали одинаковыми.
Уборка
Удалим индексы и расширение, созданные в базе demo и сбросим настройки параметров конфигурации.
Page 29: Page 29
10 Занятие 10: Производительность / Перепланирование запросов
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_10_replan.html Archive: PGPRO-handouts-16.zip Страниц PDF: 14
Page 1: Производительность / Перепланирование запросов
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Проблема и решение
- Механизм работы
- Условия перепланирования
- Особенности реализации
Page 3: Проблема и решение
Ошибки в оценке кардинальности
- статистика устаревает из-за частых изменений данных
- неравномерное распределение данных
- параметризованные запросы и подготовленные операторы
- При сильном несоответствии
- выполнение прерывается
- запрос планируется повторно с учетом полученных данных
- Классы запросов
- тяжелые аналитические OLAP-запросы
- проблемные OLTP-запросы
Комментарии преподавателя
Как правило, ошибки при планировании вызваны некорректной оценкой кардинальности. Частая причина этого — неактуальная статистика планировщика. Например, в OLTP-системах это может быть вызвано устареванием статистики из-за часто изменяющихся данных, неравномерным распределением или использованием подготовленных запросов с параметрами (когда оптимизатор переключается на общий план выполнения).
Если в процессе выполнения запроса обнаруживается, что показатели значительно отличаются от ожидаемых, можно прервать выполнение и произвести планирование повторно, воспользовавшись накопленными в процессе выполнения дополнительными данными. Для этого необходимо настроить желаемые условия перепланирования.
Перепланирование запросов в реальном времени особенно актуально для тяжелых аналитических OLAP-запросов, для которых накладные расходы на перепланирование будут относительно невелики. Перепланирование можно использовать и для проблемных OLTP-запросов.
Page 4: Перепланирование запросов
Рассмотрим запрос:
Точное количество строк отличается от оценки. Посмотрим на параметры перепланирования:
Параметры, значения которых равны минус единице, — это условия перепланирования, которые нужно будет настроить.
Page 5: Механизм работы
 {#source-figure-005 caption=“Source slide page 5: Механизм работы”}
Комментарии преподавателя
Перепланирование запросов встраивается в стандартную схему работы планировщика Postgres Pro.
Если во время или после выполнения узла плана выполняется условие перепланирования, запрос прерывается и актуальная кардинальность узлов плана (а также дополнительная служебная информация) сохраняются. Далее запускается процесс перепланирования, который может использовать сохраненную кардинальность для получения лучшего плана.
Кардинальность сохраняется только для тех узлов плана, в которых реальная кардинальность оказалась больше плановой. Эта информация хранится только в процессе перепланирования текущего запроса. Если запрос выполняется часто, новый план можно запомнить с помощью расширения pgpro_multiplan (рассматривается в теме «Сохранение планов запросов»).
Перед попыткой планирования создается вложенная транзакция. При срабатывании условия перепланирования эта транзакция обрывается и начинается новая.
Все выбранные планы для всех попыток перепланирования сохраняются в журнале сообщений сервера.
В любом случае, перепланирование необходимо использовать аккуратно и проверять его влияние на систему в целом.
Подробности можно прочитать в статье Алены Рыбакиной и Андрея Лепихова: https://habr.com/ru/companies/postgrespro/articles/819911/
Page 6: Условия перепланирования
Автоматически
- время выполнения превысило replan_query_execution_time
- узел отработал и ошибка прогноза кардинальности оказалась больше
- replan_overrun_limit
- рабочий процесс использует более replan_memory_limit памяти
- и ошибка прогноза кардинальности превысила replan_overrun_limit
- Вручную
- функция replan_signal
Комментарии преподавателя
По умолчанию перепланирование запросов отключено. Для включения достаточно установить конфигурационный параметр replan_enable и настроить условия перепланирования, или триггеры (не имеющие отношения к обычным триггерам базы данных).
В Postgres Pro Enterprise 16 перепланирование срабатывает в трех следующих случаях:
● По времени выполнения.
Запрос выполняется дольше, чем указано в параметре replan_query_execution_time.
● По ошибке оценки кардинальности после выполнения узла.
После выполнения узла плана количество обработанных строк превысило число, ожидаемое планировщиком, умноженное на значение replan_overrun_limit.
● По перерасходу памяти и ошибке оценки кардинальности во время выполнения узла.
Во время выполнения узла плана потребление памяти рабочим процессом превысило значение replan_memory_limit, а количество уже обработанных строк превысило число, ожидаемое планировщиком, умноженное на значение replan_overrun_limit.
Перепланирование можно инициировать и вручную с помощью функции replan_signal.
https://postgrespro.ru/docs/enterprise/16/realtime-query-replanning-how#RE ALTIME-QUERY-REPLANNING-TRIGGERS
Page 7: Пример перепланирования запросов
Повторим запрос:
Планировщик считает, что во внешнем наборе всего одна строка, и выбирает план без материализации. Однако в процессе выполнения запроса обнаруживается, что строк три, и в этом случае план с материализацией выглядит привлекательнее. Включим перепланирование:
Триггер по количеству строк срабатывает, если число обработанных строк превосходит ожидаемое в replan_overrun_limit раз. Пусть перепланирование срабатывает, если планировщик ошибся как минимум вдвое:
При перепланировании использовалась реальная кардинальность узлов, полученная при выполнении плана. Это привело к выбору плана с материализацией, который в данном случае более эффективен. Повторим запрос, включив вывод информации о перепланировании и добавив к команде EXPLAIN параметр verbose:
Page 8: Page 8
Теперь для узлов плана отображается более подробная информация. В нижней части вывода видно, что потребовалась одна попытка перепланирования (Replanning Attempts: 1).
Page 9: Особенности
Является частью ядра СУБД
- не нужно устанавливать расширения
- Ограничения
- поддерживает только SELECT
- не поддерживает курсоры и изменчивые функции
Комментарии преподавателя
Механизм перепланирования запросов в реальном времени является частью Postgres Pro, поэтому установки дополнительных расширений не требуется.
На данный момент у функциональности перепланирования имеются некоторые ограничения: поддерживаются только операторы SELECT (за исключением SELECT FOR UPDATE и SELECT FOR SHARE) и не поддерживаются курсоры и изменчивые (volatile) функции.
https://postgrespro.ru/docs/enterprise/16/realtime-query-replanning
В 17-й версии Postgres Pro Enterprise функциональность перепланирования переименована в адаптивное выполнение запросов (AQE, Adaptive Query Execution).
Page 10: Итоги
Если запрос выполняется неэффективно, сервер может прервать его и повторить планирование
- При перепланировании используется накопленная информация о кардинальности узлов плана
- Перепланирование позволяет автоматически ускорить проблемные запросы
Page 11: Практика
- Создайте таблицу с одним столбцом типа char(2000), с отключенной автоочисткой. Заполните ее данными.
- Получите план выполнения запроса, выполняющего декартово произведение таблицы самой с собой. Убедитесь в наличии ошибки оценки кардинальности.
- Включите перепланирование, ограничив количество попыток одной. Получите новый план.
- Снимите ограничение, установленное на количество попыток перепланирования. Сравните три получившихся плана.
Комментарии преподавателя
- Воспользуйтесь параметром конфигурации replan_max_attempts.
https://postgrespro.ru/docs/enterprise/16/runtime-config-query#GUC-REPLA N-MAX-ATTEMPTS
Page 12: 1. Таблица
Создадим базу данных и таблицу:
Вставим некоторое количество строк:
2. Стандартный планировщик
Перепланирование отключено.
Получим план выполнения запроса, соединяющего таблицу саму с собой:
Налицо ошибка оценки кардинальности в обоих узлах Seq Scan. Она связана с отключенной автоочисткой: анализ не выполнялся, планировщик не знает количество строк в таблице. Планировщик считает, что 250 строк поместятся в оперативной памяти (work_mem), поэтому вставляет узел Materialize, чтобы не считывать таблицу t2 тысячу раз с диска (или из буферного кеша). Обратите внимание, что декартово произведение всегда выполняется только вложенным циклом (подробности можно узнать из курса «QPT. Оптимизация запросов»), поэтому план в любом случае не изменится — пример носит иллюстративный, а не практический характер.
3. Перепланирование с одной попыткой
Включим перепланирование:
Page 13: Page 13
Получим новый план:
Что произошло? После завершения внутреннего цикла по таблице t2 (и одной итерации внешнего) планировщику стало известно, что в таблице t2 находится 1000 строк. Сработал триггер перепланирования. Теперь внутренний цикл выполняется по таблице t1 с промежуточным узлом материализации, поскольку планировщик все еще считает, что в t1 всего 250 строк. Кардинальность узла Seq Scan по t2 оценена верно.
4. Перепланирование с двумя попытками
Снимем ограничение на количество попыток перепланирования:
Снова получаем план:
Поскольку информация перепланирования не сохраняется между запросами, процесс повторяется. После завершения внутреннего цикла по таблице t2 планировщику стало известно, что в таблице t2 находится 1000 строк. Сработал триггер перепланирования, план был перестроен так, как мы видели в п. 3, а запрос начал выполняться с начала. Теперь после завершения внутреннего цикла по таблице t1 планировщику стало известно, что и в таблице t1 находится 1000 строк. Снова сработал триггер перепланирования, план был перестроен во второй раз. Теперь кардинальность обоих узлов Seq Scan оценена правильно; узел материализации пропал, поскольку тысяча строк не помещается в память work_mem.
Уборка
Удалим созданную базу данных.
Page 14: Page 14
11 Занятие 11: Производительность / Сохранение планов запросов
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_11_multiplan.html Archive: PGPRO-handouts-16.zip Страниц PDF: 33
Page 1: Производительность / Сохранение планов запросов
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Модуль pgpro_multiplan
- Замороженные планы
- Песочница
- Планы с шаблонами
- Базовые планы
- Совместная работа с перепланированием
Page 3: Модуль pgpro_multiplan
Стабилизация планов выполнения запросов
- заморозка плана для конкретного запроса или группы запросов
- разделяемый кеш замороженных планов
- планы сохраняются в файлах сервера,
- для репликации: pgpro_multiplan.wal_rw
- Заменяет устаревшее расширение sr_plan
Комментарии преподавателя
Расширение pgpro_multiplan позволяет «заморозить» определенный план выполнения запроса (или привязать план к целой группе запросов) и при дальнейшем исполнении запроса использовать этот план вместо того, который построил бы планировщик. Стабилизация некоторых планов полезна, например, при обновлении сервера (в новых версиях планировщик в среднем работает лучше, но планы небольшой части запросов могут измениться и в худшую сторону), или для оптимизации отдельного запроса, когда не удается иными средствами убедить планировщик построить нужный план.
Замороженные планы сохраняются в файлы в отдельном каталоге, а работа с ними происходит в разделяемой памяти. Таким образом, в отличие от обычного локального кеша разобранных запросов и их планов, кеш замороженных планов — общий для всех сеансов.
Планы хранятся в файлах, а не в таблицах БД, чтобы обеспечить совместимость расширения с системой 1С. Обратной стороной такого решения является то, что замороженные планы не передаются с мастера на реплику автоматически: если это необходимо, требуется включить параметр pgpro_multiplan.wal_rw на обоих серверах.
https://postgrespro.ru/docs/enterprise/16/pgpro-multiplan
До версии Postgres Pro Enterprise 16 включительно в продукте присутствует расширение sr_plan с аналогичным функционалом. Начиная с версии 15, оно считается устаревшим и вместо него рекомендуется использовать расширение pgpro_multiplan.
https://postgrespro.ru/docs/enterprise/16/pgpro-multiplan#PGPRO-MULTIPL AN-MIGRATION-FROM-SR-PLAN
Page 4: Типы планов
Сериализованный — serialized
- хранится внутреннее представление плана
- зависит от системного каталога: OID, структуры таблиц и т. п.
- действует только в текущей базе данных
- планирование не требуется
- Набор указаний — hintset
- хранятся указания расширения pg_hint_plan
- запрос планируется с учетом указаний
Комментарии преподавателя
План может сохраняться в двух вариантах.
Сериализованный план — это дерево плана, представленное в виде текстовой строки.
Сериализованный план действителен только в текущей базе данных, он зависит от идентификаторов объектов, структуры таблиц и индексов. Например, если пересоздать используемую в плане таблицу (даже с тем же именем), то сохраненный план станет недействительным.
Преимущество сериализованных планов состоит в том, что запрос при выполнении не требуется планировать.
Набор указаний — хранится как указания расширения pg_hint_plan. Для этого требуется, чтобы было установлено и само расширение pg_hint_plan, иначе указания будут проигнорированы. В таком случае план не зависит от идентификаторов объектов. Запрос при выполнении приходится планировать, но указания подсказывают планировщику, какой именно план требуется получить.
https://postgrespro.ru/docs/enterprise/16/pgpro-multiplan#PGPRO-MULTIPL AN-SUPPORTED-MODES
Page 5: Заморозка плана
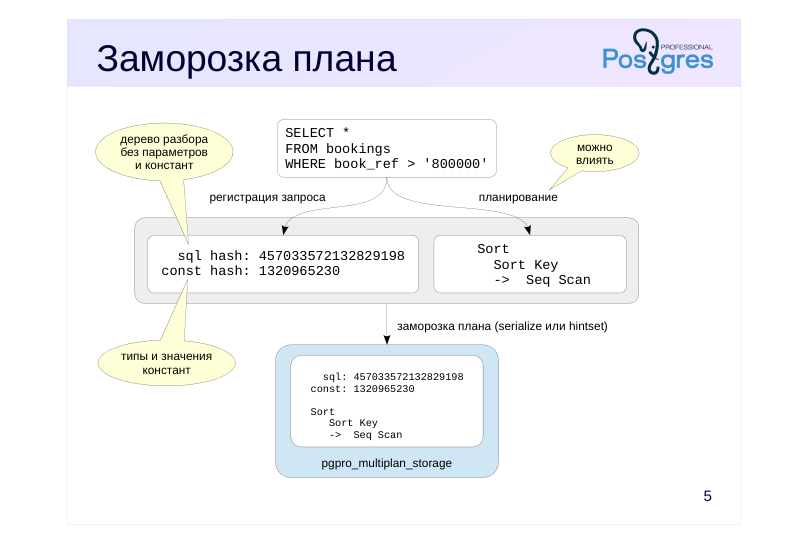 {#source-figure-005 caption=“Source slide page 5: Заморозка плана”}
Комментарии преподавателя
Первый из режимов работы расширения — заморозка плана — состоит из трех этапов: регистрации запроса, построения плана и собственно заморозки.
Зарегистрировать запрос можно одним из двух способов:
● функцией pgpro_multiplan_register_query, в которую необходимо передать текст запроса (можно в параметризованном виде) и список типов параметров (можно доверить расширению автоматически определить типы);
● с помощью автоматической регистрации запросов (параметр pgpro_multiplan.auto_tracking, по умолчанию выключен).
При этом запрос идентифицируется двумя хеш-кодами:
● sql_hash — вычисляется по дереву разбора без учета параметров и констант (тот же хеш-код используется, например, в расширении pg_stat_statements; требуется включенный compute_query_id);
● const_hash — вычисляется по типам и значениям констант.
Далее запрос планируется, при этом допускается влиять на план любыми доступными способами: параметрами оптимизатора, с помощью расширений AQO или pg_hint_plan и т. п.
На последнем шаге необходимо заморозить последний выполненный план с помощью функции pgpro_multiplan_freeze. После этого при выполнении зарегистрированного запроса будет обеспечиваться применение замороженного плана. Замороженный план будет применяться только к точно такому же запросу, для которого замораживался план.
Page 6: Замороженные планы
Начнем с установки расширения:
Обратите внимание, что библиотека pg_hint_plan загружается перед pgpro_multiplan. Необходим перезапуск экземпляра:
Добавим расширение pgpro_multiplan в базу данных:
По умолчанию функционал расширения pgpro_multiplan выключен. Включим его для текущего сеанса: установим режим frozen, позволяющий использовать замороженные планы.
Запрос, выбирающий половину бронирований, использует индексный доступ:
Допустим, мы считаем, что последовательное сканирование было бы эффективнее. Воспользуемся расширением, и сначала зарегистрируем интересующий нас запрос (используем не константу, а параметр):
Теперь в плане видно, что запрос отслеживается расширением (в корне плана появился узел Custom Scan (MultiplanScan) с пометкой Plan is: tracked):
Запретим использовать индексный доступ:
Page 7: Page 7
Чтобы заморозить полученный план, воспользуемся функцией pgpro_multiplan_freeze:
Вернем оптимизатору все возможности для построения планов:
И повторно выполним запрос — возьмем для примера другую константу:
Теперь сервер использует замороженный план: Plan is: frozen, serialized. Информацию о замороженных планах можно увидеть в представлении pgpro_multiplan_storage:
План можно заморозить и с типом hintset, то есть в виде указаний, сформированных с помощью расширения pg_hint_plan. Добавим расширение pg_hint_plan в текущую базу данных:
Page 8: Page 8
В начале этой демонстрации мы уже добавили библиотеку этого расширения в shared_preload_libraries. Следующий запрос использует последовательное сканирование:
Зарегистрируем его — на этот раз используем не параметр, а константу:
Попросим планировщик использовать сканирование индекса, используя подсказки pg_hint_plan:
Заморозим план с типом hintset:
И проверим план — в нем без указаний pg_hint_plan используется сканирование индекса:
На этот раз замена константы приводит к запросу, для которого план не замораживался, поэтому планировщик выбирает план с последовательным сканированием:
Page 9: Page 9
Посмотрим на информацию о замороженных планах:
Page 10: Песочница
Альтернативное хранилище планов
- pgpro_multiplan.sandbox = off
- необходимы права суперпользователя
- Поддерживается перенос планов в основное хранилище
- ручное копирование из представления pgpro_multiplan_storage
- данные не реплицируются из песочницы на ведомый сервер
Комментарии преподавателя
Расширение pgpro_multiplan позволяет задействовать для хранения замороженных планов песочницу: отдельную, независимую от основного хранилища область разделяемой памяти и каталог на диске. Переключением на альтернативное хранилище планов управляет параметр pgpro_multiplan.sandbox (по умолчанию он выключен). Менять значение этого параметра могут только суперпользователи.
И к основному хранилищу, и к песочнице существует только один общий интерфейс доступа — представление pgpro_multiplan_storage.
План, сохраненный в песочнице, можно перенести в основное хранилище. Для этого необходимо сохранить данные из представления pgpro_multiplan_storage в отдельную таблицу, затем отключить песочницу и восстановить данные в основное хранилище, используя функцию pgpro_multiplan_restore.
Данные из песочницы не реплицируются на ведомый сервер.
Page 11: Песочница
Включим параметр pgpro_multiplan.sandbox, чтобы переключиться на альтернативное хранилище:
Теперь в представлении pgpro_multiplan_storage пусто, так как в песочнице пока нет ни одного плана:
Повторим предыдущие действия, но для нового запроса к таблице tickets, который использует индексное сканирование:
Зарегистрируем запрос:
Запретим использовать индексный доступ:
Заморозим полученный план:
Вернем оптимизатору все возможности для построения планов:
Page 12: Page 12
И повторно выполним запрос:
Этот план сохранен в песочнице:
План можно перенести из песочницы в основное хранилище, сохранив данные из представления pgpro_multiplan_storage в таблицу:
Если переключиться на основное хранилище, расширение будет видеть сохраненные ранее данные:
Например, для запроса к таблице bookings с неравенством будет снова использоваться сохраненный план:
Page 13: Page 13
Чтобы добавить замороженный план из копии песочницы в основное хранилище, нужно воспользоваться функцией:
Этот же способ можно использовать для переноса плана из песочницы в другую базу или на другой сервер.
Page 14: Планы с шаблонами
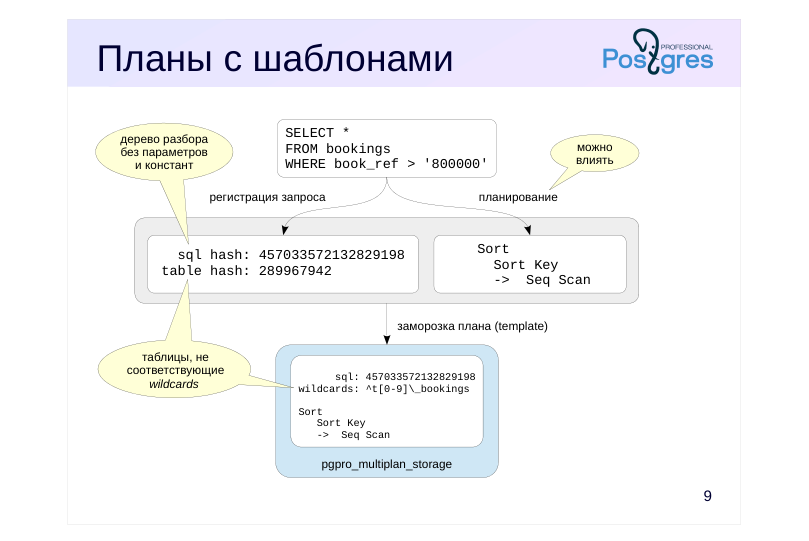 {#source-figure-014 caption=“Source slide page 14: Планы с шаблонами”}
Комментарии преподавателя
План с шаблонами (template) хранится в виде набора указаний, как и план с указаниями (hintset). Отличие состоит в том, что такой план применяется ко всех запросам, совпадающим с исходным с точностью до имен таблиц.
Говоря точнее, запрос идентифицируется двумя хеш-кодами:
● sql_hash — построен по дереву разбора,
● table_hash — построен по именам таблиц, не соответствующим регулярному выражению из параметра pgpro_multiplan.wildcards.
Константы (const_hash) не учитываются. Значение параметра pgpro_multiplan.wildcards сохраняется вместе с замороженным планом (table_hash не сохраняется, а вычисляется при необходимости).
План с шаблонами позволяет применять один и тот же план к запросам с одинаковой структурой, но разными названиями таблиц (например, запросы к временным таблицам, генерируемые системой 1С).
Такой план применяется, только если не нашлось точного соответствия (плана с типом serialized или hintset).
https://postgrespro.ru/docs/enterprise/16/pgpro-multiplan#PGPRO-MULTIPL AN-SUPPORTED-MODES
Page 15: Планы с шаблонами
Для планов с шаблонами нужно расширение pg_hint_plan, оно уже загружено в базу данных. Добавим режим wildcards, позволяющий использовать шаблоны:
Удалим всю собранную информацию из хранилища расширения:
Для экспериментов нам понадобятся две временные таблицы. Создадим их на основе таблицы bookings и дадим схожие имена:
Построим индексы, чтобы у планировщика было больше вариантов доступа к таблице:
Как и в предыдущих примерах, в запросе используется индексное сканирование:
Укажем для параметра pgpro_multiplan.wildcards регулярное выражение:
Этому регулярному выражению соответствуют имена, состоящие из символа t, цифры и суффикса _bookings — как у наших временных таблиц:
Поэтому расширение не будет различать запросы к ним. Снова временно отключим индексный доступ:
Page 16: Page 16
Зарегистрируем запрос к таблице t1_bookings:
Выполним запрос:
Он использует последовательное сканирование и отслеживается расширением (tracked). Сохраним полученный план как шаблонный:
Вместе с планом расширение сохранило текущее значение параметра pgpro_multiplan.wildcards:
В столбце hintstr находится набор указаний для pg_hint_plan. Вернем оптимизатору все возможности для построения планов:
Второй запрос теперь тоже выполняется с помощью последовательного сканирования, поскольку он совпадает с первым с точностью до имен таблиц, соответствующих шаблону. Константы не учитываются, несмотря на то, что запрос регистрировался без параметров:
Page 17: Page 17
Теперь выполним тот же запрос с таблицей, имя которой не соответствует шаблону:
Используется индексное сканирование, поскольку замороженного плана для этого запроса нет.
Page 18: Базовые планы
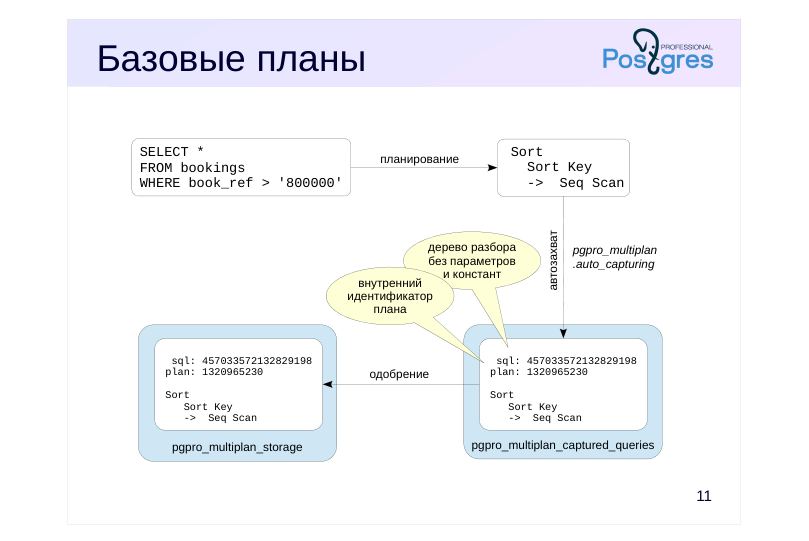 {#source-figure-018 caption=“Source slide page 18: Базовые планы”}
Комментарии преподавателя
Базовые планы применяют, когда для одного запроса может существовать несколько удачных планов. Если планировщик выбрал один из базовых планов, запрос выполняется с этим планом. В противном случае расширение принудительно устанавливает для запроса самый дешевый из существующих базовых планов. Базовые планы рассматриваются, только если не нашлось замороженного плана (с типом serialized, hintset или template).
Базовые планы идентифицируются двумя хеш-кодами:
● sql_hash — вычисляется так же, как и для замороженных планов;
● plan_hash — внутренний идентификатор плана.
Константы не учитываются, а const_hash всегда равен 0.
Чтобы добавить план как базовый, можно действовать, как в случае с заморозкой: зарегистрировать запрос, выполнить планирование и заморозить план функцией pgpro_multiplan_freeze с аргументом ‘baseline’.
Другой вариант — использовать автозахват, установив параметр pgpro_multiplan.auto_capturing. В этом случае все выполняющиеся запросы захватываются и их планы становятся кандидатами на сохранение. Захваченные запросы с планами видны в представлении pgpro_multiplan_captured_queries. Захваченный план можно одобрить, вызвав функцию pgpro_multiplan_captured_approve, после чего он попадает в общее хранилище и будет применяться.
https://postgrespro.ru/docs/enterprise/16/pgpro-multiplan#PGPRO-MULTIPL AN-SUPPORTED-MODES
Page 19: Базовые планы
Чтобы захватывать запросы, включаем конфигурационный параметр:
Воспользуемся тем же примером:
Запрос использует последовательное сканирование:
Захваченный запрос и план его выполнения можно увидеть в представлении:
Чтобы планировщик мог использовать захваченный план, его надо одобрить:
После одобрения план удаляется из хранилища захваченных планов:
Получим и одобрим еще один план:
Page 20: Page 20
Сбросим параметры и отключим автоматический захват планов:
Одобренные планы находятся в общем хранилище:
Теперь добавим baseline к списку режимов расширения, чтобы планировщик выбирал только одобренные базовые планы. Добавим также режим statistics, чтобы включить сбор статистики:
Page 21: Page 21
Доступ к статистике можно получить через представление pgpro_multiplan_stats. Пока оно пусто, поскольку сбор статистики был отключен:
Повторим запрос:
Вместо индексного сканирования используется план с последовательным сканированием, как наиболее дешевый из одобренных. Но планировщик имеет право выбрать и другой одобренный план:
Обратите внимание, что константы при идентификации запроса и плана не учитываются. Посмотрим на собранную статистику. Каждый из двух планов использовался по одному разу:
Если используется расширение pgpro_stats, о котором рассказывается в следующей теме, с его помощью можно собирать более детальную статистику планирования и выполнения запросов. Получить к ней доступ можно с помощью представления pgpro_stats_statements. Восстановим значения параметров:
Page 22: Page 22
Page 23: Совместная работа
Если план неадекватен, срабатывает условие перепланирования
- Расширение pgpro_multiplan перехватывает план и сохраняет его как одобренный или базовый
- replan_enable
- pgpro_multiplan.aqe_mode
- автоматическое сохранение новых планов
- индивидуальные значения триггеров перепланирования
- сбор статистики перепланирования в реальном времени
Комментарии преподавателя
Сервер может совместно использовать перепланирование и сохранение планов.
Если стандартный планировщик ошибается и срабатывает одно из условий перепланирования, запрос прерывается и отправляется на повторное планирование. Расширение pgpro_multiplan может захватить и одобрить новый план, а при последующих вызовах запроса сразу подставить сохраненный качественный план. Система больше не тратит ресурсы на перепланирование этого конкретного запроса — план стабилен.
Для интеграции нужно включить параметр replan_enable, а параметр pgpro_multiplan.aqe_mode задает список интегрируемых возможностей:
● auto_approve_plan — управление планами в реальном времени.
Если срабатывает триггер перепланирования, расширение pgpro_multiplan сможет автоматически выбрать новый план, одобрить его и сохранить в основное хранилище для последующего использования.
● individual_triggers — индивидуальные триггеры перепланирования для отдельных запросов.
● statistics — сбор статистики перепланирования в реальном времени.
https://postgrespro.ru/docs/enterprise/16/pgpro-multiplan#PGPRO-MULTIPL AN-USING-REAL-TIME-QUERY-REPLANNING
Page 24: Совместная работа
Модуль pgpro_multiplan можно использовать совместно с перепланированием запросов.
Выполним запрос:
Из-за большой ошибки в оценке кардинальности предложенный оптимизатором план вряд ли будет наилучшим. Включим перепланирование и зададим триггер, указав коэффициент допустимой ошибки в узле плана:
Включим автоматическое одобрение планов:
Префикс aqe_ в именах параметров отражает тот факт, что с 17-й версии Postgres Pro Enterprise перепланирование запросов называется AQE (adaptive query execution).
Выполним запрос еще раз:
Page 25: Page 25
Запрос был перепланирован в реальном времени (Replanning Attempts: 1). Обратите внимание, что оценки кардинальности улучшились и план изменился. Заглянем в хранилище планов:
План был захвачен и одобрен как базовый, указания в столбце hintstr предписывают использовать последовательное сканирование и соединение хешированием. Теперь, когда мы получили адекватный план, отключим перепланирование:
Отключим автоматическое одобрение и разрешим использование сохраненных базовых планов:
Page 26: Page 26
При следующих выполнениях запроса время планирования заметно сократится — используется сохраненный план:
Выполним теперь запрос с другим значением константы:
Сервер использует тот же базовый план.
Page 27: Итоги
Расширение pgpro\_multiplan позволяет стабилизировать выполнение запросов, сохраняя план или набор указаний оптимизатору
- Поддерживаются несколько вариантов сопоставления запросов с планами
- Дополнительное хранилище планов удобно для отладки
- Расширение интегрировано с перепланированием запросов
Page 28: Практика
- Получите план выполнения запроса для подсчета количества пассажиров, летевших рейсами, которые опоздали на время от одной минуты до четырех часов и с вылетом, и с прибытием.
- Включите автоматическое одобрение базовых планов, предварительно переключив pgpro_multiplan на песочницу. Оптимизируйте запрос с помощью перепланирования в реальном времени.
- Отключите перепланирование и сохранение планов. Проверьте, что для запроса продолжает использоваться одобренный план.
- Отключите режим песочницы и убедитесь, что используется исходный неоптимизированный план.
Комментарии преподавателя
- Используйте запрос из темы «Подходы к настройке» курса QPT-16:
- Вспомните тему «Перепланирование запросов» этого курса.
Page 29: 1. Неоптимизированный запрос
Подключимся к базе данных demo и получим план выполнения запроса:
В плане заметны ошибка оценки кардинальности в узле Seq Scan on flights f и большое число прочитанных страниц.
2. Перепланирование и базовый план в песочнице
Добавим библиотеки в shared_preload_libraries:
Перезапустим экземпляр:
Page 30: Page 30
Добавим расширение pgpro_multiplan в базу данных demo:
Используем автоматическое перепланирование, которое будет срабатывать при ошибке кардинальности более, чем в два раза.
Планы должны захватываться и одобряться автоматически.
Включим режим песочницы:
Выполним запрос:
Page 31: Page 31
Сработало перепланирование, время выполнения снизилось. План попал в хранилище:
3. Проверка одобренного плана
Page 32: Page 32
Отключим перепланирование:
Отключим автоматическое одобрение:
Для нашего запроса используется одобренный план:
4. Проверка с выключенной песочницей
Отключим песочницу:
Page 33: Page 33
Убедимся, что в хранилище плана нет:
Повторим запрос:
Сервер вернулся к исходному плану.
Уборка
Удалим расширение, созданное в базе demo и очистим список загружаемых библиотек.
12 Занятие 12: Производительность / Анализ производительности
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_12_perfanalysis.html Archive: PGPRO-handouts-16.zip Страниц PDF: 26
Page 1: Производительность / Анализ производительности
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Расширение pgpro_stats
- Агрегированная статистика
- Дополнительные метрики
- Статистика очистки
- Статистика аннулирования кеша
- Трассировка сеансов
Page 3: Расширение pgpro_stats
Статистика запросов
- затраченные ресурсы, планы и события ожиданий
- Основные настройки
- pgpro_stats.max = 5000
- предел количества запросов
- pgpro_stats.track = top
- верхний уровень или все (all)
- pgpro_stats.query_sample_rate = 1.0
- размер выборки (доля запросов)
- pgpro_stats.enable_profile = true
- профиль ожиданий
- pgpro_stats.profile_period = 10 ms
- период семплирования
- Представление pgpro_stats_statements
Комментарии преподавателя
Расширение pgpro_stats собирает статистику по выполняемым операторам. По сравнению с pg_stat_statements добавлен сбор данных о планах запросов и событиях ожидания для каждого типа запроса. Расширения pgpro_stats и pg_stat_statements несовместимы.
Статистика доступна через представление pgpro_stats_statements, максимальное число строк в нем определяет параметр pgpro_stats.max. Значение по умолчанию — 5000.
Параметр pgpro_stats.track определяет, будут отслеживаться лишь только непосредственно выполненные команды SQL (значение top — по умолчанию), или также и вложенные операторы (значение all).
Для снижения нагрузки можно уменьшить размер выборки, заданный параметром pgpro_stats.query_sample_rate. Тогда для вычисления статистики будет случайно выбираться заданная доля запросов.
Семплинг событий ожидания выполняется с периодичностью раз в pgpro_stats.profile_period единиц времени (10 мс по умолчанию), если установлен параметр pgpro_stats.enable_profile.
Статистика ожиданий доступна в поле pgpro_stats_statements.wait_stats типа jsonb. Все показатели представлены в миллисекундах и кратны параметру конфигурации pgpro_stats.profile_period.
Также собирается информация о затраченных ресурсах с точки зрения операционной системы с помощью вызова rusage:
https://postgrespro.ru/docs/enterprise/16/pgpro-stats#PGPRO-STATS-RUSA GE
Page 4: Агрегированная статистика
Статистика запросов, агрегированная по объектам
- весь кластер, база данных, пользователь, адрес, приложение, процесс
- Основные настройки
- pgpro_stats.track_totals = on
- pgpro_stats.track_cluster, pgpro_stats.track_databases и т. п.
- pgpro_stats.max_totals = 1000
- предел количества объектов
- Представление pgpro_stats_totals
Комментарии преподавателя
Модуль pgpro_stats позволяет агрегировать статистику запросов по различным объектам:
● cluster — весь кластер баз данных;
● database — отдельная база данных;
● user — пользователь;
● client_addr — адрес клиента;
● application — приложение;
● backend — обслуживающий процесс;
● session — сеанс.
Необходимость агрегации по конкретному типу объекта настраивается параметрами pgpro_stats.track_cluster, pgpro_stats.track_databases и т. п.
Агрегированная статистика доступна в представлении pgpro_stats_totals. Каждая строка в этом представлении содержит значения по конкретному объекту. Количество объектов, по которым отслеживается статистика, ограничено параметром pgpro_stats.max_totals (по умолчанию — 1000). Когда количество объектов превышает заданное, информация о наименее активно используемых объектах удаляется.
Page 5: Сбор статистики по операторам и планам
Подключим разделяемую библиотеку pgpro_stats. При наличии других загружаемых библиотек pgpro_stats должна указываться в списке параметра shared_preload_libraries последней.
Создадим тестовую базу данных на основе demo:
Для удобства настроим путь поиска:
В схеме bookings копия стандартной демобазы минимального размера.
Подключим расширение:
Выполним несколько запросов к таблице билетов tickets, предварительно добавив индекс по фамилиям пассажиров.
Пара запросов с параллельным последовательным сканированием таблицы.
Посмотрим, что накопилось в статистике операторов:
Page 6: Page 6
Два оператора, отличающиеся константами, объединены в одну запись. Поле calls показывает количество выполнений. В следующих запросах используется индексный доступ:
Теперь у нас два разных плана.
Page 7: Page 7
Для пользователя student получим агрегированную статистику по использованию некоторых системных ресурсов, а также по количеству выполненных запросов и событий ожидания.
Page 8: Page 8
В выводе этого запроса получены количество выполненных запросов, общее время выполнения запросов, а также несколько полей записи в столбце total_exec_rusage: reads — количество байтов, прочитанное из файловой системы; writes — количество байтов, записанное в файловую систему; user_time — время, потраченное на работу запроса в непривилегированном режиме (user space); system_time — время, потраченное на работу запроса на стороне ядра ОС (kernel space). Столбец total_exec_rusage составного типа pgpro_stats_rusage содержит статистику использования ресурсов на этапах планирования и выполнения запросов. Собранная статистика сбрасывается функцией pgpro_stats_statements_reset для заданного пользователя (userid), базы данных (dbid), запроса (queryid) или плана (planid). Если не указать ни один аргумент, будет очищена вся статистика:
Статистика по запросам удалена:
Агрегированная статистика для заданного типа и идентификатора объекта очищается функцией pgpro_stats_totals_reset. Например, сбросим агрегатную статистику по роли student:
Page 9: Page 9
После сброса статистики был только что выполнен единственный запрос. Поэтому queries_executed равно единице. Статистика по базе данных сохранилась, так как она не была стерта:
Page 10: Дополнительные метрики
Произвольные метрики на основе SQL-запросов
- собираются фоновыми рабочими процессами
- кольцевой буфер
- Основные настройки
- pgpro_stats.metrics_buffer_size = 16kB
- pgpro_stats.metrics_workers = 2
- pgpro_stats.metric_N_name
- имя метрики
- pgpro_stats.metric_N_query
- SQL-запрос
- pgpro_stats.metric_N_period = 1 min
- интервал сбора
- pgpro_stats.metric_N_db
- список баз данных
- pgpro_stats.metric_N_user
- пользователь
- Представление pg_stats_metrics
Комментарии преподавателя
Используя pgpro_stats, можно определить дополнительные метрики. Собираемые статистические данные будут накапливаться в кольцевом буфере (представление pgpro_stats_metrics) для последующей передачи их в систему мониторинга.
Это надежнее, чем опрос базы данных системой мониторинга, так как в случае прерывания соединения собранные данные не будут потеряны, а сохранятся в буфере и могут быть прочитаны позднее.
Для определения дополнительной метрики в конфигурацию СУБД необходимо поместить соответствующие параметры. Номер N в имени параметра служит уникальным идентификатором метрики, к которой будет применяться задаваемое значение; он должен быть положительным и уникальным среди всех метрик. Параметры:
● pgpro_stats.metric_N_name — имя метрики;
● pgpro_stats.metric_N_query — запрос для получения метрики;
● pgpro_stats.metric_N_period — периодичность измерений;
● pgpro_stats.metric_N_db — список баз данных;
● pgpro_stats.metric_N_user — пользователь, от имени которого будет собираться метрика. Пользователь должен иметь доступ к базе данных, в которой будет выполняться запрос для сбора метрики.
Обсуждение того, какие именно метрики имеет смысл собирать, выходит за рамки курса, но порекомендуем книгу Алексея Лесовского «Мониторинг PostgreSQL»: https://postgrespro.ru/education/books/monitoring
Page 11: Сбор дополнительных метрик
Предположим, что требуется раз в 30 секунд собирать количество выполнений контрольной точки по требованию. Запишем параметры в файл conf.d/metrics.conf в каталоге данных кластера и перезапустим СУБД.
Добавленная метрика — первая, поэтому N=1.
Заглянем в представление для дополнительных метрик:
Столбец value содержит результат запроса, вычисляющего метрику, в виде массива объектов jsonb. Здесь извлечен первый по порядку (нулевой) элемент, в котором по ключу checkpoints_req получено искомое значение. Поменяем сразу много строк, например, фамилии пассажиров во всех купленных авиабилетах:
Выполним контрольную точку и немного подождем.
В представлении pgpro_stats_metrics появится одна или несколько записей. Обратите внимание на значение checkpoints_req:
Удалим настройки дополнительных метрик:
Снова перезагрузим сервер.
Page 12: Статистика очистки
Собирается ядром Postgres Pro Enterprise
- Представления
- pg_stats_vacuum_database — очистка баз данных
- pg_stats_vacuum_tables — очистка таблиц текущей базы
- pg_stats_vacuum_indexes — очистка индексов текущей базы
Комментарии преподавателя
Представления pg_stats_vacuum_database, pg_stats_vacuum_tables и pg_stats_vacuum_indexes содержат статистику очистки, соответственно, баз данных, таблиц в текущей базе данных и индексов в ней. Все эти представления основаны на одноименных функциях и доступны без установки расширения pgpro_stats.
Данные собираются ядром Postgres Pro Enterprise: стандартный сборщик статистики расширен для получения этой дополнительной информации.
Отслеживается подробная информация на уровне страниц (в количественном и временнóм представлении) и журнальных записей.
Page 13: Статистика очистки
Выключим автоочистку для таблицы tickets:
Поскольку статистика по очистке собирается ядром СУБД, для ее сброса используется стандартная функция:
Статистика очистки для таблицы tickets отсутствует:
Вернем имена пассажиров к верхнему регистру и выполним очистку.
Немного ожидания… Снова проверим статистику очистки для таблицы tickets. Теперь статистика очистки собрана:
Page 14: Page 14
Вернем автоочистку для таблицы tickets:
Page 15: Аннулирование кешей
Сообщения об аннулировании метаданных измененных объектов в локальных кешах процессов
- Представления
- pgpro_stats_inval_status — состояние очереди сообщений
- pgpro_stats_statements
- pgpro_stats_totals
- счетчики сообщений для операторов
Комментарии преподавателя
Обслуживающие процессы кешируют метаданные объектов в своих локальных кешах. Когда процесс меняет метаданные объекта, нужно обновить информацию в кешах других обслуживающих процессов. Для этого процесс отправляет другим процессам сообщение аннулирования (Cache Invalidation), которое помещается в специальную очередь.
Обслуживающие процессы получают сообщения аннулирования из этой очереди. Если объект, для которого получено сообщение аннулирования, находится в кеше, его метаданные в кеше обновляются.
Когда обслуживающий процесс, добавляющий сообщения в очередь, сталкивается с пределом размера очереди, он удаляет сообщения, уже обработанные всеми обслуживающими процессами. Если какие-то обслуживающие процессы не успевают обрабатывать сообщения и задерживают очистку, им передается сигнал для сброса кеша.
В pgpro_stats значения большинства счетчиков сообщений аннулирования увеличиваются при генерации сообщений, а сообщения попадают в очередь после фиксации транзакции. При откате счетчики не уменьшаются, хотя сообщения при этом не попадают в очередь.
Представление pgpro_stats_inval_status содержит одну строку с текущим состоянием очереди аннулирования кеша. Представления pgpro_stats_statements и pgpro_stats_totals для каждого объекта показывают запись со счетчиками сообщений аннулирования кеша.
https://postgrespro.ru/docs/enterprise/16/pgpro-stats#PGPRO-STATS-CAC HE-INVALIDATION-METRICS
Page 16: Аннулирование кешей
Откроем новый сеанс и получим PID обслуживающего процесса:
Пока ни одного сообщения об аннулировании кеша нет:
Изменим, например, параметр хранения таблицы.
Сообщения об аннулировании кеша, сгенерированные текущим обслуживающим процессом:
Здесь: total — общее число сообщений аннулирования; catcache — число сообщений избирательного аннулирования кеша каталога; relcache — число сообщений избирательного аннулирования кеша отношений.
Page 17: Трассировка сеансов
Трассировка сеансов в журнал сообщений или файл
- Трассировка выполняется только для команд, удовлетворяющих критериям фильтрации
- pgpro_stats_trace_insert
- создает фильтр
- pgpro_stats_trace_update — изменяет фильтр
- pgpro_stats_trace_delete — удаляет фильтр
- pgpro_stats_trace_reset
- удаляет все фильтры
- pgpro_stats_trace_show
- показывает фильтры
Комментарии преподавателя
Расширение pgpro_stats позволяет выполнять трассировку сеансов, записывая данные о выполняемых командах в журнал сообщений или в файлы. Регистрируются команды, которые удовлетворяют фильтрам. Фильтры размещаются в таблице в общей памяти. Строки таблицы описывают фильтры, а столбцы содержат условия фильтрации.
Для управления фильтрами расширение pgpro_stats предоставляет функции, показанные на слайде.
Изменения фильтров сразу влияют на трассировку во всех сеансах экземпляра СУБД.
Условия фильтров включают:
● идентифицирующие поля — проверяются на равенство;
● ресурсные поля — проверяются на превышение порога;
● поля, определяющие параметры EXPLAIN.
Например, database_name — идентифицирующее поле: сеанс, в котором выполнена команда, должен быть в указанной базе данных. Если же в фильтре указано ресурсное поле duration, то команда должна выполняться более указанной длительности.
Подробности об условиях фильтров в документации: https://postgrespro.ru/docs/enterprise/16/pgpro-stats#PGPRO-STATS-TRAC E-SHOW-OUTPUT
Page 18: Трассировка сеансов
Откроем второй сеанс и получим PID обслуживающего процесса.
Добавим фильтр pa1, который будет записывать в файл трассировки pa1.trace вывод EXPLAIN ANALYZE для каждой команды, выполняющейся во втором сеансе:
Проверим получившийся фильтр трассировки:
Page 19: Page 19
Во втором сеансе выполним запрос.
Закроем второй сеанс и проверим файл трассировки.
Удалим фильтр трассировки.
Page 20: Итоги
Расширение pgpro\_stats позволяет выявлять и анализировать ресурсоемкие операции
- Собирается статистика по затраченным ресурсам, планам и событиям ожиданий
- Отдельно собирается агрегированная статистика
- Можно использовать метрики, определенные пользователем
- Имеется статистика по очистке и аннулированию кешей
- Можно трассировать сеансы
Page 21: Практика
- Подготовьте СУБД для работы с расширением pgpro_stats. 2. Выполните запрос с двухпроходным хеш-соединением в условиях недостаточной памяти work_mem. 3. Получите отчет pgpro_stats. 4. Выполните этот же запрос в условиях достаточной памяти work_mem и снова получите отчет.
Комментарии преподавателя
Подключите разделяемую библиотеку pgpro_stats, создайте базу данных — копию базы данных demo и подключите к ней расширение.
Запустите транзакцию с установленными локальными параметрами work_mem = ‘12MB’ и hash_mem_multiplier = 1. В транзакции получите реальный план запроса SELECT * FROM bookings b JOIN tickets t ON b.book_ref = t.book_ref
Получите отчет pgpro_stats с помощью представления pgpro_stats_statements, из которого необходимо вывести поля: query, plan, calls, temp_blks_read, temp_blks_written.
Очистите статистику и второй раз запустите транзакцию с настройками work_mem = ‘48MB’ и hash_mem_multiplier = 3 и снова получите такой же отчет. Обратите внимание во втором отчете на отсутствие операций по работе с временными файлами.
Page 22: 1. Подготовка СУБД для работы с расширением pgpro_stats
Подключим разделяемую библиотеку:
Перезагрузим сервер.
2. Запрос при недостатке памяти
Создадим тестовую базу данных на основе demo:
Для удобства настроим путь поиска:
Подключимся к базе данных.
Подключим расширение:
Зададим размер памяти:
Выполняем запрос:
3. Отчет по нагрузке
Соединение хешированием при недостатке оперативной памяти выполняется в двухпроходном режиме и использует
Page 23: Page 23
временные файлы. Проверим, что накопилось в статистике.
По столбцам temp_blks_read и temp_blks_written можно судить об активности использования временных файлов.
4. Отчет по нагрузке при достаточном объеме памяти
Сбросим статистику.
Увеличим значения параметров:
Соединение хешированием станет однопроходным и не будет использовать временные файлы.
Проверим, что накопилось в статистике.
Временные файлы не использовались.
Page 24: Уборка
Удалим созданную базу данных и очистим список загружаемых библиотек.
Page 25: Практика PPEM
- В основном экземпляре создайте из шаблона demo базу данных stats_ppem и подготовьте ее для работы с pgpro_stats. 2. С помощью psql-консоли выполните запрос из оператора EXPLAIN п. 2 задания основной практики. 3. Модифицируйте запрос так, чтобы он ограничивал результаты определенным количеством строк. Выполните запрос. 4. В статистике, собранной расширением pgpro_stats, найдите оба запроса и сравните их представления и планы.
Комментарии преподавателя
Для удобства дальнейшей работы подключитесь к базе как пользователь student с помощью метакоманды \c — student и включите в путь поиска схему bookings (или используйте запросы с квалифицированными именами таблиц): SELECT * FROM bookings.bookings AS b JOIN bookings.tickets AS t ON b.book_ref = t.book_ref;
Дополненный запрос: SELECT * FROM bookings.bookings AS b JOIN bookings.tickets AS t ON b.book_ref = t.book_ref LIMIT 555;
В разделе Мониторинг/SQL-статистика удобно поставить фильтры на базу данных и пользователя и отсортировать данные по количеству возвращенных строк.
Обратите внимание на представление константы в запросе из п. 3.
Page 26: 1. Создание базы из шаблона и установка расширения pgpro_stats
Выберите вкладку «Базы данных» и нажмите «Создать базу данных». При заполнении формы укажите шаблон — базу demo. На вкладке «Параметры» добавьте в shared_preload_libraries библиотеку pgpro_stats. Сохраните измененный параметр и перезапустите сервер. Далее на вкладке «Расширения» нажмите «Установить расширение», выберите базу, в списке расширений найдите pgpro_stats и установите его.
2,3. Выполнение запросов
В списке «Базы данных» найдите stats_ppem и в столбце «Действия» нажмите на пиктограмму «{/}» (открыть PSQL-консоль). Выполните запросы: SELECT * FROM bookings.bookings AS b JOIN bookings.tickets AS t ON b.book_ref = t.book_ref; SELECT * FROM bookings.bookings AS b JOIN bookings.tickets AS t ON b.book_ref = t.book_ref LIMIT 555;
4. Сохраненные планы запросов
На вкладке «SQL-статистика» отфильтруйте запросы для базы stats_ppem и пользователя student. Для просмотра плана запроса нажмите на значок «Раскрыть» в самом левом столбце таблицы. Запросы, различающиеся константами, объединяются расширением в одну запись, а сами эти константы заменяются обозначением параметра; в плане запроса п.3 константа 555 заменена на $1.
13 Занятие 13: Производительность / Отчеты по нагрузке pgpro_pwr
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_13_pwr.html Archive: PGPRO-handouts-16.zip Страниц PDF: 23
Page 1: Производительность / Отчеты по нагрузке pgpro_pwr
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Обзор pgpro_pwr
- Архитектура pgpro_pwr
- Установка pgpro_pwr
- Выборки
- Политика хранения
- Выборочные линии
- Размеры отношений
- Отчеты
Page 3: Обзор pgpro_pwr
Расширение для выявления ресурсоемких операций в БД
- поиск запросов, потребляющих много ресурсов
- определение характера и интенсивности нагрузки
- анализ исторической информации о нагрузке
- сравнение профилей нагрузки
- помощь в расследовании инцидентов
Комментарии преподавателя
Расширение pgpro_pwr предназначено для выявления наиболее ресурсоемких операций в базе данных. PWR произносится как «пауэр» (power) — это сокращение от Postgres Pro Workload Reporting.
Расширение основано на pg_profile — расширении с открытым исходным кодом для PostgreSQL:
https://github.com/zubkov-andrei/pg\_profile
Предназначение:
● поиск запросов, потребляющих больше всего ресурсов СУБД;
● получение информации о типе и интенсивности нагрузки;
● исследование нагрузки на «горячие» объекты;
● сохранение и анализ нагрузки в историческом разрезе;
● сравнение профилей нагрузки, имевших место в разное время;
● облегчение расследования инцидентов;
● проведение анализа нагрузочного тестирования.
Основная идея расширения — сохранение снимков собранных данных для последующего анализа.
Документация:
https://postgrespro.ru/docs/enterprise/16/pgpro-pwr
Page 4: Архитектура pgpro_pwr
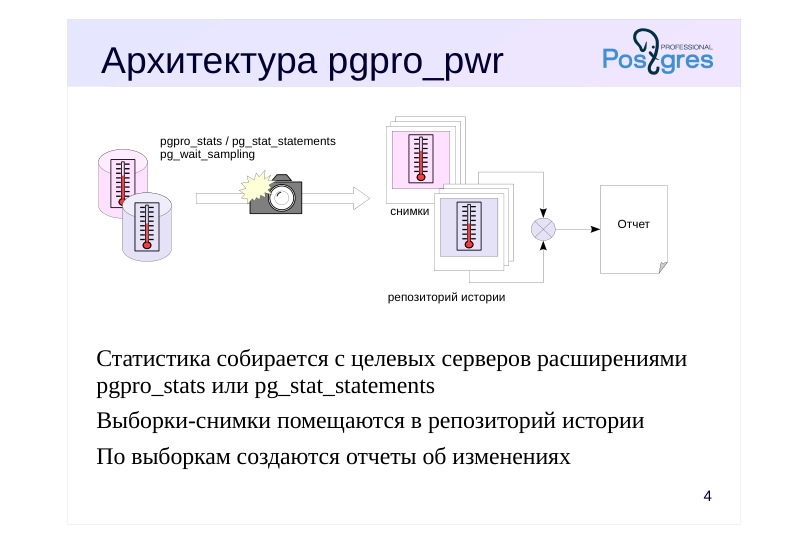 {#source-figure-004 caption=“Source slide page 4: Архитектура pgpro_pwr”}
Статистика собирается с целевых серверов расширениями pgpro\_stats или pg\_stat\_statements
- Выборки-снимки помещаются в репозиторий истории
- По выборкам создаются отчеты об изменениях
Комментарии преподавателя
Исходные данные собираются с целевых серверов с помощью представлений сборщика статистики и расширения pgpro_stats или pg_stat_statements. Рекомендуется использовать расширение pgpro_stats, так как оно выдает планы операторов, информацию о событиях ожидания и нагрузке по отдельным базам данных, ролям, клиентам и приложениям. Сводная статистика ожиданий поступает от расширения pg_wait_sampling. Если нет возможности использовать pgpro_stats, можно использовать pg_stat_kcache как источник информации об использовании ресурсов процессора и о нагрузке на файловую систему (rusage).
Работа модуля pgpro_pwr заключается в обработке накапливаемых статистических выборок. Выборка содержит статистику о наиболее активных объектах и запросах, собранную с момента получения предыдущей выборки. По выборкам строят отчеты.
Расширение pgpro_pwr состоит из следующих частей:
● репозиторий истории — хранилище собранных данных;
● механизм управления выборками — предоставляет функции для получения выборок и поддержки репозитория в актуальном состоянии посредством удаления устаревших данных;
● механизм отчетов — представляет функции построения отчетов по данным из репозитория;
● административные функции для создания серверов, линий выборок и для управления ими.
Page 5: Установка pgpro_pwr
Пакет pgpro\_pwr устанавливается средствами ОС
- Упрощенная установка
- pgpro_pwr непосредственно на целевом сервере,
- отслеживание нагрузки от имени суперпользователя
- Развернутая установка
- нагрузка отслеживается на одном или нескольких удаленных серверах
- от имени специально зарегистрированного пользователя
Комментарии преподавателя
Предполагается, что уже установлено расширение pgpro_stats или pg_stat_statements и настроен сборщик статистики Postgres Pro.
Само расширение pgpro_pwr собрано в отдельный установочный пакет и по умолчанию не устанавливается.
Упрощенная установка предназначена для случаев, когда pgpro_pwr устанавливается непосредственно на целевой сервер и будет отслеживать его нагрузку от имени суперпользователя. Она сводится к созданию отдельной схемы для объектов расширения и установке расширения. Так как pgpro_pwr зависит от расширения dblink, то либо в команду CREATE EXTENSION добавляют ключевое слово CASCADE, либо устанавливают dblink заранее.
Развернутая установка должна выполняться, когда планируется использовать pgpro_pwr для отслеживания нагрузки на одном или нескольких серверах с соблюдением принципа наименьших привилегий.
Описание вариантов установки в документации: https://postgrespro.ru/docs/enterprise/16/pgpro-pwr#PGPRO-PWR-INSTALL ATION
Page 6: Установка расширения pgpro_pwr
Создадим тестовую базу данных на основе demo:
Для удобства настроим путь поиска:
Пакет расширения pgpro_pwr уже установлен в виртуальной машине. Добавим загрузку библиотек вспомогательных расширений и зададим параметры сбора статистики.
Перезагрузим сервер.
Создадим схему для объектов расширения и добавим расширение в базу данных.
Page 7: Выборки
 {#source-figure-007 caption=“Source slide page 7: Выборки”}
Данные собираются с зарегистрированных серверов
- Выборка содержит данные с момента предыдущей выборки
Комментарии преподавателя
Расширение pgpro_pwr собирает данные с зарегистрированных серверов. По умолчанию создается активное определение сервера с именем local, соответствующее текущему кластеру.
Данные с активных серверов собираются функцией take_sample; неактивный сервер можно указывать явно. Если имеется несколько серверов, можно получить выборки с их подмножества функцией take_sample_subset.
Выборка содержит информацию об изменениях в измеряемых параметрах СУБД, происшедших с момента предыдущей выборки. Аккумулируемые регулярные выборки позволяют строить отчеты о нагрузке базы данных за предыдущее время. Обычно достаточно получать одну-две выборки в час.
При формировании выборки предыдущая статистика сбрасывается функцией pgpro_stats_statements_reset или pg_stat_statements_reset в зависимости от того, какое расширение поставляет данные.
https://postgrespro.ru/docs/enterprise/16/pgpro-pwr#PGPRO-PWR-MANAGI NG-SERVERS
https://postgrespro.ru/docs/enterprise/16/pgpro-pwr#PGPRO-PWR-SAMPL ES
Page 8: Политика хранения
 {#source-figure-008 caption=“Source slide page 8: Политика хранения”}
Настройка
- pgpro_pwr.max_sample_age = 7
- срок хранения в днях, глобально
- set_server_max_sample_age()
- для конкретного сервера
Комментарии преподавателя
Для выборок можно определять политики хранения. Политика задает временнóй интервал, в течении которого выборки сохраняются (окно удержания). Политику можно установить:
● глобально с помощью параметра конфигурации pgpro_pwr.max_sample_age;
● для конкретного сервера с помощью вызова функции set_server_max_sample_age.
Page 9: Выборочные линии
 {#source-figure-009 caption=“Source slide page 9: Выборочные линии”}
Именованная последовательность выборок
- можно использовать для построения отчета
- можно задать срок хранения (имеет приоритет над политикой)
Комментарии преподавателя
Для построения отчета по нагрузке требуется две выборки; они задают период, за который были собраны данные для отчета.
Другой способ задания периода для отчета состоит в создании выборочной линии. Линия имеет имя и определяется либо начальной и конечной выборками, либо диапазоном времени.
Выборочные линии позволяют также переопределить политику хранения отдельных выборок. Для каждой выборочной линии можно задать время хранения в днях. Если время хранения не задано, то относящиеся к выборочной линии выборки вообще не будут удаляться.
Для управления выборочными линиями предназначены функции:
● create_baseline — создает выборочную линию;
● drop_baseline — удаляет выборочную линию;
● keep_baseline — задает срок хранения;
● show_baselines — выдает информацию об имеющихся выборочных линиях.
https://postgrespro.ru/docs/enterprise/16/pgpro-pwr#PGPRO-PWR-BASELI NES
Page 10: Получение выборки и создание выборочной линии
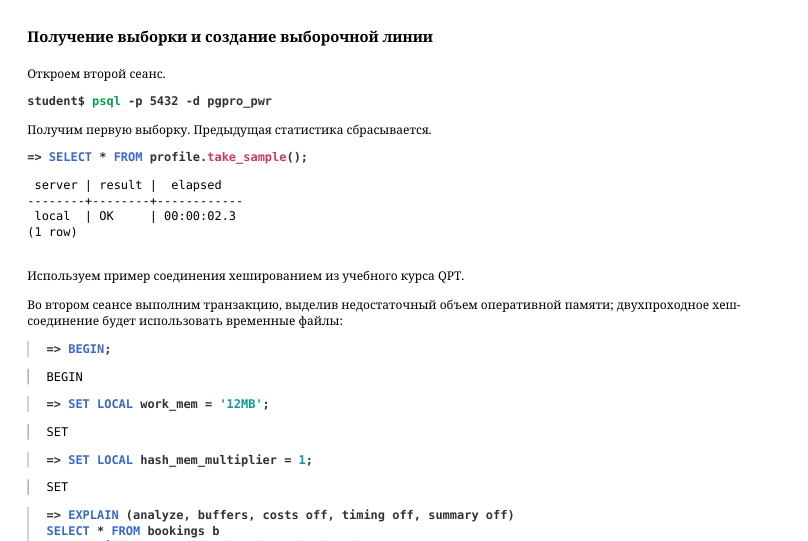 {#source-figure-010 caption=“Source slide page 10: Получение выборки и создание выборочной линии”}
Откроем второй сеанс.
Получим первую выборку. Предыдущая статистика сбрасывается.
Используем пример соединения хешированием из учебного курса QPT. Во втором сеансе выполним транзакцию, выделив недостаточный объем оперативной памяти; двухпроходное хеш-соединение будет использовать временные файлы:
Получим вторую выборку — в нее попадут данные о нагрузке после первой выборки:
Теперь во втором сеансе выполним транзакцию, выделив достаточно рабочей памяти для хеш-соединения:
Page 11: Page 11
А сейчас получим третью выборку — в нее попадут данные о нагрузке после второй выборки:
Список выборок:
Сформируем из имеющихся выборок две выборочные линии.
Список выборочных линий:
Page 12: Page 12
Page 13: Размеры отношений
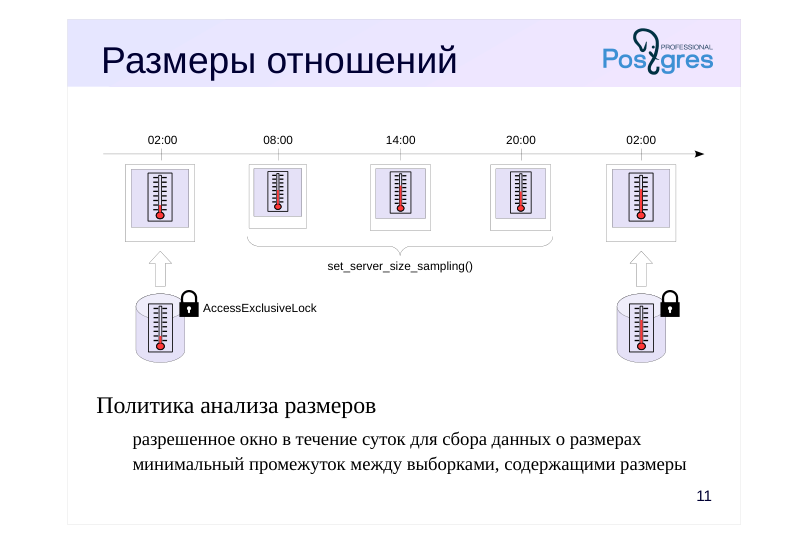 {#source-figure-013 caption=“Source slide page 13: Размеры отношений”}
Политика анализа размеров
- разрешенное окно в течение суток для сбора данных о размерах
- минимальный промежуток между выборками, содержащими размеры
Комментарии преподавателя
Сбор сведений о размерах всех отношений в базе данных занимает продолжительное время, при этом на каждое анализируемое отношение устанавливается исключительная блокировка AccessExclusiveLock.
Однако чаще всего достаточно собирать информацию о размерах один раз в сутки. Для этого можно определить политику анализа размеров для серверов, которая устанавливает:
● окно в течение суток, когда разрешается сбор сведений о размерах отношений;
● минимальный промежуток между двумя выборками со сведениями о размерах.
Политику можно задать с помощью функции set_server_size_sampling.
Просмотреть политики для серверов можно, вызвав функцию show_servers_size_sampling.
https://postgrespro.ru/docs/enterprise/16/pgpro-pwr#PGPRO-PWR-RELATI ON-SIZES-COLLECTION
Page 14: Отчеты
Отчеты pgpro\_pwr формируются в формате HTML
- get_report() — обычные отчеты, предоставляющие статистику
- по нагрузке для заданного интервала
- get_diffreport() — разностные отчеты со статистикой
- по одинаковым объектам в двух сравниваемых интервалах
- Выбранный элемент отчета автоматически выделяется в других разделах отчета
- Настройка
- pgpro_pwr.max = 7
- число первых по некоторому критерию
- объектов, выбираемых для каждой
- таблицы отчета
Комментарии преподавателя
Функции построения отчетов позволяют определить интервалы разными способами, принимая идентификаторы выборок, выборочные линии или диапазоны времени. В последнем случае выбирается минимальный интервал, охватывающий указанный диапазон.
Почти любой элемент в отчете можно выделить одним щелчком мыши. Выбранный элемент сразу будет выделен во всех разделах отчета, что облегчит его поиск.
Разделы отчета подробно описаны в документации: https://postgrespro.ru/docs/enterprise/16/pgpro-pwr#PGPRO-PWR-REPOR T-GENERATION
Page 15: Отчеты
Получим отчет. Для построения обычного отчета достаточно указать две выборки или одну выборочную линию. В плане запроса, выполненного в условиях недостатка рабочей памяти, видно, что используются временные файлы для двухпроходного хеш-соединения. Раздел отчета “Top SQL by temp usage” должен содержать сведения об этом запросе.
Открываем /tmp/report_1_2.html…
Получим разностный отчет. Используем две выборочные линии. В разностном отчете должно быть заметно, что во втором запросе рабочей памяти хватило для выполнения однопроходного хеш-соединения и временные файлы не использовались. В отчете просмотрите разделы: Top SQL by temp usage; Load distribution among heavily loaded databases; Load distribution.
Открываем /tmp/report_diff.html…
Page 16: Итоги
Расширение pgpro\_pwr предназначено для выявления ресурсоемких операций в БД
- Статистика собирается расширениями pgpro_stats или pg_stat_statements
- Поддерживается политика хранения выборок
- Можно получать обычные и разностные отчеты в HTML
Page 17: Практика
- Подготовьте СУБД для работы с расширением pgpro_pwr. 2. Создайте базу данных и установите расширение pgpro_pwr. 3. Проведите нагрузочное тестирование с помощью pgbench, получив две выборки — до и после тестирования. 4. Создайте новое табличное пространство и сделайте выборку. 5. Снова проведите тестирование с помощью pgbench так, чтобы индексы были в новом табличном пространстве, после чего сделайте еще одну выборку. 6. Получите разностный отчет для первого и второго тестов.
Комментарии преподавателя
Подключите разделяемые библиотеки pg_wait_sampling и pgpro_stats.
В базе данных создайте схему для объектов расширения pgpro_pwr.
Выполните обычную инициализацию таблиц pgbench и обычный тест нагрузки, например, на 60 секунд.
Предварительно создайте каталог для табличного пространства, например, в домашнем каталоге пользователя postgres.
Заново проведите инициализацию таблиц pgbench, указав для табличного пространства ключ –index-tablespace. Сделайте новую выборку.
Получите разностный отчет с двумя промежутками.
Page 18: 1. Подготовка СУБД для работы с расширением pgpro_pwr
Подключим разделяемые библиотеки. Расширение pgpro_pwr получает сводную статистику ожиданий от расширения pg_wait_sampling:
Параметр track_io_timing нужен для анализа времени, затраченного операторами на чтение или запись блоков:
Параметр track_functions позволяет отслеживать вызовы пользовательских функций:
Перезагрузим сервер.
2. Создание базы данных и установка расширения pgpro\_pwr
Создадим базу данных.
Создадим схему для хранения объектов расширения и установим расширение.
Page 19: 3. Нагрузочное тестирование
Сделаем выборку:
Инициализируем нагрузочные таблицы pgbench:
Запустим pgbench на 30 секунд:
Получим вторую выборку, в которую попадут данные о нагрузке при инициализации и нагрузочном тесте:
4. Создание нового табличного пространства
Создадим табличное пространство.
Сделаем выборку:
5. Нагрузочное тестирование при размещении индексов в отдельном табличном пространстве
Page 20: Page 20
Инициализируем нагрузочные таблицы pgbench:
Запустим pgbench на 30 секунд:
Получим еще одну выборку:
Получим список выборок:
5. Получение разностного отчета
Получим разностный отчет.
Открываем /tmp/report_diff.html…
Уборка
Удалим созданную базу данных, табличное пространство и файл отчета.
Page 21: Page 21
Сбросим настройки параметров конфигурации.
Page 22: Практика PPEM
- В основном экземпляре создайте базу данных demo_pwr из шаблона demo. Подготовьте новую базу к работе с pgpro_pwr. 2. Сделайте снимок статистики новой базы с учетом размеров отношений. 3. Удалите схему bookings из базы данных demo_pwr. 4. Снова сделайте снимок статистики, подобный снимку из п. 2. 5. Постройте отчет по снимкам, построенным в пунктах 2 и 4, и найдите в нем данные, отражающие изменения, сделанные в п. 3.
Комментарии преподавателя
- В созданной базе установите необходимые расширения (нужные библиотеки уже были загружены в основном практическом задании) и создайте сервер профилировщика.
Page 23: 1. Создание базы и подготовка к работе с pgpro_pwr
На вкладке «Базы данных» нажмите «Создать базу данных» и заполните форму, указав базу demo в качестве шаблона. Выбрав новую базу, из вкладки «Расширения» создайте в ней расширение pgpro_pwr, включая установку зависимых расширений. Используя вкладку «Профилировщик» / «Серверы», создайте сервер профилировщика для новой базы — в строке подключения укажите dbname=demo_pwr.
2. Снимок статистики
Выберите вкладку «Снимки статистики» и нажмите «Сделать снимок» с выключенным параметром skip_sizes.
3. Изменения в данных
На вкладке «Базы данных» выберите demo_pwr, а в ней схему bookings. В столбце «Действия» для указанной схемы нажмите на пиктограмму «Удалить». Подтвердите удаление схемы, включив параметр каскадного удаления.
4. Повторный снимок статистики
Сделайте еще один снимок статистики, как в п. 2
5. Построение и просмотр отчета
На вкладке «Профилировщик» / «Построение отчетов» создайте стандартный отчет по снимкам, созданным в пунктах 2 и 4. В полученном отчете, в разделе «Server statistics» / «Database statistics», крайний правый столбец будет отражать изменение объема данных.
14 Занятие 14: Безопасность / Профили пользователей
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_14_profile.html Archive: PGPRO-handouts-16.zip Страниц PDF: 16
Page 1: Безопасность / Профили пользователей
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Запрет простых паролей
- Профили пользователей
Page 3: Запрет простых паролей
Модуль passwordcheck
Page 4: Модуль passwordcheck
- user123
- passwordcheck
- R0cvjyfdnbrf+
- passwordcheck
- Проверка надежности паролей пользователей
- CREATE ROLE
- ALTER ROLE
- \password
Комментарии преподавателя
Модуль passwordcheck проверяет надежность паролей, задаваемых командами CREATE ROLE и ALTER ROLE, а также устанавливаемых метакомандой \password в psql.
Модуль должен быть загружен с помощью shared_preload_libraries или командой LOAD.
Модуль passwordcheck проверяет, что пароль:
● содержит не менее 8 символов;
● содержит и буквы, и иные символы;
● не содержит имя роли.
Модуль не предусматривает конфигурационных настроек.
https://postgrespro.ru/docs/enterprise/16/passwordcheck#PASSWORDCHE CK
Page 5: Модуль passwordcheck
Расширение passwordcheck требует загрузки одноименной разделяемой библиотеки:
После подключения библиотеки необходимо перезапустить СУБД.
Создадим базу данных и роль:
Запишем в дополнительный конфигурационный файл правило для парольной аутентификации нового пользователя при подключении к БД pgpro_profile:
Проверим, можно ли установить пользователю нестойкий пароль bob123:
Теперь попробуем установить сложный пароль:
Удалим модуль passwordcheck и снова перезапустим СУБД.
Page 6: Профили пользователей
Профиль
- Попытки входа
- Время жизни пароля
- Уровень сложности пароля
Page 7: Профиль
Профиль ограничивает использование системы пользователем
- количество неудачных попыток входа
- время жизни пароля и время неактивности
- уровень сложности пароля
- По умолчанию к ролям применяется профиль default
- не устанавливает никаких ограничений, но это можно изменить
- Управление профилями
- суперпользователи или роли, включенные в pg_manage_profiles
Комментарии преподавателя
Ядро Postgres Pro обеспечивает гораздо более гибкое управление парольными политиками, чем простое расширение passwordcheck.
Профиль ограничивает использование базы данных и устанавливает парольную политику для ролей. Профили определяются на уровне кластера баз данных и назначаются ролям. Новый профиль создает команда CREATE PROFILE, изменяет — ALTER PROFILE, удаляет — DROP PROFILE.
Профиль назначается при создании роли или командой ALTER ROLE. Новым ролям по умолчанию назначается профиль default. Исходно профиль default не устанавливает ограничений, но их можно добавить командой ALTER PROFILE. Если роли назначен профиль, отличный от default, рассмотренный выше модуль passwordcheck не работает.
Управлять профилями с помощью указанных команд разрешено только суперпользователям или пользователям, включенным в предустановленную роль pg_manage_profiles.
https://postgrespro.ru/docs/enterprise/16/sql-createprofile
Page 8: Попытки входа
FAILED\_LOGIN\_ATTEMPTS
- количество неудачных попыток входа до блокировки пользователя
- ALTER ROLE … ACCOUNT UNLOCK
- FAILED_AUTH_KEEP_TIME
- время в днях до сброса счетчика неудачных попыток
Комментарии преподавателя
Параметр профиля FAILED_LOGIN_ATTEMPTS ограничивает количество неудачных попыток входа. По превышении этого количества пользователь блокируется. Суперпользователь может разблокировать заблокированную роль командой ALTER ROLE с предложением ACCOUNT UNLOCK.
Параметр профиля FAILED_AUTH_KEEP_TIME задает время в днях с момента первой неудачной попытки входа; при попытке входа по истечении этого времени счетчик неудачных попыток сбрасывается, а пользователь разблокируется.
Page 9: Время жизни пароля
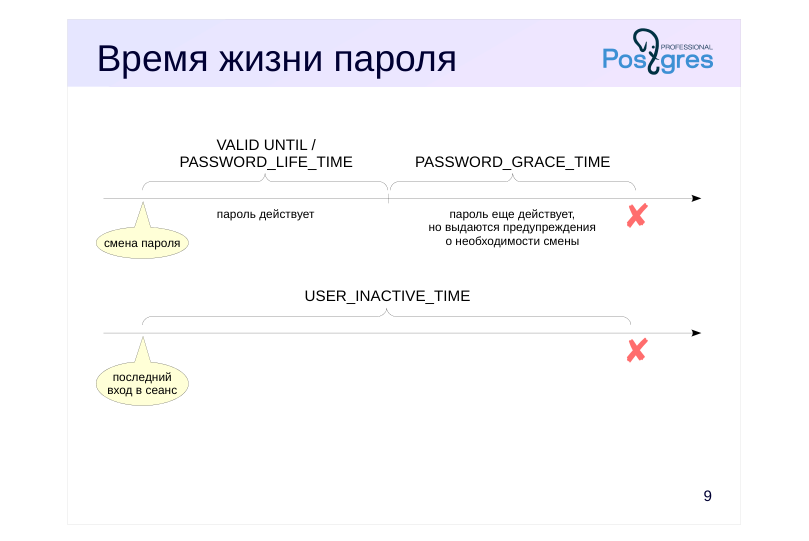 {#source-figure-009 caption=“Source slide page 9: Время жизни пароля”}
Комментарии преподавателя
Параметр профиля PASSWORD_LIFE_TIME задает период в днях, в течение которого пароль действителен. При установленном для роли атрибуте VALID UNTIL будет выбираться наиболее короткий срок действия пароля, исходя из этих двух значений.
Если установлен PASSWORD_GRACE_TIME, действие пароля продлевается, но в течение этого периода выдаются предупреждение о необходимости смены пароля. Если пароль так и не был изменен, последующие попытки входа в сеанс будут отвергнуты.
Параметр профиля USER_INACTIVE_TIME задает максимальный период в днях с момента последнего входа пользователя, в течение которого пользователь должен снова войти в сеанс. В противном случае пользователь блокируется.
Page 10: Уровень сложности пароля
PASSWORD\_MIN\_UNIQUE\_CHARS
- минимальное количество уникальных символов
- PASSWORD_MIN_LEN
- минимальная длина
- PASSWORD_REQUIRE_COMPLEX
- проверка надежности пароля
- PASSWORD_REUSE_TIME и PASSWORD_REUSE_MAX
- время в днях и количество смен паролей, после которых старый пароль
- можно использовать повторно
Комментарии преподавателя
Параметры профиля PASSWORD_MIN_UNIQUE_CHARS и PASSWORD_MIN_LEN ограничивают минимальное количество уникальных символов в пароле и его минимальную длину.
Параметр PASSWORD_REQUIRE_COMPLEX требует, чтобы пароль содержал и буквы, и небуквенные символы, а также не содержал имя пользователя.
Параметры профиля PASSWORD_REUSE_TIME и PASSWORD_REUSE_MAX определяют, когда пароль может быть использован повторно: для этого должно пройти указанное время и пароль должен быть сменен указанное количество раз.
Page 11: Профили пользователей
Пока ничего не мешает пользователю установить простой пароль:
Создадим профиль:
Этот профиль определяет, что пароль необходимо менять через 60 дней. Еще в течение 7 дней будут выводиться предупреждения о необходимости поменять пароль. Минимальная длина пароля — 8 символов, причем пароль должен содержать как буквы, так и другие символы, а имя пользователя не должно входить в пароль. Назначим роли bob профиль prof:
Проверим, какой профиль связан с ролью:
Попробуем установить короткий пароль:
Попробуем сделать пароль длиннее:
Усложним:
Модифицируем профиль prof, установив ограничение в три неудачные попытки начать сеанс до блокировки учетной записи.
Боб пытается подключиться три раза с неправильными паролями:
Page 12: Page 12
Теперь роль заблокирована:
Разблокируем роль, дадим Бобу шанс вспомнить пароль:
Теперь сократим срок действия пароля индивидуально для Боба, оставив профиль неизменным:
Попытка подключения (пароль правильный):
В журнале сообщений сервера видим причину отказа в соединении:
Следующим образом можно вернуть для роли профиль по умолчанию:
Удалим профиль:
Удалим роль:
Page 13: Итоги
Расширение passwordcheck проверяет надежность паролей
- Встроенный механизм профилей позволяет настраивать политики использования системы пользователями
- Профиль позволяет задавать уровень сложности пароля и ограничивать время его жизни
- Можно ограничивать количество неудачных попыток ввода пароля
Page 14: Практика
- Создайте профиль с ограничением на минимальное количество разных символов в пароле и проверьте его. 2. Установите ограничение в две неудачные попытки ввода пароля для пользователя и проверьте его работу.
Комментарии преподавателя
Создайте профиль mgr1 с ограничением PASSWORD_MIN_UNIQUE_CHARS = 8. Зарегистрируйте пользователя mgr1 с профилем mgr и проверьте возможность установки пароля не менее, чем с восемью отличающимися символами.
Используйте настройку LIMIT FAILED_LOGIN_ATTEMPTS по аналогии с демонстрацией.
Page 15: 1. Профиль пользователя
Создадим базу данных pgpro_profile:
Создадим профиль с ограничением на минимальное количество отличающихся символов в пароле:
Зарегистрируем пользователя с этим профилем:
Правило для парольной аутентификации нового пользователя при подключении к БД pgpro_profile:
Проверим профиль роли:
Пароль, разрешенный профилем:
Такой пароль был успешно назначен роли. Пароль с меньшим количеством отличающихся символов:
2. Ограничение неудачных попыток ввода пароля
Разрешим лишь две попытки.
Пару раз введем неверный пароль.
Page 16: Page 16
Блокировка должна быть уже установлена:
Удалим роль и профиль:
Удалим дополнительный файл конфигурации:
15 Занятие 15: Безопасность / Аудит
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_15_audit.html Archive: PGPRO-handouts-16.zip Страниц PDF: 21
Page 1: Безопасность / Аудит
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Расширение pg_proaudit
- Возможности pg_proaudit
- Аудит ролей и объектов
- Сохранение настроек
- Запись событий аудита
Page 3: Расширение pg_proaudit
Аудит — средство сбора событий безопасности
- не отладка (поиск ошибок и неисправностей)
- не мониторинг (выявление аномалий и проблем)
- Не зависит от обычного журнала сообщений
- отдельный фоновый процесс
- отдельный журнал событий безопасности
- Доступ к расширению и журналу событий безопасности должен быть предоставлен только уполномоченным ролям
Комментарии преподавателя
Аудит регистрирует действия, связанные с объектами кластера баз данных. При этом поток регистрируемых событий может быть очень велик, что затрудняет анализ инцидентов и увеличивает нагрузку на систему. Поэтому требуется точный выбор объектов наблюдения.
Расширение pg_proaudit разработано в Postgres Professional для регистрации событий, связанных с безопасностью. Оно реализует концепцию независимости подсистемы аудита. Для этого запускается отдельный фоновый процесс pg_proaudit logging worker, который регистрирует события безопасности независимо от записи в обычный журнал сообщений сервера.
Место размещения журнала событий безопасности (журнал аудита) в файловой системе и настройки для передачи сообщений в syslog или во внешнюю систему определяются параметрами конфигурации расширения pg_proaudit. Каждое событие описывается фиксированным набором полей, для него формируется отдельная строка журнала или отдельное сообщение.
Доступ к расширению pg_proaudit и журналам аудита следует предоставлять только пользователям, исполняющим роль администратора информационной безопасности (например, администратору безопасности; см. тему «Защищенная схема»).
https://postgrespro.ru/docs/enterprise/16/pg-proaudit#PG-PROAUDIT
Page 4: Установка расширения pg_proaudit
Создадим базу данных.
Расширение pg_proaudit требует загрузки одноименной разделяемой библиотеки:
Необходимо рестартовать СУБД.
Создадим расширение pg_proaudit:
В результате в списке процессов экземпляра должен быть виден процесс pg_proaudit logging worker.
Page 5: Возможности pg_proaudit
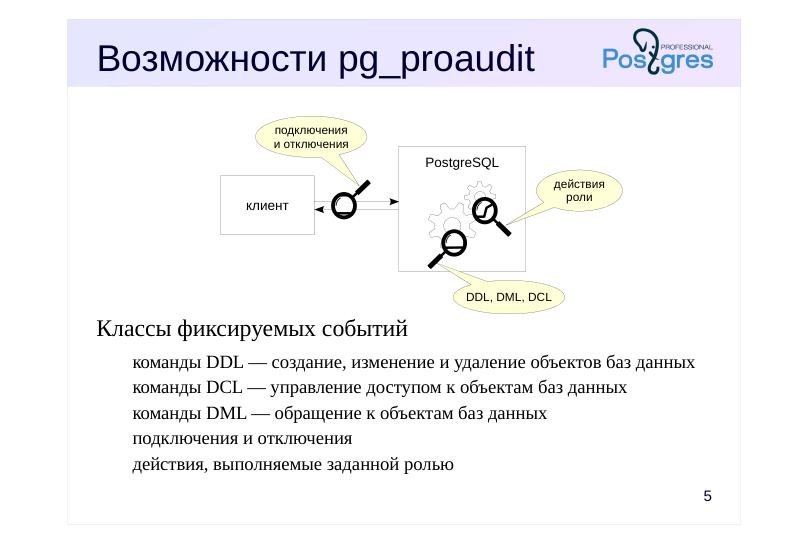 {#source-figure-005 caption=“Source slide page 5: Возможности pg_proaudit”}
Классы фиксируемых событий
- команды DDL — создание, изменение и удаление объектов баз данных
- команды DCL — управление доступом к объектам баз данных
- команды DML — обращение к объектам баз данных
- подключения и отключения
- действия, выполняемые заданной ролью
Комментарии преподавателя
Расширение pg_proaudit позволяет отслеживать действия заданных ролей, а также следить за операциями с заданными объектами (например, конкретными таблицами) или с определенными классами объектов и событий:
● команды создания, изменения и удаления объектов СУБД;
● команды управления доступом к объектам баз данных;
● команды обращения к объектам баз данных;
● события аутентификации или отключения от баз данных;
● любые команды, выполняемые заданным пользователем.
В том числе можно регистрировать в журнале аудита обращения к системному каталогу и отслеживать работу с профилями. Есть возможность исключить аудит временных объектов.
Полный список регистрируемых событий и классов событий: https://postgrespro.ru/docs/enterprise/16/pg-proaudit#PG-PROAUDIT-EVEN T-TYPES
Page 6: Аудит ролей и объектов
Управление аудитом ролей, объектов или типов объектов
- pg_proaudit_set_rule()
- pg_proaudit_remove_rule()
- Отключение аудита всех событий
- pg_proaudit_reset()
- Текущие настройки
- представление pg_proaudit_settings
Комментарии преподавателя
Для отслеживания событий или классов событий, выполняемых ролями (в том числе групповыми), а также событий, связанных с определенным объектом или типом объектов базы данных, создаются соответствующие правила. Для работы с правилами используются функции:
● pg_proaudit_set_rule — создание правила регистрации;
● pg_proaudit_remove_rule — удаление правила регистрации.
Функция pg_proaudit_reset отключает регистрацию всех событий.
Регистрация событий аудита запускается и останавливается немедленно при вызове этих функций.
Текущие настройки аудита (список правил) можно получить с помощью представления pg_proaudit_settings.
Page 7: Аудит ролей и объектов
Включим аудит всех событий, связанных с управлением ролями — для текущей базы, для всех объектов и всех ролей:
Аудит включается немедленно. Для проверки настроек аудита используется представление:
Зарегистрируем нового пользователя и отдельной командой дадим право начинать сеанс.
Теперь назначим пользователю пароль:
Ожидаем, что в журнал аудита попали три записи, по числу выполненных команд. Выведем последние строки из журнала аудита, имеющего самую свежую дату модификации:
Обратите внимание, что конфиденциальная информация (в данном случае — пароли) скрыта за пометкой
Создадим стороннюю таблицу:
Page 8: Page 8
И прочитаем из нее записи, касающиеся изменений в данных таблицы tab1:
Включим аудит всех событий подключения. Здесь функции pg_proaudit_set_rule вместо типа объекта передаем NULL.
Что теперь покажет представление pg_proaudit_settings?
Page 9: Page 9
Начнем другой сеанс от имени Алисы:
И снова проверим журнал аудита:
Следующая задача — включить регистрацию всех действий Алисы. Для этого укажем имя роли в соответствующем параметре функции pg_proaudit_set_rule:
Как это отобразилось в представлении pg_proaudit_settings?
Алиса собирается создать таблицу в схеме public, предоставим ей такие полномочия:
Алиса создает таблицу в своем сеансе:
…и сведения об этом сразу появляются в журнале аудита:
Сосредоточимся теперь на отслеживании изменений данных в таблице tab1. Отменим аудит всех действий Алисы и
Page 10: Page 10
добавим для таблицы регистрацию событий ALL_MOD, которые соответствуют вставке, обновлению и удалению строк, а также опустошению таблицы.
В сеансе Алисы выполним вставку в таблицу tab1 и проверим журнал аудита.
Обратите внимание на отсутствие записи о выполнении SELECT. Создадим второго пользователя:
Откроем от его имени еще один сеанс, в котором Боб попытается опустошить таблицу tab1:
Page 11: Page 11
Поскольку у Боба нет доступа к таблице, в журнале аудита увидим ошибку:
Page 12: Настройки
Настройки, сделанные функциями, необходимо сохранить в файле PGDATA/pg\_proaudit.conf
- pg_proaudit_save()
- Файл настроек аудита можно отредактировать напрямую, но после этого надо перечитать
- pg_proaudit_reload()
Комментарии преподавателя
Настройки аудита, произведенные вызовами функций расширения pg_proaudit, будут потеряны после перезагрузки сервера, если не сохранить их в файле настроек pg_proaudit.conf.
Файл pg_proaudit.conf размещается в каталоге кластера данных (PGDATA), изменить его расположение нельзя.
Для сохранения текущих настроек в этот файл предназначена функция pg_proaudit_save. Аудит можно настраивать и непосредственным редактированием файла pg_proaudit.conf, но это не так удобно, как вызов функций расширения.
Если изменить настройки непосредственно в файле pg_proaudit.conf, их нужно прочитать и применить функцией pg_proaudit_reload.
При запуске сервера настройки из файла считываются автоматически.
Page 13: Настройки
Функция pg_proaudit_save записывает настройки аудита в файл pg_proaudit.conf. Если не сохранить настройки, они будут потеряны при остановке сервера.
Заглянем в файл pg_proaudit.conf:
А теперь сбросим все настройки аудита:
Никакие настройки не действуют:
Можно (хотя это не очень удобно) изменять файл pg_proaudit.conf любыми средствами редактирования текста. Например, удалим строку конфигурации аудита событий подключения:
А теперь считаем настройки из файла:
Настройки аудита восстановлены, за исключением регистрации подключений.
Page 14: Запись событий аудита
 {#source-figure-014 caption=“Source slide page 14: Запись событий аудита”}
Комментарии преподавателя
Параметр расширения pg_proaudit.log_destination определяет способ регистрации (один или несколько) событий безопасности:
● csvlog — записывать события в файл CSV.
Параметр pg_proaudit.log_filename задает шаблон имен файлов CSV, а параметр pg_proaudit.log_rotation_size — максимальный размер файла в килобайтах. Другой способ настройки ротации файлов журнала — по времени — устанавливается параметром pg_proaudit.log_rotation_age.
● ceflog — передавать события в SIEM-систему в формате CEF.
Поддержка открытого формата событий CEF (Common Event Format) позволяет отправлять собранные данные различным системам управления информацией и событиями безопасности (SIEM, Security Information and Event Management).
● syslog и cefsyslog — передавать события в службу syslog в формате syslog или CEF.
Передача сообщений в системную службу регистрации событий и хранения журналов (syslog) удобна при нескольких источниках событий. Популярные реализации службы позволяют фильтровать журнальные сообщения и передавать их по сети другим серверам.
Полный список параметров конфигурации записи событий аудита в журнал содержится в документации: https://postgrespro.ru/docs/enterprise/16/pg-proaudit#PG-PROAUDIT-SECU RITY-EVENT-LOG-CONFIGURATION-PARAMETERS
Page 15: Настройка записи событий аудита
Посмотрим значения параметров регистрации событий по умолчанию:
Добавим запись в журнал аудита количества строк, затронутых SQL-командой:
Перечитаем конфигурацию.
Удалим строки в таблице tab1 в сеансе Алисы:
Теперь в конце записи о событии появилось еще одно поле. Сравните последнюю запись с записью вставки: удалена одна строка.
Page 16: Итоги
Расширение pg\_proaudit регистрирует события аудита независимо от обычного журнала сообщений
- Аудиту подлежат подключения и отключения, операции с объектами баз данных и действия ролей
- Журнал аудита может сохраняться как в формате CSV, так и передаваться службам SIEM или syslog
Page 17: Практика
- Настройте аудит для записи в CSV и syslog одновременно. Включите аудит регистрации ролей и создания таблиц. В следующих заданиях сравните сообщения, попадающие в CVS и в syslog. 2. Зарегистрируйте новую роль observed1 и настройте аудит подключений и отключений для этой роли. 3. Создайте таблицу tab1 так, чтобы роль observed1 могла выполнять команды DML с этой таблицей; владельцем таблицы должен быть другой пользователь. 4. Настройте регистрацию команд DML, выполненных любым пользователем, для таблицы tab1.
Комментарии преподавателя
- После подключения аудита используйте команду
для записи сообщений аудита и в файл, и в syslog.
Для настройки аудита используйте функцию pg_proaudit_set_rule.
В заданиях с 2 по 4 просматривать сообщения аудита в файле CSV нужно в каталоге /var/lib/pgpro/ent-16/pg_proaudit.
Идентификатор, заранее записанный в параметр сервера syslog_ident, поможет отфильтровать необходимые строки журнала сообщений syslog, который находится в файле /var/log/syslog. Воспользуйтесь следующей командой:
Page 18: 1. Настройка аудита
Создадим базу данных:
Загрузим библиотеку:
Подключение библиотеки требует перезагрузки СУБД.
Создадим расширение pg_proaudit:
Настроим запись сообщений аудита одновременно в CSV-файл и syslog:
Установим имя программы — идентификатор в записях syslog:
Наличие идентификатора облегчит поиск записей аудита в журнале сообщений. Настроим аудит регистрации пользователей и создания новых таблиц. Аудит всех событий, связанных с управлением ролями:
Аудит событий создания таблиц:
Получившиеся настройки аудита:
Page 19: 2. Регистрация событий создания и управления пользователями
Регистрация нового пользователя:
Второй сеанс от имени observed1:
Командой ls -ltr $PGDATA/pg_proaudit можно получить список файлов аудита, отсортированный по времени модификации:
Проверяем CSV-файл аудита, который был изменен последним:
Получим последние две записи в журнале /var/log/syslog по установленному идентификатору MY_audit:
3. Создание таблицы и предоставление прав на нее
Суперпользователь student создает таблицу и выдает на нее права observed1.
Проверяем CSV-файл аудита: должно быть видно CREATE TABLE, но не GRANT.
Поиск записей в журнале /var/log/syslog по установленному идентификатору MY_audit:
4. Регистрация команд DML с таблицей tab1
Установка регистрации команд DML для tab1.
Page 20: Page 20
Получившиеся настройки аудита:
Выполним несколько команд в сеансе observed1, сразу проверяя CSV-файл и журнал событий:
Page 21: Page 21
Уборка
Удалим созданную базу данных и роль, уберем каталог журналов аудита и сбросим настройки параметров конфигурации.
16 Занятие 16: Безопасность / Защищенная схема
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_16_vault.html Archive: PGPRO-handouts-16.zip Страниц PDF: 31
Page 1: Безопасность / Защищенная схема
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Разделение ролей
- Создание защищенной схемы
- Предоставление доступа к защищаемым данным
- Логическая копия защищенной схемы и ее восстановление
Page 3: Разделение ролей
Администратор ОС
- управление подключением суперпользователя Суперпользователь
- создание административных ролей
- решение особых задач
- Административные роли
- управление СУБД обеспечение работы пользователей Пользователи
- работа с объектами
Комментарии преподавателя
При развертывании СУБД и на начальных этапах работы с ней активно используется роль суперпользователя. Однако ее использование для выполнения различных рутинных операций по обслуживанию системы в дальнейшем является небезопасным.
Работая под учетной записью суперпользователя, можно создать дополнительные административные роли и делегировать им большую часть решаемых задач по обслуживанию СУБД и обеспечению работы обычных пользователей, после чего отказаться от активного использования роли суперпользователя.
https://postgrespro.ru/docs/enterprise/16/sod-separation-of-duties#SOD-SE PARATION-OF-DUTIES
Для этого администратор ОС может вообще запретить подключение к серверу под учетной записью суперпользователя с помощью правил в файле pg_hba.conf.
При этом в ряде случаев — при выполнении редких и сложных задач, требующих суперпользовательского доступа — администратор ОС может остановить и временно безопасно запустить СУБД в однопользовательском (технологическом) режиме.
https://postgrespro.ru/docs/enterprise/16/restrict-dbms-admin-data-access# REVOKE-SUPERUSER-ACCESS-1
https://postgrespro.ru/docs/enterprise/16/app-postgres#APP-POSTGRES-SI NGLE-USER
Page 4: Защищенная схема
Зона повышенной безопасности на основе схемы
- инициализируется суперпользователем закрыт доступ для административных ролей Администратор безопасности
- выдает разрешения на доступ к объектам схемы не может работать с объектами схемы Владелец схемы
- может работать с объектами
- не может управлять доступом к объектам
Комментарии преподавателя
Данные хранятся в таблицах, которые находятся в схемах баз данных. По умолчанию административные роли имеют доступ к этим данным, что может быть нежелательным. Для защиты чувствительных данных Postgres Pro Enterprise позволяет поместить их в специально созданную защищенную схему и определить правила доступа к ней.
У защищенной схемы есть владелец и выделенный администратор безопасности. Администратор безопасности (менеджер прав доступа) может лишь выдавать разрешения пользователям на доступ к объектам схемы, но сам работать с объектами не может. Владелец схемы, наоборот, может работать с объектами, но не может управлять правами доступа к ним.
https://postgrespro.ru/docs/enterprise/16/ddl-schemas#DDL-SCHEMAS-VA ULT
Предпочтительным является сценарий, когда владельца и администратора безопасности создает суперпользователь. Для этого администратор ОС временно разрешает вход для суперпользователя.
Page 5: Роли
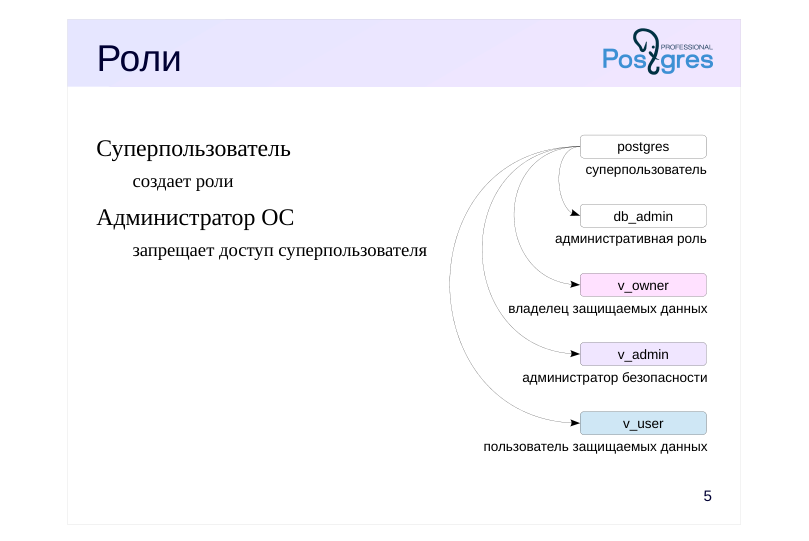 {#source-figure-005 caption=“Source slide page 5: Роли”}
Суперпользователь
- создает роли
- Администратор ОС
- запрещает доступ суперпользователя
Комментарии преподавателя
Организацию схемы для размещения защищенных данных начнем с создания ролей суперпользователем.
Роль db_admin будет служить для таких административных задач, как создание баз данных.
Далее нам потребуются роли для владельца защищенной схемы (v_owner) и для администратора безопасности этой схемы (v_admin).
https://postgrespro.ru/docs/enterprise/16/restrict-dbms-admin-data-access# CREATE-MANAGERS-OF-SECURED-SCHEMA
Если эти роли были созданы некоторой административной ролью (не суперпользователем), то у них будет право ADMIN OPTION, от которого они сами отказаться не смогут. Чтобы исключить риски, связанные с доверием к указанным ролям, суперпользователю следует это право отозвать.
https://postgrespro.ru/docs/enterprise/16/restrict-dbms-admin-data-access# PROTECT-SECURED-SCHEMA-USERS-FROM-ADMINS
Наконец, роль v_user предназначена для обычного пользователя, который должен обращаться к защищенным данным.
После создания ролей администратор ОС может запретить суперпользовательское подключение к экземпляру СУБД.
Page 6: Роли
Создадим административную роль с правом создания баз данных. Это действие выполнит суперпользователь:
Можно наделить созданную роль еще рядом полномочий, позволяющих решать нужный круг задач администрирования, но для упрощения демонстрации мы не будем этого делать. Суперпользователь также создает роли владельца защищаемых данных, будущего администратора безопасности и пользователя:
Чтобы пользователь ОС postgres, под которым работает сервер СУБД, не мог изменить конфигурацию, администратор ОС меняет владельца конфигурационных файлов.
Но postgres все же нужен доступ на чтение и просмотр подкаталога:
Теперь можно запретить доступ суперпользователя к СУБД:
Перечитаем конфигурацию и попробуем переподключиться:
Суперпользователь подключиться не может.
Page 7: База данных
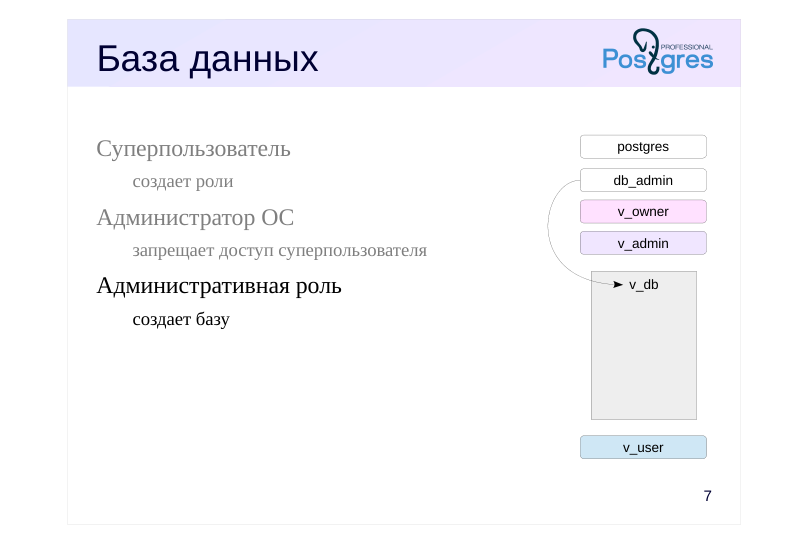 {#source-figure-007 caption=“Source slide page 7: База данных”}
Суперпользователь
- создает роли
- Администратор ОС
- запрещает доступ суперпользователя
- Административная роль
- создает базу
Комментарии преподавателя
На следующем шаге административная роль создает базу данных.
Page 8: Схема
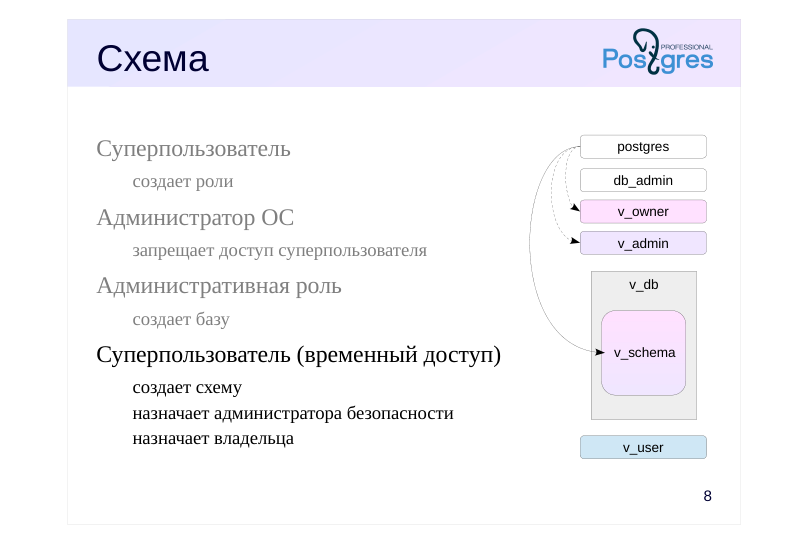 {#source-figure-008 caption=“Source slide page 8: Схема”}
Суперпользователь
- создает роли
- Администратор ОС
- запрещает доступ суперпользователя
- Административная роль
- создает базу
- Суперпользователь (временный доступ)
- создает схему
- назначает администратора безопасности
- назначает владельца
Комментарии преподавателя
Теперь уже можно создать зону повышенной безопасности — защищенную схему. Мы будем показывать одну, но, конечно, таких схем может быть несколько, и они могут принадлежать разным владельцам.
Команда ALTER SCHEMA … SECURITY OFFICER TO … устанавливает для схемы атрибут — роль администратора безопасности. После этого только указанная роль может управлять доступом к схеме и объектам в ней — схема становится защищенной.
Атрибут можно сбросить командой ALTER SCHEMA … RESET SECURITY OFFICER. Тогда схема снова станет незащищенной.
https://postgrespro.ru/docs/enterprise/16/sql-alterschema
Эти действия выполняет суперпользователь, для чего администратор ОС должен обеспечить ему временное подключение к экземпляру.
После назначения администратора безопасности можно передать владение схемой выделенной роли, не являющейся суперпользователем.
При организации зоны повышенной безопасности можно использовать более простой подход: схему создает ее владелец, а суперпользователь только назначает администратора безопасности. Однако при этом появляется риск передачи привилегий на схему другим ролям до того, как схема станет защищенной.
Page 9: Защищенная схема
Подключимся к серверу под административной ролью:
Создадим базу данных:
Чтобы сделать схему защищенной, нужно назначить для нее администратора безопасности — это может сделать только суперпользователь, для которого доступ отключен. Чтобы он мог выполнить свою работу, можно подготовить скрипт, остановить экземпляр и выполнить команды в однопользовательском режиме:
Снова запустим сервер в обычном режиме, подключимся к базе и посмотрим на схему — она защищенная (столбец Security officer):
Теперь только владелец схемы сможет управлять данными и только администратор безопасности схемы сможет управлять доступом к этим данным. Другие пользователи доступа к схеме не имеют.
Page 10: Защищаемые данные
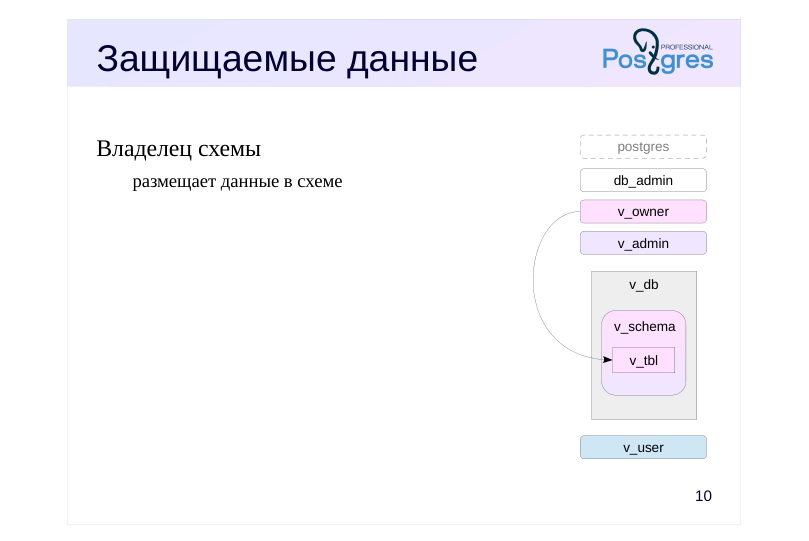 {#source-figure-010 caption=“Source slide page 10: Защищаемые данные”}
Владелец схемы
- размещает данные в схеме
Комментарии преподавателя
Если между созданием схемы и преобразованием ее в защищенную могли быть выполнены какие-либо команды, перед размещением данных в ней нужно убедиться, что к схеме нет доступа у других ролей, кроме владельца схемы и администратора безопасности.
Разместить данные в защищенной схеме можно двумя способами:
- Владелец защищенной схемы может создать объект непосредственно в этой схеме и затем наполнить его данными.
https://postgrespro.ru/docs/enterprise/16/restrict-dbms-admin-data-acces s#CREATE-TABLE-IN-SECURED-SCHEMA
- Можно перенести в защищенную схему уже существующий объект. В этом случае нужно передать его владельцу этой схемы. Однако это возможно, только если владелец объекта входит в роль владельца схемы с параметром членства SET. Владелец же защищенной схемы является независимым — у других административных ролей нет с ним общей роли. Поэтому здесь снова потребуется действие от имени суперпользователя.
https://postgrespro.ru/docs/enterprise/16/restrict-dbms-admin-data-acces s#MOVE-TABLE-TO-SECURED-SCHEMA
Page 11: Доступ к данным
 {#source-figure-011 caption=“Source slide page 11: Доступ к данным”}
Владелец схемы
- размещает данные в схеме
- Администратор безопасности
- выдает разрешения пользователям
Комментарии преподавателя
Далее разрешения на доступ к объектам защищенной схемы пользователю выдает администратор безопасности.
Пользователи с доступом к зоне повышенной безопасности должны быть защищены. У административных ролей не должно быть параметра членства ADMIN в отношении этих пользователей. Если это не так, параметр следует явно отключить.
Page 12: Данные в защищенной схеме
У ролей экземпляра не должно быть параметра членства ADMIN в отношении владельца, администратора и других пользователей, имеющих доступ к схеме, во избежание несанкционированного доступа к защищенным данным. Проверим, имеет ли кто-либо такой параметр:
Никто — это правильно. Теперь владелец схемы создает в защищенной схеме таблицу:
Но он не может выдавать права на доступ к данным в защищенной схеме:
Такой доступ выдает администратор безопасности. Обратите внимание, что привилегии выдаются от имени владельца таблицы:
Теперь пользователь может, например, читать строки таблицы:
Page 13: Page 13
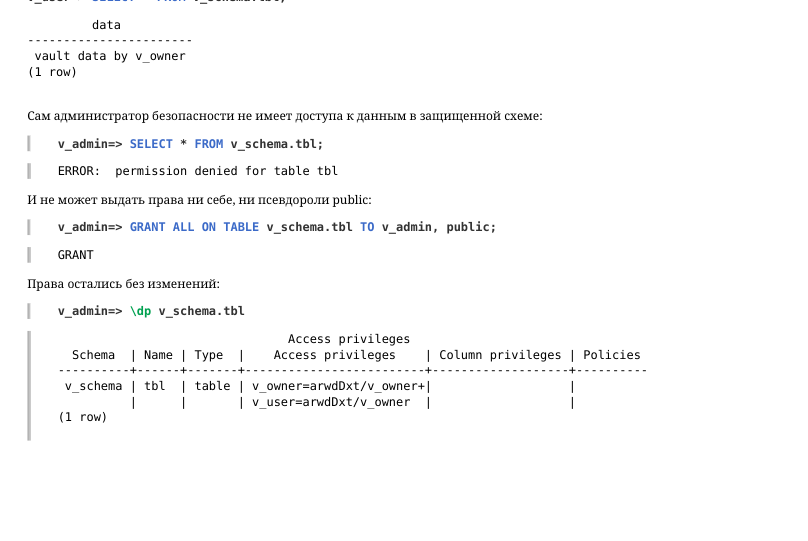 {#source-figure-013 caption=“Source slide page 13: Page 13”}
Сам администратор безопасности не имеет доступа к данным в защищенной схеме:
И не может выдать права ни себе, ни псевдороли public:
Права остались без изменений:
Page 14: Логическая копия
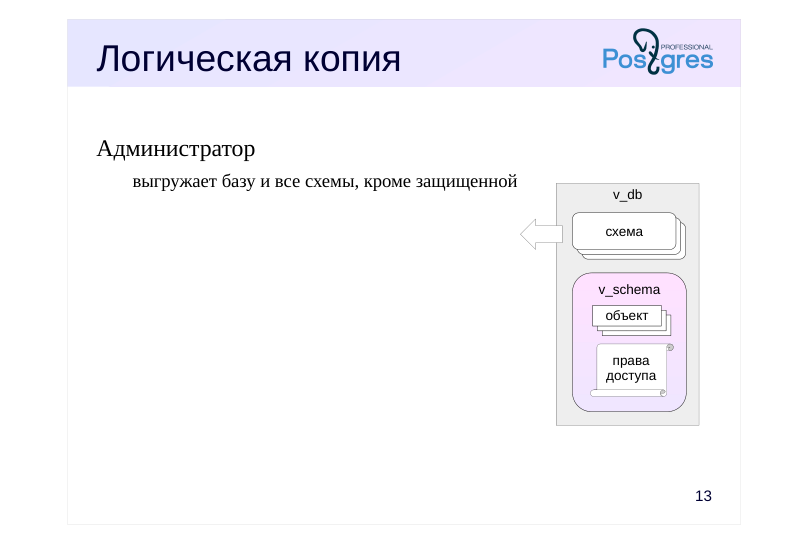 {#source-figure-014 caption=“Source slide page 14: Логическая копия”}
Администратор
- выгружает базу и все схемы, кроме защищенной
Комментарии преподавателя
Логическая резервная копия базы с зоной повышенной безопасности создается в несколько этапов без участия суперпользователя.
Сначала с помощью pg_dump администратор базы выгружает все данные, кроме данных защищенной схемы. Для этого используется параметр командной строки утилиты –exclude-schema.
https://postgrespro.ru/docs/enterprise/16/restrict-dbms-admin-data-access# BACKUP-APPLICATION-CHANGES
Page 15: Логическая копия
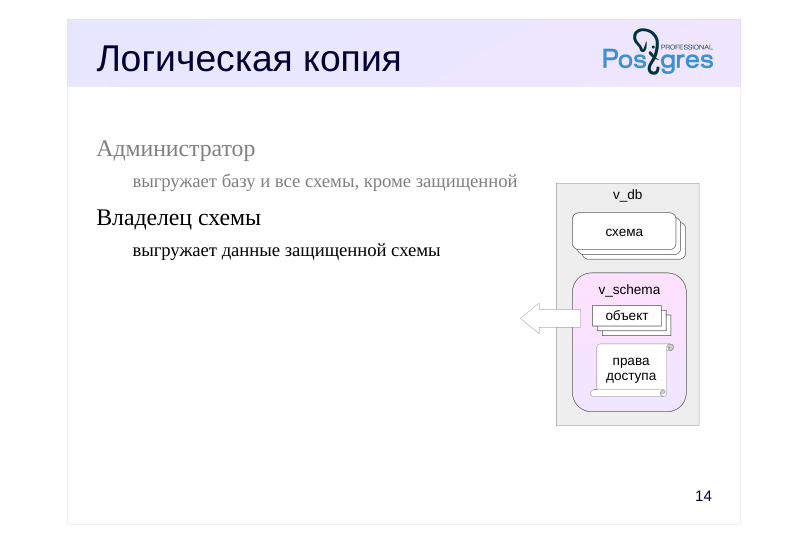 {#source-figure-015 caption=“Source slide page 15: Логическая копия”}
Администратор
- выгружает базу и все схемы, кроме защищенной
- Владелец схемы
- выгружает данные защищенной схемы
Комментарии преподавателя
Затем владелец защищенной схемы выгружает данные зоны повышенной безопасности, используя параметры –schema и –no-privileges.
Page 16: Логическая копия
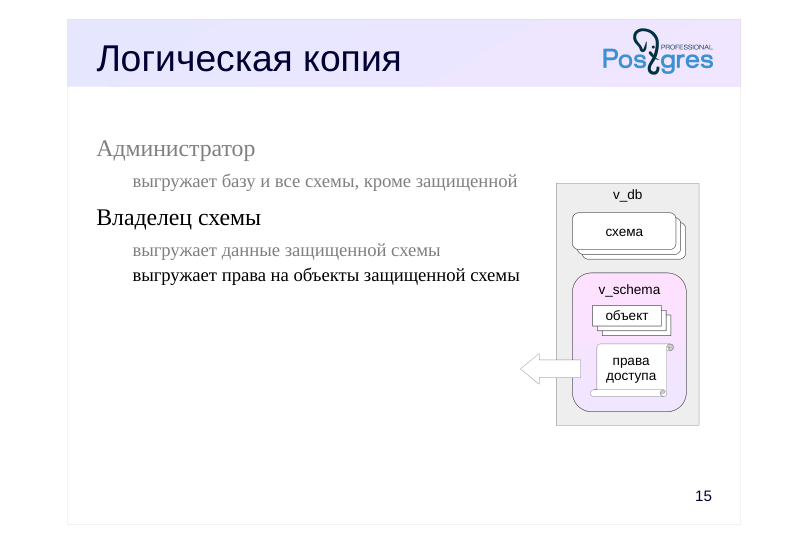 {#source-figure-016 caption=“Source slide page 16: Логическая копия”}
Администратор
- выгружает базу и все схемы, кроме защищенной
- Владелец схемы
- выгружает данные защищенной схемы
- выгружает права на объекты защищенной схемы
Комментарии преподавателя
Далее владелец защищенной схемы выгружает права доступа к объектам этой схемы. Для этого используются параметры –schema и –privileges-only.
Page 17: Логическая копия
Сделаем резервную копию базы данных. Сначала администратор базы данных выгружает все данные, кроме данных защищенной схемы:
Затем владелец защищенной схемы выгружает данные этой схемы без прав доступа:
После этого он же выгружает права доступа защищенной схемы:
Page 18: Восстановление
Администратор
- восстанавливает базу и схемы, кроме защищенной
- v_db
- схема
- схема
- схема
Комментарии преподавателя
Восстановление также выполняется в несколько этапов.
Сначала администратор СУБД восстанавливает базу со всеми данными, кроме данных защищенной схемы.
Page 19: Восстановление
Администратор
- восстанавливает базу и схемы, кроме защищенной
- v_db
- Суперпользователь
- схема
- схема
- схема
- создает защищенную схему
- v_schema
Комментарии преподавателя
На следующем этапе потребуется участие суперпользователя: он создает в новой базе схему и назначает для нее администратора безопасности, что делает схему защищенной. После этого суперпользователь назначает владельца защищенной схемы.
Page 20: Восстановление
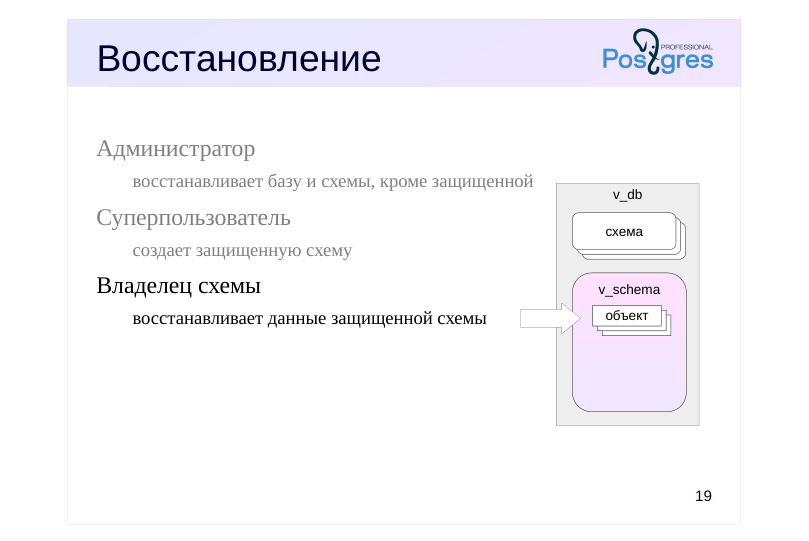 {#source-figure-020 caption=“Source slide page 20: Восстановление”}
Администратор
- восстанавливает базу и схемы, кроме защищенной
- Суперпользователь
- создает защищенную схему
- Владелец схемы
- восстанавливает данные защищенной схемы
Комментарии преподавателя
Далее владелец защищенной схемы восстанавливает объекты и данные этой схемы.
Page 21: Восстановление
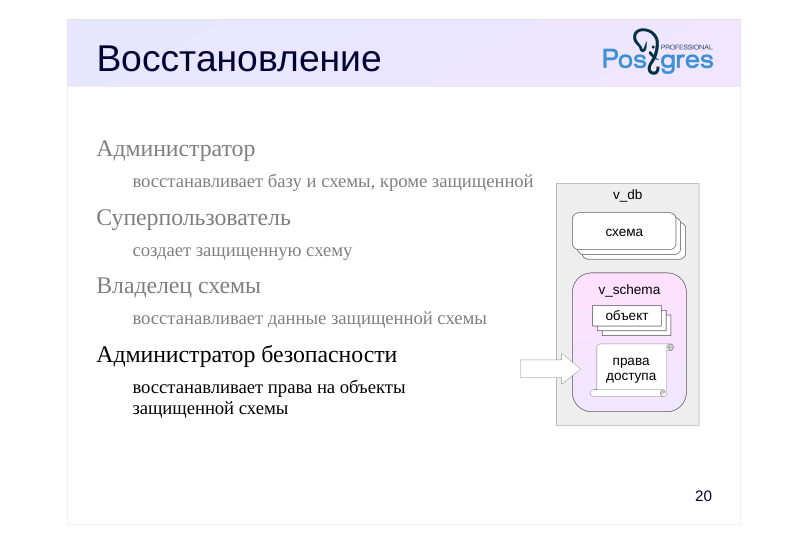 {#source-figure-021 caption=“Source slide page 21: Восстановление”}
Администратор
- восстанавливает базу и схемы, кроме защищенной
- Суперпользователь
- создает защищенную схему
- Владелец схемы
- восстанавливает данные защищенной схемы
- Администратор безопасности
- восстанавливает права на объекты
- защищенной схемы
Комментарии преподавателя
На завершающем этапе администратор безопасности восстанавливает права доступа к объектам защищенной схемы.
Приведенный сценарий восстановления не является единственно возможным. В зависимости от задачи можно изменить порядок действий и состав вовлеченных административных ролей. Но в любом случае необходимо участие суперпользователя, как минимум для назначения администратора безопасности схемы.
Снова отметим, что назначение администратора безопасности желательно выполнять раньше, чем назначение владельца схемы.
Page 22: Восстановление логической копии
Для восстановления защищенной схемы понадобятся два разных администратора: один из них сможет восстановить объекты, а другой — права доступа. Сначала администратор базы данных восстанавливает все данные, кроме защищенной схемы. Мы будем использовать тот же экземпляр, но создадим в нем новую базу:
Администратор ОС временно открывает вход для суперпользователя (переименуем дополнительный файл конфигурации):
Суперпользователь создает в новой базе схему, назначает ей администратора безопасности (схема становится защищенной) и меняет владельца на v_owner:
Также суперпользователь выдает администратору безопасности право обращаться к объектам в защищенной схеме новой базы — оно понадобится при восстановлении привилегий:
Теперь доступ суперпользователя можно закрыть. Снова подключаем дополнительный файл конфигурации:
В логической копии данных есть команда создания схемы — удалим ее, чтобы исключить ошибку при восстановлении:
Владелец защищенной схемы восстанавливает в ней данные:
Page 23: Page 23
После этого администратор безопасности восстанавливает права доступа для защищенной схемы:
Проверим, что получилось:
Пользователь v_user успешно читает данные из таблицы в новой базе:
Page 24: Page 24
Page 25: Итоги
Безопасная работа с данными подразумевает разделение полномочий, в том числе административных
- Защищенная схема снижает риски, которые не устраняются стандартными возможностями PostgreSQL
- При настройке защищенной схемы нужно строго соблюдать порядок действий, чтобы исключить несанкционированный доступ к данным
Page 26: Практика
- Исследуйте ситуацию, когда административная роль, создавшая пользователя защищенных данных, сохраняет членство в ней с параметром ADMIN. Устраните найденную уязвимость.
- Реализуйте сценарий переноса данных, созданных пользователем, не имеющим доступа к защищенной схеме, в уже существующую защищенную схему. Проверьте, что после перемещения данных бывший владелец не будет иметь к ним доступа.
- Выключите защиту схемы. Убедитесь, что разделение ролей для управления данными и доступа к ним у незащищенных схем отсутствует.
Комментарии преподавателя
Параметр членства ADMIN дает возможность включения в роль других ролей с правом наследования доступа к объектам.
Перенесите таблицу, созданную в схеме public административной ролью, не имеющей доступа к защищенной схеме.
Page 27: 1. Уязвимость ADMIN OPTION
Создадим административную роль (администратора СУБД) с правом создания ролей, а также роли владельца защищаемых данных и будущего администратора безопасности. Это делает суперпользователь:
Также он создает базу данных и схему в ней:
Назначает администратора безопасности схемы:
И предоставляет ему право обращаться к объектам в этой схеме:
А также делает владельцем схемы v_schema пользователя v_owner:
Администратор СУБД создает пользователя, который будет работать с данными в защищенной схеме:
Владелец защищенной схемы создает в ней таблицу и помещает туда данные:
Администратор безопасности предоставляет пользователю v_user доступ к схеме и таблице:
Page 28: Page 28
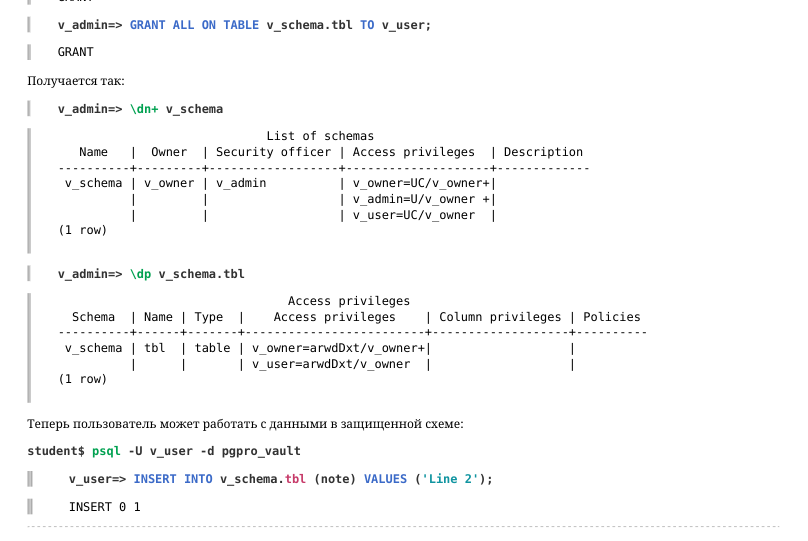 {#source-figure-028 caption=“Source slide page 28: Page 28”}
Получается так:
Теперь пользователь может работать с данными в защищенной схеме:
Администратор dbms_admin замечает, что может воспользоваться ADMIN OPTION в отношении созданной им роли v_user:
Обладая параметром членства ADMIN в роли v_user, администратор dbms_admin может включить себя в эту роль с параметром INHERIT:
Теперь у него есть такой же доступ к данным в защищенной схеме, как у доверенного пользователя v_user:
Чтобы исключить эту уязвимость, суперпользователь отзывает ADMIN OPTION у роли dbms_admin:
Page 29: Page 29
Теперь доступ к данным закрыт:
И исключена возможность включения в роль:
2. Перенос данных в защищенную схему
Администратор СУБД создает новую таблицу в схеме public и наполняет ее данными:
В дальнейшем в таблице будут храниться конфиденциальные данные, поэтому стоит задача поместить ее в зону повышенной безопасности. Для этого роль dbms_admin передаст таблицу во владение пользователю v_owner, который перенесет ее в свою защищенную схему:
Не получилось, так как для передачи владения нужно, чтобы у обоих пользователей была общая роль. Поэтому владельца меняет суперпользователь:
Новый владелец перемещает таблицу в защищенную схему:
Администратор безопасности предоставляет доступ к таблице пользователю v_user:
Теперь пользователь работает с данными:
Page 30: Page 30
А у роли dbms_admin доступа к таблице уже нет:
3. Схема без защиты
Суперпользователь делает схему v_schema обычной, убрав атрибут security officer:
Теперь владельцу данных ничего не мешает распоряжаться доступом к ним. Разделения ответственностей ролей больше нет!
Администратор СУБД может видеть данные в таблицах схемы v_schema:
Уборка
Удалим созданную базу данных и роли.
Page 31: Page 31
17 Занятие 17: Безопасность / Анонимизация данных
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_17_anonymize.html Archive: PGPRO-handouts-16.zip Страниц PDF: 23
Page 1: Безопасность / Анонимизация данных
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Анонимизация
- Стратегии анонимизации
- Расширение pgpro_anonymizer
- Правила маскирования
- Метки безопасности
- Динамическое изменение данных
- Статическое изменение по правилам
- Безопасность
Page 3: Анонимизация
 {#source-figure-003 caption=“Source slide page 3: Анонимизация”}
Статическое Динамическое изменение изменение
Комментарии преподавателя
Защитить данные от несанкционированного чтения с помощью разделения доступа между ролями и назначения привилегий не всегда возможно: иногда пользователю необходимо показать какую-то информацию.
Дополнительным средством защиты данных в таких случаях может стать анонимизация — сохранение конфиденциальности путем изменения исходных данных или их представления в измененном виде:
● Статическое изменение — сохранение анонимизированных данных и дальнейшее их предоставление в уже измененном виде.
Такой вариант, например, позволяет скрыть исходную информацию в копиях данных, предназначенных для аналитиков, разработчиков и тестировщиков.
● Динамическое изменение (маскирование) — исходные данные не изменяются, а анонимизация и представление в измененном виде выполняются «на лету», непосредственно при обращении к ним.
Такой вариант может применяться, например, для защиты данных от просмотра недоверенными пользователями в приложениях.
Изменения данных, выполняемые при анонимизации, требуют затрат процессорного времени, места в памяти и, возможно, увеличения числа операций ввода-вывода. Статическое изменение перезаписывает данные на диске и затраты на него единовременны. При динамическом маскировании ресурсы расходуются при каждом обращении.
Page 4: Стратегии анонимизации
Удаление
- Замена
- Искажение
- Рандомизация и подмена
- Псевдонимизация
- Обобщение
- Перестановка
- Пользовательские правила
Комментарии преподавателя
Для анонимизации данных могут использоваться разные стратегии:
● Удаление (сокрытие) полностью исключает доступ к данным.
● Замена — все значения заменяются одним. Возможна частичная замена, когда часть данных остается нетронутой.
● Искажение (отклонение) «сдвигает» даты и числовые значения.
● Рандомизация и подмена (фальсификация) заменяют конфиденциальные данные случайными, но правдоподобными значениями.
● Псевдонимизация защищает данные, скрывая их с помощью дополнительной информации, при этом данные остаются связаны с исходными. Примерами могут служить шифрование и хеширование.
● Обобщение заменяет данные диапазоном значений.
● Перестановка перемешивает значения в рамках столбца.
● Пользовательские правила предназначены для анонимизации данных в соответствии с особыми требованиями — например, при необходимости логически согласованных изменений в столбцах.
Выбор стратегии анонимизации зависит от типа данных и задач обеспечения конфиденциальности. Например, для имен и различных идентификаторов удобно использовать замену, рандомизацию или псевдонимизацию, а отклонение и обобщение подходят для чисел и значений даты-времени.
Page 5: pgpro_anonymizer
Инструменты внутри СУБД
- для статического и динамического изменения
- Набор функций
- для разных стратегий анонимизации
- Декларативные конструкции
Комментарии преподавателя
Расширение pgpro_anonymizer позволяет анонимизировать данные внутри экземпляра СУБД без использования внешних инструментов, что уменьшает риск утечки данных. Расширение поставляется в виде отдельного пакета pgpro-anonymizer-ent-16; за его основу был взят проект PostgreSQL Anonymizer.
https://postgrespro.ru/docs/enterprise/16/pgpro-anonymizer#PGPRO-ANON YMIZER
С помощью инструментов расширения можно выполнять статическое и динамическое изменение данных и применять в них различные стратегии анонимизации. Для этого в составе расширения имеются функции, выполняющие изменения данных в соответствии с выбранной стратегией.
https://postgrespro.ru/docs/enterprise/16/pgpro-anonymizer#MASKING-FUN CTIONS
Чтобы связать данные со стратегией анонимизации, используется декларативный подход: стратегия описывается с помощью DDL-команд.
Page 6: Статическое изменение с помощью функций
Для работы расширения требуется загрузить разделяемую библиотеку.
Будем работать с демобазой. Подключимся к ней как суперпользователь:
Создадим расширение:
Появилась одноименная схема, в которой расширение хранит свои объекты:
Создадим схему, в которой будем размещать анонимизированные данные:
Для удобства временно добавим эту схему в путь поиска:
Считаем, что нам необходимо создать небольшой набор данных для тестировщиков, в котором нужно скрыть имена и фамилии пассажиров и исказить даты и суммы бронирований. Создадим в схеме m_schema таблицы m_tickets и m_bookings, в которые скопируем часть данных из таблиц tickets и bookings схемы bookings:
Подменим в исходной таблице имя и фамилию пассажиров. В состав расширения входит набор функций для подмены и набор функций, генерирующих случайные значения:
Page 7: Page 7
Функции подмены случайным образом выбирают значения из таблиц-словарей, также расположенных в схеме anon:
Функция init импортирует в эти таблицы наборы случайных данных. Они невелики — 1000 значений для каждой категории, на английском языке.
Изменим данные в столбце passenger_name, используя значения, возвращаемые функциями fake_first_name и fake_last_name:
С помощью функции shuffle_column перемешаем данные в столбце бронирований. В качестве последнего параметра вызова требуется указать столбец, выполняющий функцию первичного ключа:
Page 8: Page 8
Дополнительно исказим суммы и даты бронирований:
Исходные данные — бронирования и билеты:
Измененные данные:
Данные бронирований и билетов анонимизированы.
Page 9: Метки и правила
Метки безопасности
- штатный универсальный механизм хранения атрибутов объектов
- назначаются администратором
- интерпретируются модулем — провайдером меток
- Правила изменения данных
- описываются меткой безопасности для провайдера anon
- на уровне столбцов таблиц
- определяют преобразование: замену на константу или значение
- функции
Комментарии преподавателя
Штатный механизм меток безопасности PostgreSQL позволяет ассоциировать метки с отдельными объектами, в том числе и со столбцами таблиц.
Метка — это атрибут объекта (текстовая строка), который устанавливается администратором, а интерпретируется при обращении к объекту загружаемым модулем — провайдером. Провайдер также определяет, допустима ли метка и разрешено ли применять ее к указанному объекту. PostgreSQL не накладывает ограничений на то, как провайдер должен интерпретировать метки безопасности; он лишь обеспечивает механизм их хранения и поддержку работы модулей-провайдеров. На базе этого механизма может быть реализована, например, система мандатного управления доступом (MAC).
https://postgrespro.ru/docs/enterprise/16/sql-security-label
Для расширения pgpro_anonymizer провайдером меток безопасности выступает модуль anon.
Помимо простого статического изменения с помощью функций, рассмотренного в демонстрации, расширение позволяет определить правила изменения данных (маскирования). Правила могут описывать замену исходного значения как на определенное статическое значение, так и на значение, возвращаемое функцией. При этом можно использовать и пользовательские функции, реализующие необходимую логику.
https://postgrespro.ru/docs/enterprise/16/pgpro-anonymizer#DECLARE-MA SKING-RULES
Page 10: Динамическое изменение
Работает для ролей, помеченных как недоверенные
- Обращение к таблице подменяется на обращение к представлению
- anon.sourceschema — схема исходных данных
- anon.maskschema — схема анонимизирующих представлений
- Ограничения и особенности
- поддержка только одной схемы
- необходимость каскадного удаления таблиц
- запрет прямого изменения типа данных
- возможное снижение производительности
Комментарии преподавателя
Динамическое маскирование работает для ролей с установленной меткой безопасности MASKED (недоверенных ролей).
В схеме, указанной в параметре anon.maskschema, создаются представления, одноименные с анонимизируемыми таблицами из схемы anon.sourceschema и изменяющие данные согласно установленным правилам. При этом для недоверенных пользователей путь поиска изменяется таким образом, что при указании целевой таблицы запрос перенаправляется к маскирующему представлению.
https://postgrespro.ru/docs/enterprise/16/pgpro-anonymizer#DYNAMIC-MA SKING
У динамического маскирования есть ряд особенностей и ограничений:
● Чтобы удалить исходную замаскированную таблицу, для нее нужно выполнять DROP … CASCADE, что позволяет сразу удалить и зависящее от нее маскирующее представление.
● Система работает только с одной схемой, указанной в параметре anon.sourceschema (по умолчанию — public).
● Когда активировано динамическое маскирование, запрещено изменять тип данных столбца, если на нем есть маска. Чтобы изменить такой столбец, маскирование нужно временно отключить.
● Динамическое маскирование может медленно работать с некоторыми запросами, например соединяющими таблицы по ключу, который маскируется хешированием.
Page 11: Динамическое изменение
Создадим пользователя, для которого будем ограничивать доступ к данным, и пометим его как недоверенного:
Установленные метки безопасности объектов можно увидеть в системном каталоге:
Предположим, что нужно предоставить минимально необходимый доступ к данным пассажиров вспомогательным службам аэропорта. В этом случае номер билета и часть персональных данных пассажира можно скрыть или подменить. Определим правило, скрывающее данные документа, идентифицирующего пассажира — они будут частично маскированы:
Столбец contact_data представлен типом jsonb, для работы с его элементами определим функцию. При включенном параметре anon.restrict_to_trusted_schemas она должна принадлежать одной из доверенных схем:
Из соображений безопасности в правилах маскирования надо явно указывать имя схемы — это не позволит пользователю-злоумышленнику подменить функцию на собственную:
В правиле для столбца укажем вызов этой функции:
Вот созданные нами метки для столбцов:
Page 12: Page 12
Более удобный способ получения информации о правилах изменения — представление anon.pg_masking_rules:
Далее нам необходимо установить исходную (bookings) и анонимизирующую (mask по умолчанию) схемы для базы данных:
Чтобы изменения вступили в силу, нужно переподключиться к базе и активировать механизм динамического маскирования:
Вызов этой функции: проверит состояние расширения и при необходимости вызовет anon.init; при необходимости создаст схему, указанную в параметре anon.maskschema; для таблиц в sourceschema создаст в maskschema одноименные представления, через которые недоверенные пользователи будут видеть маскированные данные; отзовет все права на sourceschema у всех недоверенных ролей; назначит недоверенным ролям необходимые права на схемы anon и anon.maskschema, а также на объекты в них; установит недоверенным ролям путь поиска к схеме anon.maskschema. Вот список созданных маскирующих представлений:
Page 13: Page 13
Подключаемся к базе от имени недоверенного пользователя и выполняем запрос:
В полученных данных видно, что такая анонимизация никак не учитывает смысловой взаимосвязи столбцов, содержащих имя пассажира и его контактные данные (адрес электронной почты). Для получения более правдоподобных данных можно использовать пользовательские подменяющие функции. Путь поиска и права для недоверенного пользователя изменены таким образом, что вместо схемы bookings ему видны объекты из схемы mask:
Доступа к исходным данным у пользователя looser нет:
Посмотрим также на определение представления tickets, подменяющего одноименную таблицу. В нем видны подстановки, соответствующие заданным правилам:
Page 14: Page 14
Изменим правила маскирования для столбцов. Номер билета будем считать конфиденциальным и скроем его, заменив на константу:
А для документа, идентифицирующего пассажира, маскирование отменим:
Page 15: Статическое изменение
Данные в таблицах изменяются по заданным правилам
- anon.anonymize_database() — все данные в базе
- anon.anonymize_table() — отдельная таблица
- anon.anonymize_column() — отдельный столбец таблицы
Комментарии преподавателя
Статическое изменение данных также может выполняться на основе определенных правил маскирования.
https://postgrespro.ru/docs/enterprise/16/pgpro-anonymizer#APPLYING-MA SKING-RULES
Функции anon.anonymize_database, anon.anonymize_table и anon.anonymize_column позволяют преобразовать исходные таблицы в соответствии с заранее определенными правилами.
Поскольку при этом перезаписываются все строки таблицы, даже если изменяется только один столбец, такая операция может занять продолжительное время.
Иногда может оказаться быстрее экспортировать анонимизированные данные и повторно загрузить их в базу данных. Если нужно экспортировать базу вместе с анонимизируемыми данными, следует воспользоваться скриптом pg_dump_anon.sh.
https://postgrespro.ru/docs/enterprise/16/pgpro-anonymizer#ANONYMOUS-DUMPS
Page 16: Статическое изменение по правилам
Сейчас данные в схеме m_schema выглядят следующим образом:
Определим правила, которые скроют номер бронирования, не нарушив взаимосвязь таблиц по столбцу book_ref. Применим хеширование: это преобразование является детерминированным. Вычисленное значение хеша будет слишком длинным…
…поэтому мы идем на то, чтобы сохранить только его часть. Конечно, такое сокращение повысит риск коллизии значений.
Для хеширования применяются алгоритм и соль, указанные в параметрах. Обычные пользователи не имеют к ним доступа даже на чтение:
Проверим правила:
Page 17: Page 17
Преобразуем таблицы с применением этих правил:
Результат:
Обратите внимание, что для безопасности преобразующие функции работают с правами вызывающего пользователя:
Page 18: Итоги
Анонимизация позволяет защитить конфиденциальные данные, когда разграничение ролей неприменимо
- Правила изменения данных определяются декларативно с помощью меток безопасности
- Поддерживается статическое и динамическое изменение
- Анонимизация данных влечет накладные расходы
Page 19: Практика
- Настройте правило маскирования столбца с контактными данными таблицы m_tickets так, чтобы почтовые адреса содержали имена и фамилии пассажиров. Экспортируйте данные таблицы в анонимизированном виде от лица недоверенного пользователя. 2. Включите динамическое маскирование. Объявите правило для подмены имени пассажира в таблице m_tickets. Выполните несколько запросов к одной из строк таблицы. Затем перепишите правило так, чтобы использовалась псевдонимизация и снова выполните запросы. Сравните результаты.
Комментарии преподавателя
- Установите расширение и скопируйте небольшую часть данных в таблицу m_tickets из bookings.tickets так, как это сделано в демонстрации.
Напишите функцию, формирующую контактные данные, в которых почтовый адрес имеет вид имя.фамилия@example.com. Поместите эту функцию в доверенную схему и используйте ее в правиле изменения.
Создайте недоверенного пользователя и сделайте выгрузку данных с помощью скрипта pg_dump_anon.sh от его имени.
- Для подмены имен используйте изменчивую функцию anon.fake_first_name. Для псевдонимизации замените ее на anon.pseudo_first_name.
Page 20: 1. Пользовательские правила анонимизации
Установим расширение pgpro_anonymizer в демобазе и инициализируем его.
Создадим в схеме public таблицу m_tickets, в которую скопируем часть данных из таблицы tickets схемы bookings:
Используем функцию, показанную в демонстрации, но добавим подзапрос, формирующий почтовый адрес по переданному аргументу:
Проверим:
В правиле маскирования укажем вызов этой функции:
Взглянем на созданное правило:
И на исходные данные (динамическое маскирование не включено):
Page 21: Page 21
Создадим недоверенного пользователя и выполним выгрузку данных из таблицы под его аккаунтом.
Данные таблицы выгрузились в анонимизированном виде.
2. Подмена и псевдонимизация
Активируем механизм динамического маскирования:
Сформируем правило, подменяющее имя пассажира. Для этого воспользуемся функцией anon.fake_last_name:
Подключаемся как недоверенный пользователь и выполняем несколько одинаковых запросов.
Page 22: Page 22
Подмененные значения каждый раз получаются разные. Псевдонимизация, в отличие от подмены, является детерминированной. Функции, выполняющие псевдонимизацию, всегда будут возвращать тот же результат для того же аргумента (и той же соли, если она передается). Вот список предоставляемых расширением функций псевдонимизации:
Заменим правило на новое, выполняющее псевдонимизацию имени пассажира, где в качестве затравки будем использовать код документа. Это гарантирует нам получение одинакового имени пассажира для одного и того же документа.
Page 23: Уборка
Удалим расширение и объекты, созданные в базе demo, удалим созданную роль и очистим список загружаемых библиотек.
18 Занятие 18: Резервное копирование / Основы pg_probackup
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_18_probackup_1.html Archive: PGPRO-handouts-16.zip Страниц PDF: 31
Page 1: Резервное копирование / Основы pg_probackup
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Резервное копирование
- Полное копирование
Page 3: Резервное копирование
Риски и требования
- Характеристики
- Общая классификация
- Инструменты PostgreSQL
- Возможности pg_probackup
Page 4: Риски и требования
Резервное копирование снижает риски потери данных
- отказ оборудования и сбои программного обеспечения
- порча данных вследствие человеческих ошибок
- негативное воздействие окружающей среды
- криминальная активность
- другие причины
- Обычные требования к резервному копированию
- небольшое время копирования
- минимизация места для хранения копий
- быстрое восстановление из резервной копии
Комментарии преподавателя
Любая реальная система рано или поздно столкнется с отказом, связанным с исчезновением или повреждением данных. Резервное копирование позволяет снизить риск потери данных.
Основные причины, приводящие к возможной потере данных:
● природные и антропогенные катастрофы;
● отказы и сбои оборудования;
● ошибки в программном обеспечении;
● намеренная порча или кража оборудования;
● взлом или компрометация компьютерных систем;
● человеческие ошибки.
В зависимости от ценности защищаемой информации должна быть построена более или менее сложная система, выполняющая резервное копирование по некоторому расписанию. Чтобы обеспечить максимальную защиту данных, мероприятия, связанные с резервным копированием должны включать:
● расписание резервного копирования;
● процедуры проверки целостности и исправности копий;
● систему хранения резервных копий в надлежащих условиях;
● план восстановления системы с помощью резервных копий;
● средства защиты системы резервного копирования и самих копий.
Желательно обеспечить минимальное время копирования и восстановления и ограничить пространство для хранения копий.
Page 5: Характеристики
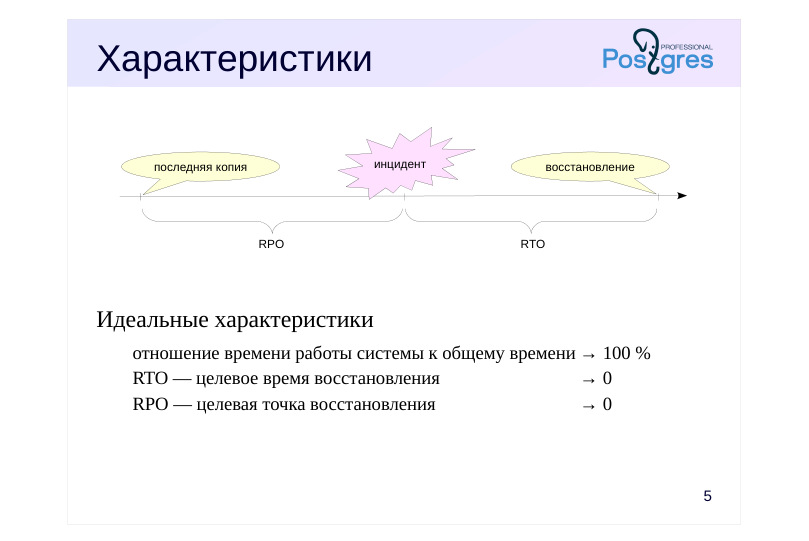 {#source-figure-005 caption=“Source slide page 5: Характеристики”}
Идеальные характеристики
- отношение времени работы системы к общему времени → 100 %
- RTO — целевое время восстановления
- → 0
- RPO — целевая точка восстановления
- → 0
Комментарии преподавателя
Идеальная система никогда не простаивает, и отношение времени продуктивной работы системы к общему времени ее эксплуатации равно 100%.
Однако в реальных системах инциденты, требующие восстановления данных из резервных копий, рано или поздно происходят.
Оценка максимального периода времени, за который данные могут быть потеряны вследствие инцидента, связана с периодичностью и способами выполнения резервного копирования. Такая оценка выражается показателем Recovery Point Objective (RPO).
После обнаружения инцидента требуется время для восстановления системы. Показатель Recovery Time Objective (RTO) указывает целевое время, по истечении которого система восстанавливается для обслуживания клиентов.
В сложных системах процесс восстановления системы проходит через несколько промежуточных стадий, что, например, может быть вызвано восстановлением из резервных копий нескольких различных экземпляров БД.
Page 6: Общая классификация
По вовлеченности администратора
- неконтролируемое (unattended)
- контролируемое (attended)
- По плановости
- незапланированное (non-scheduled)
- календарное (scheduled)
- По полноте резервирования данных
- полное (full)
- инкрементальное (incremental)
Комментарии преподавателя
Принятая в системах резервного копирования классификация подразделяет резервное копирование по следующим критериям:
● по степени вовлеченности администратора в процесс резервного копирования на требующее контроля и автоматическое неконтролируемое копирование;
● является ли резервное копирование незапланированным, или же оно выполняется в соответствии с календарным расписанием;
● копируются ли все данные (возможно, в сжатом виде) или лишь часть, измененная с момента предыдущего резервного копирования.
Незапланированное резервное копирование осуществляется с помощью команды администратора (attended non-scheduled backup).
Однако чаще всего заранее создается календарный план резервного копирования, в котором фиксируется периодичность автоматического выполнения полного (full) или инкрементального (incremental) резервного копирования. Другое название инкрементальных копий — разностные копии (в конкретных системах резервного копирования понятия инкрементальных и разностных копий могут отличаться). Инкрементальные копии содержат данные, измененные с момента последнего резервного копирования, поэтому размер такой копии меньше, чем у полной.
СУБД имеют свою специфику: резервные копии могут включать или не включать журналы, содержать данные всего экземпляра или отдельных баз данных и т. п.
Page 7: Инструменты PostgreSQL
COPY, pg\_dump, pg\_dumpall
- высокое RPO
- pg_basebackup
- нет каталога и хранилища резервных копий
- нет политик хранения и удержания копий
- нет инкрементального копирования
- невозможна параллельная работа
Комментарии преподавателя
Собственные инструменты PostgreSQL позволяют выполнять как логическое копирование всего кластера или отдельных объектов, так и физическое копирование кластера. Эти инструменты подробно рассмотрены в курсе DBA3.
Однако имеющиеся в PostgreSQL инструменты неудобны для промышленного использования.
Средства логического резервирования не удовлетворяют поставленным требованиям из-за крайне высокого RPO.
Средства физического резервирования не предоставляют возможности ведения каталога резервных копий, который содержал бы информацию о копиях (метаданные). Например, в каталоге резервных копий можно было бы хранить тип резервной копии (полная или инкрементальная), время и способ ее создания. Такой каталог позволяет выполнять проверку исправности резервных копий, а также упрощает и ускоряет восстановление данных.
Другой недостаток штатных инструментов — отсутствие политик, определяющих правила хранения копий и их последующего удаления.
Кроме того, производительность штатной утилиты pg_basebackup из-за ее однопоточности явно недостаточна для резервирования больших объемов данных.
Page 8: Возможности pg_probackup
Централизованный каталог копий и политики хранения
- Локальное или удаленное копирование, поддержка S3
- Постраничное инкрементальное копирование
- Восстановление выбранных баз данных
- Параллельное резервирование и восстановление
- Сжатие данных и поддержка CFS
- Резервирование файлов вне каталога данных
Комментарии преподавателя
Утилита pg_probackup — система резервного копирования и восстановления корпоративного уровня, разработанная компанией Postgres Professional.
Утилита работает с централизованным каталогом копий и поддерживает инкрементальное копирование и восстановление.
При локальной работе каталог резервных копий размещается на том же сервере, что и копируемые экземпляры. Для удаленного доступа к каталогу резервных копий используется SSH.
Хранилище копий позволяет выполнять сложные операции, такие как слияние копий, и реализовывать политики их хранения. Имея каталог копий, можно проверять целостность данных и возможность восстановления на заданный момент времени (PITR, Point In Time Recovery), не выполняя само восстановление.
Утилита также поддерживает работу в параллельном режиме и может выполнять роль архиватора журнала предзаписи.
Другие важные возможности pg_probackup: восстановление из копии отдельных баз данных, поддержка сжатия данных и файловой системы CFS (Compressed File System), резервирование с физической реплики и резервирование файлов, находящихся вне PGDATA (например, файлов конфигурации), поддержка хранилищ S3, возможность ограничивать скорость записи данных на диск (для снижения нагрузки на систему ввода-вывода).
https://postgrespro.ru/docs/enterprise/16/app-pgprobackup
Page 9: Полное копирование
Локальная работа
- Полная копия
- Сжатие
- Удаленная работа
- Архивирование WAL
Page 10: Локальная работа
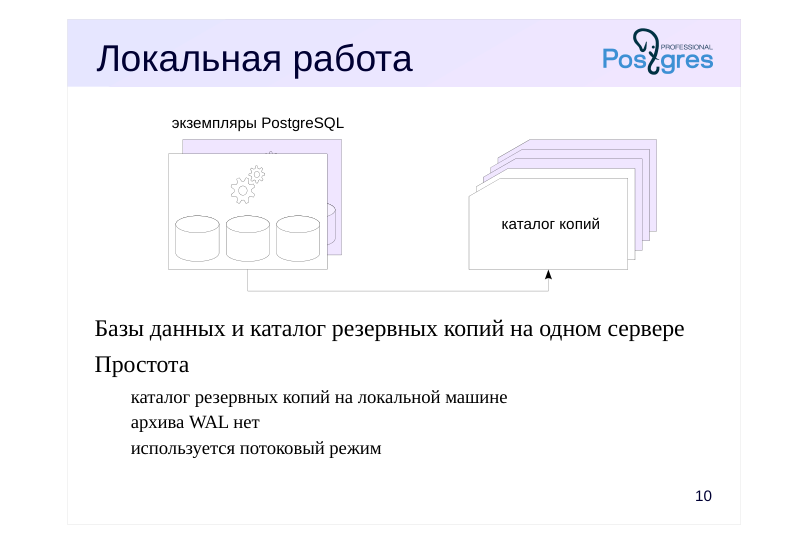 {#source-figure-010 caption=“Source slide page 10: Локальная работа”}
Базы данных и каталог резервных копий на одном сервере
- Простота
- каталог резервных копий на локальной машине
- архива WAL нет
- используется потоковый режим
Комментарии преподавателя
При локальной работе каталог резервных копий размещается на том же сервере, что и копируемые экземпляры. В каталоге копий хранятся резервные копии и данные о них (метаинформация).
Утилита pg_probackup выполняет только горячее резервирование. При самой простой стратегии резервного копирования в локальном каталоге резервных копий формируется базовая копия без журнала предзаписи. Если включено архивирование WAL, сегменты журнала также копируются в каталог.
Пользователь, запускающий pg_probackup, должен иметь полный доступ к каталогу копий. Каталог может содержать резервные копии разных кластеров баз данных; перед первым копированием кластера в каталог нужно выполнить команду pg_probackup add-instance для инициализации подкаталогов и метаданных.
Пользователь должен также иметь доступ на чтение к каталогам данных копируемых кластеров. Подробнее:
https://postgrespro.ru/docs/enterprise/16/app-initdb#APP-INITDB-ALLOW-G ROUP-ACCESS
Page 11: Подготовка pg_probackup
Чтобы не вводить в командной строке полный путь к pg_probackup, мы использовали символическую ссылку:
При локальной работе пользователь, запускающий pg_probackup, должен иметь доступ на чтение файлов каталога данных копируемого экземпляра. Для этого достаточно: при инициализации кластера запустить утилиту initdb с ключом -g; дать группе postgres право чтения каталога PGDATA; включить пользователя в группу postgres. Все эти действия были выполнены при настройке виртуальной машины курса. Работа с pg_probackup начинается с создания и инициализации каталога резервных копий.
Утилите pg_probackup необходим доступ в этот каталог. Мы будем запускать утилиту от имени пользователя student, поэтому сделаем его владельцем каталога.
Для инициализации каталога резервных копий используется команда init утилиты pg_probackup, параметр -B указывает местоположение каталога:
Заглянем в каталог, чтобы проверить результаты инициализации.
При инициализации были созданы два подкаталога: backups — для резервных копий, wal — для архива журнала предзаписи. Утилита pg_probackup имеет встроенную систему помощи. Получить информацию об отдельных командах утилиты можно командой help:
Или так:
Следующий шаг — добавление копируемого экземпляра в каталог копий — выполняется командой add-instance: ключ -D указывает путь к каталогу данных копируемого экземпляра (PGDATA); ключ –instance задает имя экземпляра в каталоге копий.
Снова проверим содержимое каталога копий.
Page 12: Page 12
В результате: в каталогах backups и wal появились подкаталоги с именем экземпляра; для экземпляра создан файл конфигурации pg_probackup.conf. Содержимое файла конфигурации можно посмотреть средствами ОС, а полную информацию о конфигурации покажет команда show-config утилиты pg_probackup:
Утилита сохранила в параметре system-identifier уникальный идентификатор экземпляра. Перед выполнением резервного копирования сохраненный идентификатор сверяется с идентификатором резервируемого экземпляра; при несовпадении резервирование не выполняется. Это защищает копии от ошибочных действий администратора. Рекомендуется использовать для резервного копирования непривилегированную роль с атрибутом replication. Такая роль создана заранее:
Создадим базу данных, к которой будет подключаться роль backup:
Мы использовали в качестве шаблона базу данных, в которой для роли backup уже предоставлены привилегии на несколько функций, необходимых для работы утилиты pg_probackup. Вот они:
Page 13: Page 13
Утилита pg_probackup использует стандартные параметры подключения к базе данных. Пользовательские параметры удобно записать в файл конфигурации с помощью команды set-config:
В результате должны поменяться параметры подключения по умолчанию и уровень важности сообщений, выводимых на терминал:
Page 14: Полная копия
 {#source-figure-014 caption=“Source slide page 14: Полная копия”}
Полная резервная копия содержит все данные экземпляра
- Потоковый способ доставки → автономная копия
Комментарии преподавателя
Команда pg_probackup backup -b FULL формирует резервную копию, состоящую из базовой копии кластера и сегментов журнала предзаписи.
Чтобы полная резервная копия была автономной, то есть самодостаточной, она должна включать в себя все записи WAL, необходимые для восстановления согласованности из базовой копии на момент начала копирования.
Если указать параметр –stream, записи журнала передаются потоковым способом. Если параметр не указать, утилита журнальные записи не получает; предполагается, что для экземпляра СУБД настроена файловая непрерывная архивация.
Оба варианта передачи WAL рассматриваются в курсе DBA3 «Резервное копирование и репликация».
Page 15: Сжатие
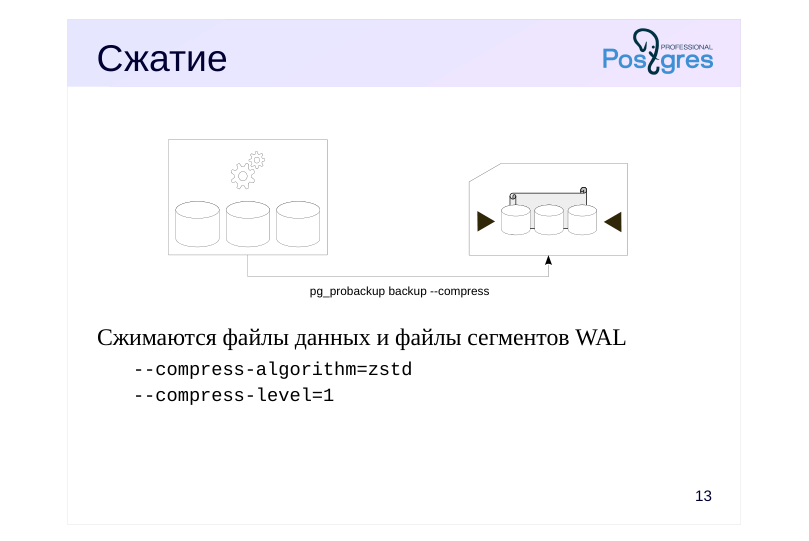 {#source-figure-015 caption=“Source slide page 15: Сжатие”}
Сжимаются файлы данных и файлы сегментов WAL
Комментарии преподавателя
Работа pg_probackup может быть существенно оптимизирована посредством сжатия файлов данных и сегментов WAL. Во-первых, экономится место хранения резервных копий, а во-вторых, потоки данных меньше загружают подсистему ввода-вывода. Взамен требуются ресурсы процессора для выполнения операций сжатия.
Сжатие настраивается с помощью параметров –compress-algorithm и – compress-level, в которых можно указать алгоритм и уровень сжатия. Поддерживаются алгоритмы zstd, lz4, zlib и pglz, если соответствующие библиотеки установлены в системе, а значение возможных уровней сжатия зависит от алгоритма.
Параметр –compress задает алгоритм сжатия по умолчанию и устанавливает его уровень в единицу, то есть переопределяет параметры –compress-algorithm и –compress-level и не может быть использован одновременно с ними.
https://postgrespro.ru/docs/enterprise/16/app-pgprobackup#PBK-COMPRE SSION-OPTS
Page 16: Полная потоковая резервная копия
Получим автономную резервную копию c потоковой доставкой записей WAL: параметр -b FULL запрашивает полную копию; параметр –stream включает потоковую доставку WAL (по умолчанию используется файловая архивация); параметр –compress включает сжатие методом, установленным по умолчанию.
По умолчанию утилита создает временный слот репликации, который не даст серверу удалить еще не скопированные сегменты WAL. Если необходимо использовать другой слот, нужно задать его имя в ключе –slot. Проверим каталог.
При выполнении резервного копирования pg_probackup вычисляет и сохраняет контрольные суммы для всех файлов. По умолчанию после копирования и перед восстановлением выполняется проверка целостности копии путем сравнения контрольных сумм. Можно проверить целостность копии и вручную с помощью команды validate:
Команда show может показывать информацию о копии по ее идентификатору.
Page 17: Page 17
Поддерживается также вывод информации о копии в формате JSON. Эти данные сохраняются в каталоге резервной копии в файле backup.control, а информация о контрольных суммах — в файле backup_content.control. Удалим всю информацию об экземпляре, включая созданные резервные копии:
Page 18: Удаленная работа
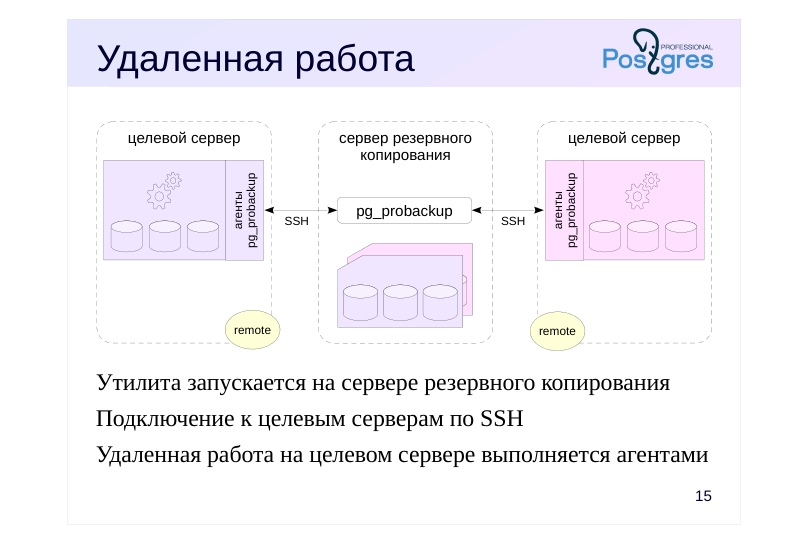 {#source-figure-018 caption=“Source slide page 18: Удаленная работа”}
Утилита запускается на сервере резервного копирования
- Подключение к целевым серверам по SSH
- Удаленная работа на целевом сервере выполняется агентами
Комментарии преподавателя
В удаленном режиме утилиту pg_probackup запускают на сервере резервного копирования (на котором расположен каталог копий); она подключается к целевому серверу по протоколу SSH (Secure Shell), запускает на нем процессы-агенты и с их помощью может выполнять резервное копирование, восстановление и архивирование WAL. Количество запускаемых агентов определяется параметром –threads. При ошибке любого агента аварийно завершаются остальные агенты экземпляра и породившая их команда pg_probackup.
На всех серверах должна быть установлена одна и та же версия pg_probackup.
При подключении по SSH аутентификация выполняется без ввода пароля, по ключу.
Параметры SSH-соединения:
● –remote-host — целевой сервер для копирования и восстановления;
● –remote-user — пользователь ОС, от имени которого работает агент на целевом сервере (владелец экземпляра Postgres);
● –remote-port — TCP-порт для подключения по SSH к целевому серверу.
https://postgrespro.ru/docs/enterprise/16/app-pgprobackup#PBK-CONFIGU RING-THE-REMOTE-MODE
Page 19: Удаленная работа
Для подготовки каталога копий экземпляра, работающего на удаленном узле сети, необходимо сообщить агенту SSH адрес или имя этого удаленного узла, а также имя пользователя, с правами которого будет работать агент.
Не забудем о настройках конфигурации:
Теперь выполним полное резервное копирование удаленного сервера, также используя потоковую доставку записей WAL:
В каталоге резервных копий появилась запись:
Page 20: Архивирование WAL
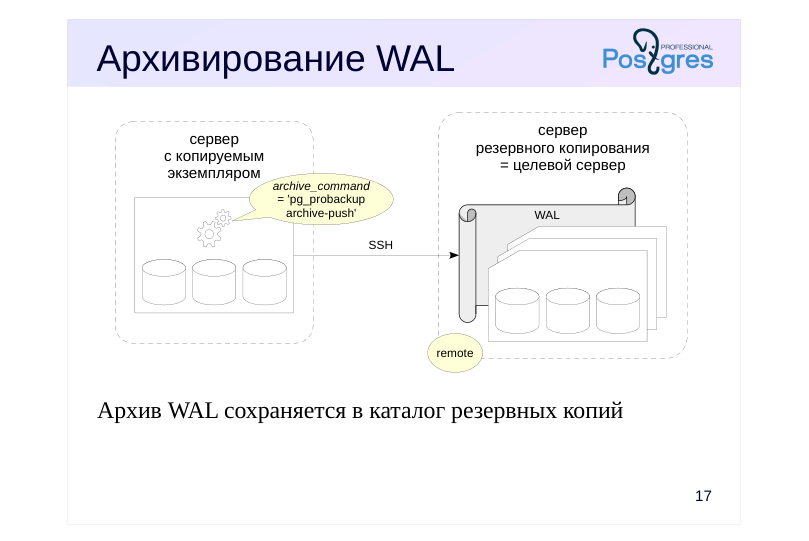 {#source-figure-020 caption=“Source slide page 20: Архивирование WAL”}
Архив WAL сохраняется в каталог резервных копий
Комментарии преподавателя
Для инкрементального резервного копирования в режиме PAGE необходим архив журнала предзаписи, который дает возможность восстановления на момент в прошлом (PITR, Point-In-Time Recovery).
При создании резервной копии pg_probackup предполагает, что на копируемом экземпляре настроен механизм пополнения архива — обычно файловым способом. Команда архивирования должна корректно работать в случае сбоев, гарантировать сохранение файлов на диске и быть достаточно производительной. Чтобы не настраивать такую команду самостоятельно, удобно задать в параметре archive_command команду pg_probackup archive-push.
В данном случае утилиту pg_probackup вызывает СУБД, поэтому при работе через SSH целевым сервером, который указывается в параметрах –remote-*, будет сервер резервного копирования с каталогом резервных копий.
Утилиту можно использовать для архивации и при локальной работе. Тогда она будет запускаться от имени владельца файлов кластера данных (обычно postgres), и каталог копий в таком случае также должен принадлежать postgres. Это особенность текущей версии pg_probackup.
https://postgrespro.ru/docs/enterprise/16/app-pgprobackup#PBK-SETTING-UP-CONTINUOUS-WAL-ARCHIVING
Page 21: Архивирование WAL
Подготовим экземпляр к работе с файловым архивированием WAL.
Для команды архивирования целевым будет сервер резервного копирования, в нашем случае это localhost. Команда подключается к серверу по SSH от имени владельца каталога резервных копий — пользователя student.
Экземпляр необходимо перезапустить.
Посмотрим на содержимое архива WAL:
Пока архив пуст. Создадим таблицу и принудительно переключим сегмент WAL.
Сегмент архивируется, когда в следующий сегмент попадает любая запись:
Сегмент WAL попал в архив:
Page 22: Page 22
Выполним полное резервное копирование. Поскольку настроена непрерывная файловая архивация, копировать WAL не нужно — параметр –stream не указываем.
Теперь в каталоге имеются две полные копии:
Если при восстановлении не указать идентификатор копии, будет использована последняя. Остановим экземпляр и удалим каталог данных кластера.
Восстанавливаемый экземпляр обычно запускается от имени пользователя ОС postgres, а каталог PGDATA принадлежит пользователю postgres и группе postgres. Есть два варианта задания прав на файлы каталога PGDATA: полные права только для владельца; дополнительно права на чтение и доступ в каталог для членов группы postgres. Обычно восстановление производится от имени суперпользователя ОС root с дальнейшей установкой владельца и прав на PGDATA. Восстанавливаем кластер от имени root:
В команде использован параметр –allow-group-access, чтобы разрешить доступ к файлам от имени группы postgres. Процедура восстановления СУБД будет вызывать утилиту pg_probackup с командой archive-get для получения сегментов WAL из архива. При этом: –archive-host задает адрес сервера, откуда нужно получать эти сегменты — он подставляется в параметр –remote-host; –archive-user задает имя пользователя, от которого будет работать команда pg_probackup archive-get — оно подставляется в параметр –remote-user. Вот как выглядит сформированное значение конфигурационного параметра restore_command:
Устанавливаем владельца файлов и группу:
Запускаем экземпляр.
Page 23: Page 23
Кластер восстановлен из самой свежей резервной копии.
Page 24: Итоги
Штатные средства резервного копирования и восстановления не всегда достаточны, pg\_probackup предоставляет дополнительные возможности
- Утилита pg_probackup поддерживает каталог резервных копий, который может находиться на отдельном сервере
- Для WAL возможно файловое архивирование и потоковая передача
- Поддерживается полное и инкрементальное резервное копирование, сжатие, параллельное резервирование и восстановление
Page 25: Практика
- Подготовьте каталог резервных копий и зарегистрируйте в нем копируемый экземпляр для работы в удаленном режиме. 2. Настройте экземпляр на работу в режиме архивирования WAL, зарегистрируйте роль backup и создайте базу данных. 3. Выполните полное резервное копирование. 4. Измените какие-либо данные в базе и переключите сегмент WAL. Убедитесь, что сегмент попал в архив. 5. Удалите каталог данных кластера и восстановите его из резервной копии. Проверьте, восстановились ли последние изменения.
Комментарии преподавателя
Создайте базу данных из шаблона templateprobackup.
Убедиться, что сегмент попал в архив, можно разными способами: средствами PostgreSQL, средствами ОС или с помощью pg_probackup.
Page 26: 1. Каталог резервных копий и регистрация экземпляра
Подготавливаем каталог в файловой системе:
Инициализируем каталог копий:
Регистрируем экземпляр:
2. Настройка архивирования WAL, роль и база данных
Подготовка экземпляра к работе с архивированием WAL.
Перезапуск экземпляра.
Создадим базу данных, к которой будет подключаться роль backup:
Запишем в конфигурацию настройку для выполнения резервной копии от имени пользователя backup:
3. Полная копия
Полное копирование в режиме архивирования WAL:
Посмотрим на состояние каталога резервных копий:
Page 27: Page 27
4. Изменение данных и переключение сегмента WAL
Изменяем данные.
Переключаем сегмент WAL.
Увеличим счетчик транзакций, чтобы сегмент оказался в архиве.
Какой последний сегмент WAL был архивирован?
Проверка в ОС:
Проверка средствами pg_probackup:
Page 28: 5. Восстановление из резервной копии
Останавливаем экземпляр.
Удаляем содержимое PGDATA:
Восстанавливаем с правами root:
Меняем владельца и группу:
Устанавливаем для группы права на чтение и доступ к каталогам; это требуется для потоковой передачи WAL.
Запускаем экземпляр.
Данные восстановлены, включая записи из архивированных сегментов WAL.
Уборка
Удалим созданную базу данных и каталог копий, сбросим настройки параметров конфигурации.
Page 29: Page 29
Page 30: Практика PPEM
- Создайте локальное хранилище резервных копий для экземпляра ent-16. Назовите его ent-16_local, а каталог данных разместите в /var/lib/pgpro/pg_probackup.
- Сделайте автономную резервную копию основного экземпляра в созданное в п. 1 хранилище. Копия должна быть максимально сжата алгоритмом lz4 и включать журнал сообщений сервера. 3. Сделайте еще одну копию экземпляра, но уже без сжатия. Сравните размер полученной копии с полученной в п. 2 и оцените выигрыш от сжатия. 4. Создайте новый экземпляр ent-16-restored из резервной копии п. 3 в каталоге /var/lib/pgpro/ent-16-restored и запустите его.
Комментарии преподавателя
- Выбор алгоритма будет доступен после установки уровня сжатия копии.
Page 31: 1. Создание локального хранилища копий
В навигационной панели выберите вкладку «Резервное копирование», в ней — «Хранилища РК» и нажмите «Добавить хранилище». Выберите локальный тип хранилища, заполните поля открывшейся формы и нажмите «Добавить».
2. Автономная резервная копия со сжатием
Выберите вкладку «Резервные копии» и нажмите кнопку «Создать резервную копию». Далее в последовательно открывающихся формах заполните необходимые поля и нажмите «Выполнить РК».
3. Автономная резервная копия без сжатия
Действуйте так же, как в предыдущем пункте задания, но не включайте сжатие. Размеры копий указаны в первом столбце списка.
4. Создание нового экземпляра из резервной копии
На главной странице, в блоке «Экземпляры», нажмите «Добавить экземпляр» и выберите вариант создания из резервной копии. Выберите для восстановления резервную копию без сжатия и заполните необходимые поля в формах. Далее, после проверки доступного пространства, появится возможность восстановления — нажмите кнопку «Выполнить».
19 Занятие 19: Резервное копирование / Использование pg_probackup
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_19_probackup_2.html Archive: PGPRO-handouts-16.zip Страниц PDF: 38
Page 1: Резервное копирование / Использование pg_probackup
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Инкрементальные копии
- Способы восстановления
- Синхронизация
Page 3: Инкрементальные копии
Разностное копирование (DELTA)
- Копирование изменений (PTRACK)
- Страничное копирование (PAGE)
- Объединение копий
Page 4: Копирование DELTA
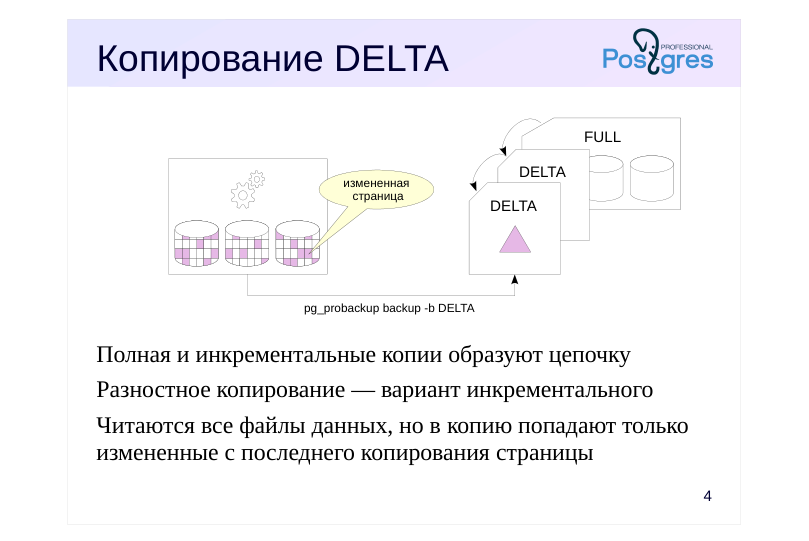 {#source-figure-004 caption=“Source slide page 4: Копирование DELTA”}
Полная и инкрементальные копии образуют цепочку
- Разностное копирование — вариант инкрементального
- Читаются все файлы данных, но в копию попадают только измененные с последнего копирования страницы
Комментарии преподавателя
Инкрементальная копия включает в себя все изменения, произошедшие после создания какой-либо другой копии.
Полная копия и набор последующих инкрементальных копий образуют цепочку. При восстановлении кластера из инкрементальной копии pg_probackup восстанавливает родительскую полную копию, а затем применяет к ней последовательно инкрементальные копии, останавливаясь после целевой.
Утилита pg_probackup поддерживает три режима инкрементального резервного копирования: DELTA, PAGE и PTRACK.
Режим DELTA — разностное копирование. Страницы файлов в каталоге данных сравниваются со страницами из последней резервной копии. В новую резервную копию попадают только измененные с момента последнего копирования страницы.
Достоинство режима DELTA — его простота: не требуется архив WAL и не надо устанавливать дополнительные расширения. Однако есть и недостаток: объем ввода-вывода может оказаться почти таким же, как при полном резервном копировании.
https://postgrespro.ru/docs/enterprise/16/app-pgprobackup#PBK-MODES-D ELTA
Page 5: Восстановление
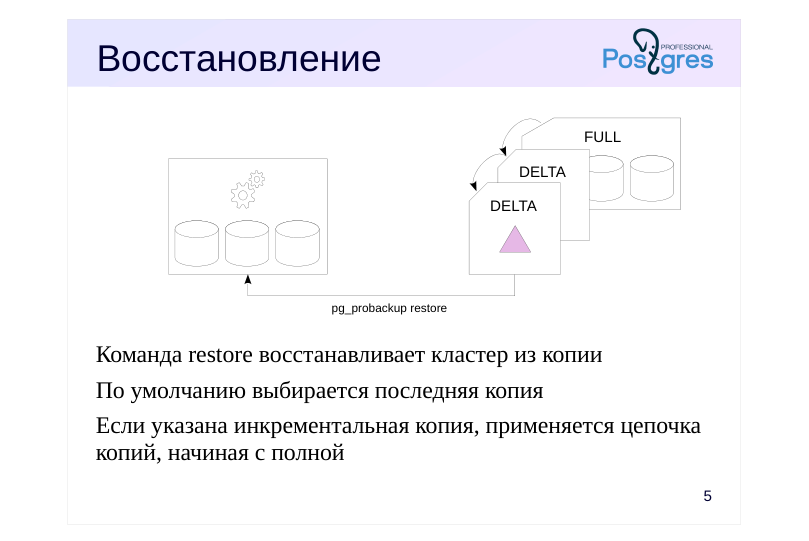 {#source-figure-005 caption=“Source slide page 5: Восстановление”}
Команда restore восстанавливает кластер из копии
- По умолчанию выбирается последняя копия
- Если указана инкрементальная копия, применяется цепочка копий, начиная с полной
Комментарии преподавателя
Если команде restore утилиты указать инкрементальную копию, pg_probackup восстановит родительскую полную копию и затем последовательно применит нужные инкрементальные копии.
Если идентификатор копии не указан, выполняется восстановление из самой последней имеющейся копии (включая копии из цепочки, если последняя копия — инкрементальная).
Page 6: Копирование DELTA
Создадим базу данных, к которой будет подключаться роль backup.
Мы будем запускать утилиту локально от имени пользователя ОС student, а агент на удаленном сервере будет обращаться к файлам кластера от имени postgres. Необходимые настройки в виртуальной машине курса уже произведены. Подготовим локальный каталог копий, владелец файлов — student.
Добавим в локальный каталог копий экземпляр БД, работающий на целевом сервере.
Не забудем о настройках конфигурации:
Каталог PGDATA принадлежит пользователю ОС postgres и группе postgres, и экземпляр обычно запускается от имени postgres. Если указан параметр –allow-group-access, при восстановлении дополнительно выдаются права на чтение и доступ в каталог группе postgres — это позволит в будущем выполнять резервное копирование от имени членов группы, не используя максимальные привилегии root. Сначала сформируем полную резервную копию удаленного сервера, используя потоковую доставку записей WAL:
В каталоге резервных копий появилась запись:
Произведем какие-нибудь изменения, например, создадим таблицу:
Page 7: Page 7
И запишем в нее данные:
Получим разностную резервную копию:
Что теперь в каталоге копий?
Обратите внимание, насколько разностная копия меньше полной. Восстановим кластер из последней копии. Остановим экземпляр:
Удалим содержимое PGDATA.
При восстановлении указываем разностную копию:
Запускаем экземпляр.
Мы восстановили данные, использовав цепочку из полной и разностной копий.
Page 8: Объединение копий
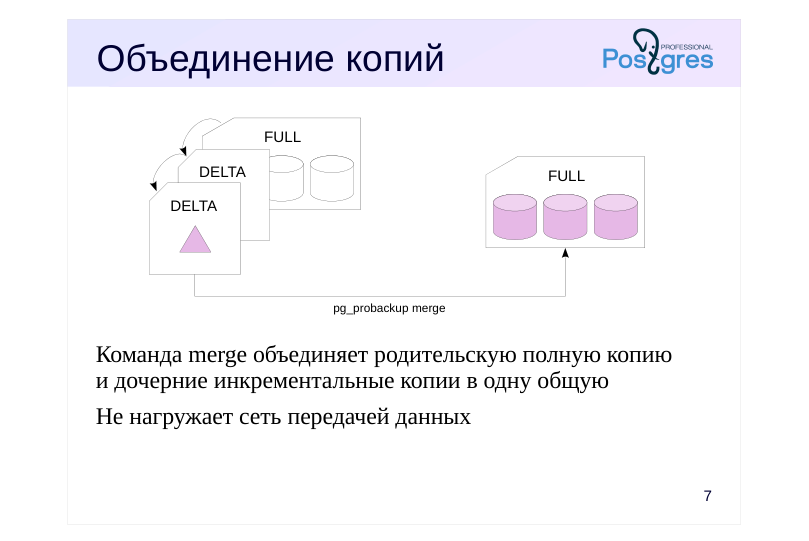 {#source-figure-008 caption=“Source slide page 8: Объединение копий”}
Команда merge объединяет родительскую полную копию и дочерние инкрементальные копии в одну общую
- Не нагружает сеть передачей данных
Комментарии преподавателя
Инкрементальная резервная копия строится быстрее полной и занимает меньше места. Однако по мере роста цепочки занимаемый объем и время восстановление будут увеличиваться.
Утилита pg_probackup позволяет объединить цепочку копий в одну полную копию командой merge.
Передав команде merge идентификатор последней инкрементальной копии в цепочке, мы получим единую полную копию, содержащую данные родительской полной копии со всеми изменениями, накопленными в цепочке инкрементальных. Все копии цепочки удаляются и остается единственная объединенная полная копия.
Указав команде идентификатор родительской копии, мы получим объединенную копию, включающую родительскую полную и первую инкрементальную.
При объединении вся работа производится в каталоге резервных копий, команда merge не передает данные по сети.
https://postgrespro.ru/docs/enterprise/16/app-pgprobackup#PBK-MERGING -BACKUPS
Page 9: Объединение копий
Еще раз изменим данные: создадим базу данных, которая нам понадобится в дальнейшем.
Получим вторую разностную резервную копию:
Состояние каталога копий:
В информации о резервной копии есть номер родительской копии:
Третья копия, последняя в цепочке, содержит изменения данных, произошедшие после построения копии с этим идентификатором. По мере добавления инкрементальных копий они будут занимать все больше дискового пространства. Можно выполнить полное копирование и удалить все предыдущие копии, но удобнее воспользоваться объединением копий.
В результате имеем единственную полную копию, объединяющую в себе три предыдущие:
Сохраним эту копию для дальнейшей демонстрации.
Page 10: Копирование PTRACK
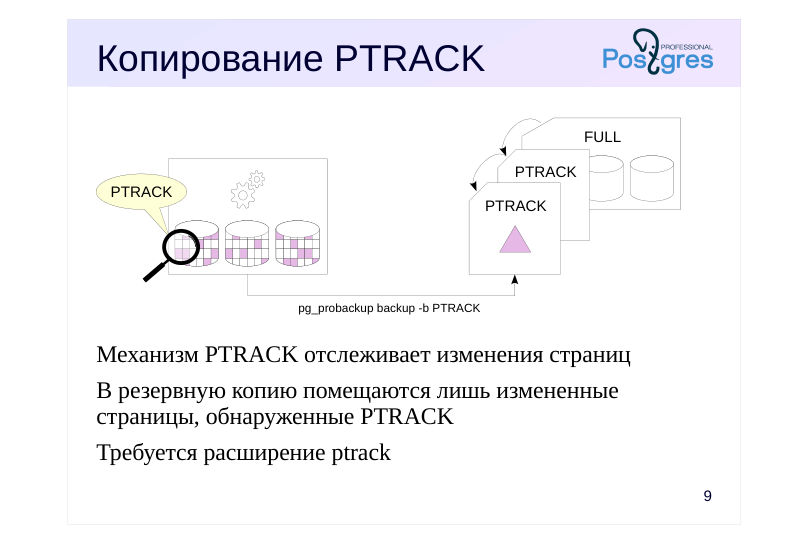 {#source-figure-010 caption=“Source slide page 10: Копирование PTRACK”}
Механизм PTRACK отслеживает изменения страниц
- В резервную копию помещаются лишь измененные страницы, обнаруженные PTRACK
- Требуется расширение ptrack
Комментарии преподавателя
PTRACK — еще один режим инкрементального резервного копирования экземпляра Postgres Pro. В копию попадают только изменившиеся страницы, но, в отличие от DELTA, утилите не требуется сравнивать данные с резервной копией: она получает список страниц с помощью механизма PTRACK.
Механизм PTRACK встроен в ядро Postgres Pro Enterprise. Он отслеживает и отмечает модификации страниц в специальной карте и предоставляет API для получения списка файлов, измененных с произвольного момента LSN, и битовых карт измененных в этих файлах страниц.
https://postgrespro.ru/docs/enterprise/16/ptrack
Утилита pg_probackup получает список страниц, подлежащих копированию, запрашивая изменения, произошедшие после создания предыдущей резервной копии. Поскольку для этого не требуется читать файлы данных и последнюю резервную копию, этот режим инкрементального резервного копирования может оказаться самым быстрым, особенно в сценариях, когда интенсивно изменяются одни и те же страницы.
https://postgrespro.ru/docs/enterprise/16/app-pgprobackup#PBK-MODES-P TRACK
Page 11: Копирование PTRACK
Подключим библиотеку PTRACK к экземпляру.
Экземпляр необходимо перезагрузить.
Установим расширение в базу pgpro_probackup_2.
Необходимо задать значение параметра ptrack.map_size, рекомендуется 1/1024 объема кластера Postgres Pro:
Изменение этого параметра также требует перезапуска.
Существующая полная копия была сделана до того, как PTRACK стал отслеживать изменения, поэтому для демонстрации работы PTRACK нам потребуется новая полная копия.
Добавим в таблицу еще одну строку.
Теперь выполним инкрементальное резервное копирование в режиме PTRACK.
В каталоге резервных копий появилась инкрементальная копия:
Восстановление в данном случае производится так же, как и для разностных копий. Однако, какая копия будет использована для восстановления, если явно не указать идентификатор?
Очистим каталог данных.
Page 12: Page 12
Восстанавливаем кластер, не указывая идентификатор копии.
Запускаем экземпляр.
Итак, была использована самая свежая копия. Удалим эти копии, больше они не потребуются.
PTRACK тоже больше не нужен.
Мы перезапустим экземпляр позже.
Page 13: Копирование PAGE
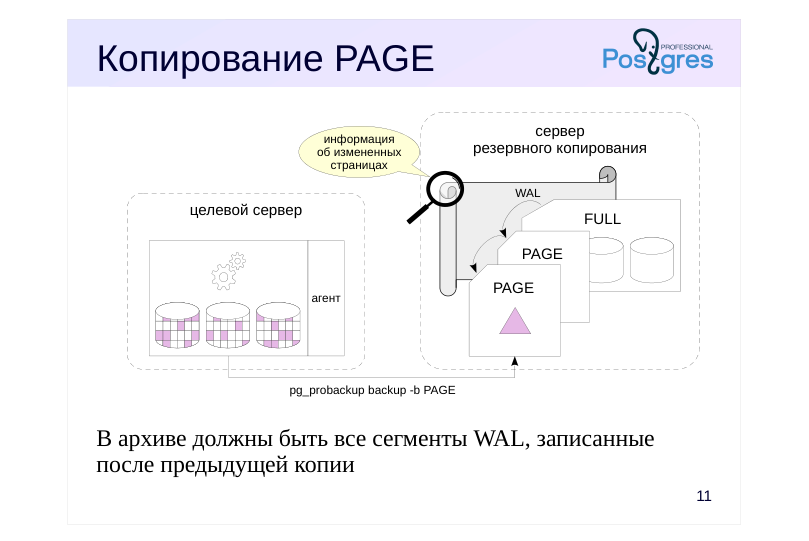 {#source-figure-013 caption=“Source slide page 13: Копирование PAGE”}
В архиве должны быть все сегменты WAL, записанные после предыдущей копии
Комментарии преподавателя
При наличии архива WAL для создания инкрементальных копий можно использовать еще один режим инкрементального резервного копирования pg_probackup — страничное копирование (PAGE).
При копировании PAGE pg_probackup сканирует все записи WAL в архиве, начиная с момента создания предыдущей полной или инкрементальной копии, и определяет по ним список изменившихся страниц. При этом необходимо, чтобы в архиве присутствовали все файлы WAL, сгенерированные после предыдущей копии.
Режим PAGE особенно эффективен, когда в базах данных происходит немного изменений. Если же объем журнальных файлов сравним с общим объемом файлов базы данных, ускорение будет незначительным, однако объем инкрементальной копии все равно будет меньше, чем полной.
https://postgrespro.ru/docs/enterprise/16/app-pgprobackup#PBK-MODES-P AGE
Page 14: Восстановление
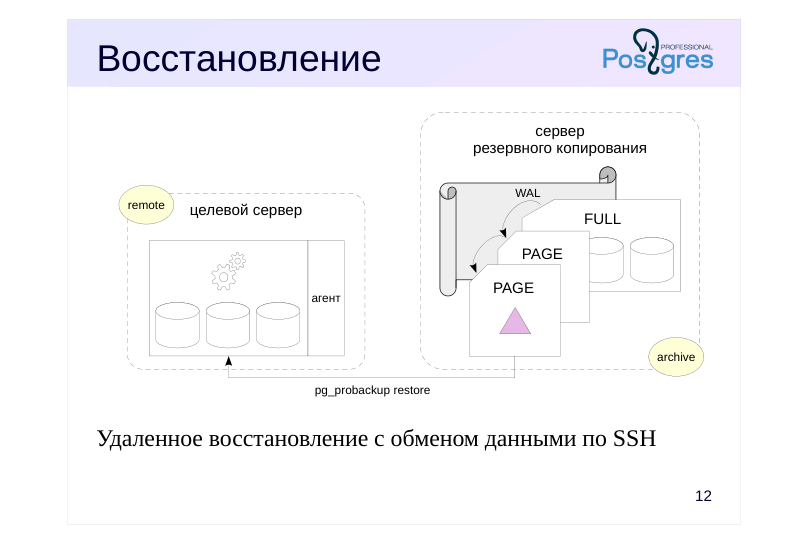 {#source-figure-014 caption=“Source slide page 14: Восстановление”}
Удаленное восстановление с обменом данными по SSH
Комментарии преподавателя
Архив WAL заполняется с целевого сервера командой pg_probackup archive-push (указанной в конфигурационном параметре archive_command) по SSH. И при восстановлении целевой сервер будет читать необходимые сегменты журнала по SSH командой pg_probackup archive-get (указанной в параметре restore_command).
Здесь мы имеем дело с удаленным восстановлением. Поэтому при вызове pg_probackup restore требуется указать два набора параметров.
Remote-параметры указывают на целевой сервер с восстанавливаемым экземпляром:
● –remote-host — адрес целевого сервера;
● –remote-user — владелец экземпляра (postgres);
● –remote-port — порт SSH.
Archive-параметры указывают на сервер резервного копирования, хранящий архив WAL:
● –archive-host — адрес сервера резервного копирования;
● –archive-user — владелец каталога резервных копий;
● –archive-port — порт SSH.
Archive-параметры используются, чтобы сформировать на целевом сервере значение параметра restore_command.
Page 15: Копирование PAGE
Подготовим экземпляр к работе с архивацией WAL.
Для команды архивирования целевым является сервер резервного копирования, здесь ему соответствует localhost. Команда архивирования будет подключаться к серверу по SSH под именем владельца каталога резервных копий — пользователя student.
Экземпляр необходимо перезапустить.
Посмотрим содержимое архива WAL:
Пока он пуст. Переключим сегмент WAL.
Сегмент WAL попал в архив:
Выполним полное резервное копирование. Поскольку настроена файловая архивация, копировать WAL не нужно, ключ – stream не указываем.
Page 16: Page 16
Проверим каталог резервных копий:
Создадим еще одну таблицу.
Увеличим счетчик транзакций и запомним номер, он потребуется нам позже.
Предположим, что оператор по ошибке удалил таблицу t1:
Выполним инкрементальное резервное копирование в режиме PAGE.
Проверим каталог резервных копий:
Сначала восстановим данные, используя инкрементальную копию. Останавливаем сервер:
Удаляем содержимое PGDATA:
Восстанавливаем из цепочки копий:
Запускаем экземпляр.
Page 17: Page 17
Для восстановления использовалась такая команда получения сегментов из архива WAL:
Ее сформировала утилита по переданным ей archive-параметрам. Восстановление прошло успешно, но, естественно, таблица t2 по-прежнему на месте, а t1 — отсутствует:
Page 18: Способы восстановления
Восстановление PITR
- Частичное восстановление
- Восстановление страниц
- Синхронизация
Page 19: Восстановление PITR
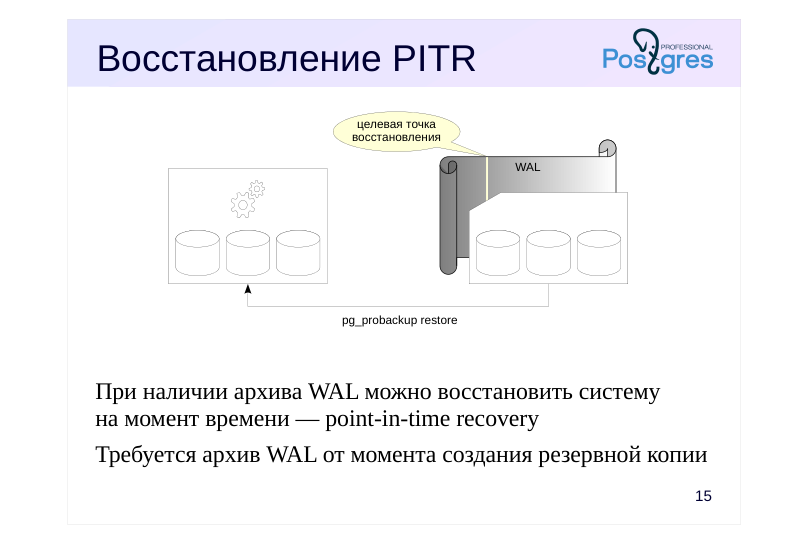 {#source-figure-019 caption=“Source slide page 19: Восстановление PITR”}
При наличии архива WAL можно восстановить систему на момент времени — point-in-time recovery
- Требуется архив WAL от момента создания резервной копии
Комментарии преподавателя
Если до выполнения резервного копирования уже был настроен архив WAL, то с помощью pg_probackup можно выполнить восстановление на момент времени в прошлом (Point-In-Time Recovery, PITR). Независимо от того, является ли резервная копия автономной (включает журнальные файлы) или нет, требуется наличие архива WAL как минимум с момента создания резервной копии.
При восстановлении на момент времени не обязательно указывать идентификатор копии. Утилита pg_probackup автоматически выберет резервную копию, ближайшую к заданной целевой точке, и начнет восстановление.
Указать точку восстановления можно параметрами:
● –recovery-target-time — на заданное время в формате timestamp;
● –recovery-target-xid — до заданной транзакции;
● –recovery-target-lsn — до заданного LSN;
● –recovery-target-name — до заранее созданной именованной точки;
● –recovery-target=‘latest’ — до последнего согласованного состояния;
● –recovery-target=‘immediate’ — до самого раннего согласованного состояния.
https://postgrespro.ru/docs/enterprise/16/app-pgprobackup#PBK-PERFORM ING-POINT-IN-TIME-PITR-RECOVERY
Page 20: Восстановление PITR
Итак, мы обнаружили, что таблица была удалена, и решили восстановить данные на момент до удаления таблицы. Ранее мы выяснили номер транзакции — 971. Восстановим данные до этого номера.
Восстанавливаемся, используя цепочку копий, до XID 971:
Запускаем экземпляр.
При запуске сервер вошел в режим восстановления и применяет журнальные записи, пока не достигнет цели восстановления.
Проверим, восстановились ли уже таблицы (если нет, нужно подождать):
Поскольку цель — момент времени в прошлом, сервер останется в режиме восстановления:
Переведем сервер в обычный режим.
Page 21: Page 21
Резервные копии, использующие архив WAL, больше не нужны. Удалим их.
Page 22: Частичное восстановление
 {#source-figure-022 caption=“Source slide page 22: Частичное восстановление”}
Восстановление только требуемых баз данных кластера
- -db-include — база данных для восстановления
- -db-exclude — база данных, которую не надо восстанавливать
Комментарии преподавателя
Частичное восстановление применяется в случаях, когда не требуется восстанавливать все базы данных кластера.
Параметром –db-include можно задать имя базы данных для восстановления. Базы template0 и template1 восстанавливаются всегда. Можно указать несколько таких параметров, по одному для каждой восстанавливаемой базы данных.
Используя параметр –db-exclude, можно попросить утилиту восстановить все базы, кроме указанных.
Все файлы пропущенных баз данных все равно создаются утилитой, но создаются пустыми. Это необходимо, поскольку при старте экземпляра процесс startup проигрывает журнальные записи (как минимум для восстановления согласованности) и ожидает обнаружить соответствующие файлы данных. Затем ненужные базы данных можно удалить.
https://postgrespro.ru/docs/enterprise/16/app-pgprobackup#PBK-PARTIAL-RESTORE
Page 23: Частичное восстановление
Восстановим из единственной оставшейся полной копии все базы данных кластера, кроме pgpro_probackup_2_bis.
Останавливаем экземпляр.
Удаляем содержимое PGDATA:
Добавим к командной строке параметр –db-exclude, чтобы база pgpro_probackup_2_bis не восстанавливалась:
Запускаем экземпляр.
База данных pgpro_probackup_2_bis есть в списке:
Однако подключиться к ней нельзя:
Page 24: Page 24
В подкаталоге PGDATA этой базы только пустые файлы:
Эту базу данных можно удалить из системного каталога, файлы при этом тоже удалятся.
Целостность восстановленных баз данных можно проверить командой checkdb:
Теперь можно работать с восстановленными данными:
Page 25: Восстановление страниц
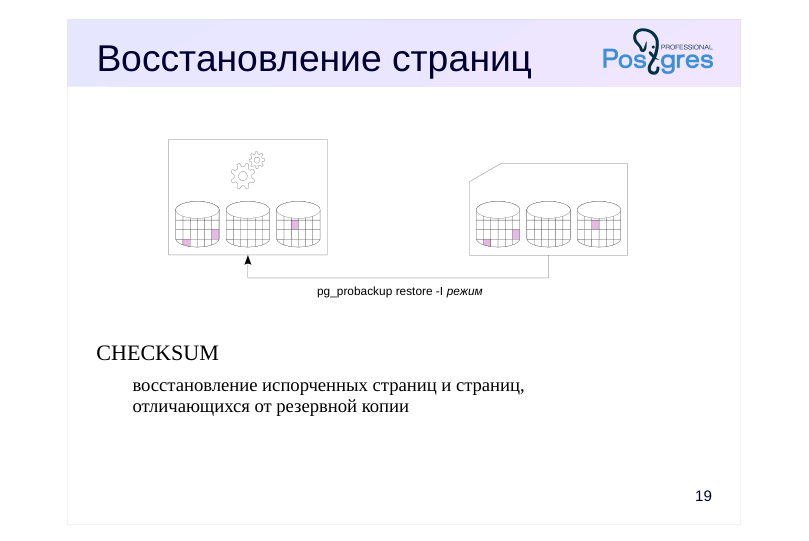 {#source-figure-025 caption=“Source slide page 25: Восстановление страниц”}
CHECKSUM
- восстановление испорченных страниц и страниц,
- отличающихся от резервной копии
Комментарии преподавателя
При инкрементальном восстановлении (восстановлении страниц) каталог данных экземпляра не перезаписывается полностью, а только обновляется теми страницами, состояние которых изменилось по сравнению с резервной копией. Если каталог данных не сильно отличается от копии, такое восстановление будет работать значительно быстрее обычного.
Для инкрементального восстановления в командную строку добавляется параметр -I, после которого указывается один из двух режимов: CHECKSUM или LSN. Эти режимы определяют, как именно будут выбираться страницы, требующие восстановления.
В режиме CHECKSUM восстанавливаются страницы с некорректной контрольной суммой или с номером LSN, отличающимся от LSN в резервной копии. Для этого утилита читает все файлы данных экземпляра, получает их контрольные суммы и LSN, а затем сравнивает эту информацию с содержимым резервной копии. Если имеет место цепочка инкрементальных резервных копий, в более ранних копиях ищутся только те страницы, которые не были найдены в более поздних.
Экономия достигается за счет того, что только изменившиеся страницы передаются по сети и записываются на диск целевого экземпляра.
https://postgrespro.ru/docs/enterprise/16/app-pgprobackup#PBK-INCREME NTAL-RESTORE
Page 26: Восстановление страниц
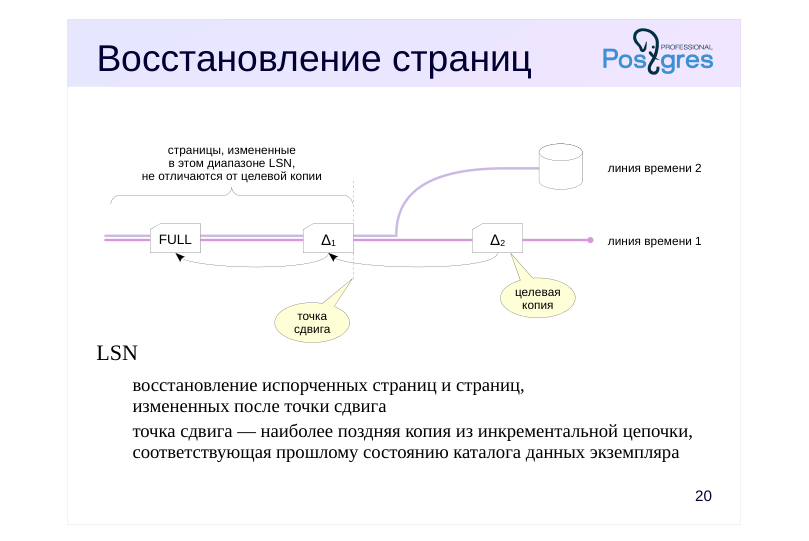 {#source-figure-026 caption=“Source slide page 26: Восстановление страниц”}
LSN
- восстановление испорченных страниц и страниц,
- измененных после точки сдвига
- точка сдвига — наиболее поздняя копия из инкрементальной цепочки,
- соответствующая прошлому состоянию каталога данных экземпляра
Комментарии преподавателя
В режиме LSN утилита пытается найти в инкрементальной цепочке целевой резервной копии наиболее позднюю копию, соответствующую какому-либо состоянию каталога данных экземпляра в прошлом. Момент завершения создания этой копии называется точкой сдвига (Shift LSN) и принадлежит некоторой линии времени. Точка сдвига важна тем, что страницы экземпляра с LSN ≤ Shift LSN заведомо совпадают со страницами, которые можно восстановить из целевой резервной копии, то есть при восстановлении такие страницы можно просто игнорировать.
Если подходящей на роль точки сдвига копии нет, восстановление в режиме LSN невозможно (режим CHECKSUM доступен всегда).
На слайде копия Δ2 не может служить точкой сдвига, поскольку не соответствует никакому прошлому состоянию экземпляра: она была сделана в первой линии времени, а экземпляр в некоторый момент переключился на вторую линию. А копия Δ1 удовлетворяет условиям и будет выбрана в качестве точки сдвига.
Режим LSN требует корректности файла pg_control, поскольку из него считывается Redo LSN и линия времени экземпляра, и наличия необходимых файлов истории в архиве WAL. Также должны быть включены контрольный суммы.
Однако если режим доступен, он оказывается более эффективным, чем CHECKSUM. Файлы каталога данных все равно читаются полностью, но в режиме CHECKSUM по резервной копии проверяются все страницы, а в LSN — только измененные позже точки сдвига.
Page 27: Восстановление страниц (инкрементальное)
В предыдущем опыте частичного восстановления база данных pgpro_probackup_2_bis не была восстановлена. Инкрементальное восстановление позволит не копировать лишние данные, ограничившись только недостающими и измененными страницами. В управляющем файле кластера есть информация о последней контрольной точке, которая определяет текущее положение экземпляра на линии времени:
В хранилище резервных копий хранится информация о линии времени и LSN завершения создания копии:
В нашем случае линия времени всего одна, а имеющаяся копия отражает прошлое состояние экземпляра, так что может служить точкой сдвига для режима LSN (Backup TIUPTT is chosen as shiftpoint):
Обратите внимание на строку «Restore incremental ratio (less is better)». Это отношение объема восстановленных страниц к общему объему данных в кластере. Чем меньше это значение, тем выше эффективность и скорость инкрементального восстановления.
База данных pgpro_probackup_2_bis восстановлена.
Page 28: Page 28
Page 29: Синхронизация
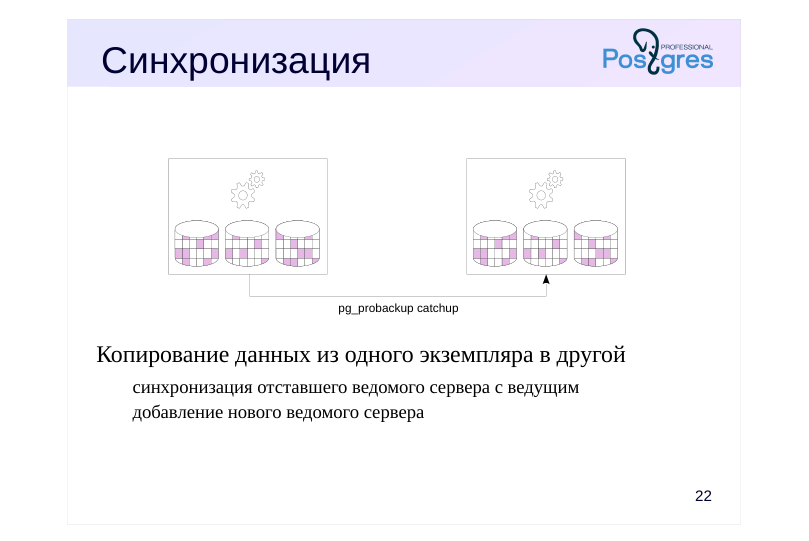 {#source-figure-029 caption=“Source slide page 29: Синхронизация”}
Копирование данных из одного экземпляра в другой
- синхронизация отставшего ведомого сервера с ведущим
- добавление нового ведомого сервера
Комментарии преподавателя
Быстро клонировать экземпляр или синхронизировать отставшую реплику позволяет команда catchup утилиты pg_probackup. Она не использует каталог резервных копий, а берет данные непосредственно из каталога данных копируемого экземпляра.
Ускорение относительно обычных средств может достигаться за счет:
● многопоточной передачи данных;
● инкрементального копирования (с дополнению к режиму FULL доступны DELTA и PTRACK).
Использование команды catchup для синхронизации отставшей реплики позволяет избежать сложных ручных процедур с использованием rsync и подобных инструментов.
Команда catchup отличается от других операций, выполняемых утилитой pg_probackup:
● по умолчанию конфигурационные файлы целевого сервера заменяются файлами исходного сервера;
● возможна только потоковая доставка WAL (архив не используется);
● не копируются внешние каталоги;
● запрещено одновременное выполнение команд DDL, создающих или удаляющих табличные пространства.
https://postgrespro.ru/docs/enterprise/16/app-pgprobackup#PBK-CREATIN G-BACKUP-TO-CATCHUP
Page 30: Синхронизация
Создадим физическую реплику с помощью утилиты pg_probackup, восстановив данные из резервной копии двумя потоками:
Здесь были использованы следующие параметры командной строки pg_probackup: -D — целевой каталог для восстановления; -j — копировать в несколько потоков; –restore-as-replica — создать файл standby.signal и настроить строку подключения к мастеру. Запустим реплику, изменив перед этим номер порта в конфигурации.
Проверим работу репликации.
Репликация работает:
Page 31: Page 31
На реплике аварийно завершается основной процесс:
Пока реплика простаивает, на основном сервере изменим тысячу строк:
Если реплика долго простаивала, ее синхронизации может занять долгое время, даже если все нужные журнальные файлы еще сохранились на основном сервере. Мы хотим ускорить синхронизацию, передав данные с мастера на реплику командой catchup, которая будет передавать только измененные страницы. Используем режим инкрементального копирования DELTA, укажем пути к каталогам данных. Дополнительный файл конфигурации не копируем:
Обратите внимание на строку «Catchup incremental ratio (less is better)» — она показывает отношение объема переданных для синхронизации страниц к их общему объему. Чем меньше значение, тем эффективнее работает синхронизация. Запустим реплику.
Page 32: Page 32
Проверим данные на реплике:
Все измененные строки синхронизированы.
Page 33: Итоги
Утилита pg\_probackup поддерживает инкрементальное копирование и инкрементальное восстановление измененных страниц
- При наличии архива WAL поддерживается восстановление на момент в прошлом
- Возможно восстановление части данных кластера и эффективная синхронизация двух кластеров
Page 34: Практика
- Подготовьте экземпляр к работе с архивированием WAL, создайте базу данных, выполните полное копирование со сжатием. 2. Измените какие-либо данные в базе и выполните инкрементальное страничное копирование со сжатием. 3. Убедитесь, что полученная цепочка копий пригодна для восстановления экземпляра. 4. Имитируйте аварию сервера с физической порчей данных. 5. Восстановите испорченные данные, не затрагивая при этом другие данные кластера.
Комментарии преподавателя
- Аварийно завершите основной процесс экземпляра. Измените файл основного слоя таблицы средствами ОС, например:
- Выполните инкрементальное восстановление в режиме CHECKSUM.
Page 35: 1. Подготовка каталога резервных копий и регистрация экземпляра. Режим WAL
Создадим и подготовим каталог копий.
Инициализируем каталог.
Регистрируем экземпляр.
Создадим базу данных.
Запомним в настройках конфигурации атрибуты подключения.
Подготовимся к работе в режиме архивирования WAL.
Перезапустим сервер:
Проверим работу архивирования WAL.
Page 36: Page 36
Проверим, попал ли сегмент WAL в архив.
Получим список сжатых сегментов WAL, помещенных в архив:
По умолчанию сжатие производится методом zstd. Теперь сделаем полную резервную копию со сжатием.
2. Инкрементальная копия
Добавим строку в таблицу.
Сформируем инкрементальную копию, тоже со сжатием.
Содержимое каталога копий:
3. Восстановление из сжатой резервной копии
Остановим экземпляр.
Удалим содержимое PGDATA.
Восстановим экземпляр из цепочки резервных копий.
Page 37: Page 37
Запустим экземпляр.
Данные восстановлены.
4. Авария сервера
Определим физический путь к файлу, содержащему страницы таблицы t.
На сервере происходит авария.
Сымитируем физическую порчу файла данных, записав в него 10 страниц (80 килобайт) случайных данных:
Запустим сервер.
Попытаемся обратиться к таблице.
5. Инкрементальное восстановление таблицы
Мы хотим восстановить испорченные страницы, не копируя при этом остальные данные кластера. Остановим сервер.
Выполним инкрементальное восстановление в режиме CHECKSUM.
Page 38: Page 38
Был скопирован примерно 1 мегабайт данных при общем объеме кластера около 300 мегабайт. Запустим сервер.
Таблица восстановлена:
Уборка
Удалим созданную базу данных и каталог копий, сбросим настройки параметров конфигурации.
20 Занятие 20: Резервное копирование / Другие возможности pg_probackup
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_20_probackup_3.html Archive: PGPRO-handouts-16.zip Страниц PDF: 21
Page 1: Резервное копирование / Другие возможности pg_probackup
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Хранилище S3
- Политики хранения
- Журнал
Page 3: Хранилище S3
 {#source-figure-003 caption=“Source slide page 3: Хранилище S3”}
Каталог копий можно размещать в хранилище S3
- MinIO
- Amazon S3
- VK Cloud
Комментарии преподавателя
Утилита pg_probackup способна работать с каталогом копий, который размещен в объектном хранилище, предоставляющем интерфейс S3 (Simple Storage Service).
В настоящее время поддерживаются: MinIO, Amazon S3 и VK Cloud. MinIO — программа с открытым кодом, реализующая API, совместимый с S3, и важнейшие возможности, аналогичные Amazon Web Services. В демонстрационных материалах курса используется именно MinIO.
https://postgrespro.ru/docs/enterprise/16/app-pgprobackup#PBK-SETUP-S3
Page 4: Хранилище S3
В виртуальной машине установлено и настроено программное обеспечение MinIO, реализующее API S3. Запустим сервис MinIO.
Объектное хранилище MinIO использует корзины — аналоги каталогов в обычных файловых системах. Создадим корзину bkp:
С помощью текстового редактора создадим файл, описывающий подключение к хранилищу S3:
access_key и secret-key задают имя учетной записи и пароль в хранилище; s3-host и s3-port — узел и порт службы S3; s3-bucket — имя корзины S3; s3-secure — использование протокола https. Создадим базу данных, к которой будет подключаться роль backup.
Инициализируем каталог копий в хранилище S3: провайдер указывается в параметре –s3; расположение файла с настройками — в параметре –s3-config-file.
Если параметр –s3-config-file опущен, pg_probackup ищет настройки подключения к S3 сначала в /etc/pg_probackup/s3.config, а затем в ~postgres/.pg_probackup/s3.config. Также параметры подключения к S3 можно задать с помощью переменных окружения. Добавим в локальный каталог копий экземпляр БД, работающий на удаленном сервере. Каталог копий будет создан в хранилище S3.
Чтобы сократить командную строку, сохраним параметры удаленного доступа в конфигурации.
Page 5: Page 5
Обратите внимание, что параметры –s3=minio и –s3-config-file=/home/student/s3.config задают подключение к S3, они в конфигурацию не записываются и должны задаваться в командной строке явно. Выполним полное резервное копирование в облако.
В каталоге теперь имеется полная потоковая копия:
Page 6: Политики хранения
Удаление лишних копий
- Закрепление копий
- Политика хранения WAL
Page 7: Удаление лишних копий
 {#source-figure-007 caption=“Source slide page 7: Удаление лишних копий”}
По умолчанию в каталоге хранятся все резервные копии
- Политика хранения определяет правила удаления копий
- количество хранимых копий
- окно удержания в днях
Комментарии преподавателя
Экземпляру можно задать индивидуальную политику хранения резервных копий, определяющую, какие резервные копии следует считать устаревшими и ненужными. Политика определяется количеством полных копий, которые должны сохраняться в каталоге, а также окном удержания, которое определяет самый ранний момент времени, на который pg_probackup должен обеспечить восстановление. Окно удержания ограничивает количество дней сохранения избыточных копий в каталоге.
Например, если окно удержания установлено в значение 7 дней, то в каталоге должна сохраняться минимум одна копия старше 7 дней с файлами WAL и цепочкой инкрементальных копий.
Политика хранения задается параметрами:
● –retention-redundancy — количество полных резервных копий, которое должно сохраняться в каталоге;
● –retention-window — количество дней от текущего момента до самого раннего момента времени в прошлом, на который может быть выполнено восстановление.
Параметры можно указать в командной строке pg_probackup для команд backup или delete, или сохранить в конфигурации командой set-config.
https://postgrespro.ru/docs/enterprise/16/app-pgprobackup#PBK-RETENTI ON-POLICY
Page 8: Закрепление копий
 {#source-figure-008 caption=“Source slide page 8: Закрепление копий”}
На закрепленные копии политика хранения не действует
- Параметры закрепления (команды backup и set-backup)
- -ttl — время закрепления
- -expire-time — срок хранения резервной копии
Комментарии преподавателя
Если нужно хранить копию дольше, чем задано политикой хранения, можно закрепить ее на определенное время.
Закрепление можно задать при выполнении команды backup или сохранить в конфигурации командой set-backup.
Параметр –ttl задает требуемое время жизни копии, по умолчанию предполагаются секунды. Значение ноль отменяет закрепление.
Другой вариант — явно задать время истечения срока хранения копии, воспользовавшись параметром –expire-time.
Определить, закреплена ли копия, можно с помощью команды show утилиты pg_probackup. Закрепленная копия имеет атрибут expire-time, содержащий время окончания срока ее хранения.
https://postgrespro.ru/docs/enterprise/16/app-pgprobackup#PBK-BACKUP-PINNING
Page 9: Политика хранения WAL
 {#source-figure-009 caption=“Source slide page 9: Политика хранения WAL”}
Политика хранения архива WAL ограничивает глубину архива для экономии места в хранилище
- Удаление устаревших копий с –delete-wal сопровождается удалением лишних сегментов WAL
Комментарии преподавателя
При работе в режиме непрерывного архивирования сегменты WAL накапливаются в хранилище. Но его емкость ограничена.
Можно удалять устаревшие резервные копии с параметром –delete-wal. При этом удаляются только те сегменты WAL, которые не относятся ни к одной из резервных копий в каталоге. Если возможность восстановления на момент времени нужна только для самых недавних резервных копий, можно, настроив политику хранения архива WAL, ограничить число таких копий — глубину архива — и сэкономить занимаемое место. Из копии, оставшейся без архива WAL, можно восстановиться, только если она является автономной (то есть содержит необходимые журнальные файлы).
Политику хранения архива WAL настраивают параметром –wal-depth. Установленная политика действует для всех линий времени, поэтому можно выполнять PITR для одинакового количества копий на каждой линии времени. Закрепленные копии в этом числе не учитываются.
Можно вручную удалить сегменты, не удовлетворяющие заданной политике хранения архива WAL, выполнив команду pg_probackup delete или pg_probackup backup –delete-wal.
https://postgrespro.ru/docs/enterprise/16/app-pgprobackup#PBK-WAL-ARC HIVE-RETENTION-POLICY
Page 10: Политики хранения копий
Выполним еще одно полное резервное копирование.
Кроме последней, актуальной копии, в каталоге есть первая, ранее созданная.
Если принята политика хранить единственную полную резервную копию, то первая созданная копия устарела. Количество хранящихся избыточных копий можно задать непосредственно в командной строке. Выполним удаление, указав, что должна храниться только одна копия.
Проверим состояние каталога резервных копий:
Осталась единственная полная резервная копия. Зафиксируем политику удержания единственной полной копии в конфигурации.
Сделаем полную копию со сжатием. Укажем, что должны быть удалены устаревшие в соответствии с политикой хранения копии и сегменты WAL.
Page 11: Page 11
Теперь в каталоге осталась последняя полная резервная копия.
Page 12: Журнал
Журнал сообщений
- Ротация журнала
Page 13: Журнал сообщений
По умолчанию pg\_probackup выводит сообщения в stderr
- Можно указать файл журнала для записи сообщений
- отдельный журнал для сообщений об ошибках
- Уровни важности сообщений настраиваются отдельно для вывода на консоль и в файл журнала
- Ротация файлов журнала
- по достижении заданного размера файла
- ограничением времени записи в файл
Комментарии преподавателя
В pg_probackup определены следующие уровни важности сообщений: verbose, log, info, warning, error и off. Каждый уровень включает все последующие, и с каждым следующим уровнем объем сообщений уменьшается. При работе pg_probackup сообщения с уровнем важности info и выше выводятся по умолчанию на консоль в стандартный поток вывода ошибок stderr.
Уровень сообщений настраивается отдельно для консоли (–log-level-console) и для файла журнала (–log-level-file).
Для записи сообщений в журнал следует задать имя файла с помощью параметра –log-filename. По умолчанию файл располагается в подкаталоге log каталога резервных копий, параметром –log-directory расположение можно переопределить.
Сообщения как на консоль, так и в журнал, можно выводить в обычном текстовом виде или в формате JSON.
Настройкой –error-log-filename можно указать шаблон имен файлов для сообщений об ошибках.
Чтобы журналы сообщений не разрастались бесконтрольно, нужно настроить ротацию. Она может происходить по достижении указанного размера файла журнала (–log-rotation-size), либо по достижении максимального времени записи в файл (–log-rotation-age).
https://postgrespro.ru/docs/enterprise/16/app-pgprobackup#PBK-LOGGING-OPTS
Page 14: Настройка журнала сообщений
Настроим параметры для журнала сообщений: –log-level-file — уровень сообщений, которые будут выводиться в файл журнала; –log-level-console — уровень сообщений, которые будут выводиться на консоль; –log-filename — имя файла журнала (по умолчанию в подкаталоге log, расположение можно изменить с помощью – log-directory); –log-rotation-size — размер файла, при превышении которого выполняется ротация. Нам потребуется каталог для хранения файлов журналов:
Выполним резервное копирование с только что заданными настройками журнала сообщений.
Заглянем в каталог с журналом:
Еще раз выполним резервное копирование, включив подробный вывод сообщений в журнал.
В журнал записалось большое количество сообщений.
Повторим эксперимент с уровнем важности сообщений по умолчанию. Файл журнала сообщений достиг размера, при котором должна произойти ротация:
Page 15: Page 15
В результате ротации журнала старые сообщения были стерты и размер файла уменьшился.
Корзина bkp нам больше не понадобится, удалим ее:
Page 16: Итоги
Каталог резервных копий может размещаться в облаке S3
- Поддерживаются политики хранения, определяющие правила удаления резервных копий и сегментов WAL
- Можно настроить журналирование сообщений и ротацию
Page 17: Практика
- Инициализируйте каталог резервных копий и добавьте в него экземпляр, подготовив его для локальной работы. 2. Настройте вывод сообщений в журнал и политику хранения единственной полной копии. 3. Проверьте удаление лишних копий, несколько раз выполнив полное копирование. Найдите в журнале сообщений соответствующие строки.
Комментарии преподавателя
Инициализируйте каталог с помощью pg_probackup init, а затем добавьте в него экземпляр командой pg_probackup add-instance. Зарегистрировав роль backup, создайте базу данных для подключения из шаблона templateprobackup.
При выполнении полного резервного копирования используйте параметр –stream.
Page 18: 1. Подготовка каталога резервных копий
Подготовим каталог в файловой системе.
Инициализируем каталог копий.
Зарегистрируем экземпляр.
Создадим базу данных для подключения.
2. Настройка журнала сообщений
Установим политику хранения единственной полной копии и вывод сообщений в журнал.
3. Полная копия
Сформируем полную копию:
Проверим каталог копий.
Еще одна полная копия.
Page 19: Page 19
Проверим каталог копий — предыдущая копия удалена:
Выведем последние строки журнала сообщений:
Уборка
Удалим созданную базу данных и каталог копий.
Page 20: Практика PPEM
- Создайте S3-хранилище резервных копий для экземпляра ent-16 и назовите его ent-16_minio, а каталог копий — /backup_s3. Определите политику хранения только одной полной копии с удалением просроченных. 2. Сделайте автономную резервную копию основного экземпляра ent-16 в созданное хранилище. 3. В базе данных student основного экземпляра создайте новую таблицу в схеме public с одним целочисленным столбцом (первичным ключом). 4. Сделайте разностную резервную копию основного экземпляра в S3-хранилище. 5. Убедитесь, что установленная в п. 1 политика хранения действует.
Комментарии преподавателя
- Используйте ПО MinIO, установленное в виртуальной машине курса. Для доступа к хранилищу нужно запустить соответствующую службу: sudo systemctl start minio
Настройки доступа к хранилищу возьмите из демонстрации.
В параметрах хранения укажите число полных копий — 1, просроченные копии — удалять.
- При отсутствии архивации WAL нужно оставить включенным параметр «создать автономную копию».
Page 21: 1. Создание S3-хранилища копий
В навигационной панели выберите вкладку «Резервное копирование», в ней — «Хранилища РК» и нажмите «Добавить хранилище». Выберите тип «S3 хранилище», заполните поля открывшейся формы, уделив особое внимание разделу «Параметры хранения» и нажмите «Добавить».
2. Автономная резервная копия
Выберите вкладку «Резервные копии» и нажмите кнопку «Создать резервную копию». Далее в последовательно открывающихся формах заполните необходимые поля и нажмите «Выполнить РК».
3. Изменения в данных экземпляра (создание таблицы)
Во вкладке «Базы данных» выберите базу student, а в ней схему public. Нажмите «Создать таблицу», заполните поля формы и нажмите «Сохранить».
4. Разностная резервная копия
Из вкладки «Резервные копии» выполните создание разностной копии, выбрав режим копирования delta.
5. Действие политики хранения
Выполните еще одно полное резервное копирование экземпляра и проверьте список резервных копий.
21 Занятие 21: Отказоустойчивые решения / Кластер multimaster
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_21_multimaster.html Archive: PGPRO-handouts-16.zip Страниц PDF: 27
Page 1: Отказоустойчивые решения / Кластер multimaster
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Возможности и ограничения
- Архитектура и принцип работы
- Распределенные транзакции
- Поколения узлов
- Проверка состояния узлов
- Отказ узла
- Режим 2+1
Page 3: Возможности
Синхронный симметричный кластер
- на всех узлах одинаковые данные, все узлы ведущие
- Распределенные транзакции
- все узлы работают как единая СУБД с ACID-гарантиями
- Отказоустойчивость и высокая доступность
- Масштабируемость чтения
Комментарии преподавателя
Расширение multimaster позволяет преобразовать сервер в синхронный симметричный кластер без разделения ресурсов — данные будут одинаковы на всех узлах кластера, клиенты могут читать и писать данные на любой из узлов. В кластере поддерживаются распределенные транзакции, дающие обычные гарантии ACID, поэтому приложения могут работать с кластером как с единой СУБД.
Multimaster обеспечивает отказоустойчивость за счет автоматического восстановления данных на вернувшихся в строй узлах; кластер имеет высокую доступность — у него нулевое время простоя. Менять конфигурацию (в том числе и обновлять в рамках одной и той же основной версии) узлов можно без остановки обслуживания. Перенаправляя на разные узлы читающие транзакции, можно повысить пропускную способность таких операций.
https://postgrespro.ru/docs/enterprise/16/multimaster
Page 4: Ограничения
Не поддерживаются
- ОС Windows и решения 1С
- репликация нескольких баз данных
- большие объекты (Large Objects)
- операции неблокирующего построения и перестроения индексов
- и работы с табличными пространствами
- Особенности работы с данными
- транзакции могут занимать длительное время
- на уровне Read Committed могут происходить сбои сериализации
- меняется поведение последовательностей
- OID могут отличаться на разных узлах
- Некоторые другие особенности и ограничения
Комментарии преподавателя
У расширения есть ряд ограничений.
Не поддерживается ОС Windows и продукты 1С.
Можно реплицировать только одну базу данных (но можно сделать несколько кластеров для разных баз данных).
Не поддерживаются большие объекты (Large Objects).
Не поддерживаются операции CREATE INDEX и REINDEX с предложением CONCURRENTLY, CREATE и DROP TABLESPACE.
Так как каждая транзакция подтверждается несколькими узлами, это занимает некоторое время. Чем больше узлов в кластере, тем дольше будет происходить фиксация изменений.
На уровне изоляции Read Committed транзакции могут завершаться ошибкой сериализации.
Последовательности по умолчанию выдают немонотонные значения, чтобы избежать конфликтов уникальных идентификаторов между узлами.
Идентификаторы OID могут быть различными на разных узлах.
Существуют и некоторые другие ограничения использования мультимастера.
https://postgrespro.ru/docs/enterprise/16/multimaster#MULTIMASTER-LIMIT ATIONS
Page 5: Подготовка сервера
Остановим основной сервер.
В этой демонстрации часть команд выполняется от имени пользователя ОС postgres. Обращайте внимание на приглашения перед командами. Для текущей демонстрации инициализированы и настроены три экземпляра Postgres Pro Enterprise. Каталоги данных и порты: /var/lib/pgpro/ent-16-MM-1, порт 5001 /var/lib/pgpro/ent-16-MM-2, порт 5002 /var/lib/pgpro/ent-16-MM-3, порт 5003 Для самостоятельной настройки кластеров обратитесь к решению практики. Дополнительные параметры первого экземпляра:
Остальные экземпляры настроены аналогично.
Инициализация кластера multimaster
Узлы кластера уже подготовлены, теперь необходимо инициализировать весь кластер multimaster из трех узлов:
Подготовим роль и базу данных для работы мультимастера на каждом из узлов. Для первого узла:
Для второго узла:
И для третьего узла:
Page 6: Page 6
Теперь объединим узлы в кластер. Для этого на любом из узлов добавим расширение multimaster в БД pgpro_multimaster…
- … и запустим функцию инициализации кластера. Первый параметр — это строка подключения к текущему узлу, второй — массив строк подключения к остальным узлам:
Функция возвращает пустой ответ в случае успеха, либо ошибку инициализации.
Page 7: Архитектура
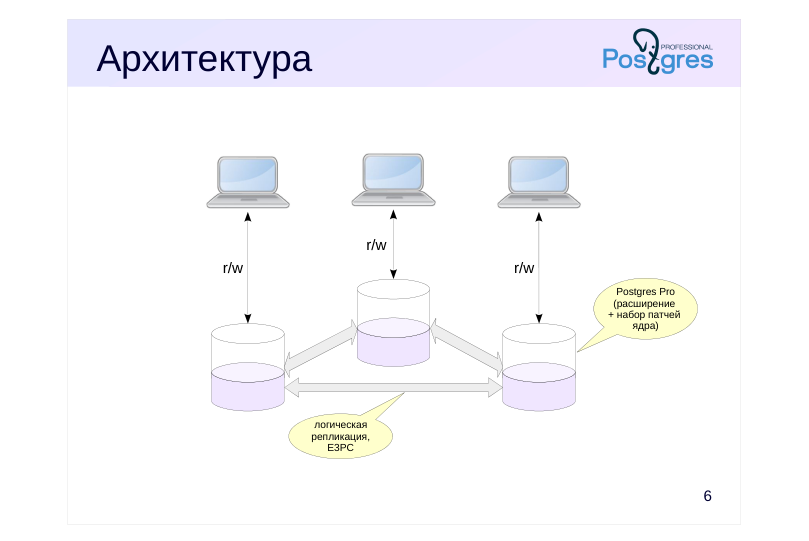 {#source-figure-007 caption=“Source slide page 7: Архитектура”}
Комментарии преподавателя
Расширение multimaster состоит из патчей ядра СУБД (входят в Postgres Pro) и непосредственно кода расширения.
Данные передаются между узлами с помощью доработанного механизма логической репликации.
Для обеспечения согласованности данных подтверждение распределенных транзакций выполняется с помощью улучшенного трехфазного протокола фиксации (E3PC). Для этого в кластере изначально должно быть не менее трех узлов.
Высокая степень доступности достигается тем, что узлы можно выводить из кластера и добавлять к кластеру «на лету». При этом клиенты могут быть подключены к любому узлу — все узлы принимают и читающую, и пишущую нагрузку.
https://postgrespro.ru/docs/enterprise/16/multimaster#MULTIMASTER-ARC HITECTURE
Page 8: Процессы
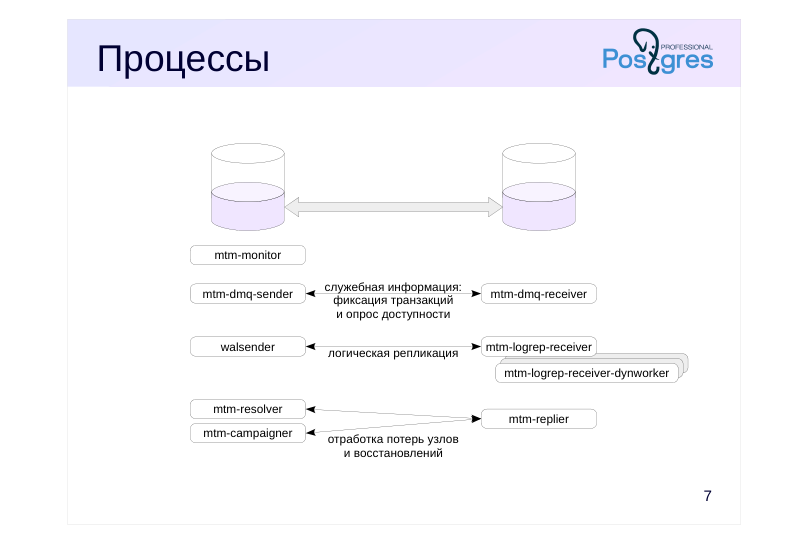 {#source-figure-008 caption=“Source slide page 8: Процессы”}
Комментарии преподавателя
За разные задачи в мультимастере отвечают разные процессы:
● Процесс mtm-monitor запускается на каждом узле и управляет остальными процессами кластера.
● Процесс mtm-logrep-receiver получает поток логической репликации от walsender. Изменения применяются пулом процессов mtm-logrep-receiver-dynworker.
● Процесс mtm-dmq-sender посылает mtm-dmq-receiver служебную информацию, необходимую для реализации распределенных транзакций, а также выполняет периодический опрос доступности узлов (DMQ — distributed message queue, распределенная очередь сообщений).
● Процессы mtm-resolver и mtm-campaigner служат для согласованного исключения узлов из кластера и возвращения узлов в кластер; им отвечает процесс mtm-replier.
На рисунке показаны только процессы-источники одного узла и соответствующие им процессы-приемники другого узла. На самом деле и те процессы, и другие работают на каждом узле. Более того, их количество зависит от числа узлов в кластере: например, на каждом узле будет запущен процесс walsender для каждого из остальных узлов кластера.
https://postgrespro.ru/docs/enterprise/16/multimaster#MULTIMASTER-BGW ORKERS
Page 9: Процессы
Посмотрим на процессы, которые запускаются на каждом узле кластера (postmaster.pid находится в первой строке файла postmaster.pid, расположенного в каталоге PGDATA):
Количество процессов довольно велико, следует обеспечить их достаточными ресурсами.
Page 10: Фиксация изменений
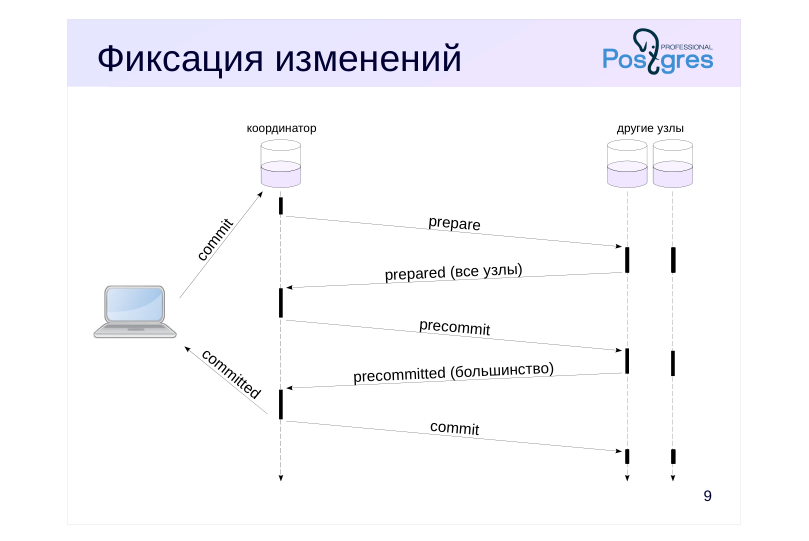 {#source-figure-010 caption=“Source slide page 10: Фиксация изменений”}
Комментарии преподавателя
Протокол трехфазной фиксации расширяет стандартный протокол двухфазной фиксации, реализованный в PostgreSQL, и работает следующим образом.
- Prepare. Когда на узле (который считается координатором транзакции) выполняется оператор COMMIT, транзакция подготавливается (PREPARE TRANSACTION) и передается на остальные доступные узлы. Эти узлы отвечают подтверждением или отказом.
Если какой-либо узел ответил отказом, транзакция обрывается.
- Precommit. Узел-координатор рассылает остальным узлам команду Precommit, которая выражает намерение зафиксировать транзакцию.
Для продолжения достаточно, чтобы подтверждением ответило большинство узлов (кворум). Если достаточного количества подтверждений не набирается, транзакция обрывается (ROLLBACK PREPARED).
- Commit. Транзакция фиксируется на всех узлах (COMMIT PREPARED).
В отличие от двухфазной фиксации, в трехфазную добавлен этап Precommit. Если после него произойдет сбой одного из узлов и третий этап Commit не будет выполнен на сбойном узле, остальные узлы, не дождавшись подтверждения, самостоятельно зафиксируют транзакцию.
https://www.sciencedirect.com/science/article/pii/S0022000098915665
Page 11: Поколения узлов
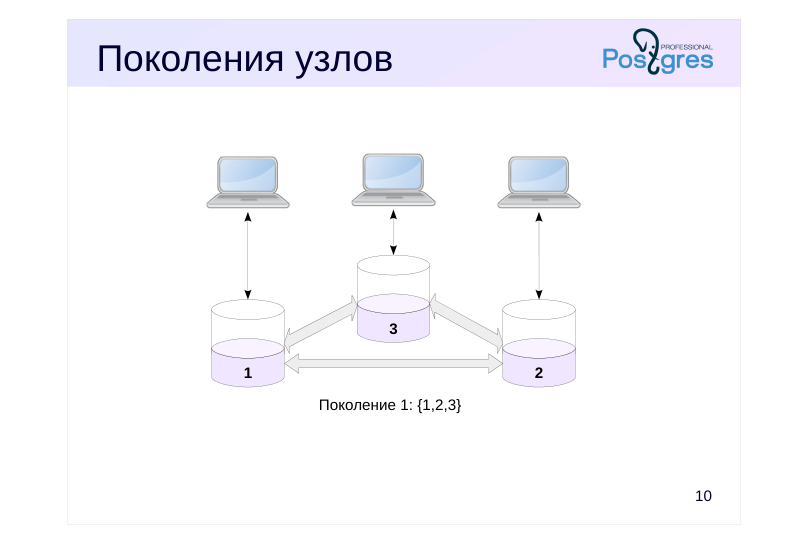 {#source-figure-011 caption=“Source slide page 11: Поколения узлов”}
Комментарии преподавателя
Подмножество узлов, которые кластер считает в данный момент рабочими, называется поколением. Поколения нумеруются последовательными целыми числами.
Узел всегда входит в какое-либо поколение. Если узел узнает, что существует поколение с бо́льшим номером, он старается перейти в него.
Новое поколение формируется большинством узлов при любом изменении списка доступных узлов кластера: в момент его запуска, при сбое узла и при добавлении в кластер нового узла.
Транзакцию можно зафиксировать только после того, как она будет подготовлена на всех представителях поколения.
На слайде показано поколение 1 в кластере из трех узлов.
Page 12: Проверка состояния кластера
Проверим статус узла кластера:
На любом из узлов кластера можно получить список всех узлов:
Проверим работу кластера — создадим таблицу на первом узле. Рекомендуется использовать таблицы с явно определенным первичным ключом — мы так и поступим:
Добавим в таблицу несколько строк:
Проверим доступность таблицы multimaster_tbl на втором узле:
Таблица и строки доступны на втором узле — кластер работает.
Page 13: Отказ узла
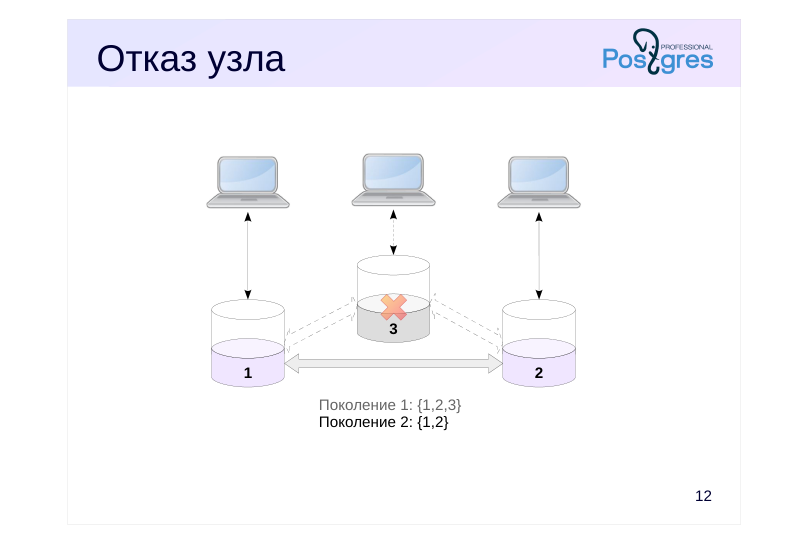 {#source-figure-013 caption=“Source slide page 13: Отказ узла”}
Комментарии преподавателя
При отказе одного из узлов (выключение узла, недоступность узла по сети) оставшиеся узлы формируют новое поколение и в дальнейшем транзакции подтверждаются большинством из оставшихся узлов.
https://postgrespro.ru/docs/enterprise/16/multimaster#MULTIMASTER-FAIL URE-DETECTION-AND-RECOVERY
Page 14: Отказ узла
Для демонстрации отказа узла остановим экземпляр Postgres Pro на третьем сервере:
Проверим доступные узлы кластера:
Номер поколения увеличился. Запишем еще три строки в таблицу, теперь на втором узле:
Проверим корректную работу кластера — прочитаем все строки на первом узле:
Добавленные строки видны — кластер продолжает работать даже при отсутствии одного из узлов.
Page 15: Восстановление узла
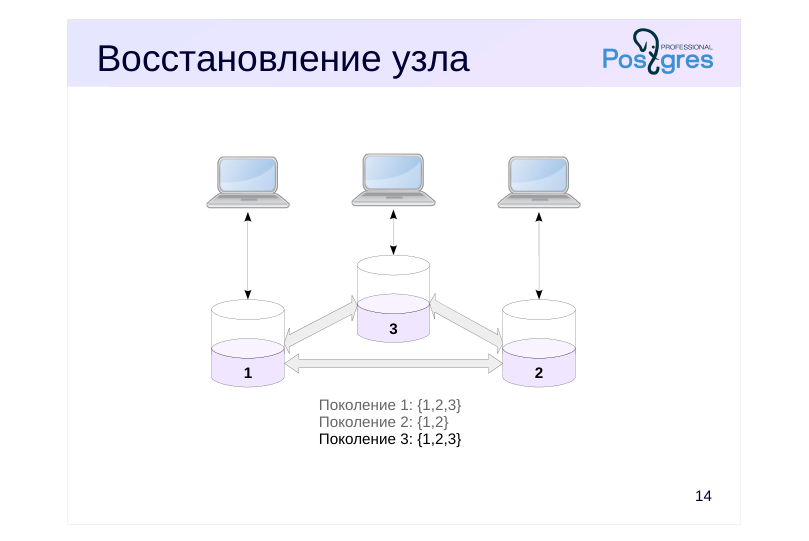 {#source-figure-015 caption=“Source slide page 15: Восстановление узла”}
Комментарии преподавателя
После восстановления третьего узла он определяет номер текущего поколения кластера, получает список узлов, находящихся в этом поколении и выполняет восстановление с одного из этих узлов.
После окончания восстановления третий узел предлагает включить его в кластер, формируя новое поколение 3.
Page 16: Восстановление узла
Текущее состояние узлов кластера:
Вернем третий узел в состав кластера. Для этого запустим экземпляр Postgres Pro на третьем узле:
Сразу после подключения видим, что третий узел пока что не готов к работе:
После запуска узел подключается к кластеру, получает все необходимые изменения… …и возвращается в строй. Номер поколения снова увеличивается:
Все добавленные ранее строки видны на третьем узле.
Page 17: Page 17
Page 18: Режим 2+1
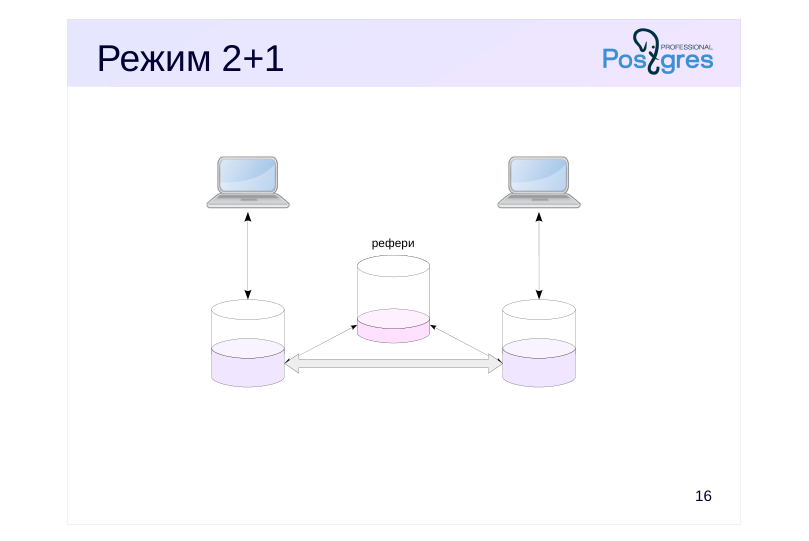 {#source-figure-018 caption=“Source slide page 18: Режим 2+1”}
Комментарии преподавателя
Для работы синхронного симметричного кластера требуется, чтобы все узлы кластера были примерно одинаковы по их аппаратным характеристикам.
Помимо этого, существует режим работы кластера мультимастера 2+1 (его еще называют режимом работы с рефери). В этом случае в кластер входят два полноценных узла, а третий узел работает только как голосующий — он принимает решения о подтверждении и отмене транзакций.
На узле-рефери достаточно установить Postgres Pro Enterprise и добавить расширение referee. Узел-рефери не хранит никакие данные кластера, поэтому нагрузка на узел невелика и он не требователен к ресурсам.
https://postgrespro.ru/docs/enterprise/16/multimaster#SETTING-UP-A-REF EREE
Page 19: Режим 2+1
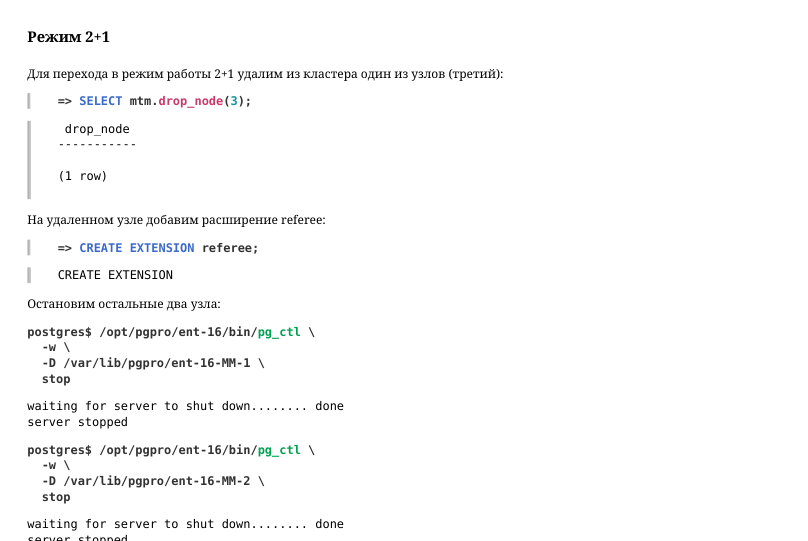 {#source-figure-019 caption=“Source slide page 19: Режим 2+1”}
Для перехода в режим работы 2+1 удалим из кластера один из узлов (третий):
На удаленном узле добавим расширение referee:
Остановим остальные два узла:
На каждом из двух узлов в файл конфигурации необходимо добавить строку подключения к узлу-рефери:
Запускаем любой из основных узлов. Например второй:
Запускаем другой узел:
Проверим статус кластера:
Page 20: Page 20
Проверим также, что ранее созданная таблица на месте:
Снова добавим строки в таблицу multimaster_tbl:
Кластер продолжает работать. Но он уже состоит из двух узлов и одного рефери. Убедиться в том, что узлы корректно взаимодействуют с рефери, можно, посмотрев их журналы сообщений. Второй узел является основным в данной конфигурации кластера:
Первый узел сообщает, что не может получить выигрышный голос (grant) при голосовании, так как такой голос уже выдан второму узлу:
Page 21: Итоги
Postgres Pro Multimaster — это кластерное решение со всеми ведущими узлами, обеспечивающее автоматическое восстановление узлов после сбоев
- Не требует установки дополнительного ПО
- Сфера применения — системы высокой доступности
Page 22: Практика
- Настройте кластер для режима работы 2+1. 2. Имитируйте отказ одного из двух узлов и проверьте работоспособность кластера. 3. Верните отключенный узел в строй.
Комментарии преподавателя
- Подготовьте три дополнительных экземпляра Postgres Pro Enterprise: для каждого из них инициализируйте каталог данных, настройте аутентификацию и задайте параметры. Подробности можно посмотреть в решении практики.
Page 23: 1. Настройка кластера для режима работы 2+1
Остановим основной сервер.
Инициализируем кластер из двух узлов и третий узел для рефери. Сначала подготовим три дополнительных экземпляра сервера Postgres Pro. Создаем каталог PGDATA (если экземпляр работает, его предварительно надо остановить):
Инициализируем каталог данных:
Роль multimaster_user должна иметь право использовать протокол репликации и подключаться к базе pgpro_multimaster, настройки аутентификации это разрешают:
Конфигурационный файл:
Page 24: Page 24
Запускаем экземпляр:
Создаем роль и базу данных для мультимастера:
Аналогично нужно подготовить еще два экземпляра на портах 5002 и 5003. На третьем узле добавим расширение referee:
На каждом из двух основных узлов добавим в файл конфигурации строку подключения к узлу-рефери:
Перезапустим первый и второй узлы, чтобы применить настройки:
Page 25: Page 25
Инициализируем кластер мультимастера.
Теперь запустим функцию инициализации кластера. Первый параметр — это строка подключения к текущему узлу, второй — подключение ко второму узлу:
Создадим таблицу с первичным ключом multimaster_tbl и добавим в нее несколько строк:
Проверим доступность таблицы multimaster_tbl на втором узле:
2. Имитация сбоя и проверка работоспособности
Имитируем отказ узла. Для этого отключим один из узлов, например, второй:
Page 26: Page 26
Добавим еще несколько строк в таблицу:
Оставшийся узел сохранил работоспособность.
3. Возвращение узла в строй
Вернем в строй второй узел:
На втором узле проверим, что таблица доступна:
Кластер мультимастера продолжает работать в режиме 2+1.
Уборка
Остановим и удалим экземпляры multimaster и запустим основной.
Page 27: Page 27
22 Занятие 22: Отказоустойчивые решения / Кластер BiHA
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: pgpro_22_biha.html Archive: PGPRO-handouts-16.zip Страниц PDF: 35
Page 1: Отказоустойчивые решения / Кластер BiHA
Авторские права
© Postgres Professional, 2023–2026 Авторы: Алексей Береснев, Илья Баштанов, Павел Толмачев, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Кластер BiHA
- Архитектура и принцип работы
- Конфигурация
- Создание кластера
- Режимы репликации
- Отработка отказов
- Выборы
- Режим 2+1
Page 3: Кластер BiHA
Кластер физической репликации
- синхронная и асинхронная репликация
- масштабируемость по операциям чтения
- Встроенная высокая доступность
- автоматическое обнаружение и отработка отказа узла
- кворум на базе алгоритма консенсуса Raft
- не требует внешнего управления кластером
- Работает на Linux-платформах
Комментарии преподавателя
Расширение BiHA (Built-in High Availability) позволяет организовать отказоустойчивый кластер физической репликации, включающий в себя выделенный узел-лидер и несколько узлов-последователей. Лидер передает потоки репликации на узлы-последователи, доступные только для чтения. Репликация может быть синхронной или асинхронной. Балансировка запросов на чтение между несколькими узлами позволяет увеличить пропускную способность системы.
Клиентские соединения могут направляться на определенные узлы внешним балансировщиком или пулером. В версии Postgres Pro Enterprise 17 для этого используют расширение Proxima.
https://postgrespro.ru/docs/enterprise/17/proxima#PROXIMA
BiHA обеспечивает отказоустойчивость за счет автоматического выявления отказа узла и изменения конфигурации кластера, означающей автоматическое переключение ролей узлов и восстановление данных на вернувшихся в строй узлах. При отказе лидера новый выбирается на основе кворума с использованием алгоритма консенсуса Raft. Ручное изменение конфигурации узлов также возможно без остановки обслуживания.
BiHA не использует внешнее программное обеспечения для управления кластером. https://postgrespro.ru/docs/enterprise/16/biha
В настоящее время BiHA не работает в среде MS Windows.
Page 4: Архитектура
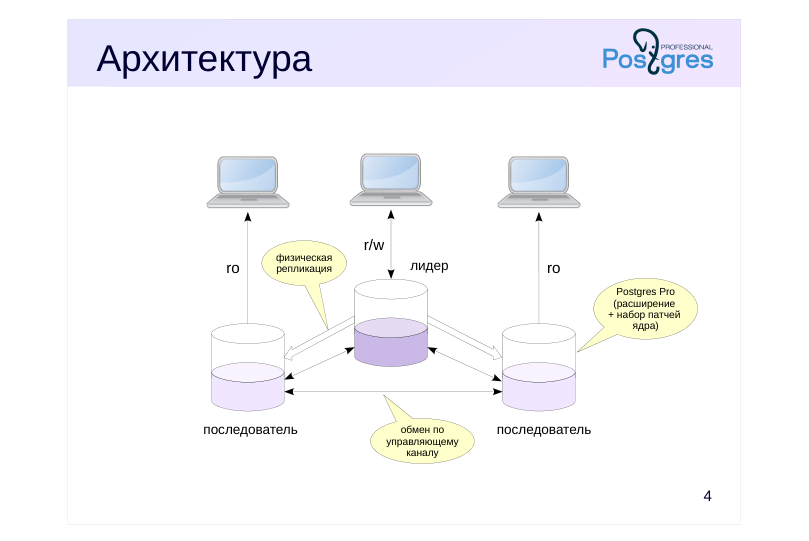 {#source-figure-004 caption=“Source slide page 4: Архитектура”}
Комментарии преподавателя
Расширение BiHA включает в себя доработанное ядро СУБД, SQL-интерфейс управления и сам код расширения.
На каждом из узлов запускаются служебные процессы BiHA worker, координирующие работу кластера. Эти процессы обмениваются служебной информацией, используя BiHA Control Protocol (BCP). Сами данные с узла-лидера передаются на последователи с помощью штатного механизма физической репликации (поток WAL-записей).
Для инициализации кластера и управления им используется утилита bihactl. Она может создавать узел-лидер, добавлять узлы-последователи, преобразовывать уже существующий экземпляр в узел-лидер или узел-последователь в кластере, а также проверять статус узлов кластера.
https://postgrespro.ru/docs/enterprise/16/biha-architecture#BIHA-ARCHITE CTURE
Page 5: Параметры конфигурации
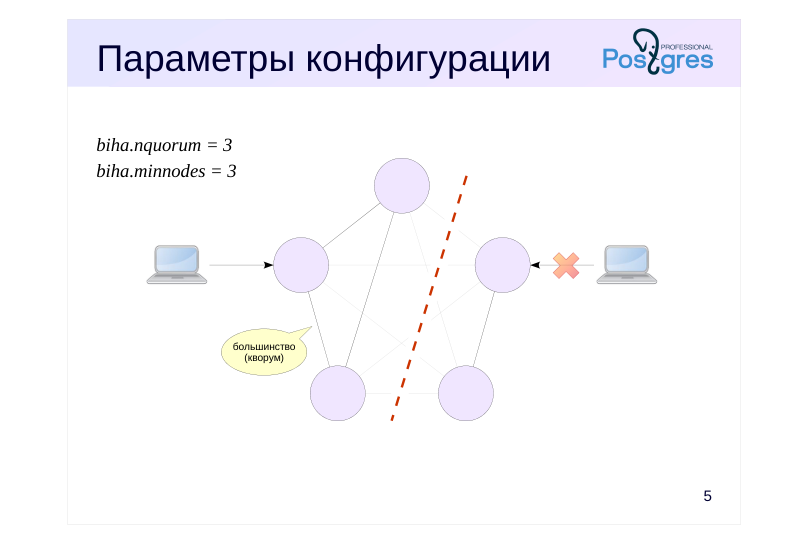 {#source-figure-005 caption=“Source slide page 5: Параметры конфигурации”}
biha.nquorum = 3 biha.minnodes = 3
Комментарии преподавателя
При создании узлов кластера с помощью утилиты bihactl, кроме очевидных параметров (адрес, порт, каталог данных) нужно указать параметры, относящиеся ко всему кластеру. Самые важные из них:
● biha.nquorum — минимальное число узлов, при котором проводятся выборы лидера;
● biha.minnodes — минимальное число узлов, при котором лидер изменяет данные.
Если biha.nquorum или более связанных узлов остались без лидера, они проводят выборы нового лидера. Поведение текущего лидера от этого параметра не зависит.
Если лидер находится в группе из не менее чем biha.minnodes узлов, он обрабатывает запросы на чтение и запись, а при меньшем числе узлов — только на чтение.
По умолчанию для biha.minnodes берется значение biha.nquorum. Чтобы избежать ситуации split-brain, оба параметра рекомендуется задать как (общее число узлов + 1) / 2, округленное в большую сторону. Тогда при разделении сети лидер, оказавшись в меньшинстве, перестанет принимать запросы на запись, а большинство узлов выберет нового лидера. Однако при четном числе узлов имеет смысл задать biha.minnodes как ровно половину от общего числа узлов, чтобы разделение на две равные части не повлияло на работу лидера.
https://postgrespro.ru/docs/enterprise/16/biha-architecture#BIHA-CLUSTER-VARIANTS
Page 6: Инициализация кластера
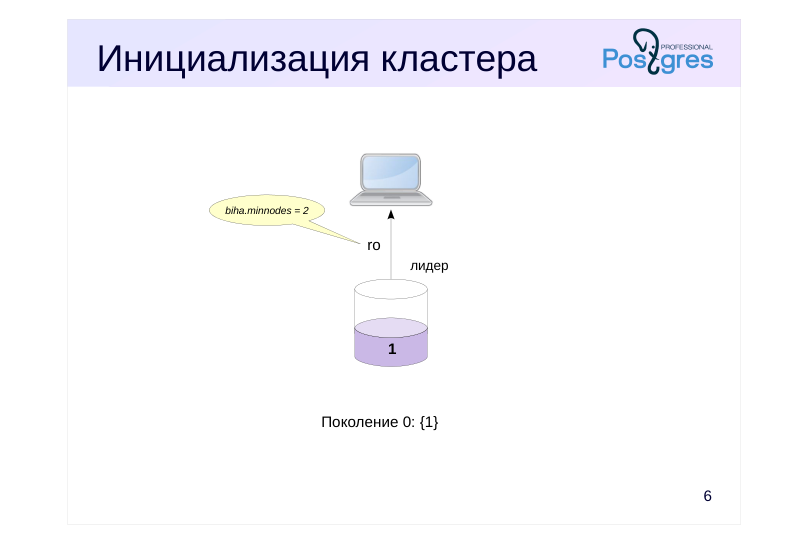 {#source-figure-006 caption=“Source slide page 6: Инициализация кластера”}
Комментарии преподавателя
Кластер BiHA можно получить из существующей системы, использующей физическую репликацию, но мы создадим новый трехузловой кластер с нуля.
Первый узел будущего кластера необходимо инициализировать командой bihactl init. Будет создан экземпляр со служебной базой данных biha_db и схемой biha, для него будут установлены необходимые конфигурационные параметры, а также создан слот репликации.
Поскольку мы рассчитываем на три узла, параметр biha.nquorum установим равным двум (параметр biha.minnodes получит то же значение).
https://postgrespro.ru/docs/enterprise/16/biha-architecture#BIHA-POSTGRE S-CONFIGURATION
Созданный узел станет лидером, но перейдет в режим только чтения, поскольку находится в одиночестве.
Далее мы будем встречаться с понятием номера поколения кластера (term). Текущее состояние соответствует нулевому поколению, в него входит единственный узел. Номер поколения автоматически увеличивается при изменении состояния кластера, например, при удалении или добавлении узла, при смене лидера.
Page 7: Подготовка BiHA-кластера
В этой демонстрации основной экземпляр PostgresPro Enterprise не используется, остановим его.
Все узлы будут локальными экземплярами. Подготовим каталог для данных узла-лидера:
Подключаться к узлам по протоколу репликации будет пользователь biha_replication_user; его пароли на всех узлах кластера BiHA должны быть одинаковыми. В нашем случае удобно включить в файл паролей одну общую строку:
С помощью команды init утилиты bihactl инициализируем кластер и создадим в нем узел-лидер. Будет запущена утилита initdb, а также сформирована конфигурация:
С помощью параметров утилиты заданы: –biha-node-id — уникальный идентификатор узла кластера; –host, –port и –pgdata — узел, порт и путь к каталогу данных создаваемого экземпляра; –biha-port — порт для обмена служебной информацией между узлами; –nquorum — значение параметра biha.nquorum для всех узлов. Команда init возвращает «магическую» строку, которая содержит данные для подключения последователей к лидеру. Строку удобно использовать в скриптах подготовки узлов-последователей, чтобы не вводить данные вручную, поэтому мы записали ее в файл /var/lib/postgresql/magic_str:
Фактически, в этой строке зашифрован набор параметров:
Запустим узел.
Конфигурационные параметры при инициализации были записаны в дополнительные файлы, подключаемые к файлам postgresql.conf и pg_hba.conf с помощью директив include. Параметры настройки узла размещаются в подключенном файле postgresql.biha.conf:
Page 8: Page 8
Параметры кластера должны быть согласованы на всех узлах, поэтому для их изменения используются специальные функции, которые следует запускать только на лидере. Настройки аутентификации находятся в подключенном файле pg_hba.biha.conf:
Ряд параметров, критически важных для работы расширения, хранится в отдельном файле pg_biha/biha.conf, и их нельзя изменить с помощью команды ALTER SYSTEM:
Кроме этого, в параметре shared_preload_libraries основного файла конфигурации указывается загружаемая библиотека расширения:
Состояние узла сохраняется в файле biha.state:
Page 9: Page 9
А состояние всего кластера можно увидеть с помощью команды bihactl status:
Состояние LEADER_RO означает, что узел находится в режиме только для чтения. При значении biha.minnodes=1 кластер состоял бы из единственного узла со статусом RW. Ту же информацию можно получить, обратившись к представлению biha.status_v.
Page 10: Добавление узла
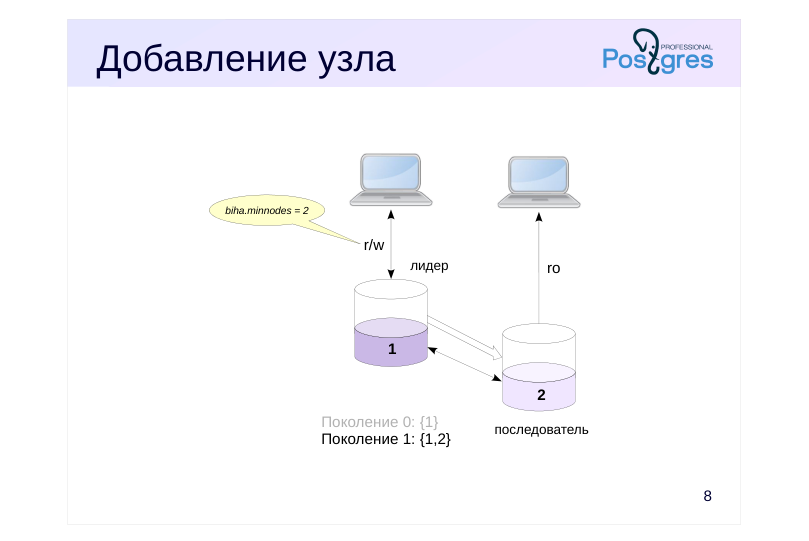 {#source-figure-010 caption=“Source slide page 10: Добавление узла”}
Комментарии преподавателя
Новый узел добавляется в кластер командой bihactl add, выполняемой на подключаемом узле; при этом в кластере будет сформировано новое поколение. Когда число узлов станет равным значению параметра biha.minnodes, кластер станет полностью работоспособным: его лидер сможет работать на запись.
Перед созданием кластера необходимо обеспечить сетевую связность и настроить на всех узлах синхронизацию времени.
Как говорилось, мы планируем развернуть трехузловой кластер — именно такая конфигурация обычно и эксплуатируется. Но что, если в нашем распоряжении только два узла? Какие значения параметров можно выбрать?
При biha.nquorum = 2 и biha.minnodes = 2 потеря любого узла приведет к недоступности кластера на запись.
Если установить biha.nquorum = 1 и biha.minnodes = 1, при разделении сети между двумя работоспособными узлами последователь станет лидером — возникнет ситуация split-brain с двумя работающими лидерами. Это самая плохая ситуация.
Если же установить biha.nquorum = 2 и biha.minnodes = 1, то отказ последователя не нарушит работу лидера, и при разделении сети split-brain не возникнет. Но при отказе лидера последователь не станет новым лидером.
Page 11: Два узла
Добавим в кластер узел-последователь. Используем магическую строку, полученную при инициализации кластера. Будет создана физическая резервная копия узла-лидера (по умолчанию с помощью pg_basebackup):
Запускаем новый узел и ждем, пока он подключится к лидеру.
Теперь кластер состоит из двух узлов. Первый из них является лидером и может теперь принимать запросы на изменение данных (LEADER_RW), а второй является последователем (FOLLOWER). Посмотрим на процессы экземпляров. Среди них есть BiHA worker, координирующие работу кластера, и обычные для физической репликации процессы.
Page 12: Три узла
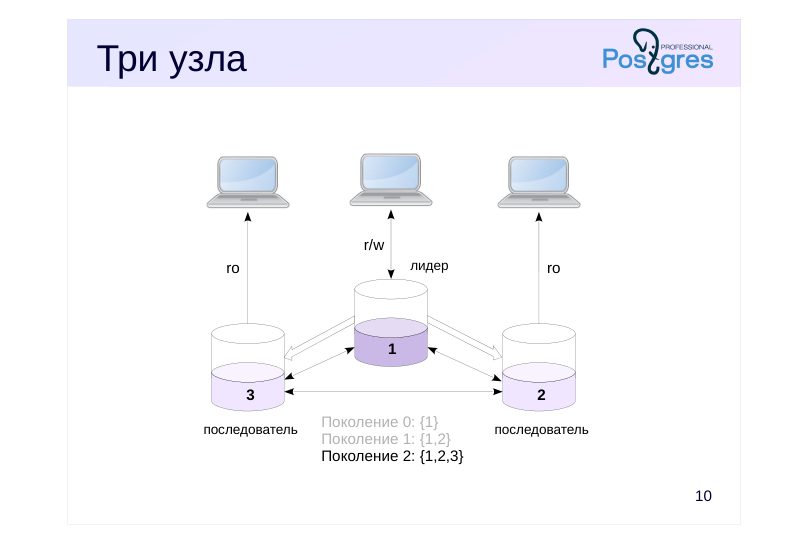 {#source-figure-012 caption=“Source slide page 12: Три узла”}
Комментарии преподавателя
Добавляя дополнительные узлы в кластер, мы избавляемся от недостатка двухузловой конфигурации: в ней невозможно продолжить запись после потери сетевой связности без риска split-brain. Трех узлов уже достаточно для того, чтобы кластер оставался полностью работоспособным после одного любого сбоя.
В такой конфигурации один из узлов является лидером, остальные — последователями. При отказе лидера новый будет автоматически избран на основе кворума. Лидер также может быть назначен вручную.
Page 13: Три узла в кластере
Добавим в кластер еще один узел-последователь:
Запустим третий узел и проверим статус кластера:
Появился еще один последователь, номер поколения увеличился. Состояние подключения узлов в кластере можно получить из представления nodes_v:
Проверим репликацию. Создадим базу на лидере, а в ней — таблицу:
Подождем завершения репликации и подключимся к созданной базе данных на втором узле:
Данные появились на втором узле:
И на третьем:
Page 14: Page 14
Page 15: Режимы репликации
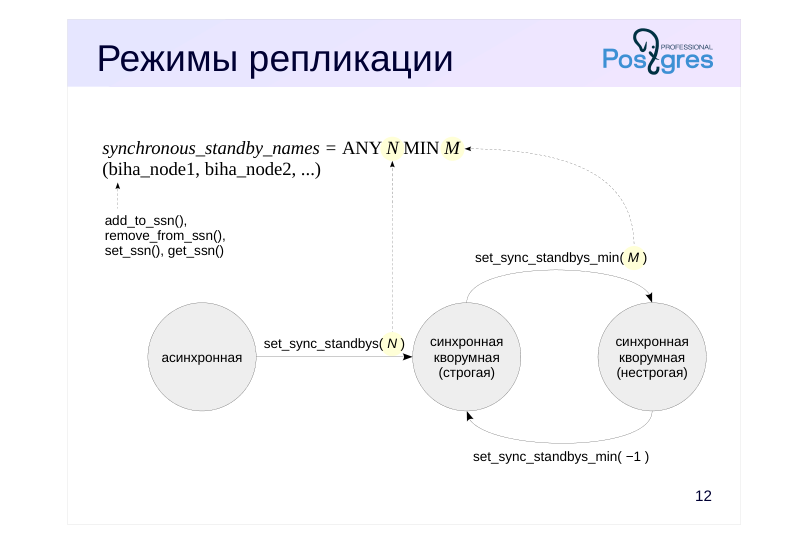 {#source-figure-015 caption=“Source slide page 15: Режимы репликации”}
synchronous_standby_names = ANY N MIN M (biha_node1, biha_node2, …)
Комментарии преподавателя
По умолчанию кластер BiHA использует асинхронную репликацию, но можно использовать и синхронную кворумную — задав ее при инициализации кластера или перейдя на нее в существующем кластере.
Синхронизацией управляет параметр synchronous_standby_names: при фиксации транзакции лидер будет ожидать подтверждения от любых N (ANY N) узлов из списка синхронных. Синхронный режим включается функцией biha.set_sync_standbys, которая и устанавливает число N.
Если временно доступно менее N синхронных узлов, фиксация транзакций будет приостановлена. Чтобы продолжить работу в случае временной недоступности синхронных узлов, можно включить нестрогую кворумную синхронную репликацию. Тогда лидер будет продолжать подтверждать транзакции, пока к нему подключено как минимум M синхронных узлов (MIN M). Значение устанавливается функцией biha.set_sync_standbys_min, а значение −1 возвращает кластер к строгой синхронной репликации.
После включения синхронной репликации перейти на асинхронную уже нельзя, но можно изменить список синхронных узлов функциями biha.set_ssn, biha.remove_from_ssn и biha.add_to_ssn. Узлы, не входящие в список, будут работать асинхронно.
https://postgrespro.ru/docs/enterprise/16/biha-administration#BIHA-ENABLI NG-SYNC-REPLICATION
https://postgrespro.ru/docs/enterprise/16/runtime-config-replication#GUC-SY NCHRONOUS-STANDBY-NAMES
Page 16: Синхронная репликация
Включим в кластере синхронную кворумную репликацию с подтверждением от двух узлов:
Для просмотра текущего значения параметра synchronous_standby_names используем функцию biha.get_ssn:
Page 17: Отказ последователя
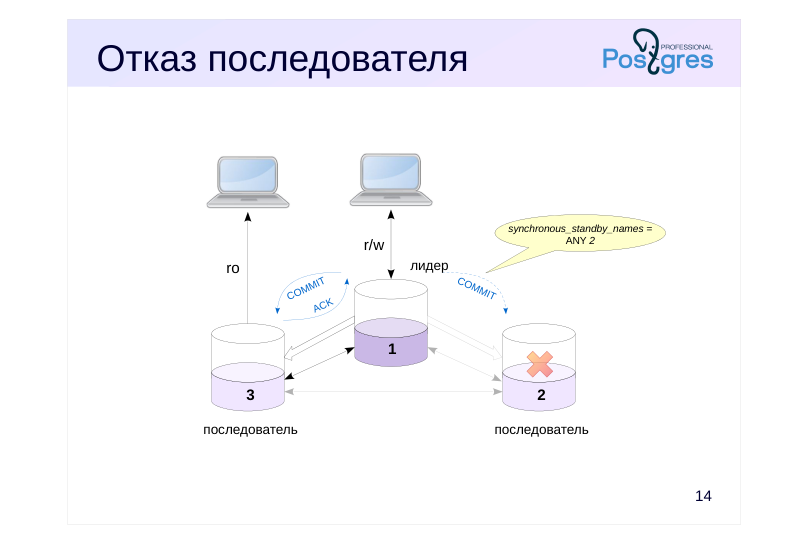 {#source-figure-017 caption=“Source slide page 17: Отказ последователя”}
Комментарии преподавателя
Если последователь был настроен как асинхронный, то отказ одного узла никак не отразится на лидере, кластер продолжит свою работу.
Если же используется синхронная репликация, то при настройке synchronous_standby_names = ANY 2 отказ узла приведет к невозможности завершения транзакции: лидер должен дождаться подтверждения от двух узлов-последователей, а работает только один.
Чтобы продолжить работу в такой ситуации, можно включить нестрогую синхронную репликацию ANY 2 MIN 1.
Page 18: Отказ синхронного последователя
Нарушим кворум синхронизации, остановив второй узел:
Кластер пока считает узел работающим. Подождем, пока будет обнаружен отказ…
После обнаружения отказа кластер продолжает работать, лидер принимает запросы на запись, но не может зафиксировать транзакцию:
Смягчим ограничение, включив нестрогую кворумную синхронную репликацию:
Теперь транзакция завершена:
В параметре synchronous_standby_names появилось указание MIN со значением 1:
Page 19: Отказ последователей
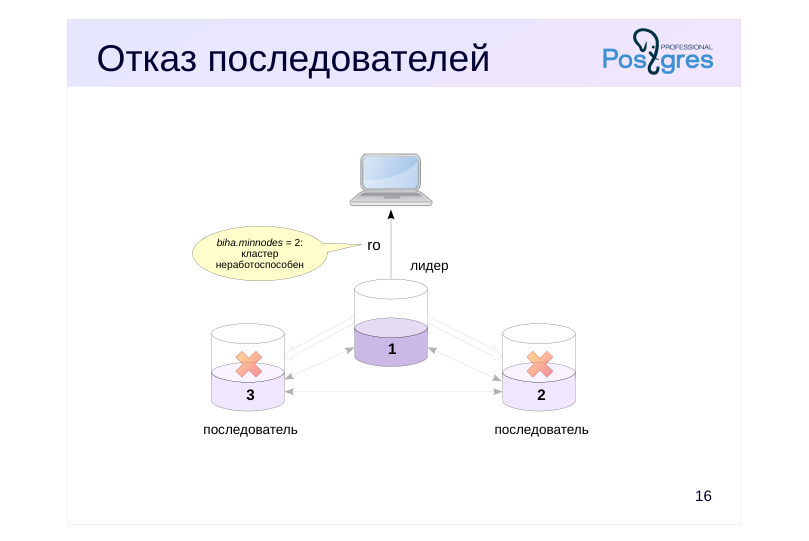 {#source-figure-019 caption=“Source slide page 19: Отказ последователей”}
Комментарии преподавателя
При отказе второго последователя оставшийся в строю лидер перестанет выполнять запросы, изменяющие данные (запросы на чтение будут продолжать работать).
Page 20: Отказ последователей
Сейчас один из последователей остановлен, но кластер в рабочем состоянии:
Остановим оставшегося последователя:
И немного подождем, чтобы кластер отработал отказ узла…
В строю остался лидер, но доступен он лишь для чтения:
Снова запустим второй узел и дождемся его возвращения в строй.
Статус лидера сменился на LEADER_RW, кластер обрабатывает запросы на изменение данных:
Page 21: Отказ лидера
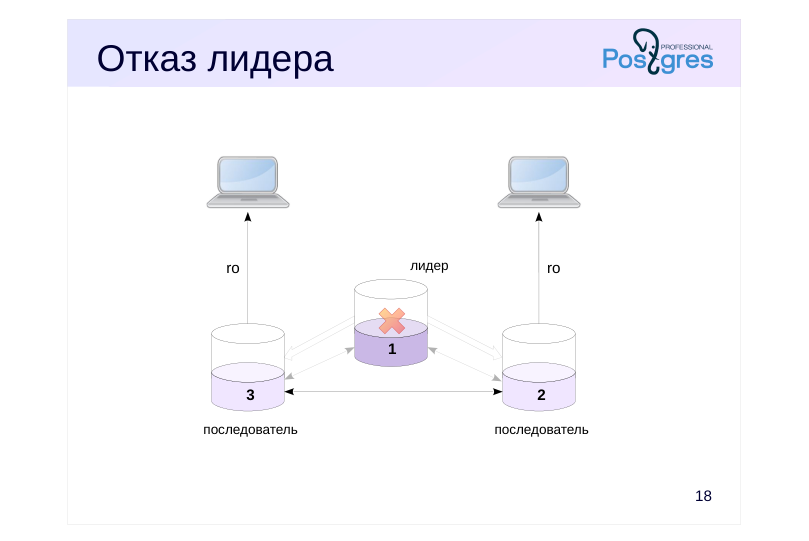 {#source-figure-021 caption=“Source slide page 21: Отказ лидера”}
Комментарии преподавателя
При отказе лидера выполняется автоматическое повышение статуса одного из последователей по результатам выборов.
Применяемый в выборах алгоритм консенсуса RAFT гарантирует однозначное определение нового лидера. Выборы проводятся в группах узлов, составляющих кворум; чтобы предотвратить ситуацию split-brain, значение параметра biha.nquorum должно превышать половину узлов.
В процессе выборов узлы выдвигают себя в качестве кандидатов на роль лидера и запрашивают голоса других узлов. Фактор победы в голосовании — наличие на узле наиболее актуальных данных, то есть новым лидером кластера становится последователь с наибольшим числом записей в WAL. В синхронном кластере можно задать для узлов приоритет, определяющий порядок выдвижения на роль лидера: для этого в параметре biha.node_priority узла указывается тайм-аут, по истечении которого узел предложит себя в качестве кандидата.
При необходимости можно вообще запретить узлу становиться лидером или участвовать в голосовании — для этого существуют параметры biha.can_be_leader и biha.can_vote.
https://postgrespro.ru/docs/enterprise/16/biha-architecture#BIHA-ELECTION S
Page 22: Новый лидер
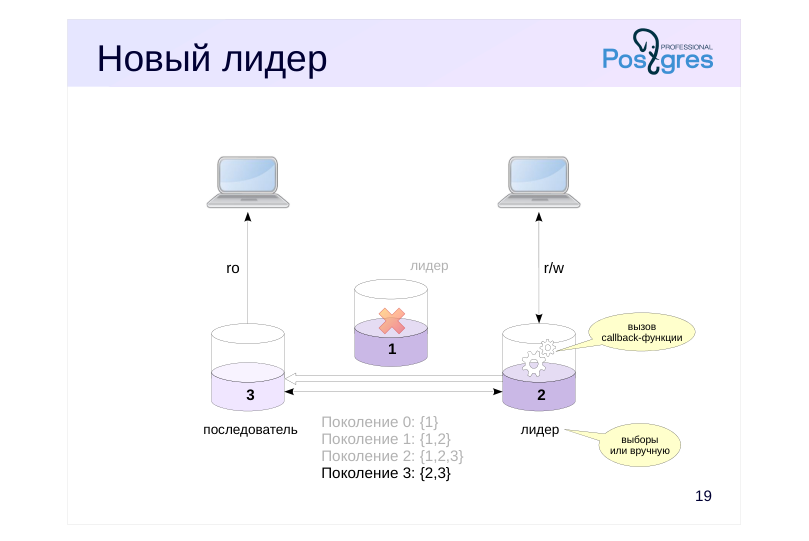 {#source-figure-022 caption=“Source slide page 22: Новый лидер”}
Комментарии преподавателя
Помимо автоматического переключения узлов, BiHA поддерживает ручное переключение. Вручную назначить нового лидера можно с помощью функции biha.set_leader; ее рекомендуется вызывать на том узле, который планируется сделать лидером.
https://postgrespro.ru/docs/enterprise/16/biha-administration#BIHA-SWITCH OVER
При изменении состояния кластера есть возможность вызывать на узлах заранее зарегистрированные пользовательские функции — обработчики событий. Это функции для обратного вызова (callback-функции), которые могут выполнить дополнительные действия, например, отправить оповещение администратору, уведомить об изменениях внешнее ПО, управляющее подключением клиентов (различные прокси и балансировщики), или обеспечить ограждение (fencing) старого лидера.
https://postgrespro.ru/docs/enterprise/16/biha-administration#BIHA-CALLBA CKS
Page 23: Возвращение узла
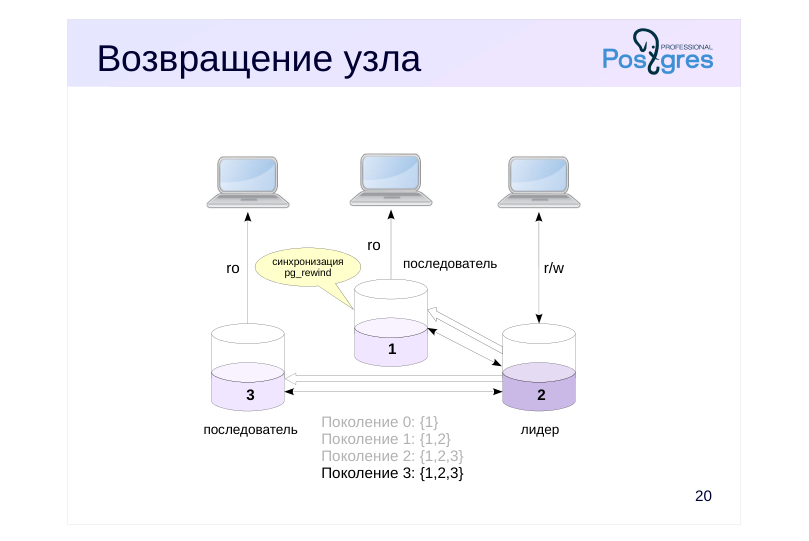 {#source-figure-023 caption=“Source slide page 23: Возвращение узла”}
Комментарии преподавателя
После переключения ролей узлов BiHA выполняет синхронизацию данных кластера в изменившейся конфигурации. Чаще всего на последователях требуется применение записей WAL, полученных с нового лидера. Однако в случае, когда в состав кластера возвращается старый лидер, может потребоваться обратное действие — его «откат» до состояния нового, который выполняется утилитой pg_rewind.
Автоматическое выполнение отката определяется параметром biha.autorewind и по умолчанию выключено. Так сделано потому, что существует риск потери пользовательских транзакций в журнале предзаписи на синхронизируемом узле. Кроме этого, при неудачной автоматической синхронизации узел может перейти в состояние ошибки, и для возвращения его в строй потребуется вмешательство администратора.
https://postgrespro.ru/docs/enterprise/16/biha-administration#BIHA-AUTOM ATIC-CLUSTER-SYNCHRONIZATION-AFTER-FAILOVER
Page 24: Отказ лидера
Сейчас в кластере два узла:
Теперь остановим лидера.
После небольшого ожидания посмотрим на втором узле, в каком состоянии находится кластер…
Последний работающий узел кластера остался в состоянии FOLLOWER. Он он может стать лидером, поскольку для кворума нужны два узла. Принудительно назначим лидера:
Новый лидер принадлежит уже новому поколению. При этом запросы на изменение данных он выполнять не может:
Снова включим первый узел.
Первый узел обнаружил новое поколение и нового лидера в нем, поэтому подключился к кластеру последователем.
Page 25: Page 25
Таким образом, узлы поменялись ролями.
Вернем в строй и третий узел, запретив ему становиться лидером:
В кластере снова три узла. Лидером по-прежнему выступает второй узел, все узлы находятся в одном новом поколении:
Если теперь остановить второй узел (лидера), то оставшиеся узлы автоматически выберут нового лидера из своего числа:
Немного подождем…
Лидером снова стал первый узел; третий мы запретили выбирать.
Page 26: Режим 2+1
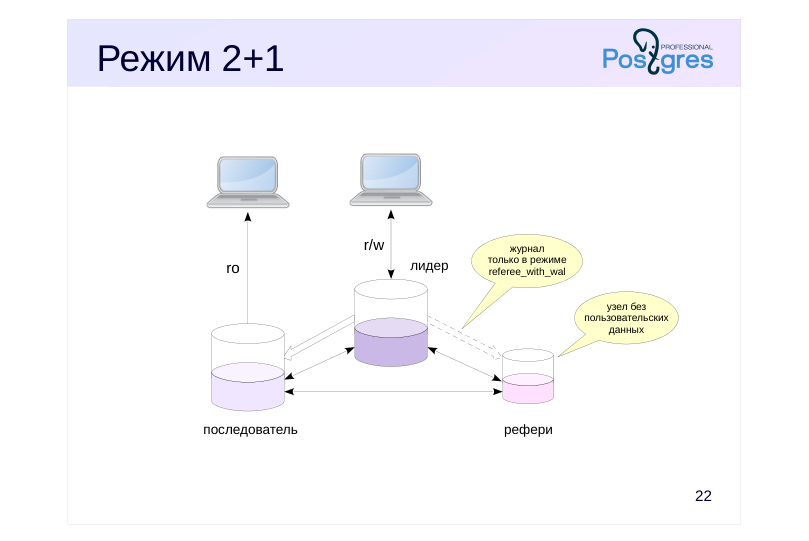 {#source-figure-026 caption=“Source slide page 26: Режим 2+1”}
Комментарии преподавателя
В кластере можно создать узел-рефери, который будет участвовать в выборах узла-лидера и поможет избежать проблемы split-brain, которая возможна, если лидер и единственный последователь перестают видеть друг друга. При инициализации узла-рефери на нем создаются лишь служебная база biha_db и системные таблицы; пользовательские данные на узел не копируются. Поэтому для рефери требуется меньше дискового пространства, ресурсов процессора и памяти.
Режим работы узла-рефери определяется параметром –mode команды bihactl add. Поддерживаются два режима:
● referee. Узел только принимает участие в выборах лидера, в синхронной репликации не участвует.
● referee_with_wal. Узел принимает участие в выборах лидера и участвует в репликации данных — получает все журналы с лидера. Если в момент начала выборов больше всего записей будет на узле-рефери, то узлы-последователи будут пытаться получать с него недостающие журнальные файлы.
В обоих режимах узел-рефери отправляет и получает сообщения о контроле состояния по каналу управления и поддерживает функции мониторинга кластера.
Рефери — это конечное состояние узла: он не может стать ни лидером, ни последователем.
https://postgrespro.ru/docs/enterprise/16/biha-architecture#BIHA-REFEREE
Page 27: Режим 2+1. Узел-рефери
Взамен остановленного нами второго узла создадим узел-рефери. Но сначала удалим второй узел из кластера. Сделать это можно с помощью функции biha.remove_node, вызывать которую нужно на лидере:
В кластере осталось два узла:
При добавлении узла-рефери (параметр –mode=referee) утилита pg_basebackup создаст частичную резервную копию лидера кластера. Данные нового экземпляра будут размещены в каталоге данных остановленного узла, поэтому этот каталог следует заранее очистить:
Стартуем вновь созданный экземпляр:
На новый экземпляр была скопирована только база biha_db и системные таблицы. Пользовательские данные других баз (даже postgres) не переносятся, чтобы уменьшить потребление ресурсов. Если все-таки необходимо, чтобы база postgres попала на узел-рефери (она может понадобится некоторым утилитам или системам мониторинга), нужно в команде выше дополнительно указать параметр –referee-with-postgres-db.
Остановим лидера.
Оставшиеся узлы должны автоматически выбрать нового. Узел-рефери участвует в голосовании, но сам стать лидером
Page 28: Page 28
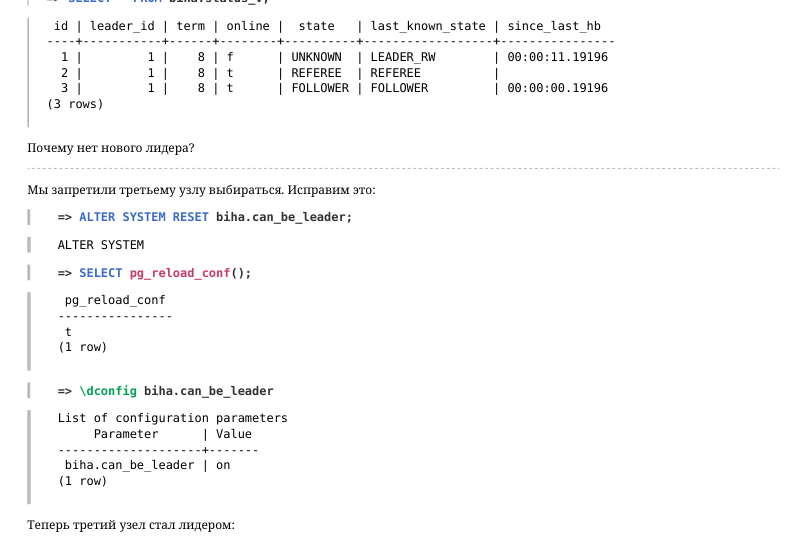 {#source-figure-028 caption=“Source slide page 28: Page 28”}
никогда не сможет.
Почему нет нового лидера? Мы запретили третьему узлу выбираться. Исправим это:
Теперь третий узел стал лидером:
Page 29: Итоги
Postgres Pro BiHA — кластерное решение для высокой доступности на основе физической репликации
- Не требует установки дополнительного ПО
- Автоматически переключает и восстанавливает узлы при сбоях
- Допускает гибкую настройку для достижения баланса производительности, надежности и стоимости системы
Page 30: Практика
- Настройте синхронную физическую репликацию между двумя серверами. 2. Преобразуйте ведущий узел в лидера синхронного трехузлового BiHA-кластера. Проверьте его статус. 3. Преобразуйте ведомый узел (реплику) в узел-последователь и проверьте статус кластера. 4. Добавьте в кластер еще один узел-последователь, работающий как асинхронная реплика. Проверьте статус кластера и работу репликации. Остановите этот узел и убедитесь в том, что это не мешает фиксации транзакций.
Комментарии преподавателя
Создайте два дополнительных экземпляра Postgres Pro Enterprise: для ведущего выполните инициализацию с помощью initdb, а ведомый создайте из копии ведущего, созданной pg_basebackup.
Используйте команду bihactl init c параметрами –convert и –sync-standbys=1.
Для добавления последователя используйте команду bihactl add c параметрами –convert-standby и –use-leader.
Для добавления последователя используйте команду bihactl add c параметрами –convert-standby и –use-leader, а затем переведите его в асинхронный режим функцией biha.remove_from_ssn.
Page 31: 1. Синхронная репликация
Подготовим экземпляр Postgres Pro, который станет ведущим. Создаем каталог PGDATA:
Инициализируем экземпляр:
Дополним конфигурацию узла 1:
Запускаем:
Разворачиваем реплику. Сделаем копию ведущего узла, разместив ее в каталоге /var/lib/pgpro/ent-16-biha-2
Page 32: Page 32
Дополним конфигурацию узла 2:
Запускаем:
Проверим статус репликации:
Настроим синхронную репликацию. Для этого установим на ведущем сервере значение параметра synchronous_standby_names:
Репликация стала синхронной:
2. Преобразование ведущего в узел-лидер BiHA
Остановим ведущий сервер.
Как и в демонстрации, зададим пароль для роли biha_replication_user, записав его в файл:
Команда bihactl init с параметром –convert преобразует узел в лидера BiHA-кластера. Мы хотим продолжить работу в синхронном режиме, поэтому в параметре –sync-standbys зададим число синхронных узлов-последователей для подключения к лидеру:
Page 33: Page 33
Запускаем лидера, проверяем статус кластера:
По умолчанию значение biha.minnodes устанавливается равным biha.nquorum (у нас это 2), поэтому новый лидер не может пока выполнять изменение данных.
3. Преобразование ведомого сервера в последователя BiHA
Остановим ведомый сервер.
Нужно, чтобы пароль роли biha_replication_user в файле паролей совпадал с паролем этой роли на лидере. В нашем случае это так, и команда bihactl init с параметром –convert-standby преобразует узел в последователя BiHA-кластера:
Запускаем последователя, с лидера проверяем статус кластера:
4. Асинхронный последователь
Page 34: Page 34
Добавим второго последователя:
Новый узел подключится как синхронный. Переведем его в асинхронный режим репликации:
Проверим статус кластера:
Проверим работу репликации:
Репликация работает в разных режимах:
Теперь отключим третий узел:
Page 35: Page 35
Поскольку узел использовал асинхронную репликацию, вывод его из строя не мешает фиксации транзакций:
Уборка
Остановим и удалим экземпляры кластера BiHA.