Разработка серверной части приложений PostgreSQL. Расширенный курс
Разработка серверной части приложений PostgreSQL. Расширенный курс
Курс сохраняет официальный порядок тем. Русские материалы извлечены из PDF в читаемый нативный Markdown для дальнейшей редакторской работы.
Состояние материалов: 官方 PDF 已提取为原生 Markdown
Базовый язык: Базовый язык: Русский. В проверенных открытых каталогах не найден текущий английский архив, поэтому базовой является русская версия.
О курсе
Расширения, пользовательские типы, классы операторов, асинхронная обработка, полнотекстовый поиск и FDW.
Состояние материалов
| Язык | Текущий архив | Версия | Темы | Страница курса |
|---|---|---|---|---|
| English | Открытый архив не найден | - | - | HTTP 404 |
| Русский | DEV2-handouts-16.zip | 16 | 21 | HTTP 200 |
Содержание
Дополнительные материалы
dev2_new_features.pdfdev2_student_guide.pdf
Редакторский статус
Русский комплект доступен в виде нативного Markdown. Если английский комплект не найден, английский маршрут оставлен для будущего источника.
00 Занятие 00: Разработка серверной части приложений / Расширенный курс
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_00_introduction.html Archive: DEV2-handouts-16.zip Страниц PDF: 10
Page 1: Разработка серверной части приложений / Расширенный курс
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Разработчикам
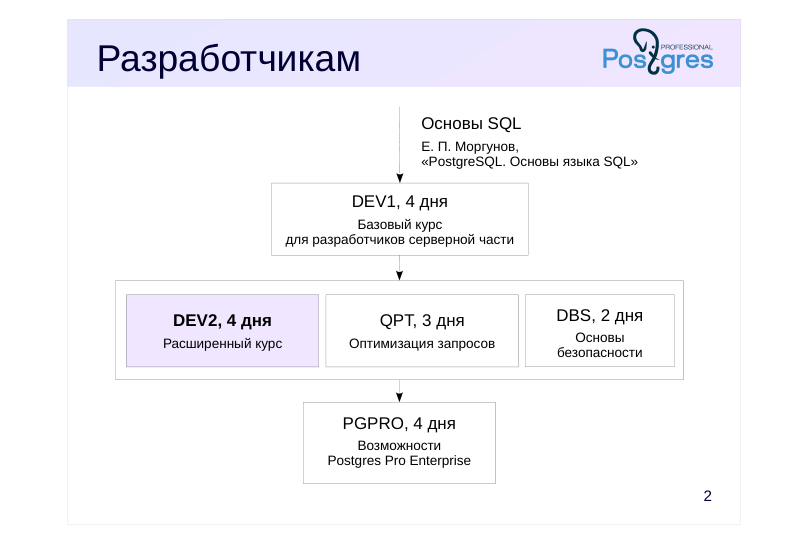 {#source-figure-002 caption=“Source slide page 2: Разработчикам”}
DEV2, 4 дня
Комментарии преподавателя
Для разработчиков серверной части приложений мы предлагаем несколько курсов.
Для прохождения всех курсов необходимы предварительные знания основ языка SQL. Специального курса по языку SQL в нашей линейке курсов нет, но существует множество книг и других образовательных ресурсов, с помощью которых можно освоить SQL. Мы рекомендуем книгу Евгения Моргунова «PostgreSQL. Основы языка SQL»:
https://postgrespro.ru/education/books/sqlprimer
Базовым курсом для разработчиков является курс DEV1, в котором даются сведения об архитектуре PostgreSQL и использовании основных объектов базы данных; изучается программирование на стороне сервера на языках SQL и PL/pgSQL с использованием основных типов данных, а также рассматривается взаимодействие с клиентской частью.
Данный курс DEV2 продолжает изучение серверной разработки на более глубоком уровне.
Курс DBS рассказывает про настройку подключений клиентов к СУБД и про управление доступом внутри самой СУБД.
В курсе QPT детально разбираются механизмы планирования и выполнения запросов, рассматривается настройка параметров экземпляра, связанных с производительностью, и изучаются возможности для поиска проблемных запросов и их оптимизации.
В курсе PGPRO рассматриваются дополнительные возможности, которые предоставляет СУБД Postgres Pro Enterprise.
https://postgrespro.ru/education/courses
Page 3: Администраторам
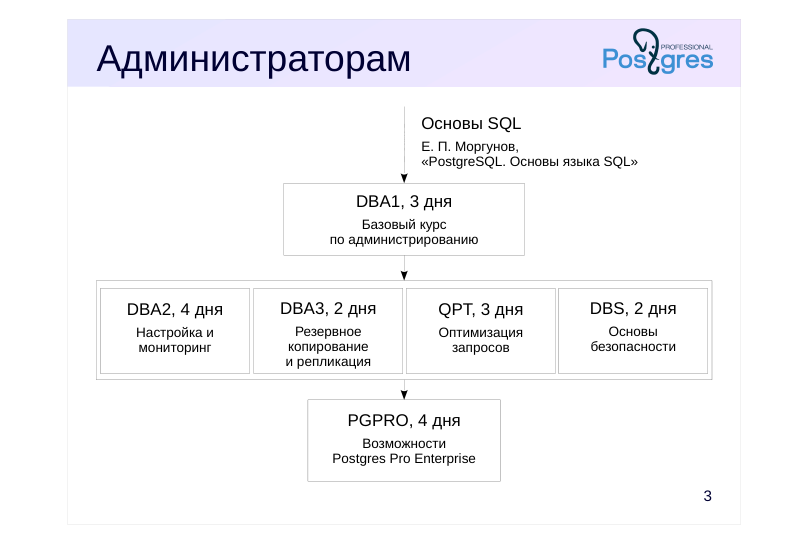 {#source-figure-003 caption=“Source slide page 3: Администраторам”}
- DBA2, 4 дня
Комментарии преподавателя
Для администраторов мы предлагаем следующие курсы.
В базовом курсе DBA1 даются общие сведения об архитектуре PostgreSQL, процессе установки, базовой настройке и управлении сервером. Рассматриваются основные задачи администрирования, вопросы управления доступом. Приводится обзор резервного копирования и репликации.
В курсе DBA2 обсуждается настройка различных конфигурационных параметров исходя из понимания внутренней организации сервера; говорится о мониторинге сервера с использованием обратной связи для итеративной настройки параметров. Также рассматриваются настройки, связанные с локализацией, управление расширениями и знакомство с процедурой обновления сервера.
Курс DBA3 посвящен рассмотрению резервного копирования, а также настройкам физической и логической репликации и сценариям ее использования. Также дается общее представление о способах и сложностях построения высокодоступных, масштабируемых кластеров.
Курсы DBS, QPT и PGPRO являются общими для разработчиков и администраторов.
Курсы по администрированию могут быть интересны и разработчикам, желающим детальнее изучить внутреннее устройство PostgreSQL, а также в случае, когда на проекте нет выделенной роли администратора.
Page 4: О курсе DEV2
Продолжительность: 4 дня
- Предварительные знания
- общие сведения об архитектуре PostgreSQL
- уверенное владение SQL и PL/pgSQL
- минимальные сведения о работе в Unix
- Какие навыки будут получены
- понимание внутренней организации сервера
- полное использование возможностей, предоставляемых PostgreSQL
- для реализации логики приложения
- расширение возможностей СУБД для решения специальных задач
Комментарии преподавателя
Основная идея курса – показать не просто базовые функции PostgreSQL, но и его расширяемость: возможность дополнить серверные механизмы собственным кодом, что позволяет использовать PostgreSQL для решения самых разнообразных задач.
Page 5: Используемые материалы
Подготовленная виртуальная машина
- ОС Xubuntu 24.04
- PostgreSQL 16 (два кластера)
- набор расширений, в том числе сторонних
- документация на русском языке
- учебное веб-приложение «Книжный магазин 2.0»
- DBeaver
- Учебные материалы
- руководство слушателя
- презентации, демонстрации, практические задания и их решение
- (в форматах html и pdf)
Комментарии преподавателя
В этом курсе мы показываем довольно много расширений (extensions), включая сторонние. Это позволяет глубже раскрыть и подчеркнуть идею курса о расширяемости PostgreSQL. Все расширения собраны и установлены в виртуальной машине курса.
Если вы проходите курс самостоятельно, обязательно начните со знакомства с Руководством слушателя. В числе прочего в нем написано, где скачать и как использовать виртуальную машину курса и прочие материалы. Все материалы курса доступны по адресу: https://postgrespro.ru/education/courses/DEV2
Выполнение практических заданий очень важно для получения навыков работы с PostgreSQL. Обязательно старайтесь сначала самостоятельно выполнить задания, а затем просмотрите предлагаемые нами решения, даже если задание не вызвало вопросов. В решениях могут содержаться дополнительные сведения, которые не упоминаются в презентациях и демонстрациях.
Учебные материалы (презентации, демонстрации, практические задания и их решения) доступны в двух форматах. Формат html удобен для онлайн-работы, он позволяет копировать фрагменты текста и кода. Формат pdf разбит на страницы и удобен для печати.
Page 6: Организационные вопросы
День: ~8 академических часов + обед (1час)
- Каждая тема состоит из
- презентации и демонстраций: ~30–60 мин
- практических заданий: ~20–30 мин, включая перерыв
Page 7: День 1
Архитектура
- Изоляция
- Многоверсионность
- Очистка
- Журналирование
- Блокировки
Комментарии преподавателя
Первый день занятий посвящен теоретической подготовке. Здесь рассматриваются темы, знакомые по курсу DEV1, но на более серьезном уровне. Полученные знания будут применяться на практике в последующих темах курса.
Page 8: День 2
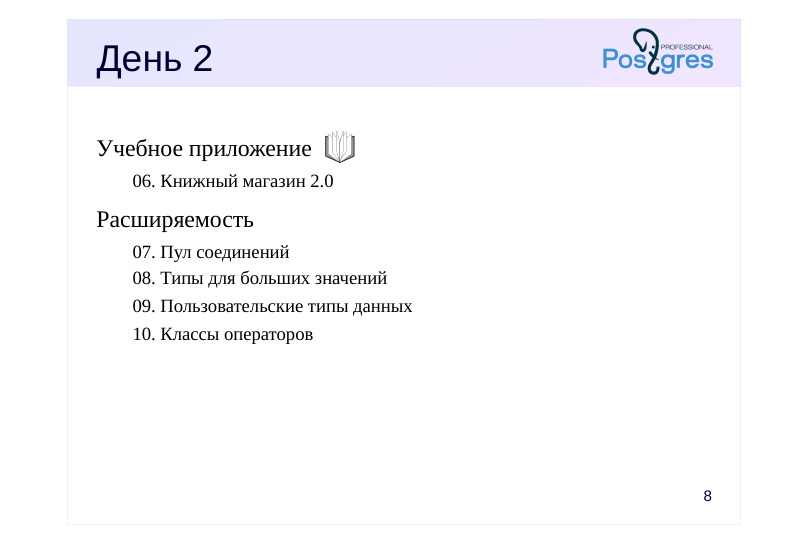 {#source-figure-008 caption=“Source slide page 8: День 2”}
Учебное приложение
- Книжный магазин 2.0
- Расширяемость
- Пул соединений
- Типы для больших значений
- Пользовательские типы данных
- Классы операторов
Комментарии преподавателя
Начиная со второго дня занятий, каждая тема содержит два набора практических заданий: связанных с приложением «Книжный магазин 2.0» (они отмечены значком книги) и дополнительных. За время, которое отводится на задания (около 30 минут), выполнить всю практику невозможно. Используйте дополнительные задания для самостоятельной работы.
Page 9: День 3
Расширяемость (продолжение)
- Слабоструктурированные данные
- Фоновые процессы
- Асинхронная обработка
- Создание расширений
- Языки программирования
Page 10: День 4
Расширяемость (продолжение)
- Агрегатные и оконные функции 17. Обзор полнотекстового поиска Репликация
- Обзор физической репликации 19. Обзор логической репликации Внешние данные
- Обзор
Комментарии преподавателя
В последних трех темах используется второй кластер PostgreSQL, установленный в виртуальной машине курса.
01 Занятие 01: Архитектура / Изоляция
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_01_arch_isolation.html Archive: DEV2-handouts-16.zip Страниц PDF: 25
Page 1: Архитектура / Изоляция
Авторские права
© Postgres Professional, 2017–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Транзакции и их свойства
- Уровни изоляции в стандарте SQL
- Особенности реализации PostgreSQL
Page 3: Транзакции и их свойства
Транзакция — последовательность операций,
- которые переводят базу данных из одного корректного состояния в другое корректное
- Согласованность
- при условии, что транзакция выполнена полностью
- Атомарность
- и без помех со стороны других транзакций
- Изоляция
- атомарность: транзакция либо выполняется полностью,
- либо не оставляет никаких следов
- согласованность определяется ограничениями целостности
- и семантикой приложения
- неполная изоляция приводит к нарушению корректности (аномалиям)
- при конкурентном выполнении транзакций
Комментарии преподавателя
Транзакцией называется последовательность операций, выполняемая приложением, которая переводит базу данных из одного корректного состояния в другое корректное состояние (согласованность) при условии, что транзакция выполнена полностью (атомарность) и без помех со стороны других транзакций (изоляция).
Корректное (согласованное) состояние определяется как ограничениями целостности, заданными на уровне базы данных, так и семантикой приложения.
Идеальная изоляция транзакций гарантирует, что на работу приложения не окажут влияния никакие другие конкурентно выполняющиеся транзакции. Однако если ослабить требования к изоляции, то транзакция, которая корректно выполнялась в базе данных в одиночестве, может выдавать некорректные результаты при наличии других транзакций — из-за того, что при выполнении операторы разных транзакций могут чередоваться. Такие некорректные ситуации называются аномалиями.
Реализация полной изоляции — сложная задача, сопряженная с уменьшением пропускной способности системы. На практике как правило применяется именно ослабленная изоляция, и поэтому важно понимать, какие это влечет последствия.
Четвертое свойство ACID — долговечность — мы рассмотрим позже, в теме «Журналирование».
Page 4: Read Uncommitted
Должен предотвращать аномалии
- потерянные изменения:
- транзакция может перезаписать изменения других транзакций,
- зафиксированных после ее начала
- Не реализован в PostgreSQL
- работает как Read Committed
Комментарии преподавателя
Стандарт SQL допускает четыре уровня изоляции, определяемые в терминах аномалий, которые допускаются при конкурентном выполнении транзакций на этом уровне.
Самый слабый уровень — Read Uncommitted, который (как следует из названия) позволяет увидеть даже незафиксированные данные.
Согласно стандарту на этом уровне должна предотвращаться единственная аномалия:
● Потерянные изменения (lost updates). Если после начала транзакции T1 другая транзакция T2 изменила и зафиксировала строки, транзакция T1 может перезаписать эти изменения.
Этот уровень вводился как требующий наименьших накладных расходов, но PostgreSQL может без потери эффективности работать на более строгом уровне. Поэтому в PostgreSQL такой уровень не реализован и говорить о нем мы больше не будем.
Page 5: Read Committed
Должен предотвращать аномалии
- потерянные изменения
- грязное чтение:
- запрос видит незафиксированные изменения других транзакций
- Реализация в PostgreSQL
- используется по умолчанию
Комментарии преподавателя
Каждый следующий уровень изоляции строже, чем предыдущий. Поэтому уровень Read Committed должен предотвращать не только потерянные изменения, но и еще одну аномалию:
● «Грязное» чтение (dirty read). Транзакция T1 может читать строки, измененные, но еще не зафиксированные, транзакцией T2. Отмена изменений (ROLLBACK) в T2 приведет к тому, что T1 прочитает данные, которых никогда не существовало.
Существует много других аномалий, которые допускаются на уровне Read Committed. Разработчик должен всегда помнить о возможных проблемах и при необходимости вручную использовать блокировки.
В PostgreSQL (как и во многих других СУБД) именно этот уровень изоляции используется по умолчанию — как компромисс между строгостью изоляции и эффективностью.
Заметим, что в PostgreSQL на уровне Read Committed можно потерять изменения — такой пример будет показан в демонстрации.
Page 6: Управление уровнем изоляции
Для демонстрации мы будем использовать отдельную базу данных для каждой темы.
Уровни изоляции посмотрим на примере с таблицей, представляющей состояние светофора:
Это будет пешеходный светофор с двумя лампочками:
Один способ установить уровень изоляции — команда SET TRANSACTION, выполненная в начале транзакции:
Проверить текущий уровень можно, посмотрев значение параметра:
А можно указать уровень прямо в команде BEGIN:
По умолчанию используется уровень Read Committed:
Page 7: Page 7
Так что если этот параметр не менялся, можно не указывать уровень явно.
Read Committed и грязное чтение
Попробуем прочитать «грязные» данные. В первой транзакции гасим красный свет:
Начнем второй сеанс.
В нем откроем еще одну транзакцию с тем же уровнем Read Committed.
Вторая транзакция не видит незафиксированных изменений. Отменим изменение.
Read Committed и чтение зафиксированных изменений
Мы проверили, что транзакция не видит незафиксированных изменений. Посмотрим, что будет при фиксации.
Page 8: Page 8
Пока не видно.
А теперь?
Итак, в режиме Read Committed операторы одной транзакции видят зафиксированные изменения других транзакций. Заметьте, что при этом запрос, выполненный повторно в той же транзакции, может выдать другой результат. Можно ли увидеть изменения, зафиксированные в процессе выполнения одного оператора? Проверим. Сейчас обе лампочки погашены. Запустим долгий запрос и, пока он работает, включим свет во втором сеансе:
Итак, если во время выполнения оператора другая транзакция успела зафиксировать изменения, то они не будут видны. Оператор видит данные в таком состоянии, в котором они находились на момент начала его выполнения. Однако если в запросе вызывается функция с категорией изменчивости volatile, выполняющая собственный запрос, то такой запрос внутри функции будет возвращать данные, не согласованные с данными основного запроса.
Повторим эксперимент, но теперь запрос будет использовать функцию:
Правильный вариант здесь — объявить функцию с категорией изменчивости stable.
Page 9: Page 9
Вывод: внимательно следите за категорией изменчивости функций на уровне изоляции Read Committed. Со значениями «по умолчанию» легко получить несогласованные данные.
Read Committed и потерянные изменения
Что происходит при попытке изменения одной и той же строки двумя транзакциями? Сейчас обе лампочки включены. Первая транзакция выключает красную лампочку, но пока не завершается.
Вторая транзакция видит, что обе лампочки горят…
… меняет состояние каждой лампочки…
… но зависает, ожидая завершения первой.
По окончании первой транзакции вторая смогла изменить данные, и мы ожидаем, что во втором сеансе обе лампочки будут выключены. Проверим.
Почему так получилось? Команда UPDATE во второй транзакции блокирует строки таблицы по очереди. Сначала блокируется зеленая лампочка и изменяется ее состояние, а затем команда ждет снятия блокировки красной лампочки первой транзакцией. При этом команда во второй транзакции не должна видеть изменений, сделанных после начала ее выполнения. С другой стороны, она не должна потерять изменения, зафиксированные другими транзакциями. Поэтому после снятия блокировки она перечитывает строку, которую пытается обновить.
Page 10: Page 10
В итоге, первая транзакция выключает красную лампочку, а вторая снова включает ее.
- В результате вторая транзакция смогла отработать успешно за счет того, что она видела несогласованные данные: часть — на один момент времени, часть — на другой. Но если изменение выполняется не в одной команде SQL, то обновление будет потеряно.
Первая транзакция переводит красную лампочку в мигающий режим. Строка при этом блокируется:
Во второй транзакции клиент видит, что красная лампочка горит…
… и выключает ее:
Вторая транзакция ждет завершения первой.
Первый сеанс ожидает увидеть, что красная лампочка мигает. Проверим:
В этом случае вторая транзакция записала свои изменения «поверх» изменений первой транзакции. На уровне Read Committed сервер не может это предотвратить, поскольку команда UPDATE фактически содержит предопределенную константу.
Page 11: Repeatable Read
Должен предотвращать аномалии
- потерянные изменения
- грязное чтение
- неповторяющееся чтение:
- повторное чтение строки вернет другие данные,
- если строка была изменена и зафиксирована другой транзакцией
- Реализация в PostgreSQL
- также не допускает фантомное чтение:
- повторный запрос по одному и тому же условию вернет иную выборку,
- если другая транзакция добавила и зафиксировала новые строки,
- удовлетворяющие этому условию
- для предотвращения аномалий транзакции могут обрываться
Комментарии преподавателя
Согласно стандарту, в дополнение к потерянным изменениям и грязным чтениям уровень изоляции Repeatable Read должен предотвращать аномалию, которую мы видели, когда рассматривали уровень Read Committed:
● Неповторяющееся чтение (non-repeatable read). После того как транзакция T1 прочитала строку, транзакция T2 изменила или удалила эту строку и зафиксировала изменения (COMMIT). При повторном чтении этой же строки транзакция T1 видит, что строка изменена или удалена.
Реализация PostgreSQL более строгая, чем того требует стандарт, и предотвращает аномалию
● Фантомное чтение (phantom read). Транзакция T1 прочитала набор строк по некоторому условию. Затем транзакция T2 добавила строки, также удовлетворяющие этому условию. Если транзакция T1 повторит запрос, она получит другую выборку строк.
На самом деле существуют и другие аномалии (не отраженные в стандарте), которые допускаются в PostgreSQL на уровне Repeatable Read.
От уровня Read Committed этот уровень изоляции отличается и тем, что на нем транзакция может быть оборвана, чтобы не допустить аномалию (такую транзакцию надо повторять). На уровне Read Committed этого не происходит никогда — если стоит выбор между корректностью и эффективностью, предпочтение всегда отдается эффективности.
Page 12: Repeatable Read и неповторяющееся чтение
Убедимся в отсутствии аномалии неповторяющегося чтения.
Какое значение получит теперь первая транзакция?
Повторное чтение измененной строки возвращает первоначальное значение.
Repeatable Read и фантомное чтение
Фантомные записи также не должны быть видны. Проверим это.
Действительно, транзакция не видит добавленной записи, удовлетворяющей первоначальному условию. Уровень изоляции Repeatable Read в PostgreSQL более строгий, чем того требует стандарт SQL.
Page 13: Repeatable Read и потерянные изменения
Уберем желтую лампочку.
Необходимость все время видеть ровно те же данные, что и в самом начале, не позволяет перечитывать измененную строку в случае обновления. Воспроизведем пример, который мы видели на уровне изоляции Read Committed. Сейчас красная лампочка включена.
Клиент запрашивает состояние красной лампочки…
…а затем меняет его на сервере:
Вторая транзакция ждет завершения первой.
Во второй транзакции получаем ошибку. Строка была изменена; обновить неактуальную версию невозможно (это будет потерянным изменением, что недопустимо), а увидеть актуальную версию тоже невозможно (это нарушило бы уровень изоляции).
Таким образом, потерянное обновление на уровне Repeatable Read не допускается.
Repeatable Read и другие аномалии
Можно ли быть уверенным в том, что следующая команда включит все лампочки?
Можно ли быть уверенным в том, что следующая команда выключит все лампочки?
Page 14: Page 14
Если одна транзакция включает лампочки, а другая — выключает, в каком состоянии останется таблица после одновременного выполнения двух этих транзакций? Включим красную лампочку и проверим.
Начальное состояние:
Первая транзакция включила зеленую лампочку, и теперь для нее все огни горят.
Вторая транзакция не видит этих, еще не зафиксированных, изменений и считает, что зеленый свет выключен. Поэтому она выключает красный и для нее все огни погашены.
Теперь обе транзакции фиксируют свои изменения…
И оказывается, что…
…одна лампочка включена, а другая — выключена. Это пример аномалии конкурентного доступа — несогласованная запись (write skew), — которая возможна, даже если нет грязного, неповторяющегося и фантомного чтений.
Page 15: Page 15
Page 16: Serializable
Должен предотвращать любые аномалии
- результат конкурентного выполнения совпадает с результатом
- выполнения транзакций в какой-либо последовательности
- Реализация в PostgreSQL
- для предотвращения аномалий транзакции могут обрываться
- для правильной работы уровень Serializable должен использоваться
- всеми транзакциями
- уровень не работает на физических репликах
Комментарии преподавателя
Полное отсутствие каких бы то ни было аномалий достигается, если команды, выполняемые в конкурентно работающих транзакциях, приводят к такому же результату, какой получился бы в случае последовательного — одна завершилась, следующая началась — выполнения этих транзакций (при каком-нибудь порядке выполнения).
В PostgreSQL этот уровень реализован и работает, если все транзакции в системе используют уровень Serializable.
Следует учитывать, что реализация имеет определенные ограничения:
● запросы не могут выполняться на физических репликах;
● транзакции могут обрываться чаще, чем это действительно необходимо (таким образом, страдает эффективность, поскольку оборванные транзакции приходится выполнять повторно).
Page 17: Serializable
На этом уровне транзакции могут положиться на то, что на их работу никто не повлияет.
Первая транзакция включила красную лампочку, для нее все огни горят.
Вторая транзакция не видит незафиксированных изменений: для нее красный свет еще выключен, и она выключает зеленый.
Для второй транзакции обе лампочки выключены:
Теперь обе транзакции фиксируют свои изменения…
И вторая транзакция получает ошибку. Действительно, при последовательном выполнении транзакций допустимо два результата: если сначала выполняется первая транзакция, а потом вторая, то все лампочки будут погашены; если сначала выполняется вторая транзакция, а потом первая, то все лампочки будут включены. «Промежуточный» вариант получить невозможно, поэтому выполнение одной из транзакций завершается ошибкой. Важный момент: чтобы уровень Serializable работал корректно, на этом уровне должны работать все транзакции. Если смешивать транзакции разных уровней, фактически Serializable будет вести себя, как Repeatable Read.
Page 18: Итоги: стандарт SQL
- неповторя-
- потерянные
- обновления
- грязное
- фантомное
- другие
- аномалии
- ющееся
- чтение
- чтение
- чтение
- Read Uncommitted ― да да да да
- Read Committed ― ― да да да
- Repeatable Read ― ― ― да да
- Serializable ― ― ― ― ―
Комментарии преподавателя
Подытожим информацию.
В стандарте SQL определены четыре уровня изоляции транзакций: Read Uncommitted, Read Committed, Repeatable Read, Serializable (по умолчанию).
Таблица показывает соответствие между уровнями изоляции и теми аномалиями, которые они могут допускать.
Отметим, что для обеспечения уровня изоляции Serializable недостаточно исключить три аномалии, определенные в стандарте.
Page 19: Итоги: PostgreSQL
- неповторя-
- потерянные
- обновления
- грязное
- фантомное
- другие
- аномалии
- ющееся
- чтение
- чтение
- чтение
- Read Uncommitted
- Read Committed * ― да да да
- Repeatable Read ― ― ― ― да
- Serializable ― ― ― ― ―
- * предотвращается не всегда
Комментарии преподавателя
Реальные СУБД, и PostgreSQL в том числе, не реализуют требования стандарта буквально (которые были сформулированы в те времена, когда вопросы изоляции еще не были изучены теоретиками). Названия уровней изоляции сохраняются, но реализация их строже, чем это требует стандарт.
В PostgreSQL используется изоляция на основе снимков данных (Snapshot Isolation) в сочетании с многоверсионностью. Это определяет следующие свойства:
● Грязное чтение не допускается вообще, причем без ущерба для производительности.
● Уровень Read Committed используется по умолчанию и применяется в большинстве систем. Зачастую он требует ручной установки блокировок, чтобы обеспечить корректность.
● Уровень Repeatable Read не допускает не только неповторяемое чтение, но и фантомное чтение (хотя и не обеспечивает полную изоляцию). Этот уровень удобен для отчетов, поскольку позволяет нескольким запросам видеть согласованные данные, а только читающие транзакции никогда не обрываются.
● Уровень Serializable также полностью реализован, но имеет определенные ограничения.
https://postgrespro.ru/docs/postgresql/16/transaction-iso
Page 20: Практика
- Создайте пустую таблицу. Проверьте, что на уровне изоляции Read Committed не предотвращается аномалия фантомного чтения.
- Откройте транзакцию с уровнем изоляции Repeatable Read (и пока не выполняйте в ней никаких команд). В другом сеансе удалите строку из таблицы. Видна ли удаленная строка в открытой транзакции? Будет ли видна удаленная строка, если после открытия транзакции выполнить запрос к базе данных, не обращаясь к таблицам?
- Убедитесь, что команда DROP TABLE транзакционна.
Page 21: 1. Фантомное чтение на уровне Read Committed
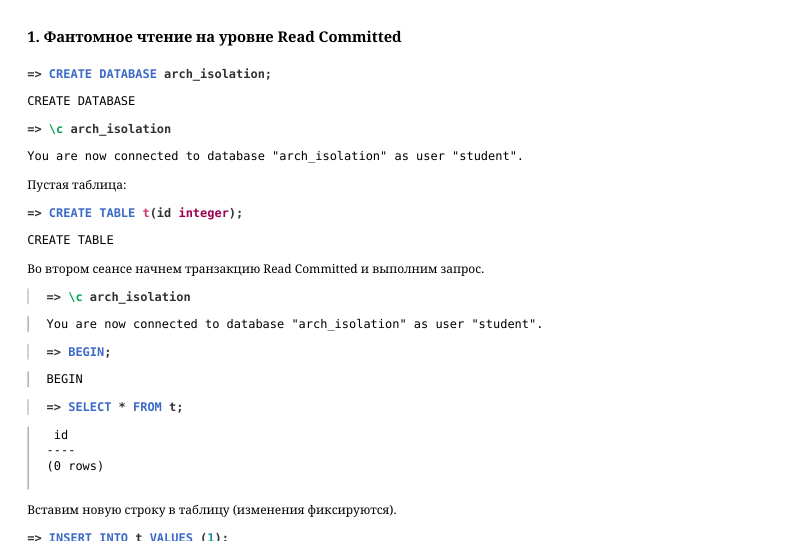 {#source-figure-021 caption=“Source slide page 21: 1. Фантомное чтение на уровне Read Committed”}
Пустая таблица:
Во втором сеансе начнем транзакцию Read Committed и выполним запрос.
Вставим новую строку в таблицу (изменения фиксируются).
Транзакция Read Committed видит добавленную строку. Отличие от аномалии неповторяющегося чтения (при которой транзакция видит зафиксированные изменения в уже существовавших строках) состоит в том, что здесь видны строки, которых не было раньше.
2. На какой момент времени видны данные?
Открываем транзакцию Repeatable Read:
Добавляем строку в таблицу (изменения фиксируются):
Проверяем содержимое таблицы в открытой транзакции:
Page 22: Page 22
Почему видны обе строки? Дело в том, что транзакции Repeatable Read (и Serializable) видят данные на момент начала первой команды, а не на момент выполнения BEGIN. Если сейчас добавить в таблицу еще строк, результат повторной выборки уже не изменится.
3. Транзакционность DDL
Откроем транзакцию и удалим таблицу t.
Таблица удалена. Теперь откатим транзакцию:
Удаление отменено, таблица опять существует.
Page 23: Практика+
- Команда COMMIT в коде на PL/pgSQL начинает новую транзакцию. Каким будет ее уровень изоляции и есть ли способ его изменить? Исследуйте анонимные блоки и процедуры.
Page 24: 1. Уровень изоляции в PL/pgSQL-коде
Уровень изоляции новой транзакции назначается в соответствии с параметром default_transaction_isolation:
Сменить уровень можно командой SET TRANSACTION:
В процедуре такой код тоже сработает, но задать уровень первоначальной транзакции не получится:
Можно в начале блока добавить COMMIT и тем самым начать новую транзакцию:
Но более правильный вариант — задать параметр default_transaction_isolation:
Page 25: Page 25
02 Занятие 02: Архитектура / Многоверсионность
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_02_arch_mvcc.html Archive: DEV2-handouts-16.zip Страниц PDF: 30
Page 1: Архитектура / Многоверсионность
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Страницы
- Версии строк
- Снимки данных
Page 3: Страницы
Структура страниц
- Формат данных
Page 4: Страницы
 {#source-figure-004 caption=“Source slide page 4: Страницы”}
Комментарии преподавателя
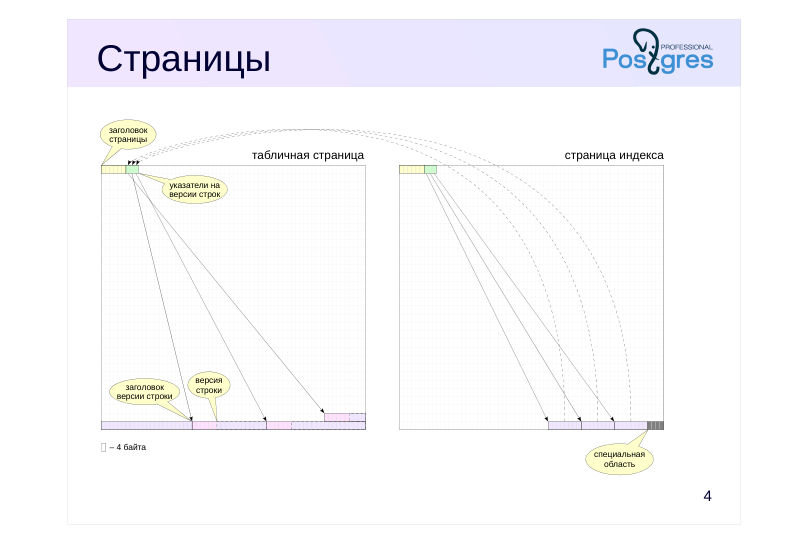
Размер страницы составляет 8 Кбайт. Это значение можно увеличить (вплоть до 32 Кбайт), но только при сборке. И таблицы, и индексы, и большинство других объектов, которые в PostgreSQL обозначаются термином relation, используют одинаковую структуру страниц, чтобы пользоваться общим буферным кешем. В начале страницы идет заголовок (24 байта), содержащий общие сведения о странице и размер ее областей: указателей, свободного пространства, версий строк и специальной области.
Версии строк содержат те самые данные, которые мы храним в таблицах и других объектах БД, плюс заголовок. «Версия строки» по-английски называется tuple; иногда мы будем говорить просто «строка».
Указатели имеют фиксированный размер (4 байта) и составляют массив, позиция в котором определяет идентификатор строки (tuple id, tid). Указатели ссылаются на версии строк (tuple), расположенные в конце блока. Такая косвенная адресация удобна тем, что во-первых, позволяет найти нужную строку, не перебирая все содержимое блока (строки имеют разную длину), а во-вторых, позволяет перемещать строку внутри блока, не ломая ссылки из индексов.
Между указателями и версиями строк находится свободное место.
Для некоторых типов индексов нужно хранить служебную информацию; для этого может использоваться нулевая страница, а также специальная область в конце каждой страницы.
https://postgrespro.ru/docs/postgresql/16/storage-page-layout
Page 5: Формат данных
 {#source-figure-005 caption=“Source slide page 5: Формат данных”}
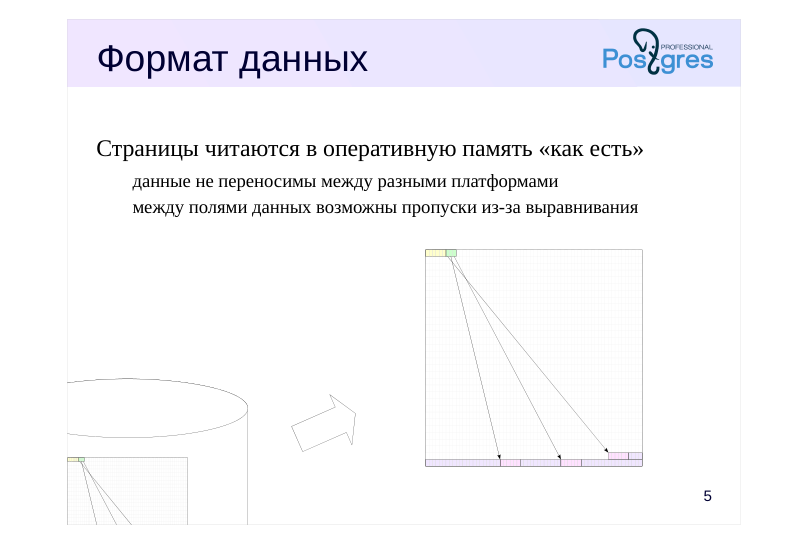
Страницы читаются в оперативную память «как есть»
- данные не переносимы между разными платформами
- между полями данных возможны пропуски из-за выравнивания
Комментарии преподавателя
Формат данных на диске полностью совпадает с представлением данных в оперативной памяти. Страница читается в буферный кеш «как есть», без преобразований.
Поэтому файлы данных на одной платформе (разрядность, порядок байтов и т. п.) оказываются несовместимыми с другими платформами.
Кроме того, многие архитектуры предусматривают выравнивание данных по границам машинных слов. Например, на 32-битной системе x86 целые числа (тип integer, занимает 4 байта) будут выровнены по границе 4-байтных слов, как и числа с плавающей точкой двойной точности (тип double precision, 8 байт). А в 64-битной системе значения double precision будут выровнены по границе 8-байтных слов.
Из-за этого размер табличной строки зависит от порядка расположения полей. Обычно этот эффект не сильно заметен, но в некоторых случаях он может привести к существенному увеличению размера. Например, если располагать поля типов char(1) и integer вперемешку, между ними, как правило, будет пропадать 3 байта.
https://pgconf.ru/rmedia/2016/05/13/tuple-internals-ru.pdf
Page 6: Подготовка
Создадим таблицу и индекс по одному из полей.
Структура страницы
Чтобы изучить структуру страницы и версий строк, воспользуемся расширением pageinspect.
Посмотрим на поля заголовка страницы, определяющие границы ее областей.
Области занимают следующие диапазоны адресов: 0 — начало заголовка страницы и указатели на версии строк, lower — начало свободного места, upper — начало данных (версий строк), special — начало спец. данных (только для индексов), pagesize — конец страницы.
Page 7: Версии строк
Структура версий строк
- Как работают операции над данными
- HOT-обновления
Page 8: Вставка
 {#source-figure-008 caption=“Source slide page 8: Вставка”}
Комментарии преподавателя
Рассмотрим, как устроены версии строк (tuples) и как выполняются операции со строками на низком уровне. Начнем со вставки.
В нашем примере — таблица с двумя столбцами (число и текст). При вставке строки в табличной странице (heap page) появится указатель с номером 1, ссылающийся на первую и единственную версию строки. Каждый такой указатель помимо ссылки содержит длину версии строки и несколько бит, определяющих ее статус.
Версии строк кроме собственно данных имеют также заголовок, занимающий минимум 23 байта. Помимо прочего он содержит:
● xmin и xmax — поля, определяющие видимость данной версии строки в терминах начального и конечного номеров транзакций;
● карту неопределенных значений (в ней отмечены поля со значением NULL);
● ряд признаков, показывающих, например, статус транзакций xmin и xmax, если он уже известен (зафиксированы или оборваны).
В нашей версии строки поле xmin заполнено номером текущей транзакции (100). Поскольку изменения еще не фиксировались и транзакция активна, то в журнале статуса транзакций (CLOG) соответствующая запись заполнена нулями. CLOG можно представить себе как массив, в котором для каждой транзакции (начиная с некоторой) отводится ровно два бита.
Поле xmax заполнено фиктивным номером 0. Транзакции не будут обращать внимание на этот номер, поскольку установлен признак, что эта транзакция оборвана.
Page 9: Вставка
 {#source-figure-009 caption=“Source slide page 9: Вставка”}
индекс не содержит информации о версионности
Комментарии преподавателя
Пусть также имеется индекс B-дерево, созданный по текстовому полю.
Информация в индексной странице сильно зависит от типа индекса. И даже у одного типа индекса бывают разные виды страниц. Например, у B-дерева есть страница с метаданными, страницы для листовых и промежуточных узлов.
Тем не менее, обычно в странице имеется массив указателей и индексные записи (аналогичные версиям строк в табличной странице).
Индексные записи тоже могут иметь очень разную структуру в зависимости от типа индекса. Например, для B-дерева записи в листовых страницах содержат значение ключа индексирования и ссылку (ctid) на соответствующую строку таблицы (структура B-дерева разбирается в теме «Классы операторов» и в учебном курсе QPT «Оптимизация запросов»).
В общем случае индекс может быть устроен совсем другим образом, но как правило он все равно будет содержать ссылки на версии строк.
В нашем примере в индексной странице также создается указатель с номером 1, который ссылается на индексную запись, которая, в свою очередь, ссылается на первую строку в табличной странице. Чтобы не загромождать рисунок, указатель и строка таблицы объединены.
Важный момент состоит в том, что никакой индекс не содержит информацию о версионности (нет полей xmin и xmax). Прочитав индексную запись, невозможно определить ее видимость, не заглянув в табличную страницу (для оптимизации служит карта видимости).
Page 10: Фиксация изменений
 {#source-figure-010 caption=“Source slide page 10: Фиксация изменений”}
Комментарии преподавателя
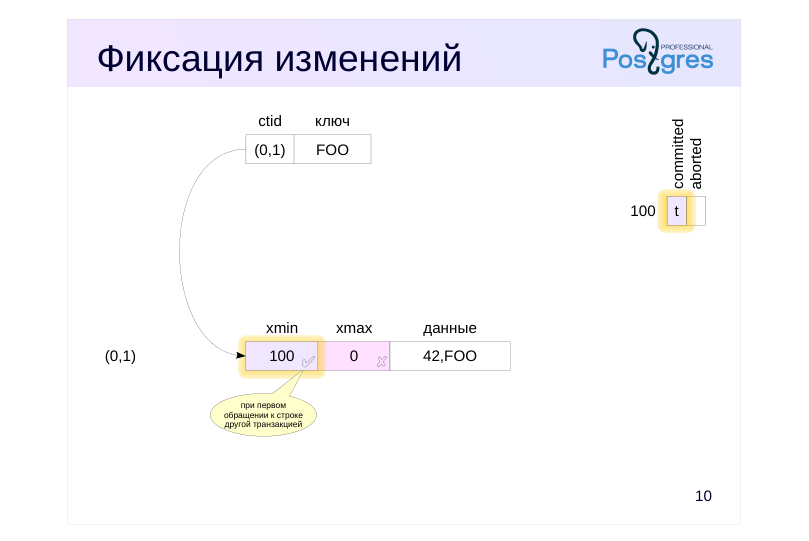
Когда транзакция фиксируется, в CLOG для этой транзакции выставляется признак committed. Это, по сути, единственная операция (не считая журнала предзаписи), которая необходима.
Когда какая-либо другая транзакция обратится к версии строки, ей придется ответить на вопросы:
завершилась ли транзакция 100 (надо проверить список активных процессов и их транзакций; такая структура в общей памяти имеет название ProcArray),
а если завершилась, то фиксацией или отменой (свериться с CLOG).
Поскольку выполнять проверку по CLOG каждый раз накладно, выясненный однажды статус транзакции записывается в информаци-онные биты-подсказки заголовка строки. Если один из этих битов установлен, то состояние транзакции xmin считается известным и следующей транзакции уже не придется обращаться к CLOG.
Почему эти биты не устанавливаются той транзакцией, которая выполняла вставку? В момент, когда транзакция фиксируется или отменяется, уже непонятно, какие именно строки в каких именно страницах транзакция успела поменять. Кроме того, часть этих страниц может быть вытеснена из буферного кеша на диск; читать их заново, чтобы изменить биты, означало бы существенно замедлить фиксацию.
Обратная сторона состоит в том, что любая транзакция (даже выполняющая простое чтение — SELECT) может загрязнить данные в буферном кеше и породить новые журнальные записи.
Page 11: Удаление
 {#source-figure-011 caption=“Source slide page 11: Удаление”}
Комментарии преподавателя
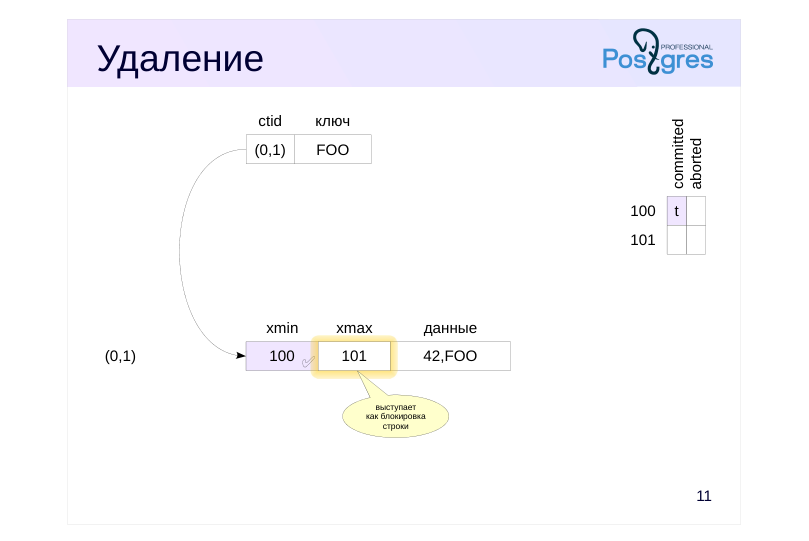
При удалении строки в поле xmax текущей версии записывается номер текущей удаляющей транзакции, а признак оборванной транзакции сбрасывается. Больше ничего не происходит.
Заметим, что установленное значение xmax, соответствующее активной транзакции (что определяется другими транзакциями по ProcArray), выступает в качестве блокировки. Если другая транзакция намерена обновить или удалить эту строку, она будет вынуждена дождаться завершения транзакции xmax.
Подробнее блокировки рассматриваются в теме «Блокировки» этого модуля. Пока отметим только, что число блокировок строк ничем не ограничено. Они не занимают место в оперативной памяти, производительность системы не страдает от их количества (разумеется, за исключением того, что первый процесс, обратившийся к версии строки, должен будет проставить биты-подсказки).
Page 12: Отмена изменений
 {#source-figure-012 caption=“Source slide page 12: Отмена изменений”}
Комментарии преподавателя
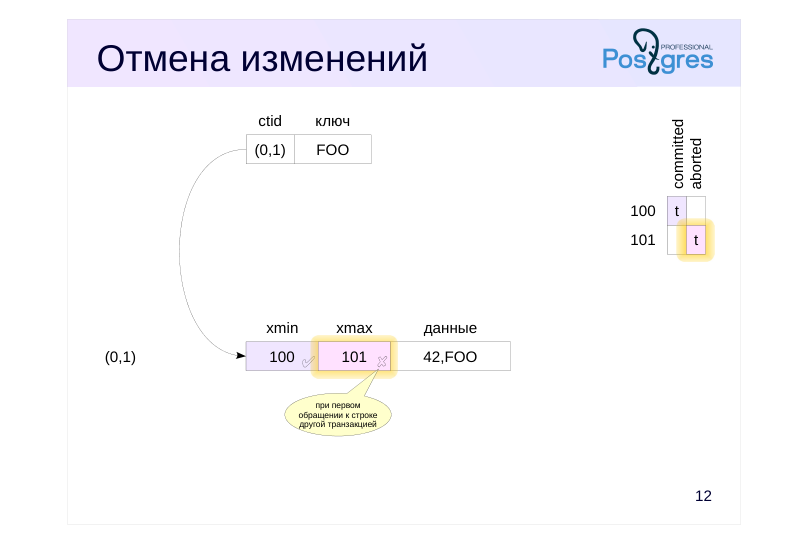
Отмена изменений работает аналогично фиксации, только в CLOG для транзакции выставляется бит оборванной транзакции. Отмена выполняется так же быстро, как и фиксация — не требуется выполнять откат выполненных действий.
Номер прерванной транзакции остается в поле xmax. Когда другая транзакция обратится к версии строки, она проверит статус транзакции 101 и установит в версию строки признак-подсказку, что транзакция оборвана. Это будет означать, что на значение в поле xmax смотреть не нужно.
Page 13: Обновление
 {#source-figure-013 caption=“Source slide page 13: Обновление”}
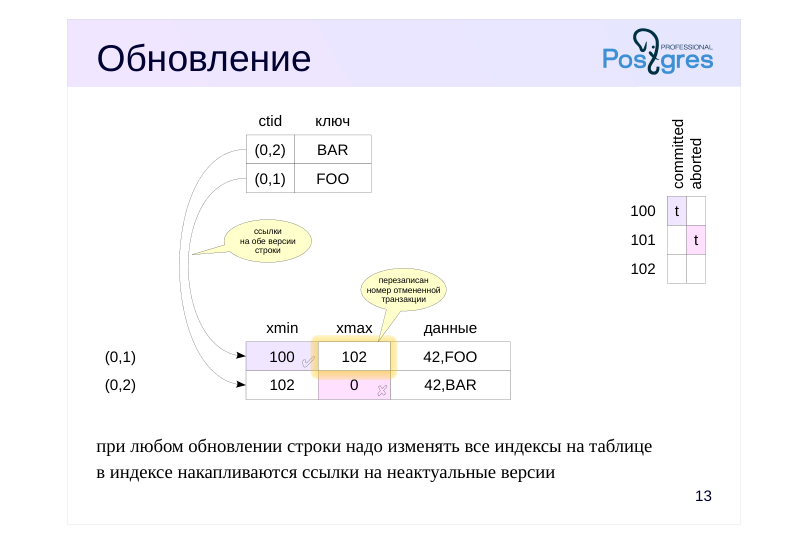
при любом обновлении строки надо изменять все индексы на таблице в индексе накапливаются ссылки на неактуальные версии
Комментарии преподавателя
Обновление работает так, как будто сначала выполняется удаление старой версии строки, а затем — вставка новой.
Старая версия помечается номером текущей транзакции в поле xmax. Обратите внимание, что новое значение 102 записалось поверх старого 101, так как транзакция 101 была отменена. Кроме того, биты-подсказки сброшены, так как статус текущей транзакции еще не известен.
В индексной странице появляется второй указатель и вторая запись, ссылающаяся на вторую версию в табличной странице.
Так же, как и при удалении, значение xmax в первой версии строки служит признаком того, что строка заблокирована.
Чем плохо такое обновление?
Во-первых, при любом изменении строки приходится обновлять все индексы, созданные для таблицы (даже если измененные поля не входят в индекс). Очевидно, это снижает производительность.
Во-вторых, в индексах накапливаются ссылки на исторические версии строки, которые потом приходится очищать.
Более того, есть особенность реализации B-дерева в PostgreSQL. Если на индексной странице недостаточно места для вставки новой записи, страница делится на две и все данные перераспределяются между ними. Однако при удалении (или очистке) записей две индексные страницы не «склеиваются» в одну. Из-за этого размер индекса может не уменьшиться даже при удалении существенной части данных.
Page 14: Версии строк
Начнем с чистого листа.
Вставим одну строку, предварительно начав транзакцию.
Номер нашей текущей транзакции:
Посмотрим на таблицу, добавив системные столбцы:
Xmin совпадает с номером нашей транзакции, а xmax равен фиктивному значению 0. Чтобы заглянуть в индекс, воспользуемся расширением pageinspect. Нулевая страница индекса содержит метаинформацию, поэтому смотрим в первую.
Видим один указатель на единственную строку таблицы. (В поле data можно угадать ASCII-коды букв FOO.) Pageinspect позволяет увидеть и полную информацию о том, что находится в табличной странице, но в этой теме мы не будем углубляться в эти детали. Зафиксируем изменение.
Теперь проверим, как работает обновление. Начнем второй сеанс.
В нем прочитаем таблицу на уровне Repeatable Read:
Page 15: Page 15
Теперь обновляем строку.
Запрос в первом сеансе выдает одну строку (новую версию):
Но в странице присутствуют обе версии. Предыдущую продолжает видеть второй сеанс:
Номер транзакции, удалившей первую версию строки, записался в xmax. При этом в индексной странице обнаруживаем указатели на обе версии:
Индексные записи внутри страницы упорядочены. Поэтому первой идет запись с ключом BAR (ссылается на версию (0,2)), а второй — запись с ключом FOO (ссылается на версию (0,1)). Завершим транзакции.
Page 16: HOT-обновление
 {#source-figure-016 caption=“Source slide page 16: HOT-обновление”}
обновляемые столбцы не должны входить ни в один индекс цепочка обновлений — только в пределах одной страницы
Комментарии преподавателя
Однако если индекс создан по полю, значение которого не изменилось в результате обновления строки, то нет смысла создавать дополнительную запись в B-дереве, содержащую то же самое значение ключа. Именно так работает оптимизация, называемая HOT-обновлением — Heap-Only Tuple Update.
При таком обновлении в индексной странице находится лишь одна запись, ссылающаяся на первую версию строки табличной страницы. А внутри табличной страницы организуется цепочка из версий, на которые гарантированно нет внешних ссылок (heap-only tuples).
Если при сканировании индекса PostgreSQL попадает в табличную страницу и обнаруживает версию, начинающую цепочку, он проходит по всей цепочке обновлений (для всех полученных таким образом версий строк проверяется видимость, прежде чем они будут возвращены).
Подчеркнем, что HOT-обновления работают в случае, если обновляемые поля не входят ни в один индекс — иначе в каком-либо индексе оказалась бы ссылка непосредственно на новую версию строки, что противоречит идее этой оптимизации. В частности, HOT-обновление используется, если у таблицы вообще нет индексов.
Оптимизация действует только в пределах одной страницы, поэтому дополнительный обход цепочки не требует обращения к другим страницам и не ухудшает производительность. Однако если на странице не хватит свободного места, чтобы разместить новую версию строки, цепочка прервется. На версию строки, размещенную на другой странице, будет сделана новая ссылка из индекса.
Page 17: HOT-обновление
Снова опустошим таблицу.
Но пусть теперь индекс будет построен по столбцу id:
Начнем транзакцию с уровнем изоляции Repeatable Read.
До этого мы обновляли проиндексированный столбец, а теперь столбец s не входит ни в один индекс.
Появляется вторая версия строки.
Но другой сеанс продолжает видеть самую первую версию:
Что же обнаружится в индексе?
Мы видим, что в индексе не добавилась новая запись. Индекс продолжает ссылаться на первую версию, а уже внутри табличной страницы первая версия связана со второй в цепочку. Еще один способ убедиться в том, что выполнилось HOT-обновление — заглянуть в статистику текущей транзакции:
Page 18: Page 18
Здесь мы видим, что всего транзакция обновила одну строку (n_tup_upd), причем с помощью HOT (n_tup_hot_upd).
Page 19: Снимки данных
Снимок данных
- Видимость версий строк
- Горизонт снимка
- Горизонт транзакции
- Горизонт базы данных
Page 20: Снимок данных
Дает согласованную картину данных на момент времени
- видны только зафиксированные на этот момент данные
- Создается:
снимок
- Read Committed —
- в начале каждого оператора
- Repeatable Read, Serializable —
- в начале первого оператора транзакции
- xid
Комментарии преподавателя
Мы видели, что в страницах данных физически могут находиться несколько версий одной и той же строки.
Транзакции работают со снимком данных, который определяет, какие версии должны быть видны, а какие — нет, чтобы обеспечить согласованную картину данных на определенный момент времени (на момент создания снимка — показан на рисунке синим цветом).
Согласованность здесь понимается в обычном ACID-смысле: данные должны быть корректны, что, по сути, означает, что видеть нужно только те данные, которые были зафиксированы на момент создания снимка. Это полностью исключает аномалию грязного чтения на любом уровне изоляции.
На уровне изоляции Read Committed снимок создается в начале каждого оператора транзакции. Снимок активен, пока выполняется оператор. Таким образом каждый оператор видит согласованные данные, но если между двумя операторами другие транзакции зафиксируют изменения, возможны неповторяемое и фантомное чтения.
На уровне Repeatable Read (и Serializable) снимок создается один раз в начале первого оператора транзакции. Такой снимок остается активным до самого конца транзакции. В этом случае неповторяемое и фантомное чтения исключаются.
Снимок данных не является физической копией версий строк, принадлежность версии строки к снимку определяется с помощью правил видимости.
Page 21: Видимость версий строк
Видимость версии строки ограничена xmin и xmax
- Версия попадает в снимок, когда
- изменения транзакции xmin видны для снимка, изменения транзакции xmax не видны для снимка Изменения транзакции видны, когда
- либо это та же самая транзакция, что создала снимок,
- либо она завершилась фиксацией до момента создания снимка
- Отдельные правила для видимости собственных изменений
- учитывается порядковый номер операции в транзакции (cmin/cmax)
Комментарии преподавателя
Будет или нет данная версия строки видна в снимке, определяется двумя полями ее заголовка — xmin и xmax, — то есть номерами создавшей и удалившей транзакций. Такие интервалы не пересекаются, поэтому одна строка представлена в любом снимке максимум одной своей версией.
Точные правила видимости довольно сложны и учитывают различные «крайние» случаи. Чуть упрощая, можно сказать, что версия строки видна, когда в снимке видны изменения, сделанные транзакцией xmin, и не видны изменения, сделанные транзакцией xmax. Иными словами, создание версии строки должно быть видно, а удаление (если оно было) — нет.
В свою очередь, изменения транзакции видны в снимке, если либо это та же самая транзакция, что создала снимок (транзакция видит свои же изменения), либо транзакция была зафиксирована до создания снимка.
Несколько усложняет картину случай определения видимости собственных изменений транзакции. Здесь может потребоваться видеть только часть таких изменений. Например, курсор, открытый в определенный момент, ни при каком уровне изоляции не должен увидеть изменений, сделанных после этого момента. Для этого в заголовке версии строки есть специальное поле (псевдостолбцы cmin и cmax), показывающее порядковый номер операции внутри транзакции, и этот номер тоже принимается во внимание.
Page 22: Снимок данных
 {#source-figure-022 caption=“Source slide page 22: Снимок данных”}
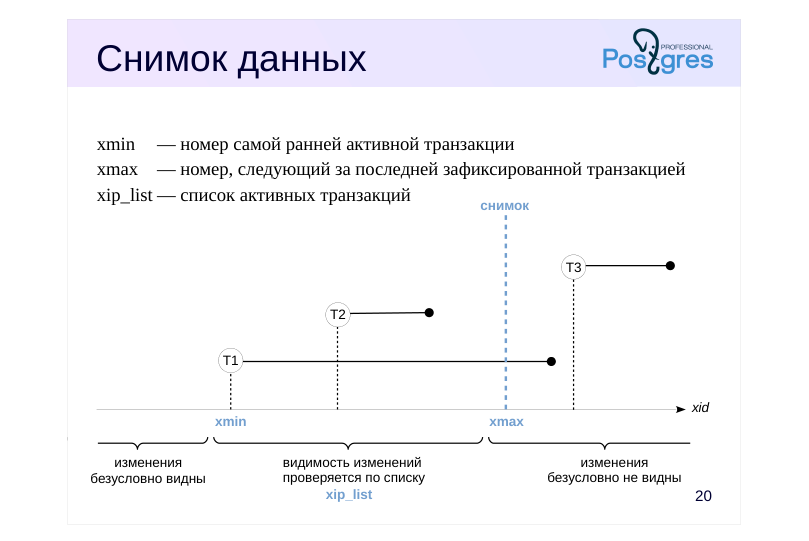
- xmin — номер самой ранней активной транзакции xmax — номер, следующий за последней зафиксированной транзакцией xip_list — список активных транзакций
Комментарии преподавателя
В момент создания снимка данных запоминаются несколько значений, которые и определяют снимок:
● xmin — нижняя граница снимка, в качестве которой выступает номер самой ранней активной транзакции.
Все транзакции с меньшими номерами либо зафиксированы, и тогда их изменения безусловно видны в снимке, либо отменены, и тогда изменения игнорируются.
● xmax — верхняя граница снимка, в качестве которой берется номер, следующий за номером последней зафиксированной транзакции. Верхняя граница определяет момент, в который был сделан снимок. Обратите внимание, что момент задается не временем (как было условно показано на предыдущих слайдах), а увеличивающимися номерами транзакций.
Все транзакции с номерами, большими или равными xmax, не существовали в момент создания снимка, поэтому изменения таких транзакций точно не видны.
● xip_list (xid-in-progress list) — список активных транзакций.
Этот список используется для того, чтобы не показывать в снимке изменения транзакций, которые уже завершились, но в момент создания снимка были еще активны.
Информацию о снимке можно получить с помощью функции pg_current_snapshot() и нескольких других: https://postgrespro.ru/docs/postgresql/16/functions-info
Page 23: Горизонт снимка
 {#source-figure-023 caption=“Source slide page 23: Горизонт снимка”}
Комментарии преподавателя
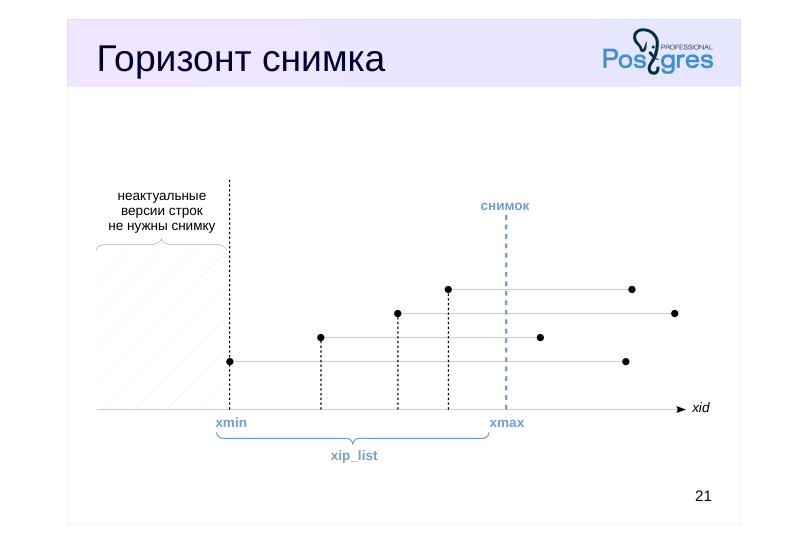
Номер самой ранней из активных транзакций (xmin снимка) имеет важный смысл — он определяет горизонт снимка.
Горизонт событий в астрофизике — это граница, за которой наблюдатель не может увидеть никакие события. А в нашем случае горизонт снимка — это граница, за которой оператор, использующий снимок, не может увидеть неактуальные версии строк.
Действительно, видеть неактуальную версию требуется только в том случае, когда актуальная создана еще не завершившейся транзакцией, и поэтому пока не видна. Но за горизонтом все транзакции уже гарантированно завершились.
Page 24: Горизонт транзакции
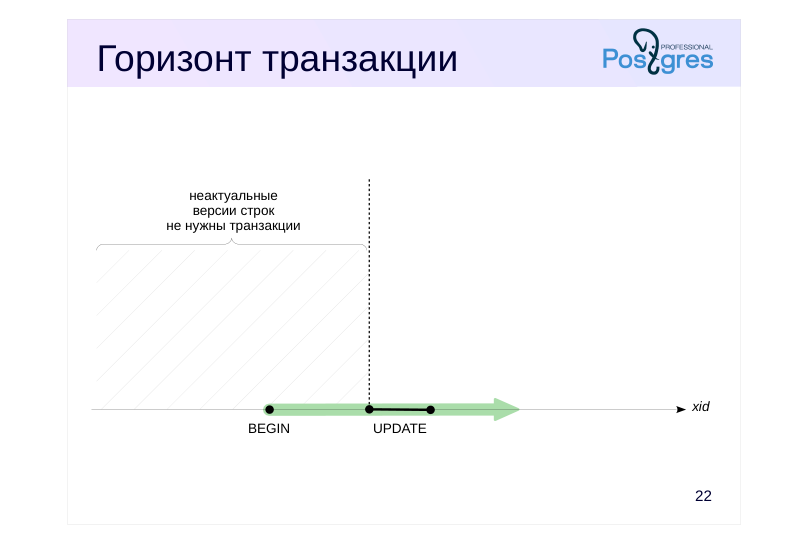 {#source-figure-024 caption=“Source slide page 24: Горизонт транзакции”}
Комментарии преподавателя
Если транзакция меняет данные, она держит горизонт на уровне своего номера на случай отката.
Если транзакция будет долго находиться в таком состоянии ожидания (оно называется idle in transaction), не выполняя никаких команд, горизонт будет оставаться на месте.
Page 25: Горизонт базы данных
 {#source-figure-025 caption=“Source slide page 25: Горизонт базы данных”}
Комментарии преподавателя
Также можно определить и горизонт базы данных как минимальный из горизонтов всех транзакций и снимков. При освобождении снимка горизонт базы данных смещается вправо к горизонту следующего активного снимка. Обратного движения быть не может, поскольку xmin вновь возникающих снимков — минимальный номер активной транзакции — сдвигается только вправо.
Неактуальные версии строк за горизонтом базы данных уже никогда не будут нужны ни одной транзакции. Такие версии строк могут быть безопасно вычищены.
На слайде показан пример трех транзакций с уровнем изоляции Read Committed. Для оператора UPDATE транзакции T1 был построен снимок. Когда оператор отрабатывает, снимок удаляется и перестает удерживать горизонт. Однако транзакция T1 по-прежнему активна, и поэтому горизонты снимков транзакций T2 и T3 не сдвинутся правее номера транзакции T1. Тем самым активная транзакция удерживает горизонт самим фактом своего существования.
А это означает, что неактуальные версии строк в этой БД не могут быть очищены. При этом «долгоиграющая» транзакция может никак не пересекаться по данным с другими транзакциями — это совершенно не важно, горизонт базы данных один на всех.
Это одна из причин, по которым транзакции не следует делать длиннее, чем абсолютно необходимо.
Page 26: Снимки данных
И еще раз начнем транзакцию в отдельном сеансе.
Одновременно с этим выполним несколько других транзакций.
Горизонт транзакций можно увидеть следующим образом:
Видно, что открытая транзакция удерживает горизонт, поскольку ей нужны старые версии строк. Завершим ее.
После этого горизонт базы данных продвигается вперед, позволяя очищать неактуальные версии:
Page 27: Итоги
PostgreSQL использует многоверсионность и изоляцию на основе снимков данных
- Индексы не содержат информации о версионности
- чтобы вернуть данные, нужно проверить видимость
- (по таблице или карте видимости)
- Лишние индексы не только влекут накладные расходы, но и препятствуют HOT-обновлениям
- Транзакции должны быть настолько длинными, насколько необходимо, но не более
Page 28: Практика
- Функционал точек сохранения должен позволять откатывать часть транзакции. Чтобы разобраться, как это работает, выполните операции внутри одной транзакции:
- вставьте строку в таблицу;
- установите точку сохранения (SAVEPOINT);
- вставьте в таблицу еще одну строку;
- откатите изменения до точки сохранения;
- вставьте еще одну строку;
- зафиксируйте изменения.
- При этом после каждой операции выводите номер текущей
- транзакции и проверяйте значения столбцов xmin и xmax.
Page 29: 1. Точки сохранения
Создадим таблицу:
Начинаем транзакцию.
Вставляем первую строку:
Вот номер нашей транзакции и состояние таблицы:
Пока все как обычно. Устанавливаем точку сохранения и вставляем вторую строку:
Номер транзакции прежний.
А вот в xmin второй строки указан другой номер. Это вложенная транзакция, она начинается сразу после установки точки сохранения. Откатим изменения до точки сохранения и вставим третью строку:
Page 30: Page 30
У третьей строки опять другой номер. Это еще одна вложенная транзакция, которая началась сразу после отката к точке сохранения. Зафиксируем изменения:
Каждая вложенная транзакция имеет собственный статус и может быть оборвана независимо от статуса основной транзакции. Откат части транзакции — это фактически откат одной или нескольких вложенных транзакций. Но при завершении основной транзакции завершаются и все еще активные вложенные транзакции: при фиксации — фиксируются, при откате — откатываются.
03 Занятие 03: Архитектура / Очистка
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_03_arch_vacuum.html Archive: DEV2-handouts-16.zip Страниц PDF: 27
Page 1: Архитектура / Очистка
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Очистка версий строк и анализ таблиц
- Заморозка версий строк
Page 3: Очистка и анализ
Как устроен процесс очистки
- Анализ таблиц
- Полная очистка
Page 4: Очистка
Выполняется командой VACUUM
- очищает ненужные версии строк в табличных страницах
- (пропуская страницы, уже отмеченные в карте видимости)
- очищает индексные записи, ссылающиеся на очищенные версии строк
- обновляет карты видимости и свободного пространства
- Обычно работает в автоматическом режиме
- частота обработки зависит от интенсивности изменений в таблице
- процессы autovacuum launcher и autovacuum worker
Комментарии преподавателя
Как мы уже знаем, при реализации многоверсионности в таблицах накапливаются исторические версии строк, а в индексах — ссылки на такие исторические версии. Когда версия строки уходит за горизонт базы данных, ее можно удалить, освобождая место для других версий.
Очистка, выполняемая командой VACUUM, обрабатывает всю таблицу, включая все созданные на ней индексы. При этом удаляются и ненужные версии строк, и указатели на них в начале страницы.
Обычно очистка запускается не вручную, а работает в автоматическом режиме, учитывая фактическое количество изменений в таблице. Чем активнее изменяются, добавляются и удаляются строки, тем чаще автоочистка обрабатывает таблицу и ее индексы.
При включенной автоочистке в системе всегда присутствует процесс autovacuum launcher, который занимается планированием работы процессов autovacuum worker, непосредственно выполняющих очистку. Несколько экземпляров таких рабочих процессов могут действовать параллельно.
Важно, чтобы процесс автоочистки был правильно настроен. Как это делается, рассматривается в курсе DBA2 «Администрирование PostgreSQL. Настройка и мониторинг». Если автоочистка не будет срабатывать вовремя, таблицы будут разрастаться в размерах. Также важно, чтобы в системе с OLTP-нагрузкой не было длинных транзакций, подолгу удерживающих горизонт базы данных и мешающих очистке.
https://postgrespro.ru/docs/postgresql/16/sql-vacuum
https://postgrespro.ru/docs/postgresql/16/routine-vacuuming
Page 5: Пример
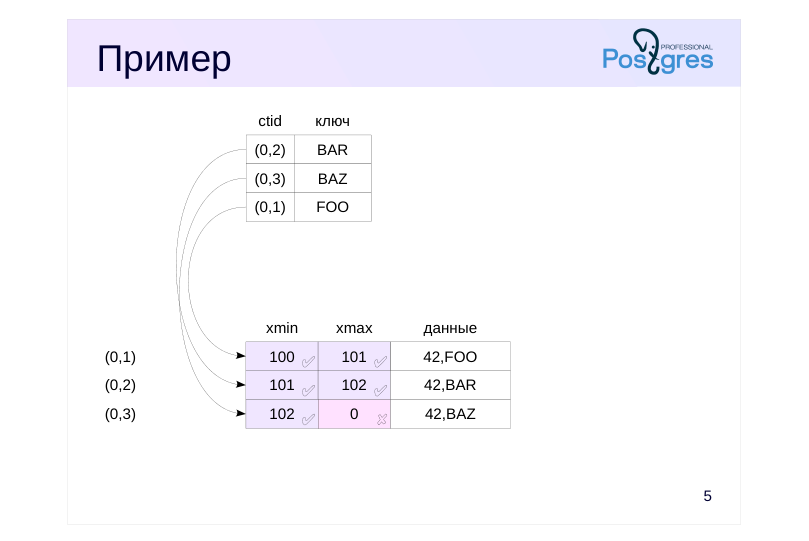 {#source-figure-005 caption=“Source slide page 5: Пример”}
Комментарии преподавателя
Рассмотрим пример.
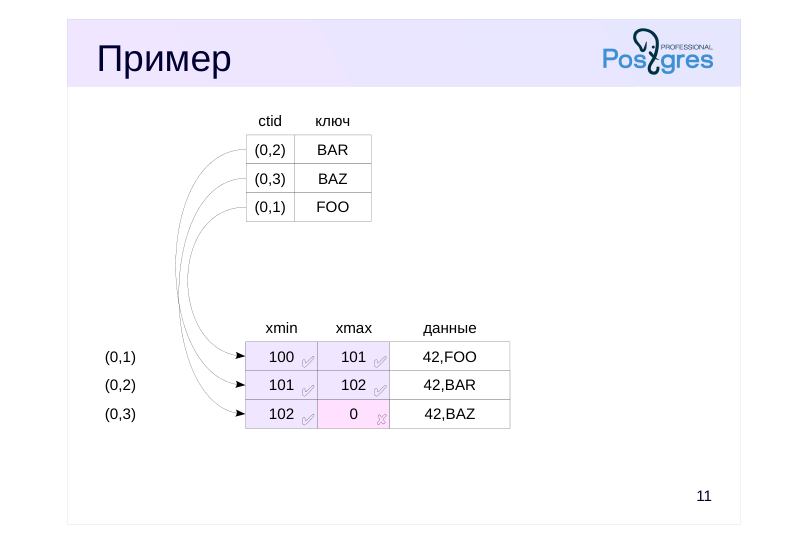
На рисунке приведена ситуация до очистки. В табличной странице три версии одной строки. Две из них неактуальны, не видны ни в одном снимке и могут быть удалены.
В индексе есть три ссылки: на каждую из версий строки.
Page 6: Фаза очистки индексов
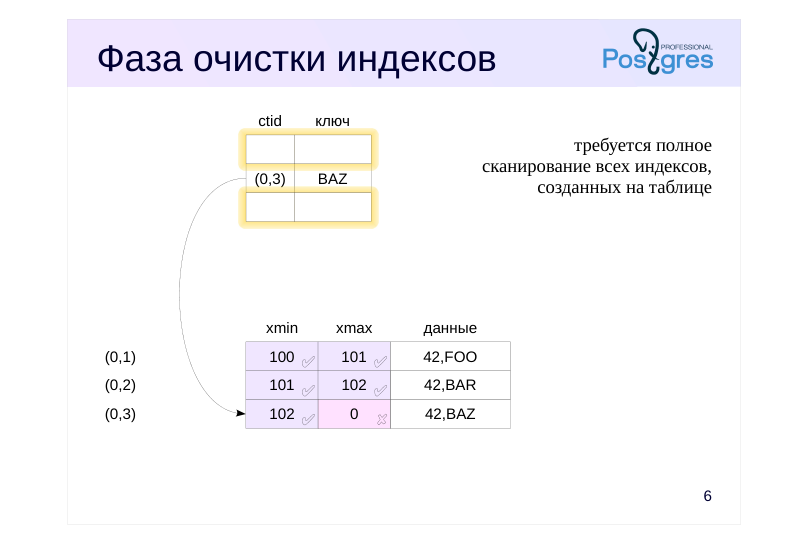 {#source-figure-006 caption=“Source slide page 6: Фаза очистки индексов”}
Комментарии преподавателя
Очистка обрабатывает данные постранично. Таблица при этом может использоваться обычным образом и для чтения, и для изменения (однако одновременное выполнение для таблицы таких команд, как CREATE INDEX, ALTER TABLE и др. будет невозможно — подробнее см. тему «Блокировки»).
Сначала таблица сканируется в поисках версий строк, которые можно очистить. Для этого (с помощью карты видимости) читаются только те страницы, в которых есть неактуальные (мертвые) версии строк. Идентификаторы очищаемых строк запоминаются в оперативной памяти.
Затем начинается фаза очистки индексов. Каждый из индексов, созданных на таблице, полностью сканируется в поисках записей, которые ссылаются на очищаемые версии строк (это еще один повод не создавать лишних индексов!). Найденные индексные записи очищаются. Эту фазу могут выполнять несколько фоновых процессов параллельно, по одному процессу на каждый индекс.
После этой фазы в индексе уже нет ссылок на устаревшие версии строк, но сами версии строк еще присутствуют в таблице.
Page 7: Фаза очистки таблицы
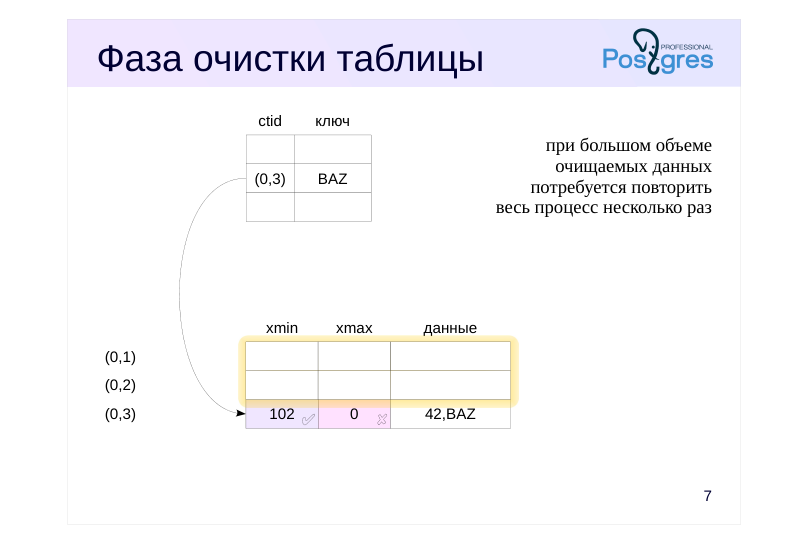 {#source-figure-007 caption=“Source slide page 7: Фаза очистки таблицы”}
Комментарии преподавателя
Затем выполняется фаза очистки таблицы. На этой фазе таблица снова сканируется, и из нее вычищаются версии строк с запомненными ранее идентификаторами. Несмотря на то, что индексы на предыдущей фазе могут очищаться параллельно, при очистке самой таблицы параллелизма нет: она очищается одним (ведущим) процессом.
После этой фазы устаревших версий строк нет ни в индексах, ни в таблице.
Заметим, что фазы очистки индексов и таблицы могут поочередно выполняться несколько раз, если не хватает памяти для того чтобы сразу запомнить все идентификаторы очищаемых строк. Такой ситуации стараются избегать правильной настройкой автоочистки.
В процессе очистки таблицы обновляются и карта видимости (если на странице не остается неактуальных версий строк), и карта свободного пространства, в которой отражается наличие свободного места в страницах.
Page 8: Очистка
Создадим таблицу и запретим для нее автоматическую очистку (чтобы управлять моментом срабатывания).
Вставим в таблицу некоторое количество строк и узнаем размер ее основного слоя:
Теперь, чтобы еще раз напомнить про понятие горизонта, откроем в другом сеансе транзакцию с активным снимком данных.
Горизонт базы данных определяется этим снимком:
Обновим все строки таблицы.
Как изменится размер таблицы?
Page 9: Page 9
 {#source-figure-009 caption=“Source slide page 9: Page 9”}
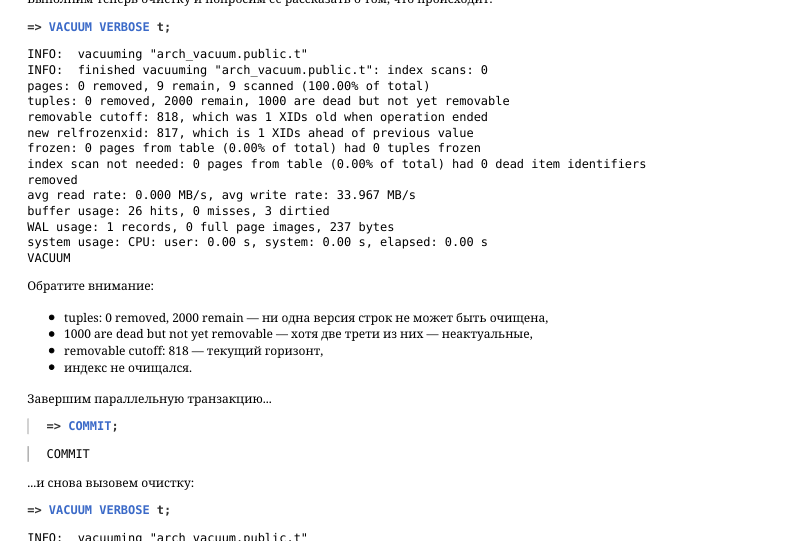
Размер основного слоя таблицы увеличился примерно вдвое. Выполним теперь очистку и попросим ее рассказать о том, что происходит:
Обратите внимание: tuples: 0 removed, 2000 remain — ни одна версия строк не может быть очищена, 1000 are dead but not yet removable — хотя две трети из них — неактуальные, removable cutoff: 818 — текущий горизонт, индекс не очищался. Завершим параллельную транзакцию…
…и снова вызовем очистку:
Теперь: removable cutoff: 819 — горизонт подвинулся, tuples: 1000 removed — очищены все неактуальные версии строк, index scan needed … 1000 dead item identifiers removed — очищены указатели на них из индекса. Посмотрим на размер:
Он не изменился, поскольку все свободное место находится внутри страниц — оно не возвращается операционной системе, но будет использовано для размещения новых версий строк.
Page 10: Анализ
Выполняется командой ANALYZE
- собирает статистику для планировщика
- можно вместе с очисткой командой VACUUM ANALYZE
- Обычно работает в автоматическом режиме
- вместе с автоматической очисткой
Комментарии преподавателя
Еще одна задача, которую обычно совмещают с очисткой, — анализ, то есть сбор статистической информации для планировщика запросов. Анализируется число строк в таблице, распределение данных по столбцам и т. п. Более подробно сбор статистики рассматривается в курсе QPT «Оптимизация запросов».
Вручную анализ выполняется командой ANALYZE (только анализ) или VACUUM ANALYZE (и очистка, и анализ).
Обычно очистка и анализ запускаются не вручную, а работают вместе в автоматическом режиме. Частота автоанализа также зависит от интенсивности изменений и допускает тонкую настройку.
https://postgrespro.ru/docs/postgresql/16/sql-analyze
Page 11: Полная очистка
Перестраивает файлы и возвращает место файловой системе
- Команда VACUUM FULL
- полностью перестраивает таблицу и все ее индексы
- монопольно блокирует таблицу и ее индексы на все время работы
- Команда REINDEX
- полностью перестраивает только индексы
- монопольно блокирует индекс и запрещает запись в таблицу
- вариант REINDEX CONCURRENTLY не мешает чтению и записи,
- но выполняется дольше
Комментарии преподавателя
Обычная очистка не решает всех задач по освобождению места. Если таблица или индекс сильно выросли в размерах, то очистка не приведет к сокращению числа страниц (и к уменьшению файлов). Вместо этого внутри существующих страниц появятся «дыры», которые могут быть использованы для вставки новых строк или изменения существующих. Единственное исключение составляют полностью очищенные страницы, находящиеся в конце файла — такие страницы «откусываются» и возвращаются операционной системе.
Если размер файлов превышает некие разумные пределы, можно выполнить команду VACUUM FULL для полной очистки. При этом таблица и все ее индексы перестраиваются полностью с нуля, а данные упаковываются максимально компактно.
Полная очистка не предполагает регулярного использования, так как полностью блокирует всякую работу с таблицей (включая и выполнение запросов к ней) на все время своего выполнения.
https://postgrespro.ru/docs/postgresql/16/sql-vacuum
Команда REINDEX перестраивает индексы, не трогая при этом таблицу. Фактически, VACUUM FULL использует эту команду для того, чтобы перестроить индексы. Вариант REINDEX CONCURRENTLY работает дольше, но не блокирует индекс и не мешает чтению и обновлению данных.
https://postgrespro.ru/docs/postgresql/16/sql-reindex
Page 12: Пример
 {#source-figure-012 caption=“Source slide page 12: Пример”}
Комментарии преподавателя
На рисунке приведена та же самая ситуация до очистки, которую мы уже рассматривали.
В табличной странице три версии одной строки. Две из них неактуальны, не видны ни в одном снимке и могут быть удалены.
В индексе есть три ссылки на каждую из версий строки.
Page 13: После полной очистки
 {#source-figure-013 caption=“Source slide page 13: После полной очистки”}
Комментарии преподавателя
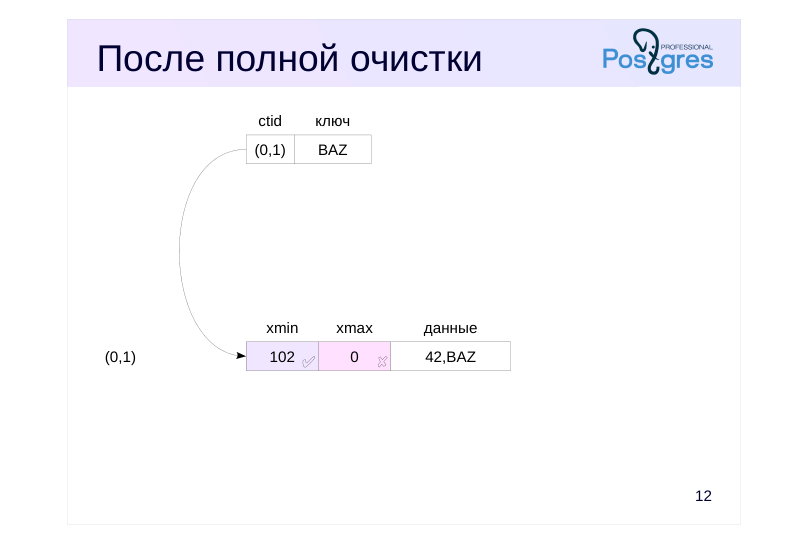
После выполнения полной очистки файлы данных индекса и таблицы перестроены заново, нумерация версий строк изменилась. В страницах отсутствуют «дыры», данные упакованы максимально плотно.
Page 14: Полная очистка
Вызываем полную очистку таблицы:
Таблица и индекс теперь полностью перестроены. Как изменился размер?
Размер вернулся к первоначальному.
Page 15: Заморозка
Проблема переполнения счетчика транзакций
- Заморозка версий строк
Page 16: Переполнение счетчика
 {#source-figure-016 caption=“Source slide page 16: Переполнение счетчика”}
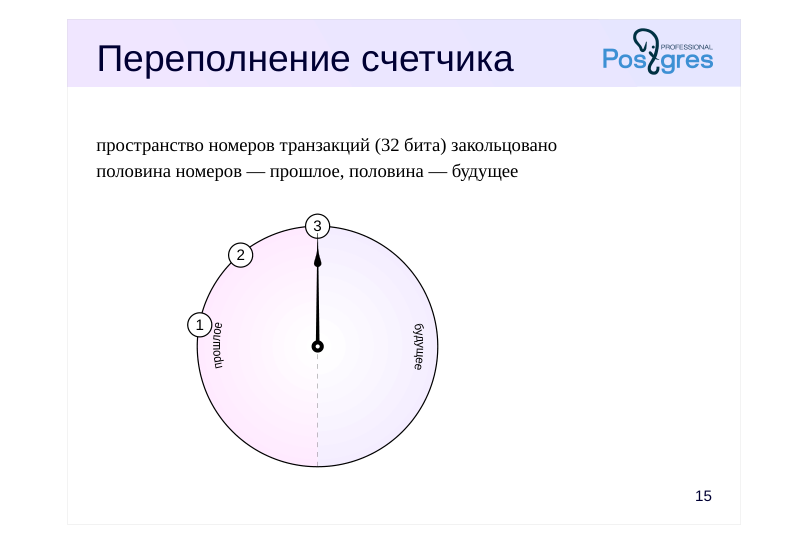
пространство номеров транзакций (32 бита) закольцовано половина номеров — прошлое, половина — будущее
Комментарии преподавателя
Под номер транзакции в PostgreSQL выделено 32 бита. Это довольно большое число (около 4 млрд номеров), но при активной работе сервера оно вполне может быть исчерпано. Например при нагрузке 1000 транзакций в секунду это произойдет всего через полтора месяца непрерывной работы.
Но мы говорили о том, что механизм многоверсионности полагается на последовательную нумерацию транзакций — из двух транзакций транзакция с меньшим номером считается начавшейся раньше. Понятно, что нельзя просто обнулить счетчик и продолжить нумерацию заново.
Почему под номер транзакции не выделено 64 бита — ведь это полностью исключило бы проблему? Дело в том, что (как рассматривалось в теме «Многоверсионность») в заголовке каждой версии строки хранятся два номера транзакций — xmin и xmax. Заголовок и так достаточно большой, а увеличение разрядности привело бы к его увеличению еще на 8 байт.
Page 17: Переполнение счетчика
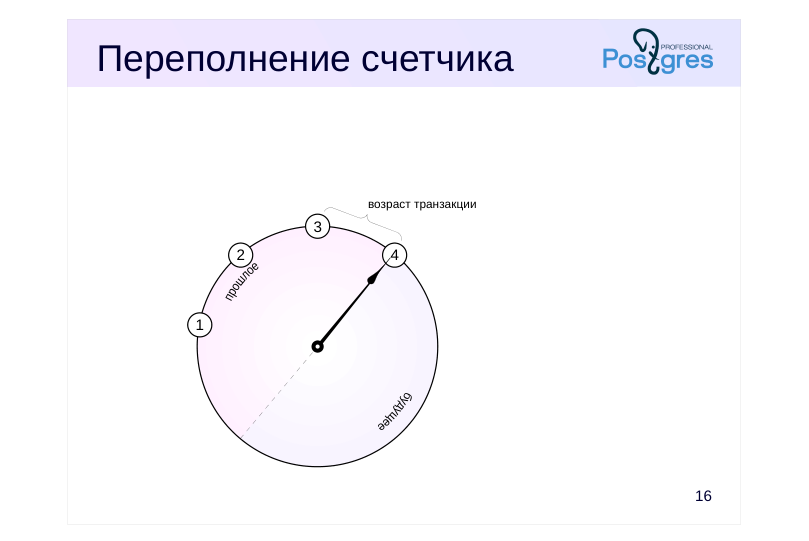 {#source-figure-017 caption=“Source slide page 17: Переполнение счетчика”}
Комментарии преподавателя
Поэтому вместо линейной схемы все номера транзакций закольцованы. Для любой транзакции половина номеров «против часовой стрелки» считается принадлежащей прошлому, а половина «по часовой стрелке» — будущему.
Возрастом транзакции называется число транзакций, прошедших с момента ее появления в системе (независимо от того, переходил ли счетчик через ноль или нет).
Page 18: Заморозка
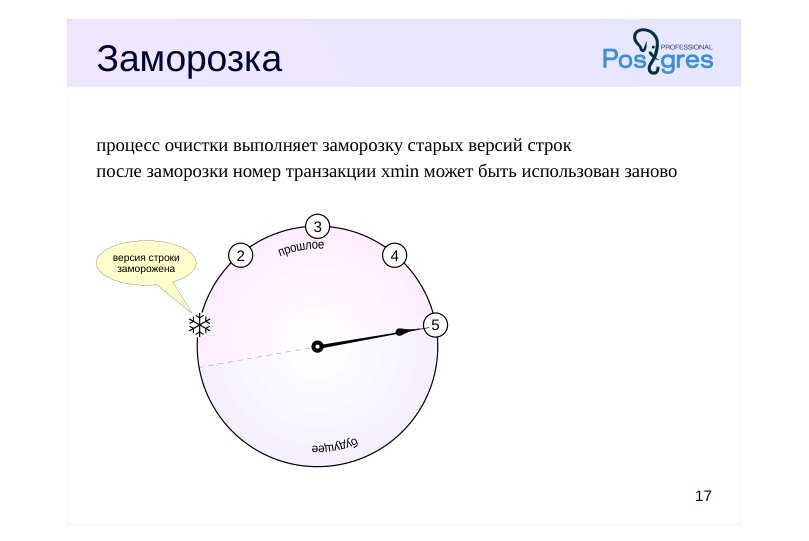 {#source-figure-018 caption=“Source slide page 18: Заморозка”}
процесс очистки выполняет заморозку старых версий строк после заморозки номер транзакции xmin может быть использован заново
Комментарии преподавателя
В такой закольцованной схеме возникает неприятная ситуация. Транзакция, находившаяся в далеком прошлом (транзакция 1), через некоторое время окажется в той половине круга, которая относится к будущему. Это, конечно, нарушило бы правила видимости для версий строк, созданных этой транзакцией, и привело бы к проблемам.
При этом проблемы вызывают только номера транзакций в поле xmin, поскольку неактуальные версии с ненулевым xmax достаточно быстро удаляются при очистке (как только перестают быть видимыми в снимках данных).
Чтобы не допустить путешествий из прошлого в будущее, процесс очистки выполняет еще одну задачу. Он находит достаточно старые и «холодные» версии строк (которые видны во всех снимках и изменение которых уже маловероятно) и специальным образом помечает — «замораживает» — их.
Page 19: Заморозка
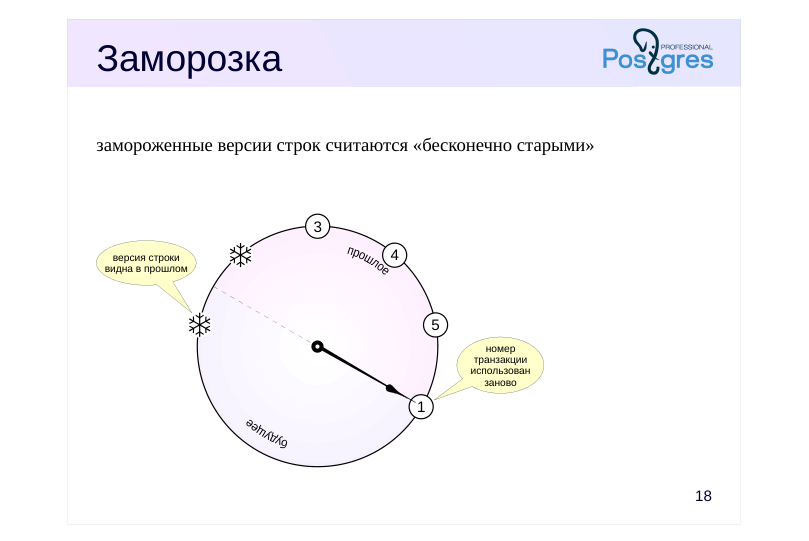 {#source-figure-019 caption=“Source slide page 19: Заморозка”}
замороженные версии строк считаются «бесконечно старыми»
Комментарии преподавателя
Замороженная версия строки считается старше любых обычных данных и всегда видна во всех снимках. При этом уже не требуется смотреть на номер транзакции xmin, и этот номер может быть безопасно использован заново. Таким образом, замороженные версии строк всегда остаются в прошлом.
https://postgrespro.ru/docs/postgresql/16/routine-vacuuming#VACUUM-FOR -WRAPAROUND
Page 20: Пример
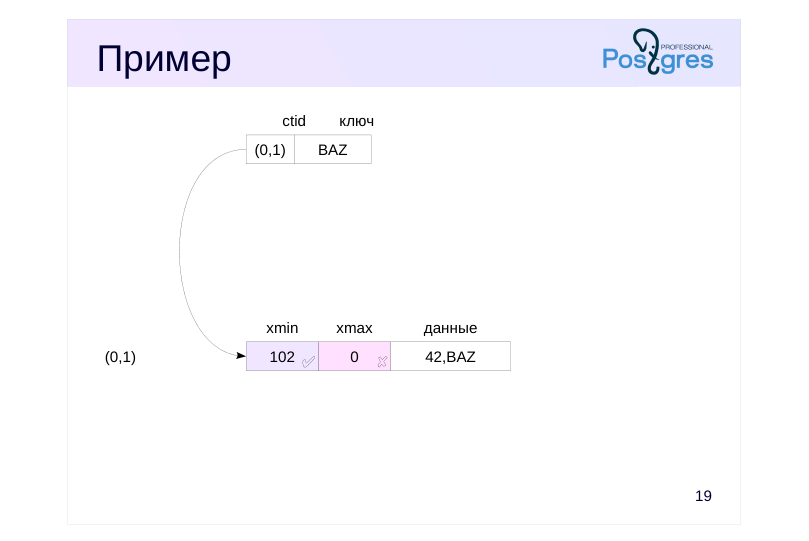 {#source-figure-020 caption=“Source slide page 20: Пример”}
Комментарии преподавателя
На рисунке приведена ситуация до заморозки. В табличной странице после очистки осталась только одна актуальная версия строки.
Page 21: После заморозки
 {#source-figure-021 caption=“Source slide page 21: После заморозки”}
замораживается только номер xmin версии строк с xmax являются неактуальными и будут очищены
Комментарии преподавателя
Для того чтобы пометить номер транзакции xmin как замороженный, выставляется специальная комбинация информационных битов в заголовке версии строки.
Важно, чтобы версии строк замораживались вовремя. Если возникнет ситуация, при которой еще не замороженная транзакция рискует попасть в будущее, PostgreSQL аварийно остановится. Это возможно в двух случаях: либо транзакция не завершена и, следовательно, не может быть заморожена, либо не сработала очистка.
При запуске сервера после аварийного останова транзакция будет автоматически оборвана; дальше администратор должен вручную выполнить очистку и после этого система сможет продолжить работать дальше.
Page 22: Заморозка вручную
VACUUM FREEZE
- принудительная заморозка версий строк с xmin любого возраста
- тот же эффект и при VACUUM FULL, CLUSTER
- COPY … WITH FREEZE
- принудительная заморозка во время загрузки
- таблица должна быть создана или опустошена в той же транзакции
- могут нарушаться правила изоляции транзакции
Комментарии преподавателя
Иногда бывает удобно управлять заморозкой вручную, а не дожидаться автоочистки.
Заморозку можно вызвать вручную командой VACUUM FREEZE — при этом будут заморожены все версии строк, без оглядки на возраст транзакций. При перестройке таблицы командами VACUUM FULL или CLUSTER все строки также замораживаются.
https://postgrespro.ru/docs/postgresql/16/sql-vacuum
Данные можно заморозить и при начальной загрузке с помощью команды COPY, указав параметр FREEZE. Для этого таблица должна быть создана (или опустошена командой TRUNCATE) в той же транзакции, что и COPY. Поскольку для замороженных строк действуют отдельные правила видимости, такие строки будут видны в снимках данных других транзакций в нарушение обычных правил изоляции (это касается транзакций с уровнем Repeatable Read или Serializable), хотя обычно это не представляет проблемы.
https://postgrespro.ru/docs/postgresql/16/sql-copy
Page 23: Итоги
Многоверсионность требует очистки старых версий строк
- обычная очистка — как правило в автоматическом режиме
- полная очистка — в экстренных случаях
- Переполнение счетчика транзакций требует заморозки
- Долгие транзакции и одномоментное обновление большого объема данных приводят к проблемам
- таблицы и индексы увеличиваются в размерах
- многократно сканируются индексы при очистке
Page 24: Практика
- В демонстрации было показано, что при обновлении всех строк таблицы одной командой UPDATE объем данных на диске увеличивается вдвое. Проделайте сходный эксперимент, но обновляйте таблицу небольшими пакетами строк, чередуя обновление с запуском очистки. Как сильно увеличилась таблица на этот раз? 2. Сравните время, за которое удаляются все строки таблицы при использовании команд DELETE и TRUNCATE.
Комментарии преподавателя
- С размером пакета можно экспериментировать; возьмите, например, 1 % от числа строк в таблице.
Для пакетной обработки нужно решить, как именно выбирать N строк из имеющихся в таблице.
Учтите, что обработка какого-то пакета может (в принципе) завершиться ошибкой. Важно, чтобы это не повлияло на возможность продолжить обработку и довести ее до конца. Например, если выбирать строки по диапазонам значений идентификатора, то как определить, какие пакеты успешно обработаны, а какие — нет?
Page 25: 1. Пакетное обновление
Создадим таблицу, сходную с той, что использовалась в демонстрации, и наполним ее данными:
Для упрощения задачи мы отказались от столбца с внешним хранением (TOAST), а дополнительный столбец processed пригодится нам для пакетного обновления. Размер таблицы:
Еще раз проверим показанное в демонстрации. Обновляем все строки:
Размер таблицы после обновления:
Таблица увеличилась в два раза. Теперь нам надо очистить таблицу, поэтому заодно засечем время выполнения команды TRUNCATE:
Заново вставляем те же строки:
Page 26: Page 26
Для того чтобы контролировать обработанные строки, будем использовать столбец processed. Для удобства создадим функцию, выполняющую обновление пакета строк, причем размер пакета задается параметром:
Предложение FOR UPDATE SKIP LOCKED будет подробнее рассмотрено в теме «Блокировки». Такой способ даст необходимое количество необработанных строк (из числа имеющихся в таблице), причем выполнение не будет задержано другими обновлениями, которые могут выполняться в это же время. Удобно также, что этот способ не требует вычисления каких-либо диапазонов. Обновление просто надо продолжать до тех пор, пока в таблице не останется необработанных строк. Поскольку выполнение команды VACUUM не допускается в блоке транзакции, воспользуется средствами bash, чтобы выполнить нужные команды:
Проверим, что все строки обработаны:
Размер таблицы после пакетного обновления:
Таблица увеличилась чуть больше, чем на 2%.
2. Удаление строк
Удаление всех строк командой DELETE выполняется значительно дольше, чем TRUNCATE. Кроме того, после DELETE в таблице остаются удаленные версии строк, которые должны быть очищены.
Page 27: Page 27
По принципу работы команда TRUNCATE напоминает VACUUM FULL: она заменяет файл данных новым (пустым) файлом, и для этого полностью блокирует работу с таблицей для других транзакций.
04 Занятие 04: Архитектура / Журналирование
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_04_arch_wal.html Archive: DEV2-handouts-16.zip Страниц PDF: 27
Page 1: Архитектура / Журналирование
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Буферный кеш
- Журнал предзаписи
Page 3: Буферный кеш
Устройство и использование
- Фоновая запись
- Локальный кеш для временных таблиц
Page 4: Буферный кеш
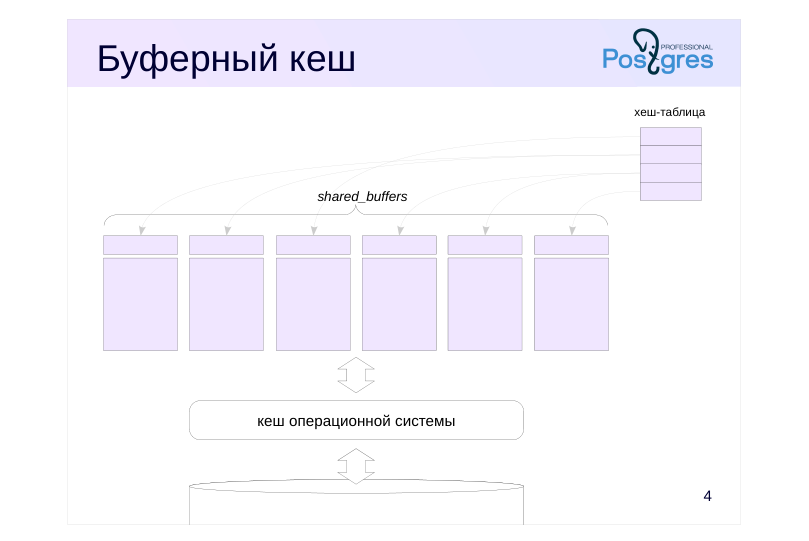 {#source-figure-004 caption=“Source slide page 4: Буферный кеш”}
Комментарии преподавателя
Задача буферного кеша — сглаживать разницу в производительности двух типов памяти: оперативной (быстрая, но мало) и дисковой (медленная, но много). Чтобы работать с данными — читать или изменять их, — процессы читают страницы в буферный кеш и, пока страница находится в кеше, мы экономим на обращениях к диску.
Буферный кеш располагается в общей памяти сервера и представляет собой массив буферов (его размер задается конфигурационным параметром shared_buffers). Каждый буфер состоит из места под одну страницу данных и заголовка. Заголовок содержит расположение страницы на диске (файл и номер страницы) и другую информацию.
Чтобы нужную страницу можно было быстро найти в кеше, используется хеш-таблица. Ключом хеширования в ней служит файл и номер страницы внутри файла. Чтобы найти страницу, надо проверить все буферы, указанные в соответствующей корзине хеш-таблицы: либо страница найдется, либо мы убедимся в том, что ее нет в кеше.
В последнем случае страницу придется прочитать в буферный кеш с диска. Однако напомним, что PostgreSQL читает и записывает данные не в обход кеша операционной системы, а через него. Это, очевидно, приводит к дублированию данных и двойному кешированию, но такова текущая реализация. Поэтому «промах» мимо буферного кеша не обязательно означает, что данные будут физически читаться с диска.
Page 5: Буферный кеш
Создадим таблицу.
В состав PostgreSQL входит расширение, которое позволяет посмотреть, что происходит в буферном кеше.
Размер кеша определяется конфигурационным параметром:
Расширение показывает каждый буфер как отдельную строку одноименного представления:
Page 6: Страница в кеше
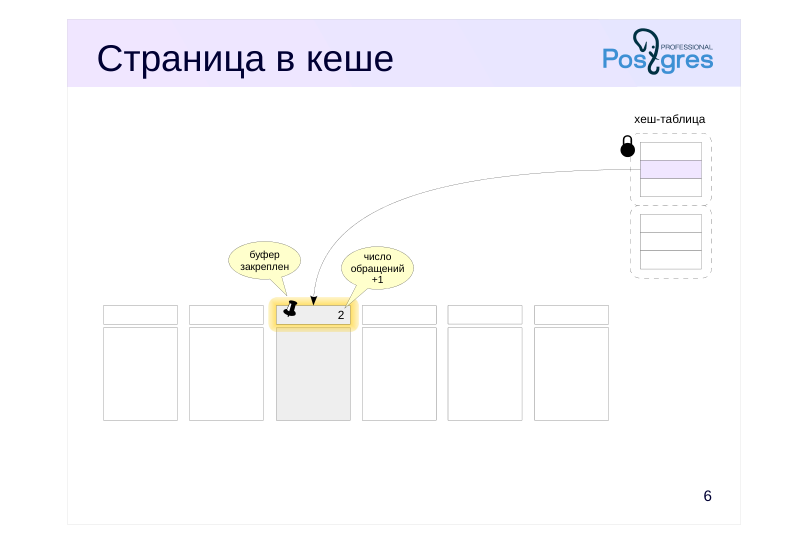 {#source-figure-006 caption=“Source slide page 6: Страница в кеше”}
Комментарии преподавателя
Рассмотрим случай, когда необходимая страница находится в кеше.
Буферный кеш и хеш-таблица находятся в общей памяти, и доступ к ним есть у всех процессов сервера. Поэтому одновременный, конкурентный доступ к этим структурам необходимо упорядочивать.
Вычислив хеш-код, процесс блокирует необходимый фрагмент хеш-таблицы в разделяемом режиме (только для чтения) с помощью так называемой «легкой блокировки», и уже затем находит буфер, содержащий нужную страницу.
Сервер управляет блокировками данных в разделяемой памяти полностью автоматически. Разработчики PostgreSQL прилагают много усилий к тому, чтобы эти блокировки работали эффективно. Например, чтобы не блокировать всю хеш-таблицу сразу, она разделена на несколько (128) фрагментов, каждый из которых может работать независимо от других. Тем не менее надо понимать, что, хотя доступ к кешу быстрее, чем к диску, он все же не бесплатен.
Дальше процесс «закрепляет» буфер, увеличивая счетчик pin count в заголовке страницы. Пока буфер закреплен (значение pin count больше нуля), считается, что буфер используется и его содержимое не должно «радикально» измениться. Например, в странице может появиться новая версия строки — обычно это не помешает другим процессам благодаря многоверсионности и правилам видимости. Но в закрепленный буфер не может быть прочитана другая страница.
Процесс также увеличивает счетчик обращений к странице (usage count). Счетчик используется для того, чтобы понимать, какие страницы используются часто, а какие нет.
Page 7: Изменение в странице
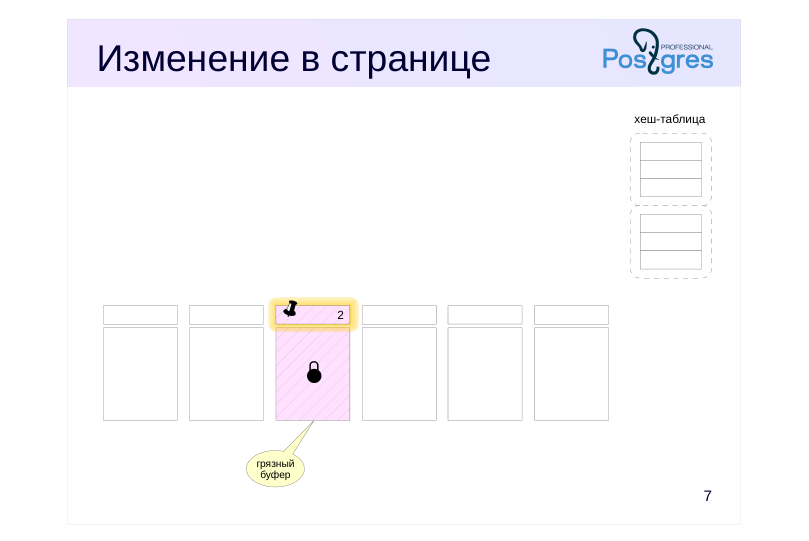 {#source-figure-007 caption=“Source slide page 7: Изменение в странице”}
Комментарии преподавателя
Если процессу необходимо изменить содержимое страницы в буфере, он должен получить монопольную блокировку для этой страницы (чтобы не менять данные в тот момент, когда их читают другие процессы).
Измененная страница, еще не записанная на диск, называется «грязной». В заголовке буфера делается отметка об этом. (На рисунках грязные буферы выделены цветом и штриховкой.)
Page 8: Чтение с вытеснением
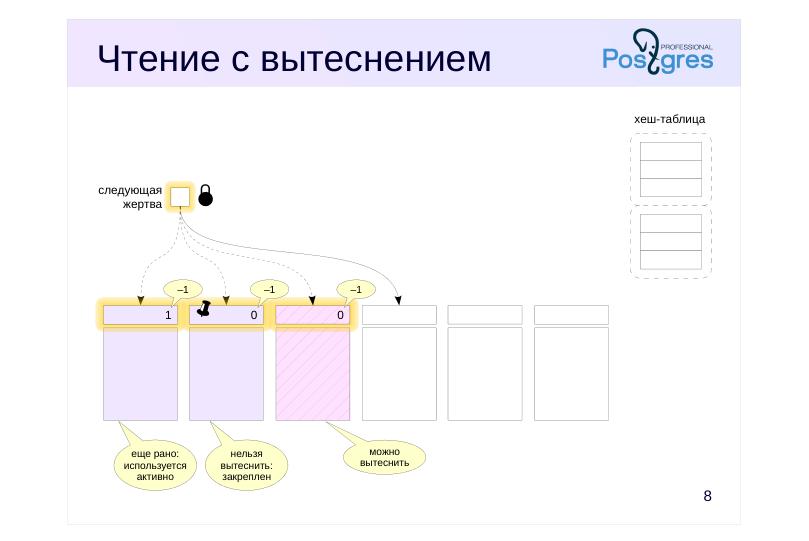 {#source-figure-008 caption=“Source slide page 8: Чтение с вытеснением”}
Комментарии преподавателя
Если нужной страницы не нашлось в кеше, ее необходимо прочитать с диска, а для этого надо освободить какой-то из буферов, вытеснив находящуюся там другую страницу. Идея состоит в том, чтобы вытеснять страницы, к которым обращались редко, с тем, чтобы активно используемые данные как можно дольше находились в кеше.
Механизм вытеснения использует указатель на следующую «жертву». Этот указатель пробегает по кругу все буферы, уменьшая на единицу их счетчики обращений (usage count). Выбирается первый же буфер, который одновременно:
● имеет значение счетчика обращений, равное 0;
● не закреплен.
По-английски этот алгоритм называется clock-sweep.
Чем больше значение счетчика у буфера (то есть чем чаще он используется), тем больше у него шансов задержаться в кеше. Чтобы избежать «наматывания кругов» при вытеснении, максимальное значение счетчика обращений ограничено числом 5.
В нашем примере процесс обращается к первому буферу по указателю. Счетчик обращений этого буфера еще не равен 0, так что он уменьшается на единицу и указатель сдвигается к следующему буферу.
Следующий буфер закреплен (то есть используется каким-то процессом), и поэтому страница не может быть вытеснена из него. Значение его счетчика также уменьшается на единицу.
Наконец, мы приходим к незакрепленному буферу с нулевым счетчиком обращений. Страница из этого буфера и будет вытеснена.
Page 9: Чтение с вытеснением
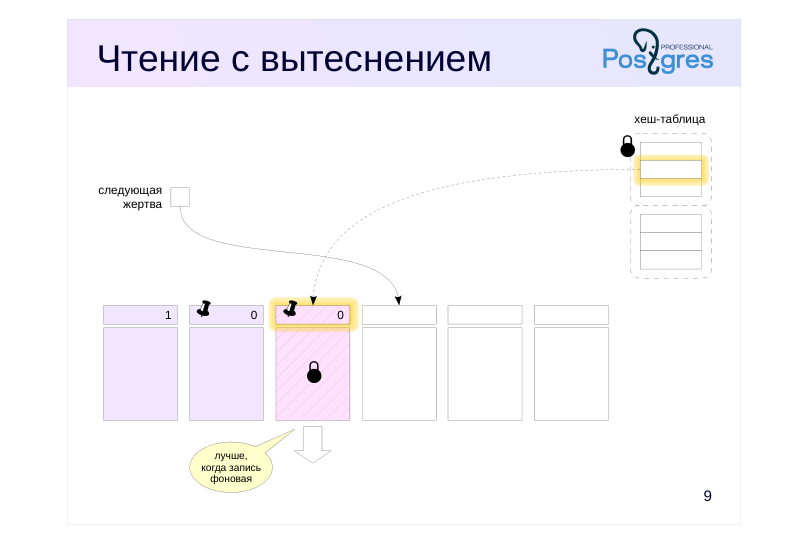 {#source-figure-009 caption=“Source slide page 9: Чтение с вытеснением”}
Комментарии преподавателя
Однако в нашем примере найденный буфер оказался грязным — он содержит измененные данные. Поэтому сначала страницу требуется сохранить на диск. Для этого буфер закрепляется и устанавливается блокировка содержимого страницы, после чего страница записывается на диск.
Значительно эффективнее, когда запись происходит асинхронно и процесс обнаруживает вытесняемую страницу чистой. Чтобы это было возможным, существует процесс фоновой записи (background writer).
Процесс фоновой записи использует тот же самый алгоритм поиска буферов для вытеснения, что и обслуживающие процессы, только указатель у него свой. Он может опережать указатель на «жертву», но никогда не отстает от него.
Записываются буферы, которые одновременно:
● содержат измененные (грязные) страницы;
● не закреплены (pin count = 0);
● имеют нулевое число обращений (usage count = 0).
Таким образом фоновый процесс записи находит те буферы, которые с большой вероятностью вскоре потребуется вытеснить.
Теперь страница может быть выброшена, а из хеш-таблицы необходимо удалить ссылку на эту страницу. Для этого потребуется монопольно заблокировать нужный фрагмент хеш-таблицы.
Page 10: Чтение с вытеснением
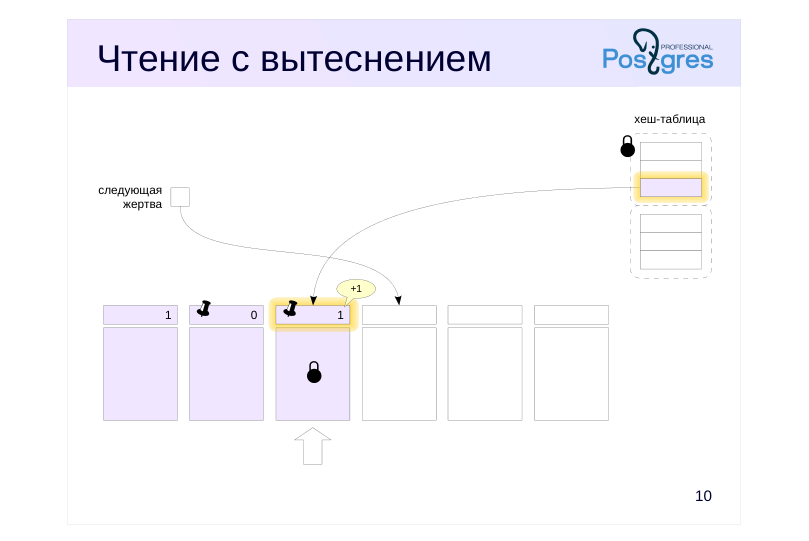 {#source-figure-010 caption=“Source slide page 10: Чтение с вытеснением”}
Комментарии преподавателя
После того, как страница из грязного буфера записана на диск, в освободившийся буфер читается новая страница, а в хеш-таблицу добавляется ссылка на нее.
Счетчик обращений увеличивается на единицу. Ссылка на следующую «жертву» уже указывает на следующий буфер, а у только что загруженного есть время нарастить свой счетчик обращений, пока указатель не обойдет по кругу весь буферный кеш и не вернется вновь.
Page 11: Использование буферного кеша
Перезапустим сервер, чтобы очистить буферный кеш.
С помощью расширения можно убедиться, что в кеше нет буферов, относящихся к нашей таблице:
Теперь выполним запрос, который прочитает все страницы таблицы. Команда EXPLAIN ANALYZE с параметром BUFFERS покажет, какое количество обращений к буферам потребовалось для выполнения.
В данном случае запрос прочитал 18 страниц, ни одной из которых не оказалось в кеше (read). А почему эти страницы были изменены (dirtied)? Как рассматривалось в теме «Многоверсионность», при первом чтении новых версий строк в заголовках этих версий проставляется статус транзакции (зафиксирована или оборвана). Это вызывает изменение страницы. Что теперь мы обнаружим в кеше?
Как раз 18 буферов заполнены данными таблицы. А как изменится выполнение того же самого запроса?
Теперь все данные были взяты из кеша (hit) и время выполнения запроса уменьшилось. Именно с наличием кеша и связан тот факт, что при повторном выполнении запросы обычно работают быстрее.
Page 12: Page 12
Page 13: Временные таблицы
Данные временных таблиц
- видны только одному сеансу — нет смысла использовать общий кеш
- существуют в пределах сеанса — не жалко потерять при сбое
- Используется локальный буферный кеш
- не требуются блокировки
- память выделяется по необходимости в пределах temp_buffers
- обычный алгоритм вытеснения
Комментарии преподавателя
Исключением из общего правила являются временные таблицы. Поскольку временные данные видны только одному процессу, им нечего делать в общем буферном кеше. Более того, временные данные существуют только в рамках одного сеанса, так что их не нужно защищать от сбоя.
Для временных данных используется облегченный локальный кеш.
Поскольку локальный кеш доступен только одному процессу, для него не требуются блокировки. Память выделяется по мере необходимости (в пределах, заданных параметром temp_buffers), ведь временные таблицы используются далеко не во всех сеансах. В локальном кеше используется обычный алгоритм вытеснения.
Page 14: Журнал предзаписи
Устройство журнала
- Контрольная точка
- Восстановление после сбоя
- Синхронный и асинхронный режимы
Page 15: Журнал предзаписи
Необходимость
- данные меняются в оперативной памяти (в частности, в буферном кеше)
- и попадают на диск асинхронно
- при сбое остается только информация, записанная на диск
- Механизм
- действия над данными записываются в журнал:
- изменение страниц в буферном кеше, фиксация и отмена транзакций
- журнальная запись попадает на диск раньше измененных данных
- после сбоя операции, записанные в журнал, но не попавшие на диск,
- можно выполнить повторно
Комментарии преподавателя
Основная причина существования журнала — необходимость восстановления согласованности данных в случае сбоя, при котором теряется содержимое оперативной памяти, в частности, буферного кеша. Тем самым обеспечивается выполнение свойства долговечности (буква «D» из набора свойств транзакций ACID).
Одновременно с изменением данных создается запись в журнале, содержащая достаточную информацию для повторения этой операции. Журнальная запись в обязательном порядке попадает на диск (или другое энергонезависимое устройство) до того, как туда попадет измененная страница — отсюда и название: «журнал предзаписи», «write-ahead log».
Журналировать нужно все операции, при выполнении которых возможна ситуация, что при сбое результат операции не дойдет до диска. В частности, в журнал записываются изменение страниц в буферном кеше и факт фиксации и отмены транзакций.
В журнал не записываются операции с нежурналируемыми (и временными) таблицами.
В случае сбоя можно прочитать журнал и при необходимости повторить те операции, которые уже были выполнены, но результат которых не успел попасть на диск.
https://postgrespro.ru/docs/postgresql/16/wal-intro
Page 16: Устройство журнала
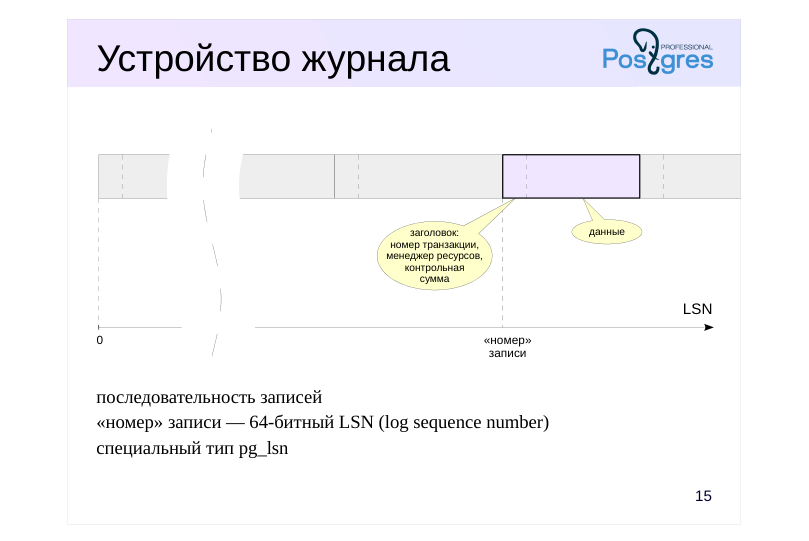 {#source-figure-016 caption=“Source slide page 16: Устройство журнала”}
последовательность записей «номер» записи — 64-битный LSN (log sequence number) специальный тип pg_lsn
Комментарии преподавателя
Логически журнал можно представить себе как последовательность записей различной длины. Каждая запись содержит данные о некоторой операции, предваренные заголовком. В заголовке, в числе прочего, указаны:
● Номер транзакции, к которой относится запись.
● Менеджер ресурсов — компонент системы, ответственный за данную запись, который понимает, как интерпретировать данные. Есть отдельные менеджеры для таблиц, для каждого типа индекса, для статуса транзакций и т. п.
● Контрольная сумма (CRC).
Для того чтобы сослаться на определенную запись, используется тип данных pg_lsn (LSN = log sequence number) — 64-битное число, представляющее собой байтовое смещение записи относительно начала журнала.
На диске журнал хранится в виде файлов фиксированного размера (обычно 16 Мбайт). Когда заканчивается место в текущем файле, система переключается на следующий.
В оперативной памяти работа с журналом ведется в специальных буферах, которые организованы наподобие буферного кеша.
Page 17: Устройство журнала
Начнем транзакцию.
Текущая позиция в журнале:
LSN выводится как два 32-битных числа в шестнадцатеричной системе через косую черту. Выполним какое-нибудь действие, например, изменим строку в таблице:
Изменится ли позиция в журнале?
Позиция увеличилась. Завершим теперь транзакцию.
Позиция в журнале снова изменилась:
Размер журнальных записей (в байтах), соответствующих нашей транзакции, можно узнать простым вычитанием одной позиции из другой:
Безусловно, в журнал попадает информация обо всех действиях во всем кластере, но в данном случае мы считаем, что в нашей системе больше ничего не происходит.
Page 18: Контрольная точка
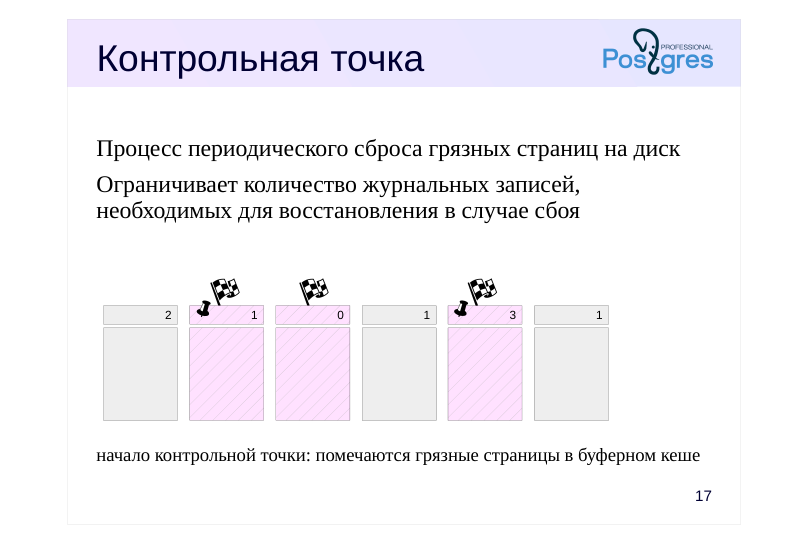 {#source-figure-018 caption=“Source slide page 18: Контрольная точка”}
Процесс периодического сброса грязных страниц на диск
- Ограничивает количество журнальных записей, необходимых для восстановления в случае сбоя
- начало контрольной точки: помечаются грязные страницы в буферном кеше
Комментарии преподавателя
Если не предпринять специальных мер, то активно использующаяся страница, попав в буферный кеш, может никогда не вытесняться. Это означает, что при восстановлении после сбоя придется просматривать все журнальные записи, созданные с момента запуска сервера.
На практике это, конечно, недопустимо. Во-первых, файлы занимают много места — их все придется хранить на сервере. Во-вторых, время восстановления будет запредельно большим.
Поэтому существует специальный фоновый процесс контрольной точки (checkpointer), который периодически сбрасывает все грязные страницы на диск (но не вытесняет их из кеша). После того, как контрольная точка завершена, журналы вплоть до начала контрольной точки больше не нужны для восстановления.
Грязных страниц может оказаться много, и сбрасывать их одно-моментно на диск — плохая идея. Поэтому в начале выполнения контрольной точки в заголовках грязных буферов ставится специальный флаг, который говорит о том, что в ходе выполнения текущей контрольной точки данная страница должна быть сброшена.
Page 19: Контрольная точка
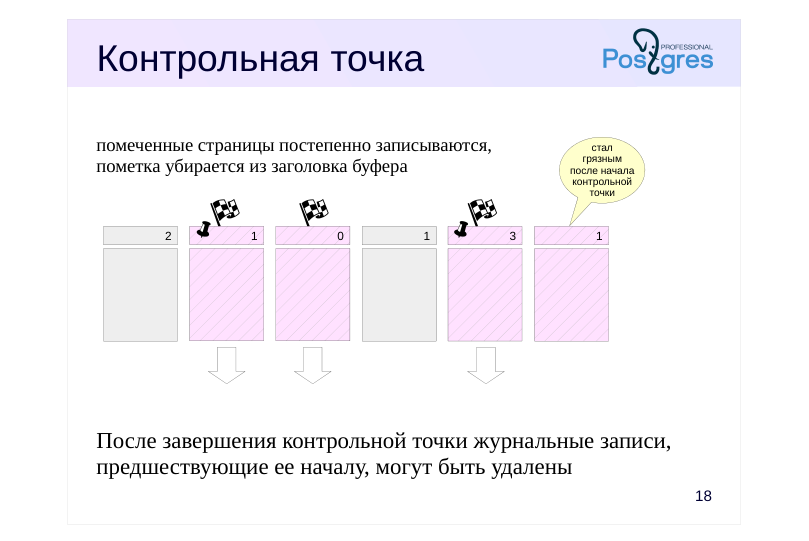 {#source-figure-019 caption=“Source slide page 19: Контрольная точка”}
помеченные страницы постепенно записываются, пометка убирается из заголовка буфера
- После завершения контрольной точки журнальные записи, предшествующие ее началу, могут быть удалены
Комментарии преподавателя
Затем процесс контрольной точки постепенно проходит по всем буферам и сбрасывает помеченные страницы на диск. Еще раз отметим, что страницы не вытесняются из кеша, а только записываются. Поэтому контрольная точка не обращает внимания на число обращений к буферу и признак закрепленности.
Конечно, в процессе работы процесса контрольной точки страницы продолжают изменяться в буферном кеше. Но новые грязные буферы уже не рассматриваются процессом контрольной точки, так как на момент начала работы они не были грязными и не отмечены флагом.
В конце работы процесс создает журнальную запись об окончании контрольной точки и сохраняет LSN ее начала, чтобы при необходимости можно было быстро найти последнюю завершенную контрольную точку.
После этого сервер имеет право удалить все журнальные записи, предшествующие началу только что завершенной контрольной точки.
Page 20: Контрольная точка
Сейчас в буферном кеше находится несколько грязных буферов:
Контрольная точка выполняется сервером периодически, но ее можно вызвать и вручную.
Поскольку по умолчанию буферный кеш имеет небольшой размер, контрольная точка выполняется очень быстро. Но в реальных системах, использующих большой буферный кеш, это может занимать существенное время. Сколько грязных буферов останется в буферном кеше?
Ни одного. Хотя, если бы в нашей системе была какая-то активность, грязные буферы — появившиеся уже после начала контрольной точки — могли бы остаться.
Page 21: Восстановление
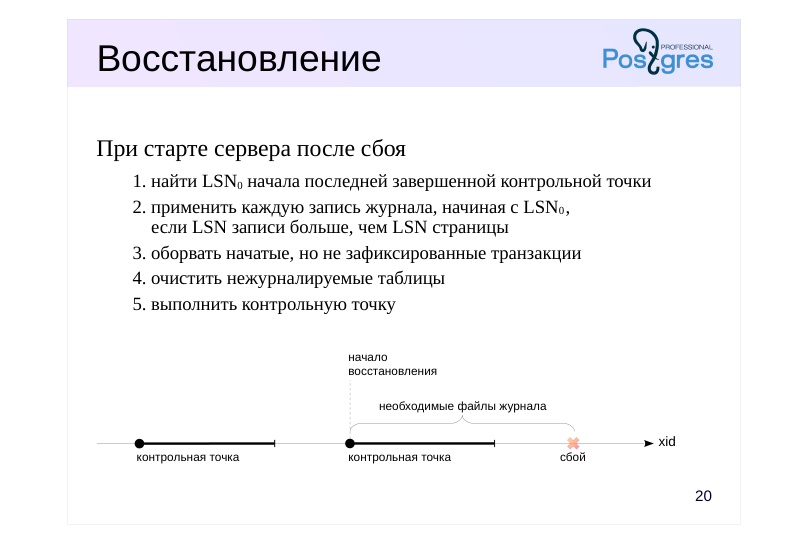 {#source-figure-021 caption=“Source slide page 21: Восстановление”}
При старте сервера после сбоя
- найти LSN0 начала последней завершенной контрольной точки
- применить каждую запись журнала, начиная с LSN0 ,
- если LSN записи больше, чем LSN страницы
- оборвать начатые, но не зафиксированные транзакции
- очистить нежурналируемые таблицы
- выполнить контрольную точку
Комментарии преподавателя
Если в работе сервера произошел сбой, то при последующем запуске процесс startup обнаруживает это и выполняет автоматическое восстановление.
Сначала процесс startup определяет LSN0 начала последней завершенной контрольной точки. Далее процесс читает журнальные записи, начиная с найденной позиции, последовательно применяя записи к страницам, если в этом есть необходимость.
Чтобы понять, нужно ли применять журнальную запись к странице, надо сравнить LSN последнего изменения страницы (который при любых изменениях записывается в ее заголовок) с LSN журнальной записи. Если LSN страницы оказывается меньше, то операцию необходимо повторить.
Таким образом восстанавливается согласованность данных во всех страницах. Все транзакции, которые были начаты, но не зафиксированы, трактуются как оборванные.
В конце процесса все нежурналируемые таблицы очищаются, поскольку их содержимое корректно восстановить невозможно.
На этом процесс startup завершает работу, а процесс checkpointer выполняет контрольную точку, чтобы зафиксировать восстановленное состояние.
Page 22: Режимы журналирования
Синхронный
- сброс журнальных записей на диск при каждой фиксации
- гарантируется долговечность
- увеличивается время отклика
- Асинхронный
- сброс журнальных записей происходит периодически
- гарантируется согласованность, но не долговечность
- недавно зафиксированные изменения могут пропасть
- Настройка
- synchronous_commit = on / off
- можно
- изменять на уровне
- транзакции
Комментарии преподавателя
Запись журнала происходит в одном из двух режимов.
В синхронном режиме при фиксации транзакции продолжение работы невозможно до тех пор, пока все журнальные записи, относящиеся к этой транзакции, не окажутся на диске (энергонезависимом носителе).
При синхронной записи гарантируется долговечность — если транзакция зафиксирована, то все ее журнальные записи уже на диске и не будут потеряны. Обратная сторона состоит в том, что синхронная запись увеличивает время отклика (команда COMMIT не возвращает управление до окончания синхронизации) и поэтому снижает производительность системы.
В асинхронном режиме журнал записывается частями в фоновом режиме.
Асинхронная запись эффективнее синхронной. Во-первых, фиксация изменений не должна ничего ждать. Во-вторых, при каждой записи на диск обрабатываются все накопившиеся журнальные записи и, таким образом, уменьшается число избыточных обращений к диску.
Однако надежность уменьшается: зафиксированные данные могут пропасть в случае сбоя, если между фиксацией и сбоем прошло не очень много времени.
Параметр synchronous_commit, управляющий режимом записи журнала, можно устанавливать не только глобально, но и в рамках отдельных транзакций. Это позволяет увеличивать производительность, жертвуя надежностью только части транзакций.
https://postgrespro.ru/docs/postgresql/16/wal-async-commit
Page 23: Итоги
Буферный кеш ускоряет доступ к часто используемым данным (но не решает всех проблем производительности)
- Использование буферов в оперативной памяти приводит к необходимости журналирования
- Процесс контрольной точки ограничивает размер хранимых журнальных файлов и сокращает время восстановления
- Журнал не только позволяет восстановить согласованность после сбоев, но может использоваться и для других задач
Page 24: Практика
- Воспользуйтесь расширением pg_prewarm, чтобы автоматически восстанавливать содержимое буферного кеша после перезагрузки сервера. Проверьте и затем отключите расширение. 2. Создайте таблицу и вставьте в нее столько строк, чтобы ее объем составлял примерно половину от объема буферного кеша. Перезагрузите сервер, чтобы очистить кеш. Выполните запрос на чтение всех строк таблицы и после этого проверьте, сколько буферов в кеше содержат страницы этой таблицы. Объясните результат. 3. Сравните производительность системы при синхронном и асинхронном режимах фиксации, используя утилиту эталонного тестирования pgbench.
Комментарии преподавателя
- Для этого потребуется добавить расширение pg_prewarm в загружаемые библиотеки:
и затем перезагрузить сервер.
https://postgrespro.ru/docs/postgresql/16/pgprewarm
Для анализа используйте расширение pg_buffercache, показанное в демонстрации.
Инициализируйте тестовые таблицы, вызвав pgbench с ключом -i.
Затем выполняйте эталонный тест в одном и другом режимах на протяжении некоторого времени.
https://postgrespro.ru/docs/postgresql/16/pgbench
Page 25: 1. Прогрев кеша с помощью pg_prewarm
Расширение необходимо добавить в загружаемые библиотеки и перезапустить сервер:
Создадим таблицу с данными:
Проверим наличие страниц в буферном кеше:
Перезапустим сервер.
Проверим буферный кеш:
Все страницы были автоматически загружены в буферный кеш при старте сервера. Отключим расширение.
2. Массовое вытеснение
Размер буферного кеша:
Page 26: Page 26
В созданной таблице 10 тысяч строк занимают:
Добавим еще строк так, чтобы увеличить размер таблицы примерно до половины буферного кеша:
Перезагрузим сервер.
Выполним запрос, читающий все табличные страницы:
В буферном кеше данные таблицы занимают всего:
Это работает механизм, защищающий буферный кеш от массового вытеснения «одноразовыми» данными, которые вряд ли понадобятся снова. Он действует при полном сканировании больших таблиц, очистке и т. п. Такие операции используют только небольшую часть кеша (так называемое буферное кольцо).
3. Зависимость производительности от режима фиксации
Инициализируем тестовые таблицы:
Синхронная фиксация включена:
Page 27: Page 27
Запускаем эталонный тест TPC-B на 30 секунд:
Показатель — количество транзакций в секунду (tps). Выключаем синхронную фиксацию:
Повторяем тест:
Число транзакций в секунду заметно выше. Ускорение, конечно, зависит от типа нагрузки и характеристик оборудования. Восстановим значение параметра по умолчанию:
05 Занятие 05: Архитектура / Блокировки
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_05_arch_locks.html Archive: DEV2-handouts-16.zip Страниц PDF: 30
Page 1: Архитектура / Блокировки
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Общая информация о блокировках
- Блокировки отношений и других объектов
- Блокировки на уровне строк
Page 3: Блокировки
Задача: упорядочение конкурентного доступа к разделяемым ресурсам
- Механизм
- перед обращением к данным процесс захватывает блокировку
- после обращения — освобождает (обычно в конце транзакции)
- несовместимые блокировки приводят к очередям
Комментарии преподавателя
Блокировки используются, чтобы упорядочить конкурентный доступ к разделяемым ресурсам.
Под конкурентным доступом понимается одновременный доступ нескольких процессов. Сами процессы могут выполняться как параллельно (если позволяет аппаратура), так и последовательно в режиме разделения времени.
Блокировки не нужны, если нет конкуренции (одновременно к данным обращается только один процесс) или если нет разделяемого ресурса (например, общий буферный кеш нуждается в блокировках, а локальный — нет).
Перед тем, как обратиться к ресурсу, защищенному блокировкой, процесс должен захватить эту блокировку. Когда процесс перестает нуждаться в ресурсе, он освобождает блокировку, чтобы ресурсом могли воспользоваться другие процессы.
Захват блокировки возможен не всегда: ресурс может оказаться уже занятым кем-то другим в несовместимом режиме. В простом случае используют два режима: исключительный (несовместим ни с чем) и разделяемый (совместим сам с собой). Но их может быть и больше, в этом случае совместимость определяется матрицей.
Если ресурс занят, процесс должен встать в очередь ожидания. Это, конечно, уменьшает производительность системы. Поэтому для создания высокоэффективных приложений важно понимать, как работает механизм блокировок.
Page 4: Блокировки объектов
Блокировки номера транзакции
- Блокировки отношений
- Очередь ожидания
Комментарии преподавателя
Из всего многообразия блокировок на уровне объектов мы рассмотрим только блокировки номера транзакции и блокировки отношений.
Еще один вид блокировок этого же типа — рекомендательные блокировки — упоминался в теме «Обработка ошибок» курса DEV1.
Page 5: Номер транзакции
Типы ресурсов в pg\_locks
- virtualxid — виртуальный номер транзакции
- transactionid — настоящий номер транзакции
- Режимы
- исключительный
- разделяемый
- Транзакция удерживает исключительную блокировку собственного номера
- способ дождаться завершения транзакции
Комментарии преподавателя
Рассмотрение блокировок на уровне объектов («обычные», «тяжелые» блокировки) мы начнем с блокировок номера транзакции.
Блокировки объектов хранятся в общей памяти сервера, поэтому их количество ограничено. Все такие блокировки можно посмотреть в представлении pg_locks: они устроены одинаково и отличаются только типами ресурсов и режимами блокирования. Номерам транзакций соответствуют типы ресурсов Transactionid и Virtualxid.
Каждой транзакции при старте назначается сначала виртуальный номер, который используется, пока транзакция только читает данные. Это сделано для экономии настоящих номеров — виртуальный номер никак не учитывается в правилах видимости. Его можно выдать быстро, без обращения к общей памяти (требуется лишь уникальность номеров всех активных транзакций).
Уникальный настоящий номер выдается счетчиком XID в тот момент, когда транзакция изменяет какие-либо данные. Он нужен, чтобы отслеживать статус пишущей транзакции (активна, зафиксирована или оборвана); такой номер можно записывать в поля xmin и xmax заголовка версий строк.
Каждая транзакция удерживает исключительную блокировку своих номеров: и виртуального, и настоящего, если он есть. Это дает простой способ дождаться окончания какой-либо транзакции: надо запросить блокировку ее номера. Если блокировку сразу получить не удастся, то запрашивающий процесс заснет и будет разбужен только по завершении транзакции — когда блокировка освободится.
Page 6: Блокировка номера транзакции
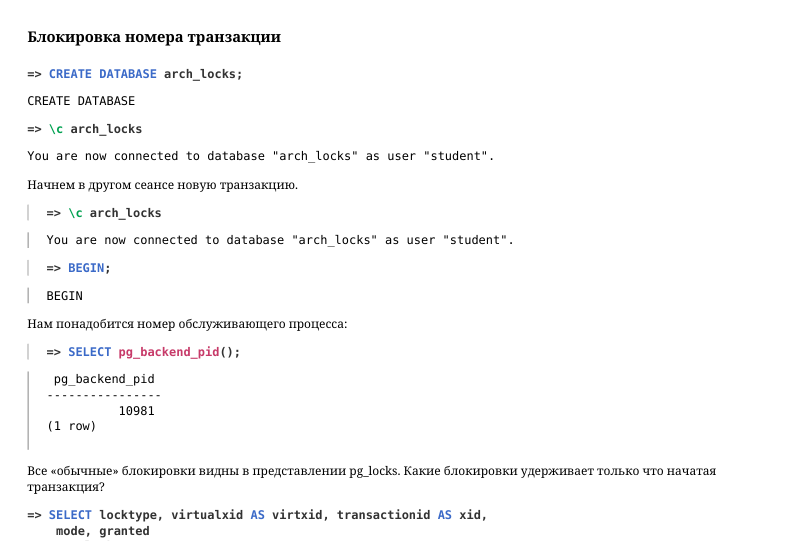 {#source-figure-006 caption=“Source slide page 6: Блокировка номера транзакции”}
Начнем в другом сеансе новую транзакцию.
Нам понадобится номер обслуживающего процесса:
Все «обычные» блокировки видны в представлении pg_locks. Какие блокировки удерживает только что начатая транзакция?
locktype — тип ресурса, mode — режим блокировки, granted — удалось ли получить блокировку. Каждой транзакции сразу выдается виртуальный номер, и транзакция удерживает его исключительную блокировку. Как только транзакция начинает менять какие-либо данные, ей выдается настоящий номер, который учитывается в правилах видимости. Номер можно получить и явно:
Теперь транзакция удерживает исключительную блокировку обоих номеров.
Page 7: Блокировки отношений
Тип ресурса в pg\_locks
- relation — таблицы, индексы и т. п.
- Режимы
- Access Share
- SELECT
- Row Share
- SELECT FOR UPDATE/SHARE
- Row Exclusive
- UPDATE, DELETE, INSERT, MERGE
- Share Update Exclusive
- VACUUM, ALTER TABLE,
- CREATE INDEX CONCURRENTLY
- Share
- CREATE INDEX
- Share Row Exclusive
- CREATE TRIGGER, ALTER TABLE
- Exclusive
- REFRESH MAT. VIEW CONCURRENTLY
- Access Exclusive
- DROP, TRUNCATE, REINDEX, VACUUM FULL,
- LOCK TABLE, ALTER TABLE, REFRESH MAT. VIEW
- допускают
- параллельное
- изменение
- данных
- в таблице
Комментарии преподавателя
Второй важный случай блокировок объектов — блокировки отношений (таблиц, индексов, последовательностей и т. п.). Такие блокировки имеют тип relation в pg_locks.
Для них определено целых 8 различных режимов, которые показаны на слайде вместе с примерами команд SQL, использующих эти режимы. Матрица совместимости здесь не показана из-за ее большого размера, но она приведена в документации:
https://postgrespro.ru/docs/postgresql/16/explicit-locking#LOCKING-TABLES
Такое количество режимов существует для того, чтобы позволить выполнять одновременно как можно большее количество команд, относящихся к одной таблице (индексу и т. п.).
Самый слабый режим — Access Share, он захватывается командой SELECT и совместим с любым режимом, кроме самого сильного — Access Exclusive. Это означает, что запрос не мешает ни другим запросам, ни изменению данных в таблице, ни чему-либо другому, но не дает, например, удалить таблицу в то время, как из нее читаются данные.
Другой пример: режим Share (как и другие более сильные режимы) не совместим с изменением данных в таблице. Например, команда CREATE INDEX заблокирует команды INSERT, UPDATE, DELETE и MERGE (и наоборот). Поэтому существует команда CREATE INDEX CONCURRENTLY, использующая режим Share Update Exclusive, который совместим с такими изменениями (за счет этого команда выполняется дольше).
Page 8: Очередь ожидания
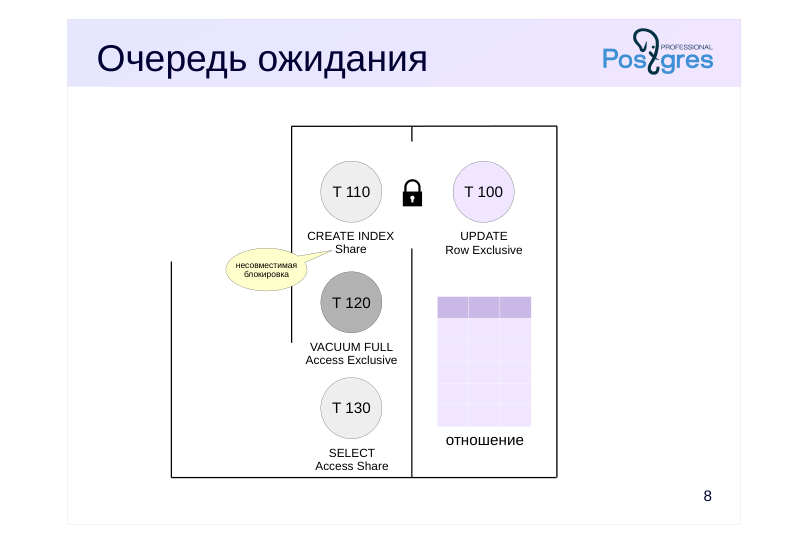 {#source-figure-008 caption=“Source slide page 8: Очередь ожидания”}
Комментарии преподавателя
Блокировки объектов используют «честную» очередь ожидания. Это означает, что запросы блокировок обслуживаются один за другим в порядке их поступления.
Пусть, как на рисунке, транзакция T100 выполняет команду UPDATE, при этом на отношение будет установлена блокировка с режимом Row Exclusive.
Транзакция T110, выполняющая CREATE INDEX, встает в очередь за T100, поскольку запрашивает режим Share, не совместимый с Row Exclusive. Если следом придет транзакция T120 с командой VACUUM FULL (ей нужен режим Access Exclusive, не совместимый ни с каким другим), она встанет в очередь за CREATE INDEX.
А еще одна транзакция с обычным запросом SELECT (требует Access Share, совместимый с выполняющейся сейчас командой UPDATE) тоже честно займет очередь за VACUUM FULL.
Page 9: Очередь ожидания
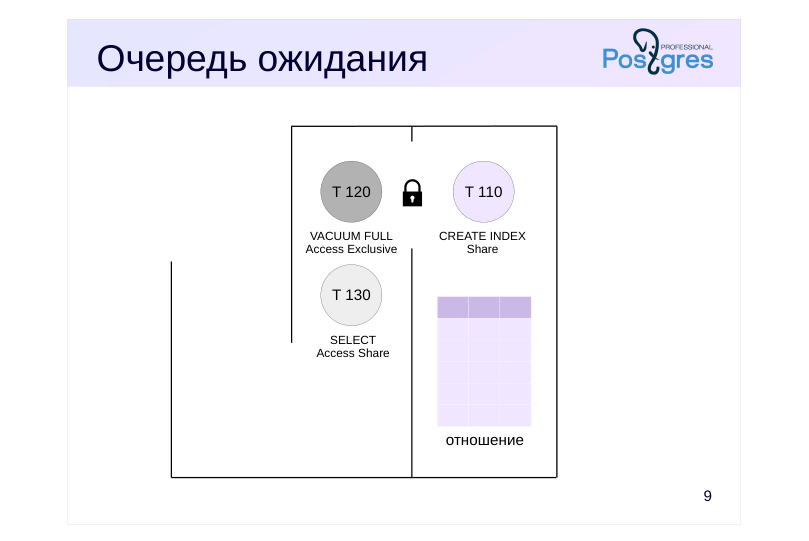 {#source-figure-009 caption=“Source slide page 9: Очередь ожидания”}
Комментарии преподавателя
После того как первая транзакция завершается, блокировку захватывает следующая транзакция, стоящая в очереди.
Page 10: Блокировка отношений
Создадим таблицу банковских счетов с тремя строками:
Вторая транзакция, которую мы не завершали, продолжает работу. Выполним в ней запрос к таблице:
Как изменятся блокировки?
Добавилась блокировка таблицы в режиме Access Share. Она совместима с блокировкой любого режима, кроме Access Exclusive, поэтому не мешает практически никаким операциям, но не дает, например, удалить таблицу. Попробуем.
Команда не выполняется — ждет освобождения блокировки. Какой?
Транзакция пыталась получить блокировку таблицы в режиме Access Exclusive, но не смогла (granted = f). Информацию о том, что транзакция ожидает чего-то для продолжения работы, можно получить и так:
Page 11: Page 11
state — состояние: активная транзакция, выполняющая команду; wait_event_type — тип ожидания: блокировка (бывают и другие, например, ожидание ввода-вывода); wait_event — конкретное ожидание: ожидание блокировки отношения. Мы можем найти номер блокирующего процесса (в общем случае — несколько номеров)…
…и посмотреть информацию о сеансах, к которым они относятся:
После завершения транзакции все блокировки снимаются и таблица удаляется:
Page 12: Блокировки строк
Разделяемые и исключительные блокировки
- «Нечестная» очередь ожидания
Page 13: Блокировки строк
Используются совместно с многоверсионностью, для чтения данных не требуются
- Информация только в страницах данных
- в оперативной памяти ничего не хранится
- Неограниченное количество
- большое число не влияет на производительность
- Инфраструктура
- очередь ожидания организована с помощью блокировок объектов
Комментарии преподавателя
Благодаря многоверсионности, блокировки уровня строк нужны только при изменении данных (или для того, чтобы не допустить изменения) и не нужны при обычном чтении.
Если в случае блокировок объектов каждый ресурс представлен собственной блокировкой в оперативной памяти, то со строками так не получается: отдельная блокировка для каждой табличной строки (которых могут быть миллионы и миллиарды) потребует непомерных накладных расходов и огромного объема оперативной памяти.
Один из вариантов решения — повышение уровня (эскалация): если уже заблокировано N строк таблицы, то при блокировке еще одной блокируется вся таблица целиком, а блокировки на уровне строк снимаются. Но в этом случае страдает пропускная способность.
Поэтому в PostgreSQL сделано иначе. Информация о том, что строка заблокирована, хранится исключительно в заголовке версии строки внутри страницы данных. Там она представлена номером блокирующей транзакции (xmax) и дополнительными информационными битами.
За счет этого можно установить неограниченное количество блокировок уровня строки, и это не требует дополнительных ресурсов и не снижает производительность системы.
Обратная сторона такого подхода — сложность организации очереди ожидания. Для этого все-таки приходится использовать блокировки уровня объектов, но удается обойтись очень небольшим их количеством (пропорциональным числу процессов, а не числу заблокированных строк).
Page 14: Блокировки строк
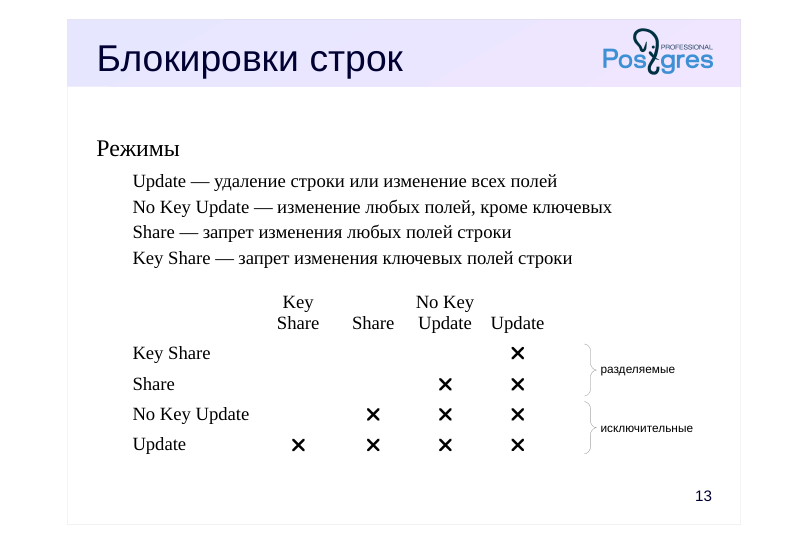 {#source-figure-014 caption=“Source slide page 14: Блокировки строк”}
Режимы
- Update — удаление строки или изменение всех полей
- No Key Update — изменение любых полей, кроме ключевых
- Share — запрет изменения любых полей строки
- Key Share — запрет изменения ключевых полей строки
- Key Share
- Share
- No Key Update
- Update
Комментарии преподавателя
Существует 4 режима, в которых можно заблокировать строку (в версии строки режим указывается с помощью дополнительных информационных битов).
Два режима представляют исключительные (exclusive) блокировки, которые одновременно может удерживать только одна транзакция. Режим UPDATE предполагает полное изменение (или удаление) строки, а режим NO KEY UPDATE — изменение только тех полей, которые не входят в уникальные индексы (иными словами, при таком изменении все внешние ключи остаются без изменений). Команда UPDATE сама выбирает минимальный подходящий режим блокировки; обычно строки блокируются в режиме NO KEY UPDATE.
Еще два режима представляют разделяемые (shared) блокировки, которые могут удерживаться несколькими транзакциями.
Режим SHARE применяется, когда нужно прочитать строку, но при этом нельзя допустить, чтобы она как-либо изменилась другой транзакцией. Режим KEY SHARE допускает изменение строки, но только неключевых полей. Этот режим, в частности, автоматически используется самим PostgreSQL при проверке внешних ключей.
Напомним, что обычное чтение (SELECT) вообще не блокирует строки.
Матрица совместимости режимов приведена внизу слайда. Из нее видно, что разделяемый режим KEY SHARE совместим с исключительным режимом NO KEY UPDATE (то есть можно обновлять неключевые поля и быть уверенным в том, что ключ не изменится).
https://postgrespro.ru/docs/postgresql/16/explicit-locking#LOCKING-ROWS
Page 15: Блокировка строк
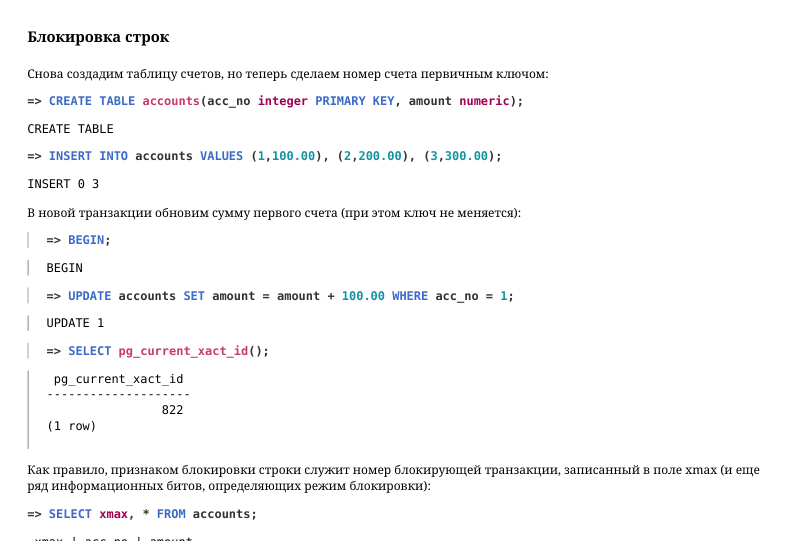 {#source-figure-015 caption=“Source slide page 15: Блокировка строк”}
Снова создадим таблицу счетов, но теперь сделаем номер счета первичным ключом:
В новой транзакции обновим сумму первого счета (при этом ключ не меняется):
Как правило, признаком блокировки строки служит номер блокирующей транзакции, записанный в поле xmax (и еще ряд информационных битов, определяющих режим блокировки):
Но в случае разделяемых блокировок такой способ не годится, поскольку в xmax нельзя записать несколько номеров транзакций. В таком случае номера транзакций хранятся в отдельной структуре, называемой мультитранзакцией, а в xmax помещается ссылка на нее. Но мы не будем вдаваться в детали реализации блокировок строк, а просто воспользуемся расширением pgrowlocks:
Чтобы показать блокировки, расширение читает табличные страницы (в отличие от обращения к pg_locks, которое читает данные из оперативной памяти). Теперь изменим номер второго счета (при этом меняется ключ):
Чтобы продемонстрировать разделяемые блокировки, начнем еще одну транзакцию. Все запрашиваемые блокировки будут совместимы друг с другом.
Page 16: Page 16
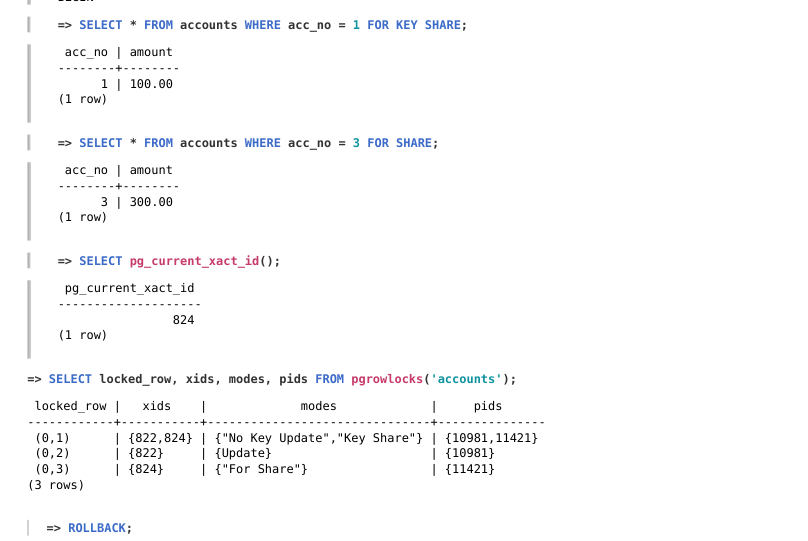 {#source-figure-016 caption=“Source slide page 16: Page 16”}
Как не ждать блокировку?
Иногда удобно не ждать освобождения блокировки, а сразу получить ошибку, если необходимый ресурс занят. Приложение может перехватить и обработать такую ошибку. Для этого ряд команд SQL (такие, как SELECT и некоторые варианты ALTER) позволяют указать ключевое слово NOWAIT. Заблокируем таблицу, обновив первую строку:
Транзакция сразу же получает ошибку.
Команды UPDATE и DELETE не позволяют указать NOWAIT. Но можно сначала выполнить команду
а затем, если строки успешно заблокированы, изменить или удалить их. Например:
Page 17: Page 17
 {#source-figure-017 caption=“Source slide page 17: Page 17”}
Снова тут же получаем ошибку - строка уже заблокирована. Но при успехе SELECT … FOR UPDATE в этой транзакции можно было бы далее изменять заблокированную строку.
Другой подход к блокировке строк предоставляет предложение SKIP LOCKED. Запросим блокировку одной строки, не указывая конкретный номер счета:
В этом случае команда пропускает уже заблокированную первую строку и мы немедленно получаем блокировку второй строки. Этот прием уже использовался в практике темы «Очистка» при выборе пакета строк для обновления. Еще одно применение — в организации очередей — будет рассмотрено в теме «Асинхронная обработка».
Для команд, не связанных с блокировкой строк, использовать NOWAIT не получится. В этом случае можно установить небольшой таймаут ожидания (по умолчанию он не задан и ожидание будет бесконечным):
Получаем ошибку без длительного ожидания освобождения ресурса.
Page 18: «Очередь» ожидания
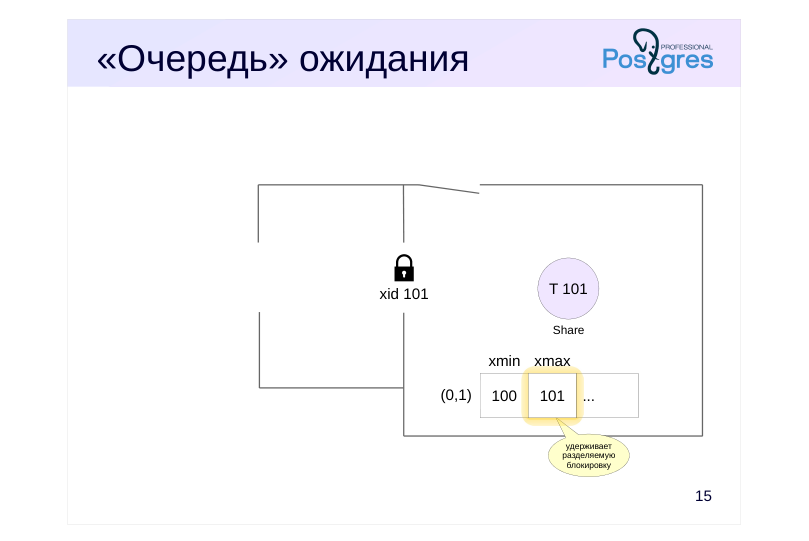 {#source-figure-018 caption=“Source slide page 18: «Очередь» ожидания”}
Комментарии преподавателя
Для эффективной организации очереди ожидания используется механизм блокировок объектов, при этом информация хранится в оперативной памяти и видна в pg_locks.
Допустим, транзакции с номером 101 удалось заблокировать строку в разделяемом режиме Share. Информация о блокировке записывается в заголовок версии строки — в поле xmax появляется номер этой транзакции.
Page 19: «Очередь» ожидания
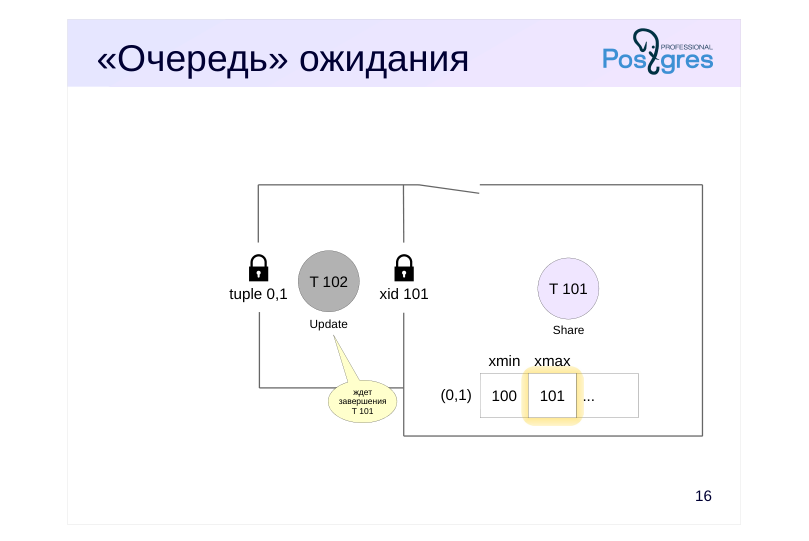 {#source-figure-019 caption=“Source slide page 19: «Очередь» ожидания”}
Комментарии преподавателя
Другая транзакция 102, желая получить блокировку, обращается к строке и видит, что строка уже заблокирована. Если режимы блокировок конфликтуют, транзакция 102 должна встать в очередь, чтобы система «разбудила» ее, когда блокировка освободится.
Поскольку каждая транзакция удерживает исключительную блокировку своего номера, транзакция 102 запрашивает блокировку номера транзакции 101, чтобы дождаться ее завершения.
Кроме того, ожидающая транзакция удерживает блокировку условного ресурса типа tuple (версия строки), показывая, что она первая в «очереди».
Page 20: «Очередь» ожидания
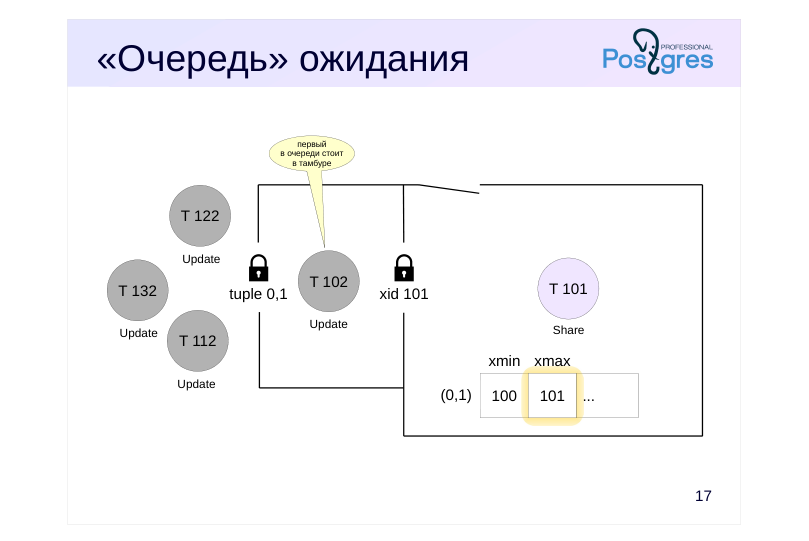 {#source-figure-020 caption=“Source slide page 20: «Очередь» ожидания”}
Комментарии преподавателя
Если появляются другие транзакции, конфликтующие с текущей блокировкой версии строки (в нашем примере — 112, 122, 132), первым делом они пытаются захватить блокировку типа tuple для этой версии.
Поскольку блокировка tuple уже удерживается транзакцией 102, другие транзакции ждут освобождения этой блокировки. Получается своеобразная «очередь», в которой есть первый и все остальные.
Если бы все прибывающие транзакции занимали очередь непосредственно за транзакцией 101, при освобождении блокировки возникала бы ситуация гонки. При неудачном стечении обстоятельств транзакция 102 могла бы ждать блокировку вечно. Двухуровневая схема блокирования немного упорядочивает подобную конкуренцию.
Стоит избегать проектных решений, которые предполагают массовые изменения одной и той же строки. В этом случае возникает «горячая точка», которая на высоких нагрузках может привести к снижению производительности.
Page 21: «Очередь» ожидания
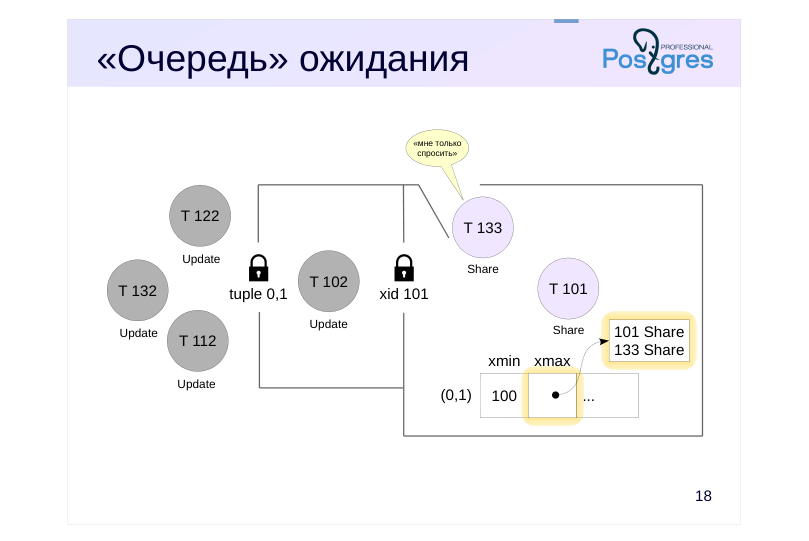 {#source-figure-021 caption=“Source slide page 21: «Очередь» ожидания”}
Комментарии преподавателя
В нашем примере транзакция 101 заблокировала строку в разделяемом (Share) режиме. Пока транзакция 102 ожидает завершения транзакции 101, может появиться еще транзакция 133, желающая получить блокировку строки в разделяемом режиме, совместимом с текущей блокировкой транзакции 101.
Такая транзакция не стоит в очереди, она сразу получает блокировку. В этом случае список номеров блокирующих транзакций будет вынесен в мультитранзакцию, а в поле xmax строки запишется номер этой мультитранзакции.
Page 22: «Очередь» ожидания
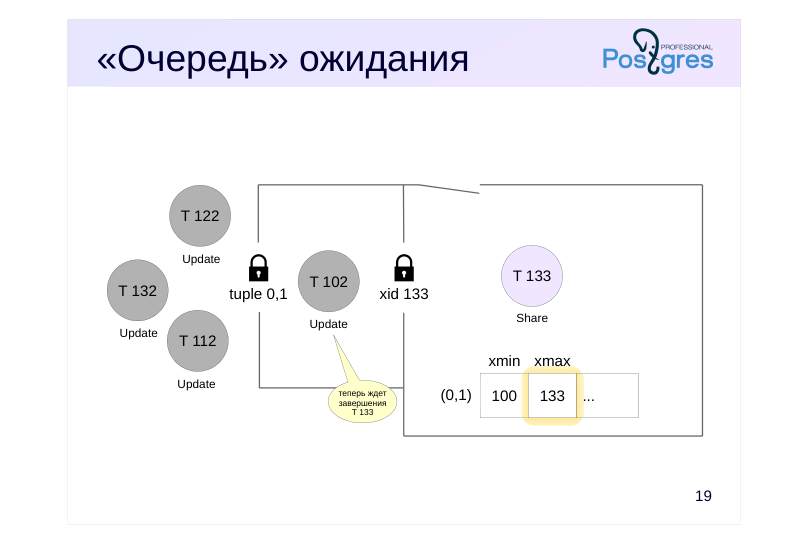 {#source-figure-022 caption=“Source slide page 22: «Очередь» ожидания”}
Комментарии преподавателя
Когда транзакция 101 завершится, транзакция 102 будет разбужена, но не сможет захватить блокировку строки, поскольку строка все еще заблокирована транзакцией 133. Транзакция 102 будет вынуждена снова «заснуть».
PostgreSQL использует разделяемые блокировки для внутренних нужд, в частности, при проверке внешних ключей. В прикладном коде можно явно запросить разделяемую блокировку с помощью команды SELECT … FOR SHARE или SELECT … FOR KEY SHARE.
Однако следует помнить, что при постоянном потоке разделяемых блокировок пишущая транзакция в худшем случае может ждать своей очереди бесконечно. Эта ситуация называется по-английски locker starvation.
Заметим, что такой проблемы в принципе не возникает при блокировках объектов (таких, как отношения). В этом случае каждый ресурс представлен собственной блокировкой в оперативной памяти и все ждущие процессы выстраиваются в «честную» очередь.
https://git.postgresql.org/gitweb/?p=postgresql.git;a=blob;f=src/backend/acc ess/heap/README.tuplock;hb=HEAD
Page 23: «Очередь» ожидания
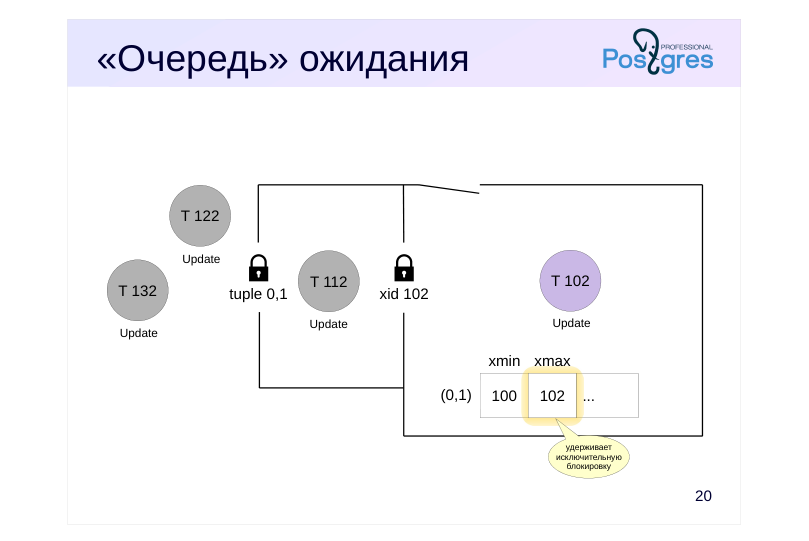 {#source-figure-023 caption=“Source slide page 23: «Очередь» ожидания”}
Комментарии преподавателя
Когда транзакция 133 завершится, транзакция 102 получит возможность первой записать свой номер в поле xmax, после чего она освободит блокировку tuple. Тогда одна случайная транзакция из всех остальных успеет захватить блокировку tuple и станет первой в «очереди».
Page 24: «Очередь» ожидания
Начинаем транзакцию и обновляем строку.
Будем смотреть только на блокировки, связанные с номерами транзакций и версиями строк:
Другая транзакция пытается обновить ту же строку:
Какие при этом возникают блокировки?
Транзакция захватила блокировку, связанную с версией строки 1 на странице 0, и ждет завершения первой транзакции:
Теперь следующая транзакция пытается обновить ту же строку:
Что увидим в pg_locks на этот раз?
Page 25: Page 25
Транзакция встала в очередь за блокировкой версии строки, очередь выросла:
Если теперь первая транзакция успешно завершается…
…выполняется UPDATE и первая версия становится неактуальной.
Все транзакции, которые стояли в очереди, будут теперь ожидать завершения второй транзакции — и будут обрабатываться в произвольном порядке. Вот как выглядит очередь в нашем случае:
Page 26: Итоги
Блокировки отношений и других объектов БД используются для организации конкурентного доступа к общим ресурсам
- хранятся в разделяемой памяти сервера
- имеется механизм очередей
- Блокировки строк реализованы иначе
- хранятся в страницах данных из-за потенциально большого количества
- используют блокировки уровня объектов для организации «очереди»
Page 27: Практика
- Какие блокировки на уровне изоляции Read Committed удерживает транзакция, прочитавшая одну строку таблицы по первичному ключу? Проверьте на практике. 2. Посмотрите, как в представлении pg_locks отображаются рекомендательные блокировки. 3. Убедитесь на практике, что проверка внешнего ключа и обновление строки могут выполняться одновременно. Изучите возникающие при этом блокировки уровня строки. 4. Воспроизведите ситуацию взаимоблокировки двух транзакций и проверьте, как она обрабатывается сервером.
Комментарии преподавателя
- Рекомендательные блокировки упоминались в теме «Обработка ошибок» курса DEV1.
https://postgrespro.ru/docs/postgresql/16/functions-admin#FUNCTIONS-AD VISORY-LOCKS
Посмотрите все столбцы представления pg_locks, чтобы определить, в каком из них отображается идентификатор ресурса.
- Для этого потребуется создать две таблицы, связанные ограничением внешнего ключа.
Для анализа блокировок используйте расширение pgrowlocks.
- Взаимоблокировка двух транзакций возникает, когда
● первая транзакция удерживает блокировку объектов, необходимых второй транзакции для продолжения работы,
● вторая транзакция удерживает блокировку объектов, необходимых первой транзакции для продолжения работы.
В общем случае может произойти взаимоблокировка более чем двух транзакций.
Page 28: 1. Блокировки при чтении строки по первичному ключу
Создадим таблицу как в демонстрации:
Прочитаем строку, начав транзакцию:
Блокировки включают блокировку индекса, поддерживающего ограничение первичного ключа, в режиме Access Share:
2. Рекомендательные блокировки
Захватим рекомендательную блокировку уровня сеанса:
Page 29: Page 29
Блокировка:
Идентификатор ресурса для блокировки типа advisory отображается в столбце objid.
3. Проверка внешнего ключа
Нам понадобится расширение для анализа блокировок на уровне строк:
Создадим таблицу клиентов:
В таблицу счетов добавим столбец для идентификатора клиента и внешний ключ:
Внутри транзакции выполним какое-нибудь действие с таблицей счетов, вызывающее проверку внешнего ключа. Например, вставим строку:
Проверка внешнего ключа приводит к появлению блокировки строки в таблице клиентов в режиме KeyShare:
Это не мешает изменять неключевые столбцы этой строки:
Page 30: 4. Взаимоблокировка двух транзакций
Обычная причина возникновения взаимоблокировок — разный порядок блокирования строк таблиц в приложении. Первая транзакция намерена перенести 100 рублей с первого счета на второй. Для этого она сначала уменьшает первый счет:
В это же время вторая транзакция намерена перенести 10 рублей со второго счета на первый. Она начинает с того, что уменьшает второй счет:
Теперь первая транзакция пытается увеличить второй счет…
…но обнаруживает, что строка заблокирована. Затем вторая транзакция пытается увеличить первый счет…
…но тоже блокируется. Возникает циклическое ожидание, которое никогда не завершится само по себе. Поэтому если какая-либо блокировка не получена за время, указанное в параметре deadlock_timeout (по умолчанию — 1 секунда), сервер проверяет наличие циклов ожидания. Обнаружив такой цикл, он прерывает одну из транзакций, чтобы остальные могли продолжить работу.
Взаимоблокировки обычно означают, что приложение спроектировано неправильно. Правильный способ выполнения таких операций — блокирование ресурсов в одном и том же порядке. Например, в данном случае можно блокировать счета в порядке возрастания их номеров. Тем не менее взаимоблокировки могут возникать и при нормальной работе (например, могут взаимозаблокироваться две команды UPDATE одной и той же таблицы). Но это очень редкие ситуации.
06 Занятие 06: Учебное приложение / Книжный магазин 2.0
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_06_bstore_advanced.html Archive: DEV2-handouts-16.zip Страниц PDF: 26
Page 1: Учебное приложение / Книжный магазин 2.0
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Обзор приложения «Книжный магазин 2.0»
- Схема данных
- Интерфейс с клиентской частью
- Разграничение доступа
Page 3: Книжный магазин
Интернет-магазин для покупателей
- поиск книг
- детальная информация о выбранной книге
- корзина для зарегистрированных пользователей
- «Админка» для сотрудников
- заказ книг у поставщика
- установка розничной цены
- фоновые задания: запуск, просмотр результатов
Комментарии преподавателя
В этом курсе, как и в DEV1, мы будем использовать приложение «Книжный магазин», но новой версии 2.0. Клиентская часть полностью готова, а серверную мы будем улучшать по мере прохождения курса.
Как и раньше, клиентская часть состоит из интернет-магазина и «админки». Однако со времен DEV1 магазин вырос и число покупателей увеличилось.
Теперь, чтобы приобрести книги, покупатели должны регистрироваться на сайте и входить под своим именем. В магазине теперь есть корзина, а книги имеют цену.
Админка позволяет заказывать книги и устанавливать на них цену. Добавление книг и авторов из админки исключено из приложения 2.0.
Зато добавилась возможность запускать фоновые задания (например, отчеты) и просматривать их результаты после завершения.
Приложение предназначено исключительно для демонстрации концепций, излагаемых в этом курсе. Оно умышленно сделано крайне упрощенным и не может служить образцом проектирования реальных систем.
Page 4: Приложение
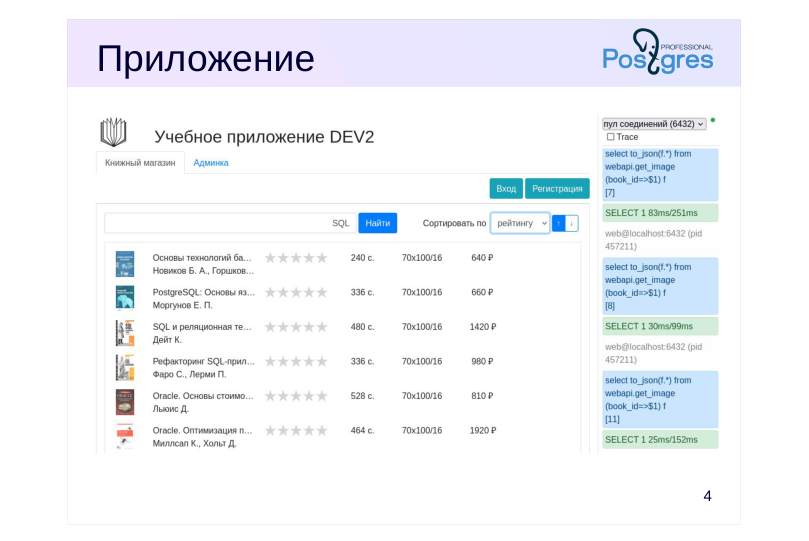 {#source-figure-004 caption=“Source slide page 4: Приложение”}
Комментарии преподавателя
Приложение состоит из двух частей, представленных вкладками.
● «Книжный магазин» — это интерфейс веб-пользователя, в котором он может просматривать и покупать книги.
● «Админка» — интерфейс сотрудников магазина, в котором они могут заказывать книги и устанавливать их цену, а также выполнять фоновые задания.
В учебных целях вся функциональность представлена на одной общей веб-странице. Если какая-то часть функциональности недоступна из-за того, что на сервере нет подходящего объекта, приложение сообщит об этом. Также приложение выводит текст запросов, которые оно посылает на сервер.
Приложение позволяет выбрать сервер для подключения. В основном мы будем использовать значение по умолчанию.
Исходный код приложения не является темой курса, но может быть получен в git-репозитории https://pubgit.postgrespro.ru/pub/dev2app.git
Page 5: Демонстрация приложения
В этой демонстрации мы показываем приложение «Книжный магазин 2.0» в том виде, в котором оно будет после завершения всех практических заданий. Приложение доступно в браузере виртуальной машины курса по адресу http://localhost/ Открываем http://localhost…
Page 6: Основные сущности
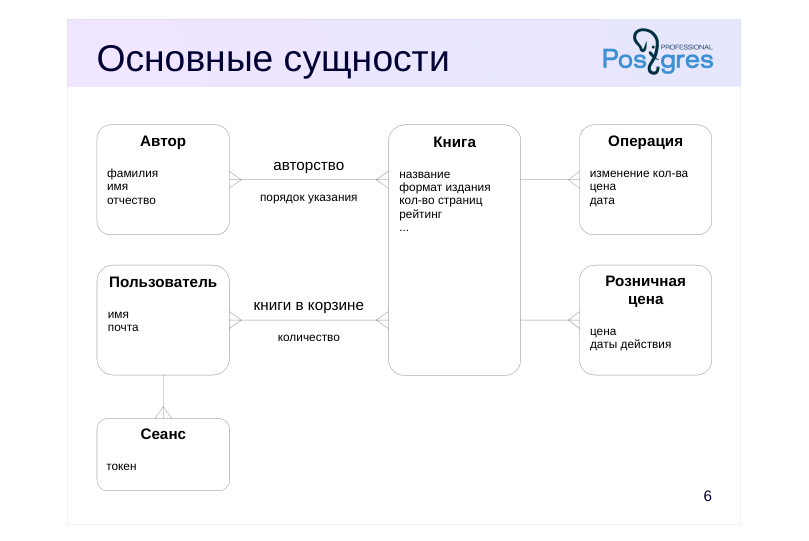 {#source-figure-006 caption=“Source slide page 6: Основные сущности”}
Комментарии преподавателя
Основные сущности нашей базы данных практически не изменились со времен курса DEV1. Это:
● Книга. К книгам добавились атрибуты.
● Автор. Книги и авторы связаны отношением многие-ко-многим (авторство).
● Операции с книгами: покупки в магазине и поступления на склад. К атрибутам добавилась цена книги.
Новые сущности:
● Розничная цена. Мы рассматриваем цену как отдельную сущность, а не атрибут книги, поскольку она может меняться со временем, то есть имеет диапазон дат действия.
● Пользователь веб-магазина. Определяется именем (логином) и имеет почтовый адрес.
Пользователь может класть книги в корзину, и поэтому связан с книгами отношением многие-ко-многим. (Отдельной сущности для корзины мы не предусматриваем.)
● Сеанс работы пользователя с магазином. Сеанс связан с вопросами аутентификации и разграничения доступа.
Page 7: Основные таблицы
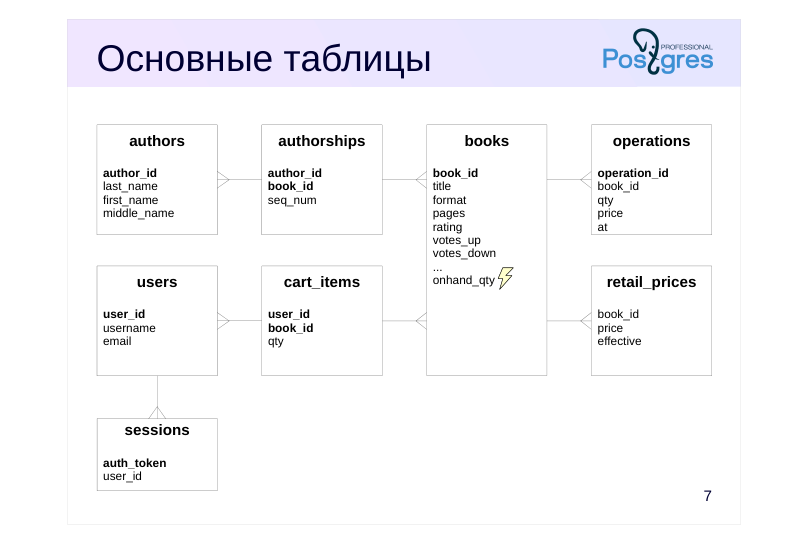 {#source-figure-007 caption=“Source slide page 7: Основные таблицы”}
Комментарии преподавателя
Основные таблицы базы данных представлены на слайде.
В качестве идентификаторов используются суррогатные ключи, генерируемые с помощью последовательностей.
Связи «многие ко многим» представлены дополнительными таблицами:
● authorships — авторство;
● cart_items — книги в корзине.
Отметим, что в таблице книг books имеется дополнительный столбец onhand_qty, содержащий текущее количество книг на складе магазина, и обновляемый триггером по таблице операций.
С расчетом рейтинга книг (rating) связаны еще два столбца: голоса пользователей «за» (votes_up) и «против» (votes_down).
Page 8: Интерфейс с клиентом
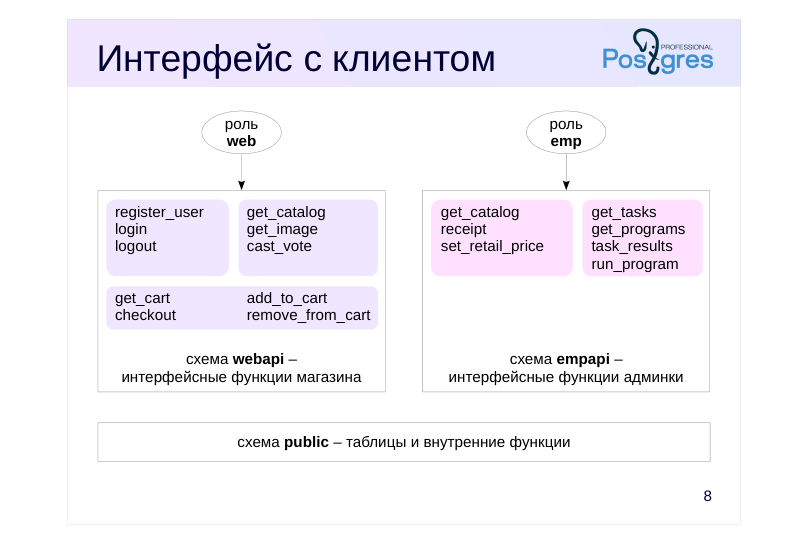 {#source-figure-008 caption=“Source slide page 8: Интерфейс с клиентом”}
Комментарии преподавателя
Клиентский API серверной части полностью построен на функциях.
Интерфейсные функции веб-магазина доступны только пользователю web и размещены в схеме webapi:
● аутентификация и разграничение доступа;
● работа с каталогом книг;
● операции с корзиной.
Интерфейсные функции админки доступны только пользователю emp и размещены в схеме empapi:
● работа с каталогом книг;
● фоновые задания.
Аутентификация в админке не предусмотрена.
Все таблицы, а также внутренние функции, не открытые напрямую для клиента, размещены в схеме public.
Интерфейсные функции объявлены как SECURITY DEFINER, чтобы иметь доступ к объектам базы данных. С помощью механизма привилегий по умолчанию (ALTER DEFAULT PRIVILEGES) доступ к функциям в схеме webapi автоматически выдается только пользователю web, в схеме empapi — пользователю emp, а доступ к функциям в схеме public отбирается у роли public.
(Вопросы разграничения доступа рассматриваются в курсе DEV1.)
Сейчас мы рассмотрим интерфейс подробнее, но обратите внимание, что информационная панель веб-клиента показывает, какие вызовы он отправляет на сервер.
Page 9: Аутентификация
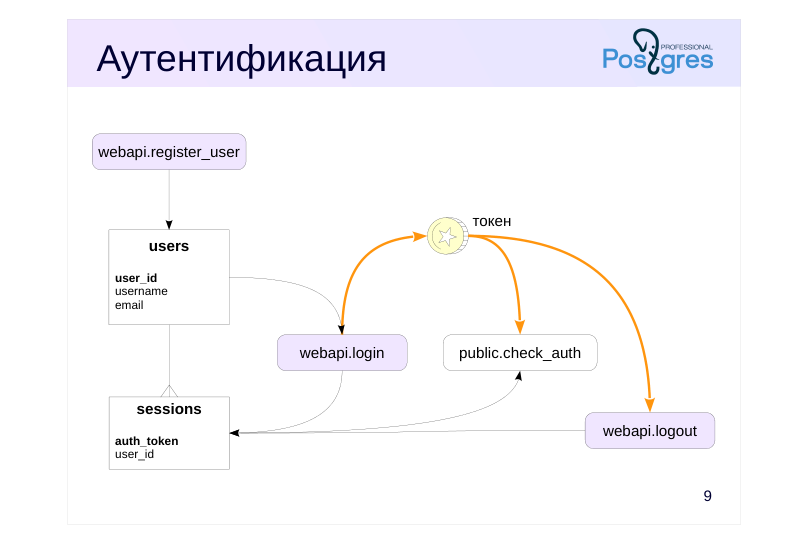 {#source-figure-009 caption=“Source slide page 9: Аутентификация”}
Комментарии преподавателя
Аутентификация пользователей интернет-магазина происходит на клиенте. С точки зрения базы данных клиент всегда представлен одной ролью web.
Новый пользователь регистрируется вызовом register_user. Для простоты мы не используем пароли (но если бы использовали, то хеш пароля хранился бы в таблице users).
Чтобы иметь возможность совершать покупки, пользователь должен войти в систему. Это выполняет функция login. Она создает сеанс пользователя, который определяется токеном (UUID).
Токен возвращается клиенту и дальше клиент передает его как параметр во все функции, связанные с покупками. Каждая такая функция первым делом проверяет правильность токена с помощью вызова check_auth, который определяет по токену имя пользователя.
Наконец, вызов logout завершает сеанс.
Функционал истечения срока сеанса не реализован, но может быть легко добавлен.
Page 10: Аутентификация
У нас уже есть два зарегистрированных пользователя:
Зарегистрируем еще одного. Почтовый адрес можно указывать любой — мы будем отправлять пользователям письма, но все они попадут в локальный почтовый ящик пользователя student.
Пользователь входит в систему и получает токен:
При этом в базе появляется сеанс:
Токен можно проверить функцией, закрытой для клиента:
Page 11: Каталог книг
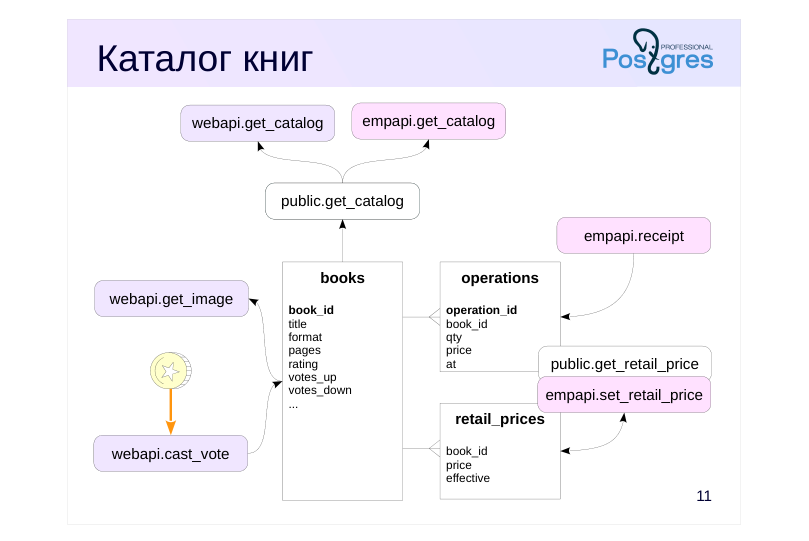 {#source-figure-011 caption=“Source slide page 11: Каталог книг”}
Комментарии преподавателя
Список книг (конечно, вместе с авторами, хотя эти таблицы не показаны на слайде для краткости) нужен как магазину, так и админке — но с разным набором полей. Всю возможную информацию выбирает закрытая функция public.get_catalog, получая на вход параметры поиска. Функции webapi.get_catalog и empapi.get_catalog реализованы как обертки вокруг public.get_catalog.
Получение обложки книги выполняет функция webapi.get_image. Обложки не входят в get_catalog, чтобы клиент как можно быстрее отобразил результаты поиска, а обложки подгружал в фоновом режиме.
Голосование «за» или «против» книги выполняется функцией webapi.cast_vote. Функция допускает голосование несколько раз, но работает только для зарегистрированных пользователей.
Заказ книги у поставщика в админке выполняет функция empapi.receipt. Она создает соответствующую операцию с книгой.
За установку розничной цены на книгу отвечает функция empapi.set_retail_price. Текущую цену возвращает функция public.get_retail_price, которую клиент никогда не вызывает напрямую, но она используется во многих интерфейсных функциях.
Page 12: Каталог книг
Информацию о книгах клиент получает функцией get_catalog. Например, для интернет-магазина:
Установим розничную цену для одной книги:
Поступление 50 книг по 100 ₽ на склад:
Этот вызов создает соответствующую операцию:
Пользователь может голосовать за книгу:
Page 13: Page 13
Page 14: Корзина
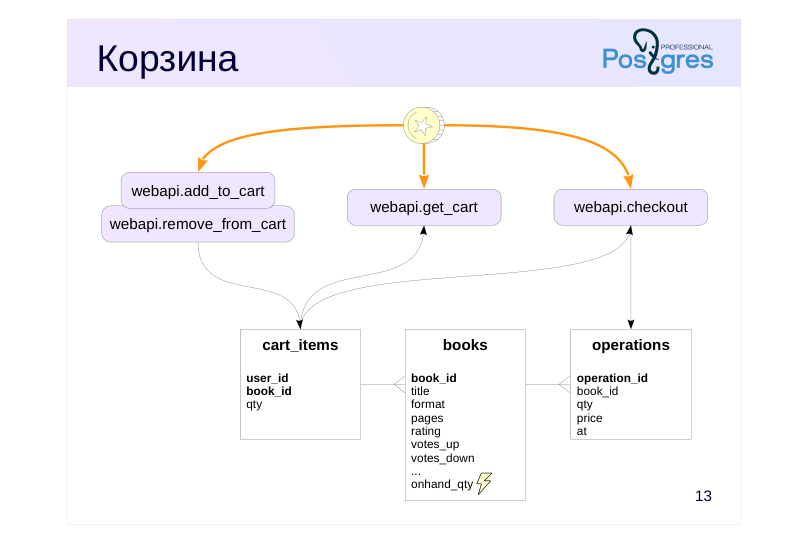 {#source-figure-014 caption=“Source slide page 14: Корзина”}
Комментарии преподавателя
Все функции, относящиеся к покупке, работают от имени конкретного пользователя магазина и поэтому требуют токена.
Функция webapi.add_to_cart добавляет в корзину одну книгу или убирает из корзины одну книгу. Функция webapi.remove_from_cart полностью удаляет всю позицию из корзины.
Функция webapi.get_cart возвращает содержимое корзины.
Функция webapi.checkout совершает покупку, убирая позиции из корзины и создавая соответствующие операции с книгами.
Весь процесс взаимодействия с пользователем во время покупки книг не может быть выполнен в рамках одной транзакции СУБД, поскольку этот процесс занимает неизвестное (большое) время. Вместо этого мы позволяем пользователю добавлять книги в корзину, не обращая внимания на наличие необходимого количества книг на складе. Каждое добавление происходит в отдельной (очень короткой) транзакции, так что в базе данных не возникает никаких долговременных блокировок. Фактическая проверка количества происходит только в транзакции при покупке: если на складе будет недостаточно книг, ограничение целостности в базе данных не позволит выполнить транзакцию.
(В реальной системе необходимо было бы предусмотреть резервирование товара и фиксацию цены на время, отведенное для оплаты онлайн. Конечно, и это действие тоже не должно приводить к длинным транзакциям.)
Page 15: Корзина
Положим книги в корзину:
Вот что у нас в корзине:
Page 16: Page 16
Уберем одну книгу:
И совершим покупку:
Что осталось в корзине?
Конечно, ничего. Зато появились операции покупки:
Page 17: Фоновые задания
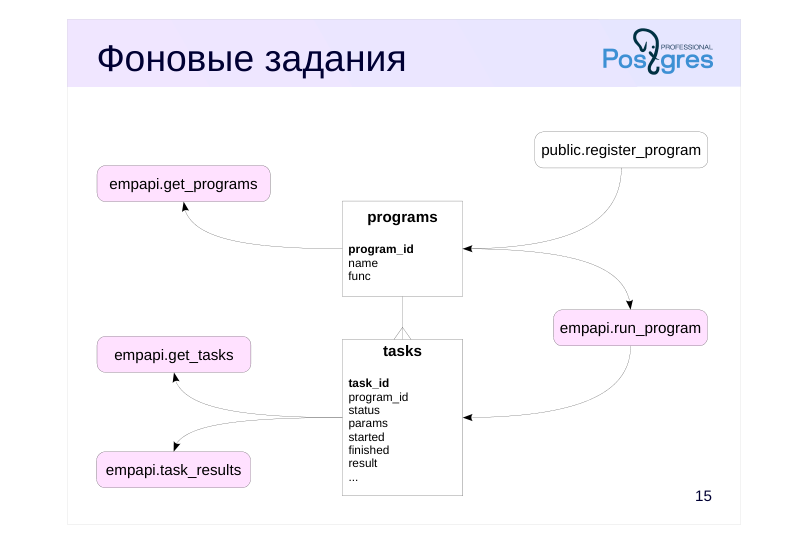 {#source-figure-017 caption=“Source slide page 17: Фоновые задания”}
Комментарии преподавателя
Для фоновых заданий используются еще две таблицы, не показанные на основной схеме:
● programs — программы, которые можно запускать. У программы есть название и имя «исполняемой» функции.
● tasks — собственно задания, то есть экземпляры программ. Задание имеет статус (запланировано к запуску, работает и т. п.), значения параметров, дату запуска и окончания работы, результат выполнения и другие.
Программа регистрируется функцией public.register_program. Клиент не вызывает эту функцию, поэтому она находится в схеме public.
Задание ставится на выполнение функцией empapi.run_program.
Несколько функций предназначены для получения информации:
● о списке программ — empapi.get_programs;
● о списке заданий — empapi.get_tasks;
● о результате выполнения — empapi.task_results.
Page 18: Фоновые задания
Список зарегистрированных программ, которые можно выполнять как фоновые задания:
Список фоновых заданий:
Поставим в очередь на выполнение еще одно задание «Приветствие»:
В ответ получаем номер задания. Немного подождем… Проверим статус задания:
Задание завершено. Получим результат:
Мы вернемся к фоновым заданиям позже в теме «Асинхронная обработка».
Page 19: Page 19
Page 20: Итоги
Часть рассмотренного функционала еще только предстоит реализовать
- Прежде чем вносить изменения в приложение, необходимо разобраться в том, как оно устроено
Page 21: Практика
Здесь и далее все практические задания, связанные с приложением, выполняются в базе данных bookstore2. 1. Сеанс удаляется, если пользователь выходит из системы, но если просто закрыть вкладку браузера, сеансы будут накапливаться. Реализуйте автоматическое удаление прошлых сеансов пользователя при повторном входе. 2. Реализуйте отсутствующую интерфейсную функцию webapi.add_to_cart. Функция должна работать только для пользователей, вошедших в систему. Если книга присутствует в корзине, количество ее экземпляров не может быть меньше одного. Проверьте результат в приложении.
- Какое обновление таблицы cart_items выполняется при
- изменении количества книг — обычное или HOT?
Комментарии преподавателя
База данных bookstore2 уже создана. При необходимости ее можно пересоздать с помощью скрипта bookstore2.sql в подкаталоге dev2 домашнего каталога.
- Внесите изменение в функцию webapi.login: перед тем как создавать новый сеанс, закройте существующие сеансы этого пользователя, используя функцию webapi.logout.
Не забудьте выбрать подключение к основному серверу на порту 5432. (Это значение не выбирается по умолчанию, поскольку в следующих темах мы будет работать с пулом соединений.)
- Функция webapi.add_to_cart присутствует в базе, но пуста. Сохраните ее сигнатуру без изменений. Функция принимает параметры:
● auth_token — токен;
● book_id — идентификатор книги;
● qty — количество (может быть +1 или −1, другие значения считаются некорректными).
Если qty = +1, надо либо добавить экземпляр книги в корзину (если такой книги еще нет в корзине), либо увеличить количество экземпляров на единицу.
Если qty = −1, надо уменьшить количество экземпляров книги в корзине на единицу. При этом количество не должно быть меньше 1 (чтобы полностью удалить книгу из корзины, используется другая функция — webapi.remove_from_cart).
Тип обновления можно узнать в таблице pg_stat_all_tables (вспомните тему «Архитектура. Многоверсионность» ).
Page 22: 1. Удаление сеансов
Добавим в функцию входа удаление существующих сеансов:
2. Функция добавления в корзину
Во-первых, определим ограничение целостности на таблице cart_items, которое не даст количеству опуститься меньше единицы. Это надежнее и проще, чем реализовывать проверку в коде.
Затем определим функцию add_to_cart. Чтобы не проверять, существует ли книга в корзине, воспользуемся командой INSERT ON CONFLICT.
Page 23: Page 23
При изменении количества книг будут выполняться HOT-обновления, поскольку обновляемое поле (qty) не входит ни в один индекс.
Page 24: Page 24
Page 25: Практика+
- Если для каждого пользователя магазина создать отдельную роль, аутентификацию можно поручить базе данных. Хорошая ли это идея и почему? 2. Вместо того, чтобы создавать функции в базе данных, можно открыть доступ к таблицам и реализовать всю логику в приложении. А генерацию запросов переложить на ORM. Хорошая ли это идея и почему? 3. Приложение реализует собственный механизм фоновых заданий. Вместо этого можно воспользоваться сторонним решением для очередей сообщений. Хорошая ли это идея и почему?
Page 26: 1. Аутентификация пользователей приложения в базе данных
Это определенно плохая идея. В приложении могут быть зарегистрированы тысячи и миллионы пользователей. С точки зрения СУБД все они абсолютно равноправны, так что создание для каждого отдельной роли не дает никаких преимуществ при разграничении доступа. А вот неприятностей не оберешься: динамическое и бесконтрольное выполнение команд CREATE ROLE и GRANT приложением ни к чему хорошему не приведет. Такие команды должен выполнять администратор базы данных.
2. Где размещать бизнес-логику?
Этот вопрос из разряда «религиозных», на него нет однозначного ответа. Все зависит от того, на какую часть системы делается акцент. Подход, при котором бизнес-логика реализуется в приложении, а от базы данных отгораживаются ORM-ом (инструментом, помогающим связать объектную модель данных приложения с реляционной моделью данных базы), удобен для разработчиков, привыкших мыслить категориями процедурных и объектно-ориентированных языков программирования. Здесь во главу угла ставится приложение, а СУБД лишь обеспечивает надежное хранение данных. В качестве плюсов этого подхода часто называют простоту масштабирования и развертывания, независимость от конкретной СУБД. Подход, при котором бизнес-логика реализуется в базе данных, а приложению предоставляется высокоуровневый интерфейс, удобен для разработчиков, глубоко знакомых с устройством конкретной СУБД и умеющих пользоваться ее возможностями. Здесь во главу угла ставится база и согласованность данных в ней, а приложений может быть и несколько. В качестве плюсов — все возможности языка SQL и реализованных в СУБД алгоритмов, тонкая оптимизация и настройка производительности, исключение пересылок по сети лишних данных. В этом курсе, во всяком случае, мы всецело на стороне базы данных.
3. Собственная реализация очередей в базе данных
На этот вопрос также нет однозначного ответа. Сравнение разных решений приведено в теме «Асинхронная обработка».
07 Занятие 07: Расширяемость / Пул соединений
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_07_ext_connpool.html Archive: DEV2-handouts-16.zip Страниц PDF: 29
Page 1: Расширяемость / Пул соединений
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Для чего используется пул соединений
- Пул соединений в общей архитектуре системы
- Доступные варианты, PgBouncer
- Режимы работы
- Вопросы аутентификации
- Управление пулом
- Особенности разработки при наличии пула
- Подготовка соединений
Page 3: Один клиент, один процесс
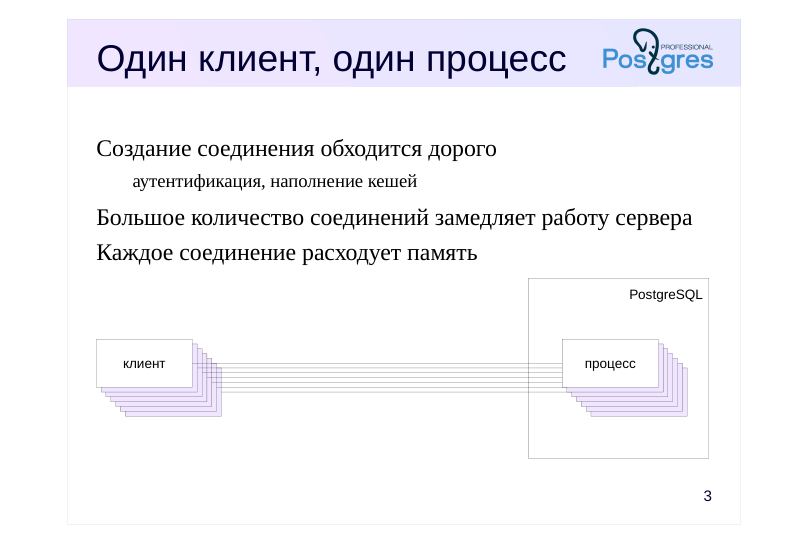 {#source-figure-003 caption=“Source slide page 3: Один клиент, один процесс”}
Создание соединения обходится дорого
- аутентификация, наполнение кешей
- Большое количество соединений замедляет работу сервера
- Каждое соединение расходует память
Комментарии преподавателя
Вспомним архитектуру PostgreSQL. Когда клиент подключается к серверу, для него создается отдельный обслуживающий процесс, с которым и происходит вся дальнейшая работа этого клиента. Поэтому количество обслуживающих процессов на сервере равно количеству клиентов.
При большом количестве клиентов это вызывает проблемы:
● Создание соединений обходится дорого, в основном из-за того, что установка соединения требует аутентификации (особенно в случае шифрованных соединений) и наполнения кешей (например, кеша системного каталога).
● Большое количество процессов замедляет работу сервера. Основная причина в том, что для создания снимка данных (а это частая операция) приходится просматривать список всех имеющихся процессов. И такой просмотр требует блокировки внутренних структур данных.
● Каждый процесс занимает определенную часть памяти сервера.
Максимальное количество соединений, не вызывающее сложностей, зависит от многих факторов (наличие свободной памяти, количество ядер) и обычно лежит в диапазоне от нескольких сотен до нескольких тысяч.
Page 4: Пул соединений
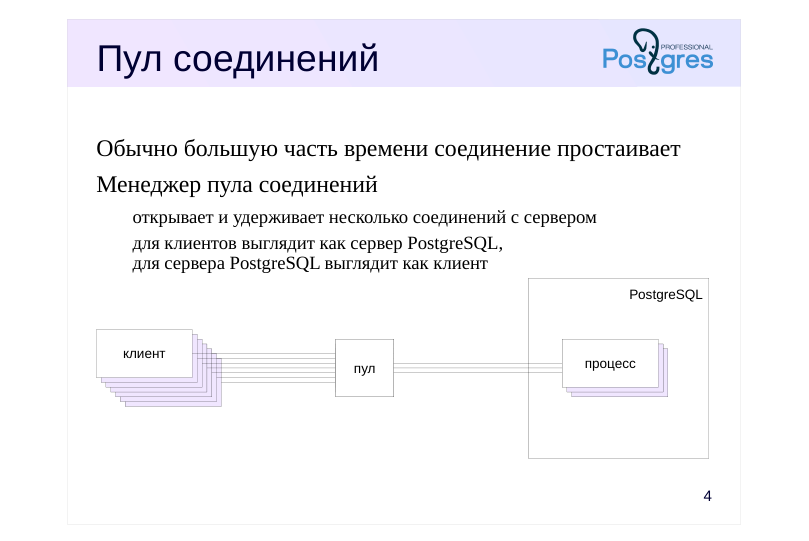 {#source-figure-004 caption=“Source slide page 4: Пул соединений”}
Обычно большую часть времени соединение простаивает
- Менеджер пула соединений
- открывает и удерживает несколько соединений с сервером
- для клиентов выглядит как сервер PostgreSQL,
- для сервера PostgreSQL выглядит как клиент
Комментарии преподавателя
Даже если клиент открывает соединение надолго, большую часть времени оно обычно простаивает, расходуя ресурсы. Если несколько клиентов смогут воспользоваться одним соединением, это поможет решить упомянутые проблемы. (Можно провести некоторую аналогию с передачей данных по сети: между абонентами нет выделенного соединения, а данные передаются небольшими пакетами, используя имеющиеся каналы связи.)
Чтобы одновременно работать с большим количеством клиентов, используется пул соединений.
Специальная программа — менеджер пула — открывает и удерживает некоторое (небольшое) количество соединений с сервером БД. Для сервера БД все выглядит так, как будто имеются несколько долгоживущих соединений.
Клиенты подключаются не к серверу БД, а к менеджеру пула. Для этого он реализует тот же клиентский протокол, что и PostgreSQL, «притворяясь» для клиентов базой данных. Клиентские запросы переадресуются серверу БД, используя одно из имеющихся свободных соединений.
Page 5: Место в архитектуре
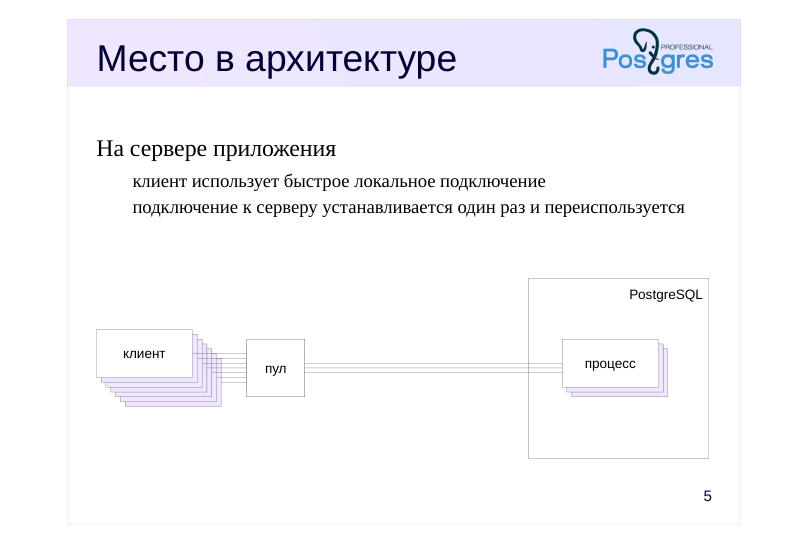 {#source-figure-005 caption=“Source slide page 5: Место в архитектуре”}
На сервере приложения
- клиент использует быстрое локальное подключение
- подключение к серверу устанавливается один раз и переиспользуется
Комментарии преподавателя
Можно по-разному встроить пул соединений в архитектуру информационной системы.
Один вариант — разместить менеджер пула на сервере приложения. Обычно это будет пул, предоставляемый самим сервером приложений или драйвером PostgreSQL, хотя при необходимости можно воспользоваться и сторонним решением.
При этом клиент получает возможность быстро подключаться к локальному менеджеру пула, а время установки соединения с сервером БД перестает играть роль, поскольку выполняется только один раз. (Это не совсем верно, поскольку реализация пула может предусматривать динамическое добавление и отключение соединений с СУБД в зависимости от нагрузки, но идея остается той же самой — одно соединение используется многократно.)
Page 6: Место в архитектуре
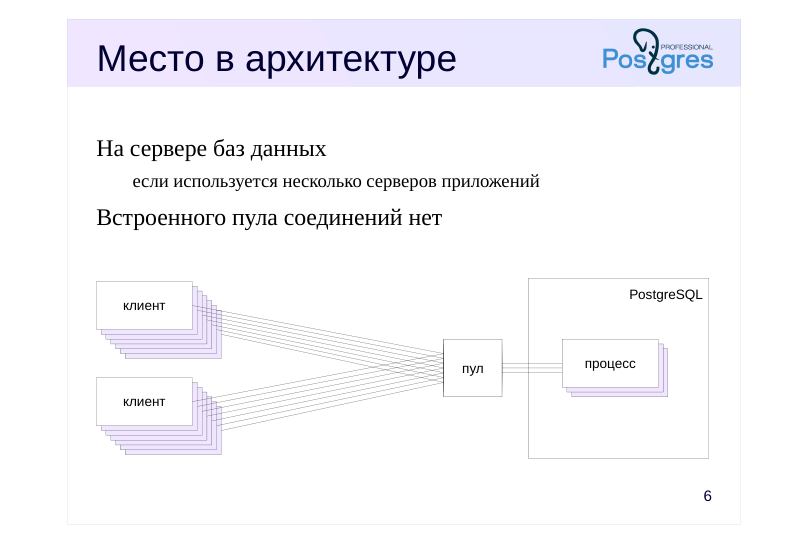 {#source-figure-006 caption=“Source slide page 6: Место в архитектуре”}
На сервере баз данных
- если используется несколько серверов приложений
- Встроенного пула соединений нет
Комментарии преподавателя
С другой стороны, если имеется несколько серверов приложений, то пул соединений имеет смысл устанавливать на сервере БД — иначе будет сложно ограничить количество соединений.
При этом в PostgreSQL пока нет встроенного пула соединений, нужно использовать сторонние решения.
Page 7: Место в архитектуре
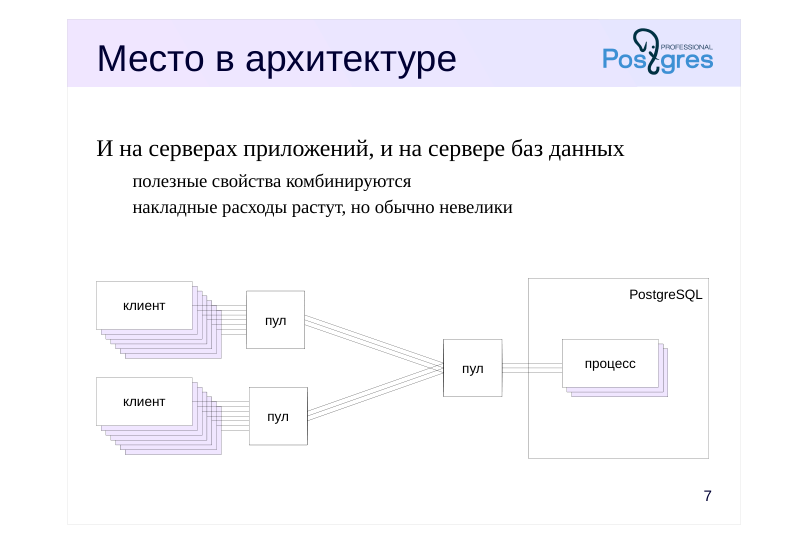 {#source-figure-007 caption=“Source slide page 7: Место в архитектуре”}
И на серверах приложений, и на сервере баз данных
- полезные свойства комбинируются
- накладные расходы растут, но обычно невелики
Комментарии преподавателя
Вообще говоря, в этом случае может иметь смысл использовать менеджеры пулов и на серверах приложений, и на сервере БД, чтобы одновременно и сократить время подключения, и ограничить количество соединений.
Следует учитывать, что каждый дополнительный узел на пути от клиента к серверу будет вносить определенные накладные расходы, но они, как правило, незначительны.
Page 8: Доступные продукты
PgBouncer
- стандарт де-факто
- используем далее как пример
- Pgpool-II
- не только пул, но и балансировка нагрузки Odyssey
- многопоточный, высокопроизводительный
- и др.
Комментарии преподавателя
Как уже говорилось, многие, если не все, серверы приложений и просто драйверы, реализующие клиент-серверный протокол PostgreSQL, предоставляют возможность организации пула соединений на клиентской стороне.
Как уже говорилось, встроенного менеджера пула в PostgreSQL пока нет, но есть сторонние продукты. Все представленные здесь менеджеры — проекты с открытым исходным кодом.
PgBouncer (https://www.pgbouncer.org/) используется очень широко и является стандартом де-факто. Это легкий пул соединений, без дополнительных функций. Именно эту программу мы будем рассматривать дальше в этой теме.
Pgpool-II (https://www.pgpool.net) разрабатывает компания SRA OSS (Япония). Это не только пул соединений, но и балансировщик нагрузки. Он реализует интересный функционал (например, анализ трафика для того чтобы отличать пишущие транзакции от только читающих).
Odyssey (https://github.com/yandex/odyssey) — пул соединений от компании Яндекс. Основное преимущество состоит в многопоточной архитектуре, позволяющей добиться высокой производительности.
Это, конечно, не полный список.
Page 9: Режимы работы
«Пул сеансов»
- может иметь смысл только для коротких сеансов
- «Пул транзакций»
- разные транзакции одного клиентского сеанса
- могут выполняться в разных соединениях с сервером
- основной режим
- есть особенности, которые надо учитывать при разработке
- «Пул операторов»
- запрещает транзакции, состоящие более чем из одного оператора
- Новый пул соединений создается для каждой пары «база данных — роль»
Комментарии преподавателя
Менеджер пула может работать в нескольких режимах.
В режиме «пул сеансов» клиенту предоставляется выделенное соединение из числа доступных. Этот режим полезен только в случае короткоживущих соединений: клиент подключается, выполняет транзакцию и тут же отключается. Например, это может быть система мониторинга, посылающая запросы раз в секунду.
Режим «пул транзакций» является наиболее универсальным и полезным. В нем соединение предоставляется отдельно для каждой транзакции. Такой режим полезен и в случае, когда клиент устанавливает долгоживущее соединение. Но из-за такого режима возникают определенные особенности, которые необходимо учитывать при разработке приложений. Мы поговорим о них немного позже.
PgBouncer имеет еще один режим — «пул операторов», но он фактически бесполезен, поскольку просто запрещает выполнение транзакций, состоящих более чем из одного оператора (работает только с режимом автофиксации).
Любое соединение с сервером всегда выполняется к определенной базе данных и под определенной ролью. Поэтому на каждую пару «база данных — роль» менеджер пулов создает новый пул соединений.
Из-за этого схема с пулом соединений вряд ли имеет смысл, если используется много различных ролей и баз данных. Однако обычно все-таки используется одна база данных и ограниченное количество ролей (с аутентификацией конечных пользователей на уровне приложения).
Page 10: Аутентификация
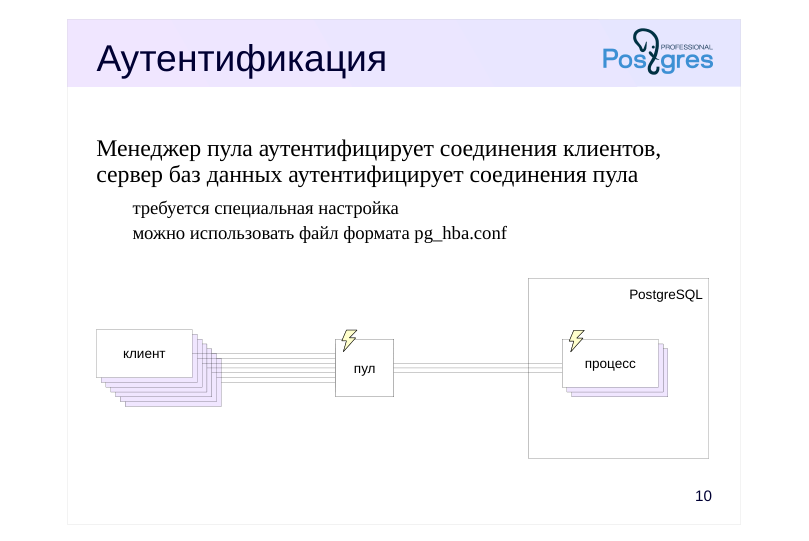 {#source-figure-010 caption=“Source slide page 10: Аутентификация”}
Менеджер пула аутентифицирует соединения клиентов, сервер баз данных аутентифицирует соединения пула
- требуется специальная настройка
- можно использовать файл формата pg_hba.conf
Комментарии преподавателя
Известно, что аутентификацию выполняет сервер БД. Но при наличии пула соединений нельзя полагаться только на нее.
Поскольку в данном случае менеджер пула является точкой входа для клиентов, он сам должен выполнять аутентификацию аналогично тому, как это делает сервер БД. Иначе любой клиент сможет получить несанкционированный доступ к уже открытому соединению (которое было аутентифицировано сервером БД один раз при открытии).
Таким образом, схема получается следующая:
- Менеджер пула выполняет аутентификацию входящего соединения.
Для этого ему требуются настройки, более или менее аналогичные имеющимся в PostgreSQL. PgBouncer позволяет обойтись более простыми настройками, но допускает и использование обычного файла формата pg_hba.conf. Необходимо учитывать, что менеджер пула может поддерживать не все методы аутентификации. Например, PgBouncer напрямую не поддерживает GSSAPI, LDAP и т. п. (Однако поддержка PAM позволяет использовать различные методы.)
- При успешной аутентификации, если потребуется открыть новое соединение с базой данных, менеджер пула передает PostgreSQL информацию, полученную от клиента (например, имя и пароль), а PostgreSQL аутентифицирует входящее соединение обычным образом. (Хотя в общем случае менеджер пула может подключаться к PostgreSQL под другой ролью, игнорируя идентификацию клиента.)
Page 11: Минимальная настройка
Файл настроек PgBouncer:
Секция [databases] позволяет переадресовывать обращения к разным БД на разные серверы PostgreSQL (в нашем случае это не используется); PgBouncer слушает порт 6432; Используется аутентификация scram-sha-256; Роль student может выполнять администрирование PgBouncer; Используется режим пула транзакций. Файл пользователей:
Чтобы не синхронизировать пароли, можно получать их непосредственно с сервера БД:
Попробуем подключиться. Поскольку PgBouncer настроен на парольную scram-sha-256-аутентификацию, зададим пароль явно в строке подключения (можно было бы использовать файл ~/.pgpass):
Подключение работает. Теперь закроем соединение и откроем его заново:
Page 12: Page 12
Фактически мы продолжаем работать в том же самом сеансе, который PgBouncer удерживает открытым.
Page 13: Управление
Консоль управления PgBouncer
- подключение psql к псевдобазе pgbouncer
- SHOW — ряд команд для вывода состояния и другой информации
- PAUSE — приостановка клиентов (для перезагрузки базы данных)
- RESUME — возобновление работы
- RELOAD — перечитывание файла конфигурации
- и другие возможности
Комментарии преподавателя
Для управления PgBouncer используется консоль, к которой можно подключиться с помощью обычного psql, указывая специальную БД pgbouncer.
Консоль позволяет запрашивать состояние системы и выполнять ряд команд. Например, можно приостановить поток запросов от клиентов на время перезагрузки сервера БД и т. п.
Page 14: Консоль управления
Чтобы работать с консолью управления PgBouncer, необходимо подключиться к одноименной базе данных (это могут сделать пользователи, определенные в параметрах admin_users и stat_users).
Теперь мы работаем не с PostgreSQL — команды обрабатывает сам PgBouncer. Например, можно получить информацию об используемых пулах:
Работой пула управляет ряд параметров, которые мы уже видели в конфигурационном файле. Из консоли управления можно увидеть их текущие и умолчательные значения и при необходимости изменить их:
Вывод команды SHOW CONFIG, показывающий информацию о параметрах, достаточно объемный, поэтому отфильтруем его, чтобы увидеть только один параметр:
Пусть к пулу подключится новый клиент:
А мы приостановим работу всех клиентов:
Page 15: Page 15
Новый клиент пытается выполнить запрос:
Для него ситуация выглядит так, как будто база данных не отвечает. Теперь мы можем даже перезапустить PostgreSQL.
Возобновляем работу клиентов, и запрос успешно выполняется:
Таким образом можно выполнять работы на сервере БД (например, обновление), не обрывая клиентские соединения.
Page 16: Особенности разработки
Действия, локализованные в сеансе, а не в транзакции
- подготовленные операторы (PREPARE/EXECUTE)
- временные таблицы (кроме ON COMMIT DROP)
- функция currval
- установка конфигурационных параметров (SET/RESET)
- рекомендательные блокировки на уровне сеанса
- межпроцессные уведомления (LISTEN/NOTIFY)
- курсоры с фразой WITH HOLD
- загрузка разделяемых библиотек (LOAD)
- расширения, сохраняющие состояние на уровне сеанса
Комментарии преподавателя
Режим «пула транзакций» имеет для разработчика приложений особенности, связанные с тем, что две транзакции, выполняемые в одном клиентском сеансе, могут выполняться в разных сеансах сервера БД. Поэтому не будут работать (точнее, будут работать не так, как задумано) любые команды, действие которых распространяется на время сеанса, а не транзакции.
К ним относятся подготовленные операторы (если подготовкой управляет клиент), использование временных таблиц, функции currval, установка параметров и рекомендательных блокировок на уровне сеанса, межпроцессные уведомления, курсоры WITH HOLD, загрузка разделяемых библиотек в сеансе, установка таймаута бездействия сеанса (idle_session_timeout) и подобные. А также расширения, реализующие «глобальные переменные» уровня сеанса, такие как pg_variables (https://postgrespro.ru/docs/enterprise/16/pg-variables).
В версии pgBouncer 1.21 (16.10.2023) реализована поддержка подготовленных операторов на стороне клиента. Надо учитывать, что команды уровня SQL (PREPARE, EXECUTE, DEALLOCATE) по-прежнему направляются напрямую на сервер, поэтому подготовка операторов будет работать только при использовании драйверов, непосредственно формирующих сообщения протокола (например, для python или perl).
https://www.pgbouncer.org/changelog.html#pgbouncer-121x
Page 17: Особенности пула транзакций
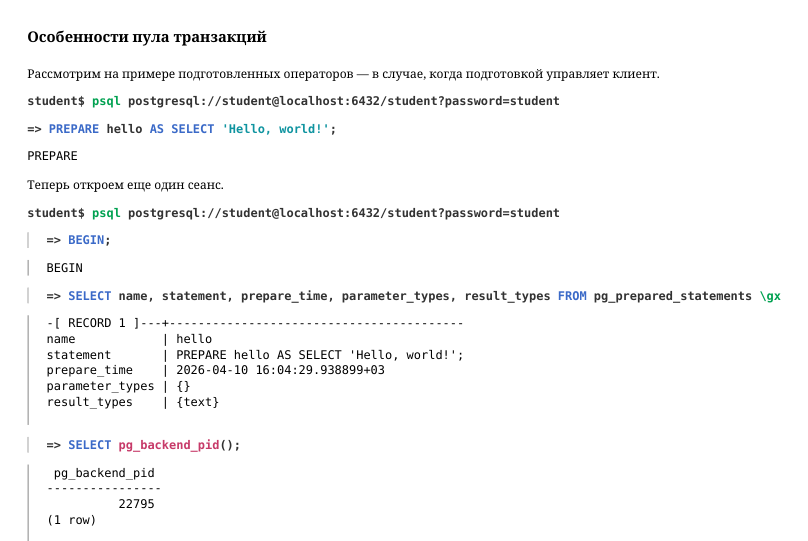 {#source-figure-017 caption=“Source slide page 17: Особенности пула транзакций”}
Рассмотрим на примере подготовленных операторов — в случае, когда подготовкой управляет клиент.
Теперь откроем еще один сеанс.
Транзакция второго сеанса выполняется в том же соединении, поэтому ей доступен подготовленный оператор:
А какое соединение будет использоваться в первом сеансе?
Уже другое, поскольку во втором сеансе транзакция не завершена.
Подготовленного оператора в памяти этого обслуживающего процесса нет.
Чтобы пользоваться и преимуществами пула соединений, и подготовленными операторами, надо переносить управление подготовкой на сторону сервера. Самый простой и удобный способ — писать функции на языке PL/pgSQL. В этом случае интерпретатор автоматически подготавливает все запросы.
Page 18: Page 18
Page 19: Подготовка соединений
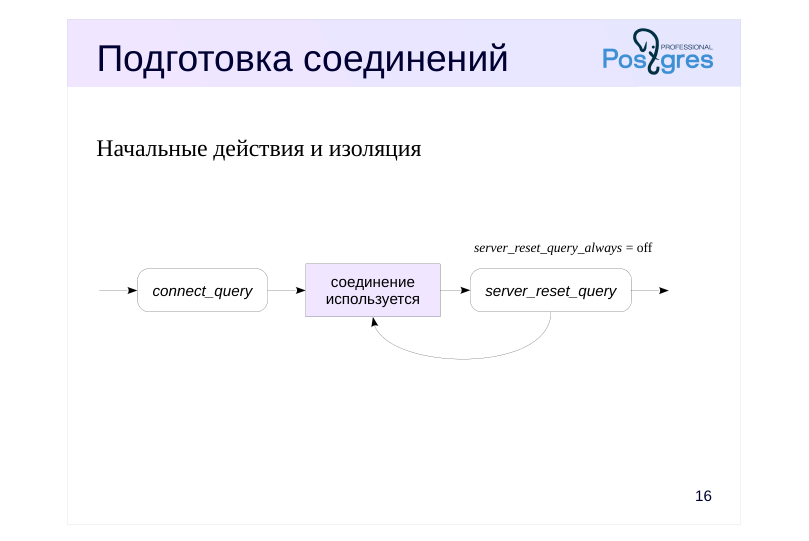 {#source-figure-019 caption=“Source slide page 19: Подготовка соединений”}
Начальные действия и изоляция
Комментарии преподавателя
PgBouncer предоставляет параметры, позволяющие с помощью SQL-команды
● настраивать только что открытое соединение,
● очищать состояние соединения после использования его клиентом.
Запрос, заданный в атрибуте connect_query строки соединения, отрабатывает при открытии соединения (перед тем, как оно будет выдано первому клиенту).
Запрос, заданный в параметре server_reset_query, по умолчанию срабатывает только в режиме пула сеансов и полностью сбрасывает состояние сеанса, включая содержимое всех кешей. Если установить server_reset_query_always = on, запрос будет срабатывать и в режиме пула транзакций. Тогда, если приложение не обеспечивает должную изоляцию действий в транзакции, в такой запрос можно поместить действия по принудительной изоляции, такие как сброс параметров сеанса, удаление подготовленных операторов, очистка временных таблиц и др.
Page 20: Подготовка соединений и изоляция
Настройки базы данных в PgBouncer позволяют при открытии соединения выполнять любую команду SQL. Для этого добавим атрибут connect_query в строку соединения:
В конфигурационном файле получили:
Подключаемся к консоли управления и перечитываем настройки:
При открытии соединения с сервером PostgreSQL в памяти обслуживающего процесса создается подготовленный оператор:
Page 21: Итоги
На каждое клиентское соединение создается обслуживающий процесс на сервере
- Большие количество соединений приводит к проблемам
- Пул соединений позволяет одновременно работать многим клиентам, ограничивая количество соединений с сервером
- Транзакционный режим пула имеет особенности с точки зрения разработки приложений
Page 22: Практика
- Убедитесь, что при работе приложения через пул соединений (порт 6432) разные пользователи обычно видят одну и ту же корзину. Выясните причину ошибки и исправьте код хранимых функций так, чтобы приложение работало корректно как без пула соединений, так и с ним. 2. Использование пула мешает выводу в журнал сообщений сервера информации, относящейся только к одному клиенту. Наше приложение вызывает в начале каждой транзакции функцию webapi.trace (или empapi.trace), если в служебной панели установлен признак трассировки. Реализуйте эти функции так, чтобы они устанавливали параметр сервера log_min_duration_statements = 0 и облегчали идентификацию клиента. Проверьте работу по журналу сообщений.
Комментарии преподавателя
Во всех темах курса, начиная с этой, мы будем использовать подключение через пул соединений на порту 6432 (настройка по умолчанию). Pgbouncer настроен точно так же, как было показано в демонстрации.
- Проблема воспроизводится следующим образом. Откройте две вкладки браузера с книжным магазином. В первой войдите как alice и положите в корзину одну или несколько книг. Во второй зайдите как bob и проверьте корзину.
Поскольку один пользователь видит корзину другого пользователя, можно предположить, что дело в разграничении доступа. Чтобы понять, в каком месте следует искать проблему, вспомните материал темы «Книжный магазин 2.0».
- Необходимые функции уже имеются в базе данных, но ничего не делают. Функция webapi.trace принимает на вход токен аутентификации (или NULL, если пользователь не вошел в систему).
Для идентификации можно использовать параметр log_line_prefix с маской %a, выводящей имя приложения. Имя приложения устанавливается параметром application_name, в которое можно записать имя пользователя, если оно известно.
Page 23: 1. Корректная работа с пулом соединений
Проблема состоит в том, что функция, проверяющая токен, запоминает пользователя в параметре сервера на уровне сеанса:
Это работает, когда для каждого клиента (в нашем случае — страницы приложения) используется собственный сеанс. Но в случае пула соединений все клиенты могут обслуживаться одним сеансом. Исправление состоит в том, чтобы честно выполнять проверку каждый раз при вызове функции:
2. Трассировка
Функция трассировки для админки:
Обратите внимание, что параметр устанавливается на время транзакции (третий параметр). Функция трассировки для магазина:
Page 24: Page 24
Чтобы имя пользователя попало в журнал сообщений, необходимо изменить параметр log_line_prefix, например, так:
Здесь к стандартному выводу добавлено имя приложения. Проверим.
Теперь этим функционалом можно пользоваться, устанавливая в приложении признак трассировки в служебной панели.
Page 25: Практика+
- В двух сеансах подключитесь к базе student ролью student через пул соединений. В третьем сеансе подключитесь к консоли pgbouncer и изучите вывод команд SHOW CLIENTS и SHOW SERVERS. 2. Перепишите следующий фрагмент SQL-кода так, чтобы он корректно выполнялся при использовании пула соединений: INSERT INTO master(id, s) SELECT nextval(’m_seq’), ‘m1’; INSERT INTO detail(id, m_id, s) SELECT nextval(’d_seq’), currval(’m_seq’), ‘d1’; 3. Воспроизведите проблему с рекомендательными блокировками уровня сеанса при использовании пула соединений в режиме транзакций.
Page 26: 1. Консоль pgbouncer
Дважды подключаемся к базе student ролью student:
Подключаемся к консоли pgbouncer:
Page 27: Page 27
Здесь отображаются три соединения к клиентами pgbouncer: два сеанса для student, подключенных к базе student, и одно подключение к консоли.
Page 28: Page 28
Здесь видно, что сейчас используется только одно соединение pgbouncer с сервером баз данных.
2. Функции nextval и currval
Все, что нужно сделать — заключить обе команды в одну транзакцию. Но на практике не стоит напрямую вызывать функции управления последовательностями без особой необходимости. Лучше объявить автоматическую генерацию уникальных значений, как это определено стандартом SQL:
А вставку можно организовать с помощью PL/pgSQL следующим образом:
3. Рекомендательные блокировки на уровне сеанса
Первый клиент устанавливает рекомендательную блокировку на уровне сеанса:
Page 29: Page 29
Блокировка удерживается после окончания транзакции:
Теперь появляется транзакция второго клиента:
В это время первый клиент пытается освободить блокировку, но не может, поскольку выполняется в другом сеансе:
Зато может второй клиент, хоть он и не устанавливал эту блокировку:
08 Занятие 08: Расширяемость / Типы для больших значений
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_08_ext_lob.html Archive: DEV2-handouts-16.zip Страниц PDF: 23
Page 1: Расширяемость / Типы для больших значений
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Хранение в файловой системе
- Технология TOAST
- Тип bytea
- Большие объекты
Page 3: Варианты хранения
Файловая система
- в базе данных только ссылки на файлы
- Встроенные типы
- PostgreSQL
- стандарт SQL
- двоичные данные
- bytea
- blob
- символьные данные
- text
- clob
- Подсистема «больших объектов»
Комментарии преподавателя
Для хранения и обработки больших объемов данных в стандарте SQL предусмотрены типы:
● clob (character large object) — для символьных данных;
● blob (binary large object) — для двоичных данных.
В PostgreSQL типы clob и blob отсутствуют. Вместо них для символьных данных можно использовать тип text, а для двоичных — bytea (byte array).
Работа с данными типа text не зависит от размера значения, поэтому в дальнейшем будем говорить только о двоичных данных. Например, об изображениях, видео, аудио и пр. Как правило такие данные хранят содержимое файлов соответствующих форматов.
В качестве альтернативы типу bytea, можно использовать «отчасти устаревшую» (цитата из документации) подсистему работы с большими объектами.
Но прежде чем размещать данные файлов внутри базы, следует рассмотреть возможность хранения их «в обычном виде» в файловой системе.
Page 4: Файловая система
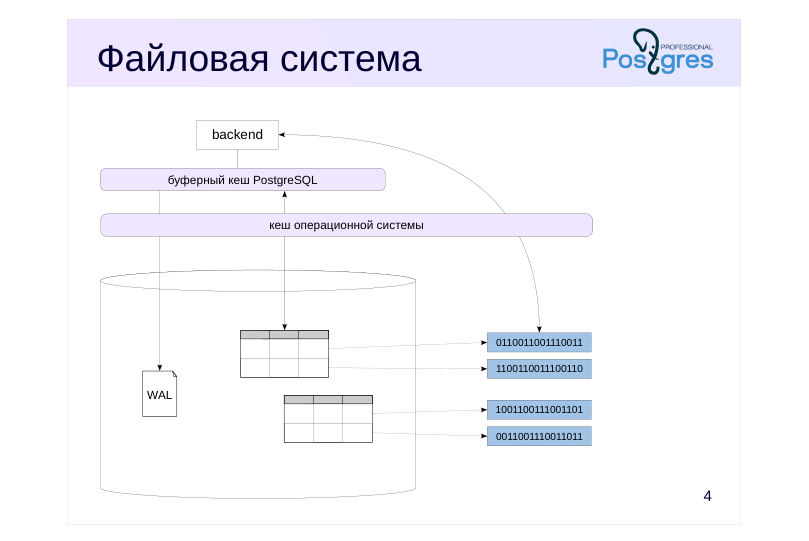 {#source-figure-004 caption=“Source slide page 4: Файловая система”}
Комментарии преподавателя
Если говорить о двоичных данных большого объема, то один из вариантов — отказаться от размещения их в СУБД. В этом случае файлы с двоичными данными располагаются непосредственно в файловой системе, а внутри базы данных поддерживаются только ссылки на них.
Page 5: Файловая система
Преимущества
- скорость чтения и записи файлов
- не увеличивается размер базы данных
- Недостатки
- не используются возможности СУБД: транзакции, управление доступом
- отсутствуют гарантии согласованности, долговечности данных
- усложняется архитектура системы,
- например, в части резервного копирования и восстановления
Комментарии преподавателя
Такой подход может быть оправдан в первую очередь производительностью. Скорость чтения и записи файлов увеличивается за счет избежания затрат, характерных для СУБД:
● двойная запись на диск (в WAL и файлы данных);
● двойное кеширование в оперативной памяти (файловый кеш и буферный кеш СУБД);
● накладные расходы на хранение в базе данных и обработку (нарезка на фрагменты для хранения и склейка их при чтении);
● возможное распухание таблиц и индексов приводит к дополнительному чтению устаревших фрагментов значения.
Кроме того, удается сократить расходы на обслуживание. Не требуется очистка и переиндексация таблиц с большими данными. Копирование файлов, в том числе инкрементальное, можно выполнять средствами ОС. А резервные копии только базы данных будут создаваться быстрее, меньшего размера и потребуют меньше времени на восстановление.
С другой стороны, становится невозможным использовать преимущества СУБД:
● транзакционная обработка: атомарность и согласованность записи, конкурентный доступ, восстановление после сбоя;
● управление доступом пользователей на чтение и запись данных.
Архитектура системы может потребовать пересмотра и доработки процедур резервного копирования и восстановления, использования реплик, обнаружения неиспользуемых файлов и пр.
Page 6: TOAST
Хранение «длинных» атрибутов в отдельной таблице
- применяется для типов переменной длины: text, bytea, xml, json и др.
- «длинные» атрибуты нарезаются на фрагменты меньше страницы
- возможно сжатие (методы pglz и lz4)
- размер значения до 1 Гбайта
- TOAST-таблица
- читается только при обращении к «длинному» атрибуту
- возможна частичная декомпрессия значения при чтении
- собственная версионность
- работает прозрачно для приложения
Комментарии преподавателя
Любая версия строки в PostgreSQL должна целиком помещаться на одну страницу. Для «длинных» версий строк применяется технология TOAST — The Oversized Attributes Storage Technique. Точнее, TOAST применяется к отдельным атрибутам, имеющим тип переменной длины, например, text и bytea, а также xml и json, которые будут рассмотрены позже в этом курсе. В любом случае размер одного значения (возможно сжатого) не должен превышать 1 Гбайта.
Для каждой основной таблицы при необходимости создается отдельная TOAST-таблица (и к ней специальный индекс). Версии строк в TOAST-таблице тоже должны помещаться на одну страницу, поэтому «длинные» значения хранятся порезанными на части, обычно около 2 Кбайт. Из этих частей PostgreSQL прозрачно для приложения «склеивает» необходимое значение.
TOAST-таблица используется только при обращении к «длинному» значению. Если эти данные упакованы, то начальные фрагменты сжатого атрибута считываются порциями и сразу распаковываются, позволяя избежать извлечения «длинного» значения целиком. Но если требуется изменить несколько байт значения, то оно будет считано и записано полностью.
Для TOAST-таблицы поддерживается своя версионность: если обновление данных не затрагивает «длинное» значение, новая версия строки будет ссылаться на то же самое значение в TOAST-таблице — это экономит место.
Page 7: Стратегии хранения
- основная
- сжатие
- данных
- TOAST-
- таблица
- таблица
- Extended да да да
- External да ― да
- в самую
- последнюю
- Main да в последнюю
- очередь
- очередь
- Plain да ― ―
Комментарии преподавателя
Столбцы таблиц используют одну из четырех стратегий хранения значений, устанавливаемую в зависимости от типа данных:
● EXTENDED. Допускается сжатие и перенос в таблицу TOAST. Для типов, поддерживающих перенос в TOAST, обычно используется эта стратегия.
● EXTERNAL. Допускается только перенос в таблицу TOAST, но не сжатие. Если загружаемые данные уже сжаты, имеет смысл выбрать стратегию EXTERNAL для экономии затрат на малоэффективное повторное сжатие.
● MAIN. Поля с этой стратегией сжимаются только в том случае, если обработки полей EXTENDED и EXTERNAL оказалось недостаточно, чтобы уместить версию строки на странице. Перенос в таблицу TOAST тоже возможен, но только как крайняя мера.
● PLAIN. Хранение только в основной таблице. Используется для типов, значения которых имеют небольшой размер.
При создании пользовательского типа данных можно задать стратегию, применяемую по умолчанию.
На уровне столбца таблицы можно переопределить стратегию, а также указать метод сжатия.
https://postgrespro.ru/docs/postgresql/16/storage-toast
Page 8: Тип bytea
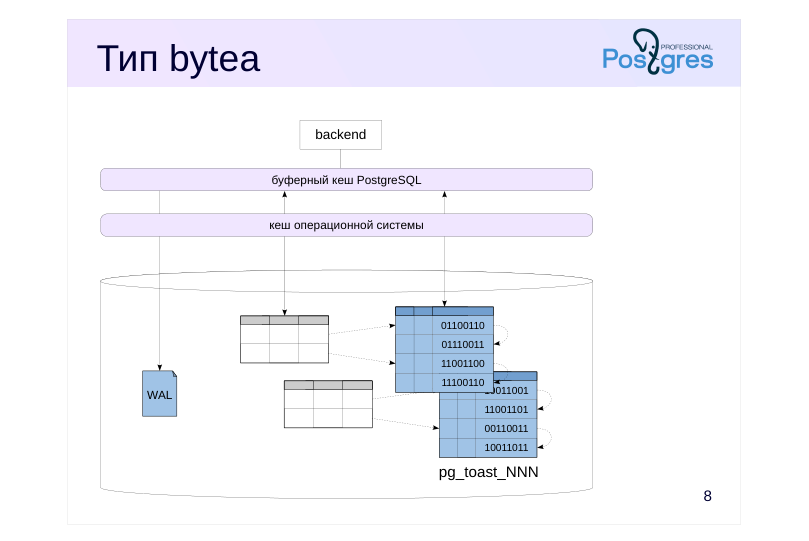 {#source-figure-008 caption=“Source slide page 8: Тип bytea”}
Комментарии преподавателя
Хранить двоичные объекты в базе данных можно двумя способами.
Первый способ заключается в создании столбцов с типом bytea в таблицах.
Тип bytea использует технологию хранения TOAST. Поэтому значения большого размера размещаются не в самой таблице, а нарезаются на фрагменты и хранятся в TOAST-таблице, связанной с основной.
Page 9: Тип bytea
Преимущества
- транзакционность, управление доступом
- согласованность и долговечность больших данных
- интерфейс SQL
- Недостатки
- увеличение размера базы данных
- меньшая скорость, чем при работе с файлами
- размер значения до 1 Гбайта
- значения считываются и записываются целиком
Комментарии преподавателя
Главное преимущество хранения больших значений в базе данных — это использование возможностей СУБД. Транзакционный механизм гарантирует согласованность данных и защиту от сбоев. А разграничивать доступ пользователей к значениям можно при помощи средств СУБД.
Для работы с типом bytea используется язык SQL, что делает эти действия удобными.
Двоичные типы данных, функции и операторы для работы с ними:
https://postgrespro.ru/docs/postgresql/16/datatype-binary
https://postgrespro.ru/docs/postgresql/16/functions-binarystring
Как мы уже говорили ранее, хранение внутри базы данных увеличивает размер базы и расходы на ее сопровождение, а также уменьшает скорость чтения и записи данных из-за необходимости нарезать значение на фрагменты и склеивать их, помещая в дополнительный кеш.
К недостаткам использования типа bytea можно отнести и ограничение TOAST на размер одного значения в 1 Гбайт.
Также отметим, что при работе c TOAST изменение даже небольшой части значения приводит к считыванию в буферный кеш всех занятых значением страниц и к перезаписи всего значения. С чтением части значения дело обстоит лучше: возможно извлечение только необходимого фрагмента.
Page 10: Тип bytea и TOAST
По умолчанию двоичные данные выводятся в шестнадцатеричном формате.
Значения начинаются с ‘\x’, далее каждый байт представлен двумя шестнадцатеричными цифрами:
Добавим нулевой символ к строке:
Шестнадцатеричный формат появился в версии 9.0. До этого был доступен только формат «спецпоследовательностей».
В этом формате ASCII-символы отображаются как есть, а остальные представлены спецпоследовательностями:
Параметр bytea_output определяет только формат вывода двоичных данных. Входные данные принимаются в любом из этих двух форматов.
Теперь создадим таблицу со столбцом типа bytea.
Таблица TOAST создается автоматически для хранения больших значений data и filename (значения типа text также могут быть большими). Найдем имя служебной таблицы:
Page 11: Page 11
Служебные таблицы TOAST всегда располагаются в специальной схеме pg_toast — чтобы не пересекаться с обычными объектами базы данных. Получить список TOAST-таблиц можно командой psql:
Посмотрим на структуру TOAST-таблицы:
chunk_id — идентификатор значения, chunk_seq — порядковый номер фрагмента значения, chunk_data — данные фрагмента. Можно обратить внимание, что вывод команды \d для TOAST-таблиц содержит название основной таблицы. Доступ к значениям в TOAST всегда осуществляется по индексу. Это самый быстрый способ получить все фрагменты одного значения для склейки, но доступ ко всем значениям будет заведомо неэффективен. Кроме того, чтение большого объема данных из TOAST-таблиц может приводить к вытеснению полезных данных из буферного кеша. Механизм буферного кольца, предотвращающий массовое вытеснение, для TOAST-таблиц не используется, так как задействуется только при полном последовательном сканировании таблицы, но не при индексном доступе. Добавим в demo_bytea строку. В качестве данных возьмем логическую резервную копию базы данных приложения.
Заметим время вставки.
Для считывания файла воспользуемся встроенной функцией pg_read_binary_file.
Использование TOAST прозрачно для приложения. Нам не нужно обращаться к служебной таблице в запросах. Вот первые 16 байт загруженного файла в двоичном виде:
Page 12: Page 12
Общий размер загруженного значения соответствует размеру файла:
Однако размер таблицы demo_bytea составляет всего одну страницу, данных загруженного файла в ней нет:
Значение столбца data попало в TOAST-таблицу. Можно убедиться, что в служебной таблице появилось одно значение:
Сколько места требуется для хранения TOAST-таблицы, если сравнивать с размером файла: меньше, больше или ровно столько же?
Почему потребовалось меньше места?
Стратегия хранения extended предполагает сжатие данных при помещении в TOAST. А текстовые данные хорошо сжимаются. Начиная с PostgreSQL 14 появилась возможность выбора метода сжатия: pglz (используется по умолчанию) и lz4. Изменим метод сжатия для столбца data и повторим наш опыт, предварительно опустошив таблицу.
Page 13: Page 13
Вставка данных выполнилась заметно быстрее, но места для сжатых данных потребуется больше — lz4 сжимает данные не так эффективно:
Сжатие вообще можно запретить, выбрав стратегию external:
Это изменение будет действовать только для новых строк, поэтому снова опустошим таблицу и загрузим файл заново.
Сколько теперь потребуется места для хранения TOAST-таблицы, если сравнивать с размером исходного файла: меньше, больше или ровно столько же?
Теперь для хранения используется немного больше места. Почему?
На размер повлияли накладные расходы на хранение фрагментов в отдельных строках с дополнительными столбцами и служебной информацией.
Page 14: Большие объекты
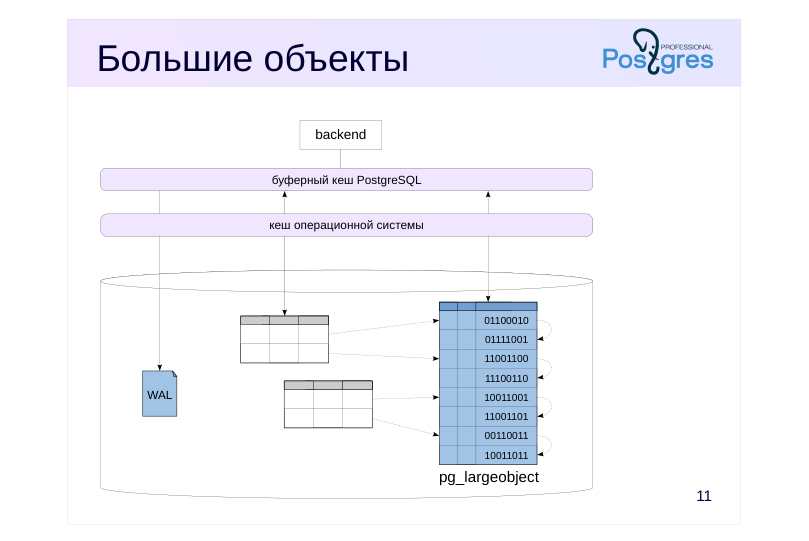 {#source-figure-014 caption=“Source slide page 14: Большие объекты”}
Комментарии преподавателя
Другой вариант хранения двоичных данных большого размера внутри базы данных — использование подсистемы «больших объектов», появившейся задолго до TOAST.
Все большие объекты сохраняются в отдельной таблице системного каталога pg_largeobject. Для ссылок на большие объекты в столбцах других таблиц предоставляются идентификаторы типа oid. Доступ к этим объектам осуществляется при помощи специального интерфейса, похожего на интерфейс работы с файлами.
https://postgrespro.ru/docs/postgresql/16/largeobjects
Page 15: Большие объекты
Преимущества
- транзакционность, управление доступом
- согласованность и долговечность больших данных
- размер значения до 4 Тбайт
- потоковое чтение и запись фрагментов значения
- Недостатки
- увеличение размера базы данных
- меньшая скорость, чем при работе с файлами
- специальный интерфейс
- риск появления осиротевших объектов
- не поддерживается логической репликацией
- ограничение на количество больших объектов (2
Комментарии преподавателя
Большие объекты наследуют те же преимущества и недостатки, что и тип bytea, относительно хранения в файловой системе.
По сравнению с типом bytea у больших объектов есть преимущества. Во-первых, размер одного объекта может достигать 4 Тбайт. А во-вторых, интерфейс для работы с большими объектами позволяет работать с произвольным фрагментом значения, а не со всем значением целиком, как обычно происходит с TOAST.
С другой стороны, использование специального интерфейса делает работу с большими объектами не такой удобной, как с чистым SQL. К тому же драйвер PostgreSQL должен поддерживать этот интерфейс.
Идентификатор большого объекта хранится в 4-байтовом типе oid, что ограничивает количество объектов в системе числом 4294967296. Таблицы TOAST тоже используют oid, но ограничение на количество значений действует в пределах таблицы, а не на всю систему.
Кроме того, хранение всех больших объектов в отдельной таблице увеличивает риск появления осиротевших объектов, на которые не осталось ссылок в обычных таблицах. Для поиска и удаления осиротевших объектов можно использовать утилиту vacuumlo, а для предотвращения их появления — расширение lo.
https://postgrespro.ru/docs/postgresql/16/lo
https://postgrespro.ru/docs/postgresql/16/vacuumlo
Логическая репликация не поддерживает изменения в таблицах системного каталога, в том числе в pg_largeobject, то есть большие объекты не реплицируются.
Page 16: Использование large objects
Большие объекты хранятся в таблице системного каталога pg_largeobject, структура которой похожа на структуру TOAST-таблицы.
Создадим таблицу для хранения ссылок на большие объекты.
Для работы с большими объектами будем использовать интерфейсные функции SQL.
Функция lo_import загружает файл с сервера в pg_largeobject и возвращает указатель на него (OID). Функция lo_get считывает указанную часть значения:
Что будет, если удалить строку из таблицы demo_largeobject?
Строка удалится, а большой объект станет «потерянным»:
Дополнительная утилита vacuumlo, поставляемая с сервером, позволяет найти большие объекты, на которые не осталось ссылок, и удалить их:
Page 17: Page 17
Для предотвращения потери ссылок также можно воспользоваться расширением lo.
Расширение создает тип данных lo (обертка над oid) и функцию lo_manage для использования в триггерных функциях.
Загрузим большой объект и поместим ссылку на него в таблицу.
Убедимся, что все на месте, и удалим.
Табличный триггер удалил связанный большой объект.
Page 18: Итоги
Для работы с двоичными данными предоставлены
- тип bytea, использующий технологию TOAST
- подсистема «больших объектов»
- Использование файловой системы позволяет добиться высокой скорости за счет отказа от возможностей СУБД
Page 19: Практика
- Добавьте в таблицу books поле cover с типом bytea. Загрузите в поле cover обложки книг из файлов формата jpeg. Файлы находятся в каталоге /home/student/covers. 2. Создайте функцию webapi.get_image, возвращающую обложку книги по переданному идентификатору. 3. Сравните время, за которое выполняется запрос ко всем столбцам таблицы books (SELECT *) и к столбцам без cover.
Комментарии преподавателя
Для чтения файлов можно использовать функцию pg_read_binary_file.
Функция get_image уже создана в базе данных, но ничего не возвращает. Заголовок функции:
Page 20: 1. Перекладывание сканов обложек в базу данных
Сканы обложек находятся в каталоге covers:
Названия файлов хранятся в таблице books в столбце cover_filename. Расширим таблицу столбцом для хранения картинок:
Используемую по умолчанию компрессию данных стоит отключить: дополнительно сжать файлы JPEG не удастся, а ресурсы на упаковку/распаковку можно сэкономить. Установить нужную стратегию хранения можно только отдельной командой после добавления столбца:
Переложим файлы в этот столбец:
2. Функция, возвращающая скан обложки
3. Время выполнения SELECT \*
Сравните время самостоятельно; здесь мы не приводим результат выполнения запросов из-за большого размера. Вывод должен быть очевиден: в промышленном коде следует обращаться только к тем столбцам, которые действительно необходимы.
Page 21: Практика+
- Создайте таблицу с полем типа bytea. Загрузите в таблицу любой файл, этот же файл загрузите как большой объект. Выполните контрольную точку, чтобы в кеше не осталось грязных буферов. 2. Добавьте один произвольный байт к значению в столбце типа bytea таблицы. Сколько грязных буферов, относящихся к TOAST-таблице, появилось в буферном кеше? 3. Добавьте один произвольный байт к значению большого объекта. Сколько грязных буферов, относящихся к таблице pg_largeobject, появилось в буферном кеше?
Комментарии преподавателя
2 и 3. Чтобы получить количество грязных буферов для таблицы, установите расширение pg_buffercache и воспользуйтесь запросом:
- Можно воспользоваться функцией lo_put, записывающей данные по заданному смещению.
Page 22: 1. Подготовка
Расширение для просмотра буферного кеша:
Создадим таблицу со столбцом типа bytea:
Загрузим файл с одной из обложек книг в таблицу:
Этот же файл загрузим как большой объект и запомним его oid:
Для чистоты эксперимента очистим таблицы и сбросим все грязные буферы на диск:
2. Изменение bytea
Добавим к значению нулевой байт:
Сколько всего страниц в основном слое TOAST-таблицы?
А сколько грязных буферов хранит страницы основного слоя?
Page 23: Page 23
То есть после изменения одного байта все страницы TOAST-таблицы стали грязными.
3. Изменение большого объекта
Добавим в конец объекта нулевой байт:
Посчитаем грязные буферы таблицы pg_largeobject:
Грязным стал всего один буфер.
09 Занятие 09: Расширяемость / Пользовательские типы данных
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_09_ext_datatypes.html Archive: DEV2-handouts-16.zip Страниц PDF: 29
Page 1: Расширяемость / Пользовательские типы данных
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Составные типы (краткое повторение)
- Типы перечислений
- Диапазонные типы и мультидиапазоны
- Базовые типы
- Домены
- Приведение типов, операторы
Page 3: Расширяемость типов
Богатый набор существующих типов
- числа, строки, даты, слабоструктурированные, геометрия, …
- массивы
- Средства для создания новых типов
- простые: на основе уже имеющихся типов
- сложные: новый тип «с нуля»
Комментарии преподавателя
PostgreSQL имеет множество встроенных типов данных (и поддержку массивов элементов любых типов данных).
https://postgrespro.ru/docs/postgresql/16/datatype
Вместе с тем имеются и средства для создания своих собственных типов данных.
В простом случае новые типы создаются по одной из предопределен-ных схем из других, уже имеющихся, типов. Это составные типы, перечисления, диапазоны, домены.
Если же необходимый тип данных не может быть выражен с помощью этих простых средств, можно создать новый тип «с нуля», детально описав его поведение на низком уровне.
Page 4: Составные типы
Набор именованных атрибутов (табличная строка)
- Создание нового типа
- вручную: CREATE TYPE AS
- автоматически при создании отношения
Комментарии преподавателя
Составные типы представляют собой набор именованных атрибутов каких-либо других типов данных. В разных языках программирования такие типы могут называться структурами или записями.
По сути, составной тип описывает табличную строку и поэтому создается автоматически при создании любой таблицы или представления.
Новый составной тип можно создать и вручную.
Составные типы определены в стандарте SQL. Они подробно рассматриваются в курсе DEV1, поэтому здесь мы не будем на них останавливаться.
https://postgrespro.ru/docs/postgresql/16/rowtypes
https://postgrespro.ru/docs/postgresql/16/functions-comparisons#COMPOSI TE-TYPE-COMPARISON
Page 5: Типы перечислений
Упорядоченный набор значений
- значения выглядят как текстовые строки
- хранятся как 4-байтовые числа (oid)
- Создание нового типа
- только вручную: CREATE TYPE AS ENUM
Комментарии преподавателя
Тип перечисления создается простым перечислением всех допустимых значений.
Значения задаются и используются в виде текстовых строк, которые хранятся в системном каталоге как упорядоченный набор значений. При использовании перечисления, например, в качестве типа столбца таблицы, каждое его значение будет представлено в виде 4-байтного целого числа (фактически, тип oid). Это позволяет использовать длинные (до 63 символов) описательные значения, не экономя на месте в таблице.
Стандартных типов перечисления в PostgreSQL нет.
https://postgrespro.ru/docs/postgresql/16/datatype-enum
https://postgrespro.ru/docs/postgresql/16/functions-enum
Page 6: Типы перечислений
Создадим новые типы перечислений для старшинства карт:
И для мастей:
Напомним, что тип данных — отдельный объект базы данных, который хранится в системном каталоге:
Чтобы вспомнить и составные типы, определим еще тип для карты:
Обратите внимание, что названия значений перечислимого типа регистрозависимы. Все значения в перечислении упорядочены, и этим можно пользоваться:
Однако сами типы перечислений считаются уникальными и поэтому значения разных перечислений нельзя сравнивать, даже если они определены одинаково:
Page 7: Page 7
При необходимости выполнить подобное сравнение придется либо реализовать собственный оператор, либо явно преобразовать типы в запросе, например так:
Можно получить список значений в виде массива (функция enum_range смотрит только на тип параметра; само значение может быть любым):
Кажется, мы забыли валета. Не беда, его можно добавить к перечислению:
А вот удалить значение из типа невозможно. Единственный вариант — удалить тип и создать его заново. Если мы заглянем в системный каталог, то увидим, что упорядоченность значений перечисления обеспечивает столбец типа real. Обратите внимание на его дробное значение для добавленного нами валета:
Page 8: Диапазонные типы
Непрерывный отрезок значений от начальной до конечной точки
- открытый (>, <), закрытый (≤, ≥), неограниченный
- Создание нового типа
- CREATE TYPE AS RANGE
- уже есть для integer, bigint, numeric, timestamp, date
- Операции
- сравнение
- проверка на включение диапазона или элемента, на пересечение
- объединение, пересечение, вычитание
- и др.
Комментарии преподавателя
Диапазонный тип представляет непрерывный отрезок значений скалярного типа. Концы отрезка могут быть открытыми (граничное значение не включается) или закрытыми (наоборот, включается), или отрезок может быть бесконечным, то есть не иметь одной или обеих границ.
Для диапазонов определено довольно много удобных операций, в том числе:
● проверки на включение одного диапазона в другой, на принадлежность значения диапазона, на пересечение двух диапазонов;
● обычные операции над множествами: объединение, пересечение, вычитание.
Диапазоны предопределены для различных числовых типов и дат (например, int4range для integer и др.). Можно создать и свой собственный диапазонный тип.
https://postgrespro.ru/docs/postgresql/16/rangetypes
https://postgrespro.ru/docs/postgresql/16/functions-range
Page 9: Мультидиапазоны
Множество диапазонов
- не должны пересекаться
- Создание нового типа
- автоматически при создании диапазона
- Операции
- сравнение
- проверка на включение мультидиапазона, диапазона или элемента
- проверка на пересечение
- объединение, пересечение, вычитание
- и др.
Комментарии преподавателя
Для каждого диапазонного типа определен соответствующий мультидиапазонный тип. Такой тип по сути представляет собой массив отдельных диапазонов. Диапазоны внутри мультидиапазонного типа не должны пересекаться между собой, но между диапазонами могут быть пропуски. Большинство диапазонных операторов работают и с мультидиапазонами. Кроме того, есть функции для работы именно с мультидиапазонными типами.
Мультидиапазонный тип определяется автоматически при определении диапазонного типа. По умолчанию имя мультидиапазонного типа генерируется PostgreSQL, но можно задать его и явно.
Page 10: Диапазонные типы
Начнем с нескольких примеров работы с уже имеющимися диапазонными типами. Диапазон целых чисел от 1 до 9, обе границы включаются (об этом говорят квадратные скобки). Что будет выведено?
Результат выводится в каноническом виде, в котором левая граница включается, а правая — нет (круглая скобка). Конечно, значение правой границы при этом увеличивается на единицу. Канонический вид определен не для всех типов. Диапазон может быть и открытым. Проверим, принадлежит ли число диапазону:
Точно так же можно проверить включение одного диапазона в другой:
Удобны функции, позволяющие работать с диапазонами как с множествами. Например, можно легко найти пересечение (общие точки) двух диапазонов:
При создании нового диапазонного типа указываются: базовый тип, значения которого должны быть сортируемыми; функция разности двух значений, которая должна возвращать результат типа double precision. Например, в PostgreSQL нет типа для диапазонов времени (без даты). Чтобы определить его, нам потребуется функция, возвращающая разность между двумя временами. Обычная разность возвращает значение типа interval:
Но мы можем воспользоваться функцией extract epoch, которая вернет длину диапазона в секундах:
Page 11: Page 11
Теперь можно определить тип диапазона, а вместе с ним — и мультидиапазона:
Последний параметр — необязательный, в его отсутствие соответствующий мультидиапазонный тип будет создан автоматически. Новый тип можно использовать аналогично уже существующим. Например, найдем объединение (здесь показаны два способа записи констант диапазонного типа):
Заметьте, что диапазон не приводится к каноническому виду. Чтобы это работало, необходимо реализовать соответствующую функцию и указать ее в определении типа. Мы не будем этого делать. Новый мультидиапазонный тип позволяет представить несколько диапазонов как одно значение:
Обратите внимание, что пересекающиеся диапазоны были объединены.
Page 12: Интервалы дат и времени
Интервал значений определенной длины
- Операции
- арифметика дат и времени
- функции корректировки
Комментарии преподавателя
В PostgreSQL есть тип interval, на первый взгляд похожий на диапазон. Но, в отличие от диапазонных типов, интервал определяется длиной, а не начальной и конечной точкой. Кроме того, интервалы существуют только для дат и времени.
Отметим также, что при работе с этим типом есть ряд тонкостей, обусловленных особенностями хранения значений интервалов. Например, существуют специальные функции для корректировки числа дней и часов при их выходе за обычные границы (одну из них мы увидим в демонстрации).
Создание собственных типов, аналогичных interval, невозможно. Здесь мы показываем этот тип только для полноты картины и не будем останавливаться на нем подробно.
https://postgrespro.ru/docs/postgresql/16/datatype-datetime
https://postgrespro.ru/docs/postgresql/16/functions-datetime
Page 13: Интервалы
Значения типа interval определяют длину временного отрезка, в отличие от диапазонного типа, значения которого состоят из начальной и конечной точек. Интервал появляется естественным образом при вычитании двух моментов времени:
(Хотя та же операция для дат (тип date) возвращает целое число.) Интервалы используются в арифметике дат и времени. Например:
Обратите внимание, что интервал ‘1 month’ может иметь разную длину — от 28 до 31 дней в зависимости от месяца. При необходимости можно преобразовать интервал так, чтобы, например, каждый 24-часовой период считался одним днем:
Page 14: Домены
Ограничение допустимых значений существующего типа
- ограничение NOT NULL
- значение по умолчанию DEFAULT
- проверка CHECK
- Создание нового типа
- только вручную: CREATE DOMAIN
Комментарии преподавателя
Домен создается на базе любого существующего типа данных и служит для ограничения множества допустимых значений этого типа.
Определяя домен, можно запретить неопределенные значения (и определить значение по умолчанию), можно также указать произвольную проверку допустимости значения.
По сути, это похоже на ограничения целостности, накладываемые на столбцы при создании таблицы. Создав тип домена, его можно использовать в нескольких таблицах, не указывая каждый раз одни и те же ограничения.
Домены определены в стандарте SQL.
https://postgrespro.ru/docs/postgresql/16/domains
https://postgrespro.ru/docs/postgresql/16/sql-createdomain
Page 15: Домены
Создадим доменный тип, ограничивающий временной диапазон рабочими часами и запрещающий неопределенные значения:
Его можно использовать при создании таблицы:
А так получится?
Нет — нарушено условие проверки. А так?
Нет — неопределенные значения не допускаются. А если так?
А так получится. Запрет неопределенных значений на уровне домена работает не так, как на уровне столбца. Ограничение NOT NULL надежнее указывать при создании таблицы. Еще одна проблема связана с тем, что при любых операциях значения приводятся к базовому типу. Это не позволяет использовать домены для контроля типов в операциях. Вот пример:
Можно ли складывать метры с граммами?
Оказывается, можно. Поэтому практическое применение доменных типов довольно ограничено.
Page 16: Базовые типы
Тип, не сводящийся к комбинации существующих
- Создание нового типа
- CREATE TYPE, требует программирования на языке C
- множество типов предоставляются расширениями
Комментарии преподавателя
Иногда может возникнуть потребность в совершенно новом типе, который нельзя представить как комбинацию уже существующих.
В этом случае потребуется определить все низкоуровневые детали внутреннего устройства типа, что можно сделать только на языке C. Поэтому мы не будем рассматривать эту возможность.
Впрочем, множество различных типов данных доступны в виде расширений (в том числе сторонних), так что вероятность того, что потребуется совершенно новый тип, очень мала.
https://postgrespro.ru/docs/postgresql/16/sql-createtype
Page 17: Действия над типами
Функции, принимающие или возвращающие значения типа
- Приведение типов
- преобразование значения одного типа к другому типу
- Операторы
- унарные (префиксные)
- бинарные (инфиксные)
Комментарии преподавателя
Понятно, что мало определить новый тип данных — надо уметь его как-то использовать.
Написанию функций, принимающих или возвращающих значения произвольных (в том числе определенных пользователем) типов посвящен курс DEV1, поэтому на этом мы не будем специально останавливаться.
На функциях основаны и другие важные объекты — приведения типов и операторы, — которые могут определяться пользователем.
Приведения типов позволяют преобразовывать значения одного типа к другому.
Операторы позволяют вместо вызова функции f(x,y) использовать инфиксную нотацию, например x+y, что позволяет сделать код проще и нагляднее. Кроме того, как мы увидим в следующей теме «Классы операторов», операторы играют важную роль в индексировании.
Приведение типов в документации:
https://postgrespro.ru/docs/postgresql/16/sql-createcast
Операторы:
https://postgrespro.ru/docs/postgresql/16/xoper
https://postgrespro.ru/docs/postgresql/16/xoper-optimization
https://postgrespro.ru/docs/postgresql/16/sql-createoperator
Page 18: Приведение типов
В качестве примера рассмотрим приведение типа timerange к типу interval. Сработает ли такое приведение само по себе?
Увы, нет. Чтобы создать такое приведение, сначала напишем функцию:
Теперь можно создать приведение типов. Здесь мы указываем AS IMPLICIT, чтобы приведение срабатывало и неявно.
Операторы
Пусть требуется узнать, сколько раз заданный интервал (тип interval) содержится в другом интервале. Например, сколько в интервале часов, или минут, или пятисекундных отрезков. Иными словами, нужно деление одного интервала на другой. Но в PostgreSQL для интервалов определен только оператор деления на целое число. Напишем соответствующую функцию:
Теперь мы можем узнать, сколько раз можно послушать композицию Your Latest Trick, длящуюся 6 минут 33 секунды, если у нас есть полтора часа времени:
Определим бинарный оператор, используя эту функцию:
Page 19: Page 19
Имя оператора можно составлять только из специальных символов, список которых приведен в документации к команде CREATE OPERATOR. Если не указать LEFTARG, будет определен префиксный оператор. Постфиксные операторы не поддерживаются начиная с PostgreSQL 14. Теперь можно пользоваться удобной инфиксной формой записи (здесь также показан другой способ записи интервалов):
Page 20: Итоги
PostgreSQL позволяет создавать новые типы данных
- составные, перечисления, диапазоны и мультидиапазоны, домены
- базовые типы
- Для работы со значениями типов могут создаваться функции, операторы и приведения типов
Page 21: Практика
- Реализуйте в приложении возможность установки розничной цены книг с указанной пользователем даты (сейчас дата просто игнорируется). Предыдущая история изменений цен должна сохраняться. Для этого добавьте в таблицу retail_prices информацию о периоде действия цены и внесите необходимые изменения в функции get_retail_price и set_retail_price. 2. Создайте составной тип для формата издания, состоящего из размеров типографского листа и доли листа. Также создайте приведение для этого нового типа к текстовому. Замените тип данных столбца format таблицы books и убедитесь, что интерфейс с приложением не изменился.
Комментарии преподавателя
- Интервал действия розничной цены можно представить по-разному:
● двумя столбцами типа timestamptz («дата с» и «дата по»);
● одним столбцом типа timestamptz («дата с»), при этом цена считается действующей до следующей даты в другой строке таблицы;
● одним столбцом диапазонного типа tstzrange.
Реализуйте последний вариант. Обратите внимание:
● В функции set_retail_price придется изменять две строки таблицы, и это должно корректно работать в случае, если несколько пользователей устанавливают цену одновременно.
● Функция get_retail_price должна получать цену на текущий момент. Используйте функцию current_timestamp (возвращающую время начала транзакции), а не clock_timestamp. Это будет важно при последующих изменениях.
- Формат издания записывается в виде WxH/N, где W и H — ширина и высота типографского листа, с которым работает печатная машина, и который разрезается потом на N одинаковых частей (страниц книги). Поэтому N как правило представляет собой степень двойки.
Несмотря на то, что отношение длины страницы к ширине может быть разным, форматы книг можно упорядочить, сравнивая площади страниц, которые равны W*H/N.
При замене типа столбца обратите внимание на блокировку, которая при этом удерживается.
Page 22: 1. Розничная цена на книги
Добавим в таблицу retail_prices столбец с диапазоном дат. Значение по умолчанию — неограниченный диапазон.
Функция получения текущей цены должна выбрать тот диапазон, в который входит текущая дата:
Функция установки цены должна изменить одну строку и добавить одну новую. Использование уровня изоляции Read Committed в этом случае может приводить к аномалиям, поэтому сначала заблокируем соответствующую запись в таблице books, чтобы в один момент времени только одна транзакция могла устанавливать цену одной и той же книги.
Проверим.
Page 23: Page 23
Вставка новой цены в конец:
Вставка не в конец:
Цена с уже существующей датой (новый интервал не появляется):
2. Тип данных для формата издания
Тип данных:
Page 24: Page 24
Преобразование в текст:
Проверим:
И обратно:
Проверим:
Обратите внимание, что если написать просто:
то произойдет ошибка: здесь срабатывает не приведение типа text в book_format, а создание типа book_format из литерала, которое использует фиксированный формат для всех составных типов:
Теперь заменим тип столбца. Это тяжелая операция, которая перезаписывает всю таблицу, полностью блокируя работу с ней. Поэтому использовать ее надо с осторожностью, особенно для больших таблиц. Вот в каком файле находятся данные сейчас:
Выполняем замену типа. Преобразование будет выполнено автоматически благодаря созданному ранее приведению типов:
Page 25: Page 25
Операция выполняется в несколько шагов, но при перезаписи таблицы используется исключительная блокировка. В этой же транзакции надо внести изменения и в интерфейсные функции приложения. Формат возвращают две функции: webapi.get_catalog и empapi.get_catalog, но обе они вызывают одну и ту же функцию public.get_catalog. К счастью, в этой функции столбец format явно приводится к типу text, поэтому никаких изменений не требуется.
Теперь данные таблицы находятся в другом файле:
Page 26: Практика+
- Производственные смены каждого сотрудника фабрики хранятся в таблице. Напишите запрос, который покажет, сколько человеко-часов пропадет даром, если в некоторый момент времени на 15 минут будет отключено электричество. 2. В таблице, содержащей много данных, используется столбец статуса, имеющий тип перечисления. Проверьте, какие блокировки будут установлены на таблицу при необходимости добавления нового статуса, и какое время занимает эта операция. Сравните с альтернативным подходом, при котором перечисление реализуется как обычный текстовый тип с ограничением CHECK на уровне столбца или домена.
Комментарии преподавателя
Производственные смены могут храниться в таблице вида: CREATE TABLE shifts ( employee_name text, work_hours tstzrange );
Блокировки можно посмотреть в таблице pg_locks, как говорилось в теме «Обзор блокировок».
Кроме обычной проверки status text CHECK (status IN (…))
рассмотрите также вариант с использованием домена.
Page 27: 1. Человеко-часы
Таблица с производственными сменами:
Добавим несколько записей (рабочий день с перерывом на обед):
Результат:
2. Блокировки при добавлении значения
Тип перечисления и таблица:
Начинаем транзакцию:
Page 28: Page 28
Выведем только блокировки таблицы:
Итак: добавление выполняется быстро; таблица не блокируется. Вариант с проверкой CHECK.
Здесь: добавление выполняется дольше — поскольку требуется перепроверка всех значений в таблице; таблица полностью блокируется на время изменения ограничения. Это плохой вариант.
Page 29: Page 29
Вариант с проверкой на домене.
В этом случае: изменение также выполняется долго; таблица блокируется в более мягком режиме (конфликтует с изменением данных, но разрешает чтение). Это вариант несколько лучше, чем CHECK.
10 Занятие 10: Расширяемость / Классы операторов
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_10_ext_opclasses.html Archive: DEV2-handouts-16.zip Страниц PDF: 27
Page 1: Расширяемость / Классы операторов
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Методы доступа (типы индексов)
- Классы и семейства операторов
- Метод доступа btree и создание класса операторов для него
- Идея метода доступа gist и примеры его использования
Page 3: Методы доступа
Определяют способ получения данных
- Табличные методы доступа — организация данных и чтение всей таблицы
- Индексные методы доступа (типы индексов) — быстрый доступ к небольшой части данных
- алгоритмы, связанные с поисковой структурой данных
- эффективная одновременная работа
- страничная организация данных
- журналирование операций
Комментарии преподавателя
Методы доступа определяют способ получения данных. Их можно разделить на табличные и индексные методы.
Табличный метод определяет организацию данных в таблице и работает, когда надо прочитать все данные (Seq Scan). В PostgreSQL существует единственный табличный метод heap, и других готовых методов (таких, например, как колоночное хранилище) еще нет, но они должны появиться в будущем.
https://postgrespro.ru/docs/postgresql/16/tableam
Индексный метод доступа работает, когда надо быстро получить часть данных (обычно небольшую) с помощью индекса.
Индексный метод можно рассматривать как каркас, который реализует основные алгоритмы для работы с индексной структурой данных, а также берет на себя заботу о низкоуровневых деталях, таких как:
● эффективная конкурентная работа с индексной структурой (в том числе стратегия блокирования);
● страничная организация данных индекса;
● журналирование операций над индексом в WAL.
https://postgrespro.ru/docs/postgresql/16/indexam
Page 4: Методы доступа
В версии 16 имеется единственный встроенный табличный метод доступа:
Зато много различных индексных методов доступа:
С btree знакомы все — это «обычный» метод доступа на основе B-дерева, который используется по умолчанию и покрывает большинство потребностей. Остальные методы доступа также очень полезны, но в специальных ситуациях. Некоторые из них мы рассмотрим позже. Для получения информации мы делали запросы к таблицам системного каталога, однако в арсенале psql есть удобная команда, позволяющая получить информацию о методах доступа, классах и семействах операторов, ей дальше мы и будем пользоваться:
Page 5: Классы операторов
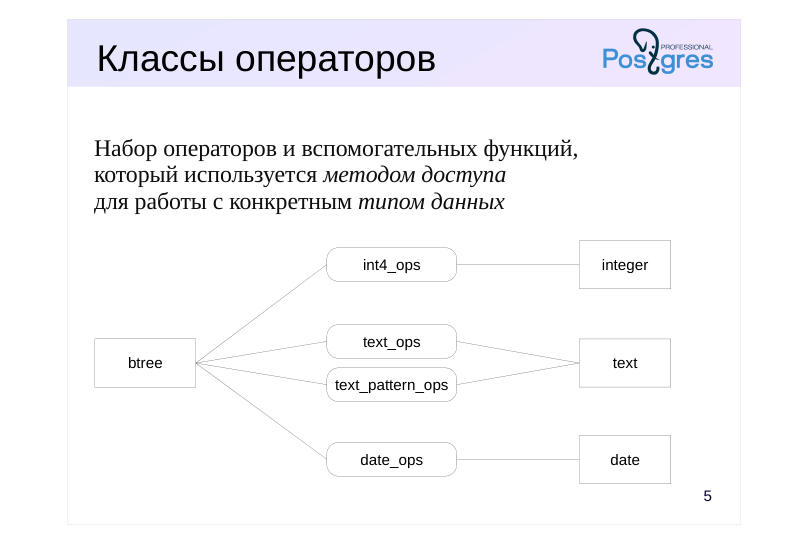 {#source-figure-005 caption=“Source slide page 5: Классы операторов”}
Набор операторов и вспомогательных функций, который используется методом доступа для работы с конкретным типом данных
Комментарии преподавателя
Дальше мы будем говорить не о табличном, а об индексном доступе.
Итак, с одной стороны есть индексный метод доступа (например, btree), а с другой — конкретные типы данных (такие, как integer, text и т. п.).
Чтобы связать метод доступа с типами данных, используются классы операторов. Класс операторов состоит из набора операторов (и, при необходимости, вспомогательных функций), который реализует API индексного метода доступа.
Важно, что часть логики индексирования находится в методе доступа, а часть — в классе операторов. Поэтому недостаточно понять только устройство метода доступа; надо учитывать и то, какой используется класс операторов.
Для B-деревьев это не так очевидно, поскольку на долю класса операторов приходится совсем немного. Но в других методах доступа разные классы операторов могут радикально менять логику.
Заметим также, что для одного и того же метода доступа и одного и того же типа данных может быть определено несколько классов операторов. В этом случае пользователь может выбирать то поведение, которое требуется.
https://postgrespro.ru/docs/postgresql/16/indexes-opclass
Page 6: Классы операторов
Посмотрим, какие классы операторов определены для B-дерева и для разных типов данных. Для целых чисел:
Для удобства такие «похожие по смыслу» классы операторов объединяются в семейства операторов:
Семейства операторов позволяют планировщику работать с выражениями разных (но «похожих») типов, даже если они не приведены к одному общему. Вот классы операторов для типа text (если для одного типа есть несколько классов операторов, то один будет помечен для использования по умолчанию):
Классы операторов pattern_ops отличаются от обычных тем, что сравнивают строки посимвольно, игнорируя правила сортировки (collation). А так можно посмотреть, какие операторы включены в конкретный класс операторов:
Метод доступа — это тип индекса, а собственно индекс — это конкретная структура, созданная на основе метода доступа, в которой для каждого столбца используется свой класс операторов. Пусть имеется какая-нибудь таблица:
Page 7: Page 7
Привычная команда создания индекса выглядит так:
Но это просто сокращение для:
Page 8: Метод доступа btree
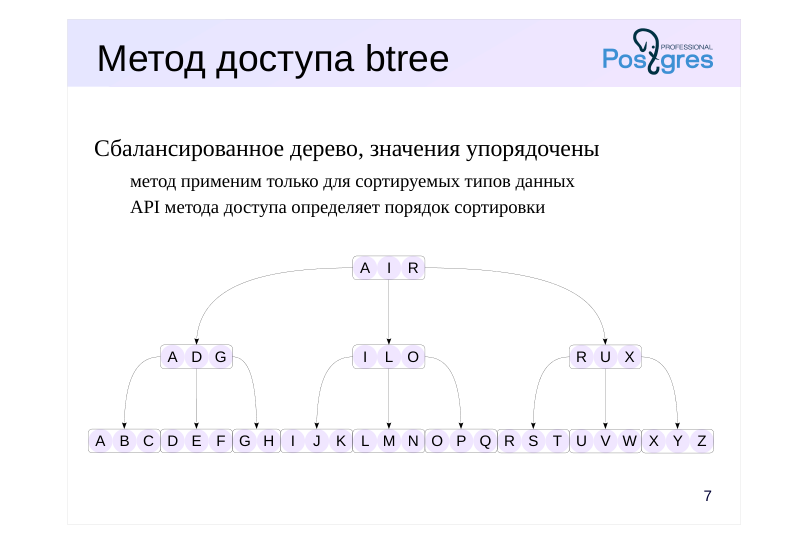 {#source-figure-008 caption=“Source slide page 8: Метод доступа btree”}
Сбалансированное дерево, значения упорядочены
- метод применим только для сортируемых типов данных
- API метода доступа определяет порядок сортировки
Комментарии преподавателя
Рассмотрим теперь несколько конкретных методов доступа, и начнем с B-деревьев.
Эта структура данных представляет собой дерево (сбалансированное по высоте), которое содержит упорядоченные данные. В каждом узле хранится информация о том, какие диапазоны значений расположены в дочерних узлах.
Это позволяет находить искомое значение, спускаясь от вершины дерева к листьям, каждый раз однозначно выбирая подходящий диапазон. Например, для поиска буквы «H» (на рисунке) мы начинаем с корня. Поскольку «A» <= «H» < «I», мы спускаемся в первый дочерний узел, и так далее.
Итак, этот метод доступа применим только для сортируемых данных (к которым относятся большинство «обычных» типов данных). От класса операторов требуется только определить, как именно упорядочиваются значения конкретного типа.
https://postgrespro.ru/docs/postgresql/16/btree
https://postgrespro.ru/docs/postgresql/16/xindex
Page 9: Класс операторов для B-дерева
Класс операторов для B-дерева определяет, как именно будут сортироваться значения в индексе. Для этого он включает пять операторов сравнения, как мы уже видели на примере bool_ops. Определим перечислимый тип для единиц измерения информации:
И объявим составной тип данных для представления объема информации:
Используем новый тип в таблице, которую заполним случайными значениями.
По умолчанию значения составного типа сортируются в лексикографическом порядке, но этот порядок не совпадает с естественным порядком:
Чтобы исправить сортировку, создадим класс операторов. Начнем с функции, которая пересчитает объем в байты.
Помимо операторов сравнения нам понадобится еще одна вспомогательная функция — тоже для сравнения. Она должна возвращать: −1, если первый аргумент меньше второго; 0, если аргументы равны; 1, если первый аргумент больше второго.
Page 10: Page 10
С помощью этой функции мы определим пять операторов сравнения (и функции для них). Начнем с «меньше»:
И аналогично остальные четыре.
Готово. Мы уже можем правильно сравнивать объемы:
Page 11: Page 11
Чтобы значения были правильно упорядочены при выборке, нам осталось создать класс операторов. За каждым оператором закреплен собственный номер (в случае btree: 1 — «меньше» и т. д.), поэтому имена операторов могут быть любыми.
Теперь значения отсортированы правильно. Наш класс операторов будет использоваться по умолчанию при создании индекса:
Любой индекс в PostgreSQL может использоваться только для выражений вида:
Причем оператор должен входить в соответствующий класс операторов. Будет ли использоваться созданный индекс в таком запросе?
Да, поскольку: поле test.cap проиндексировано с помощью метода доступа btree и класса операторов capacity_ops; оператор < входит в класс операторов capacity_ops. Поэтому и при доступе с помощью индекса значения будут возвращаться в правильном порядке:
Page 12: Page 12
Page 13: Метод доступа GiST
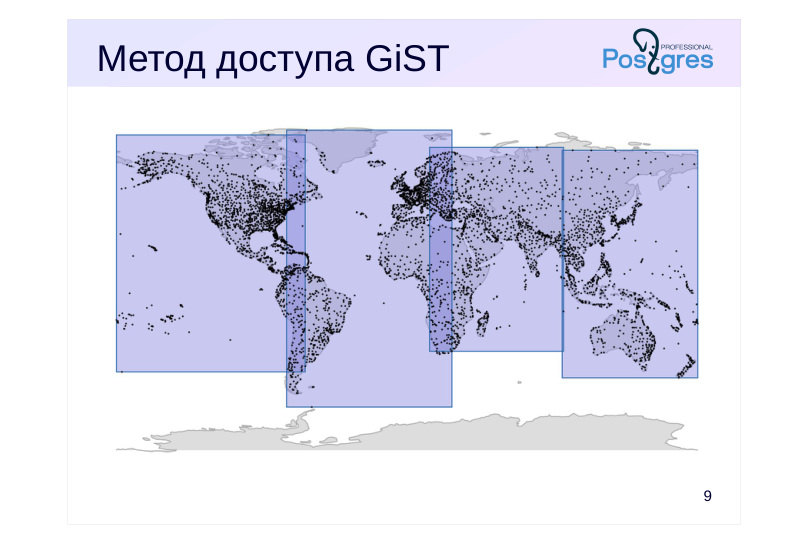 {#source-figure-013 caption=“Source slide page 13: Метод доступа GiST”}
Комментарии преподавателя
Однако не все типы данных сортируемы. Например, не имеют естественной упорядоченности геометрические фигуры (точки, прямоугольники и т. п.), диапазоны, массивы и т. п. Конечно, для таких типов данных можно определить операции сравнения, но практической пользы от них будет немного. Важнее уметь использовать индексы, например, для поиска точек, входящих в заданную область или в массив, т. е. для операторов, отличных от «больше», «меньше» и т. п.
B-дерево здесь не годится, но идею индексирования с помощью сбалансированного дерева можно обобщить. При поиске по дереву в каждом узле принимается решение, в каком поддереве (в общем случае — в нескольких поддеревьях) продолжить поиск. Для этого каждому поддереву ставится в соответствие условие (предикат), которому удовлетворяют все находящиеся в нем данные.
Класс операторов для GiST (generalized search tree — обобщенное дерево поиска) определяет, как выглядит предикат, и еще многие детали, необходимые для эффективной работы.
Идею работы GiST-индексов рассмотрим на примере точек на плоскости.
Плоскость разбивается на несколько прямоугольников, которые в сумме покрывают все индексируемые точки. Эти прямоугольники составляют верхний уровень дерева.
Как видно на рисунке, прямоугольники могут пересекаться (хотя это и уменьшает эффективность поиска).
https://postgrespro.ru/docs/postgresql/16/gist
Page 14: Метод доступа GiST
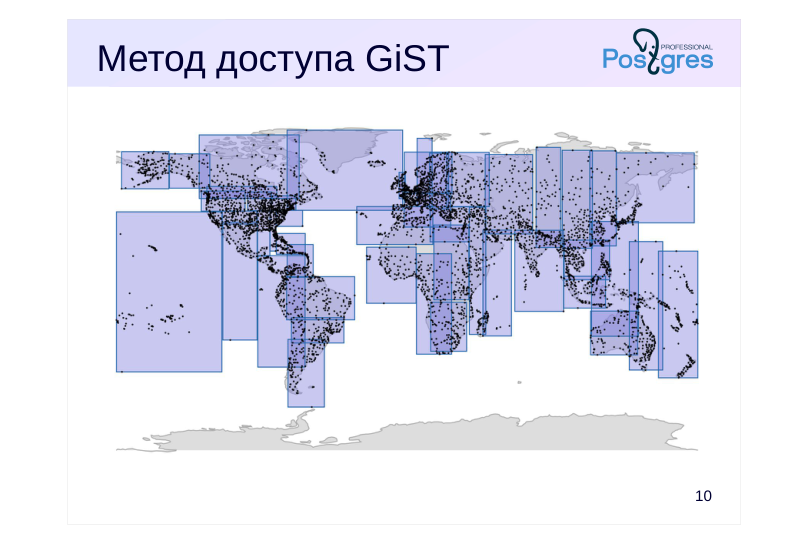 {#source-figure-014 caption=“Source slide page 14: Метод доступа GiST”}
Комментарии преподавателя
На следующем уровне дерева каждый из больших прямоугольников распадается на прямоугольники меньшего размера.
Page 15: Метод доступа GiST
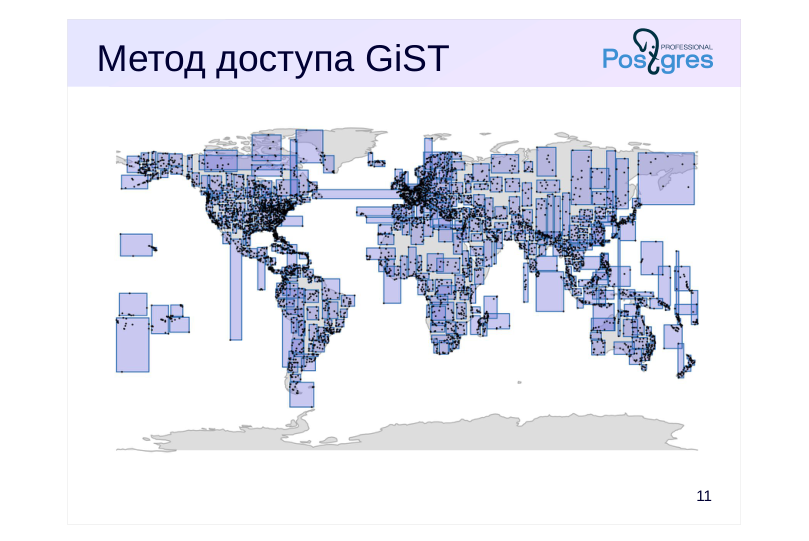 {#source-figure-015 caption=“Source slide page 15: Метод доступа GiST”}
Комментарии преподавателя
На последнем уровне дерева каждый ограничивающий прямоугольник будет содержать столько точек, сколько помещается на одну индексную страницу.
Общее условие разбиения таково: прямоугольник родительской вершины охватывает все прямоугольники соответствующего поддерева. Это позволяет, например, быстро находить точки, лежащие внутри определенной области:
находим прямоугольники, пересекающиеся с заданной областью, на верхнем уровне индекса;
спускаемся в выбранные поддеревья и повторяем поиск в них.
Такой алгоритм индексирования называется R-деревом.
Page 16: Метод доступа GiST
Какие именно операторы поддерживает GiST-индекс, существенно зависит от класса операторов. Информацию можно получить как из документации, так и из системного каталога. Возьмем, например, тип данных point (точки). Доступный класс операторов:
Операторы в этом классе:
В частности, оператор <@ проверяет, принадлежит ли точка одной из геометрических фигур. Создадим таблицу со случайными точками:
Сколько точек расположено в круге радиуса 0.1?
Как выполняется такой запрос?
Полным перебором всей таблицы. Создание GiST-индекса позволит ускорить эту операцию. Класс операторов можно не указывать, он один.
Page 17: Page 17
Еще один интересный оператор <-> вычисляет расстояние от одной точки до другой. Его можно использовать, чтобы найти точки, ближайшие к данной (так называемый поиск ближайших соседей, k-NN search):
Эта операция (весьма непростая, если реализовывать ее в приложении) также ускоряется индексом:
GiST-индекс можно построить и для столбца диапазонного типа:
Здесь мы видим другой набор операторов. Одно из применений GiST-индекса — поддержка ограничений целостности типа EXCLUDE (ограничения исключения). Возьмем классический пример бронирования аудиторий:
Page 18: Page 18
Ограничение целостности можно сформулировать так: нельзя, чтобы в разных строках таблицы были два пересекающихся (оператор &&) диапазона. Такое ограничение можно задать декларативно на уровне базы данных:
Проверим:
Частая ситуация — наличие дополнительного условия в таком ограничении целостности. Добавим номер аудитории:
Но мы не сможем добавить этот столбец в ограничение целостности, поскольку класс операторов для метода gist и типа integer не определен.
В этом случае поможет расширение btree_gist, которое добавляет классы операторов для типов данных, которые обычно индексируются с помощью B-деревьев:
Теперь разные аудитории можно бронировать на одно время:
Но одну и ту же — нельзя:
Page 19: Итоги
PostgreSQL предоставляет разнообразную индексную поддержку любых типов данных, включая пользовательские
- Методы доступа — каркас индексирования, реализующий основной алгоритм и низкоуровневые детали
- btree, hash, gist, sp-gist, gin, brin…
- Классы операторов связывают метод с типами данных
Комментарии преподавателя
В этой теме рассматриваются лишь самые основные понятия, связанные с индексной поддержкой.
Заинтересованным в подробностях рекомендуем внимательно ознакомиться с разделами документации, ссылки на которые приведены в комментариях к слайдам, а также с главами 4 и 5 книги https://postgrespro.ru/education/books/internals
Page 20: Практика
- Добавьте в таблицу retail_prices ограничение целостности, не позволяющее создать пересекающиеся диапазоны действия цен для одной книги. Проверьте план выполнения запроса для поиска актуальной цены (get_retail_price). Использует ли он индекс, созданный для поддержки ограничения целостности? 2. Сортировка книг в приложении по формату издания работает неверно, поскольку значения типа для формата издания упорядочиваются лексикографически. Сделайте так, чтобы значения упорядочивались по площади книжной страницы и проверьте, что сортировка в приложении исправилась.
Комментарии преподавателя
- Пример похожего ограничения целостности приводился в демонстрации.
Если индекс не будет использоваться запросом из функции get_retail_price, дело может быть в том, что в таблице retail_prices слишком мало строк и полное сканирование оказывается выгоднее. Чтобы проверить применимость индекса, вы можете либо добавить больше строк в таблицу, либо временно запретить использование полного сканирования: SET enable_seqscan = off;
- Создайте класс операторов для метода доступа btree и типа данных book_format, как было показано в демонстрации.
Page 21: 1. Ограничение целостности для retail_prices
Добавим ограничение целостности в таблицу:
Такое ограничение гарантирует, что данные не будет повреждены, даже если в коде функции set_retail_price будет допущена ошибка. В функции get_retail_price используется запрос следующего вида:
Как видно из плана, таблица по-прежнему перебирается полностью. Но планировщик будет использовать созданный индекс, как только это окажется выгодным:
Page 22: 2. Упорядочивание для форматов издания
Создадим класс операторов, как было показано в демонстрации.
Page 23: Page 23
Все готово. Проверим:
Page 24: Практика+
- В таблице хранятся даты событий. Какой индекс позволит ускорить запросы вида «найти определенное количество событий, наиболее близких по времени к указанной дате»? Проверьте. 2. Расширение pg_trgm добавляет функции и операторы для работы с триграммами, а также индексную поддержку. В частности, GiST-индекс ускоряет поиск по условиям вида столбец LIKE ‘%что-то%’
- Проверьте работу индекса. Найдите в системном каталоге
- все доступные операторы для класса gist_trgm_ops.
- Что в случае триграмм может служить общим предикатом,
- которому удовлетворяют все данные поддерева?
Комментарии преподавателя
- Триграммы — это последовательности из трех символов, на которые разбивается строка. Например, из «что-то» получаются следующие триграммы: « ч», « чт», «что», «то-», «о-т», «-то», «то », «о ».
Триграммы позволяют определять «похожесть» строк: если и в одной, и в другой много одинаковых триграмм, то и сами строки похожи.
Поиск по LIKE, где в начале шаблона находятся обычные символы (‘что-то%’) ускоряется и простым индексом на основе B-дерева. Но такой индекс бесполезен, если шаблон начинается с %.
https://postgrespro.ru/docs/postgresql/16/pgtrgm
Для проверки можно воспользоваться таблицей с данными почтовой рассылки pgsql-hackers. Чтобы восстановить эту таблицу в базу данных ext_opclasses, выполните команду:
В качестве запроса можно использовать следующий:
Page 25: 1. Индекс для событий
Создадим таблицу и заполним ее случайными данными:
Поиск наиболее близких дат — задача поиска ближайших соседей. Метод доступа btree не поддерживает (пока) поиск ближайших соседей, поэтому придется воспользоваться методом gist (и расширением btree_gist, добавляющим, в том числе, класс операторов для дат).
Ускорить необходимые нам запросы поможет GiST-индекс:
Вот как может выглядеть запрос:
Его план выполнения использует созданный индекс:
2. Расширение pg\_trgm
Page 26: Page 26
Установим расширение:
Посмотрим, как с его помощью ускоряется поиск по условию LIKE, на примере таблицы с архивом почтовой рассылки.
Создадим индекс:
Page 27: Page 27
Операторы для класса операторов gist_trgm_ops:
Операторы ~~ и ~~* эквивалентны LIKE и ILIKE; Операторы ~ и ~* проверяют соответствие регулярному выражению (с учетом и без учета регистра). Значение остальных операторов описано на странице документации расширения pg_trgm. Класс операторов для триграмм использует так называемое сигнатурное дерево. Триграммы заменяются на сигнатуры, то есть двоичные числа, в которых все биты нулевые, и лишь один определенный бит установлен в единицу. И вся строка заменяется на сигнатуру, которая вычисляется как побитовое ИЛИ сигнатур составляющих ее триграмм. Таким образом, вместо строки в индексе сохраняется одно число. Общим предикатом в сигнатурном дереве является побитовое ИЛИ всех сигнатур, которые находятся ниже в поддереве. Замена индексируемых элементов битовой сигнатурой позволяет индексировать с помощью GiST вообще все, что угодно (например, изображения). Но, к сожалению, это не слишком эффективный метод. Во-первых, число бит в сигнатуре ограничено, и поэтому некоторые разные элементы будут иметь одинаковую сигнатуру. Во-вторых, чем выше узел стоит в дереве, тем больше в его сигнатуре будет единиц. Это означает, что при поиске придется спускаться в лишние поддеревья и необходимо все время перепроверять полученные результаты. В теме «Слабоструктурированные данные» будет показан другой, более эффективный (но менее универсальный) метод доступа — GIN.
11 Занятие 11: Расширяемость / Слабоструктурированные данные
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_11_ext_semistruct.html Archive: DEV2-handouts-16.zip Страниц PDF: 29
Page 1: Расширяемость / Слабоструктурированные данные
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Что такое слабоструктурированные данные
- Применение в реляционных базах данных
- Необходимые операции
- Тип данных для XML: xml
- Типы данных для JSON: json и jsonb
- Индексирование документов JSON
Page 3: Что это такое
Наиболее известные примеры: XML и JSON
- Схема данных определяется самим документом
- документ содержит разметку для выделения элементов
- и определения иерархии
- Данные не соответствуют реляционной модели
- конкретный документ можно представить в виде таблиц
- документы общего вида тоже можно, но практически — неудобно
Комментарии преподавателя
Слабоструктурированные (semi-structured) данные — это данные, представленные не в реляционном (табличном) виде. Обычно это текстовый документ, но в отличие от текста на естественном языке, документ содержит разметку, определяющую структурные единицы.
Широко известными примерами форматов (языков разметки) являются XML и JSON, в последнее время также популярен YAML.
Структура, или схема, документа определяется его собственной разметкой. (Это не исключает возможности определить структуру отдельно — например, для XML есть языки DTD, XMLSchema.)
Разметка, как правило, позволяет определить вложенные элементы, образующие иерархию.
Конечно, любую конкретную иерархию можно представить и в табличном виде. Можно уложить в таблицы и произвольную иерархию без жесткой схемы, но результат будет лишен типизации данных, возможности создания ограничений целостности, с ним будет крайне неудобно работать в терминах запросов SQL. Поэтому с некоторыми видами данных действительно удобнее и логичнее работать именно в таком, слабоструктурированном, виде.
Page 4: Применение
Интерфейсный формат
- между приложением и внешней системой
- между клиентской и серверной частями приложения
- Внутри базы данных как атомарное значение
- только хранение и извлечение
- не нарушает 1NF, достаточно обычных средств SQL
- Внутри базы данных как неатомарное значение
- операции с отдельными частями документа
- SQL не достаточно; требуется специальный язык запросов
- и набор дополнительных операций
- гибкость, когда данные плохо укладываются в реляционную модель
Комментарии преподавателя
Документы XML или JSON могут применяться как удобный интерфейсный формат между разными компонентами, независимый от конкретной платформы или языка программирования. Например, для взаимодействия с внешними системами, или для обмена данными между клиентской и серверной частями системы. В последнем случае интерфейсный формат позволяет клиенту послать сложный запрос, а серверу выполнить его эффективным образом (в отличие от традиционного подхода, принятого в ORM, когда сервер базы данных нагружается большим количеством мелких запросов, не оставляя возможностей для оптимизации).
Если слабоструктурированные данные хранятся внутри самой базы данных, то все зависит от того, как эти данные используются. Если внутри SQL запросов не делается попыток работать с отдельными частями документов, то такие значения можно считать атомарными с точки зрения СУБД. Тут достаточно обычных средств SQL.
Конечно, более интересен случай, когда серверу необходимо выделять часть документа, фильтровать вывод на основе содержания документов и т. п. Для этого SQL уже не хватает и нужен специализированный язык доступа к слабоструктурированным данным. Если СУБД предоставляет такую возможность, это позволяет комбинировать строгий реляционный подход для данных, имеющих четкую структуру, и подход в духе NoSQL для данных, которые сложно представить в табличном виде.
Page 5: Операции
Преобразование документа к реляционному виду
- сохранение транспортного документа в базу данных
- использование средств SQL для обработки
- Преобразование реляционных данных к виду документа
- выгрузка данных в транспортный формат
- Выделение части документа
- специализированный язык запросов
- Индексирование документов
- поддержка операций специализированного языка запросов
Комментарии преподавателя
Чтобы работать со слабоструктурированными документами в реляционной базе данных, понадобятся возможности для преобразования данных из одного вида в другой, поскольку в одних ситуациях удобнее использовать реляционные средства, в других — документоориентированные. Особенно это важно, если такой язык, как XML или JSON, используется в качестве транспортного формата.
Кроме этого, нужны средства для выделения части документа — каких-то отдельных значений, или какого-то подмножества элементов. Такие средства обычно представлены в виде специализированного языка запросов, который учитывает иерархическую структуру документов. Такие языки запросов можно использовать не только для выделения части документа, но и, например, для выбора тех документов, в которых присутствует заданный фрагмент.
Если слабоструктурированные документы используются в реляционной СУБД, встает задача индексирования таких данных. Для этого, как правило, не годятся обычные B-деревья, поскольку требуется поддерживать не операции сравнения документов, а операции, связанные со специализированным языком запросов.
Page 6: Формат XML
eXtensible Markup Language
- универсальный язык разметки, первый стандарт 1998 года
- форматы на основе XML: XHTML, FB2, RSS и Atom, SVG, SOAP…
- Структура
- вложенные элементы
- отделяются тегами, могут иметь атрибуты, содержат текст
- Инструментарий
- описание схемы (DTD, XML Schema), языки запросов XPath и XQuery,
- язык преобразования XSLT
- PostgreSQL: XPath 1.0
Комментарии преподавателя
XML (eXtensible Markup Language) появился в контексте веба и разрабатывается консорциумом W3C. XML является текстовым документом, содержащим специальную разметку. XML определяет синтаксическую структуру разметки, которая с помощью тегов выделяет элементы (возможно, вложенные друг в друга), которые могут также иметь атрибуты. (Язык XML довольно сложен, в нем имеются также инструкции обработки, комментарии и другие сущности, но мы не будем на этом останавливаться.)
XML позволяет определить расширения XML, определяя конкретный набор элементов и их атрибутов, и наделяя их определенной семантикой. К известным расширениям относятся XHTML (более строгий HTML, совместимый с XML), FB2 (формат электронных книг), RSS и Atom (форматы для новостных лент), SVG (векторная графика), SOAP (формат сообщений веб-сервисов) и другие.
За время существования формата XML сформировался богатый инструментарий для работы с ним, включающий языки описания схемы документов (такие, как DTD, XMLSchema), языки запросов (базовый XPath и более богатый XQuery на его основе), языки преобразования документов XML (XSLT и XSL-FO на его основе).
В реляционных базах работу с XML регламентирует стандарт SQL/XML. PostgreSQL поддерживает только XPath 1.0. Преобразования XSLT доступны в расширениях (xml2 или в сторонних). Индексирование не реализовано (хотя все возможности для этого есть).
https://postgrespro.ru/docs/postgresql/16/datatype-xml
https://postgrespro.ru/docs/postgresql/16/functions-xml
Page 7: Тип данных для XML
xml
- хранение в виде обычного текста + синтаксическая проверка
- сохраняется исходное форматирование
- может хранить XML-документ или фрагмент документа
Комментарии преподавателя
Тип xml хранит документ в виде текстовой строки. Но по сравнению с типом text он проверяет введенные значения на допустимость по правилам XML.
Допускается хранение корректно оформленных документов, а также их фрагментов, в которых может быть несколько элементов верхнего уровня или текстовых узлов.
Для типа xml не определены никакие операторы сравнения, поэтому столбец этого типа нельзя проиндексировать с помощью B-tree. Однако можно, например, использовать индекс по выражению, в котором вызывается XPath и результат приводится к строке символов.
Существуют и другие ограничения реализации этого типа в PostgreSQL.
https://postgrespro.ru/docs/postgresql/16/xml-limits-conformance
Page 8: XML: тип xml
Будем работать с документом, описывающим компоненты компьютера.
Теги выделяются угловыми скобками. Для каждого открывающего тега (
В PostgreSQL имеется тип xml, значение которого хранится в виде символьной строки, а при приведении к типу происходит проверка структуры. В зависимости от значения параметра xmloption проверка ожидает: document — документ (с одним корнем), content — фрагмент документа (любой набор элементов).
При приведении к типу xml форматирование сохраняется:
А попытка привести некорректный фрагмент даст ошибку:
Page 9: XML: выражения XPath
Посмотрим, какие средства есть для получения части XML-документа. Для этого используются выражения языка запросов XPath 1.0. Мы не будем детально рассматривать все возможности XPath, но посмотрим некоторые примеры. XML состоит из иерархии элементов, поэтому язык описывает перемещения по дереву. Часть документа, соответствующая пути от корня:
В пути можно указывать не только непосредственные потомки:
По дереву элементов можно «двигаться» не только вниз к листьям, но и вверх к корню:
Вместо конкретного имени элемента можно указать, что подходит любой:
Здесь мы получили в массиве две части XML-документа. Можно посчитать количество:
Можно извлечь не весь элемент, а только его текст:
Атрибуты записываются с помощью «собаки». Найдем значения атрибутов size_gb:
Page 10: Page 10
Условия фильтрации записываются в квадратных скобках. Найдем все элементы, объем памяти которых начинается от 1000 гигабайт:
Сравнение работает, потому что XPath поддерживает числовые типы. Кроме этого, поддерживаются строки и логический тип. Выражения XPath применяются не только в функции xpath, но и в других. Например, можно проверить, содержит ли XML-документ указанный фрагмент:
XML: преобразование в реляционный вид и обратно
Для того чтобы преобразовать XML-документ к реляционному (табличному) виду, используется функция xmltable. Пусть у нас имеется таблица для дисковых накопителей:
Сначала выделим нужную часть документа:
Теперь можно написать вызов функции xmltable. В нем мы указываем выражение XPath, сам документ, а также описываем, как получать значения для столбцов таблицы с помощью дополнительных XPath-выражений:
Page 11: Page 11
Обратите внимание: выражения XPath для столбцов отсчитываются не от корня документа, а от текущего контекста (элемента, найденного основным выражением XPath); в выражениях можно использовать некоторые арифметические операции. Результат такого запроса можно непосредственно вставить в таблицу:
Для создания документов XML имеется довольно много функций, с помощью которых можно собрать документ «по кусочкам». Но есть также функции, позволяющие выгрузить в XML целую таблицу, или результат запроса, или даже всю базу данных в фиксированном формате.
Page 12: Формат JSON
JavaScript Object Notation
- простой язык разметки, стандарт 1999 года
- появился в JavaScript, но распространен повсеместно
- Структура
- объекты (пары «ключ: значение»), массивы значений
- значения текстовые, числовые, даты, логические
- Инструментарий
- PostgreSQL: язык запросов JSONPath,
- неполная пока поддержка стандарта SQL/JSON,
- индексирование
Комментарии преподавателя
Формат JSON — подмножество языка JavaScript, описывающее:
● простые значения (текстовые, числовые, даты и логические);
● объекты, состоящие из пар «ключ — значение»;
● массивы значений.
В двух последних случаях значения могут быть как простыми, так и объектами или массивами, то есть документ имеет иерархическую структуру.
Несмотря на то, что JSON — «родной» формат для JavaScript, он получил огромное распространение благодаря своей простоте и удобству, и повсеместно используется в современном интернете.
Изначально PostgreSQL предоставлял собственные операции для работы с JSON; при необходимости более серьезного инструментария можно было воспользоваться расширением jsQuery. В настоящее время в PostgreSQL реализована часть стандарта SQL/JSON:2016, включая язык запросов JSONPath.
Имеется и индексирование документов JSON. Это позволяет комбинировать реляционные возможности PostgreSQL с возможностями, предоставляемыми NoSQL-базами.
https://postgrespro.ru/docs/postgresql/16/datatype-json
https://postgrespro.ru/docs/postgresql/16/functions-json
https://github.com/postgrespro/jsquery
Page 13: Типы данных для JSON
Json
- хранение в виде обычного текста + синтаксическая проверка
- сохраняется исходное форматирование
- необходимость повторного разбора при каждом запросе
- Jsonb
- внутренний формат, исключающий повторный разбор
- поддержка SQL/JSON (язык запросов JSONPath)
- поддержка индексирования
Комментарии преподавателя
Имеются два типа данных для представления документов JSON: json и jsonb.
Первый появился раньше и, по сути, просто хранит документ в виде текстовой строки (при этом, конечно, проверяется, что строка является корректным документом JSON). Но при любом обращении к части документа JSON его приходится заново разбирать. Это вызывает большие накладные расходы. Кроме того, для формата json не реализован язык JSONPath и не работает индексирование. Поэтому json применяется редко.
Обычно используется тип jsonb (b — binary). Этот формат сохраняет однажды разобранную иерархию элементов, что позволяет эффективно работать с документом. Следует учитывать, что исходный вид документа при этом не сохраняется: нарушается порядок следования элементов, пропадают отступы и дублирующиеся ключи.
https://postgrespro.ru/docs/postgresql/16/datatype-json#DATATYPE-JSONP ATH
Page 14: JSON: типы данных json и jsonb
Документ, описывающий компоненты компьютера, может выглядеть в JSON так:
Тип json хранит документ как обычный текст:
В jsonb документ разбирается и записывается во внутреннем формате, сохраняющем структуру разбора. Из-за этого при выводе документ составляется заново в эквивалентном, но ином виде:
Чтобы вывести документ в человекочитаемом виде, можно использовать специальную функцию:
Page 15: Page 15
Дальше мы будем работать с типом jsonb, который предоставляет больше возможностей.
JSON: выражения JSONPath и другие средства
Для получения части JSON-документа стандарт SQL:2016 определил язык запросов JSONPath. Вот некоторые примеры. Так же, как и XPath, JSONPath позволяет спускаться по дереву элементов. Часть документа, соответствующая пути от корня:
Элементы массива указываются в квадратных скобках:
Можно получить и все элементы сразу:
Page 16: Page 16
Условия фильтрации записываются в скобках после вопросительного знака. Символ @ обозначает текущий путь. Найдем диски, объем памяти которых начинается от 1000 гигабайт:
Условия являются частью пути, который можно продолжить дальше. Выберем только модель:
В пути может быть и несколько условий:
Кроме средств JSONPath, можно применять и «традиционную» стрелочную нотацию. Переходим к ключу motherboard, затем к ключу ram, затем берем первый (нулевой) элемент массива:
Двойная стрелка возвращает не jsonb, а текстовое представление (необходимые фильтрации придется выполнять уже на уровне SQL):
Page 17: Page 17
Начиная с версии PostgreSQL 14 для работы c jsonb можно использовать индексную нотацию:
JSON: преобразование в реляционный вид и обратно
Стандарт определяет функцию jsontable, но ее реализация ожидается только в PostgreSQL 17. Разумеется, можно выйти из положения и теми средствами, которые существуют. Сначала выделим все диски:
На основе этого запроса несложно сделать вставку в таблицу:
Для обратного преобразования удобно воспользоваться функцией row_to_json:
Соединить строки в общий JSON-массив можно, например, так:
Здесь отдельные строки преобразуются в объекты JSON автоматически.
Page 18: Метод доступа GIN
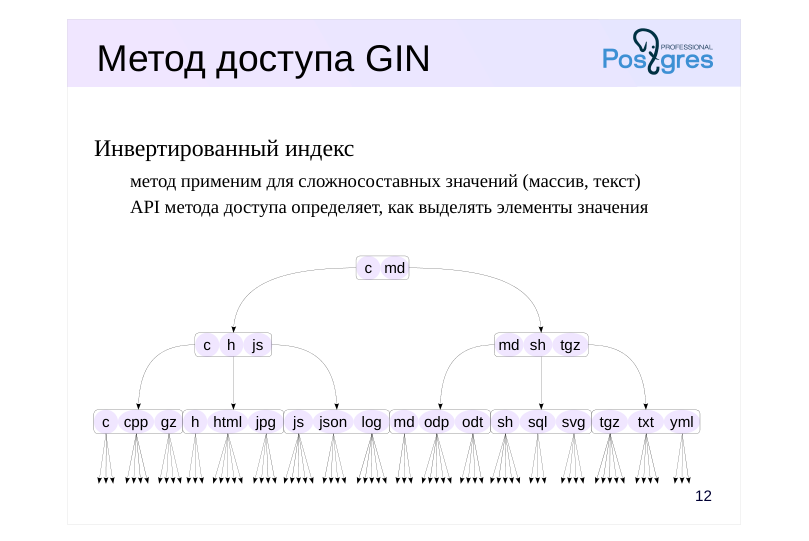 {#source-figure-018 caption=“Source slide page 18: Метод доступа GIN”}
Инвертированный индекс
- метод применим для сложносоставных значений (массив, текст)
- API метода доступа определяет, как выделять элементы значения
Комментарии преподавателя
Идея метода доступа GIN (Generalized Inverted Index) основана на том, что для сложносоставных значений имеет смысл использовать в качестве ключей элементы значений, а не значения целиком.
Представьте предметный указатель в конце книги. Страницы книги — сложносоставные значения (текст), а указатель позволяет ответить на вопрос «на каких страницах встречается такой-то термин?».
Для хранения элементов в GIN используется обычное B-дерево, поэтому элементы должны принадлежать к сортируемому типу данных. Основные отличия от B-дерева состоят в следующем:
● Когда нужно проиндексировать новое значение, это значение разбивается на элементы и индексируются сразу все элементы. Поэтому в индекс добавляется не один элемент, а сразу несколько (обычно много).
● Каждый элемент индекса ссылается на множество табличных строк.
● Хотя элементы и организованы в B-дерево, классы операторов GIN не поддерживают операции сравнения «больше», «меньше».
Таким образом, GIN оптимизирован для других условий использования, нежели B-дерево. (Но имеется расширение btree_gin, реализующее классы операторов GIN для обычных типов данных.)
https://postgrespro.ru/docs/postgresql/16/gin
https://postgrespro.ru/docs/postgresql/16/datatype-json#JSON-INDEXING
Page 19: Метод доступа GIN для индексирования JSON
Пусть теперь таблица с дисками будет содержать JSON-документы.
Заполним ее разными моделями, от 10 до 1000 Гбайт:
Вот что получилось:
Сколько всего моделей имеют емкость 10 Гбайт и сколько времени займет поиск?
Оператор @? проверяет, есть ли в документе JSON заданный путь.
Как выполняется этот запрос?
Конечно, используется полное сканирование таблицы — у нас нет подходящего индекса.
Page 20: Page 20
Документы JSONB можно индексировать с помощью метода GIN. Для этого есть два доступных класса операторов:
Класс по умолчанию, jsonb_ops, более универсален, но менее эффективен. Этот класс операторов помещает в индекс все ключи и значения. Из-за этого поиск получается неточным: значение 10 может быть найдено не только в контексте емкости (ключ capacity), но и как число пластин (ключ plates). Зато такой индекс поддерживает и другие операции с JSONB. Попробуем.
Доступ, тем не менее, ускоряется.
Другой класс операторов, jsonb_path_ops, помещает в индекс значения вместе с путем, который к ним ведет. За счет этого поиск становится более точным, хотя поддерживаются не все операции. Проверим и этот способ:
Так гораздо лучше. Еще один вариант — построить индекс на основе B-дерева по выражению. Вот так:
Page 21: Page 21
Но такой способ, конечно, менее универсален — под каждый запрос потребуется создавать отдельный индекс. Сравним размер индексов (для сравнения выводится и размер таблицы):
Page 22: Итоги
PostgreSQL поддерживает слабоструктурированные типы
- Частичная поддержка XML
- формат теряет популярность
- Полноценная поддержка JSON
- направление активно развивается
- Индексирование на основе метода доступа GIN
Page 23: Практика
- Часть сведений о книгах (ISBN, аннотация и другие) выводятся приложением только на отдельной странице. Сейчас эти данные хранятся в таблице books, но не передаются приложению. Измените функцию, реализующую API приложения, так, чтобы сведения передавались в виде одного объекта JSON. Проверьте реализацию в приложении. 2. Многочисленные столбцы, хранящие дополнительные сведения о книгах, никак не используются в серверной части приложения. Замените их на один столбец, в котором сведения будут храниться в формате JSON. Сделайте это прозрачно для приложения.
Комментарии преподавателя
Сведения должны передаваться в объекте JSON следующего формата: { “ISBN”: isbn, “Аннотация”: abstract, “Издательство”: publisher, “Год выпуска”: year, “Гарнитура”: typeface, “Издание”: edition, “Серия”: series }
Действуйте в предположении, что во время замены столбцов приложение работает и должно корректно выполнять запросы пользователей. Не забудьте, что вместе с заменой столбцов на один общий необходимо исправить и интерфейсную функцию приложения.
Кроме того, считайте, что одновременно с работой приложения могут изменяться как данные о существующих книгах, так и добавляться новые книги.
Page 24: 1. Дополнительные сведения о книгах
Приложение рассчитывает получить дополнительные сведения о книгах в столбце additional таблицы, возвращаемой вызовом webapi.get_catalog, которая, в свою очередь, обращается за данными к public.get_catalog. Последняя получает дополнительные атрибуты через отдельную функцию, которая сейчас возвращает пустой документ:
Изменим функцию следующим образом:
2. Замена нескольких столбцов на один формата JSON
Добавим к таблице books необходимый столбец:
Если данные о книгах могут изменяться в процессе наших действий, мы можем создать триггер, который будет переносить изменения в новый столбец:
Теперь перенесем в новый столбец исторические данные:
Начиная с этого момента старые столбцы менять нельзя. Если бы у нас была процедура загрузки новых поступлений, ее
Page 25: Page 25
следовало бы переделать на заполнение нового столбца. Переключим приложение на использование нового столбца:
Теперь можно удалить временный триггер:
И можно удалить ненужные теперь столбцы таблицы:
Удаление столбцов происходит быстро, поскольку данные фактически не удаляются, а только становятся невидимыми. Поэтому размер таблицы не уменьшится до тех пор, пока строки не будут физически перезаписаны, например, при обновлениях.
Page 26: Практика+
- В базе данных имеются таблицы пользователей и их заказов, связанные отношением «один ко многим». Напишите функцию, которая по идентификатору пользователя возвращает документ JSON, содержащий все сведения о пользователе вместе с массивом его заказов. 2. В пользовательском интерфейсе необходимо выводить названия городов, хранящиеся в базе данных, на выбранном языке. Один из способов — хранить все переводы названий в объекте JSON в виде пар «код языка — название». Реализуйте такой способ. Для удобства создайте представление, показывающее название городов на языке, заданном в конфигурационном параметре сервера.
Комментарии преподавателя
- Таблицы могут быть следующими: CREATE TABLE users( id integer PRIMARY KEY GENERATED ALWAYS AS IDENTITY, name text);
Результат должен иметь вид: { “user_id”: …, “name”: …, “orders”: [ { “order_id”: …, “amount”: … }, … ] }
Для того чтобы сформировать объект JSON из нескольких полей, воспользуйтесь функцией jsonb_build_object.
- Название пользовательского конфигурационного параметра должно содержать точку в своем имени, например, «translation.lang».
Получить текущее значение параметра можно функцией current_setting.
Page 27: 1. Формирование JSON
Создадим таблицы и тестовые данные:
Функция использует jsonb_build_object для создания объекта и jsonb_agg для создания массива:
Проверим:
Page 28: Page 28
2. Хранение переводов
Таблица с городами:
Представление может быть устроено следующим образом:
Проверим результат с разными значениями параметра:
Page 29: Page 29
Таким образом приложение может установить язык один раз в начале сеанса, и затем запросы не будут зависеть от выбора пользователя.
12 Занятие 12: Расширяемость / Фоновые процессы
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_12_ext_bgworkers.html Archive: DEV2-handouts-16.zip Страниц PDF: 22
Page 1: Расширяемость / Фоновые процессы
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Механизм фоновых процессов
- Применение в ядре PostgreSQL
- Возможности для прикладных задач
- Расширение dblink
- Расширение pg_background
Page 3: Фоновые процессы
Фиксированный набор служебных процессов
- postmaster
- walwriter
- checkpointer
- autovacuum
- и другие
- Динамически порождаемые фоновые процессы
- контролируются процессом postmaster
- имеют доступ к разделяемой памяти
- могут устанавливать внутреннее соединение с базами данных
- реализуются на языке C
Комментарии преподавателя
PostgreSQL состоит из набора взаимодействующих процессов. За основными процессами закреплены собственные имена и они имеют особый смысл для сервера. Например, при остановке экземпляра нужно записать в журнал сообщение о завершении контрольной точки, поэтому процесс walwriter надо останавливать после checkpointer, и т. п. Обычно (хотя и не всегда) такие процессы работают постоянно от старта сервера до его останова.
Но вместе с тем часто возникает необходимость временно запустить процесс, который выполнит необходимую работу и завершится. Такую возможность предоставляет механизм фоновых процессов (background workers): https://postgrespro.ru/docs/postgresql/16/bgworker
Как и все остальные, фоновые процессы порождаются и контролируются процессом postmaster. Фоновые процессы имеют все возможности, такие как доступ к разделяемой памяти сервера и соединение с базами данных по внутреннему протоколу SPI (рассматривается в теме «Языки программирования»).
Фоновые процессы должны быть написаны на языке C, пример можно найти в исходном коде (src/test/modules/worker_spi).
Заметим, что процесс автоочистки (autovacuum launcher) тоже динамически порождает рабочие процессы (autovacuum worker), но исторически делает это по-своему, не используя общий механизм фоновых процессов.
Page 4: Использование
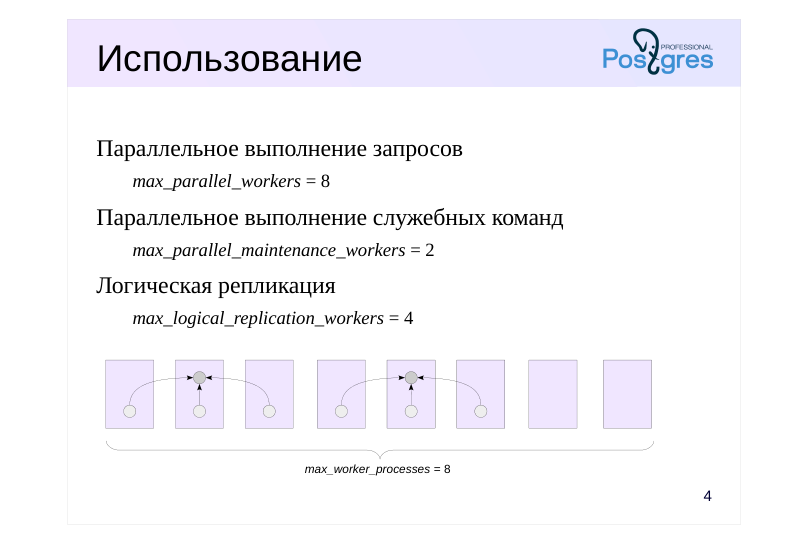 {#source-figure-004 caption=“Source slide page 4: Использование”}
Параллельное выполнение запросов
- max_parallel_workers = 8
- Параллельное выполнение служебных команд
- max_parallel_maintenance_workers = 2
- Логическая репликация
- max_logical_replication_workers = 4
Комментарии преподавателя
Фоновые процессы используются в PostgreSQL для различных целей.
Параллельное выполнение запросов.
Параллельное выполнение служебных команд (CREATE INDEX и REINDEX (в т. ч. CONCURRENTLY) для B-деревьев, VACUUM).
В этих случаях имеется ведущий процесс, инициирующий запуск рабочих процессов и получающий от них информацию.
- Логическая репликация (для процессов на стороне сервера-подписчика).
Общее количество фоновых процессов в системе ограничено значением параметра max_worker_processes, и отдельными параметрами ограничено количество процессов для каждой из трех категорий. Если в пуле недостаточно фоновых процессов, то обработка будет выполняться последовательно, а не параллельно (а логическая репликация и вовсе не будет работать).
Page 5: Использование фоновых процессов
Вот простой наглядный пример использования фоновых процессов для распараллеливания запросов. Если требуется посчитать количество строк в большой таблице, ведущий процесс запускает несколько рабочих процессов (в данном случае 2):
Запланированное количество и число реально запущенных процессов могут отличаться, если на момент запуска запроса пул фоновых процессов будет исчерпан. В конце частичные результаты собираются и агрегируются лидирующим процессом чтобы получить итоговое значение.
Page 6: Прикладные задачи
Некоторые идеи
- планировщик заданий внутри СУБД
- асинхронная обработка событий
- распараллеливание сложной обработки данных
- автономные транзакции
- и другое
- Но пользовательские задачи неудобно писать на языке C
Комментарии преподавателя
Кроме штатного использования, фоновые процессы можно приспособить и для решения пользовательских задач.
Например, можно организовать планировщик заданий внутри СУБД. В отличие от, например, cron, такой планировщик не будет зависеть от используемой операционной системы. (Планировщик внутри СУБД реализован в Postgres Pro Enterprise и рассматривается в курсе PGPRO).
Можно выполнять асинхронную обработку событий (что будет подробно рассмотрено в одноименной теме).
Можно распараллеливать сложную длинную обработку больших объемов данных.
Можно реализовать автономные транзакции, хотя и весьма дорогим способом. (В Postgres Pro Enterprise имеются автономные транзакции, они рассматриваются в курсе PGPRO).
И так далее.
Однако писать прикладные задачи на языке С крайне неудобно и требует неоправданно высокой квалификации.
Page 7: Расширение dblink
Назначение
- выполнение произвольных SQL-команд на удаленном сервере
- в качестве удаленного сервера может выступать и локальный
- Плюсы
- стандартное расширение
- Минусы
- фоновые процессы не используются,
- устанавливается новое соединение
Комментарии преподавателя
Одно из возможных решений — использовать расширение dblink, которое предназначено для выполнения SQL-запросов на удаленном сервере PostgreSQL (в качестве удаленного может выступать и локальный сервер).
Это проверенное временем стандартное расширение. Однако оно не использует механизм фоновых процессов — устанавливается полноценное новое соединение с сервером, что существенно дороже.
https://postgrespro.ru/docs/postgresql/16/dblink
Page 8: Расширение dblink
Это стандартное расширение. Установим его:
Ниже — самый простой способ выполнить одиночный запрос на удаленном сервере. Первый параметр функции — строка соединения, второй — команда, которую надо выполнить. Функция возвращает множество строк типа record, поэтому структуру составного типа необходимо указывать явно при ее вызове.
Команду, не возвращающую строки, можно выполнить с помощью другой функции:
Обе функции открывают соединение, выполняют команду и тут же закрывают соединение. Но есть возможность явно управлять соединением. Откроем его, указав имя:
Можно открыть и несколько соединений. Текущие открытые соединения показывает функция:
Теперь можно выполнять команды, используя открытое соединение. В том числе можно вручную управлять транзакциями:
Page 9: Page 9
Важная возможность — асинхронные вызовы. Следующая функция отправит запрос на сервер и тут же вернет управление:
1 — успешно; 0 — ошибка. Далее мы можем проверить, выполняется ли еще запрос:
Результат получаем так (если запрос еще не выполнился, функция сама дождется результатов):
Не забываем закрыть соединение:
Page 10: Page 10
Page 11: Расширение pg_background
Назначение
- возможность выполнить команду SQL в фоновом процессе
- команда может вызвать подпрограмму на любом серверном языке
- Плюсы
- используются фоновые процессы Минусы
- стороннее расширение
Комментарии преподавателя
Есть и другое решение, которое позволяет прикладным разработчикам воспользоваться фоновыми процессами — стороннее расширение pg_background:
https://github.com/vibhorkum/pg\_background
Фактически это небольшая обертка над низкоуровневым API фоновых процессов, позволяющая запускать в фоновом режиме произвольные команды SQL. Разумеется, таким образом можно вызывать хранимые функции и процедуры, написанные на любых серверных языках программирования (например, PL/pgSQL).
Page 12: Расширение pg_background
Расширение уже собрано и доступно для установки в виртуальной машине курса:
Расширение предоставляет всего три функции. Функция pg_background_launch запускает фоновый процесс, выполняющий одну SQL-команду. Например, выполним в фоне простой запрос. Для удобства он будет работать 10 секунд:
Пока запрос выполняется, мы можем увидеть процесс в pg_stat_activity:
Обратите внимание на ожидание. Функция pg_background_result выводит результат выполнения фоновой команды (при необходимости дожидаясь ее окончания). Функция возвращает значения типа record, поэтому для вывода необходимо конкретизировать названия и типы полей составного типа.
Функция pg_background_detach отключает текущий процесс от ожидания результатов фонового процесса. Из-за особенности текущей реализации между вызовами pg_background_launch и pg_background_detach должна быть небольшая задержка. Передача результатов выполняется через очередь сообщений в разделяемой памяти сервера. Поэтому при переполнении очереди фоновый процесс будет ждать, пока мы не прочитаем накопившиеся сообщения, даже если они нас не интересуют. Запустим процесс, возвращающий много информации:
Page 13: Page 13
Обратите внимание на ожидание. Отключимся от процесса:
Больше фоновый процесс ничего не ждет (и, возможно, уже отработал). Заметим, что в случае dblink сложностей с переполнением буфера не возникает, потому что используется не межпроцессное взаимодействие, а устанавливается обычное соединение по клиент-серверному протоколу. Интересно, что изначально в состав расширения pg_background планировалось включить четвертую функция pg_background_run(pid, query), которая должна была передавать новое задание уже запущенному процессу, избегая затрат на создание очередного фонового процесса. Однако пока что это не реализовано.
Page 14: Итоги
Сервер предоставляет механизм фоновых процессов
- Фоновые процессы используются для внутренних целей, но могут быть использованы и для прикладных задач
- Расширение pg_background позволяет реализовывать фоновые процессы на процедурных языках
Page 15: Практика
- Реализуйте расчет рейтинга книг на основе данных о голосах пользователей «за» и «против». Чтобы не допускать разрастание таблицы, выполняйте обновление пакетами по N строк. Между частичными обновлениями запускайте очистку. Оформите обновление в виде хранимой процедуры, принимающей N как параметр. 2. Выполните процедуру обновления в фоновом режиме.
Комментарии преподавателя
- Рейтинг книги оценивается числом от 0 до 1.
«Наивная» формула для определения рейтинга может быть такой:
votes_up / (votes_up + votes_down), если votes_up + votes_down > 0;
0, иначе.
Недостаток этой формулы показывает пример: книга, набравшая 100 голосов «за» и 1 голос «против», получит меньший рейтинг, чем книга, набравшая всего один голос «за».
Можно подумать над более справедливой формулой, а можно воспользоваться уже готовой функцией public.rating.
Пакетное обновление рассматривалось в практике к теме «Очистка». Здесь применим тот же подход. Однако подумайте над тем, как пересчитывать рейтинг только тех книг, для которых это необходимо.
Команда VACUUM не может быть вызвана внутри транзакции, но ее можно выполнить как отдельную SQL-команду в фоновом процессе.
Page 16: 1. Процедура расчета рейтинга
Для вычисления рейтинга мы будем пользоваться готовой функцией public.rating. Эта функция вычисляет рейтинг с учетом баланса между долей положительных оценок и неопределенностью малого числа наблюдений (нижняя граница доверительного интервала Вильсона для параметра Бернулли). Один из возможных способов не пересчитывать рейтинг без надобности состоит в том, чтобы добавить к таблице книг столбец логического типа, указывающий на необходимость пересчета. Процедура расчета рейтинга будет сбрасывать этот флаг, а любое изменение количества голосов — устанавливать. Мы реализуем другой способ. Добавим к таблице столбец с датой последнего пересчета рейтинга. Процедура пересчета будет выполняться только для тех книг, «возраст» рейтинга которых больше определенного порога. Это позволит при необходимости (например, если изменится формула) пересчитать рейтинг всех книг, не обновляя предварительно все строки таблицы.
Обратите внимание: добавление столбца затрагивает только системный каталог и не приводит к перезаписи всех строк таблицы. Для обработки строк пакетами нужно определиться: с размером пакета; с тем, как из всех строк выбирать для обработки только нужное количество. Важный момент: обработка пакета может — в принципе — завершиться ошибкой. Важно, чтобы это не повлияло на возможность продолжить обработку и довести ее до конца. Для выбора пакета строк мы используем подход, показанный ранее в практике к теме «Очистка». Будем выбирать и блокировать первые подходящие N строк, игнорируя уже заблокированные:
Здесь мы выбираем строки, для которых рейтинг не рассчитан или рассчитан «давно». Когда прекращать обновление? Если анализировать количество обновленных строк и сравнивать с размером пакета, то можно пропустить строки, которые были заблокированы каким-нибудь другим процессом. Поэтому лучше явно проверять наличие строк, требующих обработки. И еще один момент: поскольку команду VACUUM нельзя использовать в функциях и процедурах, мы будем запускать ее в фоновом процессе. Теперь мы готовы к тому, чтобы написать процедуру обновления. Для удобства передадим в качестве параметра не только размер пакета, но и порог возраста.
Page 17: Page 17
Проверим:
2. Расчета рейтинга в фоновом режиме
Page 18: Page 18
Просто вызовем процедуру в фоновом процессе. Таким образом, из одного фонового процесса можно вызывать другой (конечно, необходимо, чтобы не было превышено предельное количество фоновых процессов, установленное в системе).
Page 19: Практика+
- Фоновый процесс не будет запущен, если запуск приведет к превышению числа допустимых процессов. Напишите функцию-обертку для pg_background_launch, которая пытается запустить процесс N раз с интервалом в одну секунду. 2. Сравните накладные расходы на порождение процесса расширений dblink и pg_background, многократно выполняя простой запрос.
Комментарии преподавателя
- Предварительно исследуйте, как функция pg_background_launch сигнализирует об ошибке. Для этого удобно уменьшить значение параметра max_worker_processes, но учтите, что один фоновый процесс в системе уже запущен (logical replication launcher) — не уменьшайте значение до 1.
Обработка ошибок рассматривается в курсе DEV1.
- Разумеется, накладные расходы dblink будут существенно зависеть от способа аутентификации (в нашем случае — проверка пароля scram-sha-256).
Page 20: 1. Превышение числа фоновых процессов
Уменьшим значение параметра-ограничителя до 2, учитывая, что один фоновый процесс (logical replication launcher) запускается системой автоматически. Изменение требует рестарта сервера.
Запустим один длительный фоновый процесс:
Теперь попробуем запустить еще один, перехватывая исключение:
Ошибка с кодом 53000 относится к группе insufficient_resources. Функция может выглядеть следующим образом:
Page 21: Page 21
Проверим:
Восстановим значение параметра по умолчанию:
2. Сравнение dblink и pg\_background
Просто запрос (выполняем с помощью динамического SQL, чтобы исключить кеширование плана запроса):
Page 22: Page 22
Расширение pg_background:
Расширение dblink:
13 Занятие 13: Расширяемость / Асинхронная обработка
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_13_ext_async.html Archive: DEV2-handouts-16.zip Страниц PDF: 29
Page 1: Расширяемость / Асинхронная обработка
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Зачем нужна асинхронная обработка данных
- Доступные решения
- Реализация очереди средствами PostgreSQL
Page 3: Асинхронная обработка
Разнесение во времени возникновения события и его обработки
- Соображения производительности
- клиенту не требуется ждать ответа
- возможность управлять ресурсами для обработки
- Реализация
- очередь сообщений
- более сложный вариант: модель публикация — подписка
Комментарии преподавателя
Идея асинхронной обработки событий состоит в том, что возникновение события и его обработка разносятся во времени.
Например, пользователь хочет получить детализацию расходов на мобильную связь. Детализация формируется несколько минут. Можно показать пользователю «песочные часы» и заставить его ждать (синхронная обработка), а можно выслать детализацию по электронной почте, когда она будет готова (асинхронная обработка).
Другой пример: интеграция двух систем. Первая система обращается ко второй, передавая пакет сообщений. Обработка одного сообщения занимает несколько секунд, но в пакете может оказаться тысяча сообщений. Можно заставить первую систему ожидать получения результата (синхронная обработка), а можно ответить «работаем», обработать сообщения асинхронно и уже затем сообщить результат.
Асинхронная обработка сложнее синхронной, но часто оказывается очень удобной. Она позволяет работать эффективнее (клиенту не надо простаивать, дожидаясь ответа) и управлять ресурсами (обрабатывать события с удобной скоростью и в удобное время, а не немедленно).
(Асинхронная обработка широко применяется и в ядре PostgreSQL. Вспомните режим асинхронной фиксации; процесс контрольной точки; процесс автоочистки.)
Обычная реализация состоит в наличии очереди событий (сообщений): одни процессы создают события, другие — обрабатывают. Возможны более сложные модели, в которых есть возможность публиковать события и подписываться на события нужного типа.
Page 4: Внешние системы
RabbitMQ, ActiveMQ, ZeroMQ и т. п.
- Плюсы
- эти системы работают
- следование стандартам (AMQP, JMP, STOMP, MQTT…)
- гибкость, масштабирование, производительность
- Возможные минусы
- отдельная система (включающая отдельную СУБД)
- со своими особенностями настройки, администрирования, мониторинга
- все сложности построения распределенных систем
- (отсутствие глобальных транзакций)
Комментарии преподавателя
Одним из вариантов реализации очередей событий являются внешние системы. Названия многих из них традиционно заканчиваются на MQ — Message Queuing.
Как правило, это большие серьезные системы, обеспечивающие гибкость, масштабируемость, высокую производительность и прочие полезные свойства. К тому же они реализуют один или несколько стандартных протоколов работы с сообщениями, что позволяет интегрировать их с другими системами, понимающими те же протоколы.
Но надо понимать, что любая большая система потребует серьезных затрат на ее изучение и внедрение. Потребуется разобраться с особенностями настройки, администрирования, мониторинга. Заметим, что в состав систем работы с очередями входит и отдельная СУБД для надежного хранения очередей.
Кроме того, использование внешней системы приводит ко всем сложностям построения распределенных систем. При отсутствии глобальных транзакций, объединяющих разные системы, возможны случаи потери сообщений в результате сбоев.
Page 5: Очередь внутри базы: PgQ
Плюсы
- система давно на рынке и широко используется
- Возможные минусы
- мало гибкости, например, исключительно пакетная обработка
- плохо документирована
- внешняя программа-демон
Комментарии преподавателя
Более простым решением может служить реализация очереди в самой СУБД. Особенно это имеет смысл, если события возникают и обрабатываются на сервере баз данных.
Наиболее известна система PgQ, разработанная в свое время компанией Skype (https://github.com/pgq). Эта система достаточно широко используется и про нее известно, что она работает. Если требуется готовое решение, то ей можно и воспользоваться. Поддерживаются версии PostgreSQL 10+.
Из минусов этого решения отметим:
● Недостаточную гибкость. Например, возможна только пакетная обработка событий. Пока обработчик не пометит пакет, как полностью обработанный, все события пакета могут быть доставлены повторно в случае сбоя.
● Отсутствие качественной документации (есть описание API: https://pgq.github.io/extension/pgq/).
● Необходимость во внешней (относительно СУБД) программе, обеспечивающей работу очереди.
Page 6: Очередь внутри базы: pgmq
Плюсы
- система активно развивается
- легковесная реализация
- все компоненты внутри базы
- Возможные минусы
- недостаточная гибкость в управлении на низком уровне
- слабо документирована
- только исходные коды, необходимость сборки
Комментарии преподавателя
Решение заявлено компанией Tembo как легковесная реализация очередей. Расширение pgmq написано на Rust и использует инфраструктуру сборки расширений pgrx.
Очереди и метаинформация представлены таблицами в базе данных, а элементы очереди («сообщения») — записями в таблицах. Сообщения можно помещать в очередь (в том числе по несколько сразу), читать из очереди, удалять и архивировать. Для выполнения этих основных действий (и еще ряда дополнительных) в расширении предусмотрен набор функций. Детали реализации очереди скрыты от пользователя, что упрощает работу.
Из минусов pgmq отметим следующие:
● Недостаточная гибкость в управлении на низком уровне. Связано с тем, что расширение pgmq базируется на фреймворке pgrx, в который встроено, в том числе, управление соединениями с сервером СУБД. Повлиять на него средствами уже собранного pgmq нельзя.
● Документация недостаточно подробна.
● В репозитории отсутствуют готовые пакеты, а сборка расширения может оказаться нетривиальной и ресурсоемкой.
https://github.com/tembo-io/pgmq
Page 7: Очередь средствами расширения pgmq
Создадим базу данных и подключимся к ней:
Расширение pgmq уже собрано и доступно для установки. Выполним команду создания расширения в нашей базе. Все его объекты будут размещены в схеме pgmq:
Создадим очередь под названием pgmq_queue:
Информация об очередях хранится в таблице meta; посмотреть очереди можно с помощью табличной функции:
Также были созданы таблицы для сообщений очереди: основная q_pgmq_queue и архивная a_pgmq_queue:
Поместим в очередь несколько сообщений (полезная информация представляется значением типа jsonb)…
…и заглянем в основную таблицу очереди:
Page 8: Page 8
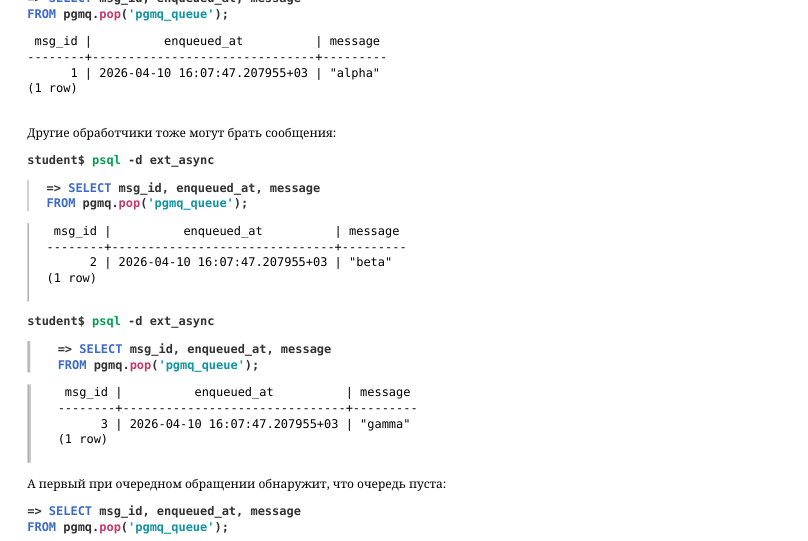 {#source-figure-008 caption=“Source slide page 8: Page 8”}
Простой способ забрать сообщение из очереди — вызвать функцию pop:
Другие обработчики тоже могут брать сообщения:
А первый при очередном обращении обнаружит, что очередь пуста:
И напоследок удалим саму очередь. При этом ее основная и архивная таблицы исчезнут, как и информация в таблице meta:
Page 9: Очередь своими руками
Возможные плюсы
- не требуются внешние зависимости
- простые требования — простая реализация
- Минусы
- требуется отладка и тестирование
- при усложнении требований готовая система может обойтись дешевле
Комментарии преподавателя
Для решения простой задачи, требующей асинхронной обработки, использование сторонних систем может оказаться невыгодным. Возможно, проще написать собственную реализацию, чем приспосабливаться к особенностям сторонней системы.
Конечно, нужно понимать, что:
● реализация должна быть сделана аккуратно, иначе она может привести к проблемам эксплуатации;
● если к системе очередей предъявляются серьезные требования (или есть шанс, что такие требования появятся в будущем), то развитие, тестирование и поддержка собственного решения, наоборот, может оказаться невыгодной.
Далее мы посмотрим, как реализовать очередь сообщений в PostgreSQL своими руками, и какие подводные камни есть на этом пути.
Page 10: Реализация очереди сообщений
Наша задача: реализовать простую очередь сообщений с возможностью конкурентного получения сообщений из нескольких процессов. Полезную информацию снова представим типом JSON — так очередь будет достаточно универсальна. В каждый конкретный момент времени в таблице сообщений не будет много строк, но за все время работы их может оказаться существенное количество. Поэтому идентификатор надо сразу сделать 64-разрядным:
Вставка сообщений в очередь проста:
Теперь займемся функцией получения и блокирования очередного сообщения. Нам требуется блокировать полученную строку, чтобы одно сообщение не могло быть выбрано два раза (двумя одновременно работающими обработчиками). Это можно сделать с помощью фразы FOR UPDATE:
Но в таком случае аналогичный запрос в другом процессе будет заблокирован до завершения первой транзакции.
Вторая транзакция заблокирована.
Page 11: Page 11
Для того чтобы не останавливаться на заблокированных строках, служит фраза SKIP LOCKED команды SELECT.
Итак, функция для получения и блокирования очередного сообщения может выглядеть следующим образом:
В практических заданиях к темам «Очистка» и «Фоновые задания» мы рассматривали типичное решение для получения пакета строк таблицы, например, с целью обновления или удаления. Запрос выглядел так:
Как видите, в обоих случаях используется тот же самый подход: выбирается и блокируется часть строк (одна или несколько), при этом уже заблокированные строки пропускаются. Теперь напишем функцию завершения работы с сообщением. Мы будем просто удалять его из очереди.
Page 12: Page 12
Теперь мы готовы написать цикл обработки сообщений. Оформим его в виде процедуры.
В этом варианте цикл заканчивается, когда в очереди не остается необработанных сообщений. Вместо этого можно не прекращать цикл, но продолжать ожидать новые события, засыпая, например, на одну секунду. Пробуем.
Теперь в два потока.
Обработка 10 сообщений двумя потоками заняла около 5 секунд, но горизонт транзакций держался на одном уровне все время обработки очереди! Это будет мешать выполнению очистки и создавать проблемы для всей базы данных.
Page 13: Вспоминаем про горизонт
Что получилось: одна большая транзакция
- take_message();
- обработка
- complete_message();
- take_message();
- обработка
- complete_message();
- take_message();
- обработка
- complete_message();
- COMMIT;
Комментарии преподавателя
Показанное решение имеет существенный недостаток: вся обработка выполняется в одной длинной транзакции. Вспоминая темы «Многоверсионность» и «Очистка» модуля «Архитектура», можно с уверенностью сказать, что обработка очереди будет мешать нормальной работе очистки.
Page 14: Вспоминаем про горизонт
Что надо: каждое событие в отдельной транзакции
- take_message();
- обработка
- complete_message();
- take_message();
- обработка
- complete_message();
- take_message();
- обработка
- complete_message();
- COMMIT;
- COMMIT;
- COMMIT;
Комментарии преподавателя
Чтобы таких проблем не возникало, надо раздробить длинную транзакцию на несколько более коротких. В нашем случае — обрабатывать каждое событие в собственной транзакции.
Page 15: Вспоминаем про горизонт
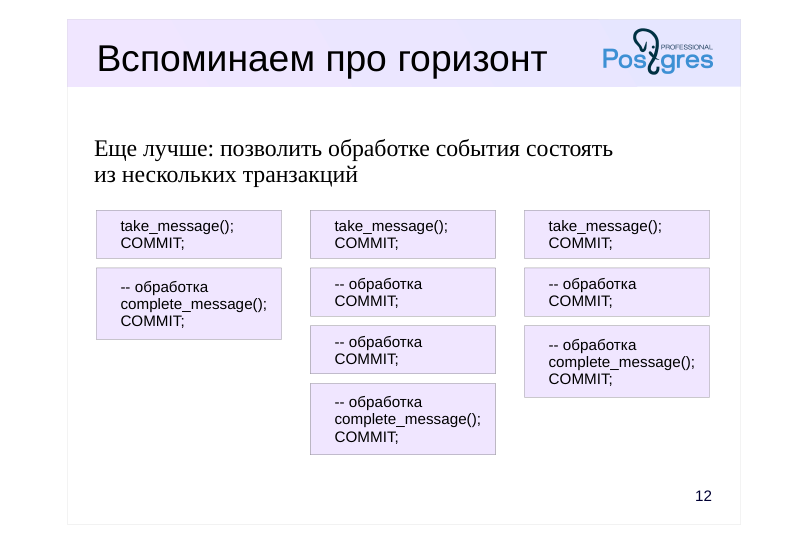 {#source-figure-015 caption=“Source slide page 15: Вспоминаем про горизонт”}
Еще лучше: позволить обработке события состоять из нескольких транзакций
Комментарии преподавателя
Более того, обработка одного события тоже может (в принципе) разбиваться на несколько транзакций.
В таком случае мы сначала фиксируем изменение статуса события в очереди («в работе»), затем выполняем обработку, а в конце фиксируем факт завершения работы с событием (например, удаляем его из таблицы).
Page 16: Учитываем горизонт транзакций
Это легко сделать, поскольку процедура позволяет управлять транзакциями.
Проверим:
Теперь горизонт транзакций продвигается вперед и не мешает очистке. Однако момент срабатывания автоматической очистки определяется на основе данных статистики, которая обновляется лишь по окончании работы всего оператора CALL.
Таким образом, чтобы таблица с очередью вовремя очищалась, можно: модифицировать процедуру process_queue таким образом, чтобы обеспечить ее гарантированное периодическое завершение и положиться на автоочистку; периодически запускать обычную (неавтоматическую) очистку. Один из способов реализации — использование фоновых процессов, которые рассмотрены в соответствующей теме этого курса.
Page 17: Чего не хватает
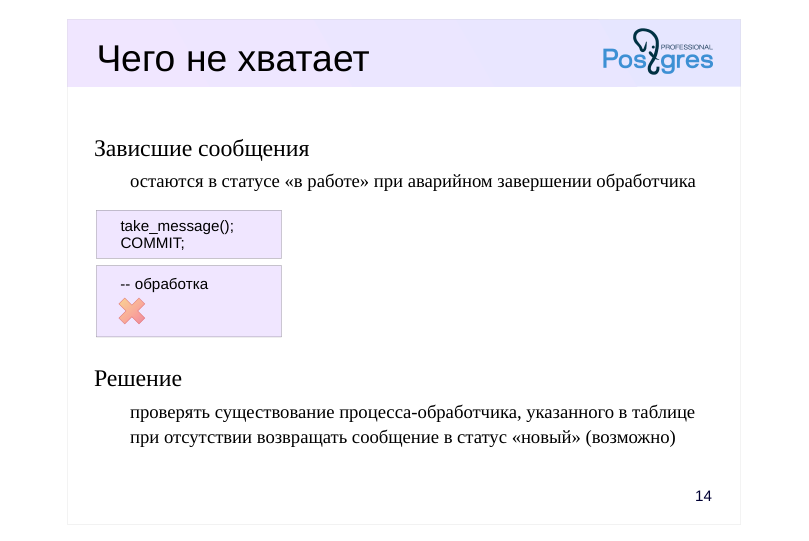 {#source-figure-017 caption=“Source slide page 17: Чего не хватает”}
Зависшие сообщения
- остаются в статусе «в работе» при аварийном завершении обработчика
- Решение
- проверять существование процесса-обработчика, указанного в таблице
- при отсутствии возвращать сообщение в статус «новый» (возможно)
Комментарии преподавателя
Чего не хватает в нашей реализации?
Во-первых, обработчик может завершиться аварийно. Если мы фиксируем изменение статуса обработки, то событие «повиснет» в статусе «в работе» и не будет больше обрабатываться.
В нашей реализации мы уже сделали шаг в нужную сторону: в таблице сохраняется номер обслуживающего процесса (pid), который взял событие в работу. Можно написать простую проверку: если pid имеется в таблице, но процесса с таким номером нет в системе — значит, произошел сбой.
Что делать в таком случае? Если обработка события выполнялась в одной транзакции, то она была прервана и, следовательно, можно безопасно вернуть событие в статус «новое» — оно будет обработано повторно.
Если же обработка делится на несколько транзакций, надо быть уверенным в том, что обработку можно запускать повторно.
Page 18: Чего не хватает
Корректная обработка исключительных ситуаций
- Сохранение результатов обработки
- Решение
- не удалять обработанные сообщения, а помечать отдельным статусом
- потребуется правильный индекс
- потребуется периодическое удаление исторических данных
- обращаем внимание на очистку
Комментарии преподавателя
Во-вторых, наша реализация никак не обрабатывает исключительные ситуации. Это, конечно, несложно добавить. При возникновении исключения хотелось бы иметь информацию о том, что случилось.
Да и если событие обработано без ошибок, может быть полезным сохранять какую-то информацию об обработке. Это, конечно, зависит от конкретной задачи.
Наша реализация удаляет обработанные события из очереди, но вместо этого можно оставлять их, помечая специальным статусом («завершено», «ошибка» и т. п.). Тогда всю информацию об обработке можно иметь непосредственно в таблице с событиями. В таком случае потребуется эффективный доступ к еще не обработанным сообщениям: частичный индекс с условием pid IS NULL. (Другим решением может быть перенос обработанных событий в отдельную таблицу.)
За удобство потребуется платить реализацией периодического удаления «хвоста» очереди — исторических данных. Если период достаточно большой, то, возможно, удаление надо выполнять пакетами — чтобы не допускать лишнего разрастания таблицы и не мешать очистке.
И, поскольку таблица очередей изменяется довольно активно, надо обеспечить ее своевременную очистку, о чем говорилось в демонстрации.
Page 19: Итоги
Асинхронная обработка полезна во многих случаях
- Внешние системы имеет смысл использовать, если
- вписываются в общую архитектуру информационной системы
- к реализации предъявляются серьезные требования
- Очередь сообщений в базе данных — простое решение для простых задач
- важна правильная реализация:
- эффективное получение очередного события (SKIP LOCKED),
- избегание долгих транзакций,
- своевременная очистка таблицы очереди
- чем больше требований, тем сложнее будет реализация
Page 20: Практика
- В приложении предусмотрен механизм фоновых заданий, но серверная часть обработки очереди отсутствует.
- Напишите недостающие функции: - take_task — получает очередное задание из очереди; - complete_task — завершает обработку задания; - process_tasks — основной цикл обработки заданий. 2. Запустите процедуру обработки очереди заданий в фоновом режиме. Проверьте, что фоновые задания, поставленные в очередь в приложении, выполняются, а результаты их работы доступны для просмотра.
Комментарии преподавателя
- Фоновые задания позволяют запустить специально зарегистрированную функцию из пользовательского интерфейса и затем просматривать состояние и результат выполнения.
В качестве результата функция может возвращать множество строк, то есть в простейшем виде тело функции может состоять из одного SQL-запроса. На вход функция должна принимать один параметр типа jsonb. Пример задания: public.greeting_program.
Напишите подпрограммы take_task, complete_task и process_tasks по аналогии с показанными в демонстрации примерами. Учтите:
● take_task должна возвращать задачу в статусе «scheduled» и заполнить подходящие поля таблицы tasks:
started = текущее время, status = «running», pid = номер процесса.
● complete_task должна не удалять задание, а заполнить поля tasks:
finished = текущее время, при нормальном завершении: status = «finished», result = результат, в случае ошибки: status = «error», result = сообщение об ошибке.
● process_tasks не должна завершаться; организуйте бесконечный цикл с задержкой в 1 сек между задачами. Убедитесь, что в режиме ожидания не возникает долгой транзакции. Для удобства установите параметр application_name в значение «process_tasks».
Для фактического выполнения задания процедура должна вызвать функцию empapi.run(task tasks). В случае успешного выполнения функция вернет результат, оформленный в виде текстовой строки. В случае ошибки будет сгенерировано исключение.
Page 21: 1. Реализация обработки очереди заданий
Функция получения задания из очереди аналогична показанной в демонстрации, но должна учитывать поля таблицы:
(Игнорируйте столбцы host и port — они пригодятся в теме «Обзор физической репликации».)
Поскольку мы не будем удалять задания из очереди, создадим частичный индекс для эффективного доступа к следующему необработанному заданию:
Функция завершения работы с заданием дополнительно принимает статус завершения и текстовый результат:
Процедура обработки очереди:
Page 22: Page 22
Обратите внимание, что первая команда COMMIT предшествует команде CONTINUE. В противном случае при отсутствии заданий возникала бы долгая транзакция. Несколько слов о том, зачем нужна функция run. В принципе, выполнить задание и получить результат можно было бы таким образом:
К сожалению, PL/pgSQL не позволяет гибко работать со значениями составного типа: у значения неизвестного наперед типа (record) нельзя перебрать все имеющиеся в нем поля. Поэтому для вывода приходится полагаться на стандартное преобразование строки в текст. Это будет некрасиво выглядеть в случае нескольких полей:
Для аккуратного оформления результата можно воспользоваться другим процедурным языком. Мы используем функцию, написанную на PL/Python. Функция run не вызывается напрямую приложением, но в теме «Обзор физической репликации» мы будем вызывать ее на другом сервере, поэтому она находится в схеме empapi, а не public. Подробнее о том, в каких случаях могут пригодиться другие языки, будет рассказано в теме «Языки программирования».
2. Запуск обработки очереди в фоновом режиме
В очереди стоит тестовое задание:
Page 23: Page 23
Запускаем обработку (в один поток) и, если все сделано правильно, оно будет выполнено.
Между вызовами нужна небольшая задержка, чтобы функция pg_background_detach не освободила общую память до того, как фоновый процесс обратится к ней — такова особенность текущей реализации. Поэтому мы не вызываем обе функции в одном операторе. Подождем немного…
Задание успешно выполнено. Обратите внимание, что результат выполнения содержит и названия столбцов из оригинального запроса. Фоновые процессы, обрабатывающие очередь, легко найти благодаря тому, что процедура устанавливает параметр application_name:
Page 24: Практика+
- Напишите тест, проверяющий, что обработка очереди, показанная в демонстрации, работает корректно при выполнении в несколько потоков. Убедитесь, что тест не проходит, если убрать предложение FOR UPDATE SKIP LOCKED. 2. Добавьте в реализацию проверку «зависших» сообщений. Если такая ситуация будет обнаружена, зависшее сообщение должно быть снова принято в работу.
Комментарии преподавателя
- Вставьте в таблицу сообщений большое количество строк и проверьте, что:
а) было обработано каждое сообщение;
б) каждое сообщение было обработано ровно один раз.
Уберите из реализации секундную задержку (имитацию работы), чтобы тест выполнялся быстрее и с достаточным уровнем конкурентности между процессами.
Page 25: 1. Тестирование реализации очереди
Повторим реализацию очереди, показанную в демонстрации. Таблица:
Функция получения и блокирования очередного сообщения:
Функция завершения работы с сообщением:
В процедуру обработки очереди внесем изменение: вместо секундной задержки будем записывать информацию об обрабатываемом сообщении в отдельную таблицу:
Page 26: Page 26
Создаем большое количество сообщений:
Запускаем обработку в два потока, засекая время:
Проанализируем результаты. При корректной работе мы должны обнаружить в журнальной таблице ровно 1000 уникальных идентификаторов, что будет означать, что обработаны все события, и ни одно не обработано дважды.
Все корректно. Проверим теперь реализацию без предложения FOR UPDATE SKIP LOCKED.
Запускаем обработку:
Page 27: Page 27
Как видим, часть сообщений была обработана дважды. Например:
Это произошло из-за того, что сообщение, обрабатываемое одним процессом, никак не блокируется и доступно для другого процесса. Восстановим корректную функцию:
2. Обработка зависших сообщений
Мы можем перехватить ошибку, возникающую при обработке события, но тем не менее всегда есть шанс того, что сама процедура-обработчик завершится аварийно. Сымитируем такую ситуацию:
Запускаем обработку…
Page 28: Page 28
…а в это время в другом сеансе:
Обработчик «упал». Причем, благодаря команде LOCK TABLE, — сразу после того, как зафиксировал номер процесса в таблице очереди. В очереди остались необработанные сообщения и среди них — одно зависшее:
Самый простой способ исправить ситуацию — изменить функцию выбора сообщения:
Если события обрабатываются быстро и важна высокая пропускная способность, то проверку лучше выполнять отдельно и только время от времени, чтобы избежать постоянного обращения к pg_stat_activity. Снова запустим обработчик, и все сообщения, включая зависшее, будут обработаны.
Page 29: Page 29
14 Занятие 14: Расширяемость / Создание расширений
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_14_ext_extensions.html Archive: DEV2-handouts-16.zip Страниц PDF: 22
Page 1: Расширяемость / Создание расширений
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Расширения в PostgreSQL
- Создание расширений
- Версии расширений и обновление
- Особенности работы утилиты pg_dump
Page 3: Расширяемость PostgreSQL
Возможности
- функции и языки программирования
- типы данных, операторы, методы доступа
- обертки сторонних данных (FDW)
- Механизмы
- изменяемый системный каталог
- API для подключения внешних обработчиков
- загрузка и выполнение пользовательского кода
Комментарии преподавателя
Расширяемость — важнейшая черта PostgreSQL — это возможность подключать «на лету» новый функционал без изменения кода сервера.
Таким образом можно добавлять языки программирования и разрабатывать на них функции, определять новые типы данных и операторы для работы с ними, создавать новые методы доступа для типов данных, разрабатывать обертки сторонних данных для подключения к внешним источникам.
Для того чтобы это было возможным, системный каталог PostgreSQL хранит большое количество информации об объектах БД. Эта информация не зашита жестко в код сервера. Пользователи могут изменять содержимое таблиц системного каталога, тем самым добавляя новые объекты и связанный с ними функционал.
Кроме того, в исходном коде PostgreSQL встроено большое количество хуков и различных API для подключения пользовательских функций. Это дает возможность разрабатывать такие расширения как pg_stat_statements, auto_explain, pldebugger и многие, многие другие.
Завершает картину возможность загружать в серверные процессы пользовательский код. Например, можно написать разделяемую библиотеку и подключать ее по ходу работы.
https://postgrespro.ru/docs/postgresql/16/extend-how
В качестве предостережения следует отметить, что выполнение процессами сервера неправильно написанного пользовательского кода может привести к катастрофическим последствиям. Следует доверять только проверенному коду из надежных источников.
Page 4: Расширения
Группа взаимосвязанных объектов БД
- установка всех объектов одной командой
- невозможность удалить отдельный объект
- сохранение связи при выгрузке с помощью pg_dump
- инструменты для перехода на новую версию
- Источники
- в составе дистрибутива (contrib)
- внешние расширения
- возможность создания собственных расширений
Комментарии преподавателя
Бывают ситуации, когда несколько объектов базы данных логически связаны между собой. Например, несколько типов данных, функции и операторы для работы с ними, классы операторов. Такую связь можно сделать явной с помощью механизма расширений.
Это облегчает управление объектами:
● все объекты устанавливаются одной командой;
● невозможно удалить отдельный объект — расширение можно удалить только полностью;
● связь между объектами сохраняется и при создании резервной копии с помощью утилиты pg_dump;
● есть инструменты для управления версиями расширений.
В состав PostgreSQL входит значительное количество полезных расширений, частью из которых мы уже пользовались.
https://postgrespro.ru/docs/postgresql/16/contrib
https://postgrespro.ru/docs/postgresql/16/contrib-prog
Другой источник — PostgreSQL Extension Network (PGXN) — сеть расширений по аналогии с CPAN для Perl: https://pgxn.org/
Расширения могут распространяться и другими способами, в том числе через пакетные репозитории дистрибутивов ОС.
В этой теме мы рассмотрим, как создавать собственные расширения.
Page 5: Создание расширения
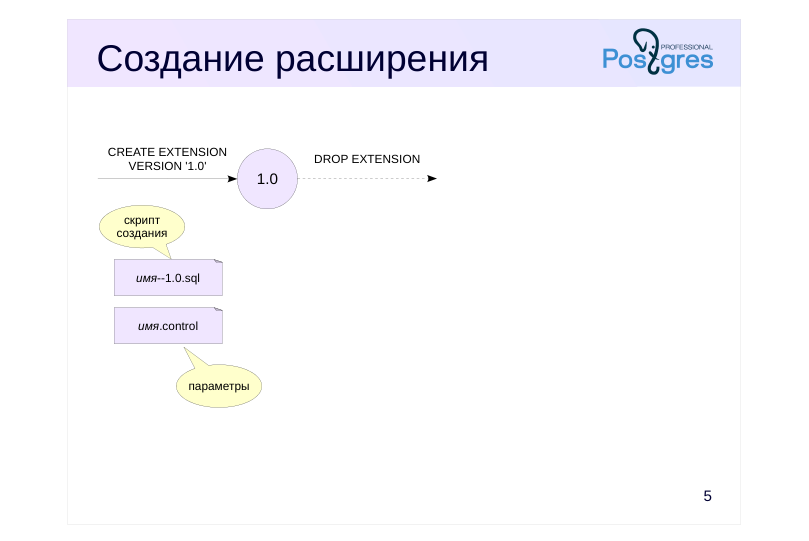 {#source-figure-005 caption=“Source slide page 5: Создание расширения”}
Комментарии преподавателя
Расширение устанавливается в базу данных командой CREATE EXTENSION. При этом должны существовать два файла:
● управляющий файл «имя.control» с параметрами расширения;
● скрипт создания объектов расширения «имя–версия.sql».
Версия традиционно имеет вид «1.0», «1.1» и т. д., но это не обязательно: ее имя может состоять из любых символов (но не должно содержать «–» и начинаться или заканчиваться на «-»).
Обычно версию не указывают в команде CREATE EXTENSION, поскольку текущая актуальная версия записана в управляющем файле (параметр default_version) и используется по умолчанию.
Другие параметры расширения указывают зависимости от других расширений (requires), возможность перемещения объектов расширения между схемами (relocatable), возможность установки только суперпользователем (superuser) и др.
https://postgrespro.ru/docs/postgresql/16/extend-extensions
https://postgrespro.ru/docs/postgresql/16/sql-createextension
Расширение удаляется командой DROP EXTENSION. Скрипт для удаления объектов писать не нужно.
https://postgrespro.ru/docs/postgresql/16/sql-dropextension
Page 6: Создание расширения
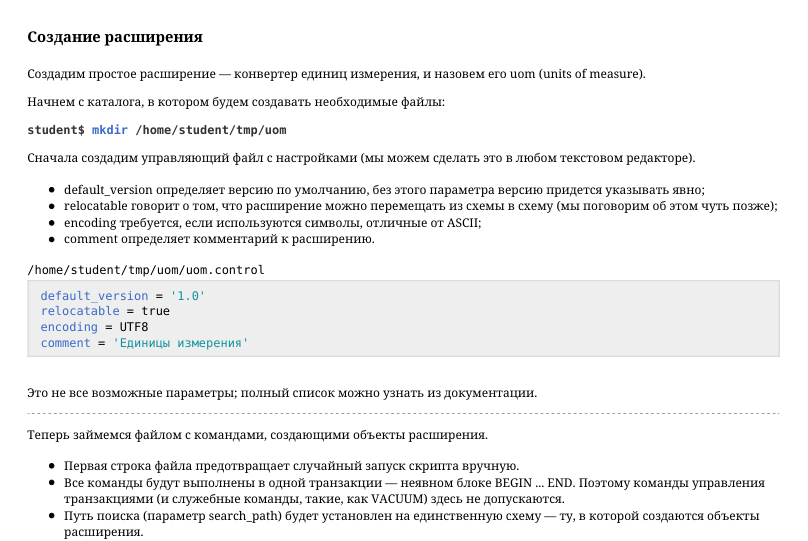 {#source-figure-006 caption=“Source slide page 6: Создание расширения”}
Создадим простое расширение — конвертер единиц измерения, и назовем его uom (units of measure). Начнем с каталога, в котором будем создавать необходимые файлы:
Сначала создадим управляющий файл с настройками (мы можем сделать это в любом текстовом редакторе). default_version определяет версию по умолчанию, без этого параметра версию придется указывать явно; relocatable говорит о том, что расширение можно перемещать из схемы в схему (мы поговорим об этом чуть позже); encoding требуется, если используются символы, отличные от ASCII; comment определяет комментарий к расширению.
Это не все возможные параметры; полный список можно узнать из документации. Теперь займемся файлом с командами, создающими объекты расширения. Первая строка файла предотвращает случайный запуск скрипта вручную. Все команды будут выполнены в одной транзакции — неявном блоке BEGIN … END. Поэтому команды управления транзакциями (и служебные команды, такие, как VACUUM) здесь не допускаются. Путь поиска (параметр search_path) будет установлен на единственную схему — ту, в которой создаются объекты расширения.
Чтобы PostgreSQL нашел созданные нами файлы, они должны оказаться в каталоге SHAREDIR/extension. Значение SHAREDIR можно узнать так:
Например, посмотрим на файлы расширения pg_background:
Конечно, файлы расширения можно скопировать вручную, но стандартный способ — воспользоваться утилитой make. Ей понадобится Makefile, который должен выглядеть, как показано ниже.
Page 7: Page 7
Переменная EXTENSION задает имя расширения; Переменная DATA определяет список файлов, которые надо скопировать в SHAREDIR (кроме управляющего); Последние строки не меняются. Они подключают специальный Makefile для расширений, который содержит всю необходимую логику сборки и установки. Важно, чтобы утилита pg_config была доступна — иначе неизвестны пути, по которым установлен PostgreSQL.
Теперь выполним make install в каталоге расширения:
Создадим базу данных и подключимся к ней:
Проверим, доступно ли наше расширение?
Попробуем создать в новой базе расширение uom:
Мы не указали версию, поэтому было взято значение из управляющего файла (1.0).
Все работает. Само расширение не относится к какой-либо схеме, но объекты расширения — относятся. В какой схеме они созданы?
Page 8: Page 8
Объекты установлены в схему, в которой они были бы созданы по умолчанию; в данном случае — public. При создании расширения мы можем указать эту схему явно:
Поскольку мы указали в управляющем файле, что расширение переносимо (relocatable), его можно переместить в другую схему:
Теперь все объекты находятся в схеме uom:
Можно ли прочитать данные из таблицы без указания схемы, где она расположена?
Нет, потому что теперь таблица не находится в пути поиска. А будет ли работать функция, если при ее вызове мы явно укажем схему? Напомним, что в определении тела функции обращение к таблице не включало название схемы.
Да, потому что код функции был оформлен в современном стиле стандарта SQL, а значит еще на этапе создания был выполнен его разбор и теперь обращение к таблице производится по ее идентификатору, а не по символическому имени. Позаботимся о путях поиска; данные из таблицы читаются:
Отметим, что некоторые расширения не допускают перемещения, но это бывает нечасто.
Page 9: Обновление расширения
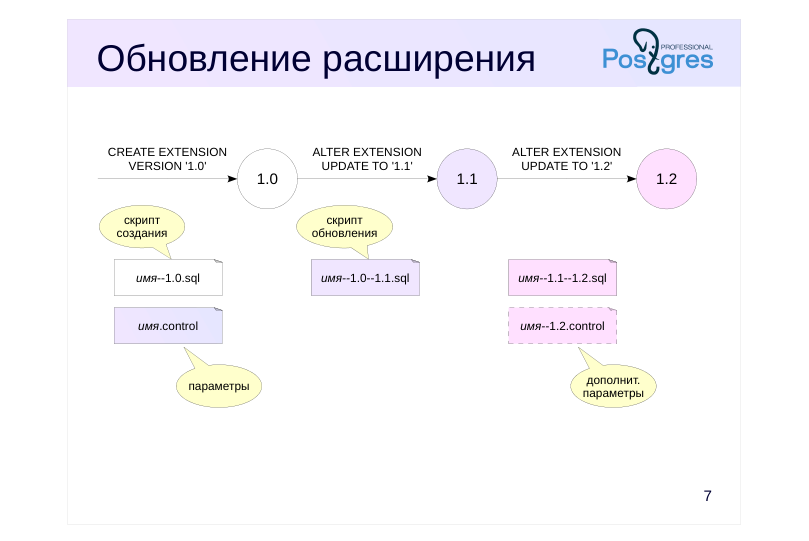 {#source-figure-009 caption=“Source slide page 9: Обновление расширения”}
Комментарии преподавателя
Обновление версии расширения выполняется командой ALTER EXTENSION UPDATE. При этом должен существовать скрипт обновления «имя–старая-версия–новая-версия.sql», содержащий необходимые для обновления команды.
Также необходимо изменить управляющий файл «имя.control», обновив актуальную версию и, возможно, другие параметры.
При необходимости может существовать и отдельный управляющий файл, привязанный к версии. Например, если в версии 1.2 появилась зависимость от другого расширения, то эту зависимость неправильно указывать в основном управляющем файле. Параметры, указанные в дополнительном управляющем файле, более приоритетны, чем параметры основного управляющего файла.
В примере, приведенном на слайде, имеются скрипты обновления 1.0→1.1 и 1.1→1.2. Можно создать и скрипт 1.0→1.2, но, как правило, это не требуется: механизм расширений сам берет на себя выбор пути с учетом доступных переходов между версиями. Например, если установлена версия 1.0, то ее можно обновить сразу до 1.2: сначала автоматически применится скрипт 1.0→1.1, а затем 1.1→1.2.
Как и при создании, при обновлении номер версии обычно не указывают — в этом случае обновление происходит до последней актуальной версии, записанной в основном управляющем файле.
https://postgrespro.ru/docs/postgresql/16/sql-alterextension
Page 10: Версии расширения и обновление
При некотором размышлении мы можем сообразить, что не любые единицы допускают преобразование. Например, метры нельзя пересчитать в килограммы. Создадим версию 1.1 нашего расширения, которая это учитывает. В управляющем файле исправим версию на 1.1:
И создадим файл с командами для обновления:
Добавим в Makefile новый файл в список DATA:
Выполним make install, чтобы разместить файлы расширения:
Какие версии расширения нам доступны?
Page 11: Page 11
Какие пути обновления доступны?
Очевидно, путь один. Заметьте, что если бы мы создали файл «uom–1.1–1.0.sql», можно было бы «понизить версию». Для механизма расширений имена версий ничего не значат. Выполним обновление:
Теперь нам доступен новый функционал:
Утилита pg\_dump
Что попадает в резервную копию базы данных, созданную с помощью утилиты pg_dump?
Page 12: Page 12
Вначале идут установки различных параметров сервера; Объекты расширения не попадают в резервную копию, вместо этого выполняется команда CREATE EXTENSION — это позволяет сохранить зависимости между объектами. В процессе работы с расширением пользователь может захотеть расширить справочник единиц измерения:
Что теперь попадает в резервную копию?
Сделанные пользователем изменения будут потеряны. Но этого можно избежать, если мы сможем разделить предустановленные значения и пользовательские. Подготовим версию 1.2 расширения.
В управляющем файле исправим версию на 1.2:
Создадим файл с командами для обновления. Вызов функции pg_extension_config_dump определяет, какие строки таблицы требуют выгрузки.
Page 13: Page 13
Добавим в Makefile новый файл в список DATA:
Выполним make install, чтобы разместить файлы расширения:
И выполним обновление:
Повторим эксперимент:
Что теперь попадает в резервную копию?
На этот раз все правильно: после создания расширения в таблицу добавляются строки, созданные пользователем.
Page 14: Page 14
Page 15: Итоги
Расширения — упаковка взаимосвязанных объектов БД, предназначенных для решения какой-либо задачи
- Расширения упрощают использование функционала
- Имеются средства для разработки собственных расширений
Page 16: Практика
- Создайте расширение bookfmt, содержащее все необходимое для работы с типом данных для формата изданий. Установите расширение, чтобы объединить имеющиеся в базе данных разрозненные объекты. 2. Воспользуйтесь стандартным расширением isn для того чтобы проверить корректность кодов ISBN у имеющихся в магазине книг.
Комментарии преподавателя
- Объекты базы данных, относящиеся к книжному формату — тип данных book_format, приведение типов, функции, операторы и класс операторов — мы создавали в темах «Пользовательские типы данных» и «Классы операторов».
Если создать расширение так, как это показывалось в демонстрации, то для его установки придется удалить из базы существующие объекты. Что, конечно, нежелательно для работающей системы.
Поэтому сначала создайте и установите пустое расширение, а затем напишите скрипт для его обновления, добавляющий к расширению уже имеющиеся в базе данных объекты с помощью команды ALTER EXTENSION ADD ….
- В достаточно старых книгах используется 10-значный код ISBN. С 2007 года для совместимости со штрихкодами используют 13-значный код ISBN (первые три цифры всегда равны 978).
Код имеет формат: 978 страна изд-во издание контрольная_цифра.
Между группами цифр обычно ставятся дефисы, но это незначащий символ. Контрольная цифра вычисляется по специальным правилам.
В расширении isn имеются функции isbn(text) для 10-значного кода и isbn13(text) для 13-значного. Если контрольная цифра неверна, функции вызывают ошибку.
Page 17: 1. Расширения для книжного формата
Сначала создадим «пустое» расширение без объектов.
Установим расширение.
Теперь напишем скрипт для обновления, в котором добавим в расширение уже существующие в базе объекты.
Page 18: Page 18
Выполним обновление:
Теперь все объекты объединены в расширение, которые мы при необходимости сможем развивать. А для того чтобы расширением могли воспользоваться другие, надо подготовить файл «bookfmt–1.0.sql» с командами, создающими все необходимые объекты.
2. Проверка кодов ISBN
Установим расширение:
Проблемные данные часто встречаются в реальных системах. В данном случае они могут быть вызваны не только ошибками при вводе, но и неправильно указанным кодом в самой книге. Расширение isn имеет возможность работы в нестрогом режиме, допуская ошибки (но предупреждая о них).
Page 19: Практика+
- Создайте расширение с функцией для подготовки текста к публикации. Функция должна применить к текстовому параметру последовательность правил, выполняющих замену по регулярному выражению, и вернуть результат. Правила должны храниться в таблице и применяться в порядке их вставки. К предопределенным правилам пользователь может добавлять собственные. Работа функции не должна зависеть от настройки пути поиска, но должна позволять выбрать схему при установке. 2. Установите расширение в схему typo, добавьте в таблицу пользовательское правило. Корректно ли выгружает копию базы данных утилита pg_dump? Проверьте возможность добавить правило после восстановления из резервной копии.
Комментарии преподавателя
- В качестве предопределенных правил используйте, например:
(^|\s)\"(\S) → \1«\2
(\S)\"(\s|$) → \1»\2
(^|\s)-(\s|$) → \1—\2
Эти правила заменяют (не всегда корректно) обычные символы на кавычки-елочки и тире:
- Буквы “р” нет, - сказал я. → — Буквы «р» нет, — сказал я.
Чтобы обеспечить независимость от пути поиска, расширение придется сделать непереносимым. Укажите соответствующий параметр в управляющем файла, а в теле функции используйте макрос @extschema@ для указания схемы, в которой находится таблица правил. Этот макрос будет заменен на выбранную схему при установке.
- Чтобы утилита pg_dump правильно выгружала пользовательские правила, используйте функцию pg_extension_config_dump и для самой таблицы, и для последовательности, созданной для первичного ключа.
При вызове pg_dump можно указать ключи –clean и –create, чтобы копия включала в себя команды для удаления и создания базы данных.
Page 20: 1. Расширение для подготовки текста
В управляющем файле указываем relocatable = false:
Создаем файл с командами.
Makefile и установка расширения в систему:
Page 21: 2. Проверка
Создаем базу данных и схему, и устанавливаем расширение:
При установке макрос был автоматически заменен на имя выбранной схемы:
Проверим:
Добавим правило:
Page 22: Page 22
Выгружаем копию базы данных и восстанавливаемся из нее (при восстановлении база данных будет удалена и создана заново):
Обратите внимание, что последней командой было установлено корректное значение последовательности. Если бы функция pg_extension_config_dump была вызвана только для таблицы, этого бы не произошло.
Проверяем:
15 Занятие 15: Расширяемость / Языки программирования
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_15_ext_languages.html Archive: DEV2-handouts-16.zip Страниц PDF: 23
Page 1: Расширяемость / Языки программирования
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Языки серверного программирования
- Доверенные и недоверенные языки
- Подключение нового языка
- Трансформации типов
- Интерфейс SPI для работы с базой
- Зачем нужны языки и из чего можно выбирать
Page 3: Языки программирования
«Встроенные»
- C
- SQL
- Стандартные (поддержка сообщества)
- PL/pgSQL
- PL/Perl, PL/Python, PL/Tcl
- Сторонние
- PL/Java, PL/V8, PL/R, PL/Lua, …
Комментарии преподавателя
Разумеется, к PostgreSQL можно обращаться «извне» из любых языков программирования (ЯП), для которых реализована поддержка клиент-серверного протокола. Но разные ЯП можно использовать и для программирования на стороне сервера: для написания хранимых функций и процедур.
В PostgreSQL «встроены» два ЯП: C, на котором написана вся система, и SQL. Эти языки доступны всегда.
В систему также входят четыре ЯП, которые имеются в стандартной поставке и поддерживаются сообществом. С одним из них — PL/pgSQL — мы уже хорошо знакомы. Он доступен по умолчанию и наиболее часто используется на стороне сервера. Другие языки — PL/Perl, PL/Python (только Python3, поддержка Python2 прекращена) и PL/Tcl — надо устанавливать как расширения. Такой (несколько странный) выбор языков обусловлен историческими причинами.
В документации языки, отличные от C и SQL, называются процедурными, отсюда и приставка «PL» в названиях. Название несколько неудачное: никто не мешает подключить к PostgreSQL функциональный или еще какой-нибудь язык. Поэтому лучше понимать PL как programming language, а не как procedural language.
https://postgrespro.ru/docs/postgresql/16/xplang
PostgreSQL — расширяемая система, поэтому имеется возможность добавления и других ЯП.
Page 4: Доверенные языки
Доверенные
- гарантируют работу пользователя в рамках выданного доступа
- ограничено взаимодействие с окружением и внутренностями СУБД,
- язык должен позволять работать в «песочнице»
- по умолчанию доступ для всех пользователей
- Недоверенные
- доступна полная функциональность языка
- доступ только у суперпользователей
- обычно к названию языка добавляют «u»: plperl → plperlu
Комментарии преподавателя
ЯП разделяются на доверенные (trusted) и недоверенные (untrusted).
Доверенные языки должны соблюдать ограничения доступа, установленные в системе. Если пользователь не имеет доступа к данным, подпрограмма на доверенном языке не должна предоставить ему такой доступ.
По сути это означает, что язык должен ограничивать взаимодействие пользователя с окружением (например, с операционной системой) и с внутренностями СУБД (чтобы нельзя было обойти обычные проверки доступа). Не все реализации языков умеют работать в таком режиме «песочницы».
Использование доверенного языка является безопасным, поэтому доступ к нему получают все пользователи (для роли public выдается привилегия usage на язык).
Недоверенные языки не имеют никаких ограничений. В частности, функция на таком языке может выполнять любые операции в ОС с правами пользователя, запустившего сервер базы данных. Это может быть небезопасным, поэтому доступ к такому языку имеют только суперпользователи PostgreSQL.
Напомним, что, если необходимо, суперпользователь может создать функцию на недоверенном языке, в том числе с указанием SECURITY DEFINER, и выдать право на ее исполнение обычным пользователям.
Page 5: Языки программирования
Проверим список установленных языков:
По умолчанию установлен только PL/pgSQL (C и SQL не в счет). Новые языки принято оформлять как расширения. Вот какие доступны для установки:
Первые четыре — из числа стандартных, а с двумя последними мы познакомимся позже. Установим в текущую базу данных два варианта языка PL/Perl: plperl (доверенный) и plperlu (недоверенный):
Чтобы языки автоматически появлялись во всех новых базах данных, расширения нужно установить в БД template1. Недоверенный язык не имеет ограничений. Например, можно создать функцию, читающую любой файл (аналогично штатной функции pg_read_file):
Page 6: Page 6
Что будет, если попробовать сделать то же самое на доверенном языке?
Вызов open (в числе прочего) запрещен в доверенном языке.
Page 7: Подключение нового языка
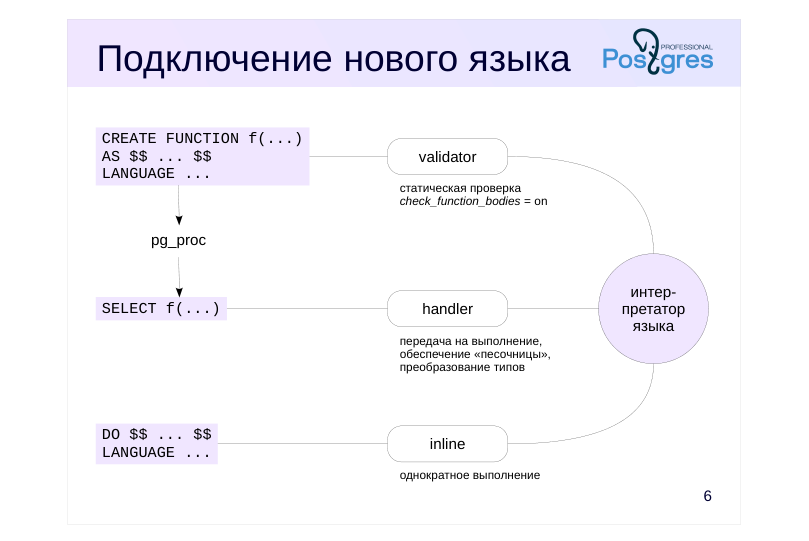 {#source-figure-007 caption=“Source slide page 7: Подключение нового языка”}
Комментарии преподавателя
Интерфейс подключения нового ЯП для использования на стороне сервера включает всего три функции.
При создании хранимой подпрограммы, ее код проверяется на наличие ошибок (validator). Если проверка проходит успешно, подпрограмма сохраняется в системном каталоге. При этом если подпрограмма оформлена в стиле стандарта SQL, то ее тело хранится в виде дерева разбора и будет обрабатываться обычным образом. В остальных случаях сохраняется только исходный код в виде текстовой строки. Компиляция поддерживается только для подпрограмм на языке C.
Проверку можно отключить параметром check_function_bodies; утилита pg_dump пользуется этим, чтобы снять зависимость от порядка создания объектов.
При вызове подпрограммы ее текст передается на выполнение интерпретатору языка, а полученный ответ возвращается в систему (handler). Если язык объявлен доверенным, интерпретатор должен запускаться в «песочнице». Здесь также решается важная задача преобразования типов. Не все типы SQL могут иметь аналоги в ЯП. Обычный подход в этом случае — передача текстового представления типа, но реализация может также учитывать определенные пользователем трансформации типов.
https://postgrespro.ru/docs/postgresql/16/sql-createtransform
При выполнении SQL-команды DO интерпретатору передается код для однократного выполнения (inline).
Из этих трех функций обязательна только функция-handler.
Page 8: Подключение нового языка
Если заглянуть, что выполняет команда CREATE EXTENSION, то для недоверенного языка в скрипте мы увидим примерно следующее:
А для доверенного (обратите внимание на слово TRUSTED):
В этой команде указываются имена функций, реализующих точки входа основного обработчика, обработчика для DO и проверки. Установим еще один язык — PL/Python. Он доступен только как недоверенный:
На его примере посмотрим, как происходит преобразование между системой типов SQL и системой типов языка. Для многих типов предусмотрены преобразования:
А что мы увидим в таком случае?
Здесь SQL-тип json был передан в функцию как строка, а возвращаемое значение было вновь преобразовано в jsonb из текстового представления.
Трансформации типов
Чтобы помочь обработчику языка, можно создать дополнительные трансформации типов. Для нашего случая есть подходящее расширение:
Page 9: Page 9
Фактически оно создает трансформацию таким образом (что позволяет передавать тип jsonb и в Python, и обратно в SQL):
Трансформацию необходимо явно указать в определении функции:
Теперь SQL-тип jsonb передается в Python как тип dict — словарь (ассоциативный массив).
Page 10: Интерфейс SPI
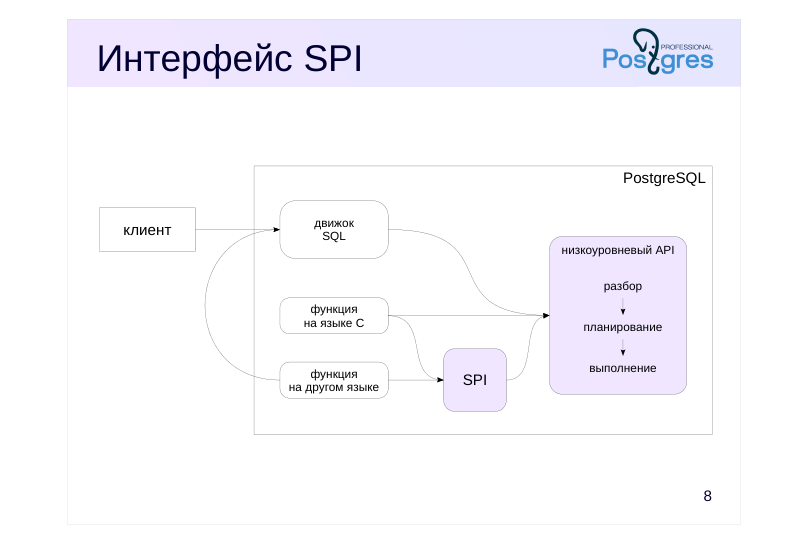 {#source-figure-010 caption=“Source slide page 10: Интерфейс SPI”}
Комментарии преподавателя
PostgreSQL располагает внутренним низкоуровневым API для работы с базой данных. Сюда входят функции для разбора и переписывания запроса, построения плана, выполнения запроса (включая обращения к таблицам, индексам и т. п.). Это самый эффективный способ работы с данными, но он требует внимания ко многим деталям, таким, как управление памятью, установка блокировок и т. д.
Движок SQL, являющийся частью каждого обслуживающего процесса, пользуется именно этим, низкоуровневым, API.
Для удобства имеется более высокоуровневый (но в ряде случаев менее эффективный) интерфейс: SPI, Server Programming Interface.
https://postgrespro.ru/docs/postgresql/16/spi
Интерфейс SPI рассчитан на язык C: подпрограмма на C может пользоваться как этим интерфейсом, так и — при необходимости — низкоуровневым.
Но, как правило, авторы языков программирования предоставляют обертки, позволяющие подпрограммам на этих языках тоже пользоваться SPI. Это значительно выгоднее, чем инициировать из подпрограммы новое соединение и использовать для работы с базой клиент-серверный протокол.
Page 11: Интерфейс SPI
Для доступа к возможностям SPI подпрограммы на языке Python автоматически импортируют модуль plpy (мы уже использовали функцию info из этого модуля — аналог команды RAISE INFO языка PL/pgSQL).
Напишем для примера функцию, возвращающую текстовое описание по ключу. Отсутствие ключа должно приводить к ошибке. Какие конструкции здесь соответствуют обращению к SPI?
Вызов plpy.prepare соответствует функции SPI_prepare (и SPI_keepplan), а plpy.execute — функции SPI_execute_plan. Также неявно вызывается SPI_connect и SPI_finish. То есть обертка языка может дополнительно упрощать интерфейс. Обратите внимание: Чтобы сохранить план подготовленного запроса, приходится использовать словарь SD, сохраняемый между вызовами функции; Требуется явная проверка того, что строка была найдена.
Показательно сравнить с аналогичной функцией на языке PL/pgSQL:
Page 12: Page 12
План подготавливается и переиспользуется автоматически; Проверка существования строки указывается словом STRICT.
Другие языки могут предоставлять другой способ доступа к функциям SPI, а могут и не предоставлять.
Page 13: Задачи
Обработка информации, хранимой в базе данных
- подпрограмма всегда выполняется в контексте подключения к БД
- PL/pgSQL интегрирован с SQL
- для остальных — интерфейс серверного программирования (SPI)
- Вычисления, не связанные с базой данных
- возможности PL/pgSQL сильно ограничены
- эффективность
- удобство использования
- наличие готовых библиотек
- специализированные задачи
Комментарии преподавателя
Задачи, для решения которых используются хранимые подпрограммы, можно условно поделить на две группы.
В первую входит работа с информацией, которая содержится внутри базы данных. Здесь любые хранимые подпрограммы выигрывают у внешних (клиентских) программ, поскольку они находятся ближе к данным: во-первых, не требуется установка соединения с сервером, и во-вторых, не требуется пересылка лишнего по сети. PL/pgSQL очень удобен для таких задач, поскольку тесно интегрирован с SQL.
Ко второй группе можно отнести обработку, не связанную с обращением к базе данных. Здесь возможности PL/pgSQL сильно ограничены. Начать с того, что он вычислительно не эффективен: любое выражение вычисляется с помощью запроса (для которого в ряде простых случаев исключен этап планирования).
Если бы были важны только эффективность и универсальность, можно было бы использовать язык C. Но писать на нем прикладной код крайне дорого и долго.
Кроме того, язык PL/pgSQL достаточно старомоден и не располагает возможностями и библиотеками, которые есть в современных ЯП, и он в принципе не пригоден для решения целого ряда задач.
Поэтому использование других языков (отличных от SQL, PL/pgSQL и C) для серверного программирования во многих случаях вполне оправдано.
Page 14: Из чего выбирать
Интенсивная работа с данными
- SQL, PL/pgSQL
- Проверенные, часто используемые
- PL/Perl, PL/Python, PL/V8, PL/Java
- Другие языки общего назначения
- PL/Go, PL/Lua, …
- Специальные задачи
- PL/R (статистика), PL/Proxy (удаленные вызовы), …
- Максимальная эффективность
- C
Комментарии преподавателя
Если подпрограммы используются для интенсивной работы с данными, лучшим выбором вероятно будут обычные SQL и PL/pgSQL.
Для других задач из штатных языков часто используют PL/Perl и PL/Python, а из сторонних — PL/V8 и PL/Java. (С PL/V8 могут быть сложности из-за того, что Debian и Red Hat перестали поставлять это расширение в виде пакета из-за сложностей со сборкой.)
Можно попробовать и другие языки, например, PL/Go или PL/Lua, если в этом есть смысл. Обязательно обращайте внимание на состояние проекта, активность сообщества, возможность получить поддержку.
Есть ряд специализированных языков. Например, для статистической обработки данных пригодится PL/R, для удаленного вызова процедур и шардинга можно использовать PL/Proxy.
В документации упомянуто некоторое количество языков:
https://postgrespro.ru/docs/postgresql/16/external-pl
Больше информации о доступных языках есть на вики:
https://wiki.postgresql.org/wiki/PL\_Matrix
Но и это не полный список. Есть множество других проектов, хотя многие из них не продвигаются дальше первой версии. Не следует сбрасывать со счетов и язык C, если нужна максимальная эффективность. Это сложнее, но в документации и в исходном коде PostgreSQL есть множество соответствующих примеров.
Page 15: Пример специализированного языка: XSLT
В качестве иллюстрации очень специализированного языка (который никак нельзя назвать процедурным!) посмотрим на PL/XSLT. Допустим, мы получаем данные для отчета с помощью запроса, и представляем их в формате XML:
Чтобы вывести отчет пользователю, его можно преобразовать в формат HTML с помощью XSLT-преобразования. Подключим язык PL/XSLT:
Вот так может выглядеть простое преобразование:
И вот результат:
Page 16: Page 16
Таким образом можно разделить логику отчета (обычный SQL-запрос) и его представление.
Page 17: Итоги
PostgreSQL позволяет подключать любые языки
- Богатый выбор языков программирования позволяет решать любые задачи на стороне сервера
Page 18: Практика
- Отправляйте пользователю, совершившему покупку в магазине, письмо-подтверждение с указанием суммы. В виртуальной машине настроен локальный почтовый сервер, пересылающий любую исходящую почту в локальный ящик пользователя student. В PostgreSQL нет встроенной функции для отправки писем, но ее можно реализовать на каком-либо недоверенном языке. Убедитесь, что письмо не может быть отправлено до того, как транзакция покупки будет завершена.
Комментарии преподавателя
- Для отправки пользуйтесь уже готовой функцией public.sendmail (посмотрите ее определение) или напишите свою.
Посылать письмо внутри транзакции покупки неправильно: транзакция может быть оборвана по какой-либо причине, а письмо уже уйдет. Воспользуйтесь механизмом фоновых заданий: в транзакции добавляйте задание на отправку письма. В таком случае оно будет отправлено, только если транзакция завершится успешно.
Page 19: 1. Почтовые сообщения
Простая функция для отправки почтовых сообщений через локальный почтовый сервер может выглядеть так:
Модуль email дает больше возможностей, но они нам не нужны. Создадим фоновое задание для отправки писем:
Функция checkout книжного приложения содержит вызов дополнительной функции, куда мы и поместим логику отправки письма:
Page 20: Page 20
Page 21: Практика+
- Языки Python и Perl имеют удобный тип данных — ассоциативный массив, — который отсутствует в PL/pgSQL. В Python это dict (словарь), в Perl — hash (хеш-таблица).
- Напишите на одном из этих языков функцию, получающую
- на вход текстовую строку и возвращающую таблицу из слов,
- которые встречаются в этой строке, с указанием количества
- вхождений.
- Решается ли эта задача на языке SQL? 2. Напишите функцию, которая по имени файла определяет и выводит его MIME-тип, аналогично команде shell
Комментарии преподавателя
Например: SELECT * FROM words_count(’the best of the best’); word | cnt ——+—– the | 2 of | 1 best | 2
Воспользуйтесь расширением plsh, установленным в виртуальной машине курса. Оно предоставляет язык PL/sh для написания функций на языке командой оболочки Unix.
Пример использования, приведенный автором (Питер Эйзентраут): CREATE FUNCTION concat(text, text) RETURNS text AS $$ #!/bin/sh echo “$1$2” $$ LANGUAGE plsh;
Обратите внимание, что обращение к параметрам возможно только по номеру.
Page 22: 1. Количество вхождений слов в строку
На SQL задача тоже решается элементарно. Здесь вместо явного использования ассоциативного массива мы полагаемся на реализацию группировки:
Фактически в обоих случаях используется хеш-таблица:
2. Тип файла
Page 23: Page 23
16 Занятие 16: Расширяемость / Агрегатные и оконные функции
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_16_ext_aggregates.html Archive: DEV2-handouts-16.zip Страниц PDF: 27
Page 1: Расширяемость / Агрегатные и оконные функции
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Создание пользовательских агрегатных функций
- Механизм работы оконных функций и их создание
- Параллельное выполнение агрегатных функций
Page 3: Агрегатные функции
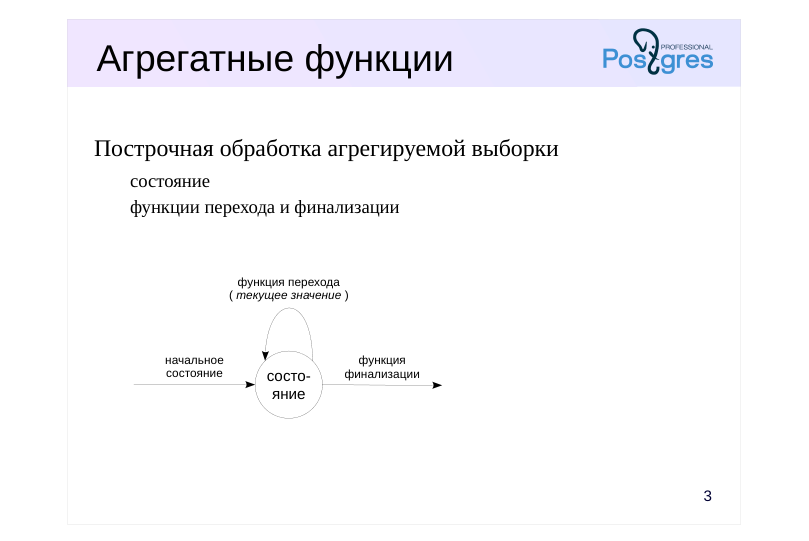 {#source-figure-003 caption=“Source slide page 3: Агрегатные функции”}
Построчная обработка агрегируемой выборки
- состояние
- функции перехода и финализации
Комментарии преподавателя
В PostgreSQL имеется достаточно много встроенных агрегатных функций. Часть из них определена стандартом (такие, как min, max, sum, count и т. п.), часть является расширением стандарта.
https://postgrespro.ru/docs/postgresql/16/functions-aggregate
Но иногда может оказаться полезным создать собственную агрегатную функцию. Такая функция работает очень просто.
Имеется некоторое состояние, представленное значением какого-либо типа данных, которое инициализируется определенным значением (например, тип numeric и начальное значение 0).
Для каждой строки агрегируемой выборки вызывается функция перехода, которая получает значение из текущей строки и должна обновить состояние (например, прибавляет текущее значение к состоянию).
В конце вызывается функция финализации, которая преобразует полученное в результате работы состояние в результат агрегатной функции (в нашем примере достаточно просто вернуть число — в итоге получается аналог функции sum).
https://postgrespro.ru/docs/postgresql/16/xaggr
Page 4: Агрегатные функции
Мы будем писать функцию для получения среднего, аналог встроенной функции avg. Начнем с того, что создадим таблицу:
Состояние должно включать сумму значений и их количество. Для его хранения создадим составной тип:
Теперь определим функцию перехода. Она возвращает новое состояние на основе текущего, прибавляя текущее значение к сумме и единицу к количеству. Мы также включим в функцию отладочный вывод, чтобы иметь возможность наблюдать за ее вызовом.
Функция финализации делит полученную сумму на количество, чтобы получить среднее:
И наконец нужно создать агрегат, указав тип состояния и его начальное значение, а также функции перехода и финализации:
Page 5: Page 5
Можно пробовать нашу агрегатную функцию в работе:
Благодаря отладочному выводу хорошо видно, как изменяется начальное состояние (0,0). Функция работает и при указании группировки GROUP BY:
Здесь видно, что используются два разных состояния — свое для каждой группы.
Page 6: Оконные функции
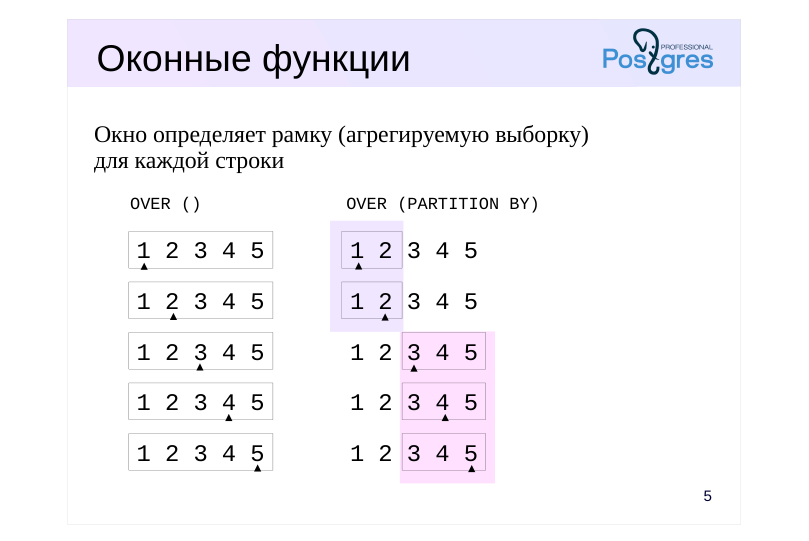 {#source-figure-006 caption=“Source slide page 6: Оконные функции”}
Окно определяет рамку (агрегируемую выборку) для каждой строки
Комментарии преподавателя
Оконные функции работают подобно агрегатным, вычисляя значение на основе некоторой выборки. Эта выборка называется рамкой. Но, в отличие от агрегатных функций, строки не сворачиваются в одну общую, а вместо этого значение вычисляется для каждой строки выборки.
Окно задается в предложении OVER после имени функции.
Если окно указано как OVER(), то оконная функция вычисляется на основе всех строк — одинаково для каждой строки выборки.
Если определение окна включает фразу PARTITION BY, то оконная функция вычисляется на основе групп строк (аналогично группировке GROUP BY). В этом случае для всех строк одной группы будет получено одинаковое значение функции.
Page 7: OVER()
Созданная нами агрегатная функция работает как оконная без всяких изменений:
Обратите внимание, что, поскольку рамка для всех строк одинакова, значение вычисляется только один раз, а не для для каждой строки. И для предложения PARTITION BY:
Здесь все работает точно так же, как для обычной группировки GROUP BY.
Page 8: Нарастающий итог
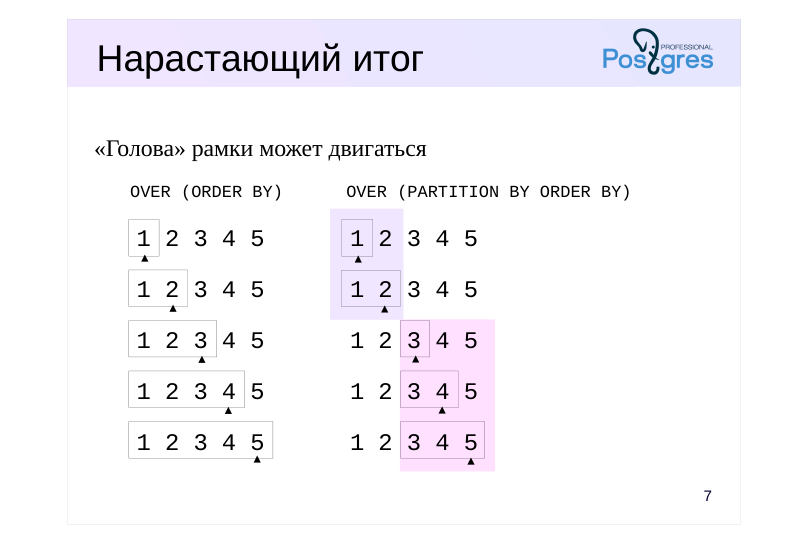 {#source-figure-008 caption=“Source slide page 8: Нарастающий итог”}
«Голова» рамки может двигаться
Комментарии преподавателя
Как только в определении окна мы указываем предложение ORDER BY, упорядочивающее строки выборки, предполагается, что рамка окна охватывает строки от самой первой до текущей. Это можно записать и явным образом: ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW.
Например, если в качестве оконной функции используется sum, мы получаем сумму «нарастающим итогом».
Конечно, для каждой группы строк, определяемых предложением PARTITION BY, рамка будет располагаться в пределах этой группы.
Page 9: OVER(ORDER BY)
Если добавить к определению окна предложение ORDER BY, получим рамку, «хвост» которой стоит на месте, а голова движется вместе с текущей строкой:
Снова не понадобилось никаких изменений — все работает. Здесь видно, как каждая следующая строка последовательно добавляется к состоянию и вызывается функция финализации. Полная форма того же запроса выглядит так:
То же самое работает и в сочетании с PARTITION BY:
Page 10: Скользящая рамка
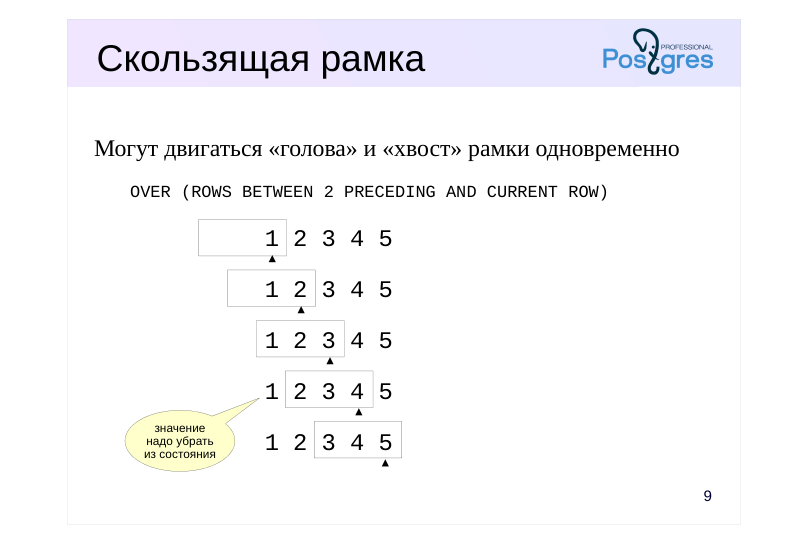 {#source-figure-010 caption=“Source slide page 10: Скользящая рамка”}
Могут двигаться «голова» и «хвост» рамки одновременно
Комментарии преподавателя
Рамку можно указать явно в предложении ROWS BETWEEN. В том числе двигаться может не только «голова» рамки, но и ее «хвост».
https://postgrespro.ru/docs/postgresql/16/sql-expressions#SYNTAX-WINDO W-FUNCTIONS
Если в предыдущих примерах рамка только расширялась (в нее добавлялись все новые значения), то теперь ранее добавленные значения значения могут «уходить» из рамки.
Чтобы пользовательская агрегатная функция работала эффективно в таком режиме, нужно реализовать функцию инверсии, которая устраняет значение из состояния.
Page 11: OVER(ROWS BETWEEN)
С помощью фразы ROWS BETWEEN можно задать любую необходимую конфигурацию рамки, указывая (в частности): UNBOUNDED PRECEDING — с самого начала; n PRECEDING — n предыдущих; CURRENT ROW — текущая строка; n FOLLOWING — n следующих; UNBOUNDED FOLLOWING — до самого конца. Рассмотрим вычисление «скользящего среднего» для трех значений. В отличие от предыдущих примеров из состояния должно «вычитаться» значение, уходящее из рамки, но у нас есть только функция «добавления». Единственный способ выполнить запрос — пересчитывать всю рамку заново:
Это, конечно, неэффективно, но мы можем написать недостающую функцию «инверсии»:
Нужно указать эту функцию в определении агрегата:
Page 12: Page 12
Пробуем:
Теперь лишние операции не выполняются.
Page 13: Параллелизм
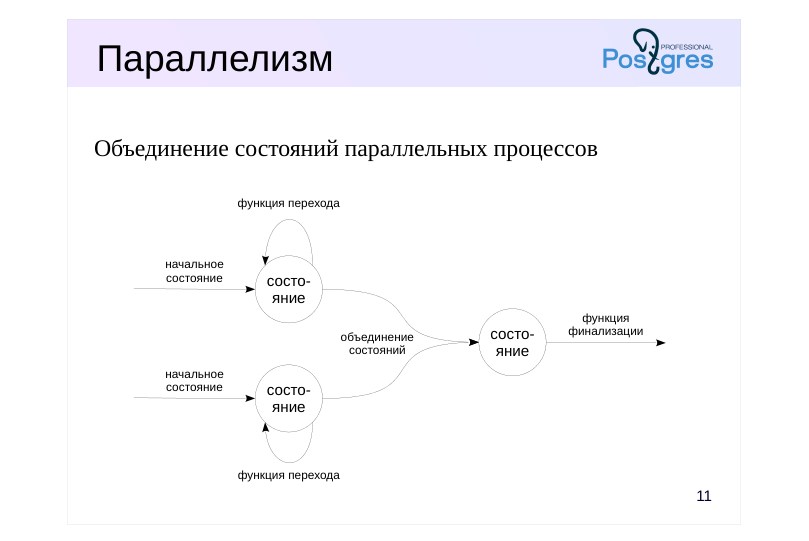 {#source-figure-013 caption=“Source slide page 13: Параллелизм”}
Объединение состояний параллельных процессов
Комментарии преподавателя
Агрегатные функции могут выполняться в параллельном режиме. Основной процесс, выполняющий запрос, может создать несколько фоновых рабочих процессов, каждый из которых будет выполнять параллельную обработку части данных в узле плана. Затем полученные результаты передаются в основной процесс, который собирает их и формирует общий результат.
Чтобы пользовательские агрегатные функции могли работать параллельно, нужно реализовать функцию объединения двух состояний в одно общее.
Page 14: Параллелизм
Таблица с пятью строчками, конечно, слишком мала для параллельного выполнения. Возьмем больше данных:
Встроенные агрегатные функции могут выполняться в параллельном режиме:
А наша функция — нет:
Чтобы поддержать параллельное выполнение, требуется еще одна функция для объединения двух состояний:
Кроме того, уберем отладочный вывод из функции перехода:
Пересоздадим агрегат, указав новую функцию и подтвердив безопасность параллельного выполнения:
Page 15: Page 15
Теперь наша функция тоже работает параллельно:
Здесь видно, что три процесса поделили работу примерно поровну, и затем три состояния были попарно объединены. В оконном режиме параллельное выполнение не поддерживается, в том числе и для встроенных функций.
Page 16: Итоги
PostgreSQL позволяет создавать агрегатные и оконные функции
- Агрегатные и оконные функции дают возможность использовать процедурную обработку в стиле SQL
Page 17: Практика
- Напишите отчет, выводящий складские остатки по каждой книге в денежном выражении (используя закупочную, а не розничную цену). Оформите отчет как фоновое задание. Учтите, что поступления происходят разными партиями по разной цене, а продажи никак не привязаны к партиям. Поэтому считайте, что в первую очередь продаются книги из более старых партий. 2. Дополните расширение bookfmt функциями min и max для формата издания. Обновите версию расширения и убедитесь, что функции появились в базе данных.
Комментарии преподавателя
- Начните с запроса к таблице operations, выводящего только поступления книг, но добавьте столбец, показывающий общее количество проданных книг данного поступления.
В качестве примера книги, для которой на складе остались экземпляры из нескольких партий, можно взять книгу с book_id = 15.
Напишите оконную функцию, вычисляющую при использовании в режиме «нарастающего итога» остаток книг данного поступления на складе (или решите задачу, используя имеющиеся оконные функции).
- Расширение bookfmt было написано в практике к теме «Создание расширений».
Page 18: 1. Отчет по складским остаткам
Начнем с простого запроса, который выводит поступления книг и добавляет к каждой строке количество проданных экземпляров данной книги:
Нам хотелось бы иметь функцию, которая на основании столбцов qty и sold_qty вычислит остаток книг от каждого поступления. Состояние такой агрегатной функции, которую мы будем использовать в режиме «нарастающего итога», включает два целых числа: количество книг, уже распределенных между поступлениями; количество нераспроданных книг в текущем поступлении.
Функция перехода увеличивает количество распределенных книг на число книг в поступлении, но только до тех пор, пока оно не превышает общего числа проданных книг:
Page 19: Page 19
Функция финализации просто возвращает количество нераспроданных книг текущего поступления:
Создаем агрегат, указав тип состояния и его начальное значение, а также функции перехода и финализации:
Добавим новую агрегатную функцию к запросу, указав группировку по книгам (book_id) и сортировку в порядке времени совершения операций:
Осталось убрать условие для конкретной книги, умножить остаток на цену, сгруппировать результат по книгам и оформить запрос в виде функции, чтобы зарегистрировать ее как фоновое задание:
Page 20: Page 20
Заметим, что задачу можно решить и с помощью стандартных оконных функций:
Page 21: Page 21
Разумеется, отчет нетрудно сделать более наглядным, выводя название книги вместо идентификатора.
2. Min и max для типа book\_format
Сейчас функции min и max работают не в соответствии с определенным ранее классом операторов:
А вот правильный порядок:
Page 22: Page 22
Создадим версию 1.1 расширения с учетом следующего: Состоянием для агрегатной функции является текущее минимальное (максимальное) значение. Функция перехода записывает в состояние минимальное (максимальное) из двух значений — запомненного в состоянии и текущего. Функция финализации не нужна — возвращается просто текущее состояние.
При создании агрегата мы дополнительно указали оператор сортировки, реализующий стратегию «меньше» («больше») класса операторов, чтобы планировщик мог оптимизировать вызов наших агрегатных функций, просто получая первое значение из индекса.
Page 23: Page 23
Выполним обновление:
Проверим:
Page 24: Практика+
- Напишите агрегатную функцию, вычисляющую средневзвешенное значение для совокупности элементов нескольких типов. Веса для типов элементов передаются функции в виде массива. 2. Бизнес-центр сдает офисы компаниям. В конце месяца администрации БЦ приходит общий счет за электроэнергию, который надо распределить между арендаторами пропорционально площади занимаемых помещений. Выставляемые арендаторам счета необходимо округлить до копеек, но так, чтобы их сумма совпала со значением, указанным в общем счете.
Комментарии преподавателя
- Средневзвешенное значение совокупности элементов — среднее значение, учитывающее вес, или важность, каждого элемента. Значение вычисляется по формуле (x1w(t1) + x2w(t2) + … + xnw(tn)) / (w(t1) + w(t2) + … + w(tn)), где
xi — значение элемента, ti — тип элемента, w(ti) — вес элемента данного типа.
Требуется написать агрегатную функцию следующего вида: w_agv(x float, t integer, w float[]).
- Помещения бизнес-центра можно представить таблицей:
Пример, показывающий проблему с обычным округлением:
Page 25: 1. Средневзвешенное значение
Рассмотрим задачу на примере данных об оценках за экзаменационные работы. Пусть в экзаменационный билет входят теоретические вопросы (тип 1) и практические задания (тип 2), причем задания имеют больший вес в итоговой оценке.
Состояние опишем как составной тип, состоящий из суммы произведений значений на соответствующий вес и суммы весов:
Функция перехода будет получать (кроме состояния) три параметра: текущее значение, его тип и массив весов:
Функция финализации вычисляет средневзвешенное как отношение суммы произведений значений на соответствующие веса к сумме весов:
Теперь объявляем агрегат:
Page 26: Page 26
А теперь подсчитаем средневзвешенные оценки за экзамен, сданный студентами, полагая, что решение практической задачи вдвое ценнее ответа на теоретический вопрос:
2. Округление копеек
Состояние агрегатной функции будет включать округленную сумму и ошибку округления:
Функция перехода добавляет к состоянию округленную сумму и ошибку округления. А если ошибка округления переваливает за полкопейки, то добавляет копейку к сумме.
Функция финализации возвращает округленную сумму:
Page 27: Page 27
Объявляем агрегат:
Пробуем. Нам нужен какой-то определенный, но не важно какой именно, порядок просмотра строк. В данном случае подходит арендатор, поскольку он уникален.
17 Занятие 17: Расширяемость / Обзор полнотекстового поиска
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_17_ext_fts_overview.html Archive: DEV2-handouts-16.zip Страниц PDF: 32
Page 1: Расширяемость / Обзор полнотекстового поиска
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Зачем нужен полнотекстовый поиск?
- Документы и запросы
- Анализаторы
- Словари и шаблоны
- Конфигурации
- Индексная поддержка
Page 3: Зачем текстовый поиск?
Средства SQL — LIKE, регулярные выражения
- нет морфологического поиска
- нет возможности ранжирования результатов
- нет индексной поддержки
- Внешние поисковые системы
- сложно синхронизировать с базой данных
- отсутствие транзакционности
- нет доступа к метаданным
- сложности с разграничением доступа
Комментарии преподавателя
В инструментарии SQL уже есть средства поиска по тексту. Это и совсем простые команды LIKE и ILIKE, и упрощенные регулярные выражения SIMILAR TO, и полноценные регулярные выражения (оператор ~). Зачем нужен отдельный механизм?
Имеющиеся средства не позволяют искать с учетом разных словоформ, не позволяют отранжировать результаты по релевантности, имеют ограниченную индексную поддержку (для простого случая префиксного поиска, либо с помощью триграмм, как было показано в практике темы «Классы операторов»).
Для поиска можно использовать внешние поисковые системы. Но и они имеют ряд ограничений, которые невозможно преодолеть из-за того, что такие системы оторваны от базы данных. Их сложно синхронизировать с актуальным содержимым БД; они не транзакционны; они видят только те документы, которые им показывают, и не видят остальной информации в базе; сложно реализовать разграничение прав доступа к информации.
Полнотекстовый поиск позволяет преодолеть ограничения обычных средств SQL и сохранить все их преимущества.
https://postgrespro.ru/docs/postgresql/16/textsearch
Page 4: Документы и запросы
Документ
- произвольный текст, который можно разобрать на слова (лексемы)
- docx, pdf и т. п. надо предварительно преобразовать в текст
- внутреннее компактное представление tsvector
- Запрос
- одна или несколько лексем, соединенных логическими связками:
- &
- и
- |
- или
- !
- не
- <->
- предшествует (фразовый поиск)
- ( )
- для изменения приоритета
- внутреннее представление tsquery
Комментарии преподавателя
Документ, по которому нужен поиск, должен быть предварительно переведен в специальное представление — тип данных tsvector.
Исходный документ может быть произвольным текстом, который можно разобрать на отдельные слова (точнее, лексемы — разницу подробнее рассмотрим дальше). По двоичным документам тоже можно искать, если предварительно перевести их в текстовый вид (с помощью сторонних библиотек).
Поисковый запрос также должен быть представлен значением специального типа — tsquery. Запрос может состоять либо из одной лексемы, либо из нескольких лексем, связанных логическими операторами «и», «или», «не». Также поддерживается оператор предшествования, который обеспечивает фразовый поиск: можно найти документ, содержащий заданные слова не в любом месте, а стоящие рядом (или на определенном расстоянии друг от друга).
https://postgrespro.ru/docs/postgresql/16/datatype-textsearch
Page 5: Соответствие
Соответствие документа запросу
- оператор @@
- Релевантность
- веса лексем (A, B, C, D в порядке убывания важности)
- ts_rank — по частоте найденных лексем
- ts_rank_cd — также учитывает близость лексем
- оператор расстояния <=> (расширение rum)
Комментарии преподавателя
Чтобы проверить, соответствует ли документ (точнее, его представление в виде tsvector) запросу (точнее, его представлению tsquery), надо использовать оператор @@.
Результаты запроса можно ранжировать по «релевантности», чтобы понять, какие из найденных документов больше соответствуют запросу, а какие — меньше.
Релевантность учитывает вес лексем, который может быть задан буквенной меткой от A до D. По умолчанию (если метки нету) лексеме присваивается наименьшая важность (D). Выделение весами позволяет считать более важными, например, слова из заголовка или краткой аннотации по сравнению со словами в основном тексте документа.
В PostgreSQL есть две встроенные функции: ts_rank (учитывает, насколько часто лексемы из запроса встречаются в документе) и ts_rank_cd (дополнительно учитывает близость найденных лексем). Обе функции позволяют отмасштабировать свой результат с учетом размера документа.
https://postgrespro.ru/docs/postgresql/16/functions-textsearch
Расширение rum (https://github.com/postgrespro/rum) вводит еще одну возможность: оператор расстояния <=>, представляющий собой комбинацию функций ts_rank и ts_rank_cd.
Заметим, что в PostgreSQL не реализована возможность поиска документов, «похожих» на другой документ (основанная, например, на методе TF-IDF).
Page 6: Язык запросов
Будем знакомиться с полнотекстовым поиском на примере базы сообщений из рассылки pgsql-hackers за 1997-2017 года. Эта база уже загружена из резервной копии командой
База представлена одной таблицей:
Мы преимущественно будем смотреть на темы писем, потому что они достаточно короткие. Общее количество записей:
Чтобы воспользоваться полнотекстовым поиском, документ надо привести к типу tsvector, а запрос — к типу tsquery. Простой пример, в котором поисковый запрос состоит из одного слова:
Стоит обратить внимание, что найдены документы, содержащие разные формы слова magical, независимо от регистра букв. Позже мы узнаем, как это происходит. Язык запросов позволяет использовать логические связки. Документы, содержащие magic и value:
Page 7: Page 7
Документы, содержащие magic и value, но не time:
Документы, содержащие magic и либо value, либо constant:
Также доступен фразовый поиск, учитывающий порядок и близость позиций лексем. Например, для фразы «time value»:
Или та же фраза «time value», но между словами должно быть еще одно любое слово:
Имеется также функция, позволяющая получить поисковый запрос, не указывая логические связки, примерно как в веб-поиске. Например, такой запрос:
эквивалентен следующему:
Page 8: Page 8
Как вывести результат, если поиск идет по большому документу? Запрос выдаст нам весь текст письма:
Но можно воспользоваться функцией для форматирования результата, чтобы показать то место в документе, где обнаружено соответствие:
Page 9: Page 9
Page 10: Анализатор
документ → анализатор → фрагмент+тип, фрагмент+тип, …
- Выделяет в тексте документа фрагменты и назначает фрагментам типы
- Штатный анализатор default
- 23 типа фрагментов (слова, числа, адреса, теги XML и т. п.)
- Другие анализаторы
- расширения
- набор функций на языке C
Комментарии преподавателя
Рассмотрим, как происходит превращение исходного документа в tsvector, а запроса в tsquery.
Вначале документ пропускается через анализатор (parser), который выделяет в нем фрагменты (tokens). Более того, каждому фрагменту анализатор сопоставляет тип, который используется для дальнейшей обработки. Например, стандартный анализатор (единственный встроенный в PostgreSQL) выделяет 23 типа фрагментов: слова, числа, адреса url и email, XML-теги и другие. За счет этого он довольно универсален.
Чтобы использовать другой анализатор, его нужно написать на языке C, скомпилировать и подключить. Существуют расширения, которые устанавливают уже готовые анализаторы. Например, https://github.com/postgrespro/pg\_tsparser — анализатор, построенный на базе стандартного, но он не считает подчеркивание и минус символами-разделителями слов (что полезно для индексации программного кода).
https://postgrespro.ru/docs/postgresql/16/textsearch-parsers
Page 11: Анализатор
Единственный установленный анализатор называется default:
Посмотрим, как он разбивает текст на фрагменты — с помощью служебной функции:
На этом этапе слова остаются без изменений. Обратите внимание, что из одного слова может получиться несколько «пересекающихся» фрагментов. Типы фрагментов, выделяемые анализатором, можно посмотреть так:
Page 12: Page 12
Page 13: Словари
фрагмент → словарь → лексема, лексема, …
- Словарь превращает фрагмент в лексему
- убрать стоп-слова
- привести буквы к одному регистру
- привести словоформы к общему виду
- привести синонимы к одному варианту
- и т. п.
- Штатные словари
- simple — нижний регистр и стоп-слова
- стемминг для 28 языков
Комментарии преподавателя
Полученный от анализатора фрагмент пропускается через словарь и превращается в лексему (lexeme) или в несколько лексем.
Смысл такого преобразования в том, чтобы «нормализовать» слова, привести их к такому виду, чтобы их было легко найти. Например:
● из текста можно убрать стоп-слова (которые встречаются почти в каждом документе, так что искать их бессмысленно);
● можно привести слова к одному регистру;
● можно отрезать от слов изменяющиеся части (окончания), чтобы находить любые словоформы (стемминг);
● можно свести все синонимы к одному.
В PostgreSQL изначально установлен словарь simple, а также словари стемминга для 28 языков, которые отрезают от слов изменяемые части. Такие словари работают быстро, но не всегда точно, потому что опираются не на словарь, а на алгоритмы.
https://postgrespro.ru/docs/postgresql/16/textsearch-dictionaries
Page 14: Шаблоны словарей
Словарь — параметризованный шаблон
- набор функций на языке C
- Штатные шаблоны
- простой словарь
- стеммер snowball
- словарь ispell
- синонимы: приведение синонимов к одному виду
- тезаурус: приведение фраз к одному виду
Комментарии преподавателя
Чтобы добавить новый словарь, нужно воспользоваться шаблоном (template), параметризовав его. Шаблон — это, по сути, набор функций на C, реализующих словарь.
В PostgreSQL входят несколько шаблонов:
● простой словарь simple (выполняет преобразование в нижний регистр и проверяет результат по списку стоп-слов);
● словарь snowball (использует специфический стеммер для заданного языка, есть возможность задать свой список стоп-слов);
● словарь ispell (поддерживает морфологические словари, в том числе MySpell и Hunspell, используемые, например, в OpenOffice);
● словарь синонимов, позволяющий определять синонимы для слов;
● «тезаурус», позволяющий заменять синонимами целые фразы.
Page 15: Словари
Посмотрим, как работает стемминг. Функция вернет нам заменяющую слово «The» лексему, обратившись к указанному в первом параметре словарю:
Это стоп-слово, оно исчезает. Другой пример:
Слово приведено к нижнему регистру и отброшено окончание «s» — таким образом, мы найдем документ, если будем искать «bell» или «bells». А превратится ли слово «went» в «go»?
Нет — стемминг не справится с формами слова, для этого нужен полноценный морфологический словарь. Представим, что в нашем документе встречаются слова с диакритическими знаками. Обычный стемминг сохранит букву с умляутом, но с точки зрения поиска это может быть нежелательным:
Воспользуемся расширением unaccent, чтобы избавиться от умляута.
Page 16: Конфигурация
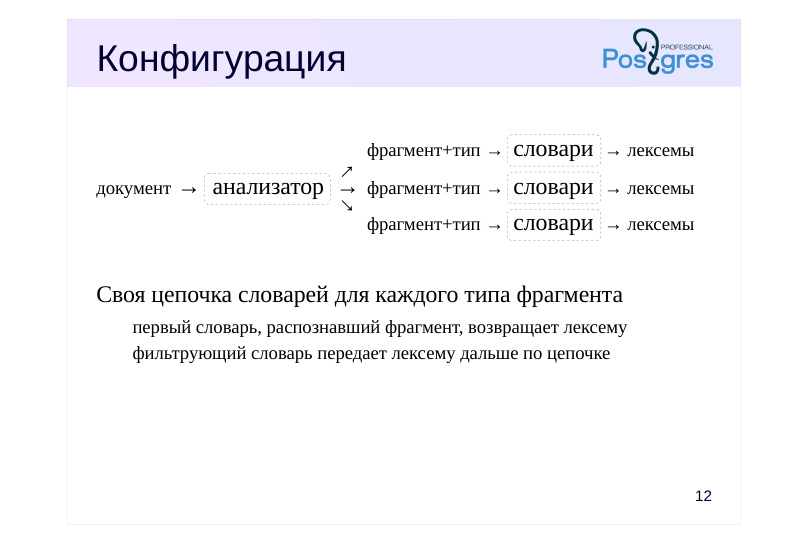 {#source-figure-016 caption=“Source slide page 16: Конфигурация”}
фрагмент+тип → словари → лексемы
- документ → анализатор → фрагмент+тип → словари → лексемы
- фрагмент+тип → словари → лексемы
- Своя цепочка словарей для каждого типа фрагмента
- первый словарь, распознавший фрагмент, возвращает лексему
- фильтрующий словарь передает лексему дальше по цепочке
Комментарии преподавателя
Итак, документ пропускается через анализатор, который выделяет в нем фрагменты. Какие именно словари будут использоваться для преобразования фрагмента в лексемы, определяется его типом. Таким образом можно по-разному обрабатывать слова, числа и т. п.
Анализатор и цепочки словарей для каждого типа фрагмента настраиваются и называются конфигурацией текстового поиска.
Каждый словарь в цепочке решает, что именно делать с фрагментом:
● Фрагмент можно отфильтровать как стоп-слово. На этом обработка фрагмента, очевидно, прекращается.
● Фрагмент можно заменить на лексему и прекратить обработку. Например, словарь simple переводит любое слово в нижний регистр и умеет фильтровать стоп-слова.
● Фрагмент можно заменить на лексему, но передать ее дальше, чтобы другие словари также смогли обработать ее (такой словарь называется фильтрующим).
● Наконец, словарь может не опознать фрагмент и передать его дальше без изменений. Так, например, поступает словарь синонимов: если синоним не найден, фрагмент передается дальше по цепочке.
https://postgrespro.ru/docs/postgresql/16/textsearch-configuration
Page 17: Настройка конфигурации
Для каждого типа фрагментов настраивается цепочка словарей — такая настройка называется конфигурацией. Доступные конфигурации:
Одна из них выбирается в качестве конфигурации по умолчанию и используется, если явно не указать другую:
Посмотрим на эту конфигурацию подробнее:
Page 18: Page 18
Например, для слов (word) используется стемминг английского языка (english_stem). Встроим в конфигурацию словарь, который при обработке английских слов устраняет диакритические знаки. Для этого зададим цепочку словарей для лексем типа «слово» (word):
Unaccent — фильтрующий словарь, поэтому к полученной лексеме далее будет применен стемминг. Проверим:
Итак, во что же превращается исходный текст при преобразовании в tsvector?
Конечный результат — список лексем и их позиций в документе.
Page 19: Page 19
Аналогичное преобразование проходит и поисковый запрос:
Page 20: Индексная поддержка
GiST
- неточное представление с обязательной перепроверкой по таблице
- эффективность уменьшается при увеличении количества слов
- поддержка INCLUDE
- быстрое обновление (зависит от числа документов)
- GIN
- точное и компактное представление
- эффективность не теряется при увеличении количества слов
- медленное обновление (зависит от числа слов в документах)
- RUM (расширение на основе GIN)
- дополнительная информация в индексе (позиции лексем и др.)
- выдача результатов сразу в порядке релевантности
Комментарии преподавателя
От полнотекстового поиска требуется не только функциональность, но и скорость работы. Для ускорения поиска используются индексы нескольких типов.
Индекс GiST хорош быстрым обновлением (что важно, если документы активно изменяются) и поддерживает функциональность INCLUDE (поможет стать покрывающим для запроса). Однако он не обеспечивает высокой скорости поиска и его эффективность понижается с ростом числа слов.
Индекс GIN — основной выбор для полнотекстового поиска. Он обеспечивает быстрый поиск (производительность не деградирует с увеличением числа слов), хотя и медленно обновляется при изменении документов.
Проблемы этих двух традиционных индексов в том, что они учитывают только лексемы, но отбрасывают их позиции в документе и другую вспомогательную информацию, в том числе веса. Поэтому они хороши для поиска, но в принципе не могут ускорить ранжирование. По той же причине не ускоряется фразовый поиск.
Индекс RUM (доступный как расширение: https://github.com/postgrespro/rum) нацелен на устранение этого недостатка: он позволяет выдавать результаты сразу в порядке релевантности и ускоряет поиск фраз.
https://postgrespro.ru/docs/postgresql/16/textsearch-indexes
Page 21: Производительность текстового поиска
Вернемся к примеру с архивом почтовых рассылок. Как мы видели, поиск может выполняться довольно долго, даже если искать по темам писем:
Что можно сделать? Во-первых, необходимо избавиться от преобразования документов в tsvector каждый раз, когда требуется что-то найти. Добавим в таблицу столбец типа tsvector и заполним его. Учтем сразу и тему письма, и текст. У вектора поиска есть ограничение на размер слова, поэтому слишком длинные последовательности символов игнорируются. Благодаря конструкции GENERATED ALWAYS, значения в столбце будут автоматически вычисляться для новых и измененных строк. Единственное ограничение: выражение должно иметь категорию изменчивости IMMUTABLE. Другой традиционный способ — обновлять значение с помощью триггера. Создание отдельного столбца для tsvector — наиболее эффективное решение. Единственный минус состоит в том, что требуется дополнительное место для хранения tsvector. Вместо создания столбца можно было бы сразу построить индекс по соответствующему выражению. В этом случае места нужно меньше, но эффективность поиска может страдать из-за необходимости повторных вычислений tsvector по документу.
Теперь в запросе можно использовать уже готовое поле, но, конечно, будет по-прежнему просматриваться вся таблица:
Поэтому следующий шаг к ускорению поиска — индексная поддержка. Мы создадим индекс типа GIN. Это обычный выбор для полнотекстового поиска: индекс имеет сравнительно небольшой размер и обеспечивает более высокую точность поиска, чем GiST.
Page 22: Page 22
Как видно, поиск теперь использует индекс и выполняется гораздо быстрее. Вряд ли нам нужны все несколько тысяч результатов. Допустим, мы хотим получить десять наиболее релевантных.
Сначала находятся все результаты, ранжируются, сортируются, и только потом отбираются 10 лучших. Конечно, это неэффективно. Такие запросы можно ускорить с помощью RUM-индекса.
Индекс типа RUM устроен так же, как GIN, но дополнительно хранит информацию о позициях лексем. Это позволяет вычислять релевантность (степень соответствия документа поисковому запросу) непосредственно при обходе индекса.
Вот как выглядит запрос, использующий упорядочивающий оператор <=>:
Page 23: Page 23
Page 24: Итоги
Интегрированный полнотекстовый поиск обеспечивает
- актуальность результатов
- транзакционность
- учет языковых особенностей
- фразовый поиск
- ранжирование результатов
- индексную поддержку
- Поиск охватывает любую информацию, приводимую к текстовому виду
- Возможна тонкая настройка под конкретные нужды
Page 25: Практика
- Сейчас поиск в книжном магазине работает только по названиям книг. Замените его на полнотекстовый поиск по названиям книг, полным именам авторов и аннотациям. Проверьте сделанные изменения в приложении. Убедитесь, что поиск не зависит от формы слов в запросе.
Комментарии преподавателя
- Добавьте в таблицу books столбец типа tsvector, генерируемый по необходимым значениям. Учтите, что значение tsvector должно зависеть от данных из нескольких таблиц.
Посмотрите код функции public.get_catalog и подумайте, что нужно сделать, чтобы заменить существующее условие поиска на полнотекстовое.
Для проверки найдите книги по запросам «проблема» и «проблемы».
Page 26: 1. Полнотекстовый поиск в приложении
Добавим столбец типа tsvector:
Для поиска нам требуются данные нескольких таблиц, поэтому конструкция GENERATED ALWAYS не годится и придется воспользоваться триггером. Начнем с функции, создающей необходимое значение tsvector:
Мы используем конфигурацию поиска для русского языка, чтобы поиск работал без учета окончаний. Теперь напишем триггерную функцию и триггер для таблицы books:
Но измениться может и имя автора, и состав авторов книги, поэтому также требуются триггеры на таблицы authors и authorships. Причем следует использовать триггеры AFTER, чтобы функция build_tsv брала из этих таблиц уже измененные данные. В случае авторов надо найти все затронутые изменением книги и обновить у них tsv:
Page 27: Page 27
Здесь мы предполагаем, что первичный ключ никогда не обновляется. Обратите внимание, что для таблицы books мы явно указали поля, на которые срабатывает триггер fill_tsv, так что триггер не будет срабатывать лишний раз. И для авторства:
Теперь обновим новый столбец у всех книг. Эту операцию, конечно, можно и нужно выполнять пакетно, как рассматривалось ранее, если количество строк велико.
Наконец, заменим функцию search_cond, которая формирует условие поиска:
Page 28: Практика+
- Восстановите базу данных с архивом рассылок из резервной копии. Добавьте в таблицу mail_messages столбец search_vector и заполните его так же, как в демонстрации. 2. Сколько документов содержат одновременно фразы «vacuum full» и «index page»? Сравните скорость поиска без индекса и с индексами разных типов (GiST, GIN, RUM), а также размер индексов. 3. Сколько документов содержит слово «vacuuming» именно в такой форме?
Комментарии преподавателя
Создавайте индексы по одному и удаляйте их сразу после эксперимента перед созданием следующего, чтобы в запросе гарантированно использовался нужный индекс.
Проще всего ответить на этот вопрос с помощью регулярных выражений. Но, поскольку тема посвящена полнотекстовому поиску, измените конфигурацию поиска, установив для лексем типа «asciiword» (к которым относятся слова из латинских букв) словарь «simple».
После этого необходимо пересоздать столбец search_vector, так как он будет содержать значение, не соответствующие новой конфигурации.
Page 29: 1. Подготовка
2. Поиск двух фраз
Запрос без индексов:
Page 30: Page 30
Запрос с индексом GiST:
Запрос с индексом GIN:
Запрос с индексом RUM:
Page 31: Page 31
Следует учитывать, что скорость выполнения запросов зависит от многих причин (от состояния буферного кеша, от нагрузки на сервер и т. д.), поэтому запросы лучше выполнить по нескольку раз и усреднить результаты.
3. Поиск точной формы слова
Изменяем конфигурацию поиска.
Теперь преобразование сохраняет форму слова:
Пересоздаем столбец.
Page 32: Page 32
18 Занятие 18: Репликация / Обзор физической репликации
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_18_replica_overview_physical.html Archive: DEV2-handouts-16.zip Страниц PDF: 26
Page 1: Репликация / Обзор физической репликации
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Задачи и виды репликации
- Физическая репликация
- Уровни журнала
- Варианты использования реплики
- Переключение на реплику
Page 3: Задачи и виды репликации
Синхронизация данных на разных серверах
- Основные задачи
- отказоустойчивость, высокая доступность
- масштабируемость
- Физическая репликация
- синхронизация на уровне страниц и версий строк
- Логическая репликация
- синхронизация на уровне строк таблиц
Комментарии преподавателя
Одиночный сервер, управляющий базами данных, может не удовлетворять предъявляемым требованиям.
Один сервер — возможная точка отказа. Два (или больше) серверов позволяют сохранить доступность системы в случае сбоя (отказоустойчивость) или — более широко — в любом случае, например, при проведении плановых работ (высокая доступность).
Один сервер может не справляться с нагрузкой. Наращивать ресурсы сервера может оказаться невыгодно или вообще невозможно. Но можно распределить нагрузку на несколько серверов (масштабирование).
Информационные системы могут использовать общие данные.
Таким образом, речь идет о том, чтобы иметь несколько серверов, работающих с одними и теми же данными. Под репликацией понимается процесс синхронизации этих данных.
В зависимости от уровня, на котором происходит синхронизация, различают физическую и логическую репликацию: при физической репликации синхронизируются изменения, произошедшие в страницах данных и статусах транзакций, а при логической — изменения строк таблиц.
Page 4: Физическая репликация
Механизм
- один сервер транслирует журнальные записи на другой сервер,
- и тот проигрывает полученные записи
- Особенности
- мастер-реплика: поток данных только в одну сторону
- требуется двоичная совместимость серверов
- возможна репликация только всего кластера
Комментарии преподавателя
Механизм физической репликации состоит в том, что один сервер передает журнальные записи на другой сервер, а тот их проигрывает — как при восстановлении после сбоя.
При физической репликации серверы имеют назначенные роли: мастер и реплика. Мастер передает на реплику свои журнальные записи в виде файлов или потока записей; реплика применяет эти записи к своим файлам данных. Применение происходит чисто механически, без «понимания смысла» изменений, поэтому важна двоичная совместимость между серверами (одинаковые платформы и основные версии PostgreSQL). Поскольку журнал общий для всего кластера, то и реплицировать можно только весь кластер целиком.
Page 5: Физическая репликация
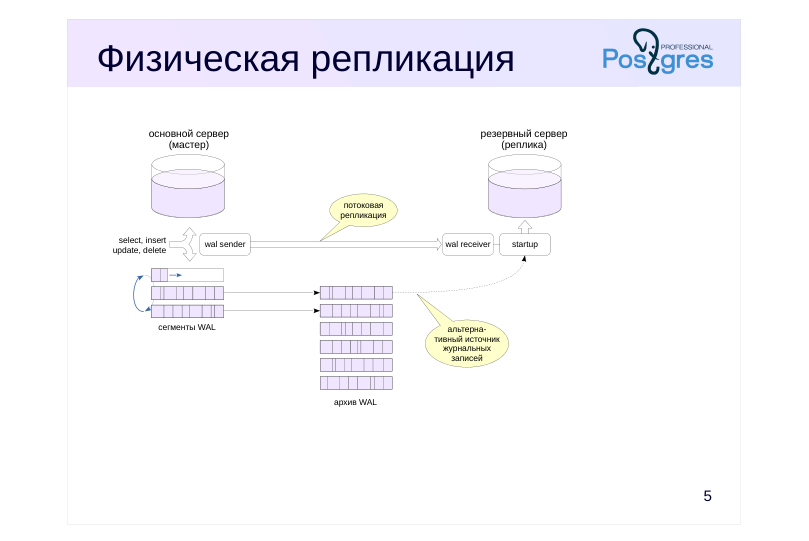 {#source-figure-005 caption=“Source slide page 5: Физическая репликация”}
Комментарии преподавателя
Чтобы организовать репликацию между двумя серверами, мы создаем реплику из физической резервной копии основного сервера. При обычном восстановлении из такой резервной копии получается новый независимый сервер. А если включить репликацию, ведомый сервер начинает работать в режиме постоянного восстановления: он все время применяет новые журнальные записи, приходящие с основного сервера (этим занимается процесс startup). Таким образом, реплика постоянно поддерживается в почти актуальном состоянии.
Есть два способа доставки журналов от мастера к реплике. Основной, который используется на практике — потоковая репликация.
В этом случае реплика (процесс walreceiver) подключается к мастеру (процесс walsender) по протоколу репликации и получает поток записей WAL. За счет этого при потоковой репликации отставание реплики сведено к минимуму или даже к нулю при синхронном режиме.
Если в системе настроено непрерывное архивирование, то возможна файловая репликация. В этом случае реплика будет заметно отставать, поскольку файловый архив пополняется только при переключении сегмента WAL.
На практике файловую репликацию используют как дополнение к потоковой. Если реплика не может получить очередную журнальную запись по протоколу репликации, она будет пробовать прочитать соответствующий файл из архива сегментов WAL.
https://postgrespro.ru/docs/postgresql/16/high-availability
Page 6: Уровни журнала
Параметр wal\_level
- minimal < replica
- восстановление восстановление после сбоя после сбоя восстановление из резервной копии, репликация
Комментарии преподавателя
Поскольку на реплику попадает только та информация, которая содержится в журнале, в журнал должны записываться все необходимые для синхронизации данные.
Состав информации, попадающей в журнал, регулируется параметром wal_level.
До версии PostgreSQL 10 уровнем по умолчанию был minimal, гарантирующий только восстановление после сбоя. На таком уровне репликация работать не может, поскольку для обеспечения надежности в этом случае часть изменений сразу записывается на энерго-независимый носитель и не попадает в журнал.
В версиях 10+ уровень по умолчанию — replica. На этом уровне в журнал записываются все изменения данных, что позволяет восстанавливать систему из горячих резервных копий, сделанных утилитой pg_basebackup, а также использовать физическую репликацию.
Поскольку резервное копирование и репликация — востребованные задачи, уровень по умолчанию и был изменен в пользу replica.
Page 7: Настройка физической репликации
Посмотрим, как организовать потоковую репликацию между двумя серверами. Мы ограничимся самым простым вариантом; детально репликация рассматривается в курсе для администраторов DBA3. Минимальный набор параметров, которые нужно проверить:
Начиная с версии PostgreSQL 10, параметры по умолчанию уже имеют подходящие значения. Разрешение на подключение по протоколу репликации в pg_hba.conf:
Разрешение тоже имеется. Развернем реплику из физической резервной копии, для этого используем утилиту pg_basebackup. Целевой каталог копии должен быть пустым или отсутствовать:
Ключ –checkpoint=fast просит утилиту выполнить контрольную точку как можно быстрее (без пауз), а ключ -R — добавить настройки для реплики:
Утилита создала заготовку конфигурационного файла…
… и сигнальный файл, который даст реплике указание перейти в режим постоянного восстановления:
Кластер, в котором мы собираемся развернуть реплику, уже предварительно инициализирован. Если сервер работает, его необходимо остановить:
Копия была размещена в домашнем каталоге пользователя student, а теперь переносим ее в каталог данных кластера и делаем владельцем файлов пользователя postgres:
Можно запускать сервер:
Page 8: Page 8
Посмотрим на процессы реплики.
Процесс walreceiver принимает поток журнальных записей, а процесс startup применяет изменения. Сравним с процессами мастера.
Процесс walsender отправляет реплике журнальные записи. Состояние репликации можно смотреть в специальном представлении на мастере:
значения *_lsn — показывают, какие журнальные записи отправлены на реплику, получены ею, записаны на диск и применены; sync_state — синхронная или асинхронная репликация (об этом подробнее позже).
Page 9: Использование реплики
Допускаются
- запросы на чтение данных (SELECT, COPY TO, курсоры)
- установка параметров сервера (SET, RESET)
- управление транзакциями (BEGIN, COMMIT, ROLLBACK…)
- создание резервной копии (pg_basebackup)
- Не допускаются
- любые изменения (INSERT, UPDATE, DELETE, TRUNCATE, nextval…)
- блокировки, предполагающие изменение (SELECT FOR UPDATE…)
- команды DDL (CREATE, DROP…), в т. ч. создание временных таблиц
- команды сопровождения (VACUUM, ANALYZE, REINDEX…)
- управление доступом (GRANT, REVOKE…)
- не срабатывают триггеры и рекомендательные блокировки
Комментарии преподавателя
По умолчанию реплика работает в режиме горячего резерва, в этом случае разрешены клиентские подключения, но только для чтения данных. Также будет работать установка параметров сервера и команды управления транзакциями — например, можно начать (читающую) транзакцию с нужным уровнем изоляции.
Кроме того, реплику можно использовать и для изготовления резервных копий (конечно, принимая во внимание возможное отставание от мастера).
В режиме горячего резерва на реплике не допускаются никакие изменения данных (включая последовательности), многие виды блокировок, команды DDL, а также такие команды, как vacuum, analyze, reindex и команды управления доступом — словом, все, что так или иначе изменяет данные.
При необходимости реплику можно запустить в режиме теплого резерва, задав параметр hot_standby = off, тогда подключения будут вообще невозможны.
https://postgrespro.ru/docs/postgresql/16/hot-standby
Page 10: Использование реплики
Выполним несколько команд на основном сервере:
Проверим реплику:
Вставим строку в таблицу на основном сервере:
Итак, репликация работает и запросы на реплике выполняются. При этом изменения на реплике не допускаются:
Page 11: Использование реплики
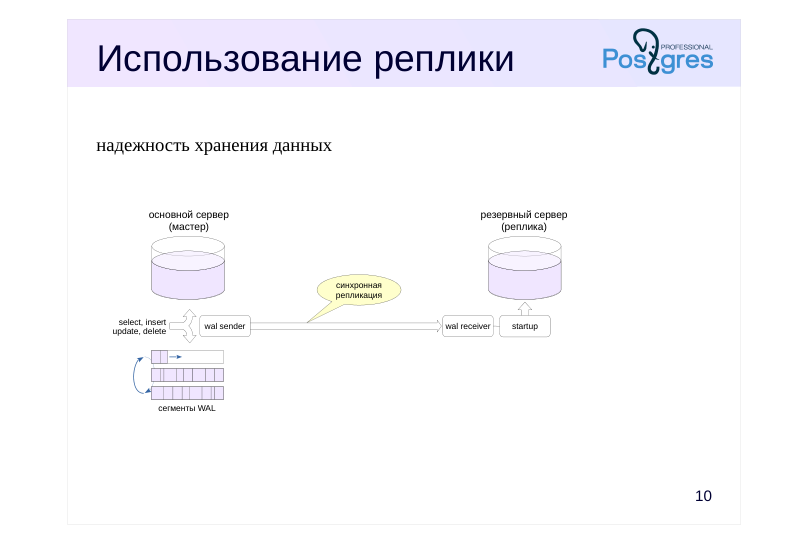 {#source-figure-011 caption=“Source slide page 11: Использование реплики”}
надежность хранения данных
Комментарии преподавателя
Механизм репликации позволяет построить систему так, чтобы она отвечала предъявляемым к ней требованиям. Рассмотрим несколько типичных задач и средства их решения.
Одна из возможных задач — обеспечить надежность хранения данных.
Напомним, что фиксация транзакций может работать в синхронном и асинхронном режимах. В первом случае фиксация не завершается до тех пор, пока данные не будут надежно записаны на энерго-независимый носитель. Во втором — есть риск потерять часть зафиксированных данных, но фиксация не ждет записи на диск, и система работает быстрее.
Аналогичная картина и с репликацией. При синхронном режиме (synchronous_commit = on) и наличии реплики фиксация ждет не только записи WAL на диск, но и подтверждения приема журнальных записей от синхронной реплики. Это еще больше увеличивает надежность (данные не пропадут, даже если основной сервер выйдет из строя), но и еще больше замедляет систему.
Существуют и промежуточные варианты настройки, которые не дают полной гарантии надежности, но все-таки снижают вероятность потери данных.
Page 12: Использование реплики
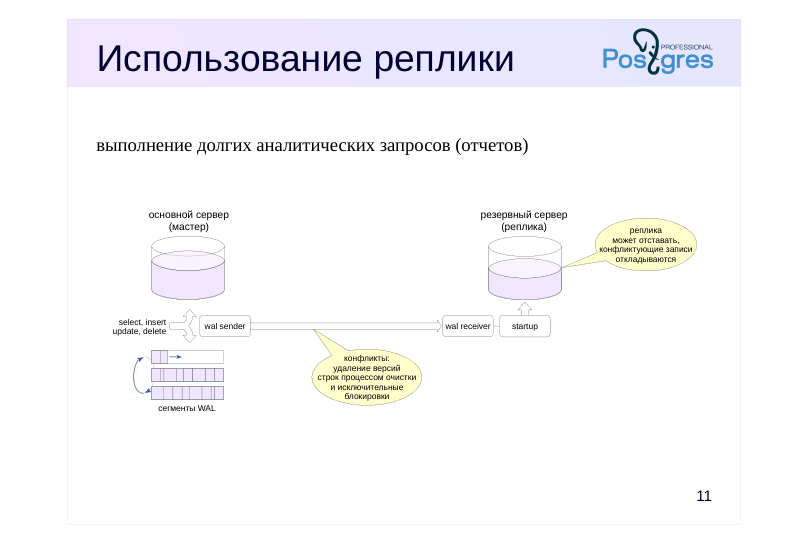 {#source-figure-012 caption=“Source slide page 12: Использование реплики”}
выполнение долгих аналитических запросов (отчетов)
Комментарии преподавателя
Как уже говорилось, долгие запросы удерживают горизонт очистки, из-за чего не удается удалять ненужные версии строк. Если какие-то таблицы в это время активно изменяются, они могут сильно вырасти в размере. Поэтому для выполнения долгих аналитических запросов можно использовать реплику.
Тонкий момент состоит в том, что с основного сервера могут приходить журнальные записи, конфликтующие с выполняющимся запросом. Есть два источника таких записей.
Очистка удаляет версии строк, уже не нужные основному серверу, но еще нужные для выполнения запроса на реплике.
Исключительные блокировки, происходящие на основном сервере, несовместимые с запросом на реплике.
Поэтому «отчетную» реплику настраивают так, чтобы она принимала WAL-записи, но откладывала их применение, если они конфликтуют с запросами. Это приводит к тому, что данные на реплике могут «отставать» от основного сервера, но, как правило, для долгих аналитических запросов это не существенно.
Page 13: Несколько реплик
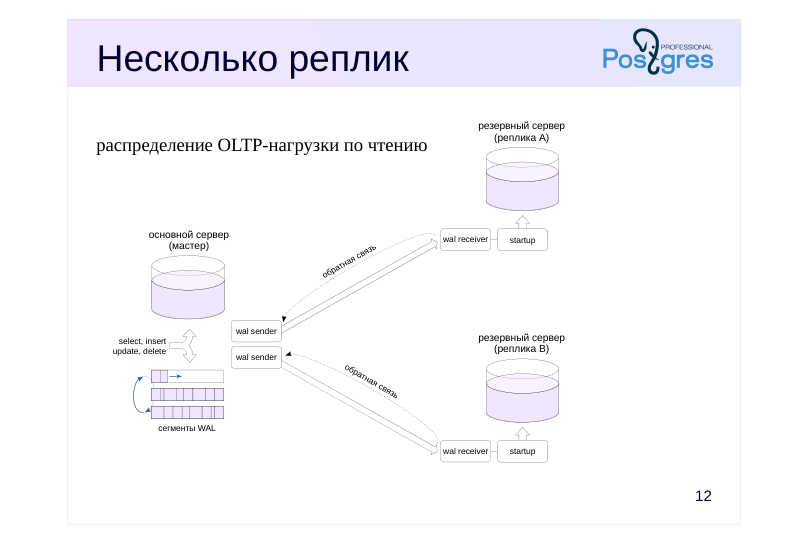 {#source-figure-013 caption=“Source slide page 13: Несколько реплик”}
распределение OLTP-нагрузки по чтению
Комментарии преподавателя
К основному серверу можно подключить несколько реплик, например, для распределения OLTP-нагрузки по чтению.
OLTP-запросы не должны быть долгими. Это позволяет использовать обратную связь между репликой и основным сервером по протоколу репликации. В этом случае основной сервер знает, какой горизонт транзакций нужен запросам на реплике, и очистка не будет удалять соответствующие версии строк. Иными словами, обратная связь дает такой же эффект, как если бы все запросы выполнялись непосредственно на основном сервере.
Однако репликация обеспечивает только базовый механизм. Для автоматического распределения нагрузки необходимы внешние средства (балансировщики). Следует также иметь в виду, что между основным сервером и репликами не гарантируется согласованность данных, даже в случае синхронной репликации. Если приложение читает данные только с одного из серверов, оно, разумеется, будет получать согласованные данные. Но это не выполняется, если приложение читает данные с нескольких серверов. С реплики можно прочитать как устаревшие данные, так и данные, которых еще не видно на основном сервере. Подробнее эти вопросы обсуждаются в курсе DBA3 «Резервное копирование и репликация».
Page 14: Каскадная репликация
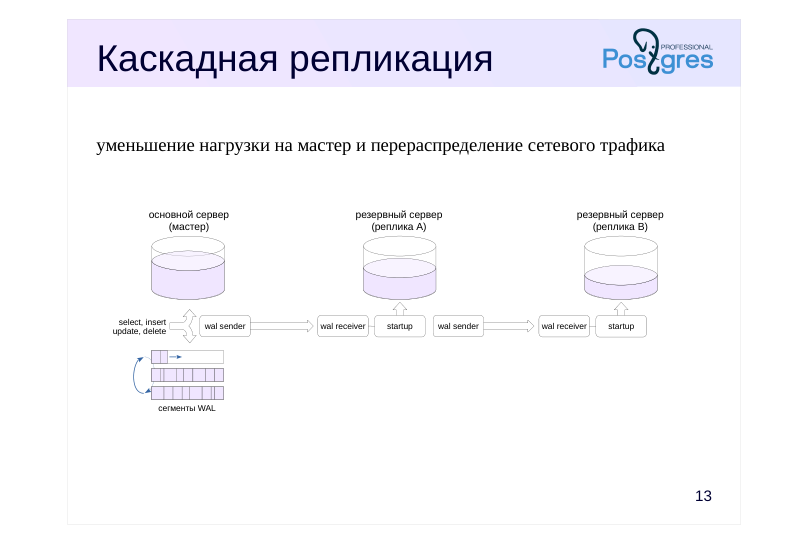 {#source-figure-014 caption=“Source slide page 14: Каскадная репликация”}
уменьшение нагрузки на мастер и перераспределение сетевого трафика
Комментарии преподавателя
Несколько реплик, подключенных к одному основному серверу, будут создавать на него определенную нагрузку. Кроме того, надо учитывать нагрузку на сеть при пересылке нескольких копий потока журнальных записей.
Для снижения нагрузки реплики можно соединять каскадом; при этом серверы передают журнальные записи друг другу по цепочке. Чем дальше от мастера, тем большее запаздывание может накопиться в изменяемых данных.
Заметим, что каскадная синхронная репликация не поддерживается: основной сервер может быть синхронизирован только с непосред-ственно подключенной к нему репликой. А вот обратная связь поступает к основному серверу от всех реплик.
Page 15: Отложенная репликация
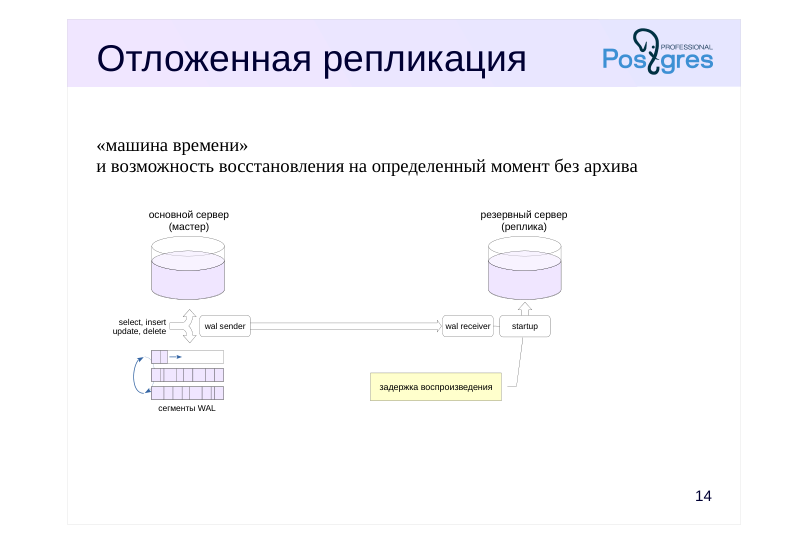 {#source-figure-015 caption=“Source slide page 15: Отложенная репликация”}
«машина времени» и возможность восстановления на определенный момент без архива
Комментарии преподавателя
Полезной может оказаться возможность просматривать данные на некоторый момент в прошлом и, при необходимости, восстановить сервер на этот момент. Это позволяет, в частности, справиться с ошибкой пользователя, совершившего неправильные действия, требующие отмены.
Обычный механизм восстановления из архива на момент времени (point-in-time recovery) в принципе позволяет решить эту задачу, но требует большой подготовительной работы и занимает много времени. А способа построить снимок данных по состоянию на произвольный момент в прошлом в PostgreSQL нет.
Задача решается созданием реплики, которая применяет записи WAL не сразу, а через установленный интервал времени.
В этом курсе мы не обсуждаем необходимые настройки для каждого из показанных вариантов. Для подробной информации обратитесь к курсу DBA3 «Резервное копирование и репликация».
Page 16: Переключение на реплику
Плановое переключение
- останов основного сервера для технических работ без прерывания
- обслуживания
- ручной режим
- Аварийное переключение
- переход на реплику из-за сбоя основного сервера
- ручной режим,
- но в принципе можно автоматизировать с помощью
- дополнительного кластерного ПО
Комментарии преподавателя
Имеющуюся реплику можно использовать и для того, чтобы переключить на нее приложение с основного сервера.
Причины перехода на резервный сервер бывают разные. Это может быть необходимость технических работ на основном сервере — тогда переход выполняется в удобное время в штатном режиме. Возможен и сбой основного сервера, в таком случае переходить на резервный сервер нужно как можно быстрее, чтобы не прерывать обслуживание пользователей.
Даже в случае сбоя переход осуществляется вручную, если не используется специальное кластерное программное обеспечение, которое следит за состоянием серверов и может инициировать переход автоматически.
Page 17: Переключение на реплику
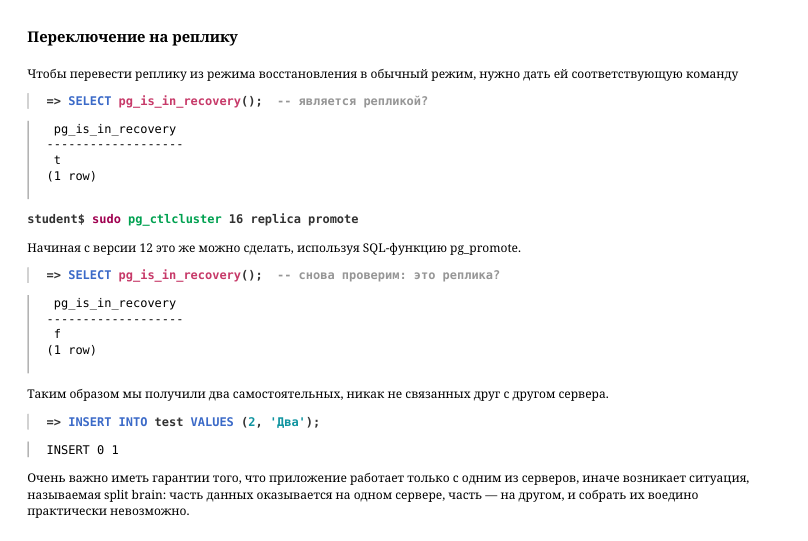 {#source-figure-017 caption=“Source slide page 17: Переключение на реплику”}
Чтобы перевести реплику из режима восстановления в обычный режим, нужно дать ей соответствующую команду
Начиная с версии 12 это же можно сделать, используя SQL-функцию pg_promote.
Таким образом мы получили два самостоятельных, никак не связанных друг с другом сервера.
Очень важно иметь гарантии того, что приложение работает только с одним из серверов, иначе возникает ситуация, называемая split brain: часть данных оказывается на одном сервере, часть — на другом, и собрать их воедино практически невозможно.
Page 18: Итоги
Механизм физической репликации основан на передаче журнальных записей на реплику и их применении
- трансляция потока записей или файлов WAL
- Физическая репликация создает точную копию всего кластера
- однонаправленная, требует двоичной совместимости
- базовый механизм для решения целого ряда задач
Page 19: Практика
- Разверните реплику так, как показано в демонстрации.
- Проверьте, как работает приложение, если переключить его на использование реплики. 2. Добавьте к механизму фоновых заданий возможность выполнять задания на реплике с помощью расширения dblink. Убедитесь, что долгое задание не приведет к появлению такой же долгой транзакции на основном сервере.
Комментарии преподавателя
- Переключатель сервера находится в верхней части информационной панели приложения.
Обратите внимание на то, какие операции по-прежнему работают, а какие — вызывают ошибку.
- Приложение позволяет при отправке задания на выполнение указать удаленный сервер, и записывает имя узла и порт в таблицу tasks.
Добавьте в процедуру process_tasks проверку: если указаны узел и порт, вызывайте функцию run не локально, а с помощью расширения dblink на указанном сервере. (Расширение рассматривалось в теме «Фоновые процессы»)
Чтобы долгое задание не приводило к появлению такой же долгой транзакции на основном сервере, используйте dblink в асинхронном режиме, и периодически опрашивайте готовность запроса в отдельных, коротких, транзакциях.
Page 20: 1. Развертывание реплики
Выполняем те же команды, что и в демонстрации.
При переключении приложения на реплику: Поиск книг и другие операции, не требующие изменения данных, работают; Вход, покупка книг и другие операции, изменяющие данные, выдают ошибку.
2. Фоновые задания в удаленном режиме
Добавим в процедуру запуска задания обработку узла и порта. Если они указаны, будем выполнять функцию run на указанном сервере с помощью расширения dblink. За основу берем вариант процедуры, написанной в практике к теме «Асинхронная обработка».
Page 21: Page 21
Обратите внимание на следующее:
Page 22: Page 22
Для краткости не обрабатывается статус вызова функции dblink_send_query, что, конечно же, необходимо делать. В цикле ожидания результатов удаленного запуска выполняется фиксация. В противном случае получалась бы долгая транзакция, удерживающая горизонт базы данных. Дублируется код для обработки исключительных ситуаций. Это связано с тем, что процедура не может выполнять фиксацию внутри блока с секцией EXCEPTION. Команда COMMIT перенесена из конца цикла forever в начало. Это сделано для удобства прерывания обработки в случае ошибки (см. обработчик dblink_connect). Работающий в системе фоновый процесс, выполняющий процедуру process_tasks, будет продолжать выполнять старую версию процедуры. Его необходимо прервать и перезапустить:
Page 23: Практика+
- Настройте физическую потоковую репликацию между двумя серверами в синхронном режиме. Проверьте работу репликации. Убедитесь, что при остановленной реплике фиксация не завершается. 2. По умолчанию применение конфликтующих записей на реплике откладывается максимум на 30 секунд. Отключите откладывание применения и убедитесь, что долгий запрос, выполняющийся на реплике, будет прерван, если необходимые ему версии строк удаляются и очищаются на мастере. Включите обратную связь и убедитесь, что теперь запрос не прерывается из-за того, что на мастере откладывается очистка.
Комментарии преподавателя
- Для этого на мастере установите с помощью ALTER SYSTEM следующие параметры:
● synchronous_commit = on
● synchronous_standby_names = ‘“16/replica”’
- За откладывание применения конфликтующих записей на реплике отвечает параметр max_standby_streaming_delay. Установите его в 0. Обратная связь включается параметром hot_standby_feedback = on. Оба параметра устанавливаются через ALTER SYSTEM с последующим перечитыванием настроек.
Чтобы запрос выполнялся долго на небольшом объеме данных, можно добавить в него вызов функции pg_sleep.
Page 24: 1. Синхронная репликация
Разворачиваем реплику, как было показано в демонстрации:
Запускаем реплику.
Настроим синхронную репликацию на мастере. По умолчанию cинхронный режим включен, но записи о фиксации транзакций синхронизируются только с локальной файловой системой:
А синхронизация с репликой не настроена:
Реплик может быть несколько, и мастер должен знать, с какой из них синхронизироваться. Реплика представляется именем, заданным в ее параметре cluster_name:
Репликация стала синхронной.
Page 25: Page 25
Теперь остановим реплику…
…и попробуем выполнить какую-либо транзакцию:
Управление возвратится только когда реплика будет снова запущена и репликация восстановится:
2. Конфликтующие записи
Отключаем откладывание применения конфликтующих записей:
Добавляем строки в таблицу:
Выполняем на реплике долгий запрос…
…а в это время на мастере удаляем строки из таблицы и выполняем очистку:
Очистка стерла все версии строк (10 removed). В итоге запрос на реплике завершается ошибкой:
Повторим эксперимент со включенной обратной связью.
Page 26: Page 26
Теперь очистка не удаляет версии строк, поскольку знает о запросе, выполняющемся на реплике (10 are dead but not yet removable ) и запрос отрабатывает:
Итак: В первом случае (max_standby_streaming_delay) откладывается воспроизведение журнальных записей на реплике. Во втором случае (hot_standby_feedback) откладывается очистка на мастере. Отключим синхронную репликацию.
19 Занятие 19: Репликация / Обзор логической репликации
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_19_replica_overview_logical.html Archive: DEV2-handouts-16.zip Страниц PDF: 26
Page 1: Репликация / Обзор логической репликации
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Логическая репликация
- Публикации и подписчики
- Уровни журнала
- Обнаружение и разрешение конфликтов
- Особенности работы триггеров
- Задачи, решаемые с помощью логической репликации
- Ограничения
Page 3: Логическая репликация
Механизм
- публикующий сервер читает собственные журнальные записи,
- декодирует их в изменения строк данных и отправляет подписчикам
- сервер-подписчик применяет изменения к своим таблицам
- Особенности
- публикация-подписка: поток данных возможен в обе стороны
- требуется совместимость на уровне протокола
- возможна выборочная репликация отдельных таблиц
Комментарии преподавателя
При физической репликации только один сервер (мастер) выполняет изменения и генерирует журнальные записи. Остальные серверы (реплики) только читают журнальные записи мастера и применяют их.
При логической репликации все серверы работают в обычном режиме, могут изменять данные и генерировать собственные журнальные записи. Любой сервер может публиковать свои изменения, а другие — подписываться на них. При этом один и тот же сервер может как публиковать изменения, так и подписываться на другие. Это позволяет организовать произвольные потоки данных между серверами.
Публикующий сервер читает собственные журнальные записи, но не пересылает их подписчикам в исходном виде (как при физической репликации), а предварительно декодирует их в «логический», независимый от платформы и версии PostgreSQL вид. Поэтому для логической репликации обычно не нужна двоичная совместимость, реплика должна лишь понимать протокол репликации. Также можно получать и применять изменения не всех объектов, а только отдельных таблиц.
https://postgrespro.ru/docs/postgresql/16/logical-replication
Page 4: Логическая репликация
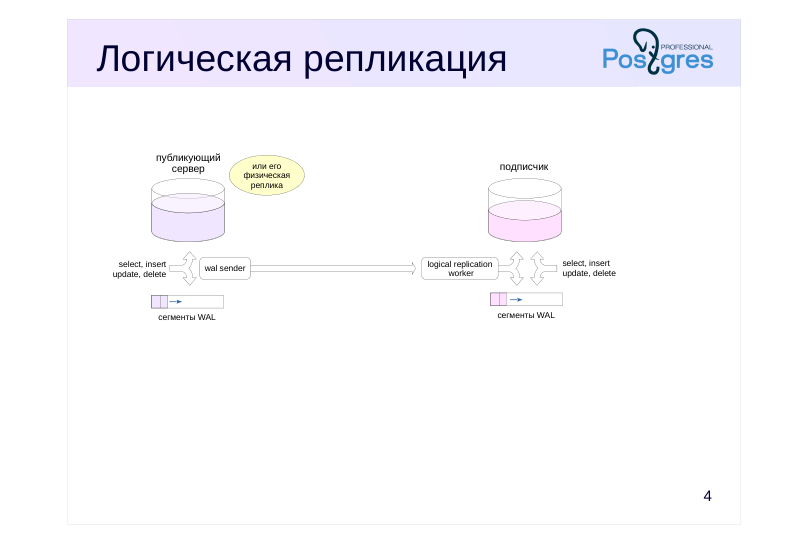 {#source-figure-004 caption=“Source slide page 4: Логическая репликация”}
Комментарии преподавателя
На публикующем сервере процесс wal_sender формирует журнальные записи, отражающие изменения в публикуемых данных, а фоновый процесс logical replication worker на сервере-подписчике получает информацию от публикующего сервера и применяет ее.
Подписчик может получать изменения не только напрямую с публикующего сервера, но и с его физической реплики. В этом случае отправку изменений подписчику выполняет процесс wal_sender физической реплики. Такая схема работы полезна для уменьшения нагрузки на публикующий сервер.
https://postgrespro.ru/docs/postgresql/16/logical-replication-publication
https://postgrespro.ru/docs/postgresql/16/logical-replication-subscription
Page 5: Публикации и подписки
Публикация
- включает одну или несколько таблиц базы данных
- можно указать столбцы и фильтр для строк
- обрабатывает команды INSERT, UPDATE, DELETE, TRUNCATE
- выдает изменения построчно после фиксации транзакции
- использует слот логической репликации
- Подписка
- получает и применяет изменения
- возможна начальная синхронизация
- без разбора, переписывания и планирования — сразу выполнение
- возможны конфликты с локальными данными
Комментарии преподавателя
Логическая репликация использует модель «публикация-подписка».
На одном сервере создается публикация, которая может включать ряд таблиц одной базы данных. Начиная с версии 15 можно опубликовать только часть данных таблицы: указать набор столбцов и задать условие фильтрации для строк. Другие серверы могут подписываться на эту публикацию: получать и применять изменения.
Реплицируются только измененные строки таблиц (а не команды SQL). Команды DDL не передаются; таблицы-приемники на подписчике надо создавать вручную. Но есть возможность автоматической начальной синхронизации содержимого таблиц при создании подписки.
После фиксации транзакции информация о строках, которые она изменила, извлекается из записей WAL на сервере публикации — эта процедура называется логическим декодированием. Сформированные сообщения пересылаются подписке по протоколу репликации в формате, независимом от платформы и версии сервера.
Применение изменений происходит без выполнения команд SQL и связанных с этим накладных расходов на разбор и планирование. С другой стороны, результат выполнения одной команды SQL может превратиться в множество однострочных изменений.
https://postgrespro.ru/docs/postgresql/16/logical-replication
Page 6: Уровни журнала
Параметр wal\_level
- minimal < replica < logical
- восстановление восстановление восстановление после сбоя после сбоя после сбоя восстановление восстановление из резервной копии, из резервной копии, репликация репликация логическая репликация
Комментарии преподавателя
Чтобы публикующий сервер смог сформировать сообщения об изменениях на уровне табличных строк, в журнал необходимо помещать дополнительную информацию, в частности идентификаторы затрагиваемых при репликации строк и сообщения о фактах изменения определений таблиц и типов данных. Это позволяет подписчику в любой момент знать структуру объектов, участвующих в репликации.
Такой расширенный уровень журнала называется logical. Поскольку по умолчанию используется уровень replica, для логической репликации потребуется изменить значение параметра wal_level на публикующем сервере.
https://postgrespro.ru/docs/postgresql/16/protocol-logical-replication#PROT OCOL-LOGICAL-MESSAGES-FLOW
Page 7: Логическая репликация
Пусть на первом сервере имеется таблица:
Склонируем кластер с помощью резервной копии, как мы делали в теме «Обзор физической репликации», но команде pg_basebackup не будем передавать ключ -R, поскольку нам потребуется независимый сервер, а не реплика.
Если второй сервер работает, остановим его
Перемещаем резервную копию в каталог данных второго сервера, поменяв владельца файлов:
Запускаем второй сервер:
Получили два независимых сервера, на каждом из них есть пустая таблица test. Добавим в таблицу на первом сервере пару строк:
Теперь мы хотим настроить между серверами логическую репликацию. Для этого понадобится дополнительная информация в журнале первого сервера:
На первом сервере создаем публикацию:
На втором сервере подписываемся на эту публикацию:
Page 8: Page 8
При создании подписки на сервере публикации автоматически создался слот репликации — объект, который помнит, какие изменения получил подписчик, и в случае разрыва соединения позволяет возобновить передачу с нужного места.
Проверяем репликацию:
Состояние подписки можно посмотреть в представлении:
К процессам сервера-подписчика добавился logical replication worker (его номер указан в pg_stat_subscription.pid):
Page 9: Конфликты
Режимы идентификации для изменения и удаления
- столбцы первичного ключа (по умолчанию)
- столбцы указанного уникального индекса с ограничением NOT NULL
- все столбцы
- без идентификации (по умолчанию для системного каталога)
- Конфликты — нарушение ограничений целостности
- репликация приостанавливается до устранения конфликта вручную
Комментарии преподавателя
Вставка новых строк происходит достаточно просто. Интереснее обстоит дело при изменениях и удалениях — в этом случае надо как-то идентифицировать старую версию строки. По умолчанию для этого используются столбцы первичного ключа, но при определении таблицы можно указать и другие способы (replica identity): использовать уникальный индекс или использовать все столбцы. Можно вообще отказаться от поддержки репликации для некоторых таблиц (по умолчанию не реплицируются таблицы системного каталога).
Поскольку таблицы на сервере публикации и сервере подписки могут изменяться независимо друг от друга, при вставке новых версий строк возможны конфликты — нарушения ограничений целостности. В этом случае процесс применения записей приостанавливается до тех пор, пока конфликт не будет разрешен вручную.
https://postgrespro.ru/docs/postgresql/16/sql-altertable
https://postgrespro.ru/docs/postgresql/16/logical-replication-conflicts
https://postgrespro.ru/docs/postgresql/16/sql-altersubscription
Page 10: Конфликты
Локальные изменения на подписчике не запрещаются, вставим строку в таблицу на втором сервере.
Если теперь строку с таким же значением первичного ключа вставить на первом сервере, при ее применении на стороне подписки произойдет конфликт.
Подписка не может применить изменение, репликация остановилась.
Чтобы разрешить конфликт, удалим строку на втором сервере и немного подождем…
Репликация возобновилась.
Page 11: Триггеры на подписчике
При обычной работе
- в обслуживающих процессах (session_replication_role = origin или local)
- ENABLE TRIGGER
- ENABLE ALWAYS TRIGGER
- При применении реплицированных изменений
- в процессе logical replication worker (session_replication_role = replica)
- ENABLE REPLICA TRIGGER
- ENABLE ALWAYS TRIGGER
- только на уровне строк (за исключением начальной синхронизации)
Комментарии преподавателя
Срабатывание триггеров на сервере-подписчике имеет некоторые особенности.
При применении изменений, полученных из публикации, обычные триггеры работать не будут. Это удобно, если на обоих серверах созданы одинаковые таблицы с одинаковым набором триггеров: в таком случае триггер уже отработал на публикующем сервере и его не надо выполнять на подписчике.
Если нужно, чтобы триггер все-таки срабатывал, его необходимо определить как репликационный (ALTER TABLE … ENABLE REPLICA TRIGGER) или универсальный (ENABLE ALWAYS TRIGGER).
Изменения реплицируются построчно, поэтому работают только триггеры таблиц на уровне строк (FOR EACH ROW), но не на уровне оператора (FOR EACH STATEMENT). Исключение составляет начальная синхронизация — при ней срабатывают триггеры и на уровне строк, и на уровне оператора.
При обычной работе срабатывают «обычные» триггеры (просто созданные командой CREATE TRIGGER, или явно разрешенные командой ALTER TABLE … ENABLE TRIGGER) и универсальные триггеры (ENABLE ALWAYS TRIGGER).
Сервер отличает обычный процесс от процесса, применяющего реплицированные изменения, с помощью параметра сеанса session_replication_role. По умолчанию параметр имеет значение origin, а процесс logical replication worker задает ему значение replica.
https://postgrespro.ru/docs/postgresql/16/sql-altertable
Page 12: Триггеры на подписчике
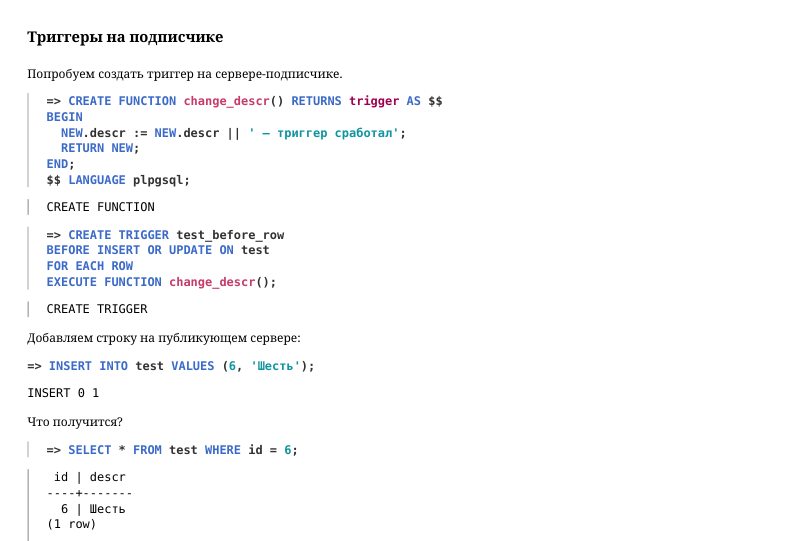 {#source-figure-012 caption=“Source slide page 12: Триггеры на подписчике”}
Попробуем создать триггер на сервере-подписчике.
Добавляем строку на публикующем сервере:
Что получится?
Обычный триггер не срабатывает при применении изменений из публикации, зато он будет срабатывать при локальных изменениях на подписчике:
Допустим, нам нужно, чтобы триггер срабатывал только для изменений, происходящих при репликации. Для этого явно включим его как репликационный:
Проверим:
Теперь триггер работает только при применении реплицированных изменений. Если необходимо добиться срабатывания триггера и при репликации, и при локальных изменениях, нужно определить его как ALWAYS TRIGGER. А чтобы различить эти изменения, используем параметр session_replication_role:
Page 13: Page 13
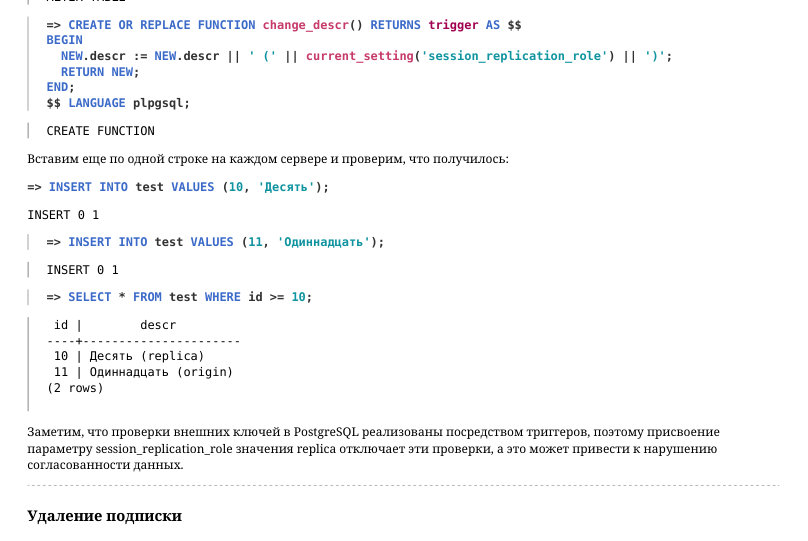 {#source-figure-013 caption=“Source slide page 13: Page 13”}
Вставим еще по одной строке на каждом сервере и проверим, что получилось:
Заметим, что проверки внешних ключей в PostgreSQL реализованы посредством триггеров, поэтому присвоение параметру session_replication_role значения replica отключает эти проверки, а это может привести к нарушению согласованности данных.
Удаление подписки
Если репликация больше не нужна, надо аккуратно удалить подписку — иначе на публикующем сервере останется открытым репликационный слот.
Page 14: Задачи: консолидация
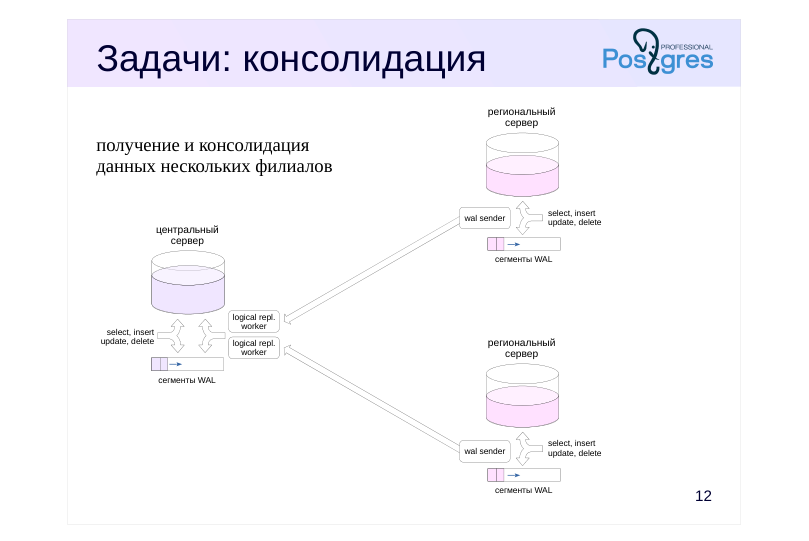 {#source-figure-014 caption=“Source slide page 14: Задачи: консолидация”}
получение и консолидация данных нескольких филиалов
Комментарии преподавателя
Рассмотрим несколько задач, которые можно решить с помощью логической репликации.
Пусть имеются несколько региональных филиалов, каждый из которых работает на собственном сервере PostgreSQL. Задача состоит в консолидации части данных на центральном сервере.
Для решения задачи на региональных серверах создаются публикации необходимых данных. Центральный сервер подписывается на эти публикации. Полученные данные можно обрабатывать с помощью триггеров на стороне центрального сервера (например, приводя данные к единому виду).
С точки зрения бизнес-логики есть множество особенностей, требующих внимания. В каких-то случаях может быть проще периодически передавать данные в пакетном режиме.
На иллюстрации: на центральном сервере работают два процесса приема журналов, по одному на каждую подписку.
Page 15: Задачи: справочники
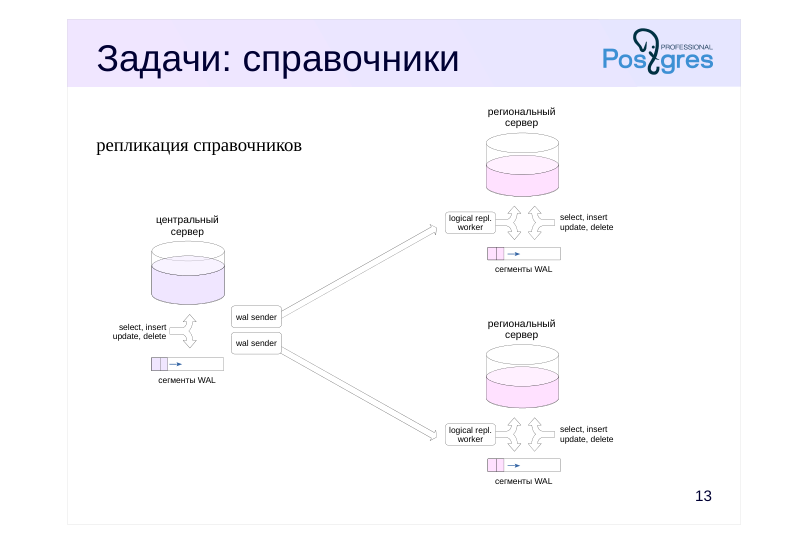 {#source-figure-015 caption=“Source slide page 15: Задачи: справочники”}
репликация справочников
Комментарии преподавателя
Другая задача: на центральном сервере поддерживаются справочники, актуальные версии которых должны быть доступны на региональных серверах.
В этом случае схему надо развернуть наоборот: центральный сервер публикует изменения, а региональные серверы подписываются на эти обновления.
Page 16: Задачи: мастер-мастер
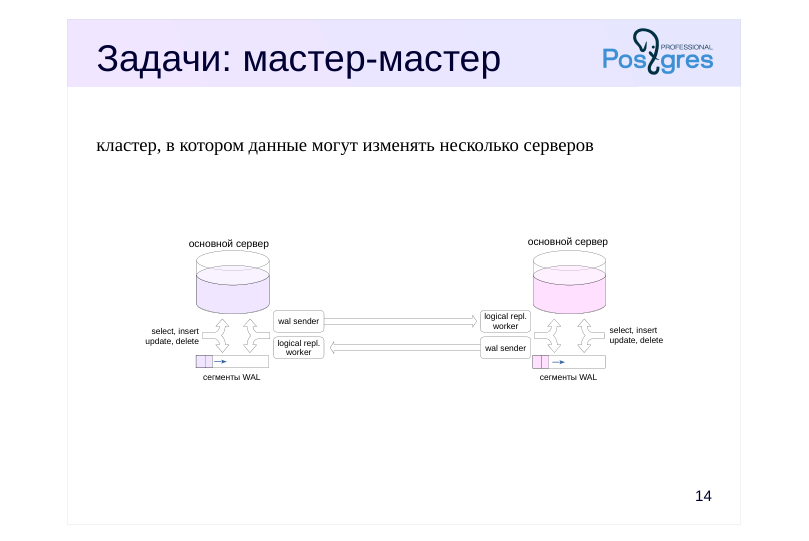 {#source-figure-016 caption=“Source slide page 16: Задачи: мастер-мастер”}
кластер, в котором данные могут изменять несколько серверов
Комментарии преподавателя
Задача: обеспечить надежное хранение данных на нескольких серверах с возможностью записи на любом сервере (что полезно, например, для геораспределенной системы).
Для решения можно использовать двунаправленную репликацию, передавая изменения в одних и тех же таблицах от одного сервера к другому и обратно.
Двунаправленная репликация появилась в PostgreSQL 16. Система умеет различать источники репликации (origin), и при создании подписки можно указать, чтобы с публикующего сервера не отправлялись изменения, помеченные определенным источником.
Конечно, прикладная система должна быть построена таким образом, чтобы избегать конфликтов при изменении данных в одних и тех же таблицах. Например, использовать глобальные уникальные идентификаторы или гарантировать, что разные серверы работают с разными диапазонами ключей.
Надо учитывать, что система мастер-мастер, построенная на логической репликации, не обеспечивает сама по себе выполнение глобальных распределенных транзакций и, следовательно, о согласованности данных между серверами придется позаботиться отдельно.
Page 17: Ограничения
Не реплицируются
- команды DDL
- значения последовательностей
- большие объекты (lo)
- изменения материализованных представлений, внешних таблиц
- Могут вызвать проблемы
- массовые изменения данных
- Не поддерживается
- автоматическое разрешение конфликтов
Комментарии преподавателя
Логическая репликация имеет ряд ограничений.
Не реплицируются команды DDL — все изменения схемы данных надо переносить вручную.
Реплицироваться могут только обычные базовые таблицы и секционированные таблицы. То есть нельзя реплицировать отношения другого рода, такие как представления, материализованные представления и внешние таблицы.
Не реплицируются значения последовательностей. Это означает, что если сервер-подписчик добавляет строки в таблицу с суррогатным уникальным ключом, для которой настроена репликация, возможны конфликты. Конфликтов можно избежать, выделяя двум серверам разные диапазоны значений последовательностей, или используя вместо них универсальные уникальные идентификаторы (UUID).
Изменения реплицируются построчно, поэтому выполнение на публикаторе команды SQL, затрагивающей много строк, приведет к повышенной нагрузке на подписчик.
И, как уже говорилось, нет возможности автоматического разрешения конфликтов.
Эти ограничения уменьшают применимость логической репликации.
https://postgrespro.ru/docs/postgresql/16/logical-replication-restrictions
Page 18: Итоги
Логическая репликация передает изменения строк отдельных таблиц
- разнонаправленная
- совместимость на уровне протокола
- Модель «публикация — подписка»
- Следует учитывать имеющиеся ограничения
Page 19: Практика
Мы открываем второй магазин. Он работает независимо от основного (свои пользователи, склад, закупки и продажи), но имеет тот же ассортимент. 1. Разверните второй сервер из резервной копии, как показано в демонстрации. Очистите таблицу операций. 2. Организуйте репликацию справочников книг и авторов из основного магазина во второй. Предполагается, что эти таблицы могут меняться только на основном сервере.
- Убедитесь, что изменения названий книг и т. п. передаются
- на второй сервер, но изменения наличного количества
- происходят на двух серверах независимо.
Page 20: 1. Развертывание второго магазина
Для развертывания сервера выполняем те же команды, что и в демонстрации:
Очистим таблицу операций, поскольку второй магазин ведет свою деятельность независимо от основного:
При выполнении команды TRUNCATE не сработает триггер update_onhand_qty_trigger, поэтому очистим наличное количество вручную:
2. Репликация справочников книг и авторов
Все три связанные таблицы должны входить в публикацию. Иначе на второй сервер реплицируются данные с нарушением внешних ключей:
Как только мы настроим репликацию справочников, на второй сервер в том числе будут передаваться и изменения наличного количества (books.onhand_qty). Очевидно, что это неудачное решение: такие изменения не нужны второму серверу, наличное количество вычисляется на нем независимо от основного сервера. Следовало бы поместить наличное количество в отдельную таблицу, изменив соответствующим образом триггер update_onhand_qty_trigger и интерфейсную функцию get_catalog. Другой способ — отменять нежелательные обновления с помощью триггера. Он не требует изменения остального кода системы, но не устраняет бесполезную пересылку данных по сети.
Page 21: Page 21
Созданный триггер будет срабатывать только при репликации и не будет мешать обновлять наличное количество при нормальной работе:
Создаем подписку. Поскольку текущее состояние справочников уже попало на второй сервер из резервной копии, отключаем начальную синхронизацию данных:
Page 22: Практика+
- На двух серверах ведутся однотипные таблицы бухгалтерских транзакций. Требуется консолидировать все записи в ту же таблицу на одном из серверов (например, для целей построения общей отчетности). Предложите способ различить «свои» и «чужие» записи и предотвратить конфликты при логической репликации. Реализуйте предложенную схему. 2. Настройте логическую репликацию в обратном направлении. Проверьте работу двунаправленной репликации.
Комментарии преподавателя
- Исходите из следующего вида таблицы транзакций:
- Чтобы публикация не отправляла реплицированные изменения, задайте подписке параметр origin = none.
Page 23: 1. Консолидация
На первом (публикующем) сервере установим необходимый уровень журнала:
Создадим таблицу транзакций:
Чтобы отличать строки разных серверов, понадобится дополнительный столбец. Например:
Чтобы не допустить конфликта значений первичного ключа, выделим каждому из серверов свое множество значений: первому серверу — нечетные, второму — четные. Имя последовательности, которая используется для генерации уникальных номеров, можно узнать с помощью функции:
Недостатком такой схемы является то, что при появлении третьего сервера ее придется перестраивать. Другой возможный вариант — использовать для первичного ключа универсальные уникальные идентификаторы, представленные типом данных uuid. Для этого можно использовать встроенную функцию get_random_uuid или средства из расширений pgcrypto и uuid-ossp:
Однако тип uuid занимает 16 байт (bigint — только 8) и генерация нового значения происходит относительно долго. Еще один вариант — создать составной первичный ключ:
В этом случае конфликтов гарантированно не будет, но индекс получится больше. Мы используем первый вариант: последовательности, генерирующие разные значения.
Page 24: Page 24
Теперь развернем второй сервер из резервной копии, как показано в демонстрации.
Заполним таблицу транзакций тестовыми данными — разными на разных серверах.
На втором сервере не забудем заменить настройки последовательности:
Настроим репликацию с первого сервера на второй.
После небольшой паузы убедимся, что данные первого сервера успешно реплицированы:
Page 25: 2. Двунаправленная репликация
Настройка уровня журнала уже скопирована на второй сервер:
Теперь очистим таблицы и сбросим последовательности
Чтобы публикация не отправляла подписке реплицированные изменения, нужно задать для подписки параметр origin:
Теперь настроим репликацию со второго сервера на первый.
Проверим:
Page 26: Page 26
Удалим треть строк на каждом сервере:
Репликация работает. Удалим подписки, чтобы не оставлять активные слоты репликации.
20 Занятие 20: Внешние данные / Обзор
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev2_20_fdw_overview.html Archive: DEV2-handouts-16.zip Страниц PDF: 27
Page 1: Внешние данные / Обзор
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Назначение оберток сторонних данных
- Настройка доступа к внешним данным
- Примеры: postgres_fdw и file_fdw
- Другие доступные обертки
Page 3: Назначение
Представление внешних данных как обычных таблиц
- стандарт ISO/IEC 9075-9 (SQL/MED)
- поддерживаются
- SELECT, INSERT, UPDATE, DELETE, TRUNCATE, COPY
- триггеры
- обычное разграничение доступа (GRANT, REVOKE)
- Способ миграции данных из других СУБД
- Механизм для шардинга
- вместе с секционированием: Postgres Pro Shardman
Комментарии преподавателя
В стандарте ISO/IEC 9075-9 (SQL/MED) определяется, как базы данных SQL должны работать с внешними источниками с учетом доступа как на чтение, так и на запись.
Внешние данные представлены в PostgreSQL как таблицы, которые называются внешними или сторонними. С ними можно работать при помощи обычных команд DML: INSERT, UPDATE, DELETE, SELECT, TRUNCATE, а также COPY. На внешние таблицы можно создавать триггеры, а для разграничения прав используются команды GRANT и REVOKE.
Основное отличие внешних таблиц от обычных в том, что данные не хранятся в самой БД PostgreSQL, а загружаются из внешней системы (отправляются во внешнюю систему) при выполнении запросов.
Обертки сторонних данных могут быть весьма полезны как при одновременной работе с данными из разных источников, так и при миграции данных в PostgreSQL из других СУБД.
Поддержка внешних данных активно развивается, поскольку (вместе с секционированием) является одним из компонентов для реализации шардинга: секции основной таблицы представляются внешними таблицами, физически находящимися на отдельных серверах.
https://postgrespro.ru/docs/postgresql/16/ddl-foreign-data
Данные из сторонних таблиц можно сохранять при логическом резервировании (используя ключ –include-foreign-data утилиты pg_dump), однако при восстановлении из такой копии нужно учитывать доступность внешних серверов и их возможности по записи данных.
https://postgrespro.ru/docs/postgresql/16/app-pgdump
Page 4: Компоненты
1. Обертка сторонних данных
- каков тип внешнего источника данных?
- postgres_fdw: внешний сервер PostgreSQL
Комментарии преподавателя
Чтобы настроить доступ к внешним данным, нужно создать несколько объектов базы данных.
Все начинается с обертки сторонних данных (foreign data wrapper, FDW). Обертка определяет тип внешнего источника данных. Например, postgres_fdw реализует доступ к базам данных PostgreSQL, а file_fdw — доступ к файлам операционной системы.
https://postgrespro.ru/docs/postgresql/16/postgres-fdw
https://postgrespro.ru/docs/postgresql/16/sql-createforeigndatawrapper
Page 5: Обертка сторонних данных
Обертка создается при создании расширения:
Page 6: Компоненты
1. Обертка сторонних данных
- каков тип внешнего источника данных?
- Внешний сервер
- как подключиться к внешнему источнику?
- postgres_fdw: узел, порт, база данных
Комментарии преподавателя
Следующий объект — внешний сервер. Сервер определяет, как подключаться к внешнему источнику данных.
Например, если источником является СУБД, то надо знать узел, порт, имя базы данных. (Но не имя пользователя и пароль. Эта информация появится чуть позже.)
Если требуется подключение к нескольким внешним источникам (одного типа, который определен оберткой), то для каждого из них нужно создать отдельный сервер.
https://postgrespro.ru/docs/postgresql/16/sql-createserver
Page 7: Внешний сервер
В качестве внешнего сервера выберем базу данных книжного магазина на нашем же локальном сервере.
Обратите внимание, что в параметрах сервера не указывается роль.
Page 8: Компоненты
1. Обертка сторонних данных
- каков тип внешнего источника данных?
- Внешний сервер
- как подключиться к внешнему источнику?
- Сопоставление ролей
- как локальные роли связаны с разграничением доступа, используемым
- внешним источником?
- postgres_fdw: и там, и там — обычные роли PostgreSQL
Комментарии преподавателя
Далее следует сопоставление ролей.
Внешний источник может выполнять аутентификацию при подключении. В таких случаях необходимо определить, какие локальные роли могут подключаться к каким учетным записям на внешнем сервере.
Если используется аутентификация по паролю, то здесь же указывается и пароль.
Суперпользователь может разрешить обычным пользователям использовать подключение без пароля, установив параметр password_required в значение false.
https://postgrespro.ru/docs/postgresql/16/sql-createusermapping
Page 9: Сопоставление ролей
Настроим соответствие: пусть локальная роль student подключается к внешнему серверу как postgres.
Разумеется, можно настраивать несколько соответствий для разных ролей.
Page 10: Компоненты
1. Обертка сторонних данных
- каков тип внешнего источника данных?
- Внешний сервер
- как подключиться к внешнему источнику?
- Сопоставление ролей
- как локальные роли связаны с ролями внешнего источника? 4. Внешние таблицы
- какова структура внешних данных?
- postgres_fdw: данные в обычных таблицах
Комментарии преподавателя
И, наконец, можно приступить к созданию внешних таблиц. Внешняя таблица определяет, как представить данные из внешнего источника в виде обычной реляционной таблицы.
Для внешних таблиц можно добавлять ограничения целостности NOT NULL и CHECK. Эти ограничения не будут применяться при выполнении команд, ведь в любом случае PostgreSQL не сможет обеспечить соблюдение ограничений на внешнем источнике. Но планировщик может использовать информацию об ограничениях при построении плана выполнения запроса.
Обертка postgres_fdw для выборки данных использует пакетный режим, записи передаются пакетами, размер которых задается параметром сервера fetch_size (по умолчанию 100 строк). Вставка (с помощью команд INSERT и COPY FROM) также использует пакетный режим, за количество строк здесь отвечает параметр сервера batch_size. Для изменения и удаления строк пакетный режим пока не реализован.
https://postgrespro.ru/docs/postgresql/16/sql-createforeigntable
https://postgrespro.ru/docs/postgresql/16/sql-importforeignschema
Page 11: Внешние таблицы
Внешнюю таблицу можно создать явным образом, при необходимости указывая названия объектов, если они отличаются:
Можно указать только некоторые ограничения целостности, но в любом случае они не проверяются локально и просто отражают ограничения, накладываемые внешней системой.
Как выполняется такой запрос? Иными словами, передается ли предикат внешнему серверу, чтобы он сам выбрал эффективный способ выполнения, или фильтрацией занимается локальный сервер?
Планировщик умеет распределять работу между серверами. Также ничто не мешает использовать в одном запросе как внешние, так и локальные данные.
Другой способ — не создавать внешние таблицы по одной, а импортировать внешнюю схему (всю или выборочно несколько таблиц), если обертка это позволяет.
Page 12: Page 12
Обертка postgres_fdw позволяет и изменять данные:
Page 13: Соединения и транзакции
Удаленное соединение
- открывается при первом обращении к внешним данным
- по умолчанию остается открытым до конца сеанса
- автоматически восстанавливается при разрыве
- Удаленная транзакция
- фиксируется или прерывается автоматически, когда фиксируется
- или прерывается локальная транзакция
- Repeatable Read для локальных транзакций уровней Read Committed
- и Repeatable Read
- Serializable для локальных транзакций Serializable
- согласованность не гарантируется (нет двухфазной фиксации)
Комментарии преподавателя
При работе с другой базой данных через postgres_fdw важно понимать, как происходит управление соединениями и транзакциями.
По умолчанию обертка postgres_fdw автоматически открывает соединение при первом обращении к внешнему серверу (одно на каждую роль) и оставляет его открытым до конца локального сеанса. Если обертка обнаружит, что соединение разорвано, она автоматически попытается установить новое подключение.
Удаленные транзакции «привязаны» к локальным:
● расширение автоматически начинает удаленную транзакцию, когда локальная обращается к внешним данным;
● удаленная транзакция автоматически завершается с завершением локальной (фиксацией или обрывом).
Тем не менее, локальная и удаленная транзакции — это разные транзакции, а не одна глобальная. Расширение postgres_fdw пока не позволяет использовать двухфазную фиксацию, поэтому согласованность не гарантируется. Например, локальная транзакция может быть зафиксирована, а удаленная — нет из-за сетевого сбоя.
При фиксации транзакции, в которой участвуют несколько внешних серверов, подключенных через postgres_fdw, удаленные транзакции могут завершаться асинхронно, а не последовательно одна за другой.
https://postgrespro.ru/docs/postgresql/16/postgres-fdw#POSTGRES-FDW-C ONNECTION-MANAGEMENT
Page 14: Соединения и транзакции
Когда выполнялся запрос к внешней таблице remote_users, обертка открыла соединение и по умолчанию не закрывает его:
Завершим обслуживающий процесс…
…и еще раз обратимся к внешней таблице:
Нам удалось получить данные! Обертка автоматически восстановила подключение, соединение теперь обслуживается другим процессом:
Поведение можно изменить, задав атрибут внешнего сервера
Тогда обертка будет открывать соединение при каждом обращении к внешней таблице и закрывать его после обращения.
Page 15: Сравнение с dblink
postgres_fdw dblink
- доступные команды SQL SELECT, INSERT, любые UPDATE, DELETE, TRUNCATE, COPY
- совмещение в запросе да сложно локальных и внешних данных
- управление соединением автоматическое ручное
- управление транзакциями автоматическое ручное
- глобальные транзакции нет нет
- стандартизованный способ да нет
Комментарии преподавателя
В теме «Фоновые процессы» рассматривалось расширение dblink, которое предназначено для выполнения запросов на удаленном сервере PostgreSQL и предоставляет возможности, схожие с возможностями postgres_fdw.
Обертка postgres_fdw позволяет выполнять ограниченный набор команд SQL, но в большинстве случаев более удобна: она сама управляет соединениями и транзакциями («привязывая» их к локальному соединению и транзакции). Обертка позволяет использовать в одном запросе как локальные, так и внешние данные; при этом автоматически формируется распределенный план выполнения запроса. Синтаксис доступа к данным определяется стандартом SQL.
Зато расширение dblink позволяет выполнять любые команды SQL. В некоторых случаях может быть нужным управлять соединениями и транзакциями вручную.
Однако оба способа не предоставляют глобальных (распределенных) транзакций.
Таким образом, для доступа к внешним данным PostgreSQL в большинстве случаев следует выбирать postgres_fdw. Расширение dblink стоит использовать, если нужны возможности, которые не предоставляет обертка сторонних данных.
Page 16: Расширение file_fdw
1. Обертка сторонних данных
- тип внешнего источника — текстовый файл с разделителями 2. Внешний сервер
- как подключиться — не требуется дополнительной информации
- Сопоставление ролей
- не имеет смысла, т. к. во внешнем источнике нет ролей
- Внешние таблицы
- структура данных — описание полей файла в виде столбцов таблицы
Комментарии преподавателя
Еще одну обертку сторонних данных предоставляет расширение file_fdw, предназначенное для доступа к файлам в файловой системе сервера PostgreSQL.
Доступ возможен только на чтение и выполняется с помощью того же механизма, что и SQL-команда COPY.
https://postgrespro.ru/docs/postgresql/16/file-fdw
Page 17: Расширение file_fdw
Расширение file_fdw позволяет обращаться к любому текстовому файлу и задействует тот же механизм, что и команда COPY. Поэтому для демонстрации мы выгрузим строки из имеющейся таблицы в файл, а затем прочитаем данные из файла.
Page 18: Другие доступные обертки
Базы данных
- ODBC, JDBC
- различные реляционные и NoSQL СУБД
- Файлы различных форматов
- Геоданные и научные данные
- Веб-ресурсы
- стандартные протоколы (RSS, IMAP, WWW…)
- для различных сайтов
- Можно написать собственную обертку
- на C или Python (с помощью расширения Multicorn)
Комментарии преподавателя
Рассмотренные обертки сторонних данных, file_fdw и postgres_fdw, поставляются вместе с PostgreSQL в виде contrib-модулей.
Помимо этого существует множество других оберток, которые предоставляют доступ ко многим популярным базам данных и не только. Информацию о них можно получить:
● на страничке wiki: https://wiki.postgresql.org/wiki/Fdw
● на сайте PGXN: http://pgxn.org/tag/fdw/
Если нужную обертку не удалось найти, то ее можно написать самостоятельно. Для этого потребуется язык C: https://postgrespro.ru/docs/postgresql/16/fdwhandler
Другой вариант — воспользоваться расширением Multicorn (https://multicorn.org/), которое позволяет написать обертку на языке Python.
Page 19: Итоги
Обертки сторонних данных — стандартный способ работы с данными любых внешних источников
- доступ к PostgreSQL и файлам «из коробки»
- есть реализации оберток для огромного числа систем
- Альтернатива — расширение dblink для выполнения произвольных запросов на удаленном сервере PostgreSQL
Page 20: Практика
- Поставщик информирует магазин о новинках книжного рынка, предоставляя CSV-файл определенного формата. Загрузите информацию из файла new_books.csv, расположенного в домашнем каталоге пользователя student, в таблицы базы данных. Формат файла описан в комментариях к слайду.
- Учтите, что авторы, указанные в файле, могут уже существовать в базе данных, но в файле могут быть допущены опечатки. 2. Проверьте в приложении, что новые книги успешно переданы на логическую реплику, и для них работает полнотекстовый поиск.
Комментарии преподавателя
- CSV-файл содержит следующие поля:
● фамилия автора;
● имя автора;
● отчество автора;
● название книги;
● формат издания;
● количество страниц;
● ISBN;
● аннотация;
● издательство;
● год выпуска;
● гарнитура;
● номер издания;
● серия;
● имя файла с обложкой (файл находится в каталоге covers).
Если у книги несколько авторов, то они следуют в файле в том порядке, в котором указаны в выходных сведениях. При этом для второго и следующих авторов все поля, относящиеся к книге — пустые.
Воспользуйтесь расширением file_fdw, указав для файла формат CSV.
Для борьбы с опечатками вспомните про расширение pg_trgm, с которым вы познакомились в практике к теме «Классы операторов».
- Логическая реплика с подпиской на изменения книг настраивалась в задании к теме «Логическая репликация».
Page 21: 1. Загрузка новых поступлений
Здесь предполагается, что несколько процедур загрузки книг не будут запускаться параллельно. Если такой гарантии нет, в коде надо отдельно предусмотреть эту возможность, устанавливая необходимые блокировки. Для сопоставления авторов используется нечеткий поиск с помощью триграмм. Оператор % отсекает совсем непохожих (предел похожести по умолчанию 0.3 слишком низок для нашего случая, поэтому увеличиваем его). Из оставшихся выбираем лучшее совпадение, упорядочивая кандидатов с помощью функции similarity.
Page 22: Page 22
Page 23: Page 23
Page 24: Практика+
- В двух разных базах данных находятся две таблицы с одинаковым набором столбцов. Выведите строки, которые присутствуют в первой таблице, но отсутствуют во второй. Решите задачу с помощью postgres_fdw и с помощью dblink и сравните два способа. 2. Как можно проверить, какой уровень изоляции использует обертка postgres_fdw и как она управляет соединениями и транзакциями?
Комментарии преподавателя
Расширение dblink демонстрировалось в теме «Фоновые процессы».
Настройте на втором сервере журнал сообщений таким образом, чтобы в него записывалась информация:
● о подключениях (log_connections);
● отключениях (log_disconnections);
● выполняемых командах (log_statement).
Обратитесь к таблице на втором сервере с помощью postgres_fdw и проверьте, что попало в журнал сообщений.
Page 25: 1. Сравнение таблиц в разных базах
Таблица в первой базе данных:
И во второй (расположим ее на втором сервере в БД postgres):
Создаем стороннюю таблицу для доступа к таблице во второй базе данных:
На втором сервере используем роль postgres:
Сравниваем:
Page 26: Page 26
С помощью расширения dblink задачу можно решить следующим образом:
В этом случае подготовительные действия практически не требуются, но сам запрос выглядит сложнее.
2. Проверка работы postgres\_fdw
На втором сервере настроим журнал сообщений так, чтобы в него попадала информация о подключениях и отключениях, а также о выполняемых командах.
Начнем новое соединение и локальную транзакцию Read Committed.
Обращаемся к сторонней таблице:
В журнале второго сервера видим: установлено новое соединение; в нем выставлены некоторые параметры; начата транзакция с уровнем изоляции Repeatable Read; с помощью курсора прочитаны записи из таблицы test.
Page 27: Page 27
Завершаем локальную транзакцию.
В журнале видим, что удаленная транзакция также завершена:
Завершаем сеанс.
В этот момент завершается и соединение с удаленным узлом:
Журнал сообщений можно использовать, чтобы разобраться, как работа внешних средств выглядит с точки зрения СУБД.