Разработка серверной части приложений PostgreSQL. Базовый курс
Разработка серверной части приложений PostgreSQL. Базовый курс
Курс сохраняет официальный порядок тем. Русские материалы извлечены из PDF в читаемый нативный Markdown для дальнейшей редакторской работы.
Состояние материалов: 官方 PDF 已提取为原生 Markdown
Базовый язык: Базовый язык: English. Текущий английский архив используется как базовый; русская версия сохранена для сверки глав.
О курсе
Функции, процедуры, триггеры, динамические команды и серверная логика на SQL и PL/pgSQL.
Состояние материалов
| Язык | Текущий архив | Версия | Темы | Страница курса |
|---|---|---|---|---|
| English | DEV1-handouts-16-en.zip | 16 | 21 | HTTP 200 |
| Русский | DEV1-handouts-16.zip | 16 | 21 | HTTP 200 |
Содержание
Дополнительные материалы
catalogs.pdfdatatypes.pdfdev1_new_features.pdfdev1_student_guide.pdfunix_commands.pdf
Редакторский статус
Русский комплект доступен в виде нативного Markdown. Если английский комплект не найден, английский маршрут оставлен для будущего источника.
00 Занятие 00: Разработка серверной части приложений / Базовый курс
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_00_introduction.html Archive: DEV1-handouts-16.zip Страниц PDF: 10
Page 1: Разработка серверной части приложений / Базовый курс
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Разработчикам
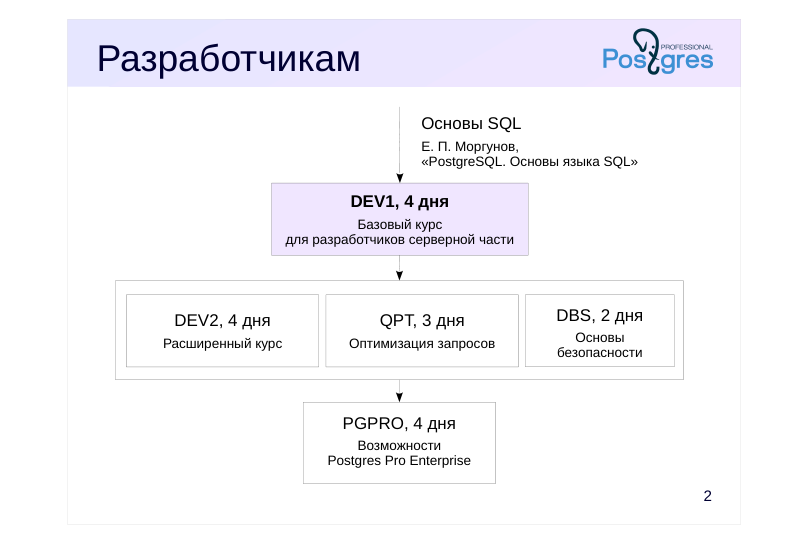 {#source-figure-002 caption=“Source slide page 2: Разработчикам”}
- DEV2, 4 дня
Комментарии преподавателя
Для разработчиков серверной части приложений мы предлагаем специальную линейку курсов.
Для прохождения этих курсов необходимы предварительные знания основ языка SQL. Специального курса по языку SQL в нашей линейке нет, но существует множество книг и других образовательных ресурсов, с помощью которых можно освоить SQL. Мы рекомендуем книгу Евгения Моргунова «PostgreSQL. Основы языка SQL»:
https://postgrespro.ru/education/books/sqlprimer
Базовым курсом для разработчиков является данный курс DEV1.
В курсе DEV2 рассматриваются особенности внутреннего устройства сервера, влияющие на разработку прикладного кода, и всесторонне изучается расширяемость: возможность дополнить серверные механизмы собственным кодом, что позволяет использовать PostgreSQL для решения самых разнообразных задач.
В курсе QPT детально разбираются механизмы планирования и выполнения запросов, рассматривается настройка параметров экземпляра, связанных с производительностью, и изучаются возможности для поиска проблемных запросов и их оптимизации.
Курс DBS рассказывает про настройку подключений клиентов к СУБД и про управление доступом внутри самой СУБД.
В курсе PGPRO рассматриваются дополнительные возможности, которые предоставляет СУБД Postgres Pro Enterprise.
https://postgrespro.ru/education/courses
Page 3: Администраторам
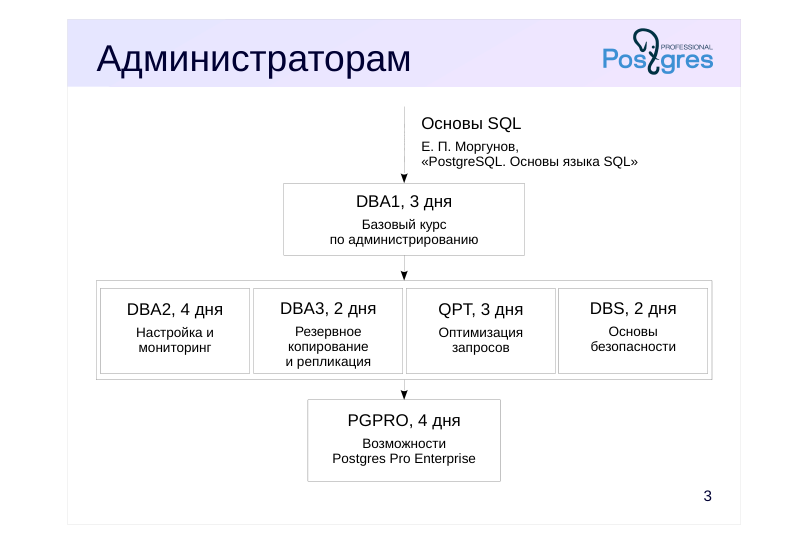 {#source-figure-003 caption=“Source slide page 3: Администраторам”}
- DBA2, 4 дня
Комментарии преподавателя
Для администраторов мы предлагаем следующие курсы.
В базовом курсе DBA1 даются общие сведения об архитектуре PostgreSQL, процессе установки, базовой настройке и управлении сервером. Рассматриваются основные задачи администрирования, вопросы управления доступом. Приводится обзор резервного копирования и репликации.
В курсе DBA2 обсуждается настройка различных конфигурационных параметров исходя из понимания внутренней организации сервера; говорится о мониторинге сервера с использованием обратной связи для итеративной настройки параметров. Также рассматриваются настройки, связанные с локализацией, управление расширениями и знакомство с процедурой обновления сервера.
Курс DBA3 посвящен рассмотрению резервного копирования, а также настройкам физической и логической репликации и сценариям ее использования. Также дается общее представление о способах и сложностях построения высокодоступных, масштабируемых кластеров.
Курсы DBS, QPT и PGPRO являются общими для разработчиков и администраторов.
Курсы по администрированию могут быть интересны и разработчикам, желающим детальнее изучить внутреннее устройство PostgreSQL, а также в случае, когда на проекте нет выделенной роли администратора.
Page 4: О курсе DEV1
Продолжительность: 4 дня
- Предварительные знания
- основы SQL
- опыт работы с любым процедурным языком программирования
- минимальные сведения о работе в Unix
- Какие навыки будут получены
- общие сведения об архитектуре PostgreSQL
- использование основных объектов БД: таблиц, индексов, представлений
- программирование на стороне сервера на языках SQL и PL/pgSQL
- использование основных типов данных, включая записи и массивы
- организация взаимодействия с клиентской частью приложения
Комментарии преподавателя
Базовый курс знакомит разработчиков приложений, работающих над серверной частью, с основами PostgreSQL и написанием хранимых процедур и функций на языках SQL и PL/pgSQL.
Page 5: Используемые материалы
Подготовленная виртуальная машина
- ОС Xubuntu 24.04
- PostgreSQL 16 с документацией на русском языке
- учебное веб-приложение «Книжный магазин»
- DBeaver
- Учебные материалы
- руководство слушателя
- презентации, демонстрации, практические задания и их решение
- (в форматах html и pdf)
- справочные материалы — функции и типы данных PostgreSQL,
- схема основных таблиц системного каталога с командами psql,
- некоторые команды Unix
Комментарии преподавателя
Если вы проходите курс самостоятельно, обязательно начните со знакомства с Руководством слушателя. В числе прочего в нем написано, где скачать и как использовать виртуальную машину курса и прочие материалы. Все материалы курса доступны по адресу:
https://postgrespro.ru/education/courses/DEV1
Выполнение практических заданий очень важно для получения навыков работы с PostgreSQL. Обязательно старайтесь сначала самостоятельно выполнить задания, а затем просмотрите предлагаемые нами решения, даже если задание не вызвало вопросов. В решениях могут содержаться дополнительные сведения, которые не упоминаются в презентациях и демонстрациях.
Учебные материалы (презентации, демонстрации, практические задания и их решения) доступны в двух форматах. Формат html удобен для онлайн-работы, он позволяет копировать фрагменты текста и кода. Документ в формате pdf разбит на страницы и удобен для печати.
Дополнительные справочные материалы помогут быстро найти нужную информацию.
В виртуальной машине установлен DBeaver. В курсе мы используем только psql, но при желании можно воспользоваться и графической средой.
Page 6: Организационные вопросы
День: ~8 академических часов + обед (1час)
- Каждая тема, как правило, состоит из
- презентации и демонстраций: ~25–60 мин
- практических заданий: ~20–30 мин, включая перерыв
Page 7: День 1
Базовый инструментарий
- Установка и управление, psql
- Архитектура
- Общее устройство PostgreSQL
- Изоляция и многоверсионность
- Буферный кеш и журнал
- Организация данных
- Логическая структура
- Физическая структура
Комментарии преподавателя
Первый день занятий посвящен в основном теоретической подготовке. Здесь рассматриваются основы архитектуры PostgreSQL, без знания которых невозможно полноценное использование СУБД. Полученные знания будут применяться на практике в последующих темах курса.
Page 8: День 2
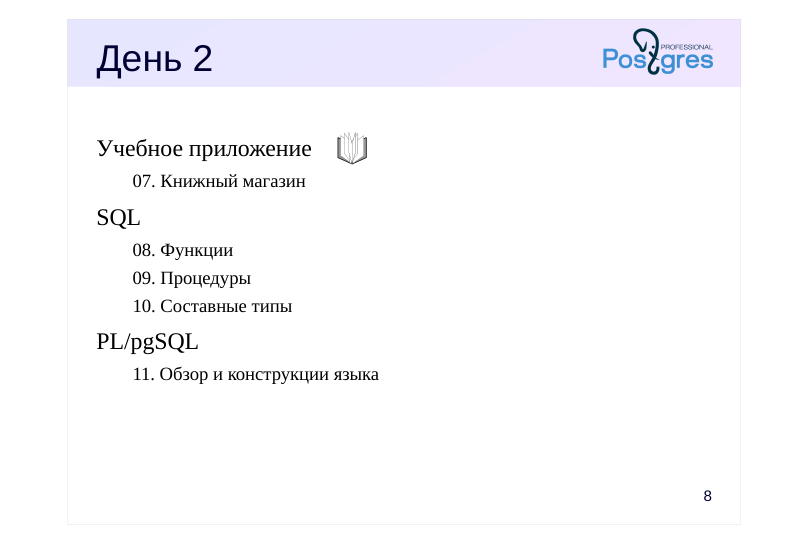 {#source-figure-008 caption=“Source slide page 8: День 2”}
Учебное приложение
- Книжный магазин
- SQL
- Функции
- Процедуры
- Составные типы
- PL/pgSQL
- Обзор и конструкции языка
Комментарии преподавателя
Начиная с модуля «Учебное приложение» второго дня занятий каждая тема содержит два набора практических заданий: основных, связанных с приложением «Книжный магазин» (они отмечены значком книги) и дополнительных. За время, которое отводится на задания (около 30 минут), выполнить всю практику невозможно. Используйте дополнительные задания для самостоятельной работы.
Page 9: День 3
PL/pgSQL (продолжение)
- Выполнение запросов
- Курсоры
- Динамические команды
- Массивы
- Обработка ошибок
Page 10: День 4
PL/pgSQL (продолжение)
- Триггеры
- Отладка
- Управление доступом
- Обзор
- Резервное копирование
- Логическое резервирование
01 Занятие 01: Обзор базового инструментария / Установка и управление, psql
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_01_tools_overview.html Archive: DEV1-handouts-16.zip Страниц PDF: 20
Page 1: Обзор базового инструментария / Установка и управление, psql
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Варианты установки PostgreSQL
- Управление сервером
- Журнал сообщений сервера
- Настройка параметров конфигурации
- Использование psql
Page 3: Кластер БД, сервер, клиент
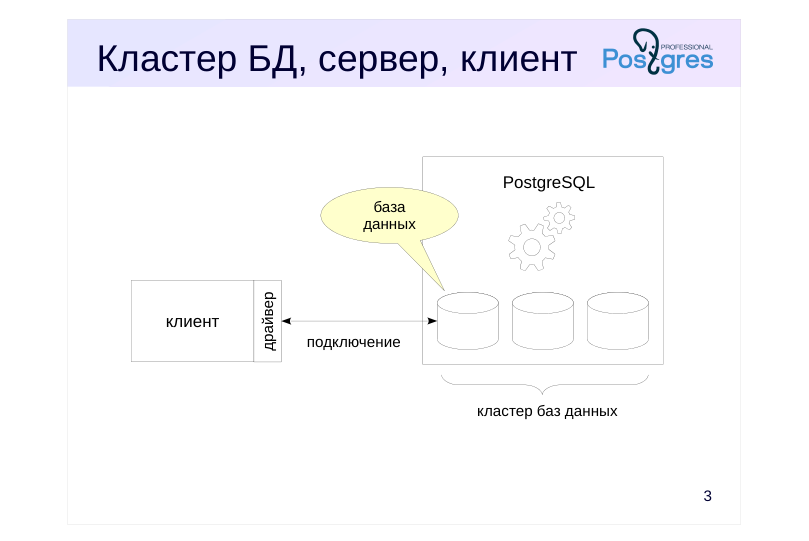 {#source-figure-003 caption=“Source slide page 3: Кластер БД, сервер, клиент”}
- клиент
Комментарии преподавателя
Начнем с основных понятий.
PostgreSQL — программа, которая относится к классу систем управления базами данных.
Когда эта программа выполняется, мы называем ее сервером PostgreSQL или экземпляром сервера. Пока сервер представляется для нас «черным ящиком», но постепенно мы познакомимся с тем, как он устроен.
Данные, которыми управляет PostgreSQL, хранятся в базах данных. Один экземпляр PostgreSQL одновременно работает с несколькими базами данных. Этот набор баз данных называется кластером баз данных. Подробнее мы будем говорить о базах данных в теме «Организация данных. Логическая структура».
С сервером взаимодействуют клиенты — внешние приложения, которые могут подключаться к одной из баз сервера и посылать запросы для выполнения.
Итак: кластер баз данных — это данные в файлах; сервер или экземпляр сервера — программа, управляющая кластером баз данных, а клиент — программа, позволяющая «общаться» с сервером.
Page 4: Установка
Варианты
- готовые пакеты (предпочтительный способ)
- установка из исходных кодов
- без установки — облачные сервисы
- Расширения
- дополнительный функционал
- устанавливаются отдельно
- в поставке с сервером — модули и программы (~50 штук)
Комментарии преподавателя
Предпочтительный вариант установки PostgreSQL — использование пакетных менеджеров (таких, как apt или rpm) и готовых пакетов. В этом случае получается понятная, поддерживаемая и легко обновляемая установка. Пакеты существуют для большинства операционных систем.
Другой вариант — самостоятельная сборка PostgreSQL из исходных кодов. Это может понадобиться для установки нестандартных значений параметров или при использовании непопулярной платформы.
Готовые пакеты и исходные коды: http://www.postgresql.org/download/
Кроме того, можно использовать готовые облачные решения, что позволяет обойтись вообще без установки. Такую возможность дают многие ведущие зарубежные (Amazon RDS, Google Cloud SQL, Microsoft Azure) и отечественные (Yandex Cloud, Облако Mail.ru) платформы.
В курсе мы будем использовать виртуальную машину с ОС Xubuntu и сервер PostgreSQL 16, установленный из пакета для этой ОС. В этом случае сразу настраивается автоматический запуск и останов сервера PostgreSQL при запуске и останове операционной системы.
Для PostgreSQL существует большое количество расширений, которые подключают новый функционал к СУБД «на лету», без изменения ядра системы. В состав дистрибутива входит 50 расширений.
https://postgrespro.ru/docs/postgresql/16/contrib
https://postgrespro.ru/docs/postgresql/16/contrib-prog
Список доступных расширений и статус их установки можно посмотреть в представлении pg_available_extensions.
Page 5: Управление сервером
Утилита для управления
- pg_ctlcluster
- pg_ctl
- Основные задачи
- запуск сервера
- останов сервера
- обновление параметров конфигурации
Комментарии преподавателя
К основным операциям управления сервером относятся начальная инициализация кластера баз данных, запуск и останов сервера, обновление конфигурации и некоторые другие. Для выполнения этих действий предназначена утилита pg_ctl, входящая в состав PostgreSQL.
В пакетном дистрибутиве для Ubuntu доступ к утилите pg_ctl осуществляется не напрямую, а через специальную обертку pg_ctlcluster. Справку по использованию pg_ctlcluster можно получить командой:
$ man pg_ctlcluster
Также можно получить информацию об установленных кластерах и их текущем состоянии при помощи команд:
$ pg_lsclusters
$ pg_ctlcluster status
Более подробная информация об управлении сервером для администраторов баз данных:
https://postgrespro.ru/docs/postgresql/16/app-pg-ctl
https://postgrespro.ru/docs/postgresql/16/runtime
Page 6: Установка и управление
В виртуальной машине курса установка выполнена из пакета. Каталог установки PostgreSQL:
Владелец ПО сервера — пользователь root. Кластер баз данных автоматически инициализируется при установке из пакета и находится в каталоге /var/lib/postgresql/16/main. В последующих темах мы будем ссылаться на этот каталог как PGDATA, по имени переменной ОС, которую можно установить для использования в некоторых утилитах сервера. Владельцем каталога является пользователь postgres. Вот содержимое каталога:
При установке из пакета в настройки запуска ОС добавляется автоматический запуск PostgreSQL. Поэтому после загрузки операционной системы отдельно стартовать PostgreSQL не нужно. Можно явным образом управлять сервером с помощью следующих команд, которые выдаются от имени привилегированного пользователя ОС через sudo: Остановить сервер:
Запустить сервер:
Перезапустить:
Обновить конфигурацию:
Получить информацию о сервере:
Список установленных экземпляров (можно без sudo):
Page 7: Page 7
Page 8: Журнал сообщений
В журнал записываются
- служебные сообщения сервера
- сообщения пользовательских сеансов
- сообщения приложений
- Настройка журнала
- расположение
- формат записей
- какие события регистрировать
Комментарии преподавателя
Информация о ходе работы СУБД записывается в журнал сообщений сервера. Сюда попадают сведения о запуске и останове сервера, различная служебная информация, в том числе сообщения о возникающих проблемах.
Также сюда могут выводиться сообщения о выполняющихся командах и времени их работы, о возникающих блокировках и тому подобное. Это позволяет выполнять трассировку пользовательских сеансов.
Разработчики приложений могут формировать и записывать в журнал сервера свои собственные сообщения.
Настройки PostgreSQL позволяют гибко определять, какие именно сообщения и в каком формате должны попадать в журнал сервера.
Например, вывод в форматах csv и json удобен для автоматизации анализа журнала.
https://postgrespro.ru/docs/postgresql/16/runtime-config-logging
Page 9: Журнал сообщений сервера
Журнал сообщений сервера находится здесь:
Заглянем в конец журнала:
Page 10: Параметры конфигурации
Для всего экземпляра
- основной файл параметров — postgresql.conf
- Для текущего сеанса
- Просмотр текущего значения
Комментарии преподавателя
Сервер PostgreSQL настраивается с помощью разнообразных параметров конфигурации, которые позволяют управлять ресурсами, настраивать служебные процессы и пользовательские сеансы, управлять журналом сервера и решать многие другие задачи. Поэтому нужно знать, как проверить текущие значения параметров и установить новые.
Настройки всего сервера обычно задаются в конфигурационных файлах. Основной конфигурационный файл — postgresql.conf, он редактируется вручную. Второй конфигурационный файл — postgresql.auto.conf — предназначен для изменения специальной командой ALTER SYSTEM. Параметры, установленные через ALTER SYSTEM, имеют приоритет над параметрами в postgresql.conf.
Директивы включения файлов и каталогов include и include_dir позволяют разделять сложные файлы postgresql.conf на части. Это может быть удобно, например, при управлении несколькими серверами с похожими конфигурациями.
Большинство параметров конфигурации допускает изменение значений в пользовательских сеансах прямо во время выполнения. Помимо системных, можно определять и пользовательские параметры и работать с ними с помощью этих же команд и функций.
Варианты установки и управления параметрами: https://postgrespro.ru/docs/postgresql/16/config-setting Текущие значения параметров доступны в представлении pg_settings: https://postgrespro.ru/docs/postgresql/16/view-pg-settings
Page 11: Параметры конфигурации
Основной файл конфигурации postgresql.conf расположен в этом каталоге:
Здесь же находятся и другие конфигурационные файлы. Проверим значение параметра work_mem:
Параметр work_mem задает объем памяти, который будет использоваться для внутренних операций сортировки и размещения хеш-таблиц, прежде чем будут задействованы временные файлы на диске. 4MB — это значение по умолчанию и оно слишком мало. Допустим, мы хотим увеличить его до 16MB для всего экземпляра. Для этого есть различные пути. Во-первых, можно внести изменение в postgresql.conf, раскомментировав и изменив строку, где определяется параметр:
Во-вторых, можно поместить определение параметра в файл с суффиксом .conf в каталоге /etc/postgresql/16/main/conf.d или в пользовательский файл конфигурации, местоположение которого следует задать в директиве include основного конфигурационного файла postgresql.conf. В-третьих, можно изменить значение параметра с помощью команды SQL — что мы и сделаем:
Такое изменение попадает не в postgresql.conf, а в файл postgresql.auto.conf, который находится в каталоге PGDATA:
Чтобы изменение вступило в силу, нужно перечитать конфигурационные файлы. Для этого можно воспользоваться pg_ctlcluster, либо использовать функцию SQL:
Убедимся, что новое значение параметра применилось. Кроме команды SHOW, можно сделать это таким образом:
Чтобы восстановить значение параметра по умолчанию, достаточно вместо SET использовать команду RESET (и, конечно, перечитать конфигурационные файлы):
Page 12: Page 12
Большинству параметров можно установить новое значение для текущего сеанса прямо во время его выполнения. Например, если мы собираемся выполнить запрос, сортирующий большой объем данных, то для сеанса можно увеличить значение work_mem:
Новое значение действует только в текущем сеансе или даже в текущей транзакции (при указании SET LOCAL). Еще один способ проверить текущее значение — выполнить запрос к представлению:
Можно увидеть значение параметра и с помощью команды \dconfig:
Page 13: Клиент psql
Терминальный клиент для работы с PostgreSQL
- Поставляется вместе с СУБД
- Используется администраторами и разработчиками для интерактивной работы и выполнения скриптов
Комментарии преподавателя
Для работы с СУБД PostgreSQL существуют различные сторонние инструменты, рассмотрение которых не входит в рамки курса.
В курсе мы будем использовать терминальный клиент psql:
psql — это единственный клиент, поставляемый вместе с СУБД.
Навыки работы c psql пригодятся разработчикам и администраторам вне зависимости от того, с каким инструментом они будут работать.
Для интерактивной работы в psql встроена поддержка readline, программ постраничного просмотра результатов запросов (таких, как less и pspg), а также подключения внешних редакторов. Возможности psql позволяют взаимодействовать с ОС, просматривать содержимое системного каталога, создавать скрипты для автоматизации повторяющихся задач.
https://postgrespro.ru/docs/postgresql/16/app-psql
Page 14: Подключение
При запуске psql нужно указать параметры подключения. К обязательным параметрам относятся: имя базы данных, по умолчанию совпадает с именем пользователя; имя пользователя (роль), по умолчанию совпадает с именем пользователя ОС; узел (host), по умолчанию — локальное соединение; порт, по умолчанию — обычно 5432. Параметры указываются так:
Настройки, сделанные в виртуальной машине курса, позволяют подключаться к PostgreSQL без указания параметров:
Проверим текущее подключение:
Команда \connect выполняет новое подключение, не покидая psql. Ее можно сократить до \c. Мы будем указывать необязательную часть имени команды в квадратных скобках: \c[onnect].
Справочная информация
Справку по psql можно получить не только в документации, но и прямо в системе. Команда
выдает справку по запуску. А если PostgreSQL устанавливался с документацией, то справочное руководство можно получить командой
Утилита psql умеет выполнять команды SQL и свои собственные команды, которые начинаются с обратной косой черты, как \conninfo. Команды psql всегда однострочные — в отличие от команд SQL. Внутри psql есть возможность получить список и краткое описание его собственных команд: \? выдает список команд psql, \h[elp] выдает список команд SQL, которые поддерживает сервер, а также синтаксис конкретной команды SQL.
Форматирование вывода
Клиент psql умеет выводить результаты запросов в разных форматах: формат с выравниванием значений; формат без выравнивания; расширенный формат. Формат с выравниванием используется по умолчанию:
Ширина столбцов выровнена по значениям. Также выводится строка заголовков и итоговая строка. Команды psql для переключения режима выравнивания: \a — переключатель режима: с выравниванием/без выравнивания. \t — переключатель отображения строки заголовка и итоговой строки. Отключим выравнивание, заголовок и итоговую строку:
Page 15: Page 15
Такой формат неудобен для просмотра, но может оказаться полезным для автоматической обработки результатов. Расширенный формат удобен, когда нужно вывести много столбцов для одной или нескольких записей. Для этого вместо точки с запятой указываем в конце команды \gx:
Если расширенный формат нужен не для одной команды, а постоянно, можно включить его переключателем \x. Все возможности форматирования результатов запросов доступны через команду \pset.
Взаимодействие с ОС и выполнение скриптов
Из psql можно выполнять команды shell:
С помощью запроса SQL можно сформировать несколько других запросов SQL и записать их в файл, используя команду \o[ut]:
На экран (в стандартный вывод) ничего не попало. Посмотрим в файле:
Вернем вывод на экран и восстановим форматирование по умолчанию.
Выполним теперь эти команды из файла с помощью \i[nclude]:
Есть и другие способы выполнить команды, в том числе из файлов. После выполнения команд сеанс psql будет завершен: psql < имя_файла psql -f имя_файла psql -c ‘команда’ (работает только для одной команды)
Переменные psql
По аналогии с shell, psql имеет собственные переменные. Установим переменную:
Page 16: Page 16
Чтобы подставить значение переменной, надо предварить ее имя двоеточием:
Значение переменной можно сбросить:
Переменные можно использовать, например, для хранения текста часто используемых запросов. Вот запрос на получение списка пяти самых больших по размеру таблиц:
Для выполнения запроса достаточно набрать:
Присвоение значения переменной top5 удобно записать в стартовый файл .psqlrc в домашнем каталоге пользователя. Команды из .psqlrc будут автоматически выполняться каждый раз при старте psql. Без параметров \set выдает значения всех переменных, включая встроенные. Справку по встроенным переменным можно получить так:
Выйти из psql можно с помощью команд \q[uit], quit, exit или нажав Ctrl+D:
Page 17: Итоги
Установка PostgreSQL из готовых пакетов — предпочтительный способ установки
- Пакетные дистрибутивы учитывают особенности ОС, которые нужно знать
- как запускать и останавливать сервер
- расположение файлов конфигурации
- расположение журнала сервера
- psql — клиент для работы с PostgreSQL
Page 18: Практика
- Установите для всех сеансов значение параметра work_mem равным 8 Мбайт. Обновите конфигурацию и проверьте, что изменения вступили в силу. Восстановите значение по умолчанию. 2. Запишите в файл ddl.sql команду CREATE TABLE на создание любой таблицы. Запишите в файл populate.sql команды на вставку строк в эту таблицу. Выполните оба скрипта и проверьте, что таблица создалась и в ней появились записи. 3. Найдите в журнале сервера строки за сегодняшний день.
Комментарии преподавателя
Для запуска psql в окне терминала наберите psql без параметров:
Для выполнения заданий каждой темы удобно создавать отдельную базу данных:
Воспользуйтесь командой ALTER SYSTEM.
Если результат запроса не помещается в окно терминала, psql передает его утилите less для постраничной выдачи. Чтобы вернуться в режим ввода команд, нажмите клавишу q.
Page 19: 1. Параметры конфигурации
Подключаемся к базе данных:
Задаем значение параметра:
Обновляем конфигурацию:
Проверяем значение параметра:
Вернем значение по умолчанию:
Применяем изменения:
2. Выполнение скриптов в psql
Запишем в файл ddl.sql команду на создание таблицы с ключевыми словами PostgreSQL (для этого можно использовать и любой текстовый редактор):
Запишем команды для заполнения таблицы keywords в файл populate.sql:
Создаем базу данных и подключаемся к ней:
Выполняем скрипты и проверяем записи в таблице:
Page 20: Page 20
3. Просмотр журнала
Журнал можно открыть любым текстовым редактором. Каждая запись в журнале начинается с даты, содержит номер серверного процесса (таковы настройки журнала после установки из пакета) и может состоять из нескольких строк. Последние записи будут в конце файла.
Созданную нами базу можно удалить, предварительно отключившись от нее (подробности будут в модуле «Организация данных»)
02 Занятие 02: Архитектура / Общее устройство PostgreSQL
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_02_arch_general.html Archive: DEV1-handouts-16.zip Страниц PDF: 20
Page 1: Архитектура / Общее устройство PostgreSQL
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Клиент-серверный протокол
- Транзакционность и механизмы ее реализации
- Схема обработки и способы выполнения запросов
- Процессы и структуры памяти
- Хранение данных на диске и работа с ними
- Расширяемость системы
Page 3: Клиент и сервер
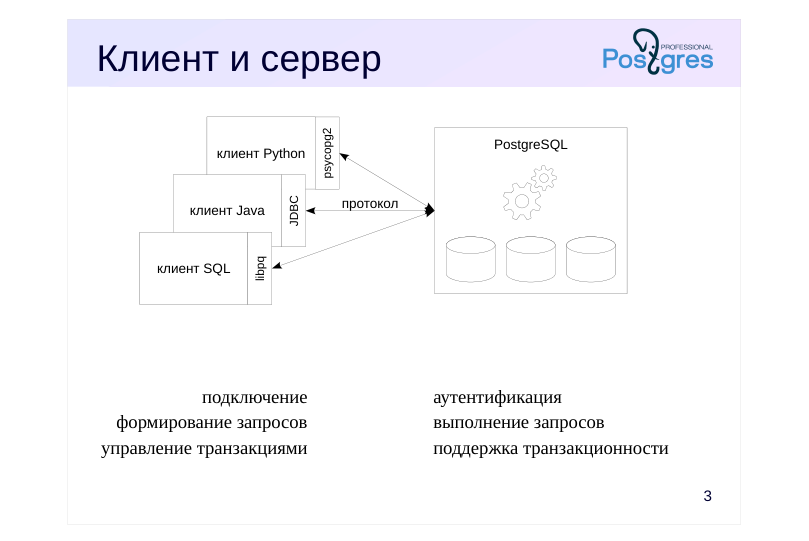 {#source-figure-003 caption=“Source slide page 3: Клиент и сервер”}
подключение аутентификация формирование запросов выполнение запросов управление транзакциями поддержка транзакционности
Комментарии преподавателя
Клиентское приложение — например, psql или любая другая программа, написанная на любом языке программирования, — подключается к серверу и «общается» с ним. Чтобы клиент и сервер понимали друг друга, они должны использовать один и тот же протокол взаимодействия. Обычно клиент использует драйвер, реализующий протокол и предоставляющий набор функций для использования в программе. Внутри драйвер может пользоваться стандартной реализацией протокола (библиотекой libpq), либо реализовывать этот протокол самостоятельно.
Не так важно, на каком языке написан клиент — за разным синтаксисом будут стоять возможности, определенные протоколом. Мы будем использовать для примеров язык SQL с помощью клиента psql. В реальной жизни клиентскую часть на SQL пишут редко, но нам это удобно для учебных целей. Мы рассчитываем, что сопоставить команды SQL с аналогичными возможностями какого-либо другого языка программирования не составит для вас большого труда.
Протокол позволяет клиенту подключиться к одной из баз данных кластера. При этом сервер выполняет аутентификацию — решает, можно ли разрешить подключение, например, запросив пароль.
Далее клиент посылает серверу запросы на языке SQL, а сервер выполняет их и возвращает результат. Наличие мощного и удобного языка запросов — одна из особенностей реляционных СУБД.
Другая особенность — поддержка согласованной работы транзакций.
https://postgrespro.ru/docs/postgresql/16/protocol
Page 4: Транзакции
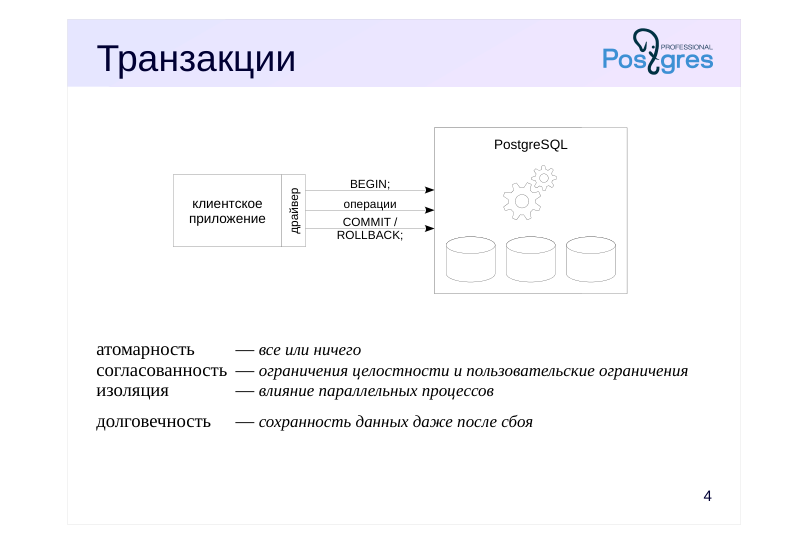 {#source-figure-004 caption=“Source slide page 4: Транзакции”}
- атомарность — все или ничего согласованность — ограничения целостности и пользовательские ограничения изоляция — влияние параллельных процессов
- долговечность — сохранность данных даже после сбоя
Комментарии преподавателя
Под транзакцией понимается последовательность операций, которая сохраняет согласованность данных при условии, что операции выполнены полностью и без помех со стороны других транзакций.
От транзакций ожидают выполнения четырех свойств (ACID):
● Атомарность: транзакция либо выполняется полностью, либо не выполняется вовсе. Для этого начало транзакции отмечается командой BEGIN, а конец — либо COMMIT (фиксация изменений), либо ROLLBACK (отмена изменений).
● Согласованность: транзакция переводит базу данных из одного согласованного состояния в другое согласованное состояние (согласованность - соблюдение установленных ограничений).
● Изоляция: другие транзакции, выполняющиеся одновременно с данной, не должны оказывать на нее влияния.
● Долговечность: после того, как данные зафиксированы, они не должны потеряться даже в случае сбоя.
За управление транзакциями (то есть за определение команд, составляющих транзакцию, и за фиксацию или отмену транзакции) в PostgreSQL, как правило, отвечает клиентское приложение. На стороне сервера управлять транзакциями могут хранимые процедуры.
https://postgrespro.ru/docs/postgresql/16/sql-begin
https://postgrespro.ru/docs/postgresql/16/sql-savepoint
https://postgrespro.ru/docs/postgresql/16/transactions
Page 5: Управление транзакциями
По умолчанию psql работает в режиме автофиксации:
Это приводит к тому, что любая одиночная команда, выданная без явного указания начала транзакции, сразу же фиксируется. Проверьте, включен ли аналогичный режим в драйвере PostgreSQL вашего любимого языка программирования? Создадим таблицу с одной строкой:
Увидит ли таблицу и строку другая транзакция?
Да. Сравните:
Что увидит другая транзакция на этот раз?
Изменения еще не зафиксированы, поэтому не видны другой транзакции.
А теперь?
Режим без автофиксации неявно начинает транзакцию при первой выданной команде; изменения надо фиксировать самостоятельно.
Page 6: Page 6
Что на этот раз?
Изменения не видны; транзакция была начата неявно.
Ну и наконец:
Восстановим режим, в котором psql работает по умолчанию.
Отдельные изменения можно откатывать, не прерывая транзакцию целиком (хотя необходимость в этом возникает нечасто).
Обратите внимание: свои собственные изменения транзакция видит, даже если они не зафиксированы. Теперь откатим все до точки сохранения. Откат к точке сохранения не подразумевает передачу управления (то есть не работает как GOTO); отменяются только те изменения состояния БД, которые были выполнены от момента установки точки до текущего момента.
Что увидим?
Сейчас изменения отменены, но транзакция продолжается:
Page 7: Page 7
Page 8: Выполнение запроса
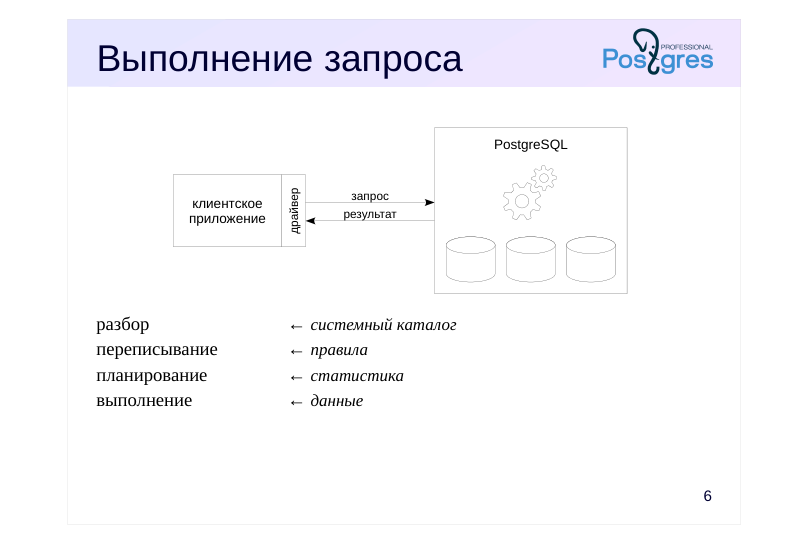 {#source-figure-008 caption=“Source slide page 8: Выполнение запроса”}
разбор ← системный каталог переписывание ← правила планирование ← статистика выполнение ← данные
Комментарии преподавателя
Выполнение запроса — довольно сложная задача. Запрос передается от клиента серверу в виде текста. Текст надо разобрать — выполнить синтаксический разбор (складываются ли буквы в слова, а слова — в команды) и семантический разбор (есть ли в базе данных таблицы и другие объекты, на которые запрос ссылается по имени). Для этого требуется информация о том, что вообще содержится в базе данных. Такая мета-информация называется системным каталогом, она хранится в самой базе данных в специальных таблицах.
Запрос может переписываться (трансформироваться) — например, вместо имени представления подставляется текст запроса. Можно придумать и свои трансформации, для чего есть механизм правил.
SQL — декларативный язык: запрос, составленный на нем, говорит о том, какие данные надо получить, но не говорит, как это сделать. Поэтому запрос (уже разобранный и представленный в виде дерева), передается планировщику, который разрабатывает план выполнения. Например, планировщик решает, надо ли использовать индексы. Чтобы качественно спланировать работу, планировщику нужна информация о размере таблиц и о распределении данных в них — статистика.
Далее запрос выполняется в соответствии с планом и результат возвращается клиенту — целиком и полностью:
https://postgrespro.ru/docs/postgresql/16/query-path
Это удобный и простой способ для небольших выборок, он обеспечи-вается простым режимом протокола.
Page 9: Подготовка операторов
 {#source-figure-009 caption=“Source slide page 9: Подготовка операторов”}
разбор переписывание
- привязка ← значения параметров планирование выполнение
Комментарии преподавателя
Итак, каждый запрос проходит перечисленные ранее шаги: разбор, переписывание, планирование и выполнение. Но если один и тот же запрос (с точностью до параметров) выполняется много раз, нет смысла каждый раз разбирать его заново.
Поэтому кроме обычного выполнения запросов протокол PostgreSQL предусматривает расширенный режим, который позволяет более детально управлять выполнением операторов.
В качестве одной из возможностей расширенный режим позволяет подготовить запрос — заранее выполнить разбор и переписывание и запомнить дерево разбора.
При выполнении запроса выполняется привязка конкретных значений параметров. Если необходимо, здесь выполняется планирование (в некоторых случаях PostgreSQL запоминает план запроса и не выполняет повторно этот шаг). Затем запрос выполняется.
Еще одно преимущество использования подготовленных операторов — невозможность внедрения SQL-кода.
https://postgrespro.ru/docs/postgresql/16/sql-prepare
https://postgrespro.ru/docs/postgresql/16/sql-execute
Page 10: Подготовленные операторы
В SQL оператор подготавливается командой PREPARE (эта команда является расширением PostgreSQL, она отсутствует в стандарте):
При этом выполняются разбор и переписывание, и полученное дерево разбора запоминается. После подготовки оператор можно вызывать по имени, передавая фактические параметры:
Если у запроса нет параметров, при подготовке запоминается и построенный план выполнения. Если же параметры есть, как в этом примере, то их фактические значения принимаются во внимание при планировании. Планировщик может счесть, что план, построенный без учета параметров, окажется не хуже, и тогда перестанет выполнять планирование повторно. А как подготовить и выполнить оператор в вашем любимом языке? Есть ли возможность выполнить оператор, НЕ подготавливая его? Все подготовленные операторы текущего сеанса можно увидеть в представлении:
Page 11: Курсоры
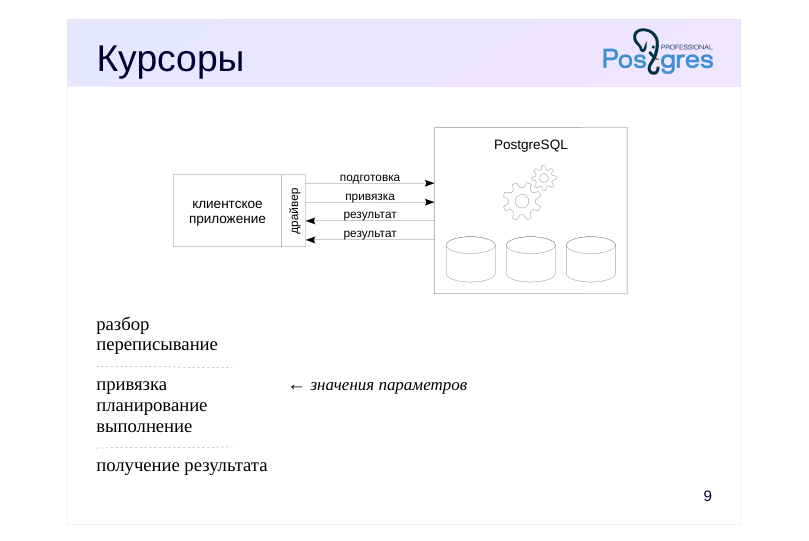 {#source-figure-011 caption=“Source slide page 11: Курсоры”}
разбор переписывание
- привязка ← значения параметров планирование выполнение
- получение результата
Комментарии преподавателя
Не всегда клиенту бывает удобно получить все результаты сразу. Данных может оказаться много, но не все они могут быть нужны.
Для этого расширенный режим протокола предусматривает курсоры. Можно открыть курсор для какого-либо оператора, а затем получать результирующие данные построчно по мере необходимости.
Курсор можно рассматривать как окно, в котором видна только часть из множества результатов. При получении строки данных окно сдвигается. Иными словами, курсоры позволяют работать с реляционными данными (множествами) итеративно, строка за строкой.
Открытый курсор представлен на сервере так называемым порталом. Это слово встречается в документации; в первом приближении можно считать «курсор» и «портал» синонимами.
Запрос, используемый в курсоре, неявно подготавливается (то есть сохраняется его дерево разбора и, возможно, план выполнения).
https://postgrespro.ru/docs/postgresql/16/sql-declare
https://postgrespro.ru/docs/postgresql/16/sql-fetch
Page 12: Курсоры
При выполнении команды SELECT сервер передает, а клиент получает сразу все строки:
Курсор позволяет получать данные построчно.
Размер выборки можно указывать:
Этот размер играет важную роль, когда строк очень много: обрабатывать большой объем данных построчно крайне неэффективно. Что, если в процессе чтения мы дойдем до конца таблицы?
FETCH просто перестанет возвращать строки. В обычных языках программирования всегда есть возможность проверить это условие. Как в вашем языке программирования получать данные построчно с помощью курсора? Есть ли возможность НЕ пользоваться курсором и получить все строки сразу? Как настраивается размер выборки для курсора? По окончании работы открытый курсор закрывают, освобождая ресурсы:
Однако курсоры автоматически закрываются по завершению транзакции, так что можно не закрывать их явно. (Исключение составляют курсоры, открытые с указанием WITH HOLD.)
Page 13: Page 13
Page 14: Процессы и память
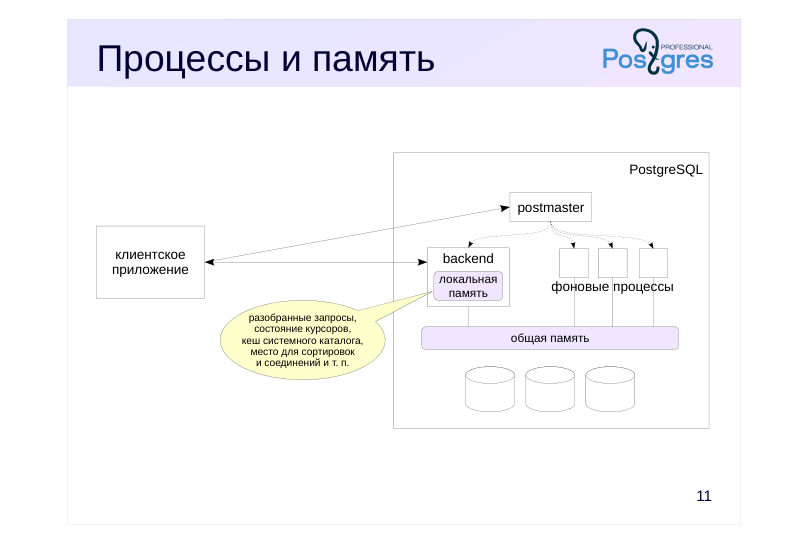 {#source-figure-014 caption=“Source slide page 14: Процессы и память”}
Комментарии преподавателя
Между обращениями клиента сервер должен хранить вспомогательную информацию: разобранные запросы и их планы, состояние открытых курсоров (порталы). Где и как он это делает?
Сервер PostgreSQL состоит из нескольких взаимодействующих процессов. В первую очередь при старте сервера запускается процесс, традиционно называемый postmaster. Он запускает все остальные процессы (с помощью системного вызова fork в Unix) и «присматривает» за ними — если какой-нибудь процесс завершится аварийно, postmaster перезапустит его (или перезапустит весь сервер, если сочтет, что процесс мог повредить общие данные).
Работу сервера обеспечивает ряд фоновых служебных процессов. В следующих темах этого модуля мы поговорим об основных из них.
Чтобы процессы могли обмениваться информацией, postmaster выделяет общую память, доступ к которой могут получить все процессы. Кроме общей памяти, каждый процесс имеет и свою локальную память, доступную только ему самому.
Postmaster слушает входящие соединения. Для каждого вновь подключающегося клиента postmaster порождает обслуживающий процесс (backend) и дальше клиент общается уже с этим процессом. Обслуживающий процесс, в том числе, производит аутентификацию.
Место, необходимое для выполнения запроса (разобранные запросы и их планы, состояние курсоров, кеш системного каталога, место для сортировки данных и т. п.), выделяется в локальной памяти обслуживающего процесса.
Page 15: Много клиентов
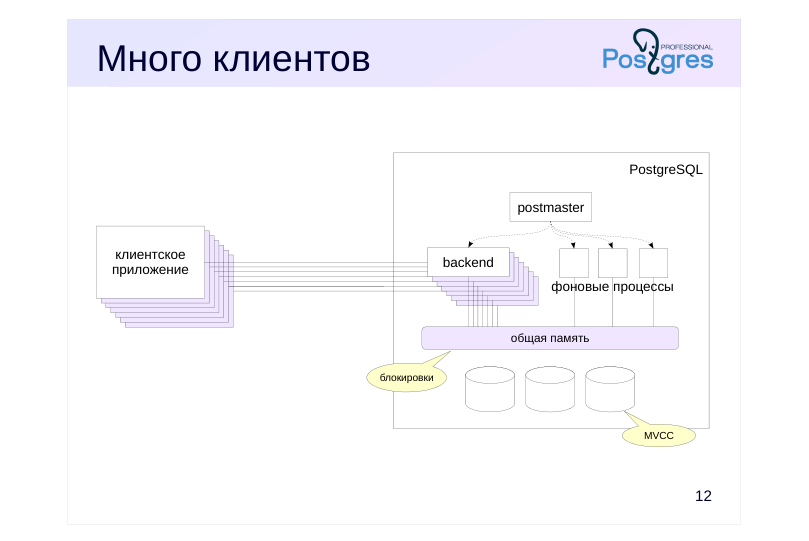 {#source-figure-015 caption=“Source slide page 15: Много клиентов”}
Комментарии преподавателя
Когда к серверу подключается много клиентов, для каждого из них порождается собственный обслуживающий процесс. Это не проблема, пока клиентов не очень много: на всех хватает оперативной памяти, а соединения не происходят слишком часто.
Тем не менее при одновременной работе с какими-либо объектами приходится принимать меры, чтобы один процесс не поменял какие-то данные в то время, пока с ними работает другой процесс.
Для объектов в общей памяти используются короткоживущие блокировки. PostgreSQL делает это достаточно аккуратно для того, чтобы система хорошо масштабировалась при увеличении числа процессоров (ядер).
С таблицами сложнее, поскольку блокировки нужно удерживать до конца транзакций (то есть потенциально в течение длительного времени), из-за чего масштабируемость может пострадать. Поэтому PostgreSQL использует механизм многоверсионности (MVCC, multiversion concurrency control) и изоляцию на основе снимков данных: одни и те же данные могут одновременно существовать в разных версиях, а каждый процесс видит собственную (но всегда согласованную) картину данных. Это позволяет блокировать только те процессы, которые пытаются изменить данные, уже измененные, но еще не зафиксированные другими процессами.
Многоверсионность — основной механизм, который обеспечивает первые три свойства транзакций (атомарность, согласованность, изоляция). Про него мы будем говорить отдельно в теме «Изоляция и многоверсионность».
Page 16: Пул соединений
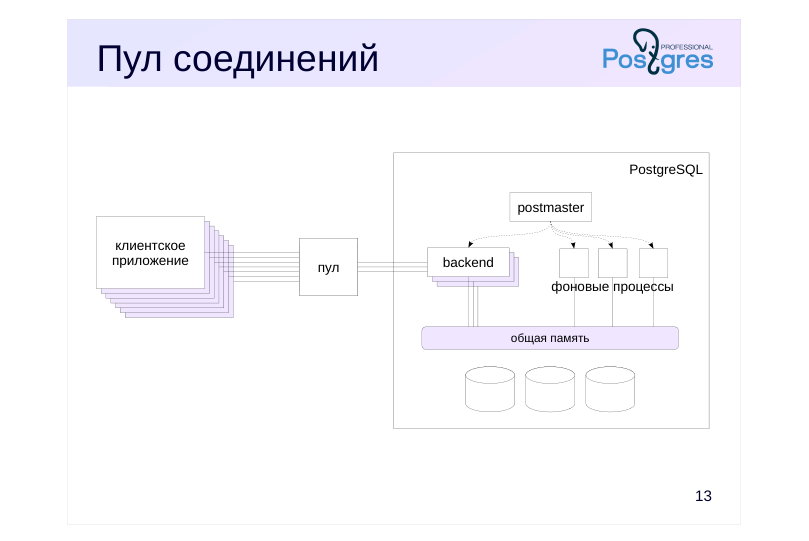 {#source-figure-016 caption=“Source slide page 16: Пул соединений”}
Комментарии преподавателя
Если клиентов слишком много, или соединения устанавливаются и разрываются слишком часто, стоит подумать о применении пула соединений. Такую функцию обычно предоставляет сервер приложений или можно воспользоваться сторонними менеджерами пула (наиболее известен pgBouncer).
Клиенты подключаются не к серверу PostgreSQL, а к менеджеру пула. Менеджер удерживает открытыми несколько соединений с сервером баз данных и использует одно из свободных для того, чтобы выполнять запросы клиента. Таким образом, с точки зрения сервера число клиентов остается постоянным вне зависимости от того, сколько клиентов обращаются к менеджеру пула.
Но при таком режиме работы несколько клиентов разделяют один и тот же обслуживающий процесс, который — как мы говорили — в своей локальной памяти хранит определенное состояние (в частности, разобранные запросы для подготовленных операторов). Как правило, это необходимо учитывать при разработке приложений.
Одна из возможностей pgBouncer — временная приостановка обслуживания клиентов без разрыва соединения. Такая приостановка может использоваться для обновления программного обеспечения сервера или других операций, требующих рестарта сервера.
Подробнее вопросы применения пула соединений рассматриваются в курсе DEV2.
Page 17: Хранение данных
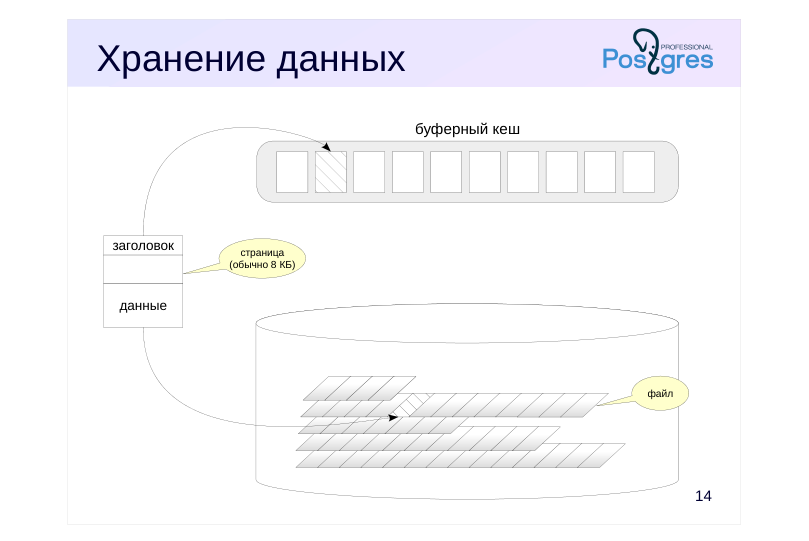 {#source-figure-017 caption=“Source slide page 17: Хранение данных”}
Комментарии преподавателя
Данные хранятся на дисках в обычных файлах операционной системы. Как именно данные распределены по файлам, рассматривается в одной из следующих тем.
Логически файлы разделены на страницы (иногда используется термин блок). Страница обычно имеет размер 8 Кбайт. Его в некоторых пределах можно поменять (16 или 32 Кбайта), но только при сборке сервера. Таким образом, собранный и запущенный кластер может работать со страницами только одного размера.
Каждая страница имеет внутреннюю разметку. Страница содержит заголовок и полезные данные; между ними может находиться свободное пространство, если страница занята не полностью.
Из-за того, что диски работают значительно медленнее, чем оперативная память (особенно HDD, но и SSD тоже), применяется кеширование: в оперативной памяти отводится место под недавно прочитанные с диска страницы — буферный кеш. Расчет делается на то, что одни и те же страницы понадобятся несколько раз и можно будет сэкономить на повторном обращении к диску. Измененные данные также записываются на диск не сразу, а через некоторое время.
Page 18: Хранение данных
 {#source-figure-018 caption=“Source slide page 18: Хранение данных”}
Комментарии преподавателя
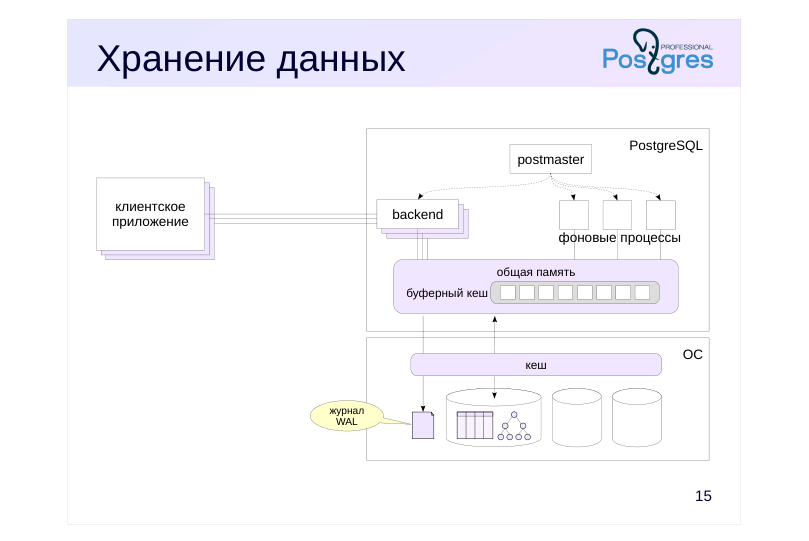
Буферный кеш PostgreSQL располагается в общей памяти, чтобы все процессы имели к нему доступ.
PostgreSQL работает с дисками, на которых находятся данные, не напрямую, а через операционную систему. У операционной системы тоже имеется собственный кеш данных. Поэтому, если страница не будет найдена в буферном кеше, остается шанс, что она есть в кеше ОС и обращения к диску удастся избежать.
При сбое (например, питания) содержимое оперативной памяти пропадает, при этом измененные, но еще не записанные на диск данные теряются. Это недопустимо и противоречит свойству долговечности транзакций. Поэтому в процессе работы PostgreSQL постоянно записывает специальный журнал, позволяющий повторно выполнить потерянные операции и восстановить данные в согласованном состоянии. Про буферный кеш и журнал мы будем говорить отдельно в одноименной теме.
Page 19: Расширяемость
 {#source-figure-019 caption=“Source slide page 19: Расширяемость”}
Комментарии преподавателя
PostgreSQL спроектирован с расчетом на расширяемость. Он предоставляет возможность создавать новые типы данных на основе уже имеющихся, писать хранимые подпрограммы для обработки данных, а также обеспечивает удобный инструментарий для администрирования, мониторинга и настройки производительности.
При необходимости можно написать расширение, которое добавляет недостающий функционал. Большинство расширений можно устанавливать «на лету», без рестарта сервера. Благодаря такой архитектуре, существует большое количество расширений, которые:
● добавляют поддержку языков программирования (помимо стандартных SQL, PL/pgSQL, PL/Perl, PL/Python и PL/Tcl);
● вводят новые типы данных и операторы для работы с ними;
● создают новые типы индексов для эффективной работы с разнообразными типами данных (помимо стандартных B-деревьев, хеш-индексов, GiST, SP-GiST, GIN, BRIN);
● запускают служебные фоновые процессы для выполнения дополнительных задач;
● позволяют подключаться к внешним источникам данных;
● собирают информацию о нагрузке на систему, выполняют мониторинг и строят отчеты;
● позволяют исследовать системные структуры данных.
Подробнее расширения рассматриваются в курсах DBA2 и DEV2.
Page 20: Итоги
Сервер управляет кластером баз данных
- Протокол позволяет клиентам подключаться к серверу, выполнять запросы и управлять транзакциями
- Каждый клиент обслуживается своим процессом
- Данные хранятся в файлах, обращение происходит через операционную систему
- Кеширование как в локальной памяти (каталог, разобранные запросы), так и в общей (буферный кеш)
03 Занятие 03: Архитектура / Изоляция и многоверсионность
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_03_arch_mvcc_overview.html Archive: DEV1-handouts-16.zip Страниц PDF: 18
Page 1: Архитектура / Изоляция и многоверсионность
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Многоверсионность
- Снимок данных
- Уровни изоляции
- Очистка и ее горизонт
- Блокировки
- Статус транзакций
Page 3: Многоверсионность
 {#source-figure-003 caption=“Source slide page 3: Многоверсионность”}
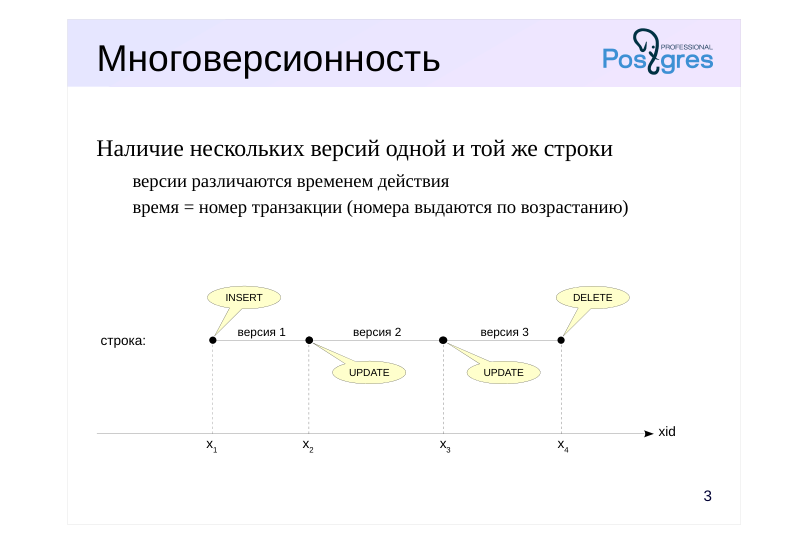
Наличие нескольких версий одной и той же строки
- версии различаются временем действия
- время = номер транзакции (номера выдаются по возрастанию)
Комментарии преподавателя
При одновременной работе нескольких сеансов возникает вопрос: что делать, если две транзакции одновременно обращаются к одной и той же строке? Если обе транзакции читающие, сложностей нет. Если обе пишущие — тоже (в этом случае они выстраиваются в очередь и выполняют изменения друг за другом). Самый интересный вариант — как взаимодействуют пишущая и читающая транзакции.
Простых пути два. Такие транзакции могут блокировать друг друга — но тогда страдает производительность. Либо читающая транзакция сразу может видеть изменения, сделанные пишущей транзакцией, даже если они не зафиксированы (это называется «грязным чтением») — но это очень плохо, ведь изменения могут быть отменены.
PostgreSQL идет сложным путем и использует многоверсионность — хранит несколько версий одной и той же строки. При этом пишущая транзакция работает со своей версией, а читающая видит свою.
Версии надо как-то отличать друг от друга. Для этого каждая из них хранит две отметки, определяющие «время действия» данной версии.
В качестве времени здесь используются всегда возрастающие номера транзакций (в действительности все немного сложнее, но это детали). Когда строка создается, она помечается номером транзакции, выполнившей команду INSERT. Когда удаляется — версия помечается номером транзакции, выполнившей DELETE (но физически не удаляется). UPDATE состоит из двух операций DELETE и INSERT.
https://postgrespro.ru/docs/postgresql/16/mvcc-intro
Page 4: Снимок данных
 {#source-figure-004 caption=“Source slide page 4: Снимок данных”}
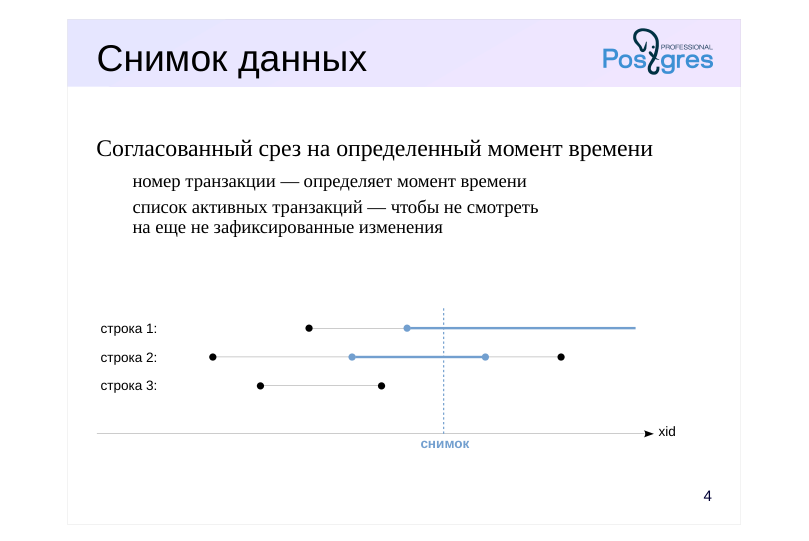
Согласованный срез на определенный момент времени
- номер транзакции — определяет момент времени
- список активных транзакций — чтобы не смотреть
- на еще не зафиксированные изменения
Комментарии преподавателя
В PostgreSQL применяется изоляция на основе снимков данных.
Транзакция, обращаясь к таблице, должна видеть только одну из имеющихся версий каждой строки (или не видеть ни одной). Для этого транзакция работает со снимком данных, созданным в определенный момент времени. В снимке видны самые последние версии уже зафиксированных данных, а еще не зафиксированные данные не видны. Иными словами, от каждой строки в снимок попадает версия, соответствующая моменту создания снимка.
Снимок — это не физическая копия данных, а всего несколько чисел:
● номер последней зафиксированной транзакции на момент создания снимка;
● список активных транзакций на этот момент.
Список нужен для того, чтобы исключить из снимка изменения тех транзакций, которые начались до создания снимка, но еще не были зафиксированы.
Зная эти числа, мы всегда можем сказать, какая из версий строки будет видна в снимке. Иногда это будет актуальная (самая последняя зафиксированная) версия, как для строки 1 на иллюстрации. Иногда не самая последняя: строка 2 удалена (и изменение уже зафиксировано), но транзакция еще продолжает видеть эту строку, пока работает со своим снимком. Это правильное поведение — оно дает согласованную картину данных на выбранный момент времени.
Какие-то строки вовсе не попадут в снимок: строка 3 удалена до того, как был построен снимок, поэтому в снимке ее нет.
Page 5: Уровни изоляции
Read Uncommitted
- не поддерживается PostgreSQL: работает как Read Committed
- Read Committed — используется по умолчанию
- снимок строится на момент начала оператора
- одинаковые запросы могут каждый раз получать разные данные
- Repeatable Read
- снимок строится на момент начала первого оператора транзакции
- транзакция может завершиться ошибкой сериализации
- Serializable
- полная изоляция, но дополнительные накладные расходы
- транзакция может завершиться ошибкой сериализации
Комментарии преподавателя
Стандарт SQL определяет четыре уровня изоляции: чем строже уровень, тем меньше влияния оказывают параллельно работающие транзакции друг на друга. Во времена, когда стандарт принимался, считалось, что чем строже уровень, тем сложнее его реализовать и тем сильнее его влияние на производительность (с тех пор эти представления несколько изменились).
Самый нестрогий уровень Read Uncommitted допускает грязные чтения. Он не поддерживается PostgreSQL, поскольку не представляет практической ценности и не дает выигрыша в производительности.
Уровень Read Committed является уровнем изоляции по умолчанию в PostgreSQL. На этом уровне снимки данных строятся в начале выполнения каждого оператора SQL. Таким образом, оператор работает с неизменной и согласованной картиной данных, но два одинаковых запроса, следующих один за другим, могут показать разные данные.
На уровне Repeatable Read снимок строится в начале транзакции (при выполнении первого оператора) — поэтому все запросы в одной транзакции видят одни и те же данные. Этот уровень удобен, например, для отчетов, состоящих из нескольких запросов.
Уровень Serializable гарантирует полную изоляцию: можно писать операторы так, как будто транзакция работает одна. Но при этом некоторая доля транзакций будет прерываться; приложение должно уметь повторять такие транзакции.
https://postgrespro.ru/docs/postgresql/16/transaction-iso
Page 6: Видимость версий строк
Как убедиться в том, что одна и та же строка может существовать в нескольких версиях? Создадим таблицу:
И вставим одну строку. Напомним, что если не начать транзакцию явно командой BEGIN, psql выполняет команду и немедленно фиксирует результат:
Начнем транзакцию и выведем ее номер:
Транзакция видит первую (и пока единственную) версию строки:
Здесь скрытые столбцы показывают номера транзакций, ограничивающих видимость версии строки: xmin — номер предыдущей транзакции, которая создала версию, а xmax=0 означает, что эта версия актуальна. Теперь начнем другую транзакцию в другом сеансе:
Транзакция видит ту же единственную версию:
Теперь изменим строку во второй транзакции.
Вот что получилось:
Page 7: Page 7
А что увидит первая транзакция?
Поскольку изменение не зафиксировано, первая транзакция продолжает видеть первую версию строки. Обратите внимание на xmax — значение показывает, что в настоящий момент другая транзакция меняет строку. Вообще говоря, такое «подглядывание» нарушает изоляцию, поэтому поля xmin и xmax скрыты и в реальной работе их использовать не стоит. Теперь зафиксируем изменения.
Что теперь увидит первая транзакция?
Теперь и первая транзакция видит вторую версию строки. После фиксации первая версия строки больше не будет видна ни в одной транзакции.
Page 8: Очистка и ее горизонт
 {#source-figure-008 caption=“Source slide page 8: Очистка и ее горизонт”}
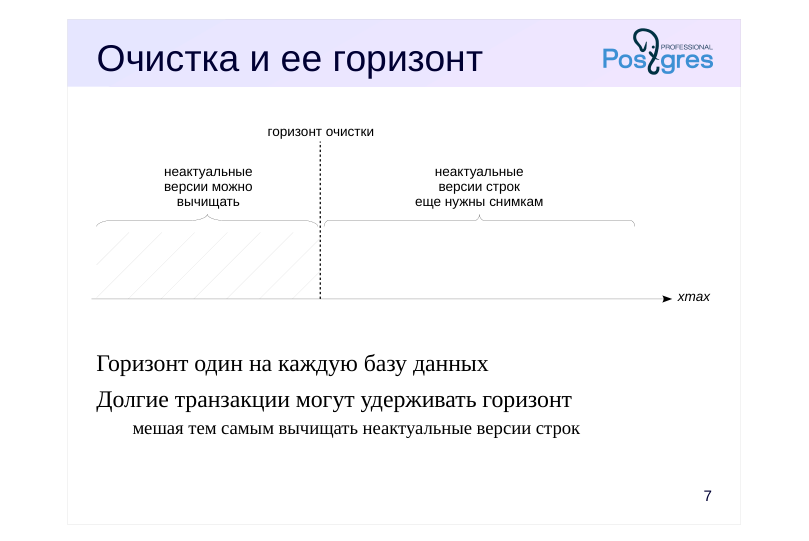
Горизонт один на каждую базу данных
- Долгие транзакции могут удерживать горизонт
- мешая тем самым вычищать неактуальные версии строк
Комментарии преподавателя
Механизм многоверсионности позволяет эффективно реализовать изоляцию на основе снимков, но в результате в табличных страницах накапливаются старые («мертвые») версии строк.
Какое-то время исторические версии нужны транзакциям, чтобы они могли работать со своим снимком данных, а в случае отката — вернуться к старым значениям. При этом для каждой базы данных существует такой номер xid, что все исторические версии, удаленные транзакциями с меньшими номерами, уже не видны ни в одном снимке. Этот номер называется горизонтом очистки.
Очистка производится группой специальных фоновых процессов; можно также выполнить ее вручную командой VACUUM.
Долгие транзакции и долго выполняющиеся запросы могут удерживать горизонт очистки, что не дает удалять накопившиеся версии строк. Если своевременно не вычищать исторические данные, таблицы и индексы будут разрастаться, занимая лишнее место на диске, а поиск в них актуальных версий строк будет замедляться.
https://postgrespro.ru/docs/postgresql/16/routine-vacuuming
Page 9: Блокировки
Блокировки строк
- чтение никогда не блокирует строки
- изменение строк блокирует их для изменений, но не для чтений
- Блокировки таблиц
- запрещают изменение или удаление таблицы, пока с ней идет работа
- запрещают чтение таблицы при перестроении или перемещении
- и т. п.
- Время жизни блокировок
- устанавливаются по мере необходимости или вручную
- снимаются автоматически при завершении транзакции или при откате
- к точке сохранения
Комментарии преподавателя
Что же дает многоверсионность? Она позволяет обойтись необходимым минимумом блокировок, тем самым увеличивая производительность системы.
Основные блокировки устанавливаются на уровне строк. При этом чтение никогда не блокирует ни читающие, ни пишущие транзакции. Изменение строки не блокирует ее чтение. Единственный случай, когда транзакция будет ждать освобождения блокировки — если она пытается менять строку, которая уже изменена другой, еще не зафиксированной транзакцией.
Блокировки также устанавливаются на более высоком уровне, в частности, на таблицах. Они нужны для того, чтобы никто не смог удалить таблицу, пока другие транзакции читают из нее данные, или чтобы запретить доступ к перестраиваемой таблице. На практике удаление и перестроение таблиц выполняются редко, поэтому обычно не вызывают проблем. Однако нужно учитывать, что перестроение таблицы происходит неявно при некоторых изменениях ее структуры и полностью блокирует доступ к таблице и ее индексам. Подробно блокировки рассматриваются в модуле «Блокировки» курса DBA2.
Все необходимые блокировки устанавливаются автоматически и автоматически же снимаются при завершении транзакции. Но если блокировка была получена после установки точки сохранения, она будет снята немедленно в случае отката к этой точке.
Можно также установить и дополнительные пользовательские блокировки; необходимость в этом возникает не часто.
https://postgrespro.ru/docs/postgresql/16/explicit-locking
Page 10: Блокировки
Повторим наш опыт, но теперь пусть обе транзакции попытаются изменить одну и ту же строку.
И во второй транзакции:
Вторая транзакция «повисла»: она не может изменить строку, пока первая транзакция не снимет блокировку.
Теперь вторая транзакция может продолжить выполнение:
Обе транзакции зафиксировали свои изменения. Первый сеанс снова читает таблицу и видит актуальную строку — это результат, зафиксированный второй транзакцией:
Page 11: Статус транзакций
Статус транзакций (clog)
- служебная информация; два бита на транзакцию
- специальные файлы на диске
- буферы в общей памяти
- Фиксация
- устанавливается бит «транзакция зафиксирована»
- Обрыв
- устанавливается бит «транзакция прервана»
- выполняется так же быстро, как и фиксация (не нужен откат данных)
Комментарии преподавателя
Для работы многоверсионности серверу надо понимать, в каком статусе находятся транзакции. Транзакция может быть активна или завершена. Завершиться транзакция может либо фиксацией, либо обрывом. Таким образом, для представления состояния каждой транзакции требуются два бита.
Статусы транзакций (commit log, clog) хранятся в специальных служебных файлах в каталоге PGDATA/pg_xact, а работа с ними происходит в общей памяти сервера, чтобы не приходилось постоянно обращаться к диску.
При любом завершении транзакции (как успешном, так и неуспешном) необходимо всего лишь установить соответствующие биты статуса. И фиксация, и обрыв транзакций происходят одинаково быстро.
Если прерванная транзакция успела создать новые версии строк, эти версии не уничтожаются (не происходит «физического» отката данных). Благодаря информации о статусах другие транзакции увидят, что транзакция, создавшая или удалившая версии строк, была прервана и не станут принимать во внимание сделанные ей изменения.
Page 12: Итоги
В файлах данных могут храниться несколько версий каждой строки
- Транзакции работают со снимками данных — согласованными срезами на определенный момент времени
- Уровни изоляции отличаются временем создания снимка
- Мертвые версии строк за горизонтом очистки должны периодически вычищаться
- Писатели не блокируют читателей, читатели не блокируют никого
Page 13: Практика
- Создайте таблицу с одной строкой. Начните первую транзакцию на уровне изоляции Read Committed и выполните запрос к таблице. Во втором сеансе удалите строку и зафиксируйте изменения. Сколько строк увидит первая транзакция, выполнив тот же запрос повторно? Проверьте. Завершите первую транзакцию. 2. Повторите то же самое, но пусть теперь транзакция работает на уровне изоляции Repeatable Read: BEGIN ISOLATION LEVEL REPEATABLE READ;
- Объясните отличия.
Page 14: 1. Уровень изоляции Read Committed
Создаем таблицу:
Запрос из первой транзакции (по умолчанию используется уровень изоляции Read Committed):
Удаляем строку во второй транзакции и фиксируем изменения:
Повторим запрос:
Первая транзакция видит произошедшие изменения: строка удалена.
2. Уровень изоляции Repeatable Read
Вернем строку:
Запрос из первой транзакции:
Удаляем строку во второй транзакции и фиксируем изменения:
Повторим запрос:
Page 15: Page 15
На этом уровне изоляции первая транзакция не видит изменений: для нее строка по-прежнему существует.
Page 16: Практика+
- Начните транзакцию и создайте новую таблицу с одной строкой. Не завершая транзакцию, откройте второй сеанс и выполните в нем запрос к таблице. Проверьте, что увидит транзакция во втором сеансе.
- Зафиксируйте транзакцию в первом сеансе и повторите
- запрос к таблице во втором сеансе.
- Повторите задание 1, но откатите, а не зафиксируйте транзакцию в первом сеансе. Что изменилось?
- В первом сеансе начните транзакцию и выполните запрос к созданной ранее таблице. Получится ли удалить эту таблицу во втором сеансе, пока первая транзакция не завершена? Проверьте.
Page 17: 1. Транзакции и команды DDL — фиксация
Начнем транзакцию и создадим новую таблицу:
Во втором сеансе сделаем запрос к таблице:
Пока создавшая таблицу транзакция не завершена, все остальные транзакции таблицу не видят. Таблица будет видна только после завершения создавшей ее транзакции:
2. Транзакции и команды DDL — откат
Снова начнем транзакцию и создадим новую таблицу:
Запрос во втором сеансе ожидаемо не видит изменений:
При откате первой транзакции команда создания таблицы тоже откатывается:
Команды DDL в PostgreSQL являются транзакционными.
3. Блокировки таблиц
Page 18: Page 18
Начав транзакцию, обратимся к таблице:
При попытке удалить таблицу вторая транзакция будет заблокирована — нельзя удалить таблицу, которая используется.
Таблица будет удалена только после завершения первой транзакции:
04 Занятие 04: Архитектура / Буферный кеш и журнал
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_04_arch_wal_overview.html Archive: DEV1-handouts-16.zip Страниц PDF: 17
Page 1: Архитектура / Буферный кеш и журнал
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Устройство буферного кеша
- Алгоритм вытеснения
- Журнал предзаписи
- Контрольная точка
- Процессы, связанные с буферным кешем и журналом
Page 3: Буферный кеш
 {#source-figure-003 caption=“Source slide page 3: Буферный кеш”}
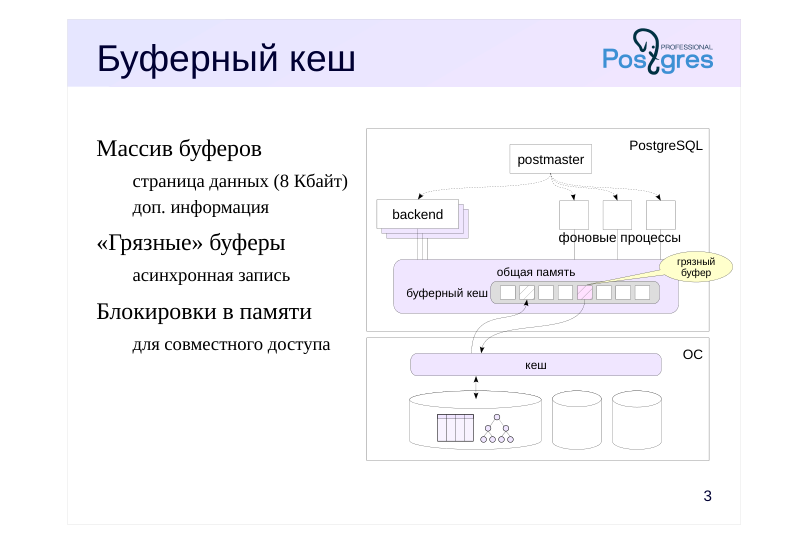
Массив буферов
- страница данных (8 Кбайт)
- доп. информация
- «Грязные» буферы
- асинхронная запись
- Блокировки в памяти
- для совместного доступа
Комментарии преподавателя
Буферный кеш используется для сглаживания скорости работы оперативной памяти и дисков. Он состоит из массива буферов, которые содержат страницы данных и дополнительную информацию (например, имя файла и положение страницы внутри этого файла).
Размер страницы обычно составляет 8 Кбайт; размер можно изменить только при сборке PostgreSQL.
Любая работа со страницами данных проходит через буферный кеш. Если какой-либо процесс собирается работать со страницей, он в первую очередь пытается найти ее в кеше. Если страницы нет, он обращается к операционной системе с просьбой прочитать эту страницу и помещает ее в буферный кеш. (Обратите внимание, что ОС может прочитать страницу с диска, а может обнаружить ее в собственном кеше.)
После того, как страница записана в буферный кеш, к ней можно обращаться многократно без накладных расходов на вызовы ОС.
Если процесс изменил данные в странице, соответствующий буфер становится «грязным». Измененная страница подлежит записи на диск, но по соображениям производительности запись происходит асинхронно и может откладываться.
Буферный кеш, как и другие структуры общей памяти, защищен блокировками для управления одновременным доступом. Хотя блокировки и реализованы эффективно, доступ к буферному кешу далеко не так быстр, как простое обращение к оперативной памяти. Поэтому в общем случае чем меньше данных читает и изменяет запрос, тем быстрее он будет работать.
Page 4: Вытеснение
 {#source-figure-004 caption=“Source slide page 4: Вытеснение”}
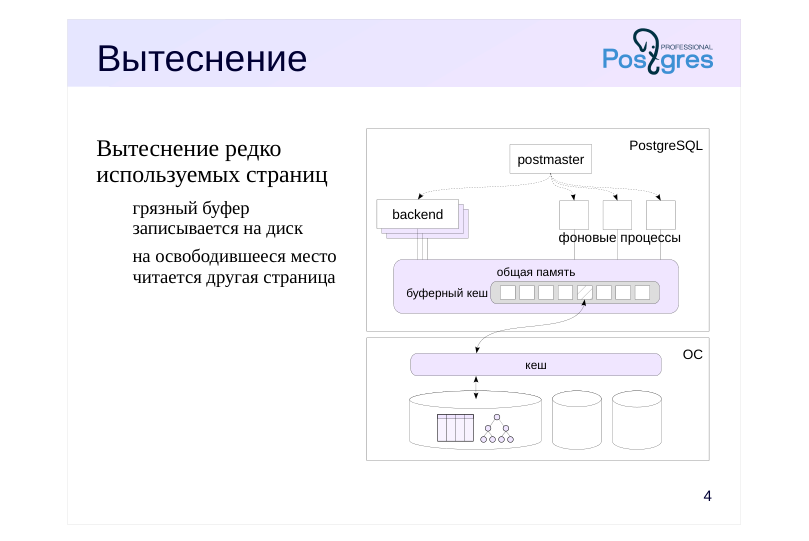
Вытеснение редко используемых страниц
- грязный буфер
- записывается на диск
- на освободившееся место
- читается другая страница
Комментарии преподавателя
Размер буферного кеша обычно не так велик, чтобы база данных помещалась в него целиком. Его ограничивают и доступная оперативная память, и возрастающие при его увеличении накладные расходы. Поэтому при чтении очередной страницы рано или поздно окажется, что место в буферном кеше закончилось. В этом случае применяется вытеснение страниц.
Алгоритм вытеснения выбирает в кеше страницу, которая в последнее время использовалась реже других. Если выбранный буфер оказался грязным, страница записывается на диск, чтобы не потерять сделанные в ней изменения. Затем в освободившийся буфер читается новая страница.
Такой алгоритм вытеснения называется LRU — Least Recently Used. Он сохраняет в кеше данные, с которыми происходит активная работа. Таких «горячих» данных обычно не слишком много, и при достаточном объеме буферного кеша получается существенно сократить количество обращений к ОС (и дисковых операций).
Page 5: Влияние буферного кеша на выполнение запросов
Создаем новую БД в кластере и подключаемся к ней (подробнее про базы данных — в модуле «Организация данных»):
Создадим таблицу:
Заполним таблицу некоторым количеством строк:
Размер буферного кеша показывает параметр shared_buffers:
Значение по умолчанию слишком мало; в любой реальной системе его требуется увеличить сразу после установки сервера (изменение требует перезапуска). Теперь перезапустим сервер, чтобы содержимое буферного кеша сбросилось.
Сравним, что происходит при первом и при втором выполнении одного и того же запроса. В этом курсе мы не рассматриваем подробно планы запросов, но иногда будем в них заглядывать. Сейчас мы воспользуемся командой EXPLAIN ANALYZE, которая выполняет запрос и выводит не только план выполнения, но и дополнительную информацию:
Строка «Buffers: shared» показывает использование буферного кеша. read — количество буферов, в которые пришлось прочитать страницы с диска.
Page 6: Page 6
hit — количество буферов, в которых нашлись нужные для запроса страницы. Обратите внимание, что во второй раз уменьшилось и время выполнения запроса, и время его планирования (потому что таблицы системного каталога тоже кешируются).
Page 7: Журнал предзаписи (WAL)
Проблема: при сбое теряются данные из оперативной памяти, не записанные на диск
- Журнал
- поток информации о выполняемых действиях,
- позволяющий повторно выполнить потерянные при сбое операции
- запись попадает на диск раньше, чем измененные данные
- Журнал защищает
- страницы таблиц, индексов и других объектов
- статус транзакций (clog)
- Журнал не защищает
- временные и нежурналируемые таблицы
Комментарии преподавателя
Наличие буферного кеша (и других буферов в оперативной памяти) увеличивает производительность, но уменьшает надежность. В случае сбоя в СУБД содержимое буферного кеша потеряется. Если сбой произойдет в операционной системе или на аппаратном уровне, то пропадет содержимое и буферов ОС (но с этим справляется сама операционная система).
Для обеспечения надежности PostgreSQL использует журналирование. При выполнении любой операции формируется запись, содержащая минимально необходимую информацию для того, чтобы операцию можно было выполнить повторно. Такая запись должна попасть на диск (или другой энергонезависимый накопитель) раньше, чем будут записаны изменяемые операцией данные (поэтому журнал и называется журналом предзаписи, write-ahead log).
Файлы журнала располагаются в каталоге PGDATA/pg_wal.
Журнал защищает все объекты, работа с которыми ведется в оперативной памяти: таблицы, индексы и другие объекты, статус транзакций.
В журнал не попадают данные о временных таблицах (такие таблицы доступны только создавшему их пользователю и только на время сеанса или транзакции) и о нежурналируемых таблицах (такие таблицы ничем не отличаются от обычных, кроме того, что не защищены журналом). В случае сбоя нежурналируемые таблицы просто очищаются, зато работа с ними происходит быстрее.
https://postgrespro.ru/docs/postgresql/16/wal-intro
Page 8: Журнал предзаписи
Логически журнал можно представить в виде непрерывного потока записей. Каждая запись имеет номер, называемый LSN (Log Sequence Number). Это 64-разрядное число — смещение записи в байтах относительно начала журнала. Текущую позицию показывает функция pg_current_wal_lsn:
Позиция записывается как два 32-разрядных числа через косую черту. Запомним это значение. Выполним теперь какие-нибудь операции и посмотрим, как изменилась позиция.
Интересны не абсолютные числа, а их разница, которая показывает размер сгенерированных журнальных записей в байтах:
Физически журнал хранится в файлах в отдельном каталоге (PGDATA/pg_wal). По умолчанию файлы имеют размер 16 Мбайт, задать другой размер можно при инициализации кластера баз данных. На файлы можно взглянуть не только средствами файловой системы, но и с помощью функции:
Page 9: Контрольная точка
 {#source-figure-009 caption=“Source slide page 9: Контрольная точка”}
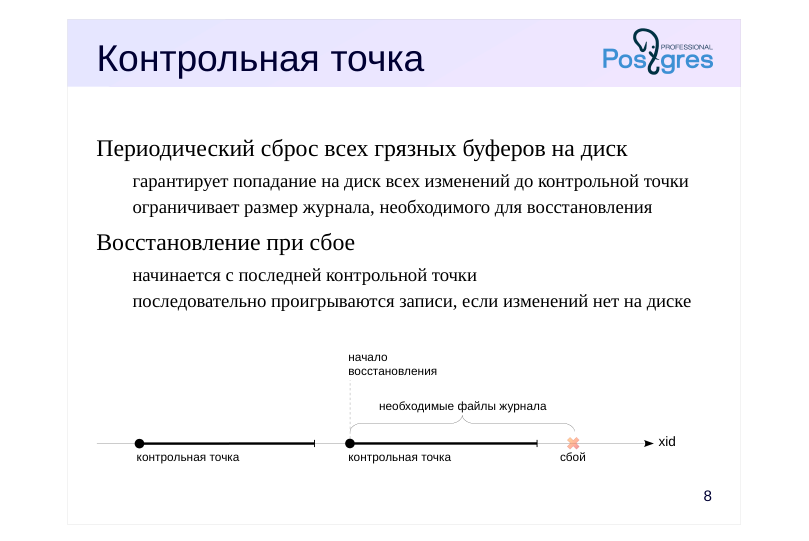
Периодический сброс всех грязных буферов на диск
- гарантирует попадание на диск всех изменений до контрольной точки
- ограничивает размер журнала, необходимого для восстановления
- Восстановление при сбое
- начинается с последней контрольной точки
- последовательно проигрываются записи, если изменений нет на диске
Комментарии преподавателя
Когда сервер PostgreSQL запускается после сбоя, он входит в режим восстановления. Информация на диске в это время несогласованна: изменения «горячих» страниц пропали, поскольку эти страницы все еще находились в кеше, а более поздние изменения уже были сброшены на диск.
Чтобы восстановить согласованность, PostgreSQL читает WAL и после-довательно проигрывает каждую его запись, если соответствующее изменение не попало на диск. Таким образом восстанавливается работа всех транзакций. Транзакции, запись о фиксации которых не успела попасть в журнал, считаются оборванными.
Однако объем журнала за время работы сервера мог бы достигнуть гигантских размеров. Хранить его целиком и просматривать при сбое совершенно не реально. Поэтому СУБД периодически выполняет контрольную точку (КТ): принудительно сбрасывает на диск все грязные буферы (включая буферы clog, хранящие состояние транзакций).
Собственно «точка» — это момент начала записи буферов, которые были грязными на этот момент. Но точка считается выполненной только после того, как все такие буферы записаны. Это гарантирует, что все изменения, сделанные до момента КТ, находятся на диске.
В реальных системах с большим буферным кешем КТ может сбрасывать много грязных буферов, поэтому сервер распределяет процесс записи по времени, чтобы сгладить нагрузку на ввод-вывод.
Восстановление после сбоя начинается с момента последней завершенной КТ, что позволяет хранить только файлы журнала, записанные после нее.
Page 10: Восстановление при помощи журнала
Измененные табличные страницы находятся в буферном кеше, но еще не записаны на диск. При обычной остановке сервер выполняет контрольную точку, чтобы записать все грязные страницы на диск, но мы сымитируем сбой системы, послав сигнал процессу postmaster.
При старте произойдет восстановление согласованности данных с помощью журнала. Проверим:
Все изменения были восстановлены. PostgreSQL автоматически удаляет журнальные файлы, не требующиеся для восстановления, после выполнения контрольной точки.
Page 11: Производительность
 {#source-figure-011 caption=“Source slide page 11: Производительность”}
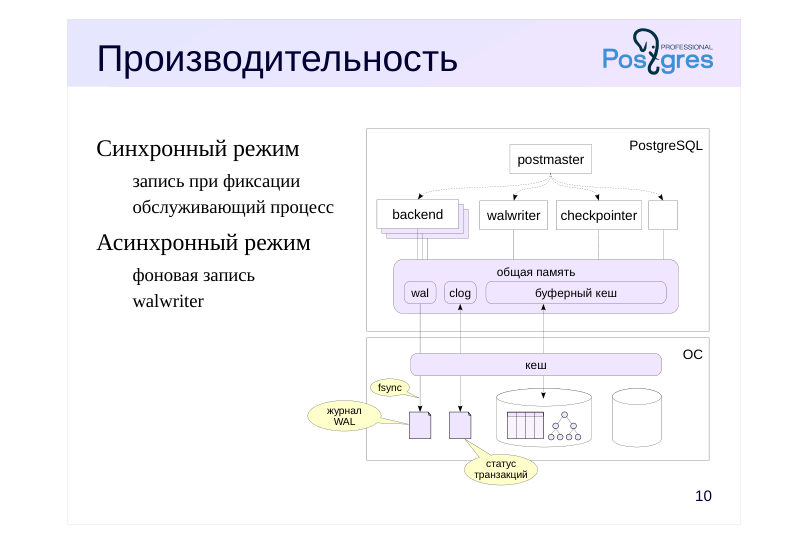
Синхронный режим
- запись при фиксации
- обслуживающий процесс
- Асинхронный режим
- фоновая запись
- walwriter
Комментарии преподавателя
Механизм журналирования более эффективен, чем работа напрямую с диском без буферного кеша. Во-первых, размер журнальных записей меньше, чем размер целой страницы данных; во-вторых, журнал записывается строго последовательно (и обычно не читается, пока не случится сбой), с чем вполне справляются простые HDD-диски.
На эффективность можно также влиять настройкой. Если запись происходит сразу (синхронно), то гарантируется, что зафиксированная транзакция не пропадет. Но запись — довольно дорогая операция, в течение которой обслуживающий процесс, выполняющий фиксацию, вынужден ждать. Чтобы журнальная запись не «застряла» в кеше операционной системы, выполняется системный вызов fsync: PostgreSQL полагается на то, что это гарантирует попадание данных на энергонезависимый носитель.
Поэтому есть и режим отложенной (асинхронной) записи. В этом случае записи пишутся фоновым процессом walwriter постепенно, с небольшой задержкой. Надежность уменьшается, зато производительность увеличивается. Но и в этом случае после сбоя гарантируется восстановление согласованности.
На самом деле оба режима работают совместно. Журнальные записи долгой транзакции будут записываться асинхронно (чтобы освободить буферы WAL). А если при сбросе страницы данных окажется, что соответствующая журнальная запись еще не на диске, она тут же будет записана в синхронном режиме.
Page 12: Основные процессы
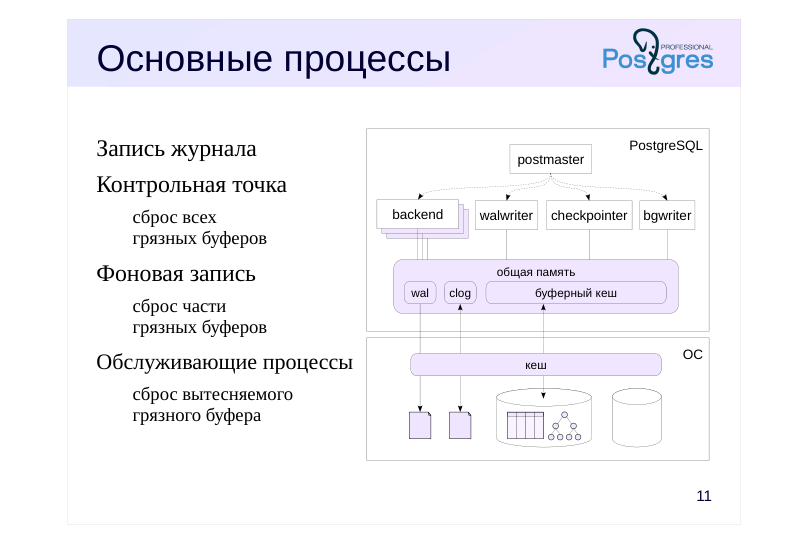 {#source-figure-012 caption=“Source slide page 12: Основные процессы”}
Запись журнала
- Контрольная точка
- сброс всех
- грязных буферов
- Фоновая запись
- сброс части
- грязных буферов
- Обслуживающие процессы
- сброс вытесняемого
- грязного буфера
Комментарии преподавателя
Вернемся еще раз к процессам, связанным с обслуживанием буферного кеша и журнала.
Во-первых, это процесс walwriter, занимающийся асинхронной записью журнала на диск. При синхронном режиме записью журнала занимается тот процесс, который выполняет фиксацию транзакции.
Во-вторых, процесс контрольной точки checkpointer, периодически сбрасывающий все грязные буферы на диск.
В-третьих, процесс фоновой записи background writer (или bgwriter). Этот процесс похож на процесс контрольной точки, но записывает только часть грязных буферов, причем те, которые с большой вероятностью будут вытеснены в ближайшее время. Таким образом, когда обслуживающий процесс выберет буфер, чтобы прочитать новую страницу, старая страница скорее всего уже не будет грязной и не надо будет тратить время, чтобы сбросить ее на диск.
И в-четвертых, обслуживающие процессы, читающие данные в буферный кеш. Если, несмотря на работу процессов контрольной точки и фоновой записи, вытесняемый буфер окажется грязным, обслуживающий процесс самостоятельно запишет его на диск.
Page 13: Уровни журнала
Minimal
- гарантия восстановления после сбоя
- Replica (по умолчанию)
- резервное копирование
- репликация: передача и проигрывание журнала на другом сервере
- Logical
- логическая репликация: информация о добавлении, изменении
- и удалении табличных строк
Комментарии преподавателя
Как уже говорилось, причиной появления журнала является необходимость защищать информацию от сбоев из-за потери содержимого оперативной памяти.
Однако журнал — механизм, который оказалось удобно применять и для других целей, если добавить в него дополнительную информацию.
Объем данных, который попадает в журнал, регулируется параметром wal_level.
● На уровне minimal журнал обеспечивает только восстановление после сбоя.
● На уровне replica в журнал добавляется информация, позволяющая использовать его для создания резервных копий и репликации. При репликации журнальные записи передаются на другой сервер и применяются там; таким образом создается и поддерживается точная копия (реплика) основного сервера.
● На уровне logical в журнал добавляется информация, позволяющая декодировать «физические» журнальные записи и сформировать из них «логические» записи о добавлении, изменении и удалении табличных строк. Это позволяет организовать логическую репликацию (рассматривается в соответствующих темах курсов DEV2 и DBA3).
Page 14: Итоги
Буферный кеш существенно ускоряет работу, уменьшая число дисковых операций
- Надежность обеспечивается журналированием
- Размер журнала ограничен благодаря контрольным точкам
- Журнал удобен и используется во многих случаях
- для восстановления после сбоя
- при резервном копировании
- для репликации между серверами
Page 15: Практика
- Средствами операционной системы найдите процессы, отвечающие за работу буферного кеша и журнала WAL. 2. Остановите PostgreSQL в режиме fast; снова запустите его. Просмотрите журнал сообщений сервера. 3. Теперь остановите в режиме immediate и снова запустите. Просмотрите журнал сообщений сервера и сравните с предыдущим разом.
Комментарии преподавателя
- Для останова в режиме fast используйте команду
При этом сервер обрывает все открытые соединения и перед выключением выполняет контрольную точку, чтобы на диск записались согласованные данные. Таким образом, выключение может выполняться относительно долго, но при запуске сервер сразу же будет готов к работе.
- Для останова в режиме immediate используйте команду
При этом сервер также обрывает открытые соединения, но не выполняет контрольную точку. На диске остаются несогласованные данные, как после сбоя. Таким образом, выключение происходит быстро, но при запуске сервер должен будет восстановить согласованность данных с помощью журнала.
Для PostgreSQL, собранного из исходных кодов, останов в режиме fast выполняется командой
а останов в режиме immediate — командой
Page 16: 1. Процессы операционной системы
Сначала получим идентификатор процесса postmaster. Он записан в первой строке файла postmaster.pid. Этот файл расположен в каталоге с данными и создается каждый раз при старте сервера.
Теперь найдем все процессы, порожденные процессом postmaster:
К процессам, обслуживающим буферный кеш и журнал, можно отнести: checkpointer; background writer; walwriter.
2. Остановка в режиме fast
Чтобы легко отделить старые сообщения от новых, очистим журнал сообщений перед перезапуском сервера. Конечно, в реальной работе так поступать не следует.
Журнал сообщений сервера:
3. Остановка в режиме immediate
Page 17: Page 17
Журнал сообщений сервера:
Перед тем, как начать принимать соединения, СУБД выполнила восстановление (automatic recovery in progress).
05 Занятие 05: Организация данных / Логическая структура
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_05_data_logical.html Archive: DEV1-handouts-16.zip Страниц PDF: 19
Page 1: Организация данных / Логическая структура
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Базы данных и шаблоны
- Схемы и путь поиска
- Специальные схемы
- Системный каталог
Page 3: Кластер баз данных
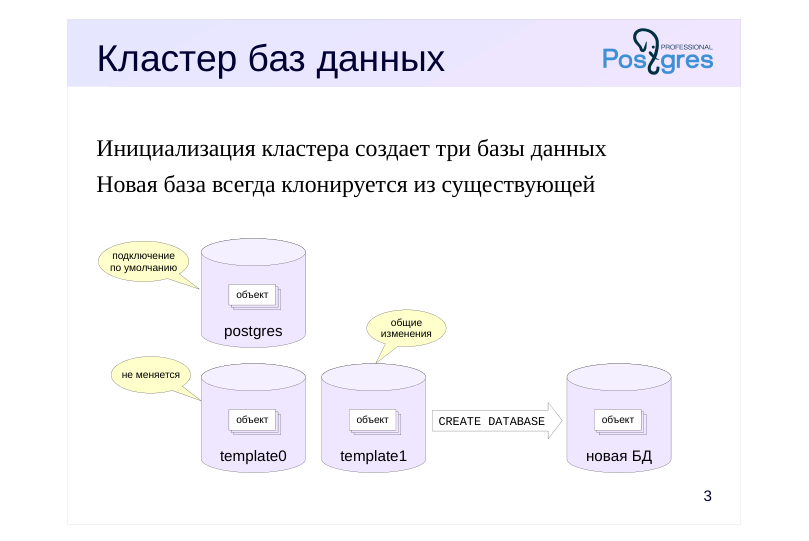 {#source-figure-003 caption=“Source slide page 3: Кластер баз данных”}
Инициализация кластера создает три базы данных
- Новая база всегда клонируется из существующей
Комментарии преподавателя
Экземпляр PostgreSQL управляет несколькими базами данных — кластером. При инициализации кластера (автоматически при установке PostgreSQL либо вручную командой initdb) создаются три одинаковые базы данных. Все остальные БД, создаваемые пользователем, клонируются из какой-либо существующей.
Шаблонная БД template1 используется по умолчанию для создания новых баз данных. В нее можно добавить объекты и расширения, которые будут копироваться в каждую новую базу данных.
Шаблон template0 не должен изменяться. Он нужен как минимум в двух ситуациях. Во-первых, для восстановления БД из резервной копии, выполненной утилитой pg_dump (это рассматривается в теме «Резервное копирование. Логическое резервирование»). Во-вторых, при создании новой БД с кодировкой, отличной от указанной при инициализации кластера (подробнее обсуждается в курсе DBA2).
База данных postgres используется при подключении по умолчанию пользователем postgres. Она не является обязательной, но некоторые утилиты предполагают ее наличие, поэтому ее не рекомендуется удалять, даже если она не нужна.
https://postgrespro.ru/docs/postgresql/16/manage-ag-templatedbs
Page 4: Базы данных
Список баз данных можно получить в psql такой командой:
База данных student была создана для удобства подключения одноименного пользователя. В выводе команды присутствует ряд столбцов, которые нас сейчас не интересуют. Когда мы создаем новую базу данных, она (по умолчанию) копируется из шаблона template1.
Page 5: Схемы
Пространство имен для объектов
- разделение объектов на логические группы
- предотвращение конфликта имен между приложениями
- Схема и пользователь — разные сущности
- Специальные схемы
- public — по умолчанию в ней создаются все объекты
- pg_catalog — системный каталог
- information_schema — вариант системного каталога
- pg_temp — для временных таблиц
- …
Комментарии преподавателя
Схемы представляют собой пространства имен для объектов БД. Они позволяют разделить объекты на логические группы для управления ими, предотвратить конфликты имен при работе нескольких пользователей или при установке приложений и расширений.
В PostgreSQL схема и пользователь — разные сущности (хотя настройки по умолчанию позволяют пользователям удобно работать с одноименными схемами).
Существует несколько специальных схем, обычно присутствующих в каждой базе данных.
Схема public используется по умолчанию для хранения объектов, если не выполнены иные настройки.
Схема pg_catalog хранит объекты системного каталога. Системный каталог — это метаинформация об объектах, принадлежащих кластеру, которая хранится в самом кластере в виде таблиц. Альтернативное представление системного каталога (определенное в стандарте SQL) дает схема information_schema.
Схема pg_temp служит для хранения временных таблиц. (На самом деле таблицы создаются в схемах pg_temp_1, pg_temp_2 и т. п. — у каждого пользователя своя схема. Но обращаются все пользователи к ней как к pg_temp.)
Есть и другие схемы, но они носят технический характер.
https://postgrespro.ru/docs/postgresql/16/ddl-schemas
Page 6: Базы и схемы кластера
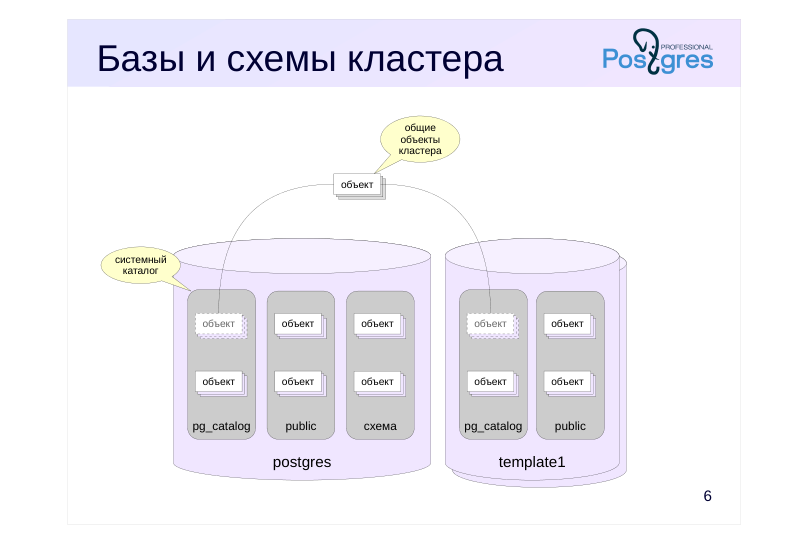 {#source-figure-006 caption=“Source slide page 6: Базы и схемы кластера”}
Комментарии преподавателя
Схемы принадлежат базам данных, все объекты БД распределены по каким-либо схемам.
Однако несколько таблиц системного каталога хранят информацию, общую для всего кластера. Это список баз данных, список пользователей и некоторые другие сведения. Эти таблицы хранятся вне какой-либо конкретной базы данных, но при этом одинаково видны из каждой БД.
Таким образом, клиент, подключенный к какой-либо базе данных, видит в системном каталоге описание объектов не только данной базы, но и общих объектов кластера. Описание объектов других баз данных можно получить, только подключившись к ним.
Page 7: Схемы
Для вывода списка схем в psql есть специальная команда (\dn = describe namespace):
Эта команда не показывает служебные схемы. Чтобы увидеть их, нужно добавить модификатор S (он работает аналогичным образом и для многих других команд):
Про некоторые из этих схем (public, pg_catalog, information_schema) мы уже говорили; про остальные поговорим позже в других темах. Еще один полезный модификатор — знак «плюс», который выводит дополнительную информацию:
Создадим новую схему:
Создадим таблицу:
По умолчанию таблица будет создана в схеме public. Список таблиц в этой схеме можно получить командой \dt с указанием шаблона для имен схем и таблиц:
Page 8: Page 8
Таблицу (как и другие объекты) можно перемещать между схемами. Поскольку речь идет о логической организации, перемещение происходит только в системном каталоге; сами данные физически остаются на месте.
Что останется в схеме public?
Ничего. А в special?
Таблица переместилась. Теперь к ней можно обращаться с явным указанием схемы:
Но если опустить имя схемы, таблица не будет найдена:
Page 9: Путь поиска
Определение схемы объекта
- квалифицированное имя (схема.имя) явно определяет схему
- имя без квалификатора проверяется в схемах, указанных в пути поиска
- Путь поиска
- определяется параметром search_path,
- реальное значение — функция current_schemas
- исключаются несуществующие схемы и схемы, к которым нет доступа
- первая явно указанная в пути схема используется для создания объектов
- схемы pg_temp и pg_catalog неявно включаются первыми,
- если не указаны в search_path
Комментарии преподавателя
При указании объекта надо определить, о какой схеме идет речь, ведь в разных схемах могут храниться объекты с одинаковыми именами.
Если имя объекта квалифицировано именем схемы, то используется явно указанная схема. Если схема не указана явным образом, то она определяется с помощью конфигурационного параметра search_path. Этот параметр содержит путь поиска — список схем, который просматривается последовательно слева направо, при этом из него исключаются несуществующие схемы и те, к которым у пользователя нет доступа.
При создании нового объекта с именем без квалификатора для выбора целевой схемы берется первая из оставшихся в списке, а при поиске объекта в начало пути неявно добавляются:
● схема pg_catalog, чтобы всегда иметь доступ к системному каталогу
● схема pg_temp, если пользователь создавал временные объекты
Реальный путь поиска, включающий неявные схемы, возвращает вызов функции: current_schemas(true).
Можно провести аналогию между путем поиска search_path и путем PATH в операционных системах.
https://postgrespro.ru/docs/postgresql/16/runtime-config-client#GUC-SEAR CH-PATH
Page 10: Путь поиска
Путь поиска по умолчанию имеет такое значение:
Конструкция «$user» обозначает схему с тем же именем, что и имя текущего пользователя (в нашем случае — student). Поскольку такой схемы нет, она игнорируется. Чтобы не думать над тем, какие схемы есть, каких нет, а какие недоступны, можно воспользоваться функцией:
Передаваемый в функцию логический параметр управляет отображением системных схем, неявно включаемых при поиске. Мы можем увидеть, что кроме исключения несуществующей схемы PostgreSQL неявно включил в начало списка схему системного каталога:
Установим путь поиска, например, так:
Теперь таблица будет найдена.
Здесь мы установили конфигурационный параметр на уровне сеанса и при переподключении его значение пропадет. Устанавливать такое значение на уровне всего кластера тоже неправильно — возможно, этот путь нужен не всегда и не всем, к тому же в разных БД может быть разный набор схем. Но параметр можно установить и на уровне отдельной базы данных:
Теперь он будет устанавливаться для всех новых подключений к БД data_logical. Проверим:
Page 11: Системный каталог
Описание всех объектов кластера
- набор таблиц в каждой базе данных (схема pg_catalog)
- и несколько глобальных объектов кластера
- набор представлений для удобства
- Доступ
- запросы SQL, специальные команды psql
- Правила организации
- названия таблиц начинаются с pg_
- имена столбцов содержат трехбуквенный префикс
- в качестве ключа используется столбец oid типа oid
- названия объектов хранятся в нижнем регистре
Комментарии преподавателя
Системный каталог хранит метаинформацию об объектах кластера. В каждой базе данных доступен собственный набор таблиц, описывающих объекты этой конкретной БД, и нескольких таблиц, общих для всего кластера. Для удобства над таблицами также определены несколько представлений.
https://postgrespro.ru/docs/postgresql/16/catalogs
К системному каталогу можно обращаться с помощью обычных запросов SQL, а выполнение команд DDL приводит к изменению данных в системном каталоге. Кроме того, psql имеет целый ряд команд, позволяющих удобно просматривать системный каталог.
https://postgrespro.ru/docs/postgresql/16/app-psql
Все имена таблиц системного каталога начинаются с pg_, например, pg_database. Столбцы таблиц начинаются с префикса, обычно соответствующего имени таблицы, например, datname. Имена объектов хранятся в нижнем регистре, например, ‘postgres’.
Таблицы системного каталога имеют первичные ключи — как правило, это столбцы с именем oid и типом oid (object identifier, целое 32-битное число). Эти идентификаторы встречаются и в других столбцах в виде отдельных значений или массивов, обеспечивая логические связи между таблицами. Внешние ключи в системном каталоге явно не определены.
https://postgrespro.ru/docs/postgresql/16/datatype-oid
Page 12: Системный каталог
Для того, чтобы вывести информацию о любых объектах, psql (как и другие интерактивные пользовательские средства) обращается к таблицам системного каталога. Например, команда \l для получения списка баз данных кластера, обращается к таблице:
Мы всегда можем посмотреть, какие запросы выполняет команда:
Таким образом можно исследовать системный каталог. Отключим вывод команд.
Список схем находится в таблице:
Page 13: Page 13
А на такие объекты, как таблицы и индексы, можно посмотреть так:
Все столбцы здесь начинаются на rel (relation, отношение). relkind — тип объекта (r — таблица, i — индекс и т. п.); relnamespace — схема. Поле relnamespace имеет тип oid; вот соответствующая строка таблицы pg_namespace:
Для удобства преобразования между текстовым представлением и oid можно воспользоваться приведением к специальному типу-псевдониму regnamespace:
А вот как можно получить список объектов в схеме, например, pg_catalog:
Аналогичные reg-типы определены и для некоторых других таблиц системного каталога. Они позволяют упростить запросы и обойтись без явного соединения таблиц.
Удаление объектов
Можно ли удалить схему special?
Схему нельзя удалить, если в ней находятся какие-либо объекты. Сначала надо удалить или перенести их. Но можно удалить схему сразу вместе со всеми ее объектами:
Page 14: Page 14
А что с удалением базы данных целиком? Во-первых, нельзя удалить базу, к которой вы подключены в данный момент, поэтому отключимся от нее.
Во-вторых, базу данных также нельзя удалить, если к ней есть активные подключения. Создадим такое подключение в отдельном сеансе и попробуем удалить ее:
Получили ошибку. Однако можно вызвать команду удаления с параметром FORCE, тогда она будет пытаться принудительно завершить все подключения к БД, а затем удалит ее:
Page 15: Итоги
Логически
- кластер содержит базы данных,
- базы данных — схемы,
- схемы — конкретные объекты (таблицы, индексы и т. п.)
- Базы данных создаются клонированием существующих
- Схема объекта определяется по пути поиска
- Полное описание содержимого кластера баз данных хранится в системном каталоге
Page 16: Практика
- В новой базе данных создайте схему, названную так же, как и пользователь. Создайте схему app. Создайте несколько таблиц в обеих схемах. 2. Получите в psql описание созданных схем и список всех таблиц в них. 3. Установите путь поиска так, чтобы при подключении к базе данных таблицы из обеих схем были доступны по неквалифицированному имени; приоритет должна иметь «пользовательская» схема. Проверьте правильность настройки.
Page 17: 1. База данных, схемы, таблицы
Создаем базу данных:
Схемы:
Таблицы для схемы student:
Таблицы для схемы app:
2. Описание схем и таблиц
Описание схем:
Описание таблиц:
Page 18: Page 18
3. Путь поиска
С текущими настройками пути поиска видны только таблицы, находящиеся в схеме student:
Изменим путь поиска на уровне базы.
Теперь видны таблицы из обеих схем, но приоритет остается за student:
Page 19: Page 19
06 Занятие 06: Организация данных / Физическая структура
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_06_data_physical.html Archive: DEV1-handouts-16.zip Страниц PDF: 15
Page 1: Организация данных / Физическая структура
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Табличные пространства и каталоги
- Файлы и страницы данных
- Слои: данные, карты видимости и свободного пространства
- Технология TOAST
Page 3: Табличные пространства
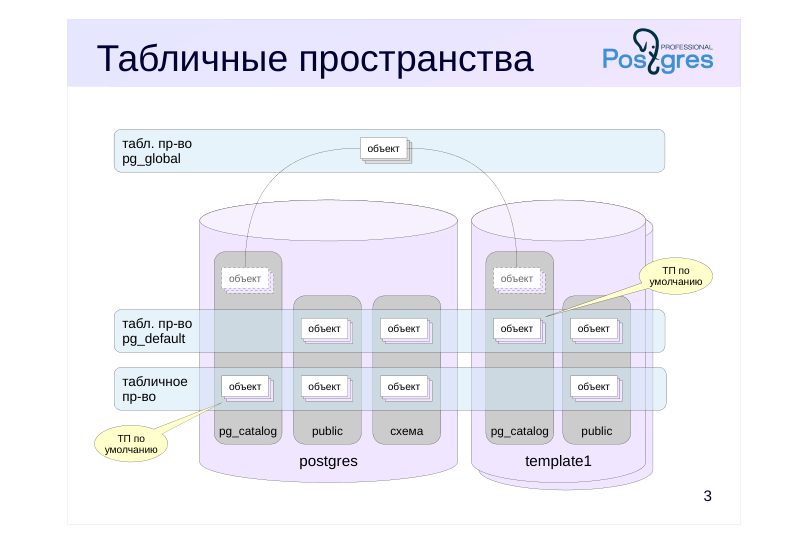 {#source-figure-003 caption=“Source slide page 3: Табличные пространства”}
Комментарии преподавателя
Табличные пространства (ТП) служат для организации физического хранения данных и определяют расположение данных в файловой системе.
Например, можно создать одно ТП на медленных дисках для архивных данных, а другое – на быстрых дисках для данных, с которыми идет активная работа.
При инициализации кластера создаются два ТП: pg_default и pg_global.
Одно и то же ТП может использоваться разными базами данных, а одна база данных может хранить данные в нескольких ТП.
При этом у каждой БД есть так называемое «ТП по умолчанию», в котором создаются все объекты базы, если явно не указать иное. В этом же ТП хранятся и объекты системного каталога. Изначально в качестве «ТП по умолчанию» используется ТП pg_default, но можно установить и другое.
ТП pg_global особенное: в нем хранятся те объекты системного каталога, которые являются общими для кластера.
Page 4: Каталоги
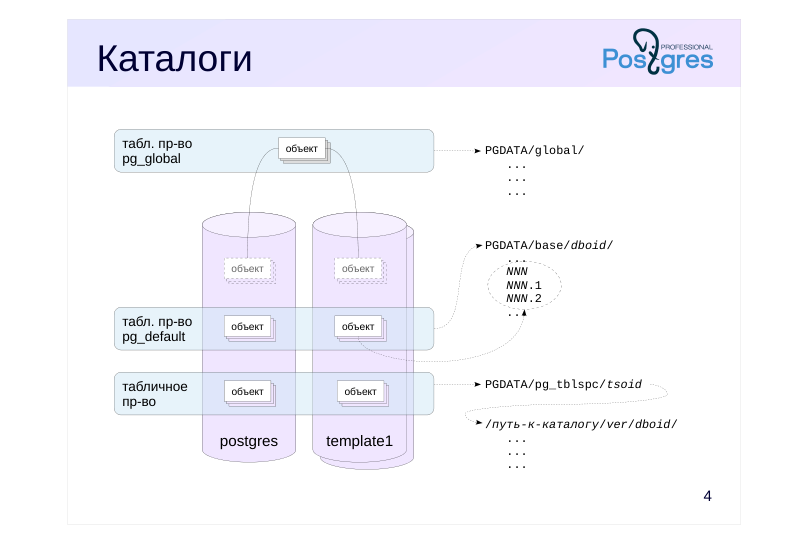 {#source-figure-004 caption=“Source slide page 4: Каталоги”}
Комментарии преподавателя
По сути, табличное пространство — это указание на каталог, в котором располагаются данные. Стандартные ТП pg_global и pg_default всегда находятся в PGDATA/global/ и PGDATA/base/ соответственно. При создании пользовательского ТП указывается произвольный каталог; для собственного удобства PostgreSQL создает на него символьную ссылку в каталоге PGDATA/pg_tblspc/.
Внутри каталога PGDATA/base/ данные дополнительно разложены по подкаталогам баз данных (для PGDATA/global/ это не требуется, так как данные в нем относятся к кластеру в целом).
Внутри каталога пользовательского ТП появляется еще один уровень вложенности: версия сервера PostgreSQL. Это сделано для удобства обновления сервера на другую версию.
Собственно объекты хранятся в файлах внутри этих каталогов — каждый объект размещается в одном или нескольких файлах.
Каждый такой файл, называемый сегментом, занимает по умолчанию не более 1 Гбайт (этот размер можно изменить при сборке сервера). В том числе поэтому каждому объекту может соответствовать несколько файлов. Необходимо учитывать влияние потенциально большого количества файлов на используемую файловую систему.
https://postgrespro.ru/docs/postgresql/16/storage-file-layout
Page 5: Использование табличных пространств
Изначально в кластере присутствуют два табличных пространства. Информация о них содержится в системном каталоге:
Конечно, это одна из глобальных для всего кластера таблиц. Аналогичная команда psql:
Для нового табличного пространства нужен пустой каталог, владельцем которого является пользователь ОС, запускающий сервер СУБД:
Сменим владельца каталога:
Теперь можем выполнить команду создания табличного пространства:
При создании базы данных можно указать табличное пространство по умолчанию:
Это означает, что все объекты базы по умолчанию будут создаваться в этом табличном пространстве.
Page 6: Слои и файлы
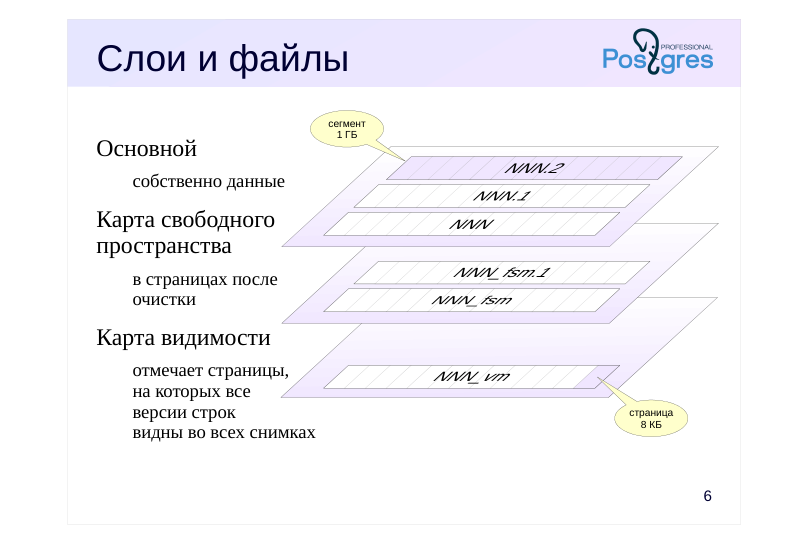 {#source-figure-006 caption=“Source slide page 6: Слои и файлы”}
Основной
- собственно данные
- Карта свободного пространства
- в страницах после
- очистки
- Карта видимости
- отмечает страницы,
- на которых все
- версии строк
- видны во всех снимках
Комментарии преподавателя
Обычно каждому объекту соответствует несколько слоев (forks). Каждый слой — это набор сегментов (то есть один или несколько файлов). Файлы-сегменты, из которых состоят слои, логически разбиты на страницы, обычно по 8 Кбайт (этот размер можно установить для всего кластера только при сборке сервера). Страницы файлов всех слоев объектов считываются с диска совершенно однотипно через общий механизм буферного кеша. Сами слои содержат разную информацию и имеют разное внутреннее устройство страниц.
Основной слой — это собственно данные: версии строк таблиц или строки индексов.
Слой vm (visibility map) — битовая карта видимости. В ней отмечены страницы, которые содержат только актуальные версии строк, причем эти версии видны во всех снимках данных. Такие страницы давно не изменялись и успели полностью очиститься от неактуальных версий.
Карта видимости применяется для оптимизации очистки (отмеченные страницы не нуждаются в очистке) и для ускорения индексного доступа. Информация о версионности строк хранится только для таблиц, но не для индексов. Поэтому, получив из индекса ссылку на версию строки, нужно проверить ее видимость, обратившись к табличной странице. Но если в самом индексе уже есть все нужные столбцы, а страница отмечена в карте видимости, то к таблице можно не обращаться.
Слой fsm (free space map) — карта свободного пространства. В ней отмечено доступное место внутри страниц, образующееся, например, при работе очистки. Эта карта используется при вставке новых версий строк для того, чтобы быстро найти подходящую страницу.
Page 7: Слои и файлы
Очистка обеспечит нам создание всех слоев таблицы:
Узнать расположение файлов, из которых состоит объект, можно так:
Посмотрим на сами файлы (имя и размер в байтах):
Видно, что они относятся к трем слоям: основному, fsm и vm. Объекты можно перемещать между табличными пространствами, но (в отличие от схем) это приводит к физическому перемещению данных:
Размер объектов
Узнать размер, занимаемый базой данных и объектами в ней, можно с помощью ряда функций.
Для упрощения восприятия можно вывести число в отформатированном виде:
Полный размер таблицы (вместе со всеми индексами):
А также отдельно размер таблицы…
Page 8: Page 8
…и индексов:
При желании можно узнать и размер отдельных слоев таблицы, например:
Объем, который занимает на диске табличное пространство, показывает другая функция:
Page 9: TOAST
Версия строки должна помещаться на одну страницу
- можно сжать часть атрибутов,
- или вынести в отдельную TOAST-таблицу,
- или сжать и вынести одновременно
- TOAST-таблица
- схема pg_toast
- поддержана собственным индексом
- «длинные» атрибуты разделены на части размером меньше страницы
- читается только при обращении к «длинному» атрибуту
- собственная версионность
- работает прозрачно для приложения
Комментарии преподавателя
Любая версия строки в PostgreSQL должна целиком помещаться на одну страницу. Для «длинных» версий строк применяется технология TOAST — The Oversized Attributes Storage Technique. Она подразумевает несколько стратегий. Подходящий «длинный» атрибут может быть сжат так, чтобы версия строки поместилась на страницу. Если это не получается, атрибут может быть отправлен в отдельную служебную таблицу. Могут применяться и оба подхода.
Для каждой основной таблицы при необходимости создается отдельная toast-таблица (и к ней специальный индекс). Такие таблицы и индексы располагаются в отдельной схеме pg_toast и поэтому обычно не видны.
Версии строк в toast-таблице тоже должны помещаться на одну страницу, поэтому «длинные» значения хранятся порезанными на части. Из этих частей PostgreSQL прозрачно для приложения «склеивает» необходимое значение.
Toast-таблица используется только при обращении к «длинному» значению. Кроме того, для toast-таблицы поддерживается своя версионность: если обновление данных не затрагивает «длинное» значение, новая версия строки будет ссылаться на то же самое значение в toast-таблице — это экономит место.
https://postgrespro.ru/docs/postgresql/16/storage-toast
Page 10: TOAST
Добавим в таблицу очень длинную строку:
Изменится ли размер таблицы?
Да. А размер основного слоя, в котором хранятся данные?
Нет. Поскольку версия строки не помещается в одну страницу, значение атрибута s будет разрезано на части и помещено в отдельную toast-таблицу. Ее можно отыскать в системном каталоге (мы используем тип regclass, чтобы преобразовать oid в имя отношения):
Символьная строка хранится по частям, из которых PostgreSQL при необходимости склеивает полное значение:
В заключение удалим базу данных.
После того, как в табличном пространстве не осталось объектов, можно удалить и его:
Page 11: Page 11
Page 12: Итоги
Физически
- данные распределены по табличным пространствам (каталогам)
- объект представлен несколькими слоями
- каждый слой состоит из одного или нескольких файлов-сегментов
- Табличными пространствами управляет администратор
- Слои, файлы, TOAST — внутренняя кухня PostgreSQL
Page 13: Практика
- Создайте новую базу данных и подключитесь к ней. Создайте табличное пространство ts. Создайте таблицу t в табличном пространстве ts и добавьте в нее несколько строк. 2. Вычислите объем, занимаемый базой данных, таблицей и табличными пространствами ts и pg_default. 3. Перенесите таблицу в табличное пространство pg_default. Как изменился объем табличных пространств? 4. Удалите табличное пространство ts.
Page 14: 1. Табличные пространства и таблица
Создаем базу данных:
Табличное пространство:
Создаем таблицу:
2. Размер данных
Объем базы данных:
Размер таблицы:
Объем табличных пространств:
Размер табличного пространства больше размера таблицы на 4kB из-за особенностей вычисления размера содержимого каталога в Linux.
3. Перенос таблицы
Перенесем таблицу:
Новый объем табличных пространств:
Page 15: 4. Удаление табличного пространства
Удаляем табличное пространство…
…и каталог, где были размещены его данные:
07 Занятие 07: Учебное приложение / Книжный магазин
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_07_bstore_schema.html Archive: DEV1-handouts-16.zip Страниц PDF: 28
Page 1: Учебное приложение / Книжный магазин
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Обзор приложения «Книжный магазин»
- Проектирование схемы данных, нормализация
- Итоговая схема данных приложения
- Организация интерфейса между клиентом и сервером
Page 3: Приложение
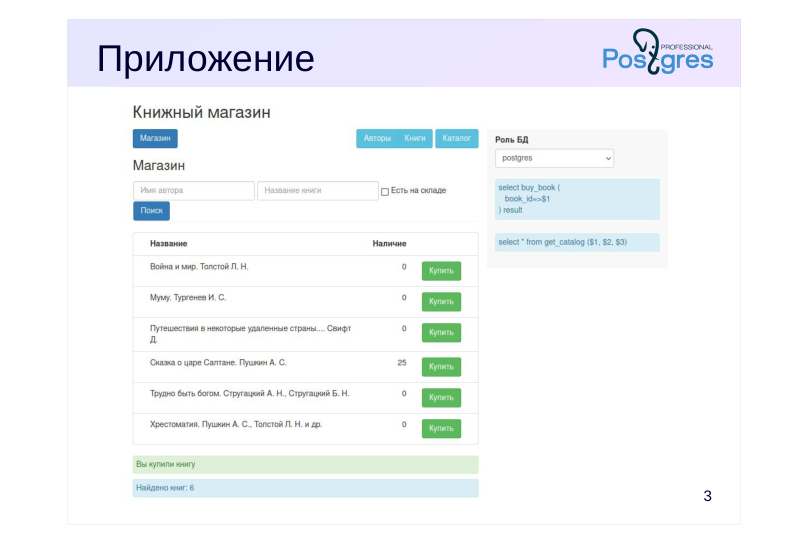 {#source-figure-003 caption=“Source slide page 3: Приложение”}
Комментарии преподавателя
Приложение состоит из нескольких частей, представленных вкладками.
«Магазин» — это интерфейс веб-пользователя, в котором он может покупать книги.
Остальные вкладки соответствуют внутреннему интерфейсу, доступному только сотрудникам («админка» сайта).
«Каталог» — интерфейс кладовщика, в котором он может заказывать закупку книг на склад магазина и просматривать операции поступлений и покупок.
«Книги» и «Авторы» — интерфейс библиотекаря, в котором он может регистрировать авторов и их книги.
В учебных целях вся функциональность представлена на одной общей веб-странице. Если какая-то часть функциональности недоступна из-за того, что на сервере нет подходящего объекта (таблицы, функции и т. п.), приложение сообщит об этом. Также приложение выводит текст запросов, которые оно посылает на сервер.
В ходе курса мы начнем с пустой базы данных и постепенно реализуем в ней все необходимые компоненты.
P. S. Исходный код приложения не является темой курса, но может быть получен в репозитории https://pubgit.postgrespro.ru/pub/dev1app.git
Page 4: Демонстрация приложения
В этой демонстрации мы показываем приложение «Книжный магазин» в том виде, в котором оно будет после завершения всех практических заданий. Приложение откроется в отдельной вкладке браузера виртуальной машины курса: Открываем http://localhost…
Page 5: Книги
ER-модель для высокоуровневого проектирования
- сущности — понятия предметной области
- связи — отношения между сущностями
- атрибуты — свойства сущностей и связей
- сущность
Книга
- атрибуты
- название
- авторы
- количество
- операции
Комментарии преподавателя
После того, как мы посмотрели на внешний вид приложения и поняли его функциональность, нам нужно разобраться со схемой данных. Мы не будем хоть сколько-нибудь глубоко вникать в вопросы проектирования баз данных — это отдельная дисциплина, не входящая в данный курс. Но совсем обойти вниманием эту тему тоже нельзя.
Часто для высокоуровневого проектирования баз данных используется модель «сущность — связи», или ER-модель (Entity — Relationship). Она оперирует сущностями (понятиями предметной области), связями между ними и атрибутами (свойствами сущностей и связей). Модель позволяет рассуждать на логическом уровне, не опускаясь до деталей представления данных на физическом (в виде таблиц).
Первым подходом к проектированию может служить диаграмма, представленная на слайде: можно представить одну большую сущность «Книга», а все остальное сделать ее атрибутами.
Page 6: Схема данных
 {#source-figure-006 caption=“Source slide page 6: Схема данных”}
- Данные дублируются
- сложно поддерживать согласованность
- сложно обновлять
- сложно писать запросы
Комментарии преподавателя
Очевидно, что это неправильный подход. На диаграмме это может быть не так заметно, но давайте попробуем отобразить диаграмму на таблицы БД. Это можно сделать разными способами, например так, как показано на слайде: сущность становится таблицей, ее атрибуты — столбцами этой таблицы.
Здесь хорошо видно, что часть данных дублируется (эти фрагменты выделены на рисунке). Дублирование приводит к сложностям с обеспечением согласованности — а это едва ли не главная задача СУБД.
Например, каждая из двух строк, относящихся к книге 3, должна содержать общее количество (7 штук). Что нужно сделать, чтобы отразить покупку книги? С одной стороны, надо добавить строки для отражения операции покупки (а сколько строк добавлять, еще две?). С другой, во всех строках надо уменьшить количество с 7 до 6. А что делать, если в результате какой-нибудь ошибки значение количества в одной из этих строк будет отличаться от значения в другой строке? Как сформулировать ограничение целостности, которое запрещает такую ситуацию?
Также усложняются и многие запросы. Как найти общее число книг? Как найти всех уникальных авторов?
Итак, такая схема плохо работает для реляционных баз данных.
Page 7: Схема данных (вариант)
- Данные без схемы
- поддержка согласованности на стороне приложения
- сложно писать запросы
- низкая производительность (множественные соединения)
Комментарии преподавателя
Другой вариант отображения сущности в таблицу — так называемая схема EAV: сущность — атрибут — значение. Она позволяет уложить вообще все, что угодно, в одну-единственную таблицу. Формально мы получаем реляционную базу данных, а фактически здесь отсутствует схема и СУБД не может гарантировать согласованность данных. Поддержка согласованности данных целиком ложится на приложение, что, безусловно, рано или поздно приведет к ее нарушению.
В такой схеме сложно писать запросы (хотя и довольно просто их генерировать), и в результате работа со сколько-нибудь большим объемом данных становится проблемой из-за постоянных многократных соединений таблицы самой с собой.
Однако следует отметить, что такой подход имеет и плюсы. Например, очевидно, что такую «схему» данных легко наращивать: при добавлении новой сущности или атрибута мы просто добавляем в нашу таблицу новые строки.
И все-таки так делать не стоит.
Page 8: Схема данных (вариант)
- Данные без схемы
- поддержка согласованности на стороне приложения
- сложно писать запросы (специальный язык)
- индексная поддержка есть
Комментарии преподавателя
Еще одна вариация на ту же тему — представление данных в виде JSON, в духе NoSQL. По сути, тут применимы все замечания, сделанные ранее.
Кроме того, запросы к такой структуре придется писать не на SQL, а используя какой-то специализированный язык (раньше скорее всего выбор пал бы на jsQuery, а в PostgreSQL 16 удобно пользоваться возможностями SQL/JSON Path Language, определенными в стандарте SQL:2016).
https://github.com/postgrespro/jsquery
https://postgrespro.ru/docs/postgresql/16/functions-json#FUNCTIONS-SQLJ SON-PATH
Хотя у PostgreSQL есть индексная поддержка JSON, производительность все равно под вопросом.
Такую схему удобно применять, когда от базы данных требуется только получение JSON по идентификатору, но не требуется серьезная работа с данными внутри JSON. Это не наш случай.
(Разумеется, это не категоричное утверждение. См. последнее задание в практике.)
Page 9: Книги и операции
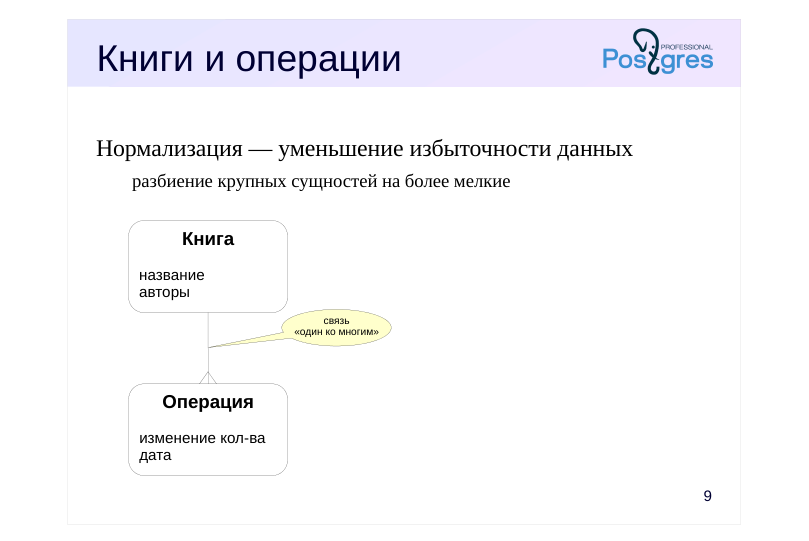 {#source-figure-009 caption=“Source slide page 9: Книги и операции”}
Нормализация — уменьшение избыточности данных
- разбиение крупных сущностей на более мелкие
Книга
Операция
Комментарии преподавателя
Итак, нам требуется устранить избыточность данных, чтобы привести их в вид, удобный для обработки в реляционной СУБД. Этот процесс называется нормализацией.
Возможно, вы знакомы с понятиями нормальных форм (первая, вторая, третья, Бойса-Кодда и т. д.). Мы не будем говорить о них; на неформальном уровне достаточно понимать, что весь этот математический аппарат преследует одну-единственную цель: устранение избыточности.
Средство для уменьшения избыточности — разбиение большой сущности на несколько меньших. Как именно это сделать, подскажет здравый смысл (который все равно нельзя заменить одним только знанием нормальных форм).
В нашем случае все достаточно просто. Давайте начнем с отделения книг от операций. Эти две сущности связаны отношением «один ко многим»: каждая книга может иметь несколько операций, но каждая операция относится только к одной книге.
Page 10: Схема данных
Комментарии преподавателя
На уровне структуры базы данных это может быть представлено двумя таблицами: книги (books) и операции (operations).
Операция состоит в изменении количества книг (положительном при заказе; отрицательном при покупке). Заметьте, что теперь у книги нет атрибута «количество». Вместо этого достаточно просуммировать изменения количества по всем операциям, относящимся к данной книге. Дополнительный атрибут «количество» у книги снова привел бы к избыточности данных.
Не исключено, что такое решение вас насторожило. Удобно ли вместо простого обращения к полю подсчитывать сумму? Но мы можем создать представление, которое для каждой книги будет показывать количество. Это не приведет к появлению избыточности, поскольку представление — это всего лишь запрос.
Второй момент — производительность. Если подсчет суммы приведет к ухудшению производительности, мы можем выполнить обратный процесс — денормализацию: добавить в таблицу книг поле «количество» и обеспечить его согласованность с таблицей операций. Надо ли этим заниматься — вопрос, ответ на который выходит за рамки этого курса (он рассматривается в курсе QPT «Оптимизация запросов»). Но из общих соображений понятно, что для нашего «игрушечного» магазина это не требуется. Однако мы еще вернемся к вопросу денормализации в теме «Триггеры».
Итак, как видно на слайде, выделение операций в отдельную сущность решило часть проблем дублирования, но не все.
Page 11: Книги, авторы и операции
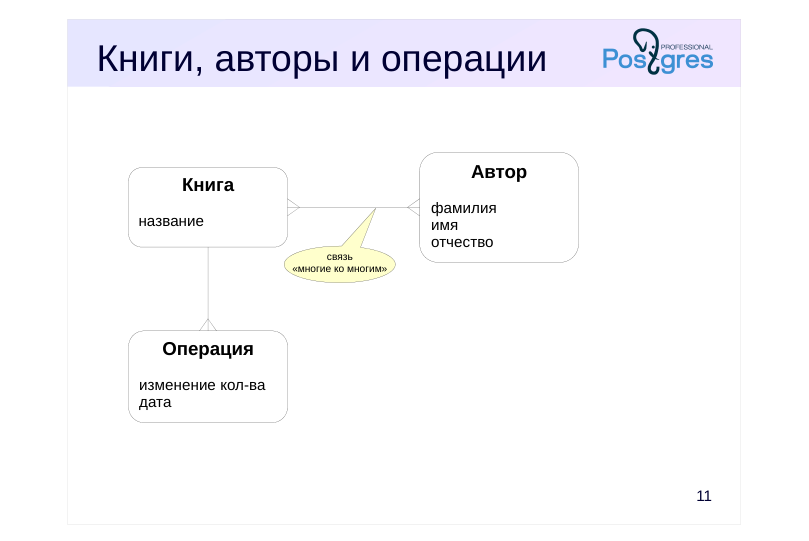 {#source-figure-011 caption=“Source slide page 11: Книги, авторы и операции”}
Книга
Операция
Комментарии преподавателя
Поэтому надо сделать еще один шаг: отделить авторов от книг и связать их соотношением «многие ко многим»: и каждая книга может быть написана несколькими авторами, и каждый автор может написать несколько книг. На уровне таблиц такая связь реализуется с помощью дополнительной промежуточной таблицы.
Атрибутами автора можно сделать фамилию, имя и отчество. Это имеет смысл, поскольку нам может потребоваться работать отдельно с каждым из этих атрибутов, например, выводить фамилию и инициалы.
Page 12: Схема данных приложения
Итак, схема данных приложения состоит из четырех таблиц:
Книги
Здесь мы используем типы данных: integer — целое число; text — символьный, текстовая строка произвольной длины. А также используем ограничение целостности: PRIMARY KEY — первичный ключ. Конструкция GENERATED AS IDENTITY служит для автоматической генерации уникальных значений (в версиях до 10 для этого использовался псевдотип serial).
- Строки столбцов, объявленных как GENERATED AS IDENTITY, получают значения из специальных объектов базы данных — последовательностей. Имя использованной последовательности можно узнать так:
Последовательности можно при необходимости создавать вручную, а также обращаться к ним непосредственно:
Последовательность — самый эффективный способ генерации уникальных номеров. Но следует иметь в виду, что последовательность не гарантирует: отсутствия пропусков в нумерации (так как изменение происходит не транзакционно); монотонного возрастания номеров (если используется кеширование значений в сеансах).
Page 13: Page 13
Вот какие данные находятся в таблице книг:
Обратите внимание, что названия могут быть длинными. Мы используем расширенный формат вывода psql, а появившийся в PostgreSQL 16 параметр xheader_width поможет обрезать строку заголовка “широкого” столбца:
Сравните вывод:
Авторы
Page 14: Page 14
Здесь дополнительно используется ограничение целостности: NOT NULL — обязательность, то есть недопустимость неопределенных значений.
Обратите внимание, что отчество может отсутствовать (или быть заданным пустой строкой). Ограничение PRIMARY KEY в выводе команды \d упоминалось вместе со словами «индекс» и «btree». Btree (B-дерево) — основной тип индекса, используемый в базах данных для ускорения поиска и для поддержки ограничений целостности (первичного ключа и уникальности). Представим себе, что в магазине продаются книги миллиона авторов-однофамильцев:
Сколько времени занимает поиск одного автора в такой таблице?
Если попросить оптимизатор показать план запроса, мы увидим в нем Seq Scan — последовательное сканирование всей таблицы в поисках нужного значения (Filter):
А если искать по полю, которое проиндексировано?
Page 15: Page 15
Время уменьшилось на несколько порядков. А в плане запроса появился индекс:
Можно создать индекс и по фамилии (и проанализировать таблицу, чтобы собрать актуальную статистику):
Однако индекс не является универсальным средством увеличения производительности. Обычно индекс очень полезен, если из таблицы требуется выбрать небольшую долю всех имеющихся строк. Если нужно прочитать много данных, индекс будет только мешать, и оптимизатор это понимает:
Кроме того, надо учитывать накладные расходы на обновление индексов при изменении таблицы и занимаемое ими место на диске. Отменим все наши изменения (включая создание индекса):
Авторства
С помощью этой таблицы реализуется связь «многие ко многим».
Page 16: Page 16
Здесь к уже использованным ограничениям добавляется ограничение ссылочной целостности: FOREIGN KEY — внешний ключ. Фактически таблица содержит два внешних ключа: один ссылается на таблицу книг, другой — на таблицу авторов. Столбец seq_num определяет последовательность, в которой должны перечисляться авторы одной книги, если их несколько. Также обратите внимание на то, что первичный ключ — составной.
Операции
В этой таблице используется еще один тип данных: date — дата (без указания времени). Для столбца date_created указано значение по умолчанию (DEFAULT) — текущая дата.
Кроме тех типов данных, которые используются в таблицах приложения, мы постоянно будем встречаться с логическим типом (boolean). Например, такой тип имеют логические выражения в условии WHERE.
Note Важно помнить, что, в отличие от традиционных языков программирования, SQL использует трехзначную логику: кроме значений true и false, логическое значение может принимать неопределенное значение NULL (которое можно понимать как «значение неизвестно»).
Page 17: Page 17
В примерах встречаются и некоторые другие типы данных, информацию о работе с ними можно найти в материалах курса («Основные типы данных и функции», datatypes.pdf). Кроме того, в курсе мы подробно рассмотрим более сложные типы: составной — записи, аналогичные строкам таблиц (в теме «SQL. Составные типы»); массивы (в теме «PL/pgSQL. Массивы»).
Page 18: Организация интерфейса
Таблицы и триггеры
- чтение данных напрямую из таблицы (представления);
- запись данных напрямую в таблицу (представление),
- плюс триггеры для изменения связанных таблиц
- приложение должно быть в курсе модели данных,
- максимальная гибкость
- сложно поддерживать согласованность
- Функции
- чтение данных из табличных функций;
- запись данных через вызов функций
- приложение отделено от модели данных и ограничено API
- большой объем работы по изготовлению функций-оберток,
- потенциальные проблемы с производительностью
Комментарии преподавателя
Есть несколько способов организации интерфейса между клиентской и серверной частями приложения.
Один вариант — разрешить приложению напрямую обращаться к таблицам в базе данных и изменять их. При этом от приложения требуется детальное «знание» модели данных. Отчасти это требование можно ослабить за счет использования представлений (view).
Кроме того, от приложения требуется и определенная дисциплина — иначе очень сложно поддержать согласованность данных, защищаясь на уровне БД от любых возможных некорректных действий приложения. Но в этом случае достигается максимальная гибкость.
Другой вариант — запретить приложению доступ к таблицам и разрешить только вызовы функций. Чтение данных можно организовать с помощью табличных функций (которые возвращают набор строк). Изменение данных можно выполнять, вызывая другие функции и передавая им необходимые данные. В этом случае внутри функций можно реализовать все необходимые проверки согласованности — база данных будет защищена, но приложение сможет пользоваться только предоставленным и ограниченным набором возможностей. Такой вариант требует написания большого количества функций-оберток и может привести к потере производительности.
Вполне возможны и промежуточные варианты. Например, разрешить чтение данных непосредственно из таблиц, а изменение выполнять только через вызов функций.
Page 19: Интерфейс покупателя
 {#source-figure-019 caption=“Source slide page 19: Интерфейс покупателя”}
Комментарии преподавателя
В нашем приложении мы попробуем разные варианты организации интерфейса (хотя в реальной жизни обычно лучше систематически придерживаться какого-то одного подхода).
Магазин будет использовать интерфейсные функции:
● для поиска книг — get_catalog (тема «SQL. Составные типы»);
● для покупки книг — buy_book («PL/pgSQL. Выполнение запросов»).
Page 20: Интерфейс сотрудника
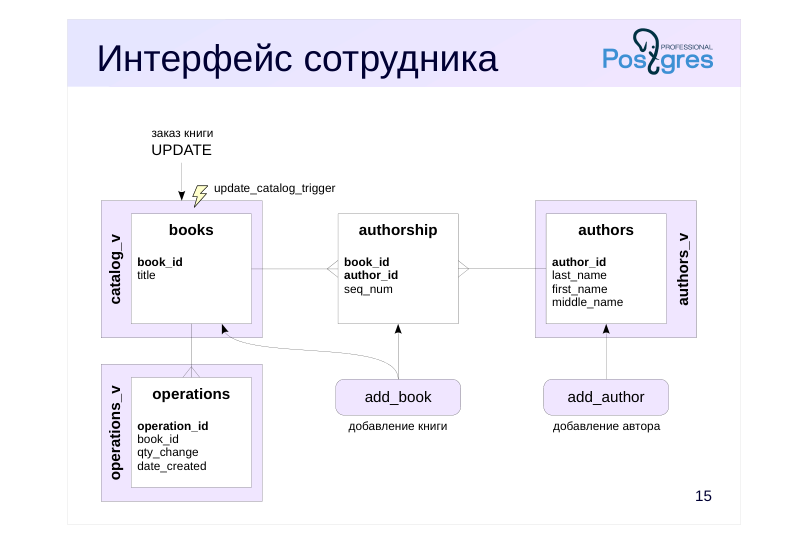 {#source-figure-020 caption=“Source slide page 20: Интерфейс сотрудника”}
Комментарии преподавателя
«Админка» для получения данных будет использовать представления (которые мы создадим в практике к этой теме):
● список книг — catalog_v;
● список авторов — authors_v;
● список операций — operations_v.
Добавление автора будет выполнять функция add_author (создадим ее в теме «PL/pgSQL. Выполнение запросов»), добавление книги — функция add_book («PL/pgSQL. Массивы»).
Для заказа книг сделаем представление catalog_v обновляемым («PL/pgSQL. Триггеры»).
Page 21: Представления
Представление — запрос, у которого есть имя. Например, можно создать представление, которое показывает только авторов без отчества:
Теперь имя представления можно использовать в запросах практически так же, как и таблицу:
В простом случае с представлением будут работать и другие операции, например:
С помощью триггеров можно сделать так, чтобы и в сложных случаях для представлений работали вставка, обновление и удаление строк. Мы рассмотрим это в теме «PL/pgSQL. Триггеры». При планировании запроса представление «разворачивается» до базовых таблиц:
Приложение использует три представления. Сначала они будут очень простыми, но в следующих темах мы перенесем в них часть логики приложения. Представление для авторов — конкатенация фамилии, имени и отчества (если оно есть):
Представление для каталога книг — пока просто название книги:
Page 22: Page 22
Представление для операций — дополнительно определяет тип операции (поступление или покупка):
Page 23: Итоги
Проектирование баз данных — отдельная тема
- теория важна, но не заменяет здравый смысл
- Отсутствие избыточности в данных делает работу удобнее и упрощает поддержку согласованности
- Для клиент-серверного интерфейса можно использовать таблицы, представления, функции, триггеры
Page 24: Практика
- В базе данных bookstore создайте схему bookstore. Настройте путь поиска к этой схеме на уровне подключения к БД. 2. В схеме bookstore создайте таблицы books, authors, authorship и operations с необходимыми ограничениями целостности так, чтобы они соответствовали показанным в демонстрации. 3. Вставьте в таблицы данные о нескольких книгах. Проверьте себя с помощью запросов. 4. В схеме bookstore создайте представления authors_v, catalog_v и operations_v так, чтобы они соответствовали показанным в демонстрации. Проверьте, что приложение стало показывать данные на вкладках «Книги», «Авторы» и «Каталог».
Комментарии преподавателя
Вспомните материал темы «Организация данных. Логическая структура».
Ориентируйтесь на показанный в демонстрации вывод команд \d утилиты psql.
Вы можете использовать те же данные, что были показаны в демонстрации, или придумать свои собственные.
Попробуйте написать запросы к базовым таблицам, возвращающие тот же результат, что и показанные в демонстрации запросы к представлениям. Затем оформите запросы в виде представлений.
После выполнения практики обязательно сверьте свои запросы с решением, приведенным к этой теме. При необходимости внесите коррективы.
Page 25: 1. Схема и путь поиска
2. Таблицы
Авторы:
Книги:
Авторство:
Операции:
3. Данные
Авторы:
Книги:
Авторство:
Page 26: Page 26
Операции:
4. Представления
Представление для авторов:
Представление для каталога:
Представление для операций:
Page 27: Практика+
- Какие дополнительные атрибуты могут появиться у выделенных сущностей при развитии приложения? 2. Допустим, требуется хранить информацию об издательстве. Дополните ER-диаграмму и отобразите ее в таблицы. 3. Некоторые книги могут входить в серии (например, «Библиотека приключений»). Как изменится схема данных? 4. Пусть наш магазин стал торговать компьютерными комплектующими (материнскими платами, процессорами, памятью, жесткими дисками, мониторами и т. п.). Какие сущности и какие атрибуты вы бы выделили? Учтите, что на рынке постоянно появляются новые типы оборудования со своими характеристиками.
Комментарии преподавателя
- Разные издательства вполне могут иметь серии, названные одинаково.
Page 28: 1. Дополнительные атрибуты
Несколько примеров: Авторы: роль (автор, редактор, переводчик и т. п.); Книги: аннотация; Операции: текущий статус (оплачено, передано в службу доставки и т. п.).
2. Издательства
Надо добавить сущность «Издательство» с атрибутом «Название» (как минимум). Книги связаны с издательствами отношением «многие ко многим»: книга может публиковаться в разных издательствах. Поэтому на физическом уровне потребуется промежуточная таблица «Публикации» с атрибутом «Год издания». (Разумеется, это упрощенная модель; при желании ее можно уточнять еще очень долго.)
3. Серии
Добавим сущность «Серия». К серии относится не сама книга, а ее конкретная публикация, так что имеет смысл вывести «Публикацию» на уровень ER-модели и связать ее с серий отношением «один ко многим» (каждая публикация принадлежит к одной серии, каждая серия может включать несколько публикаций). Также серия связана отношением «один ко многим» с издательством (у издательства может быть несколько серий, а каждая серия принадлежит конкретному издательству). Остается вопрос о внесерийных изданиях. Его можно решить либо введением фиктивной серии «Без серии», либо возможностью не указывать для публикации внешний ключ серии.
4. Компьютерные комплектующие
Рассматривая каждый конкретный тип комплектующих, можно без труда выделить необходимые атрибуты. Какие-то атрибуты будут общими (скажем, фирма-производитель и название модели), а какие-то будут иметь смысл только для данного конкретного типа. Например: Процессор: частота; Монитор: диагональ, разрешение; Жесткий диск: типоразмер, емкость. Проблема в том, что рынок комплектующих очень динамичен. Некоторое время назад жесткие диски определялись частотой вращения и емкостью, а сейчас важен тип (твердотельный, вращающийся, гибридный). Для мониторов во времена ЭЛТ была важна частота обновления, а сейчас важен тип матрицы. Дисководы уже никому не нужны, зато появились флеш-накопители. И так далее. Таким образом, либо придется постоянно изменять схему данных (а, значит, и постоянно изменять приложение, которое работает с этими данными!), либо искать более универсальную модель за счета отказа от жесткой структуры и контроля согласованности. Некоторые универсальные модели (например, хранение части данных в JSON) мы затрагивали в презентации.
08 Занятие 08: SQL / Функции
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_08_sql_func.html Archive: DEV1-handouts-16.zip Страниц PDF: 24
Page 1: SQL / Функции
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Функции и их особенности в базах данных
- Параметры и возвращаемое значение
- Способы передачи параметров при вызове
- Категории изменчивости и оптимизация
Page 3: Функции в базе данных
Основной мотив: упрощение задачи
- интерфейс (параметры) и реализация (тело функции)
- о функции можно думать вне контекста всей задачи
- Традиционные языки
- PostgreSQL
- побочные глобальные переменные вся база данных эффекты (категории изменчивости)
- модули со своим интерфейсом пространства имен, и реализацией клиент и сервер
- сложности накладные расходы скрытие запроса на вызов от планировщика (подстановка) (подстановка, подзапросы, представления)
Комментарии преподавателя
Основная цель появления функций в программировании вообще — упростить решаемую задачу за счет ее декомпозиции на более мелкие подзадачи. Упрощение достигается за счет того, что о функции можно думать, абстрагировавшись от «большой» задачи. Для этого функция определяет четкий интерфейс с внешним миром (параметры и возвращаемое значение). Ее реализация (тело функции) может меняться; вызывающая сторона «не видит» этих изменений и не зависит от них. Этой идеальной ситуации может мешать глобальное состояние (глобальные переменные), и надо учитывать, что в случае БД таким состоянием является вся база данных.
В традиционных языках функции часто объединяются в модули (пакеты, классы для ООП и т. п.), имеющие собственный интерфейс и реализацию. Границы модулей могут проводиться более или менее произвольно. Для PostgreSQL есть жесткая граница между клиентской частью и серверной: серверный код работает с базой, клиентский — управляет транзакциями. Модули (пакеты) отсутствуют, есть только пространства имен.
Для традиционных языков единственный минус широкого использования функций состоит в накладных расходах на их вызов. Иногда его преодолевают с помощью подстановки (inlining) кода функции в вызывающую программу. Для БД последствия могут быть более серьезные: если в функцию выносится часть запроса, планировщик перестает видеть «общую картину» и не может построить хороший план. В некоторых случаях PostgreSQL умеет выполнять подстановку; альтернативные варианты — использование подзапросов или представлений.
Page 4: Общие сведения
Объект базы данных
- определение хранится в системном каталоге
- Основные составные части определения
- имя
- параметры
- тип возвращаемого значения
- тело
- Доступны несколько языков, в том числе SQL
- код в виде строковой константы
- обычно интерпретируется при вызове
- Вызывается в контексте выражения
Комментарии преподавателя
Функции являются такими же объектами базы данных, как, например, таблицы и индексы. Определение функции сохраняется в системном каталоге; поэтому функции в базе данных называют хранимыми.
В PostgreSQL доступно большое количество стандартных функций, с некоторыми из них можно познакомиться в справочном материале «Основные типы данных и функции».
И, конечно, можно писать собственные функции на разных языках программирования. Материал этой темы относится к функциям на любом языке, но примеры будут использовать язык SQL.
Определение функции состоит из имени, необязательных параметров, типа возвращаемого значения и тела. Тело записывается в виде строковой константы, которая содержит код на выбранном языке. За счет этого определение функции выглядит одинаково независимо от выбранного языка. Тело-строка сохраняется в системном каталоге и интерпретируется каждый раз, когда функция вызывается. Начиная с версии PostgreSQL 14 для кода на SQL появилась возможность производить разбор заранее, в системном каталоге при этом сохраняется не исходный текст, а результат разбора. Еще один способ избежать интерпретации времени выполнения — написать функцию на языке Си, но в данном курсе эта тема не рассматривается.
Функция всегда вызывается в контексте какого-либо выражения. Например, в списке выражений команды SELECT, в условии WHERE, в ограничении целостности CHECK и т. п.
https://postgrespro.ru/docs/postgresql/16/sql-createfunction
https://postgrespro.ru/docs/postgresql/16/sql-syntax-calling-funcs
Page 5: Функции без параметров
Вот простой пример функции без параметров, содержащей один оператор:
Тело удобно записывать в строке, заключенной в кавычки-доллары, как в приведенном примере. Иначе придется заботиться об экранировании кавычек, которые наверняка встретятся в теле функции. Сравните:
При необходимости кавычки-доллары могут быть вложенными. Для этого в каждой паре кавычек надо использовать разный текст между долларами:
Функция вызывается в контексте выражения, например:
Давайте взглянем на то, как тело функции хранится в системном каталоге.
Мы видим сохраненную в исходном виде тело-строку. А теперь реализуем современную возможность пересоздать нашу функцию в другом виде — в стиле стандарта SQL. В нашем случае телом функции может быть один оператор вида RETURN <выражение>:
Снова заглянем в системный каталог — тело функции сохранено по-другому:
Page 6: Page 6
Исходный код в этом случае не хранится, получить его можно командой \sf:
В случае, если тело функции состоит из нескольких операторов SQL, в качестве результата возвращается значение из первой строки, которую вернул последний оператор. Если код такой функции написан в стиле стандарта SQL, потребуется использовать конструкцию BEGIN ATOMIC … END, которая охватывает выполняемый блок операторов:
Пробуем вызов:
Обратите внимание на особенности синтаксиса стиля стандарта SQL — в отличие от традиционного «строчного»: нет конструкции AS, содержащей код функции в виде строки; может использоваться новое ключевое слово RETURN для возврата значения; указание LANGUAGE sql не является обязательным; при создании функции ее код разбирается, а результат разбора сохраняется в pg_proc.prosqlbody (в традиционной нотации текст функции сохраняется в pg_proc.prosrc). Это лучше соответствует стандарту и в большей мере совместимо с другими реализациями SQL. Теперь при вызове функции ее команды заново не интерпретируются, а используется заранее разобранный вариант. Не все операторы SQL можно использовать в функции. Запрещены: команды управления транзакциями (BEGIN, COMMIT, ROLLBACK и т. п.); служебные команды (такие, как VACUUM или CREATE INDEX). Вот пример неправильной функции. Здесь мы использовали псевдотип void, который говорит о том, что функция не возвращает ничего.
Управлять транзакциями можно в процедурах, о чем мы будет говорить в следующей теме.
Функции с входными параметрами
Пример функции с одним параметром:
При вызове функции мы указываем фактический параметр, соответствующий формальному:
Page 7: Page 7
При указании типа параметра можно указать и модификатор (например, varchar(10)), но он игнорируется. Можно определить параметр функции без имени; тогда внутри тела функции на параметры придется ссылаться по номеру. Удалим функцию и создадим новую:
Но так лучше не делать, это неудобно. Удалим функцию и создадим заново, добавив еще два параметра — приветствие и обращение.
Здесь мы используем необязательное ключевое слово IN, обозначающее входной параметр. Предложение DEFAULT позволяет определить значение по умолчанию для параметра:
Обратите внимание, что параметры со значениями по умолчанию должны идти в конце всего списка. При вызове функции значения фактических параметров, определенных как default, можно опускать, тогда остальные default-параметры, идущие в списке после, также получат значения по умолчанию
До сих пор мы вызывали функцию, указывая фактические параметры позиционным способом — в том порядке, в котором они определены при создании функции. Во многих стандартных функциях имена параметров не заданы, так что этот способ оказывается единственным. Но если формальным параметрам даны имена, можно использовать их при указании фактических параметров. В этом случае параметры могут указываться в произвольном порядке:
Page 8: Page 8
Такой способ удобен, когда порядок параметров неочевиден, особенно если их много; также можно явно указать значение одного из параметров по умолчанию. Можно совмещать оба способа: часть параметров (начиная с первого) указать позиционно, а оставшиеся — по имени:
Если функция должна возвращать неопределенное значение, когда хотя бы один из входных параметров не определен, ее можно объявить как строгую (STRICT). Тело функции при этом вообще не будет выполняться.
Page 9: Вход и выход
Входные значения
- определяются параметрами с режимом IN и INOUT
- Выходное значение
- определяется либо предложением RETURNS,
- либо параметрами с режимом INOUT и OUT
- если одновременно указаны обе формы, они должны быть согласованы
Комментарии преподавателя
Формальные параметры с режимом IN и INOUT считаются входными. Значения соответствующих фактических параметров должны быть указаны при вызове функции (либо должны быть определены значения по умолчанию).
Возвращаемое значение можно определить двумя способами:
использовать предложение RETURNS для указания типа;
определить выходные параметры с режимом INOUT или OUT.
Две эти формы записи эквивалентны. Например, функция с указанием RETURNS integer и функция с параметром OUT integer возвращают целое число.
Можно использовать и оба способа одновременно. В этом случае функция также будет возвращать одно целое число. Но при этом типы RETURNS и выходных параметров должны быть согласованы друг с другом.
Таким образом, нельзя написать функцию, которая будет возвращать одно значение, и при этом передавать другое значение в OUT-параметре — что позволяет большинство традиционных языков программирования.
Page 10: Функции с выходными параметрами
Альтернативный способ вернуть значение — использовать выходной параметр.
Результат тот же самый. Можно использовать и RETURNS, и OUT-параметр вместе — результат снова будет тем же:
Или даже так, использовав INOUT-параметр:
Обратите внимание, что, в отличие от многих языков программирования, фактическое значение, переданное SQL-функции в INOUT-параметре, никак не изменяется: мы передаем входное значение, а выходное возвращается функцией в качестве результата. Поэтому мы можем указать константу, хотя другие языки требовали бы переменную. В то время как в RETURNS можно указать только одно значение, выходных параметров может быть несколько. Например:
Page 11: Page 11
Здесь возвращаемое RETURN выражение пришлось взять в скобки.
Действительно, наша функция вернула не одно значение, а сразу несколько. Подробнее о такой возможности и составных типах мы будем говорить в теме «SQL. Составные типы».
Page 12: Категории изменчивости
Volatile
- возвращаемое значение может произвольно меняться
- при одинаковых значениях входных параметров
- используется по умолчанию
- Stable
- значение не меняется в пределах одного оператора SQL
- функция не может менять состояние базы данных
- Immutable
- значение не меняется, функция детерминирована
- функция не может менять состояние базы данных
Комментарии преподавателя
Каждой функции сопоставлена категория изменчивости, которая определяет свойства возвращаемого значения при одинаковых значениях входных параметров.
Категория volatile говорит о том, что возвращаемое значение может произвольно меняться. Такие функции будут выполняться каждый раз при каждом вызове. Если при создании функции категория не указана, назначается именно эта категория.
Категория stable используется для функций, возвращаемое значение которых не меняется в пределах одного SQL-оператора. В частности, такие функции не могут менять состояние БД. Такая функция может быть выполнена один раз во время выполнения запроса, а затем будет использоваться вычисленное значение.
Категория immutable еще более строгая: возвращаемое значение не меняется никогда. Такую функцию можно выполнить на этапе планирования запроса, а не во время выполнения.
Можно — не означает, что всегда происходит именно так, но планировщик вправе выполнить такие оптимизации. В некоторых (простых) случаях планировщик делает собственные выводы об изменчивости функции, невзирая на указанную явно категорию.
https://postgrespro.ru/docs/postgresql/16/xfunc-volatility
Page 13: Категории изменчивости и изоляция
В целом использование функций внутри запросов не нарушает установленный уровень изоляции транзакции, но есть два момента, о которых полезно знать. Во-первых, функции с изменчивостью volatile на уровне изоляции Read Committed приводят к рассогласованию данных внутри одного запроса. Сделаем функцию, возвращающую число строк в таблице:
Теперь вызовем ее несколько раз с задержкой, а в параллельном сеансе вставим в таблицу строку.
При изменчивости stable или immutable, либо при использовании более строгих уровней изоляции такого не происходит потому, что в этих случаях всегда используется снимок основного запроса. В предыдущем же примере (volatile, Read Committed) основной запрос и запросы в функции используют разные снимки данных.
Page 14: Page 14
Второй момент связан с видимостью изменений, сделанных собственной транзакцией. Функции с изменчивостью volatile видят все изменения, в том числе сделанные текущим, еще не завершенным оператором SQL.
Это верно для любых уровней изоляции. Функции с изменчивостью stable или immutable видят изменения только уже завершенных операторов.
Категории изменчивости и оптимизация
Благодаря дополнительной информации о поведении функции, которую дает указание категории изменчивости, оптимизатор может сэкономить на вызовах функции. Для экспериментов создадим функцию, возвращающую случайное число:
Проверим план выполнения следующего запроса:
Page 15: Page 15
В плане мы видим «честное» обращение к функции generate_series; каждая строка результата сравнивается со случайным числом и при необходимости отбрасывается фильтром. В этом можно убедиться и воочию:
Здесь с разной вероятностью получаем от 0 до 10 строк. Функция с изменчивостью stable будет вызвана всего один раз — поскольку мы фактически указали, что ее значение не может измениться в пределах оператора:
Page 16: Page 16
Результатом запроса будет либо 0, либо 10 строк.
Наконец, изменчивость immutable позволяет вычислить значение функции еще на этапе планирования, поэтому во время выполнения вычисление фильтра уже не требуется:
Page 17: Page 17
Для immutable получаем случайный план! Ответственность «за дачу заведомо ложных показаний» лежит на разработчике.
Подстановка тела функции в SQL-запрос
В некоторых (очень простых) случаях тело функции на языке SQL может быть подставлено прямо в основной SQL-оператор на этапе разбора запроса. В этом случае время на вызов функции не тратится. Упрощенно — требуется выполнение следующих условий: Тело функции состоит из одного оператора SELECT; Нет обращений к таблицам, отсутствуют подзапросы, группировки и т. п.; Возвращаемое значение должно быть одно; Вызываемые функции не должны противоречить указанной категории изменчивости. Пример мы уже видели: наша функция rnd(), объявленная volatile. Посмотрим еще раз.
В фильтре упоминается функция random(), но не rnd(). Она будет вызываться напрямую, минуя «обертку» в виде функции rnd().
Page 18: Итоги
Можно создавать собственные функции и использовать их так же, как и встроенные
- Функции можно писать на разных языках, в том числе SQL
- Изменчивость влияет на возможности оптимизации
- Иногда функция на SQL может быть подставлена в запрос
Page 19: Практика
- Создайте функцию author_name для формирования имени автора. Функция принимает три параметра (фамилия, имя, отчество) и возвращает строку с фамилией и инициалами.
- Используйте эту функцию в представлении authors_v. 2. Создайте функцию book_name для формирования названия книги. Функция принимает два параметра (идентификатор книги и заголовок) и возвращает строку, составленную из заголовка и списка авторов в порядке seq_num. Имя каждого автора формируется функцией author_name.
- Используйте эту функцию в представлении catalog_v. Проверьте изменения в приложении.
Комментарии преподавателя
Напомним, что необходимые функции можно посмотреть в раздаточном материале «Основные типы данных и функции».
Все инструменты позволяют «непосредственно» редактировать хранимые функции. Например, в psql есть команда \ef, открывающая текст функции в редакторе и сохраняющая изменения в базу.
Такой возможностью лучше не пользоваться (или как минимум не злоупотреблять). В нормально построенном процессе разработки весь код должен находиться в файлах под версионным контролем. При необходимости изменить функцию файл редактируется и выполняется (с помощью psql или средствами IDE). Если же менять определение функций сразу в БД, изменения легко потерять. (Вообще же вопрос организации процесса разработки намного сложнее и в курсе мы его не затрагиваем.)
Page 20: 1. Функция author_name
Категория изменчивости — immutable. Функция всегда возвращает одинаковое значение при одних и тех же входных параметрах.
2. Функция book\_name
Категория изменчивости — stable. Функция возвращает одинаковое значение при одних и тех же входных параметрах, но только в рамках одного SQL-запроса.
Page 21: Практика+
- Напишите функцию, выдающую случайное время, равномерно распределенное в указанном отрезке. Начало отрезка задается временной отметкой (timestamptz), конец — либо временной отметкой, либо интервалом (interval). 2. В таблице хранятся номера автомобилей, введенные кое-как: встречаются как латинские, так и русские буквы в любом регистре; между буквами и цифрами могут быть пробелы. Считая, что формат номера «буква три-цифры две-буквы», напишите функцию, выдающую число уникальных номеров. Например, «К 123 ХМ» и «k123xm» считаются равными. 3. Напишите функцию, находящую корни квадратного уравнения.
Комментарии преподавателя
Во всех заданиях обратите особое внимание на категорию изменчивости функций.
- Сначала напишите функцию «нормализации» номера, то есть приводящую номер к какому-нибудь стандартному виду. Например, без пробелов и только заглавными латинскими буквами.
В номерах используются только 12 русских букв, имеющих латинские аналоги аналогичного начертания, а именно: АВЕКМНОРСТУХ.
- Для уравнения вида y = ax2 + bx + c вычисляется дискриминант D = b2 – 4ac:
при D > 0 два корня x1,2 = (–b ± √D) / 2a;
при D = 0 один корень x = –b / 2a (в качестве x2 можно вернуть null);
при D < 0 корней нет (оба корня null).
Page 22: 1. Случайная временнáя отметка
Функция с двумя временными отметками:
Категория изменчивости — volatile. Используется функция random, поэтому функция будет возвращать разные значения при одних и тех же входных параметрах.
Вторую функцию (с параметром-интервалом) можно определить через первую:
2. Автомобильные номера
Создадим таблицу с номерами.
Функция нормализации:
Page 23: Page 23
Категория изменчивости — immutable. Функция всегда возвращает одинаковое значение при одних и тех же входных параметрах.
Теперь легко исключить дубликаты:
3. Корни квадратного уравнения
Категория изменчивости — immutable. Функция всегда возвращает одинаковое значение при одних и тех же входных параметрах.
Page 24: Page 24
09 Занятие 09: SQL / Процедуры
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_09_sql_proc.html Archive: DEV1-handouts-16.zip Страниц PDF: 19
Page 1: SQL / Процедуры
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Процедуры и их отличие от функций
- Входные и выходные параметры
- Перегрузка и полиморфизм
Page 3: Подпрограммы
Функции
- вызываются в контексте выражения
- не могут управлять транзакциями
- возвращают результат
- Процедуры
- вызываются оператором CALL
- могут управлять транзакциями
- могут возвращать результат
Комментарии преподавателя
Процедуры были введены в PostgreSQL 11. Основная причина их появления состоит в том, что функции не могут управлять транзакциями. Функции вызываются в контексте какого-либо выражения, которое вычисляется как часть уже начатого оператора (например, SELECT) в уже начатой транзакции. Нельзя завершить транзакцию и начать новую «посередине» выполнения оператора.
Процедуры всегда вызываются специальным оператором CALL. Если этот оператор сам начинает новую транзакцию (а не вызывается из уже начатой), то в процедуре можно использовать команды управления транзакциями.
К сожалению, процедуры, написанные на языке SQL, лишены сейчас возможности использовать команды COMMIT и ROLLBACK, хотя те из них, что оформлены в новом стиле стандарта SQL, вероятно смогут это делать в будущем. Поэтому пример процедуры, управляющей транзакциями, придется отложить до темы «PL/pgSQL. Выполнение запросов».
Иногда можно услышать, что процедура отличается от функции тем, что не возвращает результат. Но это не так — процедуры тоже могут возвращать результат, если необходимо.
Функции и процедуры имеют общее пространство имен и вместе называются подпрограммами (routine).
https://postgrespro.ru/docs/postgresql/16/sql-createprocedure
https://postgrespro.ru/docs/postgresql/16/sql-call
Page 4: Процедуры без параметров
Начнем с примера простой процедуры без параметров.
Чтобы вызвать процедуру, необходимо использовать специальный оператор:
Результат работы виден в таблице:
А теперь переопределим нашу процедуру в стиле стандарта SQL:
Убедимся в ее работоспособности:
И попробуем в процедуре выполнить фиксацию транзакции:
Обратите внимание, что мы получили ошибку о недопустимой команде еще на этапе определения подпрограммы. Переименуем таблицу, с которой работает наша процедура:
Page 5: Page 5
Вызов ниже не приведет к ошибке — таблица в определении процедуры в системном каталоге теперь представлена не по имени, а по идентификатору, который был получен еще на этапе создания подпрограммы.
Ту же самую задачу, что выполняла процедура, можно решить и с помощью функции, возвращаемое значение которой определяется последним оператором. Можно объявить тип результата void, если фактически функция ничего не возвращает, или вернуть что-то осмысленное. Возвратим таблице прежнее имя и определим функцию:
В любом случае функция вызывается в контексте какого-либо выражения:
Чего нельзя достичь с помощью функции — это управления транзакциями. Но и в процедурах на языке SQL, как мы видели, это пока не поддерживается (зато поддерживается при использовании других языков).
Процедуры с параметрами
Добавим в процедуру входной параметр — число строк:
Точно так же, как и в случае функций, при вызове процедур фактические параметры можно передавать позиционным способом или по имени:
Page 6: Page 6
Процедуры могут также иметь OUT-и INOUT-параметры, с помощью которых можно возвращать значения:
Попробуем:
Page 7: Перегрузка
Несколько подпрограмм с одним и тем же именем
- подпрограмма однозначно определяется сигнатурой —
- именем и входными параметрами
- тип возвращаемого значения и выходные параметры игнорируются
- подходящая подпрограмма выбирается во время выполнения
- в зависимости от фактических параметров
- Команда CREATE OR REPLACE
- при несовпадении типов входных параметров создаст новую
- перегруженную подпрограмму
- при совпадении — изменит существующую подпрограмму,
- но нельзя поменять тип подпрограммы, тип возвращаемого значения,
- типы OUT-параметров
Комментарии преподавателя
Перегрузка — это возможность использования одного и того же имени для нескольких подпрограмм, отличающихся типами параметров IN и INOUT.
Сигнатура подпрограммы — ее имя и типы входных параметров. При вызове PostgreSQL находит подпрограмму, соответствующую сигнатуре. Возможны ситуации, когда подходящую подпрограмму невозможно определить однозначно; в таком случае во время выполнения возникнет ошибка.
Однако в сигнатуру, в частности, не входят:
тип подпрограммы (процедура или функция);
типы параметров OUT;
тип возвращаемого значения.
Перегрузку надо учитывать, выполняя команду CREATE OR REPLACE (FUNCTION или PROCEDURE). Если сигнатура не совпадает ни с одной из существующих, будет создана новая перегруженная подпрограмма, а при совпадении — изменена существующая. В последнем случае не разрешается изменять тип подпрограммы, тип OUT-параметров или тип возвращаемого значения, однако можно изменить язык и другие свойства. Поэтому иногда приходится удалять подпрограмму и создавать ее заново, в этом случае потребуется также удалить зависящие от нее объекты: другие подпрограммы, представления, триггеры и т. п. (DROP ROUTINE … CASCADE).
https://postgrespro.ru/docs/postgresql/16/xfunc-overload
Page 8: Полиморфизм
Подпрограмма, принимающая параметры разных типов
- формальные параметры используют полиморфные псевдотипы
- (например, anyelement или anycompatible)
- конкретный тип данных выбирается во время выполнения
- по типу фактических параметров
Комментарии преподавателя
В некоторых случаях удобно не создавать несколько перегруженных подпрограмм для разных типов, а написать одну, принимающую параметры любого (или почти любого) типа.
Для этого в качестве типа формального параметра указывается специальный полиморфный псевдотип. Пока мы рассмотрим два из них — anyelement и anycompatible — но позже встретимся и с другими.
Полиморфные псевдотипы в определении позволяют использовать в качестве параметров любые типы, при этом конкретный тип, с которым будет работать подпрограмма, выбирается во время выполнения по типу фактического параметра.
Если в определении указано несколько полиморфных параметров типа anyelement, то все фактические параметры неявно приводятся к типу первого из них. Если же указано несколько параметров типа anycompatible, то типы фактических параметров приводятся к некоторому общему типу.
Если подпрограмма объявлена с возвращаемым значением полиморфного типа, то она должна иметь по крайней мере один входной полиморфный параметр. Конкретный тип возвращаемого значения также определяется исходя из типа фактического входного параметра. Для подпрограмм в стиле стандарта SQL возможности использовать полиморфные типы данных для аргументов нет.
https://postgrespro.ru/docs/postgresql/16/extend-type-system#EXTEND-TY PES-POLYMORPHIC
https://postgrespro.ru/docs/postgresql/16/xfunc-sql#XFUNC-SQL-POLYMO RPHIC-FUNCTIONS
Page 9: Перегруженные подпрограммы
Перегрузка работает одинаково и для функций, и для процедур. Они имеют общее пространство имен. В качестве примера напишем функцию, возвращающую большее из двух целых чисел. (Похожее выражение есть в SQL и называется greatest, но мы напишем собственную функцию.)
Проверим:
Допустим, мы решили сделать аналогичную функцию для трех чисел. Благодаря перегрузке, не надо придумывать для нее какое-то новое название:
Теперь у нас две функции с одним именем, но разным числом параметров:
И обе работают:
Команда CREATE OR REPLACE позволяет создать подпрограмму или заменить существующую, не удаляя ее. Поскольку в данном случае функция с такой сигнатурой уже существует, она будет заменена:
Пусть наша функция работает не только для целых чисел, но и для вещественных. Как этого добиться? Можно определить еще такую функцию:
Page 10: Page 10
Теперь у нас три функции с одинаковым именем:
Две из них имеют одинаковое количество параметров, но отличаются их типами:
Если подпрограмма перегружена несколько раз, то для получения информации только о некоторых из них можно указать в команде \df типы интересующих параметров:
Дальше нам придется определить функции для всех остальных типов данных и повторить все то же самое для трех параметров. Притом что операторы в теле этих функций будут одни и те же.
Полиморфные функции
Здесь нам помогут полиморфные типы anyelement и anycompatible. Это псевдотипы, взамен которых при вызове и интерпретации функции будет подставлен тип фактического параметра. Разумеется, в случае определения подпрограммы в стиле стандарта SQL ее код будет разобран еще на этапе создания, и воспользоваться полиморфными псевдотипами не удастся. Удалим все три наши функции…
…и затем создадим новую:
Такая функция должна принимать любой тип данных (а работать будет с любым типом, для которого определен оператор «больше»). Получится?
Увы, нет. В данном случае строковые литералы могут быть типа char, varchar, text — конкретный тип нам неизвестен. Но можно применить явное приведение типов:
Page 11: Page 11
Еще пример с другим типом:
Тип результата функции всегда будет тот же, что и тип параметров. Но можно продвинуться еще дальше — сделать так, чтобы можно было использовать в полиморфных подпрограммах не абсолютно одинаковые типы, а совместимые, то есть те, что могут быть приведены друг к другу неявно. Для этого нужно использовать полиморфный псевдотип anycompatible. Удалим нашу функцию и взамен нее создадим другую:
Повторим наш опыт с параметрами-литералами:
Получилось! Но если типы параметров не совпадают и не могут быть неявно приведены к некоторому общему типу, то будет ошибка:
В этом примере такое ограничение выглядит естественно, хотя в некоторых случаях оно может оказаться и неудобным. Определим теперь функцию с тремя параметрами, но так, чтобы третий можно было не указывать:
Page 12: Page 12
Так работает. А так?
А так произошел конфликт перегруженных функций:
Невозможно понять, имеем ли мы в виду функцию с двумя параметрами, или с тремя (но просто не указали последний). Мы решим этот конфликт просто — удалим первую функцию за ненадобностью.
Теперь все работает. А в теме «PL/pgSQL. Массивы» мы узнаем, как определять подпрограммы с произвольным числом параметров.
Page 13: Итоги
Можно создавать и использовать собственные процедуры
- В отличие от функций, процедуры вызываются оператором CALL и могут управлять транзакциями
- Для процедур и функций поддерживаются перегрузка и полиморфизм
Page 14: Практика
- В таблице authors имена, фамилии и отчества авторов по смыслу должны быть уникальны, но это условие никак не проверяется. Напишите процедуру, удаляющую возможные дубликаты авторов. 2. Чтобы необходимость в подобной процедуре не возникала, создайте ограничение целостности, которое не позволит появляться дубликатам в будущем.
Комментарии преподавателя
- В приложении возможность добавлять авторов появится в теме «PL/pgSQL. Выполнение запросов». А пока для проверки можно добавить дубликаты в таблицу вручную.
Page 15: 1. Устранение дубликатов
В целях проверки добавим второго Пушкина:
Задачу устранения дубликатов можно решить разными способами. Например, так:
2. Ограничение целостности
Создать подходящее ограничение целостности мешает тот факт, что отчество может быть неопределенным (NULL). Неопределенные значения считаются различными, поэтому ограничение
не помешает добавить второго Джонатана Свифта без отчества. Задачу можно решить, создав уникальный индекс:
Page 16: Page 16
Проверим:
Page 17: Практика+
- Получится ли создать в одной и той же схеме и имеющие одно и то же имя: а) процедуру с одним входным параметром, б) функцию с одним входным параметром того же типа, возвращающую некоторое значение? в) процедуру с одним входным и одним выходным параметром? Проверьте. 2. В таблице хранятся вещественные числа (например, результаты каких-либо измерений). Напишите процедуру нормализации данных, которая умножает все числа на определенный коэффициент так, чтобы все значения попали в интервал от −1 до 1. Процедура должна возвращать выбранный коэффициент.
Комментарии преподавателя
- В качестве коэффициента возьмите максимальное абсолютное значение из таблицы.
Page 18: 1. Перегрузка процедур и функций
Не получится, так как в сигнатуру подпрограммы входит только имя и тип входных параметров (возвращаемое значение игнорируется), и при этом процедуры и функции имеют общее пространство имен.
В некоторых сообщениях, как и в этом, вместо слова «процедура» используется «функция», поскольку во многом они устроены одинаково.
Такую процедуру тоже создать нельзя, так как уже имеется процедура с такой же сигнатурой, а изменять выходные параметры (и факт их наличия) для имеющейся подпрограммы также запрещено. Нам предлагают удалить подпрограмму, чтобы затем создать ее заново.
2. Нормализация данных
Таблица с тестовыми данными:
Процедуру можно написать, используя один SQL-оператор:
Page 19: Page 19
10 Занятие 10: SQL / Составные типы
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_10_sql_row.html Archive: DEV1-handouts-16.zip Страниц PDF: 24
Page 1: SQL / Составные типы
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Составные типы и работа с ними
- Параметры функций составных типов
- Функции, возвращающие одну строку
- Функции, возвращающие множество строк
Page 3: Составные типы
Составной тип
- набор именованных атрибутов (полей)
- то же, что табличная строка, но без ограничений целостности
- Создание
- явное объявление нового типа
- неявно при создании таблицы
- неопределенный составной тип record
- Использование
- атрибуты как скалярные значения
- операции со значениями составного типа: сравнение, проверка
- на NULL, использование с подзапросами
Комментарии преподавателя
Составной тип — это набор атрибутов, каждый из которых имеет свое имя и свой тип. Составной тип можно рассматривать как табличную строку. Часто он называется «записью» (а в Си-подобных языках такой тип называется «структурой»).
https://postgrespro.ru/docs/postgresql/16/rowtypes
Составной тип — объект базы данных, его объявление регистрирует новый тип в системном каталоге, после чего он становится полноценным типом SQL. При создании таблицы автоматически создается и одноименный составной тип, представляющий строку этой таблицы. Важное отличие состоит в том, что в составном типе нет ограничений целостности.
https://postgrespro.ru/docs/postgresql/16/sql-createtype
Атрибуты составного типа могут использоваться как отдельные значения (хотя атрибут, в свою очередь, тоже может иметь составной тип).
Составной тип можно использовать как любой другой тип SQL, например, создавать столбцы таблиц этого типа и т. п. Значения составного типа можно сравнивать между собой, проверять на неопределенность (NULL), использовать с подзапросами в таких конструкциях, как IN, ANY/SOME, ALL.
https://postgrespro.ru/docs/postgresql/16/functions-comparisons
https://postgrespro.ru/docs/postgresql/16/functions-subquery
Page 4: Явное объявление составного типа
Первый способ ввести составной тип — явным образом объявить его:
Такой тип можно использовать точно так же, как любой другой тип SQL. Например, мы можем создать таблицу со столбцами такого типа:
Нужно ли так делать — вопрос сложный, универсальных рецептов тут не существует. В каких-то случаях это может быть полезно; в каких-то удобнее действовать в реляционных рамках: выделить сущность, представляемую типом, в отдельную таблицу и ссылаться на нее. Это позволить избежать избыточности данных (нормализация) и упростить индексирование (в случае составного типа скорее всего потребуется индекс по выражению). В целом PostgreSQL обладает достаточно большим количеством встроенных типов данных, так что, вероятно, необходимость в создании собственного типа будет возникать не часто, если не сказать редко.
Конструирование значений составных типов
Значения составного типа можно формировать в виде строки, внутри которой в скобках перечислены значения. Обратите внимание, что строковые значения заключается в двойные кавычки:
Другой способ — конструктор ROW:
Если составной тип содержит более одного поля, то слово ROW можно опустить:
Атрибуты составного типа как отдельные значения
Обращение к отдельному атрибуту составного типа — по сути то же, что и обращению к столбцу таблицы, ведь строка таблицы — это и есть составной тип:
Page 5: Page 5
Как правило, требуется брать составное значение в скобки, например, чтобы отличать атрибут записи от столбца таблицы:
Или в случае, когда используется выражение:
Составное значение не обязательно связано с каким-то конкретным типом, оно может быть неопределенной записью псевдотипа record:
Но получится ли обратиться к атрибуту такой записи?
Нет, поскольку атрибуты такого типа безымянные.
Неявный составной тип для таблиц
Более частое на практике применение составных типов — упрощение работы функций с таблицами. При создании таблицы неявно создается и одноименный составной тип. Например, места в кинотеатре:
Команда \dT «прячет» такие неявные типы, но при желании их можно увидеть непосредственно в таблице pg_type:
c — composite, то есть составной тип.
Page 6: Операции над значениями составных типов
Значения составных типов можно сравнивать между собой. Это происходит поэлементно (примерно так же, как строки сравниваются посимвольно):
Осторожно: существует много тонкостей, связанных с неопределенными значениями внутри записей. Также работает проверка на неопределенность IS [NOT] NULL и сравнение IS [NOT] DISTINCT FROM. Составные типы можно использовать с подзапросами, что бывает очень удобно. Добавим таблицу с билетами:
Теперь, например, можно написать такой запрос для поиска мест в билетах на сегодняшний сеанс:
Без возможности использовать подзапрос пришлось бы явно соединять таблицы.
Page 7: Параметры подпрограмм
Подпрограмма может принимать параметры составного типа
- Способ реализации вычисляемых полей
- взаимозаменяемость table.column и column(table)
- Другие способы
- представления
- столбцы GENERATED ALWAYS
Комментарии преподавателя
Разумеется, подпрограммы могут принимать параметры составных типов.
Интересно, что для доступа к столбцу таблицы можно использовать не только привычную форму «таблица.столбец», но и функциональную: «столбец(таблица)». Это позволяет создавать вычисляемые поля, определяя функцию, принимающую на вход составной тип.
https://postgrespro.ru/docs/postgresql/16/xfunc-sql
Это несколько курьезный способ, поскольку того же результата можно добиться более явно с помощью представления. Стандарт SQL также предусматривает генерируемые (GENERATED ALWAYS) столбцы, хотя в PostgreSQL эта возможность пока реализована не в соответствии со стандартом — столбцы не вычисляются на лету, а сохраняются в таблице.
https://postgrespro.ru/docs/postgresql/16/ddl-generated-columns
Page 8: Параметры составного типа
Определим функцию, принимающую значение составного типа и возвращающую текстовый номер места.
Обратите внимание, что в общем случае конкатенация имеет категорию изменчивости stable, а не immutable, поскольку для некоторых типов данных приведение к строке может давать разные результаты в зависимости от настроек.
Что удобно, такой функции можно передавать непосредственно строку таблицы:
Можно обойтись и без «звездочки»:
Синтаксисом допускается обращение к функции как к столбцу таблицы (и наоборот, к столбцу как к функции):
Таким образом можно использовать функции как вычисляемые «на лету» столбцы таблиц. Что, если и в таблице окажется столбец с тем же именем? Раньше в любом случае предпочтение отдавалось столбцу, а начиная с версии 11 выбор зависит от синтаксической формы. Разумеется, такого же эффекта можно добиться, определив представление.
Page 9: Page 9
А начиная с версии 12, PostgreSQL позволяет при создании таблиц объявить «настоящие» вычисляемые столбцы. Правда, в отличие от стандарта SQL, такие столбцы не вычисляются на лету, а сохраняются в таблице:
Если мы впоследствии решили, что следует явно задавать значение поля, то нам достаточно удалить выражение:
Существующие данные в столбце остались, но столбец теперь не вычисляемый, а «обычный»:
Page 10: «Однострочные» функции
Возвращают значение составного типа
- Обычно вызываются в списке выборки запроса
- При вызове в предложении FROM возвращают однострочную таблицу
Комментарии преподавателя
Функции могут не только принимать параметры составного типа, но и возвращать значение составного типа.
Обычно функции вызываются в списке выборки запроса (предложение SELECT).
Но функцию можно вызвать и в предложении FROM, как будто таблицу из одной строки.
Page 11: Функции, возвращающие одно значение
Напишем функцию, конструирующую и возвращающую табличную строку по отдельным компонентам. Такую функцию можно объявить как RETURNS seats:
Мы получаем результат составного типа. Его можно «развернуть» в однострочную таблицу:
Имена столбцов и их типы получены здесь из описания составного типа seats. Но функцию можно вызывать не только в списке выборки запроса или в условиях, как часть выражения. К функции можно обратиться и в предложении FROM, как к таблице:
При этом мы тоже получаем однострочную таблицу. Кстати, можно ли подобным образом вызвать функцию, возвращающую отдельное (скалярное) значение?
Да, так тоже можно: мы получили одну строку, состоящую из одного столбца. Другой вариант, который мы уже видели в теме «SQL. Функции» — объявить выходные параметры. Заодно отметим, что в запросе не обязательно собирать составной тип из отдельных полей — это будет проделано автоматически:
Page 12: Page 12
Получаем тот же результат — но имена и типы полей в данном случае получены из выходных параметров функции, а сам составной тип остается анонимным. И еще один вариант — объявить функцию как возвращающую псевдотип record, который обозначает составной тип «вообще», без уточнения его структуры.
Но вызвать такую функцию в предложении FROM уже не получится, поскольку возвращаемый составной тип не просто анонимный, но и количество и типы его полей заранее (на этапе разбора запроса) неизвестны:
В этом случае при вызове функции структуру составного типа придется уточнить — мы явно указываем названия и типы столбцов:
При написании функций допустим любой из этих трех вариантов, но лучше сразу подумать об использовании: будет ли удобен анонимный тип и уточнение структуры типа при вызове.
Page 13: Табличные функции
Объявляются как RETURNS SETOF или RETURNS TABLE
- Могут возвращать несколько строк
- Обычно вызываются в предложении FROM
- Можно использовать как представление с параметрами
- особенно удобно в сочетании с подстановкой тела функции в запрос
Комментарии преподавателя
Мы знаем, что к функциям можно обращаться в предложении FROM, однако до сих пор результатом была одна строка. Конечно, интереснее было бы иметь функции, возвращающие множество строк (табличные функции) — и их действительно можно определять.
Табличные функции естественно вызывать в предложении FROM и можно рассматривать их как своеобразное представление. (Формально PostgreSQL позволяет вызвать такую функцию и в списке выборки, но так лучше не делать.)
Как и с обычными функциями, в ряде случаев планировщик может подставить тело функции в основной запрос. Это позволяет создавать «представления с параметрами» без накладных расходов.
https://wiki.postgresql.org/wiki/Inlining\_of\_SQL\_functions
Page 14: Функции, возвращающие множество строк (табличные функции)
Напишем функцию, которая вернет все места в прямоугольном зале заданного размера.
Ключевое отличие — слово SETOF. В таком случае функция возвращает не первую строку последнего запроса, как обычно, а все строки последнего запроса.
Вместо SETOF seats можно использовать и SETOF record:
Но в этом случае, как мы видели, при вызове функции придется уточнять структуру составного типа:
А можно объявить функцию с выходными параметрами. Но SETOF record все равно придется написать, чтобы показать, что функция возвращает не одну строку, а множество:
Page 15: Page 15
Еще один равнозначный (и к тому же описанный в стандарте SQL) способ объявить табличную функцию — указать слово TABLE:
Иногда в запросах бывает полезно пронумеровать строки в том порядке, в котором они получены от функции. Для этого есть специальная конструкция:
При использовании функции в предложении FROM, перед ней неявно подразумевается ключевое слово LATERAL, что позволяет функции обращаться к столбцам таблиц, стоящих в запросе слева от нее. Иногда это позволяет упростить формулировку запросов. Например, напишем функцию, конструирующую зал наподобие амфитеатра, в котором дальние ряды имеют больше мест, чем ближние:
Page 16: Page 16
Интересно, что к функции, возвращающей множество строк, можно обратиться и в списке выборки запроса:
В некоторых случаях это смотрится логично, но иногда результат может удивить. Например, сколько строк вернет такой запрос?
Получается 6 строк, а в версиях до 10 получалось наименьшее общее кратное числа строк, возвращенных каждой функцией (12 в данном случае). Еще хуже, что запрос может вернуть меньше строк, чем ожидалось, если функция не вернет ни одной строки при каком-то значении параметров. Поэтому такой способ вызова не стоит использовать.
Функции как представления с параметрами
Как мы видели, функцию можно использовать во фразе FROM как таблицу или представление. Но при этом мы дополнительно получаем возможность использовать параметры, что в ряде случаев бывает удобно. Единственная сложность с таким подходом состоит в том, что при обращении к функции (Function Scan) запросы из нее сначала выполняются полностью, и только затем к результату применяются дополнительные условия из запроса.
Page 17: Page 17
Если бы функция содержала сложный, долгий запрос, это могло бы стать проблемой. В некоторых случаях тело функции может подставляться в вызывающий запрос. Для табличных функций ограничения более мягкие: функция написана на языке SQL; функция сама не должна быть изменчивой (VOLATILE) и не должна содержать вызовов таких функций; функция не должна быть строгой (STRICT); тело должно содержать единственный оператор SELECT (но он может быть сложным); и ряд других ограничений. В нашем случае дело в том, что последний раз мы объявили функцию как изменчивую, не указав категорию изменчивости явно.
Теперь нет вызова функции как такового, а условие подставлено внутрь запроса, что более эффективно.
Page 18: Итоги
Составной тип объединяет значения других типов
- Упрощает и обогащает работу функций с таблицами
- Позволяет создавать вычислимые поля и представления с параметрами
- Функции могут возвращать множество строк
Page 19: Практика
- Создайте функцию onhand_qty для подсчета имеющихся в наличии книг. Функция принимает параметр составного типа books и возвращает целое число.
- Используйте эту функцию в представлении catalog_v
- в качестве «вычисляемого поля».
- Проверьте, что приложение отображает количество книг. 2. Создайте табличную функцию get_catalog для поиска книг. Функция принимает значения полей формы поиска («имя автора», «название книги», «есть на складе») и возвращает подходящие книги в формате catalog_v.
- Проверьте, что в «Магазине» начал работать поиск и
- просмотр.
Комментарии преподавателя
При решении хотелось бы воспользоваться уже готовым представлением catalog_v, просто наложив ограничения на строки. Но в этом представлении и название книги, и авторы находятся в одном поле, к тому же в сокращенном виде. Очевидно, что поиск автора «Лев» по полю «Л .Н. Толстой» не даст результата.
Можно было бы повторить в функции get_catalog запрос из catalog_v, но это дублирование кода, что плохо. Поэтому расширьте представление catalog_v, добавив в него дополнительные поля: заголовок книги и полный список авторов.
Проверьте, что корректно обрабатываются пустые поля на форме. Когда клиент вызывает функцию get_catalog, передает ли он в этом случае пустые строки или неопределенные значения?
Page 20: 1. Функция onhand_qty
2. Функция get\_catalog
Расширяем catalog_v заголовком книги и полным списком авторов (приложение игнорирует неизвестные ему поля). Функция, возвращающая полный список авторов:
Используем эту функцию в представлении catalog_v. Такое представление уже существует; мы пересоздадим его — изменим порядок столбцов и запрос:
Функция get_catalog теперь использует расширенное представление:
Page 21: Page 21
Page 22: Практика+
- Напишите функцию, переводящую строку, содержащую число в шестнадцатеричной системе, в обычное целое число. Например: convert(‘FF’) → 255 2. Добавьте в функцию второй необязательный параметр — основание системы счисления (по умолчанию — 16). Например: convert(‘0110’,2) → 6 3. Табличная функция generate_series не работает со строковыми типами. Предложите свою функцию для генерации последовательностей строк из заглавных английских букв.
Комментарии преподавателя
- Например:
Для решения пригодятся: табличная функция regexp_split_to_table, функции upper и reverse, конструкция WITH ORDINALITY.
Другое решение возможно с помощью рекурсивного запроса.
Проверить реализацию можно, используя шестнадцатеричные константы: SELECT X’FF’::integer;
- Например:
- Считайте, что на вход подаются строки равной длины. Например:
Page 23: 1. Функция для шестнадцатеричной системы
Сначала для удобства определим функцию для одной цифры:
Теперь основная функция:
2. Функция для любой системы счисления
Предполагаем, что основание системы счисления от 2 до 36, то есть число записывается цифрами от 0 до 9, либо буквами от A до Z. В этом случае изменения минимальные.
Заметим, что в PostgreSQL начиная с версии 16 есть возможность записи целочисленных констант не только в десятичном, но и в двоичном, шестнадцатеричном и восьмеричном виде. Такая возможность закреплена в современном стандарте SQL:
Page 24: 3. Функция generate_series для строк
Сначала напишем вспомогательные функции, переводящие строку в числовое представление и обратно. Первая очень похожа на функцию из предыдущего задания:
Обратную функцию напишем с помощью рекурсивного запроса:
Теперь функцию generate_series для строк можно переписать, используя generate_series для целых чисел.
11 Занятие 11: PL/pgSQL / Обзор и конструкции языка
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_11_plpgsql_introduction.html Archive: DEV1-handouts-16.zip Страниц PDF: 24
Page 1: PL/pgSQL / Обзор и конструкции языка
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- История PL/pgSQL
- Структура блока, объявление переменных
- Анонимные блоки
- Подпрограммы на языке PL/pgSQL
- Условные операторы и циклы
- Вычисление выражений
Page 3: История PL/pgSQL
Появился в версии 6.4 в 1998 году
- устанавливается по умолчанию с версии 9.0
- Цели создания
- простой язык для написания пользовательских функций и триггеров
- добавить управляющие структуры к языку SQL
- сохранить возможность использования любых пользовательских типов,
- функций и операторов
- Родословная: Oracle PL/SQL, Ада
Комментарии преподавателя
PL/pgSQL — один из первых процедурных языков в PostgreSQL. Он впервые появился в 1998 году в версии 6.4, а с версии 9.0 стал устанавливаться по умолчанию при создании базы данных.
PL/pgSQL дополняет SQL, предоставляя такие возможности процедурных языков, как использование переменных и курсоров, условные операторы, циклы, обработка ошибок и т. д.
PL/pgSQL проектировался на основе языка Oracle PL/SQL, а тот, в свою очередь, был создан на основе подмножества языка Ада. Эта ветвь происходит от таких языков, как Алгол и Паскаль. Большинство современных языков программирования принадлежат другой ветви — ветви Си-подобных языков, поэтому PL/pgSQL может показаться непривычным, избыточно многословным (характерное отличие — использование ключевых слов BEGIN и END вместо фигурных скобок). Впрочем, этот синтаксис отлично сочетается с синтаксисом SQL.
https://postgrespro.ru/docs/postgresql/16/plpgsql-overview
Page 4: Структура блока
Метка блока
- Объявления переменных
- область действия — блок
- область видимости может перекрываться вложенными блоками,
- но можно использовать метку блока
- любые типы SQL, ссылки на типы объектов (%TYPE)
- Операторы
- управляющие конструкции
- операторы SQL, кроме служебных
- вложенные блоки
- Обработка исключительных ситуаций
Комментарии преподавателя
Операторы языка PL/pgSQL объединяются в блоки. В структуре блока можно выделить:
● Необязательную метку, которую можно использовать для устранения неоднозначности в именовании.
● Необязательную секцию, предназначенную для объявления локальных переменных и курсоров. В качестве типа можно указать любой тип, определенный в SQL. Можно также сослаться на тип столбца таблицы с помощью конструкции %TYPE.
● Основную секцию исполнения, в которой располагаются операторы.
● Необязательную секцию обработки исключительных ситуаций.
В качестве операторов можно использовать как команды PL/pgSQL, так и большинство команд SQL, то есть этих два языка интегрированы практически бесшовно. Нельзя использовать служебные команды SQL, такие, как VACUUM. А команды управления транзакциями (например, COMMIT, ROLLBACK) допускаются только в процедурах.
В качестве оператора может выступать и другой (вложенный) PL/pgSQL-блок.
https://postgrespro.ru/docs/postgresql/16/plpgsql-structure
https://postgrespro.ru/docs/postgresql/16/plpgsql-declarations#PLPGSQL-D ECLARATION-TYPE
Page 5: Анонимные блоки
Разовое выполнение процедурного кода
- без создания хранимой подпрограммы
- без возможности передать параметры
- без возможности вернуть значение
- Оператор DO языка SQL
Комментарии преподавателя
Для использования PL/pgSQL не обязательно создавать подпрограммы. Код на PL/pgSQL можно оформить и выполнить как анонимный блок, при помощи SQL-команды DO.
Эту команду можно использовать с разными серверными языками, но если язык не указать явно, то будет использоваться PL/pgSQL.
Код анонимного блока не сохраняется на сервере. Также нет возможности передать в анонимный блок параметры или вернуть из него значение. Хотя косвенно это можно сделать, например, через таблицы.
https://postgrespro.ru/docs/postgresql/16/sql-do
Page 6: Анонимные блоки
Общая структура блока PL/pgSQL:
Все секции, кроме секции операторов, являются необязательными. Минимальный блок PL/pgSQL-кода:
Вариант программы Hello, World!
После BEGIN точка с запятой не ставится! Переменные могут иметь модификаторы: CONSTANT — значение переменной не должно изменяться после инициализации; NOT NULL — не допускается неопределенное значение.
Пример вложенных блоков. Переменная во внутреннем блоке перекрывает переменную из внешнего блока, но с помощью меток можно обратиться к любой из них:
Page 7: Page 7
Page 8: Подпрограммы PL/pgSQL
Заголовок подпрограммы не зависит от языка
- имя, входные и выходные параметры
- для функций: возвращаемое значение, категория изменчивости
- Указание LANGUAGE plpgsql
- Возврат значений
- оператор RETURN
- присвоение значений выходным (INOUT, OUT) параметрам
Комментарии преподавателя
Мы уже познакомились с хранимыми функциями и процедурами на примере языка SQL. Большинство рассмотренных вопросов, связанных с созданием и управлением подпрограммами, относится и к подпрограммам на PL/pgSQL:
● создание, изменение, удаление подпрограмм;
● расположение в системном каталоге (pg_proc);
● параметры;
● возвращаемое значение и категории изменчивости (для функций);
● перегрузка и полиморфизм;
● и т. д.
Если в SQL подпрограмма возвращала значение, выданное последним SQL-оператором, то в подпрограммах на PL/pgSQL требуется либо присваивать возвращаемые значения формальным INOUT-и OUT-параметрам, либо (для функций) использовать специальный оператор RETURN.
Page 9: Подпрограммы PL/pgSQL
Пример функции, возвращающей значение с помощью оператора RETURN:
Та же функция, но с OUT-параметром. Возвращаемое значение присваивается параметру:
Та же функция, но с INOUT-параметром. Такой параметр используется и для принятия входного значения, и для возврата значения функции:
Page 10: Условные операторы
IF
- стандартный условный оператор
- CASE
- похож на CASE языка SQL, но не возвращает значение
Внимание: трехзначная логика
- условие должно быть истинно; false и NULL не подходят
Комментарии преподавателя
PL/pgSQL предлагает два условных оператора: IF и CASE.
Первый — совершенно стандартный оператор, имеющийся во всех языках.
Второй похож на конструкцию CASE в языке SQL, но это именно оператор, он не возвращает значение. Это некий аналог оператора switch в C или Java.
Важно всегда помнить о том, что логические выражения в SQL (и, следовательно, в PL/pgSQL) могут принимать три значения: true, false и NULL. Условие срабатывает, только когда оно истинно, и не срабатывает, когда ложно или не определено. Это одинаково верно и для условий WHERE в SQL, и для условных операторов PL/pgSQL.
https://postgrespro.ru/docs/postgresql/16/plpgsql-control-structures#PLPGS QL-CONDITIONALS
Page 11: Условные операторы
Общий вид оператора IF:
Секция ELSIF может повторяться несколько раз, а может отсутствовать. Секция ELSE может отсутствовать. Выполняются операторы, соответствующие первому истинному условию. Если ни одно из условий не истинно, выполняются операторы ELSE (если есть). Пример функции, использующей условный оператор для форматирования номера телефона. Функция возвращает значение составного типа:
Общий вид оператора CASE (первый вариант — по условию):
Секция WHEN может повторяться несколько раз. Секция ELSE может отсутствовать. Выполняются операторы, соответствующие первому истинному условию. Если ни одно из условий не истинно, выполняются операторы ELSE (отсутствие ELSE в таком случае — ошибка). Пример использования:
Page 12: Page 12
Общий вид оператора CASE (второй вариант — по выражению):
Секция WHEN может повторяться несколько раз. Секция ELSE может отсутствовать. Выполняются операторы, соответствующие первому истинному условию «выражение = значение». Если ни одно из условий не истинно, выполняются операторы ELSE (отсутствие ELSE в таком случае — ошибка). При однотипных условиях эта форма CASE может оказаться компактней:
Page 13: Циклы
Цикл FOR по диапазону чисел
- Цикл WHILE с предусловием
- Бесконечный цикл
- Цикл может иметь метку, как блок
- Управление
- выход из цикла (EXIT)
- переход на новую итерацию (CONTINUE)
Комментарии преподавателя
Для повторного выполнения набора операторов PL/pgSQL предлагает несколько видов циклов:
● цикл FOR по диапазону целых чисел;
● цикл WHILE с предусловием;
● бесконечный цикл.
Цикл представляет собой разновидность блока и может иметь собственную метку.
Выполнением цикла можно дополнительно управлять, инициируя переход на новую итерацию или выход из цикла.
https://postgrespro.ru/docs/postgresql/16/plpgsql-control-structures#PLPGS QL-CONTROL-STRUCTURES-LOOPS
Цикл FOR может работать не только по диапазону чисел, но и по результатам выполнения запроса и по массивам. Эти варианты цикла FOR будут рассмотрены в следующих темах.
Page 14: Циклы
В PL/pgSQL все циклы используют общую конструкцию:
К ней может добавляться заголовок, определяющий условие выхода из цикла. Цикл по диапазону FOR повторяется, пока счетчик цикла пробегает значения от нижней границы до верхней. С каждой итерацией счетчик увеличивается на 1 (но инкремент можно изменить в необязательной фразе BY).
Переменная, выступающая счетчиком цикла, объявляется неявно и существует только внутри блока LOOP — END LOOP. При указании REVERSE значение счетчика на каждой итерации уменьшается, а нижнюю и верхнюю границы цикла нужно поменять местами:
Пример использования цикла FOR — функция, “переворачивающая” строку:
Напомним, что строгая (STRICT) функция немедленно возвращает NULL, если хотя бы один из входных параметров не определен. Тело функции при этом не выполняется. Цикл WHILE выполняется до тех пор, пока истинно условие:
Та же функция, обращающая строку, с использованием цикла WHILE:
Page 15: Page 15
Цикл LOOP без заголовка выполняется бесконечно. Для выхода используется оператор EXIT:
Метка необязательна; если не указана, будет прерван самый вложенный цикл. Фраза WHEN также необязательна; при отсутствии цикл прерывается безусловно. Пример использования цикла LOOP:
Тело функции помещается в неявный блок, метка которого совпадает с именем функции. Поэтому к параметрам можно обращаться как «имя_функции.параметр». Убедимся, что все функции работают правильно:
Замечание. В PostgreSQL есть встроенная функция reverse. Иногда бывает полезен оператор CONTINUE, начинающий новую итерацию цикла:
Page 16: Вычисление выражений
Любое выражение вычисляется в контексте SQL
- выражение автоматически преобразуется в запрос
- запрос подготавливается
- переменные PL/pgSQL подставляются как параметры
- Особенности
- можно использовать все возможности SQL, включая подзапросы
- невысокая скорость выполнения,
- хотя разобранный запрос (и, возможно, план запроса) кешируются
- неоднозначности при разрешении имен требуют внимания
Комментарии преподавателя
Выражения, встречающиеся в PL/pgSQL-коде, вычисляются с помощью SQL-запросов к базе данных. Интерпретатор сам строит нужный запрос, формируя оператор вида SELECT
С одной стороны, такой подход не способствует скорости работы PL/pgSQL, зато обеспечивает теснейшую интеграцию с SQL. Фактически, в выражениях можно использовать любые возможности SQL без ограничений, включая вызов встроенных и пользовательских функций, выполнение подзапросов и т. п.
Начиная с версии PostgreSQL 14 оптимизировано выполнение простых выражений (как минимум не содержащих обращений к таблицам) — такие выражения обрабатываются синтаксическим анализатором сервера напрямую, без обращений к планировщику.
https://postgrespro.ru/docs/postgresql/16/plpgsql-expressions
Page 17: Вычисление выражений
Выражения в PL/pgSQL выполняются SQL-движком. Таким образом, в PL/pgSQL доступно ровно то, что доступно в SQL. Например, если в SQL можно использовать конструкцию CASE, то точно такая же конструкция будет работать и в коде на PL/pgSQL (в качестве выражения; не путайте с оператором CASE … END CASE, который есть только в PL/pgSQL):
В выражениях можно использовать и подзапросы:
Еще пример с вычислением выражения в PL/pgSQL — сколько функций «обращения» строк у нас в результате получилось?
Page 18: Итоги
PL/pgSQL — доступный по умолчанию, интегрированный с SQL, удобный и простой в использовании язык
- Управление подпрограммами на PL/pgSQL не отличается от работы с подпрограммами на других языках
- DO — команда SQL для выполнения анонимного блока
- Переменные PL/pgSQL могут использовать любые типы SQL
- Язык поддерживает обычные управляющие конструкции, такие как условные операторы и циклы
Page 19: Практика
- Измените функцию book_name так, чтобы длина возвращаемого значения не превышала 45 символов. Если название книги при этом обрезается, оно должно завершаться на троеточие.
- Проверьте реализацию в SQL и в приложении; при необходимости добавьте книг с длинными названиями. 2. Снова измените функцию book_name так, чтобы избыточно длинное название обрезалось по границе целого слова (укорачивание по словам).
- Проверьте реализацию.
Комментарии преподавателя
- Например:
Вот некоторые случаи, которые имеет смысл проверить:
● длина названия меньше 45 символов (не должно измениться);
● длина названия ровно 45 символов (не должно измениться);
● длина названия 46 символов (от названия должны быть отрезаны 4 символа, т. к. добавятся еще три точки).
Лучше всего написать и отладить отдельную функцию укорачивания, которую затем использовать в book_name. Это полезно и по другим соображениям:
● такая функция может пригодиться где-то еще;
● каждая функция будет выполнять ровно одну задачу.
- Например:
Как поведет себя ваша реализация, если название состоит из одного длинного слова без пробелов?
Page 20: 1. Укорачивание названия книги
Напишем более универсальную функцию, принимающую строку, максимальную длину и суффикс, добавляемый при укорачивании. Это не потребует усложнения кода, и позволит обойтись без «магических констант».
Проверим:
Используем написанную функцию:
2. Укорачивание названия книги с переносом по словам
Проверим:
Page 21: Page 21
Page 22: Практика+
- Напишите PL/pgSQL-функцию, которая возвращает строку заданной длины из случайных символов. 2. Задача про игру в «наперстки». В одном из трех наперстков спрятан выигрыш. Игрок выбирает один из этих трех. Ведущий убирает один из двух оставшихся наперстков (обязательно пустой) и дает игроку возможность поменять решение, то есть выбрать второй из двух оставшихся. Есть ли смысл игроку менять выбор или нет смысла менять первоначальный вариант? Задание: используя PL/pgSQL, посчитайте вероятность выигрыша и для начального выбора, и для измененного.
Комментарии преподавателя
Предварительно можно создать функцию rnd_integer, которая возвращает случайное целое число в заданном диапазоне. Функция будет полезна для решения обоих заданий.
- Помимо длины строки на вход функции можно подавать список допустимых символов. По умолчанию, это могут быть все символы алфавита, числа и некоторые знаки. Для определения случайных символов из списка можно использовать функцию rnd_integer. Объявление функции может быть таким:
- Для решения можно использовать анонимный блок.
Сначала нужно реализовать одну игру и посмотреть, какой вариант выиграл: начальный или измененный. Для загадывания и угадывания одного из трех наперстков можно использовать rnd_integer(1,3).
Затем игру поместить в цикл и «сыграть», например, 1000 раз, подсчитывая, какой вариант сколько раз победил. В конце через RAISE NOTICE вывести значения счетчиков и выявить победивший вариант (или отсутствие такового).
Page 23: 1. Случайная строка заданного размера
Вначале определим вспомогательную функцию для получения случайного целого числа в заданном диапазоне. Такую функцию легко написать на чистом SQL, но здесь представлен вариант на PL/pgSQL:
Проверяем работу:
Функция гарантирует равномерное распределение случайных значений по всему диапазону, включая граничные значения:
Теперь можно приступить к написанию функции для получения случайной строки заданного размера. Будем использовать функцию rnd_integer для получения случайного символа из списка.
Проверяем:
Page 24: 2. Игра в наперстки
Для загадывания и угадывания наперстка используем rnd_integer(1,3).
Вначале мы выбираем 1 из 3, поэтому вероятность начального выбора 1/3. Если же выбор изменить, то изменится и вероятность на противоположные 2/3. Таким образом, вероятность выиграть при смене выбора выше. Поэтому есть смысл выбор поменять.
12 Занятие 12: PL/pgSQL / Выполнение запросов
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_12_plpgsql_queries.html Archive: DEV1-handouts-16.zip Страниц PDF: 24
Page 1: PL/pgSQL / Выполнение запросов
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Использование команд SQL в коде PL/pgSQL
- Устранение неоднозначностей именования
- Проверка статуса команды
- Табличные функции
Page 3: Команды без результата
Команды SQL встраиваются в код PL/pgSQL
- как и в выражениях:
- запрос подготавливается,
- переменные PL/pgSQL подставляются как параметры
- SELECT → PERFORM
- удобно для вызова функций с побочными эффектами
- запросы, начинающиеся на WITH, надо «оборачивать» в SELECT
- INSERT, UPDATE, DELETE и другие команды SQL
- кроме служебных команд
- управление транзакциями — только в процедурах и анонимных блоках
Комментарии преподавателя
Как мы уже видели в предыдущей теме, PL/pgSQL очень тесно интегрирован с SQL. В частности, все выражения вычисляются с помощью подготовленных SQL-операторов. В выражениях можно использовать переменные PL/pgSQL и параметры подпрограмм — они автоматически подставляются в запрос в виде параметров.
Внутри кода на PL/pgSQL можно выполнять и отдельные SQL-запросы. Чтобы выполнить запрос, не возвращающий результат (INSERT, UPDATE, DELETE, CREATE, DROP и т. п.), достаточно просто написать команду SQL внутри кода на PL/pgSQL как отдельный оператор.
Как и выражения, команды подготавливаются, а переменные PL/pgSQL становятся параметрами. Это позволяет закешировать разобранный (или спланированный) запрос.
Таким же образом можно вызвать и обычный запрос SELECT, а если его результат не важен — тогда ключевое слово SELECT надо заменить на PERFORM. Это удобно для вызова функций с побочным эффектом. Если запрос начинается с WITH, его необходимо «обернуть» в SELECT (чтобы в конечном итоге запрос начинался на PERFORM).
Напомним также, что в подпрограммах нельзя использовать служебные команды, такие как VACUUM, REINDEX и т. п.
Команды COMMIT и ROLLBACK допускаются только в процедурах и в анонимных блоках кода (выполняемых SQL-командой DO).
https://postgrespro.ru/docs/postgresql/16/plpgsql-statements#PLPGSQL-ST ATEMENTS-GENERAL-SQL
Page 4: Команды, не возвращающие результат
Если результат запроса не нужен, заменяем SELECT на PERFORM:
Внутри PL/pgSQL можно использовать без изменений практически любые команды SQL, не возвращающие результат:
Управление транзакциями в процедурах
В процедурах (и в анонимных блоках кода) на PL/pgSQL можно использовать команды управления транзакциями:
Действуют определенные ограничения. Во-первых, процедура в таких случаях должна сама начинать новую транзакцию, а не выполняться в контексте уже начатой ранее.
Page 5: Page 5
Во-вторых, в стеке вызовов процедуры не должно быть ничего, кроме операторов CALL. Иными словами, если процедура вызывает процедуру, которая вызывает процедуру… которая выполняет команду управления транзакцией, то все работает:
Но стоит в этой цепочке появиться, например, вызову функции, то получается, что транзакция должна завершиться где-то «посередине» оператора, в контексте которого вызывается эта функция, например SELECT. Это недопустимо, получаем ошибку:
Page 6: Одна строка результата
SELECT … INTO
- получение первой по порядку строки результата
- одна переменная составного типа
- или подходящее количество скалярных переменных
- INSERT, UPDATE, DELETE RETURNING … INTO
- получение вставленной (измененной, удаленной) строки
- одна переменная составного типа
- или подходящее количество скалярных переменных
Комментарии преподавателя
Если результат запроса важен, его можно получить с помощью фразы INTO в одну переменную составного типа или в несколько скалярных переменных. Если запрос возвращает несколько строк, в переменную попадет только первая из них (порядок можно гарантировать фразой ORDER BY). Если запрос не возвращает ни одной строки, переменные (или атрибуты переменной составного типа) получат неопределенные значение.
Аналогично можно использовать команды INSERT, UPDATE, DELETE с фразой RETURNING. Отличие состоит в том, что эти команды не должны возвращать более одной строки — это приведет к ошибке, так как нет способа указать, какая из строк считается «первой».
https://postgrespro.ru/docs/postgresql/16/plpgsql-statements#PLPGSQL-ST ATEMENTS-SQL-ONEROW
Если запрос возвращает несколько строк, из которых используется только одна, это скорее всего говорит о том, что запрос написан неправильно. PL/pgSQL может сообщать о такой подозрительной ситуации (и о некоторых других).
https://postgrespro.ru/docs/postgresql/16/plpgsql-development-tips#PLPGS QL-EXTRA-CHECKS
Более широкими возможностями обладает стороннее расширение plpgsql_check (автор — Павел Стехуле).
https://github.com/okbob/plpgsql\_check
Page 7: Команды, возвращающие одну строку
Наверное, наиболее часто используется в PL/pgSQL команда SELECT, возвращающая одну строку. Пример выводит одну строку, хотя запрос внутри анонимного блока возвращает две:
Обратите внимание, что в приведенном коде PostgreSQL есть конструкция, очень похожая на SQL-команду SELECT INTO, в которой после INTO указывается имя новой таблицы, создающейся и наполняющейся результатами запроса. В PL/pgSQL для решения такой задачи нужно использовать эквивалентный синтаксис CREATE TABLE … AS SELECT. Команды INSERT, UPDATE, DELETE тоже могут возвращать результат с помощью фразы RETURNING. Их можно использовать в PL/pgSQL точно так же, как SELECT, добавив фразу INTO:
Проверки при создании и при выполнении подпрограмм
PL/pgSQL может выдавать предупреждения в некоторых подозрительных случаях. Для этого надо установить параметр (значение по умолчанию — none):
Это предупреждение о перекрывающих друг друга определениях переменных.
Page 8: Page 8
А здесь мы видим два предупреждения времени выполнения: запрос вернул более одной строки, а в предложении INTO указано неверное число параметров (PL/pgSQL присвоит второму неопределенное значение). Других проверок в настоящее время не предусмотрено, но они могут появиться в следующих версиях PostgreSQL. Значение параметра plpgsql.extra_warnings можно ограничить только определенными проверками. Аналогичный параметр plpgsql.extra_errors будет приводить не к предупреждениям, а к ошибкам.
Стороннее расширение plpgsql_check, написанное и развиваемое Павлом Стехуле, позволяет проверить код более детально. Расширение уже установлено в виртуальной машине курса.
Дополнительно обнаружены неиспользуемые переменные и тот факт, что выходному параметру не присваивается значение. Расширение имеет множество возможностей для обнаружения проблем в коде, в том числе и на этапе выполнения. Кроме того, расширение включает и профилировщик для целей оптимизации PL/pgSQL-кода.
Устранение неоднозначностей именования
Получится ли выполнить следующий код?
Page 9: Page 9
Не получится из-за неоднозначности в SELECT: id может означать и имя столбца, и имя переменной. Причем во фразе INTO неоднозначности нет — она относится только к PL/pgSQL. В сообщении, кстати, видно, как PL/pgSQL вырезает фразу INTO, прежде чем передать запрос в SQL. Есть несколько подходов к устранению неоднозначностей. Первый состоит в том, чтобы неоднозначностей не допускать. Для этого к переменным добавляют префикс, который обычно выбирается в зависимости от «класса» переменной, например: Для параметров p_ (parameter); Для обычных переменных l_ (local) или v_ (variable); Для констант c_ (constant); Это простой и действенный способ, если использовать его систематически и никогда не использовать префиксы в именах столбцов. К минусам можно отнести некоторую неряшливость и пестроту кода из-за лишних подчеркиваний. Вот как это может выглядеть в нашем случае:
Второй способ состоит в использовании квалифицированных имен — к имени объекта через точку дописывается уточняющий квалификатор: для столбца — имя или псевдоним таблицы; для переменной — метку блока; для параметра — имя функции. Такой способ более «честный», чем добавление префиксов, поскольку работает для любых названий столбцов. Вот как будет выглядеть наш пример с использованием квалификаторов:
Третий вариант — установить приоритет переменных над столбцами или наоборот, столбцов над переменными. За это отвечает конфигурационный параметр plpgsql.variable_conflict. Его возможные значения use_column, use_variable и error. В ряде случаев это упрощает разрешение конфликтов, но не устраняет их полностью. Кроме того, неявное правило (которое, к тому же, может внезапно поменяться) непременно приведет к тому, что какой-то код будет выполняться не так, как предполагал разработчик. Тем не менее приведем пример. Здесь устанавливается приоритет переменных, поэтому достаточно квалифицировать только столбцы таблицы:
Page 10: Page 10
Какой способ выбрать — дело опыта и вкуса. Мы рекомендуем остановиться либо на первом (префиксы), либо на втором (квалификаторы), и не смешивать их в одном проекте, поскольку систематичность крайне важна для облегчения понимания кода. В курсе мы будем использовать второй способ, но только в тех случаях, когда это действительно необходимо — чтобы не загромождать примеры. Однако в коде, предназначенном для промышленной эксплуатации, думать о неоднозначностях надо всегда: нет никакой гарантии, что завтра в таблице не появится новый столбец с именем, совпадающим с вашей переменной!
Page 11: Проверка результата
INTO STRICT
- гарантия получения ровно одной строки — ни больше, ни меньше
- Диагностика ROW_COUNT
- число строк, возвращенных (обработанных) последней командой SQL
- Переменная FOUND
- после команды SQL: истина, если команда вернула (обработала) строку
- после цикла: признак того, что выполнилась хотя бы одна итерация
Комментарии преподавателя
Добавив к предложению INTO ключевое слово STRICT, мы получим гарантию того, что команда вернула или обработала ровно одну строку — иначе будет зафиксирована ошибка.
Кроме того, можно узнать статус только что выполненной команды SQL (если она не завершилась ошибкой). Для этого есть два способа.
Во-первых, можно получить число строк, затронутых командой, с помощью конструкции GET DIAGNOSTICS.
Во-вторых, специальная логическая переменная FOUND показывает, были ли обработаны командой хотя бы какие-то данные.
Переменную FOUND можно использовать и как индикатор того, что тело цикла выполнилось минимум один раз.
https://postgrespro.ru/docs/postgresql/16/plpgsql-statements#PLPGSQL-ST ATEMENTS-DIAGNOSTICS
Page 12: Ровно одна строка
Что произойдет, если запрос вернет несколько строк?
В переменную будет записана только первая строка. Поскольку мы не указали ORDER BY, то порядок строк в общем случае непредсказуем:
Поскольку в командах INSERT, UPDATE, DELETE нет возможности указать порядок строк, то команда, затрагивающая несколько строк, приводит к ошибке:
А если запрос не вернет ни одной строки?
Переменные будут содержать неопределенные значения. То же относится и командам INSERT, UPDATE, DELETE. Например:
Иногда хочется быть уверенным, что в результате выборки получилась ровно одна строка: ни больше, ни меньше. В этом случае удобно воспользоваться фразой INTO STRICT:
Page 13: Page 13
Как мы видели, команды INSERT, UPDATE, DELETE, затрагивающие несколько строк, приводят к ошибке. Фраза STRICT позволяет гарантировать, что строка будет ровно одна (а не ноль):
Явная проверка состояния
Другая возможность — проверять состояние последней выполненной SQL-команды: Команда GET DIAGNOSTICS позволяет получить количество затронутых строк (ROW_COUNT); Предопределенная логическая переменная FOUND показывает, была ли затронута хотя бы одна строка.
Page 14: Page 14
Заметьте: диагностика не позволяет обнаружить, что запросу соответствует несколько строк. Элемент диагностики ROW_COUNT возвращает единицу, так как только одна строка из полученного набора была помещена в переменную r.
Page 15: Табличные функции
Строки запроса
- Одна строка
- RETURN NEXT выражение;
- если нет выходных параметров
- RETURN NEXT;
- если есть выходные параметры
- Особенности
- строки добавляются к результату,
- но выполнение функции не прекращается
- команды можно выполнять несколько раз
- результат не возвращается, пока функция не завершится
Комментарии преподавателя
Чтобы создать на PL/pgSQL табличную функцию, нужно объявить ее как RETURNS SETOF или RETURNS TABLE (точно так же, как и для SQL).
Отдельные элементы возвращаемого значения формируются в специальном буфере командами RETURN QUERY и(или) RETURN NEXT. Эти операторы не завершают выполнение, их вызовы можно смешивать и вызывать несколько раз в теле функции, при этом их результаты будут объединены. По окончании работы функции (вызов RETURN без параметров или достижение конца ее тела) будет возвращен результирующий набор строк из буфера.
Если после выполнения одиночной команды RETURN QUERY запрос выполнение будет завершено, то результат функции будет таким же, как в случае SQL-функции, содержащей этот запрос в качестве последнего. Однако запрос из SQL-функции имеет шансы быть подставленным в объемлющий запрос, а в случае PL/pgSQL это исключено.
Команда RETURN NEXT накапливает результат функции построчно, она похожа на обычный RETURN, но, как мы уже отмечали, не прекращает выполнение функции, а добавляет возвращаемое значение в качестве очередной строки будущего результата.
Таким образом, команды RETURN NEXT и RETURN QUERY не работают как yield в функциях-генераторах современных языков.
https://postgrespro.ru/docs/postgresql/16/plpgsql-control-structures#PLPGS QL-STATEMENTS-RETURNING
Page 16: Табличные функции
Пример табличной функции на PL/pgSQL:
Другой вариант — возвращать значения построчно.
Почему функция объявлена как STABLE, а не как IMMUTABLE? На первый взгляд кажется, что при повторных вызовах функция будет возвращать тот же результат, но на самом деле он неявно зависит от текущей локали:
Еще один пример иллюстрирует «смешанный» подход. Здесь мы создаем функцию, которая возвращает список подпрограмм из своей схемы. Элемент диагностики PG_ROUTINE_OID позволяет функции получить свой oid:
Page 17: Page 17
Пробуем вызов:
Page 18: Итоги
PL/pgSQL тесно интегрирован с SQL
- в процедурном коде можно выполнять запросы
- (оформленные как выражения или отдельные команды)
- в запросах можно использовать переменные
- можно получать результаты запросов и их статус
- Нужно следить за неоднозначностями разрешения имен
Page 19: Практика
- Напишите функцию add_author для добавления новых авторов. Функция должна принимать три параметра (фамилия, имя, отчество) и возвращать идентификатор нового автора.
- Проверьте, что приложение позволяет добавлять авторов. 2. Напишите функцию buy_book для покупки книги. Функция принимает идентификатор книги и уменьшает количество таких книг на складе на единицу. Возвращаемое значение отсутствует.
- Проверьте, что в «Магазине» появилась возможность
- покупки книг.
Комментарии преподавателя
Вы можете обратить внимание, что при покупке книг приложение позволяет «уйти в минус». Если бы количество книг хранилось в столбце, простым и хорошим решением было бы сделать ограничение CHECK. Но в нашем случае количество рассчитывается, и мы отложим написание проверки до темы «Триггеры».
Page 20: 1. Функция add_author
2. Функция buy\_book
Page 21: Практика+
Напишите игру, в которой сервер пытается угадать загаданное пользователем животное, задавая последовательные уточняющие вопросы, на которые можно отвечать «да» или «нет». Если сервер предложил неправильный вариант, он запрашивает у пользователя имя животного и отличающий вопрос. Эта новая информация запоминается и используется в следующих играх. 1. Создайте таблицу для представления информации. 2. Придумайте интерфейс и реализуйте необходимые функции. 3. Проверьте реализацию.
Комментарии преподавателя
Пример диалога (между людьми):
- Это млекопитающее?
- Да.
- Это слон?
- Нет.
- Сдаюсь. Кто это?
- Кит.
- Как отличить кита от слона?
- Он живет в воде.
Информацию удобно представить в виде двоичного дерева. Внутренние узлы хранят вопросы, листовые узлы — названия животных. Один из дочерних узлов соответствует ответу «да», другой — ответу «нет».
Между вызовами функций надо передавать информацию о том, на каком узле дерева мы остановились («контекст» диалога). Функции могут быть, например, такими.
● начать игру (нет входного контекста): FUNCTION start_game(OUT context integer, OUT question text)
● продолжение игры (получаем ответ, выдаем следующий вопрос): FUNCTION continue_game( INOUT context integer, IN answer boolean, OUT you_win boolean, OUT question text)
● завершение игры (внесение информации о новом животном): FUNCTION end_game( IN context integer, IN name text, IN question text) RETURNS void
Page 22: 1. Таблица
Первая строка считается корнем дерева.
2. Функции
Page 23: Page 23
3. Пример сеанса игры
Загадываем слово «кит».
Page 24: Page 24
Теперь в таблице:
Снова загадали «кит».
13 Занятие 13: PL/pgSQL / Курсоры
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_13_plpgsql_cursors.html Archive: DEV1-handouts-16.zip Страниц PDF: 19
Page 1: PL/pgSQL / Курсоры
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Причины использования
- Объявление и открытие курсора
- Операции с курсором
- Циклы по курсору и по результатам запроса
- Передача курсора клиенту
Page 3: Причины использования
Курсор подразумевает итеративную обработку
- полная выборка занимает слишком много памяти
- нужна не вся выборка, но размер заранее неизвестен
- способ отдать управление выборкой клиенту
- действительно требуется построчная обработка (обычно нет)
Комментарии преподавателя
С концепцией курсоров мы уже знакомы по теме «Архитектура. Общее устройство PostgreSQL». Там речь шла о курсорах как о возможности, предоставляемой сервером, и мы смотрели, как к этой возможности обращаться средствами SQL. Теперь поговорим о том, как использовать те же самые курсоры в языке PL/pgSQL.
Зачем вообще может возникнуть необходимость в курсорах? Декларативный SQL в первую очередь предназначен для работы с множествами строк — в этом его сила и преимущество. PL/pgSQL, как процедурный язык, должен работать со строками по одной за раз, используя явные циклы. Такой подход как раз реализуется при помощи курсоров.
Например, полная выборка может занимать слишком много места, так что приходится обрабатывать результаты по частям. Или мы получаем набор данных неизвестного заранее размера — и в процессе выборки нужно вовремя остановиться. Или есть необходимость предоставить управление выборкой клиенту.
(Однако еще раз отметим, что хотя необходимость такой построчной обработки может возникать, в большом количестве случаев ее можно заменить чистым SQL; код в итоге окажется проще и будет быстрее работать.)
Page 4: Объявление и открытие
Не связанные с запросом курсорные переменные
- объявляется переменная типа refcursor
- конкретный запрос указывается при открытии
- нет в SQL
- Связанные с запросом курсорные переменные
- при объявлении указывается запрос (возможно, с параметрами)
- при открытии указываются фактические значения параметров
- Особенности
- значение курсорной переменной — имя курсора
- (можно задать явно или сгенерируется автоматически)
- переменные PL/pgSQL в запросе становятся неявными параметрами
- (значения подставляются при открытии курсора)
- запрос предварительно подготавливается
Комментарии преподавателя
Как мы видели, в SQL курсор объявлялся и открывался одновременно командой DECLARE. В PL/pgSQL это два отдельных шага. Кроме того, для доступа к курсорам используются так называемые курсорные переменные, имеющие тип refcursor и, фактически, содержащие имя курсора (причем если не указывать это имя явно, PL/pgSQL сам позаботится о его уникальности).
Курсорную переменную можно объявить, не связывая ее с конкретным запросом. Тогда при открытии курсора нужно будет указать запрос.
Другой вариант — уже при объявлении переменной указать запрос, возможно, с параметрами. Тогда при открытии курсора указываются только фактические параметры.
Оба способа равноценны; какой использовать — дело вкуса. И связанные, и несвязанные курсорные переменные инициализируются только при открытии курсора; в обоих случаях соответствующий запрос может иметь неявные параметры — переменные PL/pgSQL.
Напомним, что запрос, открытый с помощью курсора, автоматически подготавливается.
https://postgrespro.ru/docs/postgresql/16/plpgsql-cursors#PLPGSQL-CURS OR-DECLARATIONS
https://postgrespro.ru/docs/postgresql/16/plpgsql-cursors#PLPGSQL-CURS OR-OPENING
Page 5: Объявление и открытие
Создадим таблицу:
Несвязанная переменная:
Связанная переменная: запрос указывается уже при объявлении. При этом переменная cur имеет тот же тип refcursor.
В случае связанной переменной запрос может иметь параметры. Обратите внимание на устранение неоднозначности имен в этом и следующем примерах.
Переменные PL/pgSQL также являются (неявными) параметрами курсора.
В качестве запроса можно использовать не только команду SELECT, но и любую другую, возвращающую результат (например, INSERT, UPDATE, DELETE с фразой RETURNING).
Page 6: Операции с курсором
- в SQL
- размер выборки
- Выборка
- определяется
- только по одной строке
- Обращение к текущей строке курсора
- только для простых запросов
- (одна таблица, без группировок и сортировок)
- Обычно обработка выполняется в цикле
- цикл FOR по курсору
- цикл FOR по запросу без явного определения курсора
- в SQL
- DECLARE
- WITH HOLD
- Закрытие
- явно или автоматически при завершении транзакции
Комментарии преподавателя
Выборка строк из курсора возможна в PL/pgSQL только по одной. Для этого служит команда FETCH INTO.
Если запрос достаточно простой (одна таблица, без группировок и сортировок), то в процессе работы с курсором можно обращаться к текущей строке, например, в командах UPDATE или DELETE.
Процедурная обработка данных подразумевает работу с циклами. Можно организовать перебор и обработку всех строк, возвращаемых курсором, с помощью тех управляющих команд, что мы уже знаем. Но, поскольку часто нужен именно такой цикл, в PL/pgSQL есть специальная команда FOR. Целочисленный вариант FOR мы уже видели в теме «Обзор и конструкции языка», а этот вариант работает с курсором. Более того, есть еще один вариант цикла FOR, в котором не требуется даже объявления курсора — в команде указывается сам запрос.
Курсор можно закрыть явно командой CLOSE, но он в любом случае будет закрыт по окончании транзакции (в SQL курсор может оставаться открытым и после завершения транзакции, если указать фразу WITH HOLD).
https://postgrespro.ru/docs/postgresql/16/plpgsql-cursors#PLPGSQL-CURS OR-USING
https://postgrespro.ru/docs/postgresql/16/plpgsql-cursors#PLPGSQL-CURS OR-FOR-LOOP
Page 7: Операции с курсором
Команда FETCH читает следующую строку из курсора. Если нужно только переместиться на следующую строку, можно воспользоваться другой командой — MOVE. Что будет выведено на экран?
Обычно выборка происходит в цикле, который можно организовать так:
Но чтобы не писать много команд, в PL/pgSQL имеется цикл FOR по курсору, который делает ровно то же самое:
Более того, можно вообще обойтись без явной работы с курсором, если цикл — это все, что требуется. Скобки вокруг запроса не обязательны, но удобны.
Page 8: Page 8
Как и для любого цикла, здесь можно указать метку, что может оказаться полезным во вложенных циклах: Что будет выведено?
После выполнения цикла переменная FOUND позволяет узнать, была ли обработана хотя бы одна строка:
На текущую строку курсора, связанного с простым запросом (по одной таблице, без группировок и сортировок) можно сослаться с помощью предложения CURRENT OF. Типичный случай применения — обработка пакета заданий с изменением статуса каждого из них.
Заметим, что CURRENT OF не работает с циклом FOR по запросу, поскольку этот цикл не использует курсор явным образом. Конечно, аналогичный результат можно получить, явно указав в команде UPDATE или DELETE уникальный ключ таблицы (WHERE id = rec.id). Но CURRENT OF работает быстрее и не требует наличия индекса. Следует заметить, что в большом числе случаев вместо использования циклов можно выполнить задачу одним
Page 9: Page 9
оператором SQL — и это будет проще и еще быстрее. Часто циклы используют просто потому, что это более привычный, «процедурный» стиль программирования. Но для баз данных этот стиль не подходит. Например:
Такой цикл заменяется одной простой SQL-командой:
Page 10: Передача курсора клиенту
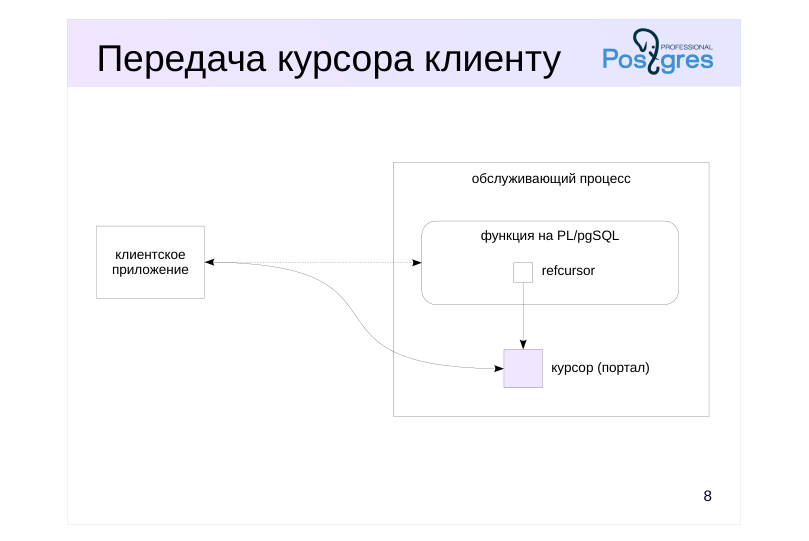 {#source-figure-010 caption=“Source slide page 10: Передача курсора клиенту”}
Комментарии преподавателя
Как уже говорилось, курсорная переменная PL/pgSQL (типа refcursor) содержит имя открытого SQL-курсора. Когда говорят о курсоре как о памяти, отведенной в обслуживающем процессе для хранения его состояния, в документации используется термин портал.
Таким образом, функция на PL/pgSQL может открыть курсор и вернуть его имя клиенту. Дальше клиент сможет работать с курсором так, как будто он сам его и открыл, но доступ будет иметь только к тем данным, которые предоставлены при открытии. Это дает еще одну возможность для организации взаимодействия приложения и базы данных.
Page 11: Передача курсора клиенту
Откроем курсор и выведем значение курсорной переменной:
Это имя курсора (портала), который был открыт на сервере. Оно было сгенерировано автоматически. При желании имя можно задать явно (но оно должно быть уникальным в сеансе):
Пользуясь этим, можно написать функцию, которая откроет курсор и вернет его имя:
Клиент начинает транзакцию…
…вызывает функцию, узнает имя курсора…
…и получает возможность читать из него данные (кавычки нужны из-за спецсимволов в имени):
Для удобства можно позволить клиенту самому устанавливать имя курсора:
Page 12: Page 12
Клиентский код упрощается:
Функция может вернуть и несколько открытых курсоров, используя OUT-параметры. Таким образом можно за один вызов функции обеспечить клиента информацией из разных таблиц, если это необходимо. Альтернативный подход — сразу выбрать все необходимые данные на стороне сервера и сформировать из них документ JSON или XML. Работа с этими форматами рассматривается в курсе DEV2.
Page 13: Итоги
Курсор позволяет получать и обрабатывать данные построчно
- Цикл FOR упрощает работу с курсорами
- Обработка в цикле естественна для процедурных языков, но этим не стоит злоупотреблять
Page 14: Практика
- Измените функцию book_name: если у книги больше двух авторов, то в названии должны указываться первые два с добавлением «и др.» в конце.
- Проверьте работу функции в SQL и в приложении. 2. Попробуйте написать функцию book_name на SQL. Какой вариант нравится больше — PL/pgSQL или SQL?
- Например:
Page 15: 1. Функция book_name (сокращение авторов)
Напишем более универсальную функцию с дополнительным параметром — максимальное число авторов в названии. Поскольку функция меняет сигнатуру (число и/или типы входных параметров), ее необходимо сначала удалить, а потом создать заново. В данном случае у функции есть зависимый объект — представление catalog_v, в котором она используется. Представление тоже придется пересоздать (в реальной работе все эти действия надо выполнять в одной транзакции, чтобы изменения вступили в силу атомарно).
Не забудем также создать заново удаленную выше функцию get_catalog:
Page 16: Page 16
2. Вариант на чистом SQL
Page 17: Практика+
- Требуется распределить расходы на электроэнергию по отделам компании пропорционально количеству сотрудников (перечень отделов находится в таблице). Напишите функцию, которая примет общую сумму расходов и запишет распределенные расходы в строки таблицы. Числа округляются до копеек; сумма расходов всех отделов должна в точности совпадать с общей суммой. 2. Напишите табличную функцию, имитирующую сортировку слиянием. Функция принимает две курсорные переменные; оба курсора уже открыты и возвращают упорядоченные по неубыванию целые числа. Требуется выдать общую упорядоченную последовательность чисел из обоих источников.
Комментарии преподавателя
- В качестве таблицы можно взять:
Функция:
Ожидаемый результат после вызова функции с параметром 100.0:
- Функция:
Например, если первый курсор возвращает последовательность 1, 3, 5, а второй — 2, 3, 4, то ожидается результат:
Page 18: 1. Распределение расходов
Таблица:
Функция:
Проверка:
Разумеется, возможны и другие алгоритмы, например, перенос всех ошибок округления на одну строку и т. п. В курсе DEV2 рассматривается другое решение этой задачи с помощью пользовательских агрегатных функций.
2. Слияние отсортированных наборов
Page 19: Page 19
Эта реализация предполагает, что числа не могут иметь неопределенные значения NULL.
Проверяем.
14 Занятие 14: PL/pgSQL / Динамические команды
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_14_plpgsql_dynamic.html Archive: DEV1-handouts-16.zip Страниц PDF: 16
Page 1: PL/pgSQL / Динамические команды
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Причины использования
- Выполнение динамического запроса
- Способы формирования динамического запроса
Page 3: Динамический SQL
Текст SQL-команды формируется в момент выполнения
- Причины использования
- дополнительная гибкость в приложении
- формирование нескольких конкретных запросов
- вместо одного универсального для оптимизации
- Цена
- операторы не подготавливаются
- возрастает риск внедрения SQL-кода
- возрастает сложность сопровождения
Комментарии преподавателя
Под динамическими командами понимаются команды SQL, текст которых формируется и затем выполняется внутри PL/pgSQL-блока в подпрограммах или в анонимных блоках.
В большинстве случаев можно обойтись без динамических команд, но иногда они могут предоставить дополнительную гибкость. Например, можно встроить в определенные места приложения возможность выполнять команды, считанные из настроек системы. Управлять такими настройками могут специалисты поддержки во время эксплуатации приложения, а не программисты в момент разработки.
Иногда, при формировании отчета с большим количеством необязательных параметров, бывает проще формировать текст запроса прямо во время выполнения только для указанных параметров, чем заранее, при разработке, писать сложный запрос, учитывающий все возможные комбинации параметров.
Платой за использование динамических команд будет отказ от подготовленных операторов, которые по умолчанию используются в PL/pgSQL. Также нужно следить за безопасностью динамических команд с точки зрения возможности внедрения SQL-кода.
Следует отметить и существенное возрастание сложности сопровождения. В частности, в исходном коде приложения невозможно будет текстовым поиском обнаружить все выполняемые команды.
Page 4: Выполнение запроса
Конструкция EXECUTE
- выполняет строковое представление SQL-запроса
- позволяет использовать параметры
- переменные PL/pgSQL не становятся неявными параметрами
- Может использоваться вместо SQL-запроса
- сама по себе
- при открытии курсора
- в цикле по запросу
- в предложении RETURN QUERY
Комментарии преподавателя
Для выполнения динамических команд в PL/pgSQL используется конструкция EXECUTE, которая выполняет SQL-оператор, заданный в виде текстовой строки.
Динамический запрос может содержать явно заданные параметры. В тексте команды параметры обозначаются как $1, $2 и т. д., а значения параметров указываются в предложении USING. Параметры работают точно так же, как в подготовленных операторах (что рассматривалось в теме «Архитектура. Общее устройство PostgreSQL»). Однако переменные PL/pgSQL не становятся неявными параметрами, как это происходит при обычном, не динамическом, использовании SQL в PL/pgSQL.
Конструкция EXECUTE может использоваться как самостоятельный оператор (в этом случае просто выполняется динамическая команда). Она также может использоваться в циклах по запросу, при открытии курсора, в операторе RETURN QUERY — во всех этих случаях EXECUTE заменяет собой команду SQL.
https://postgrespro.ru/docs/postgresql/16/plpgsql-statements#PLPGSQL-ST ATEMENTS-EXECUTING-DYN
Тонкий момент: процедура не может управлять транзакциями, если она вызывается оператором EXECUTE.
Page 5: Выполнение динамического запроса
Оператор EXECUTE позволяет выполнить SQL-команду, заданную в виде строки.
Предложение INTO оператора EXECUTE позволяет вернуть одну (первую) строку результата в переменную составного типа или несколько скалярных переменных. Для проверки результата выполнения динамической команды можно использовать команду GET DIAGNOSTICS, как и в случае статических команд (но не переменную FOUND).
При необходимости с помощью STRICT можно гарантировать, что команда обработает ровно одну строку. Результат динамического запроса можно обработать в цикле FOR.
Этот же пример с использованием курсора.
Page 6: Page 6
Оператор RETURN QUERY для возврата строк из функции также может использовать динамические запросы. Напишем функцию, возвращающую все здания, возведенные архитектором до определенной даты. Для этого нам понадобятся параметры:
Page 7: Формирование команды
Подстановка значений параметров
- предложение USING
- гарантируется невозможность внедрения SQL-кода
- Экранирование значений
- идентификаторы: format(’%I’), quote_ident
- литералы: format(’%L’), quote_literal, quote_nullable
- внедрение SQL-кода невозможно при правильном использовании
- Обычные строковые функции
- конкатенация и др.
- возможно внедрение SQL-кода!
Комментарии преподавателя
Использование оператора EXECUTE имеет смысл, если команда формируется динамически. Приведенные ранее примеры можно было бы записать и без оператора EXECUTE.
Поскольку команда представляется текстовой строкой, ее можно сформировать обычными строковыми функциями, такими как конкатенация и т. п. В этом случае надо проявлять крайнюю осторожность, поскольку возможно внедрение SQL-кода.
Внедрение SQL-кода невозможно в принципе, если значения передаются как параметры с помощью предложения USING.
Однако параметры применимы не всегда: может понадобиться конкатенировать отдельные части запроса или подставлять в запрос имя таблицы. В этом случае для защиты от внедрений следует экранировать значения, полученные из ненадежного источника.
Для идентификаторов используется функция format со спецификатором %I или функция quote_ident. Эти функции формируют правильные имена идентификаторов, при необходимости заключая их в двойные кавычки и экранируя специальные символы.
Для подстановки литералов внутрь текста команды можно использовать функции quote_literal, quote_nullable или функцию format со спецификатором %L.
https://postgrespro.ru/docs/postgresql/16/functions-string
Page 8: Возможность внедрения SQL-кода
Перепишем функцию, возвращающую здания, добавив параметр — код города. По задумке такая функция должна позволять обращаться только к таблицам, начинающимся на city_.
Функция правильно работает при «нормальных» значениях параметров:
Однако злоумышленник может подобрать такое значение, которое изменит синтаксическую конструкцию запроса и позволит ему получить несанкционированный доступ к данным:
При использовании подготовленных операторов или динамических команд с параметрами это невозможно в принципе, так как структура SQL-запроса фиксируется при синтаксическом разборе. Выражение всегда останется выражением и не сможет превратиться, например, в имя таблицы.
Формирование динамической команды
Параметры в предложении USING нельзя использовать для имен объектов (названия таблиц, столбцов и пр.) в динамической команде. Такие идентификаторы необходимо экранировать, чтобы структура запроса не могла измениться:
Page 9: Page 9
То же самое выполняет и другая функция:
Вот как может выглядеть пример с созданием таблицы:
Вместо использования параметров, можно вставлять в строку литералы. В этом случае также требуется экранирование, но другое:
Это же выполняет и функция quote_nullable:
Похожая функция quote_literal отличается тем, что не превращает неопределенное значение в литерал:
В качестве примера перепишем функцию, возвращающую здания в определенном городе, без использования параметров, но так, чтобы она осталась безопасной.
Page 10: Page 10
Обратите внимание, что в этом случае получается два лишних приведения типов: сначала параметр типа integer приводится к строке, а затем, на этапе выполнения, строка обратно приводится к integer (в случае использования параметров USING такого не происходит):
Попытка передачи некорректного значения не приведет к успеху:
Page 11: Итоги
Динамические команды дают дополнительную гибкость
- Позволяют формировать отдельные запросы для разных значений параметров с целью оптимизации
- Не подходят для коротких, частых запросов
- Увеличивается сложность поддержки
Page 12: Практика
- Измените функцию get_catalog так, чтобы запрос к представлению catalog_v формировался динамически и содержал условия только на те поля, которые заполнены на форме поиска в «Магазине».
- Убедитесь, что реализация не допускает возможности
- внедрения SQL-кода.
- Проверьте работу функции в приложении.
Комментарии преподавателя
- Скажем, если на форме поиска не заполнены поля «Название книги» и «Имя автора», но установлен флажок «Есть на складе», должен быть сформирован такой, например, запрос:
Учтите, что поиск при такой реализации вовсе не обязательно будет работать эффективнее, но поддерживать его совершенно точно будет сложнее. Поэтому в реальной работе не стоит прибегать к такому приему, если для того нет веских оснований. Тема оптимизации запросов рассматривается в курсе QPT.
Page 13: 1. Функция get_catalog
Page 14: Практика+
- Создайте функцию, которая возвращает строки матричного отчета по функциям в базе данных.
- Столбцы должны содержать имена владельцев функций,
- строки — названия схем, а ячейки — количество функций
- данного владельца в данной схеме.
- Как можно вызвать такую функцию?
Комментарии преподавателя
- Примерный вид результата:
Количество столбцов в запросе заранее не известно. Поэтому необходимо сконструировать запрос и затем динамически его выполнить. Текст запроса может быть таким:
Выделенные строки — динамическая часть — необходимо сформировать дополнительным запросом. Начало и конец запроса — статические.
Столбец proowner имеет тип oid, для получения имени владельца можно воспользоваться конструкцией proowner::regrole::text.
Page 15: Получение матричного отчета
Вспомогательная функция для формирования текста динамического запроса:
Итоговый текст запроса:
Теперь создаем функцию для матричного отчета:
Простое выполнение запроса приведет к ошибке, так как не указана структура возвращаемых записей:
Page 16: Page 16
В этом состоит важное ограничение на использование функций, возвращающих произвольную выборку. В момент вызова необходимо знать и указать структуру возвращаемой записи. В общем случае структура возвращаемой записи может быть неизвестна, но, применительно к нашему матричному отчету, можно выполнить еще один запрос, который покажет, как правильно вызвать функцию matrix. Подготовим текст запроса:
Теперь мы можем вызовом martix_call получить запрос, отражающий структуру матричного отчета, а затем выполнить этот запрос и получить отчет (psql позволяет все это сделать одной командой \gexec):
Матричный отчет корректно формируется. Уровень изоляции Repeatable Read гарантирует, что отчет сформируется, даже если между двумя запросами появится функция у нового владельца. Можно было бы и напрямую выполнить запрос, возвращаемый функцией form_query. Но задача получить в клиентском приложении список возвращаемых столбцов все равно останется. Функция matrix_call показывает, как ее можно решить дополнительным запросом. Еще один вариант решения заключается в том, чтобы вместо набора записей произвольной структуры возвращать набор строк слабоструктурированного типа (такого, как JSON или XML). Эти типы рассматриваются в курсе DEV2.
15 Занятие 15: PL/pgSQL / Массивы
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_15_plpgsql_arrays.html Archive: DEV1-handouts-16.zip Страниц PDF: 24
Page 1: PL/pgSQL / Массивы
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Массивы и работа с ними в PL/pgSQL
- Циклы по элементам массивов
- Функции с переменным числом параметров и полиморфные функции
- Использование массивов в столбцах таблиц
Page 3: Тип массива
Массив
- набор пронумерованных элементов одного и того же типа
- одномерные, многомерные
- Создание
- Использование
- элементы как скалярные значения
- срезы массива
- операции с массивами: сравнение, вхождение, пересечение,
- конкатенация, использование с ANY и ALL вместо подзапроса, …
Комментарии преподавателя
Массив, как и составной тип (запись), не является скалярным и состоит из нескольких элементов другого типа. Но, в отличие от записей, а) все эти элементы имеют одинаковый тип и б) обращение к ним происходит не по имени, а по целочисленному индексу (здесь индекс понимается в математическом смысле, а не как индекс БД).
Тип массива не надо специально объявлять, поскольку при создании любого типа (в том числе таблицы) создается также тип массива элементов этого типа с именем _тип. При объявлении переменной-массива достаточно добавить квадратные скобки к имени типа элементов.
Массив является полноценным типом SQL, его можно использовать как любой другой тип: создавать столбцы таблиц этого типа, использовать его для параметров функций и т. п. Элементы массива могут использоваться как обычные скалярные значения. Можно использовать и срезы (slice) массивов.
Массивы можно сравнивать, проверять на неопределенность, искать вхождение элемента и находить пересечение с другими массивами, конкатенировать и пр. Также массивы можно использовать по аналогии с подзапросами в конструкциях ANY/SOME и ALL.
https://postgrespro.ru/docs/postgresql/16/arrays
Различные функции для работы с массивами можно найти в справочном материале, прилагаемом к курсу.
Page 4: Инициализация и обращение к элементам
Объявление переменной и инициализация массива целиком:
Одномерный массив можно заполнять и поэлементно — при необходимости он автоматически расширяется. Если пропустить какие-то элементы, они получают неопределенные значения. Что будет выведено?
Поскольку нумерация началась не с единицы, перед самим массивом дополнительно выводится диапазон номеров элементов. Мы можем определить составной тип и создать массив из элементов этого типа:
Еще один способ получить массив — создать его из подзапроса:
Page 5: Page 5
Можно и наоборот, массив преобразовать в таблицу:
Интересно, что выражение IN со списком значений преобразуется в поиск по массиву:
Двумерный массив — прямоугольная матрица, память под которую выделяется при инициализации. Литерал выглядит как массив массивов, имеющих одинаковое число элементов. Здесь мы использовали другой способ инициализации — с помощью символьной строки. После инициализации многомерный массив уже нельзя расширить.
Page 6: Массивы и циклы
Обычный цикл по индексам элементов
- array_lower
- array_upper
- Цикл FOREACH по элементам массива
- проще, но индексы элементов недоступны
Комментарии преподавателя
Для итерации по элементам массива вполне можно использовать обычный целочисленный цикл FOR, используя функции, возвращающие минимальный и максимальный индексы массива.
Однако есть и специализированный вариант цикла: FOREACH. В таком варианте переменная цикла пробегает не индексы элементов, а сами элементы. Поэтому переменная должна иметь тот же тип, что и элементы массива (как обычно, если элементами являются записи, то одну переменную составного типа можно заменить несколькими скалярными переменными).
Тот же цикл с фразой SLICE позволяет итерировать срезы массива. Например, для двумерного массива одномерными срезами будут его строки.
https://postgrespro.ru/docs/postgresql/16/plpgsql-control-structures#PLPGS QL-FOREACH-ARRAY
Page 7: Массивы и циклы
Цикл можно организовать, итерируя индексы элементов массива. Второй параметр функций array_lower и array_upper — номер размерности (единица для одномерных массивов).
Если индексы не нужны, то проще итерировать сами элементы:
Итерация индексов в двумерном массиве:
Итерация элементов двумерного массива не требует вложенного цикла:
Page 8: Page 8
Существует также возможность выполнять в подобном цикле итерацию по срезам, а не по отдельным элементам. Значение SLICE в такой конструкции должно быть целым числом, не превышающим размерность массива, а переменная, куда читаются срезы, сама должна быть массивом. В примере — цикл по одномерным срезам:
Page 9: Массивы и подпрограммы
Подпрограммы с переменным числом параметров
- все необязательные параметры должны иметь одинаковый тип
- передаются в подпрограмму в виде массива
- последний параметр-массив определяется с режимом VARIADIC
- Полиморфные подпрограммы
- работают со значениями разных типов;
- тип конкретизируется во время выполнения
- дополнительные полиморфные псевдотипы anyarray, anynonarray,
- anycompatiblearray и anycompatiblenonarrray
- могут иметь переменное число параметров
Комментарии преподавателя
Массивы позволяют создавать подпрограммы (функции или процедуры) с переменным числом параметров.
В отличие от параметров со значениями по умолчанию, которые при объявлении подпрограммы надо явно перечислить, необязательных параметров может быть сколько угодно и все они передаются подпрограмме в виде массива. Но, как следствие, все они должны иметь один и тот же (или совместимый, в случае использования anycompatible/anycompatiblearray) тип.
При объявлении подпрограммы последним указывается один параметр с режимом VARIADIC, имеющий тип массива.
https://postgrespro.ru/docs/postgresql/16/xfunc-sql#XFUNC-SQL-VARIADIC -FUNCTIONS
Мы уже говорили про полиморфные подпрограммы, которые могут работать с параметрами разных типов. При объявлении подпрограммы указывается специальный полиморфный псевдотип, а конкретный тип уточняется во время выполнения по фактическому типу переданных параметров.
Для массивов есть отдельные полиморфные типы anyarray, anycompatiblearray (и anynonarray, anycompatiblenonarrray для не-массивов).
Эти типы можно использовать совместно с передачей переменного числа аргументов при объявлении VARIADIC-параметра.
https://postgrespro.ru/docs/postgresql/16/xfunc-sql#XFUNC-SQL-POLYMO RPHIC-FUNCTIONS
Page 10: Массивы и подпрограммы
В теме «SQL. Процедуры» мы рассматривали перегрузку и полиморфизм и создали функцию maximum, которая находила максимальное из трех чисел. Обобщим ее на произвольное число аргументов. Для этого объявим один VARIADIC-параметр:
Пробуем:
Для полноты картины и эта функция может быть сделана полиморфной, чтобы принимать любой тип данных (для которого, конечно, должны быть определены операции сравнения).
Полиморфные типы anycompatiblearray и anycompatible (а также anyarray и anyelement) всегда согласованы между собой: anycompatiblearray = anycompatible[], anyarray = anyelement[]; Нам нужна переменная, имеющая тип элемента массива. Но объявить ее как anycompatible нельзя — она должна иметь реальный тип. Здесь помогает конструкция %TYPE.
Проверим:
Page 11: Page 11
Вот теперь у нас получился практически полный аналог выражения greatest!
Page 12: Массив или таблица?
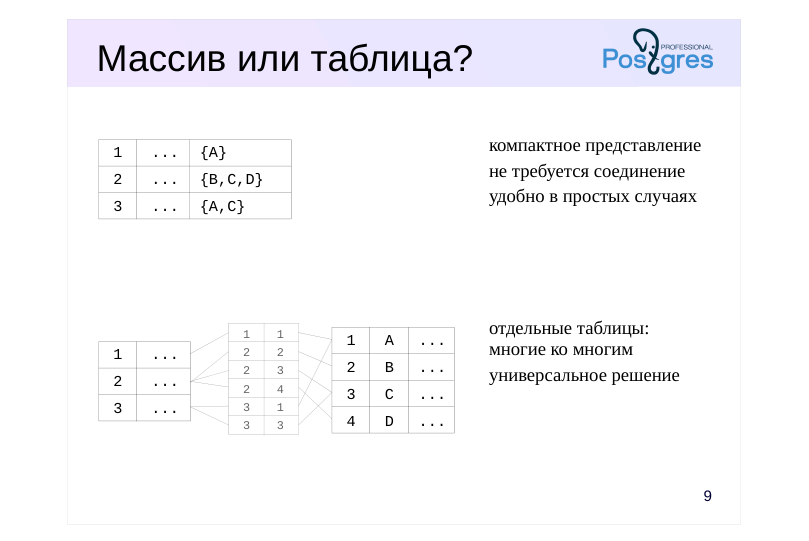 {#source-figure-012 caption=“Source slide page 12: Массив или таблица?”}
Комментарии преподавателя
Классический реляционный подход предполагает, что в таблице хранятся атомарные значения (первая нормальная форма). Язык SQL не имеет средств для «заглядывания внутрь» сложносоставных значений.
Поэтому обычный подход состоит в создании отдельной таблицы, связанной с основной отношением «многие ко многим».
Тем не менее, мы можем создать таблицу со столбцом типа массива. PostgreSQL имеет богатый набор функций для работы с массивами, а поиск элемента в массиве может быть ускорен специальными индексами (такие индексы рассматриваются в курсе DEV2).
Такой подход бывает удобен: получается компактное представление, не требующее соединений. В частности, массивы активно используются в системном каталоге PostgreSQL.
Какое решение выбрать? Зависит от того, какие ставятся задачи, какие требуются операции. Рассмотрим пример.
Page 13: Массив или таблица?
Представим себе, что мы проектируем базу данных для ведения блога. В блоге есть сообщения, и нам хотелось бы сопоставлять им теги. Традиционный подход состоит в том, что для тегов надо создать отдельную таблицу, например, так:
Связываем сообщения и теги отношением многие ко многим через еще одну таблицу:
Наполним таблицы тестовыми данными:
Теперь мы можем вывести сообщения и теги:
Или чуть иначе — возможно удобнее получить массив тегов. Для этого используем агрегирующую функцию:
Page 14: Page 14
Можем найти все сообщения с определенным тегом:
Может потребоваться найти все уникальные теги — это совсем просто:
Теперь попробуем подойти к задаче по-другому. Пусть теги будут представлены текстовым массивом прямо внутри таблицы сообщений.
Теперь у нас нет идентификаторов тегов, но они нам не очень и нужны.
Вывод всех сообщений упростился:
Сообщения с определенным тегом тоже легко найти (используем оператор пересечения &&). Эта операция может быть ускорена с помощью индекса GIN, и для такого запроса не придется перебирать всю таблицу
Page 15: Page 15
сообщений.
А вот получить список тегов довольно сложно. Это требует разворачивания всех массивов тегов в большую таблицу и поиск уникальных значений — тяжелая операция.
Тут хорошо видно, что имеет место дублирование данных. Итак, оба подхода вполне могут применяться. В простых случаях массивы выглядят проще и работают хорошо. В более сложных сценариях (представьте, что вместе с именем тега мы хотим хранить дату его создания; или требуется проверка ограничений целостности) классический вариант становится более привлекательным.
Page 16: Итоги
Массив состоит из пронумерованных элементов одного и того же типа данных
- Столбец с массивом как альтернатива отдельной таблице: удобные операции и индексная поддержка
- Позволяет создавать функции с переменным числом параметров
Page 17: Практика
- Создайте функцию add_book для добавления новой книги.
- Функция должна принимать два параметра —
- название книги и массив идентификаторов авторов —
- и возвращать идентификатор новой книги.
- Проверьте, что в приложении появилась возможность
- добавлять книги.
Page 18: 1. Функция add_book
Page 19: Практика+
- Реализуйте функцию map, принимающую два параметра: массив вещественных чисел и название вспомогательной функции, принимающей один параметр вещественного типа.
- Функция должна возвращать исходный массив, в котором
- к каждому элементу применена вспомогательная функция.
- Реализуйте функцию reduce, принимающую два параметра: массив вещественных чисел и название вспомогательной функции, принимающей два параметра вещественного типа.
- Функция должна возвращать вещественное число,
- полученное последовательной сверткой массива слева
- направо.
- Сделайте функции map и reduce полиморфными.
- Например:
- Например:
В этом случае значение вычисляется как
Page 20: 1. Функция map
INTO a[i] не работает, поэтому нужна отдельная переменная.
Другой вариант реализации с циклом FOREACH:
Page 21: 2. Функция reduce
Greatest (как и least) — не функция, а встроенное условное выражение, поэтому из-за экранирования не получится использовать ее напрямую:
Вместо нее используем реализованную в демонстрации функцию maximum.
Вариант с циклом FOREACH:
Page 22: Page 22
3. Полиморфные варианты функций
Функция map.
Требуется фиктивный параметр типа anyelement, чтобы внутри функции объявить переменную такого же типа.
Page 23: Page 23
Пример вызова с другим типом данных:
Функция reduce.
Page 24: Page 24
16 Занятие 16: PL/pgSQL / Обработка ошибок
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_16_plpgsql_exceptions.html Archive: DEV1-handouts-16.zip Страниц PDF: 27
Page 1: PL/pgSQL / Обработка ошибок
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Обработка ошибок в блоке PL/pgSQL
- Имена и коды ошибок
- Как происходит поиск обработчика
- Накладные расходы на обработку ошибок
Page 3: Обработка ошибок в блоке
Обработка выполняется, если есть секция EXCEPTION
- Выполняется откат к точке сохранения в начале блока
- точка сохранения устанавливается неявно, если в блоке есть
- секция EXCEPTION
- Если имеется обработчик, соответствующий ошибке
- выполняются команды обработчика
- блок завершается успешно
- Если нет подходящего обработчика
- блок завершается ошибкой
Комментарии преподавателя
Если внутри блока кода происходит ошибка времени выполнения, то обычно программа (блок, функция или процедура) аварийно прерывается, а текущая транзакция переходит в состояние сбоя: ее нельзя зафиксировать и можно только откатить.
Но ошибку можно перехватить и обработать. Для этого в блоке можно указать дополнительную секцию EXCEPTION, внутри которой перечислить условия, соответствующие ошибке, и операторы для обработки каждой такой ситуации.
EXCEPTION в целом соответствует конструкции try-catch в некоторых языках программирования (за исключением особенностей, связанных с обработкой транзакций, конечно).
В начале каждого блока с секцией EXCEPTION неявно устанавливается точка сохранения. Перед обработкой ошибки происходит откат к этой точке, в результате отменяются сделанные в блоке изменения, а также снимаются установленные в блоке блокировки.
Из-за наличия точки сохранения в блоках процедур с EXCEPTION запрещено использовать команды COMMIT и ROLLBACK. Зато, хотя команды SAVEPOINT и ROLLBACK TO SAVEPOINT не работают в PL/pgSQL, точку сохранения и откат к ней все-таки можно использовать и в процедурах, и в функциях — неявно.
https://postgrespro.ru/docs/postgresql/16/plpgsql-control-structures#PLPGS QL-ERROR-TRAPPING
Page 4: Обработка ошибок в блоке
Рассмотрим простой пример.
Когда нет ошибок, все операторы блока выполняются обычным образом:
Теперь добавим в таблицу «лишнюю» строку, чтобы спровоцировать ошибку.
Если в блоке нет секции EXCEPTION, выполнение операторов в блоке прерывается и весь блок считается завершившимся с ошибкой:
Чтобы перехватить ошибку, в блоке нужна секция EXCEPTION, определяющая обработчик или несколько обработчиков. Эта конструкция работает аналогично CASE: условия просматриваются сверху вниз, выбирается первая подходящая ветвь и выполняются ее операторы. Что будет выведено?
Выполняется обработчик, соответствующий ошибке too_many_rows. Обратите внимание: после обработки в таблице остается 2 строки, так как перед выполнением обработчика произошел откат к неявной точке сохранения, которая устанавливается в начале блока.
Page 5: Page 5
Также заметьте, что локальная переменная функции сохранила то значение, которое было на момент возникновения ошибки. Тонкий момент: если ошибка произойдет в секции DECLARE или в самом обработчике внутри EXCEPTION, то в этом блоке ее перехватить не получится.
Page 6: Имена и коды ошибок
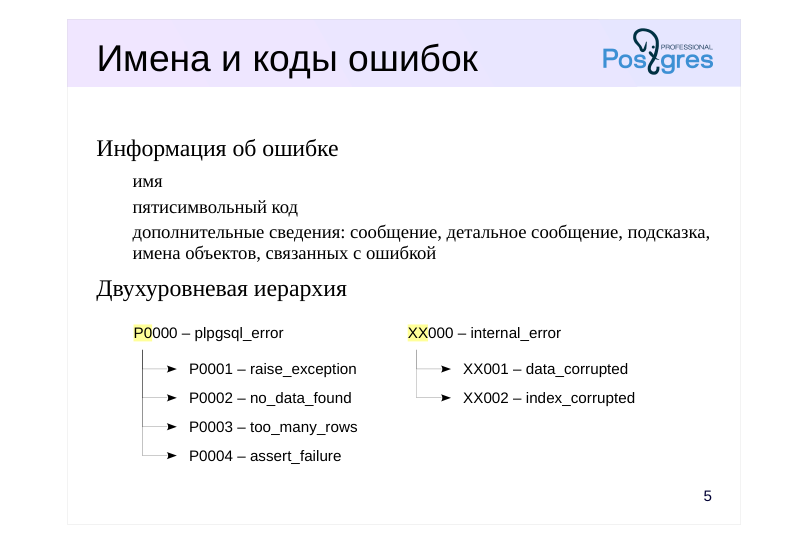 {#source-figure-006 caption=“Source slide page 6: Имена и коды ошибок”}
Информация об ошибке
- имя
- пятисимвольный код
- дополнительные сведения: сообщение, детальное сообщение, подсказка,
- имена объектов, связанных с ошибкой
- Двухуровневая иерархия
Комментарии преподавателя
Каждой возможной ошибке соответствует имя и код (строка из пяти символов). В условии WHEN можно указывать как имя, так и код.
Ошибки организованы в своеобразную двухуровневую иерархию. Категория ошибки имеет код, заканчивающийся на три нуля, и соответствует любой ошибке с теми же первыми двумя символами.
Например, код 23000 соответствует категории, которая включает все ошибки, связанные с нарушением ограничений целостности (такие, как 23502 — нарушение ограничения NOT NULL или 23505 — нарушение уникальности).
Таким образом, кроме обычных ошибок можно использовать имя или код категории. Можно также использовать специальное имя OTHERS для того, чтобы перехватить любую ошибку (кроме самых фатальных).
Кроме имени и кода любая ошибка может иметь дополнительные сведения, облегчающие ее диагностику: сообщение, детальное сообщение, подсказку.
Все ошибки описаны в приложении A документации:
https://postgrespro.ru/docs/postgresql/16/errcodes-appendix
Ошибки можно не только перехватывать, но и программно вызывать.
https://postgrespro.ru/docs/postgresql/16/plpgsql-errors-and-messages
Page 7: Имена и коды ошибок
Имена ошибок мы уже видели, а для указания кода служит конструкция SQLSTATE. В обработчике можно получить код ошибки и сообщение с помощью предопределенных переменных SQLSTATE и SQLERRM (вне блока EXCEPTION эти переменные не определены).
Какой обработчик будет использован?
Выбирается первый подходящий обработчик, в данном случае — plpgsql_error (напомним, что это не отдельная ошибка, а категория). До последнего обработчика дело никогда не дойдет. Ошибку можно принудительно вызвать по ее коду или имени. Здесь мы используем специальное имя others, соответствующее любой ошибке, которую можно перехватить (за исключением прерванного клиентом выполнения и нарушения отладочной проверки assert — их можно перехватить отдельно, но обычно это не имеет смысла).
При необходимости можно задействовать и пользовательские коды ошибок, отсутствующие в справочнике, а также указать некоторую дополнительную информацию (в примере — только часть из возможного):
Page 8: Page 8
В обработчике эту информацию нельзя получить из переменных; если нужно проанализировать такие данные в коде, есть специальная конструкция:
Page 9: Поиск обработчика
Необработанная ошибка «поднимается» на уровень выше
- в объемлющий блок PL/pgSQL, если он есть
- в вызывающую подпрограмму, если она есть
- Поиск обработчика определяется стеком вызовов
- то есть не определен статически, а зависит от выполнения программы
- Никем не обработанная ошибка отправляется клиенту
- транзакция переходит в состояние сбоя, клиент должен ее откатить
- информация об ошибке записывается в журнал сообщений сервера
Комментарии преподавателя
Если ни одно из условий, перечисленных в секции EXCEPTION, не сработает, то ошибка «поднимается» на уровень выше.
Если ошибка возникла в блоке, вложенном в другой блок, то сервер будет пытаться найти обработчик в объемлющем блоке. Если и там не найдется подходящего обработчика, весь объемлющий блок будет считаться ошибочным и ошибка поднимется еще выше, и так далее.
Если мы перебрали все объемлющие блоки и не обнаружили подходящего обработчика возникшей ошибки, ошибка «поднимается» на уровень той подпрограммы, которая вызвала наш блок. То есть, чтобы разобраться, в каком порядке будут просматриваться обработчики ошибки, надо проанализировать стек вызовов.
Если ни один из возможных обработчиков ошибки не сработает:
● сообщение об ошибке обычно попадает в журнал сообщений сервера (это зависит от настроек сервера, см. тему «PL/pgSQL. Отладка»);
● об ошибке сообщается клиенту, который инициировал вызов кода в базе данных. Клиент ставится перед фактом: транзакция переходит в состояние сбоя, и ее можно только откатить.
Как именно клиент будет обрабатывать ошибку, зависит от него самого. Например, psql выведет сообщение об ошибке и всю доступную диагностическую информацию. Клиент, ориентированный на конечного пользователя, может вывести знаменитое «обратитесь к системному администратору» и т. д.
Page 10: Поиск обработчика
Рассмотрим несколько примеров поиска обработчика в случае вложенных блоков. Что будет выведено?
Ошибка обрабатывается в том блоке, в котором она возникла. Внешний блок выполняется так, как будто никакой ошибки не было. А так?
Обработчик во внутреннем блоке не подходит; блок завершается с ошибкой, которая обрабатывается уже во внешнем блоке. Не забывайте, что в блоке с секцией EXCEPTION происходит откат к точке сохранения, неявно установленной в начале блока. В данном случае будут отменены все изменения, сделанные в обоих блоках. А так?
Page 11: Page 11
Так не срабатывает ни один обработчик, и вся транзакция обрывается. Обычно не нужно стремиться обработать все возможные ошибки в серверном коде. Нет ничего плохого в том, чтобы передать возникшую ошибку клиенту. В целом, обрабатывать ошибку имеет смысл на том уровне, на котором можно сделать что-то осмысленное в возникшей ситуации. Поэтому обрабатывать ошибку внутри базы данных стоит, когда можно что-то сделать именно на серверной стороне (например, повторить операцию при ошибке сериализации). Про журналирование сообщений об ошибках мы еще будем говорить в теме «PL/pgSQL. Отладка». Теперь рассмотрим пример с процедурами.
Что произойдет при вызове?
То, что мы видим в сообщении об ошибке — это стек вызовов: сверху вниз = изнутри наружу. Заметьте, что в этом сообщении, как и во многих других, вместо слова procedure используется function. В обработчике ошибки тоже можно получить доступ к стеку, правда, в виде одной строки:
Проверим:
Page 12: Page 12
Поскольку блок с секцией EXCEPTION устанавливает неявную точку сохранения, то и в этом блоке, и во всех блоках выше по стеку вызовов, процедуры лишаются возможности использовать команды COMMIT и ROLLBACK.
Page 13: Накладные расходы
Любой блок с секцией EXCEPTION выполняется медленнее
- из-за установки неявной точки сохранения
- Дополнительные расходы при возникновении ошибки
- из-за отката к точке сохранения
- Обработку ошибок можно и нужно использовать, но не стоит употреблять без необходимости
- PL/pgSQL и так интерпретируется и использует SQL для вычисления
- выражений
- для многих задач эта скорость более чем удовлетворительна
- проблемы с производительностью обычно связаны с запросами,
- а не с кодом PL/pgSQL
Комментарии преподавателя
Одно только указание секции EXCEPTION уже влечет за собой накладные расходы из-за того, что в начале блока будет неявно устанавливаться точка сохранения. А если ошибка действительно возникает, то накладные расходы еще более увеличиваются из-за того, что выполняется откат транзакции к точке сохранения.
Поэтому если есть простой способ обойтись без обработки исключений, лучше от нее отказаться. Не стоит строить логику работы программы на «жонглировании» исключениями.
Однако если обработка ошибок действительно нужна, не стоит сомневаться — обрабатывать ошибки можно и нужно несмотря на накладные расходы.
Во-первых, язык PL/pgSQL довольно медленный сам по себе из-за интерпретации и обращений к SQL для вычисления выражений.
Во-вторых, очень часто эта скорость вполне удовлетворительна. Да, можно и быстрее, если написать на C, но зачем?
И в-третьих, основные проблемы с производительностью, как правило, связаны со скоростью выполнения запросов из-за неправильно построенных планов, а вовсе не со скоростью работы процедурного кода (см. курс QPT «Оптимизация запросов»).
Так что если есть альтернативное решение, которое и проще, и быстрее — конечно лучше воспользоваться им.
Page 14: Накладные расходы
Чтобы оценить накладные расходы, рассмотрим простой пример. Пусть имеется таблица с текстовым полем, в которое пользователи заносят произвольные данные (обычно это признак неудачного дизайна, но иногда приходится). Нам нужно выделить числа в отдельный столбец числового типа.
Решим задачу с помощью обработки ошибок, возникающих при преобразовании текстовых данных к числу:
Проверим:
В другом варианте функции вместо обработки ошибки будем проверять формат с помощью регулярного выражения (слегка упрощенного):
Проверим этот вариант:
Page 15: Page 15
Получается заметно быстрее. В этом примере исключение срабатывало всего в 1% случаев. Чем чаще — тем больше будет дополнительных накладных расходов на откат к точке сохранения.
Встречаются (и довольно часто) случаи, когда можно обойтись без обработки ошибок, если выбрать другие подходящие средства. Задача: вернуть строку из справочника или NULL, если строки нет.
Функция с обработкой ошибки:
Проверим, что функция работает правильно:
Page 16: Page 16
Можно ли проще? Да, надо просто убрать STRICT или использовать подзапрос:
В таком варианте хорошо видно, что PL/pgSQL тут вообще не нужен — достаточно SQL. Проверим:
Задача: обновить строку таблицы с определенным идентификатором, а если такой строки нет — вставить ее. Первый подход. Что здесь плохо?
Плохо практически все, начиная с того, что такая функция будет работать некорректно на уровне изоляции Read Committed при наличии нескольких параллельно выполняющихся сеансов. Причина в том, что после выполнения SELECT и перед следующей операцией данные в базе могут измениться. Это легко продемонстрировать, если добавить задержку между командами. Для разнообразия возьмем немного другой (но тоже неправильный) вариант:
Page 17: Page 17
Теперь выполним функцию в двух сеансах почти одновременно:
Правильное решение можно построить с помощью обработки ошибки:
Проверим.
Да, теперь все правильно. Но можно решить задачу проще с помощью варианта команды INSERT, который пробует выполнить вставку, а при возникновении конфликта — обновление. И снова достаточно простого SQL.
Page 18: Page 18
Задача: гарантировать, что данные обрабатываются одновременно только одним процессом (на уровне изоляции Read Committed). Используя ту же таблицу, представим, что периодически категория требует специальной однопоточной обработки. Можно написать функцию следующим образом:
Проверим, что все правильно:
Но и эту задачу можно решить без обработки ошибок, используя рекомендательные блокировки:
Проверим:
Приведем и пример, когда без обработки ошибок не обойтись. Задача: организовать обработку пакета документов; ошибка при обработке одного документа не должна приводить к общему сбою.
Page 19: Page 19
Процедура, обрабатывающая один документ, иногда приводит к ошибке:
Теперь напишем процедуру, обрабатывающую все документы. Она вызывает в цикле обработку одного документа и при необходимости обрабатывает ошибку. Обратите внимание, что фиксация транзакции выполняется вне блока с секцией EXCEPTION.
Такую же обработку можно организовать и при помощи функции, но тогда все документы будут обрабатываться в одной общей транзакции, что может приводить к проблемам, если обработка выполняется долго. Этот вопрос детально изучается в курсе DEV2. Проверим результат:
Page 20: Page 20
Как видим, часть документов не обработалась, но это не помешало обработке остальных. Информация об ошибках удобно сохраняется в самой таблице:
И еще раз обратим внимание, что при возникновении ошибки происходит откат к точке сохранения в начале блока: благодаря этому версии документов в статусе ERROR остались равными 1.
Page 21: Итоги
Поиск обработчика ошибки происходит «изнутри наружу» в порядке вложенности блоков и вызова подпрограмм
- В начале блока с EXCEPTION устанавливается неявная точка сохранения, при ошибке происходит откат к этой точке
- Неперехваченная ошибка приводит к обрыву транзакции, сообщения отправляются клиенту и в журнал сервера
- Обработка ошибок связана с накладными расходами
Page 22: Практика
- Если при добавлении новой книги указать одного и того же автора несколько раз, произойдет ошибка. Измените функцию add_book: перехватите ошибку нарушения уникальности и вместо нее вызовите ошибку с понятным текстовым сообщением.
- Проверьте изменения в приложении.
Комментарии преподавателя
- Чтобы определить название ошибки, которую необходимо перехватить, перехватите все ошибки (WHEN OTHERS) и выведите необходимую информацию (вызвав новую ошибку с соответствующим текстом).
После этого не забудьте заменить WHEN OTHERS на конкретную ошибку — пусть остальные типы ошибок обрабатываются на более высоком уровне, раз в этом месте кода нет возможности сделать что-то конструктивное.
(В реальной жизни не стоило бы обрабатывать и нарушение уникальности — лучше было бы изменить приложение так, чтобы оно не позволяло указывать двух одинаковых авторов.)
Page 23: 1. Обработка повторяющихся авторов при добавлении книги
Page 24: Практика+
- Ряд языков имеет конструкцию try … catch … finally …, в которой try соответствует BEGIN, catch — EXCEPTION, а операторы из блока finally срабатывают всегда, независимо от того, возникло ли исключение и было ли оно обработано блоком catch. Предложите способ добиться подобного эффекта в PL/pgSQL. 2. Сравните стеки вызовов, получаемые конструкциями GET STACKED DIAGNOSTICS с элементом pg_exception_context и GET [CURRENT] DIAGNOSTICS с элементом pg_context. 3. Напишите функцию getstack, возвращающую текущий стек вызовов в виде массива строк. Сама функция getstack не должна фигурировать в стеке.
Комментарии преподавателя
Самый простой способ — просто повторить операторы finally в нескольких местах. Однако попробуйте построить такую конструкцию, чтобы эти операторы можно было написать ровно один раз.
Для начала обратитесь к документации:
https://postgrespro.ru/docs/postgresql/16/plpgsql-statements#PLPGSQL-ST ATEMENTS-DIAGNOSTICS
https://postgrespro.ru/docs/postgresql/16/plpgsql-control-structures#PLPGS QL-EXCEPTION-DIAGNOSTICS
Page 25: 1. Try-catch-finally
Сложность состоит в том, что операторы finally должны выполняться всегда, даже в случае возникновения ошибки в операторах catch (блок EXCEPTION). Решение может использовать два вложенных блока и фиктивное исключение, которое вызывается при нормальном завершении внутреннего блока. Это дает возможность поместить операторы finally в одно место — обработчик ошибок внешнего блока.
Page 26: Page 26
Но в предложенном решении всегда происходит откат всех изменений, выполненных в блоке, поэтому оно не годится для команд, изменяющих состояние базы данных. Также не стоит забывать о накладных расходах на обработку исключений: это задание — не более, чем просто упражнение.
2. GET DIAGNOSTICS
GET STACKED DIAGNOSTICS дает стек вызовов, приведший к ошибке. GET [CURRENT] DIAGNOSTICS дает текущий стек вызовов.
3. Стек вызовов как массив
Собственно функция:
Чтобы проверить ее работу, создадим несколько функций, которые вызывают друг друга:
Page 27: Page 27
17 Занятие 17: PL/pgSQL / Триггеры
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_17_plpgsql_triggers.html Archive: DEV1-handouts-16.zip Страниц PDF: 32
Page 1: PL/pgSQL / Триггеры
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Триггеры и триггерные функции
- В какой момент срабатывают триггеры
- Контекст выполнения триггерной функции
- Возвращаемое значение
- Для чего можно применять триггеры и для чего не нужно
- Событийные триггеры
Page 3: Триггеры и функции
Триггер
- объект базы данных — список обрабатываемых событий
- при возникновении события вызывается триггерная функция
- и ей передается контекст
- Триггерная функция
- объект базы данных — код обработки события
- выполняется в той же транзакции, что и основная операция
- соглашение: функция не принимает параметры,
- возвращает значение псевдотипа trigger (фактически record)
- может использоваться в нескольких триггерах
Комментарии преподавателя
Механизм триггеров позволяет выполнять определенные действия «в ответ» на определенные события. Триггер состоит из двух частей: собственно триггера (который определяет события) и триггерной функции (которая определяет действия). И триггер, и функция являются самостоятельными объектами БД.
Когда возникает событие, на которое «подписан» триггер, вызывается триггерная функция. Ей передается контекст вызова, чтобы можно было определить, какой именно триггер и в каких условиях вызвал функцию.
Триггерная функция — это обычная функция, которая написана с учетом некоторых соглашений:
● она пишется на любом языке, кроме чистого SQL;
● она не имеет параметров;
● она возвращает значение типа trigger (на самом деле это псевдотип, по факту возвращается запись, соответствующая строке таблицы).
Триггерная функция выполняется в той же транзакции, что и основная операция. Таким образом, если триггерная функция завершится с ошибкой, вся транзакция будет прервана.
https://postgrespro.ru/docs/postgresql/16/trigger-definition
Page 4: События
INSERT, UPDATE, DELETE
- таблицы
- before/after statement
- before/after row
- представления
- before/after statement
- instead of
- row
- TRUNCATE
- таблицы
- before/after statement
- Условие WHEN
- устанавливает дополнительный фильтр
Комментарии преподавателя
Триггеры могут срабатывать на вставку (INSERT), обновление (UPDATE) или удаление (DELETE) строк в таблице или представлении, а также на опустошение (TRUNCATE) таблиц.
Триггер может срабатывать до выполнения действия (BEFORE), после него (AFTER), или вместо него (INSTEAD OF).
Триггер может срабатывать один раз для всей операции (FOR EACH STATEMENT), или каждый раз для каждой затронутой строки (FOR EACH ROW).
Не для любой комбинации этих условий можно создать триггер. Например, instead-of-триггеры можно определить только для представлений на уровне строк, а truncate-триггер можно определить только для таблиц и только на уровне оператора. Допустимые варианты перечислены на слайде.
Кроме того, можно сузить область действия триггера, указав дополнительное условие WHEN: если условие не выполняется — триггер не срабатывает.
https://postgrespro.ru/docs/postgresql/16/sql-createtrigger
Page 5: Before statement
Срабатывает
- BEFORE STATEMENT
- до операции
- выполнение операции
- Возвращаемое значение
- игнорируется
- Контекст
- TG-переменные
Комментарии преподавателя
Рассмотрим подробнее разные типы триггеров.
Триггер BEFORE STATEMENT срабатывает один раз для операции независимо от того, сколько строк будет затронуто (возможно, что и ни одной). Это происходит до того, как операция начала выполняться.
Возвращаемое значение триггерной функции игнорируется. Если в триггере возникает ошибка, операция отменяется.
Поскольку триггерная функция не имеет параметров, контекст вызова в PL/pgSQL передается ей с помощью предопределенных TG-переменных, таких, как:
● TG_WHEN = «BEFORE»,
● TG_LEVEL = «STATEMENT»,
● TG_OP = «INSERT»/«UPDATE»/«DELETE»/«TRUNCATE»
и др. Триггерной функции можно также передать пользовательский контекст (аналог отсутствующих параметров) через переменную TG_ARGV, хотя зачастую лучше вместо одной «обобщенной» функции создать несколько «частных».
https://postgrespro.ru/docs/postgresql/16/plpgsql-trigger
Page 6: Before row
Срабатывает
- BEFORE STATEMENT
- перед действием со строкой
- в процессе выполнения операции
- выполнение операции
- Возвращаемое значение
- BEFORE ROW
- строка (возможно, измененная)
- null отменяет действие
- Контекст
- OLD
- update, delete
- NEW
- insert, update
- TG-переменные
Комментарии преподавателя
Триггеры BEFORE ROW срабатывают каждый раз перед тем, как операция затронет строку. Это происходит непосредственно в процессе выполнения операции.
В качестве контекста триггерная функция получает переменные:
● OLD — старая строка (не определено для операции вставки),
● NEW — измененная строка (не определено для удаления),
● TG_WHEN = «BEFORE»,
● TG_LEVEL = «ROW»,
● TG_OP = «INSERT»/«UPDATE»/«DELETE»
и др.
Возврат неопределенного значения NULL воспринимается как отмена действия над данной строкой. Сама операция продолжит выполнение, но текущая строка не будет обработана и другие триггеры для этой строки не сработают.
Чтобы не вмешиваться в работу операции, триггер должен вернуть строку в том виде, в котором ее собирается изменить операция: NEW для вставки и обновления, любое значение (но не NULL) для удаления (обычно используют OLD).
Но триггерная функция может и изменить значение NEW, чтобы повлиять на результат операции — часто именно для этого такой триггер и создают.
Page 7: Instead of row
Срабатывает
- BEFORE STATEMENT
- вместо действия со строкой
- для представлений
- выполнение операции
- Возвращаемое значение
- BEFORE ROW
- INSTEAD OF ROW
- строка (возможно, измененная) —
- будет видна в RETURNING
- null отменяет действие
- Контекст
- OLD
- update, delete
- NEW
- insert, update
- TG-переменные
Комментарии преподавателя
Триггеры INSTEAD OF очень похожи на триггеры BEFORE, но определяются только для представлений и срабатывают не до, а вместо операции.
В задачу таких триггеров обычно входит выполнение необходимых операций над базовыми таблицами представления. Также триггер может вернуть измененное значение NEW — именно оно будет видно при выполнении операции с указанием фразы RETURNING.
Page 8: After row
Срабатывает
- BEFORE STATEMENT
- после выполнения операции
- очередь из прошедших условие WHEN
- выполнение операции
- Возвращаемое значение
- BEFORE ROW
- INSTEAD OF ROW
- игнорируется
- Контекст
- OLD, OLD TABLE
- update, delete
- NEW, NEW TABLE
- insert, update
- TG-переменные
- AFTER ROW
Комментарии преподавателя
Триггеры AFTER ROW, как и BEFORE ROW, срабатывают для каждой затрагиваемой строки, но не сразу после действия над строкой, а после того, как выполнена вся операция - чтобы при обращении из этих триггеров к изменяющейся таблице результат не зависел от порядка обработки строк. Для этого события сначала помещаются в очередь и обрабатываются после окончания операции. Чем меньше событий попадет в очередь, тем меньше будет накладных расходов — поэтому именно в этом случае очень полезно использовать условие WHEN, чтобы отсечь заведомо ненужные строки.
Возвращаемое значение триггеров AFTER ROW игнорируется (поскольку операция уже выполнена).
Контекст триггерной функции составляют:
OLD — старая строка (не определено для операции вставки),
NEW — новое значение строки (не определено для удаления).
Кроме этих переменных, начиная с версии 10 триггерная функция может получить доступ к специальным переходным таблицам (transition tables). Таблица, указанная при создании триггера как OLD TABLE, содержит старые значения строк, обработанных триггером, а таблица NEW TABLE — новые значения тех же строк.
Доступны и обычные TG-переменные, включая:
● TG_WHEN = «AFTER»,
● TG_LEVEL = «ROW»,
● TG_OP = «INSERT»/«UPDATE»/«DELETE».
Page 9: After statement
Срабатывает
- BEFORE STATEMENT
- после операции
- (даже если не затронута ни одна строка)
- выполнение операции
- Возвращаемое значение
- BEFORE ROW
- INSTEAD OF ROW
- игнорируется
- Контекст
- OLD TABLE
- update, delete
- NEW TABLE
- insert, update
- TG-переменные
- AFTER ROW
- AFTER STATEMENT
Комментарии преподавателя
Триггер AFTER STATEMENT срабатывает один раз после окончания операции и после всех триггеров AFTER ROW (независимо от того, сколько строк было затронуто).
Возвращаемое значение триггерной функции игнорируется.
Контекст вызова передается с помощью переходных таблиц. Обращаясь к ним, триггерная функция может проанализировать все затронутые строки. Обычно переходные таблицы используются именно с триггерами AFTER STATEMENT, а не AFTER ROW.
Также определены обычные TG-переменные:
● TG_WHEN = «AFTER»,
● TG_LEVEL = «STATEMENT»,
● TG_OP = «INSERT»/«UPDATE»/«DELETE»/«TRUNCATE»
и др.
Page 10: Порядок вызова триггеров
Создадим «универсальную» триггерную функцию, которая описывает контекст, в котором она вызвана. Контекст передается в различных TG-переменных. Затем создадим триггеры на различные события, и будем смотреть, какие триггеры и в каком порядке вызываются при выполнении операций.
Таблица:
Триггеры на уровне оператора.
И на уровне строк:
Пробуем вставку:
Page 11: Page 11
Обновление:
Триггеры на уровне оператора сработают, даже если команда не обработала ни одной строки:
Тонкий момент: оператор INSERT с предложением ON CONFLICT приводит к тому, что срабатывают BEFORE-триггеры и на вставку, и на обновление:
И, наконец, удаление:
Для появившегося в PostgreSQL 15 оператора MERGE специального триггера нет, работают триггеры на обновление, удаление и вставку:
Переходные таблицы
Напишем триггерную функцию, показывающую содержимое переходных таблиц. Здесь мы используем имена old_table и new_table, которые будут объявлены при создании триггера.
Page 12: Page 12
Переходные таблицы «выглядят» настоящими, но не присутствуют в системном каталоге и располагаются в оперативной памяти (хотя и могут сбрасываться на диск при большом объеме).
Создадим новую таблицу:
Чтобы при выполнении операции создавались переходные таблицы, необходимо указывать их имена при создании триггера:
Проверим:
Переходные таблицы содержат только те строки, которые были затронуты операцией. Для операций вставки и удаления переходные таблицы работают точно так же, но доступна будет только одна из таблиц: NEW TABLE или OLD TABLE соответственно. Поскольку триггеры AFTER ROW срабатывают после выполнения всей операции, переходные таблицы можно использовать и в них. Но обычно это не имеет смысла.
Page 13: Возможное использование
- проверка применимости операции
- BEFORE STATEMENT
- выполнение операции
- проверка корректности;
- модификация строки
- BEFORE ROW
- изменение базовых таблиц представления
- INSTEAD OF ROW
- проверка согласованности,
- в том числе на уровне таблицы;
- «аудит» операций;
- каскадное изменение таблиц
- (денормализация, асинхронная
- обработка…)
- AFTER ROW
- AFTER STATEMENT
Комментарии преподавателя
Каково практическое применение триггеров?
BEFORE-триггеры можно использовать для проверки корректности операции и при необходимости вызывать ошибку.
Триггеры BEFORE ROW можно применять для модификации строки (например, заполнить пустое поле нужным значением). Это бывает удобно, чтобы не повторять логику заполнения «технических» полей в каждой операции, а также позволяет вмешаться в работу приложения, код которого недоступен для изменения.
Триггеры INSTEAD OF ROW применяют для того, чтобы отобразить операции над представлением в операции над базовыми таблицами.
Триггеры AFTER ROW и AFTER STATEMENT полезны в случаях, когда нужно знать точное состояние после операции (BEFORE-триггеры могут влиять на результат, так что на этом этапе ясности еще нет):
● для проверки согласованности операции;
● для «аудита», то есть записи изменений в отдельное хранилище;
● для каскадного изменения других таблиц (например, обновлять денормализованные данные при изменении базовых таблиц, или записывать изменения в очередь для последующей обработки вне данной транзакции).
Если операции затрагивают сразу много строк, то триггер AFTER STATEMENT с переходными таблицами может оказаться более эффективным решением, чем триггер AFTER ROW, поскольку позволяет обрабатывать все изменения пакетно, а не построчно.
Page 14: Сложности
Код вызывается неявно
- сложно отследить логику выполнения
- Правила видимости изменчивой триггерной функции
- виден результат триггеров BEFORE ROW или INSTEAD OF ROW
- Порядок вызова триггеров для одного события
- триггеры отрабатывают в алфавитном порядке
- Не предотвращается зацикливание
- триггер может вызвать срабатывание других триггеров
- Можно нарушить ограничения целостности
- например, исключив из обработки строки, которые должны удалиться
Комментарии преподавателя
Однако не стоит злоупотреблять триггерами. Триггеры срабатывают неявно, что сильно затрудняет понимание логики работы и крайне усложняет поддержку приложения. Попытки реализовать сложную логику на триггерах обычно заканчиваются плачевно.
В некоторых случаях вместо триггеров можно использовать вычисляемые поля (GENERATED ALWAYS AS … STORED). Такое решение — если оно подходит — будет заведомо проще и прозрачнее.
Есть ряд тонкостей, связанных с триггерами, которые мы сознательно не рассматриваем подробно:
● правила видимости изменчивых (volatile) функций в триггерах BEFORE ROW и INSTEAD OF ROW (не стоит обращаться к таблице, полагаясь на порядок, в котором сработают триггеры);
● порядок вызова нескольких триггеров, обрабатывающих одно и то же событие (не стоит усугублять и без того неявное срабатывание триггеров завязкой на последовательность обработки);
● возможность зацикливания в случае каскадного срабатывания других триггеров, которые, в свою очередь, могут приводить к новым срабатываниям данного триггера;
● возможность нарушить ограничения целостности (например, при исключении из обработки строки, которая удаляется условием ON DELETE CASCADE, может быть нарушена ссылочная целостность).
Если вы столкнулись с тем, что эти тонкости важны для вашего приложения — серьезно задумайтесь.
Page 15: Примеры использования триггеров
Пример 1: сохранение истории изменения строк. Пусть есть таблица, содержащая актуальные данные. Задача состоит в том, чтобы в отдельной таблице сохранять всю историю изменения строк основной таблицы. Поддержку исторической таблицы можно было бы возложить на приложение, но тогда велика вероятность, что в каких-то случаях из-за ошибок история не будет сохраняться. Поэтому решим задачу с помощью триггера. Основная таблица:
Историческая таблица должна называться так же, как основная, но заканчиваться на «_history». Сначала создаем клон основной таблицы…
…и затем добавляем столбцы «действительно с» и «действительно по»:
Одна триггерная функция будет вставлять новую историческую строку с открытым интервалом действия:
Другая функция будет закрывать интервал действия исторической строки:
Теперь создадим триггеры. Важные моменты: Обновление трактуется как удаление и последующая вставка; здесь важен порядок, в котором сработают триггеры (по алфавиту). Current_timestamp возвращает время начала транзакции, поэтому при обновлении start_date одной строки будет равен end_date другой. Использование AFTER-триггеров позволяет избежать проблем с INSERT … ON CONFLICT и потенциальными конфликтами с другими триггерами, которые могут существовать на основной таблице.
Page 16: Page 16
Проверим работу триггеров.
В исторической таблице хранится вся история изменений:
И теперь по ней можно восстановить состояние на любой момент времени (это немного напоминает работу механизма MVCC). Например, на самое начало:
Примеры использования триггеров
Пример 2: обновляемое представление. Пусть имеются две таблицы: аэропорты и рейсы:
Page 17: Page 17
Для удобства можно определить представление:
Но такое представление не допускает изменений. Например, не получится изменить пункт назначения таким образом:
Однако мы можем определить триггер. Триггерная функция может выглядеть, например, так (для краткости обрабатываем только аэропорт назначения, но не составит труда добавить и аэропорт вылета):
И сам триггер:
Проверим:
Page 18: Page 18
Попытка изменить аэропорт на отсутствующий в таблице:
Page 19: Событийные триггеры
Событийный триггер
- похож на обычный «табличный» триггер, но другой объект
- Триггерная функция
- соглашение: функция не принимает параметры,
- возвращает значение псевдотипа event_trigger
- для получения контекста служат специальные функции
- События
- DDL_COMMAND_START
- перед выполнением команды
- DDL_COMMAND_END
- после выполнения команды
- TABLE_REWRITE
- перед перезаписью таблицы
- SQL_DROP
- после удаления объектов
Комментарии преподавателя
Событийные триггеры — по сути те же триггеры, но срабатывают они не на DML-, а на DDL-операции (CREATE, ALTER, DROP, COMMENT, GRANT, REVOKE) и не привязаны к определенному объекту базы данных.
Такие триггеры являются не инструментом разработки приложений, а скорее служат для решения задач администрирования. Поэтому здесь мы упоминаем их только для полноты картины и рассмотрим только простые примеры.
https://postgrespro.ru/docs/postgresql/16/event-trigger-definition
https://postgrespro.ru/docs/postgresql/16/event-trigger-matrix
https://postgrespro.ru/docs/postgresql/16/sql-createeventtrigger
https://postgrespro.ru/docs/postgresql/16/functions-event-triggers
Page 20: Триггеры событий
Пример триггера для события ddl_command_end — завершение DDL-операции. Создадим функцию, которая описывает контекст вызова:
Сам триггер:
Создаем новую таблицу:
Создание таблицы может привести к выполнению нескольких команд DDL, поэтому функция pg_event_trigger_ddl_commands возвращает множество строк. Триггер на событие table_rewrite срабатывает до перезаписи таблицы командами ALTER TABLE и ALTER TYPE. Функция ниже выведет информацию о перезаписываемой таблице и код, описывающий причину перезаписи:
Теперь создаем триггер:
Изменим таблицу — назначим другой тип столбцу id:
Хотя перезапись таблицы может быть вызвана и другими командами, в частности CLUSTER и VACUUM FULL, событие table_rewrite для них не вызывается.
Page 21: Page 21
Page 22: Итоги
Триггер — способ отреагировать на возникновение события
- С помощью триггера можно отменить операцию, изменить ее результат или выполнить дополнительные действия
- Триггер выполняется как часть транзакции; ошибка в триггере приводит к откату транзакции
- Использование триггеров AFTER ROW и переходных таблиц удорожает обработку Все хорошо в меру: сложную логику трудно отлаживать из-за неявного выполнения триггеров
Page 23: Практика
- Создайте триггер, обрабатывающий обновление поля onhand_qty представления catalog_v.
- Проверьте, что в «Каталоге» появилась возможность заказывать книги. 2. Обеспечьте выполнение требования согласованности: количество книг на складе не может быть отрицательным (нельзя купить книгу, которой нет в наличии).
- Внимательно проверьте правильность реализации, учитывая,
- что с приложением могут одновременно работать несколько
- пользователей.
Комментарии преподавателя
- Может показаться, что достаточно создать AFTER-триггер на таблице operations, подсчитывающий сумму qty_change. Однако на уровне изоляции Read Committed, с которым работает приложение «Книжный магазин», нам придется блокировать таблицу operations в эксклюзивном режиме — иначе возможны сценарии, при которых такая проверка не сработает.
Лучше поступить следующим образом: добавить в таблицу books поле onhand_qty и создать триггер, изменяющий это поле при изменении таблицы operations (то есть, фактически, выполнить денормализацию данных). На поле onhand_qty теперь можно наложить ограничение CHECK, реализующее требование согласованности. А функция onhand_qty(), которую мы создавали ранее, больше не нужна.
Особое внимание надо уделить начальной установке значения, учитывая, что одновременно с выполнением наших операций в системе могут работают пользователи.
Page 24: 1. Триггер для обновления каталога
2. Проверка количества книг
Добавляем к таблице книг поле наличного количества. (До версии 11 важно было учитывать, что указание предложения DEFAULT вызывало перезапись всех строк таблицы, удерживая блокировку.)
Триггерная функция для AFTER-триггера на вставку для обновления количества (предполагаем, что поле onhand_qty не может быть пустым):
Дальше все происходит внутри транзакции.
Блокируем операции на время транзакции:
Начальное заполнение:
Теперь, когда поле заполнено, задаем ограничения:
Page 25: Page 25
Создаем триггер:
Готово.
Теперь books.onhand_qty обновляется, но представление catalog_v по-прежнему вызывает функцию для подсчета количества. Хоть в исходном запросе обращение к функции синтаксически не отличается от обращения к полю, запрос был запомнен в другом виде:
Поэтому пересоздадим представление:
Теперь функцию можно удалить.
Небольшая проверка:
Page 26: Page 26
Некорректные операции обрываются:
Page 27: Практика+
- Напишите триггер, увеличивающий счетчик (поле version) на единицу при каждом изменении строки. При вставке новой строки счетчик должен устанавливаться в единицу. Проверьте правильность работы. 2. Даны таблицы заказов (orders) и строк заказов (lines). Требуется выполнить денормализацию: автоматически обновлять сумму заказа в таблице orders при изменении строк в заказе.
- Создайте необходимые триггеры с использованием
- переходных таблиц для минимизации операций обновления.
Комментарии преподавателя
- Для создания таблиц используйте команды:
Столбец orders.total_amount должен автоматически вычисляться как сумма значений столбца lines.amount всех строк, относящихся к соответствующему заказу.
Page 28: 1. Счетчик номера версии
Таблица:
Триггерная функция:
Триггер:
Проверяем:
Явное указание version игнорируется:
Изменение:
Page 29: Page 29
Явное указание также игнорируется:
2. Автоматическое вычисление общей суммы заказов
Создаем таблицы упрощенной структуры, достаточной для демонстрации:
Создаем триггерную функцию и триггер для обработки вставки:
Предложение FROM в команде UPDATE позволяет соединить orders с подзапросом по переходной таблице и использовать столбцы подзапроса для вычисления значения.
Функция и триггер для обработки обновления:
Page 30: Page 30
Условие HAVING позволяет пропускать изменения, не влияющие на общую сумму заказа.
Функция и триггер для обработки удаления:
Остался неохваченным оператор TRUNCATE. Однако триггер для этого оператора не может использовать переходные таблицы. Но мы знаем, что после выполнения TRUNCATE в lines не останется строк, значит можно обнулить суммы всех заказов.
Page 31: Page 31
Дополнительно нужно запретить изменять значение total_amount вручную, но это задача решается не триггерами. Проверяем работу. Добавили два новых заказа без строк:
Добавили строки в заказы:
Удвоили суммы всех строк всех заказов:
Удалим одну строку первого заказа:
Опустошим таблицу строк:
Page 32: Page 32
18 Занятие 18: PL/pgSQL / Отладка
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_18_plpgsql_debug.html Archive: DEV1-handouts-16.zip Страниц PDF: 28
Page 1: PL/pgSQL / Отладка
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Проверки корректности
- Отладчик PL/pgSQL
- Служебные сообщения и различные способы их реализации
- Трассировка сеансов
Page 3: Проверки корректности
Проверки времени компиляции и времени выполнения
- plpgsql.extra_warnings
- plpgsql.extra_errors
- дополнительные проверки в расширении plpgsql_check
- Проверки в коде
- команда ASSERT
- Тестирование
Комментарии преподавателя
Отладка предполагает выполнение программы и изучение возникающих проблем, обычно с помощью специализированного отладчика или с помощью вывода отладочных сообщений.
Но можно заранее исключить определенные классы ошибок, включив проверку исходного кода во время компиляции и выполнения. Это управляется параметрами plpgsql.extra_warnings и plpgsql.extra_errors, как рассматривалось в теме «PL/pgSQL. Выполнение запросов».
https://postgrespro.ru/docs/postgresql/16/plpgsql-development-tips#PLPGS QL-EXTRA-CHECKS
Там же рассматривалось применение расширения plpgsql_check, которое обеспечивает более широкий спектр проверок.
Еще одна возможность обезопасить свой код — добавить в него проверки условий, которые всегда должны выполняться (т. н. «sanity check»). Удобный способ для этого — оператор ASSERT в PL/pgSQL.
https://postgrespro.ru/docs/postgresql/16/plpgsql-errors-and-messages#PL PGSQL-STATEMENTS-ASSERT
Нельзя не сказать и о важности тестирования кода. Тестирование не только позволяет изначально убедиться, что код работает так, как задумано, но и облегчает его дальнейшую модификацию — дает уверенность в том, что изменения не поломали существующий функционал. Мы не будем затрагивать эту тему; отметим только, что тестирование кода, работающего с базой данных, может оказаться непростым делом из-за необходимости подготовки тестовых примеров.
Page 4: Проверки корректности
Команда ASSERT позволяет указать условия, нарушения которых являются непредвиденной ошибкой. Можно провести определенную аналогию между такими условиями и ограничениями целостности в базе данных. Пример: функция, возвращающее номер подъезда по номеру квартиры:
Убедиться в правильности работы функции можно при помощи тестирования, проверив результат на некоторых «интересных» значениях:
Но при некорректных входных значениях функция будет выдавать бессмысленный результат, который, например, может быть передан дальше в другие подпрограммы, которые из-за этого тоже могут повести себя некорректно. Тестирование только кода данной функции здесь никак не поможет.
Можно обезопасить себя, добавив проверку:
Теперь некорректный вызов сразу же приведет к ошибке.
Page 5: PL/pgSQL Debugger
Состав
- расширение pldbgapi
- встроенная поддержка в некоторых графических средах
- Возможности
- установка точек прерывания
- пошаговое выполнение
- проверка и установка значений переменных
- не требуется изменение кода
- отладка работающих приложений
Комментарии преподавателя
PL/pgSQL Debugger — это отладчик для PL/pgSQL. Представляет собой расширение pldbgapi, которое официально поддерживается разработчиками PostgreSQL.
Расширение pldbgapi — это набор интерфейсных функций для сервера PostgreSQL, которые позволяют устанавливать точки прерывания, пошагово выполнять код программ, проверять и устанавливать значения переменных.
Исходный код отлаживаемых программ изменять не требуется, что дает возможность выполнять отладку работающих приложений. То есть процесс отладки не обязательно запускать отдельно, можно подключиться к уже работающему сеансу и начать его отладку.
Непосредственно пользоваться этими функциями неудобно, они в первую очередь предназначены для вызова из кода графических сред разработки. Некоторые из таких сред (включая DBeaver) имеют встроенный интерфейс для отладки. Но чтобы им воспользоваться, сначала все равно придется установить расширение pldbgapi в соответствующую базу данных.
Исходный код отладчика доступен по ссылке:
https://github.com/EnterpriseDB/pldebugger
Page 6: Отладка с PL/pgSQL Debugger
Выполним отладку одной из функций нашего приложения. Пакет поддержки отладчика postgresql-16-pldebugger уже установлен в виртуальной машине курса. Теперь нам нужно обеспечить загрузку разделяемой библиотеки, для этого установим параметр и перезапустим сервер:
Установим расширение отладчика в базу данных bookstore:
Отладку проведем с помощью графической утилиты DBeaver.
Page 7: Служебные сообщения
Не только отладка кода
- мониторинг долго выполняющихся процессов
- ведение журнала приложения
- Подходы к реализации
- вывод на консоль или в журнал сервера
- запись в таблицу или в файл
- передача информации другим процессам
Комментарии преподавателя
Второй способ отладки предполагает добавление в важные места кода служебных сообщений, выводящих информацию о текущем контексте. Анализируя сообщения, можно понять, что именно пошло не так.
Помимо собственно отладки, служебные сообщения могут выполнять и другие функции. Сообщения помогут определить, на каком этапе выполнения находится долго выполняющийся процесс. По аналогии с журналом сообщений СУБД приложение может записывать в свой собственный журнал важную информацию. Например, данные о запуске отчетов: название отчета, пользователь, когда и с какими параметрами запускался и т. д. Такая информация может сильно облегчить работу специалистов поддержки.
Можно выделить несколько подходов к реализации служебных сообщений в PL/pgSQL. Помимо уже знакомой команды RAISE, позволяющей выводить сообщения на консоль (а также в журнал сообщений сервера), можно отправлять сообщения другому процессу, записывать сообщения в таблицу или в файл.
При выборе того или иного подхода нужно обращать внимание на многие нюансы. Являются ли сообщения транзакционными (отправляются не дожидаясь окончания транзакции или только при ее завершении)? Можно ли одновременно использовать в нескольких сеансах? Как организовать доступ к журналу сообщений и как очищать его от старых записей? Какое влияние оказывают журналирование на производительность? Требуется ли модификация исходного кода?
Page 8: Команда RAISE
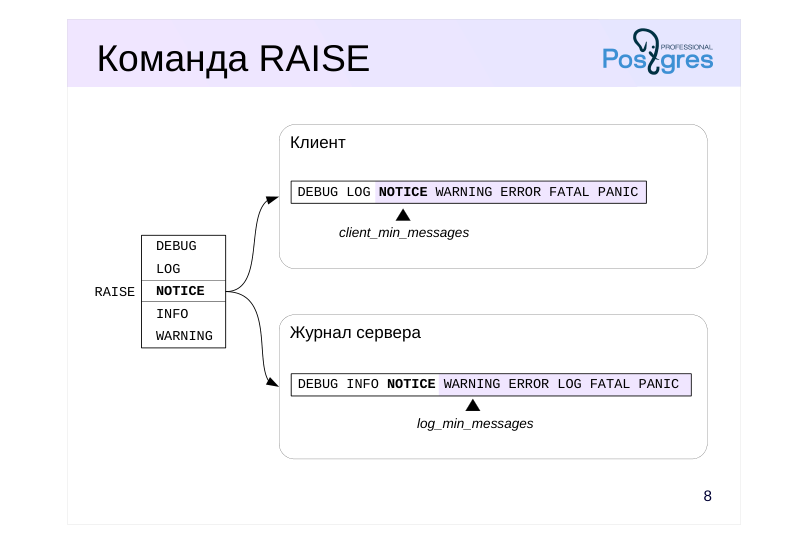 {#source-figure-008 caption=“Source slide page 8: Команда RAISE”}
Комментарии преподавателя
Мы уже встречались с командой RAISE. Она служит и для вызова исключительных ситуаций, что подробно рассматривалось в теме «PL/pgSQL. Обработка ошибок», и для отправки сообщений. Причем сообщения можно не только отправлять клиенту, но и записывать в журнал сервера.
В простом случае для отладки нужно добавить вызовы RAISE NOTICE в код функции, запустить функцию на выполнение (например в сеансе psql) и проанализировать получаемые по ходу выполнения сообщения. Сообщения RAISE нетранзакционные: они отправляются асинхронно и не зависят от статуса завершения транзакции.
Для управления отправкой сообщений используются уровень сообщения (DEBUG, LOG, NOTICE, INFO, WARNING) и параметры сервера. От значений параметров зависит, будет ли сообщение отправлено клиенту (client_min_messages) и/или записано в журнал сервера (log_min_messages). Сообщение будет отправлено, если уровень команды RAISE равен значению соответствующего параметра или больше его (находится правее на рисунке).
Значения параметров по умолчанию настроены так, что сообщения с уровнем NOTICE отправляются только клиенту, с уровнем LOG — только в журнал, а с уровнем WARNING — и клиенту, и в журнал.
Сообщения с уровнем INFO всегда отправляются клиенту, их нельзя перехватить параметром client_min_messages.
https://postgrespro.ru/docs/postgresql/16/plpgsql-errors-and-messages
Page 9: Команда RAISE
Создадим функцию для подсчета количества строк в таблице, имя которой передается во входном параметре.
Для динамического выполнения текст команды лучше предварительно записывать в переменную. В случае ошибки можно проанализировать значение этой переменной.
Строка, начинающаяся с «NOTICE» — наша отладочная информация. RAISE можно использовать для отслеживания хода выполнения долгого запроса. Предположим, что внутри кода, решающего некую задачу, четко выделяются три этапа выполнения. И по ходу работы подпрограммы мы хотим понимать, на каком из них находимся. Для этого на каждом этапе будем вызывать такую процедуру:
Основная процедура по завершении очередного этапа работы вызывает процедуру debug_message:
Команда RAISE выдает сообщения сразу, а не по окончании работы подпрограммы:
Page 10: Page 10
Такой подход удобен, когда можно вызвать функцию в отдельном сеансе. Если же функция вызывается из приложения, то удобнее писать и затем смотреть в журнал сервера. Перепишем процедуру debug_message для выдачи сообщения с уровнем, установленным в пользовательском параметре app.raise_level:
Для целей примера установим параметр на уровне сеанса:
Теперь в «обычной» жизни (app.raise_level = NONE) отладочные сообщения не будут выдаваться:
Запуская функцию в отдельном сеансе, мы можем получить отладочные сообщения, выставив app.raise_level в NOTICE:
Если же мы хотим включить отладку в приложении с записью в журнал сервера, то переключаем app.raise_level в LOG:
Смотрим в журнал сервера:
Управляя параметрами app.raise_level, log_min_messages и client_min_messages, можно добиться различного поведения при выводе отладочных сообщений.
Note Важно, что для этого не нужно менять код приложения.
Page 11: Процесс→процесс (IPC)
NOTIFY → LISTEN
- команды SQL
- транзакционное выполнение, неудобно для отладки
- Статус сеанса
- параметр application_name
- виден в представлении pg_stat_activity и выводе команды ps
- можно использовать в журнальных сообщениях
Комментарии преподавателя
Серверные процессы в PostgreSQL могут обмениваться информацией между собой.
Среди встроенных решений можно отметить следующие.
● Использование команд NOTIFY для отправки сообщений в одном процессе и LISTEN для получения в другом. Но эти команды являются транзакционными, поэтому они неудобны для отладки: 1. Сообщения отправляются только при фиксации транзакции, а не сразу после выполнения NOTIFY. Поэтому невозможно следить за ходом процесса. 2. Если транзакция завершится неуспешно, то сообщения вообще не будут отправлены.
● Использование параметра application_name. Сеанс с долго выполняющимся процессом может периодически записывать статус выполнения в application_name. В другом сеансе администратор может опрашивать представление pg_stat_activity, содержащее подробную информацию о всех выполняющихся сеансах. Также значение application_name обычно видно в выводе команды ps. Значение application_name также можно записывать в журнал сервера (настраивая параметр log_line_prefix). Это облегчит поиск нужных строк в журнале.
https://postgrespro.ru/docs/postgresql/16/runtime-config-logging#RUNTIME-CONFIG-LOGGING-WHAT
Page 12: Статус сеанса
Посмотрим, как использовать для отладки параметр application_name. Первый сеанс меняет значение этого параметра, второй — периодически опрашивает представление pg_stat_activity.
Новый вариант процедуры:
Запускаем в первом сеансе:
Во втором с паузой в две секунды обновляем строку из pg_stat_activity:
Page 13: Процесс→таблица
Расширение dblink
- входит в состав сервера
- накладные расходы на создание соединения
- Автономные транзакции
- Postgres Pro Enterprise
Комментарии преподавателя
Еще один способ сохранения отладочных сообщений — запись в таблицу базы данных.
К плюсам данного подхода относится то, что параллельная работа и доступ журналу обеспечиваются средствами самой СУБД.
Однако нужно позаботиться о том, чтобы вставка в таблицу была нетранзакционной. Для этого можно использовать расширение dblink, идущее в составе сервера PostgreSQL. Это расширение позволяет открыть новое соединение к той же самой базе данных, поэтому вставка в таблицу выполняется в другой — независимой — транзакции.
К минусам данного подхода относится то, что открытие нового соединения требует дополнительных ресурсов сервера.
Подробнее работа с dblink рассматривается в курсе DEV2.
https://postgrespro.ru/docs/postgresql/16/dblink
В Postgres Pro Enterprise доступен механизм автономных транзакций, не имеющий таких существенных накладных расходов, которые характерны для dblink (см. курс PGPRO «Возможности Postgres Pro Enterprise»).
Page 14: Запись в таблицу: расширение dblink
Установим расширение:
Создаем таблицу для записи сообщений. В таблице полезно сохранять информацию о пользователе и времени вставки. Столбец id нужен для гарантированной сортировки результата в порядке добавления строк.
Теперь перепишем процедуру так, чтобы она добавляла записи в таблицу log. Процедура открывает новый сеанс, выполняет вставку в отдельной транзакции и закрывает сеанс.
Для проверки запустим процедуру long_running в отдельной транзакции, которую в конце откатим.
Убедимся, что в таблице сохранились все вызовы debug_message. По значениям ts можно проверить, сколько времени прошло между вызовами.
Page 15: Процесс→файл
Расширение adminpack
- входит в состав сервера
- в том числе позволяет записывать текстовые файлы
- Недоверенные языки
- например, PL/Perl
Комментарии преподавателя
Записывать сообщения можно и в файл операционной системы.
Для этого, например, можно использовать расширение adminpack, позволяющее записывать данные в любой файл, доступ к которому есть у пользователя ОС postgres.
Другой вариант — написать функцию на недоверенном языке (таком, как PL/Perl — plperlu), которая будет выполнять ту же задачу. Различные языки серверного программирования рассматриваются в курсе DEV2.
https://postgrespro.ru/docs/postgresql/16/adminpack
Page 16: Запись в файл: pg_file_write
Установим расширение:
В очередной раз перепишем процедуру debug_message, теперь она будет записывать отладочную информацию в файл. Пользователь postgres, запустивший экземпляр СУБД, должен иметь возможность записи в этот файл, поэтому расположим его в домашнем каталоге этого пользователя.
Функция записывает отдельной строкой в файл журнала сообщение, переданное параметром, вместе с информацией о том, кто и когда записал строку. Для проверки запустим long_running в отдельной транзакции, которую в конце откатим.
Проверим, что записи в журнале появились. Чтобы пользователь student мог получить доступ к этому файлу, нужно использовать команду sudo:
Page 17: Трассировка SQL
Стандартная трассировка в журнал сообщений
- накладные расходы на запись в журнал
- большой размер файла журнала
- требуются инструменты для анализа
- нужен доступ к журналу (безопасность)
- Настройки
- долго выполняющиеся команды
- log_min_duration_statement
- какие команды записывать
- log_statement
- контекст сообщения
- log_line_prefix
- …
Комментарии преподавателя
В некоторых случаях может оказаться полезной трассировка всего происходящего в коде. Штатными средствами можно получить в журнале сообщений сервера SQL-запросы сеансов. Надо учитывать:
● Высоконагруженное приложение может выполнять огромное число запросов. Их запись в файл журнала может оказывать влияние на производительность подсистемы ввода-вывода.
● В большинстве случаев требуются специальные инструменты для анализа такого объема данных. Стандарт де-факто — pgBadger. https://github.com/darold/pgbadger
● К файлу журнала на сервере может не быть доступа у разработчи-ков приложений. К тому же в журнале производственной системы могут оказаться команды, содержащие конфиденциальную информацию.
Для настройки трассировки имеется ряд параметров, основные из которых приведены на слайде. Полный список:
https://postgrespro.ru/docs/postgresql/16/runtime-config-logging
Необязательно устанавливать конфигурационные параметры для всего кластера. Их действие можно ограничить отдельными сеансами при помощи команд SET, ALTER DATABASE, ALTER ROLE (как рассказы-валось в темах «Обзор базового инструментария. Установка и управление, psql» и «Организация данных. Логическая структура»).
Page 18: Трассировка SQL-команд
Расширение auto\_explain
- запись в журнал планов выполнения запросов
- трассировка вложенных запросов
- Настройки
- планы долгих команд
- auto_explain.log_min_duration
- вложенные запросы
- auto_explain.log_nested_statements
- …
Комментарии преподавателя
При включении трассировки SQL-команды попадают в журнал в том виде, в каком они отправлены на сервер. Если была вызвана подпрограмма PL/pgSQL, то в журнал будет записан только вызов этой подпрограммы (например, оператор SELECT или CALL), но не будет тех команд, которые выполняются внутри подпрограммы.
Чтобы увидеть в журнале запросы не только верхнего уровня, но и вложенные, потребуется штатное расширение auto_explain.
Как следует из названия расширения, его основная задача — записывать в журнал не только текст команды, но и план ее выполнения. Это тоже может оказаться полезно, хотя относится не к трассировке как таковой, а к оптимизации запросов (которая рассматривается в курсе QPT).
https://postgrespro.ru/docs/postgresql/16/auto-explain
Page 19: Трассировка PL/pgSQL
Расширение plpgsql\_check
- накладные расходы на запись сообщений
- большой объем выдачи
- Основные настройки
- включение трассировки
- plpgsql_check.enable_tracer
- plpgsql_check.tracer
- уровень сообщений
- plpgsql_check.tracer_errlevel
Комментарии преподавателя
Чтобы разобраться по журналу, какой процедурный код выполнялся, придется сопоставить SQL-запросы с подпрограммами на PL/pgSQL, а это может оказаться непросто. Стандартной возможности для трассировки PL/pgSQL-кода не предусмотрено, но расширение Павла Стехуле plpgsql_check (которое упоминалось в теме «PL/pgSQL. Выполнение запросов») позволяет ее выполнить.
Подобная трассировка вызывает большие накладные расходы и должна использоваться только для отладки, но не в промышленной эксплуатации.
https://github.com/okbob/plpgsql\_check
Page 20: Трассировка сеансов
Простой пример включения трассировки — установка параметра log_statement в значение all (записывать все команды, включая DDL, модификацию данных и запросы).
Выполним какой-нибудь запрос:
И выключим трассировку:
Информация о выполненных командах окажется в журнале сервера:
Однако в журнал попадает только команда верхнего уровня, но не запрос внутри функции get_count. Воспользуемся расширением auto_explain. Это расширение не нужно устанавливать в базу данных, но требуется загрузить в память. Загрузку можно настроить для всего экземпляра с помощью параметра shared_preload_libraries, либо проделать однократно для текущего процесса:
Установим трассировку всех команд независимо от длительности выполнения:
Включим трассировку вложенных запросов:
Сообщения выводятся с помощью того же механизма, что использует команда RAISE. По умолчанию используется уровень LOG, что обычно соответствует выводу в журнал. Изменив параметр, можно получать трассировку непосредственно в консоли:
Повторим запрос:
Page 21: Page 21
Мы видим не только вызов функции, но и вложенный запрос вместе с планами выполнения.
Page 22: Итоги
PL/pgSQL Debugger — API отладчика, используется в графических средах разработки
- Служебные сообщения — вывод на консоль, запись в журнал сообщений сервера, в таблицу или в файл, передача другим процессам
- Возможность трассировки сеансов
Page 23: Практика
- Измените функцию get_catalog так, чтобы динамически формируемый текст запроса записывался в журнал сообщений сервера.
- В приложении выполните несколько раз поиск, заполняя разные поля, и убедитесь, что команды SQL формируются правильно. 2. Включите трассировку команд SQL на уровне сервера.
- Поработайте в приложении и проверьте, какие команды
- попадают в журнал сообщений.
- Выключите трассировку.
Комментарии преподавателя
- Для включения трассировки установите значение параметра log_min_duration_statement в 0 и перечитайте конфигурацию. В журнал будут записываться все команды и время их выполнения.
Проще всего это сделать командой ALTER SYSTEM SET. Другие способы рассматривались в теме «Обзор базового инструментария. Установка и управление, psql». Не забудьте перечитать измененный конфигурационный файл.
После просмотра журнала следует вернуть значение параметра log_min_duration_statement в значение по умолчанию (−1), чтобы отключить трассировку. Удобный способ — команда ALTER SYSTEM RESET.
Page 24: 1. Функция get_catalog
Текст динамического запроса формируем в отдельной переменной, которую перед выполнением запишем в журнал сервера. Для более полной информации включим в сообщение значения переданных в функцию параметров. Отладочные строки в журнале можно найти по подстроке «DEBUG get_catalog». После отладки команду RAISE LOG можно удалить или закомментировать.
2. Включение и выключение трассировки SQL-запросов
Чтобы включить трассировку всех запросов на уровне сервера, можно выполнить:
Чтобы выключить:
Page 25: Page 25
Последние две команды попали в журнал сообщений:
Page 26: Практика+
1. Включите трассировку PL/pgSQL-кода средствами расширения plpgsql\_check и проверьте ее работу на примере нескольких подпрограмм, вызывающих одна другую. 2. При выводе отладочных сообщений из PL/pgSQL-кода важно понимать, к какой подпрограмме они относятся. В демонстрации имя функции выводилось вручную. Реализуйте функционал, автоматически добавляющий к тексту сообщений имя текущей функции или процедуры.
Комментарии преподавателя
Для включения трассировки загрузите расширение plpgsql_check в память сеанса командой LOAD, затем установите в сеансе оба параметра plpgsql_check.enable_tracer и plpgsql_check.tracer в значение «on».
Имя подпрограммы можно получить, разобрав стек вызовов. Воспользуйтесь подходом из практического задания 3 к теме «Обработка ошибок».
Page 27: 1. Трассировка с помощью plpgsql_check
Загрузим расширение (в данном случае устанавливать его в базу данных командой CREATE EXTENSION не нужно):
Включим трассировку:
Несколько функций, вызывающих друг друга:
Пример работы трассировки:
Выводятся не только события начала и окончания работы функций, но и значения параметров, а также затраченное на выполнение время (в расширении есть и возможность профилирования, которую мы не рассматриваем). Выключим трассировку:
Page 28: 2. Имя функции в отладочных сообщениях
Напишем процедуру, которая выводит верхушку стека вызовов (за исключением самой процедуры трассировки). Сообщение выводится с отступом, который соответствует глубине стека.
Пример работы трассировки:
19 Занятие 19: Управление доступом / Обзор
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_19_access_overview.html Archive: DEV1-handouts-16.zip Страниц PDF: 30
Page 1: Управление доступом / Обзор
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Роли и атрибуты
- Подключение к серверу
- Парольная аутентификация
- Привилегии и управление ими
- Категории ролей
- Групповые и предопределенные роли
- Привилегии по умолчанию
- Привилегии и подпрограммы
Page 3: Роли и атрибуты
Роль может быть пользователем СУБД
- не связана с пользователем ОС
- Роли можно включать друг в друга
- удобно при настройке доступа
- Свойства роли определяются атрибутами
- LOGIN
- возможность подключения
- SUPERUSER
- суперпользователь
- CREATEDB
- возможность создавать базы данных
- CREATEROLE
- возможность создавать роли
- и другие
Комментарии преподавателя
Роли в PostgreSQL используют для двух целей. Во-первых, роль может выступать как пользователь, подключающийся к СУБД. Во-вторых, роли можно включать друг в друга — это удобно при настройке доступа.
Формально роли никак не связаны с пользователями операционной системы, хотя многие программы это предполагают, выбирая значения по умолчанию. Например, psql, запущенный от имени пользователя ОС student, автоматически использует одноименную роль student (если в ключах утилиты не указана какая-либо другая роль).
При создании кластера определяется одна начальная роль, имеющая суперпользовательский доступ (обычно она называется postgres). В дальнейшем роли можно создавать, изменять и удалять.
https://postgrespro.ru/docs/postgresql/16/database-roles
Роль обладает некоторыми атрибутами, определяющими ее общие особенности и права (не связанные с определенными объектами).
Обычно атрибуты имеют два варианта, например, CREATEDB (дает право на создание БД) и NOCREATEDB (не дает такого права).
Если у роли есть атрибут LOGIN, эта роль — пользователь. Если NOLOGIN — роль не является пользовательской и не сможет подключиться к серверу; такие роли обычно используют для включения других ролей.
В таблице перечислены лишь некоторые из атрибутов.
https://postgrespro.ru/docs/postgresql/16/role-attributes
https://postgrespro.ru/docs/postgresql/16/sql-createrole
Page 4: Роли и атрибуты
Создадим роль для пользователя Алисы. В команде указаны два атрибута. В этой теме нам важно, от имени какой роли выполняются команды, поэтому имя текущей роли вынесено в приглашение.
Список ролей можно узнать командой:
Обратите внимание, что роль student является суперпользователем. Поэтому до сих пор мы не задумывались о разграничении доступа. Создадим и базу данных:
Page 5: Подключение к серверу
1. Строки pg\_hba.conf просматриваются сверху вниз
- Выбирается первая запись, соответствующая параметрам подключения (тип, база, пользователь и адрес)
- local — сокет all — любая роль host — TCP/IP имя роли
- listen_addresses
- all — любая БД
- all — любой IP
- имя БД
- IP/маска
- доменное имя
Комментарии преподавателя
Для каждого нового клиента сервер определяет, надо ли разрешить подключение к базе данных. Настройки подключения определяются в конфигурационном файле pg_hba.conf («host-based authentication»). Как и с основным конфигурационным файлом postgresql.conf, изменения вступают в силу только после перечитывания файла сервером (SQL-функцией pg_reload_conf() или командой reload утилиты управления).
При появлении нового клиента сервер просматривает конфигурацион-ный файл сверху вниз в поисках строки, подходящей к запрашиваемо-му клиентом подключению. Соответствие определяется по четырем полям: типу подключения, имени БД, имени пользователя и IP-адресу.
Ниже перечислены только самые основные возможности.
Подключение — local (unix-сокеты) или host (подключение по протоколу TCP/IP).
База данных – ключевое слово all (соответствует любой БД) или имя конкретной базы данных.
Пользователь — all или имя конкретной роли.
Адрес — all, диапазон IP-адресов или доменное имя. Не указывается для типа local. По умолчанию PostgreSQL слушает входящие соединения только с localhost; обычно параметр listen_addresses ставят в значение «*» (слушать все интерфейсы) и дальше регулируют доступ средствами pg_hba.conf.
https://postgrespro.ru/docs/postgresql/16/client-authentication
Page 6: Подключение к серверу
3. Выполняется аутентификация указанным методом
- Удачно — доступ разрешается, иначе — запрещается (если не подошла ни одна запись — доступ запрещается)
- trust — разрешить
- reject — отказать
- scram-sha-256 и md5 — запросить пароль
- peer — спросить ОС
Комментарии преподавателя
Когда в файле найдена подходящая строка, выполняется аутентификация указанным в этой строке методом, а также проверяется наличие атрибута LOGIN и привилегии CONNECT. Если результат проверки успешен, то подключение разрешается, иначе — запрещается (другие строки файла при этом уже не рассматриваются).
Если ни одна из строк не подошла, то доступ также запрещается.
Таким образом, записи в файле должны идти сверху вниз от частных правил к общим.
Существует множество методов аутентификации:
https://postgrespro.ru/docs/postgresql/16/auth-methods
Ниже перечислены только самые основные.
Метод trust безусловно разрешает подключение. Если вопросы безопасности не важны, можно указать «все all» и метод trust — тогда будут разрешены все подключения.
Метод reject, наоборот, безусловно запрещает подключение.
Метод scram-sha-256 запрашивает у пользователя пароль и проверяет его соответствие хешу, который хранится в системном каталоге кластера. Парольный метод md5 также используется, но объявлен устаревшим.
Метод peer запрашивает имя пользователя у операционной системы и разрешает подключение, если имя пользователя ОС и пользователя БД совпадают (можно установить и другие соответствия имен).
Page 7: Парольная аутентификация
На сервере
- пароль устанавливается при создании роли или позже
- пользователю без пароля будет отказано в доступе
- пароль хранится в системном каталоге pg_authid
- Ввод пароля на клиенте
- вручную
- из переменной окружения PGPASSWORD
- из файла ~/.pgpass (строки в формате узел:порт:база:роль:пароль)
Комментарии преподавателя
Если используется аутентификация по паролю, для роли обязательно должен быть установлен пароль, иначе в доступе будет отказано.
Хеш-код пароля хранится в системном каталоге в таблице pg_authid.
Пользователь может вводить пароль вручную, а может автоматизировать его ввод. Для этого есть две возможности.
Во-первых, можно задать пароль в переменной окружения PGPASSWORD на клиенте. Однако это неудобно, если приходится подключаться к нескольким базам, а также не рекомендуется из соображений безопасности.
Во-вторых, можно задать пароли в файле ~/.pgpass на клиенте. К файлу должен иметь доступ только его владелец (установлены права доступа 600), иначе PostgreSQL проигнорирует его.
Page 8: Подключение
Чтобы роль смогла подключиться к базе данных, она должна иметь не только атрибут LOGIN, но и разрешение в файле pg_hba.conf. Располагается он обычно рядом с основным конфигурационным файлом:
А прочитать его содержимое можно прямо из SQL:
(В зависимости от сборки сервера содержимое файла может отличаться.) Мы будем использовать подключение к localhost по TCP/IP (host). Такому подключению соответствует вторая строка выборки. Она предполагает аутентификацию по паролю. Роль alice была создана с паролем, но вообще его можно изменить в любой момент:
Попробуем установить соединение, указав в строке подключения всю необходимую информацию:
Получилось!
Page 9: Привилегии
Привилегии определяют права доступа ролей к объектам
- Таблицы и представления
- SELECT
- чтение данных
- INSERT
- вставка строк
- можно на уровне столбцов
- UPDATE
- изменение строк
- REFERENCES
- внешний ключ (для таблиц)
- DELETE
- удаление строк
- TRUNCATE
- опустошение (для таблиц)
- TRIGGER
- создание триггеров
Комментарии преподавателя
Привилегии устанавливают связь между субъектами (ролями) и объектами кластера. Они определяют действия, доступные для ролей в отношении этих объектов.
Список возможных привилегий отличается для объектов различных типов. Привилегии для основных типов объектов приведены на этом и следующем слайдах.
Больше всего привилегий определено для таблиц и представлений. Часть из них можно задать не только для всего отношения, но и для отдельных столбцов.
https://postgrespro.ru/docs/postgresql/16/ddl-priv
https://postgrespro.ru/docs/postgresql/16/sql-grant
Page 10: Привилегии
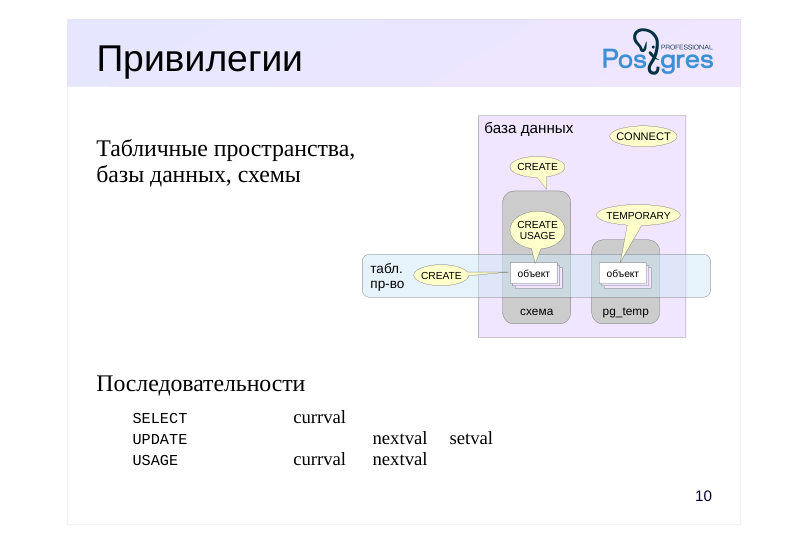 {#source-figure-010 caption=“Source slide page 10: Привилегии”}
Табличные пространства, базы данных, схемы
- Последовательности
- SELECT
- currval
- UPDATE
- nextval
- setval
- USAGE
- currval
- nextval
Комментарии преподавателя
Возможно, несколько неожиданный набор привилегий имеют последовательности. Выбирая нужные, можно разрешить или запретить доступ к трем управляющим функциям.
Для табличных пространств есть привилегия CREATE, разрешающая создание объектов в этом пространстве.
Для баз данных привилегия CREATE разрешает создавать схемы в этой БД, а для схемы привилегия CREATE разрешает создавать объекты в этой схеме.
Поскольку точное имя схемы для временных объектов заранее неизвестно, привилегия на создание временных таблиц вынесена на уровень БД (TEMPORARY).
Привилегия USAGE схемы разрешает обращаться к объектам в этой схеме.
Привилегия CONNECT базы данных разрешает подключение к этой БД.
Page 11: Категории ролей
Суперпользователи
- полный доступ ко всем объектам — проверки не выполняются
- Владельцы
- изначально все привилегии для объекта (можно отозвать)
- действия со своими объектами, не регламентируемые привилегиями,
- например: удаление, выдача и отзыв привилегий и т. п.
- Остальные роли
- доступ в рамках выданных привилегий
Комментарии преподавателя
В целом можно сказать, что доступ роли к объекту определяется привилегиями. Но имеет смысл выделить три категории ролей и рассмотреть их по отдельности:
Роли с атрибутом SUPERUSER (суперпользователи). Такие роли могут делать все, что угодно — для них проверки разграничения доступа не выполняются.
Владелец объекта. Изначально это роль, создавшая объект, хотя потом его можно сменить. Владельцем считается не только сама роль-владелец, но и любая другая роль, включенная в нее. Владелец объекта сразу получает полный набор привилегий для этого объекта.
В принципе, эти привилегии можно отозвать, но владелец объекта обладает также неотъемлемым правом совершать действия, не регламентируемые привилегиями. В частности, он может выдавать и отзывать привилегии (в том числе и себе самому), удалять объект и т. п.
- Все остальные роли имеют доступ к объекту только в рамках выданных им привилегий.
Чтобы проверить, есть ли у роли необходимая привилегия в отношении некоторого объекта, можно воспользоваться функциями has_*_privilege:
https://postgrespro.ru/docs/postgresql/16/functions-info
Page 12: Управление привилегиями
Выдача привилегий
- alice
- bob
- привилегии
- на объект
- Отзыв привилегий
Комментарии преподавателя
Право выдачи и отзыва привилегий на объект имеет владелец этого объекта (и суперпользователь).
Синтаксис команд GRANT и REVOKE достаточно сложен и позволяет указывать как отдельные, так и все возможные привилегии; как отдельные объекты, так и группы объектов, входящие в определенные схемы и т. п.
https://postgrespro.ru/docs/postgresql/16/sql-grant
https://postgrespro.ru/docs/postgresql/16/sql-revoke
Page 13: Привилегии
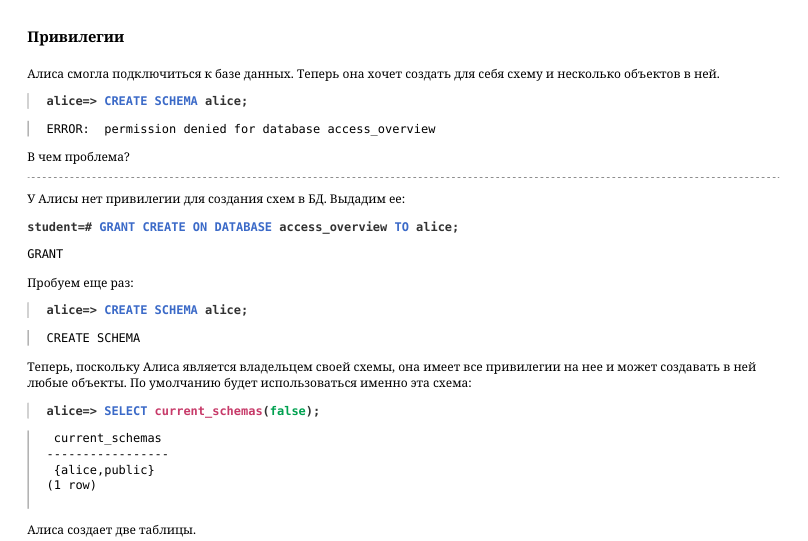 {#source-figure-013 caption=“Source slide page 13: Привилегии”}
Алиса смогла подключиться к базе данных. Теперь она хочет создать для себя схему и несколько объектов в ней.
В чем проблема? У Алисы нет привилегии для создания схем в БД. Выдадим ее:
Пробуем еще раз:
Теперь, поскольку Алиса является владельцем своей схемы, она имеет все привилегии на нее и может создавать в ней любые объекты. По умолчанию будет использоваться именно эта схема:
Алиса создает две таблицы.
А суперпользователь создает другую роль для пользователя Боба, который будет обращаться к объектам, принадлежащим Алисе.
Боб попробует обратиться к таблице t1.
В чем причина ошибки? Нет доступа к схеме, так как Боб не суперпользователь и не владелец этой схемы. Проверить права на доступ к схеме можно так (столбец Access privileges):
Page 14: Page 14
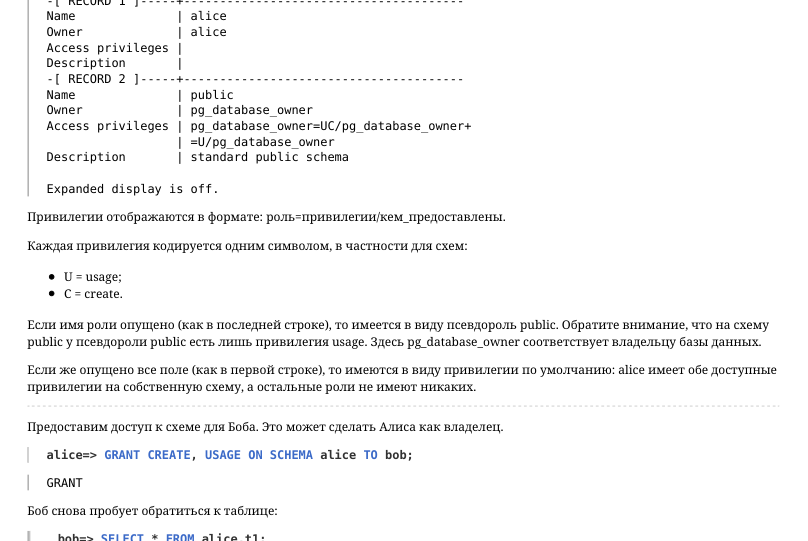 {#source-figure-014 caption=“Source slide page 14: Page 14”}
Привилегии отображаются в формате: роль=привилегии/кем_предоставлены. Каждая привилегия кодируется одним символом, в частности для схем: U = usage; C = create. Если имя роли опущено (как в последней строке), то имеется в виду псевдороль public. Обратите внимание, что на схему public у псевдороли public есть лишь привилегия usage. Здесь pg_database_owner соответствует владельцу базы данных. Если же опущено все поле (как в первой строке), то имеются в виду привилегии по умолчанию: alice имеет обе доступные привилегии на собственную схему, а остальные роли не имеют никаких. Предоставим доступ к схеме для Боба. Это может сделать Алиса как владелец.
Боб снова пробует обратиться к таблице:
Снова ошибка. В чем причина? На этот раз у Боба есть доступ к схеме, но нет доступа к самой таблице. Вот как проверить доступ:
И снова видим пустое поле: доступ есть только у владельца, то есть у Алисы. Алиса предоставляет Бобу доступ на чтение и изменение:
А для второй таблицы — доступ на вставку и чтение одного столбца:
Посмотрим, как изменились привилегии:
Теперь пустое поле «проявилось», и мы видим, что в нем находится полный перечень привилегий. Ниже — обозначения,
Page 15: Page 15
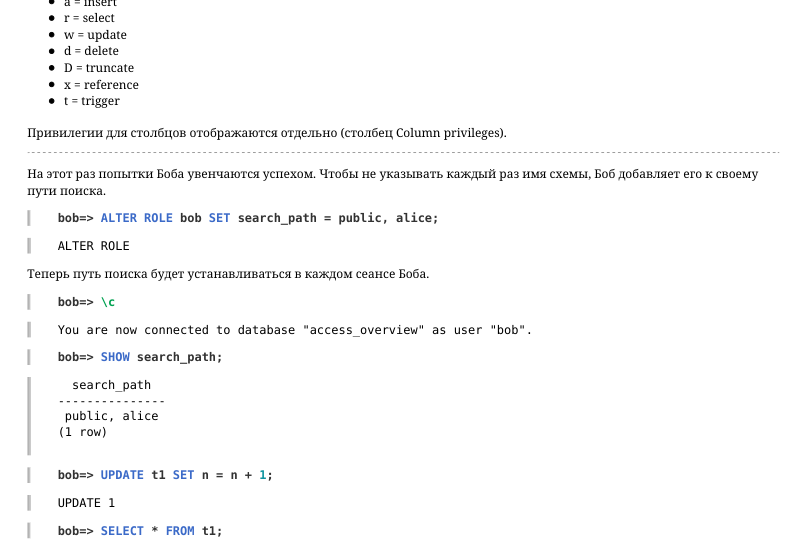 {#source-figure-015 caption=“Source slide page 15: Page 15”}
не все они вполне очевидные: a = insert r = select w = update d = delete D = truncate x = reference t = trigger Привилегии для столбцов отображаются отдельно (столбец Column privileges). На этот раз попытки Боба увенчаются успехом. Чтобы не указывать каждый раз имя схемы, Боб добавляет его к своему пути поиска.
Теперь путь поиска будет устанавливаться в каждом сеансе Боба.
Но другие операции по-прежнему запрещены:
И вторая таблица:
А чтение другого столбца запрещено:
Page 16: Включение роли в роль
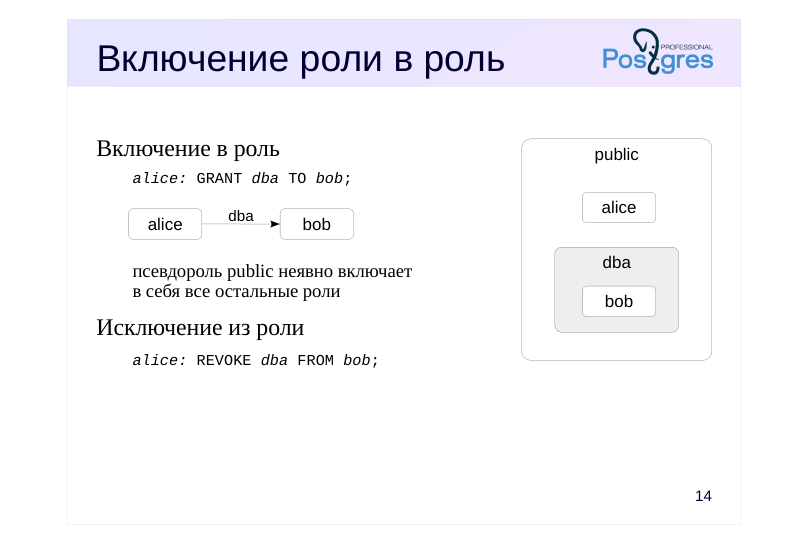 {#source-figure-016 caption=“Source slide page 16: Включение роли в роль”}
Включение в роль
- alice
- bob
- dba
- псевдороль public неявно включает
- в себя все остальные роли
- Исключение из роли
Комментарии преподавателя
В любую роль могут быть включены другие роли. В таком случае роль выступает в качестве группы. Отдельного понятия «группа» в PostgreSQL нет.
Роль может быть включена в несколько ролей; включенная роль может, в свою очередь, включать в себя третьи роли, но циклы при этом не допускаются.
По умолчанию роль наследует привилегии роли, в которую она включена. Это поведение можно изменить, указав роли атрибут NOINHERIT — тогда, чтобы воспользоваться привилегиями включающей роли, надо будет явно переключиться на нее с помощью SET ROLE. Атрибуты ролей не наследуются, но можно переключиться на включающую роль и воспользоваться ее атрибутами.
Роли, включающие другие роли, обычно имеют атрибут NOLOGIN и называются «групповыми». Фактически это именованный набор привилегий, который удобно «выдать» обычной роли точно так же, как выдается одиночная привилегия. Это упрощает управление доступом и администрирование.
Существует псевдороль public, которая неявно включает в себя все остальные роли. Если выдать какие-либо привилегии роли public, эти привилегии получат вообще все роли.
https://postgrespro.ru/docs/postgresql/16/role-membership
Page 17: Предопределенные роли
pg_monitor
- pg_read_all_settings чтение всех параметров сервера
- pg_read_all_stats доступ к статистике pg_stat_scan_tables мониторинг и блокировки таблиц
- pg_read_all_data чтение данных из всех таблиц pg_write_all_data изменение данных во всех таблицах
- pg_read_server_files чтение файлов на сервере pg_write_server_files запись в файлы на сервере
- pg_execute_server_programs выполнение программ на сервере
- …
Комментарии преподавателя
В PostgreSQL имеется набор предопределенных ролей, имеющих доступ к часто востребованным, но не общедоступным функциям и данным. Членство в этих ролях может быть предоставлено обычным пользователям для решения ряда задач администрирования — чтобы избежать наделения этих пользователей суперпользовательскими полномочиями.
Количество предопределенных ролей увеличивается с каждой новой версией PostgreSQL. Полный список всех ролей, включая предопределенные, можно просмотреть с помощью команды \duS в psql.
https://postgrespro.ru/docs/postgresql/16/predefined-roles
Можно создавать и свои собственные «административные» роли, например, для выполнения задач резервного копирования.
Page 18: Групповые роли
 {#source-figure-018 caption=“Source slide page 18: Групповые роли”}
Вспомним, что Боб не смог прочитать второй столбец таблицы:
Суперпользователь включает Боба в предопределенную роль pg_read_all_data:
Теперь Боб сможет получить доступ на чтение ко всем таблицам так, как будто ему были выданы привилегии SELECT на все таблицы и USAGE на все схемы:
Получить информацию о членстве в ролях можно с помощью команды \drg утилиты psql:
Столбец Options содержит информацию об атрибутах, описывающих включение. Здесь для роли bob, включенной в pg_read_all_data, SET означает возможность переключения на групповую роль, а INHERIT — использование привилегий группы без явного переключения на нее. Исключим пользователя bob из группы:
Page 19: Подпрограммы
Единственная привилегия для функций и процедур
- EXECUTE
- выполнение
- Характеристики безопасности
- SECURITY INVOKER
- выполняется с правами вызывающего
- (по умолчанию)
- SECURITY DEFINER
- выполняется с правами владельца
Комментарии преподавателя
Для функций и процедур есть единственная привилегия EXECUTE, разрешающая выполнение этой подпрограммы.
Тонкий момент связан с тем, от имени какого пользователя будет выполняться подпрограмма. Если подпрограмма объявлена как SECURITY INVOKER (по умолчанию), она выполняется с правами вызывающего пользователя. В этом случае операторы внутри подпрограммы смогут обращаться только к тем объектам, к которым у вызывающего пользователя есть доступ.
Если же указать фразу SECURITY DEFINER, подпрограмма работает с правами ее владельца. Это способ позволить другим пользователям выполнять определенные действия над объектами, к которым у них нет непосредственного доступа.
https://postgrespro.ru/docs/postgresql/16/sql-createfunction
https://postgrespro.ru/docs/postgresql/16/sql-createprocedure
Page 20: Привилегии по умолчанию
Привилегии псевдороли public
- подключение к любой базе данных
- доступ к системному каталогу
- выполнение любых подпрограмм
- привилегии выдаются автоматически для каждого нового объекта
- Настраиваемые привилегии по умолчанию
- возможность дополнительно выдать или отозвать привилегии
- для вновь создаваемого объекта
Комментарии преподавателя
Как уже говорилось, псевдороль public включает в себя все остальные роли, которые, таким образом, пользуются всеми привилегиями, выданными для public.
При этом public имеет довольно широкий спектр привилегий по умолчанию. В частности:
● право подключения к любой базе данных (именно поэтому роль alice смогла подключиться к базе данных несмотря на то, что привилегия CONNECT не выдавалась ей явно);
● доступ к системному каталогу;
● выполнение любых подпрограмм.
Это, с одной стороны, позволяет комфортно работать, не задумываясь о привилегиях, а с другой — создает определенные сложности, если разграничение доступа действительно необходимо.
Описанные выше привилегии появляются у public автоматически при создании новых объектов. То есть недостаточно, например, просто отозвать у public привилегию EXECUTE на все подпрограммы: как только появится новая, public немедленно получает привилегию на ее выполнение.
Однако существует специальный механизм «привилегий по умолчанию», который позволяет автоматически выдавать и отзывать привилегии при создании нового объекта. Этот механизм можно использовать и для отзыва права выполнения функций у псевдороли public.
https://postgrespro.ru/docs/postgresql/16/sql-alterdefaultprivileges
Page 21: Подпрограммы и привилегии по умолчанию
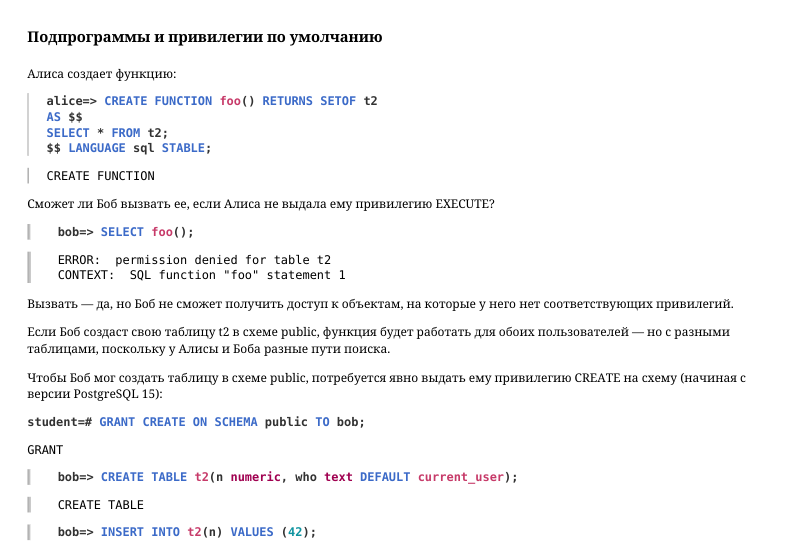 {#source-figure-021 caption=“Source slide page 21: Подпрограммы и привилегии по умолчанию”}
Алиса создает функцию:
Сможет ли Боб вызвать ее, если Алиса не выдала ему привилегию EXECUTE?
Вызвать — да, но Боб не сможет получить доступ к объектам, на которые у него нет соответствующих привилегий. Если Боб создаст свою таблицу t2 в схеме public, функция будет работать для обоих пользователей — но с разными таблицами, поскольку у Алисы и Боба разные пути поиска. Чтобы Боб мог создать таблицу в схеме public, потребуется явно выдать ему привилегию CREATE на схему (начиная с версии PostgreSQL 15):
Другой доступный вариант — объявить функцию как работающую с правами ее владельца:
В этом случае функция всегда будет выполняться с правами Алисы, независимо от того, кто ее вызывает. Боб удаляет свою таблицу…
…и получает доступ к содержимому таблицы Алисы:
В этом случае Алисе надо внимательно следить за выданными привилегиями. Скорее всего, потребуется отозвать
Page 22: Page 22
 {#source-figure-022 caption=“Source slide page 22: Page 22”}
EXECUTE у роли public и выдавать ее явно только нужным ролям.
Но дело осложняется тем, что по умолчанию привилегия на выполнение автоматически выдается роли public на каждую вновь создаваемую функцию. Для того чтобы конкретные пользователи получали или, наоборот, лишались тех или иных привилегий на вновь создаваемые объекты, можно настроить привилегии по умолчанию:
Теперь Боб сразу получает привилегию на выполнение подпрограмм, создаваемых Алисой, а остальные пользователи не смогут их выполнять.
Page 23: Итоги
Роли, атрибуты и привилегии — гибкий механизм, позволяющий по-разному организовать работу
- можно легко разрешить все всем
- можно строго разграничить доступ, если это необходимо
- При создании новых ролей надо позаботиться о возможности их подключения к серверу
Page 24: Практика
- Создайте две роли (пароль должен совпадать с именем): – employee — сотрудник магазина, – buyer — покупатель.
- Убедитесь, что созданные роли могут подключиться к БД. 2. Отзовите у роли public права выполнения всех функций и подключения к БД. 3. Разграничьте доступ таким образом, чтобы: – сотрудник мог только заказывать книги, а также – добавлять авторов и книги, – покупатель мог только приобретать книги.
- Проверьте выполненные настройки в приложении.
Комментарии преподавателя
- Сотрудник — внутренний пользователь приложения, аутентификация выполняется на уровне СУБД.
Покупатель — внешний пользователь. В реальном интернет-магазине управление такими пользователями ложится на приложение, а все запросы поступают в СУБД от одной «обобщенной» роли (buyer). Идентификатор конкретного покупателя может передаваться как параметр (но в нашем приложении мы этого не делаем).
- Вообще говоря, разграничение доступа должно быть заложено, в том числе, в приложение. В нашем учебном приложении разграничение не сделано специально: вместо этого на веб-странице можно явно выбрать роль, от имени которой пойдет запрос в СУБД. Это позволяет посмотреть, как поведет себя серверная часть при некорректной работе приложения.
Итак, пользователям нужно выдать:
● Право подключения к БД bookstore и доступ к схеме bookstore.
● Доступ к представлениям, к которым происходит непосредственное обращение.
● Доступ к функциям, которые вызываются как часть API. Если оставить функции SECURITY INVOKER, придется выдавать доступ и ко всем «нижележащим» объектам (таблицам, другим функциям). Однако удобнее просто объявить API-функции как SECURITY DEFINER.
Разумеется, ролям нужно выдать привилегии только на те объекты, доступ к которым у них должен быть.
Page 25: 1. Создание ролей
Настройки по умолчанию разрешают подключение с локального адреса по паролю. Нас это устраивает.
2. Привилегии public
У роли public надо отозвать лишние привилегии.
3. Разграничение доступа
Функции с правами создавшего.
Привилегии покупателя: покупатель должен иметь доступ к поиску книг и их покупке.
Привилегии сотрудника: сотрудник должен иметь доступ к просмотру и добавлению книг и авторов, а также к каталогу для заказа книг.
Page 26: Page 26
Page 27: Практика+
- Зарегистрируйте пользовательские роли alice и bob. 2. Отредактируйте файл pg_hba.conf так, чтобы беспарольный вход был разрешен лишь для пользователей postgres и student. Убедитесь, что доступ для alice и bob запрещен. 3. Для пользователей alice и bob включите разрешение входить в сеанс, используя метод peer. Проверьте невозможность входа в сеанс без создания отображения на пользователя ОС. Для alice создайте такое отображение. 4. Проверьте возможность использовать одно и то же отображение для разных ролей.
Комментарии преподавателя
- С помощью текстового редактора вставьте перед первой незакомментированной директивой в pg_hba.conf local all postgres,student trust
Перечитайте конфигурацию.
- Отредактируйте вставленную в pg_hba.conf директиву, заменив ее следующим: local all postgres,student trust local all alice,bob peer
В конец файла pg_ident.conf добавьте: stmap student alice
- Чтобы роли alice и bob использовали одно отображение, содержимое pg_ident.conf должно быть следующим: stmap student alice stmap student bob
Page 28: 1. Добавление ролей
Зарегистрируем роли с правом входа в сеанс.
2. Ограничение использования trust
Отредактируем содержимое pg_hba.conf, разрешив метод trust лишь для postgres и student.
Вот что получилось:
Применим конфигурацию.
Теперь alice и bob не могут подключиться:
3. Метод аутентификации peer
Используя текстовый редактор, добавим еще одну строку с методом аутентификации peer, чтобы разрешить подключение пользователям alice и bob.
Содержимое pg_hba.conf:
Page 29: Page 29
Перечитаем конфигурацию.
Однако по-прежнему эти учетные записи не могут войти в сеанс, хотя сообщение об ошибке изменилось.
Метод peer требует совпадения учетной записи в ОС с именем роли в PostgreSQL. Создадим отображение роли alice на пользователя ОС student, добавив строку в файл pg_ident.conf. Для роли bob отображение задавать не будем.
И допишем в добавленную строку параметр map, задающий имя отображения.
Содержимое pg_hba.conf:
Перечитаем конфигурацию.
Теперь alice может подключиться к базе данных и выполнить команды.
А bob — нет.
Page 30: 4. Одно отображение для нескольких ролей
Разрешим пользователю bob входить в сеанс на таких же условиях, как alice.
Добавленные строки в pg_ident.conf:
Перечитаем конфигурацию.
Теперь и alice, и bob смогут подключиться.
20 Занятие 20: Резервное копирование / Логическое резервирование
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dev1_20_backup_logical.html Archive: DEV1-handouts-16.zip Страниц PDF: 24
Page 1: Резервное копирование / Логическое резервирование
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Логические и физические резервные копии
- Копирование и восстановление таблицы
- Копирование и восстановление базы данных
- Копирование и восстановление кластера
Page 3: Логическая копия
Команды SQL для создания объектов и наполнения данными
- можно сделать копию отдельного объекта или отдельной базы
- можно восстановиться на другой версии или архитектуре
- (не требуется двоичная совместимость)
- простота использования
- − невысокая скорость работы
- − восстановление только на момент создания резервной копии
Комментарии преподавателя
Логическая резервная копия — набор команд SQL, восстанавливающих кластер (или отдельную базу данных, или отдельную таблицу) с нуля: создаются необходимые объекты и наполняются данными.
Команды можно выполнить на другой версии СУБД (при наличии совместимости на уровне команд) или на другой платформе и архитектуре (не требуется двоичная совместимость).
В частности, логическую резервную копию можно использовать для долговременного хранения: ее можно будет восстановить и после обновления сервера на новую версию.
Создание логической резервной копии — относительно несложный процесс. Обычно он требует выполнения одной команды или запуска одной утилиты.
Однако при восстановлении большой базы команды могут выполняться очень долго. Восстановить систему из логической копии можно ровно на момент начала резервного копирования.
https://postgrespro.ru/docs/postgresql/16/backup-dump
Page 4: Физическая копия
Копия файловой системы кластера баз данных
- быстрее, чем логическое резервирование
- восстанавливается статистика
- − можно восстановиться только на совместимой системе
- − и на той же самой основной версии PostgreSQL
- − выборочная копия невозможна, копируется весь кластер
- Архив журнала предзаписи
- возможность восстановления на определенный момент времени
Комментарии преподавателя
Физическое резервирование подразумевает копирование всех файлов, относящихся к кластеру БД, то есть создание полной двоичной копии.
Копирование файлов работает быстрее, чем выгрузка SQL-команд при логическом резервировании; запустить сервер из созданной физической копии — дело нескольких минут, в отличие от восстановления из логической копии. Кроме того, нет необходимости заново собирать статистику — она также восстанавливается из копии.
Но есть и минусы. Из физической резервной копии можно восстановить систему только на совместимой платформе (та же ОС, та же разрядность, тот же порядок байтов в представлении чисел и т. п.) и только на той же основной версии PostgreSQL. Кроме того, невозможно сделать физическую копию отдельных баз данных кластера, выполняется копирование всего экземпляра целиком.
Как правило, создание физических резервных копий дополняют ведением архива файлов журнала предзаписи. Это позволяет восстанавливать систему не только на момент создания резервной копии, но и на произвольный момент времени.
https://postgrespro.ru/docs/postgresql/16/backup-file
https://postgrespro.ru/docs/postgresql/16/continuous-archiving
Физическое резервирование — обычный способ создания периодических резервных копий любой сколько-нибудь серьезной системы. Создание таких копий — ответственность администратора баз данных.
Page 5: Копия таблицы в SQL
 {#source-figure-005 caption=“Source slide page 5: Копия таблицы в SQL”}
- файл в ФС сервера и доступен владельцу экземпляра PostgreSQL можно ограничить столбцы (или использовать произвольный запрос) при восстановлении строки добавляются к имеющимся в таблице
Комментарии преподавателя
Если требуется сохранить только содержимое одной таблицы, можно воспользоваться командой COPY.
Команда позволяет записать таблицу (или часть столбцов таблицы, или даже результат произвольного запроса) либо в файл, либо на консоль, либо отправить на вход какой-либо программе. При этом можно указать ряд параметров, таких как формат (текстовый, CSV или двоичный), разделитель полей, текстовое представление NULL и т. п.
Другой вариант команды, наоборот, считывает из файла или из консоли строки с полями и записывает их в таблицу. Таблица при этом не очищается, новые строки добавляются к уже существующим.
Команда COPY работает существенно быстрее, чем аналогичные команды INSERT — клиенту не нужно много раз обращаться к серверу, а серверу не нужно много раз анализировать команды.
Тонкость: при выполнении команды COPY FROM не применяются правила (rules), хотя ограничения целостности и триггеры выполняются.
https://postgrespro.ru/docs/postgresql/16/sql-copy
Page 6: Копия таблицы в psql
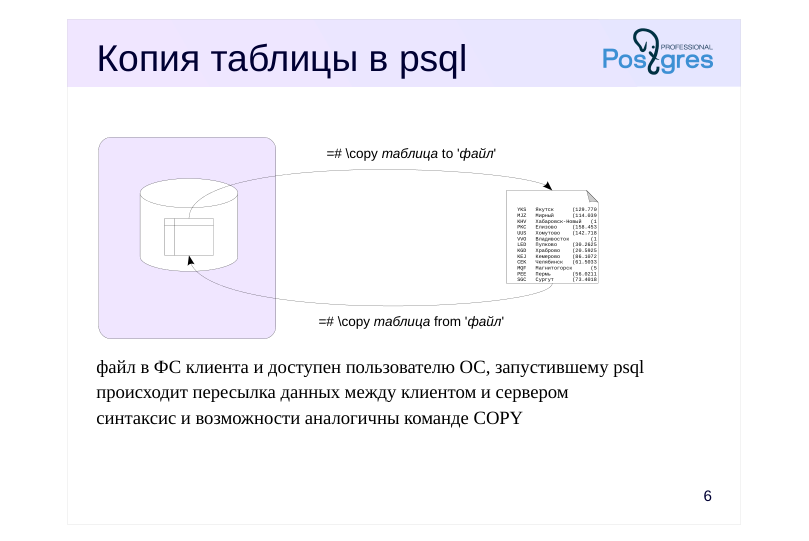 {#source-figure-006 caption=“Source slide page 6: Копия таблицы в psql”}
- файл в ФС клиента и доступен пользователю ОС, запустившему psql происходит пересылка данных между клиентом и сервером синтаксис и возможности аналогичны команде COPY
Комментарии преподавателя
В psql существует клиентский вариант команды COPY с аналогичным синтаксисом.
Указание имени файла в SQL-команде COPY соответствует файлу на сервере БД. У пользователя, под которым работает PostgreSQL (обычно postgres), должен быть доступ к этому файлу.
В клиентском же варианте команды файл располагается на клиенте, что позволяет сохранить локальную копию данных, даже не имея доступа к файловой системе сервера. Содержимое таблиц автоматически пересылается между клиентом и сервером.
https://postgrespro.ru/docs/postgresql/16/app-psql
Page 7: Команда COPY
Создадим базу данных и таблицу.
Вот что показывает команда COPY (выдаем на консоль, а не в файл):
Видно, как различаются в выводе пустые строки и неопределенные значения. Формат вывода настраивается достаточно гибко. Можно изменить разделитель, представление неопределенных значений, добавить строку с названиями столбцов и т.п. Например:
Обратите внимание, что символ-разделитель внутри строки был экранирован (символ для экранирования тоже настраивается). Вместо таблицы можно указать произвольный запрос.
Таким образом можно сохранить результат запроса, данные представления и т. п. Команда может работать и с форматом CSV, который поддерживается множеством программ.
Аналогично работает и ввод данных из файла или с консоли. При вводе с консоли требуется маркер конца файла — обратная косая черта с точкой. В обычном файле он не нужен. Все параметры при вводе должны совпадать с теми, что были указаны при выводе.
Page 8: Page 8
Если вводимые данные предваряются строкой-заголовком с именами столбцов, то возможно выполнение проверки на их соответствие столбцам принимающей таблицы.
При несовпадении получим ошибку:
Еще одна попытка добавить строку в таблицу:
Эта ошибка возникла из-за того, что успешно выполненная выше команда COPY не передвинула значение последовательности, обслуживающей столбец id. Исправим ситуацию:
Вот что загрузилось в таблицу (для наглядности настроим в psql вывод неопределенных значений):
Page 9: Копия базы данных
 {#source-figure-009 caption=“Source slide page 9: Копия базы данных”}
- формат: команды SQL при выгрузке можно выбрать отдельные объекты базы данных новая база должна быть создана из шаблона template0 заранее должны быть созданы роли и табличные пространства после загрузки имеет смысл выполнить ANALYZE
Комментарии преподавателя
Для создания полноценной резервной копии базы данных используется утилита pg_dump.
Если не указать имя файла (-f, –file), то утилита выведет результат на консоль. А результатом является скрипт, предназначенный для psql, который содержит команды для создания необходимых объектов и наполнения их данными.
Дополнительными ключами утилиты можно ограничить набор объектов: выбрать указанные таблицы, или все объекты в указанных схемах (с учетом установленных расширений), или наложить другие фильтры.
Чтобы восстановить объекты из резервной копии, достаточно выполнить полученный скрипт в psql.
Следует иметь в виду, что базу данных для восстановления надо создавать из шаблона template0, так как все изменения, сделанные в template1, также попадут в резервную копию.
Кроме того, заранее должны быть созданы необходимые роли и табличные пространства. Поскольку эти объекты не относятся к конкретной БД, они не будут выгружены в резервную копию.
После восстановления базы имеет смысл выполнить команду ANALYZE: она соберет статистику, необходимую оптимизатору для планирования запросов.
https://postgrespro.ru/docs/postgresql/16/app-pgdump
Page 10: Формат custom
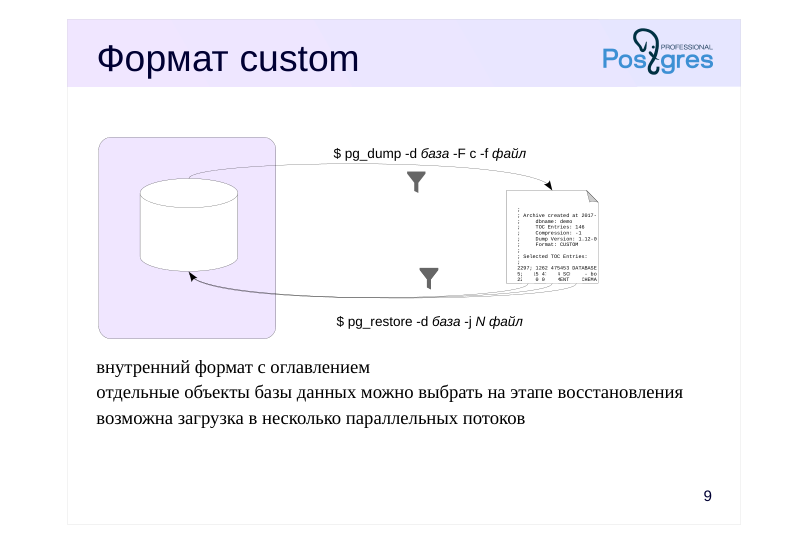 {#source-figure-010 caption=“Source slide page 10: Формат custom”}
- внутренний формат с оглавлением отдельные объекты базы данных можно выбрать на этапе восстановления возможна загрузка в несколько параллельных потоков
Комментарии преподавателя
Утилита pg_dump позволяет указать формат резервной копии. По умолчанию это plain — простые команды для psql.
Формат custom (-F c, –format=custom) – формат резервной копии, содержащий не только объекты, но и оглавление. Наличие оглавления позволяет выбирать объекты для восстановления не при создании копии, а непосредственно при восстановлении.
Файл формата custom по умолчанию сжат.
Для восстановления потребуется другая утилита — pg_restore. Она читает файл и преобразует его в команды psql. Если не указать явно имя базы данных (в ключе -d), то команды будут выведены на консоль. Если же база данных указана, утилита соединится с этой БД и выполнит команды без участия psql.
Чтобы восстановить только часть объектов, можно воспользоваться одним из двух подходов. Во-первых, можно ограничить объекты аналогично тому, как они ограничиваются в pg_dump. Вообще, утилита pg_restore понимает многие параметры из репертуара pg_dump.
Во-вторых, можно получить из оглавления список объектов, содержащихся в резервной копии (ключ –list). Затем этот список можно отредактировать вручную, удалив ненужное и передать измененный список на вход pg_restore (ключ –use-list).
https://postgrespro.ru/docs/postgresql/16/app-pgrestore.html
Page 11: Формат directory
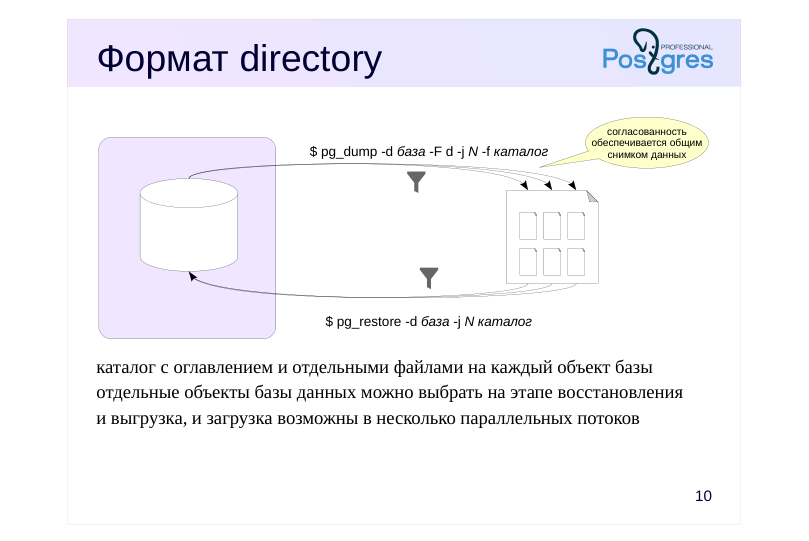 {#source-figure-011 caption=“Source slide page 11: Формат directory”}
каталог с оглавлением и отдельными файлами на каждый объект базы отдельные объекты базы данных можно выбрать на этапе восстановления и выгрузка, и загрузка возможны в несколько параллельных потоков
Комментарии преподавателя
Еще один формат резервной копии — directory. В таком случае будет создан не один файл, а каталог, содержащий объекты и оглавление. По умолчанию файлы внутри каталога будут сжаты.
Преимущество перед форматом custom состоит в том, что такая резервная копия может создаваться параллельно в несколько потоков (количество указывается в ключе -j, –jobs).
Разумеется, несмотря на параллельное выполнение, копия будет содержать согласованные данные. Это обеспечивается общим снимком данных для всех параллельно работающих процессов.
https://postgrespro.ru/docs/postgresql/16/functions-admin.html#FUNCTION S-SNAPSHOT-SYNCHRONIZATION
Восстановление также возможно в несколько потоков (это работает и для формата custom).
В остальном возможности по работе с форматом directory не отличаются от ранее рассмотренных: поддерживаются те же ключи и подходы.
Page 12: Сравнение форматов
plain custom directory tar
- утилита для восстановления psql pg_restore
- сжатие zlib
- выборочное восстановление да да да
- параллельное резервирование да
- параллельное восстановление да да
Комментарии преподавателя
В приведенной таблице разные форматы сравниваются с точки зрения предоставляемых ими возможностей.
Отметим, что имеется и четвертый формат — tar. Он не рассматривался, так как не привносит ничего нового и не дает преимуществ перед другими форматами. Фактически он соответствует созданию tar-файла из каталога в формате directory, но не поддерживает сжатие и параллелизм.
Page 13: Утилита pg_dump
При запуске без дополнительных параметров утилита pg_dump выдает команды SQL, создающие все объекты в базе данных:
Page 14: Page 14
Команда \restrict запрещает выполнение других метакоманд psql (которые мог сгенерировать злоумышленник) до соответствующей ей команды \unrestrict. Видно, что pg_dump создал таблицу t, добавил автоматическую генерацию идентификатора, заполнил таблицу с помощью уже рассмотренной нами команды COPY, и наконец добавил ограничение целостности для первичного ключа. Ключ –column-inserts позволяет использовать команды INSERT, но загрузка будет работать существенно дольше. Рассмотрим некоторые полезные ключи. Могут пригодиться при восстановлении копии на системе с другим набором ролей: -O, –no-owner — не генерировать команды для установки владельца объектов; -x, –no-acl — не генерировать команды для установки привилегий. Полезны для выгрузки и загрузки данных частями: -s, –schema-only — выгрузить только определения объектов без данных; -a, –data-only — выгрузить только данные, без создания объектов. Удобны, если восстанавливать копию на системе, в которой уже есть данные (и наоборот, на чистой системе): -c, –clean — генерировать команды DROP для создаваемых объектов; -C, –create — генерировать команды создания БД и подключения к ней. Важный момент: в выгрузку попадают и изменения, сделанные в шаблонной БД template1. Поэтому восстанавливать резервную копию лучше на базе данных, созданной из template0. При использовании ключа –create это учитывается автоматически:
Команда для создания схемы public не формируется, но если права на схему или ее владелец были изменены, то соответствующие команды появятся в выводе pg_dump:
Существуют ключи для выбора объектов, которые должны попасть в резервную копию: -n, –schema — шаблон для имен схем; -t, –table — шаблон для имен таблиц. И наоборот, включить в копию все, кроме указанного: -N, –exclude-schema — шаблон для имен схем; -T, –exclude-table — шаблон для имен таблиц. Например, восстановим таблицу t в другой базе данных.
Page 15: Page 15
Подключимся к базе данных backup_logical_dev_2 и проверим:
Утилита pg\_dump — формат custom
Серьезное ограничение обычного формата (plain) состоит в том, что выбирать объекты нужно в момент выгрузки. Формат custom позволяет сначала сделать полную копию, а выбирать объекты уже при загрузке.
Для восстановления объектов из такой копии предназначена утилита pg_restore. Повторим восстановление таблицы t.
Формат резервной копии указывать не обязательно — утилита распознает его сама. Утилита pg_restore понимает те же ключи для фильтрации объектов, что и pg_dump, и даже больше: -I, –index — загрузить определенные индексы; -P, –function — загрузить определенные функции; -T, –trigger — загрузить определенные триггеры.
Еще один пример: восстановим целиком исходную базу данных backup_logical_dev_1.
Page 16: Page 16
В ключе -d мы указываем любую существующую базу данных; с ключом –create утилита сама создаст базу, указанную в архиве, и тут же переключится в нее.
Проверим:
Резервную копию в обычном (plain) формате при необходимости можно изменить в текстовом редакторе. Резервная копия формата custom хранится в двоичном виде, но и для нее доступны более широкие возможности фильтрации объектов, чем рассмотренные ключи. Утилита pg_restore может сформировать список объектов — оглавление резервной копии:
Такой список можно записать в файл, отредактировать и использовать его для восстановления с помощью ключа –use-list.
Утилита pg\_dump — формат directory
Формат directory интересен тем, что позволяет выгружать данные в несколько параллельных потоков. При этом гарантируется согласованность данных: все потоки будут использовать один и тот же снимок данных.
Заглянем внутрь каталога:
В нем находится файл оглавления и по одному файлу на каждый выгружаемый объект (у нас он всего один):
Page 17: Page 17
Восстановим базу backup_logical_dev_1 из резервной копии, используя два потока. Здесь мы добавляем ключ –clean, который генерирует команду удаления БД, поскольку backup_logical_dev_1 существует. И предварительно надо отключиться от backup_logical_dev_1:
Page 18: Копия кластера БД
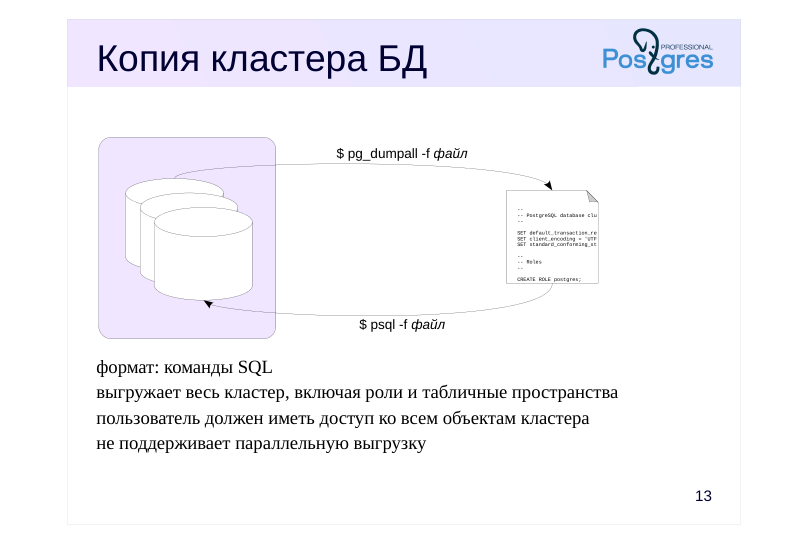 {#source-figure-018 caption=“Source slide page 18: Копия кластера БД”}
- формат: команды SQL выгружает весь кластер, включая роли и табличные пространства пользователь должен иметь доступ ко всем объектам кластера не поддерживает параллельную выгрузку
Комментарии преподавателя
Чтобы создать резервную копию всего кластера, включая роли и табличные пространства, можно воспользоваться утилитой pg_dumpall.
Поскольку pg_dumpall требуется доступ ко всем объектам всех БД, запускать ее следует суперпользователю или пользователю, включенному в предустановленную роль pg_read_all_data. Утилита по очереди подключается к каждой БД кластера и выгружает информацию с помощью pg_dump. Кроме того, она сохраняет и данные, относящиеся к кластеру в целом.
Чтобы начать работу, утилите требуется подключиться хотя бы к какой-то базе данных. По умолчанию выбирается postgres или template1, но можно указать и другую.
Результатом работы pg_dumpall является скрипт для psql. Другие форматы не поддерживаются. Это означает, что pg_dumpall не поддерживает параллельную выгрузку данных, что может оказаться проблемой при больших объемах данных. В таком случае можно воспользоваться ключом –globals-only, чтобы выгрузить только роли и табличные пространства, а сами базы данных выгружать отдельно с помощью pg_dump в параллельном режиме.
https://postgrespro.ru/docs/postgresql/16/app-pg-dumpall
Page 19: Утилита pg_dumpall
Утилита pg_dump годится для выгрузки одной базы данных, но никогда не выгружает общие объекты кластера БД, такие, как роли и табличные пространства. Чтобы сделать полную копию кластера, нужна утилита pg_dumpall. Все рассматриваемые в этой теме утилиты не требуют каких-то отдельных привилегий, но у выполняющей их роли должны быть привилегии на чтение (создание) всех затронутых объектов. Утилитой pg_dump может, например, пользоваться владелец базы данных. Но поскольку для копирования кластера утилите pg_dumpall надо иметь доступ ко всем базам данных, будем использовать роль с атрибутом суперпользователя.
В копию кластера дополнительно попадают такие команды, как:
Восстановление выполняется с помощью psql — никакой другой формат не поддерживается. Команда для восстановления (мы не будем ее выполнять):
В процессе восстановления могут возникать ошибки из-за существующих объектов — обычно это нормально и не мешает процессу, хотя все сообщения стоит проанализировать.
Page 20: Итоги
Логическое резервирование позволяет сделать копию всего кластера, базы данных или отдельных объектов
- Хорошо подходит
- для данных небольшого объема
- для длительного хранения, за время которого меняется версия сервера
- для миграции на другую платформу
- Плохо подходит
- для восстановления после сбоя с минимальной потерей данных
Page 21: Практика
- Создайте резервную копию базы данных bookstore в формате custom; действуйте от лица сотрудника магазина.
- «Случайно» удалите все записи из таблицы authorship.
- Проверьте, что приложение перестало отображать названия
- книг на вкладках «Магазин», «Книги», «Каталог».
- Используйте резервную копию для восстановления
- потерянных данных в таблице.
- Проверьте, что нормальная работа книжного магазина
- восстановилась.
Комментарии преподавателя
- Включите пользователя в предопределенную роль pg_read_all_data. При восстановлении используйте ключ –data-only, чтобы избежать ошибки при попытке создания таблицы.
Page 22: 1. Восстановление потерянных данных
Включим пользователя employee в предопределенную роль pg_read_all_data и от его лица выполним создание резервной копии:
Удаляем строки:
Выполнить восстановление у employee не получится — у него нет прав записи в таблицу, поэтому это делает student:
Page 23: Практика+
- Команда psql \copy позволяет направить результат на вход произвольной программы. Воспользуйтесь этим, чтобы открыть результаты какого-нибудь запроса в электронной таблице LibreOffice Calc.
Комментарии преподавателя
- Команда должна перенаправить результат в файл, а затем запустить libreoffice, указав этот файл в качестве параметра. Файл должен быть записан в формате CSV.
Конечно, такой способ зависит от платформы и без модификации не будет работать, например, в Windows.
Page 24: 1. Открытие результата запроса в LibreOffice
Создаем таблицу.
Выгружаем содержимое таблицы в csv-файл:
Если вместо \copy использовать SQL-команду COPY, программа будет запущена на сервере СУБД, что, конечно, неправильно. Открываем /home/student/t.csv…