Администрирование PostgreSQL. Резервное копирование и репликация
Администрирование PostgreSQL. Резервное копирование и репликация
Курс сохраняет официальный порядок тем. Русские материалы извлечены из PDF в читаемый нативный Markdown для дальнейшей редакторской работы.
Состояние материалов: 官方 PDF 已提取为原生 Markdown
Базовый язык: Базовый язык: English. Текущий английский архив используется как базовый; русская версия сохранена для сверки глав.
О курсе
Логическое и физическое резервное копирование, архивирование WAL, физическая и логическая репликация, архитектуры кластеров.
Состояние материалов
| Язык | Текущий архив | Версия | Темы | Страница курса |
|---|---|---|---|---|
| English | DBA3-handouts-16-en-20260917.zip | 16-20260917 | 9 | HTTP 404 |
| Русский | DBA3-handouts-16.zip | 16 | 9 | HTTP 200 |
Содержание
Дополнительные материалы
dba3_new_features.pdfdba3_student_guide.pdf
Редакторский статус
Русский комплект доступен в виде нативного Markdown. Если английский комплект не найден, английский маршрут оставлен для будущего источника.
00 Занятие 00: Резервное копирование и репликация / PostgreSQL 16
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba3_00_introduction.html Archive: DBA3-handouts-16.zip Страниц PDF: 10
Page 1: Резервное копирование и репликация / PostgreSQL 16
Авторские права
© Postgres Professional, 2017–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Администраторам
 {#source-figure-002 caption=“Source slide page 2: Администраторам”}
- DBA2, 4 дня
Комментарии преподавателя
Для прохождения всех курсов необходимо знание основ языка SQL. Курса по SQL в нашей линейке нет, но имеется множество книг и образовательных ресурсов для освоения SQL. Мы рекомендуем книгу Евгения Моргунова «PostgreSQL. Основы языка SQL»:
https://postgrespro.ru/education/books/sqlprimer
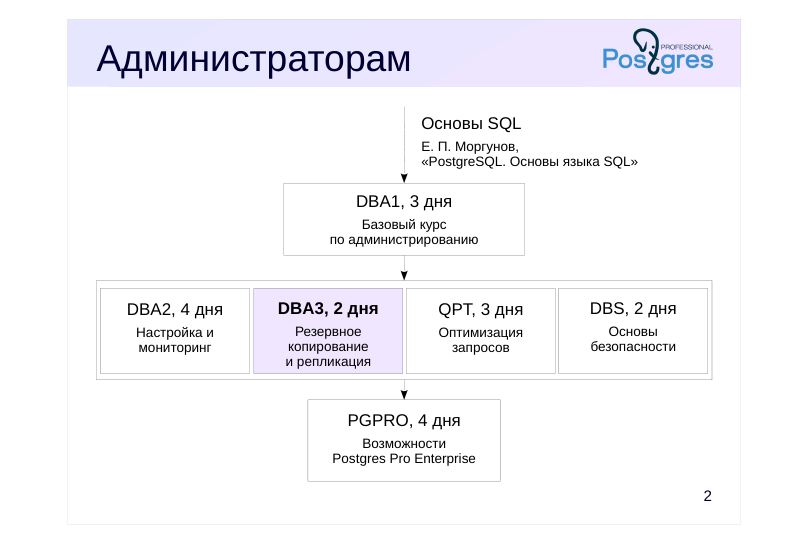
Для администраторов мы предлагаем следующие курсы.
Курс DBA1 – базовый, он дает сведения об архитектуре PostgreSQL, об установке, настройке и управлении сервером. Приводятся обзоры разграничения доступа, резервного копирования и репликации.
В курсе DBA2 обсуждается настройка конфигурационных параметров исходя из понимания внутренней организации сервера; говорится о мониторинге сервера с использованием обратной связи для итеративной настройки параметров.
Курс DBA3 посвящен рассмотрению резервного копирования, а также настройкам физической и логической репликации и сценариям ее использования. Также дается общее представление о способах и сложностях построения высокодоступных, масштабируемых кластеров.
Курс DBS рассказывает про настройку подключений клиентов к СУБД и про управление доступом внутри самой СУБД.
В курсе QPT разбираются планирование и выполнение запросов, настройка параметров экземпляра, связанных с производительностью, и изучается поиск проблемных запросов и их оптимизация.
В курсе PGPRO рассматриваются дополнительные возможности, которые предоставляет СУБД Postgres Pro Enterprise.
Page 3: Разработчикам
 {#source-figure-003 caption=“Source slide page 3: Разработчикам”}
- DEV2, 4 дня
Комментарии преподавателя
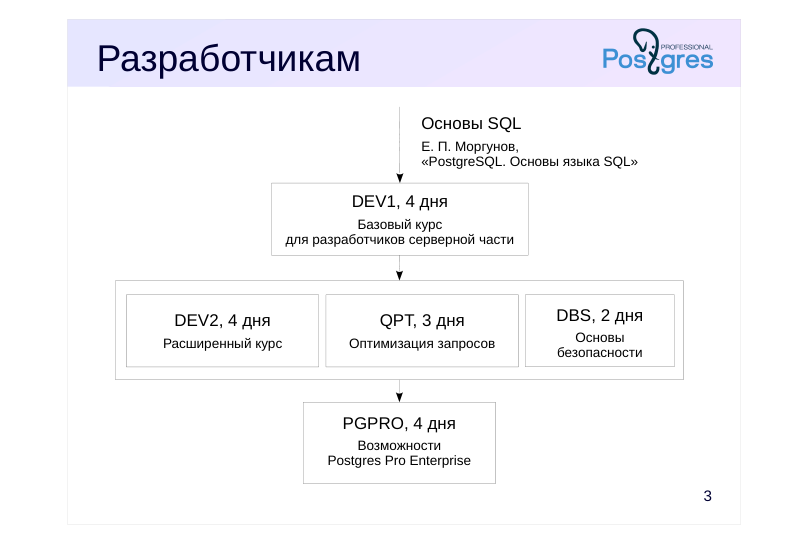
Для разработчиков серверной части приложений мы предлагаем следующие курсы.
Базовым курсом для разработчиков является курс DEV1, в котором даются общие сведения об архитектуре PostgreSQL и использовании основных объектов базы данных; изучается программирование на стороне сервера на языках SQL и PL/pgSQL с использованием основных типов данных (включая составной тип и массивы), а также рассматривается взаимодействие с клиентской частью.
В курсе DEV2 рассматриваются особенности внутреннего устройства сервера, влияющие на разработку прикладного кода, и всесторонне изучается расширяемость: возможность дополнить серверные механизмы собственным кодом, что позволяет использовать PostgreSQL для решения самых разнообразных задач.
Курсы DBS, QPT и PGPRO являются общими для разработчиков и администраторов.
Разработчикам могут быть интересны и курсы по администрированию, если есть необходимость детальнее изучить внутреннее устройство PostgreSQL, а также в случае, когда на проекте нет выделенной роли администратора.
https://postgrespro.ru/education/courses
Page 4: О курсе DBA3
Продолжительность: 2 дня
- Предварительные знания
- основы SQL
- владение ОС Unix
- знакомство с архитектурой PostgreSQL в объеме курса DBA1
- Какие навыки будут получены
- выполнение резервного копирования различными способами
- настройка сервера для физической и логической репликации
- знакомство со сценариями использования репликации
- представление о способах построения кластеров
Комментарии преподавателя
В этом курсе рассказывается о возможностях и стратегиях резервного копирования, а также о механизмах физической и логической репликации и сценариях ее использования. Дается общее представление о способах и сложностях построения высокодоступных, масштабируемых кластеров.
Page 5: Используемые материалы
Подготовленная виртуальная машина
- ОС Xubuntu 24.04
- PostgreSQL 16 (три кластера)
- документация на русском языке
- Учебные материалы
- презентации, демонстрации, практические задания и их решение
- (в форматах html и pdf)
Комментарии преподавателя
Если вы проходите курс самостоятельно, обязательно начните со знакомства с Руководством слушателя. В числе прочего в нем написано, где скачать и как использовать виртуальную машину курса и прочие материалы. Все материалы курса, включая Руководство слушателя, доступны по адресу: https://postgrespro.ru/education/courses/DBA3
Выполнение практических заданий очень важно для получения навыков работы с PostgreSQL. Обязательно старайтесь сначала самостоятельно выполнить задания, а затем просмотрите предлагаемые нами решения, даже если задание не вызвало вопросов. В решениях могут содержаться дополнительные сведения, которые не упоминаются в презентациях и демонстрациях. После выполнения задания следует удалить созданные объекты и сбросить измененные настройки, иначе они могут помешать выполнению последующих заданий.
Учебные материалы (презентации, демонстрации, практические задания и их решения) доступны в двух форматах. Формат html удобен для онлайн-работы, он позволяет копировать фрагменты текста и кода. Формат pdf разбит на страницы и удобен для печати.
Page 6: Предварительные настройки
В этом курсе мы будем использовать три экземпляра PostgreSQL, названные alpha, beta и gamma:
В демонстрациях команды, выполняемые на каждом из серверов, выделены и отличаются приглашением. Все практические задания выполняются под пользователем ОС student. В СУБД создан одноименный пользователь и база данных, чтобы psql можно было запускать без параметров. Сервер alpha работает на стандартном порту 5432:
Сервер beta — на порту 5433. Для подключения в psql достаточно указать только номер порта:
Сервер gamma — на порту 5434:
Роль student не является суперпользовательской, но обладает правом создания баз данных и ролей и разрешением на подключение по протоколу репликации, а также включена в некоторые предопределенные групповые роли:
Также student имеет привилегии на некоторые объекты, которыми по умолчанию обладает только суперпользователь. Это право изменять параметры:
Page 7: Page 7
И право выполнять системные функции (оно выдано в базе template1 и, следовательно, во всех базах, созданных командой CREATE DATABASE без указания шаблона):
Локальные подключения любых пользователей разрешены без ввода пароля:
Page 8: Организационные вопросы
День: ~8 академических часов + обед (1час)
- Каждая тема, как правило, состоит из
- презентации и демонстрации: ~40–70 мин
- практических заданий: ~30–40 мин, включая перерыв
Page 9: День 1
Резервное копирование
- Логическое резервирование
- Базовая резервная копия
- Архив журнала предзаписи
- Репликация
- Физическая репликация
Page 10: День 2
Репликация (продолжение)
- Переключение на реплику 06. Логическая репликация 07. Сценарии использования Кластерные технологии
- Обзор
01 Занятие 01: Резервное копирование / Логическое резервирование
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba3_01_backup_logical.html Archive: DBA3-handouts-16.zip Страниц PDF: 33
Page 1: Резервное копирование / Логическое резервирование
Авторские права
© Postgres Professional, 2017–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Понятие логической резервной копии
- Копирование и восстановление отдельных таблиц
- Копирование и восстановление баз данных
- Копирование и восстановление кластера
Page 3: Логическая копия
Команды SQL для создания объектов и наполнения данными
- можно сделать копию отдельного объекта или отдельной базы
- можно восстановиться на другой версии или архитектуре
- (не требуется двоичная совместимость)
- − невысокая скорость работы
- − восстановление только на момент создания резервной копии
Комментарии преподавателя
Логическая копия содержит набор команд SQL, выполнив которые можно восстановить кластер, базу данных или выбранные таблицы. В процессе восстановления из логической копии создаются необходимые объекты и наполняются данными.
Команды можно выполнить на другой версии СУБД или даже на другой платформе и архитектуре, так как не требуется двоичная совместимость.
В частности, логическую резервную копию можно использовать для долговременного хранения: ее можно будет восстановить и после обновления сервера на новую версию.
Однако для большой базы команды могут выполняться очень долго. Восстановить систему из логической копии можно ровно на момент начала резервного копирования.
https://postgrespro.ru/docs/postgresql/16/backup-dump
Page 4: SQL-команда COPY
 {#source-figure-004 caption=“Source slide page 4: SQL-команда COPY”}
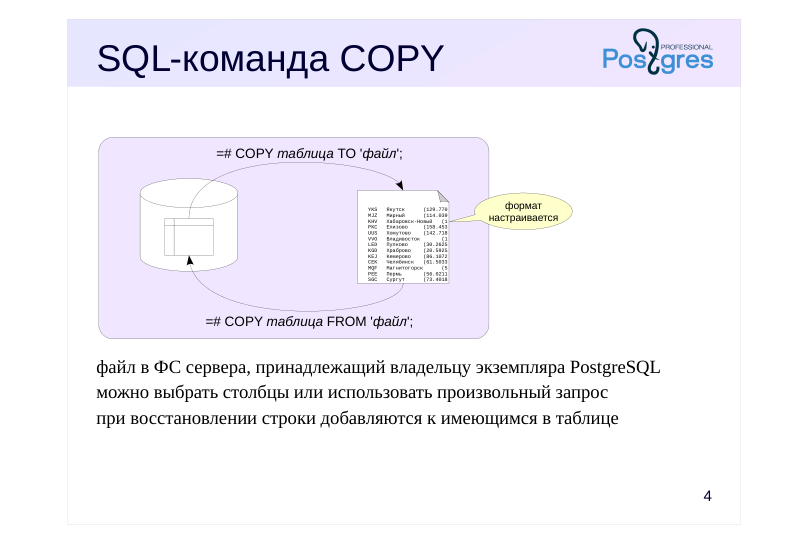
- файл в ФС сервера, принадлежащий владельцу экземпляра PostgreSQL можно выбрать столбцы или использовать произвольный запрос при восстановлении строки добавляются к имеющимся в таблице
Комментарии преподавателя
Команда COPY TO записывает содержимое таблицы или результат запроса в файл или поток вывода. Строки представлений или секционированных таблиц можно скопировать с помощью запроса.
Для использования COPY TO требуется роль pg_write_server_file.
Команда COPY FROM добавляет в таблицу строки из файла или стандартного потока ввода. Она работает существенно быстрее, чем аналогичные команды INSERT. Следить за процессом копирования можно в представлении pg_stat_progress_copy.
Для COPY FROM требуется роль pg_read_server_files (а для чтения потока ввода — pg_execute_server_program).
Тонкость: при выполнении команды COPY FROM не применяются правила (rules), хотя ограничения целостности и триггеры выполняются. Если столбец таблицы при вставке должен получать значения, генерируемые последовательностью, но COPY заполняет этот столбец явно, последовательность не будет изменять свое состояние (счетчик).
Оба варианта команды COPY позволяют выбрать столбцы таблицы, а также указать такие параметры, как:
● FORMAT — формат данных (текстовый, CSV или двоичный);
● DELIMITER — разделитель полей;
● NULL — текстовое представление NULL;
● ENCODING — кодировку;
● HEADER — заголовок, описывающий столбцы. https://postgrespro.ru/docs/postgresql/16/sql-copy
Page 5: Команда psql \copy
 {#source-figure-005 caption=“Source slide page 5: Команда psql \copy”}
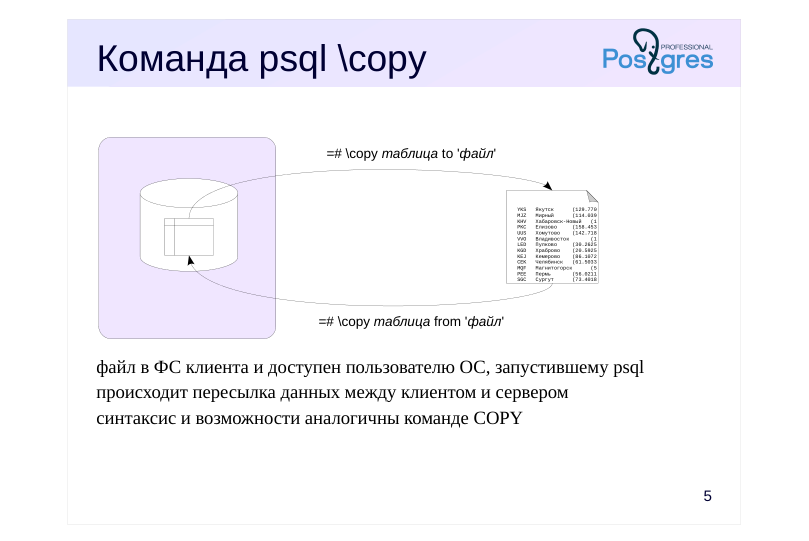
- файл в ФС клиента и доступен пользователю ОС, запустившему psql происходит пересылка данных между клиентом и сервером синтаксис и возможности аналогичны команде COPY
Комментарии преподавателя
В psql существует метакоманда \copy — вариант команды COPY с аналогичным синтаксисом, — выполняющаяся на стороне клиента.
Файл должен быть доступен пользователю операционной системы, запустившему psql. Обращение к файлу происходит на клиенте, а на сервер передается только содержимое.
https://postgrespro.ru/docs/postgresql/16/app-psql#APP-PSQL-META-COM MANDS-COPY
Page 6: Команда COPY
Создадим базу данных и таблицу.
Выведем содержимое таблицы в терминал:
Видно, как различаются в выводе пустые строки и неопределенные значения. Формат вывода настраивается достаточно гибко. Можно изменить разделитель, представление неопределенных значений и т. п. Например:
Обратите внимание, что символ-разделитель внутри строки был экранирован (символ для экранирования тоже настраивается). Вместо таблицы можно указать произвольный запрос.
Таким образом можно сохранить результат запроса, данные представления и т. п. Команда поддерживает вывод в формате CSV, который поддерживается множеством программ.
Аналогично работает и ввод данных из файла или с терминала.
Но при вводе с терминала требуется маркер конца файла — обратная косая черта с точкой; в обычном файле он не нужен. Чтобы данные загрузились, при вводе надо указать те же параметры, что были указаны при выводе.
Page 7: Page 7
При загрузке также можно указать условие:
Вот что загрузилось в таблицу (для наглядности настроим в psql вывод неопределенных значений):
Загрузим все строки:
Page 8: Копия базы данных
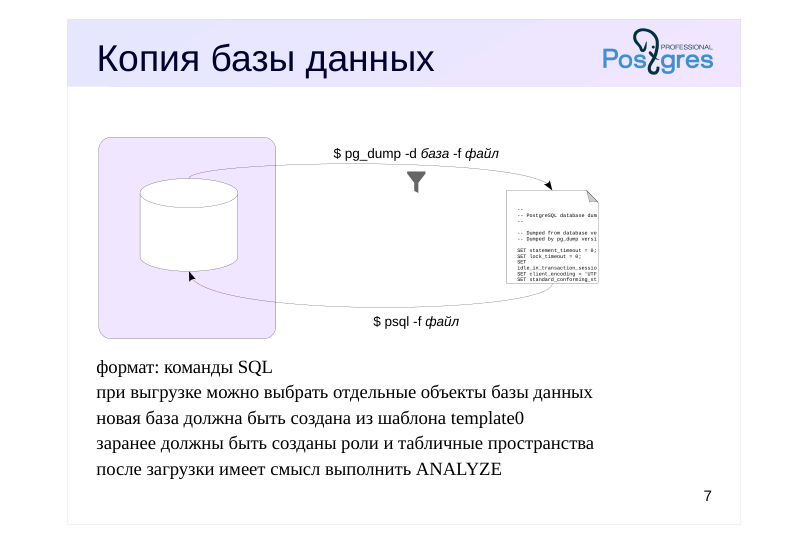 {#source-figure-008 caption=“Source slide page 8: Копия базы данных”}
- формат: команды SQL при выгрузке можно выбрать отдельные объекты базы данных новая база должна быть создана из шаблона template0 заранее должны быть созданы роли и табличные пространства после загрузки имеет смысл выполнить ANALYZE
Комментарии преподавателя
Для создания полноценной резервной копии базы данных используется утилита pg_dump.
Если не указать имя файла (-f, –file), то утилита выведет результат в стандартный поток вывода.
Результатом является скрипт, предназначенный для psql, который содержит команды для создания объектов и наполнения их данными.
Дополнительными ключами утилиты можно ограничить набор объектов: выбрать указанные таблицы или все объекты в указанных схемах, выгрузить только определения объектов или только данные и т. п.
Следует иметь в виду, что базу данных для восстановления надо создавать из шаблона template0, так как все изменения, сделанные в template1, попадут в резервную копию.
Кроме того, заранее должны быть созданы необходимые роли и табличные пространства. Поскольку эти объекты не относятся к конкретной БД, они не будут выгружены в резервную копию.
После восстановления базы данных имеет смысл выполнить команду ANALYZE — она соберет статистику, необходимую оптимизатору для планирования запросов.
https://postgrespro.ru/docs/postgresql/16/app-pgdump
Page 9: Утилита pg_dump
При запуске без дополнительных параметров утилита pg_dump выдает команды SQL, создающие все объекты в текущей базе данных. Чтобы получить команды, позволяющие восстановить копию на системе с другим набором ролей, могут пригодиться ключи: -O, –no-owner — не генерировать команды для установки владельца объектов; -x, –no-acl — не генерировать команды для установки привилегий.
Page 10: Page 10
Видно, что pg_dump создал таблицу t и заполнил ее с помощью уже рассмотренной нами команды COPY. Ключ –column-inserts позволяет использовать команды INSERT, но загрузка будет работать существенно дольше. Логическая резервная копия в формате plain может содержать злонамеренно вставленные метакоманды, например \gexec. Чтобы избежать проблем при выполнении скрипта в psql, pg_dump добавляет в его начало метакоманду \restrict с последующим ключом. Эта команда включает ограниченный режим, в котором psql игнорирует все метакоманды, кроме команды \unrestrict с таким же ключом, отменяющей ограниченный режим. Эти ключи полезны для выгрузки и загрузки данных частями: -s, –schema-only — выгрузить только определения объектов без данных; -a, –data-only — выгрузить только данные, без создания объектов. Удобны, если восстанавливать копию на системе, в которой уже есть данные (и наоборот, на чистой системе): -c, –clean — генерировать команды DROP для создаваемых объектов; -C, –create — генерировать команды создания БД и подключения к ней. Важный момент: в выгрузку попадают и изменения, сделанные в шаблонной БД template1. Поэтому восстанавливать резервную копию лучше на базе данных, созданной из template0. При использовании ключа –create это учитывается автоматически:
Существуют ключи для выбора объектов, которые должны попасть в резервную копию: -n, –schema — шаблон для имен схем; -t, –table — шаблон для имен таблиц. И наоборот, включить в копию все, кроме указанного: -N, –exclude-schema — шаблон для имен схем; -T, –exclude-table — шаблон для имен таблиц. Например, восстановим таблицу t в другой базе данных на другом сервере.
Page 11: Page 11
Page 12: Формат custom
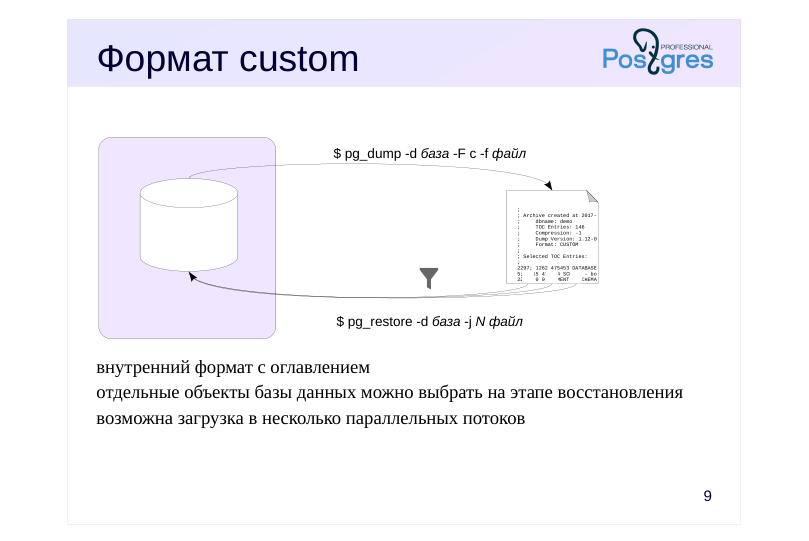 {#source-figure-012 caption=“Source slide page 12: Формат custom”}
- внутренний формат с оглавлением отдельные объекты базы данных можно выбрать на этапе восстановления возможна загрузка в несколько параллельных потоков
Комментарии преподавателя
Утилита pg_dump поддерживает несколько форматов резервной копии. По умолчанию это plain — простые команды для psql.
Формат custom (-F c, –format=custom) создает резервную копию в специальном формате, содержащем не только объекты, но и оглавление. Наличие оглавления позволяет выбирать объекты для восстановления не при создании копии, а непосредственно при восстановлении. Файл формата custom по умолчанию сжат.
Для восстановления потребуется другая утилита — pg_restore. Она читает файл и преобразует его в команды psql. Если не указать явно имя базы данных (в ключе -d), то команды будут выведены в стандартный поток вывода. Если же база данных указана — утилита соединится с этой БД и выполнит команды без участия psql.
Чтобы восстановить только часть объектов, можно воспользоваться одним из двух подходов. Во-первых, можно ограничить объекты аналогично тому, как они ограничиваются в pg_dump. Вообще, pg_restore использует многие параметры утилиты pg_dump.
Во-вторых, можно получить из оглавления список объектов, содержащихся в резервной копии (ключ –list). Затем этот список можно отредактировать вручную, удалив ненужное и передать измененный список на вход pg_restore (ключ –use-list).
Загрузку можно выполнить параллельно, указав количество потоков ключом -j — это еще одно преимущество формата custom.
https://postgrespro.ru/docs/postgresql/16/app-pgdump
Page 13: Утилита pg_dump — формат custom
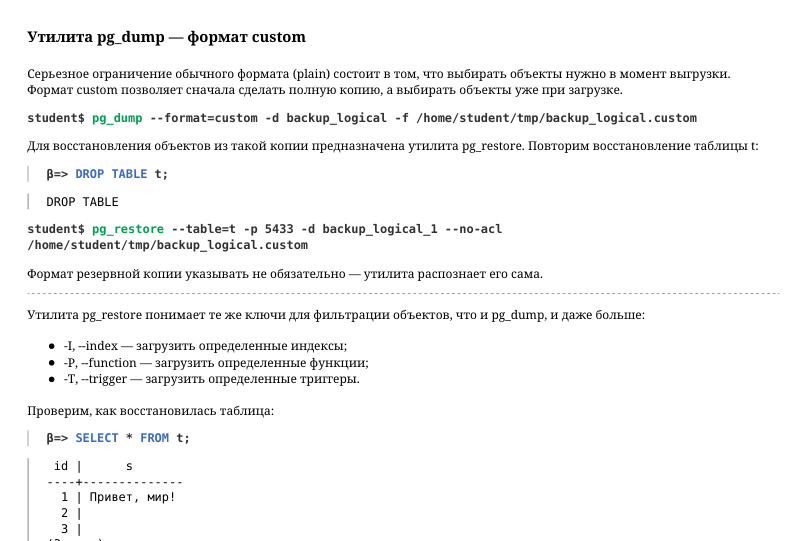 {#source-figure-013 caption=“Source slide page 13: Утилита pg_dump — формат custom”}
Серьезное ограничение обычного формата (plain) состоит в том, что выбирать объекты нужно в момент выгрузки. Формат custom позволяет сначала сделать полную копию, а выбирать объекты уже при загрузке.
Для восстановления объектов из такой копии предназначена утилита pg_restore. Повторим восстановление таблицы t:
Формат резервной копии указывать не обязательно — утилита распознает его сама. Утилита pg_restore понимает те же ключи для фильтрации объектов, что и pg_dump, и даже больше: -I, –index — загрузить определенные индексы; -P, –function — загрузить определенные функции; -T, –trigger — загрузить определенные триггеры. Проверим, как восстановилась таблица:
Еще один пример: восстановим целиком исходную базу данных backup_logical на другом сервере.
Здесь мы указали БД postgres, но могли указать любую — утилита сама создаст нужную БД и тут же переключится в нее. Проверим:
Page 14: Формат directory
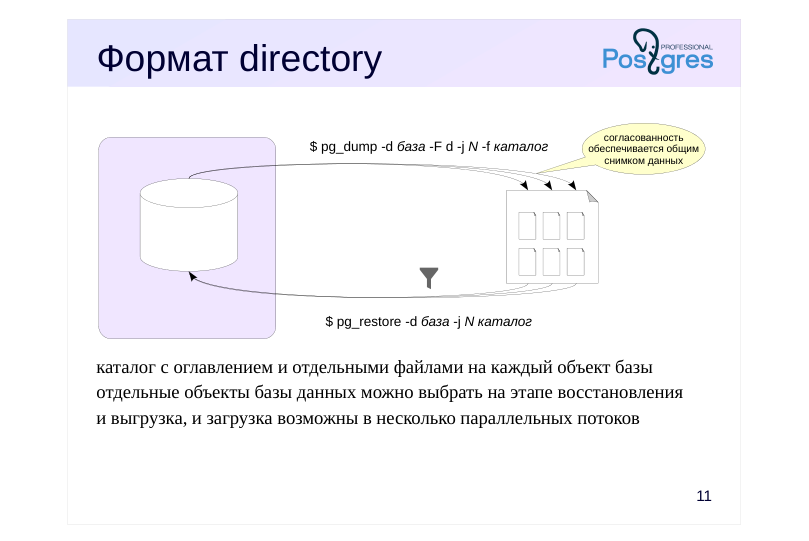 {#source-figure-014 caption=“Source slide page 14: Формат directory”}
каталог с оглавлением и отдельными файлами на каждый объект базы отдельные объекты базы данных можно выбрать на этапе восстановления и выгрузка, и загрузка возможны в несколько параллельных потоков
Комментарии преподавателя
Еще один формат резервной копии — directory. В таком случае будет создан не один файл, а каталог, содержащий объекты и оглавление. По умолчанию файлы внутри каталога будут сжаты.
Преимущество перед форматом custom состоит в том, что такая резервная копия может создаваться параллельно в несколько потоков (количество указывается в ключе -j, –jobs).
Разумеется, несмотря на параллельное выполнение, копия будет содержать согласованные данные. Это обеспечивается общим снимком данных для всех параллельно работающих процессов.
https://postgrespro.ru/docs/postgresql/16/functions-admin#FUNCTIONS-SN APSHOT-SYNCHRONIZATION
Восстановление, как и для формата custom, возможно в несколько потоков.
В остальном возможности по работе с форматом directory не отличаются от ранее рассмотренных: поддерживаются те же ключи и подходы.
Page 15: Утилита pg_dump — формат directory
Формат directory интересен тем, что позволяет выгружать данные в несколько параллельных потоков.
При этом гарантируется согласованность данных: все параллельные потоки будут использовать один и тот же снимок данных. Заглянем внутрь каталога:
В нем находится файл оглавления и по одному файлу на каждый выгружаемый объект (у нас он всего один):
Для восстановления из резервной копии предварительно отключимся от базы данных backup_logical:
В команду восстановления добавляем ключ –clean, который генерирует команду удаления существующей БД:
Page 16: Сравнение форматов
plain custom directory tar
- утилита для восстановления psql pg_restore
- сжатие gzip, lz4 или zstd
- выборочное восстановление да да да
- параллельное резервирование да
- параллельное восстановление да да
Комментарии преподавателя
В приведенной таблице разные форматы сравниваются с точки зрения предоставляемых ими возможностей.
Имеется и четвертый формат — tar. Он не рассматривался, так как не привносит ничего нового и не дает преимуществ перед другими форматами. Фактически он соответствует созданию tar-файла из каталога в формате directory, но не поддерживает сжатие и параллелизм.
Page 17: Копия кластера БД
 {#source-figure-017 caption=“Source slide page 17: Копия кластера БД”}
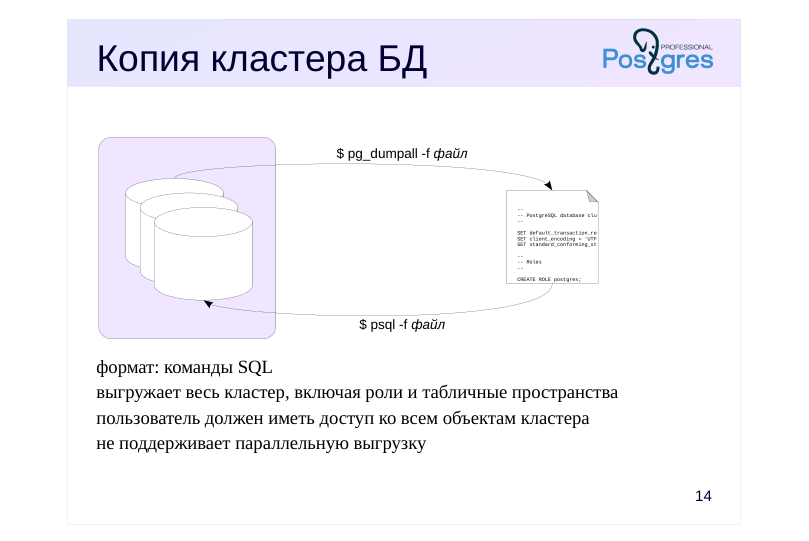
- формат: команды SQL выгружает весь кластер, включая роли и табличные пространства пользователь должен иметь доступ ко всем объектам кластера не поддерживает параллельную выгрузку
Комментарии преподавателя
Чтобы создать резервную копию всего кластера, включая роли и табличные пространства, можно воспользоваться утилитой pg_dumpall.
Поскольку pg_dumpall требуется доступ ко всем объектам всех БД, имеет смысл запускать ее от имени суперпользователя. Утилита по очереди подключается к каждой БД кластера и выгружает информацию с помощью pg_dump. Кроме того, она сохраняет и данные, относящиеся к кластеру в целом.
Чтобы начать работу, утилите требуется подключиться хотя бы к какой-то базе данных. По умолчанию выбирается postgres или template1, но можно указать и другую.
Результатом работы pg_dumpall является скрипт для psql. Другие форматы не поддерживаются. Это означает, что pg_dumpall не поддерживает параллельную выгрузку данных, что может оказаться проблемой при больших объемах данных. В таком случае можно воспользоваться ключом –globals-only, чтобы выгрузить только роли и табличные пространства, а сами базы данных выгрузить отдельно с помощью pg_dump в параллельном режиме.
https://postgrespro.ru/docs/postgresql/16/app-pg-dumpall
Page 18: Утилита pg_dumpall
Утилита pg_dump годится для выгрузки одной базы данных, но никогда не выгружает общие объекты кластера БД, такие, как роли и табличные пространства. Чтобы сделать полную копию кластера, нужна утилита pg_dumpall. Утилиты pg_dumpall, pg_dump и pg_restore не требуют каких-то отдельных привилегий, но у выполняющей их роли должны быть привилегии на чтение (создание) всех затронутых объектов. Утилитой pg_dump может, например, пользоваться владелец базы данных. Но поскольку для копирования кластера надо иметь доступ ко всем БД, мы выполняем pg_dumpall под суперпользовательской ролью.
В копию кластера попадают: команды, которые выгружает pg_dump для каждой базы; команды для общих объектов кластера (ролей и табличных пространств). Команды для общих объектов можно получить отдельно:
Page 19: Page 19
Восстановление выполняется с помощью psql — никакой другой формат не поддерживается.
Page 20: Page 20
Page 21: Page 21
Page 22: Page 22
В процессе восстановления могут возникать ошибки из-за невозможности удалить некоторые объекты или создать уже существующие, в данном случае это нормально и не мешает процессу.
Влияние политик защиты строк
Если на таблицах определены политики защиты строк (подробно рассматриваются в теме «Доступ на уровне строк» курса DBS), то есть опасность выгрузить неполные данные и даже не узнать об этом. Чтобы этого не произошло, перед выполнением команды COPY можно установить параметр row_security в значение off — в этом случае применение политики приведет к явной ошибке. Простой пример. Настроим политику так, чтобы не были видны пустые строки, и включим ее для владельца таблицы:
Теперь COPY выгрузит только две строки:
Page 23: Page 23
Но если установить параметр в off, получим ошибку:
Утилиты pg_dump и pg_dumpall автоматически устанавливают row_security = off, так что дополнительные действия не нужны:
Утилита попыталась выгрузить строки таблицы командой COPY и завершилась ошибкой — она сообщает, что выгрузить все строки таблицы t не удается. Если все-таки решим выгрузить только доступные строки, можно использовать –enable-row-security:
Чтобы обойти политики защиты строк и выгрузить все данные, пользователь должен иметь атрибут BYPASSRLS:
Теперь запросы от роли student будут игнорировать политики защиты строк:
Page 24: Page 24
Page 25: Итоги
Логическое резервирование позволяет сделать копию всего кластера, базы данных или отдельных объектов
- Хорошо подходит
- для данных небольшого объема
- для длительного хранения, за время которого меняется версия сервера
- для миграции на другую платформу
- Плохо подходит
- для восстановления после сбоя с минимальной потерей данных
Page 26: Практика
- Создайте пару баз данных с таблицами и представлениями, получите с помощью pg_dumpall копию только глобальных объектов кластера, а затем сделайте копии баз данных с помощью утилиты pg_dump в параллельном режиме. Восстановите кластер на другом сервере, используя созданные резервные копии. 2. Создайте таблицу с двумя столбцами, один из которых является первичным ключом и заполняется последовательностью. Воспроизведите ситуацию, когда при загрузке с помощью COPY последовательность не генерирует новые значения, вызывая нарушение уникальности при последующей вставке строк.
Комментарии преподавателя
- Объявите столбец как GENERATED ALWAYS AS IDENTITY.
После выполнения практических заданий удалите созданные базы данных и файлы логических копий.
Page 27: 1. Логическое копирование
Создадим базы данных, пару таблиц и представлений.
Сделаем копию глобальных объектов.
Логические копии баз данных в параллельном режиме:
Теперь восстановим кластер. Сначала восстанавливаем глобальные объекты:
Page 28: Page 28
Затем — две базы данных в параллельном режиме:
Проверим:
Удалим созданные базы данных.
2. COPY для таблицы с последовательностью
Таблица с двумя столбцами:
Page 29: Page 29
Созданы таблица и последовательность:
Загружаем строки, не указывая значения для первого столбца.
Содержимое таблицы соответствует ожиданиям:
Счетчик последовательности корректен:
Можно добавить очередную строку:
Вставляя строки с помощью команды INSERT, мы не можем указывать значение столбца, объявленного как GENERATED ALWAYS. Оно должно генерироваться последовательностью:
Однако COPY дает такую возможность:
На первый взгляд все нормально…
Page 30: Page 30
Но это не так:
Нарушение первичного ключа произошло из-за того, что COPY не обращается к последовательности:
Исправим ситуацию, изменив состояние последовательности.
Теперь добавление удастся:
Уборка
Удалим базу данных.
Page 31: Практика+
- Создайте таблицу с несколькими строками. Подберите такие параметры \copy, чтобы при записи копии в файл перепутались корректные данные и неопределенные значения (NULL) из-за неудачного выбора кода. 2. Используя \copy, создайте текстовый файл, в котором отсутствие значения обозначается как N/A. Загрузите строки из этого файла в таблицу, в которой отсутствие значения представляет NULL. 3. Создайте таблицу с данными размером несколько мегабайт и получите размеры логических копий в пользовательском формате с разными способами сжатия. Также измерьте время, затраченное при копировании с каждым методом сжатия.
Комментарии преподавателя
Если ошибочно использовать код для NULL, который будет совпадать с каким-либо нормальным содержимым столбцов таблицы, получившаяся копия не позволит корректно восстановить данные.
Сгенерировать данные можно, например, запросом SELECT (random()::numeric*(g.i))^(g.i) AS n FROM generate_series(1,2_500) AS g(i);
Измерить время можно командой /usr/bin/time -f %e pg_dump … .
После выполнения практических заданий удалите созданные базы данных и временные файлы.
Page 32: 1. Ломаем COPY
Создадим базу данных.
Например, можно установить отображение неопределенных значений, совпадающее с какими-либо данными:
Установим для неопределенных значений код N:
Вывод двух разных значений теперь неотличим друг от друга. Корректно восстановить из такой копии данные невозможно.
Осторожнее с изменением формата по умолчанию!
2. Загрузка данных с пропусками
Создадим файл, в котором отсутствие данных будет отмечено как N/A.
Создадим таблицу для загрузки данных.
Загрузим данные в таблицу из файла. Значение N/A должно загружаться как NULL.
3. Сжатие в pg\_dump
Создадим таблицу достаточно большого размера.
Page 33: Page 33
Измерим время выгрузки данных без сжатия (а также прогреем кеш).
Сколько потребуется времени на выгрузку со сжатием gzip (используется по умолчанию)?
Теперь испытаем lz4.
А теперь — zstd.
Сравним размеры полученных копий:
Выводы: gzip сжимает лучше всех, однако работает в несколько раз дольше; lz4 — самый быстрый, но дает весьма небольшой эффект; zstd — хороший компромисс: степень сжатия лишь немного уступает gzip, а скорость сравнима с lz4.
Уборка
Удалим созданные базы данных и временные файлы.
02 Занятие 02: Резервное копирование / Базовая резервная копия
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba3_02_backup_base.html Archive: DBA3-handouts-16.zip Страниц PDF: 26
Page 1: Резервное копирование / Базовая резервная копия
Авторские права
© Postgres Professional, 2017–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Понятие физической резервной копии
- Холодное и горячее резервирование
- Протокол репликации и слот
- Клонирование кластера и архивная копия
- Проверка целостности
- API резервирования
Page 3: Физическая копия
Базовая физическая копия — копия всех файлов кластера
- быстрее, чем логическое резервирование
- восстанавливается статистика
- − можно восстановиться только на совместимой системе
- − и на той же самой основной версии PostgreSQL
- − выборочная копия невозможна, копируется весь кластер
Комментарии преподавателя
Физическое резервирование подразумевает копирование всех файлов, относящихся к кластеру БД (как файлов данных, так и служебных файлов), то есть создание полной двоичной копии.
Копирование файлов работает быстрее, чем выгрузка SQL-команд при логическом резервировании; запустить сервер из созданной физической копии — дело нескольких минут, в отличие от восстановления из логической копии. Кроме того, нет необходимости заново собирать статистику — она также восстанавливается из копии.
Но есть и минусы. Из физической резервной копии можно восстановить систему только на совместимой платформе (та же ОС, та же разрядность, тот же порядок байтов в представлении чисел и т. п.) и только на той же основной версии PostgreSQL. Кроме того, невозможно сделать физическую копию отдельных баз данных кластера, возможно копирование только всего кластера целиком.
Page 4: Холодное резервирование
Выключенный сервер
- если выполнена контрольная точка, то достаточно скопировать файлы
- копию можно развернуть на другом сервере, независимо от PGDATA
- простота
- − требуется прерывание обслуживания
- Снимок файловой системы
- как при неаккуратном выключении: при старте потребуется
- восстановление, но в копию войдут все нужные файлы журнала
- данные, в т. ч. табличные пространства, должны войти в один снимок
- не надо останавливать сервер
- − файловые системы, поддерживающие снимки, работают медленней
Комментарии преподавателя
Смысл холодного резервирования состоит в том, чтобы сделать копию файлов кластера в тот момент, когда данные на диске согласованы, то есть на диск сброшено актуальное состояние всех страниц. Восстановление из такой копии происходит просто: файлы разворачиваются, запускается сервер — и он сразу же готов к работе.
Сделать такую копию можно лишь корректно остановив сервер с выполнением контрольной точки. Минус понятен: необходима остановка сервера (надолго при большом объеме данных).
Время простоя можно сократить за счет предварительного выполнения rsync (или аналогичного инструмента) при работающем сервере. Тогда после останова сервера rsync докопирует только изменения (которых, предположительно, будет немного). Но простоя все равно не избежать.
Другой вариант — сделать несогласованную копию, в которую попадут страницы, сохраненные в разное время. Такая рассогласованность неизбежна при некорректном отключении сервера или при создании снимка файловой системы. В последнем случае все файлы кластера должны попасть в один снимок. Это может оказаться невозможным, если файлы расположены в разных файловых системах.
При восстановлении из несогласованных данных серверу при старте потребуется согласовать страницы. Это обычная автоматическая процедура восстановления после сбоя. Она не представляет проблемы, так как необходимые файлы журнала гарантированно попадут в копию, но потребует некоторого времени.
https://postgrespro.ru/docs/postgresql/16/backup-file
Page 5: Холодная файловая копия
Файлы остановленного кластера можно скопировать и запустить с ними второй сервер. При этом не важно, был ли сервер остановлен корректно. Создадим базу данных и таблицу.
Аварийно останавливаем сервер alpha и копируем файлы на сервер beta:
Сервер beta запускается, восстанавливая согласованность:
Page 6: Горячее резервирование
Работающий сервер
- страницы не согласованы между собой, как при неаккуратном
- выключении
- страница может меняться во время ее копирования
- (проблема неатомарного чтения и записи)
- для восстановления согласованности необходимы журнальные записи
- от последней контрольной точки за все время копирования
- (в процессе копирования сервер может удалить часть файлов)
- не требуется прерывание обслуживания
- − нужны специальные инструменты
Комментарии преподавателя
Горячее резервирование выполняется на работающем сервере, поэтому в копию наверняка попадут несогласованные между собой страницы.
Более того. При резервном копировании данные читаются не через буферный кеш, а напрямую из файлов. Содержимое файлов на диске, очевидно, изменяется во время копирования, а гарантии атомарности чтения/записи страниц PostgreSQL может и не быть (это зависит от файловой системы и оборудования и обсуждается в теме «Настройка журнала» курса DBA2). Поэтому в резервную копию могут попадать «безнадежные» страницы, к которым даже нельзя применить журнальные записи. Это первая сложность.
Вторая сложность состоит в том, что копирование файлов данных может занимать достаточно много времени. Но сервер, после выполнения очередной контрольной точки, может удалить часть файлов журнала, которые уже не нужны ему для восстановления после сбоя, но нужны для резервной копии.
Если не принять специальных мер, сделанная резервная копия будет непригодна для восстановления. Поэтому для горячего резервирования требуются специальные инструменты. PostgreSQL предоставляет низкоуровневый интерфейс, используя который можно реализовать надежное копирование. Этот интерфейс использует и штатная утилита pg_basebackup, и другие сторонние средства резервного копирования.
https://postgrespro.ru/docs/postgresql/16/continuous-archiving#BACKUP-BA SE-BACKUP
Page 7: Протокол репликации
Задачи
- управление резервным копированием и репликацией
- в частности, получение потока журнальных записей
- Обслуживается процессом wal sender
- max_wal_senders = 10
- wal_level = replica или logical, но не minimal
- Подключение
- роль с атрибутом REPLICATION или SUPERUSER
- разрешение на подключение в pg_hba.conf
Комментарии преподавателя
Для упрощения задачи сервер PostgreSQL предоставляет протокол репликации — специальный протокол для управления как собственно репликацией (рассматривается в одноименном модуле), так и резервным копированием. В частности, он позволяет получать поток журнальных записей, которые генерирует сервер.
На сервере подключение по протоколу репликации обслуживается процессом wal sender. Он похож на обычный обслуживающий процесс, который запускается при обычном подключении клиента, но понимает не SQL, а специальные команды. Число одновременно работающих процессов wal_sender ограничено параметром max_wal_senders (значение по умолчанию — 10).
Уровень журнала должен быть не ниже, чем replica. Дело в том, что на уровне minimal такие команды, как CREATE TABLE AS SELECT, CREATE INDEX или COPY FROM не попадают в журнал: долговечность обеспечивается тем, что данные не остаются в оперативной памяти, а сразу записываются на диск. Этого достаточно для восстановления после сбоя и из холодной копии, но недостаточно для восстановления из горячей копии.
Чтобы использовать протокол репликации, клиент должен подключаться к серверу под ролью, имеющей атрибут REPLICATION (либо под суперпользователем). В pg_hba.conf надо разрешить подключение этой роли к базе данных replication (это не название БД, а ключевое слово). Причем разрешения для all недостаточно, подключение к replication должно быть разрешено отдельно.
https://postgrespro.ru/docs/postgresql/16/protocol-replication
Page 8: Слот репликации
Серверный объект для гарантии получения журнальных записей
- помнит, какая запись была передана клиенту последней
- число слотов ограничено max_replication_slots = 10
- Не позволяет удалить сегмент WAL, пока все его записи не переданы клиенту
- клиент может получать данные в удобном режиме,
- в том числе отключаться на время
- при отключении клиента журнальные файлы накапливаются на сервере
- мониторинг состояния: pg_replication_slots
Комментарии преподавателя
Чтобы при выполнении контрольной точки сервер не удалил файлы WAL преждевременно, можно применять слот репликации. Если поток журнальных записей идет через слот, то слот помнит, какие записи уже были переданы клиенту, и не позволяет серверу удалять файл WAL до тех пор, пока клиент не получит все записи из этого файла.
Использование слота позволяет клиенту не беспокоиться о том, что сервер сотрет файл журнала раньше времени. Клиент даже может отключиться и затем через какое-то время подключиться вновь и продолжить получать журнальные записи с того момента, на котором остановился.
Но надо иметь в виду, что при отключении клиента файлы журнала будут накапливаться на сервере и могут занять все свободное место. Поэтому каждый созданный слот следует добавлять в мониторинг (представление pg_replication_slots) и своевременно удалять ненужные слоты.
Общее количество слотов, которые могут быть созданы, ограничено конфигурационным параметром max_replication_slots (значение по умолчанию — 10).
Подробнее применение слотов обсуждается в модуле «Репликация».
https://postgrespro.ru/docs/postgresql/16/warm-standby#STREAMING-REP LICATION-SLOTS
Page 9: Клонирование кластера
 {#source-figure-009 caption=“Source slide page 9: Клонирование кластера”}
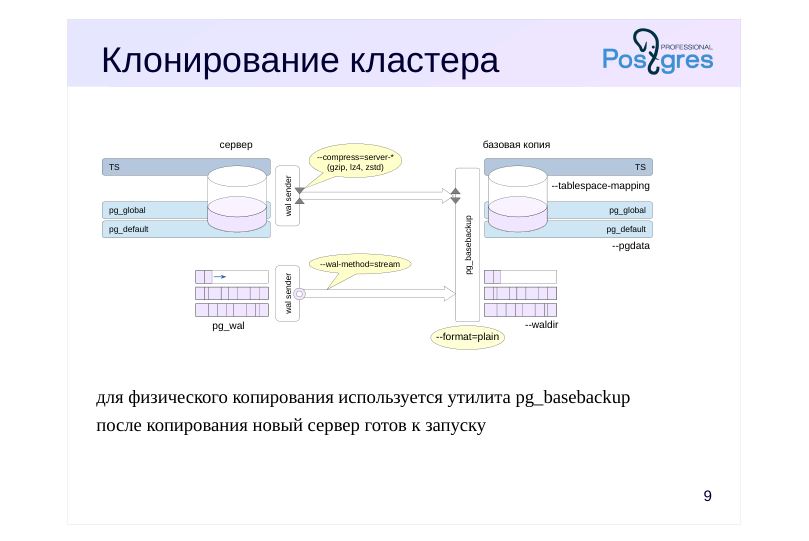
для физического копирования используется утилита pg_basebackup после копирования новый сервер готов к запуску
Комментарии преподавателя
Для немедленного развертывания нового сервера из копии вызывают pg_basebackup в обычном формате (–format=plain — по умолчанию), запуская утилиту на целевом сервере. Она подключается к серверу-источнику и копирует с него файлы в локальный каталог, указанный параметром –pgdata.
Дополнительные табличные пространства копируются по тем же абсолютным путям, что и на сервере-источнике. Пути можно переназначить, указав соответствия в параметрах –tablespace-mapping утилиты. Это необходимо, если pg_basebackup запускается на самом сервере-источнике.
При потоковой доставке (–wal-method=stream — по умолчанию) утилита устанавливает второе соединение для передачи потока журнальных записей, которые генерирует работающий сервер, в локальный каталог, указанный параметром –waldir.
По умолчанию второе соединение использует временный слот репликации, который создается при подключении и удаляется при завершении работы pg_basebackup. Однако можно указать и имя постоянного слота, который должен существовать на момент запуска утилиты или создаваться ей.
В формате plain можно сжимать данные на сервере, уменьшая нагрузку на сеть. Переданные данные затем распаковываются утилитой. Но журнальные записи в потоковом режиме не сжимаются.
https://postgrespro.ru/docs/postgresql/16/app-pgbasebackup
Page 10: Клонирование кластера
Сделаем базовую копию работающего сервера alpha и восстановим с помощью этой копии сервер beta.
Разрешение на локальное подключение по протоколу репликации в pg_hba.conf уже имеется:
Чтобы утилита pg_basebackup могла подключиться к серверу под ролью student, эта роль должна иметь атрибут REPLICATION:
Остановим сервер beta и удалим каталог данных этого сервера.
Скопируем, выполнив быструю контрольную точку. Данные будут сжаты на стороне сервера и затем распакованы утилитой — это ускоряет передачу по сети, но при локальном подключении не даст эффекта. Параметр –pgdata указывает целевой каталог для записи копии. Каталог создается автоматически, но если он уже существует, то должен быть пуст.
Эта команда использовала значения по умолчанию: –format=plain –wal-method=stream В подкаталог pg_wal скопированы файлы журнала:
Page 11: Проверка целостности
Проверка файлов данных
- задача: гарантировать, что в копию попадут целостные данные
- утилиты pg_basebackup и pg_checksums
- проверяют контрольные суммы страниц файлов отношений
- Проверка резервной копии
- задача: проверить, что целостность данных в копии
- не нарушилась со временем
- файл манифеста backup_manifest
- утилита pg_verifybackup проверяет файлы по списку из манифеста
Комментарии преподавателя
Данные могут повреждаться как при записи на носитель, так и в процессе хранения. Важно убедиться в том, что в копию попали целостные данные и в дальнейшем эта целостность не нарушилась.
Расчет контрольных сумм файлов отношений включается при инициализации кластера (или в процессе работы утилитой pg_checksums). Контрольная сумма сохраняется при каждом изменении страницы в ее заголовке. Вычисленная и сохраненная контрольная сумма сравниваются:
● при каждом чтении страницы в буферный кеш;
● утилитой pg_basebackup при формировании резервной копии;
● утилитой pg_checksums в режиме проверки.
Утилита pg_basebackup включает в копию файл backup_manifest с информацией о файлах (имена, размеры, вычисленные контрольные суммы) и журнальных записях (начальная и конечная позиции WAL, линия времени), а также контрольную сумму самого манифеста.
https://postgrespro.ru/docs/postgresql/16/backup-manifest-format
Утилита pg_verifybackup проверяет соответствие резервной копии манифесту: наличие файлов, корректность контрольных сумм, возможность чтения и разбора записей WAL, необходимых для восстановления.
https://postgrespro.ru/docs/postgresql/16/app-pgverifybackup
Для полной уверенности все же следует развернуть резервную копию и проверить работоспособность сервера, ведь совпадение контрольных сумм не дает гарантии, что данные не были повреждены.
Page 12: Проверка целостности
Резервная копия содержит файл манифеста, вот его начало и конец:
Проверим целостность копии утилитой pg_verifybackup:
Утилита проверяет по манифесту наличие файлов, их контрольные суммы, а также наличие и возможность чтения всех записей WAL, необходимых для восстановления. Запускаем второй сервер.
Теперь оба сервера работают одновременно и независимо. Проверим:
Page 13: Потоковая доставка WAL
 {#source-figure-013 caption=“Source slide page 13: Потоковая доставка WAL”}
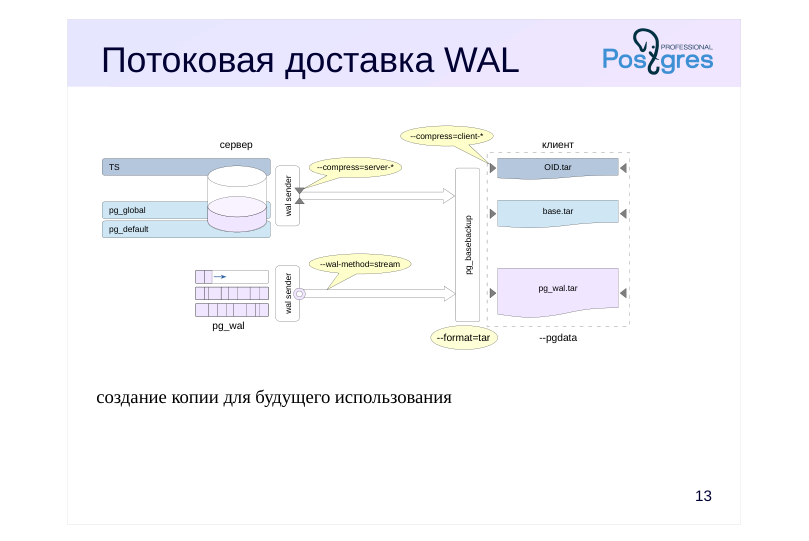
создание копии для будущего использования
Комментарии преподавателя
Для создания архивных копий используется формат tar. По умолчанию используется потоковая доставка журнальных записей (параметр –wal-method=stream).
Файлы кластера будут сохранены в файле base.tar. Каждое дополнительное табличное пространство копируется в отдельный tar-файл, имя которого совпадает с OID табличного пространства. Сегменты WAL помещаются в отдельный файл pg_wal.tar.
Утилита может выполнять сжатие как на стороне клиента, так и на стороне сервера (в последнем случае pg_wal.tar не сжимается). К именам сжатых tar-архивов добавится суффикс, соответствующий методу сжатия. Например, при сжатии методом gzip основной файл будет называться base.tar.gz.
Для восстановления из такой копии сначала потребуется развернуть tar-файлы по правильным путям. При этом пути табличных пространств можно изменить: для этого нужно перед запуском сервера отредактировать файл tablespace_map или использовать параметр командной строки –tablespace-mapping.
Page 14: Файловая доставка клиенту
 {#source-figure-014 caption=“Source slide page 14: Файловая доставка клиенту”}
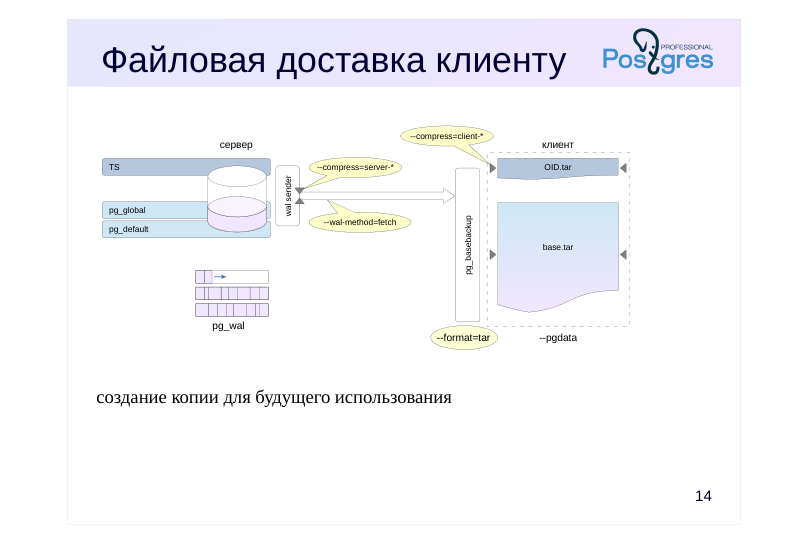
создание копии для будущего использования
Комментарии преподавателя
При создании архивной копии можно использовать другой режим — файловую доставку журнальных записей (–wal-method=fetch).
В этом случае отдельное соединение не создается, а сегменты журнала копируются и передаются по основному соединению. Это происходит после того, как скопированы все файлы кластера. Необходимо учитывать, что во время контрольной точки сервер может удалить сегменты журнала, уже не нужные для восстановления, поэтому стоит позаботиться об их сохранности, установив достаточно большое значение параметру wal_keep_size.
Журнальные сегменты записываются в файл base.tar вместе с остальными файлами кластера.
В большинстве случаев возможность использовать режим fetch при создании копии на клиенте не нужна. Она осталась с прежних версий и в настоящее время может иметь смысл только для того, чтобы передавать журнальные записи сжатыми — режим stream не дает такой возможности.
Page 15: Архивная копия на стороне клиента
Создадим архивную копию на клиенте. Сжатие будем выполнять также на стороне клиента.
В этой команде по умолчанию была использована потоковая доставка WAL (–wal-method=stream). Посмотрим на получившуюся копию:
При потоковой доставке записей WAL в формате tar для них создается отдельный файл:
Теперь создадим еще одну архивную копию на клиенте, но используем режим доставки fetch. В этом случае сегменты WAL будут передаваться по тому же соединению, что и данные. Сжатие поручим серверу.
В получившейся копии сегменты WAL помещены в файл base.tar.gz.
Page 16: Файловая доставка серверу
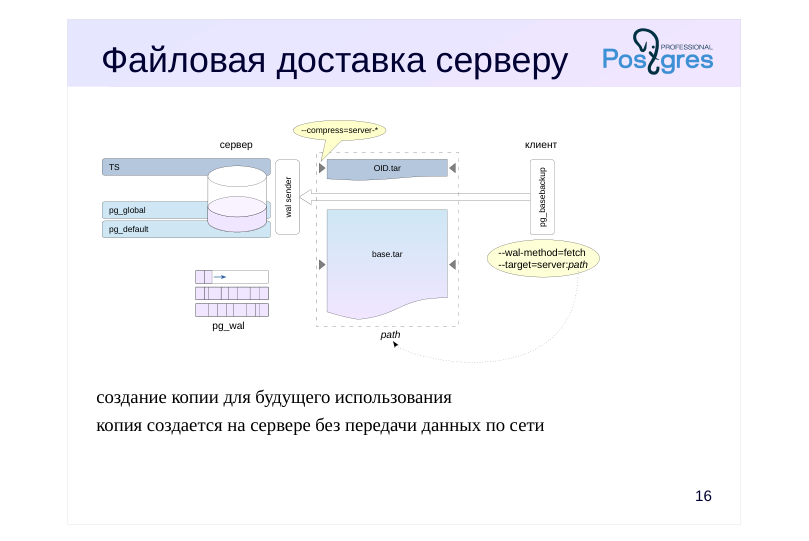 {#source-figure-016 caption=“Source slide page 16: Файловая доставка серверу”}
создание копии для будущего использования копия создается на сервере без передачи данных по сети
Комментарии преподавателя
Архивную копию можно создать на сервере, запуская pg_basebackup на клиенте. Данные при этом не передаются по сети.
Создание копии на сервере задается параметром командной строки pg_basebackup –target=server:path, где path — путь к каталогу в файловой системе сервера (по умолчанию подразумевается –target=client).
В этом режиме также можно использовать сжатие, но, конечно, только на стороне сервера.
При создании копии на сервере невозможно использовать потоковый режим доставки WAL (stream), поскольку журнальные записи вообще не передаются клиенту. Необходимо указать режим доставки fetch, при котором накопившиеся журнальные сегменты копируются и помещаются в файл base.tar вместе с остальными файлами кластера.
Page 17: Архивная копия на сервере
Запустим pg_basebackup на клиенте и при этом сохраним архивную копию на сервере. В этом случае мы обязаны использовать режим доставки fetch, поэтому установим параметр wal_keep_size (будем надеяться, что этого значения хватит):
Запустим pg_basebackup, указав каталог на сервере для сохранения архивной копии и режим сжатия zstd.
Получили сжатую архивную копию в формате tar (он подразумевается).
При режиме доставки fetch утилита сохраняет сегменты WAL в общем архиве:
Удалим архивную копию.
Page 18: Низкоуровневый взгляд
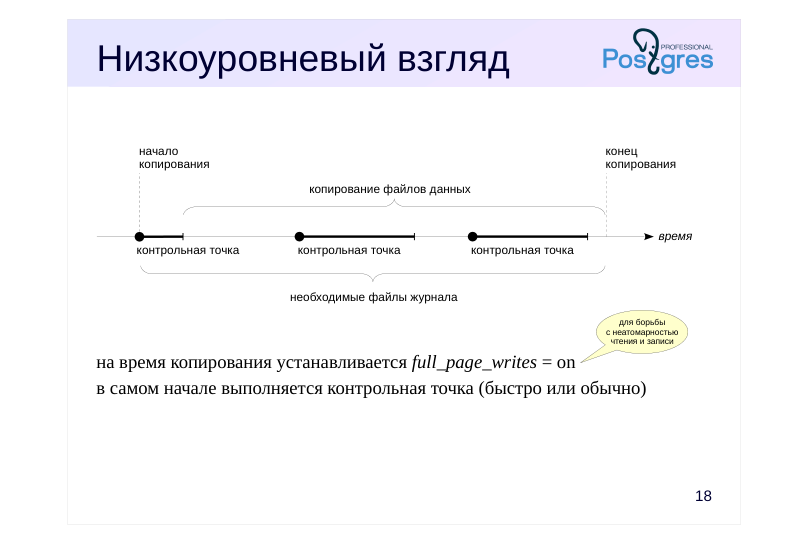 {#source-figure-018 caption=“Source slide page 18: Низкоуровневый взгляд”}
на время копирования устанавливается full_page_writes = on в самом начале выполняется контрольная точка (быстро или обычно)
Комментарии преподавателя
Общий алгоритм изготовления резервной копии на низком уровне одинаков как для pg_basebackup, так и для любых сторонних средств (которые могут потребоваться, поскольку pg_basebackup предоставляет только самую базовую функциональность).
- Надо сообщить серверу о том, что начинается резервное копирование.
При этом, во-первых, на время копирования устанавливается параметр full_page_writes: при первом изменении страницы после контрольной точки полный образ этой страницы записывается в журнал. При восстановлении журнальные записи будут применяться не к страницам в файле (из-за неатомарности ввода-вывода части страницы могут оказаться рассогласованными), а к образу страницы из журнала.
Во-вторых, выполняется контрольная точка. Предусмотрено два режима: быстрое выполнение (что может привести к пиковой нагрузке на дисковую подсистему) и протяженное (которое определяется обычным параметром checkpoint_completion_target).
После прохождения контрольной точки можно копировать файлы данных любым удобным способом.
После того, как все скопировано, надо сообщить серверу, что резервное копирование завершено.
Кроме того, так или иначе надо обеспечить попадание в резервную копию всех журнальных записей, сгенерированных с начала копирования и до его окончания.
Page 19: API резервирования
Начало копирования: pg\_backup\_start
- выполняет контрольную точку, устанавливает full_page_writes
- возвращает начальную позицию в журнале
- Конец копирования: pg_backup_stop
- возвращает конечную позицию в журнале
- Копирование файлов
- либо протокол репликации, либо любые средства ОС
- Копирование журнала от начальной до конечной позиции
- протокол репликации + слот либо средства ОС + wal_keep_size
Комментарии преподавателя
Описанный алгоритм резервного копирования можно использовать, чтобы реализовать свою собственную утилиту копирования.
Резервное копирование начинается вызовом функции pg_backup_start. Она устанавливает параметр full_page_writes и выполняет контрольную точку, как рассматривалось выше. Возвращаемое этой функцией значение — позиция в журнале, начиная с которой в копию должны попасть журнальные записи.
В конце копирования вызывается функция pg_backup_stop. Она возвращает конечную позицию в журнале.
Все журнальные записи между начальной и конечной позициями надо поместить в резервную копию. Поскольку при своей работе сервер может удалять журнальные файлы, которые не требуются для восстановления, надо либо пользоваться протоколом репликации и слотом, получая записи во время копирования (как pg_basebackup в режиме доставки –wal-method=stream), либо — что менее удобно — копировать файлы средствами ОС, установив параметр wal_keep_size. Можно копировать файлы в несколько потоков, использовать rsync и т. п.
https://postgrespro.ru/docs/postgresql/16/continuous-archiving#BACKUP-LO WLEVEL-BASE-BACKUP
Page 20: Итоги
Базовая резервная копия — полная копия кластера, включая табличные пространства, плюс журнал для восстановления согласованности
- Горячее резервирование позволяет не останавливать сервер
- Инструменты
- протокол репликации
- слот репликации
- низкоуровневый API резервирования
Page 21: Практика
- В первом кластере создайте табличное пространство и базу данных с таблицей в этом пространстве. 2. Сделайте базовую резервную копию кластера с помощью pg_basebackup в формате tar со сжатием. 3. Разверните второй кластер из этой резервной копии. Табличное пространство разместите в другом каталоге, изменив файл tablespace_map. 4. Запустите второй сервер и проверьте его работоспособность.
Комментарии преподавателя
После выполнения практики удалите базу данных и табличное пространство в обоих кластерах.
Page 22: 1. Табличное пространство и база данных
Табличные пространства может создавать только суперпользователь:
2. Базовая резервная копия
Запускаем pg_basebackup от имени роли student, указывая формат tar со сжатием:
3. Восстановление из базовой резервной копии
Очистим основной каталог данных кластера beta. Права на каталог должны быть лишь у владельца.
Каталог для табличного пространства ts на сервере, который будет развернут из резервной копии:
Разворачиваем резервную копию:
Page 23: Page 23
В каталоге pg_tblspc сейчас пусто:
Символическая ссылка появится при старте сервера в соответствии с файлом tablespace_map (который находился внутри base.tar):
Изменяем в этом файле путь для табличного пространства:
4. Запуск и проверка
Запускаем сервер.
Уборка
Удалим резервную копию.
Чтобы удалить базу данных, надо от нее отключиться.
И для второго сервера:
Page 24: Практика+
- Подключите модуль basebackup_to_shell для создания базовой резервной копии на сервере с помощью определяемой пользователем команды. Эта команда должна сжимать tar-архив копии утилитой bzip2. 2. Выполните резервное копирование на сервере в формате tar. Убедитесь, что полученный архив сжат bzip2. 3. Восстановите кластер beta из полученного сжатого архива и проверьте его работоспособность.
Комментарии преподавателя
- Для подключения модуля укажите одноименную библиотеку в параметре shared_preload_libraries. Параметром basebackup_to_shell.command задайте команду, выполняемую при резервном копировании: bzip2 -c > архив.tar.bz2
https://postgrespro.ru/docs/postgresql/16/basebackup-to-shell
Чтобы задействовать модуль при резервном копировании, укажите pg_basebackup –target=shell
Для извлечения файлов из сжатого утилитой bzip2 архива tar воспользуйтесь командой: tar xjf архив.tar.bz2 -C каталог-назначения
После выполнения практики удалите созданные базы данных и резервную копию.
Page 25: 1. Подключение модуля
Запишем настройки для подключения и конфигурации модуля basebackup_to_shell в подключаемый файл конфигурации.
Перезапустим сервер.
Проверим установки.
Создадим базу данных и таблицу в ней.
2. Резервное копирование
Создадим каталог для резервной копии.
Выполним резервное копирование. Использование потокового режима невозможно, поэтому воспользуемся режимом доставки WAL fetch.
3. Восстановление из резервной копии
Удалим файлы кластера beta.
Page 26: Page 26
 {#source-figure-026 caption=“Source slide page 26: Page 26”}
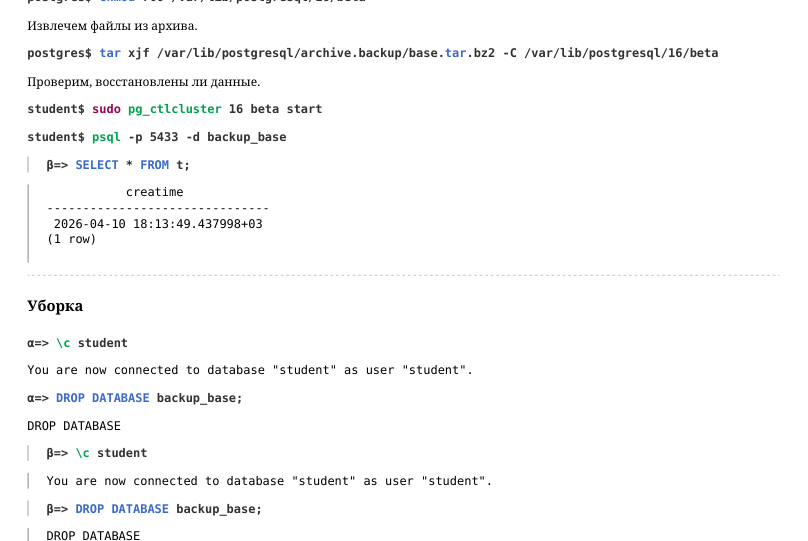
Извлечем файлы из архива.
Проверим, восстановлены ли данные.
Уборка
03 Занятие 03: Резервное копирование / Архив журналов предзаписи
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba3_03_backup_archive.html Archive: DBA3-handouts-16.zip Страниц PDF: 31
Page 1: Резервное копирование / Архив журналов предзаписи
Авторские права
© Postgres Professional, 2017–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Файловый архив — непрерывная архивация
- Потоковый архив — утилита pg_receivewal
- Восстановление с использованием архива
- Очистка архива
Page 3: Непрерывная архивация
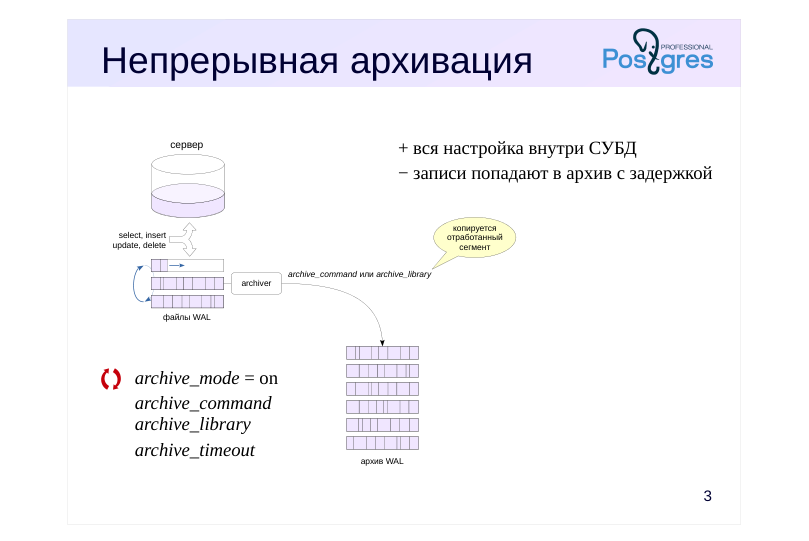 {#source-figure-003 caption=“Source slide page 3: Непрерывная архивация”}
- archive_mode = on
- archive_command
- archive_library
- archive_timeout
Комментарии преподавателя
Базовая резервная копия, рассмотренная в предыдущей теме, содержит все журнальные записи, необходимые для согласования страниц файлов данных. Такая копия называется автономной и позволяет восстановить состояние сервера на момент окончания резервирования.
Если же к автономной копии добавлять новые файлы журнала предзаписи, генерируемые сервером, можно будет восстановить кластер на произвольный момент времени. На практике заполненные журнальные сегменты копируются не в саму копию, а в отдельный архив. Этим занимается процесс archiver при значении параметра archive_mode = on.
В PostgreSQL есть два способа копирования сегмента WAL в архив:
Командой ОС. При переключении на очередной сегмент WAL процесс выполняет команду, которую он получает из параметра archive_command.
С помощью функций модуля архивирования (начиная с версии 15). Имя модуля задается параметром archive_library. https://postgrespro.ru/docs/postgresql/16/archive-modules
На слабо загруженных серверах параметром archive_timeout задают максимальное время, которое может пройти до переключения на новый сегмент WAL. Переключение можно выполнить и вручную, используя функцию pg_switch_wal.
https://postgrespro.ru/docs/postgresql/16/continuous-archiving
Page 4: archive_command
Команда ОС, архивирующая заполненный сегмент WAL
- копирует файл %p в архив под именем %f,
- сам архив может быть организован любым образом
- должна завершаться со статусом 0 только при успехе
- не должна перезаписывать уже существующие файлы
- должна гарантировать запись в энергонезависимую память
- удобно реализовать нужную логику в собственном скрипте
- Мониторинг
- текущий статус — представление pg_stat_archiver
- удобно включить коллектор сообщений (logging_collector = on)
- и получать диагностику в журнале сообщений сервера
Комментарии преподавателя
Команда архивирования должна скопировать указанный файл в некий архив. Архив может быть организован любым образом. Например, это может быть файловая система на отдельном сервере.
Команда обязана завершаться с нулевым статусом только при успехе; в этом случае скопированный сегмент может быть удален контрольной точкой. При ненулевом статусе не скопированный сегмент и следующие за ним не удаляются, а сервер периодически повторяет команду архивирования, пока не получит 0.
Команда не должна перезаписывать уже существующие файлы, так как это скорее всего означает какую-то ошибку, и перезапись файла может погубить архив.
Для гарантии надежности команда должна обеспечить попадание файла в энергонезависимую память: иначе при сбое архива можно потерять сегмент, если сервер PostgreSQL успеет его удалить.
Текущий статус архивации показывает представление pg_stat_archiver. Удобно включить сбор сообщений с помощью процесса logging_collector, так как в этом случае сообщения об ошибках при выполнения archive_command будут попадать в журнал сервера.
Если подразумевается сложная логика, то ее удобно записать в скрипт и использовать имя скрипта в качестве команды копирования.
https://postgrespro.ru/docs/postgresql/16/runtime-config-wal#GUC-ARCHIV E-COMMAND
Page 5: Настройка непрерывной архивации
Архив будем хранить в каталоге /var/lib/postgresql/archive. Он должен быть доступен пользователю-владельцу PostgreSQL.
В реальной практике архив может размещаться на отдельном сервере или дисковой системе с доступом по сети. Включим режим архивирования и установим команду копирования заполненных сегментов журнала.
В archive_command мы сначала проверяем наличие файла с указанным именем в архиве, и копируем его только в случае отсутствия.
В archive_command можно указать произвольную команду, лишь бы она завершалась со статусом 0 только в случае успеха. Например, можно организовать сжатие архивируемых сегментов:
В идеале команда архивирования должна выполнять sync, чтобы файл гарантированно попал в энергонезависимую память. Иначе при сбое он может пропасть из архива, а сервер может успеть стереть его из каталога pg_wal. Обычно удобно поместить всю необходимую логику архивирования в отдельный скрипт и вызывать его:
Изменение archive_mode требует рестарта сервера.
Появился процесс archiver:
Проверим работу архивации. Создадим базу и таблицу.
Вот какой сегмент WAL используется сейчас:
Page 6: Page 6
Чтобы заполнить файл, пришлось бы выполнить большое количество операций. В тестовых целях проще принудительно переключить сегмент:
Сегмент сменился:
А предыдущий должен был попасть в архив. Проверим:
Текущий статус архивации показывает представление pg_stat_archiver:
Таким образом, файловая архивация настроена и работает.
Page 7: pg_receivewal
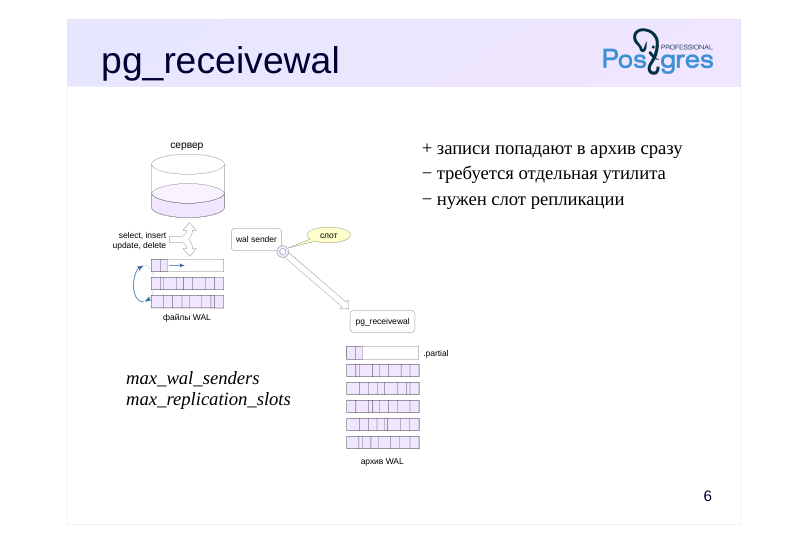 {#source-figure-007 caption=“Source slide page 7: pg_receivewal”}
- max_wal_senders
- max_replication_slots
Комментарии преподавателя
Можно организовать пополнение архива иным способом, с помощью протокола репликации. Для этого используется утилита pg_receivewal.
Обычно утилита запускается на отдельном сервере, хранящем архив. Она формирует файлы аналогично тому, как это делает сам сервер, и записывает их в указанный каталог. Не до конца заполненные сегменты имеют суффикс .partial. По умолчанию синхронизация кеша с файловой системой происходит только при закрытии сегмента WAL, но можно сделать запись синхронной, задав параметр –synchronous.
Утилита может сжимать сегменты WAL. Для этого в параметре –compress нужно указать алгоритм (gzip или lz4) и уровень сжатия.
При первом запуске (когда архив пуст) архивирование начнется с начала текущего сегмента. Обычно же архивирование начинается с начала сегмента, следующего за последним заполненным сегментом в архиве. При использовании слота репликации это гарантирует отсутствие пропусков в архиве, даже если утилита отключалась на некоторое время.
По умолчанию утилита получает записи бесконечно, но можно завершить ее работу при получении записи с заданным LSN, если указать –endpos=lsn.
Учтите, что утилита не запускается автоматически как сервис и не демонизируется.
https://postgrespro.ru/docs/postgresql/16/app-pgreceivewal
Page 8: Потоковый архив
Чтобы настроить пополнение архива по протоколу потоковой репликации, остановим сначала файловую архивацию.
Текущее состояние архива.
Сначала попросим утилиту pg_receivewal создать слот, чтобы гарантировать получение всех записей журнала.
Затем запустим ее фоном в режиме архивации. Увидев, что в архиве уже есть файлы, утилита запросит у сервера следующий сегмент, чтобы в архиве не было пропусков.
Добавим в таблицу много строк и удалим их.
В архиве появились новые файлы.
Последний файл, скорее всего, имеет суффикс .partial — в него идет запись. Теперь мы настроили потоковую архивацию.
Page 9: Базовая копия
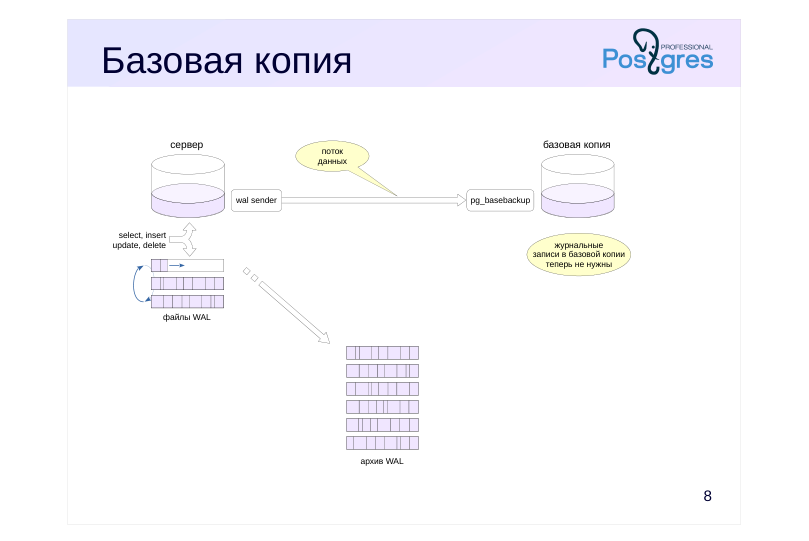 {#source-figure-009 caption=“Source slide page 9: Базовая копия”}
Комментарии преподавателя
Если мы располагаем настроенным архивом журнала предзаписи, то в базовой резервной копии файлы журнала перестают быть обязательными — ведь их при восстановлении можно получить из архива. Поэтому pg_basebackup можно запускать с ключом –wal-method=none.
(Но и никакого вреда от журнальных файлов внутри базовой копии, кроме занимаемого объема, тоже нет. Более того, они позволят восстановить систему в ситуации, если архив окажется недоступен.)
Page 10: Базовая резервная копия
Поскольку архив пополняется автоматически, попросим pg_basebackup не добавлять файлы журнала к резервной копии:
В каталоге pg_wal резервной копии сегментов WAL нет:
Зато в архиве прибавилось файлов:
Page 11: Восстановление
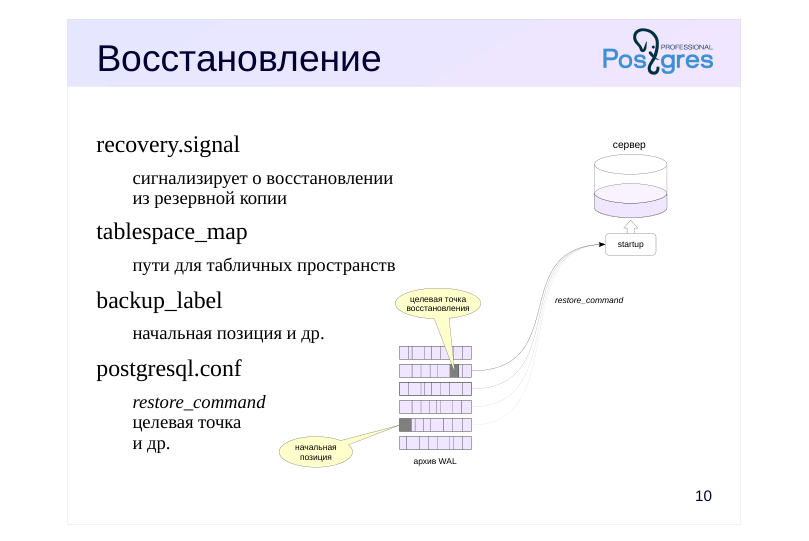 {#source-figure-011 caption=“Source slide page 11: Восстановление”}
recovery.signal
- сигнализирует о восстановлении из резервной копии tablespace_map
- пути для табличных пространств
- backup_label
- начальная позиция и др.
- postgresql.conf
- restore_command
- целевая точка
- и др.
Комментарии преподавателя
Процессом восстановления управляют три файла и параметры.
Файл recovery.signal создается вручную. Его наличие дает указание серверу перейти в режим восстановления. Содержимое файла игнорируется. Если recovery.signal отсутствует, то PostgreSQL считает, что он выполняет автоматическое восстановление после сбоя. Если же файл есть, сервер понимает, что происходит управляемое пользователем восстановление из резервной копии и обращает внимание на два других файла, которые генерируются при создании базовой резервной копии:
● Файл tablespace_map содержит пути для табличных пространств. Если символические ссылки в pg_tblspc отсутствуют (это верно для формата tar), то они будут созданы при старте сервера на основании информации в tablespace_map.
С этим файлом мы уже встречались в теме «Базовая резервная копия».
● Файл метки backup_label содержит название, время создания копии и — самое важное — название сегмента WAL и позицию в нем, с которой надо начинать восстановление.
При восстановлении процесс startup читает файлы из архива с помощью команды из параметра restore_command и применяет журнальные записи от начальной позиции, указанной в файле метки, до целевой точки восстановления.
Page 12: Настройка восстановления
Настройку восстановления начнем с создания сигнального файла.
При создании базовой резервной копии был создан файл метки backup_label.
Главная информация в этом файле — начальная точка для восстановления (START WAL LOCATION). Теоретически восстановление можно начать и с более ранней (но не более поздней) позиции, но это потребует больше времени. Поскольку в нашем кластере нет дополнительных табличных пространств, файл tablespace_map не нужен. Осталось задать в конфигурационном файле restore_command и другие параметры.
Page 13: restore_command
Команда ОС, восстанавливающая сегмент WAL
- выполняет действие, «обратное» archive_command
- копирует файл %f из архива на сервер по пути %p
- должна завершаться со статусом 0 только при успехе
- (может вызываться для несуществующих файлов)
- Мониторинг
- log_startup_progress_interval = 10s
- журналирование статуса процесса startup
Комментарии преподавателя
Параметр restore_command определяет команду, «обратную» команде архивирования archive_command. Она должна скопировать файл из архива в каталог pg_wal и завершаться со статусом 0 только при успехе. Это очень важно, так как в процессе восстановления сервер может выполнять команду восстановления для файлов, которых не окажется в архиве — это не ошибка, но команда должна завершиться с ненулевым статусом.
Начиная с 14-й версии PostgreSQL изменение параметра restore_command не требует рестарта сервера.
https://postgrespro.ru/docs/postgresql/16/runtime-config-wal#RUNTIME-CO NFIG-WAL-ARCHIVE-RECOVERY
С 15-й версии за состоянием процесса восстановления можно следить в журнале сообщений сервера при включенном параметре log_startup_progress_interval. При значении по умолчанию информация сбрасывается в журнал раз в 10 секунд.
В более ранних версиях информация о текущем состоянии восстановления отображалась только в имени unix-процесса startup.
Page 14: Точка перезапуска
Аналог контрольной точки при восстановлении
- сброс грязных буферов
- запись в управляющий файл
- удаление ненужных сегментов WAL
- Выполняется при применении записи о контрольной точке
- если после точки перезапуска прошло не менее checkpoint_timeout
- или объем WAL приближается к max_wal_size
- Мониторинг
- log_checkpoints
- pg_stat_bgwriter
Комментарии преподавателя
Когда при восстановлении процесс startup применяет журнальные записи, данные в общей памяти сервера изменяются так же, как при обычной работе: появляются грязные буферы. Если произойдет сбой, после него нужно будет повторять восстановление, и на этот случай необходимо хранить журнальные записи. Чтобы ограничить объем хранимых записей и не начинать восстановление с самого начала, сервер периодически выполняет точки перезапуска (restart points), сбрасывая, как при контрольной точке, грязные буферы структур общей памяти: буферного кеша, кеша clog и других. При успешном завершении точки перезапуска сервер делает запись в управляющем файле и удаляет сегменты WAL, которые целиком предшествуют ее началу.
Точка перезапуска выполняется, когда процесс startup встречает в WAL запись о контрольной точке, если после последней точки перезапуска прошло не менее checkpoint_timeout времени или если объем журнала приближается к значению max_wal_size. Иными словами, точка перезапуска инициируется журнальной записью о контрольной точке, но если ни одно из условий не выполняется, запись пропускается.
Если включен параметр log_checkpoints, в журнал сообщений будет попадать информация обо всех точках перезапуска, а представление pg_stat_bgwriter показывает накопленную статистику.
https://postgrespro.ru/docs/postgresql/16/wal-configuration
Page 15: Цель восстановления
 {#source-figure-015 caption=“Source slide page 15: Цель восстановления”}
Восстановление до определенной точки (PITR)
- recovery_target = ‘immediate’
- только восстановить согласованность
- recovery_target_name = ‘имя’
- до именованной точки, созданной
- pg_create_restore_point(‘имя’)
- recovery_target_time = ‘время’
- до указанного времени
- recovery_target_xid = ‘xid’
- до указанной транзакции
- recovery_target_lsn = ’lsn'
- до указанного LSN
- recovery_target_inclusive = on|off
- включать ли указанную точку
- recovery_target_action = pause
pause
- promote
- принимает подключения
- shutdown
- останавливается
Комментарии преподавателя
Если цель восстановления не задана, кластер будет восстановлен максимально близко к моменту сбоя. Однако процесс восстановления можно остановить и в любой другой момент, указав целевую точку:
● Параметр recovery_target = ‘immediate’ остановит восстановление, как только будет достигнута согласованность. Фактически, это эквивалентно восстановлению из базовой копии без архива.
● Параметр recovery_target_name позволяет указать именованную целевую точку восстановления, созданную заранее с помощью функции pg_create_restore_point.
● Параметр recovery_target_time позволяет указать произвольное время (timestamp), recovery_target_xid — произвольную транзакцию, recovery_target_lsn — номер LSN. С помощью параметра recovery_target_inclusive можно включить или исключить саму точку.
Параметр recovery_target_action позволяет выбрать состояние, в котором окажется сервер по достижении целевой точки:
● При значении pause восстановление приостанавливается. Администратор может выполнить запросы и решить, корректно ли была выбрана цель, после чего либо завершить восстановление (функция pg_wal_replay_resume), либо задать новую цель, перезапустить сервер и продолжить применение записей WAL.
● Если задано значение promote, сервер сразу сможет принимать запросы на подключения.
● Значение shutdown приведет к остановке сервера. При этом файл recovery.signal не удаляется.
Page 16: Окончание восстановления
 {#source-figure-016 caption=“Source slide page 16: Окончание восстановления”}
recovery.signal удаляется
- backup_label backup_label.old
- выполняется recovery_end_command
- проблемы диагностируются по журналу сообщений
Комментарии преподавателя
После того как восстановление закончено, процесс startup завершается, postmaster запускает остальные служебные процессы, необходимые для работы экземпляра, и сервер начинает работать в обычном режиме. Файл recovery.signal удаляется, backup_label переименовывается в backup_label.old.
В параметре recovery_end_command можно задать команду, которая выполнится по окончании восстановления; это могут быть действия с файловой системой, очистка архива, отправка уведомления и др.
Возможна ситуация, когда запущенный сервер не стартует. В этом случае в операционной системе будут отсутствовать процессы экземпляра (и не будет файла postmaster.pid), а recovery.signal не будет удален. Причину ошибки можно узнать из журнала сообщений сервера (например, в параметрах была допущена ошибка). После исправления причины ошибки сервер следует запустить еще раз.
Важный момент: если на сервере-источнике было настроено непрерывное архивирование, то на резервном сервере его надо либо отключить, либо перенаправить в другой архив.
Page 17: Восстановление из базовой резервной копии
Зададим настройки восстановления на сервере beta. В простейшем случае достаточно указать команду восстановления, которая будет копировать указанный сегмент WAL обратно из архива по указанному пути:
Если не указана целевая точка восстановления (один из параметров recovery_target*), то к базовой резервной копии будут применены записи WAL из всех файлов в архиве. Выкладываем резервную копию в каталог данных сервера beta и запускаем его.
После успешного восстановления файл recovery.signal удаляется, а файл метки переименовывается в backup_label.old:
Поскольку были применены все записи WAL, сервер beta сразу начинает принимать подключения. Проверим, что восстановлено в таблице:
Накопительная статистика сервера содержит информацию о точках перезапуска:
Page 18: Линии времени
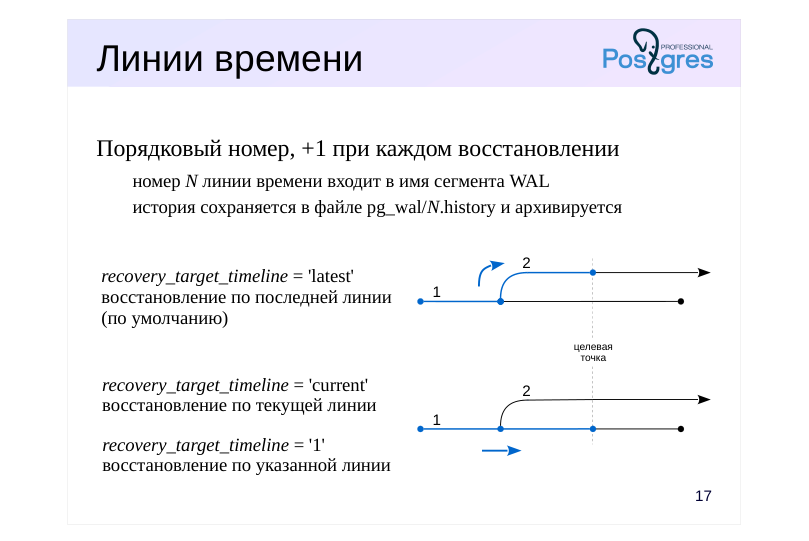 {#source-figure-018 caption=“Source slide page 18: Линии времени”}
Порядковый номер, +1 при каждом восстановлении
- номер N линии времени входит в имя сегмента WAL
- история сохраняется в файле pg_wal/N.history и архивируется
- recovery_target_timeline = ’latest’ восстановление по последней линии (по умолчанию)
- recovery_target_timeline = ‘current’ восстановление по текущей линии
- recovery_target_timeline = ‘1’ восстановление по указанной линии
Комментарии преподавателя
После восстановления на момент в прошлом сервер начинает генерировать новые записи WAL, номера которых будут повторять номера записей «из прошлой жизни». Чтобы не потерять записи и, вместе с ними, возможность восстановления на другой момент, PostgreSQL вводит понятие линии времени. После каждого восстановления с использованием recovery.signal номер линии времени увеличивается, и этот номер является частью номера сегментов WAL.
Линии времени образуют древовидную структуру, на рисунках приведен пример. Первая линия имеет номер 1. Произошло восстановление на момент времени в прошлом, и началась линия 2.
Если выполнить восстановление с указанием параметра recovery_target_timeline = ’latest’ (по умолчанию), то, дойдя то точки ветвления, применение записей WAL продолжится по второй (более поздней) линии.
Если же указать параметр recovery_target_timeline = ‘1’, то восстановление продолжится по первой (указанной) линии, а если указать recovery_target_timeline = ‘current’, то по текущей (в нашем случае тоже по линии 1).
Информацию о точках ветвления PostgreSQL берет из файлов истории pg_wal/N.history. Поэтому их никогда не следует удалять из архива.
Page 19: Линии времени
Что стало с линией времени после восстановления?
Номер увеличился на единицу. В каталоге pg_wal появился файл истории, соответствующий этой ветви:
В нем есть информация о «точках ветвления», через которые мы пришли в данную линию времени:
Эти файлы PostgreSQL использует, когда мы указываем линию времени в параметре recovery_target_timeline. Поэтому файлы истории подлежат архивации вместе с сегментами WAL, и удалять из архива их не надо.
Page 20: Очистка архива
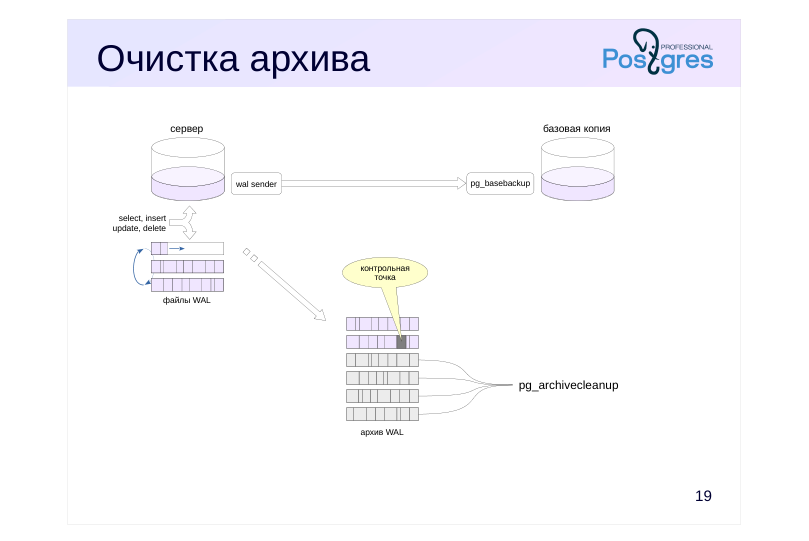 {#source-figure-020 caption=“Source slide page 20: Очистка архива”}
Комментарии преподавателя
Архив со временем разрастается, поэтому требуется периодическая очистка от ненужных файлов.
Для очистки можно воспользоваться утилитой pg_archivecleanup. Утилите нужно указать имя сегмента WAL, и она удалит все ему предшествующие.
https://postgrespro.ru/docs/postgresql/16/pgarchivecleanup
Вопрос в том, как определить позицию в архиве, начиная с которой сегменты уже не нужны.
Если архив используется только для восстановления из одной базовой резервной копии, можно выполнять очистку сразу после ее обновления.
Но если архив должен поддерживать восстановление из нескольких базовых резервных копий, то для автоматизации очистки либо придется написать собственный скрипт, либо — что лучше — воспользоваться одной из сторонних программ резервного копирования, таких как pg_probackup, которые позволяют гибко настроить политику хранения резервных копий.
Page 21: Очистка архива
Сейчас архив первого сервера содержит ненужные файлы, они попали туда до формирования базовой копии:
Утилите pg_archivecleanup нужно передать путь к архиву и имя последнего сохраняемого сегмента WAL (его можно найти в файле backup_label).
Посмотрим, какие файлы остались в архиве:
Архив очищен. Утилиту можно вызывать сразу после формирования базовой резервной копии, поместив обе команды в скрипт.
Page 22: Итоги
Физическое резервирование — базовые резервные копии и архив журнала предзаписи
- Хорошо подходит
- для текущего периодического резервирования
- для восстановления после сбоя с минимальной потерей данных
- для восстановления на произвольный момент времени
- для резервирования данных большого объема
- Плохо подходит
- для длительного хранения
- Не подходит
- для миграции на другую платформу
Page 23: Практика
- На сервере alpha создайте базу данных и таблицу с данными. 2. Настройте непрерывное архивирование. 3. Сделайте копию кластера без файлов журнала. 4. Вставьте еще несколько строк в таблицу и убедитесь, что текущий сегмент WAL попал в архив. 5. Восстановите сервер beta из резервной копии, указав в параметрах одну только команду восстановления. 6. Снова восстановите сервер beta из той же резервной копии, на этот раз указав целевую точку восстановления immediate.
Комментарии преподавателя
После выполнения практических заданий удалите базы данных и сбросьте изменения параметров конфигурации.
Page 24: 1. База данных и таблица
2. Настройка непрерывной архивации
3. Базовая резервная копия
Поскольку нам потребуется восстанавливаться из одной копии два раза, сделаем ее в формате tar со сжатием.
4. Добавление строк в таблицу
Переключаем сегмент:
Проверяем статус архивации:
5. Восстановление из базовой резервной копии
Page 25: Page 25
Для простоты отключим непрерывное архивирование на резервном сервере и укажем только команду восстановления:
Создаем recovery.signal.
Запускаем сервер.
Восстановились все строки. Поскольку по умолчанию применяются все имеющиеся журнальные записи, сервер сразу перешел в обычный режим и готов принимать запросы на изменение данных:
6. Восстановление из базовой резервной копии — immediate
Создаем recovery.signal, в конфигурационный файл записываем команду восстановления и целевую точку:
Запускаем сервер.
Восстановилась только первая строка. На этот раз были применены только журнальные записи, необходимые для согласования данных. Сервер уже принимает запросы на чтение, при необходимости восстановление можно продолжить:
Page 26: Page 26
 {#source-figure-026 caption=“Source slide page 26: Page 26”}
Функция pg_get_wal_replay_pause_state() возвращает: not paused — приостановка не запрашивалась; pause requested — запрошена приостановка; paused — восстановление приостановлено. Поскольку нам не нужно применять последующие записи, завершаем восстановление, переводя сервер в обычный режим (нужны права суперпользователя):
Чтобы не выходить из режима восстановления вручную, можно было заранее задать значение recovery_target_action = ‘promote’.
Уборка
Удалим резервную копию и базы данных, сбросим настройки параметров конфигурации.
Page 27: Практика+
- На сервере alpha создайте таблицу, в которую будут периодически записываться данные. Создайте физическую резервную копию и настройте непрерывную архивацию WAL. 2. Вставьте в подготовленную таблицу трижды по 100 строк (данные за январь, февраль и март), отмечая время сразу после вставки. Между вставками удалите некоторые строки: сымитируйте ситуацию, в которой пользователь случайно удаляет часть данных в неизвестный момент, но проблему замечают не сразу. 3. Восстановите удаленные данные, не останавливая при этом сервер alpha.
Комментарии преподавателя
- Используйте сервер beta как вспомогательный.
Page 28: 1. Таблица и резервирование с архивом WAL
Подготовим таблицу:
После формирования структуры данных создадим физическую копию:
Архив сегментов WAL:
Добавим файл параметров архивирования в каталог дополнительной конфигурации.
Перезапускаем сервер.
2. Вставка данных в таблицу
Наше условное приложение добавляет в таблицу 100 строк в конце каждого месяца. Вставка строк за январь:
Запомним момент времени после завершения вставки:
Пользователь по ошибке удаляет часть данных:
Вставим данные за февраль:
Page 29: Page 29
Снова запомним момент времени после окончания транзакции:
Пользователь зачем-то еще раз выполняет ту же команду:
Но ошибку пока не заметили. Выполняем еще одну вставку:
Опять запомним момент времени:
Теперь ошибка обнаружена:
3. Восстановление с помощью архива
Задача: восстановить данные, не останавливая сервер alpha. Пропали данные за январь и февраль, поэтому план действий таков: на сервере beta восстанавливаем, используя архив WAL, данные на конец загрузки январских строк; выгружаем логическую копию данных за январь; заново восстанавливаем данные, но теперь на конец загрузки февральских строк; выгружаем логическую копию данных за февраль (январские данные в этот момент могут быть повреждены); загружаем восстановленные данные в таблицу приложения на сервере alpha. Остановим сервер beta и поместим физическую копию в его каталог данных.
Необходимо создать файл recovery.signal:
Мы хотим восстановить состояние сервера на определенный момент времени, то есть выполнить point-in-time recovery (PITR). Зададим команду восстановления и укажем целевую точку восстановления на запомненный момент сразу после загрузки данных за январь:
Перед началом восстановления принудительно переключим сегмент на alpha, чтобы все записи WAL попали в архив.
Page 30: Page 30
Архивация происходит при начале записи в следующий сегмент.
Запускаем сервер beta.
Проверим, что данные за январь восстановлены:
Сервер beta находится в состоянии восстановления:
Однако это не помешает выгрузить логическую копию данных.
Переходим к февралю. Указываем новое время:
Чтобы продолжить восстановление, перезапустим сервер beta.
Проверяем восстановленные данные:
Мы видим, что февральские строки на месте, а январские уже повреждены. Выгружаем февраль:
Теперь восстановим выгруженные данные за два месяца на сервере alpha.
Page 31: Page 31
Все получилось:
Начиная с версии PostgreSQL 17 можно было бы не удалять строки, а воспользоваться командой COPY с параметром ON ERROR ignore, чтобы пропустить уже существующие в таблице.
Уборка
Удалим базы данных и настройки параметров конфигурации.
Удалим ненужные файлы.
04 Занятие 04: Репликация / Физическая репликация
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba3_04_replica_physical.html Archive: DBA3-handouts-16.zip Страниц PDF: 39
Page 1: Репликация / Физическая репликация
Авторские права
© Postgres Professional, 2017–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Задачи репликации
- Схема работы физической репликации
- Способы доставки журнальных записей
- Особенности и ограничения использования реплики
- Синхронная и асинхронная репликация
- Мониторинг репликации
- Возможные проблемы и способы их решения
Page 3: Задачи репликации
Репликация
- процесс синхронизации нескольких копий кластера баз данных
- на разных серверах
- Базовый механизм для решения ряда задач
- отказоустойчивость
- при возникновении сбоя система
- должна сохранить работоспособность
- масштабируемость
- распределение нагрузки между серверами
Комментарии преподавателя
Одиночный сервер, управляющий базами данных, может не удовлетворять требованиям, предъявляемым к системе. Есть две основных задачи, для решения которых требуется наличие нескольких серверов.
Во-первых, отказоустойчивость: один физический сервер — это возможная точка отказа. Если сервер выходит из строя, система становится недоступной.
Во-вторых, производительность. Один сервер может не справляться с нагрузкой. Зачастую желательна возможность не вертикального, а горизонтального масштабирования — распределения нагрузки на несколько серверов. Дело может быть как в стоимости аппаратуры, так и в необходимости различных настроек для разных типов нагрузки (например, для OLTP и отчетности).
В случае PostgreSQL распределенные системы строятся по принципу «shared nothing»: несколько серверов работают независимо друг от друга и не имеют ни общей оперативной памяти, ни общих дисков. Следовательно, если серверы должны работать с одними и теми же данными, то эти данные требуется синхронизировать между ними. Механизм синхронизации и называется репликацией.
Page 4: Мастер→реплика
Записи WAL передаются на реплику и применяются
- поток данных только в одну сторону
- реплицируется кластер целиком, выборочная репликация невозможна
- Реплика — точная копия мастера
- одна и та же основная версия сервера
- полностью совместимые архитектуры и платформы
- Реплика доступна только для чтения
Комментарии преподавателя
При физической репликации серверы имеют назначенные роли: один является ведущим («мастер»), а остальные — ведомыми («реплики»).
Мастер передает на реплику журнальные записи, а реплика применяет эти записи к своим файлам данных. Применение происходит чисто механически, без «понимания смысла» изменений, и выполняется быстрее, чем работало бы повторное выполнение операторов SQL. Но критична двоичная совместимость между серверами — они должны работать на одной и той же программно-аппаратной платформе и на них должны быть запущены одинаковые основные версии PostgreSQL.
https://postgrespro.ru/docs/postgresql/16/hot-standby#HOT-STANDBY-ADM IN
Журнал — общий для всего кластера, поэтому реплицировать можно только кластер целиком, а не отдельные базы данных или таблицы. Возможность «отфильтровать» журнальные записи отсутствует.
Реплика не генерирует журнальные записи, а лишь применяет записи мастера. Поэтому реплика может быть доступна только для чтения — никакие операции, изменяющие данные, на реплике не допустимы.
Page 5: Потоковая репликация
 {#source-figure-005 caption=“Source slide page 5: Потоковая репликация”}
Комментарии преподавателя
При наличие файла recovery.signal сервер восстанавливается из резервной копии: проигрывает журнальные записи, восстанавливает согласованность и завершает восстановление. Запуск реплики выполняется точно так же, но восстановление не завершается: реплика продолжает читать и воспроизводить журнальные записи мастера. Сигналом к этому служит файл standby.signal.
В теме «Базовая резервная копия» мы рассматривали два способа доставки журнальных записей от сервера к клиенту: потоковая и файловая. Они же применяются и для доставки журнальных записей реплике. На практике в основном используется потоковая репликация.
В этом случае процесс wal receiver реплики подключается к мастеру по протоколу репликации, используя строку подключения из параметра primary_conninfo, и читает поток записей WAL. За счет этого при потоковой репликации отставание реплики от мастера минимально (и при необходимости может быть сведено к нулю). Полученные записи пишутся на диск в виде сегментов WAL так же, как это происходит на мастере. Далее процесс startup — тот же самый, что обеспечивает восстановление после сбоев — применяет записи к файлам данных, только теперь он работает постоянно.
Мастер запускает процесс wal sender, обслуживающий соединение с репликой. Потоковая репликация может, если нужно, использовать слот репликации. Имя слота передается в параметре primary_slot_name.
Page 6: Настройка потоковой репликации
Поскольку в нашей конфигурации не будет архива журнала предзаписи, важно на всех этапах использовать слот репликации — иначе при определенной задержке мастер может успеть удалить необходимые сегменты и придется заново сформировать резервную копию и повторить действия по настройке. Создаем слот:
Посмотрим на созданный слот:
Вначале слот не инициализирован (restart_lsn и wal_status пустые). Сформируем автономную резервную копию в каталоге данных сервера beta, используя созданный слот. При запуске с ключом -R утилита добавит в копию файлы, необходимые для запуска будущей реплики.
Снова проверим слот:
Page 7: Page 7
После выполнения резервной копии слот инициализировался, и мастер теперь хранит все файлы журнала с начала копирования (restart_lsn, wal_status). Сравните со строкой в backup_label:
Файл postgresql.auto.conf был подготовлен утилитой pg_basebackup, поскольку мы указали ключ -R. Этот файл содержит информацию для подключения к мастеру и имя слота репликации:
По умолчанию реплика будет «горячей», то есть сможет выполнять запросы во время восстановления. Если такая возможность не нужна, реплику можно сделать «теплой» (hot_standby = off). Утилита также создала сигнальный файл standby.signal, наличие которого указывает серверу войти в режим постоянного восстановления.
Журнальные записи, необходимые для восстановления согласованности, реплика возьмет из автономной базовой копии. Далее она войдет в режим непрерывного восстановления и будет получать и проигрывать поток записей.
Page 8: Репликация с архивом
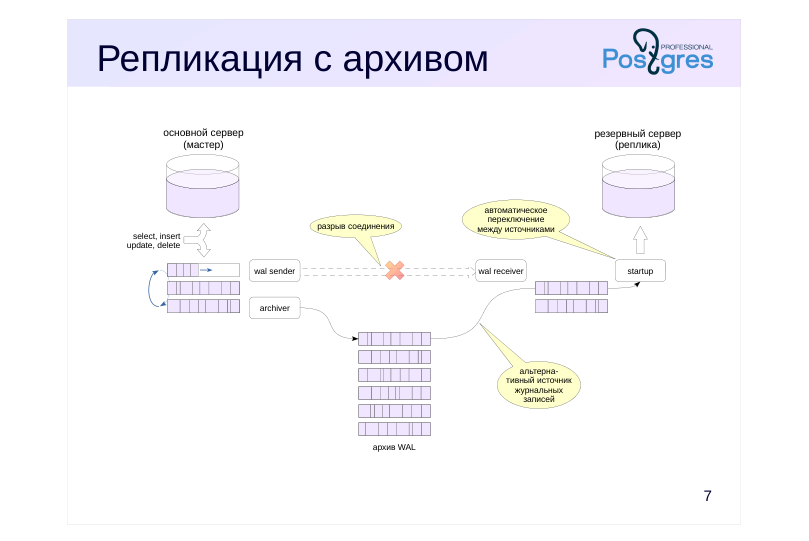 {#source-figure-008 caption=“Source slide page 8: Репликация с архивом”}
Комментарии преподавателя
Другой способ доставки журнальных записей состоит в том, чтобы предоставить реплике доступ к архиву журналов — точно так же, как при обычном восстановлении из архива (этот механизм рассмотрен в модуле «Резервное копирование»).
Если реплика по каким-то причинам не сможет получить очередную журнальную запись по протоколу репликации (например, из-за обрыва связи), она попробует прочитать ее из архива с помощью команды, заданной в параметре restore_command. При восстановлении связи реплика снова автоматически переключится на использование потоковой репликации.
В принципе, репликация может работать и с одним только архивом, без потоковой репликации. Но в этом случае:
● реплика вынужденно отстает от мастера на время заполнения сегмента;
● мастер ничего не знает о существовании реплики, что в некоторых случаях может привести к проблемам.
Page 9: Процессы
Мастер Реплика
- wal sender
- wal receiver
- startup
- archiver
- archiver
- (archive_mode = always)
- checkpointer
- checkpointer
- (контрольные точки)
- (точки перезапуска)
- background writer
- background writer
- wal writer
- autovacuum
Комментарии преподавателя
На мастере и на реплике выполняется разный набор процессов. Кроме уже рассмотренных wal sender (на мастере) и wal receiver и startup (на реплике), работают также другие процессы.
Общие процессы:
● background writer — записывает грязные страницы из буферного кеша на диск (на реплике, для того, чтобы применить журнальную запись, страницы точно так же читаются в буферный кеш и затем записываются в фоновом режиме или при вытеснении).
● checkpointer — выполняет точки перезапуска (restart point, см. тему «Архив журналов предзаписи»). Если в процессе восстановления случится сбой, реплика сможет продолжить с последней точки перезапуска, а не с самого начала.
Процессы только на мастере:
● wal writer — реплика не создает журналы упреждающей записи, а только получает их с мастера.
● autovacuum launcher/worker — реплика не выполняет очистку, ее выполнение на мастере передается реплике через журнал.
Есть также процесс, наличие которого зависит от настройки:
● archiver — при значении archive_mode = on выполняется только на мастере, а при archive_mode = always также и на реплике (подробнее рассматривается в теме «Переключение на реплику»).
Page 10: Процессы реплики
Сравним процессы на мастере:
И на реплике:
Page 11: Очистка архива
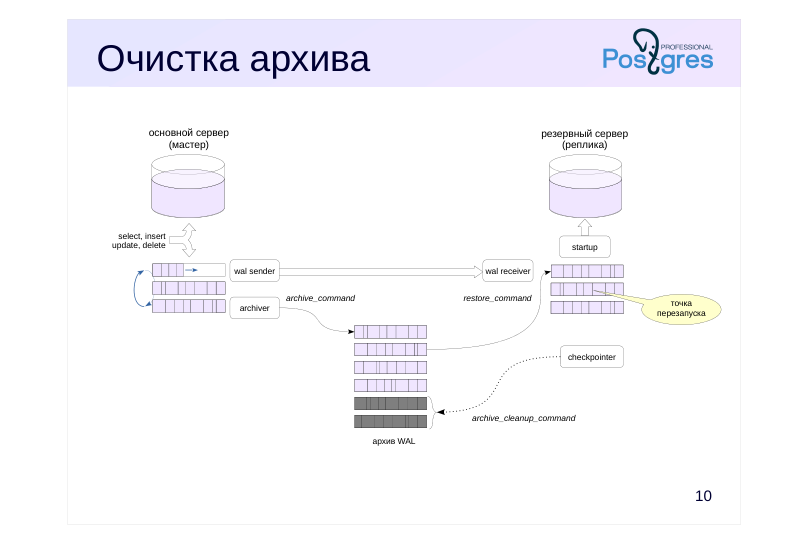 {#source-figure-011 caption=“Source slide page 11: Очистка архива”}
Комментарии преподавателя
В точках перезапуска процесс checkpointer будут удалять ненужные сегменты журнала в локальном каталоге pg_wal.
Если архив используется только для синхронизации одной реплики, можно и его очищать автоматически. Для этого в параметре archive_cleanup_command задается команда, которая будет выполняться по окончании каждой точки перезапуска. В команде удобно вызывать утилиту pg_archivecleanup (вместо %r сервер подставит имя сегмента, содержащего точку):
archive_cleanup_command = ‘pg_archivecleanup /path/to/archive %r’
https://postgrespro.ru/docs/postgresql/16/runtime-config-wal#RUNTIME-CO NFIG-WAL-ARCHIVE-RECOVERY
https://postgrespro.ru/docs/postgresql/16/pgarchivecleanup
Page 12: Использование реплики
Допускаются
- запросы на чтение данных (select, copy to, курсоры)
- установка параметров сервера (set, reset)
- управление транзакциями (begin, commit, rollback…)
- создание резервной копии (pg_basebackup)
- Не допускаются
- любые изменения (insert, update, delete, truncate, nextval…)
- блокировки, предполагающие изменение (select for update…)
- команды DDL (create, drop…), в том числе создание временных таблиц
- команды сопровождения (vacuum, analyze, reindex…)
- управление доступом (grant, revoke…)
Комментарии преподавателя
Как мы уже говорили, на реплике не допускается любое изменение данных. Более точно, не допускаются:
● изменения таблиц, материализованных представлений, последовательностей;
● блокировки (так как для этого требуется изменение страниц данных);
● команды DDL, включая создание временных таблиц;
● такие команды, как VACUUM и ANALYZE;
● команды управления доступом.
При этом реплика может выполнять запросы на чтение данных, если установлен параметр hot_standby = on. Также будет работать установка параметров сервера и команды управления транзакциями — например, можно начать (читающую) транзакцию с нужным уровнем изоляции.
Кроме того, реплику можно использовать и для изготовления резервных копий.
Page 13: Использование реплики
Выполним несколько команд на мастере:
Проверим реплику:
При этом изменения на реплике не допускаются:
Вообще реплику от мастера можно отличить с помощью функции:
Page 14: Ограничения
Изоляция и многоверсионность
- большое число точек сохранения задерживает выполнение запросов
- не поддерживается уровень изоляции Serializable
- Триггеры и блокировки
- триггеры и рекомендательные блокировки не работают
- Резервное копирование с реплики
- параметр full_page_writes должен быть заранее включен на мастере
- задержки из-за ожидания контрольной точки и переключения сегментов
- Порядок изменений
- каталоги табличных пространств нужно сначала создавать на реплике
- значения параметров max_… нужно сначала увеличивать на реплике
Комментарии преподавателя
У репликации есть ряд ограничений и особенностей.
Если на мастере выполняется транзакция с числом вложенных транзакций больше 64 (то есть активно используются точки сохранения), создание снимка на реплике будет приостановлено — это означает невозможность некоторое время выполнять запросы.
Не поддерживается уровень изоляции Serializable на реплике.
Триггеры не будут срабатывать на реплике (они выполнились на мастере и реплицируется уже результат их работы). Не будут работать и рекомендательные (advisory) блокировки.
При выполнении резервного копирования с реплики нет технической возможности полноценно управлять мастером, в частности, вызывать контрольные точки и включать параметр full_page_writes. Поэтому параметр нужно включить на мастере заранее, а контрольную точку приходится ждать (что может существенно задержать процесс).
Создание табличных пространств реплицируется, но если у пользователя ОС, под которым работает СУБД, недостаточно прав для создания каталога, произойдет ошибка. Лучше всего сначала создать каталоги на мастере и на всех репликах, а уже затем выполнять команду CREATE TABLESPACE.
Если на мастере увеличить параметр, задающий ограничение какого-либо ресурса, репликация может приостановиться. Это относится к параметрам max_connections, max_prepared_transactions, max_locks_per_transaction, max_wal_senders и max_worker_processes.
Page 15: Мониторинг
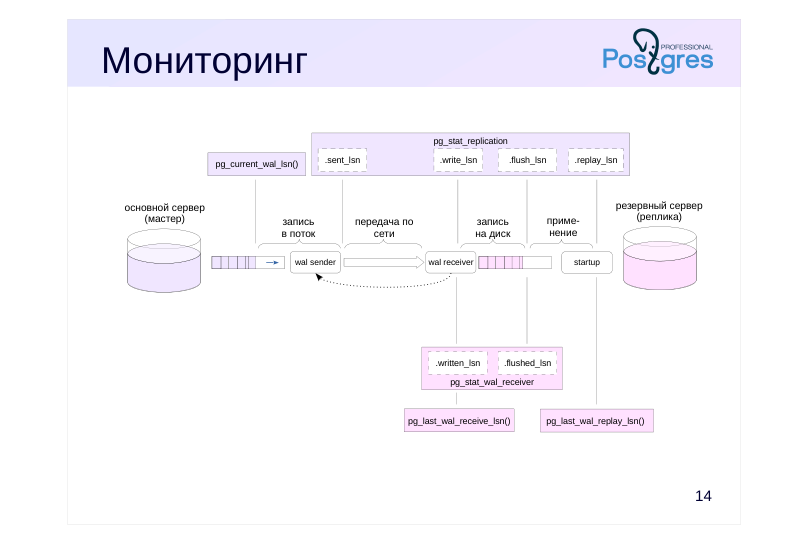 {#source-figure-015 caption=“Source slide page 15: Мониторинг”}
Комментарии преподавателя
В ходе репликации возможны проблемы, о которых должен предупредить заранее настроенный мониторинг. Основной информацией являются позиции в журнале предзаписи. Можно выделить пять важных точек:
- появление журнальной записи на мастере; 2) передача записи процессом wal sender; 3) получение записи процессом wal receiver; 4) синхронизация записи с диском (flush); 5) применение полученной записи процессом startup.
Все эти точки обычно отслеживаются на мастере. Первую точку дает функция pg_current_wal_lsn, остальные — представление pg_stat_replication. Реплика передает мастеру статус репликации при каждой записи на диск, но как минимум раз в интервал времени, указанный в wal_receiver_status_interval (по умолчанию — 10 секунд).
Если используется слот репликации, то информацию о нем можно получить из представления pg_replication_slots.
Часть информации о ходе репликации можно получить и на реплике в представлении pg_stat_wal_receiver и с помощью функций pg_last_wal_receive_lsn и pg_last_wal_replay_lsn.
Состояние репликации показывают функции pg_is_in_recovery и pg_get_wal_replay_pause_state. Параметр log_replication_commands включает вывод в журнал сообщений информации о выполняющихся командах протокола репликации.
Page 16: Мониторинг репликации
Сейчас реплика находится в режиме восстановления и применяет журнальные записи:
Текущее значение max_connections на мастере:
Если количество пользователей выросло, мы захотим увеличить это ограничение:
А что с репликой?
Репликация остановилась. В журнале видим причину:
Последуем рекомендации: увеличим значение параметра на реплике.
Проверим реплику:
Page 17: Page 17
Репликация возобновилась. Чтобы избежать остановки репликации, ограничения нужно сначала увеличивать на реплике. Состояние репликации можно смотреть в специальном представлении на мастере. Чтобы пользователь получил доступ к этой информации, он должен входить в групповую роль pg_read_all_stats или быть суперпользователем.
Роль pg_monitor входит в роль pg_read_all_stats и наследует ее привилегии.
Обратите внимание на поля *_lsn (и *_lag) — они показывают отставание реплики на разных этапах. Сейчас все позиции совпадают, отставание нулевое. Теперь вставим в таблицу большое количество строк, чтобы увидеть репликацию в процессе работы.
Page 18: Page 18
Видно, что возникла небольшая задержка. Проверим реплику:
Все строки успешно доставлены. И еще раз проверим состояние репликации:
Все позиции выровнялись.
Page 19: Режимы репликации
Асинхронный
- synchronous_commit
- = off
- local
- Синхронный
- фиксация с ожиданием подтверждения от синхронной реплики
- обеспечивает надежность, но не согласованность
- synchronous_commit
- = remote_write
- on
- remote_apply
- synchronous_standby_names = список реплик
- FIRST N (список реплик)
- ANY N (список реплик)
Комментарии преподавателя
Как известно, фиксация транзакций может выполняться в двух режимах. В более быстром асинхронном режиме есть шанс потерять уже зафиксированные изменения в случае сбоя. В синхронном режиме команда COMMIT не завершается, пока запись не дойдет до диска. При наличии нескольких серверов можно еще повысить надежность, если дожидаться от реплики подтверждения того, что она получила запись о фиксации. В этом случае данные не пропадут даже при выходе носителя из строя.
Синхронная репликация включается тем же параметром synchronous_commit, что и синхронная фиксация. Разные значения этого параметра позволяют управлять уровнем надежности. При значении remote_write мастер ожидает подтверждения о получении записи (остается шанс потерять изменения, если на реплике случится сбой и она не успеет записать данные на диск).
При значении on мастер ожидает подтверждения о попадании журнальной записи на диск реплики (это надежный режим; однако приложение, обратившись к реплике, может не увидеть изменений).
Наконец, значение remote_apply заставляет мастер дождаться применения записи на реплике. Каждый следующий режим вызывает все большие задержки.
Мастер может синхронизироваться как с одной, так и с несколькими репликами. Можно указать список реплик в порядке приоритета или организовать синхронизацию на основе кворума, при которой мастер дожидается подтверждения от любых N реплик из числа доступных.
Page 20: Потеря нужного сегмента
Мастер может удалить файл журнала, нужный реплике
- если реплика не успеет его получить
- (например, будет остановлена на некоторое время)
- Решение 1. Слот репликации
- вводит зависимость мастера от реплики, требует мониторинга
- max_slot_wal_keep_size = −1
- Решение 2. Архив журнала предзаписи
- позволяет обойтись без слота
Комментарии преподавателя
При репликации возможен ряд сложностей, которые можно решать разными способами.
Сервер PostgreSQL периодически удаляет файлы журнала, которые не требуются для восстановления. При этом мастер может удалить файл, который содержит данные, еще не переданные реплике.
Это не проблема, если используется архив журналов предзаписи, поскольку реплика, получив отказ по протоколу репликации, прочитает необходимые ей данные из архива, а затем, «догнав» мастер, снова переключится на получение данных из потока.
Но если архива нет, реплика не сможет продолжать восстановление и ее придется пересоздавать из новой резервной копии. Чтобы этого избежать, можно использовать слот репликации. Однако надо понимать, что создание слота ставит мастер в зависимость от реплики: если реплика не будет получать журнальные записи, они будут накапливаться на мастере, что может привести к заполнению файловой системы. Чтобы не допустить этого, стоит установить предел накапливаемого объема параметром max_slot_wal_keep_size. При превышении этого ограничения слот перестанет функционировать и удерживать журнальные файлы от удаления.
В любом случае слот — еще одна точка, которую необходимо включать в мониторинг.
Page 21: Влияние слота репликации
Остановим реплику.
Ограничим размер WAL двумя сегментами.
Слот неактивен, но помнит номер последней записи, полученной репликой:
Вставим еще строки в таблицу.
Номер LSN в слоте не изменился:
Выполним контрольную точку, которая должна очистить журнал, поскольку его размер превышает допустимый.
Каков теперь размер журнала?
Контрольная точка не удалила сегменты — их удерживает слот, несмотря на превышение ограничения. Если оставить слот без присмотра, дисковое пространство может быть исчерпано. Скорее всего, бесперебойная работа основного сервера важнее, чем синхронизация реплики. Чтобы предотвратить разрастание журнала, можно ограничить объем, удерживаемый слотом:
Теперь журнал очищается контрольной точкой:
Page 22: Page 22
Но слот уже не обеспечивает наличие записей WAL (wal_status=lost):
А реплика не может синхронизироваться:
Для синхронизации реплики в таких случаях можно воспользоваться архивом, задав параметр restore_command. Если это невозможно, придется заново настроить репликацию, повторив формирование базовой копии.
Page 23: Конфликты: проблема
Записи WAL, несовместимые с запросами на реплике
- очистка удаляет версии строк, нужные запросам на реплике
- исключительные блокировки объектов
- закрепление буферов
- Мониторинг
- pg_stat_database_conflicts
Комментарии преподавателя
Вторая проблема возникает, если реплика используется для выполнения запросов. Мастер может выполнить действие, несовместимое с запросом на реплике:
● очистка может удалить версию строки, которая используется запросом, или потребовать блокировку, несовместимую с запросом;
● может прийти запись об исключительной блокировке объекта (например, при удалении таблицы);
● иногда конфликт возникает из-за закрепления буфера.
Возникновение таких конфликтов можно отслеживать с помощью представления pg_stat_database_conflicts.
Page 24: Конфликты: решения
Решение 0: избегать конфликтов
- не выполнять команды, вызывающие блокировки
- отменить усечение файла в конце очистки: параметр хранения
- vacuum_truncate = off
- Решение 1: откладывать применение конфликтующих записей
- max_standby_streaming_delay
- max_standby_archive_delay
- кроме взаимоблокировок, DROP TABLESPACE, DROP DATABASE
Комментарии преподавателя
Один из путей борьбы с конфликтами — избегать действий на мастере, приводящих к исключительным блокировкам. Например, можно не выполнять команды DROP TABLE, TRUNCATE, LOCK, DROP INDEX, DROP TRIGGER и т. п. или выполнять их в то время, когда на реплике заведомо нет выполняющихся запросов.
Некоторых неявных блокировок можно избежать, отключая соответствующую функциональность на мастере. Например, если в результате очистки освободились страницы в конце файла, при уменьшении его размера устанавливается исключительная блокировка таблицы. Но можно отменить усечение файла, задав параметр хранения таблицы vacuum_truncate = off. Однако отменять или надолго откладывать очистку нельзя, поэтому избежать конфликта в случае очистки нужных запросу версий строк таким образом не получится.
Другой способ — откладывать применение полученных несовместимых журнальных записей на реплике. Этот способ работает и при потоковой репликации, и при использовании архива; он откладывает записи, относящиеся и к очистке, и к исключительным блокировкам. В параметрах устанавливается максимальная задержка применения (от времени получения записи). Если к этому моменту конфликтующий запрос не успеет завершиться, он будет прерван.
Однако конфликты, вызванные редкими причинами (удаление базы данных или табличного пространства, взаимоблокировки) не откладываются и разрешаются немедленной отменой запроса.
Page 25: Конфликты: решения
Решение 2: обратная связь по протоколу репликации
- снимок на реплике предотвращает удаление версий строк
- так же, как и локальный
- hot_standby_feedback = on
- только для конфликта очистки с запросом на реплике
- Мониторинг
- pg_stat_replication.backend_xmin
- pg_replication_slots.xmin
Комментарии преподавателя
Еще один путь решения — откладывать несовместимые действия на мастере. Для этого включается обратная связь.
Этот способ работает только для очистки (исключительную блокировку отложить не получится) и только в случае потоковой репликации (если реплика переключается на получение записей из архива, она фактически перестает существовать для мастера).
Каждый снимок данных определяет так называемый горизонт — это значение счетчика транзакций, по которому проходит граница между ненужными и нужными версиями строк. Минимальный горизонт по всем снимкам реплики определяет возможность очистки. Подробности обсуждаются в теме «Снимки данных» курса DBA2.
Благодаря обратной связи мастер понимает, какие версии строк нужны реплике. В таком случае (с точки зрения очистки) запрос на реплике ничем не отличается от запроса на самом мастере.
Обратная связь позволяет отслеживать горизонт очистки на стороне мастера. Если слот репликации не используется, горизонт виден в поле pg_stat_replication.backend_xmin, а при использовании слота — в pg_replication_slots.xmin. Нужно учитывать, что при включенной обратной связи слот, даже неактивный, будет задерживать очистку, что может привести к увеличению размеров файлов данных. Этот эффект будет исследован в практике.
Page 26: Итоги
Механизм репликации основан на передаче журнальных записей на реплику и их применении
- основной режим: потоковая репликация
- может быть поддержана архивом журнальных записей
- Реплика — точная копия мастера
- не генерирует собственные записи WAL, доступна только для чтения
- Сложный механизм, требующий настройки и мониторинга
- настройка существенно зависит от решаемых задач
Page 27: Практика
- Настройте потоковую репликацию между двумя серверами в синхронном режиме, со слотом, без обратной связи. 2. Проверьте работу репликации. Убедитесь, что при остановленной реплике фиксация не завершается. 3. Воспроизведите ситуацию, при которой запрос на реплике прерывается из-за очистки версий строк на мастере. 4. Запретите откладывать применение конфликтующих изменений; проверьте, что запрос отменяется сразу. 5. Включите обратную связь и убедитесь, что очистка на мастере не прерывает выполнение запроса. 6. Остановите реплику и убедитесь, что слот препятствует очистке. Удалите слот, чтобы очистка возобновилась.
Комментарии преподавателя
- Для синхронного режима установите на мастере параметры:
● synchronous_commit = on
● synchronous_standby_names = ‘“16/beta”’
- Для этого на реплике можно начать транзакцию с уровнем изоляции Repeatable Read и периодически выполнять запросы к таблице, а на мастере изменить эту таблицу и выполнить очистку.
Учтите, что параметр max_standby_streaming_delay по умолчанию имеет значение 30 секунд.
Установите параметр max_standby_streaming_delay в ноль.
Установите на реплике параметр hot_standby_feedback = on. Максимальный интервал оповещений устанавливается в параметре wal_receiver_status_interval (по умолчанию 10 секунд).
После выполнения практических заданий удалите созданную базу данных и сбросьте настройки параметров конфигурации.
Не забудьте отменить синхронную фиксацию, иначе при остановленной реплике не удастся зафиксировать транзакцию. Не устанавливайте synchronous_commit = off. Вместо этого установите synchronous_commit = ’local’ или сбросьте значение параметра synchronous_standby_names.
Page 28: 1. Физическая потоковая репликация в синхронном режиме
Создаем и запускаем реплику точно так же, как в демонстрации.
Резервная копия:
Для того чтобы основной сервер мог идентифицировать реплику, в основной конфигурации уже установлен параметр cluster_name:
Другой вариант — добавить атрибут application_name в строку соединения:
Теперь включаем на мастере режим синхронной репликации.
Если все реплики синхронные, можно задать значение, соответствующее любому имени:
Однако мастер не может отличить реплику от, например, утилиты pg_receivewal. При такой настройке он будет делать попытки синхронизироваться с любым клиентом, подключившимся по протоколу репликации, и это может привести к бесконечному ожиданию при фиксации транзакций. Поэтому лучше перечислять имена явно.
2. Проверка физической репликации
Page 29: Page 29
sync_state: sync говорит о том, что репликация работает в синхронном режиме; application_name: 16/beta — имя, под которым мастер знает реплику. Остановим реплику.
Фиксация ждет появления синхронной реплики…
После старта реплики фиксация завершается.
3. Отмена запроса из-за очистки на мастере
Мы хотим, чтобы в журнал сервера выводилось сообщение, если из-за конфликта с выполняющимся запросом применение журнальной записи на реплике откладывается более чем на deadlock_timeout.
Для этого установим параметр log_recovery_conflict_waits.
Также уменьшим максимальное время, на которое может быть приостановлена потоковой репликация, прежде чем запрос на реплике будет отменен.
Начинаем транзакцию с уровнем изоляции Repeatable Read: первый оператор создаст снимок данных, который будут
Page 30: Page 30
использовать все операторы транзакции.
На мастере изменяем единственную строку и выполняем очистку. При этом первая версия строки будет удалена.
Через 5 секунд запрос на реплике еще сработает — реплика задерживает применение конфликтующей журнальной записи:
А в журнале отчета сервера уже есть сообщение об ожидании разрешения конфликта:
Еще через 5 секунд такой же запрос уже будет аварийно прерван, поскольку версия строки, входящая в снимок, больше не существует.
4. Запрет откладывания применения конфликтующей записи
Выставим нулевое время задержки применения конфликтующих изменений.
Снова начинаем транзакцию…
Page 31: Page 31
На мастере изменяем строку и выполняем очистку…
Запрос на реплике прерывается тут же:
5. Обратная связь
Установим обратную связь и, чтобы не ждать долго, небольшой интервал оповещений.
Снова начинаем транзакцию…
На мастере изменяем строку и выполняем очистку…
Благодаря обратной связи, очистка не может удалить старую версию строки (tuples: 0 removed, 2 remain, 1 are dead but not
Page 32: Page 32
yet removable).
После завершения транзакции на реплике мастер может выполнить очистку (tuples: 1 removed, 1 remain, 0 are dead but not yet removable). Журнальные записи реплицируются, но ничего не сломают.
6. Влияние слота на очистку при остановленной реплике
Теперь отменим синхронизацию и остановим реплику:
Еще раз изменим строку таблицы:
Слот неактивен, но помнит минимальный xmin снимков реплики:
Это значение xmin меньше, чем минимальный xmin локальных снимков:
Поэтому слот будет задерживать очистку (tuples: 0 removed, 2 remain, 1 are dead but not yet removable).
Page 33: Page 33
Удалим слот.
Теперь очистка сработает (tuples: 1 removed).
Уборка
Удалим созданную базу данных и сбросим настройки параметров конфигурации.
Page 34: Практика+
- Настройте потоковую физическую репликацию вместе с архивацией сегментов WAL, использовав для потока репликации сетевой интерфейс виртуальной машины. 2. Проверьте работу потоковой репликации через этот сетевой интерфейс. 3. Сымитируйте отказ сети, выключив сетевой интерфейс виртуальной машины. 4. Убедитесь, что потоковая репликация остановилась, при этом реплика получает изменения благодаря архивации сегментов WAL, но с задержками. 5. Заново запустите сетевой интерфейс виртуальной машины, проверив затем, что потоковая репликация автоматически восстановилась.
Комментарии преподавателя
- Проверить состояние сетевых интерфейсов можно командой: ip a
Проверить доступность сетевого адреса можно командой: ping -c1 <IP адрес>
Внесите изменения в файл pg_hba.conf для разрешения подключений к серверу alpha через любые сетевые интерфейсы, а также измените конфигурацию этого сервера так, чтобы он прослушивал все сетевые интерфейсы.
Процесс wal_receiver завершается, если сетевое соединение отсутствует в течение времени wal_receiver_timeout. Задайте небольшое значение этого параметра.
Отказ сети смоделируйте, выключив сетевой интерфейс: sudo ip l set enp0s3 down
Убедитесь, что после переключения сегмента WAL реплика получает изменения, сделанные до переключения.
Включить сетевой интерфейс можно командой: sudo ip l set enp0s3 up
После выполнения практических заданий удалите созданную базу данных и сбросьте настройки параметров конфигурации.
Page 35: 1. Физическая потоковая репликация + архив WAL
Имя основного сетевого интерфейса виртуальной машины enp0s3:
Проверим доступность основного сетевого интерфейса виртуальной машины.
Разрешим подключения к серверу alpha с адресов IPv4, принадлежащих сетям интерфейсов сервера.
Включим прослушивание всех интерфейсов сервером и настроим архивирование WAL.
Каталог для архива WAL.
Резервная копия:
Подготовим настройки для реплики. Параметр wal_receiver_timeout задает время, по истечении которого реплика прерывает неактивное соединение. Это позволит ей быстрее обнаружить разрыв сетевого соединения.
Page 36: 2. Проверка репликации
Реплика получает записи WAL через поток…
…и сообщает мастеру о принятых записях без задержек:
Таблица реплицирована:
Page 37: 3. Отказ сети
Выключаем сетевой интерфейс — авария сети.
Сеть недоступна.
Процесс wal receiver остановлен:
На мастере добавляем строку…
…но реплика ее не получает:
Потоковая репликация остановилась:
4. Архивация
Однако архивация на мастере продолжает работать. Переключим сегмент WAL:
Сегмент попал в архив:
Теперь реплика сможет применить записи нового сегмента и мы увидим строку таблицы, вставленную до переключения.
Page 38: 5. Восстановление сети
Вставим еще одну строку в таблицу на мастере.
На реплику она не попадает.
Теперь восстановим сетевой интерфейс — авария ликвидирована.
Опять работает потоковая репликация:
На мастере добавляем еще строку.
Реплика получила все строки.
Page 39: Уборка
 {#source-figure-039 caption=“Source slide page 39: Уборка”}
Удалим созданную базу данных, сбросим значения параметров конфигурации.
05 Занятие 05: Репликация / Переключение на реплику
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba3_05_replica_switchover.html Archive: DBA3-handouts-16.zip Страниц PDF: 34
Page 1: Репликация / Переключение на реплику
Авторские права
© Postgres Professional, 2017–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Переключение на реплику
- Возвращение в строй бывшего мастера
- Особенности, связанные с файловым архивом
Page 3: Переключение на реплику
Причины
- плановое переключение (switchover):
- останов основного сервера для проведения технических работ
- аварийное переключение (failover):
- переход на реплику из-за сбоя основного сервера
- Процедура
- убедиться, что мастер остановлен
- $ pg_ctl promote или
- pg_promote()
- автоматическое переключение: отсутствует
- (для автоматизации требуется стороннее кластерное ПО)
Комментарии преподавателя
Причиной перехода на резервный сервер может быть необходимость проведения технических работ на основном сервере — тогда переход выполняется в удобное время в штатном режиме (switchover). А в случае сбоя переходить на резервный сервер нужно как можно быстрее, чтобы сократить время простоя системы (failover).
Чтобы переключить реплику в режим самостоятельного сервера, ей посылают команду, вызывая либо pg_ctl promote из операционной системы, либо функцию pg_promote из SQL. Переключение с помощью триггерного файла (параметр promote_trigger_file) начиная с 16-й версии не поддерживается.
Перед этим важно убедиться, что мастер остановлен. Если он продолжает работу и к нему еще подключены клиенты, данные на разных серверах могут «разойтись», и свести их потом воедино — нетривиальная и неавтоматизируемая задача. Скорее всего, часть данных придется просто потерять.
Для перехода на резервный сервер необходимо переключить на него клиентов. Автоматизация такого переключения требует стороннего кластерного программного обеспечения (это обсуждается в модуле «Кластерные технологии»), так как в PostgreSQL собственных средств для этого нет.
https://postgrespro.ru/docs/postgresql/16/warm-standby-failover
Page 4: Повышение реплики
Применяет журнальные записи
- уже полученные wal receiver, но еще не примененные startup
- Завершает процессы
- wal receiver
- startup
- Запускает процессы
- wal writer
- autovacuum launcher
- archiver (зависит от настройки)
- Переходит на новую линию времени
Комментарии преподавателя
Получив сигнал, реплика повышается: завершает восстановление и переходит в режим обычного сервера.
Для этого процесс startup применяет журнальные записи, которые уже были получены процессом wal receiver, но еще не применены. На этом wal receiver и startup завершают свою работу — на основном сервере они не нужны.
А вот процессы wal writer и autovacuum launcher, наоборот, запускаются. Может запускаться и процесс archiver.
Выйдя из режима восстановления, сервер переходит на новую линию времени.
С точностью до некоторых деталей, все происходит так же, как при окончании восстановления из резервной копии.
Page 5: Настройка потоковой репликации
В этой демонстрации мы будем выполнять контрольные точки вручную, а интервал расписания увеличим.
Подключим расширение pg_walinspect. Оно потребуется для исследования записей о контрольных точках в WAL. Нужны права суперпользователя.
Мы будем использовать автономную резервную копию несколько раз, поэтому создаем ее в формате tar.
Выкладываем копию в каталог PGDATA сервера beta:
Нам потребуется файл standby.signal.
Настроим подключение к мастеру.
Создадим на сервере alpha слот репликации и запустим реплику beta.
Проверим реплику:
Page 6: Page 6
Останов мастера и контрольная точка
Добавим в таблицу еще одну строку и корректно остановим мастер. При этом выполнится контрольная точка.
Информация о контрольной точке записалась в управляющий файл:
Получила ли реплика эту запись о контрольной точке? Исследуем WAL на реплике, начиная с LSN записи о контрольной точке.
В поле record_length показана длина записи в байтах. Последняя позиция, полученная репликой, больше LSN записи о контрольной точке:
Разница немного превышает длину записи (114) из-за выравнивания записей WAL: на 64-разрядной платформе LSN записей кратны восьми байтам.
Повышение реплики
Сейчас сервер beta является репликой (находится в режиме восстановления):
Повышаем реплику. Можно использовать функцию pg_promote(), которая выполняет то же действие.
Есть еще один вариант выполнить повышение: удалить файл standby.signal и перезапустить резервный сервер. Это не вполне «честный» способ, поскольку в этом случае реплика не поймет, что восстановление завершено, и не перейдет на
Page 7: Page 7
новую линию времени. Теперь бывшая реплика beta стала полноценным экземпляром.
Page 8: Возвращение в строй
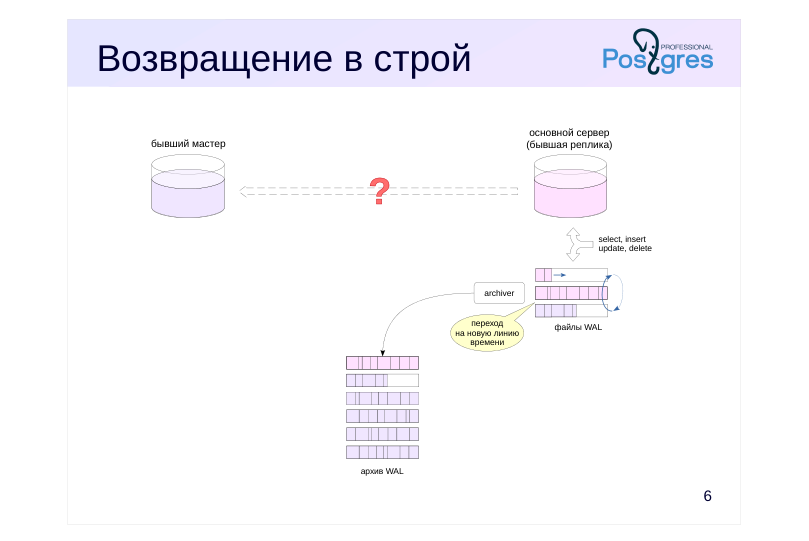 {#source-figure-008 caption=“Source slide page 8: Возвращение в строй”}
Комментарии преподавателя
После повышения бывшая реплика выступает в качестве самостоятельного сервера. Она обслуживает запросы клиентов и формирует архив журнальных записей — уже с новой линией времени.
Если переключение не было вызвано выходом сервера из строя, то нужен способ быстро вернуть старый мастер в строй — теперь уже в качестве реплики (failback).
Page 9: Простое подключение
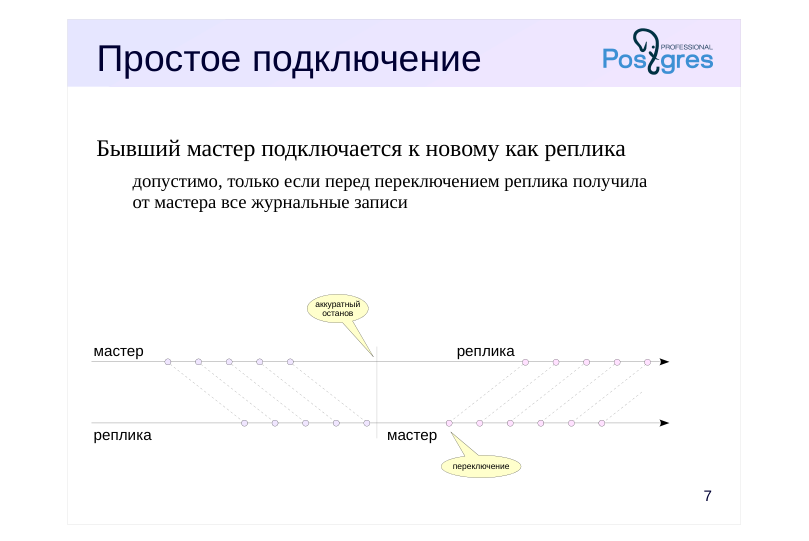 {#source-figure-009 caption=“Source slide page 9: Простое подключение”}
Бывший мастер подключается к новому как реплика
- допустимо, только если перед переключением реплика получила
- от мастера все журнальные записи
Комментарии преподавателя
В случае аккуратной остановки мастера (в режиме fast или smart) все журнальные записи мастера скорее всего дойдут до реплики, хотя это и не гарантируется. Процесс останова организован таким образом, что сначала отключаются все обслуживающие процессы, затем выполняется контрольная точка, и только в самую последнюю очередь останавливается процесс wal sender, чтобы реплика получила запись WAL о контрольной точке.
Позицию в журнале мастера можно проверить с помощью утилиты pg_controldata (запись latest checkpoint location), а позицию на реплике покажет функция pg_last_wal_receive_lsn. Эта функция возвращает текущую позицию в WAL, поэтому ее значение должно опережать latest checkpoint location на длину записи о контрольной точке.
Если все журнальные записи действительно были получены, то бывший мастер можно непосредственно подключить к новому, изменив соответствующим образом конфигурационные параметры.
В случае останова мастера без выполнения контрольной точки (сбой или режим immediate), такое подключение на нагруженном сервере, скорее всего, будет невозможно. При этом сервер не сможет стартовать, а в журнале сообщений будет фиксироваться ошибка.
Page 10: Возвращение в строй: прямое подключение
Введем сервер alpha в строй, но теперь уже в качестве реплики. Для этого создадим файл standby.signal:
Настроим подключение к мастеру.
Запустим alpha и убедимся, что этот сервер стал репликой.
На сервере beta мы можем изменять данные:
А реплика alpha их принимает.
Page 11: Резервная копия
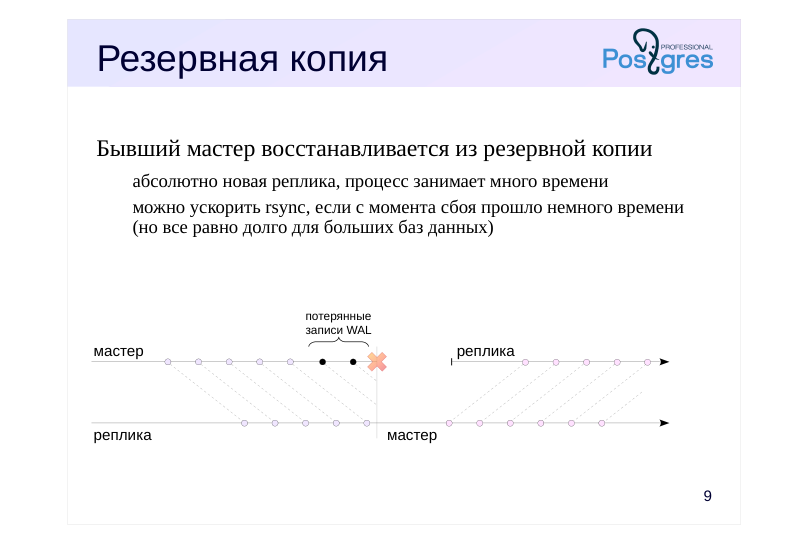 {#source-figure-011 caption=“Source slide page 11: Резервная копия”}
Бывший мастер восстанавливается из резервной копии
- абсолютно новая реплика, процесс занимает много времени
- можно ускорить rsync, если с момента сбоя прошло немного времени
- (но все равно долго для больших баз данных)
Комментарии преподавателя
Если мастер был остановлен аварийно, велика вероятность того, что часть журнальных записей не успела дойти до реплики. В этом случае просто так подключать мастер нельзя.
Простой и надежный вариант — создать абсолютно новую реплику путем изготовления и развертывания базовой резервной копии. Однако для больших баз данных этот процесс может занимать много времени.
Вариант такого подхода — не использовать утилиту pg_basebackup, а сделать копию с помощью API резервирования с использованием утилиты rsync. Если выполнять копирование сразу после перехода на реплику, то большая часть файлов не успеет поменяться и процесс может пройти существенно быстрее. Но это, конечно, усложняет процедуру.
Page 12: Утилита pg_rewind
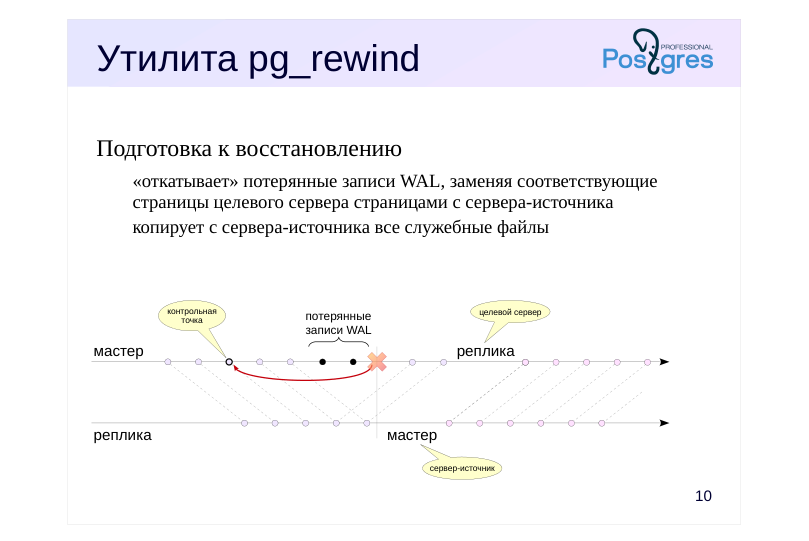 {#source-figure-012 caption=“Source slide page 12: Утилита pg_rewind”}
Подготовка к восстановлению
- «откатывает» потерянные записи WAL, заменяя соответствующие
- страницы целевого сервера страницами с сервера-источника
- копирует с сервера-источника все служебные файлы
Комментарии преподавателя
Еще более быстрый вариант состоит в использовании штатной утилиты pg_rewind.
Утилита определяет место расхождения между двумя серверами, определяет ближайшую к нему общую контрольную точку, и, просматривая журнал, определяет все страницы, измененные с момента этой контрольной точки.
Найденные страницы (которых должно быть немного) заменяются страницами с сервера-источника (нового мастера). Кроме того, утилита копирует с сервера-источника все служебные файлы.
Дальше применяются все необходимые записи WAL с нового мастера. Фактически, это выполняет уже не утилита, а обычный процесс восстановления после запуска сервера. Чтобы восстановление началось с нужного момента, утилита создает управляющий файл backup_label.
https://postgrespro.ru/docs/postgresql/16/app-pgrewind
Page 13: Особенности pg_rewind
Целевой сервер (бывший мастер)
- все необходимые журнальные файлы должны сохраниться в pg_wal
- или в архиве
- должны быть включены контрольные суммы или wal_log_hints = on
- должен быть включен параметр full_page_writes = on
- Сервер-источник (текущий мастер)
- клиент-серверное подключение:
- -source-server = строка подключения
- корректно остановленный сервер:
- -source-pgdata = каталог
Комментарии преподавателя
Для сервера-источника, если он запущен, ключом –source-server задается строка клиент-серверного подключения libpq (утилита не использует протокол репликации). Роль для подключения должна иметь право выполнения функций pg_ls_dir, pg_stat_file, pg_read_binary_file.
Если же сервер-источник остановлен корректно, можно указать его каталог данных ключом –source-pgdata.
Утилита имеет ряд особенностей:
● Все сегменты WAL, содержащие записи от последней общей контрольной точки до текущего момента, должны находиться в каталоге pg_wal целевого сервера или быть доступны для получения из архива. Во втором случае надо задать параметр restore_command и ключ –restore-target-wal.
● Из-за ошибок при записи возможно рассогласование данных внутри страницы (проблема неатомарной записи, обсуждается в теме «Базовая резервная копия»). Чтобы решить проблему, на целевом сервере первое изменение страницы после контрольной точки должно вызывать запись в WAL полного ее образа. Для этого должен быть установлен full_page_writes = on. Этот режим не учитывает «незначительные» изменения страниц (hint bits), поэтому дополнительно требуется, чтобы в кластере либо были включены контрольные суммы страниц, либо был установлен параметр wal_log_hints = on.
● Если целевой сервер был остановлен нештатно, без контрольной точки, утилита запустит его в однопользовательском режиме и тут же остановит корректно.
Page 14: Возвращение в строй: утилита pg_rewind
Воспроизведем теперь аварийную ситуацию появления двух пишущих серверов — разделение сети (мы подробно обсуждаем этот и другие виды сбоев в теме «Обзор кластерных технологий» этого курса). Выведем сервер alpha из режима реплики, не останавливая основной сервер beta.
Теперь и на alpha, и на beta можно изменять данные:
В реальности такой ситуации необходимо всячески избегать, поскольку теперь непонятно, какому серверу верить. Придется либо полностью потерять изменения на одном из серверов, либо придумывать, как объединить данные. Наш выбор — потерять изменения, сделанные на сервере beta. Откатим на beta изменения, которые противоречат изменениям, сделанным на alpha. Для этого мы используем утилиту pg_rewind, поэтому убедимся, что на целевом сервере (beta) заданы необходимые значения параметров:
Остановим целевой сервер некорректно.
В ключах утилиты pg_rewind надо указать каталог PGDATA целевого сервера и способ обращения к серверу-источнику (alpha): либо строку подключения (если сервер работает), либо местоположение его каталога PGDATA (если он выключен). В нашем случае сервер alpha запущен. Поскольку целевой сервер beta не был остановлен корректно, утилита запустит его в однопользовательском режиме и остановит с выполнением контрольной точки. Для запуска нужно указать расположение файла конфигурации. Ключ -R обеспечит запуск целевого сервера как реплики после завершения работы утилиты: восстановив согласованность, он останется в режиме восстановления.
Page 15: Page 15
В результате pg_rewind «откатила» страницы данных к последней контрольной точке перед моментом, когда изменения серверов разошлись. Утилита также создала файл backup_label с информацией о позиции WAL, с которой нужно начинать восстановление. Заглянем в него:
Используя параметр -R, мы попросили утилиту создать сигнальный файл standby.signal и задать в конфигурационном файле строку соединения.
На сервере alpha заранее создан слот репликации, задействуем его.
Теперь beta запустится в режиме реплики.
Слот репликации инициализировался и используется:
Данные, измененные на новом мастере (alpha), получены репликой (beta):
Page 16: Page 16
Добавим еще одну строку:
Итак, мы ввели бывший мастер (beta) в строй в качестве реплики.
Page 17: Переключение и архив
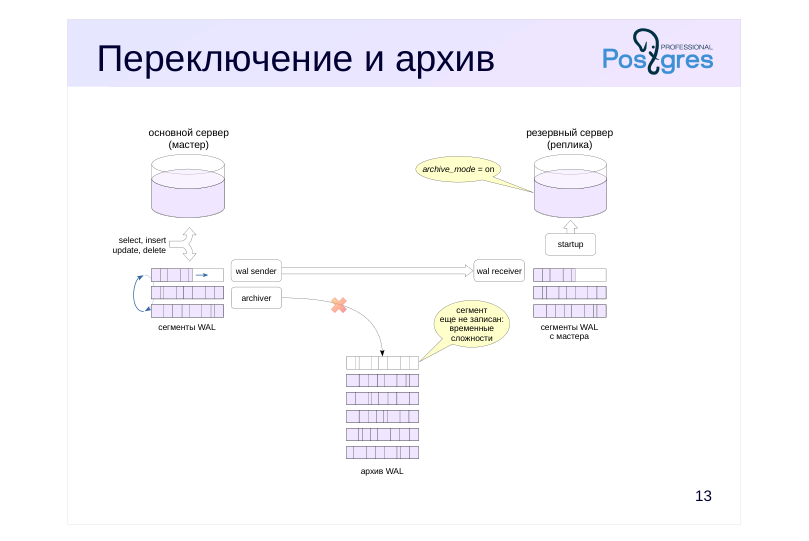 {#source-figure-017 caption=“Source slide page 17: Переключение и архив”}
Комментарии преподавателя
Архив журнала предзаписи, пополняемый с помощью механизма непрерывного архивирования, имеет неприятную особенность в контексте потоковой репликации и переключения на реплику: при отказе мастера некоторые сегменты могут не попасть в архив. Например, если возникли проблемы с местом на диске, archive_command будет возвращать ошибку.
Page 18: Переключение и архив
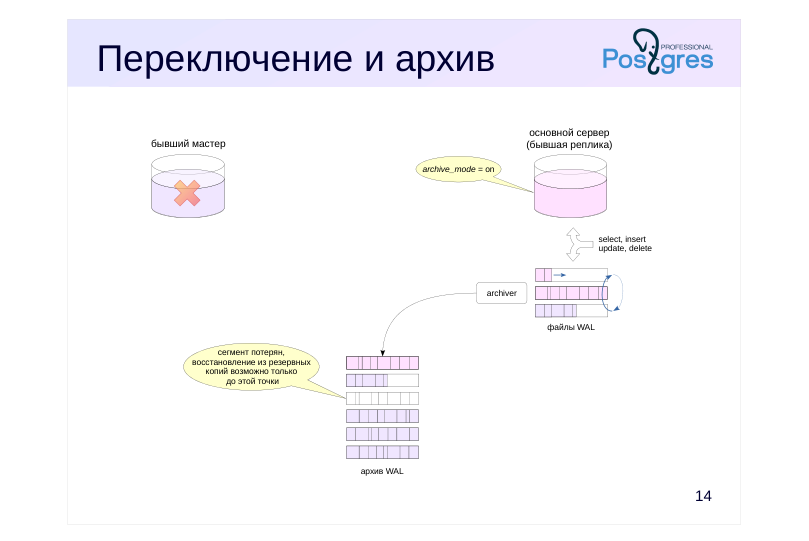 {#source-figure-018 caption=“Source slide page 18: Переключение и архив”}
Комментарии преподавателя
Но реплика не в курсе настроек архивирования на мастере. Когда бывшая реплика займет место мастера, она не запишет недостающие сегменты в архив (хотя они у нее есть), потому что рассчитывает на то, что архив работал без сбоев. В результате архив будет неполным.
А это означает, что из имеющихся резервных копий можно восстановить систему только до образовавшейся «дыры». Если такая ситуация возникла (а это еще нужно заметить), требуется в срочном порядке выполнить резервное копирование.
Потоковый архив лишен этого недостатка, поскольку утилита pg_receivewal отслеживает содержимое каталога и запрашивает у сервера недостающие журнальные записи. Но, как отмечалось в модуле «Резервное копирование», использование этой утилиты сопряжено с поддержанием дополнительной инфраструктуры.
Page 19: Проблемы с файловым архивом
Восстановим серверы alpha и beta из резервной копии и настроим на обоих файловую архивацию в общий архив.
Архив сегментов WAL.
Одинаковые настройки архивации на серверах alpha и beta.
На реплике (beta) создадим файл standby.signal и настроим подключение к мастеру.
Запускаем мастер (alpha) и создаем слот репликации.
Теперь стартуем реплику.
Текущий сегмент журнала:
Принудительно переключим сегмент WAL. Чтобы переключение произошло, нужно гарантировать, что текущий и следующий сегменты содержат какие-либо записи.
Page 20: Page 20
Теперь журнальные записи пишутся в следующий сегмент, а предыдущий попал в архив:
Представим, что возникли трудности с архивацией. Причиной может быть, например, заполнение диска или проблемы с сетевым соединением, а мы смоделируем их, возвращая статус 1 из команды архивации.
Опять переключим сегмент WAL.
Сегмент не архивируется.
Процесс archiver будет продолжать попытки, но безуспешно.
Сервер beta в режиме реплики не выполнял архивацию, а после повышения не будет архивировать пропущенный сегмент. Остановим alpha, повышаем beta.
Еще раз принудительно переключим сегмент, теперь уже на beta.
Page 21: Page 21
Что с архивом?
Сегмент 000000010000000000000004 отсутствует, архив теперь непригоден для восстановления и репликации.
Page 22: Переключение и архив
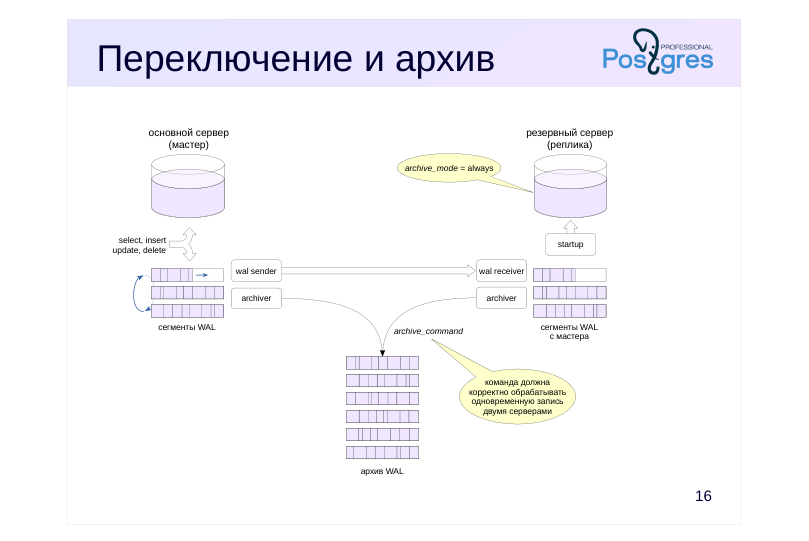 {#source-figure-022 caption=“Source slide page 22: Переключение и архив”}
Комментарии преподавателя
При установке archive_mode = always на реплике запускается процесс archiver, который записывает сегменты в архив наравне с мастером. Таким образом, один и тот же файл будет записан два раза с двух серверов. Это накладывает на команду archive_command серьезные требования:
● она не должна перезаписывать существующий файл, но должна сообщать об успехе, если файл с тем же содержимым уже есть в архиве;
● она должна корректно обрабатывать одновременный вызов с двух серверов.
При такой настройке сегмент не пропадет, поскольку реплика будет продолжать попытки записи даже после останова мастера.
(Разумеется, можно настроить archive_command и так, чтобы мастер и реплика сохраняли сегменты журнала в разные архивы, но вряд ли это практично.)
Page 23: Архивация с реплики
Чтобы при переключении на реплику архив не пострадал, на реплике нужно использовать значение archive_mode = always. При этом команда архивации должна корректно обрабатывать одновременную запись сегмента мастером и репликой. Еще раз восстановим alpha и beta из резервной копии и настроим на обоих файловую архивацию в общий архив.
Архив сегментов WAL.
Настройка архивации на мастере (alpha). Мы заменили логическую связку в команде архивации, чтобы при наличии файла она сразу возвращала 0.
Настройка архивации на реплике (beta). Используем режим always и ту же команду архивации.
На реплике нужен еще standby.signal.
Запускаем мастер и создаем слот репликации.
Теперь стартуем реплику.
Page 24: Page 24
Повторим опыт. Переключаем сегмент:
Проверяем состояние архивации:
Заполненный сегмент попал в архив. На сервере alpha возникли проблемы с архивацией, команда возвращает 1:
Alpha продолжает генерировать сегменты WAL.
Но основной сервер их не архивирует:
Однако архивация с реплики срабатывает и сегмент оказывается в архиве:
Выполняем переключение на реплику.
Beta стала основным сервером и генерирует файлы WAL.
Page 25: Page 25
Еще раз заглянем в архив:
В архиве появились файлы реплики, пропусков в нем нет, проблема решена.
Page 26: Итоги
Переключение используется как в штатных, так и в нештатных ситуациях
- После переключения бывший мастер надо вернуть в строй
- Обе процедуры должны быть заранее отработаны
- Файловый архив журнала предзаписи требует внимания
Page 27: Практика
- Выполните необходимую настройку потоковой репликации с сервера alpha на beta с использованием слота, без непрерывного архивирования. 2. Сымитируйте сбой сервера alpha и переключитесь на сервер beta. 3. Верните в строй сервер alpha в качестве реплики, выполнив резервную копию с нового мастера beta и настроив необходимые параметры.
- Убедитесь, что репликация работает и использует слот. 4. Переключитесь на сервер alpha, чтобы бывший мастер снова стал основным сервером.
Комментарии преподавателя
- Для имитации сбоя можно остановить сервер в режиме immediate:
pg_ctlcluster 16 имя_кластера stop -m immediate –skip-systemctl-redirect
или завершить основной процесс postgres:
kill -QUIT номер_процесса
Номер процесса можно найти в первой строке файла PGDATA/postmaster.pid.
После завершения практических заданий удалите слот и созданную базу данных, сбросьте измененные параметры.
Page 28: 1. Настройка репликации без архива
Настраиваем репликацию. Остановим сервер beta и очистим его каталог данных.
Формируем автономную резервную копию в каталоге данных сервера beta, предварительно создав слот replica.
Запускаем сервер в режиме реплики.
Проверим настройки. Выполним несколько команд на мастере:
Проверим реплику:
2. Сбой основного сервера и переход на реплику
Имитируем аварийную остановку мастера.
Повышаем реплику.
Page 29: 3. Возвращение в строй бывшего мастера
Создаем автономную резервную копию сервера beta в каталоге данных сервера alpha. Перед этим удалим конфигурационный файл, иначе pg_basebackup его скопирует и допишет параметры.
Очистим каталог данных на сервере alpha.
Запускаем утилиту резервного копирования, попросив ее создать слот и настройки репликации.
Параметры конфигурации и сигнальный файл подготовлены утилитой:
Слот репликации инициализировался и используется:
Проверим репликацию:
4. Переключение на новую реплику
Повышаем реплику.
Page 30: Page 30
В итоге прежний мастер снова стал основным сервером.
Уборка
Удалим слот и базу данных, сбросим измененные параметры.
Page 31: Практика+
- Настройте сервер alpha, чтобы после контрольной точки сохранялись два дополнительных сегмента WAL, и запустите физическую репликацию с alpha на сервер beta без слота репликации. 2. Аварийно остановите сервер alpha и выполните повышение beta. Запустите alpha и измените данные на нем. Убедитесь, что данные на alpha и beta не совпадают. 3. Остановите сервер alpha и запустите его в качестве реплики сервера beta, используя утилиту pg_rewind.
Комментарии преподавателя
- Настройте репликацию с простейшими настройками и без слота репликации. Для гарантии сохранения двух дополнительных сегментов WAL задайте подходящее значение wal_keep_size.
После завершения практических заданий удалите слот и созданную базу данных, сбросьте измененные параметры.
Page 32: 1. Репликация
Мы не используем слоты репликации, поэтому потребуем сохранять два дополнительных сегмента WAL.
Остановим сервер beta и сделаем его репликой для сервера alpha.
Создадим базу данных и таблицу в ней.
Изменения реплицированы на сервер beta.
Проверим статус репликации.
На реплике можно посмотреть статистику приемника WAL:
Page 33: 2. Разрыв репликации
На мастер-сервере отключено питание.
Повышаем beta.
Изменяем данные на новом мастере.
На сервере alpha питание восстановлено.
Данные на серверах разошлись.
Остановим сервер alpha (бывший мастер).
3. Ввод в строй бывшего мастера
Мы хотим запустить сервер alpha как реплику. Для этого нужно вернуть его к состоянию, совместимому с beta. Используем штатную утилиту.
На сервере beta выполняются пишущие транзакции.
Данные, измененные на сервере beta, получены сервером alpha:
Page 34: Page 34
 {#source-figure-034 caption=“Source slide page 34: Page 34”}
Уборка
Удалим созданную базу данных и сбросим настройки конфигурационных параметров.
06 Занятие 06: Репликация / Логическая репликация
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba3_06_replica_logical.html Archive: DBA3-handouts-16.zip Страниц PDF: 43
Page 1: Репликация / Логическая репликация
Авторские права
© Postgres Professional, 2017–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Сравнение логической и физической репликации
- Публикации и подписки
- Начальная синхронизация
- Идентификация и фильтрация строк
- Логическое декодирование
- Большие транзакции
- Конфликты
- Источники репликации
Page 3: Сравнение
Физическая
- мастер-реплика: поток данных только в одну сторону
- передача потока журнальных записей или файлов журнала
- требуется двоичная совместимость серверов
- реплицируется только весь кластер
- Логическая
- публикация-подписки: у сервера нет выделенной роли
- передача изменений табличных строк
- требуется совместимость на уровне протокола
- возможна выборочная репликация отдельных таблиц
Комментарии преподавателя
При физической репликации серверы имеют назначенные роли: мастер и реплика. Мастер передает журнальные записи на реплику, которая применяет эти записи к своим файлам данных. Применение происходит чисто механически, без «понимания смысла» изменений, поэтому важна двоичная совместимость между серверами (одинаковые платформы и основные версии PostgreSQL). Поскольку журнал общий для всего кластера, то и реплицировать можно только кластер целиком.
При логической репликации на одном сервере создается публикация, другие серверы могут на нее подписаться. У сервера нет выделенной роли: один и тот же сервер может как публиковать изменения, так и подписываться на другие (или даже свои) публикации.
По умолчанию информация об изменениях строк в таблицах передается подписке в текстовом, независимом от платформы виде, в котором двоичная совместимость не требуется.
https://postgrespro.ru/docs/postgresql/16/logical-replication
Page 4: Схема репликации
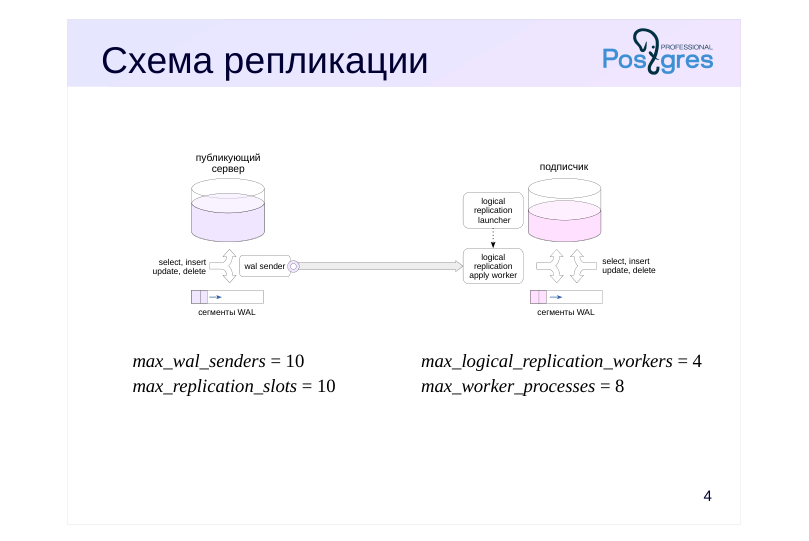 {#source-figure-004 caption=“Source slide page 4: Схема репликации”}
- max_wal_senders = 10
- max_logical_replication_workers = 4
- max_replication_slots = 10
- max_worker_processes = 8
Комментарии преподавателя
Логическая репликация использует модель «публикация–подписка».
При старте экземпляра запускается фоновый процесс logical replication launcher, периодически проверяющий таблицу pg_subscription системного каталога на предмет появления новой подписки. Как только подписка появляется, для нее запускается фоновый процесс logical replication apply worker. Он соединяется с сервером публикации, на котором, как при любом подключении по протоколу репликации, запускается процесс wal sender. Этот процесс читает журнал предзаписи, отбирает нужные и преобразует их в платформонезависимые сообщения протокола. При этом обязательно используется слот логической репликации.
На стороне подписки рабочий процесс принимает сообщения и применяет изменения. В это же время сервер-подписчик может принимать обычные запросы на чтение и запись.
Обратите внимание, что на публикующем сервере может быть запущено много процессов wal sender — по одному на каждую подписку. Значения параметров max_wal_senders и max_replication_slots должны быть не меньше этого количества.
На сервере подписки необходимо установить параметры max_logical_replication_workers (для процессов, принимающих изменения по подписке) и в целом max_worker_processes (как минимум на единицу больше, учитывая logical replication launcher, но этот пул используется и для других нужд).
https://postgrespro.ru/docs/postgresql/16/logical-replication-architecture
Page 5: Публикация
Объект базы данных
- выдает изменения данных построчно в порядке фиксации транзакций
- только базовые и секционированные таблицы
- wal_level = logical
- Публикуются операции
- insert, update, delete, truncate
- Права
- создать публикацию — привилегия CREATE на базу данных
- добавить таблицу — владелец или суперпользователь
- добавить все таблицы схемы или базы данных — суперпользователь
Комментарии преподавателя
На одном сервере создается публикация, выделяющая изменения в одной или нескольких таблицах (базовых или секционированных) одной базы данных. Чтобы создать публикацию, нужна привилегия CREATE на базу данных. Для репликации из нескольких баз данных потребуется создать несколько публикаций.
Включить в публикацию одну или несколько таблиц может их владелец или суперпользователь. Все таблицы схемы или базы данных может опубликовать только суперпользователь.
Для работы логической репликации в журнале публикующего сервера необходима дополнительная информация (параметр wal_level = logical).
Публикация включает в себя изменения строк, происходящие в таблицах в результате выполнения команд DML. Команда MERGE, выполненная на публикующем сервере, применяется как INSERT, UPDATE или DELETE.
По умолчанию изменения передаются не сразу, а только при фиксации транзакции.
https://postgrespro.ru/docs/postgresql/16/logical-replication-publication
https://postgrespro.ru/docs/postgresql/16/sql-createpublication
Page 6: Подписка
Объект базы данных
- получает сообщения от одной или нескольких публикаций
- возможна подписка в двоичном формате
- применяет изменения построчно
- таблицы и столбцы сопоставляются по полным именам
- Права
- создание подписки — роль pg_create_subscription и суперпользователи
Комментарии преподавателя
Определив в базе данных подписку на публикации, можно получать и применять изменения. По сути, подписка — это подключение к публикующему серверу, созданное для репликации данных.
Создавать подписки могут члены роли pg_create_subscription и суперпользователи.
Применение изменений всегда происходит построчно. Хотя каждое изменение не требует разбора и планирования запроса, массовые изменения из-за этого могут выполняться медленно.
Таблицы идентифицируются по полным именам (включая схему), столбцы также идентифицируются по именам. Это позволяет подписке использовать отличающуюся схему данных (например, иметь в таблице дополнительные столбцы).
При создании подписки можно указать параметр binary, устанавливающий передачу данных в двоичном формате. Двоичный формат может ускорить обработку если определены функции двоичного получения и отправки для требуемых типов данных. Однако при использовании двоичного формата важна совместимость машинного представления данных на разных платформах.
https://postgrespro.ru/docs/postgresql/16/logical-replication-subscription
Page 7: Публикации и подписки
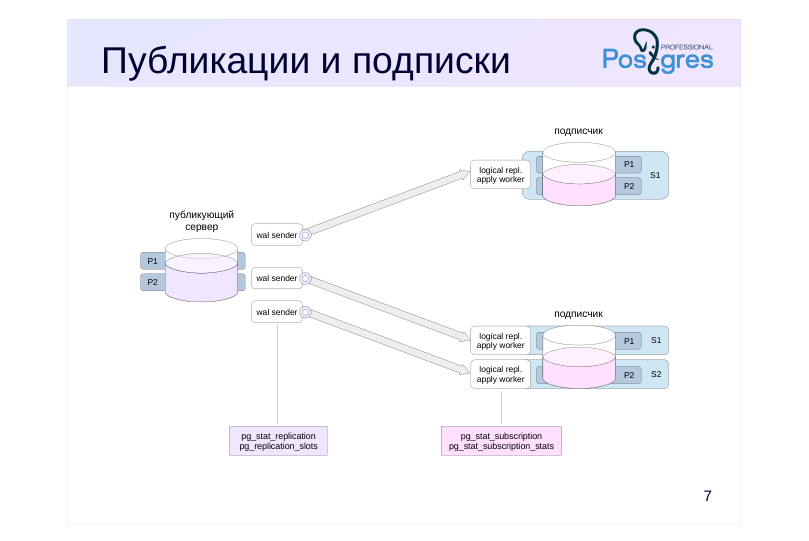 {#source-figure-007 caption=“Source slide page 7: Публикации и подписки”}
Комментарии преподавателя
На публикующем сервере можно распределять объекты по публикациям любым образом. Можно включить все таблицы в одну публикацию, можно разделить их между несколькими публикациями — это не влияет на производительность.
Однако каждая подписка создает отдельное подключение к публикующему серверу, нагружая его лишней работой. На публикующем сервере в таком случае будет запущено несколько процессов wal sender, каждый из которых будет самостоятельно читать WAL и выполнять логическое декодирование (рассматривается ниже) в своей локальной памяти. Поэтому если необходимо подписаться на несколько публикаций, это лучше сделать в одной общей подписке.
Напомним, что публикации и подписки — объекты базы данных, поэтому для каждой базы потребуется отдельное соединение.
Мониторинг логической репликации на публикующем сервере идентичен мониторингу физической репликации. Здесь важнейшие инструменты — представления pg_stat_replication и pg_replication_slots.
Информация о состоянии подписок находится в pg_subscription.
https://postgrespro.ru/docs/postgresql/16/catalog-pg-subscription#CATALO G-PG-SUBSCRIPTION
Данные о применении изменений в представлении pg_stat_subscription.
https://postgrespro.ru/docs/postgresql/16/monitoring-stats#MONITORING-P G-STAT-SUBSCRIPTION
Данные об ошибках в процессе репликации в pg_stat_subscription_stats.
https://postgrespro.ru/docs/postgresql/16/monitoring-stats#MONITORING-P G-STAT-SUBSCRIPTION-STATS
Page 8: Логическая репликация
Мы собираемся настроить логическую репликацию таблицы test с сервера alpha на сервер beta. Для начала создадим базу данных.
Для работы логической репликации понадобится изменить уровень журнала.
Второй кластер изначально будет копией первого, поэтому выполним резервное копирование в каталог PGDATA второго сервера.
Теперь на первом сервере создадим таблицу и заполним ее данными.
На втором сервере таблицы test нет. Поскольку команды DDL не реплицируются, таблицу необходимо создать вручную. Структура ее может отличаться, но таблица должна содержать все публикуемые столбцы.
На первом сервере создаем публикацию.
Заметьте, что публикация создана, хотя в ней нет ни одной таблицы. Обычно публикацию создают, указав: список таблиц, причем в этом случае можно указать публикуемые столбцы; все таблицы в заданных схемах (требует прав суперпользователя);
Page 9: Page 9
все таблицы базы данных (требует прав суперпользователя). Добавим в публикацию таблицу.
На втором сервере подписываемся на публикацию.
Проверим созданную подписку.
Значения столбцов id, descr и cluster_name были получены из публикации. Начиная с PostgreSQL 15, можно публиковать не все, а только некоторые столбцы:
Проверим:
Обратите внимание на столбец cluster_name — теперь он получил значение по умолчанию (beta) на подписчике.
Page 10: Page 10
Состояние подписки можно посмотреть в представлении:
received_lsn — позиция в журнале, до которой получены изменения; latest_end_lsn — позиция в журнале, подтвержденная процессу wal sender. К процессам сервера добавился logical replication worker (его номер указан в pg_stat_subscription.pid):
Page 11: Ограничения
Не реплицируются
- последовательности материализованные представления временные и нежурналируемые таблицы внешние таблицы большие объекты DDL Требование к TRUNCATE
- таблицы, связанные внешними ключами, должны быть в одной
- подписке
Комментарии преподавателя
Реплицируются только изменения содержимого базовых и секционированных таблиц, вызванные командами DML.
Не реплицируются содержимое остальных объектов, объединяемых термином «отношение»: последовательностей, материализованных представлений, временных и нежурналируемых таблиц, внешних таблиц. Не реплицируются большие объекты.
Команды DDL также не реплицируются, поэтому нужно предварительно создать таблицы на стороне подписки.
Команда TRUNCATE реплицируется успешно только в случае, если все таблицы подписчика, внешние ключи которых ссылаются на опустошаемые таблицы, включены в подписку.
https://postgrespro.ru/docs/postgresql/16/logical-replication-restrictions
Page 12: Начальная синхронизация
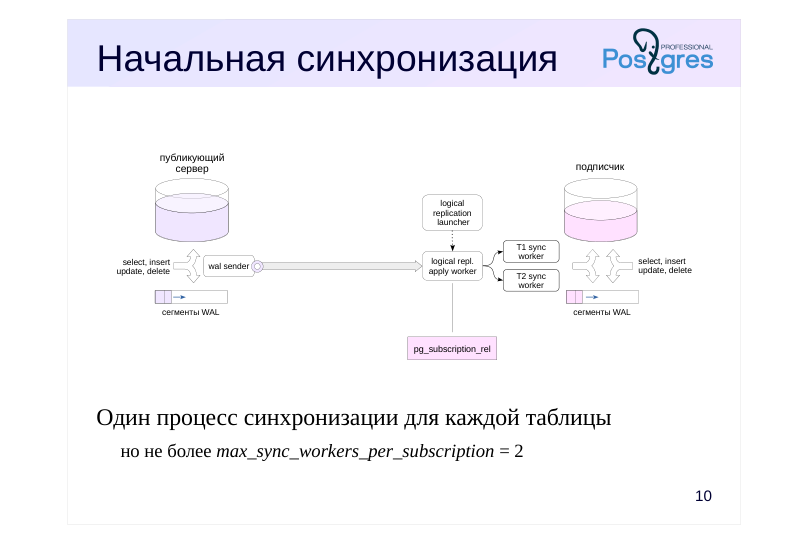 {#source-figure-012 caption=“Source slide page 12: Начальная синхронизация”}
Один процесс синхронизации для каждой таблицы
- но не более max_sync_workers_per_subscription = 2
Комментарии преподавателя
По умолчанию (если не задано значение параметра copy_data = false) при создании подписки выполняется начальная синхронизация содержимого таблиц. Она происходит бесшовно благодаря использованию механизма экспорта снимка данных.
Начальную синхронизацию желательно завершить как можно скорее, чтобы не удерживать открытым снимком горизонт очистки дольше необходимого. Поэтому синхронизация распараллеливается: процесс apply worker просматривает список реплицируемых таблиц и запускает дополнительные рабочие процессы, которые и выполняют синхронизацию. Синхронизация одной таблицы всегда выполняется одним процессом.
Максимальное количество параллельных процессов синхронизации ограничено параметром max_sync_workers_per_subscription (по умолчанию — два процесса).
Состояние репликации для каждой таблицы в подписке показывает представление pg_subscription_rel.
https://postgrespro.ru/docs/postgresql/16/catalog-pg-subscription-rel#CATAL OG-PG-SUBSCRIPTION-REL
Если для подписки указать параметр binary, то в двоичном формате будет выполняться не только репликация, но и начальная синхронизация.
Page 13: Начальная синхронизация
По умолчанию подписчик сначала получает содержимое таблиц, и только после этого запускается процесс репликации. Это выполняется бесшовно с гарантией того, что никакие изменения не будут потеряны. Создадим три таблицы с большим количеством строк и публикацию:
На подписчике создадим пустые таблицы той же структуры:
Подпишемся на публикацию и сразу же заглянем в системную таблицу, показывающую состояние репликации каждой таблицы, и в список процессов.
Здесь мы видим, что таблица test реплицируется (r), а три новые таблицы пока еще синхронизируются (i).
Добавился процесс apply worker для новой подписки и два процесса синхронизации. Таблиц три, но количество
Page 14: Page 14
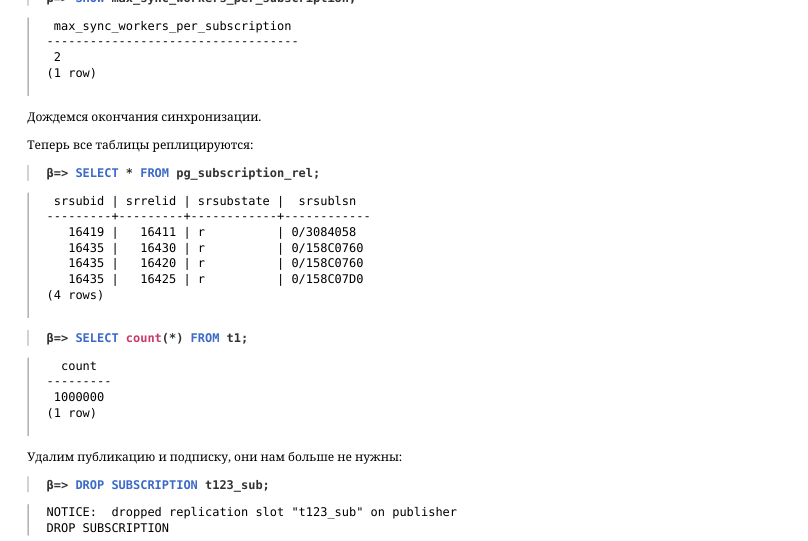 {#source-figure-014 caption=“Source slide page 14: Page 14”}
одновременно работающих процессов ограничено параметром:
Дождемся окончания синхронизации. Теперь все таблицы реплицируются:
Удалим публикацию и подписку, они нам больше не нужны:
Page 15: Идентификация строк
Для операций изменения и удаления необходимо выбрать подходящую строку
- Логический идентификатор строк
- DEFAULT
- столбцы первичного ключа (по умолчанию)
- FULL
- все столбцы
- NOTHING
- без идентификации
- (по умолчанию для системного каталога)
Комментарии преподавателя
Вставка новых строк на стороне подписки происходит однозначно. Сложнее при изменениях и удалениях — в этих случаях надо определить, к какой строке на подписчике применять операцию. Поэтому для каждой таблицы определяется логический идентификатор строк. По умолчанию строки идентифицируются столбцами первичного ключа, но идентификатор можно изменить командой ALTER TABLE … REPLICA IDENTITY.
Строки можно идентифицировать по другому уникальному индексу, в котором все столбцы имеют ограничение NOT NULL.
Еще один вариант — идентификация по всем столбцам. Начиная с версии 16, для поиска строк в этом случае может использоваться полный индекс на основе B-дерева, первое поле которого должно быть столбцом из публикации. Версии 17+ могут использовать и хеш-индексы. Если подходящего индекса нет, выполняется полное сканирование, что крайне неэффективно для больших таблиц.
Можно вообще отказаться от поддержки репликации для некоторых таблиц (по умолчанию так настроены таблицы системного каталога).
При изменении или удалении в WAL уровня replica не попадают значения столбцов удаляемой версии строки — это одна из причин, по которой на публикующем сервере необходим уровень журнала logical. На этом уровне в журнал дополнительно записываются старые значения столбцов, входящих в логический идентификатор. По этой причине при идентификации по всем столбцам объем журнала может существенно увеличиться по сравнению с уровнем replica.
https://postgrespro.ru/docs/postgresql/16/sql-altertable#SQL-ALTERTABLE-REPLICA-IDENTITY
Page 16: Фильтрация строк
Фильтр в публикации
- Возможна фильтрация
- insert
- по любым публикуемым столбцам
- delete
- по столбцам логического идентификатора
- update
- по столбцам логического идентификатора;
- в результате может получиться insert или delete
- truncate
- фильтр игнорируется
- Только простые выражения
Комментарии преподавателя
По умолчанию публикующий сервер отправляет все строки опубликованных таблиц.
В PostgreSQL 15 появилась возможность указать выражение фильтра; строки, для которых выражение имеет значение false или NULL, опубликованы не будут.
Фильтрация не распространяется на операцию truncate. Для операций insert в выражение фильтра можно включать любые публикуемые столбцы, а для update и delete — только столбцы, входящие в логический идентификатор строк.
Для операции update выражение фильтра вычисляется и для старой, и для новой версий строки. Если для обеих версий выражение фильтра дает false или NULL, строка не реплицируется. Если старая строка не соответствует фильтру, а новая — соответствует, то выполняется вставка новой строки. Если, наоборот, старая версия соответствует, а новая — нет, строка удаляется. Если обе соответствуют условию фильтра, выполняется обновление.
Фильтровать можно лишь с помощью простых выражений: запрещены пользовательские функции, операторы, типы и правила сортировки; нельзя ссылаться на системные столбцы; нельзя обращаться ко встроенным функциям с категориями изменчивости volatile и stable.
https://postgrespro.ru/docs/postgresql/16/logical-replication-row-filter.html
Page 17: Идентификация и фильтрация
По умолчанию логический идентификатор строк определяется столбцами первичного ключа:
d — по умолчанию (первичный ключ, если есть); i — индекс; f — все столбцы; n — никакие. Допустим, нужно реплицировать только те строки, у которых в поле cluster_name находится значение alpha. Столбец cluster_name участвует в выражении фильтра, поэтому его нужно опубликовать (сейчас он не опубликован). Публикуем все столбцы, не указывая их список.
Проверим, как работает репликация изменений.
Строка со значением gamma не реплицировалась. Попробуем изменить строку.
Для update и delete в выражении фильтра допускаются только столбцы, входящие в логический идентификатор строк, а для insert — любые столбцы.
Page 18: Page 18
Изменим условие фильтрации.
Теперь мы можем изменить строку:
Строка изменилась и на подписчике. Новое условие фильтрации работает:
Строка с id = 0 не была опубликована и поэтому не реплицировалась.
Page 19: Логическое декодирование
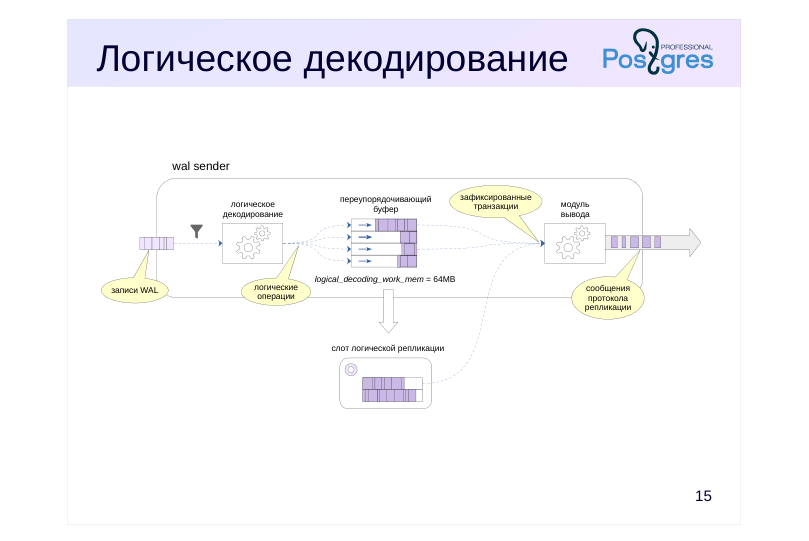 {#source-figure-019 caption=“Source slide page 19: Логическое декодирование”}
Комментарии преподавателя
При потоковой физической репликации процесс wal sender читает записи WAL и передает их реплике в неизменном виде.
При логической репликации записи преобразуются. Модуль логического декодирования отбирает из них те, которые соответствуют публикуемым операциям и таблицам, учитывая столбцы и условия фильтров. Отобранные записи преобразуется в информацию о логических операциях, направляются в переупорядочивающий буфер и сохраняются в нем в соответствии с номерами транзакций.
В журнал на уровне logical дополнительно записывается информация, необходимая для логического декодирования, в частности:
● для update — новые значения всех столбцов, а не только измененных;
● для update и delete — старые значения столбцов, входящих в логический идентификатор;
● для commit — OID базы данных.
Переупорядочивающий буфер находится в локальной памяти процесса wal sender. Если объем данных в нем приблизится к значению параметра logical_decoding_work_mem, самая большая транзакция сбрасывается в слот репликации (файл в PGDATA/pg_replslots/имя).
При фиксации транзакции все ее операции направляются в модуль вывода, который преобразует их в сообщения протокола репликации.
https://postgrespro.ru/docs/postgresql/16/logicaldecoding
https://postgrespro.ru/docs/postgresql/16/runtime-config-resource#GUC-LO GICAL-DECODING-WORK-MEM
Page 20: Слот и логическое декодирование
Очистим содержимое таблицы и посмотрим, как работает логическое декодирование.
Создадим вручную слот логической репликации. Для передачи изменений подписчику используется модуль вывода pgoutput, а для наблюдения удобнее модуль вывода test_decoding:
Теперь на сервере alpha два слота:
В отдельном сеансе начнем транзакцию и вставим строку в таблицу:
Модуль вывода может запросить у слота изменения:
Транзакция не завершена, модуль вывода пока ничего не получил. Сделаем еще несколько изменений и завершим транзакцию.
Page 21: Page 21
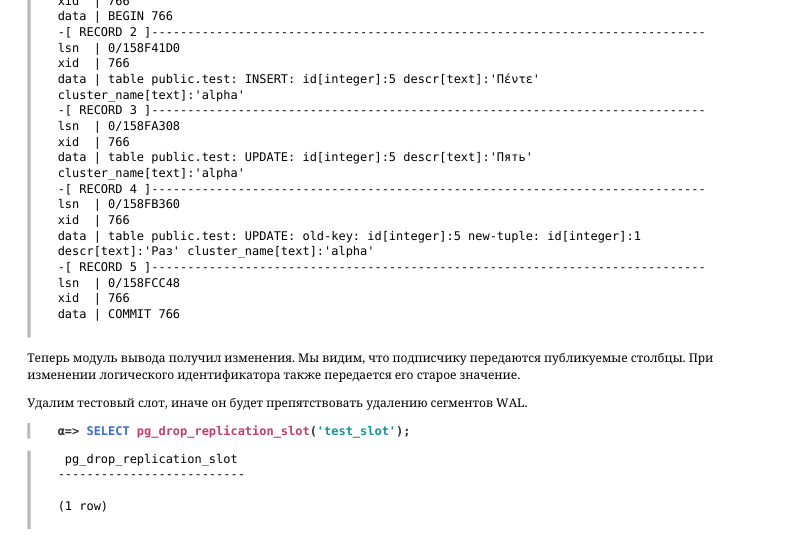 {#source-figure-021 caption=“Source slide page 21: Page 21”}
Теперь модуль вывода получил изменения. Мы видим, что подписчику передаются публикуемые столбцы. При изменении логического идентификатора также передается его старое значение. Удалим тестовый слот, иначе он будет препятствовать удалению сегментов WAL.
Page 22: Большие транзакции
 {#source-figure-022 caption=“Source slide page 22: Большие транзакции”}
Комментарии преподавателя
По умолчанию (параметр подписки streaming = off) изменения накапливаются в переупорядочивающем буфере и отправляются подписчику после фиксации транзакции.
Если транзакция изменяет много данных, могут возникать проблемы:
● расход памяти wal sender на переупорядочивающий буфер;
● запись файлов при превышении памяти, выделенной под переупорядочивающий буфер (logical_decoding_work_mem);
● отставание реплики. Если задать streaming = on, публикующий сервер будет передавать изменяемые данные подписчику во время работы транзакции. Когда общий объем изменений превышает значение параметра logical_decoding_work_mem, накопленные изменения самой большой по объему транзакции не сбрасываются в файл, а сразу передаются в модуль вывода. При этом подписчик сохраняет такие изменения в своих временных файлах и применяет при фиксации транзакции.
Начиная с PostgreSQL 16, если задано streaming = parallel и есть доступные рабочие процессы, изменения на подписчике не сохраняются, а сразу же применяются дополнительными процессами. Число таких процессов для одной подписки ограничено параметром max_parallel_apply_workers_per_subscription.
https://postgrespro.ru/docs/postgresql/16/sql-createsubscription#SQL-CREA TESUBSCRIPTION-WITH-STREAMING
https://postgrespro.ru/docs/postgresql/16/runtime-config-replication#GUC-M AX-PARALLEL-APPLY-WORKERS-PER-SUBSCRIPTION
Page 23: Конфликты
Приводят к ошибке
- нарушение ограничений целостности,
- недостаточные права на целевую таблицу или политика защиты строк
- репликация выдает ошибку,
- подписка с параметром disable_on_error отключается
- можно вручную исправить данные на стороне подписки
- или пропустить конфликтующую транзакцию
- Игнорируются
- обновляемая или удаляемая строка отсутствует на подписчике
- репликация продолжается, но согласованность может быть нарушена
Комментарии преподавателя
Поскольку таблицы на публикующем сервере и на подписчике могут изменяться независимо друг от друга, при выполнении операции, поступившей от подписки, возможен конфликт с существующими данными.
Часто конфликтом называют ситуацию, когда операция не может быть выполнена, обычно из-за нарушения ограничения целостности, или отсутствия прав у владельца подписки на целевую таблицу, или ограничений на уровне строк (RLS, row level security).
В этом случае применение операции завершается ошибкой. Подписчик периодически повторяет попытки, но до разрешения конфликта они будут неудачными. Конфликты можно разрешать только вручную, автоматическое разрешение пока не реализовано. Есть два варианта: исправить данные на подписчике или пропустить конфликтующую транзакцию. Во втором случае нужно отключить репликацию, вызвать функцию pg_replication_origin_advance или выполнить команду ALTER SUBSCRIPTION … SKIP …, и снова включить репликацию. Можно также заранее настроить автоматическое отключение репликации, указав параметр подписки disable_on_error.
Если строка, которую необходимо изменить или удалить, отсутствует на подписчике, операция не будет выполнена. В этом случае ошибка не возникает, но такие игнорируемые конфликты говорят о том, что согласованность данных между публикующим сервером и подписчиком нарушена.
https://postgrespro.ru/docs/postgresql/16/logical-replication-conflicts
Page 24: Конфликты
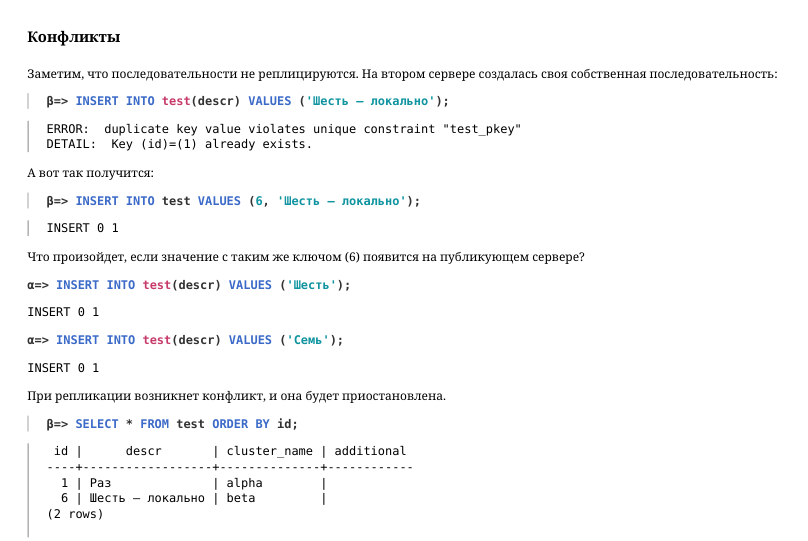 {#source-figure-024 caption=“Source slide page 24: Конфликты”}
Заметим, что последовательности не реплицируются. На втором сервере создалась своя собственная последовательность:
А вот так получится:
Что произойдет, если значение с таким же ключом (6) появится на публикующем сервере?
При репликации возникнет конфликт, и она будет приостановлена.
Фактически, процесс logical replication apply worker будет периодически перезапускаться, проверяя, не устранен ли конфликт. Поэтому информация в pg_stat_subscription пропадает:
В журнал сообщений будут попадать записи о нарушении ограничений целостности:
А в таблице pg_stat_subscription_stats при каждой очередной попытке выполнить операцию будет расти счетчик ошибок:
(В PostgreSQL 18 в эту таблицу добавлены отдельные счетчики для каждого типа конфликта.) Чтобы разрешить конфликт, удалим конфликтующую строку из таблицы и немного подождем:
Page 25: Page 25
Проверим:
Данные появились, репликация восстановлена.
Пропуск конфликтующей транзакции
Можно разрешить конфликт по-другому: пропустить транзакцию, приводящую к конфликту. Конфликтующая транзакция:
Перед пропуском транзакции подписка должна быть отключена:
Вместо отключения вручную можно было установить параметр подписки disable_on_error. Подписка остановлена:
Посмотрим в журнал сообщений:
Сообщение в журнале содержит LSN записи о фиксации конфликтующей транзакции. Транзакцию можно пропустить командой:
Вместо предыдущей команды суперпользователь мог бы использовать функцию pg_replication_origin_advance. Включим репликацию.
Page 26: Page 26
Репликация работает, но так как мы пропустили транзакцию, данные рассогласованы:
Опустошим таблицу:
Триггеры на подписчике
На подписчике могут выполняться триггеры; по умолчанию триггер будет срабатывать при локальных изменениях, но не при репликации. Это удобно, если на обоих серверах созданы одинаковые таблицы с одинаковым набором триггеров: в таком случае триггер уже отработал на публикующем сервере, его не надо выполнять на подписчике. Попробуем.
Триггер не сработал. Можно изменить таблицу, чтобы триггер срабатывал только при репликации:
Page 27: Page 27
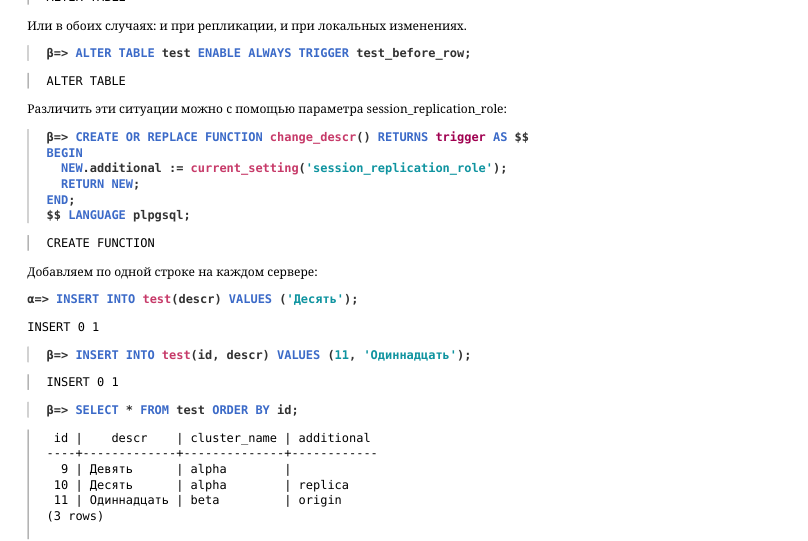 {#source-figure-027 caption=“Source slide page 27: Page 27”}
Или в обоих случаях: и при репликации, и при локальных изменениях.
Различить эти ситуации можно с помощью параметра session_replication_role:
Добавляем по одной строке на каждом сервере:
Триггер сработал в обоих случаях.
Page 28: Источник репликации
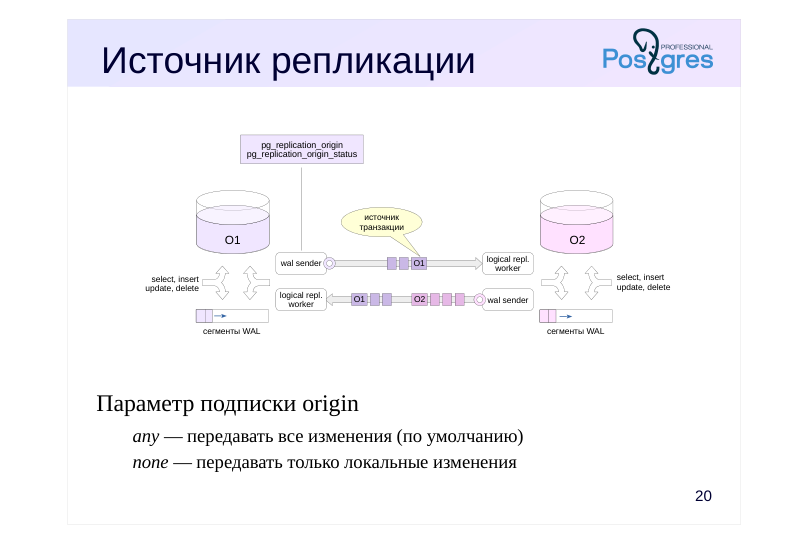 {#source-figure-028 caption=“Source slide page 28: Источник репликации”}
Параметр подписки origin
- any — передавать все изменения (по умолчанию)
- none — передавать только локальные изменения
Комментарии преподавателя
Если определить на одном сервере и публикацию, и подписку, и передавать все изменения, то реплицированные изменения будут реплицироваться и возникнет «снежный ком».
Начиная с PostgreSQL 16, публикующий сервер в начале транзакции, которая была получена с другого узла, передает по протоколу сообщение об источнике этой транзакции. Это также важно при каскадной репликации.
https://postgrespro.ru/docs/postgresql/16/protocol-logical-replication#PROT OCOL-LOGICAL-MESSAGES-FLOW
По умолчанию подписка имеет параметр origin = any и публикация передает ей все транзакции: и локальные, и полученные с другого узла.
В топологиях, где могут появиться циклы, например, при двунаправленной репликации, следует устанавливать origin = none. Тогда публикация будет передавать только локальные изменения.
https://postgrespro.ru/docs/postgresql/16/sql-createsubscription#SQL-CREA TESUBSCRIPTION-WITH-ORIGIN
Информацию об источниках можно увидеть в pg_replication_origin.
https://postgrespro.ru/docs/postgresql/16/catalog-pg-replication-origin#CATA LOG-PG-REPLICATION-ORIGIN
Текущая позиция воспроизведения для конкретного источника репликации выводится в представлении pg_replication_origin_status.
https://postgrespro.ru/docs/postgresql/16/view-pg-replication-origin-status#V IEW-PG-REPLICATION-ORIGIN-STATUS
Page 29: Источник репликации
Удалим строки таблицы:
Опубликуем несколько столбцов таблицы test на сервере beta.
Теперь публикации есть на обоих серверах. Если сейчас на alpha создать подписку, она будет принимать от beta все изменения, в том числе и те, которые были отправлены публикацией сервера alpha. Применить такие изменения alpha не сможет из-за нарушения ограничения целостности, репликация остановится. Чтобы beta получала только изменения, сделанные локально на alpha, зададим параметр подписки origin:
Для тех изменений, которые произошли в результате репликации, источник будет непуст, и публикация не отправит их подписке. Пусть и alpha станет подписчиком beta. Начальную синхронизацию отключим, поскольку таблица пуста. Также используем параметр подписки origin, чтобы получать только изменения, сделанные на beta:
Подписки теперь есть на обоих серверах.
Вставим строку на сервере alpha.
Проверяем на beta.
Вставляем строку на сервере beta.
Проверяем на alpha.
Page 30: Page 30
Проверим изменение данных.
Если репликация больше не нужна, надо удалить подписки — иначе на публикующем сервере останутся открытыми репликационные слоты.
Page 31: Итоги
Логическая репликация использует модель «публикация—подписка»
- Передаются изменения табличных строк
- Строки сопоставляются по логическим идентификаторам
- Несовпадение данных на серверах может приводить к конфликтам
- Передача информации об источнике позволяет отслеживать ход каскадной репликации и исключить зацикливание
Page 32: Практика
- Создайте две базы данных на одном сервере.
- В первой базе данных создайте таблицу с первичным ключом и добавьте в нее несколько строк. Настройте логическую репликацию таблицы из первой базы во вторую, проверьте работу репликации и удалите подписку. 2. Настройте логическую репликацию таблицы с сервера alpha на сервер beta. Выполните транзакцию, изменяющую значительный объем данных; перед ее фиксацией убедитесь, что данные помещены на диск. Повторите то же самое, но в потоковом режиме. Сохранялись ли данные на диске?
Комментарии преподавателя
- Воспользуйтесь утилитой pg_dump с ключом –schema-only.
Если попробовать выполнить это обычным образом, команда создания подписки «повиснет» из-за того, что она должна дождаться завершения активных транзакций на публикующем сервере, то есть и самой себя в том числе. В таком случае необходимо заранее создать слот логической репликации, как описано в документации: https://postgrespro.ru/docs/postgresql/16/sql-createsubscription
- Чтобы публикация не попала в логическую копию, используйте ключ –no-publications.
Проверьте значение параметра logical_decoding_work_mem, определяющего максимальный размер переупорядочивающего буфера. При превышении этого значения данные будут вытесняться на диск.
Page 33: 1. Логическая репликация на одном сервере
Сначала установим уровень журнала logical.
Базы данных:
Таблица в первой базе:
Воспользоваться логической резервной копией для переноса схемы особенно удобно, когда таблиц много.
Переносить данные с помощью pg_dump не имеет смысла, поскольку в процессе переноса таблицы могут измениться.
Публикация:
Page 34: Page 34
Поскольку репликация будет настроена на одном и том же сервере, вначале вручную создаем слот логической репликации.
И затем создаем подписку:
Проверим работу репликации:
Удалим подписку и слот.
2. Логическая репликация с сервера alpha на сервер beta
Запустим сервер beta и скопируем команды DDL для таблицы test. Команды создания публикации на подписчике не нужны.
Page 35: Page 35
Создадим подписку на сервере beta, слот на alpha создается автоматически.
Репликация работает. Опустошим таблицу test на сервере публикации (alpha):
Подписчик получил изменение. Начнем транзакцию, в которой вставим в таблицу значительное число строк.
Параметр logical_decoding_work_mem определяет максимальный размер переупорядочивающего буфера.
При превышении этого ограничения данные помещаются на диск в каталог PGDATA/pg_replslot/имя-слота. Сколько места на диске занимает каталог?
Page 36: Page 36
По умолчанию, пока транзакция не зафиксирована, никакие данные подписке не передаются.
Зафиксируем транзакцию…
…и немного подождем: Подписчик получил все строки:
А сохраненные на диске данные удалены:
Заглянем в представление pg_stat_replication_slots:
spill_txns — количество вытесненных на диск транзакций; spill_count — сколько раз данные вытеснялись на диск из-за превышения logical_decoding_work_mem; spill_bytes — сколько байт было вытеснено на диск. Повторим эксперимент в потоковом режиме. Сбросим статистику и снова опустошим таблицу.
Теперь зададим для подписки потоковый режим:
И снова запустим большую транзакцию.
Page 37: Page 37
Теперь данных в каталоге слота гораздо меньше, часть их уже отправлена подписчику:
Зафиксируем транзакцию…
…и немного подождем:
Заглянем в представление pg_stat_replication_slots:
На этот раз при исчерпании выделенной оперативной памяти данные на диск не вытеснялись, а отправлялись подписчику.
Уборка
Удалим подписку, слот и базы данных, сбросим параметры конфигурации.
Page 38: Page 38
Page 39: Практика+
- Создайте и опубликуйте на сервере alpha таблицу со столбцом типа bytea. Вставьте в таблицу несколько миллионов строк. Сравните время начальной синхронизации для подписки в обычном и двоичном режимах, используя для этого сервер beta. 2. Включите для подписки параллельную синхронизацию. Добавляя в таблицу строки, изучите процессы, обслуживающие подписку.
Комментарии преподавателя
- Оценить время начальной синхронизации можно с помощью мониторинга таблицы pg_subscription_rel. Его можно организовать на стороне клиента с помощью метакоманды \watch или на стороне сервера с помощью функции, написанной, например, на PL/pgSQL.
https://postgrespro.ru/docs/postgresql/16/catalog-pg-subscription-rel#CATAL OG-PG-SUBSCRIPTION-REL
https://postgrespro.ru/docs/postgresql/16/plpgsql
- Задайте подходящее значение параметра подписки streaming. Для мониторинга процессов подписки используйте представление pg_stat_subscription.
Page 40: 1. Начальная синхронизация данных при логической репликации
Создадим базу данных.
Изменим уровень журнала WAL и перезапустим сервер.
Создадим таблицу с большим количеством строк.
Запустим сервер beta и скопируем на него базу со структурой таблиц, но без данных.
Создадим публикацию на сервере alpha.
Page 41: Page 41
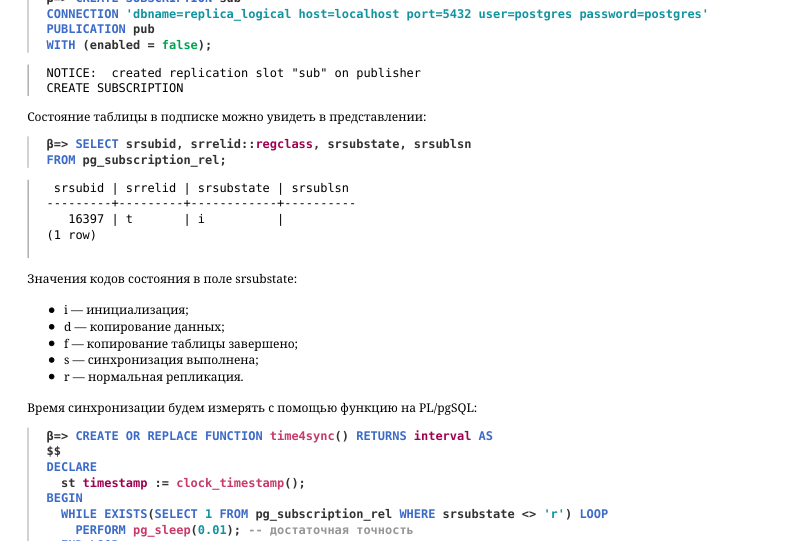 {#source-figure-041 caption=“Source slide page 41: Page 41”}
Подписка на beta исходно будет неактивна.
Состояние таблицы в подписке можно увидеть в представлении:
Значения кодов состояния в поле srsubstate: i — инициализация; d — копирование данных; f — копирование таблицы завершено; s — синхронизация выполнена; r — нормальная репликация. Время синхронизации будем измерять с помощью функцию на PL/pgSQL:
Активируем подписку и измерим время начальной синхронизации.
Теперь настроим синхронизацию в двоичном режиме. Удалим подписку, опустошим таблицу и создадим новую подписку, указав параметр binary.
Включаем подписку и измеряем время синхронизации.
Page 42: Page 42
Видим, что начальная синхронизация заметно ускорилась. Параметр binary действует и на последующую синхронизацию. Однако двоичный режим возможен не для всех типов данных; нужно также учитывать переносимость между разными архитектурами и основными версиями PostgreSQL. Двоичный режим реализован в версии 14, а в версиях до 16 начальная синхронизация всегда выполняется в текстовом режиме.
2. Параллельное применение изменений
Зададим для подписки параллельный режим.
Процессы, обслуживающие подписку:
Опустошим таблицу, вставим в нее большое число строк и повторим запрос к представлениям системного каталога:
Появился дополнительный процесс, который применяет изменения, не дожидаясь окончания транзакции на сервере публикации.
Вставка строк окончена. Подождем еще немного…
Теперь подписчик получил все строки.
Уборка
Page 43: Page 43
Удалим подписку.
Удалим базы данных.
Сбросим изменения в конфигурации.
Перезагрузим сервер alpha.
Остановим сервер beta.
07 Занятие 07: Репликация / Сценарии использования
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba3_07_replica_usecases.html Archive: DBA3-handouts-16.zip Страниц PDF: 33
Page 1: Репликация / Сценарии использования
Авторские права
© Postgres Professional, 2017–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Использование физической репликации
- Использование логической репликации
Page 3: Физическая репликация
Горячий резерв для высокой доступности
- Балансировка OLTP-нагрузки
- Реплика для отчетов
- Несколько реплик и каскадная репликация
- Отложенная репликация
Page 4: Горячий резерв для HA
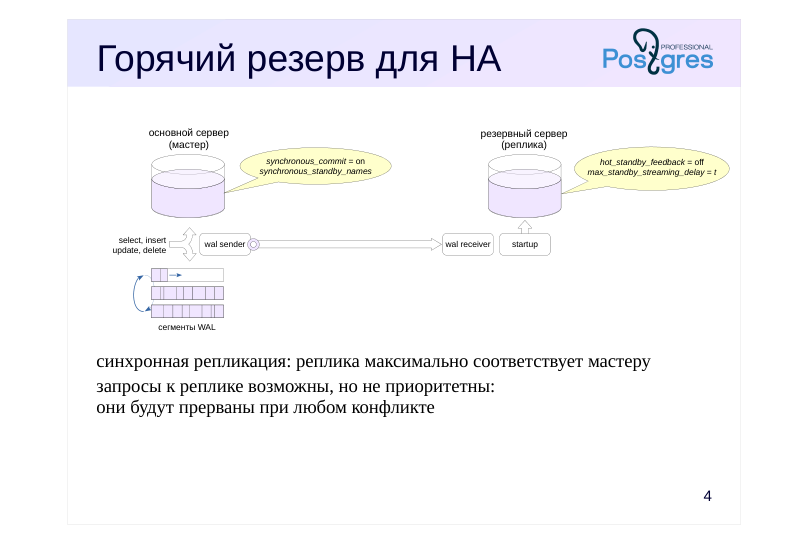 {#source-figure-004 caption=“Source slide page 4: Горячий резерв для HA”}
синхронная репликация: реплика максимально соответствует мастеру запросы к реплике возможны, но не приоритетны: они будут прерваны при любом конфликте
Комментарии преподавателя
Реплика может создаваться для решения разных задач, и настройка зависит от ее предназначения.
Один из возможных вариантов — обеспечение горячего резерва для целей высокой доступности. Это означает, что при сбое основного сервера требуется как можно быстрее перейти на реплику, не потеряв при этом данные.
Надежность обеспечивает синхронная репликация в режиме synchronous_commit = on (значение write не гарантирует надежность; значение apply может привести к неоправданным задержкам).
Для синхронной репликации значение параметра synchronous_standby_names должно содержать список резервных серверов (реплик).
Чтобы реплика как можно меньше отставала от основного сервера, нужно применять журнальные записи сразу же. Для этого выставляем задержку max_standby_streaming_delay в небольшое значение.
Чтобы запросы к реплике не могли негативно повлиять на основной сервер, выключаем обратную связь (hot_standby_feedback = off).
С такими настройками запросы к реплике возможны, но в случае конфликтов они будут прерваны. Если запросы к реплике не предполагаются, она может работать в режиме «теплого резерва» (hot_standby = off).
Заметим, что репликация — базовый механизм для обеспечения высокой доступности, но далеко не все, что нужно. Более подробнее это обсуждается в модуле «Кластерные технологии».
Page 5: Балансировка OLTP
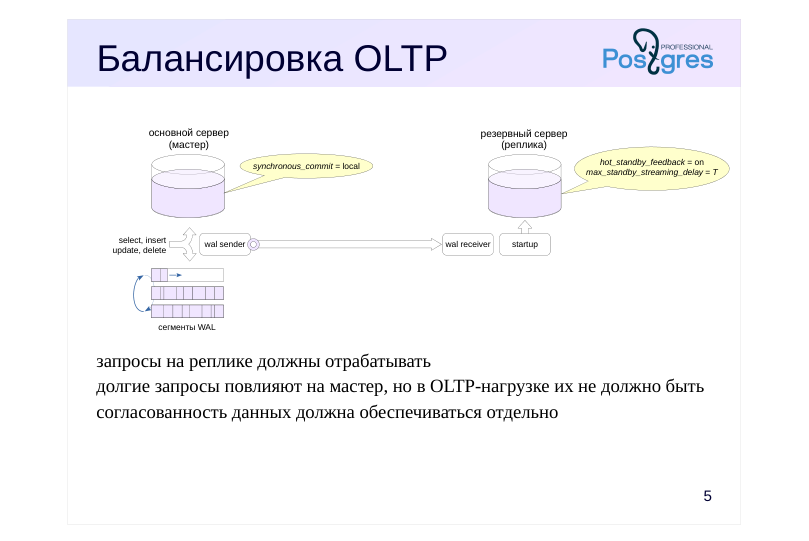 {#source-figure-005 caption=“Source slide page 5: Балансировка OLTP”}
запросы на реплике должны отрабатывать долгие запросы повлияют на мастер, но в OLTP-нагрузке их не должно быть согласованность данных должна обеспечиваться отдельно
Комментарии преподавателя
Другой вариант — реплика используется для балансировки OLTP-нагрузки на чтение.
OLTP-нагрузка характеризуется небольшими по длительности запросами. Это позволяет достаточно тесно связать реплику с основным сервером, чтобы запросы гарантированно не прерывались из-за конфликтов, и в то же время не беспокоиться о негативном влиянии на основной сервер.
Включаем обратную связь (hot_standby_feedback = on) и выставляем достаточно большую задержку применения конфликтных записей (max_standby_streaming_delay).
Синхронная репликация в такой конфигурации, скорее всего, не требуется. Она все равно не обеспечивает согласованность данных: фиксация изменения на основном сервере не гарантирует, что запрос к реплике немедленно его увидит.
Для обеспечения согласованности нужно, чтобы изменения появлялись на обоих серверах одновременно. Режим synchronous_commit = apply позволяет дождаться применения журнальной записи на реплике (ценой сильного падения производительности основного сервера), но тогда можно увидеть данные на реплике раньше, чем на мастере. Надежное и прозрачное для приложений решение можно получить, используя специальные протоколы распределенных транзакций (см. модуль «Кластерные технологии»).
Page 6: Реплика для отчетов
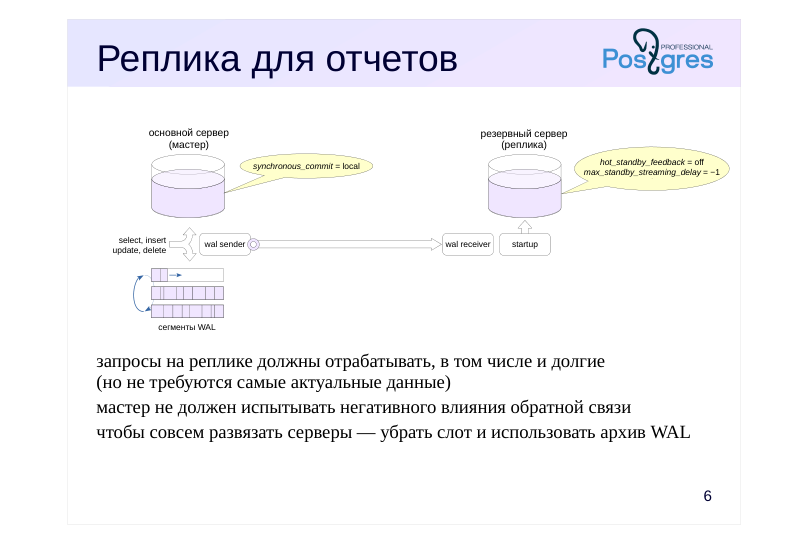 {#source-figure-006 caption=“Source slide page 6: Реплика для отчетов”}
запросы на реплике должны отрабатывать, в том числе и долгие (но не требуются самые актуальные данные) мастер не должен испытывать негативного влияния обратной связи чтобы совсем развязать серверы — убрать слот и использовать архив WAL
Комментарии преподавателя
Еще один возможный вариант — разделение по серверам нагрузки разного типа. Основной сервер может брать на себя OLTP-нагрузку, а длительные читающие запросы (отчеты) можно вынести на реплику.
Кроме распределения нагрузки между серверами, такое решение позволит избежать проблемы с тем, что длительные запросы на основном сервере могут задерживать выполнение очистки и приводить к раздуванию (bloat).
Из этих соображений «отчетная» реплика должна быть максимально отделена от основного сервера. Должна быть отключена обратная связь (hot_standby_feedback = off), а время откладывания конфликтующих журнальных записей нужно сильно увеличить, вплоть до бесконечности (max_standby_streaming_delay = −1).
Поскольку для длительных отчетов не требуются сиюминутные данные, можно, при наличии архива, отказаться от слота репликации (не забыв выставить параметр max_standby_archive_delay аналогично max_standby_streaming_delay). Тогда, если мастер успеет удалить необходимый реплике файл, реплика возьмет его из архива.
Такую реплику можно также использовать для выполнения резервного копирования.
Разумеется, на практике возможны и другие сочетания параметров. Главное — четко понимать, какую задачу требуется решить, и какое влияние оказывают те или иные параметры.
Page 7: Несколько реплик
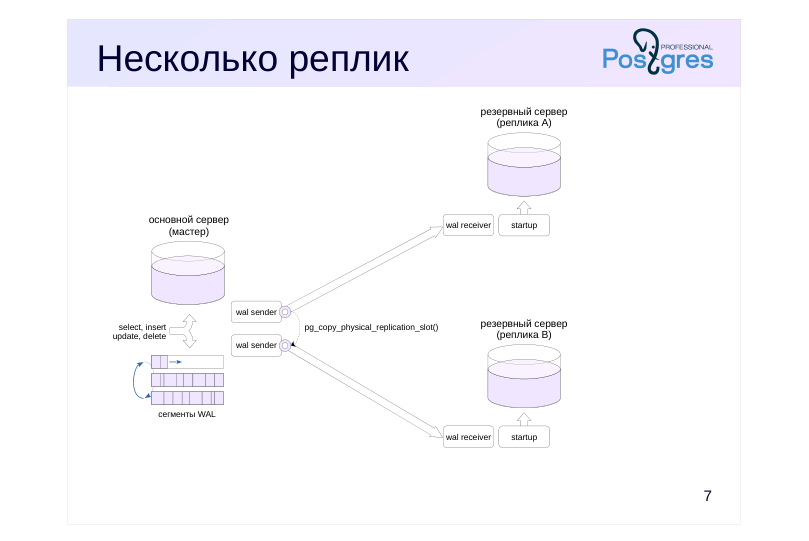 {#source-figure-007 caption=“Source slide page 7: Несколько реплик”}
Комментарии преподавателя
К основному серверу можно подключить несколько реплик. Никаких специальных настроек для этого не требуется, но надо учитывать, что каждой реплике будет соответствовать отдельный процесс wal sender и отдельный слот репликации. При развертывании можно растиражировать одну базовую копию и клонировать слот репликации функцией pg_copy_physical_replication_slot.
https://postgrespro.ru/docs/postgresql/16/functions-admin#FUNCTIONS-RE PLICATION
Обычно такая схема требуется для распределения нагрузки, но собственно распределение должно решаться внешними средствами (см. модуль «Кластерные технологии»).
Page 8: Мастер и две физические реплики
Настроим конфигурацию с двумя репликами. Создадим автономную резервную копию первого сервера, одновременно создав слот.
Поскольку третий сервер при старте начнет применять записи WAL с той же позиции, что и второй, можно дублировать слот:
Выложим автономную копию в каталоги PG_DATA второго и третьего серверов:
В конфигурации третьего сервера укажем слот gamma:
Запускаем обе реплики:
Слоты инициализировались:
Проверяем.
Page 9: Page 9
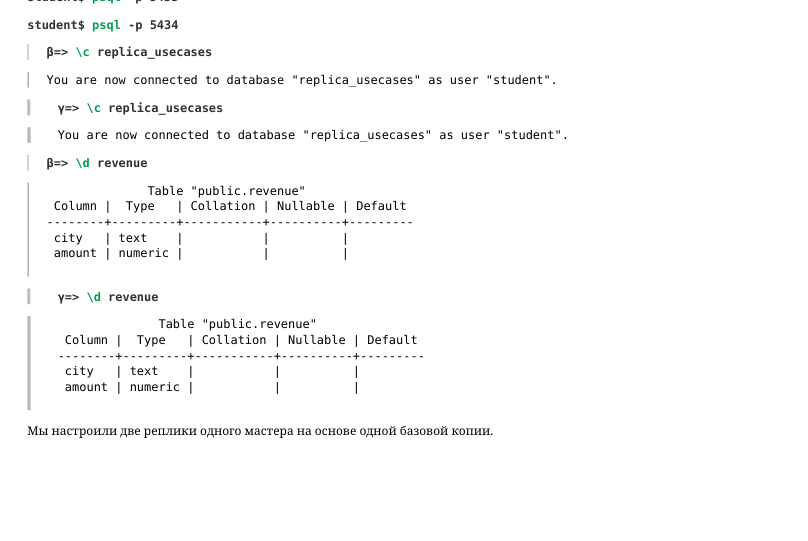 {#source-figure-009 caption=“Source slide page 9: Page 9”}
Мы настроили две реплики одного мастера на основе одной базовой копии.
Page 10: Каскадная репликация
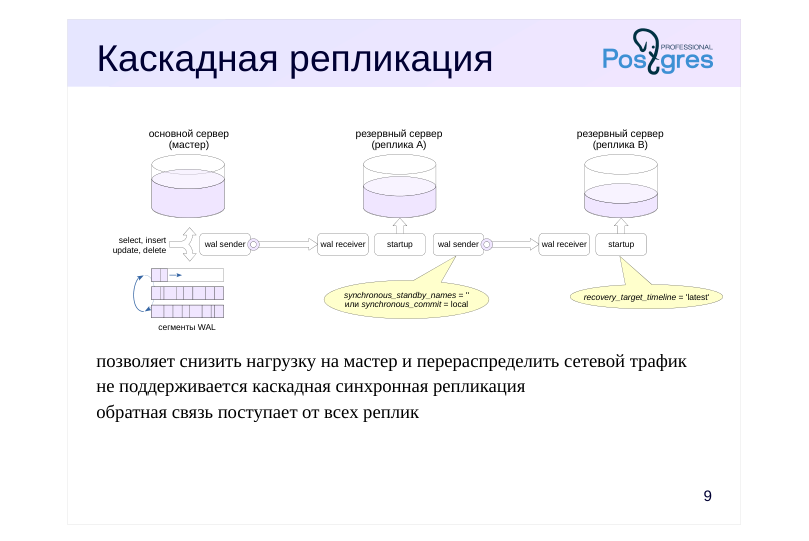 {#source-figure-010 caption=“Source slide page 10: Каскадная репликация”}
позволяет снизить нагрузку на мастер и перераспределить сетевой трафик не поддерживается каскадная синхронная репликация обратная связь поступает от всех реплик
Комментарии преподавателя
Несколько реплик, подключенных к одному основному серверу, будут создавать на него определенную нагрузку. Кроме того, надо учитывать нагрузку на сеть для пересылки нескольких копий потока журнальных записей.
Для снижения нагрузки реплики можно соединять каскадом; при этом серверы передают журнальные записи друг другу по цепочке. Чем дальше от мастера, тем большее запаздывание может накопиться. Схема мониторинга усложняется: процесс надо контролировать на нескольких серверах.
Если совершится переход на реплику (ближайшую к основному серверу), то на ней увеличится номер линии времени. Значение recovery_target_timeline = ’latest’ направит восстановление по этой новой линии (это значение по умолчанию).
Заметим, что каскадная синхронная репликация не поддерживается: основной сервер может быть синхронизирован только с непосредственно подключенной к нему репликой. Поэтому на первой в каскаде реплике нужно установить synchronous_standby_names = ’’ или synchronous_commit = ’local'.
А вот обратная связь поступает основному серверу от всех реплик.
Page 11: Отложенная репликация
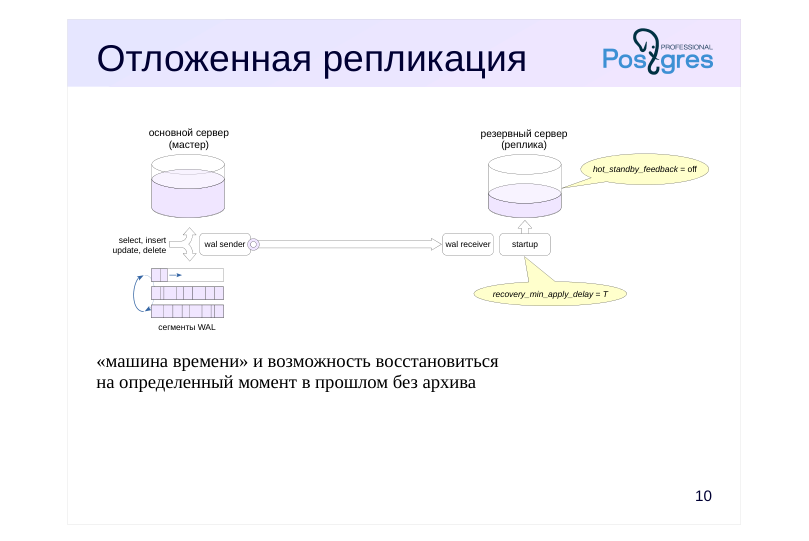 {#source-figure-011 caption=“Source slide page 11: Отложенная репликация”}
«машина времени» и возможность восстановиться на определенный момент в прошлом без архива
Комментарии преподавателя
Задача: иметь возможность просмотреть данные на некоторый момент в прошлом и, при необходимости, восстановить сервер на этот момент.
Восстановление из архива на момент времени (point-in-time recovery) решает эту задачу, но занимает много времени и требует подготовки.
Другое решение — создать реплику, которая применяет журнальные записи с заданной задержкой (recovery_min_apply_delay). При этом требуется синхронизация часов между серверами.
Откладывается применение не всех записей, а только записей о фиксации изменений. Записи до фиксации могут быть применены «раньше времени», но это не представляет проблемы благодаря многоверсионности. Обратную связь следует отключать, чтобы не вызвать разрастание таблиц на мастере.
Типичный сценарий: на основном сервере происходит какая-либо проблема (допустим, удалены критичные данные). На реплике данные еще есть, поскольку соответствующие записи еще не применены. Дальнейшее проигрывание записей приостанавливается с помощью функции pg_wal_replay_pause, пока идет исследование проблемы. Функцией pg_get_wal_replay_pause_state можно проверить состояние приостановки.
Если принято решение продолжать, функцией pg_wal_replay_resume завершают паузу в проигрывании записей WAL и восстановление продолжается. Если решено вернуться на момент времени до удаления, нужно указать целевую точку восстановления одним из параметров recovery_target_* и перезапустить реплику.
Page 12: Логическая репликация
Консолидация и общие справочники
- Обновление основной версии сервера
- Мастер-мастер
- Логическое декодирование на физической реплике
Page 13: Консолидация
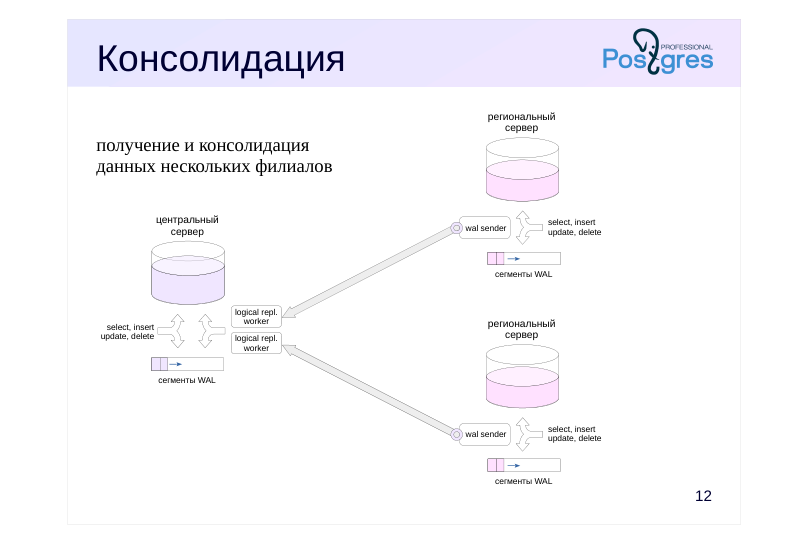 {#source-figure-013 caption=“Source slide page 13: Консолидация”}
получение и консолидация данных нескольких филиалов
Комментарии преподавателя
Пусть имеются несколько региональных филиалов, каждый из которых работает на собственном сервере PostgreSQL. Задача состоит в консолидации части данных на центральном сервере.
Для решения на региональных серверах создаются публикации необходимых данных. Центральный сервер подписывается на эти публикации. Полученные данные можно обрабатывать (например, приводить к единому виду) с помощью триггеров на стороне центрального сервера.
Поскольку репликация основана на передаче данных через слот, между серверами необходимо более или менее постоянное соединение, так как во время разрыва соединения региональные серверы будут вынуждены сохранять файлы журнала.
Есть множество особенностей такого процесса и с точки зрения бизнес-логики, требующих всестороннего изучения. В ряде случаев может оказаться проще передавать данные пакетами раз в определенный интервал времени.
Page 14: Общие справочники
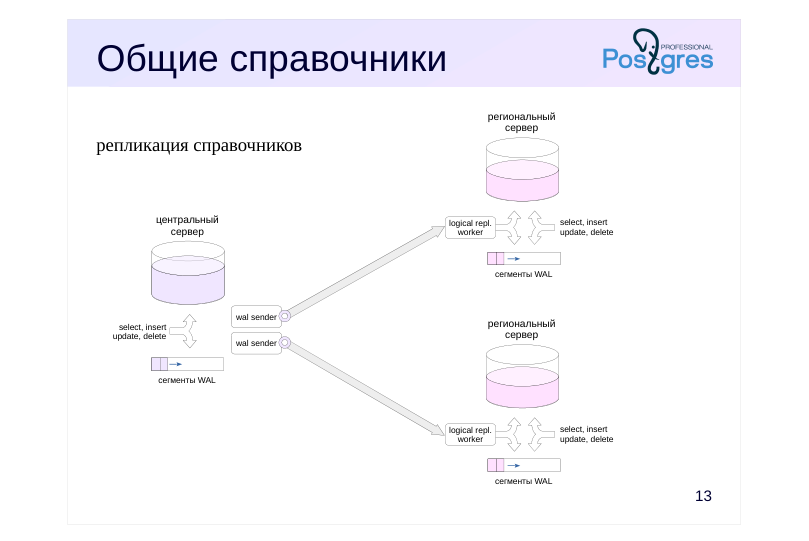 {#source-figure-014 caption=“Source slide page 14: Общие справочники”}
репликация справочников
Комментарии преподавателя
Другая задача: на центральном сервере поддерживаются справочники, актуальные версии которых должны быть доступны на региональных серверах.
В этом случае схему надо развернуть наоборот: центральный сервер публикует изменения, а региональные серверы подписываются на эти обновления.
Page 15: Консолидация с помощью логической репликации
 {#source-figure-015 caption=“Source slide page 15: Консолидация с помощью логической репликации”}
Повысим обе настроенные ранее реплики и настроим консолидацию данных.
Для логической репликации нужно повысить уровень WAL (потребуется перезапуск).
Удалим на сервере alpha слоты репликации:
Публикуем таблицу на втором и третьем серверах:
Первый сервер подписывается на обе публикации:
Page 16: Page 16
В филиалах кипит работа:
А центральный офис видит работу всей компании (подождем несколько секунд, чтобы сработала репликация):
Page 17: Обновление серверов
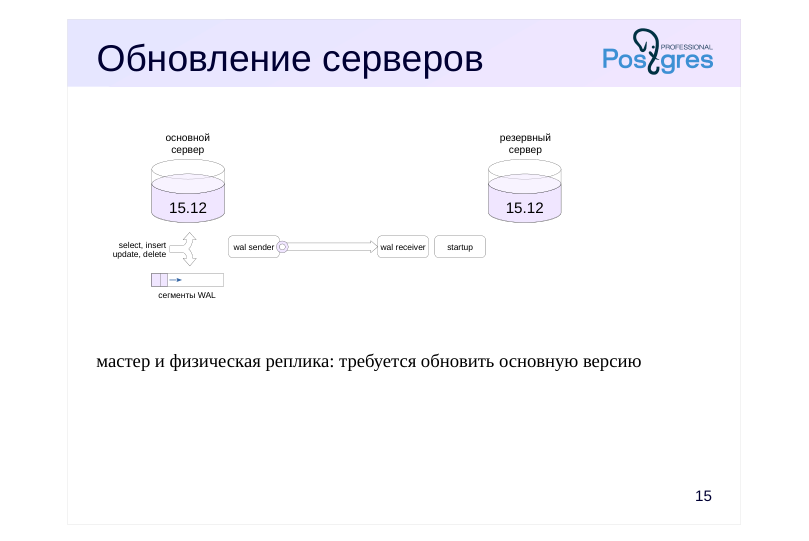 {#source-figure-017 caption=“Source slide page 17: Обновление серверов”}
мастер и физическая реплика: требуется обновить основную версию
Комментарии преподавателя
Логическая репликация может использоваться для обновления основной версии сервера без прерывания обслуживания (или с минимальным прерыванием).
Допустим, имеется основной сервер и физическая потоковая реплика.
Page 18: Обновление серверов
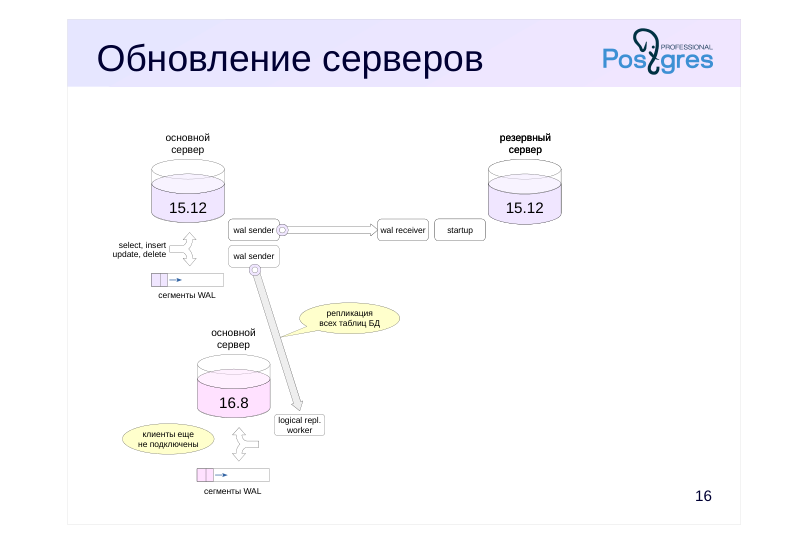 {#source-figure-018 caption=“Source slide page 18: Обновление серверов”}
Комментарии преподавателя
Создаем новый сервер с требуемой версией PostgreSQL и переносим на него структуру всех таблиц выбранной базы данных.
На основном сервере предыдущей версии публикуем изменения всех таблиц базы данных. Поскольку изменения схемы данных не реплицируются, на время обновления такие изменения должны быть запрещены.
Page 19: Обновление серверов
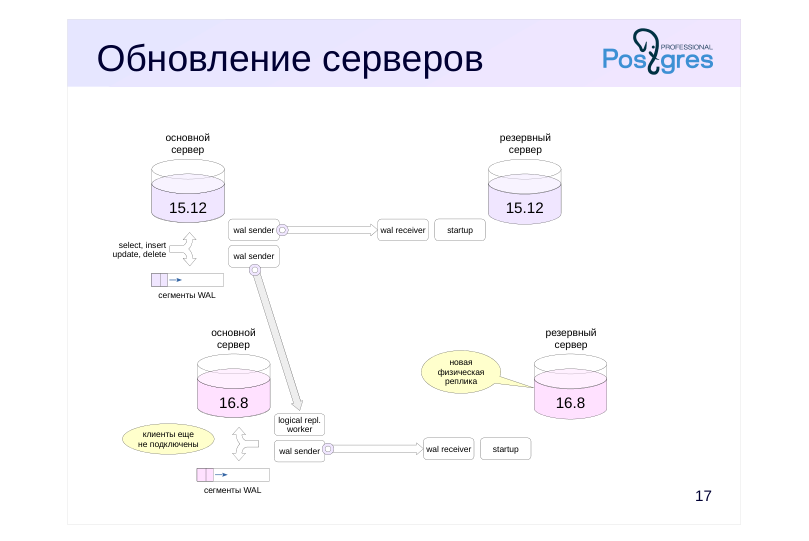 {#source-figure-019 caption=“Source slide page 19: Обновление серверов”}
Комментарии преподавателя
Создаем физическую реплику, аналогичную реплике сервера предыдущей версии.
В итоге получаем параллельную структуру серверов с новой версией PostgreSQL. Эта структура аналогична имеющейся для старой версии.
Page 20: Обновление серверов
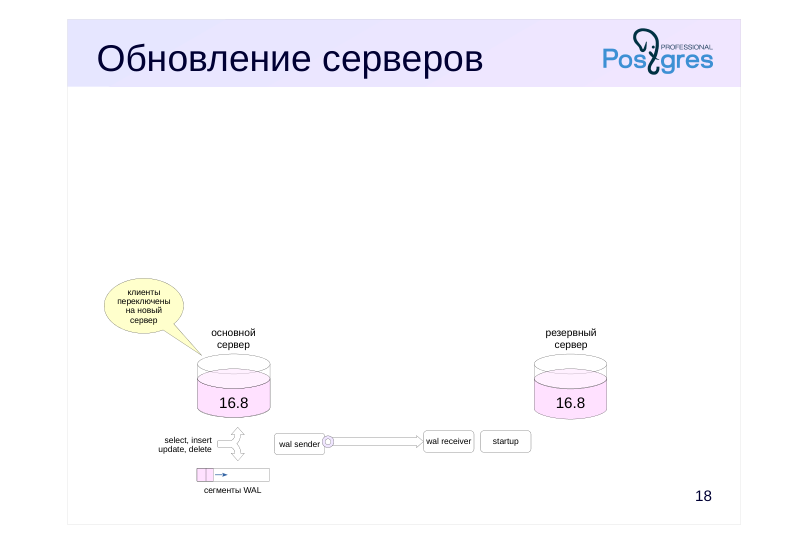 {#source-figure-020 caption=“Source slide page 20: Обновление серверов”}
Комментарии преподавателя
После этого переключаем клиентов на новые серверы, а старые останавливаем. Прерывание обслуживания будет определяться тем, насколько плавно можно выполнить это переключение.
Надо иметь в виду, что такой процесс нельзя считать универсальным: он накладывает достаточно много ограничений и существенно более сложен, чем использование утилиты pg_upgrade, которая позволяет выполнить обновление за небольшое время.
Page 21: Мастер-мастер
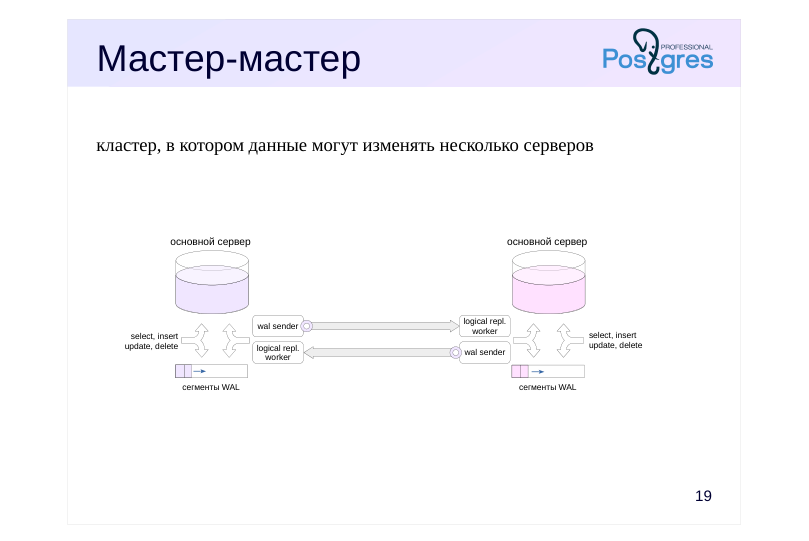 {#source-figure-021 caption=“Source slide page 21: Мастер-мастер”}
кластер, в котором данные могут изменять несколько серверов
Комментарии преподавателя
Задача: обеспечить надежное хранение данных на нескольких серверах с возможностью записи на любом сервере (что полезно, например, для геораспределенной системы).
Для решения можно использовать двунаправленную репликацию, передавая изменения в одних и тех же таблицах от одного сервера к другому и обратно (устанавливая ограничение на источник репликации, как было рассмотрено в теме «Логическая репликация»).
Конечно, прикладная система должна быть построена таким образом, чтобы избегать конфликтов при изменении данных в одних и тех же таблицах. Например, использовать глобальные уникальные идентификаторы или гарантировать, что разные серверы работают с разными диапазонами ключей. Также можно использовать фильтрацию строк таблиц, появившуюся в PostgreSQL 15.
Надо учитывать, что система мастер-мастер, построенная на логической репликации, не обеспечивает сама по себе выполнение глобальных распределенных транзакций. При использовании синхронной репликации можно гарантировать надежность, но не согласованность данных между серверами. Кроме того, никаких средств для автоматизации обработки сбоев, подключения или удаления узлов из кластера и т. п. в PostgreSQL не предусмотрено — эти задачи должны решаться внешним средствами.
Page 22: Декодирование на реплике
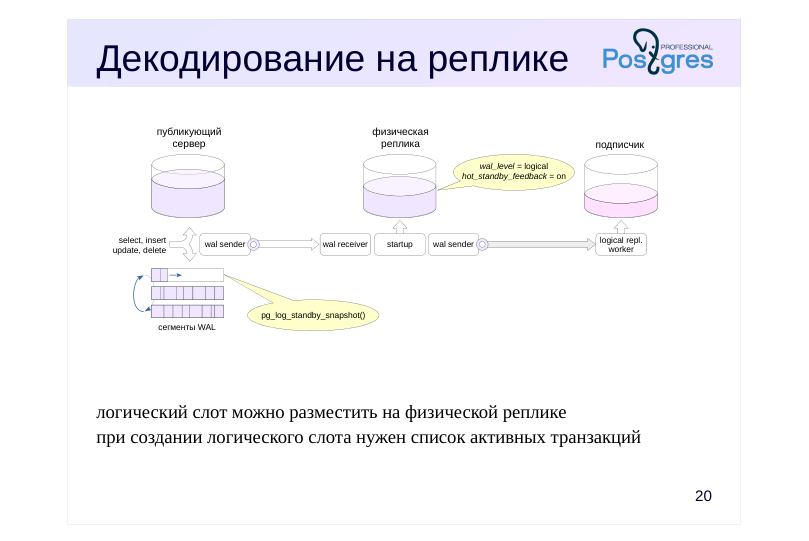 {#source-figure-022 caption=“Source slide page 22: Декодирование на реплике”}
логический слот можно разместить на физической реплике при создании логического слота нужен список активных транзакций
Комментарии преподавателя
Начиная с PostgreSQL 16, слот логической публикации может размещаться на физической реплике, что позволяет снять часть нагрузки с мастера.
На реплике следует включить обратную связь параметром hot_standby_feedback, чтобы основной сервер не удалил нужные реплике версии строк раньше времени.
При создании слота логической репликации нужна информация о номерах активных транзакций. Эту информацию передают процессы bgwriter и checkpointer мастера в виде записи WAL, и если на мастере нет активности, создание слота задержится. Чтобы избежать ожидания, можно вызвать на мастере функцию pg_log_standby_snapshot.
https://postgrespro.ru/docs/postgresql/16/logicaldecoding-explanation
https://postgrespro.ru/docs/postgresql/16/functions-admin
Page 23: Итоги
Физическая репликация — базовый механизм для решения целого ряда задач
- обеспечение высокой доступности
- балансировка однотипной нагрузки
- разделение разных видов нагрузки
- и др.
- Логическая репликация расширяет возможности
Page 24: Практика
- Настройте физическую потоковую репликацию между серверами alpha и beta. 2. Настройте каскадную репликацию на сервер gamma с задержкой применения записей WAL в десять секунд. 3. Проверьте работу репликации, убедитесь в том, что на сервере gamma данные появляются с установленной задержкой. 4. Остановите alpha и перейдите на сервер beta. 5. Проверьте, что сервер gamma продолжает работать в режиме реплики.
Комментарии преподавателя
После завершения практических заданий удалите созданную базу данных и слот репликации, а также сбросьте настройки параметров конфигурации.
Page 25: 1. Настройка репликации между серверами alpha и beta
Сначала создадим базу данных.
Создаем слот и автономную резервную копию.
Файлы postgresql.auto.conf и standby.signal подготовлены утилитой pg_basebackup.
Запускаем реплику:
2. Настройка репликации между серверами beta и gamma
Создадим автономную резервную копию с сервера beta, чтобы показать возможность выполнения резервного копирования с реплики. Слот создается утилитой.
Файл postgresql.auto.conf подготовлен утилитой pg_basebackup, добавляем задержку воспроизведения:
Вот что получилось:
Page 26: Page 26
Запускаем сервер gamma.
3. Проверка работы
На alpha создадим таблицу и проверим, что она появилась сначала на beta, а через 10 секунд — и на gamma.
Проверяем gamma:
Таблицы пока нет. Подождем 10 секунд…
Таблица появилась.
4. Переход на сервер beta
Текущая линия времени на gamma:
При повышении beta номер линии увеличится на единицу, процедура восстановления на gamma пойдет по новой линии благодаря значению по умолчанию:
Page 27: Page 27
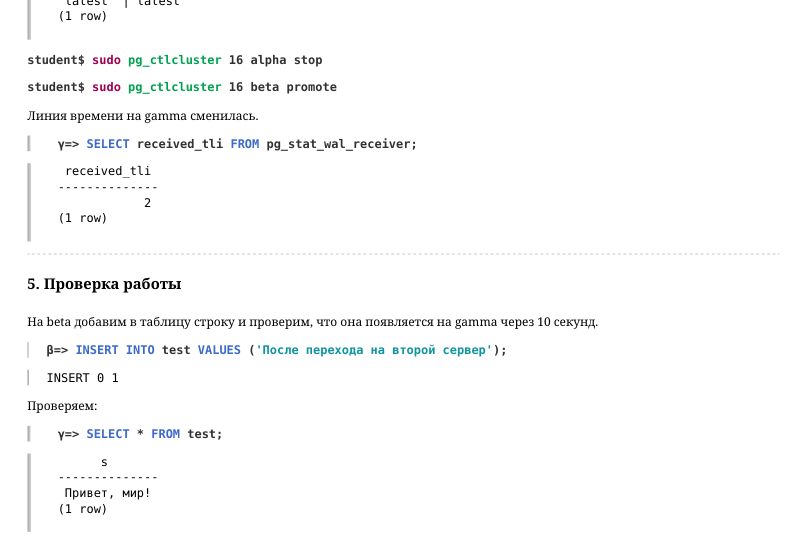 {#source-figure-027 caption=“Source slide page 27: Page 27”}
Линия времени на gamma сменилась.
5. Проверка работы
На beta добавим в таблицу строку и проверим, что она появляется на gamma через 10 секунд.
Проверяем:
Второй строки пока нет. Ждем 10 секунд…
Строка появилась.
Уборка
Удалим созданные базы данных и слоты репликации, сбросим настройки параметров конфигурации.
Page 28: Page 28
Page 29: Практика+
- Настройте физическую репликацию между серверами alpha и beta с обратной связью. При этом учтите необходимый уровень WAL для последующей настройки логической репликации. 2. Настройте логическую репликацию таблицы с сервера alpha на сервер gamma, поместив слот на beta — физическую реплику. Чтобы ускорить создание слота логической репликации на beta, воспользуйтесь функцией pg_log_standby_snapshot.
Комментарии преподавателя
- Перенесите структуру публикуемой таблицы на сервер gamma любым способом, например, используя pg_dump. Данные не переносите.
Публикация должна быть создана на alpha, подписка — на gamma, а в строке соединения подписки нужно указать сервер beta.
Верните конфигурацию системы к исходной: удалите созданную базу данных, слот репликации и сбросьте настройки параметров конфигурации.
Page 30: 1. Физическая репликация alpha → beta
Сразу включим обратную связь и установим уровень журнала, нужный для логической репликации:
Создадим базу данных и таблицу.
Создаем автономную резервную копию.
Проверим работу физической репликации.
2. Логическая репликация beta → gamma
Скопируем базу данных и структуру таблицы на сервер gamma с beta, используя pg_dump.
Page 31: Page 31
Мы скопировали лишь структуру таблицы, не данные. Создадим публикацию.
Подпишемся на публикуемые репликой (сервером beta) изменения в таблице test.
Подписка ждет создания слота на сервере beta. Чтобы сократить ожидание, попросим alpha добавить в WAL запись с номерами активных транзакций:
Page 32: Page 32
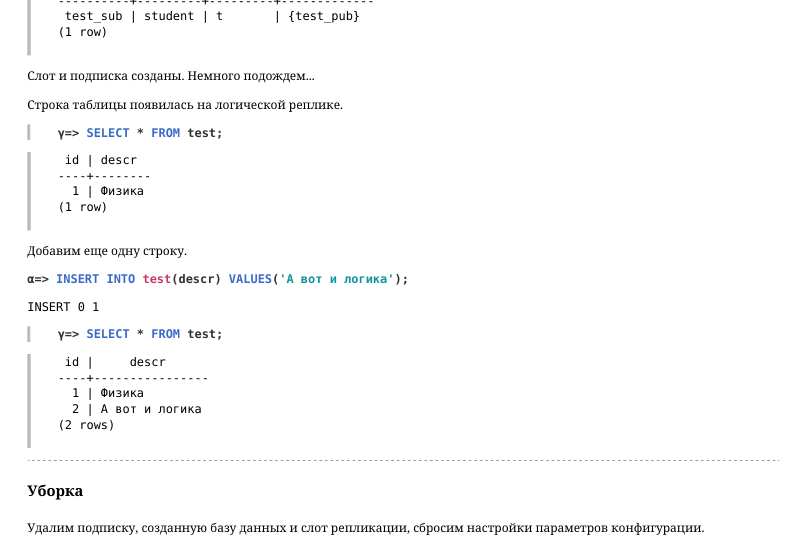 {#source-figure-032 caption=“Source slide page 32: Page 32”}
Слот и подписка созданы. Немного подождем… Строка таблицы появилась на логической реплике.
Добавим еще одну строку.
Уборка
Удалим подписку, созданную базу данных и слот репликации, сбросим настройки параметров конфигурации.
Page 33: Page 33
08 Занятие 08: Кластерные технологии / Обзор
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba3_08_cluster_overview.html Archive: DBA3-handouts-16.zip Страниц PDF: 28
Page 1: Кластерные технологии / Обзор
Авторские права
© Postgres Professional, 2017–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Ожидания от кластера
- Средства реализации
- Компоненты, необходимые для построения кластера
- Примеры систем
Page 3: Ожидания от кластера
Высокая доступность системы
- в том числе отказоустойчивость
- Масштабируемость
- Согласованность данных
Page 4: Высокая доступность
Обеспечение минимального времени простоя системы
- вызванного как сбоями, так и плановыми работами
- Различные характеристики
- отношение времени работы системы к общему времени → 100 %
- MTBF — время наработки на отказ
- → ∞
- RTO — целевое время восстановления
- → 0
- RPO — целевая точка восстановления
- → 0
- и другие
Комментарии преподавателя
Доступность системы — отношение времени, в течение которого система сохраняет доступность, к общему времени эксплуатации.
Понятие доступности более широкое, чем отказоустойчивость, поскольку простои могут быть вызваны не только отказами, но и плановыми работами.
Часто говорят о доступности:
● «одна девятка» 90 % — 36,5 дней простоя в год;
● «две девятки» 99 % — 3,65 дней простоя в год;
● «три девятки» 99,9 % — 8,76 часов простоя в год;
● «четыре девятки» 99,99 % — 52,56 минут простоя в год;
● «пять девяток» 99,999 % — 5,26 минут простоя в год и т. д.
Высокая доступность предполагает цифры, близкие к 100 %.
Для примера: сервис управляемых баз данных PostgreSQL в Yandex Cloud обещает доступность узлов на чтение 99,99 %, на запись — 99,95 % (https://yandex.cloud/ru/services/managed-postgres).
Другими характеристиками доступности могут быть:
● время наработки на отказ (Mean Time Between Failures);
● целевое время восстановления (Recovery Time Objective) — время, за которое система должна восстановиться;
● целевая точка восстановления (Recovery Point Objective) — период, за который можно потерять данные при сбое, и др.
Page 5: Масштабируемость
Масштабируемость
- способность системы справляться с увеличением рабочей нагрузки
- при добавлении ресурсов
- идеальная масштабируемость по времени отклика —
- время отклика не должно увеличиваться
- идеальная масштабируемость по пропускной способности —
- число обрабатываемых запросов должно расти линейно
- Ускорение
- отношение времени отклика на одном узле ко времени отклика
- в кластере из N узлов
Комментарии преподавателя
Важным понятием для кластера является масштабируемость: это свойство показывает, как меняется целевая характеристика системы с увеличением рабочей нагрузки при добавлении ресурсов. В контексте кластера растущая рабочая нагрузка можно вызываться не только увеличением количества запросов в единицу времени, но и увеличением объема данных. Под ресурсами мы будем в первую очередь понимать количество узлов кластера.
Масштабируемость по времени отклика показывает, как меняется время отклика (то есть время выполнения запроса) с ростом нагрузки при добавлении узлов кластера. Эта характеристика особенно важна для OLTP-систем. В идеале время отклика не должно увеличиваться.
Можно говорить не только о масштабируемости по времени отклика, но и об ускорении, которое показывает, как время отклика меняется с увеличением числа узлов при фиксированной нагрузке.
Масштабируемость по пропускной способности показывает, как меняется число обрабатываемых запросов с ростом объема данных при добавлении узлов кластера. Эта характеристика важна для OLAP-систем. В идеале число обрабатываемых запросов должно увеличиваться линейно с ростом числа узлов.
Идеальная масштабируемость (увы, не достижимая на практике) позволяет решать проблемы роста простым добавлением новых узлов в кластер.
Page 6: Согласованность
Локальные транзакции
- практически никаких гарантий при переключении между узлами
- согласованность обеспечивает приложение
- Глобальные (распределенные) транзакции
- ACID-согласованность
- проблема атомарности транзакций
Комментарии преподавателя
Чем более строгие гарантии согласованности данных предоставляет кластер, тем больше он похож на «единой целое», тем проще с ним работать, тем меньше надо учитывать особенности в прикладном коде. Но тем дороже это обходится в смысле производительности.
Если кластер основан на схеме «мастер-реплика» с одним пишущим узлом, и транзакции выполняются локально на одном из узлов, гарантии могут оказаться очень слабыми. Например, один узел мог успеть применить запись о фиксации транзакции и ее результат уже доступен клиентам, а другой узел — еще нет. В таком случае у клиента, в частности, нет гарантии, что он не прочитает старое значение (на одном узле) уже после того, как прочитал новое (на другом узле). Обработка таких ситуаций ложится на приложение, которое должно быть рассчитано на работу в этой конфигурации.
Если кластер предоставляет глобальные (распределенные) транзакции, то можно говорить о согласованности в обычном смысле ACID: глобальная транзакция должна переводить базу данных из одного согласованного состояния в другое согласованное (C), при условии, что транзакция полностью выполняется на всех узлах (A) при отсутствии помех со стороны других конкурентных транзакций (I).
В этом случае требуется обеспечить атомарность транзакций: все узлы кластера должны выполнить одинаковое действие — либо применить, либо отменить транзакцию. PostgreSQL предоставляет для этого относительно простой протокол двухфазной фиксации (2PC), который, однако, не устойчив к сбоям.
Page 7: Средства реализации
Обеспечение высокой доступности
- Синхронизация данных между узлами
- Виды сбоев и их обнаружение
- Распределенные протоколы консенсуса
- Обеспечение масштабируемости
Page 8: Высокая доступность
Плановые работы без прерывания обслуживания
- средствами PostgreSQL
- временный вывод узла из кластера
- Дублирование компонентов, исключение точек отказа
- серверы PostgreSQL (и другие необходимые системы)
- сетевое оборудование
- электропитание
- Обнаружение сбоев и управление восстановлением
Комментарии преподавателя
Время простоя может быть вызвано не только возникающими неполадками, но и плановыми работами, которые невозможно выполнить без прерывания обслуживания. С каждой версией PostgreSQL уменьшается число действий, требующих перезагрузки сервера. Кроме того, кластер должен уметь отрабатывать плановый останов одного из серверов с минимальными проблемами для пользователей.
Основа обеспечения отказоустойчивости — дублирование всех узлов системы. Речь не только о серверах баз данных, но и о сетевом оборудовании, обеспечении электропитания и пр.
Разумеется, недостаточно просто дублировать компоненты системы. Во-первых, нужно наладить синхронизацию данных между базами. Во-вторых, нужно обеспечить обнаружение сбоев в работе системы и их обработку — корректное переключение на резервные узлы и возвращение узлов в строй после устранения неисправности.
Большая часть необходимых средств отсутствует в стандартном PostgreSQL или вообще относится к другим компонентам. В целом, чем более доступной должна быть система, тем сложнее она будет устроена.
Page 9: Синхронизация
Shared nothing
- физическая репликация
- логическая репликация
- сторонние таблицы, postgres_fdw
- Shared disk
- синхронизация не нужна, но требуется отказоустойчивое хранилище
- нет штатных средств работы с общим диском
Комментарии преподавателя
Штатным образом объединение нескольких серверов PostgreSQL возможно только в архитектуре shared nothing: серверы не имеют ни общего диска, ни общей памяти, а связываются исключительно по сети. Для синхронизации данных используется репликация, рассмотренная в подробностях ранее в этом курсе.
Физическая репликация в силу своей однонаправленности позволяет строить кластер с одним ведущим узлом и несколькими репликами.
Более гибкая логическая репликация позволяет организовать как двунаправленную синхронизацию, так и выборочную репликацию отдельных таблиц или частей таблиц. На логической репликации можно строить геораспределенные кластера, в которых несколько серверов работают независимо, но обмениваются изменениями.
Для выборочной репликации можно использовать и другие средства, например, функционал сторонних таблиц с помощью расширения postgres_fdw.
Архитектура shared disk с общим дисковым хранилищем дает интересные возможности, хотя и требует изменений в ядре PostgreSQL. При общем диске синхронизация не нужна (само хранилище, конечно, может использовать блочную репликацию для отказоустойчивости, но для СУБД оно представляется единым устройством), а вычислительные узлы, не имеющие состояния, требующего надежного хранения, могут запускаться и останавливаться в любой момент. Такая схема позволяет динамически подстраиваться под нагрузку, что особенно важно при работе в облачной инфраструктуре.
Page 10: Отказ узла
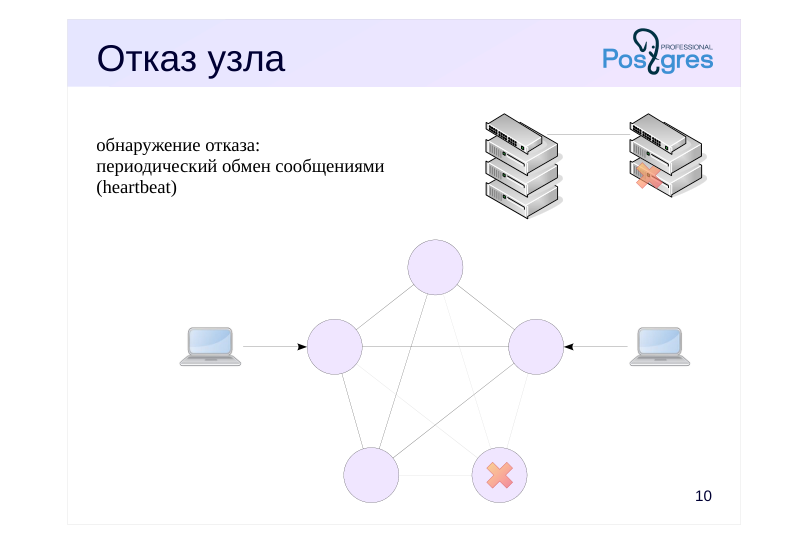 {#source-figure-010 caption=“Source slide page 10: Отказ узла”}
обнаружение отказа: периодический обмен сообщениями (heartbeat)
Комментарии преподавателя
Прежде чем говорить об обнаружении и управлении сбоями, нужно определиться, что считать сбоем. С точки зрения программного обеспечения кластера обычно рассматривают два вида сбоев: отказ узла и разделение сети (network partitioning).
При отказе узла этот узел перестает функционировать как часть кластера. Отказ может быть вызван остановом или сбоем сервера СУБД, сбоем операционной системы, выключением сервера и т. п.
Для обнаружения сбоев узлы кластера периодически обмениваются короткими сообщениями (heartbeat). Если какой-либо из узлов не отвечает в течении определенного времени, фиксируется и отрабатывается сбой этого узла.
Процедура отработки отказа зависит от архитектуры кластера. Например, в кластере, построенном на схеме «мастер–реплика», при сбое мастера какая-то из реплик должна занять его место (должно произойти переключение ролей).
Page 11: Разделение сети
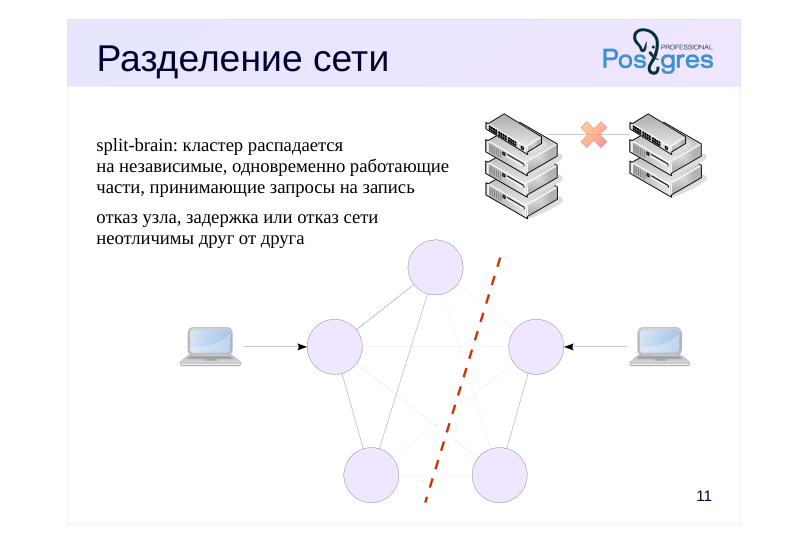 {#source-figure-011 caption=“Source slide page 11: Разделение сети”}
split-brain: кластер распадается на независимые, одновременно работающие части, принимающие запросы на запись
- отказ узла, задержка или отказ сети неотличимы друг от друга
Комментарии преподавателя
Разделение сети происходит при сбое сетевого оборудования. При этом все узлы могут сохранить работоспособность, но одна группа теряет связь с другой группой узлов кластера.
Самая неприятная ситуация возникает в случае, когда обе группы сохраняют связь с клиентами. Это может привести к проблеме split-brain: кластер распадается на две части, каждая из которых начинает работать автономно и при этом принимать запросы на запись. Возникает рассогласование данных, и при восстановлении данные одной из групп будут вынуждено потеряны.
Заметим, что сеть может выйти из строя, а может временно начать терять пакеты или доставлять их с задержкой (более того, в некоторых ОС обычная загруженность процессора тоже может приводить к сетевым задержкам). Все эти случаи неотличимы от сбоя узла: если от узла вовремя не поступит подтверждение, кластер должен считать такую ситуацию сбоем. Узел может сохранять работоспособность или нет, но узнать это невозможно, если с ним нет связи.
Многие системы будут нестабильно работать в условиях ненадежного сетевого подключения. Чтобы уменьшить вероятность ложных срабатываний, можно увеличить пороговое значение, но тогда увеличится и время обнаружения настоящего сбоя, а это приведет к снижению доступности. Для примера: распределенное хранилище пар ключ–значение etcd предлагает устанавливать порог в 10 раз выше, чем время нормального отклика узла.
https://github.com/etcd-io/etcd
Page 12: Проблема консенсуса
Узлы кластера должны уметь приходить к общему мнению
- общее представление о текущем состоянии всех узлов кластера
- атомарная фиксация глобальных транзакций
- Консенсус через обмен сообщениями
- нет общей памяти (shared nothing)
- используются специальные распределенные протоколы,
- учитывающие возможность сбоев на каждом этапе переговоров
- построение, доказательство корректности и тестирование реализации —
- сложная задача!
Комментарии преподавателя
Кластер, составленный из независимых узлов, должен работать — в некотором смысле — как единое целое. Чтобы управлять сбоями, узлы должны разделять общее представление о состоянии всех узлов кластера. Чтобы принять решение о фиксации распределенной транзакции, все узлы кластера должны согласиться, что это возможно, и в итоге выполнить фиксацию атомарно.
Поскольку никакого общего устройства хранения у узлов нет (мы рассматриваем системы класса shared nothing), то единственный способ прийти к общему мнению — договориться, используя какой-либо протокол распределенного консенсуса. Протокол определяет, какими сообщениями и в каком порядке должны обменяться узлы, чтобы прийти к соглашению.
Важный момент: распределенные алгоритмы очень сложны, поскольку учитывают множество граничных случаев. Например, они должны корректно работать в ситуациях, когда на любом этапе переговоров происходит какой-либо сбой. Доказательство корректности таких алгоритмов и тестирование их реализаций — также очень сложная задача. Поэтому не стоит пытаться создать собственный алгоритм или доверять неизвестному.
Page 13: Протоколы 2PC, 3PC
Двухфазная фиксация
- prepare:
- координатор проводит голосование;
- commit:
- если все «за», координатор сообщает о фиксации.
- поддерживается PostgreSQL (PREPARE TRANSACTION + COMMIT)
- Трехфазная фиксация
- prepare:
- координатор проводит голосование;
- precommit: если все «за», координатор сообщает всем о намерении;
- commit:
- если все успешно, координатор сообщает о фиксации.
- Свойства
- возможны ситуации (например, разделение сети),
- в которых невозможно разрешить транзакцию до устранения сбоя
Комментарии преподавателя
Простой протокол для фиксации глобальных транзакций, поддержка которого встроена в PostgreSQL, — двухфазная фиксация (2-Phase Commit). Узел, выполняющий транзакцию, считается координатором. На подготовительной фазе (prepare) координатор сообщает остальным узлам о фиксации транзакции и дожидается от них подтверждения, что они готовы выполнить фиксацию (если хотя бы один узел не готов — транзакция обрывается). На фазе фиксации (commit) координатор сообщает всем узлам о решении зафиксировать транзакцию. При получении от всех подтверждения, координатор тоже фиксирует транзакцию.
Этот протокол позволяет обойтись минимумом сообщений, но не устойчив к сбоям. Например, при отказе координатора после фазы prepare, остальные узлы не имеют информации о том, должна ли транзакция быть зафиксирована или отменена. Им придется ждать устранения сбоя.
Это ограничение преодолевает более сложный протокол трехфазной фиксации (3-Phase Commit). В нем вводится дополнительная фаза precommit, на которой координатор сообщает всем узлам о принятом решении фиксировать транзакцию. После этого, даже если произойдет сбой координатора, оставшиеся узлы будут иметь право зафиксировать транзакцию самостоятельно (а до фазы precommit — самостоятельно отменить ее).
Однако оба алгоритма не справляются с ситуациями разделения сети.
Page 14: Кворумные протоколы
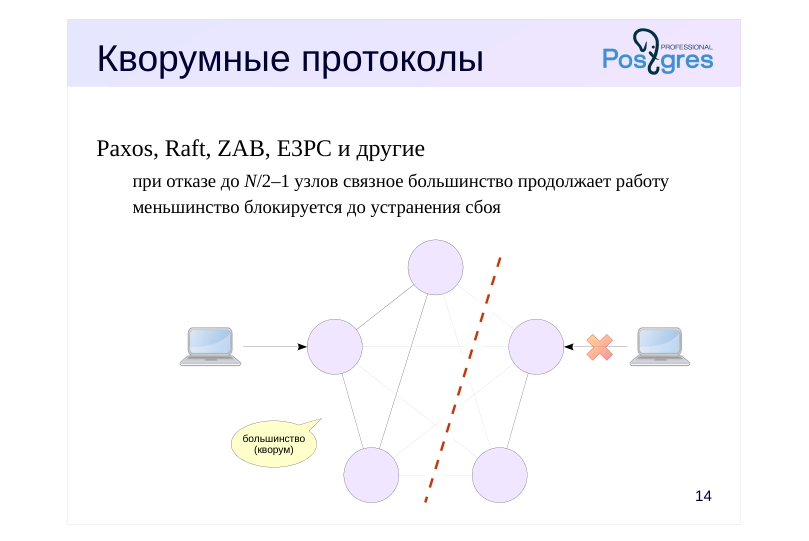 {#source-figure-014 caption=“Source slide page 14: Кворумные протоколы”}
Paxos, Raft, ZAB, E3PC и другие
- при отказе до N/2–1 узлов связное большинство продолжает работу
- меньшинство блокируется до устранения сбоя
Комментарии преподавателя
Алгоритмы, основанные на кворуме (большинстве голосов), позволяют в условиях разделения сети не блокировать узлы, сохранившие связь друг с другом и образующие кворум. Таким образом (если голоса всех узлов равны), из N узлов N/2+1 смогут продолжить работу.
Узлы, оставшиеся в меньшинстве, вынуждены ожидать исправления сбоя, чтобы принять решение о фиксации или откате открытых транзакций. Такие узлы могут полностью не обслуживать клиентов или как минимум не принимать запросы на запись, чтобы не допустить ситуацию split-brain.
Существует ряд алгоритмов, доказанных математически и имеющих протестированные и проверенные временем реализации.
● Paxos опубликован в 1998 году, а фактически появился в конце 80-х. Есть целое семейство этих алгоритмов для различных ситуаций.
● Raft создавался как алгоритм, эквивалентный Paxos, но более простой для понимания. В этом алгоритме один из узлов выбирается в качестве лидера, который может изменять данные; остальные узлы читающие. Этот протокол лежит в основе таких систем, как etcd и Consul (распределенные хранилища «ключ–значение»).
● ZAB используется в системе ZooKeeper.
● E3PC — Enhanced 3PC улучшает алгоритм трехфазной фиксации, разрешая фиксировать транзакцию при получении большинства (а не всех) голосов.
Существуют иные подходы, позволяющие решать проблему консенсуса, например, Virtual synchrony (используется в Corosync).
Page 15: Масштабируемость
Пропускная способность по чтению
- распределение нагрузки по узлам кластера
- Пропускная способность по записи
- не достигается при полной репликации данных на все узлы
- шардинг — распределение строк таблиц по разным узлам,
- сильно зависит от природы хранимых данных
- Время отклика
- параллельные вычисления на нескольких узлах
Комментарии преподавателя
Проще всего достичь масштабирования пропускной способности по отношению к читающим транзакциям. Для этого достаточно каким-то образом распределять читающие транзакции более или менее равномерно по узлам кластера.
Достичь масштабирования пишущей нагрузки обычно сложнее: в конфигурациях типа «мастер–мастер» узлы вынуждены обмениваться друг с другом сообщениями и данными, так что общая нагрузка на систему с увеличением числа узлов только возрастает. Однако это возможно, если данные распределятся между узлами, а не реплицируются на каждый узел полностью.
Обычно применяют шардинг: распределение данных на уровне строк таблиц. Можно провести аналогию с секционированием, в котором секции расположены на разных узлах кластера.
Заметим, что возможные схемы шардирования очень сильно связаны с логикой данных; какое-то универсальное решение тут невозможно.
Использование шардинга позволяет достичь и масштабирования времени отклика. Для этого кластер должен уметь распараллеливать запросы, выполняя их одновременно на нескольких узлах, имеющих необходимые данные. Это похоже на параллельное выполнение запросов в стандартном PostgreSQL, но параллельные процессы выполняются не внутри одного сервера, а на разных узлах. Конечно, при этом возрастает стоимость и пересылки данных (например, результатов частичной агрегации) между процессами.
Page 16: Распределение нагрузки
Средства, специфичные для PostgreSQL
- библиотека libpq
- PgBouncer — менеджер пула
- Pgpool-II — балансировщик и менеджер пула
- Одиссей — многопоточный менеджер пула
- …
- Другие средства
- виртуальный IP-адрес
- HAProxy — балансировщик TCP/HTTP
- round-robin DNS
- …
Комментарии преподавателя
Для распределения нагрузки уже имеется достаточно много готовых решений; обычно такие средства не входят в состав самого кластера.
● В строке подключения libpq можно указать несколько узлов, порядок подключения к которым устанавливает параметр load_balance_hosts, а параметром target_session_attrs задают свойства сеанса (например, разрешение только читающих запросов).
● PgBouncer — удобный менеджер пула соединений для PostgreSQL.
● Pgpool-II — менеджер пула и балансировщик, способный распределять пишущую нагрузку на мастер, а читающую на реплики.
● Одиссей — многопоточный менеджер пула с полной поддержкой SSL/TLS и возможностями аутентификации LDAP и PAM.
Из общих средств, не связанных с PostgreSQL, отметим:
● Виртуальный IP-адрес — IP-адрес, который управляется автоматикой кластера и направляет клиента на нужный узел.
● HAProxy — балансировщик и прокси-сервер, работающий на уровне TCP и HTTP. Для обновления списка узлов подходит средство управления конфигурациями confd. Или можно использовать способность HAProxy выполнять проверки (health check) узлов кластера для исключения неподходящих из списка балансировки.
● Некоторые системы (Consul), предоставляют round-robin DNS: выбор узлов и балансировка может происходить на этапе разрешения имени (но кеширование сводит на нет преимущества такого решения).
Есть и другие средства. Многие можно использовать совместно.
Page 17: Компоненты и примеры
Необходимые компоненты, отсутствующие в PostgreSQL
- Примеры систем
Page 18: Отказоустойчивость
Агент
- управляет одним экземпляром PostgreSQL
- Управляющий
- логика управления всем кластером
- Консенсус
- внешняя система под управлением одного из протоколов консенсуса
- поддержка общего состояния для управляющих
- Точка входа
- способ направить клиентов на нужный узел кластера
Комментарии преподавателя
Если основной целью создания кластера является высокая доступность (в частности, отказоустойчивость), естественным решением является взять несколько экземпляров обычного PostgreSQL и объединить их дополнительным программным обеспечением. Синхронизация данных возлагается на физическую репликацию, то есть в кластере выделяется основной узел (мастер) и реплики.
Поскольку PostgreSQL не может сам себя конфигурировать, перезапускать, останавливать и т. п., нужна программа, которая будет этим заниматься. Эту роль выполняет агент.
Логика управления кластером сосредоточена в управляющих. На этом уровне принимается решение о том, что такой-то узел следует считать вышедшим из строя, о том, какую из реплик следует назначить новым мастером при выходе старого из строя и т. п.
Чтобы разделять общую точку зрения, управляющие опираются на систему, работающую по одному из рассмотренных ранее распределенных протоколов консенсуса.
Наконец, для клиентов требуется единая точка входа, которая направит их на нужный узел (или узлы) кластера.
В разных кластерных системах эти компоненты могут называться по-разному; некоторые могут объединяться вместе. Если какие-то компоненты отсутствуют, кластер надо дополнять другими решениями.
Page 19: Ограждение (fencing)
Отключение узла в неизвестном состоянии от клиентов
- из-за разделения сети может возникнуть ситуация split-brain
- нужно не только оградить узел,
- но и не допустить в это время переход на реплику
- Механизмы
- отключение питания
- отключение сетевого порта
- завершение и перенаправление клиентских соединений
Комментарии преподавателя
Поскольку в этом подходе серверы PostgreSQL ничего не знают о том, что работают в кластере, важно уметь отгородить сбойный узел — возможно, работающий, но потерявший связь с кластером — от внешнего мира. Эта процедура называется fencing.
Если этого не сделать, то мастер, оказавшись в результате разделения сети в меньшинстве, может продолжить работу (ситуация split-brain). Полагаться на то, что управляющие, обнаружив сбой, сами остановят сервер PostgreSQL, нельзя: у управляющих может не оказаться связи с агентом, может произойти сбой в агенте и т. п.
Процедура может выполняться по-разному, но не должна рассчитывать на доступность узла по сети. Например:
● программно отключать питание сервера (интерфейсы IPMI, PDU);
● программно отключать сетевой порт на коммутаторе;
● если соединение идет через специализированный компонент, то клиенты могут принудительно отключаться от сбойного узла на уровне этого компонента.
Надо заметить, что процедура ограждения уменьшает масштаб проблемы, но сама по себе не решает ее полностью. Нужно также гарантировать невозможность перехода на одну из реплик до тех пор, пока сбойный мастер не будет огражден. Ведь на принятие решения об ограждении требуется время, в течение которого узел может продолжать функционирование, и, следовательно, часть зафиксированных данных может потеряться при восстановлении (нулевое RPO не достигается).
Page 20: Пример: Patroni
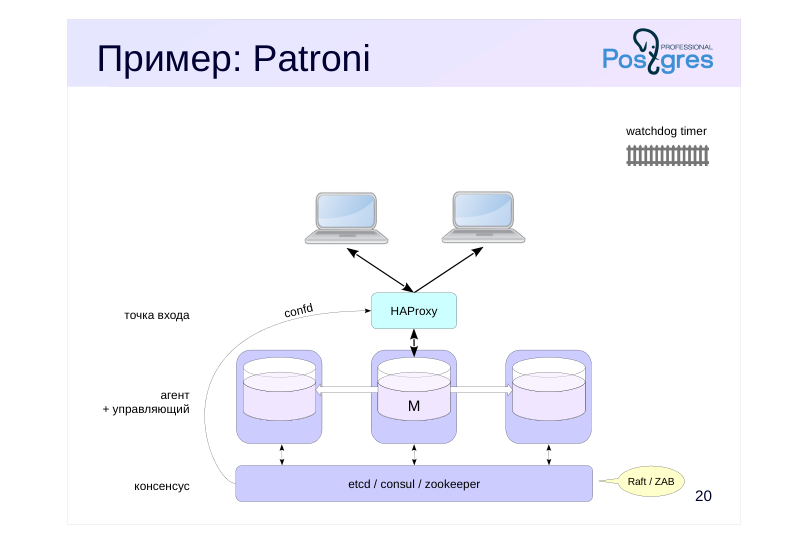 {#source-figure-020 caption=“Source slide page 20: Пример: Patroni”}
Комментарии преподавателя
Patroni https://github.com/patroni/patroni — кластерное решение с открытым исходным кодом, рассчитанное на использование как в облаках, так и на выделенных серверах.
Здесь агент и управляющий объединены в одном компоненте. Для консенсуса используется хранилище «ключ–значение», предоставляемое одной из систем etcd (Raft), Consul (Raft) или ZooKeeper (ZAB).
Для точки входа требуется использовать отдельное решение. Обычно предлагается использовать HAProxy в связке с confd, который периодически обновляет конфигурацию HAProxy на основе информации из слоя консенсуса. Стандартная настройка предполагает перенаправление всех клиентов на узел, выполняющий роль мастера.
Чтобы HAProxy сам не стал точкой отказа, необходимо иметь несколько таких серверов и, например, виртуальный IP-адрес для клиентов. Однако это приводит к тому, что конфигурации разных серверов HAProxy нужно обновлять синхронно, и мы снова сталкиваемся с вопросом построения кластера — уже на другом уровне.
Для ограждения узла (fencing) может использоваться механизм сторожевого таймера (watchdog timer) ядра Linux. Если узел, будучи мастером, не может связаться со слоем консенсуса в течение определенного времени, таймер перезагружает операционную систему.
Page 21: Пример: стек ClusterLabs
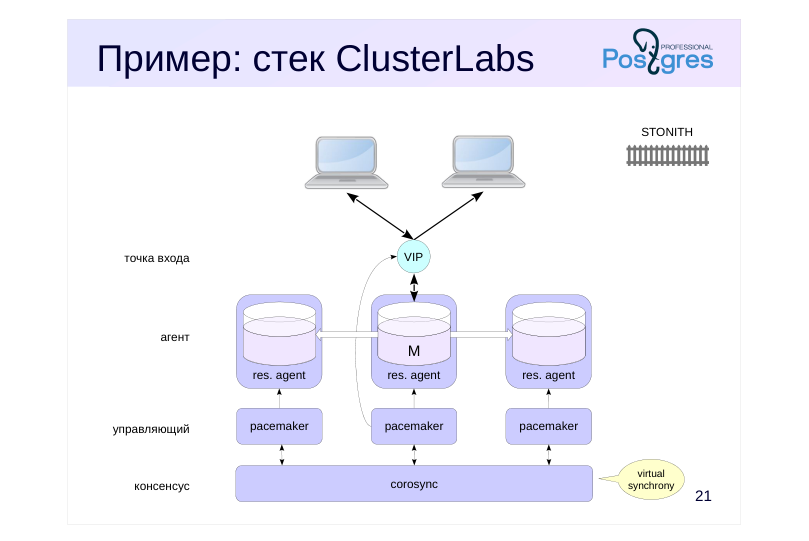 {#source-figure-021 caption=“Source slide page 21: Пример: стек ClusterLabs”}
Комментарии преподавателя
Компания ClusterLabs (https://clusterlabs.org/) предоставляет стек компонентов с открытым исходным кодом для построения кластеров из более или менее произвольных систем.
Агент (resource agent в терминологии этой системы) представляет конкретную систему как унифицированный «ресурс», реализуя операции останова, запуска, повышения реплики и т. п. Этот компонент должен быть реализован отдельно для каждой системы.
Управляющий компонент — Pacemaker — взаимодействует с ресурсом через агента. Для общего состояния и обнаружения сбоев используется Corosync (Virtual synchrony).
Ограждению (fencing) узлов уделено большое внимание. Используется технология STONITH (Shoot The Other Node In The Head), позволяющая надежно изолировать сбойный узел от кластера и клиентов путем программного отключения питания или сетевого порта на коммутаторе.
Точкой входа для клиентов обычно является виртуальный IP-адрес, который управляющий поднимает на узле, являющимся в данный момент мастером.
Дополнительно при необходимости можно распределить читающую нагрузку по репликам с помощью HAProxy, PgBouncer и т. п.
Для PostgreSQL имеется открытое решение PAF (PostgreSQL Automatic Failover): http://clusterlabs.github.io/PAF/
Page 22: Пример: BiHA
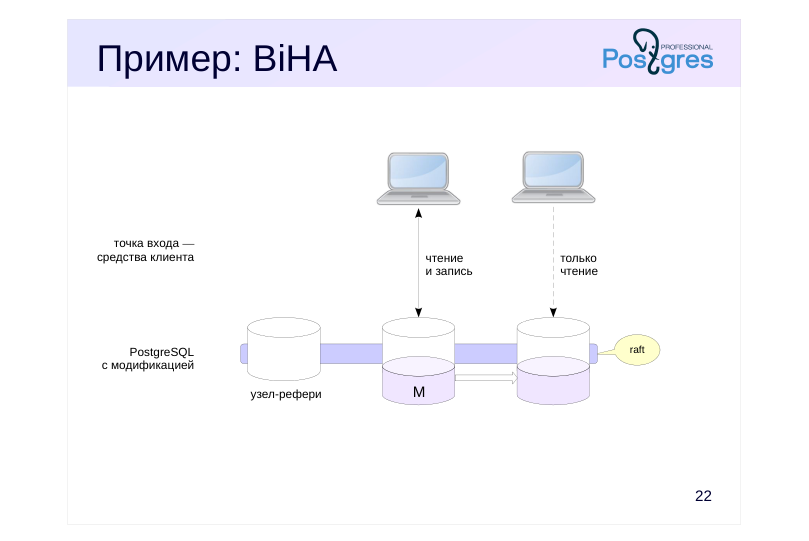 {#source-figure-022 caption=“Source slide page 22: Пример: BiHA”}
Комментарии преподавателя
Очевидно, что большое количество внешних компонентов сильно усложняет развертывание и обслуживание кластера. Чтобы упростить эти задачи, можно встроить все необходимое внутрь самого PostgreSQL. Эта нетривиальная задача решена в кластере BiHA (Built-in High Availability), который является составной частью Postgres Pro Enterprise.
Внешне такой кластер выглядит, как обычные узлы, связанные физической репликацией, но на самом деле в каждом узле Postgres Pro Enterprise реализован механизм обнаружения ошибок, предотвращения разделения кластера (split-brain), слой консенсуса (используется протокол Raft), логика управления и агент.
Для консенсуса нужно как минимум три узла, но не обязательно хранить данные на всех трех. Можно развернуть кластер, в котором третий узел будет являться рефери: он будет входить в кворум, но не будет участвовать в репликации. Для такого узла можно использовать менее мощный сервер.
Дополнительное программное обеспечение для точки входа не используется, кластер полагается на способность клиента самостоятельно определять, работает ли он с основным сервером (выполняющим пишущие и читающие запросы) или с репликой. Такие средства имеются в том числе в libpq.
https://postgrespro.ru/docs/enterprise/16/biha-solution
Page 23: Согласованность
Менеджер распределенных транзакций
- требует модификации ядра PostgreSQL
- может быть встроен или представлен отдельным компонентом
Комментарии преподавателя
В предыдущих примерах к PostgreSQL добавлялись компоненты, которые позволяют обеспечить отказоустойчивость: агенты, управляющие (включая систему обнаружения сбоев), слой консенсуса для хранения состояния кластера. Эти компоненты могли существовать как снаружи узлов PostgreSQL, так и быть встроенными в сам PostgreSQL.
Для создания кластера, предоставляющего клиентам единую согласованную картину данных, необходим менеджер распределенных транзакций (Global Transaction Manager), который реализует протокол распределенного консенсуса для атомарной фиксации транзакций, охватывающих несколько узлов.
Возможность работы с распределенными транзакциями нельзя организовать исключительно внешними средствами, она должна быть встроена в PostgreSQL путем модификации ядра. Даже в том случае, когда управление распределенными транзакциями выделено в виде самостоятельного компонента кластера, PostgreSQL должен понимать, что к этому компоненту необходимо обращаться.
Обычно помимо согласованности требуется и отказоустойчивость. В этом случае кластер должен содержать и все рассмотренные ранее компоненты. А если менеджер распределенных транзакций реализован в виде отдельного компонента, то необходимо обеспечить и его отказоустойчивость, что приводит к очередному усложнению системы.
Page 24: Пример: multimaster
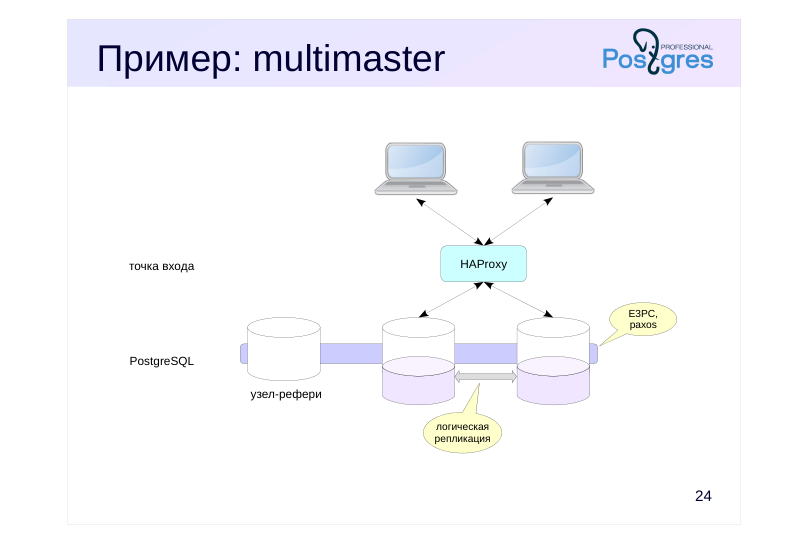 {#source-figure-024 caption=“Source slide page 24: Пример: multimaster”}
Комментарии преподавателя
Примером такой системы может служить расширение multimaster Postgres Pro Enterprise. В СУБД встраивается менеджер распределенных транзакций, который расширяет имеющийся двухфазный протокол 2PC до E3PC. Для этого на узлах запускаются процессы-арбитры, выполняющие дополнительные коммуникации. Используется алгоритм консенсуса Paxos.
https://postgrespro.ru/docs/enterprise/16/multimaster
Любой из узлов кластера multimaster (кроме рефери, если он используется) может принимать запросы как на чтение, так и на запись. Читающие транзакции выполняются локально. Пишущие транзакции являются распределенными; узел, фиксирующий транзакцию, становится координатором.
Репликация данных между узлами кластера основана на логической репликации, DDL реплицируется собственным алгоритмом.
Для распределения нагрузки имеет смысл балансировать соединения между узлами кластера. Например, можно указывать разные строки соединений для разных клиентов, а можно воспользоваться HAProxy.
Приложение, работающее на одном сервере, может быть запущено и на multimaster-кластере без дополнительных забот о согласованности данных. Поддерживаются уровни изоляции Read Committed и Repeatable Read. Однако, в силу ограничений реализации, некоторые нюансы приложение должно учитывать.
Помимо реализации распределенных транзакций, кластер обеспечивает и отказоустойчивость.
Page 25: Масштабируемость
Большое количество узлов
- репликация или общий диск
- шардинг
- параллельные вычисления
Комментарии преподавателя
В случаях, когда на первый план выходят возможности масштабирования, можно организовать относительно простой кластер, составленный из обычных экземпляров PostgreSQL без обычной кластерной обвязки. Такой кластер позволит распределять нагрузку на разные узлы, хотя и не будет обеспечивать отказоустойчивость и согласованность.
Данные между узлами могут реплицироваться полностью (получим возможность масштабирования по чтению) или частично (например, по принципу шардинга — получим возможность масштабирования и по записи). Системы, рассчитанные на облачную инфраструктуру и динамическую подстройку ресурсов под нагрузку, могут использовать вариант с общим диском и разделением узлов на вычислительные и хранящие данные.
Распределение данных по большому количеству узлов позволяет организовать и параллельное выполнение запросов.
Page 26: Пример: Citus
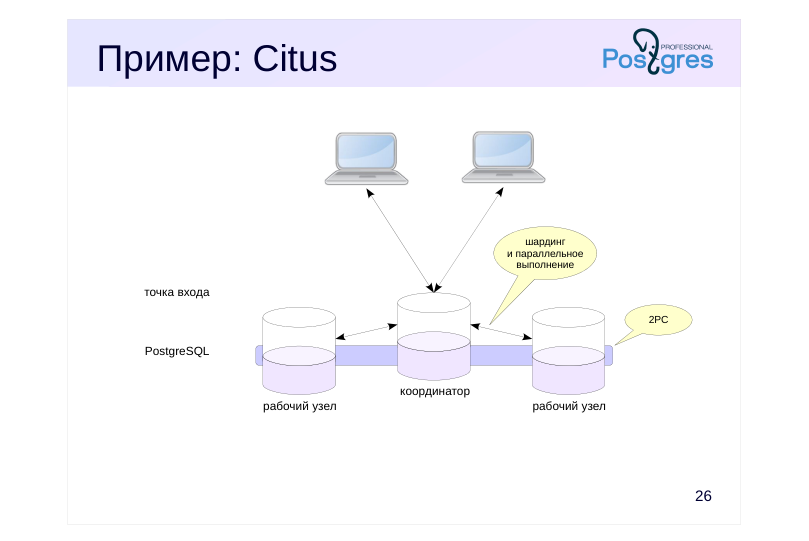 {#source-figure-026 caption=“Source slide page 26: Пример: Citus”}
Комментарии преподавателя
Citus https://github.com/citusdata/citus — расширение PostgreSQL для распределения данных и запросов по узлам кластера.
Citus — пример системы, в которой данные не реплицируются полностью, а шардируются на рабочие узлы. Один узел выделяется в качестве координатора — он содержит метаинформацию о расположении данных.
В состав расширения входит специальный оптимизатор запросов, генерирующий параллельные планы выполнения, а исполнитель выполняет запросы, распределяя их на соответствующие узлы. За счет этого кластер Citus позволяет достичь масштабируемости по времени отклика и масштабируемости пишущей нагрузки.
Citus гарантирует атомарность изменений на всех узлах кластера с помощью глобальных транзакций по протоколу двухфазной фиксации 2PC.
Перебалансировка данных между рабочими узлами (при добавлении нового узла или выведении старого) использует логическую репликацию.
В представленном виде кластер не решает задачу высокой доступности: при отказе любого узла теряется часть информации. Поэтому и координатор, и рабочие узлы могут заменяться отдельными мини-кластерами из трех узлов (мастер и две реплики), которые и обеспечат отказоустойчивость.
Page 27: Пример: Neon
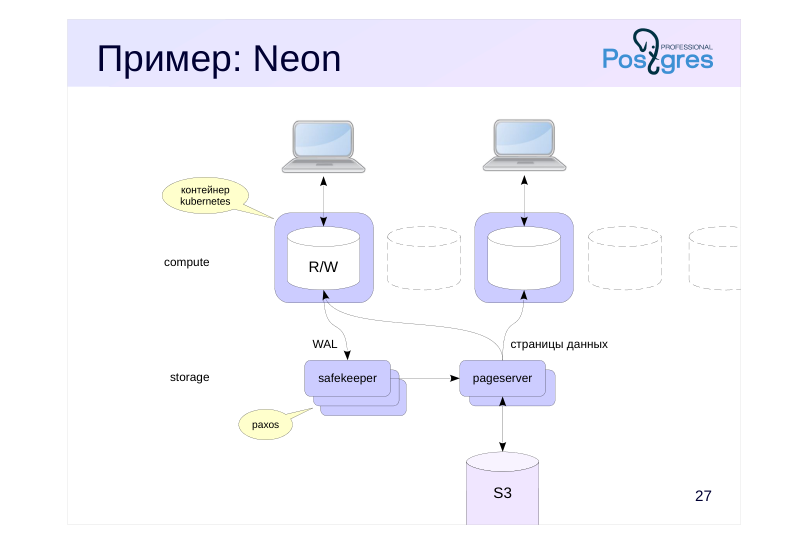 {#source-figure-027 caption=“Source slide page 27: Пример: Neon”}
Комментарии преподавателя
Решение с открытым кодом Neon продвигает концепцию облачных бессерверных вычислений. Идея заключается в разделении СУБД на отдельные узлы, не требующие хранения состояния, и использовании большого и дешевого, но медленного хранилища данных.
Вычислительные узлы (по сути, экземпляры PostgreSQL, от которого «отрезано» журналирование и работа с диском) запускаются в контейнерах под управлением Kubernetes. Поскольку эти узлы не имеют собственного состояния, контейнеры можно запускать и останавливать в любой момент в зависимости от активности клиентов, не платя за использование лишних ресурсов.
Для сохранения данных пишущий экземпляр (он может быть только один) передает журнальные записи компоненту safekeeper. Журнальные записи зафиксированных транзакций необходимо хранить надежно; для этого компоненты safekeeper образуют отдельный отказоустойчивый кластер, работающий по проколу Paxos.
Журнальные записи асинхронно передаются от safekeeper компоненту pageserver, который применяет их к страницам данных. Pageserver возвращает страницы по запросу клиентов, при необходимости сбрасывая их в «бездонное» объектное хранилище S3 и считывая их оттуда. Таким образом, pageserver служит кешем данных, с которыми ведется активная работа, и является аналогом буферного кеша.
Neon масштабируется по чтению и автоматически адаптируется к нагрузке, но неизбежно работает медленнее традиционных систем.
https://github.com/neondatabase/neon
Page 28: Итоги
Для создания кластера требуются средства, не входящие в стандартный PostgreSQL
- Огромное количество вариантов построения кластера
- разные цели: высокая доступность, масштабируемость, согласованность
- решения с внешними компонентами и с модификацией ядра
- решения с поддержкой глобальных транзакций
- Чем выше предъявляются требования, тем сложнее система и тем дороже она обходится