Администрирование PostgreSQL. Настройка и мониторинг
Администрирование PostgreSQL. Настройка и мониторинг
Курс сохраняет официальный порядок тем. Русские материалы извлечены из PDF в читаемый нативный Markdown для дальнейшей редакторской работы.
Состояние материалов: 官方 PDF 已提取为原生 Markdown
Базовый язык: Базовый язык: English. Текущий английский архив используется как базовый; русская версия сохранена для сверки глав.
О курсе
MVCC, WAL, блокировки, расширения, локализация, мониторинг и обновление.
Состояние материалов
| Язык | Текущий архив | Версия | Темы | Страница курса |
|---|---|---|---|---|
| English | DBA2-handouts-16-en.zip | 16 | 18 | HTTP 200 |
| Русский | DBA2-handouts-16.zip | 16 | 18 | HTTP 200 |
Содержание
Дополнительные материалы
dba2_new_features.pdfdba2_student_guide.pdf
Редакторский статус
Русский комплект доступен в виде нативного Markdown. Если английский комплект не найден, английский маршрут оставлен для будущего источника.
00 Занятие 00: Администрирование PostgreSQL 16 / Настройка и мониторинг
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_00_introduction.html Archive: DBA2-handouts-16.zip Страниц PDF: 11
Page 1: Администрирование PostgreSQL 16 / Настройка и мониторинг
Авторские права
© Postgres Professional, 2017–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Администраторам
 {#source-figure-002 caption=“Source slide page 2: Администраторам”}
DBA2, 4 дня
Комментарии преподавателя
Для прохождения всех курсов необходимо знание основ языка SQL. Курса по SQL в нашей линейке нет, но имеется множество книг и образовательных ресурсов для освоения SQL. Мы рекомендуем книгу Евгения Моргунова «PostgreSQL. Основы языка SQL»:
https://postgrespro.ru/education/books/sqlprimer
Для администраторов мы предлагаем следующие курсы.
Курс DBA1 – базовый, он дает сведения об архитектуре PostgreSQL, об установке, настройке и управлении сервером. Приводятся обзоры разграничения доступа, резервного копирования и репликации.
В курсе DBA2 обсуждается настройка конфигурационных параметров исходя из понимания внутренней организации сервера; говорится о мониторинге сервера с использованием обратной связи для итеративной настройки параметров.
Курс DBA3 посвящен рассмотрению резервного копирования, а также настройкам физической и логической репликации и сценариям ее использования. Также дается общее представление о способах и сложностях построения высокодоступных, масштабируемых кластеров.
Курс DBS рассказывает про настройку подключений клиентов к СУБД и про управление доступом внутри самой СУБД.
В курсе QPT разбираются планирование и выполнение запросов, настройка параметров экземпляра, связанных с производительностью, и изучается поиск проблемных запросов и их оптимизация.
В курсе PGPRO рассматриваются дополнительные возможности, которые предоставляет СУБД Postgres Pro Enterprise.
Page 3: Разработчикам
 {#source-figure-003 caption=“Source slide page 3: Разработчикам”}
- DEV2, 4 дня
Комментарии преподавателя
Для разработчиков серверной части приложений мы предлагаем следующие курсы.
Базовым курсом для разработчиков является курс DEV1, в котором даются общие сведения об архитектуре PostgreSQL и использовании основных объектов базы данных; изучается программирование на стороне сервера на языках SQL и PL/pgSQL с использованием основных типов данных (включая составной тип и массивы), а также рассматривается взаимодействие с клиентской частью.
В курсе DEV2 рассматриваются особенности внутреннего устройства сервера, влияющие на разработку прикладного кода, и всесторонне изучается расширяемость: возможность дополнить серверные механизмы собственным кодом, что позволяет использовать PostgreSQL для решения самых разнообразных задач.
Курсы DBS, QPT и PGPRO являются общими для разработчиков и администраторов.
Разработчикам могут быть интересны и курсы по администрированию, если есть необходимость детальнее изучить внутреннее устройство PostgreSQL, а также в случае, когда на проекте нет выделенной роли администратора.
https://postgrespro.ru/education/courses
Page 4: О курсе DBA2
Продолжительность: 4 дня
- Предварительные знания
- владение ОС Unix
- знакомство с PostgreSQL в объеме курса DBA1
- Какие навыки будут получены
- настройка различных конфигурационных параметров
- исходя из понимания внутренней организации сервера
- мониторинг сервера с использованием обратной связи
- для итеративной настройки параметров
- настройки, связанные с локализацией
- управление расширениями и знакомство с процедурой обновления
- сервера
Комментарии преподавателя
Задача этого курса – дать достаточно глубокое понимание внутреннего устройства PostgreSQL, которое позволит разобраться во множестве имеющихся конфигурационных параметров, и показать возможности мониторинга, которые необходимы для уточнения начальных настроек.
Более полное и подробное изложение этих тем можно найти в книге Егора Рогова «PostgreSQL изнутри»:
https://postgrespro.ru/education/books/internals
Также в этом курсе разбирается ряд других тем, связанных с администрированием и не вошедших в курс DBA1.
Page 5: Используемые материалы
Подготовленная виртуальная машина
- ОС Xubuntu 24.04
- PostgreSQL 16
- документация на русском языке
- Учебные материалы
- руководство слушателя
- презентации, демонстрации, практические задания и их решение
- (в форматах html и pdf)
Комментарии преподавателя
Если вы проходите курс самостоятельно, обязательно начните со знакомства с Руководством слушателя. В числе прочего в нем написано, где скачать и как использовать виртуальную машину курса и прочие материалы. Все материалы курса, включая Руководство слушателя, доступны по адресу: https://postgrespro.ru/education/courses/DBA2
Выполнение практических заданий очень важно для получения навыков работы с PostgreSQL. Обязательно старайтесь сначала самостоятельно выполнить задания, а затем просмотрите предлагаемые нами решения, даже если задание не вызвало вопросы. В решениях могут содержаться дополнительные сведения, которые не упоминаются в презентациях и демонстрациях.
Учебные материалы (презентации, демонстрации, практические задания и их решения) доступны в двух форматах. Формат html удобен для онлайн-работы, он позволяет копировать фрагменты текста и кода. Формат pdf разбит на страницы и удобен для печати.
Page 6: Кластеры PostgreSQL
В виртуальной машине курса из пакета установлен PostgreSQL 16 со стандартным кластером main, который запускается при старте ОС и используется почти во всех темах курса. Для темы «Обновление сервера» настроены два кластера prod для версий 15 и 16 на одном и том же порту 5433. Кроме этого, в теме «Блокировки в памяти» используется кластер slow на стандартном порту 5432. Все дополнительные кластеры остановлены и запускаются вручную. Все практические задания выполняются под пользователем ОС student. В кластере main созданы одноименные суперпользователь и база данных, чтобы psql можно было запускать без параметров.
Во всех кластерах все пользователи могут подключаться локально без аутентификации, а через сеть — с паролем:
Page 7: Организационные вопросы
День: ~8 академических часов + обед (1час)
- Каждая тема, как правило, состоит из
- презентации и демонстрации: ~30–60 мин
- практических заданий: ~30–40 мин, включая перерыв
Page 8: День 1
Многоверсионность
- Изоляция
- Страницы и версии строк
- Снимки данных
- HOT-обновления и самоочистка
Page 9: День 2
Многоверсионность (продолжение)
- Очистка
- Автоочистка
- Заморозка
- Журналирование
- Буферный кеш
- Журнал предзаписи
Page 10: День 3
Журналирование (продолжение)
- Контрольная точка
- Настройка журнала
- Блокировки
- Блокировки объектов
- Блокировки строк
Page 11: День 4
Блокировки (продолжение)
- Блокировки в оперативной памяти
- Задачи администрирования
- Управление расширениями
- Локализация
- Обновление сервера
01 Занятие 01: Многоверсионность / Изоляция
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_01_mvcc_isolation.html Archive: DBA2-handouts-16.zip Страниц PDF: 22
Page 1: Многоверсионность / Изоляция
Авторские права
© Postgres Professional, 2017–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Транзакции и их свойства
- Уровни изоляции в стандарте SQL
- Особенности реализации PostgreSQL
Page 3: Транзакции и их свойства
Транзакция — последовательность операций,
- которые переводят базу данных из одного корректного состояния в другое корректное
- Согласованность
- при условии, что транзакция выполнена полностью
- Атомарность
- и без помех со стороны других транзакций
- Изоляция
- атомарность: транзакция либо выполняется полностью,
- либо не оставляет никаких следов
- согласованность определяется ограничениями целостности
- и семантикой приложения
- неполная изоляция приводит к нарушению корректности (аномалиям)
- при конкурентном выполнении транзакций
Комментарии преподавателя
Транзакцией называется последовательность операций, выполняемая приложением, которая переводит базу данных из одного корректного состояния в другое корректное состояние (согласованность) при условии, что транзакция выполнена полностью (атомарность) и без помех со стороны других транзакций (изоляция).
Корректное (согласованное) состояние определяется как ограничениями целостности, заданными в базе данных, так и семантикой приложения.
Идеальная изоляция транзакций гарантирует, что на работу приложения не окажут влияния никакие другие конкурентно выполняющиеся транзакции. Однако если ослабить требования к изоляции, то транзакция, которая корректно выполнялась в базе данных в одиночестве, может выдавать некорректные результаты при наличии других транзакций — из-за того, что при выполнении операторы разных транзакций могут чередоваться. Такие некорректные ситуации называются аномалиями.
Реализация полной изоляции — сложная задача, сопряженная с уменьшением пропускной способности системы. На практике как правило применяется именно ослабленная изоляция, и поэтому важно понимать, какие это влечет последствия.
Четвертое свойство ACID — долговечность — мы рассмотрим позже, в теме «Журналирование».
Page 4: Read Uncommitted
Должен предотвращать аномалии
- потерянное изменение:
- транзакция может перезаписать изменения других транзакций,
- зафиксированных после ее начала
- Не реализован в PostgreSQL
- работает как Read Committed
Комментарии преподавателя
Стандарт SQL допускает четыре уровня изоляции, определяемые в терминах аномалий, которые допускаются при конкурентном выполнении транзакций на этом уровне.
Самый слабый уровень — Read Uncommitted, который (как следует из названия) позволяет увидеть даже незафиксированные данные.
Согласно стандарту на этом уровне должна предотвращаться единственная аномалия:
● Потерянное изменение (lost update). Если после начала транзакции T1 другая транзакция T2 изменила и зафиксировала строки, транзакция T1 может перезаписать эти изменения.
Этот уровень вводился как требующий наименьших накладных расходов, но PostgreSQL может без потери эффективности работать на более строгом уровне. Поэтому в PostgreSQL такой уровень не реализован и говорить о нем мы больше не будем.
Page 5: Read Committed
Должен предотвращать аномалии
- потерянное изменение
- грязное чтение:
- запрос видит незафиксированные изменения других транзакций
- Реализация в PostgreSQL
- используется по умолчанию
Комментарии преподавателя
Каждый следующий уровень изоляции строже, чем предыдущий. Поэтому уровень Read Committed должен предотвращать не только потерянные изменения, но и еще одну аномалию:
● «Грязное» чтение (dirty read). Транзакция T1 может читать строки, измененные, но еще не зафиксированные, транзакцией T2. Отмена изменений (ROLLBACK) в T2 приведет к тому, что T1 прочитает данные, которых никогда не существовало.
Существует много других аномалий, которые допускаются на уровне Read Committed. Разработчик должен всегда помнить о возможных проблемах и при необходимости вручную использовать блокировки.
В PostgreSQL (как и во многих других СУБД) именно этот уровень изоляции используется по умолчанию — как компромисс между строгостью изоляции и эффективностью.
Заметим, что в PostgreSQL на уровне Read Committed можно потерять изменения — такой пример будет показан в демонстрации.
Page 6: Управление уровнем изоляции
Для демонстрации мы будем использовать отдельную базу данных для каждой темы.
Уровни изоляции посмотрим на примере с таблицей, представляющей состояние светофора:
Это будет пешеходный светофор с двумя лампочками:
Один способ установить уровень изоляции — команда SET TRANSACTION, выполненная в начале транзакции:
Проверить текущий уровень можно, посмотрев значение параметра:
А можно указать уровень прямо в команде BEGIN:
По умолчанию используется уровень Read Committed:
Page 7: Page 7
Так что если этот параметр не менялся, можно не указывать уровень явно.
Read Committed и грязное чтение
Попробуем прочитать «грязные» данные. В первой транзакции гасим красный свет:
Начнем второй сеанс.
В нем откроем еще одну транзакцию с тем же уровнем Read Committed.
Вторая транзакция не видит незафиксированных изменений. Отменим изменение.
Read Committed и чтение зафиксированных изменений
Мы проверили, что транзакция не видит незафиксированных изменений. Посмотрим, что будет при фиксации.
Page 8: Page 8
Пока не видно.
А теперь?
Итак, в режиме Read Committed операторы одной транзакции видят зафиксированные изменения других транзакций. Заметьте, что при этом запрос, выполненный повторно в той же транзакции, может выдать другой результат. Можно ли увидеть изменения, зафиксированные в процессе выполнения одного оператора? Проверим. Сейчас обе лампочки погашены. Запустим долгий запрос и, пока он работает, включим свет во втором сеансе:
Итак, если во время выполнения оператора другая транзакция успела зафиксировать изменения, то они не будут видны. Оператор видит данные в таком состоянии, в котором они находились на момент начала его выполнения. Однако если в запросе вызывается функция с категорией изменчивости volatile, выполняющая собственный запрос, то такой запрос внутри функции будет возвращать данные, не согласованные с данными основного запроса.
Повторим эксперимент, но теперь запрос будет использовать функцию:
Правильный вариант здесь — объявить функцию с категорией изменчивости stable.
Page 9: Page 9
Вывод: внимательно следите за категорией изменчивости функций на уровне изоляции Read Committed. Со значениями «по умолчанию» легко получить несогласованные данные.
Read Committed и потерянные изменения
Что происходит при попытке изменения одной и той же строки двумя транзакциями? Сейчас обе лампочки включены. Первая транзакция выключает красную лампочку, но пока не завершается.
Вторая транзакция видит, что обе лампочки горят…
… меняет состояние каждой лампочки…
… но зависает, ожидая завершения первой.
По окончании первой транзакции вторая смогла изменить данные, и мы ожидаем, что во втором сеансе обе лампочки будут выключены. Проверим.
Почему так получилось? Команда UPDATE во второй транзакции блокирует строки таблицы по очереди. Сначала блокируется зеленая лампочка и изменяется ее состояние, а затем команда ждет снятия блокировки красной лампочки первой транзакцией. При этом команда во второй транзакции не должна видеть изменений, сделанных после начала ее выполнения. С другой стороны, она не должна потерять изменения, зафиксированные другими транзакциями. Поэтому после снятия блокировки она перечитывает строку, которую пытается обновить.
Page 10: Page 10
В итоге, первая транзакция выключает красную лампочку, а вторая снова включает ее.
- В результате вторая транзакция смогла отработать успешно за счет того, что она видела несогласованные данные: часть — на один момент времени, часть — на другой. Но если изменение выполняется не в одной команде SQL, то обновление будет потеряно.
Первая транзакция переводит красную лампочку в мигающий режим. Строка при этом блокируется:
Во второй транзакции клиент видит, что красная лампочка горит…
… и выключает ее:
Вторая транзакция ждет завершения первой.
Первый сеанс ожидает увидеть, что красная лампочка мигает. Проверим:
В этом случае вторая транзакция записала свои изменения «поверх» изменений первой транзакции. На уровне Read Committed сервер не может это предотвратить, поскольку команда UPDATE фактически содержит предопределенную константу.
Page 11: Repeatable Read
Должен предотвращать аномалии
- потерянные изменения
- грязное чтение
- неповторяющееся чтение:
- повторное чтение строки вернет другие данные,
- если строка была изменена и зафиксирована другой транзакцией
- Реализация в PostgreSQL
- также не допускает фантомное чтение:
- повторный запрос по одному и тому же условию вернет иную выборку,
- если другая транзакция добавила и зафиксировала новые строки,
- удовлетворяющие этому условию
- для предотвращения аномалий транзакции могут обрываться
Комментарии преподавателя
Согласно стандарту, в дополнение к потерянным изменениям и грязным чтениям уровень изоляции Repeatable Read должен предотвращать аномалию, которую мы видели, когда рассматривали уровень Read Committed:
● Неповторяющееся чтение (non-repeatable read). После того как транзакция T1 прочитала строку, транзакция T2 изменила или удалила эту строку и зафиксировала изменения (COMMIT). При повторном чтении этой же строки транзакция T1 видит, что строка изменена или удалена.
Реализация PostgreSQL более строгая, чем того требует стандарт, и предотвращает аномалию
● Фантомное чтение (phantom read). Транзакция T1 прочитала набор строк по некоторому условию. Затем транзакция T2 добавила строки, также удовлетворяющие этому условию. Если транзакция T1 повторит запрос, она получит другую выборку строк.
На самом деле существуют и другие аномалии (не отраженные в стандарте), которые допускаются в PostgreSQL на уровне Repeatable Read.
От уровня Read Committed этот уровень изоляции отличается и тем, что на нем транзакция может быть оборвана, чтобы не допустить аномалию (такую транзакцию надо повторять). На уровне Read Committed этого не происходит никогда — если стоит выбор между корректностью и эффективностью, предпочтение всегда отдается эффективности.
Page 12: Repeatable Read и неповторяющееся чтение
Убедимся в отсутствии аномалии неповторяющегося чтения.
Какое значение получит теперь первая транзакция?
Повторное чтение измененной строки возвращает первоначальное значение.
Repeatable Read и фантомное чтение
Фантомные записи также не должны быть видны. Проверим это.
Действительно, транзакция не видит добавленной записи, удовлетворяющей первоначальному условию. Уровень изоляции Repeatable Read в PostgreSQL более строгий, чем того требует стандарт SQL.
Page 13: Repeatable Read и потерянные изменения
Уберем желтую лампочку.
Необходимость все время видеть ровно те же данные, что и в самом начале, не позволяет перечитывать измененную строку в случае обновления. Воспроизведем пример, который мы видели на уровне изоляции Read Committed. Сейчас красная лампочка включена.
Клиент запрашивает состояние красной лампочки…
…а затем меняет его на сервере:
Вторая транзакция ждет завершения первой.
Во второй транзакции получаем ошибку. Строка была изменена; обновить неактуальную версию невозможно (это будет потерянным изменением, что недопустимо), а увидеть актуальную версию тоже невозможно (это нарушило бы уровень изоляции).
Таким образом, потерянное обновление на уровне Repeatable Read не допускается.
Repeatable Read и другие аномалии
Можно ли быть уверенным в том, что следующая команда включит все лампочки?
Можно ли быть уверенным в том, что следующая команда выключит все лампочки?
Page 14: Page 14
Если одна транзакция включает лампочки, а другая — выключает, в каком состоянии останется таблица после одновременного выполнения двух этих транзакций? Включим красную лампочку и проверим.
Начальное состояние:
Первая транзакция включила зеленую лампочку, и теперь для нее все огни горят.
Вторая транзакция не видит этих, еще не зафиксированных, изменений и считает, что зеленый свет выключен. Поэтому она выключает красный и для нее все огни погашены.
Теперь обе транзакции фиксируют свои изменения…
И оказывается, что…
…одна лампочка включена, а другая — выключена. Это пример аномалии конкурентного доступа — несогласованная запись (write skew), — которая возможна, даже если нет грязного, неповторяющегося и фантомного чтений.
Page 15: Page 15
Page 16: Serializable
Должен предотвращать любые аномалии
- результат конкурентного выполнения совпадает с результатом
- выполнения транзакций в какой-либо последовательности
- Реализация в PostgreSQL
- для предотвращения аномалий транзакции могут обрываться
- для правильной работы уровень Serializable должен использоваться
- всеми транзакциями
- уровень не работает на физических репликах
Комментарии преподавателя
Полное отсутствие каких бы то ни было аномалий достигается, если команды, выполняемые в конкурентно работающих транзакциях, приводят к такому же результату, какой получился бы в случае последовательного — одна завершилась, следующая началась — выполнения этих транзакций (при каком-нибудь порядке выполнения).
В PostgreSQL этот уровень реализован и работает, если все транзакции в системе используют уровень Serializable.
Следует учитывать, что реализация имеет определенные ограничения:
● запросы не могут выполняться на физических репликах;
● транзакции могут обрываться чаще, чем это действительно необходимо (таким образом, страдает эффективность, поскольку оборванные транзакции приходится выполнять повторно).
Page 17: Serializable
На этом уровне транзакции могут положиться на то, что на их работу никто не повлияет.
Первая транзакция включила красную лампочку, для нее все огни горят.
Вторая транзакция не видит незафиксированных изменений: для нее красный свет еще выключен, и она выключает зеленый.
Для второй транзакции обе лампочки выключены:
Теперь обе транзакции фиксируют свои изменения…
И вторая транзакция получает ошибку. Действительно, при последовательном выполнении транзакций допустимо два результата: если сначала выполняется первая транзакция, а потом вторая, то все лампочки будут погашены; если сначала выполняется вторая транзакция, а потом первая, то все лампочки будут включены. «Промежуточный» вариант получить невозможно, поэтому выполнение одной из транзакций завершается ошибкой. Важный момент: чтобы уровень Serializable работал корректно, на этом уровне должны работать все транзакции. Если смешивать транзакции разных уровней, фактически Serializable будет вести себя, как Repeatable Read.
Page 18: Итоги: стандарт SQL
- неповторя-
- потерянные
- обновления
- грязное
- фантомное
- другие
- аномалии
- ющееся
- чтение
- чтение
- чтение
- Read Uncommitted ― да да да да
- Read Committed ― ― да да да
- Repeatable Read ― ― ― да да
- Serializable ― ― ― ― ―
Комментарии преподавателя
Подытожим информацию.
В стандарте SQL определены четыре уровня изоляции транзакций: Read Uncommitted, Read Committed, Repeatable Read, Serializable (по умолчанию).
Таблица показывает соответствие между уровнями изоляции и теми аномалиями, которые они могут допускать.
Отметим, что для обеспечения уровня изоляции Serializable недостаточно исключить три аномалии, определенные в стандарте.
Page 19: Итоги: PostgreSQL
- неповторя-
- потерянные
- обновления
- грязное
- фантомное
- другие
- аномалии
- ющееся
- чтение
- чтение
- чтение
- Read Uncommitted
- Read Committed * ― да да да
- Repeatable Read ― ― ― ― да
- Serializable ― ― ― ― ―
- * предотвращается не всегда
Комментарии преподавателя
Реальные СУБД, и PostgreSQL в том числе, не реализуют требования стандарта буквально (которые были сформулированы в те времена, когда вопросы изоляции еще не были изучены теоретиками). Названия уровней изоляции сохраняются, но реализация их строже, чем это требует стандарт.
В PostgreSQL используется изоляция на основе снимков данных (Snapshot Isolation) в сочетании с многоверсионностью. Это определяет следующие свойства:
● Грязное чтение не допускается вообще, причем без ущерба для производительности.
● Уровень Read Committed используется по умолчанию и применяется в большинстве систем. Зачастую он требует ручной установки блокировок, чтобы обеспечить корректность.
● Уровень Repeatable Read не допускает не только неповторяемое чтение, но и фантомное чтение (хотя и не обеспечивает полную изоляцию). Этот уровень удобен для отчетов, поскольку позволяет нескольким запросам видеть согласованные данные, а только читающие транзакции никогда не обрываются.
● Уровень Serializable также полностью реализован, но имеет определенные ограничения.
https://postgrespro.ru/docs/postgresql/16/transaction-iso
Page 20: Практика
- Создайте пустую таблицу. Проверьте, что на уровне изоляции Read Committed не предотвращается аномалия фантомного чтения.
- Откройте транзакцию с уровнем изоляции Repeatable Read (и пока не выполняйте в ней никаких команд). В другом сеансе удалите строку из таблицы. Видна ли удаленная строка в открытой транзакции? Будет ли видна удаленная строка, если после открытия транзакции выполнить запрос к базе данных, не обращаясь к таблицам?
- Убедитесь, что команда DROP TABLE транзакционна.
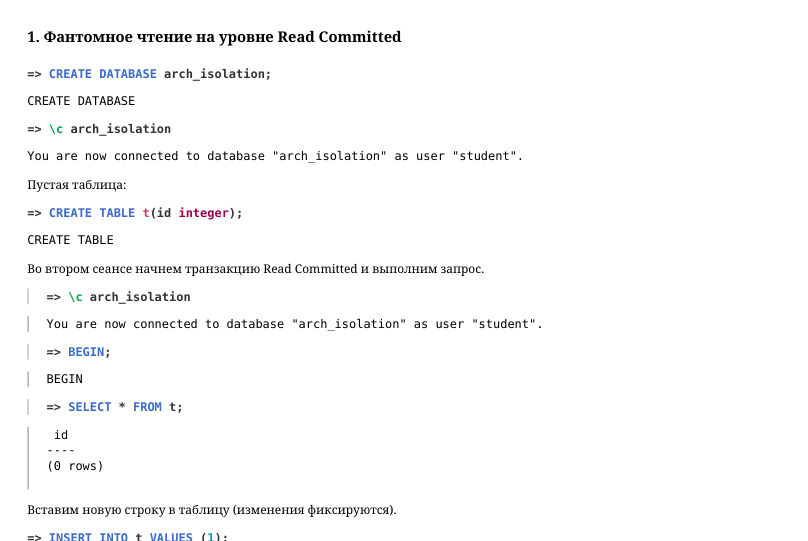
Page 21: 1. Фантомное чтение на уровне Read Committed
 {#source-figure-021 caption=“Source slide page 21: 1. Фантомное чтение на уровне Read Committed”}
Пустая таблица:
Во втором сеансе начнем транзакцию Read Committed и выполним запрос.
Вставим новую строку в таблицу (изменения фиксируются).
Транзакция Read Committed видит добавленную строку. Отличие от аномалии неповторяющегося чтения (при которой транзакция видит зафиксированные изменения в уже существовавших строках) состоит в том, что здесь видны строки, которых не было раньше.
2. На какой момент времени видны данные?
Открываем транзакцию Repeatable Read:
Добавляем строку в таблицу (изменения фиксируются):
Проверяем содержимое таблицы в открытой транзакции:
Page 22: Page 22
Почему видны обе строки? Дело в том, что транзакции Repeatable Read (и Serializable) видят данные на момент начала первой команды, а не на момент выполнения BEGIN. Если сейчас добавить в таблицу еще строк, результат повторной выборки уже не изменится.
3. Транзакционность DDL
Откроем транзакцию и удалим таблицу t.
Таблица удалена. Теперь откатим транзакцию:
Удаление отменено, таблица опять существует.
02 Занятие 02: Многоверсионность / Страницы и версии строк
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_02_mvcc_tuples.html Archive: DBA2-handouts-16.zip Страниц PDF: 27
Page 1: Многоверсионность / Страницы и версии строк
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Структура страниц и версий строк
- Как работают операции над данными
- Вложенные транзакции
Page 3: Структура страниц
 {#source-figure-003 caption=“Source slide page 3: Структура страниц”}
Комментарии преподавателя
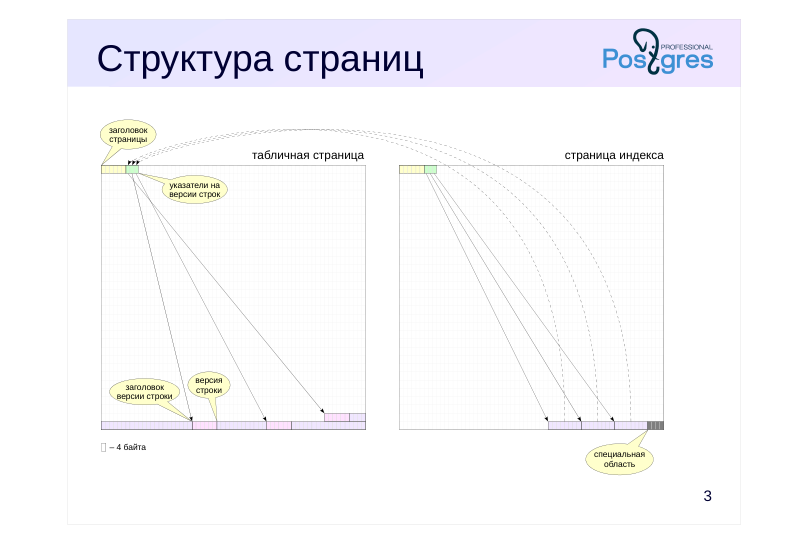
Размер страницы составляет 8 Кбайт. Это значение можно увеличить (вплоть до 32 Кбайт), но только при сборке. И таблицы, и индексы, и большинство других объектов, которые в PostgreSQL обозначаются термином relation, используют одинаковую структуру страниц, чтобы пользоваться общим буферным кешем. В начале страницы идет заголовок (24 байта), содержащий общие сведения о странице и размер ее областей: указателей, свободного пространства, версий строк и специальной области.
Версии строк содержат те самые данные, которые мы храним в таблицах и других объектах БД, плюс заголовок. «Версия строки» по-английски называется tuple; иногда мы будем говорить просто «строка».
Указатели имеют фиксированный размер (4 байта) и составляют массив, позиция в котором определяет идентификатор строки (tuple id, tid). Указатели ссылаются на версии строк (tuple), расположенные в конце блока. Такая косвенная адресация удобна тем, что во-первых, позволяет найти нужную строку, не перебирая все содержимое блока (строки имеют разную длину), а во-вторых, позволяет перемещать строку внутри блока, не ломая ссылки из индексов
Между указателями и версиями строк находится свободное место.
Для некоторых типов индексов нужно хранить служебную информацию; для этого может использоваться нулевая страница, а также специальная область в конце каждой страницы.
https://postgrespro.ru/docs/postgresql/16/storage-page-layout
Page 4: Формат данных
 {#source-figure-004 caption=“Source slide page 4: Формат данных”}
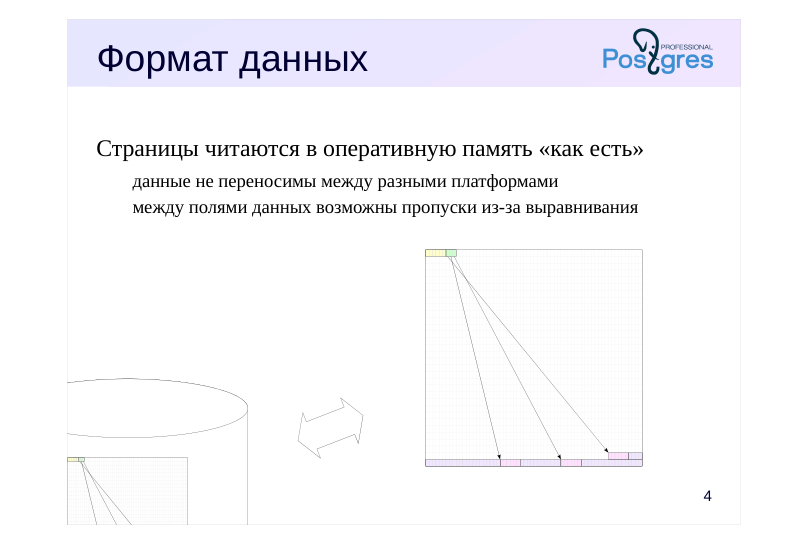
Страницы читаются в оперативную память «как есть»
- данные не переносимы между разными платформами
- между полями данных возможны пропуски из-за выравнивания
Комментарии преподавателя
Формат данных на диске полностью совпадает с представлением данных в оперативной памяти. Страница записывается в файл и читается в буферный кеш «как есть», без преобразований.
Поэтому файлы данных на одной платформе (разрядность, порядок байтов и т. п.) оказываются несовместимыми с другими платформами.
Кроме того, многие архитектуры предусматривают выравнивание данных по границам машинных слов. Например, на 32-битной системе x86 целые числа (тип integer, занимает 4 байта) будут выровнены по границе 4-байтных слов, как и числа с плавающей точкой двойной точности (тип double precision, 8 байт). А в 64-битной системе значения double precision будут выровнены по границе 8-байтных слов.
Из-за этого размер табличной строки зависит от порядка расположения и типов полей. Обычно этот эффект не сильно заметен, но в некоторых случаях он может привести к существенному увеличению размера. Например, если располагать поля типов boolean и integer вперемежку, между ними, как правило, будет пропадать 3 байта.
https://pgconf.ru/rmedia/2016/05/13/tuple-internals-ru.pdf
Page 5: Структура страниц
Для изучения структуры и содержания страниц предназначено расширение pageinspect.
Границы областей страницы записаны в ее заголовке. Возьмем для примера нулевую страницу одной из таблиц системного каталога:
Области занимают следующие диапазоны адресов: 0 — начало заголовка страницы и указатели на версии строк, lower — начало свободного места, upper — начало данных (версий строк), special — начало спец. данных (только для индексов), pagesize — конец страницы.
Page 6: Указатели на версии строк
 {#source-figure-006 caption=“Source slide page 6: Указатели на версии строк”}
Комментарии преподавателя
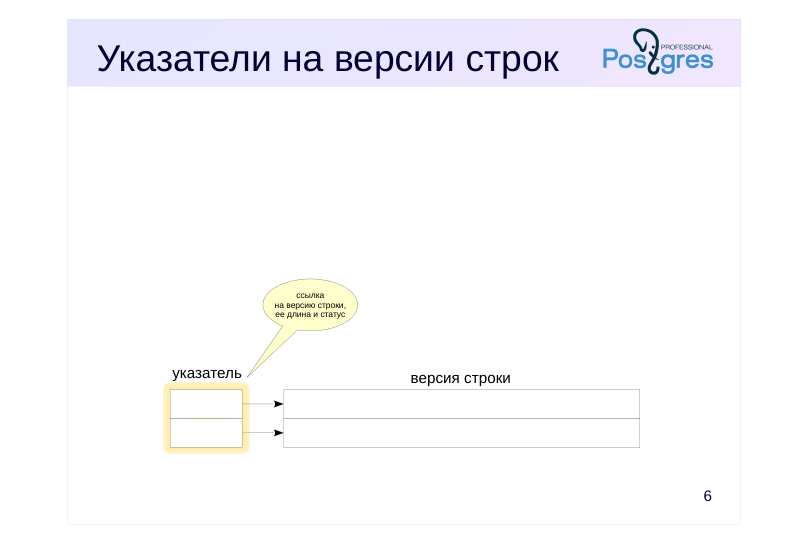
Страница содержит массив указателей на версии строк.
Каждый указатель (занимающий 4 байта) содержит:
● ссылку на версию строки;
● длину этой версии строки (для удобства);
● несколько бит, определяющих статус версии строки.
Page 7: Версии строк в таблице
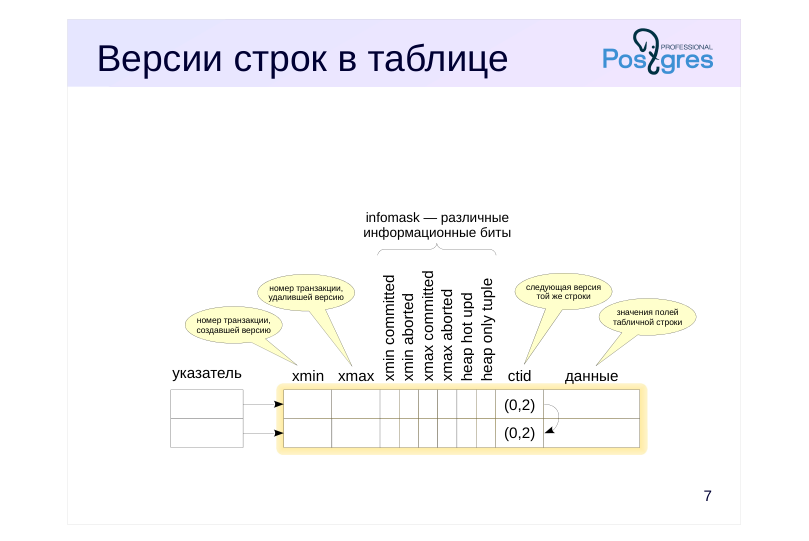 {#source-figure-007 caption=“Source slide page 7: Версии строк в таблице”}
Комментарии преподавателя
Версии строк (tuples) в табличных страницах (heap pages) кроме собственно данных также имеют заголовок. Этот заголовок, помимо прочего, содержит следующие важные поля:
● xmin и xmax определяют видимость данной версии строки в терминах начального и конечного номеров транзакций. Номера транзакций (TransactionId или xid) последовательно выбираются для транзакций из глобального счетчика, который используется всеми базами данных в рамках кластера PostgreSQL.
● infomask содержит ряд битов, определяющих свойства данной версии. На рисунке показаны основные из них, но далеко не все. Часть показанных битов будет рассмотрена в этой теме, часть — в других темах этого модуля.
● ctid является ссылкой на следующую, более новую, версию той же строки. У самой новой, актуальной, версии строки ctid ссылается на саму эту версию. Такие ссылки используются не всегда, мы рассмотрим их в теме «HOT-обновления и самоочистка».
Заголовок версии строки на табличной странице составляет 23 байта (или больше: в него включается битовая карта неопределенных значений).
Напомним, что каждая версия строки всегда целиком помещается внутрь одной страницы. Если версия строки имеет большой размер, PostgreSQL попробует сжать часть полей или вынести часть полей во внешнее TOAST-хранилище (это рассматривается в модуле «Организация данных» курса DBA1).
Page 8: ctid ключ Индексные записи
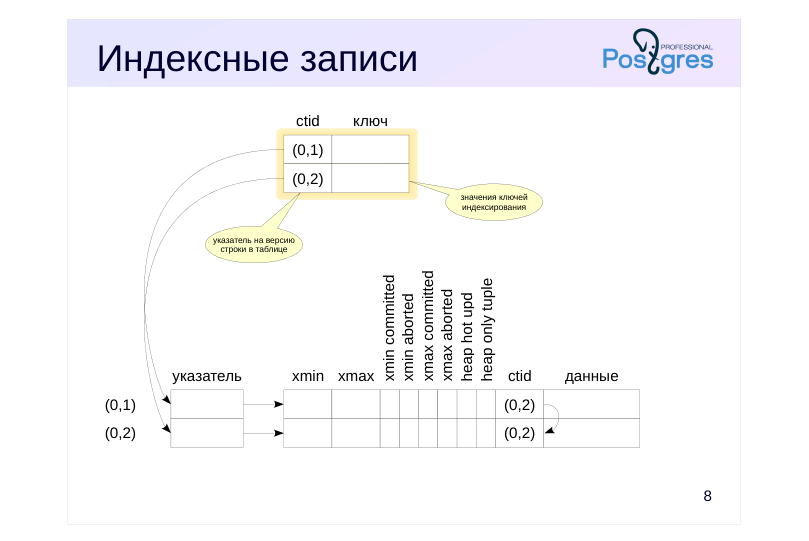 {#source-figure-008 caption=“Source slide page 8: ctid ключ Индексные записи”}
Комментарии преподавателя
Информация в индексной странице сильно зависит от типа индекса. И даже у одного типа индекса бывают разные виды страниц. Например, у B-дерева есть страница с метаданными и «обычные» страницы.
Тем не менее, обычно в странице имеется массив указателей и строки (так же, как и в табличной странице). Во избежание путаницы мы будем называть индексные строки записями. Кроме того, в конце индексной страницы отводится место под специальные данные.
Сами индексные записи тоже могут иметь очень разную структуру в зависимости от типа индекса. Например, для B-дерева записи, относящиеся к листовым страницам, содержат значение ключа индексирования и идентификатор (ctid) строки таблицы (подробно структура B-дерева и другие индексы разбираются в учебном курсе QPT «Оптимизация запросов»).
Устройство индексов других типов может быть разным, но, как правило, страницы индекса все равно содержат ссылки на версии строк.
Идентификаторы ctid имеют вид (x,y): здесь x — номер страницы, y — порядковый номер указателя в массиве. Для удобства мы будем показывать их слева от указателей на табличные версии строк.
Никакой индекс не содержит информацию о версионности (в нем нет полей xmin и xmax). Прочитав только индексную запись, невозможно определить видимость строки, на которую она ссылается: приходится обращаться к табличной странице или карте видимости.
На рисунке показаны записи листовых страниц обычного индекса — B-дерева. Для простоты указатели на эти записи опущены.
Page 9: Вставка
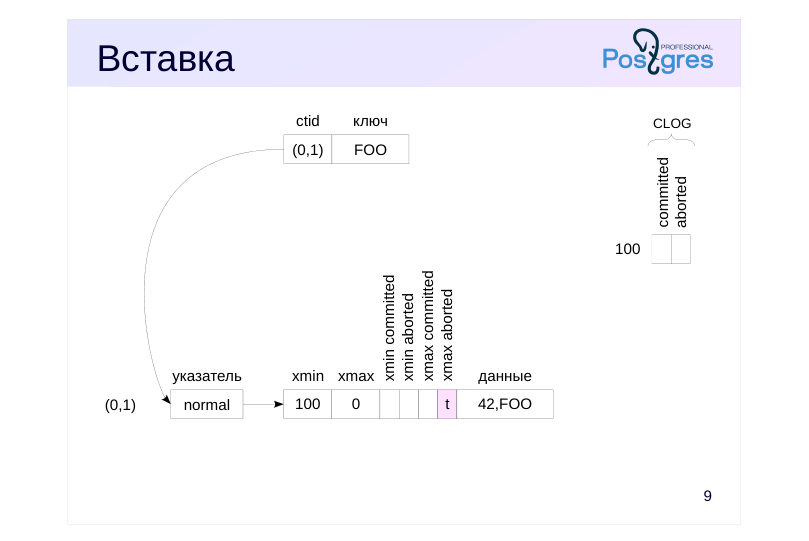 {#source-figure-009 caption=“Source slide page 9: Вставка”}
Комментарии преподавателя
Рассмотрим, как выполняются операции со строками на низком уровне, и начнем со вставки.
В нашем примере предполагается таблица с двумя столбцами (числовой и текстовый); по текстовому полю создан индекс B-дерево.
При вставке строки в табличной странице появится указатель с номером 1, ссылающийся на первую и единственную версию строки. В версии строки поле xmin заполнено номером текущей транзакции (100 в нашем примере).
В журнале статусов транзакций (CLOG) хранятся состояния всех транзакций (начиная с некоторой), для каждой транзакции отведено два бита. Эти данные хранятся в каталоге PGDATA/pg_xact, а несколько наиболее актуальных страниц кешируются в разделяемой памяти сервера. Поскольку в нашем примере транзакция 100 еще активна, оба бита пока сброшены.
В индексной странице также создается указатель с номером 1, который ссылается на индексную запись, которая, в свою очередь, ссылается на первую версию строки в табличной странице. Чтобы не загромождать рисунок, указатель на индексную запись не показан.
Поле xmax заполнено фиктивным номером 0, поскольку данная версия строки не удалена и является актуальной. Транзакции не будут обращать внимание на этот номер, поскольку установлен бит xmax aborted.
Page 10: Вставка
Создадим таблицу и индекс:
Для удобства создадим представление, которое с помощью расширения pageinspect покажет интересующую нас информацию о версиях строк из нулевой страницы таблицы:
Также создадим представление, чтобы заглянуть в индекс. Нулевая страница индекса содержит метаинформацию, поэтому смотрим в первую:
Вставим одну строку, предварительно начав транзакцию.
Вот номер нашей текущей транзакции и ее статус:
Вот что содержится в табличной странице:
Page 11: Page 11
Похожую, но существенно менее детальную информацию можно получить и из самой таблицы, используя псевдостолбцы ctid, xmin и xmax:
В индексной странице видим один указатель на единственную строку таблицы:
Page 12: Фиксация изменений
 {#source-figure-012 caption=“Source slide page 12: Фиксация изменений”}
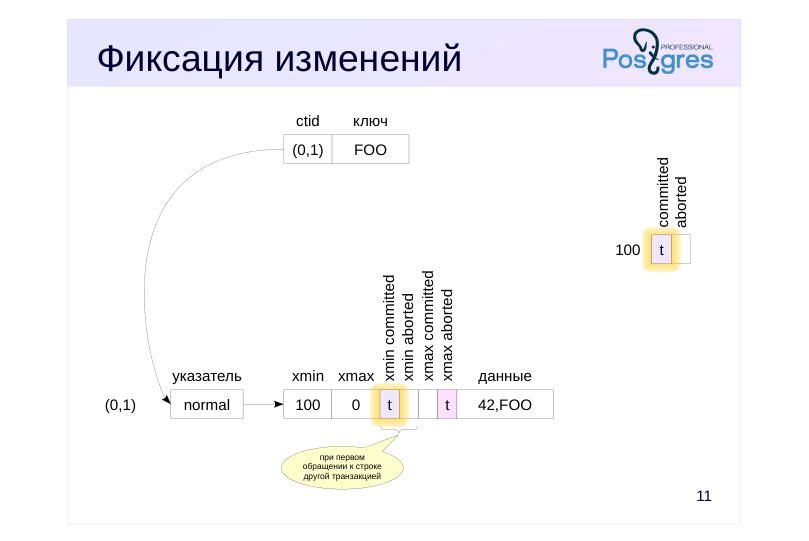
Комментарии преподавателя
При фиксации изменений в CLOG для данной транзакции выставляется признак committed. Это, по сути, единственная операция (не считая журнала упреждающей записи), которая необходима.
Когда какая-либо другая транзакция обратится к этой версии строки, ей придется ответить на вопросы:
завершилась ли транзакция 100 (надо проверить список активных транзакций — такая структура поддерживается в общей памяти сервера),
а если завершилась, то фиксацией или отменой (свериться с CLOG).
Поскольку выполнять проверку по CLOG каждый раз накладно, выясненный однажды статус транзакции записывается в биты-подсказки xmin committed и xmin aborted. Если один из этих битов установлен, то состояние транзакции xmin считается известным и следующей транзакции уже не придется обращаться к CLOG.
Почему эти биты не устанавливаются той транзакцией, которая выполняла вставку? В момент, когда транзакция фиксируется или отменяется, уже непонятно, какие именно строки в каких именно страницах транзакция успела поменять. Кроме того, часть этих страниц может быть вытеснена из буферного кеша на диск; читать их заново, чтобы изменить биты, означало бы существенно замедлить фиксацию.
Обратная сторона состоит в том, что любая транзакция (даже выполняющая простое чтение — SELECT) может загрязнить данные в буферном кеше и породить новые журнальные записи.
Page 13: Фиксация изменений
Выполним фиксацию:
Что изменилось в странице?
Ничего, так как единственная операция, которая выполняется при фиксации — запись статуса транзакции в CLOG.
Информация о статусах транзакций хранится в подкаталоге pg_xact каталога PGDATA и кешируется в общей памяти. Начиная с PostgreSQL 13, статистику использования кешей, в том числе кеша статусов транзакций, показывает представление pg_stat_slru:
Транзакция, первой обратившаяся к странице, должна будет определить статус транзакции xmin. Этот статус будет записан в информационные биты:
Page 14: Удаление
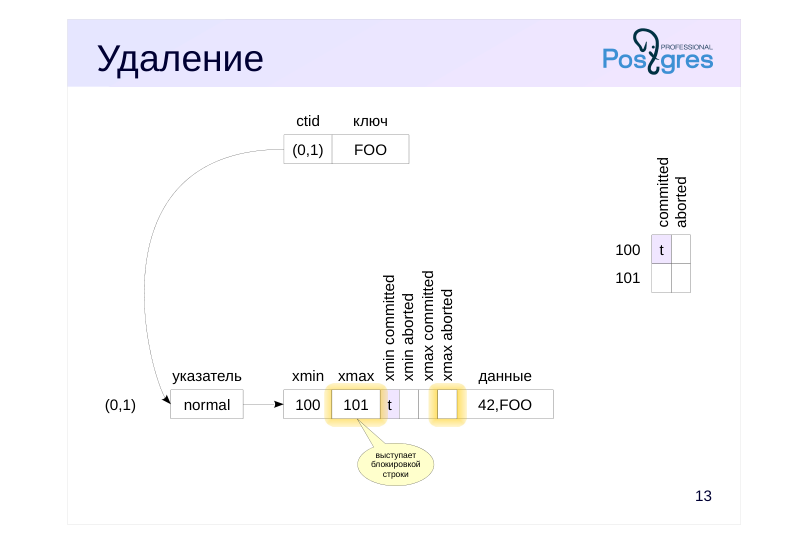 {#source-figure-014 caption=“Source slide page 14: Удаление”}
Комментарии преподавателя
При удалении строки в поле xmax текущей версии записывается номер удаляющей транзакции, а бит xmax aborted сбрасывается. Больше ничего не происходит.
Заметим, что установленное значение xmax, соответствующее активной транзакции (что определяется другими транзакциями по списку активных), выступает в качестве признака блокировки. Если другая транзакция намерена обновить или удалить эту строку, она будет вынуждена дождаться завершения транзакции xmax.
Подробнее блокировки рассматриваются в одноименном модуле. Пока отметим только, что число блокировок строк ничем не ограничено. Они не занимают место в оперативной памяти и производительность системы не страдает от их количества (разумеется, за исключением того, что первый процесс, обратившийся к странице, должен будет проставить биты-подсказки).
Page 15: Удаление
Теперь удалим строку.
Номер транзакции записался в поле xmax:
Page 16: Отмена изменений
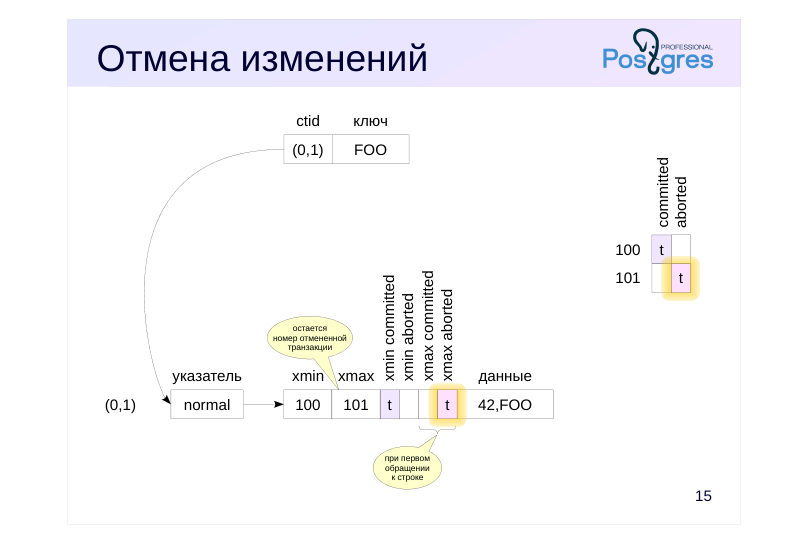 {#source-figure-016 caption=“Source slide page 16: Отмена изменений”}
Комментарии преподавателя
Отмена изменений работает аналогично фиксации, только в CLOG для транзакции выставляется бит aborted. Отмена выполняется так же быстро, как и фиксация — не требуется выполнять откат выполненных действий.
Номер прерванной транзакции остается в поле xmax — его можно было бы стереть, но в этом нет смысла. При обращении к странице будет проверен статус и в версию строки будет установлен бит подсказки xmax aborted. Это будет означать, что на поле xmax смотреть не нужно.
Page 17: Отмена изменений
При обрыве транзакции номер xmax остается в заголовке.
А при первом обращении к странице выставляется соответствующий бит:
Page 18: Обновление
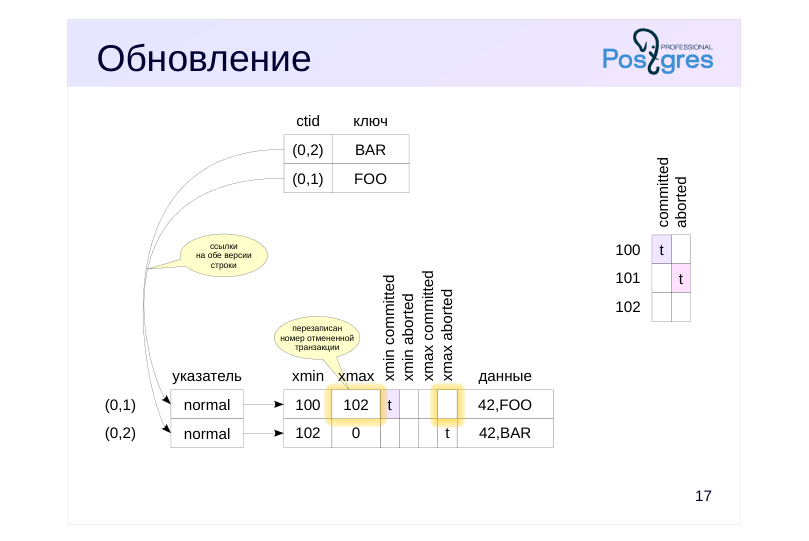 {#source-figure-018 caption=“Source slide page 18: Обновление”}
Комментарии преподавателя
Обновление работает так, как будто сначала выполнялось удаление старой версии строки, а затем вставка новой.
Старая версия помечается номером текущей транзакции в поле xmax. Обратите внимание, что новое значение 102 записалось поверх старого 101, так как транзакция 101 была отменена. Кроме того, биты xmax committed и xmax aborted старой версии строки сброшены, так как статус текущей транзакции еще не известен.
В индексной странице появляется второй указатель и вторая запись, ссылающаяся на вторую версию в табличной странице.
Так же, как и при удалении, значение xmax в первой версии строки служит признаком того, что строка заблокирована.
Page 19: Обновление
Теперь проверим обновление.
Запрос выдает одну строку (новую версию):
Но в странице мы видим обе версии. Причем новый номер транзакции записался на место старого (поскольку старая транзакция была отменена).
При этом в индексной странице обнаруживаем указатели на обе версии:
Индексные записи внутри страницы упорядочены по значению ключа. Поэтому первой идет запись с ключом BAR (ссылается на версию (0,2)), а второй — запись с ключом FOO (ссылается на версию (0,1)).
Page 20: Точка сохранения
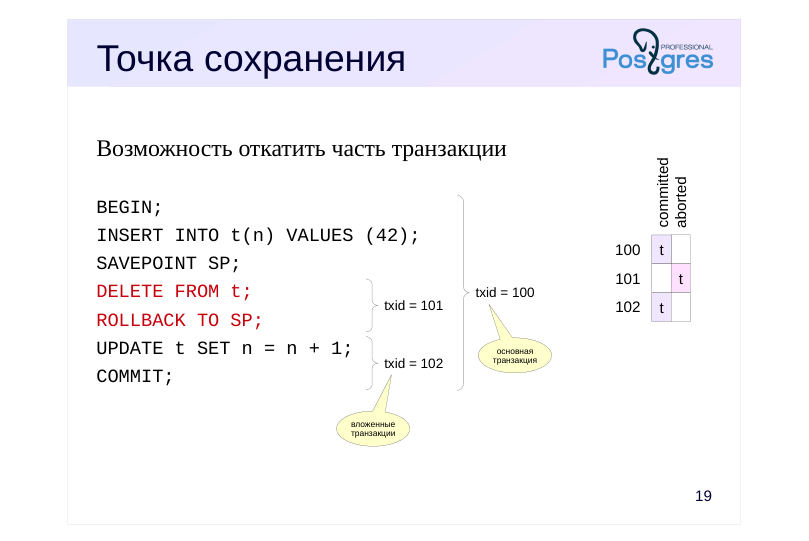 {#source-figure-020 caption=“Source slide page 20: Точка сохранения”}
Возможность откатить часть транзакции
Комментарии преподавателя
Тонкий момент представляет функционал точек сохранения, позволяющий отменить часть операций текущей транзакции. Это не укладывается в приведенную выше схему, поскольку физически никакие данные не откатываются, а лишь изменяется статус всей транзакции целиком.
Поэтому транзакция с точкой сохранения состоит из отдельных вложенных (не путать с автономными!) транзакций (subtransactions), статусом которых можно управлять отдельно.
Page 21: Вложенные транзакции
Собственный номер и статус в CLOG
- конечный статус зависит от статуса основной транзакции
- Информация о вложенности сохраняется на диске
- каталог PGDATA/pg_subtrans
- данные кешируются в буферах общей памяти (аналогично CLOG)
- Примеры использования
- точка сохранения SAVEPOINT
- обработка исключений в PL/pgSQL (EXCEPTION)
- режим psql ON_ERROR_ROLLBACK = on/interactive
Комментарии преподавателя
Вложенные транзакции имеют свой номер (бóльший, чем номер основной транзакции). Статус вложенных транзакций записывается обычным образом в CLOG, однако финальный статус зависит от статуса основной транзакции: если она отменена, то отменяются также и все вложенные транзакции.
Информация о вложенности транзакций хранится в каталоге PGDATA/pg_subtrans. Обращение к файлам происходит через буферы в общей памяти сервера, организованные так же, как и буферы CLOG.
Вложенные транзакции нельзя использовать явно, то есть нельзя начать новую транзакцию, не завершив текущую. Этот механизм задействуется неявно при использовании точек сохранения, при обработке исключений PL/pgSQL и т. п.
Особенный интерес представляет режим ON_ERROR_ROLLBACK в psql, при включении которого транзакция, выполнившая ошибочную операцию, не прерывается, а продолжает работать. Почему этот режим не включен по умолчанию? Дело в том, что ошибка может произойти где-то в середине выполнения оператора, и таким образом нарушится атомарность выполнения оператора. Единственный способ отменить изменения, уже сделанные этим оператором, не трогая остальные изменения — использовать вложенные транзакции. Поэтому режим ON_ERROR_ROLLBACK фактически ставит перед каждой командой неявную точку сохранения. А это чревато существенными накладными расходами.
Page 22: Точки сохранения и вложенные транзакции
Опустошим таблицу (при этом опустошаются файлы таблицы и индекса):
Начинаем транзакцию и вставляем строку.
Ставим точку сохранения и удаляем строку.
Обратите внимание: функция pg_current_xact_id() выдает номер основной, а не вложенной, транзакции:
Откатимся к точке сохранения. Версии строк в странице остаются на месте, но изменится статус вложенной транзакции:
Запрос к таблице снова покажет строку — ее удаление было отменено:
Для дальнейших изменений создается новая вложенная транзакция. Ее номер будет записан в поле xmax первой версии строки вместо номера отмененной вложенной транзакции 754 и в поле xmin новой версии:
Page 23: Page 23
Фиксируем изменения. При этом в таблице, как и прежде, ничего не меняется:
А в CLOG основная транзакция и все вложенные, которые еще не завершены, получают статус committed:
Информация о вложенности транзакций хранится в подкаталоге pg_subtrans каталога PGDATA. Она кешируется в общей памяти, как и информация о статусах транзакций:
Page 24: Итоги
В табличных страницах может храниться несколько версий одной и той же строки, ограниченных номерами транзакций xmin и xmax
- В индексных записях нет информации о версионности
- Фиксация и откат выполняются одинаково быстро
- Для точек сохранения используются вложенные транзакции
Page 25: Практика
- Создайте таблицу и вставьте в нее одну строку. Затем дважды обновите эту строку и удалите ее. Сколько версий строк находится сейчас в таблице? Проверьте, используя расширение pageinspect.
- Определите, в какой странице находится строка таблицы pg_class, относящаяся к самой таблице pg_class. Сколько актуальных версий строк находится в той же странице?
- Включите в psql параметр ON_ERROR_ROLLBACK и убедитесь, что этот режим использует вложенные транзакции.
Page 26: 1. Версии строк
Создаем расширение и таблицу.
Вставляем строку, обновляем ее и затем удаляем:
В таблице ничего нет:
Проверяем версии в странице:
2. Версии строк на определенной странице
Номер страницы содержится в первой компоненте значения ctid:
К сожалению, тип данных tid не позволяет непосредственно получить номер страницы, но можно, например,
Page 27: Page 27
воспользоваться приведением к типу point:
Количество строк на той же странице:
3. Режим ON\_ERROR\_ROLLBACK
Включим режим:
Начнем транзакцию и вставим строку.
Вставим еще одну строку.
Каждая команда происходит в отдельной вложенной транзакции, что и требовалось установить.
Установленный режим будет действовать вплоть до завершения сеанса psql. А чтобы эта настройка не помешала дальнейшей работе в этом же сеансе, вернем прежний режим:
03 Занятие 03: Многоверсионность / Снимки данных
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_03_mvcc_snapshots.html Archive: DBA2-handouts-16.zip Страниц PDF: 31
Page 1: Многоверсионность / Снимки данных
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Видимость версий строк
- Снимок данных
- Виртуальный номер транзакции
- Горизонт транзакции и базы данных
- Экспорт снимка
Page 3: Снимок
Дает согласованную картину данных на момент времени
- видны только зафиксированные на этот момент данные
- Создается:
снимок
- Read Committed —
- в начале каждого оператора
- Repeatable Read, Serializable —
- в начале первого оператора транзакции
- xid
Комментарии преподавателя
В теме «Страницы и версии строк» мы видели, что в страницах данных физически может находиться несколько версий одной и той же строки.
Транзакции работают со снимком данных, который определяет, какие версии должны быть видны, а какие — нет, чтобы обеспечить согласованную картину данных на определенный момент времени (на момент создания снимка — показан на рисунке синим цветом).
Согласованность здесь понимается в обычном ACID-смысле: данные должны быть корректны, что, по сути, означает, что видеть нужно только те данные, которые были зафиксированы на момент создания снимка. Это полностью исключает аномалию грязного чтения на любом уровне изоляции.
На уровне изоляции Read Committed снимок создается в начале каждого оператора транзакции. Снимок активен, пока выполняется оператор. Таким образом каждый оператор видит согласованные данные, но если между двумя операторами другие транзакции зафиксируют свои изменения, возможны неповторяемое и фантомное чтения.
На уровне Repeatable Read (и Serializable) снимок создается один раз в начале первого оператора транзакции. Такой снимок остается активным до самого конца транзакции. В этом случае неповторяемое и фантомное чтения исключаются.
Page 4: Видимость версий строк
Видимость версии строки ограничена xmin и xmax
- Версия попадает в снимок, когда
- изменения транзакции xmin видны для снимка,
- изменения транзакции xmax не видны для снимка
- Изменения транзакции видны, когда
- либо это та же самая транзакция, что создала снимок,
- либо она завершилась фиксацией до момента создания снимка
- Отдельные правила для видимости собственных изменений
- учитывается порядковый номер операции в транзакции (cmin/cmax)
Комментарии преподавателя
Снимок данных не является физической копией версий строк, принадлежность версии строки к снимку определяют правила видимости.
Будет или нет данная версия строки видна в снимке, определяется двумя полями ее заголовка — xmin и xmax, — то есть номерами создавшей и удалившей транзакций. Интервалы для разных версий одной строки не пересекаются, поэтому строка таблицы представлена в любом снимке максимум одной своей версией.
Точные правила видимости довольно сложны и учитывают различные «крайние» случаи. Чуть упрощая, можно сказать, что версия строки видна, когда в снимке видны изменения, сделанные транзакцией xmin, и не видны изменения, сделанные транзакцией xmax. Иными словами, создание версии строки должно быть видно, а удаление (если оно было) — нет.
В свою очередь, изменения транзакции видны в снимке, если либо это та же самая транзакция, что создала снимок (она сама видит свои же изменения), либо транзакция была зафиксирована до создания снимка.
Несколько усложняет картину случай определения видимости собственных изменений транзакции. Здесь может потребоваться видеть только часть таких изменений. Например, курсор, открытый в определенный момент, ни при каком уровне изоляции не должен увидеть изменений, сделанных после этого момента. Для этого в заголовке версии строки есть специальное поле (псевдостолбцы cmin и cmax), показывающее номер операции внутри транзакции, и этот номер тоже принимается во внимание.
Page 5: Видимость версий строк
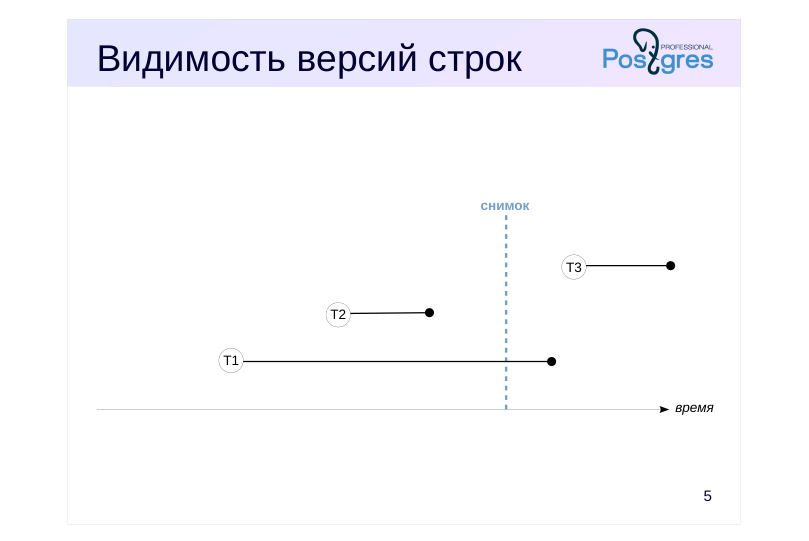 {#source-figure-005 caption=“Source slide page 5: Видимость версий строк”}
Комментарии преподавателя
Рассмотрим, как это работает, на простом примере.
На рисунке синим цветом отмечен момент создания снимка. Черные линии показывают транзакции от момента начала до момента фиксации (оборванные транзакции никогда не учитываются снимком).
В данном случае в снимке должны быть видны только изменения, сделанные транзакцией T2, поскольку только она была зафиксирована до момента создания снимка.
Изменения транзакции T1 не должны быть видны, поскольку на момент создания снимка она еще не была зафиксирована. А изменения транзакции T3 не должны быть видны, поскольку она еще не началась в момент создания снимка.
Page 6: Видимость версий строк
 {#source-figure-006 caption=“Source slide page 6: Видимость версий строк”}
Воспроизведем ситуацию, показанную на слайде. Каждая из трех транзакций будет добавлять новую строку в таблицу.
Первая транзакция (не завершится до создания снимка):
Вторая транзакция (завершается сразу):
Теперь создаем снимок в транзакции в отдельном сеансе.
И завершаем первую транзакцию после того, как создан снимок:
Page 7: Page 7
 {#source-figure-007 caption=“Source slide page 7: Page 7”}
Третья транзакция начинается после создания снимка:
Очевидно, что в нашем снимке видна одна строка:
Вопрос в том, как это понимает PostgreSQL.
Page 8: Видимость версий строк
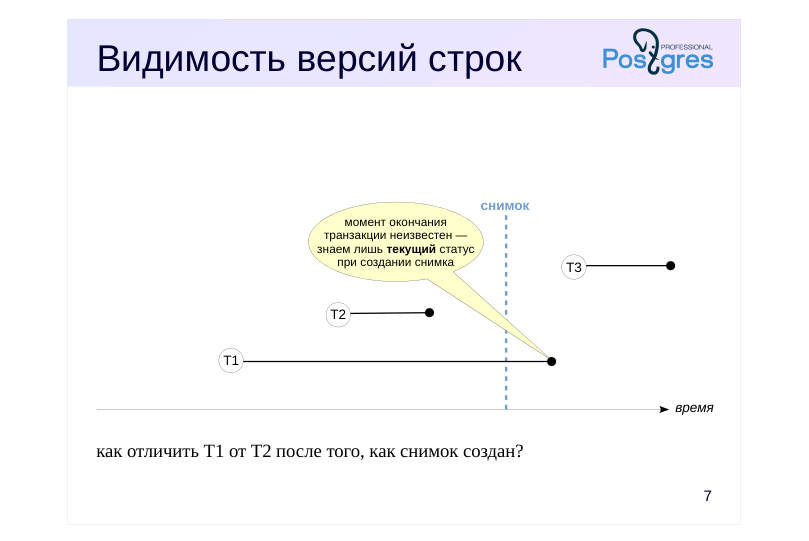 {#source-figure-008 caption=“Source slide page 8: Видимость версий строк”}
как отличить T1 от T2 после того, как снимок создан?
Комментарии преподавателя
Сложность реализации состоит в том, что нам известен только момент начала транзакции. Он определяется номером транзакции (xid), с которым можно сравнить номер xmin или xmax версии строки. Но момент завершения транзакции нигде не записывается. Все, что мы можем узнать — это текущий статус транзакций.
То есть после того, как транзакция T1 завершится фиксацией, она ничем не будет отличаться от транзакции T2: нет способа выяснить, что одна из них была зафиксирована до создания снимка, а другая — после.
Поскольку историческая информация об активности транзакций нигде не хранится, снимок можно создать только в текущий момент. Нельзя, например, создать снимок, показывающий согласованные данные по состоянию на пять минут назад, даже если все необходимые версии строк существуют в табличных страницах.
Page 9: Снимок данных
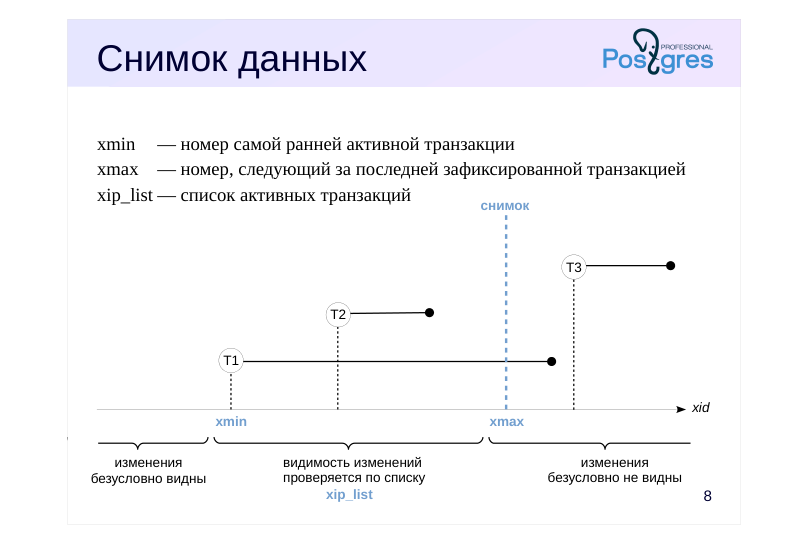 {#source-figure-009 caption=“Source slide page 9: Снимок данных”}
- xmin — номер самой ранней активной транзакции xmax — номер, следующий за последней зафиксированной транзакцией xip_list — список активных транзакций
Комментарии преподавателя
В момент создания снимка в локальной памяти обслуживающего процесса запоминаются значения, которые и определяют снимок:
● xmin — нижняя граница снимка, в качестве которой выступает номер самой ранней активной транзакции.
Все транзакции с меньшими номерами либо зафиксированы, и тогда их изменения безусловно видны в снимке, либо отменены, и тогда изменения игнорируются.
● xmax — верхняя граница снимка, в качестве которой берется номер, следующий за номером последней зафиксированной транзакции. Верхняя граница определяет момент, в который был сделан снимок. Обратите внимание, что момент задается не временем (как было условно показано на предыдущих слайдах), а увеличивающимися номерами транзакций.
Все транзакции с номерами, большими или равными xmax, в момент создания снимка заведомо не были зафиксированы — они либо были активны, либо отменены, либо еще не начались.
● xip_list (xid-in-progress list) — список активных транзакций.
Этот список используется для того, чтобы не учитывать в снимке изменения транзакций, которые уже завершились, но в момент создания снимка еще были активны.
Информацию о снимке можно получить с помощью функции pg_current_snapshot() и нескольких других, см. https://postgrespro.ru/docs/postgresql/16/functions-info#FUNCTIONS-INFO-SNAPSHOT
Page 10: Снимок данных
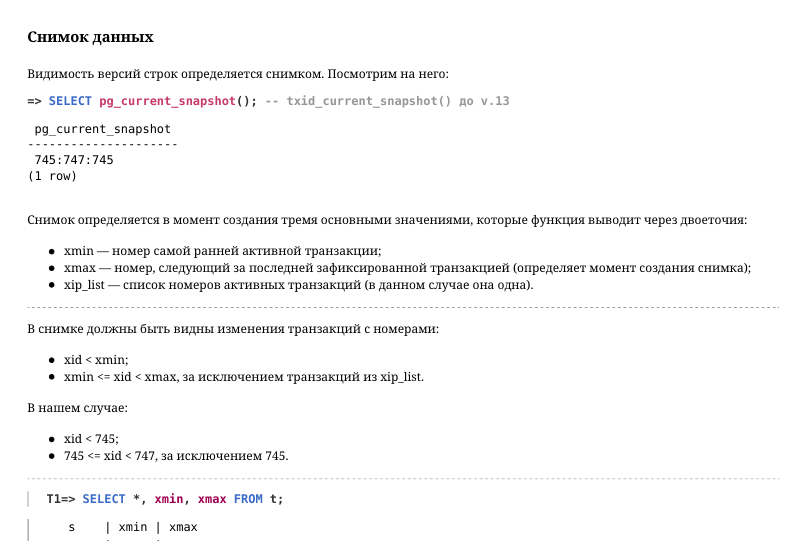 {#source-figure-010 caption=“Source slide page 10: Снимок данных”}
Видимость версий строк определяется снимком. Посмотрим на него:
Снимок определяется в момент создания тремя основными значениями, которые функция выводит через двоеточия: xmin — номер самой ранней активной транзакции; xmax — номер, следующий за последней зафиксированной транзакцией (определяет момент создания снимка); xip_list — список номеров активных транзакций (в данном случае она одна). В снимке должны быть видны изменения транзакций с номерами: xid < xmin; xmin <= xid < xmax, за исключением транзакций из xip_list. В нашем случае: xid < 745; 745 <= xid < 747, за исключением 745.
Первая строка не видна — она создана транзакцией 745, которая входит в список активных. Вторая строка видна — она создана транзакцией 746, которая попадает в диапазон снимка. Третья строка не видна — она создана транзакцией 747, которая не входит в диапазон снимка.
Page 11: Виртуальные транзакции
Только читающая транзакция никак не влияет на видимость
- обслуживающий процесс выделяет виртуальный номер
- виртуальный номер не учитывается в снимках
- виртуальный номер никогда не попадает в страницы
- постоянный номер выделяется при первом изменении данных
Комментарии преподавателя
На практике PostgreSQL использует оптимизацию, позволяющую «экономить» номера транзакций.
Если транзакция только читает данные, то она никак не влияет на видимость версий строк и ее номер не надо учитывать в снимках данных.
Поэтому вначале обслуживающий процесс выдает транзакции виртуальный номер (virtual xid). Номер состоит из внутреннего идентификатора процесса и последовательного числа.
Выдача этого номера не требует синхронизации между всеми процессами и поэтому выполняется очень быстро. С другой причиной использования виртуальных номеров мы познакомимся в теме «Заморозка» этого модуля.
Такой виртуальный номер нельзя записывать в страницы данных, потому что при следующем обращении к странице он может потерять всякий смысл.
Как только транзакция начинает изменять данные, ей сразу же выдается постоянный номер (xid), который может появляться в страницах данных — в полях xmin и xmax версий строк.
Page 12: Виртуальные транзакции
Только читающие транзакции никак не влияют на видимость версий строк и не учитываются в снимках данных. Они не имеют постоянного номера:
Постоянный номер присваивается при первом изменении, выполненном транзакцией, а также при вызове функции pg_current_xact_id().
Page 13: Горизонт снимка
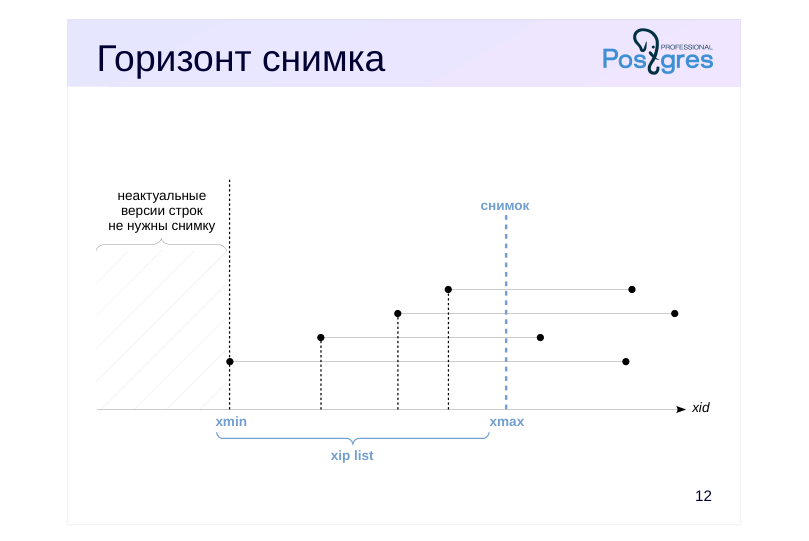 {#source-figure-013 caption=“Source slide page 13: Горизонт снимка”}
Комментарии преподавателя
Номер самой ранней из активных транзакций (xmin снимка) имеет важный смысл — он определяет горизонт снимка.
Горизонт событий в астрофизике — это граница, за которой наблюдатель не может увидеть никакие события. А в нашем случае горизонт снимка — это граница, за которой оператор, использующий снимок, не может увидеть неактуальные версии строк.
Действительно, при построении снимка ему требуется видеть неактуальную версию только если она удалена (заменена) еще не завершившейся транзакцией, поэтому снимок этого изменения не видит. Но за горизонтом все транзакции уже гарантированно завершились.
Page 14: Горизонт транзакции
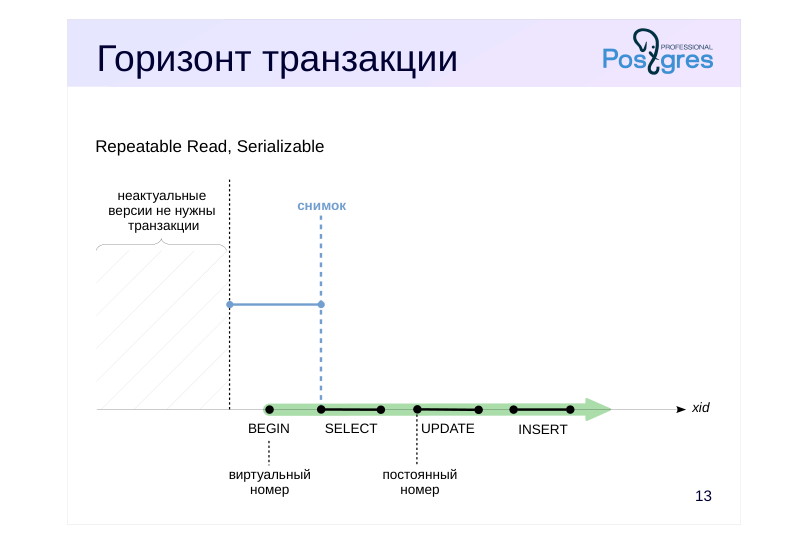 {#source-figure-014 caption=“Source slide page 14: Горизонт транзакции”}
Repeatable Read, Serializable
Комментарии преподавателя
На разных уровнях изоляции транзакции по-разному используют снимки данных.
Для уровней Repeatable Read и Serializable транзакция строит снимок при первом обращении к серверу и использует его до своего окончания.
Левая граница снимка (начало горизонтального отрезка на слайде) определяющая горизонт транзакции, равна номеру самой ранней активной транзакции. Поскольку текущая транзакция сама является активной, горизонт никогда не может оказаться правее постоянного номера данной транзакции.
Page 15: Горизонт транзакции
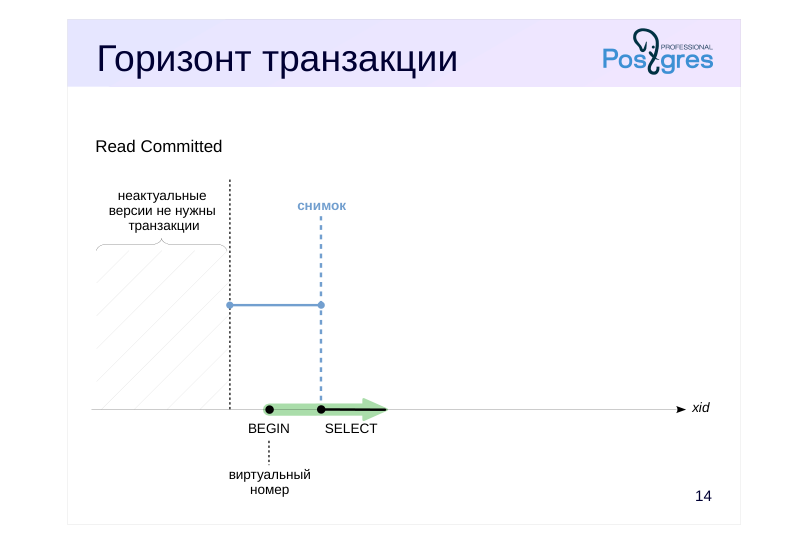 {#source-figure-015 caption=“Source slide page 15: Горизонт транзакции”}
Read Committed
Комментарии преподавателя
В случае уровня изоляции Read Committed снимков может быть несколько.
Сначала транзакция получает виртуальный номер. При первом обращении к базе данных строится снимок.
Page 16: Горизонт транзакции
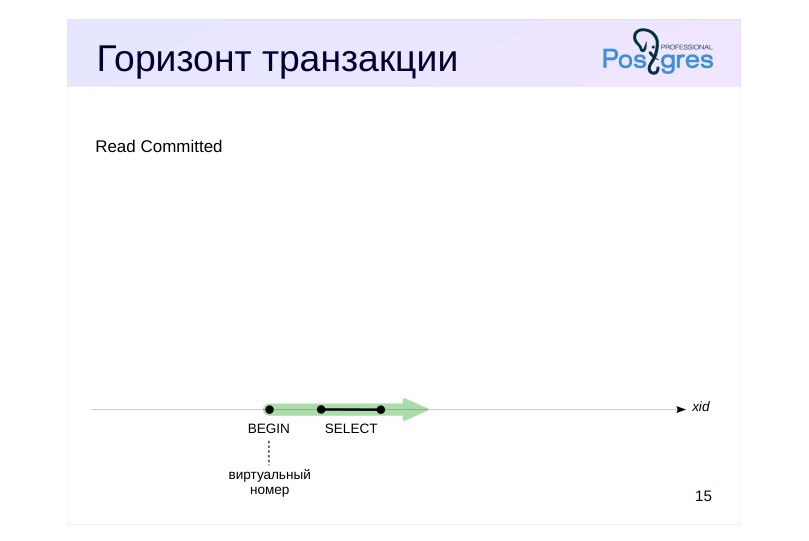 {#source-figure-016 caption=“Source slide page 16: Горизонт транзакции”}
Read Committed
Комментарии преподавателя
По окончании запроса снимок освобождается. Поскольку в нашем примере первый оператор транзакции не менял данные, транзакция пока не получила постоянный номер и не будет удерживать горизонт до начала следующего оператора.
Page 17: Горизонт транзакции
 {#source-figure-017 caption=“Source slide page 17: Горизонт транзакции”}
Read Committed
Комментарии преподавателя
Если транзакция начинает менять данные, ей выдается постоянный номер. В этот же момент строится новый снимок, горизонт которого (xmin), как и всегда, находится на уровне самой ранней активной транзакции.
Поскольку текущая транзакция сама является активной, горизонт никогда не может оказаться правее номера данной транзакции.
Page 18: Горизонт транзакции
 {#source-figure-018 caption=“Source slide page 18: Горизонт транзакции”}
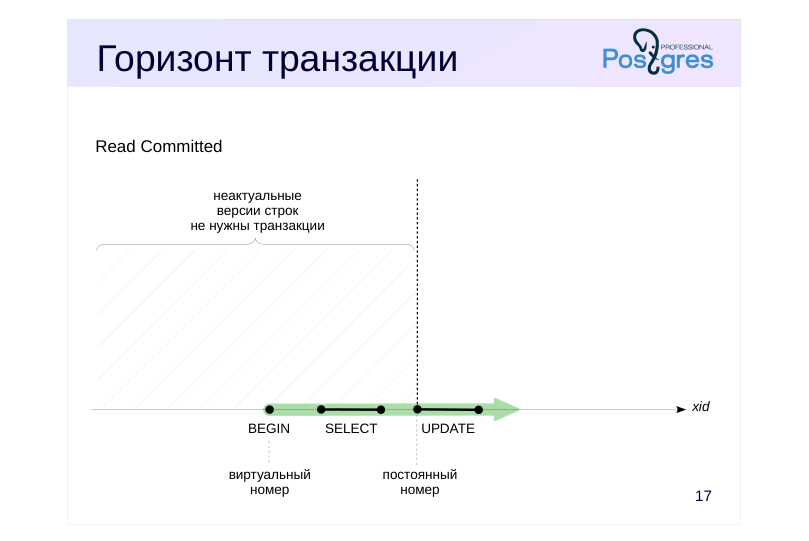
Read Committed
Комментарии преподавателя
Когда оператор завершает работу, снимок освобождается, а транзакция держит горизонт на уровне своего номера на случай отката.
Если транзакция будет долго находиться в таком состоянии (оно называется idle in transaction), не выполняя никаких команд, горизонт будет оставаться на месте.
Page 19: Горизонт транзакции
 {#source-figure-019 caption=“Source slide page 19: Горизонт транзакции”}
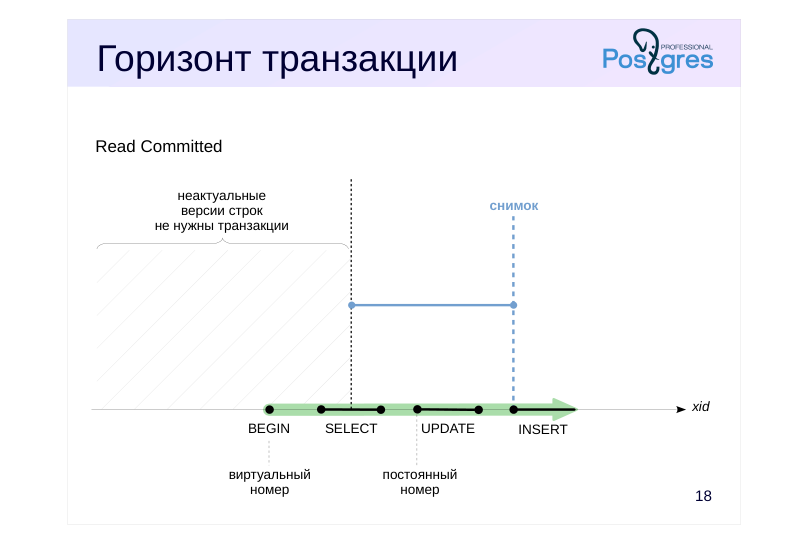
Read Committed
Комментарии преподавателя
Следующий оператор использует новый снимок, горизонт которого учитывает номера других активных транзакций. Текущая транзакция по-прежнему активна, поэтому горизонт снимка (xmin) не может быть больше ее номера.
Page 20: Горизонт транзакции
 {#source-figure-020 caption=“Source slide page 20: Горизонт транзакции”}
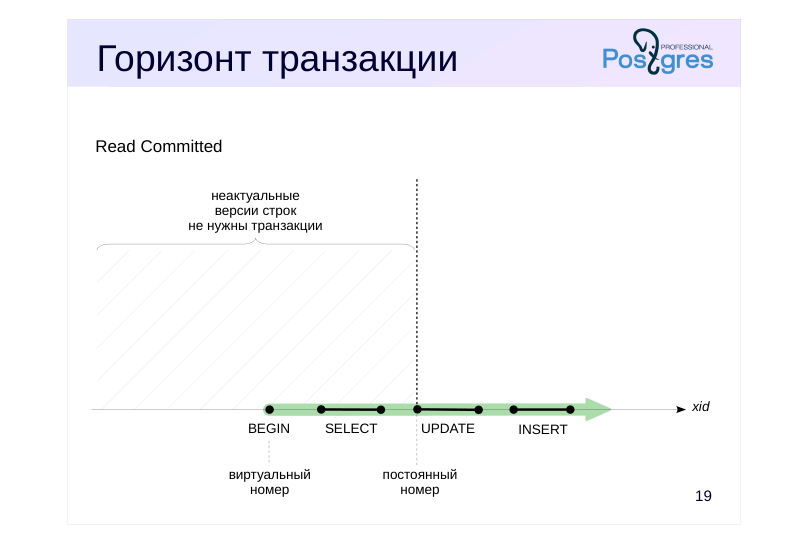
Read Committed
Комментарии преподавателя
Между операторами, когда нет активного снимка, горизонт опять смещается к номеру транзакции. Если транзакция так и не получила постоянный номер (не начала изменять данные), она вообще не будет держать горизонт.
Page 21: Горизонт базы данных
 {#source-figure-021 caption=“Source slide page 21: Горизонт базы данных”}
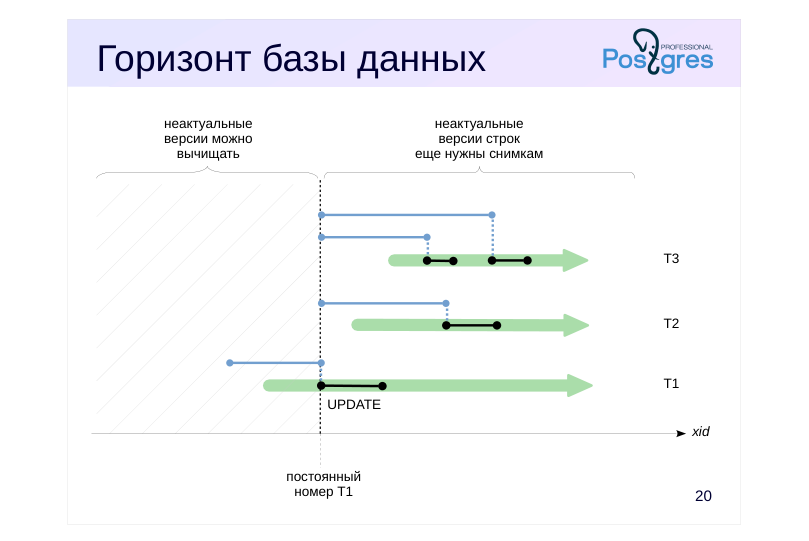
Комментарии преподавателя
Также можно определить и горизонт базы данных как минимальный из горизонтов всех транзакций и снимков. При освобождении снимка горизонт базы данных смещается вправо к горизонту следующего активного снимка. Обратного движения быть не может, поскольку xmin вновь возникающих снимков — минимальный номер активной транзакции — может только увеличиваться.
Неактуальные версии строк за горизонтом базы данных уже никогда не будут нужны ни одной транзакции. Такие версии строк могут быть безопасно вычищены.
На слайде показан пример трех транзакций с уровнем изоляции Read Committed. Для оператора UPDATE транзакции T1 был построен снимок. Когда оператор отрабатывает, снимок удаляется и перестает удерживать горизонт. Однако транзакция T1 по-прежнему активна, и поэтому горизонты снимков транзакций T2 и T3 не сдвинутся правее номера транзакции T1. Тем самым активная транзакция, если у нее есть постоянный номер, удерживает горизонт самим фактом своего существования.
А это означает, что неактуальные версии строк в этой БД не могут быть очищены. При этом «долгоиграющая» транзакция может никак не пересекаться по данным с другими транзакциями — это совершенно не важно, горизонт базы данных общий для всех транзакций.
Это одна из причин, по которым транзакции не следует делать длиннее, чем абсолютно необходимо.
Page 22: Горизонт базы данных
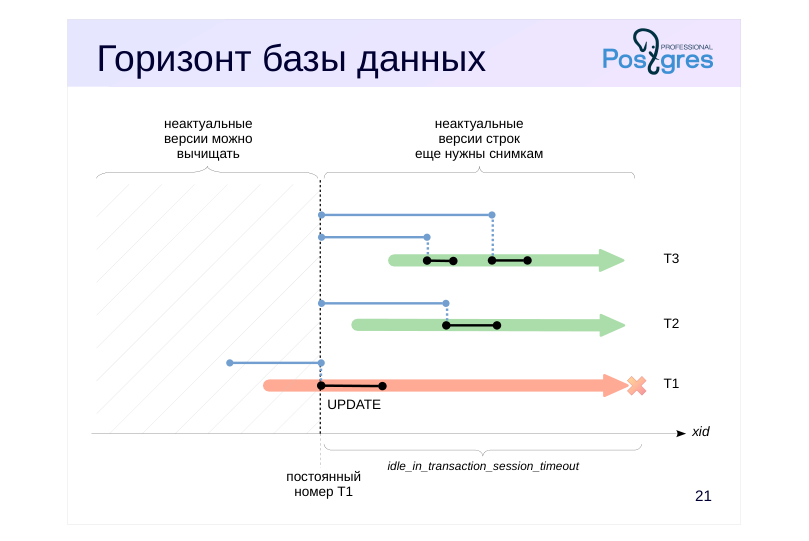 {#source-figure-022 caption=“Source slide page 22: Горизонт базы данных”}
Комментарии преподавателя
Если описанная ситуация действительно создает проблемы и нет способа избежать ее на уровне приложения, может помочь параметр idle_in_transaction_session_timeout. Он определяет максимальное время бездействия активной транзакции. После этого времени сеанс прерывается.
Page 23: Горизонт транзакции и базы данных
Свой горизонт транзакция может увидеть в представлении:
Хотя наша транзакция является виртуальной и не влияет на видимость других транзакций, она обращается к данным, используя снимок, и поэтому удерживает горизонт базы данных. После завершения транзакции горизонт продвигается вперед, позволяя очищать неактуальные версии строк:
Page 24: Экспорт снимка
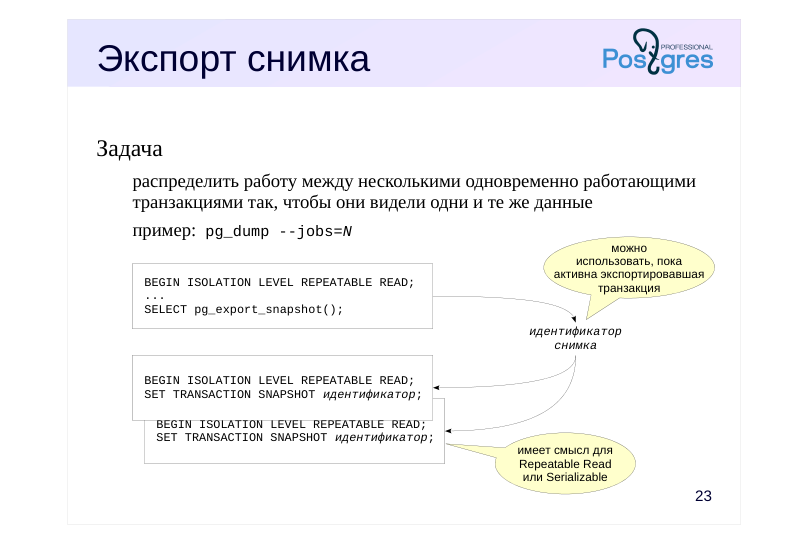 {#source-figure-024 caption=“Source slide page 24: Экспорт снимка”}
Задача
- распределить работу между несколькими одновременно работающими
- транзакциями так, чтобы они видели одни и те же данные
- пример: pg_dump –jobs=N
Комментарии преподавателя
Бывают ситуации, когда несколько транзакций должны гарантированно видеть одну и ту же картину данных. Разумеется, нельзя полагаться на то, что картины совпадут просто из-за того, что транзакции запущены «одновременно». Для этого есть механизм экспорта и импорта снимка.
Функция pg_export_snapshot сохраняет информацию о снимке в виде файла в каталоге PGDATA/pg_snapshots и возвращает идентификатор снимка, который может быть передан (внешними по отношению к СУБД средствами) в другую транзакцию.
https://postgrespro.ru/docs/postgresql/16/functions-admin#FUNCTIONS-SN APSHOT-SYNCHRONIZATION
Экспортированный снимок существует до окончания экспортировавшей его транзакции. В это время другая транзакция может импортировать снимок с помощью команды SET TRANSACTION SNAPSHOT до выполнения первого запроса в ней. Предварительно надо установить и уровень изоляции Repeatable Read или Serializable, потому что на уровне Read Committed операторы будут использовать собственные снимки.
https://postgrespro.ru/docs/postgresql/16/sql-set-transaction
Экспорт снимка применяется, например, утилитой pg_dump при параллельном режиме работы или логической репликацией для получения начального состояния таблиц, входящих в подписку (подробнее см. курс DBA3 «Резервное копирование и репликация»).
Page 25: Итоги
Снимок содержит информацию, необходимую для определения видимости версий строк
- Время создания снимка определяется уровнем изоляции
- Снимок определяет горизонт транзакции, влияющий на возможность удаления неактуальных версий
Page 26: Практика
- Воспроизведите ситуацию, при которой одна транзакция еще видит удаленную строку, а другая — уже нет. Посмотрите снимки данных этих транзакций и значения полей xmin и xmax удаленной строки. Объясните видимость на основании этих данных.
- Если в запросе вызывается функция, содержащая другой запрос, какой снимок данных будет использоваться для «вложенного» запроса? Проверьте уровни изоляции Read Committed и Repeatable Read и категории изменчивости функций volatile и stable.
- В одной транзакции экспортируйте снимок, затем в другой транзакции измените данные. Импортируйте снимок и проверьте, что в нем видны еще не измененные данные.
Комментарии преподавателя
- Можно воспользоваться следующим шаблоном функции, в предположении, что создана таблица t:
Также может пригодиться функция pg_sleep(n), вызывающая задержку на n секунд.
Page 27: 1. Снимки данных двух транзакций
Таблица с одной строкой:
Первая транзакция видит строку:
Вторая транзакция в другом сеансе удаляет строку:
Page 28: Page 28
Первая транзакция продолжает видеть строку:
Снимки обеих транзакций одинаковы, и по правилам видимости они обе должны были бы видеть строку, так как изменения транзакции xmin = 745 видны в снимке (745 < 746), изменения транзакции xmax = 746 не видны в снимке (746 >= 746). Однако вторая транзакция все-таки не видит строку, поскольку она сама ее удалила, а это — исключение из обычных правил видимости.
2. Снимок вложенного запроса
Внутри функции, подсчитывающей число строк таблицы, вставим односекундную задержку для удобства тестирования:
Теперь начинаем транзакцию с уровнем изоляции Read Committed и в запросе несколько раз вызываем функцию, одновременно подсчитывая количество строк подзапросом.
Параллельно выполняем другую транзакцию, которая увеличивает число строк в таблице. Если основной запрос и вложенный запрос используют разные снимки, мы обнаружим это по разнице в результате.
Page 29: Page 29
Значение первого столбца не изменяется — запрос использует снимок, созданный в начале выполнения. Однако значение во втором столбце изменяется — запросы внутри volatile-функции используют отдельные снимки. Повторим эксперимент для уровня изоляции Repeatable Read:
Теперь еще раз то же самое для функции с категорией изменчивости stable.
Уровень Read Committed:
Page 30: Page 30
Уровень Repeatable Read:
Выводы: Запросы в volatile-функциях на уровне изоляции Read Committed используют собственные снимки и могут видеть изменения в процессе работы оператора. Такая возможность скорее опасна, чем полезна. При любых других комбинациях категории изменчивости и уровня изоляции вложенные запросы используют снимок основного запроса.
3. Экспорт снимка
Функция pg_export_snapshot возвращает идентификатор снимка, который можно передать в другую транзакцию (внешними по отношению к СУБД средствами):
В другом сеансе удаляем все строки из таблицы:
Затем транзакция импортирует снимок и видит в нем те же данные, что и экспортировавшая этот снимок транзакция:
Page 31: Page 31
04 Занятие 04: Многоверсионность / HOT-обновления и самоочистка
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_04_mvcc_hot.html Archive: DBA2-handouts-16.zip Страниц PDF: 26
Page 1: Многоверсионность / HOT-обновления и самоочистка
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Почему очистки не хватает
- HOT-обновления
- Самоочистка в таблице
- Самоочистка в индексе
Page 3: Почему очистки не хватает
Мертвые версии строк
- приводят к разрастанию файлов
- Синхронизация индексов
- при любом изменении строки таблицы нужно менять все индексы
- Расщепление индексных страниц
- снижает производительность
- увеличивает размер
Комментарии преподавателя
При работе механизма многоверсионности образуются ненужные версии строк, что приводит к разрастанию таблиц и индексов и, как следствие, снижает производительность запросов.
Если у таблицы есть индексы, при изменении таблицы приходится их синхронизировать. Это приводит к изменению большого числа страниц и также снижает производительность.
Проблема усугубляется особенностью реализации B-дерева в PostgreSQL: если на индексной странице недостаточно места для вставки новой записи, страница делится («расщепляется») на две и все данные перераспределяются между ними. Частые расщепления снижают производительность при вставке и изменении строк.
Более того, при удалении (или очистке) записей две индексные страницы не «склеиваются обратно» в одну. Из-за этого размер индекса может не уменьшиться даже при удалении существенной части данных.
Регулярная очистка решает проблему разрастания таблиц и индексов, однако требует значительных ресурсов. Поэтому даже при обычном, не связанном с очисткой, обращении к странице желательно удалять ненужные версии строк или индексные записи. А чтобы предотвратить избыточные обновления индексов при изменении таблицы, PostgreSQL объединяет версии строк в HOT-цепочки. Мы рассмотрим их на следующих слайдах.
Page 4: Обычное обновление
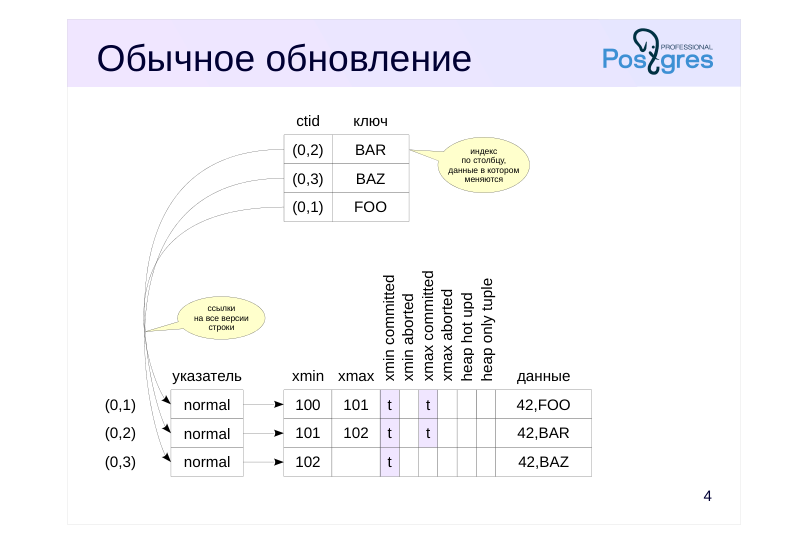 {#source-figure-004 caption=“Source slide page 4: Обычное обновление”}
Комментарии преподавателя
Напомним, что при обычном обновлении в индексе создаются ссылки на все версии строки, присутствующие в табличных страницах.
(Исключение составляет индекс BRIN, который не содержит ссылок на отдельные табличные строки; подробности устройства индексов различных типов рассматриваются в курсе QPT «Оптимизация запросов»).
Чем это плохо?
При любом изменении строки придется изменять все индексы, созданные для таблицы (даже если измененные поля не входят в индекс). Естественно, чем больше индексов создано на таблице, тем с большими сложностями приходится сталкиваться.
Page 5: HOT-обновление
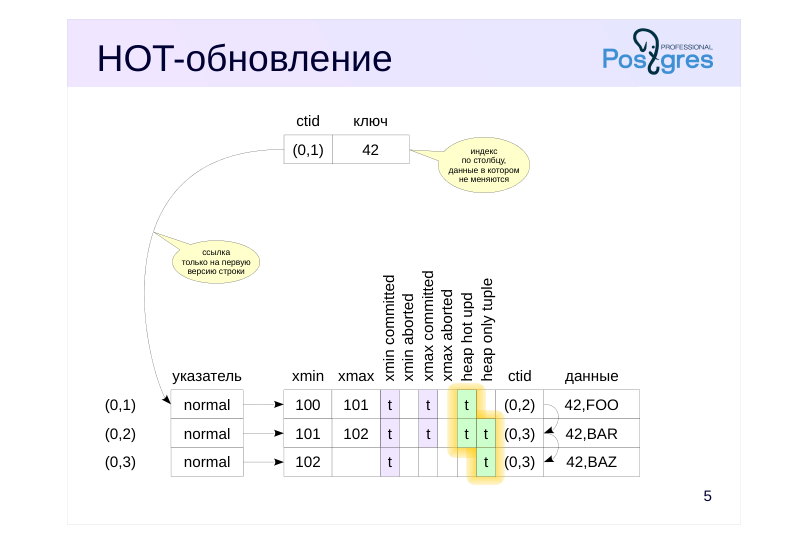 {#source-figure-005 caption=“Source slide page 5: HOT-обновление”}
Комментарии преподавателя
Если индекс создан по полю, значение которого не изменилось в результате обновления строки, можно не создавать в B-дереве дополнительную ссылку для того же значения ключа. Именно так работает оптимизация, называемая HOT-обновлением — Heap-Only Tuple Update.
При таком обновлении в индексной странице находится лишь одна ссылка – на первую версию строки табличной страницы, а внутри табличной страницы организуется цепочка версий:
● строки, которые изменены и входят в цепочку, маркируются битом Heap Hot Updated;
● строки цепочки, на которые нет ссылок из индекса, маркируются битом Heap Only Tuple (то есть — «только табличная версия строки»);
● версии строк связаны в список с помощью поля ctid, входящего в заголовок версий.
Если при сканировании индекса PostgreSQL попадает в табличную страницу и обнаруживает версию, помеченную как Heap Hot Updated, он понимает, что надо пройти дальше по цепочке обновлений. (Разумеется, для всех полученных таким образом версий строк проверяется видимость, прежде чем они будут возвращены клиенту.)
https://git.postgresql.org/gitweb/?p=postgresql.git;f=src/backend/access/hea p/README.HOT;hb=HEAD
Page 6: HOT-обновление
Значения индексированных столбцов не должны изменяться
- иначе придется добавить в индекс ссылку на новую версию строки,
- и версию нельзя будет пометить как «heap only»
- Цепочка обновлений — только в пределах одной страницы
- не требуется обращение к другим страницам,
- обход цепочки не ухудшает производительность
- если в табличной странице не хватает места для новой версии,
- цепочка обрывается (как если бы оптимизация не работала)
- место в странице можно зарезервировать, уменьшив параметр
- хранения таблицы fillfactor (100 % → 10 %)
Комментарии преподавателя
Подчеркнем, что HOT-обновления работают только в случае, если не изменяется ни один ключ в индексах. Иначе в каком-либо индексе появилась бы ссылка непосредственно на новую версию строки, что противоречит идее этой оптимизации. Только упомянутый выше индекс BRIN не препятствует HOT-обновлению (в нем нет ссылок на табличные строки).
В том числе HOT-обновления применяются и к таблицам, на которых нет вообще ни одного индекса: при обновлении любых полей такой таблицы будет строиться цепочка версий.
Оптимизация действует только в пределах одной страницы, поэтому дополнительный обход цепочки не требует обращения к другим страницам и не ухудшает производительность.
Однако если на странице не хватит свободного места, чтобы разместить новую версию строки, цепочка прервется. На версию строки, размещенную на другой странице, придется сделать и ссылку из индекса.
Поэтому при частых обновлениях неиндексированных полей может иметь смысл уменьшить параметр хранения fillfactor. Этот параметр определяет пороговый процент занятого на странице места, после которого вставка новых строк в эту страницу будет запрещена. Значение по умолчанию – 100%, можно уменьшать до 10%. Оставшееся место резервируется для обновлений: в этом случае новая версия строки может занять свободное место на той же странице. (С другой стороны, чем выше fillfactor, тем компактнее располагаются записи и, соответственно, размер таблицы получается меньше.)
Page 7: HOT-обновление
Создадим таблицу. Для простоты не будем создавать индекс: любое обновление будет HOT-обновлением. Каждая строка таблицы состоит из 2000 символов; если использовать только латинские буквы, то версия строки будет занимать 2000 байт плюс заголовок. Параметр fillfactor установим в 75%, чтобы на страницу помещалось только три версии и одна была доступна для обновления.
Для изучения содержимого страницы используем расширение pageinspect.
Для удобства создадим уже знакомое представление в немного более компактном виде и дополненное двумя полями:
Вставим строку и обновим ее, чтобы создать новую версию:
Поскольку обновленный столбец не входит ни в какой индекс (в нашем случае ни одного индекса просто нет), в табличной странице появляется цепочка версий:
Page 8: Page 8
флаг hhu (Heap Hot Updated) показывает, что надо идти по цепочке ctid, флаг hot (Heap Only Tuple) показывает, что на данную версию строки нет ссылок из индексов. При дальнейших изменениях цепочка будет расти (в пределах страницы):
Page 9: Самоочистка в таблице
Выполняется при любом обращении к странице
- если ранее выполненное обновление не нашло места
- для новой версии строки на этой же странице
- если страница заполнена более чем на fillfactor или более чем на 90%
- Действует в пределах одной табличной страницы
- не освобождает указатели, на которые могут ссылаться индексы
- не обновляет карту свободного пространства
- не обновляет карту видимости
Комментарии преподавателя
При обращении к странице — как при обновлении, так и при чтении — может происходить быстрая самоочистка, если PostgreSQL сочтет, что место на странице заканчивается. Должно выполниться одно из условий:
Ранее выполненное на этой странице обновление не обнаружило достаточного места, чтобы разместить здесь же новую версию строки и установило в заголовке страницы соответствующий признак, по которому при следующем обращении к ней срабатывает очистка.
Страница заполнена более чем на fillfactor или более чем на 90% — очистка сработает сразу.
Самоочистка убирает версии строк, не видимые ни в одном снимке (находящиеся за горизонтом базы данных), но работает строго в пределах одной табличной страницы. Указатели на версии строк не освобождаются, так как на них могут быть ссылки из индексов, а это уже другая страница — она не очищается.
Карта свободного пространства не обновляется из экономии ресурсов, а также из соображения, что освобожденное место лучше приберечь для обновлений, а не для вставок. Также не обновляется и карта видимости.
Тот факт, что страница может очищаться при чтении, означает, что запрос SELECT может вызвать изменение страниц. Это еще один такой случай, в дополнение к рассмотренному в теме «Страницы и версии строк» изменению битов-подсказок.
Page 10: До HOT-самоочистки
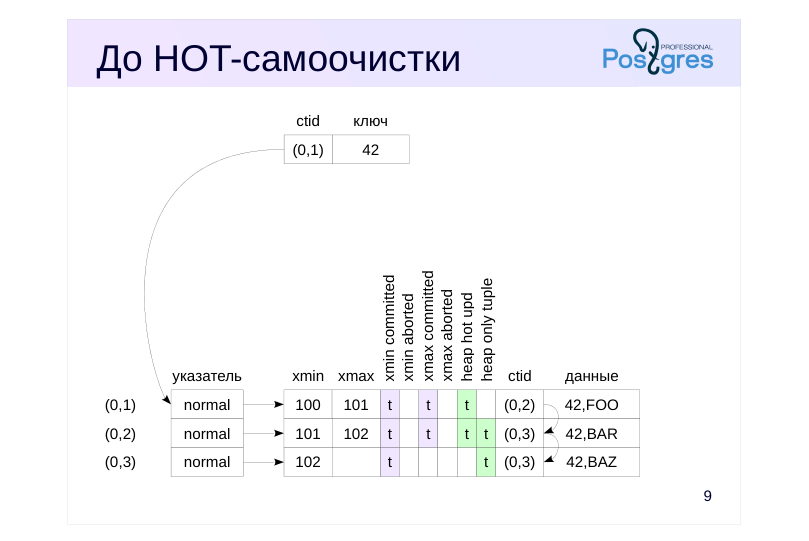 {#source-figure-010 caption=“Source slide page 10: До HOT-самоочистки”}
Комментарии преподавателя
Частный, но важный случай самоочистки представляет собой очистка при HOT-обновлениях.
На рисунке приведена ситуация до очистки. В таблице три версии одной и той же строки. На первую из них (0,1) ссылается индекс, остальные две (0,2) и (0,3) помечены как «только табличные».
Версии строк (0,1) и (0,2) неактуальны, не видны ни в одном снимке и могут быть удалены.
Page 11: После HOT-самоочистки
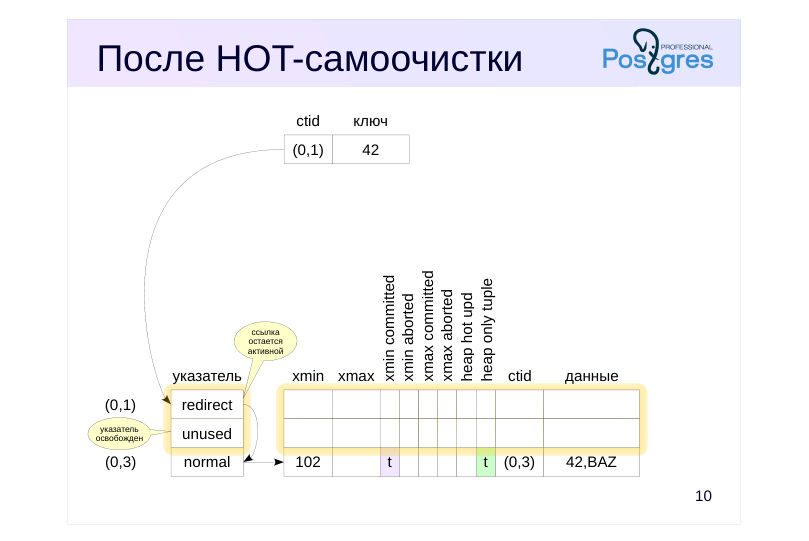 {#source-figure-011 caption=“Source slide page 11: После HOT-самоочистки”}
Комментарии преподавателя
Самоочистка удаляет неактуальные версии строк.
При HOT-обновлениях в индексе может быть только одна ссылка на версию строки, представляющую собой «голову» HOT-цепочки, которая поддерживается внутри одной табличной страницы. При любых изменениях версий строки указатель должен оставаться на своем месте и ссылаться на голову цепочки.
Поэтому применяется двойная адресация: для указателя, на который ссылается индекс — в данном случае (0,1), — используется статус «redirect», перенаправляющий на указатель нужной версии строки.
Указатель на вторую версию (0,2) больше не нужен. Он получает статус «unused» и будет использован при вставке какой-нибудь новой версии строки.
Все оставшиеся версии строк сдвигаются вместе так, чтобы свободное место на странице было представлено одним фрагментом. Соответствующим образом изменяются и значения указателей. Благодаря этому не возникает проблем с фрагментацией свободного места в странице.
Page 12: HOT-самоочистка
Проверим, как работает самоочистка при HOT-обновлениях. Обновим строку еще раз:
В странице сейчас четыре версии строки:
На самом деле мы только что превысили порог fillfactor. 75% от размера страницы составляет 6144 байтов, а разница между значениями pagesize и upper равна 8192-64=8128:
Проверим, что порог действительно превышен. Обновим строку еще раз:
Какие изменения произойдут со страницей?
Все неактуальные версии строк (0,1), (0,2) и (0,3) были очищены; после этого новая версия строки была добавлена на освободившееся место. Указатели на очищенные строки освобождены (имеют статус unused). При этом указатель на первую версию остался на месте, но получил статус redirect. Проследите ссылки от этой головной версии до конца HOT-цепочки. Выполним обновление еще несколько раз:
Page 13: Page 13
Следующее обновление снова вызывает самоочистку:
А теперь построим индекс по столбцу s и создадим вспомогательное представление, чтобы заглянуть в него:
При создании индекса перестройки данных в табличных страницах не происходит, HOT-цепочки сохраняются:
А из индекса ссылка ведет к указателю начала цепочки:
Page 14: До самоочистки
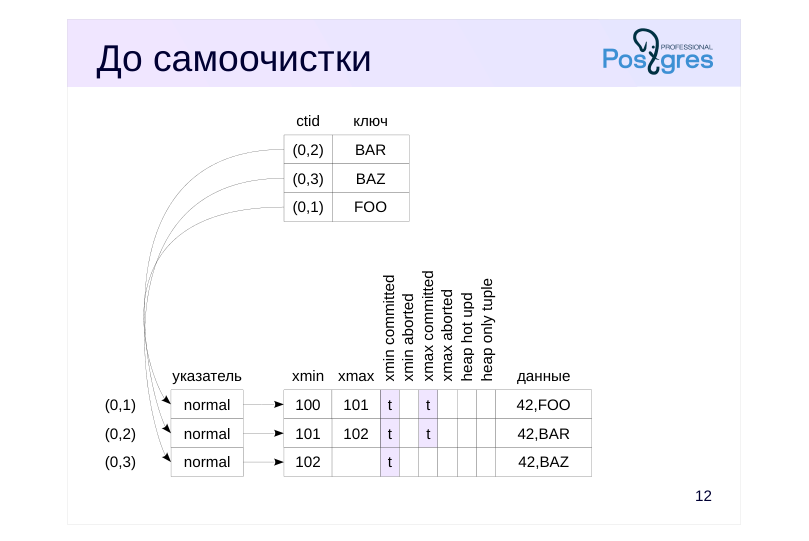 {#source-figure-014 caption=“Source slide page 14: До самоочистки”}
Комментарии преподавателя
Разумеется, самоочистка работает и для версий, появившихся в результате обычного (не HOT) обновления.
На рисунке приведена ситуация до очистки. В табличной странице три версии одной строки. Две из них неактуальны, не видны ни в одном снимке и могут быть удалены.
В индексе есть три ссылки на каждую из версий строки.
Page 15: После самоочистки
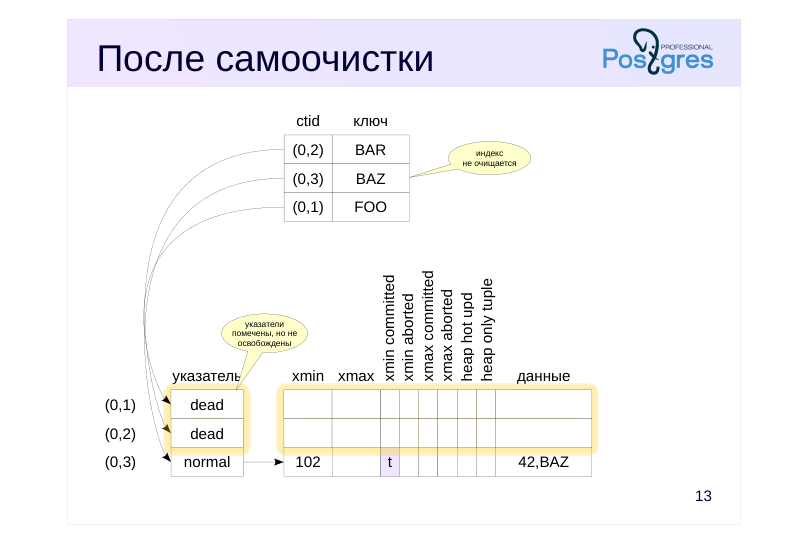 {#source-figure-015 caption=“Source slide page 15: После самоочистки”}
Комментарии преподавателя
Если выполнено условие для срабатывания самоочистки, две неактуальные версии строки (0,1) и (0,2) могут быть ею удалены. Тогда указатели на удаленные версии получают статус «dead», а освободившееся место может быть использовано для вставки новых версий.
В отличие от ситуации с HOT-обновлениями, здесь нельзя освободить указатели на удаленные версии строк, поскольку на них существуют ссылки из индексной страницы. При индексном доступе PostgreSQL может получить (0,1) или (0,2) в качестве идентификатора версии строки, а затем попробовать пройти по этому идентификатору в табличную страницу, но благодаря статусу указателя обнаружит, что эта версия уже не существует.
Принципиально то, что самоочистка работает только в пределах одной табличной страницы и не очищает страницы индекса.
Page 16: Самоочистка в индексе
Ненужные индексные записи
- помечаются при выполнении запросов
- будут удалены, если в странице не хватает места
- Восходящее удаление индексных записей
- если места все равно не хватает, проверяются версии строк
Комментарии преподавателя
Если таблица имеет несколько индексов и обновляемый столбец входит хотя бы в один из них, HOT-обновление будет невозможно. При этом значения столбцов, входящих в другой индекс, могут не измениться, однако в такой индекс все равно придется добавить ссылку на новую версию строки (индекс изменяется физически, но не логически). Чтобы избежать частой очистки или перестройки индекса, можно заранее распознавать ненужные индексные записи и удалять их при недостатке места в индексной странице. В PostgreSQL есть два механизма, позволяющие это делать.
Если при выполнении запроса выясняется, что индексная запись ссылается на версию строки, которая не существует или находится за горизонтом, такая запись помечается как мертвая. Если не удается разместить в странице очередную индексную запись, в первую очередь удаляются такие помеченные записи.
Если избежать расщепления таким образом не удается, включается механизм «восходящего удаления кортежей» (bottom-up delete), добавленный в PostgreSQL 14. Для индексных записей с одинаковым значением ключа проверяются соответствующие версии строк. Если оказывается, что версия отсутствует или находится за горизонтом, индексная запись будет удалена. Проверка требует обращения к таблице, но это оказывается выгоднее, чем лишнее расщепление индексной страницы.
Page 17: Самоочистка индекса
Уменьшим длину строки таблицы, опустошим ее, вставим семь строк и обновим их:
Заглянем в постраничную статистику индекса с помощью функции из расширения pageinspect:
В индексе сейчас всего одна листовая страница (она же корневая), в которой осталось около 900 байт свободного места. В ней находятся 14 индексных записей:
А вот строки, на которые они указывают:
Page 18: Page 18
Семь записей ссылаются на актуальные версии табличных строк, остальные семь — на мертвые, но получить эту информацию из индекса невозможно. Поэтому при следующем обновлении страница индекса расщепится. Но если какой-то запрос обратится к таблице через индекс, ему придется пройти по ссылкам и узнать статусы табличных строк:
Такой запрос помечает ненужные индексные записи как dead…
… и если после этого выполнить обновление,..
… то оно не приводит к расщеплению страницы, поскольку удается освободить место для новых записей:
Page 19: Восходящее удаление
Теперь добавим к таблице второй текстовый столбец и индекс по нему:
Опять опустошим таблицу и вставим строки в таблицу:
Теперь, поскольку оба столбца проиндексированы, при обновлении HOT-цепочки строиться не будут. Если изменять только первый столбец, индекс по нему будет расти:
Однако ключи второго индекса логически не изменяются, поэтому при недостатке места срабатывает механизм восходящего удаления и страница второго индекса расщепляться не будет:
Page 20: Page 20
Page 21: Итоги
Если изменяемый столбец не входит ни в один индекс и на странице есть место — применяется HOT-обновление
- При недостатке места в странице таблицы или индекса автоматически выполняется самоочистка
Page 22: Практика
- Воспроизведите ситуацию самоочистки без участия HOT-обновлений. Проверяйте содержимое табличной и индексной страниц с помощью расширения pageinspect.
- Воспроизведите ситуацию HOT-обновления на таблице с индексом по некоторым полям.
- Воспроизведите ситуацию HOT-обновления, при которой самоочистка не освобождает достаточно места на странице и новая версия создается на другой странице. Сколько записей будет в индексе в этом случае?
Комментарии преподавателя
- Запрос для индексной страницы появлялся в демонстрации к теме «Страницы и версии строк» этого модуля:
Page 23: 1. Самоочистка
Создадим таблицу с двумя полями. Параметр fillfactor установим в 75%, как в демонстрации.
Создадим индекс по столбцу s:
Как обычно, используем расширение pageinspect.
Добавим строку и будем обновлять столбец s:
При этом в индексе для каждой из версий была сформирована запись:
Page 24: Page 24
Наличие индекса на обновляемом столбце привело к тому, что HOT-обновление не использовалось:
Как и в демонстрации, еще одно обновление строки приводит к самоочистке:
Все неактуальные версии строк (0,1), (0,2) и (0,3) очищены; после этого на освободившееся место добавлена новая версия строки (0,5). Самоочистка не затрагивает индекс:
По этой причине указатели на очищенные строки в таблице не освобождены, а имеют статус dead.
2. HOT-обновление при наличии индекса
Удалим индекс по столбцу s и добавим другой, по столбцу id:
Опустошим таблицу и повторим команды, приводящие к самоочистке:
Page 25: Page 25
В индексной странице только одна ссылка на таблицу:
В табличной странице — версии строки, объединенные в список:
Индекс на столбце не мешает HOT-обновлению, если этот столбец не обновляется.
3. Разрыв HOT-цепочки
В новом сеансе начнем транзакцию и построим снимок:
Теперь выполняем обновление в первом сеансе:
Page 26: Page 26
Следующее обновление уже не сможет освободить место на странице:
Видим ссылку (1,1), ведущую на страницу 1. Представление pg_stat_all_tables покажет количество измененных строк (в том числе с применением HOT), а также количество измененных строк с переходом на новую табличную страницу. Если это значение при работе с таблицей будет достаточно большим, то следует задуматься об уменьшении значения fillfactor.
Теперь в индексе две записи, каждая указывает на начало своей HOT-цепочки:
05 Занятие 05: Многоверсионность / Очистка
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_05_mvcc_vacuum.html Archive: DBA2-handouts-16.zip Страниц PDF: 24
Page 1: Многоверсионность / Очистка
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Обычная очистка и схема ее работы
- Регулирование нагрузки
- Анализ
- Полная очистка и аналоги
Page 3: Обычная очистка
Выполняется командой VACUUM
- не конфликтует с обычной активностью в системе
- Обрабатывает таблицу и все ее индексы
- очищает ненужные версии строк в табличных страницах
- (пропуская страницы, уже отмеченные в карте видимости)
- очищает индексные записи, ссылающиеся на очищенные версии строк
- освобождает указатели
- обновляет карту свободного пространства
- обновляет карту видимости
- возможна отдельная очистка основной таблицы и TOAST-части
Комментарии преподавателя
Самоочистка таблицы выполняется быстро, но не решает всех задач. Она работает только в пределах одной табличной страницы и не затрагивает индексы.
Очистка, выполняемая командой VACUUM, обрабатывает всю таблицу, включая все созданные на ней индексы. При этом удаляются и ненужные версии строк, и указатели на них в начале страницы.
Во время работы очистки таблица может использоваться обычным образом и для чтения, и для изменения данных. Но одновременное выполнение ряда команд (например CREATE INDEX, ALTER TABLE и некоторых других) будет невозможно.
Очистка пропускает страницы таблицы, в которых нет ненужных версий строк. Для этого используется карта видимости (visibility map), где отмечаются страницы, заведомо содержащие только актуальные версии. Сама карта при этом тоже обновляется. Если нужно, чтобы очистка обработала все страницы, следует включить параметр DISABLE_PAGE_SKIPPING.
В процессе работы обновляется также и карта свободного пространства (free space map), в которой отражается наличие свободного места в страницах.
Можно отказаться от очистки основной таблицы или ее TOAST-части, выключив параметры PROCESS_MAIN или PROCESS_TOAST (по умолчанию оба включены).
https://postgrespro.ru/docs/postgresql/16/sql-vacuum
https://postgrespro.ru/docs/postgresql/16/routine-vacuuming
Page 4: До очистки
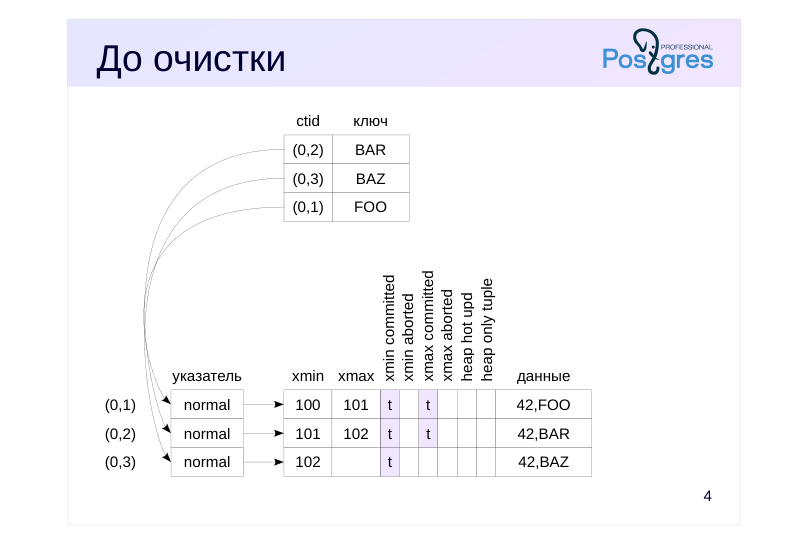 {#source-figure-004 caption=“Source slide page 4: До очистки”}
Комментарии преподавателя
На рисунке приведена ситуация до очистки. В табличной странице три версии одной строки. Две из них неактуальны, не видны ни в одном снимке и могут быть удалены.
В индексе есть три ссылки: на каждую из версий строки.
Page 5: 1. Сканирование таблицы
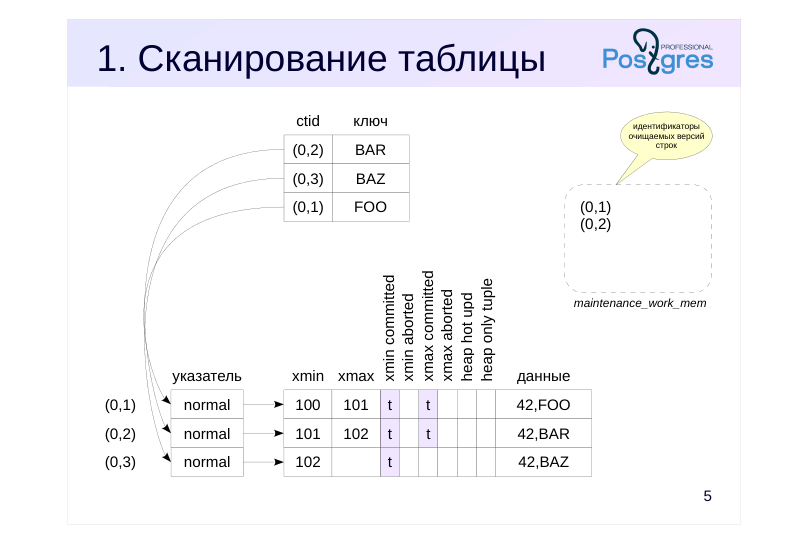 {#source-figure-005 caption=“Source slide page 5: 1. Сканирование таблицы”}
Комментарии преподавателя
Сначала VACUUM выполняет сканирование таблицы (пропуская те страницы, которые помечены в карте видимости).
В прочитанных страницах процесс определяет ненужные версии строк и записывает их идентификаторы в специальный массив. Для этого в локальной памяти процесса VACUUM выделяется фрагмент размером maintenance_work_mem (или меньший, если его заведомо будет достаточно). Значение этого параметра по умолчанию — 64 Мбайт. Отметим, что эта память выделяется сразу в полном объеме, а не по мере необходимости.
Page 6: 2. Очистка индексов
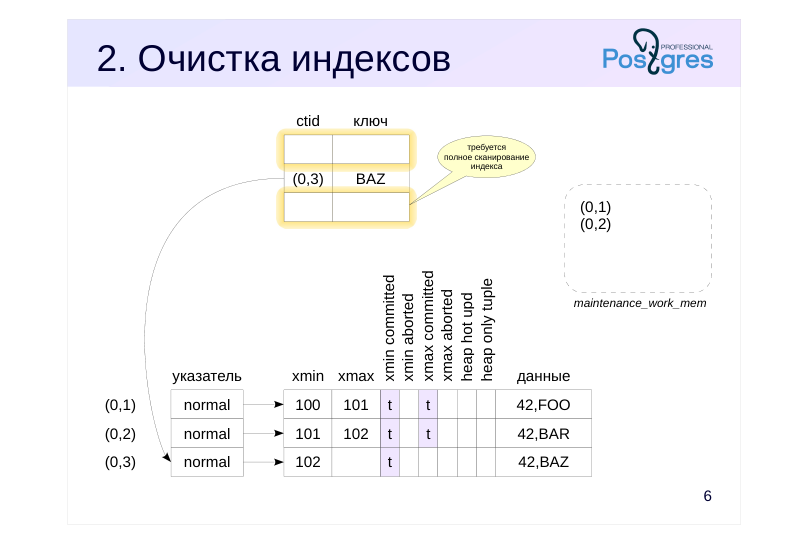 {#source-figure-006 caption=“Source slide page 6: 2. Очистка индексов”}
Комментарии преподавателя
Когда выделенная под массив память заканчивается (или если мы уже дошли до конца таблицы), выполняется очистка индексов.
Для этого каждый из индексов, созданных на таблице, полностью сканируется в поисках записей, которые ссылаются на очищаемые версии строк. Найденные записи вычищаются из индексных страниц.
Начиная с PostgreSQL 14, очистка пропускает сканирование индексов, если это малоэффективно (когда количество страниц, содержащих мертвые строки, не превышает 2% от общего количества страниц таблицы). Но если параметр INDEX_CLEANUP выставлен в значение on, то VACUUM будет безусловно удалять ненужные записи из индексов.
Page 7: 3. Очистка таблицы
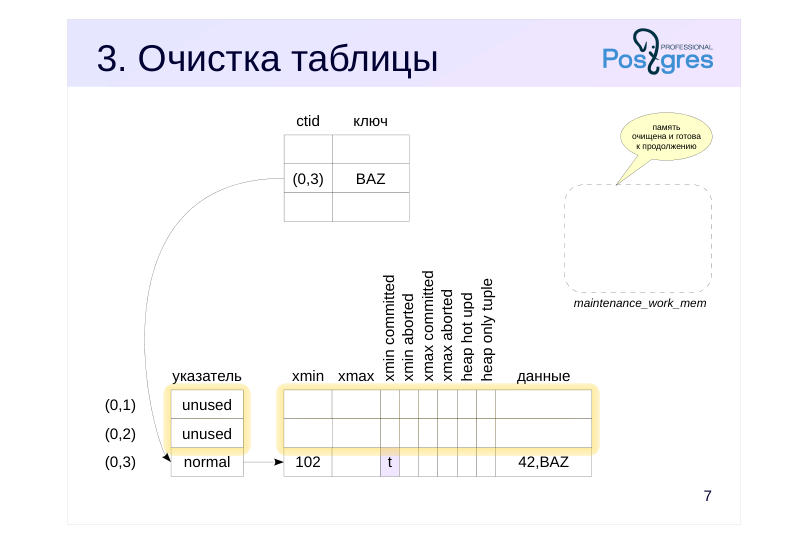 {#source-figure-007 caption=“Source slide page 7: 3. Очистка таблицы”}
Комментарии преподавателя
После этого необходимые табличные страницы повторно читаются, чтобы очистить в них ненужные версии строк и освободить указатели, на которые больше нет ссылок из индексов.
Если на первом проходе таблица не была просканирована полностью, VACUUM очищает массив в памяти и продолжает работу с этой точки.
Таким образом, если при очистке удаляется так много версий строк, что их идентификаторы не помещаются в память размером maintenance_work_mem, все индексы будут полностью сканироваться несколько раз. На больших таблицах это может занимать существенное время и заметно нагружать систему. В таком случае можно либо распределить нагрузку во времени, вызывая очистку чаще (чтобы за каждый раз очищалось не очень большое количество версий строк), либо выделить больше памяти, чтобы исключить повторную обработку индексов.
В конце очистки выполняется этап усечения таблицы. Если в самом конце файла образовалось достаточно много пустых страниц, они «откусываются» и освободившееся место возвращается операционной системе. Это действие требует установки исключительной блокировки. Если такая блокировка вызывает проблемы, этап усечения можно отключить параметром хранения vacuum_truncate или явно: VACUUM (TRUNCATE off). Подробнее см. модуль «Блокировки».
Page 8: Мониторинг
VACUUM VERBOSE Представление pg\_stat\_progress\_vacuum
- полный размер таблицы
- число прочитанных страниц и число очищенных страниц
- количество уже завершенных циклов очистки индексов
- число идентификаторов версий строк, помещающихся в память
- и текущее число идентификаторов в памяти
- текущая фаза очистки
Комментарии преподавателя
Если очистка выполняется долго, может потребоваться узнать текущее состояние дел.
Для этого можно вызывать VACUUM с указанием VERBOSE — на консоль будет выводиться информация о ходе выполнения.
Кроме того, есть представление pg_stat_progress_vacuum, которое содержит всю информацию о выполняющейся в данный момент очистке. Ход очистки таблицы можно отслеживать, сравнивая число очищенных страниц (heap_blks_vacuumed) с общим количеством (heap_blks_total). Ход очистки индексов детально не отображается, но основное внимание надо обращать на количество циклов очистки (index_vacuum_count) — значение больше 1 означает, что памяти maintenance_work_mem не хватило для того, чтобы завершить очистку за один проход.
https://postgrespro.ru/docs/postgresql/16/progress-reporting#VACUUM-PRO GRESS-REPORTING
Page 9: Обычная очистка
Создадим таблицу и индекс.
Как обычно, используем расширение pageinspect:
А также представление для табличной страницы:
И представление для индекса:
Вставим строку в таблицу и обновим ее:
Теперь, чтобы еще раз напомнить про понятие горизонта, откроем в другом сеансе транзакцию с активным снимком данных.
Page 10: Page 10
Горизонт базы данных определяется этим снимком:
Снова обновим строку.
Сейчас в таблице три версии строки:
Выполним теперь очистку.
Как изменится табличная страница?
Очистка освободила одну версию строки, а вторая осталась без изменений, так как параллельная транзакция до сих пор не завершена и ее снимок активен. В индексе — два указателя на оставшиеся версии:
Можно попросить очистку рассказать о том, что происходит:
Page 11: Page 11
Обратите внимание: tuples: 0 removed, 2 remain, 1 are dead but not yet removable, index scan not needed removable cutoff показывает текущий горизонт Теперь завершим параллельную транзакцию и снова вызовем очистку.
Горизонт сдвинулся вперед и позволил очистке удалить мертвую строку — tuples: 1 removed. Теперь в странице осталась только последняя актуальная версия строки:
В индексе также осталась только одна запись:
Page 12: Регулирование нагрузки
Процесс чередует работу и ожидание
- примерно vacuum_cost_limit условных единиц работы,
- затем засыпает на vacuum_cost_delay мс
- Настройки
- vacuum_cost_limit = 200
- vacuum_cost_delay = 0 ms
- стоимость обработки:
- vacuum_cost_page_hit = 1
- страница нашлась в кеше
- vacuum_cost_page_miss = 2
- страница прочитана с диска
- vacuum_cost_page_dirty = 20
- чистая страница стала грязной
Комментарии преподавателя
Поскольку процесс очистки интенсивно работает с таблицами и индексами, может оказаться необходимым распределить действия во времени и тем самым сгладить пики нагрузки. Для этого существует возможность выполнять очистку порциями, чередуя работу и ожидание.
Размер порции vacuum_cost_limit указывается в условных единицах. Три других параметра, указанных на слайде, определяют стоимость обработки одной страницы в этих единицах в зависимости от выполненных действий. В лучшем случае стоимость будет равна vacuum_cost_page_hit (если страница нашлась в кеше и либо не изменилась, либо уже была грязной); в худшем случае — vacuum_cost_page_miss + vacuum_cost_page_dirty (если страница была прочитана с диска и изменилась в результате очистки).
Настройка по умолчанию фактически отключает механизм регулирования нагрузки, так как время ожидания выставлено в ноль. Это сделано из тех соображений, что если администратору пришлось запускать VACUUM вручную, он, скорее всего, хочет выполнить очистку как можно быстрее.
https://postgrespro.ru/docs/postgresql/16/runtime-config-resource#RUNTIM E-CONFIG-RESOURCE-VACUUM-COST
Page 13: Параллельная очистка
Сканирование и очистка таблицы — последовательно
- Очистка индексов может выполняться параллельно
- каждый индекс — только одним рабочим процессом
- размер индекса должен превышать min_parallel_index_scan_size
- количество процессов ограничено max_parallel_maintenance_workers
- и, если указано, значением VACUUM (PARALLEL n)
Комментарии преподавателя
Этапы сканирования и очистки таблицы всегда выполняются последовательно одним процессом.
Этап очистки индексов может выполняться в параллельном режиме. Это происходит, если на таблице создано несколько (больше одного) достаточно больших индексов: размер индекса должен превышать значение параметра min_parallel_index_scan_size (512 Кбайт по умолчанию). Тогда для каждого подходящего индекса запускается отдельный рабочий процесс.
Каждый индекс обрабатывается только одним рабочим процессом, то есть несколько процессов не могут очищать один и тот же индекс.
Количество процессов ограничено сверху значением параметра max_parallel_maintenance_workers и может быть дополнительно ограничено явным указанием степени параллелизма при вызове команды VACUUM (PARALLEL n).
Page 14: Анализ
Выполняется при VACUUM ANALYZE или ANALYZE
- не конфликтует с обычной активностью в системе
- Собирает статистику для планировщика
Комментарии преподавателя
Еще одна задача, которую обычно совмещают с очисткой, — анализ, то есть сбор статистической информации для планировщика запросов. Анализируется число строк в таблице, распределение данных по столбцам и т. п. Подробно сбор статистики рассматривается в курсе QPT «Оптимизация запросов» .
Вручную анализ выполняется командой ANALYZE (только анализ) или VACUUM ANALYZE (и очистка, и анализ).
Как и в случае очистки, обработка происходит в фоновом режиме и не мешает обычному использованию таблиц и индексов.
https://postgrespro.ru/docs/postgresql/16/sql-analyze
Page 15: Анализ
Создадим таблицу с большим количеством одинаковых строк и проиндексируем ее:
Планировщик ничего не знает про данные и выбирает индексный доступ, хотя читать придется всю таблицу:
При анализе собирается статистика по случайной выборке строк:
Статистика сохраняется в системном каталоге. После этого планировщик знает, что во всех строках находится одно и то же значение, и перестает использовать индекс:
Page 16: Полная очистка
Выполняется командой VACUUM FULL
- не совместима ни с какими операциями над таблицей, включая чтение
- Полностью перестраивает таблицу и все ее индексы
- при работе потребуется дополнительное место для новых файлов
- освобожденное место возвращается операционной системе
- выполняется дольше, чем обычная очистка
Комментарии преподавателя
Обычная очистка не решает всех задач по освобождению места. Если таблица или индекс сильно выросли в размерах, то очистка не приведет к сокращению числа страниц (и к уменьшению файлов). Вместо этого внутри существующих страниц появятся «дыры», которые могут быть использованы для вставки новых строк или изменения существующих. Единственное исключение составляют полностью очищенные страницы, находящиеся в конце файла — такие страницы «откусываются» и освободившееся место возвращается операционной системе.
Если размер файлов превышает некие разумные пределы, можно выполнить полную очистку. При этом таблица и все ее индексы перестраиваются полностью с нуля, а данные упаковываются максимально компактно (разумеется, с учетом fillfactor).
При перестройке PostgreSQL последовательно перестраивает сначала таблицу, а затем и каждый из индексов. Для них создаются новые файлы, а старые удаляются. Следует учитывать, что в процессе работы на диске потребуется дополнительное место.
Полная очистка не предполагает регулярного использования, так как полностью блокирует все действия с таблицей (включая ее чтение) на все время своей работы. На активно используемой системе это может быть неприемлемым; в таком случае может помочь расширение pg_repack (https://github.com/reorg/pg\_repack), не входящее в поставку.
Page 17: До полной очистки
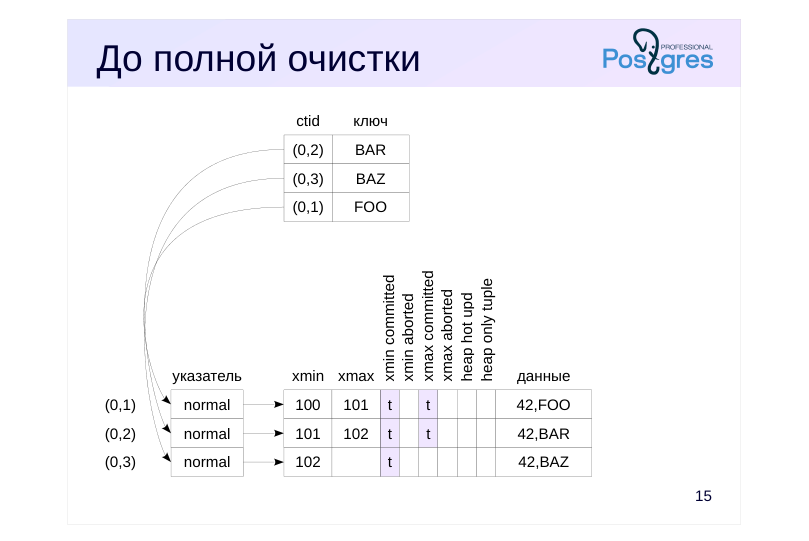 {#source-figure-017 caption=“Source slide page 17: До полной очистки”}
Комментарии преподавателя
На рисунке приведена ситуация до полной очистки. В табличной странице три версии одной строки. Две из них неактуальны, не видны ни в одном снимке и могут быть удалены.
В индексе есть три ссылки на каждую из версий строки.
Page 18: После полной очистки
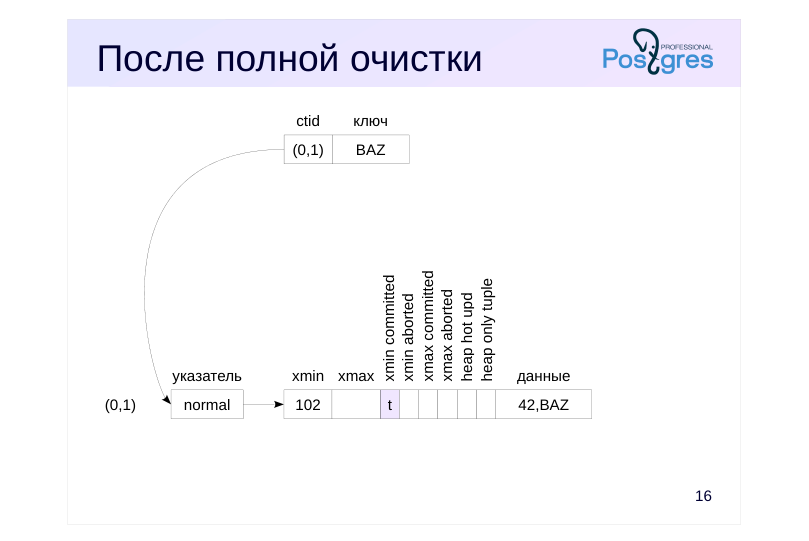 {#source-figure-018 caption=“Source slide page 18: После полной очистки”}
Комментарии преподавателя
После выполнения полной очистки содержимое таблицы и индекса полностью перестроено и физически находится в других файлах. При этом OID таблицы в системном каталоге сохраняется.
Page 19: Полная очистка
Файлы, занимаемые таблицей и индексом:
Вызываем полную очистку.
Таблица и индекс теперь полностью перестроены:
Имена файлов поменялись:
Page 20: Аналоги полной очистки
CLUSTER
- полностью перестраивает таблицу и все ее индексы
- дополнительно физически упорядочивает версии строк
- в соответствии с одним из индексов
- REINDEX
- полностью перестраивает индексы
- TRUNCATE
- «опустошает» таблицу
- Особенности
- все команды полностью блокируют работу с таблицей
- все команды создают новые файлы для данных
Комментарии преподавателя
Есть несколько команд, которые работают, используя схожий механизм. Все они полностью блокируют работу с таблицей, все они удаляют старые файлы данных и создают новые.
Команда CLUSTER во всем аналогична VACUUM FULL, но дополнительно физически упорядочивает версии строк в соответствии с одним из индексов. Это дает планировщику возможность более эффективно использовать индексный доступ в некоторых случаях. Однако надо понимать, что кластеризация не поддерживается: при последующих изменениях таблицы физический порядок версий строк будет нарушаться.
Команда REINDEX перестраивает индексы, не трогая при этом таблицу. Фактически, VACUUM FULL использует эту команду для перестроения индексов. При этом читать таблицу формально не запрещается, однако планировщик попытается получить блокировку перестраиваемого индекса, чтобы рассмотреть все планы, и до окончания работы команды прочитать таблицу фактически не удастся. Вариант REINDEX CONCURRENTLY работает дольше, но не блокирует индекс и не мешает чтению и обновлению данных.
Команда TRUNCATE логически работает так же, как и DELETE — удаляет все табличные строки. Но DELETE, как уже было рассмотрено, помечает версии строк как удаленные, что требует дальнейшей очистки. TRUNCATE же просто создает новый, чистый файл. Это работает быстрее, но надо учитывать, что TRUNCATE заблокирует работу с таблицей на все время до конца транзакции.
Page 21: Итоги
Обычная очистка освобождает место в страницах
- выполняется в фоновом режиме
- может потребоваться несколько раз сканировать индексы
- Анализ собирает статистику для планировщика
- выполняется в фоновом режиме можно совместить с очисткой Полная очистка перестраивает таблицу и индексы
- блокирует работу с таблицей на все время выполнения
Page 22: Практика
- Создайте большую таблицу с индексом. Временно уменьшите значение maintenance_work_mem так, чтобы потребовалось несколько проходов для очистки индекса. Проконтролируйте, запуская VACUUM VERBOSE.
- Удалите из большой таблицы 90% случайных строк и проверьте, как изменился объем, который таблица занимает на диске, после выполнения обычной очистки. 3. Повторите п. 2 с полной очисткой.
Комментарии преподавателя
- Чтобы исключить срабатывание автоматической очистки (рассматривается в следующей теме), при создании таблицы укажите параметр хранения autovacuum_enabled: CREATE TABLE … WITH (autovacuum_enabled = off);
Page 23: 1. Сканирование индексов при очистке
Создадим таблицу с данными и индекс. Параметр autovacuum_enabled выключен, чтобы не срабатывала автоматическая очистка.
Уменьшаем размер памяти, выделяемой под массив идентификаторов:
Обновляем все строки:
Запускаем очистку. Через небольшое время в другом сеансе обратимся к pg_stat_progress_vacuum.
2. Очистка большого количества строк
Page 24: Page 24
Текущий размер файла данных:
- Удалим 90% случайных строк. Случайность важна, чтобы в каждой странице остались какие-нибудь неудаленные строки — в противном случае очистка имеет шанс уменьшить размер файла.
Объем после очистки:
Объем не изменился.
3. Полная очистка большого количества строк
Заново наполним таблицу.
Текущий размер файла данных:
Обратите внимание, что в прошлый раз размер был примерно в два раза больше. Вторая половина была занята версиями строк, которые создала команда UPDATE. Объем после удаления и полной очистки:
Объем уменьшился на 90%.
06 Занятие 06: Многоверсионность / Автоочистка
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_06_mvcc_autovacuum.html Archive: DBA2-handouts-16.zip Страниц PDF: 20
Page 1: Многоверсионность / Автоочистка
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Автоматическая очистка (autovacuum)
- Автоанализ
- Настройка процесса автоочистки
Page 3: Автоматическая очистка
Работает аналогично обычной очистке
- Выполняется периодически
- для таблиц с определенным количеством изменений
- в том числе для toast-таблиц
- Процесс autovacuum launcher
- постоянно запущен
- планирует запуск рабочих процессов
- Процессы autovacuum worker
- запускаются процессом postmaster по просьбе autovacuum launcher
- подключаются к заданной БД, перебирают и очищают таблицы
Комментарии преподавателя
Автоматическая очистка — механизм, позволяющий запускать обычную очистку в определенные моменты времени, в зависимости от количества изменений в таблицах. Это удобнее и правильнее, чем запуск по расписанию (cron), поскольку учитывает динамику системы.
При включенной автоочистке в системе всегда присутствует процесс autovacuum launcher, который занимается планированием работы. Реальную очистку выполняют процессы autovacuum worker, несколько экземпляров которых могут работать параллельно.
Процессы autovacuum worker запускаются процессом postmaster по просьбе autovacuum launcher (поскольку именно postmaster отвечает за порождение всех новых процессов).
https://postgrespro.ru/docs/postgresql/16/routine-vacuuming#AUTOVACUU M
Page 4: Autovacuum launcher
Периодически запускает рабочий процесс в каждую активную базу данных
- раз в autovacuum_naptime
- над одной базой могут работать несколько процессов
- общее количество рабочих процессов ≤ autovacuum_max_workers
- Настройки
- autovacuum = on
- track_counts = on
- autovacuum_naptime = 60 s
- autovacuum_max_workers = 3
- должны быть включены оба
- ?
Комментарии преподавателя
Процесс autovacuum launcher составляет список баз данных, в которых есть какая-либо активность (точнее, для которых собирается статистика использования).
Новый рабочий процесс запускается раз в autovacuum_naptime для каждой базы данных из списка (то есть при наличии N баз процессы будут порождаться в N раз чаще). Если за время autovacuum_naptime рабочий процесс не успел очистить всю базу данных, в ту же базу будет направлен другой рабочий процесс, и они будут работать вместе. Общее количество рабочих процессов ограничено параметром autovacuum_max_workers.
Чтобы автоматическая очистка в принципе работала, должны быть установлены параметры autovacuum и track_counts. Последний включает сбор статистики использования.
Page 5: Autovacuum worker
Составляет список объектов базы данных для очистки
- число ненужных версий строк превышает
- autovacuum_vacuum_threshold +
- autovacuum_vacuum_scale_factor × число строк в таблице
- число строк, вставленных с момента последней очистки, превышает
- autovacuum_vacuum_insert_threshold +
- autovacuum_vacuum_insert_scale_factor × число строк в таблице
- включаются обычные таблицы и toast-таблицы,
- материализованные представления
- не включаются временные таблицы
Комментарии преподавателя
Рабочий процесс подключается к указанной базе данных и строит список всех таблиц, материализованных представлений и toast-таблиц, требующих очистки.
Очистки требуют объекты, в которых накопилось значительное количество ненужных («мертвых») версий строк.
Очищаются также объекты, в которые с момента прошлой очистки было вставлено значительное количество новых строк. Это важно для таблиц, в которые данные только вставляются: их тоже необходимо очищать, чтобы обновить карту видимости и заморозить старые версии (рассматривается в теме «Заморозка»).
Точные формулы приведены на слайде. Каждая из них использует два параметра, один из которых (*_threshold) определяет абсолютное значение, а другой (*_scale_factor) — относительную долю строк.
Число строк определяется приблизительно, по статистике:
● общее число — pg_class.reltuples,
● число ненужных — pg_stat_all_tables.n_dead_tup,
● число вставленных — pg_stat_all_tables.n_ins_since_vacuum.
Page 6: Autovacuum worker
Составляет список объектов базы данных для анализа
- число изменившихся версий строк превышает
- autovacuum_analyze_threshold +
- autovacuum_analyze_scale_factor × число строк в таблице
- включаются обычные таблицы и материализованные представления
- не включаются toast-таблицы и временные таблицы
- По очереди очищает и/или анализирует выбранные объекты
- в одной базе может одновременно работать несколько процессов
- на уровне одной таблицы параллелизма нет
Комментарии преподавателя
Также строится список всех таблиц и материализованных представлений, требующих анализа. Toast-таблицы не анализируются.
Анализа требуют объекты, в которых с момента предыдущего анализа изменилось значительное число строк. Оно определяется по статистике: pg_stat_all_tables.n_mod_since_analyze.
Построив два списка, рабочий процесс по очереди очищает и/или анализирует отобранные объекты и по окончании очистки завершается.
В одной БД может одновременно работать несколько процессов, параллельно обрабатывая разные таблицы. На уровне одной таблицы параллелизма нет.
Page 7: Autovacuum worker
Настройки автоочистки
- autovacuum_vacuum_threshold = 50
- autovacuum_vacuum_scale_factor = 0.2
- ↓
- autovacuum_vacuum_insert_threshold = 1000
- autovacuum_vacuum_insert_scale_factor = 0.2
- ↓?
- Параметры хранения таблиц
- autovacuum_enabled
- toast.autovacuum_enabled
- и одноименные настроечные параметры
Комментарии преподавателя
Настройки по умолчанию предполагают вызов автоочистки при изменении таблицы на 20% или вставке 20% новых строк. Это достаточно высокое значение: автоочистка будет вызываться редко, но работать будет долго, особенно для больших таблиц. В большинстве случаев эти проценты следует уменьшить.
В случае необходимости можно настроить эти параметры на уровне отдельных таблиц с помощью параметров хранения:
CREATE TABLE … WITH (параметр=значение)
Причем параметры можно отдельно настраивать для toast-таблиц.
Кроме того, на уровне отдельных таблиц автоочистку можно отключить.
https://postgrespro.ru/docs/postgresql/16/runtime-config-autovacuum
https://postgrespro.ru/docs/postgresql/16/sql-createtable#SQL-CREATETAB LE-STORAGE-PARAMETERS
Page 8: Autovacuum worker
Настройки автоанализа
- autovacuum_analyze_threshold = 50
- autovacuum_analyze_scale_factor = 0.1
- ?
- Параметры хранения таблиц
- autovacuum_analyze_threshold
- autovacuum_analyze_scale_factor
- для toast-таблиц анализ не выполняется
Комментарии преподавателя
Настройки по умолчанию предполагают вызов автоанализа при изменении таблицы на 10%.
В случае необходимости, можно настроить эти параметры на уровне отдельных таблиц с помощью параметров хранения.
Toast-таблицы не анализируются, поэтому соответствующих параметров для них нет.
Page 9: Autovacuum worker
Настройки для регулирования нагрузки
- общий предел
- для всех рабочих
- autovacuum_vacuum_cost_limit = −1
- (при −1 используется vacuum_cost_limit = 200)
- ↑
- процессов
- autovacuum_vacuum_cost_delay = 2ms
- (при −1 используется vacuum_cost_delay = 0)
- vacuum_cost_page_hit, vacuum_cost_page_miss, vacuum_cost_page_dirty
- Параметры хранения таблиц
- autovacuum_vacuum_cost_limit
- toast.autovacuum_vacuum_cost_limit
- autovacuum_vacuum_cost_delay
- toast.autovacuum_vacuum_cost_delay
Комментарии преподавателя
Регулирование нагрузки при автоматической очистке работает так же, как и при обычной. Однако существуют дополнительные параметры autovacuum_vacuum_cost_limit и autovacuum_vacuum_cost_delay, которые, если не равны −1, перекрывают параметры vacuum_cost_limit и vacuum_cost_delay.
Для ускорения работы автоочистки можно увеличить значение autovacuum_vacuum_cost_limit, но при этом следует учитывать, что предел, устанавливаемый этим параметром, общий для всех рабочих процессов. Поэтому при увеличении autovacuum_max_workers следует увеличивать и autovacuum_vacuum_cost_limit.
Также эти параметры могут указываться и на уровне отдельных таблиц.
https://postgrespro.ru/docs/postgresql/16/runtime-config-resource#RUNTIM E-CONFIG-RESOURCE-VACUUM-COST
Page 10: Autovacuum worker
Настройки памяти
- autovacuum_work_mem = −1
- (при –1 используется maintenance_work_mem = 64MB)
- настройки действуют для каждого рабочего процесса,
- память выделяется сразу в полном объеме
- больший объем памяти уменьшает избыточную обработку
- индексных страниц
- Мониторинг
- log_autovacuum_min_duration = 10min
- pg_stat_progress_vacuum
Комментарии преподавателя
Кроме настроек, влияющих на то, когда и как работать процессу автоочистки, есть возможность отрегулировать выделяемую память для рабочих процессов (autovacuum worker).
По умолчанию размер памяти ограничен параметром maintenance_work_mem, который действует не только на автоочистку, но и на другие служебные операции. Обычно этот параметр можно установить в достаточно большое значение, поскольку фоновых процессов не так много. Однако число рабочих процессов автоочистки (регулируемое параметром autovacuum_max_workers) может быть большим, и память выделяется сразу полностью (а не по необходимости). Поэтому для процессов автоочистки можно настроить отдельное ограничение с помощью параметра autovacuum_work_mem.
Как говорилось в теме «Очистка», процесс очистки может работать и с минимальным объемом памяти. Но если на таблице созданы индексы, то небольшое значение может привести к повторным сканированиям одних и тех же индексных страниц — автоочистка будет работать медленнее. В идеале следует подобрать такое минимальное значение, при котором нет повторных сканирований.
Для мониторинга есть параметр log_autovacuum_min_duration, задающий время выполнения автоочистки, при превышении которого информация будет записываться в журнал сообщений сервера, и представление pg_stat_progress_vacuum, показывающее информацию в реальном времени.
Напомним, что зачастую следует не увеличивать размер памяти, а уменьшать порог срабатывания очистки, чтобы за один раз обрабатывалось меньше данных.
Page 11: Автоочистка
Создадим таблицу с 1000 строками:
Выставим настройки автоочистки. Небольшое время ожидания, чтобы сразу видеть результат:
Один процент строк:
Нулевой порог:
Выставим настройки автоанализа. Два процента строк:
Нулевой порог:
Перечитаем настройки:
И подождем немного, чтобы сработал автоанализ. Создадим представление, показывающее, нуждается ли наша таблица в очистке. Здесь мы учитываем только мертвые версии, но аналогично можно добавить и условие для вставленных строк.
Page 12: Page 12
Сейчас таблица не требует очистки (в ней нет ненужных версий) и она ни разу не очищалась:
Можно создать аналогичное представление и для анализа:
Представление показывает, что таблица не требует анализа; автоанализ уже был выполнен:
Отключим автоочистку на уровне таблицы и изменим 11 строк (больше 1%):
Проверим представления:
Page 13: Page 13
Как видно, таблице требуется автоочистка. Включим автоочистку для таблицы и подождем несколько секунд…
Автоочистка пришла и обработала таблицу. Число ненужных версий снова равно нулю. При этом автоанализ не выполнялся. Изменим еще 11 строк:
Теперь должна отработать и автоочистка, и автоанализ. Проверим это.
Несколько секунд ожидания…
Page 14: Page 14
Все правильно, отработали оба процесса. Показанные представления можно использовать для мониторинга очереди таблиц, ожидающих очистку и анализ, убрав условие на имя таблицы. Для полноты картины в них требуется учесть параметры хранения на уровне отдельных таблиц.
Page 15: Подход к настройке
Баланс между разрастанием и накладными расходами
- итеративный процесс
- Основные параметры
- autovacuum_vacuum_scale_factor
- частота обработки
- autovacuum_max_workers
- параллелизм
- autovacuum_vacuum_cost_limit
- скорость работы
- индивидуальная настройка важных таблиц параметрами хранения
- Мониторинг
- разрастание таблиц
- очередь таблиц, ожидающих очистки
- нагрузка на ввод-вывод при работе очистки
Комментарии преподавателя
Автоочистка управляется довольно большим числом взаимосвязанных параметров. В хорошо настроенной системе автоочистка не дает таблицам неадекватно разрастаться и при этом не создает лишних накладных расходов.
Поиск баланса — итеративный процесс. Нужно выставить разумные начальные значения исходя из размера и характера использования таблиц, проводить постоянный мониторинг и вносить коррективы.
Увеличение threshold/scale_factor приводит к большему разрастанию таблиц, но очистка выполняется реже и большими порциями (возможны пиковые нагрузки), суммарные накладные расходы ниже. Уменьшение параметров приводит к более частой обработке небольшими порциями, общие накладные расходы увеличиваются, но таблицы разрастаются меньше. Пиковые нагрузки можно пытаться сгладить параметрами cost_limit/cost_delay, уменьшающими скорость работы очистки.
Значение, заданное параметрами threshold/scale_factor, определяет лишь желаемый момент срабатывания очистки. При большом числе сильно измененных таблиц процесс очистки может долго выполнять проход и приступит к обработке очередной таблицы далеко не сразу. В этом случае надо либо увеличивать скорость работы очистки (если она была уменьшена параметрами cost_limit/cost_delay), либо увеличивать число параллельно работающих процессов параметром max_workers (что приведет к увеличению накладных расходов).
Начиная с 16-ой версии процессы автоочистки применяют изменения параметров прямо во время обработки очередного отношения. Поэтому можно «на лету» ускорить уже начавшуюся очистку большой таблицы.
Page 16: Итоги
Автоматическая очистка запускает очистку и анализ таблиц, динамически реагируя на изменения данных
- Автоочистка допускает тонкую настройку как на уровне системы, так и отдельных таблиц
- Настройка автоочистки — итеративный поиск баланса
Page 17: Практика
- Настройте автоочистку на запуск при изменении 10% строк, время «сна» — одна секунда.
- Создайте таблицу с большим количеством строк.
- Двадцать раз с интервалом в несколько секунд изменяйте по 5–6% случайных строк. Каждое изменение выполняйте в отдельной транзакции.
- Сколько раз отработала автоочистка? Насколько разрослась таблица? Совпадают ли результаты с ожидаемыми и как их объяснить?
Page 18: 1. Настройка автоочистки
Настраиваем автоочистку на 10% строк.
Устанавливаем запуск рабочих процессов на один раз в секунду:
2. Таблица
3. Изменение данных
Начальный размер таблицы:
Выполняем обновление таблицы с задержками в несколько секунд между командами.
Page 19: Page 19
4. Оценка разрастания
Статистика по таблице (autovacuum_count — сколько раз выполнялась автоочистка):
Page 20: Page 20
Вот как увеличилась таблица:
Суммарно изменилось порядка 110000 строк, что составляет 110% от размера таблицы. Можно было бы предположить, что автоочистка сработает 10–11 раз. Однако автоочистка выполнялась примерно в два раза реже, поскольку существенная часть обновлений была оптимизирована самоочисткой (в нашем случае, HOT-очисткой: поле n_tup_hot_upd). Таблица увеличилась не в два раза, а меньше — примерно на треть. В идеале достаточно было бы 5–6%, но: карта свободного пространства не обновляется при самоочистке, а автоочистка срабатывает только на второй раз; в результате HOT-обновлений на страницах появляются «лишние» redirect-указатели — при небольшой длине строк, как в нашем примере, этот эффект становится заметен; карта свободного пространства хранит не точную, а округленную информацию.
07 Занятие 07: Многоверсионность / Заморозка
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_07_mvcc_freeze.html Archive: DBA2-handouts-16.zip Страниц PDF: 24
Page 1: Многоверсионность / Заморозка
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Проблема переполнения счетчика транзакций
- Заморозка версий строк и правила видимости
- Настройка автоочистки для выполнения заморозки
- Заморозка вручную
Page 3: Переполнение счетчика
меньшие номера — прошлое, бóльшие — будущее разрядность счетчика — 32 бита, что делать при переполнении?
- транзакция 2
- началась позже
- транзакции 1
- 1
- 2
- прошлое
- будущее
Комментарии преподавателя
Кроме освобождения места в страницах, очистка выполняет также задачу по предотвращению проблем, связанных с переполнением счетчика транзакций.
Под номер транзакции в PostgreSQL выделено 32 бита. Это довольно большое число (около 4 млрд номеров), но при активной работе сервера оно вполне может быть исчерпано. Например при нагрузке 1000 транзакций в секунду это произойдет всего через полтора месяца непрерывной работы.
Но мы говорили о том, что механизм многоверсионности полагается на последовательную нумерацию транзакций — из двух транзакций транзакция с меньшим номером считается начавшейся раньше. Понятно, что нельзя просто обнулить счетчик и продолжить нумерацию заново.
Почему под номер транзакции не выделено 64 бита — ведь это полностью исключило бы проблему? Дело в том, что (как рассматривалось в теме «Страницы и версии строк») в заголовке каждой версии строки хранятся два номера транзакций — xmin и xmax. Заголовок и так достаточно большой, а увеличение разрядности привело бы к его увеличению еще на 8 байт.
Page 4: Нумерация по кругу
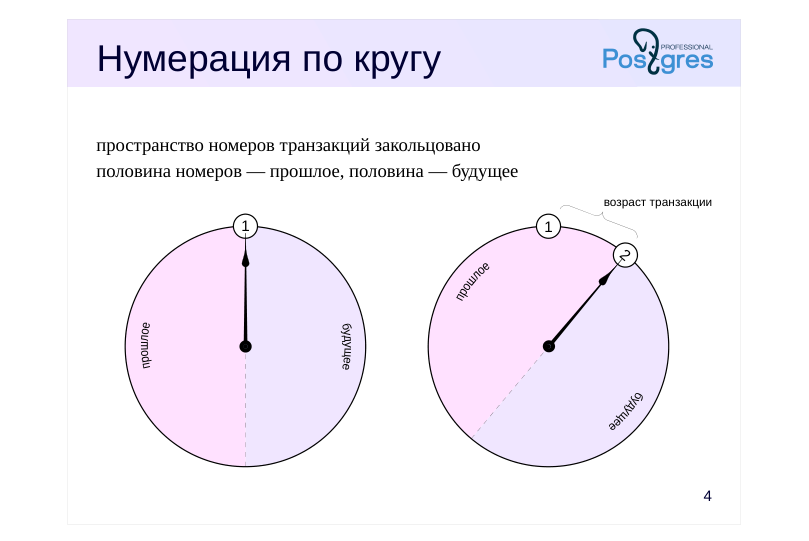 {#source-figure-004 caption=“Source slide page 4: Нумерация по кругу”}
пространство номеров транзакций закольцовано половина номеров — прошлое, половина — будущее
Комментарии преподавателя
Поэтому вместо линейной схемы все номера транзакций закольцованы. Для любой транзакции половина номеров «против часовой стрелки» считается принадлежащей прошлому, а половина «по часовой стрелке» — будущему.
Возрастом транзакции называется число транзакций, прошедших с момента ее появления в системе (независимо от того, переходил ли счетчик через ноль или нет).
Page 5: Проблема видимости
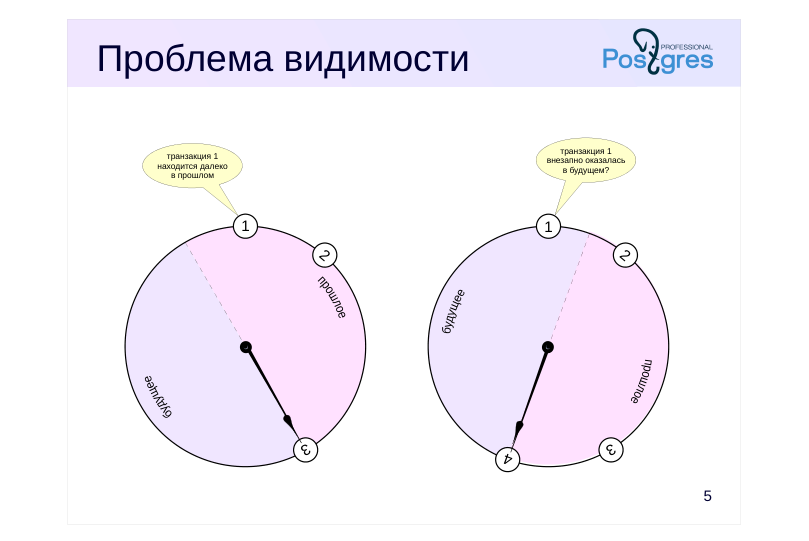 {#source-figure-005 caption=“Source slide page 5: Проблема видимости”}
Комментарии преподавателя
В такой закольцованной схеме возникает неприятная ситуация. Транзакция, находившаяся в далеком прошлом (транзакция 1 на слайде), через некоторое время окажется в той половине круга, которая относится к будущему. Это, конечно, нарушит правила видимости и приведет к проблемам.
Page 6: Заморозка версий строк
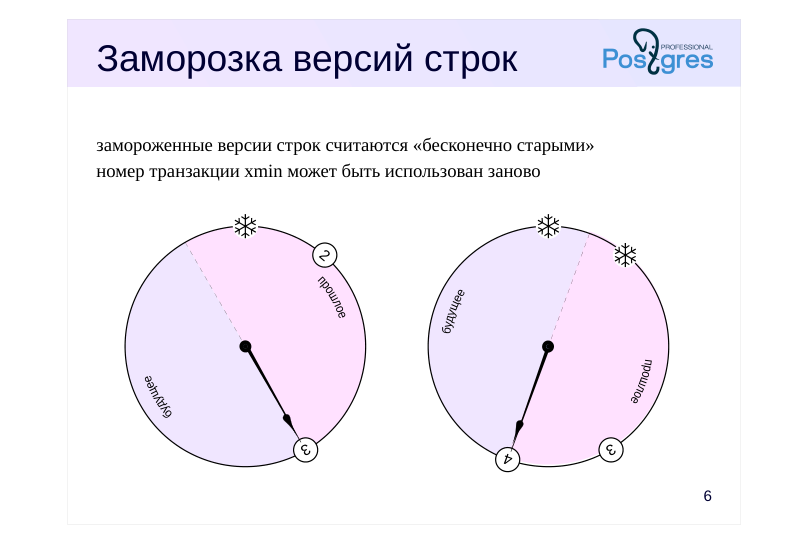 {#source-figure-006 caption=“Source slide page 6: Заморозка версий строк”}
замороженные версии строк считаются «бесконечно старыми» номер транзакции xmin может быть использован заново
Комментарии преподавателя
Чтобы не допустить путешествий из прошлого в будущее, процесс очистки выполняет еще одну задачу. Он находит достаточно старые и «холодные» версии строк (которые видны во всех снимках и изменение которых уже маловероятно) и специальным образом помечает — «замораживает» — их. Замороженная версия строки считается старше любых обычных данных и всегда видна во всех снимках данных. При этом уже не требуется смотреть на номер транзакции xmin, и этот номер может быть безопасно использован заново. Таким образом, замороженные версии строк всегда остаются в прошлом.
https://postgrespro.ru/docs/postgresql/16/routine-vacuuming#VACUUM-FOR -WRAPAROUND
Page 7: Заморозка версий строк
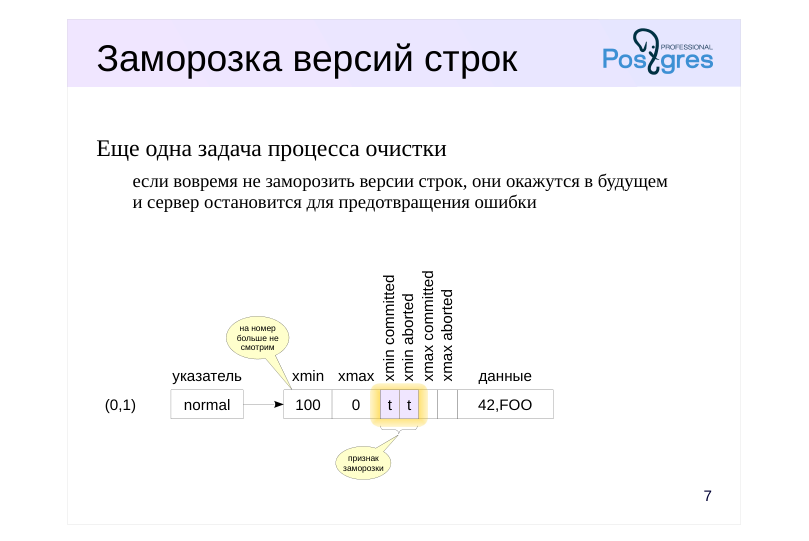 {#source-figure-007 caption=“Source slide page 7: Заморозка версий строк”}
Еще одна задача процесса очистки
- если вовремя не заморозить версии строк, они окажутся в будущем
- и сервер остановится для предотвращения ошибки
Комментарии преподавателя
Для того чтобы пометить версию строки как замороженную, для транзакции xmin выставляются одновременно оба бита-подсказки — бит фиксации и бит отмены.
Заметим, что транзакцию xmax замораживать не нужно. Ее наличие означает, что данная версия строки больше не актуальна. После того, как она перестанет быть видимой в снимках данных, такая версия строки будет очищена.
Многие источники (включая документацию) упоминают специальный номер FrozenTransactionId = 2, который записывается на место xmin в замороженных версиях. Такая система действовала до версии 9.4, но сейчас заменена на биты-подсказки — это позволяет сохранить в версии строки исходный номер транзакции, что удобно для целей поддержки и отладки. Однако транзакции с номером 2 еще могут встретиться в старых системах, даже обновленных до последних версий.
Важно, чтобы версии строк замораживались вовремя. Если возникнет ситуация, при которой еще не замороженный номер транзакции рискует попасть в будущее, PostgreSQL аварийно остановится. Это возможно в двух случаях: либо транзакция не завершена и, следовательно, не может быть заморожена, либо не сработала очистка.
При запуске сервера транзакция будет автоматически отменена; дальше администратор должен вручную выполнить очистку, и после этого система сможет продолжить работу.
Page 8: Настройка
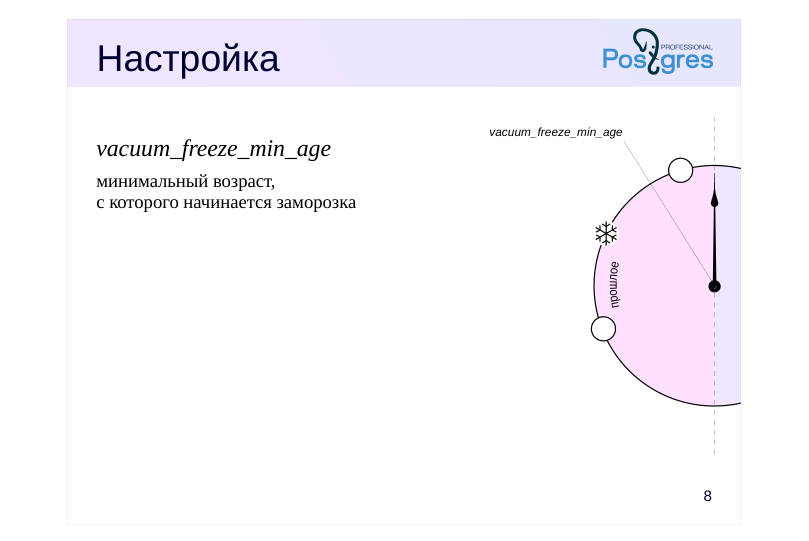 {#source-figure-008 caption=“Source slide page 8: Настройка”}
vacuum\_freeze\_min\_age
- минимальный возраст, с которого начинается заморозка
Комментарии преподавателя
Заморозкой управляют четыре основных параметра.
Параметр vacuum_freeze_min_age определяет минимальный возраст транзакции xmin, с которого начинается заморозка.
Чем меньше это значение, тем больше может быть накладных расходов. Если строка «горячая» и активно меняется, заморозка ее версий будет пропадать без пользы: уже замороженные версии будут вычищаться, а новые версии придется снова замораживать.
Поэтому более молодые версии строк замораживаются только в тех случаях, когда это точно не добавляет работы, например, если в странице уже требуется заморозка других (более старых) строк или при полной очистке таблицы.
Заметим, что очистка просматривает только страницы, не отмеченные в карте видимости. Если на странице остались только актуальные версии, то очистка не придет в такую страницу и не заморозит их.
В заголовке табличной страницы также имеется признак видимости всех версий строк в ней; очистка использует его вместе с соответствующей отметкой в карте видимости.
Page 9: Настройка
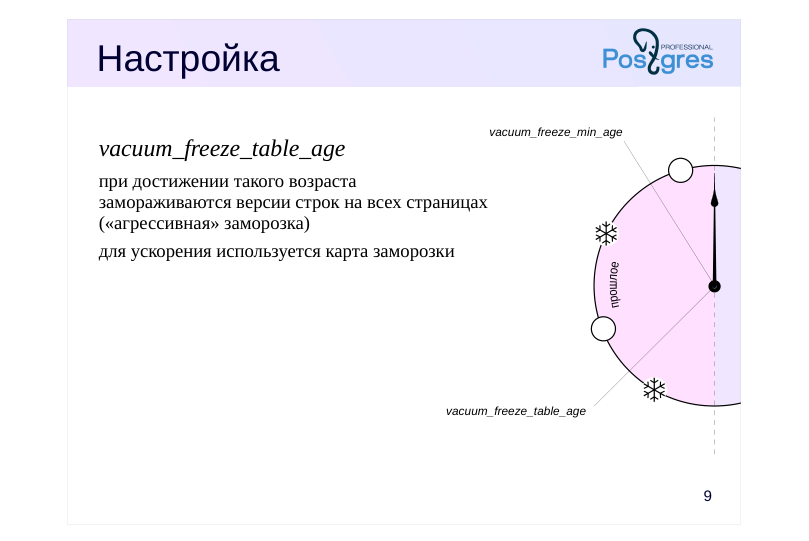 {#source-figure-009 caption=“Source slide page 9: Настройка”}
vacuum\_freeze\_table\_age
- при достижении такого возраста замораживаются версии строк на всех страницах («агрессивная» заморозка) для ускорения используется карта заморозки
Комментарии преподавателя
Параметр vacuum_freeze_table_age определяет возраст транзакции, при котором пора выполнять заморозку версий строк на всех страницах таблицы. Такая заморозка называется «агрессивной».
Для каждой таблицы хранится номер транзакции (pg_class.relfrozenxid), для которого известно, что в версиях строк не осталось более старых незамороженных номеров транзакций. Возраст этой транзакции и сравнивается со значением параметра.
Чтобы не просматривать всю таблицу целиком, вместе с картой видимости ведется карта заморозки. В ней отмечены страницы, в которых заморожены все версии строк. Такие страницы при заморозке можно пропускать.
Даже в агрессивном режиме все версии строк с транзакциями младше vacuum_freeze_min_age не замораживаются, поэтому после заморозки новый возраст транзакции relfrozenxid будет равен не нулю, а vacuum_freeze_min_age. Таким образом, заморозка всех страниц выполняется раз в (vacuum_freeze_table_age − vacuum_freeze_min_age) транзакций.
Мы уже говорили, что слишком маленькое значение параметра vacuum_freeze_min_age увеличивает накладные расходы на очистку. Но при больших значениях агрессивная заморозка будет выполняться слишком часто, что тоже плохо. Установка этого параметра требует компромисса.
Page 10: Настройка
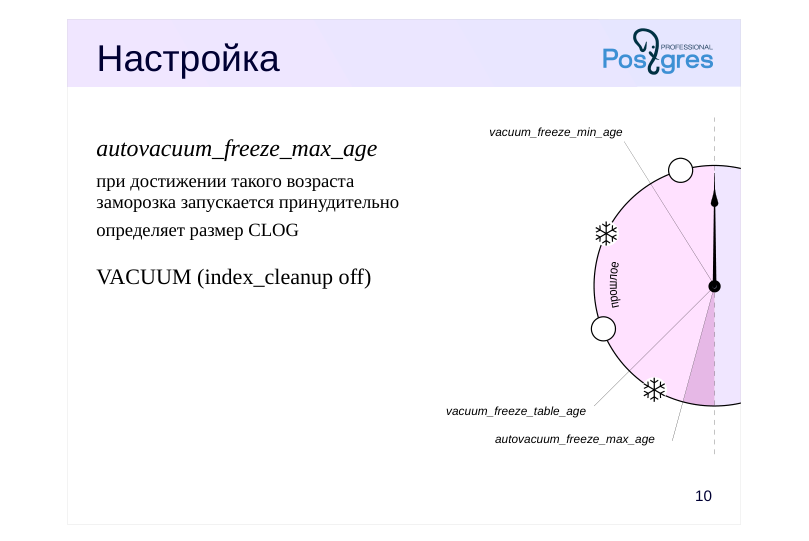 {#source-figure-010 caption=“Source slide page 10: Настройка”}
autovacuum\_freeze\_max\_age
- при достижении такого возраста заморозка запускается принудительно определяет размер CLOG
- VACUUM (index_cleanup off)
Комментарии преподавателя
Параметр autovacuum_freeze_max_age определяет возраст транзакции, при котором заморозка будет выполняться принудительно. Автоочистка для предотвращения последствий переполнения счетчика транзакций запустится, даже если она отключена параметрами.
Этот параметр также определяет размер структуры CLOG: данные о статусе более старых транзакций точно никогда не понадобятся, поэтому часть файлов из PGDATA/pg_xact может быть удалена.
Если администратор понимает, что автоочистка не успеет заморозить версии строк до переполнения счетчика транзакций, можно воспользоваться ручной очисткой с параметром index_cleanup off. В этом случае индексы не будут очищаться, но за счет этого версии строк в таблицах будут заморожены быстрее.
Page 11: Настройка
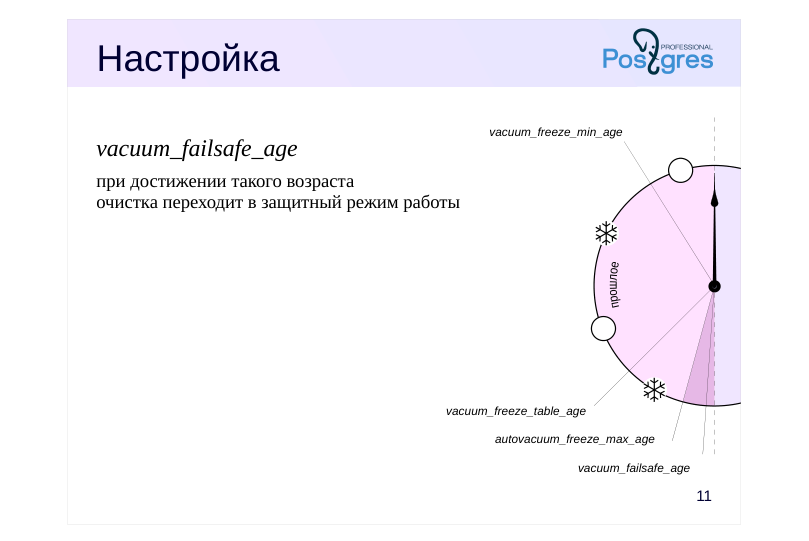 {#source-figure-011 caption=“Source slide page 11: Настройка”}
vacuum\_failsafe\_age
- при достижении такого возраста очистка переходит в защитный режим работы
Комментарии преподавателя
Параметр vacuum_failsafe_age управляет включением защитного режима работы очистки, который служит для ускорения заморозки номеров транзакций.
В этом режиме задержки, задаваемые параметрами autovacuum_vacuum_cost_delay и vacuum_cost_delay, будут отменены. Также не будут выполняться некоторые необязательные работы (например очистка индексов). Такие меры позволят очистке быстрее заморозить старые транзакции и перейти в обычный режим работы.
Page 12: Настройка
Конфигурационные параметры
- vacuum_freeze_min_age
- = 0 50 000 000
- vacuum_freeze_table_age
- = 150 000 000
- autovacuum_freeze_max_age = 200 000 000
- vacuum_failsafe_age
- = 1 600 000 000
- ↑?
- Параметры хранения таблиц
- autovacuum_freeze_min_age
- toast.autovacuum_freeze_min_age
- autovacuum_freeze_table_age
- toast.autovacuum_freeze_table_age
- autovacuum_freeze_max_age
- toast.autovacuum_freeze_max_age
Комментарии преподавателя
Значения по умолчанию довольно консервативны. Предел для autovacuum_freeze_max_age – порядка 2 млрд транзакций, а используется значение в 10 раз меньшее. Можно увеличить значения vacuum_freeze_table_age и autovacuum_freeze_max_age для уменьшения накладных расходов, но важно понимать, что если по каким-то причинам (например, из-за активной транзакции) автоочистка вовремя не справится с заморозкой, у администратора останется мало времени для принятия мер. Заметьте, что изменение параметра autovacuum_freeze_max_age требует перезапуска сервера.
Значение по умолчанию vacuum_failsafe_age значительно больше, чем autovacuum_freeze_max_age, и если до исчерпания номеров останется мало времени, защитный режим ускорит заморозку.
Отметим, что сервер может скорректировать установленные значения параметров vacuum_freeze_min_age, vacuum_freeze_table_age и vacuum_failsafe_age исходя из значения autovacuum_freeze_max_age.
Ряд параметров также можно устанавливать на уровне отдельных таблиц с помощью параметров хранения. Это имеет смысл делать только в особенных случаях, когда таблица действительно требует особого обхождения. Заметьте, что имена параметров на уровне таблиц немного отличаются от имен конфигурационных параметров.
В модуле «Блокировки» рассматриваются т. н. мультитранзакции и дополнительные параметры настройки заморозки для них.
https://postgrespro.ru/docs/postgresql/16/runtime-config-client
https://postgrespro.ru/docs/postgresql/16/runtime-config-autovacuum
Page 13: Заморозка
Установим для демонстрации параметры заморозки. Небольшой возраст транзакции:
Возраст, после которого будет выполняться заморозка всех страниц:
И отключим автоматическую очистку, чтобы запускать ее вручную в нужный момент.
Создадим таблицу с данными. Установим минимальный fillfactor: на каждой странице будет всего две строки.
Создадим представление для наблюдения за битами-подсказками на первых двух страницах таблицы. Сейчас нас интересует только xmin и биты, которые относятся к нему, поскольку версии строк с ненулевым xmax будут очищены. Кроме того, выведем и возраст транзакции xmin.
Для того чтобы заглянуть в карту видимости и заморозки, воспользуемся еще одним расширением:
Page 14: Page 14
Вставляем данные. Сразу выполним очистку, чтобы построить карту видимости.
После очистки обе страницы отмечены в карте видимости (all_visible):
Каков возраст транзакции, создавшей строки?
Возраст равен 1; версии строк с такой транзакцией еще не будут заморожены. Обновим строку на нулевой странице. Новая версия попадет на ту же страницу благодаря небольшому значению fillfactor.
Сейчас нулевая страница уже будет обработана заморозкой: возраст транзакции превышает значение, установленное в vacuum_freeze_min_age; страница изменена и исключена из карты видимости.
Выполняем очистку.
Очистка обработала измененную страницу. У одной версии строки установлены оба бита — это признак заморозки. Другая версия строки слишком молода, однако тоже была заморожена при проходе страницы (это позволило отметить нулевую страницу в карте заморозки):
Page 15: Page 15
Теперь обе страницы отмечены в карте видимости (все версии строк на них актуальны). Очистка теперь не будет обрабатывать ни одну из этих страниц, и незамороженные версии строк на первой странице так и останутся незамороженными.
Именно для такого случая и требуется параметр vacuum_freeze_table_age, определяющий, в какой момент нужно просмотреть страницы, отмеченные в карте видимости, если они не отмечены в карте заморозки. Для каждой таблицы сохраняется наибольший номер транзакции, для которого все версии строк с меньшими номерами xmin гарантированно заморожены. Ее возраст и сравнивается со значением параметра.
Сымитируем выполнение еще одной транзакции, чтобы возраст relfrozenxid таблицы достиг значения параметра vacuum_freeze_table_age.
Теперь, поскольку гарантированно была проверена вся таблица, номер замороженной транзакции можно увеличить — мы уверены, что в страницах не осталось более старой незамороженной транзакции.
Вот что получилось в страницах:
Page 16: Page 16
Обе страницы теперь отмечены в карте заморозки.
Номер последней замороженной транзакции есть и на уровне всей БД:
Он устанавливается в минимальное значение из relfrozenxid всех таблиц этой БД. Если возраст datfrozenxid превысит значение параметра autovacuum_freeze_max_age, автоочистка будет запущена принудительно.
Page 17: Заморозка вручную
VACUUM
- заморозка версий строк по возрасту в соответствии с настройками
- VACUUM FREEZE
- принудительная заморозка версий строк с xmin любого возраста
- тот же эффект и при VACUUM FULL, CLUSTER
- COPY … WITH FREEZE
- принудительная заморозка сразу после загрузки
- таблица должна быть создана или опустошена в той же транзакции
- могут нарушиться правила изоляции транзакции
Комментарии преподавателя
Несмотря на то, что во время работы автоочистки при необходимости выполняется и заморозка, иногда бывает удобно управлять заморозкой вручную.
Команда VACUUM, как и автоочистка, выполнит заморозку в соответствии с настройками.
Если выполнить команду VACUUM FREEZE, будут заморожены все версии строк без оглядки на возраст транзакций (как будто параметры vacuum_freeze_min_age и vacuum_freeze_table_age равны нулю). При перестройке таблицы командами VACUUM FULL или CLUSTER все строки также замораживаются.
https://postgrespro.ru/docs/postgresql/16/sql-vacuum
Данные можно заморозить и при начальной загрузке с помощью команды COPY, указав параметр FREEZE. Для этого таблица должна быть создана (или опустошена командой TRUNCATE) в той же транзакции, что и COPY. Поскольку для замороженных строк действуют отдельные правила видимости, такие строки будут видны в снимках данных других транзакций в нарушение обычных правил изоляции (для транзакций с уровнем Repeatable Read или Serializable), но обычно это не представляет проблемы. Подробнее такой случай рассматривается в практике.
https://postgrespro.ru/docs/postgresql/16/sql-copy
Текущая реализация такой заморозки для таблиц с TOAST строит карту видимости только для основной части таблицы, но не для TOAST. Это приводит к дополнительному проходу по всем страницам при последующей очистке.
Page 18: Итоги
Пространство номеров транзакций закольцовано
- Достаточно старые версии строк замораживаются процессом очистки
- Для оптимизации используется карта заморозки
Page 19: Практика
- Проверьте с помощью расширения pageinspect, что при использовании команды COPY … WITH FREEZE версии строк действительно замораживаются.
- Убедитесь, что даже на уровне изоляции Repeatable Read строки, загруженные командой COPY … WITH FREEZE, оказываются видны в снимке данных.
- Уменьшив значение параметра autovacuum_freeze_max_age и отключив автоочистку, воспроизведите ситуацию принудительного срабатывания автоочистки, выполнив соответствующее количество транзакций. Учтите, что срабатывание произойдет не сразу, а при выполнении ручной очистки какой-нибудь таблицы (или при перезапуске сервера).
Комментарии преподавателя
- Чтобы транзакциям выделялись постоянные (не виртуальные) номера, в транзакции нужно менять данные.
Можно организовать цикл в bash, в котором вызывать psql с командой обновления: psql -c ‘UPDATE …’
Другой вариант — использовать для организации цикла PL/pgSQL. Для этого можно создать процедуру, выполняющую фиксацию транзакции или использовать блок с обработкой исключений. При перехвате исключения транзакция будет откатываться к неявной точке сохранения: фактически начнется новая вложенная транзакция (см. тему «Страницы и версии строк»).
Третий вариант — использовать утилиту pgbench:
https://postgrespro.ru/docs/postgresql/16/pgbench
Page 20: 1. Заморозка при COPY WITH FREEZE
Создаем таблицу и загружаем несколько строк в одной и той же транзакции:
Проверяем версии строк:
2. COPY WITH FREEZE и изоляция
В другом сеансе начнем транзакцию с уровнем изоляции Repeatable Read.
Page 21: Page 21
Обратите внимание, что эта транзакция не должна обращаться к таблице t. Теперь опустошим таблицу и загрузим в нее новые строки в одной транзакции. Если бы параллельная транзакция прочитала содержимое t, команда TRUNCATE ожидала бы ее завершения.
Теперь параллельная транзакция видит новые данные, хотя это и нарушает изоляцию:
3. Аварийное срабатывание автоочистки
Предварительно заморозим все транзакции во всех базах. Для этого удобно воспользоваться командой vacuumdb:
Максимальный возраст незамороженных транзакций по всем БД:
Отключаем автоочистку.
Page 22: Page 22
Уменьшаем значения параметров:
Требуется перезагрузка сервера.
Получить большое количество транзакций можно разными способами; например, можно воспользоваться утилитой pgbench. Попросим ее инициализировать свои таблицы и выполнить 100000 транзакций.
Выполнение ста тысяч транзакций может занять заметное время, ключ –protocol=prepared немного ускоряет работу за счет использования подготовленных операторов:
Page 23: Page 23
Видно, что возраст незамороженных транзакций превышает установленное пороговое значение (100000):
Теперь при выполнении команды VACUUM для любой таблицы будет запущен процесс автоочистки.
Среди процессов появился autovacuum worker:
И через некоторое время транзакции окажутся замороженными:
Page 24: Page 24
08 Занятие 08: Журналирование / Буферный кеш
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_08_wal_buffercache.html Archive: DBA2-handouts-16.zip Страниц PDF: 29
Page 1: Журналирование / Буферный кеш
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Устройство и использование буферного кеша
- Механизм вытеснения страниц
- Массовое вытеснение и буферные кольца
- Настройка размера кеша
- Локальный кеш для временных таблиц
- Прогрев кеша
Page 3: Буферный кеш
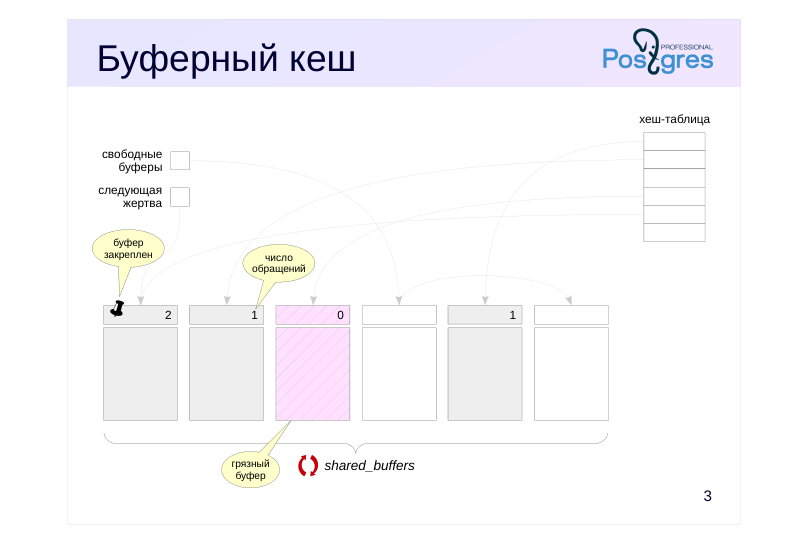 {#source-figure-003 caption=“Source slide page 3: Буферный кеш”}
Комментарии преподавателя
Задача буферного кеша — сглаживать разницу в производительности двух типов памяти: оперативной (быстрая, но мало) и дисковой (медленная, но много). Чтобы работать с данными — читать или изменять, — процессы читают страницы в буферный кеш. Пока страница находится в кеше, мы экономим на обращениях к диску.
Буферный кеш располагается в общей памяти сервера и представляет собой массив буферов. Каждый буфер состоит из места под одну страницу данных и заголовка. Заголовок содержит, в числе прочего:
● расположение страницы на диске (файл и номер страницы в нем);
● число обращений к буферу (счетчик usage count, увеличивается каждый раз, когда процесс читает или изменяет буфер);
● признак того, что данные на странице изменились и рано или поздно должны быть записаны на диск (такой буфер называют грязным);
● признак закрепления (счетчик pin count количества процессов, работающих в данный момент с содержимым буфера).
Размер буферного кеша задается параметром shared_buffers. Его изменение требует перезапуска сервера.
Изначально кеш содержит пустые буферы, и все они связаны в список свободных буферов. Смысл указателя на «следующую жертву» станет ясен чуть позже.
Чтобы быстро находить нужную страницу в кеше, используется хеш-таблица.
Page 4: Страница в кеше
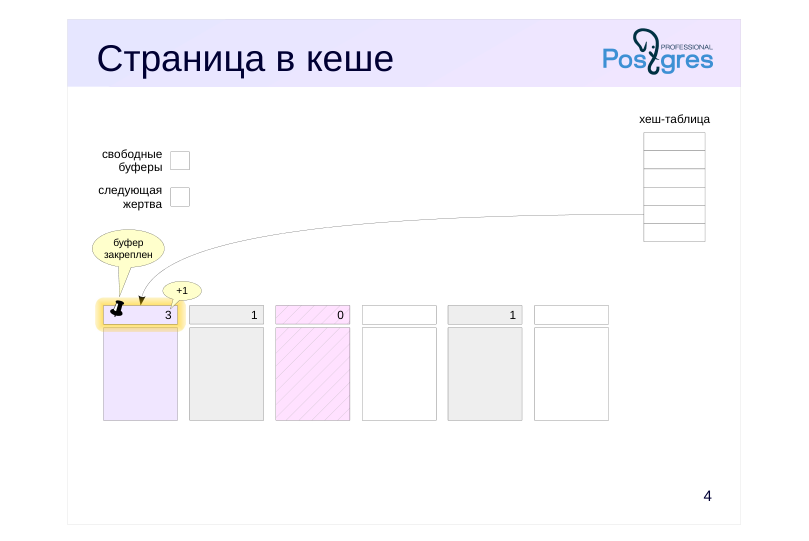 {#source-figure-004 caption=“Source slide page 4: Страница в кеше”}
Комментарии преподавателя
Когда процессу требуется прочитать страницу, он сначала пытается найти ее в буферном кеше с помощью хеш-таблицы.
Ключом хеширования служит файл и номер страницы внутри файла; получив номер буфера, процесс быстро проверяет, действительно ли он содержит нужную страницу. Как и в любой хеш-таблице, здесь возможны коллизии; в таком случае процессу придется проверить несколько страниц.
Если нужная страница найдена в кеше, процесс должен «закрепить» буфер (увеличить счетчик pin count) и увеличить число обращений (счетчик usage count). Буфер могут закреплять несколько процессов одновременно, поэтому используется именно счетчик, а не логический признак.
Пока буфер закреплен (значение pin count больше нуля), считается, что буфер используется и его содержимое не должно «радикально» измениться. Например, в странице может появиться новая версия строки — это никому не мешает благодаря многоверсионности и правилам видимости. Но в закрепленный буфер не может быть прочитана другая страница.
Page 5: Страница в кеше
Создадим таблицу с одной строкой:
Информацию о содержимом буферного кеша и его использовании можно получить с помощью расширения pg_buffercache, включающего в себя одноименное представление и дополнительные функции:
Создадим для удобства представление, расшифровывающее некоторые столбцы. Условие на базу данных необходимо, так как в буферном кеше содержатся данные всего кластера. Расшифровать мы можем только информацию из той БД, к которой подключены. Глобальные объекты считаются принадлежащими БД с нулевым OID.
В буферном кеше уже находятся страницы таблицы; они появились при выполнении вставки:
Команда EXPLAIN с указанием analyze и buffers показывает использование буферного кеша при выполнении запроса:
Page 6: Page 6
Строка «Buffers: shared hit=1» говорит о том, что страница была найдена в кеше. После выполнения запроса счетчик использования увеличился на единицу:
Page 7: Чтение в свободный буфер
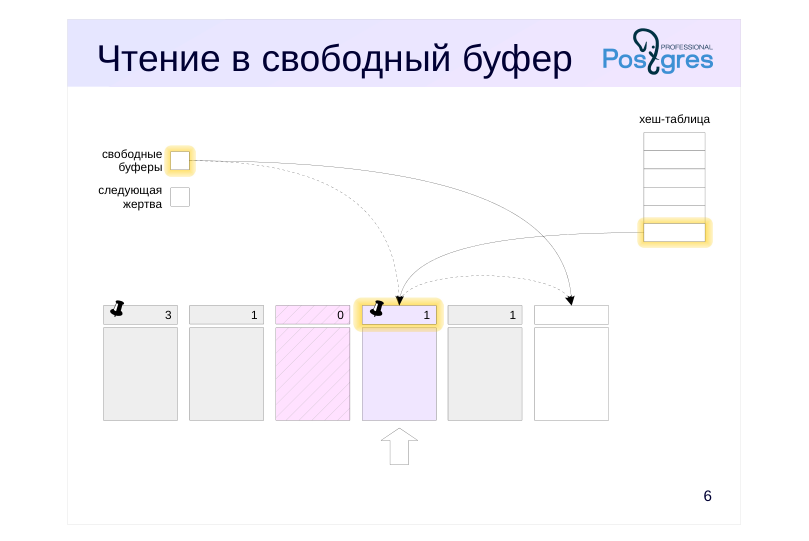 {#source-figure-007 caption=“Source slide page 7: Чтение в свободный буфер”}
Комментарии преподавателя
Может получиться так, что необходимая страница не будет найдена в кеше. В этом случае ее необходимо считать с диска в какой-либо буфер.
В первую очередь поиск подходящего буфера будет проходить по списку свободных буферов, если он не пуст.
Найденный по указателю буфер закрепляется, в него читается необходимая страница, число обращений устанавливается в единицу.
Указатель на свободный буфер передвигается на следующий по списку буфер, если он есть.
Кроме того, ссылку на загруженную страницу необходимо прописать в хеш-таблицу, чтобы в дальнейшем ее можно было найти.
Page 8: Чтение в свободный буфер
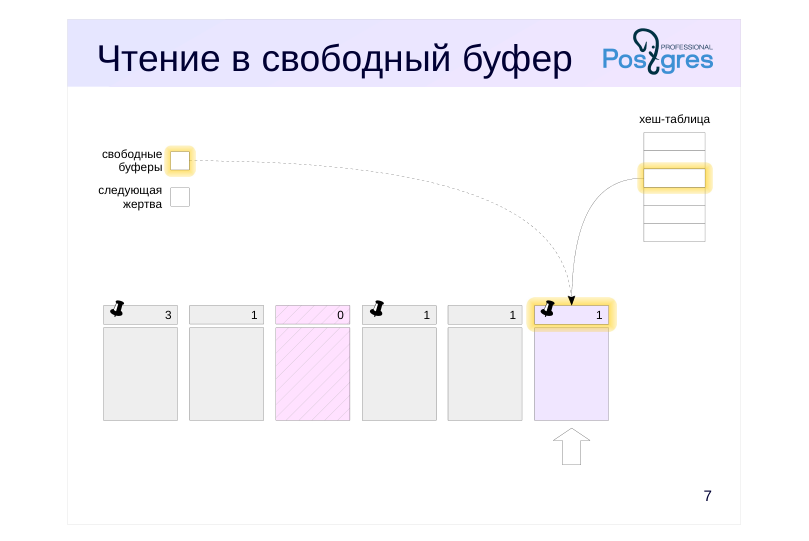 {#source-figure-008 caption=“Source slide page 8: Чтение в свободный буфер”}
Комментарии преподавателя
В конце концов будет заполнен и последний свободный буфер.
Теперь ссылка на свободный буфер пуста — в дальнейшем, чтобы прочитать новую страницу в любой занятый буфер, придется из этого буфера вытеснить страницу, которая там находится.
Буферы возвращаются в список свободных при удалении или опустошении таблицы или при отсечении части хвостовых страниц при очистке — то есть в случаях, когда страница в буфере не заменяется другой, а просто исчезает.
Page 9: Чтение в свободный буфер
Перезагрузим сервер, чтобы сбросить буферный кеш.
В кеше есть свободные буферы:
Выполним запрос к таблице:
Строка «Buffers: shared read=1» показывает, что страницу пришлось прочитать с диска. Вот она:
Количество свободных буферов уменьшилось:
В кеш попала не только прочитанная страница, но и страницы таблиц системного каталога, которые потребовались планировщику.
Page 10: Чтение с вытеснением
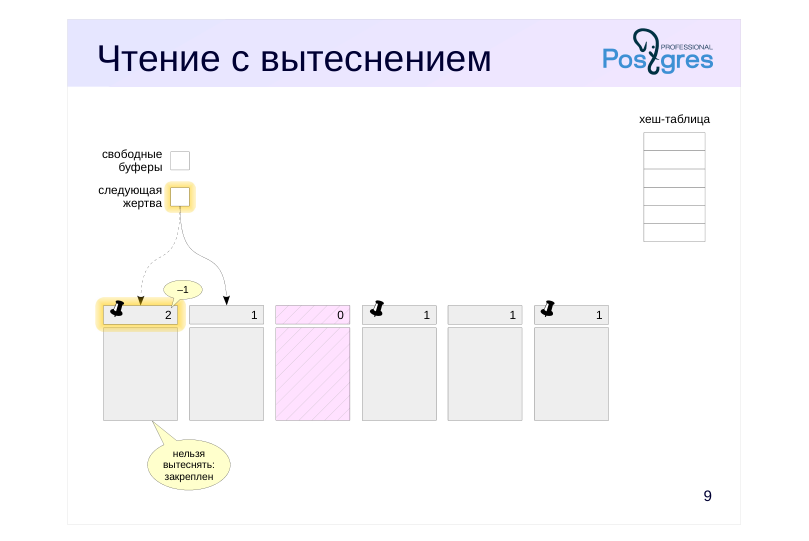 {#source-figure-010 caption=“Source slide page 10: Чтение с вытеснением”}
Комментарии преподавателя
Механизм вытеснения использует указатель на следующую «жертву».
Алгоритм состоит в том, чтобы перебирать по кругу все буферы, уменьшая их счетчики обращений (usage count). Выбирается первый же буфер, у которого значение счетчика равно нулю и который в принципе может быть занят новой страницей. По-английски этот алгоритм называется clock-sweep: аналогия с часовой стрелкой, которая пробегает циферблат по кругу.
Чем больше значение счетчика у буфера (то есть чем чаще он используется), тем больше у него шансов задержаться в кеше. Максимальное значение счетчика обращений ограничено числом 5, чтобы избежать «наматывания кругов» при больших значениях.
В нашем примере процесс сначала обращается к буферу по указателю. Буфер закреплен (то есть используется каким-то процессом), и поэтому страница не может быть вытеснена из него. Тем не менее мы уменьшаем значение счетчика обращений на единицу и переходим к следующему буферу.
Page 11: Чтение с вытеснением
 {#source-figure-011 caption=“Source slide page 11: Чтение с вытеснением”}
Комментарии преподавателя
Следующий буфер не закреплен, однако его счетчик обращений больше нуля.
Мы уменьшаем счетчик на единицу и даем странице шанс остаться в кеше.
Page 12: Чтение с вытеснением
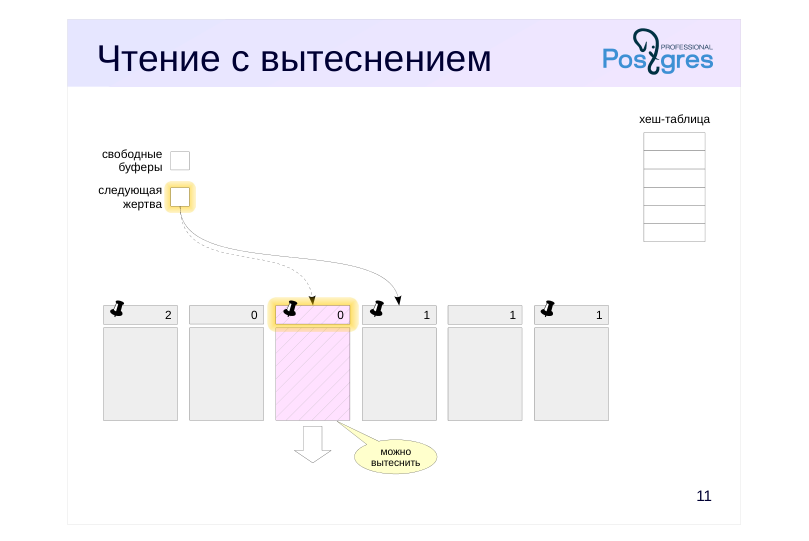 {#source-figure-012 caption=“Source slide page 12: Чтение с вытеснением”}
Комментарии преподавателя
Наконец, мы доходим до незакрепленного буфера с нулевым счетчиком обращений. Страница из этого буфера и будет вытеснена.
Однако в нашем примере найденный буфер оказался грязным — он содержит измененные данные. Поэтому сначала страницу требуется сохранить на диск. Для этого буфер закрепляется (чтобы показать остальным процессам, что он используется), после чего страница записывается на диск.
Это не очень хорошая ситуация: процессу, который собирался прочитать страницу, придется ждать, пока «чужие» данные будут записаны. Этот эффект сглаживается процессами контрольной точки и фоновой записи, которые рассмотрены в теме «Контрольная точка».
Page 13: Чтение с вытеснением
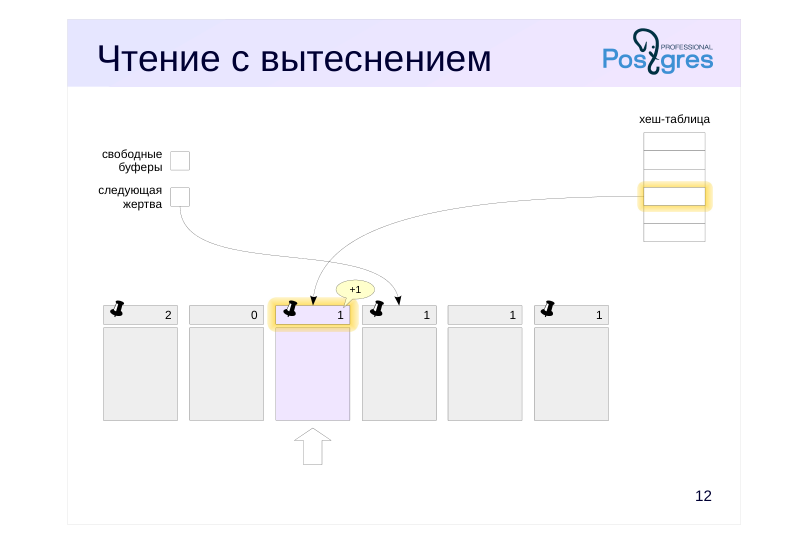 {#source-figure-013 caption=“Source slide page 13: Чтение с вытеснением”}
Комментарии преподавателя
После того как страница из грязного буфера записана на диск, в освободившийся буфер ранее рассмотренным образом читается новая страница.
Ссылка на следующую «жертву» уже указывает на следующий буфер, а у только что загруженного есть время нарастить счетчик обращений, пока указатель не обойдет по кругу весь буферный кеш и не вернется вновь.
Page 14: Настройка размера кеша
Настройка
- ↑
- shared_buffers = 128MB
- Буферный кеш должен содержать «активные» данные
- при меньшем размере постоянно вытесняются полезные страницы
- при большем размере бессмысленно растут накладные расходы
- начальное приближение — 1/4 ОЗУ
- Нужно учитывать двойное кеширование
- если страницы нет в кеше СУБД, она может оказаться в кеше ОС
- алгоритм вытеснения ОС не учитывает специфики базы данных
Комментарии преподавателя
Размер кеша устанавливается параметром shared_buffers. Значение по умолчанию — 128 МБ — сильно занижено.
Как выбрать подходящее значение? Даже самая большая база имеет ограниченный набор данных, с которыми ведется активная работа. В идеале этот набор (плюс некоторое место для «одноразовых» данных) должен помещаться в буферный кеш.
При меньшем размере кеша активно используемые страницы будут постоянно вытеснять друг друга, создавая избыточный ввод-вывод. Признаком такой ситуации может служить то, что все страницы в кеше имеют большое число обращений (usage count).
Однако при большом размере кеша будут расти накладные расходы на его поддержание.
В качестве первого приближения можно взять 1/4 оперативной памяти, но надо понимать, что оптимальное значение зависит не от размера ОЗУ, а от конкретных данных и нагрузки.
Не следует забывать и о том, что PostgreSQL работает с диском через операционную систему и, таким образом, происходит двойное кеширование: страницы попадают как в буферный кеш, так и в кеш ОС. Таким образом, «непопадание» в буферный кеш не всегда приводит к необходимости реального ввода-вывода. Но стратегия вытеснения ОС не учитывает специфики баз данных.
https://postgrespro.ru/docs/postgresql/16/runtime-config-resource#RUNTIM E-CONFIG-RESOURCE-MEMORY
Page 15: Настройка размера кеша
Используя расширение pg_buffercache, можно наблюдать за состоянием кеша под разными углами. Кроме информации о том, как представлена в кеше та или иная страница, можно, например, посмотреть распределение буферов по их «популярности».
Функция pg_buffercache_usage_counts возвращает количество общих буферов для всех возможных значений счетчика использования. Как и представление pg_buffercache, функция не использует блокировки менеджера буферов, поэтому при параллельной работе в базе данных возможна незначительная погрешность результатов функции. Посмотрим, какая доля каких таблиц закеширована (и насколько активно используются эти данные):
А сводную информацию о буферном кеше нам покажет другая функция из расширения:
Подобные запросы могут подсказать, насколько активно используется буферный кеш и дать пищу для размышлений о том, стоит ли увеличивать или уменьшать его размер. Надо учитывать, что такие запросы надо повторять несколько раз: цифры будут меняться в определенных пределах, а набор результатов, полученный для всех буферов, в целом может оказаться несогласованным. Информацию, подобную той, что возвращают функции pg_buffercache_summary() и pg_buffercache_usage_counts(), можно получить и с помощью представления pg_buffercache, однако использование функций менее затратно, что удобно для использования в системах мониторинга.
Page 16: Page 16
Page 17: Массовое вытеснение
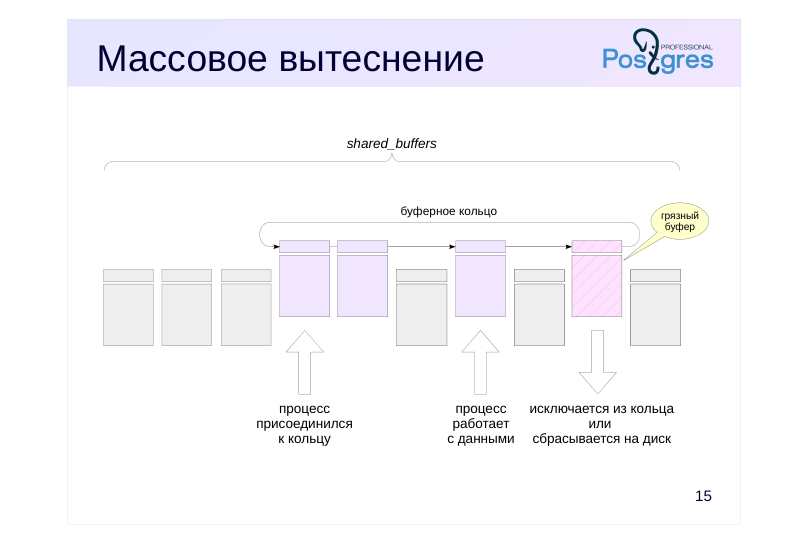 {#source-figure-017 caption=“Source slide page 17: Массовое вытеснение”}
Комментарии преподавателя
При операциях, выполняющих массовое чтение или запись данных, есть опасность вытеснения полезных страниц из буферного кеша «одноразовыми» данными. Чтобы этого не происходило, для таких операций используются буферные кольца — выделенные небольшие части буферного кеша. Вытеснение действует в этом случае только в пределах кольца, и остальные данные в кеше не страдают.
Если в процессе работы в кольце появляются грязные буферы, то они будут отключены от кольца или записаны на диск.
Page 18: Буферное кольцо
Последовательное чтение
- 32 страницы
- грязный буфер исключается из кольца
- Очистка
- vacuum_buffer_usage_limit = 32
- грязный буфер вытесняется на диск
- Массовая запись
- ≤2048 страниц
- грязный буфер вытесняется на диск
Комментарии преподавателя
При последовательном чтении (sequential scan) таблиц используется кольцо размером 32 страницы. Если при работе с этими данными появляются грязные буферы (в результате простановки битов-подсказок или при выполнении UPDATE), они отключаются от кольца, возвращаются в основной кеш и вытесняются затем уже на общих основаниях. А вместо отключенного буфера в кольцо из кеша подключается другой буфер. Такая стратегия рассчитана на то, что данные в основном читаются, а не изменяются.
Если в процессе чтения таблицы другой процесс начнет последовательное сканирование, он подключается к уже имеющемуся буферному кольцу, а потом дочитывает страницы, которые были вытеснены из кольца.
Для работы очистки используется кольцо, размер которого задается параметром vacuum_buffer_usage_limit. По умолчанию его значение невелико (32 страницы), так как замедление очистки обычно не столь критично, как замедление пользовательских процессов (исключение — защитный режим: в нем очистка может использовать весь кеш).
Для массовых операций записи, таких как COPY или CREATE TABLE AS SELECT, кольцо имеет достаточно большой размер (обычно 2048 страниц, но не больше одной восьмой всего буферного кеша).
Page 19: Массовое вытеснение
Для полного чтения таблиц, размер которых превышает четверть буферного кеша, используется буферное кольцо. Размер кеша (в страницах):
Добавим строк в таблицу:
Перезагрузим сервер, чтобы сбросить буферный кеш.
И сбросим общую статистику ввода-вывода:
Прочитаем данные из таблицы:
Были прочитаны все страницы с данными, но сколько буферов кеша ими занято?
При сканировании большой таблицы размер кольца — 32 буфера. В 16-й версии PostgreSQL появилось представление pg_stat_io, которое показывает статистику ввода/вывода с точки зрения СУБД (кеширование на уровне ОС в нем не учитывается).
Page 20: Page 20
Строка с контекстом normal показывает операции чтения-записи в общей части буферного кеша, а bulkread — в буферных кольцах. reads — количество чтений из файлов, hits — сколько раз страница нашлась в кеше, reuses — число повторных использований буферов в буферном кольце. Разность между reads и reuses в строке bulkread равна размеру кольца (32). А теперь сбросим статистику и изменим все строки таблицы. При этом буферы со страницами будут отсоединяться от буферного кольца и оставаться в кеше:
Сейчас в кеше находятся все или почти все страницы таблицы, количество которых удвоилось из-за появления новых версий строк:
Еще раз заглянем в статистику.
Таблица еще раз полностью сканируется через буферное кольцо. При этом 32 страницы остались в кольце от предыдущего сканирования, а остальные пришлось прочитать заново. Измененные страницы одна за другой передаются в общий кеш, обращения к ним учитываются в строке normal. При этом обновление каждой из 30 тысяч строк таблицы требует нескольких обращений к страницам, поэтому значение в поле hits довольно велико.
Page 21: Локальный кеш
Временные таблицы
- видны только одному сеансу — нет смысла использовать общий кеш
- существуют в пределах сеанса — не жалко потерять при сбое
- Особенности
- не требуются блокировки
- память выделяется по необходимости в пределах temp_buffers
- обычный алгоритм вытеснения
- механизм буферных колец не используется
Комментарии преподавателя
Исключением из общего правила являются временные таблицы. Поскольку временные данные видны только одному процессу, им нечего делать в общем буферном кеше. Более того, временные данные существуют только в рамках одного сеанса, так что их не нужно защищать от сбоя.
Для временных данных используется облегченный локальный кеш.
Поскольку локальный кеш доступен только одному процессу, для него не требуются блокировки. Память выделяется по мере необходимости (в пределах, заданных параметром temp_buffers), ведь временные таблицы используются далеко не во всех сеансах. В локальном кеше используется обычный алгоритм вытеснения.
Временные таблицы на физическом уровне хранятся схожим с обычными таблицами образом. Параметр temp_tablespaces задает табличные пространства, в которых будут создаваться временные объекты (временные таблицы и индексы временных таблиц), когда в команде CREATE табличное пространство не указывается явно.
Значение параметра temp_tablespaces может содержать список имен табличных пространств. Когда этот список содержит больше одного имени, PostgreSQL выбирает из него случайный элемент при создании каждого временного объекта; однако при создании последующих объектов внутри транзакции табличные пространства перебираются последовательно. Если же в списке оказывается пустая строка (значение по умолчанию), PostgreSQL будет использовать табличное пространство по умолчанию для текущей базы данных.
Page 22: Временные таблицы
Создадим временную таблицу с одной строкой:
В плане выполнения запроса обращение к локальному кешу выглядит как «Buffers: local»:
Видим, что вставка строки привела к расширению таблицы (extends).
Page 23: Прогрев кеша
Расширение pg\_prewarm
- ручной прогрев кеша операционной системы
- ручной прогрев буферного кеша
- автоматический прогрев буферного кеша при перезапуске сервера
Комментарии преподавателя
После перезапуска сервера буферный кеш пуст и должно пройти некоторое время, чтобы он «прогрелся», то есть набрал актуальные активно использующиеся данные. Иногда может оказаться полезным сразу прочитать в кеш данные определенных таблиц.
Расширение pg_prewarm позволяет в ручном режиме прочитать некоторые таблицы либо в кеш операционной системы, либо и в буферный кеш СУБД тоже.
Расширение также позволяет в автоматическом режиме восстановить содержимое буферного кеша после перезапуска сервера. Для этого необходимо подключить библиотеку расширения, добавив ее в параметр shared_preload_libraries.
https://postgrespro.ru/docs/postgresql/16/pgprewarm
Page 24: Прогрев кеша
Рассмотрим самый простой сценарий использования расширения для прогрева кеша.
В очередной раз перезапустим сервер, чтобы в кеше не было данных таблицы test:
Вызов функции pg_prewarm без дополнительных параметров полностью считывает основной слой указанной таблицы в буферный кеш:
Page 25: Итоги
Вся работа с данными происходит через буферный кеш
- Редко используемые страницы вытесняются, часто используемые — остаются
- Буферный кеш сокращает объем ввода-вывода, но приводит к необходимости журналирования
Page 26: Практика
- Создайте таблицу и вставьте в нее некоторое количество строк. Определите, сколько занимает таблица а) страниц на диске, б) буферов в кеше.
- Узнайте количество грязных буферов в кеше на текущий момент. Выполните контрольную точку командой CHECKPOINT. Сколько грязных буферов осталось теперь?
- Подключите библиотеку расширения pg_prewarm и проверьте, что после перезапуска сервера содержимое буферного кеша восстанавливается.
Комментарии преподавателя
Чтобы проверить содержимое буферного кеша, используйте расширение pg_buffercache: https://postgrespro.ru/docs/postgresql/16/pgbuffercache.html
Page 27: 1. Таблица в кеше
Создадим таблицу:
Выполним VACUUM — это обеспечит нам наличие всех слоев:
Сколько страниц на диске занимает таблица?
Из них основной слой:
Карта свободного пространства:
И карта видимости:
Сколько буферов в кеше занимает таблица?
Page 28: Page 28
2. Грязные буферы в кеше
Выполним контрольную точку:
Грязных буферов не осталось. Подробнее о контрольной точке рассказывается в отдельной теме.
3. Автоматический прогрев кеша
Подключим библиотеку pg_prewarm и перезапустим сервер.
Теперь отдельный фоновый процесс будет сбрасывать на диск список страниц, находящихся в буферном кеше, раз в pg_prewarm.autoprewarm_interval единиц времени.
Прочитаем таблицу t в буферный кеш:
Page 29: Page 29
Можно либо подождать, либо сбросить список страниц вручную:
В файл записываются идентификаторы базы данных, табличного пространства и файла, номер слоя и номер страницы:
Снова перезапустим сервер.
После запуска фоновый процесс прочитает в буферный кеш все страницы, указанные в файле.
Вернемся к настройкам по умолчанию.
09 Занятие 09: Журналирование / Журнал предзаписи
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_09_wal_log.html Archive: DBA2-handouts-16.zip Страниц PDF: 22
Page 1: Журналирование / Журнал предзаписи
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Журнал предзаписи (WAL)
- Логическое и физическое устройство журнала
- Процесс упреждающей записи и восстановление
Page 3: Журнал предзаписи
Основная задача
- возможность восстановления согласованности данных после сбоя
- Механизм
- при изменении данных действие также записывается в журнал
- журнальная запись попадает на диск раньше измененных данных
- восстановление после сбоя — повторное выполнение потерянных
- операций с помощью журнальных записей
Комментарии преподавателя
Основная причина существования журнала — необходимость восстановления согласованности данных в случае сбоя, при котором теряется содержимое оперативной памяти, в частности, буферного кеша. Тем самым обеспечивается выполнение свойства долговечности (буква «D» из набора свойств транзакций ACID).
Одновременно с изменением данных создается запись в журнале, содержащая достаточную информацию для повторения этой операции. Журнальная запись в обязательном порядке попадает на диск (или другое энергонезависимое устройство) до того, как туда попадет измененная страница — отсюда и название: «журнал предзаписи», «write-ahead log».
В случае сбоя можно прочитать журнал и при необходимости повторить те операции, которые уже были выполнены, но результат которых не успел попасть на диск.
https://postgrespro.ru/docs/postgresql/16/wal-intro
Page 4: Что защищено журналом
Изменение любых страниц в буферном кеше
- в том числе страницы таблиц и индексов
- кроме нежурналируемых и временных таблиц
- Фиксация и отмена транзакций — буферы CLOG
- Файловые операции
- создание и удаление файлов
- добавление и удаление страниц файлов
- создание и удаление каталогов
Комментарии преподавателя
Журналировать нужно все операции, при выполнении которых возможна ситуация, что при сбое изменения (или часть изменений) не дойдут до диска.
В частности, в журнал записываются следующие действия:
● изменение страниц в буферном кеше (как правило, это страницы таблиц и индексов) — так как измененная страница попадает на диск не сразу;
● фиксация и отмена транзакций — точно так же, изменение статуса происходит в буфере CLOG и попадает на диск не сразу;
● файловые операции (создание и удаление файлов и каталогов, например, создание файлов при создании таблицы) — так как эти операции должны происходить синхронно с изменением данных.
При этом в журнал не записываются:
● операции с нежурналируемыми таблицами — их название говорит само за себя;
● операции с временными таблицами — они существуют не дольше, чем создавший их сеанс, и поэтому не нуждаются в восстановлении.
Page 5: Логическое устройство
 {#source-figure-005 caption=“Source slide page 5: Логическое устройство”}
последовательность записей «номер» записи — 64-битный LSN (log sequence number) специальный тип pg_lsn
Комментарии преподавателя
Логически журнал можно представить себе как последовательность записей различной длины. Каждая запись содержит данные о некоторой операции, предваренные заголовком. В заголовке, в числе прочего, указаны:
● номер транзакции, к которой относится запись;
● менеджер ресурсов — компонент системы, ответственный за данную запись, который понимает, как интерпретировать данные. Есть отдельные менеджеры для таблиц, для каждого типа индекса, для статуса транзакций и т. п.;
● контрольная сумма (CRC).
Начиная с версии 16 расширения могут создавать собственные менеджеры ресурсов, использующие специфический формат для своих записей WAL. Это поможет разработчикам создавать расширения, реализующие новые табличные и индексные методы доступа.
https://postgrespro.ru/docs/postgresql/16/custom-rmgr
Для того чтобы сослаться на определенную запись, используется тип данных pg_lsn (LSN = log sequence number) — 64-битное число, представляющее собой байтовое смещение до записи относительно начала журнала.
Начало каждой записи выравнивается по границе машинного слова, это одна из причин двоичной несовместимости WAL на разных платформах.
https://postgrespro.ru/docs/postgresql/16/datatype-pg-lsn
Page 6: Логическое устройство журнала
Список менеджеров ресурсов покажет утилита pg_waldump:
LSN выводится как два 32-битных числа в шестнадцатеричной системе через косую черту. Текущая позиция в журнале:
При помощи утилиты pg_waldump и появившегося в 15-й версии PostgreSQL расширения pg_walinspect мы можем исследовать содержимое журнала предзаписи. Создадим базу данных и установим расширение (чтобы воспользоваться расширением, роль должна быть включена в pg_read_server_files или быть суперпользовательской):
Нам понадобится небольшая таблица:
Получим текущую позицию в журнале, после чего вставим в таблицу строку:
Теперь позиция журнала такая:
Page 7: Page 7
Посмотрим, какие записи появились в журнале:
Операция INSERT+INIT инициализирует страницу и добавляет в нее версию строки, операция COMMIT фиксирует транзакцию. Для записи INSERT+INIT в журнале сохраняется блок данных, содержащий значения полей вставляемой версии строки. Расширение позволяет увидеть эти данные (в столбце block_data можно различить коды символов добавленной строки):
Page 8: Физическое устройство
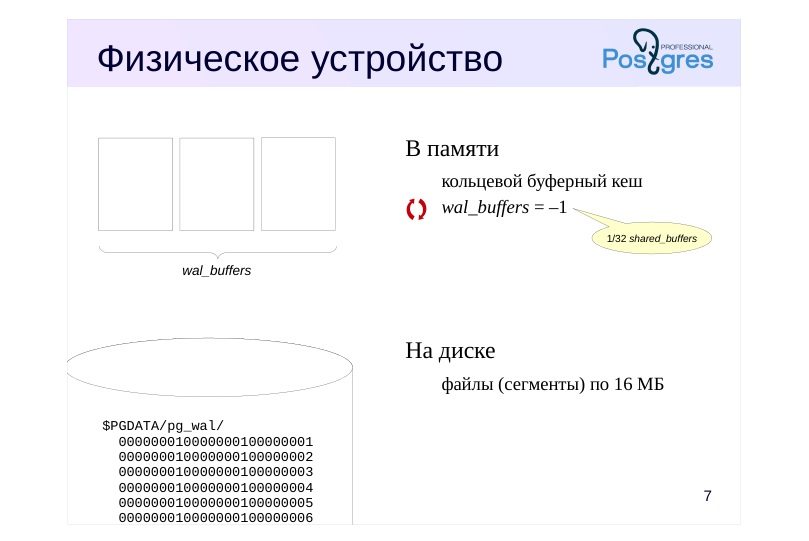 {#source-figure-008 caption=“Source slide page 8: Физическое устройство”}
В памяти
- На диске
Комментарии преподавателя
На диске журнал хранится в виде файлов (сегментов) в каталоге PGDATA/pg_wal. Каждый файл по умолчанию занимает 16 Мбайт. Размер сегмента может быть задан при инициализации кластера.
Журнальные записи попадают в текущий файл; когда он заполняется — начинает использоваться следующий.
В оперативной памяти для журнала выделены специальные буферы. Размер кеша задается параметром wal_buffers (значение по умолчанию подразумевает автоматическую настройку: выделяется 1/32 часть буферного кеша, но не меньше чем 64 Кбайт и не больше чем размер одного сегмента WAL).
Журнальный кеш устроен наподобие буферного кеша, но работает преимущественно в режиме кольцевого буфера: записи добавляются в «голову» буфера, а записываются на диск с «хвоста».
Page 9: Физическое устройство журнала
Размер кеша журнала в общей памяти:
Все журнальные файлы (сегменты) находятся в каталоге /var/lib/postgresql/16/main/pg_wal/, их также показывает специальная функция:
Имена файлов составлены из трех чисел. Первое — номер линии времени (используется при восстановлении из архива), а два следующих — старшие разряды LSN. Размер файлов можно задать при инициализации кластера, по умолчанию — 16 Мбайт. Запись INSERT+INIT находится в этом файле:
Текущий сегмент:
Page 10: Упреждающая запись
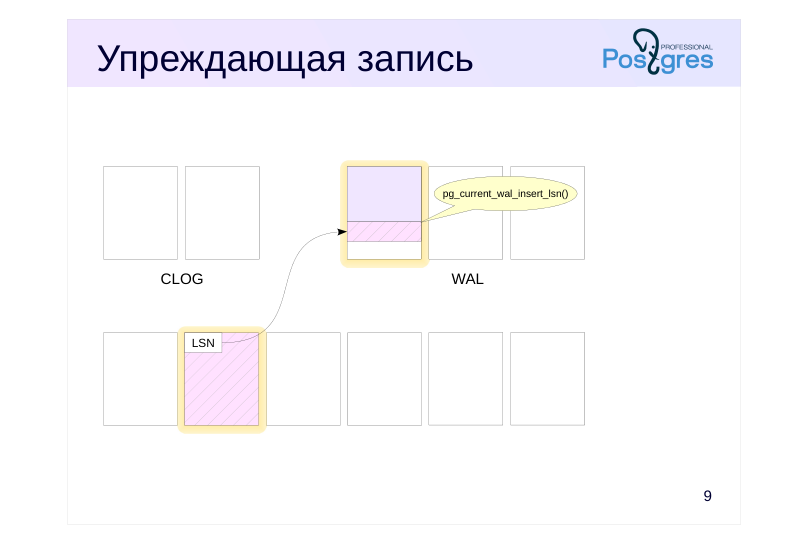 {#source-figure-010 caption=“Source slide page 10: Упреждающая запись”}
- • •
Комментарии преподавателя
Проиллюстрируем сказанное выше про упреждающую запись. На слайде показаны три важные области общей памяти экземпляра:
● буферный кеш (размером shared_buffers),
● только что рассмотренный журнальный кеш WAL (размером wal_buffers),
● кеш состояния транзакций, называемый также CLOG (размером 128 страниц).
При изменении страницы данных в буферном кеше формируется журнальная запись. Она помещается в страницу журнала, а ссылка на запись (а точнее ее LSN + длина, то есть LSN следующей записи) записывается в специальное поле LSN в заголовке страницы данных.
Позицию для записи можно узнать с помощью функции pg_current_wal_insert_lsn().
Page 11: Упреждающая запись
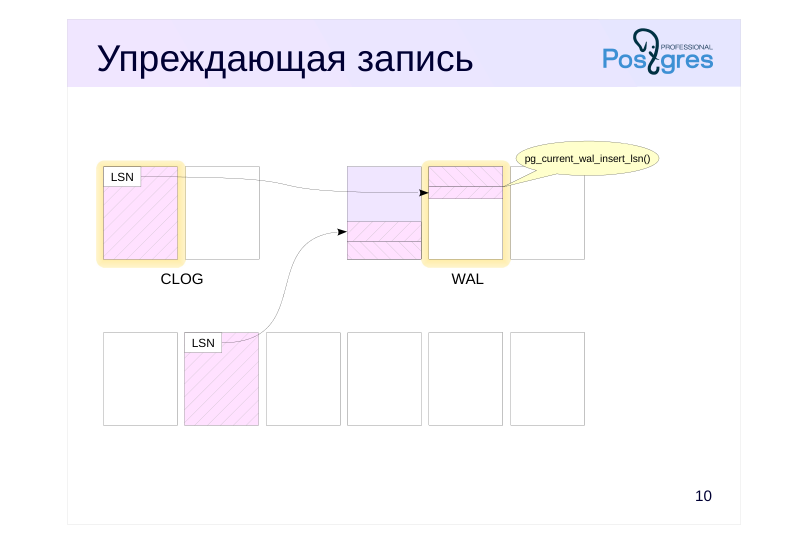 {#source-figure-011 caption=“Source slide page 11: Упреждающая запись”}
- • •
Комментарии преподавателя
Допустим, далее происходит фиксация транзакции. Для этого формируется еще одна журнальная запись, меняется бит состояния на странице CLOG и ссылка на эту запись проставляется в поле LSN измененной страницы.
При вставке указатель pg_current_wal_insert_lsn сдвигается вперед.
Заметим, что между записями, относящимися к одной транзакции, могут попасть записи других транзакций, относящихся к любой БД. Журнал — общий для всего кластера.
Page 12: Упреждающая запись
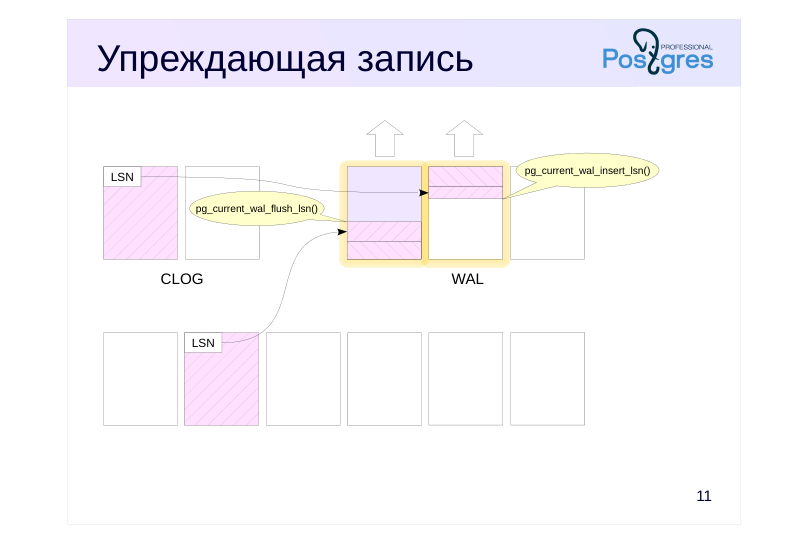 {#source-figure-012 caption=“Source slide page 12: Упреждающая запись”}
- • •
Комментарии преподавателя
Далее в какой-то момент (в какой именно — будет рассмотрено в теме «Настройка журнала») журнальные записи, которые еще не попали на диск, должны на него попасть.
Функция pg_current_wal_flush_lsn() показывает последнюю запись, уже дошедшую до диска.
Page 13: Упреждающая запись
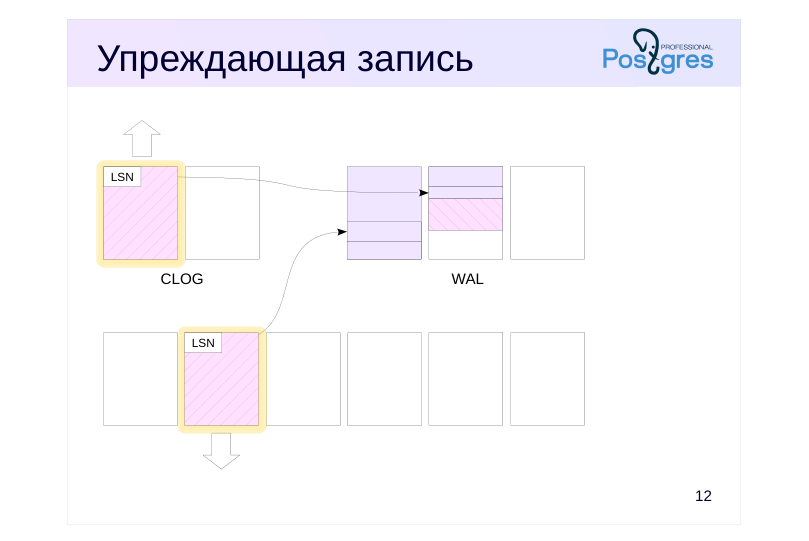 {#source-figure-013 caption=“Source slide page 13: Упреждающая запись”}
- • •
Комментарии преподавателя
Только после того, как на диск попали журнальные записи, могут быть сброшены и сами измененные страницы. Порядок контролируется с учетом LSN последнего изменения страницы и текущего значения pg_current_wal_flush_lsn. При этом работа продолжается, в журнал будут попадать новые и новые записи. Для сброса страницы главное, чтобы запись с LSN последнего ее изменения уже была на диске.
Если окажется, что страница данных должна быть сброшена (например, она вытесняется из буферного кеша), а журнальная запись еще не попала на диск, журнальные буферы сбрасываются принудительно.
Page 14: Упреждающая запись
Мы будем заглядывать в заголовок табличной страницы. Для этого понадобится расширение:
Начнем транзакцию.
Текущая позиция и текущий сегмент журнала:
Изменим строку в таблице:
Позиция в журнале изменилась:
Этот же номер LSN (или меньший, если в журнал попали дополнительные записи) мы найдем и в заголовке измененной страницы:
Завершим транзакцию.
Позиция в журнале снова изменилась:
Размер фрагмента журнала (в байтах), соответствующий нашей транзакции:
Безусловно, в журнал попадает информация обо всех действиях во всем кластере, но в данном случае мы рассчитываем на то, что в системе ничего не происходит. Вот сами записи:
Page 15: Page 15
Заметим, что из-за выравнивания длина записи обычно меньше, чем занимаемое ей место (столбец occupied). Увидеть содержимое журнала можно и с помощью утилиты pg_waldump. Она может работать с диапазоном LSN (как в этом примере), выбрать записи для определенного отношения и отдельного слоя, а также для отдельной страницы или указанной транзакции. В отличие от расширения pg_walinspect, утилитой можно пользоваться и на остановленном сервере, при этом ей нужен доступ на чтение журнальных файлов, поэтому мы выполним команду от имени суперпользователя:
Мы видим заголовки журнальных записей: операция HOT_UPDATE, относящаяся к измененной странице (rel+blk), операция COMMIT с указанием времени.
Page 16: Восстановление
Алгоритм (упрощенный)
- при старте сервера после сбоя
- (состояние кластера в pg_control отличается от «shut down»):
- для каждой журнальной записи:
- 1.1. определить страницу, к которой относится эта запись
- 1.2. применить запись, если ее LSN больше, чем LSN страницы
- перезаписать нежурналируемые таблицы init-файлами
Комментарии преподавателя
Если в работе сервера произошел сбой, то при последующем запуске процесс startup (запускаемый postmaster-ом в самом начале работы) обнаружит это, посмотрев в файл pg_control и увидев статус, отличный от «shut down». Тогда автоматически будет выполнено восстановление.
Процесс startup будет последовательно читать журнал и применять записи к страницам, если в этом есть необходимость (что можно проверить, сравнив LSN страницы на диске с LSN журнальной записи). Изменение страниц происходит в буферном кеше, как при обычной работе — для этого postmaster запускает необходимые фоновые процессы.
Аналогично записи применяются и к файлам: например, если запись говорит о том, что файл должен существовать, а его нет — файл создается.
В конце процесса все нежурналируемые таблицы перезаписываются с помощью образов в init-файлах.
В PostgreSQL 15 реализована возможность предвыборки данных журнала при восстановлении — за это отвечает параметр recovery_prefetch. По умолчанию его значение — try (предвыборка используется, если ее поддерживает ОС). Если предвыборка включена, то значение параметра wal_decode_buffer_size определяет, как далеко сервер будет заглядывать в журнал, чтобы найти там номера нужных страниц.
Приведенный алгоритм является упрощенным. В частности, мы ничего не сказали о том, с какого места надо начинать чтение журнальных записей (это будет рассмотрено в теме «Контрольная точка»).
Page 17: Итоги
Использование буферов в оперативной памяти приводит к необходимости журналирования
- Журнал содержит информацию, позволяющую повторно выполнить операции после сбоя и восстановить согласованность
- Журнал всегда записывается на диск до того, как записываются измененные страницы данных
Page 18: Практика
- Создайте таблицу с первичным ключом и добавьте в нее несколько строк. Сколько байт занимают сгенерированные журнальные записи?
- Чем можно объяснить довольно большое их число? Просмотрите заголовки этих журнальных записей и проверьте свои предположения.
- Измените добавленные в таблицу строки. Снова измените строки, но не фиксируйте транзакцию. Сымитируйте сбой, прервав процесс postmaster.
- Запустите сервер и убедитесь, что зафиксированные
- изменения не пропали, а незафиксированная транзакция
- оборвана. Найдите информацию о восстановлении после
- сбоя в журнале сообщений сервера.
Комментарии преподавателя
Можно воспользоваться утилитой pg_waldump или расширением pg_walinspect.
Воспользуйтесь командой $ sudo kill -QUIT номер-процесса
Номер процесса находится в первой строке файла postmaster.pid в каталоге PGDATA сервера.
Page 19: 1. Размер журнальных записей
Запомним начальную позицию в журнале:
Создадим таблицу и добавим строки:
Запомним конечную позицию:
Размер журнальных записей:
2. Состав журнальных записей
Журнальный файл:
Понадобится расширение pg_walinspect:
Смотрим записи:
Page 20: Page 20
Page 21: Page 21
Вначале (до первой операции COMMIT) происходит активная работа с таблицами и индексами системного каталога. За счет этого размер записей и получился существенно больше, чем в демонстрации.
3. Восстановление после сбоя
Обновляем строки:
Прерываем основной серверный процесс.
Запускаем сервер.
Page 22: Page 22
Проверяем изменения:
Журнал сообщений:
10 Занятие 10: Журналирование / Контрольная точка
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_10_wal_checkpoint.html Archive: DBA2-handouts-16.zip Страниц PDF: 25
Page 1: Журналирование / Контрольная точка
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Процесс контрольной точки
- Процесс фоновой записи
- Мониторинг
Page 3: Контрольная точка
Необходимость контрольной точки
- Процесс выполнения контрольной точки
- Алгоритм восстановления после сбоя
- Настройка
Page 4: Необходимость
Размер хранимых журнальных записей
- с какого сегмента начинать применять журнальные записи
- при восстановлении?
- активно использующаяся страница может не вытесняться из кеша
- Время восстановления
- сколько времени займет восстановление после сбоя?
Комментарии преподавателя
Если не предпринять специальных мер, то активно использующаяся страница, попав в буферный кеш, может никогда не вытесняться. Это означает, что при восстановлении после сбоя нам придется просматривать все журнальные записи, созданные с момента запуска сервера.
На практике это, конечно, недопустимо. Во-первых, файлы занимают много места — их все придется хранить на сервере. Во-вторых, время восстановления будет запредельно большим — придется просмотреть множество журнальных записей.
Поэтому существует процедура контрольной точки, которая выполняет сброс всех грязных страниц на диск, но не вытесняет их из кеша. Специальный фоновый процесс checkpointer периодически выполняет контрольную точку. После того как контрольная точка завершена, журнальные записи, предшествующие ее началу, больше не нужны для восстановления.
Page 5: Процедура КТ
 {#source-figure-005 caption=“Source slide page 5: Процедура КТ”}
записываются грязные буферы CLOG
Комментарии преподавателя
Рассмотрим подробнее, что происходит при выполнении контрольной точки.
Во-первых, помимо буферного кеша, в оперативной памяти располагаются и другие структуры, содержимое которых нужно сохранять на диске.
В частности, контрольная точка сбрасывает на диск буферы статуса транзакций (CLOG). Поскольку количество таких буферов невелико (их 128 штук), они записываются сразу же.
Page 6: Процедура КТ
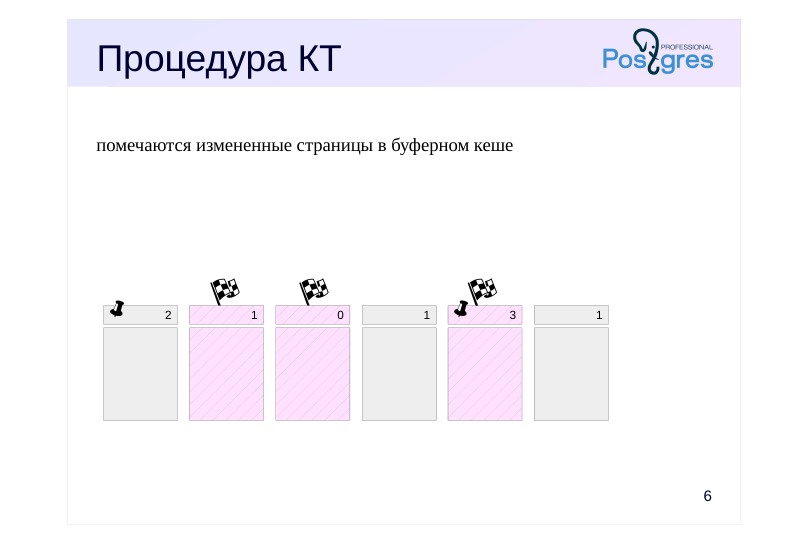 {#source-figure-006 caption=“Source slide page 6: Процедура КТ”}
помечаются измененные страницы в буферном кеше
Комментарии преподавателя
Во-вторых, основная работа контрольной точки — сбросить на диск все страницы из буферного кеша, которые были грязными на момент начала контрольной точки.
Поскольку размер буферного кеша может быть очень велик, сбрасывать сразу все страницы плохо — это приостановит нормальную работу сервера и создаст большую нагрузку на дисковую подсистему. Поэтому контрольная точка растягивается во времени и фактически превращается в отрезок.
Сначала все измененные на текущий момент страницы помечаются в заголовке буфера специальным флагом…
Page 7: Процедура КТ
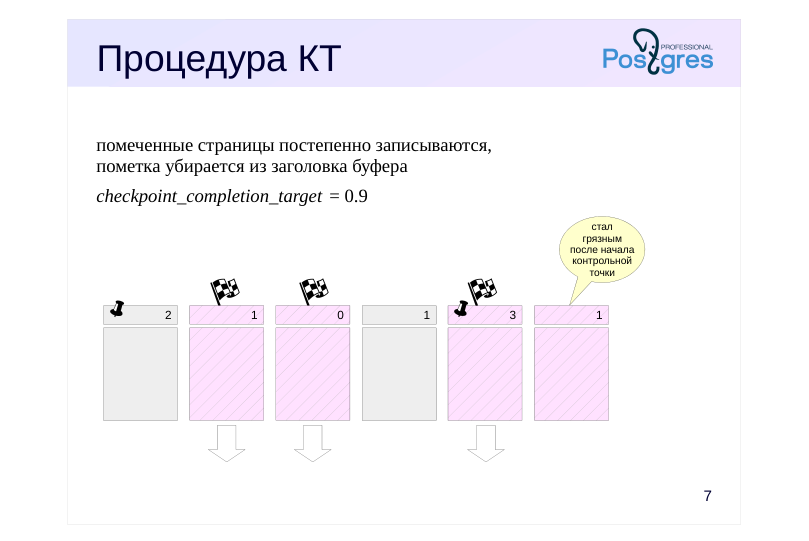 {#source-figure-007 caption=“Source slide page 7: Процедура КТ”}
помеченные страницы постепенно записываются, пометка убирается из заголовка буфера
- checkpoint_completion_target = 0.9
Комментарии преподавателя
…а затем процедура контрольной точки постепенно проходит по всем буферам и сбрасывает помеченные страницы на диск. Еще раз отметим, что страницы не вытесняются из кеша, а только записываются. Поэтому контрольная точка не обращает внимания на число обращений к буферу и признак закрепленности.
Помеченные буферы могут также быть записаны и обслуживающими процессами — смотря кто доберется до буфера первым. В любом случае при записи снимается установленный ранее флаг, так что буфер будет записан только один раз.
В процессе работы контрольной точки страницы продолжают изменяться в буферном кеше. Но новые грязные буферы уже не рассматриваются процедурой контрольной точки, так как на момент начала работы они не были грязными.
Активность записи грязных буферов определяется значением параметра checkpoint_completion_target. Он показывает, какую часть времени между двумя соседними контрольными точками следует использовать для записи страниц. Со значением 0.9, заданным по умолчанию, можно ожидать, что PostgreSQL завершит процедуру контрольной точки незадолго до следующей запланированной. Значения выше умолчательного 0.9 использовать не рекомендуется, поскольку фактически процедура может занять несколько больше времени, чем указано в параметре.
Page 8: Процедура КТ
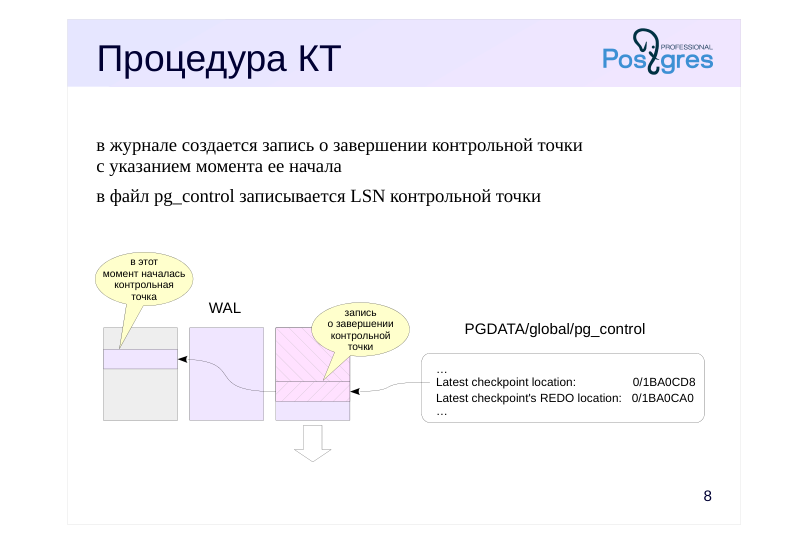 {#source-figure-008 caption=“Source slide page 8: Процедура КТ”}
в журнале создается запись о завершении контрольной точки с указанием момента ее начала
- в файл pg_control записывается LSN контрольной точки
Комментарии преподавателя
В конце работы процедура создает журнальную запись об окончании контрольной точки. В этой записи содержится LSN момента начала работы контрольной точки. Поскольку контрольная точка ничего не записывает в журнал в начале своей работы, по этому LSN может находиться любая журнальная запись.
Кроме того, в специальный файл PGDATA/global/pg_control записывается указание на созданную журнальную запись. Таким образом можно быстро выяснить последнюю пройденную контрольную точку.
Page 9: Контрольная точка
Заглянем в управляющий файл /var/lib/postgresql/16/main/global/pg_control. Это можно сделать с помощью утилиты pg_controldata.
Видим много справочной информации, из которой особый интерес представляют данные о последней контрольной точке и статус кластера: «in production». Выполним вручную контрольную точку и посмотрим, как это отражается в журнале и в управляющем файле.
Page 10: Page 10
В журнал попадает запись о том, что контрольная точка пройдена (CHECKPOINT_ONLINE):
В описании записи указан LSN начала контрольной точки (redo). Сравним с данными управляющего файла:
Информация об LSN, очевидно, совпадает.
Page 11: Восстановление
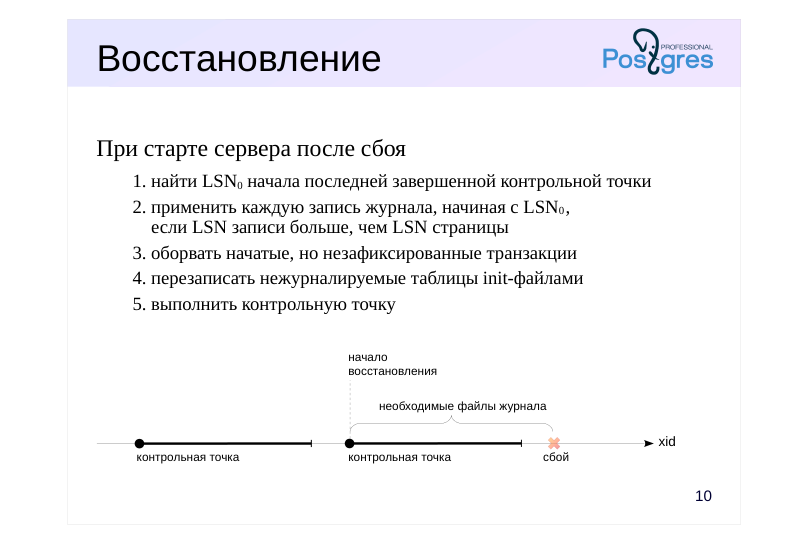 {#source-figure-011 caption=“Source slide page 11: Восстановление”}
При старте сервера после сбоя
- найти LSN0 начала последней завершенной контрольной точки
- применить каждую запись журнала, начиная с LSN0 ,
- если LSN записи больше, чем LSN страницы
- оборвать начатые, но незафиксированные транзакции
- перезаписать нежурналируемые таблицы init-файлами
- выполнить контрольную точку
Комментарии преподавателя
Если в работе сервера произошел сбой, то при последующем запуске процесс startup обнаруживает это (в файле pg_control статус отличен от «shut down») и выполняет автоматическое восстановление.
Сначала процесс читает из того же файла LSN записи о последней завершенной контрольной точке. Из этой записи процесс узнает позицию LSN0 начала этой контрольной точки.
(Для полноты картины заметим: если присутствует файл backup_label, запись о контрольной точке читается из него — это нужно для восстановления из резервных копий. Подробнее см. курс DBA3.)
Далее процесс startup читает журнал вперед от найденной позиции, последовательно применяя записи к страницам, если в этом есть необходимость (что можно проверить, сравнив LSN страницы на диске с LSN журнальной записи). Изменение страниц происходит в буферном кеше, как при обычной работе.
Записи, относящиеся к страницам CLOG, восстанавливают статус транзакций. Транзакции, не зафиксированные к концу восстановления, считаются оборванными; их изменения не видны в снимках данных.
Аналогично записи применяются и к файлам: например, если запись говорит, что файл должен быть создан, а его нет — файл создается.
В конце процесса все нежурналируемые таблицы перезаписываются с помощью образов в init-файлах. На этом процесс startup завершает восстановление и выполняет контрольную точку, чтобы зафиксировать восстановленное состояние.
Page 12: Восстановление
Теперь сымитируем сбой, принудительно выключив сервер.
Сейчас на диске находятся журнальные записи, но табличные страницы не были сброшены на диск. Проверим состояние кластера:
Состояние не изменилось. При запуске PostgreSQL поймет, что произошел сбой и требуется восстановление.
Как видим, таблица и данные восстановлены. Теперь остановим экземпляр корректно. При такой остановке PostgreSQL выполняет контрольную точку, чтобы сбросить на диск все данные.
Проверим состояние кластера:
Теперь состояние — «shut down», что соответствует корректной остановке.
Page 13: Частота контрольных точек
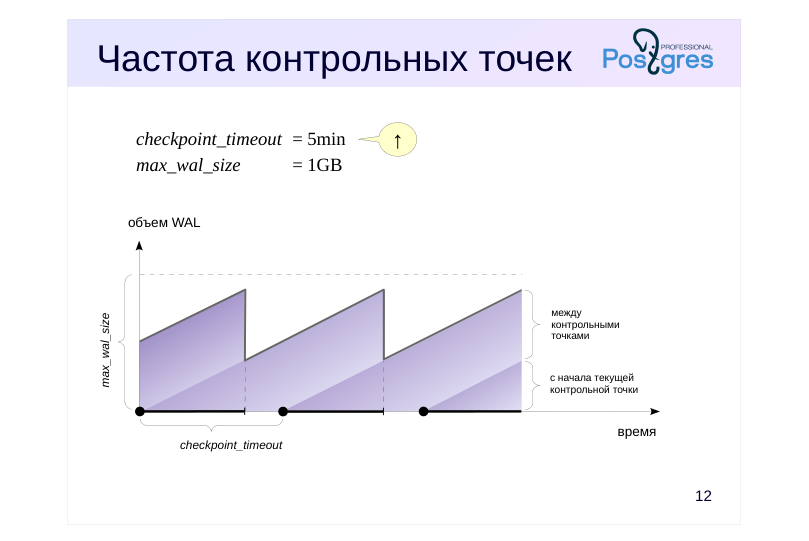 {#source-figure-013 caption=“Source slide page 13: Частота контрольных точек”}
↑
- checkpoint_timeout = 5min
- max_wal_size
- = 1GB
Комментарии преподавателя
Обычно контрольная точка настраивается из следующих соображений.
Сначала надо определиться, какая частота срабатываний нас устраивает (исходя из допустимого времени восстановления и объема журнальных файлов за это время при стандартной нагрузке). Чем реже можно позволить себе контрольные точки, тем лучше — это сокращает накладные расходы.
Устраивающая частота записывается в параметр checkpoint_timeout (значение по умолчанию — 5 минут — слишком мало, часто время увеличивают до получаса).
Однако возможна ситуация, когда нагрузка станет выше расчетной и за указанное время будет сгенерирован слишком большой объем журнальных записей. Чтобы этого не случилось, в параметре max_wal_size указывают общий допустимый объем журнальных записей.
Для восстановления после сбоя сервер должен хранить файлы с момента начала последней завершенной контрольной точки до начала текущей (объем между контрольными точками) плюс файлы, накопившиеся во время работы текущей контрольной точки. Поэтому общий объем можно оценить как
(1 + checkpoint_completion_target) * объем-между-контр-точками.
Таким образом большая часть контрольных точек происходит по расписанию, раз в checkpoint_timeout единиц времени. Но при повышенной нагрузке контрольная точка вызывается чаще, чтобы постараться уложиться в объем max_wal_size.
Page 14: Объем файлов журнала
Сервер хранит журнальные файлы
- необходимые для восстановления (обычно < max_wal_size)
- еще не прочитанные через слоты репликации
- еще не записанные в архив, если настроена непрерывная архивация
- не превышающие по объему wal_keep_size
- не превышающие по объему min_wal_size (при переиспользовании)
- Настройки
- max_wal_size
- = 1GB
- wal_keep_size
- = 0
- wal_recycle
- = on
- min_wal_size
- = 80MB
Комментарии преподавателя
Надо понимать, что объем, указанный в параметре max_wal_size, может быть превышен. Это не жесткое ограничение, а ориентир для процесса checkpointer, влияющий на активность записи грязных буферов.
Кроме того, сервер не имеет права стереть журнальные файлы, еще не переданные через слоты репликации, и файлы, еще не записанные в архив при непрерывном архивировании. Это может привести к перерасходу места, так что если этот функционал используется, необходим постоянный мониторинг.
Можно на случай отставания реплики параметром wal_keep_size установить минимальный объем файлов журнала, остающихся после контрольной точки. Это не гарантирует, что журнальная запись сохранится до момента, когда она понадобится реплике, но все же позволяет работать без слота репликации.
По умолчанию некоторое количество журнальных файлов будет не удаляться, а переименовываться и использоваться заново. Параметр min_wal_size задает минимальный неудаляемый объем. Это позволяет сэкономить на постоянном создании и удалении файлов. Однако для файловых систем с copy-on-write быстрее создать новый файл, поэтому для них рекомендуется отключить переиспользование, установив wal_recycle=off.
https://postgrespro.ru/docs/postgresql/16/wal-configuration
https://postgrespro.ru/docs/postgresql/16/runtime-config-wal#RUNTIME-CO NFIG-WAL-CHECKPOINTS
Page 15: Объем журнала
Снова запустим экземпляр.
Установим минимальное значение min_wal_size и отключим переиспользование, чтобы после контрольной точки оставалось не больше двух сегментов.
Добавим строки в таблицу.
Список файлов журнала:
Выполним вручную контрольную точку и опять посмотрим на журнал:
После контрольной точки в журнале осталось не более двух сегментов, в том числе тот, который был текущим в момент ее начала. А если в кластере после начала контрольной точки происходили какие-либо изменения, в журнале могли появиться и другие сегменты.
Page 16: Фоновая запись
Процесс фоновой записи
- Настройка
Page 17: Процесс фоновой записи
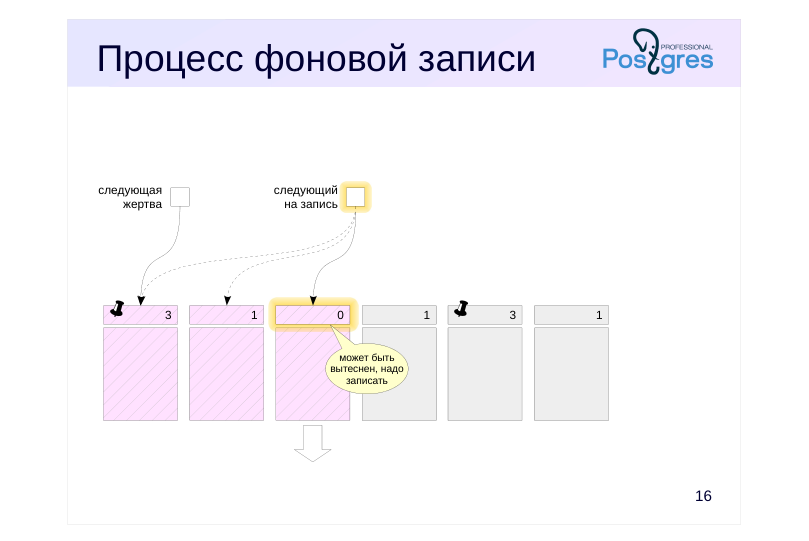 {#source-figure-017 caption=“Source slide page 17: Процесс фоновой записи”}
Комментарии преподавателя
Когда обслуживающий процесс собирается вытеснить страницу из буфера, он может обнаружить, что буфер грязный, и ему придется записывать эту страницу на диск. Чтобы снизить вероятность таких ситуаций, в дополнение к процессу контрольной точки (checkpointer) существует также процесс фоновой записи (background writer, bgwriter или просто writer).
Процесс фоновой записи использует тот же самый алгоритм поиска буферов, что и обслуживающие процессы, только использует свой указатель. Он может опережать указатель на «жертву», но никогда не отстает от него.
Записываются буферы, которые одновременно:
● содержат измененные данные (грязные),
● не закреплены (pin count = 0),
● имеют нулевое число обращений (usage count = 0).
Таким образом, фоновый процесс записи, «забегая вперед», находит те буферы, которые с большой вероятностью вскоре потребуется вытеснить. За счет этого обслуживающий процесс скорее всего обнаружит, что выбранный им буфер не является грязным.
Page 18: Процесс фоновой записи
Алгоритм
- уснуть на bgwriter_delay
- если в среднем за цикл запрашивается N буферов, то записать
- N * bgwriter_lru_multiplier
- ≤ bgwriter_lru_maxpages
- грязных буферов
- Настройки
- bgwriter_delay
- = 200ms
- bgwriter_lru_maxpages
- = 100
- bgwriter_lru_multiplier
- = 2.0
- bgwriter_flush_after
- = 512kB
Комментарии преподавателя
Процесс фоновой записи работает циклами максимум по bgwriter_lru_maxpages страниц, засыпая между циклами на время bgwriter_delay.
(Таким образом, если установить параметр bgwriter_lru_maxpages в ноль, процесс фактически не будет работать.)
Точное число буферов для записи определяется по среднему количеству буферов, которые запрашивались обслуживающими процессами с прошлого цикла (используется скользящее среднее, чтобы сгладить неравномерность между циклами, но при этом не зависеть от давней истории). Вычисленное количество буферов умножается на коэффициент bgwriter_lru_multiplier.
Если процесс совсем не обнаружил грязных буферов (то есть в системе ничего не происходит), он «впадает в спячку», из которой его выводит обращение серверного процесса за буфером. После этого процесс просыпается и опять работает обычным образом.
При необходимости записи большого количества данных сервер даёт указание ОС произвести промежуточный сброс данных в хранилище (fsync) по достижении объема, задаваемого параметром bgwriter_flush_after. Это уменьшает задержки фиксации транзакций и выполнение синхронизации в конце контрольной точки.
Процесс фоновой записи имеет смысл настраивать после того, как настроена контрольная точка. Совместно с контрольной точкой эти процессы должны успевать записывать грязные буферы до того, как они потребуются обслуживающим процессам.
Page 19: Мониторинг
Контрольные точки
- checkpoint_warning = 30s
- log_checkpoints = on
- статусы процессов startup, checkpointer
- Запись грязных буферов процессами
- представления pg_stat_bgwriter, pg_stat_io
Комментарии преподавателя
Параметр checkpoint_warning позволяет выводить в журнал предупреждение, если интервал между контрольными точками меньше, чем значение параметра. Если это происходит регулярно, следует подумать об увеличении max_wal_size или уменьшении интервала между контрольными точками checkpoint_timeout.
Включенный по умолчанию параметр log_checkpoints выводит в журнал подробную информацию о каждой выполненной контрольной точке.
Когда сервер находится в режиме восстановления, можно следить за статусом процессов startup и checkpointer средствами операционной системы, например с помощью утилиты ps.
Статистику работы процессов, записывающих грязные буферы (контрольной точки, фоновой записи и обслуживающих процессов), показывает представление pg_stat_bgwriter, а начиная с версии 16 — представление pg_stat_io.
В 17-ой версии PostgreSQL появится новое представление pg_stat_checkpointer, в которое из pg_stat_bgwriter будет перенесена информация о статистике процесса контрольной точки.
Page 20: Мониторинг
Параметр checkpoint_warning выводит предупреждение, если контрольные точки, вызванные переполнением размера журнальных файлов, выполняются слишком часто. Его значение по умолчанию:
Его следует привести в соответствие со значением checkpoint_timeout. Параметр log_checkpoints позволяет получать в журнале сообщений сервера информацию о выполняемых контрольных точках. По умолчанию (начиная с PostgreSQL 15) параметр включен:
Запишем что-нибудь в таблицу и выполним контрольную точку.
Вот какую информацию можно узнать из журнала сообщений:
Статистика работы процессов контрольной точки и фоновой записи отражается в одном общем представлении (раньше обе задачи решались одним процессом; затем их функции разделили, но представление осталось).
checkpoints_timed — контрольные точки по расписанию (checkpoint_timeout); checkpoints_req — контрольные точки по требованию (max_wal_size) и выполненные вручную; buffers_checkpoint — страницы, сброшенные при контрольных точках; buffers_clean — страницы, сброшенные процессом фоновой записи; buffers_backend — страницы, сброшенные обслуживающими процессами; maxwritten_clean — количество остановок по достижению bgwriter_lru_maxpages. В хорошо настроенной системе значение buffers_backend должно быть существенно меньше, чем сумма buffers_checkpoint и buffers_clean. Большое значение checkpoints_req (по сравнению с checkpoints_timed) говорит о том, что контрольные точки происходят чаще, чем предполагалось.
Page 21: Page 21
Однако информация об объеме ввода-вывода, выдаваемая представлением pg_stat_bgwriter, не вполне корректна: в столбце buffers_backend отражены результаты работы не только клиентских процессов, но и некоторых других (например, автоочистки). В этот же столбец добавляются операции расширения файлов отношений, хотя это не запись из буферного кеша на диск. Использованное нами ранее представление pg_stat_io предоставляет статистику в более информативном виде:
writes — количество операций записи; fsyncs — количество вызовов fsync; extends — количество операций расширения отношений.
Page 22: Итоги
Процесс контрольной точки ограничивает размер хранимых журнальных файлов и сокращает время восстановления
- Контрольная точка и фоновая запись сбрасывают на диск грязные буферы
- Обслуживающие процессы могут сбрасывать грязные буферы, но не должны этим заниматься
Page 23: Практика
- Настройте выполнение контрольной точки раз в 30 секунд. Установите параметры min_wal_size и max_wal_size в 32 МБ.
- Несколько минут c помощью утилиты pgbench подавайте нагрузку 100 транзакций/сек.
- Измерьте, какой объем журнальных файлов был сгенерирован за это время.
- Проверьте данные статистики и оцените, какой объем приходится в среднем на одну контрольную точку. Все ли контрольные точки выполнялись по расписанию? Как можно объяснить полученный результат?
- Сбросьте настройки к значениям по умолчанию.
Page 24: 1. Настройка контрольной точки
2. Нагрузка
Инициализируем таблицы.
Сбросим статистику.
Запускаем pgbench, предварительно запомнив позицию в журнале.
Page 25: 3. Объем журнальных файлов
4. Статистика
Число контрольных точек по расписанию и по требованию:
Средний объем на контрольную точку:
Несмотря на то что в среднем объем журнальных записей за контрольную точку не превосходит установленного предела, часть контрольных точек выполнялась не по расписанию. Это говорит о неравномерности потока журнальных записей (вызванной выполнением автоочистки и другими причинами). Поэтому в реальной системе замеры лучше выполнять на достаточно больших интервалах времени.
5. Настройки по умолчанию
11 Занятие 11: Журналирование / Настройка журнала
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_11_wal_tuning.html Archive: DBA2-handouts-16.zip Страниц PDF: 22
Page 1: Журналирование / Настройка журнала
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Уровни журнала и решаемые задачи
- Надежность записи
- Производительность
Page 3: Уровни журнала
Настройка
- чем выше уровень,
- тем больше информации
- wal_level = replica
- в журнале
- Minimal
- восстановление после сбоя
- Replica
- восстановление из резервной копии, физическая репликация
- операции массовой обработки данных, блокировки,
- номера выполняющихся транзакций
- Logical
- логическая репликация
- информация для логического декодирования
Комментарии преподавателя
Кроме основной задачи — восстановления согласованности после сбоя — журнал можно использовать и для других целей, если добавить в него дополнительную информацию. Для этого существуют несколько уровней журнала, устанавливаемых параметром wal_level.
Уровень minimal содержит только информацию, необходимую для восстановления после сбоя. В журнал не записываются операции массовой обработки данных (такие, как CREATE TABLE AS SELECT, CREATE INDEX и т. п.), их долговечность гарантируется немедленной записью данных на диск.
Уровень replica (используется по умолчанию) позволяет восстанавливать систему из горячих резервных копий, сделанных утилитой pg_basebackup. Для этого в журнал записываются все изменения данных, включая операции массовой обработки. Уровень также позволяет организовать физическую репликацию — передавать поток журнальных записей на другой сервер (рассматривается в курсе DBA3), для чего в журнал включается информация о ряде блокировок.
Уровень logical используется для логической репликации — он должен быть включен на сервере, публикующем изменения. Для правильной работы логического декодирования в журнал записывается дополнительная информация, позволяющая корректно расшифровать смысл операций по журнальным записям.
Чем выше уровень, тем больше информации попадает в журнал и, следовательно, тем больше его объем.
Page 4: Уровни журнала
Используем новую базу данных.
Установим для журнала уровень minimal (при этом придется также задать нулевое значение параметра max_wal_senders и перезапустить сервер).
Посмотрим, как записывается в журнал команда CREATE TABLE AS SELECT.
Объем журнала:
В журнале нет записей, описывающих вставку строк в таблицу:
На уровне minimal изменения, выполненные операторами CREATE TABLE AS SELECT, CREATE INDEX, TRUNCATE и некоторыми другими, не журналируются. Эти операторы всегда сами выполняют синхронизацию, обеспечивая долговечность. А журнал содержит только записи, необходимые для восстановления после сбоя.
Page 5: Page 5
Удалим таблицу, вернем уровень по умолчанию (replica) и повторим эксперимент.
Посмотрим, как теперь записывается в журнал команда CREATE TABLE AS SELECT.
Объем журнала увеличился:
Помимо изменений системного каталога, в журнал попадают записи: CREATE — создание файла отношения; INSERT+INIT — вставка строк в таблицу; COMMIT — фиксация транзакции.
Page 6: Page 6
На уровне replica журнал содержит все изменения данных, что позволяет применить их к физической резервной копии или к реплике.
Page 7: Надежность записи
Кеширование
- Повреждение данных
- Неатомарность записи страниц
Page 8: Кеширование
 {#source-figure-008 caption=“Source slide page 8: Кеширование”}
Синхронизация с диском
- данные должны дойти до энергонезависимого
- хранилища через многочисленные кеши
- СУБД сообщает о синхронизации операционной системе
- способом, указанным в wal_sync_method
- надо учитывать аппаратное кеширование
- Настройки
- fsync = on
- wal_sync_method
- (утилита pg_test_fsync)
Комментарии преподавателя
Есть несколько моментов, которые влияют на надежность. Во-первых, всевозможные кеши, находящиеся на пути к энергонезависимому хранилищу (такому как пластина жесткого диска).
Когда PostgreSQL требуется надежно записать данные, он пользуется способом, указанным в параметре wal_sync_method. Вариантов несколько, но основных — два: либо после записи операционной системе дается команда синхронизации (fsync, fdatasync), либо файл открывается или записывается со специальным флагом, который говорит о необходимости синхронизации, а по возможности — прямой записи, минуя кеш ядра ОС. Утилита pg_test_fsync позволяет выбрать способ, наиболее подходящий для конкретной ОС и конкретной файловой системы. Но в любом случае это дорогостоящая операция.
Кроме этого, администратор должен гарантировать, что данные действительно доходят до диска, а не задерживаются в кеше контроллера или самого диска. Если кеш контроллера откладывает запись, то контроллер в обязательном порядке должен иметь батарею резервного питания. Для дисков лучше устанавливать сквозную запись.
Вообще говоря, синхронизацию можно отменить (параметр fsync), но в этом случае про надежность хранения следует забыть. Единственный разумный вариант отключения этого параметра — временное увеличение производительности в случае, если данные можно легко восстановить (например, при начальной миграции).
https://postgrespro.ru/docs/postgresql/16/wal-reliability
Page 9: Повреждение данных
Контрольные суммы журнальных записей
- включены всегда, CRC-32
- Контрольные суммы страниц
- нужно включить при инициализации кластера
- накладные
- расходы, увеличение
- размера журнала
- Настройки
- data_checksums
- ignore_checksum_failure = off
Комментарии преподавателя
Во-вторых, данные могут быть повреждены на носителе, при передаче данных по интерфейсным кабелям и т. п. Часть таких ошибок обрабатывается на аппаратном уровне, но часть — нет.
Чтобы вовремя обнаружить возникшую проблему, журнальные записи всегда снабжаются контрольными суммами.
Страницы данных также можно защитить контрольными суммами. Это лучше сделать сразу при инициализации кластера, но можно включить утилитой pg_checksums и потом, остановив сервер. В производственной среде контрольные суммы должны быть включены обязательно, несмотря на накладные расходы на их вычисление и контроль. Иначе можно получить ситуацию, когда возникший сбой не будет вовремя обнаружен.
Проверить, включены ли контрольные суммы, можно с помощью параметра data_checksums (только для чтения). Параметр ignore_checksum_failure позволяет не прерывать транзакцию, прочитавшую сбойную страницу, но обычно его не следует включать.
Page 10: Неатомарность записи
Образ страницы
- при сбое страница может быть записана не полностью
- в журнал записывается образ страницы
- при первом ее изменении после контрольной точки
- при восстановлении журнальные записи
- применяются к записанному образу
- Настройки
- увеличивает
- размер журнала
- full_page_writes = on
- wal_compression = off
Комментарии преподавателя
В-третьих, есть проблема атомарности записи.
Страница данных занимает 8 КБ (или больше: 16 КБ, 32 КБ), а на низком уровне запись происходит блоками, которые обычно имеют меньший размер (512 байт, 4 КБ, хотя бывают и другие размеры). Поэтому при сбое питания страница данных может записаться частично. Понятно, что при восстановлении бессмысленно применять к такой странице обычные журнальные записи.
Для защиты PostgreSQL позволяет записывать в журнал образ всей страницы при первом ее изменении после контрольной точки — этим управляет параметр full_page_writes. Отключать его имеет смысл, только если используемая файловая система и аппаратура сами по себе гарантируют атомарность записи.
Если при восстановлении мы встречаем в журнале образ страницы, то безусловно записываем его на диск (к нему больше доверия, так как он, как и всякая журнальная запись, защищен контрольной суммой). И далее к нему уже применяем обычные журнальные записи.
Хотя PostgreSQL исключает из полного образа страницы незанятое место, все же объем журнальных записей увеличивается. Если в кластере включены контрольные суммы страниц, при изменении битов-подсказок в журнале появляется дополнительная запись, отражающая изменение контрольной суммы.
Размер журнала можно уменьшить за счет сжатия полных образов, задав метод сжатия параметром wal_compression. Поддерживаются методы pglz, lz4, zstd. Значение on соответствует выбору pglz, off отключает сжатие.
Page 11: Контрольные суммы
Создадим еще одну таблицу:
Вот файл, в котором находятся данные:
Остановим сервер и поменяем несколько байтов в странице (сотрем из заголовка LSN последней журнальной записи).
Можно было бы и не останавливать сервер. Достаточно, чтобы: страница записалась на диск и была вытеснена из кеша; произошло повреждение; страница была прочитана с диска. Теперь запускаем сервер.
Попробуем прочитать таблицу:
Параметр ignore_checksum_failure позволяет попытаться все-таки прочитать таблицу, хоть и с риском получить искаженные данные (например, если нет резервной копии):
Page 12: Производительность
Характер нагрузки
- Синхронная запись
- Асинхронная запись
Page 13: Характер нагрузки
Постоянный поток записи
- последовательная запись, отсутствие случайного доступа
- характер нагрузки отличается от остальной системы
- при высокой нагрузке — размещение на отдельных физических дисках
- (символическая ссылка из PGDATA/pg_wal)
- Редкое чтение
- при восстановлении
- при работе процессов walsender, если реплика не успевает быстро
- получать записи
Комментарии преподавателя
При обычной работе происходит постоянная и последовательная запись журнальных файлов. Поскольку отсутствует случайный доступ, с такой нагрузкой отлично справляются и обычные диски HDD.
Но такой характер нагрузки существенно отличается от того, как происходит доступ к файлам данных. Поэтому обычно выгодно размещать журнал на отдельном физическом диске (дисках), примонтированных к ФС сервера; вместо каталога PGDATA/pg_wal нужно создать символическую ссылку на соответствующий каталог.
Однако есть ситуация, при которой журнальные файлы необходимо читать (кроме понятного случая восстановления после сбоя). Она возникает, если используется потоковая репликация и реплика не успевает получать журнальные записи, пока они еще находятся в буферах оперативной памяти основного сервера. Тогда процессу walsender приходится читать нужные данные с диска. Взаимодействие с репликой подробно рассматривается в курсе DBA3 в модуле «Репликация».
Для мониторинга и оценки производительности работы WAL в PostgreSQL версии 14 было добавлено представление pg_stat_wal.
Page 14: Синхронная запись
Алгоритм
- при фиксации изменений сбрасываются все накопившиеся записи,
- включая запись о фиксации
- ожидание commit_delay, если активно не менее commit_siblings
- транзакций
- Свойства
- гарантируется долговечность
- увеличивается время отклика
- Настройки
- включать
- при большом потоке
- коротких транзакций
- synchronous_commit = on
- commit_delay
- = 0
- commit_siblings
- = 5
Комментарии преподавателя
Запись журнала происходит в одном из двух режимов: синхронном (когда при фиксации транзакции продолжение работы невозможно до тех пор, пока все журнальные записи о транзакции не окажутся на диске) и асинхронном (когда журнал записывается частями в фоне).
Синхронный режим включается параметром synchronous_commit.
Поскольку синхронизация работает долго, выгодно выполнять ее как можно реже. Для этого процесс, записывающий журнал, делает паузу, определяемую параметром commit_delay, но только в том случае, если имеется не менее commit_siblings активных транзакций — в расчете на то, что за время ожидания часть транзакций успеет завершиться и можно будет синхронизировать их записи за один раз.
Затем процесс выполняет сброс журнала на диск до необходимого LSN (или несколько больше, если за время ожидания добавились новые записи).
При синхронной записи гарантируется долговечность — если транзакция зафиксирована, то все ее журнальные записи уже есть на диске и не будут потеряны. Обратная сторона состоит в том, что синхронная запись увеличивает время отклика (команда COMMIT не возвращает управление до окончания синхронизации) и снижает производительность системы.
Page 15: Асинхронная запись
Алгоритм
- циклы записи через wal_writer_delay
- записываются только целиком заполненные страницы;
- но если новых полных страниц нет, то записывается текущая
- Свойства
- гарантируется согласованность, но не долговечность
- зафиксированные изменения могут пропасть (3 × wal_writer_delay)
- Настройки
- можно
- изменять на уровне
- synchronous_commit
- wal_writer_delay = 200ms
- wal_writer_flush_after = 1MB
- транзакции
Комментарии преподавателя
При асинхронной записи работает процесс wal writer, сбрасывая накопившиеся журнальные записи либо через wal_writer_delay единиц времени, либо по достижении объема wal_writer_flush_after:
● Если с прошлого раза в буферах была целиком заполнена одна или несколько страниц, сбрасываются только такие, полностью заполненные, страницы (или часть таких страниц; вспомним, что журнальный кеш представляет собой кольцевой буфер — записывается только непрерывная последовательность страниц). При большом потоке изменений это позволяет не синхронизировать одну и ту же страницу несколько раз.
● Если же заполненные страницы не появились, записывается текущая (не до конца заполненная) страница журнала.
Асинхронная запись эффективнее синхронной — фиксация изменений не ждет записи. Однако надежность уменьшается: зафиксированные данные могут пропасть в случае сбоя, если между фиксацией и сбоем прошло менее 3 × wal_writer_delay единиц времени.
Параметр synchronous_commit можно устанавливать в рамках транзакций. Это позволяет увеличивать производительность, жертвуя надежностью только части транзакций.
https://postgrespro.ru/docs/postgresql/16/wal-async-commit
В реальности оба режима работают совместно. Журнальные записи долгой транзакции будут записываться асинхронно (чтобы освободить буферы WAL). А если при сбросе грязного буфера окажется, что соответствующая журнальная запись еще не на диске, она тут же будет сброшена в синхронном режиме.
Page 16: Влияние синхронной фиксации на производительность
Режим, включенный по умолчанию, — синхронная фиксация.
Запустим простой тест производительности с помощью утилиты pgbench. Для этого сначала инициализируем необходимые таблицы…
…а также сбросим статистику о работе журнала предзаписи:
Запускаем тест на 10 секунд.
В результатах pgbench нас интересует число транзакций или скорость (tps), а в данных представления pg_stat_wal — количество операций записи и синхронизации журнала:
Page 17: Page 17
Теперь установим асинхронный режим.
Сбросим накопленные данные.
И снова запускаем тест.
Кроме повышения tps, мы видим и саму причину повышения производительности: количество операций синхронизации журнала значительно уменьшилось. Разумеется, на реальной системе соотношение может быть другим, но видно, что в асинхронном режиме производительность существенно выше.
Page 18: Итоги
Журнал позволяет восстановить согласованность после сбоев, но может использоваться и для других задач
- Надежность записи требует настройки не только СУБД, но и на уровне ОС, ФС и аппаратуры
- Настройка позволяет достичь баланса между долговечностью и производительностью
Page 19: Практика
- Изучите, как влияет на размер журнальных записей значение параметра full_page_writes.
- Для этого повторите простой тест pgbench, показанный
- в демонстрации, с разными настройками журнала. Перед
- запуском каждого теста выполняйте контрольную точку.
- Объясните полученный результат.
- Во сколько раз уменьшается размер журнальных записей при включении параметра wal_compression?
Комментарии преподавателя
Для детального анализа может пригодиться функция pg_get_wal_stats из расширения pg_walinspect.
Page 20: 1a. Full page writes = on
Запускаем тест на 10 секунд.
Смотрим статистику журнальных записей:
Page 21: Page 21
Значительную часть объема журнала составляют полные образы страниц (FPI).
1b. Full page writes = off
Запускаем тест на 10 секунд.
Смотрим статистику журнальных записей:
Объем заметно сократился, полные образы страниц в журнал теперь не записываются.
Page 22: 2. Сжатие
Запускаем тест на 10 секунд.
Смотрим статистику журнальных записей:
В данном случае — при наличии большого числа полных образов страниц — размер журнальных записей уменьшился в несколько раз. Хотя сжатие и нагружает процессор, практически наверняка им стоит воспользоваться при включенных полных образах страниц.
12 Занятие 12: Блокировки / Блокировки объектов
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_12_locks_objects.html Archive: DBA2-handouts-16.zip Страниц PDF: 34
Page 1: Блокировки / Блокировки объектов
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Общая информация о блокировках
- Блокировки отношений и других объектов
- Предикатные блокировки
Page 3: Общая информация
Задача и механизм использования блокировок
- Блокируемые ресурсы
- Факторы, влияющие на эффективность
- Время жизни блокировок
Page 4: Блокировки
Задача: упорядочение конкурентного доступа к разделяемым ресурсам
- Механизм
- перед обращением к ресурсу процесс захватывает блокировку,
- после обращения — освобождает
- блокировки приводят к очередям и ожиданиям
- Альтернативы
- многоверсионность — несколько версий данных
- оптимистические блокировки — процессы не блокируются,
- но при неудачном стечении обстоятельств возникает ошибка
Комментарии преподавателя
Блокировки используются, чтобы упорядочить конкурентный доступ к разделяемым ресурсам.
Под конкурентным доступом понимается одновременный доступ нескольких процессов. Сами процессы могут выполняться как параллельно (если позволяет аппаратура), так и последовательно в режиме разделения времени.
Блокировки не нужны, если нет конкуренции (одновременно к данным обращается только один процесс) или если нет разделяемого ресурса (например, общий буферный кеш нуждается в блокировках, а локальный — нет).
Перед тем как обратиться к ресурсу, защищенному блокировкой, процесс должен захватить эту блокировку. Когда процесс больше не нуждается в ресурсе, он освобождает блокировку, чтобы ресурсом могли воспользоваться другие процессы.
Захват блокировки возможен не всегда: ресурс может оказаться уже занятым кем-то другим. Тогда процесс либо встает в очередь ожидания, либо повторяет попытку захвата блокировки через определенное время. Так или иначе это приводит к тому, что процесс вынужден простаивать в ожидании освобождения блокировки.
Иногда удается применить другие, неблокирующие, стратегии. Например, в одноименном модуле мы обсуждали механизм многоверсионности. Еще один пример — оптимистические блокировки, которые не блокируют процесс, но в случае неудачи приводят к ошибке.
Page 5: Ресурсы
Ресурс
- все, что можно идентифицировать
- Примеры ресурсов
- реальные хранимые объекты: страницы, таблицы, строки и т. п.
- структуры данных в общей памяти (хеш-таблицы, буферы…)
- абстрактные ресурсы (число)
Комментарии преподавателя
Ресурсом, защищаемым блокировкой, в принципе может быть все, что угодно, лишь бы ресурс можно было однозначно идентифицировать.
Например, ресурсом может быть объект, с которым работает СУБД, такой как страница данных (идентифицируется именем файла и позицией внутри файла), таблица (oid в системном каталоге), версия строки (страница и позиция внутри страницы).
Ресурсом может быть структура в памяти, такая как хеш-таблица, буфер и т. п. (идентифицируется заранее присвоенным номером).
Иногда даже бывает удобно использовать абстрактные ресурсы, не имеющие никакого физического смысла (идентифицируются числом).
Page 6: Факторы эффективности
Гранулярность блокировки
- степень детализации, уровень в иерархии ресурсов
- например: таблица → страница → строки, хеш-таблица → корзины
- выше гранулярность — больше возможностей для параллелизма
- Режимы блокировок
- совместимость режимов определяется матрицей
- больше совместимых режимов — больше возможностей для
- параллелизма
Комментарии преподавателя
На эффективность блокировок оказывает влияние много факторов, из которых мы выделим всего несколько.
Гранулярность (степень детализации) важна, если ресурсы образуют иерархию. Например, таблица состоит из страниц, которые содержат табличные строки. Все эти объекты могут выступать в качестве ресурсов. Если процесс заинтересован всего в нескольких строках, а блокировка устанавливается на уровне таблицы, другие процессы не смогут работать с остальными строками.
Поэтому чем выше гранулярность – тем больше возможностей для распараллеливания, но это приводит к увеличению числа блокировок, информацию о которых надо где-то хранить.
Блокировки могут захватываться в разных режимах. Имена режимов могут быть абсолютно произвольными, важна лишь матрица их совместимости друг с другом.
Режим, несовместимый ни с каким режимом, принято называть исключительным (exclusive). Если режимы совместимы, блокировка может захватываться несколькими процессами одновременно; такие режимы называют разделяемыми (shared).
В целом, чем больше можно найти режимов, совместимых друг с другом, тем больше возможностей для параллелизма.
Page 7: Время жизни
Долговременные блокировки
- обычно захватываются до конца транзакции
- и относятся к хранимым данным
- большое число режимов
- развитая «тяжеловесная» инфраструктура, мониторинг
- Краткосрочные блокировки
- обычно захватываются на доли секунды
- и относятся к структурам в оперативной памяти
- минимум режимов
- «легковесная» инфраструктура, мониторинг может отсутствовать
Комментарии преподавателя
По времени использования блокировки можно разделить на длительные и короткие.
Долговременные блокировки захватываются на потенциально большое время (обычно до конца транзакции) и чаще всего относятся к таким ресурсам, как таблицы (отношения) и строки. Как правило, PostgreSQL управляет такими блокировками автоматически, но пользователь, тем не менее, имеет определенный контроль над этим процессом.
Для длительных блокировок характерно большое число режимов, чтобы допускать как можно больше одновременных действий над данными.
Обычно для долговременных блокировок предусмотрены развитая инфраструктура (например, поддержка очередей и обнаружение взаимоблокировок) и средства мониторинга.
Краткосрочные блокировки захватываются на небольшое время (от нескольких тактов процессора до долей секунд) и обычно относятся к структурам данных в общей памяти. Такими блокировками PostgreSQL управляет полностью автоматически — об их существовании надо просто знать.
Для коротких блокировок характерны ограниченный набор простых режимов (часто всего лишь исключительный и разделяемый) и простая инфраструктура. Средства мониторинга могут отсутствовать.
Page 8: Виды блокировок
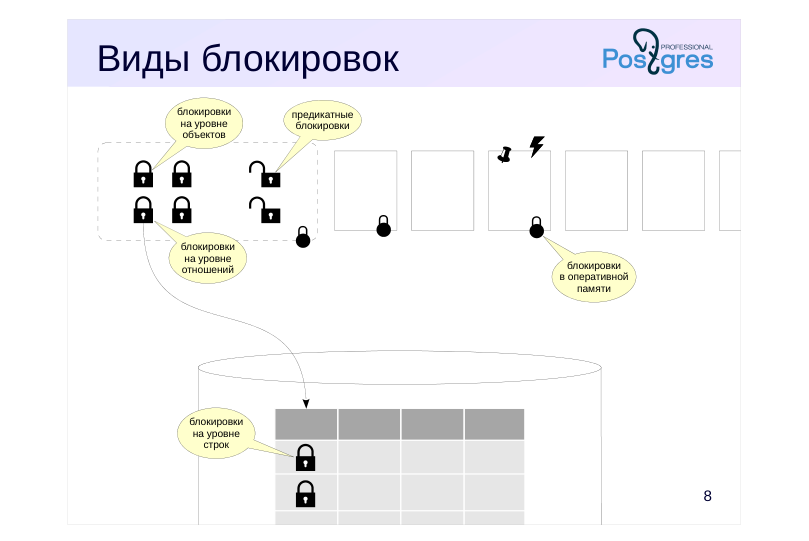 {#source-figure-008 caption=“Source slide page 8: Виды блокировок”}
Комментарии преподавателя
В PostgreSQL используются разные виды блокировок.
Блокировки на уровне объектов относятся к долговременным, «тяжеловесным». В качестве ресурсов здесь выступают отношения и другие объекты (например, схемы).
Еще один класс блокировок (оптимистических) — предикатные.
Информация обо всех этих блокировках хранится однотипным образом в оперативной памяти. Перечисленные виды блокировок подробно рассматриваются дальше в данной теме.
Среди долговременных блокировок особо выделяются блокировки на уровне строк. Их реализация отличается от остальных видов долговременных блокировок из-за потенциально огромного их количества (представьте обновление миллиона строк). Эти блокировки будут рассмотрены в теме «Блокировки строк».
К краткосрочным блокировкам относятся различные блокировки структур оперативной памяти. Они рассматриваются в теме «Блокировки в оперативной памяти».
Page 9: Блокировки объектов
 {#source-figure-009 caption=“Source slide page 9: Блокировки объектов”}
Page 10: Устройство
Информация в общей памяти сервера
- представление pg_locks:
- locktype — тип блокируемого ресурса,
- mode — режим блокировки
- Ограниченное количество
- max_locks_per_transaction × max_connections
- Инфраструктура
- очередь ожидания: ждущие процессы не потребляют ресурсы
- обнаружение взаимоблокировок
Комментарии преподавателя
Начнем рассмотрение блокировок с блокировок уровня объектов, таких как таблицы, индексы, страницы, номера транзакций и др. Такие блокировки защищают объекты от одновременного изменения или использования в то время, когда объект изменяется, а также для ряда других нужд.
Информация о блокировках объектов располагается в общей памяти сервера. Их количество ограничено произведением значений двух параметров: max_locks_per_transaction и max_connections (по умолчанию 64 × 100). Этот пул блокировок — общий для всех транзакций, то есть одна транзакция вполне может захватить больше блокировок, чем max_locks_per_transaction; важно лишь, чтобы общее число блокировок в системе не превысило установленный предел.
Все блокировки можно увидеть в представлении pg_locks.
Если ресурс уже заблокирован, и транзакция пытается захватить блокировку в несовместимом режиме, то она становится в очередь и ожидает освобождения блокировки. Ожидающие транзакции не потребляют ресурсы процессора, они «засыпают» и пробуждаются только при освобождении ресурса. Ряд команд SQL позволяют указать ключевое слово NOWAIT: в этом случае попытка захватить занятый ресурс приводит не к ожиданию, а к ошибке.
Возможна ситуация взаимоблокировки (тупика), при которой две или более транзакций ждут друг друга. PostgreSQL автоматически определяет такие ситуации и аварийно прерывает бесконечное ожидание.
Page 11: Блокировки отношений
Тип ресурса: Relation
- Режимы
- Access Share
- SELECT
- Row Share
- SELECT FOR UPDATE/SHARE
- Row Exclusive
- UPDATE, DELETE, INSERT, MERGE
- Share Update Exclusive
- VACUUM, ANALYZE, ALTER TABLE,
- СREATE INDEX CONCURRENTLY
- Share
- CREATE INDEX
- Share Row Exclusive
- CREATE TRIGGER, ALTER TABLE
- Exclusive
- REFRESH MATERIALIZED VIEW
- CONCURRENTLY
- Access Exclusive
- DROP, TRUNCATE, REINDEX, VACUUM FULL,
- LOCK TABLE, ALTER TABLE,
- REFRESH MATERIALIZED VIEW
- допускают
- параллельное
- изменение
- данных
- в таблице
Комментарии преподавателя
Важный частный случай блокировок — блокировки отношений (таблиц, индексов, последовательностей и т. п.). Такие блокировки имеют тип relation в представлении pg_locks.
Для них определено целых 8 различных режимов, которые показаны на слайде вместе с примерами команд SQL, использующих эти режимы. Матрица совместимости, которая показывает, какие блокировки можно захватывать совместно, приведена в документации.
Такое количество режимов существует для того, чтобы позволить выполнять одновременно как можно большее количество команд, относящихся к одной таблице (индексу и т. п.).
Самый слабый режим — Access Share, он захватывается командой SELECT и совместим с любым режимом, кроме самого сильного — Access Exclusive. Это означает, что запрос не мешает ни другим запросам, ни изменению данных в таблице, ни чему-либо другому, но не дает, например, удалить таблицу в то время, когда из нее читаются данные.
Другой пример: режим Share (как и другие более сильные режимы) не совместим с изменением данных в таблице. Например, команда CREATE INDEX заблокирует команды INSERT, UPDATE и DELETE (и наоборот). Поэтому существует команда CREATE INDEX CONCURRENTLY, использующая режим Share Update Exclusive, который совместим с такими изменениями (за счет этого команда выполняется дольше).
https://postgrespro.ru/docs/postgresql/16/explicit-locking#LOCKING-TABLE S
Page 12: Очередь ожидания
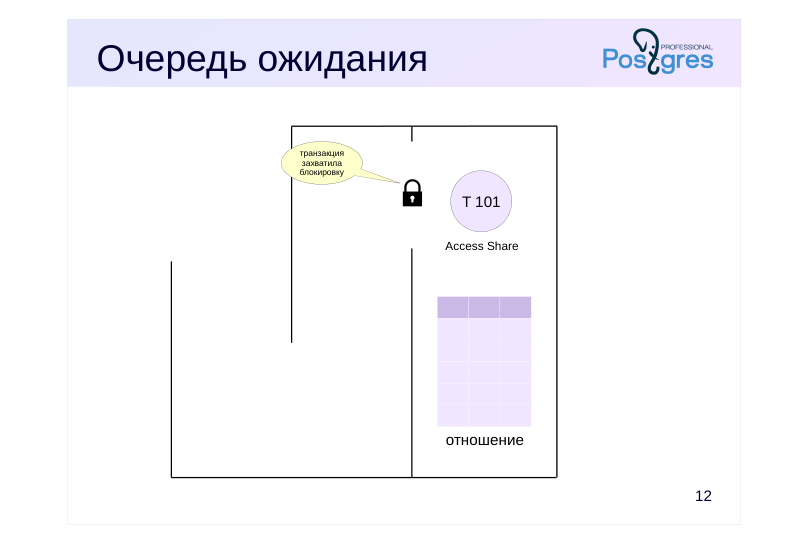 {#source-figure-012 caption=“Source slide page 12: Очередь ожидания”}
Комментарии преподавателя
Чтобы лучше представить, к чему приводит появление несовместимой блокировки, можно посмотреть на приведенный пример.
Вначале на таблице выполняется команда SELECT, которая запрашивает и получает блокировку уровня Access Share.
Page 13: Очередь ожидания
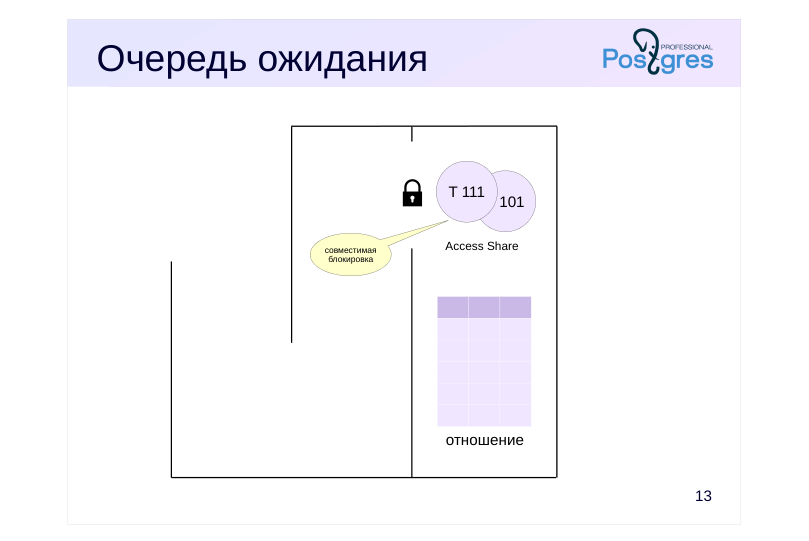 {#source-figure-013 caption=“Source slide page 13: Очередь ожидания”}
Комментарии преподавателя
Затем еще одна команда SELECT запрашивает блокировку уровня Access Share и получает ее, так как запрошенная блокировка совместима с существующей.
Page 14: Очередь ожидания
 {#source-figure-014 caption=“Source slide page 14: Очередь ожидания”}
Комментарии преподавателя
Затем администратор выполняет команду VACUUM FULL, которой требуется блокировка уровня Access Exclusive, несовместимая с существующими Access Share. Транзакция встает в очередь.
Page 15: Очередь ожидания
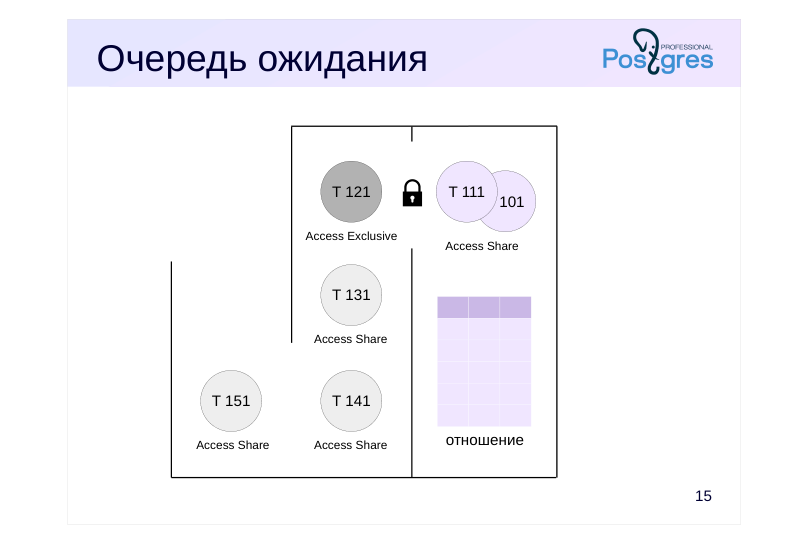 {#source-figure-015 caption=“Source slide page 15: Очередь ожидания”}
Комментарии преподавателя
Затем в системе появляются еще несколько команд SELECT. И, хотя какие-то из них теоретически могли бы «проскочить вперед», пока VACUUM FULL ждет своей очереди, все они честно занимают место за VACUUM FULL.
Page 16: Очередь ожидания
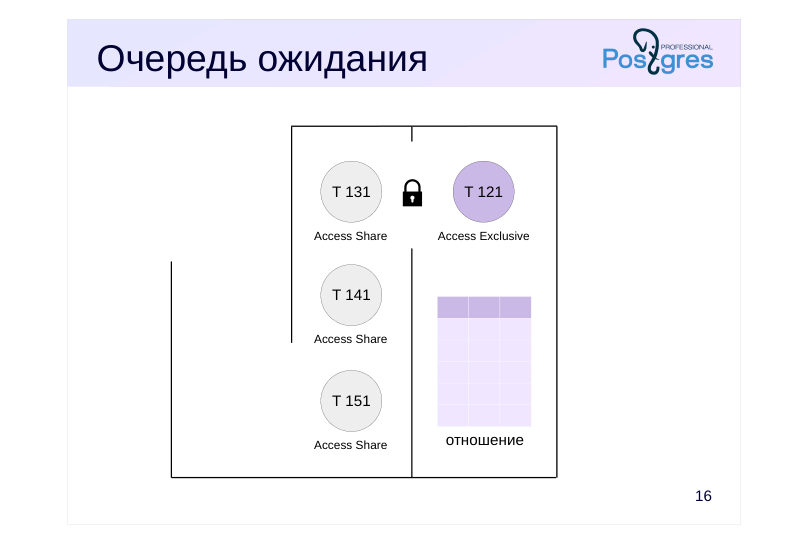 {#source-figure-016 caption=“Source slide page 16: Очередь ожидания”}
Комментарии преподавателя
После того, как две первые транзакции с командами SELECT завершаются и освобождают блокировки, VACUUM FULL начинает выполняться.
Теперь только когда VACUUM FULL завершит свою работу и снимет (исключительную) блокировку, все накопившиеся в очереди команды SELECT смогут захватить блокировки уровня Access Share и начать выполняться.
Таким образом, не вовремя выполненная команда может парализовать работу системы на время, значительно превышающее время выполнения самой команды.
Обратите внимание: исключительная блокировка может потребоваться также обычной очистке (и автоочистке), чтобы в конце своей работы выполнить усечение таблицы, то есть «откусить» пустой хвост файла данных и вернуть место операционной системе. Очистка не должна допускать ситуаций долгого ожидания, поэтому в случае проблем этап усечения можно отключить параметром хранения vacuum_truncate или вызывая очистку с указанием VACUUM (truncate off).
Page 17: Другие ресурсы
Типы
- Extend — добавление страниц к файлу отношения
- Object — не-отношение: база данных, схема и т. п.
- Page — страница (используется некоторыми типами индексов)
- Tuple — версия строки
- Advisory — рекомендательная блокировка
- Transactionid — транзакция
- Virtualxid — виртуальная транзакция
- Режимы
- исключительный
- разделяемый
Комментарии преподавателя
Кроме отношений есть еще несколько типов блокируемых ресурсов. Их блокировки захватываются либо только в исключительном режиме, либо в исключительном и разделяемом. К ним относятся:
● Extend при добавлении страниц к файлу какого-либо отношения;
● Object для блокирования объекта, который не является отношением (примеры таких объектов: база данных, схема, подписка и т. п.);
● Page для блокирования страницы (редкая блокировка, используется некоторыми типами индексов);
● Tuple используется в некоторых случаях для установки приоритета среди нескольких транзакций, ожидающих блокировку одной строки (подробнее см. тему «Блокировка строк» этого модуля);
● Advisory для рекомендательных блокировок (о них чуть позже).
Особый интерес представляют блокировки типа Transactionid и Virtualxid. Каждая транзакция удерживает исключительную блокировку своих номеров: и виртуального, и настоящего, если он есть. Это дает простой способ дождаться окончания какой-либо транзакции: надо запросить блокировку ее номера. Подробнее это рассматривается в теме «Блокировки строк».
Page 18: Средства мониторинга
Вывод сообщений в журнал сервера
- параметр log_lock_waits:
- выводит сообщение об ожидании дольше deadlock_timeout
- Текущие блокировки
- представление pg_locks
- функция pg_blocking_pids
Комментарии преподавателя
Возникающие в системе блокировки необходимы для обеспечения целостности и изоляции, однако могут приводить к нежелательным ожиданиям. Такие ожидания можно отслеживать, чтобы разобраться в их причине и по возможности устранить (например, изменив алгоритм работы приложения).
Один способ мониторинга состоит в том, чтобы включить параметр log_lock_waits. В этом случае в журнал сообщений сервера будет попадать информация, если транзакция ждала дольше, чем deadlock_timeout (несмотря на то, что используется параметр для взаимоблокировок, здесь речь идет об обычных ожиданиях).
Второй способ состоит в том, чтобы в момент возникновения долгой блокировки (или на периодической основе) выполнять запрос к представлению pg_locks, смотреть на блокируемые и блокирующие транзакции (функция pg_blocking_pids) и расшифровывать их при помощи pg_stat_activity.
Page 19: Блокировки отношений и других объектов
Создадим таблицу «банковских» счетов. В ней будем хранить номер счета и сумму.
Во втором сеансе начнем транзакцию. Нам понадобится номер обслуживающего процесса.
Какие блокировки удерживает только что начавшаяся транзакция?
Только блокировку собственного виртуального номера. Теперь обновим строку таблицы. Как изменится ситуация?
Добавилась блокировка отношения в режиме RowExclusiveLock (что соответствует команде UPDATE) и исключительная блокировка собственного номера (который появился, как только транзакция начала изменять данные). Теперь попробуем в еще одном сеансе создать индекс по таблице.
Page 20: Page 20
Команда не выполняется — ждет освобождения блокировки. Какой?
Видим, что транзакция пыталась получить блокировку таблицы в режиме ShareLock, но не смогла (granted = f). Столбец waitstart в этом случае показывает время, когда обслуживающий процесс начал ожидать блокировку. Мы можем найти номер блокирующего процесса (в общем виде — несколько номеров)…
…и посмотреть информацию о сеансах, к которым они относятся:
После завершения транзакции блокировки снимаются и индекс создается.
Page 21: Advisory Locks
Устанавливаются приложением
- Продолжительность
- до конца сеанса
- до конца транзакции
- Режимы
- исключительный
- разделяемый
Комментарии преподавателя
Рекомендательные блокировки можно использовать, если нужна логика блокирования, которую неудобно реализовывать с помощью других, «обычных» блокировок. Рекомендательные блокировки устанавливаются только приложением; PostgreSQL никогда не делает этого автоматически.
Имена функций, связанных с рекомендательными блокировками, начинаются с pg_advisory и могут содержать уточняющие ключевые слова.
Рекомендательная блокировка может быть установлена до конца сеанса (функция pg_advisory_lock) или до конца транзакции (pg_advisory_xact_lock).
Блокировки уровня сеанса, в отличие от блокировок уровня транзакции, не освобождаются автоматически по окончании транзакции, их нужно явно освобождать функцией pg_advisory_unlock. Таким образом, сеансовые рекомендательные блокировки нарушают обычную логику транзакций — блокировка, полученная в транзакции, даже если произойдет откат этой транзакции, будет сохраняться в сеансе; аналогично, освобождение блокировки остается в силе, даже если транзакция, в которой оно было выполнено, позже прерывается.
По умолчанию рекомендательные блокировки захватываются в исключительном режиме. Для использования разделяемого режима к имени функции добавляется слово shared, например, pg_advisory_lock_shared и pg_advisory_unlock_shared.
https://postgrespro.ru/docs/postgresql/16/explicit-locking#ADVISORY-LOCK S
Page 22: Рекомендательные блокировки
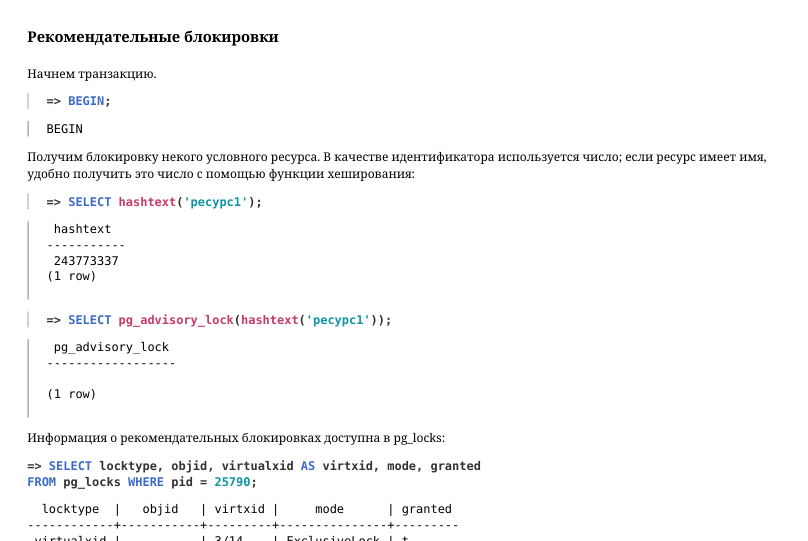 {#source-figure-022 caption=“Source slide page 22: Рекомендательные блокировки”}
Начнем транзакцию.
Получим блокировку некого условного ресурса. В качестве идентификатора используется число; если ресурс имеет имя, удобно получить это число с помощью функции хеширования:
Информация о рекомендательных блокировках доступна в pg_locks:
Если другой сеанс попробует захватить ту же блокировку, он будет ждать ее освобождения:
В приведенном примере блокировка действует до конца сеанса, а не транзакции, как обычно.
Захвативший блокировку сеанс может получить ее повторно, даже если есть очередь ожидания.
Блокировку можно явно освободить:
Но в нашем примере блокировка была получена сеансом дважды, поэтому придется освободить ее еще раз:
Page 23: Page 23
Существуют другие варианты функций для получения рекомендательных блокировок до конца транзакции, для получения разделяемых блокировок и т. п. Вот их полный список:
Page 24: Предикатные блокировки
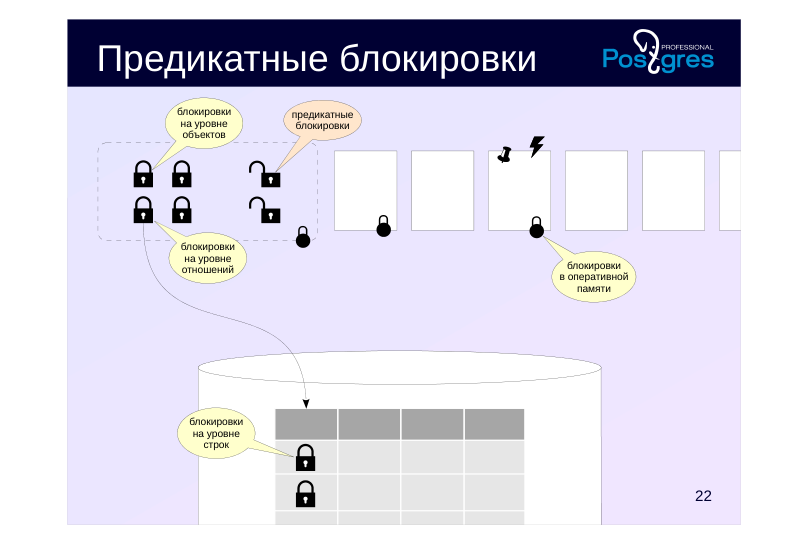 {#source-figure-024 caption=“Source slide page 24: Предикатные блокировки”}
Page 25: Предикатные блокировки
Задача: реализация уровня изоляции Serializable
- используются в дополнение к обычной изоляции на снимках данных
- оптимистические блокировки, название сложилось исторически
- Информация в общей памяти сервера
- представление pg_locks
- Ограниченное количество
- max_pred_locks_per_transaction × max_connections
Комментарии преподавателя
Термин предикатная блокировка появился давно, еще при первых попытках реализовать полную изоляцию (Serializable) на основе блокировок в ранних СУБД. Идея состояла в том, что блокировать надо не только определенные строки, но и предикаты. Например, при выполнении запроса с условием a > 10 надо заблокировать диапазон a > 10, чтобы избежать появления фантомных строк и других аномалий.
В PostgreSQL уровень Serializable реализован поверх существующего механизма снимков данных, но термин остался. Фактически такие «блокировки» ничего не блокируют, а используются для отслеживания зависимостей транзакций по данным.
Как и для обычных блокировок, информация о предикатных блокировках отображается в представлении pg_locks, все они устанавливаются в одном специальном режиме SIRead (Serializable Isolation Read).
Число предикатных блокировок ограничено произведением параметров max_pred_locks_per_transaction и max_connections (= 64 × 100).
Именно с использованием предикатных блокировок связано ограничение, что для достижения полной изоляции все транзакции должны работать на уровне Serializable. Отслеживание зависимостей будет работать только для транзакций, которые устанавливают предикатные блокировки.
https://postgrespro.ru/docs/postgresql/16/transaction-iso#XACT-SERIALIZA BLE
https://wiki.postgresql.org/wiki/SSI
https://github.com/postgres/postgres/blob/REL\_16\_STABLE/src/backend/sto rage/lmgr/README-SSI
Page 26: Предикатные блокировки
Типы ресурсов
- Relation — отношение
- max_pred_locks_per_relation
- Page — страница
- max_pred_locks_per_page
- Tuple — версия строки
- повышение
- Режим
- уровня
- SIRead
Комментарии преподавателя
Предикатные блокировки захватываются на трех уровнях.
При полном сканировании таблицы блокировка устанавливается на уровне всей таблицы.
При индексном сканировании устанавливаются блокировки тех страниц индекса, которые соответствуют условию доступа (предикату). Кроме того, устанавливаются блокировки на уровне отдельных табличных версий строк (это не то же самое, что блокировки строк, которые рассматриваются в одноименной теме).
При увеличении количества предикатных блокировок происходит автоматическое повышение уровня (эскалация): вместо нескольких мелких блокировок захватывается одна более высокого уровня.
Если число блокировок версий строк одной страницы превышает значение параметра max_pred_locks_per_page (2 по умолчанию), вместо них захватывается одна блокировка уровня страницы.
Если число блокировок страниц или версий одной таблицы (индекса) превышает значение параметра max_pred_locks_per_relation, вместо них захватывается одна блокировка на все отношение. По умолчанию параметр равен −2; для отрицательных чисел значение вычисляется как max_pred_locks_per_transaction / abs(max_pred_locks_per_relation).
Повышение уровня блокировок может приводить к ложным ошибкам сериализации, из-за чего снижается пропускная способность системы.
Page 27: Предикатные блокировки
Начнем транзакцию с уровнем Serializable и прочитаем одну строку таблицы последовательным сканированием.
Посмотрим на блокировки:
Появилась предикатная блокировка всей таблицы accounts (несмотря на то что читается одна строка).
Теперь прочитаем одну строку таблицы, используя индекс:
Блокировки:
При индексном сканировании устанавливаются мелкогранулярные предикатные блокировки: блокировки прочитанных страниц индекса; блокировки прочитанных версий строк.
Page 28: Page 28
Page 29: Итоги
Блокировки отношений и других объектов БД используются для организации конкурентного доступа к общим ресурсам
- поддерживаются очереди и обнаружение взаимоблокировок
- рекомендательные блокировки для ресурсов, не связанных
- с хранимыми объектами
- Предикатные блокировки используются для реализации уровня изоляции Serializable
- ничего не блокируют, отслеживают зависимости транзакций по данным
Page 30: Практика
- Какие блокировки на уровне изоляции Read Committed удерживает транзакция, прочитавшая одну строку таблицы по первичному ключу? Проверьте на практике.
- Воспроизведите автоматическое повышение уровня предикатных блокировок при чтении строк таблицы по индексу. Покажите, что при этом возможна ложная ошибка сериализации.
- Настройте сервер так, чтобы в журнал сообщений сбрасывалась информация о долгих (более 100 миллисекунд) ожиданиях блокировок. Воспроизведите ситуацию, при которой в журнале появятся такие сообщения.
Комментарии преподавателя
- В каждой из двух транзакций прочитайте две строки таблицы, используя индекс, и измените одну из прочитанных строк. Такие транзакции сериализуются. Задайте max_pred_locks_per_relation = 2 и повторите опыт.
Page 31: 0. Подготовка
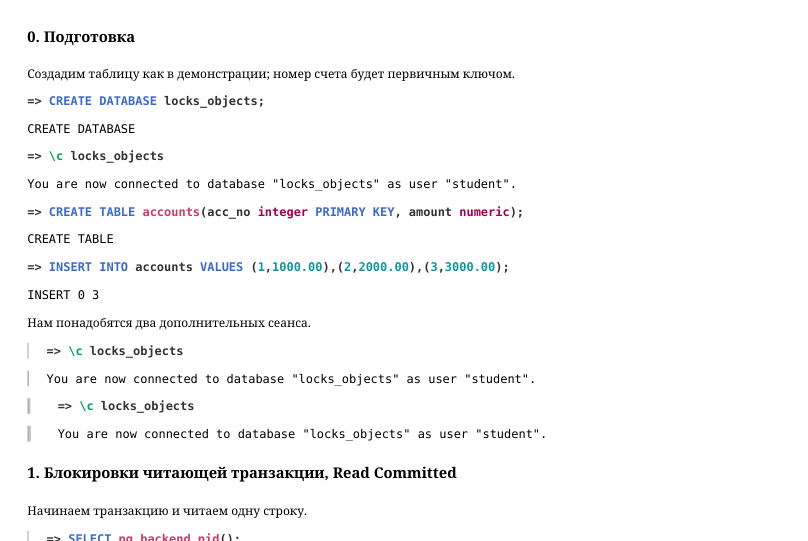 {#source-figure-031 caption=“Source slide page 31: 0. Подготовка”}
Создадим таблицу как в демонстрации; номер счета будет первичным ключом.
Нам понадобятся два дополнительных сеанса.
1. Блокировки читающей транзакции, Read Committed
Начинаем транзакцию и читаем одну строку.
Блокировки:
Здесь мы видим: Блокировку таблицы accounts в режиме AccessShareLock; Блокировку индекса accounts_pkey, созданного для первичного ключа, в том же режиме; Исключительную блокировку собственного номера виртуальной транзакции. Если смотреть блокировки в самой транзакции, к ним добавится блокировка на представление pg_locks:
Page 32: Page 32
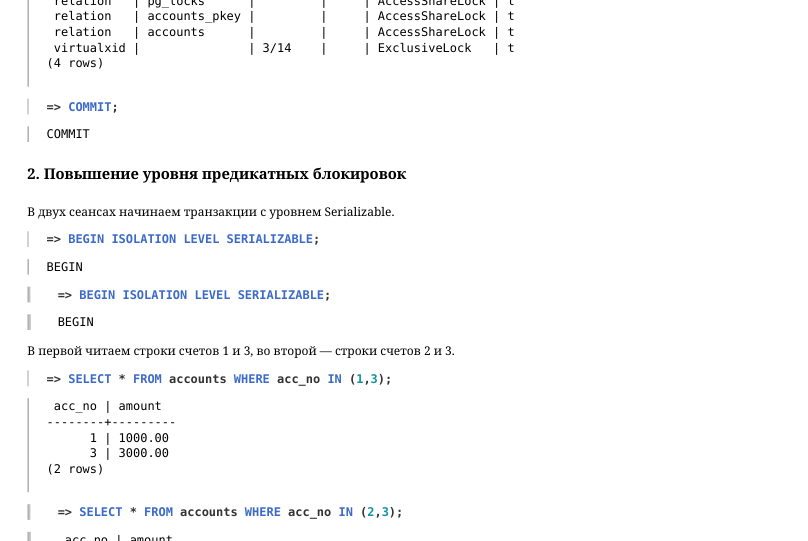 {#source-figure-032 caption=“Source slide page 32: Page 32”}
2. Повышение уровня предикатных блокировок
В двух сеансах начинаем транзакции с уровнем Serializable.
В первой читаем строки счетов 1 и 3, во второй — строки счетов 2 и 3.
Блокируются страница индекса и отдельные версии строк:
Изменим в первом сеансе остаток первого счета, во втором — второго.
Транзакции сериализуются:
Теперь настроим повышение уровня так, чтобы при блокировке двух версий строк блокировалась вся таблица.
Page 33: Page 33
 {#source-figure-033 caption=“Source slide page 33: Page 33”}
Повторяем опыт.
Теперь каждая транзакция блокирует всю таблицу:
Изменяем остатки…
…и фиксируем транзакции.
Из-за повышения уровня блокировок сериализация невозможна.
3. Вывод в журнал информации о блокировках
Требуется изменить параметры:
Page 34: Page 34
Воспроизведем блокировку.
В первом сеансе выполним задержку и после этого завершим транзакцию.
Вот что попало в журнал:
13 Занятие 13: Блокировки / Блокировки строк
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_13_locks_rows.html Archive: DBA2-handouts-16.zip Страниц PDF: 32
Page 1: Блокировки / Блокировки строк
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Исключительные и разделяемые блокировки строк
- Мультитранзакции и заморозка
- Реализация очереди ожидания
- Взаимоблокировки
Page 3: Блокировки строк
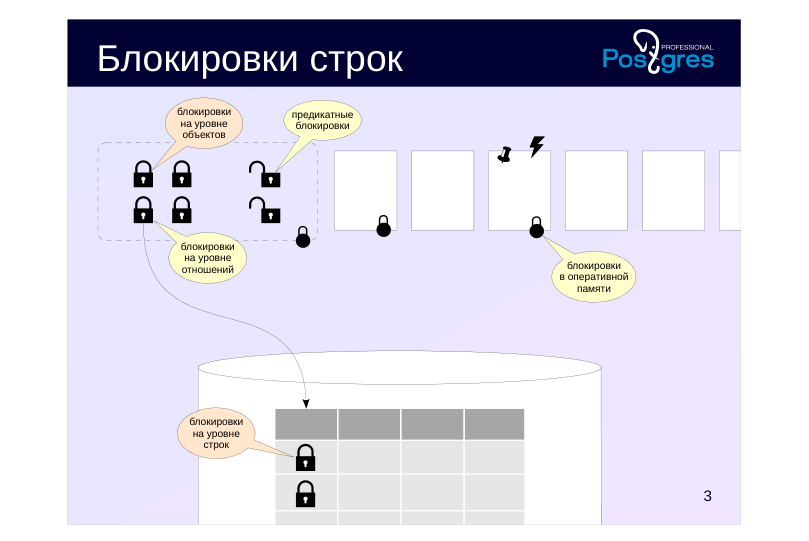 {#source-figure-003 caption=“Source slide page 3: Блокировки строк”}
Комментарии преподавателя
Несмотря на то, что информация о блокировках строк хранится в версиях строк на диске, очередь ожидания для исключительных блокировок строк организована с помощью блокировок объектов tuple.
Page 4: Устройство
Информация только в страницах данных
- поле xmax заголовка версии строки + информационные биты
- в оперативной памяти ничего не хранится
- Неограниченное количество
- большое число не влияет на производительность
- Инфраструктура
- «очередь» ожидания организована с помощью блокировок объектов
Комментарии преподавателя
Благодаря многоверсионности, блокировки уровня строк нужны только при изменении данных (или для того, чтобы не допустить изменения) и не нужны при чтении.
Если в случае блокировок объектов каждый ресурс представлен собственной блокировкой в оперативной памяти, то со строками так не получается: отдельная блокировка для каждой табличной строки (которых могут быть миллионы и миллиарды) потребует непомерных накладных расходов и огромного объема оперативной памяти.
Один из вариантов решения — повышение уровня (эскалация): если уже заблокировано N строк таблицы, то при блокировке еще одной блокируется вся таблица целиком, а блокировки на уровне строк снимаются. Но в этом случае страдает пропускная способность.
Поэтому в PostgreSQL сделано иначе. Информация о том, что строка заблокирована, хранится исключительно в заголовке версии строки внутри страницы данных. Там она представлена номером блокирующей транзакции (xmax) и дополнительными информационными битами.
За счет этого можно установить неограниченное количество блокировок уровня строки, и это не требует дополнительных ресурсов и не снижает производительность системы.
Обратная сторона такого подхода — сложность организации очереди ожидания. Для этого все-таки приходится использовать блокировки уровня объектов, но удается обойтись очень небольшим их количеством (пропорциональным числу процессов, а не числу заблокированных строк).
Page 5: Исключительные режимы
Update No Key Update
- удаление строки
- изменение любых полей,
- или изменение всех полей
- кроме ключевых
- UPDATE
- UPDATE
- (с изменением ключевых полей)
- (без изменения ключевых полей)
Комментарии преподавателя
Всего существует 4 режима, в которых можно заблокировать строку (в версии строки режим проставляется с помощью дополнительных информационных битов).
Два режима представляют исключительные (exclusive) блокировки, которые одновременно может удерживать только одна транзакция. Режим Update предполагает полное изменение (или удаление) строки, а режим No Key Update — изменение только тех полей, которые не входят в уникальные индексы (иными словами, при таком изменении все внешние ключи остаются без изменений).
Команда UPDATE сама выбирает минимальный подходящий режим блокировки; обычно строки блокируются в режиме No Key Update.
https://postgrespro.ru/docs/postgresql/16/explicit-locking#LOCKING-ROWS
Page 6: Исключительные режимы
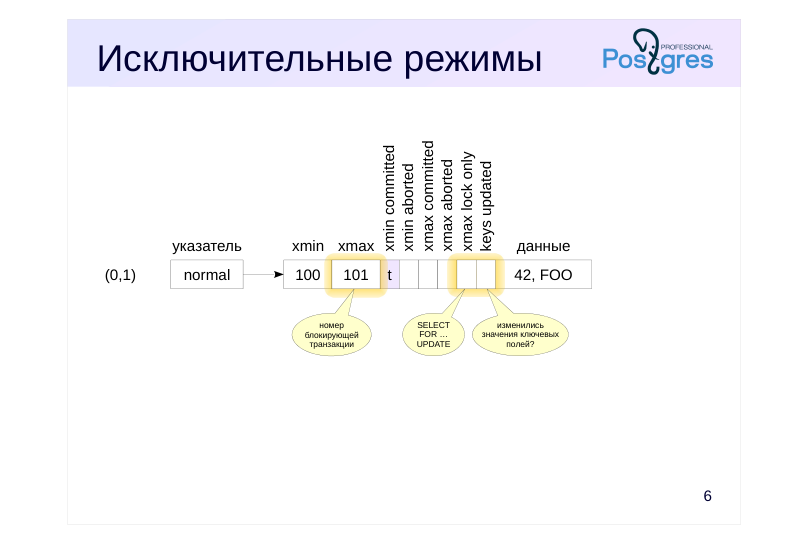 {#source-figure-006 caption=“Source slide page 6: Исключительные режимы”}
Комментарии преподавателя
При изменении или удалении строки в поле xmax актуальной версии записывается номер текущей транзакции. Установленное значение xmax, соответствующее активной транзакции, выступает в качестве блокировки.
То же самое происходит и при явном блокировании строки командой SELECT FOR UPDATE, но еще проставляется дополнительный информационный бит (xmax lock only), который говорит о том, что версия строки по-прежнему актуальна, хоть и заблокирована.
Режим блокировки определяется еще одним информационным битом (keys updated).
(На самом деле используется большее количество битов с более сложными условиями и проверками, что связано с поддержкой совместимости с предыдущими версиями. Но это не принципиально.)
Если другая транзакция намерена обновить или удалить заблокированную строку в несовместимом режиме, она будет вынуждена дождаться завершения транзакции с номером xmax.
Page 7: Разделяемые режимы
Share Key Share
- запрет изменения
- запрет изменения
- любых полей строки
- ключевых полей строки
- SELECT FOR SHARE
- SELECT FOR KEY SHARE
- и проверка внешних ключей
- Матрица совместимости режимов
- Key
- No Key
- Share
- Share
- Update
- Update
- Key Share × Share × × No Key Update × × × Update × × × ×
Комментарии преподавателя
Еще два режима представляют разделяемые (shared) блокировки, которые могут удерживаться несколькими транзакциями.
Режим Share применяется, когда нужно прочитать строку, но при этом нельзя допустить, чтобы она как-либо изменилась другой транзакцией.
Режим Key Share допускает изменение строки, но только неключевых полей. Этот режим, в частности, автоматически используется PostgreSQL при проверке внешних ключей.
Общая матрица совместимости режимов приведена внизу слайда. Из нее видно, что:
● исключительные режимы конфликтуют между собой;
● разделяемые режимы совместимы между собой;
● разделяемый режим Key Share совместим с исключительным режимом No Key Update (то есть можно обновлять неключевые поля и быть уверенным в том, что ключ не изменится).
https://postgrespro.ru/docs/postgresql/16/explicit-locking#LOCKING-ROWS
Page 8: Разделяемые режимы
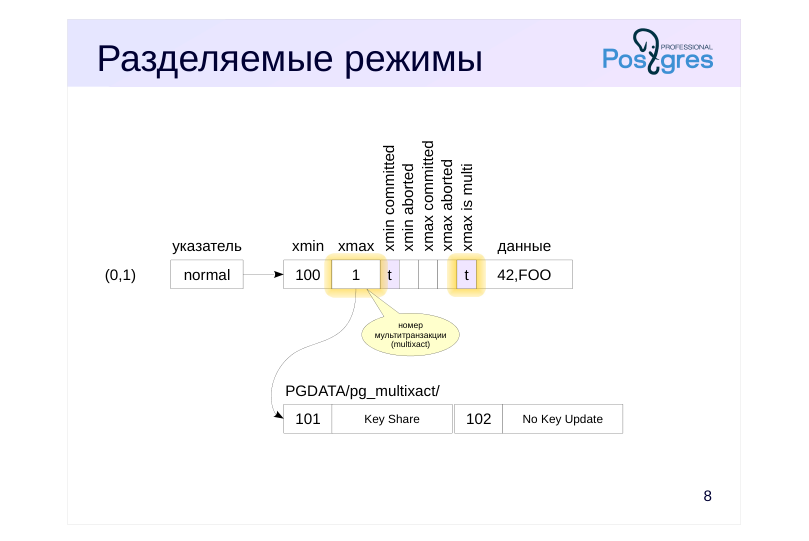 {#source-figure-008 caption=“Source slide page 8: Разделяемые режимы”}
Комментарии преподавателя
Мы говорили о том, что блокировка представляется номером блокирующей транзакции в поле xmax. Разделяемые блокировки могут удерживаться несколькими транзакциями, но в одно поле xmax нельзя записать несколько номеров.
Поэтому для разделяемых блокировок применяются так называемые мультитранзакции (MultiXact). Им выделяются отдельные номера, которые соответствуют не одной транзакции, а целой группе. Чтобы отличить мультитранзакцию от обычной, используется еще один информационный бит (xmax is multi), а детальная информация об участниках такой группы и режимах блокировки находится в каталоге PGDATA/pg_multixact/. Естественно, последние использованные данные хранятся в буферах в общей памяти сервера для ускорения доступа.
Page 9: Настройка заморозки
Параметры для мультитранзакций
- vacuum_multixact_freeze_min_age
- = 5 000 000
- vacuum_multixact_freeze_table_age
- = 150 000 000
- autovacuum_multixact_freeze_max_age = 400 000 000
- vacuum_multixact_failsafe_age
- = 1 600 000 000
- Параметры хранения таблиц
- autovacuum_multixact_freeze_min_age
- toast.autovacuum_multixact_freeze_min_age
- autovacuum_multixact_freeze_table_age
- toast.autovacuum_multixact_freeze_table_age
- autovacuum_multixact_freeze_max_age
- toast.autovacuum_multixact_freeze_max_age
Комментарии преподавателя
Поскольку для мультитранзакций выделяются отдельные номера, которые записываются в поле xmax версий строк, из-за ограничения разрядности счетчика с ними возникают такие же сложности, как и с обычным номером транзакции. Речь идет о переполнении счетчика транзакций, которое рассматривалось в теме «Заморозка» модуля «Многоверсионность».
Поэтому для номеров мультитранзакций тоже необходимо выполнять аналог заморозки — старые номера multixact id заменяются на новые (или на обычный номер, если в текущий момент блокировка уже удерживается только одной транзакцией).
Заметим, что обычная заморозка версий строк выполняется для поля xmin (если у версии строки непустое поле xmax, то либо это уже неактуальная версия и она будет очищена, либо транзакция xmax отменена и ее номер нас не интересует). А для мультитранзакций речь идет о поле xmax актуальной версии строки, которая может оставаться актуальной, но при этом постоянно блокироваться разными транзакциями в разделяемом режиме.
За заморозку мультитранзакций отвечают параметры, аналогичные параметрам обычной заморозки.
Page 10: Блокировки строк
Наиболее частый случай блокировок — блокировки, возникающие на уровне строк. Создадим таблицу счетов, как в прошлой теме.
Поскольку информация о блокировке строк хранится только в самих версиях строк, воспользуемся знакомым расширением pageinspect.
Для удобства создадим представление, расшифровывающее интересующие нас информационные биты в первых трех версиях строк.
Обновляем сумму первого счета (ключ не меняется) и номер второго счета (ключ меняется):
Заглянем в представление. Напомним, что оно показывает только первые три (то есть исходные) версии строк.
Строки, соответствующие первому и второму счету, заблокированы — в поле xmax записан номер блокирующей транзакции. Биты в столбце keys_upd показывают, что строки заблокированы в разных режимах. Теперь в другом сеансе запросим разделяемые блокировки первого и третьего счетов:
Page 11: Page 11
 {#source-figure-011 caption=“Source slide page 11: Page 11”}
Все запрошенные блокировки совместимы друг с другом. В версиях строк видим:
Столбец lock_only позволяет отличить просто блокировку от обновления или удаления. Видим также, что в первой строке обычный номер в столбце xmax заменен на номер мультитранзакции — об этом говорит столбец is_multi. Чтобы не вникать в детали информационных битов и реализацию мультитранзакций, можно воспользоваться еще одним расширением, которое позволяет увидеть всю информацию о блокировках строк в удобном виде.
Расширение дает информацию о номерах транзакций, мультитранзакций и режимах всех блокировок.
Page 12: «Очередь» ожидания
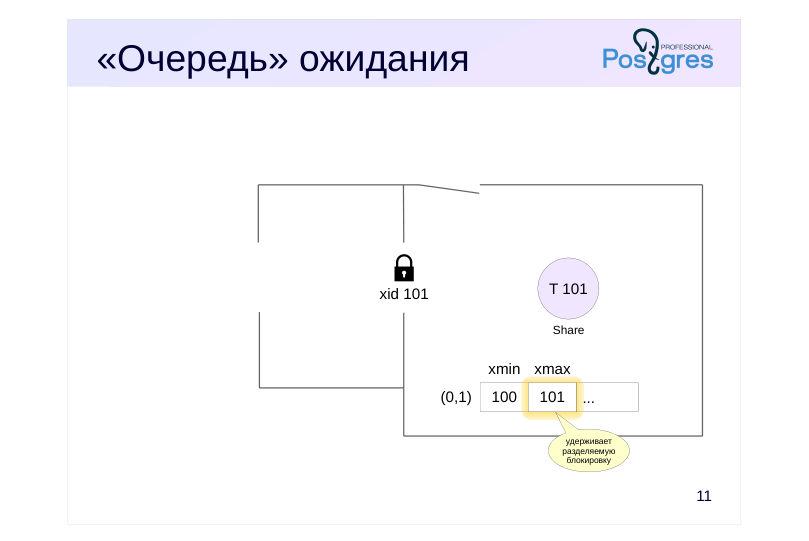 {#source-figure-012 caption=“Source slide page 12: «Очередь» ожидания”}
Комментарии преподавателя
Для организации очереди ожидания дополнительно используется механизм блокировок объектов, при этом информация хранится в оперативной памяти и видна в pg_locks.
Допустим, транзакции с номером 101 (пример на слайде) удалось заблокировать строку в разделяемом режиме Share. Информация о блокировке записывается в заголовок версии строки — в поле xmax появляется номер этой транзакции.
Page 13: «Очередь» ожидания
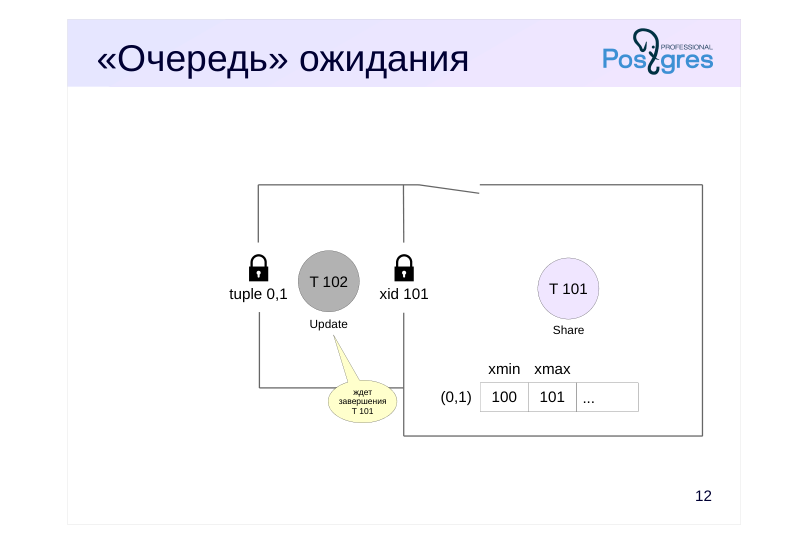 {#source-figure-013 caption=“Source slide page 13: «Очередь» ожидания”}
Комментарии преподавателя
Другая транзакция 102, желая получить блокировку, обращается к строке и видит, что строка заблокирована. Если режимы блокировок конфликтуют, она должна каким-то образом встать в очередь, чтобы система «разбудила» ее, когда блокировка освободится. Но блокировки на уровне строк не предоставляют такой возможности — они никак не представлены в оперативной памяти, это просто байты внутри страницы данных.
Как мы видели в теме «Блокировки объектов», каждая транзакция удерживает исключительную блокировку своего номера. Поскольку транзакция 102 фактически должна дождаться завершения транзакции 101 (ведь блокировка строки освобождается только при завершении транзакции), она запрашивает блокировку номера 101.
Когда транзакция 101 завершится, заблокированный ресурс освободится (при фиксации — просто исчезнет), транзакция 102 будет разбужена и сможет заблокировать строку (установить xmax = 102 в соответствующей версии строки).
Кроме того, ожидающая транзакция удерживает блокировку ресурса типа tuple (версия строки), показывая, что она первая в «очереди».
Page 14: «Очередь» ожидания
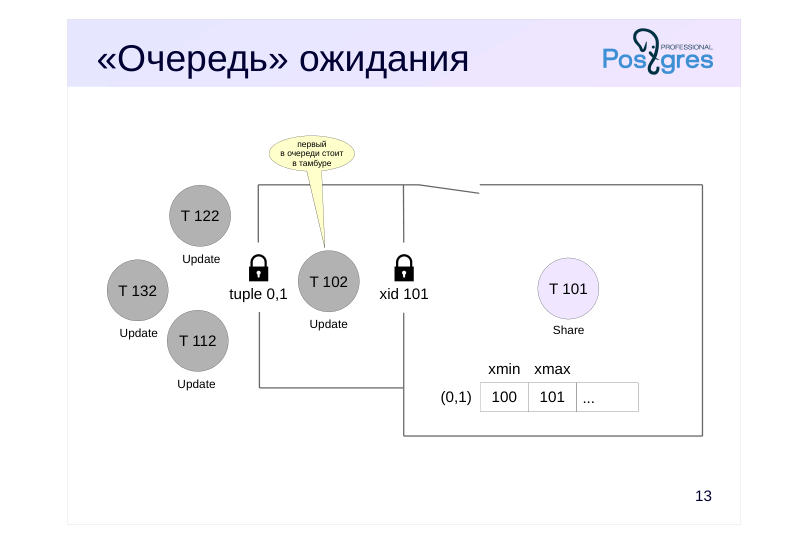 {#source-figure-014 caption=“Source slide page 14: «Очередь» ожидания”}
Комментарии преподавателя
Если появляются другие транзакции, конфликтующие с текущей блокировкой версии строки (в нашем примере — 112, 122, 132), первым делом они пытаются захватить блокировку типа tuple для этой версии.
Поскольку блокировка tuple уже удерживается транзакцией 102, другие транзакции ждут освобождения этой блокировки. Получается своеобразная «очередь», в которой есть первый и все остальные.
Если бы все прибывающие транзакции занимали очередь непосредственно за транзакцией 101, при освобождении блокировки возникала бы ситуация гонки. При неудачном стечении обстоятельств транзакция 102 могла бы ждать блокировку вечно. Двухуровневая схема блокирования немного упорядочивает подобную конкуренцию.
Стоит избегать проектных решений, которые предполагают частые изменения одной и той же строки. В этом случае возникает «горячая точка», которая на высоких нагрузках может привести к снижению производительности.
Page 15: «Очередь» ожидания
Для удобства создадим представление над pg_locks, «свернув» в одно поле идентификаторы разных типов блокировок:
Пусть одна транзакция заблокирует строку в разделяемом режиме…
…а другая попробует выполнить обновление:
В представлении pg_locks можно увидеть, что вторая транзакция ожидает завершения первой (granted = f), удерживая при этом блокировку версии строки (locktype = tuple):
Чтобы не разбираться, кто кого блокирует, по представлению pg_locks, можно узнать номер (или номера) процесса блокирующего сеанса с помощью функции:
Page 16: Page 16
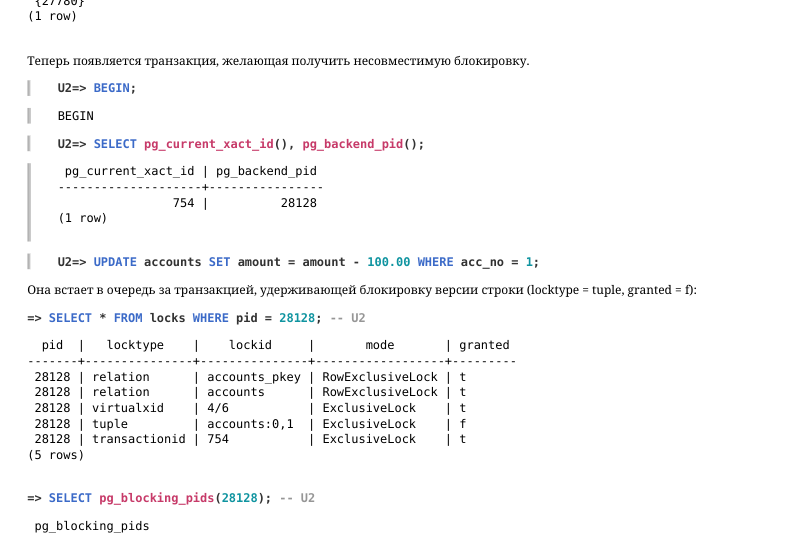 {#source-figure-016 caption=“Source slide page 16: Page 16”}
Теперь появляется транзакция, желающая получить несовместимую блокировку.
Она встает в очередь за транзакцией, удерживающей блокировку версии строки (locktype = tuple, granted = f):
Page 17: «Очередь» ожидания
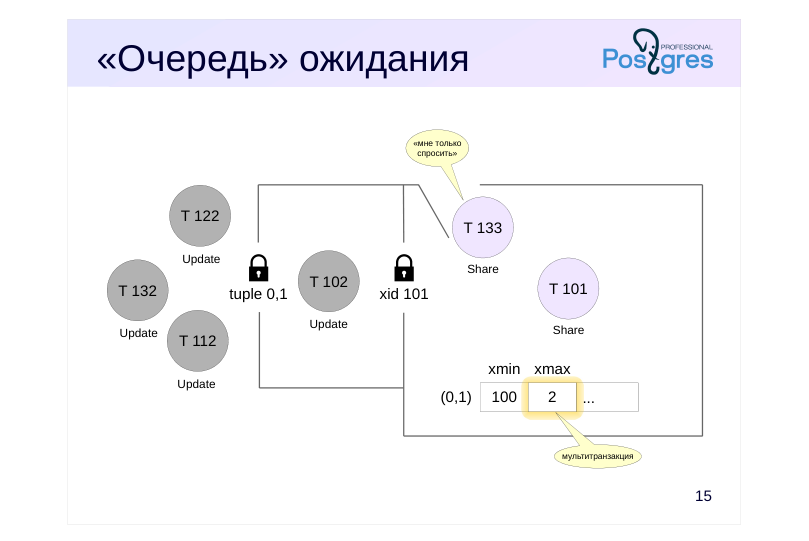 {#source-figure-017 caption=“Source slide page 17: «Очередь» ожидания”}
Комментарии преподавателя
В нашем примере транзакция 101 заблокировала строку в разделяемом (Share) режиме. Пока транзакция 102 ожидает завершения транзакции 101, может появиться еще транзакция 133, желающая получить блокировку строки в разделяемом режиме, совместимом с текущей блокировкой транзакции 101.
Такая транзакция не стоит в очереди, она сразу получает блокировку. В этом случае из списка номеров блокирующих транзакций 101 и 133 формируется мультитранзакция 2, номер которой запишется в поле xmax строки.
Page 18: «Очередь» ожидания
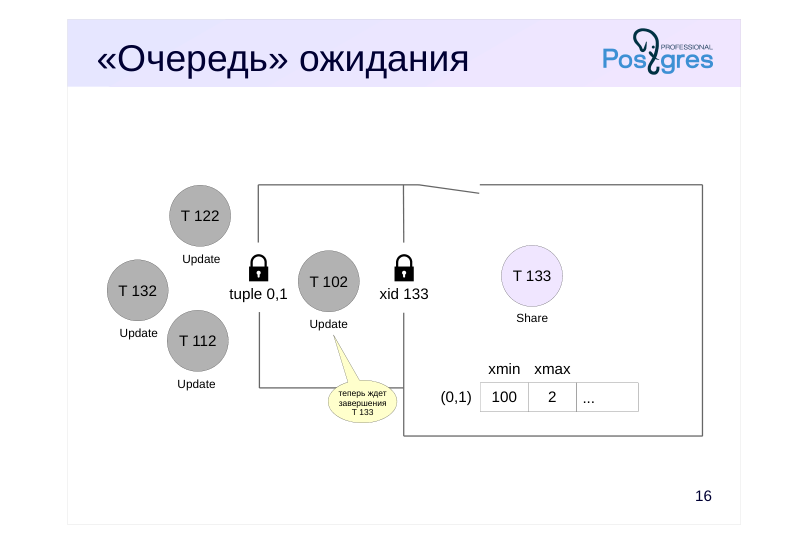 {#source-figure-018 caption=“Source slide page 18: «Очередь» ожидания”}
Комментарии преподавателя
Когда транзакция 101 завершится, транзакция 102 будет разбужена, но не сможет захватить блокировку строки, поскольку строка все еще заблокирована транзакцией 133. Транзакция 102 будет вынуждена снова «заснуть».
При постоянном потоке разделяемых блокировок пишущая транзакция может ждать своей очереди бесконечно. Это ситуация называется по-английски locker starvation.
Заметим, что такой проблемы в принципе не возникает при блокировках объектов (таких, как отношения). В этом случае каждый ресурс представлен собственной блокировкой в оперативной памяти, и все ждущие процессы выстраиваются в «честную» очередь.
https://git.postgresql.org/gitweb/?p=postgresql.git;f=src/backend/access/hea p/README.tuplock;hb=HEAD
Page 19: «Очередь» ожидания
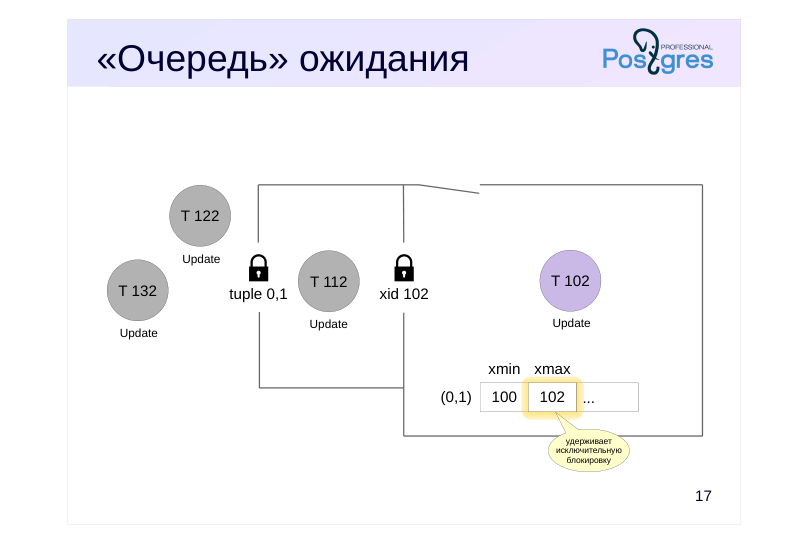 {#source-figure-019 caption=“Source slide page 19: «Очередь» ожидания”}
Комментарии преподавателя
Когда транзакция 133 завершится, транзакция 102 получит возможность первой записать свой номер в поле xmax, после чего она освободит блокировку tuple. Тогда одна случайная транзакция из всех остальных успеет захватить блокировку tuple и станет первой в «очереди».
Page 20: Page 20
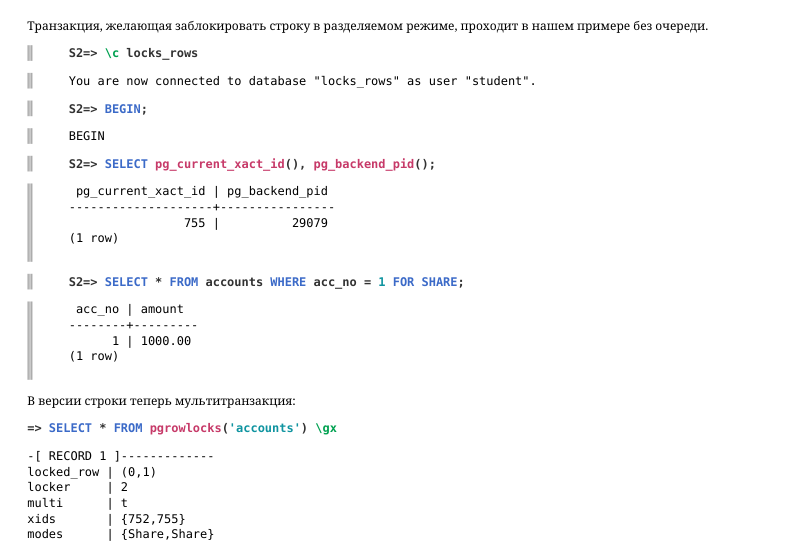 {#source-figure-020 caption=“Source slide page 20: Page 20”}
Транзакция, желающая заблокировать строку в разделяемом режиме, проходит в нашем примере без очереди.
В версии строки теперь мультитранзакция:
После того как одна из транзакций, удерживающих строку в разделяемом режиме, завершится, другая продолжит удерживать блокировку.
Транзакция, стоящая первой в очереди, теперь ждет завершения оставшейся транзакции.
Обратите внимание, что в поле xmax остался номер мультитранзакции, хотя одна из входящих в нее транзакций уже завершилась. Этот номер может быть заменен на другой (новой мультитранзакции или обычной транзакции) при очистке.
Теперь завершается и вторая транзакция, удерживавшая разделяемую блокировку.
Page 21: Page 21
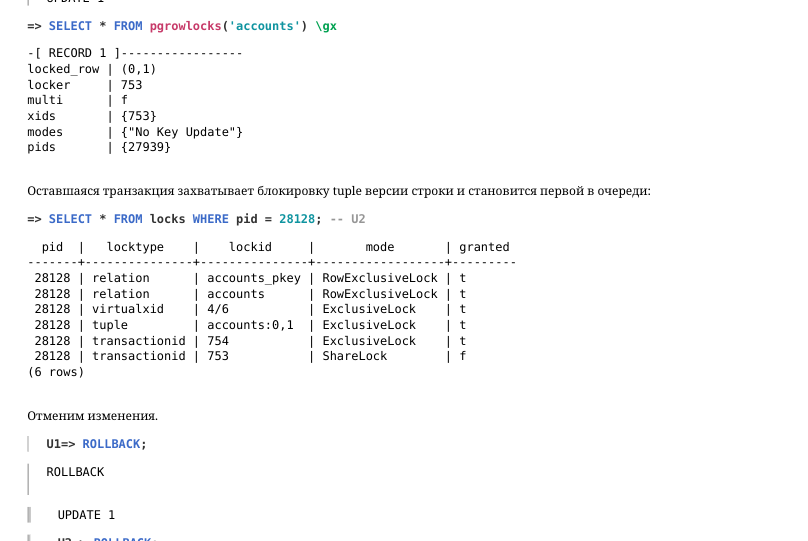 {#source-figure-021 caption=“Source slide page 21: Page 21”}
Транзакция, стоявшая первой в очереди, получает доступ к версии строки:
Оставшаяся транзакция захватывает блокировку tuple версии строки и становится первой в очереди:
Отменим изменения.
Как не ждать блокировку?
Иногда удобно не ждать освобождения блокировки, а сразу получить ошибку, если необходимый ресурс занят. Приложение может перехватить и обработать такую ошибку. Для этого ряд команд SQL (такие, как SELECT и некоторые варианты ALTER) позволяют указать ключевое слово NOWAIT. Заблокируем таблицу, обновив первую строку:
Транзакция сразу же получает ошибку.
А для рекомендательных блокировок есть функции, позволяющие либо сразу захватить блокировку, либо вернуть false в случае неудачи:
Page 22: Page 22
Команды UPDATE и DELETE не позволяют указать NOWAIT. Но можно сначала выполнить команду
а затем, если строки успешно заблокированы, изменить или удалить их. Например:
Тут же получаем ошибку и не пытаемся вызывать DELETE или UPDATE.
Другой способ не ждать снятия блокировки строк предоставляет предложение SKIP LOCKED. Заблокируем одну строку, но без указания конкретного номера счета:
В этом случае команда пропускает заблокированную первую строку и мы немедленно получаем блокировку уже второй строки.
Для команд, не связанных с блокировкой строк, использовать NOWAIT не получится. В этом случае можно установить небольшой тайм-аут ожидания. (По умолчанию его значение нулевое, что означает бесконечное ожидание):
Получаем ошибку без длительного ожидания освобождения ресурса.
Page 23: Page 23
А при выполнении очистки можно указать, что она должна пропускать обработку таблицы, если ее блокировку не удалось получить немедленно. Это может оказаться особенно актуальным, когда выполняется очистка всей базы:
Page 24: Взаимоблокировки
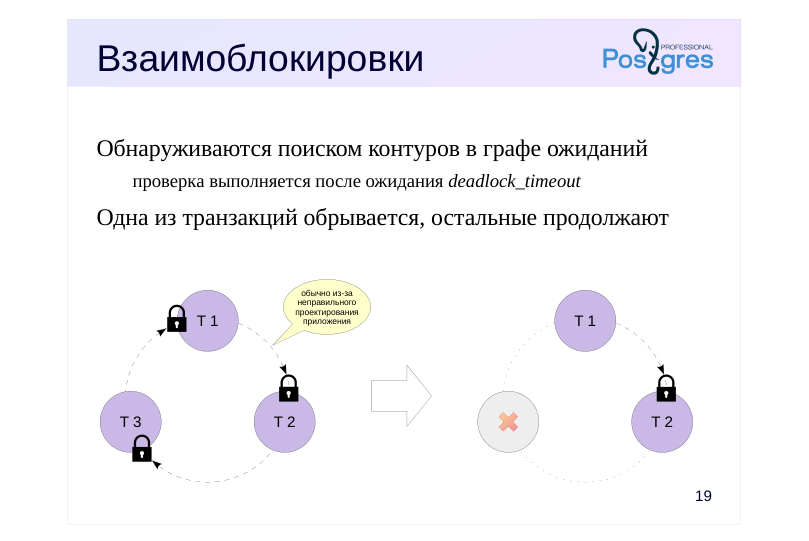 {#source-figure-024 caption=“Source slide page 24: Взаимоблокировки”}
Обнаруживаются поиском контуров в графе ожиданий
- проверка выполняется после ожидания deadlock_timeout
- Одна из транзакций обрывается, остальные продолжают
Комментарии преподавателя
Возможна ситуация взаимоблокировки, когда одна транзакция пытается захватить ресурс, уже захваченный другой транзакцией, в то время как другая транзакция пытается захватить ресурс, захваченный первой. Взаимоблокировка возможна и при нескольких транзакциях: на слайде показан пример такой ситуации для трех транзакций.
Визуально взаимоблокировку удобно представлять, построив граф ожиданий. Для этого мы убираем конкретные ресурсы и оставляем только транзакции, отмечая, какая транзакция какую ожидает. Если в графе есть контур (из некоторой вершины можно по стрелкам добраться до нее же самой) — это взаимоблокировка.
Отметим, что заблокированными ресурсами могут оказаться не только строки; для разрешения взаимоблокировки важен не тип заблокированных ресурсов, а взаимозависимость ожидающих их освобождения транзакций.
Если взаимоблокировка возникла, участвующие транзакции уже не могут ничего с этим сделать — они будут ждать бесконечно. Поэтому PostgreSQL автоматически отслеживает взаимоблокировки. Проверка выполняется, если какая-либо транзакция ожидает освобождения ресурса дольше, чем указано в параметре deadlock_timeout. Если выявлена взаимоблокировка, одна из транзакций принудительно прерывается, чтобы остальные могли продолжить работу.
Взаимоблокировки обычно означают, что приложение спроектировано неправильно. Сообщения в журнале сервера или увеличивающееся значение pg_stat_database.deadlocks — повод задуматься о причинах.
https://postgrespro.ru/docs/postgresql/16/explicit-locking#LOCKING-DEADL OCKS
Page 25: Взаимоблокировка
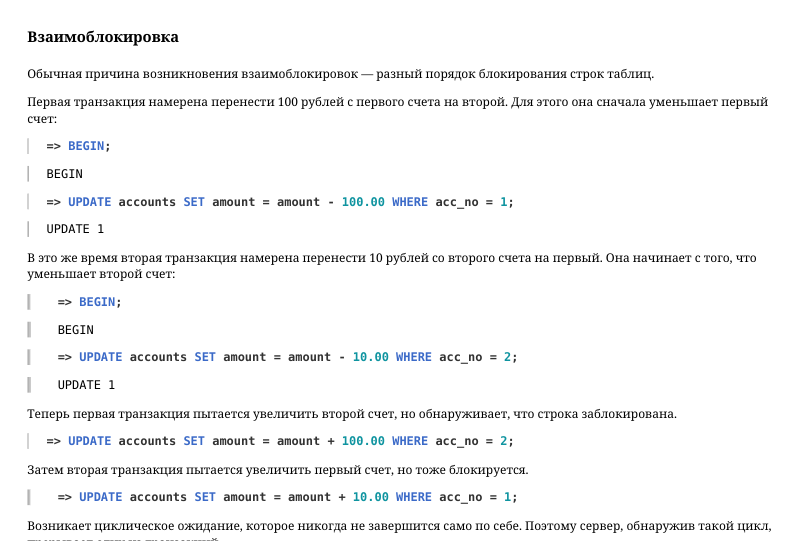 {#source-figure-025 caption=“Source slide page 25: Взаимоблокировка”}
Обычная причина возникновения взаимоблокировок — разный порядок блокирования строк таблиц. Первая транзакция намерена перенести 100 рублей с первого счета на второй. Для этого она сначала уменьшает первый счет:
В это же время вторая транзакция намерена перенести 10 рублей со второго счета на первый. Она начинает с того, что уменьшает второй счет:
Теперь первая транзакция пытается увеличить второй счет, но обнаруживает, что строка заблокирована.
Затем вторая транзакция пытается увеличить первый счет, но тоже блокируется.
Возникает циклическое ожидание, которое никогда не завершится само по себе. Поэтому сервер, обнаружив такой цикл, прерывает одну из транзакций.
Правильный способ выполнения таких операций — блокирование ресурсов в одном и том же порядке. Например, в данном случае можно блокировать счета в порядке возрастания их номеров.
Page 26: Итоги
Блокировки строк хранятся в страницах данных
- из-за потенциально большого количества
- Очереди и обнаружение взаимоблокировок обеспечиваются блокировками объектов
- приходится прибегать к сложным схемам блокирования
Page 27: Практика
- Смоделируйте ситуацию обновления одной и той же строки тремя командами UPDATE в разных сеансах. Изучите возникшие блокировки в представлении pg_locks и убедитесь, что все они понятны.
- Воспроизведите взаимоблокировку трех транзакций. Можно ли разобраться в ситуации постфактум, изучая журнал сообщений?
- Могут ли две транзакции, выполняющие единственную команду UPDATE одной и той же таблицы, заблокировать друг друга? Попробуйте воспроизвести такую ситуацию.
Page 28: 1. Блокировки при нескольких обновлениях строки
Для простоты создадим таблицу без первичного ключа.
Создадим представление над pg_locks как в демонстрации:
Первая транзакция обновляет и, соответственно, блокирует строку:
Вторая транзакция делает то же самое:
И третья:
Page 29: Page 29
Блокировки для первой транзакции:
Тип relation для pg_locks и locks в режиме AccessShareLock — устанавливаются на читаемые отношения. Тип relation для accounts в режиме RowExclusiveLock — устанавливается на изменяемое отношение. Типы virtualxid и transactionid в режиме ExclusiveLock — удерживаются транзакцией для самой себя. Блокировки для второй транзакции:
По сравнению с первой транзакцией: Блокировки для pg_locks и locks отсутствуют, так как вторая транзакция не обращалась к этим отношениям. Транзакция ожидает получение блокировки типа transactionid в режиме ShareLock для первой транзакции. Удерживается блокировка типа tuple для обновляемой строки. Блокировки для третьей транзакции:
Транзакция ожидает получение блокировки типа tuple для обновляемой строки. Общую картину текущих ожиданий можно увидеть в представлении pg_stat_activity. Для удобства можно добавить и информацию о блокирующих процессах:
Page 30: Page 30
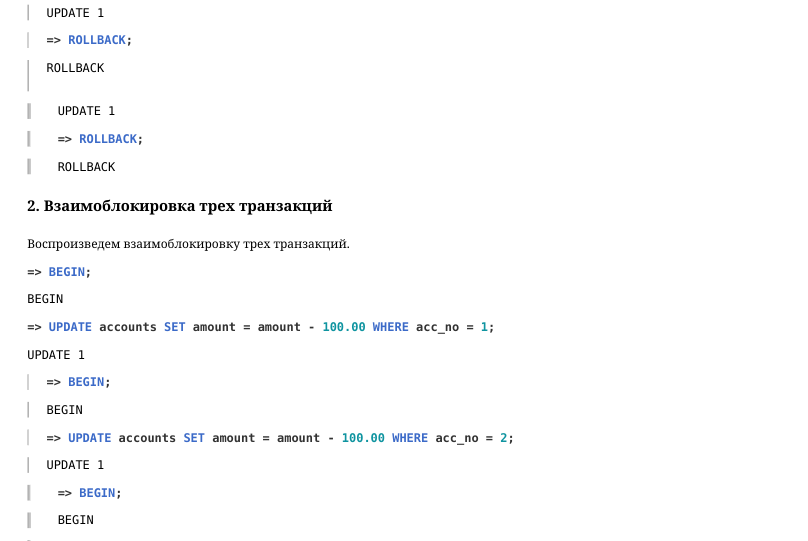 {#source-figure-030 caption=“Source slide page 30: Page 30”}
2. Взаимоблокировка трех транзакций
Воспроизведем взаимоблокировку трех транзакций.
Вот какую информацию о взаимоблокировке можно получить из журнала:
Page 31: 3. Взаимоблокировка двух операций UPDATE
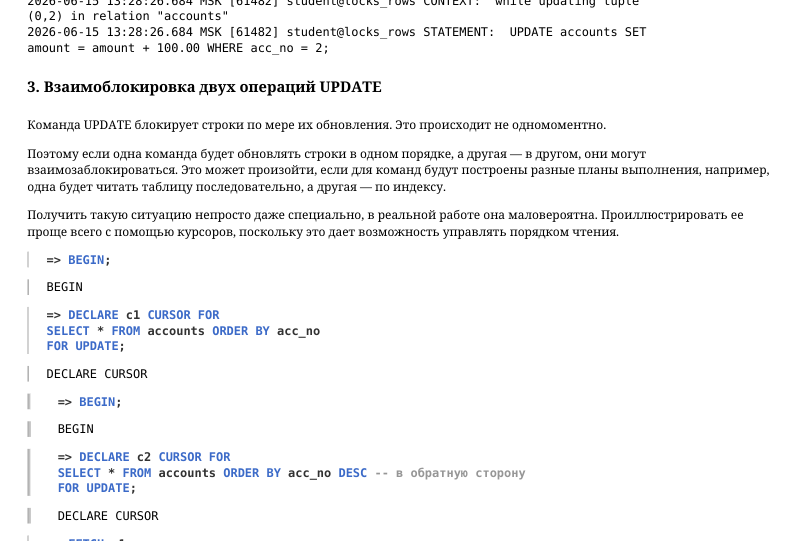 {#source-figure-031 caption=“Source slide page 31: 3. Взаимоблокировка двух операций UPDATE”}
Команда UPDATE блокирует строки по мере их обновления. Это происходит не одномоментно. Поэтому если одна команда будет обновлять строки в одном порядке, а другая — в другом, они могут взаимозаблокироваться. Это может произойти, если для команд будут построены разные планы выполнения, например, одна будет читать таблицу последовательно, а другая — по индексу. Получить такую ситуацию непросто даже специально, в реальной работе она маловероятна. Проиллюстрировать ее проще всего с помощью курсоров, поскольку это дает возможность управлять порядком чтения.
Вторая команда ожидает блокировку…
Произошла взаимоблокировка. И через некоторое время:
Page 32: Page 32
14 Занятие 14: Блокировки / Блокировки в оперативной памяти
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_14_locks_memory.html Archive: DBA2-handouts-16.zip Страниц PDF: 20
Page 1: Блокировки / Блокировки в оперативной памяти
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Блокировки в памяти
- Мониторинг ожиданий
Page 3: Блокировки в памяти
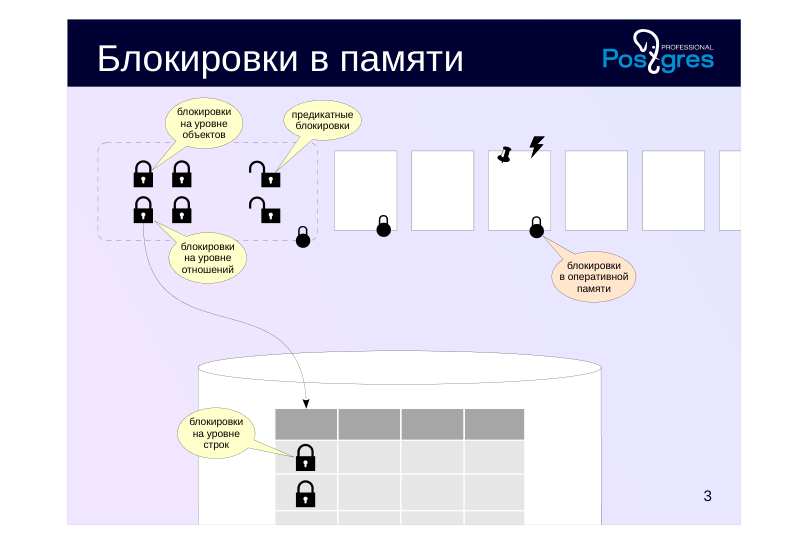 {#source-figure-003 caption=“Source slide page 3: Блокировки в памяти”}
Page 4: Спин-блокировки
Устанавливаются на очень короткое время
- несколько инструкций процессора
- Исключительный режим
- Есть мониторинг
- pg_stat_activity
- Нет обнаружения взаимоблокировок
- Цикл активного ожидания
- используются атомарные инструкции процессора
Комментарии преподавателя
Мы уже рассмотрели долговременные блокировки, действующие как правило до конца транзакции и поддерживающие множество режимов. Для защиты структур в оперативной памяти, разделяемой несколькими процессами, используются более простые (и дешевые в смысле накладных расходов) блокировки.
Самые простые из них — спин-блокировки или спинлоки (spinlock). Они предназначены для захвата на очень короткое время (несколько инструкций процессора) и защищают отдельные поля структур данных от одновременного изменения.
Спин-блокировки реализуются на основе атомарных инструкций процессора, например, compare-and-swap (https://ru.wikipedia.org/wiki/Сравнение\_с\_обменом).
Они захватываются только в исключительном режиме. Если блокировка занята, выполняется цикл активного ожидания — команда повторяется до тех пор, пока не выполнится успешно. Это имеет смысл, поскольку спин-блокировки применяются только в тех случаях, когда вероятность конфликта очень мала. Существует и мониторинг отслеживания ожиданий, связанных со спин-блокировками.
Однако спин-блокировки не обеспечивают обнаружения взаимоблокировок — за этим следят разработчики кода PostgreSQL.
Page 5: Легкие блокировки
Устанавливаются на короткое время
- обычно доли секунды
- Исключительный и разделяемый режимы
- Есть мониторинг
- pg_stat_activity
- Нет обнаружения взаимоблокировок
- «Нечестная» очередь
- разделяемая блокировка позволяет читающим процессам
- проходить без очереди
Комментарии преподавателя
Следом идут так называемые легкие блокировки (lightweight locks, lwlocks).
Их захватывают на короткое время, которое требуется для работы со структурой данных (например, с хеш-таблицей или списком указателей). Как правило, легкая блокировка удерживается недолго, но в процессе ее удержания могут выполняться операции ввода-вывода, так что иногда время может оказаться и значительным.
Используются два режима блокирования: исключительный (для записи) и разделяемый (для чтения).
Поддерживается очередь ожидания. Однако пока блокировка удерживается в разделяемом режиме, другие читающие процессы проходят вне очереди. В системах с высокой степенью параллельности и большой нагрузкой это может приводить к непредсказуемо долгим ожиданиям процессов, которым требуется изменять данные (https://postgrespro.ru/list/thread-id/2400193).
Проверка взаимоблокировок не выполняется, как и для спин-блокировок. Легкие блокировки также имеют средства для мониторинга.
Page 6: Закрепление буфера
Устанавливается на время работы с буфером
- возможно, длительное
- Разделяемый режим
- Есть мониторинг
- pg_stat_activity
- pg_buffercache
- Нет обнаружения взаимоблокировок
- Пассивное ожидание
- но обычно закрепленный буфер пропускается
Комментарии преподавателя
Еще один вид блокировки, который мы уже рассматривали в теме «Буферный кеш» модуля «Журналирование» — закрепление буфера (buffer pin).
Для каждого буфера ведется список работающих с ним процессов. Если буфер закреплен, в нем запрещены некоторые действия. Например, в страницу можно вставить новую строку (которую остальные процессы не увидят благодаря многоверсионности), но нельзя заменить одну страницу на другую.
Как правило, процессы пропускают закрепленный буфер и выбирают другой, чтобы не ждать снятия закрепления. Но в некоторых случаях, когда требуется именно этот буфер, запрашивается легкая блокировка в исключительном режиме. При необходимости процесс ждет, пока все остальные процессы закончат работу с буфером. Ожидание при этом пассивное: система «будит» ожидающий процесс, когда закрепление снимается.
Взаимоблокировки невозможны, за этим следят разработчики PostgreSQL.
Ожидания, связанные с закреплением, доступны для мониторинга через представление pg_stat_activity. Текущее количество закреплений буфера показывает расширение pg_buffercache.
Page 7: Пример: буферный кеш
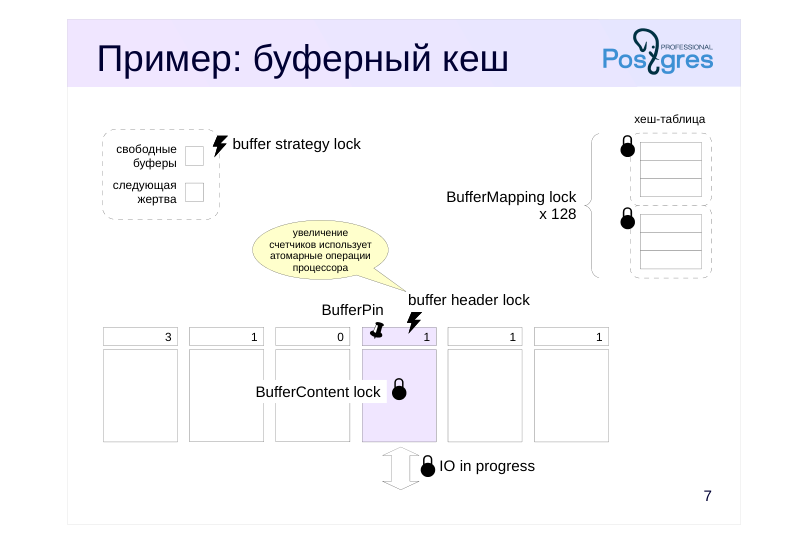 {#source-figure-007 caption=“Source slide page 7: Пример: буферный кеш”}
Комментарии преподавателя
Чтобы получить некоторое (неполное) представление о том, как и где используются блокировки, рассмотрим пример буферного кеша.
Чтобы обратиться к хеш-таблице, содержащей ссылки на буферы, процесс должен захватить легкую блокировку BufferMapping lock в разделяемом режиме, а если таблицу требуется изменять — то в исключительном режиме. Чтобы увеличить гранулярность, эта блокировка устроена как транш, состоящий из 128 отдельных блокировок, каждая из которых защищает свою часть хеш-таблицы.
Доступ к заголовку буфера процесс получает с помощью спин-блокировки. Отдельные операции (такие, как увеличение счетчика) могут выполняться и без явных блокировок, с помощью атомарных инструкций процессора.
Чтобы прочитать содержимое буфера, требуется блокировка BufferContent lock. Обычно она захватывается только для чтения указателей на версии строк, а дальше достаточно защиты, предоставляемой закреплением буфера. Для изменения содержимого буфера эта блокировка захватывается в исключительном режиме.
При чтении буфера с диска (или записи на диск) в его заголовке устанавливается признак IO in progress, который сигнализирует другим процессам, что страница читается — они могут встать в очередь, если им тоже нужна та же самая страница.
Указатели на свободные буферы и на следующую жертву защищены одной спин-блокировкой buffer strategy lock.
Page 8: Пример: буферы журнала
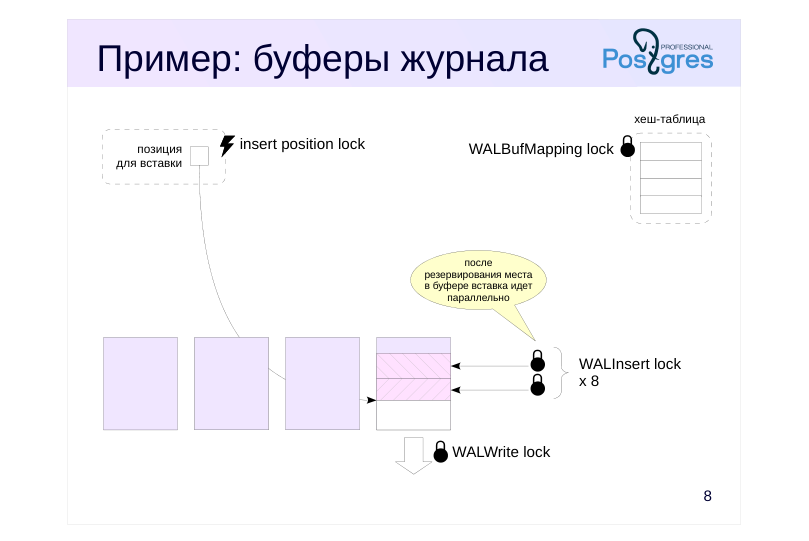 {#source-figure-008 caption=“Source slide page 8: Пример: буферы журнала”}
Комментарии преподавателя
Еще один пример: буферы журнала.
Для журнального кеша тоже используется хеш-таблица, содержащая отображение страниц в буферы. В отличие от хеш-таблицы буферного кеша, эта хеш-таблица защищена единственной легкой блокировкой WALBufMapping lock, поскольку размер журнального кеша меньше (обычно 1/32 от буферного кеша) и обращение к его буферам более упорядочено.
Запись страниц на диск защищена легкой блокировкой WALWrite lock, чтобы только один процесс одновременно мог выполнять эту операцию.
Чтобы создать журнальную запись, процесс должен сначала зарезервировать место в странице. Для этого он захватывает спин-блокировку insert position lock. После того, как место зарезервировано, процесс копирует содержимое своей записи в отведенное место. Эта операция может выполняться несколькими процессами одновременно, для чего запись защищена траншем из восьми легких блокировок WALInsert lock.
Здесь представлены не все блокировки, имеющие отношение к журналу предзаписи, но эта и предыдущая иллюстрации должны дать некоторое представление об использовании блокировок в оперативной памяти.
Page 9: Мониторинг ожиданий
Ожидания в pg\_stat\_activity и семплирование
- Типы ожиданий
Page 10: Семплирование ожиданий
Когда процесс ожидает чего-либо, этот факт отражается в представлении pg\_stat\_activity
- wait_event_type — тип ожидания
- wait_event — имя конкретного ожидания
- Информация может быть неполной
- охвачены не все места в коде, в которых могут быть ожидания
- Информация только на текущий момент
- единственный способ получить картину во времени — семплирование
- достоверная картина только при большом числе измерений
Комментарии преподавателя
Для мониторинга ожиданий используется представление pg_stat_activity. Когда процесс (системный или обслуживающий) не может выполнять свою работу и ждет чего-либо, это ожидание можно увидеть в представлении. Столбец wait_event_type показывает тип ожидания, а столбец wait_event — имя конкретного ожидания.
Следует учитывать, что представление показывает только те ожидания, которые соответствующим образом обрабатываются в исходном коде. Если представление не показывает ожидание, это вообще говоря не означает со 100-процентной вероятностью, что процесс действительно ничего не ждет.
К сожалению, единственная доступная информация об ожиданиях — информация на текущий момент. Никакой накопленной статистики не ведется. Единственный способ получить картину ожиданий во времени — семплирование состояния представления с определенным интервалом. Встроенных средств для этого не предусмотрено, но можно использовать расширения, например, pg_wait_sampling.
https://github.com/postgrespro/pg\_wait\_sampling
При семплировании надо учитывать его вероятностный характер. Чтобы получить более или менее достоверную картину, число измерений должно быть достаточно высоко. Поэтому семплирование с низкой частотой не даст достоверной картины, а повышение частоты приводит к увеличению накладных расходов. По той же причине семплирование бесполезно для анализа короткоживущих сеансов.
Page 11: Типы ожиданий
Блокировки
- pg_stat_activity.wait_event_type
- блокировки объектов
- Lock
- легкие блокировки
- LWLock
- закрепление буфера
- BufferPin
- Другие ожидания
- ввод-вывод
- IO
- получение данных от другого процесса
- IPC
- получение данных от клиента
- Client
- ожидание в модуле расширения
- Extension
- «безделье»
- Activity, Timeout
- Все остальное — неучтенное время
Комментарии преподавателя
Все ожидания можно разделить на несколько типов. Ожидания рассмотренных блокировок составляют большую категорию: ожидание блокировок объектов (значение Lock в столбце wait_event_type), ожидание легких блокировок (LWLock) и ожидание закрепленного буфера (BufferPin).
Но процессы могут ожидать и другие события. Ожидания ввода-вывода (IO) возникают, когда процессу требуется записать или прочитать данные. Процесс может ждать данные, необходимые для работы, от клиента (Client) или от другого процесса (IPC).
Расширения могут регистрировать свои специфические ожидания (Extension).
Бывают ситуации, когда процесс просто не выполняет полезной работы. К этой категории относится ожидание фоновых процессов в своем основном цикле (Activity), ожидание таймера (Timeout). Как правило, такие ожидания «нормальны» и не говорят о каких-либо проблемах.
Тип ожидания сопровождается именем конкретного ожидания: https://postgrespro.ru/docs/postgresql/16/monitoring-stats#WAIT-EVENT-TA BLE
Если имя ожидания не определено, процесс не находится в состоянии ожидания. Такое время следует считать неучтенным, так как на самом деле неизвестно, что именно происходит в этот момент.
В следующей демонстрации для замедления ввода-вывода мы используем файловую систему FUSE (https://github.com/libfuse/libfuse) и проект slowfs, построенный с ее помощью (https://github.com/nirs/slowfs).
Page 12: Мониторинг ожиданий
Текущие ожидания можно посмотреть в представлении pg_stat_activity, которое показывает информацию о работающих процессах. Выберем только часть полей:
Пустые значения говорят о том, что процесс ничего не ждет и выполняет полезную работу. Чтобы получить более или менее полную картину ожиданий процесса, требуется выполнять семплирование с некоторой частотой. Воспользуемся расширением pg_wait_sampling. Расширение уже установлено в ОС виртуальной машины курса, но необходимо внести в конфигурационный параметр shared_preload_libraries название загружаемой библиотеки расширения. Применение этого параметра требует перезагрузки сервера.
Теперь создадим расширение в базе данных.
Расширение позволяет просмотреть некоторую историю ожиданий, которая хранится в кольцевом буфере. Но интереснее увидеть профиль ожиданий — накопленную статистику за все время работы. Подождем несколько секунд и заглянем в профиль…
Поскольку за прошедшее после запуска сервера время ничего не происходило, основные ожидания относятся к типам Activity (служебные процессы ждут, пока появится работа) и Client (обслуживающий процесс ждет, пока пользователь
Page 13: Page 13
пришлет запрос). Строки с пустыми значениями event_type и event соответствуют ситуациям, когда процесс ничего не ожидает (но работает и занимает процессорное время). По умолчанию такие ситуации регистрируются, и это позволяет оценить долю ожиданий в общем времени наблюдения. Но регистрацию можно отключить (например, чтобы сэкономить память), изменив значение параметра:
С установками по умолчанию частота семплирования — 100 раз в секунду. Поэтому, чтобы оценить длительность ожиданий в секундах, значение count надо делить на 100. Чтобы понять, к какому процессу относятся ожидания, добавим к запросу представление pg_stat_activity:
Готовимся дать нагрузку с помощью pgbench и наблюдать, как изменится картина.
Сбрасываем собранный профиль в ноль и запускаем тест на 30 секунд в отдельном процессе. Одновременно будем смотреть, как изменяется профиль.
Page 14: Page 14
Ожидания процесса pgbench будут получаться разными в зависимости от конкретной системы. В нашем случае с большой вероятностью будет представлено ожидание записи и синхронизации журнала (IO/WALSync, IO/WALWrite).
Легкие блокировки
Всегда нужно помнить, что отсутствие какого-либо ожидания при семплировании не говорит о том, что ожидания не было. Если оно было короче, чем период семплирования (сотая часть секунды в нашем примере), то могло просто не попасть в выборку. Поэтому легкие блокировки скорее всего не появились в профиле — но появятся, если собирать данные в течении длительного времени. Чтобы гарантированно увидеть их, подключимся к кластеру slow с замедленной файловой системой: в ней любая операция ввода-вывода будет занимать 1/10 секунды.
Еще раз сбросим профиль и дадим нагрузку.
Page 15: Page 15
Теперь основное ожидание процесса pgbench связано с вводом-выводом, точнее с записью журнала, которая выполняется в синхронном режиме при каждой фиксации. Поскольку (вспомним слайд презентации) запись журнала на диск защищена легкой блокировкой WALWriteLock, она также присутствует в профиле.
Page 16: Итоги
Блокировки в оперативной памяти реализуются по-разному
- спин-блокировки, легкие блокировки, закрепление буфера
- относительно короткое время и облегченная инфраструктура
- Мониторинг текущих ожиданий с помощью представления pg_stat_activity
- семплирование для получения картины во времени
Page 17: Практика
- Открытый курсор удерживает закрепление буфера, чтобы чтение следующей строки выполнялось быстрее. Убедитесь в этом с помощью расширения pg_buffercache.
- Откройте курсор по таблице и, не закрывая его, выполните очистку таблицы (VACUUM). Будет ли очистка ждать освобождения закрепления буфера?
- Повторите эксперимент, выполнив очистку с заморозкой (VACUUM FREEZE). Убедитесь, что в профиль ожиданий обслуживающего процесса попало ожидание закрепления буфера.
Комментарии преподавателя
- Расширение pg_buffercache было рассмотрено в модуле «Журналирование», тема «Буферный кеш».
https://postgrespro.ru/docs/postgresql/16/pgbuffercache.html
Page 18: 1. Закрепление буфера при открытом курсоре
Сначала выполняем подготовительные действия. Устанавливаем необходимые расширения:
Таблица, как в предыдущих практиках:
Изменим остаток по счету 2 — в странице появится мертвая версия строки:
Начинаем транзакцию, открываем курсор и выбираем одну строку.
Проверим, закреплен ли буфер:
Page 19: 2. Очистка закрепленного буфера
Да, pinning_backends = 1. Выполним очистку:
Как мы видим, мертвая строка не была очищена: …tuples missed: 1 dead from 1 pages not removed due to cleanup lock contention. Если буфер закреплен, из страницы запрещено удалять версии строк. Но очистка не ждет, пока буфер освободится — строка будет очищена при следующем сеансе очистки.
3. Заморозка закрепленного буфера
Выполняем очистку с заморозкой:
Очистка зависает до закрытия курсора. При явно запрошенной заморозке все страницы, не отмеченные в карте заморозки, должны быть обработаны — иначе невозможно уменьшить максимальный возраст незамороженных транзакций в pg_class.relfrozenxid.
Page 20: Page 20
Профиль ожиданий:
Тип ожидания BufferPin говорит о том, что очистка ждала освобождения буфера.
15 Занятие 15: Задачи администрирования / Управление расширениями
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_15_admin_extensions.html Archive: DBA2-handouts-16.zip Страниц PDF: 19
Page 1: Задачи администрирования / Управление расширениями
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Расширения в PostgreSQL
- Создание расширений и управление ими
- Обновление расширений
- Особенности работы pg_dump
Page 3: Расширяемость PostgreSQL
Возможности
- функции и языки программирования
- типы данных, операторы, методы доступа
- обертки сторонних данных (FDW)
- Механизмы
- изменяемый системный каталог
- API для подключения внешних обработчиков
- загрузка и выполнение пользовательского кода
Комментарии преподавателя
Расширяемость — важнейшая черта PostgreSQL — это возможность подключать «на лету» новый функционал без изменения кода сервера.
Таким образом можно добавлять языки программирования и разрабатывать на них функции, определять новые типы данных и операторы для работы с ними, создавать новые методы доступа для типов данных, разрабатывать обертки сторонних данных для подключения к внешним источникам.
Для того чтобы это было возможным, системный каталог PostgreSQL хранит большое количество информации об объектах БД. Эта информация не зашита жестко в код сервера. Пользователи могут изменять содержимое таблиц системного каталога, тем самым добавляя новые объекты и связанный с ними функционал.
Кроме того, в исходном коде PostgreSQL встроено большое количество хуков и различных API для подключения пользовательских функций. Это дает возможность разрабатывать такие расширения как pg_stat_statements, auto_explain, pldebugger и многие, многие другие.
Завершает картину возможность загружать в серверные процессы пользовательский код. Например, можно написать разделяемую библиотеку и подключать ее по ходу работы.
https://postgrespro.ru/docs/postgresql/16/extend-how
В качестве предостережения следует отметить, что выполнение процессами сервера неправильно написанного пользовательского кода может привести к катастрофическим последствиям. Следует доверять только проверенному коду из надежных источников.
Page 4: Расширения
Группа взаимосвязанных объектов БД
- установка всех объектов одной командой
- невозможность удалить отдельный объект
- сохранение связи при выгрузке с помощью pg_dump
- инструменты для перехода на новую версию
- Источники
- в составе дистрибутива (contrib)
- внешние расширения
- возможность создания собственных расширений
Комментарии преподавателя
Бывают ситуации, когда несколько объектов базы данных логически связаны между собой. Например, несколько типов данных, функции и операторы для работы с ними, классы операторов. Такую связь можно сделать явной с помощью механизма расширений.
Это облегчает управление объектами:
● все объекты устанавливаются одной командой;
● невозможно удалить отдельный объект — расширение можно удалить только полностью;
● связь между объектами сохраняется и при создании резервной копии с помощью утилиты pg_dump;
● есть инструменты для управления версиями расширений.
В состав PostgreSQL входит значительное количество полезных расширений, частью из которых мы уже пользовались.
https://postgrespro.ru/docs/postgresql/16/contrib
https://postgrespro.ru/docs/postgresql/16/contrib-prog
Другой источник — PostgreSQL Extension Network (PGXN) — сеть расширений по аналогии с CPAN для Perl: https://pgxn.org/
Расширения могут распространяться и другими способами, в том числе через пакетные репозитории дистрибутивов ОС.
Page 5: Создание расширения
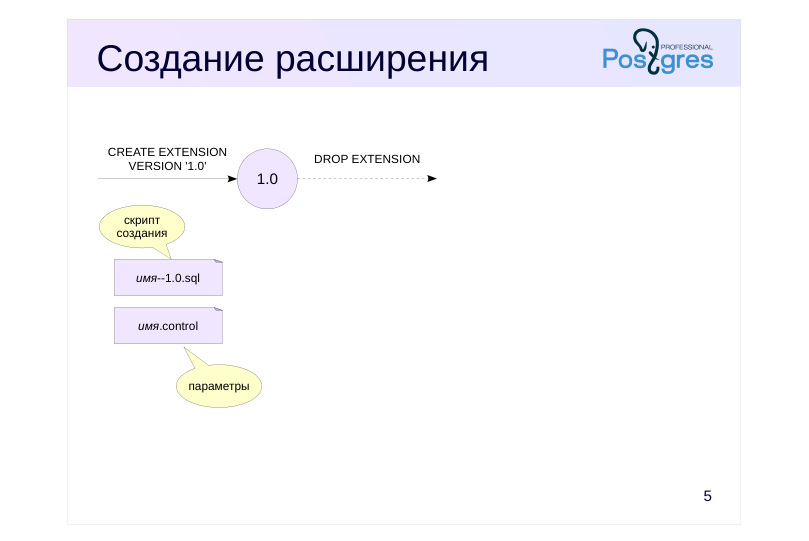 {#source-figure-005 caption=“Source slide page 5: Создание расширения”}
Комментарии преподавателя
Расширение устанавливается в базу данных командой CREATE EXTENSION. При этом должны существовать два файла:
● управляющий файл «имя.control» с параметрами расширения;
● скрипт создания объектов расширения «имя–версия.sql».
Версия традиционно имеет вид «1.0», «1.1» и т. д., но это не обязательно: она может состоять из любых символов (но не должна содержать «–» и начинаться или заканчиваться на «-»).
Обычно версию не указывают в команде CREATE EXTENSION, поскольку текущая актуальная версия записана в управляющем файле (параметр default_version) и используется по умолчанию.
Другие параметры в управляющем файле указывают на возможность перемещения объектов расширения между схемами (relocatable), зависимости от других расширений (requires), возможность установки только суперпользователем (superuser) и пр.
https://postgrespro.ru/docs/postgresql/16/extend-extensions
https://postgrespro.ru/docs/postgresql/16/sql-createextension
Расширение удаляется командой DROP EXTENSION. Скрипт для удаления объектов не требуется.
https://postgrespro.ru/docs/postgresql/16/sql-dropextension
Page 6: Установка расширения
Файлы с исходным кодом учебного расширения UOM (единицы измерения) расположены в каталоге uom домашнего каталога пользователя student:
Среди файлов есть управляющий файл с настройками:
default_version определяет версию по умолчанию, без этого параметра версию придется указывать явно; relocatable говорит о том, что расширение можно перемещать из схемы в схему (мы поговорим об этом чуть позже); encoding требуется, если используются символы, отличные от ASCII; comment определяет комментарий к расширению. Это не все возможные параметры; полный список можно узнать из документации. Файлы, общие для всех кластеров одной версии PostgreSQL, находятся в каталоге SHAREDIR:
В частности, файлы установленных расширений находятся в каталоге SHAREDIR/extension. Например, файлы расширения pg_buffercache:
Для установки расширений обычно используется утилита make. Если расширение требует компиляции, а PostgreSQL установлен из пакета, дополнительно нужно установить пакет для разработчиков; его имя обычно содержит слово dev, например postgresql-server-dev-16. Пакет включает все необходимое для сборки, в том числе заголовочные файлы PostgreSQL. Наше расширение содержит только функции на SQL и не требует компиляции и сборки, поэтому Makefile должен обеспечить только копирование файлов расширения в SHAREDIR/extension:
Переменная EXTENSION задает имя расширения; Переменная DATA определяет список файлов, которые надо скопировать в SHAREDIR (кроме управляющего); Последние строки не меняются, они подключают инфраструктуру PGXS для установки расширений. Важно, чтобы утилита pg_config была доступна — иначе неизвестны пути, по которым установлен PostgreSQL. Установим расширение, выполнив make install в каталоге расширения:
Page 7: Page 7
Установка расширения обычно выполняется суперпользователем, в окружении которого путь до исполняемых файлов PostgreSQL может быть не указан. В этом случае в команде установки нужно явно задать расположение утилиты pg_config:
Список расширений, установленных на сервере и доступных для загрузки в базы данных кластера, виден в системном каталоге:
В стандартных базах данных установлено только расширение plpgsql. Список версий нашего расширения:
Page 8: Page 8
Версии расширений в PostgreSQL понимаются как имена, а не как номера. Другими словами, 1.1 и 1.2 — это просто две разные версии, их порядок не определен. Загрузим в новую базу данных версию 1.0 расширения uom:
Расширение появилось в базе данных, оно содержит таблицу и функцию:
Объекты установлены в схему, в которой они были бы созданы по умолчанию; в данном случае — public. При создании расширения мы могли бы указать схему явно:
Функция умеет переводить значения из одной единицы длины в другую:
А в таблице хранится список поддерживаемых единиц измерения:
Объекты расширения были созданы SQL-скриптом для версии 1.0:
Page 9: Page 9
Первая строка файла предотвращает случайный запуск скрипта вручную, он должен работать только при выполнении CREATE EXTENSION. При создании расширения все команды выполняются в одной транзакции, поэтому команды управления транзакциями (и служебные команды, такие, как VACUUM) здесь не допускаются. Путь поиска (параметр search_path) будет установлен на единственную схему — ту, в которой создаются объекты расширения. Принадлежность к расширению не дает напрямую удалять объекты:
При этом механизм расширений не отслеживает изменения самих объектов. Например, добавление столбца в таблицу или изменение функции не вызовет ошибки. Вносить изменения в объекты расширения не следует. Расширение и его объекты можно переносить в другую схему (relocatable=true):
Вернем расширение в public:
Page 10: Обновление расширения
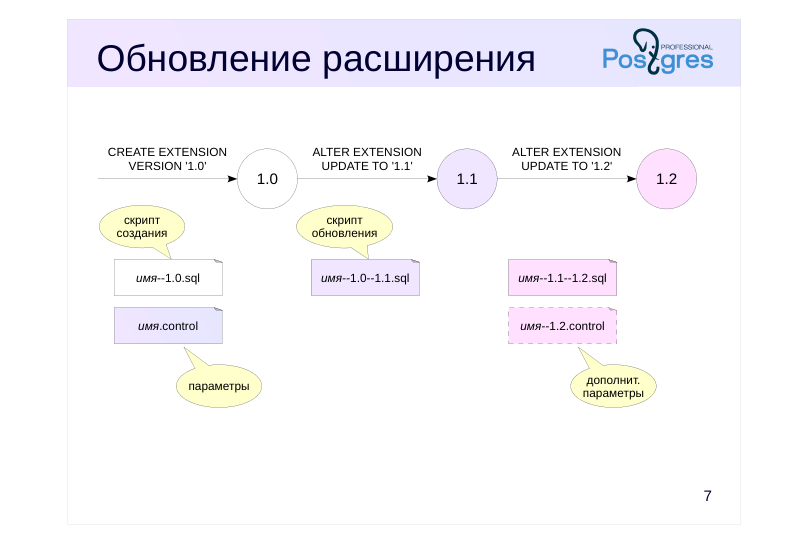 {#source-figure-010 caption=“Source slide page 10: Обновление расширения”}
Комментарии преподавателя
Обновление версии расширения выполняется командой ALTER EXTENSION UPDATE. При этом должен существовать скрипт обновления «имя–старая-версия–новая-версия.sql», содержащий необходимые для обновления команды.
Также необходимо изменить управляющий файл «имя.control», обновив актуальную версию и, возможно, другие параметры.
При необходимости может существовать и отдельный управляющий файл, привязанный к версии. Например, если в версии 1.2 появилась зависимость от другого расширения, то эту зависимость лучше указать не в основном управляющем файле, а в дополнительном файле версии 1.2. Параметры, указанные в дополнительном управляющем файле, имеют приоритет над параметрами основного.
В примере, приведенном на слайде, показаны скрипты обновления 1.0→1.1 и 1.1→1.2. Можно создать и скрипт 1.0→1.2, но, как правило, это не требуется: механизм расширений сам берет на себя выбор пути обновления с учетом доступных переходов между версиями. Например, если установлена версия 1.0, то ее можно обновить сразу до 1.2: сначала автоматически применится скрипт 1.0→1.1, а затем 1.1→1.2.
Как и при создании, при обновлении номер версии обычно не указывают — в этом случае обновление происходит до последней актуальной версии, записанной в основном управляющем файле.
https://postgrespro.ru/docs/postgresql/16/sql-alterextension
Page 11: Версии расширения и обновление
В следующей версии uom 1.1 добавлен тип данных для единиц длины, операторы сравнения для значений этого типа и класс операторов, позволяющий индексировать столбцы таблиц такого типа. Файл с изменениями:
При создании новой версии расширения возможны два сценария: В базе данных есть предыдущая версия, нужно обновить расширение. Предыдущей версии нет, нужно сразу создать более позднюю версию расширения. Убедимся, что мы можем перейти с версии 1.0 на версию 1.1. Список доступных вариантов обновления:
Выполним обновление:
Page 12: Page 12
Теперь будем создавать версию 1.1, предварительно удалив расширение. При удалении расширения удаляются и его объекты:
Сразу создаем расширение версии 1.1 в отдельной схеме, обеспечив видимость объектов в ней:
Для создания версии 1.1 механизм расширений сначала будет искать файл uom–1.1.sql, которого нет. Но к версии 1.1 можно прийти по цепочке: сначала создать версию 1.0, затем обновить до 1.1. Это самый короткий путь до версии 1.1, а в нашем примере и единственный. Посмотрим на тип данных uom. Для него определены операторы сравнения единиц длины:
Новый тип можно использовать в качестве типа данных для столбца таблицы:
Данные в таблице можно сортировать:
Page 13: Page 13
Можно построить индекс B-дерево:
И если запретить планировщику последовательный доступ, новый индекс будет использован при выполнении запроса:
Утилита pg\_dump
Утилита pg_dump выгружает только команду CREATE EXTENSION, но не команды создания объектов расширения. Поэтому для восстановления из резервной копии нужно, чтобы на сервере были установлены все используемые расширения. В следующей версии расширения 1.2 в таблицу добавлен столбец predefined. Он нужен для определения строк, которые были вставлены в таблицу не скриптом расширения, а уже после его создания. Файл обновления:
Скрипт вызывает функцию pg_extension_config_dump, чтобы утилита выгружала строки таблицы, удовлетворяющие условию. Для перехода на версию 1.2 мы не можем просто удалить расширение и пересоздать его. Помешает столбец len таблицы t:
Если мы не готовы удалять таблицу (или столбец len), то следует выполнить обновление:
Без указания версии обновление выполняется до версии по умолчанию из управляющего файла:
Page 14: Page 14
Теперь в логическую копию будут попадать, кроме CREATE EXTENSION, и данные таблицы uom_ref. Если выгружать базу данных целиком, то в резервную копию попадают все установленные расширения и такое поведение обычно нас устраивает. Однако если при выгрузке указать схему, то установленные в ней расширения в копию не попадут:
Восстановить содержимое таблицы uom_ref из такой копии не получится. Чтобы выгрузить определенные расширения, нужно указать их имена в ключе –extension. Но при этом придется позаботиться о зависимостях — если в нашем случае выгрузить только схему util, то зависящая от расширения таблица public.t в резервную копию не попадет:
После создания расширения привилегии на его объекты сохраняются в системном каталоге. Если к моменту выгрузки привилегии изменились, pg_dump добавит в резервную копию команды для формирования новых привилегий.
Page 15: Итоги
Расширяемость — важнейшее свойство PostgreSQL
- Расширения — упаковка связанных объектов БД
- Механизм расширений содержит инструменты для обновления версий, поддержки работы pg_dump
Page 16: Практика
- Установите расширение uom и убедитесь, что оно появилось в списке доступных.
- Создайте расширение uom, не указывая версию. Какая версия создалась и какими скриптами?
- Добавьте в справочник футы и дюймы.
- Измените доступ к справочной таблице: привилегия SELECT должна быть только у специально созданной роли, а не у всех.
- Проверьте, как pg_dump выгружает объекты расширения: таблицу, тип, функции и операторы, содержимое таблицы, права доступа.
Комментарии преподавателя
Файлы расширения расположены в подкаталоге uom домашнего каталога пользователя student. Процесс установки аналогичен тому, что использовался в демонстрации.
При добавлении данных важно, чтобы у новых записей значение столбца predefined было false. Коэффициенты пересчета:
1 фут = 0,3048 м 1 дюйм = 0,0254 м
Page 17: 1. Установка расширения
Устанавливаем файлы расширения:
Проверим, что расширение доступно для загрузки в базу данных:
2. Создание расширения в базе данных
Создаем расширение uom в новой базе:
Версия расширения соответствует значению параметра default_version:
Поскольку для версии 1.2 есть файл uom–1.2.sql, то он и используется для создания расширения. А для тех, кто хочет перейти с 1.1 или с 1.0, имеются соответствующие пути обновления.
3. Расширение справочника
Добавляем футы и дюймы. Столбец predefined заполняется значением по умолчанию (false):
Сколько же дюймов в футе?
Page 18: 4. Изменение доступа
Создаем отдельную роль для доступа к таблице uom_ref:
Читать из таблицы может только новая роль:
5. pg\_dump и объекты расширений
Информация о том, содержимое каких таблиц будет выгружать pg_dump, сохраняется в pg_extension:
Запускаем pg_dump:
Page 19: Page 19
Проверим, как pg_dump выгружает объекты расширения: Таблица, тип, функции и операторы не выгружаются. Они будут созданы командой CREATE EXTENSION. В системе, где производится восстановление, должна быть та же версия расширения, что при выгрузке. Содержимое вновь добавленных строк таблицы выгружается в виде команды COPY. Права доступа к таблице uom_ref формируются такими, какими они были на момент запуска pg_dump. Для того чтобы правильно выгрузить права доступа, в системном каталоге сохраняется информация о правах на объекты, выданные скриптами создания расширений:
Без этого было бы невозможно сформировать команду REVOKE.
16 Занятие 16: Задачи администрирования / Локализация
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_16_admin_localization.html Archive: DBA2-handouts-16.zip Страниц PDF: 32
Page 1: Задачи администрирования / Локализация
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Назначение локализации
- Локали и категории
- Провайдеры локалей
- Настройка сервера
- Работа с датами, числами, денежными единицами
- Настройка клиента
- Сообщения сервера и клиентских утилит
- Правила сортировки
Page 3: Назначение
Поддержка кодировок
- выбор кодировки символов для различных языков
- перекодировка символов между клиентом и сервером
- Функционал, зависящий от локализации
- сортировка и сравнение символов
- функции upper, lower, initcap
- поиск по шаблону
- функции to_char с датами, числами, денежными единицами
- язык сообщений сервера и утилит
Комментарии преподавателя
Возможности локализации в PostgreSQL позволяют хранить текст в различных кодировках. Для русского языка поддерживаются все основные кодировки символов, включая UTF8, WIN1251, KOI8R, ISO_8859_5.
Клиентское приложение может работать в кодировке, отличной от кодировки сервера, в таком случае выполняется преобразование символов между клиентом и сервером.
Кроме поддержки различных кодировок локализация влияет на работу следующего функционала сервера:
● сортировка символов, например в предложениях ORDER BY или в операциях сравнения (>, <);
● преобразование букв в верхний и нижний регистр в функциях upper, lower, initcap;
● поиск по шаблону в регулярных выражениях, операторах LIKE, SIMILAR TO, включая поиск без учета регистра символов;
● форматирование дат, чисел и денежных единиц в функциях to_char;
● выбор языка сообщений сервера и утилит.
https://postgrespro.ru/docs/postgresql/16/locale
Page 4: Локали и категории
Локали
- определяют язык, территорию и кодировку символов,
- например ru_RU.UTF8
- установлены в операционной системе
- Категории локали и соответствующие им параметры
- LC_COLLATE
- правила сортировки символов
- LC_CTYPE
- классификация символов
- LC_MESSAGES
- lc_messages
- язык сообщений
- LC_MONETARY
- lc_monetary
- формат денежных единиц
- LC_NUMERIC
- lc_numeric
- формат чисел
- LC_TIME
- lc_time
- формат даты и времени
Комментарии преподавателя
PostgreSQL использует возможности локализации, предоставляемые операционной системой. Поэтому в ОС следует предварительно настроить локали, которые потребуются для работы СУБД.
Обычно локали в ОС задаются в формате «язык_регион.кодировка». Например, ru_RU.UTF8 определяет локаль с русским языком (ru), на котором говорят в России (RU), и кодировкой UTF8. В Windows используются развернутые имена: Russian_Russia.1251.
Язык и территория определяют такие национальные особенности, как порядок символов, формат даты, разделитель десятичных разрядов и т. п.
Иногда бывает нужно комбинировать поведение разных локалей. Например, вместе с форматами даты и времени, принятыми в России, использовать английские сообщения сервера. PostgreSQL поддерживает раздельную установку категорий локали через одноименные параметры конфигурации.
Для категорий локали LC_COLLATE и LC_CTYPE соответствующие неизменяемые параметры сервера удалены начиная с версии PostgreSQL 16; теперь за информацией о локали базы данных следует обращаться к таблице системного каталога pg_database.
Page 5: Провайдеры локалей
Стандартная библиотека libc
- соответствие POSIX
- Внешняя библиотека ICU
- переносимое решение
- широкие дополнительные возможности
Комментарии преподавателя
PostgreSQL реализует поддержку различных провайдеров локалей. Провайдеры — это библиотеки, предоставляющие данные локалей и реализующие сортировку. Стандартный провайдер libc использует системную библиотеку C и предоставляет ее локали. Эти локали используются большинством утилит операционной системы.
Также поддерживается провайдер ICU, использующий одноименную внешнюю библиотеку. Имена локалей в ICU строятся по правилам языковых меток IETF BCP 47. Такие метки имеют вид «язык-регион» или просто «язык» (например ru-RU). При использовании локалей ICU PostgreSQL проверяет имена и приводит их к каноническому виду в соответствии с правилами. Параметр icu_validation_level позволяет настроить уровень сообщений при проверках локалей.
https://postgrespro.ru/docs/postgresql/16/locale#ICU-LANGUAGE-TAG
https://www.rfc-editor.org/rfc/bcp/bcp47.txt
Информация о выбранном провайдере и локали базы сохраняется в столбцах pg_datlocprovider и daticulocale таблицы pg_database. По ряду причин настройки libc нужны во всех базах данных (даже использующих провайдер ICU), поэтому в столбцах datcollate и datctype всегда будет информация о локали libc.
Команды и утилиты для установки параметров локали позволяют явно выбрать и провайдера. По умолчанию используется провайдер libc.
https://postgrespro.ru/docs/postgresql/16/locale#LOCALE-PROVIDERS
Page 6: Настройка сервера
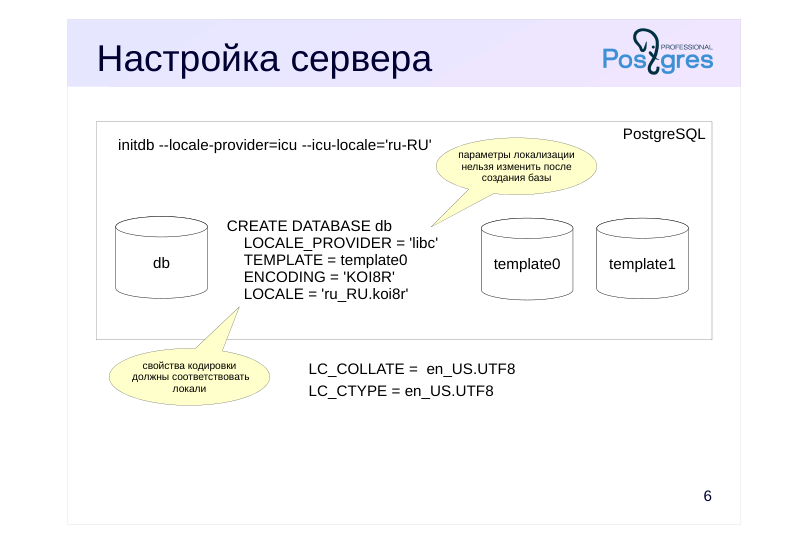 {#source-figure-006 caption=“Source slide page 6: Настройка сервера”}
Комментарии преподавателя
При инициализации кластера провайдер и локаль шаблонных баз задаются с помощью ключей утилиты initdb. По умолчанию используется провайдер libc и локаль из окружения ОС.
При создании базы данных она наследует настройки локализации шаблона. Если требуется создать базу с другими параметрами локализации, нужно использовать шаблон template0, в котором гарантированно нет никаких данных, зависящих от локали. При этом можно сменить провайдера, кодировку символов, а также категории локали LC_CTYPE и LC_COLLATE. Значения для категорий обычно совпадают, поэтому их удобно задавать одним параметром (ключом): для libc — LOCALE, а для ICU — ICU_LOCALE.
При этом кодировка базы данных должна быть совместима с параметрами локали LC_CTYPE и LC_COLLATE этой базы данных. Локали C и POSIX совместимы с любым набором символов, а для остальных локалей провайдера libc есть только один набор символов, который будет работать правильно. (Исключение: в среде Windows кодировка UTF-8 может использоваться с любой локалью.) Локали провайдера ICU можно использовать с большинством кодировок.
Page 7: Локали и категории
В операционной системе сервера уже установлены локали с поддержкой русского языка:
Параметры локализации сеанса ОС определяются переменными окружения:
Помимо переменных, соответствующих категориям локали, здесь также присутствуют переменные, имеющие особое значение: LC_ALL — если установлена, то используется для всех категорий локали, даже если они заданы; LANG — используется для тех категорий локали, для которых значение не задано; LANGUAGE — если установлена, то используется вместо LC_MESSAGES (об этом далее). При установке PostgreSQL из пакета в виртуальной машине курса для инициализации кластера main были использованы параметры сеанса ОС и провайдер libc. Чтобы задать другие значения, можно использовать ключи –locale-provider, –locale (эквивалентен LANG), а также ключи для категорий, например так:
Четыре параметра PostgreSQL соответствуют одноименным категориям локали. Видно, что их меньше чем в ОС:
Значения этих параметров записываются в конфигурационный файл. При этом параметры lc_monetary, lc_numeric и lc_time может изменить любой пользователь (context=user), а lc_messages — только суперпользователь. Для категорий локали LC_COLLATE и LC_CTYPE соответствующих серверных параметров нет. Каждый обслуживающий процесс при запуске сбрасывает значение LC_ALL и устанавливает переменные окружения ОС для категорий локали в соответствии с конфигурационными параметрами lc_*. При изменении параметра по ходу сеанса обслуживающий процесс устанавливает это же значение для соответствующей переменной окружения. Стандартные базы postgres, template0 и template1 используют значения LC_COLLATE, LC_CTYPE a также провайдера локали, установленные при инициализации кластера. Новые базы данных по умолчанию копируют параметры используемого шаблона:
Page 8: Page 8
Даты и LC\_TIME
Параметр конфигурации, отвечающий за соответствующую категорию локали:
Для использования названий месяцев и дней недели на русском языке в форматной маске функции to_char используется префикс TM:
То же самое для американского английского:
Вернем параметр к исходному значению:
Функции to_date/to_char позволяют в явном виде указать формат даты и времени при вводе/выводе значений. На неявное преобразование даты в текст и наоборот влияет параметр datestyle. Вот несколько примеров:
Page 9: Page 9
Числа и LC\_NUMERIC
Параметр конфигурации, отвечающий за соответствующую категорию локали:
Разделители групп разрядов (G), а также целой и дробной части (D), принятые в России:
То же для США:
Денежные единицы и LC\_MONETARY
Параметр конфигурации, отвечающий за соответствующую категорию локали:
Денежный тип данных money добавляет к сумме код валюты:
Page 10: Page 10
Но нужно учитывать, что в таблице с таким типом можно хранить только одну валюту, и та будет меняться вместе с LC_MONETARY:
Page 11: Настройка клиента
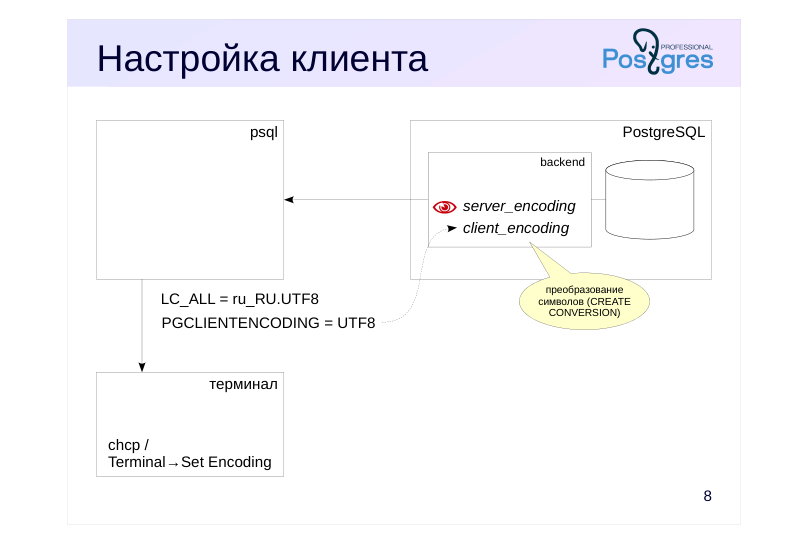 {#source-figure-011 caption=“Source slide page 11: Настройка клиента”}
Комментарии преподавателя
Для настройки локализации клиентского приложения нужно сделать следующее.
● Проверить, что настройки сервера корректны. Как минимум, что используется правильная кодировка БД (неизменяемый параметр server_encoding покажет кодировку, заданную при создании БД).
● Проверить, что в клиентской ОС установлены нужные локали, и настроить категории локали (переменные среды LC_*) в сеансе ОС.
● Настроить кодировку, с которой работает приложение, и проверить настройки устройства вывода. Например, psql в Windows обычно использует кодировку Win-1251, поэтому в терминале (cmd.exe) необходимо выполнить команду chcp 1251 и установить шрифт true type (например, Lucida Console).
● После подключения к БД проверить параметр client_encoding. Этот параметр отвечает за перекодировку символов между клиентом и сервером. При необходимости установить в значение кодировки приложения. Значение client_encoding можно задать и в переменной среды PGCLIENTENCODING.
Обслуживающий процесс автоматически перекодирует символы между кодировкой БД (server_encoding) и кодировкой клиента (client_encoding). Для большинства пар кодировок в PostgreSQL преднастроены необходимые процедуры преобразования символов: они находятся в таблице системного каталога pg_conversion. Можно определить дополнительную процедуру перекодировки (CREATE CONVERSION), однако на практике это вряд ли потребуется.
Page 12: Работа клиента и сервера в разных кодировках
Создадим базу данных с кодировкой KOI8R, а клиент по-прежнему будет использовать UTF8. В качестве провайдера локалей укажем ICU. Чтобы база данных успешно создалась, нужно использовать шаблон template0: это пустая БД, индексы в которой гарантированно не пострадают в результате изменения кодировки:
В нашем случае (при создании базы с провайдером ICU) нам понадобилось указать параметры LC_CTYPE и LC_COLLATE для соответствия устанавливаемой кодировке.
Подключимся к admin_localization_koi8r и убедимся, что работает перекодировка символов.
Кодировки клиента и сервера:
Значение параметра client_encoding устанавливает клиент, в данном случае psql. В интерактивном режиме значение устанавливается по кодировке клиента (переменной LC_CTYPE в ОС). Но при запуске из скрипта, как сейчас в демонстрации, параметр устанавливается в значение кодировки базы данных. Явно зададим такое же значение, как и у клиентской локали:
Теперь символы будут правильно конвертироваться из UTF8 в KOI8R и обратно:
Page 13: Page 13
Список доступных перекодировок для koi8:
Page 14: Сообщения сервера
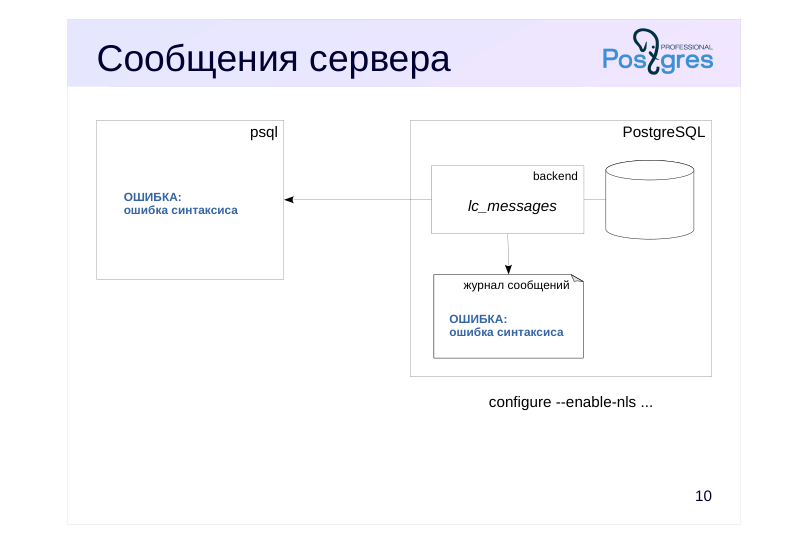 {#source-figure-014 caption=“Source slide page 14: Сообщения сервера”}
Комментарии преподавателя
Сообщения сервера (и утилит) PostgreSQL переведены на несколько языков, в том числе и на русский.
Для того чтобы сообщения сервера выводились на русском языке, нужно, чтобы сервер PostgreSQL был собран с поддержкой национальных языков (configure –enable-nls). Большинство пакетов собирается с таким параметром.
Параметр конфигурации lc_messages управляет языком сообщений сервера.
Сообщения сервера не только отправляются клиенту, но и записываются в журнал сервера. При выборе языка, отличного от английского, следует убедиться, что инструменты работы с журналом сервера понимают этот язык. Например pgBadger может работать только с английскими сообщениями.
Подробнее о переводе сообщений сервера для переводчиков и разработчиков: https://postgrespro.ru/docs/postgresql/16/nls
Page 15: Сообщения утилит
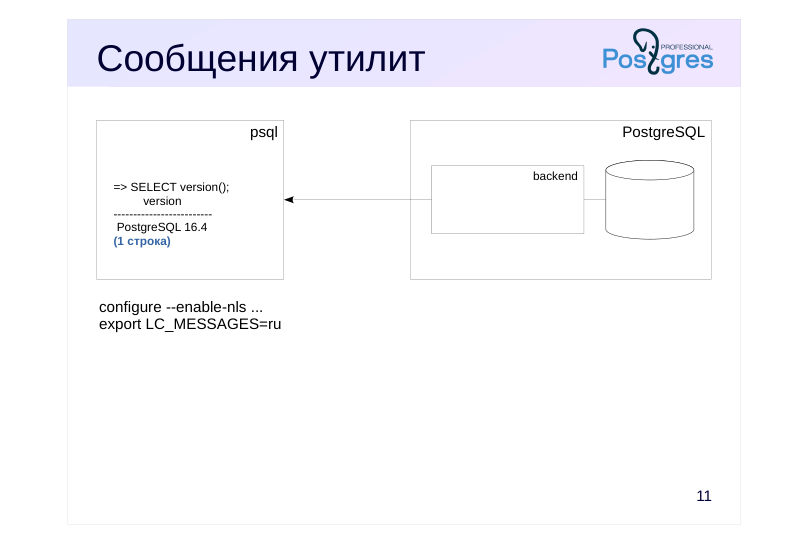 {#source-figure-015 caption=“Source slide page 15: Сообщения утилит”}
Комментарии преподавателя
Утилиты PostgreSQL (psql, pg_dump и пр.) также поддерживают национальные языки.
Для того, чтобы сообщения утилит выводились на языке, отличном от английского, нужно, чтобы клиент PostgreSQL был собран с поддержкой NLS (обычно это так). Язык вывода устанавливается на клиенте переменной среды LC_MESSAGES (параметр сервера lc_messages влияет только на сообщения самого сервера, но не клиента).
Большинство ОС (включая Windows) используют следующий порядок просмотра переменных среды для языка сообщений: LANGUAGE, LC_ALL, LC_MESSAGES, LANG.
Page 16: Сообщения сервера и клиента
Сообщения сервера можно выводить на разных языках. Предварительно нужно убедиться, что PostgreSQL собран с поддержкой национальных языков:
Список доступных языков и файлы сообщений здесь:
Для записи в журнал будем использовать ошибочную команду:
В журнал сервера записывается такое же сообщение об ошибке и сама ошибочная команда.
Page 17: Page 17
Для вывода сообщений на русском языке надо изменить параметр lc_messages.
Теперь сообщение выводится клиенту и в журнал на русском языке. Посмотрим на сообщения, которые выводит клиент psql. Они остались на английском языке:
Язык сообщений клиента, собранного с поддержкой национальных языков, определяется переменными ОС LC_MESSAGES и LANGUAGE, причем LANGUAGE имеет приоритет:
Для полной русификации установим русский язык и для сообщений psql.
Теперь все сообщения выводятся на русском языке.
Page 18: Правила сортировки
Объекты базы данных
- разные правила сортировки в одной БД
- начальное наполнение при создании БД
- Использование правил
- кластер
- база данных
- столбец таблицы
- выражение
- Стандартные правила сортировки
- default, C, POSIX
- unicode, ucs_basic
Комментарии преподавателя
Чтобы в одной базе данных можно было по-разному сортировать и сравнивать текстовые данные, в PostgreSQL существуют специальные объекты — правила сортировки (collation).
Правила сортировки позволяют использовать порядок сортировки, отличный от установленного по умолчанию для базы данных. Их можно использовать для столбцов таблиц, в определении доменов и просто в выражениях, где сортируются или сравниваются символьные строки. При создании нового правила сортировки указываются провайдер и классификация символов.
Начальный список правил сортировки формируется при инициализации кластера: для всех имеющихся в ОС локалей загружаются их правила сортировки. В дальнейшем при добавлении локалей в ОС можно дозагрузить правила.
Стандартные правила сортировки C и POSIX работают одинаково и создаются для всех кодировок сервера. Для этих правил буквами считаются латинские символы от A до Z, а остальные сортируются в соответствии со своими кодами в данной кодировке. Правило default использует значения LC_COLLATE, LC_CTYPE и провайдера, заданных при создании базы данных. Также доступны правила сортировки unicode и ucs_basic, определенные в стандарте SQL.
Все имеющиеся правила сортировки можно увидеть в таблице системного каталога pg_collation.
https://postgrespro.ru/docs/postgresql/16/collation
Page 19: Провайдер libc
Порядок символов
- зависит от реализации в операционной системе
- отслеживается версия библиотеки
- Используется по умолчанию
- для кластера и базы данных
Комментарии преподавателя
Правила сортировки провайдера libc в PostgreSQL работают точно так же, как и в операционной системе. Однако библиотека libc может быть реализована по-разному в разных операционных системах. Как следствие, сортировка для одних и тех же локалей может отличаться в зависимости от ОС сервера базы данных. Если приложение должно поддерживать работу (включая логическую репликацию) СУБД на разных ОС, следует убедиться, что сортировка везде работает корректно.
Более серьезной потенциальной проблемой является установка новой версии библиотеки libc в ОС. Такое может произойти, например, при переходе на новый сервер с новой версией ОС. Изменение в новой версии libc используемых в базе данных правил сортировки может привести к некорректной работе индексов и другим проблемам.
Page 20: Провайдер ICU
Порядок символов
- зависит от версии библиотеки, но не от операционной системы
- отслеживается версия библиотеки
- Дополнительные возможности
- управление порядком сортировки групп символов
- дополнительные (особые) правила сортировки
Комментарии преподавателя
Для использования провайдера ICU в определении правил сортировки необходимо, чтобы PostgreSQL был собран с поддержкой этой библиотеки. Библиотека ICU и реализованные в ней правила сортировки работают одинаково на всех операционных системах.
Библиотека ICU допускает видоизменение правил сортировки без смены языка и территории. Можно указать разный порядок сортировки для отдельных групп символов. Например, символы какой группы должны идти раньше: кириллица, латиница или цифры; буквы в верхнем регистре или в нижнем. Для настройки этих правил можно включить в языковую метку соответствующие параметры.
Дополнительные правила сортировки задаются особым синтаксисом, их примеры приведены в демонстрации.
https://postgrespro.ru/docs/postgresql/16/collation#ICU-CUSTOM-COLLATI ONS
Page 21: Правила сортировки
При инициализации кластера в системном каталоге каждой базы данных создаются специальные объекты — правила сортировки. Они создаются на основе информации об установленных в ОС локалях. Начальное наполнение базы правилами сортировки:
Правила сортировки для русского языка, полученные из ОС:
Обратите внимание, что отображаются только правила сортировки, применимые к кодировке текущей базы данных, поэтому для разных баз одного экземпляра PostgreSQL результат команды может отличаться. Правила сортировки для провайдера ICU создаются только в том случае, если сервер собран с параметром –with-icu. Для таких правил сортировки формируются имена, включающие метку языка и указание суффикса «-x-icu» для отличия от локалей libc.
Page 22: Правила сортировки ICU
Сортировка для правила ru-x-icu отличается от используемой по умолчанию сортировки для правила ru_RU. Кириллица идет раньше латиницы:
Ключевое слово COLLATE после выражения (в ORDER BY) явно задает правило сортировки. По умолчанию используется правило с именем default, соответствующее параметрам локали базы данных. Возможности библиотеки ICU позволяют по-разному настраивать сортировку отдельных групп символов путем определения новых правил с параметрами, заданными в виде части языковой метки. Создадим новое правило сортировки, где латинские символы идут раньше символов кириллицы:
Еще одно, где в дополнение к предыдущему буквы идут раньше цифр:
Проверяем сортировку:
Если вышеуказанных параметров правил сортировки недостаточно, порядок элементов можно изменить с помощью особых правил сортировки:
И еще один пример. Обратите внимание на синтаксис правила:
Page 23: Page 23
Page 24: Детерминизм
Детерминированные правила сортировки
- равенство строк при побайтовом совпадении
- Недетерминированные правила сортировки
- строки, состоящие из разных байтов, могут быть равными
- дополнительная гибкость
- производительность ниже
- не поддерживают LIKE и другие операции
Комментарии преподавателя
Правило сортировки в зависимости от типа используемого сравнения может быть детерминированным или недетерминированным.
Детерминированные сравнения считают равными строки, состоящие из одних и тех же байтов. При недетерминированном сравнении даже не совпадающие побайтово строки могут считаться равными. Например, в Unicode буква «ё» может быть представлена одним символом Cyrillic Small Letter Io (U+0451), а может быть составлена из буквы «е» (U+0435) и диакритического знака «диерезис» (U+0308).
Все стандартные правила — детерминированные. Пользовательские правила по умолчанию тоже будут детерминированными.
Недетерминированные правила дают дополнительную гибкость: можно, например, задать ограничение уникальности без учета регистра или диакритических символов. Но производительность детерминированных правил обычно выше. К тому же недетерминированные правила не поддерживают некоторые операции, такие как поиск по шаблону.
Page 25: Недетерминированные правила сортировки
Определим недетерминированное правило для регистронезависимой сортировки:
Теперь строки в разных регистрах могут быть равными:
Но поиск по шаблону для недетерминированного правила невозможен:
Page 26: Отслеживание изменений
Изменение библиотеки-провайдера приводит к проблемам
- неправильная сортировка значений в индексах
- сравнения строк в ограничениях целостности
- сравнения строк в запросах
- и т. д.
- Номер версии библиотеки хранится в системном каталоге
- При изменении установленной версии — предупреждение
- libc не гарантирует стабильность и платформонезависимость версии
Комментарии преподавателя
Если при изменении библиотеки-провайдера сравнение начинает работать иначе, это может повлиять на используемые в базе данных правила сортировки и вызвать проблемы:
● неправильную работу запросов из-за нарушения сортировки значений в индексах;
● некорректные данные из-за изменившегося поведения при сравнении строк в ограничениях целостности CHECK и триггерах;
● некорректные результаты из-за изменившегося поведения сравнения строк в запросах, процедурном коде и политиках защиты строк.
Поэтому при использовании правил сортировки PostgreSQL будет предупреждать о возможных проблемах, связанных с изменением библиотек.
При создании правила текущий номер версии библиотеки сохраняется в системном каталоге, в таблицах pg_collation и pg_database. При каждом использовании правила сохраненный номер версии сверяется с текущим номером, и при их несоответствии запросы будут выдавать предупреждения.
Если обнаружено расхождение, следует пересоздать индексы, использующие измененные правила сортировки, а также проверить все места, где используются эти правила.
Нужно помнить, что, в отличие от ICU, провайдер libc не гарантирует одинаковую работу сортировки даже при совпадении версий библиотеки.
Page 27: Изменения в библиотеках-провайдерах
При создании правила сортировки в системном каталоге сохраняется версия библиотеки, переданная операционной системой. Если в ОС изменится версия библиотеки, каждый раз при использовании правила будет выдаваться предупреждение о том, что версии не совпадают. Проверить соответствие версий можно запросом:
Изменение правила сортировки может привести к некорректной работе индексов. Если подобное произошло, рекомендуется пересоздать индексы с новой версией правила сортировки. После этого можно обновить версию в системном каталоге командой ALTER COLLATION … REFRESH VERSION и предупреждения перестанут выдаваться. Запрос для получения списка объектов, которые зависят от требующих обновления правил сортировки:
Такая же проверка выполняется и для правил сортировки на уровне баз данных. Функция pg_database_collation_actual_version показывает актуальную версию правила сортировки в операционной системе:
Если версия правила, заданного для базы данных, не совпадает с версией библиотеки в ОС, при подключении к базе данных выдается предупреждение. В этом случае рекомендуется перестроить индексы, использующие правило default. После этого можно обновить номер версии, хранящийся в pg_database, командой ALTER DATABASE … REFRESH COLLATION VERSION.
Page 28: Page 28
Page 29: Итоги
Перед инициализацией кластера нужные для СУБД локали должны быть установлены в ОС
- Клиент и сервер могут работать в различных кодировках с автоматическим преобразованием символов
- Сообщения сервера и утилит переведены на множество языков, включая русский
- Правила сортировки используют внешние библиотеки, изменения в которых могут привести к повреждению данных и некорректным результатам
Page 30: Практика
- Перенос данных между базами в разных кодировках.
- Создайте базу данных с кодировкой KOI8R. Создайте
- таблицу и добавьте в нее строки, содержащие символы
- кириллицы. Сделайте копию базы данных утилитой
- pg_dump. Восстановите таблицу из копии в базу
- с кодировкой UTF8.
- Получите номер сегодняшнего дня недели. Меняется ли номер дня недели в зависимости от настроек локализации?
Комментарии преподавателя
- Для создания БД в кодировке KOI8R:
● убедитесь, что в ОС установлена нужная локаль;
● в команде CREATE DATABASE используйте шаблон template0 и параметры ENCODING и LOCALE.
- Для получения номера дня недели используйте функцию to_char.
Допустимые форматные маски даты:
https://postgrespro.ru/docs/postgresql/16/functions-formatting#FUNCTIONS-FORMATTING-DATETIME-TABLE
Page 31: 1. Кодировки базы данных
Проверим, что в ОС есть локали с кодировкой koi8:
Создаем базы данных с кодировками KOI8R и UTF8:
Подключаемся к базе с кодировкой KOI8R:
Убедимся, что клиент и сервер используют разные кодировки:
Создаем таблицу, содержащую строки с кириллицей:
Page 32: Page 32
Получаем логическую копию:
Содержимое копии выгружается в кодировке базы данных (KOI8R), а в начале файла есть команда установки параметра client_encoding в то же значение KOI8R. Восстанавливаем таблицу в базе данных admin_localization_utf8:
Благодаря установке client_encoding при восстановлении символы автоматически перекодируются. Проверим, что кириллица корректно перенесена:
2. Номер сегодняшнего дня недели
Текущие настройки локализации даты и времени:
Для получения номера дня недели есть две форматные маски: ID — неделя начинается с понедельника; D — неделя начинается с воскресенья.
Номер дня недели не зависит от настроек локализации, в частности, от параметра lc_time:
17 Занятие 17: Задачи администрирования / Обновление сервера
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba2_17_admin_upgrade.html Archive: DBA2-handouts-16.zip Страниц PDF: 37
Page 1: Задачи администрирования / Обновление сервера
Авторские права
© Postgres Professional, 2016–2025 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Нумерация версий и общие замечания
- Обновление на дополнительный выпуск
- Обновление основной версии
Page 3: Версии сервера
Основные версии (9.6, 10, 11, …)
- поддержка сообщества в течение 5 лет
- добавляется и изменяется функционал
- новая версия не совместима на двоичном уровне с предыдущей
- для обновления всегда требуются специальные действия
- Дополнительные выпуски (16.1, 16.2, …)
- только исправление ошибок и проблем безопасности
- гарантируется двоичная совместимость
- обычно достаточно установить новые исполняемые файлы
Комментарии преподавателя
Номер версии PostgreSQL состоит из двух частей: номер основной версии (major release) и номер дополнительного выпуска (minor release). До версии 10 основной номер состоял из двух чисел (9.5, 9.6), затем перешли на одно (10, 11). Номер дополнительного выпуска — последнее число через точку (например, 2 в 16.2).
Дополнительные выпуски служат только и исключительно для исправления ошибок, найденных в основной версии. Для них гарантируется сохранение двоичной совместимости (на одной платформе). Поэтому обновление на следующий дополнительный выпуск делается максимально просто и рекомендуется, как только дополнительный выпуск появляется.
Новая основная версия привносит изменение функционала: какие-то возможности добавляются, изменяются, реже — удаляются. В этом случае двоичная совместимость отсутствует. Если попробовать подключить новую версию исполняемых файлов к старой версии кластера БД, PostgreSQL откажется с ним работать.
Для обновления основной версии требуется предпринимать специальные шаги. Не исключено, что помимо обновления сервера БД, потребуется внесение изменений и в приложение. Мотивацией для перехода на новую версию служит появление новых возможностей и окончание поддержки старой версии (которая распространяется на 5 лет с момента выпуска). Из-за сложности процесса часто пропускают несколько версий, например, переходят с 13 сразу на 16 и т. п.
https://postgrespro.ru/docs/postgresql/16/upgrading
Page 4: Общие соображения
«Замечания к выпуску»
- необходимо изучить раздел «Миграция» всех промежуточных версий
- Проверка обновления на тестовом окружении
- заранее обнаружить возможные проблемы
- автоматизировать процесс для сокращения времени простоя
- Запасной вариант
- на случай проблем при обновлении производственного сервера
Комментарии преподавателя
Независимо от того, какое обновление выполняется, стоит обратить внимание на некоторые моменты.
Всегда следует внимательно ознакомиться с приложением «Замечания к выпуску» (Release Notes) документации. В нем в разделе «Миграция» описаны все несовместимости и нестандартные действия, необходимые при обновлении.
Например, если планируется переход с 15.4 на 16.4 (последний доп. выпуск выбранной основной версии), надо прочитать все замечания к версиям 15.4, …, 15.8 (последний доп. выпуск для 15), 16.0, …, 16.4.
Обновление следует проверять на тестовой среде, эквивалентной производственной, с последующим тестированием приложения, что позволит заранее выявить возможные проблемы, а также «обкатать» и автоматизировать процедуру обновления.
Это существенно снижает риск возникновения проблем при обновлении производственного сервера, хотя и не исключает его полностью. Поэтому всегда необходимо иметь (протестированный) запасной вариант на случай, если обновление пойдет не так. Таким вариантом, например, может быть готовая реплика или резервная копия, в зависимости от требований к возможному времени простоя.
Page 5: Дополнительный выпуск
Обновление на дополнительный выпуск
- Использование физических реплик
Page 6: Дополнительный выпуск
16.3
- установка пакетов новой версии (сервер, клиент, расширения)
- перезапуск сервера
- при необходимости обновление расширений, доп. действия
- 16.4
- простота – вынужденное прерывание обслуживания
Комментарии преподавателя
Для того чтобы обновить сервер до очередного дополнительного выпуска, требуется:
Установить новые исполняемые файлы. Если PostgreSQL был установлен из пакета, необходимо установить новые версии пакетов (сервер, клиент, расширения). Некоторые пакетные менеджеры, в частности, apt в ОС Ubuntu, по умолчанию автоматически сразу перезапускают сервер; обычно это нежелательно. Если PostgreSQL был собран из исходных кодов, необходимо выполнить make install.
Перезапустить сервер. После перезапуска он продолжит работу уже на новой версии. Обслуживание клиентов прерывается на время, требуемое для перезапуска.
После перезапуска может понадобиться обновить расширения (ALTER EXTENSION … UPDATE) и выполнить дополнительные действия, указанные в «Замечаниях к выпуску». Однако в большинстве случаев это не требуется.
Page 7: аpt install
Обновление средствами операционной системы
- Может автоматически перезапустить сервер
- утилита needrestart
Комментарии преподавателя
Если PostgreSQL установлен из пакета, операционная система сама может обновить его версию. В Ubuntu для этого используется команда
sudo apt-get install –only-upgrade имя-пакета
или
sudo apt install имя-пакета
При таком обновлении сервер обычно автоматически перезапускается, что может быть неудобно. Это поведение настраивается, подробности описаны в документации утилиты needrestart:
https://github.com/liske/needrestart
Page 8: Уменьшение простоя
Процесс перезапуска сервера
- запрещаются новые соединения
- smart
- ожидает завершения всех сеансов
- fast
- принудительно отключает все сеансы (по умолчанию)
- выполняется контрольная точка
- Контрольная точка
- вручную до перезапуска сервера
- PgBouncer
- «пауза» на время перезапуска сервера
- открытые транзакции продолжают выполняться,
- все новые — приостанавливаются
Комментарии преподавателя
Прерывание обслуживания можно сократить, а в некоторых случаях и устранить полностью.
Что происходит при перезапуске сервера?
Во-первых, PostgreSQL перестает принимать новые подключения (клиенты будут получать ошибку «shutdown in progress»).
Во-вторых, в зависимости от режима останова, сервер либо дожидается завершения активных сеансов, либо принудительно завершает их. Последнее подразумевается по умолчанию утилитой управления, но, вероятно, это не лучший выбор для производственной среды, если сервер в основном имеет дело с OLTP-нагрузкой (короткие запросы).
В-третьих, выполняется финальная контрольная точка (shutdown checkpoint), чтобы синхронизировать данные из буферов в оперативной памяти с диском (как рассматривалось в модуле «Журналирование»). При большом размере буферного кеша этот процесс может занимать значительное время. Поэтому может оказаться целесообразным сначала выполнить контрольную точку вручную (CHECKPOINT), а затем перезапустить сервер. В этом случае финальная контрольная точка все равно будет выполнена, но значительно быстрее.
Если используется PgBouncer (https://pgbouncer.org), имеет смысл поставить его на «паузу» на время перезагрузки. При этом (подразумевается режим «transaction») работающие транзакции продолжат выполнение, но все новые будут отложены. Таким образом для OLTP-приложения перезапуск будет выглядеть как увеличившееся время отклика СУБД.
Page 9: Репликация
основной резерв
- резервный сервер
- обновляется первым
- резервный сервер догнал основной, переключение
- основной
- резерв
- возможно обновление без или с минимальным прерыванием обслуживания
Комментарии преподавателя
Если в системе используется физическая репликация и предусмотрен механизм плавного переключения пользователей между серверами, процедуру обновления можно провести и без прерывания обслуживания.
Для этого сначала выполняют обновление резервного сервера. Во время его перезапуска вся нагрузка ложится на основной сервер. Поскольку версии двоично-совместимы, репликация работает между уже обновленным резервным сервером и еще не обновленным основным. В абсолютном большинстве случаев репликация будет работать и в другом направлении (от обновленного сервера к серверу со старой версией), но от ошибок обратной совместимости никто не застрахован. Поэтому сначала лучше обновлять именно резервный сервер.
Затем, когда резервный сервер «догоняет» после перезагрузки основной сервер, основной сервер останавливают и выполняют переключение на резервный. После запуска бывшего основного сервера он подключается к новому основному в качестве резервного (это может потребовать запуска утилиты pg_rewind; вся процедура рассматривается подробно в курсе DBA3).
Page 10: Обновление на дополнительную версию
Выясним текущую версию PostgreSQL:
А в репозитории есть более новая версия:
Проведем обновление на версию 16.14 — обновим пакет postgresql-16 средствами ОС:
Заметим, что пакет postgresql-client-16 тоже обновился, а сервер был перезапущен:
Снова запросим у сервера номер версии:
Page 11: Основная версия
Логическая резервная копия pg\_dumpall
- Утилита pg_upgrade
- Логическая репликация
Page 12: pg_dumpall
- установка пакетов и инициализация кластера
- отключение пользователей (только чтение)
- логическая копия (pg_dumpall)
- восстановление копии (psql)
- сбор статистики
- начало работы
- можно сменить платформу, разрядность, кодировку баз данных и т. п. – большое время обновления, требуется много дискового пространства
Комментарии преподавателя
Самый простой способ обновления на основную версию — сделать логическую резервную копию и развернуть ее на другом сервере с новой версией. (Логическая копия — это набор команд SQL, воссоздающих базу данных; подробнее см. курс DBA3).
Сначала устанавливаем новый сервер и инициализируем кластер (некоторые пакетные менеджеры выполняют инициализацию сразу при установке).
Если новый сервер разворачивается на том же компьютере, надо позаботиться, чтобы каталоги данных не пересекались. Обычно пакеты собираются с учетом этого требования (например, /var/lib/postgresql/15/ и /var/lib/postgresql/16/). Также потребуется изменить конфигурационные файлы нового кластера, внеся в них изменения с работающего.
Резервную копию можно делать при работающем сервере, но требуется отключить всех пользователей (кроме только читающих), поскольку изменения, сделанные после запуска резервного копирования, не попадут в копию.
После этого можно запускать новый сервер и в нем разворачивать подготовленную резервную копию. А затем собрать статистику — без этого оптимизатор не сможет строить адекватные планы запросов.
После всех необходимых проверок каталоги старого сервера (исполняемые файлы, содержимое PGDATA, пользовательские табличные пространства) можно удалить.
Page 13: pg_dumpall
Ускорение переноса данных
- для каждой базы данных отдельно
- Экономия места
- Сбор статистики
- Быстрая проверка
Комментарии преподавателя
Хотя утилита pg_dumpall и делает резервную копию всего кластера, она всегда выполняется в один поток. Восстановление также выполняется в один поток утилитой psql.
Если аппаратные ресурсы позволяют, можно сохранить глобальные объекты кластера с помощью pg_dumpall, а затем выполнить копии каждой БД отдельно в параллельном режиме с помощью утилиты pg_dump в формате directory. В таком случае и восстановление можно выполнять в параллельном режиме утилитой pg_restore. Подробности см. в курсе DBA3.
Если стоит задача сэкономить место на диске, можно не сохранять резервную копию, а просто направить вывод pg_dumpall на вход psql.
Чтобы как можно раньше собрать хоть какую-то статистику, можно выполнять ее сбор в несколько (3) этапов. Можно попробовать начать работу с СУБД уже после второго этапа, сократив тем самым время прерывания обслуживания. Еще одна возможность — использовать внешнее расширение dump_stat:
https://postgrespro.ru/docs/postgrespro/16/dump-stat
При проверке обновления на тестовой среде сначала можно выполнить обновление с переносом только схемы данных (без самих данных). Таким образом можно достаточно быстро выявить часть возможных проблем.
Заметим, что лучше использовать все утилиты от новой (уже установленной) версии, поскольку они могут содержать улучшения, недоступные в предыдущей версии.
Page 14: Кластер PostgreSQL 15
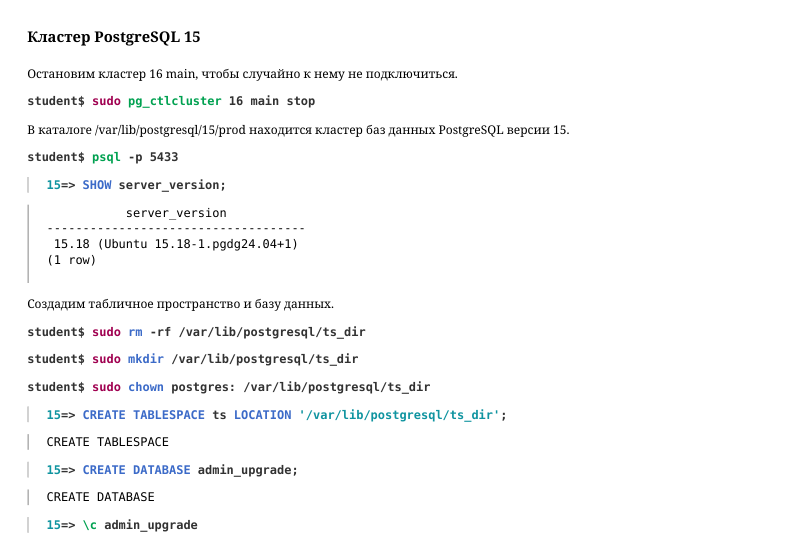 {#source-figure-014 caption=“Source slide page 14: Кластер PostgreSQL 15”}
Остановим кластер 16 main, чтобы случайно к нему не подключиться.
В каталоге /var/lib/postgresql/15/prod находится кластер баз данных PostgreSQL версии 15.
Создадим табличное пространство и базу данных.
Создадим таблицу в созданном табличном пространстве:
Установим расширение pgaudit:
Page 15: Page 15
Утилита pg\_dumpall
Сделаем резервную копию всего кластера. Сервер должен работать, но изменения, сделанные после запуска pg_dumpall, в копию не попадут.
Созданная резервная копия — текстовый файл с командами SQL. В нем есть команды для создания баз данных:
И команды для создания таблицы:
А также команды для создания таких объектов уровня кластера, как роли и табличные пространства, например:
Мы не будем восстанавливать резервную копию на сервере PostgreSQL версии 16; такое задание есть в практике.
Page 16: pg_upgrade
Условия применимости
- в новой версии изменяется формат только служебной информации
- в остальном сохраняется двоичная совместимость,
- включая представление типов и файлы данных
- в базах данных не используются REG-типы
- обновление с версии 8.4 или более поздней
- обновление до версии, соответствующей утилите
Комментарии преподавателя
Второй, наиболее распространенный, способ обновления — утилита pg_upgrade, которая умеет приводить файлы кластера к виду, совместимому с новой основной версией.
https://postgrespro.ru/docs/postgresql/16/pgupgrade
Возможность применения утилиты обусловлена тем, что при обновлении основной версии меняются служебные таблицы, относящиеся к системному каталогу, но форматы файлов данных и индексов как правило остаются без изменений. Поэтому достаточно поправить только небольшую часть данных, оставив основной массив как есть, без изменений. При этом новый кластер должен быть совместим со старым по разрядности, кодировке и локалям.
В некоторых версиях (достаточно редко) изменяется двоичное представление типов данных. В таких случаях утилита не сможет помочь, но по крайней мере перечислит, где используется проблемный тип. Это поможет избавиться от него вручную перед обновлением.
Есть и дополнительные ограничения. Например, утилита не сможет обновить кластер, если в одной из баз данных используются REG-типы (кроме regtype, regclass и regrole).
При запуске pg_upgrade проверяет совпадение своей версии и версий исполняемых файлов, задействованных в обновлении, с версией нового сервера. Утилитой поддерживается обновление любой версии, начиная с 8.4, на версию, соответствующую утилите. Таким образом, pg_upgrade от версии 16 может обновить старый сервер только до 16, но не до 15. Уменьшение версии сервера (downgrade) невозможно.
Page 17: pg_upgrade
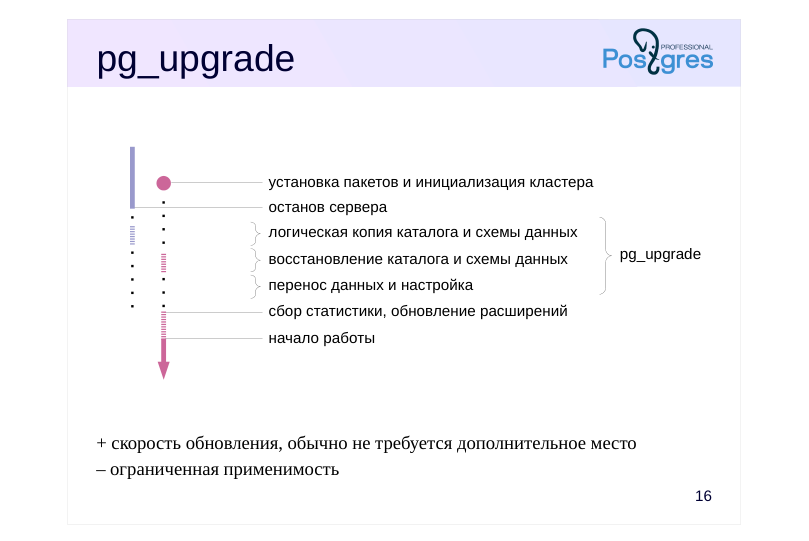 {#source-figure-017 caption=“Source slide page 17: pg_upgrade”}
- скорость обновления, обычно не требуется дополнительное место – ограниченная применимость
Комментарии преподавателя
Вначале рассмотрим общую (упрощенную) последовательность действий при обновлении с помощью pg_upgrade.
Сначала необходимо установить новый сервер и инициализировать (но не запускать) кластер. Этот шаг выполняется так же, как и при обновлении с помощью pg_dumpall.
Затем старый сервер останавливается и запускается утилита pg_upgrade. Пока обозначим схематически, что она делает:
● Старый сервер запускается на время, чтобы сделать логическую резервную копию общих объектов кластера и схемы данных всех БД. Это как раз та информация, для которой теряется двоичная совместимость.
● Временно запускается новый сервер, выполняются необходимые проверки применимости, из резервной копии восстанавливаются глобальные объекты и схема данных.
● Выполняется перенос данных: либо копирование, либо простановка жестких ссылок, либо клонирование (для файловых систем с копированием при записи, copy-on-write).
В результате работы утилиты новый кластер становится обновленной версией старого. Далее выполняются заключительные действия, такие, как сбор статистики и обновление расширений.
Огромный плюс pg_upgrade состоит в возможности очень быстрого обновления кластера любого размера без дополнительного места на диске (при использовании жестких ссылок). Из минусов отметим то, что утилита применима не всегда.
Page 18: pg_upgrade
 {#source-figure-018 caption=“Source slide page 18: pg_upgrade”}
Комментарии преподавателя
Чуть более подробно рассмотрим, что происходит с файловыми системами старого и нового кластера при обновлении.
Шаг 1. Установлены пакеты с новой версией и инициализирован кластер. Новый сервер выключен и не содержит никаких пользовательских объектов, только стандартные базы данных и системный каталог.
Старый сервер продолжает работать.
Важный момент: новый кластер должен быть инициализирован с той же локалью, что и старый.
Page 19: Кластер PostgreSQL 16
PostgreSQL версии 16 уже установлен, кластер инициализирован в каталоге /var/lib/postgresql/16/prod. Убедимся, что сервер работает и использует ту же локаль, что и PostgreSQL 15, после чего остановим его.
Остановим сервер.
Проверка возможности обновления
Перед тем как выполнять настоящее обновление, имеет смысл запустить pg_upgrade в режиме проверки с ключом – check. Мы планируем не копировать файлы данных, а использовать ссылки, поэтому указываем ключ –link. Также мы должны указать пути к исполняемым файлам и к каталогу данных как для старой версии, так и для новой. Обратите внимание, что программа запускается от имени пользователя ОС postgres, так как ей требуется доступ к каталогам данных.
Note Важно, чтобы версии pg_upgrade и других серверных утилит (pg_controldata, initdb) соответствовали версиям клиентских утилит, которые она вызывает (pg_dump, pg_dumpall, pg_restore, psql, vacuumdb), иначе при запуске получим ошибку. Поскольку мы обновили на версию 16.14 и серверный, и клиентский пакеты, это требование выполнено:
Следует обратить внимание на настройки соединений. Утилита в процессе работы запускает и останавливает серверы, и для этого нужно, чтобы к обоим кластерам у нее был локальный суперпользовательский доступ. У нас такой доступ есть,
Page 20: Page 20
а в общем случае может потребоваться временно изменить файл pg_hba.conf. Также программа pg_upgrade создает различные временные файлы в специально создаваемом рабочем каталоге pg_upgrade_output.d внутри каталога данных нового кластера, доступ на запись к которому ей тоже необходим. Серверы поднимаются по очереди на порту 50432, чтобы не допустить случайного подключения к ним пользователей; при необходимости номер порта можно указать явно.
Утилита обнаружила проблему: в новом кластере не хватает библиотек. Посмотрим их список:
Это библиотека установленного нами расширения, от которого зависит индекс в базе admin_upgrade. Его необходимо установить и для новой версии.
Не забываем дать указание загружать библиотеку в память каждого обслуживающего процесса:
Проверяем еще раз.
Page 21: Page 21
Теперь кластеры совместимы.
Page 22: pg_upgrade
 {#source-figure-022 caption=“Source slide page 22: pg_upgrade”}
Комментарии преподавателя
Шаг 2. Старый сервер останавливается, запускается утилита pg_upgrade. Она создает резервную копию каталога и схем данных всех баз с помощью утилит pg_dump и pg_dumpall в особом режиме –binary-upgrade, который сохраняет нумерацию файлов (этот режим не нужен для обычной работы и официально не поддерживается):
pg_dumpall –globals-only –binary-upgrade pg_dump –schema-only –binary-upgrade
Затем эти объекты восстанавливаются на новом сервере с помощью pg_restore (подробно эти утилиты рассматриваются в курсе DBA3). Имена файлов каталогов для баз данных и табличных пространств, а также имена файлов отношений остаются прежними после обновления.
Все эти действия выполняются достаточно быстро — время не зависит от объема данных в кластере.
После этого системный каталог нового кластера будет соответствовать системному каталогу старого кластера с точностью до изменения формата данных (именно поэтому для него и используется логическая, а не физическая резервная копия). Фактически, в новом кластере будут созданы все базы данных и все объекты внутри них, но системный каталог будет ссылаться на еще не существующие файлы данных.
На самом деле утилита pg_upgrade выполняет еще много довольно тонких операций. Она замораживает все транзакции нового кластера (чтобы не зависеть от номеров транзакций, которые там выполнялись), копирует статусы транзакций (CLOG), копирует информацию о мультитранзакциях и устанавливает счетчик транзакций в значение, взятое со старого кластера.
Page 23: pg_upgrade
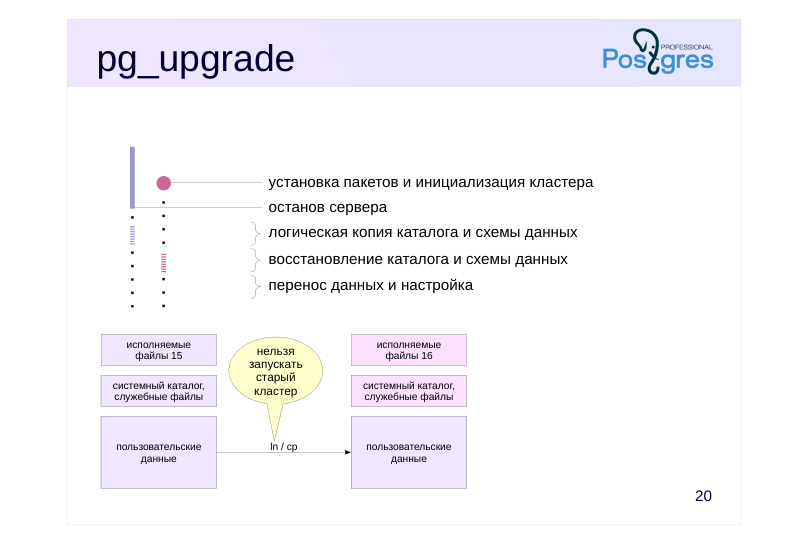 {#source-figure-023 caption=“Source slide page 23: pg_upgrade”}
Комментарии преподавателя
Шаг 3. Утилита pg_upgrade выполняет перенос пользовательских данных.
Теперь либо файлы данных нового кластера скопированы со старого, либо на них проставлены жесткие ссылки.
Заметим, что если файлы данных копируются, то старый кластер никак не затрагивается обновлением и можно в любой момент вернуться к нему, если при обновлении что-то пошло не так.
Однако при использовании жестких ссылок файлы данных фактически становятся общими — точнее, одноименные файлы двух кластеров ссылаются на одинаковые индексные дескрипторы файловой системы (inode). Поэтому, как только новый кластер будет запущен первый раз, старый уже станет невозможно запустить безопасным образом. Такой режим обновления требует наличия «плана Б».
Для файловых систем c copy-on-write возможен третий вариант — клонирование (–clone), сочетающий преимущества двух предыдущих: быстрый перенос данных и возможность запуска обоих кластеров.
После переноса пользовательских данных утилите остается выставить счетчик OID в значение со старого кластера (это выполняется утилитой pg_resetwal).
А администратору остается обновить расширения, собрать статистику и не забыть про плановое резервное копирование обновленного кластера.
Page 24: Обновление
Выполняем обновление в режиме создания ссылок.
Page 25: Page 25
Перед запуском сервера следовало бы перенести изменения, сделанные в конфигурационных файлах старого сервера, на новый. Мы не будем этого делать, поскольку работаем с настройками по умолчанию. Итак, проверим результат.
Обновление прошло успешно: нам доступно содержимое старого кластера.
Табличные пространства
Посмотрим на файлы табличного пространства:
Внутри каталога табличного пространства создается подкаталог для каждой версии, поэтому пересечения по файлам не происходит. Как видно по числу в квадратных скобках (inode), файлы в каталогах старой и новой версий на самом деле разделяют общее содержимое.
Действия после обновления
Библиотеки установленных расширений заменяются при установке новой версии, но на уровне объектов баз данных версия расширения остается неизменной:
Утилита обнаружила этот факт и сгенерировала скрипт, обновляющий расширения во всех базах данных:
Выполним его.
Page 26: Page 26
В нашем случае разработчики расширения не предоставили скрипт для обновления версии, поэтому придется удалить расширение и установить его заново.
Утилита pg_upgrade сгенерировала еще один скрипт, удаляющий файлы старого кластера:
И напомнила, что нужно собрать статистику. Ключ –analyze-in-stages просит собрать статистику в три этапа, каждый раз увеличивая ее точность, чтобы оптимизатор смог начать строить планы как можно раньше.
Page 27: pg_upgradecluster
Утилита-обертка
- pg_dump + pg_restore
- -method=dump
- pg_upgradecluster
- pg_upgrade
- -method=upgrade
- старый кластер переключается на другой порт
- файлы конфигурации копируются
- pg_dump: можно сменить локаль
- pg_upgrade: копирование файлов или жесткие ссылки
- Неприменима для табличных пространств
Комментарии преподавателя
Утилита-обертка pg_upgradecluster для ОС Ubuntu облегчает обновление кластера в простых случаях. По умолчанию используется вариант с логической копией, также поддерживается обновление утилитой pg_upgrade как в режиме копирования файлов, так и в режиме жестких ссылок.
Новый кластер использует тот же порт, а старый настраивается на другой (неиспользуемый) порт и ручной запуск. Утилита копирует конфигурационные файлы в новый кластер, поэтому может потребоваться их дополнительная настройка.
При обновлении через логическую копию можно поменять локаль или отдельные категории локали.
Но если в кластере имеются дополнительные табличные пространства, придется выполнять обновление вручную: утилита такую конфигурацию не поддерживает.
Page 28: Физическая репликация
Реплики нужно создать заново
- обновление обязательно (обеспечение двоичной совместимости)
- использование pg_upgrade невозможно (недетерминированность)
- Вариант 1 (pg_basebackup)
- развернуть новые реплики из физической резервной копии, сделанной
- после обновления основного сервера
- надежно, но долго
- Вариант 2 (rsync)
- воспользоваться тем, что файлы данных не изменяются
- применимо только для Unix и только для жестких ссылок
- быстро, но сложно
Комментарии преподавателя
При использовании физической репликации возникают дополнительные трудности. Дело в том, что и мастер, и его реплики необходимо обновлять одновременно. Соединение мастера одной версии с репликой другой версии скорее всего приведет к потере данных.
Еще одна тонкость: реплику нельзя обновлять с помощью pg_upgrade. Такое обновление не дает 100% гарантии того, что два идентичных экземпляра после обновления также получатся идентичными.
Обычный способ состоит в том, чтобы забыть про существующие реплики и создать их заново. Для этого надо создать базовую резервную копию мастера и развернуть из нее новую реплику (процедура подробно рассматривается в курсе DBA3). Понятно, что это достаточно длительная процедура.
Если речь идет об операционной системе семейства Unix и при обновлении мастера использовался режим жестких ссылок, то время развертывания новой реплики можно существенно ускорить, получив примерно такой же выигрыш по времени, который дает pg_upgrade для мастера. Для этого надо правильным образом воспользоваться утилитой rsync.
Page 29: Физическая репликация
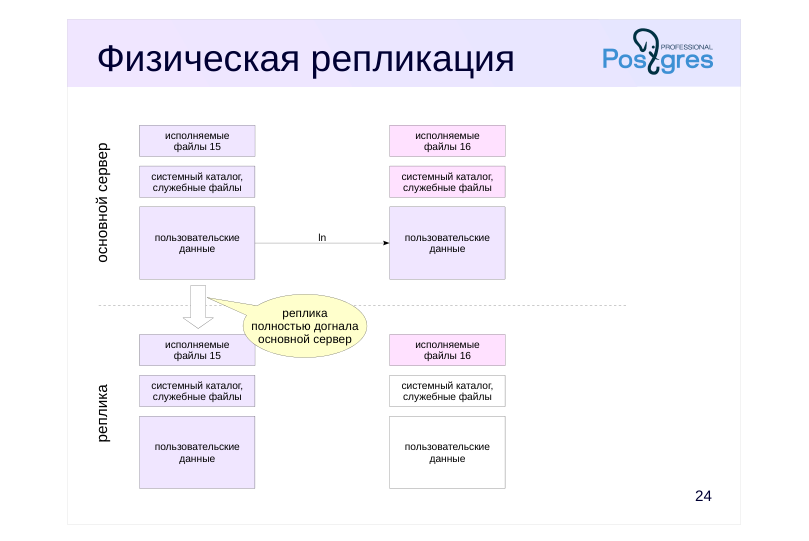 {#source-figure-029 caption=“Source slide page 29: Физическая репликация”}
Комментарии преподавателя
Исходная позиция: мастер обновлен, но новый сервер еще не запускался. Реплика выключена, причем перед выключением она полностью догнала мастер (таким образом файлы данных совпадают).
На реплике устанавливается новая версия сервера, но кластер пока не инициализируется.
Page 30: Физическая репликация
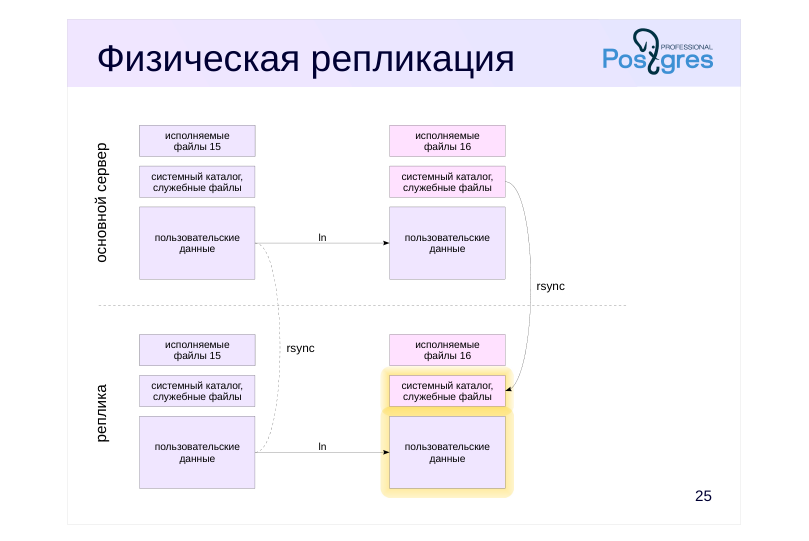 {#source-figure-030 caption=“Source slide page 30: Физическая репликация”}
Комментарии преподавателя
Дальше запускается rsync так, чтобы в одной команде скопировать с мастера оба кластера, старый и новый, на реплику.
В таком режиме rsync понимает, что:
● старый и новый кластеры разделяют общие файлы данных;
● файлы данных старого кластера на мастере и на реплике совпадают (чтобы не зависеть от объема, сравниваются только размеры файлов, а не их содержимое);
● следовательно, файлы данных не надо физически копировать на реплику, а достаточно проставить жесткие ссылки.
И rsync остается скопировать только файлы, относящиеся к системному каталогу, а они имеют небольшой размер.
Этот процесс описан в документации к pg_upgrade (https://postgrespro.ru/docs/postgresql/16/pgupgrade), в том числе приведены и конкретные команды, которые необходимо выполнить. К сожалению, документация не объясняет, почему необходимы именно такие команды. Для того, чтобы разобраться в этом вопросе детально, полезно ознакомиться с перепиской разработчиков:
https://www.postgresql.org/message-id/flat/54C95E66.1000309@agliodbs.c om
Page 31: Логическая репликация
- создание публикации
- создание схемы данных и подписка на публикацию
- синхронизация данных
- переключение
- возможно обновление без или с минимальным прерыванием обслуживания – сложная настройка, не реплицируются схема данных и команды DDL,
- требуется дополнительное место на диске и т. д.
Комментарии преподавателя
Можно выполнить обновление основной версии без прерывания обслуживания (или с минимальным прерыванием), если использовать логическую репликацию.
Для этого требуется установить и настроить необходимым образом новый экземпляр. На старом сервере создаются публикации всех изменений во всех базах данных. На новом сервере создаются подписки на эти публикации с синхронизацией данных. После того как данные синхронизированы, остается переключить пользователей на новый сервер, удалить подписки и остановить старый сервер.
Штатная логическая репликация появилась в PostgreSQL 10. Это решение активно развивается, но пока далеко от идеала: не реплицируются схема данных, команды DDL, данные последовательностей. Все это делает такой подход более сложным и менее привлекательным, чем использование pg_upgrade.
Page 32: Итоги
Обновление на дополнительный выпуск — простая замена исполняемых файлов
- физическая репликация может помочь не прерывать обслуживание
- Обновление основной версии:
- резервная копия (pg_dumpall)
- утилита обновления (pg_upgrade)
- логическая репликация
- наличие физической репликации усложняет процедуру
- сразу после — сделать физическую резервную копию
Page 33: Практика
- В кластере PostgreSQL 15 создайте пользователя с аутентификацией по паролю.
- От имени нового пользователя создайте в базе данных таблицу со столбцом типа uom.
- Обновите кластер 15 на версию 16 с помощью логической резервной копии. При обновлении сделайте так, чтобы все данные оказались размещены в отдельном табличном пространстве.
- Проверьте корректность обновления: доступность сервера, аутентификацию пользователя, содержимое таблицы.
Комментарии преподавателя
- PostgreSQL 15 уже установлен, в каталоге /var/postgresql/15/prod инициализирован кластер, сервер работает на порту 5433. Локальные соединения безусловно разрешены, при подключении по TCP/IP настроена парольная аутентификация. В кластере создана единственная роль postgres с правами суперпользователя.
Для начального подключения к кластеру используйте команду
psql -p 5433 -U postgres
Рекомендуем остановить основной кластер main, чтобы при выполнении практики не подключиться к нему по ошибке.
При создании нового пользователя укажите пароль. Не забудьте изменить настройки аутентификации для нового пользователя в pg_hba.conf.
Тип данных uom доступен в одноименном расширении (см. тему «Расширения»).
PostgreSQL 16 уже установлен, в каталоге /var/postgresql/16/prod инициализирован кластер аналогично кластеру prod версии 15.
Чтобы разместить данные в отдельном табличном пространстве, предварительно создайте его и отредактируйте файл с резервной копией (добавьте табличное пространство по умолчанию для БД).
Чтобы сохранить аутентификацию, внесите в файл pg_hba.conf те же изменения, что были сделаны в старом кластере.
Page 34: 1. Пользователь и аутентификация в кластере 15
Остановим основной кластер, чтобы случайно к нему не подключиться, и запустим кластер 15 prod:
Пользователь dbuser:
Добавляем в начало pg_hba.conf правило для нового пользователя:
Вот что получилось:
Добавим пароль в .pgpass, чтобы не вводить его вручную (при выполнении задания этот шаг лучше пропустить: будет непонятно, срабатывает аутентификация по паролю или безусловный доступ, включенный по умолчанию).
2. Таблица в кластере 15
Сначала создадим базу данных.
Тип данных uom доступен в расширении uom, установим версию 1.1.
Page 35: Page 35
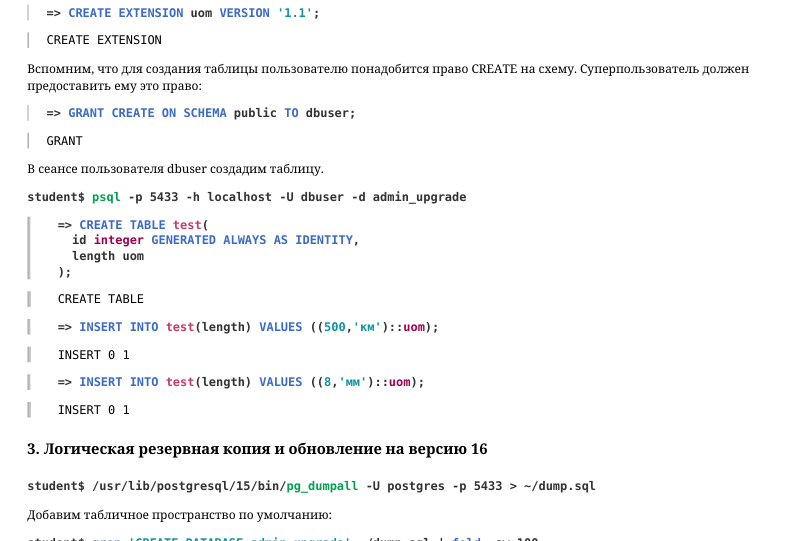 {#source-figure-035 caption=“Source slide page 35: Page 35”}
Вспомним, что для создания таблицы пользователю понадобится право CREATE на схему. Суперпользователь должен предоставить ему это право:
В сеансе пользователя dbuser создадим таблицу.
3. Логическая резервная копия и обновление на версию 16
Добавим табличное пространство по умолчанию:
Останавливаем сервер.
Настройки postgresql.conf не переносим, хотя в реальной жизни это, конечно, необходимо. Изменяем pg_hba.conf так же, как для версии 15:
Создаем каталог для табличного пространства.
Стартуем кластер 16 и создаем табличное пространство от имени суперпользователя.
Устанавливаем расширение:
Page 36: Page 36
Восстанавливаем кластер из резервной копии:
Page 37: Page 37
При создании роли postgres выдается ошибка, поскольку такая роль уже существует; это нормально.