Администрирование PostgreSQL. Базовый курс
Администрирование PostgreSQL. Базовый курс
Курс сохраняет официальный порядок тем. Русские материалы извлечены из PDF в читаемый нативный Markdown для дальнейшей редакторской работы.
Состояние материалов: 官方 PDF 已提取为原生 Markdown
Базовый язык: Базовый язык: English. Текущий английский архив используется как базовый; русская версия сохранена для сверки глав.
О курсе
Установка, архитектура сервера, базовая настройка и повседневное администрирование PostgreSQL.
Состояние материалов
| Язык | Текущий архив | Версия | Темы | Страница курса |
|---|---|---|---|---|
| English | DBA1-handouts-16-en.zip | 16 | 17 | HTTP 200 |
| Русский | DBA1-handouts-16.zip | 16 | 17 | HTTP 200 |
Содержание
Дополнительные материалы
catalogs.pdfdba1_new_features.pdfdba1_student_guide.pdfunix_commands.pdf
Редакторский статус
Русский комплект доступен в виде нативного Markdown. Если английский комплект не найден, английский маршрут оставлен для будущего источника.
00 Занятие 00: Администрирование PostgreSQL 16 / Базовый курс
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba1_00_introduction.html Archive: DBA1-handouts-16.zip Страниц PDF: 9
Page 1: Администрирование PostgreSQL 16 / Базовый курс
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Администраторам
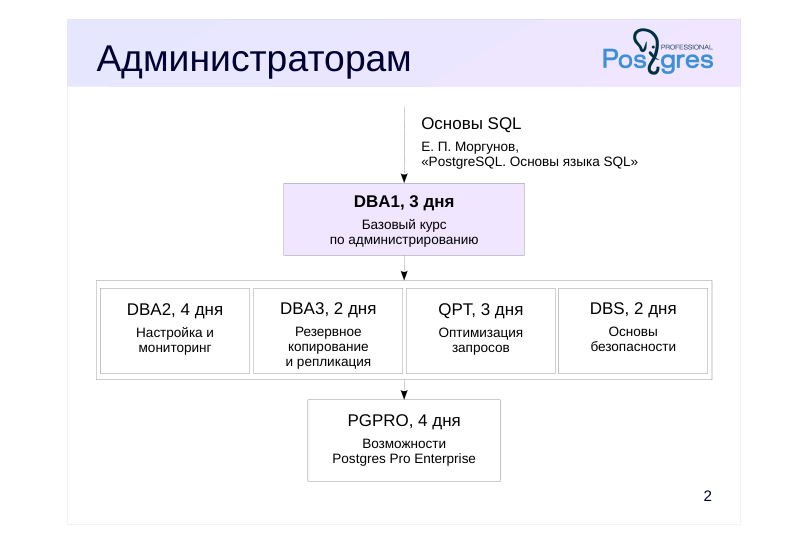 {#source-figure-002 caption=“Source slide page 2: Администраторам”}
- DBA2, 4 дня
Комментарии преподавателя
Для прохождения всех курсов необходимо знание основ языка SQL. Курса по SQL в нашей линейке нет, но имеется множество книг и образовательных ресурсов для освоения SQL. Мы рекомендуем книгу Евгения Моргунова «PostgreSQL. Основы языка SQL»:
https://postgrespro.ru/education/books/sqlprimer
Для администраторов мы предлагаем следующие курсы.
Курс DBA1 – базовый, он дает сведения об архитектуре PostgreSQL, об установке, настройке и управлении сервером. Приводятся обзоры разграничения доступа, резервного копирования и репликации.
В курсе DBA2 обсуждается настройка конфигурационных параметров исходя из понимания внутренней организации сервера; говорится о мониторинге сервера с использованием обратной связи для итеративной настройки параметров.
Курс DBA3 посвящен рассмотрению резервного копирования, а также настройкам физической и логической репликации и сценариям ее использования. Также дается общее представление о способах и сложностях построения высокодоступных, масштабируемых кластеров.
Курс DBS рассказывает про настройку подключений клиентов к СУБД и про управление доступом внутри самой СУБД.
В курсе QPT разбираются планирование и выполнение запросов, настройка параметров экземпляра, связанных с производительностью, и изучается поиск проблемных запросов и их оптимизация.
В курсе PGPRO рассматриваются дополнительные возможности, которые предоставляет СУБД Postgres Pro Enterprise.
Page 3: Разработчикам
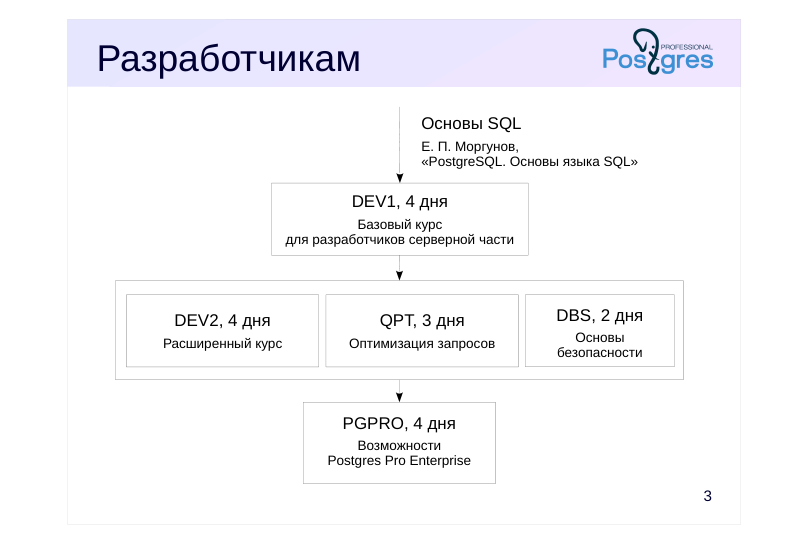 {#source-figure-003 caption=“Source slide page 3: Разработчикам”}
- DEV2, 4 дня
Комментарии преподавателя
Для разработчиков серверной части приложений мы предлагаем следующие курсы.
Базовым курсом для разработчиков является курс DEV1, в котором даются общие сведения об архитектуре PostgreSQL и использовании основных объектов базы данных; изучается программирование на стороне сервера на языках SQL и PL/pgSQL с использованием основных типов данных (включая составной тип и массивы), а также рассматривается взаимодействие с клиентской частью.
В курсе DEV2 рассматриваются особенности внутреннего устройства сервера, влияющие на разработку прикладного кода, и всесторонне изучается расширяемость: возможность дополнить серверные механизмы собственным кодом, что позволяет использовать PostgreSQL для решения самых разнообразных задач.
Курсы DBS, QPT и PGPRO являются общими для разработчиков и администраторов.
Разработчикам могут быть интересны и курсы по администрированию, если есть необходимость детальнее изучить внутреннее устройство PostgreSQL, а также в случае, когда на проекте нет выделенной роли администратора.
https://postgrespro.ru/education/courses
Page 4: О курсе DBA1
Продолжительность: 3 дня
- Предварительные знания
- минимальные сведения о базах данных и SQL
- знакомство с Unix
- Какие навыки будут получены
- общие сведения об архитектуре PostgreSQL
- установка, базовая настройка, управление сервером
- организация данных на логическом и физическом уровнях
- базовые задачи администрирования
- основные сведения об управлении доступом
- представление о резервном копировании и репликации
Page 5: Используемые материалы
Подготовленная виртуальная машина
- ОС Xubuntu 24.04
- PostgreSQL 16
- документация на русском языке
- Учебные материалы
- презентации, демонстрации, практические задания и их решение
- (в форматах html и pdf)
- справочные материалы — используемые в курсе команды Unix,
- схема основных таблиц системного каталога с командами psql
Комментарии преподавателя
Если вы проходите курс самостоятельно, обязательно начните со знакомства с Руководством слушателя. В числе прочего в нем написано, где скачать и как использовать виртуальную машину курса и прочие материалы. Все материалы курса, включая Руководство слушателя, доступны по адресу: https://postgrespro.ru/education/courses/DBA1
Выполнение практических заданий очень важно для получения навыков работы с PostgreSQL. Обязательно старайтесь сначала самостоятельно выполнить задания, а затем просмотрите предлагаемые нами решения, даже если задание не вызвало вопросы. В решениях могут содержаться дополнительные сведения, которые не упоминаются в презентациях и демонстрациях.
Учебные материалы (презентации, демонстрации, практические задания и их решения) доступны в двух форматах. Формат html удобен для онлайн-работы, он позволяет копировать фрагменты текста и кода. Формат pdf разбит на страницы и удобен для печати на бумаге.
Дополнительные справочные материалы помогут быстро найти нужную информацию.
Page 6: Организационные вопросы
День: ~8 академических часов + обед (1час)
- Каждая тема, как правило, состоит из
- презентации и демонстрации: ~20–60 мин
- практических заданий: ~20–30 мин, включая перерыв
Page 7: День 1
Базовый инструментарий
- Установка и управление сервером
- Использование psql
- Конфигурирование
- Архитектура
- Общее устройство PostgreSQL
- Изоляция и многоверсионность
- Очистка
Page 8: День 2
Архитектура (продолжение)
- Буферный кеш и журнал
- Организация данных
- Базы данных и схемы
- Системный каталог
- Табличные пространства
- Низкий уровень
- Задачи администрирования
- Мониторинг
Page 9: День 3
Управление доступом
- Обзор
- Резервное копирование
- Обзор
- Репликация
- Обзор физической репликации
- Обзор логической репликации
01 Занятие 01: Базовый инструментарий / Установка и управление сервером
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba1_01_tools_install.html Archive: DBA1-handouts-16.zip Страниц PDF: 23
Page 1: Базовый инструментарий / Установка и управление сервером
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы занятия
Основные понятия
- Установка из исходных кодов
- Управление сервером
- Пакетная установка
- Управление сервером в Ubuntu
- Облачные решения
Page 3: Кластер БД и сервер
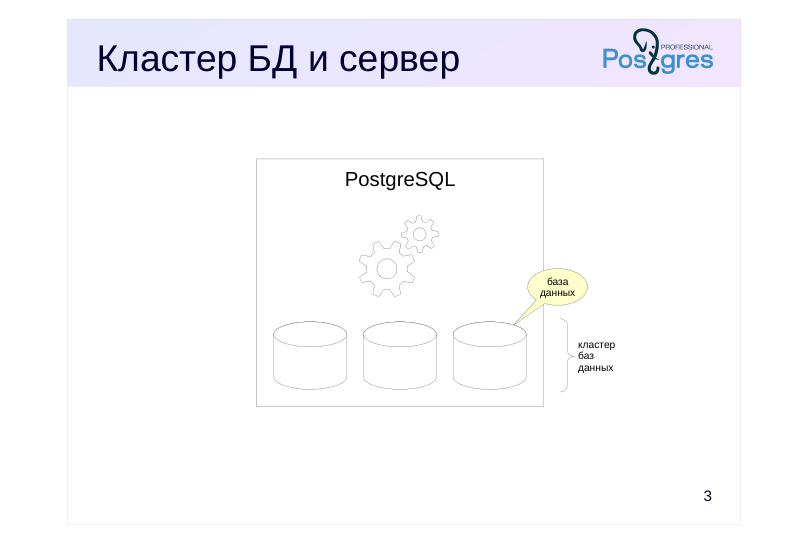 {#source-figure-003 caption=“Source slide page 3: Кластер БД и сервер”}
Комментарии преподавателя
Прежде чем говорить об установке, рассмотрим некоторые основные понятия.
PostgreSQL — программа, которая относится к классу систем управления базами данных.
Когда эта программа выполняется, мы называем ее сервером PostgreSQL или экземпляром сервера. Пока сервер представляется для нас «черным ящиком», но постепенно мы познакомимся с тем, как он устроен.
Данные, которыми управляет PostgreSQL, хранятся в базах данных. Один экземпляр PostgreSQL одновременно работает с несколькими базами данных. Этот набор баз данных называется кластером баз данных. Подробнее мы будем говорить о базах данных в теме «Организация данных. Базы данных и схемы».
Итак: кластер баз данных — это данные в файлах; сервер или экземпляр сервера — программа, управляющая кластером баз данных.
Page 4: Исходные коды
Установка из исходных кодов
- стабильная версия сервера
- можно использовать нестандартные параметры
- или собрать на специфичной архитектуре
- Установка из репозитория git
- текущая версия сервера
- необходимо в первую очередь для разработчиков ядра;
- требует более широкого набора инструментов
Комментарии преподавателя
Полезно иметь представление о том, как происходит установка из исходных кодов, чтобы в случае необходимости можно было собрать PostgreSQL с нестандартными параметрами или на специфичной архитектуре.
По адресу https://www.postgresql.org/ftp/source доступен исходный код в двух вариантах: gzip и bzip2. В виртуальной машине необходимый файл уже находится в домашнем каталоге пользователя student.
Исходные коды можно взять и непосредственно из git-репозитория проекта: git://git.postgresql.org/git/postgresql.git (проект имеет зеркала, в том числе на github).
В этом случае можно собрать не только стабильную версию, но и версию на любой конкретный коммит, в том числе наиболее актуальную.
При установке из репозитория git требуется более широкий набор инструментов. Например, лексический и синтаксический анализатор сделан с помощью Flex и Bison, и в git хранятся именно исходные коды для этих инструментов. При сборке из них генерируются файлы на Си, которые затем компилируются. При этом в архиве с исходными кодами находятся уже сгенерированные файлы Си.
Page 5: Необходимое ПО
Обязательно
- tar, gzip/bzip2, GNU make, компилятор Си (C89)
- Используются, но можно отключить
- библиотеки GNU Readline, zlib, lz4, zstd
- Дополнительно
- языки программирования Perl, Python, Tcl
- для использования PL/Perl, PL/Python, PL/Tcl
- Kerberos, OpenSSL, OpenLDAP, PAM
- для аутентификации и шифрования
- библиотека ICU для кроссплатформенной поддержки UNICODE
- Отдельные инструменты при сборке из репозитория git
Комментарии преподавателя
Сборка и установка традиционно основывается на GNU Make и Autoconf:
https://postgrespro.ru/docs/postgresql/16/install-make
В этом курсе рассматривается традиционный способ сборки.
Начиная с версии 16 можно также использовать систему сборки программного обеспечения Meson:
https://postgrespro.ru/docs/postgresql/16/install-meson
Для сборки требуется ряд программ и утилит.
Библиотека readline дает возможность редактировать командную строку, пользоваться историей команд и автодополнением. В серверной инсталляции может быть и не нужна, если не предполагается запускать psql в консоли.
Библиотеки zlib, lz4 и zstd используются для сжатия.
Page 6: Распаковка архива
Архив с исходными кодами находится в домашнем каталоге пользователя student. Распаковываем архив:
Создание конфигурации
Настройку сборки выполним в каталоге с распакованным исходным кодом, используя скрипт configure.
Внимание! Если сборка производится повторно, например с другими параметрами конфигурации, то предварительно нужно убрать файлы, оставшиеся от предыдущей сборки:
В команде configure можно указать различные параметры конфигурации. Например: –prefix — каталог установки, по умолчанию /usr/local/pgsql; –enable-debug — для включения отладочной информации. Полный список параметров есть в документации. Также принимаются во внимание переменные окружения. Например, CC и CFLAGS настраивают компилятор C. Скрипт configure по умолчанию подготавливает сборку и установку исполняемых файлов, библиотек и прочих файлов PostgreSQL в каталог /usr/local/pgsql. Обычно каталог установки доступен для записи только суперпользователю ОС. В целях демонстрации ключом –prefix укажем каталог установки ПО сервера в подкаталог pgsql16 домашнего каталога пользователя student. Кроме того, будем использовать порт 5555 вместо порта 5432 по умолчанию:
Вывод этой и следующих команд занимает очень много места, мы не будем его показывать.
Сборка и установка PostgreSQL
Возможные варианты: make — сборка только сервера; make world — сборка сервера, всех расширений и документации. Собираем сервер. В зависимости от характеристик компьютера команда make может работать достаточно долго (минуты и даже десятки минут).
Теперь устанавливаем сервер.
Для сборки расширений нужно повторить make и make install в подкаталоге contrib.
Page 7: Page 7
Если бы мы собирали сервер с расширениями и документацией (make world), то можно было бы установить все вместе командой make install-world.
Page 8: Создание кластера
 {#source-figure-008 caption=“Source slide page 8: Создание кластера”}
Утилита
- initdb
- Особенности
- новый кластер баз данных не может принадлежать
- суперпользователю ОС
- PGDATA — удобная переменная для каталога кластера
- файлы конфигурации создаются в каталоге PGDATA
- желательно включить расчет контрольных сумм
- для страниц с данными
Комментарии преподавателя
После установки сервера необходимо создать кластер баз данных. Для этого предназначена утилита initdb.
В целях безопасности каталог, в котором инициализируется кластер, не может принадлежать суперпользователю ОС. Владельцем кластера обычно делают пользователя postgres.
Владелец кластера может определить переменную окружения PGDATA, указывающую на каталог кластера. Эту переменную используют некоторые утилиты сервера, когда им нужно узнать расположение кластера. К таким утилитам относится initdb, а также основная утилита управления сервером pg_ctl, о которой мы будем говорить дальше.
В процессе инициализации кластера утилита initdb создает конфигурационные файлы в этом же каталоге PGDATA. Подробнее о файлах конфигурации мы расскажем в одной из следующих тем.
Утилита initdb имеет множество ключей, влияющих на ее работу. Один из важных — -k, или –data-checksums — включает подсчет контрольных сумм на страницах данных. Проверка контрольной суммы будет выполняться при обращении к любой странице данных в кластере. Это несколько снижает производительность, но позволяет оперативно обнаружить повреждения в данных.
https://postgrespro.ru/docs/postgresql/16/app-initdb
Page 9: Создание кластера
Теперь необходимо создать каталог для данных. Для промышленного использования владельцем каталога обычно назначают отдельного пользователя ОС. В нашем случае, пусть это будет каталог пользователя student внутри /home/student/pgsql16
Этот каталог часто называют PGDATA по имени переменной окружения, которую удобно использовать при работе с утилитами сервера.
Все утилиты сервера установлены в подкаталоге bin, который стоит добавить в переменную PATH:
Для инициализации кластера баз данных используется утилита initdb. В ключе -U можно указать имя суперпользователя СУБД. Если его не задать, то используется имя пользователя ОС, в нашем случае student. Обычно таким пользователем является postgres, так что зададим это имя явно. Ключ -k включает подсчет контрольных сумм страниц, что позволяет своевременно обнаруживать повреждения данных. Если переменная PGDATA не установлена, то в ключе -D следует указать каталог для данных. В нашем случае этот ключ можно было бы не указывать.
Page 10: Управление сервером
Утилита
- pg_ctl
- Основные задачи
- запуск, останов и получение статуса сервера
- обновление параметров конфигурации
- переключение на реплику
Комментарии преподавателя
К основным операциям управления сервером относятся запуск и останов сервера, получение текущего статуса сервера, обновление конфигурации и некоторые другие.
Для выполнения этих действий предназначена утилита pg_ctl, идущая в составе PostgreSQL.
Запускать pg_ctl следует от имени владельца кластера баз данных.
Более подробная информация об управлении сервером для администраторов баз данных:
https://postgrespro.ru/docs/postgresql/16/app-pg-ctl
https://postgrespro.ru/docs/postgresql/16/runtime
Page 11: Управление сервером
Теперь все готово к запуску сервера. В ключе -l укажем файл журнала сообщений сервера. Ключ -D опускаем, поскольку задана переменная PGDATA.
Для проверки работы можно вызвать утилиту psql, которая подключится к серверу и вернет текущее время:
Для останова сервера используется следующая команда:
Page 12: Установка пакета
 {#source-figure-012 caption=“Source slide page 12: Установка пакета”}
Готовые пакеты — предпочтительный способ
- Linux ( , Debian, Red Hat, SUSE и другие)
- входит в дистрибутив ОС
- репозиторий (yum, apt) или пакеты RPM, DEB
- FreeBSD, OpenBSD
- пакеты из Ports and Packages Collection
- Mac OS X
- Windows
Комментарии преподавателя
Предпочтительным вариантом является использование готовых пакетов, так как в этом случае получается понятная, поддерживаемая и легко обновляемая установка.
Пакеты существуют для большинства широко распространенных систем. В каждой из них могут быть свои особенности, с которыми стоит ознакомиться перед установкой.
В пакетные репозитории некоторых систем уже входит PostgreSQL, но, обычно, не самой последней версии. Актуальная версия может быть взята из репозитория PostgreSQL Global Development Group (PGDG):
https://www.postgresql.org/download/
Мы рассмотрим особенности пакета PostgreSQL для Ubuntu.
Page 13: Создание кластера
 {#source-figure-013 caption=“Source slide page 13: Создание кластера”}
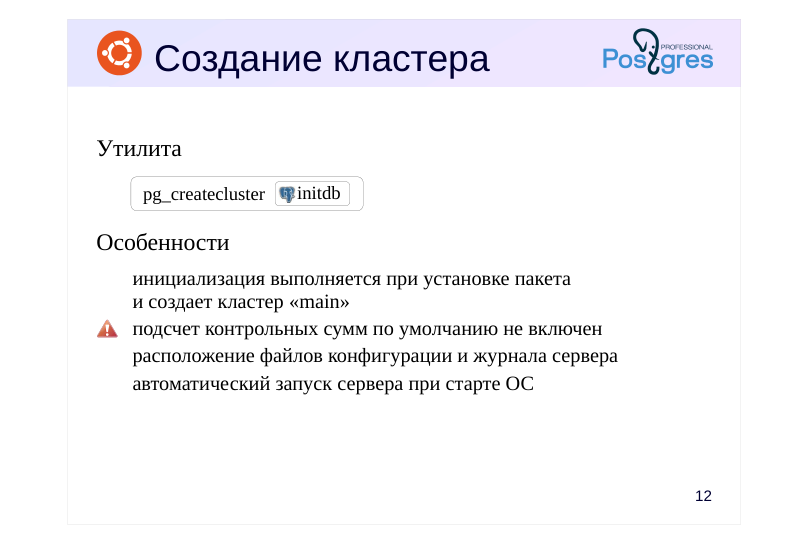
Утилита
- pg_createcluster
- initdb
- Особенности
- инициализация выполняется при установке пакета
- и создает кластер «main»
- подсчет контрольных сумм по умолчанию не включен
- расположение файлов конфигурации и журнала сервера
- автоматический запуск сервера при старте ОС
Комментарии преподавателя
Для инициализации кластера в Ubuntu создана обертка pg_createcluster над утилитой initdb.
Справку по использованию pg_createcluster можно получить командой: $ man pg_createcluster
Утилита pg_createcluster автоматически запускается при установке пакета и создает кластер баз данных с именем «main».
Стоит обратить внимание, что инициализация кластера проходит с отключенным подсчетом контрольных сумм в страницах данных.
Исполняемые файлы, файлы конфигурации и журнал сервера размещены в соответствии с правилами, принятыми в Ubuntu.
Кроме того, настраивается автоматический запуск и останов сервера PostgreSQL при запуске и останове операционной системы.
Для удаления кластера используется утилита pg_dropcluster.
Утилиты pg_createcluster и pg_dropcluster специфичны для Ubuntu. В других системах нужно явно инициализировать кластер с помощью initdb и задействовать подходящие средства операционной системы.
Page 14: Создание кластера в Ubuntu
В виртуальной машине курса PostgreSQL установлен из пакета командой:
Каталог установки PostgreSQL:
Владелец ПО сервера — пользователь root. Утилита pg_config показывает, с какими параметрами был собран сервер:
Кластер баз данных с именем main уже инициализирован и находится в каталоге /var/lib/postgresql/16/main. Владельцем каталога является пользователь postgres. Вот содержимое каталога:
Page 15: Page 15
Page 16: Управление сервером
Утилита
- pg_ctlcluster
- pg_ctl
- Основные задачи
- запуск, останов и получение статуса сервера
- перечитывание параметров конфигурации
- переключение на реплику
Комментарии преподавателя
В пакетном дистрибутиве для Ubuntu доступ к утилите pg_ctl осуществляется не напрямую, а через специальную обертку pg_ctlcluster. Справку по использованию pg_ctlcluster можно получить командой: $ man pg_ctlcluster
В других системах утилита pg_ctl может использоваться непосредственно.
Page 17: Управление сервером в Ubuntu
При установке из пакета в настройки запуска ОС добавляется запуск PostgreSQL. Поэтому после загрузки операционной системы отдельно стартовать PostgreSQL не нужно. Можно явным образом управлять сервером с помощью утилиты pg_ctlcluster, которая запускается либо от имени пользователя ОС postgres, либо через sudo. Утилита pg_ctlcluster позволяет управлять несколькими серверами разных версий. В качестве параметров ей передаются: 16 — номер версии сервера; main — название сервера; команда Остановить сервер:
Запустить сервер:
Перезапустить:
Получить текущий статус сервера:
Перечитать файлы конфигурации:
Журнал сообщений сервера при пакетной установке находится здесь:
Заглянем в конец журнала:
Page 18: Облачные решения
PostgreSQL в виртуальной среде
- накладные расходы на виртуализацию
- администратор имеет полный доступ к экземпляру
- PostgreSQL as a Service
- предлагается многими облачными провайдерами
- основное администрирование берет на себя провайдер
- доступ только к ограниченным инструментам для управления,
- резервного копирования, мониторинга
Комментарии преподавателя
Средства виртуализации могут использоваться и для баз данных, в том числе PostgreSQL. Надо понимать, что за удобства этой технологии приходится расплачиваться накладными расходами. Для высоконагруженных систем любые дополнительные промежуточные слои между СУБД и железом нежелательны.
Кроме того, многие ведущие зарубежные и российские облачные провайдеры предлагают использовать PostgreSQL как сервис (Database as a Service, managed database).
В этом случае провайдер берет на себя большинство задач администрирования. Полного доступа к экземпляру в этом случае нет, а возможности управления ограничиваются предоставленными инструментами для таких задач, как мониторинг производительности или резервное копирование и восстановление.
В рамках курса мы не будем рассматривать особенности отдельных облачных решений. Для этого стоит изучить документацию, предоставляемую провайдерами услуг.
Page 19: Итоги
Два варианта установки — пакеты или исходный код
- Доступны облачные решения
- Сервер выполняется под выделенным пользователем ОС
- Перед использованием сервера необходимо инициализировать кластер баз данных
- Специальные команды для управления сервером
Page 20: Практика
Включение расчета контрольных сумм в кластере.
- Остановите сервер.
- Проверьте, рассчитываются ли контрольные суммы в кластере.
- Включите расчет контрольных сумм.
- Запустите сервер.
Комментарии преподавателя
2, 3. Используйте утилиту pg_checksums. Для ее запуска укажите полный путь: /usr/lib/postgresql/16/bin/pg_checksums
https://postgrespro.ru/docs/postgresql/16/app-pgchecksums
Page 21: 1. Останов сервера
2. Проверка
Чтобы узнать, включен ли расчет контрольных сумм страниц, запустим утилиту pg_checksums с ключом –check:
3. Включение расчета контрольных сумм
Выполняем pg_checksums с ключом –enable:
Расчет контрольных сумм включен.
4. Запуск сервера
Page 22: Практика+
- Установите PostgreSQL из исходных кодов так, как это показано в демонстрации.
- Создайте кластер баз данных, запустите сервер.
- Убедитесь, что сервер работает.
- Остановите сервер.
Page 23: 1. Сборка PostgreSQL из исходных кодов
Все необходимые команды были показаны в демонстрации, но они не выполнялись. Повторите эти действия своими руками в виртуальной машине курса. Имейте в виду, что компиляция исходных кодов может занимать продолжительное время (от нескольких минут до десятков минут в зависимости от мощности компьютера).
02 Занятие 02: Базовый инструментарий / Использование psql
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba1_02_tools_psql.html Archive: DBA1-handouts-16.zip Страниц PDF: 17
Page 1: Базовый инструментарий / Использование psql
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы занятия
Запуск psql и подключение к БД
- Получение справочной информации
- Работа в psql
- Настройка
Page 3: Назначение
Терминальный клиент для работы с PostgreSQL
- Поставляется вместе с СУБД
- Используется администраторами и разработчиками для интерактивной работы и выполнения скриптов
Комментарии преподавателя
Для работы с СУБД PostgreSQL существуют различные сторонние инструменты, рассмотрение которых не входит в рамки курса.
В курсе мы будем использовать терминальный клиент psql. Этот клиент может показаться непривычным для тех, кто предпочитает графические инструменты; тем не менее, он весьма удобен.
Это единственный клиент, поставляемый вместе с СУБД. Навыки работы c psql пригодятся разработчикам и администраторам БД вне зависимости от того, с каким инструментом они будут работать дальше.
https://postgrespro.ru/docs/postgresql/16/app-psql
Page 4: Подключение
Запуск
- Новое подключение в psql
- Информация о текущем подключении
Комментарии преподавателя
При запуске psql определяет параметры подключения: имя базы данных, имя пользователя, имя сервера, номер порта. Если эти параметры не указаны, psql попробует подключиться, используя значения по умолчанию:
● база — совпадает с именем пользователя;
● пользователь — совпадает с именем пользователя ОС;
● узел — соединение через Unix socket;
● порт — обычно 5432.
Если требуется выполнить новое подключение не выходя из psql, нужно выполнить команду \connect. Значения по умолчанию для нее берутся из текущего соединения.
Дополнительная информация о возможностях настройки подключения:
https://postgrespro.ru/docs/postgresql/16/libpq-envars
https://postgrespro.ru/docs/postgresql/16/libpq-pgservice
https://postgrespro.ru/docs/postgresql/16/libpq-pgpass
Page 5: Получение справки
В командной строке ОС
- В psql
- => \?
- список команд psql
- => \? variables
- переменные psql
- => \h[elp]
- список команд SQL
- => \h команда
- синтаксис команды SQL
- => \q
- выход
Комментарии преподавателя
Справочную информацию по psql можно получить не только в документации, но и прямо в системе.
psql с ключом –help выдает справку по запуску. А если в системе была установлена документация, то справочное руководство можно получить командой man psql.
psql умеет выполнять команды SQL и свои собственные команды. Все команды psql начинаются с обратной косой черты и, как правило, их можно сокращать до первой буквы.
Внутри psql есть возможность получить список и краткое описание команд psql: \?.
Команда \help выдает список команд SQL, которые поддерживает сервер, а также синтаксис конкретной команды SQL.
И еще одна команда, которую полезно знать, хоть она и не имеет отношения к справке: это \q — выход из psql. В качестве альтернативы для выхода можно использовать команды exit и quit.
Page 6: Выполнение команд SQL и форматирование результатов
Запускаем psql:
Проверим текущее подключение:
С параметрами по умолчанию мы подключились к базе данных student под пользователем student. Подробнее о базах данных и пользователях будет рассказано в следующих темах курса. Команда \c[onnect] выполняет новое подключение, не покидая psql. Команды SQL, в отличие от команд psql, могут располагаться на нескольких строках. Для отправки команды SQL на выполнение завершаем ее точкой с запятой:
Утилита psql умеет выводить результат запросов в разных форматах. Вот только некоторые из них: формат с выравниванием значений; формат без выравнивания; расширенный формат. Формат с выравниванием используется по умолчанию. Ширина столбцов выровнена по значениям. Также выводится строка заголовков и итоговая строка. Команды psql для переключения режима выравнивания: \a — переключает режим с выравниванием и без выравнивания; \t — переключает отображения строки заголовка и итоговой строки. Отключим выравнивание, вывод заголовка и итоговой строки, а в качестве разделителя столбцов установим пробел:
Расширенный формат удобен, когда нужно вывести много столбцов для одной или нескольких записей:
Page 7: Page 7
Расширенный формат можно установить только для одного запроса, если в конце вместо точки с запятой указать \gx:
Все возможности форматирования результатов запросов доступны через команду \pset. А без параметров она покажет текущие настройки форматирования:
Взаимодействие с ОС
В psql можно выполнять команды shell:
Можно установить переменную окружения операционной системы:
Можно записать вывод команды в файл с помощью \o[ut]:
На экран ничего не попало. Посмотрим в файле:
Вернем вывод на экран:
Выполнение скриптов
Еще один вариант отправить запрос на выполнение — команда \g. В скобках можно указать параметры форматирования только для этого запроса. Вывод запроса можно направить команде ОС, если указать ее после вертикальной черты. Например, можно вывести результат запроса на экран, пронумеровав строки:
Page 8: Page 8
В команде \g можно указать имя файла, в который будет направлен вывод:
Вот что получилось в файле:
Выполняем теперь этот файл как скрипт с помощью \i[nclude]:
Другие способы выполнить команды из файла: psql < filename psql -f filename В предыдущем примере можно обойтись и без создания файла, если завершить запрос командой \gexec:
Команда gexec считает, что в каждом столбце каждой строки выборки содержится SQL-оператор, и выполняет эти операторы один за другим.
Переменные psql и управляющие конструкции
По аналогии с shell, psql имеет собственные переменные, среди которых есть ряд встроенных (имеющих особый смысл для psql). Запомним в переменной psql User значение переменной окружения USER:
И установим переменную Test:
Чтобы подставить ее значение, надо предварить имя переменной двоеточием:
Сбросить переменную можно так:
Результат запроса можно записать в переменную. Для этого запрос нужно завершить командой \gset:
Page 9: Page 9
Запрос должен возвращать только одну запись. Без параметров \set выдает значения всех установленных переменных:
В скриптах можно использовать условные операторы. Предположим, что мы хотим проверить, установлено ли значение переменной working_dir, и если нет, то присвоить ей имя текущего каталога. Для проверки существования переменной можно использовать следующую конструкцию, возвращающую логическое значение:
Следующий условный оператор psql проверяет существование переменной и при необходимости устанавливает значение по умолчанию:
Теперь мы можем быть уверены, что переменная working_dir определена:
Команды для работы с системным каталогом
С помощью серии команд, в основном начинающихся на \d, можно быстро и удобно получать информацию об объектах БД. Например:
Подробнее такие команды будут рассмотрены позже.
Page 10: Настройка psql
При запуске psql выполняются два скрипта (при их наличии): сначала общий системный скрипт psqlrc; затем пользовательский файл .psqlrc. Пользовательский файл должен располагаться в домашнем каталоге, а расположение системного скрипта можно узнать командой:
По умолчанию оба файла отсутствуют. В эти файлы можно поместить команды для настройки сеанса, например: приглашение psql; программу постраничного просмотра результатов запросов; переменные для хранения текста часто используемых команд. Для примера запишем в переменную top5 текст запроса на получение пяти самых больших по размеру таблиц:
Для выполнения запроса достаточно набрать:
Если записать эту команду \set в файл ~/.psqlrc, переменная top5 будет доступна сразу после запуска psql. Благодаря поддержке readline, в psql работает автодополнение ключевых слов и имен объектов, а также сохраняется история команд. Имя и размер файла истории настраиваются переменными HISTFILE, HISTSIZE.
Page 11: Итоги
psql — терминальный клиент для работы с СУБД
- При запуске требуются параметры подключения
- Выполняет команды SQL и psql
- Содержит инструменты для интерактивной работы, а также для подготовки и выполнения скриптов
Page 12: Практика
- Запустите psql и проверьте информацию о текущем подключении. 2. Выведите список баз данных в подробном виде. 3. По умолчанию psql использует команду «less» для постраничного просмотра результатов запроса. Замените ее на команду «less -XS» и снова выведите подробный список баз данных. 4. По умолчанию приглашение psql показывает только имя базы данных. Настройте вид приглашения так: пользователь@база=#. 5. Настройте psql так, чтобы для всех команд выводилась длительность выполнения. Убедитесь, что при повторном запуске эта настройка сохраняется.
Комментарии преподавателя
При запуске psql можно не указывать параметры подключения, будут действовать значения по умолчанию.
Используйте команду \l+.
Программа постраничного просмотра настраивается переменной окружения PSQL_PAGER. Настройку можно сделать в файле .psqlrc с помощью команды \setenv. Это позволит задать значение «less -XS» только для работы в psql, а в остальных случаях будут действовать обычные настройки ОС. По умолчанию less переносит длинные строки при просмотре и очищает свой вывод при выходе. Параметр -XS отменяет это поведение.
Описание настройки приглашения в документации:
https://postgrespro.ru/docs/postgresql/16/app-psql#APP-PSQL-PROMPTIN G
- Команду psql для вывода длительности выполнения запросов можно найти в документации или с помощью команды \?.
Page 13: 1. Запуск psql и просмотр информации о подключении
2. Список баз данных
Команда \l+ выводит подробную информацию о базах данных. Если результат запроса не помещается в окне терминала, psql передает его программе less. В ней можно просматривать результаты запроса, используя клавиши навигации. Команда h выводит справку по less, команда q завершает просмотр.
Однако просматривать результат команды неудобно. По умолчанию less переносит длинные строки, из-за чего результаты бывает сложно читать. Также при выходе из less ранее выведенный текст стирается.
3. Команда постраничного просмотра
Если использовать утилиту less с параметрами -XS, длинные строки не будут разбиваться переносами, а при выходе из less предыдущий вывод будет сохраняться. Для такой настройки достаточно установить переменную PSQL_PAGER с помощью \setenv. Запишем эту настройку в скрипт ~/.psqlrc:
4. Настройка приглашения
Для добавления информации о роли нужно в начало переменных PROMPT1 и PROMPT2 добавить %n@.
Переменная PROMPT1 определяет приглашение для первой строки вводимого пользователем запроса. Если запрос занимает более одной строки, начиная со второй за приглашение отвечает переменная PROMPT2. Обе переменные имеют одинаковое значение по умолчанию, но можно установить разные приглашения для первой и последующих строк запроса. Переменная PROMPT3 используется только для команды COPY.
5. Вывод длительности выполнения команд SQL
В итоге содержимое файла .psqlrc станет таким:
Page 14: Page 14
Чтобы изменения вступили в силу, нужно выйти и заново войти в psql.
Проверьте после повторного запуска: приглашение (должно включать имя роли); вывод подробной информации о базах данных; вывод времени выполнения команд.
Page 15: Практика+
- Откройте транзакцию и выполните команду, которая завершается любой ошибкой. Убедитесь, что продолжить работу в этой транзакции невозможно.
- Задайте переменной ON_ERROR_ROLLBACK значение on и убедитесь, что после ошибки можно выполнять команды внутри транзакции.
Комментарии преподавателя
- Чтобы открыть транзакцию, выполните команду
- Значение ON_ERROR_ROLLBACK = on заставляет psql устанавливать точку сохранения (SAVEPOINT) перед каждой командой SQL в открытой транзакции и в случае ошибки откатываться к этой точке сохранения.
https://postgrespro.ru/docs/postgresql/16/sql-savepoint
Page 16: 1. Утилита psql и обработка ошибок внутри транзакций
Утилита psql по умолчанию работает в режиме автоматической фиксации транзакций. Поэтому любая команда SQL выполняется в отдельной транзакции. Чтобы явно начать транзакцию, нужно выполнить команду BEGIN:
Обратите внимание на то, что приглашение psql изменилось. Символ «звездочка» говорит о том, что транзакция сейчас активна.
Предположим, мы случайно сделали ошибку в следующей команде:
О случившейся ошибке можно узнать из приглашения: звездочка изменилась на восклицательный знак. Попробуем исправить команду:
Но PostgreSQL не умеет откатывать только одну команду транзакции, поэтому транзакция обрывается и откатывается целиком. Чтобы продолжить работу, мы должны выполнить команду завершения транзакции. Не важно, будет ли это COMMIT или ROLLBACK, ведь транзакция уже отменена.
Создание таблицы было отменено, поэтому ее нет в базе данных:
2. Переменная ON\_ERROR\_ROLLBACK
Изменим поведение psql.
Теперь перед каждой командой транзакции неявно будет устанавливаться точка сохранения, а в случае ошибки будет происходить автоматический откат к этой точке. Это даст возможность продолжить выполнение команд транзакции.
Page 17: Page 17
Переменной ON_ERROR_ROLLBACK можно установить значение interactive, тогда подобное поведение будет только в интерактивном режиме работы, но не при выполнении скриптов.
Уборка
03 Занятие 03: Базовый инструментарий / Конфигурирование сервера
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba1_03_tools_configuration.html Archive: DBA1-handouts-16.zip Страниц PDF: 22
Page 1: Базовый инструментарий / Конфигурирование сервера
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Параметры конфигурации
- Файлы конфигурации
- Управление параметрами на уровнях экземпляра и сеанса
Page 3: Параметры
Задача
- управление работой и поведением СУБД
- Установка
- для экземпляра — файлы конфигурации
- для отдельной базы или пользователя
- для текущего сеанса
Комментарии преподавателя
В PostgreSQL существует большое количество параметров, влияющих на работу СУБД. Параметры позволяют управлять потреблением ресурсов, настраивать работу серверных процессов и многое другое.
Например, при помощи параметра max_connections можно ограничить количество одновременных подключений к серверу.
Полный список и описание параметров конфигурации: https://postgrespro.ru/docs/postgresql/16/runtime-config
В этой теме мы не изучаем назначение отдельных параметров конфигурации, а лишь рассматриваем, какими способами им можно устанавливать значения.
Для установки параметров, в первую очередь, используются файлы конфигурации. Если не определено иное, значения, установленные в этих файлах, действуют для всего экземпляра СУБД.
Ряд параметров можно установить для сеансов в отдельной базе данных или для сеансов отдельного пользователя. Такие установки будут иметь предпочтение перед файлами конфигурации. Мы подробнее коснемся этого варианта в следующих темах курса.
Наконец, многими параметрами можно управлять на уровне отдельного сеанса, прямо во время работы.
Page 4: postgresql.conf
Основной файл конфигурации
- считывается при старте сервера
- возможность подключения дополнительных файлов
- по умолчанию находится в каталоге с данными (PGDATA)
- При изменении параметров необходимо перечитать файл
- => SELECT pg_reload_conf();
- изменение ряда параметров требует перезапуска сервера
Комментарии преподавателя
Основной конфигурационный файл — postgresql.conf.
Расположение файла по умолчанию задается при сборке PostgreSQL. При запуске исполняемого файла сервера с помощью аргумента командной строки -c config_file можно задать требуемое местонахождение файла конфигурации.
По умолчанию файл располагается в каталоге с данными (PGDATA), но пакетные дистрибутивы обычно размещают этот файл в другом месте, в соответствии с правилами, принятыми в конкретной ОС.
Это текстовый, хорошо документированный файл, хранящий параметры в формате «ключ=значение».
Есть возможность подключать дополнительные файлы. По умолчанию в Ubuntu подключаются все файлы из каталога /etc/postgresql/16/main/conf.d.
Если один и тот же параметр указан в конфигурационных файлах несколько раз, будет использоваться значение, считанное последним.
Для вступления в силу внесенных в файл изменений необходимо, чтобы сервер перечитал файл. Для некоторых параметров требуется перезагрузка сервера.
Page 5: Файл postgresql.conf и представление pg_file_settings
Имя конфигурационного файла содержится в доступном для чтения параметре config_file. Имя конфигурационного файла можно указать с помощью ключа командной строки при запуске postgres.
Посмотрим небольшой фрагмент конфигурационного файла.
К основному конфигурационному файлу postgresql.conf можно подключать дополнительные файлы конфигурации. Директивы подключения: include_dir — каталог с дополнительными файлами конфигурации; include — включает дополнительный файл конфигурации; include_if_exists — включает дополнительный файл конфигурации, если он существует. Обычно эти директивы располагаются в завершающей части файла postgresql.conf:
Чтобы увидеть настройки в конфигурационных файлах, можно обратиться к представлению pg_file_settings:
Page 6: Page 6
Представление выводит незакомментированные строки конфигурационных файлов. Столбец applied показывает, будет ли заданное значение применено при перечитывании. В частности, в столбце будет false, если: изменение требует рестарта сервера; существует строка с тем же параметром, которая будет прочитана позже; в одной из строк, где задается параметр, есть ошибка. Представление также показывает имя файла конфигурации и номер строки, что удобно для поиска ошибок.
Представление pg\_settings
Возьмем для примера параметр work_mem. Он определяет объем памяти, выделяемый для таких операций, как сортировка или хеш-соединение. Не для всех запросов значения по умолчанию может быть достаточно. Подробнее о параметре work_mem можно узнать в курсе QPT «Оптимизация запросов». Действующие значения всех параметров доступны в представлении pg_settings. Вот что в нем содержится для параметра work_mem:
Page 7: Page 7
 {#source-figure-007 caption=“Source slide page 7: Page 7”}
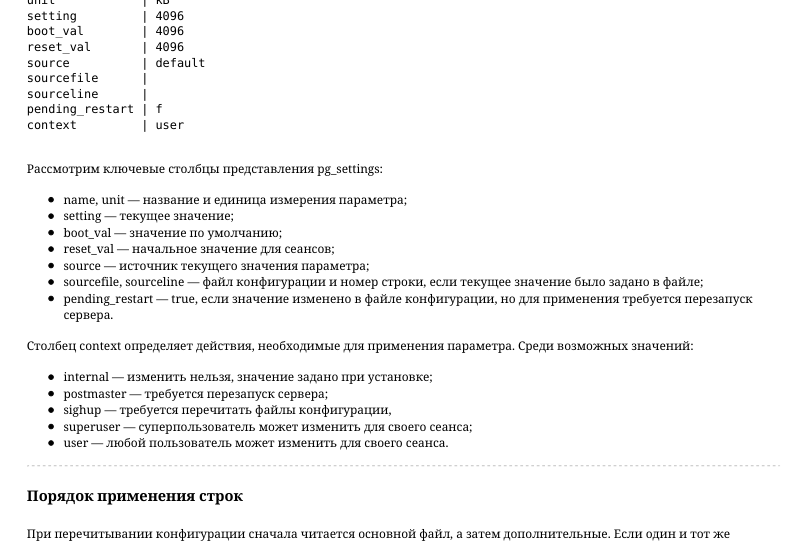
Рассмотрим ключевые столбцы представления pg_settings: name, unit — название и единица измерения параметра; setting — текущее значение; boot_val — значение по умолчанию; reset_val — начальное значение для сеансов; source — источник текущего значения параметра; sourcefile, sourceline — файл конфигурации и номер строки, если текущее значение было задано в файле; pending_restart — true, если значение изменено в файле конфигурации, но для применения требуется перезапуск сервера. Столбец context определяет действия, необходимые для применения параметра. Среди возможных значений: internal — изменить нельзя, значение задано при установке; postmaster — требуется перезапуск сервера; sighup — требуется перечитать файлы конфигурации, superuser — суперпользователь может изменить для своего сеанса; user — любой пользователь может изменить для своего сеанса.
Порядок применения строк
При перечитывании конфигурации сначала читается основной файл, а затем дополнительные. Если один и тот же параметр встречается несколько раз, то устанавливается значение из последней считанной строки. Например, укажем дважды параметр work_mem в дополнительном файле конфигурации:
Содержимое файла /etc/postgresql/16/main/conf.d/work_mem.conf:
Значение applied = f для первой строки показывает, что она не будет применена. Для параметра work_mem поле context имеет значение user. Значит, параметр можно менять прямо во время сеанса, и позже мы увидим, как это сделать. А чтобы изменить значение во всех сеансах, достаточно перечитать файлы конфигурации:
Убедимся, что параметр work_mem получил значение из второй строки:
Page 8: Page 8
Page 9: postgresql.auto.conf
Файл конфигурации, управляемый командами SQL
- ALTER SYSTEM
- добавляет или изменяет строку
- SET параметр TO значение;
- ALTER SYSTEM RESET параметр;
- удаляет строку
- ALTER SYSTEM RESET ALL;
- удаляет все строки
- Расположение
- всегда в каталоге с данными (PGDATA)
- Действия при изменении
Комментарии преподавателя
Последним считывается файл postgresql.auto.conf. Он всегда располагается в каталоге данных (PGDATA).
Этот файл не следует изменять вручную, для его редактирования предназначена команда ALTER SYSTEM. По сути, ALTER SYSTEM представляет собой SQL-интерфейс для управления параметрами конфигурации.
Для применения изменений, сделанных командой ALTER SYSTEM, сервер должен перечитать конфигурационные файлы, как и в случае с изменением файла postgresql.conf.
Содержимое файлов конфигурации можно увидеть в представлении pg_file_settings. А действующие значения параметров — в представлении pg_settings.
Более подробная информация о команде ALTER SYSTEM:
https://postgrespro.ru/docs/postgresql/16/sql-altersystem
Page 10: Команда ALTER SYSTEM и файл postgresql.auto.conf
Для примера установим параметр work_mem:
Что случилось? ALTER SYSTEM выполняет проверку на допустимые значения.
Вот теперь все правильно. В результате выполнения команды значение 16MB записано в файл postgresql.auto.conf:
Но это значение не применено:
Чтобы применить изменение work_mem, перечитаем файлы конфигурации:
Для удаления строк из postgresql.auto.conf используется команда ALTER SYSTEM RESET:
Page 11: Page 11
Еще раз перечитаем конфигурацию. Теперь восстановится значение из work_mem.conf:
Page 12: В текущем сеансе
 {#source-figure-012 caption=“Source slide page 12: В текущем сеансе”}
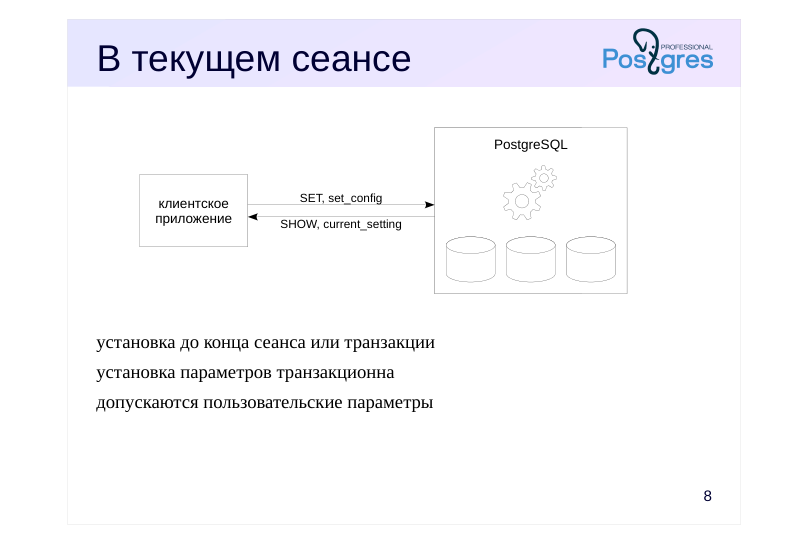
установка до конца сеанса или транзакции
- установка параметров транзакционна
- допускаются пользовательские параметры
Комментарии преподавателя
Значения параметров можно изменить прямо во время сеанса командой SET или функцией set_config. А для получения текущего значения служит команда SHOW или функция current_setting.
Устанавливая новое значение, можно указать срок его действия: до конца сеанса (по умолчанию) или до конца транзакции (SET LOCAL).
В любом случае установка параметров транзакционна: в случае отмены текущей транзакции, значения измененных в ней параметров вернутся к состоянию на начало транзакции.
Помимо системных параметров PostgreSQL, этими же командами и функциями можно пользоваться для создания и получения значений пользовательских параметров.
Page 13: Установка параметров для текущего сеанса
Для изменения параметров во время сеанса можно использовать команду SET:
Или функцию set_config:
Третий параметр функции говорит о том, нужно ли устанавливать значение только для текущей транзакции (true) или до конца работы сеанса (false). Это важно при работе приложения через пул соединений, когда в одном сеансе могут выполняться транзакции разных пользователей.
Чтение значений параметров во время выполнения
Получить значение параметра можно разными способами:
Сбросим значение к тому, которое действовало в начале сеанса:
Установка параметров внутри транзакции
Откроем транзакцию и установим новое значение work_mem:
Page 14: Page 14
Если транзакция откатывается, установка параметра отменяется, хотя при успешной фиксации новое значение продолжало бы действовать.
Можно установить значение только до конца текущей транзакции:
По завершении транзакции значение восстанавливается:
Пользовательские параметры
Параметры можно создавать прямо во время сеанса, в том числе с предварительной проверкой на существование. В имени пользовательских параметров обязательно должна быть точка, чтобы отличать их от стандартных параметров.
Теперь myapp.currency_code можно использовать как глобальную переменную сеанса:
Page 15: Page 15
Пользовательские параметры можно указывать и в конфигурационных файлах, тогда они автоматически будут инициализироваться во всех сеансах.
Page 16: Итоги
Основной файл конфигурации — postgresql.conf
- ALTER SYSTEM — SQL-интерфейс для управления параметрами конфигурации в postgresql.auto.conf
- При изменениях в файлах нужно перечитать конфигурацию
- Многие параметры можно изменять для текущего сеанса
- Изменение части параметров требует перезапуска сервера
Page 17: Практика
- Получите список параметров, для изменения которых требуется перезапуск сервера.
- В дополнительном подключаемом файле конфигурации сделайте ошибку при изменении параметра max_connections.
- Перезапустите сервер. Убедитесь, что сервер не стартует,
- и проверьте журнал сообщений.
- Исправьте ошибку и запустите сервер.
Комментарии преподавателя
- Расположение файла postgresql.conf можно найти, посмотрев значение параметра config_file, как это сделано в демонстрации.
В завершающей части этого файла имеется директива include_dir, подключающая дополнительные файлы конфигурации.
Создайте в указанном этой директивой каталоге файл max_connections.conf, отредактировав его либо от имени пользователя postgres, либо от имени суперпользователя операционной системы.
Для получения соответствующих прав используйте команду операционной системы sudo.
Используйте знакомый вам текстовый редактор. Например, так: sudo nano /etc/postgresql/16/main/conf.d/max_connections.conf
Для выхода из nano используйте сочетание клавиш Ctrl+X.
Page 18: 1. Параметры, изменение которых требует перезапуска сервера
2. Установка параметра max\_connections
Текущее значение параметра max_connections:
Page 19: Page 19
Допустим, мы решили уменьшить это значение до 50, но ошиблись и вместо нуля написали букву O:
Обнаружить ошибку можно, посмотрев в представление pg_file_settings:
Предположим, мы не посмотрели в pg_file_settings и все-таки решили перезапустить сервер:
Сервер не запускается. Причина записана в журнал сообщений сервера. Вот последние строки журнала:
Исправим ошибку в файле конфигурации:
Сервер не работает, поэтому для проверки воспользуемся командой операционной системы.
Пробуем запустить сервер:
Сервер успешно стартовал, проверяем значение max_connections:
Page 20: Page 20
Page 21: Практика+
- Установите параметр work_mem = 32MB в командной строке запуска утилиты psql. 2. В пакетном дистрибутиве для Ubuntu файл postgresql.conf находится не в каталоге PGDATA. Каким образом сервер находит этот файл конфигурации при запуске?
Комментарии преподавателя
- Используйте один из двух способов: ключ options в строке подключения или переменная среды PGOPTIONS.
Информация о формировании строки подключения:
https://postgrespro.ru/docs/postgresql/16/libpq-connect#LIBPQ-CONNSTRING
- Расположение файла postgresql.conf можно посмотреть в параметре config_file.
Чтобы узнать, где задается этот параметр, посмотрите вывод команды ps для основного процесса postgres. Идентификатор процесса (PID) записан в первой строке файла postmaster.pid, который находится в каталоге с данными (PGDATA).
Page 22: 1. Установка параметров при запуске приложения
Если приложение использует библиотеку libpq для подключения к серверу, установить параметры при запуске можно двумя способами. Первый способ — указать ключ options в строке параметров подключения:
Второй способ — установить переменную окружения PGOPTIONS:
2. Где определяется config\_file
Файл postgresql.conf расположен не в каталоге с данными:
Каким же образом сервер находит postgresql.conf? В пакетном дистрибутиве для Ubuntu значение параметра config_file указано в командной строке запуска сервера. Это позволяет разместить postgresql.conf в каталоге, отличном от PGDATA. Командную строку запуска сервера можно посмотреть с помощью команды ps. Сначала найдем идентификатор (PID) основного процесса сервера, он находится в первой строке файла postmaster.pid, расположенного в каталоге PGDATA:
Теперь мы можем получить командную строку запуска процесса postmaster:
04 Занятие 04: Архитектура / Общее устройство PostgreSQL
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba1_04_arch_general.html Archive: DBA1-handouts-16.zip Страниц PDF: 20
Page 1: Архитектура / Общее устройство PostgreSQL
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Клиент-серверный протокол
- Транзакционность и механизмы ее реализации
- Схема обработки и способы выполнения запросов
- Процессы и структуры памяти
- Хранение данных на диске и работа с ними
- Расширяемость системы
Page 3: Клиент и сервер
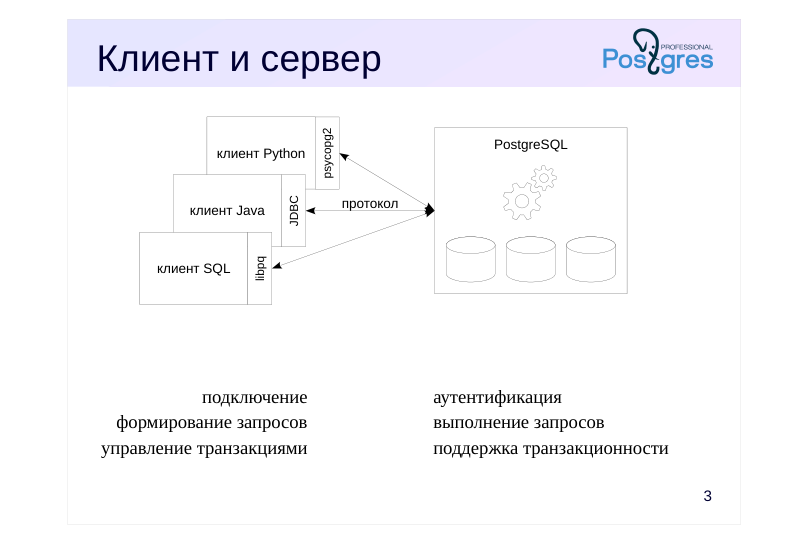 {#source-figure-003 caption=“Source slide page 3: Клиент и сервер”}
подключение аутентификация формирование запросов выполнение запросов управление транзакциями поддержка транзакционности
Комментарии преподавателя
Клиентское приложение — например, psql или любая другая программа, написанная на любом языке программирования, — подключается к серверу и «общается» с ним. Чтобы клиент и сервер понимали друг друга, они должны использовать один и тот же протокол взаимодействия. Обычно клиент использует драйвер, реализующий протокол и предоставляющий набор функций для использования в программе. Внутри драйвер может пользоваться стандартной реализацией протокола (библиотекой libpq), либо реализовывать этот протокол самостоятельно.
Не так важно, на каком языке написан клиент — за разным синтаксисом будут стоять возможности, определенные протоколом. Мы будем использовать для примеров язык SQL с помощью клиента psql. В реальной жизни клиентскую часть на SQL пишут редко, но нам это удобно для учебных целей. Мы рассчитываем, что сопоставить команды SQL с аналогичными возможностями какого-либо другого языка программирования не составит для вас большого труда.
Протокол позволяет клиенту подключиться к одной из баз данных кластера. При этом сервер выполняет аутентификацию — решает, можно ли разрешить подключение, например, запросив пароль.
Далее клиент посылает серверу запросы на языке SQL, а сервер выполняет их и возвращает результат. Наличие мощного и удобного языка запросов — одна из особенностей реляционных СУБД.
Другая особенность — поддержка согласованной работы транзакций.
https://postgrespro.ru/docs/postgresql/16/protocol
Page 4: Транзакции
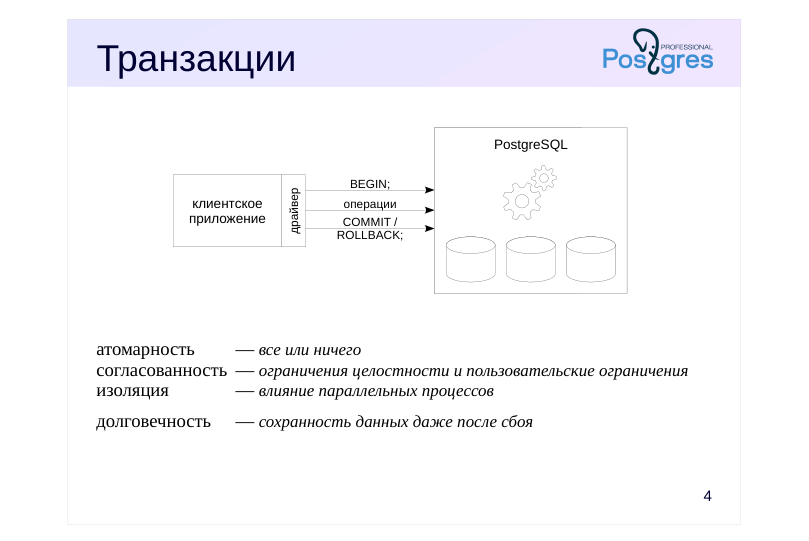 {#source-figure-004 caption=“Source slide page 4: Транзакции”}
- атомарность — все или ничего согласованность — ограничения целостности и пользовательские ограничения изоляция — влияние параллельных процессов
- долговечность — сохранность данных даже после сбоя
Комментарии преподавателя
Под транзакцией понимается последовательность операций, которая сохраняет согласованность данных при условии, что операции выполнены полностью и без помех со стороны других транзакций.
От транзакций ожидают выполнения четырех свойств (ACID):
● Атомарность: транзакция либо выполняется полностью, либо не выполняется вовсе. Для этого начало транзакции отмечается командой BEGIN, а конец — либо COMMIT (фиксация изменений), либо ROLLBACK (отмена изменений).
● Согласованность: транзакция переводит базу данных из одного согласованного состояния в другое согласованное состояние (согласованность - соблюдение установленных ограничений).
● Изоляция: другие транзакции, выполняющиеся одновременно с данной, не должны оказывать на нее влияния.
● Долговечность: после того, как данные зафиксированы, они не должны потеряться даже в случае сбоя.
За управление транзакциями (то есть за определение команд, составляющих транзакцию, и за фиксацию или отмену транзакции) в PostgreSQL, как правило, отвечает клиентское приложение. На стороне сервера управлять транзакциями могут хранимые процедуры.
https://postgrespro.ru/docs/postgresql/16/sql-begin
https://postgrespro.ru/docs/postgresql/16/sql-savepoint
https://postgrespro.ru/docs/postgresql/16/transactions
Page 5: Управление транзакциями
По умолчанию psql работает в режиме автофиксации:
Это приводит к тому, что любая одиночная команда, выданная без явного указания начала транзакции, сразу же фиксируется. Проверьте, включен ли аналогичный режим в драйвере PostgreSQL вашего любимого языка программирования? Создадим таблицу с одной строкой:
Увидит ли таблицу и строку другая транзакция?
Да. Сравните:
Что увидит другая транзакция на этот раз?
Изменения еще не зафиксированы, поэтому не видны другой транзакции.
А теперь?
Режим без автофиксации неявно начинает транзакцию при первой выданной команде; изменения надо фиксировать самостоятельно.
Page 6: Page 6
Что на этот раз?
Изменения не видны; транзакция была начата неявно.
Ну и наконец:
Восстановим режим, в котором psql работает по умолчанию.
Отдельные изменения можно откатывать, не прерывая транзакцию целиком (хотя необходимость в этом возникает нечасто).
Обратите внимание: свои собственные изменения транзакция видит, даже если они не зафиксированы. Теперь откатим все до точки сохранения. Откат к точке сохранения не подразумевает передачу управления (то есть не работает как GOTO); отменяются только те изменения состояния БД, которые были выполнены от момента установки точки до текущего момента.
Что увидим?
Сейчас изменения отменены, но транзакция продолжается:
Page 7: Page 7
Page 8: Выполнение запроса
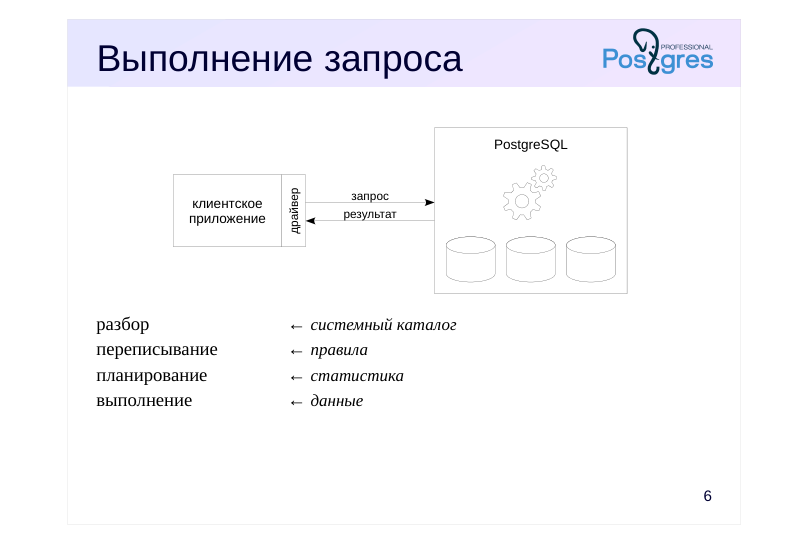 {#source-figure-008 caption=“Source slide page 8: Выполнение запроса”}
разбор ← системный каталог переписывание ← правила планирование ← статистика выполнение ← данные
Комментарии преподавателя
Выполнение запроса — довольно сложная задача. Запрос передается от клиента серверу в виде текста. Текст надо разобрать — выполнить синтаксический разбор (складываются ли буквы в слова, а слова — в команды) и семантический разбор (есть ли в базе данных таблицы и другие объекты, на которые запрос ссылается по имени). Для этого требуется информация о том, что вообще содержится в базе данных. Такая мета-информация называется системным каталогом, она хранится в самой базе данных в специальных таблицах.
Запрос может переписываться (трансформироваться) — например, вместо имени представления подставляется текст запроса. Можно придумать и свои трансформации, для чего есть механизм правил.
SQL — декларативный язык: запрос, составленный на нем, говорит о том, какие данные надо получить, но не говорит, как это сделать. Поэтому запрос (уже разобранный и представленный в виде дерева), передается планировщику, который разрабатывает план выполнения. Например, планировщик решает, надо ли использовать индексы. Чтобы качественно спланировать работу, планировщику нужна информация о размере таблиц и о распределении данных в них — статистика.
Далее запрос выполняется в соответствии с планом и результат возвращается клиенту — целиком и полностью:
https://postgrespro.ru/docs/postgresql/16/query-path
Это удобный и простой способ для небольших выборок, он обеспечи-вается простым режимом протокола.
Page 9: Подготовка операторов
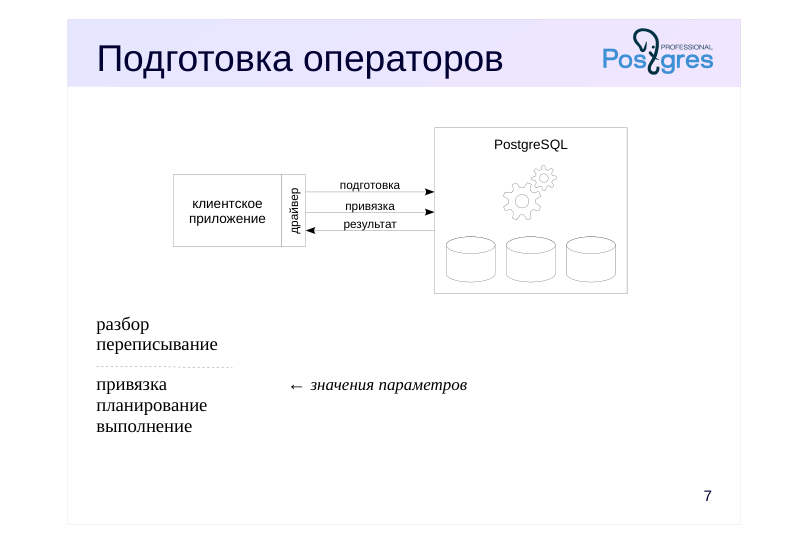 {#source-figure-009 caption=“Source slide page 9: Подготовка операторов”}
разбор переписывание
- привязка ← значения параметров планирование выполнение
Комментарии преподавателя
Итак, каждый запрос проходит перечисленные ранее шаги: разбор, переписывание, планирование и выполнение. Но если один и тот же запрос (с точностью до параметров) выполняется много раз, нет смысла каждый раз разбирать его заново.
Поэтому кроме обычного выполнения запросов протокол PostgreSQL предусматривает расширенный режим, который позволяет более детально управлять выполнением операторов.
В качестве одной из возможностей расширенный режим позволяет подготовить запрос — заранее выполнить разбор и переписывание и запомнить дерево разбора.
При выполнении запроса выполняется привязка конкретных значений параметров. Если необходимо, здесь выполняется планирование (в некоторых случаях PostgreSQL запоминает план запроса и не выполняет повторно этот шаг). Затем запрос выполняется.
Еще одно преимущество использования подготовленных операторов — невозможность внедрения SQL-кода.
https://postgrespro.ru/docs/postgresql/16/sql-prepare
https://postgrespro.ru/docs/postgresql/16/sql-execute
Page 10: Подготовленные операторы
В SQL оператор подготавливается командой PREPARE (эта команда является расширением PostgreSQL, она отсутствует в стандарте):
При этом выполняются разбор и переписывание, и полученное дерево разбора запоминается. После подготовки оператор можно вызывать по имени, передавая фактические параметры:
Если у запроса нет параметров, при подготовке запоминается и построенный план выполнения. Если же параметры есть, как в этом примере, то их фактические значения принимаются во внимание при планировании. Планировщик может счесть, что план, построенный без учета параметров, окажется не хуже, и тогда перестанет выполнять планирование повторно. А как подготовить и выполнить оператор в вашем любимом языке? Есть ли возможность выполнить оператор, НЕ подготавливая его? Все подготовленные операторы текущего сеанса можно увидеть в представлении:
Page 11: Курсоры
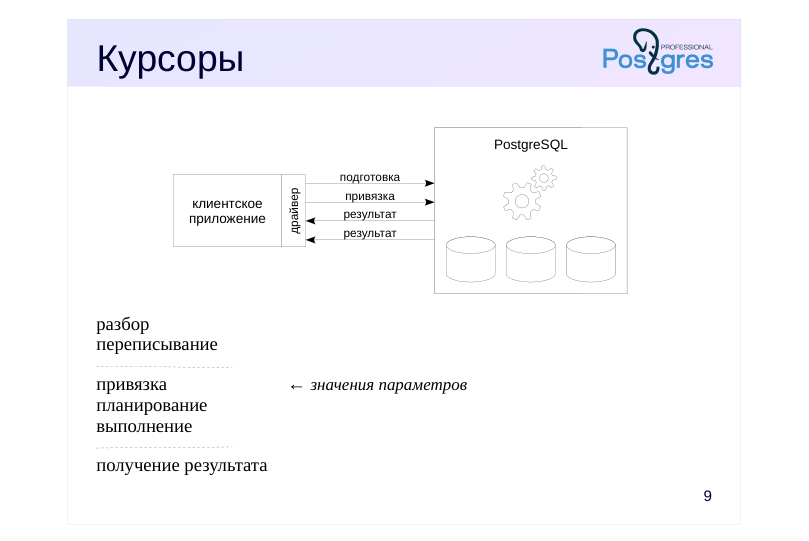 {#source-figure-011 caption=“Source slide page 11: Курсоры”}
разбор переписывание
- привязка ← значения параметров планирование выполнение
- получение результата
Комментарии преподавателя
Не всегда клиенту бывает удобно получить все результаты сразу. Данных может оказаться много, но не все они могут быть нужны.
Для этого расширенный режим протокола предусматривает курсоры. Можно открыть курсор для какого-либо оператора, а затем получать результирующие данные построчно по мере необходимости.
Курсор можно рассматривать как окно, в котором видна только часть из множества результатов. При получении строки данных окно сдвигается. Иными словами, курсоры позволяют работать с реляционными данными (множествами) итеративно, строка за строкой.
Открытый курсор представлен на сервере так называемым порталом. Это слово встречается в документации; в первом приближении можно считать «курсор» и «портал» синонимами.
Запрос, используемый в курсоре, неявно подготавливается (то есть сохраняется его дерево разбора и, возможно, план выполнения).
https://postgrespro.ru/docs/postgresql/16/sql-declare
https://postgrespro.ru/docs/postgresql/16/sql-fetch
Page 12: Курсоры
При выполнении команды SELECT сервер передает, а клиент получает сразу все строки:
Курсор позволяет получать данные построчно.
Размер выборки можно указывать:
Этот размер играет важную роль, когда строк очень много: обрабатывать большой объем данных построчно крайне неэффективно. Что, если в процессе чтения мы дойдем до конца таблицы?
FETCH просто перестанет возвращать строки. В обычных языках программирования всегда есть возможность проверить это условие. Как в вашем языке программирования получать данные построчно с помощью курсора? Есть ли возможность НЕ пользоваться курсором и получить все строки сразу? Как настраивается размер выборки для курсора? По окончании работы открытый курсор закрывают, освобождая ресурсы:
Однако курсоры автоматически закрываются по завершению транзакции, так что можно не закрывать их явно. (Исключение составляют курсоры, открытые с указанием WITH HOLD.)
Page 13: Page 13
Page 14: Процессы и память
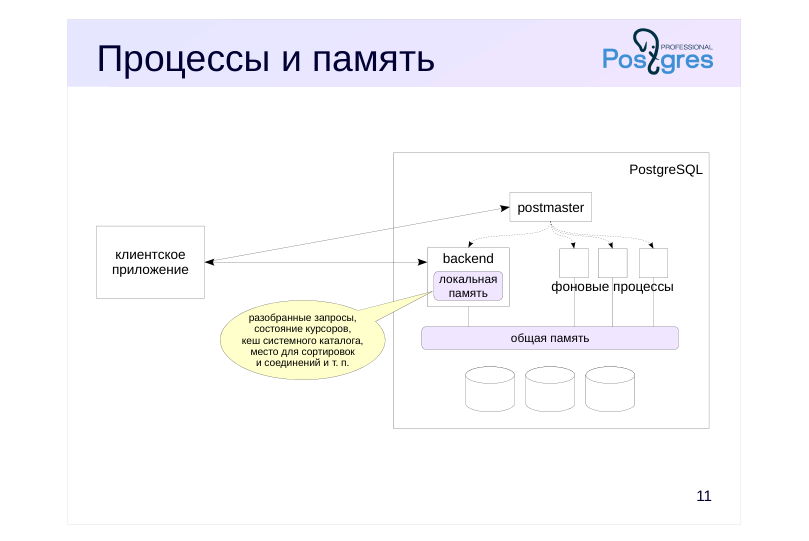 {#source-figure-014 caption=“Source slide page 14: Процессы и память”}
Комментарии преподавателя
Между обращениями клиента сервер должен хранить вспомогательную информацию: разобранные запросы и их планы, состояние открытых курсоров (порталы). Где и как он это делает?
Сервер PostgreSQL состоит из нескольких взаимодействующих процессов. В первую очередь при старте сервера запускается процесс, традиционно называемый postmaster. Он запускает все остальные процессы (с помощью системного вызова fork в Unix) и «присматривает» за ними — если какой-нибудь процесс завершится аварийно, postmaster перезапустит его (или перезапустит весь сервер, если сочтет, что процесс мог повредить общие данные).
Работу сервера обеспечивает ряд фоновых служебных процессов. В следующих темах этого модуля мы поговорим об основных из них.
Чтобы процессы могли обмениваться информацией, postmaster выделяет общую память, доступ к которой могут получить все процессы. Кроме общей памяти, каждый процесс имеет и свою локальную память, доступную только ему самому.
Postmaster слушает входящие соединения. Для каждого вновь подключающегося клиента postmaster порождает обслуживающий процесс (backend) и дальше клиент общается уже с этим процессом. Обслуживающий процесс, в том числе, производит аутентификацию.
Место, необходимое для выполнения запроса (разобранные запросы и их планы, состояние курсоров, кеш системного каталога, место для сортировки данных и т. п.), выделяется в локальной памяти обслуживающего процесса.
Page 15: Много клиентов
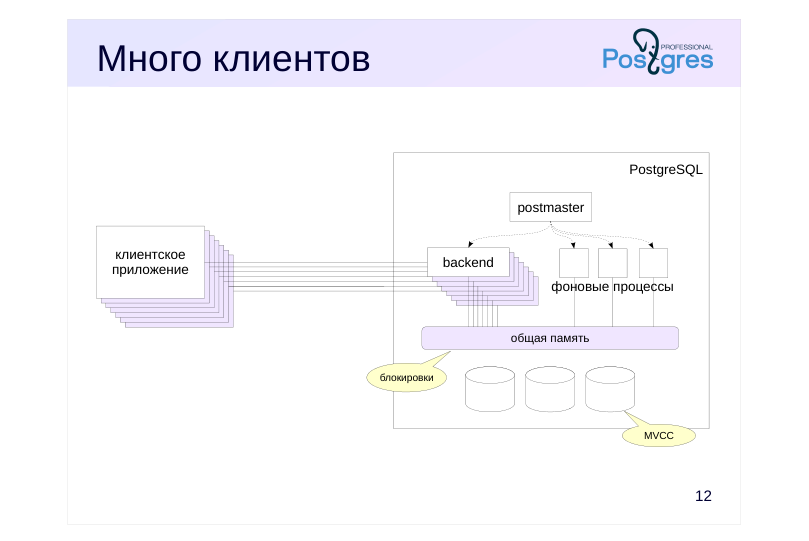 {#source-figure-015 caption=“Source slide page 15: Много клиентов”}
Комментарии преподавателя
Когда к серверу подключается много клиентов, для каждого из них порождается собственный обслуживающий процесс. Это не проблема, пока клиентов не очень много: на всех хватает оперативной памяти, а соединения не происходят слишком часто.
Тем не менее при одновременной работе с какими-либо объектами приходится принимать меры, чтобы один процесс не поменял какие-то данные в то время, пока с ними работает другой процесс.
Для объектов в общей памяти используются короткоживущие блокировки. PostgreSQL делает это достаточно аккуратно для того, чтобы система хорошо масштабировалась при увеличении числа процессоров (ядер).
С таблицами сложнее, поскольку блокировки нужно удерживать до конца транзакций (то есть потенциально в течение длительного времени), из-за чего масштабируемость может пострадать. Поэтому PostgreSQL использует механизм многоверсионности (MVCC, multiversion concurrency control) и изоляцию на основе снимков данных: одни и те же данные могут одновременно существовать в разных версиях, а каждый процесс видит собственную (но всегда согласованную) картину данных. Это позволяет блокировать только те процессы, которые пытаются изменить данные, уже измененные, но еще не зафиксированные другими процессами.
Многоверсионность — основной механизм, который обеспечивает первые три свойства транзакций (атомарность, согласованность, изоляция). Про него мы будем говорить отдельно в теме «Изоляция и многоверсионность».
Page 16: Пул соединений
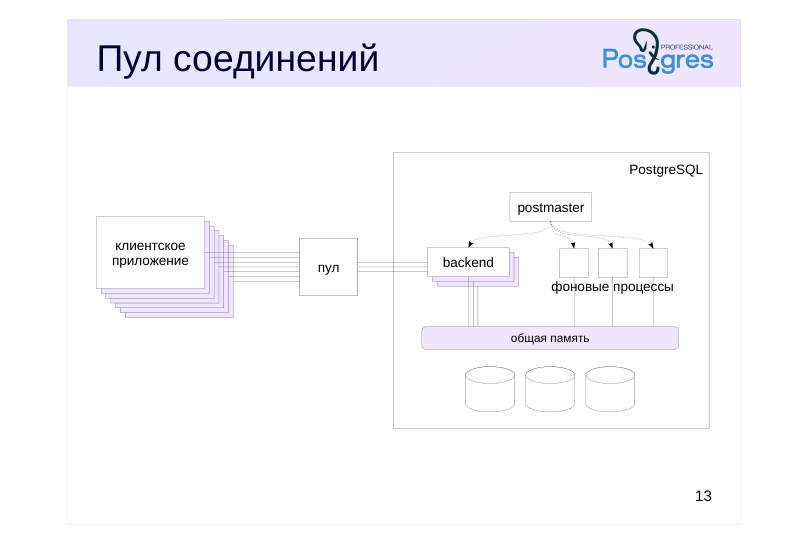 {#source-figure-016 caption=“Source slide page 16: Пул соединений”}
Комментарии преподавателя
Если клиентов слишком много, или соединения устанавливаются и разрываются слишком часто, стоит подумать о применении пула соединений. Такую функцию обычно предоставляет сервер приложений или можно воспользоваться сторонними менеджерами пула (наиболее известен pgBouncer).
Клиенты подключаются не к серверу PostgreSQL, а к менеджеру пула. Менеджер удерживает открытыми несколько соединений с сервером баз данных и использует одно из свободных для того, чтобы выполнять запросы клиента. Таким образом, с точки зрения сервера число клиентов остается постоянным вне зависимости от того, сколько клиентов обращаются к менеджеру пула.
Но при таком режиме работы несколько клиентов разделяют один и тот же обслуживающий процесс, который — как мы говорили — в своей локальной памяти хранит определенное состояние (в частности, разобранные запросы для подготовленных операторов). Как правило, это необходимо учитывать при разработке приложений.
Одна из возможностей pgBouncer — временная приостановка обслуживания клиентов без разрыва соединения. Такая приостановка может использоваться для обновления программного обеспечения сервера или других операций, требующих рестарта сервера.
Подробнее вопросы применения пула соединений рассматриваются в курсе DEV2.
Page 17: Хранение данных
 {#source-figure-017 caption=“Source slide page 17: Хранение данных”}
Комментарии преподавателя
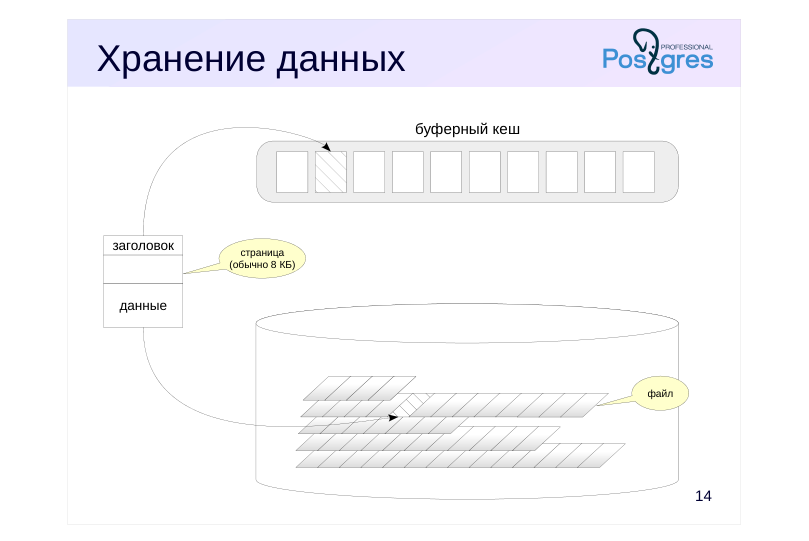
Данные хранятся на дисках в обычных файлах операционной системы. Как именно данные распределены по файлам, рассматривается в одной из следующих тем.
Логически файлы разделены на страницы (иногда используется термин блок). Страница обычно имеет размер 8 Кбайт. Его в некоторых пределах можно поменять (16 или 32 Кбайта), но только при сборке сервера. Таким образом, собранный и запущенный кластер может работать со страницами только одного размера.
Каждая страница имеет внутреннюю разметку. Страница содержит заголовок и полезные данные; между ними может находиться свободное пространство, если страница занята не полностью.
Из-за того, что диски работают значительно медленнее, чем оперативная память (особенно HDD, но и SSD тоже), применяется кеширование: в оперативной памяти отводится место под недавно прочитанные с диска страницы — буферный кеш. Расчет делается на то, что одни и те же страницы понадобятся несколько раз и можно будет сэкономить на повторном обращении к диску. Измененные данные также записываются на диск не сразу, а через некоторое время.
Page 18: Хранение данных
 {#source-figure-018 caption=“Source slide page 18: Хранение данных”}
Комментарии преподавателя
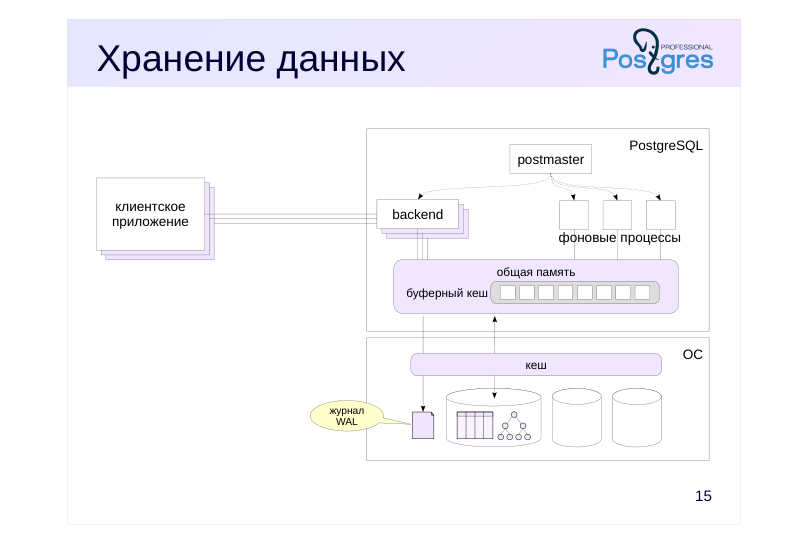
Буферный кеш PostgreSQL располагается в общей памяти, чтобы все процессы имели к нему доступ.
PostgreSQL работает с дисками, на которых находятся данные, не напрямую, а через операционную систему. У операционной системы тоже имеется собственный кеш данных. Поэтому, если страница не будет найдена в буферном кеше, остается шанс, что она есть в кеше ОС и обращения к диску удастся избежать.
При сбое (например, питания) содержимое оперативной памяти пропадает, при этом измененные, но еще не записанные на диск данные теряются. Это недопустимо и противоречит свойству долговечности транзакций. Поэтому в процессе работы PostgreSQL постоянно записывает специальный журнал, позволяющий повторно выполнить потерянные операции и восстановить данные в согласованном состоянии. Про буферный кеш и журнал мы будем говорить отдельно в одноименной теме.
Page 19: Расширяемость
 {#source-figure-019 caption=“Source slide page 19: Расширяемость”}
Комментарии преподавателя
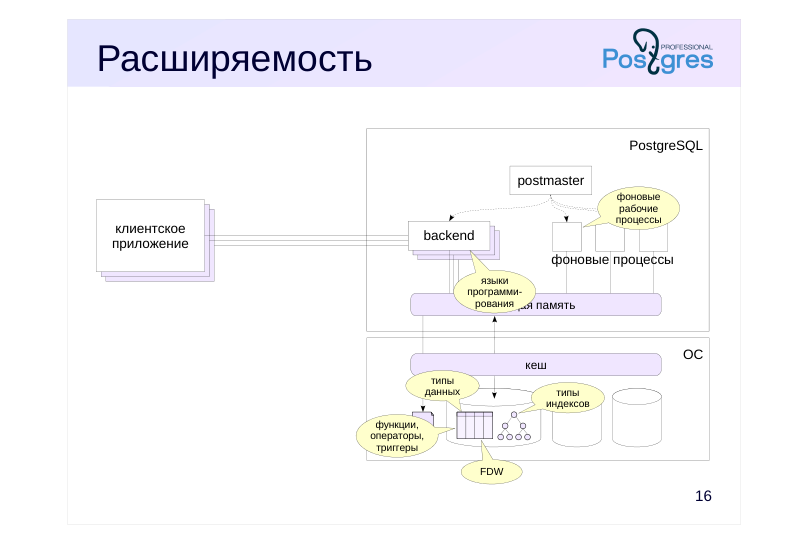
PostgreSQL спроектирован с расчетом на расширяемость. Он предоставляет возможность создавать новые типы данных на основе уже имеющихся, писать хранимые подпрограммы для обработки данных, а также обеспечивает удобный инструментарий для администрирования, мониторинга и настройки производительности.
При необходимости можно написать расширение, которое добавляет недостающий функционал. Большинство расширений можно устанавливать «на лету», без рестарта сервера. Благодаря такой архитектуре, существует большое количество расширений, которые:
● добавляют поддержку языков программирования (помимо стандартных SQL, PL/pgSQL, PL/Perl, PL/Python и PL/Tcl);
● вводят новые типы данных и операторы для работы с ними;
● создают новые типы индексов для эффективной работы с разнообразными типами данных (помимо стандартных B-деревьев, хеш-индексов, GiST, SP-GiST, GIN, BRIN);
● запускают служебные фоновые процессы для выполнения дополнительных задач;
● позволяют подключаться к внешним источникам данных;
● собирают информацию о нагрузке на систему, выполняют мониторинг и строят отчеты;
● позволяют исследовать системные структуры данных.
Подробнее расширения рассматриваются в курсах DBA2 и DEV2.
Page 20: Итоги
Сервер управляет кластером баз данных
- Протокол позволяет клиентам подключаться к серверу, выполнять запросы и управлять транзакциями
- Каждый клиент обслуживается своим процессом
- Данные хранятся в файлах, обращение происходит через операционную систему
- Кеширование как в локальной памяти (каталог, разобранные запросы), так и в общей (буферный кеш)
05 Занятие 05: Архитектура / Изоляция и многоверсионность
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba1_05_arch_mvcc_overview.html Archive: DBA1-handouts-16.zip Страниц PDF: 18
Page 1: Архитектура / Изоляция и многоверсионность
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Многоверсионность
- Снимок данных
- Уровни изоляции
- Очистка и ее горизонт
- Блокировки
- Статус транзакций
Page 3: Многоверсионность
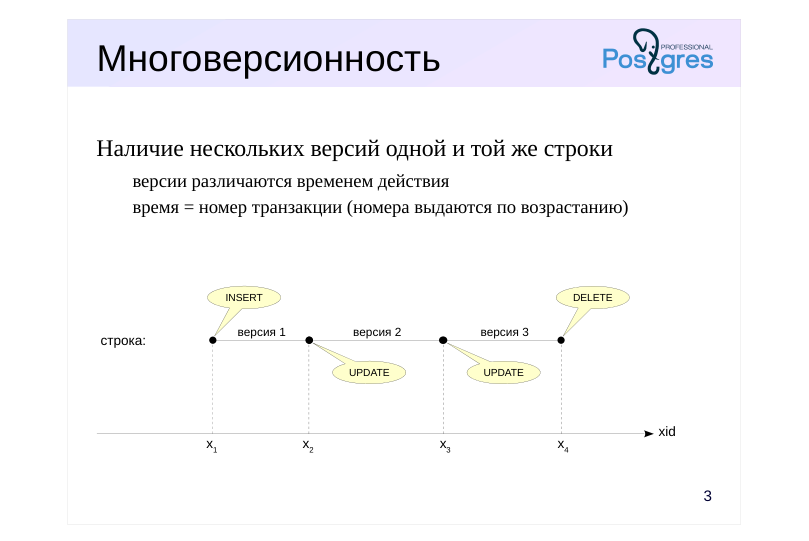 {#source-figure-003 caption=“Source slide page 3: Многоверсионность”}
Наличие нескольких версий одной и той же строки
- версии различаются временем действия
- время = номер транзакции (номера выдаются по возрастанию)
Комментарии преподавателя
При одновременной работе нескольких сеансов возникает вопрос: что делать, если две транзакции одновременно обращаются к одной и той же строке? Если обе транзакции читающие, сложностей нет. Если обе пишущие — тоже (в этом случае они выстраиваются в очередь и выполняют изменения друг за другом). Самый интересный вариант — как взаимодействуют пишущая и читающая транзакции.
Простых пути два. Такие транзакции могут блокировать друг друга — но тогда страдает производительность. Либо читающая транзакция сразу может видеть изменения, сделанные пишущей транзакцией, даже если они не зафиксированы (это называется «грязным чтением») — но это очень плохо, ведь изменения могут быть отменены.
PostgreSQL идет сложным путем и использует многоверсионность — хранит несколько версий одной и той же строки. При этом пишущая транзакция работает со своей версией, а читающая видит свою.
Версии надо как-то отличать друг от друга. Для этого каждая из них хранит две отметки, определяющие «время действия» данной версии.
В качестве времени здесь используются всегда возрастающие номера транзакций (в действительности все немного сложнее, но это детали). Когда строка создается, она помечается номером транзакции, выполнившей команду INSERT. Когда удаляется — версия помечается номером транзакции, выполнившей DELETE (но физически не удаляется). UPDATE состоит из двух операций DELETE и INSERT.
https://postgrespro.ru/docs/postgresql/16/mvcc-intro
Page 4: Снимок данных
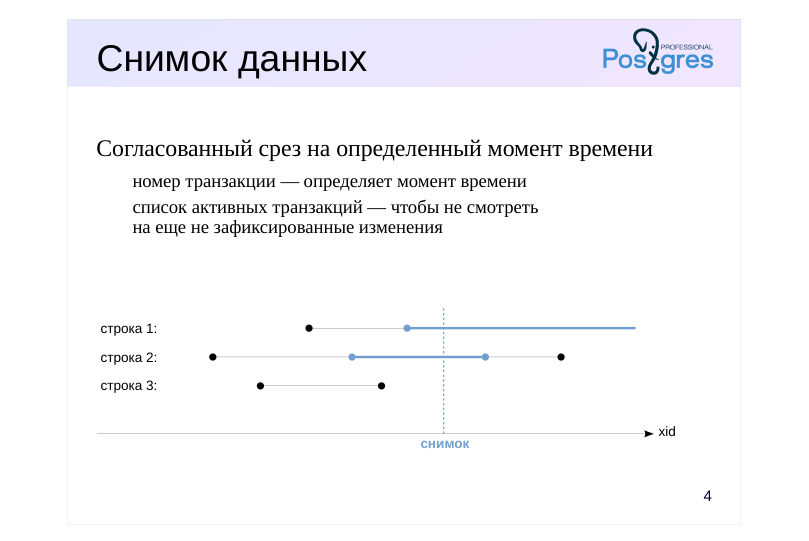 {#source-figure-004 caption=“Source slide page 4: Снимок данных”}
Согласованный срез на определенный момент времени
- номер транзакции — определяет момент времени
- список активных транзакций — чтобы не смотреть
- на еще не зафиксированные изменения
Комментарии преподавателя
В PostgreSQL применяется изоляция на основе снимков данных.
Транзакция, обращаясь к таблице, должна видеть только одну из имеющихся версий каждой строки (или не видеть ни одной). Для этого транзакция работает со снимком данных, созданным в определенный момент времени. В снимке видны самые последние версии уже зафиксированных данных, а еще не зафиксированные данные не видны. Иными словами, от каждой строки в снимок попадает версия, соответствующая моменту создания снимка.
Снимок — это не физическая копия данных, а всего несколько чисел:
● номер последней зафиксированной транзакции на момент создания снимка;
● список активных транзакций на этот момент.
Список нужен для того, чтобы исключить из снимка изменения тех транзакций, которые начались до создания снимка, но еще не были зафиксированы.
Зная эти числа, мы всегда можем сказать, какая из версий строки будет видна в снимке. Иногда это будет актуальная (самая последняя зафиксированная) версия, как для строки 1 на иллюстрации. Иногда не самая последняя: строка 2 удалена (и изменение уже зафиксировано), но транзакция еще продолжает видеть эту строку, пока работает со своим снимком. Это правильное поведение — оно дает согласованную картину данных на выбранный момент времени.
Какие-то строки вовсе не попадут в снимок: строка 3 удалена до того, как был построен снимок, поэтому в снимке ее нет.
Page 5: Уровни изоляции
Read Uncommitted
- не поддерживается PostgreSQL: работает как Read Committed
- Read Committed — используется по умолчанию
- снимок строится на момент начала оператора
- одинаковые запросы могут каждый раз получать разные данные
- Repeatable Read
- снимок строится на момент начала первого оператора транзакции
- транзакция может завершиться ошибкой сериализации
- Serializable
- полная изоляция, но дополнительные накладные расходы
- транзакция может завершиться ошибкой сериализации
Комментарии преподавателя
Стандарт SQL определяет четыре уровня изоляции: чем строже уровень, тем меньше влияния оказывают параллельно работающие транзакции друг на друга. Во времена, когда стандарт принимался, считалось, что чем строже уровень, тем сложнее его реализовать и тем сильнее его влияние на производительность (с тех пор эти представления несколько изменились).
Самый нестрогий уровень Read Uncommitted допускает грязные чтения. Он не поддерживается PostgreSQL, поскольку не представляет практической ценности и не дает выигрыша в производительности.
Уровень Read Committed является уровнем изоляции по умолчанию в PostgreSQL. На этом уровне снимки данных строятся в начале выполнения каждого оператора SQL. Таким образом, оператор работает с неизменной и согласованной картиной данных, но два одинаковых запроса, следующих один за другим, могут показать разные данные.
На уровне Repeatable Read снимок строится в начале транзакции (при выполнении первого оператора) — поэтому все запросы в одной транзакции видят одни и те же данные. Этот уровень удобен, например, для отчетов, состоящих из нескольких запросов.
Уровень Serializable гарантирует полную изоляцию: можно писать операторы так, как будто транзакция работает одна. Но при этом некоторая доля транзакций будет прерываться; приложение должно уметь повторять такие транзакции.
https://postgrespro.ru/docs/postgresql/16/transaction-iso
Page 6: Видимость версий строк
Как убедиться в том, что одна и та же строка может существовать в нескольких версиях? Создадим таблицу:
И вставим одну строку. Напомним, что если не начать транзакцию явно командой BEGIN, psql выполняет команду и немедленно фиксирует результат:
Начнем транзакцию и выведем ее номер:
Транзакция видит первую (и пока единственную) версию строки:
Здесь скрытые столбцы показывают номера транзакций, ограничивающих видимость версии строки: xmin — номер предыдущей транзакции, которая создала версию, а xmax=0 означает, что эта версия актуальна. Теперь начнем другую транзакцию в другом сеансе:
Транзакция видит ту же единственную версию:
Теперь изменим строку во второй транзакции.
Вот что получилось:
Page 7: Page 7
А что увидит первая транзакция?
Поскольку изменение не зафиксировано, первая транзакция продолжает видеть первую версию строки. Обратите внимание на xmax — значение показывает, что в настоящий момент другая транзакция меняет строку. Вообще говоря, такое «подглядывание» нарушает изоляцию, поэтому поля xmin и xmax скрыты и в реальной работе их использовать не стоит. Теперь зафиксируем изменения.
Что теперь увидит первая транзакция?
Теперь и первая транзакция видит вторую версию строки. После фиксации первая версия строки больше не будет видна ни в одной транзакции.
Page 8: Очистка и ее горизонт
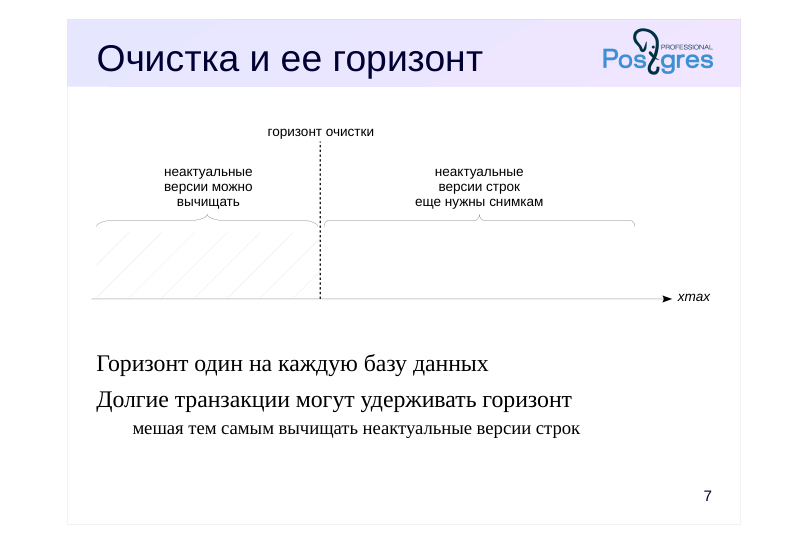 {#source-figure-008 caption=“Source slide page 8: Очистка и ее горизонт”}
Горизонт один на каждую базу данных
- Долгие транзакции могут удерживать горизонт
- мешая тем самым вычищать неактуальные версии строк
Комментарии преподавателя
Механизм многоверсионности позволяет эффективно реализовать изоляцию на основе снимков, но в результате в табличных страницах накапливаются старые («мертвые») версии строк.
Какое-то время исторические версии нужны транзакциям, чтобы они могли работать со своим снимком данных, а в случае отката — вернуться к старым значениям. При этом для каждой базы данных существует такой номер xid, что все исторические версии, удаленные транзакциями с меньшими номерами, уже не видны ни в одном снимке. Этот номер называется горизонтом очистки.
Очистка производится группой специальных фоновых процессов; можно также выполнить ее вручную командой VACUUM.
Долгие транзакции и долго выполняющиеся запросы могут удерживать горизонт очистки, что не дает удалять накопившиеся версии строк. Если своевременно не вычищать исторические данные, таблицы и индексы будут разрастаться, занимая лишнее место на диске, а поиск в них актуальных версий строк будет замедляться.
https://postgrespro.ru/docs/postgresql/16/routine-vacuuming
Page 9: Блокировки
Блокировки строк
- чтение никогда не блокирует строки
- изменение строк блокирует их для изменений, но не для чтений
- Блокировки таблиц
- запрещают изменение или удаление таблицы, пока с ней идет работа
- запрещают чтение таблицы при перестроении или перемещении
- и т. п.
- Время жизни блокировок
- устанавливаются по мере необходимости или вручную
- снимаются автоматически при завершении транзакции или при откате
- к точке сохранения
Комментарии преподавателя
Что же дает многоверсионность? Она позволяет обойтись необходимым минимумом блокировок, тем самым увеличивая производительность системы.
Основные блокировки устанавливаются на уровне строк. При этом чтение никогда не блокирует ни читающие, ни пишущие транзакции. Изменение строки не блокирует ее чтение. Единственный случай, когда транзакция будет ждать освобождения блокировки — если она пытается менять строку, которая уже изменена другой, еще не зафиксированной транзакцией.
Блокировки также устанавливаются на более высоком уровне, в частности, на таблицах. Они нужны для того, чтобы никто не смог удалить таблицу, пока другие транзакции читают из нее данные, или чтобы запретить доступ к перестраиваемой таблице. На практике удаление и перестроение таблиц выполняются редко, поэтому обычно не вызывают проблем. Однако нужно учитывать, что перестроение таблицы происходит неявно при некоторых изменениях ее структуры и полностью блокирует доступ к таблице и ее индексам. Подробно блокировки рассматриваются в модуле «Блокировки» курса DBA2.
Все необходимые блокировки устанавливаются автоматически и автоматически же снимаются при завершении транзакции. Но если блокировка была получена после установки точки сохранения, она будет снята немедленно в случае отката к этой точке.
Можно также установить и дополнительные пользовательские блокировки; необходимость в этом возникает не часто.
https://postgrespro.ru/docs/postgresql/16/explicit-locking
Page 10: Блокировки
Повторим наш опыт, но теперь пусть обе транзакции попытаются изменить одну и ту же строку.
И во второй транзакции:
Вторая транзакция «повисла»: она не может изменить строку, пока первая транзакция не снимет блокировку.
Теперь вторая транзакция может продолжить выполнение:
Обе транзакции зафиксировали свои изменения. Первый сеанс снова читает таблицу и видит актуальную строку — это результат, зафиксированный второй транзакцией:
Page 11: Статус транзакций
Статус транзакций (clog)
- служебная информация; два бита на транзакцию
- специальные файлы на диске
- буферы в общей памяти
- Фиксация
- устанавливается бит «транзакция зафиксирована»
- Обрыв
- устанавливается бит «транзакция прервана»
- выполняется так же быстро, как и фиксация (не нужен откат данных)
Комментарии преподавателя
Для работы многоверсионности серверу надо понимать, в каком статусе находятся транзакции. Транзакция может быть активна или завершена. Завершиться транзакция может либо фиксацией, либо обрывом. Таким образом, для представления состояния каждой транзакции требуются два бита.
Статусы транзакций (commit log, clog) хранятся в специальных служебных файлах в каталоге PGDATA/pg_xact, а работа с ними происходит в общей памяти сервера, чтобы не приходилось постоянно обращаться к диску.
При любом завершении транзакции (как успешном, так и неуспешном) необходимо всего лишь установить соответствующие биты статуса. И фиксация, и обрыв транзакций происходят одинаково быстро.
Если прерванная транзакция успела создать новые версии строк, эти версии не уничтожаются (не происходит «физического» отката данных). Благодаря информации о статусах другие транзакции увидят, что транзакция, создавшая или удалившая версии строк, была прервана и не станут принимать во внимание сделанные ей изменения.
Page 12: Итоги
В файлах данных могут храниться несколько версий каждой строки
- Транзакции работают со снимками данных — согласованными срезами на определенный момент времени
- Уровни изоляции отличаются временем создания снимка
- Мертвые версии строк за горизонтом очистки должны периодически вычищаться
- Писатели не блокируют читателей, читатели не блокируют никого
Page 13: Практика
- Создайте таблицу с одной строкой. Начните первую транзакцию на уровне изоляции Read Committed и выполните запрос к таблице. Во втором сеансе удалите строку и зафиксируйте изменения. Сколько строк увидит первая транзакция, выполнив тот же запрос повторно? Проверьте. Завершите первую транзакцию. 2. Повторите то же самое, но пусть теперь транзакция работает на уровне изоляции Repeatable Read: BEGIN ISOLATION LEVEL REPEATABLE READ;
- Объясните отличия.
Page 14: 1. Уровень изоляции Read Committed
Создаем таблицу:
Запрос из первой транзакции (по умолчанию используется уровень изоляции Read Committed):
Удаляем строку во второй транзакции и фиксируем изменения:
Повторим запрос:
Первая транзакция видит произошедшие изменения: строка удалена.
2. Уровень изоляции Repeatable Read
Вернем строку:
Запрос из первой транзакции:
Удаляем строку во второй транзакции и фиксируем изменения:
Повторим запрос:
Page 15: Page 15
На этом уровне изоляции первая транзакция не видит изменений: для нее строка по-прежнему существует.
Page 16: Практика+
- Начните транзакцию и создайте новую таблицу с одной строкой. Не завершая транзакцию, откройте второй сеанс и выполните в нем запрос к таблице. Проверьте, что увидит транзакция во втором сеансе.
- Зафиксируйте транзакцию в первом сеансе и повторите
- запрос к таблице во втором сеансе.
- Повторите задание 1, но откатите, а не зафиксируйте транзакцию в первом сеансе. Что изменилось?
- В первом сеансе начните транзакцию и выполните запрос к созданной ранее таблице. Получится ли удалить эту таблицу во втором сеансе, пока первая транзакция не завершена? Проверьте.
Page 17: 1. Транзакции и команды DDL — фиксация
Начнем транзакцию и создадим новую таблицу:
Во втором сеансе сделаем запрос к таблице:
Пока создавшая таблицу транзакция не завершена, все остальные транзакции таблицу не видят. Таблица будет видна только после завершения создавшей ее транзакции:
2. Транзакции и команды DDL — откат
Снова начнем транзакцию и создадим новую таблицу:
Запрос во втором сеансе ожидаемо не видит изменений:
При откате первой транзакции команда создания таблицы тоже откатывается:
Команды DDL в PostgreSQL являются транзакционными.
3. Блокировки таблиц
Page 18: Page 18
Начав транзакцию, обратимся к таблице:
При попытке удалить таблицу вторая транзакция будет заблокирована — нельзя удалить таблицу, которая используется.
Таблица будет удалена только после завершения первой транзакции:
06 Занятие 06: Архитектура / Очистка
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba1_06_arch_vacuum_overview.html Archive: DBA1-handouts-16.zip Страниц PDF: 21
Page 1: Архитектура / Очистка
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Задачи, требующие периодического выполнения
- Автоочистка
- Очистка и анализ вручную
- Разрастание таблиц и индексов
- Полная очистка и перестроение индексов
Page 3: Периодические задачи
Очистка страниц от исторических данных, которые образуются из-за многоверсионности
- из таблиц вычищаются мертвые версии строк
- из индексов вычищаются записи, ссылающиеся на мертвые версии
Комментарии преподавателя
Механизм многоверсионности позволяет эффективно реализовать изоляцию на основе снимков, но в результате в табличных страницах накапливаются старые версии строк, а в страницах индексов — ссылки на эти версии. Какое-то время исторические версии нужны, чтобы транзакции могли работать со своими снимками данных. Но со временем не остается ни одного снимка данных, которому требовалась бы старая версия строки; такая версия называется «мертвой».
Процедура очистки вычищает мертвые версии строк из табличных страниц и ненужные индексные записи, которые ссылались на такие версии.
Если своевременно не вычищать исторические данные, таблицы и индексы будут неконтролируемо разрастаться и поиск в них актуальных версий строк будет замедляться.
https://postgrespro.ru/docs/postgresql/16/routine-vacuuming
Page 4: Периодические задачи
Обновление карты видимости
- отмечает страницы, на которых все версии строк видны во всех снимках
- используется для оптимизации работы процесса очистки
- и ускорения индексного доступа
- существует только для таблиц
Комментарии преподавателя
Кроме этой главной задачи, процедура очистки берет на себя и другие задачи по поддержанию работоспособности экземпляра. Очистка обновляет карту видимости и карту свободного пространства. Это служебная информация, которая хранится вместе с основными данными.
В карте видимости отмечены страницы, которые содержат только актуальные версии строк, причем эти версии видны во всех снимках данных. Такие страницы давно не изменялись и успели полностью очиститься от неактуальных версий.
Карта видимости применяется:
● Для оптимизации очистки. В отмеченные страницы очистке не надо заглядывать — в них не может быть мертвых версий.
● Для ускорения доступа только по индексу. Информация о версионности хранится только для таблиц, но не для индексов (поэтому у индексов не бывает карты видимости). Получив из индекса ссылку на версию строки, нужно прочитать табличную страницу, чтобы проверить ее видимость. Но если в самом индексе уже есть все нужные столбцы, и при этом страница отмечена в карте видимости, то обращения к таблице можно избежать.
Если не обновлять карту видимости, индексный доступ будет работать менее эффективно. Более подробно об этом рассказывается в курсе QPT «Оптимизация запросов».
Page 5: Периодические задачи
Обновление карты свободного пространства
- отмечает свободное пространство в страницах после очистки
- используется при вставке новых версий строк
- существует и для таблиц, и для индексов
Комментарии преподавателя
В карте свободного пространства отмечен объем пустого места внутри страниц. Этот объем постоянно меняется: при добавлении новых версий строк он уменьшается, при очистке — увеличивается.
Карта используется при вставке новых версий строк, чтобы быстро найти подходящую страницу, на которую поместятся добавляемые данные. Для ускорения поиска карта свободного пространства имеет сложную древовидную структуру.
Карта свободного пространства может существовать и для индексов. Но, поскольку индексная запись вставляется в строго определенное место индекса, в карте отмечаются только пустые страницы, образовавшиеся при удалении из них всех записей. Такие страницы исключаются из индексной структуры и при необходимости подключаются затем в подходящее место индекса.
Page 6: Периодические задачи
Обновление статистики
- используется оптимизатором запросов
- вычисляется на основе случайной выборки
Комментарии преподавателя
Для работы оптимизатора запросов необходима статистическая информация («статистика») о данных, такая как количество строк в таблицах и распределение данных в столбцах. Сбор статистики называется анализом.
Для анализа из таблицы читается случайная выборка данных определенного размера. Это позволяет быстро собрать информацию даже по очень большим таблицам. Результат получается не точный, но этого и не требуется. В любом случае данные все время изменяются и постоянно поддерживать абсолютно точную статистику невозможно. Достаточно, чтобы она периодически обновлялась и не слишком сильно отличалась от действительности.
Если не обновлять статистику, она перестанет соответствовать реальным данным и оптимизатор станет строить плохие планы выполнения. Из-за этого запросы могут начать выполняться на порядки медленнее, чем могли бы.
Page 7: Периодические задачи
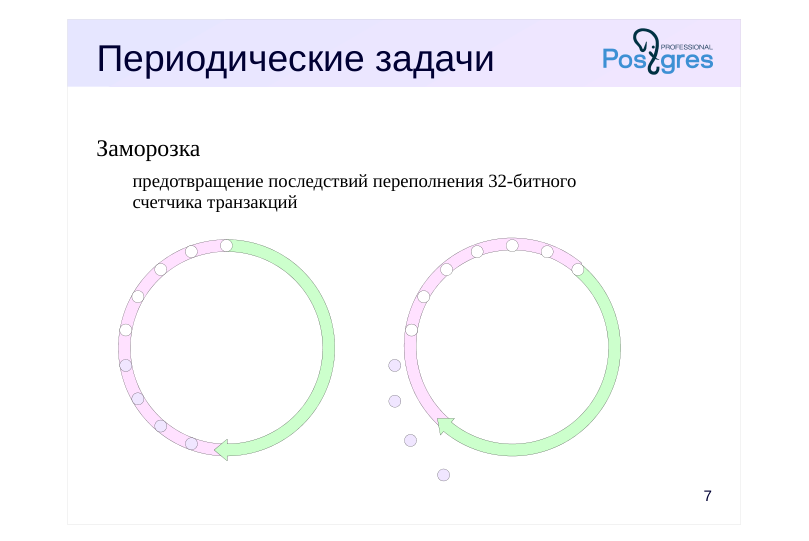 {#source-figure-007 caption=“Source slide page 7: Периодические задачи”}
Заморозка
- предотвращение последствий переполнения 32-битного
- счетчика транзакций
Комментарии преподавателя
Как уже говорилось, PostgreSQL упорядочивает события с помощью номеров транзакций. Под счетчик отведено 32 бита и рано или поздно он переполнится.
Чтобы многоверсионность продолжила работать, пространство номеров закольцовано: для любой транзакции половина номеров против часовой стрелки находится в прошлом, а другая половина — в будущем.
Но если счетчик перейдет через ноль, упорядоченность транзакций нарушится, если не принять специальных мер. Достаточно старые версии строк помечаются как «замороженные». Такой признак говорит о том, что версия строки появилась так давно, что номер создавшей ее транзакции больше не имеет значения и его можно использовать повторно. Замороженные версии строк видны во всех снимках всех транзакций.
Чтобы при заморозке не просматривать лишние страницы, в карту видимости добавлен бит, отмечающий страницы, на которых все версии строк уже заморожены.
Если не выполнять заморозку своевременно, сервер не сможет выделить очередной номер транзакции. Это аварийная ситуация: сервер остановится, все незавершенные транзакции оборвутся. После этого администратор должен будет вручную стартовать сервер и выполнить заморозку.
Page 8: Автоматическая очистка
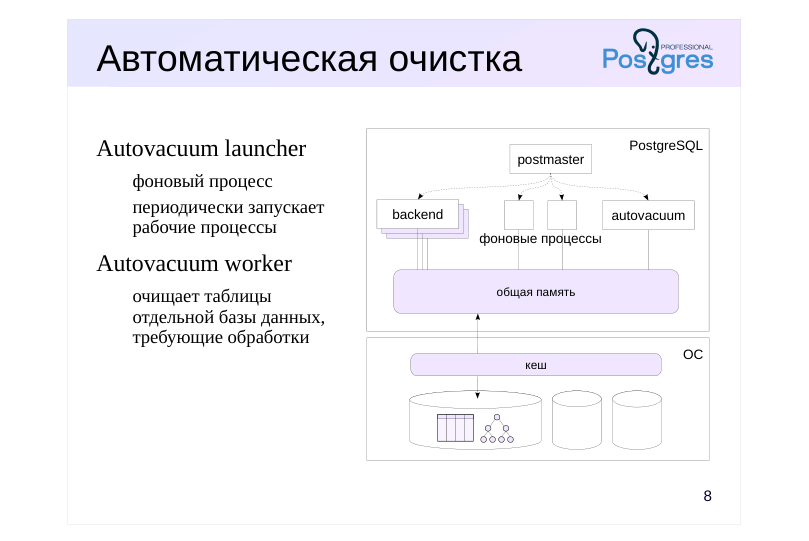 {#source-figure-008 caption=“Source slide page 8: Автоматическая очистка”}
Autovacuum launcher
- фоновый процесс
- периодически запускает
- рабочие процессы
- Autovacuum worker
- очищает таблицы
- отдельной базы данных,
- требующие обработки
Комментарии преподавателя
Выполнение всех описанных выше периодических задач обслуживания берет на себя фоновый процесс автоочистки (autovacuum). Он динамически реагирует на частоту обновления таблиц: чем активней изменения, тем чаще таблица будет обрабатываться.
В системе постоянно присутствует процесс autovacuum launcher, который планирует работу очистки и запускает необходимое число рабочих процессов autovacuum worker, работающих параллельно.
Очистка работает постранично, не приводя к блокировкам других транзакций, хотя и создает, конечно, нагрузку на подсистему ввода-вывода.
Автоматическая очистка не будет работать, если отключен любой из двух параметров: autovacuum или track_counts. Может ошибочно показаться, что отключение способно увеличить производительность системы за счет исключения «лишних» операций ввода-вывода. На самом деле отказ от очистки влечет за собой последствия, описанные выше: неконтролируемое разрастание файлов, замедление запросов и риск аварийной остановки сервера. В конечном итоге это приведет к полному параличу системы.
Автоочистка должна работать. Она настраивается большим количеством конфигурационных параметров; эта настройка детально обсуждается в курсе DBA2 «Настройка и мониторинг».
Page 9: Запуск вручную
Очистка
- VACUUM [таблица, …]
- очистка отдельных таблиц
- VACUUM
- очистка всей БД
- $ vacuumdb
- обертка для использования в ОС
- Анализ
- Очистка и анализ
Комментарии преподавателя
При необходимости очистку и анализ можно запускать вручную.
Для этого служат команды VACUUM (только очистка), ANALYZE (только анализ), а также VACUUM ANALYZE (и очистка, и анализ).
Автоочистка отличается от запуска очистки и анализа по расписанию тем, что реагирует на активность изменения данных. Слишком частый запуск по расписанию создаст ненужную нагрузку на систему. Если же запускать очистку редко, при большом объеме изменений файлы могут успеть существенно вырасти в размерах.
https://postgrespro.ru/docs/postgresql/16/sql-vacuum
https://postgrespro.ru/docs/postgresql/16/sql-analyze
Page 10: Очистка
Создадим таблицу, в целях эксперимента отключив для нее автоматическую очистку, чтобы контролировать время срабатывания:
Заполним таблицу данными и создадим индекс:
Сейчас все строки таблицы имеют ровно одну, актуальную, версию. Теперь обновим часть строк:
Запустим очистку вручную и попросим ее рассказать о том, что происходит:
Из вывода команды можно заключить, что: из таблицы вычищены мертвые версии строк (tuples: 10000 removed…); из индекса удалены ссылки на них (index scan needed… 10000 dead item identifiers removed).
Page 11: Проблема разрастания
Очистка не уменьшает размер таблиц и индексов
- «дыры» в страницах используются для новых данных,
- но место не возвращается операционной системе
- Причины разрастания
- неправильная настройка автоочистки
- массовое изменение данных
- долгие транзакции
- Негативное влияние
- перерасход места на диске
- замедление последовательного просмотра таблиц
- уменьшение эффективности индексного доступа
Комментарии преподавателя
Очистка вычищает неактуальные версии строк из страниц. В страницах образуется свободное пространство, которое затем используется для размещения новых данных. Но освободившееся место не возвращается операционной системе, то есть с точки зрения ОС размер файлов данных не уменьшается.
В случае индексов (B-деревьев) дело осложняется тем, что если на странице не хватает места для размещения индексной записи, страница расщепляется на две. Получившиеся страницы уже никогда не объединяются, даже если из них будут удалены все индексные записи.
При правильной настройке процесса автоочистки файлы данных вырастают на некоторую постоянную величину за счет обновлений между запусками очистки. Но если выполняется одномоментное изменение большого объема данных или в системе присутствуют долгие транзакции (удерживающие снимки данных и не позволяющие вычищать неактуальные версии строк), очистка не сможет своевременно освобождать место. В результате размер таблиц и индексов может продолжать увеличиваться.
Разрастание файлов данных ведет не только к перерасходу места на диске (в том числе и для резервных копий), но и к ухудшению производительности.
https://wiki.postgresql.org/wiki/Show\_database\_bloat
https://postgrespro.ru/docs/postgresql/16/pgstattuple
Page 12: Оценка разрастания таблиц и индексов
Понять, насколько критично разрослись объекты и пора ли предпринимать радикальные меры, можно разными способами: запросами к системному каталогу; используя расширение pgstattuple.
С помощью расширения можно проверить состояние таблицы:
tuple_percent — доля полезной информации (не 100% из-за накладных расходов). И индекса:
leaf_pages — количество листовых страниц индекса; avg_leaf_density — заполненность листовых страниц; leaf_fragmentation — характеристика физической упорядоченности листовых страниц (0 — порядок, 100 — беспорядок). Теперь обновим сразу половину строк:
Посмотрим на таблицу снова:
Плотность уменьшилась. Чтобы не читать всю таблицу целиком, можно попросить pgstattuple показать приблизительную информацию:
Page 13: Page 13
И посмотрим на индекс:
Заполненность листовых страниц осталась на прежнем уровне, но количество страниц заметно увеличилось.
Page 14: Перестроение объектов
Полная очистка
- полностью перестраивает содержимое таблиц и индексов
- полностью блокирует работу с таблицей
- Перестроение индексов
- перестраивает индексы
- полностью блокирует работу с индексом
- и блокирует изменение таблицы
Комментарии преподавателя
Для того чтобы уменьшить физический размер разросшихся таблиц и индексов, требуется полная очистка.
Команда VACUUM FULL полностью перезаписывает содержимое таблицы и ее индексов, минимизируя занимаемое место. Однако этот процесс требует исключительной блокировки таблицы и поэтому не может выполняться параллельно с другими транзакциями.
https://postgrespro.ru/docs/postgresql/16/sql-vacuum
Можно перестроить один индекс или несколько индексов, не трогая таблицу, — это делает команда REINDEX. Она устанавливает блокировки на запись в таблицу и на использование перестраиваемого индекса, поэтому транзакции, пытающиеся изменить таблицу или планировать запрос к ней, будут приостановлены.
https://postgrespro.ru/docs/postgresql/16/sql-reindex
Если долгая исключительная блокировка нежелательна, можно рассмотреть стороннее расширение pg_repack https://github.com/reorg/pg\_repack, позволяющее выполнить перестроение таблицы и ее индексов «на лету».
Page 15: Перестроение объектов
Неблокирующее перестроение индексов
- перестраивает индексы, не блокируя изменение таблицы
- выполняется дольше и может завершиться неудачно
- не транзакционно
- не работает для системных индексов
- не работает для индексов, связанных с ограничениями-исключениями
Комментарии преподавателя
Команда REINDEX с указанием CONCURRENTLY работает без блокировки таблицы на запись. Однако неблокирующее перестроение выполняется дольше и может завершиться неудачно (из-за взаимоблокировок) — в таком случае индекс потребуется еще раз перестроить.
У неблокирующего перестроения индексов есть ряд ограничений. Такая операция не может выполняться внутри транзакции. В неблокирующем режиме нельзя перестроить системные индексы и индексы, связанные с ограничениями-исключениями (EXCLUDE).
Page 16: Перестроение объектов
Для перестроения индексов удобно использовать команду REINDEX с указанием CONCURRENTLY. Это позволяет не останавливать работу системы на время перестроения.
Теперь посмотрим на индекс:
Количество страниц и плотность вернулись к начальным значениям. Для перестроения таблицы вместе с ее индексами можно воспользоваться командой VACUUM FULL. Однако, в отличие от REINDEX CONCURRENTLY, она полностью блокирует работу с таблицей.
Плотность увеличилась, освобожденное место отдано операционной системе.
Page 17: Итоги
Версии строк накапливаются, поэтому необходима периодическая очистка
- Процедура очистки решает много других задач:
- обновление карт видимости и свободного пространства
- сбор статистики для планировщика
- заморозка старых версий строк
- Автоочистка должна работать, но требует настройки
- При разрастании может потребоваться полная очистка
Page 18: Практика
- Отключите процесс автоочистки и убедитесь, что он не работает. 2. В новой базе данных создайте таблицу с одним числовым столбцом и индекс по этой таблице. Вставьте в таблицу 100 000 случайных чисел. 3. Несколько раз измените половину строк таблицы, контролируя на каждом шаге размер таблицы и индекса. 4. Выполните полную очистку. 5. Повторите действия пункта 3, вызывая после каждого изменения обычную очистку. Сравните результаты. 6. Включите процесс автоочистки.
Комментарии преподавателя
Установите параметр autovacuum в значение off и попросите сервер перечитать файлы конфигурации.
Используйте функции pg_table_size(имя-таблицы) и pg_indexes_size(имя-таблицы). Подробнее о функциях для вычисления размеров различных объектов говорится в модуле «Организация данных».
Установите параметр autovacuum в значение on (или сбросьте значение этого параметра командой RESET), затем попросите сервер перечитать файлы конфигурации.
Page 19: 1. Отключение автоочистки
Пока автоочистка запущена.
Выключаем автоочистку и перечитываем настройки конфигурации.
Теперь процесса autovacuum launcher нет.
2. База данных, таблица и индекс
Создаем базу данных, таблицу и индекс:
Вставляем строки:
3. Изменение строк без очистки
Для удобства записываем запрос, вычисляющий размер таблицы и индекса, в переменную psql:
Page 20: Page 20
Размер таблицы и индекса постоянно растет.
4. Полная очистка
Размер таблицы практически вернулся к начальному, индекс стал компактнее (построить индекс по большому объему данных эффективнее, чем добавлять эти данные к индексу построчно).
5. Изменение строк с очисткой
Размер увеличился один раз и затем стабилизировался. Пример показывает, что удаление (и изменение) большого объема данных по возможности следует разделить на несколько транзакций. Это позволит автоматической очистке своевременно удалять ненужные версии строк, что позволит избежать чрезмерного разрастания таблицы.
6. Восстанавливаем автоочистку
Page 21: Page 21
07 Занятие 07: Архитектура / Буферный кеш и журнал
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba1_07_arch_wal_overview.html Archive: DBA1-handouts-16.zip Страниц PDF: 17
Page 1: Архитектура / Буферный кеш и журнал
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Устройство буферного кеша
- Алгоритм вытеснения
- Журнал предзаписи
- Контрольная точка
- Процессы, связанные с буферным кешем и журналом
Page 3: Буферный кеш
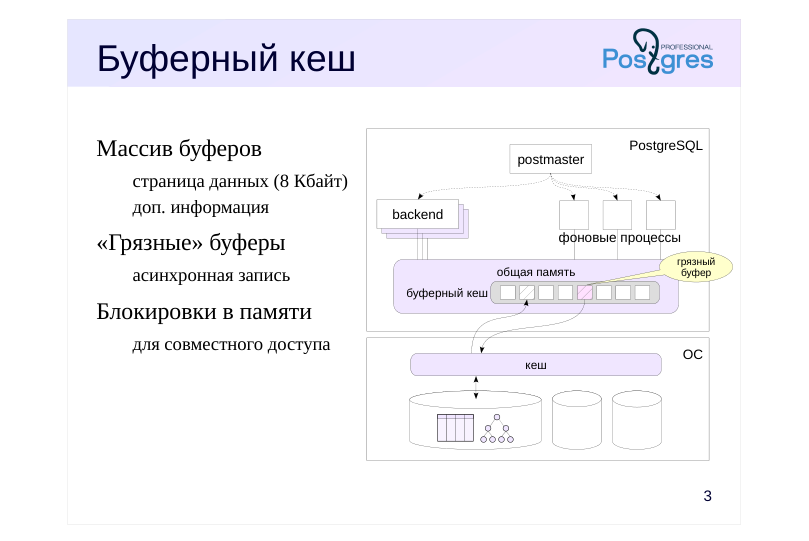 {#source-figure-003 caption=“Source slide page 3: Буферный кеш”}
Массив буферов
- страница данных (8 Кбайт)
- доп. информация
- «Грязные» буферы
- асинхронная запись
- Блокировки в памяти
- для совместного доступа
Комментарии преподавателя
Буферный кеш используется для сглаживания скорости работы оперативной памяти и дисков. Он состоит из массива буферов, которые содержат страницы данных и дополнительную информацию (например, имя файла и положение страницы внутри этого файла).
Размер страницы обычно составляет 8 Кбайт; размер можно изменить только при сборке PostgreSQL.
Любая работа со страницами данных проходит через буферный кеш. Если какой-либо процесс собирается работать со страницей, он в первую очередь пытается найти ее в кеше. Если страницы нет, он обращается к операционной системе с просьбой прочитать эту страницу и помещает ее в буферный кеш. (Обратите внимание, что ОС может прочитать страницу с диска, а может обнаружить ее в собственном кеше.)
После того, как страница записана в буферный кеш, к ней можно обращаться многократно без накладных расходов на вызовы ОС.
Если процесс изменил данные в странице, соответствующий буфер становится «грязным». Измененная страница подлежит записи на диск, но по соображениям производительности запись происходит асинхронно и может откладываться.
Буферный кеш, как и другие структуры общей памяти, защищен блокировками для управления одновременным доступом. Хотя блокировки и реализованы эффективно, доступ к буферному кешу далеко не так быстр, как простое обращение к оперативной памяти. Поэтому в общем случае чем меньше данных читает и изменяет запрос, тем быстрее он будет работать.
Page 4: Вытеснение
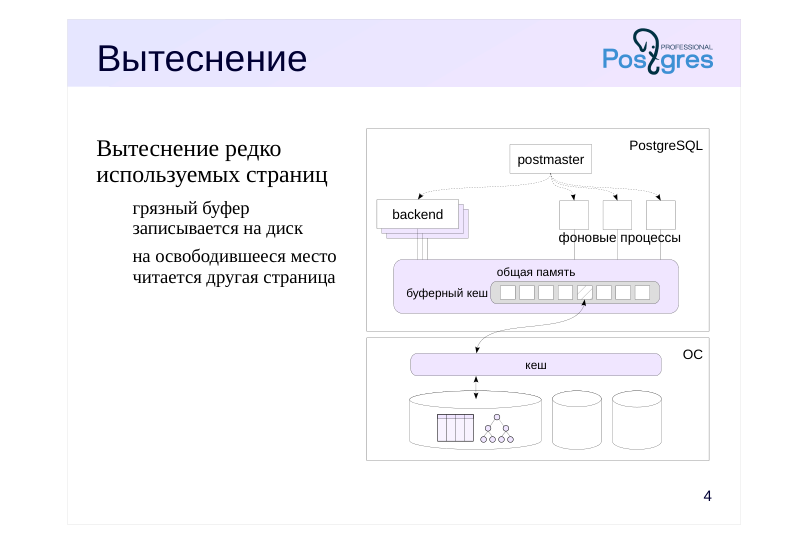 {#source-figure-004 caption=“Source slide page 4: Вытеснение”}
Вытеснение редко используемых страниц
- грязный буфер
- записывается на диск
- на освободившееся место
- читается другая страница
Комментарии преподавателя
Размер буферного кеша обычно не так велик, чтобы база данных помещалась в него целиком. Его ограничивают и доступная оперативная память, и возрастающие при его увеличении накладные расходы. Поэтому при чтении очередной страницы рано или поздно окажется, что место в буферном кеше закончилось. В этом случае применяется вытеснение страниц.
Алгоритм вытеснения выбирает в кеше страницу, которая в последнее время использовалась реже других. Если выбранный буфер оказался грязным, страница записывается на диск, чтобы не потерять сделанные в ней изменения. Затем в освободившийся буфер читается новая страница.
Такой алгоритм вытеснения называется LRU — Least Recently Used. Он сохраняет в кеше данные, с которыми происходит активная работа. Таких «горячих» данных обычно не слишком много, и при достаточном объеме буферного кеша получается существенно сократить количество обращений к ОС (и дисковых операций).
Page 5: Влияние буферного кеша на выполнение запросов
Создаем новую БД в кластере и подключаемся к ней (подробнее про базы данных — в модуле «Организация данных»):
Создадим таблицу:
Заполним таблицу некоторым количеством строк:
Размер буферного кеша показывает параметр shared_buffers:
Значение по умолчанию слишком мало; в любой реальной системе его требуется увеличить сразу после установки сервера (изменение требует перезапуска). Теперь перезапустим сервер, чтобы содержимое буферного кеша сбросилось.
Сравним, что происходит при первом и при втором выполнении одного и того же запроса. В этом курсе мы не рассматриваем подробно планы запросов, но иногда будем в них заглядывать. Сейчас мы воспользуемся командой EXPLAIN ANALYZE, которая выполняет запрос и выводит не только план выполнения, но и дополнительную информацию:
Строка «Buffers: shared» показывает использование буферного кеша. read — количество буферов, в которые пришлось прочитать страницы с диска.
Page 6: Page 6
hit — количество буферов, в которых нашлись нужные для запроса страницы. Обратите внимание, что во второй раз уменьшилось и время выполнения запроса, и время его планирования (потому что таблицы системного каталога тоже кешируются).
Page 7: Журнал предзаписи (WAL)
Проблема: при сбое теряются данные из оперативной памяти, не записанные на диск
- Журнал
- поток информации о выполняемых действиях,
- позволяющий повторно выполнить потерянные при сбое операции
- запись попадает на диск раньше, чем измененные данные
- Журнал защищает
- страницы таблиц, индексов и других объектов
- статус транзакций (clog)
- Журнал не защищает
- временные и нежурналируемые таблицы
Комментарии преподавателя
Наличие буферного кеша (и других буферов в оперативной памяти) увеличивает производительность, но уменьшает надежность. В случае сбоя в СУБД содержимое буферного кеша потеряется. Если сбой произойдет в операционной системе или на аппаратном уровне, то пропадет содержимое и буферов ОС (но с этим справляется сама операционная система).
Для обеспечения надежности PostgreSQL использует журналирование. При выполнении любой операции формируется запись, содержащая минимально необходимую информацию для того, чтобы операцию можно было выполнить повторно. Такая запись должна попасть на диск (или другой энергонезависимый накопитель) раньше, чем будут записаны изменяемые операцией данные (поэтому журнал и называется журналом предзаписи, write-ahead log).
Файлы журнала располагаются в каталоге PGDATA/pg_wal.
Журнал защищает все объекты, работа с которыми ведется в оперативной памяти: таблицы, индексы и другие объекты, статус транзакций.
В журнал не попадают данные о временных таблицах (такие таблицы доступны только создавшему их пользователю и только на время сеанса или транзакции) и о нежурналируемых таблицах (такие таблицы ничем не отличаются от обычных, кроме того, что не защищены журналом). В случае сбоя нежурналируемые таблицы просто очищаются, зато работа с ними происходит быстрее.
https://postgrespro.ru/docs/postgresql/16/wal-intro
Page 8: Журнал предзаписи
Логически журнал можно представить в виде непрерывного потока записей. Каждая запись имеет номер, называемый LSN (Log Sequence Number). Это 64-разрядное число — смещение записи в байтах относительно начала журнала. Текущую позицию показывает функция pg_current_wal_lsn:
Позиция записывается как два 32-разрядных числа через косую черту. Запомним это значение. Выполним теперь какие-нибудь операции и посмотрим, как изменилась позиция.
Интересны не абсолютные числа, а их разница, которая показывает размер сгенерированных журнальных записей в байтах:
Физически журнал хранится в файлах в отдельном каталоге (PGDATA/pg_wal). По умолчанию файлы имеют размер 16 Мбайт, задать другой размер можно при инициализации кластера баз данных. На файлы можно взглянуть не только средствами файловой системы, но и с помощью функции:
Page 9: Контрольная точка
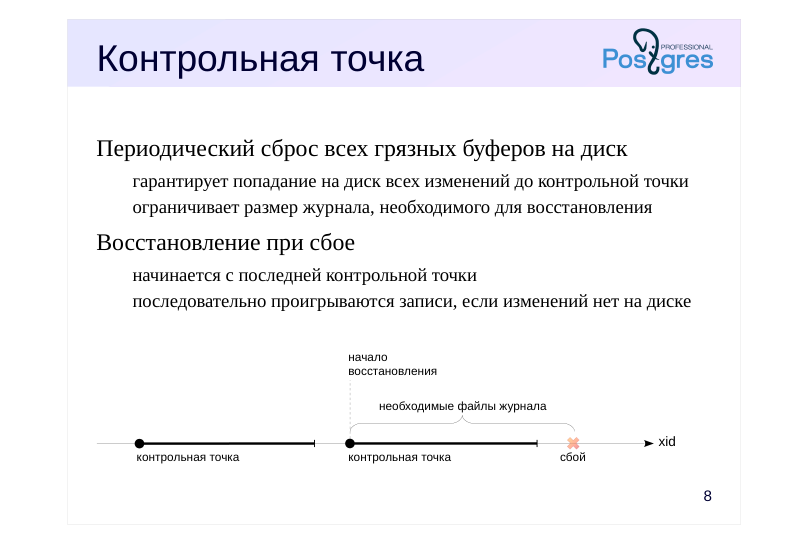 {#source-figure-009 caption=“Source slide page 9: Контрольная точка”}
Периодический сброс всех грязных буферов на диск
- гарантирует попадание на диск всех изменений до контрольной точки
- ограничивает размер журнала, необходимого для восстановления
- Восстановление при сбое
- начинается с последней контрольной точки
- последовательно проигрываются записи, если изменений нет на диске
Комментарии преподавателя
Когда сервер PostgreSQL запускается после сбоя, он входит в режим восстановления. Информация на диске в это время несогласованна: изменения «горячих» страниц пропали, поскольку эти страницы все еще находились в кеше, а более поздние изменения уже были сброшены на диск.
Чтобы восстановить согласованность, PostgreSQL читает WAL и после-довательно проигрывает каждую его запись, если соответствующее изменение не попало на диск. Таким образом восстанавливается работа всех транзакций. Транзакции, запись о фиксации которых не успела попасть в журнал, считаются оборванными.
Однако объем журнала за время работы сервера мог бы достигнуть гигантских размеров. Хранить его целиком и просматривать при сбое совершенно не реально. Поэтому СУБД периодически выполняет контрольную точку (КТ): принудительно сбрасывает на диск все грязные буферы (включая буферы clog, хранящие состояние транзакций).
Собственно «точка» — это момент начала записи буферов, которые были грязными на этот момент. Но точка считается выполненной только после того, как все такие буферы записаны. Это гарантирует, что все изменения, сделанные до момента КТ, находятся на диске.
В реальных системах с большим буферным кешем КТ может сбрасывать много грязных буферов, поэтому сервер распределяет процесс записи по времени, чтобы сгладить нагрузку на ввод-вывод.
Восстановление после сбоя начинается с момента последней завершенной КТ, что позволяет хранить только файлы журнала, записанные после нее.
Page 10: Восстановление при помощи журнала
Измененные табличные страницы находятся в буферном кеше, но еще не записаны на диск. При обычной остановке сервер выполняет контрольную точку, чтобы записать все грязные страницы на диск, но мы сымитируем сбой системы, послав сигнал процессу postmaster.
При старте произойдет восстановление согласованности данных с помощью журнала. Проверим:
Все изменения были восстановлены. PostgreSQL автоматически удаляет журнальные файлы, не требующиеся для восстановления, после выполнения контрольной точки.
Page 11: Производительность
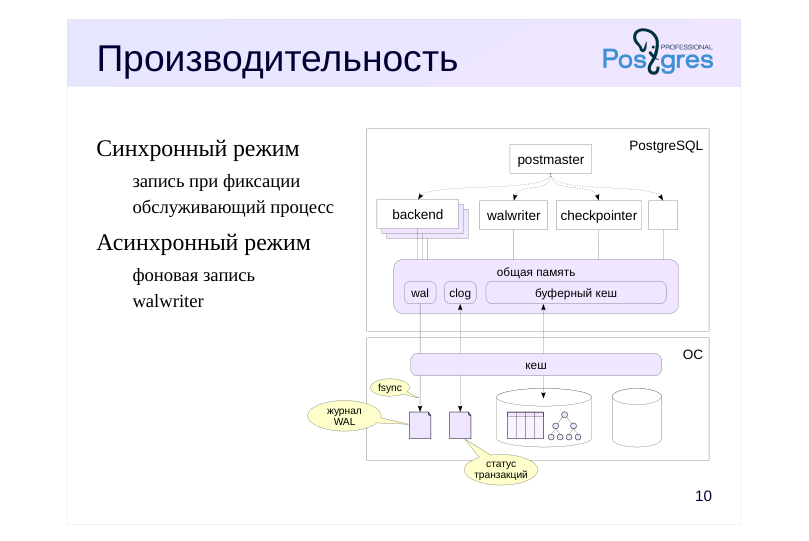 {#source-figure-011 caption=“Source slide page 11: Производительность”}
Синхронный режим
- запись при фиксации
- обслуживающий процесс
- Асинхронный режим
- фоновая запись
- walwriter
Комментарии преподавателя
Механизм журналирования более эффективен, чем работа напрямую с диском без буферного кеша. Во-первых, размер журнальных записей меньше, чем размер целой страницы данных; во-вторых, журнал записывается строго последовательно (и обычно не читается, пока не случится сбой), с чем вполне справляются простые HDD-диски.
На эффективность можно также влиять настройкой. Если запись происходит сразу (синхронно), то гарантируется, что зафиксированная транзакция не пропадет. Но запись — довольно дорогая операция, в течение которой обслуживающий процесс, выполняющий фиксацию, вынужден ждать. Чтобы журнальная запись не «застряла» в кеше операционной системы, выполняется системный вызов fsync: PostgreSQL полагается на то, что это гарантирует попадание данных на энергонезависимый носитель.
Поэтому есть и режим отложенной (асинхронной) записи. В этом случае записи пишутся фоновым процессом walwriter постепенно, с небольшой задержкой. Надежность уменьшается, зато производительность увеличивается. Но и в этом случае после сбоя гарантируется восстановление согласованности.
На самом деле оба режима работают совместно. Журнальные записи долгой транзакции будут записываться асинхронно (чтобы освободить буферы WAL). А если при сбросе страницы данных окажется, что соответствующая журнальная запись еще не на диске, она тут же будет записана в синхронном режиме.
Page 12: Основные процессы
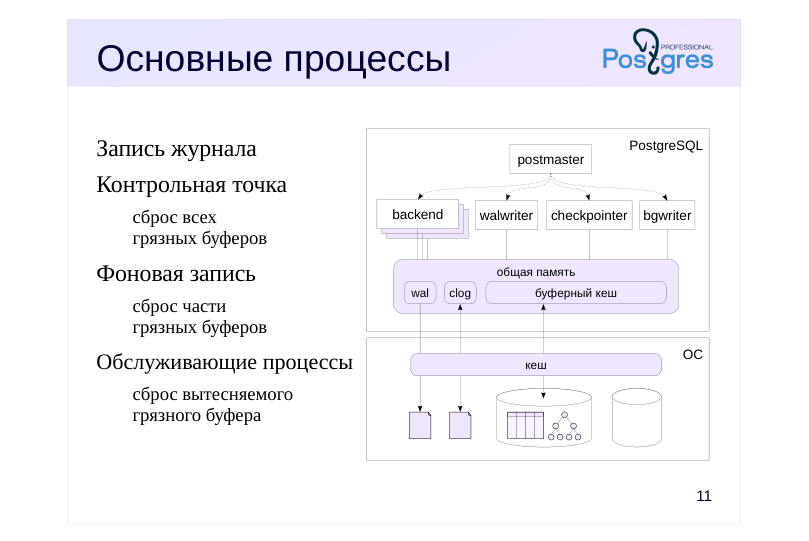 {#source-figure-012 caption=“Source slide page 12: Основные процессы”}
Запись журнала
- Контрольная точка
- сброс всех
- грязных буферов
- Фоновая запись
- сброс части
- грязных буферов
- Обслуживающие процессы
- сброс вытесняемого
- грязного буфера
Комментарии преподавателя
Вернемся еще раз к процессам, связанным с обслуживанием буферного кеша и журнала.
Во-первых, это процесс walwriter, занимающийся асинхронной записью журнала на диск. При синхронном режиме записью журнала занимается тот процесс, который выполняет фиксацию транзакции.
Во-вторых, процесс контрольной точки checkpointer, периодически сбрасывающий все грязные буферы на диск.
В-третьих, процесс фоновой записи background writer (или bgwriter). Этот процесс похож на процесс контрольной точки, но записывает только часть грязных буферов, причем те, которые с большой вероятностью будут вытеснены в ближайшее время. Таким образом, когда обслуживающий процесс выберет буфер, чтобы прочитать новую страницу, старая страница скорее всего уже не будет грязной и не надо будет тратить время, чтобы сбросить ее на диск.
И в-четвертых, обслуживающие процессы, читающие данные в буферный кеш. Если, несмотря на работу процессов контрольной точки и фоновой записи, вытесняемый буфер окажется грязным, обслуживающий процесс самостоятельно запишет его на диск.
Page 13: Уровни журнала
Minimal
- гарантия восстановления после сбоя
- Replica (по умолчанию)
- резервное копирование
- репликация: передача и проигрывание журнала на другом сервере
- Logical
- логическая репликация: информация о добавлении, изменении
- и удалении табличных строк
Комментарии преподавателя
Как уже говорилось, причиной появления журнала является необходимость защищать информацию от сбоев из-за потери содержимого оперативной памяти.
Однако журнал — механизм, который оказалось удобно применять и для других целей, если добавить в него дополнительную информацию.
Объем данных, который попадает в журнал, регулируется параметром wal_level.
● На уровне minimal журнал обеспечивает только восстановление после сбоя.
● На уровне replica в журнал добавляется информация, позволяющая использовать его для создания резервных копий и репликации. При репликации журнальные записи передаются на другой сервер и применяются там; таким образом создается и поддерживается точная копия (реплика) основного сервера.
● На уровне logical в журнал добавляется информация, позволяющая декодировать «физические» журнальные записи и сформировать из них «логические» записи о добавлении, изменении и удалении табличных строк. Это позволяет организовать логическую репликацию (рассматривается в соответствующих темах курсов DEV2 и DBA3).
Page 14: Итоги
Буферный кеш существенно ускоряет работу, уменьшая число дисковых операций
- Надежность обеспечивается журналированием
- Размер журнала ограничен благодаря контрольным точкам
- Журнал удобен и используется во многих случаях
- для восстановления после сбоя
- при резервном копировании
- для репликации между серверами
Page 15: Практика
- Средствами операционной системы найдите процессы, отвечающие за работу буферного кеша и журнала WAL. 2. Остановите PostgreSQL в режиме fast; снова запустите его. Просмотрите журнал сообщений сервера. 3. Теперь остановите в режиме immediate и снова запустите. Просмотрите журнал сообщений сервера и сравните с предыдущим разом.
Комментарии преподавателя
- Для останова в режиме fast используйте команду
При этом сервер обрывает все открытые соединения и перед выключением выполняет контрольную точку, чтобы на диск записались согласованные данные. Таким образом, выключение может выполняться относительно долго, но при запуске сервер сразу же будет готов к работе.
- Для останова в режиме immediate используйте команду
При этом сервер также обрывает открытые соединения, но не выполняет контрольную точку. На диске остаются несогласованные данные, как после сбоя. Таким образом, выключение происходит быстро, но при запуске сервер должен будет восстановить согласованность данных с помощью журнала.
Для PostgreSQL, собранного из исходных кодов, останов в режиме fast выполняется командой
а останов в режиме immediate — командой
Page 16: 1. Процессы операционной системы
Сначала получим идентификатор процесса postmaster. Он записан в первой строке файла postmaster.pid. Этот файл расположен в каталоге с данными и создается каждый раз при старте сервера.
Теперь найдем все процессы, порожденные процессом postmaster:
К процессам, обслуживающим буферный кеш и журнал, можно отнести: checkpointer; background writer; walwriter.
2. Остановка в режиме fast
Чтобы легко отделить старые сообщения от новых, очистим журнал сообщений перед перезапуском сервера. Конечно, в реальной работе так поступать не следует.
Журнал сообщений сервера:
3. Остановка в режиме immediate
Page 17: Page 17
Журнал сообщений сервера:
Перед тем, как начать принимать соединения, СУБД выполнила восстановление (automatic recovery in progress).
08 Занятие 08: Организация данных / Базы данных и схемы
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba1_08_data_databases.html Archive: DBA1-handouts-16.zip Страниц PDF: 24
Page 1: Организация данных / Базы данных и схемы
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Базы данных и шаблоны
- Схемы и путь поиска
- Специальные схемы, временные объекты
- Управление базами, схемами и объектами в них
Page 3: Кластер баз данных
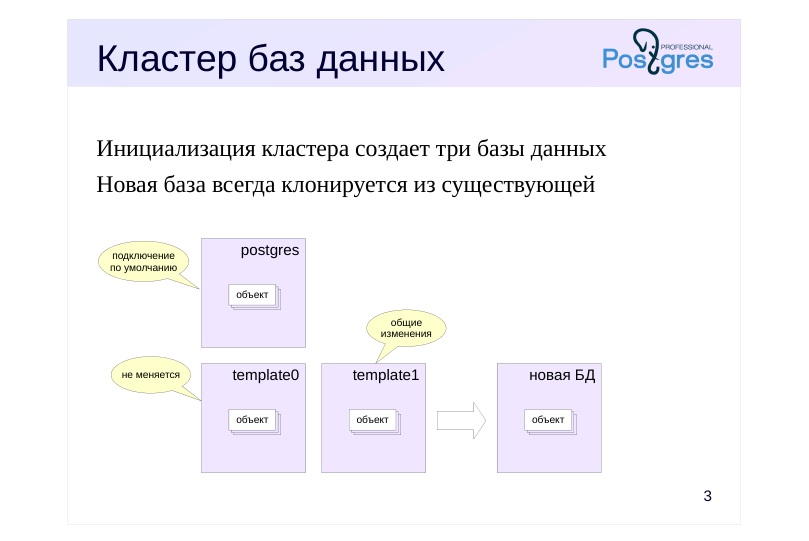 {#source-figure-003 caption=“Source slide page 3: Кластер баз данных”}
Инициализация кластера создает три базы данных
- Новая база всегда клонируется из существующей
Комментарии преподавателя
Экземпляр PostgreSQL управляет несколькими базами данных — кластером. При инициализации кластера с помощью специальной процедуры создаются три одинаковые базы данных. https://postgrespro.ru/docs/postgresql/16/bki
Все остальные БД, создаваемые пользователем, клонируются из какой-либо существующей.
Шаблон template1 используется по умолчанию для создания новых БД. В него можно добавить объекты и расширения, которые будут копироваться в каждую новую базу данных.
Шаблон template0 не должен изменяться. Он нужен как минимум в двух ситуациях. Во-первых, для восстановления БД из резервной копии, выполненной pg_dump (так как в эту копию попадут не только объекты данной БД, но и объекты, установленные в template1). Во-вторых, при создании новой БД с кодировкой, отличной от указанной при инициализации кластера.
База данных postgres используется при подключении по умолчанию пользователем postgres. Она не является обязательной, но некоторые утилиты предполагают ее наличие, поэтому ее не рекомендуется удалять, даже если она не нужна.
https://postgrespro.ru/docs/postgresql/16/manage-ag-templatedbs
Page 4: Базы данных
Список имеющихся баз показывает команда \l[ist]:
В списке присутствует четвертая база данных student, которая не создается при инициализации кластера. Она была создана для целей курса, чтобы при запуске psql не указывать базу данных: ведь по умолчанию используется база данных с таким же именем, как и пользователь ОС. Список баз данных можно посмотреть и в самой базе данных:
datistemplate — является ли база данных шаблоном; datallowconn — разрешены ли соединения с базой данных; datconnlimit — максимальное количество соединений (-1 = без ограничений).
Создание базы из шаблона
Подключимся к шаблонной базе template1:
Проверим, доступна ли функция digest, вычисляющая хеш-код текстовой строки:
Такой функции нет. На самом деле digest определена в пакете pgcrypto. Установим его:
Теперь нам доступны функции, входящие в расширение pgcrypto. Например, можно вычислить MD5-дайджест:
Page 5: Page 5
Чтобы шаблон можно было использовать для создания базы, к нему не должно быть активных подключений, поэтому отключимся от базы template1.
Для создания новой базы данных служит команда CREATE DATABASE:
Базу данных можно создать и из операционной системы утилитой createdb.
Поскольку по умолчанию для создания используется шаблон template1, в новой базе также будут доступны функции пакета pgcrypto:
Управление базами данных
Созданную базу данных можно переименовать (к ней не должно быть подключений):
Можно изменить и другие параметры, например, ограничить количество подключений:
Page 6: Размер базы данных
Размер базы данных можно узнать с помощью функции:
Чтобы не считать разряды, можно вывести размер в читаемом виде:
В этой базе данных еще нет пользовательских объектов (кроме расширения pgcrypto); фактически, это размер «пустой» базы.
Page 7: Схемы
Пространство имен для объектов внутри базы данных
- каждый объект принадлежит какой-либо схеме
- Задачи
- разделение объектов на логические группы
- предотвращение конфликта имен между приложениями
- Схема и пользователь — разные сущности
Комментарии преподавателя
Схемы представляют собой пространства имен для объектов БД. Они позволяют разделить объекты на логические группы для управления ими, предотвратить конфликты имен при работе нескольких пользователей или при установке приложений.
Каждый объект, существующий в базе данных, принадлежит какой-либо схеме.
В PostgreSQL схема и пользователь — разные сущности (хотя настройки по умолчанию позволяют пользователям удобно работать с одноименными схемами).
https://postgrespro.ru/docs/postgresql/16/ddl-schemas
Page 8: Базы и схемы кластера
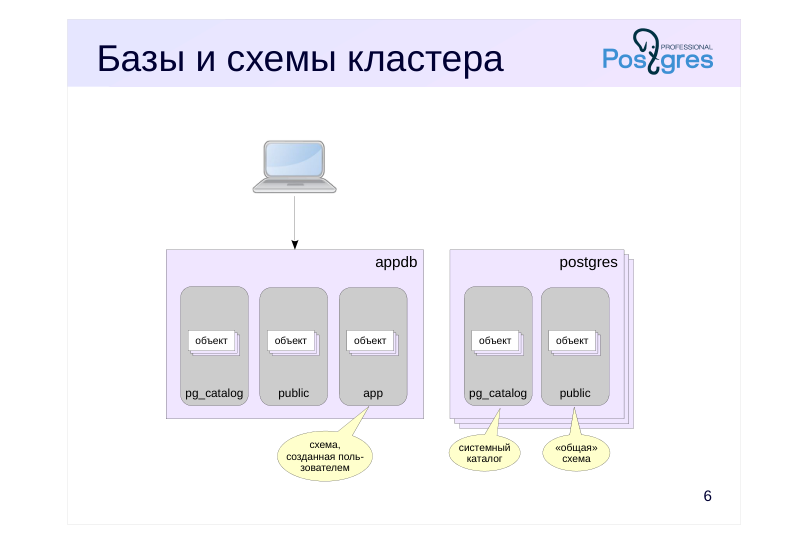 {#source-figure-008 caption=“Source slide page 8: Базы и схемы кластера”}
Комментарии преподавателя
Кластер состоит из баз данных; база содержит различные схемы, по которым, в свою очередь, распределены объекты.
Есть некоторое количество стандартных схем, которые существуют в любой базе данных. Кроме того, пользователь может создавать свои собственные схемы.
Клиент подключается одновременно только к одной базе данных, но в этой базе может работать с объектами в любых схемах.
Page 9: Схемы
Список схем можно узнать командой psql (dn = describe namespace):
Создадим новую схему:
Теперь создадим таблицу — по умолчанию она будет создана в схеме public:
Список таблиц можно получить командой \dt:
Объект можно перемещать между схемами. Поскольку речь идет о логической организации, перемещение происходит только в системном каталоге; сами данные физически остаются на месте.
Теперь к таблице t можно обращаться с явным указанием схемы:
Но если опустить имя схемы, таблица не будет найдена:
Как же работать с объектами, располагающимися в разных схемах?
Page 10: Page 10
Page 11: Путь поиска
Определение схемы объекта
- квалифицированное имя (схема.имя) явно определяет схему
- имя без квалификатора проверяется в схемах, указанных в пути поиска
- Путь поиска
- определяется параметром search_path
- исключаются несуществующие схемы и схемы, к которым нет доступа;
- подставляются неявно подразумеваемые схемы
- реальное значение показывает функция current_schemas
- первая явно указанная в пути схема используется для создания объектов
Комментарии преподавателя
При указании объекта надо определить, о какой схеме идет речь, поскольку в разных схемах могут храниться одноименные объекты.
Если имя объекта квалифицировано именем схемы, то все просто — используется явно указанная схема (как на рисунке на предыдущем слайде). Если имя использовано без квалификатора, PostgreSQL пытается найти имя в одной из схем, перечисленных в пути поиска, который определяется конфигурационным параметром search_path.
Реальный путь поиска может отличаться от значения параметра search_path. Из указанного пути исключаются несуществующие схемы, а также схемы, к которым у пользователя нет доступа (этому вопросу посвящен обзор разграничения доступа). Кроме того, в начало пути поиска неявно добавляются некоторые специальные схемы.
Реальный путь поиска, включая неявные схемы, возвращает вызов функции current_schemas(true). Схемы перебираются в указанном в пути поиска порядке, слева направо. Если в схеме нет объекта с нужным именем, поиск продолжается в следующей схеме.
При создании нового объекта с именем без квалификатора он попадает в первую явно указанную в пути схему.
Можно провести аналогию между путем поиска search_path и путем PATH в операционных системах.
https://postgrespro.ru/docs/postgresql/16/ddl-schemas#DDL-SCHEMAS-PA TH
https://postgrespro.ru/docs/postgresql/16/runtime-config-client#GUC-SEAR CH-PATH
Page 12: Специальные схемы
Схема public
- по умолчанию входит в путь поиска
- если ничего не менять и есть доступ к этой схеме,
- все объекты будут в ней
- Схема, совпадающая по имени с пользователем
- по умолчанию входит в путь поиска, но не существует
- если создать, объекты пользователя будут в этой схеме
- Схема pg_catalog
- схема для объектов системного каталога
- если pg_catalog нет в пути, она неявно подразумевается первой
Комментарии преподавателя
Существует несколько специальных схем, обычно присутствующих в каждой базе данных.
Схема public используется по умолчанию для хранения объектов, если у пользователя есть доступ к ней. Начиная с PostgreSQL 15, начальные права доступа к схеме public ограничены.
Схема pg_catalog хранит объекты системного каталога. Системный каталог — это метаинформация об объектах, принадлежащих кластеру, которая хранится в самом кластере в виде таблиц. Альтернативное представление системного каталога (определенное в стандарте SQL) дает схема information_schema.
В схеме pg_catalog находятся объекты системного каталога (в частности, таблицы pg_*).
Если не указать в пути поиска pg_catalog, эта схема будет проверяться раньше других, чтобы системные объекты были видны.
Page 13: Путь поиска
Разберемся, почему новая таблица создается в схеме public. Для этого надо посмотреть на путь поиска:
Конструкция “$user” обозначает схему с тем же именем, что и имя текущего пользователя (в нашем случае — student). Поскольку такой схемы нет, она игнорируется, и таблица создается в схеме public. Чтобы не думать над тем, какие схемы существуют, каких нет, и какие не указаны явно, можно воспользоваться следующей функцией:
Если функция вызывается с аргументом true, в результат включаются системные схемы, например, pg_catalog. Установим путь поиска, например, так:
Теперь таблица t будет найдена:
Здесь мы установили конфигурационный параметр на уровне сеанса (при повторном подключении значение пропадет). Устанавливать такое значение на уровне всего кластера тоже не правильно — возможно, этот путь нужен не всегда и не всем. Но параметр можно установить и на уровне отдельной базы данных:
Теперь он будет устанавливаться для всех новых подключений к базе appdb. Проверим:
Еще одна функция — current_schema — возвращает первое имя схемы, не являющейся системной. Это имя той обычной схемы, в которой будут создаваться новые объекты.
Page 14: Page 14
Page 15: Специальные схемы
Временные таблицы
- существуют на время сеанса или транзакции
- не журналируются (невозможно восстановление после сбоя)
- не попадают в общий буферный кеш
- Схема pg_temp_N
- автоматически создается для временных таблиц
- pg_temp — ссылка на конкретную временную схему данного сеанса
- если pg_temp нет в пути, она неявно подразумевается самой первой
- по окончании сеанса все объекты временной схемы удаляются,
- а сама схема остается и повторно используется для других сеансов
Комментарии преподавателя
PostgreSQL умеет работать с временными таблицами. Такие таблицы предназначены для хранения данных, которые должны быть доступны только текущему сеансу (и только на время его жизни, или даже на время текущей транзакции).
При восстановлении после сбоя прежних сеансов не существует, так что временные таблицы не восстанавливаются. Поэтому такие таблицы не журналируются. Кроме того, страницы временных таблиц не попадают в общий буферный кеш — работа с ними ведется во внутренней памяти обслуживающего процесса. Благодаря этому, работа с временной таблицей происходит несколько более эффективно, чем с обычной.
Доступ к временным таблицам организован с помощью схем. Для сеанса создается временная схема с именем pg_temp_N (pg_temp_1, pg_temp_2 и т. п.). Обращаться к ней нужно по имени pg_temp (без номера) — для каждого сеанса это имя ссылается на конкретную временную схему.
Если pg_temp нет в пути, то эта схема просматривается перед всеми остальными. При желании можно указать схему pg_temp (как и pg_catalog) явно на нужном месте.
После окончания сеанса все объекты временной схемы удаляются, а сама схема остается для повторного использования.
Есть и другие специальные схемы; они носят более технический характер.
Page 16: Временные таблицы и pg_temp
Создадим временную таблицу:
Таблица создана в специальной схеме. Каждому сеансу выделяется отдельная «временная» схема, так что он может видеть только свои собственные временные таблицы. Но куда пропала из списка обычная таблица t? Ответ дает развернутый путь поиска: в него теперь подставлена временная схема, и объект в ней «перекрывает» одноименный объект схемы app.
Тем не менее, к каждой из таблиц можно обращаться с явным указанием схемы. Для временной таблицы надо использовать псевдосхему pg_temp — она автоматически отображается в нужную схему pg_temp_N:
В принципе, во временной схеме можно создавать не только таблицы.
Временные таблицы и данные в них могут иметь различные сроки жизни (в зависимости от указания ON COMMIT DELETE, PRESERVE или DROP). В любом случае при переподключении все объекты во временной схеме уничтожаются:
Page 17: Удаление объектов
Схему нельзя удалить, если в ней находятся какие-либо объекты:
Но можно удалить схему вместе со всеми ее объектами:
Если база данных больше не нужна, ее также можно удалить.
Page 18: Итоги
Логически
- кластер содержит базы данных,
- базы данных — схемы,
- схемы — конкретные объекты (таблицы, индексы и т. п.)
- Базы данных создаются клонированием существующих
- Схема указывается явно или определяется по пути поиска
- Некоторые схемы имеют специальное назначение
Page 19: Практика
- Создайте новую базу данных и подключитесь к ней. 2. Проверьте размер созданной базы данных. 3. Создайте две схемы: app и названную так же, как пользователь.
- Создайте несколько таблиц в обеих схемах и наполните их какими-нибудь данными. 4. Проверьте, на сколько увеличился размер базы данных. 5. Установите путь поиска так, чтобы при подключении к БД таблицы из обеих схем были доступны по неквалифицированному имени; приоритет должна иметь «пользовательская» схема.
Page 20: 1. База данных
2. Размер БД
Запомним значение в переменной psql:
3. Схемы и таблицы
В какой схеме будут созданы таблицы без явного указания?
Таблицы для схемы student:
Таблицы для схемы app:
Page 21: 4. Изменение размера БД
Размер изменился на:
5. Путь поиска
С текущими настройками пути поиска видны таблицы только схемы student:
Изменим путь поиска:
Теперь видны таблицы из обеих схем, но приоритет остается за student:
Page 22: Page 22
Page 23: Практика+
- Создайте базу данных. Сделайте так, чтобы в каждом новом сеансе, подключенном к этой базе данных, устанавливалось значение параметра temp_buffers, в четыре раза превышающее значение по умолчанию.
Комментарии преподавателя
- Используйте команду ALTER DATABASE … SET
https://postgrespro.ru/docs/postgresql/16/sql-alterdatabase
Подробнее о параметре temp_buffers:
https://postgrespro.ru/docs/postgresql/16/runtime-config-resource#GUC-TE MP-BUFFERS
Page 24: 1. Установка temp_buffers
Параметр temp_buffers определяет объем памяти, выделяемый в каждом сеансе под локальный кеш для временных таблиц. Если данные временных таблиц не помещаются в temp_buffers, страницы вытесняются, как это происходит в обычном буферном кеше. Недостаточное значение может привести к деградации производительности при активном использовании временных таблиц. Значение по умолчанию для temp_buffers составляет 8 Мбайт:
Установим для всех новых сеансов базы данных значение 32 Мбайта:
Настройки, сделанные командой ALTER DATABASE, сохраняются в таблице pg_db_role_setting. Их можно посмотреть в psql следующей командой:
Конечно, параметр temp_buffers не обязательно настраивать на уровне базы данных. Например, его можно настроить в postgresql.conf для всего кластера.
09 Занятие 09: Организация данных / Системный каталог
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba1_09_data_catalog.html Archive: DBA1-handouts-16.zip Страниц PDF: 18
Page 1: Организация данных / Системный каталог
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Что такое системный каталог и как к нему обращаться
- Объекты системного каталога и их расположение
- Правила именования объектов
- Специальные типы данных
Page 3: Системный каталог
Набор таблиц и представлений, описывающих все объекты кластера баз данных
- Схемы
- SQL-доступ
- Доступ в psql
- специальные команды для удобства просмотра
Комментарии преподавателя
Системный каталог представляет собой набор таблиц и представлений с описанием всех объектов СУБД, «метаинформация» о содержимом кластера: https://postgrespro.ru/docs/postgresql/16/catalogs. Начиная с 14-й версии PostgreSQL для большинства таблиц системного каталога добавлены первичные ключи и ограничения уникальности.
Для доступа к этой информации используются обычные запросы SQL. При помощи команд SELECT можно получить описание любых объектов, а при помощи команд DDL (Data Definition Language) можно добавлять и изменять объекты.
Все таблицы и представления системного каталога располагаются в схеме pg_catalog. Существует и другая схема, предписанная стандартом SQL: information_schema. Она более стабильна и переносима, чем pg_catalog, но не отражает специфику PostgreSQL.
Клиентские программы могут читать содержимое системного каталога и показывать его пользователю в удобном виде. Например, графические среды разработки и управления обычно изображают иерархический «навигатор» объектов.
Программа psql тоже предлагает ряд удобных встроенных команд для работы с системным каталогом. Как правило, эти команды начинаются на \d (от describe). Подробности об этих командах в документации: https://postgrespro.ru/docs/postgresql/16/app-psql#APP-PSQL-META-COM MANDS
Наиболее часто используемые из них мы посмотрим в демонстрации. В материалах курса есть файл catalogs.pdf со схемой основных таблиц системного каталога и команд psql для работы с ними.
Page 4: Общие объекты кластера
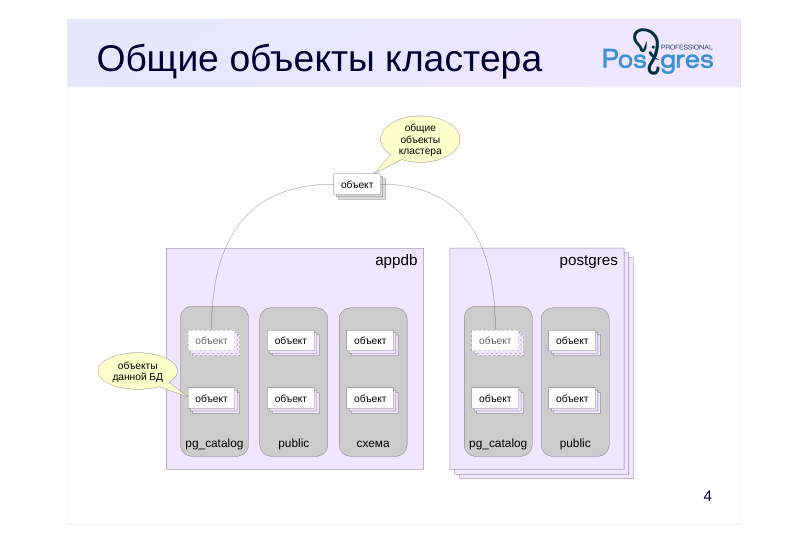 {#source-figure-004 caption=“Source slide page 4: Общие объекты кластера”}
Комментарии преподавателя
В каждой базе данных кластера создается свой набор таблиц системного каталога. Однако существует несколько объектов каталога, которые являются общими для всего кластера. Наиболее очевидный пример — список самих баз данных.
Эти таблицы хранятся вне какой-либо базы данных, но при этом одинаково видны из каждой БД.
Page 5: Правила именования
Префиксы имен объектов (таблиц, представлений) и столбцов
- префикс столбцов
- (обычно повторяет
- общий префикс
- всех объектов
- имя объекта)
- Названия объектов всегда хранятся в нижнем регистре
Комментарии преподавателя
Все таблицы и представления системного каталога начинаются с префикса «pg_». Для предотвращения потенциальных конфликтов, не рекомендуется создавать собственные объекты, начинающиеся с «pg_».
Названия столбцов имеют трехбуквенный префикс, который, как правило, соответствует имени таблицы. После префикса нет знака подчеркивания. Имеются некоторые исключения из этого правила, например, столбец oid и другие.
Названия объектов хранятся в нижнем регистре.
Page 6: Некоторые объекты системного каталога
Создадим базу данных и тестовые объекты:
Некоторые таблицы системного каталога нам уже знакомы из предыдущей темы. Это базы данных:
И схемы:
Важная таблица pg_class хранит описание целого ряда объектов: таблиц, представлений, индексов, последовательностей. Все эти объекты называются в PostgreSQL общим словом «отношение» (relation), отсюда и префикс «rel» в названии столбцов:
Page 7: Page 7
Тип объекта определяется столбцом relkind, по значению в relpersistence можно отличить временные объекты от постоянных. При активном использовании временных объектов в таблицах системного каталога будет возникать большое количество неактуальных версий строк, что может привести к снижению производительности на всех этапах выполнения запроса. В таком случае следует позаботиться о своевременной очистке таблиц системного каталога. Конечно, для каждого типа объектов в pg_class имеет смысл только часть столбцов; кроме того, удобнее смотреть не на идентификаторы (relnamespace, relowner, и т. д.), а на названия соответствующих объектов. Для этого существуют различные системные представления, например:
Использование команд psql
В psql встроен набор команд для получения информации из системного каталога. Это короткие команды, пользоваться которыми проще, чем писать запросы к системным таблицам или представлениям. Получить список таблиц можно командой:
Список всех представлений в схеме public:
Список таблиц, представлений, индексов и последовательностей:
Page 8: Page 8
Эти команды можно снабдить модификатором «+», чтобы получить больше информации:
Чтобы получить детальную информацию об отдельном объекте, надо воспользоваться командой \d (без дополнительной буквы):
Модификатор «+» остается в силе:
Помимо отношений, аналогичным образом можно смотреть и на другие объекты, такие как схемы (\dn) или функции (\df). Еще один модификатор «S» позволяет вывести не только пользовательские, но и системные объекты. С помощью шаблона можно ограничить выборку:
Page 9: Page 9
Как правило, эти команды psql имеют мнемонические имена. Например, \df — describe function, \sf — show function:
Полный список всегда можно посмотреть в документации или командой psql \?.
Изучение структуры системного каталога
Все команды psql, описывающие объекты, обращаются к таблицам системного каталога. Чтобы увидеть эти запросы, следует установить переменную psql ECHO_HIDDEN. Получим, например, информацию о таблице employees:
Для большинства таблиц системного каталога имеются первичные ключи (обычно это столбец oid) и ограничения уникальности. Например, таблица pg_attribute с информацией об атрибутах отношений имеет ограничения:
Page 10: Page 10
Ссылочная целостность обеспечивается с помощью ограничений, похожих на внешние ключи, но немного более сложных: ссылающийся столбец может быть массивом ссылающихся элементов, а неопределенность может обозначаться в нем нулем. Получить список таких псевдо-внешних ключей можно функцией pg_get_catalog_foreign_keys(). Например, pg_attribute “ссылается” на:
fktable, fkcols — ссылающаяся таблица и ее столбцы; pktable, pkcols — ключ, на который ссылаются; is_array — является ли ссылающийся столбец массивом; is_opt — может ли ссылающийся столбец содержать 0.
Page 11: Специальные типы данных
Тип oid — идентификатор объекта
- целочисленный тип данных с автоинкрементом
- Типы reg*
Комментарии преподавателя
Большинство таблиц системного каталога используют в качестве первичного ключа столбец с именем oid и одноименным типом данных.
Тип oid (object identifier) представляет собой целочисленный тип данных с разрядностью 32 бита (около 4 млрд. значений) и автоинкрементом.
Существует несколько специальных типов данных (фактически псевдонимов oid), начинающихся на «reg», которые позволяют преобразовывать имена объектов в oid и обратно.
https://postgrespro.ru/docs/postgresql/16/datatype-oid
Page 12: Тип oid и reg-типы
Как мы видели, описания таблиц и представлений хранятся в таблице pg_class, а описание столбцов располагаются в отдельной таблице pg_attribute. Чтобы получить список столбцов конкретной таблицы, надо соединить pg_class и pg_attribute:
Используя reg-типы, запрос можно написать проще, без явного обращения к pg_class:
Здесь мы преобразовали строку ’employees’ к типу oid. Аналогично мы можем вывести oid как текстовое значение:
Полный список reg-типов:
Page 13: Итоги
Системный каталог — метаинформация о кластере в самом кластере
- SQL-доступ и дополнительные команды psql
- Часть таблиц системного каталога хранится в базах данных, часть — общая для всего кластера
- Системный каталог использует специальные типы данных
Page 14: Практика
- Получите описание таблицы pg_class.
- Получите подробное описание представления pg_tables.
- Создайте базу данных и временную таблицу в ней. Получите полный список схем в базе, включая системные.
- Получите список представлений в схеме information_schema.
- Какие запросы выполняет следующая команда psql? \d+ pg_views
Page 15: 1. Описание pg_class
2. Подробное описание pg\_tables
Page 16: 3. Полный список схем
Временная таблица расположена в схеме pg_temp_N, где N — некоторое число. Такие схемы создаются для каждого сеанса, в котором появляются временные объекты, поэтому их может быть несколько. Имя схемы для временных объектов текущего сеанса можно получить, обратившись к системной функции:
Однако в большинстве случаев точное имя схемы знать не нужно, поскольку при необходимости к временному объекту можно обратиться, используя имя схемы pg_temp:
Предназначение некоторых других схем нам уже известно, а с оставшимися (pg_toast*) познакомимся позже.
4. Список представлений в information\_schema
Используем шаблон:
Page 17: Page 17
5. Запросы к системному каталогу
Чтобы увидеть запросы, которые выполняют команды psql, включим переменную ECHO_HIDDEN.
Page 18: Page 18
Для формирования вывода потребовалось выполнить пять запросов.
10 Занятие 10: Организация данных / Табличные пространства
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba1_10_data_tablespaces.html Archive: DBA1-handouts-16.zip Страниц PDF: 15
Page 1: Организация данных / Табличные пространства
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Табличные пространства и каталоги
- Создание, изменение и удаление табличных пространств
- Хранение данных в файловой системе
- Перемещение данных
Page 3: Табличные пространства
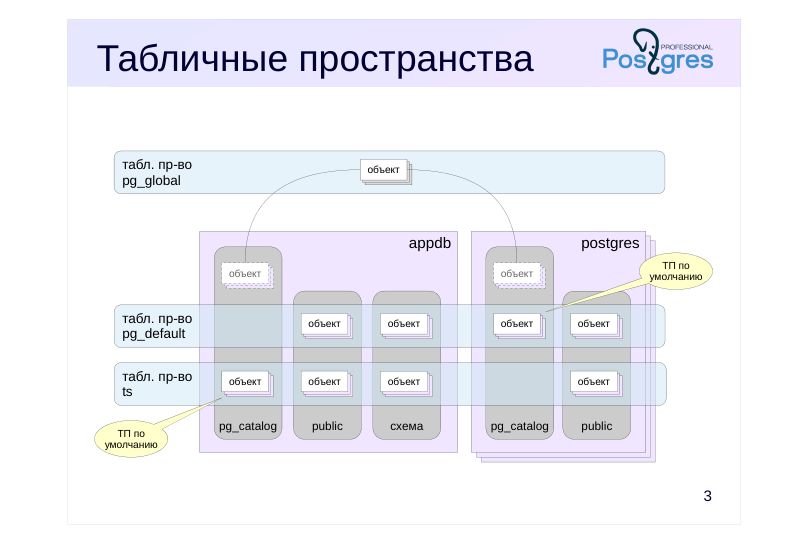 {#source-figure-003 caption=“Source slide page 3: Табличные пространства”}
Комментарии преподавателя
Табличные пространства (ТП) служат для организации физического хранения данных и определяют расположение данных в файловой системе.
Например, можно создать одно ТП на медленных дисках для архивных данных, а другое — на быстрых дисках для данных, с которыми идет активная работа.
При инициализации кластера создаются два ТП: pg_default и pg_global.
Одно и то же ТП может использоваться разными базами данных, а одна база данных может хранить данные в нескольких ТП.
При этом у каждой БД есть так называемое «ТП по умолчанию», в котором создаются все объекты, если не указано иное. В этом же ТП хранятся и объекты системного каталога. Изначально в качестве «ТП по умолчанию» используется ТП pg_default, но можно установить и другое.
ТП pg_global особенное: в нем хранятся те объекты системного каталога, которые являются общими для кластера.
https://postgrespro.ru/docs/postgresql/16/manage-ag-tablespaces
Page 4: Каталоги
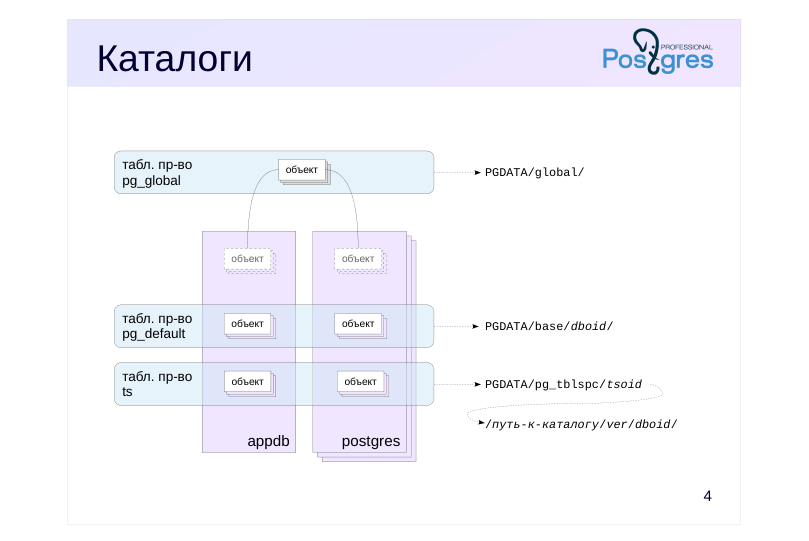 {#source-figure-004 caption=“Source slide page 4: Каталоги”}
Комментарии преподавателя
По сути, табличное пространство — это указание на каталог, в котором располагаются данные. Стандартные ТП pg_global и pg_default всегда находятся в PGDATA/global/ и PGDATA/base/ соответственно. При создании пользовательского ТП указывается произвольный каталог; для собственного удобства PostgreSQL создает на него символическую ссылку в каталоге PGDATA/pg_tblspc/.
Внутри каталога PGDATA/base/ данные дополнительно разложены по подкаталогам баз данных (для PGDATA/global/ это не требуется, так как данные в нем относятся к кластеру в целом).
Внутри каталога пользовательского ТП появляется еще один уровень вложенности: версия сервера PostgreSQL. Это сделано для удобства обновления сервера на другую версию.
Собственно объекты хранятся в файлах внутри этих каталогов — каждый объект в отдельных файлах.
Page 5: Системные табличные пространства
При создании кластера создаются два табличных пространства:
pg_global — общие объекты кластера; pg_default — табличное пространство по умолчанию.
Пользовательские табличные пространства
Для нового табличного пространства нужен пустой каталог, владельцем которого является пользователь postgres.
Теперь можно создать табличное пространство:
Список табличных пространств можно получить и командой psql:
У каждой базы данных есть табличное пространство «по умолчанию». Создадим базу и назначим ей ts в качестве такого пространства:
Теперь все создаваемые таблицы и индексы будут попадать в ts, если явно не указать другое. Подключимся к базе:
Создадим таблицу:
При создании объекта можно указать табличное пространство явно:
Page 6: Page 6
Пустое поле tablespace указывает на табличное пространство по умолчанию, а у второй таблицы поле заполнено. Для индекса также можно указать табличное пространство:
Еще один способ задать табличное пространство без явного указания при создании объекта — предварительно установить значение параметра default_tablespace. Одно табличное пространство может использоваться для объектов нескольких баз данных.
У этой БД табличным пространством по умолчанию будет pg_default.
Для временных таблиц и их индексов можно указать отдельное табличное пространство по умолчанию:
В параметре temp_tablespaces можно указать несколько табличных пространств, в этом случае сервер выберет одно из них случайным образом.
Управление объектами в табличных пространствах
Таблицы (и другие объекты, например, индексы), можно перемещать между табличными пространствами.
Page 7: Page 7
Перенести индексы можно и при перестроении:
Можно переместить и все объекты из одного табличного пространства в другое:
Note Важно понимать, что перенос в другое табличное пространство (в отличие от переноса в другую схему) — физическая операция, связанная с копированием файлов данных из каталога в каталог. На время ее выполнения доступ к перемещаемому объекту полностью блокируется.
Размер табличного пространства
Мы уже рассматривали, как узнать объем, занимаемый базой данных. Можно узнать и объем объектов в табличном пространстве:
Почему размер так велик, хотя в табличном пространстве всего несколько пустых таблиц? Поскольку ts является табличным пространством по умолчанию для базы appdb, в нем хранятся объекты системного каталога. Они и занимают место. В psql получить размер табличных пространств можно командой:
Удаление табличного пространства
Табличное пространство можно удалить, но только в том случае, если оно пусто:
Page 8: Page 8
В отличие от удаления схемы, в команде DROP TABLESPACE нельзя использовать предложение CASCADE: объекты табличного пространства могут принадлежать разным базам данных, а подключены мы только к одной. Но можно выяснить, в каких базах есть зависимые объекты. В этом нам поможет системный каталог. Сначала узнаем и запомним идентификатор табличного пространства:
Затем получим список баз данных, в которых есть объекты из удаляемого пространства:
Дальше подключаемся к каждой базе данных и получаем список объектов из pg_class:
Таблица больше не нужна, удалим ее.
И вторая база данных. Поскольку ts является табличным пространством по умолчанию, у объектов в pg_class идентификатор табличного пространства равен нулю. Это, как нам уже известно, объекты системного каталога:
Табличное пространство по умолчанию можно сменить; при этом все таблицы из старого пространства физически переносятся в новое. Предварительно надо отключиться от базы.
Вот теперь табличное пространство может быть удалено.
Page 9: Page 9
От имени пользователя postgres удалим каталог, созданный для табличного пространства.
Page 10: Итоги
Табличные пространства — средство для организации физического хранения данных
- Логическое (базы данных, схемы) и физическое (табличные пространства) разделения данных независимы
Page 11: Практика
Почему при создании базы данных без предложения TABLESPACE табличным пространством по умолчанию становится pg_default?
- Создайте новое табличное пространство.
- Измените табличное пространство по умолчанию для базы данных template1 на созданное пространство.
- Создайте новую базу данных. Проверьте, какое табличное пространство по умолчанию установлено для новой базы данных.
- Найдите в PGDATA символическую ссылку на каталог табличного пространства.
- Удалите созданное табличное пространство.
Page 12: 1. Новое табличное пространство
Каждая база данных имеет табличное пространство по умолчанию. В том числе и template1:
По умолчанию новые базы данных создаются копированием template1, поэтому они получают такое же табличное пространство, как установлено для template1. Создадим новое табличное пространство.
2. Табличное пространство по умолчанию для template1
3. Новая база данных и проверка
Табличное пространство по умолчанию — ts. Вывод: если нет явного указания, табличное пространство по умолчанию определяется шаблоном, из которого клонируется новая база данных.
4. Символическая ссылка
Page 13: 5. Удаление табличного пространства
Page 14: Практика+
- Установите параметр random_page_cost в значение 1.1 для табличного пространства pg_default.
Комментарии преподавателя
- Используйте команду ALTER TABLESPACE … SET:
https://postgrespro.ru/docs/postgresql/16/sql-altertablespace
Параметры seq_page_cost и random_page_cost используются планировщиком запросов и задают примерную стоимость чтения с диска одной страницы данных при последовательном и произвольном доступе соответственно.
Чем меньше соотношение между этими параметрами, тем чаще планировщик будет предпочитать индексный доступ последовательному сканированию таблицы.
Более подробно параметры *_cost, и в частности random_page_cost, рассматриваются в курсе QPT «Оптимизация запросов».
Page 15: 1. Установка random_page_cost для табличного пространства
Значения по умолчанию параметров seq_page_cost и random_page_cost больше подходят для медленных HDD-дисков. Предполагается, что доступ к произвольной странице данных в четыре раза дороже последовательного:
Если используются диски с разными характеристиками, для них можно создать разные табличные пространства и настроить подходящие соотношения этих параметров. Например для быстрых SSD-дисков значение random_page_cost можно уменьшить практически до значения seq_page_cost.
Настройки, сделанные командой ALTER TABLESPACE, сохраняются в таблице pg_tablespace. Их можно посмотреть в psql следующей командой:
Параметры *_cost можно установить и в postgresql.conf. Тогда они будут действовать для всех табличных пространств.
11 Занятие 11: Организация данных / Низкий уровень
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba1_11_data_lowlevel.html Archive: DBA1-handouts-16.zip Страниц PDF: 20
Page 1: Организация данных / Низкий уровень
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Файлы данных
- Слои: данные, карты видимости и свободного пространства
- Длинные версии строк и TOAST
Page 3: Слои объекта
 {#source-figure-003 caption=“Source slide page 3: Слои объекта”}
Комментарии преподавателя
Обычно каждому объекту БД, хранящему данные (таблице, индексу, последовательности, материализованному представлению), соответствует несколько слоев (forks). Каждый слой содержит определенный вид данных.
Вначале слой содержит один-единственный файл. Имя файла состоит из числового идентификатора, к которому может быть добавлено окончание, соответствующее имени слоя.
Файл постепенно растет и, когда его размер доходит до 1 Гбайта, создается следующий файл этого же слоя. Такие файлы иногда называют сегментами. Порядковый номер сегмента добавляется в конец имени файла. Общий размер любого слоя показывает функция pg_relation_size.
Ограничение размера файла в 1 Гбайт возникло исторически для поддержки различных файловых систем, некоторые из которых не умеют работать с файлами большого размера. Установить другой размер можно только при сборке сервера из исходных кодов (–with-segsize).
Таким образом, одному объекту БД на диске может соответствовать несколько файлов. Для небольшой таблицы их будет 3, для индекса — два. Все файлы объектов, принадлежащих одному табличному пространству и одной БД, будут помещены в один каталог. Это необходимо учитывать, потому что файловые системы могут не очень хорошо работать с большим количеством файлов в каталоге.
Page 4: Слои
Основной слой
- собственно данные (версии строк)
- существует для всех объектов
- Слой инициализации (init)
- «пустышка» для основного слоя
- используется при сбое; только для нежурналируемых таблиц
- Карта видимости (vm)
- существует только для таблиц
- Карта свободного пространства (fsm)
- существует и для таблиц, и для индексов
Комментарии преподавателя
Посмотрим теперь на типы слоев.
Основной слой — это собственно данные: версии строк таблиц или индексные записи. Имена файлов основного слоя совпадают с идентификатором. Основной слой существует для любых объектов.
Имена файлов слоя инициализации оканчиваются на «_init». Этот слой существует только для нежурналируемых таблиц (созданных с указанием UNLOGGED) и их индексов. Такие объекты ничем не отличаются от обычных, но действия с ними не записываются в журнал упреждающей записи. За счет этого работа с ними происходит быстрее, но в случае сбоя их содержимое невозможно восстановить. При восстановлении PostgreSQL просто удаляет все слои таких объектов и записывает слой инициализации на место основного слоя. В результате получается пустая таблица.
https://postgrespro.ru/docs/postgresql/16/storage-init
Слой vm (visibility map) — битовая карта видимости. Имена файлов этого слоя оканчиваются на «_vm». Слой существует только для таблиц; для индексов не поддерживается отдельная версионность.
Слой fsm (free space map) — карта свободного пространства. Имена файлов этого слоя оканчиваются на «_fsm». Этот слой существует и для таблиц, и для индексов.
Про две эти карты рассказывалось в модуле «Архитектура».
https://postgrespro.ru/docs/postgresql/16/storage-fsm
https://postgrespro.ru/docs/postgresql/16/storage-vm
Page 5: Расположение файлов
Создадим таблицу и посмотрим на файлы, принадлежащие ей.
Чтобы сформировались дополнительные слои, выполним очистку:
Путь до основного файла относительно PGDATA можно получить функцией:
Поскольку таблица находится в табличном пространстве pg_default, путь начинается с base. Затем идет имя каталога для базы данных:
Затем — собственно имя файла. Его можно узнать следующим образом:
Тем и удобна функция pg_relation_filepath, что выдает готовый путь без необходимости выполнять несколько запросов к системному каталогу. Посмотрим на файлы. Доступ к каталогу PGDATA имеет только пользователь ОС postgres, поэтому команда ls выдается от его имени:
Мы видим три слоя: основной слой, карту свободного пространства (fsm) и карту видимости (vm). Аналогично можно посмотреть и на файлы индекса:
Page 6: Page 6
И на файлы последовательности, созданной для первичного ключа:
Для индекса карта свободного пространства строится при наличии пустых страниц, а для последовательности существует только основной слой. Временные таблицы хранятся так же, как и постоянные.
К имени файла добавляется префикс, соответствующий номеру схемы для временных объектов.
Существует полезное приложение oid2name, входящее в стандартную поставку, с помощью которого можно легко связать объекты БД и файлы. Можно посмотреть все базы данных:
Page 7: Page 7
Можно посмотреть все объекты в базе:
Или все табличные пространства в базе:
Можно по имени таблицы узнать имя файла:
Или наоборот, по номеру файла узнать таблицу:
Размер слоев
Размер файлов, входящих в слой, можно, конечно, посмотреть в файловой системе, но существует специальная функция для получения размера каждого слоя в отдельности:
Page 8: TOAST
Версия строки должна помещаться на одну страницу
- можно сжать часть полей
- можно вынести часть полей в отдельную toast-таблицу
- можно сжать и вынести одновременно
- Toast-таблица
- находится в схеме pg_toast (pg_toast_temp_N)
- поддержана собственным индексом
- содержит фрагменты «длинных» значений размером меньше страницы
- читается только при обращении к «длинному» полю
- имеет собственную версионность
- используется прозрачно для приложения
Комментарии преподавателя
Любая версия строки в PostgreSQL должна целиком помещаться на одну страницу. Для «длинных» версий строк применяется технология TOAST — The Oversized Attributes Storage Technique. Она подразумевает несколько стратегий работы с «длинными» полями. Значение поля может быть сжато так, чтобы версия строки поместилась на страницу. Значение может быть убрано из версии и перемещено в отдельную служебную таблицу. Могут применяться и оба подхода: какие-то значения будут сжаты, какие-то — перемещены, какие-то — сжаты и перемещены одновременно.
Для каждой основной таблицы при необходимости создается отдельная toast-таблица (и к ней специальный индекс). Такие таблицы и индексы располагаются в отдельной схеме pg_toast и поэтому обычно не видны (для временных таблиц используется схема pg_toast_temp_N аналогично обычной pg_temp_N).
Версии строк в toast-таблице тоже должны помещаться на одну страницу, поэтому длинные значения хранятся порезанными на фрагменты. Из этих фрагментов PostgreSQL прозрачно для приложения «склеивает» необходимое значение.
Toast-таблица используется только при обращении к длинному значению. Кроме того, для toast-таблицы поддерживается своя версионность: если обновление данных не затрагивает «длинное» значение, новая версия строки будет ссылаться на то же самое значение в toast-таблице — это экономит место.
https://postgrespro.ru/docs/postgresql/16/storage-toast
Page 9: TOAST
В таблице t есть столбец типа numeric. Этот тип может работать с очень большими числами. Например, с такими:
При этом, если вставить такое значение в таблицу, размер файлов не изменится:
Поскольку версия строки не может поместиться на одну страницу, значение атрибута n хранится в отдельной TOAST-таблице. TOAST-таблица и индекс к ней создаются автоматически для каждой таблицы, в которой есть потенциально «длинный» тип данных, и используются по необходимости. Имя и идентификатор такой таблицы можно найти следующим образом:
Вот и файлы TOAST-таблицы:
Существуют несколько стратегий работы с длинными значениями. Название стратегии показывается в поле Storage:
plain — TOAST не применяется (тип имеет фиксированную длину);
Page 10: Page 10
extended — применяется как сжатие, так и отдельное хранение; external — сжатие не используется, только отдельное хранение; main — такие поля обрабатываются в последнюю очередь и выносятся в TOAST-таблицу, только если сжатия недостаточно. Стратегия назначается для каждого столбца при создании таблицы. Ее можно указать явно, а значение по умолчанию зависит от типа данных. При необходимости стратегию можно впоследствии изменить. Например, если известно, что в столбце хранятся уже сжатые данные, разумно поставить стратегию external. Просто для примера:
Эта операция не меняет существующие данные в таблице, но определяет стратегию работы с новыми версиями строк.
Page 11: Размер таблицы
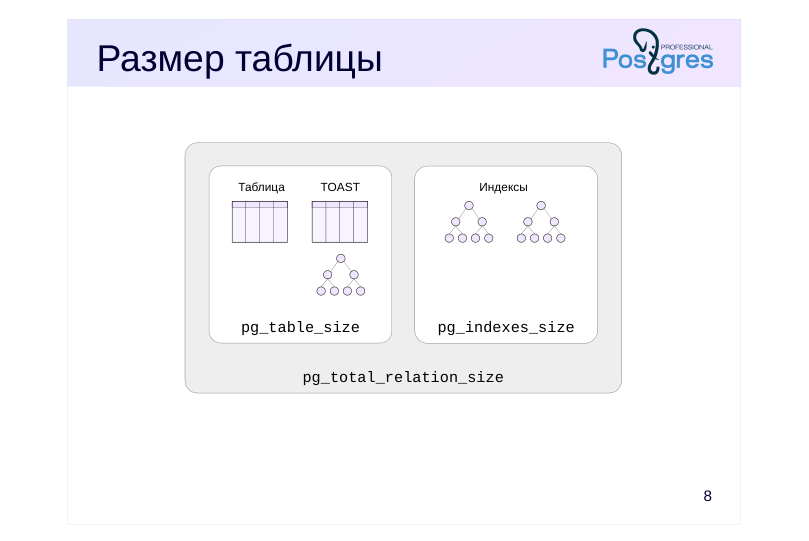 {#source-figure-011 caption=“Source slide page 11: Размер таблицы”}
Комментарии преподавателя
Как уже говорилось, размер отдельного слоя можно получить функцией pg_relation_size. Чтобы не суммировать размеры отдельных слоев, есть несколько функций, показывающих размеры таблицы:
● pg_table_size показывает размер таблицы и ее toast-части (toast-таблицы и обслуживающего ее индекса), но без обычных индексов. Эту же функцию можно использовать для вычисления размера отдельного индекса: и таблицы, и индексы являются отношениями, и, несмотря на название, функция принимает любое отношение.
● pg_indexes_size суммирует размеры всех индексов таблицы, кроме индекса toast-таблицы.
● pg_total_relation_size показывает полный размер таблицы, вместе со всеми ее индексами.
Page 12: Размер таблицы
Размер таблицы, включая TOAST-таблицу и обслуживающий ее индекс:
Общий размер всех индексов таблицы:
Для получения размера отдельного индекса можно воспользоваться функцией pg_table_size. TOAST-части у индексов нет, поэтому функция покажет только размер всех слоев индекса (main, fsm). Сейчас у таблицы есть только индекс по первичному ключу, поэтому размер этого индекса совпадает со значением pg_indexes_size:
Общий размер таблицы, включающий TOAST и все индексы:
Page 13: Итоги
Объект представлен несколькими слоями
- Слой состоит из одного или нескольких файлов-сегментов
- Для «длинных» версий строк используется TOAST
Page 14: Практика
- Создайте нежурналируемую таблицу в пользовательском табличном пространстве и убедитесь, что для таблицы существует слой init.
- Удалите созданное табличное пространство. 2. Создайте таблицу со столбцом типа text. Какая стратегия хранения применяется для этого столбца?
- Измените стратегию на external и вставьте в таблицу
- короткую и длинную строки.
- Проверьте, попали ли строки в toast-таблицу, выполнив
- прямой запрос к ней. Объясните, почему.
Page 15: 1. Нежурналируемая таблица
Посмотрим на файлы таблицы. Обратите внимание, что следующая команда ls выполняется от имени пользователя postgres. Чтобы повторить такую команду, удобно сначала открыть еще одно окно терминала и переключиться в нем на другого пользователя командой:
И затем в этом же окне выполнить:
Удалим созданное табличное пространство:
2. Таблица с текстовым столбцом
По умолчанию для типа text используется стратегия extended.
Page 16: Page 16
Изменим стратегию на external:
Проверим TOAST-таблицу:
TOAST-таблица «спрятана», так как находится в схеме, которой нет в пути поиска. И это правильно, поскольку TOAST работает прозрачно для пользователя. Но заглянуть в таблицу все-таки можно:
Видно, что в TOAST-таблицу попала только длинная строка (два фрагмента, общий размер совпадает с длиной строки). Короткая строка не вынесена в TOAST просто потому, что в этом нет необходимости — версия строки и без этого помещается в страницу.
Page 17: Практика+
- Создайте базу данных.
- Сравните размер базы данных, возвращаемый функцией
- pg_database_size, с общим размеров всех таблиц в этой базе.
- Объясните полученный результат. 2. В TOAST поддерживаются два метода сжатия: pglz и lz4. Проверьте средствами SQL, был ли PostgreSQL скомпилирован с поддержкой этих методов. 3. Создайте текстовый файл размером больше 10 Мбайт. Загрузите его содержимое в таблицу с текстовым полем, сначала без сжатия, а затем используя каждый из алгоритмов. Сравните итоговый размер таблицы и время загрузки данных для трех вариантов.
Комментарии преподавателя
Список таблиц базы данных можно получить из таблицы pg_class системного каталога.
С помощью представления pg_config можно узнать, какие параметры были установлены скрипту configure при сборке ПО сервера. Строка, содержащая список параметров, велика; выделить необходимые параметры можно функцией string_to_table().
Чтобы получить текст для эксперимента, можно взять достаточно большой двоичный файл (например, исполняемый файл postgres) и преобразовать его в текст. Для преобразования можно использовать алгоритм Base32 (ключ -w0 отменяет переносы строк):
Page 18: 1. Сравнение размеров базы данных и таблиц в ней
Даже пустая база данных содержит таблицы, относящиеся к системного каталогу. Полный список отношений можно получить из таблицы pg_class. Из выборки надо исключить: таблицы, общие для всего кластера (они не относятся к текущей базе данных); индексы и TOAST-таблицы (они будут автоматически учтены при подсчете размера).
Размер базы данных оказывается несколько больше:
Дело в том, что функция pg_database_size возвращает размер каталога файловой системы, а в этом каталоге находятся несколько служебных файлов.
Обратите внимание, что следующая команда ls выполняется от имени пользователя postgres. Чтобы повторить такую команду, удобно сначала открыть еще одно окно терминала и переключиться в нем на другого пользователя командой:
И затем в этом же окне выполнить:
pg_filenode.map — отображение oid некоторых таблиц в имена файлов; pg_internal.init — кеш системного каталога; PG_VERSION — версия PostgreSQL. Из-за того, что одни функции работают на уровне объектов базы данных, а другие — на уровне файловой системы, бывает сложно точно сопоставить возвращаемые размеры. Это относится и к функции pg_tablespace_size.
2. Поддержка методов сжатия TOAST
Представление pg_config показывает параметры, которые были переданы скрипту configure при сборке PostgreSQL.
Page 19: Page 19
Какой метод сжатия TOAST используется по умолчанию?
Какие методы можно применять?
3. Сравнение методов сжатия
Сравним методы сжатия на примере текстовых данных. Чтобы получить текст большого объема, возьмем исполняемый файл postgres и преобразуем его в текст с помощью алгоритма Base 32, который применяется в электронной почте.
Получившийся текстовый файл имеет достаточный размер.
Создадим таблицу для загрузки текстовых данных. Для столбца txt установим стратегию хранения external, которая допускает отдельное хранение, но не сжатие.
Загрузим данные из текстового файла.
Проверим размер таблицы, включая TOAST.
Опустошим таблицу и зададим сжатие с помощью pglz.
Page 20: Page 20
Теперь используется стратегия EXTENDED, которая допускает как сжатие, так и отдельное хранение. Снова загрузим данные.
Размер таблицы значительно уменьшился, но при этом заметно выросло время загрузки. Снова опустошим таблицу и зададим теперь сжатие с помощью lz4.
Еще раз загрузим данные и сравним.
Алгоритм lz4 слегка уступает pglz по степени сжатия, однако работает значительно быстрее. Удалим текстовый файл.
12 Занятие 12: Задачи администрирования / Мониторинг
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba1_12_admin_monitoring.html Archive: DBA1-handouts-16.zip Страниц PDF: 30
Page 1: Задачи администрирования / Мониторинг
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Средства операционной системы
- Накопительная статистика сервера
- Журнал сообщений сервера
- Внешние системы мониторинга
Page 3: Средства ОС
Процессы
- ps, pgrep…
- параметр update_process_title для обновления статуса процессов
- параметр cluster_name для установки имени кластера
- Использование ресурсов
- iostat, vmstat, sar, top…
- Дисковое пространство
- df, du, quota…
Комментарии преподавателя
PostgreSQL работает под управлением операционной системы и в известной степени зависит от ее настроек.
Используя инструменты операционной системы, можно посмотреть информацию о процессах PostgreSQL. При включенном (по умолчанию) параметре сервера update_process_title в имени процесса отображается его текущее состояние. Параметр cluster_name задает имя экземпляра, по которому его можно отличать в списке процессов.
Использование системных ресурсов (процессора, ОЗУ, дисков) в Unix проверяют с помощью iostat, vmstat, sar, top и других инструментов.
Необходимо следить и за размером дискового пространства. Место, занимаемое базой данных, можно смотреть как из самой БД (см. модуль «Организация данных»), так из ОС (команда du). Размер доступного дискового пространства надо смотреть в ОС (команда df).
Дисковые квоты Unix ограничивают использование диска пользователями ОС. Так как процессы PostgreSQL принадлежат единственному пользователю postgres (по умолчанию), дисковая квота для него должна быть достаточной. PostgreSQL не позволяет квотировать использование ролями дискового пространства.
В целом набор инструментов и подходы могут сильно различаться в зависимости от используемой ОС и файловой системы, поэтому подробно здесь не рассматриваются.
https://postgrespro.ru/docs/postgresql/16/monitoring-ps
https://postgrespro.ru/docs/postgresql/16/diskusage
Page 4: Накопительная статистика
Процесс сбора статистики
- Текущие активности системы
- Отслеживание выполнения команд
- Дополнительные расширения
Комментарии преподавателя
Существует два основных источника информации о происходящем в системе. Первый из них — статистическая информация, которая собирается PostgreSQL и хранится в кластере.
Page 5: Сбор статистики
Настройки накопительной статистики
- параметр
- действие
- track_activities
- включает мониторинг текущих команд
- track_counts
- сбор статистики по обращениям к таблицам
- и индексам
- track_functions
- отслеживание использования пользовательских
- функций
- выключен по умолчанию
- track_io_timing
- мониторинг времени чтения и записи блоков
- выключен по умолчанию
- track_wal_io_timing
- мониторинг времени записи WAL
- выключен по умолчанию
Комментарии преподавателя
Система накопительной статистики в PostgreSQL собирает и позволяет получать информацию о работе сервера. Накопительная статистика отслеживает обращения к таблицам и индексам как на уровне блоков на диске, так и на уровне отдельных строк. Кроме того, для каждой таблицы собираются сведения о количестве строк и действиях по очистке и анализу.
Можно также учитывать количество вызовов пользовательских функций и время, затраченное на их выполнение.
Количеством собираемой информации управляют несколько параметров сервера, так как чем больше информации собирается, тем больше и накладные расходы.
https://postgrespro.ru/docs/postgresql/16/monitoring-stats
Page 6: Архитектура
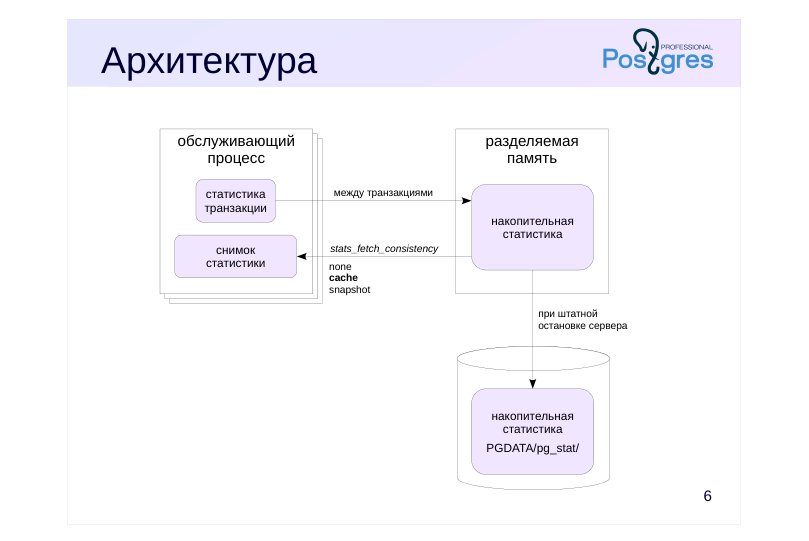 {#source-figure-006 caption=“Source slide page 6: Архитектура”}
Комментарии преподавателя
Обслуживающие процессы собирают статистику в рамках транзакций. Затем эта статистика самим процессом записывается в разделяемую память, но не чаще, чем раз в одну секунду (задано при компиляции).
Накопительная статистика запоминается в PGDATA/pg_stat/ при штатной остановке сервера и считывается при его запуске. При аварийной остановке все счетчики сбрасываются.
Обслуживающий процесс может кешировать данные статистики при обращении к ней. Уровнем кеширования управляет параметр stats_fetch_consistency:
● none — без кеширования, статистика только в разделяемой памяти;
● cache — кешируется статистика по одному объекту;
● snapshot — кешируется вся статистика текущей базы данных.
По умолчанию используется значение cache — это компромисс между согласованностью и эффективностью.
Закешированная статистика не перечитывается и сбрасывается в конце транзакции или при вызове pg_stat_clear_snapshot().
Из-за задержек и кеширования обслуживающий процесс использует не самую свежую статистику, но обычно это и не требуется.
Page 7: Накопительная статистика
Вначале включим сбор статистики ввода-вывода:
Смотреть на активности сервера имеет смысл, когда какие-то активности на самом деле есть. Чтобы сымитировать нагрузку, воспользуемся pgbench — штатной утилитой для запуска эталонных тестов. Сначала утилита создает набор таблиц и заполняет их данными.
Сбросим накопленную ранее статистику по базе данных:
А также статистику экземпляра по вводу-выводу:
Запускаем тест TPC-B на несколько секунд:
Page 8: Page 8
Теперь мы можем посмотреть статистику обращений к таблицам в терминах строк:
И в терминах страниц:
Существуют аналогичные представления для индексов:
Page 9: Page 9
Эти представления, в частности, могут помочь определить неиспользуемые индексы. Такие индексы не только бессмысленно занимают место на диске, но и тратят ресурсы на обновление при каждом изменении данных в таблице. Есть также представления для пользовательских и системных объектов (all, user, sys), для статистики текущей транзакции (pg_stat_xact*) и другие. Можно посмотреть общую статистику по базе данных:
Здесь есть много полезной информации о количестве произошедших взаимоблокировок, зафиксированных и отмененных транзакций, использовании временных файлов, ошибках подсчета контрольных сумм. Здесь же хранится статистика общего количества сеансов и количества прерванных по разным причинам сеансов. Столбец numbackends показывает текущее количество обслуживающих процессов, подключенных к базе данных. Статистика ввода-вывода на уровне сервера доступна в представлении pg_stat_io. Например, выполним контрольную точку и посмотрим количество операций чтения и записи страниц по типам процессов:
Page 10: Page 10
Page 11: Текущие активности
Настройка
- статистика
- параметр
- текущие активности
- track_activities
- и ожидания обслуживающих
- включен по умолчанию
- и фоновых процессов
Комментарии преподавателя
Текущие активности всех обслуживающих и фоновых процессов отображаются в представлении pg_stat_activity. Подробнее на нем мы остановимся в демонстрации.
Работа этого представления зависит от параметра track_activities, включенного по умолчанию.
Page 12: Текущие активности
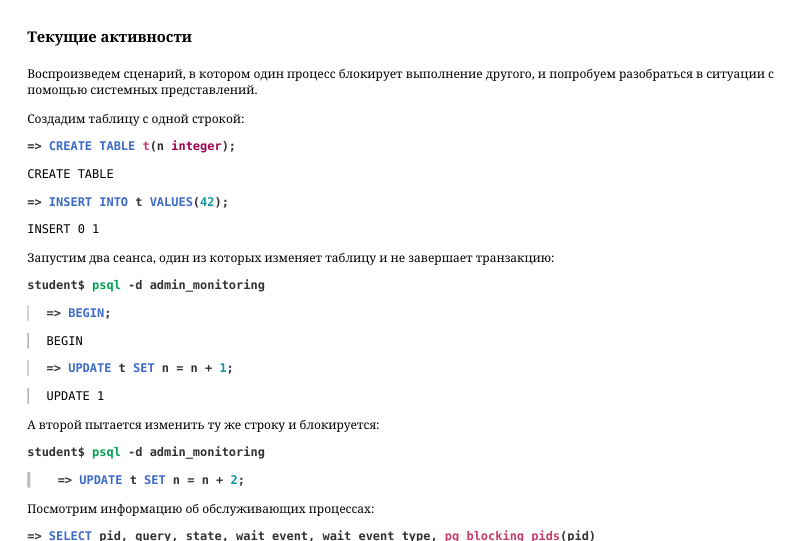 {#source-figure-012 caption=“Source slide page 12: Текущие активности”}
Воспроизведем сценарий, в котором один процесс блокирует выполнение другого, и попробуем разобраться в ситуации с помощью системных представлений. Создадим таблицу с одной строкой:
Запустим два сеанса, один из которых изменяет таблицу и не завершает транзакцию:
А второй пытается изменить ту же строку и блокируется:
Посмотрим информацию об обслуживающих процессах:
Состояние «idle in transaction» означает, что сеанс начал транзакцию, но в настоящее время ничего не делает, а транзакция осталась незавершенной. Это может стать проблемой, если ситуация возникает систематически (например, из-за некорректной реализации приложения или из-за ошибок в драйвере), поскольку открытая транзакция удерживает снимок данных и таким образом препятствует очистке. В арсенале администратора имеется параметр idle_in_transaction_session_timeout, позволяющий принудительно завершать сеансы, в которых транзакция простаивает больше указанного времени. Также имеется параметр idle_session_timeout — принудительно завершает сеансы, простаивающие больше указанного времени вне транзакции.
Page 13: Page 13
А мы покажем, как завершить блокирующий сеанс вручную. Сначала узнаем номер заблокированного процесса при помощи функции pg_blocking_pids:
Блокирующий процесс можно вычислить и без функции pg_blocking_pids, используя запросы к таблице блокировок. Запрос покажет две строки: одна транзакция получила блокировку (granted), а другая ее ожидает.
В общем случае нужно аккуратно учитывать тип блокировки. Выполнение запроса можно прервать функцией pg_cancel_backend. В нашем случае транзакция простаивает, так что просто прерываем сеанс, вызвав pg_terminate_backend:
Функция unnest нужна, поскольку pg_blocking_pids возвращает массив идентификаторов процессов, блокирующих искомый обслуживающий процесс. В нашем примере блокирующий процесс один, но в общем случае их может быть несколько. Подробнее о блокировках рассказывается в курсе DBA2. Проверим состояние обслуживающих процессов.
Осталось только два, причем заблокированный успешно завершил транзакцию. Представление pg_stat_activity показывает информацию не только про обслуживающие процессы, но и про служебные фоновые процессы экземпляра:
Page 14: Page 14
Сравним с тем, что показывает операционная система:
Page 15: Выполнение команд
Представления для отслеживания выполнения
- команда
- представление
- ANALYZE
- pg_stat_progress_analyze
- CREATE INDEX, REINDEX
- pg_stat_progress_create_index
- VACUUM
- pg_stat_progress_vacuum
- включая процессы автоочистки
- CLUSTER, VACUUM FULL
- pg_stat_progress_cluster
- Создание базовой резервной копии
- pg_stat_progress_basebackup
- COPY
- pg_stat_progress_copy
Комментарии преподавателя
Следить за ходом выполнения некоторых потенциально долгих команд можно, выполняя запросы к соответствующим представлениям.
Структуры представлений описаны в документации:
https://postgrespro.ru/docs/postgresql/16/progress-reporting
Создание резервных копий рассматривается в модуле «Резервное копирование».
Page 16: Дополнительная статистика
Расширения в поставке
- pg_stat_statements
- статистика по запросам
- pgstattuple
- статистика по версиям строк
- pg_buffercache
- состояние буферного кеша
- Другие расширения
- pg_wait_sampling
- статистика ожиданий
- pg_stat_kcache
- статистика по процессору и вводу-выводу
- pg_qualstats
- статистика по предикатам
- …
Комментарии преподавателя
Существуют расширения, позволяющие собирать дополнительную статистику, как входящие в поставку, так и внешние.
Например, расширение pg_stat_statements сохраняет информацию о запросах, выполняемых СУБД; pg_buffercache позволяет заглянуть в содержимое буферного кеша и т. п.
Многие важные расширения рассматриваются в курсах DBA2 и DEV2.
Page 17: Журнал сообщений
Настройка журнальных записей
- Ротация файлов журнала
- Анализ журнала
Комментарии преподавателя
Второй важный источник информации о происходящем на сервере — журнал сообщений.
Page 18: Журнал сообщений
Приемник сообщений (log\_destination = список)
- stderr
- поток ошибок
- csvlog
- формат CSV (только с коллектором)
- jsonlog
- формат JSON (только с коллектором)
- syslog
- демон syslog
- eventlog
- журнал событий Windows
- Коллектор сообщений (logging_collector = on)
- позволяет собирать дополнительную информацию
- никогда не теряет сообщения (в отличие от syslog)
- записывает stderr, csvlog и jsonlog в файл log_directory/log_filename
Комментарии преподавателя
Журнал сообщений сервера можно направлять в разные приемники и выводить в разных форматах. Основной параметр, который определяет приемник и формат — log_destination (можно указать один или несколько приемников через запятую).
Значение stderr (установленное по умолчанию) выводит сообщения в стандартный поток ошибок в текстовом виде. Значение syslog направляет сообщения демону syslog в Unix-системах, а eventlog — в журнал событий Windows.
Обычно дополнительно включают специальный процесс — коллектор сообщений. Он позволяет записать больше информации, поскольку собирает ее со всех процессов, составляющих PostgreSQL. Он спроектирован так, что никогда не теряет сообщения; как следствие, при большой нагрузке он может стать узким местом.
Коллектор сообщений включается параметром logging_collector. При значении stderr информация записывается в каталог, определяемый параметром log_directory, в файл, определяемый параметром log_filename.
Включенный коллектор сообщений позволяет также указать приемник csvlog; в этом случае информация будет сбрасываться в формате CSV в файл log_filename с расширением csv. При использовании приемника jsonlog содержимое файла отчета будет записываться в формате JSON, а имя файла будет иметь расширение json.
Page 19: Информация в журнале
Настройки
- информация
- параметр
- сообщения определенного уровня
- log_min_messages
- время выполнения длинных команд
- log_min_duration_statement
- время выполнения команд
- log_duration
- имя приложения
- application_name
- контрольные точки
- log_checkpoints
- подключения и отключения
- log_(dis)connections
- длинные ожидания
- log_lock_waits
- текст выполняемых команд
- log_statement
- использование временных файлов
- log_temp_files
- …
Комментарии преподавателя
В журнал сообщений сервера можно выводить множество полезной информации. По умолчанию почти весь вывод отключен, чтобы не превратить запись журнала в узкое место для подсистемы ввода-вывода. Администратор должен решить, какая информация важна, обеспечить необходимое место на диске для ее хранения и оценить влияние записи журнала на общую производительность системы.
Page 20: Ротация файлов журнала
С помощью коллектора сообщений
- настройка
- параметр
- маска имени файла
- log_filename
- время ротации, мин
- log_rotation_age
- размер файла для ротации, КБ
- log_rotation_size
- перезаписывать ли файлы
- log_truncate_on_rotation = on
- комбинируя маску файла и время ротации, получаем разные схемы:
- ‘postgresql-%H.log’, ‘1h’
- 24 файла в сутки
- ‘postgresql-%a.log’, ‘1d’
- 7 файлов в неделю
- Внешние средства
- системная утилита logrotate
Комментарии преподавателя
Если записывать журнал в один файл, рано или поздно он вырастет до огромных размеров, что крайне неудобно для администрирования и анализа. Поэтому обычно используется та или иная схема ротации журналов.
https://postgrespro.ru/docs/postgresql/16/logfile-maintenance
Коллектор сообщений имеет встроенные средства ротации, которые настраиваются несколькими параметрами, основные из которых приведены на слайде.
Параметр log_filename позволяет задавать не просто имя, а маску имени файла с помощью спецсимволов даты и времени.
Параметр log_rotation_age задает время переключения на следующий файл в минутах (а log_rotation_size — размер файла, при котором надо переключаться на следующий).
Включение log_truncate_on_rotation перезаписывает уже существующие файлы.
Таким образом, комбинируя маску и время переключения, можно получать разные схемы ротации.
https://postgrespro.ru/docs/postgresql/16/runtime-config-logging#RUNTIME-CONFIG-LOGGING-WHERE
В качестве альтернативы можно воспользоваться внешними программами ротации, например пакетный дистрибутив для Ubuntu использует системную утилиту logrotate (ее настройки находятся в файле /etc/logrotate.d/postgresql-common).
Page 21: Анализ журнала
Средства операционной системы
- grep, awk…
- Специальные средства анализа
- pgBadger — требует определенных настроек журнала
Комментарии преподавателя
Анализировать журналы можно по-разному.
Можно искать определенную информацию средствами ОС или специально разработанными скриптами.
Стандартом де-факто для анализа является программа PgBadger https://github.com/darold/pgbadger, но надо иметь в виду, что она накладывает определенные ограничения на содержимое журнала. В частности, допускаются сообщения только на английском языке.
Page 22: Анализ журнала
Посмотрим самый простой случай. Например, нас интересуют сообщения FATAL:
Сообщение «terminating connection» вызвано тем, что мы завершали блокирующий процесс. Обычное применение журнала — анализ наиболее продолжительных запросов. Включим вывод всех команд и времени их выполнения:
Теперь выполним какую-нибудь команду:
И посмотрим журнал:
Page 23: Внешний мониторинг
Универсальные системы мониторинга
- Zabbix, Munin, Cacti…
- в облаке: Okmeter, NewRelic, Datadog…
- Системы мониторинга PostgreSQL
- pg_profile, pgpro_pwr
- PGObserver
- PostgreSQL Workload Analyzer (PoWA)
- Open PostgreSQL Monitoring (OPM)
- …
Комментарии преподавателя
На практике требуется полноценная система мониторинга, которая собирает различные метрики как с PostgreSQL, так и с операционной системы, хранит историю этих метрик, отображает их в виде понятных графиков, имеет средства оповещения при выходе определенных метрик за установленные границы и т. д.
Собственно PostgreSQL не располагает такой системой; он только предоставляет средства для получения информации о себе (которые мы рассмотрели). Поэтому для полноценного мониторинга нужно выбрать внешнюю систему. Таких систем существует довольно много. Есть универсальные системы, имеющие плагины или агенты для PostgreSQL. К ним относятся Zabbix, Munin, Cacti, облачные сервисы Okmeter, NewRelic, Datadog и другие.
Есть и системы, ориентированные специально на PostgreSQL, такие, как PGObserver, PoWA, OPM и т. д. Расширение pg_profile позволяет строить снимки статических данных и сравнивать их, выявляя ресурсоемкие операции и их динамику. Расширенная коммерческая версия этого расширения — pgpro_pwr.
https://postgrespro.ru/docs/enterprise/16/pgpro-pwr
Неполный, но представительный список систем мониторинга можно посмотреть на странице https://wiki.postgresql.org/wiki/Monitoring
Для более глубокого погружения в эту тему можно прочитать книгу Алексея Лесовского «Мониторинг PostgreSQL»: https://edu.postgrespro.ru/monitoring.pdf
Page 24: Итоги
Мониторинг заключается в контроле работы сервера как со стороны операционной системы, так и со стороны самого сервера
- PostgreSQL предоставляет накопительную статистику и журнал сообщений сервера
- Для полноценного мониторинга требуется внешняя система
Page 25: Практика
- В новой базе данных создайте таблицу, выполните вставку нескольких строк, а затем удалите все строки.
- Посмотрите статистику обращений к таблице и сопоставьте
- цифры (n_tup_ins, n_tup_del, n_live_tup, n_dead_tup)
- с вашей активностью.
- Выполните очистку (vacuum), снова проверьте статистику и сравните с предыдущими цифрами. 2. Создайте ситуацию взаимоблокировки двух транзакций.
- Посмотрите, какая информация записывается при этом
- в журнал сообщений сервера.
Комментарии преподавателя
- Взаимоблокировка (deadlock) — ситуация, в которой две (или больше) транзакций ожидают друг друга. В отличие от обычной блокировки при взаимоблокировке у транзакций нет возможности выйти из этого «тупика» и СУБД вынуждена принимать меры — одна из транзакций будет принудительно прервана, чтобы остальные могли продолжить выполнение.
Проще всего воспроизвести взаимоблокировку на таблице с двумя строками. Первая транзакция меняет (и, соответственно, блокирует) первую строку, а вторая — вторую. Затем первая транзакция пытается изменить вторую строку и «повисает» на блокировке. А потом вторая транзакция пытается изменить первую строку — и тоже ждет освобождения блокировки.
Page 26: Статистика обращений к таблице
Создаем базу данных и таблицу:
Проверяем статистику обращений.
Мы вставили 1000 строк (n_tup_ins = 1000), удалили 1000 строк (n_tup_del = 1000). После этого не осталось активных версий строк (n_live_tup = 0), все 1000 строк не актуальны на текущий момент (n_dead_tup = 1000). Выполним очистку.
Page 27: Page 27
Неактуальные версии строк убраны при очистке (n_dead_tup = 0), очистка обрабатывала таблицу один раз (vacuum_count = 1).
2. Взаимоблокировка
Одна транзакция блокирует первую строку таблицы…
Затем другая транзакция блокирует вторую строку…
Теперь первая транзакция пытается изменить вторую строку и ждет ее освобождения…
А вторая транзакция пытается изменить первую строку…
…и происходит взаимоблокировка. Сервер обрывает одну из транзакций:
Page 28: Page 28
Другая транзакция разблокируется:
Проверим информацию в журнале сообщений:
Page 29: Практика+
- Установите расширение pg_stat_statements.
- Выполните несколько произвольных запросов.
- Посмотрите, какую информацию показывает представление
- pg_stat_statements.
Комментарии преподавателя
- Для установки расширения потребуется перед выполнением команды CREATE EXTENSION изменить значение параметра shared_preload_libraries с последующей перезагрузкой сервера.
https://postgrespro.ru/docs/postgresql/16/pgstatstatements
Page 30: 1. Расширение pg_stat_statements
Расширение собирает статистику планирования и выполнения всех запросов. Для работы расширения требуется загрузить одноименный модуль. Для этого имя модуля нужно прописать в параметре shared_preload_libraries и перезагрузить сервер. Изменять этот параметр лучше в файле postgresql.conf, но для целей демонстрации установим параметр с помощью команды ALTER SYSTEM.
Теперь выполним несколько запросов.
Посмотрим на статистику запроса, который выполнялся чаще всего.
Разделяемая библиотека больше не требуется, восстановим исходное значение параметра:
13 Занятие 13: Управление доступом / Обзор
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba1_13_access_overview.html Archive: DBA1-handouts-16.zip Страниц PDF: 30
Page 1: Управление доступом / Обзор
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Роли и атрибуты
- Подключение к серверу
- Парольная аутентификация
- Привилегии и управление ими
- Категории ролей
- Групповые и предопределенные роли
- Привилегии по умолчанию
- Привилегии и подпрограммы
Page 3: Роли и атрибуты
Роль может быть пользователем СУБД
- не связана с пользователем ОС
- Роли можно включать друг в друга
- удобно при настройке доступа
- Свойства роли определяются атрибутами
- LOGIN
- возможность подключения
- SUPERUSER
- суперпользователь
- CREATEDB
- возможность создавать базы данных
- CREATEROLE
- возможность создавать роли
- и другие
Комментарии преподавателя
Роли в PostgreSQL используют для двух целей. Во-первых, роль может выступать как пользователь, подключающийся к СУБД. Во-вторых, роли можно включать друг в друга — это удобно при настройке доступа.
Формально роли никак не связаны с пользователями операционной системы, хотя многие программы это предполагают, выбирая значения по умолчанию. Например, psql, запущенный от имени пользователя ОС student, автоматически использует одноименную роль student (если в ключах утилиты не указана какая-либо другая роль).
При создании кластера определяется одна начальная роль, имеющая суперпользовательский доступ (обычно она называется postgres). В дальнейшем роли можно создавать, изменять и удалять.
https://postgrespro.ru/docs/postgresql/16/database-roles
Роль обладает некоторыми атрибутами, определяющими ее общие особенности и права (не связанные с определенными объектами).
Обычно атрибуты имеют два варианта, например, CREATEDB (дает право на создание БД) и NOCREATEDB (не дает такого права).
Если у роли есть атрибут LOGIN, эта роль — пользователь. Если NOLOGIN — роль не является пользовательской и не сможет подключиться к серверу; такие роли обычно используют для включения других ролей.
В таблице перечислены лишь некоторые из атрибутов.
https://postgrespro.ru/docs/postgresql/16/role-attributes
https://postgrespro.ru/docs/postgresql/16/sql-createrole
Page 4: Роли и атрибуты
Создадим роль для пользователя Алисы. В команде указаны два атрибута. В этой теме нам важно, от имени какой роли выполняются команды, поэтому имя текущей роли вынесено в приглашение.
Список ролей можно узнать командой:
Обратите внимание, что роль student является суперпользователем. Поэтому до сих пор мы не задумывались о разграничении доступа. Создадим и базу данных:
Page 5: Подключение к серверу
1. Строки pg\_hba.conf просматриваются сверху вниз
- Выбирается первая запись, соответствующая параметрам подключения (тип, база, пользователь и адрес)
- local — сокет all — любая роль host — TCP/IP имя роли
- listen_addresses
- all — любая БД
- all — любой IP
- имя БД
- IP/маска
- доменное имя
Комментарии преподавателя
Для каждого нового клиента сервер определяет, надо ли разрешить подключение к базе данных. Настройки подключения определяются в конфигурационном файле pg_hba.conf («host-based authentication»). Как и с основным конфигурационным файлом postgresql.conf, изменения вступают в силу только после перечитывания файла сервером (SQL-функцией pg_reload_conf() или командой reload утилиты управления).
При появлении нового клиента сервер просматривает конфигурацион-ный файл сверху вниз в поисках строки, подходящей к запрашиваемо-му клиентом подключению. Соответствие определяется по четырем полям: типу подключения, имени БД, имени пользователя и IP-адресу.
Ниже перечислены только самые основные возможности.
Подключение — local (unix-сокеты) или host (подключение по протоколу TCP/IP).
База данных – ключевое слово all (соответствует любой БД) или имя конкретной базы данных.
Пользователь — all или имя конкретной роли.
Адрес — all, диапазон IP-адресов или доменное имя. Не указывается для типа local. По умолчанию PostgreSQL слушает входящие соединения только с localhost; обычно параметр listen_addresses ставят в значение «*» (слушать все интерфейсы) и дальше регулируют доступ средствами pg_hba.conf.
https://postgrespro.ru/docs/postgresql/16/client-authentication
Page 6: Подключение к серверу
3. Выполняется аутентификация указанным методом
- Удачно — доступ разрешается, иначе — запрещается (если не подошла ни одна запись — доступ запрещается)
- trust — разрешить
- reject — отказать
- scram-sha-256 и md5 — запросить пароль
- peer — спросить ОС
Комментарии преподавателя
Когда в файле найдена подходящая строка, выполняется аутентификация указанным в этой строке методом, а также проверяется наличие атрибута LOGIN и привилегии CONNECT. Если результат проверки успешен, то подключение разрешается, иначе — запрещается (другие строки файла при этом уже не рассматриваются).
Если ни одна из строк не подошла, то доступ также запрещается.
Таким образом, записи в файле должны идти сверху вниз от частных правил к общим.
Существует множество методов аутентификации:
https://postgrespro.ru/docs/postgresql/16/auth-methods
Ниже перечислены только самые основные.
Метод trust безусловно разрешает подключение. Если вопросы безопасности не важны, можно указать «все all» и метод trust — тогда будут разрешены все подключения.
Метод reject, наоборот, безусловно запрещает подключение.
Метод scram-sha-256 запрашивает у пользователя пароль и проверяет его соответствие хешу, который хранится в системном каталоге кластера. Парольный метод md5 также используется, но объявлен устаревшим.
Метод peer запрашивает имя пользователя у операционной системы и разрешает подключение, если имя пользователя ОС и пользователя БД совпадают (можно установить и другие соответствия имен).
Page 7: Парольная аутентификация
На сервере
- пароль устанавливается при создании роли или позже
- пользователю без пароля будет отказано в доступе
- пароль хранится в системном каталоге pg_authid
- Ввод пароля на клиенте
- вручную
- из переменной окружения PGPASSWORD
- из файла ~/.pgpass (строки в формате узел:порт:база:роль:пароль)
Комментарии преподавателя
Если используется аутентификация по паролю, для роли обязательно должен быть установлен пароль, иначе в доступе будет отказано.
Хеш-код пароля хранится в системном каталоге в таблице pg_authid.
Пользователь может вводить пароль вручную, а может автоматизировать его ввод. Для этого есть две возможности.
Во-первых, можно задать пароль в переменной окружения PGPASSWORD на клиенте. Однако это неудобно, если приходится подключаться к нескольким базам, а также не рекомендуется из соображений безопасности.
Во-вторых, можно задать пароли в файле ~/.pgpass на клиенте. К файлу должен иметь доступ только его владелец (установлены права доступа 600), иначе PostgreSQL проигнорирует его.
Page 8: Подключение
Чтобы роль смогла подключиться к базе данных, она должна иметь не только атрибут LOGIN, но и разрешение в файле pg_hba.conf. Располагается он обычно рядом с основным конфигурационным файлом:
А прочитать его содержимое можно прямо из SQL:
(В зависимости от сборки сервера содержимое файла может отличаться.) Мы будем использовать подключение к localhost по TCP/IP (host). Такому подключению соответствует вторая строка выборки. Она предполагает аутентификацию по паролю. Роль alice была создана с паролем, но вообще его можно изменить в любой момент:
Попробуем установить соединение, указав в строке подключения всю необходимую информацию:
Получилось!
Page 9: Привилегии
Привилегии определяют права доступа ролей к объектам
- Таблицы и представления
- SELECT
- чтение данных
- INSERT
- вставка строк
- можно на уровне столбцов
- UPDATE
- изменение строк
- REFERENCES
- внешний ключ (для таблиц)
- DELETE
- удаление строк
- TRUNCATE
- опустошение (для таблиц)
- TRIGGER
- создание триггеров
Комментарии преподавателя
Привилегии устанавливают связь между субъектами (ролями) и объектами кластера. Они определяют действия, доступные для ролей в отношении этих объектов.
Список возможных привилегий отличается для объектов различных типов. Привилегии для основных типов объектов приведены на этом и следующем слайдах.
Больше всего привилегий определено для таблиц и представлений. Часть из них можно задать не только для всего отношения, но и для отдельных столбцов.
https://postgrespro.ru/docs/postgresql/16/ddl-priv
https://postgrespro.ru/docs/postgresql/16/sql-grant
Page 10: Привилегии
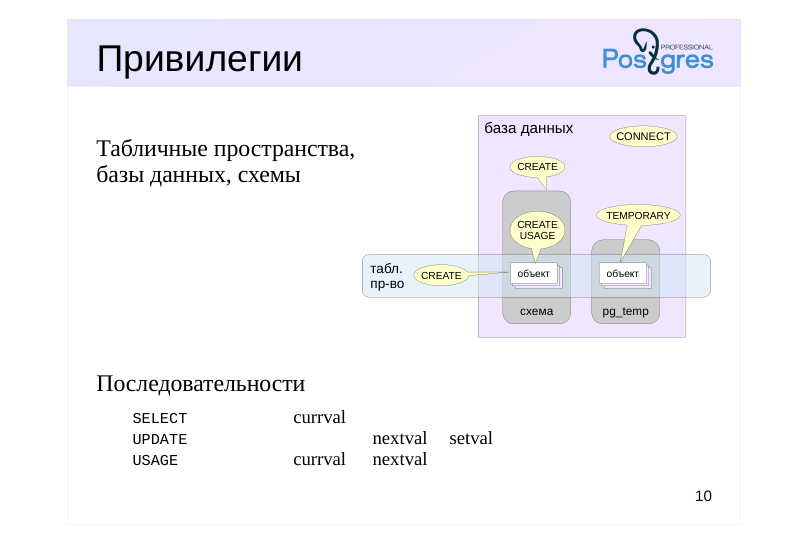 {#source-figure-010 caption=“Source slide page 10: Привилегии”}
Табличные пространства, базы данных, схемы
- Последовательности
- SELECT
- currval
- UPDATE
- nextval
- setval
- USAGE
- currval
- nextval
Комментарии преподавателя
Возможно, несколько неожиданный набор привилегий имеют последовательности. Выбирая нужные, можно разрешить или запретить доступ к трем управляющим функциям.
Для табличных пространств есть привилегия CREATE, разрешающая создание объектов в этом пространстве.
Для баз данных привилегия CREATE разрешает создавать схемы в этой БД, а для схемы привилегия CREATE разрешает создавать объекты в этой схеме.
Поскольку точное имя схемы для временных объектов заранее неизвестно, привилегия на создание временных таблиц вынесена на уровень БД (TEMPORARY).
Привилегия USAGE схемы разрешает обращаться к объектам в этой схеме.
Привилегия CONNECT базы данных разрешает подключение к этой БД.
Page 11: Категории ролей
Суперпользователи
- полный доступ ко всем объектам — проверки не выполняются
- Владельцы
- изначально все привилегии для объекта (можно отозвать)
- действия со своими объектами, не регламентируемые привилегиями,
- например: удаление, выдача и отзыв привилегий и т. п.
- Остальные роли
- доступ в рамках выданных привилегий
Комментарии преподавателя
В целом можно сказать, что доступ роли к объекту определяется привилегиями. Но имеет смысл выделить три категории ролей и рассмотреть их по отдельности:
Роли с атрибутом SUPERUSER (суперпользователи). Такие роли могут делать все, что угодно — для них проверки разграничения доступа не выполняются.
Владелец объекта. Изначально это роль, создавшая объект, хотя потом его можно сменить. Владельцем считается не только сама роль-владелец, но и любая другая роль, включенная в нее. Владелец объекта сразу получает полный набор привилегий для этого объекта.
В принципе, эти привилегии можно отозвать, но владелец объекта обладает также неотъемлемым правом совершать действия, не регламентируемые привилегиями. В частности, он может выдавать и отзывать привилегии (в том числе и себе самому), удалять объект и т. п.
- Все остальные роли имеют доступ к объекту только в рамках выданных им привилегий.
Чтобы проверить, есть ли у роли необходимая привилегия в отношении некоторого объекта, можно воспользоваться функциями has_*_privilege:
https://postgrespro.ru/docs/postgresql/16/functions-info
Page 12: Управление привилегиями
Выдача привилегий
- alice
- bob
- привилегии
- на объект
- Отзыв привилегий
Комментарии преподавателя
Право выдачи и отзыва привилегий на объект имеет владелец этого объекта (и суперпользователь).
Синтаксис команд GRANT и REVOKE достаточно сложен и позволяет указывать как отдельные, так и все возможные привилегии; как отдельные объекты, так и группы объектов, входящие в определенные схемы и т. п.
https://postgrespro.ru/docs/postgresql/16/sql-grant
https://postgrespro.ru/docs/postgresql/16/sql-revoke
Page 13: Привилегии
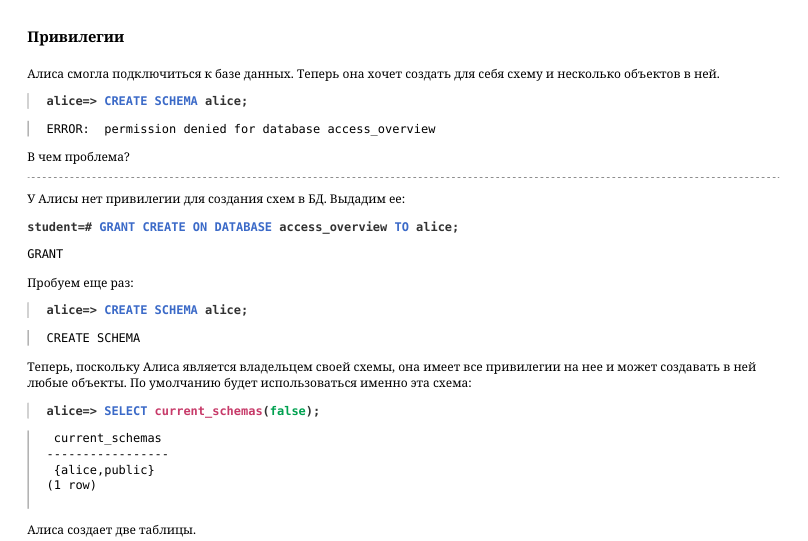 {#source-figure-013 caption=“Source slide page 13: Привилегии”}
Алиса смогла подключиться к базе данных. Теперь она хочет создать для себя схему и несколько объектов в ней.
В чем проблема? У Алисы нет привилегии для создания схем в БД. Выдадим ее:
Пробуем еще раз:
Теперь, поскольку Алиса является владельцем своей схемы, она имеет все привилегии на нее и может создавать в ней любые объекты. По умолчанию будет использоваться именно эта схема:
Алиса создает две таблицы.
А суперпользователь создает другую роль для пользователя Боба, который будет обращаться к объектам, принадлежащим Алисе.
Боб попробует обратиться к таблице t1.
В чем причина ошибки? Нет доступа к схеме, так как Боб не суперпользователь и не владелец этой схемы. Проверить права на доступ к схеме можно так (столбец Access privileges):
Page 14: Page 14
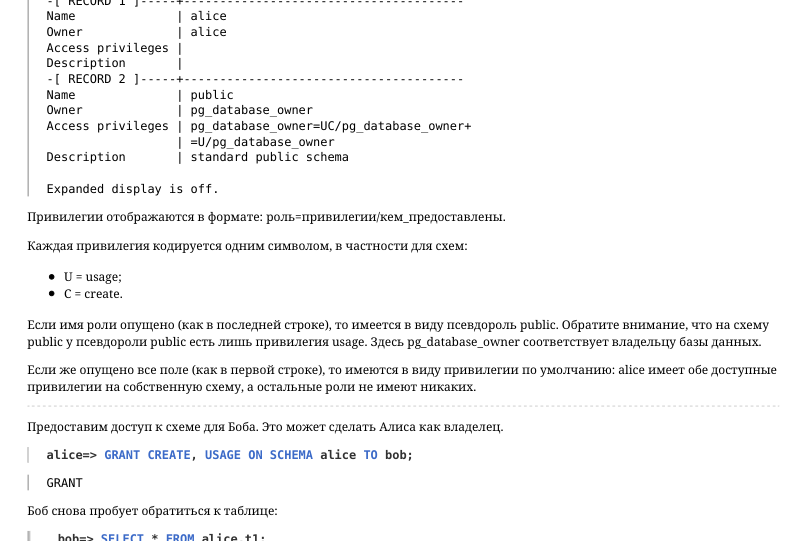 {#source-figure-014 caption=“Source slide page 14: Page 14”}
Привилегии отображаются в формате: роль=привилегии/кем_предоставлены. Каждая привилегия кодируется одним символом, в частности для схем: U = usage; C = create. Если имя роли опущено (как в последней строке), то имеется в виду псевдороль public. Обратите внимание, что на схему public у псевдороли public есть лишь привилегия usage. Здесь pg_database_owner соответствует владельцу базы данных. Если же опущено все поле (как в первой строке), то имеются в виду привилегии по умолчанию: alice имеет обе доступные привилегии на собственную схему, а остальные роли не имеют никаких. Предоставим доступ к схеме для Боба. Это может сделать Алиса как владелец.
Боб снова пробует обратиться к таблице:
Снова ошибка. В чем причина? На этот раз у Боба есть доступ к схеме, но нет доступа к самой таблице. Вот как проверить доступ:
И снова видим пустое поле: доступ есть только у владельца, то есть у Алисы. Алиса предоставляет Бобу доступ на чтение и изменение:
А для второй таблицы — доступ на вставку и чтение одного столбца:
Посмотрим, как изменились привилегии:
Теперь пустое поле «проявилось», и мы видим, что в нем находится полный перечень привилегий. Ниже — обозначения,
Page 15: Page 15
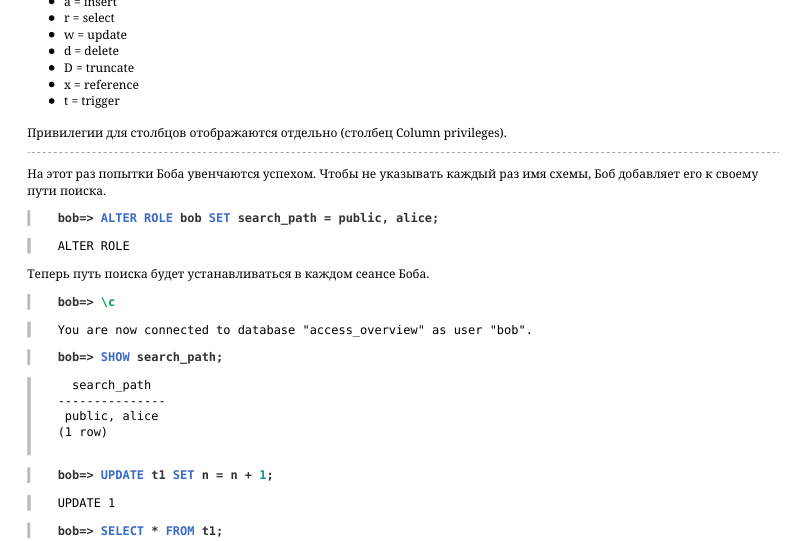 {#source-figure-015 caption=“Source slide page 15: Page 15”}
не все они вполне очевидные: a = insert r = select w = update d = delete D = truncate x = reference t = trigger Привилегии для столбцов отображаются отдельно (столбец Column privileges). На этот раз попытки Боба увенчаются успехом. Чтобы не указывать каждый раз имя схемы, Боб добавляет его к своему пути поиска.
Теперь путь поиска будет устанавливаться в каждом сеансе Боба.
Но другие операции по-прежнему запрещены:
И вторая таблица:
А чтение другого столбца запрещено:
Page 16: Включение роли в роль
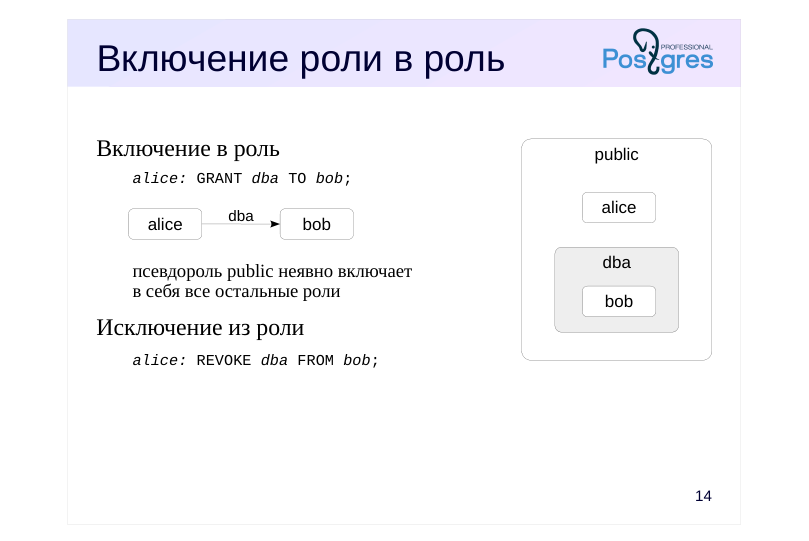 {#source-figure-016 caption=“Source slide page 16: Включение роли в роль”}
Включение в роль
- alice
- bob
- dba
- псевдороль public неявно включает
- в себя все остальные роли
- Исключение из роли
Комментарии преподавателя
В любую роль могут быть включены другие роли. В таком случае роль выступает в качестве группы. Отдельного понятия «группа» в PostgreSQL нет.
Роль может быть включена в несколько ролей; включенная роль может, в свою очередь, включать в себя третьи роли, но циклы при этом не допускаются.
По умолчанию роль наследует привилегии роли, в которую она включена. Это поведение можно изменить, указав роли атрибут NOINHERIT — тогда, чтобы воспользоваться привилегиями включающей роли, надо будет явно переключиться на нее с помощью SET ROLE. Атрибуты ролей не наследуются, но можно переключиться на включающую роль и воспользоваться ее атрибутами.
Роли, включающие другие роли, обычно имеют атрибут NOLOGIN и называются «групповыми». Фактически это именованный набор привилегий, который удобно «выдать» обычной роли точно так же, как выдается одиночная привилегия. Это упрощает управление доступом и администрирование.
Существует псевдороль public, которая неявно включает в себя все остальные роли. Если выдать какие-либо привилегии роли public, эти привилегии получат вообще все роли.
https://postgrespro.ru/docs/postgresql/16/role-membership
Page 17: Предопределенные роли
pg_monitor
- pg_read_all_settings чтение всех параметров сервера
- pg_read_all_stats доступ к статистике pg_stat_scan_tables мониторинг и блокировки таблиц
- pg_read_all_data чтение данных из всех таблиц pg_write_all_data изменение данных во всех таблицах
- pg_read_server_files чтение файлов на сервере pg_write_server_files запись в файлы на сервере
- pg_execute_server_programs выполнение программ на сервере
- …
Комментарии преподавателя
В PostgreSQL имеется набор предопределенных ролей, имеющих доступ к часто востребованным, но не общедоступным функциям и данным. Членство в этих ролях может быть предоставлено обычным пользователям для решения ряда задач администрирования — чтобы избежать наделения этих пользователей суперпользовательскими полномочиями.
Количество предопределенных ролей увеличивается с каждой новой версией PostgreSQL. Полный список всех ролей, включая предопределенные, можно просмотреть с помощью команды \duS в psql.
https://postgrespro.ru/docs/postgresql/16/predefined-roles
Можно создавать и свои собственные «административные» роли, например, для выполнения задач резервного копирования.
Page 18: Групповые роли
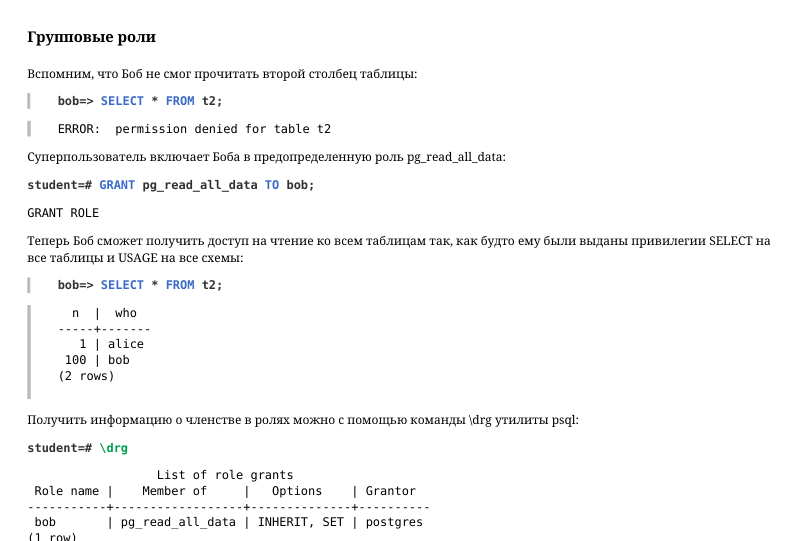 {#source-figure-018 caption=“Source slide page 18: Групповые роли”}
Вспомним, что Боб не смог прочитать второй столбец таблицы:
Суперпользователь включает Боба в предопределенную роль pg_read_all_data:
Теперь Боб сможет получить доступ на чтение ко всем таблицам так, как будто ему были выданы привилегии SELECT на все таблицы и USAGE на все схемы:
Получить информацию о членстве в ролях можно с помощью команды \drg утилиты psql:
Столбец Options содержит информацию об атрибутах, описывающих включение. Здесь для роли bob, включенной в pg_read_all_data, SET означает возможность переключения на групповую роль, а INHERIT — использование привилегий группы без явного переключения на нее. Исключим пользователя bob из группы:
Page 19: Подпрограммы
Единственная привилегия для функций и процедур
- EXECUTE
- выполнение
- Характеристики безопасности
- SECURITY INVOKER
- выполняется с правами вызывающего
- (по умолчанию)
- SECURITY DEFINER
- выполняется с правами владельца
Комментарии преподавателя
Для функций и процедур есть единственная привилегия EXECUTE, разрешающая выполнение этой подпрограммы.
Тонкий момент связан с тем, от имени какого пользователя будет выполняться подпрограмма. Если подпрограмма объявлена как SECURITY INVOKER (по умолчанию), она выполняется с правами вызывающего пользователя. В этом случае операторы внутри подпрограммы смогут обращаться только к тем объектам, к которым у вызывающего пользователя есть доступ.
Если же указать фразу SECURITY DEFINER, подпрограмма работает с правами ее владельца. Это способ позволить другим пользователям выполнять определенные действия над объектами, к которым у них нет непосредственного доступа.
https://postgrespro.ru/docs/postgresql/16/sql-createfunction
https://postgrespro.ru/docs/postgresql/16/sql-createprocedure
Page 20: Привилегии по умолчанию
Привилегии псевдороли public
- подключение к любой базе данных
- доступ к системному каталогу
- выполнение любых подпрограмм
- привилегии выдаются автоматически для каждого нового объекта
- Настраиваемые привилегии по умолчанию
- возможность дополнительно выдать или отозвать привилегии
- для вновь создаваемого объекта
Комментарии преподавателя
Как уже говорилось, псевдороль public включает в себя все остальные роли, которые, таким образом, пользуются всеми привилегиями, выданными для public.
При этом public имеет довольно широкий спектр привилегий по умолчанию. В частности:
● право подключения к любой базе данных (именно поэтому роль alice смогла подключиться к базе данных несмотря на то, что привилегия CONNECT не выдавалась ей явно);
● доступ к системному каталогу;
● выполнение любых подпрограмм.
Это, с одной стороны, позволяет комфортно работать, не задумываясь о привилегиях, а с другой — создает определенные сложности, если разграничение доступа действительно необходимо.
Описанные выше привилегии появляются у public автоматически при создании новых объектов. То есть недостаточно, например, просто отозвать у public привилегию EXECUTE на все подпрограммы: как только появится новая, public немедленно получает привилегию на ее выполнение.
Однако существует специальный механизм «привилегий по умолчанию», который позволяет автоматически выдавать и отзывать привилегии при создании нового объекта. Этот механизм можно использовать и для отзыва права выполнения функций у псевдороли public.
https://postgrespro.ru/docs/postgresql/16/sql-alterdefaultprivileges
Page 21: Подпрограммы и привилегии по умолчанию
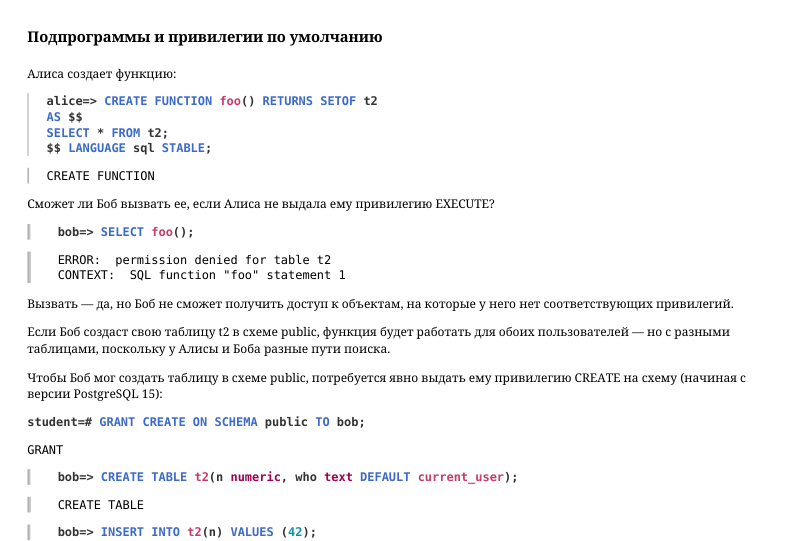 {#source-figure-021 caption=“Source slide page 21: Подпрограммы и привилегии по умолчанию”}
Алиса создает функцию:
Сможет ли Боб вызвать ее, если Алиса не выдала ему привилегию EXECUTE?
Вызвать — да, но Боб не сможет получить доступ к объектам, на которые у него нет соответствующих привилегий. Если Боб создаст свою таблицу t2 в схеме public, функция будет работать для обоих пользователей — но с разными таблицами, поскольку у Алисы и Боба разные пути поиска. Чтобы Боб мог создать таблицу в схеме public, потребуется явно выдать ему привилегию CREATE на схему (начиная с версии PostgreSQL 15):
Другой доступный вариант — объявить функцию как работающую с правами ее владельца:
В этом случае функция всегда будет выполняться с правами Алисы, независимо от того, кто ее вызывает. Боб удаляет свою таблицу…
…и получает доступ к содержимому таблицы Алисы:
В этом случае Алисе надо внимательно следить за выданными привилегиями. Скорее всего, потребуется отозвать
Page 22: Page 22
 {#source-figure-022 caption=“Source slide page 22: Page 22”}
EXECUTE у роли public и выдавать ее явно только нужным ролям.
Но дело осложняется тем, что по умолчанию привилегия на выполнение автоматически выдается роли public на каждую вновь создаваемую функцию. Для того чтобы конкретные пользователи получали или, наоборот, лишались тех или иных привилегий на вновь создаваемые объекты, можно настроить привилегии по умолчанию:
Теперь Боб сразу получает привилегию на выполнение подпрограмм, создаваемых Алисой, а остальные пользователи не смогут их выполнять.
Page 23: Итоги
Роли, атрибуты и привилегии — гибкий механизм, позволяющий по-разному организовать работу
- можно легко разрешить все всем
- можно строго разграничить доступ, если это необходимо
- При создании новых ролей надо позаботиться о возможности их подключения к серверу
Page 24: Практика
Настройте привилегии таким образом, чтобы одни пользователи имели полный доступ к таблицам, а другие могли только запрашивать, но не изменять информацию.
- Создайте новую базу данных и двух пользователей: writer и reader. 2. Отзовите у роли public все привилегии на схему public, выдайте роли writer обе привилегии, а роли reader — только usage. 3. Настройте привилегии по умолчанию так, чтобы роль reader получала доступ на чтение к таблицам в схеме public, принадлежащим writer. 4. Создайте пользователя w1, включив его в роль writer, и пользователя r1, включив его в reader. 5. Под ролью writer создайте таблицу. 6. Убедитесь, что r1 имеет доступ к таблице только на чтение, а w1 имеет к ней полный доступ, включая удаление.
Page 25: 1. База данных и роли
2. Привилегии
3. Привилегии по умолчанию
4. Пользователи
Пишущая роль:
Конструкция IN ROLE сразу же добавляет новую роль в указанную. То есть такая команда эквивалентна двум:
Читающая роль:
5. Таблица
6. Проверка
Роль w1 может вставлять строки:
Page 26: Page 26
Роль r1 может читать таблицу:
Но не может изменить:
Роль w1 может удалить таблицу:
Напомним, что в PostgreSQL начиная с версии 14 доступна предопределенная роль pg_read_all_data, автоматически дающая возможность чтения любых данных. А удалить базу данных сможет или ее владелец, или суперпользователь:
Page 27: Практика+
- Зарегистрируйте пользовательские роли alice и bob. 2. Отредактируйте файл pg_hba.conf так, чтобы беспарольный вход был разрешен лишь для пользователей postgres и student. Убедитесь, что доступ для alice и bob запрещен. 3. Для пользователей alice и bob включите разрешение входить в сеанс, используя метод peer. Проверьте невозможность входа в сеанс без создания отображения на пользователя ОС. Для alice создайте такое отображение. 4. Проверьте возможность использовать одно и то же отображение для разных ролей.
Комментарии преподавателя
- С помощью текстового редактора вставьте перед первой незакомментированной директивой в pg_hba.conf local all postgres,student trust
Перечитайте конфигурацию.
- Отредактируйте вставленную в pg_hba.conf директиву, заменив ее следующим: local all postgres,student trust local all alice,bob peer
В конец файла pg_ident.conf добавьте: stmap student alice
- Чтобы роли alice и bob использовали одно отображение, содержимое pg_ident.conf должно быть следующим: stmap student alice stmap student bob
Page 28: 1. Добавление ролей
Зарегистрируем роли с правом входа в сеанс.
2. Ограничение использования trust
Отредактируем содержимое pg_hba.conf, разрешив метод trust лишь для postgres и student.
Вот что получилось:
Применим конфигурацию.
Теперь alice и bob не могут подключиться:
3. Метод аутентификации peer
Используя текстовый редактор, добавим еще одну строку с методом аутентификации peer, чтобы разрешить подключение пользователям alice и bob.
Содержимое pg_hba.conf:
Page 29: Page 29
Перечитаем конфигурацию.
Однако по-прежнему эти учетные записи не могут войти в сеанс, хотя сообщение об ошибке изменилось.
Метод peer требует совпадения учетной записи в ОС с именем роли в PostgreSQL. Создадим отображение роли alice на пользователя ОС student, добавив строку в файл pg_ident.conf. Для роли bob отображение задавать не будем.
И допишем в добавленную строку параметр map, задающий имя отображения.
Содержимое pg_hba.conf:
Перечитаем конфигурацию.
Теперь alice может подключиться к базе данных и выполнить команды.
А bob — нет.
Page 30: 4. Одно отображение для нескольких ролей
Разрешим пользователю bob входить в сеанс на таких же условиях, как alice.
Добавленные строки в pg_ident.conf:
Перечитаем конфигурацию.
Теперь и alice, и bob смогут подключиться.
14 Занятие 14: Резервное копирование / Обзор
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba1_14_backup_overview.html Archive: DBA1-handouts-16.zip Страниц PDF: 36
Page 1: Резервное копирование / Обзор
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Логическое резервное копирование
- Физическое резервное копирование
Page 3: Логическое копирование
Что такое логическое резервное копирование
- Копия таблицы
- Копия базы данных
- Копия кластера
Page 4: Логическая копия
Команды SQL для восстановления данных с нуля
- можно сделать копию отдельного объекта или базы
- можно восстановиться на кластере другой основной версии
- можно восстановиться на другой архитектуре
- − невысокая скорость
- восстановление только на момент копирования
Комментарии преподавателя
Существует два вида резервирования: логическое и физическое.
Логическая резервная копия — это набор команд SQL, восстанавливающий кластер (или базу данных, или отдельный объект) с нуля.
Такая копия представляет собой, по сути, обычный текстовый файл, что дает известную гибкость. Например, можно сделать копию только тех объектов, которые нужны; можно отредактировать файл, изменив имена или типы данных и т. п.
Кроме того, команды SQL можно выполнить на другой версии СУБД или на другой архитектуре. Для этого требуется только совместимость на уровне команд; двоичная совместимость не нужна.
Однако для большой базы этот механизм неэффективен, поскольку выполнение команд (в частности, создание индексов) займет много времени. К тому же восстановить систему из такой резервной копии можно только на тот момент, в который она была сделана.
https://postgrespro.ru/docs/postgresql/16/backup-dump
Page 5: COPY: копия таблицы
Резервное копирование
- вывод содержимого таблицы или результатов запроса в файл, в поток
- или в программу
- Восстановление
- добавление строк из файла или из потока ввода к существующей
- таблице
- Серверный вариант Клиентский вариант
- команда SQL COPY
- команда psql \copy
- файл должен быть доступен
- файл должен быть доступен
- пользователю postgres
- запустившему psql
- на сервере
- на клиенте
Комментарии преподавателя
Если требуется сохранить только содержимое одной таблицы, можно воспользоваться командой COPY.
Команда позволяет записать таблицу (или результат произвольного запроса) либо в файл, либо в поток вывода, либо на вход произвольной программе. При этом можно указать ряд параметров, таких как формат (текстовый, csv или двоичный), разделитель полей, текстовое представление NULL и др.
Другой вариант команды, наоборот, считывает из файла или из потока ввода строки с полями и записывает их в таблицу. Таблица при этом не очищается, новые строки добавляются к уже существующим.
Команда COPY работает существенно быстрее, чем аналогичные команды INSERT — клиенту не нужно много раз обращаться к серверу, а серверу не нужно много раз анализировать команды.
https://postgrespro.ru/docs/postgresql/16/sql-copy
В psql существует клиентский вариант команды COPY с аналогичным синтаксисом. В отличие от серверного варианта COPY, который является командой SQL, клиентский вариант — это команда psql.
Указание имени файла в команде SQL соответствует файлу на сервере БД. У пользователя, под которым работает PostgreSQL (обычно postgres), должен быть доступ к этому файлу. В клиентском варианте обращение к файлу происходит на клиенте, а на сервер передается только содержимое.
https://postgrespro.ru/docs/postgresql/16/app-psql
Page 6: COPY
Создадим базу данных и таблицу в ней.
Вот как выглядит таблица в выводе команды COPY:
Обратите внимание на то, что пустая строка и NULL — разные значения, хотя, выполняя запрос, этого и не заметно. Аналогично можно вводить данные:
Проверим:
Page 7: pg_dump: копия базы
Резервное копирование
- выводит в поток или в файл SQL-скрипт,
- либо архив в специальном формате с оглавлением
- поддерживает параллельное выполнение
- позволяет ограничить набор выгружаемых объектов
- (таблицы, схемы, только DML или только DDL и т. п.)
- Восстановление
- SQL-скрипт — psql
- формат с оглавлением — pg_restore
- (позволяет ограничить набор объектов при восстановлении
- и поддерживает параллельное выполнение)
- новая база должна быть создана из шаблона template0
- заранее должны быть созданы роли и табличные пространства
Комментарии преподавателя
Для создания полноценной резервной копии базы данных используется утилита pg_dump. В зависимости от указанных параметров, результатом работы является либо SQL-скрипт, содержащий команды, создающие выбранные объекты, либо файл в специальном формате с оглавлением.
Чтобы восстановить объекты из SQL-скрипта, достаточно выполнить его в psql.
https://postgrespro.ru/docs/postgresql/16/app-pgdump
Для восстановления из резервной копии в специальном формате требуется другая утилита — pg_restore. Она читает файл и преобразует его в обычные команды psql. Преимущество в том, что набор объектов можно ограничить не при создании резервной копии, а уже при восстановлении. Кроме того, создание резервной копии в специальном формате и восстановление из нее может выполняться параллельно.
https://postgrespro.ru/docs/postgresql/16/app-pgrestore
Базу данных для восстановления надо создавать из шаблона template0, так как все изменения, сделанные в template1, также попадут в резервную копию. Кроме того, заранее должны быть созданы необходимые роли и табличные пространства, поскольку эти объекты относятся ко всему кластеру. После восстановления базы имеет смысл выполнить команду ANALYZE, которая соберет статистику.
Page 8: pg_dumpall: копия кластера
Резервирование
- сохраняет весь кластер, включая роли и табличные пространства
- выдает на консоль или в файл SQL-скрипт
- параллельное выполнение не поддерживается, но можно выгрузить
- только глобальные объекты и воспользоваться pg_dump
- Восстановление
- с помощью psql
Комментарии преподавателя
Чтобы создать резервную копию всего кластера, включая роли и табличные пространства, можно воспользоваться утилитой pg_dumpall.
Поскольку pg_dumpall требуется доступ ко всем объектам всех БД, имеет смысл запускать ее от имени суперпользователя. Утилита по очереди подключается к каждой БД кластера и выгружает информацию с помощью pg_dump. Кроме того, она сохраняет и данные, относящиеся к кластеру в целом.
Результатом работы pg_dumpall является скрипт для psql. Другие форматы не поддерживаются. Это означает, что pg_dumpall не поддерживает параллельную выгрузку данных, что может оказаться проблемой при больших объемах данных. В таком случае можно воспользоваться ключом –globals-only, чтобы выгрузить только роли и табличные пространства, а сами базы данных выгрузить с помощью утилиты pg_dump.
https://postgrespro.ru/docs/postgresql/16/app-pg-dumpall
Page 9: Утилита pg_dump
Посмотрим на результат работы утилиты pg_dump в простом формате (plain). Обратите внимание на то, в каком виде сохранены данные из таблицы. Если в шаблон template1 вносились какие-либо изменения, они также попадут в резервную копию. Поэтому при восстановлении базы данных имеет смысл предварительно создать ее из шаблона template0 (указанный ключ –create добавляет нужные команды автоматически).
Page 10: Page 10
При выполнении скриптов psql трактует символ \ как начало метакоманды. Чтобы обратная косая черта в данных не привела (случайно или преднамеренно) к нежелательным последствиям, строка \restrict в резервной копии включает безопасный режим, который запрещает выполнение любых метакоманд psql. В качестве примера использования скопируем таблицу в другую базу.
Page 11: Физическое копирование
Что такое физическое резервное копирование
- Холодное и горячее резервное копирование
- Протокол репликации
- Автономные резервные копии
- Непрерывная архивация журналов предзаписи
Page 12: Физическая копия
Используется механизм восстановления после сбоя: копия данных и журналы предзаписи
- скорость восстановления
- можно восстановить кластер на определенный момент времени
- − нельзя восстановить отдельную базу данных, только весь кластер
- − восстановление только на той же основной версии и архитектуре
Комментарии преподавателя
Физическое резервирование использует механизм восстановления после сбоев. Для этого требуются:
● базовая резервная копия — копия файлов кластера (файлов данных и служебных файлов);
● набор журналов предзаписи, необходимых для восстановления согласованности.
Если файловая система уже согласована (копия снималась при корректно остановленном сервере), то журналы не требуются.
Однако наличие архива журналов позволяет получить из базовой резервной копии состояние кластера на любой момент времени. Таким образом можно восстановить резервную копию практически на момент сбоя (либо сознательно восстановить систему на некоторый момент в прошлом).
Высокая скорость восстановления и возможность создавать копию «на лету», не выключая сервер, делает физическое резервирование основным инструментом периодического резервного копирования.
https://postgrespro.ru/docs/postgresql/16/backup-file
https://postgrespro.ru/docs/postgresql/16/continuous-archiving
Page 13: Горячо или холодно?
- Холодное резервирование
- Горячее
- резервирование
- выключенном
- неаккуратно
- выключенном
- работающем
- Файлы кластера копируются при…
- сервере
- сервере
- сервере
- нужны
- специальные
- средства
- не нужны
- нужны с последней
- нужны за время
- Журналы предварительной записи…
- контрольной точки
- копирования
- находятся
- в файловой
- сервер
- не должен удалить WAL
- системе
- раньше времени
Комментарии преподавателя
Физическое резервирование так или иначе предполагает создание копии файлов кластера баз данных.
Если копия создается при выключенном сервере, она называется «холодной». Такая копия либо содержит согласованные данные (если сервер был выключен аккуратно), либо содержит все необходимые для восстановления журналы (например, если используется снимок данных средствами операционной системы). Это упрощает восстановление, но требует останова сервера.
Если копия создается при работающем сервере (что требует определенных действий — просто так копировать файлы нельзя), она называется «горячей». В этом случае процедура сложнее, но позволяет обойтись без останова.
При горячем резервировании копия файлов кластера будет содержать несогласованные данные. Однако механизм восстановления после сбоев можно успешно применить и к восстановлению из резервной копии. Для этого потребуются журналы предзаписи как минимум за время копирования файлов.
Page 14: Автономная копия
Базовая копия + WAL
- Резервное копирование — pg_basebackup
- подключается к серверу по протоколу репликации
- выполняет контрольную точку
- копирует файлы кластера баз данных в указанный каталог
- сохраняет все сегменты WAL, сгенерированные за время копирования
- Восстановление
- разворачиваем созданную автономную копию
- запускаем сервер
Комментарии преподавателя
Для создания горячей резервной копии используется утилита pg_basebackup.
Вначале утилита выполняет контрольную точку. Затем копируются файлы кластера баз данных.
Все файлы WAL, сгенерированные сервером за время от контрольной точки до окончания копирования файлов кластера, также копируются в резервную копию. Такая копия называется автономной, поскольку содержит в себе все необходимое для восстановления.
Для восстановления достаточно развернуть автономную копию и запустить сервер. При необходимости он выполнит восстановление согласованности с помощью имеющихся файлов WAL и будет готов к работе.
https://postgrespro.ru/docs/postgresql/16/app-pgbasebackup
Page 15: Протокол репликации
Протокол
- получение потока журнальных записей
- команды управления резервным копированием и репликацией
- Обслуживается процессом wal_sender
- Параметр wal_level = replica
- Слот репликации
- серверный объект для получения журнальных записей
- помнит, какая запись была считана последней
- сегмент WAL не удаляется, пока он полностью не прочитан через слот
Комментарии преподавателя
Чтобы сохранить файлы WAL, сгенерированные сервером за время копирования файлов кластера, утилита подключается к серверу по специальному протоколу репликации. Несмотря на название, этот протокол используется не только для репликации (о которой пойдет речь в следующей теме), но и для резервного копирования. Протокол позволяет одновременно копировать файлы кластера и передавать поток журнальных записей.
Чтобы сервер не удалил преждевременно необходимые файлы WAL, может использоваться слот репликации, который хранит на сервере информацию о последней полученной клиентом записи.
Чтобы подключение было возможно, необходим ряд настроек.
Во-первых, роль должна обладать атрибутом REPLICATION (или быть суперпользователем) и иметь разрешение на подключение по протоколу репликации в конфигурационном файле pg_hba.conf.
Во-вторых, параметр max_wal_senders должен быть установлен в достаточно большое значение. Этот параметр ограничивает число одновременно работающих процессов wal_sender, обслуживающих подключения по протоколу репликации.
В-третьих, параметр wal_level, определяющий количество информации в журнале, должен быть установлен в значение replica.
Настройки по умолчанию включают все эти требования (при локальном подключении).
https://postgrespro.ru/docs/postgresql/16/protocol-replication
Page 16: Автономная копия
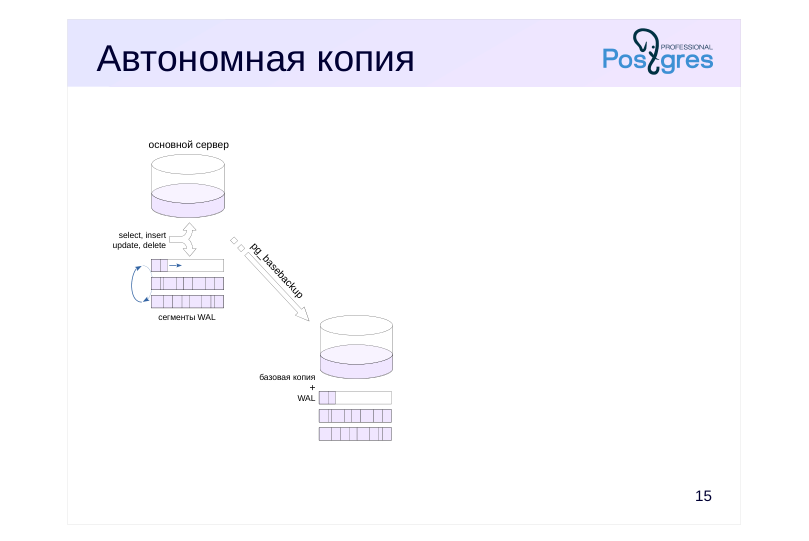 {#source-figure-016 caption=“Source slide page 16: Автономная копия”}
Комментарии преподавателя
На этом рисунке слева представлен основной сервер. Он обрабатывает поступающие запросы; при этом формируются записи WAL и изменяется состояние баз данных (сначала в буферном кеше, потом на диске). Сегменты WAL циклически перезаписываются (точнее, удаляются старые сегменты, так как имена файлов уникальны).
Внизу рисунка (а в реальной жизни — обычно на другом сервере) изображена созданная резервная копия — базовая копия данных и набор файлов WAL.
Page 17: Автономная резервная копия
Значения параметров по умолчанию позволяют использовать протокол репликации:
Разрешение на локальное подключение по протоколу репликации в pg_hba.conf также прописано по умолчанию (хотя это и зависит от конкретной пакетной сборки):
Еще один кластер баз данных replica был предварительно инициализирован на порту 5433. Убедимся, что кластер остановлен, с помощью утилиты пакета для Ubuntu:
Создадим резервную копию. Используем формат по умолчанию (plain):
Утилита pg_basebackup сразу после подключения к серверу выполняет контрольную точку. По умолчанию грязные буферы записываются постепенно, чтобы не создавать пиковую нагрузку (запись длится до 4,5 минут). Если указать – checkpoint=fast, буферы записываются без пауз.
Page 18: Восстановление
 {#source-figure-018 caption=“Source slide page 18: Восстановление”}
Комментарии преподавателя
При восстановлении базовая резервная копия, включающая необходимые файлы WAL, разворачивается, например, на другом сервере (справа на рисунке).
После старта сервера он восстанавливает согласованность и приступает к работе. Восстановление происходит на тот момент времени, на который была сделана резервная копия. Разумеется, за прошедшее время основной сервер может уйти далеко вперед.
Page 19: Восстановление
Заменим каталог кластера replica созданной копией, предварительно убедившись, что кластер остановлен:
Файлы кластера должны принадлежать пользователю postgres.
Проверим содержимое каталога:
В процессе запуска произойдет восстановление из резервной копии.
Теперь оба сервера работают одновременно и независимо. Основной сервер:
Сервер, восстановленный из резервной копии:
Page 20: Page 20
Page 21: Архив журналов
Файловый архив
- сегменты WAL копируются в архив по мере переключения
- механизм работает под управлением сервера
- неизбежны задержки попадания данных в архив
- Потоковый архив
- в архив постоянно записывается поток журнальных записей
- требуются внешние средства
- задержки минимальны
Комментарии преподавателя
Дальнейшее развитие идеи горячей резервной копии: поскольку у нас есть копия файлов кластера баз данных и журналы упреждающей записи, то, постоянно сохраняя новые журналы, мы сможем восстановить систему не только на момент копирования файлов, но и вообще на произвольный момент.
Для этого есть два способа. Первый состоит в том, чтобы не просто перезаписывать файлы WAL, а предварительно откладывать их куда-то в архив. Это можно реализовать специальными настройками сервера. К сожалению, при таком варианте файл WAL не попадет в архив, пока сервер не переключится на запись в другой файл.
Второй способ — постоянно читать журнальные записи по протоколу репликации и записывать их в тот же архив. При таком варианте задержки будут минимальны, но потребуется настроить отдельную от сервера утилиту для получения данных из потока.
Page 22: Файловый архив журналов
Процесс archiver Параметры
- archive_mode = on archive_command команда shell для копирования сегмента WAL в отдельное хранилище Алгоритм
- при переключении сегмента WAL вызывается команда archive_command
- если команда завершается со статусом 0, сегмент удаляется
- если команда возвращает не 0 (или если команда не задана), сегмент
- остается до тех пор, пока попытка не будет успешной
Комментарии преподавателя
Файловый архив реализуется фоновым процессом archiver.
PostgreSQL позволяет определить для копирования произвольную команду shell в параметре archive_command. Сам механизм включается параметром archive_mode = on.
Общий алгоритм таков. При заполнении очередного сегмента WAL вызывается команда копирования. Если она завершается с нулевым статусом, то сегмент может быть удален. Если же нет, сегмент (и следующие за ним) не будет удален, а сервер будет периодически пытаться выполнить команду, пока не получит 0.
https://postgrespro.ru/docs/postgresql/16/continuous-archiving
Page 23: Файловый архив журналов
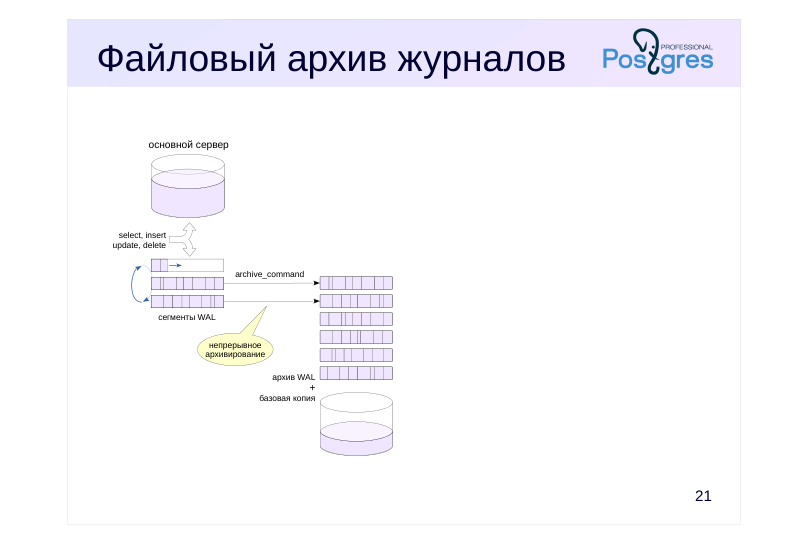 {#source-figure-023 caption=“Source slide page 23: Файловый архив журналов”}
Комментарии преподавателя
На этом рисунке изображен основной сервер с настроенным непрерывным архивированием: заполненные сегменты WAL копируются в отдельный архив с помощью команды в параметре archive_command. Обычно такой архив расположен на другом сервере.
Там же создается базовая резервная копия (или несколько копий, сделанных в разные моменты времени).
Page 24: Потоковый архив журналов
Утилита pg\_receivewal
- подключается по протоколу репликации (можно использовать слот)
- и направляет поток записей WAL в файлы-сегменты
- стартовая позиция — начало сегмента, следующего за последним
- заполненным сегментом в каталоге,
- или начало текущего сегмента сервера, если каталог пустой
- в отличие от файлового архива, записи пишутся постоянно
- при переходе на новый сервер надо перенастраивать параметры
Комментарии преподавателя
Другое решение — использовать утилиту pg_receivewal, которая получает записи WAL по протоколу репликации и записывает сегменты в архив.
Обычно утилита запускается на отдельном «архивном» сервере и подключается к серверу с параметрами, указанными в ключах. Утилита может (и должна) использовать слот репликации, чтобы гарантированно не потерять записи.
Утилита формирует файлы аналогично тому, как это делает сервер, и записывает их в указанный каталог. Еще не заполненные сегменты записываются с суффиксом .partial.
При запуске утилита начинает архивирование с начала сегмента, следующего за последним заполненным сегментом архива. Если архив пуст (первый запуск), утилита запрашивает записи с начала текущего сегмента.
При переходе на новый сервер утилиту придется остановить и запустить заново с новыми параметрами.
В PostgreSQL нет средств для запуска утилиты в фоновом режиме (демонизации) и для автоматического запуска (как сервис), для этого нужно использовать возможности операционной системы.
https://postgrespro.ru/docs/postgresql/16/app-pgreceivewal
Page 25: Потоковый архив журналов
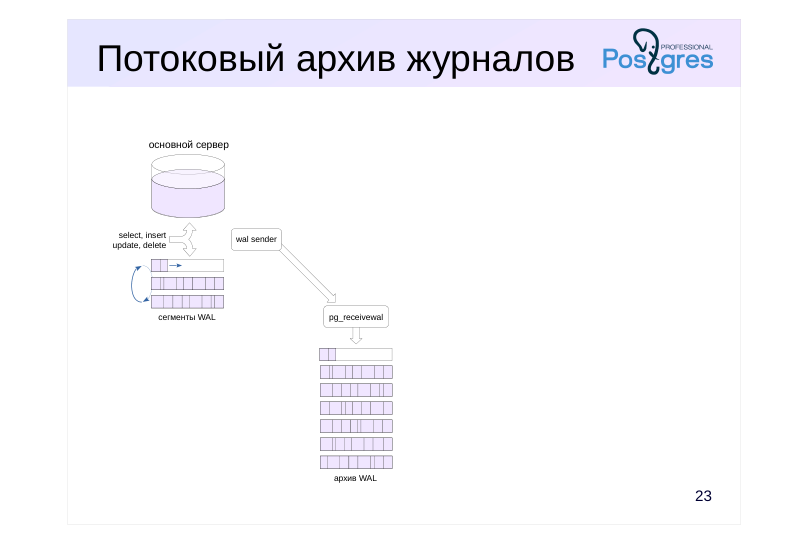 {#source-figure-025 caption=“Source slide page 25: Потоковый архив журналов”}
Комментарии преподавателя
Утилита pg_receivewal подключается к серверу по протоколу репликации. Подключение обслуживается отдельным процессом wal sender (это необходимо учесть при установке параметра max_wal_senders).
Утилита записывает данные, не дожидаясь получения всего сегмента.
Page 26: Базовая копия + архив
Настроенное непрерывное архивирование журналов
- Резервное копирование — pg_basebackup
- подключается к серверу по протоколу репликации
- выполняет контрольную точку
- копирует файлы кластера в указанный каталог
- сегменты WAL
- в копии не нужны
- Восстановление
- разворачиваем резервную копию
- задаем конфигурационные параметры
- (команда чтения WAL из архива, целевая точка восстановления)
- создаем сигнальный файл recovery.signal
- запускаем сервер
Комментарии преподавателя
Для создания резервной копии при настроенном непрерывном архивировании используется та же утилита pg_basebackup, но с другим набором параметров. В этом случае файлы WAL не включаются в резервную копию, поскольку они уже есть в архиве.
Восстановление в таком случае выполняется более сложно. Помимо разворачивания базовой резервной копии, требуется задать настройки восстановления:
● команду restore_command (обратную archive_command — она копирует нужные файлы из архива в каталог сервера);
● целевую точку восстановления.
Кроме этого, нужен сигнальный файл recovery.signal, наличие которого при старте сервера означает указание войти в режим управляемого восстановления (содержимое файла игнорируется).
Page 27: Восстановление
 {#source-figure-027 caption=“Source slide page 27: Восстановление”}
Комментарии преподавателя
Процедура восстановления (например, при выходе из строя основного сервера), выполняется следующим образом. На другом (или на том же) сервере разворачивается базовая резервная копия и создается файл recovery.signal. Сервер запускается, начинает копировать сегменты WAL из архива, используя restore_command, и применять их.
Следует обратить внимание, что при файловой архивации последний незаполненный сегмент WAL основного сервера не попадет в архив. Однако сегмент можно вручную скопировать в каталог pg_wal резервного сервера, если есть такая возможность. В случае сбоя файловой архивации таких сегментов может оказаться и несколько.
Page 28: Восстановление
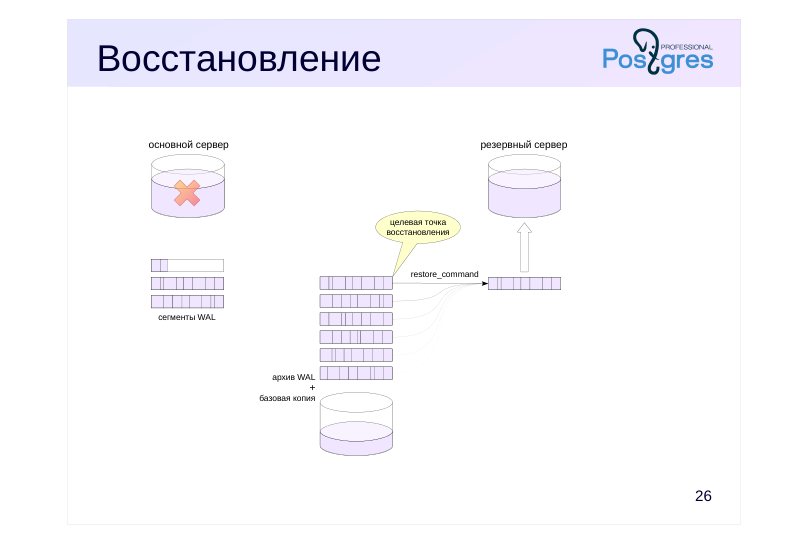 {#source-figure-028 caption=“Source slide page 28: Восстановление”}
Комментарии преподавателя
Резервный сервер применяет все доступные записи WAL, читая сегменты из каталога pg_wal (при отсутствии сегмента делается попытка скопировать его из архива), тем самым доводя состояние баз данных до актуального. Максимально возможная потеря — незаполненный сегмент WAL, не попавший в архив, если его по каким-то причинам невозможно скопировать.
По умолчанию применяются все доступные журнальные записи, а указание целевой точки восстановления позволяет остановить их применение в желаемый момент.
Page 29: Восстановление
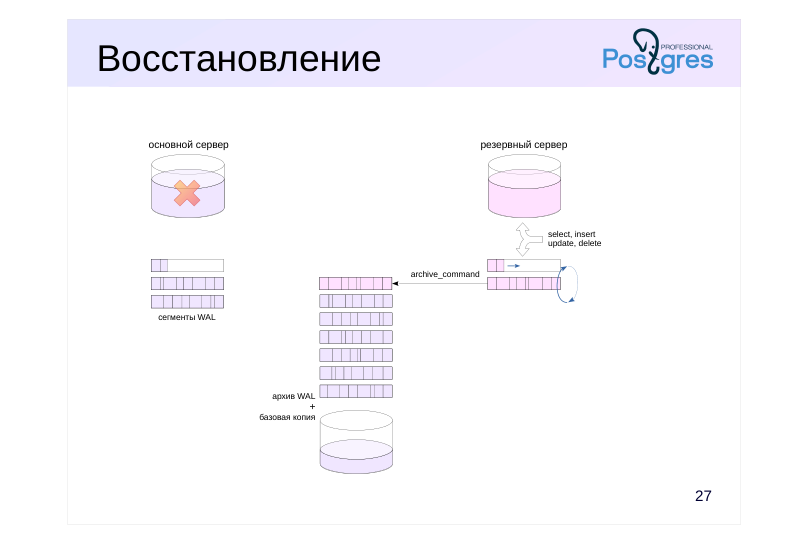 {#source-figure-029 caption=“Source slide page 29: Восстановление”}
Комментарии преподавателя
После завершения восстановления резервный сервер переходит в обычный режим работы: принимает запросы, записывает сегменты WAL в архив и так далее, выступая в качестве нового полноценного основного сервера.
Если развернутый сервер предполагается использовать вместо основного, то имеет смысл расположить его на таком же или, по крайней мере, сравнимом по характеристикам аппаратуры сервере, чтобы избежать снижения производительности.
Page 30: Итоги
Логическая резервная копия — команды SQL для восстановления состояния объектов
- команда copy, утилиты pg_dump и pg_dumpall
- Физическая резервная копия — копия файлов кластера + набор файлов WAL
- утилита pg_basebackup
- Архив WAL
- файловый или потоковый
- позволяет восстановить систему на произвольный момент времени
Page 31: Практика
- Создайте базу данных и таблицу в ней с несколькими строками. 2. Сделайте логическую копию базы данных с помощью утилиты pg_dump.
- Удалите базу данных и восстановите ее из сделанной копии. 3. Сделайте автономную физическую резервную копию кластера с помощью утилиты pg_basebackup.
- Измените таблицу.
- Восстановите новый кластер из сделанной резервной копии
- и проверьте, что база данных не содержит более поздних
- изменений.
Комментарии преподавателя
- В виртуальной машине курса уже создан кластер replica на порту 5433. Используйте этот кластер, для того чтобы восстановить данные из резервной копии.
Каталог данных кластера – /var/lib/postgresql/16/replica.
Для подключения укажите номер порта: psql -p 5433
Page 32: 1. База данных и таблица
2. Логическая резервная копия
Создаем резервную копию:
Удаляем базу данных и восстанавливаем ее из копии:
Page 33: 3. Физическая автономная резервная копия
Создаем резервную копию, выполняя «быструю» контрольную точку:
Убеждаемся, что второй сервер остановлен, и выкладываем резервную копию:
Изменяем таблицу:
Запускаем сервер из резервной копии:
Уборка
Page 34: Практика+
- Организуйте потоковую архивацию кластера main с помощью утилиты pg_receivewal.
- Сделайте автономную резервную копию кластера main (без WAL) с помощью утилиты pg_basebackup. 3. В кластере main создайте базу данных и таблицу в ней. 4. Выполните восстановление кластера replica из базовой копии с использованием архива. Убедитесь, что база и таблица тоже восстановились.
Комментарии преподавателя
Кластер replica находится в /var/lib/postgresql/16/replica.
Текущий файл, записываемый утилитой pg_receivewal, имеет суффикс .partial, по окончании записи файл переименовывается. При восстановлении наряду с обычными сегментами нужно использовать и последний недозаписанный файл.
Для подключения к кластеру replica укажите номер порта: psql -p 5433.
Page 35: 1. Потоковый архив
Обратите внимание, что часть команд выполняется от имени пользователя postgres, а часть — от имени student. Создаем каталог для архива WAL:
Создаем слот, чтобы в архиве не было пропусков:
Запускаем утилиту pg_receivewal в фоновом режиме. Для этого следующую команду нужно выполнить в отдельном окне терминала или добавить в конце командной строки символ &.
2. Базовая физическая копия без журнала
3. Новые база данных и таблица
4. Настройка восстановления
Убеждаемся, что второй сервер остановлен, и выкладываем резервную копию:
Page 36: Page 36
При восстановлении также используем частично записанный сегмент:
Запустим сервер и проверим результат:
Уборка
Архивация больше не нужна. Остановим утилиту и удалим слот, чтобы он не мешал очистке WAL.
15 Занятие 15: Репликация / Обзор физической репликации
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba1_15_replica_overview_physical.html Archive: DBA1-handouts-16.zip Страниц PDF: 22
Page 1: Репликация / Обзор физической репликации
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Игорь Гнатюк Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Задачи и виды репликации
- Физическая репликация
- Уровни журнала
- Варианты использования реплики
- Переключение на реплику
Page 3: Задачи и виды репликации
Синхронизация данных на разных серверах
- Основные задачи
- отказоустойчивость, высокая доступность
- масштабируемость
- Физическая репликация
- синхронизация на уровне страниц и версий строк
- Логическая репликация
- синхронизация на уровне строк таблиц
Комментарии преподавателя
Одиночный сервер, управляющий базами данных, может не удовлетворять предъявляемым требованиям.
Один сервер — возможная точка отказа. Два (или больше) серверов позволяют сохранить доступность системы в случае сбоя (отказоустойчивость) или — более широко — в любом случае, например, при проведении плановых работ (высокая доступность).
Один сервер может не справляться с нагрузкой. Наращивать ресурсы сервера может оказаться невыгодно или вообще невозможно. Но можно распределить нагрузку на несколько серверов (масштабирование).
Информационные системы могут использовать общие данные.
Таким образом, речь идет о том, чтобы иметь несколько серверов, работающих с одними и теми же данными. Под репликацией понимается процесс синхронизации этих данных.
В зависимости от уровня, на котором происходит синхронизация, различают физическую и логическую репликацию: при физической репликации синхронизируются изменения, произошедшие в страницах данных и статусах транзакций, а при логической — изменения строк таблиц.
Page 4: Физическая репликация
Механизм
- один сервер транслирует журнальные записи на другой сервер,
- и тот проигрывает полученные записи
- Особенности
- мастер-реплика: поток данных только в одну сторону
- требуется двоичная совместимость серверов
- возможна репликация только всего кластера
Комментарии преподавателя
Механизм физической репликации состоит в том, что один сервер передает журнальные записи на другой сервер, а тот их проигрывает — как при восстановлении после сбоя.
При физической репликации серверы имеют назначенные роли: мастер и реплика. Мастер передает на реплику свои журнальные записи в виде файлов или потока записей; реплика применяет эти записи к своим файлам данных. Применение происходит чисто механически, без «понимания смысла» изменений, поэтому важна двоичная совместимость между серверами (одинаковые платформы и основные версии PostgreSQL). Поскольку журнал общий для всего кластера, то и реплицировать можно только весь кластер целиком.
Page 5: Физическая репликация
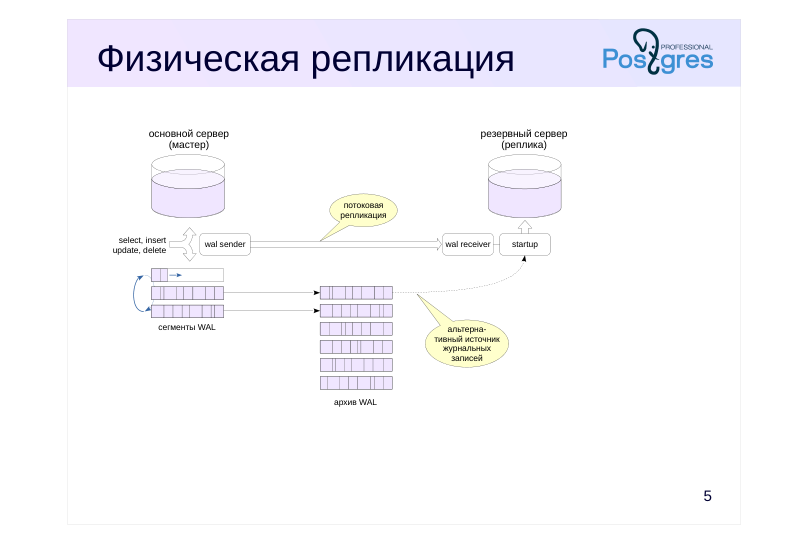 {#source-figure-005 caption=“Source slide page 5: Физическая репликация”}
Комментарии преподавателя
Чтобы организовать репликацию между двумя серверами, мы создаем реплику из физической резервной копии основного сервера. При обычном восстановлении из такой резервной копии получается новый независимый сервер. А если включить репликацию, ведомый сервер начинает работать в режиме постоянного восстановления: он все время применяет новые журнальные записи, приходящие с основного сервера (этим занимается процесс startup). Таким образом, реплика постоянно поддерживается в почти актуальном состоянии.
Есть два способа доставки журналов от мастера к реплике. Основной, который используется на практике — потоковая репликация.
В этом случае реплика (процесс walreceiver) подключается к мастеру (процесс walsender) по протоколу репликации и получает поток записей WAL. За счет этого при потоковой репликации отставание реплики сведено к минимуму или даже к нулю при синхронном режиме.
Если в системе настроено непрерывное архивирование, то возможна файловая репликация. В этом случае реплика будет заметно отставать, поскольку файловый архив пополняется только при переключении сегмента WAL.
На практике файловую репликацию используют как дополнение к потоковой. Если реплика не может получить очередную журнальную запись по протоколу репликации, она будет пробовать прочитать соответствующий файл из архива сегментов WAL.
https://postgrespro.ru/docs/postgresql/16/high-availability
Page 6: Уровни журнала
Параметр wal\_level
- minimal < replica
- восстановление восстановление после сбоя после сбоя восстановление из резервной копии, репликация
Комментарии преподавателя
Поскольку на реплику попадает только та информация, которая содержится в журнале, в журнал должны записываться все необходимые для синхронизации данные.
Состав информации, попадающей в журнал, регулируется параметром wal_level.
До версии PostgreSQL 10 уровнем по умолчанию был minimal, гарантирующий только восстановление после сбоя. На таком уровне репликация работать не может, поскольку для обеспечения надежности в этом случае часть изменений сразу записывается на энерго-независимый носитель и не попадает в журнал.
В версиях 10+ уровень по умолчанию — replica. На этом уровне в журнал записываются все изменения данных, что позволяет восстанавливать систему из горячих резервных копий, сделанных утилитой pg_basebackup, а также использовать физическую репликацию.
Поскольку резервное копирование и репликация — востребованные задачи, уровень по умолчанию и был изменен в пользу replica.
Page 7: Настройка физической репликации
Посмотрим, как организовать потоковую репликацию между двумя серверами. Мы ограничимся самым простым вариантом; детально репликация рассматривается в курсе для администраторов DBA3. Минимальный набор параметров, которые нужно проверить:
Начиная с версии PostgreSQL 10, параметры по умолчанию уже имеют подходящие значения. Разрешение на подключение по протоколу репликации в pg_hba.conf:
Разрешение тоже имеется. Развернем реплику из физической резервной копии, для этого используем утилиту pg_basebackup. Целевой каталог копии должен быть пустым или отсутствовать:
Ключ –checkpoint=fast просит утилиту выполнить контрольную точку как можно быстрее (без пауз), а ключ -R — добавить настройки для реплики:
Утилита создала заготовку конфигурационного файла…
… и сигнальный файл, который даст реплике указание перейти в режим постоянного восстановления:
Кластер, в котором мы собираемся развернуть реплику, уже предварительно инициализирован. Если сервер работает, его необходимо остановить:
Копия была размещена в домашнем каталоге пользователя student, а теперь переносим ее в каталог данных кластера и делаем владельцем файлов пользователя postgres:
Можно запускать сервер:
Page 8: Page 8
Посмотрим на процессы реплики.
Процесс walreceiver принимает поток журнальных записей, а процесс startup применяет изменения. Сравним с процессами мастера.
Процесс walsender отправляет реплике журнальные записи. Состояние репликации можно смотреть в специальном представлении на мастере:
значения *_lsn — показывают, какие журнальные записи отправлены на реплику, получены ею, записаны на диск и применены; sync_state — синхронная или асинхронная репликация (об этом подробнее позже).
Page 9: Использование реплики
Допускаются
- запросы на чтение данных (SELECT, COPY TO, курсоры)
- установка параметров сервера (SET, RESET)
- управление транзакциями (BEGIN, COMMIT, ROLLBACK…)
- создание резервной копии (pg_basebackup)
- Не допускаются
- любые изменения (INSERT, UPDATE, DELETE, TRUNCATE, nextval…)
- блокировки, предполагающие изменение (SELECT FOR UPDATE…)
- команды DDL (CREATE, DROP…), в т. ч. создание временных таблиц
- команды сопровождения (VACUUM, ANALYZE, REINDEX…)
- управление доступом (GRANT, REVOKE…)
- не срабатывают триггеры и рекомендательные блокировки
Комментарии преподавателя
По умолчанию реплика работает в режиме горячего резерва, в этом случае разрешены клиентские подключения, но только для чтения данных. Также будет работать установка параметров сервера и команды управления транзакциями — например, можно начать (читающую) транзакцию с нужным уровнем изоляции.
Кроме того, реплику можно использовать и для изготовления резервных копий (конечно, принимая во внимание возможное отставание от мастера).
В режиме горячего резерва на реплике не допускаются никакие изменения данных (включая последовательности), многие виды блокировок, команды DDL, а также такие команды, как vacuum, analyze, reindex и команды управления доступом — словом, все, что так или иначе изменяет данные.
При необходимости реплику можно запустить в режиме теплого резерва, задав параметр hot_standby = off, тогда подключения будут вообще невозможны.
https://postgrespro.ru/docs/postgresql/16/hot-standby
Page 10: Использование реплики
Выполним несколько команд на основном сервере:
Проверим реплику:
Вставим строку в таблицу на основном сервере:
Итак, репликация работает и запросы на реплике выполняются. При этом изменения на реплике не допускаются:
Page 11: Использование реплики
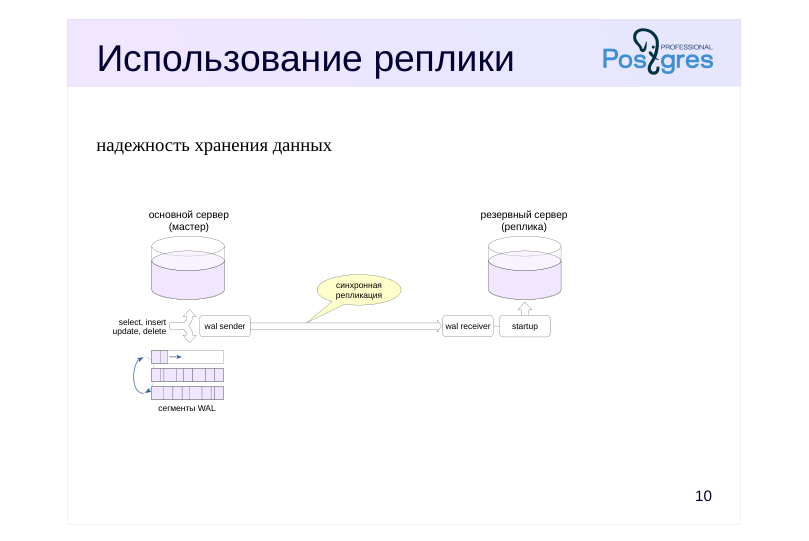 {#source-figure-011 caption=“Source slide page 11: Использование реплики”}
надежность хранения данных
Комментарии преподавателя
Механизм репликации позволяет построить систему так, чтобы она отвечала предъявляемым к ней требованиям. Рассмотрим несколько типичных задач и средства их решения.
Одна из возможных задач — обеспечить надежность хранения данных.
Напомним, что фиксация транзакций может работать в синхронном и асинхронном режимах. В первом случае фиксация не завершается до тех пор, пока данные не будут надежно записаны на энерго-независимый носитель. Во втором — есть риск потерять часть зафиксированных данных, но фиксация не ждет записи на диск, и система работает быстрее.
Аналогичная картина и с репликацией. При синхронном режиме (synchronous_commit = on) и наличии реплики фиксация ждет не только записи WAL на диск, но и подтверждения приема журнальных записей от синхронной реплики. Это еще больше увеличивает надежность (данные не пропадут, даже если основной сервер выйдет из строя), но и еще больше замедляет систему.
Существуют и промежуточные варианты настройки, которые не дают полной гарантии надежности, но все-таки снижают вероятность потери данных.
Page 12: Использование реплики
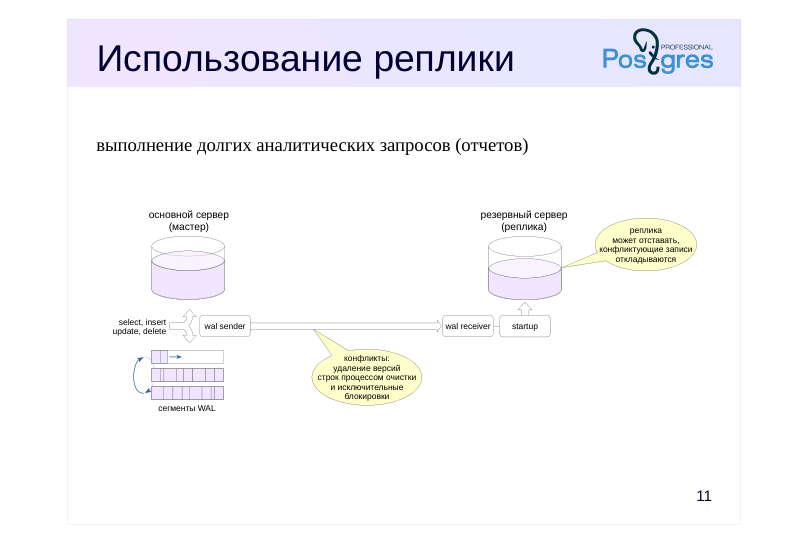 {#source-figure-012 caption=“Source slide page 12: Использование реплики”}
выполнение долгих аналитических запросов (отчетов)
Комментарии преподавателя
Как уже говорилось, долгие запросы удерживают горизонт очистки, из-за чего не удается удалять ненужные версии строк. Если какие-то таблицы в это время активно изменяются, они могут сильно вырасти в размере. Поэтому для выполнения долгих аналитических запросов можно использовать реплику.
Тонкий момент состоит в том, что с основного сервера могут приходить журнальные записи, конфликтующие с выполняющимся запросом. Есть два источника таких записей.
Очистка удаляет версии строк, уже не нужные основному серверу, но еще нужные для выполнения запроса на реплике.
Исключительные блокировки, происходящие на основном сервере, несовместимые с запросом на реплике.
Поэтому «отчетную» реплику настраивают так, чтобы она принимала WAL-записи, но откладывала их применение, если они конфликтуют с запросами. Это приводит к тому, что данные на реплике могут «отставать» от основного сервера, но, как правило, для долгих аналитических запросов это не существенно.
Page 13: Несколько реплик
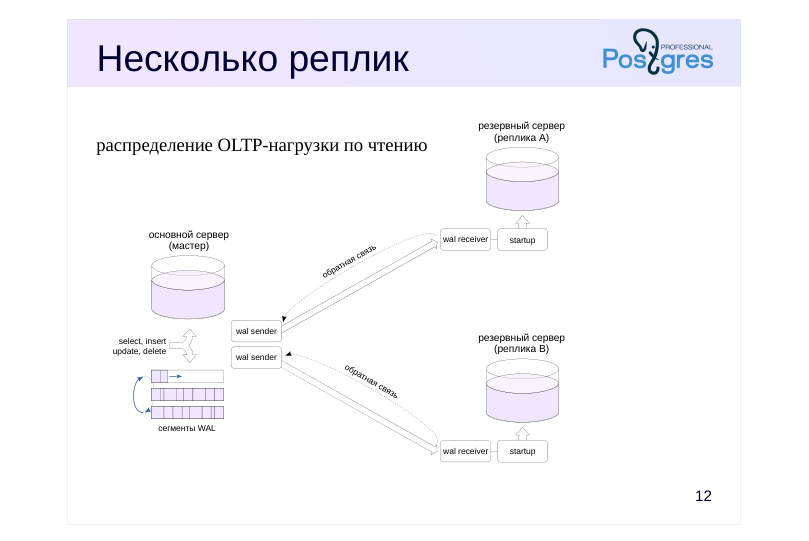 {#source-figure-013 caption=“Source slide page 13: Несколько реплик”}
распределение OLTP-нагрузки по чтению
Комментарии преподавателя
К основному серверу можно подключить несколько реплик, например, для распределения OLTP-нагрузки по чтению.
OLTP-запросы не должны быть долгими. Это позволяет использовать обратную связь между репликой и основным сервером по протоколу репликации. В этом случае основной сервер знает, какой горизонт транзакций нужен запросам на реплике, и очистка не будет удалять соответствующие версии строк. Иными словами, обратная связь дает такой же эффект, как если бы все запросы выполнялись непосредственно на основном сервере.
Однако репликация обеспечивает только базовый механизм. Для автоматического распределения нагрузки необходимы внешние средства (балансировщики). Следует также иметь в виду, что между основным сервером и репликами не гарантируется согласованность данных, даже в случае синхронной репликации. Если приложение читает данные только с одного из серверов, оно, разумеется, будет получать согласованные данные. Но это не выполняется, если приложение читает данные с нескольких серверов. С реплики можно прочитать как устаревшие данные, так и данные, которых еще не видно на основном сервере. Подробнее эти вопросы обсуждаются в курсе DBA3 «Резервное копирование и репликация».
Page 14: Каскадная репликация
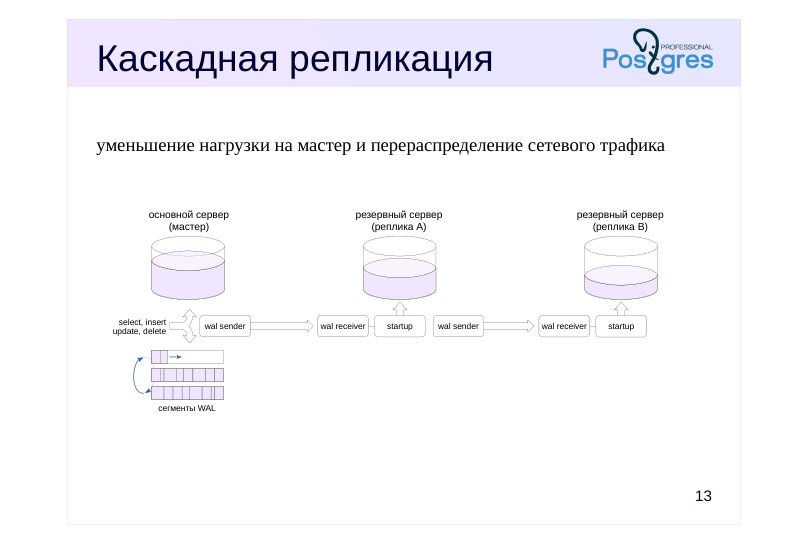 {#source-figure-014 caption=“Source slide page 14: Каскадная репликация”}
уменьшение нагрузки на мастер и перераспределение сетевого трафика
Комментарии преподавателя
Несколько реплик, подключенных к одному основному серверу, будут создавать на него определенную нагрузку. Кроме того, надо учитывать нагрузку на сеть при пересылке нескольких копий потока журнальных записей.
Для снижения нагрузки реплики можно соединять каскадом; при этом серверы передают журнальные записи друг другу по цепочке. Чем дальше от мастера, тем большее запаздывание может накопиться в изменяемых данных.
Заметим, что каскадная синхронная репликация не поддерживается: основной сервер может быть синхронизирован только с непосред-ственно подключенной к нему репликой. А вот обратная связь поступает к основному серверу от всех реплик.
Page 15: Отложенная репликация
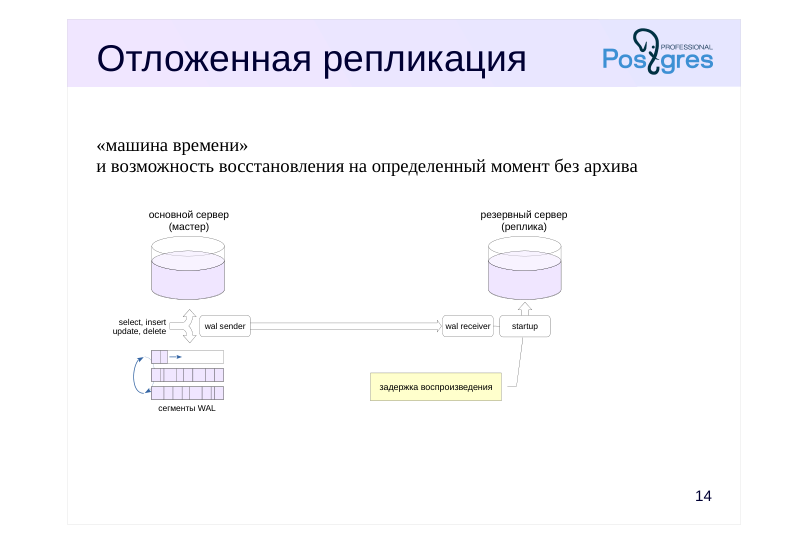 {#source-figure-015 caption=“Source slide page 15: Отложенная репликация”}
«машина времени» и возможность восстановления на определенный момент без архива
Комментарии преподавателя
Полезной может оказаться возможность просматривать данные на некоторый момент в прошлом и, при необходимости, восстановить сервер на этот момент. Это позволяет, в частности, справиться с ошибкой пользователя, совершившего неправильные действия, требующие отмены.
Обычный механизм восстановления из архива на момент времени (point-in-time recovery) в принципе позволяет решить эту задачу, но требует большой подготовительной работы и занимает много времени. А способа построить снимок данных по состоянию на произвольный момент в прошлом в PostgreSQL нет.
Задача решается созданием реплики, которая применяет записи WAL не сразу, а через установленный интервал времени.
В этом курсе мы не обсуждаем необходимые настройки для каждого из показанных вариантов. Для подробной информации обратитесь к курсу DBA3 «Резервное копирование и репликация».
Page 16: Переключение на реплику
Плановое переключение
- останов основного сервера для технических работ без прерывания
- обслуживания
- ручной режим
- Аварийное переключение
- переход на реплику из-за сбоя основного сервера
- ручной режим,
- но в принципе можно автоматизировать с помощью
- дополнительного кластерного ПО
Комментарии преподавателя
Имеющуюся реплику можно использовать и для того, чтобы переключить на нее приложение с основного сервера.
Причины перехода на резервный сервер бывают разные. Это может быть необходимость технических работ на основном сервере — тогда переход выполняется в удобное время в штатном режиме. Возможен и сбой основного сервера, в таком случае переходить на резервный сервер нужно как можно быстрее, чтобы не прерывать обслуживание пользователей.
Даже в случае сбоя переход осуществляется вручную, если не используется специальное кластерное программное обеспечение, которое следит за состоянием серверов и может инициировать переход автоматически.
Page 17: Переключение на реплику
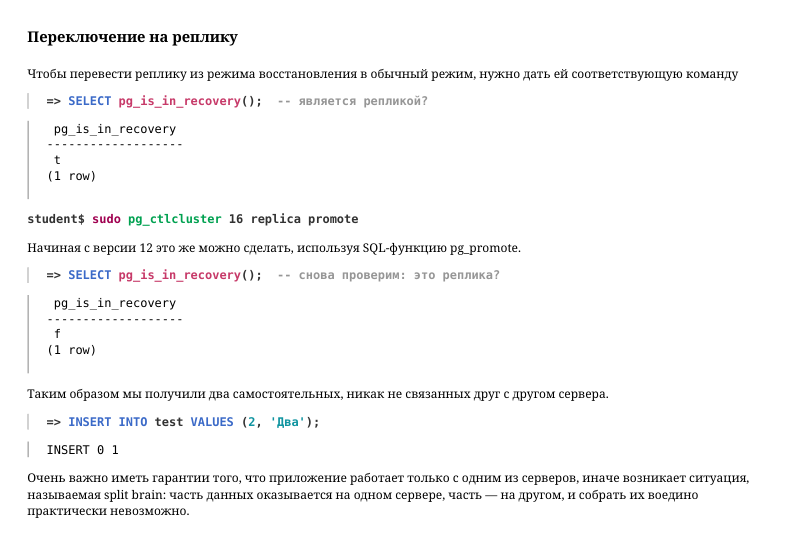 {#source-figure-017 caption=“Source slide page 17: Переключение на реплику”}
Чтобы перевести реплику из режима восстановления в обычный режим, нужно дать ей соответствующую команду
Начиная с версии 12 это же можно сделать, используя SQL-функцию pg_promote.
Таким образом мы получили два самостоятельных, никак не связанных друг с другом сервера.
Очень важно иметь гарантии того, что приложение работает только с одним из серверов, иначе возникает ситуация, называемая split brain: часть данных оказывается на одном сервере, часть — на другом, и собрать их воедино практически невозможно.
Page 18: Итоги
Механизм физической репликации основан на передаче журнальных записей на реплику и их применении
- трансляция потока записей или файлов WAL
- Физическая репликация создает точную копию всего кластера
- однонаправленная, требует двоичной совместимости
- базовый механизм для решения целого ряда задач
Page 19: Практика
- Настройте физическую потоковую репликацию между двумя серверами в синхронном режиме. Проверьте работу репликации. Убедитесь, что при остановленной реплике фиксация не завершается. 2. По умолчанию применение конфликтующих записей на реплике откладывается максимум на 30 секунд. Отключите откладывание применения и убедитесь, что долгий запрос, выполняющийся на реплике, будет прерван, если необходимые ему версии строк удаляются и очищаются на мастере. Включите обратную связь и убедитесь, что теперь запрос не прерывается из-за того, что на мастере откладывается очистка.
Комментарии преподавателя
- Для этого на мастере установите с помощью ALTER SYSTEM следующие параметры:
● synchronous_commit = on
● synchronous_standby_names = ‘“16/replica”’
- За откладывание применения конфликтующих записей на реплике отвечает параметр max_standby_streaming_delay. Установите его в 0. Обратная связь включается параметром hot_standby_feedback = on. Оба параметра устанавливаются через ALTER SYSTEM с последующим перечитыванием настроек.
Чтобы запрос выполнялся долго на небольшом объеме данных, можно добавить в него вызов функции pg_sleep.
Page 20: 1. Синхронная репликация
Разворачиваем реплику, как было показано в демонстрации:
Запускаем реплику.
Настроим синхронную репликацию на мастере. По умолчанию cинхронный режим включен, но записи о фиксации транзакций синхронизируются только с локальной файловой системой:
А синхронизация с репликой не настроена:
Реплик может быть несколько, и мастер должен знать, с какой из них синхронизироваться. Реплика представляется именем, заданным в ее параметре cluster_name:
Репликация стала синхронной.
Page 21: Page 21
Теперь остановим реплику…
…и попробуем выполнить какую-либо транзакцию:
Управление возвратится только когда реплика будет снова запущена и репликация восстановится:
2. Конфликтующие записи
Отключаем откладывание применения конфликтующих записей:
Добавляем строки в таблицу:
Выполняем на реплике долгий запрос…
…а в это время на мастере удаляем строки из таблицы и выполняем очистку:
Очистка стерла все версии строк (10 removed). В итоге запрос на реплике завершается ошибкой:
Повторим эксперимент со включенной обратной связью.
Page 22: Page 22
Теперь очистка не удаляет версии строк, поскольку знает о запросе, выполняющемся на реплике (10 are dead but not yet removable ) и запрос отрабатывает:
Итак: В первом случае (max_standby_streaming_delay) откладывается воспроизведение журнальных записей на реплике. Во втором случае (hot_standby_feedback) откладывается очистка на мастере. Отключим синхронную репликацию.
16 Занятие 16: Репликация / Обзор логической репликации
Эта страница извлечена из официального PDF в нативный Markdown. Текст слайдов, код и комментарии сохранены в порядке чтения; исходные PDF и HTML остаются эталоном макета. HTML source: dba1_16_replica_overview_logical.html Archive: DBA1-handouts-16.zip Страниц PDF: 23
Page 1: Репликация / Обзор логической репликации
Авторские права
© Postgres Professional, 2017–2024 Авторы: Егор Рогов, Павел Лузанов, Илья Баштанов, Алексей Береснев Фото: Олег Бартунов (монастырь Пху и пик Бхрикути, Непал)
Использование материалов курса
Некоммерческое использование материалов курса (презентации, демонстрации) разрешается без ограничений. Коммерческое использование возможно только с письменного разрешения компании Postgres Professional. Запрещается внесение изменений в материалы курса.
Обратная связь
Отзывы, замечания и предложения направляйте по адресу: edu@postgrespro.ru
Отказ от ответственности
Компания Postgres Professional не несет никакой ответственности за любые повреждения и убытки, включая потерю дохода, нанесенные прямым или непрямым, специальным или случайным использованием материалов курса. Компания Postgres Professional не предоставляет каких-либо гарантий на материалы курса. Материалы курса предоставляются на основе принципа «как есть» и компания Postgres Professional не обязана предоставлять сопровождение, поддержку, обновления, расширения и изменения.
Page 2: Темы
- Логическая репликация
- Уровни журнала
- Публикации и подписки
- Обнаружение и разрешение конфликтов
- Варианты использования реплики
Page 3: Логическая репликация
Публикующий сервер
- читает собственные журнальные записи
- декодирует их в изменения строк данных
- отправляет подписчикам
- Сервер-подписчик
- получает записи из потока репликации
- применяет изменения к своим таблицам
- Особенности
- публикация-подписка: поток данных возможен в обе стороны
- требуется совместимость на уровне протокола
- возможна выборочная репликация отдельных таблиц
Комментарии преподавателя
При физической репликации только один сервер (мастер) выполняет изменения и генерирует журнальные записи. Остальные серверы (реплики) только читают журнальные записи мастера и применяют их.
При логической репликации все серверы работают в обычном режиме, могут изменять данные и генерировать собственные журнальные записи. Любой сервер может публиковать свои изменения, а другие — подписываться на них. При этом один и тот же сервер может как публиковать изменения, так и подписываться на другие. Это позволяет организовать произвольные потоки данных между серверами.
Публикующий сервер читает собственные журнальные записи, но пересылает их подписчикам не в исходном виде (как при физической репликации), а предварительно декодирует их в «логический», независимый от платформы и версии PostgreSQL вид. Поэтому для логической репликации обычно не нужна двоичная совместимость, реплика должна лишь понимать протокол репликации. Также можно получать и применять изменения не всех объектов, а только отдельных таблиц.
https://postgrespro.ru/docs/postgresql/16/logical-replication
Page 4: Логическая репликация
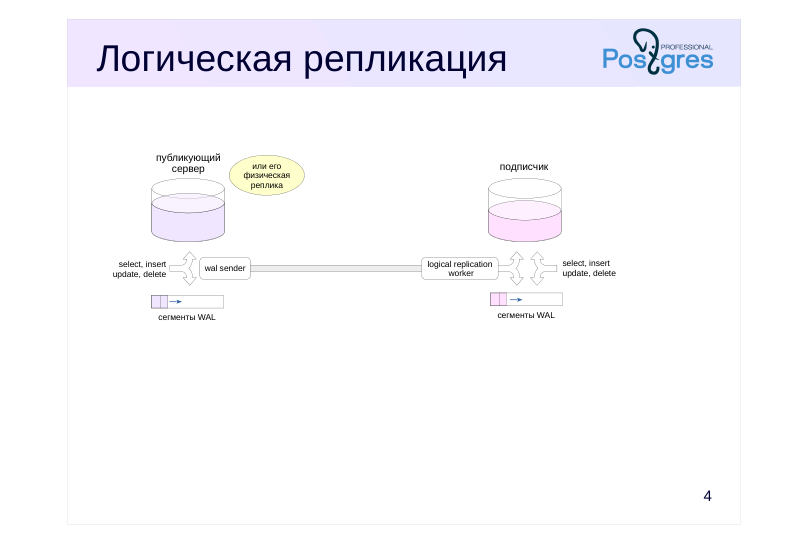 {#source-figure-004 caption=“Source slide page 4: Логическая репликация”}
Комментарии преподавателя
На публикующем сервере процесс wal_sender формирует журнальные записи, отражающие изменения в публикуемых данных, а фоновый процесс logical replication worker на сервере-подписчике получает информацию от публикующего сервера и применяет ее.
Подписчик может получать изменения не только напрямую с публикующего сервера, но и с его физической реплики. В этом случае отправку изменений подписчику выполняет процесс wal_sender физической реплики. Такая схема работы полезна для уменьшения нагрузки на публикующий сервер.
https://postgrespro.ru/docs/postgresql/16/logical-replication-publication
https://postgrespro.ru/docs/postgresql/16/logical-replication-subscription
Page 5: Публикации и подписки
Публикация
- включает одну или несколько таблиц базы данных
- можно указать столбцы и фильтр для строк
- обрабатывает команды INSERT, UPDATE, DELETE, TRUNCATE
- выдает изменения построчно после фиксации транзакции
- использует слот логической репликации
- Подписка
- получает и применяет изменения
- возможна начальная синхронизация
- без разбора, переписывания и планирования — сразу выполнение
- возможны конфликты с локальными данными
Комментарии преподавателя
Логическая репликация использует модель «публикация-подписка».
На одном сервере создается публикация, которая может включать ряд таблиц одной базы данных. Начиная с версии 15 можно опубликовать только часть данных таблицы: указать набор столбцов и задать условие фильтрации для строк. Другие серверы могут подписываться на эту публикацию: получать и применять изменения.
Реплицируются только измененные строки таблиц (а не команды SQL). Команды DDL не передаются; таблицы-приемники на подписчике надо создавать вручную. Но есть возможность автоматической начальной синхронизации содержимого таблиц при создании подписки.
После фиксации транзакции информация о строках, которые она изменила, извлекается из записей WAL на сервере публикации — эта процедура называется логическим декодированием. Сформированные сообщения пересылаются подписке по протоколу репликации в формате, независимом от платформы и версии сервера.
Применение изменений происходит без выполнения команд SQL и связанных с этим накладных расходов на разбор и планирование. С другой стороны, результат выполнения одной команды SQL может превратиться в множество однострочных изменений.
https://postgrespro.ru/docs/postgresql/16/logical-replication
Page 6: Уровни журнала
Параметр wal\_level
- minimal < replica < logical
- восстановление восстановление восстановление после сбоя после сбоя после сбоя восстановление восстановление из резервной копии, из резервной копии, репликация репликация логическая репликация
Комментарии преподавателя
Чтобы публикующий сервер смог сформировать сообщения об изменениях на уровне табличных строк, в журнал необходимо помещать дополнительную информацию, в частности идентификаторы затрагиваемых при репликации строк и сообщения о фактах изменения определений таблиц и типов данных. Это позволяет подписчику в любой момент знать структуру объектов, участвующих в репликации.
Такой расширенный уровень журнала называется logical. Поскольку по умолчанию используется уровень replica, для логической репликации потребуется изменить значение параметра wal_level на публикующем сервере.
https://postgrespro.ru/docs/postgresql/16/protocol-logical-replication#PROT OCOL-LOGICAL-MESSAGES-FLOW
Page 7: Логическая репликация
Пусть на первом сервере имеется таблица:
Склонируем кластер с помощью автономной копии, как мы делали в теме «Обзор физической репликации», но команде pg_basebackup не будем передавать ключ -R, поскольку нам потребуется независимый сервер, а не реплика.
Если второй сервер работает, остановим его.
Перемещаем резервную копию в каталог данных второго сервера, поменяв владельца файлов:
Запускаем второй сервер:
Получили два независимых сервера, на каждом из них есть пустая таблица test. Добавим в таблицу на первом сервере пару строк:
Теперь мы хотим настроить между серверами логическую репликацию. Для этого понадобится дополнительная информация в журнале публикующего сервера:
На первом сервере создаем публикацию:
На втором сервере подписываемся на эту публикацию:
Page 8: Page 8
Проверяем репликацию:
Состояние подписки можно посмотреть в представлении:
К процессам сервера-подписчика добавился logical replication worker (его номер указан в pg_stat_subscription.pid):
Page 9: Конфликты
Режимы идентификации для изменения и удаления
- столбцы первичного ключа (по умолчанию)
- столбцы указанного уникального индекса с ограничением NOT NULL
- все столбцы
- без идентификации (по умолчанию для системного каталога)
- Конфликты — нарушение ограничений целостности
- репликация приостанавливается до устранения конфликта вручную
Комментарии преподавателя
Вставка новых строк происходит достаточно просто. Интереснее обстоит дело при изменениях и удалениях — в этом случае надо как-то идентифицировать старую версию строки. По умолчанию для этого используются столбцы первичного ключа, но при определении таблицы можно указать и другие способы (replica identity): использовать уникальный индекс или использовать все столбцы. Можно вообще отказаться от поддержки репликации для некоторых таблиц (по умолчанию не реплицируются таблицы системного каталога).
Поскольку таблицы на сервере публикации и сервере подписки могут изменяться независимо друг от друга, при вставке новых версий строк возможны конфликты — нарушения ограничений целостности. В этом случае процесс применения записей приостанавливается до тех пор, пока конфликт не будет разрешен вручную.
https://postgrespro.ru/docs/postgresql/16/sql-altertable
https://postgrespro.ru/docs/postgresql/16/logical-replication-conflicts
https://postgrespro.ru/docs/postgresql/16/sql-altersubscription
Page 10: Конфликты
Локальные изменения на подписчике не запрещаются. Вставим строку в таблицу на втором сервере:
Если теперь строку с таким же значением первичного ключа вставить на публикующем сервере, при ее применении на стороне подписки произойдет конфликт.
Подписка не может применить изменение, репликация остановилась.
Чтобы разрешить конфликт, удалим строку на втором сервере и немного подождем…
Репликация возобновилась.
Удаление подписки
Если репликация больше не нужна, надо аккуратно удалить подписку — иначе на публикующем сервере останется открытым репликационный слот.
Page 11: Page 11
Page 12: Ограничения
Не реплицируются
- команды DDL
- значения последовательностей
- большие объекты (lo)
- изменения представлений, материализованных представлений и
- внешних таблиц
- Не поддерживаются
- автоматическое разрешение конфликтов
Комментарии преподавателя
Логическая репликация имеет довольно много ограничений.
Не реплицируются команды DDL — все изменения схемы данных надо переносить вручную.
Реплицироваться могут только обычные базовые таблицы и секционированные таблицы. То есть нельзя реплицировать отношения другого рода, такие как представления, материализованные представления и внешние таблицы.
Не реплицируются значения последовательностей. Это означает, что если сервер-подписчик добавляет строки в таблицу с суррогатным уникальным ключом, для которой настроена репликация, возможны конфликты. Конфликтов можно избежать, выделяя двум серверам разные диапазоны значений последовательностей, или используя вместо них универсальные уникальные идентификаторы (UUID).
Нет возможности автоматического разрешения конфликтов.
Эти ограничения уменьшают применимость логической репликации.
https://postgrespro.ru/docs/postgresql/16/logical-replication-restrictions
Page 13: Особенности
Ссылочная целостность
- для TRUNCATE нужно включать в публикацию все таблицы,
- на которые ссылаются внешние ключи
- Нужно постоянное соединение
- неактивный слот препятствует удалению сегментов WAL
- и удерживает горизонт очистки
- Могут вызвать проблемы
- массовые изменения данных
- изменения, сделанные долгими транзакциями
Комментарии преподавателя
Для правильной репликации команды TRUNCATE нужно включать в ту же публикацию все таблицы, у которых внешние ключи ссылаются на опустошаемую таблицу.
Соединение между серверами публикации и подписки должно быть достаточно стабильным. При разрыве слот репликации становится неактивным и сервер вынужден хранить сегменты WAL до момента восстановления соединения. Неактивный слот также удерживает горизонт очистки.
Изменения реплицируются построчно, поэтому выполнение на публикующем сервере команды SQL, затрагивающей много строк, приведет к повышенной нагрузке на подписчик.
Конфигурация по умолчанию не очень хорошо справляется с долгими транзакциями — они увеличивают нагрузку на публикующий сервер, поскольку публикация передает изменения только после фиксации транзакции. Параметр подписки streaming позволяет сгладить проблему: подписка может получать изменения строк без задержки и либо накапливать их во временном файле, либо сразу же применять, если есть свободный фоновый процесс.
Page 14: 1. Консолидация
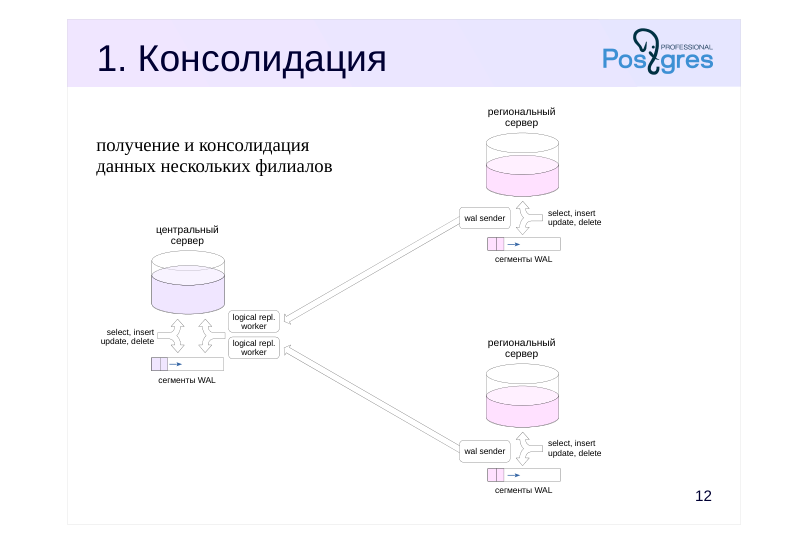 {#source-figure-014 caption=“Source slide page 14: 1. Консолидация”}
получение и консолидация данных нескольких филиалов
Комментарии преподавателя
Рассмотрим несколько задач, которые можно решить с помощью логической репликации.
Пусть имеются несколько региональных филиалов, каждый из которых работает на собственном сервере PostgreSQL. Задача состоит в консолидации части данных на центральном сервере.
Для решения задачи на региональных серверах создаются публикации необходимых данных. Центральный сервер подписывается на эти публикации. Полученные данные можно обрабатывать с помощью триггеров на стороне центрального сервера (например, приводя данные к единому виду).
Такая же схема, развернутая наоборот, позволяет, например, передавать справочную информацию от центрального сервера региональным.
С точки зрения бизнес-логики также есть множество особенностей, требующих внимания. В каких-то случаях может быть проще периодически передавать данные в пакетном режиме.
На иллюстрации: на центральном сервере работают два процесса приема журналов, по одному на каждую подписку.
Page 15: 2. Обновление серверов
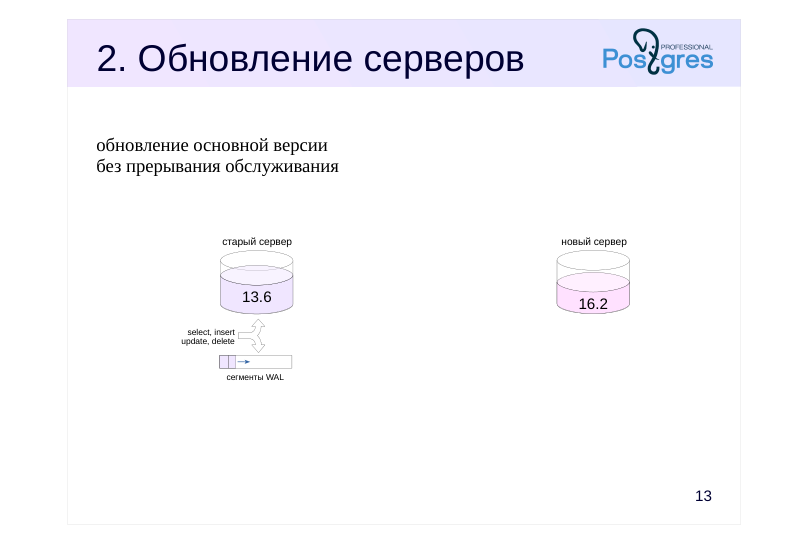 {#source-figure-015 caption=“Source slide page 15: 2. Обновление серверов”}
обновление основной версии без прерывания обслуживания
Комментарии преподавателя
Задача: обеспечить обновление основной версии сервера без прерывания обслуживания клиентов.
Поскольку между разными основными версиями нет двоичной совместимости, физическая репликация не помогает. Однако логическая репликация дает возможности для решения этой задачи.
Как обычно, требуются внешние средства для переключения пользователей между серверами.
Вначале создается новый сервер с желаемой версией PostgreSQL.
Page 16: 2. Обновление серверов
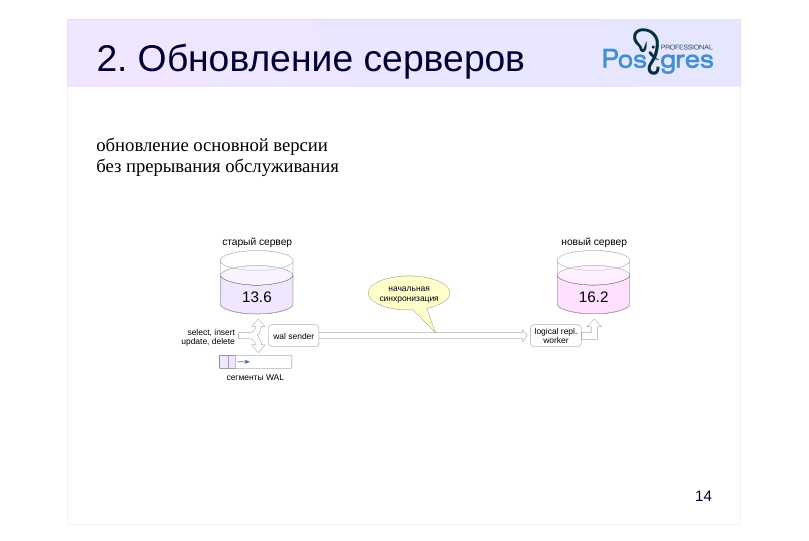 {#source-figure-016 caption=“Source slide page 16: 2. Обновление серверов”}
обновление основной версии без прерывания обслуживания
Комментарии преподавателя
Затем между серверами настраивается логическая репликация всех необходимых баз и данные синхронизируются. Это возможно благодаря тому, что для логической репликации не требуется двоичной совместимости между серверами.
Page 17: 2. Обновление серверов
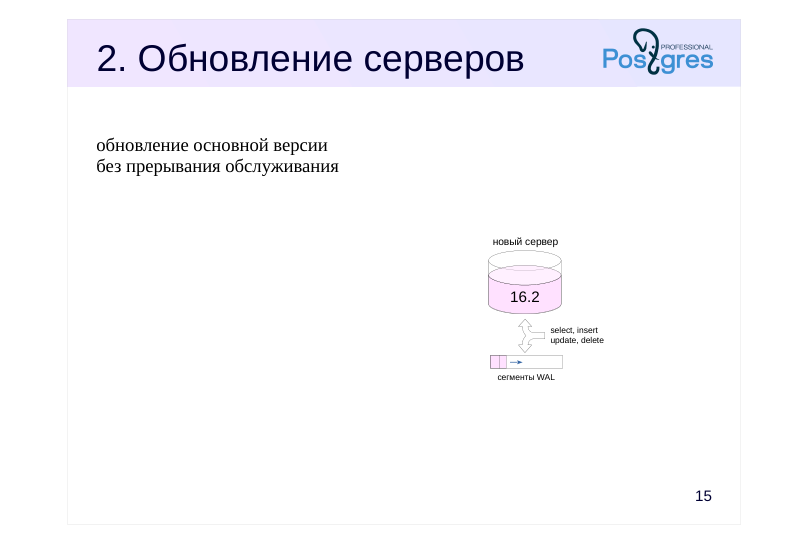 {#source-figure-017 caption=“Source slide page 17: 2. Обновление серверов”}
обновление основной версии без прерывания обслуживания
Комментарии преподавателя
После этого клиенты переключаются на новый сервер, а старый выключается.
На самом деле процесс обновления с помощью логической репликации гораздо более сложен и сопряжен со значительными трудностями. Несколько подробнее он рассматривается в курсе DBA2, тема «Обновление сервера».
Page 18: 3. Мастер-мастер
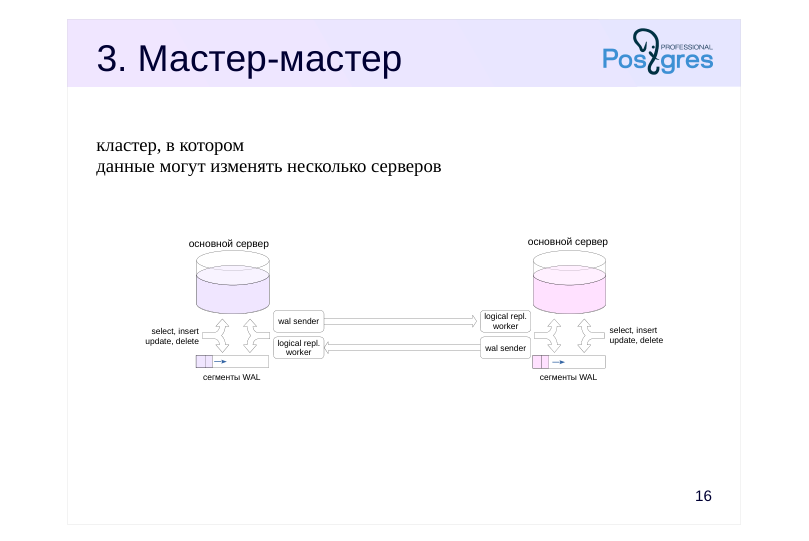 {#source-figure-018 caption=“Source slide page 18: 3. Мастер-мастер”}
кластер, в котором данные могут изменять несколько серверов
Комментарии преподавателя
Задача: обеспечить надежное хранение данных на нескольких серверах с возможностью записи на любом сервере (что полезно, например, для геораспределенной системы).
Для решения можно использовать двунаправленную репликацию, передавая изменения в одних и тех же таблицах от одного сервера к другому и обратно.
Двунаправленная репликация появилась в PostgreSQL 16: можно одновременно опубликовать таблицу и подписаться на ее изменения на другом сервере.
Конечно, прикладная система должна быть построена таким образом, чтобы избегать конфликтов при изменении данных в одних и тех же таблицах. Например, использовать глобальные уникальные идентификаторы или гарантировать, что разные серверы работают с разными диапазонами ключей.
Надо учитывать, что система мастер-мастер, построенная на логической репликации, не обеспечивает сама по себе выполнение глобальных распределенных транзакций и, следовательно, согласованность данных между серверами. Кроме того, никаких средств для автоматизации обработки сбоев, подключения или удаления узлов из кластера и т. п. в PostgreSQL не предусмотрено — эти задачи должны решаться внешним средствами.
Page 19: Итоги
Логическая репликация передает изменения строк отдельных таблиц
- разнонаправленная
- совместимость на уровне протокола Модель публикация — подписчик
- Следует учитывать имеющиеся ограничения
Page 20: Практика
- Настройте логическую репликацию произвольной таблицы в другую на том же самом сервере. 2. Настройте двунаправленную логическую репликацию одной и той же таблицы на двух разных серверах.
Комментарии преподавателя
- Если попробовать выполнить обычные действия, команда CREATE SUBSCRIPTION «повиснет». Внимательно изучите документацию:
https://postgrespro.ru/docs/postgresql/16/sql-createsubscription
- Склонируйте второй сервер из резервной копии, как было показано в демонстрации.
При создании подписок на обоих серверах укажите следующие параметры: copy_data = false, origin = none.
Page 21: 1. Репликация на одном сервере
Тестовая таблица:
Копия базы с таблицей:
И установим необходимый уровень журнала:
Подключаемся к базам данных:
В первой базе создадим публикацию:
Команда CREATE SUBSCRIPTION по умолчанию создает слот репликации, а для этого дожидается завершения всех транзакций, активных на момент начала создания слота. Одной из таких транзакция является та, которая выполняет команду CREATE SUBSCRIPTION, что приводит к бесконечному ожиданию. Проблема решается созданием слота вручную и указанием его имени при создании подписки:
Проверим:
Page 22: Page 22
Репликация работает. Удалим публикацию, подписку и вторую базу данных.
2. Двунаправленная репликация
Клонируем сервер с помощью резервной копии:
Убеждаемся, что второй сервер остановлен, и выкладываем резервную копию:
Запускаем второй сервер:
База данных с таблицей и настройка уровня журнала также были склонированы:
Публикуем таблицу на обоих серверах:
Подписываемся:
Page 23: Page 23
Изменяем строки таблицы:
Чтобы изменения и удаления реплицировались, нужно задать идентификацию строк. По умолчанию строки идентифицируются по первичному ключу.
Повторяем попытку:
Смотрим результат: